
Dans le domaine des sciences contemporaines, et tout particulièrement au sein de la psychologie empirique, des neurosciences cognitives et des sciences sociales, l’inférence statistique constitue le pont méthodologique indispensable reliant l’observation empirique locale à la découverte de lois générales régissant le comportement humain. Lorsque les chercheurs publient une découverte relative à l’efficacité d’une nouvelle approche psychothérapeutique, à l’évaluation des capacités mnésiques d’une cohorte clinique ou à l’estimation de la prévalence d’un trouble psychiatrique dans une population donnée, ils ne manipulent presque jamais des certitudes absolues. Ils travaillent sous un régime d’incertitude quantifiée, où chaque observation est inévitablement entachée d’une part irréductible de variabilité d’échantillonnage et de bruit de mesure.
Au cœur de cet arsenal probabiliste se trouvent deux notions intimement liées, souvent confondues dans le discours public, et parfois même mal articulées par les praticiens de la recherche : la marge d’erreur et l’intervalle de confiance. Bien que ces deux concepts dérivent des mêmes axiomes mathématiques et partagent une mécanique sous-jacente commune issue de la théorie de l’échantillonnage, ils ne remplissent pas la même fonction sémiotique, descriptive ou décisionnelle dans la communication scientifique. La marge d’erreur exprime un rayon d’incertitude absolu ou relatif autour d’une estimation ponctuelle, tandis que l’intervalle de confiance définit la région bornée au sein de laquelle le paramètre inconnu de la population est présumé résider selon un modèle fréquentiste rigoureux.
Cet article propose une dissection exhaustive, conceptuelle, mathématique et appliquée de ces deux grandeurs fondamentales. En parcourant les exigences de l’inférence fréquentiste, l’anatomie géométrique de la distribution d’échantillonnage, les calculs appliqués aux moyennes continues et aux proportions discrètes, ainsi que les directives de publication selon les normes académiques internationales, nous mettrons en lumière la relation symbiotique qui unit ces indices. Nous explorerons également les pièges d’interprétation les plus pernicieux qui altèrent la validité des conclusions psychométriques, fournissant ainsi aux étudiants, chercheurs et analystes un cadre de référence complet pour conceptualiser, calculer et rapporter la précision de leurs estimations statistiques avec une clarté sans équivoque.
1. Introduction conceptuelle : fondements de l’inférence statistique
1.1 La nécessité de l’échantillonnage en sciences psychologiques
L’étude systématique des processus cognitifs, émotionnels et comportementaux se heurte d’emblée à un obstacle logistique et métrologique infranchissable : l’impossibilité d’évaluer l’intégralité d’une population cible. Qu’il s’agisse de mesurer le niveau d’anxiété généralisée des étudiants universitaires européens, d’évaluer le temps de réaction visuo-moteur chez les adultes vieillissants ou d’analyser l’impact d’un protocole de remédiation cognitive auprès de patients atteints de traumatismes crâniens, le chercheur ne peut prétendre administrer son protocole expérimental à l’ensemble du recensement humain concerné. Les contraintes financières, temporelles, techniques et surtout éthiques interdisent une exhaustivité censitaire. Par conséquent, la recherche scientifique moderne repose sur la constitution d’échantillons représentatifs, c’est-à-dire de sous-ensembles d’individus extraits de la population parente.
Cette sélection n’est pas sans conséquence sur la nature même des connaissances générées. La représentativité d’un échantillon clinique ou expérimental n’est jamais absolue ni définitive ; elle dépend des procédures d’échantillonnage probabiliste, de la randomisation et du contrôle scrupuleux des biais d’attrition ou de sélection. Les statistiques inférentielles interviennent précisément à ce stade pour surmonter cette incomplétude constitutive. Elles fournissent les outils mathématiques permettant d’extrapoler de manière rigoureuse les observations recueillies sur un groupe restreint de participants vers la population générale dont ils sont issus, tout en reconnaissant que cette généralisation comporte structurellement une marge d’aléa incontournable.
Dans les disciplines psychologiques, où la réplicabilité des résultats est devenue une exigence cardinale, l’inférence statistique ne se contente pas de formuler une hypothèse sur un groupe particulier : elle quantifie la légitimité du passage du particulier au général. Sans cette armature méthodologique, les observations empiriques demeureraient cantonnées au statut de simples anecdotes locales, dépourvues de toute portée théorique ou d’application clinique universelle.
1.2 Le passage du paramètre populationnel à l’estimateur empirique
Pour formaliser la démarche scientifique, il est impératif d’établir une distinction épistémologique nette entre deux entités fondamentales : le paramètre populationnel et l’estimateur empirique. Le paramètre populationnel, généralement noté à l’aide de lettres grecques (telles que $\mu$ pour la moyenne ou $\sigma$ pour l’écart-type), représente la grandeur fixe, invariante et objective qui caractérise la population dans son ensemble. Ce paramètre constitue la « valeur vraie » que le chercheur aspire à découvrir, mais qui demeure intrinsèquement inaccessible en raison de l’impossibilité d’effectuer un recensement exhaustif.
À l’opposé, l’estimateur empirique est une statistique calculée à partir des données d’un échantillon singulier, couramment désignée par des symboles latins ou coiffée d’un accent circonflexe (comme $\bar{X}$ pour la moyenne d’échantillon ou $\hat{p}$ pour une proportion observée). Cet estimateur ponctuel constitue une variable aléatoire : si l’on procédait au tirage d’un échantillon différent selon le même protocole, la valeur numérique obtenue oscillerait inévitablement. Cette variabilité intrinsèque, inhérente au processus même d’échantillonnage aléatoire, signifie qu’une estimation ponctuelle brute n’a presque aucune chance de coïncider exactement avec le paramètre de la population.
Par conséquent, présenter un résultat empirique sous la seule forme d’un chiffre isolé sans y adjoindre un indice de précision revient à occulter la nature stochastique de l’observation. L’assignation d’une mesure de dispersion de l’estimation n’est pas un raffinement optionnel ; elle constitue une exigence fondamentale de l’intégrité scientifique, signalant la marge d’approximation inhérente au processus d’investigation.
1.3 L’incertitude inhérente à la mesure du comportement humain
La psychométrie et les neurosciences comportementales présentent des défis de mesure singulièrement plus complexes que les sciences physiques. Lorsqu’un physicien quantifie la masse ou la constante gravitationnelle, l’instrumentation bénéficie d’une stabilité relative. En revanche, lorsqu’un clinicien évalue un trait latent tel que le névrosisme, les fonctions exécutives ou la sévérité d’un épisode dépressif majeur, il manipule des variables psychologiques soumises à des fluctuations temporelles rapides, à la fatigue cognitive, à l’anxiété de performance et à des effets d’habituation au matériel de test.
Il importe de distinguer rigoureusement deux formes distinctes d’incertitude qui se superposent dans l’évaluation psychologique. D’une part, l’erreur de mesure instrumentale découle de l’imprécision des outils psychométriques eux-mêmes, de l’ambiguïté potentielle des items d’un questionnaire, ou du manque de fidélité test-retest des épreuves cognitives. D’autre part, l’erreur d’échantillonnage émerge du tirage aléatoire des individus composant la cohorte expérimentale. Alors que la première relève de la théorie classique des tests et de la fidélité des mesures, la seconde relève de la mécanique inférentielle.
Le cadre probabiliste s’avère dès lors incontournable pour modéliser mathématiquement ce doute scientifique. Face à l’impossibilité d’éliminer l’aléa humain et l’hétérogénéité biologique, les statisticiens recourent à des lois de distribution théoriques afin d’encadrer l’imprécision. L’objectif n’est pas de faire disparaître l’incertitude par décret, mais d’en cartographier l’étendue de manière objective et reproductible, offrant ainsi une assise rationnelle à la prise de décision diagnostique et thérapeutique.
2. Définition rigoureuse de l’intervalle de confiance
2.1 Nature mathématique et bornes de l’intervalle
L’intervalle de confiance constitue l’une des constructions les plus raffinées de l’inférence fréquentiste moderne, introduite par le mathématicien et statisticien Jerzy Neyman dans les années 1930. D’un point de vue strictement mathématique, un intervalle de confiance n’est pas un nombre unique mais un ensemble continu de valeurs délimité par deux bornes numériques : une borne inférieure (notée $L$, pour lower limit) et une borne supérieure (notée $U$, pour upper limit). Cet intervalle est formellement désigné par l’expression vectorielle ou ensembliste $[L ; U]$.
La caractéristique fondamentale de cet intervalle réside dans le fait que ses bornes sont elles-mêmes des variables aléatoires. En effet, $L$ et $U$ sont calculées à partir des statistiques de l’échantillon prélevé (comme la moyenne empirique $\bar{X}$ et la variance empirique $s^2$). Si un chercheur répète l’expérience mille fois en prélevant mille échantillons indépendants de même taille au sein de la même population, il obtiendra mille paires de bornes $[L_i ; U_i]$ distinctes. Chaque intervalle présentera une localisation légèrement différente sur l’axe des réels, et son étendue pourra fluctuer selon la dispersion observée au sein de chaque sous-groupe.
La largeur totale de l’intervalle, définie par la différence arithmétique $(U – L)$, fournit un indicateur direct de la précision globale de la mesure statistique. Plus cette largeur est étroite, plus l’estimation du paramètre est précise et informative. Inversement, un intervalle excessivement large révèle une grande incertitude d’échantillonnage, indiquant que les données empiriques recueillies sont insuffisantes pour localiser le paramètre avec une résolution satisfaisante.
2.2 L’interprétation fréquentiste du niveau de confiance
L’interprétation correcte du niveau de confiance, classiquement fixé à des seuils nominaux tels que 95 % ou 99 %, requiert une rigueur conceptuelle absolue. Dans l’épistémologie fréquentiste, le paramètre de la population (par exemple, la moyenne $\mu$) est une constante fixe, universelle et immuable dans les conditions de l’étude. Ce n’est pas une variable aléatoire. Par conséquent, il est mathématiquement dénué de sens d’affirmer qu’« il y a 95 % de chances que la vraie moyenne de la population se trouve à l’intérieur de l’intervalle calculé spécifique [102,4 ; 108,6] ».
Une fois les données recueillies et les bornes calculées, l’intervalle résultant soit contient la valeur vraie, soit ne la contient pas ; la probabilité a posteriori est alors binaire (0 ou 1), bien qu’elle demeure inconnue du chercheur. Le pourcentage de 95 % fait référence au taux de couverture à long terme du protocole mathématique utilisé. Pour appréhender cette subtilité, il convient d’invoquer l’expérience de pensée de la répétition asymptotique : si nous pouvions répliquer l’étude une infinité de fois dans des conditions rigoureusement identiques, en extrayant des échantillons indépendants de même taille et en appliquant systématiquement la même formule de calcul, exactement 95 % de la totalité des intervalles construits recouvriraient la valeur vraie du paramètre, tandis que 5 % échoueraient à l’englober.
Le niveau de confiance mesure donc la fiabilité globale d’un procédé d’estimation sur le long terme plutôt que la probabilité d’occurrence relative à une tranche numérique unique. Cette nuance méthodologique sépare radicalement l’approche fréquentiste de l’approche bayésienne, qui recourt quant à elle à des intervalles de crédibilité pour attribuer une distribution de probabilité subjective ou conditionnelle au paramètre lui-même.
2.3 Les idées reçues courantes en psychométrie
Dans la littérature psychométrique et clinique, la mauvaise interprétation des intervalles de confiance est un phénomène documenté de longue date par de multiples enquêtes méthodologiques. Le sophisme le plus récurrent consiste en l’attribution erronée d’une distribution de probabilité au paramètre fixe, conduisant les cliniciens à interpréter un intervalle à 95 % comme une zone de certitude statistique immédiate. Ce contresens masque le fait que l’intervalle concret obtenu dans une publication peut tout à fait appartenir aux 5 % d’intervalles défaillants qui manquent la cible populationnelle.
Une seconde confusion majeure consiste à assimiler l’intervalle de confiance à un intervalle de prédiction individuelle ou à un intervalle de tolérance. Un intervalle de confiance pour la moyenne à 95 % n’indique en aucun cas que 95 % des individus de la population obtiennent un score compris entre ses bornes. L’intervalle de confiance renseigne exclusivement sur l’emplacement plausible du paramètre central agrégé (la moyenne de population), et non sur la variabilité interindividuelle des scores bruts. Cette méprise peut induire des erreurs diagnostiques graves, par exemple lorsqu’un psychologue considère à tort qu’un score individuel tombant en dehors de l’intervalle de confiance de la moyenne normative est pathologique ou anormal.
L’assimilation trompeuse de ces concepts engendre une surestimation dramatique de la certitude des conclusions cliniques. Lorsque les praticiens confondent la précision de l’estimation d’un indice moyen avec la variabilité biologique ou comportementale des patients, ils s’exposent à des décisions erronées lors de l’attribution de ressources thérapeutiques ou de la validation de tests psychométriques.
3. Définition et anatomie de la marge d’erreur
3.1 La marge d’erreur comme demi-largeur de l’intervalle
Tandis que l’intervalle de confiance appréhende l’estimation sous la forme d’un domaine ou d’un segment sur une droite numérique, la marge d’erreur (souvent abrégée ME ou notée $E$) représente l’indice scalaire de cette incertitude. D’un point de vue géométrique, lorsque la distribution d’échantillonnage est symétrique (ce qui est le cas pour les grands échantillons régis par des distributions normales ou des distributions $t$ de Student centrées), la marge d’erreur correspond rigoureusement à la demi-largeur de l’intervalle de confiance. Elle exprime la distance maximale de divergence tolérée de part et d’autre de l’estimation ponctuelle.
Arithmétiquement, si un intervalle de confiance est formalisé par ses bornes $[L ; U]$, la marge d’erreur se déduit par une opération élémentaire de soustraction divisée par deux :
$$E = \frac{U – L}{2}$$
Cette relation géométrique directe souligne la symétrie de l’estimation autour de la moyenne observée : le rayon d’incertitude s’étend équitablement vers la gauche (dans le sens négatif) et vers la droite (dans le sens positif). La marge d’erreur condense ainsi en une seule quantité numérique la distance spatiale qui sépare le centre de la distribution de ses limites de plausibilité fixées par le niveau de confiance.
Cette symétrie canonique repose toutefois sur l’hypothèse de distributions d’échantillonnage asymptotiquement normales. Dès lors que l’on manipule des échelles bornées, des proportions proches des extrêmes ou des données asymétriques soumises à des transformations non linéaires, la symétrie se rompt, exigeant des modélisations plus sophistiquées que nous détaillerons ultérieurement.
3.2 Composantes mathématiques : valeur critique et erreur-type
La marge d’erreur n’est pas une valeur arbitraire décrétée par l’expérimentateur ; elle est le produit algébrique rigoureux de deux composantes interdépendantes : un coefficient théorique déterminé par la distribution probabiliste retenue (la valeur critique) et un indice de variabilité empirique (l’erreur-type de l’estimateur). L’équation fondamentale de la marge d’erreur s’écrit formellement :
$$E = \text{Valeur Critique} \times \text{Erreur-Type}$$
La valeur critique (notée couramment $z^*$ pour une loi normale standard ou $t^*$ pour une loi de Student) reflète le facteur d’amplification requis pour englober la proportion souhaitée de l’aire sous la courbe de la distribution d’échantillonnage. Ce coefficient dépend exclusivement du seuil de confiance nominal choisi par le chercheur et, le cas échéant, des degrés de liberté associés à la taille de l’échantillon.
L’erreur-type (notée $SE$, pour Standard Error) mesure quant à elle la dispersion théorique de la statistique d’échantillonnage autour du paramètre inconnu. Pour une moyenne d’échantillon, elle est égale à l’écart-type de la population divisé par la racine carrée de la taille de l’échantillon ($\sigma / \sqrt{n}$). L’erreur-type incarne ainsi l’unité de mesure de la variabilité d’échantillonnage, et la valeur critique agit comme le multiplicateur probabiliste déterminant combien d’unités d’erreur-type doivent être ajoutées et soustraites pour garantir la couverture souhaitée.
3.3 Le rôle du seuil de signification dans l’amplitude de la marge
Le paramètre gouvernant directement la valeur critique est le seuil de signification, universellement désigné par la lettre grecque $\alpha$ (alpha). Ce seuil correspond au risque toléré d’erreur de première espèce, c’est-à-dire la probabilité de rejeter une hypothèse nulle vraie ou, dans le cadre de l’estimation par intervalle, la proportion d’intervalles qui manqueront le paramètre populationnel lors de réplications infinies. Le niveau de confiance s’exprime alors mathématiquement par la relation $1 – \alpha$.
L’expérimentateur est confronté à un arbitrage méthodologique fondamental entre la sécurité statistique et la précision de l’estimation. Si un chercheur désire réduire le risque d’erreur en élevant le niveau de confiance de 95 % ($\alpha = 0{,}05$) à 99 % ($\alpha = 0{,}01$), la valeur critique $z^*$ passe mécaniquement de 1,960 à 2,576. Cet accroissement entraîne un élargissement immédiat de la marge d’erreur, et par conséquent de l’intervalle de confiance, à condition que la taille d’échantillon demeure inchangée.
Dans les enquêtes d’opinion publique et les études épidémiologiques en santé mentale, ce dilemme est omniprésent. Vouloir une certitude quasi absolue exige d’accepter une marge d’erreur si vaste qu’elle peut vider la conclusion de son intérêt pratique. Définir le niveau de confiance revient ainsi à placer le curseur d’un compromis incontournable entre la résolution spatiale de l’estimation et le risque acceptable de déclarer un résultat erroné.
4. La relation mathématique directe entre marge d’erreur et intervalle de confiance
4.1 La décomposition formelle : estimation ponctuelle et marge
L’articulation entre marge d’erreur et intervalle de confiance s’illustre par une syntaxe mathématique universelle qui unifie l’estimation ponctuelle et son halo d’incertitude. L’écriture canonique d’un intervalle de confiance bilatéral se présente traditionnellement sous la forme suivante :
$$\text{Intervalle de Confiance} = \text{Estimateur Ponctuel} \pm \text{Marge d’Erreur}$$
Soit, en termes symboliques pour une moyenne :
$$IC = \bar{X} \pm E$$
Cette formulation condense élégamment l’ensemble de la logique inférentielle : le premier terme ($\bar{X}$) fixe le barycentre empirique de l’observation, c’est-à-dire le meilleur pari ponctuel que nous puissions faire au vu des données de l’échantillon. Le second terme ($E$), précédé du symbole composite « $\pm$ », déploie la zone d’incertitude symétrique de part et d’autre de cet ancrage central.
Il existe ainsi une continuité parfaite entre l’expression scalaire compacte et la forme vectorielle développée :
$$IC = [\bar{X} – E ;;; \bar{X} + E]$$
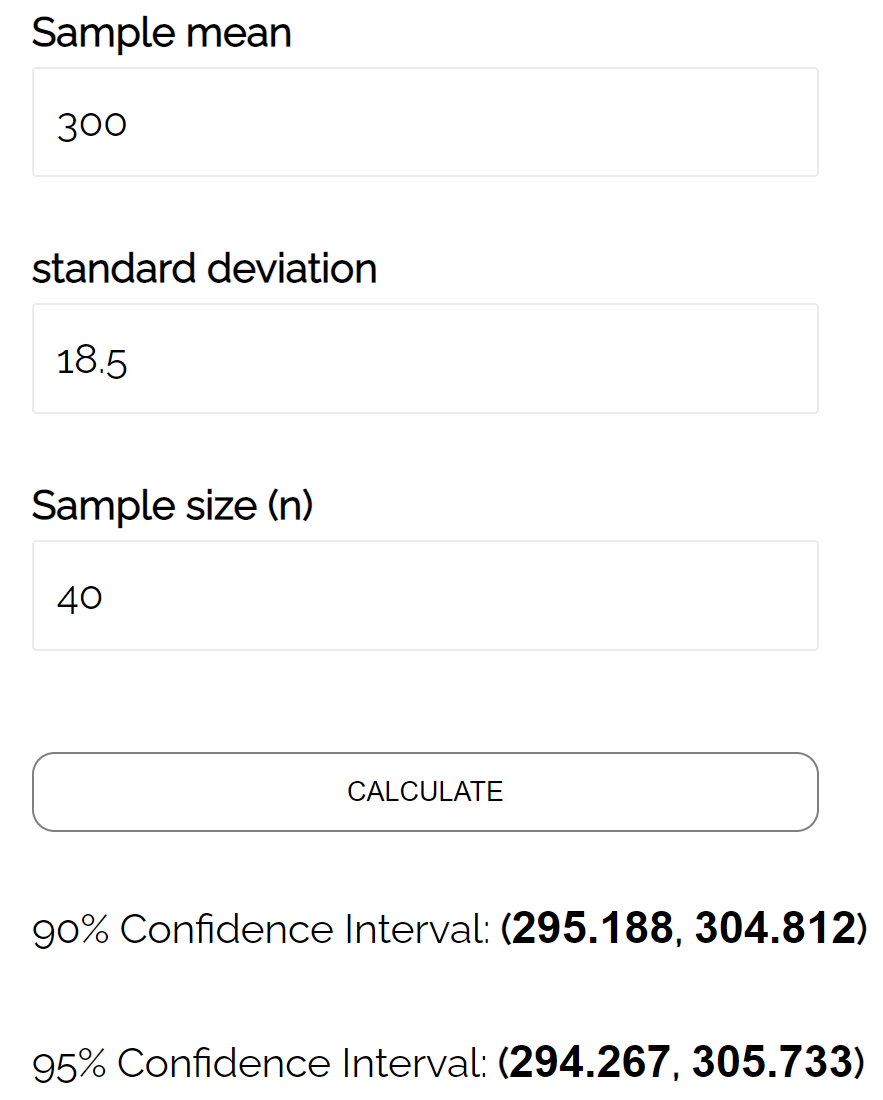
La borne inférieure correspond à la soustraction de la marge d’erreur à l’estimateur, tandis que la borne supérieure découle de son addition. Cette relation réversible permet aux statisticiens d’alterner à tout moment entre la présentation synthétique de la marge d’erreur et la présentation spatialisée de l’intervalle de confiance.
4.2 Calcul de la marge d’erreur à partir d’un intervalle connu
Dans de nombreuses situations de lecture critique d’articles scientifiques ou de méta-analyses, les chercheurs ne disposent pas explicitement de la marge d’erreur dans le texte, mais font face à un intervalle de confiance rapporté sous sa forme bornée. L’extraction de la marge d’erreur à partir d’un intervalle donné s’avère extrêmement simple et repose sur la manipulation algébrique directe des bornes.
Considérons, à titre d’exemple pédagogique concret, une publication psychométrique évaluant un score de flexibilité cognitive où l’intervalle de confiance à 95 % est formulé comme suit : $[12{,}5 ;;; 18{,}5]$. Pour retrouver la marge d’erreur $E$, il suffit d’appliquer la formule de la demi-largeur :
$$E = \frac{18{,}5 – 12{,}5}{2} = \frac{6{,}0}{2} = 3{,}0$$
Simultanément, il est possible de valider l’estimation ponctuelle centrale ($\bar{X}$) en calculant la moyenne arithmétique de la borne supérieure et de la borne inférieure :
$$\bar{X} = \frac{L + U}{2} = \frac{12{,}5 + 18{,}5}{2} = \frac{31{,}0}{2} = 15{,}5$$
Le résultat peut ainsi être réécrit sous sa notation condensée équivalente : $15{,}5 \pm 3{,}0$. Cette opération de décomposition élémentaire constitue une compétence de base pour quiconque entreprend l’analyse quantitative de données publiées ou la vérification de rapports d’évaluation psychologique.
4.3 Reconstruction de l’intervalle à partir de l’estimation et de la marge
À l’inverse, lorsque les synthèses épidémiologiques ou les rapports de sondages fournissent l’estimation ponctuelle couplée à sa marge d’erreur absolue, la restitution de l’intervalle complet requiert l’addition et la soustraction de la marge d’erreur. Si une enquête d’opinion ou une étude de santé mentale rapporte qu’un taux de conformité thérapeutique est estimé à $42,%$ avec une marge d’erreur de $\pm 3{,}5,%$, le lecteur reconstitue l’intervalle de confiance par les calculs suivants :
$$\text{Borne inférieure } (L) = 42,% – 3{,}5,% = 38{,}5,%$$
$$\text{Borne supérieure } (U) = 42,% + 3{,}5,% = 45{,}5,%$$
L’intervalle de confiance restitué est ainsi $[38{,}5,% ;;; 45{,}5,%]$. Cette reconstruction arithmétique immédiate permet de vérifier la cohérence interne des données présentées dans un rapport technique.
Toutefois, cette réciprocité arithmétique stricte n’est valide que si le modèle sous-jacent est symétrique. Dès lors que les données subissent des transformations non linéaires (comme des transformations logarithmiques ou logit), ou lorsque des méthodes d’estimation robustes (comme le bootstrap ou la méthode de Wilson) sont appliquées, l’intervalle devient asymétrique par rapport à l’estimateur ponctuel ($U – \bar{X} \neq \bar{X} – L$). Dans ces cas de figure spécifiques, une seule marge d’erreur globale ne suffit plus à décrire adéquatement l’intervalle de confiance, et les deux distances doivent être explicitées séparément.
5. Facteurs déterminant l’amplitude de l’incertitude
5.1 L’impact critique de la taille de l’échantillon
Parmi tous les déterminants contrôlables par l’expérimentateur, la taille de l’échantillon (universellement symbolisée par $n$) exerce l’influence la plus puissante sur l’amplitude de l’erreur d’échantillonnage. En observant l’expression analytique de l’erreur-type ($\sigma / \sqrt{n}$), il apparaît immédiatement que l’effectif des participants figure au dénominateur sous une racine carrée. Cette propriété mathématique a des répercussions empiriques considérables : la précision statistique augmente proportionnellement à la racine carrée de la taille de l’échantillon, et non de façon linéaire.
Cette relation implique ce que les économistes et les méthodologues nomment la loi des rendements décroissants de l’effort d’échantillonnage. Pour réduire la marge d’erreur de moitié, il ne suffit pas de doubler le nombre de participants : il est impératif de multiplier la taille de l’échantillon par quatre ($2^2 = 4$). De même, pour diviser la marge d’erreur initiale par dix, il faudra recruter un effectif cent fois plus imposant ($10^2 = 100$).
Cette contrainte de la racine carrée pèse lourdement sur la logistique des laboratoires de recherche en psychologie et en imagerie cérébrale. Le passage d’une cohorte de 50 participants à une cohorte de 200 participants offre un gain de précision substantiel, mais passer de 800 à 3 200 sujets exige un investissement financier et temporel massif pour un rétrécissement de la marge d’erreur qui peut s’avérer marginal sur le plan clinique. Le dimensionnement d’une étude requiert donc une optimisation rigoureuse entre gain statistique et faisabilité pragmatique.
5.2 La dispersion inhérente aux variables psychologiques
Le second levier modulant directement la magnitude de l’incertitude est la variance intrinsèque du phénomène mesuré dans la population parente, formalisée par l’écart-type $\sigma$. Plus la population étudiée est hétérogène quant au trait cognitif ou comportemental évalué, plus les valeurs recueillies au sein des échantillons successifs seront dispersées, ce qui engendre mécaniquement une augmentation de l’erreur-type et, par voie de conséquence, un élargissement de la marge d’erreur.
Dans les cohortes cliniques caractérisées par une polymorbidité ou une large diversité sociodémographique, la variabilité des scores est structurellement élevée. À l’inverse, l’analyse d’une sous-population hautement homogène (par exemple des jumeaux homozygotes élevés ensemble, ou des étudiants sélectionnés sur des critères stricts) tend à réduire la variance empirique, comprimant ainsi la marge d’erreur pour une taille d’échantillon équivalente.
Les chercheurs emploient diverses stratégies méthodologiques pour juguler cette dispersion parasitaire sans altérer artificiellement la représentativité. Parmi celles-ci, le raffinement des protocoles expérimentaux, l’utilisation de mesures standardisées présentant une excellente cohérence interne, et le recours à des plans expérimentaux intra-sujets (mesures répétées) permettent de soustraire la variance interindividuelle globale de l’erreur résiduelle, affinant considérablement la précision finale des estimations.
5.3 Le choix stratégique du niveau de confiance
Le troisième déterminant fondamental relève d’une décision délibérée du chercheur : le calibrage du niveau de confiance souhaité ($1 – \alpha$). Comme explicité lors de l’examen de la valeur critique, le choix du seuil statistique module directement le coefficient multiplicateur appliqué à l’erreur-type. Une comparaison des valeurs critiques standard issues de la loi normale centrée réduite illustre clairement ce phénomène :
- Pour un niveau de confiance de 90 % ($\alpha = 0{,}10$), la valeur critique bilatérale est $z^* \approx 1{,}645$.
- Pour un niveau de confiance de 95 % ($\alpha = 0{,}05$), la valeur critique bilatérale est $z^* \approx 1{,}960$.
- Pour un niveau de confiance de 99 % ($\alpha = 0{,}01$), la valeur critique bilatérale est $z^* \approx 2{,}576$.
Choisir un intervalle de confiance à 99 % au lieu du seuil conventionnel de 95 % augmente l’amplitude de la marge d’erreur de plus de 31 % pour un échantillon strictly identique. Ce conservatisme statistique garantit un risque moindre de produire un intervalle erroné, mais il se paye au prix fort : l’élargissement de l’intervalle peut rendre l’estimation trop imprécise pour étayer une conclusion clinique claire.
Un intervalle excessivement large peut englober à la fois un effet thérapeutique trivial et un effet cliniquement majeur, laissant le clinicien dans une perplexité décisionnelle insoluble. Les comités scientifiques préconisent ainsi de maintenir le niveau conventionnel de 95 % pour la vaste majorité des recherches exploratoires et confirmatoires, ne réservant le seuil de 99 % qu’aux études décisionnelles à très haut risque (comme les essais pharmaceutiques de phase III conditionnant la sécurité vitale des patients).
6. Procédure de calcul pour une moyenne : applications psychométriques
6.1 Modélisation avec la distribution normale et le score z
La dérivation d’un intervalle de confiance pour une moyenne d’échantillon continue repose sur le socle théorique fourni par le Théorème Central Limite (TCL). Selon ce principe fondamental, lorsque la taille de l’échantillon $n$ est suffisamment importante (classiquement $n ge 30$), la distribution d’échantillonnage de la moyenne converge asymptotiquement vers une loi normale, même si la distribution parente de la population s’écarte modérément de la gaussianité.
Dans l’hypothèse théorique où l’écart-type de la population ($\sigma$) est connu d’avance — une situation rare en psychologie, mais fréquente dans l’usage de tests psychométriques standardisés comme les échelles d’efficience intellectuelle de Wechsler où $\sigma = 15$ par construction — le calcul fait intervenir le score critique $z^*$. La marge d’erreur se formule de manière explicite :
$$E = z^* \times \frac{\sigma}{\sqrt{n}}$$
Pour un niveau de confiance nominal de 95 %, $z^* = 1{,}96$. Si un échantillon de 100 individus obtient un score moyen de 105 à un indice de mémoire de travail dont l’écart-type populationnel théorique est de 15, la marge d’erreur se calcule directement :
$$E = 1{,}96 \times \frac{15}{\sqrt{100}} = 1{,}96 \times \frac{15}{10} = 1{,}96 \times 1{,}5 = 2{,}94$$
L’intervalle de confiance à 95 % s’établit alors formellement entre $105 – 2{,}94 = 102{,}06$ et $105 + 2{,}94 = 107{,}94$, soit $[102{,}06 ;;; 107{,}94]$. L’application de la distribution normale standard procure ainsi une procédure d’estimation élégante et calculatoirement robuste lorsque l’écart-type de référence est avéré.
6.2 Utilisation de la distribution t de Student pour les petits échantillons
En pratique clinique réelle, l’écart-type de la population $\sigma$ est presque universellement inconnu. Le chercheur est donc contraint de l’estimer à partir des observations recueillies, en calculant l’écart-type corrigé de l’échantillon, universellement désigné par la lettre $s$ :
$$s = \sqrt{\frac{\sum_{i=1}^{n} (X_i – \bar{X})^2}{n – 1}}$$
L’introduction de cette seconde source de fluctuation d’échantillonnage (le remplacement de la constante $\sigma$ par la variable aléatoire $s$) modifie la loi mathématique régissant le ratio inférentiel. Comme l’a démontré William Sealy Gosset sous le pseudonyme de Student en 1908, le ratio ne suit plus une distribution normale centrée réduite, mais une distribution t de Student, conditionnée par ses degrés de liberté ($ddl = n – 1$).
La distribution $t$ possède des queues de distribution plus épaisses que la loi normale, reflétant l’incertitude accrue propre aux petits échantillons. Par conséquent, la valeur critique $t^*$ est systématiquement supérieure à son analogue $z^*$. La formule d’ajustement de la marge d’erreur s’énonce :
$$E = t^*_{(alpha/2 ,;, n-1)} \times \frac{s}{\sqrt{n}}$$
Lorsque la taille de l’échantillon augmente, les degrés de liberté progressent et la distribution $t$ converge vers la loi normale. Néanmoins, pour des cohortes restreintes (typiques des neurosciences translationnelles ou de la neuropsychologie, avec $n < 30$), omettre la distribution $t$ au profit de la loi normale conduirait à sous-estimer artificiellement la marge d'erreur et à produire des intervalles trop étroits.
6.3 Étude de cas guidée : évaluation d’un score de stress post-traumatique
Afin de concrétiser la démarche calculatoire dans un contexte clinique rigoureux, examinons une étude fictive mais méthodologiquement réaliste consacrée à l’évaluation de la sévérité du stress post-traumatique chez des primo-intervenants d’urgence à l’aide de l’échelle PCL-5 (Posttraumatic Stress Disorder Checklist for DSM-5). Une cohorte restreinte de 16 intervenants ($n = 16$) est examinée. Les scores observés génèrent une moyenne empirique $\bar{X} = 38{,}40$ points et un écart-type d’échantillon $s = 8{,}00$ points.
Le chercheur souhaite encadrer la moyenne réelle de cette population à un niveau de confiance de 95 % ($\alpha = 0{,}05$). L’écart-type populationnel étant inconnu et l’échantillon étant restreint ($n < 30$), le recours à la distribution $t$ de Student est impératif. Les degrés de liberté sont définis par :
$$ddl = n – 1 = 16 – 1 = 15$$
La consultation d’une table de Student bilatérale ou d’un logiciel d’analyse statistique indique que pour $ddl = 15$ et $\alpha = 0{,}05$, la valeur critique est $t^* = 2{,}131$. Nous pouvons dès lors procéder à la chaîne de calculs :
- Calcul de l’erreur-type de la moyenne :
$$SE = \frac{s}{\sqrt{n}} = \frac{8{,}00}{\sqrt{16}} = \frac{8{,}00}{4} = 2{,}00$$ - Calcul de la marge d’erreur absolue :
$$E = t^* \times SE = 2{,}131 \times 2{,}00 = 4{,}262$$ - Détermination des bornes de l’intervalle de confiance à 95 % :
$$L = \bar{X} – E = 38{,}40 – 4{,}262 = 34{,}138 \approx 34{,}14$$
$$U = \bar{X} + E = 38{,}40 + 4{,}262 = 42{,}662 \approx 42{,}66$$
L’intervalle de confiance final s’énonce : $IC_{95%} = [34{,}14 ;;; 42{,}66]$. L’interprétation clinique s’articule ainsi : en supposant que le processus d’échantillonnage soit exempt de biais systématique, le protocole utilisé garantit que 95 % des intervalles ainsi générés contiennent la moyenne populationnelle inconnue de ces intervenants. Notons que si le seuil clinique de stress sévère est fixé à 33 points sur la PCL-5, le fait que la borne inférieure ($34{,}14$) soit strictement supérieure à ce repère suggère que la population ciblée souffre, en moyenne, d’une charge post-traumatique cliniquement significative.
7. Procédure de calcul pour une proportion : sondages et épidémiologie psychiatrique
7.1 Formulation théorique pour les variables qualitatives dichotomiques
L’inférence statistique ne s’applique pas uniquement à des variables quantitatives continues. En épidémiologie psychiatrique et en psychologie de la santé, les chercheurs travaillent abondamment avec des variables qualitatives nominales dichotomiques (présence ou absence d’un trouble, succès ou échec à une épreuve, rémission ou rechute clinique). La variable aléatoire sous-jacente suit alors une distribution binomiale paramétrée par la proportion populationnelle $p$.
L’estimation ponctuelle de cette proportion est désignée par $\hat{p} = k / n$, où $k$ représente le nombre de cas positifs recensés et $n$ le nombre total de répondants observés. La théorie de la variance binomiale démontre que la variance d’une proportion empirique est égale à $p(1 – p) / n$. Par dérivation directe, l’erreur-type asymptotique d’une proportion s’écrit :
$$SE_{\hat{p}} = \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}$$
Une caractéristique fondamentale de cette équation réside dans la dépendance directe de la dispersion vis-à-vis de la valeur de la proportion elle-même. La quantité $\hat{p}(1 – \hat{p})$ atteint son maximum théorique absolu lorsque $\hat{p} = 0{,}50$ ($0{,}50 \times 0{,}50 = 0{,}25$). Par conséquent, la marge d’erreur d’un sondage ou d’une prévalence épidémiologique est structurellement maximale lorsque les avis ou les états cliniques sont parfaitement partagés à 50/50. Plus la proportion s’écarte de ce pivot central pour se rapprocher de 0 ou de 1, plus la marge d’erreur théorique rétrécit de façon asymétrique.
7.2 Approximation normale et conditions de validité de Wald
Dans l’approche conventionnelle dite de Wald, la construction de l’intervalle de confiance d’une proportion repose sur l’approximation normale de la loi binomiale, autorisant l’usage du score critique standard $z^*$. La marge d’erreur prend alors la forme classique suivante :
$$E = z^* \times \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}$$
Cependant, cette approximation normale n’est pas inconditionnelle. Elle repose sur des critères de validité empiriques rigoureux, historiquement définis par les conditions de Wald : il est généralement requis que le nombre attendu d’événements favorables et le nombre attendu d’événements défavorables soient tous deux supérieurs ou égaux à 10 :
$$n\hat{p} ge 10 \quad \text{et} \quad n(1 – \hat{p}) ge 10$$
Lorsque ces critères ne sont pas remplis — notamment face à des affections psychiatriques rares dont la prévalence est inférieure à 2 %, ou face à des échantillons de taille modeste —, l’intervalle de Wald devient notoirement défaillant. Il génère des taux de couverture empiriques bien inférieurs au niveau de confiance nominal affiché (par exemple 88 % au lieu de 95 %) et peut produire des aberrations mathématiques, telles que des bornes inférieures négatives ou des bornes supérieures excédant 100 %.
Pour pallier ces dérives méthodologiques, la littérature statistique contemporaine recommande formellement de délaisser la méthode de Wald standard au profit d’alternatives plus robustes : la méthode de Wilson avec correction de score (Wilson score interval) ou la méthode exacte de Clopper-Pearson fondée sur la loi bêta.
7.3 Étude de cas guidée : prévalence d’un trouble anxieux en milieu universitaire
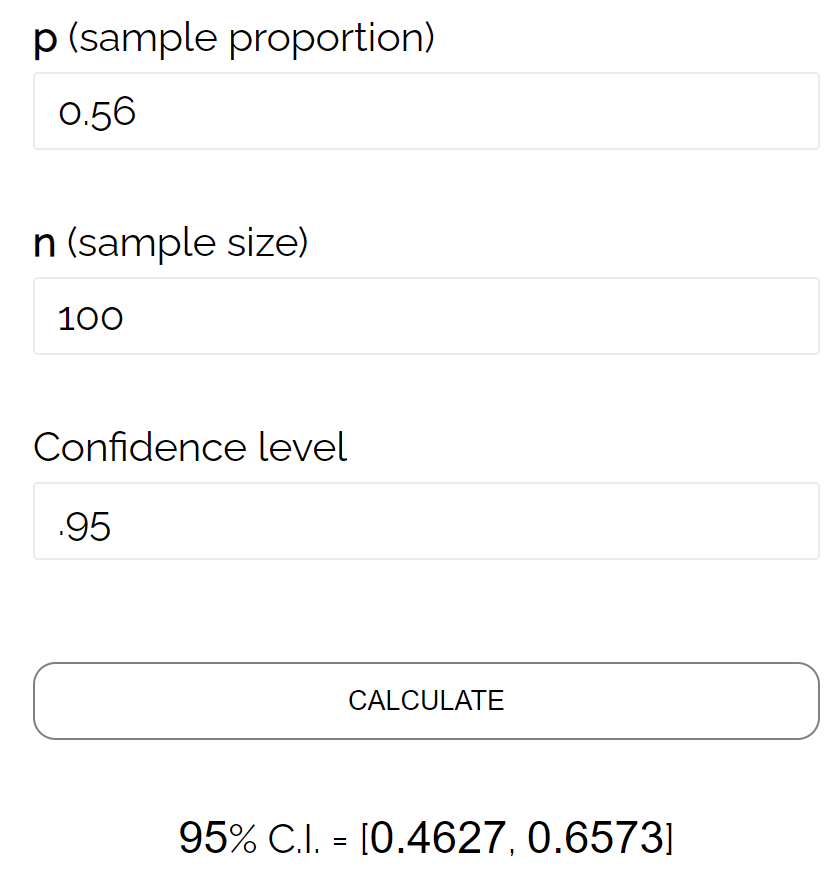
Illustrons cette modélisation à travers une enquête épidémiologique axée sur la santé mentale des étudiants en première année de licence. Une équipe de recherche administre le questionnaire validé GAD-7 (Generalized Anxiety Disorder-7) à un échantillon aléatoire de $n = 400$ étudiants. Le dépouillement diagnostique révèle que 88 étudiants présentent des symptômes répondant aux critères d’un trouble d’anxiété généralisée modéré à sévère.
Le traitement analytique se déploie selon les étapes suivantes :
- Calcul de la proportion empirique observée ($\hat{p}$) :
$$\hat{p} = \frac{88}{400} = 0{,}22 \quad (22,%)$$ - Vérification des conditions de validité de l’approximation normale :
$$n\hat{p} = 400 \times 0{,}22 = 88 ge 10$$
$$n(1 – \hat{p}) = 400 \times (1 – 0{,}22) = 400 \times 0{,}78 = 312 ge 10$$
Les deux conditions sont largement vérifiées ; l’usage du score $z^*$ est parfaitement légitime. - Sélection du niveau de confiance à 95 % :
$$\alpha = 0{,}05 implies z^* = 1{,}96$$ - Calcul de l’erreur-type de la proportion :
$$SE = \sqrt{\frac{0{,}22 \times 0{,}78}{400}} = \sqrt{\frac{0{,}1716}{400}} = \sqrt{0{,}000429} \approx 0{,}02071 \quad (2{,}071,%)$$ - Calcul de la marge d’erreur :
$$E = 1{,}96 \times 0{,}02071 \approx 0{,}04059 \quad (4{,}06,%)$$ - Calcul des bornes de l’intervalle de confiance :
$$L = 0{,}22 – 0{,}0406 = 0{,}1794 \quad (17{,}94,%)$$
$$U = 0{,}22 + 0{,}0406 = 0{,}2606 \quad (26{,}06,%)$$
L’intervalle de confiance à 95 % s’établit à $[17{,}94,% ;;; 26{,}06,%]$. La marge d’erreur absolue associée à cette enquête épidémiologique est de $\pm 4{,}06$ points de pourcentage. Ce résultat indique aux instances sanitaires universitaires que la prévalence réelle du trouble anxieux au sein de la cohorte générale ne peut être ramenée au chiffre ponctuel de 22 %, mais qu’elle se situe, avec un niveau de confiance fréquentiste de 95 %, dans un intervalle compris approximativement entre 18 % et 26 %. Cet éclairage quantifié s’avère fondamental pour dimensionner adéquatement les cellules d’écoute et de soutien psychologique du campus.
8. Distinctions conceptuelles et sémiotiques majeures
8.1 Rayon versus région : une distinction géométrique fondamentale
Pour appréhender sans confusion possible la différence entre marge d’erreur et intervalle de confiance, une analogie géométrique rigoureuse s’impose : la distinction entre un rayon et une région spatiale. La marge d’erreur représente une grandeur unidimensionnelle scalaire : elle correspond à la longueur d’un segment de vecteur partant du centre pour atteindre une limite périphérique. Elle quantifie un écart d’éloignement maximal admis.
En revanche, l’intervalle de confiance incarne la surface ou le volume géométrique balayé par ce rayon : il s’agit d’une région continue sur la droite des nombres réels, clairement identifiée par son début ($L$) et sa fin ($U$). La marge d’erreur stipule combien d’incertitude nous tolérons autour de l’estimation, tandis que l’intervalle de confiance décrit où se situent concrètement les valeurs plausibles du paramètre étudié.
Ces deux entités ne s’opposent pas : elles constituent les deux faces complémentaires d’un même phénomène stochastique. L’une fournit l’indice d’imprécision métrique brut ($E$), tandis que l’autre projette cette imprécision dans le repère opérationnel de la variable mesurée ($[L ; U]$), permettant la confrontation directe avec des seuils critiques, des normes cliniques ou des valeurs théoriques d’hypothèse nulle.
8.2 Usage en communication grand public versus rigueur académique
La distinction entre marge d’erreur et intervalle de confiance se double d’une divergence sociologique majeure dans leurs modes d’appropriation respectifs. Les médias grand public, les instituts de sondage sociopolitique et les synthèses exécutives privilégient massivement la marge d’erreur. La formulation « une avance de 4 points avec une marge d’erreur de 2 % » possède un impact cognitif immédiat, direct et intuitif pour un lectorat non initié aux arcanes des distributions d’échantillonnage.
Toutefois, cette concision journalistique comporte des risques notables de simplification abusive. Les médias omettent quasi systématiquement de préciser le niveau de confiance nominal (présumé être de 95 % sans que cela ne soit explicité) et passent sous silence la violation fréquente des hypothèses de distribution. De surcroît, la simple mention de « $\pm 3,%$ » conduit fréquemment les citoyens à croire que la probabilité est uniformément répartie au sein de cette tranche, alors que la distribution des probabilités d’échantillonnage est concentrée de façon hautement leptokurtique autour de la valeur centrale.
À l’opposé, les publications scientifiques à comité de lecture et les monographies académiques réclament impérativement la spécification intégrale de l’intervalle de confiance $[L ; U]$. Dans un article de psychologie expérimentale, l’omission des bornes précises au profit de la simple notation abrégée « $\pm$ » est considérée comme une insuffisance méthodologique majeure, car elle prive le lecteur de la vérification immédiate des asymétries éventuelles et des inférences cliniques liées aux frontières de l’intervalle.
8.3 Tableau comparatif détaillé des propriétés analytiques
Afin de synthétiser sans équivoque les propriétés analytiques, métrologiques et interprétatives différenciant ces deux grandeurs, le tableau analytique ci-dessous récapitule leurs attributs distinctifs :
| Critère d’analyse | Marge d’Erreur (ME / $E$) | Intervalle de Confiance (IC) |
|---|---|---|
| Nature géométrique | Scalaire représentant un rayon (demi-largeur de l’intervalle symétrique). | Segment continu multidimensionnel représentant une région fermée $[L ; U]$. |
| Formulation mathématique | $E = \text{Valeur Critique} \times SE$ | $IC = [\text{Estimateur} – E ;;; \text{Estimateur} + E]$ |
| Format d’expression | Valeur numérique unique précédée du signe $\pm$ (absolue ou en %). | Paire ordonnée de bornes délimitées par des crochets $[L ; U]$. |
| Usage privilégié | Sondages politiques, synthèses managériales, communications médiatiques. | Articles scientifiques révisés par les pairs, méta-analyses, rapports d’évaluation clinique. |
| Sensibilité à l’asymétrie | Généralement inopérante ou trompeuse face à des distributions fortement asymétriques. | Parfaitement adaptable aux distributions asymétriques (ex. bootstrap, Wilson). |
| Prise de décision clinique | Indique la tolérance d’imprécision sans situer directement les seuils pathologiques. | Permet de vérifier directement si des seuils diagnostiques critiques sont inclus ou exclus. |
Ce comparatif met en relief la complémentarité structurelle des deux notions : la marge d’erreur condense l’incertitude dans un indice de dispersion synthétique, tandis que l’intervalle de confiance la déploie dans le système de coordonnées de la mesure, guidant ainsi l’interprétation diagnostique et méthodologique.
9. Normalisation des publications scientifiques selon les normes APA
9.1 Exigences du style APA (7e édition) pour l’inférence
L’American Psychological Association (APA), dans la 7e édition de son manuel de publication officiel, impose des standards particulièrement rigoureux quant à la restitution des résultats quantitatifs. Les recommandations actuelles stipulent que toute estimation de taille d’effet ou de paramètre central doit impérativement être accompagnée de son intervalle de confiance. L’usage exclusif de la marge d’erreur sous le format « $\pm$ » est explicitement déconseillé dans les sections de résultats des manuscrits académiques.
Le style APA exige une syntaxe typographique stricte : l’intervalle de confiance doit être désigné par l’abréviation « CI » (en anglais) ou « IC » (en français), obligatoirement indexé par son niveau de confiance en pourcentage (par exemple 95 % IC). Les bornes inférieure et supérieure sont encadrées par des crochets, séparées par une virgule (ou un point-virgule dans les contextes francophones pour éviter toute confusion avec la virgule décimale), conformément à la convention mathématique standard :
95 % IC [10,45 ; 14,82]
Les recommandations APA insistent également sur l’interdiction de juxtaposer inutilement le signe « $\pm$ » avec des intervalles asymétriques ou standardisés. En imposant la formalisation explicite des deux bornes réelles, les normes garantissent une transparence statistique absolue, empêchant les ambiguïtés interprétatives qui découlaient historiquement de notations simplifiées.
9.2 Représentation graphique de l’incertitude
La restitution visuelle des données expérimentales obéit à des contraintes méthodologiques tout aussi exigeantes. L’insertion de barres d’erreur (error bars) sur les diagrammes à bandes (bar charts) ou les profils d’interaction linéaire est indispensable. Cependant, la publication scientifique souffre d’un manque d’uniformité critique dans l’annotation de ces figures, générant régulièrement des malentendus chez les lecteurs.
Une barre d’erreur graphique peut en effet représenter trois entités radicalement différentes :
- L’écart-type ($SD$), qui illustre la dispersion interindividuelle des scores observés dans l’échantillon.
- L’erreur-type de la moyenne ($SE$), qui illustre la variabilité de la moyenne d’échantillonnage théorique.
- La marge d’erreur associée à l’intervalle de confiance (généralement à 95 %), qui étend la barre à $1{,}96 \times SE$ ou $t^* \times SE$.
Les normes de l’APA imposent aux auteurs de déclarer explicitement, dans la légende de chaque figure, l’identité mathématique exacte des barres d’erreur affichées. Une barre représentant un écart-type ne permet pas d’inférer la significativité statistique, alors qu’une barre illustrant un intervalle de confiance à 95 % offre des indices immédiats sur l’existence de contrastes statistiquement significatifs entre les conditions expérimentales.
9.3 Rédaction transparente de la section des résultats
La rédaction de la section des résultats d’un article scientifique requiert un équilibre subtil entre élégance textuelle et exactitude mathématique. Les chercheurs doivent rapporter conjointement les indicateurs descriptifs centraux, les tailles d’effet empiriques et les intervalles de confiance respectifs sans surcharger la narration cognitive du lecteur.
Voici un modèle rédactionnel exemplaire, conforme aux standards internationaux de publication en psychologie expérimentale :
« Le temps de réaction moyen des participants exposés à la condition de surcharge cognitive était significativement plus élevé ($\bar{X} = 485\text{ ms}$, $s = 45\text{ ms}$) que celui des participants de la condition contrôle ($\bar{X} = 410\text{ ms}$, $s = 38\text{ ms}$). La différence moyenne entre les deux groupes s’élevait à $75\text{ ms}$, $95,%\text{ IC } [52{,}4 ;;; 97{,}6]$, $t(58) = 6{,}65$, $p < 0{,}001$, avec une taille d'effet substantielle mesurée par le $d$ de Cohen ($d = 1{,}72$, $95,%\text{ IC } [1{,}15 ;;; 2{,}27]$). »
Cette formulation articule rigoureusement les paramètres de centralité, la marge de variation probabiliste via les intervalles de confiance, et l’évaluation de la magnitude clinique du phénomène via la taille d’effet standardisée. L’intégration harmonieuse des intervalles dans le corps du texte garantit que la signification substantive du travail de recherche s’exprime dans le respect intégral du formalisme statistique.
10. Articulation avec les tests d’hypothèses nulles (NHST)
10.1 Correspondance théorique entre p-valeur et intervalle de confiance
Il existe une correspondance mathématique directe entre les tests bilatéraux de l’hypothèse nulle conventionnelle (Null Hypothesis Significance Testing – NHST) et les intervalles de confiance construits selon le paradigme fréquentiste. Cette dualité s’énonce simplement : un test d’hypothèse bilatéral conduit au rejet de l’hypothèse nulle ($H_0 : \theta = \theta_0$) au seuil de signification $\alpha$ si et seulement si la valeur de référence sous l’hypothèse nulle ($\theta_0$, typiquement 0 pour une différence de moyennes) tombe strictement en dehors de l’intervalle de confiance calculé à $(1 – \alpha)$.
Ainsi, si un intervalle de confiance à 95 % ($\alpha = 0{,}05$) pour la différence entre deux traitements s’établit à $[+1{,}2 ;;; +5{,}8]$, la valeur zéro se situe hors de l’intervalle. L’analyste peut déduire immédiatement, sans même consulter la valeur précise de la $p$-valeur, que le test statistique correspondant sera statistiquement significatif au seuil $p < 0{,}05$. Inversement, si l'intervalle avait été $[-0{,}5 ;;; +4{,}1]$, incluant la valeur nulle zéro, le test aurait irrémédiablement produit une valeur $p ge 0{,}05$.
Malgré cette équivalence formelle, l’intervalle de confiance présente une supériorité informationnelle flagrante sur la simple $p$-valeur. Alors que la valeur de $p$ se résume à un indice conditionnel binaire indiquant l’incompatibilité des données avec l’hypothèse nulle, l’intervalle de confiance dévoile simultanément l’estimation ponctuelle de l’effet et la marge d’incertitude qui l’entoure. Il fournit un panorama complet des valeurs plausibles du paramètre, ce que la $p$-valeur est structurellement incapable d’accomplir.
10.2 Évaluation de la signification clinique versus signification statistique
L’un des apports majeurs de l’intervalle de confiance réside dans sa capacité à dissocier sans ambiguïté la signification statistique de la pertinence clinique ou pratique. La $p$-valeur dépend fortement de la taille de l’échantillon : avec un effectif massif ($n = 10,000$), le moindre effet insignifiant (par exemple une réduction d’anxiété de 0,1 point sur une échelle de 100) atteindra un seuil de significativité hautement significatif ($p < 0{,}001$).
L’examen de l’intervalle de confiance permet de démasquer instantanément ces artéfacts de puissance. Si l’intervalle de confiance pour ce gain thérapeutique s’énonce $[0{,}08 ;;; 0{,}12]$, le praticien constate que, bien que statistiquement indiscutable, l’effet est d’une trivialité clinique absolue, incapable de générer une amélioration perceptible dans la vie quotidienne du patient.
Inversement, dans des études cliniques pilotes portant sur des pathologies rares avec de faibles effectifs de participants, un traitement prometteur peut échouer à atteindre le seuil conventionnel de significativité ($p = 0{,}08$) en raison d’une puissance statistique déficitaire. L’intervalle de confiance correspondant, par exemple $[-1{,}0 ;;; +14{,}0]$, révélera que des gains cliniques spectaculaires demeurent tout à fait plausibles au vu des données. L’intervalle de confiance empêche ainsi le chercheur d’assimiler hâtivement une absence de preuve statistique à une preuve d’absence d’effet clinique.
10.3 L’interprétation conjointe de la précision et de la taille d’effet
La révolution méthodologique qui traverse la recherche comportementale depuis deux décennies promeut la transition de la statistique de la décision binaire (significatif vs non significatif) vers une statistique d’estimation axée sur la taille d’effet et sa précision. Dans ce cadre épistémologique renouvelé, l’intervalle de confiance n’est plus seulement calculé pour les scores bruts ou les moyennes empiriques, mais systématiquement appliqué aux indices standardisés tels que le $d$ de Cohen, le coefficient de corrélation $r$ de Pearson, ou l’odds ratio (rapport des cotes).
Le calcul d’intervalles de confiance sur les tailles d’effet permet de relativiser la portée des interventions thérapeutiques. Un rapport annonçant un $d = 0{,}80$ (généralement qualifié d’effet de grande magnitude) perd une part substantielle de sa force persuasive si son intervalle de confiance à 95 % s’étend de $0{,}05$ à $1{,}55$. Cette amplitude démontre que la précision empirique de l’étude est médiocre, et que l’effet réel de la psychothérapie pourrait aussi bien être négligeable qu’extraordinaire.
Ce couplage taille d’effet-précision constitue le fondement des méta-analyses scientifiques contemporaines. Dans les méta-analyses, les résultats de multiples études primaires indépendantes ne sont pas agrégés par un vote majoritaire fondé sur les $p$-valeurs, mais combinés à travers des modèles à effets fixes ou aléatoires où chaque étude est pondérée proportionnellement à l’inverse de sa variance (l’inverse du carré de son erreur-type). Plus la marge d’erreur d’une étude primaire est réduite, plus son poids métanalytique dans l’estimation de l’effet global est déterminant.
11. Erreurs fréquentes d’interprétation et pièges méthodologiques
11.1 La confusion récurrente entre écart-type et erreur-type
Parmi toutes les confusions méthodologiques qui polluent la littérature biomédicale et comportementale, la substitution illégitime de l’écart-type ($SD$, pour Standard Deviation) par l’erreur-type ($SE$, pour Standard Error) demeure la plus pernicieuse et la plus répandue. Bien que ces deux indices partagent une étymologie proche et mesurent tous deux des dispersions, leurs finalités théoriques et leurs réalités empiriques sont diamétralement opposées.
L’écart-type mesure la variabilité descriptive interindividuelle naturelle des scores au sein d’une population ou d’un échantillon. Il quantifie la dispersion des trajectoires comportementales ou biologiques singulières autour de leur barycentre moyen. L’écart-type ne tend pas vers zéro lorsque la taille de l’échantillon croît : il converge vers la véritable variance de la population $\sigma$.
À l’opposé, l’erreur-type (et par extension la marge d’erreur) mesure l’incertitude inférentielle liée au processus d’échantillonnage. Elle quantifie la fluctuation théorique de l’estimateur d’un échantillon à un autre. L’erreur-type est une fonction décroissante de l’effectif : elle tend asymptotiquement vers zéro lorsque $n$ approche de l’infini. Certains auteurs peu scrupuleux ou mal informés choisissent délibérément de rapporter l’erreur-type ($SE$) en lieu et place de l’écart-type ($SD$) dans leurs tableaux descriptifs initiaux, dans le seul but cosmétique de réduire artificiellement la dispersion apparente de leurs données brutes et de faire paraître leurs groupes plus homogènes qu’ils ne le sont en réalité.
11.2 Le piège du chevauchement de deux intervalles indépendants
L’une des méprises d’interprétation les plus séduisantes sur le plan intuitif, mais mathématiquement fausse, concerne la comparaison visuelle de deux intervalles de confiance indépendants. De nombreux cliniciens et chercheurs présument à tort que si les intervalles de confiance à 95 % de deux groupes expérimentaux se chevauchent (c’est-à-dire si la borne inférieure de l’un pénètre dans la région délimitée par les bornes de l’autre), il n’y a pas de différence statistiquement significative au seuil $\alpha = 0{,}05$.
Cette déduction rapide est incorrecte. La non-disjonction de deux intervalles de confiance à 95 % n’implique nullement l’absence de différence statistiquement significative. En réalité, un test de comparaison de deux moyennes indépendantes évalue l’erreur-type de la différence :
$$SE_{(\bar{X}_1 – \bar{X}_2)} = \sqrt{SE_1^2 + SE_2^2}$$
Cette quantité est strictement inférieure à la somme arithmétique directe des deux erreurs-types ($SE_1 + SE_2$).
Comme l’ont magistralement démontré Geoff Cumming et ses collaborateurs dans leurs travaux sur la « nouvelle statistique », deux moyennes indépendantes issues d’échantillons de taille modérée peuvent présenter une différence statistiquement significative au seuil conventionnel de $p < 0{,}05$ même si leurs intervalles de confiance respectifs à 95 % se chevauchent sur environ la moitié de la longueur d'un bras d'intervalle (soit un chevauchement d'approximativement 25 % à 50 % de leur marge d'erreur). Pour affirmer visuellement une absence de significativité par la méthode des intervalles, il faut que le chevauchement soit massif, ou mieux encore, il convient de tracer directement l'intervalle de confiance de la différence entre les moyennes et de vérifier si cet intervalle spécifique englobe la valeur zéro.
11.3 L’interprétation abusive des intervalles asymétriques ou tronqués
L’emploi non critique de la formule symétrique élémentaire « $\bar{X} \pm \text{marge d’erreur}$ » génère des distorsions méthodologiques sévères dès lors que l’on manipule des variables psychologiques contraintes par des frontières naturelles ou artificielles. C’est le cas récurrent des échelles bornées (par exemple un questionnaire de bien-être borné entre 0 et 100) ou des données d’asymétrie positive marquée, telles que les temps de réaction, les taux d’erreur enzymatiques ou les durées de latence comportementale.
Lorsqu’un chercheur analyse un temps de réaction cognitif moyen de 180 ms avec un écart-type d’échantillon élevé, l’application aveugle d’une marge d’erreur symétrique gaussienne peut générer une borne inférieure négative (par exemple $[-15\text{ ms} ;;; 375\text{ ms}]$), ce qui représente une impossibilité neurobiologique flagrante, le temps de conduction synaptique ne pouvant être négatif. De même, pour des proportions proches des bornes 0 % ou 100 %, les formules élémentaires produisent fréquemment des marges d’erreur aberrantes dépassant les limites logiques de la métrique.
Face à de telles configurations réelles, l’adhésion à une marge d’erreur symétrique unique doit être révoquée au profit de méthodes avancées d’estimation non paramétrique ou transformée :
- Le rééchantillonnage par bootstrap avec correction d’asymétrie et accélération (BCa bootstrap), qui calcule empiriquement les centiles inférieur et supérieur de la distribution empirique.
- Les modélisations linéaires généralisées avec fonctions de lien adaptées (telles que les régressions Gamma ou log-normales).
- L’intervalle de confiance de Wilson pour les proportions, qui produit des bornes asymétriques strictement contenues dans le segment mathématique $[0 ;;; 1]$.
12. Synthèse pratique et guide décisionnel pour les chercheurs
12.1 Algorithme de sélection de la métrique selon le public cible
Face à la dualité opérationnelle entre marge d’erreur et intervalle de confiance, le praticien de la recherche et le communicant scientifique doivent sélectionner le vecteur d’information le plus adapté à leur objectif communicationnel et à l’expertise cognitive de leur public. Cette prise de décision stratégique peut être systématisée à l’aide de l’arbre décisionnel suivant :
Cas 1 : Communication grand public, restitutions managériales, synthèses d’orientation stratégique
Privilégier l’expression sous forme de Marge d’Erreur. Dans ces contextes décisionnels, les récepteurs de l’information recherchent un indice synthétique de tolérance et de précision opérationnelle. L’expression scalaire compacte (« un score moyen de satisfaction de 78/100, avec une marge d’incertitude de $\pm 2{,}5$ points ») évite la surcharge cognitive associée à la lecture de segments d’intervalles complexes, tout en préservant la probité déontologique de la transmission en signalant explicitement l’incertitude sous-jacente.
Cas 2 : Rapports cliniques approfondis, soumissions d’articles académiques, méta-analyses
Exiger impérativement l’usage formalisé de l’Intervalle de Confiance $[L ; U]$. Dans ce cadre de rigueur scientifique, l’intervalle est irremplaçable : il positionne les estimations par rapport aux critères diagnostiques universels, autorise l’appréciation directe de l’hypothèse nulle, conserve la transparence sur les éventuelles corrections asymétriques appliquées, et offre aux futurs réviseurs métanalytiques la totalité de la matière première requise pour l’agrégation statistique cumulative des preuves.
12.2 Planification de l’échantillonnage axée sur la précision (AIPE)
Traditionnellement, la planification de la taille d’échantillon dans les laboratoires de psychologie expérimentale est menée à travers le prisme exclusif de l’analyse de puissance statistique (Power Analysis). Cette approche consiste à déterminer le nombre minimal de sujets $n$ nécessaire pour rejeter l’hypothèse nulle avec une probabilité fixée (généralement $1 – \beta = 0{,}80$) sachant qu’un effet d’une certaine magnitude existe dans la population.
Bien que cette démarche soit indispensable, elle est de plus en plus complétée ou supplantée par une approche méthodologique plus moderne et constructive : la planification axée sur la précision de l’estimation des paramètres (Accuracy in Parameter Estimation – AIPE), popularisée par des méthodologues tels que Ken Kelley et Scott Maxwell. Dans le paradigme AIPE, le chercheur ne cherche pas prioritairement à franchir le seuil d’une $p$-valeur significative, mais planifie son échantillonnage de manière à garantir que la largeur de l’intervalle de confiance final ne dépassera pas une marge d’erreur maximale tolérable ($E_{\max}$), fixée sur des critères cliniques rigoureux.
En réarrangeant algébriquement la formule de la marge d’erreur pour une moyenne, nous obtenons directement l’algorithme de calcul de la taille d’échantillon optimale sous l’angle de la précision :
$$E = z^* \times \frac{\sigma}{\sqrt{n}} implies \sqrt{n} = \frac{z^* \times \sigma}{E} implies n = \left( \frac{z^* \times \sigma}{E} \right)^2$$
Si un laboratoire de neuropsychologie souhaite étalonner une épreuve de vitesse d’inhibition cognitive ($\sigma = 20\text{ ms}$) avec une marge d’erreur ne devant pas excéder $E = 2{,}5\text{ ms}$ au niveau de confiance de 95 % ($z^* = 1{,}96$), le calcul AIPE stipule :
$$n = \left( \frac{1{,}96 \times 20}{2{,}5} \right)^2 = \left( \frac{39{,}2}{2{,}5} \right)^2 = (15{,}68)^2 \approx 245{,}86$$
L’équipe de recherche doit donc recruter un effectif minimal de 246 participants pour assurer la précision métrologique requise. L’approche AIPE élève ainsi la marge d’erreur du statut de simple constat statistique passif au rang d’instrument d’optimisation méthodologique actif dans la conception expérimentale.
12.3 Check-list méthodologique pour la validation des résultats
Avant de finaliser et de soumettre un manuscrit académique ou un rapport diagnostique intégrant des marges d’erreur et des intervalles de confiance, tout chercheur rigoureux gagne à confronter son travail à la grille de validation systématique ci-dessous :
- Vérification des postulats distributionnels : La variable continue est-elle asymptotiquement normale ou l’échantillon est-il suffisamment volumineux ($n ge 30$) pour légitimer l’usage du Théorème Central Limite ? Pour les proportions, les conditions de Wald ($n\hat{p} ge 10$ et $n(1 – \hat{p}) ge 10$) sont-elles satisfaites ? Si non, des méthodes adaptées (loi de Student, correction de Wilson, rééchantillonnage par bootstrap) ont-elles été employées ?
- Exactitude de la relation arithmétique : En cas de distribution symétrique, la marge d’erreur déclarée correspond-elle rigoureusement à la demi-largeur de l’intervalle publié ($E = [U – L] / 2$) ? L’estimation ponctuelle correspond-elle précisément à la médiane géométrique des deux bornes ($[L + U] / 2$) ?
- Rigueur de la notation syntaxique : L’intervalle de confiance est-il rapporté dans le format typographique requis par les comités éditoriaux (ex. 95 % IC [L ; U] selon l’APA 7), en proscrivant l’usage ambigu de la seule notation « $\pm$ » pour les tailles d’effet critiques ?
- Annotation sans équivoque des représentations visuelles : La légende accompagnant chaque graphique stipule-t-elle sans aucune ambiguïté si les barres d’erreur représentent l’écart-type descriptif ($SD$), l’erreur-type théorique ($SE$), ou l’intervalle de confiance probabiliste à 95 % ?
- Intégrité interprétative : Le texte évite-t-il les sophismes fréquents, tels que l’attribution d’une probabilité conditionnelle a posteriori au paramètre fixe, la confusion entre intervalle de confiance et intervalle de prédiction individuelle, ou l’affirmation hâtive d’absence de différence fondée sur le simple chevauchement partiel de deux intervalles indépendants ?
En respectant scrupuleusement ces impératifs méthodologiques, les chercheurs s’assurent que leurs estimations quantitatives constituent des contributions solides, vérifiables et reproductibles au progrès de l’édifice scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Kelley, K., & Maxwell, S. E. (2003). Sample size for rough confidence intervals on differences between means of normal distributions. Educational and Psychological Measurement, 63(2), 245–270. https://doi.org/10.1177/0013164402251034
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Schenker, N., & Gentleman, J. F. (2001). On judging the significance of differences by examining the overlap between confidence intervals. The American Statistician, 55(3), 182–186. https://doi.org/10.1198/000313001317098149
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA’s statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953