
Dans le champ contemporain de la psychologie quantitative et des sciences computationnelles du comportement, l’évaluation des modèles prédictifs constitue un jalon méthodologique dont dépend la validité épistémologique des inférences scientifiques. Face à la prolifération des approches d’apprentissage automatique, de modélisation statistique avancée et d’analyse psychométrique à haute dimension, les chercheurs sont constamment confrontés au défi de caractériser la fidélité de leurs modèles face à la complexité des manifestations comportementales humaines. L’ajustement empirique ne saurait se résumer à une simple convergence descriptive ; il exige une quantification rigoureuse, standardisée et théoriquement articulée de l’erreur résiduelle.
Ce défi prend une résonance particulière dès lors qu’il s’agit d’arbitrer entre deux métriques fondamentales de régression : l’erreur absolue moyenne (Mean Absolute Error, MAE) et la racine de l’erreur quadratique moyenne (Root Mean Squared Error, RMSE). Si ces deux indices partagent l’objectif apparent d’agréger les écarts individuels entre observations empiriques et valeurs prédites au sein d’une échelle comparable à la mesure d’origine, ils reposent sur des fondements géométriques, probabilistes et philosophiques radicalement divergents. Le choix entre ces deux instruments d’évaluation ne relève nullement d’une préférence cosmétique ou d’une convention arbitraire, mais conditionne directement l’architecture d’optimisation, la tolérance aux valeurs atypiques et l’interprétation substantielle des données psychologiques.
Cet article se propose d’offrir une exploration exhaustive, rigoureuse et ancrée dans la pratique académique du dilemme opposant la MAE et la RMSE au sein de la recherche comportementale. En décortiquant leurs propriétés mathématiques, leur comportement face aux singularités distributionnelles propres aux sciences humaines et leurs répercussions méthodologiques concrètes, nous établirons une grille d’analyse systématique. L’objectif ultime consiste à doter les chercheurs, méthodologistes et praticiens d’un cadre théorique et pratique clair permettant de sélectionner, d’interpréter et de restituer la métrique la plus adéquate face aux impératifs scientifiques de leurs protocoles empiriques.
1. Introduction aux métriques d’évaluation dans la recherche quantitative en psychologie
1.1 Le rôle des modèles de régression dans la modélisation comportementale
La recherche contemporaine en sciences psychologiques et cognitives s’est largement émancipée des descriptions purement qualitatives pour embrasser des architectures mathématiques formalisées, au premier rang desquelles trônent les modèles de régression linéaire, non linéaire et généralisée. Ces modèles ont pour vocation de formaliser les liaisons fonctionnelles unissant un ensemble de variables indépendantes — qu’il s’agisse de traits de personnalité, de biomarqueurs neurophysiologiques, d’antécédents anamnestiques ou de stresseurs environnementaux — à une variable dépendante traduisant une réponse psychologique ou un comportement observable. Qu’il s’agisse de modéliser la détresse psychologique à partir de facteurs psychosociaux ou de prédire les temps de latence cognitive au cours de tâches attentionnelles complexes, la régression agit comme un pont théorique entre construits latents et manifestations empiriques.
Cette formalisation exige une validation empirique scrupuleuse, qui ne peut être postulée a priori. La rigueur scientifique impose de confronter les trajectoires calculées par le modèle aux comportements effectivement enregistrés au sein d’échantillons représentatifs. Dans le domaine psychométrique, où les instruments de mesure sont soumis à d’importantes marges d’erreur inhérentes à l’évaluation humaine, la précision des algorithmes prédictifs doit être vérifiée sur des cohortes indépendantes. Cette étape de validation permet d’assurer que le modèle abstrait capture fidèlement la dynamique sous-jacente des processus psychologiques plutôt qu’un ensemble de fluctuations stochastiques propres à l’échantillon d’étalonnage.
À cet égard, la littérature méthodologique insiste désormais sur une distinction essentielle : la dissociation entre l’ajustement statistique descriptif, souvent quantifié par des indices d’adéquation globale au sein de l’échantillon d’apprentissage, et la performance prédictive réelle, mesurée hors échantillon par des procédures de validation croisée. Un modèle peut exhiber un ajustement descriptif remarquable tout en échouant tragiquement à prédire le comportement de nouveaux participants en raison d’un phénomène de surajustement statistique. L’évaluation de l’erreur résiduelle en dehors de l’échantillon primaire constitue le garant fondamental de la généralisabilité des conclusions psychologiques.
1.2 La quantification de l’erreur prédictive comme impératif méthodologique
Au cœur de l’entreprise de validation prédictive réside la notion fondamentale de résidu. Dans toute tentative de modélisation du psychisme, le résidu représente l’écart algébrique calculé entre la mesure objectivement constatée chez un sujet donné et la valeur estimée par la fonction algorithmique. Loin de constituer un simple déchet calculatoire négligeable, ce résidu condense l’ensemble des sources de variance inexpliquée : imprécision des instruments psychométriques, fluctuations temporelles de l’état émotionnel du sujet, variables latentes omises dans l’architecture théorique du modèle, ou indétermination fondamentale propre aux systèmes vivants hautement adaptatifs.
La précision avec laquelle ces écarts sont agrégés et quantifiés influe de manière directe sur la validité interne et externe des recherches. Sur le plan interne, une métrique inadéquate risque de masquer des faiblesses structurelles du modèle ou d’attribuer une supériorité trompeuse à un algorithme biaisé, compromettant l’analyse causale. Sur le plan externe, l’application de conclusions erronées à des environnements écologiques réels — tels que le milieu clinique hospitalier, la sélection professionnelle ou les politiques publiques d’intervention préventive — expose les décideurs à des interventions inadaptées, fondées sur des prédictions fallacieuses du comportement humain.
Il existe ainsi des risques épistémiques substantiels associés au mauvais calibrage de ce que l’on nomme, en modélisation mathématique, la fonction de perte. Si un chercheur en sciences humaines retient une méthode d’agrégation des résidus qui surpondère aveuglément les données bruitées au détriment du comportement général de la cohorte, il déforme la nature même de la théorie psychologique qu’il cherche à valider. L’erreur de prédiction n’est pas qu’un indicateur mathématique neutre ; elle matérialise le système de valeurs accordé à l’incertitude dans l’investigation empirique de l’esprit humain.
1.3 Présentation du dilemme : erreur absolue moyenne contre racine de l’erreur quadratique moyenne
L’histoire de la psychométrie et de la modélisation quantitative est jalonnée de débats théoriques portant sur la manière appropriée de résumer une série de déviations empiriques. Dès le début du XXe siècle, avec l’émergence des travaux fondateurs de Francis Galton, Karl Pearson et Charles Spearman, la nécessité de quantifier la dispersion des erreurs s’est imposée. C’est dans ce sillage que se sont affrontées deux philosophies concurrentes : l’une privilégiant la somme des écarts absolus, popularisée initialement dans le cadre de la théorie des erreurs par Laplace, et l’autre adossée au principe des moindres carrés développé indépendamment par Gauss et Legendre, donnant naissance respectivement à l’erreur absolue moyenne (MAE) et à la racine de l’erreur quadratique moyenne (RMSE).
Le dilemme contemporain réside dans le traitement analytique de la magnitude des erreurs résiduelles. Alors que la MAE traite chaque unité d’écart selon une proportionnalité géométrique uniforme le long de l’espace métrique, la RMSE soumet chaque résidu à une opération d’élévation à la puissance deux avant d’extraire la moyenne globale et d’en calculer la racine carrée. Cette nuance algorithmique entraîne une divergence conceptuelle vertigineuse : la RMSE confère un poids disproportionné aux écarts majeurs, tandis que la MAE maintient une tolérance linéaire insensible à l’éloignement d’une déviation par rapport à la médiane du groupe.
Le dessein fondamental de cet article est d’édifier un cadre décisionnel académique rigoureux pour éclairer le choix du chercheur entre ces deux approches. En nous écartant des jugements d’autorité dogmatiques qui déclarent alternativement l’une ou l’autre métrique universellement supérieure, nous explorerons les implications mathématiques, statistiques et empiriques de ces deux indices au regard des réalités distributionnelles de la psychologie contemporaine, afin de déterminer les conditions formelles de leur applicabilité.
2. Fondements mathématiques et conceptuels de l’erreur absolue moyenne (MAE)
2.1 Définition formelle et décomposition de la formule
L’erreur absolue moyenne, universellement désignée par le sigle MAE (pour Mean Absolute Error), constitue l’une des métriques les plus élémentaires et pourtant les plus robustes de la régression statistique. Sur le plan analytique, pour un échantillon de taille n comportant des observations vectorielles réelles, la métrique se définit selon la formulation suivante :
MAE = (1 / n) * Σ |yi – ŷi|
Dans cette équation formelle, n représente le volume total d’observations ou de participants inclus dans le protocole expérimental, yi figure la valeur empiriquement observée pour le i-ème sujet sur l’échelle psychologique considérée, et ŷi désigne l’estimation fournie par le modèle algorithmique pour cette même observation. L’opérateur de sommation (Σ) additionne l’ensemble des déviations individuelles après que ces dernières eurent été transformées par la fonction valeur absolue (| |). Cette transformation mathématique primordiale a pour fonction de priver chaque résidu de sa polarité vectorielle, transformant les déviations positives et négatives en distances scalaires strictement non négatives.
Sur le plan de l’analyse fonctionnelle et de la géométrie vectorielle, la MAE s’inscrit directement dans le cadre théorique de la norme L1, également formalisée sous l’appellation de distance de Manhattan ou métrique des blocs urbains (taxicab metric). Dans un espace vectoriel de dimension n représentant l’ensemble des erreurs résiduelles possibles, la distance globale n’est pas mesurée par le segment le plus court à vol d’oiseau, mais par la somme des déplacements orthogonaux nécessaires le long des axes de coordonnées. Il en résulte une caractéristique déterminante : la MAE n’applique aucune pondération exponentielle ou progressive sur la magnitude des écarts individuels ; un résidu d’une magnitude de 4 unités contribue exactement quatre fois plus à la valeur finale qu’un résidu d’une seule unité, préservant une linéarité parfaite au sein de l’espace métrique.
2.2 Propriétés statistiques de l’échelle linéaire des écarts
L’un des attributs fondamentaux de la MAE réside dans la conservation intégrale de l’unité de mesure originale caractérisant la variable dépendante psychologique sous investigation. Si un protocole expérimental mesure des scores d’anxiété sur l’échelle de Spielberger (STAI) graduée de 20 à 80 points, une MAE de 4,5 points indique immédiatement et sans conversion intermédiaire que le modèle commet un écart moyen de 4,5 points par rapport à la réponse d’un participant. Cette commensurabilité absolue préserve la lisibilité phénoménologique des résultats au sein de l’espace empirique propre aux sciences du comportement.
Sur le plan topologique, la MAE possède une propriété de monotonicité uniforme face à l’accroissement continu des erreurs résiduelles. Chaque accroissement incrémental de l’erreur observée chez n’importe quel sujet de l’échantillon entraîne une variation strictement proportionnelle de l’indice agrégé, indépendamment de la position initiale de ce sujet au sein de la distribution des déviations. Cette caractéristique confère à la MAE une stabilité remarquable, protégeant l’investigateur contre les distorsions d’interprétation provoquées par des phénomènes mathématiques de non-linéarité scalaire.
Cependant, cette simplicité géométrique s’accompagne d’un défi majeur pour le calcul numérique et l’optimisation mathématique : la non-dérivabilité de la fonction en son origine (zéro). La présence de la valeur absolue engendre une singularité anguleuse au point où le résidu s’annule, interdisant le calcul d’une dérivée première continue au sens classique de Leibniz-Newton. Dans les procédures d’estimation automatisée utilisant des algorithmes d’optimisation basés sur le gradient, tels que la descente de gradient stochastique, la MAE nécessite le recours au calcul sous-différentiel (sous-gradients), ce qui peut introduire des instabilités d’oscillation autour de la solution optimale lors des phases terminales de convergence algorithmique.
2.3 Interprétation intuitive des résidus en recherche comportementale
Dans l’écosystème de la recherche quantitative appliquée à l’humain, la valeur de la MAE se distingue par son adéquation cognitive avec les structures de raisonnement des cliniciens et des chercheurs de terrain. Elle correspond directement à ce qu’un esprit humain conçoit spontanément lorsqu’il s’interroge sur l’erreur moyenne typique d’une méthode d’évaluation. Déclarer qu’un algorithme de traitement automatisé du langage naturel présente une MAE de 2,3 points sur une échelle d’évaluation de la dépression majeure fournit une information concrète, opérationnelle et dénuée d’artifice statistique sur la proximité moyenne constatée entre le score généré et le jugement d’un panel d’experts psychiatres.
Cette clarté d’interprétation s’avère un atout stratégique inestimable lors de la restitution des travaux scientifiques auprès de publics non spécialistes de l’économétrie ou de l’apprentissage statistique. Les psychologues praticiens, les psychiatres d’institutions hospitalières et les cadres administratifs du secteur médico-social ont besoin de métriques dont la substance s’articule directement avec la clinique quotidienne. Contrairement aux variances abstraites ou aux indices composites normalisés, la MAE s’énonce dans le registre du diagnostic direct : elle incarne le décalage usuel attendu lors de l’administration du test à un patient singulier.
En matière d’instrumentation psychométrique — par exemple lors de l’évaluation standardisée d’échelles de sévérité symptomatique comme l’inventaire de dépression de Beck (BDI-II) ou le questionnaire sur l’anxiété généralisée (GAD-7) — la MAE permet de situer instantanément l’erreur de prédiction par rapport au changement minimal cliniquement significatif (MCID). Si la MAE d’un modèle prédictif est inférieure au seuil de changement cliniquement tangible pour un instrument donné, le chercheur peut déduire avec certitude que les erreurs commises par l’algorithme demeurent indiscernables d’une fluctuation subclinique de l’humeur, attestant ainsi de l’utilité fonctionnelle de son outil d’estimation.
3. Fondements mathématiques et conceptuels de la racine de l’erreur quadratique moyenne (RMSE)
3.1 Formulation mathématique et décomposition quadratique
La racine de l’erreur quadratique moyenne, couramment désignée par l’acronyme RMSE (pour Root Mean Squared Error), constitue sans conteste l’indice de performance résiduelle le plus ancré dans l’histoire de la statistique inférentielle paramétrique. Analytiquement, elle s’énonce à travers l’expression suivante :
RMSE = √[ (1 / n) * Σ (yi – ŷi)² ]
Dans cette architecture calculatoire, l’opérateur primaire consiste à soumettre chaque résidu empirique (yi – ŷi) à une élévation au carré. Cette opération quadratique remplit simultanément deux offices : elle convertit l’intégralité des déviations en scalaires strictement positifs — résolvant le problème de l’annulation mutuelle des résidus de polarités opposées —, tout en conférant à chaque terme une pondération géométrique dépendante de sa magnitude initiale. Les carrés ainsi produits sont ensuite moyennés sur l’ensemble des n participants composant la série d’observations empiriques.
Sur le plan des espaces vectoriels, la RMSE incarne l’application rigoureuse de la norme L2, également désignée sous l’appellation canonique de distance euclidienne. Dans un espace géométrique euclidien à n dimensions, elle quantifie la longueur réelle du segment de droite reliant le vecteur des observations réelles au vecteur des valeurs prédites par la fonction de régression. L’étape finale d’extraction de la racine carrée opère une reconversion dimensionnelle : elle rétablit l’indice statistique dans la même unité de mesure que les variables empiriques d’origine, corrigeant l’altération scalaire induite par l’élévation initiale au carré qui s’exprimait dans des unités quadratiques dépourvues de sens phénoménologique.
3.2 Mécanisme de pénalisation non linéaire des déviations extrêmes
Le trait distinctif le plus remarquable de la RMSE réside dans sa relation non linéaire avec l’ampleur des écarts individuels. En vertu de la nature de la fonction exponentielle de puissance 2, tout résidu de forte amplitude subit une amplification drastique de sa contribution à la somme globale. À titre d’illustration, si une déviation mineure d’une unité génère un poids quadratique de 1 (1² = 1), une déviation d’une magnitude de 5 unités ne participe pas cinq fois plus à l’évaluation du modèle, mais engendre un poids de 25 unités quadratiques (5² = 25). Cette distorsion délibérée confère à la RMSE une asymétrie de tolérance fondamentale.
Ce mécanisme punitif asymétrique modifie en profondeur la dynamique de calibrage des modèles statistiques. Confronté à une fonction d’optimisation cherchant à minimiser la RMSE, l’algorithme consacre la majeure partie de sa capacité de réglage à résorber les quelques résidus colossaux présents dans la cohorte d’entraînement, quitte à tolérer une multitude d’erreurs d’intensité modeste ou moyenne sur le reste de la population étudiée. La RMSE conçoit l’erreur comme un phénomène à criticité hautement progressive : plus un résidu grandit, plus son coût marginal explose de façon géométrique.
Néanmoins, cette propriété géométrique quadratique présente un atout algorithmique considérable par rapport aux métriques absolues : la fonction d’erreur quadratique est partout continue et indéfiniment différentiable sur l’ensemble des nombres réels. L’absence totale de points anguleux garantit l’existence d’une dérivée première lisse et continue en tout point de l’espace paramétrique, y compris à l’origine où le résidu est nul. Cette propriété de courbure régulière constitue le socle mathématique de la résolution analytique exacte et de la convergence rapide des méthodes de descente de gradient et des équations normales en modélisation mathématique.
3.3 Relation structurelle entre la RMSE et la variance résiduelle
Au-delà de son statut de métrique prédictive, la RMSE entretient une parenté analytique intime avec les fondements de la statistique descriptive et de la théorie des probabilités. Dans un modèle de régression classique ajusté selon des critères assurant l’absence de biais systématique — c’est-à-dire une situation idéale où la moyenne arithmétique globale des résidus est rigoureusement égale à zéro — la RMSE s’identifie mathématiquement à l’écart-type empirique des résidus. Elle représente donc très exactement la dispersion canonique des observations autour de la surface de régression estimée.
Cette relation d’équivalence structurelle confère à la RMSE un rôle central au sein de l’inférence paramétrique gaussienne. Sous l’hypothèse canonique selon laquelle les erreurs résiduelles du modèle sont indépendantes et distribuées selon une loi normale de moyenne nulle et de variance constante (σ²), la minimisation de la somme des erreurs quadratiques équivaut rigoureusement à l’estimation du maximum de vraisemblance des paramètres du modèle. La RMSE est donc l’estimateur naturel et optimal de l’écart-type des perturbations stochastiques dans tout univers probabiliste gouverné par le théorème central limite.
Cette filiation théorique explique pourquoi la RMSE est traditionnellement omniprésente dans la littérature statistique orthodoxe. Elle converge organiquement avec le cadre conceptuel séculaire des moindres carrés ordinaires (MCO), de l’analyse de la variance (ANOVA) et de la modélisation par équations structurelles (SEM). Dans ces paradigmes, la variance totale d’une réponse psychologique est partitionnée de façon additive en variance expliquée et variance résiduelle, une architecture matricielle qui s’effondrerait sur le plan algébrique si l’on tentait de substituer les sommes de valeurs absolues aux sommes de carrés.
4. Comparaison directe des propriétés mathématiques et distributionnelles
4.1 Sensibilité différentielle aux valeurs aberrantes
L’opposition entre la MAE et la RMSE se cristallise avant tout autour de leur comportement en présence de données atypiques ou extrêmes, communément qualifiées de valeurs aberrantes (outliers). En psychologie empirique, où la variabilité interindividuelle est vaste et où des erreurs de saisie ou des comportements non conformes polluent régulièrement les bases de données, cette sensibilité différentielle constitue le critère méthodologique d’arbitrage le plus déterminant.
La MAE présente une tolérance et une robustesse remarquables face aux observations extrêmes isolées. Dans la mesure où chaque résidu intervient par sa valeur absolue sans élévation de puissance, une déviation gigantesque commise sur un sujet unique ne peut exercer qu’un effet infinitésimal sur la métrique agrégée, proportionnel à sa part relative dans l’effectif total (1/n). Le point de rupture de la fonction de perte basée sur la norme L1 est nettement supérieur : la MAE refuse de laisser quelques individus périphériques dicter l’orientation générale du modèle, préservant ainsi la fidélité de l’estimation pour le corps central de l’échantillon.
À l’inverse, la RMSE s’avère extrêmement vulnérable à l’action de ces points aberrants. Dès lors qu’une déviation se détache substantiellement de la distribution résiduelle usuelle, son élévation au carré la propulse à des niveaux d’amplitude capables de dominer intégralement le numérateur de la formule. Dans un échantillon expérimental typique en psychologie cognitive comptant par exemple 80 participants, la présence d’un unique sujet ayant produit un temps de réaction aberrant ou manifesté une désinhibition totale sous l’effet de l’ennui peut faire doubler la valeur de la RMSE à elle seule. L’inférence issue de la RMSE risque alors de refléter l’anomalie d’un cas marginal plutôt que la compétence prédictive réelle de l’algorithme sur la population cible.
4.2 Impact de la forme de la distribution des erreurs
Le choix optimal entre ces deux métriques est intrinsèquement tributaire de la morphologie distributionnelle des perturbations aléatoires caractérisant le phénomène comportemental sous investigation. En vertu des principes de l’inférence bayésienne et de l’estimation par maximum de vraisemblance, chaque fonction de perte d’erreur correspond mathématiquement à une hypothèse distributionnelle a priori formulée sur la nature des résidus sous-jacents.
D’un point de vue théorique formel, la MAE représente l’estimateur de vraisemblance maximale optimal lorsque les résidus suivent rigoureusement une distribution double-exponentielle, universellement connue sous le nom de loi de Laplace. Cette distribution statistique se distingue par une pointe centrale très aiguë et des queues épaisses (fat tails), signifiant que les déviations modérées et fortes y sont considérablement plus fréquentes que dans un univers purement gaussien. En sciences comportementales, nombre de phénomènes marqués par des accès périodiques de scores extrêmes sans rupture de continuité répondent fidèlement à cette dynamique laplacienne, justifiant théoriquement l’emploi préférentiel de la MAE.
La RMSE, quant à elle, revendique une supériorité statistique indiscutable dès lors que les erreurs d’estimation s’alignent rigoureusement le long de la courbe en cloche de la distribution normale (loi de Gauss). Lorsque la kurtosis (l’aplatissement) et la skewness (l’asymétrie) des résidus empiriques oscillent autour de leurs valeurs canoniques de normalité, l’estimateur RMSE atteint la borne de Cramér-Rao, garantissant la variance d’échantillonnage minimale parmi tous les estimateurs non biaisés possibles. Évaluer préalablement les coefficients d’asymétrie et d’aplatissement des déviations résiduelles s’impose donc comme une démarche diagnostique incontournable avant d’arrêter son choix métrique.
4.3 L’inégalité triangulaire et la relation structurelle MAE ≤ RMSE
Sur le plan de l’analyse mathématique pure, il existe une contrainte structurelle absolue reliant la MAE et la RMSE, régie par l’inégalité de Cauchy-Schwarz et l’inégalité des moyennes d’ordre p. Pour n’importe quel ensemble de données empiriques et n’importe quel modèle de prédiction statistique, la relation d’ordre suivante est universellement et inconditionnellement vérifiée :
MAE ≤ RMSE ≤ √n * MAE
Cette inégalité mathématique garantit que la valeur numérique de la RMSE sera invariablement supérieure ou, au strict minimum, égale à celle de la MAE. Il est logiquement et algorithmiquement impossible de concevoir un scénario empirique où la RMSE produirait un score inférieur à la MAE calculée sur la même partition d’échantillon. La borne d’égalité absolue (RMSE = MAE) ne peut être observée que dans un cas de figure mathématique singulier et hautement théorique : celui où la totalité des résidus individuels sans aucune exception présenterait exactement la même amplitude scalaire absolue (|e1| = |e2| = … = |en|).
La conséquence méthodologique directe de cette propriété d’inégalité réside dans le potentiel informatif de l’intervalle séparant les deux métriques. Dès que l’écart entre la MAE et la RMSE s’accroît, cela signale formellement au chercheur que la variabilité de la magnitude des erreurs résiduelles est importante. Si tous les résidus étaient de taille similaire, les deux indices convergeraient vers un niveau équivalent. L’amplification de la RMSE par rapport à la MAE fournit ainsi une jauge directe de l’hétérogénéité des déviations au sein de l’échantillon analysé.
5. Comportement face aux données aberrantes en psychologie expérimentale
5.1 Typologie des anomalies de mesure dans les protocoles comportementaux
Les protocoles de collecte de données en psychologie expérimentale et en psychiatrie quantitative sont particulièrement perméables à la survenue d’anomalies de mesure. Contrairement aux sciences physiques où les capteurs peuvent être étalonnés avec une précision micrométrique, l’investigation du psychisme humain repose sur des canaux hautement vulnérables aux interférences cognitives et motivationnelles.
On peut distinguer schématiquement trois grandes catégories de données polluantes :
- Les erreurs d’inattention et d’abandon motivationnel : très fréquentes lors des passations de questionnaires longitudinaux ou d’épreuves de vigilance prolongées, caractérisées par un décrochage cognitif temporaire.
- Les réponses aléatoires et biais de désengagement : observables lors des enquêtes massives en ligne non supervisées, où des participants cochent des modalités arbitraires pour obtenir rapidement leur compensation financière.
- Les biais de désirabilité sociale et de dissimulation délibérée : fréquents lors de l’évaluation de traits sensibles (délinquance, impulsivité sexuelle, psychopathie), générant des aberrations unilatérales dans les distributions.
À ces artéfacts purement méthodologiques s’ajoute une source d’hétérogénéité plus complexe : l’authentique singularité clinique. En psychologie, une observation extrême ne relève pas obligatoirement d’une erreur d’enregistrement ou d’un défaut de conformité à la consigne. Un patient traversant une phase d’accès maniaque aigu, un individu atteint d’un syndrome de stress post-traumatique complexe ou un participant doué de capacités mnésiques hors normes produisent des valeurs authentiquement aberrantes qui capturent la vérité substantielle de leur état mental, posant un redoutable dilemme quant à leur traitement statistique.
5.2 Comportement de la MAE face aux scores extrêmes
Lorsqu’un chercheur fait face à une cohorte contaminée par des comportements parasites — tels que des réponses compulsives et aléatoires générées sur une plateforme d’étude en ligne —, la MAE déploie une fonction protectrice essentielle. En limitant l’influence des écarts monstres à une proportion strictement arithmétique, elle évite que les paramètres du modèle ne soient déformés par les signaux hautement dysfonctionnels d’une minorité d’individus déviants. Le modèle continue de caractériser avec élégance et vérité le fonctionnement psychologique de la majorité attentive et coopérative.
Cette résilience confère à la MAE un statut de métrique conservatrice au sens noble du terme. Elle autorise l’inclusion de cohortes hétérogènes sans contraindre l’expérimentateur à purger agressivement sa base de données par des procédures contestables d’élagage (data trimming) ou de winsorisation artificielle. En acceptant les déviations sans leur conférer un pouvoir destructeur sur l’évaluation globale, la MAE maintient une représentativité écologique maximale de la cohorte initiale.
Toutefois, cette insensibilité comporte un revers épistémique qu’il convient de ne point occulter. Dans des contextes de veille clinique ou de détection psychopathologique précoce, les déviations majeures constituent précisément le signal thérapeutique critique qu’il s’agit de diagnostiquer. Si un algorithme prédictif sous-estime drastiquement l’émergence d’une crise dépressive sévère chez trois patients au sein d’un échantillon de cent individus, la MAE absorbera ces erreurs graves en les lissant dans la masse des petites déviations insignifiantes. La robustesse de la MAE peut alors se muer en un aveuglement méthodologique périlleux.
5.3 Amplification des pénalités par la RMSE et ses répercussions
En vertu de son opérateur quadratique, la RMSE réagit de manière spectaculaire à la survenue de n’importe quelle distorsion majeure au sein des résidus. Dès qu’un participant s’écarte brutalement de la tendance générale prédite, la RMSE répercute cette déviation sous forme d’une onde de choc sur le score global. Si l’objectif du chercheur est de s’assurer qu’aucun individu ne subisse une erreur d’estimation colossale, la RMSE agit comme un dispositif d’alarme intransigeant.
Cette sensibilité engendre néanmoins un risque majeur dans la phase d’apprentissage des modèles statistiques : le surajustement (overfitting) pathologique. Dans sa tentative désespérée de minimiser une fonction de coût quadratique dominée par une poignée d’anomalies de mesure ou de réponses bruitées, l’algorithme déforme sa surface de décision. Il consent à sacrifier la qualité d’ajustement sur des dizaines de profils normatifs au seul bénéfice de tenter de rapprocher sa prédiction de deux ou trois observations bizarres qui ne résultent en réalité que d’un cliquetis aléatoire d’artéfacts expérimentaux.
Il existe néanmoins un champ où cette amplification punitive s’avère méthodologiquement et éthiquement indispensable : la recherche sur les événements psychologiques critiques et les états de décompensation aiguë. Dans de telles configurations, une erreur prédictive de forte magnitude n’est pas simplement une variation quantitative neutre, mais représente un échec clinique potentiellement fatal. La sévérité de la RMSE trouve alors toute sa légitimité en contraignant les ingénieurs et chercheurs à concevoir des architectures qui interdisent catégoriquement les dérives prédictives catastrophiques.
6. Implications méthodologiques selon les domaines de la psychologie
6.1 Modélisation des temps de réaction en psychologie cognitive
La psychologie cognitive expérimentale s’appuie massivement sur le chronométrage des latences de traitement de l’information pour déduire l’architecture des fonctions exécutives, de l’attention sélective ou des mécanismes d’accès lexical. Or, les distributions empiriques de temps de réaction (TR) violent systématiquement l’hypothèse de symétrie gaussienne : elles adoptent universellement une forme asymétrique positive caractérisée par une montée abrupte et une longue queue descendante vers les valeurs temporelles élevées, une morphologie excellemment capturée par la loi théorique ex-gaussienne ou la loi de Wald.
Dans ce contexte distributionnel singulier, l’application aveugle de la RMSE soulève de sévères difficultés interprétatives. La longue traîne des temps de latence cognitive — générée naturellement par des fluctuations momentanées de la vigilance ou des épisodes micro-attentionnels involontaires — produit des résidus unilatéraux considérables. Évaluer un modèle cognitif par le prisme de la RMSE revient à évaluer prioritairement sa capacité à modéliser la queue asymétrique de la distribution plutôt que la vitesse centrale du traitement de l’information (la composante motrice et décisionnelle stable).
C’est pourquoi la MAE s’impose fréquemment comme une métrique d’une pertinence supérieure pour l’évaluation des architectures prédictives en chronométrie mentale. En se montrant résiliente face à la traîne des latences, la MAE permet de juger avec une fidélité accrue l’adéquation du modèle au fonctionnement cognitif modal des sujets. Elle garantit que la performance agrégée ne soit pas indûment pénalisée par des défaillances attentionnelles transitoires inhérentes à la condition biologique du participant humain au cours de tâches répétitives.
6.2 Psychométrie et validation d’inventaires de personnalité
La modélisation de la personnalité et des traits latents repose principalement sur l’administration de questionnaires psychométriques structurés selon des échelles ordinales de type Likert (par exemple graduées de 1 à 5 ou de 1 à 7 points). Qu’il s’agisse de mesurer les dimensions du modèle des Big Five (extraversion, névrosisme, etc.) ou des spectres psychopathologiques, les données ainsi collectées présentent des bornes strictes (planchers et plafonds) interdisant mathématiquement l’apparition de résidus infinis.
Dans cet univers psychométrique, le comportement des métriques se heurte à des contraintes structurelles spécifiques. Lorsque les scores latents sont étalonnés à l’aide de la théorie de réponse aux items (TRI) ou intégrés dans des modèles à équations structurelles, l’évaluation des erreurs prédictives hors échantillon s’inscrit au sein d’une échelle strictement bornée. La présence d’effets de plafond ou de plancher crée artificiellement une hétéroscédasticité le long du continuum du trait latent : l’erreur résiduelle est structurellement restreinte aux extrémités de l’instrument psychométrique.
La RMSE demeure dans ce domaine une référence incontournable en raison de son articulation directe avec les concepts classiques de fidélité du test et d’erreur standard de mesure (SEM). Dans la mesure où les inventaires de personnalité sont standardisés en scores réduits (notes z ou scores T), la RMSE s’interprète directement comme l’écart-type de l’erreur d’estimation du construit latent. Toutefois, l’utilisation conjointe de la MAE permet de s’assurer que des biais systématiques de réponse (comme la complaisance ou l’extrémisme de cotation) ne viennent pas fausser artificiellement la variance d’erreur globale modélisée par les équations psychométriques.
6.3 Prédiction des comportements cliniques à haut risque
Le champ de la psychologie clinique computationnelle et de la psychiatrie prédictive s’oriente résolument vers la conception d’algorithmes destinés à anticiper des bifurcations comportementales critiques : passages à l’acte suicidaires, épisodes de rechute addictive dans la dépendance aux substances, ou décompensations hétéro-agressives chez des patients judiciarisés. Dans ces scénarios tragiques, l’erreur de prédiction change radicalement de statut : elle cesse d’être une préoccupation académique abstraite pour devenir une question de préservation de la vie humaine.
Dans un tel contexte méthodologique, les conséquences pratiques d’une erreur d’estimation ne sont absolument pas linéaires. Prédire qu’un patient présente un score d’idéation suicidaire de 12 sur une échelle clinique alors que son niveau de détresse réel se situe à 15 engendre des implications thérapeutiques limitées. En revanche, sous-estimer massivement le tableau clinique en prédisant un score anodin de 15 chez un sujet présentant une intensité suicidaire paroxystique de 45 relève d’une faillite prédictive impardonnable aux conséquences médico-légales et humaines désastreuses.
Sur le plan épistémologique, la RMSE est la seule métrique capable de formaliser mathématiquement ce coût asymétrique sociosanitaire disproportionné. En propulsant les déviations majeures à des niveaux d’amende quadratique exorbitants, la RMSE force impérativement les algorithmes d’apprentissage statistique à concevoir des frontières de décision ultra-sécurisées pour les cas extrêmes. Dans la prédiction des risques vitaux, privilégier la MAE sous prétexte de préserver la robustesse face au bruit statistique reviendrait à banaliser dangereusement les sous-estimations critiques de la détresse psychologique.
7. Critères décisionnels pour sélectionner la métrique adéquate
7.1 L’alignement avec la fonction de perte implicite du chercheur
L’arbitrage ultime entre la MAE et la RMSE ne réside pas dans une supériorité intrinsèque que posséderait l’une des formules mathématiques sur l’autre, mais dans l’alignement rigoureux de la métrique avec la fonction de perte implicite — voire explicite — gouvernant la recherche comportementale entreprise. Une fonction de perte est une formalisation mathématique qui associe à chaque amplitude d’erreur une pénalité théorique ou concrète traduisant le coût réel de l’imprécision pour l’utilisateur final du modèle.
Lorsque le coût pratique ou psychologique induit par une déviation est proportionnel à sa magnitude, la MAE s’impose comme l’unique choix rationnel. Si sous-estimer le temps d’acquisition d’un apprentissage de 10 minutes est exactement dix fois plus préjudiciable que de le sous-estimer d’une minute, la linéarité de la norme L1 reflète fidèlement la structure du problème investigué. Les erreurs sont alors sommées comme des coûts unitaires constants sans que la dispersion des déviations n’ajoute une pénalité exponentielle artificielle.
En revanche, dès lors que le coût de l’erreur bascule dans une dynamique de rupture d’équilibre — où une déviation modérée est facilement absorbable par le système alors qu’une déviation massive provoque une catastrophe opérationnelle, organisationnelle ou clinique —, la RMSE s’impose comme une nécessité formelle. En adoptant la géométrie de la norme L2, le chercheur assume formellement que l’accumulation de nombreuses petites imperfections d’estimation est infiniment préférable à l’occurrence, même rarissime, d’une erreur de prédiction colossale.
7.2 La nature de la tendance centrale visée : médiane ou moyenne
Un principe fondamental d’analyse mathématique trop souvent occulté dans la littérature psychologique appliquée concerne la nature de la cible statistique optimisée par chacune de ces métriques. Du point de vue de l’espérance conditionnelle et de la minimisation du risque empirique, le choix de la métrique détermine directement quelle statistique de tendance centrale le modèle de régression tentera d’estimer :
La minimisation de la MAE converge universellement vers la médiane conditionnelle de la variable dépendante sachant les prédicteurs [E(y|X) médian]. Inversement, la minimisation de la RMSE optimise rigoureusement la moyenne arithmétique conditionnelle [E(y|X) moyen]. Ce distinguo est d’une portée méthodologique décisive dès lors que les distributions empiriques s’écartent de la stricte symétrie.
Si la variable comportementale sous étude présente une forte asymétrie — ce qui est le cas des distributions de revenus, des consommations de toxiques ou des fréquences de crises d’angoisse —, la moyenne statistique est inexorablement aspirée vers les valeurs extrêmes de la queue de distribution, cessant de refléter l’expérience du sujet typique. Dans ce contexte, un modèle optimisé sur la RMSE cherchera à prédire une moyenne qui n’est représentative de presque aucun participant de la cohorte. Opter pour la MAE contraint le modèle à prédire la médiane empirique, offrant ainsi une caractérisation infiniment plus pertinente de la tendance centrale des conduites humaines investiguées.
7.3 Taille de l’échantillon et stabilité de l’estimation
La volumétrie de l’échantillon expérimental constitue un autre déterminant technique influant sur la fiabilité des métriques d’erreur. Les sciences du comportement se caractérisent souvent par des études impliquant des cohortes de taille modeste (typiquement 20 ≤ n ≤ 60), en raison des contraintes logistiques colossales associées à la passation de protocoles en neuro-imagerie fonctionnelle, en psychophysiologie ou auprès de populations psychiatriques hospitalisées.
Dans les échantillons restreints, la RMSE affiche une instabilité d’échantillonnage considérable. Parce qu’elle élève au carré des valeurs qui peuvent fluctuer de façon aléatoire d’un sous-groupe de participants à un autre, sa variance d’échantillonnage s’envole dès lors que l’effectif n se contracte. L’inclusion fortuite d’un seul sujet atypique dans un groupe expérimental restreint entraîne des fluctuations erratiques de la RMSE, rendant toute comparaison entre modèles fragile et non reproductible. La MAE démontre quant à elle une robustesse et une stabilité d’estimation remarquables au sein des petits échantillons, garantissant un pouvoir de réplication supérieur.
Cependant, dans l’ère naissante des mégadonnées (big data) en psychologie comportementale — impliquant des registres d’évaluations longitudinales massives par smartphones, des cohortes épidémiologiques nationales ou des données issues de réseaux sociaux comptant des dizaines de milliers d’utilisateurs —, la sensibilité de la RMSE aux faibles effectifs s’estompe en vertu de la loi des grands nombres. Dans ce cas de figure asymptotique, l’estimation de l’erreur quadratique se stabilise parfaitement, permettant d’exploiter la puissance paramétrique de la norme L2 sans redouter les distorsions stochastiques d’échantillonnage.
8. Utilisation conjointe de la MAE et de la RMSE comme outil diagnostique
8.1 Interprétation de l’écart et du ratio RMSE / MAE
Plutôt que d’enfermer le débat méthodologique dans une opposition binaire et stérile conduisant à l’exclusion arbitraire de l’une des deux métriques, l’approche scientifique la plus féconde consiste à exploiter leur synergie analytique. L’examen simultané de la MAE et de la RMSE transforme ces deux indices descriptifs en un formidable appareil de diagnostic statistique de la structure d’erreur sous-jacente au modèle psychologique développé.
Le paramètre central à examiner est le ratio empirique formulé par l’expression (RMSE / MAE). En vertu des démonstrations mathématiques relatives à la norme L1 et la norme L2, ce ratio est rigoureusement borné dans un intervalle fermé défini par l’unité à sa frontière inférieure et la racine carrée de la taille d’échantillon à sa frontière supérieure théorique :
1 ≤ (RMSE / MAE) ≤ √n
Lorsque le ratio empirique calculé oscille à proximité immédiate de 1 (par exemple entre 1,10 et 1,25), le chercheur obtient la démonstration formelle que la distribution des résidus d’erreur se caractérise par une remarquable homogénéité. Cela signifie que le modèle commet des déviations de magnitudes analogues et régulières à travers l’ensemble des participants. À l’opposé, dès que le ratio s’envole pour dépasser des valeurs substantielles (supérieures à 1,50 ou 1,60), cela constitue l’indicateur sans équivoque de la présence d’une variance d’erreur hautement instable, marquée soit par l’existence de sous-groupes cliniques réfractaires au modèle, soit par l’émergence ponctuelle d’erreurs massives et aberrantes au sein de la cohorte.
8.2 Détection précoce de l’hétéroscédasticité dans les modèles de régression
L’hétéroscédasticité — définie comme la non-constance de la variance des résidus le long des différents segments de la surface de prédiction ou à travers les niveaux successifs des variables indépendantes — représente l’une des violations les plus pernicieuses des postulats de la régression classique en psychologie. Elle induit un affaiblissement dramatique de la validité des tests de significativité statistique, faussant le calcul des intervalles de confiance et des valeurs p associées aux coefficients de modélisation.
L’observation conjointe de la divergence entre MAE et RMSE agit comme un puissant détecteur précoce d’hétéroscédasticité avant même la passation formelle de tests d’hypothèse complexes tels que le test de Breusch-Pagan ou le test de White. Si la RMSE dérive fortement à la hausse dans certains sous-segments prédictifs tandis que la MAE demeure modérée, cela signale que l’erreur s’évase considérablement pour certaines tranches spécifiques de la population étudiée (par exemple une imprécision qui explose uniquement chez les participants manifestant les scores d’anxiété les plus sévères).
Ce signal d’alarme statistique oriente immédiatement l’expérimentateur vers les corrections méthodologiques appropriées : application de transformations non linéaires stabilisatrices de variance (telles que les transformations logarithmiques ou de Box-Cox sur les variables dépendantes), révision de l’architecture fonctionnelle vers des modèles de régression robuste, ou migration vers des modèles de régression hétéroscédastique permettant d’estimer conjointement la trajectoire moyenne et la structure de variance résiduelle.
8.3 Validation croisée et stabilité de l’évaluation prédictive
La confrontation dynamique de la MAE et de la RMSE prend tout son sens lors des processus itératifs de validation croisée à k blocs (k-fold cross-validation), standard méthodologique universel en psychologie computationnelle moderne. En analysant le comportement relatif des deux métriques sur les partitions de validation à travers les différentes itérations de rééchantillonnage, le méthodologiste accède à une radiographie complète de la robustesse algorithmique.
Si, d’un bloc de validation à l’autre, la MAE conserve une fixité remarquable tandis que la RMSE subit d’erratiques et vertigineuses poussées de fièvre métrique, cette discordance dénonce l’incapacité du modèle à gérer les particularités distributionnelles de certains sous-groupes de l’échantillon. Ce phénomène met en lumière un surajustement (overfitting) qui cible sélectivement des configurations spécifiques de prédicteurs, générant occasionnellement des échecs d’estimation dévastateurs sur des profils atypiques.
L’évaluation conjointe permet ainsi de sélectionner un modèle comportemental équilibré qui optimise simultanément sa fidélité générale sur l’ensemble de la cohorte (MAE minimale) et sa résilience structurelle face aux risques d’erreurs démesurées (RMSE maîtrisée). Un modèle présentant une MAE légèrement moins compétitive mais associé à une RMSE nettement plus faible pourra rationnellement être préféré par le clinicien soucieux de juguler tout risque d’écart prédictif aberrant dans son protocole diagnostique.
9. Implémentation pratique et restitution selon les standards académiques
9.1 Calcul et programmation avec l’environnement statistique R
Dans l’écosystème de la recherche universitaire en psychologie, le logiciel d’analyse statistique R demeure l’un des environnements computationnels les plus rigoureux et les plus largement adoptés. Le calcul empirique rigoureux de la MAE et de la RMSE s’y effectue à travers de multiples bibliothèques spécialisées dans la modélisation prédictive et la psychométrie, notamment les paquets caret, Metrics et le métapaquet moderne tidymodels via la bibliothèque yardstick.
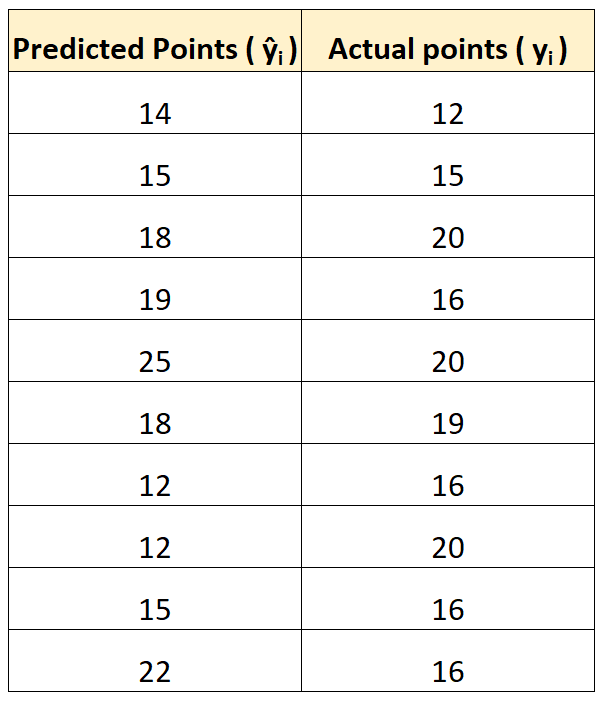
Pour illustrer la démarche computationnelle, considérons le vecteur empirique des réponses réelles et celui des prédictions générées hors échantillon. L’implémentation algorithmique de base ne requiert aucun artifice complexe : le calcul direct de la MAE s’obtient par l’expression arithmétique vectorisée calculant la moyenne des valeurs absolues de la différence entre les observations et les estimations. De façon parfaitement symétrique, le calcul de la RMSE s’articule autour de l’extraction de la racine carrée de la moyenne arithmétique de la différence vectorielle élevée au carré.
Néanmoins, la pratique scientifique moderne exige d’aller au-delà de l’estimation ponctuelle d’un scalaire d’erreur en intégrant la quantification de son incertitude d’échantillonnage. Il est impératif pour l’expérimentateur d’adjoindre à chacune de ces métriques un intervalle de confiance empirique à 95 % dérivé par des procédures de rééchantillonnage non paramétrique (bootstrap). En générant un millier d’itérations rééchantillonnées avec remise à partir de la matrice d’évaluation de test, on calcule la distribution empirique de la MAE et de la RMSE, permettant d’extraire les quantiles à 2,5 % et 97,5 % qui délimiteront l’intervalle d’incertitude associé à la performance de l’algorithme comportemental.
9.2 Implémentation sous Python avec scikit-learn et statsmodels
Avec l’essor fulgurant des sciences cognitives computationnelles, du traitement automatisé du langage en psychiatrie et du phénotypage numérique, le langage de programmation Python s’est imposé comme une plateforme d’analyse majeure. Au sein de cet écosystème, la bibliothèque de référence scikit-learn propose des modules d’évaluation hautement optimisés au sein du sous-paquet sklearn.metrics.
Dans cet environnement, la fonction mean_absolute_error permet d’évaluer directement la métrique linéaire L1. Concernant l’évaluation quadratique, la fonction historique mean_squared_error a longtemps exigé de l’utilisateur qu’il active un argument spécifique désactivant le calcul du carré simple (via le paramètre squared=False) afin d’extraire directement la véritable racine carrée (RMSE), bien que les versions les plus récentes de la bibliothèque aient formellement introduit la fonction explicite root_mean_squared_error afin de prévenir toute erreur de transcription de la part des utilisateurs.
L’intégration de ces métriques au sein de pipelines de traitement intégrant standardisation préalable, imputation des données psychométriques manquantes et validation croisée stratifiée constitue le standard de rigueur méthodologique contemporain. De surcroît, le couplage de ces estimations quantitatives avec des environnements graphiques avancés tels que seaborn ou matplotlib permet de générer simultanément des représentations visuelles de la distribution des résidus — notamment via des diagrammes de dispersion confrontant les valeurs observées aux résidus individuels ou des graphiques de type Bland-Altman —, rendant palpable pour l’investigateur la géométrie de l’erreur commise.
9.3 Recommandations de publication et normes APA (7e édition)
L’American Psychological Association (APA), à travers les directives stipulées dans le manuel de publication de sa septième édition (APA 7), accorde une place prépondérante à la transparence, à la reproductibilité et à la déontologie du reporting statistique au sein des revues scientifiques à comité de lecture. Les standards de reporting des études quantitatives (JARS-Quant) découragent formellement la dissimulation des indices d’imprécision et préconisent une exposition complète des métriques d’évaluation.
Dans ce cadre normatif, le chercheur a pour obligation méthodologique de ne pas restreindre sa communication à un indice unique et flatteur. Il est fortement recommandé de consigner simultanément dans les tableaux de résultats la MAE et la RMSE, accompagnées systématiquement de leurs intervalles de confiance respectifs et de la taille exacte des partitions d’échantillons évaluées. Les tableaux synthétiques de performance de régression doivent expliciter clairement l’unité de mesure originale afin que le lecteur puisse saisir sans ambiguïté la signification concrète des écarts observés.
Au sein de la section méthodologie du manuscrit, les auteurs sont tenus de formaliser et de justifier épistémologiquement le choix de la métrique retenue comme critère d’optimisation principal ou de sélection finale du modèle. Il convient d’expliciter sans ambiguïté si l’algorithme a été calibré pour viser la médiane conditionnelle (par l’usage de la perte absolue) ou la moyenne conditionnelle (par la perte quadratique), en articulant cette décision mathématique avec la théorie psychologique sous-jacente et les répercussions pratiques des erreurs de prédiction dans le domaine d’application considéré.
10. Limites respectives et pièges fréquents dans la littérature empirique
10.1 Le mythe de la supériorité absolue d’une métrique universelle
La littérature scientifique en sciences sociales et comportementales a trop souvent été traversée par des querelles scolastiques cherchant à décréter la supériorité absolue et définitive d’une métrique sur l’autre. Pendant des décennies, un préjugé positiviste solidement enraciné a attribué à la RMSE une aura de noblesse scientifique supérieure, postulant implicitement que le recours aux moindres carrés et à la distance euclidienne relevait d’une mathématisation plus sophistiquée et plus digne de considération que la simple moyenne des écarts absolus.
Cette hégémonie historique a été profondément ébranlée par une série de débats fondamentaux, notamment marqués par les travaux pionniers de Willmott et Matsuura (2005), qui ont vigoureusement contesté la pertinence universelle de la RMSE. Ces auteurs ont démontré avec rigueur que la RMSE, en combinant inextricablement la magnitude moyenne de l’erreur et la variabilité de la distribution des résidus, constituait un indicateur ambigu et malaisé à interpréter sur le plan géométrique. Cette charge a ultérieurement été nuancée par les interventions de Chai et Draxler (2014), qui ont rappelé la suprématie mathématique incontestable de la RMSE dans le cadre d’erreurs suivant une distribution strictement normale et son rôle irremplaçable dans l’assimilation de données géophysiques et probabilistes.
L’enseignement fondamental qui se dégage de cette controverse pour la psychologie moderne est qu’aucune métrique ne possède d’autorité morale ou scientifique universelle. Proclamer que la RMSE est « meilleure » que la MAE, ou inversement, relève d’un non-sens épistémologique absolu. Toute métrique d’évaluation est un prisme déformant particulier projeté sur la matrice résiduelle : elle ne prend son sens et sa légitimité qu’en fonction directe de la morphologie distributionnelle empirique de l’objet d’investigation psychique et des contraintes pragmatiques associées à la prise de décision thérapeutique ou théorique.
10.2 L’illusion d’échelle et les données psychométriques non standardisées
Un écueil interprétatif récurrent au sein des publications empiriques réside dans ce que l’on peut désigner sous le vocable d’illusion d’échelle. Dans la mesure où la MAE et la RMSE préservent scrupuleusement l’unité de mesure propre à la variable dépendante investiguée, leurs grandeurs numériques respectives sont totalement tributaires des propriétés scalaires de l’instrument psychométrique employé au cours du protocole expérimental.
Cette dépendance d’échelle interdit catégoriquement toute comparaison directe et naïve de la performance prédictive à travers des études ayant employé des instruments distincts, quand bien même ces derniers mesureraient le même construit psychologique sous-jacent. Obtenir une MAE de 2,8 points sur une version courte de l’inventaire d’anxiété de Beck (graduée sur une étendue restreinte) peut dénoter une imprécision prédictive dramatique, alors qu’une MAE de 4,2 points calculée sur l’inventaire complet de Spielberger (STAI, étendu sur 60 points de dynamique) traduit en réalité une précision algorithmique remarquable. Ignorer l’amplitude d’étendue totale de l’échelle d’évaluation conduit inévitablement à des contresens majeurs lors de tentatives de synthèse narrative de la littérature.
Le risque d’interprétation fallacieuse culmine lors des comparaisons inter-domaines ou au sein de méta-analyses quantitatives lorsque les variables sous étude n’ont pas subi une procédure rigoureuse de normalisation préalable. Pour autoriser des jugements croisés équitables sur la fidélité de modèles concurrents évaluant des dimensions hétérogènes (par exemple comparer la prédiction du rythme cardiaque à celle de scores d’humeur autorapportés), les chercheurs sont impérativement tenus de rapporter des métriques standardisées ou de ramener leurs résidus à des échelles de pourcentage d’étendue standardisées avant d’énoncer des conclusions comparatives.
10.3 Biais de sélection de métrique induit par la recherche de significativité
L’intégrité de la recherche contemporaine en psychologie a été ébranlée par la crise de la reproductibilité, mettant en lumière l’impact dévastateur des pratiques de recherche contestables (Questionable Research Practices, QRPs) et du « p-hacking ». Dans le sous-champ de l’apprentissage automatique et de la modélisation comportementale prédictive, ce péril méthodologique se manifeste par un biais subtil mais ravageur : le biais de sélection opportuniste de la métrique d’évaluation (ou métrique cherry-picking).
Ce biais consiste pour un groupe de recherche à évaluer simultanément plusieurs algorithmes concurrents à l’aide de la MAE et de la RMSE, puis à ne retenir et ne publier dans le manuscrit final que la métrique spécifique qui présente leur propre modèle sous le jour le plus favorable tout en disqualifiant les modèles alternatifs. Si un algorithme nouveau exhibe une sensibilité fâcheuse à quelques cas extrêmes (gonflant sa RMSE) tout en étant très précis sur le reste des sujets, les auteurs peuvent être tentés de ne documenter exclusivement que la MAE pour dissimuler délibérément l’instabilité structurelle de leur méthode.
Cette dérive méthodologique nuit gravement à la reproductibilité des modèles de machine learning en psychologie et altère l’accumulation cumulative des connaissances scientifiques. Pour éradiquer ce danger épistémique, la communauté scientifique internationale plébiscite désormais massivement le pré-enregistrement (pre-registration) des plans d’analyse de régression au sein de plateformes ouvertes comme l’Open Science Framework (OSF). Ce protocole oblige les chercheurs à statuer publiquement, avant toute phase de recueil ou d’exploration des données, sur la métrique principale d’arbitrage et sur les critères formels de réussite prédictive.
11. Indicateurs alternatifs et complémentaires pour l’évaluation de régression
11.1 Le coefficient de détermination (R²) et ses nuances d’interprétation
Dans l’arsenal classique de l’évaluation statistique en psychologie, le coefficient de détermination — symbolisé par l’incontournable R² — a historiquement régné en maître absolu pour sanctionner la valeur heuristique des modèles de régression. Pourtant, l’articulation entre le R² et les métriques résiduelles brutes que sont la MAE et la RMSE est fréquemment mal comprise par les praticiens de la recherche.
Le R² fournit une estimation relative de la proportion de variance de la variable dépendante qui est mathématiquement expliquée ou capturée par les prédicteurs du modèle. En conséquence, cette valeur scalaire est intrinsèquement dépendante de la dispersion initiale de l’échantillon analysé : un modèle conservant une précision de mesure absolue rigoureusement identique (exprimée par une MAE et une RMSE invariantes) exhibera un R² artificiellement gonflé s’il est appliqué à un échantillon présentant une grande hétérogénéité naturelle, et un R² déprimé s’il est testé sur une cohorte homogène dont la variance totale est restreinte. Le R² ne renseigne donc en rien sur l’amplitude physique brute de l’erreur commise.
Dès lors, l’évaluation moderne de la régression en sciences du comportement récuse le recours isolé au coefficient de détermination. Un portrait méthodologique rigoureux impose une articulation tripartite formalisée : associer systématiquement le R² (pour situer la part de variance globale expliquée au regard de la population), la MAE (pour appréhender l’écart typique linéaire éprouvé par un sujet individuel) et la RMSE (pour quantifier la dispersion paramétrique et surveiller l’absence d’erreurs aberrantes). Cette complémentarité triangulaire évite tout aveuglement statistique.
11.2 L’erreur absolue médiane (MedAE) et les fonctions de perte robustes
Lorsque les données comportementales sont contaminées par des pourcentages substantiels de valeurs hautement dysfonctionnelles ou de bruits systématiques — une occurrence classique lors des évaluations neuropsychologiques de patients sévèrement cérébrolésés incapables de suivre des consignes complexes —, même la MAE peut voir sa représentativité altérée. Dans ces environnements stochastiques extrêmes, la statistique non paramétrique propose un instrument à la robustesse décuplée : l’erreur absolue médiane (Median Absolute Error, MedAE).
Sur le plan formel, la MedAE se définit comme la médiane arithmétique de l’ensemble des écarts absolus constatés au sein de l’échantillon :
MedAE = Médiane( |yi – ŷi| )
La MedAE présente la propriété mathématique exceptionnelle de posséder un point de rupture (breakdown point) atteignant le seuil maximal de 50 %. Cela signifie que l’estimation de l’erreur typique demeure rigoureusement invulnérable quand bien même jusqu’à la moitié exacte de l’échantillon d’évaluation serait composée de réponses totalement chaotiques ou aberrantes. Elle capture avec une pureté absolue la déviation commise sur le segment véritablement médian de la cohorte.
Parallèlement à la MedAE, les méthodologistes contemporains mobilisent de plus en plus fréquemment des fonctions de perte hybrides paramétrées, au sommet desquelles trône la perte de Huber (Huber Loss). Cette dernière opère une synthèse fonctionnelle remarquable entre la géométrie L1 et la géométrie L2 : elle se comporte comme une fonction quadratique (de type RMSE) pour toutes les erreurs résiduelles inférieures à un seuil critique paramétrable (δ), assurant une différentiabilité lisse au centre, et commute automatiquement vers une fonction linéaire absolue (de type MAE) pour l’ensemble des résidus excédant ce seuil, immunisant le modèle contre l’effet d’amplification exponentielle des déviations extrêmes.
11.3 Métriques relatives et normalisées (NRMSE et MAPE)
Pour contourner l’illusion d’échelle précédemment évoquée et permettre l’intégration méta-analytique de protocoles psychométriques hétérogènes, la littérature quantitative a élaboré des déclinaisons normalisées et relatives des métriques d’erreur fondamentales. La première d’entre elles est la racine de l’erreur quadratique moyenne normalisée, universellement abrégée sous le sigle NRMSE (Normalized Root Mean Squared Error).
La normalisation de la RMSE s’effectue généralement en divisant la métrique par l’étendue globale observée des données empiriques (ymax – ymin) ou par l’écart-type (σy) de la variable dépendante au sein de l’échantillon d’évaluation. Ce rapport sans dimension permet d’exprimer la dispersion de l’erreur en fraction unitaire ou en pourcentage standardisé de l’échelle d’évaluation, autorisant des comparaisons directes de performances entre des inventaires comptant 10 items et des batteries en comportant une centaine.
La seconde métrique largement répandue est l’erreur moyenne absolue en pourcentage (Mean Absolute Percentage Error, MAPE), qui évalue la moyenne des déviations absolues exprimées chacune en pourcentage relatif de la valeur observée correspondante :
MAPE = (1 / n) * Σ |(yi – ŷi) / yi| * 100
Toutefois, la MAPE soulève des pathologies mathématiques sévères dès lors qu’elle est importée au sein de la recherche psychologique. Dans la mesure où elle impose une division directe par chaque observation empirique individuelle yi, sa valeur tend asymptotiquement vers l’infini dès qu’une valeur observée se rapproche de zéro, et devient purement et simplement indéfinie pour toute réponse rigoureusement nulle (ce qui survient massivement sur des échelles d’inventaires cliniques où la cote 0 indique l’absence totale de symptôme). De surcroît, la MAPE pénalise beaucoup plus sévèrement les prédictions par excès que les prédictions par défaut lorsque les valeurs observées sont faibles, générant un biais directionnel asymétrique indésirable. Ces limites rédhibitoires rendent la MAPE généralement impropre à l’analyse psychométrique rigoureuse, justifiant de lui préférer la NRMSE ou la MAE standardisée.
12. Guide de synthèse et recommandations pour les chercheurs en psychologie
12.1 Arbre décisionnel séquentiel pour le choix de la métrique principale
Afin de guider rationnellement les chercheurs, méthodologistes et étudiants de troisième cycle au sein du paysage complexe de la modélisation comportementale, nous proposons ici un algorithme décisionnel séquentiel structuré en trois étapes formelles successives :
Étape 1 : Analyse diagnostique approfondie de la distribution des données empiriques et des résidus.
Avant tout arbitrage métrique, l’investigateur doit soumettre ses résidus d’estimation à des tests formels de normalité (Shapiro-Wilk, Kolmogorov-Smirnov) et examiner l’aplatissement (kurtosis) et l’asymétrie (skewness). Si la distribution résiduelle s’avère approximativement normale, symétrique et dénuée de valeurs hautement singulières, la RMSE s’impose d’emblée comme l’estimateur de maximum de vraisemblance optimal. Si, à l’inverse, la distribution résiduelle exhibe une longue traîne asymétrique, une distribution de type laplacienne ou une contamination avérée par des bruits d’inattention, la MAE revendique une priorité mathématique immédiate.
Étape 2 : Évaluation des coûts différentiels associés aux erreurs de prédiction extrêmes.
L’investigateur doit expliciter la fonction de perte substantielle propre à son domaine d’application. Si les conséquences d’une déviation prédictive augmentent de façon linéaire — chaque unité d’écart engendrant un désagrément constant sans péril systémique —, la MAE doit être sélectionnée comme métrique pivot. Si, au contraire, le protocole s’inscrit dans un contexte à haut risque (prédiction de décompensations suicidaires, posologies d’interventions thérapeutiques) où une déviation majeure induit une catastrophe clinique, la RMSE doit impérativement être adoptée pour son pouvoir de pénalisation quadratique dissuasif.
Étape 3 : Détermination de la cible de tendance centrale requise pour l’inférence psychologique.
Le chercheur doit statuer sur la statistique de tendance centrale qu’il ambitionne d’attribuer aux prédictions de son modèle. Si la volonté heuristique est d’anticiper le comportement du sujet représentatif modal et médian d’une population caractérisée par une asymétrie de traits, la MAE (qui optimise la médiane conditionnelle) constitue l’unique choix cohérent. Si le chercheur vise à intégrer son modèle au sein de bilans d’allocations de ressources globales ou d’analyses de variance paramétriques préservant la somme additive totale, la RMSE (qui optimise la moyenne conditionnelle) s’avère requise.
12.2 Protocole pour une transparence méthodologique optimale
Au-delà de la sélection argumentée d’une métrique primaire, l’éthique de la recherche moderne et les exigences de la science ouverte imposent une discipline de communication rigoureuse lors de la rédaction de manuscrits scientifiques soumis aux revues de psychologie :
- Déclaration systématique conjointe : Ne jamais publier isolément la MAE ou la RMSE. Les deux métriques doivent figurer côte à côte dans les rapports d’analyse, accompagnées systématiquement de la restitution explicite de leur ratio (RMSE / MAE) pour éclairer instantanément le lectorat sur le degré d’hétérogénéité des déviations du modèle.
- Inclusion des intervalles de confiance par rééchantillonnage : Bannir impérativement la présentation de scalaires d’erreur isolés. Chaque indice d’erreur (MAE et RMSE) doit obligatoirement être escorté de son intervalle de confiance à 95 % dérivé par bootstrap non paramétrique afin de rendre compte fidèlement de la précision d’échantillonnage.
- Fourniture exhaustive des représentations résiduelles : Intégrer au sein du corps de l’article ou au titre du matériel supplémentaire en ligne (Supplementary Material) les visualisations graphiques de la distribution des résidus : histogrammes d’erreurs, diagrammes quantile-quantile (Q-Q plots) et graphiques de dispersion des résidus en fonction des valeurs prédites.
- Partage intégral des scripts de calcul : Déposer sur des entrepôts pérennes et ouverts (tels que l’Open Science Framework ou Zenodo) l’intégralité du code reproductible (R, Python) ayant servi au fractionnement des données, à la validation croisée et au calcul exact des fonctions de perte d’évaluation.
12.3 Perspectives futures de l’évaluation prédictive en psychologie computationnelle
L’horizon méthodologique des sciences comportementales est marqué par une hybridation croissante entre modélisation statistique bayésienne et intelligence artificielle prédictive. Dans ce paysage en mutation rapide, la conception des métriques d’évaluation s’émancipe progressivement des formalismes standardisés L1 et L2 pour embrasser des architectures de perte personnalisées, directement adossées à la théorie de la décision bayésienne.
Cette évolution prend une résonance majeure dans le cadre de l’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) et du phénotypage numérique mobile. Dans ces paradigmes où les comportements psychologiques, les émotions et les états physiologiques sont enregistrés sous forme de séries temporelles denses, les résidus d’erreur ne sont plus indépendants : ils présentent une forte autocorrélation temporelle et une instabilité dynamique permanente. Les métriques d’évaluation de demain devront intégrer des opérateurs capables de pondérer les erreurs non seulement en fonction de leur magnitude scalaire brute, mais également en tenant compte de leur chronologie et de leur persistance temporelle au cours des trajectoires de vie des participants.
Enfin, la recherche computationnelle en psychologie s’oriente vers une réconciliation réflexive entre critères statistiques quantitatifs et signification clinique réelle. Aucune fonction mathématique d’agrégation d’écarts — qu’elle prenne la forme élégante d’une distance euclidienne ou celle d’un segment absolu de Manhattan — ne saurait s’exonérer du regard qualitatif du clinicien. La véritable excellence méthodologique ne réside pas dans l’abandon aveugle de la décision scientifique à des indices algorithmiques automatisés, mais dans la capacité permanente du chercheur à articuler l’algèbre rigoureuse de ses métriques avec la fragile complexité phénoménologique de l’expérience humaine.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
Chai, T., & Draxler, R. R. (2014). Root mean squared error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature. Geoscientific Model Development, 7(3), 1247–1250. https://doi.org/10.5194/gmd-7-1247-2014
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001
Kuhn, M., & Johnson, K. (2013). Applied predictive modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance. Climate Research, 30(1), 79–82. https://doi.org/10.3354/cr030079
Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: An evaluation. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393