
Dans le champ des sciences comportementales et de la psychologie contemporaine, l’évaluation empirique des modèles théoriques repose quasi systématiquement sur la quantification et la modélisation probabiliste. Qu’il s’agisse de scruter les modifications de la connectivité fonctionnelle cérébrale consécutives à une psychothérapie cognitive, de quantifier l’efficacité différentielle de deux paradigmes d’apprentissage mnésique ou de mesurer l’impact d’un biais attentionnel sur les scores d’anxiété sociale, les chercheurs mobilisent massivement l’arsenal de l’inférence statistique. Au cœur de cette entreprise scientifique se trouve une distinction fondamentale entre les méthodologies non paramétriques, fondées sur les rangs ou la distribution empirique, et les approches paramétriques, qui s’appuient sur l’estimation de paramètres distributionnels spécifiques au sein d’une population cible.
Toutefois, la puissance analytique et l’élégance formelle des tests paramétriques ne sont pas octroyées sans contrepartie épistémologique. Ces procédures mathématiques ne sont valides que dans la mesure où les données observées se conforment à une série d’axiomes fondamentaux régissant la structure des distributions et la nature stochastique de l’échantillonnage. En pratique expérimentale, ces conditions d’application — fréquemment qualifiées d’hypothèses ou de postulats sous-jacents — sont trop souvent reléguées au rang de simples formalités rituelles ou commodément ignorées face à la pression de publication et au désir d’aboutir au seuil canonique de significativité. Une telle négligence méthodologique fragilise l’édifice de la preuve, fausse les estimations de la taille d’effet et contribue directement à la crise de la réplicabilité qui secoue la psychologie empirique depuis plus d’une décennie.
Le présent traité propose une déconstruction exhaustive des quatre postulats cardinaux qui fondent la théorie des tests paramétriques univariés et multivariés : la normalité distributionnelle, l’homogénéité des variances (ou homoscédasticité), l’indépendance stochastique des observations et l’absence de valeurs aberrantes à fort levier d’influence. À travers une analyse croisée combinant dérivation théorique, diagnostics graphiques et numériques avancés, et étude des conséquences computationnelles de leurs violations, cet article vise à fournir aux chercheurs et analystes de données un cadre méthodologique exhaustif, rigoureux et opérationnel pour garantir la validité de leurs conclusions inférentielles.
1. Introduction aux tests paramétriques en recherche psychologique
1.1 Définition et nature des statistiques paramétriques
L’inférence statistique paramétrique repose sur le principe fondamental selon lequel les données empiriques recueillies constituent des réalisations d’une variable aléatoire régie par une fonction de densité de probabilité connue, caractérisée par un ensemble fini et fixe de paramètres mathématiques. Dans le cadre de la théorie classique de l’échantillonnage développée notamment par Ronald Fisher, Karl Pearson et Jerzy Neyman, ces paramètres correspondent généralement à des valeurs inconnues de la population mère, au premier rang desquelles figurent la moyenne arithmétique (μ) et la variance (σ²). L’objectif du chercheur consiste à déduire la valeur probable de ces paramètres populationnels à partir des statistiques calculées sur un échantillon fini, respectivement la moyenne empirique (M) et la variance corrigée (s²), tout en quantifiant précisément l’incertitude inhérente à ce processus d’échantillonnage.
Cette approche se distingue radicalement des statistiques non paramétriques — dites également statistiques à distribution libre (*distribution-free*) — qui ne postulent aucune forme fonctionnelle spécifique pour la distribution de la population sous-jacente. Alors que les tests non paramétriques opèrent la plupart du temps par transformation des données quantitatives brutes en rangs ordinaux ou par réagencement combinatoire, les tests paramétriques exploitent l’intégralité de l’information contenue dans les distances numériques séparant les observations. En psychologie expérimentale et clinique, cette préservation de l’échelle d’intervalle ou de rapport est cruciale : elle permet d’estimer des grandeurs psychométriques continues, telles que la latence d’une réponse électrophysiologique, le degré de réduction d’une symptomatologie dépressive sur une échelle standardisée, ou la capacité de rétention en mémoire de travail.
Cependant, l’exactitude de la modélisation dépend entièrement de l’adéquation distributionnelle du modèle au phénomène biologique ou psychologique sous-jacent. Si la distribution théorique assignée aux erreurs résiduelles ne concorde pas avec la réalité empirique, l’estimation des erreurs-types est mathématiquement biaisée, ce qui compromet immédiatement la validité interne des conclusions de la recherche. La validité statistique conditionne la validité conceptuelle : aucune interprétation théorique solide d’un mécanisme cognitif ou émotionnel ne peut émerger d’une statistique inférentielle dont les axiomes d’échantillonnage ont été enfreints de manière non contrôlée.
1.2 Les tests paramétriques couramment employés
Dans l’arsenal quantitatif de la recherche comportementale, quatre grandes familles de tests paramétriques prédominent, toutes dérivées ou affiliées au Modèle Linéaire Général (GLM). En premier lieu figure le test *t* de Student pour échantillon unique et pour échantillons appariés, conceptualisé par William Sealy Gosset en 1908. Le test *t* pour échantillon unique compare la moyenne observée au sein d’un groupe à une valeur théorique de référence fixée a priori par la littérature, tandis que la variante pour mesures répétées compare deux conditions expérimentales appliquées aux mêmes sujets (ou à des paires de sujets appariés), évaluant si la moyenne différentielle intra-individuelle s’écarte significativement de zéro.
En second lieu, le test *t* de Student pour échantillons indépendants s’applique aux plans factoriels inter-sujets comportant deux modalités distinctes. Il permet, par exemple, de vérifier si un groupe soumis à un entraînement métacognitif obtient des scores d’apprentissage significativement supérieurs à ceux d’un groupe contrôle passif. Ce test repose sur le calcul du ratio entre la différence brute des deux moyennes d’échantillon et l’erreur-type de cette différence, cette dernière étant estimée par une mise en commun pondérée des variances d’échantillon respectives.
Lorsque le devis de recherche implique la comparaison simultanée de trois groupes ou davantage, l’analyse de variance univariée (ANOVA à un facteur, ou *One-Way ANOVA*) prend le relais méthodologique du test *t*. Conçue par Ronald Fisher, l’ANOVA partitionne la somme totale des carrés des écarts à la moyenne générale en deux composantes orthogonales et additives : la variance inter-groupes (due à l’effet du traitement expérimental ou à l’appartenance catégorielle) et la variance intra-groupes (attribuée aux fluctuations stochastiques individuelles et à l’erreur de mesure). Le rapport de ces deux composantes, pondéré par leurs degrés de liberté respectifs, fournit la statistique *F* de Fisher-Snedecor.
Enfin, pour l’étude des relations continues bidirectionnelles ou prédictives entre variables, la corrélation produit-moment de Pearson et la régression linéaire simple ou multiple constituent les piliers paramétriques cardinaux. Le coefficient *r* de Pearson quantifie l’intensité et le sens de la covariance linéaire standardisée entre deux distributions continues, tandis que l’équation des moindres carrés ordinaires (MCO) permet de projeter la trajectoire d’une variable dépendante continue à partir d’un ou plusieurs régresseurs continus ou catégoriels, sous l’hypothèse d’une dispersion gaussienne stationnaire des résidus.
1.3 Le rôle critique de la validité des inférences statistiques
L’inférence statistique ne se résume pas à l’application mécanique d’un algorithme mathématique sur une matrice de chiffres : elle formalise une décision épistémique dans des conditions d’incertitude probabiliste. L’ensemble de la théorie des tests d’hypothèse nulle (NHST, *Null Hypothesis Significance Testing*) est calibré de manière à maîtriser deux types de risques décisionnels symétriquement opposés. Le premier est le risque d’erreur de type I, conventionnellement désigné par la lettre grecque α (alpha), qui représente la probabilité de rejeter à tort l’hypothèse nulle ($H_0$) alors que celle-ci est vérifiée dans la population. Par convention scientifique, ce seuil nominal est fixé à 5% (α = 0,05).
Lorsque les postulats fondamentaux des tests paramétriques sont enfreints, la valeur nominale du seuil alpha devient caduque. Dans de nombreux scénarios méthodologiques dégradés — tels que la présence conjointe d’un déséquilibre d’effectifs et d’une disparité des variances —, le taux effectif d’erreurs de type I s’envole pour atteindre des valeurs inacceptables de 15%, 25%, voire 40%. Cela signifie que le chercheur identifie des « découvertes statistiquement significatives », c’est-à-dire des faux positifs, sur de simples artéfacts mathématiques. Ces faux positifs encombrent la littérature scientifique de théories chimériques et d’effets thérapeutiques illusoires qui s’avèrent impossibles à reproduire.
Inversement, le non-respect des postulats peut provoquer une inflation du risque d’erreur de type II (β), c’est-à-dire l’incapacité à rejeter une hypothèse nulle pourtant fausse dans la réalité biologique ou psychologique. Ce phénomène entraîne un effondrement de la puissance statistique (1 – β), réduisant dramatiquement la sensibilité du devis de recherche. Des interventions psychologiques véritablement efficaces ou des corrélations neurocognitives substantielles peuvent ainsi être faussement déclarées non significatives en raison d’une dispersion anormale des données ou de résidus asymétriques. Au final, les compromissions faites avec les postulats paramétriques alimentent directement le scepticisme entourant la réplicabilité des sciences sociales et affaiblissent l’assise empirique des paradigmes théoriques.
2. Fondements théoriques et épistémologiques des conditions d’application
2.1 Pourquoi les modèles paramétriques imposent-ils des contraintes strictes ?
L’existence de conditions préalables à l’exécution d’un test paramétrique n’est pas le fruit d’un conservatisme méthodologique arbitraire, mais découle directement de la dérivation mathématique des lois de probabilité sous-jacentes. Lorsqu’un statisticien affirme qu’une statistique de test suit une distribution de Student à ν degrés de liberté sous l’hypothèse nulle, cette affirmation n’est vraie que parce que la statistique *t* est construite algébriquement comme le ratio d’une variable normale centrée réduite standard $Z$ et de la racine carrée d’une variable indépendante distribuée selon une loi du Khi-deux divisée par ses degrés de liberté :
$$t = \frac{Z}{\sqrt{\chi^2 / \nu}}$$
Si la variable étudiée ne suit pas une loi normale dans la population, le numérateur ne constitue plus une variable normale standard, et le dénominateur — qui repose sur la somme des carrés des écarts à la moyenne — ne suit plus rigoureusement une distribution du Khi-deux. Par voie de conséquence, la distribution de la statistique de test calculée sur l’échantillon ne converge plus vers la distribution théorique tabulée de Student. Les tables de probabilités et les algorithmes logiciels qui calculent les fameuses p-valeurs se basent sur l’aire sous la courbe d’une fonction mathématique idéalisée. Si la distribution réelle de la statistique d’échantillonnage s’écarte de cette géométrie théorique, les probabilités associées deviennent mathématiquement erronées.
Ce lien formel s’enracine également dans la théorie classique de la mesure et la modélisation des erreurs expérimentales initiée par Carl Friedrich Gauss et Pierre-Simon de Laplace. La distribution gaussienne émerge historiquement comme la description analytique par excellence de l’accumulation d’une infinité de micro-erreurs de mesure indépendantes et additives. Les modèles paramétriques assument donc que le phénomène psychologique étudié est modélisable par une composante déterministe (le signal ou l’effet du traitement) entourée d’un bruit blanc stochastique purement additif et symétrique. Si ce bruit structurel obéit à d’autres lois — par exemple des mécanismes multiplicatifs, des rétroactions dynamiques non linéaires ou des seuils de blocage psychophysique —, l’équation fondamentale du modèle linéaire perd sa correspondance avec la réalité empirique.
2.2 Vue d’ensemble des quatre grands postulats méthodologiques
Pour assurer la concordance rigoureuse entre le comportement mathématique des données et les distributions théoriques d’échantillonnage, la littérature statistique a articulé quatre postulats méthodologiques cardinaux. La non-satisfaction d’un seul de ces postulats altère l’intégrité de l’inférence, bien que leur criticité respective varie selon la robustesse propre à chaque test et le design expérimental adopté.
Le premier postulat exige la **normalité distributionnelle** de la variable dépendante au sein de chaque population ou, plus précisément dans le cadre du modèle linéaire général, la distribution gaussienne des erreurs résiduelles du modèle. Il garantit que l’estimation de la moyenne constitue le prédicteur optimal non biaisé et de variance minimale de la tendance centrale, et que l’estimation des erreurs-types est mathématiquement exacte.
Le deuxième postulat impose l’**homogénéité des variances**, désignée sous le terme technique d’**homoscédasticité**. Il postule que la dispersion de l’erreur résiduelle demeure constante à travers tous les niveaux de la variable indépendante catégorielle (dans le cas des tests *t* et de l’ANOVA) ou le long de l’ensemble du continuum de prédiction (dans le cas des modèles de régression linéaire). L’absence d’homogénéité (hétéroscédasticité) déstabilise l’estimation de l’erreur quadratique moyenne commune.
Le troisième postulat, de loin le plus intransigeant et le plus dévastateur sur le plan inférentiel s’il est enfreint, est l’**indépendance stochastique des observations et des résidus**. Il implique que la valeur mesurée sur un sujet donné, ainsi que l’erreur de prédiction associée à cette mesure, n’entretient aucune corrélation probabiliste avec la valeur ou l’erreur mesurée chez tout autre sujet de l’échantillon.
Enfin, le quatrième postulat concerne l’**absence de valeurs aberrantes extrêmes** (*outliers*) et d’observations présentant un levier disproportionné. Bien que parfois considéré comme un corollaire des distributions normales, ce postulat requiert une attention dédiée car l’estimation par les moindres carrés ordinaires s’avère hypersensible aux points singuliers, une seule observation aberrante pouvant distordre massivement la moyenne, dilater la variance résiduelle et faire basculer artificiellement un résultat de la significativité vers la non-significativité, ou inversement.
3. Postulat 1 : La normalité de la distribution des données
3.1 Signification statistique de la distribution normale
La distribution normale, ou courbe en cloche de Laplace-Gauss, est définie analytiquement par sa fonction de densité de probabilité continue :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2}$$
Cette fonction est intégralement paramétrée par deux valeurs uniques : la moyenne arithmétique de la population ($\mu$), qui détermine la localisation de l’axe de symétrie centrale, et l’écart-type de la population ($\sigma$), qui régit le degré d’étalement horizontal de la cloche. Sur le plan géométrique et probabiliste, la distribution normale présente des propriétés de symétrie absolue autour de son centre : la moyenne, la médiane et le mode sont strictement confondus. De surcroît, elle possède deux points d’inflexion situés exactement à $\mu \pm \sigma$, et l’intégrale sous la courbe garantit qu’exactement 68,27% des observations se situent dans un intervalle d’un écart-type autour de la moyenne, 95,45% dans un intervalle de deux écarts-types, et 99,73% dans un intervalle de trois écarts-types.
Sur le plan des moments statistiques standardisés de Fisher, la loi normale se caractérise par un coefficient d’asymétrie (*skewness*) exactement égal à 0, et un coefficient d’aplatissement (*kurtosis*) théorique de 3, souvent recalculé sous forme d’excès d’aplatissement (*excess kurtosis*) égal à 0 pour servir de point de repère mésokurtique.
Il est capital d’apporter ici une clarification épistémologique majeure qui échappe fréquemment aux praticiens débutants : dans le cadre du modèle linéaire général, la condition de normalité ne stipule pas impérativement que la distribution marginale globale de la variable dépendante ($Y$) doive présenter une forme gaussienne. Si l’on administre une tâche de performance cognitive à deux groupes distincts (par exemple des individus sains versus des patients amnésiques), la distribution agrégée de l’échantillon total sera potentiellement bimodale si le traitement produit une séparation nette des moyennes. Ce que le postulat de normalité exige rigoureusement, c’est la normalité conditionnelle : la variable dépendante doit suivre une loi normale *à l’intérieur de chaque population représentée par les cellules du plan factoriel*, ce qui équivaut formellement à exiger que la distribution des erreurs résiduelles ($\epsilon_i = y_i – \hat{y}_i$) obéisse à une loi normale d’espérance nulle.
3.2 L’influence de la taille d’échantillon et le théorème central limite
L’un des arguments les plus couramment invoqués pour s’abstraire de la vérification du postulat de normalité repose sur l’appel au théorème central limite (TCL). Formulé sous sa version moderne par Lindeberg et Lévy, le TCL établit que, pour une suite de variables aléatoires indépendantes et identiquement distribuées (i.i.d.) possédant une moyenne $\mu$ et une variance finie $\sigma^2$, la distribution d’échantillonnage de la moyenne empirique converge asymptotiquement vers une loi normale au fur et à mesure que la taille d’échantillon ($n$) tend vers l’infini, quelle que soit la forme de la distribution d’origine dans la population :
$$\lim_{n to \infty} P\left(\frac{\bar{X}_n – \mu}{\sigma / \sqrt{n}} le z\right) = \Phi(z)$$
Dans la pratique de la recherche psychologique, une règle empirique informelle affirme couramment qu’un effectif de $n ge 30$ participants par groupe expérimental suffirait pour invoquer le TCL et garantir la robustesse des tests paramétriques tels que le test *t* de Student ou l’ANOVA. Bien que cette heuristique offre une approximation raisonnable dans les cas d’écarts légers à la normalité (par exemple des distributions modérément platykurtiques ou symétriques non gaussiennes), elle s’avère dangereusement erronée face à des asymétries sévères ou des distributions à queue lourde (*heavy-tailed distributions*).
Des simulations computationnelles de type Monte Carlo démontrent sans ambiguïté que lorsque les données sous-jacentes suivent une loi log-normale prononcée, une loi exponentielle ou une distribution de Cauchy, des effectifs de $n = 50$, $n = 100$ ou même $n = 500$ observations par groupe peuvent demeurer totalement insuffisants pour stabiliser le comportement stochastique des queues de distribution de la statistique de test. Dans ces configurations réelles, la vitesse de convergence vers la normalité est excessivement lente. Compter aveuglément sur le théorème central limite pour s’exonérer du diagnostic de normalité constitue une imprudence méthodologique majeure, en particulier lorsque l’hypothèse de recherche cible les queues de distribution ou implique des intervalles de confiance à 99%.
3.3 Impact psychologique et méthodologique de la non-normalité
En psychologie et en neurosciences cognitives, l’émergence de distributions parfaitement gaussiennes est davantage l’exception théorique que la règle empirique. De nombreux processus cognitifs et psychopathologiques génèrent structurellement des distributions asymétriques. L’exemple paradigmatique est constitué par les **temps de réaction** (TR) dans les tâches d’attention ou de décision lexicale. La latence motrice impose une limite physiologique infranchissable (environ 150 à 200 millisecondes), créant un plancher dur à gauche, tandis que les lapses attentionnels sporadiques étirent une longue queue de distribution vers la droite. Les TR obéissent historiquement à des distributions ex-gaussiennes, de Weibull ou de Wald plutôt qu’à une courbe normale.
De même, les inventaires d’évaluation clinique standardisés, tels que le questionnaire de dépression de Beck (BDI) ou l’inventaire d’anxiété état-trait de Spielberger (STAI), administrés au sein d’échantillons issus de la population générale non clinique, manifestent de manière prévisible des **effets de plancher** massifs. La majorité des participants rapporte une symptomatologie nulle ou minime, concentrant les observations sur le zéro ou l’extrême bas de l’échelle psychométrique, tandis qu’une minorité seulement s’écarte vers les scores élevés. À l’inverse, des tests d’aptitude cognitive trop aisés déclenchent des **effets de plafond**, comprimant les données contre le score maximal possible.
L’impact statistique de ces asymétries intrinsèques est pernicieux : la moyenne arithmétique n’est plus représentative du centre de gravité typique de la distribution, car elle est irrésistiblement tractée dans le sens de la queue de distribution par les quelques valeurs distales. De surcroît, l’écart-type est artificiellement amplifié. Il en résulte que le test statistique compare des paramètres mathématiques qui ne décrivent plus adéquatement le profil psychologique de la population, tout en affaiblissant la capacité à détecter des variations comportementales fines situées dans la zone de densité médiane.
4. Protocoles de diagnostic de la normalité
4.1 Évaluation par les tests d’hypothèse formels
Pour statuer sur l’adéquation d’un ensemble de données au postulat de normalité, les chercheurs ont recours à des tests d’hypothèse dédiés. Parmi ceux-ci, le **test de Shapiro-Wilk** (1965) s’impose dans la littérature comme la référence méthodologique dotée de la puissance statistique la plus élevée face à un large éventail d’alternatives non gaussiennes. Ce test repose sur le calcul d’un coefficient $W$, qui représente le ratio entre le carré d’une combinaison linéaire optimale des statistiques d’ordre de l’échantillon et la somme usuelle des carrés des écarts à la moyenne :
$$W = \frac{\left( \sum_{i=1}^n a_i x_{(i)} \right)^2}{\sum_{i=1}^n (x_i – \bar{x})^2}$$
Si la statistique $W$ est significativement inférieure à 1 (associée à une p-valeur inférieure au seuil critique $\alpha = 0,05$), l’hypothèse nulle de normalité est formellement rejetée.
Une alternative historique très répandue est le test d’adéquation de **Kolmogorov-Smirnov**, qui compare la fonction de répartition empirique de l’échantillon à la fonction de répartition théorique cumulative normale. Cependant, l’usage du test de Kolmogorov-Smirnov classique exige que les paramètres de la population ($\mu$ et $\sigma$) soient connus *a priori*, ce qui n’est jamais le cas en recherche. L’utilisation des paramètres estimés à partir de l’échantillon lui-même impose d’appliquer la correction de Lilliefors, sans laquelle le test souffre d’un déficit dramatique de puissance statistique. Même corrigé, le test de Lilliefors demeure notablement moins sensible aux asymétries et anomalies d’aplatissement que le test de Shapiro-Wilk ou le test d’Anderson-Darling.
Néanmoins, l’interprétation de ces tests formels se heurte à ce que les statisticiens nomment le « paradoxe de la taille d’échantillon ». Sur des petits échantillons ($n 500$), le test acquiert une sensibilité hyperspécifique : il détecte des écarts minuscules, imperceptibles et sans aucune conséquence pratique sur l’intégrité de l’inférence, conduisant le chercheur à rejeter indûment la normalité alors que le modèle linéaire général opérerait avec une robustesse exemplaire.
4.2 Approches graphiques et visuelles
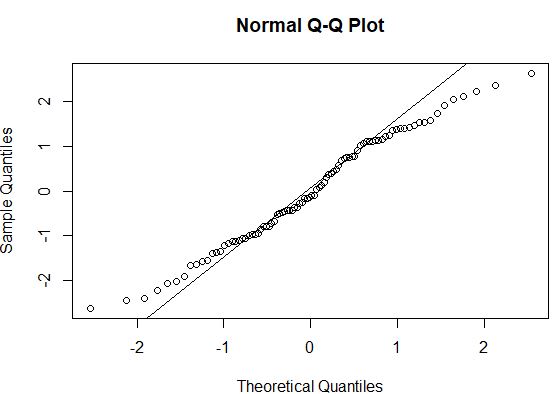
Face aux limites inhérentes aux tests d’hypothèse formels, le consensus méthodologique moderne préconise de privilégier l’inspection graphique instrumentée. L’outil analytique le plus précis, informatif et robuste est le **diagramme quantile-quantile normal** (communément désigné sous l’anglicisme *Q-Q plot*). Ce tracé cartographie les quantiles empiriques ordonnés observés dans la série de données en abscisse contre les quantiles théoriques attendus sous une distribution normale standardisée en ordonnée.
Si la distribution observée se conforme rigoureusement à l’hypothèse gaussienne, les points expérimentaux s’alignent étroitement le long d’une droite de référence bissectrice à 45 degrés. Toute déviation morphologique récurrente de cet alignement permet un diagnostic qualitatif immédiat de la nature de la violation :
- Une courbure convexe ou concave continue des points signale une **asymétrie** directionnelle (positive ou négative).
- Une disposition en forme de « S » étiré ou de sigmoïde inversée reflète un problème d’**aplatissement**, signalant soit des queues de distribution excessivement lourdes (*leptokurticité* avec propension aux valeurs extrêmes), soit des queues tronquées et une dispersion uniforme (*platykurticité*).
- Un décollement soudain d’un ou deux points isolés aux extrémités de la ligne trahit sans ambiguïté la présence d’observations aberrantes singulières.
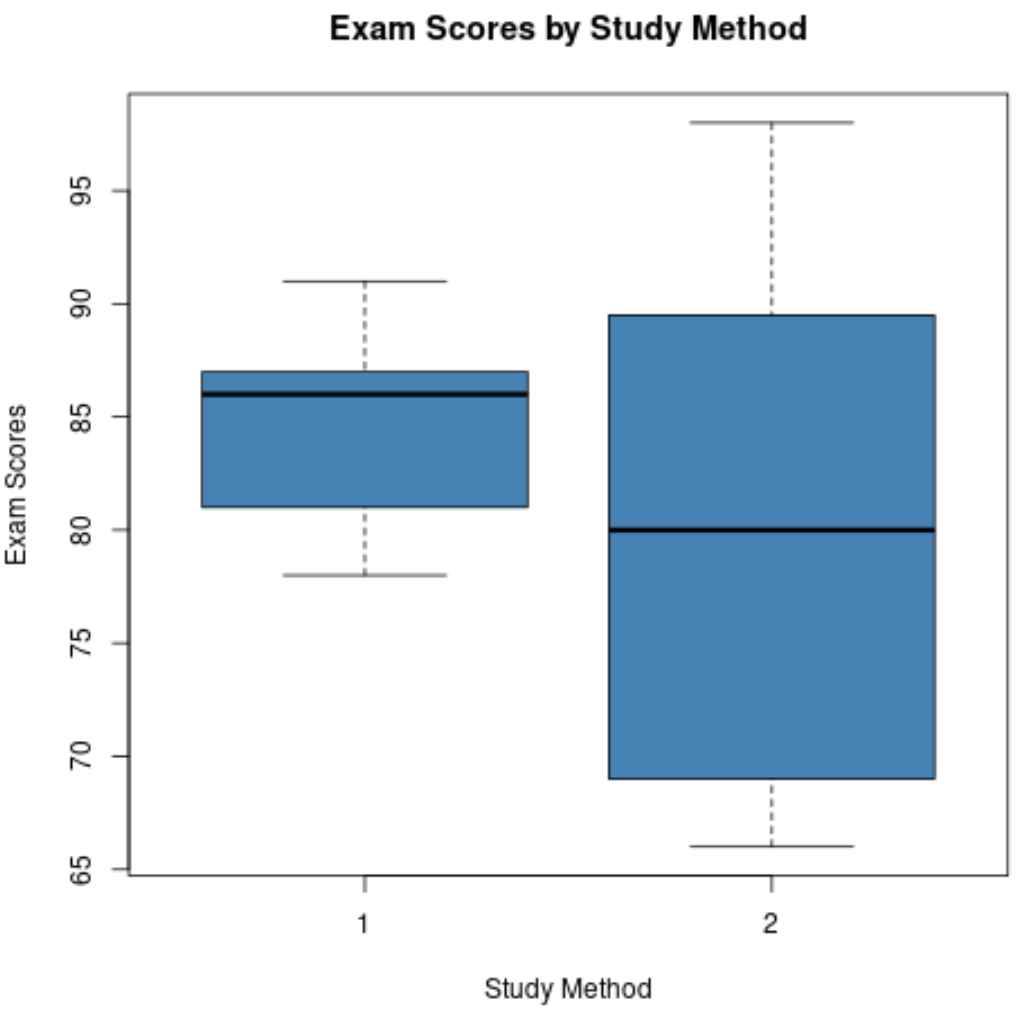
Les **histogrammes de fréquences** pourvus d’une courbe de densité normale théorique superposée constituent un complément visuel direct, bien que leur interprétation soit fortement tributaire du choix de la largeur des intervalles de classe (*bin width*). Enfin, les **boîtes à moustaches** (*boxplots* de Tukey) offrent un diagnostic structural précieux : le positionnement asymétrique de la ligne médiane à l’intérieur de la boîte interquartile et l’inégalité de longueur des deux moustaches renseignent instantanément sur la distorsion de l’échantillon.
4.3 Indices numériques de forme : Skewness et Kurtosis
Pour dépasser la subjectivité inhérente à l’analyse visuelle sans tomber dans le piège de l’hypersensibilité des tests d’hypothèse formels sur grands échantillons, le calcul des coefficients standardisés de forme constitue la solution d’arbitrage méthodologique optimale. Le coefficient d’asymétrie de Fisher-Pearson (*Skewness*, noté $g_1$ ou $\sqrt{b_1}$) quantifie le degré d’asymétrie de la distribution autour de sa moyenne :
$$g_1 = \frac{\frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^3}{\left( \frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^2 \right)^{3/2}}$$
Une valeur nulle ($g_1 = 0$) correspond à une symétrie parfaite. Une valeur positive indique un étirement de la distribution vers la droite (valeurs élevées), tandis qu’une valeur négative indique une queue étirée vers la gauche.
Le coefficient d’aplatissement de Fisher (*Excess Kurtosis*, noté $g_2$ ou $b_2 – 3$) évalue le poids stochastique des queues de distribution relativement au centre de la masse :
$$g_2 = \frac{\frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^4}{\left( \frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^2 \right)^2} – 3$$
Une distribution normale possède un excès de kurtosis égal à 0. Un excès positif ($g_2 > 0$) caractérise une distribution **leptokurtique**, pointue au centre avec des queues épaisses génératrices de valeurs extrêmes. Un excès négatif ($g_2 < 0$) traduit une distribution **platykurtique**, aplatie avec des queues légères.
Dans la pratique psychométrique et statistique, la standardisation de ces coefficients sous forme de scores z ($z_{skewness} = g_1 / SE_{g_1}$ et $z_{kurtosis} = g_2 / SE_{g_2}$) est fréquemment employée sur de petits échantillons, un score $|z| > 1,96$ indiquant un écart significatif au seuil $\alpha = 0,05$. Cependant, sur des échantillons de taille intermédiaire à grande, les critères empiriques avancés par Barbara Tabachnick et Linda Fidell, ou par West, Finch et Curran (1995), font autorité :
- Des valeurs absolues de Skewness comprises entre -1 et +1 dénotent une distribution quasi-normale ne menaçant aucunement la robustesse des tests paramétriques.
- Des valeurs de Skewness comprises entre $|1|$ et $|2|$ signalent une asymétrie modérée exigeant une vigilance quant aux autres postulats (notamment l’équilibre des effectifs).
- Un Skewness excédant $|2|$ ou un Kurtosis absolu excédant $|7|$ traduisent des violations massives et sévères qui invalident formellement l’usage direct des estimateurs par les moindres carrés ordinaires.
5. Postulat 2 : L’homogénéité des variances (Homoscédasticité)
5.1 Définition mathématique et conceptuelle de l’homoscédasticité
Le postulat d’homogénéité des variances, conceptuellement désigné sous le vocable d’**homoscédasticité** (issu du grec ancien *homos*, signifiant « même », et *skedasis*, signifiant « dispersion »), stipule que les différentes sous-populations comparées au sein d’un plan factoriel possèdent une variance résiduelle strictement identique. Dans le cadre d’une comparaison de plusieurs groupes par ANOVA à un facteur comportant $k$ niveaux indépendants, ce postulat s’énonce mathématiquement comme suit :
$$\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$$
Dans la géométrie du modèle de régression linéaire général, l’homoscédasticité exige que la variance conditionnelle des termes d’erreur résiduelle ($\epsilon_i$) demeure constante le long de l’ensemble du continuum des valeurs ajustées ou prédites par le modèle :
$$\text{Var}(\epsilon_i mid X = x_i) = \sigma^2, \quad \forall i$$
La nécessité théorique de ce postulat découle de l’architecture même de la mise en commun des variances (*pooled variance*) opérée par les tests paramétriques. Pour calculer la statistique *t* d’un test de Student pour échantillons indépendants ou le carré moyen de l’erreur ($MS_{erreur}$) au dénominateur du ratio *F* de l’ANOVA, l’algorithme procède à une moyenne pondérée des sommes de carrés intra-groupes divisée par la somme des degrés de liberté respectifs :
$$s_p^2 = \frac{\sum_{j=1}^k (n_j – 1)s_j^2}{\sum_{j=1}^k (n_j – 1)}$$
Cette opération mathématique assume axiomatiquement que chaque échantillon fournit une estimation d’un seul et même paramètre populationnel latent commun ($\sigma^2$). L’ensemble des sujets partage la même variabilité stochastique résiduelle. Si cette condition est transgressée — c’est-à-dire en présence d’**hétéroscédasticité** —, la variance mise en commun ne correspond plus à aucune entité physique ou probabiliste cohérente, rendant caduque l’étalonnage des distributions d’échantillonnage théoriques.
5.2 Conséquences de l’hétéroscédasticité sur les tests de comparaison
L’hétéroscédasticité constitue l’une des infractions les plus pernicieuses en statistique appliquée, ses effets délétères étant directement tributaires du rapport entre les variances respectives des groupes et la structure des effectifs d’échantillonnage ($n_j$). Les travaux pionniers de Box (1954) ont démontré que deux dynamiques inverses d’altération du risque alpha se manifestent dès lors que les tailles de groupes sont inégales :
Le scénario le plus dévastateur pour la validité de la recherche est l’**appariement négatif** (*negative pairing*). Il survient lorsque le groupe possédant le plus faible effectif ($n_{petit}$) présente la variance la plus élevée ($s_{grand}^2$). Dans cette situation, la variance mise en commun ($s_p^2$) est mathématiquement tirée vers le bas par l’échantillon majoritaire à faible variance, car ce dernier pèse plus lourd dans la pondération par les degrés de liberté. En conséquence, le dénominateur de la statistique *t* ou *F* est massivement sous-estimé. La statistique de test calculée s’en trouve artificiellement gonflée, conduisant à une **explosion incontrôlable du taux d’erreur de type I**. Le seuil nominal de $\alpha = 0,05$ peut être pulvérisé pour atteindre en réalité 0,15, 0,25 ou 0,35. Le chercheur rejette continuellement l’hypothèse nulle à tort, identifiant des effets expérimentaux qui ne sont que de purs artefacts computationnels induits par l’hétérogénéité des dispersions.
Inversement, le scénario de l’**appariement positif** (*positive pairing*) se produit lorsque le groupe comportant l’effectif le plus large ($n_{grand}$) héberge également la variance la plus élevée ($s_{grand}^2$). Dans ce cas de figure, la variance mise en commun est artificiellement surévaluée par le poids du grand groupe. Le dénominateur du ratio de test devient excessivement large, ce qui comprime la valeur de la statistique *t* ou *F*. Le test devient alors excessivement conservateur : le taux effectif d’erreur de type I chute bien en dessous de 0,05 (par exemple 0,01 ou 0,005), mais au prix d’une **perte dramatique de puissance statistique** (hausse massive de l’erreur de type II). De véritables découvertes scientifiques et des avancées cliniques substantielles sont ainsi systématiquement occultées en raison d’une baisse anormale de sensibilité décisionnelle.
5.3 Cas particulier : La sphéricité dans les plans à mesures répétées
Lorsque le protocole de recherche abandonne les plans factoriels inter-sujets au profit de plans intra-sujets (mesures répétées au cours desquelles chaque participant subit l’ensemble des conditions expérimentales ou est évalué à multiples intervalles longitudinaux), l’homoscédasticité prend une forme mathématique plus complexe et contraignante : le **postulat de sphéricité**.
Introduite par John Wishart et formalisée par Box, la condition de sphéricité ne requiert pas seulement que les variances de la variable dépendante soient équivalentes entre les différentes conditions expérimentales prises individuellement. Elle exige impérativement que **les variances de toutes les différences possibles entre n’importe quelle paire de modalités du facteur intra-sujets soient mathématiquement égales** :
$$\text{Var}(Y_A – Y_B) \approx \text{Var}(Y_A – Y_C) \approx \text{Var}(Y_B – Y_C)$$
La sphéricité constitue une condition nécessaire et suffisante pour que la statistique $F$ de l’ANOVA à mesures répétées suive fidèlement sa distribution théorique sous l’hypothèse nulle. Si un plan intra-sujets ne comporte que deux modalités temporelles ou expérimentales, le postulat est tautologiquement vérifié puisqu’il n’existe qu’une seule variance de différence possible. En revanche, dès lors que le facteur comporte trois modalités ou plus, la sphéricité est quasi systématiquement violée dans les contextes psychologiques réels.
En effet, les mesures temporelles adjacentes (ex. : temps 1 et temps 2) partagent généralement une corrélation intra-individuelle beaucoup plus étroite que des mesures temporellement distantes (ex. : temps 1 et temps 4). Cette matrice de covariance hétérogène détruit la sphéricité, provoquant une distorsion majeure des degrés de liberté du numérateur et du dénominateur du test $F$, et induisant un taux de faux positifs substantiellement supérieur au seuil nominal fixé.
6. Diagnostics et vérification de l’égalité des variances
6.1 Tests inférentiels de variances
Afin de sonder statistiquement la validité de l’hypothèse d’homogénéité des variances entre plusieurs groupes, plusieurs procédures inférentielles concurrentes ont été élaborées. Historiquement, le **test de Bartlett** (1937) a longtemps constitué la norme computationnelle. Ce test évalue la divergence entre la moyenne géométrique et la moyenne arithmétique des variances d’échantillon au moyen d’une statistique approximant une distribution du Khi-deux. Toutefois, les recherches méthodologiques ont démontré que le test de Bartlett est pathologiquement vulnérable aux déviations de la normalité : il est incapable de discriminer si un rejet d’hypothèse découle d’une réelle hétérogénéité des variances ou simplement d’une leptokurticité des données. Son usage en sciences comportementales est aujourd’hui formellement déconseillé.
Pour s’affranchir de cette dépendance critique à la normalité, Howard Levene a introduit en 1960 le **test de Levene**. Sa mécanique consiste à effectuer une analyse de variance classique à un facteur, non pas sur les données brutes, mais sur la valeur absolue des écarts des observations individuelles à la moyenne de leur groupe respectif :
$$z_{ij} = |x_{ij} – \bar{x}_j|$$
Bien que considérablement plus robuste que le test de Bartlett, le test de Levene classique fondé sur la moyenne souffre encore d’un biais résiduel face aux distributions asymétriques. Pour pallier cette faiblesse, Morton Brown et Alan Forsythe ont perfectionné l’algorithme en 1974 en substituant la médiane du groupe (˜x) à la moyenne arithmétique pour le calcul des écarts absolus :
$$z_{ij} = |x_{ij} – \tilde{x}_j|$$
Ce **test de Brown-Forsythe** (ou test de Levene modifié basé sur la médiane) représente actuellement l’étalon-or pour vérifier l’homogénéité des variances, offrant une résistance statistique exceptionnelle contre la non-normalité sans perte substantielle de puissance. Une p-valeur associée inférieure à 0,05 conduit au rejet de l’hypothèse nulle d’homoscédasticité.
Pour les devis à mesures répétées, la sphéricité est quant à elle diagnostiquée au moyen du **test de sphéricité de Mauchly**. Ce test évalue la déviation de la matrice de covariance observée par rapport à une matrice sphérique orthogonale. Lorsque le test de Mauchly s’avère statistiquement significatif ($p < 0,05$), la violation de la sphéricité est formellement actée.
6.2 Analyses graphiques et ratios descriptifs
À l’instar des protocoles de diagnostic de la normalité, l’évaluation de l’homoscédasticité ne saurait reposer exclusivement sur les tests d’hypothèse formels, assujettis eux aussi au dilemme de la sur-détection sur grands échantillons et du manque de sensibilité sur petits groupes. Les analystes chevronnés s’appuient sur une combinaison d’indicateurs visuels et de métriques heuristiques éprouvées.
Dans les modèles de régression et l’ANOVA, le graphique diagnostique cardinal est le **tracé des résidus standardisés en fonction des valeurs prédites** (*Residuals vs Fitted plot*). Sous l’hypothèse d’homoscédasticité, le nuage de points doit former une bande horizontale stationnaire, rectangulaire et homogène, distribuée symétriquement autour de la ligne zéro sur toute l’amplitude de l’abscisse. Si le nuage de résidus adopte une morphologie en entonnoir, en trompette ou en éventail — s’élargissant ou se comprimant progressivement à mesure que les valeurs prédites augmentent —, l’hétéroscédasticité est visuellement prouvée. Cette géométrie traduit le fait que la précision prédictive du modèle n’est pas constante le long de l’axe de la variable dépendante.
Dans les plans factoriels inter-sujets catégoriels, l’**inspection visuelle comparée des boîtes à moustaches** permet une première approximation empirique : un groupe dont la hauteur de la boîte interquartile (IQR) est trois à quatre fois plus étalée que celle de son homologue signale une disparité substantielle de dispersion.
Sur le plan métrique, la **règle du ratio de Hartley** ($F_{\max}$) fournit un critère pragmatique robuste. Ce coefficient est simplement le ratio arithmétique de la variance empirique la plus élevée sur la variance la plus basse observée parmi les différents groupes :
$$\text{Ratio de variance} = \frac{s_{\max}^2}{s_{\min}^2}$$
Selon les lignes directrices formulées par Dean et Voss (1999) et abondamment validées par des études de robustesse :
- Lorsque les effectifs par cellule sont rigoureusement égaux ou équilibrés, l’ANOVA tolère un ratio de variance atteignant jusqu’à 3 ou 4 sans distorsion dommageable du taux d’erreur alpha.
- En revanche, si les effectifs sont inégaux (déséquilibre supérieur à un ratio de 1,5 entre le plus grand et le plus petit groupe), un ratio de variance excédant 1,5 à 2 est suffisant pour induire des distorsions statistiques majeures exigeant un ajustement immédiat.
Concernant le postulat de sphéricité, les logiciels quantifient l’amplitude de la déviation via l’indice d’**epsilon ($epsilon$)**. Si l’epsilon est égal à 1, la sphéricité est parfaite. Deux estimateurs concurrents permettent d’évaluer cet écart : l’epsilon de **Greenhouse-Geisser**, particulièrement conservateur et recommandé lorsque l’échantillon est restreint ou l’écart à la sphéricité substantiel ($epsilon 0,75$).
7. Postulat 3 : L’indépendance des observations et des résidus
7.1 Fondement théorique de l’échantillonnage aléatoire simple
L’axiome d’indépendance stochastique constitue le socle mathématique le plus fondamental, le plus déterminant et le moins négociable de l’ensemble de la théorie statistique classique. Sur le plan formel, deux événements probabilistes $A$ et $B$ sont dits stochastiquement indépendants si et seulement si leur probabilité conjointe équivaut au produit strict de leurs probabilités marginales respectives :
$$P(A \cap B) = P(A) \cdot P(B)$$
Transposé au modèle linéaire général, ce postulat stipule que la valeur quantitative mesurée sur une unité d’échantillonnage (un participant individuel) ne conditionne, n’influence, ni n’est influencée en aucune manière par la valeur mesurée sur une autre unité d’échantillonnage. Sur le plan des termes d’erreur, cela impose que la matrice de variance-covariance des erreurs résiduelles soit rigoureusement diagonale : tous les termes de covariance extra-diagonaux doivent être rigoureusement égaux à zéro :
$$\text{Cov}(\epsilon_i, \epsilon_j) = 0, \quad \forall i ne j$$
Cet axiome dérive directement de la théorie de l’échantillonnage aléatoire simple, qui postule que chaque membre d’une population cible dispose d’une chance égale, non nulle et mutuellement indépendante d’être sélectionné dans l’échantillon expérimental. Contrairement au postulat de normalité ou à celui d’homoscédasticité, qui concernent la morphologie et l’étalement de la distribution, le postulat d’indépendance concerne **la structure relationnelle sous-jacente des données**. C’est le postulat le plus critique, car aucune compensation asymptotique liée à l’augmentation de la taille d’échantillon ne permet de neutraliser ses biais : à vrai dire, l’augmentation du nombre de participants non indépendants ne fait que cristalliser et amplifier la défaillance inférentielle.
7.2 Les sources courantes de dépendance en sciences comportementales
En pratique expérimentale et observationnelle en psychologie, le non-respect de l’indépendance est extraordinairement fréquent, souvent insidieux et méconnu des équipes de recherche. La première source structurelle de dépendance réside dans le **regroupement hiérarchique ou écologique naturel des participants** (*hierarchical clustering*). Lorsqu’une étude évalue les effets d’un programme pédagogique innovant en sélectionnant des élèves au sein de plusieurs salles de classe, les élèves appartenant à une même classe partagent un enseignant commun, une dynamique de groupe, un niveau socio-économique de quartier et des perturbations environnementales identiques. Leurs trajectoires cognitives sont intrinsèquement corrélées, violant immédiatement l’indépendance des observations.
La même vulnérabilité méthodologique frappe les recherches conduites en milieu clinique hospitalier (où les patients sont groupés par service ou thérapeute), en psychologie sociale des groupes, ou en génétique comportementale lors de l’évaluation de dyades familiales ou de jumeaux. Les mesures collectées sur des conjoints ou des frères et sœurs ne constituent en rien des réplicats indépendants.
Une seconde source majeure de dépendance émerge de la **passation collective d’épreuves de laboratoire**. Tester des sujets en grappes simultanées dans une même salle informatique génère une contagion comportementale et attentionnelle invisible : une exclamation verbale d’un sujet, un soupir d’agacement, le bruit d’un clavier actionné à un rythme effréné ou une baisse de tension électrique partagée constituent des covariations contextuelles qui s’injectent directement dans les résidus du modèle.
Enfin, la troisième source classique d’interdépendance découle des **processus séquentiels et temporels**. Dès lors que des mesures sont collectées à répétition dans le temps chez un même individu, ou qu’un protocole expérimental s’étale sur de longues durées de test chez un même sujet sans modélisation sérielle adéquate, l’**autocorrélation temporelle** s’installe. Les phénomènes psychophysiologiques de fatigue cognitive, de lassitude, d’apprentissage procédural ou d’échauffement font en sorte que l’erreur commise à l’essai $t$ prédit statistiquement l’erreur à l’essai $t+1$.
7.3 Conséquences désastreuses du non-respect de l’indépendance
Les conséquences computationnelles d’une rupture de l’indépendance stochastique sont catastrophiques pour la validité de l’inférence statistique. Le mécanisme mathématique destructeur sous-jacent est la **sous-estimation dramatique de l’erreur-type de la moyenne** ($SE_M$). L’erreur-type standard est calculée sous la formule classique :
$$SE_M = \frac{\sigma}{\sqrt{n}}$$
Cette formule assume axiomatiquement une covariance nulle entre les unités. Si une corrélation positive même minime existe entre les observations — situation universelle en cas de regroupement spatial ou social —, la variance réelle de la moyenne d’échantillon ne converge pas vers $\sigma^2 / n$, mais intègre l’ensemble des termes de covariance croisés :
$$\text{Var}(\bar{X}) = \frac{\sigma^2}{n} \left[ 1 + (n – 1)\rho \right]$$
où $rho$ représente le coefficient de corrélation intraclasse. Le terme $[1 + (n – 1)rho]$ est connu en méthodologie d’enquête sous le nom de **facteur d’inflation de la variance** ou effet de plan (*design effect*).
Même lorsque la corrélation intra-groupe $rho$ semble trivialement basse (par exemple $rho = 0,05$ ou $0,10$), le fait d’échantillonner des grappes de taille substantielle (par exemple des classes de 30 élèves) dilate exponentiellement l’effet de plan. L’algorithme logiciel conventionnel, ignorant cette dépendance, calcule une erreur-type beaucoup trop étroite. Les intervalles de confiance à 95% calculés deviennent factices et ne couvrent le paramètre réel que dans 60% ou 70% des cas. En corollaire direct, le dénominateur des ratios *t* ou *F* s’effondre artificiellement, catapultant le taux effectif d’erreur de type I vers des sommets stupéfiants : une modélisation ignorant une corrélation résiduelle positive de seulement 0,10 peut porter le risque réel de faux positifs de 5% à **plus de 30% ou 50%**. L’ensemble de l’inférence statistique devient une pure illusion computationnelle.
8. Diagnostics et préservation de l’indépendance méthodologique
8.1 Prévention par le devis de recherche et l’assignation aléatoire
Face à la sévérité des sanctions computationnelles induites par la dépendance, une vérité épistémologique fondamentale s’impose : **l’indépendance ne peut pas être rétablie par un artifice mathématique a posteriori sur un devis expérimental déficient**. Contrairement à la non-normalité ou à l’hétéroscédasticité qui peuvent être corrigées par des transformations numériques ou des ajustements de degrés de liberté, le viol de l’indépendance nécessite d’être prévenu dès la conception de la recherche.
Le premier rempart méthodologique repose sur la rigueur de l’**échantillonnage et de l’assignation aléatoire** (*random assignment*). Dans un plan expérimental inter-sujets, chaque participant doit être affecté de façon rigoureusement randomisée à l’une des conditions expérimentales. Cette randomisation casse systématiquement les associations systématiques entre variables parasites non mesurées et conditions de traitement. De surcroît, les passations individuelles doivent impérativement être privilégiées par rapport aux passations collectives synchrones : un expérimentateur évaluant des sujets un à un, dans des box acoustiquement isolés et sous des conditions environnementales rigoureusement contrôlées et standardisées (température, éclairage, heure de la journée), limite drastiquement l’irruption de covariations parasites contextuelles.
Dans les tâches cognitives informatisées générant de multiples essais intra-sujets, la **randomisation pseudo-aléatoire** ou le contrebalancement (carrés latins) de l’ordre de présentation des stimuli expérimentaux constitue un impératif méthodologique incontournable. Elle évite que l’ordre des conditions ne devienne un facteur de confusion corrélé séquentiellement avec la dérive attentionnelle du participant.
8.2 Détection statistique des dépendances résiduelles
Bien que l’indépendance doive être garantie en amont par le protocole expérimental, des outils de diagnostic statistique permettent de traquer l’émergence de dépendances résiduelles résurgentes au sein des matrices de données finales.
Pour déceler la présence d’une autocorrélation séquentielle dans les erreurs d’un modèle de régression ou au cours de séries temporelles, le **test de Durbin-Watson** (1950) représente l’instrument analytique standard. Ce test évalue si les résidus successifs sont linéairement corrélés à l’ordre un via la statistique $d$ :
$$d = \frac{\sum_{i=2}^n (e_i – e_{i-1})^2}{\sum_{i=1}^n e_i^2}$$
La valeur numérique de la statistique $d$ oscille structurellement entre 0 et 4. Une valeur de $d = 2$ correspond à une absence totale d’autocorrélation résiduelle de premier ordre. Une valeur tombant significativement sous la barre des 1,5 indique une **autocorrélation positive** critique (où des résidus positifs tendent à être immédiatement suivis de résidus positifs), situation particulièrement destructrice qui écrase artificiellement l’erreur-type. Une valeur excédant 2,5 trahit une **autocorrélation négative**.
Pour les devis hiérarchiques ou écologiques impliquant des regroupements spatiaux, institutionnels ou sociaux, le diagnostic repose obligatoirement sur l’estimation du **Coefficient de Corrélation Intraclasse (CCI)**, issu d’une décomposition de la variance par un modèle linéaire mixte ou une ANOVA à effets aléatoires :
$$\text{CCI} = \frac{\tau_{00}}{\tau_{00} + \sigma^2}$$
où $\tau_{00}$ représente la variance inter-grappes (entre les classes ou les hôpitaux) et $\sigma^2$ la variance intra-grappe (entre les individus au sein d’une même unité). Si le CCI s’écarte significativement de zéro (même pour des valeurs aussi modestes que 0,02 ou 0,05), l’hypothèse d’indépendance des observations individuelles est formellement réfutée. Ce constat impose d’abandonner immédiatement le modèle ANOVA ou régression conventionnel sous peine de produire des inférences lourdement biaisées, et d’adopter des modèles hiérarchiques à effets mixtes (HLM).
Enfin, sur le plan graphique, l’**inspection temporelle des résidus en fonction de l’ordre séquentiel de passation des participants** (*Residuals vs Order plot*) permet de repérer instantanément des dynamiques d’échauffement ou de dérive expérimentale (par exemple une baisse progressive de la motivation de l’expérimentateur au fil de la journée entraînant une déviation systématique des scores).
9. Postulat 4 : L’absence de valeurs aberrantes extrêmes
9.1 Typologie des observations atypiques
L’intégrité de l’estimation paramétrique classique requiert l’absence d’observations extrêmes aberrantes (*outliers*), qui ne représentent pas la population cible et altèrent de manière disproportionnée les statistiques computationnelles. En recherche psychologique, ces singularités de mesure proviennent de trois étiologies distinctes qu’il convient de discriminer avec précision avant toute décision analytique :
La première catégorie regroupe les **erreurs de saisie cléricale et les défaillances instrumentales informatisées**. Il s’agit des artéfacts triviaux mais dévastateurs : une faute de frappe manuelle saisissant un âge de « 220 ans » au lieu de « 22 ans », un bogue logiciel enregistrant une latence motrice négative (-999 ms) codée à l’origine pour une valeur manquante, ou une perte temporaire de signal d’une électrode électroencéphalographique saturant l’amplitude de microvolts à des seuils physiologiquement impossibles. Ces aberrations doivent faire l’objet d’une rectification immédiate ou d’une suppression sans compromis.
La seconde catégorie découle du **non-respect manifeste des consignes ou du manque d’engagement motivationnel du sujet**. En psychologie cognitive sur plateformes de passation en ligne (telles que Prolific ou Mechanical Turk), il est fréquent que des répondants cliquent de façon stéréotypée et frénétique sur la même touche pour terminer l’expérience le plus rapidement possible, générant des temps de réponse moyens de 100 ms incompatibles avec le traitement visuel supérieur. De même, un sujet ne comprenant pas la langue expérimentale ou simulant une pathologie crée des distorsions qui contaminent la validité de l’échantillon.
La troisième catégorie, de loin la plus complexe sur le plan déontologique, concerne la **variabilité biologique et psychologique authentique issue de sous-populations cliniques non diagnostiquées**. Il s’agit de participants réels et engagés qui manifestent des capacités exceptionnelles (douance intellectuelle, synesthésie) ou des traumatismes sévères méconnus. Ces individus ne commettent aucune erreur méthodologique : ils représentent la queue distale de la diversité humaine. Les supprimer aveuglément pour « nettoyer » les données constitue une altération épistémologique majeure de la réalité clinique.
9.2 Distinction entre valeurs aberrantes, leviers et points influents
Dans la géométrie multidimensionnelle du modèle linéaire général, une confusion courante consiste à assimiler indifféremment valeurs aberrantes, points de levier et observations influentes. La théorie statistique opère pourtant des distinctions cruciales entre ces trois notions mathématiques :
Une **valeur aberrante univariée ou résiduelle** (*outlier*) désigne une observation dont la valeur pour la variable dépendante ($Y$) s’écarte de manière substantielle de la valeur prédite par le modèle conditionnel ($\hat{Y}$). Sur le plan graphique, ce point se situe verticalement très loin de la droite de régression, produisant un résidu standardisé ou studentisé de magnitude extrême ($|r_i| > 3$). Cependant, un outlier résiduel situé au centre du nuage des variables indépendantes ($X$) possède un impact relativement modéré sur l’inclinaison de la pente.
Un **point de levier** (*leverage point*) qualifie une observation située dans les zones extrêmes ou isolées de l’espace des prédicteurs ($X$). Mathématiquement, le levier d’un sujet est quantifié par la valeur diagonale $h_{ii}$ de la matrice de projection (*hat matrix* $H$) :
$$H = X(X^T X)^{-1} X^T$$
Le levier mesure la distance entre les valeurs de $X$ pour un sujet et le centre de gravité multidimensionnel des prédicteurs ($\bar{X}$). Un point doté d’un fort levier possède un potentiel destructeur considérable, analogue à une personne pesant sur l’extrémité d’une bascule : même une force modeste y produit un couple de rotation colossal.
Enfin, un **point influent** (*influential observation*) représente une observation qui modifie substantiellement, à elle seule, les estimations des paramètres de régression (l’ordonnée à l’origine ou la pente $\beta$) dès lors qu’on la retire du modèle. Une observation n’est réellement influente que si elle combine simultanément un fort résidu et un fort levier. L’indice d’évaluation de référence est la **distance de Cook** ($D_i$), qui intègre formellement le résidu studentisé ($e_{si}$) et la mesure de levier ($h_{ii}$) :
$$D_i = \frac{e_{si}^2}{k + 1} \left( \frac{h_{ii}}{1 – h_{ii}} \right)$$
Une distance de Cook excédant le seuil de coupure empirique $D_i > 4/n$ ou s’approchant de 1 signale une observation hautement influente qui dicte de manière disproportionnée la trajectoire des conclusions statistiques.
9.3 Impact direct sur l’estimation des paramètres
L’estimation des paramètres dans les modèles paramétriques univariés et multivariés s’effectue par l’algorithme des **moindres carrés ordinaires** (MCO). Cet algorithme minimise la somme des erreurs résiduelles élevées au carré :
$$\min \sum_{i=1}^n (y_i – \hat{y}_i)^2$$
Parce que la fonction de perte élève les écarts au carré, une observation située à 4 ou 5 écarts-types de la moyenne pèse 16 à 25 fois plus lourd dans l’équation d’ajustement qu’un point situé à un écart-type. L’estimation des moindres carrés possède ce que les statisticiens appellent un **point de rupture** (*breakdown point*) de $1/n$ : il suffit d’une seule observation isolée arbitrairement extrême pour faire basculer la moyenne arithmétique ou faire pivoter la droite de régression de manière catastrophique.
L’impact délétère des outliers est double et asymétrique :
- D’une part, ils peuvent engendrer des **faux positifs par effet d’illusion statistique**. Un point isolé à fort levier situé dans le quadrant supérieur droit d’un plan factoriel peut faire basculer un coefficient de corrélation nul ($r = 0,02$, non significatif) vers une corrélation apparemment massive ($r = 0,54$, $p < 0,001$). Deux sous-groupes sans différence réelle peuvent sembler significativement disjoints en ANOVA simplement parce qu'un sujet unique présente un score anormalement dilaté.
- D’autre part, et plus fréquemment encore, les valeurs aberrantes provoquent des **faux négatifs par gonflement artificiel de la variance résiduelle**. En dilatant démesurément la somme des carrés de l’erreur ($SS_{erreur}$), l’outlier augmente dramatiquement le dénominateur de la statistique $F$ ou $t$. L’erreur-type s’élargit, occultant des effets réels et écrasant la puissance statistique du test expérimental.
10. Outils de détection et prise de décision face aux valeurs aberrantes
10.1 Méthodes univariées de repérage
L’identification des valeurs singulières débute systématiquement par un dépistage univarié variable par variable. La méthode la plus intuitive repose sur la **standardisation en scores z** :
$$z_i = \frac{x_i – \bar{x}}{s}$$
Sous l’hypothèse de normalité, la probabilité d’observer un score $|z| > 3$ est inférieure à 0,27%. Dans les protocoles de recherche en psychologie, les seuils critiques de coupure recommandés par Tabachnick et Fidell (2019) s’établissent classiquement à $|z| ge 3,29$ (correspondant à une probabilité bilatérale infinitésimale de $p < 0,001$). Néanmoins, cette méthode standardisée souffre d'un biais structural fondamental d'auto-masquage (*masking effect*) : la présence même d'un outlier extrême gonfle considérablement l'écart-type ($s$) servant de dénominateur, ce qui comprime mécaniquement la valeur des scores z des autres points atypiques et empêche leur identification.
Pour contourner ce biais d’auto-masquage, les statisticiens recommandent l’emploi de métriques non paramétriques robustes, au premier plan desquelles trône la **règle de Tukey** fondée sur l’écart interquartile (IQR = $Q_3 – Q_1$). Un point est identifié comme un outlier univarié s’il se situe au-delà des limites intérieures de Tukey :
$$\text{Limite basse} = Q_1 – 1,5 \cdot \text{IQR} \quad \text{et} \quad \text{Limite haute} = Q_3 + 1,5 \cdot \text{IQR}$$
Pour la détection d’observations univariées sévères ou extrêmes, la barrière extérieure de Tukey porte le multiplicateur à 3 fois l’écart interquartile ($Q_3 + 3 \cdot \text{IQR}$). L’immense avantage de cette méthode réside dans le fait que ni les quartiles ni l’écart interquartile ne sont sensibles aux points singuliers, préservant ainsi l’intégralité du pouvoir de détection du diagnostic.
10.2 Méthodes multivariées
Dans les devis expérimentaux complexes impliquant plusieurs variables dépendantes (MANOVA) ou un faisceau de régresseurs multiples, un sujet peut tout à fait présenter des scores univariés parfaitement normaux sur chaque axe considéré isolément, tout en constituant une anomalie statistique multidimensionnelle aberrante par la combinaison extravagante de ses réponses.
L’instrument diagnostique fondamental pour le repérage de ces singularités combinatoires est la **distance de Mahalanobis** ($D^2$). Contrairement à la distance euclidienne classique qui traite l’espace géométrique comme isotrope, la distance de Mahalanobis intègre la matrice de variance-covariance ($S$) des variables, pondérant les distances géométriques par la corrélation structurelle existant entre les indicateurs :
$$D_i^2 = (x_i – \bar{x})^T S^{-1} (x_i – \bar{x})$$
Dans un échantillon issu d’une population normale multivariée, les distances de Mahalanobis suivent asymptotiquement une distribution théorique du Khi-deux ($\chi^2$) dont les degrés de liberté équivalent au nombre de variables analysées ($k$). Une observation est formellement catégorisée comme un outlier multivarié critique si sa statistique $D^2$ est associée à une p-valeur $le 0,001$.
Toutefois, la distance de Mahalanobis classique peut elle aussi succomber aux phénomènes de masquage multivarié. Les analystes avancés recourent alors à des estimateurs robustes de dispersion multivariée, tels que l’algorithme du **Déterminant de Covariance Minimale** (*Minimum Covariance Determinant*, MCD) développé par Peter Rousseeuw. Le MCD identifie le sous-ensemble de taille $h$ d’observations qui minimise le déterminant de la matrice de variance-covariance, calculant ensuite les distances de Mahalanobis robustes uniquement sur ce noyau non contaminé.
En psychométrie, ces procédures sont complétées par des indices de détection de profils aberrants d’inattention, tels que les statistiques d’adéquation individuelle (*person fit statistics*, ex. l’indice $l_z$), qui repèrent les participants dont les patrons de réponses transgressent ouvertement le modèle de réponse à l’item théorique.
10.3 Déontologie et traitement analytique des données extrêmes
L’identification d’une valeur aberrante ne confère en aucun cas au chercheur le droit d’effacer opportunément cette donnée pour des motifs de convenance analytique. La suppression discrétionnaire non justifiée d’observations s’apparente à une faute éthique grave et participe directement au problème des degrés de liberté du chercheur (*researcher degrees of freedom*) et au p-hacking.
Une fois les erreurs instrumentales et cléricales corrigées, trois grandes stratégies méthodologiquement défendables s’offrent à l’analyste :
- La **winsorisation** (du nom du statisticien Charles Winsor) : Cette procédure consiste à ramener la valeur aberrante extrême au seuil du percentile valide le plus proche (par exemple au 95e percentile pour les valeurs distales hautes ou au 5e percentile pour les valeurs basses). La winsorisation permet de préserver l’ensemble de l’échantillon tout en neutralisant l’impact démesuré des valeurs extrêmes sur la somme des carrés.
- La **troncature contrôlée** (*trimming*) : Elle consiste à éliminer un pourcentage fixe prédéterminé des scores les plus extrêmes aux deux extrémités de la distribution (typiquement les 10% ou 20% des valeurs les plus basses et les plus hautes) pour calculer des moyennes tronquées.
- La conduite systématique d’**analyses de sensibilité** (*sensitivity analysis*) : Il s’agit de la démarche épistémologique la plus transparente et irréprochable. L’analyste exécute le test statistique à deux reprises : une première fois sur la totalité de l’échantillon brut incluant les valeurs extrêmes, et une seconde fois après exclusion ou ajustement des outliers. Si le patron de résultats, la taille d’effet et les conclusions théoriques demeurent structurellement convergents entre les deux modélisations, la robustesse empirique de la découverte est attestée. En cas de divergence majeure, le chercheur a le devoir déontologique de rapporter les deux séries de résultats en explicitant précisément comment l’exclusion d’un faible contingent d’observations conditionne la confirmation de son hypothèse.
11. Robustesse intrinsèque des tests paramétriques face aux infractions
11.1 Quand le test t et l’ANOVA demeurent-ils valides ?
L’existence de conditions d’application formelles ne signifie pas que les tests paramétriques s’effondrent à la moindre déviation empirique microscopique. Au contraire, le test *t* de Student et l’analyse de variance univariée de Fisher bénéficient d’une **propriété de robustesse remarquable** face à certaines classes d’infractions, à la condition absolue que le devis méthodologique respecte certains critères d’équilibre structural.
Le facteur de protection numéro un contre la défaillance des tests paramétriques est l’**équilibre parfait des effectifs par cellule** ($n_1 = n_2 = dots = n_k$). Dès lors que tous les groupes comparés contiennent exactement le même effectif de participants, la statistique $F$ de l’ANOVA manifeste une immunité mathématique spectaculaire contre l’hétéroscédasticité symétrique : les distorsions introduites par les variances élevées au numérateur et au dénominateur ont tendance à se compenser mutuellement de manière algébrique, maintenant le taux nominal d’erreur de type I très proche des 5% conventionnels.
De même, face aux **écarts modérés à la normalité**, l’ANOVA et le test *t* démontrent une résilience très élevée, particulièrement lorsque la non-normalité se manifeste sous la forme d’un aplatissement platykurtique ou leptokurtique symétrique. Tant que la taille d’échantillon globale est suffisante (typiquement $N ge 60$ avec au moins 20 à 30 sujets par condition), la convergence stochastique garantie par le théorème central limite permet de stabiliser les distributions d’échantillonnage de la statistique de test. Des distributions d’échantillons qui ne franchiraient pas le crible strict du test de Shapiro-Wilk peuvent tout à fait être analysées par une ANOVA paramétrique sans biaiser significativement l’inférence.
11.2 Les scénarios critiques d’échec complet des approximations
À l’opposé de ces zones de résilience, il existe des configurations méthodologiques hautement pathologiques où l’ensemble des approximations paramétriques s’effondre intégralement, rendant l’interprétation des valeurs statistiques obtenues totalement erronée et illusoire.
Le premier scénario critique absolu est la **combinaison fatale du déséquilibre sévère des effectifs et de l’hétérogénéité des variances**. Les simulations de robustesse démontrent que dès lors que le ratio d’effectifs entre groupes atteint 1:2, 1:3 ou 1:4 (situation fréquente lors de la comparaison d’un groupe clinique rare à un groupe contrôle standard volumineux), et que ce déséquilibre se couple à une variance inégale, aucune robustesse ne persiste. En cas d’appariement négatif ($n_{petit}$ associé à $s_{grand}^2$), l’erreur de type I réelle explose pour atteindre 20% à 40%, vidant la notion même de significativité de toute substance scientifique.
Le second scénario critique réside dans la **violation conjointe de la normalité et de l’homoscédasticité**. Lorsqu’un groupe présente une asymétrie positive prononcée tandis que l’autre présente une dispersion platykurtique ou une asymétrie opposée, les fonctions de densité s’écartent radicalement du modèle linéaire additif. L’utilisation aveugle du test *t* classique sur de telles distributions asymétriques inégales produit des biais massifs tant sur le seuil alpha que sur la puissance statistique.
Enfin, le troisième scénario d’échec absolu concerne toute **violation du postulat d’indépendance sans modélisation adéquate**. Aucune taille d’échantillon, aucun équilibre des effectifs ne peut neutraliser la distorsion infligée par une corrélation intra-classe ignorée : le test paramétrique sous-estimera irrévocablement l’erreur-type et affichera une certitude fallacieuse basée sur des degrés de liberté artificiellement démultipliés.
12. Stratégies d’ajustement, transformations et alternatives statistiques
12.1 Corrections paramétriques spécifiques
Lorsqu’un protocole de diagnostic révèle sans équivoque la rupture d’un ou plusieurs postulats paramétriques, le chercheur ne doit pas nécessairement abandonner l’ensemble du cadre de la modélisation linéaire. Dans de très nombreuses configurations, des corrections algorithmiques élégantes permettent de restaurer la validité inférentielle sans quitter le giron paramétrique.
Face à l’hétérogénéité avérée des variances entre deux groupes indépendants, le **test t de Welch-Satterthwaite** (souvent simplement dénommé test *t* de Welch) s’impose comme la solution universelle. Contrairement au test *t* classique de Student qui effectue une mise en commun artificielle des variances ($s_p^2$), le test de Welch calcule séparément la variance de chaque échantillon et ajuste dynamiquement les degrés de liberté ($\nu$) du test au moyen de l’équation de Satterthwaite :
$$\nu \approx \frac{\left( \frac{s_1^2}{n_1} + \frac{s_2^2}{n_2} \right)^2}{\frac{(s_1^2 / n_1)^2}{n_1 – 1} + \frac{(s_2^2 / n_2)^2}{n_2 – 1}}$$
Les degrés de liberté corrigés qui en résultent sont non entiers et s’ajustent précisément pour compenser le déséquilibre de dispersion. Des méthodologistes majeurs, tels que Delacre, Lakens et Leys (2017), ont démontré de manière irréfutable que **le test t de Welch devrait être utilisé par défaut en lieu et place du test t de Student standard**. Le test de Welch conserve un contrôle parfait de l’erreur de type I en cas d’hétéroscédasticité et d’inégalité des effectifs, tout en égalant rigoureusement la puissance du test de Student classique lorsque les variances sont parfaitement homogènes.
Dans le cadre de l’ANOVA univariée à plusieurs groupes, les **corrections de Welch et de Brown-Forsythe pour l’ANOVA** appliquent des principes similaires de pondération par l’inverse des variances de cellule. En régression linéaire, l’hétéroscédasticité des erreurs se corrige quant à elle par le recours aux **estimateurs de variance-covariance robustes hétéroscédastiques** (dits estimateurs sandwich de Huber-White ou corrections HC3 et HC4), qui redressent mathématiquement le calcul des erreurs-types sans modifier les coefficients de régression estimés.
12.2 Transformations mathématiques des variables
L’une des stratégies historiques les plus répandues pour traiter les violations conjointes de la normalité et de l’homoscédasticité consiste à appliquer une fonction mathématique non linéaire univariée sur les données brutes avant l’ajustement du modèle. L’objectif est de recalibrer la métrique de la variable pour compresser les queues de distribution et stabiliser la dispersion.
Parmi les opérateurs de transformation classiques :
- La **transformation logarithmique** ($log(X)$ ou $ln(X)$) : Idéale pour corriger les asymétries positives marquées ($g_1 > 1,5$), telles que celles observées universellement sur les temps de réaction, les taux salivaires de cortisol ou les temps de fixation oculaire. Elle comprime drastiquement la longue queue droite des valeurs distales. Si les données comportent des zéros stricts, l’ajustement $log(X + 1)$ est conventionnellement utilisé.
- La **transformation racine carrée** ($\sqrt{X}$) : Particulièrement adaptée aux données discrètes de comptage (ex. : nombre d’erreurs commises dans une tâche, fréquence de comportements répétitifs) régies structurellement par des processus poissonniens où la variance est mathématiquement proportionnelle à la moyenne.
- La **transformation inverse** ($1/X$) : Traitement drastique réservé aux asymétries positives extrêmes. Dans l’analyse des temps de réaction, l’inversion de la métrique convertit avantageusement le temps de latence en score de vitesse de traitement par seconde.
- La famille de **transformations de Box-Cox** (1964) : Représente une méthode d’optimisation paramétrique continue où un paramètre exponentiel $lambda$ (lambda) est déterminé par le maximum de vraisemblance pour identifier la transformation mathématique optimale qui maximise la normalité des résidus :
$$y^{(\lambda)} = \begin{\cases} \frac{y^\lambda – 1}{\lambda} &a\mp; \text{si } \lambda \neq 0 \ln(y) &a\mp; \text{si } \lambda = 0 \end{\cases}$$
Cependant, l’usage des transformations mathématiques soulève un **défi épistémologique et interprétatif majeur**. En modifiant l’échelle de mesure, le chercheur ne teste plus des hypothèses sur la moyenne arithmétique originale de la variable psychologique, mais sur des grandeurs géométriques ou des abstractions numériques non linéaires. Une différence significative trouvée sur des scores d’anxiété log-transformés ne se traduit pas directement par une différence équivalente sur les scores bruts de l’inventaire psychométrique. C’est pourquoi la communauté méthodologique contemporaine préfère souvent l’usage de modèles statistiques naturellement adaptés aux distributions non normales plutôt que la distorsion arbitraire des métriques comportementales.
12.3 Passage aux méthodes non paramétriques et ré-échantillonnage
Lorsque les données accumulent des infractions sévères et simultanées (par exemple une asymétrie dramatique associée à une hétéroscédasticité extrême sur de petits échantillons inégaux) ou lorsque l’échelle de mesure originale est purement ordinale, le chercheur doit renoncer aux tests paramétriques classiques pour s’orienter vers des architectures analytiques alternatives de haute robustesse.
La première alternative consiste à mobiliser les **tests fondés sur les rangs**. Le **test de Mann-Whitney-Wilcoxon** (pour deux groupes indépendants) et le **test de Kruskal-Wallis** (pour trois groupes ou plus) ne postulent aucune normalité distributionnelle : ils convertissent les scores bruts en rangs croissants ($1, 2, dots, N$) et évaluent si la somme ou la moyenne des rangs diffère significativement entre les conditions. Toutefois, une précaution théorique majeure s’impose : ces tests ne comparent les médianes des populations que si et seulement si les distributions des groupes partagent strictement la même forme et la même variance. En présence d’hétéroscédasticité, le test de Mann-Whitney-Wilcoxon est lui-même sévèrement invalidé sur le plan de l’erreur alpha.
La seconde alternative, immensément plus puissante et polyvalente à l’ère computationnelle contemporaine, repose sur les **méthodes de ré-échantillonnage non paramétriques**, au premier rang desquelles trône le **Bootstrap** développé par Bradley Efron (1979). Le bootstrap s’affranchit totalement de l’hypothèse de normalité asymptotique : en générant des milliers de sous-échantillons synthétiques par tirage avec remise à partir du jeu de données empiriques d’origine (typiquement 5 000 à 10 000 réplications), l’algorithme construit empiriquement la distribution d’échantillonnage de n’importe quel paramètre d’intérêt (la moyenne différentielle, un coefficient de régression, ou une taille d’effet de type d de Cohen). L’extraction d’**intervalles de confiance bootstrap corrigés pour le biais et accélérés** (intervalles $BC_a$) fournit une inférence d’une précision remarquable, exempte de tout biais distributionnel.
Dans un cadre similaire, les **tests de randomisation ou de permutations exactes** reconstruisent empiriquement la distribution de la statistique de test sous l’hypothèse nulle en réaffectant aléatoirement les scores individuels entre les groupes expérimentaux des milliers de fois, fournissant des p-valeurs exactes sans recours aux approximations de Student ou de Fisher.
Enfin, la modélisation statistique moderne privilégie de plus en plus l’abandon du modèle linéaire ordinaire au profit des **Modèles Linéaires Généralisés** (GLM, *Generalized Linear Models*) et de leurs extensions mixtes (GLMM). Au lieu de déformer artificiellement les données par des transformations mathématiques pour les forcer à entrer dans un carcan gaussien, les GLM permettent de modéliser directement les variables psychologiques dans leur distribution probabiliste native : régression logistique pour les choix binaires de réponse, régression de Poisson ou binomiale négative pour les comptages comportementaux, ou régression Gamma pour les latences temporelles et les temps de réaction. Cette démarche représente l’aboutissement méthodologique contemporain : faire coïncider rigoureusement le modèle mathématique avec la structure intrinsèque de la réalité empirique plutôt que de contraindre la réalité à satisfaire des postulats obsolètes.
Références
Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A, Mathematical and Physical Sciences, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Dean, A., & Voss, D. (1999). Design and analysis of experiments. Springer New York. https://doi.org/10.1007/b97673
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409–428. https://doi.org/10.2307/2332388
Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
Rousseeuw, P. J., & Driessen, K. V. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Student [Gosset, W. S.] (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. In R. H. Hoyle (Ed.), Structural equation modeling: Concepts, issues, and applications (pp. 56–75). Sage Publications, Inc.