
Dans le champ de la recherche scientifique contemporaine, et tout particulièrement au sein des sciences du comportement, de la psychométrie et de la modélisation statistique, l’analyse des données repose sur des postulats mathématiques dont la robustesse conditionne la validité des inférences théoriques. Parmi les paramètres fondamentaux de la statistique descriptive et inférentielle, la notion de dispersion occupe une place souveraine aux côtés des indices de tendance centrale. Lorsqu’un chercheur, un statisticien ou un étudiant découvre sur sa console d’analyse — que ce soit sur R, SPSS, SAS ou Mplus — une valeur négative associée à une estimation de variance, une stupeur méthodologique s’installe inévitablement. L’esprit rationnel se heurte immédiatement à une aporie logique apparente : comment une mesure quantifiant l’étalement d’une distribution ou l’intensité moyenne des écarts quadratiques pourrait-elle adopter une valeur inférieure au néant absolu ?
Cette interrogation transcende la simple hésitation technique du praticien débutant. Elle constitue le point de départ d’une réflexion épistémologique et computationnelle profonde sur la frontière séparant les définitions mathématiques fondamentales de leurs approximations empiriques et algorithmiques. Dans le domaine abstrait des mathématiques pures et de la théorie de la mesure, la réponse à la question « la variance peut-elle être négative ? » est catégorique, immuable et sans équivoque : non, la variance d’une variable aléatoire réelle ne peut en aucun cas être négative. Elle est, par essence ontologique et géométrique, bornée inférieurement par zéro.
Pourtant, dans la pratique empirique de la modélisation statistique avancée, l’apparition d’une variance négative — qu’elle prenne la forme d’un « cas de Heywood » en analyse factorielle, d’une estimation résiduelle aberrante en équations structurelles, d’un composant de variance sous zéro dans un modèle linéaire mixte ou d’un résidu de soustraction computationnelle lié à l’arithmétique en virgule flottante — est un phénomène bien documenté. Le présent traité a pour vocation de déconstruire exhaustivement cette dichotomie entre impossibilité théorique absolue et manifestations empirico-numériques concrètes, en offrant aux chercheurs et aux analystes un guide analytique, mathématique, clinique et diagnostique de premier ordre.
1. Introduction conceptuelle à la variance statistique
1.1 Définition formelle de la dispersion des données
L’appréhension quantitative de tout phénomène naturel ou psychologique exige la caractérisation conjointe de la valeur typique autour de laquelle s’agencent les observations et de l’amplitude avec laquelle ces mêmes observations s’écartent de ce repère central. En statistique descriptive et théorique, cette seconde dimension est désignée sous le concept d’étalement ou de dispersion d’une distribution. Si les mesures de tendance centrale, telles que la moyenne arithmétique, la médiane ou le mode, identifient le barycentre ou le point d’équilibre informationnel d’une série de données, elles demeurent fondamentalement aveugles à la variabilité structurelle qui anime le groupe étudié. Deux cohortes expérimentales peuvent présenter une moyenne strictement identique sur une échelle d’évaluation clinique tout en révélant des architectures de distribution diamétralement opposées : l’une regroupée de manière quasi compacte autour de la moyenne, l’autre fragmentée entre des pôles symptomatiques extrêmes.
C’est précisément pour lever cette ambiguïté que la théorie statistique distingue rigoureusement la position centrale de la variabilité intra-groupe. L’évolution historique du concept moderne de variance trouve son ancrage définitif dans les travaux séminaux du généticien et statisticien britannique Ronald Aylmer Fisher. Dans son article fondateur de 1918 intitulé The Correlation Between Relatives on the Supposition of Mendelian Inheritance, Fisher formalise le vocable de « variance » pour désigner le carré de l’écart-type, offrant ainsi un cadre mathématique révolutionnaire permettant de partitionner la variabilité totale d’un système biologique ou psychologique en fractions explicatives indépendantes et additives.
Dans l’évaluation empirique, la variance s’établit dès lors comme la métrique reine de la dispersion paramétrique. Elle quantifie l’énergie informationnelle déployée par les données autour de leur centre de gravité. Sans une métrique rigoureuse de la dispersion, aucune estimation de l’erreur d’échantillonnage ne devient possible, interdisant de facto l’établissement d’intervalles de confiance et l’exécution de tests d’hypothèses univariés ou multivariés. La variance n’est pas un simple descripteur secondaire ; elle constitue le dénominateur même de l’inférence scientifique.
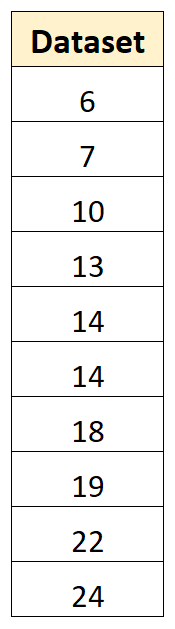
1.2 Rôle pivot de la variance dans la recherche psychologique
Au sein des sciences psychologiques, de la neuropsychologie et des sciences comportementales, la variance ne représente pas seulement une mesure technique, mais le substrat même de l’investigation empirique. Toute la discipline repose sur l’identification, la mesure et la compréhension des différences interindividuelles et des fluctuations intra-individuelles. Si tous les êtres humains réagissaient de manière parfaitement uniforme aux sollicitations de l’environnement ou aux traumatismes psychiques, la psychologie différentielle et clinique perdrait sa raison d’être. La variance capture mathématiquement la pluralité des trajectoires cognitives, émotionnelles et comportementales observées dans la population.
En psychométrie, la variance est le constituant fondamental permettant d’évaluer la précision des instruments d’évaluation, qu’il s’agisse de tests d’intelligence, d’échelles de personnalité ou d’inventaires psychopathologiques standardisés. L’estimation de la consistance interne, de la stabilité temporelle par test-retest, ainsi que la détermination de la sensibilité discriminante d’un item reposent sur l’examen minutieux des variances d’items et de la variance totale de l’échelle composite. Une échelle qui ne produirait aucune variance face à un échantillon hétérogène échouerait lamentablement dans sa mission diagnostique.
Dans les paradigmes de la psychologie cognitive et expérimentale, la variance permet d’opérer la séparation cruciale entre le signal théorique recherché et le bruit expérimental inhérent à la mesure du vivant. L’évaluation de l’effet d’une variable indépendante manipulée en laboratoire — telle qu’une charge cognitive induite ou une privation de sommeil — se traduit par une tentative délibérée de générer de la variance inter-conditions supérieure à la variance résiduelle non contrôlée intra-condition. La modélisation de la variabilité des temps de réaction ou des taux d’erreur requiert ainsi une conceptualisation irréprochable de la géométrie de la variance sous-jacente.
1.3 La réponse catégorique : l’impossibilité théorique d’une variance négative
Face aux perplexités occasionnelles des praticiens confrontés à des sorties de calculs complexes, il est indispensable de réitérer le principe axiomatique fondateur de l’analyse des données : dans le cadre formel de la théorie des probabilités et de l’algèbre linéaire, la variance d’une variable aléatoire réelle ne peut jamais être négative. Ce principe ne souffre d’aucune exception ontologique. La borne inférieure théorique absolue de la variance est rigoureusement et invariablement fixée à zéro :
$$\mathrm{Var}(X) ge 0$$
Cette non-négativité absolue découle directement des axiomes de Kolmogorov qui régissent l’espace probabilisé et de la définition euclidienne de l’opérateur d’espérance mathématique des carrés. Un score de variance négatif est, d’un point de vue axiomatique, un contresens logique aussi absurde que l’affirmation d’une distance physique négative entre deux points de l’espace ou d’une masse gravitationnelle intrinsèquement inférieure à zéro.
Dès lors, d’où proviennent les doutes persistants et les interrogations récurrentes observés chez les chercheurs, étudiants et analystes quantitatifs ? Ils naissent précisément du fait que les logiciels d’analyse statistique de pointe, lorsqu’ils mettent en œuvre des procédures d’optimisation non contraintes, des estimations de modèles structurels complexes ou des décompositions de composantes de variance dans des plans déséquilibrés, affichent parfois des coefficients assortis d’un signe négatif. Pour appréhender correctement ce dilemme, le chercheur doit opérer une distinction épistémologique préalable fondamentale : la réalité mathématique pure de la distribution empirique interdit toute variance négative, tandis que les anomalies computationnelles, les artefacts algorithmiques et les vices de spécification de modèles théoriques peuvent générer des estimations aberrantes hors du domaine de définition admissible.
2. Fondements mathématiques : l’interdiction géométrique et algébrique de la négativité
2.1 La propriété fondamentale des carrés réels
Pour comprendre l’impossibilité mathématique d’une variance négative, il convient de remonter aux propriétés algébriques élémentaires du corps des nombres réels ($\mathbb{R}$). L’axiome fondamental sur lequel repose l’édifice arithmétique stipule que pour tout nombre réel $a in \mathbb{R}$, son carré est rigoureusement supérieur ou égal à zéro :
$$\forall a in \mathbb{R}, \quad a^2 ge 0$$
Si la quantité scalaire $a$ est positive ($a > 0$), son produit par elle-même est trivialement positif. Si la quantité $a$ est strictement négative ($a < 0$), la règle des signes de la multiplication dans un corps ordonné implique que le produit de deux grandeurs de même signe négatif engendre nécessairement une grandeur strictement positive. Enfin, si $a = 0$, son carré est exactement nul. Il n'existe aucun nombre réel dont le produit par lui-même produise une grandeur inférieure à zéro. L'élévation au carré opère donc une neutralisation absolue et systématique des polarités directionnelles négatives.
Dans l’espace vectoriel euclidien à $n$ dimensions ($\mathbb{R}^n$), cette propriété algébrique s’interprète directement à travers la notion de distance géométrique et de norme euclidienne. La distance entre deux points dans l’espace ne saurait exprimer une valeur rétrograde ou négative ; elle représente une séparation physique ou spatiale absolue. Dans la dérivation de la variance, chaque écart individuel par rapport au point central est élevé au carré, ce qui équivaut à calculer le carré de la longueur d’un segment géométrique. Les conséquences de cet axiome métrique interdisent formellement qu’une mesure basée sur l’agrégation de telles grandeurs puisse violer la barrière de la positivité.
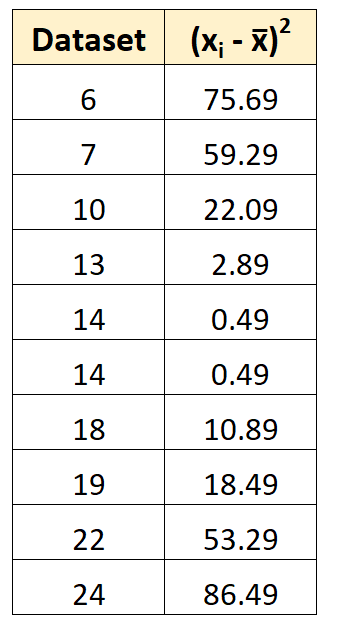
2.2 La sommation des déviations quadratiques
La variance d’un ensemble fini de $n$ observations quantitatives repose structurellement sur l’opérateur de sommation appliqué à l’ensemble des déviations individuelles élevées au carré. Considérons une série de valeurs observées $x_1, x_2, dots, x_n$ dont la moyenne arithmétique empirique est notée $\bar{x}$. Pour chaque individu statistique $i$, l’écart à la moyenne est défini par le résidu centré $(x_i – \bar{x})$. L’élévation au carré de cet écart donne lieu au terme quadratique $(x_i – \bar{x})^2$.
En vertu de la propriété des carrés réels démontrée précédemment, chacun des termes constitutifs de cette sommation vérifie l’inégalité fondamentale :
$$(x_i – \bar{x})^2 ge 0 \quad \text{pour tout } i in {1, dots, n}$$
Lorsque l’on applique l’opérateur de sommation discrète à ces grandeurs, on obtient la Somme des Carrés des déviations (souvent abrégée en $SC$ ou $SS$ pour Sum of Squares) :
$$SS = \sum_{i=1}^{n} (x_i – \bar{x})^2$$
Une règle arithmétique élémentaire dispose que la somme de $n$ termes tous individuellement supérieurs ou égaux à zéro est elle-même obligatoirement supérieure ou égale à zéro. Il est formellement impossible qu’une compensation destructive s’opère entre les termes : aucun terme ne possédant un signe négatif, aucun phénomène d’annulation soustractive ne peut faire basculer la somme sous le seuil du zéro absolu. Lors de l’accroissement de la taille de l’échantillon ($n to \infty$), la somme des carrés croît de manière monotone et strictement non décroissante. Le signe positif est ainsi rigoureusement préservé lors de chaque étape de l’agrégation numérique.
2.3 Le dénominateur et les degrés de liberté
Une fois établie la stricte non-négativité de la somme quadratique des déviations ($SS ge 0$), l’obtention de la variance d’échantillon nécessite la division de ce cumul par un facteur d’échelle approprié lié à la taille de l’échantillon, traditionnellement désigné par les degrés de liberté. Dans le cadre de l’échantillonnage aléatoire, la taille de l’échantillon $n$ représente un décompte d’unités d’observation discrètes, appartenant par définition au sous-ensemble des entiers strictement positifs :
$$n in \mathbb{N}^* \quad (n ge 1)$$
Pour corriger le biais inhérent à l’estimation de la moyenne de la population par la moyenne empirique de l’échantillon — phénomène connu sous le nom de correction de Bessel —, le diviseur retenu pour l’estimateur sans biais de la variance d’échantillon ($s^2$) n’est pas $n$, mais les degrés de liberté résiduels, à savoir $(n – 1)$. Pour tout échantillon statistiquement viable destiné à estimer une dispersion, la taille d’échantillon doit être au minimum de deux unités ($n ge 2$), ce qui implique mathématiquement :
$$n – 1 ge 1 > 0$$
L’équation formelle de l’estimateur non biaisé de la variance s’écrit alors :
$$s^2 = \frac{\sum_{i=1}^n (x_i – \bar{x})^2}{n – 1}$$
Sur le plan algébrique, la variance $s^2$ se présente donc comme le quotient direct d’un numérateur supérieur ou égal à zéro ($SS ge 0$) par un dénominateur strictement positif ($n – 1 > 0$). Le quotient de deux grandeurs réelles positives étant impérativement positif ou nul, le résultat final est nécessairement assujetti à la contrainte :
$$s^2 ge 0$$
Dans l’hypothèse limite où la taille de l’échantillon est strictement unitaire ($n = 1$), le dénominateur s’annule ($1 – 1 = 0$), ce qui plonge la formule dans une indétermination mathématique par division par zéro ($0/0$). L’analyse d’une observation unique ne permet pas d’évaluer la moindre dispersion. Mais en aucun cas, même sous des conditions limites ou pathologiques, le dénominateur ne peut adopter un signe négatif dès lors que les données proviennent d’une démarche d’échantillonnage authentique.
3. Décomposition pas à pas de l’équation de la variance d’échantillon
3.1 Calcul du centre de gravité : la moyenne arithmétique
L’opération initiale requise pour déterminer la dispersion consiste à identifier avec une rigueur absolue le centre d’inertie de la distribution. La moyenne empirique de l’échantillon, désignée par $\bar{x}$, est obtenue par la sommation linéaire de l’ensemble des scores bruts pondérée par l’inverse de la taille de l’échantillon :
$$\bar{x} = \frac{1}{n}\sum_{i=1}^n x_i$$
En psychologie expérimentale et clinique, la moyenne arithmétique se distingue par une vulnérabilité reconnue : son extrême sensibilité aux scores aberrants ou extrêmes. Toutefois, dans le calcul formel de la variance des moindres carrés, cette propriété de la moyenne constitue précisément sa force théorique. La moyenne arithmétique se définit mathématiquement comme l’unique valeur scalaire qui minimise la somme des carrés des déviations de l’ensemble des points d’observation.
Elle sert ainsi de point d’ancrage central rigide et absolu. Une propriété fondamentale de ce centre de gravité réside dans le fait que la somme brute des écarts linéaires par rapport à la moyenne s’annule toujours parfaitement :
$$\sum_{i=1}^n (x_i – \bar{x}) = \sum_{i=1}^n x_i – n\bar{x} = n\bar{x} – n\bar{x} = 0$$
Cette annulation structurelle illustre pourquoi la simple moyenne arithmétique des écarts bruts est totalement inopérante pour quantifier la dispersion : les déviations positives compensent trait pour trait les déviations négatives, restituant une valeur nulle quelle que soit l’immensité de l’étalement réel des scores.
3.2 Dérivation des écarts individuels et quadrature
Afin de contourner l’écueil de l’annulation spontanée des écarts linéaires, le formalisme statistique procède à la dérivation méthodique des scores centrés. Pour chaque mesure individuelle $x_i$, on retranche la moyenne empirique calculée, générant un vecteur de résidus ou d’écarts individuels :
$$d_i = x_i – \bar{x}$$
Ces écarts individuels adoptent des valeurs scalaires positives lorsque le sujet présente un score supérieur à la moyenne du groupe, et des valeurs négatives lorsque la performance se situe en deçà du repère central. L’opération décisive intervient alors : la quadrature systématique de chaque résidu centré. En calculant $d_i^2 = (x_i – \bar{x})^2$, la statistique transforme chaque déviation scalaire unidimensionnelle en une surface géométrique carrée abstraite.
Cette transformation par élévation au carré possède deux conséquences théoriques majeures. D’une part, comme souligné dans l’analyse de l’algèbre des réels, elle élimine définitivement toute polarité directionnelle : les écarts situés en dessous de la moyenne deviennent des grandeurs strictement positives au même titre que les écarts situés au-dessus. D’autre part, elle induit une pondération quadratique des déviations extrêmes. Un écart deux fois plus important qu’un autre pèse quatre fois plus lourd dans le calcul final de la variance ; un écart trois fois plus grand pèse neuf fois plus lourd. Cette sensibilité géométrique accentue la détection des dispersions hétérogènes au sein des cohortes expérimentales.
3.3 Consolidation et normalisation du score de dispersion
L’étape de consolidation consiste à agréger l’ensemble de ces surfaces élémentaires au sein de la Somme des Carrés totale :
$$SS = \sum_{i=1}^n d_i^2 = \sum_{i=1}^n (x_i – \bar{x})^2$$
Pour transformer cette mesure cumulative — dont la magnitude absolue dépend linéairement de l’effectif d’échantillon recruté — en un indicateur standardisé et généralisable, il est impératif de la normaliser. C’est ici qu’intervient la division par les degrés de liberté corrigés $(n – 1)$. On obtient ainsi la variance d’échantillon corrigée ($s^2$).
Une caractéristique mathématique prépondérante de la variance réside dans ses unités d’expression. Puisque les écarts ont été élevés au carré, la variance s’exprime dans le carré de l’unité de mesure initiale de la variable étudiée. Si l’on évalue un temps de réaction en millisecondes ($\text{ms}$), la variance obtenue se quantifie en millisecondes carrées ($\text{ms}^2$). Si l’on évalue le taux salivaire de cortisol en microgrammes par décilitre ($\mu\text{g/dL}$), la variance s’énonce en $(\mu\text{g/dL})^2$.
Cette métrique au carré, bien que parfaite sur le plan des théorèmes d’additivité algébrique (notamment dans le théorème de Pythagore appliqué aux espaces hilbertiens et dans les décompositions de l’analyse de variance), s’avère peu intuitive pour l’interprétation clinique directe. La transition vers l’écart-type s’effectue donc naturellement par l’extraction de la racine carrée positive de la variance :
$$s = \sqrt{s^2} = \sqrt{\frac{\sum_{i=1}^n (x_i – \bar{x})^2}{n – 1}}$$
L’écart-type réintègre immédiatement l’unité d’origine des scores observés, restaurant une intelligibilité clinique immédiate tout en conservant comme socle immuable la positivité structurelle de la variance dont il est issu.
4. Signification théorique et clinique d’une variance égale à zéro
4.1 Le cas limite de l’homogénéité absolue
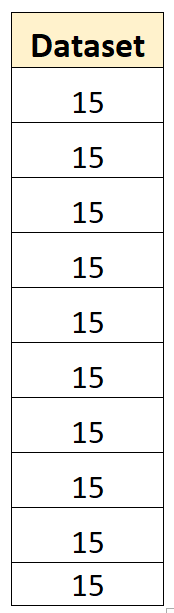
Puisque la variance ne peut jamais descendre sous la barre du zéro, l’analyse de sa borne inférieure exacte ($s^2 = 0$) révèle la limite conceptuelle de la dispersion statistique. Ce cas particulier d’homogénéité parfaite correspond mathématiquement à ce que l’on qualifie de distribution dégénérée ou d’état d’invariance absolue des données. La démonstration de cette situation s’établit de manière univoque :
$$\text{Si } s^2 = 0 iff \sum_{i=1}^n (x_i – \bar{x})^2 = 0$$
Puisque chaque terme $(x_i – \bar{x})^2$ est obligatoirement supérieur ou égal à zéro, la seule manière logique pour qu’une somme de termes positifs s’annule est que chacun des termes individuels soit lui-même strictement égal à zéro :
$$\forall i in {1, dots, n}, \quad (x_i – \bar{x})^2 = 0 implies x_i – \bar{x} = 0 implies x_i = \bar{x}$$
La variance d’une série statistique est donc égale à zéro si, et seulement si, toutes les observations sont strictement identiques entre elles. Dans un tel échantillon, chaque sujet présente rigoureusement la même performance, la même valeur ou la même intensité symptomatique. L’information différentielle au sein du groupe est totalement annihilée ; la variable cesse d’être une véritable variable aléatoire pour devenir une simple constante déterministe. Il est impossible de descendre en deçà de ce seuil : pour franchir le zéro vers les valeurs négatives, il faudrait qu’au moins un terme $(x_i – \bar{x})^2$ devienne négatif, ce qui est formellement prohibé dans le domaine des nombres réels.
4.2 Implications psychométriques d’un score de variance nulle
Dans le domaine de l’évaluation psychologique et des mesures comportementales standardisées, l’observation d’une variance empirique nulle constitue un diagnostic critique de dysfonctionnement méthodologique. Ce phénomène survient fréquemment en présence d’effets de plafond ou d’effets de plancher sévères. Si un questionnaire d’anxiété est soumis à une cohorte et que chaque participant sélectionne systématiquement le score plancher minimal de zéro, la variance de l’item s’effondre à zéro.
Sur le plan de la psychométrie fondamentale, un item ou un test présentant une variance nulle est rigoureusement inutilisable car son pouvoir discriminant est inexistant. L’indice de discrimination d’un item repose sur sa capacité à séparer les individus présentant des niveaux élevés du trait latent de ceux présentant des niveaux faibles. Si tous les individus obtiennent le même résultat, l’item ne fournit aucune information diagnostique exploitable.
De surcroît, une variance nulle entraîne un effondrement mathématique des corrélations et des covariances. La formule du coefficient de corrélation linéaire de Pearson entre deux variables $X$ et $Y$ place au dénominateur le produit de leurs écarts-types :
$$r_{XY} = \frac{\mathrm{Cov}(X, Y)}{\sigma_X \sigma_Y}$$
Si la variance de la variable $X$ est nulle ($\sigma_X^2 = 0 implies \sigma_X = 0$), le dénominateur devient identiquement nul, provoquant une division par zéro non définie. Une variable constante ne peut donc covarier ni corréler avec aucune autre métrique psychologique. Cet effondrement relationnel paralyse les algorithmes de régression, d’analyse factorielle et de classification, signant l’échec de la standardisation de l’outil pour la population cible.
5. Pourquoi des valeurs négatives apparaissent-elles dans les logiciels statistiques ?
5.1 Les artefacts de calcul et limites de la précision flottante
Si la variance est théoriquement bornée à zéro, pourquoi l’écran d’un ordinateur affiche-t-il parfois des résultats tels que -0.0000000000000002 ou des avertissements mentionnant une « estimated variance is negative » ? La première source majeure de ce paradoxe réside dans l’architecture matérielle des ordinateurs modernes et dans les contraintes de l’arithmétique binaire en virgule flottante, gouvernée par la norme standard IEEE 754.
Les microprocesseurs ne représentent pas les nombres réels avec une précision infinie, mais sous la forme de fractions binaires discrètes allouant un nombre fini de bits à la mantisse et à l’exposant (typiquement 64 bits en double précision). Lors de la manipulation de grands jeux de données comportant des nombres d’une magnitude élevée mais dotés d’une dispersion minuscule, un phénomène redouté des numériciens surgit : la perte d’importance numérique, également appelée annulation catastrophique. Lorsque deux valeurs numériques quasi identiques sont soustraites l’une de l’autre au sein de certains algorithmes informatiques, les erreurs d’arrondi infinitésimales peuvent produire une valeur résiduelle très légèrement négative.
En outre, l’utilisation historique d’algorithmes à passage unique (dits one-pass algorithms), privilégiés autrefois pour optimiser la mémoire vive en calculant simultanément la somme des scores et la somme de leurs carrés, accentue ce risque par rapport aux algorithmes rigoureux à double passage. Un logiciel non protégé par des clauses de vérification logique peut ainsi laisser s’échapper un zéro machine négatif (-0.0), laissant l’utilisateur non averti dans un désarroi interprétatif profond face à une apparente violation des lois fondamentales de la statistique.
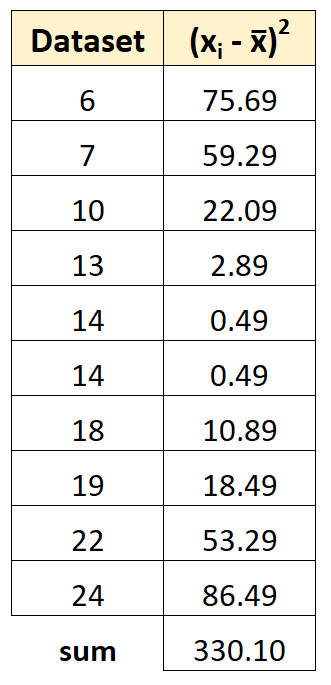
5.2 L’estimation statistique itérative versus le calcul descriptif direct
La seconde cause, et de loin la plus fréquente en recherche avancée, réside dans le fossé méthodologique séparant le calcul direct d’une variance descriptive sur des données brutes observables de l’estimation statistique paramétrique au sein de modèles mathématiques complexes. Dans un cadre descriptif direct, les scores sont figés et la formule de Bessel ne produit jamais de signe négatif. En revanche, dans les architectures d’estimation multivariée — telles que l’analyse factorielle confirmatoire, la modélisation par équations structurelles ou les modèles hiérarchiques linéaires —, les variances de facteurs inobservés ou de termes d’erreur résiduelle ne sont pas calculées directement à partir d’écarts observés : elles sont déduites par des algorithmes d’optimisation numérique.
Ces algorithmes d’estimation itérative, au premier rang desquels figurent l’algorithme de Newton-Raphson, la méthode de scoring de Fisher ou les procédures Quasi-Newton (comme le célèbre algorithme BFGS), cherchent à maximiser une fonction de log-vraisemblance ou à minimiser une fonction de perte quadratique (moindres carrés généralisés). À chaque itération, l’algorithme explore une surface multidimensionnelle de paramètres pour ajuster la matrice de covariance théorique implicite du modèle à la matrice de covariance empirique observée.
Or, sauf si le programmeur ou le statisticien impose explicitement des contraintes de non-négativité sur l’espace des paramètres explorés (par exemple via des reparamétrisations logarithmiques ou des barrières de pénalisation), l’optimiseur mathématique traite les variances résiduelles comme de simples paramètres scalaires libres au sein de l’espace vectoriel $\mathbb{R}$. Si la topologie de la surface de vraisemblance présente un gradient descendant orienté vers des valeurs inférieures à zéro, l’algorithme s’y engouffre sans hésiter pour tenter d’améliorer l’adéquation globale du modèle mathématique, aboutissant à une solution formelle convergée mais scientifiquement aberrante.
6. Les cas de Heywood en analyse factorielle et équations structurelles
6.1 Nature et définition exacte du cas de Heywood
Dans l’univers de la modélisation par équations structurelles (SEM) et de l’analyse factorielle exploratoire ou confirmatoire, l’apparition d’une variance négative porte une dénomination historique classique : le « cas de Heywood » (Heywood case). Ce phénomène méthodologique doit son nom au mathématicien et psychométricien H. B. Heywood qui, dès 1931 dans un article princeps publié dans le British Journal of Psychology, démontra les paradoxes de l’estimation de facteurs communs à partir de matrices de corrélation.
Pour appréhender formellement un cas de Heywood, considérons l’équation de mesure classique d’un indicateur observable $X$ dans un modèle factoriel standard :
$$X = \lambda \xi + \delta$$
où $lambda$ représente la charge factorielle (saturation), $xi$ désigne le facteur latent commun sous-jacent, et $\delta$ constitue le terme d’erreur résiduelle de mesure ou la composante unique. En supposant la standardisation des variables (variance totale de $X$ égale à 1) et l’orthogonalité entre le facteur et le résidu, la décomposition de la variance s’exprime selon l’identité fondamentale :
$$\mathrm{Var}(X) = \lambda^2 \mathrm{Var}(\xi) + \mathrm{Var}(\delta) = \lambda^2 + \theta_\delta = 1$$
Dans ce cadre, la communalité (notée $h^2 = \lambda^2$) correspond à la proportion de variance de l’indicateur expliquée par le facteur latent, tandis que $\theta_\delta = \mathrm{Var}(\delta)$ représente la variance d’erreur unique résiduelle. Un cas de Heywood survient précisément lorsque l’algorithme d’estimation numérique aboutit à :
$$\hat{\theta}_\delta < 0$$
Par conséquence algébrique immédiate, puisque la variance totale doit demeurer égale à l’unité, la communalité estimée franchit sa borne maximale théorique :
$$\hat{h}^2 = 1 – \hat{\theta}_\delta > 1$$
Le modèle prétend alors absurdement que le facteur commun explique plus de 100 % de la variance de la variable observée. Ce problème s’observe couramment dans les logiciels leaders tels que SPSS, lavaan dans l’environnement R, Mplus, AMOS ou LISREL, lesquels déclenchent généralement des avertissements d’anomalie signalant que la matrice de covariance résiduelle n’est pas définie positive.
6.2 Causes méthodologiques sous-jacentes aux variances d’erreur négatives
L’émergence d’une variance d’erreur négative dans une analyse factorielle n’est jamais le fruit du hasard ; elle constitue le symptôme révélateur d’un dysfonctionnement méthodologique profond au sein du protocole de recherche. La littérature psychométrique identifie quatre sources majeures génératrices de cas de Heywood :
- La présence d’une multicolinéarité aiguë : Lorsque deux ou plusieurs indicateurs observables présentent des corrélations bivariées extrêmement élevées (par exemple $r > 0.90$), souvent parce qu’ils reformulent exactement la même question avec des termes quasi synonymes, le modèle tente d’attribuer une charge factorielle disproportionnée à ces items redondants. L’algorithme compense ce sur-ajustement en faisant basculer la variance résiduelle de l’un des indicateurs dans le domaine négatif.
- L’extraction d’un nombre inadéquat de facteurs : L’extraction d’un nombre excessif de facteurs (sur-factorisation) fragmente la variance et crée des facteurs d’instabilité mathématique qui tentent d’absorber des fluctuations d’échantillonnage aléatoires. À l’inverse, une sous-factorisation sévère peut forcer un facteur unique à agréger des indicateurs mutuellement incompatibles, générant des distorsions résiduelles extrêmes.
- Une taille d’échantillon déficiente : L’instabilité de la matrice de corrélation empirique constitue la cause statistique la plus fréquente. Dans les échantillons réduits (par exemple $N < 100$ pour un modèle complexe), l'erreur d'échantillonnage est considérable. Des fluctuations aléatoires peuvent faire dévier la matrice d'échantillon des conditions d'admissibilité de la population, favorisant l'apparition de cas de Heywood par simple instabilité stochastique.
- La contamination par des valeurs aberrantes multivariées : Quelques observations déviantes atypiques au sein de la distribution multidimensionnelle suffisent à biaiser massivement le calcul des produits croisés de covariance, poussant les solutions factorielles vers des minima locaux non admissibles.
6.3 Interprétation psychologique face à une variance d’erreur négative
Face à l’apparition d’un cas de Heywood dans une sortie logicielle, la posture déontologique et scientifique du chercheur doit être impérative et sans concession : il est formellement interdit d’interpréter cliniquement ou théoriquement les paramètres d’un modèle contenant une variance négative. L’inclusion d’une variance d’erreur négative invalide l’intégralité de l’espace mathématique du modèle ; elle détruit la validité structurelle de l’échelle ou du construit latent sous-jacent.
Sur le plan psychologique, affirmer qu’un indicateur possède une variance d’erreur négative équivaudrait à déclarer que l’évaluation du sujet engendre une « certitude négative » ou que la variance observée est supérieure à la totalité de la réalité mesurable additionnée à une erreur imaginaire. La fidélité de mesure de l’item concerné s’effondre dans une absurdité arithmétique. Le chercheur ne peut en aucun cas faire abstraction de cet avertissement logiciel en publiant les saturations factorielles sans mentionner l’aberration résiduelle.
L’analyste doit impérativement distinguer s’il s’agit d’une simple fluctuation d’échantillonnage (phénomène bénin lié à une taille d’échantillon modeste où la vraie variance dans la population est très proche de zéro et où l’estimation empirique a franchi par hasard la frontière) ou d’un vice rédhibitoire de modélisation théorique (spécification erronée du construit psychologique). Dans les deux cas, le modèle en l’état est scientifiquement nul et non avenu.
7. Erreurs de spécification de modèle et défaillances structurelles
7.1 Problèmes d’identification du modèle statistique
Dans la modélisation statistique avancée, la capacité d’un algorithme à estimer des paramètres réels et admissibles dépend au premier chef de l’identification mathématique du modèle. Un modèle est dit identifié si et seulement s’il existe une solution unique pour chaque paramètre inconnu à partir des covariances observées. La règle fondamentale d’identification impose que le nombre d’éléments d’information empiriques indépendants au sein de la matrice de covariance observée (donné par la formule $p(p+1)/2$, où $p$ est le nombre d’indicateurs observés) soit strictement supérieur ou égal au nombre de paramètres libres à estimer.
Lorsque cette condition n’est pas remplie, le modèle se trouve en état de sous-identification (degrés de liberté négatifs). L’algorithme est alors confronté à une infinité de solutions mathématiquement équivalentes, parmi lesquelles figurent d’innombrables configurations comportant des variances résiduelles négatives. De surcroît, même lorsqu’un modèle est théoriquement sur-identifié au niveau global, il peut souffrir d’une sous-identification locale ou empirique : une portion spécifique du réseau structurel (par exemple un facteur latent mesuré par seulement deux indicateurs dont les saturations sont instables) ne dispose pas d’un socle d’information suffisant pour contraindre la variance résiduelle au-dessus de zéro.
Une autre défaillance classique provient de l’absence de fixation de l’échelle métrique des variables latentes. Une variable latente étant par nature abstraite et non mesurée directement, elle n’a pas d’unité propre. Le chercheur doit obligatoirement fixer son échelle, soit en assignant la valeur fixe de 1 à la saturation factorielle d’un indicateur de référence (paramétrisation par variable marqueuse), soit en fixant la variance du facteur latent lui-même à 1 (standardisation factorielle). Si cette contrainte d’échelle est omise ou mal codée, la matrice de covariance implicite s’effondre dans une indétermination mathématique complète, entraînant l’explosion des variances estimées vers des valeurs aberrantes négatives ou infinies.
7.2 Impact des données non normales et des distributions asymétriques
L’immense majorité des estimateurs usuels en analyse factorielle confirmatoire et en modélisation par équations structurelles — au premier rang desquels figure le standard du Maximum de Vraisemblance (ML pour Maximum Likelihood) — repose sur le postulat strict que les variables observables suivent une distribution normale multivariée au sein de la population. Or, en psychologie clinique, en psychopathologie et dans les sciences du comportement, ce postulat est quasi systématiquement violé.
Les données cliniques présentent de manière endémique des asymétries prononcées (skewness) et des aplatissements excessifs (kurtosis ou leptocurticité), générés par des phénomènes de seuils cliniques ou de distribution des traits rares (comme les conduites addictives, les idéations suicidaires ou les accès de panique). L’impact de ces non-normalités multivariées sévères sur l’estimation de dispersion est délétère :
Les matrices de déviations quadratiques subissent des distorsions asymétriques brutales qui faussent les calculs de covariances et détruisent la précision des erreurs types asymptotiques. L’estimateur du maximum de vraisemblance standard devient inefficace et biaisé, ayant tendance à sous-estimer radicalement les variances d’erreur de mesure pour les indicateurs hautement asymétriques, précipitant fréquemment l’estimation algorithmique dans les régions interdites des nombres négatifs. Pour immuniser le modèle contre ce phénomène pathologique, le recours à des estimateurs robustes (tels que le robuste maximum de vraisemblance MLM ou MLR avec correction de Satorra-Bentler) ou à des méthodes adaptées aux données catégorielles ordonnées (WLSMV) est indispensable.
8. Les modèles mixtes et l’estimation de composantes de variance négatives
8.1 Modèles linéaires à effets aléatoires et hiérarchiques
Le champ des modèles linéaires mixtes, modèles hiérarchiques ou multiniveaux, représente un autre domaine méthodologique central où la confrontation avec des estimations de variance négatives est couramment observée. Ces architectures statistiques sont mobilisées dès lors que les données présentent une structure groupée, hiérarchique ou répétée (par exemple des élèves nichés au sein de classes scolaires, des patients suivis par différents thérapeutes, ou des mesures cognitives répétées dans le temps chez un même individu).
Dans un tel contexte, la variabilité totale d’un score d’observation $Y_{ij}$ (mesure sur l’individu $i$ niché dans le groupe $j$) est décomposée en deux composantes fondamentales : la variance intra-groupe ($\sigma_e^2$, reflétant les variations individuelles résiduelles au sein d’un même groupe) et la variance inter-groupes ($\sigma_u^2$, reflétant l’hétérogénéité véritable des moyennes d’un groupe à un autre) :
$$\mathrm{Var}(Y_{ij}) = \sigma_u^2 + \sigma_e^2$$
Dans la théorie classique de l’analyse de variance (ANOVA) à effets aléatoires formalisée au milieu du XXe siècle, l’estimation de la composante de variance inter-groupes ($\sigma_u^2$) n’était pas issue d’une formule quadratique directe, mais procédait par une déduction soustractive basée sur les carrés moyens du tableau d’ANOVA :
$$\hat{\sigma}_u^2 = \frac{MS_{\text{inter}} – MS_{\text{intra}}}{n}$$
où $MS_{\text{inter}}$ représente le carré moyen entre les groupes, $MS_{\text{intra}}$ le carré moyen au sein des groupes, et $n$ le nombre d’observations par groupe. C’est précisément au sein de cette opération de soustraction arithmétique élémentaire que le piège se referme : si, par pure fluctuation d’échantillonnage, la variabilité mesurée entre les groupes s’avère inférieure au bruit de fond intra-groupe ($MS_{\text{inter}} < MS_{\text{intra}}$), le numérateur devient négatif, produisant une estimation de variance inter-groupes $\hat{\sigma}_u^2$ strictement inférieure à zéro.
8.2 Estimateurs ANOVA non restreints contre méthode REML
Cette vulnérabilité structurelle de l’estimateur de type ANOVA réside dans son exigence absolue d’impartialité mathématique : il s’agit d’un estimateur sans biais (unbiased estimator). Pour maintenir formellement son absence de biais sur une infinité d’échantillonnages théoriques répétés, un estimateur sans biais dont la vraie valeur dans la population est proche de zéro doit obligatoirement être autorisé à fluctuer symétriquement de part et d’autre de zéro, franchissant donc inévitablement la frontière négative dans une fraction substantielle des tirages empiriques.
Pour affranchir la recherche de cette aporie physique, la méthodologie statistique moderne a progressivement abandonné les estimateurs ANOVA au profit des méthodes du Maximum de Vraisemblance Restreint (REML, pour Restricted Maximum Likelihood ou Residual Maximum Likelihood), développées initialement par Patterson et Thompson en 1971. La méthode REML sépare l’estimation des composantes de variance de l’estimation des effets fixes, corrigeant les pertes de degrés de liberté tout en appliquant les principes de l’optimisation sur un espace délimité.
Dans la quasi-totalité des logiciels modernes appliquant la méthode REML (comme les packages lme4 ou nlme dans R, ou les procédures MIXED sous SPSS), une frontière de contrainte paramétrique est automatiquement imposée :
$$\hat{\sigma}^2 ge 0$$
Si la dynamique des données tend vers une valeur négative, l’algorithme REML contraint tronque l’estimation et s’arrête net sur la frontière admissible, affichant une estimation rigoureusement égale à zéro ($\hat{\sigma}_u^2 = 0.000$). Cela donne lieu à un débat épistémologique passionnant en métrologie statistique : préfère-t-on conserver un estimateur strictement sans biais quitte à accepter des grandeurs mathématiquement aberrantes et impossibles dans le monde réel (approche ANOVA non restreinte), ou privilégier un estimateur légèrement biaisé à la frontière mais respectant impérativement la plausibilité physique des paramètres (approche REML contrainte) ? La communauté scientifique contemporaine a quasi unanimement tranché en faveur de la seconde option.
8.3 Interprétation pratique pour le chercheur en sciences sociales
Lorsqu’un chercheur en sciences sociales ou en psychologie observe qu’une composante de variance inter-groupes tend vers le zéro absolu ou que son logiciel d’analyse non restreinte rapporte une valeur négative, quelle signification substantielle doit-il conférer à ce résultat ?
La première conclusion pragmatique est que l’appartenance aux groupes (les classes, les services hospitaliers, les quartiers) n’explique absolument aucune part significative de la variance des scores observés. L’hétérogénéité entre les groupes est négligeable, voire inférieure à ce que le simple hasard de l’échantillonnage produirait au sein d’une population totalement indifférenciée. Dans cette situation, le recours à un modèle hiérarchique complexe n’est plus méthodologiquement justifié, et le modèle peut être avantageusement simplifié en une régression linéaire ordinaire (OLS).
Toutefois, dans certaines configurations psychosociales particulières, une tendance vers une variance inter-groupe négative révèle un phénomène comportemental bien documenté : l’existence d’une corrélation intraclasse (ICC) négative. Ce phénomène survient typiquement dans des contextes de petits groupes interactifs, tels que des dyades ou des triades d’apprentissage, soumis à des dynamiques de compétition intense ou de différenciation de rôles (inhibition sociale, division stricte du travail). Au sein de ces groupes, si un membre adopte un comportement à un niveau très élevé, l’autre membre adopte obligatoirement un niveau très bas par complémentarité ou contraste. Les scores intra-groupes deviennent ainsi plus divergents entre eux que ne le seraient deux scores tirés au hasard dans la population globale. Cette divergence intra-groupe exacerbée gonfle artificiellement le terme d’erreur résiduel, provoquant la négativité de la soustraction des variances de groupe.
9. Erreurs algorithmiques manuelles et pièges computationnels classiques
9.1 L’usage imprudent de la formule développée de la variance
En dehors des architectures logicielles de pointe, un nombre considérable de variances négatives observées par les étudiants et les praticiens lors de travaux appliqués provient d’erreurs de calcul manuel générées par l’usage imprudent d’une simplification algébrique très populaire. Dans les manuels scolaires d’initiation à la statistique, l’équation fondamentale de la variance d’échantillon est régulièrement réécrite sous sa forme développée, dite formule de Koenig-Huygens :
$$s^2 = \frac{1}{n-1} \left( \sum_{i=1}^n x_i^2 – \frac{1}{n} \left(\sum_{i=1}^n x_i\right)^2 \right) = \frac{\sum x_i^2 – n\bar{x}^2}{n-1}$$
Sur le plan de l’algèbre pure, cette identité est rigoureusement exacte et équivalente à la somme des déviations quadratiques. Elle présente l’avantage pédagogique apparent de ne nécessiter qu’un seul balayage des données, puisqu’il suffit de cumuler simultanément la somme des scores et la somme de leurs carrés.
Néanmoins, sur le plan computationnel et appliqué, cette formule développée représente une bombe à retardement numérique extrêmement vulnérable à l’annulation catastrophique. Lorsque les données de l’échantillon sont composées de nombres de grande magnitude situés dans un intervalle d’étalement minuscule (par exemple les cinq observations suivantes : $1000001, 1000002, 1000003, 1000004, 1000005$), les deux termes constitutifs de la soustraction — $\sum x^2$ et $n\bar{x}^2$ — deviennent des nombres astronomiques presque identiques :
$$\sum x_i^2 \approx 5.000015 \times 10^{12} \quad \text{et} \quad n\bar{x}^2 \approx 5.000015 \times 10^{12}$$
Si l’analyste effectue ce calcul à l’aide d’une calculatrice de poche ou d’un tableur sans une précision de mantisse suffisante, ou s’il introduit un arrondi prématuré sur la valeur de la moyenne arithmétique au carré, l’arrondi peut faire basculer le second terme légèrement au-dessus du premier lors de la soustraction. Le chercheur voit alors apparaître une somme de carrés négative, et par conséquent une variance négative. Cet accident de calcul n’a aucun fondement théorique : il est l’enfant exclusif d’un vice algorithmique et d’une imprudence d’arrondi numérique.
9.2 Erreurs de codage et confusion dans les degrés de liberté
L’autre source majeure d’anomalies univariées basiques se loge dans l’écriture de scripts de programmation personnalisés sous Python, R, MATLAB ou C++. Une erreur classique consiste en une inversion accidentelle dans l’ordonnancement des termes scalaires lors de l’implémentation manuelle de l’estimateur, ou en une confusion élémentaire sur les degrés de liberté résiduels.
Certains analystes débutants, cherchant à appliquer des filtres ou des sélections conditionnelles sur leurs bases de données, se retrouvent parfois confrontés à des sous-échantillons pathologiques où, suite à un filtrage trop restrictif ou à une mauvaise gestion des codes de données manquantes, la taille d’échantillon effective devient inférieure à 1 ($n = 0$ ou $n < 1$ dans des pondérations probabilistes complexes). L'application machinale de la division par $(n – 1)$ introduit alors au dénominateur une valeur négative. Le numérateur étant positif, le script retourne un résultat négatif aberrant que l'utilisateur non vigilant intègre parfois à tort dans ses rapports d'analyse.
Une confusion tout aussi pernicieuse réside dans le mélange non maîtrisé de scores bruts non centrés et de variables préalablement standardisées en scores z au sein d’opérations matricielles manuelles. La multiplication d’une matrice de corrélation par des vecteurs de transformation non conformes peut violer la semi-définitude positive de l’opérateur de dispersion, corrompant la métrique des variances résultantes.
10. Différence fondamentale entre variance, covariance et corrélation
10.1 La variance comme cas particulier unidimensionnel
Pour éliminer définitivement toute ambiguïté conceptuelle, il est nécessaire d’inscrire la variance dans le cadre plus large de l’analyse conjointe des variables aléatoires. La variance n’est pas un concept isolé des autres métriques d’association ; elle constitue en réalité le cas particulier unidimensionnel fondamental de la covariance. La covariance formelle entre deux variables aléatoires $X$ et $Y$ est définie par l’espérance mathématique du produit de leurs déviations respectives à leurs moyennes :
$$\mathrm{Cov}(X, Y) = \mathbb{E}\left[(X – \mathbb{E}[X])(Y – \mathbb{E}[Y])\right]$$
Si l’on évalue la covariance d’une variable aléatoire $X$ non pas avec une variable extérieure, mais rigoureusement avec elle-même, l’équation se métamorphose instantanément :
$$\mathrm{Cov}(X, X) = \mathbb{E}\left[(X – \mathbb{E}[X])(X – \mathbb{E}[X])\right] = \mathbb{E}\left[(X – \mathbb{E}[X])^2\right] = \mathrm{Var}(X)$$
La variance est donc très exactement la covariance d’une variable avec elle-même. Cette démonstration apporte un éclairage décisif sur la question de la négativité. Dans le calcul univarié de $\mathrm{Cov}(X, X)$, les deux termes du produit croisé sont strictement identiques. Dès lors, quelle que soit la déviation du score observé, le produit $(x_i – \bar{x}) \times (x_i – \bar{x})$ revient à multiplier un nombre par lui-même, garantissant une positivité absolue. Dans la géométrie vectorielle des variables, la variance correspond au carré de la norme du vecteur centré, une quantité obligatoirement positive ou nulle par définition de toute norme dans un espace de Hilbert.
10.2 Pourquoi la covariance peut légitimement être négative
Si la variance est astreinte à une non-négativité absolue, la covariance bivariée entre deux variables distinctes $X$ et $Y$ peut, quant à elle, tout à fait légitimement adopter un signe négatif. Cette polarité négative ne constitue nullement une anomalie mathématique, mais représente la traduction algébrique fidèle d’une association inverse entre deux construits psychologiques ou physiques :
$$\mathrm{Cov}(X, Y) < 0 iff r_{XY} < 0$$
Le mécanisme arithmétique de cette polarité négative s’explique sans peine par l’étude des signes au sein des produits croisés :
$$\text{Produit croisé } = (x_i – \bar{x})(y_i – \bar{y})$$
Lorsqu’une relation fonctionnelle inverse anime deux variables — par exemple le niveau d’anxiété pré-compétitive et la précision gestuelle fine dans un paradigme d’évaluation sous pression —, les individus présentant une valeur très élevée pour la première variable ($x_i > \bar{x}$, écart positif) auront systématiquement tendance à présenter une valeur très basse pour la seconde ($y_i < \bar{y}$, écart négatif). Le produit d'un écart positif par un écart négatif engendre un terme strictement négatif :
$$(+) \times (-) = (-)$$
Lors de la consolidation sommative, l’accumulation de ces produits croisés négatifs domine largement l’ensemble de l’équation, conférant à la covariance globale une valeur négative. Cette négativité est informationnelle : elle indique la direction de la pente de régression liant les deux entités. La confusion entre variance et covariance est l’une des sources majeures d’incompréhension chez les néophytes : la covariance traduit une orientation relationnelle conjointe (qui peut être inverse), tandis que la variance quantifie un volume de dispersion autonome (qui ne peut être que positif).
10.3 La structure des matrices de covariance et la semi-définitude positive
Lorsque l’on étend l’analyse à un ensemble multivarié de $p$ indicateurs, l’ensemble des dispersions individuelles et des associations croisées s’organise au sein d’une matrice symétrique de dimensions $p \times p$, appelée matrice de variance-covariance ($\mathbf{\Sigma}$ ou $\mathbf{S}$) :
$$\mathbf{S} = \begin{\pmatrix} s_{1}^2 &a\mp; s_{12} &a\mp; dots &a\mp; s_{1p} s_{21} &a\mp; s_{2}^2 &a\mp; dots &a\mp; s_{2p} \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots s_{p1} &a\mp; s_{p2} &a\mp; dots &a\mp; s_{p}^2 \end{\pmatrix}$$
La diagonale principale de cette matrice est exclusivement constituée des variances univariées de chaque variable ($s_1^2, s_2^2, dots, s_p^2$), tandis que les éléments hors diagonale abritent les covariances bivariées ($s_{ij}$). Pour être mathématiquement valide et représenter fidèlement un système multidimensionnel admissible, toute matrice de covariance doit respecter un théorème d’algèbre linéaire fondamental : elle doit être une matrice semi-définie positive (notée couramment $\mathbf{S} succeq 0$).
Ce postulat implique que pour tout vecteur non nul $\mathbf{v} in \mathbb{R}^p$, la forme quadratique associée doit être supérieure ou égale à zéro :
$$\mathbf{v}^T \mathbf{S} \mathbf{v} ge 0$$
Sur le plan spectral, cette condition exige que l’ensemble des valeurs propres (eigenvalues) de la matrice de covariance soient supérieures ou égales à zéro ($\lambda_k ge 0$). Si une matrice présente ne serait-ce qu’une seule valeur propre négative, son déterminant peut devenir négatif ou incohérent, signifiant que le volume de dispersion de l’ellipsoïde multidimensionnel des données s’est effondré dans un espace non euclidien impossible. Dans les logiciels de modélisation avancée, l’apparition d’un avertissement tel que « covariance matrix is not positive definite » signale directement la violation de cette propriété fondamentale, souvent consécutive à l’émergence d’une variance univariée négative sur la diagonale ou d’une corrélation hors diagonale supérieure à 1.
11. Conséquences psychométriques et interprétatives des anomalies de variance
11.1 L’effondrement de la théorie classique des tests
L’impact méthodologique de l’apparition d’une variance négative s’avère particulièrement dévastateur lorsqu’on l’examine sous le prisme de la Théorie Classique des Tests (TCT), formulée historiquement par Spearman et systématisée par Gulliksen, Lord et Novick. La TCT postule que le score brut observé $X$ d’un sujet à un test est la résultante linéaire additive de deux composantes latentes inobservables : le score vrai $T$ (l’attribut psychologique réel du sujet) et une erreur de mesure aléatoire $E$ :
$$X = T + E$$
En vertu de l’hypothèse d’indépendance stochastique entre le score vrai et l’erreur aléatoire ($\mathrm{Cov}(T, E) = 0$), la variance du score observé se décompose rigoureusement selon l’axiome d’additivité univariée :
$$\sigma_X^2 = \sigma_T^2 + \sigma_E^2$$
La théorie repose sur l’axiome ontologique que la variance de l’erreur ($\sigma_E^2$) et la variance du score vrai ($\sigma_T^2$) sont toutes deux des grandeurs strictement positives ou nulles. Le coefficient de fidélité du test ($\rho_{XX’}$) se définit formellement comme la proportion de variance observée attribuable au score vrai :
$$\rho_{XX’} = \frac{\sigma_T^2}{\sigma_X^2} = 1 – \frac{\sigma_E^2}{\sigma_X^2}$$
Si un algorithme d’estimation d’équations structurelles attribue à la variance d’erreur une valeur négative ($\hat{\sigma}_E^2 1$), ce qui constitue un non-sens absolu en théorie de la mesure. De même, ce mécanisme éclaire l’énigme redoutée de l’obtention d’un coefficient alpha de Cronbach négatif :
$$\alpha = \frac{k}{k – 1} \left(1 – \frac{\sum_{i=1}^k \sigma_i^2}{\sigma_X^2}\right)$$
Bien que les variances d’items $\sigma_i^2$ soient toutes individuellement positives, si les items d’une échelle sont massivement corrélés négativement entre eux (par exemple en raison d’items inversés non recodés au préalable), la variance du score total composite $\sigma_X^2$ s’effondre jusqu’à devenir inférieure à la somme des variances individuelles ($\sigma_X^2 < \sum \sigma_i^2$). La fraction devient alors supérieure à 1, précipitant l'alpha de Cronbach dans des valeurs négatives aberrantes, signant l'absence totale de consistance interne de l'instrument.
11.2 Remise en question de la validité de construit
Au-delà de l’effondrement des équations de fidélité, l’émergence d’une anomalie de variance porte un coup d’arrêt brutal à l’établissement de la validité de construit, pierre angulaire de l’évaluation scientifique en psychologie et en sciences sociales. En analyse factorielle confirmatoire, l’évaluation de la validité convergente d’une échelle repose traditionnellement sur le critère de Fornell-Larcker et le calcul de la Variance Moyenne Extraite (AVE pour Average Variance Extracted) :
$$\mathrm{AVE} = \frac{\sum_{i=1}^k \lambda_i^2}{\sum_{i=1}^k \lambda_i^2 + \sum_{i=1}^k \theta_i}$$
Si l’une des variances d’erreur résiduelle $\theta_i$ bascule dans les valeurs négatives, le dénominateur de cette équation se contracte artificiellement, gonflant le ratio d’AVE au-dessus de 1 ou introduisant des discontinuités asymptotiques indéterminées. L’analyste se trouve dans l’incapacité statistique de certifier que les indicateurs partagent une variance commune adéquate reflétant le trait latent théorisé.
De plus, l’acceptation involontaire ou négligente d’un modèle non admissible infecte dramatiquement l’ensemble de la chaîne inférentielle : les erreurs types des estimations deviennent totalement fausses, les tests d’adéquation globale (tels que le Chi-deux de significativité, le RMSEA ou le CFI) perdent toute signification probabiliste, et le taux d’erreur de Type I (rejet à tort de l’hypothèse nulle d’absence d’effet) subit une inflation exponentielle incontrôlée. Sur le plan éthique et déontologique, soumettre à la publication scientifique des résultats de recherche comportant des paramètres de variance négatifs occultés constitue une grave faute méthodologique, susceptible de nourrir des crises de réplication majeures au sein de la discipline.
12. Protocoles diagnostiques et remèdes méthodologiques face à une variance négative
12.1 Audit rigoureux de la base de données brutes
Lorsqu’un chercheur ou un data analyst se trouve confronté à une alerte logicielle signalant une variance négative ou une absence de positivité matricielle, la première étape du protocole de résolution ne réside pas dans la modification aveugle du modèle théorique, mais dans un audit systématique, méticuleux et rigoureux de la base de données brutes :
- Vérification des codes de données manquantes : L’une des erreurs les plus banales mais les plus destructrices réside dans l’omission de déclarer les valeurs sentinelles attribuées aux données manquantes (telles que
-99,-999ou9999). Si un logiciel traite ces valeurs sentinelles numériques négatives comme des scores cliniques réels, les calculs de covariances et de déviations quadratiques subissent des distorsions cataclysmiques capables de faire basculer n’importe quel optimiseur dans l’incohérence la plus totale. - Détection des valeurs aberrantes multivariées : L’inspection des données univariées (scores $z > 3.29$) doit être impérativement complétée par un diagnostic de déviance multidimensionnelle via le calcul de la distance de Mahalanobis ($D^2$). Les observations individuelles présentant une valeur de distance significativement associée à un $p < .001$ au test du Chi-deux doivent être minutieusement examinées : leur exclusion temporaire permet souvent de restaurer instantanément la positivité de la matrice.
- Contrôle de la dépendance linéaire parfaite : Il convient de vérifier qu’aucun indicateur n’est la résultante arithmétique directe d’autres indicateurs présents dans le modèle. L’inclusion simultanée des sous-échelles partielles et du score total composite d’une même échelle dans une analyse factorielle introduit une dépendance linéaire déterministe (colinéarité exacte), réduisant le rang de la matrice et générant des singularités résiduelles négatives inévitables.
12.2 Ajustement et ré-estimation des modèles statistiques complexes
Si la base de données brute est irréprochable sur le plan de la qualité métrologique, l’anomalie prend sa source dans la structure même de la spécification statistique ou dans la taille d’échantillonnage. Plusieurs voies d’ajustement méthodologique s’offrent alors au statisticien :
En premier lieu, l’examen attentif de la taille effective de l’échantillon ($N$) est primordial. Si le ratio entre le nombre d’observations et le nombre de paramètres libres est défavorable (par exemple inférieur à 5 ou 10 sujets par paramètre dans une analyse confirmatoire), l’instabilité de la matrice empirique est la cause directe du cas de Heywood. La solution structurelle réside dans l’accroissement substantiel de la taille d’échantillon par la poursuite des inclusions empiriques.
En second lieu, l’élimination des indicateurs dysfonctionnels ou redondants doit être engagée. Si deux items présentent une corrélation bivariée excessive ($r > .85$), l’un des deux items doit être écarté du protocole pour résorber la multicolinéarité locale. Si un indicateur présente une saturation factorielle insignifiante ou incohérente, sa suppression stabilise immédiatement l’espace d’estimation des résidus.
En troisième lieu, le statisticien peut recourir à des méthodes d’estimation alternatives. L’adoption de l’estimation bayésienne (notamment via des algorithmes MCMC d’échantillonnage de Gibbs ou hamiltonien) constitue un remède particulièrement élégant. En spécifiant des distributions a priori informatives ou simplement propres et tronquées (telles qu’une loi Gamma inverse ou une loi demi-Cauchy pour les composantes d’erreur), l’estimation bayésienne borne naturellement l’espace des paramètres postérieurs dans le domaine strictement positif, interdisant formellement l’émergence de variances négatives tout en intégrant l’incertitude épistémique de l’échantillon.
Enfin, dans les cas où l’analyste a la certitude théorique que la variance résiduelle négative n’est qu’une fluctuation aléatoire autour d’une valeur réelle quasi nulle, il est techniquement possible d’imposer au sein du logiciel une contrainte d’égalité fixant explicitement le paramètre litigieux à une borne admissible supérieure ou égale à zéro (par exemple $\theta = 0$ ou $\theta > 0.001$). Cette procédure doit toutefois être explicitement justifiée et documentée dans le rapport méthodologique final.
12.3 Guide décisionnel pour le chercheur et l’analyste de données
Pour accompagner méthodiquement les chercheurs et analystes de données confrontés à une notification logicielle d’anomalie de variance, le logigramme décisionnel suivant résume les étapes critiques à franchir de manière séquentielle :
- Étape 1 : Localiser la nature de l’anomalie. S’agit-il d’un calcul univarié descriptif ou d’une estimation issue d’un modèle itératif multivarié ? Si le calcul est univarié descriptif, rechercher immédiatement une erreur d’arrondi dans la formule de Koenig-Huygens, une division par un effectif nul/négatif, ou une confusion de codage dans la déclaration des variables.
- Étape 2 : Auditer l’intégrité de la matrice empirique. Examiner le tableau des corrélations et des covariances. Existe-t-il des corrélations supérieures ou égales à 1.00 en valeur absolue ? Si oui, supprimer immédiatement les items redondants ou les sous-échelles dérivées linéairement. Traiter les codes d’absence de données non déclarés.
- Étape 3 : Diagnostiquer l’identification structurelle. Le modèle comporte-t-il un nombre suffisant de degrés de liberté ? L’échelle métrique de chaque variable latente est-elle correctement et univoquement fixée ? Les facteurs sont-ils mesurés par au moins trois indicateurs fiables (règle des trois indicateurs) ? Restructurer le modèle si une sous-identification locale est constatée.
- Étape 4 : Évaluer l’effet de l’échantillon et de la non-normalité. L’échantillon est-il suffisamment robuste ($N > 200$) ? Les distributions présentent-elles une déviation sévère de normalité multivariée ? Si oui, basculer immédiatement vers des estimateurs robustes (MLR/WLSMV) ou envisager une modélisation bayésienne contrainte.
- Étape 5 : Rédaction et transparence scientifique. Si une contrainte de positivité à zéro a été manuellement appliquée pour finaliser l’ajustement du modèle, l’analyste a l’obligation morale et déontologique de consigner rigoureusement cette intervention dans ses publications scientifiques, en fournissant les indices comparatifs d’ajustement avant et après contrainte.
En conclusion définitive de cette investigation, il convient de réaffirmer la vérité immuable de l’édifice statistique : dans le monde réel de la mesure empirique et dans l’univers formel des mathématiques euclidiennes, la variance ne peut jamais être négative. Elle commence au zéro absolu de l’homogénéité parfaite et s’étend vers l’infini positif de la dispersion des êtres et des choses. Toute intrusion d’une valeur négative sur l’écran d’un ordinateur n’est jamais la découverte d’un nouveau principe probabiliste, mais le signal d’alarme bienveillant qu’un algorithme numérique envoie au chercheur pour lui rappeler les limites de ses données, de ses équations ou de ses modèles.
Références
- Bollen, K. A. (1989). Structural Equations with Latent Variables. John Wiley & Sons. https://doi.org/10.1002/9781118619179
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Fisher, R. A. (1918). The correlation between relatives on the supposition of Mendelian inheritance. Transactions of the Royal Society of Edinburgh, 52(2), 399–433. https://doi.org/10.1017/S008045680001216X
- Heywood, H. B. (1931). On finite sequences of real numbers. Proceedings of the Royal Society of London. Series A, 134(824), 486–501. https://doi.org/10.1098/rspa.1931.0209
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- Kline, R. B. (2023). Principles and Practice of Structural Equation Modeling (5th ed.). Guilford Press.
- Lord, F. M., & Novick, M. R. (1968). Statistical Theories of Mental Test Scores. Addison-Wesley.
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance Components. John Wiley & Sons. https://doi.org/10.1002/9780470316856