
Dans l’histoire des sciences quantitatives, peu de constructions conceptuelles ont exercé une influence aussi profonde, ubiquitaire et structurante que la distribution normale, communément désignée sous le vocable de courbe de Gauss ou courbe en cloche. Véritable clef de voûte de la théorie des probabilités et de la statistique inférentielle moderne, cette fonction mathématique singulière transcende son statut d’objet abstrait pour s’ériger en modèle descriptif universel. Des fluctuations infinitésimales des erreurs de mesure astronomique aux oscillations complexes des cours boursiers, en passant par les distributions biométriques et l’évaluation standardisée des fonctions cognitives humaines, la loi normale s’impose comme une régularité phénoménologique et méthodologique fondamentale.
L’omniprésence de cette distribution ne relève pas d’une simple coïncidence empirique, mais d’une propriété mathématique fondamentale formalisée par le théorème central limite. Ce principe établit que l’agrégation d’une multiplicité de forces indépendantes, aléatoires et de faible amplitude relative produit inéluctablement une distribution globale asymptotiquement normale, quelle que soit la morphologie des lois probabilistes sous-jacentes. En conséquence, les sciences humaines, et tout particulièrement la psychologie et la psychométrie, ont adopté cette distribution comme le paradigme de référence pour quantifier la variabilité interindividuelle, étalonner les instruments psychométriques et circonscrire les frontières fluctuantes entre le fonctionnement ordinaire et les déviations cliniques.
Toutefois, cette ubiquité théorique suscite de profondes interrogations épistémologiques, techniques et éthiques. L’assimilation fréquente de la normalité statistique à une norme fonctionnelle, voire à un idéal d’adaptabilité psychologique ou biologique, a parfois conduit à des réductions méthodologiques contestables et à des dérives interprétatives dommageables. Cet article propose un examen exhaustif et rigoureux de la distribution normale : depuis ses prolégomènes historiques et ses fondements analytiques stricts, jusqu’à ses manifestations empiriques, ses anomalies structurelles dans les sciences comportementales contemporaines et ses implémentations informatiques les plus avancées.
1. Fondements théoriques et genèse historique de la distribution normale
1.1 Origines mathématiques : des travaux de De Moivre à Carl Friedrich Gauss
La découverte de la distribution normale s’inscrit au sein d’une trajectoire intellectuelle jalonnée par les avancées majeures du calcul infinitésimal et de l’analyse combinatoire aux dix-huitième et dix-neuvième siècles. La genèse de ce concept remonte initialement aux travaux du mathématicien français huguenot réfugié à Londres, Abraham de Moivre. En 1733, dans un supplément à son ouvrage pionnier The Doctrine of Chances intitulé Approximatio ad Summam Terminorum Binomii (a + b)n in Seriem expansi, De Moivre cherchait à simplifier le calcul exponentiellement laborieux des probabilités associées à des séquences répétées de lancers d’une pièce de monnaie équilibrée. Face à l’impossibilité pratique d’évaluer directement les coefficients binomiaux pour des échantillons de taille considérable par la simple formule combinatoire de Blaise Pascal, De Moivre démontra que le développement symétrique de la loi binomiale convergeait, pour une grande valeur du paramètre de répétition, vers une fonction exponentielle continue modulée par un terme quadratique négatif. Cette intuition fondatrice constituait l’ébauche formelle de l’approximation normale de la loi binomiale, bien que De Moivre n’ait pas encore perçu la portée générale de cette fonction en tant que loi continue universelle.
Il fallut attendre la seconde moitié du dix-huitième siècle pour que Pierre-Simon de Laplace réexamine et généralise ces conclusions avec une acuité analytique sans précédent. Dans son chef-d’œuvre de 1812, la Théorie analytique des probabilités, Laplace formula de manière explicite et démontra rigoureusement la première version formelle du théorème de Moivre-Laplace. Dépassant le cas particulier de la parité probabiliste stricte d’un tirage binaire, Laplace formalisa l’approximation asymptotique de toute distribution binomiale asymétrique par une intégrale continue spécifique. De surcroît, Laplace conçut la célèbre intégrale eulérienne qui porte son nom et établit les premières connexions analytiques entre l’accumulation d’aléas infinitésimaux et la morphologie de la courbe exponentielle symétrique, posant ainsi les assises du calcul moderne des probabilités continues.
Conjointement et de manière indépendante, l’illustre astronome et mathématicien allemand Carl Friedrich Gauss aborda la problématique par le prisme de l’astronomie de position et de la mécanique céleste. Confronté au défi récurrent posé par le traitement des erreurs d’observation télescopique lors de la prédiction orbitale de la planète naine Cérès en 1801, Gauss développa la méthode des moindres carrés. Dans son traité magistral Theoria motus corporum coelestium in sectionibus conicis solem ambientium publié en 1809, Gauss démontra qu’en postulant l’espérance mathématique arithmétique d’un ensemble de mesures empiriques indépendantes comme l’estimateur le plus vraisemblable de la valeur vraie inconnue, la fonction régissant la distribution différentielle des erreurs d’observation prenait nécessairement la forme d’une courbe en cloche exponentielle. Dès lors, cette courbe devint familièrement désignée sous le syntagme de « loi des erreurs » ou « distribution gaussienne ». La dénomination contemporaine de « loi normale » s’est progressivement cristallisée à la fin du dix-neuvième siècle sous l’impulsion de statisticiens tels que Charles S. Peirce, Francis Ysidro Edgeworth et Karl Pearson, ces derniers souhaitant dissocier cette modélisation de sa stricte assignation aux seules erreurs métrologiques pour célébrer son statut de distribution typique et prédominante dans les configurations naturelles.
1.2 Introduction de la courbe en cloche dans les sciences humaines
L’émancipation de la distribution normale hors du pré carré de l’astronomie métrologique et son incorporation au cœur des sciences de l’homme résultent des travaux pionniers de l’astronome, météorologue et sociologue belge Adolphe Quetelet. Séduit par l’universalité mathématique de la loi des erreurs de Gauss lors de ses séjours d’apprentissage à Paris auprès de Laplace, Quetelet entreprit d’appliquer ces schémas probabilistes aux données anthropométriques et démographiques collectées à grande échelle au sein des populations européennes. Dans son ouvrage fondamental paru en 1835, Sur l’homme et le développement de ses facultés, ou Essai de physique sociale, Quetelet analyse notamment les registres de conscription militaire relatifs à la taille corporelle et au tour de poitrine des conscrits écossais et français. Il constate avec stupéfaction que les variations de la stature humaine individuelle autour de la moyenne arithmétique de la population se conforment rigoureusement au modèle gaussien des erreurs de tir d’artillerie.
Cette congruence empirique conduisit Quetelet à échafauder le concept théorique controversé de « l’homme moyen » (l’homme moyen). Pour le savant belge, la moyenne de la distribution normale n’était pas un simple indice de centralité comptable, mais représentait la concrétisation de l’archétype téléologique ou du projet intentionnel de la Nature, tandis que les écarts individuels symétriques par rapport à cette valeur nodale étaient réinterprétés comme l’analogue d’erreurs d’exécution accidentelles dues à la variabilité des circonstances environnementales. Ce glissement épistémologique transformait un dispositif purement métrologique en un instrument de mesure ontologique des sociétés humaines, opérant une confusion philosophique durable entre régularité probabiliste et idéal normatif.
Quelques décennies plus tard, en Angleterre, Francis Galton prolongea et refonda radicalement cette démarche anthropométrique pour l’étendre aux facultés psychologiques et intellectuelles. Dans son ouvrage emblématique Hereditary Genius paru en 1869, Galton formula l’hypothèse audacieuse que les aptitudes mentales, le talent créatif, la mémoire et le tempérament se distribuaient au sein de la population générale selon la même loi géométrique que les caractéristiques morphologiques externes comme la taille ou l’envergure brachiale. Pour étayer cette conjecture, Galton mit au point le « quincunx » (ou planche de Galton), un appareil mécanique où des billes chutant à travers un réseau d’obstacles triangulaires forment au sol une accumulation physique illustrant la loi binomiale convergeant vers la distribution normale. Par cette démonstration visuelle de l’émergence d’une forme collective déterministe à partir d’événements élémentaires stochastiques, Galton inaugurait la psychométrie différentielle et la biométrie moderne, tout en jetant les bases des débats méthodologiques et sociétaux sur la quantification du psychisme humain.
1.3 Définition formelle et fonction de densité de probabilité
Sur le plan mathématique rigoureux, la distribution normale constitue une variable aléatoire continue dont la distribution probabiliste ne dépend que de deux grandeurs scalaires réelles : son espérance mathématique ou moyenne théorique, traditionnellement notée $\mu$ ($\mu in \mathbb{R}$), et son écart-type, noté $\sigma$ ($\sigma in \mathbb{R}_{>0}$). La fonction de densité de probabilité, conventionnellement notée $f(x)$ ou $phi(x)$, caractérise la probabilité relative infinitésimale pour que la variable aléatoire continue $X$ adopte une valeur située au voisinage immédiat d’un point $x$ donné le long du continuum des réels. Cette fonction est explicitement définie par l’équation d’une remarquable concision analytique :
f(x) = (1 / (σ √(2π))) × exp(- (x – μ)² / (2σ²))
L’observation attentive de cette formulation révèle l’articulation organique de constantes mathématiques universelles fondamentales qui transcendent les disciplines scientifiques : le nombre irrationnel transcendant $\pi \approx 3{,}14159$, issu de la géométrie euclidienne et des propriétés circonférentielles du cercle, et la constante d’Euler $e \approx 2{,}71828$, base canonique du logarithme népérien caractérisant les dynamiques d’accroissement et de décroissance infinitésimales. La présence du facteur $1 / (\sigma \sqrt{2\pi})$ assure le rôle de constante de normalisation indispensable à la cohérence probabiliste du système. En vertu des principes cardinaux de la théorie des probabilités de Kolmogorov, l’aire totale délimitée par la courbe de densité et l’axe des abscisses sur l’ensemble de son domaine de définition doit être strictement égale à l’unité (1), formalisant ainsi la certitude logique que l’événement aléatoire prendra une valeur quelconque au sein de l’espace fondamental :
∫-∞+∞ f(x) dx = 1
Le domaine de définition de la loi normale s’étend rigoureusement sans aucune interruption ni discontinuité depuis $-\infty$ jusqu’à $+\infty$. Cette continuité intégrale implique que, pour toute variable aléatoire $X$ gouvernée par une loi normale stricte, aucune valeur réelle concevable n’est théoriquement impossible, aussi éloignée soit-elle de la moyenne centrale $\mu$. La fonction $f(x)$ ne s’annule en aucun point fini de l’axe réel ; elle demeure strictement positive pour tout $x in ]-\infty, +\infty[$, ce qui confère à cette structure une souplesse calculatoire absolue tout en posant des défis méthodologiques notables lors de la modélisation de grandeurs physiques ou psychologiques naturellement contraintes par des limites matérielles ou physiologiques.
2. Caractéristiques géométriques et propriétés analytiques fondamentales
2.1 Symétrie bilatérale et convergence des mesures de tendance centrale
La première caractéristique visuelle et géométrique frappante de la distribution normale réside dans sa symétrie bilatérale parfaite par rapport à une droite verticale orthogonale passant par l’abscisse $x = \mu$. Cette symétrie axiale se vérifie formellement par l’invariance de la fonction de densité face à toute translation symétrique : pour tout écart réel arbitraire noté $\delta in \mathbb{R}$, on observe l’égalité fonctionnelle stricte $f(\mu – \delta) = f(\mu + \delta)$. Par conséquent, l’axe vertical d’équation $x = \mu$ coupe la surface sous la courbe en deux moitiés géométriquement et probabilistiquement congruentes, assignant exactement une intégrale de surface de 0,5 (soit 50 % de la masse de probabilité globale) à l’intervalle semi-infini $]-\infty, \mu]$ et une fraction identique de 0,5 à l’intervalle complémentaire $[\mu, +\infty[$.
Une conséquence analytique majeure de cette symétrie parfaite est la coïncidence mathématique rigoureuse des trois métriques canoniques de tendance centrale :
- La moyenne arithmétique ($\mu$) : qui correspond au barycentre ou centre de gravité mécanique de la distribution, calculée comme l’espérance mathématique de la variable.
- La médiane : qui représente la valeur médiane partageant exactement l’échantillon ordonné ou la population en deux quantiles contenant chacun 50 % des occurrences probabilistes cumulées.
- Le mode : défini comme la valeur où la fonction de densité atteint son extremum global, c’est-à-dire le sommet culminant de la courbe où la concentration locale de probabilité est maximale.
Dans toute distribution normale univariée, ces trois mesures convergent vers un point géométrique unique : $\mu = \text{Médiane} = \text{Mode}$. Par corollaire, le troisième moment centré de la distribution, qui quantifie l’asymétrie statistique (désignée en terminologie anglo-saxonne par le terme de skewness), est strictement nul : $\gamma_1 = 0$. Il n’existe aucun étirement, déportement ou biais morphologique vers la droite ou la gauche de la courbe, ce qui garantit que la dispersion des observations négatives compense mathématiquement et symétriquement la dispersion des observations positives.
2.2 Les deux paramètres cardinaux : espérance mathématique et variance
La morphologie tridimensionnelle de la distribution normale est entièrement et univoquement déterminée par un binôme de paramètres scalaires indépendants : le paramètre d’emplacement ou de localisation, $\mu$, et le paramètre d’échelle ou de dispersion, $\sigma$ (dont le carré, $\sigma^2$, désigne la variance théorique de la variable aléatoire). Le paramètre $\mu$ dicte exclusivement la position spatiale relative de la courbe le long du continuum infini de l’axe des abscisses. Toute modification appliquée à $\mu$ induit une translation isométrique rigoureuse de l’ensemble de la silhouette graphique, vers les valeurs positives ou négatives, sans altérer d’aucune manière son profilage, sa compacité ou son étalement latéral.
Inversement, le paramètre $\sigma$, représentant l’écart-type de la population, exerce un contrôle total sur l’amplitude de l’étalement horizontal et, de facto, sur la hauteur du pic vertical. L’ordonnée maximale du sommet culminant de la distribution, atteinte précisément en $x = \mu$, est directement inversement proportionnelle à $\sigma$, étant donnée par la relation $f(\mu) = 1 / (\sigma \sqrt{2\pi})$. Ainsi, lorsque l’écart-type diminue pour refléter un ensemble d’observations hautement homogènes et peu dispersées, le dénominateur de la fraction se réduit, projetant le sommet de la courbe vers des ordonnées élevées et resserrant drastiquement les flancs de la cloche (structure leptocurtique). À l’opposé, si la variabilité intrinsèque du phénomène s’accroît, la valeur de $\sigma$ augmente corrélativement, entraînant un affaissement substantiel de l’apex et un élargissement conséquent des ailes latérales (structure platycurtique). Malgré ces variations morphologiques spectaculaires, la surface délimitée sous le profil conserve impérativement sa mesure unitaire invariable de 1.
2.3 Points d’inflexion et propriétés asymptotiques
Au-delà de son sommet culminant, l’architecture géométrique de la distribution normale est rythmée par deux singularités analytiques remarquables : ses points d’inflexion. Un point d’inflexion marque la transition géométrique où le tracé d’une fonction cesse d’être concave pour devenir convexe, ou réciproquement, ce qui correspond mathématiquement à l’annulation de sa dérivée seconde. En calculant les dérivées première et seconde successives de la densité de probabilité normale :
f'(x) = – ((x – μ) / σ²) × f(x)
f »(x) = ( ((x – μ)² – σ²) / σ&sup4; ) × f(x)
On constate sans ambiguïté que la dérivée seconde s’annule lorsque le terme quadratique $((x – \mu)^2 – \sigma^2)$ devient nul, c’est-à-dire précisément lorsque $(x – \mu)^2 = \sigma^2$, ce qui livre les solutions exactes $x = \mu – \sigma$ et $x = \mu + \sigma$. Ces deux abscisses désignent l’emplacement précis des points d’inflexion. Au centre de la courbe, dans l’intervalle $]\mu – \sigma, \mu + \sigma[$, la courbe adopte une courbure concave tournée vers le bas (analogue à un dôme protecteur). Dès que l’on franchit la frontière extérieure d’un écart-type de part et d’autre de la moyenne, la courbure s’inverse pour devenir strictement convexe, s’évasant doucement pour épouser le comportement asymptotique latéral.
Ce comportement asymptotique constitue la seconde caractéristique analytique fondamentale de la loi de Gauss : lorsque la distance $|x – mu|$ tend vers l’infini, la valeur de la fonction de densité $f(x)$ converge de manière asymptotique vers l’axe des abscisses ($y = 0$), sans jamais l’intercepter ni le franchir formellement :
limx → ±∞ f(x) = 0
Cette décroissance rapide est gouvernée par le facteur exponentiel quadratique négatif $\exp(-x^2)$. Cette propriété implique qu’aucun événement, aussi aberrant ou colossalement disproportionné soit-il, ne se voit assigner une probabilité théorique rigoureusement nulle. Dans les contextes de modélisation empirique, les statisticiens doivent demeurer conscients que ce modèle postule une perméabilité continue aux valeurs extrêmes, imposant des seuillages méthodologiques prudents pour distinguer les fluctuations aléatoires légitimes des artéfacts d’échantillonnage.
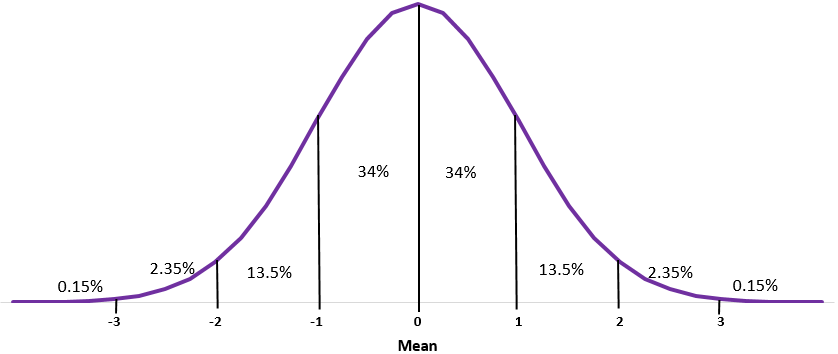
3. La règle empirique (68-95-99,7) et la dispersion probabiliste
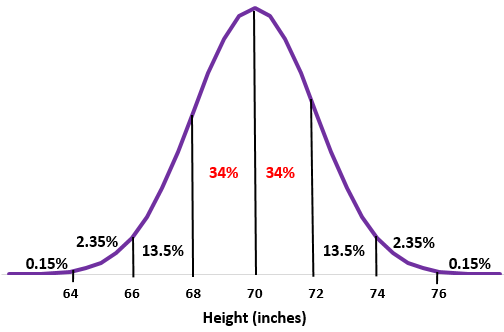
3.1 L’intervalle du premier écart-type : les 68 pour cent centraux
L’une des propriétés les plus commodes et fréquemment mobilisées de la distribution normale est incarnée par la règle empirique des trois sigmas, également désignée sous l’appellation canonique de règle 68-95-99,7. Cette règle dérive directement du calcul intégral de la fonction de densité normale sur des segments fermés symétriques définis par des multiples entiers consécutifs du paramètre d’écart-type $\sigma$. L’intégration de la fonction de densité entre les bornes $\mu – \sigma$ et $\mu + \sigma$ livre une probabilité cumulée très précisément égale à :
P(μ – σ ≤ X ≤ μ + σ) = ∫μ-σμ+σ f(x) dx ≈ 0{,}68268949…
En termes pratiques et appliqués, cela signifie qu’approximativement 68,27 % de la population totale d’une variable normalement distribuée se situe au sein de cet intervalle restreint adjacent au centre de gravité de la cohorte. Du fait de la symétrie axiale inviolable de la distribution, cette surface cumulée se subdivise de manière équipartite : exactement 34,13 % des observations se logent entre la moyenne $\mu$ et le seuil supérieur $\mu + \sigma$, et une proportion strictement symétrique de 34,13 % s’insère entre le seuil inférieur $\mu – \sigma$ et la moyenne centrale.
Dans le domaine de la psychométrie différentielle et de l’évaluation diagnostique, cet intervalle canonique délimite conventionnellement la zone de fonctionnement cognitif, émotionnel ou comportemental dite « ordinaire », « modale » ou « moyenne ». Un individu dont le score standardisé s’inscrit à l’intérieur de ces deux bornes symétriques est ainsi considéré comme manifestant une expression phénotypique ou une performance instrumentale typique de l’échantillon normatif d’étalonnage. Cette zone absorbe plus des deux tiers de la variabilité globale, conférant au système une stabilité descriptive substantielle.
3.2 L’intervalle de deux écarts-types : le standard des 95 pour cent
Lorsque l’on élargit le domaine d’observation pour intégrer une amplitude bilatérale équivalente à deux écarts-types de part et d’autre de l’espérance arithmétique, l’intégrale de densité englobe une fraction massive de la masse de probabilité :
P(μ – 2σ ≤ X ≤ μ + 2σ) = ∫μ-2σμ+2σ f(x) dx ≈ 0{,}95449973…
Soit environ 95,45 % de l’ensemble des données observables au sein de l’espace échantillonnal. L’importance théorique et méthodologique de cette frontière est incommensurable dans l’édifice scientifique occidental. Bien que la valeur d’intervalle rigoureusement associée au seuil de signification de 95 % corresponde en réalité à un coefficient non entier de $\mu \pm 1{,}96\sigma$, l’arrondi conventionnel à deux écarts-types constitue le pivot heuristique de la statistique inférentielle fisherienne.
L’espace résiduel exclu de cet intervalle majeur représente seulement 4,55 % de la population globale. Distribuée de manière symétrique dans les deux extensions extrêmes de la courbe, cette marge résiduelle se scinde en deux zones de rejet ou queues de distribution pesant chacune très exactement 2,275 % de la distribution totale :
- Une queue inférieure unilatérale regroupant les observations situées strictement en deçà de la limite $\mu – 2\sigma$ ($P(X < \mu – 2\sigma) \approx 0{,}02275$).
- Une queue supérieure unilatérale regroupant les observations situées strictement au-delà de la limite $\mu + 2\sigma$ ($P(X > \mu + 2\sigma) \approx 0{,}02275$).
Dans la pratique clinique, neuropsychologique et pédopsychiatrique, le franchissement du seuil critique des deux écarts-types déclenche généralement la qualification d’atypicité statistique. C’est à partir de cette démarcation probabiliste que s’échafaudent historiquement les classifications nosographiques relatives aux troubles d’apprentissage, aux déficiences fonctionnelles ou aux talents intellectuels exceptionnels, érigeant cette frontière quantitative en critère régulateur du diagnostic médical et psychosocial.
3.3 L’intervalle de trois écarts-types et la détection des cas rares
L’extension finale de la règle empirique classique englobe l’intervalle défini par une amplitude bilatérale de trois écarts-types centrés sur la moyenne ($\mu \pm 3\sigma$). L’évaluation analytique de l’intégrale sur ce segment livre une couverture presque intégrale de l’univers probabiliste :
P(μ – 3σ ≤ X ≤ μ + 3σ) = ∫μ-3σμ+3σ f(x) dx ≈ 0{,}99730020…
Ce résultat démontre que 99,73 % des réalisations empiriques d’une variable gaussienne idéale tombent inéluctablement sous cette voûte d’observation. Réciproquement, la probabilité d’observer un cas déviant de la moyenne d’une quantité supérieure à trois écarts-types, toutes directions confondues, est infinitésimale : elle n’atteint que 0,27 %, soit une proportion statistique équivalente à approximativement un individu sur 370.
Dans le domaine méthodologique du nettoyage des données (data cleaning) et du contrôle qualité industriel (dont s’inspire la fameuse méthodologie Six Sigma), les frontières $\mu \pm 3\sigma$ sont usuellement consacrées comme les délimitations formelles délimitant les valeurs aberrantes légitimes des aberrations métrologiques (outliers). Tout enregistrement empirique s’échouant au-delà de ces frontières doit faire l’objet d’un examen approfondi afin de déterminer s’il traduit une erreur manifeste de saisie instrumentale, une contamination de l’échantillon par un phénomène parasite étranger ou, au contraire, l’observation véridique d’un événement rare d’une grande valeur heuristique. Dans les études épidémiologiques ou psychométriques massives impliquant des centaines de milliers de sujets, ces queues de distribution hébergent des sous-cohortes entières dont l’analyse affine les connaissances sur les marges extrêmes de la variabilité biologique et comportementale.
4. Standardisation statistique et manipulation de la loi normale centrée réduite
4.1 Le principe de transformation par le score z
Dans le cours naturel des investigations empiriques, les chercheurs recueillent des métriques dimensionnelles disparates caractérisées par des unités de mesure incommensurables : des millimètres de mercure pour la pression artérielle, des millisecondes pour des latences d’inhibition cognitive, ou des scores bruts entiers sur une batterie d’évaluation de la dépression. Afin de comparer valablement des mesures issues de répertoires instrumentaux aussi divergents, le statisticien recourt à l’opération de standardisation, formalisée par le calcul du score z (ou score réduit standardisé). L’opérateur algébrique de transformation s’articule comme suit :
z = (x – μ) / σ
Cette transformation élémentaire opère une double métamorphose géométrique linéaire sur les données initiales :
- Le centrage : la soustraction systématique du paramètre de position $\mu$ ($x – \mu$) déplace l’origine du référentiel scalaire au centre de gravité de la distribution, annulant l’espérance mathématique de la série transformée ($\mathbb{E}[Z] = 0$).
- La réduction : la division séquentielle par l’écart-type de référence $\sigma$ rééchelonne la variance globale de la série transformée à une échelle normalisée unitaire ($\mathbb{V}[Z] = 1$).
La nouvelle variable standardisée $Z$ obéit dès lors à la loi normale centrée réduite, conventionnellement symbolisée par la notation compacte $\mathcal{N}(0, 1)$. Il est essentiel de souligner la nature purement linéaire de cet opérateur algébrique : la standardisation ne modifie en aucune manière les distances relatives intrinsèques séparant les points d’observation individuels et n’altère absolument pas la morphologie topologique sous-jacente de la distribution. Si les données brutes initiales ne sont pas issues d’un générateur de données intrinsèquement gaussien, le passage au score z produira une distribution standardisée dotée d’une moyenne nulle et d’une variance unitaire, mais qui conservera inaltérées ses caractéristiques d’asymétrie ou d’aplatissement aberrantes d’origine.
4.2 Lecture et exploitation des tables de la loi normale standardisée
Avant l’avènement ubiquitaire de l’informatique moderne et des algorithmes d’intégration numérique programmés en virgule flottante, le calcul des probabilités relatives sous une cloche gaussienne exigeait la consultation manuelle de tables statistiques imprimées, dont les tables de la loi normale standardisée $\mathcal{N}(0, 1)$ constituent l’archétype documentaire. La fonction mathématique tabulated dans ces fascicules canoniques est la fonction de répartition cumulative unilatérale, conventionnellement identifiée par la lettre grecque majuscule $Phi(z)$, qui caractérise l’aire cumulée sous la courbe comprise entre l’extrême négatif infini et le seuil d’intérêt $z$ :
Φ(z) = P(Z ≤ z) = (1 / √(2π)) × ∫-∞z exp(- t² / 2) dt
L’architecture matricielle typique de ces tables organise en marge verticale gauche les unités et la première décimale du score $z$ ciblé, tandis que la ligne horizontale supérieure énumère la deuxième décimale (les centièmes d’unité standard). À l’intersection de la ligne et de la colonne appropriées, le praticien extrait directement la probabilité cumulée correspondante, exprimée sous la forme d’un nombre réel compris entre 0,5000 et 0,9999 pour les valeurs positives du score standardisé.
L’exploitation fine de ces tables repose sur une maîtrise rigoureuse des déductions induites par la symétrie axiale parfaite de la loi normale centrée réduite. Par exemple, la détermination probabiliste pour un score $z$ strictement négatif tire profit de l’identité géométrique fondamentale $Phi(-z) = 1 – Phi(z)$. De même, pour calculer la probabilité exacte qu’un individu ou qu’une mesure physique aléatoire se stabilise à l’intérieur d’un corridor d’observation délimité par deux bornes distinctes $a$ et $b$ (avec $a < b$), l’utilisateur soustrait simplement les fonctions cumulatives respectives : $P(a le Z le b) = Phi(b) – Phi(a)$. Lorsque les scores calculés s’intercalent entre deux centièmes successifs imprimés dans la table, le recours à l’interpolation linéaire élémentaire permet d’affiner l’évaluation décimale à la précision requise sans recourir à un calculateur algorithmique externe.
4.3 Applications pratiques de comparabilité inter-échelles
L’utilité méthodologique la plus spectaculaire de la loi normale standardisée se matérialise dans l’harmonisation comparative d’évaluations cliniques divergentes. Considérons un cas classique en évaluation neuropsychologique où un patient subit deux tests distincts : une épreuve de rétention mnésique visuelle (Score brut $X_1 = 42$, au sein d’une échelle normée à $\mu_1 = 30$ et $\sigma_1 = 8$) et une tâche d’attention sélective informatisée mesurant les temps d’inhibition (Score brut $X_2 = 380$ millisecondes, au sein d’une échelle normée à $\mu_2 = 450$ ms et $\sigma_2 = 50$ ms). La simple juxtaposition arithmétique des scores bruns 42 et 380 est formellement stérile et conceptuellement dénuée de sens.
Le recours à la conversion vers l’espace standardisé métamorphose ces mesures hétérogènes en indices universellement intelligibles :
- Pour la mémoire visuelle : $z_1 = (42 – 30) / 8 = +1{,}50$. Le patient performe 1,5 écart-type au-dessus de la moyenne de sa cohorte d’âge, le situant au 93,32e rang centile ($\Phi(1{,}50) \approx 0{,}9332$).
- Pour l’attention sélective : $z_2 = (380 – 450) / 50 = -1{,}40$. S’agissant d’un temps de réaction où l’efficience est inversement proportionnelle à la latence chronométrique, un score standardisé inférieur de 1,4 écart-type sous la moyenne désigne en réalité une rapidité d’exécution supérieure à 91,92 % de la population générale ($P(Z > -1{,}40) = \Phi(1{,}40) \approx 0{,}9192$).
Au-delà du score z originel, la psychométrie a développé une pluralité d’échelles dérivées par simple reparamétrage affine direct afin d’annihiler la manipulation de valeurs décimales ou de préfixes négatifs, souvent anxiogènes ou sources d’erreurs pour les cliniciens et usagers :
| Échelle dérivée | Moyenne (μ) | Écart-type (σ) | Formule de transformation |
|---|---|---|---|
| Score T (McCall) | 50 | 10 | T = 50 + 10z |
| Quotient Intellectuel standard (QI) | 100 | 15 | QI = 100 + 15z |
| Stens (Standard Ten) | 5,5 | 2 | Sten = 5{,}5 + 2z |
| Stanines (Standard Nine) | 5 | 2 | Stanine = 5 + 2z |
Il importe toutefois de rappeler qu’une conversion inter-échelles n’est légitime que si et seulement si l’hypothèse distributionnelle de normalité des scores initiaux est formellement corroborée empiriquement, sous peine de diffuser des équivalences métriques spécieuses.
5. Protocole méthodologique pour le tracé et la représentation graphique
5.1 Étapes systématiques de construction d’une courbe normale
La transcription manuelle ou graphique rigoureuse d’une distribution normale exige l’application scrupuleuse d’une chaîne opératoire standardisée afin d’éviter les distorsions visuelles récurrentes observées dans la littérature vulgarisée. Le protocole d’ingénierie graphique procède impérativement par les étapes séquentielles suivantes :
- Étape 1 : Détermination des paramètres structuraux fondamentaux. L’opérateur doit définir avec exactitude la moyenne arithmétique $\mu$ et l’écart-type de référence $\sigma$ de la série quantitative étudiée.
- Étape 2 : Établissement du référentiel orthogonal et graduation de l’axe des abscisses. L’axe horizontal doit couvrir une amplitude symétrique minimale de six écarts-types, s’étendant formellement de $\mu – 3\sigma$ jusqu’à $\mu + 3\sigma$. L’axe doit idéalement porter une double graduation étalonnée : une graduation inférieure en métrique originale brute et une graduation sous-jacente en unités de scores $z$ centrés réduits ($[-3, -2, -1, 0, +1, +2, +3]$).
- Étape 3 : Positionnement de l’axe de symétrie et de l’apex culminant. Tracer un repère vertical orthogonal discret érigé à partir de l’abscisse médiane $x = \mu$. Le point culminant absolu de la cloche est placé à ce niveau d’abscisse précis, sa hauteur relative correspondant à $1/(\sigma \sqrt{2\pi})$.
- Étape 4 : Délimitation des points d’inflexion morphologiques. Marquer les deux coordonnées spatiales caractéristiques de concavité aux abscisses $x = \mu – \sigma$ et $x = \mu + \sigma$. La hauteur de ces deux points correspond mathématiquement à très exactement $f(\mu) \times e^{-1/2} \approx 0{,}6065 \times f(\mu)$, soit approximativement 60,6 % de la hauteur totale du sommet de la cloche.
- Étape 5 : Lissage géométrique de la voûte et raccordement asymptotique. Dessiner le dôme supérieur concave courbé vers le bas épousant le sommet et passant par les deux points d’inflexion. Dès que les coordonnées de transition $x = \mu \pm \sigma$ sont franchies, inverser immédiatement la courbure du tracé pour développer une trajectoire convexe fuyante vers les abscisses extrêmes, rasant progressivement l’axe horizontal sans jamais le toucher ni rebondir vers le haut.
5.2 Exemple didactique : distribution d’une variable biométrique continue
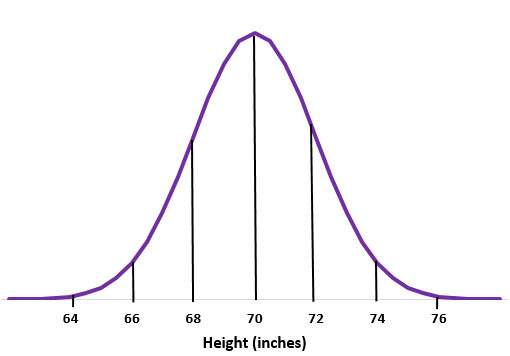
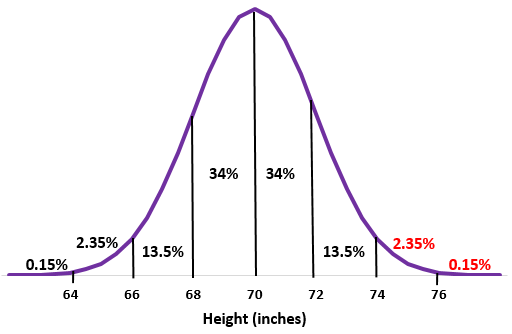
Afin d’illustrer concrètement ce protocole, appliquons-le à la modélisation de la stature physique au sein d’une cohorte masculine adulte hypothétique issue d’une population européenne contemporaine. Les paramètres métriques empiriques observés s’établissent à une taille moyenne de $\mu = 178$ centimètres et un écart-type de dispersion de $\sigma = 7$ centimètres. La construction du système de coordonnées sur une amplitude de six sigmas délimite un continuum s’étendant de $178 – (3 \times 7) = 157$ cm jusqu’à $178 + (3 \times 7) = 199$ cm.
Le calcul méthodique des paliers successifs de la règle empirique produit les seuils opérationnels suivants :
- Intervalle $\mu \pm 1\sigma$ : compris entre 171 cm et 185 cm. Cette bande centrale concentre 68,27 % de l’effectif global de la cohorte. Deux hommes sur trois présentent une stature s’inscrivant au sein de cette fourchette ordinaire.
- Intervalle $\mu \pm 2\sigma$ : compris entre 164 cm et 192 cm. Cet intervalle regroupe 95,45 % de la population. Les individus mesurant moins de 164 cm constituent le contingent statistiquement atypique inférieur (2,275 % de l’échantillon), tandis que les sujets toisant plus de 192 cm forment la marge symétrique supérieure de même densité probabiliste.
- Intervalle $\mu \pm 3\sigma$ : délimité par les bornes 157 cm et 199 cm. Cet espace absorbe 99,73 % des sujets. L’observation d’un adulte franchissant le seuil des 2 mètres d’envergure ($z > +3{,}14$) relève dès lors d’un événement rare, ne concernant que 0,08 % de cette population globale spécifique.
5.3 Exemple psychologique : modélisation d’une mesure cognitive standardisée
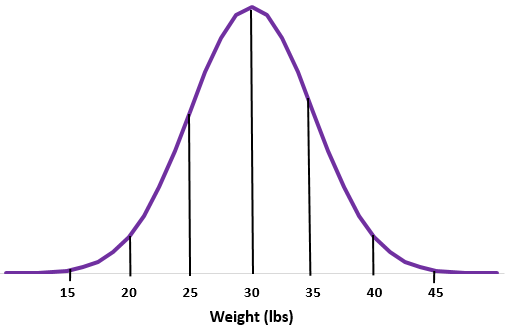
Transposons à présent cette méthode à une variable abstraite issue de la neuropsychologie clinique : un indice d’attention soutenue standardisé sur un échantillon étalon représentatif, paramétré canoniquement selon une espérance arithmétique de $\mu = 100$ et une déviation standard de $\sigma = 15$. La graduation ordonnée de la base de distribution positionne l’apex structural à la valeur pivot 100, flanqué de points d’inflexion morphologiques précisément ancrés aux valeurs 85 ($100 – 15$) et 115 ($100 + 15$).
La cartographie fonctionnelle de cette distribution permet d’opérer une stratification diagnostique rigoureuse :
- Zone de performance normale centrale : Scores échelonnés de 85 à 115 ($z in [-1, +1]$), regroupant 68,27 % de la population d’étalonnage.
- Zones de fragilité ou d’efficience supérieure : Scores compris entre 70 et 85 pour la tranche liminaire inférieure (-2 ≤ z < -1), et scores compris entre 115 et 130 pour le versant dynamique supérieur (+1 < z ≤ +2).
- Seuil critique de déficience neuropsychologique : Score inférieur ou égal à 70 ($z le -2{,}00$). Moins de 2,28 % des individus manifestent spontanément des latences ou des effondrements attentionnels d’une telle magnitude sans atteinte pathologique ou trouble neurodéveloppemental associé.
- Seuil d’excellence cognitive : Score excédant la valeur 130 ($z ge +2{,}00$), désignant les profils cognitifs aux aptitudes exécutives particulièrement aiguisées.
Les erreurs de tracé graphique les plus ubiquitaires dans ce contexte consistent en l’écrasement des queues latérales qui entrent prématurément en collision avec l’axe des abscisses, ou la confusion des points d’inflexion avec les paliers à deux écarts-types, créant des cloches au profil excessivement conique et pointu qui masquent la concavité du dôme supérieur.
6. Le théorème central limite : pilier de l’inférence en psychologie
6.1 Formulation théorique et intuition mathématique
Si la distribution normale s’est arrogée un statut aussi prédominant au sein de l’arsenal statistique contemporain, ce n’est nullement en vertu d’un postulat axiomatique arbitraire, mais sous l’égide d’un des résultats les plus spectaculaires de toute l’histoire des mathématiques : le théorème central limite (TCL). Élaboré initialement par Laplace et enrichi successivement par des mathématiciens russes et français tels qu’Alexandre Liapounov, Jarl Waldemar Lindeberg et Paul Lévy, ce théorème élucide le comportement probabiliste de la moyenne arithmétique d’une collection de variables aléatoires indépendantes.
Formulé de manière formelle, soit une suite ordonnée de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), notées $X_1, X_2, dots, X_n$, caractérisées par une espérance commune finie $\mathbb{E}[X_i] = \mu$ et une variance théorique commune non nulle et finie $\mathbb{V}[X_i] = \sigma^2$. Lorsque le nombre d’observations $n$ tend vers l’infini, la variable aléatoire standardisée représentant la distribution des moyennes d’échantillonnage $\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i$ converge asymptotiquement en loi vers la distribution normale standardisée $\mathcal{N}(0, 1)$ :
limn → ∞ P( (√n × (‾Xn – μ)) / σ ≤ z ) = Φ(z)
La puissance épistémologique de ce résultat réside dans son affranchissement total de la forme de la population d’origine : que les variables aléatoires primitives obéissent à une loi de probabilité continue uniforme, exponentielle, triangulaire, ou même à une distribution discrète binaire ou multimodale fortement asymétrique, la distribution théorique de la somme et de la moyenne de ces variables tendra inéluctablement vers une loi de Gauss dès lors que la taille d’échantillon devient suffisante. L’erreur type de la distribution d’échantillonnage de la moyenne, notée $\sigma_{\bar{X}} = \sigma / \sqrt{n}$, décroît de manière inversement proportionnelle à la racine carrée de l’effectif d’observation, condensant la précision de l’estimation autour du paramètre cible.
6.2 La règle du seuil d’échantillonnage de taille n supérieure à 30
Dans la littérature méthodologique et les manuels de formation quantitative en sciences humaines, une convention heuristique universelle prescrit que la normalité de la distribution des moyennes d’échantillonnage est raisonnablement assurée dès lors que la taille d’échantillon $n$ est strictement supérieure ou égale à 30 ($n ge 30$). Ce chiffre canonique dérive d’investigations computationnelles menées au début du vingtième siècle, notamment par Walter Shewhart pour le contrôle de processus et William Sealy Gosset (alias « Student »), démontrant que pour une vaste diversité de distributions parentes modérément dysmorphiques, l’erreur d’approximation commise en assimilant la loi d’échantillonnage à une courbe normale devient mathématiquement négligeable au-delà d’une trentaine d’unités indépendantes.
Il importe toutefois d’appréhender ce seuil de $n = 30$ comme une règle empirique indicative plutôt que comme un absolu nomothétique indépassable. La vitesse de convergence de la distribution d’échantillonnage vers la normalité théorique dépend organiquement du degré d’asymétrie structurelle de la distribution parente initiale. Si la variable fondamentale d’intérêt est extraite d’une population modérément asymétrique ou d’une distribution uniforme symétrique, un effectif restreint de $n = 10$ ou $n = 15$ individus suffit fréquemment à générer une distribution de moyennes d’une remarquable adéquation gaussienne. À l’opposé, si le phénomène investigué présente une asymétrie monumentale ou des queues particulièrement épaisses (telles que des distributions parétiennes de revenus, des données de prévalence de maladies rares ou des temps d’accès mnésiques pollués par des blocs attentionnels prolongés), un échantillon de $n = 50$, voire $n = 100$ sujets peut s’avérer nécessaire pour compenser l’inertie du biais asymétrique initial.
6.3 Fondement des statistiques inférentielles paramétriques
Le théorème central limite constitue le socle mathématique sur lequel repose l’ensemble de l’édifice de la statistique paramétrique inférentielle, laquelle irrigue les paradigmes de recherche en psychologie cognitive, sociale et différentielle. C’est grâce aux propriétés de convergence normale que l’usage de modèles linéaires conventionnels — tels que le test t de Student pour échantillons indépendants ou appariés, l’analyse de variance univariée et multivariée (ANOVA/MANOVA), ainsi que la régression linéaire multiple — est théoriquement validé.
En vertu du TCL, l’estimation des intervalles de confiance associés à des grandeurs empiriques bénéficie d’une formalisation analytique directe. Pour un paramètre de moyenne empirique $\bar{X}$ issu d’un échantillon d’effectif $n$, l’intervalle de confiance bilatéral classique au niveau d’assurance de 95 % est borné par :
IC95% = [ ‾X – 1{,}96 × (s / √n) , ‾X + 1{,}96 × (s / √n) ]
Où $s$ représente l’écart-type d’échantillon non biaisé. De surcroît, le TCL confère à ces procédures une résilience méthodologique remarquable : la robustesse statistique face aux déviations mineures de la normalité univariée. Il existe en effet une distinction épistémologique cardinale, fréquemment obscurcie chez les praticiens novices, entre la normalité des observations brutes initiales et la normalité des résidus ou des erreurs d’échantillonnage. Le modèle linéaire n’exige pas formellement que la variable dépendante brute soit intrinsèquement distribuée selon une loi normale, mais postule exclusivement que les résidus d’estimation (les écarts entre valeurs prédites et observées) se conforment à une dispersion gaussienne i.i.d. de moyenne nulle.
7. Applications psychométriques : étalonnage des tests et scores cognitifs
7.1 La mesure de l’intelligence et l’échelle standard du QI
L’application historique la plus emblématique de la distribution normale dans le champ des sciences humaines réside indubitablement dans la conceptualisation du Quotient Intellectuel (QI) de déviation, formalisé dans sa configuration moderne par le psychologue américain David Wechsler en 1939. Wechsler rompit délibérément avec la conceptualisation pionnière développée au début du siècle par Alfred Binet et Théodore Simon, qui s’adossait à la notion arithmétique de « quotient » par le calcul du ratio entre l’âge mental mesuré et l’âge chronologique réel du sujet ($\text{QI mental} = (\text{Âge mental} / \text{Âge réel}) \times 100$). Cette métrique originelle manifestait des limites insurmontables dès l’entrée dans l’âge adulte, la progression de l’âge biologique n’étant plus accompagnée d’une expansion parallèle de l’âge mental.
Wechsler substitua à cette mécanique un étalonnage purement statistique fondé sur la loi normale centrée réduite, configurant l’échelle globale du QI de déviation selon une distribution gaussienne théorique paramétrée par une moyenne de $\mu = 100$ et un écart-type canonique de $\sigma = 15$ :
| Intervalle de QI standard | Zone en écarts-types (Score z) | Pourcentage théorique | Qualification psychométrique |
|---|---|---|---|
| > 130 | z > +2,00 | 2,28 % | Très supérieur / Haut Potentiel Intellectuel (HPI) |
| 120 – 129 | +1,33 ≤ z ≤ +2,00 | 6,87 % | Supérieur / Au-dessus de la moyenne |
| 110 – 119 | +0,67 ≤ z < +1,33 | 16,12 % | Moyen supérieur |
| 90 – 109 | -0,67 ≤ z ≤ +0,67 | 49,46 % | Moyen / Zone modale ordinaire |
| 80 – 89 | -1,33 ≤ z < -0,67 | 16,12 % | Moyen inférieur |
| 70 – 79 | -2,00 ≤ z < -1,33 | 6,87 % | Zone limite / Fonctionnement déficitaire léger |
| < 70 | z < -2,00 | 2,28 % | Déficience intellectuelle caractérisée |
Cette échelle relative impose que l’efficience intellectuelle soit continuellement réévaluée au prisme de la cohorte d’âge contemporaine du sujet. Cette exigence est particulièrement mise en exergue par l’effet Flynn, documenté par le chercheur James Flynn, qui décrit un glissement séculaire continu vers le haut des scores moyens bruts aux épreuves d’intelligence non verbale au cours du vingtième siècle à travers le monde industrialisé. Ce phénomène impose aux éditeurs de tests un réétalonnage périodique des échelles afin que le point $\mu = 100$ coïncide fidèlement avec le niveau d’efficience contemporain de la population générale, évitant ainsi des dérives diagnostiques induites par des normes obsolètes.
7.2 Standardisation des inventaires de personnalité et échelles cliniques
L’application du modèle gaussien s’étend avec une vigueur identique à la modélisation de la personnalité et à la métrologie psychopathologique. Au sein de la psychologie dimensionnelle moderne, gouvernée par le modèle des Big Five (Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme ou OCEAN) développé par Paul Costa et Robert McCrae, chaque trait fondamental est théorisé comme une variable continue normale. La plupart des individus exhibent une intensité modérée d’extraversion ou de méticulosité, tandis que les phénotypes d’introversion radicale ou d’obsession méticuleuse extrême occupent les extensions marginales de part et d’autre des points d’inflexion.
Au sein des instruments psychopathologiques d’envergure, tels que le célèbre Minnesota Multiphasic Personality Inventory (MMPI), les scores bruts sont transformés en scores standardisés T de McCall ($\mu = 50$, $\sigma = 10$). Cette transformation permet d’instituer des démarcations sémiologiques rigoureuses :
- Un score $T$ oscillant entre 45 et 55 matérialise l’absence totale de souffrance ou d’atypie clinique.
- Le seuil critique $T = 65$ (soit $z = +1{,}50$) marque l’amorce de la zone d’alerte clinique, requérant une vigilance diagnostique accrue.
- Le seuil $T ge 70$ (soit $z ge +2{,}00$) établit formellement le franchissement du critère de déviation pathologique statistiquement significative, indiquant la présence d’une symptomatologie aiguë invalidante (épisode dépressif sévère, manie, manifestations psychotiques).
Il est toutefois nécessaire de souligner le caractère fréquemment artificiel de cette normalisation. Les inventaires d’auto-évaluation mobilisent des échelles de réponse discrètes ordonnées de type Likert (par exemple graduées de 1 à 5). La normalisation des sommes d’items par le score z repose souvent sur l’hypothèse audacieuse que les intervalles subjectifs entre les choix de réponse sont équidistants, opérant ainsi la conversion d’une échelle ordinale en une métrique d’intervalle continue.
7.3 Étalonnage par percentiles et correspondances métriques
Dans la pratique de la restitution des conclusions psychométriques aux patients ou aux institutions éducatives, les cliniciens privilégient souvent les rangs centiles (ou percentiles), jugés intuitivement plus intelligibles que les abstractions algébriques des scores standardisés. Le rang centile indique le pourcentage précis d’individus de l’échantillon normatif d’étalonnage qui obtiennent un score strictement inférieur ou égal au résultat du sujet examiné. Le calcul formel s’appuie directement sur la fonction de répartition normale standardisée : $\text{Rang Centile} = \Phi(z) \times 100$.
Toutefois, cette passerelle recèle un écueil interprétatif majeur : la distorsion non linéaire fondamentale de l’espacement des percentiles. Sous la voûte d’une distribution normale en cloche, la densité d’observations est formidablement concentrée à proximité immédiate de la moyenne et s’amenuise drastiquement dans les queues latérales. En conséquence, un minuscule écart d’un tiers d’écart-type au cœur de la distribution propulse le rang centile d’une amplitude colossale, alors qu’une variation similaire à la périphérie produit une progression en pourcentage infinitésimale :
| Progression en Score z | Évolution du Rang Centile | Gain absolu en Percentiles | Région de la distribution |
|---|---|---|---|
| De z = 0,00 à z = +0,50 | Du 50,0e au 69,1e centile | +19,15 % | Centre immédiat (haute densité) |
| De z = +1,00 à z = +1,50 | Du 84,1e au 93,3e centile | +9,20 % | Zone intermédiaire |
| De z = +2,00 à z = +2,50 | Du 97,7e au 99,4e centile | +1,65 % | Queue extrême (faible densité) |
Une confusion fréquente chez les profanes consiste à interpréter les centiles comme s’il s’agissait d’une échelle à intervalles réguliers. Passer du 50e au 60e centile requiert un gain cognitif modeste (0,25 écart-type), alors que passer du 90e au 99e centile exige une progression spectaculaire de plus d’un écart-type complet (soit 15 points de QI standard supplémentaires). Les praticiens doivent donc faire preuve d’une grande rigueur herméneutique lors de la communication de ces bilans quantitatifs.
8. Diagnostic de normalité : outils graphiques et tests statistiques
8.1 Méthodes exploratoires et inspections graphiques
L’application non critique de tests inférentiels paramétriques présupposant une distribution normale impose, comme prérequis méthodologique fondamental, de tester l’adéquation de la distribution empirique des données à la courbe théorique de Gauss. Ce diagnostic débute par l’inspection visuelle et l’analyse exploratoire des données. La première approche élémentaire repose sur la construction d’un histogramme de fréquences pondéré par la superposition de la courbe de densité théorique calibrée sur les paramètres de l’échantillon ($\bar{X}$ et $s$). Bien qu’accessible, cette méthode souffre d’une dépendance directe au choix de la largeur de classe (ou nombre de casiers, bins), une segmentation arbitraire pouvant masquer ou exagérer artificiellement des asymétries locales.
L’instrument graphique le plus robuste et le plus discriminant demeure le diagramme quantile-quantile, universellement désigné sous le terme de diagramme Q-Q plot. Ce dispositif met en relation les quantiles calculés à partir de la distribution empirique de l’échantillon en ordonnée et les quantiles théoriques attendus sous une loi normale centrée réduite en abscisse. Si les données proviennent d’une population parente strictement normale, les points individuels s’alignent rigoureusement le long d’une bissectrice diagonale idéale à 45 degrés :
- Déviation en forme de « S » ou sigmoïde : témoigne d’un problème d’aplatissement ; les points s’écartent vers le haut ou le bas aux extrémités selon la nature leptocurtique ou platycurtique des queues de distribution.
- Courbure systématique en parabole (forme de banane) : révèle une asymétrie marquée (positive si la concavité est tournée vers le haut, négative si elle est inversée).
Enfin, le diagramme en boîte (box plot de Tukey) complète cette première évaluation exploratoire en illustrant la position de la médiane au sein de l’espace interquartile et en isolant graphiquement les points marginaux s’écartant au-delà de 1,5 fois l’écart interquartile (IQR).
8.2 Indices numériques de forme : asymétrie et aplatissement
Pour dépasser la subjectivité inhérente aux évaluations visuelles exploratoires, le statisticien quantifie rigoureusement la morphologie de la distribution par l’estimation des troisième et quatrième moments centrés standardisés : l’indice d’asymétrie (skewness) et l’indice d’aplatissement (kurtosis).
Le coefficient d’asymétrie non biaisé de Fisher, noté $g_1$, mesure le degré de déséquilibre directionnel de la distribution autour de la moyenne arithmétique :
- Une valeur $g_1 = 0$ reflète une symétrie parfaite.
- Un indice $g_1 > 0$ signe une asymétrie positive (ou étirement à droite), signalant une accumulation d’observations dans les valeurs basses associée à une longue traîne de valeurs élevées isolées.
- Un indice $g_1 < 0$ traduit une asymétrie négative (ou étirement à gauche), fréquente lors de l’observation d’effets de plafond.
Le coefficient d’aplatissement non biaisé (excès de kurtosis de Fisher, noté $g_2$) évalue la propension de la distribution à concentrer sa masse de probabilité au niveau de ses queues extrêmes comparativement à la loi normale standard :
- Un excès de kurtosis $g_2 = 0$ correspond à la distribution normale de référence, qualifiée de mésocurtique.
- Un indice $g_2 > 0$ correspond à une distribution leptocurtique, caractérisée par des queues particulièrement lourdes et épaisses et un pic central pointu.
- Un indice $g_2 < 0$ désigne une morphologie platycurtique, avec des queues allégées et un sommet aplati.
Dans la pratique de la psychométrie appliquée et de la modélisation par équations structurelles, des critères conventionnels d’acceptabilité tolèrent généralement une distribution comme compatible avec l’inférence normale dès lors que l’indice de skewness demeure compris dans l’intervalle $[-1, +1]$ (voire $[-2, +2]$ selon des auteurs plus permissifs) et que l’excès de kurtosis ne franchit pas les bornes $[-2, +2]$. Il est impératif d’examiner les erreurs types associées à ces indices ($\text{SE}_{g1} \approx \sqrt{6/n}$ et $\text{SE}_{g2} \approx \sqrt{24/n}$), car leur fiabilité dépend étroitement de la taille de l’échantillon considéré.
8.3 Tests formels d’adéquation à la loi normale
L’arbitrage ultime de la conformité à la normalité s’appuie sur des batteries d’inférence d’hypothèse formelle, où l’hypothèse nulle ($H_0$) postule que la variable aléatoire est issue d’une population gouvernée par une loi normale. Le rejet de cette hypothèse au seuil d’incertitude critique traditionnel $\alpha = 0{,}05$ indique une divergence statistiquement significative par rapport au modèle gaussien idéal.
Le test de référence le plus puissant et le plus couramment préconisé dans la littérature méthodologique contemporaine est le test de Shapiro-Wilk. Développé en 1965 par Samuel Sanford Shapiro et Martin Wilk, ce test repose sur le calcul d’une statistique $W$ représentant le rapport entre l’estimateur de la pente d’un diagramme Q-Q par régression généralisée et la variance d’échantillon classique. Proche de l’unité ($W \approx 1$) sous l’hypothèse normale, le test démontre une sensibilité analytique remarquable pour des effectifs restreints à modérés ($n in [7, 50]$), surpassant systématiquement les méthodes concurrentes.
Parallèlement, d’autres procédures inférentielles sont largement répandues :
- Le test de Kolmogorov-Smirnov avec correction de Lilliefors : adapté lorsque les paramètres $\mu$ et $\sigma$ de la population ne sont pas préalablement fixés mais directement estimés à partir de l’échantillon, évitant ainsi une sous-estimation systématique du risque d’erreur de type I.
- Le test d’Anderson-Darling : une variante du test de Cramér-von Mises qui applique une fonction de pondération quadratique sur les extrémités de la distribution, conférant à cette épreuve une sensibilité spécifique pour déceler les épaississements de queues.
Toutefois, le chercheur aguerri doit impérativement composer avec le paradoxe de la puissance statistique propre à l’ensemble de ces épreuves d’adéquation : dans les échantillons de taille colossale ($n > 1000$), le test formel de Shapiro-Wilk devient si puissant qu’il détecte et rejette formellement $H_0$ pour d’infimes fluctuations aléatoires totalement dénuées d’impact sur la validité des modèles linéaires paramétriques. Inversement, dans les échantillons très restreints ($n < 20$), son manque de puissance statistique peut conduire à ne pas rejeter $H_0$ face à des asymétries majeures. Il est donc recommandé de croiser systématiquement ces tests d’hypothèse avec une inspection graphique méthodique et l’évaluation des coefficients d’asymétrie et d’aplatissement.
9. Écarts à la normalité dans les données psychologiques réelles
9.1 Effets de plancher et de plafond dans les épreuves psychologiques
Dans l’évaluation empirique des conduites humaines, la parfaite conformité à une distribution gaussienne idéale constitue l’exception plutôt que la norme. Les déviations les plus structurantes et délétères rencontrées par les méthodologues résultent de l’inadéquation entre le niveau d’étalonnage de difficulté d’une épreuve psychométrique et la capacité fonctionnelle réelle de la population cible, provoquant l’émergence d’effets de plancher (floor effect) ou d’effets de plafond (ceiling effect).
Un effet de plancher se manifeste lorsqu’une tâche cognitive s’avère excessivement complexe, obscure ou discriminante pour l’échantillon considéré. Une masse considérable de sujets échoue à l’ensemble des items proposés, enregistrant des scores bruts agrégés autour de la valeur minimale de l’échelle (zéro). Ce phénomène génère une distribution tronquée marquée par une accumulation artificielle de fréquences à la marge gauche et une longue traîne vers la droite (forte asymétrie positive). C’est fréquemment le cas lorsque des épreuves d’évaluation des fonctions exécutives conçues pour des adultes sains sont administrées sans adaptation à des patients cérébrolésés graves ou à des enfants en bas âge.
Réciproquement, l’effet de plafond s’établit dès lors que l’instrument instrumente une épreuve cognitive ou psychosociale trop élémentaire ou insuffisamment discriminante : une proportion disproportionnée de participants atteint le score parfait maximal possible. La distribution consécutive exhibe alors une asymétrie négative prononcée, la variance métrique s’effondrant drastiquement par saturation supérieure. Ces anomalies de mesure détruisent l’hypothèse de continuité normale, oblitèrent le pouvoir discriminant du test et compressent artificiellement les corrélations bivariées entre construits théoriques (problème d’atténuation statistique). La parade méthodologique exige l’intégration systématique d’items de calibrages gradués couvrant l’ensemble du continuum de difficulté lors de la phase de validation de l’épreuve.
9.2 Distributions bimodales et hétérogénéité d’échantillon
L’émergence d’une distribution bimodale — manifestant deux pics distincts de fréquence séparés par un creux intermédiaire — signale généralement une violation de l’hypothèse d’homogénéité de la population sous-jacente. Cette morphologie singulière constitue une anomalie diagnostique majeure : la variable mesurée ne provient pas d’un ensemble unique d’agents gouvernés par les mêmes processus probabilistes, mais trahit l’agrégation de deux (ou plusieurs) sous-populations distinctes non identifiées ou confondues au sein d’une même cohorte d’analyse.
Dans la recherche neuropsychologique ou psychiatrique, ce phénomène s’observe de manière paradigmatique lorsque l’échantillon collige simultanément, à l’insu du chercheur, des individus asymptomatiques ordinaires et des patients porteurs d’une lésion organique non diagnostiquée, d’un déficit génétique sous-jacent ou d’une mutation métabolique singulière. La distribution globale enregistrée reflète alors la sommation mathématique de deux sous-courbes normales distantes dotées d’espérances arithmétiques divergentes ($\mu_{\text{sain}} \neq \mu_{\text{pathologique}}$).
De même, des variables médiatrices ou modératrices non contrôlées (telles que le sexe biologique sur certaines aptitudes spatiales ou perceptivo-motrices, le statut socio-économique ou le bilinguisme précoce dans des épreuves linguistiques) peuvent scinder artificiellement une distribution normale attendue en deux entités composites. Face à ce défi méthodologique, l’usage des modèles de mélanges gaussiens (Gaussian Mixture Models, GMM) permet de décomposer algorithmiquement la distribution agrégée empirique en ses composantes univariées sous-jacentes, restaurant la pertinence des inférences statistiques.
9.3 Asymétrie positive endémique : le cas des temps de réaction
S’il existe un domaine où le postulat de normalité gaussienne stricte est fondamentalement invalidé par la physiologie humaine, c’est celui de la chronométrie mentale et de la psychologie cognitive expérimentale. L’enregistrement des latences temporelles nécessaires au cerveau humain pour percevoir, discriminer un stimulus et orchestrer une réponse motrice produit systématiquement une distribution grevée d’une asymétrie positive structurelle incompressible.
Cette asymétrie résulte d’une asymétrie physiologique fondamentale :
- Il existe une limite physiologique incompressible inférieure rigoureuse (le temps de conduction axonale et synaptique minimale, situé historiquement aux alentours de 100 à 150 millisecondes pour des stimuli auditifs ou visuels simples). Aucune réponse humaine ne peut s’affranchir de cette barrière biologique.
- À l’opposé, la frontière supérieure est théoriquement illimitée : des micro-décrochages attentionnels, des hésitations délibératives ou des défaillances motrices passagères étirent une traîne de latences vers des valeurs de plusieurs centaines, voire milliers de millisecondes.
L’inadéquation de la distribution normale pour modéliser des temps de réaction a conduit les cognitivistes à recourir à des modélisations mathématiques alternatives infiniment plus représentatives de la dynamique des flux d’information cérébraux :
- La loi log-normale : postulant que le logarithme népérien du temps de réaction obéit à une courbe de Gauss régulière.
- La distribution ex-gaussienne : formalisée comme la convolution mathématique directe d’une distribution normale (modélisant les composantes perceptives et motrices basales) et d’une distribution exponentielle (modélisant les fluctuations de l’attention et des processus décisionnels centraux).
- La loi de Weibull : fréquemment employée dans la modélisation probabiliste des temps de survie et des dynamiques d’activation neuronale.
10. Stratégies méthodologiques face aux distributions non normales
10.1 Transformations mathématiques des variables brutes
Lorsque les données empiriques dérogent de manière substantielle aux exigences de symétrie et de mésocurticité du modèle gaussien, les méthodologues disposent d’un arsenal d’interventions correctives. La démarche classique la plus éprouvée repose sur l’application d’une fonction mathématique non linéaire aux scores bruts initiaux afin de compresser l’asymétrie structurelle et de rétablir la normalité des résidus d’estimation.
Le choix de la transformation idoine est directement dicté par la nature morphologique de l’anomalie :
- La transformation logarithmique ($X’ = ln(X)$ ou $\log_{10}(X)$) : instrument d’élection face à des asymétries positives sévères (comme les données de latence temporelle ou les indicateurs de salaires et de patrimoines). La fonction logarithmique exerce une compression géométrique proportionnelle d’autant plus violente que la valeur d’observation est élevée, resserrant drastiquement les extensions latérales. (Si la variable comporte des zéros réels, on utilise canoniquement la variante $ln(X + 1)$).
- La transformation par racine carrée ($X’ = \sqrt{X}$) : particulièrement adaptée aux asymétries positives modérées et aux données discrètes issues de processus de comptage ou d’occurrence d’erreurs rares répondant traditionnellement à une loi de Poisson.
- La transformation réciproque ($X’ = 1 / X$) : constitue l’outil le plus radical pour réduire les asymétries positives monumentales en inversant l’ordre métrique, souvent employée pour métamorphoser un temps de réaction en vitesse de traitement de l’information.
Pour dépasser l’empirisme du choix fonctionnel, statisticiens George Box et David Cox ont développé la célèbre famille de transformations de Box-Cox, qui automatise la quête algorithmique d’un paramètre continu d’optimisation noté $lambda$ (lambda) par maximisation de la fonction de vraisemblance :
y(λ) = (yλ – 1) / λ (pour λ ≠ 0) | y(λ) = ln(y) (pour λ = 0)
Il importe toutefois d’émettre une réserve herméneutique majeure : si ces transformations stabilisent la variance et restaurent la validité des modèles linéaires, elles compliquent l’interprétation sémantique directe des résultats, le chercheur raisonnant dès lors sur des échelles transformées (logarithmes, racines carrées) qui ne partagent plus les caractéristiques d’intelligibilité des métriques originelles.
10.2 Alternatives non paramétriques et tests robustes
Lorsque la taille d’échantillon est restreinte ($n < 30$) et que les distorsions par rapport à la normalité sont trop sévères pour être corrigées par une transformation mathématique, le renoncement aux modèles paramétriques devient méthodologiquement impératif. Le chercheur se tourne alors vers la statistique non paramétrique, également désignée sous l’appellation de statistique à distribution libre (distribution-free statistics).
Ces méthodologies évacuent tout postulat relatif à la forme géométrique sous-jacente de la population en substituant aux valeurs continues brutes leur rang ordinal séquentiel au sein de la série ordonnée ascendante de données :
| Épreuve paramétrique classique | Contrepartie non paramétrique sur les rangs | Objectif d’évaluation |
|---|---|---|
| Test t de Student pour échantillons indépendants | Test U de Mann-Whitney (Wilcoxon rank-sum) | Comparaison de deux groupes indépendants |
| Test t de Student pour échantillons appariés | Test des rangs signés de Wilcoxon | Comparaison intra-sujets de mesures répétées |
| ANOVA à un facteur inter-sujets | Test de Kruskal-Wallis (H-test) | Comparaison de k groupes indépendants (> 2) |
| ANOVA à mesures répétées | Test de Friedman | Comparaison intra-sujets multivariée |
| Corrélation linéaire r de Pearson | Coefficient rho de Spearman ou tau de Kendall | Association monotone bivariée |
Le privilège inestimable des approches fondées sur les rangs réside dans leur insensibilité face aux valeurs aberrantes extrêmes (outliers) et aux violations majeures de l’homoscédasticité. Cependant, cette résilience se paie d’un tribut méthodologique : une perte substantielle de puissance statistique asymptotique (généralement évaluée à une efficacité relative d’environ 95 % face à une véritable loi normale de référence) et une incapacité relative à modéliser des interactions complexes de facteurs d’ordre élevé, pour lesquelles le recours aux estimateurs statistiques robustes (moyennes tronquées de Yuen, médianes bootstrapées) s’avère nettement supérieur.
10.3 Approches computationnelles modernes par rééchantillonnage
L’essor de la puissance de calcul informatique au cours des dernières décennies a révolutionné la prise en charge des données non gaussiennes en promouvant l’ingénierie computationnelle du rééchantillonnage, matérialisée de manière emblématique par le bootstrap non paramétrique conceptualisé par Bradley Efron en 1979. Le bootstrap contourne élégamment l’obligation de postuler une fonction de densité théorique a priori en considérant l’échantillon empirique recueilli comme la meilleure approximation disponible de la population parente inconnue.
La méthodologie algorithmique du bootstrap procède par itérations intensives :
- À partir de l’échantillon empirique initial d’effectif $n$, l’ordinateur tire par tirage au sort avec remise un nombre colossal de pseudo-échantillons (typiquement $B = 5,000$ à $10,000$ réplications), chacun possédant une taille strictement identique de $n$ unités.
- Pour chaque réplication de bootstrap, la statistique d’intérêt est recalculée (qu’il s’agisse d’une médiane, d’un ratio de corrélation, d’un coefficient de régression ou d’un paramètre d’interaction).
- L’agrégation de ces milliers d’estimations engendre la distribution d’échantillonnage empirique directe du paramètre.
Sur cette base, le calcul d’intervalles de confiance corrigés du biais et accélérés (Bias-Corrected and Accelerated, BCa) fournit des estimations d’une exactitude remarquable, totalement libérées de l’hypothèse de normalité des résidus. Conjointement, les tests de permutations (ou tests de randomisation d’exactitude) réassignent aléatoirement les étiquettes de groupes d’observation des milliers de fois pour déduire la probabilité critique $p$ sous l’hypothèse nulle pure d’interchangeabilité. Ces technologies algorithmiques s’imposent désormais comme le standard méthodologique contemporain face aux architectures de données complexes en sciences comportementales.
11. Enjeux épistémologiques et éthiques de la normalité en psychologie
11.1 Le concept de normalité : glissement de la statistique au normatif
L’assimilation conceptuelle entre la régularité statistique et la « normalité » fonctionnelle ou éthique constitue un des glissements sémantiques les plus prégnants et problématiques de l’histoire des sciences de l’esprit. Dès les prolégomènes théoriques d’Adolphe Quetelet, l’architecture probabiliste de la courbe de Gauss a fait l’objet d’une surinterprétation idéologique : en déclarant que l’Homme moyen incarnait la perfection esthétique, morale et sociale, et que les déviations périphériques étaient l’analogue d’imperfections ou de monstres de la nature, Quetelet injectait subrepticement un jugement de valeur moral au sein d’une simple modélisation géométrique de distribution.
En psychologie et en psychiatrie, ce glissement a historiquement nourri une propension épistémologique pernicieuse : déduire la désirabilité sociale ou la santé mentale de la fréquence statistique pure. Pourtant, une régularité probabiliste n’a jamais constitué en soi une preuve d’adaptabilité fonctionnelle. Être statistiquement « dans la norme » signifie exclusivement partager le comportement, l’attitude ou la performance du contingent le plus nombreux à une époque donnée et dans un environnement culturel circonscrit. À titre d’exemple, sous des régimes politiques totalitaires ou dans des sociétés ségréguées, la conformité aveugle ou les préjugés xénophobes constituent statistiquement des comportements modaux dominants situés au cœur de la courbe en cloche ; ils n’en demeurent pas moins des altérations de la liberté éthique et du discernement rationnel.
Inversement, les singularités situées dans les queues latérales de la distribution — qu’il s’agisse de sensibilités empathiques hors du commun, d’aptitudes créatrices visionnaires ou de modes de raisonnement atypiques — ont souvent fait l’objet d’une pathologisation réflexe par les appareils diagnostiques, confondant la rareté distributionnelle avec une dysfonction adaptative, et oblitérant le fait que la variabilité marginale est le moteur indispensable de l’évolution biologique et culturelle des sociétés.
11.2 La délimitation arbitraire du normal et du pathologique
L’adoption quasi dogmatique de la frontière des deux écarts-types ($\mu \pm 2\sigma$) pour séparer le champ de la santé de celui de la pathologie pose de redoutables dilemmes nosographiques et diagnostiques, brillamment disséqués par le philosophe et médecin Georges Canguilhem dans son essai séminal Le Normal et le Pathologique (1943). Canguilhem a démontré avec une force clinique imparable que la santé n’est pas une moyenne statistique impersonnelle, mais une dynamique individuelle de normativité vitale, c’est-à-dire la capacité d’un organisme singulier à instaurer de nouvelles normes de fonctionnement adaptées à son contexte écologique.
Sur le plan métrologique, l’établissement d’une démarcation catégorielle dichotomique (Normal vs Pathologique) sur un trait d’expression continuel relève d’une convention statistique arbitraire. Rien dans la physiologie cérébrale ou l’ontologie psychique ne justifie qu’un individu doté d’un score standardisé $z = -1{,}95$ soit qualifié de neurotypique sain, tandis qu’un individu voisin enregistrant un score $z = -2{,}05$ se voie assigner une étiquette nosographique formelle de déficience intellectuelle ou de trouble attentionnel. Cette discontinuité artificielle génère une insécurité diagnostique majeure :
- Des risques constants de faux positifs ou de surdiagnostic à la périphérie immédiate des frontières de coupure.
- L’exclusion injustifiée de la prise en charge thérapeutique de profils en grande souffrance adaptative mais dont le score brut échoue d’une fraction d’écart-type sous le seuil d’admissibilité administrative.
Cette vulnérabilité des classifications catégorielles a stimulé l’évolution contemporaine de la nosographie psychiatrique internationale — illustrée par les évolutions de la cinquième édition du Manuel diagnostique et statistique des troubles mentaux (DSM-5) et de la CIM-11 — vers des modèles dimensionnels hybrides. Ces approches évaluent la sévérité fonctionnelle sur un continuum dynamique gradué plutôt que d’imposer des démarcations binaires rigides adossées aux seules queues de la courbe de Gauss.
11.3 Neurodiversité et remise en question du modèle de la courbe unique
L’hégémonie de la courbe en cloche en tant que matrice d’évaluation des compétences et personnalités humaines est aujourd’hui vigoureusement contestée par le paradigme de la neurodiversité. Conceptualisé à la fin des années 1990 par la sociologue australienne Judy Singer, ce paradigme récuse l’idée qu’il existerait un profil neurologique humain « étalon » universel dont toutes les déviations constitueraient des pathologies, plaidant pour la reconnaissance des fonctionnements cognitifs atypiques (tels que l’autisme, les troubles des apprentissages « dys », le TDAH) comme des variations naturelles et légitimes du génome humain.
D’un point de vue méthodologique, l’erreur séculaire de la psychométrie a consisté à postuler l’adéquation universelle d’une courbe en cloche unitaire pour l’ensemble de l’espèce humaine, masquant les biais systématiques inhérents aux échantillons normatifs d’étalonnage. Historiquement, ces panels d’étalonnage ont été massivement constitués à partir d’individus répondant au profil dit WEIRD (Western, Educated, Industrialized, Rich, Democratic). Les épreuves verbales, spatiales et perceptives reflètent inévitablement les codes communicationnels et les priorités éducatives de cette sous-population dominante.
De surcroît, le profil psychologique d’un individu neuroatypique ne se prête pas à une réduction synthétique univariée. Un profil autistique de haut niveau manifestera fréquemment un fonctionnement dit « en dents de scie » (spiky profile), caractérisé par des compétences de traitement perceptif ou logique culminant à plus de trois écarts-types au-dessus de la moyenne ($z > +3{,}00$) combinées à des habiletés d’intégration sociale ou d’inhibition se situant à deux écarts-types sous la moyenne ($z < -2{,}00$). Réduire un tel fonctionnement à une note médiane globale ou tenter de le forcer à s’ajuster à un gabarit gaussien classique trahit la réalité de son écologie psychique. La pratique contemporaine impose ainsi de coupler l’évaluation quantitative standardisée à des analyses qualitatives fines et écosystémiques.
12. Implémentation informatique et modélisation de la loi normale
12.1 Analyse et traitement de la distribution normale sous l’environnement R
Dans l’écosystème de la recherche quantitative et de la biostatistique contemporaine, le langage de programmation statistique R s’affirme comme l’outil privilégié pour la modélisation analytique de la loi normale. Le noyau de base du langage implémente de façon native un ensemble cohérent de quatre fonctions primitives, identifiables par les préfixes directeurs d, p, q et r associés au radical canonique norm :
dnorm(x, mean, sd): Évalue ponctuellement la fonction de densité de probabilité $f(x)$ pour une valeur d’abscisse donnée. Utilisée pour tracer des courbes de distribution théoriques.pnorm(q, mean, sd): Calcule la fonction de répartition cumulative unilatérale $Phi(q)$, retournant la probabilité formelle $P(X le q)$. Essentielle pour déterminer les rangs centiles et les valeurs $p$.qnorm(p, mean, sd): La fonction quantile inverse de la précédente ; pour une probabilité cumulée donnée, elle identifie l’abscisse métrique correspondante ($x$). Outil clé pour fixer des scores seuils critiques.rnorm(n, mean, sd): Génère un vecteur de $n$ réalisations de variables pseudo-aléatoires distribuées selon la loi normale spécifiée, servant de base aux simulations de Monte-Carlo.
Au-delà de ces primitives de base, l’exploitation avancée de la normalité mobilise des bibliothèques spécialisées comme ggplot2 pour la sémiologie graphique et car ou nortest pour le diagnostic distributionnel. Le calcul formel du test de Shapiro-Wilk est exécuté directement par la commande shapiro.test(variable), tandis que la projection des quantiles est automatisée par qqnorm(variable) et qqline(variable). L’utilisateur peut ainsi superposer aux diagrammes de dispersion des enveloppes de confiance paramétriques à 95 % issues du bootstrap, permettant une détection visuelle sans équivoque des déviations aux extrémités.
12.2 Modélisation computationnelle avec l’écosystème Python
Au sein de la science des données et de l’apprentissage automatique (machine learning), le langage Python propose un écosystème hautement performant pour le traitement de la distribution normale, principalement articulé autour de la triade de bibliothèques scientifiques NumPy, SciPy et Matplotlib/Seaborn.
Le sous-module scipy.stats abrite la classe générique norm, qui expose l’ensemble des méthodes statistiques indispensables à l’analyse :
scipy.stats.norm.pdf(x, loc, scale): Calcul de la densité probabiliste univariée ($loc = \mu$, $scale = \sigma$).scipy.stats.norm.cdf(x, loc, scale): Intégration de la fonction de répartition cumulative unilatérale.scipy.stats.norm.ppf(q, loc, scale): Calcul de la fonction inverse des centiles (percent point function).scipy.stats.norm.fit(data): Ajuste un échantillon empirique à la loi normale en estimant les paramètres $\mu$ et $\sigma$ optimaux selon le principe du maximum de vraisemblance (MLE).
Pour le calcul matriciel intensif, numpy.random.normal(loc, scale, size) permet d’échantillonner des millions de valeurs gaussiennes en quelques millisecondes grâce à l’implémentation de générateurs rapides de nombres pseudo-aléatoires comme l’algorithme de Box-Muller ou la méthode Ziggurat. Sur le plan de la visualisation, l’appel combiné de seaborn.histplot(data, kde=True) et scipy.stats.probplot(data, plot=plt) génère instantanément des représentations associant histogrammes pondérés, estimations de densité par noyau (KDE) et diagrammes Q-Q plots standardisés. Ces routines s’intègrent au sein de pipelines de prétraitement automatisés, tels que la classe StandardScaler de scikit-learn, qui applique le centrage-réduction ($z$-score) sur des matrices multidimensionnelles avant l’entraînement d’algorithmes prédictifs.
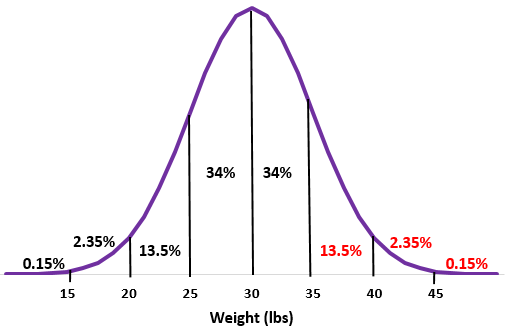
12.3 A priori gaussiens et modélisation bayésienne en sciences comportementales
L’exploitation contemporaine la plus sophistiquée de la loi normale réside dans la transition méthodologique vers la statistique et l’inférence bayésiennes en sciences cognitives, soutenue par des logiciels probabilistes d’échantillonnage par chaînes de Markov Monte-Carlo (MCMC) tels que Stan, PyMC ou le paquet R brms.
Contrairement au paradigme fréquentiste orthodoxe qui appréhende les paramètres $\mu$ et $\sigma$ comme des constantes réelles fixes mais inconnues, la théorie bayésienne postule que les paramètres eux-mêmes sont des variables aléatoires gouvernées par des distributions de probabilité a priori (priors), reflétant le degré de croyance initiale du chercheur avant l’acquisition des données empiriques :
- L’a priori gaussien comme principe de régularisation : L’assignation d’une loi normale centrée à un coefficient de régression ($\beta \sim \mathcal{N}(0, \sigma_{\beta})$) agit comme une pénalisation mathématique rigoureuse (analogue à la régression Ridge / pénalisation $L_2$). Elle restreint la liberté d’oscillation des paramètres vers des valeurs disproportionnées, atténuant le surajustement (overfitting) et stabilisant l’inférence dans les configurations à faibles effectifs.
- Le principe d’entropie maximale : En vertu des axiomes de la théorie de l’information de Shannon, si l’on ne connaît d’une variable que son espérance mathématique et sa variance finie, la distribution qui maximise rigoureusement l’ignorance sans ajouter d’informations parasitaires est précisément la distribution normale. Choisir un a priori gaussien constitue dès lors la décision computationnelle la plus conservative et neutre possible.
Par l’évaluation récursive de la règle de Bayes, le croisement de cet a priori gaussien avec la fonction de vraisemblance des données engendre la distribution a posteriori conjointe des paramètres. L’exploration de cet espace probabiliste par les algorithmes de Monte-Carlo Hamiltonien (HMC) permet aux chercheurs en psychologie d’estimer avec précision des trajectoires d’apprentissage individuelles ou des paramètres cognitifs latents sans avoir à postuler des hypothèses de normalité rigides sur les données d’observation finales.
Références
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://www.jstor.org/stable/2984418
- Canguilhem, G. (1966). Le normal et le pathologique. Presses Universitaires de France. https://www.puf.com/content/Le_normal_et_le_pathologique
- De Moivre, A. (1738). The Doctrine of Chances: Or, A Method of Calculating the Probabilities of Events in Play (2e éd.). H. Woodfall. https://mathshistory.st-andrews.ac.uk/Biographies/De_Moivre/
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Flynn, J. R. (1987). Massive IQ gains in 14 nations: What IQ tests really measure. Psychological Bulletin, 101(2), 171–191. https://doi.org/10.1037/0033-2909.101.2.171
- Galton, F. (1869). Hereditary Genius: An Inquiry into Its Laws and Consequences. Macmillan and Co. https://wellcomecollection.org/works/y5tq6jve
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser. https://www.gutenberg.org/ebooks/40727
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier. https://gallica.bnf.fr/ark:/12148/bpt6k1061730v
- Quetelet, A. (1835). Sur l’homme et le développement de ses facultés, ou Essai de physique sociale. Bachelier. https://gallica.bnf.fr/ark:/12148/bpt6k106178x
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Wechsler, D. (1939). The Measurement of Adult Intelligence. Williams & Wilkins. https://doi.org/10.1037/10020-000