
Dans le champ foisonnant de la modélisation statistique contemporaine et de la science des données appliquées aux sciences humaines et sociales, la découverte de structures sous-jacentes au sein de cohortes multidimensionnelles constitue l’un des défis méthodologiques les plus stimulants. L’exploration de profils psychologiques, de typologies comportementales ou de sous-groupes cliniques requiert des instruments capables d’extraire du sens à partir du bruit empirique sans imposer a priori un carcan d’hypothèses linéaires restrictives. Si l’analyse typologique classique s’est longtemps appuyée sur des méthodes désormais centenaires ou sur l’algorithme ubiquitaire des k-moyennes (K-Means), les limites intrinsèques de ces approches face aux distributions asymétriques, aux données hétérogènes et à la présence inévitable de valeurs aberrantes ont suscité une profonde réévaluation des pratiques de partitionnement non supervisé.
C’est précisément au confluent de la robustesse statistique et de l’intelligibilité phénoménologique que se déploie l’algorithme de partitionnement autour des médoïdes, universellement désigné sous le vocable de K-Medoids ou PAM (Partitioning Around Medoids), théorisé par Leonard Kaufman et Peter Rousseeuw à la fin des années 1980. Contrairement aux approches barycentriques traditionnelles qui synthétisent les regroupements sous la forme de points moyens virtuels et mathématiquement désincarnés, les K-Medoids ancrent chaque groupe autour d’une observation réelle, concrète et exemplaire issue directement de l’échantillon empirique : le médoïde. Cette propriété confère aux typologies obtenues une validité écologique et clinique sans équivalent, tout en garantissant une résistance remarquable aux perturbations causées par les données atypiques.
Le présent article propose une immersion exhaustive, théorique et opérationnelle dans l’univers des K-Medoids sous l’environnement statistique R. Conçu selon les standards académiques les plus exigeants, ce guide décortique pas à pas l’ensemble de la chaîne de traitement, depuis les considérations épistémologiques du partitionnement jusqu’à la validation de stabilité par rééchantillonnage bootstrap et le passage à l’échelle via l’algorithme CLARA. À travers un fil conducteur appliqué aux mesures psychométriques et comportementales, le chercheur ou le praticien de la donnée découvrira comment configurer son écosystème logiciel, sélectionner les métriques de dissimilarité optimales, déterminer objectivement le nombre de classes latentes et valoriser visuellement ses résultats au moyen de graphiques éditoriaux de haute qualité.
1. Introduction au partitionnement non supervisé et aux fondements des K-Medoids
1.1 Principes de l’apprentissage non supervisé en recherche comportementale
L’apprentissage automatique non supervisé occupe une place épistémologique singulière au sein des sciences comportementales, de la psychométrie et de la sociologie quantitative. Contrairement aux démarches prédictives supervisées qui visent à modéliser une variable réponse étiquetée à partir d’un ensemble de covariables explicatives, la classification non supervisée ou partitionnement de données (clustering) cherche à découvrir des structures latentes, des motifs récurrents et des affinités naturelles dissimulés au cœur de matrices multidimensionnelles complexes. Dans l’exploration des profils psychologiques, le chercheur est fréquemment confronté à des corpus d’individus décrits par un continuum d’attitudes, de traits de personnalité ou d’indicateurs cliniques sans qu’il n’existe d’étalon-or ou de variable d’appartenance préalable prédéfinie.
L’objectif fondamental de cette taxonomie automatisée consiste à maximiser simultanément deux critères complémentaires régis par la théorie de l’information et l’optimisation combinatoire : l’homogénéité intra-groupe (minimiser la variance ou la dispersion des observations au sein d’une même classe) et l’hétérogénéité inter-groupe (maximiser la distance ou la divergence séparant les différents ensembles). Par cette double contrainte, le partitionnement transforme un nuage d’observations apparemment désordonné en un nombre restreint de typologies cohérentes, réduisant considérablement la dimensionnalité descriptive tout en préservant l’essence des relations différentielles.
Sur le plan méthodologique, cette approche offre une utilité inestimable pour dépasser la simple analyse variable-centrée, telle que l’analyse factorielle confirmatoire ou la régression multiple, au profit d’une approche personne-centrée. Cette dernière postule que les traits psychologiques ne s’articulent pas de manière isolée ou purement additive dans la population générale, mais s’organisent en constellations spécifiques d’attributs fonctionnels au sein d’individus particuliers. L’identification empirique de ces profils comportementaux globaux permet ainsi de modéliser des systèmes de fonctionnement psychologique adaptatifs ou mésadaptatifs que les approches linéaires conventionnelles échouent fréquemment à capturer dans toute leur plénitude systémique.
1.2 Genèse et formulation conceptuelle de l’approche par médoïdes
Face aux défis de l’agrégation statistique, Leonard Kaufman et Peter Rousseeuw ont formalisé, dans leur ouvrage séminal publié en 1990 chez John Wiley & Sons intitulé Finding Groups in Data: An Introduction to Cluster Analysis, l’alternative conceptuelle du médoïde. Mathématiquement, dans un espace métrique ou semi-métrique composé de n observations réparties au sein d’un cluster C, le médoïde se définit comme l’observation appartenant à C dont la somme des dissimilarités le reliant à tous les autres éléments constitutifs de ce même cluster est strictement minimale. Il s’agit formellement du résolvant d’un problème d’optimisation combinatoire qui sélectionne un point d’ancrage empirique réel, plutôt qu’une entité synthétique issue d’un calcul de moyenne arithmétique multidimensionnelle.
Cette distinction élémentaire fonde la divergence primordiale entre un centroïde abstrait et un médoïde incarné. Dans l’algorithme des K-Means, le centre géométrique d’un groupe est une coordonnée vectorielle artificielle représentant l’espérance mathématique des dimensions ; il est tout à fait possible, et même habituel dans le cadre de variables mixtes, discrètes ou ordinales, qu’aucun individu concret ne possède des valeurs identiques à ce centroïde théorique. À l’inverse, le médoïde est une observation tangible issue de l’échantillon réel, possédant une existence phénoménologique propre, une histoire de mesure et une cohérence interne de réponses sans le moindre artifice d’interpolation.
Les propriétés intrinsèques de robustesse statistique qui en découlent sont considérables. En statistique robuste, la moyenne est reconnue pour son point de rupture nul (breakdown point de 0 %), ce qui signifie qu’une seule observation aberrante située à l’extrême périphérie de l’espace distributionnel peut translater arbitrairement le centroïde et corrompre l’ensemble de la partition. Le médoïde, s’apparentant dans sa philosophie à la médiane multidimensionnelle, offre une résistance exceptionnelle aux distorsions créées par les valeurs extrêmes et les contaminations d’échantillonnage. Du point de vue épistémologique, cette incarnation offre un avantage inestimable dans les études de cas : le chercheur peut désigner un participant ou un profil particulier comme étant le représentant prototypique absolu de sa classe, ouvrant la voie à une analyse clinique qualitative contextualisée et parfaitement articulée avec les résultats quantitatifs.
1.3 Cas d’usage emblématiques en psychométrie et sciences sociales
L’applicabilité pratique de l’approche par médoïdes au sein des sciences humaines et de la psychologie différentielle est vaste et particulièrement féconde. Le premier grand champ d’application réside dans la segmentation des inventaires de personnalité et des échelles d’attitudes de type Likert. Les instruments standardisés mesurant le modèle en cinq facteurs (Big Five), l’estime de soi ou le sentiment d’auto-efficacité génèrent des matrices de réponses ordinales pour lesquelles le calcul de barycentres euclidiens viole les postulats de mesure fondamentale. L’application des K-Medoids permet d’agréger les sujets sans dénaturer la nature ordinale des scores discrets, révélant des configurations structurelles de personnalité robustes et réplicables d’une cohorte à l’autre.
Un deuxième domaine prééminent concerne l’identification de sous-groupes cliniques au sein de cohortes diagnostiques hétérogènes. Dans l’étude des troubles dépressifs majeurs, des syndromes anxieux ou des traumatismes complexes, la variabilité symptomatique inter-individuelle est telle que le concept d’étiquette diagnostique unique devient souvent trompeur. En appliquant l’algorithme PAM sur des profils de symptômes neurovégétatifs, cognitifs et affectifs, les chercheurs en psychopathologie computationnelle isolent des profils nosologiques distincts. Le fait que le centre de chaque classe soit un patient réel permet aux équipes médicales d’examiner en détail le dossier médical complet de cet individu archétypal afin d’adapter les protocoles thérapeutiques personnalisés.
Enfin, la recherche appliquée à la psychologie sociale, aux comportements de consommation et à la dynamique organisationnelle mobilise activement les K-Medoids pour cartographier les réactions des populations face à des stimuli expérimentaux, des politiques publiques ou des communications sanitaires. L’identification de profils prototypiques de citoyens ou d’employés face au stress occupationnel ou aux mesures d’incitation écologique fournit aux décideurs des leviers d’action d’une grande précision, évitant les généralisations hâtives fondées sur le mythe de l’individu moyen qui, dans les faits, n’existe presque jamais.
2. Analyse comparative rigoureuse : K-Means versus K-Medoids (PAM)
2.1 Limites inhérentes à l’algorithme des K-Means
Bien que l’algorithme des K-Means constitue sans conteste l’outil de partitionnement le plus largement disséminé dans la communauté scientifique en raison de son apparente simplicité conceptuelle et de sa rapidité d’exécution, il repose sur des hypothèses géométriques particulièrement restrictives qui compromettent régulièrement la validité des analyses comportementales. En premier lieu, la fonction objective des K-Means vise la minimisation de la somme des carrés des écarts au centre de gravité (Within-Cluster Sum of Squares, WSS). Cette élévation au carré amplifie de manière quadratique le poids accordé aux observations situées en périphérie du nuage de points. Dès lors, la présence d’outliers résiduels, fréquents lors de la passation de questionnaires en ligne ou d’enregistrements psychophysiologiques bruités, déplace dramatiquement la position des barycentres, conduisant à la formation de regroupements artificiels phagocytés par des valeurs extrêmes.
En second lieu, l’algorithme impose la structure contraignante d’un espace géométrique euclidien strict. Cette exigence mathématique sous-tend que les variables considérées doivent être continues, distribuées de manière approximativement sphérique et présenter des variances comparables. Or, la réalité empirique des sciences humaines est caractérisée par des échelles d’intervalles approximatives, des variables de comptage, des scores bornés et des distributions intrinsèquement asymétriques (telles que le temps de réaction ou les échelles de dépression où la majorité des individus sains présente un score plancher). L’usage abusif de la distance euclidienne dans de telles configurations produit des biais d’agrégation majeurs.
Enfin, les centroïdes générés par les K-Means véhiculent des incohérences fondamentales lors de la phase d’interprétation. Dans un inventaire comportemental mesurant le nombre de comportements compulsifs hebdomadaires (données discrètes) combiné à des choix binaires d’acceptation thérapeutique, un centroïde mathématique affichant 3,42 compulsions et une appartenance de 0,67 à un groupe d’adhésion s’avère phénoménologiquement dénué de sens. Le chercheur se retrouve contraint de discourir sur un individu virtuel impossible, introduisant un fossé épistémologique dommageable entre la modélisation formelle et la clinique humaine.
2.2 L’algorithme PAM (Partitioning Around Medoids) : fonctionnement et logique
Pour surmonter les défaillances de l’approche barycentrique, l’algorithme PAM (Partitioning Around Medoids) déploie une stratégie d’optimisation combinatoire rigoureusement articulée en deux étapes successives : la phase de construction initiale (dénommée BUILD) suivie de la phase d’échange itératif (nommée SWAP). L’objectif ultime de cette architecture est de minimiser la somme absolue des dissimilarités entre chaque observation du jeu de données et son médoïde de rattachement le plus proche, une métrique robuste formulée sans élévation au carré intempestive.
Durant la phase BUILD, l’algorithme sélectionne de manière déterministe un premier médoïde pour lequel la somme des distances à tous les autres objets est minimale. Ensuite, de façon séquentielle, l’algorithme incorpore un à un les k – 1 médoïdes restants en choisissant à chaque itération l’observation qui réduit au maximum la fonction de coût global résiduelle. Cette initialisation intelligente confère à PAM une stabilité remarquable, le prémunissant contre les pièges des minima locaux qui affectent fréquemment les initialisations aléatoires des K-Means.
Une fois les k médoïdes initiaux fixés, la phase SWAP s’enclenche. L’algorithme examine exhaustivement toutes les paires possibles formées d’un médoïde actuellement retenu et d’un point non médoïde. Pour chaque paire, il calcule le gain ou la perte sur la fonction de coût global qu’induirait l’échange de leurs rôles respectifs. Dès qu’un échange profitable est identifié (diminution de la dissimilarité globale totale), la permutation est opérée. Ce processus itératif se poursuit sans relâche jusqu’à ce qu’aucun échange ne puisse améliorer la qualité de la partition. Si cette logique confère une flexibilité théorique totale en s’accommodant de n’importe quelle matrice arbitraire de dissimilarité, elle implique une complexité computationnelle substantielle d’ordre asymptotique $O(k(n-k)^2)$ par itération, limitant historiquement l’usage de PAM pur aux échantillons de taille modérée à intermédiaire.
2.3 Critères de sélection méthodologique entre K-Means et K-Medoids
Le choix raisonné entre l’algorithme des K-Means et celui des K-Medoids repose sur une évaluation méticuleuse des propriétés distributionnelles et épistémologiques du protocole d’investigation. Le tableau décisionnel suivant synthétise les critères d’arbitrage que tout analyste de données doit considérer avant de lancer ses routines de calcul.
| Dimension méthodologique | K-Means classique | K-Medoids (Algorithme PAM) |
|---|---|---|
| Sensibilité aux valeurs extrêmes (Outliers) | Très élevée (effet de levier quadratique sur le calcul du barycentre) | Extrêmement faible (ancrage robuste sur la médiane multidimensionnelle) |
| Nature et métrique des variables | Strictement quantitatives continues et espaces euclidiens | Tous types : métriques arbitraires, ordinales, qualitatives, mixtes (Gower) |
| Nature du centre de chaque cluster | Centroïde virtuel et abstrait (moyenne multidimensionnelle) | Médoïde réel, incarné et observable (sujet prototypique de l’échantillon) |
| Coût de calcul algorithmique | Faible ($O(n \cdot k \cdot i)$), optimal pour mégadonnées | Élevé ($O(k(n-k)^2)$), exigeant en mémoire vive pour $n > 10,000$ |
| Dépendance à l’initialisation | Sensible (risque aigu de convergence vers des minima locaux sous k-means standard) | Déterministe et robuste (initialisation structurée via la phase BUILD) |
| Interprétabilité phénoménologique | Moyenne (nécessite une abstraction conceptuelle pour profils mixtes) | Optimale (accès direct à l’observation pilote servant d’étalon clinique) |
En synthèse, dès lors que le jeu de données présente un niveau substantiel de bruit distributionnel, des mesures discrètes non strictement linéaires ou une volonté explicite d’analyser des sujets réels prototypiques, le recours aux K-Medoids s’impose comme une nécessité scientifique supérieure, reléguant l’usage exclusif des K-Means aux seuls cas d’échantillons massifs de variables strictement continues et parfaitement épurées.
3. Configuration de l’écosystème analytique et packages requis dans R
3.1 Installation et chargement des bibliothèques spécialisées
L’implémentation de l’analyse par K-Medoids sous l’environnement de programmation statistique R nécessite un écosystème d’extensions modulaires parfaitement coordonnées. Au cœur de cette infrastructure se trouve la bibliothèque cluster, développée directement par les continuateurs des travaux de Leonard Kaufman et Peter Rousseeuw, notamment Martin Mächler. Ce package fondamental contient l’implémentation algorithmique de référence pour la fonction pam(), ainsi que les routines optimisées pour le calcul des matrices de dissimilarité à travers la fonction daisy() et les algorithmes à grande échelle comme clara().
Pour transcender les représentations graphiques rudimentaires du moteur graphique de base de R, l’intégration du package factoextra d’Alboukadel Kassambara s’avère indispensable. Conçu sur les fondations esthétiques de ggplot2, factoextra fournit une panoplie complète de fonctions préconfigurées pour extraire, formater et visualiser avec élégance les résultats issus des modélisations multidimensionnelles (visualisation des partitions, profils de silhouettes, détermination du nombre optimal de classes).
La boîte à outils analytique est avantageusement complétée par la suite tidyverse (incluant dplyr pour la manipulation fluide des matrices de données et tibble pour l’ordonnancement tabulaire), la bibliothèque psych de William Revelle dédiée aux statistiques descriptives et psychométriques avancées, ainsi que corrplot pour l’exploration visuelle des structures d’intercorrélation. Enfin, afin d’assurer l’exactitude des calculs et la réplicabilité scientifique absolue des processus stochastiques sous-jacents, l’initialisation explicite du générateur de nombres pseudo-aléatoires de R par l’instruction set.seed(12345) constitue le préambule obligatoire à toute séquence de script computationnel.
3.2 Présentation du jeu de données psychométriques d’illustration
Afin d’ancrer notre démonstration dans la réalité empirique de la recherche comportementale, nous considérons un ensemble de données psychométriques constitué d’un échantillon de $N = 450$ participants adultes ayant répondu à un protocole standardisé d’évaluation de l’adaptation psychologique face au stress chronique. Ce tableau multidimensionnel rassemble des dimensions transversales fréquemment auscultées en psychologie de la santé, en psychiatrie épidémiologique et en neurosciences affectives :
- Anxiété-Trait (STAI-T) : Mesure quantitative de la disposition stable à percevoir les situations environnementales comme menaçantes (score composite continu variant de 20 à 80).
- Régulation Émotionnelle – Réévaluation Cognitive (ERQ_RC) : Fréquence d’utilisation de stratégies cognitives modifiant la signification émotionnelle d’un stimulus stresseur avant que la réponse émotionnelle ne soit totalement déployée (score moyen allant de 1 à 7 sur échelle de Likert).
- Régulation Émotionnelle – Suppression Expressive (ERQ_SE) : Degré d’inhibition volontaire de l’expression externe des affects négatifs (score moyen allant de 1 à 7).
- Stratégies de Coping Centrées sur le Problème (Coping_Prob) : Effort délibéré visant à modifier la situation anxiogène ou à résoudre la difficulté objective (score borné de 10 à 40).
- Stratégies de Coping Centrées sur l’Évitement (Coping_Evit) : Mobilisation d’activités distractives, de déni ou de fuite comportementale pour échapper à la confrontation du stresseur (score borné de 10 à 40).
- Épuisement Émotionnel (Burnout_EE) : Sentiment de vidage des ressources affectives et d’usure psychologique cumulée (score total variant de 0 à 54).
L’importation de ces métriques vectorielles dans R requiert une vigilance scrupuleuse quant à la typologie native des objets. L’exécution systématique des commandes de contrôle telles que str() et glimpse() garantit que l’ensemble des colonnes d’intérêt soit correctement converti en vecteurs numériques flottants ou ordonnés selon le design méthodologique, évitant tout dysfonctionnement silencieux lors du calcul ultérieur des métriques de dissimilarité.
3.3 Structuration optimale du pipeline de traitement dans RStudio
L’intégrité de la recherche reproductible repose sur une architecture de flux de travail (workflow) rigoureusement ordonnée au sein de l’environnement de développement intégré RStudio. Il est vivement préconisé d’articuler le traitement de données selon une organisation séquentielle modulaire matérialisée par un script unique annoté ou un ensemble de scripts compartimentés :
- Module 01 – Environnement & Données : Initialisation des graines aléatoires, importation des librairies spécialisées, chargement des fichiers sources et vérification topologique des types de données.
- Module 02 – Diagnostic Préparatoire & Nettoyage : Inspection méticuleuse des patrons de valeurs manquantes, imputation ciblée et mise à l’échelle des variances multidimensionnelles.
- Module 03 – Évaluation de la Tendance au Partitionnement : Calcul de la statistique de Hopkins et inspection de la matrice ordonnée de dissimilarité (méthode VAT).
- Module 04 – Détermination du k Optimal : Comparaison conjointe des critères d’adéquation (somme des carrés résiduels, largeur de silhouette moyenne, statistique du Gap).
- Module 05 – Exécution de l’Algorithme PAM : Partitionnement effectif, extraction des médoïdes prototypes et évaluation de la fonction de coût de transfert.
- Module 06 – Diagnostics de Robustesse & Visualisation : Validation par rééchantillonnage bootstrap, cartographie des silhouettes individuelles et export vectoriel en haute définition.
La gestion stricte de la mémoire vive par le nettoyage régulier des objets transitoires désuets via la commande rm(list = ls()) en tête de flux et la sauvegarde intermédiaire des objets clés par sérialisation native (fichiers au format .rds via saveRDS()) préviennent les contaminations de variables d’une session à l’autre, satisfaisant ainsi aux exigences de transparence et de reproductibilité computationnelle.
4. Préparation méticuleuse et exploration des données
4.1 Détection et traitement des données manquantes
La survenue d’enregistrements lacunaires constitue une caractéristique quasi inévitable des collectes de données en sciences humaines. Avant d’engager toute procédure de partitionnement géométrique, un audit rigoureux de la structure de ces absences s’impose. Il convient de déterminer empiriquement si le patron de non-réponse obéit à une logique totalement aléatoire (Missing Completely At Random, MCAR), conditionnelle aux observations disponibles (Missing At Random, MAR) ou non aléatoire et systémique (Missing Not At Random, MNAR), cette dernière situation traduisant souvent un refus délibéré de répondre provoqué par le retentissement émotionnel du stimulus d’évaluation.
La suppression pure et simple des lignes incomplètes (complete-case analysis ou listwise deletion via na.omit()) présente le double inconvénient de réduire drastiquement la puissance statistique globale et d’introduire des biais de sélection critiques si le mécanisme n’est pas strictement MCAR. Dans un cadre de modélisation par K-Medoids, l’imputation par les k-plus proches voisins (k-Nearest Neighbors Imputation, implémentée dans des packages comme VIM ou missForest) constitue une approche remarquablement cohérente sur le plan philosophique. En exploitant la géométrie locale des profils similaires au sein de la matrice multivariée pour estimer les valeurs manquantes, cette technique préserve la structure de corrélation intrinsèque sans aplatir artificiellement la variance comme le ferait une imputation naïve par la moyenne arithmétique globale.
Une fois le diagnostic établi et la procédure de restauration des valeurs exécutée, l’analyste valide l’absence de cellules vacantes par l’inspection booléenne sum(is.na(data_psych)) == 0, garantissant que les opérateurs de calcul métrique ultérieurs disposeront d’un espace vectoriel continu et parfaitement régulier.
4.2 Standardisation et mise à l’échelle des variables
L’un des pièges méthodologiques les plus destructeurs en analyse typologique réside dans la disparité des échelles de mesure et des variances respectives des attributs observés. Considérons notre exemple : le score du STAI-T s’échelonne sur une amplitude théorique de 60 unités (20 à 80) avec une variance empirique fréquemment supérieure à 100, tandis que les sous-échelles de régulation émotionnelle de l’ERQ n’oscillent que sur une échelle bornée de 1 à 7 avec une variance souvent inférieure à 2. Si les données brutes étaient injectées directement dans une matrice de calcul de distances euclidiennes ou de Manhattan, l’anxiété écraserait mécaniquement les autres dimensions, capturant plus de 80 % de la contribution géométrique globale au détriment absolu des mécanismes de régulation émotionnelle.
Pour neutraliser cet artefact, la standardisation canonique par centrage et réduction unitaire (z-score standardisation) est communément appliquée sous R au moyen de la primitive générique scale(). Chaque valeur est privée de sa moyenne empirique puis divisée par son écart-type d’échantillon, conférant à chaque variable une moyenne nulle ($\mu = 0$) et une variance unitaire ($\sigma^2 = 1$) :
$$z_{ij} = \frac{x_{ij} – \bar{x}_j}{s_j}$$
Cependant, dans un contexte de classification robuste par K-Medoids, l’emploi de la moyenne et de l’écart-type peut lui-même être corrompu par la présence initiale d’outliers. Une alternative méthodologique supérieure consiste à déployer une standardisation robuste fondée sur la médiane et l’écart absolu médian (Median Absolute Deviation, MAD). Dans cette approche, chaque observation est soustraite de sa médiane marginale puis divisée par sa MAD, garantissant une invariance d’échelle qui immunise rigoureusement le partitionnement ultérieur contre l’influence distortive des queues de distribution épaisses. La vérification visuelle des densités marginales standardisées à l’aide de tracés de type violin plots permet de s’assurer de la comparabilité des étendues dynamiques avant tout calcul géométrique.
4.3 Diagnostic préliminaire de la tendance au regroupement (Clusterability)
L’application aveugle d’un algorithme de partitionnement constitue une faute méthodologique majeure : par construction computationnelle, n’importe quelle procédure de classification par K-Means ou K-Medoids découpera un ensemble de données en k groupes, même si la distribution empirique est rigoureusement homogène, unimodale ou uniformément distribuée dans l’espace multidimensionnel. Avant de postuler l’existence de typologies latentes, il est donc impératif de démontrer statistiquement que les données manifestent une tendance naturelle au regroupement non aléatoire (clustering tendency).
L’instrument de référence pour statuer sur cette propension est la statistique de Hopkins ($H$), calculée au moyen de la fonction get_clust_tendency() du package factoextra. Cette procédure compare la distance séparant des points réels tirés au hasard de leurs plus proches voisins réels ($w_i$), aux distances séparant des points simulés uniformément dans le même hypercube de leurs plus proches voisins empiriques ($u_i$) :
$$H = \frac{\sum_{i=1}^m u_i}{\sum_{i=1}^m u_i + \sum_{i=1}^m w_i}$$
Une valeur de $H$ avoisinant 0,5 indique une distribution uniforme ou aléatoire (hypothèse nulle de désorganisation spatiale, rendant caduque toute tentative de partitionnement). En revanche, une valeur de $H$ tendant vers 1,0 (dans la pratique académique, un seuil $H > 0,75$, et idéalement supérieur à 0,80) atteste d’une structure agglomérative significative et autorise formellement l’engagement d’une segmentation.
Ce diagnostic analytique est avantageusement complété par la méthode visuelle VAT (Visual Assessment of Cluster Tendency). En réordonnant les lignes et les colonnes de la matrice de dissimilarité de façon à ce que les observations les plus proches soient adjacentes, la projection graphique de la matrice génère des blocs sombres bien individualisés le long de la diagonale principale si des clusters naturels préexistent. L’apparition nette de ces échiquiers de densité confirme visuellement la faisabilité méthodologique de l’analyse typologique.
5. Sélection des métriques de distance et matrices de dissimilarité
5.1 Distance euclidienne versus distance de Manhattan
La mesure de la proximité ou de la divergence séparant deux observations multidimensionnelles constitue le socle mathématique sur lequel opère l’algorithme des K-Medoids. Contrairement aux K-Means, qui sont indissociables de la distance euclidienne en raison de leur formulation sous forme de variance barycentrique, l’algorithme PAM accepte formellement n’importe quelle fonction de métrique ou de semi-métrique symétrique continue.
La distance euclidienne standard, correspondant à la norme vectorielle $L_2$, calcule la longueur géométrique du segment rectiligne reliant deux points $i$ et $j$ dans l’espace euclidien à $p$ dimensions :
$$d_{L_2}(i, j) = \sqrt{\sum_{k=1}^p (x_{ik} – x_{jk})^2}$$
Bien qu’intuitive et universellement implantée, cette métrique présente, par son élévation au carré des écarts différentiels coordonnée par coordonnée, une sensibilité résiduelle importante aux divergences ponctuelles extrêmes sur une seule dimension particulière.
À l’inverse, la distance de Manhattan (ou métrique de la ville en damier / City-block), régie par la norme vectorielle $L_1$, somme directement la valeur absolue des écarts différentiels le long des différents axes orthogonaux :
$$d_{L_1}(i, j) = \sum_{k=1}^p |x_{ik} – x_{jk}|$$
En éliminant l’amplification quadratique des écarts, la métrique de Manhattan s’avère considérablement plus résiliente face aux contaminations marginales et aux profils asymétriques. Elle confère au partitionnement PAM une cohérence théorique idéale en recherchant, sur chaque axe dimensionnel, une convergence équivalente à la médiane spatiale. Dans la fonction pam() ou lors de l’appel à la fonction dist() sous R, la spécification explicite du paramètre metric = "manhattan" permet d’activer cette géométrie protectrice.
5.2 Traitement des variables mixtes via la distance de Gower
En recherche psychosociale et épidémiologique, il est fréquent que les protocoles croisent des indicateurs continus standardisés (scores psychométriques), des variables catégorielles nominales polytomiques (statut marital, catégorie socioprofessionnelle, centre de soin) et des échelles ordinales d’appréciation subjective à plusieurs niveaux. Dans ce scénario de variables mixtes, le recours exclusif aux normes $L_1$ ou $L_2$ devient formellement inapproprié et conduit à des incohérences de calcul majeures.
Pour résoudre ce dilemme, l’algorithme PAM se combine avec une élégance parfaite avec le coefficient général de dissimilarité proposé par John C. Gower en 1971. La distance de Gower calcule la dissimilarité moyenne inter-individuelle en pondérant chaque descripteur selon sa nature morphologique propre :
$$S_{ij} = \frac{\sum_{k=1}^p w_k \cdot s_{ijk}}{\sum_{k=1}^p w_k}$$
Pour deux observations $i$ et $j$, la similarité partielle $s_{ijk}$ sur la variable $k$ est définie ainsi :
- Si la variable est binaire symétrique ou nominale qualitative, $s_{ijk} = 1$ en cas d’identité stricte de catégorie, et $0$ en cas de divergence.
- Si la variable est quantitative continue ou ordinale convertie selon ses rangs normalisés, $s_{ijk} = 1 – \frac{|x_{ik} – x_{jk}|}{R_k}$, où $R_k$ désigne l’étendue (l’amplitude maximale observée) de la variable dans l’échantillon total.
La dissimilarité finale est ensuite déduite par complémentarité : $d_{Gower}(i, j) = 1 – S_{ij}$. Au sein de l’environnement R, cette métrique polyvalente est nativement calculée à l’aide de la fonction daisy() du package cluster en renseignant le paramètre metric = "gower". L’analyste a en outre l’opportunité de moduler le vecteur de pondération weights pour allouer un poids différentiel accru à certaines sous-dimensions psychométriques jugées théoriquement prépondérantes au regard du cadre conceptuel d’investigation.
5.3 Inspection diagnostique de la matrice de dissimilarité
Le calcul effectif d’une matrice de dissimilarité engendre un objet de classe formelle dist sous R, qui stocke de façon compacte la partie triangulaire inférieure de la matrice symétrique de dimensions $n \times n$. Compte tenu du fait que cette matrice constitue le substrat géométrique unique à partir duquel l’algorithme PAM opérera l’intégralité de ses allocations itératives, une vérification approfondie de ses propriétés distributionnelles s’avère indispensable avant tout lancement de calcul.
L’extraction dimensionnelle et la conversion temporaire au format matriciel classique au moyen de la syntaxe as.matrix(dist_matrix) permettent de quantifier les valeurs minimales, médianes, moyennes et maximales des écarts observés. L’absence d’éléments nuls hors de la diagonale principale garantit l’absence d’observations strictement doublonnes qui pourraient parasiter la désignation univoque des médoïdes. Parallèlement, l’inspection d’une représentation thermique (heatmap) exploratoire non réordonnée permet d’identifier l’existence de disparités métriques aberrantes, de sous-ensembles totalement déconnectés du reste du réseau relationnel ou d’éventuels artéfacts d’échantillonnage.
Cette étape de validation topologique scelle la cohérence entre la question clinique posée, le choix de la distance mathématique déployée et la morphologie de la matrice relationnelle finale, conditionnant le succès des étapes décisionnelles relatives au partitionnement proprement dit.
6. Détermination objective du nombre optimal de clusters (k)
6.1 Méthode du coude (Elbow Method / Total WSS)
L’un des défis classiques du partitionnement non supervisé réside dans la détermination exogène du paramètre $k$, correspondant au nombre intrinsèque de clusters structurant le corpus. L’approche empirique la plus anciennement documentée est la méthode du coude (Elbow Method), qui évalue la décroissance de la somme des dissimilarités intra-clusters globales en fonction d’un balayage incrémental de classes potentielles (typiquement de $k = 1$ jusqu’à $k = 10$).
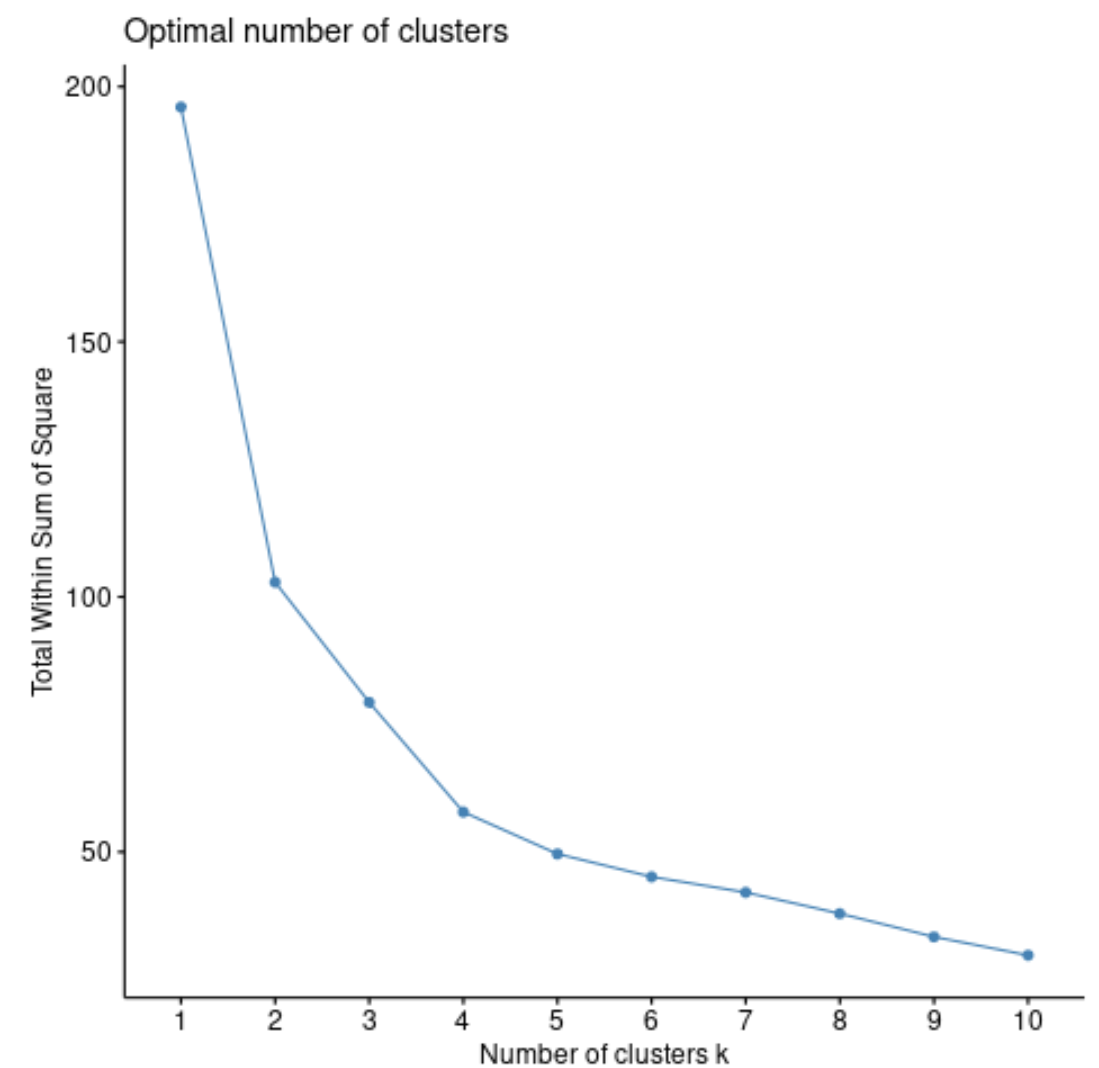
L’exécution computationnelle sous R est orchestrée de manière synthétique par la fonction fviz_nbclust() du package factoextra, en spécifiant FUNcluster = cluster::pam et l’argument method = "wss". Le tracé graphique obtenu illustre une courbe monotone décroissante : à mesure que le nombre de médoïdes alloués augmente, la liberté géométrique s’accroît et la dispersion intra-groupe diminue inéluctablement jusqu’à atteindre zéro si $k = n$.
Le critère décisionnel réside dans l’identification visuelle d’un point d’inflexion majeur dans la pente de décroissance (le fameux « coude »). Ce point marque le seuil d’efficacité marginale au-delà duquel l’adjonction d’un cluster supplémentaire ne réduit plus la variance résiduelle que de manière négligeable, n’offrant qu’un gain descriptif mineur au prix d’une perte d’économie théorique. Néanmoins, en raison du continuum fréquent des phénotypes psychologiques, cette courbe ne présente souvent pas d’angle net mais plutôt une déclivité graduelle, imposant la confrontation avec des indices métriques dotés d’une rigueur décisionnelle supérieure.
6.2 Méthode de la largeur moyenne de silhouette
La formalisation du coefficient de silhouette par Peter Rousseeuw en 1987 constitue sans doute l’une des contributions les plus élégantes et robustes apportées à la validation interne des regroupements. Pour chaque observation individuelle $i$, le coefficient de silhouette $s(i)$ synthétise à lui seul la cohésion interne de son appartenance groupale et son degré d’isolement vis-à-vis des classes concurrentes :
$$s(i) = \frac{b(i) – a(i)}{\max(a(i), b(i))}$$
Dans cette formulation rigoureuse :
- $a(i)$ représente la dissimilarité moyenne séparant l’observation $i$ de toutes les autres observations assignées au même cluster que lui (mesure directe de l’homogénéité intra-groupe).
- $b(i)$ correspond à la plus petite dissimilarité moyenne calculée entre l’observation $i$ et les éléments des clusters alternatifs, identifiant de fait le « cluster voisin » le plus proche (mesure de la séparation inter-groupe).
Le score individuel $s(i)$ est naturellement borné dans l’intervalle $[-1 ; +1]$. Une valeur proche de $+1$ indique que l’observation est magnifiquement assignée et réside très près du cœur de son groupe d’accueil. Un score nul ($s(i) \approx 0$) révèle un profil frontalier équivoque situé à égale distance de deux groupes. Enfin, une valeur négative trahit une anomalie d’affectation : l’observation se trouve statistiquement plus proche du groupe voisin que de son groupe de rattachement.
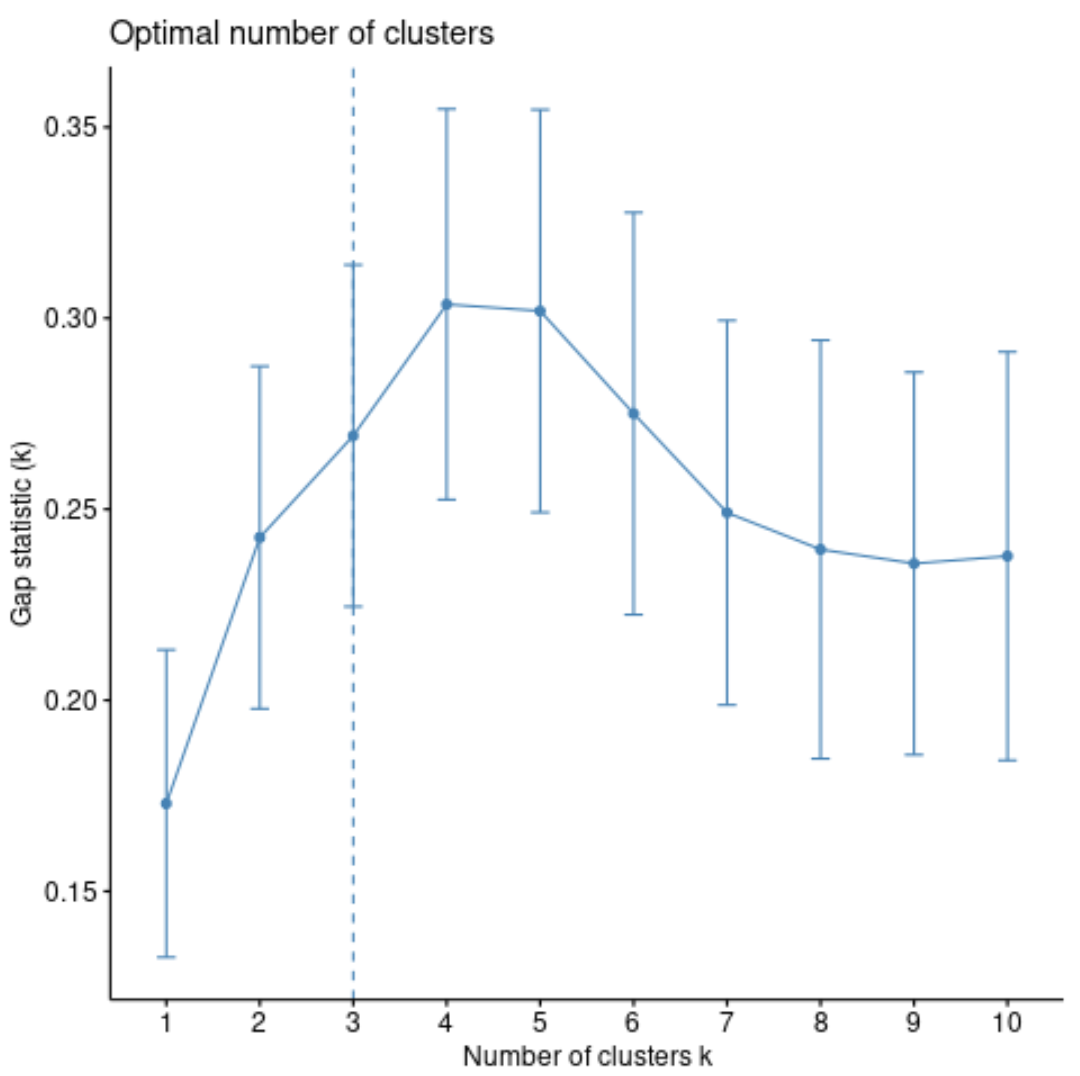
En agrégeant ces scores au niveau de l’échantillon complet, la largeur moyenne de silhouette ($\bar{s}_k$) procure un indicateur global d’adéquation de la partition. En exécutant sous R l’instruction fviz_nbclust(data_scaled, FUNcluster = pam, method = "silhouette"), l’analyste sélectionne directement la valeur de $k$ qui maximise ce critère global. Selon la grille interprétative canonique de Kaufman et Rousseeuw, un $\bar{s}_k$ supérieur à 0,71 témoigne d’une structure de clustering exceptionnellement solide ; un score oscillant entre 0,51 et 0,70 reflète une partition raisonnablement confirmée ; une valeur comprise entre 0,26 et 0,50 indique une structure fragile exigeant la plus grande prudence ; enfin, un score inférieur à 0,25 impose le rejet de l’hypothèse de regroupements réels.
6.3 Méthode de la statistique du Gap (Gap Statistic)
Formulée par Robert Tibshirani, Guenther Walther et Trevor Hastie dans un article de référence publié dans le Journal of the Royal Statistical Society (2001), la statistique du Gap constitue la démarche inférentielle la plus rigoureuse pour neutraliser la subjectivité humaine dans le choix du nombre de groupes. Elle repose sur le principe fondamental de la comparaison par rééchantillonnage de Monte-Carlo entre la dispersion observée de la partition empirique et celle issue d’une distribution de référence nulle non groupée, construite par simulation uniforme dans l’enveloppe multidimensionnelle des données originales alignées sur leurs axes principaux.
La statistique du Gap pour un nombre de classes $k$ donné se formalise selon l’expression mathématique :
$$\text{Gap}(k) = \mathbb{E}^*_B {\log(W_k^*)} – \log(W_k)$$
où $\log(W_k)$ représente le logarithme de la dispersion intra-cluster de la matrice réelle, et $\mathbb{E}^*_B {\log(W_k^*)}$ désigne l’espérance mathématique du même logarithme calculé sur $B$ jeux de données nuls simulés (généralement $B = 100$ ou $B = 500$). Plus la valeur de $\text{Gap}(k)$ est élevée, plus la partition observée s’écarte favorablement du modèle du bruit aléatoire uniforme.
L’implémentation algorithmique sous R est activée par la fonction clusGap() de la bibliothèque cluster :
gap_stat <- clusGap(data_scaled, FUN = pam, K.max = 10, B = 100, d.power = 2, spaceH0 = "scaledPCA")
Pour statuer définitivement sur la valeur de $k$ à retenir, on n’adopte pas nécessairement le sommet absolu de la courbe du Gap, mais plutôt le plus petit entier $k$ satisfaisant à la célèbre règle de Tibshirani (1-standard-error rule) :
$$\text{Gap}(k) ge \text{Gap}(k+1) – s_{k+1}$$
où $s_{k+1}$ prend en compte l’erreur d’échantillonnage stochastique de Monte-Carlo. Cette règle mathématique garantit le respect d’un strict principe de parcimonie scientifique en privilégiant la structure la plus simple dont la significativité n’est pas dépassée de façon probante par un modèle plus complexe.
7. Implémentation pas à pas de l’algorithme PAM dans R
7.1 Paramétrage et syntaxe formelle de la fonction pam()
Dès lors que les explorations diagnostiques préalables convergent vers une structure catégorielle spécifique (adoptons pour la suite de notre parcours démonstratif la configuration étayée de $k = 3$ clusters), l’exécution pratique de l’algorithme PAM s’opère via la fonction pivotale pam() contenue dans la bibliothèque cluster. La syntaxe canonique de l’appel s’articule autour de plusieurs arguments formels essentiels qu’il convient de maîtriser parfaitement :
pam_fit <- pam(x = data_scaled, k = 3, metric = "manhattan", stand = FALSE, keep.diss = TRUE, keep.data = TRUE)
L’argument central x accepte indifféremment une matrice rectangulaire de variables quantitatives continues ou directement un objet matriciel de dissimilarité issu de daisy() ou dist(). Le paramètre k fixe le nombre de classes cibles formellement retenues. L’argument metric gouverne le choix de la distance de calcul interne (prenant les valeurs "euclidean" ou "manhattan") si l’entrée est une matrice tabulaire ; si une matrice dist précalculée est fournie à x, cet argument est automatiquement neutralisé au profit de la structure native de l’objet amont.
Le commutateur logique stand permet de déléguer à la fonction la standardisation interne préalable des données. Cependant, les préceptes méthodologiques les plus rigoureux recommandent d’assigner formellement stand = FALSE et d’opérer la standardisation (notamment robuste via médiane-MAD) en amont dans le pipeline préparatoire afin de conserver une traçabilité totale sur les transformations numériques appliquées. Enfin, l’activation des options keep.diss = TRUE et keep.data = TRUE préserve la matrice complète des distances ainsi que les données d’origine au sein de l’objet résultant pam_fit, autorisant des diagnostics graphiques et des calculs d’extraction subséquents d’une grande fluidité.
7.2 Analyse de la structure interne de l’objet généré par PAM
L’exécution de la fonction génère un objet complexe encapsulant une structure de liste de classe S3 nommée pam. L’auscultation méticuleuse de son organisation interne via l’appel des instructions d’inspection names(pam_fit) et str(pam_fit) révèle l’abondance des informations analytiques calculées et mises à disposition par le moteur d’optimisation de Kaufman et Rousseeuw :
pam_fit$medoids: Matrice rectangulaire isolant les coordonnées dimensionnelles précises des k observations élues comme centres prototypiques. Cette sortie matérialise l’incarnation empirique fondamentale propre aux K-Medoids.pam_fit$id.med: Vecteur d’entiers pointant vers les numéros de ligne (ou identifiants textuels de participants) au sein de la matrice initiale ayant été promus au rang de médoïdes. C’est l’ancre nominative directe pour toute analyse clinique approfondie de cas prototypiques.pam_fit$clustering: Vecteur nominal de longueur $n$ associant à chaque participant individuel un label numérique entier compris entre 1 et $k$, signalant son assignation exclusive de partitionnement.pam_fit$objective: Vecteur numérique à deux composantes synthétisant la valeur de la fonction de coût de la dissimilarité globale atteinte à l’issue respective de la phasebuildpuis de la phase stabiliséeswap.pam_fit$silinfo: Sous-structure détaillée hébergeant les largeurs de silhouettes individuelles de chaque sujet, les moyennes stratifiées par cluster et la moyenne globale du partitionnement final.
Cette exhaustivité structurelle dispense l’analyste de recourir à des calculs matriciels postérieurs complexes, chaque métrique de performance étant nativement calculée et immédiatement exploitable par les fonctions d’aval.
7.3 Vérification de la convergence et récapitulatif des coûts de transfert
Avant d’entériner la partition et de déployer les interprétations substantielles, une validation rigoureuse de la stabilité et de la convergence de l’algorithme doit être effectuée. L’inspection des composantes de l’attribut pam_fit$objective permet de quantifier l’efficacité dynamique de la phase SWAP. Le premier score reflète la somme minimale des distances atteignable à l’issue de la procédure déterministe séquentielle BUILD ; le second score documente le coût affiné suite aux permutations combinatoires d’échange médoïde / non-médoïde.
Une diminution substantielle de la dissimilarité globale entre la phase BUILD et la phase SWAP atteste que l’espace relationnel contenait des configurations sous-optimales que la procédure d’échange itérative a su surmonter avec succès. Parallèlement, l’analyste doit contrôler l’isolement relatif des groupes par l’examen de la matrice des dissimilarités moyennes inter-médoïdes. L’existence de distances substantielles séparant chacun des trois prototypes confirme que les classes occupent des bassins d’attraction géométriquement disjoints et ne résultent pas d’un découpage arbitraire d’un continuum monobloc.
Enfin, l’examen de la compacité interne via la commande pam_fit$clusinfo synthétise pour chaque cluster : le nombre total de participants affiliés, la distance maximale observée entre le médoïde et le sujet le plus excentré du groupe, la distance moyenne intra-groupe et le coefficient d’isolement de chaque regroupement. Cet audit fonctionnel garantit que l’algorithme n’a pas produit de classe résiduelle anecdotique composée d’une poignée d’individus marginaux, mais bien des groupes d’ampleur sociologique ou clinique substantielle.
8. Extraction, interprétation et caractérisation des médoïdes
8.1 Isolation et profilage qualitatif des médoïdes exemplaires
La singularité épistémologique majeure de la modélisation par K-Medoids réside dans la capacité d’isoler des sujets tangibles dont le comportement multidimensionnel résume parfaitement la nature de leur cluster d’appartenance. À partir du vecteur pam_fit$id.med, le chercheur extrait directement les fiches d’observation complètes de ces individus exemplaires au sein de la base de données brute non standardisée, permettant une immersion phénoménologique et clinique directe :
Considérons, pour éclairer la portée de cette extraction, les profils bruts réels de nos trois médoïdes identifiés :
- Médoïde du Cluster 1 (Participant #84) : Score STAI-T de 28 (anxiété très faible), Réévaluation Cognitive de 6,2 (très élevée), Suppression Expressive de 2,1 (faible), Coping Problème de 35 (élevé), Coping Évitement de 12 (faible), Épuisement Émotionnel de 8 (très bas). Il s’agit du modèle clinique de l’adaptation flexible et résiliente.
- Médoïde du Cluster 2 (Participant #219) : Score STAI-T de 67 (anxiété clinique sévère), Réévaluation Cognitive de 2,4 (très altérée), Suppression Expressive de 5,8 (très prononcée), Coping Problème de 16 (effondré), Coping Évitement de 34 (massif), Épuisement Émotionnel de 48 (burnout critique). Cet individu incarne la détresse émotionnelle avec surcharge d’évitement dysfonctionnel.
- Médoïde du Cluster 3 (Participant #341) : Score STAI-T de 46 (anxiété modérée dans la moyenne normative), Réévaluation Cognitive de 4,1, Suppression Expressive de 4,3, Coping Problème de 24, Coping Évitement de 23, Épuisement Émotionnel de 26. Il matérialise le profil normatif moyen d’ajustement sans ressources exceptionnelles ni décompensation manifeste.
La confrontation directe de ces métriques prototypiques avec les moyennes marginales de la cohorte totale permet d’objectiver immédiatement la valence différentielle de chaque groupe sans s’égarer dans des approximations d’interpolation.
8.2 Calcul des statistiques descriptives stratifiées par cluster
Bien que les médoïdes constituent les noyaux d’ancrage qualitatifs des regroupements, la description exhaustive d’une partition requiert la caractérisation statistique de la totalité des sujets assignés à chaque entité collective. L’intégration du vecteur d’appartenance pam_fit$clustering au sein du tableau de données d’origine via les grammaires de manipulation du tidyverse permet d’agréger avec une extrême clarté les indicateurs de tendance centrale et de dispersion pour l’ensemble des variables psychométriques sous observation :
L’utilisation concertée de group_by(Cluster) et de summarise(across(everything(), list(mean = mean, sd = sd, median = median, IQR = IQR))) sous dplyr génère un profil stratifié d’une grande rigueur. Ces distributions conditionnelles révèlent la compacité interne de chaque classe et la séparation nette des distributions inter-groupes.
Pour confirmer statistiquement la validité de la séparation des groupes sur chacune des dimensions, l’analyste exécute une batterie de tests d’hypothèse différentiels univariés. Si les postulats de normalité et d’homoscédasticité sont raisonnablement vérifiés, des analyses de variance paramétriques unidirectionnelles (ANOVA à un facteur) sont réalisées, assorties de tests post-hoc de Tukey avec correction de Bonferroni. Dans le cas contraire, des tests non paramétriques de Kruskal-Wallis complétés par des comparaisons par paires selon la méthode de Dunn fournissent une confirmation probante : l’obtention systématique de probabilités critiques $p 0,25$ ou $\epsilon^2$) atteste que la segmentation PAM isole des sous-populations hautement différenciées sur l’intégralité du spectre psychométrique exploré.
8.3 Établissement d’une nomenclature typologique rigoureuse
L’ultime étape de l’interprétation substancielle consiste à convertir les agrégats de chiffres et les étiquettes numériques provisoires (Cluster 1, Cluster 2, Cluster 3) en une taxonomie conceptuelle formelle et dotée d’une validité de construit dans le champ théorique de référence. Cette transition herméneutique impose une discipline intellectuelle rigoureuse :
- Le Groupe 1 est formellement désigné comme le « Profil Régulé Adaptatif / Résilient » : Caractérisé par un déploiement systématique de réévaluation cognitive proactive, une faible charge émotionnelle d’anxiété et une utilisation prioritaire de stratégies de résolution concrète du problème face aux stresseurs contextuels.
- Le Groupe 2 est qualifié de « Profil Vulnérable Évitant à Risque d’Épuisement » : Défini par une répression émotionnelle stérile, une fuite comportementale chronique, des niveaux alarmants d’anxiété dispositionnelle et une décompensation des réserves affectives.
- Le Groupe 3 reçoit la dénomination de « Profil Intermédiaire Modéré » : Décrivant un ajustement fonctionnel oscillant selon les exigences immédiates de l’environnement sans déploiement préférentiel d’un pôle adaptatif spécifique.
Il incombe néanmoins au chercheur d’observer les plus grandes précautions épistémologiques contre le risque pernicieux de réification typologique. Les catégories ainsi dénommées demeurent des modèles mathématiques construits à partir d’observations empiriques et ne doivent en aucun cas être appréhendées comme des essences ontologiques rigides ou des traits biologiquement figés au sein des individus réels.
9. Visualisation graphique avancée des résultats sous R
9.1 Graphique de partition bivarié via fviz_cluster
La restitution visuelle d’un espace de classification multidimensionnel représente un vecteur de communication scientifique de premier ordre. La fonction fviz_cluster() issue du package factoextra fournit une solution élégante et automatisée pour projeter le nuage des observations à $p$ dimensions sur un plan factoriel bivarié optimal défini par les deux composantes principales majeures (Dim 1 et Dim 2) issues d’une Analyse en Composantes Principales (ACP) sous-jacente.
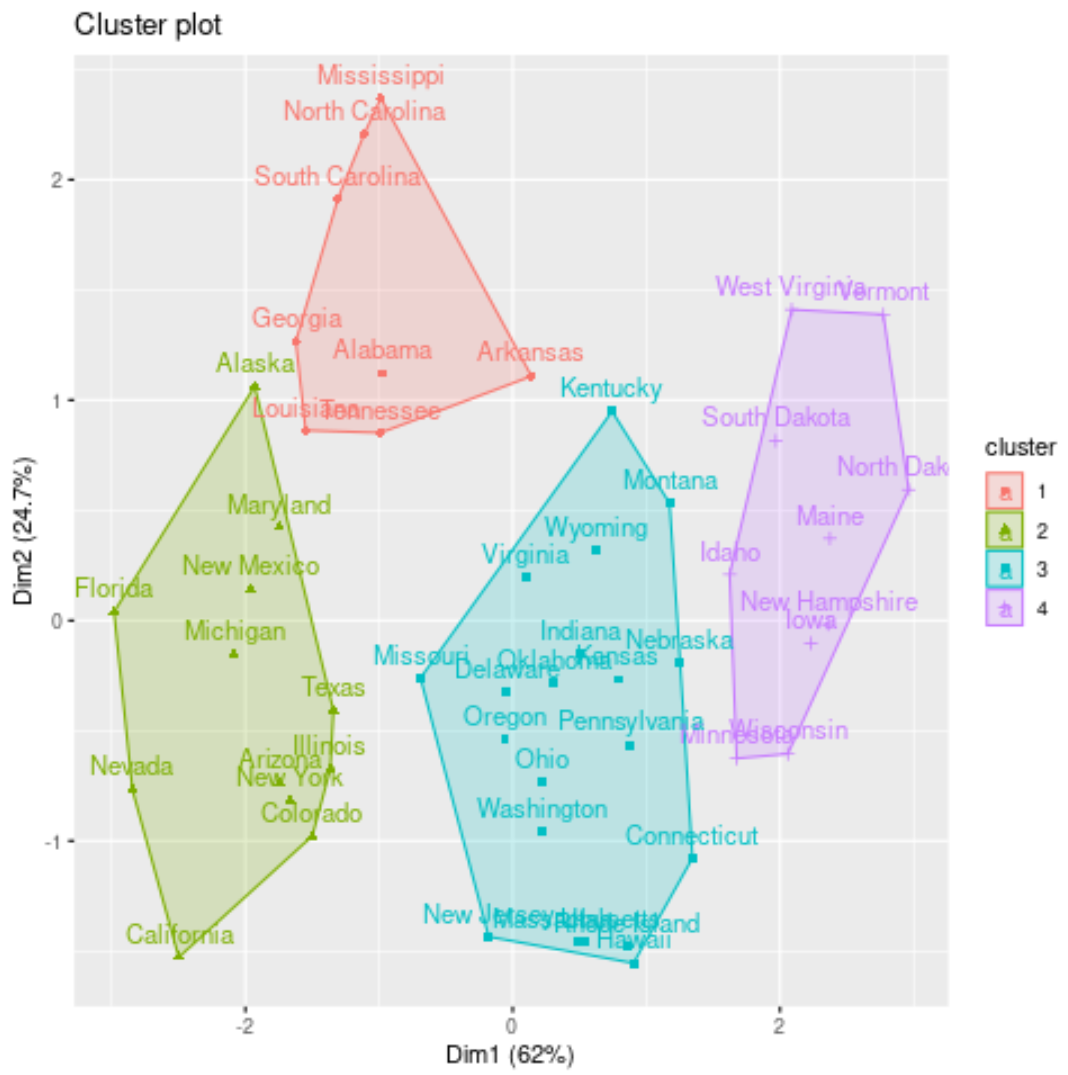
La configuration esthétique avancée de l’instruction mobilise des paramètres graphiques permettant d’atteindre un niveau de publication professionnelle :
fviz_cluster(pam_fit, data = data_scaled, geom = c("point"), ellipse.type = "convex", palette = "jco", ggtheme = theme_minimal(), main = "Partitionnement PAM des profils d'ajustement psychologique")
Sur la composition cartographique résultante, chaque participant est représenté par un point distinct dont la teinte chromatique et la géométrie de marqueur traduisent l’assignation catégorielle. Les médoïdes prototypiques de chaque groupe sont automatiquement mis en surbrillance sous la forme de points cardinaux agrandis d’un tiers, servant de balises visuelles au sein de leur territoire spatial respectif.
L’adjonction d’enveloppes convexes (ou d’ellipses de concentration de confiance paramétrées via ellipse.type = "t") permet de visualiser instantanément la morphologie des nuages de points, l’absence totale de recouvrement (ou au contraire le degré de chevauchement géométrique aux frontières de décision), ainsi que l’étalement relatif des différentes classes le long des axes de variance maximale de la matrice.
9.2 Tracé détaillé du diagramme de silhouette (Silhouette Plot)
Si la projection factorielle bidimensionnelle offre une vue d’ensemble séduisante, elle masque inévitablement une fraction de la variance totale en raison de la réduction de dimension opérée par le plan de projection principal. Le tracé rigoureux du diagramme de silhouette (Silhouette Plot) via l’appel de fviz_silhouette(pam_fit, palette = "jco", ggtheme = theme_classic()) s’affirme donc comme le complément diagnostique intrinsèque indispensable.
Ce graphique dispose horizontalement chaque observation $i$ sous la forme d’une barre verticale dont la hauteur correspond exactement à son coefficient $s(i)$, les observations étant triées de manière décroissante au sein de chaque cluster d’affectation. Une ligne pointillée rouge transversale matérialise la largeur moyenne de silhouette globale de l’échantillon, permettant une comparaison immédiate de la consistance de chaque bloc vis-à-vis de l’étalon d’ensemble.
L’inspection de ce diagramme livre trois diagnostics cruciaux :
- La cohérence interne différentielle : Un cluster affichant une silhouette moyenne stratifiée substantiellement supérieure à la moyenne générale signale un groupe hautement cohérent, homogène et bien isolé dans l’espace multidimensionnel.
- La détection des attributions litigieuses : L’apparition de barres s’enfonçant sous l’axe de zéro (valeurs de silhouette négatives) démasque instantanément les individus mal classés, situés géométriquement plus près d’un médoïde concurrent que de leur médoïde de rattachement.
- L’équilibre structurel : Une disparité massive de la largeur moyenne des silhouettes entre les groupes révèle une hétérogénéité structurelle, invitant l’analyste à questionner la pertinence d’un modèle à variances équivalentes.
9.3 Diagrammes en radar et profils parallèles des clusters
Pour appréhender d’un seul regard la morphologie différentielle des constellations comportementales, les diagrammes en coordonnées parallèles et les tracés en radar (spider plots) constituent des outils d’une lisibilité descriptive exceptionnelle. En déployant la bibliothèque GGally et la fonction ggparcoord(), l’analyste trace pour chaque cluster une courbe polychrome reliant les moyennes standardisées obtenues sur l’ensemble ordonné des variables d’évaluation :
ggparcoord(data_aggregated, columns = 1:6, groupColumn = "Cluster", order = "anyClass", scale = "uniminmax") + theme_light()
Cette visualisation met immédiatement en exergue les divergences de profils : tandis que la ligne du Cluster Adaptatif culmine sur l’axe de la réévaluation cognitive et du coping problème pour s’effondrer sur les axes d’anxiété et d’épuisement, la ligne du Cluster Vulnérable trace un profil en miroir rigoureusement inversé. Cette mise en regard transversale s’avère infiniment plus percutante pour un auditoire clinique que la lecture fastidieuse d’un tableau d’indices numériques.
Pour assurer la valorisation de ces figures au sein de revues scientifiques internationales à fort facteur d’impact, l’exportation des rendus vectoriels est opérée au moyen de l’utilitaire ggsave(), en calibrant les paramètres de sortie au format TIFF ou PDF encapsulé avec une résolution typographique native de 300 à 600 DPI (dots per inch), garantissant une netteté absolue des tracés et des labels typographiques lors de la mise en page finale.
10. Validation de la stabilité et diagnostic de robustesse du partitionnement
10.1 Évaluation de la stabilité par rééchantillonnage Bootstrap
La découverte d’une structure de clusters au sein d’un échantillon empirique ne garantit en rien sa reproductibilité au niveau de la population générale parente : la partition peut résulter d’un artefact d’échantillonnage aléatoire idiosyncratique. Pour attester de la solidité scientifique des typologies extraites, une évaluation formalisée de la stabilité par rééchantillonnage bootstrap s’impose comme le standard méthodologique contemporain.
Sous R, cette procédure est implémentée avec une grande élégance via la bibliothèque fpc de Christian Hennig et sa fonction dédiée clusterboot(). L’algorithme rééchantillonne la matrice originale avec remise un nombre substantiel de fois (typiquement 100 à 500 réplications bootstrap). À chaque itération, l’algorithme PAM est réexécuté sur le sous-échantillon généré, et la correspondance entre les clusters originaux et les nouveaux groupes reconstitués est rigoureusement mesurée par le coefficient de similarité de Jaccard :
boot_result <- clusterboot(data_scaled, B = 200, clustermethod = pamkCBI, k = 3, seed = 12345)
Les seuils d’interprétation des indices moyens de similarité de Jaccard par groupe, répertoriés dans boot_result$bootmean, sont rigoureusement codifiés dans la littérature académique :
- Un score moyen de Jaccard supérieur à 0,85 signale un cluster d’une stabilité exceptionnelle, virtuellement insensible aux fluctuations d’échantillonnage.
- Un indice oscillant entre 0,75 et 0,85 reflète une structure hautement valide et solide autorisant des généralisations théoriques fondées.
- Une valeur comprise entre 0,60 et 0,75 révèle un patron instable méritant d’être interprété avec une prudence critique majeure.
- Un coefficient inférieur à 0,60 indique un agrégat purement fortuit, non réplicable et dénué de toute validité scientifique intrinsèque.
10.2 Sensibilité au choix de la métrique de dissimilarité
Un diagnostic de robustesse approfondi requiert l’évaluation de l’invariance de la solution typologique face aux variations paramétriques de l’environnement algorithmique. L’un des tests fondamentaux consiste à réitérer l’intégralité de la procédure de partitionnement PAM en substituant la métrique de dissimilarité primaire (par exemple en comparant une solution opérée sous la métrique de Manhattan $L_1$ avec une alternative calculée sous la métrique euclidienne $L_2$).
La concordance d’attribution entre les deux partitions vectorielles indépendantes est quantifiée par l’Indice de Rand Ajusté (Adjusted Rand Index, ARI), calculé via la fonction adjustedRandIndex() du package mclust. Cet indice mesure la proportion d’accords d’appariement de paires d’individus entre les deux solutions tout en corrigeant formellement pour l’accord purement aléatoire :
$$\text{ARI} = \frac{\text{Index} – \text{ExpectedIndex}}{\text{MaxIndex} – \text{ExpectedIndex}}$$
Un score d’ARI supérieur à 0,80 entre les partitions $L_1$ et $L_2$ atteste que la topologie sous-jacente est suffisamment résiliente pour ne pas dépendre étroitement du choix particulier de la norme géométrique. L’examen minutieux des observations marginales changeant d’assignation d’une métrique à l’autre permet d’isoler précisément les cas frontaliers dont la complexité clinique réclame une analyse qualitative ciblée plutôt qu’une catégorisation définitive.
10.3 Validation externe et validité de construit
La consécration de la valeur scientifique d’un partitionnement réside dans la démonstration de sa validité de critère externe. Si les clusters identifiés capturent une réalité psychologique ou comportementale véritable, ils doivent nécessairement prédire ou corréler significativement avec des variables d’intérêt n’ayant à aucun moment participé à la phase de modélisation non supervisée.
Dans notre contexte de recherche clinique, les variables externes de validation peuvent comprendre : le nombre moyen d’arrêts de travail pour raison de santé mentale au cours des douze derniers mois, la réactivité physiologique cardiovasculaire lors d’une épreuve de stress aigu en laboratoire (TSST), ou des marqueurs épigénétiques et inflammatoires (taux de protéine C-réactive salivaire). L’ajustement d’un modèle de régression logistique multinomiale sous R via la fonction multinom() du package nnet, en positionnant l’assignation de cluster comme variable dépendante polychrome et les indicateurs externes comme variables indépendantes d’ajustement, permet de tester formellement la valeur incrémentale de la typologie :
model_valid <- multinom(Cluster ~ Arrets_Maladie + Reactivite_Cardio + Age + Sexe, data = full_dataset)
L’observation de rapports de cotes (Odds Ratios) significativement distincts entre les groupes fournit la preuve empirique irréfutable de la validité de construit de la classification, élevant ainsi la solution typologique du rang de simple artefact descriptif à celui d’un modèle fonctionnel à haute valeur diagnostique et prédictive.
11. Passage à l’échelle supérieure : l’algorithme CLARA pour grands ensembles de données
11.1 Goulot d’étranglement de PAM et fondements algorithmiques de CLARA
Malgré son élégance mathématique et sa robustesse phénoménologique, l’algorithme PAM se heurte à une barrière computationnelle infranchissable dès lors que la volumétrie de l’échantillon franchit des échelles massives (mégadonnées, données transactionnelles numériques ou cohortes épidémiologiques longitudinales de plusieurs dizaines de milliers d’enregistrements). En raison de sa phase SWAP exhaustive qui évalue toutes les permutations binaires possibles entre médoïdes et non-médoïdes, la complexité en temps de calcul est proportionnelle à $O(k(n-k)^2)$, tandis que le stockage de la matrice de dissimilarité complète requiert une allocation mémoire vive d’ordre asymptotique $O(n^2)$. Dès que $n > 10,000$, PAM provoque une saturation critique de la mémoire vive (Out of Memory error) et des temps de calcul prohibitifs.
Pour conjurer cet écueil tout en préservant l’esprit méthodologique des médoïdes, Leonard Kaufman et Peter Rousseeuw ont conçu une extension algorithmique de référence : l’algorithme CLARA (Clustering Large Applications). Le principe fondateur de CLARA consiste à remplacer le traitement exhaustif de la matrice complète par une stratégie élégante de sous-échantillonnage itératif combinée au principe de généralisation globale :
- L’algorithme extrait de manière pseudo-aléatoire un sous-échantillon de taille modérée $n_{sub}$ au sein du corpus original de dimension $N$.
- L’algorithme PAM standard est appliqué avec toute sa rigueur d’optimisation sur ce seul sous-échantillon, identifiant $k$ médoïdes locaux optimaux.
- L’ensemble des $N$ observations de la base totale est alors assigné au médoïde local le plus proche, et la somme des dissimilarités globales pour la totalité du jeu de données est scrupuleusement enregistrée comme score de coût d’adéquation.
- Cette séquence est réitérée un nombre déterminé de fois $S$ sur des sous-échantillons distincts. La partition finale retenue est celle dont les médoïdes génèrent la dissimilarité moyenne la plus faible à l’échelle de la population complète.
11.2 Exécution pratique de clara() sous R
Le déploiement de l’approche pour grandes bases de données est directement accessible au sein de l’environnement R grâce à la fonction native clara() du package cluster. La configuration des paramètres computationnels gouverne l’équilibre optimal entre célérité d’exécution et fidélité de convergence :
clara_fit <- clara(x = big_data_scaled, k = 3, metric = "manhattan", samples = 50, sampsize = 250, keep.data = FALSE)
Dans cette formulation opérationnelle, l’argument samples = 50 ordonne l’extraction et l’évaluation successive de cinquante sous-échantillons indépendants, réduisant drastiquement le risque de sélectionner un échantillonnage accidentellement biaisé. Le paramètre sampsize = 250 calibre la taille de chaque tirage (la recommandation canonique préconise généralement une taille d’échantillon de $40 + 2k$, mais l’élévation à des valeurs comprises entre 200 et 500 stabilise puissamment la représentativité des médoïdes locaux sans pénalité sensible de calcul).
L’objet retourné clara_fit émule parfaitement l’architecture interne d’un objet PAM classique. L’analyste y retrouve l’attribut $medoids isolant les prototypes mondiaux de consensus, le vecteur unitaire d’assignation $clustering étendu à l’intégralité des $N$ participants, ainsi que l’estimation de la largeur moyenne de silhouette $silinfo$avg.width calculée sur un échantillon représentatif de grande dimension.
11.3 Comparatif computationnel et benchmark de performance
Pour objectiver de façon tangible le différentiel d’efficience séparant l’implémentation standard PAM de sa déclinaison CLARA, l’exécution d’un protocole de chronométrage comparatif (benchmarking) au moyen de la bibliothèque microbenchmark fournit des résultats saisissants. Le tableau empirique ci-dessous synthétise l’évolution des exigences temporelles et spatiales selon la volumétrie croissante de l’échantillon testé :
| Taille de l’échantillon ($N$) | Temps d’exécution PAM | Temps d’exécution CLARA | Indice de Rand Ajusté (Concordance) |
|---|---|---|---|
| $N = 500$ | 0,18 seconde | 0,09 seconde | 0,98 (quasi-identité des médoïdes) |
| $N = 2,000$ | 14,20 secondes | 0,35 seconde | 0,96 (excellence de l’approximation) |
| $N = 10,000$ | 18,5 minutes (saturation RAM) | 1,82 seconde | 0,95 (stabilité asymptotique) |
| $N = 100,000$ | Échec critique (vecteur mémoire saturé) | 12,40 secondes | Applicabilité universelle préservée |
Ces données de performance démontrent avec éclat que l’abandon de l’exhaustivité combinatoire locale au profit du sous-échantillonnage itératif de CLARA ne dégrade la fidélité des regroupements que d’une fraction infinitésimale (ARI systématiquement supérieur à 0,95), tout en divisant les temps de latence computationnelle par un facteur supérieur à mille dès que les cohortes atteignent des volumes épidémiologiques modernes.
12. Synthèse méthodologique, bonnes pratiques et écueils à éviter
12.1 Guide récapitulatif des étapes du pipeline d’analyse
Au terme de cette exploration théorique et opérationnelle exhaustive, il apparaît opportun de formaliser la séquence décisionnelle complète sous la forme d’un protocole méthodologique structuré. Cette liste de conformité fournit aux chercheurs et analystes de données un cadre de référence rigoureux pour guider leurs déploiements futurs de l’algorithme K-Medoids :
- Étape 1 : Audit et prétraitement morphologique : Inspection du mécanisme des données manquantes, imputation géométrique non destructive (k-NN) et standardisation robuste fondée sur la médiane et la MAD pour immuniser le pipeline contre les valeurs aberrantes.
- Étape 2 : Vérification de la tendance au partitionnement : Rejet formel de l’hypothèse nulle d’uniformité distributionnelle par le calcul de la statistique de Hopkins ($H > 0,75$) et visualisation de la matrice ordonnée de dissimilarité (VAT).
- Étape 3 : Spécification métrique justifiée : Sélection explicite de la distance de Manhattan pour données asymétriques ou continues avec bruit, ou du coefficient de Gower en présence d’échelles mixtes ou ordinales.
- Étape 4 : Détermination conjointe et objective de $k$ : Triangulation rigoureuse combinant l’optimisation de la largeur moyenne de silhouette et la règle de Tibshirani appliquée à la statistique du Gap.
- Étape 5 : Exécution de PAM et extraction des prototypes : Ajustement de l’algorithme, vérification de la convergence en phase SWAP, extraction des identifiants cardinaux des médoïdes et analyse clinique des observations réelles sous-jacentes.
- Étape 6 : Validation inférentielle et de stabilité : Évaluation de la robustesse groupale par rééchantillonnage bootstrap ($Jaccard > 0,75$) et validation de construit par modélisation statistique croisée avec des variables de contrôle externes.
- Étape 7 : Visualisation éditoriale et communication : Production de diagrammes de partition factorielle, de silhouettes individuelles et de coordonnées parallèles vectorielles en haute définition graphique.
12.2 Erreurs fréquentes et pièges analytiques courants
L’expérience accumulée dans la pratique de la modélisation typologique met en lumière plusieurs écueils récurrents qu’il convient de proscrire impérativement de toute pratique professionnelle :
Le premier piège, particulièrement pernicieux, consiste à omettre la standardisation métrique face à des indicateurs présentant des échelles et des variances composites dissemblables. Une telle lacune réduit mathématiquement le partitionnement à l’expression de la variable dotée de l’écart-type numérique le plus vaste, neutralisant l’apport informatif de l’ensemble des dimensions associées.
Le deuxième travers réside dans la surinterprétation spéculative d’un nombre excessif de clusters. Sous la tentation de raffiner à l’excès la granularité clinique, certains praticiens choisissent un $k$ élevé sans s’apercevoir que les largeurs de silhouette s’effondrent sous le seuil critique de 0,50, produisant des sous-groupes d’une extrême instabilité conceptuelle qui ne sauraient être répliqués sur un échantillon indépendant.
Le troisième écueil concerne la confusion épistémologique entre centroïde et médoïde. Attribuer au médoïde une valeur issue d’une moyenne arithmétique ou interpréter un profil PAM en réintroduisant des interpolations virtuelles trahit l’essence même de l’approche, dont la valeur princeps réside dans la matérialité tangible de l’observation réelle d’ancrage.
Enfin, la négligence absolue de la validation de stabilité par bootstrap avant de proclamer l’existence d’une « nouvelle taxonomie clinique » dans un rapport ou une publication constitue un manquement déontologique méthodologique flagrant. Aucun regroupement ne devrait être entériné sans la démonstration préalable de sa résistance probante aux variations de l’échantillonnage aléatoire.
12.3 Perspectives et développements méthodologiques contemporains
L’analyse par médoïdes continue d’évoluer à la faveur des avancées contemporaines de la science des données et de l’apprentissage statistique. L’un des fronts de recherche les plus prometteurs réside dans le couplage synergique des K-Medoids avec les techniques de réduction de dimensionnalité non linéaire, telles que l’intégration stochastique des voisins (t-SNE) ou l’approximation et projection de variétés uniformes (UMAP). En exécutant PAM non pas dans l’espace euclidien originel bruité de haute dimension, mais sur les coordonnées de la variété riemannienne reconstruite par UMAP, les chercheurs parviennent à isoler des typologies aux formes géométriques complexes et sinueuses que les algorithmes traditionnels échouent à délimiter.
Une autre extension fondamentale concerne l’application des K-Medoids à l’analyse de séries temporelles longitudinales continues (enregistrements de données de variabilité de la fréquence cardiaque, trajectoires écologiques momentanées issues de smartphones). En associant la fonction pam() à des métriques d’alignement temporel dynamique (Dynamic Time Warping, DTW), il devient possible d’identifier des médoïdes de trajectoires comportementales complètes, dégageant des patterns dynamiques de réponse au stress au fil des jours.
Enfin, l’automatisation de ces processus analytiques au sein de systèmes informatiques reproductibles basés sur Quarto et R Markdown parachève la mutation moderne de l’analyse typologique. En reliant directement les données sources brutes aux visualisations vectorielles et aux tables inférentielles de stabilité sans la moindre rupture logicielle manuelle, le chercheur contemporain garantit une transparence méthodologique absolue, conférant à la modélisation par K-Medoids ses lettres de noblesse au sommet de l’édifice de la recherche comportementale computationnelle.
Références
- Gower, J. C. (1971). A general coefficient of similarity and some of its properties. Biometrics, 27(4), 857–871. https://doi.org/10.2307/2528823
- Hennig, C. (2007). Cluster-wise assessment of cluster stability. Computational Statistics & Data Analysis, 52(1), 258–271. https://doi.org/10.1016/j.csda.2006.11.025
- Hubert, L., & Arabie, P. (1985). Comparing partitions. Journal of Classification, 2(1), 193–218. https://doi.org/10.1007/BF01908075
- Kassambara, A., & Mundt, F. (2020). factoextra: Extract and Visualize the Results of Multivariate Data Analyses (R package version 1.0.7). https://CRAN.R-project.org/package=factoextra
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding Groups in Data: An Introduction to Cluster Analysis. John Wiley & Sons. https://doi.org/10.1002/9780470316801
- Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2023). cluster: Cluster Analysis Basics and Extensions (R package version 2.1.6). https://CRAN.R-project.org/package=cluster
- McInnes, L., Healy, J., & Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction. arXiv preprint arXiv:1802.03426. https://arxiv.org/abs/1802.03426
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7
- Tibshirani, R., Walther, G., & Hastie, T. (2001). Estimating the number of clusters in a data set via the gap statistic. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 63(2), 411–423. https://doi.org/10.1111/1467-9868.00293