
Dans le paysage contemporain de l’analyse de données quantitatives et de la modélisation statistique appliquée aux sciences humaines, la compréhension fine des mécanismes décisionnels, comportementaux et psychopathologiques constitue un enjeu épistémologique majeur. Pendant des décennies, le modèle de régression linéaire classique par les moindres carrés ordinaires a constitué le pilier fondamental de la recherche empirique. Toutefois, lorsqu’un chercheur est confronté à des phénomènes dont la nature intrinsèque est binaire — la survenue ou l’absence d’un épisode dépressif caractérisé, l’échec ou la réussite à une tâche cognitive complexe, la démission d’un collaborateur ou son maintien en poste —, les assises théoriques du modèle linéaire standard s’effondrent sous le poids de violations mathématiques rédhibitoires.
La transition vers la régression logistique ne relève pas d’une simple préférence technique ou d’un raffinement accessoire ; elle incarne un changement de paradigme fondamental dans la manière de conceptualiser la relation entre des covariables — qu’elles soient psychométriques, sociodémographiques ou neurobiologiques — et un événement discret. En substituant à l’hypothèse de linéarité continue l’élégance de la transformation sigmoïdale et de la métrique des cotes (odds), la régression logistique permet de préserver l’intégrité probabiliste des prédictions tout en s’affranchissant des contraintes restrictives d’homoscédasticité et de normalité des résidus.
Ce guide exhaustif a pour vocation d’offrir une immersion rigoureuse, didactique et approfondie dans les fondements théoriques, les mécanismes algorithmiques, l’interprétation diagnostique et les applications concrètes de la régression logistique binaire et de ses extensions polytomiques. Conçu spécifiquement pour les chercheurs, statisticiens et praticiens des sciences comportementales et biomédicales, ce document détaille l’ensemble de la chaîne méthodologique, depuis la formulation analytique du modèle jusqu’aux normes les plus strictes de publication académique.
1. Fondements théoriques : De la régression linéaire à la régression logistique
1.1 Limites de la régression linéaire pour les variables catégorielles
L’application directe de la méthode des moindres carrés ordinaires (MCO) à une variable dépendante dichotomique — souvent qualifiée de modèle de probabilité linéaire (MPL) — se heurte à des apories structurales insurmontables. En premier lieu, la fonction linéaire Y = β₀ + β₁X + ε postule une relation sans borne entre les prédicteurs et la variable dépendante. Dès lors que l’on interprète la valeur ajustée Ŷ comme une probabilité conditionnelle d’occurrence de l’événement, le modèle produit inévitablement, pour des valeurs extrêmes des covariables, des probabilités estimées aberrantes, strictement inférieures à 0 ou supérieures à 1. Cette incohérence axiologique vicie la validité interne du modèle, une probabilité ne pouvant mathématiquement s’extraire de l’intervalle fermé [0, 1].
En second lieu, l’hypothèse cardinale d’homoscédasticité — stipulant la variance constante du terme d’erreur conditionnellement aux prédicteurs — est systématiquement violée dans le cadre d’une variable réponse binaire Y ∈ {0, 1}. Si l’on pose P(Y = 1 | X) = π(X), la variable aléatoire suit une distribution de Bernoulli dont la variance théorique s’exprime par la fonction Var(Y | X) = π(X)(1 – π(X)). Cette variance dépend intrinsèquement du niveau des covariables X ; elle atteint son paroxysme lorsque π(X) = 0,5 et converge vers zéro aux bornes extrêmes. L’hétéroscédasticité qui en découle n’invalide pas la non-biaicité des estimateurs MCO, mais elle détruit leur efficacité statistique, rendant les calculs d’erreurs-types erronés et les tests d’hypothèses associés (notamment le test t de Student) fallacieux.
Enfin, l’hypothèse de normalité des résidus ε = Y – π(X) est intrinsèquement intenable. Pour une valeur fixée du vecteur de prédicteurs, le résidu ne peut prendre que deux valeurs discrètes : 1 – π(X) si l’événement survient, ou -π(X) si l’événement fait défaut. L’erreur conditionnelle suit donc une distribution discrète bimodale hautement asymétrique, ce qui compromet définitivement l’inférence statistique standard reposant sur la loi normale pour des échantillons de taille modeste.
1.2 Concept de classification probabiliste en sciences comportementales
Dans l’investigation des conduites humaines, les phénomènes mesurés ne répondent que très exceptionnellement à des déterminismes mécanistes univoques. La psychologie différentielle, la neuropsychologie et la psychiatrie computationnelle appréhendent l’individu à travers des structures de vulnérabilité, des gradients de traits et des constellations de facteurs de risque. Dès lors, substituer un modèle de classification probabiliste à une classification déterministe découle d’un impératif théorique : il ne s’agit pas d’affirmer si un individu précis manifestera un comportement avec certitude, mais d’estimer avec précision sa propension — ou probabilité latente — à émettre ce comportement à l’intérieur d’un contexte écologique donné.
Sur le plan épistémologique, la modélisation probabiliste permet de séparer la composante structurelle du phénomène — captée par les scores psychométriques, les variables physiologiques ou les antécédents environnementaux — du bruit stochastique résiduel inhérent à l’indétermination des conduites humaines. L’approche déterministe impose une dichotomie artificielle prématurée, alors que la régression logistique préserve la nuance métrique continue de la probabilité conditionnelle P(Y = 1 | X).
Dans les contextes diagnostiques et d’évaluation, la prise en compte de l’incertitude probabiliste est le seul rempart contre les erreurs de décision clinique. Attribuer à un patient une probabilité de rechute de 51 % ne véhicule pas la même signification clinique que de lui attribuer une probabilité de 95 %, bien que ces deux valeurs soient catégorisées de façon identique par un algorithme binaire fonctionnant au seuil standard de 0,5. L’estimation probabiliste offre la flexibilité nécessaire pour intégrer des fonctions d’utilité et de coût différentiels, pivots de la décision clinique rationnelle.
1.3 Nature des variables dépendantes dichotomiques en psychologie
La modélisation de variables réponses dichotomiques s’avère omniprésente dans tous les domaines des sciences de l’esprit. En psychopathologie clinique, les classifications nosographiques telles que le Manuel diagnostique et statistique des troubles mentaux (DSM-5) ou la Classification internationale des maladies (CIM-11) opèrent selon des frontières discrètes : un sujet répond ou ne répond pas aux critères de l’épisode dépressif caractérisé, de l’état de stress post-traumatique ou du trouble panique. Bien que la symptomatologie sous-jacente s’inscrive sur un continuum dimensionnel, l’action clinique — l’initiation d’une chimiothérapie antidépressive ou la prescription d’une psychothérapie structurée — est catégorielle.
En neuropsychologie cognitive, les paradigmes expérimentaux font appel de façon prépondérante à des variables dichotomiques lors de l’administration d’épreuves mesurant l’attention soutenue, la flexibilité mentale ou la mémoire épisodique. La performance à un essai spécifique au test d’appariement de cartes de Wisconsin ou au paradigme d’inhibition de la réponse (Go/No-Go) se quantifie classiquement par un code binaire : succès (1) ou échec/erreur (0). L’analyse logistique permet de modéliser comment la vitesse d’encodage, l’âge chronologique ou la charge cognitive influencent la probabilité d’une exécution motrice sans faute.
En psychologie de la santé et recherche sur l’observance thérapeutique, l’adhésion à un protocole ou l’interruption prématurée de la prise en charge (dropout) constitue l’exemple canonique d’une issue binaire. La préservation de l’engagement dans une thérapie comportementale et cognitive contre les addictions est conditionnée par des variables d’alliance thérapeutique, de motivation au changement et de soutien perçu. Modéliser avec précision ces comportements d’abandon répond à une double exigence scientifique et organisationnelle au sein des institutions de soins.
2. La fonction logistique et la transformation Logit
2.1 Propriétés mathématiques de la courbe sigmoïde
Pour contraindre structurellement les prédictions d’un modèle statistique à s’inscrire dans l’intervalle probabiliste borné [0, 1], l’analyse mathématique a recours à la courbe sigmoïde standard, couramment dénommée fonction logistique standard. Cette fonction non linéaire prend la forme algébrique canonique suivante :
f(z) = 1 / (1 + e-z) = ez / (1 + ez)
Lorsque la variable intermédiaire z — qui représentera ultérieurement la combinaison linéaire de nos prédicteurs — tend vers l’infini négatif (z → -∞), la quantité e-z croît indéfiniment, conduisant le dénominateur vers l’infini et la fonction f(z) vers une asymptote horizontale à 0. Réciproquement, lorsque z tend vers l’infini positif (z → +∞), e-z converge vers 0, contraignant f(z) à s’approcher indéfiniment de son asymptote horizontale supérieure fixée à 1. Cette propriété d’enclosement strict éradique le risque de produire des probabilités impossibles.
La courbe sigmoïde se distingue par une symétrie centrale remarquable autour de son point d’inflexion, situé précisément aux coordonnées (z = 0, f(z) = 0,5). En ce point, la dérivée première de la fonction atteint son maximum — la pente est la plus abrupte —, ce qui signifie que de menues variations des prédicteurs autour de ce seuil médian induisent des modifications substantielles de la probabilité prédite. À mesure que l’on s’écarte du point d’inflexion vers les régions asymptotiques, la dérivée première tend asymptotiquement vers zéro : le modèle exprime ainsi un phénomène de saturation ou de rendement marginal décroissant.
2.2 Du risque absolu au concept de cote (Odds)
L’appréhension intuitive des résultats de la régression logistique exige une compréhension préalable du concept de cote, issu historiquement de la théorie des probabilités appliquées aux jeux d’argent et adopté par l’épidémiologie anglo-saxonne sous le terme d’odds. Si l’on désigne par p la probabilité de survenue d’un événement d’intérêt au sein d’une population cible, la cote de cet événement est définie formellement comme le ratio entre la probabilité de survenue et la probabilité complémentaire de non-survenue :
Cote = p / (1 – p)
Cette formulation induit un basculement métrologique fondamental. Alors que la probabilité p est confinée dans l’espace fermé [0, 1], la cote s’étend quant à elle sur un espace asymétrique non borné à droite, soit l’intervalle [0, +∞[. Une cote inférieure à 1 indique que l’événement a moins d’une chance sur deux de survenir ; une cote égale à 1 — la cote unitaire — correspond à une probabilité stricte de 0,5, symbolisant l’équiprobabilité parfaite entre survenue et non-survenue (comme dans le tirage à pile ou face d’une pièce non truquée). À l’inverse, dès lors que la probabilité excède 0,5, la cote croît de façon exponentielle vers l’infini (une probabilité de 0,80 correspondant par exemple à une cote de 0,80 / 0,20 = 4, signifiant que l’événement a quatre fois plus de chances de se produire que d’échouer).
2.3 La transformation logit et le rétablissement de la linéarité
Bien que le concept de cote libère la métrique de son plafond supérieur unitaire, son asymétrie — bornée par zéro à gauche, mais infinie à droite — demeure impropre à l’ajustement par des combinaisons linéaires de prédicteurs pouvant légitimement produire des valeurs négatives. Pour pallier cette incongruité topologique, la régression logistique applique la fonction logarithme népérien (ou log naturel) à la cote, opération mathématique désignée sous le terme de transformation logit :
Logit(p) = ln(Cote) = ln( p / (1 – p) )
En projetant le ratio p / (1 – p) dans l’espace logarithmique, la fonction logit opère une déformation métrique essentielle : l’intervalle semi-borné [0, +∞[ est converti en un espace continu parfaitement continu et bidirectionnellement symétrique, s’étendant de ]-∞, +∞[. Lorsque la probabilité p tend vers 0, la cote converge vers 0 et son logarithme plonge vers l’infini négatif ; lorsque p est exactement égal à 0,5, le logit s’annule (ln(1) = 0) ; et lorsque p tend vers 1, le logit s’élève vers l’infini positif.
Cette transformation réussit le tour de force de rétablir une parfaite linéarité entre les variables explicatives et une grandeur latente non bornée, tout en garantissant par rétro-conversion (l’exponentiation inverse) que les probabilités conditionnelles estimées ne violeront jamais les postulats de l’analyse stochastique.
3. Formulation mathématique du modèle de régression logistique
3.1 Équation fondamentale du modèle binaire
La formulation mathématique de la régression logistique binaire univariée ou multivariée découle directement de l’égalisation entre le logit de la probabilité conditionnelle et la combinaison linéaire des variables prédictives. Pour un individu i caractérisé par un vecteur de k prédicteurs Xi = (Xi1, Xi2, …, Xik), le modèle postule la relation fonctionnelle suivante :
Logit(P(Yi = 1 | Xi)) = ln[ P(Yi = 1 | Xi) / (1 – P(Yi = 1 | Xi)) ] = β₀ + β₁Xi1 + β₂Xi2 + … + βkXik
En inversant l’opérateur logarithmique par l’application de la fonction exponentielle des deux côtés de l’égalité, nous pouvons isoler la cote conditionnelle, puis exprimer directement la probabilité conditionnelle de succès par l’équation logistique inverse :
P(Yi = 1 | Xi) = e(β₀ + ∑ βⱼXij) / (1 + e(β₀ + ∑ βⱼXij)) = 1 / (1 + e-(β₀ + ∑ βⱼXij))
Dans ce cadre structurel, le paramètre β₀ (l’ordonnée à l’origine ou constante du modèle) représente la valeur du logit de l’événement lorsque l’ensemble des prédicteurs continus et catégoriels inclus dans le modèle sont fixés à la valeur zéro. Par conséquent, la transformation logistique inverse de β₀ — soit 1 / (1 + e-β₀) — reflète la probabilité de base (ou prévalence intrinsèque) d’occurrence de l’événement lorsque l’ensemble des covariables d’ajustement est nul.
3.2 Intégration de prédicteurs continus et catégoriels
La flexibilité opérationnelle du modèle logistique réside dans sa propension à incorporer simultanément des covariables issues d’échelles de mesure hétérogènes. Lorsqu’un prédicteur psychométrique continu (par exemple, le score global à une échelle d’évaluation de la névrose ou de l’anxiété-trait) est introduit, le coefficient β associé quantifie la variation marginale du logit pour chaque incrément d’une unité sur l’échelle de ce test, en maintenant constantes toutes les autres variables du modèle.
Pour les variables indépendantes catégorielles — telles que l’appartenance à un groupe thérapeutique (contrôle, placebo, intervention comportementale) ou le statut marital —, un codage préalable s’avère indispensable. Le codage binaire indicatif (dummy coding) constitue la modalité standard : une modalité de référence est définie de manière théorique ou empirique, et k – 1 variables dichotomiques indicatrices sont injectées dans la régression. Le coefficient β associé à chaque modalité indicatrice représente alors la déviation en log-odds de ce groupe par rapport au groupe de référence choisi. À l’inverse, le codage d’écart (effect coding) compare chaque modalité non pas à un groupe pivot, mais à la moyenne générale non pondérée de l’ensemble des modalités, offrant une interprétation analogue à celle des contrastes en analyse de variance.
Afin de comparer directement l’importance relative de prédicteurs continus aux unités de mesure disparates (par exemple, comparer l’impact du cortisol salivaire en nmol/L à celui du score total au BDI-II), le statisticien peut recourir à la standardisation centrée-réduite des covariables avant estimation. Le coefficient obtenu reflète alors le changement de log-odds induit par une déviation standard d’augmentation sur le prédicteur considéré.
3.3 Hypothèse de distribution sous-jacente
D’un point de vue fondamental, la régression logistique s’inscrit au sein de la théorie unifiée des modèles linéaires généralisés (GLM), formalisée par Nelder et Wedderburn en 1972. Dans ce cadre, la variable dépendante Y conditionnellement aux covariables suit une distribution issue de la famille exponentielle, précisément une loi de Bernoulli pour des événements individuels binaires. L’espérance conditionnelle E(Y | X) coïncide rigoureusement avec la probabilité d’occurrence π(X).
Le modèle linéaire généralisé couple la composante aléatoire (la distribution de Bernoulli) à la composante systématique linéaire au moyen d’une fonction de liaison mathématique g(·) telle que g(E(Y|X)) = η = Xβ. Dans la régression logistique, la fonction de liaison sélectionnée est la fonction logit, qui présente la propriété singulière d’être la fonction de lien canonique de la distribution de Bernoulli. Ce statut canonique implique des simplifications analytiques considérables lors de l’inversion de l’information de Fisher et confère aux statistiques de suffisance des propriétés mathématiques optimales de régularité.
Il est instructif de situer le modèle logistique en miroir du modèle probit, son principal alter ego historique. Si la régression logistique recourt à la fonction de répartition de la loi logistique, le modèle probit adopte la fonction de répartition de la loi normale standard cumulée Φ(z) comme fonction de lien inverse. Les deux courbes se superposent de manière quasi parfaite entre les probabilités 0,1 et 0,9. Toutefois, la distribution logistique possède des queues de distribution plus lourdes (kurtosis plus élevée) que la loi normale. Le choix du lien logit en sciences comportementales prévaut largement pour une raison d’intelligibilité : seul le lien logit permet une rétro-transformation directe des coefficients en ratios de cotes (Odds Ratios), absents du modèle probit.
4. Estimation des paramètres : La méthode du maximum de vraisemblance
4.1 Principes de la fonction de vraisemblance
Contrairement aux modèles de régression linéaire qui emploient l’inversion matricielle analytique directe pour minimiser la somme des carrés des écarts, la régression logistique fait appel à la théorie de l’estimation par le maximum de vraisemblance (MLE). Cette approche statistique fondamentale part du postulat d’indépendance conditionnelle des observations pour formuler la probabilité conjointe — appelée fonction de vraisemblance L(β) — d’observer très exactement le patron empirique de données recueilli dans l’échantillon, sous l’hypothèse d’un vecteur de coefficients β donné.
Pour un échantillon aléatoire de n observations indépendantes (y₁, y₂, …, yₙ) où chaque yᵢ prend la valeur 0 ou 1 avec une probabilité πᵢ = P(Yᵢ = 1 | Xᵢ), la fonction de vraisemblance s’exprime comme le produit des probabilités individuelles de Bernoulli :
L(β) = ∏ [ πᵢyᵢ × (1 – πᵢ)(1 – yᵢ) ]
Comme le produit de centaines ou de milliers de probabilités fractionnaires engendre des nombres infinitésimaux susceptibles de générer des erreurs de dépassement de capacité arithmétique (underflow) au sein des calculateurs numériques, l’opération standard consiste à appliquer le logarithme népérien à la fonction de vraisemblance, définissant ainsi la fonction de log-vraisemblance (log-likelihood, notée ℓ(β) ou LL) :
ℓ(β) = ln(L(β)) = ∑ [ yᵢ ln(πᵢ) + (1 – yᵢ) ln(1 – πᵢ) ]
La fonction logarithmique étant strictement monotone et croissante, maximiser la log-vraisemblance revient strictement au même que maximiser la vraisemblance originelle, tout en transformant le produit matriciel en une sommation linéaire plus stable et calculatoirement optimale.
4.2 Procédures d’optimisation numérique itérative
L’obtention des coefficients optimaux β̂ implique théoriquement d’annuler les dérivées partielles de la log-vraisemblance par rapport à chacun des paramètres, constituant un système de k + 1 équations dites équations du gradient (ou score) :
∂ℓ(β) / ∂βⱼ = ∑ (yᵢ – πᵢ) Xij = 0
Toutefois, en raison de la présence de la non-linéarité introduite par l’exponentielle au sein de πᵢ, ce système n’admet aucune solution analytique fermée (closed-form solution). Il est indispensable de déployer un algorithme d’optimisation numérique itérative. La procédure de référence est l’algorithme de Newton-Raphson, qui procède par approximations quadratiques successives de la surface de log-vraisemblance à partir d’un vecteur initial β⁽⁰⁾.
À chaque itération t + 1, le nouveau vecteur de paramètres est mis à jour selon l’équation matricielle :
β⁽ᵗ⁺¹⁾ = β⁽ᵗ⁾ – [ H(β⁽ᵗ⁾) ]⁻¹ × U(β⁽ᵗ⁾)
où U(β⁽ᵗ⁾) représente le vecteur gradient du score et H(β⁽ᵗ⁾) désigne la matrice hessienne, c’est-à-dire la matrice des dérivées secondes partielles de la log-vraisemblance par rapport aux paramètres. Dans le cadre canonique du modèle logistique, cette procédure se reformule rigoureusement sous la forme de l’algorithme des moindres carrés repondérés itératifs (IRLS, Iteratively Reweighted Least Squares). L’algorithme réévalue les résidus et les poids à chaque cycle jusqu’à ce que la différence de log-vraisemblance entre deux étapes consécutives passe sous un seuil infinitésimal de tolérance (couramment 10⁻⁶ ou 10⁻⁸), attestant de la convergence de l’estimateur.
4.3 Problématiques de non-convergence et de séparation
En pratique, l’algorithme de Newton-Raphson peut échouer à converger ou aboutir à des estimations hautement pathologiques lorsqu’il est confronté au phénomène mathématique de séparation des données, identifié initialement par Albert et Anderson (1984). La séparation parfaite (complete separation) survient lorsqu’une variable indépendante continue ou une combinaison linéaire de prédicteurs divise les sujets de façon si absolue qu’il est possible de tracer un hyperplan séparant intégralement les cas Y = 1 des cas Y = 0 sans la moindre superposition empirique.
La quasi-séparation (quasi-complete separation) se produit quant à elle lorsque, pour un sous-ensemble d’une covariable ou d’un croisement de catégories, tous les individus observés présentent invariablement la même modalité de la variable réponse (par exemple, aucun patient d’une tranche d’âge donnée n’a rechuté). Face à ces configurations, l’algorithme tente d’estimer une probabilité de 1 ou de 0, ce qui correspond mathématiquement à un logit égal à +∞ ou -∞. Les itérations s’enchaînent sans atteindre le critère d’arrêt usuel, conduisant les logiciels statistiques à émettre des alertes de non-convergence, caractérisées par des coefficients régressifs démesurément élevés et des erreurs-types qui explosent vers des valeurs gigantesques.
Pour remédier à ces distorsions dévastatrices sans devoir amputer arbitrairement les données, plusieurs stratégies de régularisation ont été développées. La méthode la plus élégante en inférence classique est la méthode de pénalisation de Firth (1993), qui introduit un terme de pénalisation proportionnel à la racine carrée du déterminant de la matrice d’information de Fisher directement dans la fonction de vraisemblance, garantissant des estimations finies et non biaisées même en situation de séparation complète. Dans les contextes de grande dimensionnalité où le nombre de prédicteurs menace la stabilité de l’estimation, le recours à la régression logistique pénalisée sous contrainte Ridge (pénalité L2) ou Lasso (pénalité L1) permet de contraindre les coefficients et de stabiliser drastiquement le modèle.
5. Interprétation des coefficients et notion d’Odds Ratio
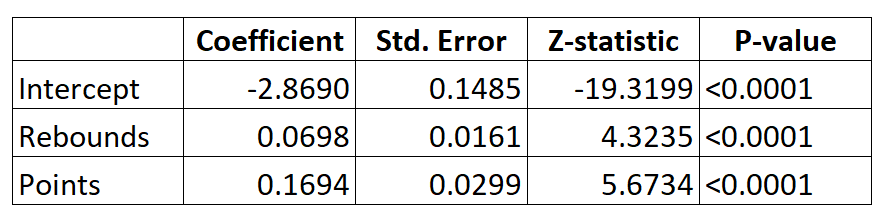
5.1 Signification des coefficients bruts en échelle logit
L’obtention des résultats bruts d’une régression logistique livre un vecteur de coefficients notés β qui s’expriment sur l’échelle continue du logit. De par la nature même de la transformation, le coefficient βⱼ traduit la modification attendue du logarithme de la cote (ou log-odds) d’occurrence de l’événement d’intérêt induite par l’accroissement d’une unité de la variable explicative Xⱼ, toutes les autres covariables du modèle étant maintenues constantes.
Le signe associé au coefficient renseigne directement sur la directionnalité de l’effet. Un coefficient β positif dénote qu’une augmentation de la valeur du prédicteur élève le log-odds, et par conséquent accroît de manière monotone la probabilité que l’événement survienne. Symétriquement, un coefficient négatif atteste qu’une hausse du prédicteur entraîne une diminution de la probabilité conditionnelle d’occurrence de l’issue clinique ou comportementale. Si le coefficient est rigoureusement nul, le prédicteur n’exerce aucune influence sur la propension de l’événement.
Cependant, l’interprétation concrète et la vulgarisation clinique de ces coefficients bruts s’avèrent périlleuses en pratique. L’esprit humain ne conceptualise pas spontanément les phénomènes en termes d’unités de log-odds. Affirmer à une équipe médicale qu’une thérapie abaisse le risque d’épuisement professionnel de « 0,693 unité logit » présente une utilité communicative quasi nulle. C’est précisément cette opacité psychométrique qui impose le recours systématique à l’exponentiation des coefficients.
5.2 Calcul et déchiffrage de l’Odds Ratio exponentié
Pour convertir le coefficient linéaire abstrait en une grandeur interprétable par les chercheurs et cliniciens, on applique la fonction exponentielle au coefficient estimé, ce qui génère l’Odds Ratio (OR) ou rapport des cotes :
OR = eβ
L’Odds Ratio constitue un multiplicateur d’échelle. Il quantifie la manière dont la cote (et non la probabilité) d’occurrence de l’événement est multipliée à chaque incrément unitaire de la variable indépendante continue, ou lors du passage de la modalité de référence à la modalité cible pour un prédicteur dichotomique. La valeur pivot fondamentale de l’Odds Ratio est 1,00, laquelle correspond à l’exponentiation d’un coefficient nul (e⁰ = 1) et caractérise l’absence totale d’association statistique entre le prédicteur et la variable dépendante.
Lorsque l’Odds Ratio est strictement supérieur à 1, l’exposition ou l’accroissement du trait favorise la survenue de l’issue. À titre d’illustration, si un modèle étudiant le maintien dans les soins psychiatriques met en évidence un Odds Ratio de 1,45 pour une échelle d’alliance thérapeutique, cela signifie que chaque point supplémentaire sur cette échelle majore la cote de rétention de 45 % (calculé par la relation (OR – 1) × 100 %). À l’opposé, un Odds Ratio compris dans l’intervalle ouvert ]0, 1[ désigne un facteur protecteur ou inhibiteur. Un Odds Ratio de 0,60 indique que la cote de survenue de l’événement est réduite de 40 % (calculé par (1 – OR) × 100 %) pour chaque unité additionnelle du prédicteur.
5.3 Calcul des intervalles de confiance et significativité
L’estimation ponctuelle de l’Odds Ratio n’offre qu’une approximation échantillonnale du paramètre populationnel sous-jacent. Il est impératif d’assortir chaque estimation d’un intervalle de confiance à 95 % (IC 95 %), qui cristallise le degré de précision statistique du recueil empirique. Le calcul de cet intervalle ne s’effectue jamais directement sur l’échelle multiplicative des Odds Ratios en raison de son asymétrie structurale prononcée (les effets réducteurs étant comprimés entre 0 et 1, tandis que les effets amplificateurs s’étendent de 1 à l’infini).
La démarche statistique rigoureuse implique de dériver d’abord l’intervalle de confiance symétrique sur l’échelle normale du logit brut en utilisant l’erreur-type du coefficient (SE(β)), dérivée des éléments diagonaux de l’inverse de la matrice d’information de Fisher :
IC₉₅%(β) = [ β – 1,96 × SE(β) ; β + 1,96 × SE(β) ]
Ce n’est qu’à l’issue de cette étape que l’on applique la transformation exponentielle aux bornes inférieure et supérieure obtenues, ce qui projette l’intervalle sur l’échelle asymétrique des Odds Ratios :
IC₉₅%(OR) = [ e(β – 1,96 × SE(β)) ; e(β + 1,96 × SE(β)) ]
L’inférence statistique sur la significativité de l’Odds Ratio est directe : si l’intervalle de confiance à 95 % englobe la valeur unitaire neutre 1,00 (par exemple, IC 95 % [0,92 ; 1,84]), le chercheur ne peut rejeter l’hypothèse nulle H₀ : β = 0 au seuil de significativité conventionnel α = 0,05. À l’inverse, un intervalle excluant 1,00 (par exemple, IC 95 % [1,12 ; 2,35]) confirme que l’effet observé est statistiquement robuste et non imputable aux seules fluctuations d’échantillonnage.
6. Hypothèses sous-jacentes et diagnostics de validité
6.1 Hypothèse de linéarité du logit pour les variables continues
Bien que la régression logistique s’affranchisse de l’hypothèse de linéarité directe entre les prédicteurs et la probabilité conditionnelle π(X), elle repose impérieusement sur l’hypothèse d’une relation linéaire stricte entre chaque variable indépendante continue et le logit de la probabilité. Si la relation véritable entre une dimension psychologique — comme le niveau d’éveil physiologique (arousal) — et la performance à un test suit une forme curvilinéaire en U inversé (loi de Yerkes-Dodson), l’ajustement d’un terme logistique unitaire linéaire standard générera des biais de modélisation notables et une sous-estimation systématique de l’association réelle.
Pour tester formellement cette assertion méthodologique, la procédure de référence la plus élégante est le test de Box-Tidwell. Cette technique consiste à enrichir le modèle d’évaluation en y ajoutant, pour chaque covariable continue X d’intérêt, un terme d’interaction non linéaire composé du produit de la variable avec sa propre transformation logarithmique, soit X × ln(X). Si le coefficient de régression associé à ce terme d’interaction s’avère statistiquement significatif au test de Wald, l’hypothèse de linéarité du logit est formellement rejetée.
Face à une infraction constatée à la linéarité du logit, le praticien dispose de plusieurs voies de rémédiation. Il est possible de discrétiser la variable en quantiles cliniquement pertinents, bien que cette méthode entraîne une perte de puissance statistique. Une approche méthodologique supérieure réside dans l’adjonction de polynômes orthogonaux d’ordre supérieur ou, idéalement, dans le déploiement de fonctions de lissage par des splines de régression cubiques restreintes (restricted cubic splines), qui épousent avec souplesse les modulations empiriques sans dénaturer la modélisation sous-jacente.
6.2 Indépendance des observations et structure des données
L’estimation par le maximum de vraisemblance classique repose de manière incontournable sur l’hypothèse d’indépendance statistique des résidus individuels. Dans les paradigmes expérimentaux ou longitudinaux des sciences comportementales, cette clause d’indépendance est fréquemment mise à mal par des designs factoriels imbriqués ou séquentiels. Dès lors que les données proviennent de mesures répétées recueillies auprès des mêmes participants (études écologiques momentanées – EMA, suivis de cohortes pré/post-test) ou d’unités sociales clusterisées (élèves au sein de classes scolaires, patients regroupés par thérapeute ou centre hospitalier), les observations issues d’une même grappe présentent une covariance intra-classe non nulle.
L’ignorance délibérée de cette dépendance intra-groupe provoque une sous-estimation artificielle dramatique des erreurs-types des paramètres. En prétendant disposer de n observations strictement autonomes alors que l’information empirique est redondante, le modèle engendre des statistiques de test artificiellement gonflées, multipliant le risque de commettre une erreur de type I (faux positif).
Pour traiter adéquatement cette complexité structurale, la régression logistique binaire standard doit être délaissée au profit de modélisations avancées : soit les équations d’estimation généralisées (GEE, Generalized Estimating Equations) qui corrigent empiriquement la matrice de variance-covariance via des erreurs-types dites « sandwich » robustes, soit, de manière encore plus robuste et raffinée, les modèles mixtes logistiques généralisés (GLMM). Ces derniers incorporent des effets aléatoires spécifiques aux sujets ou aux contextes, séparant la variabilité inter-individuelle des déterminants populationnels globaux.
6.3 Multicolinéarité et dimensionnement de l’échantillon
La présence d’une multicolinéarité sévère — c’est-à-dire d’intercorrélations linéaires excessives entre deux ou plusieurs prédicteurs — représente un écueil classique lors de l’administration de batteries psychométriques explorant des construits voisins (par exemple, anxiété, névrosisme et stress perçu). Bien que la colinéarité ne biaise pas l’estimation ponctuelle des coefficients, elle a pour effet délétère de gonfler la variance d’échantillonnage de ces derniers. Les erreurs-types deviennent massives, les intervalles de confiance s’élargissent démesurément et des prédicteurs théoriquement déterminants peuvent perdre toute significativité statistique individuelle.
Le diagnostic de la multicolinéarité s’opère usuellement par le calcul du Facteur d’Inflation de la Variance (VIF) et de la tolérance. En pratique, une valeur de VIF excédant le seuil de 5 (voire 10 selon les critères les plus conservateurs) ou une tolérance chutant sous 0,20 atteste d’une redondance d’information critique, justifiant soit la synthèse des covariables par des méthodes d’analyse en composantes principales, soit l’exclusion théorique de l’un des prédicteurs redondants.
Parallèlement, la validité asymptotique de la méthode du maximum de vraisemblance impose des exigences strictes quant au dimensionnement de l’échantillon. En régression logistique, la puissance statistique et la prévention du surajustement (overfitting) ne dépendent pas tant du volume total N des sujets inclus que du dénombrement de la classe d’événements la moins représentée (les événements Y = 1 ou les non-événements Y = 0). La littérature méthodologique moderne préconise rigoureusement la règle empirique dite des Événements Par Variable (EPV) : un ratio minimal de 10 à 20 événements de l’issue la plus rare par paramètre (coefficient) introduit dans le modèle final. L’ignorance de cette contrainte lors de l’étude d’issues cliniques rares (comme le passage à l’acte suicidaire ou l’entrée précoce dans la psychose) produit des modèles instables caractérisés par un optimisme d’ajustement artificiel incapable de se généraliser à des échantillons indépendants.
7. Évaluation de l’ajustement global du modèle
7.1 Statistique de déviance et test du rapport de vraisemblance
L’évaluation de la qualité globale d’ajustement d’un modèle logistique repose fondamentalement sur la métrique de la déviance, qui matérialise l’écart de log-vraisemblance entre le modèle théorique idéal — le modèle saturé possédant autant de paramètres que d’observations individuelles et ajustant impeccablement les données — et le modèle candidat restreint spécifié par le chercheur. La déviance résiduelle (Residual Deviance) s’exprime par la formule :
D = -2 × [ ℓ(modèle candidat) – ℓ(modèle saturé) ]
Dans les modèles pour données individuelles où le modèle saturé a une vraisemblance égale à 1 (donc un logit nul), la déviance se simplifie en -2 × ℓ(modèle candidat), grandeur communément désignée sous la terminologie -2LL (-2 Log-Likelihood).
Pour tester formellement si l’adjonction d’un bloc de covariables explicatives confère un gain prédictif statistiquement authentique par rapport à un modèle réduit (ou au modèle nul ne comportant que l’ordonnée à l’origine), on emploie le test du rapport de vraisemblance (Likelihood Ratio Test – LRT). La statistique de test correspond à la différence de déviance entre les deux modèles emboîtés :
G = -2LL(modèle nul) – [-2LL(modèle complet)]
En vertu du théorème de Wilks, sous l’hypothèse nulle d’inutilité prédictive des covariables additionnelles, la quantité G suit asymptotiquement une loi du chi-deux (χ²) dont le nombre de degrés de liberté (ddl) correspond précisément à la différence du nombre de paramètres estimés entre les deux spécifications. Un test du chi-deux statistiquement significatif (p < 0,05) permet de rejeter l’hypothèse nulle et atteste que le modèle complet explique une fraction statistiquement significative de la variabilité logistique de l’événement.
7.2 Test d’adéquation de Hosmer-Lemeshow
Tandis que le test du rapport de vraisemblance évalue l’utilité globale des coefficients, le test de Hosmer-Lemeshow propose une évaluation directe du calibrage du modèle — c’est-à-dire de la concordance empirique entre les taux d’événements observés et les probabilités conditionnelles prédites par l’équation mathématique à travers l’ensemble du spectre de risque.
L’algorithme de calcul débute par le classement de l’intégralité des sujets de l’échantillon par ordre croissant de probabilité prédite π̂ᵢ. Les observations sont ensuite fractionnées en un nombre prédéfini de classes ordinales contiguës, traditionnellement g = 10 groupes (les déciles de risque prédit). Au sein de chaque strate k, la procédure calcule la fréquence observée des succès (Oₖ) et la compare à l’effectif attendu (Eₖ = ∑ π̂ᵢ) calculé sous les hypothèses du modèle. La statistique de test adopte une structure de type Pearson :
H = ∑ [ (Oₖ – Eₖ)² / (Nₖ × π̄ₖ × (1 – π̄ₖ)) ]
La statistique H suit approximativement une loi du chi-deux à g – 2 degrés de liberté (soit usuellement 10 – 2 = 8 ddl). À l’inverse de la conventionnelle recherche d’une valeur p < 0,05, le chercheur espère ici obtenir une p-valeur non significative (p > 0,05). L’échec du rejet de l’hypothèse nulle signale en effet qu’il n’existe pas de divergence statistique significative entre les observations du terrain et les prédictions computationnelles, corroborant ainsi le bon calibrage global du modèle.
Il importe toutefois de souligner les réserves méthodologiques émises par les biostatisticiens contemporains vis-à-vis de ce test. Le test de Hosmer-Lemeshow souffre d’une sensibilité excessive à la taille de l’échantillon : avec de vastes cohortes (N > 10 000), de minuscules discordances sans pertinence clinique font rejeter l’adéquation du modèle ; à l’inverse, dans de petits échantillons, le test présente une puissance statistique déficiente incapable de déceler des anomalies de calibrage flagrantes.
7.3 Indicateurs de pseudo-R-deux
L’absence de décomposition de la variance par somme des carrés interdit le recours au coefficient de détermination classique R² des moindres carrés ordinaires. Pour pallier cette lacune et proposer une métrique intuitive renseignant sur la part relative de variabilité expliquée par le modèle logistique, plusieurs indicateurs de pseudo-R² ont été développés, dont l’interprétation exige une grande précaution épistémologique.
Le R² de McFadden — sans doute le plus rigoureux conceptuellement — repose sur la comparaison directe des fonctions de log-vraisemblance entre le modèle nul (intercept seul, ℓ₀) et le modèle ajusté complet (ℓₘ) :
R²McFadden = 1 – ( ℓₘ / ℓ₀ )
Si les covariables n’apportent aucun pouvoir explicatif, ℓₘ ≈ ℓ₀ et le ratio tend vers 1, annulant l’indice de McFadden. Si le modèle ajustait parfaitement l’événement (vraisemblance unitaire, ℓₘ = 0), l’indicateur atteindrait 1,00. En psychologie et recherche comportementale, des valeurs de R²McFadden comprises entre 0,20 et 0,40 caractérisent un ajustement hautement performant, équivalant grossièrement à un R² linéaire oscillant entre 0,70 et 0,90.
Deux autres formules dominent la littérature empirique : le R² de Cox & Snell, basé sur la déviance statistique, qui possède l’inconvénient théorique majeur d’avoir une borne supérieure maximale strictement inférieure à 1 (plafonnant souvent autour de 0,75 pour des distributions asymétriques), et le R² de Nagelkerke (ou Cragg-Uhler), qui introduit une division correctrice par la borne maximale théorique afin de restaurer une amplitude s’étendant formellement de 0 à 1 :
R²Nagelkerke = [ 1 – ( L₀ / Lₘ )2/n ] / [ 1 – ( L₀ )2/n ]
Il est impératif que le praticien ne confonde jamais ces grandeurs avec une véritable proportion de variance expliquée, au risque de déprécier indûment des modèles psychologiques dont les qualités de discrimination s’avèrent par ailleurs exemplaires.
8. Performance diagnostique et précision de la classification
8.1 Matrice de confusion et métriques dérivées
Dès lors qu’un modèle logistique a délivré une probabilité conditionnelle continue π̂ᵢ pour chaque individu, le chercheur ou le clinicien est fréquemment contraint de basculer dans l’univers de l’action discrète en assignant chaque sujet à une catégorie prédite : événement ou non-événement. Cette dichotomisation s’opère par la confrontation des prédictions à l’état de réalité empirique via une matrice de confusion (tableau de contingence à double entrée croisant réalité clinique et décision algorithmique).
Cette confrontation génère quatre quadrants fondamentaux : les Vrais Positifs (VP, sujets présentant le trouble et classés comme tels), les Faux Positifs (FP ou erreur de type I, sujets sains étiquetés à tort comme pathologiques), les Vrais Négatifs (VN, sujets exempts d’atteinte classés sains) et les Faux Négatifs (FN ou erreur de type II, sujets porteurs de l’affection non identifiés par le modèle). À partir de cette partition, plusieurs métriques de performance s’imposent :
- Sensibilité : propension du modèle à identifier les vrais cas positifs. Sensibilité = VP / (VP + FN).
- Spécificité : aptitude du modèle à écarter formellement les individus indemnes. Spécificité = VN / (VN + FP).
- Valeur Prédictive Positive (VPP) : probabilité qu’un individu réellement porteur du trait le soit sachant que le test est positif. VPP = VP / (VP + FP).
- Valeur Prédictive Négative (VPN) : probabilité qu’un sujet soit authentiquement sain lorsque le test classe négativement. VPN = VN / (VN + FN).
Il est capital d’assimiler le rôle modérateur de la prévalence sur ces grandeurs. Si la sensibilité et la spécificité sont des caractéristiques intrinsèques au modèle, la VPP et la VPN sont structurellement dépendantes de la fréquence de l’événement dans la population explorée. Même avec une sensibilité et une spécificité admirables de 95 %, l’application d’un modèle à un trouble psychologique rare frappant 1 % de la population générale aboutira à une VPP médiocre d’environ 16 %, l’immense majorité des signaux positifs n’étant que des faux positifs émergeant de l’immensité de la cohorte saine.
8.2 Ajustement du seuil de décision probabiliste
Par défaut, la quasi-totalité des logiciels d’analyse de données fixe le seuil d’assignation diagnostique (cut-off) à la valeur arbitraire p = 0,50. Cette règle assigne l’individu au groupe 1 dès lors que sa probabilité prédite franchit 50 %. Cette convention mathématique implicite postule cependant deux prémisses fréquemment fausses en sciences cliniques : premièrement, que les classes d’événements sont parfaitement équilibrées dans l’échantillon (50/50), et deuxièmement, que le coût psychologique, éthique et financier d’une erreur de type I équivaut rigoureusement au coût d’une erreur de type II.
En psychopathologie clinique, ce postulat d’équivalence des coûts est insoutenable. Dans l’évaluation du risque de passage à l’acte suicidaire ou de violence hétéro-agressive imminente, l’erreur par faux négatif (ne pas hospitaliser un patient en détresse vitale absolue) entraîne un préjudice irréversible sans commune mesure avec l’erreur par faux positif (conserver temporairement en observation une personne qui n’aurait finalement pas agi). Dans une telle configuration, la déontologie clinique impose de drastiquement abaisser le seuil de décision (par exemple à p = 0,15 ou 0,20), maximisant délibérément la sensibilité au détriment calculé de la spécificité.
À l’inverse, si une intervention neuropsychologique impose des contraintes invasives ou délétères, le seuil sera rehaussé pour éviter tout faux positif. Lorsque le chercheur souhaite identifier empiriquement le seuil optimisant simultanément les deux paramètres sans pondération différentielle des coûts, il recourt couramment à la maximisation de l’indice de Youden (J) :
J = Sensibilité + Spécificité – 1
Le seuil c maximisant cette fonction correspond géométriquement au point de la courbe ROC le plus éloigné de la diagonale de hasard.
8.3 Analyse de la courbe ROC et de l’aire sous la courbe (AUC)
Pour affranchir l’évaluation de la performance du modèle du carcan restrictif d’un seuil de coupe arbitraire unique, la méthodologie contemporaine préconise l’élaboration de la courbe ROC (Receiver Operating Characteristic). Dérivée historiquement de la théorie de la détection du signal radar durant la Seconde Guerre mondiale, cette courbe représente graphiquement l’évolution de la sensibilité (taux de vrais positifs, en ordonnée) en fonction de 1 – Spécificité (taux de faux positifs, en abscisse) pour toutes les valeurs possibles de seuils de coupure comprises entre 0 et 1.
L’indicateur synthétique de discrimination global d’un modèle logistique est l’Aire Sous la Courbe (AUC), mathématiquement équivalente à la statistique non paramétrique c de concordance ou au U de Mann-Whitney. D’un point de vue probabiliste, l’AUC quantifie la probabilité que, face à une paire de sujets sélectionnés au hasard — l’un présentant authentiquement l’événement clinique et l’autre en étant exempt —, le modèle logistique attribue une probabilité prédite π̂ plus élevée au sujet malade qu’au sujet sain.
L’interprétation clinique et psychométrique de l’AUC s’opère selon des balises reconnues :
- AUC = 0,50 : Discrimination strictement nulle (performance équivalente au hasard, matérialisée par la diagonale de 45°).
- 0,70 ≤ AUC < 0,80 : Discrimination acceptable selon les standards épidémiologiques.
- 0,80 ≤ AUC < 0,90 : Excellente capacité de discrimination diagnostique.
- AUC ≥ 0,90 : Capacité de discrimination exceptionnelle (rarement observée en sciences comportementales sans surajustement).
La comparaison formelle de l’AUC de deux modèles logistiques compétitifs (par exemple, évaluer si l’ajout d’un biomarqueur d’imagerie cérébrale améliore la discrimination au-delà d’un test papier-crayon classique) s’exécute couramment à l’aide de l’algorithme non paramétrique de DeLong, qui teste l’égalité des aires sans supposer la normalité bivariée sous-jacente.
9. Régression logistique multiple et contrôle des biais de confusion
9.1 Ajustement pour les variables confondantes
L’un des apports majeurs de la régression logistique multiple en sciences psychologiques réside dans sa faculté d’isoler l’effet spécifique d’un prédicteur d’intérêt tout en purgeant la relation statistique de l’influence parasite d’un ou plusieurs facteurs de confusion (confounders). Un facteur de confusion est une variable associée de façon conjointe au prédicteur théorique et à l’issue binaire, créant une corrélation fallacieuse ou masquant au contraire une authentique association causale.
Par exemple, si l’on étudie l’impact de l’exposition à la précarité socioéconomique sur le risque d’émergence d’un trouble anxieux, l’âge chronologique, le tabagisme et l’accès aux soins représentent des covariables confondantes massives. En modélisant simultanément l’ensemble de ces facteurs dans l’équation logistique, le coefficient β associé à la précarité capture son impact toutes choses étant égales par ailleurs (effet ajusté ou net). L’introduction séquentielle par blocs — d’abord les déterminants sociodémographiques structurels, puis les variables cliniques, et enfin les construits psychologiques spécifiques — offre une vision fine de la résilience statistique des estimations face au contrôle progressif des biais.
Sur le plan conceptuel, le modélisateur doit distinguer rigoureusement les variables de confusion des variables médiatrices et modératrices. Ajuster à tort le modèle sur une variable médiatrice — c’est-à-dire un maillon intermédiaire positionné sur la trajectoire causale reliant le prédicteur à l’issue — aboutirait à une sur-correction dommageable (overadjustment bias), annihilant artificiellement l’effet réel de la variable explicative fondamentale.
9.2 Modélisation des effets d’interaction
Dans l’investigation des dynamiques du comportement humain, l’effet d’une variable indépendante X₁ sur la probabilité d’une issue dépend fréquemment du niveau d’une seconde variable X₂ (effet de modération). La régression logistique modélise cette contingence par l’adjonction explicite d’un terme d’interaction multiplicatif :
Logit(P(Y = 1 | X)) = β₀ + β₁X₁ + β₂X₂ + β₃(X₁ × X₂)
L’interprétation de ces termes exige une subtilité analytique sans commune mesure avec celle requise en régression linéaire standard. Sur l’échelle logit linéaire, le coefficient β₃ représente directement le changement de pente du log-odds de X₁ induit par l’accroissement d’une unité de X₂. Lorsque l’on procède à l’exponentiation pour dériver les Odds Ratios, eβ₃ exprime le facteur multiplicatif par lequel l’Odds Ratio associé à X₁ est modulé lorsque X₂ augmente d’une unité.
Cependant, une complexité théorique majeure — formalisée notamment par Ai et Norton (2003) — émerge dès lors que l’on transpose l’analyse sur l’échelle naturelle des probabilités brutes. En raison de la courbure non linéaire de la fonction sigmoïde, l’effet marginal de l’interaction sur la probabilité finale dépend de l’ensemble des valeurs prises par tous les prédicteurs du modèle. Il est parfaitement concevable que le terme d’interaction soit statistiquement non significatif sur l’échelle logit alors qu’il induit des variations substantielles de probabilités dans certaines sous-populations, ou réciproquement. Le recours au calcul des effets marginaux moyens (Average Marginal Effects – AME) est dès lors vivement recommandé pour expliciter cliniquement ces modérations complexes.
9.3 Procédures de sélection de variables et risques méthodologiques
Face à des protocoles empiriques comprenant des dizaines d’indices psychométriques, les praticiens cèdent régulièrement à la tentation d’utiliser des algorithmes automatisés de sélection de variables, tels que les procédures pas à pas (stepwise ascendante, descendante ou bidirectionnelle). Ces techniques reposent sur l’inclusion ou l’éviction itérative des prédicteurs en fonction exclusive de seuils de significativité statistique locale (valeurs p des tests de Wald ou du score).
La communauté méthodologique et biostatistique contemporaine condamne unanimement l’usage de ces sélections automatisées pilotées par les seules données (Harrell, 2015). Les lacunes intrinsèques des procédures pas à pas sont dévastatrices :
- Elles engendrent une inflation massive de l’erreur de type I par le jeu de tests d’hypothèses multiples non corrigés.
- Les erreurs-types des coefficients retenus sont systématiquement sous-estimées et les coefficients eux-mêmes sont artificiellement biaisés à la hausse (phénomène de « malédiction du vainqueur » ou biais d’optimisme).
- L’ordonnancement final des prédicteurs s’avère hautement instable : de menues perturbations d’échantillonnage modifient radicalement la liste des covariables sélectionnées.
L’alternative méthodologique consiste à privilégier la sélection guidée par la théorie, où l’introduction des prédicteurs repose sur un modèle conceptuel a priori soutenu par la littérature scientifique. Si une réduction dimensionnelle exploratoire est requise, il convient de s’appuyer sur des critères d’information pénalisant la complexité du modèle, à l’instar du critère d’information d’Akaike (AIC) ou du critère bayésien de Schwarz (BIC), ou d’implémenter des techniques modernes d’apprentissage statistique pénalisé garantissant la régularisation des paramètres.
10. Extensions du modèle : Régression logistique multinomiale et ordinale
10.1 Régression logistique multinomiale pour issues polytomiques
Lorsque la variable dépendante d’intérêt est polytomique — c’est-à-dire qu’elle comprend plus de deux modalités discrètes — et que ces catégories ne présentent aucun agencement hiérarchique ou ordinal sous-jacent, le cadre binaire s’élargit naturellement vers la régression logistique multinomiale. En recherche psychiatrique, cette architecture permet par exemple d’explorer les déterminants orientant un patient vers trois diagnostics différentiels distincts : Trouble unipolaire, Trouble bipolaire, ou Schizophrénie.
La formalisation mathématique repose sur le choix stratégique d’une catégorie de référence (ou modalité pivot, notée K). Pour une variable réponse comprenant J modalités, le modèle estime simultanément J – 1 équations logit indépendantes, chacune comparant une catégorie spécifique j à la modalité pivot :
ln[ P(Y = j | X) / P(Y = K | X) ] = β₀ⱼ + ∑ βkjXₖ
Les probabilités conditionnelles individuelles pour chaque modalité j se déduisent par la généralisation de la fonction softmax :
P(Y = j | X) = e(Xβⱼ) / [ 1 + ∑ e(Xβₘ) ]
Chaque vecteur de coefficients βⱼ livre des Odds Ratios qui se lisent comme des ratios de cotes relatives (Relative Risk Ratios) d’appartenir à la catégorie j plutôt qu’à la catégorie de référence K, conférant au chercheur une cartographie exhaustive de la différentiation typologique.
10.2 Modèle à cotes proportionnelles pour issues ordinales
Dans les protocoles expérimentaux des sciences humaines, une multitude d’issues s’expriment sous une forme ordinale : échelles de réponse de type Likert (par exemple : Pas du tout d’accord, Neutre, D’accord, Tout à fait d’accord), scores de stadification de la sévérité d’une pathologie (Léger, Modéré, Sévère), ou paliers d’autonomie fonctionnelle. Bien que l’ordre des catégories soit parfaitement connu, la distance métrique séparant deux modalités successives demeure indéterminée, ce qui récuse l’emploi de la régression linéaire standard.
La solution méthodologique canonique est le modèle logistique à cotes proportionnelles (ou modèle logit cumulatif). Ce modèle appréhende l’ordination en décomposant la variable dépendante ordonnée Y ∈ {1, 2, …, J} en J – 1 dichotomies cumulatives simultanées. On modélise la probabilité que la réponse atteigne ou soit inférieure à un seuil ordinal j :
Logit(P(Y ≤ j | X)) = αⱼ – ∑ βₖXₖ
Dans cette équation, αⱼ matérialise le seuil d’interception propre à chaque palier ordinal (avec α₁ < α₂ < … < αJ-1). Le fondement structural majeur de ce modèle réside dans l’hypothèse des cotes proportionnelles (ou hypothèse de parallélisme) : le vecteur de coefficients de régression β est rigoureusement invariant à travers tous les seuils de coupure cumulatifs j. Cela implique que l’effet d’un trait psychologique sur la cote d’atteindre un stade de sévérité supérieur est postulé strictement identique, que l’on compare la transition « Léger vs [Modéré ou Sévère] » ou la transition « [Léger ou Modéré] vs Sévère ».
10.3 Tests d’adéquation spécifiques aux modèles ordinaux
La recevabilité d’un modèle logistique ordinal est subordonnée au respect inconditionnel de l’hypothèse de parallélisme des pentes. Si cette hypothèse est violée — c’est-à-dire si une covariable exerce une influence majeure sur le premier seuil de transition mais s’avère totalement inopérante pour discriminer les stades de sévérité les plus avancés —, le modèle à cotes proportionnelles produit des inférences statistiques erronées.
La vérification empirique du parallélisme s’effectue usuellement au moyen du test de Brant ou via un test du rapport de vraisemblance omnibus confrontant le modèle contraint à pentes parallèles à un modèle multinomial sans contrainte structurelle. Si le test de Brant se révèle statistiquement significatif (p < 0,05), l’hypothèse de proportionnalité des cotes est caduque pour l’ensemble du modèle ou pour les covariables incriminées.
En cas de violation caractérisée, le statisticien doit impérativement abandonner le modèle à cotes proportionnelles simple et s’orienter vers des structures plus flexibles :
- Le modèle à cotes proportionnelles partielles (Partial Proportional Odds Model), qui autorise les prédicteurs violant l’hypothèse à posséder des coefficients variables d’un seuil à l’autre, tout en maintenant contraints les prédicteurs respectueux de l’invariance.
- Le modèle logit stéréotype (Anderson, 1984), qui ajuste des contraintes paramétriques sur les distances relatives inter-catégories.
- La régression multinomiale non ordonnée, bien que celle-ci présente l’inconvénient méthodologique d’annihiler délibérément l’information ordinale précieuse acquise lors du recueil.
11. Applications concrètes en recherche psychologique et comportementale
11.1 Psychopathologie et prédiction du risque clinique
En psychopathologie computationnelle et en psychiatrie de liaison, la modélisation fine du risque clinique binaire représente un champ d’application paradigmatique de la régression logistique multiple. L’identification des déterminants de la récidive dépressive majeure post-rémission fournit une illustration concrète de cette démarche. Dans une cohorte prospective suivie sur deux ans, des chercheurs modélisent la variable binaire « Survenue d’une rechute clinique caractérisée (1 = Oui, 0 = Non) » à l’aide d’un ensemble hétérogène de prédicteurs : réactivité cognitive mesurée par l’échelle DAS (Dysfunctional Attitude Scale), volume hippocampique bilatéral en IRM structurelle, concentration sérique de BDNF et présence d’antécédents d’abus physique durant l’enfance.
L’estimation logistique permet de démontrer que pour chaque élévation d’un écart-type sur le score de rumination cognitive négative, la cote de rechute dépressive subit une amplification multiplicative de 1,78 (OR = 1,78 ; IC 95 % [1,34 ; 2,36] ; p < 0,001), et ce après ajustement multivarié pour le volume hippocampique et les biomarqueurs périphériques. Cette méthodologie permet d’isoler l’impact psychologique propre au-delà du substrat neurobiologique sous-jacent.
De même, dans les services d’accueil des urgences médico-psychologiques, l’évaluation du passage à l’acte suicidaire dans les 72 heures suivant l’admission fait appel à des scores logistiques combinant anamnèse psychiatrique, sentiment de désespoir (échelle de Beck) et impulsivité motrice. En calibrant la matrice de confusion pour maximiser l’indice de Youden sous contrainte de sensibilité extrême (> 0,95), les algorithmes logistiques fournissent une aide à la décision pour orienter les patients vers une hospitalisation sous surveillance continue ou vers un suivi ambulatoire intensif.
11.2 Psychologie organisationnelle et comportement au travail
Dans les organisations de travail contemporaines, la régression logistique est largement employée pour décrypter les dynamiques de démission volontaire des salariés (turnover intentionnel ou effectif) et l’effondrement de l’engagement professionnel. En se basant sur le modèle Exigences-Ressources du Travail (Job Demands-Resources Model), des psychologues du travail modélisent la décision formelle d’un collaborateur de rompre son contrat de travail au cours d’une période de douze mois (1 = Rupture, 0 = Maintien).
L’intégration de termes d’interaction au sein de la régression logistique permet d’attester empiriquement le modèle d’amortissement (buffering hypothesis). Les résultats révèlent que l’effet de l’épuisement émotionnel sévère sur la cote de démission est hautement conditionné par le niveau perçu de soutien managérial et d’autonomie décisionnelle. Pour un salarié bénéficiant d’une faible autonomie, un niveau élevé de surcharge de travail multiplie la cote de démission par 3,42 (OR = 3,42 ; IC 95 % [2,10 ; 5,58]). En revanche, chez les salariés rapportant un score d’autonomie situé dans le quartile supérieur, l’Odds Ratio associé à la surcharge s’infléchit pour atteindre 1,18 — un niveau non significatif sur le plan statistique.
Ce type de modélisation trouve également son utilité dans l’analyse de l’adhésion des salariés aux programmes de prévention primaire des risques psychosociaux ou de promotion de la santé au travail. Comprendre quels profils sociologiques et motivationnels prédisent l’engagement ou l’abandon vis-à-vis des dispositifs institutionnels permet d’adapter les politiques de ressources humaines de façon ciblée.
11.3 Neuropsychologie et sciences cognitives
En neuropsychologie du vieillissement, l’un des défis majeurs réside dans la prédiction probabiliste de la conversion nosologique des patients présentant un Déficit Cognitif Léger (MCI) vers une démence avérée de type Alzheimer sur un horizon longitudinal à trois ans (Issue : 1 = Conversion, 0 = Stabilité cognitive). Les modèles logistiques intègrent des covariables composites combinant scores d’évaluation neuropsychologique fine (empan mnésique, rappel différé au test de Grober et Buschke), statut allélique de l’Apolipoprotéine E (présence de l’allèle ε4) et marqueurs quantitatifs de tomographie par émission de positons (TEP-Amyloïde).
L’évaluation de la courbe ROC démontre que le modèle logistique combiné atteint une AUC de 0,89 (IC 95 % [0,83 ; 0,95]), surpassant significativement le modèle univarié fondé sur les seuls tests psychométriques (AUC = 0,74 ; test de DeLong p = 0,004). L’analyse logistique fournit au neurologue un outil de stratification pronostique permettant de cibler les patients éligibles à des essais cliniques novateurs avant la phase irréversible d’atrophie corticale massive.
En sciences cognitives fondamentales, la régression logistique est fréquemment mobilisée pour modéliser les taux d’erreur au niveau de l’essai individuel au cours de paradigmes de laboratoire (tâches de Stroop, tâche de Simon, saccades anti-oculaires). Les modèles logistiques mixtes permettent d’analyser l’influence du temps de réaction précédent, de l’état de fatigue cognitive et de la modulation par stimulation magnétique transcrânienne (TMS) sur la probabilité unitaire d’inhibition comportementale réussie.
12. Directives de publication et rapportage rigoureux selon les normes APA
12.1 Structure tabulaire normalisée des résultats
L’American Psychological Association (APA, 7e édition) impose un protocole de formalisation strict pour la restitution des modèles de régression logistique dans les revues internationales à comité de lecture. La dissémination transparente des résultats exige la conception de tableaux synthétiques évitant toute dissimulation de la variabilité d’échantillonnage.
Un tableau conforme aux exigences académiques doit impérativement comporter, pour chaque prédicteur retenu dans le modèle :
- Le coefficient de régression non standardisé brut (B) exprimé en unité logit.
- L’erreur-type du coefficient (SE B).
- La statistique de test paramétrique, traditionnellement la statistique de Wald (z ou Wald χ²).
- Le niveau de significativité statistique bilatérale exacte (valeur p, rapportée par exemple sous la forme p = 0,023 plutôt que p < 0,05, sauf pour les seuils infinitésimaux p < 0,001).
- L’Odds Ratio exponentié (OR ou Exp(B)).
- L’intervalle de confiance à 95 % de l’Odds Ratio, présenté sous forme de bornes inférieure et supérieure explicites (ex. : [1,24 ; 2,89]).
En note de bas de tableau, le chercheur doit obligatoirement expliciter les indicateurs d’adéquation globale du modèle : la statistique globale du rapport de vraisemblance du chi-deux avec ses degrés de liberté (ex. : χ²(4) = 45,67, p < 0,001), la déviance résiduelle (-2LL), les pseudo-R² (Nagelkerke et/ou McFadden), la statistique du test d’adéquation de Hosmer-Lemeshow, ainsi que l’indice de concordance AUC issu de la courbe ROC. En présence de plusieurs modèles emboîtés hiérarchiques, chaque étape d’introduction séquentielle doit afficher la statistique de variation de déviance (Δχ²) pour attester de l’apport incrémental des nouvelles covariables.
12.2 Rédaction textuelle des conclusions statistiques
La formulation narrative des résultats dans le corps de la section « Résultats » doit allier une précision mathématique rigoureuse à une clarté conceptuelle totale, en s’abstenant rigoureusement de trois confusions analytiques classiques : la confusion entre cotes et probabilités, la confusion entre corrélation conditionnelle et causalité avérée, et l’omission des catégories de référence.
Une formulation textuelle canonique conforme aux normes de publication s’articule comme suit :
« Une régression logistique binaire multivariée a été conduite pour déterminer l’effet des traumatismes infantiles, de l’anxiété-trait et du soutien social perçu sur la probabilité de survenue d’un trouble anxieux généralisé à l’âge adulte. Le modèle global s’est révélé statistiquement significatif par rapport au modèle nul, χ²(3, N = 450) = 58,34, p < 0,001, attestant d’un excellent pouvoir de discrimination, AUC = 0,84, IC 95 % [0,79 ; 0,88]. Le test de Hosmer-Lemeshow a confirmé l’absence d’inadéquation de calibrage, χ²(8) = 6,42, p = 0,601, et le pseudo-R² de McFadden s’est élevé à 0,26 (R² de Nagelkerke = 0,38). »
« L’analyse des coefficients spécifiques révèle que, toutes choses étant égales par ailleurs, chaque élévation d’une unité sur l’échelle des traumatismes infantiles majore significativement la cote d’apparition du trouble anxieux d’un facteur de 1,32, B = 0,28, SE = 0,07, Wald = 15,21, p < 0,001, OR = 1,32, IC 95 % [1,15 ; 1,52]. À l’inverse, l’appartenance au groupe bénéficiant d’un niveau élevé de soutien social (la catégorie de référence étant le faible soutien) est associée à une réduction significative de 54 % de la cote d’émergence pathologique, B = -0,78, SE = 0,24, Wald = 10,56, p = 0,001, OR = 0,46, IC 95 % [0,29 ; 0,73]. »
Cette rigueur d’écriture doit s’accompagner d’une transparence absolue quant aux méthodes appliquées pour traiter les valeurs aberrantes et les données manquantes (imputation multiple, analyse de cas complets).
12.3 Écueils interprétatifs fréquents en sciences humaines
L’exploitation de la régression logistique dans la littérature des sciences humaines et sociales est émaillée d’approximations méthodologiques récurrentes qu’il convient de proscrire avec fermeté.
Le premier écueil — et sans doute le plus pernicieux — réside dans l’assimilation fallacieuse de l’Odds Ratio au Risque Relatif (RR). L’Odds Ratio n’approxime convenablement le Risque Relatif que dans une condition épidémiologique stricte : l’hypothèse des maladies rares (lorsque la prévalence de l’événement dans la cohorte est strictement inférieure à 10 %, idéalement < 5 %). Dès lors que l’événement étudié est fréquent — par exemple un taux d’échec scolaire ou un niveau de stress au travail avoisinant 40 % ou 50 % —, l’Odds Ratio s’éloigne drastiquement du Risque Relatif en surestimant systématiquement l’ampleur de la force d’association. Un Odds Ratio de 3,00 calculé sur une issue fréquente ne correspond souvent qu’à un Risque Relatif réel de 1,50 ou 1,70. Présenter un OR comme multipliant le « risque » par trois induit les cliniciens et décideurs en erreur sur la portée de l’intervention.
Le second écueil consiste en l’occultation des diagnostics de validité au bénéfice de la seule quête de valeurs p significatives. La publication d’un modèle logistique sans vérification documentée de la linéarité du logit pour les variables continues, sans contrôle des colinéarités et sans métrique de discrimination (AUC) relève d’une pratique scientifique fragile. Un modèle affichant une p-valeur globale infinitésimale peut masquer un calibrage défaillant incapable de classer les sujets de façon cohérente.
Enfin, le troisième écueil majeur renvoie à la sur-généralisation prématurée de modèles sur-ajustés. Construire une équation logistique en explorant cinquante prédicteurs psychométriques au sein d’un échantillon restreint de cent patients produit inéluctablement un ajustement flatteur au sein de la cohorte initiale (bruit statistique modélisé comme signal réel). Cependant, sans procédures strictes de validation croisée (k-fold cross-validation) ou d’échantillonnage par ré-échantillonnage (bootstrap), l’application de cette formule prédictive à une cohorte clinique externe indépendante se soldera invariablement par une chute dramatique de ses performances de classification.
Références
- Ai, C., & Norton, E. C. (2003). Interaction terms in logit and probit models. Economics Letters, 80(1), 123-129. https://doi.org/10.1016/S0165-1765(03)00032-6
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1-10. https://doi.org/10.1093/biomet/71.1.1
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anderson, J. A. (1984). Regression and ordered categorical variables. Journal of the Royal Statistical Society: Series B (Methodological), 46(1), 1-22. https://doi.org/10.1111/j.2517-6161.1984.tb01270.x
- Box, G. E., & Tidwell, P. W. (1962). Transformation of the independent variables. Technometrics, 4(4), 531-550. https://doi.org/10.1080/00401706.1962.10487771
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171-1178. https://doi.org/10.2307/2532457
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837-845. https://doi.org/10.2307/2531595
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27-38. https://doi.org/10.1093/biomet/80.1.27
- Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105-142). Academic Press.
- Nagelkerke, N. J. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691-692. https://doi.org/10.1093/biomet/78.3.691
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373-1379. https://doi.org/10.1016/S0895-4356(96)00236-3
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32-35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″>https://doi.org/10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3