
L’analyse des phénomènes humains et sociaux se heurte inévitablement à la complexité intrinsèque de leurs déterminants. En psychologie, en sociologie, en économie ou en sciences de la santé, un comportement, un état émotionnel ou une performance cognitive ne résultent pratiquement jamais de l’action isolée d’un facteur unique. Tenter d’appréhender la détresse psychologique, la réussite académique ou la fidélité organisationnelle à travers le prisme exclusif d’une variable indépendante singulière expose le chercheur à des conclusions méthodologiquement biaisées et épistémologiquement fragiles. C’est précisément pour dépasser ce réductionnisme bivarié que la modélisation statistique avancée s’est développée, offrant des cadres formels capables d’appréhender la réalité dans son intime multidimensionnalité.
Parmi cet arsenal méthodologique, la régression linéaire multiple occupe une place matricielle. Développée dans le prolongement direct des travaux pionniers de Sir Francis Galton et de Karl Pearson, formalisée au fil du XXe siècle par les géants de la biométrie et de l’économétrie, cette méthode constitue bien plus qu’un simple outil de calcul : elle représente une véritable grille de lecture scientifique. Elle permet non seulement d’estimer avec précision la force et le sens de l’association unissant un ensemble hétérogène de prédicteurs à une variable continue d’intérêt, mais également d’isoler la contribution spécifique de chaque composante en neutralisant statistiquement l’influence perturbatrice des autres covariables. Elle fournit ainsi aux chercheurs le pouvoir d’exercer un contrôle quasi expérimental sur des données recueillies en contextes naturels ou observationnels.
Le présent traité propose une immersion exhaustive, rigoureuse et didactique au cœur de la régression linéaire multiple. Conçu pour les chercheurs, les doctorants et les praticiens de la recherche empirique, ce guide s’articule autour des fondements théoriques, des démonstrations mathématiques matricielles, des protocoles de diagnostic des hypothèses, des subtilités d’interprétation clinique et des standards contemporains de publication scientifique selon les normes de l’American Psychological Association. En naviguant des principes fondamentaux aux considérations méthodologiques les plus pointues, ce document vise à consolider les compétences analytiques nécessaires à une pratique quantitative lucide, éthique et reproductible.
1. Fondements théoriques : De la régression simple à la régression linéaire multiple
1.1 Limites épistémologiques de la régression linéaire simple
La régression linéaire bivariée, bien qu’élégante et intuitive, présente des limites méthodologiques majeures dès lors qu’il s’agit de modéliser des systèmes comportementaux ou psychologiques réels. L’une de ses faiblesses fondamentales réside dans son incapacité structurelle à isoler l’influence conjointe de plusieurs facteurs opérant simultanément sur une variable réponse. Dans le monde empirique, une variable explicative unique n’agit presque jamais en vase clos ; elle interagit avec un réseau complexe de covariables environnementales, biologiques et individuelles. Réduire un phénomène à une seule trajectoire linéaire directe conduit inévitablement à une sursimplification dommageable.
Cette insuffisance engendre un écueil économétrique redoutable connu sous le nom de biais de variable omise. Lorsqu’un facteur explicatif pertinent, corrélé à la fois au prédicteur étudié et à la variable dépendante, est exclu du modèle statistique, la covariance partagée est artificiellement attribuée au seul prédicteur présent. Il en résulte une distorsion systématique et souvent substantielle des coefficients de régression estimés, conduisant à des surestimations spectaculaires ou, à l’inverse, à des phénomènes d’atténuation illusoires. L’effet attribué à une variable peut ainsi n’être qu’un épiphénomène reflétant l’action invisible d’une troisième variable non mesurée.
Dans les plans d’échantillonnage non expérimentaux, où la randomisation totale demeure impossible pour des raisons éthiques ou logistiques, l’ajustement statistique pour les variables confondantes devient un impératif méthodologique incontournable. Seule l’intégration délibérée et théoriquement guidée de ces régresseurs tiers au sein d’une équation multivariée permet de « neutraliser » leur variance partagée. La transition conceptuelle d’une relation bivariée vers un système explicatif multivarié marque ainsi le passage d’une observation naïve de covariations de surface à une entreprise rigoureuse d’évaluation conditionnelle des mécanismes sous-jacents.
1.2 Définition conceptuelle de la régression linéaire multiple
La régression linéaire multiple se définit formellement comme une technique statistique paramétrique visant à modéliser, expliquer et prédire les variations d’une variable quantitative continue — désignée sous les termes de variable dépendante, critère ou variable réponse — à partir d’un ensemble structuré de deux ou plusieurs prédicteurs continus ou catégoriels, également qualifiés de variables indépendantes ou covariables. L’objectif fondamental consiste à estimer les paramètres d’une fonction linéaire combinant de façon optimale ces différentes sources d’information pour reproduire le plus fidèlement possible les données observées.
Au cœur de cette démarche réside la distinction conceptuelle majeure entre corrélation bivariée brute et corrélation partielle. Tandis que la première mesure la simple association linéaire globale unissant deux entités sans égard aux influences périphériques, la seconde quantifie le degré d’association persistant entre le prédicteur et le critère une fois extraite toute la variance linéairement attribuable aux autres variables introduites dans l’équation. C’est cette opération d’orthogonalisation statistique qui confère à la méthode son pouvoir d’élucidation théorique en sciences sociales.
Sur le plan mathématique, cette technique postule une hypothèse de linéarité globale au sein d’un espace vectoriel multidimensionnel : la valeur attendue de la variable dépendante est modélisée sous la forme d’une combinaison linéaire pondérée des valeurs prises par les prédicteurs. Cette approche s’avère particulièrement adaptée à l’étude des comportements et des construits psychologiques complexes, tels que la motivation intrinsèque, les traits de personnalité ou la régulation émotionnelle, qui par définition ne se manifestent jamais de manière isolée mais participent d’équilibres dynamiques pluriels.
1.3 Applications empiriques en sciences psychologiques
Les sciences psychologiques fournissent un terreau d’application privilégié pour la régression linéaire multiple en raison du caractère multidéterminé des phénomènes psychiques. Un premier exemple paradigmatique concerne la modélisation de la détresse psychologique chez des populations vulnérables. Un tel modèle intègre simultanément le niveau d’exposition au stress perçu, la quantité de soutien social perçu et le score global de résilience individuelle. L’analyse permet non seulement d’évaluer la proportion globale de variance expliquée dans le sentiment de détresse, mais aussi de quantifier l’effet protecteur propre du soutien social indépendamment du niveau de sévérité du stress ressenti.
Un autre champ d’application classique réside dans la neuropsychologie et la psychométrie cognitive, où la performance à des tests de mémoire ou de fonctions exécutives doit être rigoureusement évaluée en contrôlant pour des variables démographiques telles que l’âge chronologique et le niveau d’éducation formelle. L’ajustement par régression multiple permet d’isoler l’impact potentiel d’un biomarqueur ou d’une lésion cérébrale circonscrite, en garantissant que le déclin observé ne constitue pas un simple artefact attribuable au vieillissement normal ou à une réserve cognitive différentielle.
Enfin, la recherche sur l’adhésion thérapeutique et la médecine comportementale mobilise massivement ces devis pour étudier les déterminants cognitifs multifactoriels influençant le suivi des prescriptions : croyances envers les traitements, perception de la maladie et alliance thérapeutique. De manière analogue, en psychologie différentielle, la validation de modèles structuraux impose fréquemment d’éprouver la validité incrémentielle de nouveaux construits de personnalité — par exemple l’intelligence émotionnelle — en s’assurant qu’ils prédisent les trajectoires de vie au-delà des facteurs traditionnels du modèle en cinq facteurs (Big Five).
2. Formulation mathématique et structure du modèle multivarié
2.1 L’équation générale de la population
Au niveau de la population parente, la régression linéaire multiple formalise la relation liant la variable dépendante continue aux multiples variables prédictives par une équation stochastique générale décomposée comme suit :
Y = β₀ + β₁X₁ + β₂X₂ + … + βₚXₚ + ε
Dans cette formalisation mathématique rigoureuse, Y symbolise la variable réponse quantitative observée pour un individu donné. Les termes X₁, X₂, …, Xₚ correspondent aux p variables explicatives ou régresseurs mesurés sur le même individu. Le paramètre β₀ représente l’intercepte de la population, c’est-à-dire la valeur mathématique attendue de Y lorsque l’ensemble des prédicteurs X₁ à Xₚ prend simultanément la valeur zéro. Les coefficients scalaires β₁, β₂, …, βₚ désignent les pentes de régression partielles de la population associées à chaque régresseur respectif.
L’élément ε constitue le terme d’erreur résiduel, une variable aléatoire inobservable qui capture l’ensemble des influences omises, des erreurs aléatoires de mesure ainsi que le caractère stochastique intrinsèque du comportement humain. La modélisation repose sur l’hypothèse d’espérance conditionnelle nulle de l’erreur mathématique : E(ε | X₁, X₂, …, Xₚ) = 0. Cette condition fondamentale signifie que pour toute combinaison donnée des prédicteurs, la moyenne théorique des perturbations résiduelles est rigoureusement égale à zéro, garantissant ainsi que la partie systématique du modèle décrit fidèlement le centre de gravité distributionnel de la relation sous-jacente.
2.2 Signification géométrique et hyperplan de régression
La compréhension approfondie de la régression multivariée gagne à être abordée sous l’angle de la géométrie euclidienne. Alors que la régression simple se matérialise dans un espace cartésien à deux dimensions par une droite d’ajustement reliant l’axe des abscisses à celui des ordonnées, la régression multiple projette la relation dans un espace géométrique à p + 1 dimensions. Lorsque le modèle comprend exactement deux variables explicatives (p = 2), la droite se métamorphose en un plan bidimensionnel flottant au sein d’un espace tridimensionnel ; l’inclinaison de ce plan est gouvernée simultanément par les pentes β₁ et β₂ selon leurs axes respectifs.
Dès lors que le nombre de régresseurs excède deux (p ≥ 3), la représentation mentale intuitive devient impossible pour l’esprit humain, mais les principes de la géométrie vectorielle demeurent strictement identiques : le modèle définit un hyperplan de régression à p dimensions traversant le nuage de points multidimensionnel. Dans ce cadre d’analyse, l’ajustement du modèle correspond algébriquement à une projection orthogonale du vecteur des observations de la variable dépendante sur le sous-espace vectoriel engendré par l’ensemble des vecteurs colonnes des prédicteurs.
Il importe d’opérer une distinction théorique cardinale entre l’hyperplan théorique de la population, régi par les paramètres inconnus β, et l’hyperplan empirique estimé sur un échantillon d’observations particulières. Ce dernier, gouverné par les coefficients échantillonnés b₀, b₁, …, bₚ, constitue une approximation probabiliste fluctuante du plan théorique véritable. Les écarts verticaux mesurés entre les points d’observations réels et cet hyperplan estimé représentent les résidus d’échantillonnage, matérialisant l’erreur d’ajustement empirique locale.
2.3 Représentation matricielle du modèle
L’écriture scalaire du modèle devenant rapidement encombrante à mesure que le nombre d’observations N et de prédicteurs p s’accroît, l’algèbre matricielle fournit un langage compact et opératoire pour traiter l’intégralité du système d’équations. Pour un échantillon comprenant N sujets et p prédicteurs, le modèle s’exprime sous la forme vectorielle synthétique :
Y = Xβ + ε
Dans cette structure matricielle, Y est un vecteur colonne de dimensions N × 1 regroupant les valeurs observées sur la variable dépendante pour chaque participant de l’échantillon. X représente la matrice de design (ou matrice d’expérimentation) de dimensions N × (p + 1). Sa toute première colonne est uniformément constituée de chiffres 1 — un vecteur unitaire permettant d’intégrer le calcul de l’ordonnée à l’origine β₀ —, tandis que les p colonnes subséquentes hébergent les observations effectives associées aux p prédicteurs statistiques pour chacun des N individus.
Le terme β désigne le vecteur colonne des paramètres de dimensions (p + 1) × 1, contenant l’intercepte ainsi que l’ensemble des coefficients de régression partiels. Enfin, ε symbolise le vecteur colonne des erreurs de dimensions N × 1. L’utilisation efficiente de cette formulation requiert que la matrice carrée résultante X’X (obtenue en multipliant la transposée de X par X) soit d’ordre (p + 1) × (p + 1) et possède la propriété algébrique essentielle d’inversibilité, ce qui implique rigoureusement que ses colonnes soient linéairement indépendantes.
3. La méthode des moindres carrés ordinaires et l’estimation des paramètres
3.1 Principe de minimisation de la somme des carrés des résidus
L’estimation des coefficients empiriques constitutifs du vecteur β̂ repose le plus classiquement sur la méthode des moindres carrés ordinaires (MCO), initialement formalisée par Carl Friedrich Gauss et Adrien-Marie Legendre. Le principe directeur de cet algorithme d’optimisation mathématique consiste à trouver le vecteur de coefficients qui rend minimale la somme des carrés des écarts séparant les scores réels observés des scores prédits par le modèle. La fonction de coût ainsi ciblée, couramment appelée somme des carrés des résidus (RSS pour Residual Sum of Squares), s’exprime de la manière suivante :
RSS = Σ (yᵢ – ŷᵢ)² = Σ eᵢ²
Le recours à l’élévation au carré de ces déviations résiduelles, de préférence à la simple somme des valeurs absolues, se justifie par des motifs analytiques et probabilistes profonds. Sur le plan analytique, la fonction quadratique résultante est continue et différentiable en tout point de son domaine, ce qui autorise l’usage du calcul différentiel pour identifier son extremum global. Sur le plan géométrique, l’élévation au carré pénalise de façon disproportionnée les erreurs de prédiction de grande magnitude, conférant au modèle une sensibilité accrue aux déviations majeures et garantissant une variance minimale des estimateurs sous les lois normales.
Pour déterminer le point d’inflexion unique où cette fonction d’erreur quadratique atteint son minimum absolu, on procède au calcul des dérivées partielles de la RSS par rapport à chacun des coefficients βⱼ inconnus. En annulant simultanément l’ensemble de ces dérivées partielles, on obtient un système d’équations algébriques linéaires simultanées connu sous le nom de système des « équations normales ». La résolution rigoureuse de ce système conduit à une solution d’estimation unique et déterministe pour l’échantillon analysé.
3.2 Dérivation matricielle des coefficients
Sous la notation matricielle exposée précédemment, la dérivation mathématique des coefficients de régression s’effectue avec une remarquable concision conceptuelle. La somme matricielle des carrés des résidus peut être reformulée par l’expression quadratique e’e = (Y – Xβ)'(Y – Xβ). En développant cette multiplication et en tirant profit des propriétés de transposition des matrices, nous obtenons l’expression développée : e’e = Y’Y – 2β’X’Y + β’X’Xβ.
Pour trouver le vecteur d’estimations β̂ qui minimise cette quantité scalaire, il convient de calculer la dérivée première de la fonction matricielle par rapport au vecteur colonne β et d’égaler le gradient résultant au vecteur nul :
∂(e’e) / ∂β = -2X’Y + 2X’Xβ = 0
Cette égalité conduit directement à l’équation normale matricielle fondamentale X’Xβ̂ = X’Y. Pour autant que la matrice symétrique X’X soit régulière et de plein rang colonne — ce qui signifie mathématiquement qu’aucune variable prédictive ne constitue une combinaison linéaire parfaite des autres régresseurs —, nous pouvons multiplier les deux membres de l’équation par la matrice inverse (X’X)⁻¹. Nous obtenons alors la formule analytique universelle de l’estimateur des moindres carrés ordinaires :
β̂ = (X’X)⁻¹X’Y
Au-delà de l’estimation ponctuelle des coefficients, le calcul matriciel permet de dériver instantanément la matrice de variance-covariance des coefficients estimés, notée Var(β̂) = σ²(X’X)⁻¹, où σ² représente la variance des erreurs résiduelles de la population, estimée sans biais dans l’échantillon par le carré moyen des résidus s² = e’e / (N – p – 1). Les éléments situés sur la diagonale principale de cette matrice inverse fournissent les variances d’échantillonnage de chaque coefficient, dont la racine carrée constitue directement les erreurs types associées. Dans l’écosystème de la recherche moderne, les logiciels statistiques effectuent ces lourdes inversions matricielles de façon instantanée et automatisée par le biais d’algorithmes de décomposition QR ou de décomposition en valeurs singulières.
3.3 Le théorème de Gauss-Markov et les propriétés de l’estimateur
La légitimité historique et l’hégémonie méthodologique de la méthode des moindres carrés ordinaires reposent sur un résultat central de la théorie statistique : le théorème de Gauss-Markov. Ce théorème démontre mathématiquement que, sous un ensemble précis d’hypothèses relatives à la structure des données et des résidus, l’estimateur des MCO constitue le meilleur estimateur linéaire sans biais de l’ensemble des paramètres réels de la population. Ce statut d’exception est universellement résumé sous l’acronyme anglophone BLUE (Best Linear Unbiased Estimator).
La qualification « linéaire » indique que les coefficients estimés s’expriment comme des combinaisons linéaires directes des observations de la variable dépendante Y. La propriété « sans biais » garantit que la valeur espérée de l’estimateur est rigoureusement identique à la vraie valeur paramétrique sous-jacente : E(β̂) = β. En d’autres termes, si l’on répétait indéfiniment la collecte de données sur des échantillons aléatoires indépendants de même taille issus de la même population, la moyenne asymptotique de tous les vecteurs β̂ convergerait avec exactitude vers le vecteur des paramètres β.
Enfin, l’attribut « meilleur » fait référence à la notion fondamentale d’efficacité statistique : au sein de la classe infinie de tous les estimateurs linéaires et sans biais possibles, l’estimateur des moindres carrés ordinaires possède la variance d’échantillonnage la plus faible imaginable. Cela signifie qu’il optimise la précision mathématique et resserre au maximum l’incertitude autour des paramètres. Cependant, si l’une des hypothèses régissant le théorème de Gauss-Markov vient à être enfreinte, l’estimateur peut perdre son efficacité ou son absence de biais, compromettant la validité des inférences statistiques ultérieures.
4. Les postulats et hypothèses fondamentales du modèle classique
4.1 Hypothèses distributionnelles relatives aux résidus
Pour que les tests de significativité statistique (notamment les tests F de Snedecor et les tests t de Student) soient parfaitement valides sur le plan inférentiel, le modèle de régression classique linéaire exige la satisfaction d’un ensemble de postulats distributionnels pesant sur les perturbations résiduelles de la population, formalisés par l’expression matricielle unifiée : ε ~ N(0, σ²I).
Cette formule condensée intègre trois exigences distinctes mais complémentaires :
- La normalité des erreurs résiduelles : Pour chaque combinaison conditionnelle des prédicteurs, les perturbations inobservables εᵢ se distribuent selon une loi normale centrée d’espérance nulle.
- L’homoscédasticité : La variance des perturbations résiduelles, notée σ², doit demeurer rigoureusement constante le long de l’ensemble du continuum des valeurs prédites par le modèle. La dispersion des résidus ne doit ni s’évaser ni se contracter lorsque le niveau des prédicteurs varie.
- L’indépendance conditionnelle des erreurs : Les termes d’erreur résiduelle associés à deux observations distinctes quelconques (i et j) doivent présenter une covariance nulle : Cov(εᵢ, εⱼ) = 0 pour tout i ≠ j. Cela proscrit toute forme d’autocorrélation temporelle ou spatiale des données.
Lorsque l’hypothèse de normalité est violée dans des échantillons de taille modeste, les distributions d’échantillonnage théoriques des tests t et F ne suivent plus exactement leurs lois de référence, ce qui fausse les seuils de décision critique et les valeurs p associées.
4.2 Hypothèses structurelles relatives aux variables explicatives
En complément des contraintes imposées au terme d’erreur, le modèle linéaire multivarié s’appuie sur plusieurs hypothèses structurelles déterminantes portant directement sur la nature et le comportement des variables indépendantes sélectionnées au sein de la matrice de design :
- Linéarité intrinsèque : La relation mathématique reliant la variable dépendante à chaque variable explicative doit être rigoureusement linéaire dans les paramètres. Si la relation sous-jacente est curvilinéaire ou exponentielle sans qu’un terme polynomial ou logarithmique approprié n’ait été incorporé, le modèle souffrira d’une erreur de spécification systématique.
- Absence d’erreur de mesure dans les prédicteurs : Le modèle postule formellement que les covariables Xⱼ sont mesurées sans la moindre erreur instrumentale ou bruit aléatoire. En psychométrie, où les échelles reposent souvent sur des auto-évaluations imparfaites, cette hypothèse d’exogénéité stricte est fréquemment mise à mal, provoquant un phénomène dit d’atténuation des coefficients réels vers la valeur zéro.
- Exogénéité stricte et absence de corrélation avec l’erreur : La matrice des régresseurs X doit être entièrement indépendante du terme d’erreur résiduel, ce qui s’exprime par Cov(Xⱼ, ε) = 0 pour tout j. La violation de cette règle engendre une endogénéité destructrice pour les coefficients.
- Absence de multicolinéarité parfaite : Il ne doit exister aucune relation linéaire déterministe exacte entre deux ou plusieurs prédicteurs. Le déterminant de la matrice X’X ne doit en aucun cas s’annuler, sous peine de rendre l’inversion matricielle rigoureusement impossible.
4.3 Conséquences théoriques du non-respect des postulats
L’ignorance ou la tolérance passive des violations de ces postulats fondateurs expose le chercheur à des désordres statistiques majeurs qui ruinent la reproductibilité des inférences scientifiques. La méconnaissance de l’hétéroscédasticité — lorsque la variance des erreurs résiduelles fluctue systématiquement en fonction des valeurs des prédicteurs — laisse certes les estimations ponctuelles des coefficients sans biais, mais elle produit une sous-estimation systématique spectaculaire des erreurs types standards associées. Par conséquent, les statistiques de Student calculées s’en trouvent artificiellement gonflées, induisant une inflation massive du taux d’erreur de type I : le chercheur conclut à la significativité statistique d’un effet qui n’est en réalité qu’un artefact d’échantillonnage.
De surcroît, le non-respect de l’indépendance des observations — fréquent lorsque les données psychologiques présentent une structure hiérarchique ou en grappes (élèves nichés au sein de classes, mesures répétées dans le temps chez un même patient) — démolit l’architecture probabiliste du modèle classique en compressant dramatiquement les erreurs types calculées. Le modèle perd alors toute efficacité statistique au sens du théorème de Gauss-Markov, devenant extrêmement instable face aux fluctuations d’échantillonnage les plus minimes.
Enfin, les données psychométriques issues de questionnaires d’auto-évaluation présentent régulièrement des asymétries de distribution prononcées (effets de plafond ou de plancher) ou des bruits de mesure différentiels. Ces singularités de mesure se traduisent directement dans l’espace résiduel par une vulnérabilité extrême aux observations aberrantes distantes, capables d’attirer à elles l’hyperplan de régression comme des points d’ancrage artificiels et de fausser irrémédiablement le sens des conclusions psychologiques avancées.
5. Diagnostic approfondi et vérification des hypothèses de régression
5.1 Détection visuelle et numérique de l’hétéroscédasticité
Le contrôle rigoureux du postulat d’homoscédasticité combine l’exploration graphique attentive et l’administration de tests inférentiels dédiés. Sur le plan visuel, l’outil de référence demeure l’inspection minutieuse du nuage de dispersion croisant les résidus studentisés (ou standardisés) sur l’axe vertical en fonction des valeurs prédites ajustées (ŷᵢ) positionnées sur l’axe horizontal. Dans une situation idéale d’homoscédasticité parfaite, ce graphique doit révéler une dispersion parfaitement aléatoire, homogène et rectangulaire de points, distribués équitablement de part et d’autre de la ligne horizontale centrale d’ordonnée zéro, sans motif reconnaissable.
L’apparition d’une structure résiduelle caractéristique en entonnoir (la dispersion s’accroissant de manière monotone à mesure que les scores prédits augmentent) ou en forme de fuseau trahit instantanément la présence d’une hétéroscédasticité manifeste. Cette défaillance signale que la capacité prédictive du modèle est variable et inégale selon le segment de l’espace des prédicteurs considéré. Pour dépasser le jugement visuel subjectif, des tests statistiques formels s’imposent :
- Le test de Breusch-Pagan : Il régresse les résidus carrés sur l’ensemble des prédicteurs initiaux afin de tester si une part significative de la variabilité résiduelle dépend linéairement des variables indépendantes sélectionnées.
- Le test de White : Plus généraliste, il teste la présence d’hétéroscédasticité sans présumer d’une forme fonctionnelle linéaire, en incluant également les termes quadratiques et les produits croisés des covariables.
En présence d’hétéroscédasticité confirmée, la solution contemporaine la plus recommandée consiste à substituer aux erreurs types conventionnelles des estimateurs de variance asymptotiquement robustes, connus sous l’appellation d’erreurs types robustes de Huber-White (ou estimateurs sandwich HC3/HC4), permettant de maintenir des inférences valides sans modifier la valeur des coefficients estimés.
5.2 Évaluation de la normalité et de l’indépendance
L’examen du postulat de normalité des résidus s’appuie au premier chef sur le diagramme quantile-quantile normal (couramment désigné sous le terme de Q-Q plot). Ce graphique projette les quantiles empiriques de la distribution des résidus standardisés de l’échantillon contre les quantiles théoriques attendus d’une loi normale standardisée idéale. Si l’hypothèse de normalité est respectée, les observations s’alignent étroitement le long d’une droite de référence diagonale à 45 degrés. Tout décrochage structurel aux extrémités — qu’il prenne la forme d’ondulations en « S » caractéristiques de queues lourdes ou de concavités marquées révélant une asymétrie — signale une anomalie distributionnelle substantielle.
Ces observations visuelles peuvent être corroborées par l’application de tests d’adéquation probabilistes, tels que le test de Shapiro-Wilk (particulièrement puissant pour des échantillons n’excédant pas quelques centaines de sujets) ou le test de Kolmogorov-Smirnov corrigé par Lilliefors. Toutefois, la portée pratique de ces tests d’hypothèse doit être contextualisée en vertu des enseignements du théorème central limite : lorsque la taille de l’échantillon devient substantielle (typiquement N > 200 ou 300 observations en psychologie), les distributions d’échantillonnage des coefficients convergent asymptotiquement vers la normalité, rendant les tests t et F particulièrement robustes aux écarts modérés à la normalité résiduelle.
Concernant l’indépendance sérielle des erreurs, essentielle dès lors que les données présentent une composante longitudinale ou temporelle ordonnée, le test classique de Durbin-Watson permet de détecter l’autocorrélation d’ordre 1. La statistique d obtenue oscille structurellement entre 0 et 4 ; une valeur voisine de 2 atteste de l’absence d’autocorrélation linéaire, tandis que des valeurs substantiellement inférieures à 1,5 signalent une corrélation sérielle positive problématique imposant des ajustements de modélisation auto-régressive.
5.3 Identification des observations influentes et aberrantes
L’architecture matricielle des moindres carrés ordinaires possède une vulnérabilité reconnue : elle accorde un poids disproportionné aux points d’observation extrêmes situés à la périphérie du domaine expérimental. Il est impératif de distinguer rigoureusement trois notions connexes mais opérationnellement distinctes : les valeurs aberrantes (outliers), les points à fort effet de levier (leverage) et les observations influentes proprement dites.
Une valeur aberrante se caractérise par un résidu de prédiction anormalement grand, indiquant que le modèle échoue spectaculairement à ajuster cette observation spécifique. On les identifie usuellement en calculant les résidus studentisés supprimés (jackknife residuals) : toute observation dont la valeur absolue excède le seuil conventionnel de |2,5| ou |3,0| doit faire l’objet d’un examen attentif. L’effet de levier mesure quant à lui l’éloignement d’une observation par rapport au centre de gravité multidimensionnel des prédicteurs ; il s’évalue à partir des éléments diagonaux hᵢᵢ de la matrice chapeau H = X(X’X)⁻¹X’. Une valeur hᵢᵢ excédant le double ou le triple du levier moyen établi à (p + 1) / N traduit une position atypique dans l’espace des covariables.
L’influence statistique globale découle directement de la conjonction d’un fort effet de levier et d’un résidu élevé : un point influent déplace substantiellement à lui seul la position géométrique de l’hyperplan d’ajustement. La statistique de référence pour quantifier cette influence globale est la distance de Cook (Dᵢ). Les recommandations méthodologiques contemporaines suggèrent d’examiner toute observation présentant un Dᵢ supérieur à 4 / (N – p – 1) ou s’approchant de la valeur unitaire. En recherche clinique, la gestion prudente de ces cas impose de vérifier d’éventuelles erreurs de saisie matérielle, puis de conduire des analyses de sensibilité comparant les modèles estimés avec et sans les observations influentes, plutôt que de procéder à leur suppression aveugle et automatique.
6. Interprétation statistique et clinique des coefficients de régression
6.1 L’ordonnée à l’origine (β₀) et son utilité interprétative
L’ordonnée à l’origine — ou intercepte du modèle empirique (b₀) — capture la valeur numérique quantitativement prédite pour la variable dépendante Y lorsque l’ensemble exhaustif des prédicteurs X₁ à Xₚ inclus dans l’équation prend simultanément et rigoureusement la valeur zéro. Bien que son estimation soit indispensable pour garantir que la moyenne arithmétique des erreurs résiduelles soit exactement nulle dans le cadre des moindres carrés, son interprétation directe se heurte fréquemment à un obstacle épistémologique majeur dans le champ des sciences humaines et sociales.
En psychométrie, le zéro absolu naturel est pratiquement inexistant : une personne ne saurait présenter un score de zéro à une échelle de quotient intellectuel, un niveau d’extraversion rigoureusement nul sur un inventaire standardisé, ou un âge chronologique égal à zéro dans une étude portant sur le vieillissement cognitif. Dans ces conditions, le paramètre b₀ se trouve projeté dans une zone de vide empirique complet, dépourvue de toute signification concrète ou clinique.
Pour restaurer la lisibilité théorique et pratique de l’intercepte, la technique méthodologique universelle consiste à procéder au centrage sur la moyenne de l’ensemble des prédicteurs continus (calcul de X_centré = X – X̄). Dès lors que cette transformation linéaire préliminaire est appliquée, la valeur zéro correspond précisément au niveau moyen de chaque prédicteur dans l’échantillon. L’ordonnée à l’origine b₀ se réinterprète alors élégamment comme le niveau moyen attendu de la variable dépendante pour un individu moyen présentant les caractéristiques centrales du groupe étudié.
6.2 Coefficients partiels non standardisés (bêta non standardisés, b)
Les coefficients de régression non standardisés, usuellement notés bⱼ dans la littérature académique francophone et anglo-saxonne, constituent le socle quantitatif fondamental de la modélisation. La formulation verbale de leur signification doit faire l’objet d’une rigueur absolue : le coefficient bⱼ quantifie l’ampleur moyenne du changement attendu dans la variable dépendante Y (exprimée dans son unité de mesure d’origine) consécutif à une augmentation d’une unité entière de la variable prédictive Xⱼ, toutes choses égales par ailleurs.
Cette clause restrictive — traduite du latin classique par l’expression méthodologique ceteris paribus — est capitale. Elle formalise le fait que le coefficient mesure l’effet marginal pur du prédicteur en contrôlant statistiquement pour l’ensemble des covariables co-présentes dans l’équation. Ainsi, dans une recherche en psychologie clinique mesurant la dépression sur l’inventaire de Beck (BDI) en fonction des heures d’activité physique et du nombre de ruminations quotidiennes, un coefficient b = -0,45 pour l’activité physique signifie que pour chaque heure supplémentaire d’exercice par semaine, le score de dépression diminue en moyenne de 0,45 point, à fréquence de ruminations rigoureusement égale.
Il demeure toutefois impératif de rappeler que ces coefficients partiels mesurent des ajustements statistiques conditionnels et non des dynamiques causales directes, à moins que le devis méthodologique sous-jacent ne repose sur une assignation aléatoire rigoureuse ou sur un contrôle quasi expérimental sans faille. En pratique translationnelle et clinique, ces coefficients bruts présentent l’inestimable avantage de conserver l’échelle métrique naturelle des instruments utilisés, permettant d’appréhender directement si le gain ou la perte théorique prédit par le modèle possède une pertinence clinique substantielle au-delà de sa simple significativité numérique.
6.3 Coefficients de régression standardisés (bêta standardisés, β*)
Lorsque les prédicteurs intégrés au sein d’un même modèle linéaire ont été collectés au moyen d’instruments hétérogènes employant des métriques radicalement différentes — par exemple le niveau de cortisol salivaire mesuré en nanomoles par litre, le revenu annuel brut exprimé en dizaines de milliers d’euros et un score d’anxiété gradué de 1 à 7 sur une échelle de Likert —, la comparaison directe de la magnitude de leurs coefficients bruts b respectifs devient strictement impossible. Un coefficient brut peut être minuscule en valeur absolue simplement parce que l’unité de mesure sous-jacente est particulièrement large.
Pour contourner ce biais d’échelle et permettre une évaluation relative du pouvoir d’association des différents prédicteurs, on recourt à la standardisation : les scores de toutes les variables (critère et prédicteurs) sont centrés et réduits avant l’estimation, en soustrayant leur moyenne arithmétique et en divisant par leur écart-type d’échantillon. Les paramètres estimés résultants sont qualifiés de coefficients standardisés, conventionnellement désignés sous le symbole β (ou β*). Le coefficient standardisé se définit comme le déplacement moyen attendu de la variable dépendante, exprimé en fractions d’écart-type, consécutif à une progression d’un écart-type complet de la variable indépendante considérée, toutes les autres variables du modèle demeurant maintenues constantes.
Bien que séduisants pour identifier rapidement la variable qui « pèse » le plus lourd au sein de l’équation sur un échantillon donné, les coefficients standardisés doivent être maniés avec circonspection. Leur amplitude dépend étroitement de la dispersion et de la variabilité interne de l’échantillon à l’étude. Par conséquent, il est méthodologiquement erroné d’utiliser les coefficients standardisés pour comparer la force d’un prédicteur entre deux groupes distincts (par exemple des patients cliniques versus un groupe témoin) si les variances des variables ne sont pas strictement identiques entre ces deux populations.
7. Évaluation de la qualité globale de l’ajustement du modèle
7.1 Décomposition de la variance et coefficient de détermination (R²)
L’évaluation de la qualité avec laquelle l’hyperplan de régression capture la dispersion des données empiriques repose sur le principe de partition de la variance totale de la variable dépendante. La somme totale des carrés des écarts à la moyenne arithmétique, désignée sous l’appellation de somme des carrés totale (SST pour Total Sum of Squares), peut être décomposée de manière exacte et univoque en deux composantes additives orthogonales :
SST = SSR + SSE
Dans cette équation structurelle, la composante SSR (Regression Sum of Squares) représente la variabilité expliquée par le modèle linéaire, c’est-à-dire la somme des carrés des écarts entre les valeurs prédites ajustées (ŷᵢ) et la moyenne générale (Ȳ). À l’opposé, la composante SSE (Error Sum of Squares) capture la somme des carrés des erreurs résiduelles inexpliquées, correspondant à la distance verticale séparant les points réels observés (yᵢ) de l’hyperplan estimé (ŷᵢ). À partir de cette décomposition vectorielle s’établit la définition formelle du coefficient de détermination, universellement désigné par le symbole R² :
R² = SSR / SST = 1 – (SSE / SST)
Le R² quantifie de façon synthétique la proportion de la variance totale de la variable dépendante qui est directement expliquée ou prise en compte par l’ensemble des prédicteurs inclus dans l’équation. Cet indice varie strictement au sein de l’intervalle fermé [0, 1]. Cependant, le R² possède une propriété mathématique pernicieuse : il s’agit d’une fonction monotone non décroissante du nombre de prédicteurs. L’ajout d’une variable indépendante supplémentaire dans le modèle, aussi farfelue ou dépourvue de sens théorique soit-elle, provoquera inévitablement une hausse mécanique (ou une stagnation absolue) du R², en réduisant artificiellement la somme des carrés résiduels de l’échantillon.
Dans le domaine des sciences humaines et de la psychologie empirique, où la variabilité humaine est soumise à une multitude de déterminants diffus, les seuils d’interprétation conventionnels proposés par Jacob Cohen suggèrent qu’un R² de l’ordre de 0,02 correspond à un effet de petite taille, un R² de 0,13 reflète un effet de taille moyenne, tandis qu’un score approchant ou excédant 0,26 caractérise un effet de grande ampleur.
7.2 Le coefficient de détermination ajusté (R² ajusté)
Face à la propension structurelle du R² standard à surestimer systématiquement la véritable capacité explicative du modèle au sein de la population parente — un phénomène connu sous le nom de surapprentissage ou de biais d’optimisme d’échantillonnage —, les statisticiens ont développé une correction pénalisant mathématiquement l’inflation artificielle des régresseurs : le coefficient de détermination ajusté, conventionnellement noté R²_adj.
La formule analytique du R² ajusté incorpore explicitement les degrés de liberté respectifs de la variance totale et de la variance résiduelle, pondérant ainsi chaque somme de carrés par sa complexité dimensionnelle :
R²_adj = 1 – [ (SSE / (N – p – 1)) / (SST / (N – 1)) ] = 1 – (1 – R²) × [ (N – 1) / (N – p – 1) ]
Dans cette expression algébrique, N représente la taille globale de l’échantillon d’observation et p désigne le nombre exact de prédicteurs intégrés dans la modélisation. Cette formulation établit une véritable pénalité statistique : si un régresseur supplémentaire est introduit dans l’analyse sans apporter une réduction de l’erreur résiduelle supérieure à ce qui serait attendu par le simple jeu du hasard, la valeur du R² ajusté diminuera consécutivement.
Le R² ajusté constitue donc un indicateur indispensable pour comparer la performance de modèles concurrents non emboîtés testés sur les mêmes données empiriques. L’observation d’un écart substantiel entre le R² conventionnel et le R² ajusté envoie un signal d’alerte méthodologique immédiat, trahissant un modèle surspécifié, surchargé de paramètres superflus et susceptible de présenter une instabilité généralisée en dehors de l’échantillon d’estimation d’origine.
7.3 L’erreur standard de l’estimation et critères d’information
Bien que le R² et sa variante ajustée soient universellement rapportés, ils ne fournissent qu’une appréciation relative de la qualité de la modélisation. Un indicateur absolu fondamental d’ajustement réside dans l’erreur standard de l’estimation (SEE pour Standard Error of the Estimate), qui correspond à la racine carrée non biaisée du carré moyen des résidus : SEE = √(SSE / (N – p – 1)). La SEE s’exprime directement dans l’unité de mesure native de la variable dépendante Y. Elle quantifie l’écart-type moyen des erreurs commises par le modèle lors de la prédiction des données réelles. Dans une perspective clinique, une valeur SEE faible est le gage d’une prévision individuellement fiable.
Parallèlement à ces métriques traditionnelles, la sélection moderne de modèles s’est enrichie des critères d’information issus de la théorie probabiliste et de la théorie de la communication, au premier rang desquels figurent le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC). Ces indices partent de la log-vraisemblance maximale du modèle ajusté tout en lui appliquant une pénalité rigoureusement calibrée en fonction du nombre total de paramètres estimés :
- L’AIC : AIC = 2k – 2ln(L), où k est le nombre de paramètres et L la vraisemblance. Il optimise la divergence de Kullback-Leibler et privilégie la puissance prédictive.
- Le BIC : BIC = k ln(N) – 2ln(L). Il applique une pénalité logarithmique indexée sur la taille d’échantillon N, favorisant plus drastiquement la parcimonie structurelle.
Dans les démarches comparatives de modèles compétitifs, le chercheur privilégie systématiquement le modèle affichant la valeur AIC ou BIC la plus basse, réalisant ainsi un compromis optimal entre richesse théorique et élégance parcimonieuse.
8. Tests de significativité statistique globale et individuelle
8.1 Le test F global du modèle
L’inférence statistique au sein de la modélisation linéaire multiple débute par une vérification omnibus préalable : il s’agit de s’assurer que le modèle pris dans sa globalité explique une quantité de variance significativement supérieure à ce que produirait un générateur aléatoire pur. Cette interrogation fait l’objet du test F global d’ajustement, dont les hypothèses formelles s’énoncent de la manière suivante :
Hypothèse nulle (H₀) : β₁ = β₂ = … = βₚ = 0
Hypothèse alternative (H₁) : Au moins un coefficient βⱼ ≠ 0
La statistique de test F est construite à partir de l’analyse de la variance (ANOVA) appliquée à la régression. Elle exprime le ratio direct entre le carré moyen expliqué par le modèle (MSR = SSR / p) et le carré moyen des erreurs résiduelles (MSE = SSE / (N – p – 1)) :
F = MSR / MSE = [ R² / p ] / [ (1 – R²) / (N – p – 1) ]
Cette statistique suit sous l’hypothèse nulle une loi de Fisher-Snedecor paramétrée par p degrés de liberté au numérateur et (N – p – 1) degrés de liberté au dénominateur. L’obtention d’une valeur F associée à une valeur p inférieure au seuil conventionnel alpha (typiquement p < 0,05) autorise le rejet de l’hypothèse nulle omnibus. Il existe toutefois une distinction logique fondamentale entre significativité globale et significativité locale : un modèle peut afficher un test F extrêmement robuste et significatif à p < 0,001 sous l’effet conjugué d’une taille d’échantillon massive, alors même que certains prédicteurs individuels considérés isolément ne présentent aucune contribution statistiquement démontrable.
8.2 Les tests t de Student pour les coefficients individuels
Dès lors que la significativité globale du modèle a été formellement validée par le test F, l’attention analytique se déplace vers l’évaluation de la contribution incrémentale propre apportée par chaque régresseur particulier. Pour chacun des coefficients bⱼ estimés, on soumet à l’épreuve l’hypothèse nulle unitaire selon laquelle la pente partielle de la variable correspondante est nulle au sein de la population parente, une fois contrôlée l’influence de l’ensemble des autres variables explicatives :
Hypothèse nulle (H₀) : βⱼ = 0
Hypothèse alternative (H₁) : βⱼ ≠ 0
Le test de cette hypothèse repose sur la statistique du test t de Student, qui calcule le ratio entre le coefficient empirique non standardisé obtenu et son erreur type standard d’échantillonnage :
t = bⱼ / SE(bⱼ)
Sous l’hypothèse nulle, cette quantité statistique suit fidèlement une loi de Student à (N – p – 1) degrés de liberté. La statistique t quantifie le nombre d’erreurs types séparant le coefficient estimé de la valeur nulle. La valeur de SE(bⱼ) est hautement sensible à trois composantes : la variance résiduelle globale du modèle (plus le modèle global est précis, plus l’erreur type diminue), la variance spécifique du prédicteur Xⱼ (une variabilité étendue du prédicteur améliore la précision de l’estimation), et enfin le degré d’association liant Xⱼ aux autres régresseurs (une redondance élevée gonfle l’erreur type). Le rejet de H₀ au seuil bilatéral spécifié confirme que le prédicteur apporte une fraction d’information explicative unique et statistiquement non négligeable pour comprendre la variabilité du critère.
8.3 Intervalles de confiance des paramètres
Bien que les valeurs p issues des tests t soient systématiquement scrutées, les canons contemporains de l’inférence statistique et les recommandations méthodologiques formelles exigent de compléter systématiquement ces indices binaires par le calcul et la déclaration des intervalles de confiance à 95 % (ou 99 %) pour l’ensemble des coefficients non standardisés estimés. La borne inférieure et la borne supérieure de cet intervalle se dérivent aisément à l’aide de l’expression analytique suivante :
IC₉₅% = bⱼ ± [ t_critique(0,05 ; df = N – p – 1) × SE(bⱼ) ]
L’intervalle de confiance fournit un volume d’information méthodologique infiniment supérieur à la simple valeur p. Alors que cette dernière ne renseigne que sur le rejet d’une valeur ponctuelle nulle arbitraire, l’intervalle de confiance explicite directement la marge d’incertitude entourant l’estimation dans l’unité de mesure originale. La largeur absolue de l’intervalle constitue un reflet direct de la précision de l’échantillonnage : un intervalle excessivement large signale un manque de puissance statistique ou une multicolinéarité sous-jacente pernicieuse.
L’inclusion de la valeur zéro au sein de l’intervalle de confiance correspond rigoureusement à l’incapacité de rejeter l’hypothèse nulle au niveau alpha sélectionné. Cependant, sur le plan de la plausibilité clinique, l’intervalle de confiance permet d’examiner si les bornes empiriques capturent des grandeurs d’effet triviales ou, au contraire, des modifications comportementales majeures, protégeant ainsi le chercheur des pièges de la significativité purement statistique induite par des cohortes d’échantillonnage disproportionnées.
9. Gestion de la multicolinéarité et sélection des prédicteurs
9.1 Nature et manifestations de la multicolinéarité
Dans un devis de régression linéaire multiple idéal, les variables indépendantes choisies devraient être fortement corrélées avec la variable dépendante tout en étant parfaitement orthogonales (non corrélées) entre elles. Dans la réalité des recherches empiriques et comportementales, cette configuration idéale n’existe pour ainsi dire jamais. La situation où les prédicteurs présentent des intercorrélations modérées à très élevées définit le phénomène de la multicolinéarité.
Il convient de dissocier conceptuellement la multicolinéarité parfaite — survenant lorsqu’une variable explicative est une fonction mathématique linéaire exacte d’une ou plusieurs autres, ce qui rend le déterminant de X’X strictement égal à zéro et bloque totalement la résolution algorithmique — de la multicolinéarité imparfaite, infiniment plus fréquente mais méthodologiquement redoutable. Cette dernière ne rend pas le calcul impossible, mais elle engendre une instabilité numérique chronique :
- Les coefficients de régression estimés deviennent extrêmement volatils, fluctuant drastiquement au gré de l’ajout ou du retrait de quelques observations.
- Les erreurs types SE(bⱼ) subissent un gonflement spectaculaire, laminant la puissance des tests t individuels.
- Un paradoxe classique émerge : le test F global s’avère hautement significatif (R² très élevé), tandis qu’aucun des tests t individuels n’atteint le seuil de significativité.
En sciences psychologiques, ce syndrome trouve fréquemment sa source dans une redondance sémantique lors de l’administration de questionnaires multidimensionnels, où des sous-échelles mesurent des construits théoriquement distincts mais opérationnellement indiscernables.
9.2 Indices quantitatifs de diagnostic de colinéarité
Pour déceler la présence et quantifier la sévérité de la multicolinéarité au sein d’un ensemble de covariables, la simple lecture de la matrice des corrélations bivariées de Pearson entre prédicteurs s’avère manifestement insuffisante : une variable peut n’avoir aucune corrélation bivariée alarmante supérieure à 0,70 avec une autre variable prise isolément, tout en étant presque parfaitement prédite par la combinaison linéaire de l’ensemble des autres régresseurs réunis.
L’indicateur diagnostique de référence le plus largement employé est le facteur d’inflation de la variance (VIF pour Variance Inflation Factor), calculé pour chaque régresseur à partir du coefficient de détermination partiel (R²ⱼ) issu de la régression auxiliaire de ce prédicteur Xⱼ sur tous les autres prédicteurs restants :
VIFⱼ = 1 / (1 – R²ⱼ)
Le VIF indique directement dans quelle proportion la variance d’échantillonnage du coefficient de régression estimé est multipliée par rapport à une situation théorique d’orthogonalité parfaite. Directement liée au VIF, la tolérance statistique se définit par l’inverse direct : Tolérance = 1 / VIFⱼ = 1 – R²ⱼ. Elle exprime la fraction de variance du prédicteur qui n’est pas partagée avec les autres covariables.
Bien que des débats méthodologiques animent la littérature spécialisée, les seuils critiques conventionnels d’alerte s’établissent généralement à un VIF supérieur à 5 (Tolérance < 0,20) comme révélateur d’une colinéarité préoccupante, et à un VIF excédant 10 (Tolérance < 0,10) comme marquant une colinéarité critique invalidant la stabilité des inférences individuelles. Des méthodes plus poussées, telles que l’analyse des valeurs propres et des indices de conditionnement de la matrice X’X (procédure de Belsley, Kuh et Welsch), complètent avantageusement ce dispositif en identifiant avec exactitude les sous-espaces de dépendance linéaire.
9.3 Méthodes de sélection de variables : hiérarchique versus automatique
La question de la sélection des variables constitue une ligne de démarcation épistémologique fondamentale entre modélisation théorique raisonnée et exploration algorithmique opportuniste. La régression hiérarchique (ou entrée séquentielle par blocs) représente l’approche préférentielle par excellence en sciences sociales. Dans ce cadre, l’ordre d’introduction des prédicteurs dans l’équation mathématique est rigoureusement dicté par un modèle conceptuel préétabli ou par des considérations logiques fondées sur la littérature scientifique :
- Le Bloc 1 accueille typiquement les variables de contrôle démographiques ou les facteurs confondants avérés (âge, sexe biologique, statut socioéconomique).
- Le Bloc 2 intègre les prédicteurs théoriques principaux déjà établis dans la littérature.
- Le Bloc 3 reçoit la variable novatrice dont le chercheur entend démontrer la validité incrémentielle unique par l’examen de la variation du R² (ΔR²).
À l’opposé de cette rigueur conceptuelle se situent les méthodes de sélection automatique de variables, qu’elles opèrent de manière progressive (forward selection), régressive (backward elimination) ou par étapes itératives combinées (stepwise). Ces algorithmes informatisés ajoutent ou retranchent des prédicteurs sur la seule base de critères de significativité statistique brute (seuils de p-value ou maximisation aveugle du F). De nombreuses publications méthodologiques ont largement démontré les dangers destructeurs de ces algorithmes pas à pas : inflation dramatique de l’erreur de type I, surajustement massif aux idiosyncrasies de l’échantillon, biais vers le haut des coefficients estimés et abolition complète de la logique déductive.
Pour les devis complexes caractérisés par un très grand nombre de régresseurs potentiels, la statistique moderne privilégie désormais des méthodes de régularisation pénalisée — telles que la régression Ridge, le Lasso ou l’Elastic Net — qui appliquent une contrainte géométrique sur la norme du vecteur des coefficients, ou encore des démarches de réduction dimensionnelle par analyse en composantes principales (ACP) en amont de la modélisation.
10. Intégration de prédicteurs catégoriels et modélisation des interactions
10.1 Codage des variables qualitatives (Dummy Coding)
Bien que la formulation mathématique classique de la régression linéaire multivariée exige que la variable dépendante soit de nature métrique continue, elle dispose d’une remarquable souplesse analytique permettant d’incorporer sans réserve des variables indépendantes qualitatives ou catégoriques — telles que le statut matrimonial, le groupe expérimental, l’appartenance socioprofessionnelle ou le diagnostic psychiatrique. Cette prouesse repose sur la technique fondamentale du codage d’indicatrices binaires, universellement désigné par le terme de dummy coding.
Le principe mathématique cardinal gouvernant cette opération stipule qu’une variable qualitative polymorphe comportant k modalités distinctes et mutuellement exclusives doit être traduite en exactement k – 1 variables indicatrices artificielles distinctes, dont les valeurs d’affectation sont strictement limitées aux nombres entiers binaires 0 ou 1. La modalité qui ne fait l’objet d’aucune création de variable indicatrice dédiée est désignée sous le terme de modalité ou « groupe de référence ».
Le choix de cette modalité de référence possède un impact direct et déterminant sur l’architecture interprétative des paramètres statistiques estimés :
- L’ordonnée à l’origine b₀ correspond désormais avec précision au niveau moyen attendu de la variable dépendante Y pour les individus appartenant exclusivement au groupe de référence désigné (lorsque tous les autres prédicteurs sont nuls ou centrés).
- Le coefficient de régression b associable à une variable indicatrice spécifique exprime le contraste direct, c’est-à-dire l’écart moyen constaté entre cette modalité particulière et le groupe de référence sélectionné.
D’autres schémas de paramétrisation existent, tels que le codage par déviation (effect coding), où les coefficients mesurent la différence entre chaque modalité et la grande moyenne générale de l’ensemble de la population, ou encore le codage des contrastes polynomiaux adapté aux facteurs nominaux ou ordinaux ordonnés.
10.2 Modélisation des effets de modération et termes d’interaction
L’une des avancées méthodologiques les plus cruciales permises par la régression linéaire multiple concerne sa capacité à tester des hypothèses de modération, conceptualisant la façon dont la force ou la direction de la relation linéaire unissant un prédicteur focal X et un critère Y dépend directement du niveau d’une troisième variable M, désignée comme variable modératrice. Il convient ici d’insister sur la frontière conceptuelle absolue séparant la médiation statistique — qui décrit un mécanisme causal indirect d’acheminement par lequel une variable transite pour agir sur une autre (X → M → Y) — de la modération, qui formalise une interaction statistique conditionnelle conditionnant l’intensité d’un lien.
Pour implémenter formellement un modèle de modération bilinéaire, on génère un terme d’interaction consistant en un produit multiplicatif croisé simple des deux variables concernées : X × M. L’équation de régression générale se complexifie alors de la façon suivante :
Y = β₀ + β₁X + β₂M + β₃(X × M) + ε
Cette multiplication brute de deux prédicteurs engendre presque systématiquement une multicolinéarité structurelle artificielle très marquée entre le terme de produit résultant et les régresseurs constitutifs pris isolément. Pour juguler cette redondance numérique indésirable et restaurer une interprétabilité intuitive immédiate aux paramètres, il est méthodologiquement impératif de procéder au centrage sur la moyenne préalable des variables X et M avant d’exécuter la multiplication de leurs vecteurs.
Lorsque le modèle intègre un terme interactif multiplicatif dont le coefficient b₃ s’avère statistiquement significatif au test t (p < 0,05), les coefficients linéaires β₁ et β₂ perdent leur statut classique d’effets principaux globaux pour devenir des « effets conditionnels simples ». Ainsi, β₁ ne reflète plus l’effet marginal universel de X sur Y, mais quantifie exclusivement l’impact attendu de X lorsque la variable modératrice M est strictement égale à sa moyenne (soit M_centré = 0).
10.3 Analyse post-hoc des interactions : pentes simples et Johnson-Neyman
L’observation d’un coefficient d’interaction multiplicatif statistiquement significatif impose au chercheur de poursuivre l’investigation analytique afin d’expliciter concrètement la nature et les contours empiriques de cette modulation relationnelle. Deux approches post-hoc complémentaires sont universellement plébiscitées dans les publications de premier rang :
La première démarche, classique et intuitive, réside dans l’analyse des pentes simples (simple slopes analysis). Elle consiste à réestimer et tester la significativité du coefficient de régression linéaire de la variable indépendante focale X à des niveaux opérationnels précis et prédéterminés de la variable modératrice M. Suivant les canons formalisés par Leona Aiken et Stephen West, ces coupes transversales d’évaluation s’opèrent usuellement à la valeur moyenne du modérateur (M = 0), à un niveau conditionnel élevé correspondant à un écart-type au-dessus de la moyenne (+1 SD), et à un niveau conditionnel faible fixé à un écart-type en deçà de la moyenne (-1 SD).
Bien qu’informative, cette technique des pentes simples souffre du caractère arbitraire du choix des points de coupure conditionnels fixés conventionnellement à ±1 écart-type. Pour s’affranchir de cette rigidité discrète, les méthodologues contemporains privilégient largement la technique de Johnson-Neyman. Cette méthode d’intégration continue résout mathématiquement l’équation de régression pour identifier avec une précision absolue les frontières de transition exactes (les valeurs seuils critiques le long du continuum métrique de la variable modératrice M) en deçà ou au-delà desquelles l’effet du prédicteur focal X bascule formellement d’une significativité statistique vérifiée (p < 0,05) vers une zone de non-significativité.
La transcription graphique rigoureuse de ces plans d’interaction, assortie des bandes d’intervalles de confiance à 95 % associées aux pentes conditionnelles de Johnson-Neyman, constitue désormais l’étalon-or des figures de résultats dans les revues internationales de psychologie et de psychiatrie comportementale, autorisant une contextualisation clinique fine des dynamiques thérapeutiques modulées.
11. Application pratique, logiciels statistiques et analyse d’un cas réel
11.1 Présentation du cas pratique en psychologie de la santé
Afin d’ancrer ces considérations mathématiques et méthodologiques dans la réalité empirique du laboratoire, nous déployons une illustration clinique issue de la psychologie de la santé. Imaginons une recherche transversale ciblant l’étude des déterminants psychologiques de la sévérité des symptômes dépressifs au sein d’une cohorte de patients adultes suivis en soins primaires (N = 350 participants complétant un protocole d’évaluation standardisé). Les mesures ont été administrées à l’aide d’instruments validés garantissant d’excellentes qualités métrologiques :
- Variable dépendante (Y) : Sévérité de la symptomatologie dépressive, évaluée par le score total à l’inventaire de dépression de Beck révisé (BDI-II), s’étendant sur un continuum métrique continu de 0 à 63 points.
- Prédicteur focal 1 (X₁) : Perfectionnisme inadapté (souci excessif des erreurs), mesuré par la sous-échelle dédiée de la Multidimensional Perfectionism Scale (FMPS).
- Prédicteur focal 2 (X₂) : Niveau d’exposition au stress perçu quotidien au cours du dernier trimestre, quantifié par l’échelle de stress perçu de Cohen (PSS-10).
- Prédicteur de contrôle/ressource (X₃) : Score de soutien social perçu multidimensionnel (MSPSS), théorisé comme un facteur tampon de protection psychologique.
L’exploration préliminaire rigoureuse du jeu de données implique l’analyse univariée des statistiques descriptives élémentaires (moyennes arithmétiques, écarts-types, asymétries et kurtosis) ainsi que le criblage méticuleux des scores extrêmes univariés au moyen des cotes z standardisées (exclusion des cotes |z| > 3,29). Le cadre théorique déductif dicte une stratégie de régression hiérarchique séquentielle en deux blocs ordonnés :
- Bloc 1 : Introduction des variables d’environnement et de ressources psychologiques (Stress perçu PSS et Soutien social MSPSS).
- Bloc 2 : Inclusion incrémentale de la composante de personnalité cognitive (Perfectionnisme inadapté FMPS) pour tester si cette disposition de personnalité améliore significativement la prédiction de la dépression au-delà des contraintes contextuelles perçues.
11.2 Mise en œuvre technique sous SPSS et R
La réalisation opératoire de cette modélisation linéaire multiple au sein des environnements d’analyse contemporains requiert la maîtrise des commandes syntaxiques appropriées, gages de reproductibilité scientifique intégrale. Dans l’écosystème open-source R, la modélisation s’articule élégamment autour de la fonction de base lm() couplée aux bibliothèques d’analyse diagnostique de référence car et performance. Le chercheur spécifie l’ajustement hiérarchique séquentiel par le code suivant :
# Modèle 1 : Facteurs environnementaux et ressources
modele1 <- lm(Depression ~ Stress + SoutienSocial, data = donnees_sante)
# Modèle 2 : Modèle hiérarchique complet intégrant la personnalité
modele2 <- lm(Depression ~ Stress + SoutienSocial + Perfectionnisme, data = donnees_sante)
# Comparaison statistique des deux blocs
anova(modele1, modele2)
# Synthèse exhaustive et diagnostics de colinéarité
summary(modele2)
car::vif(modele2)
Sous l’environnement graphique SPSS, l’exécution s’effectue soit par les menus déroulants d’analyse, soit préférentiellement via la fenêtre de syntaxe statistique standardisée :
REGRESSION
/MISSING LISTWISE
/STATISTICS COEFF OUTS R ANOVA COLLIN TOL CHANGE ZPP
/CRITERIA=PIN(.05) POUT(.10)
/NOORIGIN
/DEPENDENT Depression
/METHOD=ENTER Stress SoutienSocial
/METHOD=ENTER Perfectionnisme
/SCATTERPLOT=(*ZRESID ,*ZPRED)
/RESIDUALS DURBIN HISTOGRAM(ZRESID) NORMPROB(ZRESID)
/SAVE COOK RESID LEVER.
Cette instruction SPSS configure explicitement l’entrée séquentielle hiérarchique grâce aux sous-commandes successives /METHOD=ENTER, commande l’extraction intégrale des matrices de colinéarité (/STATISTICS COLLIN TOL), réclame le calcul des variations statistiques associées au changement de bloc (/STATISTICS CHANGE) et génère immédiatement les graphiques indispensables d’homoscédasticité et de normalité résiduelle.
11.3 Lecture critique pas à pas des sorties logicielles
L’analyse méthodologique approfondie des tableaux de résultats statistiques générés par les logiciels d’analyse constitue une étape charnière qui demande une méthode structurée de décodage.
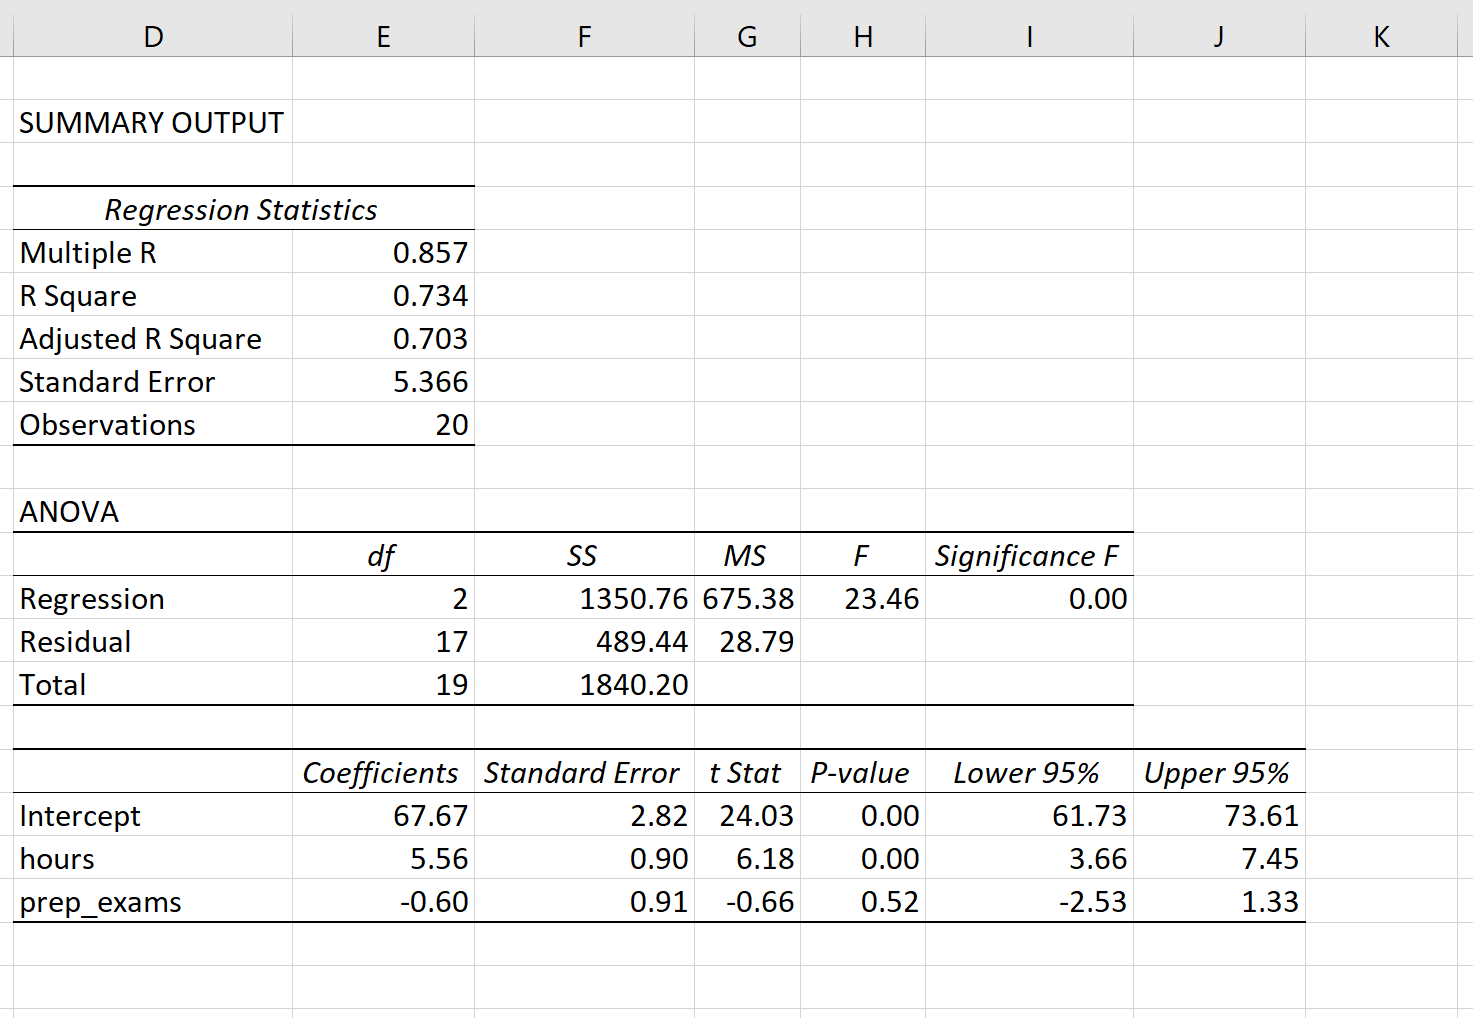
La première phase d’interprétation exige un examen attentif du tableau récapitulatif des modèles successifs (Model Summary). Dans notre cas pratique d’investigation clinique, le Modèle 1 (stress perçu et soutien social) produit un coefficient de corrélation multiple R = 0,58 et un coefficient de détermination R² = 0,336, F(2, 347) = 87,85, p < 0,001. Cela indique que l’environnement de stress et le soutien perçu rendent compte ensemble de 33,6 % de la variabilité globale de la dépression. Lors de l’incorporation de la dimension cognitive de perfectionnisme au Modèle 2, le R² s’élève à 0,412, F(3, 346) = 80,72, p < 0,001. La statistique de modification de F (F-change) s’avère hautement significative : ΔR² = 0,076, F_change(1, 346) = 44,68, p < 0,001. L’adjonction du perfectionnisme inadapté explique ainsi à lui seul 7,6 % de variance résiduelle unique supplémentaire, confirmant sans équivoque sa validité incrémentielle théorique.
La seconde phase consiste à vérifier la significativité omnibus au sein du tableau d’analyse de variance globale (ANOVA), où la valeur globale F(3, 346) = 80,72 confirme que l’hyperplan à trois régresseurs s’ajuste globalement de façon spectaculairement meilleure à la structure des données qu’un modèle nul composé de la seule ordonnée à l’origine (p = 0,0000000000001).
La troisième phase déploie la lecture clinique détaillée du tableau analytique des coefficients pour le modèle complet final :
- Stress perçu (PSS) : b = 0,42, SE = 0,05, β = 0,38, t = 8,40, p < 0,001, IC₉₅% [0,32 ; 0,52]. L’effet partiel est robuste, positif et hautement significatif.
- Soutien social (MSPSS) : b = -0,28, SE = 0,06, β = -0,21, t = -4,67, p < 0,001, IC₉₅% [-0,40 ; -0,16]. L’effet est protecteur, traduisant une réduction des symptômes à mesure que le réseau social s’étoffe.
- Perfectionnisme inadapté (FMPS) : b = 0,35, SE = 0,05, β = 0,30, t = 6,68, p < 0,001, IC₉₅% [0,25 ; 0,45]. La vulnérabilité cognitive accentue directement les manifestations dépressives.
Enfin, l’examen scrupuleux des colonnes d’orientation diagnostique de la colinéarité rassure intégralement le méthodologue : les facteurs d’inflation de la variance s’échelonnent entre 1,18 et 1,35, et les indices de tolérance oscillent de 0,74 à 0,85, demeurant remarquablement distants des seuils critiques conventionnels de dysfonctionnement (VIF > 5). Les résidus studentisés ne révèlent aucun point excédant l’intervalle [-3, +3] et les distances de Cook maximales culminent à D_max = 0,042, attestant de la remarquable stabilité inférentielle de l’ajustement modélisé.
12. Bonnes pratiques de publication scientifique et conformité aux normes APA
12.1 Rédaction académique des résultats de régression selon l’APA 7e édition
La transcription des résultats issus d’une modélisation de régression linéaire multiple dans le corps narratif d’un manuscrit scientifique se doit d’obéir aux canons formels particulièrement rigoureux édictés par le manuel de style de l’American Psychological Association (APA, 7e édition). La prose académique ne doit en aucun cas se limiter à une récitation brute de valeurs numériques, mais tisser une narration méthodologique fluide articulant l’objectif d’investigation théorique, la logique d’agencement des prédicteurs, l’orientation directionnelle des coefficients observés et le contrôle rigoureux des hypothèses.
La formulation conventionnelle des indicateurs inférentiels au sein du texte implique le respect de conventions typographiques strictes : les symboles statistiques mathématiques fondamentaux (F, t, R, R², p, b, β, z) doivent impérativement être typographiés en italique. Pour les métriques bornées d’avance par construction mathématique au sein de l’intervalle [0, 1] — telles que la valeur p, le coefficient R² ou les corrélations de Pearson —, la règle typographique anglo-saxonne APA proscrit l’adjonction du zéro précédant la virgule décimale (écrire p = .003 ou R² = .412, et non 0.003 ou 0.412).
Sur le plan textuel, la présentation formalisée s’énonce selon des schémas rédactionnels normés :
« Afin d’examiner la contribution incrémentale du perfectionnisme inadapté dans la prédiction de la sévérité des symptômes dépressifs au-delà du stress perçu et du soutien social, une régression linéaire multiple hiérarchique a été réalisée. Les conditions préalables d’application du modèle linéaire généralisé ont été scrupuleusement vérifiées : l’inspection visuelle du graphique de dispersion des résidus studentisés en fonction des valeurs prédites atteste de l’homoscédasticité des variances, tandis que le diagramme quantile-quantile confirme la normalité distributionnelle des résidus. Aucun indice de multicolinéarité problématique n’a été détecté (tous les VIF ≤ 1,35).
Au premier bloc, le stress perçu et le soutien social expliquent conjointement une part statistiquement significative de la variance de la dépression, R² = .336, F(2, 347) = 87.85, p < .001. L’introduction au second bloc du perfectionnisme inadapté entraîne une amélioration significative et substantielle du pouvoir explicatif du modèle, ΔR² = .076, ΔF(1, 346) = 44.68, p < .001. Dans ce modèle final, qui rend compte de 41,2 % de la variance totale des scores de dépression (R²_ajusté = .407), le perfectionnisme inadapté constitue un prédicteur positif indépendant majeur (B = 0.35, SE = 0.05, β = .30, t(346) = 6.68, p < .001, IC 95 % [0.25, 0.45]). »
Il est en outre méthodologiquement fondamental de veiller au choix scrupuleux du registre sémantique déployé : le chercheur veillera rigoureusement à bannir toute formulation verbale suggérant une causalité active unilatérale (telle que « le perfectionnisme produit, induit ou cause la dépression ») lorsqu’il analyse des données observationnelles corrélationnelles transversales, lui préférant les termes neutres et conformes de prédiction statistique, d’association dépendante ou de contribution incrémentale.
12.2 Conception de tableaux de régression clairs et normés
Lorsque la structure de l’analyse comporte des modèles séquentiels emboîtés ou mobilise de nombreuses covariables explicatives, le texte narratif s’avère insuffisant pour communiquer l’intégralité des métriques numériques sans alourdir indûment la lecture. La confection d’un tableau synthétique normé devient alors incontournable. Selon les directives typographiques strictes de l’APA 7e édition, un tableau académique ne doit comporter absolument aucune ligne de séparation verticale ; son ossature n’admet qu’un nombre extrêmement sobre et minimal de filets de démarcation horizontaux (marquant le sommet du tableau, la séparation des intitulés de colonnes et la base de clôture des données).
L’agencement des colonnes répond à un ordonnancement conventionnel immuable :
- Colonne 1 : Intitulé descriptif clair des prédicteurs textuels déclinés selon l’arborescence des blocs successifs du modèle hiérarchique.
- Colonne 2 : Coefficients de régression non standardisés bruts, notés sous l’en-tête typographique B.
- Colonne 3 : Erreurs types d’échantillonnage associées aux coefficients bruts, libellées sous l’en-tête SE B.
- Colonne 4 : Coefficients de régression standardisés, formellement signalés par la lettre grecque β.
- Colonne 5 : Statistique empirique de test, notée t.
- Colonne 6 : Valeur p exacte rapportée à trois décimales (ex. .002) ou indiquée sous la mention d’inégalité absolue p < .001.
- Colonne 7 : Bornes inférieure et supérieure de l’intervalle de confiance à 95 % pour les coefficients bruts, titrées sous le libellé formel 95 % IC [LL, UL].
À la base de ce tableau s’insèrent impérativement les statistiques récapitulatives d’ajustement global propres à chaque étape d’estimation : valeurs respectives de R², de R² ajusté, ampleur des incréments successifs de variance (ΔR²) et tests de variation d’ajustement correspondants (ΔF). Enfin, une note de bas de tableau (intitulée en italique Note.) vient expliciter de façon systématique la taille de l’échantillon analysé (N = 350), la nature de la méthode de traitement des données incomplètes appliquée, ainsi que la signification univoque des astérisques de probabilité (*p < .05. **p < .01. ***p < .001).
12.3 Transparence méthodologique, reproductibilité et science ouverte
À l’ère contemporaine de la crise de la reproductibilité scientifique qui a profondément ébranlé la psychologie expérimentale et les sciences médicales, la conduite et la diffusion d’une analyse de régression linéaire multiple ne sauraient plus s’affranchir des impératifs éthiques et techniques du mouvement de la science ouverte (Open Science). La crédibilité d’un modèle statistique dépend intimement de la transparence méthodologique totale déployée en amont et en aval de l’analyse calculatoire.
Le premier gage d’intégrité réside dans la déclaration transparente et exhaustive du traitement des données manquantes. Les pratiques désuètes d’amputation automatique par élimination de listes complètes (listwise deletion) provoquent des biais d’attrition systématiques majeurs tout en détruisant inutilement la puissance d’échantillonnage. Le chercheur contemporain se doit d’expliciter le mécanisme probabiliste supposé régissant ces données manquantes (MCAR, MAR ou MNAR) et de documenter l’application de protocoles de traitement modernes et non biaisés, tels que l’imputation multiple par équations chaînées (MICE) ou l’estimation par maximum de vraisemblance à information complète (FIML).
Le second pilier méthodologique impose la justification statistique rigoureuse a priori de la taille de l’échantillon d’investigation par une analyse formelle de puissance statistique (réalisée par exemple au moyen de l’utilitaire de référence G*Power). Les anciennes règles empiriques superficielles (telles que la recommandation naïve de disposer d’exactement 10 ou 15 sujets par variable prédictive) sont désormais unanimement disqualifiées par les méthodologues ; la puissance statistique doit être rigoureusement modélisée en fonction de la taille d’effet minimale théoriquement intéressante à détecter (définie par l’indice de Cohen f² = R² / (1 – R²)), du seuil d’erreur alpha consenti et de la puissance d’analyse désirée (généralement fixée à un standard de 1 – β = 0,80 ou 0,90).
Enfin, l’inscription pleine et entière de la recherche dans l’écosystème de la science ouverte se concrétise par le pré-enregistrement formel et horodaté des hypothèses théoriques, des modèles de régression et des plans analytiques prévus sur des plateformes certifiées telles que l’Open Science Framework (OSF). Ce pré-enregistrement scrupuleux constitue le plus formidable rempart méthodologique contre les dérives éthiques du HARKing (Hypothesizing After the Results are Known) et du « p-hacking » (exploration opportuniste d’un nombre infini de prédicteurs jusqu’à l’obtention accidentelle d’une significativité statistique factice). Cet engagement se parachève par le dépôt public, transparent et accessible de scripts d’analyse complets et annotés (fichiers de syntaxe R, Python ou SPSS) accompagnés des jeux de données anonymisés, assurant ainsi la reproductibilité informatique intégrale et pérenne des connaissances scientifiques produites.
Références
Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression: II. Biometrika, 38(1/2), 159-177. https://doi.org/10.2307/2332580
Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149-1160. https://doi.org/10.3758/BRM.41.4.1149
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press.
Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217-224. https://doi.org/10.1080/00031305.2000.10474549
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934