
L’avènement des mégadonnées et la prolifération de variables explicatives dans les sciences contemporaines ont profondément transformé les pratiques de modélisation statistique. Qu’il s’agisse de déchiffrer les bases neurobiologiques de la cognition à travers des milliers de voxels d’imagerie par résonance magnétique fonctionnelle ou d’évaluer les dynamiques complexes de la psychopathologie par le biais d’inventaires psychométriques exhaustifs, les chercheurs sont constamment confrontés au défi de la dimensionnalité. Dans ce contexte, la méthode classique des moindres carrés ordinaires, longtemps considérée comme le pilier inébranlable de l’analyse linéaire, manifeste des faiblesses structurelles majeures caractérisées par une instabilité numérique critique et une incapacité congénitale à trier le signal informatif du bruit aléatoire.
Face aux écueils de la multicolinéarité et du surapprentissage, les techniques d’apprentissage statistique supervisé ont introduit des mécanismes sophistiqués de régularisation. Parmi ces innovations, la régression Lasso (Least Absolute Shrinkage and Selection Operator), conceptualisée par Robert Tibshirani au milieu des années 1990, s’impose comme une avancée méthodologique majeure. En associant une pénalité fondée sur la norme $L_1$ à la fonction de perte empirique standard, le Lasso ne se contente pas de réduire l’amplitude des coefficients de régression pour tempérer la variance de prédiction : il opère une sélection rigoureuse et parcimonieuse des variables en contraignant un sous-ensemble d’estimateurs à s’annuler exactement.
Ce traité exhaustif explore les dimensions théoriques, géométriques, algorithmiques et appliquées de la régression Lasso, en portant un regard attentif sur les sciences du comportement, la psychométrie et les neurosciences cognitives. À travers une analyse comparative approfondie avec d’autres méthodes de régularisation telles que la régression Ridge et le modèle composite Elastic Net, nous détaillerons les fondements mathématiques, les procédures d’optimisation numérique, les protocoles de validation croisée et les défis émergents de l’inférence post-sélection, offrant ainsi aux chercheurs une boussole conceptuelle et technique indispensable pour naviguer dans l’analyse moderne des données multidimensionnelles.
1. Fondements théoriques de la régression linéaire multiple et ses limites
1.1 Le modèle linéaire classique et la méthode des moindres carrés ordinaires
La modélisation linéaire multiple repose sur le postulat d’une relation structurelle affine reliant une variable dépendante continue, notée $Y in \mathbb{R}^n$, à une collection de $p$ variables prédictives compilées dans une matrice de conception $X in \mathbb{R}^{n \times p}$. Sur le plan formel, le modèle s’exprime sous la forme vectorielle matricielle :
$$Y = X\beta + \varepsilon$$
où $\beta in \mathbb{R}^p$ représente le vecteur inconnu des paramètres de régression et $\varepsilon in \mathbb{R}^n$ désigne le terme d’erreur stochastique inobservable. Dans le paradigme traditionnel, la détermination de l’estimateur des moindres carrés ordinaires (MCO), désigné par $\hat{\beta}_{\text{MCO}}$, découle de la minimisation de la somme des carrés des résidus (Residual Sum of Squares, RSS) :
$$\text{RSS}(\beta) = |Y – Xbeta|_2^2 = (Y – X\beta)^T(Y – X\beta)$$
Lorsque la matrice de Gram $X^T X$ est de plein rang et strictement inversible, l’annulation du gradient de cette fonction quadratique convexe conduit à la célèbre équation normale, dont la résolution explicite livre la solution fermée :
$$\hat{\beta}_{\text{MCO}} = (X^T X)^{-1} X^T Y$$
En vertu du théorème de Gauss-Markov, cet estimateur jouit des propriétés BLUE (Best Linear Unbiased Estimator) sous les hypothèses classiques d’homoscédasticité et d’absence d’autocorrélation spatiale ou temporelle des résidus ($\mathbb{E}[\varepsilon] = 0$ et $\text{Var}(\varepsilon) = \sigma^2 I_n$). L’estimateur MCO présente alors une variance minimale au sein de la classe des estimateurs linéaires sans biais, conférant une légitimité mathématique solide à son déploiement séculaire en statistique inférentielle.
1.2 La problématique de la multicolinéarité dans les données psychologiques
Bien que mathématiquement séduisant, le cadre des moindres carrés ordinaires s’effondre fréquemment lorsqu’il est confronté aux réalités empiriques des données observationnelles, en particulier dans le champ de la psychologie différentielle et de la psychométrie clinique. Dans ces disciplines, les prédicteurs correspondent souvent à des scores sous-dimensionnels issus d’échelles de personnalité, à des indicateurs de charge cognitive ou à des variables socio-émotionnelles intrinsèquement enchevêtrées. Cette dépendance structurelle engendre le phénomène de multicolinéarité, caractérisé par une quasi-dépendance linéaire entre les colonnes de la matrice $X$.
Sur le plan algébrique, la multicolinéarité entraîne une mauvaise condition numérique de la matrice $X^T X$, dont les valeurs propres les plus faibles tendent vers zéro. Sachant que la matrice de covariance de l’estimateur MCO est formulée par :
$$\text{Var}(\hat{\beta}_{\text{MCO}}) = \sigma^2 (X^T X)^{-1}$$
l’inversion d’une matrice mal conditionnée provoque un gonflement catastrophique de la variance des coefficients estimés. Ce phénomène se traduit par une instabilité numérique notoire : une infime fluctuation d’échantillonnage ou une légère perturbation dans les données peut modifier radicalement le signe, la magnitude et la significativité statistique des paramètres estimés. Pour le clinicien ou le chercheur en sciences cognitives, il devient alors impossible d’isoler l’effet spécifique de prédicteurs étroitement intriqués, tels que l’anxiété-trait et la dépression subclinique, rendant toute interprétation étiologique particulièrement périlleuse.
1.3 Le compromis biais-variance et l’écueil du surapprentissage
La dégradation des performances prédictives du modèle linéaire en présence d’une forte dimensionnalité s’éclaire à travers la décomposition canonique de l’erreur quadratique moyenne (Mean Squared Error, MSE). Pour un nouvel individu doté du vecteur de caractéristiques $x_0$ et de la réponse $y_0 = x_0^T\beta + \varepsilon_0$, l’erreur de prédiction attendue se partitionne rigoureusement en trois composantes orthogonales :
$$\text{MSE}(\hat{f}(x_0)) = \mathbb{E}\left[(y_0 – \hat{f}(x_0))^2\right] = \left(\text{Biais}[\hat{f}(x_0)]\right)^2 + \text{Var}(\hat{f}(x_0)) + \sigma^2$$
où $\sigma^2$ représente le bruit irréductible inhérent au processus générateur de données stochastique. L’estimateur MCO impose par construction que $\text{Biais}[\hat{f}(x_0)] = 0$. Bien que cette absence de biais soit conceptuellement rassurante, elle s’avère stratégiquement contre-productive lorsque $p$ est grand par rapport à $n$, car la variance globale $\text{Var}(\hat{\beta}_{\text{MCO}}) = \sigma^2 \text{Tr}((X^T X)^{-1})$ croît proportionnellement au nombre de dimensions intégrées.
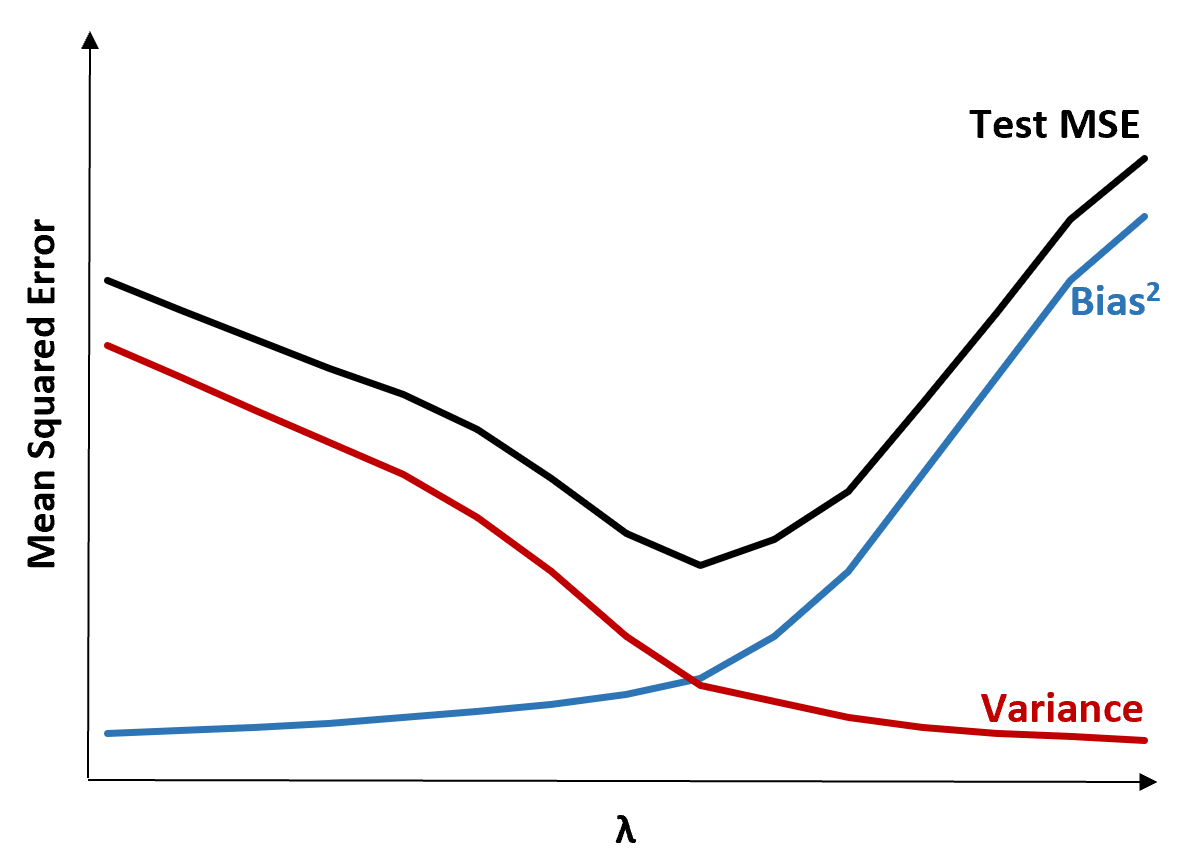
Cette variance excessive conduit inévitablement au surapprentissage (overfitting) : le modèle ajuste les bruits d’échantillonnage idiosyncrasiques au détriment des structures sous-jacentes généralisables, compromettant gravement sa validité externe et la réplication des résultats dans des cohortes indépendantes. D’un point de vue théorique, il devient dès lors avantageux d’abandonner l’exigence dogmatique de non-biais. En autorisant un biais délibéré et contrôlé, les techniques de rétrécissement (shrinkage) parviennent à une réduction massive de la variance d’estimation, induisant ainsi une chute substantielle de l’erreur quadratique moyenne totale.
2. Genèse et concept fondamental de la régression Lasso
2.1 Origine historique et publication séminale de Robert Tibshirani
L’histoire de l’apprentissage statistique contemporain a été marquée par la parution en 1996 de l’article séminal de Robert Tibshirani, intitulé Regression Shrinkage and Selection via the Lasso, publié dans le Journal of the Royal Statistical Society. Dans les années 1990, la communauté statistique faisait face à un dilemme méthodologique polarisé : d’un côté subsistait la régression Ridge, introduite par Hoerl et Kennard en 1970, qui stabilisait efficacement la variance grâce à une pénalisation quadratique $L_2$, mais conservait irrémédiablement l’intégralité des variables dans le modèle sans en annuler aucune ; de l’autre subsistaient les algorithmes heuristiques de sélection pas à pas (forward, backward, stepwise), reconnus pour leur instabilité discrète, leur absence d’optimalité globale et la distorsion systématique des distributions de test conventionnelles.
Tibshirani s’inspira notamment des travaux de Leo Breiman sur le Non-negative Garrote pour concevoir un opérateur continu capable de fusionner l’élégance algorithmique de la régularisation et la puissance sélective des méthodes de sous-ensembles. En remplaçant la pénalisation quadratique par une contrainte absolue de type $L_1$, Tibshirani jeta les fondations d’un cadre mathématique unifié, ouvrant une nouvelle ère pour l’exploitation des données à haute dimension qui allaient bientôt submerger la génomique fonctionnelle, la vision par ordinateur et les neurosciences cognitives.
2.2 Définition et étymologie : Least Absolute Shrinkage and Selection Operator
L’acronyme Lasso condense l’essence fonctionnelle de la technique : Least Absolute Shrinkage and Selection Operator, que l’on traduit en français par « opérateur de sélection et de rétrécissement absolu minimal ». Chaque terme de cette appellation éclaire une dimension mathématique précise :
- Least Absolute : fait référence à l’emploi de la norme $ell_1$, soit l’addition arithmétique des valeurs absolues des paramètres individuels $\sum_{j=1}^p |\beta_j|$, marquant une rupture avec les métriques quadratiques traditionnelles ;
- Shrinkage : désigne la rétraction continue des coefficients estimés en direction du point d’origine zéro, amortissant la sensibilité du système face aux fluctuations stochastiques ;
- Selection Operator : met en exergue l’aptitude singulière de cette formulation à opérer une sélection automatique et parcimonieuse en attribuant un coefficient strictement nul à une fraction substantielle des régresseurs initiaux.
Ce double mécanisme surpasse les limitations des méthodes de sélection pas à pas, lesquelles procèdent par sauts combinatoires discontinus, engendrant des modèles hypersensibles aux variations locales des jeux de données d’apprentissage.
2.3 Philosophie de la régularisation en modélisation comportementale
L’adoption de la régularisation Lasso en modélisation computationnelle du comportement répond à un impératif épistémologique profond résonnant avec le principe de parcimonie, communément désigné sous le nom de rasoir d’Ockham : face à des explications empiriquement concurrentes, la formulation la plus économe en hypothèses doit être systématiquement privilégiée. Dans l’exploration du phénotype humain, où des batteries de questionnaires complexes mesurent des facettes psychologiques qui se chevauchent largement, la sélection parcimonieuse permet de tamiser les descripteurs pertinents pour en extraire un noyau théorique condensé.
Cette approche matérialise une transition paradigmatique majeure : on délaisse la modélisation explicative universelle — souvent illusoire face à des systèmes biopsychosociaux ouverts et bruités — au profit d’une modélisation prédictive robuste et reproductible. L’apprentissage statistique supervisé régularisé s’affranchit ainsi de la quête obstinée d’une valeur $p$ nominale pour embrasser la minimisation de l’erreur de généralisation sur des populations non observées, assurant une transférabilité clinique pérenne aux biomarqueurs comportementaux identifiés.
3. Formulation mathématique et fonction de perte du Lasso
3.1 La fonction objectif pénalisée par la norme L1
D’un point de vue analytique, la régression Lasso se structure comme un problème d’optimisation convexe globale non linéaire. En fixant une matrice de prédicteurs standardisés $X in \mathbb{R}^{n \times p}$ et un vecteur réponse centré $Y in \mathbb{R}^n$, l’estimateur Lasso $\hat{\beta}_{\text{Lasso}}$ est défini comme l’argument minimisant la fonction de perte empirique augmentée d’un terme pénalisateur dépendant de la norme de Banach $ell_1$ :
$$\hat{\beta}_{\text{Lasso}} = \underset{\beta in \mathbb{R}^p}{arg\min} \left{ \frac{1}{2n} |Y – Xbeta|_2^2 + \lambda |beta|_1 \right}$$
Dans cette formulation, le terme de fidélité aux données correspond à la demi-moyenne de la somme des carrés résiduels, tandis que le terme de régularisation s’explicite par la somme discrète des modules :
$$|beta|_1 = \sum_{j=1}^p |\beta_j|$$
La singularité mathématique de cette expression réside dans la non-dérivabilité de la fonction valeur absolue au point zéro ($\frac{d}{d\beta_j}|\beta_j|$ n’existe pas en $\beta_j = 0$). Cette propriété interdit le recours aux techniques classiques de différentiation vectorielle directe et aux inversions matricielles fermées. Elle requiert l’utilisation d’outils analytiques avancés issus de l’analyse convexe, tels que le sous-gradient et les conditions de transversalité non lisses.
3.2 Le rôle du paramètre d’ajustement lambda
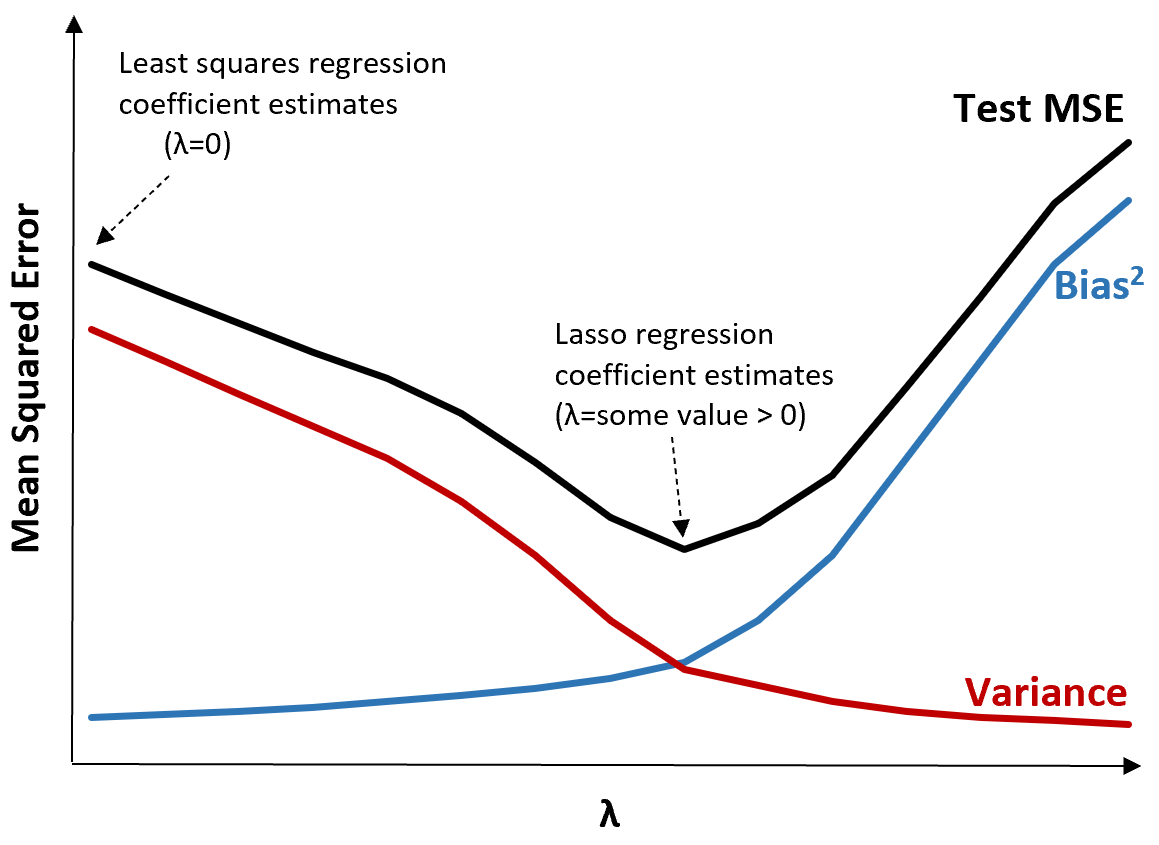
Le scalaire $\lambda \geq 0$ constitue l’hyperparamètre régissant le niveau d’intensité de la pénalisation appliquée au système d’équations. Il module dynamiquement le point d’équilibre le long du continuum biais-variance :
- Lorsque $lambda to 0$, le terme pénalisateur s’estompe jusqu’à disparaître complètement. La fonction objectif converge vers la formulation classique des moindres carrés ordinaires, produisant un modèle sans biais structurel mais potentiellement grevé d’une variance d’échantillonnage rédhibitoire ;
- Lorsque $\lambda to \infty$, l’influence du terme $\lambda |beta|_1$ devient infiniment prépondérante par rapport à la variance résiduelle. L’unique solution minimisatrice consiste à écraser uniformément l’ensemble des coefficients, aboutissant au modèle nul où $\hat{\beta}_j = 0$ pour tout $j in {1, dots, p}$ ;
- Pour des valeurs intermédiaires rigoureusement calibrées de $lambda$, la pénalité contraint progressivement les trajectoires de coefficients : certains paramètres s’atténuent continûment tandis que d’autres s’éteignent brutalement dès que leur contribution marginale à la réduction de la somme résiduelle devient inférieure au coût mathématique induit par la valeur $lambda$.
Il existe une borne supérieure critique analytique, notée $\lambda_{\max} = \frac{1}{n} \max_j |X_j^T Y|$, au-delà de laquelle l’orthogonalité du gradient assure qu’aucun coefficient ne peut entrer dans le modèle, servant d’ancrage fondamental pour le calcul des chemins de régularisation algorithmiques.
3.3 Formulation sous forme de problème d’optimisation sous contrainte
En vertu du théorème de dualité de Fenchel-Rockafellar et de la théorie de l’optimisation sous contraintes convexes, la forme lagrangienne pénalisée du Lasso admet une formulation duale strictement équivalente sous la forme d’un problème aux limites bornées :
$$\min_{\beta in \mathbb{R}^p} \frac{1}{2n} |Y – Xbeta|_2^2 \quad \text{sous la contrainte} \quad |beta|_1 \leq t$$
Il existe une correspondance bijective décroissante entre le multiplicateur de Lagrange $lambda$ et le rayon de confiance $t in \mathbb{R}^+$ : à chaque valeur assignée à $lambda$ correspond un unique seuil géométrique $t(lambda)$, et réciproquement. Lorsque la contrainte globale $t \geq |\hat{\beta}_{\text{MCO}}|_1$, la frontière géométrique n’est pas active, et la solution Lasso coïncide fidèlement avec la solution des moindres carrés ordinaires.
Inversement, lorsque $t < |\hat{\beta}_{\text{MCO}}|_1$, la solution est projetée sur le bord du polytope convexe délimité par l'inégalité de contrainte. Dans l'espace paramétrique multidimensionnel des indicateurs psychométriques, la valeur $t$ peut être conceptualisée comme un « budget global » de prédictibilité alloué au système : les variables se disputent cette ressource métrique finie, seules les plus informatives conservant une quote-part non nulle au terme de l'optimisation.
4. Mécanisme géométrique et propriété de parcimonie
4.1 Géométrie de la contrainte L1 versus la sphère L2
La capacité du Lasso à annuler rigoureusement des coefficients — propriété qualifiée de parcimonie ou sparsité — s’explique de manière transparente par l’analyse géométrique comparée des espaces de contrainte dans $\mathbb{R}^p$. Considérons un espace bidimensionnel où deux paramètres $\beta_1$ et $\beta_2$ doivent être estimés. Les lignes de niveau de la fonction de perte RSS forment une famille d’ellipsoïdes concentriques centrés sur la solution non contrainte des moindres carrés $\hat{\beta}_{\text{MCO}}$. L’objectif d’optimisation consiste à déterminer le premier point de tangence géométrique entre ces ellipsoïdes résiduels en expansion et la zone de contrainte admissible délimitée par la norme employée.
Dans la régression Ridge, la contrainte $|beta|_2^2 \leq t^2$ circonscrit une boule euclidienne, qui prend la forme d’un disque parfaitement lisse et isotrope dans $\mathbb{R}^2$ ou d’une hypersphère continue dans $\mathbb{R}^p$. En raison de sa différentiabilité universelle et de l’absence totale de singularités angulaires, la surface de cette sphère n’a qu’une probabilité infinitésimale de rencontrer l’ellipse des résidus exactement sur l’un des axes de coordonnées. En conséquence, les points de tangence se distribuent de manière ubiquitaire sur la périphérie circulaire : les coefficients subissent une contraction vers zéro mais conservent indéfiniment des valeurs résiduelles non nulles.
À l’opposé, la contrainte Lasso $|beta|_1 \leq t$ engendre dans l’espace plan un losange régulier dont les pointes sont alignées sur les axes canoniques du repère cartésien, formant un polyèdre convexe (cross-polytope) en dimension supérieure doté d’arêtes planes et de sommets pointus aigus. Ces sommets représentent des configurations algébriques où l’un ou plusieurs paramètres valent identiquement zéro.
4.2 L’émergence mathématique de coefficients strictement nuls
L’apparition de solutions structuralement creuses dépend directement de l’angle formé par les singularités de la boule unité $ell_1$. Comme les courbes de niveau d’une fonction quadratique régulière progressent de façon convexe autour de leur centre d’attraction, les points de contact tangents surviennent majoritairement au niveau des singularités pointues de la frontière $ell_1$ plutôt que sur ses facettes lisses multidimensionnelles. Mathématiquement, le sous-différentiel de la norme $ell_1$ par rapport à une coordonnée s’annulant $\beta_j = 0$ couvre un intervalle compact fermé continu :
$$\partial |\beta_j| = [-1, 1]$$
Pour qu’un coefficient quitte la valeur zéro et s’active dans la configuration optimale, le gradient local de la fonction résiduelle associé à ce régresseur particulier doit vaincre une barrière finie imposée par $lambda$. Si le produit scalaire partiel $|X_j^T (Y – X\beta)| \leq n\lambda$, la condition d’optimalité du premier ordre stipule que le paramètre reste verrouillé à zéro. Ce phénomène de coin confère au Lasso sa nature d’opérateur de seuillage non linéaire continu, réalisant l’élagage direct des axes paramétriques orthogonaux superflus.
4.3 Interprétabilité des modèles résultants en sciences humaines
Dans le domaine des sciences humaines et de la psychologie différentielle, la parcimonie géométrique induite par la norme $ell_1$ transforme la lisibilité des résultats statistiques. Les praticiens sont régulièrement confrontés à des matrices d’inventaires composées de centaines d’items manifestes conçus pour capturer des entités latentes telles que l’intelligence émotionnelle, le névrosisme ou la flexibilité cognitive. Face à de tels faisceaux d’observations, l’interprétation d’un vecteur dense de moindres carrés saturé de coefficients résiduels microscopiques (par exemple $\beta = 0{,}0034$) s’avère cognitivement fastidieuse et scientifiquement peu défendable.
Le Lasso filtre le bruit de fond méthodologique généré par les redondances de formulation dans les questionnaires d’auto-évaluation et met en évidence les prédicteurs au poids clinique prédominant. En produisant un modèle clair, la méthode fournit une cartographie comportementale intelligible où seuls les signaux prédictifs dominants subsistent, ce qui renforce l’opérationnalisation des concepts psychométriques et optimise la formulation d’interventions ciblées sur des cibles thérapeutiques définies.
5. Comparaison critique : Lasso, Ridge et Elastic Net
5.1 Régression Ridge : régularisation sans sélection de variables
La régression Ridge, formulée initialement par Hoerl et Kennard, repose sur l’adjonction d’une pénalité quadratique de norme $L_2$ appliquée sur les coefficients vectoriels :
$$\hat{\beta}_{\text{Ridge}} = \underset{\beta in \mathbb{R}^p}{arg\min} \left{ \frac{1}{2n} |Y – Xbeta|_2^2 + \lambda |beta|_2^2 \right}$$
Sur le plan computationnel, l’un des attraits historiques de Ridge réside dans l’existence d’une solution matricielle explicite directe et infiniment différentiable :
$$\hat{\beta}_{\text{Ridge}} = (X^T X + 2n\lambda I_p)^{-1} X^T Y$$
En injectant une constante positive proportionnelle à $lambda$ le long de la diagonale principale de la matrice de Gram empirique, Ridge rétablit son strict conditionnement numérique, même dans des cas extrêmes où $p gg n$ ou lorsque la colinéarité entre colonnes est quasi absolue. Toutefois, cette régularisation sphérique répartit proportionnellement la pénalité sur l’intégralité des coefficients sans jamais forcer aucun d’entre eux à s’annuler formellement. Lorsque le problème compte plusieurs centaines de prédicteurs interconnectés, le modèle résultant conserve chaque variable dans son équation finale, interdisant toute décomposition parcimonieuse des structures latentes sous-jacentes.
5.2 Comportement du Lasso face à des variables hautement corrélées
En contrepartie de sa capacité de sélection, le Lasso présente un comportement singulier en présence de multicolinéarité extrême. Lorsque deux ou plusieurs prédicteurs affichent un coefficient de corrélation bivariée avoisinant l’unité (par exemple $r > 0{,}90$), la convexité stricte de la fonction de perte combinée à la géométrie de la norme $ell_1$ fait défaut. Le Lasso tend alors à sélectionner arbitrairement l’une des variables colinéaires dans le modèle tout en écrasant les autres à zéro de manière abrupte, selon de microscopiques fluctuations aléatoires dans les données d’apprentissage.
En psychométrie, cette instabilité de sélection pose un problème d’interprétabilité : deux formulations alternatives d’un même item d’anxiété peuvent voir leur sort diverger radicalement d’un sous-échantillon d’étalonnage à l’autre, l’une étant retenue comme déterminant majeur et l’autre purement éliminée. De surcroît, lorsque le nombre de prédicteurs $p$ excède la taille de la cohorte $n$, le Lasso est théoriquement incapable d’intégrer plus de $n$ variables dans son ensemble actif, constituant une limitation structurelle majeure lors de l’exploitation de données omiques ou de neuro-imagerie dense.
5.3 Elastic Net comme solution de compromis hybride
Pour dépasser les limites respectives du Lasso et de Ridge, Zou et Hastie ont introduit en 2005 le modèle régularisé Elastic Net. Cette architecture hybride intègre simultanément les deux normes au sein d’une enveloppe de perte convexe unifiée :
$$\hat{\beta}_{\text{ElasticNet}} = \underset{\beta in \mathbb{R}^p}{arg\min} \left{ \frac{1}{2n} |Y – Xbeta|_2^2 + \lambda \left( \alpha |beta|_1 + \frac{1 – \alpha}{2} |beta|_2^2 \right) \right}$$
Le paramètre de mélange $\alpha in [0, 1]$ module la trajectoire entre l’exclusivité Ridge ($\alpha = 0$) et la sparsité Lasso ($\alpha = 1$). La composante strictement convexe $L_2$ restaure l’effet de regroupement (grouping effect) : des régresseurs fortement corrélés reçoivent alors des coefficients d’amplitudes comparables et franchissent conjointement le seuil de sélection. L’Elastic Net résout également l’écueil de la dimensionnalité en autorisant l’activation stable de plus de $n$ descripteurs lorsque $\alpha < 1$, faisant de cette formulation une alternative robuste pour les batteries d'items psychométriques entrelacés ou les panels de biomarqueurs neuroendocriniens.
6. Optimisation algorithmique et sélection de l’hyperparamètre lambda
6.1 Validation croisée k-fold pour le calibrage de lambda
La performance prédictive et la consistance structurelle du modèle Lasso dépendent de la valeur assignée à l’hyperparamètre de régularisation $lambda$. La méthode standard pour calibrer cette constante consiste à implémenter une procédure de validation croisée k-fold. L’échantillon initial de taille $n$ est partitionné de manière aléatoire et équilibrée en $K$ blocs disjoints d’effectifs approximativement homogènes ($K=5$ ou $K=10$ dans les applications conventionnelles).
Pour chaque tranche de valeurs échantillonnée sur une grille logarithmique décroissante $[\lambda_{\max}, dots, \lambda_{\min}]$, le modèle est entraîné sur $K-1$ sous-ensembles fusionnés, puis son erreur quadratique moyenne de prédiction (CV-MSE) est calculée sur le $K$-ième volet préservé de toute interaction paramétrique :
$$\text{CV}_{(K)}(\lambda) = \frac{1}{K}\sum_{k=1}^K \text{MSE}_k(\lambda)$$
Cette approche prévient les biais de fuite d’information (data leakage) et offre une estimation non biaisée du risque empirique de généralisation, assurant un calibrage équilibré entre sous-ajustement et surapprentissage.
6.2 Critères de sélection : lambda minimal versus règle du 1-SE
L’examen de la courbe d’erreur quadratique moyenne de validation croisée en fonction du logarithme népérien de $lambda$ fait apparaître deux seuils méthodologiques concurrents :
- $\lambda_{\min}$ : la valeur numérique exacte du paramètre qui minimise rigoureusement l’erreur quadratique moyenne globale sur les $K$ itérations. Bien qu’optimale au strict sens de la minimisation de la perte quadratique, elle a tendance à intégrer un nombre trop élevé de variables fallacieuses présentant de très faibles contributions marginales (taux d’erreur de Type I accru) ;
- $\lambda_{1\text{-SE}}$ : conceptualisé par Breiman et Friedman, ce critère désigne la valeur la plus parcimonieuse (soit le $lambda$ le plus élevé) dont l’erreur moyenne résiduelle ne dévie pas de plus d’une erreur-type (standard error) au-dessus du minimum absolu observé :
$$\text{CV}(\lambda_{1\text{-SE}}) \leq \text{CV}(\lambda_{\min}) + \text{SE}(\lambda_{\min})$$
En privilégiant un modèle structurellement plus dense mais statistiquement indistinguable sur le plan de la variance d’échantillonnage, la règle heuristique dite « one-standard-error rule » favorise les modèles concis et stables, ce qui en fait un filtre performant contre les faux positifs dans les inventaires cliniques exploratoires.
6.3 Algorithmes de résolution numérique : descente de coordonnées et LARS
En raison de la non-différentiabilité locale de la norme $ell_1$, la résolution numérique du Lasso a nécessité le développement de schémas d’optimisation dédiés. Deux algorithmes dominent la littérature contemporaine :
La descente de coordonnées cyclique (coordinate descent), popularisée par Friedman, Hastie et Tibshirani, résout le problème multivarié en une succession de sous-problèmes unidimensionnels minimisés séparément. En fixant tous les coefficients sauf le $j$-ième à leurs valeurs courantes, la mise à jour s’exécute de manière analytique à l’aide de l’opérateur de seuillage doux (soft-thresholding) :
$$\hat{\beta}_j \leftarrow \mathcal{S}\left( \frac{1}{n} \sum_{i=1}^n x_{ij} r_{i}^{(-j)}, \lambda \right) = \text{signe}\left(z_j\right)\max\left(0, |z_j| – \lambda\right)$$
où $r_{i}^{(-j)} = y_i – \sum_{k \neq j} x_{ik}\hat{\beta}_k$ constitue le résidu partiel courant et $z_j = \frac{1}{n} X_j^T r^{(-j)}$. Cette méthode converge rapidement même sur des matrices de données massives contenant des millions d’entrées.
L’algorithme LARS (Least Angle Regression), formalisé par Efron, Hastie, Johnstone et Tibshirani en 2004, exploite la structure géométrique du problème : il avance dans la direction qui maintient l’équiangularité avec les corrélations résiduelles courantes. LARS fournit le tracé complet, continu et mathématiquement exact des sentiers de régularisation (path algorithms) pour un coût computationnel équivalent à une unique régression MCO standard sur l’ensemble des variables.
7. Prétraitement rigoureux des données avant l’application du Lasso
7.1 L’impératif absolu du centrage et de la standardisation
L’utilisation de la régression pénalisée impose une discipline méthodologique stricte en amont de toute phase d’optimisation : la normalisation intégrale des échelles de mesure. La fonction objectif du Lasso applique une pénalité indifférenciée $\lambda \sum |\beta_j|$ qui additionne directement des grandeurs numériques sans distinction d’échelle. Par conséquent, si une variable présente une variance native très étendue (par exemple un temps de réaction consigné en millisecondes s’étalant de 200 à 1500), son coefficient associé sera mécaniquement minuscule pour compenser l’amplitude de $X_j$, ce qui la protège artificiellement de la pénalisation $ell_1$. Inversement, un score psychométrique normalisé ou un indice binaire mesuré sur une plage restreinte subira une troncature injustifiée.
Il est donc indispensable de transformer l’ensemble des prédicteurs continus par standardisation en scores réduits ($z$-scores) :
$$\tilde{x}_{ij} = \frac{x_{ij} – \bar{x}_j}{\sigma_{x_j}}$$
Dans cette configuration, toutes les colonnes présentent une moyenne nulle et une variance empirique unitaire. Parallèlement, le vecteur de réponse $Y$ est usuellement centré ($\tilde{y}_i = y_i – \bar{y}$), ce qui permet d’extraire la constante d’ordonnée à l’origine (intercept $\beta_0$) hors de la pénalité Lasso : celle-ci se déduit immédiatement par $\hat{\beta}_0 = \bar{y}$ sans subir de distorsion de rétrécissement.
7.2 Encodage des prédicteurs qualitatifs et variables catégorielles
L’intégration de variables qualitatives et de prédicteurs nominaux au sein du cadre Lasso requiert des précautions particulières. Lorsqu’un facteur catégoriel à plusieurs niveaux (comme un groupe diagnostique ou une classification socio-démographique) fait l’objet d’un codage disjonctif complet en variables muettes indicatrices (dummy / one-hot encoding), le Lasso standard traite chaque variable binaire comme une dimension indépendante.
Cette approche désagrégée pose deux difficultés majeures : d’une part, le choix de la modalité de référence introduit une asymétrie d’invariance dans le traitement de la pénalité ; d’autre part, la pénalité Lasso peut éliminer sélectivement certaines modalités tout en conservant d’autres au sein d’une même échelle catégorielle, fragmentant la cohérence structurelle de la variable sous-jacente. Pour pallier cette anomalie, l’utilisation de variantes adaptées telles que le Group Lasso s’avère indispensable : elle pénalise collectivement le bloc de variables indicatrices dérivé du même facteur nominal, garantissant que l’ensemble du facteur soit retenu ou exclu de manière coordonnée.
7.3 Gestion des données manquantes et valeurs aberrantes en psychologie
Les investigations psychométriques et les expérimentations comportementales sont particulièrement exposées aux distorsions de distribution causées par les valeurs atypiques (outliers) et les non-réponses aux protocoles. La fonction de perte standard du Lasso repose sur l’erreur quadratique $|Y – Xbeta|_2^2$, qui élève les écarts au carré et amplifie ainsi l’influence des déviations extrêmes. Un sujet consignant un score pathologique extrême ou répondant de manière désordonnée peut déplacer les ellipsoïdes de résidus et fausser l’entrée de variables non pertinentes dans le modèle actif.
Face à ces distorsions, l’utilisation de fonctions de perte composites et robustes — telle que la perte de Huber couplée à la pénalité $L_1$ (régression robuste régularisée) — offre une alternative performante. Par ailleurs, l’existence de données manquantes invalide l’application directe des produits matriciels. Les chercheurs doivent donc recourir à des protocoles méthodologiques stricts basés sur l’imputation multiple par équations chaînées (MICE) ou des modèles matriciels régularisés, sous peine d’altérer la composition factorielle avant la sélection des variables.
8. Applications empiriques du Lasso en recherche psychologique
8.1 Purification d’échelles et réduction de dimensions psychométriques
L’un des terrains d’application les plus fertiles de la régression régularisée réside dans la rationalisation et l’abrégement des inventaires psychométriques multidimensionnels. Les questionnaires évaluant les grands traits de la personnalité, comme le modèle en cinq facteurs (Big Five) ou l’inventaire de dépression de Beck, comportent historiquement une proportion importante d’items hautement corrélés introduits pour maximiser la consistance interne brute (l’alpha de Cronbach). Cette surcharge allonge inutilement le temps de passation et induit une fatigue attentionnelle chez les participants, susceptible d’altérer la qualité des réponses recueillies.
En employant une stratégie Lasso où un critère comportemental externe ou un score diagnostique global sert de variable dépendante face à l’ensemble des items détaillés, la pénalisation $ell_1$ agit comme un filtre d’élagage psychométrique. Elle élimine les items redondants dont la contribution d’information marginale est négligeable compte tenu des autres énoncés déjà retenus. On parvient ainsi à synthétiser des échelles ultracourtes qui conservent une validité de critère et une robustesse psychométrique quasi identiques à celles des batteries originales complètes, illustrant l’utilité du Lasso pour optimiser la collecte de données cliniques.
8.2 Neurosciences cognitives et analyse de données de neuroimagerie
Les investigations menées en imagerie cérébrale fonctionnelle (IRMf) ou par magnétoencéphalographie (MEG) illustrent de manière paradigmatique le problème de haute dimensionnalité $p gg n$. Dans une configuration expérimentale standard, l’analyste dispose d’enregistrements volumétriques fractionnés en un volume phénoménal de coordonnées tridimensionnelles (typiquement entre 50 000 et 200 000 voxels cérébraux), tandis que la cohorte clinique ne réunit couramment que 30 à 100 participants en raison des contraintes logistiques et financières.
Le traitement de ces données par les estimateurs classiques des moindres carrés est impossible sans réduction drastique de dimension. La régression Lasso permet d’analyser l’activité métabolique ou les flux de désoxyhémoglobine à l’échelle du voxel pour prédire un statut cognitif ou comportemental donné. Grâce à sa parcimonie, le Lasso isole les quelques grappes de voxels ou les nœuds de connectivité intrinsèque qui prédisent les performances amnésiques ou les déficits exécutifs, filtrant les variations physiologiques non informatives sans requérir de découpage anatomique préalable restrictif.
8.3 Psychopathologie computationnelle et analyse de réseaux de symptômes
La psychopathologie computationnelle s’est récemment affranchie de la perspective néo-kraepelinienne — qui considérait les troubles mentaux comme des entités pathologiques latentes universelles générant des symptômes passifs — au profit du paradigme dynamique des réseaux de symptômes. Dans ce modèle novateur formalisé par Borsboom et al., un trouble tel que l’épisode dépressif majeur est conceptualisé comme un système complexe d’interactions causales directes où l’insomnie alimente l’épuisement, qui induit à son tour l’anhédonie par rétroaction positive continue.
L’estimation des réseaux de corrélation partielle régularisés repose sur l’application conjointe de régressions nodales Lasso ou du Graphical Lasso (GLasso). En régressant successivement chaque symptôme sur l’ensemble de tous les autres au moyen d’une pénalisation $ell_1$, le système supprime les associations fallacieuses induites par le conditionnement colinéaire. Il en émerge un graphe pondéré clair (sparse network) au sein duquel les arêtes restantes symbolisent des interactions directes authentiques, permettant aux cliniciens d’identifier les symptômes ponts et les cibles d’intervention prioritaires.
9. Inférence statistique et défis méthodologiques post-sélection
9.1 L’invalidation des tests d’hypothèses traditionnels
L’adoption de la régression Lasso engendre une difficulté majeure souvent méconnue des praticiens formés aux statistiques inférentielles traditionnelles : l’effondrement systématique de la théorie classique des tests d’hypothèses. Dans le cadre conventionnel de Gauss-Markov, le calcul des valeurs $p$ et des intervalles de confiance pour l’estimateur $\hat{\beta}_{\text{MCO}}$ repose sur sa distribution gaussienne asymptotique non biaisée centrée sur la valeur théorique $\beta^*$. Or, le Lasso introduit un double mécanisme destructeur pour l’inférence naïve :
- Un biais déterministe de contraction vers l’origine : pour toute valeur non nulle, $\mathbb{E}[\hat{\beta}_{\text{Lasso}}] \neq \beta^*$, ce qui décale le centre de la loi d’échantillonnage ;
- Un conditionnement stochastique à l’étape de sélection : les variables soumises à l’inférence ont été choisies précisément parce qu’elles maximisaient l’ajustement empirique sur l’échantillon observé, créant un phénomène de surajustement adaptatif désigné sous le terme d’inflation post-sélection.
Si un analyste applique naïvement un test de Student usuel ou reconstruit les intervalles de confiance sur le sous-modèle final sélectionné par le Lasso comme s’il avait été spécifié a priori, les valeurs $p$ obtenues s’avèrent fallacieuses, conduisant à une inflation incontrôlée des faux positifs qui compromet la reproductibilité des conclusions scientifiques.
9.2 Méthodes d’inférence sélective et approches par rééchantillonnage
Pour restaurer la légitimité des tests d’hypothèses à la suite d’une procédure Lasso, des avancées théoriques majeures ont vu le jour dans le champ de l’inférence post-sélection conditionnelle (selective inference), notamment formalisée par Lockhart, Taylor, Tibshirani et Tibshirani sous le cadre du Covariance Test et de la distribution de polyèdre de Lee et al. Ces approches mathématiques ajustent la loi de référence nulle des estimateurs en conditionnant formellement les probabilités sur l’événement combinatoire de sélection :
$$\mathcal{M} = {j : \hat{\beta}_j \neq 0}$$
En complément, la méthodologie de sélection de stabilité (stability selection), introduite par Meinshausen et Bühlmann, contourne les formulations analytiques complexes en combinant la régularisation Lasso avec des techniques intensives de rééchantillonnage de type bootstrap. En perturbant de manière itérative les observations et en introduisant des variations aléatoires dans les pénalités appliquées, la méthode quantifie la probabilité empirique d’entrée de chaque variable dans le sous-ensemble actif. Ce mécanisme permet de contrôler rigoureusement le taux d’erreur par famille (Family-Wise Error Rate, FWER) ou le taux de fausse découverte (False Discovery Rate, FDR) sous des hypothèses distributionnelles très souples.
9.3 Le Lasso dés-biaisé (Debiased / Desparsified Lasso)
L’une des réponses contemporaines les plus abouties pour restaurer l’inférence asymptotique en haute dimension réside dans la technique du Lasso dés-biaisé (Debiased ou Desparsified Lasso), conceptualisée simultanément par Zhang et Zhang, van de Geer et al., et Javanmard et Montanari. Le principe fondamental consiste à corriger l’estimateur Lasso pénalisé par l’inversion approchée de la matrice de Gram empirique :
$$\hat{b} = \hat{\beta}_{\text{Lasso}} + \frac{1}{n} \hat{\Theta} X^T (Y – X\hat{\beta}_{\text{Lasso}})$$
Dans cette formulation, $\hat{\Theta}$ matérialise une approximation détendue de la matrice de précision globale $(X^T X / n)^{-1}$, calculée par une séquence de régressions Lasso nodales auxiliaires. En combinant judicieusement le terme régularisé d’origine et une correction proportionnelle au gradient des résidus non projetés, on parvient à éliminer intégralement le biais de rétrécissement tout en préservant la stabilité numérique. L’estimateur corrigé $\hat{b}$ suit asymptotiquement une distribution normale multivariée centrée sur la véritable valeur paramétrique :
$$\sqrt{n}(\hat{b} – \beta^*) \sim \mathcal{N}\left(0, \sigma^2 \hat{\Theta} \hat{\Sigma} \hat{\Theta}^T\right)$$
Cette avancée méthodologique permet d’obtenir des intervalles de confiance rigoureux à 95 % et des valeurs $p$ robustes dans des modèles comportant plus de variables que d’observations.
10. Mise en œuvre pratique : Analyse de données avec R et Python
10.1 Mise en pratique sous R avec la bibliothèque glmnet
L’écosystème statistique du logiciel libre R fournit une implémentation de référence pour les modèles linéaires pénalisés via la bibliothèque glmnet, développée originellement par Jerome Friedman, Trevor Hastie et Rob Tibshirani. Cette bibliothèque exploite un cœur computationnel codé en Fortran qui implémente l’algorithme de descente de coordonnées par blocs cycliques avec des routines d’accélération matricielle.
Sur le plan opérationnel, la démarche d’analyse requiert la séparation préalable du jeu de données en une matrice de prédicteurs $X$ — formulée préférentiellement à l’aide de la syntaxe model.matrix() pour gérer les contrastes d’indicatrices catégorielles — et un vecteur réponse $Y$. L’exécution de la validation croisée s’opère par l’appel à la fonction cv.glmnet() :
L’utilisateur configure l’argument alpha = 1 pour commander explicitement la formulation Lasso pure (tandis qu’alpha = 0 assignerait Ridge). L’algorithme standardise automatiquement en interne les colonnes à moyenne nulle et variance unitaire, garantissant un traitement symétrique de l’opérateur de seuillage, avant de rétablir les coefficients sur leur échelle numérique d’origine lors de l’extraction terminale. L’exécution de la commande plot() sur l’objet de validation croisée génère la trajectoire empirique des erreurs résiduelles avec l’intervalle de confiance associé en fonction de $log(lambda)$, traçant deux lignes pointillées marquant précisément $\lambda_{\min}$ et $\lambda_{1\text{-SE}}$. L’extraction analytique des coefficients parcimonieux s’obtient enfin par la fonction générique coef(cv_fit, s = "lambda.1se").
10.2 Implémentation sous Python avec scikit-learn
Dans l’environnement de programmation Python dédié à la science des données, la bibliothèque scikit-learn constitue la référence pour le déploiement du Lasso à travers ses modules linear_model.Lasso et linear_model.LassoCV. Afin de respecter les meilleures pratiques méthodologiques et de prévenir toute contamination des données (data leakage) au cours de la standardisation, l’utilisation de la classe Pipeline est requise.
Le protocole technique associe le transformateur de normalisation StandardScaler et l’estimateur pénalisé LassoCV au sein d’un même flux unifié :
Le module évalue les grilles de régularisation sur des sous-échantillons d’entraînement dédiés sans que les métriques d’échelle des blocs de test n’interfèrent dans le centrage des observations. La classe LassoCV intègre des générateurs d’optimisation par défaut analysant généralement 100 seuils le long d’une échelle logarithmique ajustée. Une fois l’hyperparamètre calibré, les performances prédictives finales doivent être évaluées sur un ensemble de test indépendant (hold-out test set) tenu à l’écart durant tout le processus, à l’aide d’indicateurs standardisés tels que le coefficient de détermination ($R^2$) ou la racine de l’erreur quadratique moyenne (RMSE).
10.3 Interprétation des trajectoires de coefficients et diagnostics
L’évaluation d’un modèle Lasso implique l’inspection visuelle des profils de convergence (coefficient paths), qui tracent l’évolution dynamique de la valeur de chaque coefficient $\hat{\beta}_j$ en fonction de l’échelle d’atténuation $-log(lambda)$ ou du ratio de norme $L_1$ :
Cette représentation fournit une synthèse qualitative de l’ordre d’entrée des variables explicatives dans le modèle. Les régresseurs dotés des signaux prédictifs les plus marqués s’écartent rapidement de l’axe zéro pour de faibles intensités d’ajustement, tandis que les variables secondaires ne s’activent que lorsque la pénalisation décroît vers les moindres carrés ordinaires. Des croisements de trajectoires prononcés ou des inversions de pente brutales trahissent des interactions colinéaires locales qui méritent une attention particulière.
Le diagnostic post-ajustement requiert également l’examen de la distribution des résidus d’estimation $\hat{\varepsilon}_i = y_i – \hat{y}_i$. Bien que le Lasso n’impose pas formellement la normalité stricte des perturbations pour son exécution numérique, une hétéroscédasticité prononcée ou une asymétrie marquée dans les résidus signale la non-prise en compte d’effets non linéaires sous-jacents, alertant le modélisateur sur les limites structurelles d’un cadre linéaire régularisé.
11. Avantages, limites et pièges courants de la régression Lasso
11.1 Forces majeures pour l’analyse moderne des comportements
La régression Lasso s’est affirmée comme un outil méthodologique incontournable pour l’analyse des comportements, grâce à des atouts théoriques et pratiques substantiels face aux limites de la statistique linéaire conventionnelle :
- Maîtrise de la haute dimensionnalité : capacité éprouvée à converger vers une solution mathématiquement stable lorsque le nombre de variables dépasse le volume d’observations ($p gg n$), là où les moindres carrés ordinaires échouent par indétermination matricielle ;
- Parcimonie automatique et lisibilité : transformation d’un modèle complexe comportant des centaines d’indicateurs psychologiques en une structure simplifiée centrée sur un sous-ensemble restreint de prédicteurs dominants ;
- Atténuation du surapprentissage : optimisation systématique du compromis biais-variance via le rétrécissement $L_1$, conférant aux modèles une meilleure validité externe lors de la réplication sur des cohortes indépendantes ;
- Efficience algorithmique : algorithmes de descente de coordonnées permettant d’ajuster des modèles volumineux en quelques fractions de seconde, facilitant les protocoles intensifs de rééchantillonnage et de validation croisée.
11.2 Contraintes structurelles et risques de sous-estimation des effets
En dépit de ses qualités démontrées, le Lasso présente des contraintes algorithmiques inhérentes qui peuvent fausser l’interprétation des données psychométriques si elles sont négligées :
- Plafond de sélection en grande dimension : lorsque $p > n$, le Lasso ne peut sélectionner au maximum que $n$ variables distinctes avant d’atteindre la saturation de rang, écrasant d’office les dimensions excédentaires même si elles portent une information théorique pertinente ;
- Biais systématique d’atténuation : la pénalité proportionnelle $\lambda |\beta_j|$ applique une réduction d’amplitude uniforme à l’ensemble des estimateurs. Les coefficients finaux sous-estiment donc systématiquement la magnitude réelle des effets par rapport à leurs valeurs asymptotiques non contraintes ;
- Instabilité face aux réseaux colinéaires : face à des prédicteurs très fortement corrélés, le Lasso sélectionne arbitrairement l’une des variables et annule les autres, ce qui peut masquer des structures latentes sous-jacentes d’intérêt clinique ;
- Vulnérabilité aux ruptures d’échelle : en l’absence d’une standardisation rigoureuse, les coefficients sont pénalisés de manière disproportionnée en fonction de leurs unités de mesure brutes, invalidant toute interprétation comparative.
11.3 Erreurs fréquentes commises par les chercheurs
La démocratisation des outils de régularisation logicielle a favorisé la diffusion de plusieurs erreurs méthodologiques récurrentes dans les publications scientifiques :
La méprise la plus fréquente consiste à réajuster une régression des moindres carrés ordinaires standard naïve uniquement sur le sous-ensemble de variables sélectionnées par le Lasso pour en extraire des valeurs $p$ et des intervalles de confiance conventionnels. Cette pratique invalide la théorie de l’échantillonnage : le chercheur réutilise les mêmes données empiriques pour découvrir la structure du modèle puis pour tester ses hypothèses, ce qui engendre un biais de confirmation majeur et produit des tests statistiques artificiellement sur-optimistes.
Une autre dérive courante consiste à interpréter de manière causale les coefficients retenus par le Lasso. L’annulation d’un coefficient par la norme $L_1$ ne signifie pas que la variable associée est dépourvue d’influence étiologique réelle sur le phénomène étudié : elle indique simplement que, compte tenu des autres régresseurs déjà intégrés dans la matrice, son apport additif direct n’abaisse pas suffisamment la fonction de perte pour compenser le coût mathématique $lambda$. Le Lasso est avant tout un algorithme prédictif parcimonieux, et non un outil de découverte causale en milieu observationnel complexe.
12. Variantes modernes et extensions avancées du Lasso
12.1 Le Lasso adaptatif (Adaptive Lasso) et la propriété oracle
Pour corriger le biais d’atténuation uniforme et pallier l’instabilité de sélection du Lasso conventionnel en présence de variables modérément corrélées, Hui Zou a introduit en 2006 l’Adaptive Lasso. Cette variante raffine le terme de régularisation en introduisant des poids spécifiques individualisés inversement proportionnels à la magnitude d’une estimation préalable non biaisée :
$$\hat{\beta}_{\text{AdaLasso}} = \underset{\beta in \mathbb{R}^p}{arg\min} \left{ \frac{1}{2n} |Y – Xbeta|_2^2 + \lambda \sum_{j=1}^p w_j |\beta_j| \right} \quad \text{a\vec} \quad w_j = \frac{1}{|\hat{\beta}_{j,\text{init}}|^\gamma}$$
où $\hat{\beta}_{\text{init}}$ découle typiquement d’une estimation initiale par MCO (si $n gg p$) ou par régression Ridge, et $\gamma > 0$ constitue un paramètre d’accentuation réglable. Grâce à cette pondération adaptative, les variables dont l’effet initial est fort reçoivent un poids $w_j$ très faible (subissant ainsi une pénalité négligeable qui préserve la magnitude réelle de leur effet), tandis que les variables mineures voient leur pénalité multipliée, accélérant leur écrasement à zéro.
Sur le plan théorique, Zou a démontré que l’Adaptive Lasso jouit de la propriété oracle formalisée par Fan et Li : asymptotiquement, l’algorithme identifie le véritable sous-ensemble de prédicteurs non nuls avec une probabilité tendant vers 1 ($\mathbb{P}(\mathcal{M}_{\text{sélectionné}} = \mathcal{M}_{\text{vrai}}) to 1$), et les coefficients des variables retenues convergent vers la distribution normale multivariée optimale qui aurait été obtenue si le vrai modèle avait été connu a priori.
12.2 Le Group Lasso et le Sparse Group Lasso en psychométrie
Dans de nombreuses applications psychométriques, les variables prédictives présentent une structure hiérarchique ou se regroupent naturellement par domaines conceptuels. C’est le cas des batteries d’évaluation où plusieurs items mesurent des facettes distinctes d’un même trait de personnalité, ou des études génétiques agrégeant des polymorphismes par voies métaboliques. Face à cette organisation fonctionnelle, le Lasso classique applique une sélection au niveau individuel qui déstructure les blocs de mesure.
Le Group Lasso, conceptualisé par Yuan et Lin, résout cette difficulté en définissant la pénalité sur des sous-groupes prédéterminés de régresseurs à travers une norme mixte $ell_1/ell_2$ :
$$\min_{\beta} \left{ \frac{1}{2n} |Y – \sum_{l=1}^L X_{(l)}\beta_{(l)}|_2^2 + \lambda \sum_{l=1}^L \sqrt{p_l} |\beta_{(l)}|_2 \right}$$
Ici, chaque vecteur de coefficients $\beta_{(l)}$ correspondant au $l$-ième domaine est pénalisé par sa norme euclidienne composite pondérée par sa dimension spatiale $\sqrt{p_l}$. En conséquence, l’ensemble des variables d’un groupe est soit intégré conjointement au modèle, soit entièrement exclu. L’extension ultérieure du Sparse Group Lasso (Simon et al., 2013) réunit au sein d’une même formulation la pénalité de groupe et la pénalité individuelle $ell_1$ : elle opère simultanément une sélection globale entre les groupes et un élagage sélectif à l’intérieur des blocs retenus, adaptant la modélisation aux échelles psychométriques à structure emboîtée.
12.3 Intégration du Lasso dans la modélisation par équations structurelles (regsem)
L’une des avancées méthodologiques les plus prometteuses en psychométrie contemporaine réside dans l’hybridation des méthodes de régularisation avec la modélisation par équations structurelles régularisée (Regularized Structural Equation Modeling, ou regsem), développée principalement par Jacobucci, Grimm et McArdle. Les équations structurelles classiques (SEM) articulent des structures factorielles confirmatoires rigides souvent confrontées au problème du surajustement ou à des dégradations d’indices d’ajustement dues à de multiples saturations croisées résiduelles ou à des corrélations résiduelles mineures entre items.
En introduisant une fonction de pénalité de type Lasso directement dans la fonction d’ajustement du maximum de vraisemblance de la matrice de covariance :
$$F_{\text{regsem}}(\theta) = F_{\text{ML}}(\Sigma(\theta), S) + \lambda \sum_{m} |\theta_m|$$
la méthodologie regsem permet d’estimer des modèles factoriels confirmatoires semi-exploratoires. La pénalité $L_1$ est appliquée sélectivement sur les paramètres secondaires incertains — tels que les saturations croisées mineures ou les covariances d’erreurs résiduelles — tout en préservant d’éventuelles contraintes structurales directes non pénalisées sur les saturations principales. Cette stratégie identifie de manière empirique et continue les écarts à la structure théorique sans recourir aux démarches heuristiques instables des indices de modification traditionnels (modification indices). Elle affine la détection des non-invariances de mesure à travers les groupes culturels et préserve la validité conceptuelle des construits psychologiques face aux bruits d’échantillonnage.
Références
- Borsboom, D., & Cramer, A. O. (2013). Network analysis: An integrative approach to the structure of psychopathology. Annual Review of Clinical Psychology, 9(1), 91–121. https://doi.org/10.1146/annurev-clinpsy-050212-185608
- Breiman, L. (1995). Better subset selection using the non-negative garrote. Technometrics, 37(4), 373–384. https://doi.org/10.1080/00401706.1995.10484371
- Efron, B., Hastie, T., Johnstone, I., & Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. https://doi.org/10.1214/009053604000000067
- Fan, J., & Li, R. (2001). Variable selection via nonconcave penalized likelihood and its oracle properties. Journal of the American Statistical Association, 96(456), 1348–1360. https://doi.org/10.1198/016214501753382273
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Wainwright, M. (2015). Statistical learning with sparsity: The Lasso and generalizations. CRC Press. https://doi.org/10.1201/b18401
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Jacobucci, R., Grimm, K. J., & McArdle, J. J. (2016). Regularized structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 23(4), 555–566. https://doi.org/10.1080/10705511.2016.1154793
- Javanmard, A., & Montanari, A. (2014). Confidence intervals and hypothesis testing for high-dimensional regression. The Journal of Machine Learning Research, 15(1), 2869–2909.
- Lockhart, R., Taylor, J., Tibshirani, R. J., & Tibshirani, R. (2014). A significance test for the lasso. The Annals of Statistics, 42(2), 413–468. https://doi.org/10.1214/13-AOS1175
- Meinshausen, N., & Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x
- Simon, N., Friedman, J., Hastie, T., & Tibshirani, R. (2013). A sparse-group lasso. Journal of Computational and Graphical Statistics, 22(2), 231–245. https://doi.org/10.1080/10618600.2012.681250
- Tibshirani, R. (1996). Regression shrinkage and selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- van de Geer, S., Bühlmann, P., Ritov, Y., & Dezeure, R. (2014). On asymptotically optimal confidence regions and tests for high-dimensional models. The Annals of Statistics, 42(3), 1166–1202. https://doi.org/10.1214/14-AOS1221
- Yuan, M., & Lin, Y. (2006). Model selection and estimation in regression with grouped variables. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 68(1), 49–67. https://doi.org/10.1111/j.1467-9868.2005.00532.x
- Zhang, C. H., & Zhang, S. S. (2014). Confidence intervals for low dimensional parameters in high dimensional linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 76(1), 217–242. https://doi.org/10.1111/rssb.12026
- Zou, H. (2006). The adaptive Lasso and its oracle properties. Journal of the American Statistical Association, 101(476), 1418–1429. https://doi.org/10.1198/016214506000000735
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the Elastic Net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x