
Dans le vaste panorama de la théorie des probabilités et de la statistique inférentielle, peu de constructions conceptuelles possèdent la pureté géométrique et la portée fondatrice de la distribution uniforme. Souvent appréhendée lors des premiers contacts avec le calcul stochastique sous les traits intuitifs d’un dé non pipé ou d’un tirage au sort parfaitement équilibré, cette loi incarne l’expression mathématique la plus rigoureuse de ce que l’esprit humain conçoit comme le hasard pur, exempt de tout biais directionnel ou de toute préférence structurelle. Pourtant, derrière cette apparente simplicité opératoire se dissimule une armature théorique d’une remarquable profondeur, dont les racines plongent dans l’épistémologie de l’ignorance, la théorie de la mesure et l’axiomatisation moderne formulée au XXe siècle par Andreï Kolmogorov.
Comprendre la distribution uniforme ne relève pas d’un simple exercice pédagogique préliminaire à l’étude de lois plus complexes, telles que la distribution normale de Gauss ou la loi gamma. Au contraire, la loi uniforme constitue la matrice computationnelle et épistémologique de l’ensemble de la modélisation probabiliste contemporaine. Qu’il s’agisse de concevoir des protocoles expérimentaux sophistiqués en sciences cognitives, de calibrer des générateurs de nombres pseudo-aléatoires au cœur des supercalculateurs, ou de formaliser l’état d’indifférence cognitive préalable à l’acquisition de données empiriques au sein du cadre bayésien, la distribution uniforme s’impose comme un étalon universel. Sa fonction de densité constante traduit l’indifférence informationnelle maximale sur un domaine borné, conférant à chaque segment de son support une égale prétention à la réalisation de l’événement.
Le présent traité se propose d’explorer de manière exhaustive l’ensemble des dimensions analytiques, computationnelles et appliquées de la distribution uniforme. De ses assises philosophiques héritées de Pierre-Simon de Laplace jusqu’aux subtilités de son estimation par le maximum de vraisemblance, en passant par sa différenciation ontologique entre domaines discret et continu, son comportement au sein des dynamiques psychophysiques et ses extensions géométriques multidimensionnelles, cette analyse offre une plongée structurée au cœur de l’équiprobabilité. L’ambition de ce document est de fournir aux chercheurs, statisticiens et praticiens des sciences du comportement une référence d’une absolue rigueur mathématique et d’une clarté conceptuelle totale, éclairant la façon dont le continuum mathématique permet d’appréhender le désordre parfait.
## 1. Fondements conceptuels de la loi uniforme : Définitions et principes de base
### 1.1 Genèse et nature du concept d’équiprobabilité
L’émergence formelle du concept d’équiprobabilité s’enracine dans la transition intellectuelle qui a vu les jeux de hasard se métamorphoser en une discipline mathématique formalisée. Dès les premiers travaux de Jérôme Cardan, Blaise Pascal et Pierre de Fermat, l’évaluation des chances reposait implicitement sur l’hypothèse d’une symétrie physique parfaite des dispositifs mécaniques utilisés : les faces d’un cube d’os ou les secteurs d’une roue de loterie devaient être intrinsèquement indiscernables du point de vue de la dynamique de leur stabilisation. Cependant, c’est à Pierre-Simon de Laplace que revient la première tentative de formalisation épistémologique globale à travers l’énonciation de son célèbre « principe de raison insuffisante », ultérieurement rebaptisé « principe d’indifférence » par le logicien John Maynard Keynes. Selon ce principe, lorsque l’esprit humain ne dispose d’aucune raison probante d’estimer qu’un événement particulier parmi un ensemble exhaustif d’éventualités mutuellement exclusives a plus de propension à se réaliser qu’un autre, ces événements doivent être considérés comme ayant exactement la même probabilité d’occurrence.
D’un point de vue formel, sur un univers fini noté $\Omega = {\omega_1, \omega_2, dots, \omega_n}$, l’équiprobabilité assigne à chaque singleton ${\omega_i}$ la masse de probabilité invariante $P({\omega_i}) = \frac{1}{n}$. Cette symétrie discrète postule une égale distribution de la crédence ou du poids ontologique des états du monde. Toutefois, l’extension de ce concept au domaine du continu mathématique soulève des questions conceptuelles d’une nature radicalement différente. Lorsque l’espace d’échantillonnage n’est plus dénombrable mais s’identifie à un intervalle compact de la droite réelle, l’équiprobabilité ne peut plus s’exprimer par la masse attribuée à des points individuels, sous peine de violer la dénombrable additivité des probabilités. Elle doit être redéfinie comme une invariance de la mesure par rapport au groupe des translations internes au support considéré. Dès lors, deux sous-ensembles de même mesure géométrique héritent d’une probabilité strictement identique, indépendamment de leur localisation le long de l’intervalle support.
Sur le plan philosophique, cette absence de biais distributionnel a priori reflète une condition d’entropie informationnelle maximale dans un contexte d’information restreinte aux seules bornes d’existence du phénomène. Dans l’interprétation objectiviste ou fréquentiste, l’équiprobabilité traduit une homogénéité physique absolue du milieu ou des forces agissant sur le système stochastique. Dans l’interprétation subjectiviste ou épistémique, elle formalise un état d’ignorance symétrique : attribuer des probabilités inégales sans information empirique préalable constituerait une distorsion cognitive arbitraire, violant le rasoir d’Ockham. La loi uniforme s’impose donc comme la traduction géométrique de la neutralité épistémique la plus pure que le mathématicien puisse formuler face au déploiement du hasard.
### 1.2 Définition axiomatique de la variable aléatoire uniforme
L’ancrage de la loi uniforme au sein de la théorie contemporaine des probabilités s’articule rigoureusement sur le système d’axiomes posé par Andreï Kolmogorov en 1933. Soit un espace probabilisé complet désigné par le triplet $(\Omega, \mathcal{F}, P)$, où $\Omega$ représente l’univers des événements élémentaires, $\mathcal{F}$ une tribu (ou $\sigma$-algèbre) définie sur $\Omega$, et $P$ une mesure de probabilité assignant à tout ensemble mesurable de $\mathcal{F}$ une valeur comprise dans le segment réel $[0, 1]$, vérifiant $P(\Omega) = 1$ et la $\sigma$-additivité pour toute suite dénombrable d’événements disjoints. Une variable aléatoire réelle $X$ est une application mesurable définie de $\Omega$ dans l’espace mesurable $(\mathbb{R}, \mathcal{B}(\mathbb{R}))$, où $\mathcal{B}(\mathbb{R})$ représente la tribu borélienne engendrée par les intervalles ouverts de la droite des réels.
Une variable aléatoire continue $X$ est dite distribuée uniformément sur un support compact non dégénéré $[a, b]$, où $a$ et $b$ sont deux nombres réels tels que $-\infty < a < b 0$ à chaque point réel, l’agrégation sur une infinité indénombrable mènerait instantanément à une divergence vers l’infini. Inversement, si cette masse ponctuelle est nulle, leur sommation discrète ne permettrait jamais d’atteindre l’unité requise par l’axiome de Kolmogorov.
Pour résoudre ce paradoxe, la théorie moderne de la mesure délaisse la fonction de masse au profit de la fonction de densité de probabilité, adossée à la mesure de Lebesgue. Sur un support continu compact $[a, b]$, la densité de la loi uniforme continue est une fonction $f: \mathbb{R} to \mathbb{R}^+$ définie de manière invariante par une valeur constante non nulle sur l’intervalle et nulle partout ailleurs :
$$f(x) = \frac{1}{b – a} \cdot \mathbf{1}_{[a, b]}(x)$$
où $\mathbf{1}_{[a, b]}$ désigne la fonction indicatrice du support.
Cette formulation implique une rupture conceptuelle majeure : pour tout point isolé $x_0 in [a, b]$, la probabilité ponctuelle est strictement nulle :
$$P(X = x_0) = \int_{x_0}^{x_0} f(t) , dt = 0$$
L’événement ${X = x_0}$ est donc un événement que le calcul stochastique qualifie de négligeable (ou quasi-impossible), bien qu’il ne soit pas formellement impossible au sens de l’ensemble vide, puisque l’expérience réalisera inéluctablement l’un des points du support. La probabilité n’acquiert de consistance physique et opérationnelle que lorsqu’elle est mesurée sur un sous-ensemble borélien de mesure de Lebesgue non nulle, matérialisé par un intervalle $[x_1, x_2]$.
### 2.3 Comparaison structurelle et critères de choix du modèle
Le choix entre une formalisation discrète ou continue pour représenter un phénomène physique, biologique ou comportemental repose sur une analyse critique de la granularité instrumentale et des propriétés intrinsèques de l’espace d’état. En métrologie et dans l’étude des processus comportementaux humains, de nombreuses variables phénoménologiquement continues — telles que le temps de réponse à un stimulus visuel, la force exercée sur un capteur de pression, ou la latence motrice — se trouvent inévitablement numérisées par des convertisseurs analogique-numérique (CAN). Ce processus de discrétisation introduit une erreur de quantification. Si le pas de discrétisation $\Delta$ est extrêmement fin par rapport à la variance intrinsèque du processus, l’utilisation de la loi uniforme continue sur l’intervalle réel correspondant constitue une idéalisation mathématique hautement pertinente et simplificatrice. Inversement, lorsque la granularité de mesure est grossière (par exemple, des notations sur une échelle de Likert à sept points), l’application forcée d’un modèle continu engendre des distorsions prédictives non négligeables.
Le tableau analytique ci-dessous synthétise les propriétés formelles comparées des distributions uniformes selon la nature de leur support :
| Propriété Statistique | Loi Uniforme Discrète $\mathcal{U}{1, dots, n}$ | Loi Uniforme Continue $\mathcal{U}(a, b)$ |
|---|---|---|
| Support de définition | Ensemble fini ${1, 2, dots, n} \subset \mathbb{N}$ | Intervalle compact $[a, b] \subset \mathbb{R}$ |
| Caractérisation fondamentale | Fonction de masse : $P(X=k) = \frac{1}{n}$ | Densité : $f(x) = \frac{1}{b – a} \cdot \mathbf{1}_{[a, b]}(x)$ |
| Probabilité ponctuelle $P(X = x_0)$ | $\frac{1}{n} > 0$ | $0$ (pour tout $x_0 in \mathbb{R}$) |
| Espérance mathématique $E[X]$ | $\frac{n + 1}{2}$ | $\frac{a + b}{2}$ |
| Variance théorique $\text{Var}(X)$ | $\frac{n^2 – 1}{12}$ | $\frac{(b – a)^2}{12}$ |
| Entropie différentielle / discrète | $H(X) = ln(n)$ (en nats) | $h(X) = ln(b – a)$ (en nats) |
L’analyse de ces expressions met en lumière une convergence asymptotique fondamentale : lorsque le nombre de subdivisions discrètes $n$ tend vers l’infini au sein d’un intervalle fixe de longueur $L = b – a$, l’espérance et la variance discrètes renormalisées convergent exactement vers les valeurs obtenues par l’intégration continue le long de l’intervalle réel.
## 3. Formalisme mathématique : Fonction de densité et fonction de répartition
### 3.1 Dérivation de la fonction de densité de probabilité (PDF)
La dérivation analytique de la fonction de densité de probabilité (PDF pour *Probability Density Function*) d’une variable aléatoire continue uniforme repose exclusivement sur l’imposition de deux contraintes fondamentales : l’invariance spatiale de la probabilité sur le support $[a, b]$ et la normalisation unitaire de l’intégrale de Lebesgue sur la droite réelle. Supposons une fonction de densité définie par :
$$f_X(x) = c \cdot \mathbf{1}_{[a, b]}(x)$$
où $c$ est une constante positive réelle à déterminer. Par le deuxième axiome de Kolmogorov, l’aire totale sous la courbe de la fonction de densité doit être rigoureusement égale à l’unité :
$$\int_{-\infty}^{+\infty} f_X(x) , dx = 1$$
En décomposant l’intégrale en fonction des sous-ensembles du domaine support, on obtient :
$$\int_{-\infty}^{+\infty} f_X(x) , dx = \int_{-\infty}^{a} 0 , dx + \int_{a}^{b} c , dx + \int_{b}^{+\infty} 0 , dx = c [x]_{a}^{b} = c (b – a)$$
Pour satisfaire l’axiome de normalisation, l’égalité $c (b – a) = 1$ impose de façon catégorique :
$$c = \frac{1}{b – a}$$
Il en découle l’expression complète de la fonction de densité de la variable $X \sim \mathcal{U}(a, b)$ :
$$f_X(x) = \begin{\cases} 0 &a\mp; \text{si } x b \end{\cases}$$
Sur le plan de l’analyse fonctionnelle, cette fonction présente deux discontinuités de première espèce (discontinuités de saut) aux bornes $x = a$ et $x = b$. Bien que la valeur ponctuelle de la densité en ces deux points frontières soit mathématiquement sans impact sur le calcul des probabilités d’intervalles (puisqu’un ensemble de mesure nulle ne modifie pas l’intégrale de Lebesgue), elle impose des précautions analytiques dès lors que l’on manipule la dérivation distributionnelle. Au sens des distributions de Laurent Schwartz, la dérivée faible de $f_X$ n’est pas nulle mais se compose de deux distributions de Dirac : $f’_X(x) = \frac{1}{b – a} \delta(x – a) – \frac{1}{b – a} \delta(x – b)$.
### 3.2 Construction de la fonction de répartition cumulative (CDF)
La fonction de répartition cumulative (CDF pour *Cumulative Distribution Function*), classiquement désignée par la notation $F_X(x)$, caractérise de manière exhaustive la distribution probabiliste d’une variable aléatoire sans requérir la différentiabilité de la mesure. Pour tout réel $x in \mathbb{R}$, elle exprime la probabilité que la variable $X$ prenne une valeur inférieure ou égale à $x$ :
$$F_X(x) = P(X le x) = \int_{-\infty}^{x} f_X(t) , dt$$
L’évaluation de cette intégrale par morceaux permet d’expliciter le comportement fonctionnel de $F_X(x)$ sur trois zones distinctes :
L’expression synthétique de la fonction de répartition s’écrit par conséquent :
$$F_X(x) = \begin{\cases} 0 &a\mp; \text{si } x b \end{\cases}$$
Contrairement à la densité $f_X$, la fonction de répartition $F_X$ est continue en tout point de $\mathbb{R}$, y compris aux singularités $x = a$ et $x = b$. Sur le segment $[a, b]$, elle prend la forme d’une rampe linéaire parfaite, à coefficient directeur rigoureusement constant égal à la densité de probabilité $\frac{1}{b – a}$. Cette linéarité absolue traduit directement l’accumulation uniforme de la masse probabiliste au fur et à mesure que l’on progresse à travers le support.
### 3.3 Caractérisation de la fonction quantile
La fonction quantile, également nommée fonction de répartition inverse ou fonction de pourcentages, constitue l’opérateur réciproque de la fonction de répartition cumulative. Désignée par $Q:(0, 1) to [a, b]$ ou formellement par $F_X^{-1}(p)$, elle détermine la valeur seuil $x$ en deçà de laquelle se situe une proportion $p$ de la distribution probabiliste totale. Étant donné que la fonction $F_X$ est strictement croissante et bijective sur l’intervalle ouvert $(a, b)$, l’inversion s’opère de façon algébrique directe en résolvant l’équation $F_X(x) = p$ pour $p in (0, 1)$ :
$$p = \frac{x – a}{b – a} iff x – a = p(b – a) iff x = a + p(b – a)$$
Par conséquent, la formulation analytique de la fonction quantile d’une loi uniforme continue $\mathcal{U}(a, b)$ s’écrit :
$$Q(p) = a + p(b – a), \quad \forall p in (0, 1)$$
Cette formulation explicite met en relief la structure d’interpolation linéaire opérée par la fonction quantile. Les statistiques de position fondamentales d’une population uniforme se déduisent immédiatement de cette équation sans approximation numérique :
* **Le premier quartile ($Q_1$)** correspond à $p = 0{,}25$ :
$$Q_1 = Q(0{,}25) = a + 0{,}25(b – a) = \frac{3a + b}{4}$$
* **La médiane ($Q_2$ ou Med)** correspond à $p = 0{,}50$ :
$$Med = Q(0{,}50) = a + 0{,}50(b – a) = \frac{a + b}{2}$$
* **Le troisième quartile ($Q_3$)** correspond à $p = 0{,}75$ :
$$Q_3 = Q(0{,}75) = a + 0{,}75(b – a) = \frac{a + 3b}{4}$$
* **L’intervalle interquartile (IQR)** s’obtient par différence directe :
$$\text{IQR} = Q_3 – Q_1 = \frac{a + 3b}{4} – \frac{3a + b}{4} = \frac{2(b – a)}{4} = \frac{b – a}{2}$$
De la même manière, le $k$-ième décile $D_k$ s’obtient en posant $p = \frac{k}{10}$, fournissant la formule $D_k = a + \frac{k(b – a)}{10}$ pour $k in {1, 2, dots, 9}$. Cette régularité structurelle montre que tous les sous-intervalles quantiles d’égale largeur probabiliste (déciles, centiles) correspondent à des segments géométriques d’exacte même longueur sur l’axe des réels.
## 4. Calcul opérationnel des probabilités d’intervalle
### 4.1 Application de la formule analytique d’intervalle
Le calcul de la probabilité associée à la localisation de la variable aléatoire $X \sim \mathcal{U}(a, b)$ à l’intérieur d’un sous-intervalle quelconque $[x_1, x_2]$ inclus dans le domaine support $[a, b]$ constitue l’opération fondamentale de l’inférence pratique sous hypothèse d’uniformité. En exploitant la propriété d’additivité de la mesure probabiliste via la fonction de répartition cumulative, cette probabilité correspond à la variation d’ordonnée de $F_X$ :
$$P(x_1 le X le x_2) = F_X(x_2) – F_X(x_1)$$
En substituant les expressions analytiques obtenues précédemment, on aboutit à la relation canonique :
$$P(x_1 le X le x_2) = \frac{x_2 – a}{b – a} – \frac{x_1 – a}{b – a} = \frac{x_2 – x_1}{b – a}$$
Cette formulation possède une interprétation géométrique limpide : la probabilité d’un événement correspond strictement au rapport de la longueur de l’intervalle cible $\Delta x = x_2 – x_1$ sur la longueur totale du domaine d’échantillonnage $L = b – a$.
Une implication mathématique centrale de la continuité de la mesure est l’équivalence parfaite entre les formulations strictes et larges des inégalités encadrant l’intervalle. Étant donné que la probabilité ponctuelle en tout point isolé est rigoureusement nulle ($P(X = x_1) = 0$ et $P(X = x_2) = 0$), les quatre expressions suivantes sont interchangeables :
$$P(x_1 le X le x_2) = P(x_1 < X le x_2) = P(x_1 le X < x_2) = P(x_1 < X < x_2) = \frac{x_2 – x_1}{b – a}$$
Cette propriété évacue toute ambiguïté relative à l'inclusion ou à l'exclusion des frontières, une distinction qui s'avère au contraire critique lors du traitement de variables aléatoires discrètes.
### 4.2 Résolution analytique d'un cas empirique standard
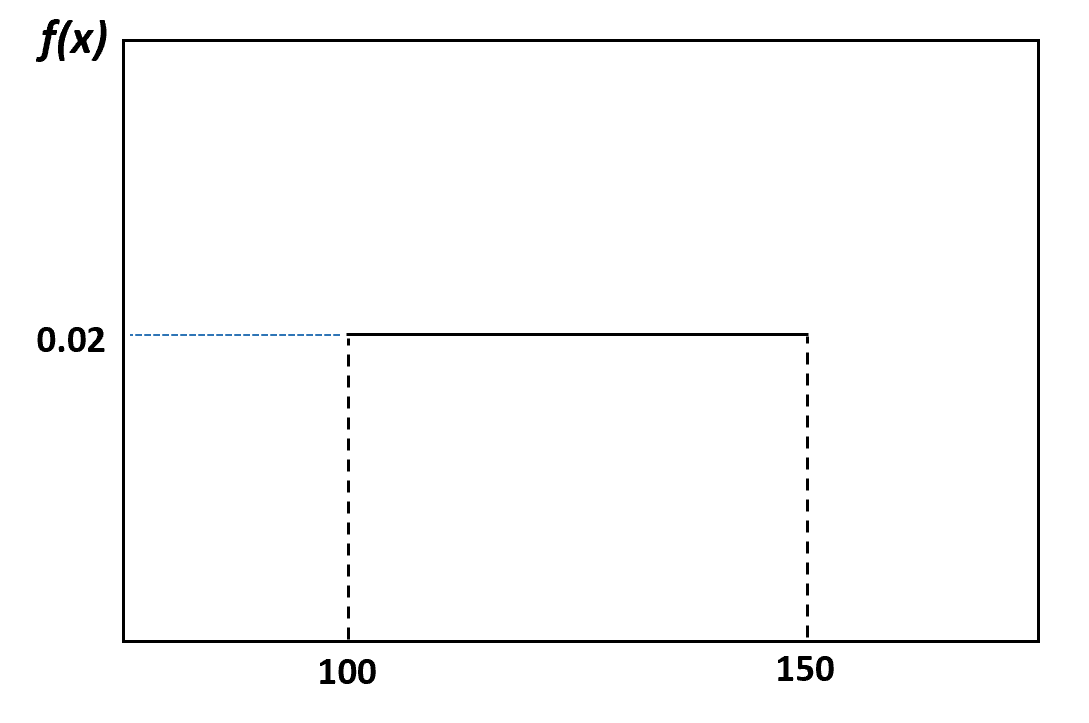
Pour illustrer le déploiement opérationnel de cette formulation au sein d'une problématique d'analyse de données concrète, considérons un cas d'école fréquemment documenté dans la littérature pédagogique en biologie marine et modélisation écologique : l'analyse du poids d'une cohorte homogène de dauphins nouveau-nés au sein d'une réserve protégée. Supposons que les observations biométriques préliminaires autorisent à postuler que le poids de ces cétacés à la naissance, désigné par la variable aléatoire $X$, est distribué de manière rigoureusement uniforme entre une borne inférieure $a = 100$ livres et une borne supérieure $b = 150$ livres. La variable aléatoire obéit ainsi à la loi :
$$X \sim \mathcal{U}(100, 150)$$
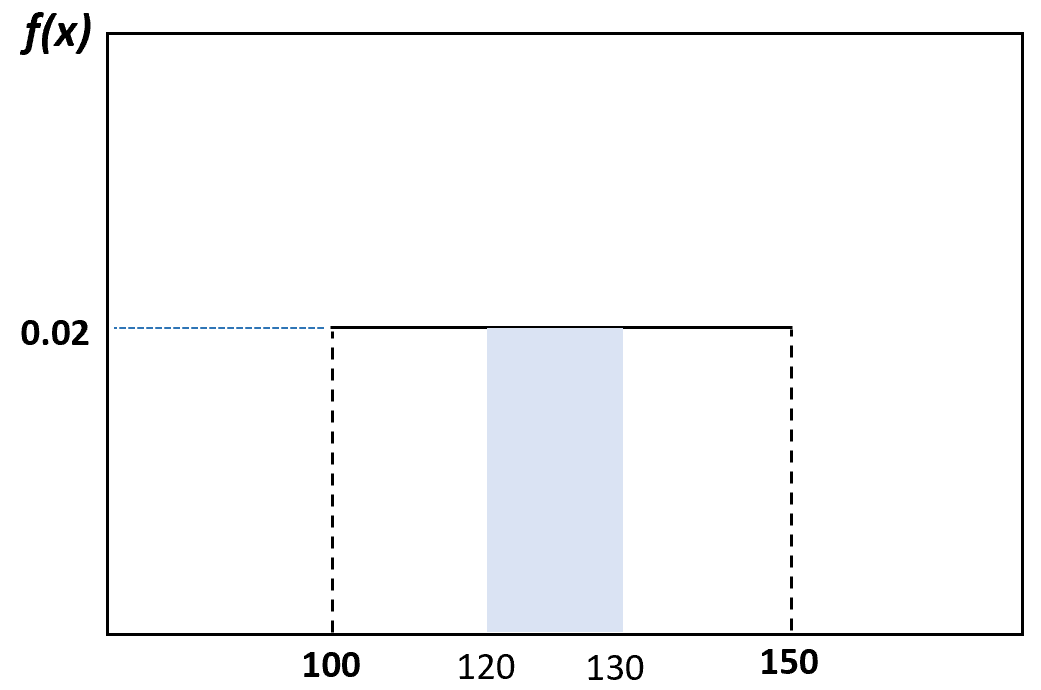
Supposons que les équipes vétérinaires cherchent à quantifier la probabilité précise qu'un nouveau-né sélectionné de façon aléatoire présente un poids corporel compris entre $x_1 = 120$ livres et $x_2 = 130$ livres, intervalle critique associé à une susceptibilité métabolique spécifique.
La résolution analytique pas à pas s'opère selon les étapes séquentielles suivantes :
1. **Vérification de la validité du support** : L'intervalle cible $[120, 130]$ est un sous-ensemble strict du support global :
$$[120, 130] \subset [100, 150]$$
2. **Calcul de la longueur du support total ($b – a$)** :
$$b – a = 150 – 100 = 50 \text{ livres}$$
3. **Calcul de la longueur du sous-intervalle cible ($x_2 – x_1$)** :
$$x_2 – x_1 = 130 – 120 = 10 \text{ livres}$$
4. **Application du ratio probabiliste** :
$$P(120 le X le 130) = \frac{x_2 – x_1}{b – a} = \frac{10}{50} = \frac{1}{5} = 0{,}20$$
L'interprétation de ce résultat est sans ambiguïté : exactement $20,%$ de la population totale des nouveau-nés présentera une masse corporelle comprise dans cet intervalle de dix livres. Ce calcul illustre la commodité opérationnelle de la loi uniforme : toute fenêtre de dix livres localisée n'importe où à l'intérieur des bornes globales (par exemple entre 105 et 115 livres, ou entre 138 et 148 livres) présentera une probabilité invariable d'occurrence rigoureusement égale à 0,20.
### 4.3 Gestion des probabilités conditionnelles
L'analyse des probabilités conditionnelles sous l'hypothèse d'une loi uniforme met en évidence des propriétés structurales particulièrement élégantes relatives au conditionnement de l'information. Supposons que l'on dispose de l'information préalable selon laquelle la variable aléatoire uniforme $X \sim \mathcal{U}(a, b)$ a déjà dépassé un seuil plancher $x_1$, où $a le x_1 < b$. Nous cherchons à évaluer la probabilité conditionnelle que cette même variable dépasse un second seuil $x_2$, tel que $x_1 x_2 mid X > x_1) = frac{P((X > x_2) cap (X > x_1))}{P(X > x_1)}$x_2 > x_1$ implique une inclusion stricte des ensembles d'événements ${X > x_2} \subset {X > x_1}$, l'intersection se simplifie en $(X > x_2) \cap (X > x_1) = {X > x_2}$. Par conséquent : »>$$Puisque la condition $x_2 > x_1$ implique une inclusion stricte des ensembles d’événements ${X > x_2} \subset {X > x_1}$, l’intersection se simplifie en $(X > x_2) \cap (X > x_1) = {X > x_2}$. Par conséquent :$$P(X > x_2 mid X > x_1) = frac{P(X > x_2)}{P(X > x_1)} = frac{frac{b – x_2}{b – a}}{frac{b – x_1}{b – a}} = frac{b – x_2}{b – x_1}$[x_1, b]$. La densité conditionnelle induite s'écrit désormais $g(x) = \frac{1}{b – x_1}$ pour tout $x in [x_1, b]$.
Contrairement à la distribution exponentielle qui possède la propriété d'absence de mémoire absolue ($P(X > t + s mid X > t) = P(X > s)$), la distribution uniforme continue présente une dépendance temporelle ou spatiale marquée par l'épuisement progressif de son support résiduel. Au fur et à mesure que le conditionnement $x_1$ s'approche de la borne terminale $b$, la probabilité que la variable franchisse un pas supplémentaire constant se dégrade jusqu'à s'annuler, le rapport de troncature altérant dynamiquement l'échelle de probabilité résiduelle.
## 5. Moments statistiques et propriétés descriptives fondamentales
### 5.1 Mesures de tendance centrale : Espérance et médiane
L'évaluation de la tendance centrale d'une variable aléatoire uniforme continue s'appuie sur le calcul intégral de son espérance mathématique, représentant le centre d'inertie ou le barycentre de la distribution continue. Soit $X \sim \mathcal{U}(a, b)$, l'espérance $E[X]$ s'établit par l'intégration de la variable pondérée par sa fonction de densité constante sur son support : »>$$Ce résultat démontre que la distribution conditionnelle d’une variable aléatoire uniforme tronquée par la gauche reste une distribution uniforme, dont le nouveau support compact est redéfini sur $[x_1, b]$. La densité conditionnelle induite s’écrit désormais $g(x) = \frac{1}{b – x_1}$ pour tout $x in [x_1, b]$.
Contrairement à la distribution exponentielle qui possède la propriété d’absence de mémoire absolue ($P(X > t + s mid X > t) = P(X > s)$), la distribution uniforme continue présente une dépendance temporelle ou spatiale marquée par l’épuisement progressif de son support résiduel. Au fur et à mesure que le conditionnement $x_1$ s’approche de la borne terminale $b$, la probabilité que la variable franchisse un pas supplémentaire constant se dégrade jusqu’à s’annuler, le rapport de troncature altérant dynamiquement l’échelle de probabilité résiduelle.
## 5. Moments statistiques et propriétés descriptives fondamentales
### 5.1 Mesures de tendance centrale : Espérance et médiane
L’évaluation de la tendance centrale d’une variable aléatoire uniforme continue s’appuie sur le calcul intégral de son espérance mathématique, représentant le centre d’inertie ou le barycentre de la distribution continue. Soit $X \sim \mathcal{U}(a, b)$, l’espérance $E[X]$ s’établit par l’intégration de la variable pondérée par sa fonction de densité constante sur son support :$$E[X] = int_{-infty}^{+infty} x cdot f_X(x) , dx = int_{a}^{b} x cdot left(frac{1}{b – a}right) dx = frac{1}{b – a} int_{a}^{b} x , dx$$L’évaluation de la primitive élémentaire donne :$$E[X] = frac{1}{b – a} left[ frac{x^2}{2} right]_{a}^{b} = frac{1}{b – a} cdot frac{b^2 – a^2}{2}$b^2 – a^2 = (b – a)(b + a)$), le binôme $(b – a)$ se simplifie : »>$$En appliquant l’identité remarquable relative à la factorisation de la différence de deux carrés ($b^2 – a^2 = (b – a)(b + a)$), le binôme $(b – a)$ se simplifie :$$E[X] = frac{1}{b – a} cdot frac{(b – a)(a + b)}{2} = frac{a + b}{2}$x = \frac{a + b}{2}$, la médiane théorique s'aligne formellement sur cette même valeur : »>$$L’espérance coïncide rigoureusement a\vec le milieu arithmétique exact des bornes du support. De par la symétrie parfaite de la fonction de densité par rapport à l’axe vertical $x = \frac{a + b}{2}$, la médiane théorique s’aligne formellement sur cette même valeur :$$text{Med}(X) = frac{a + b}{2} = E[X]$f_X(x)$ étant strictement plane et invariante sur l'ensemble du domaine ouvert $(a, b)$, chaque p\oint du support constitue simultanément un ma\ximum global et local. Il n'existe donc aucun mode unique : la distribution est qualifiée de non-modale ou de plurimodale diffuse, traduisant l'absence totale de concentration probabiliste locale.
### 5.2 Mesures de dispersion : Variance et écart-type
La détermination de la variance d'une variable uniforme requiert le calcul préalable du moment non centré d'ordre deux, désigné par $E[X^2]$. L'évaluation de l'intégrale correspondante s'écrit : »>$$En revanche, la notion de mode statistique devient structurellement indéterminée ou dégénérée au sein de la distribution uniforme continue. La fonction de densité $f_X(x)$ étant strictement plane et invariante sur l’ensemble du domaine ouvert $(a, b)$, chaque p\oint du support constitue simultanément un ma\ximum global et local. Il n’existe donc aucun mode unique : la distribution est qualifiée de non-modale ou de plurimodale diffuse, traduisant l’absence totale de concentration probabiliste locale.
### 5.2 Mesures de dispersion : Variance et écart-type
La détermination de la variance d’une variable uniforme requiert le calcul préalable du moment non centré d’ordre deux, désigné par $E[X^2]$. L’évaluation de l’intégrale correspondante s’écrit :$$E[X^2] = int_{a}^{b} x^2 cdot left(frac{1}{b – a}right) dx = frac{1}{b – a} left[ frac{x^3}{3} right]_{a}^{b} = frac{b^3 – a^3}{3(b – a)}$b^3 – a^3 = (b – a)(b^2 + ab + a^2)$), nous obtenons : »>$$En déployant la factorisation de la différence de deux cubes ($b^3 – a^3 = (b – a)(b^2 + ab + a^2)$), nous obtenons :$$E[X^2] = frac{(b – a)(a^2 + ab + b^2)}{3(b – a)} = frac{a^2 + ab + b^2}{3}$\text{Var}(X) = E[X^2] – (E[X])^2$ se développe comme suit : »>$$En mobilisant le théorème d’Huygens-König, la variance théorique $\text{Var}(X) = E[X^2] – (E[X])^2$ se développe comme suit :$$text{Var}(X) = frac{a^2 + ab + b^2}{3} – left(frac{a + b}{2}right)^2 = frac{a^2 + ab + b^2}{3} – frac{a^2 + 2ab + b^2}{4}$$La réduction au même dénominateur commun (12) conduit à l’expression :$$text{Var}(X) = frac{4(a^2 + ab + b^2) – 3(a^2 + 2ab + b^2)}{12} = frac{4a^2 + 4ab + 4b^2 – 3a^2 – 6ab – 3b^2}{12}$$Ce qui donne la formule canonique de la variance d’une loi uniforme :$$text{Var}(X) = frac{a^2 – 2ab + b^2}{12} = frac{(b – a)^2}{12}$\sigma_X$, défini comme la racine carrée arithmétique de la variance, s'exprime immédiatement par : »>$$L’écart-type théorique $\sigma_X$, défini comme la racine carrée arithmétique de la variance, s’exprime immédiatement par :$$sigma_X = sqrt{text{Var}(X)} = frac{b – a}{sqrt{12}} = frac{b – a}{2sqrt{3}}$\sqrt{12} \approx 3{,}4641$ traduit l'étalement volumique d'une densité rectangulaire. À titre de comparaison, pour une distribution normale coupée arbitrairement à ses extrémités, la dispersion est beaucoup plus concentrée autour du centre. La dispersion de la loi uniforme est maximale pour un intervalle borné sans accumulation centrale.
### 5.3 Moments d'ordres supérieurs : Asymétrie et aplatissement
Les caractéristiques morphologiques fines de la distribution uniforme s'évaluent par l'examen de ses moments centrés d'ordres supérieurs. Le coefficient d'asymétrie de Fisher-Pearson (noté $\gamma_1$ ou *skewness*) est défini par le rapport entre le troisième moment centré et le cube de l'écart-type : »>$$Le dénominateur $\sqrt{12} \approx 3{,}4641$ traduit l’étalement volumique d’une densité rectangulaire. À titre de comparaison, pour une distribution normale coupée arbitrairement à ses extrémités, la dispersion est beaucoup plus concentrée autour du centre. La dispersion de la loi uniforme est maximale pour un intervalle borné sans accumulation centrale.
### 5.3 Moments d’ordres supérieurs : Asymétrie et aplatissement
Les caractéristiques morphologiques fines de la distribution uniforme s’évaluent par l’examen de ses moments centrés d’ordres supérieurs. Le coefficient d’asymétrie de Fisher-Pearson (noté $\gamma_1$ ou *skewness*) est défini par le rapport entre le troisième moment centré et le cube de l’écart-type :$$gamma_1 = frac{mu_3}{sigma^3} = frac{E[(X – mu)^3]}{sigma^3}$\mu = \frac{a + b}{2}$, la fonction $(x – \mu)^3$ est impaire par rapport au centre de symétrie. L'intégrale d'une fonction impaire sur un intervalle symétrique centré en zéro étant identiquement nulle, on obtient de façon immédiate : »>$$Étant donné que la distribution uniforme est symétrique par rapport à sa moyenne $\mu = \frac{a + b}{2}$, la fonction $(x – \mu)^3$ est impaire par rapport au centre de symétrie. L’intégrale d’une fonction impaire sur un intervalle symétrique centré en zéro étant identiquement nulle, on obtient de façon immédiate :$$mu_3 = int_{a}^{b} left(x – frac{a+b}{2}right)^3 frac{1}{b-a} , dx = 0 implies gamma_1 = 0$$Cette nullité atteste d’une absence absolue de distorsion directionnelle de la distribution, excluant tout étirement vers la gauche ou vers la droite.
Le moment centré d’ordre quatre s’obtient par l’intégration suivante :$$mu_4 = Eleft[left(X – frac{a+b}{2}right)^4right] = frac{1}{b – a} int_{a}^{b} left(x – frac{a+b}{2}right)^4 dx$u = x – \frac{a+b}{2}$, a\vec $u$ variant de $-\frac{b-a}{2}$ à $\frac{b-a}{2}$ : »>$$Par le changement de variable $u = x – \frac{a+b}{2}$, a\vec $u$ variant de $-\frac{b-a}{2}$ à $\frac{b-a}{2}$ :$$mu_4 = frac{1}{b – a} left[ frac{u^5}{5} right]_{-frac{b-a}{2}}^{frac{b-a}{2}} = frac{1}{b – a} cdot frac{2 left(frac{b-a}{2}right)^5}{5} = frac{(b – a)^4}{80}$\beta_2$) s'obtient en normalisant ce quatrième moment centré par le carré de la variance : »>$$Le coefficient d’aplatissement ou kurtosis de Pearson ($\beta_2$) s’obtient en normalisant ce quatrième moment centré par le carré de la variance :$$beta_2 = frac{mu_4}{sigma^4} = frac{frac{(b – a)^4}{80}}{left(frac{(b – a)^2}{12}right)^2} = frac{frac{(b – a)^4}{80}}{frac{(b – a)^4}{144}} = frac{144}{80} = frac{9}{5} = 1{,}8$\gamma_2 = \beta_2 – 3$) vaut donc rigoureusement : »>$$Le coefficient d’excès d’aplatissement ($\gamma_2 = \beta_2 – 3$) vaut donc rigoureusement :$$gamma_2 = 1{,}8 – 3 = -1{,}2$t in \mathbb{R}^*$ par $M_X(t) = E[e^{tX}]$, s'obtient par intégration directe de l'exponentielle : »>$$Cette valeur négative prononcée caractérise formellement une distribution **platykurtique**. Elle matérialise l’absence totale de « queues de distribution lourdes » : les données ne présentent aucune traînée asymptotique et sont strictement contenues dans le rectangle formé par le support, a\vec des épaules extrêmement larges et carrées.
Enfin, la fonction génératrice des moments (MGF), définie pour tout $t in \mathbb{R}^*$ par $M_X(t) = E[e^{tX}]$, s’obtient par intégration directe de l’exponentielle :$$M_X(t) = int_{a}^{b} e^{tx} left(frac{1}{b – a}right) dx = frac{1}{b – a} left[ frac{e^{tx}}{t} right]_{a}^{b} = frac{e^{tb} – e^{ta}}{t(b – a)}$t = 0$, un développement limité au premier ordre confirme la continuité de la fonction a\vec $M_X(0) = 1$. Par simple substitution complexe $t = it$, la fonction caractéristique de la variable aléatoire uniforme s'écrit : »>$$Pour $t = 0$, un développement limité au premier ordre confirme la continuité de la fonction a\vec $M_X(0) = 1$. Par simple substitution complexe $t = it$, la fonction caractéristique de la variable aléatoire uniforme s’écrit :$$phi_X(t) = E[e^{itX}] = frac{e^{itb} – e^{ita}}{it(b – a)}$X \sim \mathcal{U}(a, b)$ se distingue par son tracé rectangulaire. Représentée dans un repère cartésien où l'axe des abscisses porte les réalisations potentielles $x$ de la variable et l'axe des ordonnées l'intensité de la densité $f_X(x)$, la courbe est formée d'un plateau horizontal strictement conti\nu d'altitude constante $h = \frac{1}{b – a}$, s'étendant exactement du p\oint $x = a$ jusqu'au p\oint $x = b$. En deçà de la frontière inférieure ($x <a> b$), le tracé se confond a\vec l'axe horizontal des abscisses ($y = 0$).
Sur le plan géométrique, l'événement probabiliste global est matérialisé par la surface du rectangle délimité par les segments $[a, b]$ sur l'axe des abscisses et $[0, \frac{1}{b – a}]$ sur l'axe des ordonnées. L'aire $\mathcal{A}$ de ce polygone quadrilatéral régulier se calcule par le produit élémentaire de sa base par sa hauteur : »>$$Cette fonction caractéristique constitue l’outil analytique pivot permettant de démontrer la convergence en loi d’agrégats de variables uniformes vers d’autres familles fondamentales de la théorie des probabilités.
## 6. Représentation graphique et interprétation géométrique
### 6.1 Analyse du graphique de densité de probabilité
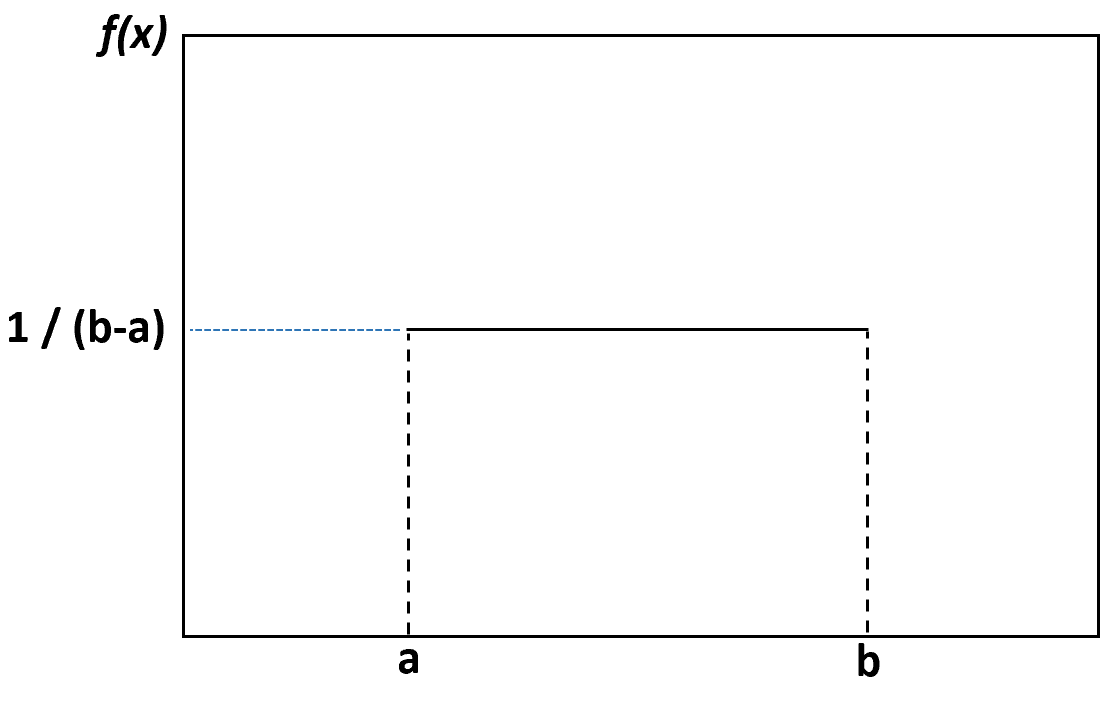
La signature visuelle de la fonction de densité d’une variable aléatoire continue uniforme $X \sim \mathcal{U}(a, b)$ se distingue par son tracé rectangulaire. Représentée dans un repère cartésien où l’axe des abscisses porte les réalisations potentielles $x$ de la variable et l’axe des ordonnées l’intensité de la densité $f_X(x)$, la courbe est formée d’un plateau horizontal strictement conti\nu d’altitude constante $h = \frac{1}{b – a}$, s’étendant exactement du p\oint $x = a$ jusqu’au p\oint $x = b$. En deçà de la frontière inférieure ($x b$), le tracé se confond a\vec l’axe horizontal des abscisses ($y = 0$).
Sur le plan géométrique, l’événement probabiliste global est matérialisé par la surface du rectangle délimité par les segments $[a, b]$ sur l’axe des abscisses et $[0, \frac{1}{b – a}]$ sur l’axe des ordonnées. L’aire $\mathcal{A}$ de ce polygone quadrilatéral régulier se calcule par le produit élémentaire de sa base par sa hauteur :$$mathcal{A} = text{Base} times text{Hauteur} = (b – a) times frac{1}{b – a} = 1$(b – a)$ double, la hauteur de densité se réduit automatiquement de moitié afin de préserver l'invariance unitaire de la surface globale. Les deux ruptures verticales observées en $x = a$ et $x = b$ constituent des discontinuités de saut franches, qui signalent l'absence totale de transition douce entre l'impossibilité de l'événement et sa réalisation potentielle.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/uniform2.png" alt="" /></figure>
### 6.2 Analyse du tracé de la fonction cumulative
Le profil graphique de la fonction de répartition cumulative $F_X(x)$ présente une morphologie en rampe linéaire continue, souvent qualifiée de profil « en rampe d'escalier unitaire dégénérée ». Sur le plan cartésien, ce tracé se décompose en trois sections connectées de façon continue mais non différentiable aux points d'inflexion frontaliers :
1. **Le segment horizontal basal** : Pour tout p\oint situé sur le demi-axe $]-\infty, a]$, la courbe est rigoureusement plate et fixée sur la droite $y = 0$, indiquant qu'aucune particule de probabilité n'a encore été interceptée.
2. **La rampe linéaire médiane** : Sur le segment $[a, b]$, la fonction décrit une droite oblique reliant de façon continue le p\oint d'ancrage $(a, 0)$ au sommet $(b, 1)$. La pente de cette rampe est constante et s'identifie précisément à la dérivée de $F_X$, c'est-à-dire la densité : »>$$Cette relation géométrique illustre de façon visuelle la contrainte de normalisation de Kolmogorov. Si l’étendue du support $(b – a)$ double, la hauteur de densité se réduit automatiquement de moitié afin de préserver l’invariance unitaire de la surface globale. Les deux ruptures verticales observées en $x = a$ et $x = b$ constituent des discontinuités de saut franches, qui signalent l’absence totale de transition douce entre l’impossibilité de l’événement et sa réalisation potentielle.
### 6.2 Analyse du tracé de la fonction cumulative
Le profil graphique de la fonction de répartition cumulative $F_X(x)$ présente une morphologie en rampe linéaire continue, souvent qualifiée de profil « en rampe d’escalier unitaire dégénérée ». Sur le plan cartésien, ce tracé se décompose en trois sections connectées de façon continue mais non différentiable aux points d’inflexion frontaliers :
1. **Le segment horizontal basal** : Pour tout p\oint situé sur le demi-axe $]-\infty, a]$, la courbe est rigoureusement plate et fixée sur la droite $y = 0$, indiquant qu’aucune particule de probabilité n’a encore été interceptée.
2. **La rampe linéaire médiane** : Sur le segment $[a, b]$, la fonction décrit une droite oblique reliant de façon continue le p\oint d’ancrage $(a, 0)$ au sommet $(b, 1)$. La pente de cette rampe est constante et s’identifie précisément à la dérivée de $F_X$, c’est-à-dire la densité :$$text{Pente} = frac{dF_X(x)}{dx} = frac{1}{b – a}$[b, +\infty[$, la courbe redevient horizontale et stationne indéfiniment sur la ligne de saturation unitaire $y = 1$, exprimant l'accumulation exhaustive de toute la masse de probabilité disponible.
Cette disposition graphique offre une méthode de lecture directe du calcul de probabilité d'intervalle : évaluer graphiquement $P(x_1 le X le x_2)$ revient à mesurer la projection verticale $\Delta y = F_X(x_2) – F_X(x_1)$ le long de la rampe oblique. La pente constante garantit que la variation d'élévation est strictement proportionnelle à la progression horizontale, confirmant visuellement l'absence d'accumulation préférentielle.
### 6.3 Diagnostics graphiques empiriques
Dans le cadre de l'analyse exploratoire de données, le statisticien est fréquemment confronté à la nécessité de vérifier si un ensemble d'échantillons continus observés ${x_1, x_2, dots, x_n}$ procède effectivement d'une population parente distribuée selon une loi uniforme. Pour ce faire, deux outils de diagnostic graphique sont universellement employés : l'histogramme de fréquences empiriques et le diagramme quantile-quantile (Q-Q plot).
La construction d'un histogramme de données uniformes requiert un paramétrage adéquat de la largeur de classe (les *bins*). Si la loi sous-jacente est rigoureusement uniforme, l'histogramme doit afficher des hauteurs de barres statistiquement homogènes, fluctuant de manière symétrique autour du niveau théorique moyen sans faire apparaître de profil en cloche central ni de queues asymétriques. Le choix de la discrétisation spatiale est gouverné par des règles empiriques reconnues, telles que la règle de Scott : »>$$3. **Le plateau asymptotique supérieur** : Pour tout p\oint sur le demi-axe $[b, +\infty[$, la courbe redevient horizontale et stationne indéfiniment sur la ligne de saturation unitaire $y = 1$, exprimant l’accumulation exhaustive de toute la masse de probabilité disponible.
Cette disposition graphique offre une méthode de lecture directe du calcul de probabilité d’intervalle : évaluer graphiquement $P(x_1 le X le x_2)$ revient à mesurer la projection verticale $\Delta y = F_X(x_2) – F_X(x_1)$ le long de la rampe oblique. La pente constante garantit que la variation d’élévation est strictement proportionnelle à la progression horizontale, confirmant visuellement l’absence d’accumulation préférentielle.
### 6.3 Diagnostics graphiques empiriques
Dans le cadre de l’analyse exploratoire de données, le statisticien est fréquemment confronté à la nécessité de vérifier si un ensemble d’échantillons continus observés ${x_1, x_2, dots, x_n}$ procède effectivement d’une population parente distribuée selon une loi uniforme. Pour ce faire, deux outils de diagnostic graphique sont universellement employés : l’histogramme de fréquences empiriques et le diagramme quantile-quantile (Q-Q plot).
La construction d’un histogramme de données uniformes requiert un paramétrage adéquat de la largeur de classe (les *bins*). Si la loi sous-jacente est rigoureusement uniforme, l’histogramme doit afficher des hauteurs de barres statistiquement homogènes, fluctuant de manière symétrique autour du niveau théorique moyen sans faire apparaître de profil en cloche central ni de queues asymétriques. Le choix de la discrétisation spatiale est gouverné par des règles empiriques reconnues, telles que la règle de Scott :$$h = frac{3{,}49 cdot S}{sqrt[3]{n}}$S$ représente l'écart-type de l'échantillon, ou encore la règle de Freedman-Diaconis basée sur l'intervalle interquartile : »>$$où $S$ représente l’écart-type de l’échantillon, ou encore la règle de Freedman-Diaconis basée sur l’intervalle interquartile :$$h = frac{2 cdot text{IQR}(X)}{sqrt[3]{n}}$x_{(1)} le x_{(2)} le dots le x_{(n)}$, aux quantiles théoriques attendus d'une loi uniforme standard $p_{(i)} = \frac{i – 0{,}5}{n}$.
Si l'hypothèse de distribution uniforme est respectée, le nuage de points s'ajuste étroitement sur la bissectrice linéaire d'équation $y = x$. Des écarts spécifiques à cet alignement révèlent des anomalies structurelles précises :
* Une cambrure sigmoïde (en forme de « S ») signale un excès d'aplatissement ou la présence de queues de distribution plus étalées qu'attendu (contamination par une loi gaussienne ou logistique).
* Une courbure concave ou convexe systématique indique une asymétrie non nulle, révélant un gradient de probabilité non uniforme au sein de l'e\space de mesure.
* Des décrochages brutaux aux extrémités droite et gauche trahissent la présence de valeurs aberrantes (*outliers*) ou un problème de troncature sévère du capteur de mesure.
## 7. Estimation des paramètres et inférence statistique
### 7.1 Méthode des moments pour l'estimation de a et b
Dans les situations opérationnelles où les bornes physiques du système $[a, b]$ ne sont pas fixées de façon axiomatique mais doivent être inférées à partir d'un échantillon de $n$ variables aléatoires indépendantes et identiquement distribuées (i.i.d.) $X_1, X_2, dots, X_n$ issues d'une loi uniforme $\mathcal{U}(a, b)$, l'application de la méthode des moments offre une première approche d'estimation élémentaire. Cette méthode consiste à égaliser les moments théoriques de la population a\vec les moments empiriques calculés sur l'échantillon collecté.
Soient la moyenne empirique $\bar{X}_n$ et la variance empirique non corrigée $S_n^2$ définies par : »>$$Toutefois, l’histogramme présente une forte sensibilité aux frontières de découpage des classes. C’est pourquoi on lui adj\oint quasi-systématiquement le tracé du **diagramme Q-Q plot uniforme**. Ce dernier confronte sur un même graphique les quantiles empiriques observés, issus de la série triée par ordre croissant $x_{(1)} le x_{(2)} le dots le x_{(n)}$, aux quantiles théoriques attendus d’une loi uniforme standard $p_{(i)} = \frac{i – 0{,}5}{n}$.
Si l’hypothèse de distribution uniforme est respectée, le nuage de points s’ajuste étroitement sur la bissectrice linéaire d’équation $y = x$. Des écarts spécifiques à cet alignement révèlent des anomalies structurelles précises :
* Une cambrure sigmoïde (en forme de « S ») signale un excès d’aplatissement ou la présence de queues de distribution plus étalées qu’attendu (contamination par une loi gaussienne ou logistique).
* Une courbure concave ou convexe systématique indique une asymétrie non nulle, révélant un gradient de probabilité non uniforme au sein de l’e\space de mesure.
* Des décrochages brutaux aux extrémités droite et gauche trahissent la présence de valeurs aberrantes (*outliers*) ou un problème de troncature sévère du capteur de mesure.
## 7. Estimation des paramètres et inférence statistique
### 7.1 Méthode des moments pour l’estimation de a et b
Dans les situations opérationnelles où les bornes physiques du système $[a, b]$ ne sont pas fixées de façon axiomatique mais doivent être inférées à partir d’un échantillon de $n$ variables aléatoires indépendantes et identiquement distribuées (i.i.d.) $X_1, X_2, dots, X_n$ issues d’une loi uniforme $\mathcal{U}(a, b)$, l’application de la méthode des moments offre une première approche d’estimation élémentaire. Cette méthode consiste à égaliser les moments théoriques de la population a\vec les moments empiriques calculés sur l’échantillon collecté.
Soient la moyenne empirique $\bar{X}_n$ et la variance empirique non corrigée $S_n^2$ définies par :$$bar{X}_n = frac{1}{n} sum_{i=1}^n X_i, quad S_n^2 = frac{1}{n} sum_{i=1}^n (X_i – bar{X}_n)^2$a$ et $b$ s'écrit : »>$$Le système d’équations structurelles liant les deux premiers moments théoriques aux paramètres inconnus $a$ et $b$ s’écrit :$$begin{cases} bar{X}_n = frac{a + b}{2} S_n^2 = frac{(b – a)^2}{12} end{cases}$(b – a)$ à partir de la seconde équation, on obtient $\sqrt{12 S_n^2} = b – a$, ce qui donne $b – a = 2\sqrt{3} S_n$. En combinant ce résultat a\vec la première équation exprimant la somme $a + b = 2\bar{X}_n$, la résolution algébrique conduit aux estimateurs par méthode des moments (désignés par l'indice MM) : »>$$En extrayant la différence $(b – a)$ à partir de la seconde équation, on obtient $\sqrt{12 S_n^2} = b – a$, ce qui donne $b – a = 2\sqrt{3} S_n$. En combinant ce résultat a\vec la première équation exprimant la somme $a + b = 2\bar{X}_n$, la résolution algébrique conduit aux estimateurs par méthode des moments (désignés par l’indice MM) :$$hat{a}_{text{MM}} = bar{X}_n – sqrt{3} S_n, quad hat{b}_{text{MM}} = bar{X}_n + sqrt{3} S_n$\hat{a}_{\text{MM}}$ de générer une valeur supérieure au minimum empirique observé $X_{(1)} = \min(X_i)$, ou à $\hat{b}_{\text{MM}}$ d'être inférieur au ma\ximum empirique $X_{(n)} = \max(X_i)$. Dans un tel cas de figure, l'échantillon observé posséderait des réalisations formellement extérieures à l'intervalle estimé $[\hat{a}_{\text{MM}}, \hat{b}_{\text{MM}}]$, ce qui correspond à une impossibilité logique totale dans le cadre d'un modèle uniforme (la vraisemblance de l'échantillon s'effondrant alors à zéro). Cette anomalie structurelle justifie le recours prioritaire à l'estimation par le ma\ximum de vraisemblance.
### 7.2 Estimation par le ma\ximum de vraisemblance (EMV)
L'estimation par le ma\ximum de vraisemblance (EMV) repose sur la formalisation de la fonction de vraisemblance conjointe $L(a, b; x_1, dots, x_n)$ associée à un échantillon i.i.d. de taille $n$. Par indépendance des tirages, la fonction de vraisemblance correspond au produit des densités individuelles : »>$$Bien que ces estimateurs soient asymptotiquement sans biais et d’un calcul analytique immédiat, ils présentent une faiblesse méthodologique rédhibitoire pour les petits ou moyens échantillons. En effet, rien n’interdit mathématiquement à l’estimateur $\hat{a}_{\text{MM}}$ de générer une valeur supérieure au minimum empirique observé $X_{(1)} = \min(X_i)$, ou à $\hat{b}_{\text{MM}}$ d’être inférieur au ma\ximum empirique $X_{(n)} = \max(X_i)$. Dans un tel cas de figure, l’échantillon observé posséderait des réalisations formellement extérieures à l’intervalle estimé $[\hat{a}_{\text{MM}}, \hat{b}_{\text{MM}}]$, ce qui correspond à une impossibilité logique totale dans le cadre d’un modèle uniforme (la vraisemblance de l’échantillon s’effondrant alors à zéro). Cette anomalie structurelle justifie le recours prioritaire à l’estimation par le ma\ximum de vraisemblance.
### 7.2 Estimation par le ma\ximum de vraisemblance (EMV)
L’estimation par le ma\ximum de vraisemblance (EMV) repose sur la formalisation de la fonction de vraisemblance conjointe $L(a, b; x_1, dots, x_n)$ associée à un échantillon i.i.d. de taille $n$. Par indépendance des tirages, la fonction de vraisemblance correspond au produit des densités individuelles :$$L(a, b; mathbf{x}) = prod_{i=1}^n f_X(x_i) = prod_{i=1}^n left( frac{1}{b – a} cdot mathbf{1}_{[a, b]}(x_i) right) = frac{1}{(b – a)^n} prod_{i=1}^n mathbf{1}_{[a, b]}(x_i)$a le x_i le b$. Cette condition conjointe s'exprime de manière compacte au moyen des statistiques d'ordre extrêmes de l'échantillon, à savoir le minimum $X_{(1)} = \min(X_1, dots, X_n)$ et le ma\ximum $X_{(n)} = \max(X_1, dots, X_n)$ : »>$$Pour que le produit des indicatrices soit non nul (et prenne la valeur 1), il est impératif que chaque observation individuelle satisfasse simultanément la condition $a le x_i le b$. Cette condition conjointe s’exprime de manière compacte au moyen des statistiques d’ordre extrêmes de l’échantillon, à savoir le minimum $X_{(1)} = \min(X_1, dots, X_n)$ et le ma\ximum $X_{(n)} = \max(X_1, dots, X_n)$ :$$L(a, b; mathbf{x}) = begin{cases} frac{1}{(b – a)^n} & text{si } a le X_{(1)} le X_{(n)} le b 0 & text{sinon} end{cases}$a$ et $b$, il convient de rendre la quantité $(b – a)^n$ aussi petite que possible, ce qui revient à minimiser la portée de l'intervalle $(b – a)$ tout en respectant la contrainte stricte de non-nullité qui impose $a le X_{(1)}$ et $b ge X_{(n)}$.
Cette fonction ne pouvant être dérivée au sens classique en raison de la présence des fonctions indicatrices, le problème d'optimisation se résout géométriquement : le minimum de $(b – a)$ est atte\int lorsque $a$ est le plus grand possible et $b$ le plus petit possible sous les contraintes du support. Il en découle directement les estimateurs du ma\ximum de vraisemblance : »>$$Pour maximiser cette fonction de vraisemblance par rapport aux paramètres $a$ et $b$, il convient de rendre la quantité $(b – a)^n$ aussi petite que possible, ce qui revient à minimiser la portée de l’intervalle $(b – a)$ tout en respectant la contrainte stricte de non-nullité qui impose $a le X_{(1)}$ et $b ge X_{(n)}$.
Cette fonction ne pouvant être dérivée au sens classique en raison de la présence des fonctions indicatrices, le problème d’optimisation se résout géométriquement : le minimum de $(b – a)$ est atte\int lorsque $a$ est le plus grand possible et $b$ le plus petit possible sous les contraintes du support. Il en découle directement les estimateurs du ma\ximum de vraisemblance :$$hat{a}_{text{ML}} = X_{(1)}, quad hat{b}_{text{ML}} = X_{(n)}$a$, et le ma\ximum observé sera presque sûrement inférieur à la vraie borne $b$.
Dans le cas fréquent où la borne inférieure est connue et fixée (cas standard $a = 0$ et $b$ incon\nu), la distribution de la statistique d'ordre maximale $X_{(n)}$ possède la fonction de densité $f_{X_{(n)}}(x) = \frac{n x^{n-1}}{b^n}$ pour $x in [0, b]$. L'espérance mathématique de l'estimateur vaut alors : »>$$Cependant, ces estimateurs sont intrinsèquement **biaisés**. En effet, par nature géométrique, le minimum d’un échantillon fini de variables uniformes sera presque sûrement supérieur à la vraie borne $a$, et le ma\ximum observé sera presque sûrement inférieur à la vraie borne $b$.
Dans le cas fréquent où la borne inférieure est connue et fixée (cas standard $a = 0$ et $b$ incon\nu), la distribution de la statistique d’ordre maximale $X_{(n)}$ possède la fonction de densité $f_{X_{(n)}}(x) = \frac{n x^{n-1}}{b^n}$ pour $x in [0, b]$. L’espérance mathématique de l’estimateur vaut alors :$$E[hat{b}_{text{ML}}] = E[X_{(n)}] = int_{0}^{b} x cdot left(frac{n x^{n-1}}{b^n}right) dx = frac{n}{b^n} int_{0}^{b} x^n , dx = frac{n}{b^n} left[ frac{x^{n+1}}{n + 1} right]_{0}^{b} = frac{n}{n + 1} b$b$ d'un facteur $\frac{n}{n+1}$. Pour éliminer ce biais, l'estimateur sans biais à variance minimale (UMVU) est construit par simple renormalisation algébrique : »>$$L’estimateur du ma\ximum de vraisemblance sous-estime donc systématiquement la portée réelle de la borne $b$ d’un facteur $\frac{n}{n+1}$. Pour éliminer ce biais, l’estimateur sans biais à variance minimale (UMVU) est construit par simple renormalisation algébrique :$$hat{b}_{text{sans biais}} = frac{n + 1}{n} X_{(n)}$X \sim \mathcal{U}(0, b)$ a\vec $b$ inconnu. Afin de construire un intervalle de confiance au niveau de confiance $1 – \alpha$ (par exemple 95 % pour $\alpha = 0{,}05$), il est nécessaire d'identifier une fonction pivotale dont la distribution d'échantillonnage ne dép\end pas du paramètre incon\nu $b$.
Définissons la variable pivotale $T = \frac{X_{(n)}}{b}$. La fonction de répartition cumulative de cette quantité pivotale s'établit pour tout $t in [0, 1]$ par : »>$$Cette formulation est célèbre dans l’histoire des statistiques militaires sous le nom de résolution du problème des chars de combat allemands (*German Tank Problem*), mise en œuvre par les analystes alliés durant la Seconde Guerre mondiale pour estimer a\vec succès la production mensuelle industrielle ennemie à partir des seuls numéros de série séquentiels découverts sur des équipements capturés.
### 7.3 Intervalles de confiance pour les bornes de support
L’inférence statistique sur les paramètres d’une loi uniforme se prolonge par l’élaboration d’intervalles de confiance exacts (non asymptotiques) pour les bornes du support. Considérons à nouveau le cas fondamental où $X \sim \mathcal{U}(0, b)$ a\vec $b$ inconnu. Afin de construire un intervalle de confiance au niveau de confiance $1 – \alpha$ (par exemple 95 % pour $\alpha = 0{,}05$), il est nécessaire d’identifier une fonction pivotale dont la distribution d’échantillonnage ne dép\end pas du paramètre incon\nu $b$.
Définissons la variable pivotale $T = \frac{X_{(n)}}{b}$. La fonction de répartition cumulative de cette quantité pivotale s’établit pour tout $t in [0, 1]$ par :$$P(T le t) = Pleft(frac{X_{(n)}}{b} le tright) = P(X_{(n)} le t b)${X_{(n)} le t b}$ équivaut à affirmer que toutes les $n$ observations indépendantes sont simultanément inférieures ou égales à $tb$ : »>$$Puisque l’événement ${X_{(n)} le t b}$ équivaut à affirmer que toutes les $n$ observations indépendantes sont simultanément inférieures ou égales à $tb$ :$$P(X_{(n)} le t b) = prod_{i=1}^n P(X_i le t b) = left( frac{t b}{b} right)^n = t^n$T$ suit donc une loi connue indépendante de $b$, de fonction de répartition $F_T(t) = t^n$. Nous pouvons dès lors déterminer deux bornes critiques $t_1$ et $t_2$ telles que : »>$$La variable pivotale $T$ suit donc une loi connue indépendante de $b$, de fonction de répartition $F_T(t) = t^n$. Nous pouvons dès lors déterminer deux bornes critiques $t_1$ et $t_2$ telles que :$$P(t_1 le T le t_2) = 1 – alpha$t_2 = 1$ (car $X_{(n)}$ ne peut jamais dépasser $b$, ce qui r\end le rapport $T$ structurellement borné par 1) et à fixer la borne inférieure $t_1$ de sorte que $P(T le t_1) = \alpha$, ce qui conduit à : »>$$En adoptant une allocation conventionnelle des risques aux extrémités ou en minimisant la longueur de l’intervalle résultant, le choix le plus optimal consiste à poser la borne supérieure $t_2 = 1$ (car $X_{(n)}$ ne peut jamais dépasser $b$, ce qui r\end le rapport $T$ structurellement borné par 1) et à fixer la borne inférieure $t_1$ de sorte que $P(T le t_1) = \alpha$, ce qui conduit à :$$t_1^n = alpha iff t_1 = alpha^{1/n}$$Nous en déduisons l’encadrement pivotal exact :$$Pleft(alpha^{1/n} le frac{X_{(n)}}{b} le 1right) = 1 – alpha$b$, nous obtenons l'intervalle de confiance non asymptotique exact : »>$$En inversant cet encadrement pour isoler le paramètre structurel $b$, nous obtenons l’intervalle de confiance non asymptotique exact :$$Pleft(X_{(n)} le b le frac{X_{(n)}}{alpha^{1/n}}right) = 1 – alpha$1 – \alpha$ pour la borne supérieure s'écrit de façon rigoureuse : »>$$Ainsi, l’intervalle de confiance bilatéral de niveau $1 – \alpha$ pour la borne supérieure s’écrit de façon rigoureuse :$$text{IC}_{1-alpha}(b) = left[ X_{(n)}, ; frac{X_{(n)}}{alpha^{1/n}} right]$\mathcal{O}(n^{-1/2})$ selon le théorème central limite), la précision sur les bornes de la loi uniforme converge à une vitesse hyper-rapide d'ordre $\mathcal{O}(n^{-1})$. Dès que $n$ grandit, le terme $\alpha^{1/n}$ converge rapidement vers 1, ce qui resserre l'intervalle de confiance autour de la statistique d'ordre maximale. Cependant, cette performance analytique a pour corollaire une extrême sensibilité à la présence de valeurs aberrantes de mesure (*outliers*), qui faussent directement les statistiques d'ordre sans l'effet d'amortissement offert par les moyennes globales.
## 8. Applications en psychologie expérimentale et sciences cognitives
### 8.1 Conception de protocoles et neutralisation des attentes temporelles
Dans les laboratoires de psychologie cognitive et de neurosciences comportementales, la distribution uniforme constitue un outil méthodologique incontournable pour le contrôle des variables parasites temporelles lors des tâches d'évaluation des temps de réaction. Lors d'un protocole expérimental standard, un stimulus d'avertissement préparatoire (par exemple, un signal auditif bref) précède l'affichage du stimulus cible impératif nécessitant une décision motrice (comme l'appui sur un bouton de réponse). L'intervalle séparant ces deux événements est désigné sous le terme d'intervalle pré-stimulus ou *foreperiod*.
Si la durée de cette période de préparation était maintenue constante tout au long de l'expérience, le système cognitif du sujet apprendrait très rapidement cette régularité temporelle, développant une anticipation motrice qui réduirait artificiellement les temps de réaction mesurés. Pour neutraliser ce conditionnement prédictif, les expérimentateurs font fréquemment varier cette durée de façon stochastique selon une loi uniforme continue définie sur un intervalle temporel maîtrisé, typiquement $T_{\text{attente}} \sim \mathcal{U}(1000 \text{ ms}, 2500 \text{ ms})$.
Néanmoins, la manipulation de la loi uniforme dans ce contexte a révélé un biais cognitif fondamental documenté dans la littérature expérimentale sous le nom d'**effet de foreperiod variable**. Bien que la distribution physique des durées soit parfaitement uniforme, la perception subjective du risque d'apparition du stimulus cible par le participant ne l'est aucunement. La fonction de taux de hasard (*hazard rate*) conditionnel d'une distribution uniforme continue s'exprime par le ratio : »>$$Il convient de souligner que, contrairement aux intervalles de confiance usuels basés sur la normalité asymptotique (dont la demi-largeur diminue en $\mathcal{O}(n^{-1/2})$ selon le théorème central limite), la précision sur les bornes de la loi uniforme converge à une vitesse hyper-rapide d’ordre $\mathcal{O}(n^{-1})$. Dès que $n$ grandit, le terme $\alpha^{1/n}$ converge rapidement vers 1, ce qui resserre l’intervalle de confiance autour de la statistique d’ordre maximale. Cependant, cette performance analytique a pour corollaire une extrême sensibilité à la présence de valeurs aberrantes de mesure (*outliers*), qui faussent directement les statistiques d’ordre sans l’effet d’amortissement offert par les moyennes globales.
## 8. Applications en psychologie expérimentale et sciences cognitives
### 8.1 Conception de protocoles et neutralisation des attentes temporelles
Dans les laboratoires de psychologie cognitive et de neurosciences comportementales, la distribution uniforme constitue un outil méthodologique incontournable pour le contrôle des variables parasites temporelles lors des tâches d’évaluation des temps de réaction. Lors d’un protocole expérimental standard, un stimulus d’avertissement préparatoire (par exemple, un signal auditif bref) précède l’affichage du stimulus cible impératif nécessitant une décision motrice (comme l’appui sur un bouton de réponse). L’intervalle séparant ces deux événements est désigné sous le terme d’intervalle pré-stimulus ou *foreperiod*.
Si la durée de cette période de préparation était maintenue constante tout au long de l’expérience, le système cognitif du sujet apprendrait très rapidement cette régularité temporelle, développant une anticipation motrice qui réduirait artificiellement les temps de réaction mesurés. Pour neutraliser ce conditionnement prédictif, les expérimentateurs font fréquemment varier cette durée de façon stochastique selon une loi uniforme continue définie sur un intervalle temporel maîtrisé, typiquement $T_{\text{attente}} \sim \mathcal{U}(1000 \text{ ms}, 2500 \text{ ms})$.
Néanmoins, la manipulation de la loi uniforme dans ce contexte a révélé un biais cognitif fondamental documenté dans la littérature expérimentale sous le nom d’**effet de foreperiod variable**. Bien que la distribution physique des durées soit parfaitement uniforme, la perception subjective du risque d’apparition du stimulus cible par le participant ne l’est aucunement. La fonction de taux de hasard (*hazard rate*) conditionnel d’une distribution uniforme continue s’exprime par le ratio :$$h(t) = frac{f(t)}{1 – F(t)} = frac{frac{1}{b – a}}{1 – frac{t – a}{b – a}} = frac{1}{b – t}, quad forall t in [a, b[$t$ progresse vers la borne supérieure $b$. Dès lors, plus le stimulus tarde à apparaître, plus le sujet humain devient certain de son émergence imminente, ce qui accélère la préparation motrice et raccourcit les temps de réaction pour les durées les plus longues. Pour obtenir une incertitude temporelle subjective constante (un taux de hasard plat), les chercheurs doivent paradoxalement substituer à la loi uniforme une loi exponentielle tronquée non vieillissante.
### 8.2 Psychophysique et échelonnement sensoriel
La psychophysique, discipline fondée par Gustav Fechner et Ernst Weber visant à relier les grandeurs physiques objectives aux sensations perceptives subjectives, exploite activement la distribution uniforme pour calibrer ses plans d'échantillonnage de stimuli. Dans le cadre de la méthode des stimuli constants, un observateur se voit présenter de multiples itérations d'un signal dont l'intensité varie aléatoirement le long d'une échelle graduée (luminescence d'un p\oint optique, fréquence d'un son pur, concentration d'une solution olfactive).
L'utilisation d'une distribution uniforme pour sélectionner l'intensité des stimuli physiques garantit qu'aucune zone de l'e\space sensoriel investigué ne bénéficie d'une fréquence de présentation surévaluée qui induirait une habituation neuronale ou un ancrage perceptif artificiel. Cependant, les lois fondamentales de la psychophysique (telle que la loi logarithmique de Fechner, $S = k \ln(I)$, ou la loi de puissance de Stevens, $S = k I^\beta$) révèlent une distorsion systématique : une distribution uniforme de stimuli physiques d'intensité $I \sim \mathcal{U}(a, b)$ ne produit nullement une distribution uniforme de sensations internes $S$.
Si la transformation psychophysiologique $g(I)$ est fortement non linéaire, la densité de probabilité résultante de la sensation subjective $S$, obtenue par le théorème de changement de variable de densité : »>$$Ce ratio mathématique démontre sans équivoque que le taux de hasard croît de manière hyperbolique à mesure que le temps $t$ progresse vers la borne supérieure $b$. Dès lors, plus le stimulus tarde à apparaître, plus le sujet humain devient certain de son émergence imminente, ce qui accélère la préparation motrice et raccourcit les temps de réaction pour les durées les plus longues. Pour obtenir une incertitude temporelle subjective constante (un taux de hasard plat), les chercheurs doivent paradoxalement substituer à la loi uniforme une loi exponentielle tronquée non vieillissante.
### 8.2 Psychophysique et échelonnement sensoriel
La psychophysique, discipline fondée par Gustav Fechner et Ernst Weber visant à relier les grandeurs physiques objectives aux sensations perceptives subjectives, exploite activement la distribution uniforme pour calibrer ses plans d’échantillonnage de stimuli. Dans le cadre de la méthode des stimuli constants, un observateur se voit présenter de multiples itérations d’un signal dont l’intensité varie aléatoirement le long d’une échelle graduée (luminescence d’un p\oint optique, fréquence d’un son pur, concentration d’une solution olfactive).
L’utilisation d’une distribution uniforme pour sélectionner l’intensité des stimuli physiques garantit qu’aucune zone de l’e\space sensoriel investigué ne bénéficie d’une fréquence de présentation surévaluée qui induirait une habituation neuronale ou un ancrage perceptif artificiel. Cependant, les lois fondamentales de la psychophysique (telle que la loi logarithmique de Fechner, $S = k \ln(I)$, ou la loi de puissance de Stevens, $S = k I^\beta$) révèlent une distorsion systématique : une distribution uniforme de stimuli physiques d’intensité $I \sim \mathcal{U}(a, b)$ ne produit nullement une distribution uniforme de sensations internes $S$.
Si la transformation psychophysiologique $g(I)$ est fortement non linéaire, la densité de probabilité résultante de la sensation subjective $S$, obtenue par le théorème de changement de variable de densité :$$f_S(s) = f_I(g^{-1}(s)) cdot left| frac{d}{ds} g^{-1}(s) right|$90,%$ pour une quantité numérique dont il ignore totalement les déterminants fondamentaux (par exemple, la longueur du cours d'un fleuve étranger ou l'année de naissance d'un monarque antique), son esprit tente souvent d'appliquer le principe d'indifférence de Laplace en postulant une distribution uniforme de ses croyances entre une borne inférieure et une borne supérieure intuitives.
Toutefois, la recherche en métacognition montre que les sujets humains échouent systématiquement à modéliser correctement cette loi uniforme subjective. Deux biais dominants sont observés lors des protocoles d'élicitation :
1. **Le biais d'équiprobabilité fallacieux** : Les individus présument fréquemment que la distribution des probabilités est uniforme alors même que des contraintes structurelles évidentes imposent une concentration centrale (par exemple, supposer que toutes les causes de retard d'un train ont la même probabilité de se produire).
2. **L'illusion de précision et l'excès de confiance (*overconfidence*)** : Lorsqu'ils définissent les bornes $[a, b]$ de leur estimation, les participants construisent des intervalles beaucoup trop étroits par rapport à la variance objective de leur état d'incertitude, produisant des taux de capture empiriques observés avoisinant 50 % là où des intervalles de crédibilité à 90 % étaient visés.
L'étude des distributions de jugements continus a conduit les chercheurs en psychométrie à développer des échelles d'évaluation visuelle analogique (EVA), où le sujet déplace un curseur conti\nu sur un segment sans graduations numériques. Les réponses agrégées sont alors analysées au regard d'une hypothèse de distribution uniforme de base pour vérifier si les participants ont exploité l'ensemble du continuum décisionnel ou s'ils ont manifesté des préférences d'ancrage aux extrémités ou au centre géométrique de l'échelle.
## 9. Rôle pivot dans la simulation stochastique et les méthodes computationnelles
### 9.1 Génération de nombres pseudo-aléatoires fondamentaux
L'ensemble de l'architecture algorithmique des ordinateurs numériques actuels repose sur un paradoxe fonctionnel : bien qu'une machine de Turing soit par essence un dispositif purement déterministe, les calculs modernes nécessitent l'injection continue d'aléatoire. Pour surmonter cette contradiction, l'ingénierie logicielle s'appuie sur des générateurs de nombres pseudo-aléatoires (PRNG pour *Pseudo-Random Number Generators*), dont la mission première est de produire des flux de données discrètes simulant les propriétés de réalisations i.i.d. de variables issues d'une loi uniforme standard continue sur le segment unitaire : »>$$affiche une forte asymétrie et une concentration de masse probabiliste vers les faibles intensités perceptives. Pour obtenir un déploiement uniforme de l’activité cognitive le long de l’axe sensoriel, les concepteurs d’expériences doivent ajuster la distribution d’entrée physique en appliquant la transformation inverse de la fonction psychophysique du système perceptif considéré.
### 8.3 Modélisation de l’ignorance subjective dans les jugements
Au sein des modèles d’évaluation de la rationalité humaine et de prise de décision en situation d’incertitude (heuristiques et biais cognitifs identifiés par Daniel Kahneman et Amos Tversky), la distribution uniforme sert fréquemment de modèle de base pour caractériser l’ignorance épistémique totale. Lorsqu’un participant est sommé d’estimer un intervalle de confiance subjectif à $90,%$ pour une quantité numérique dont il ignore totalement les déterminants fondamentaux (par exemple, la longueur du cours d’un fleuve étranger ou l’année de naissance d’un monarque antique), son esprit tente souvent d’appliquer le principe d’indifférence de Laplace en postulant une distribution uniforme de ses croyances entre une borne inférieure et une borne supérieure intuitives.
Toutefois, la recherche en métacognition montre que les sujets humains échouent systématiquement à modéliser correctement cette loi uniforme subjective. Deux biais dominants sont observés lors des protocoles d’élicitation :
1. **Le biais d’équiprobabilité fallacieux** : Les individus présument fréquemment que la distribution des probabilités est uniforme alors même que des contraintes structurelles évidentes imposent une concentration centrale (par exemple, supposer que toutes les causes de retard d’un train ont la même probabilité de se produire).
2. **L’illusion de précision et l’excès de confiance (*overconfidence*)** : Lorsqu’ils définissent les bornes $[a, b]$ de leur estimation, les participants construisent des intervalles beaucoup trop étroits par rapport à la variance objective de leur état d’incertitude, produisant des taux de capture empiriques observés avoisinant 50 % là où des intervalles de crédibilité à 90 % étaient visés.
L’étude des distributions de jugements continus a conduit les chercheurs en psychométrie à développer des échelles d’évaluation visuelle analogique (EVA), où le sujet déplace un curseur conti\nu sur un segment sans graduations numériques. Les réponses agrégées sont alors analysées au regard d’une hypothèse de distribution uniforme de base pour vérifier si les participants ont exploité l’ensemble du continuum décisionnel ou s’ils ont manifesté des préférences d’ancrage aux extrémités ou au centre géométrique de l’échelle.
## 9. Rôle pivot dans la simulation stochastique et les méthodes computationnelles
### 9.1 Génération de nombres pseudo-aléatoires fondamentaux
L’ensemble de l’architecture algorithmique des ordinateurs numériques actuels repose sur un paradoxe fonctionnel : bien qu’une machine de Turing soit par essence un dispositif purement déterministe, les calculs modernes nécessitent l’injection continue d’aléatoire. Pour surmonter cette contradiction, l’ingénierie logicielle s’appuie sur des générateurs de nombres pseudo-aléatoires (PRNG pour *Pseudo-Random Number Generators*), dont la mission première est de produire des flux de données discrètes simulant les propriétés de réalisations i.i.d. de variables issues d’une loi uniforme standard continue sur le segment unitaire :$$U sim mathcal{U}(0, 1)$$Historiquement, cette génération s’est articulée autour des générateurs congruenceurs linéaires (LCG), introduits par Lehmer en 1951, reposant sur une récurrence arithmétique modulaire :$$Z_{n+1} = (a Z_n + c) pmod m, quad U_{n+1} = frac{Z_{n+1}}{m}$2^{19937} – 1$ itérations et d'une propriété d'équidistribution garantie jusqu'à la dimension 623 pour des mots de 32 bits, il assure une approximation quasi-parfaite de la loi uniforme $\mathcal{U}(0, 1)$. La conformité empirique des suites générées est soumise à des batteries de tests statistiques rigoureuses, telles que les suites de tests *Diehard* de George Marsaglia ou la suite *TestU01* de L'Ecuyer et Simard, qui évaluent la blancheur spectrale, l'entropie binaire, la distribution des rangs de matrices booléennes et l'absence d'autocorrélation linéaire ou non linéaire.
### 9.2 Méthode de la transformée inverse
La primauté de la distribution uniforme standard $\mathcal{U}(0, 1)$ dans le calcul scientifique découle d'un théorème mathématique élégant : le **théorème de la transformation intégrale de probabilité** (ou méthode de la transformée inverse). Ce théorème garantit que si $U$ est une variable aléatoire distribuée selon une loi uniforme continue standard $U \sim \mathcal{U}(0, 1)$, et si $F$ est une fonction de répartition continue et strictement croissante associée à une distribution probabiliste quelconque arbitraire, alors la variable aléatoire transformée $X = F^{-1}(U)$ admet rigoureusement $F$ pour fonction de répartition.
La démonstration analytique de ce résultat s'articule par l'évaluation directe de la fonction cumulative de $X$ : »>$$Bien que computationnellement performants, ces générateurs primitifs souffrent d’une structure réticulaire sous-jacente (théorème de Marsaglia), dans laquelle les vecteurs de nombres consécutifs se concentrent sur un nombre réduit d’hyperplans au sein de l’e\space multidimensionnel, violant l’indépendance statistique nécessaire aux simulations rigoureuses.
Les architectures modernes mobilisent des algorithmes de pointe, au premier rang desquels figure le générateur **Mersenne Twister** (MT19937), conçu par Makoto Matsumoto et Takuji Nishimura. Doté d’une période gigantesque de $2^{19937} – 1$ itérations et d’une propriété d’équidistribution garantie jusqu’à la dimension 623 pour des mots de 32 bits, il assure une approximation quasi-parfaite de la loi uniforme $\mathcal{U}(0, 1)$. La conformité empirique des suites générées est soumise à des batteries de tests statistiques rigoureuses, telles que les suites de tests *Diehard* de George Marsaglia ou la suite *TestU01* de L’Ecuyer et Simard, qui évaluent la blancheur spectrale, l’entropie binaire, la distribution des rangs de matrices booléennes et l’absence d’autocorrélation linéaire ou non linéaire.
### 9.2 Méthode de la transformée inverse
La primauté de la distribution uniforme standard $\mathcal{U}(0, 1)$ dans le calcul scientifique découle d’un théorème mathématique élégant : le **théorème de la transformation intégrale de probabilité** (ou méthode de la transformée inverse). Ce théorème garantit que si $U$ est une variable aléatoire distribuée selon une loi uniforme continue standard $U \sim \mathcal{U}(0, 1)$, et si $F$ est une fonction de répartition continue et strictement croissante associée à une distribution probabiliste quelconque arbitraire, alors la variable aléatoire transformée $X = F^{-1}(U)$ admet rigoureusement $F$ pour fonction de répartition.
La démonstration analytique de ce résultat s’articule par l’évaluation directe de la fonction cumulative de $X$ :$$P(X le x) = P(F^{-1}(U) le x)$F$ est supposée strictement croissante, son inverse $F^{-1}$ l'est également, ce qui autorise l'application directe de la fonction $F$ des deux côtés de l'inégalité sans modification de son sens : »>$$Puisque $F$ est supposée strictement croissante, son inverse $F^{-1}$ l’est également, ce qui autorise l’application directe de la fonction $F$ des deux côtés de l’inégalité sans modification de son sens :$$P(F^{-1}(U) le x) = P(F(F^{-1}(U)) le F(x)) = P(U le F(x))$[0, 1]$, la fonction de répartition cumulative de $U$ s'identifie à l'identité pour toute valeur située entre 0 et 1 : $F_U(u) = u$. Sachant que la valeur $F(x)$ appartient structurellement au domaine $[0, 1]$, on en déduit immédiatement : »>$$Or, par construction de la loi uniforme continue sur $[0, 1]$, la fonction de répartition cumulative de $U$ s’identifie à l’identité pour toute valeur située entre 0 et 1 : $F_U(u) = u$. Sachant que la valeur $F(x)$ appartient structurellement au domaine $[0, 1]$, on en déduit immédiatement :$$P(U le F(x)) = F(x)$X = F^{-1}(U)$ présente la distribution cible souhaitée.
À titre d'exemple opérationnel, supposons que l'on cherche à générer des durées de réponse motrice distribuées selon une loi exponentielle de paramètre d'échelle $lambda$, dont la fonction de répartition s'écrit $F(x) = 1 – e^{-\lambda x}$ pour $x ge 0$. L'inversion analytique s'opère en résolvant $u = 1 – e^{-\lambda x}$, ce qui donne : »>$$Ce résultat établit de façon universelle que la variable aléatoire générée $X = F^{-1}(U)$ présente la distribution cible souhaitée.
À titre d’exemple opérationnel, supposons que l’on cherche à générer des durées de réponse motrice distribuées selon une loi exponentielle de paramètre d’échelle $lambda$, dont la fonction de répartition s’écrit $F(x) = 1 – e^{-\lambda x}$ pour $x ge 0$. L’inversion analytique s’opère en résolvant $u = 1 – e^{-\lambda x}$, ce qui donne :$$e^{-lambda x} = 1 – u iff -lambda x = ln(1 – u) iff x = -frac{1}{lambda} ln(1 – u)$U \sim \mathcal{U}(0, 1)$, la variable complémentaire $1 – U$ suit exactement la même distribution uniforme $\mathcal{U}(0, 1)$, l'algorithme de génération se résume à une ligne de calcul déterministe appliquée à chaque tirage pseudo-aléatoire unitaire : »>$$Étant donné que si $U \sim \mathcal{U}(0, 1)$, la variable complémentaire $1 – U$ suit exactement la même distribution uniforme $\mathcal{U}(0, 1)$, l’algorithme de génération se résume à une ligne de calcul déterministe appliquée à chaque tirage pseudo-aléatoire unitaire :$$X = -frac{1}{lambda} ln(U)$g(x)$ sur un intervalle compact $[a, b]$ : »>$$Cette méthode élégante s’ét\end à de nombreuses lois usuelles (loi de Cauchy, loi logistique, loi de Pareto, loi de Weibull). Lorsque la fonction de répartition n’admet pas d’inverse analytique explicite sous forme close (comme c’est le cas pour la loi normale standard de Gauss), des méthodes dérivées telles que la transformation de Box-Muller s’appuient sur des tirages uniformes bivariés pour générer des échantillons conformes.
### 9.3 Intégration de Monte-Carlo et échantillonnage de rejet
Au-delà de la synthèse de variables aléatoires simples, la distribution uniforme continue constitue le moteur opérationnel de l’**intégration de Monte-Carlo**, technique numérique indispensable pour calculer des intégrales définies en dimensions multiples qui défient les méthodes de quadrature déterministes classiques (règles des trapèzes ou de Simpson).
Considérons le calcul de l’intégrale d’une fonction mesurable complexe $g(x)$ sur un intervalle compact $[a, b]$ :$$I = int_{a}^{b} g(x) , dx$(b – a)$, l'expression peut être reformulée comme l'espérance mathématique d'une transformation de la variable aléatoire uniforme $X \sim \mathcal{U}(a, b)$ : »>$$En multipliant et en divisant cette intégrale par l’étendue du support $(b – a)$, l’expression peut être reformulée comme l’espérance mathématique d’une transformation de la variable aléatoire uniforme $X \sim \mathcal{U}(a, b)$ :$$I = (b – a) int_{a}^{b} g(x) left(frac{1}{b – a}right) dx = (b – a) E[g(X)]$N$ tirages pseudo-aléatoires uniformes i.i.d. $X_1, X_2, dots, X_N \sim \mathcal{U}(a, b)$, l'estimateur empirique de Monte-Carlo défini par : »>$$En vertu de la loi forte des grands nombres, si l’on génère une suite de $N$ tirages pseudo-aléatoires uniformes i.i.d. $X_1, X_2, dots, X_N \sim \mathcal{U}(a, b)$, l’estimateur empirique de Monte-Carlo défini par :$$hat{I}_N = (b – a) cdot frac{1}{N} sum_{i=1}^N g(X_i)$I$ lorsque $N to \infty$. Par application directe du théorème central limite, l'erreur quadratique moyenne de cette approximation décroît à une vitesse caractéristique de $\mathcal{O}(N^{-1/2})$, une cadence de convergence totalement indépendante de la dimension spatiale du domaine d'intégration. Cette invariance dimensionnelle fait de l'intégration par tirage uniforme le seul algorithme traitable pour la résolution d'intégrales computationnelles complexes en physique statistique et en inférence bayésienne multidimensionnelle.
De manière analogue, la distribution uniforme intervient comme distribution d'enveloppe fondamentale au sein des **méthodes d'acceptation-rejet** de John von Neumann. Pour échantillonner une densité de probabilité cible complexe $f(x)$ bornée sur $[a, b]$ par une constante $M$, on génère simultanément deux variables uniformes indépendantes : $X \sim \mathcal{U}(a, b)$ pour l'abscisse et $Y \sim \mathcal{U}(0, M)$ pour l'ordonnée. Le p\oint candidat $(X, Y)$ est rete\nu si et seulement si $Y le f(X)$, et rejeté sinon. L'ensemble des points acceptés sous cette enveloppe uniforme reproduit rigoureusement la distribution cible $f$.
## 10. Modèles de choix, théorie de la décision et psychométrie
### 10.1 Théorie de l'utilité espérée et états d'équiprobabilité
Dans le cadre formel de la théorie de la décision et de la microéconomie comportementale, la modélisation du comportement rationnel s'appuie sur le paradigme de l'utilité espérée formalisé par John von Neumann et Oskar Morgenstern. Face à un ensemble de choix menant à des conséquences probabilistes distribuées sur un spectre de gains ou de pertes continues $[w_{\min}, w_{\max}]$, un décideur neutre au risque maximise la valeur monétaire attendue, tandis qu'un décideur présentant une aversion ou une appétence pour le risque maximise l'espérance mathématique de son utilité subjective $E[u(W)]$.
Lorsque l'environnement informationnel est caractérisé par une absence totale de signaux différenciés, le sujet modélise l'e\space d'état par une distribution uniforme continue $W \sim \mathcal{U}(w_{\min}, w_{\max})$. Dans cette condition de neutralité informationnelle, l'utilité espérée d'un agent présentant une fonction d'utilité de type von Neumann-Morgenstern s'écrit de façon continue : »>$$converge presque sûrement vers la valeur exacte de l’intégrale $I$ lorsque $N to \infty$. Par application directe du théorème central limite, l’erreur quadratique moyenne de cette approximation décroît à une vitesse caractéristique de $\mathcal{O}(N^{-1/2})$, une cadence de convergence totalement indépendante de la dimension spatiale du domaine d’intégration. Cette invariance dimensionnelle fait de l’intégration par tirage uniforme le seul algorithme traitable pour la résolution d’intégrales computationnelles complexes en physique statistique et en inférence bayésienne multidimensionnelle.
De manière analogue, la distribution uniforme intervient comme distribution d’enveloppe fondamentale au sein des **méthodes d’acceptation-rejet** de John von Neumann. Pour échantillonner une densité de probabilité cible complexe $f(x)$ bornée sur $[a, b]$ par une constante $M$, on génère simultanément deux variables uniformes indépendantes : $X \sim \mathcal{U}(a, b)$ pour l’abscisse et $Y \sim \mathcal{U}(0, M)$ pour l’ordonnée. Le p\oint candidat $(X, Y)$ est rete\nu si et seulement si $Y le f(X)$, et rejeté sinon. L’ensemble des points acceptés sous cette enveloppe uniforme reproduit rigoureusement la distribution cible $f$.
## 10. Modèles de choix, théorie de la décision et psychométrie
### 10.1 Théorie de l’utilité espérée et états d’équiprobabilité
Dans le cadre formel de la théorie de la décision et de la microéconomie comportementale, la modélisation du comportement rationnel s’appuie sur le paradigme de l’utilité espérée formalisé par John von Neumann et Oskar Morgenstern. Face à un ensemble de choix menant à des conséquences probabilistes distribuées sur un spectre de gains ou de pertes continues $[w_{\min}, w_{\max}]$, un décideur neutre au risque maximise la valeur monétaire attendue, tandis qu’un décideur présentant une aversion ou une appétence pour le risque maximise l’espérance mathématique de son utilité subjective $E[u(W)]$.
Lorsque l’environnement informationnel est caractérisé par une absence totale de signaux différenciés, le sujet modélise l’e\space d’état par une distribution uniforme continue $W \sim \mathcal{U}(w_{\min}, w_{\max})$. Dans cette condition de neutralité informationnelle, l’utilité espérée d’un agent présentant une fonction d’utilité de type von Neumann-Morgenstern s’écrit de façon continue :$$E[u(W)] = int_{w_{min}}^{w_{max}} u(w) cdot frac{1}{w_{max} – w_{min}} , dw$p = 0{,}5$), plutôt que pour des situations où la probabilité d'un état est distribuée de façon uniforme sur $[0, 1]$.
Les théories modernes de la décision, telles que la théorie des perspectives (*Prospect Theory*) de Daniel Kahneman et Amos Tversky ou la théorie de l'utilité espérée dépendante du rang (RDU), formalisent ces déviations par le biais de fonctions de pondération des probabilités non linéaires $w(p)$. Ces fonctions ont pour effet de surpondérer systématiquement les probabilités d'événements rares et de sous-pondérer les probabilités d'événements modérés à élevés. Ainsi, même lorsqu'un dispositif expérimental garantit une distribution uniforme objective des gains, la représentation cognitive subjective du décideur altère cette équi-répartition en une distribution perçue déformée, caractérisée par une surévaluation des gains extrêmes et des pertes maximales.
### 10.2 Loi uniforme standard dans les théories des tests psychométriques
En psychométrie contemporaine et dans la théorie de la réponse aux items (TRI), la distribution uniforme standard intervient de façon déterminante dans les processus de standardisation des scores d'aptitude et d'étalonnage des instruments d'évaluation comportementale. Lorsqu'un test psychométrique (mesurant par exemple un trait latent de personnalité, une capacité mnésique ou un quotient intellectuel) est administré à une cohorte représentative, les scores bruts collectés présentent généralement une distribution unimodale asymétrique ou approximativement gaussienne.
Pour rendre ces résultats opérationnels et comparables entre différentes cohortes ou différentes échelles, les spécialistes recourent à la transformation en percentiles ou rangs percentiles. Soit $\theta$ le trait latent estimé d'un individu et $F_{\Theta}$ la fonction de répartition cumulative empirique de ce trait au sein de la population de référence. La variable transformée : »>$$Cependant, les recherches menées en économie comportementale ont révélé que la prise de décision humaine en présence d’une distribution uniforme théorique est profondément troublée par l’ambiguïté. Le célèbre **paradoxe d’Ellsberg** (1961) a mis en évidence le phénomène d’aversion pour l’ambiguïté : les individus manifestent une préférence marquée pour les loteries dont les probabilités objectives sont précisément connues et quantifiées (comme une probabilité binomiale calibrée à $p = 0{,}5$), plutôt que pour des situations où la probabilité d’un état est distribuée de façon uniforme sur $[0, 1]$.
Les théories modernes de la décision, telles que la théorie des perspectives (*Prospect Theory*) de Daniel Kahneman et Amos Tversky ou la théorie de l’utilité espérée dépendante du rang (RDU), formalisent ces déviations par le biais de fonctions de pondération des probabilités non linéaires $w(p)$. Ces fonctions ont pour effet de surpondérer systématiquement les probabilités d’événements rares et de sous-pondérer les probabilités d’événements modérés à élevés. Ainsi, même lorsqu’un dispositif expérimental garantit une distribution uniforme objective des gains, la représentation cognitive subjective du décideur altère cette équi-répartition en une distribution perçue déformée, caractérisée par une surévaluation des gains extrêmes et des pertes maximales.
### 10.2 Loi uniforme standard dans les théories des tests psychométriques
En psychométrie contemporaine et dans la théorie de la réponse aux items (TRI), la distribution uniforme standard intervient de façon déterminante dans les processus de standardisation des scores d’aptitude et d’étalonnage des instruments d’évaluation comportementale. Lorsqu’un test psychométrique (mesurant par exemple un trait latent de personnalité, une capacité mnésique ou un quotient intellectuel) est administré à une cohorte représentative, les scores bruts collectés présentent généralement une distribution unimodale asymétrique ou approximativement gaussienne.
Pour rendre ces résultats opérationnels et comparables entre différentes cohortes ou différentes échelles, les spécialistes recourent à la transformation en percentiles ou rangs percentiles. Soit $\theta$ le trait latent estimé d’un individu et $F_{\Theta}$ la fonction de répartition cumulative empirique de ce trait au sein de la population de référence. La variable transformée :$$U = F_{Theta}(theta)$[0, 1]$, en vertu directe de la transformation intégrale de probabilité évoquée précédemment.
Cette transformation unitaire présente des propriétés d'une grande valeur normative :
* Chaque tranche de pourcentage (par exemple, chaque intervalle de dix centiles) rassemble exactement la même proportion de $10,%$ de la population évaluée, matérialisant l'uniformité du découpage normatif.
* Elle neutralise les déformations métriques liées aux particularités idiosyncrasiques de l'échelle brute de mesure, convertissant des scores arbitraires en une échelle de position relative standardisée.
Toutefois, les psychométriciens doivent éviter un écueil d'interprétation fréquent : si la distribution des percentiles transformés est rigoureusement uniforme, l'écart métrique sous-jacent entre les individus n'est pas préservé. En raison de la densité plus élevée au centre d'une distribution gaussienne d'origine, une différence de 5 rangs percentiles observée entre le 50e et le 55e centile correspond à un différentiel de trait latent infinitésimal, tandis que la même différence de 5 percentiles située aux extrémités (entre le 94e et le 99e centile) représente un écart substantiel d'aptitude psychologique.
### 10.3 Théorie de la détection du signal et bruit de fond continu
La théorie de la détection du signal (TDS), initialement développée pour l'analyse des récepteurs radar et largement adoptée en psychophysique auditive et visuelle, modélise la capacité d'un observateur humain à discriminer la présence d'un signal faible au sein d'un environnement sensoriel pollué par un bruit de fond stochastique. Dans la formulation conventionnelle introduite par Green et Swets, le bruit de fond conti\nu et l'agrégat signal-plus-bruit sont modélisés par des distributions normales de variances équivalentes séparées par un indice de sensibilité $d'$.
Toutefois, dans certains contextes d'expérimentation visuelle contrainte ou de stimulation binaire à artefacts contrôlés, l'hypothèse d'un bruit modélisé par une loi uniforme continue offre des solutions analytiques instructives. Considérons un bruit de fond sensoriel distribué selon la loi $X_{\text{bruit}} \sim \mathcal{U}(-L, L)$ et une cible induisant un décalage sensoriel constant $\Delta$, conduisant à la distribution $X_{\text{signal+bruit}} \sim \mathcal{U}(-L + \Delta, L + \Delta)$.
L'analyse de la performance décisionnelle dans un tel cadre se traduit par des caractéristiques de fonctionnement du récepteur (courbes ROC pour *Receiver Operating Characteristic*) très différentes des courbes courbes sigmoïdes usuelles issues du modèle gaussien. Le taux de fausses alarmes ($P_{\text{FA}}$) et le taux de détections correctes ($P_{\text{Hit}}$) associés à un critère de décision $C$ s'expriment par des relations linéaires par morceaux : »>$$est distribuée selon une loi uniforme continue standard sur l’intervalle $[0, 1]$, en vertu directe de la transformation intégrale de probabilité évoquée précédemment.
Cette transformation unitaire présente des propriétés d’une grande valeur normative :
* Chaque tranche de pourcentage (par exemple, chaque intervalle de dix centiles) rassemble exactement la même proportion de $10,%$ de la population évaluée, matérialisant l’uniformité du découpage normatif.
* Elle neutralise les déformations métriques liées aux particularités idiosyncrasiques de l’échelle brute de mesure, convertissant des scores arbitraires en une échelle de position relative standardisée.
Toutefois, les psychométriciens doivent éviter un écueil d’interprétation fréquent : si la distribution des percentiles transformés est rigoureusement uniforme, l’écart métrique sous-jacent entre les individus n’est pas préservé. En raison de la densité plus élevée au centre d’une distribution gaussienne d’origine, une différence de 5 rangs percentiles observée entre le 50e et le 55e centile correspond à un différentiel de trait latent infinitésimal, tandis que la même différence de 5 percentiles située aux extrémités (entre le 94e et le 99e centile) représente un écart substantiel d’aptitude psychologique.
### 10.3 Théorie de la détection du signal et bruit de fond continu
La théorie de la détection du signal (TDS), initialement développée pour l’analyse des récepteurs radar et largement adoptée en psychophysique auditive et visuelle, modélise la capacité d’un observateur humain à discriminer la présence d’un signal faible au sein d’un environnement sensoriel pollué par un bruit de fond stochastique. Dans la formulation conventionnelle introduite par Green et Swets, le bruit de fond conti\nu et l’agrégat signal-plus-bruit sont modélisés par des distributions normales de variances équivalentes séparées par un indice de sensibilité $d’$.
Toutefois, dans certains contextes d’expérimentation visuelle contrainte ou de stimulation binaire à artefacts contrôlés, l’hypothèse d’un bruit modélisé par une loi uniforme continue offre des solutions analytiques instructives. Considérons un bruit de fond sensoriel distribué selon la loi $X_{\text{bruit}} \sim \mathcal{U}(-L, L)$ et une cible induisant un décalage sensoriel constant $\Delta$, conduisant à la distribution $X_{\text{signal+bruit}} \sim \mathcal{U}(-L + \Delta, L + \Delta)$.
L’analyse de la performance décisionnelle dans un tel cadre se traduit par des caractéristiques de fonctionnement du récepteur (courbes ROC pour *Receiver Operating Characteristic*) très différentes des courbes courbes sigmoïdes usuelles issues du modèle gaussien. Le taux de fausses alarmes ($P_{\text{FA}}$) et le taux de détections correctes ($P_{\text{Hit}}$) associés à un critère de décision $C$ s’expriment par des relations linéaires par morceaux :$$P_{text{FA}}(C) = P(X_{text{bruit}} > C) = begin{cases} 1 & text{si } C L end{cases}$$$$P_{text{Hit}}(C) = P(X_{text{signal+bruit}} > C) = begin{cases} 1 & text{si } C L + Delta end{cases}$L_\infty$) séparant la fonction de répartition empirique $F_n(x)$ de la fonction de répartition théorique uniforme $F_0(x) = \frac{x – a}{b – a}$. La statistique de test s'écrit : »>$$La courbe ROC reliant le taux de détection au taux de fausse alarme est alors constituée de segments de droite à raccordement anguleux. L’investigation de ces scénarios montre que l’hypothèse de distribution uniforme du bruit permet de dissocier de façon nette les seuils décisionnels limites des variations graduelles de sensibilité, fournissant aux psychologues cognitivistes un modèle théorique pour tester la robustesse des systèmes de vigilance face à des bruits bornés saturants.
## 11. Limites épistémologiques, tests d’adéquation et écueils d’interprétation
### 11.1 Tests statistiques de conformité à l’uniformité
L’assignation d’une loi uniforme à un jeu de données empiriques ne peut être postulée de façon purement axiomatique ; elle requiert une validation empirique rigoureuse via des tests statistiques d’adéquation (*goodness-of-fit tests*). La question fondamentale posée s’énonce ainsi : les données observées s’écartent-elles de manière statistiquement significative d’un modèle d’équiprobabilité continue ?
Trois outils d’inférence non paramétriques dominent l’analyse de conformité à l’uniformité :
1. **Le test de Kolmogorov-Smirnov (K-S)** : Il repose sur la quantification de la distance suprémum (distance $L_\infty$) séparant la fonction de répartition empirique $F_n(x)$ de la fonction de répartition théorique uniforme $F_0(x) = \frac{x – a}{b – a}$. La statistique de test s’écrit :$$D_n = sup_{x in [a, b]} |F_n(x) – F_0(x)| = max_{1 le i le n} left{ maxleft( frac{i}{n} – F_0(x_{(i)}), F_0(x_{(i)}) – frac{i – 1}{n} right) right}$H_0$ de parfaite uniformité, la loi de la statistique $\sqrt{n} D_n$ converge asymptotiquement vers la distribution de Kolmogorov. Si $D_n$ excède la valeur critique au seuil choisi (par exemple $\frac{1{,}36}{\sqrt{n}}$ pour $\alpha = 0{,}05$), l'hypothèse d'uniformité est rejetée.
2. **Le test du Chi-deux ($\chi^2$) d'adéquation** : Applicable après discrétisation de l'intervalle continue en $k$ classes équiprobables disjointes de largeur égale. Si $O_j$ désigne l'effectif observé dans la classe $j$ et $E_j = \frac{n}{k}$ l'effectif théorique attendu sous $H_0$, la statistique : »>$$Sous l’hypothèse nulle $H_0$ de parfaite uniformité, la loi de la statistique $\sqrt{n} D_n$ converge asymptotiquement vers la distribution de Kolmogorov. Si $D_n$ excède la valeur critique au seuil choisi (par exemple $\frac{1{,}36}{\sqrt{n}}$ pour $\alpha = 0{,}05$), l’hypothèse d’uniformité est rejetée.
2. **Le test du Chi-deux ($\chi^2$) d’adéquation** : Applicable après discrétisation de l’intervalle continue en $k$ classes équiprobables disjointes de largeur égale. Si $O_j$ désigne l’effectif observé dans la classe $j$ et $E_j = \frac{n}{k}$ l’effectif théorique attendu sous $H_0$, la statistique :$$D^2 = sum_{j=1}^k frac{(O_j – E_j)^2}{E_j} = frac{k}{n} sum_{j=1}^k O_j^2 – n$\chi^2$ à $k – 1$ degrés de liberté (ou $k – 3$ si les bornes $a$ et $b$ sont estimées par la méthode des moments). Bien que populaire, ce test présente une faiblesse méthodologique notoire : la perte d'information consécutive au découpage en classes arbitraires et sa faible puissance face à des alternatives subtiles.
3. **Le test d'Anderson-Darling ($A^2$)** : Version pondérée du test de Cramér-von Mises, il est particulièrement efficace pour détecter les déviations d'uniformité localisées aux abords immédiats des bornes de support $a$ et $b$. Sa formulation mathématique : »>$$suit asymptotiquement une loi du $\chi^2$ à $k – 1$ degrés de liberté (ou $k – 3$ si les bornes $a$ et $b$ sont estimées par la méthode des moments). Bien que populaire, ce test présente une faiblesse méthodologique notoire : la perte d’information consécutive au découpage en classes arbitraires et sa faible puissance face à des alternatives subtiles.
3. **Le test d’Anderson-Darling ($A^2$)** : Version pondérée du test de Cramér-von Mises, il est particulièrement efficace pour détecter les déviations d’uniformité localisées aux abords immédiats des bornes de support $a$ et $b$. Sa formulation mathématique :$$A^2 = -n – frac{1}{n} sum_{i=1}^n left( (2i – 1) ln(u_{(i)}) + (2(n – i) + 1) ln(1 – u_{(i)}) right)$u_{(i)} = \frac{x_{(i)} – a}{b – a}$, attribue un poids analytique prépondérant aux résidus périphériques, garantissant une détection des contaminations ou des compressions marginales souvent manquées par le test de Kolmogorov-Smirnov.
### 11.2 Le paradoxe de Bertrand et les problèmes de paramétrisation
Les limites épistémologiques du concept d'équiprobabilité sur un univers conti\nu ont été mises en évidence en 1889 par le mathématicien français <a href="https://fr.wikipedia.org/wiki/Joseph_Bertrand">Joseph Bertrand</a> à travers un résultat célèbre de la théorie géométrique des probabilités : le **paradoxe de Bertrand**. Ce problème démontre qu'appliquer le principe d'indifférence de Laplace en postulant une distribution uniforme sans spécifier de manière univoque le groupe d'invariance géométrique conduit à des contradictions insolubles.
Le problème s'énonce simplement : *Quelle est la probabilité qu'une corde choisie au hasard dans un cercle donné soit plus longue que le côté du triangle équilatéral inscrit dans ce même cercle ?*
Bertrand démontre que la réponse dép\end entièrement de la méthode de tirage uniforme adoptée :
1. **Méthode des extrémités aléatoires** : On fixe un premier p\oint sur la circonférence et on choisit uniformément le second p\oint le long du périmètre circulaire. La probabilité est alors rigoureusement égale à $\frac{1}{3} \approx 0{,}333$.
2. **Méthode du rayon aléatoire** : On choisit un rayon de manière uniforme et, sur ce rayon, on choisit uniformément la distance du milieu de la corde au centre du cercle. La probabilité résultante est égale à $\frac{1}{2} = 0{,}500$.
3. **Méthode du p\oint intérieur aléatoire** : On choisit un p\oint uniformément distribué à l'intérieur de la surface du disque pour servir de milieu à la corde. La probabilité s'établit alors à $\frac{1}{4} = 0{,}250$.
Ce paradoxe révèle que la notion de « distribution uniforme » n'est pas invariante par changement de variable ou de système de coordonnées. Une variable aléatoire $X$ distribuée uniformément selon $X \sim \mathcal{U}(a, b)$ ne produit pas une variable uniforme lorsqu'on lui applique une transformation non linéaire simple telle que $Y = X^2$ ou $Y = \frac{1}{X}$. La densité de la nouvelle variable $Y$ sera fortement modulée par la dérivée du changement de variable.
Comme l'a formellement établi Edwin Jaynes en 1973 grâce au principe de transformation des groupes d'invariance (invariance par translation et par rotation), la détermination d'une loi uniforme n'est objectivement définie que si l'on précise le groupe de symétries physiques sous-jacent au problème. En l'absence de ces précisions de géométrie différentielle, l'assignation d'une loi uniforme relève d'une convention subjective arbitraire, invalidant l'illusion d'une neutralité probabiliste universelle.
### 11.3 Erreurs méthodologiques courantes dans la recherche empirique
L'intégration de la distribution uniforme au sein des protocoles de recherche en sciences humaines et comportementales donne lieu à plusieurs erreurs méthodologiques récurrentes qui faussent l'interprétation des données empiriques :
* **La confusion entre étalement empirique et équiprobabilité réelle** : Les praticiens confondent parfois un histogramme aplati ou une forte dispersion des scores a\vec une véritable loi uniforme. Cette apparence plane résulte souvent de la superposition de sous-populations hétérogènes (mélange de lois normales aux moyennes divergentes) ou d'un artefact de sur-dispersion. Postuler une loi uniforme dans un tel contexte revient à ignorer la structure multimodale sous-jacente du phénomène psychologique.
* **La négligence de la troncature instrumentale aux frontières** : Tout instrument de mesure comportemental possède des limites techniques d'enregistrement (temps d'affichage minimal d'un écran, saturation d'un capteur de force, échelle d'évaluation finie). Lorsque des observations empiriques s'accumulent au contact immédiat des bornes minimales ou maximales, postuler une loi uniforme continue $[a, b]$ engendre un biais d'estimation sévère. Cette accumulation périphérique correspond à un processus de censure ou de troncature, qui doit être modélisé par une loi mixte (atomique aux bornes et continue au centre) sous peine de fausser l'estimation de la variance.
* **Le sophisme de l'équiprobabilité a priori en inférence bayésienne** : Dans l'analyse bayésienne de données comportementales, assigner par réflexe un a priori uniforme $p(\theta) \sim \mathcal{U}(-\infty, +\infty)$ (a priori impropre) ou $p(\theta) \sim \mathcal{U}(a, b)$ sous prétexte de « laisser parler les données » peut induire des distorsions imprévues sur les fonctions dérivées. Par exemple, si l'on pose un a priori uniforme sur la variance $\sigma^2 \sim \mathcal{U}(0, C)$, cela induit un a priori non uniforme sur l'écart-type $\sigma$ ou sur la précision $\tau = \frac{1}{\sigma^2}$, favorisant indirectement certaines plages de valeurs. L'utilisation d'a priori de référence non informatifs de Jeffreys (invariants par reparamétrisation) est souvent préférable à l'uniformité naïve.
## 12. Synthèse théorique et extensions multidimensionnelles
### 12.1 Généralisation à la loi uniforme multivariée
L'extension de la loi uniforme à des espaces de dimension supérieure s'articule par l'application de la théorie de la mesure multidimensionnelle. Soit $\mathcal{D}$ un sous-ensemble borélien compact, connexe et non dégénéré de l'e\space vectoriel euclidien $\mathbb{R}^n$, dont la mesure de Lebesgue $n$-dimensionnelle (son volume euclidien), notée $\lambda_n(\mathcal{D}) = \text{Vol}(\mathcal{D})$, est strictement positive et finie ($0 < \text{Vol}(\mathcal{D}) < +\infty$).
Un vecteur aléatoire $\mathbf{X} = (X_1, X_2, dots, X_n)^T$ suit une distribution uniforme continue sur le domaine spatial $\mathcal{D}$, noté $\mathbf{X} \sim \mathcal{U}(\mathcal{D})$, si sa fonction de densité de probabilité conjointe $f_{\mathbf{X}}(\mathbf{x})$ est rigoureusement constante sur l'intégralité du domaine $\mathcal{D}$ et identiquement nulle en dehors : »>$$où $u_{(i)} = \frac{x_{(i)} – a}{b – a}$, attribue un poids analytique prépondérant aux résidus périphériques, garantissant une détection des contaminations ou des compressions marginales souvent manquées par le test de Kolmogorov-Smirnov.
### 11.2 Le paradoxe de Bertrand et les problèmes de paramétrisation
Les limites épistémologiques du concept d’équiprobabilité sur un univers conti\nu ont été mises en évidence en 1889 par le mathématicien français Joseph Bertrand à travers un résultat célèbre de la théorie géométrique des probabilités : le **paradoxe de Bertrand**. Ce problème démontre qu’appliquer le principe d’indifférence de Laplace en postulant une distribution uniforme sans spécifier de manière univoque le groupe d’invariance géométrique conduit à des contradictions insolubles.
Le problème s’énonce simplement : *Quelle est la probabilité qu’une corde choisie au hasard dans un cercle donné soit plus longue que le côté du triangle équilatéral inscrit dans ce même cercle ?*
Bertrand démontre que la réponse dép\end entièrement de la méthode de tirage uniforme adoptée :
1. **Méthode des extrémités aléatoires** : On fixe un premier p\oint sur la circonférence et on choisit uniformément le second p\oint le long du périmètre circulaire. La probabilité est alors rigoureusement égale à $\frac{1}{3} \approx 0{,}333$.
2. **Méthode du rayon aléatoire** : On choisit un rayon de manière uniforme et, sur ce rayon, on choisit uniformément la distance du milieu de la corde au centre du cercle. La probabilité résultante est égale à $\frac{1}{2} = 0{,}500$.
3. **Méthode du p\oint intérieur aléatoire** : On choisit un p\oint uniformément distribué à l’intérieur de la surface du disque pour servir de milieu à la corde. La probabilité s’établit alors à $\frac{1}{4} = 0{,}250$.
Ce paradoxe révèle que la notion de « distribution uniforme » n’est pas invariante par changement de variable ou de système de coordonnées. Une variable aléatoire $X$ distribuée uniformément selon $X \sim \mathcal{U}(a, b)$ ne produit pas une variable uniforme lorsqu’on lui applique une transformation non linéaire simple telle que $Y = X^2$ ou $Y = \frac{1}{X}$. La densité de la nouvelle variable $Y$ sera fortement modulée par la dérivée du changement de variable.
Comme l’a formellement établi Edwin Jaynes en 1973 grâce au principe de transformation des groupes d’invariance (invariance par translation et par rotation), la détermination d’une loi uniforme n’est objectivement définie que si l’on précise le groupe de symétries physiques sous-jacent au problème. En l’absence de ces précisions de géométrie différentielle, l’assignation d’une loi uniforme relève d’une convention subjective arbitraire, invalidant l’illusion d’une neutralité probabiliste universelle.
### 11.3 Erreurs méthodologiques courantes dans la recherche empirique
L’intégration de la distribution uniforme au sein des protocoles de recherche en sciences humaines et comportementales donne lieu à plusieurs erreurs méthodologiques récurrentes qui faussent l’interprétation des données empiriques :
* **La confusion entre étalement empirique et équiprobabilité réelle** : Les praticiens confondent parfois un histogramme aplati ou une forte dispersion des scores a\vec une véritable loi uniforme. Cette apparence plane résulte souvent de la superposition de sous-populations hétérogènes (mélange de lois normales aux moyennes divergentes) ou d’un artefact de sur-dispersion. Postuler une loi uniforme dans un tel contexte revient à ignorer la structure multimodale sous-jacente du phénomène psychologique.
* **La négligence de la troncature instrumentale aux frontières** : Tout instrument de mesure comportemental possède des limites techniques d’enregistrement (temps d’affichage minimal d’un écran, saturation d’un capteur de force, échelle d’évaluation finie). Lorsque des observations empiriques s’accumulent au contact immédiat des bornes minimales ou maximales, postuler une loi uniforme continue $[a, b]$ engendre un biais d’estimation sévère. Cette accumulation périphérique correspond à un processus de censure ou de troncature, qui doit être modélisé par une loi mixte (atomique aux bornes et continue au centre) sous peine de fausser l’estimation de la variance.
* **Le sophisme de l’équiprobabilité a priori en inférence bayésienne** : Dans l’analyse bayésienne de données comportementales, assigner par réflexe un a priori uniforme $p(\theta) \sim \mathcal{U}(-\infty, +\infty)$ (a priori impropre) ou $p(\theta) \sim \mathcal{U}(a, b)$ sous prétexte de « laisser parler les données » peut induire des distorsions imprévues sur les fonctions dérivées. Par exemple, si l’on pose un a priori uniforme sur la variance $\sigma^2 \sim \mathcal{U}(0, C)$, cela induit un a priori non uniforme sur l’écart-type $\sigma$ ou sur la précision $\tau = \frac{1}{\sigma^2}$, favorisant indirectement certaines plages de valeurs. L’utilisation d’a priori de référence non informatifs de Jeffreys (invariants par reparamétrisation) est souvent préférable à l’uniformité naïve.
## 12. Synthèse théorique et extensions multidimensionnelles
### 12.1 Généralisation à la loi uniforme multivariée
L’extension de la loi uniforme à des espaces de dimension supérieure s’articule par l’application de la théorie de la mesure multidimensionnelle. Soit $\mathcal{D}$ un sous-ensemble borélien compact, connexe et non dégénéré de l’e\space vectoriel euclidien $\mathbb{R}^n$, dont la mesure de Lebesgue $n$-dimensionnelle (son volume euclidien), notée $\lambda_n(\mathcal{D}) = \text{Vol}(\mathcal{D})$, est strictement positive et finie ($0 < \text{Vol}(\mathcal{D}) < +\infty$).
Un vecteur aléatoire $\mathbf{X} = (X_1, X_2, dots, X_n)^T$ suit une distribution uniforme continue sur le domaine spatial $\mathcal{D}$, noté $\mathbf{X} \sim \mathcal{U}(\mathcal{D})$, si sa fonction de densité de probabilité conjointe $f_{\mathbf{X}}(\mathbf{x})$ est rigoureusement constante sur l'intégralité du domaine $\mathcal{D}$ et identiquement nulle en dehors :$$f_{mathbf{X}}(mathbf{x}) = frac{1}{text{Vol}(mathcal{D})} cdot mathbf{1}_{mathcal{D}}(mathbf{x}) = begin{cases} frac{1}{int_{mathcal{D}} dmathbf{x}} & text{si } mathbf{x} in mathcal{D} 0 & text{si } mathbf{x} notin mathcal{D} end{cases}$\mathcal{D}$ correspond à un hyperpavé droit (hypercube cartésien) défini par le produit cartésien d'intervalles réels indépendants : $\mathcal{D} = [a_1, b_1] \times [a_2, b_2] \times dots \times [a_n, b_n]$. Le volume s'écrit alors comme le produit des longueurs de chaque arête : $\text{Vol}(\mathcal{D}) = \prod_{i=1}^n (b_i – a_i)$. La fonction de densité conjointe s'exprime sous une forme entièrement séparable : »>$$Un cas d'application canonique est celui où le domaine $\mathcal{D}$ correspond à un hyperpavé droit (hypercube cartésien) défini par le produit cartésien d'intervalles réels indépendants : $\mathcal{D} = [a_1, b_1] \times [a_2, b_2] \times dots \times [a_n, b_n]$. Le volume s'écrit alors comme le produit des longueurs de chaque arête : $\text{Vol}(\mathcal{D}) = \prod_{i=1}^n (b_i – a_i)$. La fonction de densité conjointe s'exprime sous une forme entièrement séparable :$$f_{mathbf{X}}(x_1, dots, x_n) = prod_{i=1}^n left( frac{1}{b_i – a_i} cdot mathbf{1}_{[a_i, b_i]}(x_i) right) = prod_{i=1}^n f_{X_i}(x_i)$X_i \sim \mathcal{U}(a_i, b_i)$.
En revanche, si le domaine support n'est pas séparable en coordonnées cartésiennes (par exemple, un disque bidimensionnel $\mathcal{D} = {(x, y) in \mathbb{R}^2 mid x^2 + y^2 le R^2}$, où $\text{Vol}(\mathcal{D}) = \pi R^2$), les coordonnées cessent d'être indépendantes. Bien que la densité conjointe soit uniforme sur le disque ($f_{X, Y}(x, y) = \frac{1}{\pi R^2}$), la densité marginale de la composante $X$ s'obtient en intégrant le long de l'axe des ordonnées : »>$$Cette factorisation prouve formellement que sur un support hyper-rectangulaire régulier, les composantes marginales du vecteur aléatoire uniforme sont des variables aléatoires **stochastiquement indépendantes**, chacune distribuée selon une loi uniforme univariée $X_i \sim \mathcal{U}(a_i, b_i)$.
En revanche, si le domaine support n'est pas séparable en coordonnées cartésiennes (par exemple, un disque bidimensionnel $\mathcal{D} = {(x, y) in \mathbb{R}^2 mid x^2 + y^2 le R^2}$, où $\text{Vol}(\mathcal{D}) = \pi R^2$), les coordonnées cessent d'être indépendantes. Bien que la densité conjointe soit uniforme sur le disque ($f_{X, Y}(x, y) = \frac{1}{\pi R^2}$), la densité marginale de la composante $X$ s'obtient en intégrant le long de l'axe des ordonnées :$$f_X(x) = int_{-sqrt{R^2 – x^2}}^{+sqrt{R^2 – x^2}} frac{1}{pi R^2} , dy = frac{2sqrt{R^2 – x^2}}{pi R^2}, quad forall x in [-R, R]$\mathbb{S}^1$ ou sur l'intervalle angulaire $[0, 2\pi[$. Dans l'étude des rythmes circadiens ou de l'orientation spatiale chez l'animal (statistique directionnelle), les observations correspondent à des angles $\theta$. Une variable aléatoire angulaire $Theta$ est uniformément distribuée sur le cercle si sa fonction de densité par rapport à la mesure angulaire de Lebesgue s'écrit : »>$$Cette densité marginale n'est plus uniforme, mais semi-elliptique de Wigner. Cet exemple illustre une propriété géométrique centrale : la projection marginale d'une loi uniforme multivariée sur un sous-e\space vectoriel n'est uniforme que si et seulement si la géométrie du domaine global est le produit tensoriel des géométries des sous-espaces.
En sciences cognitives, cette modélisation multivariée est exploitée pour cartographier le déploiement spatial de l'attention visuelle sur des écrans d'affichage ou pour modéliser des paysages d'apprentissage associatif multidimensionnels où aucun p\oint saillant n'attire le regard de manière préférentielle.
### 12.2 Loi uniforme sur des variétés géométriques non euclidiennes
Lorsque l'e\space des données ne s'identifie pas à un e\space plat euclidien mais à une variété différentielle riemannienne courbe, la caractérisation de l'équiprobabilité requiert le formalisme de la théorie de l'intégration sur les variétés et de la mesure de Haar associée aux groupes de Lie compacts.
L'exemple le plus représentatif en modélisation comportementale et en chronobiologie est la **loi uniforme circulaire**, définie sur le cercle unité $\mathbb{S}^1$ ou sur l'intervalle angulaire $[0, 2\pi[$. Dans l'étude des rythmes circadiens ou de l'orientation spatiale chez l'animal (statistique directionnelle), les observations correspondent à des angles $\theta$. Une variable aléatoire angulaire $Theta$ est uniformément distribuée sur le cercle si sa fonction de densité par rapport à la mesure angulaire de Lebesgue s'écrit :$$f_{Theta}(theta) = frac{1}{2pi}, quad forall theta in [0, 2pi[$\mathbb{S}^2 \subset \mathbb{R}^3$, utile pour modéliser le cha\mp visuel complet ou la direction des mouvements oculaires en trois dimensions. La surface totale de la sphère unité étant égale à $4\pi$ stéradians, la densité surfacique uniforme d'un vecteur directionnel unitaire $\mathbf{V}$ s'écrit $f_{\mathbf{V}}(\mathbf{v}) = \frac{1}{4\pi}$.
En coordonnées sphériques usuelles (longitude $\phi in [0, 2\pi[$ et colatitude $\theta in [0, \pi]$), l'élément de surface différentiel est $d\Omega = \sin(\theta) , d\theta , d\phi$. La densité de probabilité conjointe correspondante s'exprime donc par : »>$$Cette distribution angulaire uniforme constitue l'hypothèse nulle fondamentale (test de Rayleigh) pour évaluer si une colonie animale ou une fonction physiologique manifeste une orientation directionnelle ou un pic périodique significatif par rapport au cycle jour-nuit.
Cette logique se généralise directement à la surface de la sphère unité bidimensionnelle $\mathbb{S}^2 \subset \mathbb{R}^3$, utile pour modéliser le cha\mp visuel complet ou la direction des mouvements oculaires en trois dimensions. La surface totale de la sphère unité étant égale à $4\pi$ stéradians, la densité surfacique uniforme d'un vecteur directionnel unitaire $\mathbf{V}$ s'écrit $f_{\mathbf{V}}(\mathbf{v}) = \frac{1}{4\pi}$.
En coordonnées sphériques usuelles (longitude $\phi in [0, 2\pi[$ et colatitude $\theta in [0, \pi]$), l'élément de surface différentiel est $d\Omega = \sin(\theta) , d\theta , d\phi$. La densité de probabilité conjointe correspondante s'exprime donc par :$$f_{Theta, Phi}(theta, phi) = frac{sin(theta)}{4pi}$$
Ce résultat souligne une erreur classique de programmation : pour générer des points uniformément distribués à la surface d'une sphère (par exemple pour explorer un champ de vision immersif en réalité virtuelle), il ne faut pas tirer l'angle polaire $\theta$ de manière uniforme sur $[0, \pi]$. Un tel tirage créerait une concentration artificielle de points aux pôles. L'algorithme correct requiert de poser $\cos(\theta) \sim \mathcal{U}(-1, 1)$ et $\phi \sim \mathcal{U}(0, 2\pi)$, illustrant à nouveau l'interaction étroite entre métrique riemannienne de l'espace et formalisme probabiliste de l'uniformité.
### 12.3 Bilan récapitulatif pour le praticien des données comportementales
Pour le praticien des sciences comportementales, de la psychologie quantitative et de l'analyse computationnelle des données, la distribution uniforme ne doit être réduite ni à une curiosité théorique élémentaire, ni à une panacée automatique pour formaliser l'ignorance. Elle constitue un modèle stochastique précis, soumis à des contraintes structurelles strictes et porteur d'hypothèses géométriques lourdes.
Le schéma décisionnel suivant synthétise les critères de mobilisation de la loi uniforme au sein d'une chaîne de modélisation :
1. **Vérification de la nature du support** : Le phénomène observé est-il strictement borné par des contraintes physiques, biologiques ou temporelles indépassables ($a$ et $b$ finis) ? Si le support théorique est infini ou semi-infini ($[0, +\infty[$), la distribution uniforme continue n'existe pas comme mesure de probabilité propre.
2. **Sélection du modèle nul** : L'hypothèse nulle scientifique postule-t-elle une indifférence spatiale, temporelle ou perceptive absolue ? Si oui, la loi uniforme fournit le cadre mathématique standard pour tester les déviations directionnelles via les tests de Kolmogorov-Smirnov, d'Anderson-Darling ou de Rayleigh.
3. **Gestion de la non-invariance par transformation** : L'échelle de mesure fait-elle l'objet d'un changement de variable non linéaire ? Si une transformation logarithmique ou quadratique est appliquée aux scores bruts, l'uniformité est irrémédiablement rompue sur la nouvelle échelle.
4. **Inférence et estimation** : En présence d'un échantillon à bornes inconnues, privilégier systématiquement les estimateurs corrigés du maximum de vraisemblance basés sur les statistiques d'ordre plutôt que la méthode des moments, qui peut projeter des points observés en dehors du support estimé.
En respectant ces principes fondamentaux issus de la théorie de la mesure et de l'analyse stochastique, le chercheur s'assure d'exploiter la distribution uniforme dans toute sa rigueur analytique. Elle demeure ainsi l'étalon par rapport auquel toute structure, tout biais cognitif et toute régularité statistique peuvent être rigoureusement identifiés, quantifiés et compris dans l'exploration du comportement humain et des dynamiques du monde réel.
## Références
* Bertrand, J. (1889). *Calcul des probabilités*. Gauthier-Villars. https://gallica.bnf.fr/ark:/12148/bpt6k29007t
* Ellsberg, D. (1961). Risk, ambiguity, and the Savage axioms. *The Quarterly Journal of Economics*, 75(4), 643–669. https://doi.org/10.2307/1884324
* Fechner, G. T. (1860). *Elemente der Psychophysik*. Breitkopf und Härtel.
* Green, D. M., & Swets, J. A. (1966). *Signal detection theory and psychophysics*. John Wiley & Sons.
* Jaynes, E. T. (1968). Prior probabilities. *IEEE Transactions on Systems Science and Cybernetics*, 4(3), 227–241. https://doi.org/10.1109/TSSC.1968.300117
* Jaynes, E. T. (1973). The well-posed problem. *Foundations of Physics*, 3(4), 477–492. https://doi.org/10.1007/BF00709116
* Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. *Econometrica*, 47(2), 263–291. https://doi.org/10.2307/1914185
* Kolmogorov, A. N. (1933). *Grundbegriffe der Wahrscheinlichkeitsrechnung*. Springer. https://doi.org/10.1007/978-3-642-49888-6
* Laplace, P.-S. (1814). *Essai philosophique sur les probabilités*. Courcier. https://gallica.bnf.fr/ark:/12148/bpt6k202570g
* L'Ecuyer, P., & Simard, R. (2007). TestU01: A C library for empirical testing of random number generators. *ACM Transactions on Mathematical Software*, 33(4), Article 22. https://doi.org/10.1145/1268776.1268777
* Marsaglia, G. (1968). Random numbers fall mainly in the planes. *Proceedings of the National Academy of Sciences*, 61(1), 25–28. https://doi.org/10.1073/pnas.61.1.25
* Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. *ACM Transactions on Modeling and Computer Simulation*, 8(1), 3–30. https://doi.org/10.1145/272991.272995
* Niemi, P., & Näätänen, R. (1981). Foreperiod and simple reaction time. *Psychological Bulletin*, 89(1), 133–162. https://doi.org/10.1037/0033-2909.89.1.133
* von Neumann, J. (1951). Various techniques used in connection with random digits. *National Bureau of Standards Applied Mathematics Series*, 12, 36–38.
* von Neumann, J., & Morgenstern, O. (1944). *Theory of games and economic behavior*. Princeton University Press.