
L’avènement de l’apprentissage automatique contemporain a profondément bouleversé l’édifice de l’analyse prédictive et de l’inférence statistique. Alors que les paradigmes classiques de la modélisation reposaient sur une quête d’élégance analytique et de parcimonie mathématique, incarnée par des structures rigides et paramétriques, l’essor exponentiel des capacités computationnelles et la disponibilité de corpus de données massifs ont révélé les limites intrinsèques de ces approches fondatrices. Face à des phénomènes du monde réel caractérisés par des topologies hautement non linéaires, des interactions multifactorielles complexes et des distributions sous-jacentes méconnues, la science des données s’est progressivement détournée des postulats déductifs stricts pour embrasser des méthodologies empiriques inductives. C’est au cœur de cette mutation épistémologique qu’ont émergé les méthodes ensemblistes, reposant sur un principe philosophique et mathématique d’une remarquable puissance : la combinaison synergique d’une multiplicité d’estimateurs individuels permet d’atteindre un niveau de précision et de robustesse inaccessible au meilleur des modèles isolés.
Parmi ces architectures collectives, le Bootstrap Aggregating, universellement désigné sous l’acronyme de Bagging et théorisé de manière séminale par le statisticien Leo Breiman en 1996, constitue l’un des jalons les plus déterminants de l’histoire de l’intelligence artificielle moderne. En fusionnant l’ingéniosité computationnelle du rééchantillonnage par bootstrap non paramétrique — formalisé initialement par Bradley Efron en 1979 — avec la flexibilité expressive des arbres de décision, le Bagging apporte une solution élégante et rigoureusement étayée au problème lancinant du compromis biais-variance. L’intuition de Breiman transcende la simple heuristique informatique : elle démontre formellement qu’en agrégeant les prédictions d’estimateurs structurellement instables mais non biaisés, il est possible de compresser drastiquement l’erreur stochastique sans altérer la fidélité de l’approximation fonctionnelle.
Ce traité exhaustif se propose d’explorer les fondements théoriques, la cinématique algorithmique et les répercussions pratiques du Bagging dans l’écosystème de l’apprentissage automatique. Du déclin programmé des modèles linéaires classiques jusqu’aux raffinements contemporains appliqués aux séries temporelles et aux réseaux neuronaux profonds, nous disséquerons les rouages intimes de cette technique d’ensemble. À travers une analyse rigoureuse des mécanismes de partitionnement récursif, de la décomposition analytique des erreurs de généralisation, de la géométrie des frontières de décision et de la validation hors sac (Out-Of-Bag), ce document offre aux chercheurs, praticiens et étudiants avancés un panorama exhaustif des vertus statistiques et des défis opérationnels inhérents à l’agrégation bootstrap.
1. Fondements de la modélisation statistique : De la linéarité à la complexité non linéaire
1.1 Les postulats des modèles linéaires classiques
L’architecture intellectuelle de la statistique inférentielle a longtemps été dominée par le cadre d’analyse de la régression linéaire multiple et le théorème de Gauss-Markov. Dans ce cadre, la relation unissant un vecteur de prédicteurs continus ou catégoriels à une variable de réponse continue est modélisée sous la forme d’une combinaison linéaire de paramètres pondérée par une perturbation stochastique. L’orthogonalité requise entre les régresseurs et le terme d’erreur, l’hypothèse fondamentale d’exogénéité stricte, ainsi que la condition sine qua non d’homoscédasticité — prescrivant une variance résiduelle constante sur l’ensemble du spectre des valeurs prédites — constituent l’échafaudage indispensable garantissant l’optimalité des estimateurs des moindres carrés ordinaires au sein de la classe des estimateurs linéaires sans biais (propriété BLUE, pour Best Linear Unbiased Estimator).
Toutefois, la confrontation de ces postulats canoniques à des données empiriques non contrôlées met en lumière une incapacité structurelle à capturer les interactions d’ordre supérieur en l’absence d’un travail d’ingénierie explicite et exhaustif des variables explicatives. Dans un espace multidimensionnel, supposer que l’impact marginal d’une variable prédictive sur la cible demeure strictement additif et invariable, quel que soit l’état d’activation des autres attributs du système, relève d’une simplification souvent excessive. Dès lors qu’un phénomène physique, économique ou biologique fait intervenir des boucles de rétroaction, des saturations ou des effets de seuil, le modèle linéaire impose une projection coercitive qui mutile la réalité topologique des données, générant un biais de spécification irréductible.
À cette rigidité structurelle s’ajoute une vulnérabilité critique vis-à-vis des valeurs aberrantes ou des points de fort levier dans l’espace des variables explicatives. La fonction de perte quadratique usuelle, par sa nature convexe et strictement croissante à l’infini, attribue un poids disproportionné aux observations périphériques, ce qui peut déstabiliser l’orientation de l’hyperplan de régression de manière désastreuse. De surcroît, dans les contextes de classification linéaire (à l’instar de l’analyse discriminante linéaire de Fisher ou de la régression logistique bivariée), la détermination de frontières de décision paramétriques hyperplanaires s’avère incapable de segmenter des variétés riemanniennes imbriquées ou des distributions non séparables linéairement sans un recours périlleux à des transformations polynomiales d’ordre élevé, lesquelles induisent une explosion combinatoire du nombre de dimensions.
1.2 L’émergence des approches non paramétriques
L’accumulation exponentielle de données de haute dimensionnalité a catalysé une rupture paradigmatique majeure en faveur des approches dites non paramétriques. Contrairement aux formulations classiques qui assument une distribution probabiliste théorique préexistante (telle que la loi normale multidimensionnelle), les méthodologies non paramétriques n’imposent pas a priori de forme fonctionnelle analytique fixe à la relation reliant les covariables à la variable d’intérêt. L’impératif n’est plus de contraindre les observations à s’insérer dans le carcan d’une équation prédéfinie, mais de permettre aux données d’informer directement et souverainement la géométrie de la fonction d’approximation, épousant ainsi les sinuosités, les discontinuités et les courbures intrinsèques des variétés sous-jacentes.
Cette transition technique s’accompagne d’un glissement épistémologique fondamental : le passage d’une focalisation exclusive sur l’inférence causale et l’interprétabilité asymptotique des paramètres à la maximisation résolue de la performance prédictive hors échantillon. Tandis que l’économétrie traditionnelle privilégie des estimateurs convergents et des tests d’hypothèses fondés sur des distributions asymptotiques (tests de Wald, rapports de vraisemblance), l’apprentissage statistique contemporain érige la généralisation empirique sur des données jamais rencontrées en critère d’évaluation absolu. Ce basculement a été magistralement explicité par Leo Breiman dans son essai fondateur sur les deux cultures statistiques, dans lequel il oppose la culture de la modélisation des données à celle des modèles algorithmiques.
Dans ce nouveau cadre méthodologique, la performance d’un algorithme n’est plus évaluée à l’aune de sa significativité statistique sous des hypothèses restrictives souvent irréalistes, mais par sa faculté intrinsèque à minimiser une fonction de risque empirique régularisée. L’apprentissage automatique moderne s’émancipe des contraintes matricielles traditionnelles telles que l’inversion de matrices de variance-covariance mal conditionnées par la multicolinéarité pour déployer des procédures itératives d’optimisation numérique. C’est précisément au confluent de cette quête de flexibilité non paramétrique et de la rigueur algorithmique que s’inscrivent les modèles à base d’arbres de décision, socles privilégiés de l’apprentissage ensembliste.
2. Les arbres de classification et de régression (CART)
2.1 Mécanisme de partitionnement récursif binaire
L’architecture des arbres de classification et de régression, universalisée sous l’appellation d’algorithme CART par Leo Breiman, Jerome Friedman, Richard Olshen et Charles Stone en 1984, repose sur une stratégie de décomposition séquentielle et hiérarchique de l’espace des descripteurs. Le mécanisme fondamental consiste en un partitionnement récursif binaire, où l’espace des variables d’entrée est subdivisé en une multitude d’hyperrectangles disjoints alignés sur les axes de coordonnées. À chaque nœud de l’arbre, l’algorithme explore de manière exhaustive toutes les variables explicatives disponibles et, pour chacune d’elles, l’ensemble des points de coupure envisageables, afin de sélectionner le diptyque variable-seuil qui maximise une métrique prédéfinie de gain d’homogénéité au sein des sous-nœuds résultants.
Dans le contexte de la régression, où la cible est quantitative, le critère d’optimalité de la division est invariablement la minimisation de la somme des erreurs au carré (SSE, pour Sum of Squared Errors) au sein des deux sous-régions filles créées. Soit une division d’une région parente en deux sous-espaces distincts : l’algorithme calcule la moyenne de la variable cible dans chaque sous-espace et cherche le seuil qui minimise la déviance totale par rapport à ces moyennes locales respectives. Le prédicteur terminal assigné à chaque feuille de l’arbre correspond alors simplement à l’espérance empirique de la variable réponse des observations tombant dans cette cellule de l’espace partitionné.
Pour les problèmes de classification, où la variable d’intérêt est qualitative à plusieurs modalités, la recherche de la scission optimale fait appel à des critères d’impureté probabilistes. Le critère prépondérant de CART est l’indice de diversité de Gini, qui quantifie la probabilité qu’un individu sélectionné au hasard soit mal classé s’il recevait une étiquette attribuée aléatoirement selon la distribution des classes dans le nœud considéré. Une alternative classique, issue de la théorie de l’information de Claude Shannon et popularisée par les algorithmes ID3 et C4.5 de Ross Quinlan, est l’entropie croisée, qui mesure le désordre informationnel du nœud. Le partitionnement progresse tant que des règles d’arrêt algorithmiques — telles qu’un seuil minimal de gain d’impureté, une profondeur maximale de l’arborescence ou un effectif plancher d’individus par feuille — ne sont pas activées, figeant ainsi un maillage orthogonal continu par morceaux de l’espace des données.
2.2 Avantages inhérents des architectures arborescentes
Les arbres de décision ont conquis une place de premier plan dans le corpus de la modélisation statistique en raison d’un ensemble exceptionnel de propriétés structurelles. Le premier atout réside incontestablement dans leur interprétabilité géométrique et heuristique immédiate. Contrairement aux modèles à paramètres distribués ou aux systèmes à représentations latentes continues, un arbre CART peut être intégralement transcrit sous la forme d’un ensemble déterministe de règles logiques conditionnelles imbriquées (de type « SI condition ALORS conséquence »). Cette structure logique offre une visibilité directe sur la prise de décision automatisée, un impératif éthique et juridique prépondérant dans des domaines critiques tels que le diagnostic médical ou le crédit bancaire.
Sur le plan de la prétraitabilité des données, les arbres CART manifestent une agnosticité technique remarquable. Ils traitent avec une égale aisance des variables quantitatives continues et des covariables qualitatives polytomiques sans nécessiter d’imputations complexes ou d’encodages artificiels susceptibles de distordre la topologie des données. De surcroît, le partitionnement binaire étant invariant vis-à-vis de toute transformation strictement monotone appliquée aux descripteurs unidimensionnels, l’utilisateur est affranchi des opérations laborieuses de centrage, de réduction ou de normalisation logarithmique indispensables au bon conditionnement des modèles linéaires ou des réseaux de neurones.
Enfin, CART démontre une robustesse intrinsèque face aux pathologies courantes de la modélisation classique. En effectuant des sélections locales de variables à chaque étape du partitionnement récursif, l’arbre neutralise la multicolinéarité sévère : si deux variables contiennent une information redondante, l’une d’elles est sélectionnée pour la division sans que le conditionnement numérique du système global n’en soit pénalisé. De même, l’exclusion automatique des covariables dénuées de pouvoir discriminant procure une sélection de caractéristiques intrinsèque et dynamique, tout en s’émancipant radicalement de toute hypothèse relative à la normalité des distributions multivariées.
2.3 Le talon d’Achille de CART : L’instabilité structurelle
En dépit de leur remarquable flexibilité fonctionnelle, les arbres de classification et de régression souffrent d’une tare méthodologique majeure qui entrave leur exploitation isolée dans des contextes prédictifs exigeants : leur phénoménale instabilité structurelle. Cette vulnérabilité découle directement de la nature intrinsèquement myope et gloutonne (greedy) de l’algorithme de partitionnement. À chaque nœud, la scission optimale est déterminée sur la base exclusive du gain d’impureté immédiat, sans considération prospective des divisions ultérieures. En conséquence, une perturbation marginale apportée à l’échantillon d’apprentissage — par exemple l’adjonction, la suppression ou la modification de quelques observations isolées — peut altérer le choix de la variable de scission au niveau du nœud racine ou des premiers niveaux hiérarchiques.
Cette altération liminaire produit des conséquences dévastatrices sur l’ensemble de la structure topologique subséquente. En vertu du mécanisme hiérarchique, une décision de division modifiée au sommet de l’arbre conditionne l’ensemble des sous-espaces disponibles pour les étapes suivantes. Les erreurs ou divergences de partitionnement ne s’amortissent pas : elles se propagent de manière cumulative et exponentielle le long des branches, engendrant des configurations de feuilles terminales et des allocations spatiales radicalement dissemblables. Un arbre entraîné sur une fraction d’un échantillon donné peut ainsi adopter une géométrie décisionnelle orthogonale totalement décorrélée de celle obtenue sur l’autre fraction.
Cette sensibilité aiguë aux fluctuations stochastiques d’échantillonnage confère aux arbres individuels une variance statistique colossale. Deux jeux de données générés par un même processus stochastique sous-jacent donneront naissance à des prédicteurs CART dont les prédictions locales peuvent être diamétralement opposées. Les arbres profonds, nécessaires pour capturer des interactions subtiles d’ordre supérieur, ont tendance à sculpter leurs frontières en épousant les idiosyncrasies et le bruit propre à l’échantillon d’entraînement plutôt que d’isoler la composante structurelle du signal. C’est cette faiblesse architecturale fondamentale qui justifie et nécessite la mise en œuvre de méthodologies d’ensemble stabilisatrices.
3. Le dilemme biais-variance sous l’angle des modèles ensemblistes
3.1 Décomposition formelle de l’erreur de généralisation
Pour appréhender rigoureusement la genèse du Bagging et son apport à la théorie de l’apprentissage, il est impératif de formaliser le comportement de l’erreur de généralisation au travers du prisme de la décomposition canonique biais-variance, théorisée pour la régression par Stuart Geman, Elie Bienenstock et René Doursat en 1992. Considérons une variable dépendante quantitative générée par un processus stochastique idéal sous la forme d’une fonction cible continue altérée par un terme d’erreur additif non observable d’espérance nulle et de variance homoscédastique finie. Soit un estimateur paramétrique ou non paramétrique calibré sur un ensemble fini d’apprentissage constitué de réalisations indépendantes et identiquement distribuées.
L’erreur quadratique moyenne de prédiction (MSE, pour Mean Squared Error) conditionnelle en un point d’interrogation donné de l’espace des caractéristiques se décompose analytiquement en trois termes distincts sous l’opérateur d’espérance pris sur l’ensemble des jeux d’apprentissage possibles de taille identique :
Premièrement, le carré du biais quantifie l’écart systématique entre l’espérance mathématique de la fonction d’ajustement estimée sur une infinité d’échantillons hypothétiques et la valeur théorique réelle de la fonction sous-jacente. Un biais élevé traduit un modèle d’une rigidité excessive, incapable de reproduire la complexité géométrique de la réalité (sous-apprentissage ou underfitting), à l’image d’une droite linéaire forcée sur un nuage de points sinusoïdal.
Deuxièmement, la variance statistique mesure la dispersion stochastique des prédictions du modèle autour de sa propre espérance empirique lorsqu’il est entraîné sur des répliques indépendantes issues de la même population source. Une variance élevée indique une sensibilité pathologique du modèle aux spécificités accidentelles de l’échantillon d’apprentissage particulier auquel il a été confronté.
Troisièmement, le bruit irréductible représente la variance stochastique intrinsèque au système physique ou mesuré, découlant de variables latentes non observées ou d’une imprécision expérimentale incontournable. Ce seuil incompressible, correspondant à la limite bayésienne du problème, délimite la borne inférieure théorique de l’erreur de généralisation qu’aucun algorithme, quelle que soit sa sophistication, ne saurait transgresser.
3.2 Diagnostic de la variance élevée chez les arbres profonds
L’application de cette grille de lecture analytique aux arbres de classification et de régression permet de caractériser avec une précision mathématique la pathologie structurelle identifiée par Breiman. Un arbre CART que l’on autorise à croître sans contrainte d’élagage (pruning) — c’est-à-dire jusqu’à ce que chaque feuille devienne pure ou ne contienne qu’un nombre infime d’observations — présente une propriété fondamentale : son biais d’ajustement est extrêmement faible. Sa capacité à découper l’espace des prédicteurs en un grand nombre de régions hyperrectangulaires disjointes lui permet d’approximer avec une grande acuité n’importe quelle surface de régression complexe ou frontière de décision discontinue.
Néanmoins, cette malléabilité quasi infinie s’obtient au prix d’une explosion incontrôlée de la composante de variance. Dans les régions terminales de l’arbre, les prédictions sont formulées à partir de sous-échantillons d’une taille dérisoire. L’estimateur local est dès lors soumis aux pires fluctuations d’échantillonnage : une simple fluctuation aléatoire dans l’étiquetage ou la valeur d’une seule observation suffit à modifier substantiellement le plateau prédictif de toute la région correspondante. L’arbre non élagué souffre ainsi d’un surapprentissage aigu (overfitting) : il mémorise par cœur le bruit expérimental et les artefacts stochastiques du jeu d’entraînement au détriment de l’apprentissage des régularités universelles du phénomène.
Les stratégies de régularisation traditionnelles, telles que l’élagage par complexité de coût (cost-complexity pruning), procèdent par arbitrage direct en tronquant l’arborescence : elles réduisent la variance au prix délibéré d’une augmentation substantielle du biais, sacrifiant ainsi les détails les plus fins de la fonction sous-jacente. L’enjeu méthodologique majeur auquel se sont heurtés les statisticiens consistait donc à concevoir une architecture capable d’annihiler la variance stochastique des arbres profonds sans dégrader leur remarquable absence de biais structurel. C’est précisément à cette quadrature du cercle algorithmique que répond le concept de Bagging en mobilisant la théorie du bootstrap.
4. Les fondements statistiques du rééchantillonnage par Bootstrap
4.1 Genèse et principe du bootstrap non paramétrique d’Efron
Pour s’affranchir de la dépendance à des hypothèses de distribution non vérifiables et contourner l’impossibilité pratique de collecter indéfiniment de nouveaux jeux de données auprès de la population réelle, Bradley Efron a introduit en 1979 une méthodologie informatique novatrice : le bootstrap non paramétrique. Le cœur conceptuel du bootstrap réside dans l’analogie féconde établie entre la population théorique parente et la distribution empirique observée au sein d’un échantillon représentatif de taille finie ( n ).
Le principe opérationnel repose sur le tirage uniforme avec remise de ( n ) observations individuelles à partir de l’échantillon initial de référence. Cette opération élémentaire de rééchantillonnage stochastique génère ce que l’on nomme un échantillon bootstrap (ou pseudo-échantillon). La caractéristique cardinale de ce processus réside dans le tirage avec remise : chaque observation du jeu initial dispose, à chaque itération de sélection élémentaire, d’une probabilité constante égale à ( 1/n ) d’être extraite, indépendamment de ses sélections antérieures. Par voie de conséquence, un échantillon bootstrap donné peut comporter des duplications multiples de certaines observations originales, tandis que d’autres en sont totalement absentes.
Sur le plan mathématique, le bootstrap repose sur le principe de substitution (plug-in principle). En vertu du théorème de Glivenko-Cantelli, la fonction de répartition empirique converge uniformément et presque sûrement vers la fonction de répartition théorique de la population d’origine lorsque la taille d’échantillon tend vers l’infini. Il s’ensuit que la distribution d’échantillonnage d’une statistique calculée sur des répliques bootstrap imite fidèlement la distribution d’échantillonnage réelle de cette statistique par rapport à la population parente. Cette percée théorique a transformé l’inférence statistique en substituant à des dérivations asymptotiques analytiques souvent insolubles la puissance brute de la simulation computationnelle intensive.
4.2 Dynamique combinatoire des échantillons bootstrap
L’analyse probabiliste du mécanisme de sélection avec remise révèle une constante asymptotique fondamentale qui gouverne l’ensemble de l’édifice du Bagging. Considérons un échantillon d’entraînement originel constitué de ( n ) vecteurs d’observations distincts. Lorsque l’on effectue un tirage aléatoire uniforme unitaire, la probabilité qu’une observation donnée ne soit pas sélectionnée équivaut strictement à :
[ P(text{non-sélection en un tirage}) = 1 – frac{1}{n} ]
Puisque la constitution d’un pseudo-échantillon bootstrap requiert l’exécution successive de ( n ) tirages stochastiques parfaitement indépendants et identiquement distribués avec remise, la probabilité conjointe qu’une observation déterminée échappe à la totalité des tirages s’écrit sous la forme factorisée du produit de ces probabilités élémentaires :
[ P(text{exclusion d’un échantillon bootstrap}) = left(1 – frac{1}{n}right)^n ]
En mobilisant la définition analytique classique de la fonction exponentielle comme limite d’une suite géométrique, nous examinons le comportement asymptotique de cette probabilité lorsque la taille de l’échantillon devient infiniment grande :
[ lim_{n to infty} left(1 – frac{1}{n}right)^n = e^{-1} = frac{1}{e} approx 0{,}367879 ]
Par complémentarité à l’unité, la probabilité qu’une observation empirique particulière apparaisse au moins une fois dans une réplique bootstrap donnée converge inexorablement vers la valeur limite :
[ lim_{n to infty} left(1 – left(1 – frac{1}{n}right)^nright) = 1 – frac{1}{e} approx 0{,}632121 ]
Cette dérivation combinatoire établit qu’en moyenne, pour tout échantillon d’apprentissage de dimension substantielle, une réplique bootstrap n’incorpore qu’approximativement 63,2 % d’individus distincts issus de la matrice source, chacun étant répété en moyenne selon une loi de Poisson de paramètre ( lambda = 1 ). Symétriquement, environ 36,8 % des observations originelles sont purement et simplement délaissées lors de chaque itération d’échantillonnage. Ce sous-ensemble récurrent d’individus exclus, loin de constituer une perte informationnelle, constitue la pierre angulaire de la validation interne des modèles ensemblistes, formalisée sous le concept d’échantillons Out-Of-Bag.
5. L’architecture algorithmique du Bagging (Bootstrap Aggregating)
5.1 Définition conceptuelle et formalisation de Leo Breiman
Constatant d’une part que les arbres de décision possèdent une expressivité non linéaire remarquable assortie d’un biais intrinsèque minime, et d’autre part que leur instabilité stochastique engendre une variance prédictive néfaste, Leo Breiman publia en 1996 un article fondateur intitulé « Bagging Predictors ». Il y formalise le concept de Bootstrap Aggregating, une méta-méthodologie algorithmique destinée à métamorphoser des prédicteurs instables en prédicteurs hautement fiables et robustes grâce à la création délibérée de diversité statistique suivie d’une consolidation collective.
Le protocole opératoire du Bagging se déploie selon une séquence parfaitement modulaire. Soit une matrice de données initiale composée de ( n ) couples d’observations associant un vecteur de descripteurs à une variable cible. L’algorithme procède en premier lieu à la génération stochastique de ( B ) répliques bootstrap distinctes et indépendantes, chacune dotée d’une taille strictement égale à ( n ), obtenues par tirage avec remise conformément aux règles combinatoires explicitées précédemment.
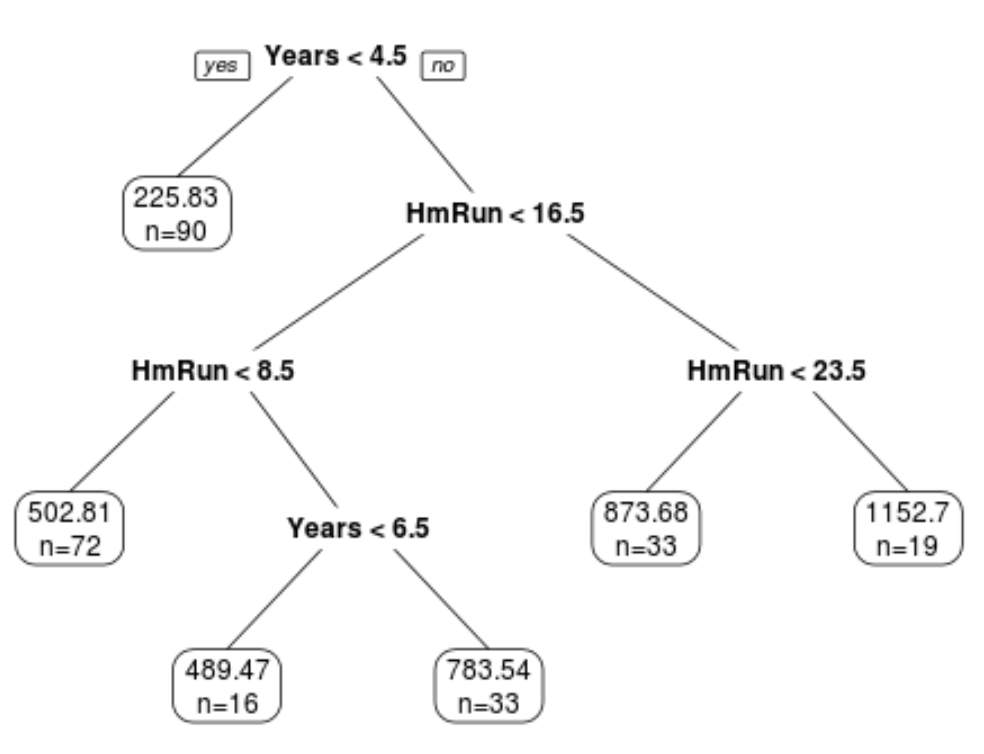
Dans un second temps, l’algorithme ajuste de manière strictement indépendante un estimateur de base (désigné en terminologie spécialisée sous le vocable de base learner ou d’apprenant élémentaire) sur chacune des ( B ) répliques bootstrap. La consigne méthodologique primordiale édictée par Breiman est de ne soumettre ces estimateurs de base — généralement des arbres CART — à aucune contrainte d’élagage sévère. On laisse délibérément croître des arbres très profonds afin de garantir que chaque modèle individuel possède un biais d’ajustement infinitésimal. Enfin, les ( B ) modèles entraînés sont rassemblés au sein d’un collège décisionnel ensembliste dont la sortie collective est synthétisée par une fonction d’agrégation déterministe.
5.2 Mécanisme théorique de réduction de variance
L’assise mathématique qui consacre la supériorité du Bagging réside dans la loi de composition des variances statistiques appliquées à des combinaisons linéaires d’estimateurs. Pour en expliciter la dynamique élégante, considérons un ensemble de ( B ) estimateurs individuels de régression obtenus sur des échantillons bootstrap, possédant chacun une variance théorique identique ( sigma^2 ). Bien que calibrés sur des pseudo-échantillons distincts, ces estimateurs ne sont pas statistiquement indépendants, puisqu’ils procèdent tous du même jeu d’apprentissage matriciel d’origine. Désignons par ( rho ) le coefficient de corrélation linéaire par paire mesurant la dépendance stochastique entre deux estimateurs quelconques de la collection.
L’estimateur agrégé du Bagging est défini comme la moyenne arithmétique continue des prédictions émises par les ( B ) modèles individuels. En mobilisant les propriétés fondamentales de l’opérateur de variance bilinéaire, la variance de cette moyenne empirique s’écrit formellement comme suit :
[ operatorname{Var}left(frac{1}{B}sum_{b=1}^{B} hat{f}_b(x)right) = frac{1}{B^2} left( sum_{b=1}^B operatorname{Var}(hat{f}_b(x)) + sum_{b=1}^B sum_{j neq b} operatorname{Cov}(hat{f}_b(x), hat{f}_j(x)) right) ]
En substituant la variance unitaire ( sigma^2 ) et la covariance mutuelle ( operatorname{Cov}(hat{f}_b(x), hat{f}_j(x)) = rho sigma^2 ), l’expression se simplifie analytiquement en une formule d’une limpidité remarquable :
[ operatorname{Var}(hat{f}_{text{bag}}(x)) = rho sigma^2 + frac{1 – rho}{B} sigma^2 ]
Cette égalité met à nu l’ingénierie interne du Bagging. Lorsque le nombre d’estimateurs ensemblistes ( B ) s’accroît et tend vers l’infini, le second terme de la somme s’annihile asymptotiquement :
[ lim_{B to infty} frac{1 – rho}{B} sigma^2 = 0 ]
Il en résulte que la variance globale de l’ensemble se contracte jusqu’à converger vers une borne incompressible définie par le produit de la variance intrinsèque de l’estimateur unitaire par le coefficient de corrélation inter-arbres : ( rho sigma^2 ). Parallèlement, en vertu de la linéarité de l’espérance mathématique, l’espérance de l’agrégat reste strictement égale à l’espérance individuelle de chaque apprenant non biaisé. Le Bagging accomplit ainsi l’exploit de préserver l’excellence du biais initial tout en divisant la variance par un facteur directement proportionnel à l’indépendance des modèles individuels.
5.3 Pseudo-code et chronologie du pipeline de calcul
Pour illustrer avec netteté la chronologie d’exécution au sein d’un environnement de calcul, décrivons la logique séquentielle régissant le pipeline de calcul du Bagging sous une forme narrative rigoureuse :
Le protocole algorithmique s’initialise par la réception d’une matrice de descripteurs de dimensions ( n times p ) et d’un vecteur de réponses cibles de longueur ( n ). Deux hyperparamètres cardinaux sont fixés a priori par l’opérateur : la cardinalité de l’ensemble, notée ( B ), représentant le nombre d’itérations d’échantillonnage, et la configuration structurelle des arbres de base (notamment l’absence d’élagage ou la définition d’un seuil plancher d’observations par feuille terminale).
L’algorithme enclenche ensuite une boucle itérative cadencée de ( b = 1 ) jusqu’à ( B ). À chaque itération, un générateur de nombres pseudo-aléatoires exécute un tirage uniforme avec remise de ( n ) indices compris dans l’intervalle unitaire de l’ensemble d’apprentissage originel, érigeant ainsi le sous-ensemble bootstrap ( mathcal{D}_b^* ). Immédiatement après cette extraction, l’algorithme instancie un arbre de décision non contraint et procède à son entraînement déterministe exclusif sur la partition ( mathcal{D}_b^* ), optimisant les scissions selon les critères d’impureté canoniques jusqu’à saturation des conditions terminales. Le modèle résultant, dénoté ( hat{f}^{*b} ), est consigné dans une structure de données sérialisée.
Une fois la boucle épuisée et les ( B ) estimateurs compilés en mémoire vive, le pipeline active sa phase d’inférence prédictive. Pour tout nouveau point de test se présentant sous la forme d’un vecteur de caractéristiques non labellisé, le pipeline propage ce vecteur simultanément à travers les ramifications décisionnelles des ( B ) modèles distincts. Les ( B ) sorties ponctuelles obtenues sont ensuite transmises à une fonction de consolidation unifiée qui renvoie l’estimation finale agrégée, matérialisant ainsi la décision conjointe de l’ensemble.
6. Le Bagging appliqué à la régression : Agrégation par moyenne arithmétique
6.1 Formulation mathématique de l’estimateur agrégé
Dans le domaine de l’apprentissage supervisé continu, le Bagging opère une synthèse fonctionnelle d’une remarquable élégance mathématique. Soit une fonction de régression multivariée que l’on cherche à approcher. Chaque estimateur arborescent calibré sur la réplique bootstrap ( b ) partitionne l’espace dimensionnel en un ensemble de régions mutuellement exclusives et assigne à chacune une constante locale. L’estimateur agrégé du Bagging pour une observation nouvelle se formalise rigoureusement sous la forme de l’espérance empirique discrète des sorties quantitatives produites par l’ensemble des prédicteurs unitaires :
[ hat{f}_{text{bag}}(x) = frac{1}{B} sum_{b=1}^{B} hat{f}^{*b}(x) ]
Cette simple formulation arithmétique recèle des implications géométriques profondes. Un arbre de régression CART unique génère par définition une fonction prédictive discontinue, caractérisée par une topologie par paliers (ou marches d’escalier). Dans les zones de transition spatiale entre deux feuilles adjacentes, de minuscules variations le long d’une dimension d’entrée peuvent provoquer des sauts discrets abrupts de la valeur prédite. En superposant et en moyennant ( B ) surfaces de partitionnement disjointes, dont les seuils orthogonaux de découpage diffèrent stochastiquement d’une itération bootstrap à l’autre, le Bagging opère un lissage spatial des discontinuités.
La fonction par paliers heurtée et rigide inhérente à l’arbre singulier s’efface au profit d’une surface d’approximation piecewise linéaire hautement nuancée et quasi continue. Ce lissage spatial permet d’approcher les courbures intrinsèques des véritables surfaces de régression sous-jacentes avec une fidélité inaccessible aux modèles discrets élémentaires. En outre, au fur et à mesure que la cardinalité ( B ) progresse vers des valeurs asymptotiques, la loi forte des grands nombres garantit que l’estimateur agrégé stabilise son espérance conditionnelle, éliminant définitivement les oscillations parasites causées par les fluctuations stochastiques propres aux arbres individuels.
6.2 Étude de cas détaillée : Modélisation continue
Afin de matérialiser empiriquement l’efficacité prédictive du Bagging appliqué à la régression, examinons une étude de cas portant sur la modélisation macroéconomique de la volatilité financière ou l’évaluation de prix fonciers au sein d’une métropole dense. Ce type de problématique confronte le statisticien à des phénomènes régis par de multiples interactions non linéaires sévères, telles que des effets conjoints de localisation géographique, de superficie, de proxémie aux infrastructures de transport et d’indicateurs macroéconomiques conjoncturels, le tout pollué par des chocs exogènes extrêmes.
Lorsqu’un arbre CART unitaire est ajusté sur ce jeu de données sans restriction sur sa profondeur, l’analyse des résidus de prédiction révèle des pathologies classiques. Bien que l’erreur quadratique moyenne calculée sur les données d’entraînement soit virtuellement nulle (reflétant une mémorisation parfaite des observations historiques), la dispersion résiduelle évaluée sur un échantillon de test indépendant explose. L’arbre isole des valeurs atypiques dans des feuilles exiguës composées d’une ou deux transactions singulières, érigeant des îlots prédictifs absurdes déconnectés de la tendance économique globale.
Le déploiement d’un ensemble de Bagging constitué de plusieurs centaines d’arbres profonds inverse spectaculairement cette dynamique défaillante. La dispersion des résidus hors échantillon subit une contraction massive, matérialisée par une réduction substantielle de l’erreur quadratique moyenne de test pouvant fréquemment excéder 20 à 40 % par rapport à l’arbre de décision unique optimalement élagué. Les valeurs aberrantes, diluées par le processus d’échantillonnage bootstrap dans seulement un sous-ensemble marginal d’arbres, perdent leur pouvoir de nuisance : leur influence locale est neutralisée lors de l’agrégation arithmétique par la majorité saine des autres estimateurs, conférant au modèle agrégé une résilience exceptionnelle.
7. Le Bagging appliqué à la classification : Stratégies de vote et probabilités
7.1 Agrégation par vote majoritaire (Hard Voting)
Lorsque le Bagging est transposé à des tâches de discrimination catégorielle polytomique, où l’objectif est d’affecter une observation à l’une des ( K ) classes qualitatives discrètes envisageables, la stratégie d’intégration canonique théorisée par Breiman repose sur la logique du vote majoritaire, fréquemment désigné dans la littérature sous l’anglicisme de Hard Voting. Dans cette configuration, chaque arbre de base non élagué opère en tant que classifieur binaire ou multiclasse absolu, émettant une décision univoque d’appartenance catégorielle.
Mathématiquement, soit ( hat{C}_b(x) in {1, 2, dots, K} ) la classe nominale assignée par le ( b )-ième arbre élémentaire au point de test ( x ). L’affectation finale arrêtée par l’agrégat de Bagging découle de l’évaluation de la fonction indicatrice sommé sur l’ensemble des apprenants, attribuant l’observation à la modalité qui recueille la pluralité stricte des suffrages :
[ hat{C}_{text{bag}}(x) = underset{k in {1, dots, K}}{operatorname{argmax}} sum_{b=1}^{B} mathbb{I}(hat{C}_b(x) = k) ]
Dans l’hypothèse opérationnelle où une situation de parité arithmétique survient (scénario de tie-breaking), notamment dans les cadres binaires dotés d’un paramètre ( B ) pair ou dans les espaces polytomiques complexes, des règles déterministes d’arbitrage doivent être spécifiées a priori. Celles-ci consistent généralement soit en une rupture aléatoire uniforme de l’égalité, soit en une préséance accordée à la classe présentant la prévalence empirique la plus élevée au sein de la population d’apprentissage originale.
Bien que robuste et intuitivement séduisante, la modalité du vote majoritaire rigide comporte une limite conceptuelle indiscutable : elle postule une équivalence absolue entre l’ensemble des votes exprimés. Un arbre qui affecterait une observation à une classe donnée avec une certitude absolue se voit octroyer un poids strictement identique à celui d’un arbre dont la feuille terminale contiendrait une distribution quasi équiproquable. Cette cécité vis-à-vis des degrés de certitude intrinsèques des modèles élémentaires peut occasionner des erreurs de classification aux frontières de décision hautement compétitives.
7.2 Agrégation par probabilités a posteriori (Soft Voting)
Pour pallier les insuffisances inhérentes au vote majoritaire rigide, la pratique moderne de l’apprentissage statistique privilégie très largement le recours au vote probabiliste pondéré, couramment désigné sous le terme de Soft Voting. Cette approche repose sur l’exploitation des distributions de fréquences relatives observées au sein des feuilles terminales de chaque arbre CART, appréhendées comme des estimations non paramétriques des probabilités a posteriori conditionnelles de Bayes.
Pour un vecteur d’entrée donné, chaque arbre individuel renvoie un vecteur stochastique dont la ( k )-ième composante quantifie la proportion empirique d’individus appartenant à la modalité ( k ) dans la région terminale activée. Le prédicteur agrégé de Bagging procède alors au calcul de la moyenne arithmétique vectorielle de ces distributions de probabilités conditionnelles à travers l’ensemble des ( B ) modèles élémentaires :
[ hat{P}_{text{bag}}(Y = k mid x) = frac{1}{B} sum_{b=1}^{B} hat{P}^{*b}(Y = k mid x) ]
L’assignation finale de la classe s’effectue ensuite par application de la règle d’affectation bayésienne standard consistant à choisir la classe maximisant cette espérance probabiliste agrégée. Cette méthodologie présente une supériorité structurelle indiscutable. En premier lieu, elle assure une bien meilleure calibration des probabilités de classe finales, ce qui est capital pour les applications industrielles requérant une hiérarchisation fine du risque (comme la détection de fraudes ou la tarification assurantielle). En second lieu, sur le plan géométrique, l’intégration des scores continus permet de générer des surfaces de séparation multidimensionnelles infiniment plus lisses et nuancées que les cloisons abruptes et disjointes imposées par les discontinuités du vote majoritaire dur.
8. L’évaluation hors sac (Out-Of-Bag) : Validation interne sans fractionnement
8.1 Fondement théorique de l’ensemble Out-Of-Bag (OOB)
L’une des vertus statistiques et computationnelles les plus élégantes du Bagging réside dans son protocole d’auto-évaluation interne intégré, universellement désigné sous le vocable d’évaluation Out-Of-Bag (OOB) ou « hors sac ». Comme établi précédemment lors de l’analyse combinatoire du bootstrap non paramétrique, chaque arbre individuel entraîné sur un échantillon de taille ( n ) avec remise ne voit qu’environ 63,2 % des observations distinctes composant le jeu d’apprentissage source. Réciproquement, chaque observation individuelle du corpus se trouve statistiquement exclue de l’échantillon d’apprentissage d’environ 36,8 % des arbres de la collection globale.
Cette propriété stochastique permet de construire, sans mobiliser le moindre jeu de validation externe, un estimateur d’évaluation de la performance prédictive rigoureusement non biaisé. Pour chaque observation ( (x_i, y_i) ) présente dans le jeu de données d’origine, on identifie l’ensemble des sous-modèles élémentaires pour lesquels cette observation particulière n’a pas été incluse dans la partition bootstrap d’entraînement. Cet ensemble d’indices est désigné comme le collège d’arbres hors sac de l’observation ( i ).
Le prédicteur OOB associé à l’individu ( i ), noté ( hat{f}_{text{OOB}}(x_i) ), est alors formulé en restreignant strictement l’agrégation aux seuls modèles constituant son collège hors sac spécifique :
[ hat{f}_{text{OOB}}(x_i) = frac{1}{sum_{b=1}^B mathbb{I}(i notin mathcal{D}_b^*)} sum_{b: i notin mathcal{D}_b^*} hat{f}^{*b}(x_i) ]
Puisque aucun des arbres participant à cette prédiction locale n’a eu accès à l’observation ( i ) durant sa phase d’ajustement, la sortie prédite est parfaitement intègre vis-à-vis du risque de contamination d’information (data leakage). L’erreur globale OOB est ensuite obtenue en calculant la moyenne de la perte empirique calculée sur les ( n ) observations. Des démonstrations mathématiques formelles ont prouvé que cette métrique converge asymptotiquement vers une estimation rigoureusement sans biais de l’erreur de généralisation du modèle ensembliste complet.
8.2 OOB versus validation croisée k-fold : Analyse comparative
L’existence de l’estimateur OOB transforme radicalement le protocole expérimental de sélection et d’évaluation des modèles en apprentissage automatique. Dans le cadre conventionnel de la modélisation statistique, l’estimation objective du risque prédictif hors échantillon requiert la mise en œuvre d’une procédure de validation croisée à k blocs (k-fold cross-validation). Or, cette dernière impose une pénalité computationnelle particulièrement onéreuse : pour évaluer un modèle avec une validation croisée à 10 blocs, il est nécessaire de répéter l’intégralité du cycle d’apprentissage à dix reprises sur 90 % des données, multipliant d’autant l’empreinte carbone et la durée de calcul du pipeline.
À l’inverse, l’évaluation OOB est obtenue de manière concomitante et gratuite durant la passe unique d’ajustement de l’ensemble de Bagging. Dès lors que le nombre d’estimateurs ( B ) est raisonnablement dimensionné (généralement ( B ge 200 )), chaque observation originale dispose d’un effectif suffisant d’arbres hors sac pour stabiliser son estimation locale. Des travaux empiriques et théoriques de premier plan ont démontré que l’estimation d’erreur délivrée par le score OOB est asymptotiquement équivalente à celle d’une validation croisée exhaustive de type Leave-One-Out, tout en éradiquant son coût computationnel prohibitif.
Il convient néanmoins de circonscrire les frontières de validité statistique de cette équivalence. Sur des corpus de données caractérisés par un volume d’observations extrêmement ténu (( n < 50 )), la variance d’échantillonnage inhérente au tirage bootstrap peut faire fluctuer la représentativité des ensembles OOB. De même, en présence d'une structure de corrélation temporelle, spatiale ou hiérarchique au sein des données, le tirage i.i.d. conventionnel du bootstrap est mis en défaut, rendant l'erreur OOB artificiellement optimiste en l'absence de protocoles de rééchantillonnage par blocs adaptés.
9. Interprétabilité et extraction de connaissances dans les modèles de Bagging
9.1 La dégradation de l’explicabilité intrinsèque
L’accroissement spectaculaire de l’exactitude prédictive obtenu par le déploiement du Bagging s’accompagne d’un coût épistémologique sévère : la perte irréversible de l’interprétabilité géométrique directe qui conférait aux arbres CART leur attrait originel. Alors qu’un arbre de décision singulier peut être commodément visualisé sous la forme d’un graphe orienté acyclique inspectable, où chaque nœud explicite une règle de ségrégation binaire univoque, l’agrégation de centaines d’arbres déploie une fonctionnelle opaque au sein d’un espace multidimensionnel discontinu. Le modèle bascule irrémédiablement dans la catégorie des algorithmes dits de « boîte noire ».
Il est rigoureusement impossible de synthétiser la décision collégiale issue d’une forêt d’estimateurs en une structure arborescente unique équivalente. Deux arbres formés sur des répliques bootstrap distinctes peuvent adopter des segmentations spatiales contradictoires au sommet tout en délivrant des prédictions conjointes harmonieuses. Cette opacité structurelle pose des défis critiques en matière d’auditabilité algorithmique, de traçabilité des décisions et de conformité réglementaire. Dans le cadre de législations exigeantes telles que le Règlement Général sur la Protection des Données (RGPD) en Europe ou les directives encadrant l’Intelligence Artificielle, le « droit à l’explication » accordé aux justiciables et aux consommateurs exige des justifications causales explicites que le Bagging brut est organiquement incapable de formuler sans le recours à des couches interprétatives tierces.
9.2 Mesures de l’importance des variables
Afin de restaurer la capacité d’extraction de connaissances et de percer l’opacité inhérente aux architectures agrégées, Breiman a développé des métriques statistiques permettant de quantifier l’impact relatif de chaque variable explicative sur le comportement global de l’ensemble. Deux méthodologies prédominent au sein de la littérature spécialisée.
La première est l’importance basée sur la diminution moyenne de l’impureté (MDI, pour Mean Decrease Impurity). Cette heuristique comptabilise, pour chaque variable du jeu de données, la somme cumulée des gains d’homogénéité (réduction de l’indice de Gini en classification, ou diminution de la somme des erreurs au carré en régression) générés par l’ensemble des nœuds où cette variable a été sélectionnée pour opérer une scission. Cette mesure est ensuite moyennée à travers les ( B ) arbres de la collection. Bien que séduisante par sa simplicité de calcul, cette métrique est notoirement sujette à un biais statistique documenté : elle favorise systématiquement les variables continues ou les descripteurs catégoriels possédant une forte cardinalité (un nombre élevé de modalités distinctes), car ces attributs offrent mécaniquement un plus grand nombre de points de coupure potentiels au partitionnement glouton.
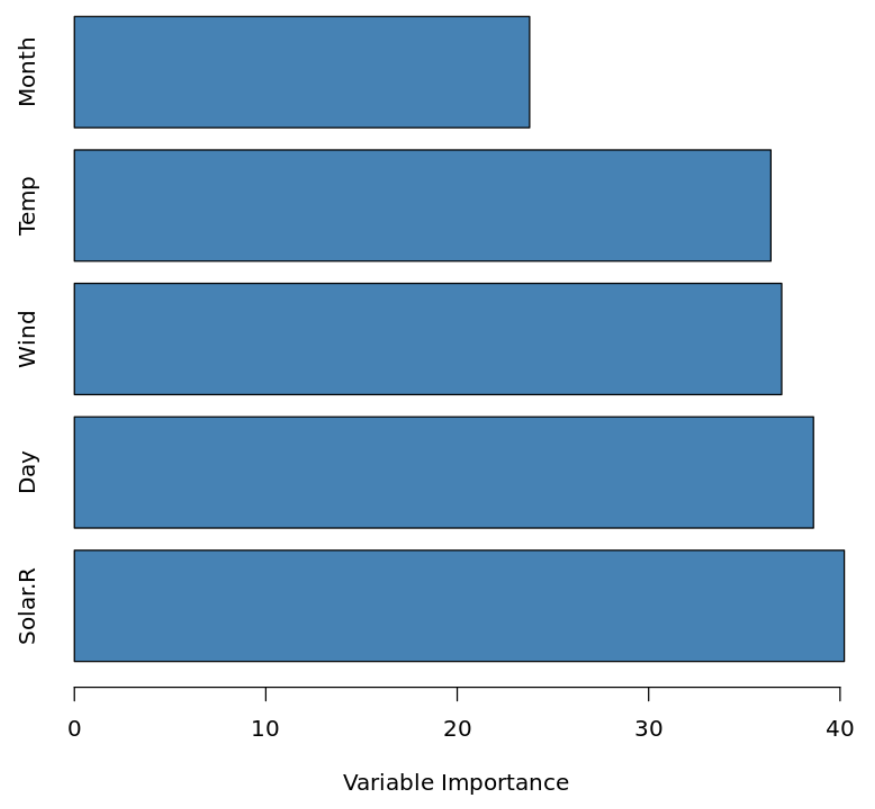
La seconde mesure, infiniment plus rigoureuse et robuste, est l’importance par permutation OOB (MDA, pour Mean Decrease Accuracy). Cette approche tire parti de la partition hors sac. Pour chaque arbre de l’ensemble, l’erreur de prédiction est initialement évaluée sur ses données OOB intègres. Puis, les valeurs de la variable candidate ( X_j ) sont mélangées de manière pseudo-aléatoire le long de l’axe des observations au sein de l’échantillon OOB, rompant ainsi tout lien stochastique réel entre cette covariable et la cible tout en préservant intacte sa distribution marginale. L’échantillon ainsi altéré est repassé à travers l’arbre, et la dégradation de l’exactitude prédictive est mesurée. L’importance par permutation de ( X_j ) correspond à la moyenne normalisée de ces augmentations d’erreurs sur l’ensemble des arbres. Une chute vertigineuse de performance après permutation atteste d’un rôle structural prépondérant de la variable dans la prédiction ensembliste.
10. Analyse comparative : Bagging, Forêts Aléatoires et Boosting
10.1 Du Bagging aux Forêts Aléatoires (Random Forests)
L’analyse théorique de la formule de décomposition de variance démontrée à la section 5.2 a mis en lumière que la limite asymptotique incompressible de la variance d’un ensemble de Bagging est gouvernée par le produit ( rho sigma^2 ), où ( rho ) désigne le coefficient de corrélation moyen existant entre deux arbres quelconques de la collection. Dans un scénario opérationnel où le jeu de données héberge un prédicteur structurellement dominant — c’est-à-dire une variable dont le pouvoir explicatif surpasse écrasamment celui de tous les autres descripteurs —, un phénomène délétère survient inévitablement : la quasi-totalité des arbres CART non contraints de la collection vont infailliblement sélectionner ce descripteur hégémonique lors de la première scission au nœud racine.
Cette redondance systématique engendre une similarité topologique prononcée entre l’ensemble des arborescences de la collection. En dépit de la stochasticité introduite par le rééchantillonnage bootstrap, les arbres se ressemblent structurellement, ce qui induit un coefficient de corrélation ( rho ) élevé qui bloque le potentiel de compression de la variance. C’est précisément pour pulvériser ce verrou statistique que Leo Breiman, en s’inspirant des travaux pionniers d’Amit et Geman ainsi que de Tin Kam Ho sur la méthode des sous-espaces aléatoires, a formulé en 2001 l’algorithme des Forêts Aléatoires (Random Forests).
L’innovation conceptuelle introduite par Breiman réside dans l’injection d’un second niveau d’aléa, appliqué non plus seulement aux observations, mais directement à l’espace vectoriel des descripteurs à chaque étape du partitionnement récursif. Lors de la division d’un nœud quelconque au sein d’une forêt aléatoire, l’algorithme s’interdit d’évaluer l’intégralité des ( p ) variables disponibles. Il procède au tirage aléatoire uniforme d’un sous-ensemble restreint de variables, dont la taille est conventionnellement fixée à ( lfloor sqrt{p} rfloor ) pour la classification et à ( lfloor p/3 rfloor ) pour la régression, et détermine la scission optimale exclusivement parmi ce sous-ensemble réduit. Cette contrainte force les arbres à explorer des trajectoires de division hétérodoxes et alternatives, diminuant drastiquement la corrélation inter-arbres ( rho ), ce qui permet une contraction de la variance globale inaccessible au Bagging standard.
10.2 Bagging versus Boosting : Paradigmes parallèles et séquentiels
Dans la taxonomie de l’apprentissage ensembliste, le Bagging et le Boosting incarnent deux philosophies computationnelles et mathématiques radicalement divergentes, presque orthogonales, bien que toutes deux dévolues à l’optimisation de l’erreur de généralisation :
Le Bagging constitue une méthodologie intrinsèquement parallèle. Les apprenants de base sont formés de manière totalement indépendante les uns des autres sur des répliques stochastiques créées a priori. La stratégie sous-jacente consiste à mobiliser des modèles caractérisés par une complexité structurelle maximale (arbres profonds non régularisés), dotés d’un très faible biais mais d’une forte variance, et à exploiter la moyenne collective pour éradiquer cette variance parasite sans dégrader le biais initial.
À l’opposé, le Boosting — initié par Robert Schapire et Yoav Freund avec AdaBoost en 1997, puis généralisé par Jerome Friedman sous le formalisme du Gradient Boosting en 2001 — opère selon une cinématique strictement séquentielle et adaptative. Les modèles de base ne sont pas formés en parallèle mais à la chaîne. Chaque nouvel estimateur introduit au sein de la structure est explicitement optimisé pour corriger les erreurs résiduelles commises par la combinaison des modèles antérieurs. Les apprenants mobilisés en Boosting sont des modèles volontairement rudimentaires et rigides (souvent des arbres réduits à une seule scission, appelés decision stumps), présentant un biais initial très élevé mais une faible variance.
Cette divergence architecturale dicte des comportements opérationnels diamétralement opposés. Le Bagging est une procédure exceptionnellement tolérante au bruit d’étiquetage et aux données aberrantes, car la moyenne dilue les artefacts stochastiques isolés. De plus, il est structurellement immunisé contre le surapprentissage par ajout d’arbres supplémentaires. Le Boosting, en revanche, en s’acharnant séquentiellement à rectifier les observations les plus difficiles, manifeste une vulnérabilité extrême au surapprentissage en présence de bruit aléatoire mal étiqueté, focalisant son attention sur des aberrations expérimentales irréductibles.
11. Implémentation technique et optimisation des hyperparamètres
11.1 Paramètres structurels déterminants
Bien que le Bagging soit souvent célébré par les praticiens pour son caractère remarquablement robuste et sa relative insensibilité au dérèglement de ses paramètres (faisant de lui une méthode hautement opérationnelle « sur étagère »), l’obtention d’une performance statistique optimale requiert un calibrage méticuleux d’un ensemble de paramètres structurels clés.
Le premier paramètre décisionnel réside dans le calibrage de la cardinalité de l’ensemble, c’est-à-dire le nombre d’arbres ( B ) à injecter dans l’agrégat. Contrairement aux modèles de type réseaux de neurones ou algorithmes de Boosting où un nombre excessif d’itérations induit un surapprentissage dévastateur, l’augmentation de ( B ) dans le Bagging ne présente aucun risque de dégradation de l’erreur de généralisation. En vertu de la loi des grands nombres, l’erreur converge vers une asymptote plane stable. Dès lors, le choix de ( B ) résulte d’un arbitrage pragmatique entre les rendements décroissants de la précision statistique et l’explosion du coût computationnel en temps de calcul et en mémoire vive. En pratique, des valeurs oscillant entre 100 et 500 estimateurs se révèlent amplement suffisantes pour saturer la réduction de variance sur la plupart des jeux de données tabulaires usuels.
Le second axe de paramétrage concerne le contrôle de la topologie individuelle des apprenants de base. Si la théorie classique prescrit de laisser croître les arbres jusqu’à pureté totale, la présence d’un bruit expérimental massif peut justifier l’introduction de contraintes légères de régularisation, telles qu’un effectif minimal d’échantillons par feuille (min_samples_leaf) ou un seuil d’arrêt de scission (min_samples_split), afin d’éviter que des feuilles individuelles ne modélisent des singularités numériques extrêmes.
Enfin, une variante architecturale notable réside dans l’alternative entre le Bagging conventionnel (échantillonnage avec remise de taille ( n )) et le Pasting (échantillonnage sans remise de sous-ensembles de taille ( m < n )), théorisé par Leo Breiman en 1999. Le Pasting s’avère particulièrement pertinent lors du traitement de corpus volumineux où la saturation de la mémoire vive empêche l’instanciation répétée de matrices de taille intégrale, apportant une diversification stochastique compétitive tout en accélérant les temps d'entraînement.
11.2 Scalabilité et parallélisation computationnelle
Sur le plan de l’ingénierie logicielle et du calcul intensif, l’architecture du Bagging présente une propriété algorithmique hautement convoitée : elle est intrinsèquement et impeccablement parallélisable (propriété qualifiée dans le lexique académique d’architecture embarrassingly parallel). En effet, l’entraînement de l’estimateur ( hat{f}^{*b} ) ne requiert à aucun moment l’accès à l’état interne, aux prédictions ou aux gradients de l’estimateur ( hat{f}^{*j} ) pour ( j neq b ). L’ensemble des ( B ) processus d’ajustement peuvent dès lors être distribués simultanément sur une multiplicité de cœurs de calcul, de processeurs graphiques ou de nœuds au sein d’un cluster informatique sans nécessiter de synchronisation intermédiaire.
Cette totale indépendance se heurte néanmoins à un goulot d’étranglement matériel non négligeable : l’empreinte en mémoire vive (RAM). Conserver en mémoire plusieurs centaines d’arbres décisionnels CART complètement développés, dont chacun héberge des milliers de nœuds décisionnels, de vecteurs de seuils et de distributions probabilistes locales, peut rapidement saturer les capacités matérielles lors du passage à l’échelle sur des jeux de données comportant des dizaines de millions de lignes. Lors de la phase de prédiction, l’obligation d’interroger séquentiellement ou concurremment l’intégralité de ces structures sérialisées induit une latence d’inférence notable, difficilement compatible avec les contraintes temporelles ultra-strictes des systèmes de négociation à haute fréquence ou des moteurs de recommandation en temps réel milliseconde.
Pour contourner ces limites matérielles dans les environnements distribués à très grande échelle (à l’instar des architectures Apache Spark), des stratégies de distribution spécifiques sont déployées. Elles consistent à partitionner horizontalement les blocs de données, à ajuster des sous-ensembles de Bagging sur chaque machine nœud, puis à concaténer les collèges de prédiction au sein d’une méta-structure unifiée, optimisant ainsi les flux d’échanges de données sur le réseau.
12. Limites épistémologiques et perspectives avancées du Bagging
12.1 Contextes d’inefficacité ou d’échec de la méthode
En dépit de sa remarquable puissance prédictive, le Bagging ne saurait être appréhendé comme une panacée algorithmique universelle. Son efficacité statistique dépend organiquement de la vérification d’un postulat axiomatique formulé dès l’origine par Breiman : le prédicteur de base sous-jacent doit impérativement être instable. Si l’on applique le mécanisme de Bagging à des modèles de base intrinsèquement stables — c’est-à-dire des algorithmes dont la topologie de sortie ne varie que de façon infinitésimale lorsqu’on perturbe marginalement leurs données d’entraînement —, l’ensemble échoue spectaculairement à apporter le moindre gain de performance.
L’illustration la plus probante de cette carence se manifeste lors de l’application du Bagging à des modèles de régression linéaire standard par moindres carrés ordinaires, à des modèles linéaires généralisés rigides ou à des classifieurs par plus proches voisins (k-nearest neighbors) configurés avec une valeur de ( k ) élevée. Ces estimateurs possèdent par nature une variance stochastique modérée mais un biais de spécification incompressible. Dans cette configuration, le coefficient de corrélation inter-modèles ( rho ) tend vers l’unité : les modèles ajustés sur les différentes répliques bootstrap sont rigoureusement identiques entre eux. En conséquence, la formule de contraction de la variance s’annihile, et l’agrégation finale ne procure aucune réduction d’erreur mesurable par rapport à un estimateur linéaire unitaire isolé, tout en exigeant une débauche de ressources informatiques inutiles.
Une autre pathologie sévère concerne le traitement des jeux de données caractérisés par un déséquilibre extrême des classes (par exemple, un ratio de 1 pour 10 000 dans les problématiques de détection de fraudes bancaires ou de maladies rares). Dans un tel scénario, le tirage uniforme avec remise au sein de l’échantillon bootstrap aboutit à une probabilité alarmante d’extraire des répliques ne contenant aucune observation de la classe minoritaire. Les arbres entraînés sur ces sous-échantillons dégénèrent alors en classifieurs triviaux n’assignant que la classe majoritaire, annihilant le rappel du modèle global. Ce dysfonctionnement a nécessité le développement de variantes spécialisées, à l’instar du Balanced Bagging, combinant bootstrap et sous-échantillonnage dirigé au sein de chaque réplique.
Enfin, la rupture la plus critique survient lors de la manipulation de données sérialisées violant frontalement l’hypothèse d’indépendance et d’identique distribution (i.i.d.). En présence d’autocorrélation temporelle (séries chronologiques), de dépendance spatiale (géostatistique) ou de structures hiérarchiques de réseaux, le tirage uniforme avec remise détruit la structure causale et dynamique sous-jacente du phénomène stochastique, conduisant à des modèles d’ensemble fallacieux et surajustés.
12.2 Extensions méthodologiques contemporaines
Face à ces verrous méthodologiques, la recherche contemporaine en statistique mathématique et en apprentissage machine a développé des extensions raffinées qui repoussent les frontières fonctionnelles du Bagging originel :
Dans le domaine des séries temporelles et des signaux stochastiques non stationnaires, la réponse théorique aux limites du tirage i.i.d. a été apportée par le développement du Bagging par blocs mobiles (Moving Block Bootstrap et Stationary Bootstrap de Politis et Romano). Plutôt que de prélever des observations ponctuelles isolées, l’algorithme procède au découpage et au rééchantillonnage de segments continus de données temporelles dont la longueur est calibrée pour préserver intacte la structure d’autocovariance locale des processus markoviens ou autorégressifs.
Une autre frontière féconde réside dans les architectures hybrides associant le Bagging à des modèles d’apprentissage profond (Deep Bagging). Bien que l’entraînement d’ensembles de réseaux de neurones profonds soit traditionnellement freiné par des temps de calcul colossaux, l’agrégation bootstrap de modèles neuronaux distincts — initialisés avec des poids stochastiques hétérogènes et exposés à des régimes d’échantillonnage différenciés — démontre des capacités remarquables pour contrer les attaques contradictoires (adversarial attacks) et améliorer la généralisation sur des variétés d’images ou de traitement automatique du langage naturel.
Enfin, l’apport contemporain le plus décisif réside dans l’exploitation des distributions d’ensemble pour la quantification formelle de l’incertitude prédictive. En ne se limitant plus à la simple espérance de l’agrégat, mais en analysant l’intégralité de la dispersion empirique, des quantiles et de la kurtosis des sorties générées par les ( B ) estimateurs élémentaires, les praticiens sont désormais en mesure de dissocier mathématiquement l’incertitude aléatoire (inhérente au bruit des données) de l’incertitude épistémique (découlant du manque de connaissance du modèle dans les régions sous-représentées de l’espace des caractéristiques). Cette percée fait du Bagging un outil privilégié pour le déploiement d’une intelligence artificielle responsable, sûre et auto-consciente de ses propres limites statistiques.
Références
- Amit, Y., & Geman, D. (1997). Shape quantization and recognition with randomized trees. Neural Computation, 9(7), 1545–1588. https://doi.org/10.1162/neco.1997.9.7.1545
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
- Breiman, L. (1999). Pasting small votes for classification in large databases and on-line. Machine Learning, 36(1), 85–103. https://doi.org/10.1023/A:1007563306331
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and Regression Trees. Wadsworth & Brooks/Cole Advanced Books & Software. https://doi.org/10.1201/9781315139470
- Bühlmann, P., & Yu, B. (2002). Analyzing bagging. The Annals of Statistics, 30(4), 927–961. https://doi.org/10.1214/aos/1031689014
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B., & Tibshirani, R. J. (1994). An Introduction to the Bootstrap. CRC Press. https://doi.org/10.1201/9780429246593
- Freund, Y., & Schapire, R. E. (1997). A decision-theoretic generalization of on-line learning and an application to boosting. Journal of Computer and System Sciences, 55(1), 119–139. https://doi.org/10.1006/jcss.1997.1504
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Geman, S., Bienenstock, E., & Doursat, R. (1992). Neural networks and the bias/variance dilemma. Neural Computation, 4(1), 1–58. https://doi.org/10.1162/neco.1992.4.1.1
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Ho, T. K. (1998). The random subspace method for constructing decision forests. IEEE Transactions on Pattern Analysis and Machine Intelligence, 20(8), 832–844. https://doi.org/10.1109/34.709601
- Politis, D. N., & Romano, J. P. (1994). The stationary bootstrap. Journal of the American Statistical Association, 89(428), 1303–1313. https://doi.org/10.1080/01621459.1994.10476870
- Quinlan, J. R. (1986). Induction of decision trees. Machine Learning, 1(1), 81–106. https://doi.org/10.1007/BF00116251