
Dans l’histoire moderne de la modélisation statistique et de l’apprentissage automatique, peu d’innovations méthodologiques ont exercé une influence aussi structurante et pérenne que l’algorithme des arbres de classification et de régression, universellement désigné sous l’acronyme CART (Classification and Regression Trees). Conçue au confluent des mathématiques appliquées, du calcul intensif et de l’analyse exploratoire de données, cette approche a profondément renouvelé la manière dont les chercheurs appréhendent les structures empiriques complexes. En substituant aux équations algébriques rigides une stratégie de partitionnement géométrique récursif de l’espace des descripteurs, CART a jeté les bases d’une modélisation non paramétrique capable d’allier puissance prédictive et lisibilité cognitive. Cette synthèse méthodologique singulière permet de contourner les postulats distributionnels souvent irréalistes imposés par les modèles paramétriques classiques, tout en offrant une formalisation rigoureuse de la prise de décision séquentielle.
L’essor de cette technologie algorithmique a incarné une véritable bascule épistémologique, formalisée de manière magistrale par le statisticien de Berkeley Leo Breiman dans son manifeste fondateur sur les deux cultures de la modélisation statistique. D’un côté, la culture prédominante de l’inférence stochastique postulait l’existence d’une mécanique génératrice théorique régie par des lois probabilistes spécifiques, exigeant du chercheur la spécification a priori d’une forme fonctionnelle fermée. De l’autre, la culture émergente de l’apprentissage algorithmique considérait le mécanisme sous-jacent de la nature comme une boîte noire complexe et inaccessible, devant être appréhendée par des algorithmes flexibles gouvernés par la seule performance d’ajustement empirique et la validation croisée. Les arbres décisionnels représentent le jalon historique fondamental par lequel cette seconde culture a acquis sa légitimité théorique et opérationnelle, établissant des standards d’optimisation numérique qui sous-tendent aujourd’hui les architectures d’apprentissage supervisé les plus sophistiquées.
Au-delà de leur élégance formelle, les arbres de décision répondent avec une acuité particulière aux défis analytiques rencontrés dans les sciences humaines, biologiques et comportementales. Face à des jeux de données caractérisés par une non-linéarité omniprésente, des effets d’interaction d’ordre élevé, des distributions fortement asymétriques et des patrons complexes de données manquantes, les modèles de régression traditionnels révèlent fréquemment leurs limites opérationnelles. À l’inverse, l’architecture CART propose un cadre d’induction logique qui reproduit fidèlement les heuristiques de raisonnement différentiel propres au diagnostic médical ou psychologique. En disséquant de vastes ensembles d’observations en sous-groupes de plus en plus homogènes au moyen de règles de décision univariées binaires, cette méthodologie offre une transparence analytique exceptionnelle. Elle constitue une interface naturelle entre la complexité stochastique brute et les exigences d’intelligibilité indispensables à l’action clinique et à l’élaboration théorique.
1. Fondements théoriques et genèse de la méthodologie CART
1.1 Origines historiques et rupture épistémologique
La publication en 1984 de l’ouvrage séminal Classification and Regression Trees par Leo Breiman, Jerome Friedman, Richard Olshen et Charles Stone a constitué une déflagration épistémologique dans le champ de la statistique computationnelle. Jusqu’alors, la pratique de l’analyse multivariée demeurait largement inféodée à l’héritage formaliste de Ronald Fisher et de Karl Pearson, au sein duquel l’ajustement d’un modèle statistique supposait impérativement la conformité des données à une classe paramétrique prédéfinie. Les premières tentatives d’arborescences de partitionnement, telles que le programme Automatic Interaction Detection (AID) proposé par Sonquist et Morgan au début des années 1960 ou le modèle THAID de Morgan et Messenger, souffraient d’instabilités numériques rédhibitoires et d’une propension pathologique au surapprentissage en l’absence de théories rigoureuses de régularisation.
Le quatuor d’auteurs de 1984 a opéré une véritable rupture en combinant l’optimisation combinatoire rigoureuse, la théorie du partitionnement géométrique et les procédures de rééchantillonnage algorithmique. Ils ont formalisé le passage de l’estimation de paramètres distributionnels vers l’apprentissage supervisé non paramétrique guidé par le risque empirique. Cette transition a redéfini le rôle de la statistique dans les sciences empiriques : il ne s’agissait plus exclusivement d’éprouver la significativité de coefficients au sein d’une relation linéaire idéalisée, mais de découvrir de manière inductive la structure topologique sous-jacente aux signaux observationnels. Les sciences comportementales, la biomédecine et l’économétrie appliquée ont immédiatement trouvé dans cette méthodologie une réponse technique à l’hétérogénéité foncière des phénotypes observés sur le terrain.
L’innovation centrale de Breiman et de ses confrères résidait dans l’abandon complet de l’hypothèse de continuité globale des relations fonctionnelles. En concevant l’espace des données non comme une variété différentiable continue à laquelle appliquer une régression polynomiale, mais comme un ensemble mesurable à segmenter récursivement, CART a libéré l’analyste des contraintes imposées par la géométrie euclidienne globale. Ce saut conceptuel a permis de modéliser avec une fidélité inédite des processus non stationnaires et des phénomènes comportementaux contingents, où le comportement d’une variable change radicalement de nature en fonction de l’environnement contextuel défini par les autres prédicteurs.
1.2 Limites des modèles linéaires classiques
Pour mesurer la portée de l’apport méthodologique de CART, il convient d’examiner avec précision les écueils structuraux inhérents aux modèles linéaires généralisés (GLM) et à la régression des moindres carrés ordinaires. Ces approches classiques reposent sur un socle d’hypothèses gaussiennes et de linéarité qui se trouvent presque systématiquement transgressées lors de l’étude de données observationnelles complexes :
- L’hypothèse d’additivité stricte et de linéarité fonctionnelle : Le modèle postule que l’effet marginal d’un prédicteur sur la variable dépendante est invariable, quel que soit le niveau des autres covariables, à moins d’intégrer manuellement des termes d’interaction croisés.
- La contrainte d’homoscédasticité : La variance des résidus d’estimation doit impérativement demeurer constante à travers l’ensemble des strates du continuum de prédiction, une condition notoirement violée dans les données de santé mentale ou de psychologie clinique.
- La vulnérabilité critique aux observations aberrantes : En minimisant la somme globale des carrés des erreurs, la régression multiple confère un poids disproportionné aux points extrêmes de levier, déformant l’hyperplan d’ajustement au détriment de la validité générale du modèle.
- L’incapacité à déceler nativement les interactions d’ordre supérieur : Dès lors qu’un phénomène dépend de la conjonction de trois, quatre ou cinq facteurs de risque qui n’agissent que de manière coordonnée, le nombre de combinaisons multiplicatives à spécifier a priori explose de façon exponentielle, entraînant un problème insoluble de saturation des degrés de liberté et de multicolinéarité sévère.
Ces contraintes structurales transforment trop souvent l’ajustement d’un modèle paramétrique en un exercice artificiel de forçage statistique. Face à une asymétrie marquée ou à des frontières non lisses, l’analyste linéaire est contraint d’appliquer des transformations mathématiques ad hoc (telles que les fonctions logarithmiques ou de Box-Cox), au détriment de l’interprétabilité directe des variables sur leur échelle naturelle de mesure. L’échec des approches linéaires traditionnelles à modéliser sans artifice ces discontinuités a pavé la voie à l’adoption de structures algorithmiques affranchies de toute contrainte de courbure globale.
1.3 Philosophie de l’apprentissage non paramétrique
La philosophie fondamentale régissant les approches non paramétriques, et tout particulièrement l’architecture CART, repose sur le principe de l’adaptation locale : la structure du modèle n’est pas fixée a priori par le chercheur, mais émerge dynamiquement de la topographie propre des données. Contrairement aux modèles paramétriques dont la complexité est invariante quelle que soit la taille de l’échantillon, la flexibilité opérationnelle d’un arbre s’accroît organiquement avec le volume d’observations disponibles, autorisant l’approximation universelle de surfaces de réponse arbitrairement complexes.
Dans cette perspective épistémologique, aucune hypothèse n’est émise concernant la distribution probabiliste conjointe des descripteurs. Les variables prédictives peuvent être asymétriques, multimodales, fortement corrélées ou constituées d’un mélange disparate d’échelles discrètes et continues sans que l’algorithme ne perde de son efficacité. Cette robustesse est précieuse dans les disciplines empiriques comme la psychométrie, où les instruments de mesure génèrent des scores qui satisfont rarement aux exigences de la normalité multivariée. La modélisation par CART traite l’information de manière ordinale, préservant la validité des inférences même en présence de planchers ou de plafonds de mesure marqués.
De surcroît, cette plasticité non paramétrique garantit une insensibilité totale aux transformations monotones appliquées aux variables explicatives univariées. Remplacer un descripteur continu par son logarithme, sa racine carrée ou toute fonction strictement croissante ne modifie en rien la séquence des partitions opérées par l’arbre, car seuls comptent l’ordre de tri relatif des observations et la localisation des coupures dans la distribution empirique. Cette propriété libère l’expérimentateur des arbitrages arbitraires sur la normalisation des données et recentre l’effort analytique sur l’architecture relationnelle des phénomènes étudiés.
2. Topologie et architecture conceptuelle des arbres de décision
2.1 Composantes anatomiques de l’arbre
L’anatomie formelle d’un arbre de décision s’organise selon une structure de graphe orienté acyclique inversé, qui emprunte son vocabulaire à la fois à la dendrologie et à la théorie des graphes. L’arbre prend sa source dans un nœud unique situé à son sommet structural, désigné sous le terme de nœud racine. Ce point originel contient la totalité de l’échantillon d’entraînement non différencié, caractérisé par sa distribution marginale initiale pour la variable cible, qu’il s’agisse de la moyenne globale pour une variable continue ou du vecteur de proportions de classes pour un statut qualitatif.
À partir de cette origine, l’algorithme génère des divisions successives matérialisées par des nœuds internes, également qualifiés de nœuds de décision ou de points d’aiguillage. Chaque nœud interne formule une condition logique univariée portant sur un unique descripteur prédictif, divisant le flux des observations en deux trajectoires mutuellement exclusives. Enfin, les extrémités terminales de cette arborescence constituent les nœuds terminaux ou feuilles. Dépourvues de descendance, les feuilles représentent les réceptacles finaux au sein desquels s’effectue l’attribution prédictive. C’est à leur niveau que sont agrégées les observations ayant partagé la même séquence de filtres décisionnels, et qu’est formalisée la distribution conditionnelle a posteriori de la variable dépendante.
Chaque composante anatomique assume ainsi une fonction épistémique dédiée dans le dispositif : le nœud racine mesure l’entropie ou la variance totale non expliquée du système ; les nœuds internes opèrent l’extraction active d’information en scindant l’hétérogénéité résiduelle ; et les feuilles synthétisent le savoir inductif final sous forme de prédictions locales ponctuelles ou probabilistes.
2.2 Principes de hiérarchie et de connectivité
La connectivité d’un arbre CART est gouvernée par le principe strict de la bipartition récursive. À la différence d’autres familles d’arbres décisionnels comme ID3 ou C4.5 développés par Ross Quinlan qui autorisent des scissions polytomiques (multiples) pour les variables catégorielles, la méthodologie de Breiman restreint rigoureusement chaque division à deux sous-nœuds dépendants : le nœud enfant gauche et le nœud enfant droit. Cette binarité systématique prévient la fragmentation trop rapide des effectifs d’échantillon et garantit une structure mathématique stable lors des calculs d’optimisation combinatoire.
Sur le plan de la topologie géométrique, cette hiérarchie binaire opère une tessellation de l’espace vectoriel des descripteurs en sous-régions orthogonales étanches et disjointes. Si l’espace initial est défini par un hypercube à $p$ dimensions déterminé par l’ensemble des variables prédictives $X_1, X_2, dots, X_p$, chaque partitionnement d’un nœud interne équivaut à projeter un hyperplan orthogonal à l’axe de la variable sélectionnée, tranchant la région parente en deux sous-polyèdres hyper-parallélépipédiques :
- La région gauche, définie par la condition $R_1(j, s) = {X mid X_j le s}$ pour un seuil continu $s$,
- La région droite, définie par la condition complémentaire $R_2(j, s) = {X mid X_j > s}$.
Cette logique de segmentation s’applique de manière fractale : chaque nœud enfant devient à son tour le parent d’une nouvelle sous-partition, restreinte au seul sous-espace géométrique défini par ses ancêtres. L’ensemble des feuilles forme une partition exacte et exhaustive de l’espace des descripteurs, garantissant que chaque observation théorique ou empirique se voit assignée à une feuille et une seule, sans recouvrement ni indétermination.
2.3 Interprétation graphique et lisibilité cognitive
Le succès phénoménal de l’approche CART réside incontestablement dans son interprétabilité directe et sa translucidité cognitive. Alors que la majorité des modèles prédictifs complexes opèrent comme des « boîtes noires » opaques générant des prédictions à partir de combinaisons pondérées inintelligibles pour l’esprit humain, un arbre de décision se matérialise sous la forme d’un organigramme intuitif qui calque fidèlement les structures du raisonnement diagnostique clinique.
Chaque cheminement tracé de la racine vers une feuille donnée peut être immédiatement transcrit sous la forme d’une règle logique booléenne disjonctive du type « SI condition 1 ET condition 2 ET condition 3, ALORS issue Y ». Cette formulation confère au modèle une transparence auditable essentielle dans les contextes à haute responsabilité sociétale ou médicale. Un psychiatre, un juge ou un analyste du risque financier n’est pas contraint d’accorder une confiance aveugle à une probabilité abstraite : il peut inspecter chaque seuil critique le long de la trajectoire décisionnelle, vérifier la plausibilité clinique de l’enchaînement des prédicteurs et comprendre précisément pourquoi un cas particulier est orienté vers un groupe pronostique spécifique.
Cette conformité avec les processus cognitifs humains favorise l’adhésion des praticiens de terrain. L’architecture arborescente ne se contente pas de prédire : elle structure le savoir empirique en une taxonomie explicative directement opérationnalisable sous forme de protocoles d’intervention séquentiels ou d’arbres de décision appliqués en situation d’urgence.
3. Mécanique des arbres de régression pour variables continues
3.1 Critère d’homogénéité locale et métrique d’erreur
Lorsqu’il s’agit de prédire une variable quantitative continue $Y in \mathbb{R}$, le modèle généré prend le nom d’arbre de régression. L’objectif mathématique central consiste à partitionner l’espace des données de manière à ce que les observations rassemblées au sein de chaque feuille terminale présentent la variabilité intra-groupe la plus restreinte possible autour de leur valeur centrale.
Le critère universel d’évaluation de la performance d’ajustement est la somme des résidus au carré, traditionnellement désignée par l’acronyme RSS (Residual Sum of Squares). Pour une partition donnée de l’espace en $M$ régions terminales distinctes $R_1, R_2, dots, R_M$, la perte d’ajustement globale du modèle s’exprime formellement par la relation :
$$RSS = \sum_{m=1}^M \sum_{i in R_m} (y_i – \hat{y}_{R_m})^2$$
Dans cette formulation, $y_i$ représente la valeur empirique observée pour le $i$-ème individu tombant dans la région $R_m$, tandis que $\hat{y}_{R_m}$ symbolise la prédiction ponctuelle assignée à cette même région. Sur le plan statistique, la constante $\hat{y}_{R_m}$ qui minimise mathématiquement la somme des carrés des écarts locaux est rigoureusement égale à la moyenne arithmétique empirique des observations appartenant à la feuille :
$$\hat{y}_{R_m} = \frac{1}{N_m} \sum_{i in R_m} y_i$$
où $N_m$ correspond au cardinal de la région $R_m$. L’optimisation algorithmique cherche donc à chaque division binaire la coupure qui maximise la réduction de la variance interne globale, transférant ainsi la variance des observations de l’intérieur des nœuds vers une différenciation entre les nœuds.
3.2 Exemple paradigmatique de la prédiction continue
Pour illustrer concrètement cette mécanique d’induction, examinons un jeu de données classique abondamment commenté dans la littérature pédagogique de l’apprentissage statistique : la modélisation du salaire annuel de joueurs professionnels de baseball de la ligue majeure américaine (MLB), documentée dans l’ouvrage de référence de James, Witten, Hastie et Tibshirani, An Introduction to Statistical Learning. La variable cible quantitative correspond au logarithme du salaire annuel, modélisée à partir de deux prédicteurs fondamentaux : le nombre d’années d’expérience dans la ligue professionnelle (Years) et le nombre total de coups de circuit ou de frappes réussies au cours de la saison précédente (Hits).
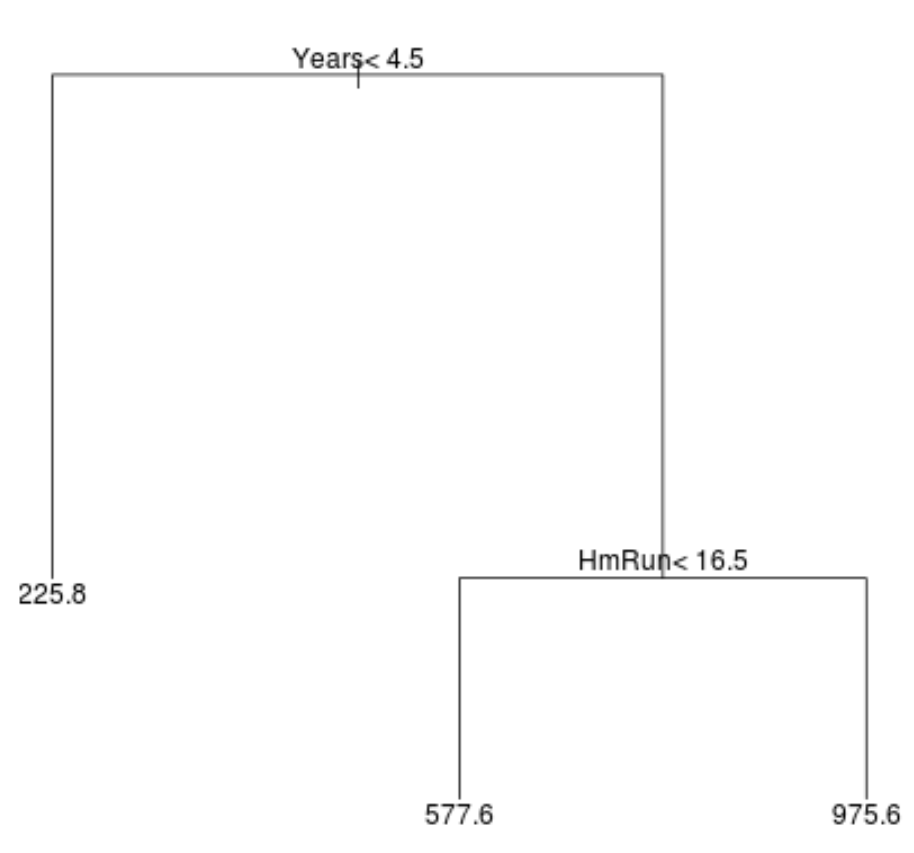
L’application de l’algorithme CART à cette structure de données isole immédiatement un premier point de rupture déterminant sur la variable Years, avec un seuil positionné exactement à 4,5 années. Cette première scission binaire coupe le nœud racine en deux branches : les joueurs possédant moins de 4,5 années d’ancienneté sont orientés vers la feuille terminale gauche, tandis que les joueurs plus expérimentés bifurquent vers la droite. Pour la population novice, le modèle n’opère aucune division ultérieure : la modélisation établit que le facteur prépondérant conditionnant leur rémunération est le statut contractuel d’entrée, qui plafonne les salaires indépendamment des performances sportives individuelles immédiates. La valeur prédite pour ce groupe se résume à la moyenne géométrique de leurs salaires, nettement inférieure à la médiane générale.
En revanche, pour le sous-groupe des vétérans totalisant plus de 4,5 années d’expérience, l’algorithme identifie une seconde rupture critique, cette fois-ci conditionnée par la variable Hits, à hauteur de 117,5 frappes réussies. Les joueurs expérimentés ayant réalisé moins de 117,5 frappes sont assignés à une feuille prédisant un salaire intermédiaire, tandis que les athlètes combinant ancienneté supérieure à 4,5 ans et rendement athlétique élevé (plus de 117,5 frappes) atteignent la feuille terminale dotée de la prédiction salariale la plus astronomique. Ce modèle capture élégamment une interaction multiplicative : la performance individuelle en termes de frappes n’exerce une influence déterminante sur les émoluments financiers que si l’ancienneté du joueur lui confère l’accès au statut d’agent libre. Cette modélisation s’applique de façon analogue en sciences psychologiques, par exemple lorsqu’on cherche à prédire l’intensité du score d’épuisement professionnel (burnout) en fonction de la charge horaire hebdomadaire et du niveau de soutien organisationnel perçu.
3.3 Topographie des prédictions par fonctions en escalier
La nature de la surface prédictive produite par un arbre de régression se distingue fondamentalement des plans inclinés réguliers produits par les modèles linéaires ordinaires. L’architecture CART génère une fonction constante par morceaux (piecewise constant function), caractérisée sur le plan topologique par une succession de plateaux horizontaux étagés en escalier le long de l’espace multidimensionnel.
Au sein de chaque hyper-parallélépipède terminal $R_m$, la valeur estimée $\hat{y}$ est strictement invariante : tous les profils d’individus captés par cette même feuille reçoivent la même valeur prédite, quelle que soit leur position relative à l’intérieur de la sous-région. Dès lors que l’on traverse la frontière délimitée par un seuil de coupure $s$, la prédiction subit une discontinuité brutale en sautant instantanément vers le plateau voisin. Cette caractéristique confère à la fonction d’ajustement une allure rugueuse et crénelée.
Si cette morphologie discontinue permet de capturer sans peine des paliers de transition brusques ou des effets de seuil psychophysiques, elle présente l’inconvénient théorique de ne pouvoir approcher une véritable pente linéaire continue qu’au prix d’une multitude de scissions successives en marche d’escalier. La finesse de résolution du maillage prédictif dépend alors exclusivement du nombre total de feuilles terminales autorisées au sein de l’architecture, soulevant un arbitrage fondamental entre précision locale de l’ajustement et parcimonie du modèle.
4. Mécanique des arbres de classification pour variables qualitatives
4.1 Structure de la réponse catégorielle et distribution de probabilités
Lorsque la variable cible $Y$ est qualitative et prend ses valeurs au sein d’un ensemble fini de $K$ classes discrètes ou catégorielles ($k in {1, 2, dots, K}$), l’arbre de décision relève de la classification. Dans ce cas de figure, l’objectif algorithmique n’est plus de prédire une moyenne arithmétique continue, mais de cartographier la distribution de probabilité conditionnelle d’appartenance catégorielle à travers les différentes régions de l’espace des descripteurs.
Pour chaque feuille terminale $m$ représentant une sous-région $R_m$ contenant $N_m$ observations d’apprentissage, la proportion empirique d’individus appartenant à la classe $k$ est formellement définie par :
$$\hat{p}_{mk} = \frac{1}{N_m} \sum_{i in R_m} I(y_i = k)$$
où $I(\cdot)$ désigne la fonction indicatrice booléenne qui prend la valeur 1 lorsque l’événement entre parenthèses est vrai et 0 dans le cas contraire. Ce vecteur de proportions $(\hat{p}_{m1}, \hat{p}_{m2}, dots, \hat{p}_{mK})$ constitue l’estimation non paramétrique de la distribution conditionnelle a posteriori $P(Y = k mid X in R_m)$.
Pour assigner une étiquette catégorielle unique et univoque à une observation inconnue tombant dans la feuille $m$, l’algorithme applique classiquement la règle du vote majoritaire issue de la théorie de la décision bayésienne. L’observation est ainsi formellement étiquetée selon la classe modale dominante au sein du nœud terminal :
$$\hat{Y}_{R_m} = arg\max_k (\hat{p}_{mk})$$
Cette approche s’adapte sans artifice aux classifications binaires (présence/absence d’une pathologie) ainsi qu’aux cadres polytomiques multivariés impliquant des dizaines de classes taxonomiques concurrentes, sans exiger l’ajustement de régressions logistiques multinomiales imbriquées sous hypothèse d’indépendance des alternatives non pertinentes.
4.2 Applications au diagnostic clinique et nosographique
En psychopathologie et en médecine différentielle, la mécanique de classification binaire et polytomique de CART offre un cadre d’opérationnalisation exceptionnel pour la nosographie et le dépistage. Prenons l’exemple clinique de l’orientation diagnostique face à un tableau dépressif complexe au sein duquel il convient de discriminer un épisode dépressif majeur isolé d’un virage thymique entrant dans le cadre d’un trouble bipolaire de type II.
À partir d’un ensemble d’indicateurs psychométriques et anamnestiques (tels que l’âge d’apparition du premier épisode, la réactivité émotionnelle, les antécédents familiaux au premier degré et le score de cyclothymie), CART segmente la cohorte clinique en classes homogènes. Une première scission peut intervenir sur l’âge précoce de début des symptômes (par exemple $le 21$ ans), orientant immédiatement le patient vers un sous-groupe à risque bipolaire accru. Au sein de cette branche, une seconde coupure portant sur l’échelle de labilité de l’humeur permet d’isoler un isolat clinique terminal où 88 % des sujets présentent un phénotype bipolaire avéré.
Dans ce type d’application nosologique, la gestion des asymétries de coût d’erreur revêt une importance éthique prépondérante. Poser un diagnostic faux positif de trouble bipolaire expose l’individu à un traitement régulateur d’humeur potentiellement hépatotoxique inutile ; inversement, générer un faux négatif en prescrivant un antidépresseur en monothérapie chez un patient en réalité bipolaire risque de déclencher un virage maniaque ou une accélération des cycles thymiques. L’algorithme CART autorise l’intégration directe d’une matrice de coûts de mauvais classement dissymétriques $C(j mid k)$, qui pénalise plus lourdement certaines erreurs spécifiques lors de l’évaluation des scissions, déplaçant le seuil d’attribution de classe pour sécuriser la décision thérapeutique.
4.3 Matrices de confusion et évaluation catégorielle
L’évaluation rigoureuse de la capacité discriminante d’un arbre de classification exige l’analyse approfondie de sa matrice de confusion, tableau croisé croisant les classes réelles du jeu de validation et les classes prédites par l’arborescence :
- Exactitude globale (Accuracy) : Ratio de l’ensemble des classifications correctes rapporté à la taille globale de l’échantillon. Cette métrique élémentaire s’avère toutefois trompeuse en cas de fort déséquilibre de classes.
- Sensibilité (Recall ou taux de vrais positifs) : Capacité intrinsèque de l’arbre à repérer l’intégralité des individus porteurs de la condition étudiée ($\frac{VP}{VP + FN}$).
- Spécificité (Taux de vrais négatifs) : Aptitude du modèle à exclure rigoureusement les individus exempts de la pathologie ($\frac{VN}{VN + FP}$).
- Valeur prédictive positive (Precision) : Probabilité effective qu’un patient assigné à une classe clinique anormale présente réellement les altérations correspondantes ($\frac{VP}{VP + FP}$).
Pour s’affranchir du biais inhérent au choix d’un seuil de vote majoritaire arbitraire fixé à 0,5, la performance discriminative d’un arbre de classification binaire est synthétisée à travers le tracé de la courbe ROC (Receiver Operating Characteristic). En faisant varier le seuil d’assignation probabiliste $\hat{p}_{m1}$ nécessaire pour classer une feuille comme positive, la courbe ROC projette la sensibilité en fonction du complémentaire de la spécificité ($1 – \text{Spécificité}$). L’aire sous cette trajectoire, formalisée par l’AUC (Area Under the Curve), mesure la séparabilité globale offerte par l’arbre. Une AUC de 0,5 correspond à une assignation purement aléatoire, tandis qu’une valeur de 1,0 caractérise une séparation nosographique parfaite.
Dans les contextes épidémiologiques marqués par des prévalences marginales très réduites (par exemple le risque suicidaire touchant moins de 1 % d’une population générale dépistée), CART offre la faculté théorique d’ajuster les probabilités a priori $\pi_k$ au sein même de la fonction de perte, contraignant l’algorithme à privilégier la sensibilité sans être submergé par la masse des cas négatifs dominants.
5. Métriques de pureté et critères mathématiques de partitionnement
5.1 L’indice de diversité de Gini
Le moteur d’un arbre de classification repose sur sa capacité à maximiser la « pureté » des nœuds enfants résultants. Dans la formulation canonique de CART proposée par Breiman et ses collègues en 1984, la métrique par défaut employée pour quantifier l’impureté d’un nœud donné $t$ est l’indice de diversité de Gini, à ne pas confondre avec le coefficient d’inégalité économique du même nom. Pour un nœud $t$ hébergeant une distribution de proportions empiriques de classes $p(k mid t)$ pour $k = 1, dots, K$, l’indice de Gini s’exprime sous la forme :
$$I_G(t) = \sum_{k=1}^K p(k mid t) \big(1 – p(k mid t)\big) = 1 – \sum_{k=1}^K p(k mid t)^2$$
Sur le plan probabiliste, l’indice de Gini admet une interprétation élégante : il mesure la probabilité qu’une observation extraite aléatoirement du nœud $t$ soit incorrectement étiquetée si on lui assignait arbitrairement une classe selon la distribution discrète de probabilités régnant au sein de ce nœud. Lorsque le nœud $t$ est parfaitement pur — c’est-à-dire que toutes les observations appartiennent exclusivement à une seule et unique classe $k$ —, la proportion $p(k mid t)$ vaut 1, toutes les autres valent 0, et l’indice de Gini s’annule rigoureusement : $I_G(t) = 0$.
À l’inverse, l’impureté de Gini atteint son maximum mathématique lorsque l’hétérogénéité est totale, c’est-à-dire quand l’ensemble des classes se distribue de manière strictement uniforme et équiprobable ($p(k mid t) = \frac{1}{K}$), plafonnant l’indice à la valeur limite $1 – \frac{1}{K}$. Dans le cadre d’une classification binaire ($K = 2$), la fonction prend une forme parabolique symétrique culminant à 0,5 lorsque le nœud héberge exactement 50 % de cas positifs et 50 % de cas négatifs.
5.2 L’entropie de Shannon et le gain d’information
Une alternative théorique majeure à l’indice de Gini, mobilisée préférentiellement dans les algorithmes de la lignée de Quinlan (ID3, C4.5) mais également disponible dans l’implémentation de CART, provient de la théorie statistique de la communication et de la cybernétique : l’entropie de Shannon. Cette métrique quantifie le degré d’incertitude distributionnelle ou le désordre informationnel résidant au sein du nœud $t$. Elle est définie formellement par :
$$H(t) = – \sum_{k=1}^K p(k mid t) \log_2 p(k mid t)$$
avec la convention mathématique standard que si $p(k mid t) = 0$, le terme $0 \log_2(0)$ s’annule par continuité asymptotique. À l’instar de l’indice de Gini, l’entropie s’annule lorsque le nœud est constitué d’observations homogènes appartenant à une classe unique (l’incertitude quant à l’appartenance d’un nouveau cas est alors nulle). Pour un problème binaire, l’entropie culmine à la valeur exacte de 1,0 bit d’information lorsque les deux classes se partagent à parts égales la population du nœud.
Lorsqu’on envisage une scission potentielle $s$ fractionnant le nœud parent $t$ en deux sous-nœuds dépendants $t_L$ (gauche) et $t_R$ (droit) contenant respectivement des fractions $p_L = \frac{N_L}{N}$ et $p_R = \frac{N_R}{N}$ des observations initiales, la réduction d’entropie réalisée correspond au gain d’information (Information Gain) :
$$\Delta H(t, s) = H(t) – \left( p_L H(t_L) + p_R H(t_R) \right)$$
Bien que l’entropie pénalise légèrement plus sévèrement les probabilités intermédiaires en raison de la concavité logarithmique de sa formulation comparée à la courbure quadratique de Gini, les études empiriques systématiques ont démontré que ces deux critères conduisent dans plus de 98 % des cas à la sélection rigoureuse de seuils de coupure strictement identiques. L’indice de Gini est souvent préféré en pratique computationnelle car il fait l’économie du calcul transcendant de logarithmes en base 2, optimisant ainsi la vitesse de convergence des algorithmes sur des données massives.
5.3 Réduction de la variance pour les modèles continus
Pour les arbres de régression, le critère d’impureté ne repose plus sur la dispersion catégorielle, mais sur la théorie classique de la décomposition de la variance formulée par Christian Huygens. L’impureté du nœud $t$ s’exprime par la variance empirique de la variable continue $Y$ calculée sur les observations résidant au sein de ce nœud :
$$s^2(t) = \frac{1}{N_t} \sum_{i in t} (y_i – \bar{y}_t)^2$$
Le bénéfice analytique apporté par une division candidate binaire $s$ se traduit par la quantification de la réduction de variance (Variance Reduction), qui calcule le différentiel entre l’impureté du parent et la moyenne pondérée des impuretés des deux nœuds enfants engendrés :
$$\Delta s^2(t, s) = s^2(t) – \left( \frac{N_L}{N_t} s^2(t_L) + \frac{N_R}{N_t} s^2(t_R) \right)$$
En vertu du théorème de König-Huygens sur la décomposition de la variance totale en somme de la variance intra-groupe (within-group) et de la variance inter-groupes (between-group), maximiser la réduction de variance intra-nœud équivaut rigoureusement à maximiser la distance quadratique entre les deux moyennes des sous-groupes enfants $\bar{y}_{t_L}$ et $\bar{y}_{t_R}$ :
$$\Delta s^2(t, s) = \frac{N_L N_R}{N_t^2} (\bar{y}_{t_L} – \bar{y}_{t_R})^2$$
Cette élégante dualité mathématique souligne que le critère de scission continue isole les segments de l’échantillon présentant les disparités de moyennes locales les plus prononcées. Toutefois, cette sensibilité aux écarts quadratiques expose la procédure de partitionnement aux perturbations causées par des valeurs extrêmes isolées dans la variable cible. Une observation déviante atypique peut polariser la scission, générant une division artificielle visant à isoler ce point unique au sein d’une feuille individualisée. Ce phénomène justifie la surveillance rigoureuse des résidus et l’application éventuelle de fonctions de perte plus robustes fondées sur les déviations absolues (médianes locales).
6. Algorithme de partitionnement récursif binaire
6.1 Procédure d’optimisation gloutonne (greedy approach)
La recherche théorique de l’arbre décisionnel optimal constitue sur le plan algorithmique un problème d’optimisation combinatoire appartenant à la classe de complexité NP-difficile. Pour un espace vectoriel de descripteurs modeste, le nombre d’arbres possibles croît de manière superexponentielle avec la dimension des données et la taille de l’échantillon, interdisant toute énumération exhaustive en temps polynomial.
Pour contourner ce verrou calculatoire, l’algorithme CART adopte une heuristique gloutonne ascendante (greedy algorithm), fondée sur un partitionnement récursif binaire descendant à pas myope. Le qualificatif « myope » caractérise le fait que l’algorithme sélectionne à chaque étape successive la meilleure scission immédiate disponible, c’est-à-dire celle qui optimise localement le critère de pureté (Gini ou réduction de variance), sans jamais évaluer si cette division locale facilitera ou compromettra la découverte d’une partition globale supérieure ultérieurement. Il n’effectue aucun retour en arrière (backtracking).
La procédure s’exécute selon une boucle récursive universelle :
- À partir du nœud courant contenant $N$ observations, l’algorithme parcourt séquentiellement l’intégralité des $p$ prédicteurs disponibles ${X_1, X_2, dots, X_p}$.
- Pour chaque descripteur $X_j$, il évalue tous les points de coupure potentiels admissibles $s$ et calcule le gain de pureté résultant $\Delta I(t, j, s)$.
- Le couple optimal $(X_{j^*}, s^*)$ qui maximise l’amélioration de la pureté est formellement isolé : $(j^*, s^*) = arg\max_{j, s} \Delta I(t, j, s)$.
- Le nœud est fractionné en deux sous-ensembles géométriques à l’aide de cette condition univariée optimale.
- La même opération est appliquée de manière récursive et indépendante au nœud enfant gauche et au nœud enfant droit, et ainsi de suite jusqu’à la rencontre d’un critère d’arrêt délibéré.
Bien que cette stratégie heuristique puisse parfois aboutir à des minima locaux, son efficacité computationnelle exceptionnelle permet de traiter des bases de données volumineuses tout en identifiant avec une robustesse empirique remarquable les signaux structuraux les plus saillants.
6.2 Traitement différentiel des types de variables prédictives
L’un des atouts méthodologiques majeurs de CART réside dans sa capacité unifiée à traiter de façon équitable des variables explicatives de natures d’échelles divergentes, au prix d’aménagements combinatoires spécifiques :
Pour les variables numériques continues, l’algorithme ordonne préalablement les $N$ valeurs observées par ordre croissant : $x_{(1)} le x_{(2)} le dots le x_{(N)}$. Il existe au maximum $N – 1$ points de scission candidats distincts, généralement définis par les points médians adjacents :
$$s = \frac{x_{(i)} + x_{(i+1)}}{2}$$
Pour les variables ordinales comportant un ordonnancement qualitatif intrinsèque (par exemple les échelles de Likert en psychométrie : « Jamais », « Parfois », « Fréquemment », « Toujours »), l’algorithme conserve l’intégrité de la relation d’ordre monotone et évalue uniquement les divisions qui respectent la hiérarchie séquentielle des catégories.
Pour les variables qualitatives nominales non ordonnées comportant $L$ catégories disjointes (par exemple les catégories professionnelles ou les codes géographiques), la scission consiste à partitionner l’ensemble des modalités en deux sous-ensembles complémentaires non vides $A$ et $B$. L’évaluation de l’ensemble des combinaisons possibles soulève une explosion combinatoire égale à $2^{L-1} – 1$ scissions candidates. Si $L$ est grand, cette recherche devient prohibive. Dans le cas spécifique de la classification binaire ou de la régression, Breiman et ses collègues ont apporté une simplification algorithmique : en ordonnant les modalités qualitatives selon la proportion croissante de la classe cible ou selon la moyenne croissante de la variable continue $Y$, le problème combinatoire exponentiel se réduit rigoureusement à un tri linéaire équivalent à une variable continue, ramenant l’examen à seulement $L – 1$ coupures candidates sans perte d’optimalité.
6.3 Critères d’arrêt de la croissance de l’arbre
Sans l’imposition de contraintes strictes, le partitionnement récursif poursuivrait son expansion jusqu’à ce que chaque observation isolée de l’échantillon d’apprentissage soit confinée dans sa propre feuille terminale unitaire. L’arbre atteindrait alors une pureté absolue ($I_G = 0$, $RSS = 0$), mais sa capacité à généraliser ses prédictions à des données indépendantes serait anéantie par le surapprentissage. Pour prévenir cette expansion pathologique, l’algorithme applique une série de critères d’arrêt primaires qui suspendent l’exploration récursive :
- Le seuil minimal d’effectif parent (minsplit) : Aucune tentative de scission n’est engagée au sein d’un nœud si le nombre total d’observations qu’il héberge est strictement inférieur à un seuil critique prédéterminé (par exemple $N_{nœud} < 20$).
- L’effectif plancher de nœud terminal (minbucket) : Une partition binaire candidate, même si elle engendre un fort gain d’impureté, est systématiquement rejetée si l’un des deux nœuds enfants engendrés présente un effectif d’observations inférieur à un quota minimal de sécurité (par exemple $N_{enfant} < 7$).
- La profondeur maximale de l’arbre (maxdepth) : Limite absolue imposée au nombre de strates hiérarchiques reliant la racine aux feuilles les plus lointaines, prévenant l’enchevêtrement cognitif de règles excessivement spécifiques.
- Le seuil minimal d’amélioration de pureté (complexity parameter $\alpha$ ou $cp$) : Interdiction de fragmenter un nœud si le différentiel d’impureté apporté par la scission optimale ne dépasse pas un incrément marginal prédéfini.
Toutefois, la pratique moderne a démontré que l’arrêt précoce de la croissance de l’arbre via ces seuls seuils (stratégie dite d’élagage préventif ou pre-pruning) constitue une approche sous-optimale. Une scission n’apportant qu’un gain marginal d’information à l’étape $t$ peut conditionner une scission ultérieure hautement discriminante à l’étape $t+1$. La doctrine rigoureuse formalisée par CART prescrit par conséquent de laisser croître l’arbre jusqu’à une saturation contrôlée, pour ensuite réduire sa taille selon la procédure d’élagage rétrospectif.
7. Gestion du surapprentissage et élagage coût-complexité
7.1 Le paradoxe biais-variance appliqué aux arbres
L’analyse structurelle des arbres de décision offre une illustration du compromis universel entre le biais et la variance en théorie de l’apprentissage statistique. Un arbre très peu développé, bridé à une ou deux scissions univariées (parfois désigné sous le terme de stump ou souche décisionnelle), présente un biais statistique très élevé : son armature fonctionnelle rigide est incapable d’épouser la morphologie réelle des interactions présentes dans la population d’étude, conduisant à une sous-estimation systématique des structures sous-jacentes (underfitting).
À l’inverse, un arbre géant pleinement déployé sans régularisation souffre d’une variance statistique considérable. En raison de sa plasticité non paramétrique, l’arbre se met à mémoriser fidèlement le bruit stochastique, les idiosyncrasies locales et les fluctuations aléatoires d’échantillonnage de la cohorte d’entraînement. La topologie arborescente devient instable : le déplacement minime d’une poignée d’individus ou la réplication de l’expérience sur un échantillon parallèle issu de la même population peut modifier la première coupure à la racine et bouleverser la configuration générale des branches. La performance d’ajustement empirique sur l’échantillon d’apprentissage apparaît flatteuse, mais le taux d’erreur mesuré sur des cas indépendants non vus s’effondre drastiquement.
Le défi méthodologique réside donc dans l’identification d’un compromis optimal : concevoir un sous-arbre emboîté dont la complexité topologique est suffisamment riche pour extraire les interactions prédictives réelles sans absorber le bruit observationnel.
7.2 Mécanisme formel de l’élagage coût-complexité (Cost-Complexity Pruning)
Pour résoudre le paradoxe du surapprentissage, Breiman, Friedman, Olshen et Stone ont élaboré l’élagage coût-complexité (Minimal Cost-Complexity Pruning). Cette méthode consiste à faire croître initialement un arbre très vaste $T_0$, atteignant les limites fixées par les effectifs minimaux, pour ensuite couper méthodiquement ses branches terminales les moins performantes.
Le dispositif repose sur la définition formelle d’une fonction de coût régularisée, désignée sous la notation $R_\alpha(T)$, qui applique une pénalisation linéaire proportionnelle au nombre total de feuilles terminales présentes dans l’arborescence :
$$R_\alpha(T) = R(T) + \alpha |T|$$
Dans cette équation régulatrice :
- $R(T)$ représente le risque empirique non pénalisé de l’arbre $T$ (mesuré par la somme totale des résidus au carré $RSS$ en régression, ou par le nombre absolu d’erreurs de classement en classification).
- $|T|$ matérialise la complexité topologique de l’arbre, mesurée rigoureusement par le nombre total de ses nœuds terminaux (feuilles).
- $\alpha ge 0$ constitue le paramètre de complexité (ou paramètre de régularisation), qui pondère le coût marginal infligé à l’arbre pour chaque feuille additionnelle autorisée dans son architecture.
Lorsque $\alpha = 0$, le terme de pénalisation s’annule et le minimiseur de la fonction n’est autre que l’arbre maximal d’origine $T_0$. Lorsque $\alpha$ tend vers l’infini, la pénalité sur la structure devient prohibitive, et l’arbre optimal se réduit au nœud racine unitaire. Pour chaque valeur intermédiaire continue fixée de $\alpha$, il existe un sous-arbre emboîté unique $T \subseteq T_0$ qui minimise la fonction de coût $R_\alpha(T)$.
L’une des percées théoriques majeures de CART réside dans la démonstration que, bien que $\alpha$ varie de façon continue sur l’intervalle $[0, +\infty[$, il n’engendre qu’une séquence finie et emboîtée de sous-arbres optimaux : $T_0 \supset T_1 \supset T_2 \supset dots \supset T_m \supset {Racine}$. Cette propriété remarquable permet de concevoir un algorithme d’élagage à rebours extrêmement efficace : à chaque itération, l’algorithme identifie la branche qui présente le ratio de performance locale $\frac{R(t) – R(T_t)}{|T_t| – 1}$ le plus faible (où $T_t$ désigne le sous-arbre enraciné au nœud interne $t$) et l’efface en transformant le nœud $t$ en feuille terminale. L’ensemble de la trajectoire d’élagage est ainsi obtenu avec une dépense computationnelle modérée.
7.3 Optimisation par validation croisée à k-blocs
L’enjeu méthodologique consiste dès lors à sélectionner la valeur numérique optimale du paramètre de pénalisation $\alpha$ qui maximise les facultés de généralisation hors échantillon. L’instrument privilégié pour opérer cette calibration est la validation croisée à $k$-blocs (généralement fixée à $k = 10$).
La cohorte totale d’apprentissage est scindée aléatoirement en 10 partitions mutuellement exclusives de taille équivalente. À 10 reprises consécutives, l’algorithme CART fait croître un arbre maximal sur 90 % des données, génère la séquence emboîtée d’élagage, puis évalue l’erreur quadratique moyenne ou le taux de mal-classement de chaque niveau d’élagage sur les 10 % de données réservées non vues. En moyennant ces performances de test sur l’ensemble des dix itérations, on obtient une estimation non biaisée du risque de prédiction en fonction de la complexité de l’arbre, matérialisée par une courbe caractéristique en forme de $U$.
Au minimum absolu de cette courbe se trouve la valeur optimale $\alpha_{\min}$. Toutefois, pour prévenir le surajustement résiduel lié aux fluctuations stochastiques du partitionnement d’échantillon, Breiman a introduit une convention pragmatique universellement adoptée : la règle de l’écart-type unique (1-SE rule ou one standard error rule). Cette règle préconise de sélectionner l’arbre le plus sobre et le plus court dont l’erreur estimée par validation croisée ne dépasse pas le seuil plancher du minimum absolu augmenté d’un écart-type statistique d’erreur d’estimation :
$$CV(T) le CV(T_{\min}) + SE(CV(T_{\min}))$$
Cette approche favorise la parcimonie structurelle et garantit la sélection d’une arborescence épurée, insensible au bruit d’échantillonnage et plus simple à interpréter sur le plan substantiel.
8. Gestion des données manquantes et scissions de substitution
8.1 Vulnérabilité des méthodes traditionnelles face aux données manquantes
La présence d’observations incomplètes constitue un problème récurrent dans l’analyse de données en sciences humaines, épidémiologiques et cliniques. Dans la modélisation paramétrique traditionnelle (régressions linéaires ou logistiques), le traitement par défaut repose sur l’exclusion par liste (listwise deletion ou complete case analysis) : tout individu présentant une valeur manquante sur un seul des prédicteurs inclus dans l’équation d’ajustement est rejeté de l’échantillon d’analyse.
Cette pratique engendre des conséquences méthodologiques délétères :
- Une amputation drastique de la puissance statistique : Dès lors qu’un protocole d’évaluation croise plusieurs dizaines d’échelles psychométriques ou de biomarqueurs, le cumul des non-réponses sporadiques peut réduire la cohorte d’entraînement de 30 à 60 %, rendant impossible l’inférence fiable de paramètres fins.
- L’introduction de biais systématiques majeurs : Les omissions d’observation relèvent rarement d’un mécanisme purement aléatoire au sens de Rubin (Missing Completely At Random – MCAR). Dans les questionnaires portant sur des conduites addictives, la dépression sévère ou les difficultés financières, l’absence de réponse est intrinsèquement corrélée à l’état de détresse de l’enquêté (mécanismes MAR ou MNAR). L’exclusion systématique des profils incomplets sélectionne artificiellement les individus les plus stables et déforme les distributions empiriques réelles.
- L’artificialité des imputations naïves : Le remplacement systématique des valeurs manquantes par la moyenne ou la médiane de l’échantillon réduit artificiellement la variance naturelle des descripteurs et atténue les corrélations bivariées sous-jacentes.
8.2 Mécanisme algorithmique des variables substitutives (Surrogate Splits)
Pour surmonter cette faiblesse structurelle sans recourir à des procédures d’imputation complexes, la méthodologie CART a inauguré une innovation élégante : le mécanisme des scissions de substitution (surrogate splits). Cette approche exploite l’architecture univariée de l’arbre pour compenser localement l’absence d’information.
Lorsqu’une scission primaire optimale est identifiée sur une variable donnée $X^*$ au nœud $t$ (par exemple « Revenu annuel $le$ 35 000 € »), l’algorithme ne se borne pas à enregistrer cette seule règle. Il procède immédiatement à l’identification exhaustive de variables substitutives au sein de l’ensemble des descripteurs résiduels ${X_j}_{j ne *}$. Une variable substitutive est un descripteur alternatif doté de son propre point de coupure spécifique, sélectionné pour sa capacité à reproduire le plus fidèlement possible l’orientation binaire imposée par la scission primaire, en mimant le tri des observations entre nœud gauche et nœud droit.
La performance d’ajustement de chaque scission de substitution concurrente est quantifiée par une métrique formelle de concordance prédictive, corrigée de la probabilité d’accord fortuit par la formule :
$$\lambda(X^*, \tilde{X}) = \frac{\min(p_L, p_R) – (1 – P_{accord})}{\min(p_L, p_R)}$$
où $P_{accord}$ mesure la fraction exacte d’individus de l’échantillon d’apprentissage classés rigoureusement dans la même branche enfant à la fois par la scission d’origine $X^*$ et par la scission substitutive $\tilde{X}$, tandis que $\min(p_L, p_R)$ matérialise l’accord trivial obtenu en orientant aveuglément l’intégralité des sujets vers la branche majoritaire. Seules les variables présentant une concordance prédictive positive ($lambda > 0$) sont conservées, hiérarchisées par ordre de redondance décroissante au sein d’une pile ordonnée de substituts de secours.
8.3 Robustesse intrinsèque et préservation des observations
L’exploitation opérationnelle des scissions de substitution confère à l’architecture CART une tolérance exceptionnelle face aux données parcellaires lors de la phase de déploiement prédictif ou de validation :
Lorsqu’un profil clinique ou comportemental doit être évalué par l’arbre décisionnel, l’algorithme soumet ses valeurs aux conditions des nœuds internes. Si l’individu possède une observation valide pour la variable de scission primaire du nœud $t$, il emprunte la trajectoire conventionnelle. En revanche, si la mesure relative à ce descripteur principal fait défaut pour ce sujet, l’algorithme convoque immédiatement la première variable de substitution de la pile hiérarchisée. Si la valeur de cette variable de secours est renseignée, la décision d’orientation vers la droite ou la gauche est prise sur la base de sa coupure de substitution. Si cette première variable substitutive est également manquante, l’algorithme interroge la seconde, puis la troisième, n’ayant recours à l’orientation par défaut vers le nœud enfant majoritaire qu’en cas d’épuisement complet de la liste des descripteurs de secours.
Ce dispositif permet de conserver 100 % de l’échantillon d’origine, à la fois lors de la construction mathématique de l’arbre et lors de son application diagnostique ultérieure. Les informations partielles dispersées au sein d’un dossier médical ou psychométrique sont ainsi exploitées au maximum, sans déformation artificielle des relations inter-variables ni abandon des observations les plus sévèrement atteintes.
9. Interprétabilité, diagnostic et extraction d’interactions
9.1 Quantification de l’importance relative des variables
Si la topologie graphique d’un arbre permet de visualiser les variables mobilisées dans les premières scissions, cette lecture visuelle peut s’avérer trompeuse pour juger de la contribution réelle d’un prédicteur. Un descripteur prédictif central peut être masqué par un autre facteur légèrement plus informatif au nœud racine et n’apparaître explicitement sur aucune branche, alors même qu’il partage l’essentiel de sa variance explicative avec les variables sélectionnées (phénomène de masquage ou masking effect).
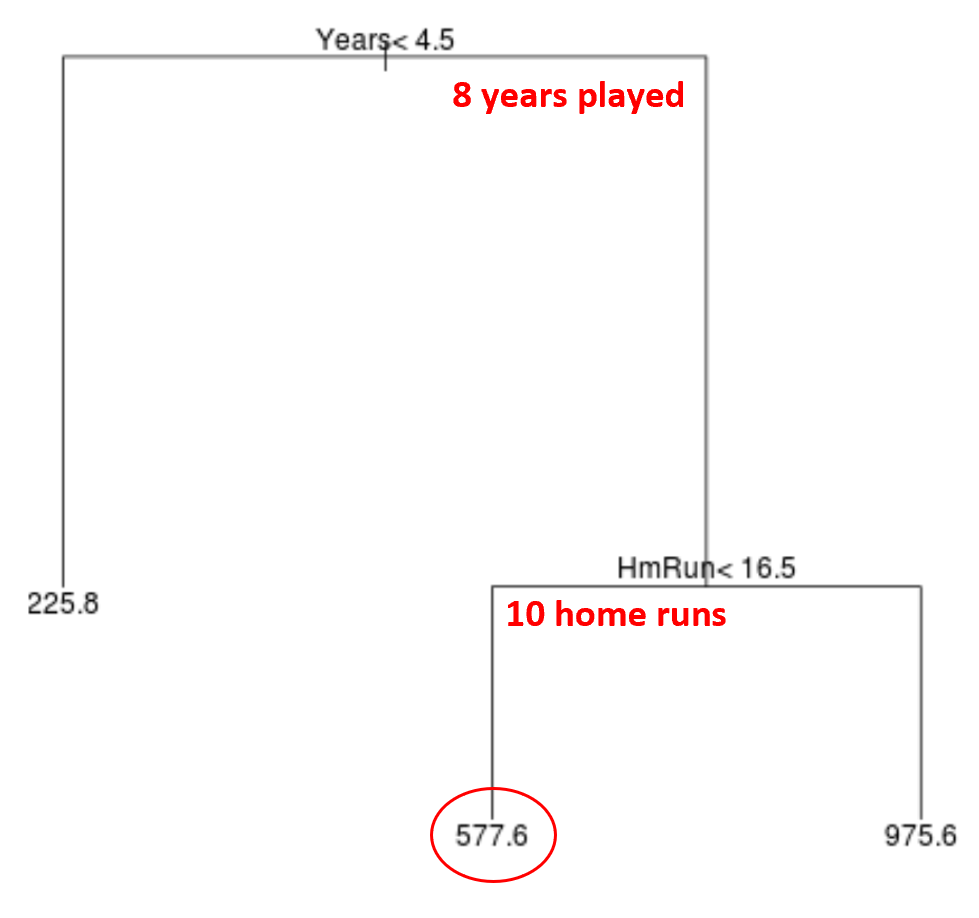
Pour corriger ce biais d’interprétation, Breiman a formalisé un indice synthétique : la mesure d’importance relative des variables (Variable Importance Measure – VIM). L’importance d’un prédicteur $X_j$ ne se limite pas aux nœuds où il a été retenu comme scissionneur principal, mais intègre l’ensemble des gains de pureté qu’il engendre en qualité de variable primaire ou de variable de substitution à travers l’ensemble des nœuds internes de l’arbre global :
$$VI(X_j) = \sum_{t in T} \Delta I(t, X_j)$$
Dans cette formulation, $\Delta I(t, X_j)$ quantifie l’amélioration de pureté effectivement réalisée par $X_j$ au nœud $t$ s’il s’agit du descripteur primaire, ou l’amélioration pondérée par la concordance prédictive s’il a agi comme substitut d’un scissionneur défaillant. Pour faciliter les comparaisons inter-modèles, ces scores bruts sont ensuite normalisés sur une échelle relative variant de 0 à 100 % par rapport au descripteur dominant de l’analyse :
$$VIM(X_j) = \frac{VI(X_j)}{\max_k VI(X_k)} \times 100$$
Cette métrique attribue un rôle aux variables redondantes ou corrélées, fournissant une vue d’ensemble du paysage informatif du modèle. Toutefois, l’analyste doit veiller à ne pas confondre le pouvoir prédictif mesuré par l’importance relative avec une quelconque causalité ontologique : une variable peut s’avérer statistiquement discriminante sans constituer le levier étiologique du phénomène modélisé.
9.2 Identification native des interactions non linéaires complexes
L’un des apports majeurs de CART vis-à-vis des modèles linéaires réside dans son aptitude à isoler spontanément des interactions multiplicatives d’ordre supérieur sans nécessiter leur spécification analytique préalable par l’expérimentateur. Dans le cadre d’un modèle paramétrique standard, modéliser une modulation contextuelle exige d’anticiper la relation et d’introduire des termes de produit croisé ($X_1 \times X_2$), augmentant ainsi le risque d’inflation de variance et de collinearité.
Dans un arbre de décision, l’interaction est inhérente à la hiérarchie de la structure. Dès lors qu’une scission sur un descripteur $X_2$ est opérée en aval d’une division sur $X_1$, l’effet de $X_2$ est conditionné par la strate définie par $X_1$. Si la variable $X_2$ fait l’objet d’un seuil critique à 50 sur la branche gauche ($X_1 le c$) mais ne subit aucune division ou présente un seuil radicalement divergent à 120 sur la branche droite ($X_1 > c$), le modèle capture nativement une interaction non linéaire locale entre $X_1$ et $X_2$.
Cette architecture s’adapte à la détection d’effets de seuil comportementaux et de modérations contextuelles asymétriques. En psychologie du travail, par exemple, un niveau élevé d’autonomie organisationnelle peut exercer un effet protecteur majeur contre l’anxiété uniquement chez les salariés soumis à une surcharge cognitive extrême, tout en demeurant sans effet mesurable chez les collaborateurs exposés à une charge de travail modérée. L’arbre révélera cette modération sous la forme d’un découpage unilatéral conditionné, inaccessible à une régression multiple sans hypothèse formulée a priori.
9.3 Traduction en systèmes d’aide à la décision clinique
Au-delà de ses qualités métriques pures, l’architecture CART s’impose comme un standard pour la conception de systèmes d’aide à la décision clinique (Clinical Decision Support Systems). Contrairement aux réseaux de neurones ou aux méthodes à vecteurs de support dont les mécanismes internes sont souvent opaques, les arbres de décision sont des systèmes transparents de type « boîte blanche » dont la logique d’assignation est auditable et vérifiable à chaque étape.
Cette lisibilité opérationnelle permet de convertir l’arborescence en un protocole clinique standardisé. Dans un contexte de régulation d’urgence hospitalière ou de permanence psychiatrique, un personnel soignant peut être confronté à des décisions sous haute contrainte temporelle. Un arbre CART élagué permet d’orienter le tri des patients en posant un nombre restreint de questions ciblées ordonnées par pertinence diagnostique :
- Étape 1 : Le patient présente-t-il une désorientation spatio-temporelle aiguë ? Si Non $\rightarrow$ Branche A ; Si Oui $\rightarrow$ Branche B.
- Étape 2 (sur Branche B) : La saturation en oxygène est-elle inférieure à 92 % ? Si Oui $\rightarrow$ Alerte d’admission immédiate en soins intensifs.
La validation de la plausibilité clinique et psychologique des trajectoires identifiées consolide l’adhésion des praticiens. En rendant visible l’enchaînement des inférences, l’algorithme favorise le dialogue entre la modélisation statistique computationnelle et l’expertise de terrain, garantissant une meilleure intégration de l’intelligence artificielle dans les protocoles de soin.
10. Forces et limites comparatives face aux approches alternatives
10.1 Atouts majeurs de l’architecture CART
Pour apprécier la place de l’algorithme CART dans l’arsenal de l’apprentissage statistique supervisé, il convient d’en synthétiser les avantages méthodologiques et techniques majeurs :
- L’invariance stricte sous transformations monotones : L’approche étant fondée sur le tri ordinal des descripteurs, l’application de fonctions strictement croissantes univariées (logarithmes, exponentielles, transformations puissances) sur les prédicteurs continus ne modifie ni les scissions retenues ni l’architecture de l’arbre, affranchissant l’analyste des étapes lourdes de normalisation ou de centrage-réduction.
- La gestion native des types de variables hétérogènes : L’algorithme intègre conjointement et sur un pied d’égalité des facteurs qualitatifs non ordonnés, des échelles ordinales et des variables quantitatives continues sans imposer de codage artificiel en variables indicatrices (one-hot encoding) susceptible de gonfler la dimensionnalité de l’espace.
- L’insensibilité structurelle à la multicolinéarité : Alors qu’une corrélation quasi-parfaite entre plusieurs variables déstabilise l’inversion matricielle d’un modèle linéaire, CART choisit simplement à chaque étape le descripteur le plus informatif, reléguant les variables concurrentes redondantes au statut de variables substitutives sans dégrader la robustesse du modèle.
- La sélection de variables intégrée et automatique : Les prédicteurs dénués de valeur ajoutée informative sont systématiquement ignorés lors de l’arborescence et exclus des partitions, opérant de fait une réduction de dimensionnalité parcimonieuse.
10.2 Vulnérabilités structurelles et faiblesses statistiques
En dépit de ces atouts substantiels, l’architecture CART unitaire souffre de fragilités inhérentes à sa conception géométrique et algorithmique, que l’analyste averti doit appréhender avec lucidité :
La faiblesse la plus critique réside incontestablement dans l’instabilité topologique majeure des arbres unitaires, conséquence directe de leur forte variance d’échantillonnage. En raison de la nature hiérarchique et descendante de l’algorithme glouton, une légère fluctuation aléatoire affectant une poignée d’observations peut conduire à retenir une variable concurrente différente lors de la toute première scission au nœud racine. Cette bifurcation initiale modifie l’ensemble des sous-espaces de projection en aval, produisant au final une arborescence à la structure morphologique et aux règles terminales complètement divergentes, bien que sa performance prédictive globale puisse demeurer similaire.
Sur le plan géométrique, l’obligation de scinder l’espace des données au moyen d’hyperplans strictement orthogonaux aux axes univariés handicape l’algorithme face à des relations obliques ou purement linéaires simples. Pour approximer une droite diagonale de type $Y = X_1 + X_2$, l’arbre univarié CART est contraint de générer une infinité de scissions orthogonales microscopiques en marche d’escalier, mobilisant une arborescence hypertrophiée pour modéliser une relation qu’une régression multiple basique résume en une ligne d’équation.
Enfin, la recherche heuristique gloutonne s’avère intrinsèquement myope : elle ne peut anticiper des relations logiques complexes de type « OU exclusif » (XOR), où chaque prédicteur pris isolément ne présente aucun pouvoir discriminant univarié, mais dont l’association interactive simultanée détermine l’appartenance de classe.
10.3 Positionnement épistémologique vis-à-vis de la régression paramétrique
L’arbitrage entre l’usage d’un modèle de régression linéaire ou logistique paramétrique et l’implémentation d’un arbre de décision unitaire CART dépend de la nature des objectifs scientifiques poursuivis et de la configuration du jeu de données :
La régression paramétrique s’impose lorsqu’il existe des hypothèses théoriques formalisées suggérant l’existence d’une relation continue lisse, et que l’ambition principale réside dans l’estimation non biaisée d’effets marginaux moyens à travers des coefficients interprétables ($\beta$), encadrés par des intervalles de confiance asymptotiques rigoureux. Lorsque la véritable surface de réponse s’approche d’une relation linéaire et que la taille d’échantillon est restreinte, la régression linéaire surpasse l’arbre de décision grâce à son faible niveau de variance structurelle.
À l’inverse, l’approche CART devient préférentielle dès lors que l’objectif principal est la découverte exploratoire, la modélisation de sous-populations cliniquement distinctes ou la prédiction dans des contextes où l’on soupçonne de fortes discontinuités topologiques et des interactions d’ordre élevé non spécifiées. L’absence de forme fonctionnelle prédéfinie confère à l’arbre une flexibilité morphologique que la régression paramétrique ne peut approcher qu’au prix d’une complexification manuelle fastidieuse.
11. Applications avancées en psychologie et sciences du comportement
11.1 Psychométrie computationnelle et stratification diagnostique
Dans le domaine de la psychométrie et de la recherche comportementale contemporaine, les méthodologies de partitionnement récursif ont renouvelé la mesure et la nosologie computationnelle. Une application réside dans l’identification de sous-types dépressifs homogènes au sein de cohortes diagnostiques caractérisées par une hétérogénéité sémiologique notoire.
En croisant les inventaires standardisés d’affects négatifs (tels que le BDI-II), des biomarqueurs neuroendocriniens (taux de cortisol salivaire matinal) et des paramètres électrophysiologiques, CART permet d’isoler des grappes d’individus partageant des profils fonctionnels cohérents. L’arbre peut ainsi démontrer que l’altération du sommeil n’est corrélée à une anédonie majeure que chez les patients présentant un niveau d’inflammation systémique périphérique élevé (protéine C-réactive $> 3$ mg/L), dessinant une sous-entité nosographique d’« immuno-dépression » directement transposable en essai clinique pharmacologique.
De surcroît, le couplage des arbres avec la théorie de la réponse aux items (IRT) a donné naissance aux arbres psychométriques (Psychometric Trees). Cette méthode est dédiée à la détection du fonctionnement différentiel des items (Differential Item Functioning – DIF). En modélisant les paramètres de difficulté et de discrimination d’une épreuve cognitive au sein des nœuds d’un arbre alimenté par des covariables socio-démographiques, l’algorithme isole de façon non biaisée les sous-groupes de répondants pour lesquels l’instrument de mesure manifeste une invalidité de construit ou une partialité de mesure involontaire.
11.2 Prédiction des risques suicidaires et crises comportementales
La prédiction du passage à l’acte suicidaire et des crises hétéro-agressives aiguës constitue un défi méthodologique pour la psychiatrie moderne, caractérisé par un très faible taux de prévalence de base et une intriquation dynamique de facteurs de vulnérabilité distaux et d’éléments précipitants proximaux.
L’application d’arbres de classification enrichis par des matrices de coûts asymétriques permet de décortiquer ces constellations de vulnérabilité. L’algorithme démontre avec netteté la non-linéarité du risque :
- Un facteur distal comme les traumatismes infantiles graves ne prédit pas à lui seul l’imminence d’une crise au cours des 72 heures, mais crée un terrain de réactivité émotionnelle amplifiée.
- La scission décisive intervient en aval, associant la survenue récente d’une rupture sentimentale aiguë à une insomnie terminale réfractaire mesurée sur les dernières 48 heures.
- L’arbre fait émerger un profil d’urgence où le taux de passage à l’acte est multiplié par un facteur 40 par rapport au risque de base de la population clinique générale.
L’évaluation éthique de l’impact des faux négatifs s’avère ici capitale. En intégrant un coût de pénalisation mille fois supérieur pour un faux négatif (non-détection d’un patient en péril imminent) par rapport à un faux positif (déclenchement préventif d’une mesure de surveillance hospitalière transitoire), l’arbre déplace ses frontières pour maximiser la sensibilité du modèle, fournissant aux équipes de liaison psychiatrique des grilles d’évaluation décisionnelles protectrices pour la prise en charge des patients.
11.3 Neuropsychologie et profilage cognitif individualisé
En neuropsychologie du vieillissement, l’investigation différentielle précoce du déclin cognitif bénéficie de la modularité des arbres CART pour discriminer les stades inauguraux de la maladie d’Alzheimer, de la démence vasculaire sous-corticale et des altérations mnésiques bénignes associées à la sénescence physiologique.
À partir de batteries de tests neuropsychologiques standardisés évaluant la mémoire épisodique verbale, les fonctions exécutives d’inhibition et la fluence phonémique, l’arbre extrait des profils fonctionnels sans exiger l’agrégation arbitraire des scores en un composite global. Par exemple, une scission inaugurale portant sur le score de rappel libre différé (mettant en évidence un déficit de stockage hippocampique) sépare d’emblée la suspicion de pathologie d’Alzheimer des profils fronto-sous-corticaux. Au sein de cette sous-branche, une coupure ultérieure sur la réponse à l’indiçage sémantique confirme le caractère isolé du trouble mnésique, tandis que l’adjonction de marqueurs volumétriques d’imagerie par résonance magnétique (atrophie du cortex entorhinal) raffine la certitude diagnostique au niveau des feuilles ultimes.
Cette approche permet d’individualiser l’évaluation : le cheminement décisionnel ne sollicite que les épreuves neuropsychologiques indispensables pour lever l’indécision diagnostique spécifique d’un patient donné, limitant la fatigabilité des sujets âgés lors des passations cliniques.
12. Perspectives d’ensemble et transition vers les méta-modèles
12.1 Le bootstrap aggregating (Bagging) comme remède à la variance
Bien que l’architecture CART unitaire offre une interprétabilité directe, ses faiblesses statistiques chroniques — au premier rang desquelles figure son instabilité structurelle face aux variations d’échantillonnage — ont incité Leo Breiman à poser les jalons d’un nouveau paradigme de l’apprentissage supervisé : les méthodes d’ensemble (ensemble methods).
En 1996, Breiman formalise le concept de Bootstrap Aggregating, couramment désigné sous le terme de Bagging. Le principe théorique sous-jacent repose sur la réduction mathématique de la variance d’un estimateur non biaisé par le truchement de la moyenne d’échantillons indépendants multiples. La procédure algorithmique s’articule comme suit :
- À partir de la cohorte d’entraînement originale comportant $N$ observations, l’algorithme extrait un grand nombre $B$ de sous-échantillons par rééchantillonnage avec remise (échantillons bootstrap), chacun hébergeant une taille équivalente à $N$.
- Sur chaque échantillon bootstrap $b in {1, dots, B}$, un arbre décisionnel complet et non élagué $T_b$ est déployé jusqu’à saturation, maximisant ainsi la réduction du biais au prix d’une forte variance unitaire.
- Pour formuler la prédiction finale face à une nouvelle observation vectorielle $x$, le modèle agrège démocratiquement les résultats de l’ensemble des $B$ arbres indépendants : par moyennage arithmétique pour les problèmes de régression ($\hat{f}_{bag}(x) = \frac{1}{B} \sum_{b=1}^B T_b(x)$), ou par vote majoritaire pour la classification catégorielle.
Le bagging permet d’atténuer la variance globale de l’estimation sans altérer le faible biais inhérent aux arbres développés, générant un gain de précision prédictive et une résistance accrue au surapprentissage. Toutefois, ce gain s’opère au détriment de la lisibilité : la synthèse de centaines d’arbres divergents détruit l’interprétabilité graphique directe propre à l’arbre unitaire.
12.2 L’avènement des Forêts Aléatoires (Random Forests)
Malgré l’avancée majeure incarnée par le bagging, cette approche se heurte à une limite structurelle : la corrélation résiduelle entre les arbres générés. Dès lors qu’un prédicteur dominant structure l’échantillon d’entraînement, ce descripteur est systématiquement sélectionné au nœud racine de la quasi-totalité des arbres bootstrap, rendant les trajectoires de prédiction interdépendantes et limitant la réduction théorique de variance.
Pour dépasser cet écueil, Leo Breiman publie en 2001 l’algorithme des Forêts Aléatoires (Random Forests), qui enrichit le bagging d’une seconde source d’aléation délibérée : le tirage aléatoire d’un sous-ensemble restreint de descripteurs à chaque nœud. Lors de l’évaluation d’une scission binaire au cours de la croissance d’un arbre, l’algorithme n’est plus autorisé à balayer la totalité des $p$ covariables candidates, mais se voit contraint d’optimiser la séparation sur un sous-ensemble tiré au sort de taille $m \approx \sqrt{p}$ (en classification) ou $m \approx \frac{p}{3}$ (en régression).
Ce mécanisme contraint l’arborescence à explorer des prédicteurs alternatifs et minoritaires, décorrélant ainsi les différents arbres de la forêt. Lorsque l’on procède à l’agrégation collective de plusieurs centaines d’arbres décorrélés, l’erreur quadratique moyenne subit une réduction substantielle. De plus, la procédure offre une mesure de généralisation par l’évaluation hors sac (Out-Of-Bag error – OOB), qui calcule la performance d’ajustement de chaque individu sur les seuls arbres au sein desquels il ne figurait pas dans l’échantillon bootstrap d’apprentissage, fournissant un équivalent computationnel immédiat à la validation croisée.
12.3 Les méthodes d’amplification de gradient (Gradient Boosting)
Parallèlement à l’approche par moyennage parallèle des forêts aléatoires, une direction complémentaire et concurrente s’est affirmée à travers la formalisation de l’amplification de gradient (Gradient Boosting), initiée par Jerome Friedman au début des années 2000. Contrairement au bagging où les arbres croissent de manière indépendante et parallèle, le boosting repose sur une construction séquentielle et cumulative d’arbres très simples et superficiels (faibles apprenants ou weak learners).
À chaque itération successive $m$, un nouvel arbre de décision de faible profondeur est ajusté non pas sur la variable cible d’origine $Y$, mais sur les résidus d’erreur pseudo-résiduels (le gradient négatif de la fonction de perte) générés par la somme pondérée de l’ensemble des arbres construits lors des étapes antérieures :
$$f_m(x) = f_{m-1}(x) + \gamma_m h_m(x)$$
L’algorithme concentre progressivement ses efforts d’apprentissage sur les observations complexes ou atypiques mal ajustées par les itérations précédentes. L’implémentation de ce principe algorithmique au sein de bibliothèques logicielles optimisées telles que XGBoost (Chen & Guestrin, 2016) et LightGBM (Ke et al., 2017) a établi les arbres amplifiés comme l’une des références actuelles en matière de performance brute sur des données tabulaires volumineuses.
Ce saut de performance accentue l’arbitrage contemporain de la science des données : l’opposition entre la recherche d’une exactitude prédictive maximale incarnée par les méta-modèles d’ensemble (forêts aléatoires et gradient boosting) et l’impératif de transparence explicative garanti par l’arbre de décision unitaire CART. Si les méta-modèles dominent les compétitions d’apprentissage automatique, l’arbre unitaire demeure un instrument analytique privilégié pour la formalisation des protocoles cliniques et la découverte de règles décisionnelles interprétables.
Références
- Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and Regression Trees. Wadsworth & Brooks/Cole Advanced Books & Software. https://doi.org/10.1201/9781315139470
- Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785–794). ACM. https://doi.org/10.1145/2939672.2939785
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- Ke, G., Meng, Q., Finley, T., Wang, T., Chen, W., Ma, W., Ye, Q., & Liu, T. Y. (2017). LightGBM: A highly efficient gradient boosting decision tree. In Advances in Neural Information Processing Systems 30 (pp. 3146–3154). Curran Associates, Inc.
- Quinlan, J. R. (1986). Induction of decision trees. Machine Learning, 1(1), 81–106. https://doi.org/10.1007/BF00116251
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Strobl, C., Malley, J., & Tutz, G. (2009). An introduction to recursive partitioning: Rationale, application, and characteristics of classification and regression trees, bagging, and random forests. Psychological Methods, 14(4), 323–348. https://doi.org/10.1037/a0016973