
L’avènement de l’apprentissage automatique au sein des sciences quantitatives contemporaines a profondément transformé notre manière de modéliser les systèmes complexes. Historiquement dominée par des paradigmes linéaires et paramétriques hérités de la statistique classique, l’analyse des données a longtemps privilégié la tractabilité mathématique et la parcimonie formelle au détriment, parfois, de la fidélité phénoménologique. Or, que ce soit en biologie computationnelle, en économétrie ou au sein des sciences psychologiques et comportementales, les relations unissant les variables explicatives aux phénomènes observés se caractérisent rarement par une stricte proportionnalité géométrique ou une additivité parfaite. Les rétroactions, les effets de seuil, les saturations et les configurations interactives d’ordre supérieur constituent bien souvent la règle plutôt que l’exception.
Face à cette complexité intrinsèque, les approches traditionnelles contraignent fréquemment le chercheur à postuler des structures distributionnelles arbitraires ou à spécifier manuellement des termes d’interaction dont le nombre croît de manière exponentielle avec la dimensionnalité des données. Cette limitation a favorisé l’essor d’algorithmes non paramétriques capables d’apprendre directement la topologie sous-jacente des données à partir de l’expérience empirique. Parmi ces innovations, l’arbre de décision s’est d’abord imposé par son élégance heuristique et sa translucidité sémiotique, avant que ses défaillances structurelles — au premier rang desquelles figurent une variance excessive et une instabilité pathologique face aux fluctuations d’échantillonnage — ne freinent son adoption généralisée dans les contextes requérant une haute précision prédictive.
C’est précisément à ce carrefour méthodologique que se situe la proposition révolutionnaire formalisée par Leo Breiman au tournant des années 2000 : les forêts aléatoires (Random Forests). En combinant les vertus de l’agrégation par rééchantillonnage bootstrap avec une injection délibérée et systématique de stochasticité dans la sélection des descripteurs, ce méta-algorithme résout de manière magistrale le dilemme biais-variance. L’objectif de cet article est de proposer une analyse rigoureuse, didactique et exhaustive de l’architecture des forêts aléatoires, depuis leurs racines théoriques issues de la théorie de l’apprentissage statistique jusqu’à leurs applications empiriques les plus raffinées dans l’étude des comportements humains et de la cognition.
1. Introduction aux modèles non linéaires et fondements conceptuels
1.1 La complexité des relations entre variables prédictives et réponses
L’analyse statistique traditionnelle s’est édifiée autour du modèle linéaire général, dont l’élégance calculatoire repose sur l’hypothèse fondamentale que l’espérance conditionnelle d’une variable réponse s’exprime sous la forme d’une combinaison linéaire de prédicteurs. Toutefois, lorsqu’il s’agit de modéliser des dynamiques psychologiques, cognitives ou comportementales, cette hypothèse se heurte immédiatement à la texture même de la réalité empirique. La réactivité émotionnelle, la détresse psychologique ou la performance cognitive ne progressent pas le long de trajectoires strictement linéaires ; elles manifestent des non-linéarités profondes, caractérisées par des phénomènes d’hystérésis, des effets de plancher et de plafond, ou encore des transitions de phase abruptes qui défient toute description par une simple pente constante.
De surcroît, les interactions d’ordre supérieur posent un défi redoutable à la régression classique. Dans l’étude de la vulnérabilité psychopathologique, par exemple, l’impact d’un polymorphisme génétique ou d’un facteur de stress environnemental ne s’exerce presque jamais de façon isolée ni purement additive. Il se trouve médié, modéré et catalysé par une constellation de variables tierces telles que le soutien social perçu, l’histoire développementale précoce, les schémas cognitifs préexistants et l’âge chronologique. Tenter d’intégrer l’ensemble des termes d’interaction multiplicative dans une équation linéaire conduit inéluctablement au fléau de la dimensionnalité (curse of dimensionality), provoquant une inflation catastrophique de l’erreur standard des coefficients estimés et une perte dramatique de puissance statistique.
Cette impasse méthodologique a rendu indispensable l’émergence d’approches algorithmiques non paramétriques affranchies de toute spécification fonctionnelle a priori. L’apprentissage automatique s’est constitué autour de cet impératif épistémologique : substituer à la formulation déductive d’une équation rigide un processus inductif d’optimisation numérique capable de cartographier de manière autonome la géométrie d’espaces multidimensionnels complexes. En renonçant à contraindre les relations au sein d’un carcan linéaire préétabli, les méthodes algorithmiques contemporaines permettent de capturer des configurations d’interactions hautement non linéaires sans que l’analyste n’ait à deviner par anticipation leur forme analytique exacte.
1.2 Transition de la modélisation explicative à la modélisation prédictive
L’adoption des forêts aléatoires s’inscrit au cœur d’un basculement paradigmatique majeur au sein de la science des données, théorisé avec acuité par le statisticien Leo Breiman dans son texte fondateur sur les « deux cultures » de la modélisation statistique. La première culture, incarnée par l’analyse inférentielle traditionnelle, postule que les données sont générées par un mécanisme stochastique élégant et identifiable dont les paramètres doivent être estimés pour tester des hypothèses formelles de nullité. La seconde culture, d’obédience algorithmique, considère la boîte noire de la nature comme un système inconnu et potentiellement rétif à la modélisation analytique fermée, privilégiant dès lors la capacité prédictive brute et la validité de généralisation sur des échantillons indépendants.
Cette divergence épistémologique induit des exigences opérationnelles radicalement distinctes. Alors que l’inférence classique requiert des conditions draconiennes — homoscédasticité, normalité multivariée des résidus, indépendance des observations et absence de multicolinéarité stricte —, la modélisation prédictive moderne tolère et absorbe avec une grande robustesse les pathologies courantes des jeux de données observationnelles. Les données réelles issues de protocoles psychométriques ou observationnels présentent fréquemment des distributions fortement asymétriques, des queues épaisses et des valeurs aberrantes (outliers) qui faussent irrémédiablement les estimations fondées sur les moindres carrés ordinaires.
En outre, la recherche comportementale manipule par nature une taxonomie composite d’attributs : scores d’échelles de Likert ordinales, temps de latence continus, indicateurs nosologiques catégoriels binaires ou polytomiques, et variables contextuelles qualitatives. La modélisation prédictive non paramétrique offre un cadre unifié permettant d’ingérer conjointement ces prédicteurs hétérogènes sans exiger de transformations mathématiques complexes, d’imputations contraintes ou d’encodages disjonctifs destructeurs de structure géométrique, assurant ainsi une passerelle méthodologique idéale vers l’analyse d’écosystèmes de données denses et écologiques.
2. Les arbres de décision (CART) : Architecture et fonctionnement
2.1 Structure fondamentale des arbres de classification et de régression
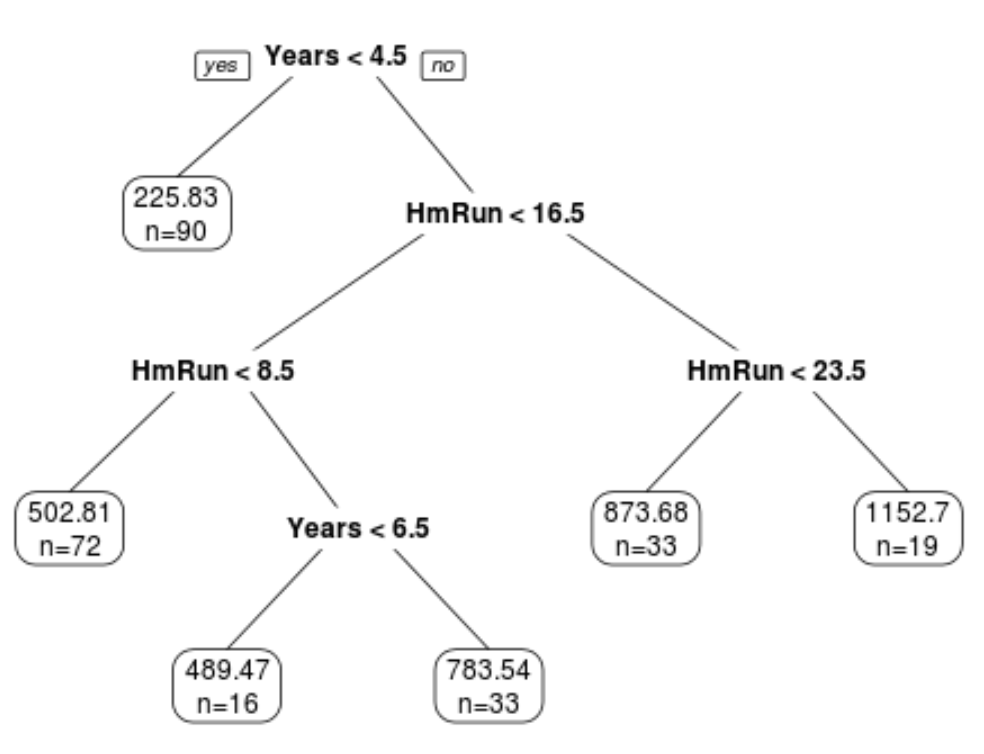
L’algorithme CART (Classification and Regression Trees), conceptualisé au début des années 1980 par Leo Breiman, Jerome Friedman, Richard Olshen et Charles Stone, constitue la cellule fondamentale sur laquelle repose l’édifice des forêts aléatoires. L’arbre de décision se présente formellement sous la forme d’un graphe orienté acyclique dont l’architecture hiérarchique émule un organigramme séquentiel de conditions logiques. Le sommet de la structure est occupé par le nœud racine (root node), qui rassemble la totalité de la population statistique d’entraînement.
À partir de cette origine, l’espace multidimensionnel des descripteurs est soumis à un processus de partitionnement récursif binaire. À chaque étape, une règle de coupure univariée scinde le nœud parent en deux nœuds enfants mutuellement exclusifs et exhaustivement conjoints, selon une condition booléenne relative à l’un des prédicteurs disponibles (par exemple, le fait qu’une variable quantitative soit inférieure ou supérieure à un seuil critique $s$, ou qu’une variable catégorielle appartienne à un sous-ensemble défini de modalités). Ce fractionnement se poursuit de façon itérative le long des nœuds internes jusqu’à ce qu’un critère d’arrêt algorithmique soit formellement atteint.
Les ramifications terminales du graphe sont désignées sous le vocable de feuilles (terminal nodes ou leaves). Chaque feuille correspond à un hyper-rectangle distinct au sein de l’espace géométrique originel des variables prédictives. Dans le cadre d’une tâche de régression, la valeur prédite attribuée à toute nouvelle observation atterrissant dans une feuille spécifique est généralement égale à la moyenne arithmétique de la variable réponse des observations d’entraînement y résidant. Dans le cas d’une classification, l’attribution correspond à la classe modale dominante ou au vecteur des fréquences relatives d’appartenance catégorielle. Les critères de terminaison du partitionnement incluent traditionnellement l’atteinte d’une profondeur maximale préétablie, un nombre minimal d’observations résiduelles par nœud, ou une absence de gain significatif d’homogénéité.
2.2 Critères de division et mesures d’impureté
Pour déterminer, à chaque nœud d’un arbre, quelle variable retenir et quel seuil géométrique appliquer, l’algorithme met en œuvre une fonction de coût fondée sur le concept mathématique d’impureté. L’objectif est d’isoler la scission binaire capable de maximiser la décroissance de cette impureté, garantissant que les sous-populations résultantes soient aussi homogènes que possible du point de vue de la variable cible $Y$. L’optimisation repose sur une heuristique gloutonne (greedy search) : à chaque étape séquentielle, l’algorithme évalue de manière exhaustive l’ensemble des seuils possibles pour toutes les variables candidates, sélectionnant le point de rupture optimal local sans rétroaction ni considération prévisionnelle des étapes ultérieures.
Pour les problématiques de classification catégorielle impliquant $K$ classes, deux métriques dominent la littérature statistique. La première est l’indice de Gini, formulé comme :
$$I_G(p) = \sum_{k=1}^K p_k (1 – p_k) = 1 – \sum_{k=1}^K p_k^2$$
où $p_k$ représente la proportion d’observations appartenant à la classe $k$ au sein du nœud considéré. L’indice s’annule lorsque le nœud est d’une pureté absolue (toutes les instances appartiennent à une classe unique) et atteint son maximum lorsque les classes y sont équiprobables. La seconde métrique est l’entropie de Shannon, issue de la théorie de l’information :
$$H(p) = – \sum_{k=1}^K p_k \log_2(p_k)$$
Elle pénalise plus sévèrement les mélanges de classes et quantifie l’incertitude informationnelle résiduelle.
Dans le domaine des arbres de régression continue, l’impureté est naturellement mesurée par la variance interne du nœud ou, de manière équivalente, par la somme des carrés des résidus (Residual Sum of Squares, RSS) calculée par rapport à la moyenne locale $\bar{y}$ :
$$RSS = \sum_{i in \text{nœud}} (y_i – \bar{y})^2$$
Le meilleur découpage est alors celui qui minimise la somme pondérée des RSS des deux nœuds enfants dérivés, assurant une modélisation locale par paliers constants optimisée au sens des moindres carrés.
2.3 Interprétabilité et lisibilité clinique des arbres simples
Le succès phénoménal des arbres de décision CART dans les disciplines appliquées — et singulièrement en psychologie clinique, en psychiatrie et en médecine diagnostique — tient pour une large part à leur intelligibilité intrinsèque. Contrairement aux modèles dits de « boîte noire », un arbre de décision unitaire peut être traduit sans aucune ambiguïté sémantique sous la forme d’un ensemble ordonné de règles déductives élémentaires de type « SI condition ALORS conséquence ». Cette lisibilité algorithmique supprime la distance herméneutique qui sépare souvent le praticien de terrain du modèle statistique formel.
Sur le plan cognitif, la topologie arborescente mime avec une fidélité frappante la structure du raisonnement clinique humain. Le clinicien confronté à un diagnostic de trouble dépressif majeur ou à l’évaluation d’un risque suicidaire n’applique pas mentalement une fonction de régression logistique continue pondérant quarante variables de manière simultanée. Il opère par catégorisations successives, bifurcations logiques et éliminations graduelles : présence ou absence d’idéation aiguë, antécédents de passage à l’acte, intensité des affects anhédoniques, disponibilité d’un réseau de soutien.
Cette congruence psychologique confère aux arbres une acceptabilité clinique exceptionnelle. L’analyste peut inspecter visuellement chaque embranchement, comprendre immédiatement pourquoi une trajectoire individuelle aboutit à une décision nosologique donnée, et identifier des profils de risque spécifiques définis par la conjonction exacte de plusieurs seuils empiriques. Cette transparence géométrique et logique demeure, à ce jour, l’étalon-or de l’interprétabilité en apprentissage automatique.
3. Les limites structurelles des arbres simples : Le dilemme biais-variance
3.1 L’écueil de la variance élevée et de l’instabilité
En dépit de leur élégance visuelle et de leur accessibilité cognitive, les arbres de décision isolés souffrent d’une tare statistique rédhibitoire qui restreint sévèrement leur viabilité prédictive dans des contextes complexes : une variance d’échantillonnage exceptionnellement élevée, couplée à une instabilité structurelle congénitale. L’algorithme CART est hypersensible aux plus infimes perturbations intervenant dans les données d’entraînement. La modification, l’ajout ou la suppression d’une seule observation au sein du jeu de données peut altérer de manière drastique le premier découpage opéré au niveau du nœud racine.
Cette sensibilité découle de la nature hiérarchique et descendante (top-down) du partitionnement récursif. Dès lors qu’une décision de scission inaugurale est modifiée, l’ensemble de l’espace géométrique subséquent est redistribué selon de nouvelles coordonnées. Il en résulte une propagation cumulative des erreurs tout au long de la descendance arborescente : les sous-arbres issus d’une coupure modifiée divergeront totalement des structures précédemment établies. Deux échantillons tirés aléatoirement de la même population parente peuvent ainsi engendrer deux arbres morphologiquement méconnaissables, professant des règles de décision contradictoires et exploitant des prédicteurs distincts.
D’un point de vue clinique ou scientifique, cette volatilité détruit la fiabilité des inférences. Comment accorder une valeur diagnostique pérenne à un algorithme prédictif dont l’architecture même se disloque dès qu’on le ré-entraîne sur un sous-groupe légèrement différent de patients ? Cette inconsistance topologique démontre que, sous sa forme élémentaire, l’arbre unique souffre d’un défaut fondamental d’estimation : il s’adapte aux singularités idiosyncrasiques de l’échantillon plutôt que d’en extraire la régularité populationnelle véritable.
3.2 Le surapprentissage (overfitting) des arbres non contraints
Ce phénomène d’instabilité est intimement lié à la propension pathologique des arbres non contraints au surapprentissage (overfitting). Lorsqu’un arbre de décision est déployé sans contrainte de profondeur ni de taille minimale de nœud, son algorithme d’optimisation gloutonne poursuit les divisions jusqu’à isoler des feuilles quasi-pures, ne contenant souvent qu’une poignée d’individus, voire une observation unique. À ce stade ultime de développement arborescent, l’arbre n’apprend plus la structure relationnelle liant les variables au phénomène étudié : il procède à une mémorisation brute du jeu d’entraînement.
Dans cette configuration hypertrophiée, le modèle capture le bruit aléatoire, les fluctuations de mesure et les artéfacts d’échantillonnage comme s’il s’agissait de signaux déterministes. Si l’erreur empirique calculée sur les données d’entraînement décroît continuellement jusqu’à frôler la perfection statistique (avec un taux de classification parfaite ou une somme des résidus quasi-nulle), l’erreur de généralisation mesurée sur des données indépendantes se dégrade de manière spectaculaire. Le modèle présente un biais excessivement faible au prix d’une explosion incontrôlée de sa variance d’estimation.
Les méthodologies classiques de régularisation, telles que l’élagage par complexité de coût (cost-complexity pruning), visent à amputer l’arbre hypertrophié de ses branches terminales les moins informatives afin de restaurer un équilibre au sein du compromis biais-variance. Bien que l’élagage améliore substantiellement les performances moyennes d’un arbre individuel, il ne constitue qu’un palliatif partiel. La variance résiduelle demeure intrinsèquement trop élevée pour que l’arbre unitaire puisse rivaliser avec des prédicteurs continus régularisés ou des architectures d’ensemble sophistiquées.
4. Le principe du Bagging : Agrégation par rééchantillonnage
4.1 Le concept de Bootstrap dans l’inférence statistique
Pour contourner les apories de l’arbre unique sans renoncer à sa capacité d’absorption des non-linéarités, il convenait de repenser radicalement la gestion de la variabilité d’échantillonnage. La solution conceptuelle a été offerte par une avancée majeure de la statistique computationnelle moderne : le principe du bootstrap, formalisé par Bradley Efron en 1979. Le bootstrap repose sur une intuition à la fois simple et vertigineuse : en l’absence d’accès direct à la distribution génératrice de la population globale, l’échantillon empirique observé constitue notre meilleure approximation de cette réalité.
Le procédé consiste à simuler le processus d’échantillonnage originel en générant de multiples pseudo-échantillons par tirage aléatoire uniforme avec remise (sampling with replacement) à partir du jeu de données initial, chacun possédant une taille rigoureusement identique à celle de l’échantillon source ($N$). Étant donné la nature du tirage avec remise, certaines observations individuelles sont sélectionnées plusieurs fois au sein d’un même pseudo-échantillon bootstrap, tandis qu’une fraction substantielle d’entre elles s’en trouve mécaniquement exclue à chaque tirage.
Cette approche purement non paramétrique permet de modéliser avec précision la variabilité distributionnelle d’un estimateur statistique quelconque — qu’il s’agisse d’une moyenne, d’une médiane, d’un coefficient de régression ou d’un arbre prédictif — sans avoir à postuler d’hypothèses théoriques restrictives sur la normalité ou la convexité de la population sous-jacente. Le bootstrap fournit ainsi le socle opérationnel nécessaire à l’exploration empirique de l’espace des modèles.
4.2 L’agrégation des prédicteurs individuels (Bootstrap Aggregating)
S’appuyant directement sur les propriétés fondamentales du rééchantillonnage de Bradley Efron, Leo Breiman propose en 1996 une méthode méta-heuristique générale qu’il baptise Bagging, contraction syntaxique de Bootstrap Aggregating. Le principe opérationnel est limpide : au lieu d’ajuster un unique modèle prédictif complexe sur le jeu de données d’entraînement complet, l’analyste génère une vaste collection de $B$ sous-ensembles bootstrap distincts et calibre un modèle indépendant sur chacun d’entre eux.
Chacun des $B$ modèles ainsi entraînés — traditionnellement des arbres non élagués à forte croissance — formule sa propre prédiction en réponse à une configuration donnée de prédicteurs. Le système procède ensuite à la synthèse collective de ces avis individuels. Dans le cadre de problèmes de régression continue, l’agrégation finale s’effectue par l’opération d’une moyenne arithmétique simple :
$$\hat{f}_{\text{bag}}(x) = \frac{1}{B} \sum_{b=1}^B \hat{f}^{*b}(x)$$
où $\hat{f}^{*b}(x)$ dénote la fonction de prédiction ajustée sur le $b$-ième échantillon bootstrap.
Pour les tâches de classification supervisée portant sur des labels discrets, la prise de décision repose majoritairement sur le vote d’assemblée ou vote plural (majority voting). La classe finale assignée à l’observation est celle qui a recueilli la majorité relative des suffrages parmi les $B$ classificateurs de l’ensemble. Alternativement, le modèle peut moyenner les distributions de probabilités conditionnelles estimées par chaque arbre terminal afin de fournir une prédiction probabiliste continue particulièrement fine et bien graduée.
4.3 La réduction mathématique de la variance par moyennage
La rationalité formelle du Bagging réside dans une démonstration statistique élémentaire mais d’une portée pratique fondamentale : l’effet réducteur de variance opéré par le moyennage de variables aléatoires. Considérons un ensemble de $B$ estimateurs statistiques aléatoires identiquement distribués $\hat{f}_1(x), dots, \hat{f}_B(x)$, chacun caractérisé par une variance d’estimation individuelle $\sigma^2$ et partageant entre eux une corrélation positive par paire notée $rho$.
La variance mathématique de leur moyenne arithmétique s’exprime rigoureusement selon la formulation suivante :
$$operatorname{Var}\left(\frac{1}{B} \sum_{b=1}^B \hat{f}_b(x)\right) = \rho \sigma^2 + \frac{1 – \rho}{B} \sigma^2$$
L’examen minutieux de cette formule révèle deux leviers opérationnels majeurs. D’une part, lorsque le nombre d’arbres générés $B$ tend vers l’infini, le second terme $\frac{1 – \rho}{B} \sigma^2$ décroît de manière monotone jusqu’à converger vers zéro. Dès lors, le simple fait de moyenner un volume massif d’estimateurs non contraints permet d’éradiquer la quasi-totalité de la composante instable de l’erreur d’estimation liée à la taille de la forêt.
D’autre part, la variance globale résiduelle demeure inexorablement bornée inférieurement par le premier terme : $\rho \sigma^2$. Cette borne incompressible dépend exclusivement du coefficient de corrélation linéaire moyen $rho$ entre les prédicteurs. Or, dans le cadre du Bagging standard, tous les arbres sont construits à partir du même jeu initial de données empiriques. Si le problème analysé comporte une ou deux variables prédictives exceptionnellement dominantes, celles-ci seront inlassablement sélectionnées au niveau du nœud racine et des premières bifurcations de chaque arbre bootstrap. Les architectures arborescentes résultantes se ressembleront structurellement, maintenant un niveau de corrélation inter-arbres $rho$ élevé qui bride l’effet d’atténuation de la variance. Il devenait donc théoriquement indispensable d’introduire un mécanisme supplémentaire capable de casser cette corrélation.
5. Des arbres isolés à la forêt aléatoire : La proposition de Leo Breiman
5.1 Genèse et rupture épistémologique de l’algorithme
La découverte de la solution à cette corrélation résiduelle des estimateurs est indissociable de la trajectoire scientifique de Leo Breiman à l’Université de Californie à Berkeley, jalonnée par les contributions pionnières de la chercheuse Tin Kam Ho aux laboratoires Bell. En 1995 et 1998, Ho introduit la méthode des sous-espaces aléatoires (Random Subspace Method), démontrant que la sélection aléatoire d’un sous-ensemble strict de dimensions projectives lors de la phase de construction peut considérablement enrichir la diversité géométrique de classificateurs linéaires ou arborescents.
Saisissant avec une remarquable acuité mathématique le lien intime entre la formule de la variance d’un ensemble et les limites du Bagging, Leo Breiman fusionne en 2001 la dynamique du rééchantillonnage des observations avec la projection stochastique dans l’espace des attributs de Tin Kam Ho. Cette synthèse donne naissance à l’algorithme définitif des forêts aléatoires (Random Forests). Cette avancée consacre l’avènement officiel de l’apprentissage d’ensemble (ensemble learning) comme paradigme dominant de la statistique algorithmique.
La rupture épistémologique accomplie ici est d’une profonde élégance : plutôt que de s’épuiser à concevoir un modèle monolithique ultra-raffiné, doté d’un ajustement mathématique optimal mais fragile, Breiman prend le contrepied méthodologique absolu. Il postule que la combinaison démocratique d’une multitude de modèles délibérément affaiblis, imparfaits et stochastiquement diversifiés — souvent qualifiés d’« apprenants faibles » (weak learners) — s’avère infiniment plus robuste, résiliente et prédictivement performante que le meilleur des estimateurs individuels élaborés de manière déterministe.
5.2 Principes directeurs régissant la forêt aléatoire
Le fonctionnement des forêts aléatoires s’articule autour d’un double principe de perturbation stochastique, injecté de manière symétrique aux deux étapes névralgiques de l’apprentissage machine :
- Aléa sur les observations (échantillonnage de lignes) : À l’instar du Bagging canonique, chaque arbre de la forêt est cultivé sur un échantillon bootstrap distinct généré par tirage avec remise à partir de la base de données originelle. Cette première couche de variabilité assure que chaque modèle explore une version marginalement modifiée de la distribution empirique des individus.
- Aléa sur les variables explicatives (échantillonnage de colonnes) : Contrairement aux arbres CART conventionnels qui examinent l’ensemble exhaustif des prédicteurs pour déterminer chaque coupure, l’algorithme de Breiman impose une restriction stochastique. À chaque nœud de chaque arbre, seul un sous-ensemble tiré au sort de prédicteurs est autorisé à concourir pour déterminer le point de scission.
Cette stratégie délibérée poursuit un objectif théorique univoque : maintenir un biais statistique individuel extrêmement bas tout en annihilant mécaniquement la variance collective. Les arbres individuels sont intentionnellement cultivés jusqu’à leur plein épanouissement, sans application d’aucun protocole d’élagage contraignant. Pris isolément, chaque arbre possède un biais quasi-nul (il apprend les structures relationnelles les plus fines) au prix d’une variance exubérante. Mais une fois agrégés au sein de la structure chorale de la forêt, leurs idiosyncrasies s’annulent mutuellement.
De surcroît, cette double stochasticité confère au modèle une résistance exceptionnelle face au bruit blanc et aux données incomplètes. La dégradation locale d’un capteur, l’absence de réponse à un item d’évaluation clinique ou la présence d’aberrations de mesure isolées ne peuvent en aucun cas déstabiliser la forêt dans son ensemble. L’information n’étant jamais concentrée au sein d’un axe décisionnel unique, le méta-modèle conserve une capacité de généralisation d’une constance remarquable à travers des conditions d’observation dégradées.
6. L’aléa au cœur du modèle : Sélection stochastique des variables
6.1 Sous-échantillonnage aléatoire des prédicteurs à chaque nœud
Le cœur algorithmique qui singularise fondamentalement la forêt aléatoire de toutes les procédures d’agrégation antérieures réside dans la sélection stochastique des variables opérée de manière locale et récurrente. Soit un problème modélisant une réponse $Y$ à partir d’un ensemble de $p$ variables prédictives distinctes. Lors de la construction d’un arbre au sein d’une forêt de Breiman, à chaque nœud intermédiaire sans exception, l’algorithme procède au tirage aléatoire uniforme, sans remise, d’un nombre restreint $m_{\text{try}}$ de prédicteurs parmi les $p$ disponibles, avec la contrainte stricte que $m_{\text{try}} < p$.
La recherche gloutonne de la division optimale — c’est-à-dire le choix de la variable de coupe et l’identification du seuil numérique $s$ maximisant le gain d’impureté de Gini ou la réduction de la somme des résidus — est alors exclusivement circonscrite à ce contingent temporaire de dimension $m_{\text{try}}$. Les $(p – m_{\text{try}})$ variables restantes sont totalement occultées lors de cette scission précise. Dès que le partitionnement du nœud est opéré et que l’algorithme bascule vers les nœuds descendants, un nouveau tirage stochastique indépendant de taille $m_{\text{try}}$ est régénéré pour chacun des nœuds enfants.
Les valeurs canoniques assignées par convention à cet hyperparamètre dépendent de la nature du paradigme prédictif traité :
- En classification binaire ou multiclasse, la valeur par défaut préconisée par Leo Breiman et sanctionnée par l’usage empirique est $m_{\text{try}} = \lfloor\sqrt{p}\rfloor$. Dans une étude psychologique intégrant 100 prédicteurs comportementaux, seuls 10 prédicteurs sont examinés à chaque niveau de bifurcation.
- En régression quantitative continue, la valeur par défaut généralement retenue s’établit à $m_{\text{try}} = \lfloor p / 3 \rfloor$. Des configurations plus restrictives peuvent être privilégiées selon la densité informative de la matrice de données.
Ce filtre aléatoire continu empêche mécaniquement la colonisation systématique des sommets arborescents par une ou deux variables omnipotentes. Même en présence d’un prédicteur d’une puissance explicative démesurée, celui-ci sera exclu de la compétition dans une proportion statistique substantielle des nœuds — précisément égale à $(1 – m_{\text{try}}/p)$. Dès lors, l’algorithme se trouve contraint d’explorer des dimensions prédictives subsidiaires, forçant la mise au jour d’effets subtils et de corrélations distales qui seraient restés irrémédiablement masqués au sein d’une structure CART standard.
6.2 Décorrélation structurelle des arbres individuels
L’impact statistique direct de ce sous-échantillonnage aléatoire des descripteurs réside dans la décorrélation structurelle forcée de la population d’arbres. En interdisant aux prédicteurs prééminents d’orienter systématiquement les premiers partitionnements spatiaux, l’algorithme brise l’homogénéité architecturale du Bagging. Chaque arbre se voit contraint d’adopter une perspective géométrique singulière sur l’espace d’entrée, explorant des combinatoires de variables et des plans de coupe inédits.
Si l’on réexamine attentivement l’équation gouvernant la variance du prédicteur d’ensemble formulée précédemment :
$$operatorname{Var}\left(\hat{f}_{\text{ensemble}}\right) = \rho \sigma^2 + \frac{1 – \rho}{B} \sigma^2$$
on constate immédiatement que l’introduction du paramètre $m_{\text{try}}$ cible avec une précision chirurgicale le terme $rho$. En forçant les arbres à diverger dans leur morphologie de découpage, l’algorithme abaisse dramatiquement la corrélation par paire $rho$ sans induire d’accroissement substantiel du terme de biais intrinsèque individuel. Bien que la variance individuelle $\sigma^2$ de chaque arbre stochastique pris isolément augmente légèrement en raison du caractère sous-optimal de ses divisions contraintes, cette modeste perte unitaire est écrasée par le gain colossal résultant de la chute drastique du coefficient de corrélation moyen $rho$.
Ce mécanisme exploite à son plein potentiel asymptotique la puissance du théorème de la limite centrale. L’assemblée de modèles hétérogènes génère une annulation quasi-parfaite des erreurs résiduelles indépendantes. Ce que la forêt perd en précision géométrique locale au niveau de chaque ramification unitaire, elle le regagne centuplé en stabilité prédictive et en robustesse de généralisation macroscopique.
7. Mécanisme d’agrégation et prise de décision collective
7.1 Agrégation en classification : Vote majoritaire et probabilités
Une fois le cycle d’apprentissage mené à son terme sur l’ensemble des $B$ arbres de la forêt, le modèle dispose d’une congrégation de prédicteurs entièrement constituée. L’inférence sur une nouvelle observation $x$ s’engage par la traversée descendante simultanée de l’intégralité des architectures arborescentes de la forêt. L’individu statistique $x$ est soumis aux filtres logiques successifs de chaque modèle jusqu’à atteindre, dans chacun des $B$ arbres, une feuille terminale précise.
Dans le domaine de la classification catégorielle, le mode d’agrégation premier est le vote majoritaire dur (hard voting). Chaque arbre émet une prédiction unitaire assignant le vecteur $x$ à l’une des classes discrètes du problème nosologique ou comportemental. La forêt compile ensuite l’ensemble des suffrages et promulgue le verdict collectif :
$$\hat{C}_{\text{RF}}(x) = operatorname{arg,\max}_{k} \sum_{b=1}^B \mathbb{I}\left(\hat{C}_b(x) = k\right)$$
où $\mathbb{I}(\cdot)$ désigne la fonction indicatrice booléenne prenant la valeur 1 lorsque la condition est satisfaite et 0 dans le cas contraire.
Néanmoins, la pratique clinique et épidémiologique moderne requiert rarement des assignations qualitatives rigides ; elle réclame des estimations probabilistes nuancées de l’appartenance de classe. Les forêts aléatoires excellent dans cette tâche par l’implémentation du vote pondéré ou agrégation douce (soft voting). Chaque feuille terminale d’un arbre $b$ héberge une fréquence observée de cas d’entraînement appartenant à chaque classe $k$, dénotée $p_k^b(x)$. La forêt estime la probabilité a posteriori globale d’appartenance catégorielle par la moyenne arithmétique continue de ces proportions locales :
$$\hat{P}_{\text{RF}}(Y = k mid X = x) = \frac{1}{B} \sum_{b=1}^B p_k^b(x)$$
Cette estimation produit des probabilités remarquablement bien calibrées. Dans des contextes de déséquilibre de classes prononcé — par exemple, l’identification d’idéations suicidaires rares au sein d’une cohorte non clinique —, l’analyste peut délaisser le seuil conventionnel décisionnel de 0,5 pour faire coulisser le point de coupure opérationnel le long de la courbe ROC (Receiver Operating Characteristic), optimisant ainsi arbitrairement la sensibilité diagnostique ou la spécificité clinique selon les impératifs déontologiques du protocole.
7.2 Agrégation en régression : Estimation continue robuste
Dans le cas des cibles quantitatives d’ordre continu — telles que la mesure d’un temps de réponse cognitif, le niveau d’un biomarqueur inflammatoire plasmatique ou le score global à un inventaire de personnalité —, la forêt aléatoire résout la discontinuité géométrique propre aux arbres CART unitaires en moyennant leurs sorties de régression. Chaque arbre unitaire génère une fonction par paliers constants $\hat{f}_b(x)$, dont le profil géométrique dessine une surface orthogonale irrégulière et abrupte.
L’estimation globale d’ensemble est définie par l’opérateur d’espérance conditionnelle empirique :
$$\hat{f}_{\text{RF}}(x) = \frac{1}{B} \sum_{b=1}^B \hat{f}_b(x)$$
Cette sommation continue de milliers de fonctions en escalier, décalées géométriquement les unes par rapport aux autres du fait de la double sélection stochastique des individus et des variables, produit un lissage régularisateur spectaculaire de la surface de décision. L’estimation résultante s’affranchit des rugosités locales et approche avec une haute fidélité mathématique les courbures relationnelles véritablement sous-jacentes du phénomène générant les données.
Sur le plan analytique, ce lissage collectif se traduit par une réduction drastique de l’erreur quadratique moyenne (Mean Squared Error, MSE) comparativement à ce que produirait n’importe lequel des arbres constituants. Les surestimations locales des uns viennent compenser harmonieusement les sous-estimations des autres en tout point de l’espace des variables. Le modèle converge ainsi vers un estimateur à faible biais et à dispersion ultra-faible, offrant une stabilité de prédiction continue particulièrement adaptée aux variables psychométriques raffinées.
8. L’évaluation Out-Of-Bag (OOB) : Validation interne sans partitionnement externe
8.1 Origine statistique et proportion des observations non sélectionnées
L’une des propriétés les plus brillantes des forêts aléatoires réside dans leur capacité d’auto-évaluation interne par l’exploitation des données dites Out-Of-Bag (OOB). Cette ingénieuse mécanique d’échantillonnage permet d’estimer avec une rigueur absolue l’erreur de généralisation du modèle sans avoir à amputer préalablement le jeu de données d’un échantillon de test dédié, ni à déployer des schémas lourds de validation croisée externe (k-fold cross-validation).
La dérivation mathématique sous-jacente s’appuie sur les lois classiques de la combinatoire et de l’analyse asymptotique. Soit un échantillon d’entraînement comptant exactement $n$ observations uniques. Chaque échantillon bootstrap est confectionné en procédant à $n$ tirages successifs et indépendants avec remise au sein de cette matrice mère. À chaque extraction individuelle, la probabilité d’extraire une observation spécifique donnée est égale à $1/n$. Réciproquement, la probabilité que cette observation spécifique soit épargnée par le tirage s’élève exactement à $1 – 1/n$.
Considérant que le tirage avec remise réitère cette épreuve de Bernoulli $n$ fois de manière strictement indépendante, la probabilité conjointe qu’une observation spécifique donnée n’apparaisse jamais au sein d’un échantillon bootstrap de taille $n$ s’établit selon la formule :
$$P(\text{non-sélection}) = \left(1 – \frac{1}{n}\right)^n$$
Lorsque la taille de l’échantillon $n$ croît vers l’infini — ce qui caractérise les jeux de données réels —, cette expression converge analytiquement vers la limite fondamentale du calcul différentiel :
$$\lim_{n to \infty} \left(1 – \frac{1}{n}\right)^n = \frac{1}{e} \approx 0{,}36787944…$$
Il en découle une constante statistique remarquable : lors de la génération de chaque pseudo-échantillon bootstrap, environ 36,8 % de la population globale des données se trouve mécaniquement exclue du sous-ensemble d’apprentissage. Ces observations non sélectionnées constituent, pour l’arbre spécifique ainsi calibré, un échantillon de test naturel et impartial désigné sous le terme de cohorte Out-Of-Bag.
8.2 Calcul et fiabilité de l’erreur Out-Of-Bag
Le calcul de l’erreur globale Out-Of-Bag tire un parti algorithmique optimal de cette structure résiduelle. Pour évaluer la performance prédictive du méta-modèle sur une observation quelconque $x_i$ issue du jeu de données original, l’algorithme procède comme suit :
- Il identifie l’ensemble de tous les arbres constitutifs de la forêt (soit un sous-ensemble d’environ $B \times 0{,}368$ arbres) pour lesquels l’observation $x_i$ figurait dans leur cohorte OOB respective — c’est-à-dire les arbres qui n’ont jamais « vu » ni manipulé $x_i$ durant leur phase de croissance.
- Il soumet $x_i$ exclusivement à ce sous-ensemble d’arbres indépendants et compile leur prédiction agrégée (par vote majoritaire ou moyenne continue).
- Cette opération d’évaluation impartiale est systématiquement répétée pour chaque observation $i = 1, dots, n$ du jeu de données original.
- L’erreur OOB finale est alors formalisée en calculant la divergence globale moyenne — taux d’erreur de classification, perte logarithmique ou erreur quadratique moyenne — entre les valeurs empiriques observées $y_i$ et les prédictions agrégées construites uniquement à partir des modèles tenus dans l’ignorance stricte de ces individus.
De volumineuses études de validation empirique et formelle, initiées dès les travaux originels de Breiman, ont rigoureusement démontré que l’erreur Out-Of-Bag constitue un estimateur quasi-parfaitement non biaisé de l’erreur de généralisation sur des données nouvelles, affichant une équivalence statistique étroite avec les résultats produits par une validation croisée à dix plis ($k=10$). Cette propriété représente une économie colossale de ressources de calcul : le chercheur peut surveiller la convergence et régler ses hyperparamètres de manière fluide au cours d’un passage unique d’entraînement, sans jamais gaspiller de précieuses observations empiriques dans un partitionnement test rigide.
9. L’interprétabilité des modèles : Mesure de l’importance des variables
9.1 Diminution moyenne de l’impureté (Mean Decrease Impurity)
Bien que la forêt aléatoire agrège des centaines d’architectures disparates abolissant la visualisation directe sous forme d’arbre unique, elle n’abandonne en rien la dimension interprétative. Elle fournit des métriques statistiques élaborées permettant d’ordonner hiérarchiquement les variables prédictives en fonction de leur contribution informative réelle. La première de ces métriques historiques est la Diminution Moyenne de l’Impureté (Mean Decrease Impurity, MDI), couramment dénommée indice d’importance de Gini.
Le formalisme sous-jacent à la MDI s’appuie sur la comptabilisation cumulative des gains d’homogénéité réalisés à chaque embranchement. Chaque fois qu’un prédicteur $X_j$ est retenu pour opérer une division au niveau d’un nœud $s$, l’impureté du nœud parent $I(s)$ se trouve diminuée de la somme pondérée des impuretés des nœuds enfants résultants, $I(s_L)$ et $I(s_R)$. Le gain brut d’impureté s’écrit :
$$\Delta I(s, X_j) = I(s) – \left( \frac{n_L}{n} I(s_L) + \frac{n_R}{n} I(s_R) \right)$$
Le score global de MDI attribué à la variable $X_j$ sur l’ensemble de la forêt est alors égal à la somme de tous les gains $\Delta I(s, X_j)$ enregistrés à chaque fois que $X_j$ a été sélectionnée, moyennée sur les $B$ arbres constitutifs :
$$operatorname{MDI}(X_j) = \frac{1}{B} \sum_{b=1}^B \sum_{s in T_b : v(s) = X_j} \Delta I(s, X_j)$$
Malgré son accessibilité calculatoire immédiate — le score étant compilé organiquement au cours du processus d’entraînement standard —, la MDI présente un biais méthodologique pernicieux qu’il convient de souligner avec gravité : elle surestime artificiellement l’importance des prédicteurs continus ou des variables qualitatives disposant d’un nombre élevé de catégories (haute cardinalité). Ces variables offrant mécaniquement une combinatoire infiniment plus vaste de seuils de coupure potentiels, l’heuristique gloutonne les sélectionne de manière disproportionnée au niveau des nœuds, gonflant indûment leur score de MDI au détriment de facteurs binaires ou discrets pourtant hautement informatifs.
9.2 Importance par permutation (Mean Decrease Accuracy)
Pour s’affranchir définitivement des biais d’impureté liés à la cardinalité des descripteurs, Leo Breiman a conçu une méthodologie universelle, considérablement plus rigoureuse et ancrée dans le paradigme expérimental : l’Importance par Permutation, également désignée sous le terme de Mean Decrease Accuracy (MDA). L’élégance de cette technique repose sur l’introduction d’un protocole de permutation aléatoire appliqué directement au sein des cohortes Out-Of-Bag (OOB).
Le protocole opératoire de la MDA se décompose rigoureusement selon les étapes suivantes :
- Pour chaque arbre $b$ de la forêt, on calcule le taux d’exactitude (ou toute métrique de performance pertinente, telle que l’AUC ou la MSE négative) sur son échantillon de validation Out-Of-Bag originel, noté $\text{Score}_b(\text{OOB})$.
- Pour chaque variable prédictive $X_j$ soumise à évaluation, on permute aléatoirement l’ordre des valeurs de la colonne $X_j$ au sein de cet échantillon OOB spécifique, tout en maintenant rigoureusement intactes l’ensemble des autres variables prédictives et les réponses cibles $Y$. Ce processus brise délibérément le lien statistique liant $X_j$ à la variable réponse, sans modifier en aucune manière la distribution marginale de la variable.
- On fait prédire cet échantillon OOB altéré par l’arbre $b$ et on consigne la nouvelle performance dégradée résultante, notée $\text{Score}_b(\text{OOB}^{\pi j})$.
- L’importance par permutation MDA du prédicteur $X_j$ correspond à la dégradation moyenne de performance enregistrée sur l’intégralité des arbres de la forêt :
$$operatorname{MDA}(X_j) = \frac{1}{B} \sum_{b=1}^B \left( \text{Score}_b(\text{OOB}) – \text{Score}_b(\text{OOB}^{\pi j}) \right)$$
Si la variable $X_j$ est cruciale pour le modèle, le fait de désynchroniser stochastiquement ses valeurs précipitera l’effondrement de la précision prédictive, engendrant un score de MDA élevé. À l’inverse, si une variable ne véhicule que du bruit résiduel, sa permutation n’aura strictement aucun impact mesurable sur la qualité des prédictions, produisant un score nul ou marginalement négatif. La MDA constitue ainsi l’un des indicateurs d’importance les plus fiables, impartiaux et conceptuellement transparents de l’arsenal statistique moderne.
9.3 Graphiques de dépendance partielle et analyse des effets marginaux
Si le classement hiérarchique de l’importance des variables identifie avec certitude les descripteurs prépondérants d’un système, il ne renseigne en rien sur la directionnalité ou la morphologie géométrique de leur influence. Une variable est-elle positivement ou négativement associée à la cible ? Son impact est-il linéaire, exponentiel ou soumis à un effet de seuil critique ? Pour répondre à ces interrogations fondamentales, les analystes mobilisent les graphiques de dépendance partielle (Partial Dependence Plots, PDP), introduits par Jerome Friedman.
La fonction de dépendance partielle capture l’effet marginal théorique d’un ou deux prédicteurs spécifiques $X_S$ sur la fonction d’approximation collective $\hat{f}(x)$, en intégrant et en neutralisant l’influence de l’ensemble complémentaire des autres variables du système, noté $X_C$. Elle s’exprime formellement par l’espérance marginale empirique :
$$\bar{f}_S(x_S) = \frac{1}{n} \sum_{i=1}^n \hat{f}_{\text{RF}}(x_S, x_{i,C})$$
où les $x_{i,C}$ désignent les valeurs observées des variables complémentaires au sein du jeu d’entraînement. L’algorithme fait varier séquentiellement la valeur ciblée $x_S$ à travers son domaine de définition, tout en calculant la prédiction moyenne obtenue lorsque toutes les autres caractéristiques de l’échantillon sont conservées à leurs valeurs originelles.
Dans la recherche psychologique et comportementale, les graphiques de dépendance partielle se révèlent d’une puissance herméneutique inestimable. Ils permettent d’objectiver empiriquement l’existence de bifurcations qualitatives et de seuils de vulnérabilité non linéaires : par exemple, la démonstration graphique qu’un score d’anxiété n’exerce aucun impact mesurable sur la rechute addictive tant qu’il demeure inférieur à un seuil critique $T$, avant de provoquer une augmentation quasi-verticale du risque clinique au-delà de cette valeur pivot. Pour aller plus loin dans l’interprétabilité locale et décomposer l’attribution granulaire d’une décision au niveau d’un patient individuel spécifique, les analystes couplent désormais régulièrement ces courbes aux valeurs de Shapley (SHAP, issues de la théorie des jeux coopératifs), assurant ainsi une auditabilité clinique totale du méta-modèle.
10. Hyperparamètres critiques et stratégies de réglage algorithmique
10.1 Dimensionnement de la forêt : Nombre d’arbres et convergence
La performance, la stabilité statistique et l’efficience calculatoire d’une forêt aléatoire dépendent d’un nombre extrêmement restreint d’hyperparamètres architecturaux, ce qui constitue l’un de ses plus grands atouts opérationnels face à des algorithmes hypersensibles comme le Boosting ou les réseaux de neurones artificiels. Le premier de ces paramètres est la taille globale de la congrégation, c’est-à-dire le nombre total d’arbres constitutifs $B$, couramment labellisé n_estimators ou ntree.
Il importe d’énoncer un théorème rassurant propre aux forêts aléatoires de Breiman : augmenter indéfiniment le nombre d’arbres $B$ ne conduit jamais à un phénomène de surapprentissage. En vertu de la loi forte des grands nombres, la variance d’estimation de l’ensemble décroît de façon asymptotique et monotone au fur et à mesure que de nouveaux arbres sont agrégés, jusqu’à ce que l’erreur de généralisation Out-Of-Bag converge de manière définitive vers un palier stable d’équilibre géométrique.
Dès lors, l’arbitrage quant au dimensionnement optimal de $B$ n’est pas guidé par un compromis statistique de sur-ajustement, mais exclusivement par un compromis d’efficience computationnelle. Un volume de 100 arbres peut suffire pour obtenir une ébauche de prédiction, mais s’avère bien trop instable pour obtenir des estimations fiables de l’importance par permutation (MDA). Une fourchette comprise entre 500 et 2000 arbres est généralement nécessaire pour stabiliser parfaitement les scores d’importance et garantir une reproductibilité parfaite des inférences à travers différents tirages de graines aléatoires.
10.2 Paramètres de complexité arborescente et profondeur
Bien que Leo Breiman préconisât originellement de laisser croître chaque arbre de manière non contrainte jusqu’à son épuisement structurel, le contrôle de la finesse du partitionnement terminal offre un levier puissant pour réguler la variance globale et juguler le volume de mémoire vive requis par le modèle. Deux hyperparamètres interconnectés exercent une influence déterminante sur cette granularité :
- Le nombre minimal d’échantillons par feuille (
min_samples_leafounodesize) : Ce paramètre détermine le contingent démographique plancher d’observations empiriques requis pour autoriser l’existence d’une feuille terminale. Fixé conventionnellement à 1 pour la classification et à 5 pour la régression continue, relever ce seuil — par exemple à 10 ou 20 — force l’arbre à lisser ses décisions et empêche la création de micro-partitions isolées sensibles aux données aberrantes. - Le nombre minimal d’échantillons pour autoriser une scission (
min_samples_split) : Il prescrit le volume minimal d’observations devant résider dans un nœud intermédiaire pour que l’algorithme soit autorisé à rechercher une coupure binaire. - La profondeur maximale (
max_depth) : Elle plafonne strictement la longueur de la plus longue trajectoire hiérarchique reliant le nœud racine à une feuille. Borner la profondeur maximale d’un arbre revient à brider l’ordre maximal des interactions multiplicatives que le modèle est capable de modéliser. Un arbre de profondeur $d$ ne peut capturer au maximum que des interactions d’ordre $d$. Dans les disciplines comportementales où les interactions d’ordre astronomique sont souvent synonymes de bruit stochastique, restreindre délibérément la profondeur permet d’agir comme un régulateur vertueux.
10.3 Taille du sous-espace aléatoire des variables
L’hyperparamètre le plus influent sur la dynamique prédictive et la convergence mathématique du modèle demeure indubitablement la taille du sous-espace stochastique de prédicteurs candidates, notée formellement $m_{\text{try}}$ (ou max_features selon les implémentations logicielles). Ce paramètre constitue le régulateur pivot du dilemme biais-variance au sein de l’assemblée.
Une valeur de $m_{\text{try}}$ très faible — par exemple $m_{\text{try}} = 1$ — force une décorrélation absolue entre les arbres de la forêt : aucun modèle ne peut s’appuyer de manière fiable sur les mêmes descripteurs. La corrélation inter-arbres $rho$ s’effondre vers des niveaux planchers. Cependant, la force prédictive de chaque arbre individuel s’en trouve sévèrement compromise, car les modèles sont régulièrement contraints de partitionner l’espace sur des variables sans aucune pertinence informative, provoquant une remontée substantielle du biais global du méta-modèle. Réciproquement, si $m_{\text{try}} to p$, la force explicative unitaire des arbres est maximisée, mais leur diversité s’érode totalement, ramenant le modèle vers les limites du Bagging classique avec un terme $rho$ trop élevé.
Bien que les valeurs heuristiques par défaut ($\sqrt{p}$ et $p/3$) fournissent d’excellents résultats dans la majorité des situations standard, l’optimisation rigoureuse de $m_{\text{try}}$ par exploration méthodique de l’espace des hyperparamètres — via une recherche sur grille (Grid Search), une recherche aléatoire (Random Search) ou une optimisation bayésienne par processus gaussiens — constitue une étape impérative pour quiconque cherche à maximiser les performances de généralisation sur des matrices de données complexes et déséquilibrées.
11. Applications en psychologie empirique et sciences comportementales
11.1 Psychométrie computationnelle et sélection d’items
La psychométrie moderne assiste aujourd’hui à une féconde hybridation entre les modèles classiques de la théorie de la réponse aux items (TRI) et les algorithmes d’apprentissage statistique. Dans la construction d’instruments psychométriques standardisés — tels que les inventaires de personnalité multidimensionnels, les échelles d’intelligence ou les batteries d’évaluation neuropsychologique —, les chercheurs se trouvent confrontés à la nécessité d’élaguer de vastes réservoirs initiaux comptant des centaines d’items expérimentaux afin d’aboutir à des formes courtes applicables en routine clinique sans perte de fidélité diagnostique ni de validité de construit.
Les forêts aléatoires se révèlent être des instruments de sélection d’items remarquablement performants. Contrairement aux approches factorielles linéaires classiques qui n’évaluent que la corrélation partagée sous hypothèse de linéarité monotone stricte, la forêt capture les items qui participent à des configurations interactionnelles non linéaires d’ordre supérieur pour prédire un critère externe (tel qu’un statut diagnostique validé par un entretien structuré). En mesurant l’importance par permutation (MDA) des items au sein d’une forêt entraînée sur la population cible, le psychomètre peut identifier les questions spécifiques les plus discriminantes.
Cette méthodologie permet de procéder à une réduction drastique de la dimensionnalité du protocole. Il devient possible de concevoir des versions abrégées de tests réduisant le temps d’administration de 70 % tout en préservant 95 % de la précision prédictive du modèle initial. En outre, la robustesse de l’algorithme face aux réponses manquantes et aux distributions asymétriques — situation omniprésente dans les échelles cliniques où la majorité des individus sains côtoient le plancher du score de sévérité — confère aux forêts aléatoires un avantage méthodologique écrasant sur les modélisations d’équations structurelles traditionnelles lors des phases exploratoires initiales.
11.2 Psychopathologie et modélisation du risque clinique
L’un des défis les plus cruciaux de la psychiatrie contemporaine concerne l’identification précoce des trajectoires évolutives défavorables, qu’il s’agisse de la transition vers un épisode psychotique aigu, de l’émergence d’une pharmaco-résistance dans la dépression unilaire majeure ou de l’estimation du risque de récidive suicidaire. La vulnérabilité psychopathologique ne procède pas d’une cause étiologique univoque ; elle résulte de l’entrelacement dynamique de facteurs d’ordre génétique, immunologique, neurocognitif, biographique et psychosocial.
Les forêts aléatoires fournissent une plateforme analytique d’une plasticité exemplaire pour fédérer ces données hétérogènes. Un jeu de données clinique peut ainsi incorporer simultanément :
- Des variables biologiques continues (taux sériques de cytokines pro-inflammatoires, volumétrie hippocampique issue de l’IRM, polymorphismes mononucléotidiques) ;
- Des scores psychométriques scalaires issus d’auto-questionnaires validés ;
- Des facteurs catégoriels nominaux (présence d’antécédents d’abus physique ou sexuel dans l’enfance, statut marital, antécédents familiaux de trouble bipolaire).
La capacité de la forêt aléatoire à digérer naturellement ces prédicteurs multimodaux sans standardisation préalable contraignante en fait le modèle d’élection pour le profilage nosologique computationnel. De surcroît, l’algorithme excelle dans la détection des sous-types cliniques atypiques au sein de populations réputées homogènes. En observant les profils de co-localisation des patients au sein des feuilles terminales de la forêt — ce qui permet de définir une métrique formelle de proximité ou de dissimilarité empirique entre individus —, les cliniciens peuvent isoler des grappes (clusters) de patients présentant des endophénotypes singuliers qui échappaient totalement aux catégorisations nosographiques nosologiques rigides du DSM-5.
11.3 Analyse du comportement décisionnel et cognitif
L’essor fulgurant des technologies numériques et des smartphones a catalysé le développement de l’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) ou méthode d’échantillonnage de l’expérience (ESM). Les participants à ces études sont sollicités plusieurs fois par jour au sein de leur environnement écologique naturel pour renseigner leur niveau d’affect, leur contexte environnemental immédiat et leur sentiment de contrôle, générant des séries temporelles longitudinales hautement denses et corrélées.
L’analyse de ces dynamiques temporelles et des données issues de tâches comportementales sur ordinateur — telles que la mesure des temps de réaction milliseconde par milliseconde, les patrons de dérive décisionnelle dans les tâches d’épreuve de tri de cartes de Wisconsin (WCST) ou les paradigmes d’inhibition de type Stop-Signal — se heurte traditionnellement à une multicolinéarité massive. Dans une tâche informatisée, les temps de réaction enregistrés aux essais $t$, $t-1$ et $t-2$ affichent des corrélations mutuelles qui dépassent couramment 0,85, plongeant les modèles linéaires multivariés dans l’instabilité numérique.
Les forêts aléatoires démontrent une résilience et une indifférence mathématique presque totale face à la multicolinéarité. Même en présence de centaines de prédicteurs fortement interconnectés, le mécanisme d’échantillonnage stochastique $m_{\text{try}}$ garantit que chaque prédicteur correlated conserve une opportunité d’être sélectionné indépendamment de ses congénères. Il en résulte une capacité unique à démêler les contributions relatives de signaux temporels subtils, permettant de prédire avec une précision inédite les fluctuations aiguës du craving, les crises d’angoisse panique ou les failles attentionnelles chez les sujets souffrant de troubles déficitaires de l’attention avec hyperactivité (TDAH).
12. Forces, limites comparatives et perspectives méthodologiques
12.1 Synthèse des avantages compétitifs de l’algorithme
Au terme de cet examen approfondi, il est aisé de conceptualiser les fondements de l’extraordinaire popularité dont jouissent les forêts aléatoires au sein de la communauté scientifique internationale. Leurs avantages compétitifs se situent tant sur le plan de la théorie mathématique que sur celui de la pragmatique opérationnelle :
- Invariance aux transformations monotones : L’algorithme se fondant exclusivement sur l’ordre relatif des observations plutôt que sur leurs valeurs numériques brutes lors des étapes de scission, les forêts aléatoires sont rigoureusement insensibles aux transformations monotones des variables explicatives ($x$, $log(x)$, $\sqrt{x}$). Toute opération de normalisation, de centrage ou de réduction devient superflue.
- Absence de postulats distributionnels préalables : Aucune hypothèse d’homoscédasticité, de linéarité ou de normalité des résidus n’est requise. Le modèle traite avec une égale sérénité des données gaussiennes, exponentielles, de Poisson ou empiriquement multimodales.
- Excellence opérationnelle immédiate (Out-of-the-box performance) : Contrairement aux modèles à gradient boosting ou aux réseaux neuronaux profonds qui nécessitent des journées entières de réglage fastidieux d’hyperparamètres pour éviter l’explosion ou le surapprentissage, la forêt aléatoire fournit des performances quasi-optimales dès l’application de ses paramètres théoriques par défaut.
- Parallélisme natif et passage à l’échelle : Chaque arbre de la forêt étant cultivé de manière totalement indépendante des autres sur son propre échantillon bootstrap stochastique, l’algorithme est intrinsèquement parallélisable (embarrassingly parallel). Il s’exécute avec une vélocité calculatoire remarquable sur des processeurs multi-cœurs sans requérir d’infrastructures informatiques distribuées hors normes.
12.2 Vulnérabilités théoriques et contraintes pratiques
Toutefois, une lucidité épistémologique rigoureuse impose de circonscrire les frontières méthodologiques et les faiblesses inhérentes aux forêts aléatoires. Le premier écueil structural — partagé d’ailleurs par l’ensemble des architectures à base d’arbres — réside dans son incapacité absolue d’extrapolation au-delà de l’enveloppe convexe délimitée par les données d’entraînement. Un arbre de régression formulant ses prédictions sous la forme d’une constante locale définie par la moyenne des observations résidentes dans ses feuilles terminales, il lui est rigoureusement impossible de prédire une valeur continue supérieure au maximum ou inférieure au minimum observé dans son jeu d’apprentissage. Dans l’analyse de tendances temporelles globales d’accroissement continu, la forêt aléatoire prédit des plateaux horizontaux là où un modèle paramétrique extrapolerait une croissance linéaire continue.
La seconde vulnérabilité majeure concerne le coût d’empreinte mémoire et la charge de stockage induits par le déploiement de modèles massifs. Une forêt aléatoire mature constituée de 2000 arbres entièrement développés et conservés sans élagage sur un jeu de données de plusieurs centaines de milliers d’individus et de caractéristiques peut aisément requérir plusieurs gigaoctets d’espace mémoire vive. Ce volume de paramètres interdit souvent son intégration directe au sein de puces électroniques embarquées ou de dispositifs mobiles à ressources computationnelles ultra-restreintes.
Enfin, sur le plan de l’interprétation, la forêt consomme le sacrifice définitif de la lisibilité sémiotique immédiate propre à l’arbre CART unitaire. Si la forêt préserve une auditabilité globale par l’ordonnancement de l’importance des variables (MDI, MDA) et par les graphiques de dépendance partielle, elle ne permet plus de tracer graphiquement sur une feuille de papier l’organigramme décisionnel déterministe d’un individu statistique singulier. Pour les institutions judiciaires ou certaines agences de régulation sanitaire exigeant qu’une décision d’admission ou de refus soit traçable par une règle logique explicite univoque, le statut de « boîte semi-opaque » de la forêt peut soulever des résistances réglementaires légitimes.
12.3 Positionnement face aux architectures concurrentes
Pour l’analyste de données et le chercheur en sciences empiriques, le choix d’un modèle statistique ne procède pas d’une allégeance idéologique, mais d’une adéquation instrumentale stricte entre les exigences de la question de recherche et les propriétés structurales des données disponibles. Dans le paysage de l’apprentissage automatique contemporain, trois grandes familles algorithmiques se disputent la primauté sur les données tabulaires :
| Architecture | Avantages distinctifs | Vulnérabilités critiques | Sensibilité aux hyperparamètres |
|---|---|---|---|
| Forêts Aléatoires (Breiman) | Robustesse absolue, pas d’overfitting par l’ajout d’arbres, OOB natif, insensibilité au bruit. | Pas d’extrapolation hors du domaine observé, volume mémoire élevé. | Très faible (performances excellentes par défaut). |
| Gradient Boosting (XGBoost, LightGBM) | Performances prédictives pures souvent marginalement supérieures, optimisation de fonctions de perte arbitraires. | Surapprentissage rapide si le taux d’apprentissage est mal calibré, vulnérabilité face au bruit étiqueté. | Élevée à critique (nécessite une optimisation croisée rigoureuse). |
| Réseaux de Neurones Profonds (MLP, TabNet) | Idéaux pour données non structurées (images, texte brut, audio), représentations latentes de bas niveau. | Médiocres sur petites matrices tabulaires bruitées, temps d’entraînement astronomique, boîte noire opaque. | Extrême (architecture, initialisation, régularisation, optimisation). |
Face aux méthodes de Gradient Boosting telles que XGBoost, CatBoost ou LightGBM, la forêt aléatoire cède parfois un léger différentiel d’exactitude prédictive sur de gigantesques jeux de données ultra-propres où chaque dixième de point de métrique compte (comme dans les compétitions Kaggle). Néanmoins, dans l’écologie réelle de la recherche clinique et comportementale — caractérisée par des échantillons de taille modeste (quelques centaines à quelques milliers d’individus), des taux élevés de données manquantes, une incertitude substantielle sur la fiabilité des étiquettes diagnostiques et des contraintes temporelles fortes —, la forêt aléatoire s’impose régulièrement comme l’outil le plus équilibré, le plus sûr et le plus éthiquement défendable.
Quant aux réseaux neuronaux profonds, des études empiriques systématiques comparatives — notamment celles menées par Grinsztajn et al. en 2022 — ont sans équivoque démontré qu’ils demeurent structurellement inférieurs aux modèles d’ensemble fondés sur des arbres pour l’analyse de données tabulaires hétérogènes. La géométrie des frontières de décision des forêts aléatoires, constituée d’hyper-rectangles orthogonaux modulaires, est intrinsèquement adaptée à la topologie discontinue des variables socio-comportementales et psychométriques, scellant la pérennité scientifique de la formidable intuition formulée par Leo Breiman au seuil du XXIe siècle.
Références
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and Regression Trees. Wadsworth & Brooks/Cole Advanced Books & Software.
- Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785–794). ACM. https://doi.org/10.1145/2939672.2939785
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Grinsztajn, L., Oyallon, E., & Varoquaux, G. (2022). Why do tree-based models still outperform deep learning on tabular data? Advances in Neural Information Processing Systems, 35, 507–520. https://openreview.net/forum?id=Fp7__phQszn
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Ho, T. K. (1995). Random decision forests. In Proceedings of the 3rd International Conference on Document Analysis and Recognition (Vol. 1, pp. 278–282). IEEE Computer Society. https://doi.org/10.1109/ICDAR.1995.598994
- Ho, T. K. (1998). The random subspace method for constructing decision forests. IEEE Transactions on Pattern Analysis and Machine Intelligence, 20(8), 832–844. https://doi.org/10.1109/34.709601
- Lundberg, S. M., & Lee, S.-I. (2017). A unified approach to interpreting model predictions. In Advances in Neural Information Processing Systems (Vol. 30, pp. 4765–4774). Curran Associates.
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8, Article 25. https://doi.org/10.1186/1471-2105-8-25
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: An evaluation. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393