
Dans le champ de l’apprentissage automatique et de l’économétrie moderne, la modélisation prédictive oscille continuellement entre deux impératifs souvent contradictoires : la transparence interprétative des architectures algorithmiques et leur capacité de généralisation statistique face à des structures de données complexes. Au cœur de cette dialectique se trouvent les arbres de décision et leur extension ensembliste la plus emblématique, les forêts aléatoires. Conçus initialement pour émuler la prise de décision séquentielle humaine par le biais de segmentations dichotomiques de l’espace des variables, les arbres de décision ont révolutionné l’analyse des données non linéaires en s’affranchissant des hypothèses paramétriques rigides inhérentes aux régressions linéaires ou logistiques classiques. Toutefois, cette élégance structurelle et cette lisibilité immédiate dissimulent une fragilité fondamentale : une instabilité asymptotique critique et une propension marquée au surapprentissage, issues d’une variance d’échantillonnage substantielle.
Face à ces limites intrinsèques, l’avènement des méthodes d’ensemble, formalisé de manière magistrale par Leo Breiman au tournant du XXIe siècle, a constitué une rupture épistémologique majeure. Les forêts aléatoires ne cherchent plus à construire un estimateur individuel parfait, mais articulent au contraire une multiplicité d’arbres délibérément perturbés, combinant le rééchantillonnage avec remise (bootstrap) et la sélection stochastique de descripteurs. En agrégeant les prédictions d’une assemblée d’arbres structurellement décorrélés, la forêt opère une métamorphose statistique : elle préserve le faible biais inhérent aux arbres profonds tout en écrasant leur variance résiduelle par la mécanique du théorème central limite et de la loi des grands nombres. Cette transition d’un modèle unitaire déterministe à un méta-estimateur probabiliste soulève des questions fondamentales sur le statut de l’explication scientifique, le compromis entre performance et intelligibilité, ainsi que les paradigmes computationnels sous-jacents.
Cet article se propose d’explorer exhaustivement la frontière conceptuelle, mathématique et opérationnelle qui sépare l’arbre de décision unitaire de la forêt aléatoire. En disséquant les métriques de partitionnement, les dynamiques de régularisation, les mécanismes d’échantillonnage et les propriétés asymptotiques de ces deux approches, nous fournirons un cadre théorique rigoureux et des repères pragmatiques indispensables aux chercheurs, ingénieurs et analystes. De l’évaluation clinique aux neurosciences computationnelles, en passant par le traitement de données tabulaires massives, nous mettrons en lumière les conditions précises sous lesquelles l’arbre isolé conserve sa pertinence analytique, et celles où le déploiement d’une forêt s’impose comme une nécessité méthodologique incontournable.
1. Fondements épistémologiques et théoriques de l’arbre de décision
1.1 Définition et structure hiérarchique du modèle
L’arbre de décision constitue une modélisation non paramétrique supervisée dont l’architecture géométrique repose sur un graphe orienté acyclique structuré de manière strictement hiérarchique. Au sommet de cette architecture trône le nœud racine (root node), lequel englobe l’intégralité de l’espace d’échantillonnage initial. Cet espace multidimensionnel, défini par le produit cartésien des domaines de définition des variables prédictives, fait ensuite l’objet d’un partitionnement récursif par le biais de nœuds internes de test. Chaque nœud intermédiaire formule un prédicat logique univarié ou multivarié — le plus souvent sous la forme d’une inégalité scalaire pour les attributs continus ou d’une appartenance ensembliste pour les attributs catégoriels —, scindant l’échantillon parental en sous-ensembles mutuellement exclusifs acheminés le long de branches conditionnelles.
Le processus de subdivision se poursuit jusqu’à l’atteinte de nœuds terminaux, dénommés feuilles (leaf nodes), au sein desquels aucune scission ultérieure n’est opérée. Ces feuilles matérialisent une tessellation de l’espace des descripteurs en une collection d’hyper-rectangles disjoints, alignés sur les axes du repère canonique défini par les covariables. D’un point de vue formel, un arbre de décision transcrit une fonction mathématique constante par morceaux, associant à tout vecteur d’entrée une valeur prédictive unique correspondant à la distribution empirique ou à la moyenne conditionnelle de la variable cible observée dans l’hyper-rectangle correspondant. Cette géométrie orthogonale confère au modèle une spécificité analytique immédiate : la complexité d’une surface de réponse continue est approximée par une fonction en escalier.
Sur le plan épistémologique et cognitif, la topologie arborescente s’avère singulièrement remarquable par son parallélisme avec les heuristiques de décision humaine, notamment dans le champ des sciences médicales et du diagnostic différentiel. Les praticiens recourent spontanément à des organigrammes décisionnels séquentiels pour hiérarchiser les signes cliniques, éliminant progressivement des hypothèses pathologiques par paliers successifs. De ce fait, l’arbre de décision bénéficie d’une représentabilité formelle sous la forme d’un système disjonctif de règles propositionnelles de type « SI-ALORS » (IF-THEN). Chaque chemin reliant la racine à une feuille terminale constitue une conjonction logique de conditions primitives, tandis que l’ensemble de l’arbre forme la disjonction exhaustive de ces chemins, offrant une translittération directe de la structure inférentielle en langage naturel accessible aux non-spécialistes.
1.2 Traitement de la non-linéarité et des interactions complexes
L’un des atouts prééminents de l’arbre de décision réside dans son affranchissement total des postulats paramétriques qui régissent traditionnellement les modèles statistiques classiques tels que la régression linéaire multiple ou les modèles linéaires généralisés (GLM). Contrairement à ces architectures, l’arbre ne présuppose aucune relation de linéarité entre les variables indépendantes et l’espérance mathématique de la variable dépendante, pas plus qu’il ne requiert l’homoscédasticité ou la normalité des résidus. En scindant l’espace selon des seuils locaux sans contraindre la forme fonctionnelle globale, l’algorithme est intrinsèquement apte à approximer des surfaces de réponse hautement non linéaires, qu’elles soient concaves, convexes, sinusoïdales ou discontinues.
De surcroît, les arbres de décision capturent de manière purement endogène les interactions d’ordre supérieur entre les covariables, sans qu’il soit nécessaire pour le modélisateur de spécifier préalablement des termes d’interaction multiplicative. En effet, lorsqu’une scission est réalisée sur une variable spécifique $X_j$ à la racine, toute partition subséquente opérée sur une seconde variable $X_k$ au sein de l’un des sous-nœuds s’avère conditionnée par le statut de $X_j$. Ainsi, la relation entre $X_k$ et la cible $Y$ est modélisée différemment selon la strate définie par $X_j$, ce qui constitue l’acception statistique stricte d’un effet d’interaction. Cette capacité à cartographier des dépendances conditionnelles imbriquées s’avère cruciale dans l’analyse de systèmes complexes, par exemple lors de l’étude de profils psychométriques ou génomiques où l’expression d’un trait dépend entièrement de la présence simultanée d’autres facteurs contextuels.
Parallèlement, la nature univariée des tests d’impureté confère à l’arbre une propriété mathématique remarquable d’invariance face aux transformations monotones des variables explicatives. Qu’un attribut continu soit soumis à une transformation logarithmique, exponentielle, racine carrée ou à un rééchelonnage affine (normalisation centré-réduit), l’ordre relatif des observations demeure rigoureusement identique. Par conséquent, les points de coupure optimaux sélectionnés par l’algorithme restent invariants au sens de l’ordonnancement, dispensant le praticien de phases fastidieuses de prétraitement des données. Cette insensibilité aux déformations monotones s’accompagne d’une résilience méthodologique naturelle face aux distributions fortement asymétriques ou multimodales, les valeurs extrêmes se trouvant isolées dans des partitions marginales sans exercer d’effet de levier disproportionné sur l’ajustement global, contrairement à ce qui s’observe dans les estimations par moindres carrés ordinaires.
1.3 Exemple paradigmatique : modélisation de variables hétérogènes
Afin d’illustrer la mécanique séquentielle de l’arbre, considérons un scénario économétrique appliqué à la modélisation de la rémunération annuelle de sportifs professionnels en fonction de leur expérience en ligue majeure (variable continue mesurée en années) et de leur indice de performance globale (variable composite continue). Dans un cadre paramétrique standard, le modélisateur introduirait une forme quadratique pour capturer le déclin de performance lié à l’âge ainsi qu’un terme d’interaction entre l’expérience et le rendement actuel. L’arbre de décision procède quant à lui par segmentation itérative purement empirique.
À la racine, l’algorithme évalue l’ensemble des scissions possibles sur les deux variables et identifie, par exemple, qu’un seuil fixé à 4,5 années d’expérience minimise l’hétérogénéité globale du salaire. L’échantillon est alors scindé en deux cohortes. Pour le sous-groupe des athlètes juniors (expérience $le$ 4,5), une seconde division est immédiatement établie sur l’indice de performance : les sportifs dont l’indice est inférieur à 65 unités se voient assigner un salaire moyen prédit de 45 000 euros, tandis que ceux affichant un indice supérieur accèdent à une espérance salariale de 120 000 euros. Inversement, pour le sous-ensemble des vétérans (expérience $>$ 4,5), la scission prioritaire s’opère sur un seuil de performance beaucoup plus élevé, par exemple 80 unités, conduisant à des feuilles terminales associées respectivement à 250 000 euros et 850 000 euros.
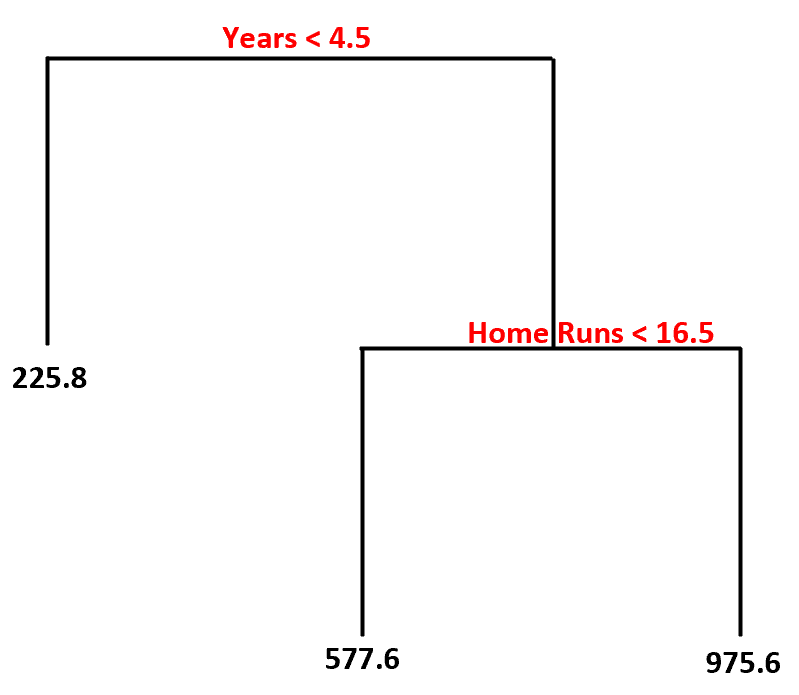
Cette formalisation met en évidence le calcul de l’espérance conditionnelle sur les nœuds terminaux : au sein de chaque hyper-rectangle $R_m$, la prédiction $\hat{c}_m$ s’établit simplement par la moyenne arithmétique des observations d’entraînement y résidant :
$$\hat{c}_m = \frac{1}{N_m} \sum_{x_i in R_m} y_i$$
Toutefois, cet exemple paradigmatique révèle également la limitation structurelle majeure de l’arbre unitaire : la rigidité granulaire de ses partitions. La fonction de prédiction résultante procède par sauts discontinus le long des frontières de décision. Un sportif cumulant 4,4 années d’expérience sera traité de manière drastiquement distincte d’un athlète affichant 4,6 années, alors même que leur profil réel s’avère infinitésimalement proche. Cette rigidité par morceaux engendre une imprécision fondamentale lors de l’estimation de phénomènes continus et explique l’inefficacité relative de l’arbre de décision isolé lorsqu’il s’agit de capturer des gradients lisses de réponse.
2. Mécanismes algorithmiques et métriques de partitionnement
2.1 Critères d’impureté pour la classification
L’induction d’un arbre de classification repose sur le principe de la minimisation de l’hétérogénéité des classes au sein des nœuds successifs, concept formalisé mathématiquement sous le vocable d’« impureté ». Parmi les métriques fondamentales consacrées par la littérature statistique, l’indice d’impureté de Gini — popularisé par l’algorithme CART (Breiman et al., 1984) — occupe une place centrale. Pour un nœud donné $t$ hébergeant une distribution de $K$ classes distinctes, la proportion d’observations appartenant à la classe $k$ étant notée $p(k|t)$, l’indice de Gini est défini par :
$$I_G(t) = 1 – \sum_{k=1}^K p(k|t)^2 = \sum_{k ne l} p(k|t) p(l|t)$$
Sur le plan probabiliste, l’impureté de Gini mesure la probabilité qu’un élément sélectionné au hasard dans le sous-ensemble soit incorrectement étiqueté s’il recevait une classe attribuée aléatoirement selon la distribution empirique du nœud. Cette métrique est strictement concave, bornée entre 0 (pureté absolue, l’ensemble des éléments appartenant à une classe unique) et $(K-1)/K$ (distribution parfaitement équiprobable des classes).
Une approche alternative, issue de la théorie de l’information de Claude Shannon (1948) et implémentée dans les algorithmes ID3 et C4.5 développés par Ross Quinlan, mobilise l’entropie statistique :
$$H(t) = – \sum_{k=1}^K p(k|t) \log_2 p(k|t)$$
L’entropie quantifie l’incertitude informationnelle moyenne contenue dans le nœud. Le partitionnement optimal est alors déterminé par la maximisation du gain d’information $\Delta H$, représentant la réduction de l’entropie obtenue en scindant le nœud parent $t$ en sous-nœuds enfants pondérés par leurs effectifs relatifs. Bien que Gini et l’entropie convergent fréquemment vers des topologies décisionnelles similaires dans la plupart des contextes expérimentaux, leurs sensibilités différentielles aux probabilités marginales s’avèrent manifestes. L’entropie tend à pénaliser plus sévèrement les incertitudes diffuses et présente une convexité plus accentuée que la métrique de Gini, conférant à cette dernière une propension plus élevée à isoler rapidement la classe la plus fréquente.
Dans l’analyse de cohortes cliniques caractérisées par des classes fortement minoritaires (par exemple, la prévalence rare d’une mutation génétique ou d’un syndrome psychopathologique spécifique au sein d’une population générale), ces divergences prennent une importance critique. L’indice de Gini tend à privilégier les scissions créant une feuille très pure au détriment de l’homogénéité du nœud résiduel, ce qui peut masquer des signaux subtils relatifs à la classe rare. Par ailleurs, la nature du partitionnement constitue une divergence algorithmique majeure : alors que l’architecture CART impose strictement un partitionnement binaire récursif en testant pour chaque attribut continu des seuils scalaires $X_j le s$, l’algorithme C4.5 autorise des scissions multiples (multiway splits) pour les attributs nominaux, ce qui nécessite d’ajuster le gain d’information par le ratio de gain (gain ratio) afin d’éviter le biais systématique en faveur des variables possédant de nombreuses modalités.
2.2 Critères d’homogénéité pour la régression
Dans le contexte où la variable cible $Y$ est quantitativement continue, la notion d’impureté de classe cède la place à des métriques de dispersion statistique et de variance intra-nœud. Le critère canonique, adopté par les arbres de régression CART, repose sur la minimisation de l’erreur quadratique moyenne intra-nœud, ce qui équivaut à maximiser la réduction de variance consécutive à la scission. Pour un nœud parent contenant $N_t$ observations, la division candidate scindant l’ensemble en deux partitions d’effectifs $N_L$ et $N_R$ est évaluée par l’optimisation de la quantité :
$$\Delta V = \frac{1}{N_t} \sum_{i in t} (y_i – \bar{y}_t)^2 – \left[ \frac{N_L}{N_t} \frac{1}{N_L} \sum_{i in L} (y_i – \bar{y}_L)^2 + \frac{N_R}{N_t} \frac{1}{N_R} \sum_{i in R} (y_i – \bar{y}_R)^2 \right]$$
où $\bar{y}_t$, $\bar{y}_L$ et $\bar{y}_R$ désignent respectivement les moyennes arithmétiques empiriques de la cible dans le nœud parent et les nœuds enfants gauche et droit. Cette mécanique inductive récursive recherche de manière gloutonne le descripteur et le seuil qui maximisent l’homogénéité interne des sous-groupes, ce qui revient à maximiser la variance inter-classes conformément au théorème de décomposition de la variance (formule de Huygens).
Cependant, l’utilisation de l’erreur quadratique confère à la fonction de perte une sensibilité disproportionnée aux observations aberrantes (outliers) et aux distributions de résidus caractérisées par des queues lourdes. Une observation extrême située dans la périphérie de l’espace des cibles peut forcer une scission artificielle dédiée exclusivement à son isolement, altérant la stabilité structurelle du sous-arbre. Pour pallier cette vulnérabilité, des critères de robustesse alternatifs s’appuient sur la minimisation de l’écart absolu moyen (perte $L_1$) :
$$MAE(t) = \frac{1}{N_t} \sum_{i in t} |y_i – \text{médiane}(y)_t|$$
Le recours à la médiane empirique au détriment de la moyenne arithmétique assure une immunité statistique accrue face aux anomalies de distribution, stabilisant l’induction des règles décisionnelles au prix d’une intensité computationnelle supérieure liée au tri itératif des valeurs cibles. L’évaluation de l’erreur résiduelle standardisée à travers les partitions successives permet ainsi de suivre la convergence du modèle vers une variance asymptotique minimale.
2.3 Heuristiques d’arrêt et stratégies de simplification
En l’absence de régulation algorithmique, un arbre de décision développera sa ramification de manière exponentielle jusqu’à ce que chaque observation réside dans une feuille unitaire totalement pure. Un tel modèle présente une erreur d’ajustement empirique nulle sur l’échantillon d’entraînement mais exhibe une faillite prédictive totale face à de nouvelles données : c’est l’archétype du surapprentissage statistique. Pour circonscrire cette dérive, deux paradigmes interviennent : le pré-élagage (pre-pruning) et le post-élagage (post-pruning).
Le pré-élagage repose sur l’implémentation de critères d’arrêt stochastiques ou structurels imposés en amont de l’induction récursive. Ces heuristiques comprennent :
- La limitation de la profondeur maximale de l’arbre ($\max_depth$), bornant la longueur maximale de la trajectoire décisionnelle depuis la racine ;
- Le seuillage de l’effectif minimal d’échantillons requis pour autoriser la scission d’un nœud interne ($\min_samples_split$) ou pour peupler une feuille terminale ($\min_samples_leaf$) ;
- La définition d’un seuil minimal de décroissance de l’impureté ($\min_impurity_decrease$), en deçà duquel aucune partition n’est validée.
Bien que séduisantes sur le plan computationnel par l’arrêt précoce de la construction du graphe, ces heuristiques souffrent d’une myopie algorithmique congénitale : une scission apparemment médiocre à l’étape $k$ peut s’avérer la condition indispensable à l’émergence d’une scission exceptionnellement discriminante à l’étape $k+1$. Le pré-élagage risque ainsi de tronquer prématurément des interactions complexes.
Le post-élagage, et plus particulièrement la méthode de pénalisation coût-complexité (minimal cost-complexity pruning), formalisée dans l’algorithme CART, constitue la référence méthodologique. Cette approche consiste à développer l’arbre jusqu’à sa saturation maximale, puis à contracter rétrospectivement ses branches terminales en introduisant un paramètre de complexité $\alpha ge 0$. Pour un sous-arbre $T \subseteq T_{\max}$, la fonctionnelle de coût pénalisée s’écrit :
$$R_\alpha(T) = R(T) + \alpha |T|$$
où $R(T)$ représente l’erreur globale d’entraînement du sous-arbre et $|T|$ désigne le nombre de ses feuilles terminales. Lorsque le scalaire $\alpha$ varie continûment de zéro à l’infini, il engendre une suite finie et imbriquée de sous-arbres optimaux. Le sous-arbre idéal est alors sélectionné de manière non biaisée par validation croisée à $K$ blocs ($k$-fold cross-validation), identifiant le point d’équilibre optimal entre la fidélité aux données et la parcimonie architecturale, garantissant ainsi une régularisation efficace de l’estimateur unitaire.
3. Émergence des forêts aléatoires : de l’arbre unique au paradigme d’ensemble
3.1 Origines conceptuelles et formulation de Leo Breiman
Malgré les raffinements algorithmiques apportés par l’élagage coût-complexité, la communauté statistique a été confrontée à la fin du XXe siècle à un constat d’échec méthodologique concernant l’arbre de décision unique : son instabilité intrinsèque face aux fluctuations d’échantillonnage. Dès 1996, Leo Breiman a qualifié les arbres de décision d’estimateurs « instables », signifiant qu’une modification infinitésimale apportée aux données d’entraînement — telle que l’adjonction ou la suppression de quelques observations — peut induire une reconfiguration radicale de la scission initiale à la racine, et propager en cascade une distorsion complète de la topologie de l’arbre. L’arbre unique se heurte ainsi à une aporie : il ne peut simultanément garantir une finesse d’ajustement aux non-linéarités et une stabilité de prédiction en milieu stochastique.
Pour résoudre cette tension, Breiman s’est inspiré de la théorie de l’agrégation d’opinions et du théorème de la « sagesse des foules », conceptualisé sur le plan mathématique par le marquis de Condorcet en 1785. Selon ce principe, la combinaison probabiliste des décisions prises par un ensemble étendu d’individus faillibles, mais détenant un niveau de compétence marginalement supérieur au hasard pur, converge asymptotiquement vers une inférence optimale, sous réserve que les avis exprimés soient indépendants les uns des autres. En transposant ce théorème aux modèles d’apprentissage, la littérature a vu éclore les premiers arbres de décision randomisés (Amit & Geman, 1997 ; Ho, 1995), préparant le terrain pour la formulation canonique des forêts aléatoires par Breiman en 2001.
La formalisation de Breiman repose sur la synthèse du vote majoritaire (pour la classification) ou de la moyenne simple (pour la régression) appliquée à une famille d’estimateurs arborescents construits sur des distributions de probabilité perturbées. L’originalité fondamentale du méta-modèle réside dans l’injection délibérée et systématique de stochasticité au sein du processus de construction de chaque arbre. Plutôt que de rechercher l’optimisation déterministe d’une structure unique, les forêts aléatoires génèrent délibérément une diversité de structures sous-optimales individuellement, mais mutuellement décorrélées, exploitant les propriétés stabilisatrices de la moyenne arithmétique pour écraser la variance d’échantillonnage.
3.2 Loi des grands nombres et convergence asymptotique
L’une des préoccupations majeures formulées lors de l’introduction des méthodes d’ensemble concernait le risque d’aggraver le surapprentissage en juxtaposant des centaines, voire des milliers d’arbres décisionnels hautement complexes. Breiman a dissipé cette inquiétude par une démonstration mathématique élégante fondée sur la loi forte des grands nombres. Considérons un ensemble de classifieurs arborents individuels ${h_b(X, \Theta_b)}_{b=1}^B$, où les vecteurs aléatoires $\Theta_b$ sont indépendants et identiquement distribués (i.i.d.) et gouvernent le tirage stochastique des échantillons et des variables pour chaque arbre $b$. Pour toute distribution conjointe de probabilité régissant le couple $(X, Y)$, lorsque le nombre d’arbres $B$ tend vers l’infini :
$$\lim_{B to \infty} \frac{1}{B} \sum_{b=1}^B h_b(X, \Theta_b) = P_\Theta(h(X, \Theta) = Y) \quad \text{presque sûrement}$$
Cette convergence presque sûre prouve de façon irréfutable que les forêts aléatoires ne surapprennent pas par la simple accumulation d’arbres supplémentaires. Contrairement aux réseaux neuronaux profonds non régularisés ou aux méthodes d’amplification de gradient (boosting), pour lesquels l’adjonction itérative de capacité peut conduire à une détérioration de la performance hors-échantillon après un seuil critique, la fonction d’erreur de généralisation d’une forêt aléatoire décroît de manière monotone jusqu’à atteindre un plateau asymptotique invariant.
Breiman a formalisé la borne supérieure de l’erreur de généralisation pour les forêts de classification sous l’inégalité suivante :
$$PE^* le \frac{\bar{\rho} (1 – s^2)}{s^2}$$
où $\bar{\rho}$ représente la corrélation moyenne entre les résidus des arbres individuels composant la forêt, et $s$ désigne la « force » (strength) moyenne de ces mêmes arbres, mesurée par leur précision individuelle au-delà du hasard. Cette équation met en exergue l’impératif théorique qui gouverne l’architecture des forêts aléatoires : pour minimiser l’erreur de prédiction asymptotique, il est mathématiquement nécessaire de maximiser la force individuelle des arbres tout en minimisant leur corrélation mutuelle $\bar{\rho}$. C’est précisément pour réduire cette corrélation que Breiman a introduit le double mécanisme de randomisation.
4. Le double mécanisme de randomisation dans les forêts aléatoires
4.1 L’agrégation bootstrap (Bagging)
Le premier étage de la randomisation repose sur le concept d’agrégation bootstrap, communément désigné sous l’acronyme de Bagging (Breiman, 1996). Étant donné un jeu de données d’entraînement initial $\mathcal{D}_n$ de taille $n$, l’algorithme génère pour chaque arbre $b in {1, dots, B}$ un sous-échantillon $\mathcal{D}_n^{*b}$ obtenu par tirage aléatoire uniforme avec remise de $n$ observations parmi $\mathcal{D}_n$. Cette procédure confère à chaque observation individuelle une probabilité élémentaire $1/n$ d’être sélectionnée lors d’un tirage singulier.
Considérons la probabilité asymptotique qu’une observation spécifique soit totalement omise d’un échantillon bootstrap donné. Lors d’un tirage, la probabilité d’exclusion d’un point est de $1 – 1/n$. Pour une séquence de $n$ tirages indépendants avec remise, la probabilité de non-sélection s’élève à :
$$P(\text{exclusion}) = \left( 1 – \frac{1}{n} \right)^n$$
En mobilisant la définition exponentielle de la constante d’Euler, la limite asymptotique lorsque la taille de l’échantillon $n$ tend vers l’infini s’établit à :
$$\lim_{n to \infty} \left( 1 – \frac{1}{n} \right)^n = \frac{1}{e} \approx 0{,}3678 \approx 36{,}8%$$
En conséquence, chaque échantillon bootstrap contient en moyenne approximativement $63{,}2%$ d’observations distinctes du jeu de données original, les $36{,}8%$ restants constituant des duplications stochastiques issues du principe de remise.
Cette préservation contrôlée de la variabilité d’échantillonnage joue un rôle déstabilisateur positif. En soumettant chaque arbre à une composition d’échantillonnage modifiée, l’agrégation bootstrap garantit que les partitions optimales calculées diffèrent d’un modèle à l’autre. La dépendance stricte de l’arbre unique vis-à-vis des données d’observation se trouve rompue, les estimateurs individuels explorant des régions distinctes de l’espace empirique.
4.2 Sélection aléatoire des sous-espaces de descripteurs (Random Subspace)
Bien que le bagging réduise substantiellement la variance, il s’avère insuffisant lorsque les données d’apprentissage comportent un prédicteur à l’effet prépondérant, c’est-à-dire une variable dont le pouvoir explicatif surpasse massivement celui de toutes les autres. Dans une telle configuration, chaque arbre entraîné sur un échantillon bootstrap continuera inexorablement de sélectionner ce descripteur dominant lors de la première scission à la racine. Par conséquent, les sous-arbres descendants demeureront fortement corrélés entre eux sur le plan structural, empêchant la corrélation moyenne $\bar{\rho}$ de chuter, ce qui borne sévèrement les gains de variance attendus.
Pour neutraliser ce masquage des prédicteurs secondaires, les forêts aléatoires incorporent la méthode des sous-espaces aléatoires formulée initialement par Tin Kam Ho (1998). À chaque nœud de chaque arbre individuel, l’algorithme tire un sous-ensemble aléatoire de $m$ variables parmi les $p$ descripteurs totaux disponibles, sans remise, avec la contrainte stricte $m < p$. L'algorithme CART standard est alors contraint d'identifier le point de scission optimal exclusivement parmi ces $m$ variables présélectionnées stochastiquement.
La littérature et la pratique empirique ont établi des règles de calibration canoniques régissant le choix de $m$ :
- En classification, la valeur par défaut est traditionnellement fixée à $m = \lfloor \sqrt{p} \rfloor$ ;
- En régression, la recommandation standard s’établit à $m = lfloor p/3 rfloor$.
En privant délibérément l’algorithme d’accès au prédicteur dominant dans une proportion notable de nœuds ($1 – m/p$), le mécanisme force l’exploration de descripteurs latents ou subordonnés. Ces prédicteurs secondaires, bien que modérément informatifs individuellement, révèlent alors des combinaisons interactives locales qui seraient demeurées invisibles dans un arbre unitaire standard. Cette décorrélation active des structures décisionnelles comprime significativement la covariance entre estimateurs sans dégrader substantiellement leur force moyenne.
4.3 Estimation intégrée de l’erreur hors sac (Out-Of-Bag)
Une retombée méthodologique élégante du processus de rééchantillonnage par bootstrap est la constitution endogène d’un échantillon de test virtuel, dénommé données « hors sac » (Out-Of-Bag ou OOB). Comme établi précédemment, pour chaque arbre $b$, approximativement $36{,}8%$ des observations n’ont pas participé à son ajustement. Ces données OOB constituent ainsi un ensemble de validation interne parfaitement non biaisé pour évaluer la capacité de généralisation de cet arbre particulier.
L’estimateur d’erreur hors sac globale se calcule de la manière suivante : pour chaque observation $i in {1, dots, n}$ de l’ensemble d’entraînement original, on identifie le sous-ensemble d’arbres $\mathcal{B}_{(i)}$ pour lesquels l’observation $i$ était effectivement OOB, soit :
$$\mathcal{B}_{(i)} = {b in {1, dots, B} mid i \notin \mathcal{D}_n^{*b}}$$
La prédiction agrégée OOB pour l’observation $i$, notée $\hat{y}_i^{OOB}$, est ensuite formulée par le vote majoritaire (classification) ou la moyenne arithmétique (régression) restreint exclusivement aux estimateurs appartenant à $\mathcal{B}_{(i)}$ :
$$\hat{y}_i^{OOB} = \frac{1}{|\mathcal{B}_{(i)}|} \sum_{b in \mathcal{B}_{(i)}} h_b(x_i, \Theta_b)$$
L’erreur OOB agrégée sur les $n$ observations offre une approximation asymptotiquement équivalente à celle obtenue par une validation croisée à $K$ blocs complète ($K$-fold CV). Cette équivalence mathématique confère un avantage computationnel considérable aux forêts aléatoires : la performance de généralisation et l’absence de sous-ajustement peuvent être évaluées en temps réel durant l’entraînement sans qu’il soit nécessaire d’orchestrer des cycles d’apprentissage croisés itératifs, réduisant ainsi drastiquement l’empreinte de calcul.
5. Comparaison architecturale : modèle unitaire versus méta-estimateur
5.1 Structure déterministe contre agrégation stochastique
La divergence architecturale fondamentale entre l’arbre de décision et la forêt aléatoire réside dans le passage d’une structure singulière rigide à une distribution probabiliste d’arbres décisionnels. Un arbre de décision classique (tel qu’implémenté dans l’algorithme CART déterministe sans sous-échantillonnage) est caractérisé par une reproductibilité absolue : à données d’entraînement invariantes et hyperparamètres constants, l’algorithme d’induction récursive restituera rigoureusement la même topologie arborescente, nœud par nœud, seuil par seuil. Cette certitude procédurale découle de la nature gloutonne de l’optimisation, qui sélectionne systématiquement le partitionnement univarié réalisant l’extremum local de la métrique d’impureté.
À l’opposé, la forêt aléatoire relève intrinsèquement de l’agrégation stochastique. En intégrant deux générateurs de nombres pseudo-aléatoires indépendants — l’un gouvernant la composition des sous-échantillons bootstrap et l’autre le tirage des sous-espaces de covariables à chaque nœud —, la forêt génère un ensemble d’arbres dont aucun n’a vocation à représenter la vérité structurelle sous-jacente des données. La prédiction finale ne s’appuie plus sur une trajectoire décisionnelle déterministe, mais résulte de l’espérance calculée sur l’ensemble de ces trajectoires aléatoires.
Sur le plan géométrique, cette différence se traduit par une modification profonde de la frontière de décision. Alors que l’arbre unitaire engendre des frontières de classification discontinues, formant des partitions rectangulaires abruptes parallèles aux axes orthogonaux des prédicteurs, la forêt aléatoire superpose des milliers de ces hyper-rectangles décalés les uns par rapport aux autres. Par l’effet du lissage d’ensemble, la frontière de décision globale résultante s’affranchit de la contrainte d’orthogonalité stricte et adopte des courbures douces, permettant d’épouser avec une précision géométrique supérieure les variétés différentiables non linéaires sous-jacentes dans les espaces multidimensionnels.
5.2 Sensibilité aux perturbations et instabilité de variance
L’architecture hiérarchique de l’arbre de décision unitaire le rend hypersensible aux fluctuations d’échantillonnage, une propriété que la littérature statistique qualifie de haute variance d’instabilité structurelle. La cause première de ce phénomène réside dans la propagation séquentielle des erreurs le long du graphe acyclique : le choix de la scission optimale au nœud racine conditionne irrévocablement l’ensemble des partitions ultérieures. Si une perturbation marginale des données conduit à substituer la variable de scission initiale par une covariable concurrente dont le gain d’impureté était infinitésimalement proche, l’espace des données se trouve projeté dans des sous-régions radicalement différentes. L’intégralité du sous-arbre en aval s’effondre et se reconstruit selon une logique orthogonale à la précédente, induisant une dérive massive des prédictions finales.
Dans la forêt aléatoire, ce problème d’amplification d’instabilité locale est résolu par la dérivation du principe d’absorption de variance inhérent aux estimateurs d’ensemble. Soit une famille de variables aléatoires $Z_1, dots, Z_B$, chacune possédant une variance individuelle $\sigma^2$, et caractérisées par un coefficient de corrélation par paire invariant $rho$. La variance de la moyenne arithmétique de cet ensemble est donnée par l’identité statistique :
$$operatorname{Var}\left( \frac{1}{B} \sum_{b=1}^B Z_b \right) = \rho \sigma^2 + \frac{1 – \rho}{B} \sigma^2$$
Lorsque le nombre d’arbres $B$ devient grand, le second terme $(1 – \rho)\sigma^2 / B$ s’annule asymptotiquement. La variance de la forêt se trouve ainsi bornée inférieurement par $\rho \sigma^2$. Cette formulation mathématique met en lumière le rôle capital de la décorrélation : en abaissant $rho$ grâce au tirage aléatoire des prédicteurs, la forêt absorbe la majeure partie de la variance individuelle $\sigma^2$ des arbres non élagués, conférant au méta-estimateur une stabilité structurelle face au rééchantillonnage qu’aucun arbre de décision isolé ne peut espérer atteindre.
6. Le dilemme biais-variance : divergence théorique et pratique
6.1 Décomposition mathématique de l’erreur quadratique attendue
Pour appréhender formellement la supériorité prédictive usuelle de la forêt aléatoire sur l’arbre unitaire, il est indispensable de formaliser le dilemme biais-variance. Soit un modèle de régression standard défini par la relation $Y = f(X) + varepsilon$, où l’erreur aléatoire irréductible $varepsilon$ vérifie $\mathbb{E}[\varepsilon] = 0$ et $operatorname{Var}(\varepsilon) = \sigma_\varepsilon^2$. Soit $\hat{f}(X)$ un estimateur empirique calibré sur un ensemble d’entraînement donné. Pour un point de test $x_0$, l’erreur quadratique moyenne attendue (Expected Prediction Error) se décompose selon l’identité classique :
$$\mathbb{E}[(Y – \hat{f}(x_0))^2] = \underbrace{\left( f(x_0) – \mathbb{E}[\hat{f}(x_0)] \right)^2}_{\text{Biais}^2} + \underbrace{operatorname{Var}(\hat{f}(x_0))}_{\text{Variance}} + \underbrace{\sigma_\varepsilon^2}_{\text{Bruit irréductible}}$$
Dans le cas d’un arbre de décision unitaire développé sans contrainte d’élagage, l’algorithme poursuit la subdivision des nœuds jusqu’à isoler des groupes extrêmement restreints d’observations. Ce comportement confère à l’arbre un biais structurellement très faible : le modèle possède une capacité d’ajustement suffisante pour capturer les nuances locales les plus fines de la fonction sous-jacente $f(X)$. Toutefois, cette flexibilité extrême se paie au prix d’une variance critique : $operatorname{Var}(\hat{f}(x_0))$ explose en raison de la forte dépendance du modèle vis-à-vis de l’échantillon d’entraînement spécifique.
L’application d’un élagage par coût-complexité permet de réduire cette variance, mais cette atténuation s’opère mécaniquement au détriment d’une augmentation du biais au carré : en simplifiant les partitions, l’arbre lisse excessivement les gradients locaux et peut omettre des interactions fines. L’analyse graphique de la courbe d’erreur globale d’un arbre unitaire en fonction de sa profondeur révèle ainsi une forme en $U$ caractéristique, dont le minimum matérialise le compromis classique biais-variance, mais dont la valeur absolue d’erreur globale demeure souvent élevée.
6.2 L’effet réducteur de variance des forêts aléatoires
La stratégie computationnelle des forêts aléatoires contourne ce dilemme d’une manière conceptuellement radicale. Au lieu de rechercher un compromis en élaguant les arbres pour restreindre leur variance, l’algorithme de Breiman préserve délibérément des arbres unitaires profonds, non élagués, développés jusqu’à une pureté maximale ou jusqu’à des seuils de feuilles minuscules ($\min_samples_leaf = 1$ en classification). En procédant ainsi, chaque arbre individuel conserve un biais extrêmement faible, au prix d’une variance individuelle $\sigma^2$ très élevée.
C’est ici qu’intervient l’effet réducteur de variance de l’assemblage. Reprenant la relation établie dans la section précédente :
$$operatorname{Var}(\text{Forêt}) = \rho \sigma^2 + \frac{1 – \rho}{B} \sigma^2$$
Dans cette équation, puisque les arbres conservent leur profondeur maximale, l’opération de moyennage n’augmente nullement le biais du modèle global : l’espérance de la moyenne de variables aléatoires distribuées de manière identique est égale à l’espérance de chacune d’elles ($\mathbb{E}[\frac{1}{B} \sum \hat{f}_b(x)] = \mathbb{E}[\hat{f}_1(x)]$). Le biais d’une forêt aléatoire est donc sensiblement égal au faible biais des arbres unitaires profonds qui la composent (avec une élévation infinitésimale due à la randomisation des prédicteurs).
En augmentant massivement la taille de l’assemblée $B$ (souvent plusieurs centaines d’arbres), la composante résiduelle de variance s’annule, tandis que le tirage aléatoire des sous-espaces de descripteurs réduit activement le coefficient de corrélation moyen $rho$. Par conséquent, la forêt aléatoire parvient à réduire drastiquement la variance globale sans subir l’élévation compensatoire de biais qui pénalise inévitablement les modèles unitaires élagués. Elle déplace ainsi vers le bas la courbe du compromis biais-variance, atteignant un seuil d’erreur quadratique globale inaccessible à un arbre isolé.
7. Interprétabilité, explicabilité et compromis épistémologique
7.1 L’arbre de décision comme modèle intrinsèquement transparent
Sur le plan épistémologique, l’arbre de décision unitaire est régulièrement érigé en étalon d’or de la transparence algorithmique, désigné dans la nomenclature contemporaine de l’intelligence artificielle sous le terme de modèle intrinsèquement explicable (interpretable by design). Sa structure arborescente permet une auditabilité cognitive directe : un être humain peut appréhender la logique sous-jacente à une prédiction sans recourir à un quelconque intermédiaire mathématique. L’utilisateur suit le flux séquentiel des conditions le long d’un chemin unique, validant à chaque bifurcation l’adéquation clinique ou métier du seuil appliqué.
Cette transparence native est en conformité étroite avec les cadres réglementaires contemporains, à l’instar du Règlement Général sur la Protection des Données (RGPD) au sein de l’Union européenne, qui consacre en son article 22 un véritable « droit à l’explication » face aux décisions automatisées ayant un impact juridique ou significatif sur les personnes physiques. Dans le secteur assurantiel ou médico-légal, l’extraction de propositions logiques formulées directement en langage naturel (« Si l’âge est supérieur à 60 ans et que le taux d’hémoglobine glyquée dépasse 7 %, alors le risque est classifié comme élevé ») garantit une justification immédiate, opposable et vérifiable.
Toutefois, cette interprétabilité proclamée s’effondre lorsque la structure de l’arbre atteint un degré de complexité supérieur. Au-delà d’une profondeur de partitionnement excédant quatre ou cinq niveaux, et lorsque le nombre total de feuilles terminales se compte par dizaines, la capacité de mémoire de travail de l’opérateur humain (bornée selon la célèbre heuristique de Miller à sept éléments d’information simultanés) est saturée. L’arbre devient alors une structure confuse d’interactions conditionnelles en cascade dont la lecture exhaustive ne procure plus aucune intuition explicative authentique, transformant le modèle transparent en un labyrinthe cognitif impénétrable.
7.2 La forêt aléatoire comme modèle boîte noire
En opérant la transition vers la forêt aléatoire, la transparence géométrique et logique de l’arbre de décision se dissout totalement. En superposant les votes pondérés ou non de 500 à 1 000 arbres décisionnels distincts, chacun ayant exploré des sous-espaces de variables fragmentés et des échantillons d’individus divergents, le modèle acquiert le statut opérationnel de « boîte noire » (black box model). L’intrication stochastique des trajectoires d’inférence prive le praticien de la possibilité d’énoncer une règle de décision unique pour expliciter l’attribution d’une classe ou d’une valeur à un vecteur de test.
Cette opacité structurelle suscite des tensions éthiques et professionnelles sévères, singulièrement dans les disciplines à haute responsabilité telles que l’oncologie, la justice prédictive ou la gestion du risque systémique bancaire. Face à un patient recevant un diagnostic défavorable émis par une forêt aléatoire, le clinicien est incapable d’articuler un raisonnement déductif linéaire pour justifier la classification algorithmique. L’affirmation selon laquelle « 73 % des 500 arbres ont voté pour la malignité par des combinaisons variées de biomarqueurs » ne répond pas aux exigences de la déontologie médicale, qui réclame la traçabilité causale ou phénoménologique du diagnostic.
Le chercheur est ainsi confronté au dilemme épistémologique formulé par Leo Breiman lui-même dans son manifeste sur les deux cultures statistiques (2001) : choisir entre un modèle simple et élégant, immédiatement intelligible mais statistiquement imprécis car trop rustique face aux complexités de la nature, ou adopter un modèle algorithmique hautement performant mais dont les mécanismes internes demeurent réfractaires à l’intuition humaine directe. Pour tenter de combler ce fossé sans sacrifier la puissance prédictive, le domaine de l’apprentissage automatique a dû développer des méthodologies d’explicabilité post-hoc dédiées.
7.3 Outils d’explicabilité post-hoc pour les forêts aléatoires
Pour dissiper l’opacité inhérente aux forêts aléatoires, plusieurs techniques analytiques ont été formalisées. Historiquement, la première mesure intégrée développée par Breiman est l’importance des variables par décroissance moyenne d’impureté (Mean Decrease Impurity ou MDI). Le score MDI d’un descripteur $X_j$ correspond à la somme, pondérée par l’effectif des nœuds, de toutes les réductions d’impureté (Gini ou variance) induites par ce descripteur à travers l’ensemble des arbres de la forêt :
$$MDI(X_j) = \frac{1}{B} \sum_{b=1}^B \sum_{t in T_b : v(t) = X_j} \frac{N_t}{N} \Delta I(t, X_j)$$
Cependant, le score MDI souffre d’un biais statistique documenté par Strobl et al. (2007) : il surestime systématiquement l’importance des variables numériques continues ou des variables catégorielles possédant un nombre élevé de modalités, car celles-ci offrent mécaniquement un spectre de seuils de partitionnement candidats beaucoup plus large, augmentant artificiellement la probabilité d’optimisation fortuite.
Pour pallier ce biais, l’importance par permutation des variables (Permutation Feature Importance ou PFI), également désignée sous le vocable de Mean Decrease Accuracy (MDA), s’impose comme une alternative statistiquement plus rigoureuse. Le protocole s’articule comme suit :
- Pour chaque arbre $b$, calculer l’erreur de prédiction sur son échantillon hors sac spécifique $\mathcal{D}_{OOB}^b$ ;
- Permuter aléatoirement les valeurs de la variable $X_j$ au sein de cet échantillon OOB afin de détruire sa corrélation avec la cible tout en préservant la distribution marginale globale ;
- Recalculer l’erreur de prédiction de l’arbre sur ces données corrompues ;
- La dégradation moyenne de la performance prédictive à travers tous les arbres matérialise l’importance effective de $X_j$.
À l’ère moderne, ces métriques globales sont avantageusement complétées par des cadres théoriques unifiés fondés sur la théorie des jeux coopératifs, à l’instar des valeurs de SHAP (Shapley Additive exPlanations) formulées par Lundberg et Lee (2017). En s’appuyant sur l’algorithme TreeSHAP, conçu spécifiquement pour exploiter l’architecture interne des ensembles d’arbres en complexité polynomiale, cette approche calcule l’attribution marginale exacte de chaque prédicteur à la décision formulée pour une observation spécifique. Ces outils, complétés par les graphiques de dépendance partielle (Partial Dependence Plots) qui isolent l’effet marginal moyen d’une covariable sur la réponse globale, réconcilient en partie performance d’ensemble et exigence de transparence clinique.
8. Efficience computationnelle, passage à l’échelle et déploiement
8.1 Complexité temporelle d’apprentissage et d’inférence
L’arbitrage entre un arbre de décision isolé et une forêt aléatoire s’évalue également à l’aune des contraintes matérielles, de la complexité algorithmique et des impératifs de déploiement en production. Pour un jeu de données comportant $n$ observations et $p$ descripteurs continus, l’entraînement d’un arbre de décision binaire équilibré requiert, à chaque niveau de profondeur, le tri des observations pour chaque variable afin d’identifier les seuils de coupure candidats optimaux. La complexité temporelle asymptotique pour la construction d’un arbre complet s’établit à :
$$\mathcal{O}(p \cdot n \log n \cdot d)$$
où $d$ désigne la profondeur maximale atteinte par le graphe décisionnel ($d \approx \log n$ pour un arbre équilibré). En phase d’inférence, le passage d’une nouvelle observation nécessite la traversée séquentielle de la racine à la feuille, induisant une complexité en temps remarquablement faible de $\mathcal{O}(d)$, soit de l’ordre de quelques microsecondes, parfaitement adaptée aux systèmes embarqués critiques à latence ultra-faible.
Pour une forêt aléatoire composée de $B$ arbres, la phase d’apprentissage multiplie cette complexité théorique par le volume de l’assemblée, tout en bénéficiant de la réduction dimensionnelle induite par la sélection aléatoire de $m$ variables à chaque scission au lieu de $p$ :
$$\mathcal{O}(B \cdot m \cdot n \log n \cdot d)$$
Bien que cette charge soit substantiellement supérieure à celle d’un arbre unitaire, c’est principalement lors de la phase d’inférence et d’exploitation en production que la divergence devient pénalisante. Prédire une issue requiert de faire transiter l’observation à travers les $B$ arbres individuels, puis de réaliser l’agrégation statistique des réponses, portant la complexité d’inférence à $\mathcal{O}(B \cdot d)$. Dans les architectures transactionnelles à très haut débit (moteurs de recommandation en ligne, détection de fraude financière à grande échelle), cette multiplication linéaire de la latence peut constituer un goulot d’étranglement rédhibitoire.
De surcroît, les contraintes volumétriques relatives au stockage en mémoire vive (RAM) et sur disque divergent de manière spectaculaire. Un arbre élagué peut être encodé de manière extrêmement compacte sous la forme de quelques tableaux d’entiers et de flottants de quelques kilo-octets. En revanche, une forêt massive de 1 000 arbres profonds, intégrant des millions de nœuds internes et de métadonnées associées, requiert fréquemment plusieurs gigaoctets de mémoire, compliquant considérablement son instanciation au sein de terminaux mobiles ou d’environnements computationnels contraints.
8.2 Parallélisation et scalabilité dans les architectures modernes
En contrepoint de son coût computationnel global plus élevé, la forêt aléatoire présente une propriété algorithmique remarquable sur le plan de l’architecture distribuée : elle est intrinsèquement et idéalement parallélisable (embarrassingly parallel). En effet, chaque arbre $b$ de la forêt est généré de façon totalement indépendante des autres estimateurs, en s’appuyant uniquement sur son propre tirage bootstrap et ses germes stochastiques locaux. Il n’existe aucune dépendance séquentielle ni transfert d’état entre les arbres, contrairement aux algorithmes de boosting (comme XGBoost ou LightGBM) qui contraignent le modèle $k$ à attendre la convergence des résidus calculés par le modèle $k-1$.
Cette indépendance structurelle autorise une répartition directe de la charge sur des architectures de calcul multi-cœurs modernes, des fermes de calcul distribué (via des frameworks tels qu’Apache Spark) ou des grappes de GPU. La durée effective d’apprentissage d’une forêt de $B$ arbres sur un processeur doté de $C$ cœurs s’évalue schématiquement par le temps de calcul unitaire multiplié par $B/C$, permettant une scalabilité quasi-linéaire avec l’infrastructure matérielle mobilisée.
À l’inverse, l’arbre de décision unitaire standard ne peut être parallélisé selon cette dimension d’ensemble. Les gains de scalabilité doivent alors être recherchés au sein même de la construction du nœud : parallélisation du tri des variables ou calcul distribué des métriques d’impureté sur de très grands volumes de données. Ces opérations nécessitent des protocoles de synchronisation fréquents en mémoire, limitant l’efficience d’accélération matérielle. Néanmoins, il importe de souligner l’impact écologique et énergétique de ces entraînements : l’ajustement systématique de méta-modèles complexes sur des téraoctets de données tabulaires engendre une facture carbone non négligeable, incitant à évaluer avec rigueur si le surcroît de performance justifie le déploiement d’une architecture d’ensemble.
9. Résistance au bruit, valeurs manquantes et anomalies de distribution
9.1 Vulnérabilité de l’arbre unique face au bruit statistique
L’une des fragilités structurelles les plus préjudiciables de l’arbre de décision unitaire est sa vulnérabilité extrême face au bruit statistique, qu’il s’agisse de variables prédictives imprécises, d’artéfacts expérimentaux ou de bruit d’étiquetage sur la variable dépendante $Y$. En raison de son moteur d’optimisation glouton qui inspecte chaque descripteur jusqu’au seuil le plus infime pour maximiser le gain d’impureté immédiat, l’arbre a une propension pathologique à modéliser le bruit idiosyncrasique comme s’il traduisait un signal théorique authentique. Une observation mal étiquetée à proximité d’une frontière de classe peut inciter le modèle à construire un rameau complexe de sous-branches pour isoler cette anomalie, fragmentant l’espace des données de façon aberrante.
Cette propension au surajustement des anomalies engendre une instabilité topologique sévère : les seuils de coupure calculés au voisinage de données extrêmes deviennent des artéfacts de l’échantillon d’ajustement. Lorsqu’une division erratique est introduite à un niveau supérieur de la hiérarchie en raison de la présence d’une valeur extrême exerçant un fort effet de levier local, l’intégralité des inférences produites en aval se trouve irrémédiablement faussée. L’arbre unique manque d’un système de rappel ou d’amortissement interne capable de neutraliser la contamination causée par des étiquettes erratiques ou des covariables bruitées.
9.2 Résilience systémique de la forêt aléatoire
À l’inverse, la forêt aléatoire manifeste une résilience systémique remarquable face aux anomalies distributionnelles et au bruit d’échantillonnage. Cette robustesse s’explique par la mécanique collective du vote majoritaire ou de l’agrégation par moyenne. Si un sous-ensemble d’arbres individuels surajuste un artéfact statistique ou subit une division initiale biaisée induite par une observation aberrante, ces distorsions locales sont massivement diluées au sein du collectif. La grande majorité des autres arbres, entraînés sur des sous-échantillons bootstrap distincts et inspectant d’autres combinaisons de prédicteurs, ne reproduiront pas cette scission erratique particulière. Le consensus collectif agit ainsi comme un filtre passe-bas éliminant le bruit à haute fréquence.
Par ailleurs, les forêts aléatoires intègrent des mécanismes sophistiqués pour traiter nativement le problème critique des données manquantes, tant en phase d’entraînement qu’en prédiction. L’algorithme original de Breiman exploite pour ce faire une matrice de proximité ($N \times N$). Après la génération de la forêt, l’ensemble des observations est acheminé le long de tous les arbres ; la proximité entre deux individus $i$ et $j$ est incrémentée de 1 chaque fois qu’ils aboutissent dans la même feuille terminale, avant d’être normalisée par le nombre total d’arbres $B$ :
$$operatorname{Prox}(i, j) = \frac{1}{B} \sum_{b=1}^B \mathbb{I}(t_b(x_i) = t_b(x_j))$$
Cette matrice de proximité permet une imputation hautement efficace des valeurs manquantes : pour un attribut continu manquant chez l’observation $i$, la valeur imputée est calculée par la moyenne pondérée des valeurs observées chez les autres individus, les poids étant proportionnels à leur proximité structurelle $operatorname{Prox}(i, j)$ dans la forêt. Ce processus d’imputation itératif peut être répété jusqu’à convergence des proximités. De même, cette matrice permet la détection automatisée des valeurs aberrantes multivariées : un individu dont la proximité globale avec l’ensemble des autres observations de sa classe est anormalement faible est immédiatement isolé comme une anomalie statistique, offrant un outil précieux pour le contrôle de la qualité de grands bilans psychométriques ou cliniques.
10. Applications psychologiques, neuroscientifiques et cliniques
10.1 Diagnostics catégoriels et arbres de décision cliniques
Dans le domaine de la psychologie clinique, de la psychiatrie et de la médecine d’urgence, l’arbre de décision unitaire demeure une architecture fondamentale, non pas en dépit de sa simplicité mathématique, mais précisément en raison de celle-ci. Lorsque les cliniciens doivent procéder à un triage psychiatrique d’urgence face à des patients en état de décompensation aiguë, l’application d’algorithmes complexes de type boîte noire est à la fois impraticable et déontologiquement contestable. L’arbre de décision clinique, standardisé sous la forme d’organigrammes séquentiels déterministes, fournit un cadre opératoire direct, rapide et cognitivable sous forte pression temporelle.
À titre d’exemple, l’évaluation structurée du risque suicidaire dans les services d’accueil et d’urgence s’appuie fréquemment sur des arbres de décision formalisés à partir de critères nosographiques validés (issus du DSM-5 ou de la CIM-11). L’arbre formule une séquence stricte d’interrogations :
- Présence d’idées suicidaires actives avec plan structuré (Oui/Non) ;
- Tentative de suicide antérieure au cours des douze derniers mois (Oui/Non) ;
- Présence de facteurs de soutien psychosocial immédiats (Oui/Non) ;
- Comorbidité avec un trouble de l’usage de substances psychoactives (Oui/Non).
Chaque embranchement oriente immédiatement l’équipe vers une décision standardisée : hospitalisation immédiate sous contrainte, surveillance psychiatrique ambulatoire renforcée ou retour à domicile sécurisé avec relais médicosocial. L’adhésion des soignants à ces protocoles arborescents est maximale parce qu’ils garantissent une conformité avec les recommandations de bonne pratique clinique et permettent d’identifier instantanément des contre-indications thérapeutiques absolues sans nécessiter d’outils informatiques sophistiqués au lit du patient.
10.2 Phénotypage complexe et forêts aléatoires en psychiatrie computationnelle
À l’opposé du triage d’urgence, la recherche translationnelle en psychiatrie computationnelle, en neuroimagerie et en génomique comportementale se heurte à des espaces de données dont la dimensionalité dépasse radicalement les capacités d’analyse de l’arbre unitaire. Dans l’étude des troubles dépressifs majeurs, des spectres de l’autisme ou de la schizophrénie, les chercheurs font face à ce qu’il est convenu d’appeler le fléau de la dimension : les cohortes comportent souvent quelques centaines ou milliers de patients pour lesquels sont recueillis des dizaines de milliers de biomarqueurs neurocomportementaux — volumétrie des sous-régions cérébrales par IRM structurelle, connectivité fonctionnelle au repos (fMRI), polymorphismes nucléotidiques simples (SNP) et profils épigénétiques.
Dans cette configuration critique où le nombre de descripteurs $p$ surpasse massivement le nombre d’observations $n$ ($p gg n$), un arbre de décision unitaire subit un surajustement catastrophique dès le premier nœud, incapable de séparer les signaux biologiques subtils du bruit de fond expérimental. La forêt aléatoire s’est imposée dans ce domaine comme une méthode de référence. Grâce au tirage aléatoire des sous-espaces de descripteurs à chaque nœud, elle neutralise le fléau de la dimension en testant des sous-ensembles réduits de variables génétiques ou neuroanatomiques, découvrant ainsi des interactions multigéniques et des circuits neuronaux interconnectés prédictifs de la résistance aux traitements.
De vastes études longitudinales mobilisent ainsi les forêts aléatoires pour la modélisation de l’hétérogénéité des troubles bipolaires et la prédiction individualisée de la réponse thérapeutique au lithium ou aux psychothérapies cognitivo-comportementales (TCC). En exploitant la résilience du modèle face aux données tabulaires manquantes et aux distributions bruitées issues de questionnaires d’auto-évaluation en ligne, la forêt aléatoire parvient à extraire des signatures prédictives stables à partir de données hautement hétérogènes, traçant la voie d’une psychiatrie de précision fondée sur l’exploitation statistique d’ensembles décisionnels complexes.
11. Méthodologie d’optimisation et réglage des hyperparamètres
11.1 Espace hyperparamétrique de l’arbre de décision
L’étalonnage rigoureux d’un arbre de décision unitaire requiert une exploration méthodique de son espace d’hyperparamètres afin de naviguer sur la courbe du compromis biais-variance. L’architecture algorithmique de CART met en jeu une série de leviers de régularisation dont l’interaction conjointe détermine la structure finale du graphe :
- La profondeur maximale ($\max_depth$) : Contrôle direct de l’horizon hiérarchique du modèle. Une profondeur trop contraignante ($d le 2$) induit un sous-apprentissage sévère en bloquant la capture d’interactions d’ordre supérieur, tandis qu’une profondeur non bridée conduit à une ramification idiosyncrasique.
- L’effectif minimal par division ($\min_samples_split$) : Fixe la masse empirique requise pour qu’un nœud soit éligible à un partitionnement supplémentaire. Un seuil élevé prévient l’adaptation à des sous-groupes statistiques marginaux.
- L’effectif minimal par feuille ($\min_samples_leaf$) : Constitue sans doute l’hyperparamètre de lissage le plus influent pour l’arbre unique. En garantissant que chaque feuille contienne au minimum $k$ observations, il restreint la sensibilité aux étiquettes bruitées et force un calcul d’espérance conditionnelle sur une assiette statistiquement significative.
- Le paramètre de complexité coût-élagage ($\alpha$ ou $ccp_\alpha$) : Régit la pénalisation appliquée au nombre de feuilles lors du post-élagage, permettant d’extraire la sous-arborescence optimale identifiée par validation croisée.
Il importe toutefois de souligner le danger inhérent à l’application d’un balayage par grille (Grid Search) trop dense et exhaustif sur un arbre unitaire. En raison de l’instabilité de l’estimateur face aux données d’échantillonnage, une optimisation excessive des hyperparamètres sur le jeu de validation croisée peut conduire à un surapprentissage des hyperparamètres eux-mêmes. Le modèle sélectionné risque d’exhiber une configuration architecturale performante sur les blocs de découpage spécifiques de l’échantillon, mais structurellement instable lors de sa confrontation à une cohorte indépendante.
11.2 Hyperparamétrage stratégique des forêts aléatoires
L’optimisation d’une forêt aléatoire obéit à une logique conceptuelle radicalement différente, marquée par une robustesse beaucoup plus élevée vis-à-vis des réglages par défaut, ce qui constitue l’une des raisons majeures de son succès empirique dans les compétitions de science des données. Les hyperparamètres fondamentaux s’articulent comme suit :
- Le nombre d’estimateurs ($n_estimators$ ou $B$) : Contrairement à la majorité des algorithmes d’apprentissage automatique, le nombre d’arbres dans une forêt aléatoire ne constitue pas un paramètre de régularisation et ne favorise pas le surapprentissage lorsqu’il croît. Il doit simplement être calibré à une échelle suffisamment élevée pour assurer la stabilisation asymptotique de l’erreur hors sac (OOB). Dans la pratique, une assemblée de 300 à 1 000 arbres garantit une convergence robuste de la surface de décision.
- Le nombre de prédicteurs par nœud ($\max_features$ ou $m$) : C’est l’hyperparamètre central de régularisation et de décorrélation. Diminuer la valeur de $m$ force l’algorithme à explorer des descripteurs alternatifs, réduisant ainsi la corrélation inter-arbres $\bar{\rho}$ au détriment d’une légère baisse de leur force individuelle $s$. À l’inverse, une valeur de $m$ trop proche du nombre total de covariables $p$ transforme la forêt en une simple agrégation bootstrap d’arbres corrélés, bridant la réduction de variance.
- La profondeur des arbres ($\max_depth$) et taille minimale de feuille ($\min_samples_leaf$) : Dans la formulation canonique de Breiman, ces paramètres sont laissés libres ($\max_depth = \infty$, $\min_samples_leaf = 1$ en classification) afin de minimiser le biais individuel de chaque estimateur. Néanmoins, sur des jeux de données volumineux comportant un bruit résiduel important ou des contraintes strictes d’occupation mémoire, fixer $\min_samples_leaf$ à des valeurs modérées (par exemple, 3, 5 ou 10) permet de comprimer drastiquement la taille de la forêt sans dégrader sa précision prédictive.
- La fraction d’échantillonnage ($\max_samples$) : Règle la taille relative des tirages bootstrap. Si la norme standard est de tirer un effectif égal à la taille de l’échantillon d’entraînement ($100%$ avec remise), l’utilisation de sous-échantillons plus restreints (ex. $60%$ à $80%$) accroît la diversification des estimateurs, accélère le temps d’entraînement et se révèle parfois efficace face à des distributions fortement bruitées.
12. Grille d’arbitrage décisionnel : critères de sélection pragmatiques
12.1 Matrice comparative des dimensions clés
L’arbitrage entre l’arbre de décision unique et la forêt aléatoire ne doit jamais être formulé comme une hiérarchie méthodologique absolue où l’un surclasserait universellement l’autre. Le choix dépend fondamentalement des contraintes opérationnelles, de la nature du problème mathématique, du volume de données mobilisable et des exigences légales d’auditabilité. Le tableau suivant synthétise les propriétés distinctives des deux modèles à travers leurs dimensions analytiques déterminantes.
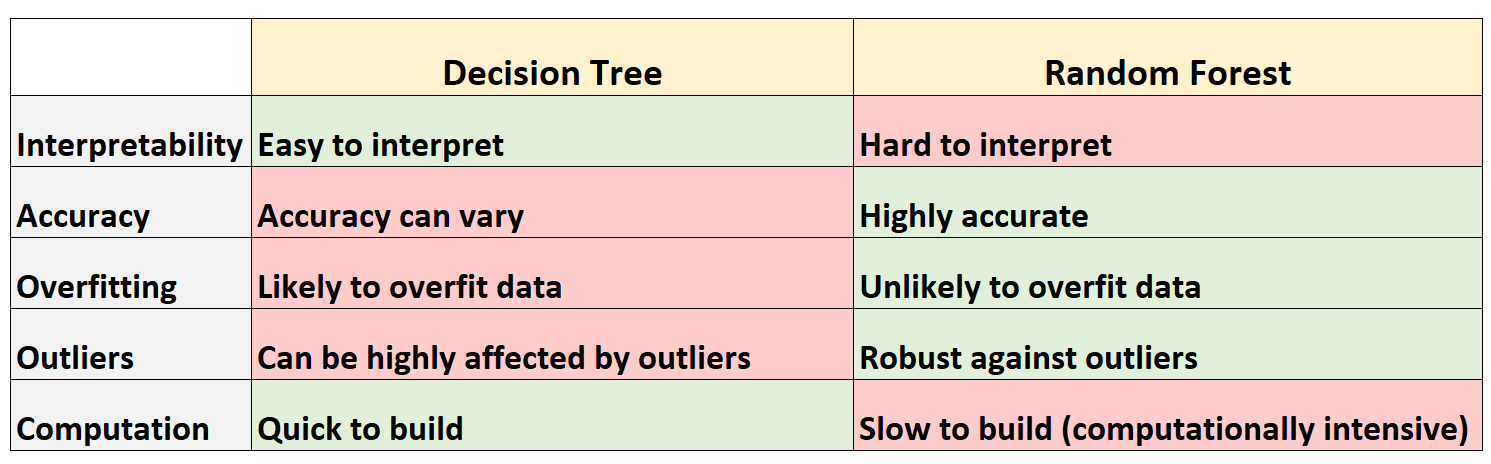
Cette grille d’arbitrage permet d’énoncer des règles pragmatiques d’orientation méthodologique :
- Privilégier l’arbre de décision unitaire lorsque : Le volume d’échantillons est réduit ($n < 1,000$), le processus de décision doit être impérativement auditable par un régulateur ou exécutable manuellement par des opérateurs de terrain sans infrastructure informatique, la latence d'inférence doit être inférieure à la milliseconde, et l'explication causale de chaque prédiction prime sur le pourcentage absolu de précision.
- Privilégier la forêt aléatoire lorsque : L’objectif prépondérant est la maximisation de la performance prédictive sur des données tabulaires complexes et non linéaires, le jeu de données comporte un volume d’observations et de variables substantiel, les données contiennent des valeurs manquantes et du bruit de mesure, et des outils d’interprétabilité post-hoc (PFI, TreeSHAP) suffisent à satisfaire les impératifs d’auditabilité du système.
12.2 Approches hybrides et orientations futures
Face à la dichotomie classique entre la transparence fragile de l’arbre unique et l’opacité performante de la forêt aléatoire, la recherche en apprentissage automatique a vu émerger au cours des dernières années des méthodologies novatrices visant à transcender ce compromis épistémologique. L’une des voies les plus fécondes est la « distillation de modèles » (model distillation), transposée au champ des ensembles d’arbres. Cette approche consiste à entraîner une forêt aléatoire massive sur les données brutes afin de capturer l’intégralité des interactions non linéaires et de stabiliser la surface décisionnelle, puis à utiliser les prédictions lissées générées par cette forêt comme cible pour entraîner un arbre de décision unitaire régularisé.
En apprenant non pas sur les étiquettes originales bruitées mais sur les probabilités a posteriori calibrées par la forêt aléatoire, l’arbre unitaire distillé bénéficie de l’effet réducteur de variance du méta-modèle. Il parvient ainsi à synthétiser les motifs les plus discriminants de l’assemblée au sein d’une structure géométrique singulière, préservant une interprétabilité directe tout en affichant une fidélité prédictive très supérieure à celle d’un arbre entraîné directement sur les données empiriques brutes. Des frameworks contemporains tels que RuleFit (Friedman & Popescu, 2008) incarnent une logique similaire en extrayant automatiquement les règles décisionnelles les plus stables d’une forêt avant de les sélectionner via une régression parcimonieuse pénalisée par régularisation LASSO.
Une seconde orientation novatrice explore l’hybridation des arbres de décision avec les architectures d’apprentissage profond. Des architectures telles que les Neural Decision Forests intègrent des mécanismes de scission différentiables au sein de réseaux neuronaux convolutifs ou récurrents, permettant l’optimisation conjointe par descente de gradient stochastique de représentations latentes de haut niveau et de structures arborescentes de décision. Enfin, dans le champ des sciences comportementales et biomédicales, la rigueur méthodologique impose désormais d’évaluer tout algorithme complexe face à un arbre de décision simple élagué en tant que référence minimale (baseline). Cette discipline méthodologique garantit que la complexité computationnelle, le coût énergétique et l’opacité inhérents au déploiement d’une forêt aléatoire ne soient consentis que lorsqu’ils apportent une plus-value statistique tangible et reproductible sur le problème d’intérêt.
Références
- Amit, Y., & Geman, D. (1997). Shape quantization and recognition with randomized trees. Neural Computation, 9(7), 1545-1588. https://doi.org/10.1162/neco.1997.9.7.1545
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123-140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5-32. https://doi.org/10.1023/A:1010933404324
- Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199-231. https://doi.org/10.1214/ss/1009213726
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. Wadsworth & Brooks/Cole Advanced Books & Software.
- Friedman, J. H., & Popescu, B. E. (2008). Predictive learning via rule ensembles. The Annals of Applied Statistics, 2(3), 916-954. https://doi.org/10.1214/07-AOAS148
- Ho, T. K. (1995). Random decision forests. In Proceedings of the Third International Conference on Document Analysis and Recognition (Vol. 1, pp. 278-282). IEEE. https://doi.org/10.1109/ICDAR.1995.598994
- Ho, T. K. (1998). The random subspace method for constructing decision forests. IEEE Transactions on Pattern Analysis and Machine Intelligence, 20(8), 832-844. https://doi.org/10.1109/34.709601
- Lundberg, S. M., & Lee, S.-I. (2017). A unified approach to interpreting model predictions. In Advances in Neural Information Processing Systems (Vol. 30, pp. 4765-4774). Curran Associates, Inc. https://proceedings.neurips.cc/paper_files/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html
- Quinlan, J. R. (1993). C4.5: Programs for machine learning. Morgan Kaufmann Publishers.
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8(1), Article 25. https://doi.org/10.1186/1471-2105-8-25