
Dans le paysage foisonnant de la recherche quantitative en psychologie, en neurosciences cognitives et en sciences de l’éducation, l’inférence statistique repose sur une quête permanente : isoler avec exactitude l’effet d’un traitement, d’une intervention ou d’une appartenance groupale au milieu du bruit inhérent à la variabilité humaine. Alors que l’analyse de variance classique a longtemps constitué la clé de voûte de cette démarche, elle montre rapidement ses limites dès lors que les individus diffèrent systématiquement avant même l’administration de toute condition expérimentale. L’hétérogénéité des participants, loin d’être une simple nuisance négligeable, constitue souvent une source majeure de variance résiduelle qui obscurcit les effets réels des dispositifs étudiés.
C’est précisément pour surmonter cette entrave méthodologique majeure que l’analyse de covariance, universellement désignée par son acronyme ANCOVA (Analysis of Covariance), a été conceptualisée par Sir Ronald Fisher au début des années 1930. En combinant l’élégance de la partition de variance propre aux devis factoriels et la puissance prédictive de la régression linéaire, l’ANCOVA permet d’ajuster statistiquement la variable dépendante en fonction d’une ou plusieurs variables concomitantes continues, appelées covariables. Ce faisant, elle opère une double prouesse : purifier l’erreur expérimentale pour accroître la puissance statistique et recalculer les moyennes de groupe comme si les participants avaient tous débuté l’expérimentation sur un pied d’égalité absolue.
Destiné aux chercheurs, doctorants, cliniciens et étudiants avancés désireux de maîtriser les subtilités du modèle linéaire général, cet ouvrage de référence propose une exploration exhaustive de l’ANCOVA. De ses fondements mathématiques rigoureux à ses postulats stricts d’homogénéité des pentes, en passant par ses applications cliniques concrètes, sa programmation informatique et ses controverses méthodologiques telles que le paradoxe de Lord, ce guide offre une boussole conceptuelle et pratique indispensable pour quiconque souhaite manier avec rigueur cet outil statistique fondamental.
1. Fondements théoriques : De l’ANOVA à l’ANCOVA
1.1 Rappel conceptuel de l’analyse de variance classique (ANOVA)
L’analyse de variance univariée à un facteur, introduite par Ronald Fisher, répond historiquement à la nécessité de comparer simultanément les moyennes de trois groupes indépendants ou plus, sans subir l’inflation catastrophique du risque d’erreur de type I inhérente à la multiplication anarchique des tests de Student. Le principe architectural de l’ANOVA repose sur la décomposition mathématique de la variabilité globale observée au sein des données, quantifiée par la somme des carrés totale. Cette dernière est partitionnée en deux composantes mutuellement exclusives : la variance inter-groupes, qui reflète la dispersion des moyennes de chaque condition autour de la moyenne générale et traduit l’effet supposé du traitement, et la variance intra-groupes, traditionnellement qualifiée d’erreur expérimentale ou de variance résiduelle, qui capture les fluctuations idiosyncrasiques existant entre individus soumis à une condition strictement identique.
Le ratio de ces deux variances, normalisé par leurs degrés de liberté respectifs, génère la statistique F de Snedecor. Si ce rapport s’écarte significativement de l’unité, le chercheur conclut au rejet de l’hypothèse nulle d’égalité parfaite des moyennes populationnelles. Néanmoins, l’ANOVA classique postule implicitement que la variance intra-groupe résulte d’un bruit blanc aléatoire, homogène et non structuré. Or, dans les investigations empiriques portant sur le comportement humain, cette supposition s’avère fréquemment erronée : les participants apportent avec eux un bagage génétique, cognitif, émotionnel et socio-éducatif profondément dissemblable, créant une dispersion colossale au sein même de chaque bras expérimental.
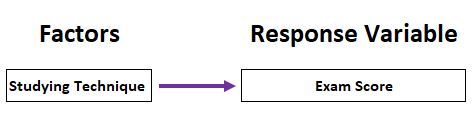
Considérons, à titre d’illustration paradigmatique, une recherche pédagogique évaluant l’efficacité comparée de trois méthodes d’apprentissage de la lecture chez des élèves de cours préparatoire. En appliquant une ANOVA classique sur les scores de fluence verbale obtenus en fin d’année scolaire sans considérer le niveau d’éveil phonologique mesuré lors de la rentrée de septembre, le statisticien commet une imprudence majeure. Si des enfants possédaient déjà des aptitudes lexicales précoces exceptionnelles et d’autres des retards développementaux marqués, la variance au sein de chaque classe sera immense. Cette dispersion interne démesurée va gonfler le dénominateur du test F, occultant potentiellement la supériorité pédagogique authentique de l’une des approches didactiques testées.
1.2 Origine et définition de l’analyse de covariance (ANCOVA)
Pour dépasser l’impasse d’une variance d’erreur hypertrophiée par des différences interindividuelles préexistantes, Fisher a formalisé l’analyse de covariance en tant qu’extension directe et naturelle du modèle linéaire général. D’un point de vue conceptuel, l’ANCOVA réalise une synthèse théorique remarquable entre deux paradigmes statistiques majeurs : la régression linéaire simple ou multiple et l’analyse de variance factorielle. Elle permet d’étudier l’impact d’une ou plusieurs variables indépendantes catégorielles (les facteurs expérimentaux) sur une variable réponse métrique continue, tout en modélisant et en extrayant simultanément l’influence linéaire exercée par une ou plusieurs variables continues supplémentaires, désignées sous le terme de covariables.
Sur le plan structural, l’ANCOVA ne se contente pas d’ajouter une variable de contrôle de manière superficielle ; elle réorganise intégralement la décomposition de la variance. En ajustant préalablement les observations individuelles de la variable dépendante sur la base de leur relation linéaire avec la covariable, l’ANCOVA soustrait mathématiquement la part prédictible de variance attribuable à cette variable concomitante. Le modèle linéaire général s’exprime alors comme une équation où la variable dépendante devient une fonction additive de la moyenne générale, de l’effet différentiel du groupe d’appartenance, de la pente de régression liant la réponse à la covariable, et d’un terme résiduel purgé de cette influence externe.
Cette hybridation méthodologique revêt une pertinence singulière dans les domaines de la psychologie cognitive, de la psychiatrie clinique et de l’ergonomie cognitive. Dans ces disciplines, les protocoles expérimentaux se heurtent continuellement à l’impossibilité pratique ou éthique de standardiser intégralement le profil des sujets humains. Qu’il s’agisse de contrôler le niveau d’intelligence fluide dans une tâche de mémoire de travail ou de neutraliser la sévérité initiale des symptômes dans un essai contrôlé randomisé évaluant une psychothérapie, l’ANCOVA s’impose comme l’instrument d’élection pour obtenir une estimation non contaminée de l’effet d’intervention.
1.3 Différences fondamentales entre ANOVA et ANCOVA
Bien que l’ANOVA et l’ANCOVA partagent une généalogie commune ancrée dans la théorie de la décision statistique bayésienne et fréquentiste, leurs mécanismes internes divergent sur deux aspects cruciaux : la restructuration du terme d’erreur et le recalcul systématique des moyennes de groupe. Dans une ANOVA standard, la somme des carrés résiduelle regroupe sans distinction l’ensemble de la variabilité inexpliquée par les facteurs catégoriels. Dès lors que l’on introduit une covariable statistiquement corrélée au critère d’évaluation, l’ANCOVA partitionne cette erreur brute en deux fractions distinctes : la variance attribuable à la covariable via la droite de régression commune, et la véritable variance résiduelle non modélisable.
Cette soustraction mathématique entraîne une diminution substantielle du carré moyen de l’erreur, qui constitue le dénominateur de la statistique F. Dès lors, le signal expérimental émerge avec une netteté accrue hors du bruit de fond. Parallèlement, l’ANCOVA modifie profondément la nature même des grandeurs comparées. Alors que l’ANOVA se borne à juxtaposer les moyennes arithmétiques observées au sein des échantillons, l’ANCOVA calcule des moyennes marginales estimées, également qualifiées de moyennes ajustées par les moindres carrés. Ces estimations représentent les moyennes théoriques que chaque groupe aurait obtenues si tous les participants avaient partagé une valeur rigoureusement identique sur la covariable, correspondant conventionnellement à la moyenne générale de l’échantillon complet.
Le tableau comparatif suivant synthétise les propriétés fondamentales différenciant ces deux approches d’inférence statistique univariée :
- Structure des prédicteurs : L’ANOVA emploie exclusivement des facteurs discrets ou catégoriels, tandis que l’ANCOVA combine obligatoirement des variables catégorielles avec au moins une covariable quantitative continue.
- Dénominateur du test F : Dans l’ANOVA, il correspond au carré moyen résiduel total. Dans l’ANCOVA, il s’agit du carré moyen résiduel ajusté, réduit de la fraction de variance absorbée par la droite de régression linéaire de la covariable.
- Moyennes comparées : L’ANOVA effectue le test sur les moyennes observées brutes, potentiellement faussées par des écarts initiaux. L’ANCOVA teste l’égalité des moyennes marginales estimées, projetées sur le point moyen de la covariable.
- Degrés de liberté de l’erreur : L’ANOVA conserve N – k degrés de liberté résiduels (où N est la taille totale de l’échantillon et k le nombre de groupes). L’ANCOVA en concède un par covariable introduite, soit N – k – c (où c est le nombre de covariables).
2. Le concept de covariable en psychologie et sciences du comportement
2.1 Définition opérationnelle de la covariable
Sur le plan strictement opérationnel, une covariable se définit comme une variable quantitative continue ou métrique, mesurée à un niveau d’échelle d’intervalles ou de rapports, qui entretient une association statistique monotone et linéaire avec la variable dépendante d’intérêt. Contrairement aux facteurs manipulés activement par l’expérimentateur selon un plan factoriel préétabli, la covariable constitue une caractéristique concomitante observée, non soumise à une assignation expérimentale directe. Elle traduit une variabilité déjà présente chez le sujet ou inhérente au contexte expérimental au moment où débute le protocole d’observation.
Pour mériter le statut de covariable légitime dans un modèle d’analyse de covariance, cette mesure doit posséder un ancrage théorique et empirique solide. Il ne saurait s’agir d’une simple variable de commodité introduite au hasard dans les logiciels statistiques. Le chercheur doit pouvoir postuler, sur la base de la littérature scientifique existante, que cette dimension exerce une influence prédictive robuste sur la réponse comportementale, cognitive ou physiologique évaluée. La covariable capture ainsi un déterminant secondaire mais puissant du comportement étudié, agissant indépendamment ou conjointement avec les processus mobilisés par les conditions expérimentales.
Dans les paradigmes psychologiques standards, les exemples de covariables canoniques abondent : le quotient intellectuel mesuré par les matrices progressives de Raven lors de protocoles de résolution de problèmes complexes, l’âge chronologique exprimé en mois dans les études développementales, ou encore le score initial à l’inventaire d’anxiété état-trait de Spielberger préalablement à une tâche de stress aigu induit en laboratoire. Dans chacun de ces cas, la métrique concomitante offre une fenêtre de calibration permettant de standardiser a posteriori la variabilité interindividuelle.
2.2 Critères de sélection rigoureuse d’une covariable pertinente
L’introduction d’une covariable dans un devis statistique ne doit jamais relever d’un opportunisme méthodologique post-hoc, souvent assimilé à des pratiques contestables de manipulation des données pour atteindre le seuil fatidique de significativité. Une covariable doit faire l’objet d’une sélection rigoureuse, pré-enregistrée et justifiée en amont de toute collecte de données. Le premier critère opérationnel réside dans l’intensité de sa corrélation avec la variable dépendante : il est communément admis dans la littérature méthodologique qu’un coefficient de corrélation linéaire de Pearson r inférieur en valeur absolue à 0,30 apporte un bénéfice négligeable. En deçà de ce seuil, la réduction de la somme des carrés résiduelle ne compense pas la perte mécanique d’un degré de liberté au dénominateur, ce qui dégrade la puissance statistique globale au lieu de l’optimiser.
Le second critère fondamental concerne la fidélité psychométrique de l’instrument de mesure utilisé pour quantifier la covariable. Le modèle mathématique sous-jacent à l’ANCOVA classique suppose explicitement que la covariable est mesurée sans aucune erreur de mesure. Si l’instrument présente une faible consistance interne ou une instabilité temporelle marquée, le coefficient de régression linéaire sous-estimera systématiquement la véritable relation existant dans la population (phénomène d’atténuation de régression), conduisant à un ajustement biaisé et incomplet des moyennes de groupe.
Enfin, le troisième impératif méthodologique réside dans l’absence absolue de lien causal entre la covariable et le facteur de traitement. La covariable doit être totalement imperméable à l’intervention expérimentale, ce qui impose en pratique qu’elle soit évaluée chronologiquement en amont du déploiement des conditions expérimentales ou qu’elle mesure un trait invariant. L’intégration non réfléchie de variables recueillies après coup expose l’expérimentateur au risque majeur de neutraliser une part de la variance causée par le traitement lui-même, détruisant ainsi la validité interne de la recherche.
2.3 Typologie des covariables courantes en recherche clinique et cognitive
Les devis de recherche contemporains en neurosciences comportementales et en psychologie clinique mobilisent des catégories distinctes de covariables, chacune répondant à des finalités heuristiques spécifiques. La première classe, et sans conteste la plus répandue, regroupe les mesures de pré-test dans les protocoles longitudinaux ou quasi-expérimentaux à mesures répétées. Dans ce contexte, la variable dépendante post-test et la covariable pré-test constituent exactement la même mesure psychologique ou neuropsychologique, administrée à deux moments temporels distincts. Ce design pré-test/post-test confère à l’ANCOVA une puissance statistique optimale, la corrélation test-retest dépassant régulièrement des coefficients de 0,70 ou 0,80.
La deuxième catégorie englobe les variables démographiques continues fondamentales, telles que l’âge chronologique des participants, le nombre précis d’années de scolarisation formelle ou le niveau socio-économique indicé de manière métrique. Dans les études portant sur le vieillissement cognitif sain ou pathologique, par exemple, la vitesse de traitement de l’information et les performances mnésiques déclinent selon des trajectoires fortement conditionnées par l’âge ; neutraliser l’effet continu de l’âge permet ainsi d’évaluer la spécificité clinique d’une pathologie neurodégénérative naissante sans interférence de la sénescence biologique ordinaire.
La troisième typologie rassemble les traits dispositionnels et les dimensions de personnalité stables, souvent évalués via les modèles à cinq facteurs ou les échelles de tempérament. Enfin, une quatrième famille émerge puissamment avec les neurosciences contemporaines : les indices biologiques et physiologiques de base. La variabilité de la fréquence cardiaque au repos, le taux de cortisol salivaire matinal lors de la ligne de base ou la densité spectrale de puissance électroencéphalographique représentent des covariables d’une valeur inestimable pour contrôler le tonus neurovégétatif des participants avant une épreuve de réactivité émotionnelle.
3. Les objectifs statistiques et méthodologiques de l’ANCOVA
3.1 Réduction de la variance résiduelle non expliquée
L’objectif mathématique primaire de l’analyse de covariance réside dans l’extraction ciblée et méthodique de la variance résiduelle non expliquée. Dans toute analyse de variance classique, le dénominateur de la statistique F, à savoir le carré moyen de l’erreur, englobe indistinctement l’ensemble des sources de variation interindividuelle qui n’ont pas été explicitement modélisées par les facteurs du plan expérimental. Cette masse d’hétérogénéité agit comme un filtre opaque qui affaiblit le rapport signal sur bruit : plus la dispersion des individus au sein de chaque cellule du plan est forte, plus la valeur calculée du F sera faible, augmentant le risque de ne pas rejeter l’hypothèse nulle alors qu’un effet expérimental authentique existe bel et bien.
En introduisant une covariable substantiellement corrélée à la variable réponse, l’ANCOVA modélise formellement cette dépendance à travers une équation de régression. La part de variance que la covariable partage avec la variable dépendante est alors littéralement soustraite de la somme des carrés résiduelle. Cette purge statistique a pour conséquence mécanique immédiate d’abaisser drastiquement le carré moyen résiduel.
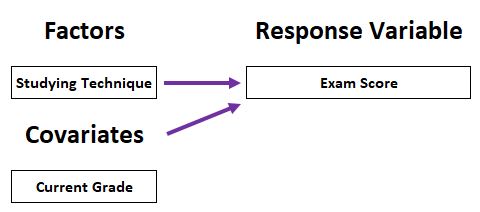
Le gain méthodologique qui en découle est directement proportionnel à la magnitude de la corrélation existant entre le critère et la covariable. Dès lors que cette association est substantielle, la réduction du terme d’erreur surpasse largement l’amputation marginale d’un degré de liberté résiduel consécutive à l’estimation de la pente de régression. Le signal expérimental émerge avec une acuité accrue, permettant de mettre en lumière des variations subtiles mais déterminantes induites par les conditions thérapeutiques ou comportementales testées.
3.2 Ajustement des moyennes de groupes et contrôle des biais
Le second objectif fondamental de l’ANCOVA, d’une portée méthodologique inestimable dans les recherches de terrain, concerne l’ajustement systématique des moyennes de groupe. Dans un protocole expérimental idéal, la randomisation pure garantit que les groupes constitués sont équivalents sur l’ensemble des variables parasites potentielles, tant mesurées que non mesurées. Cependant, dans les contextes réels de recherche clinique, scolaire, organisationnelle ou épidémiologique, l’attribution aléatoire parfaite des participants s’avère souvent irréalisable sur le plan éthique ou logistique, contraignant l’investigateur à recourir à des devis quasi-expérimentaux.
Même lorsque la randomisation a été formellement mise en œuvre, les échantillons de taille modeste présentent régulièrement des déséquilibres fortuits non négligeables au niveau de leurs lignes de base. Si, par un caprice du sort échantillonnal, les participants assignés au groupe recevant une thérapie innovante présentent un niveau initial d’anxiété ou de dépression plus sévère que ceux affectés au groupe témoin, la comparaison naïve des scores post-intervention par une simple ANOVA mènera à des conclusions profondément biaisées, voire totalement erronées.
L’ANCOVA résout élégamment cette distorsion en calculant des moyennes marginales estimées. En faisant glisser virtuellement chaque moyenne de groupe le long de la pente de régression commune jusqu’à la coordonnée correspondant à la moyenne générale de la covariable pour l’ensemble des participants, elle répond avec précision à la question contrefactuelle suivante : « Quels auraient été les scores moyens de chaque groupe si tous les individus avaient débuté l’expérimentation avec un niveau strictement identique sur la covariable ? » Ce réajustement statistique neutralise les avantages ou désavantages initiaux, rétablissant la comparabilité des conditions.
3.3 Optimisation de la puissance statistique
L’effet conjugué de la réduction du terme d’erreur et de l’ajustement structurel des moyennes concourt directement au rehaussement de la puissance statistique de l’analyse, définie comme la probabilité (1 – β) de rejeter avec raison une hypothèse nulle fausse. En abaissant le seuil de bruit résiduel au dénominateur du test de Fisher, l’ANCOVA provoque une augmentation mécanique de la valeur observée du F pour l’effet principal du traitement. Ce saut de précision autorise l’expérimentateur à détecter des tailles d’effet modérées, voire ténues, qui seraient restées totalement invisibles sous les radars d’une ANOVA conventionnelle manquant de sensibilité.
Cette optimisation présente des implications pragmatiques et éthiques de premier ordre, singulièrement dans les recherches biomédicales et psychologiques impliquant des populations cliniques rares ou vulnérables, telles que les patients atteints de démences précoces, d’autisme sévère ou de troubles psychiatriques réfractaires. Le recrutement de telles cohortes impose des coûts logistiques et temporels colossaux. En augmentant la puissance statistique sans modifier le design physique de l’étude, l’ANCOVA permet de réduire la taille d’échantillon minimale requise pour garantir un niveau d’adéquation statistique conventionnel de 80 %.
En limitant le nombre de sujets devant être exposés à des conditions contrôles inactives ou à des protocoles invasifs, l’ANCOVA s’aligne scrupuleusement sur les principes éthiques contemporains de la recherche scientifique. Elle réduit drastiquement le risque de commettre une erreur de type II, évitant ainsi l’abandon prématuré de thérapies prometteuses qui auraient été injustement recalées en raison d’une analyse statistique trop peu sensible aux variations interindividuelles initiales.
4. Les postulats fondamentaux de l’ANCOVA
4.1 Postulats standards hérités du modèle linéaire général
En tant qu’extension directe du modèle linéaire général, l’ANCOVA hérite de la totalité des hypothèses de distribution qui conditionnent la validité asymptotique de la régression linéaire et de l’analyse de variance classique. Le premier postulat incontournable stipule que les résidus du modèle doivent suivre une loi normale au sein de chaque niveau de la variable factorielle. Ce ne sont nullement les distributions brutes de la variable dépendante ou de la covariable qui doivent faire preuve de normalité, mais spécifiquement les écarts individuels par rapport au modèle ajusté global. Les violations substantielles de ce postulat peuvent déformer les valeurs de p calculées, bien que le test F conserve une robustesse remarquable face aux déviations modérées dès lors que les effectifs par cellule sont équilibrés et suffisamment volumineux.
Le deuxième postulat réside dans l’homoscédasticité, désignant l’homogénéité stricte des variances conditionnelles résiduelles à travers tous les niveaux du facteur expérimental. La dispersion des points autour de la droite de régression ne doit présenter aucune hétérogénéité systématique d’un groupe à un autre. Le troisième réquisit, absolu et non négociable, est celui de l’indépendance mutuelle des observations et des termes d’erreur stochastiques. Tout phénomène de dépendance contextuelle, qu’il résulte d’un regroupement des individus au sein d’unités écologiques partagées (telles que des salles de classe, des services hospitaliers ou des fratries) ou d’une répétition temporelle séquentielle, pulvérise le calcul des degrés de liberté et gonfle artificiellement le taux d’erreur de type I.
Enfin, le modèle postule une linéarité sans équivoque de la relation fonctionnelle reliant la variable dépendante à la covariable au sein de chaque groupe. Si l’influence de la covariable adopte une cinétique curvilinéaire (quadratique, cubique ou exponentielle), l’ajustement par une droite de régression standard s’avérera déficient, laissant une fraction substantielle de variance non modélisée dans l’erreur résiduelle et produisant un réalignement défaillant des moyennes marginales.
4.2 L’homogénéité des pentes de régression : le postulat central
Au-delà des exigences communes au modèle linéaire général, l’analyse de covariance repose sur un postulat distinctif et fondamental qui conditionne toute son architecture d’inférence : l’homogénéité des pentes de régression, couramment conceptualisée comme l’hypothèse de parallélisme strict des droites d’ajustement. Sur le plan mathématique, cette condition exige que le coefficient directeur de la droite de régression modélisant la variable dépendante sur la covariable soit rigoureusement identique dans chacun des sous-groupes expérimentaux. Autrement formulé, l’effet propre de la covariable sur le critère d’évaluation ne doit subir aucune modulation sous l’action du traitement expérimental.
Dans l’équation du modèle, ce postulat se traduit par l’absence impérative de terme d’interaction statistique significatif entre le facteur de groupe catégoriel et la covariable continue. Si les droites de régression ne sont pas rigoureusement parallèles, l’hypothèse d’une pente globale commune s’effondre. Dès lors, le calcul d’un ajustement moyen unique perd toute signification mathématique et conceptuelle. Lorsque les pentes divergent de façon statistiquement robuste, l’écart spatial existant entre les différents groupes varie continuellement en fonction des valeurs assignées à la covariable.
Sur le plan de l’interprétation clinique ou théorique, une rupture d’homogénéité des pentes ne constitue pas un simple désagrément statistique, mais révèle une découverte substantielle : le traitement administré ne produit pas un effet universel uniforme, mais interagit avec le profil de départ du sujet. L’impact de la thérapie dépend intrinsèquement de la valeur initiale présentée par l’individu sur la covariable. Dans une telle conjoncture, appliquer une ANCOVA conventionnelle masquerait cette dynamique d’interaction essentielle et conduirait à des conclusions fallacieuses concernant l’efficacité thérapeutique globale.
4.3 Indépendance de la covariable et du facteur expérimental
L’un des postulats méthodologiques les plus cruciaux et les plus fréquemment méconnus de l’ANCOVA concerne l’indépendance stricte qui doit prévaloir entre la variable concomitante et les niveaux du facteur expérimental manipulé. Ce réquisit théorique implique formellement que l’attribution d’un individu à un groupe particulier ne doit en aucun cas modifier, altérer ou prédire la valeur prise par la covariable. Si les groupes présentent des différences systématiques substantielles sur la covariable avant tout réajustement statistique, le modèle se retrouve confronté à un phénomène d’interférence conceptuelle majeure.
Ce postulat impose une directive temporelle et procédurale absolue quant au calendrier du recueil des données : la covariable doit impérativement être mesurée antérieurement à l’application de toute manipulation expérimentale, ou porter sur un trait temporellement invariant. Si la mesure de la covariable est effectuée de manière concomitante ou consécutive à l’intervention, il devient hautement probable que l’intervention elle-même ait contaminé ou modifié le score de cette variable de contrôle.
Lorsque cette contamination survient, l’introduction de la covariable dans l’équation a pour effet délétère d’absorber et de neutraliser une part substantielle de la variance causale directement induite par le traitement expérimental. Au lieu d’isoler l’effet du traitement, l’ANCOVA le vide artificiellement de sa substance empirique, augmentant le risque d’aboutir à un résultat faussement non significatif. L’expérimentateur en viendrait ainsi à jeter le bébé avec l’eau du bain statistique, en éliminant précisément l’effet clinique ou pédagogique qu’il cherchait à démontrer.
4.4 Fiabilité de la mesure de la covariable
La théorie mathématique qui soutient l’ANCOVA classique postule formellement que la covariable est observée sans aucune erreur de mesure instrumentale, une supposition qui s’avère héroïque et perpétuellement démentie dans les sciences psychologiques et sociales. La réalité de la mesure psychométrique est que toute métrique humaine – qu’il s’agisse d’un score d’anxiété, d’une évaluation d’extraversion ou d’une performance en mémoire à court terme – comprend inévitablement une composante de score vrai et une composante d’erreur aléatoire de mesure.
Lorsqu’une variable entachée d’erreur de mesure est intégrée comme covariable dans un modèle de régression, son coefficient de pente effectif se trouve systématiquement biaisé vers zéro, un artéfact méthodologique bien documenté sous le vocable d’atténuation de régression. Dans le cadre de l’ANCOVA, cette sous-estimation de la pente a pour conséquence directe une purge incomplète de la variance résiduelle, laissant une fraction substantielle de bruit d’erreur intacte au sein du dénominateur du test F. Plus alarmant encore : dans les protocoles quasi-expérimentaux où les groupes présentent des moyennes de départ inégales sur la covariable, cette atténuation empêche un réalignement rigoureux des moyennes marginales estimées, induisant un biais systématique résiduel qui gonfle substantiellement le taux d’erreur de type I.
Pour prémunir le modèle contre ce phénomène délétère, les chercheurs doivent faire preuve d’une exigence psychométrique absolue lors de la sélection de leurs outils de mesure. Il est impératif de n’adopter que des instruments validés démontrant des coefficients de consistance interne élevés, tels qu’un coefficient alpha de Cronbach ou un oméga de McDonald excédant rigoureusement le seuil de 0,80, voire 0,85. Si la fiabilité de la covariable s’avère médiocre, les estimations issues de l’ANCOVA deviennent structurellement suspectes, justifiant le recours à des approches plus avancées issues de la modélisation par équations structurelles.
5. Diagnostic et vérification pratique des postulats
5.1 Évaluation formelle de l’homogénéité des pentes
L’évaluation rigoureuse de l’homogénéité des pentes de régression ne doit jamais être présumée sur la foi d’arguments théoriques invérifiés ; elle requiert une procédure diagnostique formelle en amont de l’ajustement du modèle définitif de l’ANCOVA. Cette vérification s’opère par la spécification d’un modèle linéaire univarié préparatoire incluant explicitement le terme de produit croisé, matérialisant l’interaction factorielle entre le facteur indépendant catégoriel et la covariable continue (Groupe × Covariable). Ce modèle préliminaire capture la possibilité que l’inclinaison des droites d’ajustement diffère d’un sous-groupe à l’autre.
La statistique décisionnelle repose sur l’examen minutieux de la valeur de p associée au test F de ce terme d’interaction. Si cette probabilité s’avère statistiquement non significative (traditionnellement au seuil d’arbitrage p > 0,05, ou mieux encore p > 0,10, afin d’adopter une posture de précaution conservatrice face à un test manquant parfois de puissance), l’hypothèse nulle de parallélisme strict n’est pas rejetée. L’analyste est alors méthodologiquement fondé à supprimer ce terme d’interaction et à estimer le modèle ANCOVA définitif, caractérisé par une pente moyenne unique commune à l’ensemble des cellules.
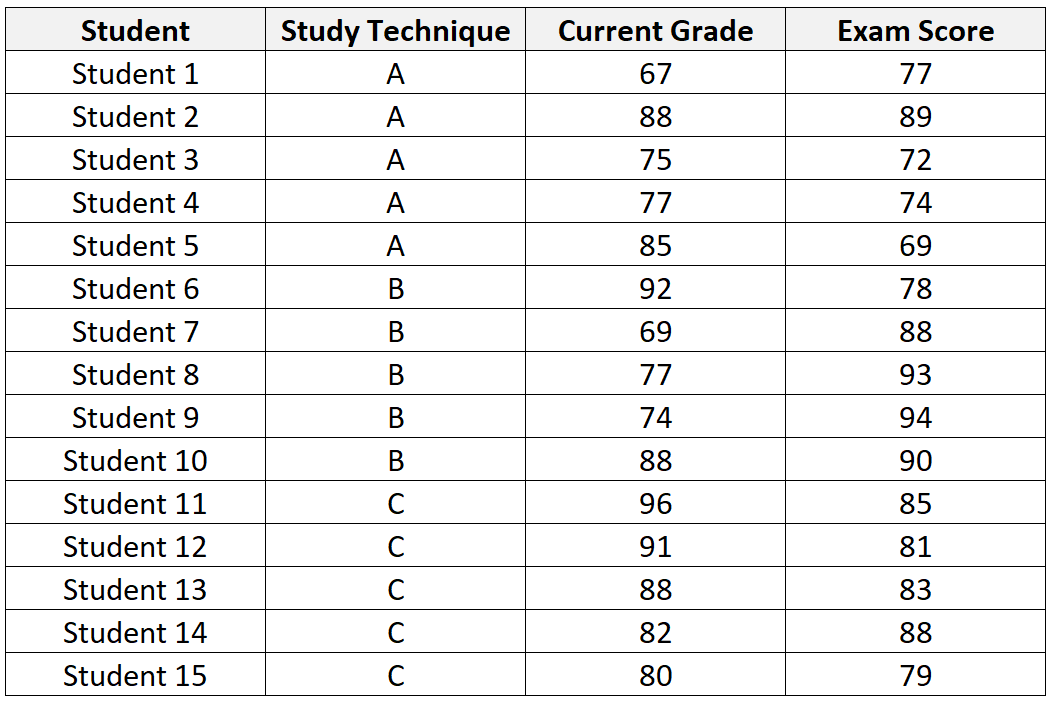
Ce contrôle statistique analytique doit impérativement s’accompagner d’une inspection graphique intuitive au moyen d’un nuage de points où sont tracées simultanément les différentes droites d’ajustement linéaire calculées spécifiquement au sein de chaque groupe expérimental. Si les droites se superposent visuellement selon des trajectoires rigoureusement parallèles, la conformité du modèle est empiriquement corroborée. À l’inverse, si les trajectoires linéaires se croisent de manière flagrante ou manifestent des divergences angulaires marquées confirmées par une interaction significative (p ≤ 0,05), l’ANCOVA standard est formellement invalidée et doit être abandonnée au profit d’approches méthodologiques alternatives adaptées.
5.2 Diagnostics graphiques et tests de distribution
La validation globale du modèle linéaire général requiert le déploiement d’une batterie complète de diagnostics portant sur les résidus studentisés ou standardisés, extraits après estimation des paramètres. L’exploration de la normalité distributionnelle s’effectue préférentiellement via la construction d’un graphique quantile-quantile (Q-Q plot), confrontant les quantiles empiriques des résidus aux quantiles théoriques attendus sous l’hypothèse d’une loi normale univariée. L’alignement étroit des points d’observation le long de la diagonale de référence témoigne de la préservation de la normalité, tandis que des courbures systématiques ou des écartements notables aux extrémités signalent des distributions asymétriques ou leptokurtiques nécessitant une vigilance accrue.
Pour vérifier l’hypothèse d’homoscédasticité, le chercheur génère un diagramme de dispersion confrontant les résidus studentisés en ordonnée aux valeurs prédites par le modèle en abscisse. Une distribution équilibrée des résidus formant une bande horizontale de largeur constante et symétrique de part et d’autre de la ligne d’origine zéro atteste de la parfaite stabilité de la variance d’erreur. À l’inverse, l’apparition d’un motif en entonnoir (ou mégaphone) met en évidence une hétéroscédasticité manifeste, traduisant une augmentation ou une diminution de la variance résiduelle à mesure que les scores prédits s’élèvent.
Bien que des tests inférentiels formels existent – tels que le test de Levene pour l’égalité des variances ou le test de Breusch-Pagan pour l’hétéroscédasticité continue –, leur usage exclusif demeure controversé en raison de leur extrême sensibilité aux effectifs massifs (qui conduit à rejeter l’hypothèse nulle pour des déviations sans conséquence pratique) et de leur manque de puissance dans les cohortes réduites. Enfin, l’identification impérative des données aberrantes, des valeurs à fort effet de levier (leverage) et des points excessivement influents repose sur le calcul de la distance de Cook. Toute observation affichant une distance de Cook excédant la valeur seuil de 1 (ou le seuil relatif 4/N) doit faire l’objet d’un examen approfondi pour vérifier d’éventuelles erreurs de saisie ou des profils cliniques aberrants.
5.3 Mesures correctives en cas de non-respect des hypothèses
Lorsque les procédures diagnostiques révèlent des violations substantielles des postulats sous-jacents, l’analyste ne doit en aucun cas forcer l’interprétation d’une ANCOVA classique standard. Diverses voies de remédiation méthodologique existent. En présence d’une asymétrie marquée des résidus ou d’une hétéroscédasticité modérée, la première réponse technique consiste à appliquer des transformations mathématiques non linéaires sur la variable dépendante ou sur la covariable. L’application d’une fonction logarithmique (adaptée aux distributions étirées vers la droite), de la racine carrée (appropriée pour les données de comptage) ou d’une transformation de Box-Cox automatisée permet fréquemment de restaurer la normalité distributionnelle et de linéariser des dynamiques bivariées curvilinéaires.
Si la violation majeure concerne l’hypothèse centrale de parallélisme des pentes de régression (interaction Groupe × Covariable avérée), la démarche d’excellence réside dans l’adoption de la technique de Johnson-Neyman. Dépassant l’impasse d’un coefficient unique, cette modélisation continue des effets conditionnels permet de cartographier avec exactitude les régions précises de la covariable au sein desquelles les différences entre les groupes atteignent ou perdent leur significativité statistique. Cette approche transforme une contrainte méthodologique invalidante en une découverte clinique majeure, identifiant pour quel niveau précis de la variable initiale un traitement commence à surclasser ses compétiteurs.
En présence d’une hétéroscédasticité sévère et incurable, le recours à des estimateurs de variance robustes (tels que les matrices de covariance asymptotiques de White ou de Huber-White dites sandwich, désignées par HC3 ou HC4) garantit des erreurs types non biaisées et préserve l’exactitude des tests inférentiels. Enfin, si l’absence d’indépendance des observations est documentée – par exemple si des patients sont regroupés au sein de multiples centres de consultation thérapeutique –, l’analyste doit impérativement s’orienter vers les modèles linéaires mixtes ou hiérarchiques, capables d’incorporer des effets aléatoires de site tout en ajustant pour la covariable continue.
6. Le modèle mathématique sous-jacent à l’ANCOVA
6.1 Équation générale du modèle linéaire
L’architecture formelle de l’analyse de covariance univariée à un facteur s’articule comme une spécification particulière du modèle linéaire général. Dans le cadre d’un devis comprenant k groupes expérimentaux indépendants et une unique covariable quantitative continue, l’observation individuelle Yij, correspondant au score obtenu sur la variable dépendante par le j-ième participant (avec j = 1, …, ni) appartenant au i-ième groupe de traitement (avec i = 1, …, k), est formellement décomposée selon l’équation stochastique suivante :
Yij = μ + αi + β(Xij – X̄..) + εij
Dans cette formulation paramétrique rigoureuse, les différents termes constitutifs du modèle revêtent une signification statistique et géométrique univoque :
- μ : représente la moyenne générale non pondérée de la variable dépendante projetée au point où la covariable est égale à sa propre moyenne d’échantillonnage globale.
- αi : traduit l’effet différentiel fixe propre au i-ième niveau de la variable indépendante factorielle, soumis à la contrainte standard d’identifiabilité Σαi = 0 (codage d’effets).
- β : désigne le coefficient de régression linéaire univarié commun, représentant la pente unique qui relie la variable dépendante à la covariable au sein de l’ensemble de la population échantillonnée. Il mesure l’accroissement espéré de Y consécutif à une élévation unitaire de la covariable X.
- (Xij – X̄..) : matérialise l’expression centrée de la covariable individuelle par rapport à la moyenne arithmétique globale de l’échantillon complet. Ce centrage confère aux paramètres μ et αi une interprétabilité immédiate et directement évaluable au point moyen de référence.
- εij : symbolise le terme d’erreur stochastique résiduelle propre à chaque individu, postulé comme étant indépendant et identiquement distribué selon une loi normale d’espérance nulle et de variance scalaire constante, soit formellement εij ~ N(0, σ2).
6.2 Décomposition des sommes de carrés ajustées
L’estimation des paramètres de l’ANCOVA repose sur le principe fondamental des moindres carrés ordinaires, mais sa logique de partitionnement de la variance diffère substantiellement de celle de l’ANOVA en raison de l’introduction de l’espace vectoriel engendré par la covariable. Dans une ANOVA classique, la décomposition fondamentale s’énonce selon la relation vectorielle orthogonale : SSTotale = SSGroupes + SSRésiduelle. Dans le formalisme matriciel de l’ANCOVA, la covariance existant entre le critère et la variable de contrôle impose de passer par des sommes de carrés ajustées, couramment désignées comme des sommes de carrés de Type III dans la littérature contemporaine.
La somme des carrés totale ajustée est d’abord corrigée de la composante linéaire directe imputable à la covariable :
SSRésiduelle(Ajustée) = SSRésiduelle(Brute) – [ (SPRésiduelle(XY))2 / SSRésiduelle(X) ]
où SPRésiduelle(XY) représente la somme des produits croisés résiduels entre X et Y, et SSRésiduelle(X) la somme des carrés résiduelle calculée exclusivement sur la covariable. Cette formule matérialise explicitement le retranchement direct de la variance prévisible à partir de la covariable. Parallèlement, la somme des carrés du traitement est elle-même réajustée pour tenir compte de la corrélation éventuelle préexistante entre le facteur de groupe et la covariable :
SSTraitement(Ajustée) = SSTotal(Modèle) – SSModèle(Covariable Seule)
Le calcul du carré moyen résiduel ajusté nécessite d’amputer le nombre de degrés de liberté disponible d’une unité supplémentaire pour chaque covariable intégrée au modèle. Dès lors, le degré de liberté de l’erreur devient dferreur = N – k – 1. Le ratio F de Snedecor évaluant l’effet principal du facteur expérimental après purge statistique s’établit dès lors sous la forme classique :
FAjusté = [ SSTraitement(Ajustée) / (k – 1) ] / [ SSRésiduelle(Ajustée) / (N – k – 1) ]
6.3 Formulation des moyennes marginales estimées
L’une des contributions majeures du formalisme mathématique de l’ANCOVA réside dans la dérivation analytique des moyennes marginales estimées (parfois dénommées moyennes ajustées par les moindres carrés ou lsmeans). Ces valeurs représentent les espérances conditionnelles prévues pour chaque groupe sous la contrainte mathématique que la covariable prenne une valeur égale à la moyenne arithmétique globale de l’échantillon complet, désignée par X̄... L’équation de calcul de la moyenne marginale ajustée du i-ième groupe (notée Ȳi(ajustée)) s’exprime analytiquement comme suit :
Ȳi(ajustée) = Ȳi – b(X̄i – X̄..)
où Ȳi est la moyenne empirique brute observée au sein du groupe i, X̄i représente la moyenne observée de la covariable au sein de ce même groupe i, et b symbolise l’estimateur de la pente de régression intra-groupe commune obtenu par la méthode des moindres carrés ordinaires. D’un point de vue géométrique, cette formule déplace la moyenne observée de chaque cellule le long de la ligne de régression directionnelle sur une distance proportionnelle à l’écart qui séparait initialement ce groupe de la moyenne générale.
Ce redressement affecte corolairement l’erreur standard associée à chaque moyenne ajustée, qui n’est plus simplement dépendante de la taille interne du groupe et de la variance de l’erreur, mais incorpore la distance entre le centre du groupe et la moyenne globale de la covariable. L’erreur type de la moyenne ajustée pour le groupe i se formalise ainsi :
SE(Ȳi(ajustée)) = √ [ MSRésiduelle(Ajustée) × ( (1 / ni) + ( (X̄i – X̄..)2 / SSRésiduelle(X) ) ) ]
Cette formulation révèle avec acuité que plus un groupe s’écartait initialement de la moyenne générale sur la covariable, plus l’incertitude statistique entourant sa moyenne ajustée s’accroît, ce qui se traduit par des intervalles de confiance à 95 % élargis.
7. Protocole appliqué en psychologie : Exemple détaillé pas à pas
7.1 Scénario clinique : Évaluation d’interventions thérapeutiques sur l’anxiété
Afin de concrétiser de façon didactique et rigoureuse le déroulement séquentiel d’une analyse de covariance, examinons un protocole d’évaluation clinique standardisé en psychothérapie. Une équipe de psychologues hospitaliers cherche à comparer l’efficacité de trois approches d’intervention distinctes pour la prise en charge du trouble d’anxiété généralisée : une Thérapie Cognitive et Comportementale structurée (TCC, n = 30), un protocole basé sur la Réduction du Stress basée sur la Pleine Conscience (Mindfulness/MBSR, n = 30), et une condition témoin avec Liste d’Attente recevant un suivi médical standard (Témoin, n = 30), formant un échantillon total de N = 90 participants adultes.
Le critère d’évaluation primaire (la variable dépendante métrique, Y) est mesuré à l’issue de 8 semaines de traitement au moyen du score obtenu à l’échelle d’anxiété état-trait de Spielberger (STAI-Forme Y2), dont les scores peuvent s’échelonner théoriquement de 20 à 80, une valeur élevée traduisant une symptomatologie anxieuse sévère. Connaissant l’hétérogénéité marquée de l’anxiété clinique à l’admission, les investigateurs ont systématiquement recueilli le score à cette même échelle STAI-Y2 lors de l’inclusion initiale des participants, préalablement à toute intervention thérapeutique. Ce score initial constitue la covariable continue de base (X).
L’enjeu méthodologique fondamental de cette expérimentation réside dans la détermination rigoureuse de la supériorité d’une ou plusieurs des modalités thérapeutiques actives, en purgeant les résultats finaux de la variabilité liée à l’anxiété de départ des sujets et en neutralisant les éventuels déséquilibres fortuits apparus lors de l’assignation initiale des patients au sein des trois protocoles.
7.2 Statistiques descriptives et exploration des relations bivariées
L’inspection analytique préliminaire des données brutes colligées met en lumière des configurations descriptives révélatrices des limites inhérentes à l’échantillonnage aléatoire en milieu clinique. Les moyennes observées non ajustées du score d’anxiété post-thérapie révèlent un score de ȲTCC = 43,20 (SD = 8,90), de ȲMBSR = 46,10 (SD = 9,15) et de ȲTémoin = 49,80 (SD = 9,05). À première vue, la TCC semble induire une réduction plus substantielle du score anxieux que le MBSR et la liste d’attente.
Cependant, l’examen scrupuleux des scores initiaux mesurés sur la covariable lors de la ligne de base révèle un déséquilibre notable : le groupe affecté à la TCC affichait déjà une moyenne de base plus faible (X̄TCC = 48,10, SD = 8,10) comparativement au groupe MBSR (X̄MBSR = 52,40, SD = 7,90) et au groupe Témoin (X̄Témoin = 54,60, SD = 8,30), la moyenne générale de la cohorte totale s’établissant à X̄.. = 51,70. L’avantage apparent de la TCC en fin d’étude ne traduisait-il donc pas simplement le fait que ses participants étaient initialement moins anxieux dès le départ ?
Le calcul de la matrice de corrélation linéaire de Pearson entre la covariable pré-test et la variable dépendante post-test confirme une relation positive d’une intensité majeure : r = 0,72 (p < 0,001). Cette très forte corrélation indique que plus de 51 % (r2 = 0,518) de la variance des scores finaux est strictement prédictible à partir de l’état initial des participants. La construction d’un diagramme de dispersion confirme la linéarité parfaite de cette association à travers l’ensemble des trois cohortes thérapeutiques, légitimant pleinement l’utilisation de l’anxiété basale en tant que covariable privilégiée.
7.3 Comparaison directe : Résultats ANOVA versus résultats ANCOVA
Pour appréhender concrètement la supériorité de l’ajustement méthodologique, exécutons d’abord une ANOVA univariée standard à un facteur sur les scores post-thérapeutiques sans tenir compte de la ligne de base. Les sommes de carrés obtenues s’établissent comme suit : SSGroupes = 661,40 avec 2 degrés de liberté (MS = 330,70), tandis que la variance d’erreur résiduelle absorbe une somme de carrés immense : SSRésiduelle = 7125,30 avec 87 degrés de liberté (MS = 81,90). Le ratio F résultant s’élève à F(2, 87) = 330,70 / 81,90 = 4,04, associé à une valeur de probabilité p = 0,021 et un êta-carré η2 = 0,085. L’effet omnibus apparaît modérément significatif, mais l’imposante masse d’erreur résiduelle limite l’interprétation des contrastes fins.
Procédons à présent à l’ajustement du modèle ANCOVA en intégrant la covariable pré-test. La pente de régression intra-groupe commune estimée s’établit à b = 0,784. L’incorporation de la covariable opère une transformation radicale : la somme des carrés résiduelle s’effondre de 7125,30 à seulement SSRésiduelle(Ajustée) = 3432,20, pour 86 degrés de liberté, faisant chuter le carré moyen d’erreur de 81,90 à MSRésiduelle(Ajustée) = 39,91. Le bruit non expliqué a ainsi été réduit de plus de 51 %.
Simultanément, les moyennes de groupe sont recalculées pour être projetées au niveau de la moyenne de base commune (51,70). La moyenne marginale estimée de la TCC s’élève désormais à Ȳajustée(TCC) = 43,20 – 0,784(48,10 – 51,70) = 46,02. Pour le groupe MBSR, elle s’établit à Ȳajustée(MBSR) = 46,10 – 0,784(52,40 – 51,70) = 45,55. Pour le groupe Témoin, elle atteint Ȳajustée(Témoin) = 49,80 – 0,784(54,60 – 51,70) = 47,53. L’écart entre les deux thérapies actives s’est presque totalement estompé après neutralisation du niveau initial. La statistique F ajustée pour l’effet du traitement ressort désormais à F(2, 86) = 7,62 avec p < 0,001 et un êta-carré partiel η2p = 0,151. Le signal statistique a gagné en clarté, éliminant l’illusion d’une supériorité artificielle de la TCC sur la Pleine Conscience.
8. Implémentation pratique dans les logiciels statistiques académiques
8.1 Mise en œuvre sous le langage de programmation R
L’écosystème open-source R constitue sans conteste l’un des environnements les plus rigoureux et flexibles pour modéliser des analyses de covariance conformes aux plus hauts standards de publication internationale. La mise en œuvre ne saurait se limiter à la fonction générique aov(), dont les sommes de carrés séquentielles de Type I peuvent fausser gravement les tests d’effets principaux en présence de plans déséquilibrés. Il convient de mobiliser conjointement le paquetage car pour le calcul des sommes de carrés de Type III et le paquetage emmeans pour l’extraction exhaustive des moyennes marginales estimées.
Le protocole scriptural s’articule impérativement en deux phases distinctes. En premier lieu, la validation de l’homogénéité des pentes requiert la modélisation formelle de l’interaction à l’aide de la syntaxe suivante :
modele_pentes <- lm(STAI_Post ~ Groupe * STAI_Pre, data = donnees_anxiete)
Anova(modele_pentes, type = "III")
Si la ligne affichant l’interaction Groupe:STAI_Pre confirme l’absence de significativité statistique (p > 0,05), le statisticien peut en toute sécurité paramétrer le modèle ANCOVA définitif sans interaction, en veillant scrupuleusement à spécifier des contrastes orthogonaux sum-to-zero (par exemple via contrasts(donnees$Groupe) <- contr.sum) :
modele_ancova <- lm(STAI_Post ~ STAI_Pre + Groupe, data = donnees_anxiete)
Anova(modele_ancova, type = "III")
moyennes_ajustees <- emmeans(modele_ancova, ~ Groupe)
pairs(moyennes_ajustees, adjust = "bonferroni")
Cette séquence de commandes génère une table d’analyse de variance ajustée irréprochable et réalise les comparaisons par paires sur les moyennes estimées au point moyen de la covariable en appliquant un contrôle strict du risque d’erreur par famille.
8.2 Déroulement pas à pas sous IBM SPSS Statistics
Au sein du logiciel commercial IBM SPSS Statistics, référence historique dans les facultés de psychologie et de sciences humaines, la conduite d’une analyse de covariance s’opère au travers du module du Modèle Linéaire Général. L’utilisateur navigue à travers l’arborescence : Analyser > Modèle linéaire général > Uvarié. Dans l’interface principale, la variable réponse post-test est assignée au champ « Variable dépendante », le facteur expérimental catégoriel est transféré dans l’encadré « Facteurs fixes », tandis que la variable continue de contrôle est glissée dans le compartiment intitulé « Covariable(s) ».
Avant d’extraire la table définitive, une étape procédurale impérative consiste à cliquer sur le bouton Modèle, basculer vers l’option « Personnalisé », et insérer manuellement les effets principaux de la variable factorielle, de la covariable, ainsi que leur produit croisé d’interaction. Après validation et exécution, l’examen de la table de sortie doit attester du caractère non significatif du F de l’interaction. Cette validation accomplie, l’analyste réintègre l’interface, rétablit le modèle factoriel par défaut (effets principaux sans interaction) et clique sur le sous-menu Options.
Dans ce volet secondaire, il est indispensable de transférer le facteur de groupe dans la fenêtre « Afficher les moyennes pour » afin de forcer SPSS à calculer les moyennes marginales estimées (EM Means), plutôt que d’afficher les moyennes descriptives brutes. L’utilisateur veille à cocher les cases « Comparer les effets principaux » (en sélectionnant l’ajustement des intervalles de confiance selon Bonferroni ou Sidak), « Estimations de la taille de l’effet » pour extraire systématiquement les êta-carrés partiels, ainsi que « Tests d’homogénéité » pour obtenir le test de Levene des égalités de variance d’erreur.
8.3 Analyse intuitive sous JASP et Jamovi
L’essor contemporain de suites statistiques libres basées sur des interfaces graphiques intuitives connectées au moteur computationnel de R, à l’instar de JASP (développé par l’Université d’Amsterdam) et de Jamovi, a révolutionné la pratique de l’inférence statistique dans les laboratoires académiques. Ces logiciels permettent de s’affranchir des lignes de commande complexes tout en garantissant une rigueur méthodologique absolue et une reproductibilité totale des analyses.
Sous JASP comme sous Jamovi, la modélisation de l’ANCOVA s’effectue au sein du module unifié « ANOVA » en sélectionnant la commande spécifique « ANCOVA ». L’utilisateur fait glisser par simple glisser-déposer ses variables dans leurs cadres respectifs : la variable dépendante, les facteurs fixes catégoriels et les covariables continues. Immédiatement, une table de résultats formatée selon les standards typographiques stricts de l’American Psychological Association (APA) est générée dynamiquement sur le panneau latéral droit.
Ces logiciels intègrent des sous-menus dédiés d’une ergonomie exemplaire. L’onglet « Assumption Checks » permet de générer simultanément le test de Levene, le test de normalité de Shapiro-Wilk appliqué sur les résidus et le tracé direct du Q-Q plot diagnostique. L’onglet « Model » offre la flexibilité nécessaire pour spécifier l’inclusion de l’interaction Groupe × Covariable afin d’en vérifier la significativité avant de basculer vers le modèle d’ajustement sans interaction. Enfin, la section « Marginal Means » (ou Moyennes Estimées) propose non seulement le calcul instantané des valeurs marginales avec leurs intervalles de confiance à 95 %, mais également leur représentation visuelle sous forme de graphiques d’une netteté immédiatement publiable.
9. Interprétation et communication des résultats selon les normes APA
9.1 Décodage complet du tableau de sortie de l’ANCOVA
Le tableau d’analyse de variance délivré par les logiciels statistiques académiques constitue la synthèse numérique formelle des tests d’hypothèses conduits. Sa lecture analytique requiert une méthode rigoureuse consistant à examiner successivement chaque ligne d’effet pour en décoder la portée théorique. La première ligne d’intérêt correspond généralement à la covariable elle-même. La statistique F et la valeur de probabilité associée (p) testent l’hypothèse nulle selon laquelle le coefficient de pente intra-groupe commun β est égal à zéro. Un test statistiquement hautement significatif pour la covariable (par exemple p < 0,001) démontre que la variable de contrôle est substantiellement liée au critère d’évaluation, confirmant la pertinence de son inclusion et son rôle déterminant dans la purge de l’erreur résiduelle.
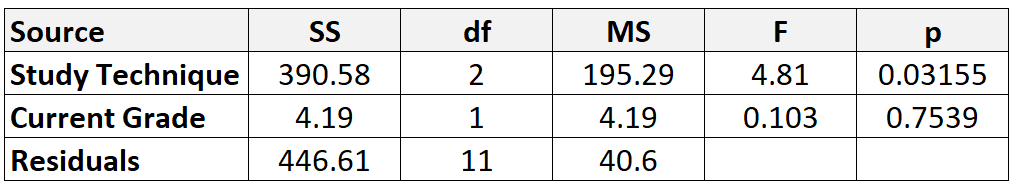
La ligne subséquente détaille l’effet principal du facteur expérimental catégoriel. La statistique F calculée sur cette ligne évalue l’égalité des moyennes marginales estimées à travers les différents groupes après que l’impact de la covariable a été totalement neutralisé. Si cette valeur de p franchit le seuil critique α = 0,05, l’expérimentateur rejette légitimement l’hypothèse nulle d’égalité des traitements. L’analyse des degrés de liberté attachés au test s’avère tout aussi capitale : le premier chiffre reflète le nombre de groupes moins un (k – 1), tandis que le second matérialise les degrés de liberté résiduels réajustés (N – k – c).
Il importe toutefois de maintenir une distinction fondamentale entre cet effet omnibus global et les divergences ponctuelles inter-groupes. Un test omnibus statistiquement significatif indique seulement qu’au moins une paire de moyennes marginales estimées diffère de façon statistiquement robuste au sein de la population. Il ne permet nullement d’affirmer de facto que toutes les conditions se distinguent mutuellement, rendant indispensable le recours subséquent à des contrastes planifiés ou à des procédures d’analyse post-hoc adaptées.
9.2 Quantification de la taille de l’effet : L’êta-carré partiel
La simple attestation d’une significativité statistique matérialisée par une valeur de p inférieure au seuil conventionnel de 0,05 ne renseigne en rien sur la magnitude clinique ou théorique de l’effet observé. Dans le cadre de l’ANCOVA, l’indice d’estimation d’amplitude standardisé universellement plébiscité par les comités éditoriaux est l’êta-carré partiel (η2p). Sur le plan mathématique, cet indice exprime la proportion de la variance de la variable dépendante spécifiquement expliquée par le facteur d’intérêt, après que l’effet linéaire de la covariable a été intégralement extrait du dénominateur d’erreur :
η2p = SSEffet / [ SSEffet + SSErreur ]
Cette métrique se distingue fondamentalement de l’êta-carré classique (η2 simple), dont le dénominateur incorpore la somme des carrés totale non purgée, ce qui tend à sous-estimer artificiellement la force d’impact des manipulations au sein de modèles factoriels complexes ou enrichis de covariables. Néanmoins, l’analyste averti doit garder à l’esprit que l’êta-carré partiel souffre d’un biais d’échantillonnage positif systématique, surestimant légèrement la taille d’effet réelle dans les petits échantillons. Dans une optique de robustesse maximale, certains méthodologistes recommandent le calcul complémentaire de l’oméga-carré partiel (ω2p), qui corrige formellement ce biais en incorporant le carré moyen résiduel dans son équation.
Concernant les seuils conventionnels d’interprétation empirique en sciences psychologiques, les repères canoniques formulés par Jacob Cohen demeurent la référence dominante : une valeur d’η2p oscillant autour de 0,01 traduit une taille d’effet modeste ou ténue ; un score atteignant 0,06 signale un effet d’ampleur moyenne ; enfin, toute valeur franchissant le cap de 0,14 caractérise un effet expérimental d’une ampleur considérable. Le rapport systématique de ces indicateurs constitue désormais un prérequis déontologique absolu pour prévenir les écueils de surinterprétation liés au p-hacking.
9.3 Rédaction académique formalisée au format APA 7e édition
La communication scientifique des résultats issus d’une ANCOVA doit se conformer de manière rigoureuse aux directives de l’American Psychological Association (APA, 7e édition). La restitution textuelle doit obligatoirement expliciter la validation préalable des postulats, rapporter la statistique F complète du modèle d’homogénéité des pentes, mentionner la force de l’association unissant la covariable au critère, puis décliner l’effet principal du traitement en citant scrupuleusement les degrés de liberté, la valeur de F observée, le niveau de significativité exact et l’êta-carré partiel. Enfin, les comparaisons par paires doivent impérativement s’appuyer sur les moyennes marginales estimées accompagnées de leurs erreurs types ou de leurs intervalles de confiance à 95 %.
Un paragraphe type conforme aux standards de publication académique internationale se structure ainsi :
« Une analyse de covariance (ANCOVA) univariée à un facteur a été conduite afin d’évaluer l’efficacité de trois interventions thérapeutiques (TCC, MBSR, Liste d’attente) sur le niveau d’anxiété post-traitement évalué par le STAI-Y2, en contrôlant pour le niveau d’anxiété mesuré lors de la ligne de base. Les analyses préliminaires ont confirmé la normalité distributionnelle des résidus ainsi que l’homoscédasticité des variances (test de Levene, F(2, 87) = 1,14, p = 0,324). Le postulat fondamental d’homogénéité des pentes de régression a été vérifié, l’interaction entre le groupe de traitement et la covariable n’atteignant pas le seuil de significativité statistique, F(2, 84) = 0,48, p = 0,621, η2p = 0,011.
Après neutralisation de l’effet hautement significatif de la ligne de base, F(1, 86) = 92,54, p < 0,001, η2p = 0,518, un effet principal significatif du traitement thérapeutique a été mis en évidence sur les scores d’anxiété post-intervention, F(2, 86) = 7,62, p < 0,001, η2p = 0,151. Les comparaisons multiples post-hoc ajustées selon la méthode de Bonferroni sur les moyennes marginales estimées indiquent que les participants ayant bénéficié de la TCC (Majustée = 46,02, SE = 1,16, IC 95 % [43,71, 48,33]) et du MBSR (Majustée = 45,55, SE = 1,15, IC 95 % [43,26, 47,84]) rapportent des scores d’anxiété significativement inférieurs à ceux des participants maintenus sur Liste d’attente (Majustée = 47,53, SE = 1,17, IC 95 % [45,20, 49,86], p < 0,01). En revanche, aucune différence statistiquement significative n’a été détectée entre le protocole TCC et le protocole MBSR (p = 0,772). »
10. Analyses post-hoc et contrastes planifiés après une ANCOVA
10.1 Nécessité des comparaisons multiples sur moyennes ajustées
L’obtention d’une statistique F omnibus statistiquement significative au terme d’une ANCOVA constitue une étape indispensable mais fondamentalement incomplète : elle atteste qu’il existe une variabilité systématique entre les groupes au-delà du bruit résiduel, mais ne précise aucunement la topologie exacte de ces divergences. L’investigateur doit alors entreprendre des comparaisons multiples pour délimiter quelles paires de conditions diffèrent de manière statistiquement concluante. À ce stade, une erreur méthodologique gravissime – hélas fréquemment observée dans les manuscrits soumis à évaluation – consiste à exécuter des tests post-hoc de Student ou de Tukey sur les moyennes brutes d’échantillonnage.
Agir de la sorte revient à anéantir rétroactivement l’ensemble du travail d’ajustement opéré par l’ANCOVA. Les comparaisons par paires doivent être impérativement et exclusivement conduites sur les moyennes marginales estimées (estimated marginal means). Ce sont ces grandeurs redressées qui incarnent la projection des groupes au point d’équivalence théorique de la covariable. Utiliser les moyennes non corrigées réintroduirait subrepticement les biais d’échantillonnage initiaux et l’inflation d’erreur d’estimation que la modélisation statistique venait précisément d’éradiquer.
Le choix de la stratégie décisionnelle dépend intimement de l’architecture épistémologique du projet de recherche. Si les comparaisons découlent d’hypothèses théoriques précises forgées a priori avant le début de l’expérimentation, le recours à des contrastes planifiés directionnels s’impose méthodologiquement. Si, en revanche, l’investigateur explore l’ensemble des divergences émergentes sans orientation théorique préalable stricte, il s’engage dans une démarche post-hoc nécessitant une correction rigoureuse du risque d’erreur globale.
10.2 Techniques de correction du taux d’erreur par famille (FWER)
Dès lors que l’analyste multiplie les comparaisons bivariées entre plusieurs modalités thérapeutiques ou expérimentales, il s’expose au phénomène d’inflation du taux d’erreur par famille (Family-Wise Error Rate, FWER). Si l’on compare trois groupes deux à deux, trois contrastes distincts sont exécutés ; sans correction probabiliste, le risque cumulé de rejeter au moins une fois l’hypothèse nulle par simple fluctuation d’échantillonnage n’est plus de 0,05, mais s’élève à 1 – (1 – 0,05)3 ≈ 0,143, soit plus de 14 % de faux positifs.
Pour juguler cette dérive probabiliste, la méthode la plus classique et universellement reconnue est l’ajustement de Bonferroni. Cette correction repose sur un principe strictement conservateur consistant à diviser le seuil de significativité nominal α par le nombre total m de comparaisons effectuées (α’ = α / m). Bien que d’une simplicité arithmétique rassurante, cette procédure devient excessivement pénalisante dès que le nombre de groupes s’accroît, restreignant considérablement la puissance statistique au détriment de la détection d’effets authentiques.
Une alternative élégante est constituée par la correction de Šidák (α’ = 1 – (1 – α)1/m), mathématiquement exacte sous l’hypothèse d’indépendance des tests et légèrement plus puissante que celle de Bonferroni. Dans le contexte de l’ANCOVA, l’adaptation de la procédure du test HSD (Honestly Significant Difference) de Tukey, via la formalisation de Tukey-Kramer conçue pour intégrer les matrices de covariance résiduelles ajustées et les tailles de groupes inégales, représente le compromis méthodologique idéal. Elle garantit un contrôle parfait du FWER à 5 % tout en préservant une sensibilité statistique supérieure à celle des corrections d’inégalité stricte de Bonferroni.
10.3 Contrastes orthogonaux et tests ciblés
Lorsque le dispositif expérimental a été structuré autour de questionnements scientifiques hautement spécifiques, l’application de tests post-hoc omnibus non discriminants constitue une stratégie sous-optimale. L’approche méthodologique d’excellence réside dans la spécification de contrastes orthogonaux planifiés a priori. Un contraste statistique se définit formellement comme une combinaison linéaire des moyennes marginales estimées, Γ = Σ ci Ȳi(ajustée), soumise à la contrainte fondamentale selon laquelle la somme arithmétique de ses coefficients scalaires doit être rigoureusement nulle : Σ ci = 0.
Considérons à nouveau l’exemple thérapeutique précédent impliquant une TCC, un protocole MBSR et une Liste d’Attente. Une interrogation clinique primordiale consiste à vérifier en premier lieu si les deux thérapies actives, considérées conjointement, surclassent l’absence d’intervention représentée par la liste d’attente. Ce questionnement se traduit par le vecteur de coefficients pondérateurs c1 = +1 (TCC), c2 = +1 (MBSR) et c3 = -2 (Témoin). La seconde interrogation, strictement orthogonale à la première (Σ c1ic2i = 0), vise à comparer directement les deux thérapies actives entre elles : c1 = +1, c2 = -1 et c3 = 0.
Le calcul de la somme des carrés associée à chaque contraste ajusté permet d’extraire des statistiques F directes à un seul degré de liberté au numérateur, en mobilisant le terme d’erreur résiduel de l’ANCOVA globale. En concentrant la variance d’évaluation sur un espace décisionnel ciblé à un degré de liberté, les contrastes planifiés a priori offrent une puissance statistique remarquablement supérieure aux tests post-hoc conventionnels, tout en dispensant l’investigateur de corrections pénalisantes sur le seuil d’erreur de type I, à condition que le nombre de contrastes n’excède pas les degrés de liberté disponibles du facteur (k – 1).
11. Pièges méthodologiques, controverses et paradoxes
11.1 Le paradoxe de Lord et les limites des plans quasi-expérimentaux
L’une des controverses les plus fascinantes et les plus ardues de l’épistémologie statistique appliquée aux sciences sociales est sans conteste le célèbre paradoxe formalisé par Frederic M. Lord en 1967. Ce paradoxe met en lumière une contradiction mathématique et inférentielle déroutante : face à un ensemble rigoureusement identique de données pré-test/post-test recueillies au sein de deux groupes intacts non randomisés, l’analyse d’un score de gain ou de différence brute (Post – Pré) par une ANOVA et l’ajustement du score Post en fonction du score Pré par une ANCOVA peuvent aboutir à des conclusions diamétralement opposées, l’une concluant à l’absence totale d’effet et l’autre affirmant l’existence d’une différence thérapeutique hautement significative.
Ce phénomène survient de manière spectaculaire lorsque les deux groupes étudiés présentent des distributions initiales distinctes et disjointes sur la ligne de base avant toute intervention. L’analyse des gains postule implicitement un modèle où la pente de régression théorique entre le pré-test et le post-test est rigoureusement égale à 1,0. À l’inverse, l’ANCOVA estime cette pente empiriquement à partir des données via les moindres carrés ordinaires ; or, en présence d’erreur de mesure ou de régression vers la moyenne, cette pente observée s’avère systématiquement inférieure à l’unité (par exemple β = 0,70).
Dès lors, l’ANCOVA opère un réalignement différentiel des moyennes qui peut faire apparaître un effet statistique totalement artificiel ou, inversement, masquer une divergence clinique pourtant authentique. En l’absence d’une randomisation préalable stricte assurant l’équivalence probabiliste initiale des groupes, l’ANCOVA ne saurait faire de miracle ontologique : elle ne permet pas d’inférer de relation causale certaine à partir d’échantillons non équivalents. Tenter de « contrôler statistiquement » des disparités écologiques massives entre des groupes préexistants (comme comparer des étudiants de filières d’élite à des élèves en difficulté scolaire) expose inéluctablement l’investigateur aux pièges redoutables de l’artéfact méthodologique.
11.2 L’écueil du sur-ajustement et de l’inclusion massive de covariables
Face à la complexité des déterminants du comportement humain, certains praticiens cèdent à l’illusion technologique consistant à saturer leurs modèles linéaires d’une multitude de covariables hétéroclites, dans l’espoir naïf de « contrôler tout ce qui bouge ». Cette pratique de sur-ajustement (overfitting) constitue une dérive méthodologique lourde de conséquences préjudiciables. En premier lieu, chaque nouvelle covariable insérée dans l’équation consomme irrévocablement un degré de liberté au niveau du dénominateur d’erreur résiduel. Si les variables introduites ne partagent qu’une corrélation anecdotique avec le critère dépendant, le bénéfice en réduction de la somme des carrés résiduelle devient infinitésimal, tandis que la perte de degrés de liberté pénalise mécaniquement le ratio F, érodant la puissance statistique de l’étude.
En second lieu, l’accumulation effrénée de covariables engendre fréquemment des phénomènes délétères de multicolinéarité. Lorsque plusieurs covariables sont fortement corrélées entre elles (par exemple en incluant simultanément l’âge, les années d’études, le score de vocabulaire et le quotient intellectuel global), la matrice de corrélation frôle la singularité mathématique. Les estimateurs des coefficients de pente deviennent alors extraordinairement instables, leurs erreurs standards explosent, et l’ajustement marginal des moyennes devient erratique et non reproductible.
Pour conjurer cet écueil méthodologique, les règles de l’art imposent une parcimonie rigoureuse. Une règle empirique solidement ancrée dans la littérature recommande d’observer un ratio minimal d’au moins 20 à 25 participants par variable prédictive (facteurs et covariables confondus) au sein de la cellule d’échantillonnage la plus petite. Au-delà du volume échantillonnal, la justification théorique préalable demeure l’unique rempart légitime contre le surapprentissage des données.
11.3 L’interférence du traitement sur la covariable
L’un des pièges méthodologiques les plus insidieux guettant les chercheurs lors de protocoles d’intervention complexes réside dans la violation du principe d’imperméabilité de la covariable au facteur de traitement. Ce phénomène d’interférence survient avec une acuité particulière dans les protocoles longitudinaux ou multicentriques lorsque la collecte de la covariable, pour des motifs de commodité logistique ou d’organisation hospitalière défaillante, est effectuée après que les patients ont déjà été exposés, ne serait-ce que partiellement ou brièvement, à la condition expérimentale assignée.
Imaginons une investigation en psychothérapie où une mesure de l’alliance thérapeutique perçue est intégrée comme covariable, mais administrée aux participants après la troisième séance d’intervention. L’alliance thérapeutique ne constitue plus ici une mesure de pré-test neutre et indépendante : elle a été profondément façonnée, médiatisée et modulée par la qualité propre du protocole clinique délivré. Dès lors qu’un lien causal s’est tissé entre la variable indépendante factorielle et la variable concomitante, l’ANCOVA procède mathématiquement à l’extraction de toute la variance commune aux deux variables.
En retirant de la variable dépendante la variance partagée avec cette pseudo-covariable contaminée, le modèle soustrait littéralement la fraction la plus noble et la plus active de l’effet thérapeutique lui-même. Ce biais procédural d’endogénéité a pour corollaire dramatique d’annihiler artificiellement la significativité statistique de l’effet principal du traitement, conduisant les chercheurs à rejeter une thérapie révolutionnaire au motif fallacieux d’une absence apparente d’efficacité post-ajustement. L’indépendance de la covariable n’est donc pas une simple formalité technique, mais une exigence absolue de validité interne.
12. Extensions et alternatives modernes à l’ANCOVA univariée
12.1 L’analyse multivariée de la covariance (MANCOVA)
Dans de nombreux champs des neurosciences cognitives, de la neuropsychologie et de la psychiatrie, les effets d’une intervention thérapeutique ou d’une pathologie lésionnelle ne se manifestent que rarement au travers d’un indicateur comportemental unique et isolé. Les protocoles cliniques recueillent de multiples variables dépendantes continues mutuellement corrélées, telles que des scores évaluant simultanément la mémoire épisodique verbale, la vitesse de traitement psychomoteur et les fonctions exécutives d’inhibition. Dans une telle configuration, multiplier les ANCOVA univariées sur chaque variable séparée gonflerait de façon incontrôlable le risque global de faux positifs et occulterait la structure de corrélation interne des données.
L’analyse multivariée de la covariance (MANCOVA) apporte une réponse méthodologique intégrée à ce défi conceptuel. Extension directe de l’ANCOVA dans le formalisme matriciel multidimensionnel, la MANCOVA permet d’évaluer l’impact d’un ou plusieurs facteurs catégoriels sur un vecteur conjoint de multiples variables dépendantes, tout en ajustant statistiquement ce vecteur sur une ou plusieurs covariables quantitatives continues. Les opérations matricielles ne reposent plus sur de simples sommes de carrés, mais sur des matrices de sommes de carrés et de produits croisés (matrices H d’hypothèse et E d’erreur).
Les tests d’inférence globale mobilisent des statistiques multivariées dédiées, au premier rang desquelles figurent le Lambda de Wilks (Λ), la Trace de Pillai-Bartlett (reconnue pour sa robustesse exceptionnelle face aux déviations modérées de multinormalité), la Trace de Hotelling-Lawley et la Plus Grande Racine de Roy. Lorsqu’une MANCOVA révèle un effet multivarié significatif, elle autorise des analyses univariées descendantes protégées, garantissant une cartographie neuropsychologique fine des profils cognitifs tout en neutralisant rigoureusement l’influence de facteurs confondants comme l’âge ou la réserve cognitive basale.
12.2 L’ANCOVA non paramétrique et les modèles de régression robuste
Lorsque les données recueillies résistent obstinément à toute tentative de mise en conformité avec les postulats du modèle linéaire général – affichant des asymétries distributionnelles sévères, des hétéroscédasticités résiduelles incurables ou la présence irréductible de valeurs extrêmes –, le statisticien contemporain ne se trouve plus démuni. Plusieurs alternatives méthodologiques non paramétriques et robustes ont été développées pour pallier les faiblesses asymptotiques de l’ANCOVA classique de Fisher.
L’approche non paramétrique historique la plus réputée est la méthode de Quade (1967). Cette procédure ingénieuse consiste à remplacer d’abord les scores bruts de la variable dépendante et de la covariable par leurs rangs respectifs au sein de l’échantillon combiné complet. Une régression linéaire est ensuite ajustée sur ces rangs pour prédire le rang du critère à partir du rang de la covariable. Les résidus de cette régression de rangs sont alors soumis à une analyse de variance univariée standard à un facteur. Bien que conceptuellement séduisante, la technique de Quade tend à perdre de son efficacité lorsque les variances résiduelles diffèrent de façon trop asymétrique d’un groupe à l’autre.
Une alternative moderne réside dans le recours aux modèles de régression linéaire robuste basés sur des estimateurs de type M ou des estimateurs d’échelle MM (Huber-White). Ces algorithmes itératifs réassignent dynamiquement des poids décroissants aux observations affichant des résidus massifs ou un fort effet de levier, neutralisant ainsi l’impact délétère des données aberrantes sans nécessiter leur suppression arbitraire. Combinée à des méthodes de rééchantillonnage non paramétriques de type bootstrap percentile ou BCa (biais-corrigé et accéléré), l’ANCOVA robuste permet de dériver des intervalles de confiance et des tests d’hypothèses d’une fiabilité exemplaire sur les moyennes ajustées, même face à des cohortes cliniques fortement asymétriques.
12.3 Modèles mixtes et modélisation par équations structurelles (SEM)
Au sommet de l’arsenal contemporain de l’inférence statistique en psychologie et en sciences comportementales se déploient les modèles linéaires mixtes (LMM) et la modélisation par équations structurelles (SEM), qui transcendent les frontières historiques et les rigidités intrinsèques de l’ANCOVA classique. Les modèles linéaires mixtes s’avèrent indispensables dès lors que les données présentent une structure hiérarchique complexe ou des mesures répétées dans le temps. Ils permettent d’incorporer aisément des covariables dynamiques variant au cours du temps (time-varying covariates), surpassant l’ANCOVA traditionnelle qui se trouve mathématiquement limitée à l’ajustement de covariables statiques mesurées une seule fois à l’origine.
De son côté, la modélisation par équations structurelles apporte une réponse définitive et magistrale à la faille la plus critique de l’ANCOVA : l’hypothèse d’une covariable mesurée sans aucune erreur instrumentale. Au sein d’un modèle SEM, la variable concomitante de base n’est plus traitée comme une variable observée imparfaite, mais modélisée comme une variable latente pure, extraite à partir de multiples indicateurs psychométriques confluents. L’erreur de mesure propre à chaque item ou test est alors formellement isolée et évacuée dans des termes de variance d’unicité distincts.
En estimant la régression structurale entre le facteur de traitement et la variable dépendante post-test au niveau strict de ces construits latents épurés de tout bruit de mesure, le cadre des équations structurelles élimine intégralement le biais d’atténuation de régression documenté dans les sections précédentes. Cette intégration contemporaine assure un réalignement parfait des trajectoires de groupe, hissant l’inférence causale et la précision méthodologique à un niveau de rigueur scientifique sans précédent dans l’étude quantitative de l’esprit et du comportement humain.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1932). Statistical methods for research workers (4th ed.). Oliver and Boyd.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57-93.
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press.
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.5). https://CRAN.R-project.org/package=emmeans
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(4), 304-305. https://doi.org/10.1037/h0024967
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40-48. https://doi.org/10.1037/0021-843X.110.1.40
- Quade, D. (1967). Rank analysis of covariance. Journal of the American Statistical Association, 62(320), 1187-1200. https://doi.org/10.1080/01621459.1967.10500925
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.