
L’analyse de régression constitue depuis plus d’un siècle l’armature méthodologique prépondérante de la modélisation statistique appliquée aux sciences empiriques. Qu’il s’agisse de quantifier l’influence de déterminants socio-économiques, de démêler les contributions relatives de biomarqueurs neurophysiologiques ou de modéliser des réseaux d’attributs psychométriques, les chercheurs ont traditionnellement accordé une confiance quasi absolue à la méthode des moindres carrés ordinaires. Ce paradigme d’estimation, sanctifié par des propriétés analytiques élégantes et une interprétabilité intuitive, a longtemps incarné l’étalon-or de l’inférence causale et descriptive. Pourtant, à mesure que les dispositifs expérimentaux se sont sophistiqués et que la dimensionnalité des jeux de données a crû de manière exponentielle, les failles structurelles de cette approche classique sont apparues au grand jour, révélant une vulnérabilité critique face aux pathologies informationnelles des matrices de données contemporaines.
Au cœur de ces difficultés réside le fléau de la colinéarité et de la haute dimensionnalité. Lorsque les covariables collectées présentent de fortes corrélations mutuelles — une situation non pas exceptionnelle mais omniprésente dans l’observation des systèmes complexes et des conduites humaines —, l’édifice mathématique des moindres carrés vacille. L’exigence fondamentale d’indépendance linéaire se heurte à la réalité d’espaces prédictifs saturés de redondance, provoquant une instabilité numérique dramatique, une inflation démesurée de la variance d’échantillonnage et une incapacité chronique des modèles à reproduire fidèlement leurs prédictions sur des cohortes indépendantes. Face à cette crise de réplicabilité, le dogme classique postulant qu’un bon estimateur se doit d’être rigoureusement sans biais a dû être profondément réévalué au profit de paradigmes d’optimisation plus pragmatiques et mathématiquement plus robustes.
C’est précisément à cette croisée des chemins épistémologiques que s’inscrit la régression ridge. Conçue initialement pour remédier au mauvais conditionnement des systèmes linéaires en ingénierie chimique avant de conquérir l’ensemble des sciences quantitatives, cette technique de régularisation propose un compromis théorique audacieux : renoncer délibérément à la pureté formelle de l’absence de biais afin d’obtenir en contrepartie un effondrement spectaculaire de la variance des estimations. En introduisant une contrainte quadratique sur la magnitude des coefficients, la régression pénalisée opère un rétrécissement continu et harmonieux des poids statistiques, garantissant l’inversibilité des matrices d’information et préservant l’intégrité globale du système explicatif. Ce traité offre une immersion exhaustive dans les fondements mathématiques, les propriétés spectrales, les dynamiques computationnelles et les applications concrètes de la régularisation ridge, traçant ainsi la voie vers une modélisation prédictive et inférentielle d’une robustesse optimale.
1. Les fondements de la régression linéaire multiple et ses limites intrinsèques
1.1 Formalisation mathématique des moindres carrés ordinaires
La formalisation du modèle de régression linéaire multiple repose sur la postulation d’une relation affine entre un vecteur de réponse continue et un ensemble structuré de variables explicatives. Dans une notation matricielle standardisée, considérons un échantillon constitué de n observations indépendantes et de p prédicteurs. Le vecteur des observations Y ∈ ℜn est modélisé par l’équation matricielle fondamentale Y = Xβ + ε, où X désigne la matrice de conception de dimensions n × (p + 1), intégrant conventionnellement une colonne unitaire dédiée à l’ordonnée à l’origine, β ∈ ℜ(p + 1) représente le vecteur inconnu des paramètres de régression à estimer, et ε ∈ ℜn correspond au vecteur des perturbations stochastiques inobservables.
L’estimation conventionnelle des paramètres s’effectue via le critère d’optimisation des moindres carrés ordinaires (MCO), dont la finalité consiste à minimiser la somme des carrés des résidus, formalisée analytiquement par la fonction de coût S(β) = ||Y – Xβ||2 = (Y – Xβ)T(Y – Xβ). En développant cette expression quadratique sous la forme YTY – 2βTXTY + βTXTXβ et en annulant son gradient par rapport au vecteur β, nous obtenons le système classique des équations normales : XTXβ = XTY. Dès lors que la matrice carrée de Gram XTX est d’ordre plein et non singulière, l’estimateur analytique s’écrit de manière unique : βMCO = (XTX)-1XTY.
Sous la validité des hypothèses classiques formalisées par le théorème de Gauss-Markov, cet estimateur jouit de la propriété BLUE (Best Linear Unbiased Estimator), affirmant qu’au sein de la classe des estimateurs linéaires et sans biais, βMCO minimise la variance d’échantillonnage de chaque coefficient individuel. La matrice de variance-covariance associée à ce vecteur d’estimation s’exprime rigoureusement par Var(βMCO) = σ2(XTX)-1, où σ2 dénote la variance résiduelle homoscédastique de la perturbation ε. Toutefois, cette élégance théorique masque une sensibilité opérationnelle extrême : l’inversion de la matrice d’information XTX s’avère hautement vulnérable au mauvais conditionnement numérique, transformant le moindre bruit stochastique en distorsions paramétriques colossales.
1.2 Les postulats fondamentaux du modèle linéaire classique
L’intégrité inférentielle du modèle des moindres carrés ordinaires repose sur un ensemble d’axiomes probabilistes rigides, formulés dès les origines de l’économétrie et de la biométrie moderne. Le premier postulat exige l’exogénéité stricte des régresseurs, stipulant que l’espérance conditionnelle des perturbations par rapport à la matrice de conception s’annule identiquement : E(ε|X) = 0. Cette condition implique l’absence d’omission de variables explicatives pertinentes corrélées aux régresseurs inclus, ainsi que l’absence d’erreurs de mesure systématiques au sein des variables indépendantes. Parallèlement, la structure de variance des erreurs est assujettie à l’hypothèse d’homoscédasticité, selon laquelle la variance conditionnelle Var(εi|X) demeure strictement constante et égale à σ2 pour tout indice i, proscrivant toute dépendance fonctionnelle entre l’échelle de dispersion des résidus et les niveaux des variables prédictives.
Le deuxième volet axiomatique concerne l’indépendance stochastique mutuelle des résidus, formalisée par l’absence d’autocorrélation : Cov(εi, εj|X) = 0 pour tout couple d’observations distinctes où i ≠ j. Cette clause d’orthogonalité est fréquemment violée au sein des protocoles longitudinaux ou spatiaux. En outre, pour autoriser la dérivation exacte des lois de distribution d’échantillonnage relatives aux statistiques de test t de Student et F de Fisher-Snedecor en petits échantillons, la théorie impose la normalité multidimensionnelle du vecteur des perturbations, formulée par ε ~ N(0, σ2In). L’exigence la plus contraignante pour le calcul matriciel réside cependant dans le rang plein de la matrice de conception : le rang de X doit être strictement égal à (p + 1), interdisant formellement toute dépendance linéaire exacte entre les colonnes explicatives.
Dans la pratique empirique des sciences humaines, cliniques et sociales, la violation concomitante de ces postulats n’est point une anomalie marginale, mais l’état habituel des données d’observation. Lorsque les covariables s’entrelacent au sein de systèmes interactifs non contrôlés, l’illusion d’une indépendance linéaire stricte s’effondre. Les tests d’hypothèses conventionnels s’en trouvent irrémédiablement faussés : les seuils de significativité empiriques s’écartent drastiquement des distributions théoriques tabulées, induisant des taux d’erreur de type I massifs et conduisant les chercheurs à rejeter à tort l’hypothèse nulle d’absence d’effet pour de simples artéfacts d’instabilité matricielle.
1.3 Vulnérabilité des moindres carrés ordinaires en haute dimension
L’émergence contemporaine de méthodologies d’acquisition massives de données a précipité la faillite opérationnelle de l’estimateur des moindres carrés ordinaires face au phénomène de haute dimensionnalité. Lorsque le nombre de prédicteurs p s’accroît jusqu’à approcher la taille de l’échantillon n, le volume de l’espace géométrique engendré par les colonnes de X devient disproportionné par rapport au nombre restreint de points de données disponibles pour calibrer l’hyperplan de régression. Dans la situation limite où p ≥ n, la matrice XTX devient structurellement singulière, son rang ne pouvant excéder n. Le déterminant matriciel s’annule rigoureusement, rendant l’opération d’inversion classique algébriquement impossible et plongeant le système dans une infinité d’hyperplans ajustant parfaitement les données observées au prix d’une perte totale de généralisation.
Même lorsque la configuration demeure en régime sous-saturé où p < n mais avec un ratio p/n non négligeable, la solution MCO subit une dégradation pathologique de ses propriétés de stabilité numérique. L’espace vectoriel d’estimation se caractérise par des valeurs propres quasi nulles au sein de la matrice de Gram, ce qui précipite l’explosion de la trace de la matrice de variance-covariance des coefficients : tr(Var(βMCO)) = σ2 ∑ (1 / λj), où les λj représentent les valeurs propres de XTX. Dès lors qu’une seule valeur propre λmin s’approche de zéro, la variance globale de l’estimateur tend vers l’infini, engendrant une fluctuation chaotique des coefficients d’un échantillon d’apprentissage à un autre.
Cette instabilité structurelle se traduit concrètement par un surapprentissage (overfitting) aigu. Le modèle MCO, doté d’une flexibilité paramétrique démesurée par rapport à la contrainte informationnelle disponible, incorpore avidement le bruit stochastique propre à l’échantillon d’entraînement comme s’il s’agissait d’un signal causal authentique. Bien que le coefficient de détermination R2 apparent puisse frôler l’unité sur la cohorte d’estimation, l’erreur quadratique moyenne de prédiction évaluée sur des cohortes indépendantes subit une dégradation exponentielle. L’estimateur sans biais garantit théoriquement une espérance asymptotique conforme à la vérité paramétrique, mais il le fait au prix d’une telle incertitude d’échantillonnage que toute tentative de prédiction individualisée en haute dimension devient scientifiquement caduque.
2. Le phénomène de la multicolinéarité en modélisation quantitative
2.1 Définition et mécanismes sous-jacents de la colinéarité
La multicolinéarité désigne une configuration structurelle au sein de laquelle deux ou plusieurs variables explicatives d’un modèle de régression linéaire sont unies par une relation de dépendance linéaire approchée ou quasi stochastique. Il convient d’opérer une césure conceptuelle fondamentale entre la colinéarité exacte, situation mathématique dégénérée où il existe une combinaison linéaire non triviale telle que c1X1 + c2X2 + … + cpXp = 0 empêchant toute inversion matricielle, et la multicolinéarité imparfaite ou quasi-colinéarité, caractérisée par une équation de la forme c1X1 + … + cpXp + ν = 0, où ν représente un vecteur résiduel stochastique d’amplitude infinitésimale.
Dans l’investigation empirique, particulièrement au sein des sciences psychologiques, cognitives et comportementales, la présence de covariables hautement corrélées constitue non pas une anomalie expérimentale, mais le reflet direct de l’architecture des construits mesurés. Lorsque des investigateurs administrent des batteries psychométriques complexes comprenant des inventaires de personnalité, des évaluations d’affects ou des sous-tests d’efficience cognitive, les différents items ou sous-échelles puisent inéluctablement dans des dimensions latentes communes. Par exemple, l’évaluation conjointe de l’anxiété-trait, du neuroticisme, de la tendance à la rumination et de la détresse psychologique générale génère une matrice de données saturée de redondance informationnelle intrinsèque.
Cette architecture se formalise au niveau algébrique par une structure de covariance largement non diagonale au sein de la matrice de conception standardisée. Les vecteurs colonnes de X cessent de former une base orthogonale dans l’espace euclidien ℜn ; ils se regroupent au sein de sous-espaces de faible dimensionnalité, pointant dans des directions géométriques quasi indiscernables. Cette redondance implique que le modèle linéaire se voit assigner la tâche théoriquement impossible d’attribuer de façon univoque des parts de variance spécifiques à des variables explicatives qui ne partagent entre elles aucune variabilité indépendante dans l’échantillon collecté.
2.2 Impact direct sur la variance des estimateurs
L’expression analytique de la variance du j-ième coefficient de régression estimé par la méthode des moindres carrés ordinaires fournit une illustration implacable des ravages provoqués par la colinéarité : Var(β̂j) = σ2 / [(1 – Rj2) ∑ (xij – x̄j)2], où Rj2 désigne le coefficient de détermination issu de la régression auxiliaire du prédicteur Xj sur l’ensemble exhaustif des (p – 1) autres variables explicatives du modèle. Lorsque la multicolinéarité s’intensifie, Rj2 converge de manière asymptotique vers la valeur 1, ce qui entraîne la chute du dénominateur (1 – Rj2) vers zéro et projette la variance de l’estimateur vers des valeurs vertigineuses.
Ce gonflement artificiel des erreurs-types des coefficients de régression a pour corollaire une fragilisation extrême de la solution numérique. Les coefficients estimés deviennent hyper-réactifs : une altération infinitésimale d’une seule mesure expérimentale, la suppression fortuite de quelques sujets au sein de l’échantillon ou l’adjonction d’un léger bruit instrumental suffit à provoquer des oscillations spectaculaires de l’amplitude des estimations, pouvant aller jusqu’à décupler la magnitude d’un coefficient ou en inverser radicalement le sens arithmétique. Cette sensibilité pathologique interdit toute interprétation substantielle de l’influence isolée d’un facteur sur le phénomène étudié.
Sur le plan de l’inférence hypothétique, cette inflation de la variance pulvérise la puissance statistique des tests de Student portant sur les coefficients individuels. La statistique de test t = β̂j / SE(β̂j) subit un écrasement systématique en raison de la magnitude excessive du dénominateur d’erreur standard. Il en résulte une situation paradoxale emblématique de la multicolinéarité : le test global d’analyse de variance F de Snedecor rejette triomphalement l’hypothèse nulle globale à p < 0,001 (attestant que le modèle dans son ensemble capte une part substantielle de variance), tandis que l’intégralité des tests univariés associés aux prédicteurs s’avère non significative. Enfin, la multicolinéarité induit fréquemment des inversions de signes contre-intuitives, où une variable notoirement corrélée positivement au critère se voit attribuer une pente fortement négative, heurtant de plein fouet la validité théorique de l’investigation.
2.3 Outils classiques de détection et leurs limites
Pour diagnostiquer la présence et la sévérité de ces dépendances linéaires, la méthodologie quantitative a développé divers indicateurs canoniques. Le plus répandu d’entre eux est incontestablement le facteur d’inflation de la variance, ou VIF (Variance Inflation Factor), défini mathématiquement comme VIFj = 1 / (1 – Rj2). L’indice de tolérance associé n’étant que l’inverse arithmétique de ce coefficient (Tolérance = 1 / VIF). Bien que la littérature empirique véhicule des règles pragmatiques fixant des seuils d’alerte stéréotypés à un VIF excédant 5 ou 10, ces critères heuristiques demeurent arbitraires et n’offrent aucune indication sur la structure globale des interdépendances multidimensionnelles.
Une approche diagnostique mathématiquement plus rigoureuse consiste à réaliser l’analyse spectrale de la matrice d’information standardisée XTX par le calcul des indices de conditionnement. L’indice de conditionnement maximal, ou nombre de conditionnement κ, est défini par le ratio κ = √(λmax / λmin), où λmax et λmin représentent respectivement la plus grande et la plus petite valeur propre de la matrice. Une valeur de κ supérieure à 30 signale une instabilité numérique sévère, matérialisant l’existence de relations de colinéarité complexes engageant simultanément de multiples vecteurs sans que les corrélations bivariées prises deux à deux ne soient nécessairement alarmantes.
Face à ces diagnostics, les réponses traditionnellement apportées par les praticiens se révèlent méthodologiquement insatisfaisantes. La stratégie rudimentaire consistant à éliminer manuellement ou séquentiellement les variables affichant les VIF les plus élevés entraîne une amputation de l’intégrité théorique de l’étude. En psychométrie, retrancher des facettes entières d’un inventaire clinique altère la validité de contenu du construit exploré et peut introduire un biais de variable omise bien plus pernicieux que la colinéarité initiale. De surcroît, le recours aux algorithmes de sélection pas à pas (stepwise regression) souffre d’instabilités d’échantillonnage rédhibitoires, les choix algorithmiques étant dictés par des fluctuations aléatoires d’erreurs d’échantillonnage. Il apparaît dès lors impératif de recourir à une méthodologie alternative, capable de conserver la totalité des prédicteurs dans le modèle tout en immunisant structurellement l’estimation contre les effondrements de conditionnement matriciel.
3. Genèse théorique de la régression ridge
3.1 Les travaux fondateurs de Hoerl et Kennard
L’acte de naissance officiel de la régression ridge dans le corpus de la statistique mathématique moderne remonte à l’année 1970, marqué par la publication conjointe de deux articles devenus historiques dans la revue Technometrics par les mathématiciens américains Arthur E. Hoerl et Robert W. Kennard. Confrontés dans le secteur de l’ingénierie chimique à des systèmes physiques complexes régis par des réactions hautement corrélées où l’inversion par les moindres carrés produisait des estimations physiquement aberrantes et dénuées de sens pratique, Hoerl et Kennard entreprirent de formaliser une réponse analytique pérenne au problème du mauvais conditionnement des matrices de Gram.
Leur proposition conceptuelle consistait à adapter au champ de la statistique paramétrique les techniques de régularisation analytique formulées antérieurement par le mathématicien soviétique Andreï Tikhonov dans le contexte de la résolution des problèmes inverses mal posés. Tikhonov avait démontré que l’inversion d’opérateurs intégraux instables pouvait être stabilisée par l’adjonction d’une fonctionnelle de pénalisation bornant l’énergie de la solution. Hoerl et Kennard traduisirent cette intuition dans l’algèbre du modèle linéaire en altérant délibérément la diagonale de la matrice XTX par une constante positive avant son inversion.
Cette innovation marqua une rupture épistémologique majeure avec l’orthodoxie statistique régnante. Depuis les travaux de Gauss et de Legendre, l’absence de biais statistique (l’exigence formelle que l’espérance mathématique de l’estimateur coïncide exactement avec la cible paramétrique, E(β̂) = β) était considérée comme une vertu quasi inviolable. Hoerl et Kennard démontrèrent avec brio qu’en concédant l’introduction d’un biais systématique d’ampleur infinitésimale et parfaitement maîtrisée, il devenait possible de juguler l’explosion de la variance d’échantillonnage et d’obtenir un estimateur globalement bien plus performant et fidèle que le vénérable estimateur MCO.
3.2 Philosophie de la régularisation en modélisation statistique
La philosophie sous-tendant le paradigme de la régularisation repose sur le principe du rétrécissement continu (shrinkage) de l’espace des solutions admissibles. Dans le cadre conventionnel des moindres carrés, l’algorithme d’optimisation dispose d’une liberté absolue pour étirer les amplitudes des coefficients dans des directions opposées afin d’annihiler artificiellement les résidus d’entraînement, ce qui culmine dans des valeurs aberrantes dès que des régresseurs redondants entrent en conflit. La régularisation agit comme une force de rappel élastique, limitant la dépense paramétrique globale en sanctionnant l’amplitude globale du vecteur des paramètres.
Contrairement aux techniques d’élagage discontinu — telles que la sélection de sous-ensembles optimaux ou les régressions pas à pas qui procèdent à une dichotomisation brutale en attribuant soit un poids libre, soit un poids rigoureusement nul à une variable —, la pénalisation ridge applique une contraction continue et douce. Chaque covariable se voit maintenue au sein de l’architecture prédictive finale, conservant ainsi sa capacité à véhiculer un fragment d’information unique, mais sa contribution quantitative est amortie pour interdire toute dominance excessive issue d’un artefact colinéaire.
Cette perspective s’accorde remarquablement avec la réalité ontologique des phénomènes observés en sciences humaines et comportementales. Les comportements humains complexes, les profils cognitifs ou les états affectifs ne résultent presque jamais d’un petit nombre de déterminants isolés agissant en autarcie sur le mode de la parcimonie stricte. Ils émergent bien plus fréquemment d’une multitude infinie de signaux subtils, faiblement corrélés ou partagés au sein de vastes réseaux syndromiques. Le rétrécissement continu fournit le réceptacle computationnel idéal pour agréger l’ensemble de ces micro-contributions sans provoquer l’implosion numérique du modèle explicatif.
3.3 Transition conceptuelle des estimateurs sans biais vers les estimateurs régularisés
Le passage méthodologique de l’estimateur sans biais de Gauss-Markov vers l’estimateur régularisé de Hoerl-Kennard constitue une révolution dans la hiérarchisation des vertus statistiques. Dans l’approche classique, l’absence de biais était érigée en prérequis dogmatique absolu, la minimisation de la variance n’étant recherchée qu’au sein de la sous-classe restreinte des estimateurs satisfaisant strictement cette condition d’espérance non déviée. Or, dans une perspective décisionnelle rationnelle, s’obstiner à exiger qu’un tirage moyen infini converge vers la valeur vraie n’offre qu’un piètre réconfort si la variance associée à une estimation singulière présente une amplitude kilométrique.
La métrique d’arbitrage suprême s’est donc déplacée vers l’erreur quadratique moyenne (EQM, ou Mean Squared Error – MSE), qui quantifie l’écart quadratique global attendu entre l’estimateur β̂ et le paramètre latent β. L’acceptation pragmatique d’une légère sous-estimation systématique — c’est-à-dire un biais résiduel déterministe qui tire modérément les coefficients vers l’origine — s’avère un investissement méthodologique immensément rentable dès lors que ce sacrifice paramétrique entraîne un effondrement d’un ordre de grandeur supérieur de l’incertitude d’échantillonnage stochastique.
Cette transition conceptuelle résonne puissamment avec les exigences contemporaines de réplicabilité scientifique. En acceptant ce compromis régularisé, les modèles statistiques cessent de mémoriser les contingences idiosyncratiques des cohortes d’apprentissage pour se focaliser sur la structure invariante des phénomènes. Pour les sciences de l’esprit et du comportement, régulièrement confrontées à des écueils de non-reproductibilité de leurs résultats expérimentaux, l’adoption d’estimateurs régularisés marque l’avènement d’une modélisation plus humble dans ses prétentions d’exactitude locale, mais infiniment plus souveraine dans sa validité externe.
4. Formulation mathématique et mécanisme de pénalisation L2
4.1 La fonction de coût augmentée
L’ossature mathématique de la régression ridge se déploie à travers l’adjonction explicite d’un terme de pénalisation quadratique à la fonction d’ajustement empirique originelle des moindres carrés. Dans le paradigme d’optimisation classique, le vecteur β est déterminé exclusivement par la minimisation de la somme des carrés des résidus, notée RSS(β). Dans le formalisme ridge, nous définissons une fonctionnelle de coût augmentée, notée J(β), combinant linéairement l’erreur d’ajustement et la norme euclidienne au carré du vecteur des pentes régularisées :
J(β) = ||Y – Xβ||22 + λ ||β||22 = ∑i=1n (yi – xiTβ)2 + λ ∑j=1p βj2
Dans cette formalisation rigoureuse, ||β||2 représente la norme L2 standard du vecteur des coefficients, définie par la racine carrée de la somme de leurs carrés. L’élévation au carré de cette norme supprime l’opérateur de racine, conférant à la pénalité une différentiabilité analytique continue sur l’ensemble du domaine ℜp. Le terme de pénalisation agit comme une sanction directe proportionnelle à la magnitude au carré de chaque coefficient individuel : plus un coefficient s’écarte de zéro, plus la pénalité imposée à la fonction de coût croît de manière parabolique, interdisant aux paramètres d’adopter des valeurs compensatoires gigantesques face aux perturbations colinéaires.
Sur le plan analytique, la fonction de coût augmentée J(β) demeure strictement convexe pour toute valeur positive de λ. En effet, la matrice hessienne associée à J(β) est donnée par ∇2J(β) = 2(XTX + λIp). Étant donné que la matrice XTX est semi-définie positive et que λIp est strictement définie positive dès que λ > 0, leur somme constitue une matrice strictement définie positive, garantissant l’existence d’un minimum global unique et éliminant tout risque de convergence vers des minima locaux sous-optimaux.
4.2 Le rôle du paramètre de régularisation lambda
Le scalaire non négatif λ (lambda), parfois désigné sous le vocable de paramètre de régularisation ou hyperparamètre de pénalité, opère comme le curseur de compromis fondamental régissant l’équilibre structurel du modèle. Sa magnitude quantifie l’importance relative accordée à la parcimonie paramétrique par rapport à la fidélité de l’ajustement empirique aux données d’observation. L’analyse des comportements asymptotiques de ce régulateur permet d’en saisir la dynamique opératoire globale :
Dans le premier cas limite où λ → 0, le terme de pénalisation s’évanouit complètement de l’équation d’optimisation. La fonction J(β) redevient rigoureusement superposable à la somme classique des carrés des résidus MCO. L’estimateur ridge converge ainsi asymptotiquement vers l’estimateur des moindres carrés ordinaires : limλ→0 βridge = βMCO. Si la matrice XTX est mal conditionnée, le modèle hérite instantanément de toutes les instabilités et variances délétères documentées précédemment.
À l’inverse, dans le second cas limite où λ → ∞, le poids accordé au terme de pénalité devient infiniment supérieur à celui de l’erreur d’ajustement résiduelle. Pour empêcher la fonction de coût de diverger vers l’infini, l’algorithme d’optimisation n’a d’autre alternative que d’écraser l’ensemble des coefficients de pente vers le point origine : limλ→∞ βridge = 0. Le modèle se contracte alors en une projection horizontale pure où l’ensemble des prédictions équivaut invariablement à la moyenne marginale globale de l’échantillon. L’espace de régularisation explore précisément l’ensemble du continuum continu situé entre ces deux pôles extrêmes, l’enjeu étant de calibrer λ pour extraire le signal fonctionnel optimal tout en filtrant le bruit d’échantillonnage.
4.3 Résolution analytique de l’estimateur ridge
L’un des atouts computationnels majeurs de la régression ridge, qui la distingue avantageusement de pénalités non différentiables comme celle du Lasso, réside dans l’existence d’une solution analytique exacte sous forme fermée. Pour dériver formellement cette expression matricielle, nous exprimons la fonction de coût sous sa forme vectorielle matricielle intégrale : J(β) = (Y – Xβ)T(Y – Xβ) + λβTβ = YTY – 2βTXTY + βTXTXβ + λβTIβ.
En factorisant les termes quadratiques par rapport à β, l’équation se condense en : J(β) = YTY – 2βTXTY + βT(XTX + λI)β. Pour déterminer le minimiseur global, nous calculons le gradient de cette expression par rapport au vecteur β et nous l’égalisons au vecteur nul :
∂J(β) / ∂β = -2XTY + 2(XTX + λI)β = 0 ⇒ (XTX + λI)β = XTY
Dès lors que λ > 0, l’opérateur matriciel (XTX + λI) est mathématiquement garanti d’être strictement défini positif et inversible sans la moindre ambiguïté, y compris dans les situations pathologiques où p >> n ou lorsque la matrice de Gram originelle XTX souffre d’un rang incomplet. Nous obtenons ainsi la formule consacrée de l’estimateur ridge :
β̂ridge = (XTX + λI)-1XTY
L’adjonction de la matrice diagonale pondérée λI — désignée dans la littérature sous le nom de « crête » (ridge), qui a donné son nom historique au modèle — injecte une perturbation positive uniforme directement sur la diagonale principale de la matrice d’information. Cette altération chirurgicale décolle immédiatement les valeurs propres de l’opérateur de leur voisinage critique avec zéro, assurant une stabilité numérique absolue lors de l’inversion matricielle et conférant à la solution une robustesse algorithmique remarquable.
5. Le compromis biais-variance dans la régression ridge
5.1 Décomposition formelle de l’erreur quadratique moyenne
L’évaluation de la performance d’un estimateur statistique β̂ vis-à-vis d’un vecteur paramétrique cible β se formalise à travers l’erreur quadratique moyenne (EQM), définie comme l’espérance du carré de la distance euclidienne séparant l’estimation de la vérité : EQM(β̂) = E[||β̂ – β||2]. Grâce aux propriétés de linéarité de l’opérateur d’espérance mathématique, cette métrique admet une décomposition canonique universelle en deux composantes constitutives antagonistes :
EQM(β̂) = tr(Var(β̂)) + ||Biais(β̂)||2
Où tr(Var(β̂)) représente la trace de la matrice de variance-covariance de l’estimateur, quantifiant la dispersion stochastique globale des estimations autour de leur propre espérance d’échantillonnage, et ||Biais(β̂)||2 = ||E(β̂) – β||2 mesure l’éloignement structurel déterministe entre l’espérance de l’estimateur et le paramètre latent générateur des observations. Cette relation algébrique fondamentale met en scène une dynamique de vases communicants : minimiser l’erreur globale exige un arbitrage optimisé entre l’amplitude du biais consenti et la dispersion aléatoire résiduelle.
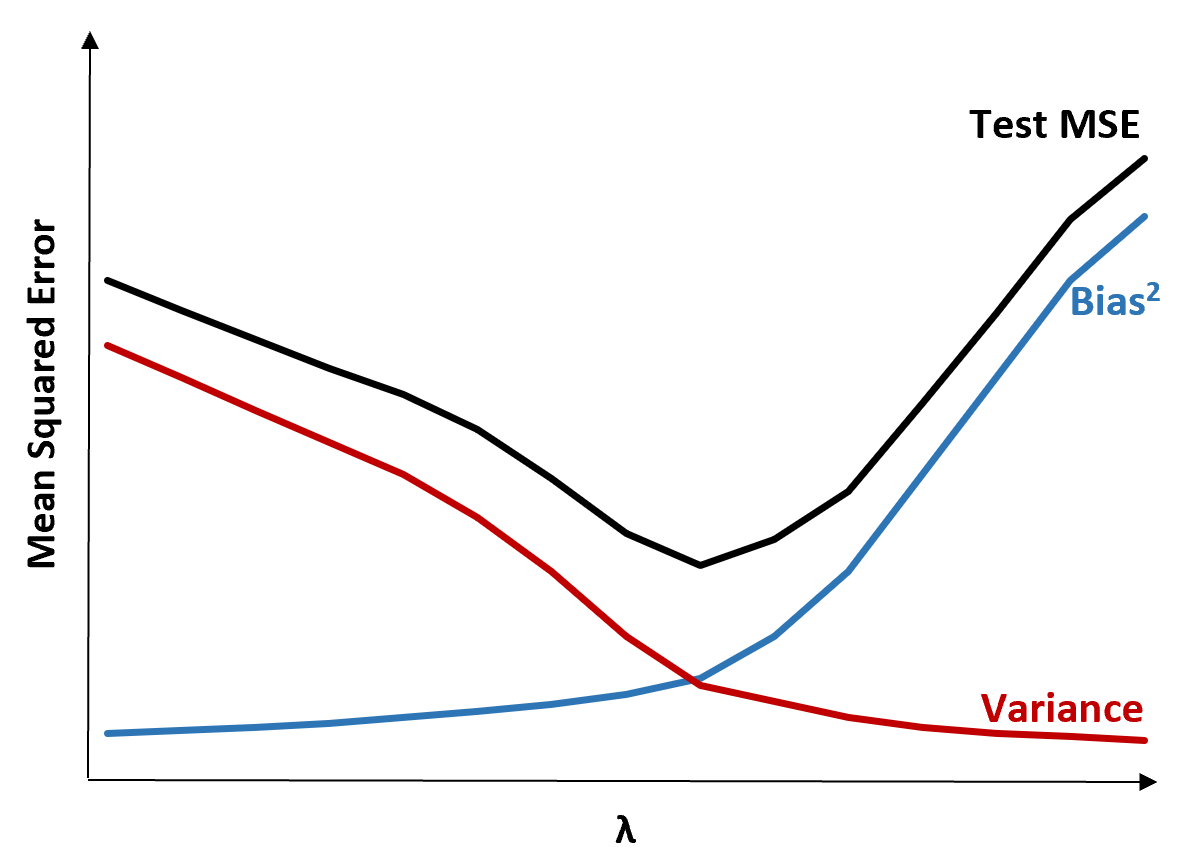
Lorsque le paramètre de pénalité λ s’élève, les deux composantes adoptent des trajectoires diamétralement opposées. Le biais déterministe, nul en λ = 0, croît de manière strictement monotone au fur et à mesure que les coefficients sont contraints vers l’origine. À l’opposé, la variance de l’estimateur subit une décrue accélérée, amorçant une chute spectaculaire dès l’introduction des premiers incréments infinitésimaux de pénalité. La courbe résultante de l’EQM adopte ainsi une allure convexe caractéristique, plongeant vers un minimum global strictement inférieur à l’erreur initiale des moindres carrés avant de remonter à mesure que le biais d’écrasement devient prépondérant.
5.2 Contraction de la variance au prix d’un biais maîtrisé
L’analyse analytique des espérances et covariances de l’estimateur ridge permet d’expliciter le mécanisme exact de cette contraction salvatrice. En substituant le modèle générateur Y = Xβ + ε au sein de la formulation explicite de β̂ridge, et en posant la matrice de rétrécissement Wλ = (XTX + λI)-1XTX, nous découvrons que :
E(β̂ridge) = Wλβ
Puisque la matrice Wλ n’est égale à la matrice identité I que pour λ = 0, l’estimateur ridge est formellement biaisé pour toute valeur λ > 0. L’amplitude de ce biais s’écrit de façon transparente : Biais(β̂ridge) = (Wλ – I)β = -λ(XTX + λI)-1β. Le biais est donc une fonction proportionnelle à λ et dépend de la projection du véritable paramètre sur la résolvante du système régularisé. Cette déviation systématique tire les paramètres vers zéro, opérant une compression contrôlée de l’amplitude globale du vecteur.
En contrepartie de cette altération déterministe, la matrice de dispersion stochastique connaît un assainissement immédiat :
Var(β̂ridge) = σ2(XTX + λI)-1XTX(XTX + λI)-1 = Wλ Var(βMCO) WλT
Étant donné que les valeurs propres de l’opérateur de rétrécissement Wλ sont strictement inférieures à 1 pour tout λ > 0 (elles s’écrivent λj / (λj + λ)), la variance de chaque coefficient ridge est rigoureusement et strictement inférieure à la variance homologue issue des moindres carrés ordinaires. Sur le plan empirique, cette chute foudroyante de l’instabilité confère aux indices prédictifs calculés une invariance d’échantillonnage exceptionnelle, protégeant les chercheurs contre les fluctuations stochastiques propres aux cohortes expérimentales restreintes.
5.3 Preuve d’existence d’une pénalité strictement supérieure aux MCO
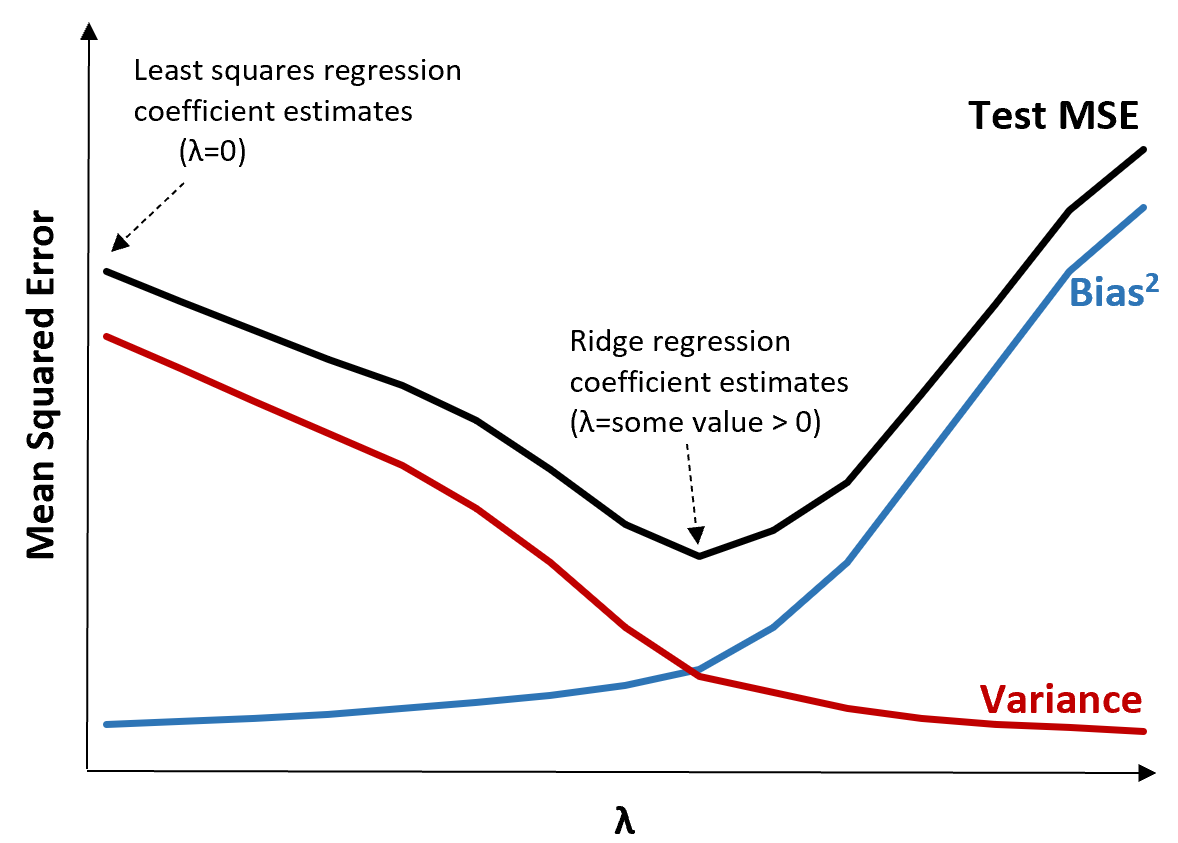
L’argumentaire en faveur de la régression ridge atteindrait difficilement un tel niveau de solidité théorique sans le théorème fondamental établi par Hoerl et Kennard dans leur publication de 1970. Ce théorème d’existence stipule sans équivoque qu’il existe systématiquement une valeur positive non nulle du paramètre de régularisation λ pour laquelle l’erreur quadratique moyenne globale de l’estimateur ridge est strictement inférieure à l’erreur quadratique moyenne de l’estimateur des moindres carrés ordinaires :
∃ λ* > 0 tel que EQM(β̂ridge(λ*)) < EQM(βMCO)
La dérivation analytique de ce résultat repose sur l’évaluation de la dérivée première de la fonction d’erreur quadratique moyenne totale g(λ) = EQM(β̂ridge(λ)) évaluée en λ = 0. En décomposant la fonction selon le spectre des valeurs propres {γj} de la matrice XTX et les composantes rotationnelles associées α = Pβ, l’expression de l’erreur se formule comme suit :
EQM(β̂ridge(λ)) = σ2 ∑j=1p γj / (γj + λ)2 + λ2 ∑j=1p αj2 / (γj + λ)2
En dérivant cette équation par rapport à λ et en considérant la limite lorsque λ tend vers zéro par valeurs positives, nous constatons que la dérivée de la composante de variance vaut -2σ2 ∑ (1 / γj2), une quantité strictement négative et finie, tandis que la dérivée de la composante de biais s’annule identiquement en zéro en raison de la présence du terme quadratique λ2. Par conséquent, la dérivée initiale globale de l’EQM en λ = 0 est rigoureusement négative : g‘(0+) < 0. Cela prouve irréfutablement que la courbe d’erreur entame obligatoirement une trajectoire descendante dès l’abandon de λ = 0, établissant la supériorité structurelle d’une pénalisation modérée sur l’estimation MCO non régularisée.
6. L’importance cruciale de la standardisation des variables
6.1 Sensibilité mathématique de la pénalité quadratique aux échelles
L’introduction d’une norme euclidienne dans la fonction de coût modifie la sensibilité de l’algorithme d’estimation aux unités de mesure adoptées pour les variables explicatives. Dans le cadre canonique des moindres carrés ordinaires, l’estimateur jouit d’une invariance d’échelle naturelle : multiplier un prédicteur Xj par une constante scalaire c entraîne une division exacte du coefficient correspondant β̂j par cette même constante c, maintenant inchangée la prédiction globale Xβ ainsi que la valeur minimale des résidus.
Dans la régression ridge, cette propriété d’invariance d’échelle est formellement rompue par la nature isotrope et aveugle de la pénalité λ ∑ βj2. La fonction de coût inflige une sanction mathématique aveugle à la valeur absolue brute du coefficient, sans considération de l’unité de mesure sous-jacente. Considérons un modèle intégrant d’une part l’âge d’un sujet exprimé en décennies et d’autre part son revenu annuel formulé en centimes de devise. Pour produire un impact prédictif identique, le coefficient associé à l’âge devra adopter une magnitude quantitative des millions de fois supérieure au coefficient associé au revenu. Dès lors, le mécanisme de pénalisation L2 s’abattra massivement sur le coefficient de l’âge tout en épargnant quasi totalement celui du revenu, introduisant une distorsion purement artéfactuelle dictée par le choix des unités de notation.
Cette asymétrie de contraction est particulièrement préjudiciable dans les études psychologiques et comportementales faisant appel à des instruments de recueil composites. Lorsqu’une équation juxtapose des temps de réaction enregistrés en millisecondes, des fréquences cardiaques en battements par minute et des scores d’échelles de Likert bornés entre 1 et 5, l’absence d’harmonisation de la dispersion initiale condamne les prédicteurs mesurés sur de petites échelles à une sous-pénalisation paradoxale, tout en écrasant indûment les coefficients associés aux variables caractérisées par de larges amplitudes métriques.
6.2 Procédures recommandées de centrage et de réduction
Pour immuniser le modèle contre ces distorsions dimensionnelles et restaurer une équité géométrique absolue au sein de la sphère de contrainte L2, il est méthodologiquement indispensable de procéder à une standardisation préalable intégrale de la matrice des régresseurs. Cette transformation, désignée couramment sous le terme d’opération de centrage et réduction (transformation en scores z), s’applique individuellement à chaque variable explicative j pour l’ensemble des observations i selon la formule canonique :
x̃ij = (xij – x̄j) / sj
Où x̄j = (1/n) ∑i=1n xij désigne la moyenne empirique de l’échantillon pour le prédicteur j, et sj = √[(1/n) ∑i=1n (xij – x̄j)2] représente son écart-type d’échantillonnage. À l’issue de cette transformation, chaque vecteur colonne de la matrice de conception standardisée X̃ affiche une moyenne rigoureusement nulle et une variance empirique unitaire standardisée. Dès cet instant, une altération d’une unité sur n’importe quel régresseur standardisé renvoie invariablement à une excursion d’un écart-type, rendant la pénalisation quadratique λ ∑ β̃j2 universellement équitable à travers l’ensemble des dimensions de l’espace prédictif.
D’un point de vue méthodologique et prudentiel, il convient de souligner un écueil expérimental majeur : le risque de fuite d’information (data leakage). Dans le cadre d’un protocole d’apprentissage validé par découpage de cohortes ou par validation croisée, le calcul des moyennes x̄j et des écarts-types sj doit impérativement être opéré de manière exclusive sur les données assignées à la partition d’entraînement. L’application ultérieure de ces paramètres de standardisation aux sous-ensembles de validation et de test garantit qu’aucune information globale relative à la distribution de test ne contamine la phase de calibration du modèle pénalisé.
6.3 Traitement particulier du terme constant dans l’équation
La formulation standard de la régularisation ridge impose une exception fondamentale concernant le coefficient d’interception, β0, qui quantifie la valeur attendue de la réponse lorsque tous les régresseurs s’annulent. L’inclusion du terme constant dans la pénalisation L2 constituerait une aberration conceptuelle : cela reviendrait à affirmer que le modèle doit pénaliser le niveau moyen absolu de la variable d’intérêt Y, forçant arbitrairement la trajectoire des prédictions à transiter par l’origine du système de coordonnées cartésiennes.
Par conséquent, la convention théorique absolue prescrit l’exclusion stricte de β0 du terme de régularisation. La fonction de coût augmentée prend ainsi la formulation asymétrique suivante :
J(β0, β) = ∑i=1n (yi – β0 – ∑j=1p x̃ijβj)2 + λ ∑j=1p βj2
Dans la pratique computationnelle, pour simplifier la résolution analytique matricielle et éviter la manipulation d’opérateurs de projection asymétriques, la démarche standardisée consiste à centrer préalablement la variable dépendante Y en soustrayant sa moyenne empirique globale : ỹi = yi – ȳ. Dès lors que Y et les colonnes de X sont rigoureusement centrées, l’estimateur optimal de l’ordonnée à l’origine s’annule identiquement : β̂0 = 0.
Les solveurs matriciels peuvent ainsi opérer directement sur les données centrées sans intégrer de vecteur unitaire au sein de la matrice explicative, en résolvant l’équation fermée β̃ridge = (X̃TX̃ + λIp)-1X̃TỸ. Une fois les coefficients standardisés régularisés β̃ridge obtenus, le terme constant d’origine peut être restitué pour le déploiement sur les échelles naturelles via la relation algébrique déterministe : β̂0 = ȳ – ∑j=1p β̂j(naturel) x̄j, préservant ainsi l’exactitude de l’ancrage empirique global.
7. Méthodes d’optimisation et sélection de l’hyperparamètre lambda
7.1 Validation croisée k-fold et stratégies de rééchantillonnage
L’efficacité prédictive et la consistance inférentielle du modèle ridge dépendent du calibrage du paramètre λ. Dans la mesure où les données empiriques ne dévoilent jamais a priori la magnitude optimale de cette pénalité, la détermination de λ relève de l’optimisation des hyperparamètres par rééchantillonnage empirique, au sein duquel la validation croisée à k blocs (k-fold cross-validation) s’impose comme la méthodologie de référence.
Le protocole algorithmique s’amorce par la partition aléatoire et équilibrée de l’ensemble d’entraînement en K sous-ensembles mutuellement exclusifs (généralement K = 5 ou K = 10). Une grille discrétisée de valeurs candidates pour λ, déployée conventionnellement sur une échelle logarithmique s’étendant par exemple de 10-4 à 104, est préalablement circonscrite. Pour chaque valeur candidate λm de cette grille, le modèle ridge est ajusté K fois consécutives sur la réunion de (K – 1) blocs, puis évalué sur le bloc résiduel laissé en réserve. L’erreur quadratique moyenne de prédiction hors-échantillon est compilée sur l’intégralité des plis de validation pour générer l’indice de performance agrégé :
CV(λm) = (1 / n) ∑k=1K ∑i ∈ Block (yi – xiTβ̂ridge(-k)(λm))2
La valeur d’hyperparamètre minimisant cette fonction de perte empirique, notée λmin, constitue le premier point d’ancrage de la sélection optimale. Néanmoins, afin de se prémunir contre la stochasticité inhérente au découpage des blocs et de privilégier un modèle structurellement plus robuste, les méthodologistes appliquent fréquemment la règle heuristique de l’écart-type minimal (« one standard error rule »). Cette approche conservatrice préconise de sélectionner la valeur de pénalité la plus forte λ1se dont l’erreur moyenne de validation croisée n’excède pas la borne supérieure de l’intervalle de confiance à un écart-type de l’erreur minimale : CV(λ1se) ≤ CV(λmin) + SE(CV(λmin)), garantissant ainsi un surcroît de parcimonie paramétrique sans dégradation significative de l’ajustement.
7.2 L’outil diagnostique de la trace ridge
Parallèlement aux algorithmes automatisés d’optimisation prédictive, l’analyse visuelle outillée par la trace ridge (ridge trace) constitue l’un des instruments sémiologiques les plus puissants introduits par Hoerl et Kennard. La trace ridge est une représentation graphique bivariée traçant en ordonnée l’évolution continue des valeurs numériques prises par chaque coefficient de régression β̂j(λ) en fonction de la progression continue du paramètre de régularisation λ déployé sur l’axe des abscisses.
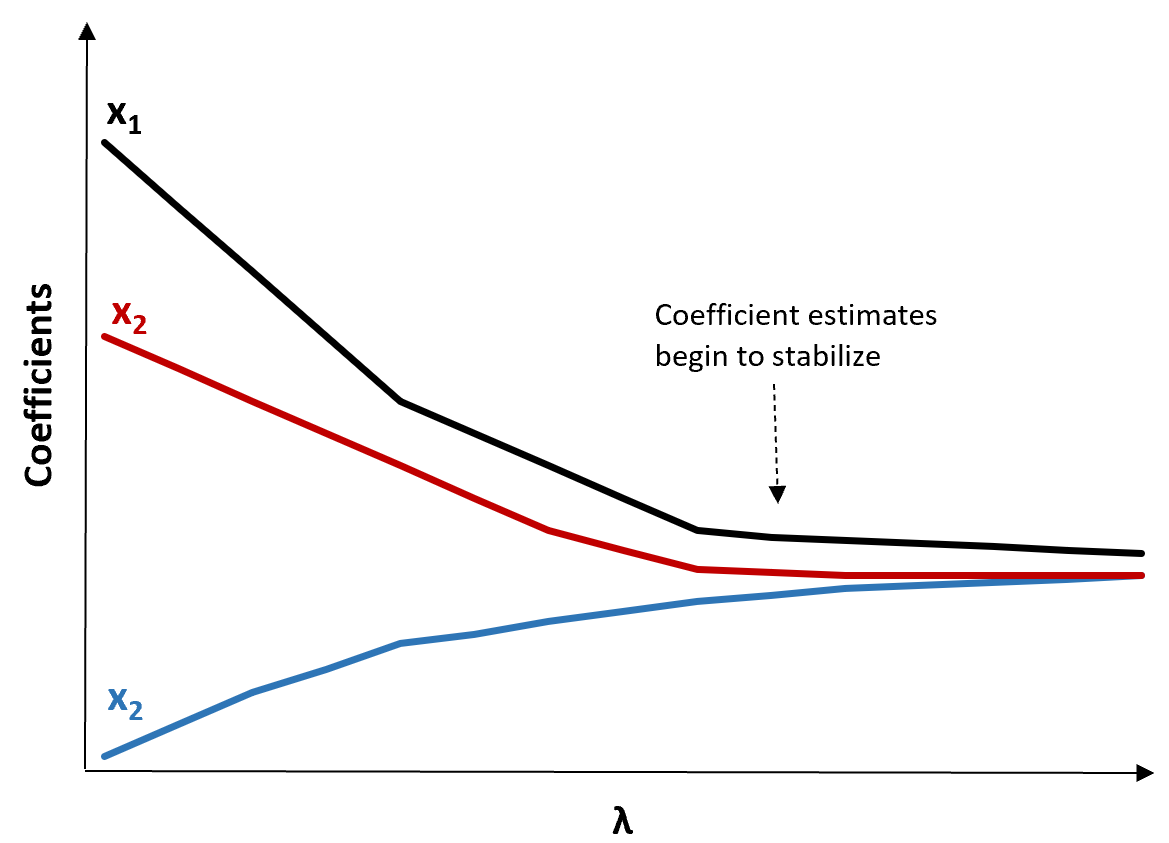
L’inspection analytique de ces trajectoires paramétriques offre une fenêtre directe sur la dynamique de décollement de la multicolinéarité. Au voisinage immédiat de λ = 0, correspondant au régime non régularisé des moindres carrés, la trace ridge donne à voir l’instabilité typique des systèmes mal conditionnés : des coefficients oscillent de manière erratique avec des amplitudes dissemblables, certains affichant des valeurs positives massives tandis que leurs homologues colinéaires plongent dans des abîmes négatifs irréalistes.
Au fur et à mesure que la valeur de λ s’élève, un phénomène d’amortissement spectral se produit : les amplitudes délétères s’apaisent rapidement, les coefficients en conflit convergent conjointement vers des trajectoires coordonnées et ordonnées, et les estimations se stabilisent sur des plateaux d’évolution asymptotique douce vers zéro. Hoerl et Kennard recommandaient initialement de fixer λ au point précis d’inflexion visuelle où l’ensemble du système atteint cette stabilité structurelle globale. Bien que l’automatisation par validation croisée prévale aujourd’hui pour des raisons de reproductibilité formelle, la trace ridge demeure un outil qualitatif d’une valeur inestimable pour cartographier les réseaux de redondance et identifier les groupes de prédicteurs partageant des structures sous-jacentes d’information.
7.3 Critères d’information pénalisés et méthodes analytiques
En dépit de sa robustesse empirique universellement reconnue, la validation croisée k-fold impose un coût computationnel non négligeable lors du traitement d’échantillons massifs ou d’architectures dimensionnelles volumineuses. Pour pallier cette lourdeur, des alternatives analytiques déterministes fondées sur la théorie de l’information et le concept de degrés de liberté effectifs ont été développées. Dans une régression ridge caractérisée par une pénalité λ, la matrice chapeau (ou matrice de projection) s’écrit Hλ = X(XTX + λI)-1XT. Contrairement au modèle MCO où les degrés de liberté équivalent strictement au rang de la matrice p, les degrés de liberté effectifs du modèle régularisé correspondent à la trace de cet opérateur de projection non orthogonal :
df(λ) = tr(Hλ) = ∑j=1p λj / (λj + λ)
Cette formulation élégante démontre que df(λ) est une fonction strictement décroissante de λ, s’étendant de façon continue de p (lorsque λ = 0) jusqu’à 0 (lorsque λ → ∞). Dès lors que cette complexité paramétrique effective est quantifiée, il devient possible d’évaluer directement des critères d’information pénalisés sans procéder à des rééchantillonnages itératifs, à l’instar du critère d’Akaike pénalisé AIC(λ) = n ln(RSS(λ) / n) + 2 df(λ) ou du critère bayésien BIC(λ) = n ln(RSS(λ) / n) + ln(n) df(λ).
Une méthode analytique particulièrement raffinée est la validation croisée généralisée (GCV, pour Generalized Cross-Validation). Conçue originellement par Grace Wahba, la GCV fournit une approximation asymptotique de la validation croisée unitaire (leave-one-out) sans requérir l’inversion répétée de n systèmes linéaires, en exploitant l’invariance rotationnelle de la trace :
GCV(λ) = (1 / n) ||Y – Xβ̂ridge(λ)||2 / [1 – df(λ) / n]2
La minimisation directe de la fonctionnelle GCV(λ) par des algorithmes de recherche scalaire unidimensionnelle permet d’isoler quasi instantanément l’hyperparamètre optimal, conférant aux chercheurs une réactivité computationnelle exceptionnelle, particulièrement adaptée aux analyses exploratoires de flux de données continus.
8. Propriétés géométriques et spectrales de la régression ridge
8.1 Interprétation géométrique sous contrainte sphérique
L’élucidation géométrique du mécanisme ridge enrichit la compréhension algébrique de son fonctionnement. Le problème d’optimisation sans contrainte formulé à travers la fonction de coût augmentée J(β) = ||Y – Xβ||2 + λ ||β||2 est rigoureusement équivalent, en vertu du théorème des multiplicateurs de Lagrange, à un problème d’optimisation sous contrainte d’inégalité explicite, désigné sous le formalisme de Karush-Kuhn-Tucker :
Minimiser ||Y – Xβ||2 sous la contrainte ||β||22 ≤ t
Dans cette perspective duelle, la constante t ≥ 0 entretient une relation bijective strictement décroissante avec le multiplicateur de Lagrange λ. L’espace des solutions admissibles ne s’étend plus à la totalité de l’espace euclidien ℜp, mais se voit confiné à l’intérieur ou à la frontière d’une hypersphère (ou d’un hyper-ellipsoïde isotrope) de rayon √t centrée à l’origine du système de coordonnées.
D’un point de vue géométrique dans le plan des paramètres, la fonction objectif des moindres carrés engendre des contours de niveau elliptiques concentriques, dont le centre géométrique coïncide avec la solution non contrainte βMCO. La solution régularisée ridge β̂ridge correspond au point de tangence exact entre la plus petite ellipse d’ajustement résiduel et la surface sphérique de la boule de contrainte L2. La courbure lisse et différentiable de la sphère euclidienne implique que ce point de contact tangentiel s’établit quasi systématiquement sur une portion continue de l’hypersphère où aucune coordonnée ne s’annule identiquement. Cela explique pourquoi la régression ridge rétrécit tous les coefficients vers zéro avec une grande progressivité, mais sans jamais provoquer d’annulation stricte, à la différence des polyèdres de contrainte angulaires caractéristiques de la norme L1.
8.2 Décomposition en valeurs singulières et analyse spectrale
La compréhension intime des transformations spectrales opérées par la régression ridge se révèle à travers le prisme de la décomposition en valeurs singulières (SVD, pour Singular Value Decomposition) appliquée à la matrice de conception standardisée X. Toute matrice réelle de dimensions n × p admet une factorisation canonique de la forme X = UDVT, où U est une matrice orthogonale n × p dont les colonnes forment les vecteurs propres de XXT, V est une matrice orthogonale p × p dont les colonnes constituent les directions principales (ou vecteurs propres de XTX), et D est une matrice diagonale contenant les valeurs singulières ordonnées d1 ≥ d2 ≥ … ≥ dp ≥ 0.
En substituant cette décomposition spectrale dans l’expression des prédictions d’échantillon Ŷ, nous obtenons pour le modèle des moindres carrés l’écriture canonique ŶMCO = XβMCO = UUTY = ∑j=1p ujujTY. Chaque composante principale orthogonale uj issue des régresseurs contribue sans atténuation à la prédiction finale de Y. En appliquant la même substitution à l’estimateur ridge, l’équation prédictive se transmute de manière révélatrice :
Ŷridge = Xβ̂ridge = ∑j=1p [dj2 / (dj2 + λ)] ujujTY
Cette équation spectrale démontre que la régression ridge applique un facteur de filtrage multiplicatif fj = dj2 / (dj2 + λ) à chaque projection de la variable réponse sur les axes principaux de variation. Lorsque la valeur singulière dj est élevée — ce qui correspond à une direction spatiale supportant une forte variance empirique au sein des données —, le ratio d’amortissement s’approche de 1 et le signal est préservé. En revanche, lorsque dj est infinitésimale — matérialisant une direction de colinéarité critique caractérisée par une variance résiduelle infime et une variance d’estimation MCO explosive —, le dénominateur est dominé par λ, provoquant un effondrement du coefficient de filtrage vers zéro. La régression ridge agit donc comme un filtre passe-bas directionnel adaptatif, amortissant les fluctuations statistiques associées aux directions de faible inertie informationnelle.
8.3 Correction du conditionnement matriciel de l’information
L’instabilité chronique de l’inversion matricielle au sein des systèmes colinéaires découle directement de la définition du nombre de conditionnement de l’opérateur linéaire d’information. Pour la matrice de Gram classique A = XTX, le nombre de conditionnement spectral au sens de Turing s’exprime par le ratio de ses valeurs extrêmes :
κ(XTX) = λmax(XTX) / λmin(XTX) = dmax2 / dmin2
Lorsqu’un ensemble de variables explicatives affiche de puissantes corrélations internes, la plus petite valeur propre λmin converge vers des valeurs infinitésimales, projetant κ vers des seuils critiques excédant 103 ou 104. Dans de telles conditions de fragilité, l’erreur relative affectant la solution numérique β peut égaler l’erreur relative sur les données initiales multipliée par κ, induisant une perte totale de précision arithmétique et une sensibilité chaotique à l’arrondi informatique.
L’introduction chirurgicale de la perturbation ridge λI sur la matrice transforme le spectre d’inversion en déplaçant uniformément l’ensemble des valeurs propres vers la droite sur l’axe réel. Le spectre de la nouvelle matrice régularisée Aridge = XTX + λI devient {λj + λ}. Dès lors, le nombre de conditionnement corrigé s’exprime par :
κ(XTX + λI) = (λmax + λ) / (λmin + λ)
Même dans la conjecture la plus désespérée où λmin s’annule rigoureusement (matrice dégénérée de rang incomplet), le nouveau nombre de conditionnement est majoré par (λmax + λ) / λ, une quantité finie, parfaitement contrôlée et tempérée dès que λ adopte une amplitude substantielle. L’opérateur matriciel est ainsi ramené au sein d’une zone de stabilité numérique absolue, immunisant le solveur informatique contre la propagation du bruit numérique et restituant une reproductibilité parfaite aux coefficients calculés.
9. Comparaison critique : Ridge, Lasso et Elastic Net
9.1 Régularisation L2 versus régularisation L1
La distinction conceptuelle et opérationnelle séparant la régularisation ridge de la technique du Lasso (Least Absolute Shrinkage and Selection Operator), introduite par Robert Tibshirani en 1996, réside dans le choix topologique de la fonction de contrainte. Tandis que la méthode ridge pénalise la somme des carrés des coefficients via la norme L2 euclidienne (||β||22), le Lasso substitue à cette fonction quadratique la norme L1, correspondant à la sommation des valeurs absolues des paramètres :
JLasso(β) = ||Y – Xβ||22 + λ ∑j=1p |βj|
Cette altération géométrique engendre des comportements méthodologiques distincts. L’espace de contrainte défini par la norme L1 adopte la forme d’un hyper-polyèdre régulier doté de sommets et d’arêtes pointues alignés avec les axes de coordonnées cartésiennes. L’ellipsoïde des résidus entre fréquemment en tangence avec ces singularités angulaires non différentiables, provoquant l’annulation arithmétique exacte d’une partie des coefficients. Le Lasso opère ainsi une sélection automatique et parcimonieuse de variables, élaguant le système explicatif pour ne retenir qu’un sous-ensemble restreint de régresseurs actifs.
En revanche, la régression ridge se singularise par sa totale incapacité à réaliser une sélection discrète de variables : chaque prédicteur se voit assigner une pente infinitésimale mais strictement non nulle. Cette propriété, qui pourrait sembler un désavantage dans une optique de compression parcimonieuse, devient un atout méthodologique majeur en présence de fortes corrélations. Confronté à un groupe de variables hautement corrélées, le Lasso se montre erratique : il sélectionne arbitrairement une seule variable au sein du cluster et annule brutalement les autres, sans considération pour leur fondement théorique. La régression ridge, fidèle à son principe de rétrécissement continu, préserve l’intégralité du groupe en partageant harmonieusement la magnitude des coefficients entre les prédicteurs redondants, un comportement désigné sous le vocable de propriété de regroupement (grouping effect).
9.2 L’approche combinée de l’Elastic Net
Pour dépasser les limites inhérentes à chacune des pénalités pures — le refus de sélection du modèle ridge et l’instabilité face aux clusters colinéaires du Lasso —, Hui Zou et Trevor Hastie ont conceptualisé en 2005 une synthèse théorique élégante : l’Elastic Net. Cette méthodologie hybride incorpore de façon simultanée les deux métriques de pénalisation au sein d’une fonction de coût convexe augmentée à double régulateur :
JElasticNet(β) = ||Y – Xβ||22 + λ [ α ||β||1 + ((1 – α) / 2) ||β||22 ]
Dans cette architecture bi-paramétrique, le scalaire global λ contrôle l’énergie totale du rétrécissement, tandis que le paramètre de pondération convexe α ∈ [0, 1] arbitre l’équilibre entre les deux philosophies. Lorsque α = 1, le modèle s’identifie rigoureusement au Lasso pur ; lorsque α = 0, il rétrograde exactement vers la régression ridge standard. Pour les valeurs intermédiaires de α, l’Elastic Net mobilise conjointement les bénéfices de ses deux composantes : le terme de courbure L2 stabilise le conditionnement matriciel et impose l’effet de regroupement des variables corrélées, tandis que le terme L1 applique une troncature nette pour éliminer les prédicteurs sans signal.
Cette polyvalence opérationnelle fait de l’Elastic Net un instrument de choix lors de l’investigation de panels phénotypiques ou d’enregistrements psychophysiologiques complexes caractérisés par des milliers de régresseurs mutuellement intriqués. Ce gain d’adaptabilité s’accompagne néanmoins d’une contrainte computationnelle substantielle : l’espace d’optimisation des hyperparamètres cesse d’être une ligne unidimensionnelle pour devenir une grille bidimensionnelle, requérant des explorations croisées plus dispendieuses en temps de calcul.
9.3 Critères méthodologiques de sélection du modèle approprié
L’arbitrage méthodologique entre l’adoption d’un formalisme ridge, d’une modélisation Lasso ou d’une calibration Elastic Net doit être guidé par la congruence entre les propriétés formelles de chaque régulateur et la structure sous-jacente postulée du système étudié. Il n’existe pas d’algorithme suprême au sens absolu du théorème du « No Free Lunch » ; la performance comparative de chaque paradigme dépend de la conformité de sa topologie mathématique avec le paysage informationnel réel du champ d’investigation :
- Adoption de la régression Ridge : Recommandée lorsque la théorie scientifique postule une architecture causale diffuse, c’est-à-dire une réalité ontologique au sein de laquelle un très grand nombre de facteurs concourent simultanément à l’émergence du critère d’étude, chacun déployant un effet de taille modeste à modérée. Ce scénario correspond fidèlement à la majorité des inventaires psychométriques larges, des profils de personnalité et des déterminants polyfonctionnels du comportement.
- Adoption du Lasso : Méthodologiquement justifiée lorsque l’hypothèse de travail postule une parcimonie biologique ou environnementale stricte (sparse signal), impliquant qu’au sein d’un catalogue massif de plusieurs centaines ou milliers de variables exploratoires, seule une minorité substantielle exerce une influence causale déterminante, l’ensemble résiduel n’étant constitué que de bruits aléatoires parasites.
- Adoption de l’Elastic Net : Indispensable lorsque l’investigateur se trouve confronté à la combinaison conjointe d’une structure causale présumée parcimonieuse et de sous-ensembles de covariables fortement intercorrélées formant des blocs syndromiques indissociables, comme dans les profils d’expression génétique ou les cartographies neuro-anatomiques en imagerie cérébrale.
En psychométrie et en sciences sociales, où les postulats de parcimonie stricte sont rarement corroborés par la complexité intégrative des mécanismes mentaux, la régression ridge demeure le modèle par excellence pour consolider l’estimation globale des systèmes prédictifs sans mutiler arbitrairement la richesse dimensionnelle des protocoles d’évaluation standardisés.
10. Applications méthodologiques dans la recherche en psychologie
10.1 Analyse de batteries psychométriques denses et redondantes
L’une des applications empiriques les plus fécondes de la régression ridge réside dans l’analyse de batteries psychométriques complexes. La construction des inventaires de personnalité contemporains — tels que les instruments dérivés du modèle en cinq facteurs (NEO-PI-R), le modèle HEXACO ou les questionnaires d’évaluation de la symptomatologie psychopathologique à l’instar du MMPI-3 — repose sur l’agrégation d’échelles composées d’items mutuellement corrélés pour maximiser la consistance interne via le coefficient alpha de Cronbach ou l’oméga de McDonald.
Lorsque les chercheurs cherchent à prédire un critère comportemental ou clinique externe (par exemple, la réactivité émotionnelle face à un facteur de stress aigu ou l’observance thérapeutique au long cours) en intégrant simultanément l’ensemble de ces échelles psychométriques comme prédicteurs au sein d’un modèle linéaire standard, la colinéarité omniprésente induit des effets destructeurs. Des échelles mesurant des construits convergents, comme l’anxiété et la dépression, entrent en concurrence stochastique, aboutissant à des coefficients insignifiants ou à l’apparition de paradoxes d’inversion de signes psychologiquement invraisemblables (où, par exemple, un niveau d’anxiété élevé semblerait faussement protéger contre la détresse émotionnelle).
L’implémentation de la régression ridge désamorce ces pathologies statistiques. En contractant conjointement les coefficients des dimensions en conflit sans en évincer aucune, la régularisation L2 préserve la validité de contenu du profil psychologique complet. Le praticien et le chercheur obtiennent des estimations paramétriques stables, théoriquement cohérentes et dont les magnitudes reflètent enfin la contribution conjointe et partagée des dimensions évaluées, sans que la redondance psychométrique ne vienne fragiliser la robustesse prédictive du modèle.
10.2 Exploitation de données neurobiologiques et cognitives
L’intégration grandissante des neurosciences cognitives au sein de la psychologie contemporaine confronte les méthodologistes à des typologies de données massives caractérisées par un ratio prédicteurs-observations chroniquement défavorable (p >> n). Les investigations s’appuyant sur l’imagerie par résonance magnétique fonctionnelle (IRMf), les tracés d’électroencéphalographie (EEG) à haute densité ou les cartographies de connectivité structurelle génèrent des milliers de voxels, de capteurs ou de biomarqueurs corticaux pour des cohortes cliniques excédant rarement quelques dizaines ou centaines d’individus.
Au-delà de cette disproportion dimensionnelle, ces descripteurs neurophysiologiques présentent une autocorrélation spatiale et temporelle continue. Deux voxels cérébraux contigus ou deux capteurs scalaires voisins enregistrent des signaux électrophysiologiques quasi superposables, induisant une structure d’interdépendance spatiale maximale. Tenter de régresser une performance cognitive ou un indice clinique de déclin mnésique sur de tels signaux via les moindres carrés constitue une impossibilité mathématique absolue en raison de la singularité de la matrice de Gram.
La régression ridge résout avec brio cette contrainte d’inversion tout en amortissant la dispersion propre aux mesures neuro-implicites. En conservant l’intégralité des signaux spatiaux au sein de l’équation prédictive sans procéder à une sélection parcimonieuse discontinue qui mutilerait l’organisation distribuée des réseaux neuronaux, la pénalisation L2 permet d’isoler des profils prédictifs cérébraux continus et biologiquement interprétables. Les modèles d’encodage et de décodage neuronal s’appuient ainsi massivement sur la régularisation ridge pour extraire des prédictions robustes de l’activité cognitive à partir des flux de signaux neurobiologiques denses.
10.3 Évaluation longitudinale et dynamique des traits de personnalité
L’exploration contemporaine des processus psychologiques a connu une transformation paradigmatique grâce au déploiement de protocoles de recueil intensifs en vie quotidienne, tels que les méthodologies d’évaluation écologique instantanée (ESM, pour Experience Sampling Methodology) et les protocoles longitudinaux multi-vagues. Ces approches permettent d’évaluer de manière répétée les états affectifs, les fluctuations du stress perçu et les régulations comportementales d’un sujet sur des dizaines d’occurrences temporelles successives.
La modélisation de ces données dynamiques impose l’analyse de mesures répétées caractérisées par une puissante autocorrélation temporelle sérielle et des dépendances stationnaires marquées entre les mesures décalées dans le temps (effets autorégressifs d’ordre un ou supérieur, effets croisés décalés). L’introduction conjointe de trajectoires temporelles longitudinales au sein d’un même modèle d’ajustement réveille des mécanismes colinéaires prononcés entre les états successifs observés.
En exploitant la régression ridge, les investigateurs peuvent intégrer sereinement ces séries temporelles denses afin de prédire des indicateurs de santé mentale ou de basculement émotionnel sans subir l’explosion d’instabilité propre aux modèles autorégressifs non régularisés. Le modèle préserve la cohérence longitudinale du développement individuel, stabilisant l’estimation des forces de rappel dynamiques face aux aléas de l’échantillonnage temporel et permettant d’isoler les marqueurs prédictifs fondamentaux de la résilience psychologique avec une fidélité reproductible.
11. Implémentation computationnelle et analyse empirique pas à pas
11.1 Mise en œuvre sous l’environnement R
L’écosystème statistique du logiciel libre R dispose d’une infrastructure dédiée à l’estimation régularisée à travers le package de référence glmnet, développé initialement par Jerome Friedman, Trevor Hastie et Robert Tibshirani. Ce package implémente des solveurs d’optimisation par descente de coordonnées par blocs cycliques d’une efficience algorithmique remarquable, capables de traiter des matrices de très haute dimensionnalité en un temps computationnel minime.
La séquence opérationnelle débute impérativement par la conversion rigoureuse des données sous la forme d’une matrice numérique pure pour les prédicteurs explicatifs et d’un vecteur continu pour la variable réponse. Contrairement aux fonctions classiques de modélisation univariée, l’interface de calcul n’utilise pas la syntaxe des formules symboliques conventionnelles afin de préserver l’intégrité de la mémoire vive. La fonction cv.glmnet exécute ensuite de manière entièrement automatisée une validation croisée à k blocs (par défaut k = 10) sur une grille de 100 valeurs de lambda distribuées logarithmiquement. Le paramètre alpha est rigoureusement fixé à 0 pour commander l’exécution exclusive de la régularisation ridge quadratique L2, tandis que l’argument standardize est configuré à TRUE pour contraindre le logiciel à centrer et réduire l’ensemble des colonnes avant l’engagement des boucles numériques.
À l’issue de l’optimisation croisée, l’objet de diagnostic résultant permet d’extraire immédiatement deux métriques fondamentales : lambda.min, correspondant au coefficient de pénalité qui réalise l’infimum absolu de l’erreur quadratique moyenne empirique, et lambda.1se, matérialisant la valeur la plus régularisée située à moins d’un écart-type de cette performance minimale. L’invocation des méthodes génériques de visualisation graphique permet de projeter la courbe d’évolution de l’erreur de validation croisée en fonction du logarithme de lambda, complétée par les intervalles d’incertitude stochastique associés à chaque pli, fournissant au praticien une validation visuelle immédiate de la stabilité du point d’ancrage sélectionné.
11.2 Application sous Python avec Scikit-Learn
Au sein de l’environnement Python, l’analyse prédictive régularisée est principalement opérée via la bibliothèque fondamentale Scikit-Learn. L’architecture orientée objet de ce framework impose la construction d’un pipeline de traitement hermétique, garantissant la standardisation rigoureuse des covariables et prévenant les fuites d’information lors du conditionnement croisé.
Le workflow méthodologique s’articule autour de la classe Pipeline, encapsulant l’opérateur de prétraitement StandardScaler et la classe d’estimation RidgeCV. L’opérateur StandardScaler réalise le centrage par la moyenne et la division par la variance empirique unitaire, tandis que RidgeCV intègre nativement un algorithme d’optimisation hautement accéléré basé sur la validation croisée généralisée (GCV). Cette routine exploite la décomposition spectrale fermée pour explorer une grille logarithmique d’hyperparamètres (généralement construite via une séquence logarithmique s’étalant de 10-3 à 105) sans recalculer intégralement les projections matricielles pour chaque sous-échantillon.
Une fois le pipeline instancié, l’appel de sa méthode d’ajustement sur les données d’entraînement déclenche l’exécution séquentielle du prétraitement et de la calibration optimale. Le modèle extrait alors l’hyperparamètre retenu ainsi que le vecteur des coefficients régularisés, exprimés dans l’espace métrique transformé. L’accès aux métriques post-ajustement s’opère par le calcul des résidus prédictifs sur la partition de test laissée en réserve, permettant d’évaluer le coefficient de détermination R2 de généralisation ainsi que l’erreur absolue moyenne (MAE) en conditions réelles de déploiement.
11.3 Diagnostics post-estimation et validation croisée externe
L’ajustement d’un modèle pénalisé ne dispense en rien le chercheur de réaliser un examen approfondi de la distribution des résidus d’estimation post-régularisation. Les résidus ridge, calculés par ei = yi – ŷi(ridge), doivent faire l’objet de visualisations graphiques diagnostiques pour attester de l’absence de non-linéarité patente ou de patterns d’hétéroscédasticité majeurs. Bien que l’estimateur ridge tolère une violation modérée des hypothèses gaussiennes quant à son pouvoir prédictif brut, l’apparition d’une structure résiduelle fortement déviante signale une omission fonctionnelle que la simple pénalité L2 ne saurait corriger.
Le protocole de validation méthodologique le plus irréprochable consiste à soumettre l’architecture globale à un schéma de validation croisée imbriquée (nested cross-validation), ou à défaut, à une séparation définitive entre un échantillon d’apprentissage-optimisation (80% des observations) et un échantillon test de réplication externe rigoureusement indépendant (20% des sujets), sanctuarisé jusqu’à l’étape finale. Le modèle ridge, calibré et régularisé exclusivement sur le premier volet, est alors projeté sur les observations test sans la moindre modification paramétrique.
Les métriques de performance obtenues sur ce jeu de test externe fournissent une quantification non contaminée de la capacité réelle de généralisation du modèle. Une comparaison chiffrée de ces résultats avec les performances obtenues par une régression classique des moindres carrés ordinaires permet de documenter formellement le gain méthodologique engrangé : effondrement de l’erreur quadratique moyenne de test, stabilité confirmée de la variance des coefficients individuels et élimination des amplitudes excessives. Ce reporting comparatif rigoureux répond aux exigences méthodologiques les plus strictes de la communication scientifique internationale.
12. Limites épistémologiques, défis actuels et perspectives futures
12.1 Le défi de l’inférence statistique sous estimation biaisée
Si la régression ridge triomphe avec brio sur le terrain de la prédiction pure et de la minimisation de l’erreur quadratique moyenne, elle pose un défi méthodologique fondamental dès lors que l’objectif de la modélisation concerne l’inférence confirmatoire stricte et le test formel d’hypothèses nulles. Dans le cadre canonique des moindres carrés ordinaires, la théorie statistique classique fournit une formule exacte et élégante pour déterminer les distributions asymptotiques des estimateurs sans biais, autorisant le calcul immédiat des erreurs-types, des intervalles de confiance exacts et des p-valeurs associées aux statistiques de Student : t = β̂MCO / SE(β̂MCO).
Dans la régression ridge, l’introduction délibérée du terme de biais déterministe λ(XTX + λI)-1β pulvérise la simplicité de ces distributions d’échantillonnage. Dans la mesure où la valeur vraie du paramètre β demeure par essence inobservable, la magnitude exacte du biais résiduel demeure inconnue. Dès lors, construire un intervalle de confiance centré naïvement sur l’estimateur ridge sans corriger ce décalage structurel aboutit à un intervalle qui ne respecte plus son niveau de couverture nominale de 95%, induisant une sous-estimation systématique du risque d’erreur.
Pour surmonter cet écueil épistémologique majeur, la recherche méthodologique s’est orientée vers le déploiement de techniques de rééchantillonnage non paramétriques, au premier rang desquelles figure le bootstrap par paires ou le bootstrap résiduel. En générant par tirage avec remise des milliers de pseudo-échantillons expérimentaux, le bootstrap permet de cartographier empiriquement la distribution d’échantillonnage de l’estimateur ridge et de dériver des intervalles de confiance ajustés au biais. Parallèlement, des développements récents en statistique théorique ont donné naissance à des procédures d’inférence débiaisée (de-biased ridge inference), qui appliquent des corrections analytiques projectives pour restaurer la validité asymptotique des tests de significativité au sein des modèles régularisés.
12.2 Prise en compte des données manquantes et des structures hiérarchiques
L’application empirique de la régression ridge se heurte fréquemment à des singularités architecturales inhérentes aux données des sciences humaines et de santé, notamment l’incomplétude informationnelle issue des données manquantes et la dépendance stochastique générée par les données hiérarchiques ou emboîtées. Lorsque les prédicteurs comportent des valeurs manquantes, la combinaison de la régularisation quadratique avec les techniques d’imputation multiple impose un protocole computationnel rigoureux : la régularisation et l’optimisation de λ doivent impérativement être conduites séparément au sein de chaque matrice imputée, avant que les vecteurs de paramètres régularisés ne soient consolidés selon les règles de combinaison de Rubin.
De surcroît, lorsque les observations sont hiérarchiquement imbriquées au sein de structures collectives (par exemple des élèves regroupés au sein de classes scolaires, ou des patients suivis au sein de différents centres hospitaliers), l’axiome d’indépendance conditionnelle s’effondre sous l’effet des corrélations intra-classes. Pour modéliser adéquatement ces données stratifiées, la régression ridge s’étend naturellement au champ des modèles linéaires à effets mixtes (LMM), sous la forme de pénalités différentielles appliquées distinctement aux composantes de variance fixe et aux matrices de covariance des effets aléatoires.
Enfin, pour capturer les non-linéarités complexes et les surfaces de réponse interactives sans renoncer à la structure du rétrécissement L2, les théoriciens ont formalisé la régression ridge à noyaux reproduisants (Kernel Ridge Regression). En projetant implicitement les prédicteurs d’origine vers un espace de Hilbert de dimension infinie via l’artifice du noyau (noyau gaussien RBF ou polynomial), le modèle calcule un hyperplan régularisé optimal au sein de cet espace enrichi, fournissant une modélisation non linéaire puissante tout en maintenant une immunité absolue contre les effondrements de conditionnement matriciel.
12.3 L’interprétation bayésienne de la régression ridge
L’un des accomplissements théoriques les plus saisissants de la statistique moderne est sans conteste la démonstration de l’équivalence formelle unissant la régression ridge fréquentiste à l’inférence bayésienne des paramètres. Dans le paradigme bayésien, les paramètres β ne sont plus considérés comme des constantes physiques figées, mais comme des variables aléatoires gouvernées par des lois de probabilité a priori traduisant l’état de connaissance de l’investigateur préalablement à la collecte des données empiriques.
Considérons un modèle probabiliste standard où la vraisemblance conditionnelle des données Y sachant les paramètres β et la variance σ2 suit une distribution gaussienne multivariée : Y|X, β, σ2 ~ N(Xβ, σ2In). Assignons désormais à chaque coefficient βj une loi de probabilité a priori normale, indépendante, strictement centrée sur zéro et dotée d’une variance commune τ2, formalisée par β ~ N(0, τ2Ip). En vertu du théorème fondamental de Bayes, la distribution conditionnelle a posteriori des paramètres s’écrit proportionnellement au produit de la vraisemblance empirique et de la densité a priori :
p(β|Y, X, σ2, τ2) ∝ p(Y|X, β, σ2) × p(β|τ2)
En développant le logarithme népérien de cette densité de probabilité a posteriori, nous découvrons que la recherche de l’estimateur du maximum a posteriori (MAP) — qui identifie la configuration paramétrique la plus probable au regard conjoint des observations et de l’a priori — revient rigoureusement à minimiser l’expression algébrique suivante :
-ln p(β|Y, X) = (1 / 2σ2) ||Y – Xβ||2 + (1 / 2τ2) ||β||2 + Constante
En multipliant l’ensemble de cette équation différentielle par la quantité 2σ2, nous retrouvons rigoureusement la fonction de coût augmentée canonique de la régression ridge : ||Y – Xβ||2 + λ ||β||2, au sein de laquelle le paramètre d’arbitrage scalaire s’identifie de façon déterministe comme le ratio exact des variances stochastiques : λ = σ2 / τ2.
Cette convergence conceptuelle magistrale illumine le sens profond de la régularisation ridge. Pénaliser la magnitude quadratique des coefficients au sens fréquentiste équivaut axiomatiquement à formuler la conviction bayésienne a priori que les véritables effets paramétriques ont une forte probabilité de résider dans un voisinage étroit autour de zéro. Plus la variance résiduelle de l’observation empirique σ2 est massive face à la dispersion attendue du signal τ2, plus le ratio λ s’élève, imposant une contraction proportionnelle de la solution vers l’origine afin de ne pas surinterpréter le bruit stochastique. En scellant ainsi la réconciliation épistémologique entre rigueur fréquentiste et intuition bayésienne, la régression ridge s’impose comme une charpente méthodologique fondamentale de la science des données moderne.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1-22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2e éd.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Applications to nonorthogonal problems. Technometrics, 12(1), 69-82. https://doi.org/10.1080/00401706.1970.10488635
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Tikhonov, A. N. (1963). On the solution of ill-posed problems and the method of regularization. Doklady Akademii Nauk SSSR, 151(3), 501-504.
- Wahba, G. (1990). Spline models for observational data. Society for Industrial and Applied Mathematics. https://doi.org/10.1137/1.9781611970128
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301-320. https://doi.org/10.1111/j.1467-9868.2005.00503.x