
L’inférence statistique contemporaine constitue le socle méthodologique sur lequel reposent l’ensemble des sciences quantitatives, de l’épidémiologie clinique à la psychométrie expérimentale. Parmi les instruments fondamentaux d’estimation de paramètres, l’intervalle de confiance pour une proportion occupe une place à la fois omniprésente et singulière. Tandis que l’attention des chercheurs s’est historiquement concentrée sur les variables continues régies par des distributions gaussiennes, une part prépondérante des phénomènes psychologiques, comportementaux et médicaux se manifeste sous une forme discrète, catégorielle ou dichotomique. Qu’il s’agisse de documenter l’occurrence d’un trouble neuropsychiatrique, d’évaluer le taux d’abandon d’une thérapie cognitive ou d’attester de la réussite à une épreuve neuropsychologique standardisée, le statisticien est perpétuellement confronté à la nécessité d’estimer une proportion populationnelle inconnue à partir des données partielles et intrinsèquement fluctuantes d’un échantillon fini.
Pourtant, la simplicité apparente de la proportion empirique occulte une complexité épistémologique et probabiliste remarquable. La substitution d’une estimation ponctuelle unique par un intervalle de valeurs plausibles ne procède pas seulement d’un raffinement technique, mais d’une exigence scientifique cardinale : celle de formaliser rigoureusement le degré d’incertitude indissociable de tout acte d’échantillonnage probabiliste. La transposition mécanique de l’approximation normale aux distributions binaires engendre fréquemment des distorsions préjudiciables lorsque la taille d’échantillon s’avère restreinte ou que le phénomène étudié relève d’une prévalence marginale. L’analyste se trouve dès lors à la croisée de modélisations concurrentes, oscillant entre l’approximation asymptotique classique de Wald, les réajustements de Wilson ou d’Agresti-Coull, et les approches exactes dérivées des travaux de Clopper et Pearson.
Le présent traité propose une déconstruction exhaustive des fondements théoriques, des formulations mathématiques, des conditions d’application et des enjeux pratiques présidant à la dérivation de l’intervalle de confiance pour une proportion. À travers une approche résolument rigoureuse et ancrée dans les exigences de la recherche empirique moderne, ce document offre une analyse approfondie des mécanismes de transition de la loi binomiale vers la distribution normale, détaille les protocoles de calcul pas à pas, discute des implications épistémologiques du paradigme fréquentiste et expose l’implémentation logicielle au sein des environnements d’analyse R et Python. Enfin, une attention toute particulière est accordée aux écueils d’interprétation récurrents et aux directives rédactionnelles issues des normes internationales les plus strictes.
1. Cadre conceptuel et définition de l’intervalle de confiance pour une proportion
L’estimation par intervalle d’une proportion s’inscrit au cœur de la théorie statistique de l’échantillonnage, fournissant un cadre formalisé pour extrapoler les observations empiriques à des populations entières tout en quantifiant la marge d’erreur inhérente à cette inférence.
1.1 Définition formelle de la proportion dans une population et son estimateur ponctuel
Au sein de la théorie classique de l’échantillonnage, une population cible est modélisée comme un ensemble d’unités statistiques, dénombrables ou conceptuellement infinies, au sein desquelles chaque individu possède ou ne possède pas une caractéristique d’intérêt bien déterminée. Sur le plan mathématique, cette variable indicatrice d’appartenance est formalisée par une variable aléatoire binaire de Bernoulli $X$, adoptant la valeur 1 lorsque l’unité exhibe la caractéristique observée (succès conceptuel) et la valeur 0 dans le cas contraire. La proportion populationnelle, conventionnellement notée $p$ (ou $\pi$ dans certains traités académiques pour souligner son statut de paramètre théorique), représente l’espérance mathématique de cette variable dans la population globale : $p = \mathbb{E}[X] = \mathbb{P}(X = 1)$. Ce paramètre constitue une constante déterministe, invariante et fixe à un instant donné, mais fondamentalement inconnaissable dans la quasi-totalité des contextes empiriques en raison de l’impossibilité pratique ou éthique de conduire un recensement exhaustif.
Afin d’appréhender cette quantité non observable, le chercheur extrait un échantillon aléatoire de taille $n$ composé de variables aléatoires indépendantes et identiquement distribuées $(X_1, X_2, dots, X_n)$. La proportion empirique observée au sein de cet échantillon, notée $\hat{p}$ (prononcée « p-chapeau »), est définie comme la moyenne arithmétique de ces variables indicatrices, soit $\hat{p} = \frac{1}{n} \sum_{i=1}^n X_i = \frac{k}{n}$, où $k$ désigne le nombre total de réalisations positives enregistrées dans la cohorte. L’estimateur $\hat{p}$ est ainsi doté de propriétés statistiques idéales au sens de la théorie de l’estimation ponctuelle. D’une part, il est rigoureusement non biaisé, ce qui implique que l’espérance de sa distribution d’échantillonnage coïncide parfaitement avec le paramètre cible : $\mathbb{E}[\hat{p}] = p$. D’autre part, en vertu de la loi forte des grands nombres, cet estimateur fait preuve de convergence stochastique presque sûre vers la véritable valeur populationnelle à mesure que la taille d’échantillon $n$ tend vers l’infini.
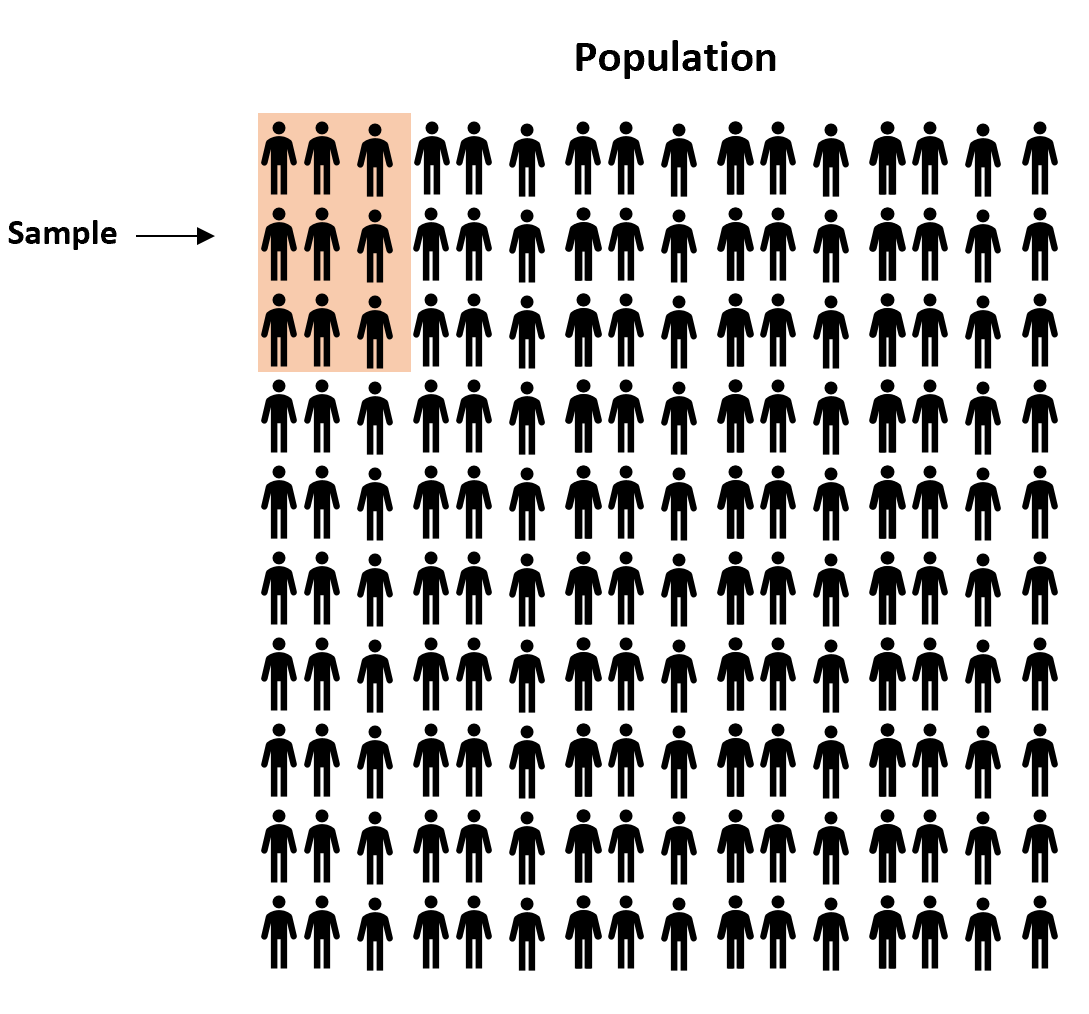
Néanmoins, la perfection asymptotique d’un estimateur ponctuel dissimule son insuffisance intrinsèque lorsqu’il est confronté aux exigences de la pratique scientifique. Présenter un score ponctuel unique revient à ignorer la variabilité d’échantillonnage, c’est-à-dire le fait indiscutable qu’une réplication du protocole expérimental menée dans des conditions rigoureusement identiques aboutirait inéluctablement à une valeur numérique divergente de $\hat{p}$. Une valeur ponctuelle isolée ne véhicule aucune information relative à sa propre précision : observer une proportion de 50 % de rémission au sein d’une cohorte expérimentale de 4 patients génère une intuition clinique fondamentalement dissemblable d’une proportion identique observée auprès d’un panel de 4 000 individus. L’estimation ponctuelle doit donc impérativement être suppléée par un dispositif analytique capable de borner la dispersion attendue du paramètre.
1.2 Définition fréquentiste de l’intervalle de confiance
L’intervalle de confiance, formulé originellement par le mathématicien et statisticien Jerzy Neyman dans les années 1930, constitue la réponse orthodoxe de l’école fréquentiste à la variabilité inhérente aux mesures d’échantillons. Dans ce paradigme épistémologique, la probabilité est définie exclusivement comme la limite de la fréquence relative d’un événement au cours d’une série infinie de répétitions indépendantes d’un même protocole probabiliste. Appliqué à l’estimation d’une proportion, un intervalle de confiance bilatéral au niveau nominal de confiance $(1 – \alpha)$, couramment fixé à 95 % ($\alpha = 0{,}05$), est délimité par deux statistiques d’échantillonnage aléatoires, la borne inférieure $L(X_1, dots, X_n)$ et la borne supérieure $U(X_1, dots, X_n)$, conçues de telle sorte que la probabilité a priori que l’intervalle recouvre le paramètre fixe inconnu $p$ s’établisse précisément à $(1 – \alpha)$ :
$$\mathbb{P}\left( L le p le U \right) = 1 – \alpha$$
Il est impératif de souligner la dissymétrie ontologique fondamentale sous-tendant cette formulation. Le paramètre populationnel $p$ est une constante ontologique immuable, dépourvue de toute nature stochastique ; il n’est donc en aucun cas une variable susceptible d’osciller ou d’être caractérisée par une distribution de probabilité dans le modèle fréquentiste. Ce sont les bornes $L$ et $U$ qui possèdent une nature strictement aléatoire, puisqu’elles dépendent directement des données fluctuantes de l’échantillon empirique recueilli. Par conséquent, affirmer qu’un intervalle de confiance à 95 % calculé sur un échantillon donné (par exemple $[0{,}42 ,;, 0{,}58]$) a « 95 % de chances de contenir le vrai paramètre » constitue une méprise conceptuelle majeure : l’intervalle numérique étant désormais figé, soit il contient la valeur $p$, soit il ne la contient pas, assignant à cet événement une probabilité rétrospective binaire égale à 0 ou à 1.
Le sens exact du risque d’erreur $\alpha$ et du niveau de couverture réside ainsi dans un engagement procédural à long terme. Si un protocole d’échantillonnage probabiliste venait à être répliqué un nombre infini de fois de manière indépendante, et que pour chaque itération un intervalle de confiance était calculé selon le même algorithme mathématique, une proportion exactement égale à $(1 – \alpha)$ de l’ensemble des intervalles construits recouvrirait effectivement la valeur inconnue du paramètre $p$, tandis qu’une proportion marginale $\alpha$ échouerait à capturer la cible. L’intervalle de confiance fournit ainsi une garantie d’efficacité attachée à la méthode d’estimation elle-même, plutôt qu’une assertion probabiliste quant à la réalisation numérique spécifique issue d’un ensemble unique d’observations.
1.3 Pertinence de l’analyse des proportions en sciences psychologiques
Les sciences du comportement et les disciplines psychologiques opèrent continuellement avec des variables qualitatives nominales et ordinales. Bien que les modèles psychométriques s’efforcent fréquemment de quantifier des construits latents continus tels que l’intelligence fluide, l’anxiété-trait ou l’extraversion, la réalité clinique et la recherche expérimentale contraignent régulièrement l’analyste à dichotomiser ou à catégoriser des états comportementaux discrets. Une décision diagnostique obéit par essence à un filtre binaire : un sujet répond ou ne répond pas aux critères d’un trouble psychiatrique définis par le Manuel diagnostique et statistique des troubles mentaux (DSM-5). L’estimation de la prévalence d’un trouble au sein d’une cohorte spécifique — qu’il s’agisse du syndrome d’épuisement professionnel chez le personnel soignant ou de la dépression post-partum chez les jeunes mères — repose invariablement sur la dérivation d’intervalles de confiance pour des proportions.
En outre, l’évaluation des programmes thérapeutiques et des interventions psychologiques s’articule largement autour de métriques binaires de compliance, de rétention et d’efficacité clinique. Calculer la proportion de patients interrompant prématurément un protocole de thérapie d’exposition face à des stimuli anxiogènes (taux de désistement ou d’attrition), mesurer le pourcentage d’individus manifestant une réponse thérapeutique cliniquement significative, ou encore évaluer le taux de récidive symptomatique à six mois post-traitement constituent des étapes incontournables de la validation des psychothérapies fondées sur des preuves. Un estimateur ponctuel du taux de rechute s’avère manifestement insuffisant pour attester de la sécurité d’une prise en charge ; seul un intervalle de confiance permet d’exclure avec un degré de certitude formalisé des scénarios cliniques défavorables situés sur la borne supérieure de l’estimation.
Enfin, la psychologie cognitive et la neuropsychologie expérimentale mobilisent de manière constante l’analyse de proportions lors de paradigmes d’apprentissage, de détection de signaux ou de tâches de mémoire de travail. Les indicateurs opérationnels y sont fréquemment formulés en termes de taux de réussite, de proportions d’erreurs d’inhibition dans les épreuves de type Go/No-Go, ou de fréquences de fausses reconnaissances au sein d’épreuves de mémoire épisodique. Dans ces contextes hautement contrôlés, l’intervalle de confiance permet de départager si une variation de performance observée entre deux conditions expérimentales reflète une véritable modulation cognitive ou si elle relève simplement de la dispersion d’échantillonnage inhérente aux séries d’essais limitées.
2. Motivation épistémologique et nécessité de l’estimation par intervalle
Comprendre pourquoi l’estimation par intervalle s’est imposée comme un standard méthodologique inébranlable requiert d’examiner les limites épistémologiques des approches réductionnistes fondées uniquement sur le rejet d’hypothèses nulles ou sur l’illusion d’une mesure exhaustive.
2.1 Quantification rigoureuse de l’erreur d’échantillonnage
L’illusion d’une omniscience empirique se heurte invariablement aux réalités matérielles, financières et temporelles de la recherche en sciences humaines. Il est matériellement impossible de soumettre l’intégralité d’une population clinique — par exemple tous les adultes diagnostiqués avec un trouble obsessionnel-compulsif dans un pays donné — à un protocole d’évaluation neuropsychologique de plusieurs heures. Le recours à l’échantillonnage probabiliste constitue dès lors une nécessité structurelle. Toutefois, dès l’instant où l’on extrait une sous-fraction d’une population globale, un phénomène inévitable émerge : le bruit d’échantillonnage. Ce dernier ne procède d’aucune défaillance instrumentale ni d’aucune maladresse de l’expérimentateur, mais découle directement de la combinatoire stochastique régissant la sélection des sujets.
La formalisation mathématique de cette incertitude repose sur le concept d’erreur type (souvent désignée par son vocable anglophone standard error). L’erreur type de l’estimateur quantifie l’écart-type de la distribution d’échantillonnage théorique de $\hat{p}$. Elle matérialise l’amplitude moyenne des écarts attendus entre la statistique empirique observée et la réalité populationnelle sous-jacente. L’intervalle de confiance opère comme un transducteur mathématique traduisant cette erreur type en une zone de plausibilité directement interprétable sur l’échelle de mesure originale du phénomène. Sans cette quantification explicite, les chercheurs s’exposent au risque constant de surinterpréter des variations fortuites, prenant des artefacts de fluctuations d’échantillonnage pour des découvertes psychologiques authentiques.
La maîtrise de l’erreur d’échantillonnage via l’intervalle de confiance joue un rôle régulateur crucial dans la crise de reproductibilité traversée par les sciences contemporaines. En documentant explicitement la dispersion admissible des estimations, les chercheurs fournissent aux réplicateurs futurs une base de comparaison transparente. Deux études évaluant la même proportion qui rapportent des estimations ponctuelles divergentes (par exemple 40 % et 52 %) ne sont nullement en contradiction si leurs intervalles de confiance respectifs présentent un chevauchement substantiel incluant ces deux valeurs. L’intervalle permet ainsi de dissocier les divergences substantielles des fluctuations statistiques incompressibles.
2.2 Dépassement du paradigme exclusif des tests d’hypothèse nulle
Durant plusieurs décennies, la recherche comportementale a été dominée par une application rituelle et souvent mécanique du test d’hypothèse nulle de Neyman-Pearson et de la signification statistique de Ronald Fisher, cristallisée par le fameux seuil $p < 0{,}05$. Cette focalisation excessive sur la p-valeur a fait l’objet de critiques méthodologiques dévastatrices de la part de théoriciens éminents tels que Jacob Cohen ou Paul Meehl. Une valeur de $p$ dichotomise artificiellement les résultats scientifiques en un verdict binaire simpliste — significatif ou non significatif — sans apporter la moindre indication quant à la taille de l’effet observé, à sa pertinence clinique pratique ou à la précision avec laquelle cet effet a été mesuré.
Face à ces dérives, les institutions savantes internationales, au premier rang desquelles l’American Psychological Association (APA) à travers son Task Force on Statistical Inference, ont édicté des directives formelles exigeant l’intégration systématique d’estimations par intervalles pour toute statistique descriptive et inférentielle majeure. L’intervalle de confiance transcende les faiblesses inhérentes au test d’hypothèse en fournissant simultanément trois niveaux d’information complémentaires :
- La direction de l’effet : en observant la position globale de l’intervalle sur le continuum probabiliste (inférieur, supérieur ou centré autour d’une valeur de référence théorique).
- La magnitude de l’effet : l’estimation ponctuelle située au cœur de la structure fournit la meilleure approximation empirique de l’amplitude du phénomène étudié.
- La précision de l’estimation : l’amplitude totale de l’intervalle (sa largeur) informe immédiatement le lecteur sur le degré de résolution atteint par le protocole de mesure.
Un test d’hypothèse concluant à une différence statistiquement significative ($p < 0{,}05$) pour une proportion de guérison peut parfaitement masquer un intervalle d'une imprécision déconcertante si l'échantillon est faible (par exemple une efficacité comprise entre 51 % et 99 %). Inversement, un résultat étiqueté « non significatif » au regard d'un seuil critique arbitraire peut être adossé à un intervalle extrêmement étroit et informatif, permettant d'exclure formellement l'existence d'un effet cliniquement valorisable. L'intervalle de confiance déplace le centre de gravité de l'évaluation scientifique de l'illusion d'une certitude dichotomique vers la reconnaissance assumée et calibrée de l'incertitude.
2.3 Implications diagnostiques et décisionnelles en psychologie appliquée
Dans l’exercice professionnel appliqué, la décision clinique ne peut s’accommoder de l’ambiguïté des estimateurs sans contrôle d’incertitude. Considérons le cas d’un psychologue du travail mandaté pour auditer le climat organisationnel d’une grande entreprise industrielle et devant déterminer la proportion de salariés exposés à des facteurs de risques psychosociaux sévères. Si le diagnostic est utilisé pour déclencher des plans de prévention obligatoires assortis de réallocations budgétaires majeures dès lors que le seuil critique de 15 % de prévalence est franchi, l’observation ponctuelle d’un taux d’échantillon de 16 % ne saurait suffire. Si l’intervalle de confiance calculé à 95 % s’étend de 11 % à 21 %, le décideur est immédiatement alerté sur le fait que les données empiriques ne permettent pas d’écarter avec un niveau de sécurité suffisant l’hypothèse selon laquelle la prévalence réelle se situe en deçà du seuil d’intervention.
De même, dans le champ de la psychologie médicale et des politiques de santé mentale publique, l’évaluation des campagnes de dépistage précoce de troubles cognitifs chez les personnes âgées exige des garanties quantitatives précises sur les taux de faux positifs et de faux négatifs. Les sensibilités et spécificités des instruments psychométriques de dépistage (comme le MoCA ou le MMSE) sont des proportions conditionnelles. Exprimer ces propriétés diagnostiques sous forme d’intervalles de confiance étroits est une condition préalable impérative avant toute généralisation à grande échelle. Une sensibilité estimée ponctuellement à 90 %, mais dont la borne inférieure d’un intervalle de confiance s’effondre à 72 % en raison d’un sous-dimensionnement de l’échantillon pilote, représenterait un danger éthique et sanitaire considérable si l’outil était déployé pour le diagnostic différentiel de pathologies neurodégénératives irréversibles.
3. Fondements probabilistes : de la loi binomiale à l’approximation normale
La dérivation analytique des bornes de confiance repose sur des théorèmes probabilistes majeurs établissant la passerelle fonctionnelle entre la loi exacte régissant les dénombrements discrets et les approximations continues issues du calcul différentiel.
3.1 Modélisation par le schéma de Bernoulli et la loi binomiale
Le socle probabiliste de l’inférence sur une proportion repose sur l’expérience conceptuelle formalisée par Jacques Bernoulli au début du XVIIIe siècle. Considérons une suite de $n$ épreuves aléatoires binaires répondant à des conditions expérimentales rigoureusement invariantes. Ce protocole, qualifié d’épreuves de Bernoulli répétées, obéit à deux axiomes structurels fondamentaux :
- La constance de la probabilité : la probabilité $p$ d’observer l’événement cible (le « succès ») demeure parfaitement identique d’un essai à l’autre, quel que soit le rang de l’essai dans la séquence.
- L’indépendance mutuelle : l’issue statistique de tout essai est strictement indépendante des résultats survenus lors des essais antérieurs ou subséquents, ce qui se traduit formellement par la factorisation des probabilités conjointes.
Sous ces postulats stricts, la variable aléatoire globale $K = \sum_{i=1}^n X_i$, matérialisant le nombre cumulé d’événements observés parmi les $n$ individus examinés, suit une loi binomiale caractérisée par les paramètres scalaires $n$ et $p$, notée classiquement $\mathcal{B}(n, p)$. La fonction de masse de probabilité de cette variable discrète, dérivée par des considérations de combinatoire élémentaire, attribue à chaque entier $k in {0, 1, dots, n}$ la probabilité exacte d’occurrence suivante :
$$\mathbb{P}(K = k) = \binom{n}{k} p^k (1 – p)^{n – k} = \frac{n!}{k!(n – k)!} p^k (1 – p)^{n – k}$$
Les moments statistiques théoriques de la variable de dénombrement $K$ sont parfaitement définis : son espérance s’élève à $\mathbb{E}[K] = n \cdot p$, et sa variance est donnée par $\mathrm{Var}(K) = n \cdot p(1 – p)$. Puisque la proportion empirique $\hat{p}$ n’est qu’une transformation linéaire scalaire de la variable binomiale ($\hat{p} = \frac{K}{n}$), ses propres propriétés distributionnelles exactes se déduisent immédiatement par les règles d’homogénéité des opérateurs statistiques :
$$\mathbb{E}[\hat{p}] = \mathbb{E}\left[\frac{K}{n}\right] = \frac{\mathbb{E}[K]}{n} = \frac{n \cdot p}{n} = p$$
$$\mathrm{Var}(\hat{p}) = \mathrm{Var}\left(\frac{K}{n}\right) = \frac{\mathrm{Var}(K)}{n^2} = \frac{n \cdot p(1 – p)}{n^2} = \frac{p(1 – p)}{n}$$
Bien que la distribution binomiale fournisse la vérité stochastique exacte du phénomène, sa manipulation arithmétique directe au cours des siècles passés s’avérait extrêmement laborieuse, singulièrement lorsqu’il s’agissait de calculer des factorielles pour des effectifs massifs, nécessitant l’émergence de théorèmes limites d’approximation.
3.2 Le Théorème Central Limite et la distribution d’échantillonnage
L’édifice de la statistique paramétrique classique repose sur l’un des monuments les plus célèbres de l’analyse mathématique : le Théorème Central Limite (TCL), dont les développements successifs par Abraham de Moivre (1738), Pierre-Simon de Laplace (1812) et Aleksandr Liapounov ont établi les conditions de convergence de sommes de variables indépendantes. Dans le cas spécifique de variables de Bernoulli indépendantes et de même paramètre $p$, le théorème de Moivre-Laplace démontre que la distribution de la variable centrée et réduite converge en loi vers la distribution normale standardisée lorsque la taille de l’échantillon croît vers l’infini :
$$\lim_{n to \infty} \mathbb{P}\left( \frac{K – np}{\sqrt{np(1 – p)}} le z \right) = \Phi(z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^z e^{-\frac{t^2}{2}} , \mathrm{d}t$$
Exprimé directement au niveau de la proportion empirique d’échantillonnage $\hat{p}$, le théorème assure que lorsque la cohorte est de dimension adéquate, la distribution de fréquence relative de l’estimateur autour du paramètre populationnel inconnu est remarquablement bien approximée par une densité gaussienne continue :
$$\hat{p} mathrel{\dot{\sim}} \mathcal{N}\left( p, , \frac{p(1 – p)}{n} \right)$$
Cette convergence asymptotique est d’une portée opérationnelle gigantesque pour le chercheur. Elle signifie que la géométrie complexe et discrète de la distribution binomiale — caractérisée par des marches d’escalier et des calculs combinatoires fastidieux — peut être valablement remplacée par la courbe en cloche continue et parfaitement symétrique de la loi normale. C’est précisément cette régularité asymptotique qui autorise l’utilisation de quantiles normalisés universels pour découper la surface sous la courbe et édifier les bornes théoriques d’un intervalle de confiance.
3.3 Comportement de l’erreur type de la proportion
L’examen minutieux de l’expression mathématique de l’erreur type asymptotique, définie théoriquement par $\sigma_{\hat{p}} = \sqrt{\frac{p(1 – p)}{n}}$, révèle des propriétés intrinsèques fondamentales qui conditionnent la largeur de tout intervalle d’estimation. La variance d’échantillonnage est régie par une fonction parabolique du paramètre $p$, à savoir le polynôme $f(p) = p(1 – p) = p – p^2$. Cette fonction quadratique est rigoureusement symétrique par rapport à l’axe $p = 0{,}5$, point où elle atteint son extremum théorique maximal :
$$f_{\max} = f(0{,}5) = 0{,}5 \times (1 – 0{,}5) = 0{,}25$$
Il en résulte une conséquence méthodologique directe : l’incertitude d’échantillonnage maximale pour une taille d’échantillon $n$ donnée se produit toujours lorsque la proportion de la population est divisée de manière parfaitement équiprobable entre les deux modalités possibles ($p = 0{,}5$). À mesure que le véritable paramètre s’éloigne de ce point central pour s’approcher des frontières déterministes du domaine probabiliste ($p to 0$ ou $p to 1$), le produit $p(1 – p)$ décroît de manière accélérée, entraînant une diminution mécanique de l’erreur type et, par conséquent, un resserrement structurel de la variance d’échantillonnage.
Cependant, cette dynamique mathématique introduit une asymétrie distributionnelle prononcée aux abords des frontières 0 et 1. Lorsque $p$ est proche de 0, la distribution binomiale présente une asymétrie positive (étalement vers la droite avec une longue traîne de valeurs positives rares), alors que lorsque $p$ est proche de 1, elle présente une asymétrie négative prononcée. L’approximation normale, qui impose une forme de cloche parfaitement symétrique autour de son centre, perd ainsi rapidement de sa fidélité géométrique lorsque la proportion d’intérêt dévie des valeurs médianes, posant un défi conceptuel majeur pour le calcul des intervalles de confiance standards.
4. Conditions d’application et postulats de validité
L’utilisation de modèles gaussiens pour estimer des données issues de dénombrements discrets n’est scientifiquement recevable que sous réserve du respect scrupuleux d’un ensemble de critères de validité probabilistes et de protocoles méthodologiques stricts.
4.1 Critères de validité pour l’approximation normale
La légitimité de la substitution de la loi binomiale par la loi normale repose sur la rapidité de la convergence garantie par le Théorème Central Limite. Pour évaluer si un échantillon a atteint un degré de maturité suffisant pour autoriser cette continuité analytique, les méthodologistes et biostatisticiens ont historiquement élaboré des règles empiriques conventionnelles portant sur les effectifs attendus de succès et d’échecs.
La règle empirique la plus classique et universellement enseignée stipule que l’échantillon doit simultanément satisfaire aux conditions suivantes :
$$n \hat{p} ge 10 \quad \text{et} \quad n (1 – \hat{p}) ge 10$$
Certains manuels d’introduction plus libéraux abaissent ce seuil critique à 5 succès et 5 échecs observés, mais cette tolérance accrue se paie au prix d’une dégradation substantielle des propriétés inférentielles de l’intervalle. L’enjeu sous-jacent à ces seuils numériques réside dans la prévention du phénomène de « glissement de couverture ». Si un chercheur tente d’appliquer l’approximation normale alors que le produit $n \hat{p}$ ne vaut que 3 (par exemple lors de l’étude d’une maladie orpheline touchant 1 individu sur 100 au sein d’une cohorte de 300 patients), l’asymétrie résiduelle de la distribution binomiale est si marquée que l’intervalle asymptotique standard fournit un taux de couverture réel largement inférieur à sa valeur nominale : un intervalle supposé garantir 95 % de confiance ne capturera en réalité le paramètre que dans 85 % ou 88 % des cas lors de réplications successives.
De plus, lorsque l’échantillon est restreint ou que le paramètre empirique est très asymétrique, l’intervalle normal présente le défaut absurde de générer des bornes mathématiques dépassant les limites strictes de l’espace de définition probabiliste $[0, 1]$, produisant des limites inférieures négatives ou des limites supérieures supérieures à l’unité, ce qui constitue une aberration sur le plan de la logique scientifique.
4.2 Postulat d’indépendance et représentativité de l’échantillon
Au-delà des contraintes d’effectifs, la validité interne de l’intervalle de confiance est subordonnée au respect rigoureux de l’hypothèse fondamentale d’indépendance probabiliste entre les observations individuelles composant la base de données. Chaque individu inclus dans le protocole expérimental doit fournir une réponse ou un état clinique qui n’est en aucune manière corrélé, influencé ou déterminé par les réponses des autres participants.
En sciences psychologiques et sociales, cette condition théorique est perpétuellement menacée par la structure intrinsèquement groupée ou hiérarchique des collectifs humains. L’échantillonnage d’élèves nichés au sein de classes scolaires spécifiques, de patients traités au sein d’une même unité hospitalière par le même psychothérapeute, ou de membres issus des mêmes cellules familiales engendre inéluctablement une corrélation intra-classe positive. L’existence d’une telle dépendance mutuelle a pour conséquence immédiate de réduire la « taille effective » de l’échantillon. Appliquer la formule conventionnelle de l’erreur type en ignorant ces regroupements revient à sous-estimer artificiellement la variance d’échantillonnage réelle, produisant des intervalles de confiance indûment étroits qui confèrent un faux sentiment de précision scientifique.
De surcroît, la représentativité de l’échantillon constitue la condition sine qua non de la validité externe de l’inférence. Le recours omniprésent aux échantillons dits de « convenance » en recherche psychologique — typiquement des étudiants de premier cycle universitaire en psychologie participant à des expérimentations contre l’attribution de crédits académiques — vicie structurellement l’estimation d’une proportion populationnelle. Si les étudiants universitaires diffèrent systématiquement de la population générale quant à leur niveau socio-économique, leur tranche d’âge ou leurs compétences métacognitives, l’intervalle de confiance estimé, aussi impeccablement calculé soit-il sur le plan algébrique, ne capturera pas le paramètre de la population nationale, mais uniquement celui du sous-groupe hautement sélectionné dont il est issu.
4.3 Correction pour population finie
Les formulations mathématiques usuelles de l’inférence reposent sur le postulat implicite que la population cible est infinie ou que l’échantillon est recueilli avec remise, de sorte que le tirage d’une unité ne modifie en rien la composition probabiliste de la population résiduelle. Toutefois, dans de nombreuses situations de recherche ciblée — par exemple lorsqu’un neuropsychologue évalue une pathologie génétique rarissime identifiée au sein d’un registre épidémiologique comprenant un total mondial exhaustif de $N = 400$ patients répertoriés — la taille de l’échantillon extrait $n$ représente une fraction appréciable de l’ensemble de la population mère.
Lorsque la fraction d’échantillonnage, définie par le ratio $f = \frac{n}{N}$, excède le seuil conventionnel de 5 % ($f > 0{,}05$), le prélèvement sans remise altère les probabilités conditionnelles des tirages successifs, relevant désormais de la loi hypergéométrique plutôt que de la loi binomiale stricte. Pour réajuster l’estimation et tenir compte de l’épuisement progressif de la population, il convient d’adjoindre à la variance d’échantillonnage un multiplicateur de contraction, désigné sous le terme de facteur de correction pour population finie (FCPF) :
$$\mathrm{FCPF} = \sqrt{\frac{N – n}{N – 1}}$$
L’erreur type corrigée de la proportion s’exprime alors rigoureusement par :
$$\mathrm{SE}_{\text{corrigée}} = \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}} \times \sqrt{\frac{N – n}{N – 1}}$$
L’impact mécanique de ce facteur correctif est évident : à mesure que la taille d’échantillon $n$ se rapproche de la taille totale de la population $N$, le numérateur $(N – n)$ tend vers zéro, comprimant l’erreur type vers une valeur nulle. Lorsque le recensement devient complet ($n = N$), le facteur s’annule totalement, dissolvant l’intervalle en un point fixe parfait, traduisant la disparition intégrale de l’incertitude d’échantillonnage statistique.
5. Formulation mathématique standard de l’intervalle de Wald
L’intervalle de Wald représente la méthode historique dominante d’estimation par intervalle d’une proportion, caractérisée par une élégance algébrique remarquable découlant directement de l’inversion analytique d’un test d’hypothèse asymptotique.
5.1 Dérivation analytique de l’intervalle asymptotique
La formulation standard de l’intervalle de confiance pour une proportion, conceptualisée originellement par Abraham Wald dans le cadre plus large de la théorie des tests de rapports de vraisemblance, découle de la statistique de test standardisée suivante :
$$Z = \frac{\hat{p} – p}{\sqrt{\frac{p(1 – p)}{n}}}$$
Sous l’empire du Théorème Central Limite, cette statistique $Z$ suit asymptotiquement une loi normale centrée et réduite $\mathcal{N}(0, 1)$. Pour isoler les bornes de l’intervalle de confiance, la démarche formelle exigerait de résoudre une inéquation quadratique complexe où le paramètre inconnu $p$ figure simultanément au numérateur et sous le radical du dénominateur. Afin de contourner cette complexité analytique, l’approximation de Wald introduit une simplification computationnelle majeure : la substitution immédiate du paramètre inconnu $p$ par son estimateur ponctuel empirique $\hat{p}$ au sein de l’expression de la variance d’échantillonnage. L’erreur type ainsi estimée devient :
$$\widehat{\mathrm{SE}}(\hat{p}) = \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}$$
Dès lors, l’encadrement probabiliste classique stipule que la statistique standardisée modifiée réside entre deux bornes symétriques définies par les quantiles d’une loi normale avec une probabilité théorique de $(1 – \alpha)$ :
$$\mathbb{P}\left( -z_{1 – alpha/2} le \frac{\hat{p} – p}{\sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}} le z_{1 – alpha/2} \right) \approx 1 – \alpha$$
Par un jeu d’inversions algébriques élémentaires isolant le paramètre central $p$, on aboutit à la formulation scalaire canonique de l’intervalle de confiance de Wald :
$$\mathrm{IC}_{1 – \alpha}(p) = \left[ \hat{p} – z_{1 – alpha/2} \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}} ; ; ; \hat{p} + z_{1 – alpha/2} \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}} \right]$$
Cette expression formalise le fait que les frontières de plausibilité du paramètre s’articulent autour d’une translation symétrique de l’estimation empirique $\hat{p}$ vers le bas et vers le haut, modulée exclusivement par le produit de l’incertitude d’échantillonnage estimée et du niveau d’exigence inférentiel matérialisé par le coefficient critique normal.
5.2 Détermination du coefficient critique selon la loi normale standardisée
Le coefficient multiplicateur $z_{1 – alpha/2}$ figurant dans l’équation de Wald représente la valeur d’abscisse de la fonction de répartition de la loi normale centrée réduite qui laisse une aire surfacique unilatérale résiduelle égale à $alpha/2$ sous la queue de distribution supérieure. En vertu de la parfaite symétrie de la densité gaussienne autour de zéro, les surfaces d’exclusion bilatérale totalisent exactement la probabilité d’erreur nominale tolérée $\alpha$.
Le tableau théorique des valeurs critiques couramment mobilisées dans les disciplines comportementales et médicales s’établit comme suit :
- Pour un niveau de confiance de 90 % ($\alpha = 0{,}10$, queue unilatérale $alpha/2 = 0{,}05$) : $z_{0{,}95} \approx 1{,}645$
- Pour un niveau de confiance de 95 % ($\alpha = 0{,}05$, queue unilatérale $alpha/2 = 0{,}025$) : $z_{0{,}975} \approx 1{,}960$
- Pour un niveau de confiance de 99 % ($\alpha = 0{,}01$, queue unilatérale $alpha/2 = 0{,}005$) : $z_{0{,}995} \approx 2{,}576$
- Pour un niveau de confiance de 99{,}9 % ($\alpha = 0{,}001$, queue unilatérale $alpha/2 = 0{,}0005$) : $z_{0{,}9995} \approx 3{,}291$
Le choix du niveau de confiance procède toujours d’un arbitrage épistémologique quantitatif entre la certitude inférentielle désirée et l’utilité pratique de la résolution obtenue. Accroître le niveau de confiance de 95 % à 99 % requiert de substituer le multiplicateur 1,960 par 2,576, ce qui dilate mécaniquement la largeur de l’intervalle de plus de 31 % pour une taille d’échantillon rigoureusement constante. Un intervalle excessivement large, bien que protégeant le chercheur contre le risque d’omettre la vraie valeur, peut aboutir à des conclusions triviales dénuées de toute pertinence pour la prise de décision empirique.
5.3 Analyse structurelle de la marge d’erreur
Le terme additif et soustractif qui s’agrège à l’estimation ponctuelle est désigné sous le vocable technique de marge d’erreur, souvent notée $E$ ou $m$ dans la littérature méthodologique :
$$E = z_{1 – alpha/2} \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}$$
La marge d’erreur matérialise la demi-largeur totale de l’intervalle de confiance. L’analyse analytique de ses composantes met en lumière les leviers fondamentaux permettant au chercheur de maîtriser la précision de son dispositif d’investigation. L’élément régulateur prépondérant réside dans la présence de la racine carrée de la taille d’échantillon $n$ au dénominateur de la fraction. Cette dépendance non linéaire selon la loi en racine inverse ($\frac{1}{\sqrt{n}}$) gouverne le rendement décroissant des collectes de données statistiques :
- Pour réduire la marge d’erreur d’un facteur deux (diviser la demi-largeur par 2), il est impératif de multiplier la taille d’échantillon par quatre ($2^2 = 4$).
- Pour réduire la marge d’erreur d’un facteur dix, l’effort d’échantillonnage doit être amplifié d’un facteur cent ($10^2 = 100$).
Cette réalité mathématique explique pourquoi l’accroissement indéfini de la précision expérimentale devient rapidement prohibitif sur le plan logistique et budgétaire. Par ailleurs, la marge d’erreur dépend intrinsèquement de la valeur même de la proportion observée $\hat{p}$. Lorsque la proportion dérive vers les extrémités de l’espace probabiliste, le terme $\sqrt{\hat{p}(1 – \hat{p})}$ s’amenuise, induisant une marge d’erreur plus faible à effectif égal. Ainsi, estimer une proportion attendue autour de 0,05 bénéficie d’une erreur standard intrinsèquement plus basse qu’estimer un équilibre parfait à 0,50, bien que les défis liés à l’asymétrie de la distribution d’échantillonnage deviennent alors prédominants.
6. Méthodes alternatives et corrections pour petits échantillons
L’accumulation d’études de simulations de Monte Carlo au cours des dernières décennies a rigoureusement prouvé que l’intervalle standard de Wald présente des défaillances systématiques sévères. Ce constat a motivé le développement de méthodes de rechange beaucoup plus robustes, désormais recommandées par les statisticiens méthodologistes contemporains.
6.1 L’intervalle de score de Wilson
Formulé dès 1927 par Edwin Bidwell Wilson, l’intervalle de score constitue une avancée mathématique décisive par rapport à l’heuristique de Wald. Le vice structurel de l’intervalle de Wald réside dans l’utilisation de l’estimateur empirique $\hat{p}$ sous le radical de la variance lors du pivotement. L’approche de Wilson refuse cette approximation opportuniste et repose sur l’inversion rigoureuse du test du score (ou test de Rao), en conservant le véritable paramètre $p$ dans la variance asymptotique sous l’hypothèse nulle :
$$-z le \frac{\hat{p} – p}{\sqrt{\frac{p(1 – p)}{n}}} le z$$
En élevant cette relation bilatérale au carré, on obtient une équation polynomiale du second degré en $p$ :
$$(\hat{p} – p)^2 = z^2 \frac{p(1 – p)}{n}$$
Le déploiement et la réorganisation des termes aboutissent à l’équation quadratique standard suivante :
$$\left(1 + \frac{z^2}{n}\right) p^2 – 2 \left(\hat{p} + \frac{z^2}{2n}\right) p + \hat{p}^2 = 0$$
La résolution analytique de ce polynôme fournit les racines réelles déterminant avec une élégance absolue les bornes inférieure et supérieure de l’intervalle de Wilson :
$$\mathrm{IC}_{\text{Wilson}} = \frac{\hat{p} + \frac{z^2}{2n} \pm z \sqrt{\frac{\hat{p}(1 – \hat{p})}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}}$$
L’inspection de cette formule révèle deux propriétés fondamentales. D’une part, le centre de l’intervalle de Wilson n’est plus la proportion observée $\hat{p}$, mais un estimateur corrigé qui opère une régularisation (ou « rétrécissement », shrinkage) attirant l’estimation vers la médiane probabiliste 0,5 :
$$\tilde{p}_{\text{centre}} = \frac{\hat{p} + \frac{z^2}{2n}}{1 + \frac{z^2}{n}} = \frac{k + \frac{z^2}{2}}{n + z^2}$$
D’autre part, la largeur des ailes inférieure et supérieure n’est plus symétrique autour de $\hat{p}$. L’intervalle de Wilson s’adapte dynamiquement à l’asymétrie de la distribution binomiale sous-jacente. Il garantit que les bornes calculées demeurent strictement confinées à l’intérieur de l’intervalle réel $[0, 1]$, et assure un taux de couverture empirique exceptionnellement fidèle au niveau nominal théorique, y compris pour des cohortes de très faibles effectifs ($n < 20$) ou pour des proportions infinitésimales.
6.2 L’ajustement d’Agresti-Coull et l’heuristique des pseudo-observations
Bien que l’intervalle de score de Wilson offre des qualités inférentielles optimales, sa formulation algébrique complexe a longtemps constitué une barrière pédagogique pour les chercheurs non mathématiciens. Pour surmonter cet obstacle, les statisticiens Alan Agresti et Brent Coull ont proposé en 1998 une approximation d’une limpidité remarquable qui réconcilie la simplicité algorithmique de l’intervalle de Wald avec la robustesse de l’intervalle de Wilson.
L’intervalle d’Agresti-Coull procède par une modification directe des données brutes de l’échantillon. Pour un niveau de confiance fixé à 95 % ($\alpha = 0{,}05$, où $z^2 = 1{,}96^2 \approx 3{,}84 \approx 4$), la méthode prescrit d’ajouter formellement deux succès et deux échecs fictifs à la cohorte empirique recueillie, une démarche souvent baptisée « règle d’addition des quatre observations » (plus-four rule). Les statistiques transformées se formalisent ainsi :
$$\tilde{n} = n + z^2 \approx n + 4$$
$$\tilde{k} = k + \frac{z^2}{2} \approx k + 2$$
$$\tilde{p} = \frac{\tilde{k}}{\tilde{n}} = \frac{k + 2}{n + 4}$$
Une fois cette proportion ajustée calculée, l’analyste applique simplement la mécanique opérationnelle classique de l’intervalle de Wald, mais en employant exclusivement ces pseudo-observations transformées :
$$\mathrm{IC}_{\text{Agresti-Coull}} = \left[ \tilde{p} – z \sqrt{\frac{\tilde{p}(1 – \tilde{p})}{\tilde{n}}} ; ; ; \tilde{p} + z \sqrt{\frac{\tilde{p}(1 – \tilde{p})}{\tilde{n}}} \right]$$
Cette régularisation par pseudo-observations opère comme un amortisseur statistique prévenant les distorsions extrêmes. Dans le cas dramatique où un échantillon restreint de 10 patients ne révélerait aucun succès ($k = 0$), la formule conventionnelle de Wald produit un estimateur ponctuel nul ($\hat{p} = 0$), une erreur standard nulle ($\mathrm{SE} = 0$) et donc un intervalle de confiance dégénéré de largeur nulle $[0, 0]$, ce qui est une aberration probabiliste trompeuse. La méthode d’Agresti-Coull introduit une incertitude régularisée avec $\tilde{p} = \frac{2}{14} \approx 0{,}143$, générant un intervalle non dégénéré doté d’une largeur réaliste et capturant adéquatement la variabilité potentielle du phénomène.
6.3 L’intervalle exact de Clopper-Pearson
Conçu dès 1934 par C. J. Clopper et Egon Pearson, l’intervalle éponyme représente la référence historique des méthodes dites « exactes ». Contrairement aux solutions asymptotiques de Wald ou de Wilson, la méthode de Clopper-Pearson s’affranchit totalement du Théorème Central Limite et résout directement les sommes cumulatives discrètes de la fonction de masse binomiale sans la moindre approximation gaussienne.
L’inversion exacte procède en définissant la borne inférieure $p_L$ comme la valeur minimale du paramètre $p$ sous laquelle la probabilité cumulée d’observer un nombre de succès supérieur ou égal au score empirique $k$ atteint au moins $alpha/2$. Symétriquement, la borne supérieure $p_U$ correspond à la valeur maximale sous laquelle la probabilité cumulative d’observer un nombre de succès inférieur ou égal à $k$ s’élève à $alpha/2$ :
$$\sum_{j=k}^n \binom{n}{j} p_L^j (1 – p_L)^{n-j} = \frac{\alpha}{2} \quad \text{pour } k > 0 \quad (\text{a\vec } p_L = 0 \text{ si } k = 0)$$
$$\sum_{j=0}^k \binom{n}{j} p_U^j (1 – p_U)^{n-j} = \frac{\alpha}{2} \quad \text{pour } k < n \quad (\text{a\vec } p_U = 1 \text{ si } k = n)$$
Bien que ces équations combinatoires polynomiales n’admettent pas de solution analytique directe par radicaux élémentaires, elles peuvent être résolues par des algorithmes numériques itératifs ou formulées de manière close via les quantiles de la loi Bêta d’Euler ou de la loi de Fisher-Snedecor :
$$p_L = \mathrm{B\eta}^{-1}\left( \frac{\alpha}{2} ,;, k, , n – k + 1 \right)$$
$$p_U = \mathrm{B\eta}^{-1}\left( 1 – \frac{\alpha}{2} ,;, k + 1, , n – k \right)$$
L’appellation d’intervalle « exact » requiert une clarification épistémologique cruciale. Si l’évaluation des probabilités est mathématiquement exacte, la couverture statistique ne correspond pas rigoureusement à $(1 – \alpha)$ de manière continue, en raison de la nature intrinsèquement discontinue (en escalier) de la variable binomiale entière. Pour garantir que le taux de couverture réel ne chute jamais sous le seuil nominal visé, l’intervalle de Clopper-Pearson est contraint d’intégrer un conservatisme structurel important. Le taux de couverture réel oscille fréquemment entre 96 % et 99 % pour un niveau nominal déclaré de 95 %. Cet hyperconservatisme se traduit par une largeur d’intervalle systématiquement plus grande que celle de ses compétiteurs modernes (Wilson ou Agresti-Coull), réduisant d’autant la puissance de résolution statistique des données empiriques.
7. Protocole de calcul pas à pas d’un intervalle de confiance
Pour ancrer ces théorèmes mathématiques dans la praxis de la recherche empirique, examinons une application concrète pas à pas issue d’un protocole d’investigation en neuropsychologie clinique.
7.1 Mise en situation empirique en psychométrie
Imaginons un laboratoire universitaire de sciences cognitives mandaté pour valider une nouvelle batterie informatisée d’évaluation des fonctions exécutives, spécifiquement conçue pour détecter les altérations précoces de la mémoire de travail chez des adultes âgés de 60 à 75 ans présentant une plainte mnésique subjective. Le protocole inclut une épreuve complexe de double tâche attentionnelle exigeant la manipulation concomitante d’informations visuo-spatiales et verbales sous pression temporelle.
L’équipe d’investigation administre cette épreuve standardisée à un échantillon probabiliste composé de $n = 80$ participants recrutés au sein de consultations mémoires hospitalières. Au terme de la phase d’évaluation standardisée, l’algorithme psychométrique classe la performance de chaque individu selon un barème normatif dichotomique strict : « Performance dans la norme » (échec de détection) ou « Performance cliniquement déficitaire » (succès du critère diagnostique d’altération cognitive). Les résultats empiriques compilés font état de $k = 28$ participants manifestant un déficit exécutif objectivé, tandis que les 52 sujets restants obtiennent des scores préservés. Le comité scientifique requiert l’établissement d’une estimation par intervalle de confiance au seuil d’exigence conventionnel de 95 % ($\alpha = 0{,}05$) afin de documenter la prévalence de ce profil cognitif déficitaire au sein de la population clinique ciblée.
7.2 Contrôle algorithmique des prérequis méthodologiques
Avant d’engager toute machinerie calculatoire, une rigueur méthodologique élémentaire impose d’effectuer un audit formel des conditions d’application des différents estimateurs théoriques disponibles.
Examinons en premier lieu les effectifs attendus sous l’estimateur ponctuel :
- Nombre d’événements positifs observés : $k = n \hat{p} = 28$
- Nombre d’événements négatifs observés : $n – k = n (1 – \hat{p}) = 80 – 28 = 52$
Les deux conditions de la règle empirique conventionnelle de l’approximation normale sont rigoureusement satisfaites :
$$n \hat{p} = 28 ge 10 \quad \text{et} \quad n (1 – \hat{p}) = 52 ge 10$$
L’approximation asymptotique par la loi normale est donc théoriquement autorisée au regard des manuels classiques. Néanmoins, la taille d’échantillon globale ($n = 80$) demeurant modeste et la proportion empirique ($\hat{p} = 0{,}35$) s’écartant sensiblement de l’équilibre parfait de 0,50, l’analyste consciencieux mènera en parallèle le calcul de l’intervalle de Wald standard et de l’intervalle de score de Wilson afin d’identifier d’éventuelles distorsions de frontière et d’arbitrer en faveur du modèle le plus robuste.
7.3 Exécution arithmétique et établissement des bornes
Déployons les calculs étape par étape pour les deux méthodes concurrentes.
Étape 1 : Calcul ponctuel et erreur type de Wald
La proportion ponctuelle empirique s’établit à :
$$\hat{p} = \frac{k}{n} = \frac{28}{80} = 0{,}3500 \quad (35{,}00,%)$$
L’erreur standard de l’estimateur de Wald est calculée selon l’expression asymptotique :
$$\widehat{\mathrm{SE}}_{\text{Wald}} = \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}} = \sqrt{\frac{0{,}35 \times (1 – 0{,}35)}{80}} = \sqrt{\frac{0{,}35 \times 0{,}65}{80}} = \sqrt{\frac{0{,}2275}{80}} = \sqrt{0{,}00284375} \approx 0{,}053327$$
Étape 2 : Marge d’erreur et bornes de Wald
Pour un niveau de confiance à 95 %, le quantile normal standardisé symétrique s’établit à $z_{0{,}975} = 1{,}95996 \approx 1{,}960$. La marge d’erreur $E_{\text{Wald}}$ correspondante est :
$$E_{\text{Wald}} = z \times \widehat{\mathrm{SE}}_{\text{Wald}} = 1{,}960 \times 0{,}053327 \approx 0{,}10452$$
Les limites numériques de l’intervalle de Wald sont déduites par soustraction et addition :
$$L_{\text{Wald}} = \hat{p} – E_{\text{Wald}} = 0{,}3500 – 0{,}10452 = 0{,}24548 \approx 0{,}2455 \quad (24{,}55,%)$$
$$U_{\text{Wald}} = \hat{p} + E_{\text{Wald}} = 0{,}3500 + 0{,}10452 = 0{,}45452 \approx 0{,}4545 \quad (45{,}45,%)$$
$$\mathrm{IC}_{\text{Wald, } 95%} = [0{,}2455 ,;, 0{,}4545] \quad \text{ou} \quad [24{,}55,% ,;, 45{,}45,%]$$
Étape 3 : Calcul arithmétique de l’intervalle de Wilson
Appliquons à présent la dérivation quadratique de Wilson avec $n = 80$, $\hat{p} = 0{,}35$ et $z = 1{,}960$ ($z^2 \approx 3{,}8416$) :
Dénominateur commun :
$$D = 1 + \frac{z^2}{n} = 1 + \frac{3{,}8416}{80} = 1 + 0{,}04802 = 1{,}04802$$
Centre régularisé :
$$\text{Centre} = \frac{\hat{p} + \frac{z^2}{2n}}{D} = \frac{0{,}35 + \frac{3{,}8416}{160}}{1{,}04802} = \frac{0{,}35 + 0{,}02401}{1{,}04802} = \frac{0{,}37401}{1{,}04802} \approx 0{,}35687$$
Terme de variabilité sous le radical :
$$\mathrm{Radical} = \sqrt{\frac{\hat{p}(1 – \hat{p})}{n} + \frac{z^2}{4n^2}} = \sqrt{0{,}00284375 + \frac{3{,}8416}{4 \times 6400}} = \sqrt{0{,}00284375 + 0{,}00015006} = \sqrt{0{,}00299381} \approx 0{,}054716$$
Marge d’oscillation modulée :
$$\mathrm{\Delta} = \frac{z \times \mathrm{Radical}}{D} = \frac{1{,}960 \times 0{,}054716}{1{,}04802} = \frac{0{,}107243}{1{,}04802} \approx 0{,}10233$$
Bornes finales de Wilson :
$$L_{\text{Wilson}} = 0{,}35687 – 0{,}10233 = 0{,}25454 \approx 0{,}2545 \quad (25{,}45,%)$$
$$U_{\text{Wilson}} = 0{,}35687 + 0{,}10233 = 0{,}45920 \approx 0{,}4592 \quad (45{,}92,%)$$
$$\mathrm{IC}_{\text{Wilson, } 95%} = [0{,}2545 ,;, 0{,}4592] \quad \text{ou} \quad [25{,}45,% ,;, 45{,}92,%]$$
La confrontation des deux résultats met en évidence le glissement correctif de l’intervalle de Wilson : son centre s’est légèrement déplacé vers 0,5 ($0{,}3569$ contre $0{,}3500$), réhaussant la borne inférieure de près d’un point de pourcentage ($25{,}45,%$ contre $24{,}55,%$). Ce recalibrage élimine le déficit de couverture inhérent à l’intervalle de Wald, offrant une assise empirique infiniment plus rigoureuse pour l’article scientifique en préparation.
8. Interprétation épistémologique et écueils interprétatifs fréquents
L’élégance de la formulation mathématique ne prémunit aucunement contre les contresens épistémologiques. Les statistiques inférentielles sont le théâtre d’incompréhensions conceptuelles récurrentes au sein de la littérature scientifique publiée.
8.1 Sens strict de la confiance fréquentiste
La rigueur scientifique impose de rappeler avec intransigeance ce qu’énonce formellement la notion de « confiance » dans la tradition fréquentiste issue de Neyman et Pearson. L’indice de confiance de 95 % n’est nullement une métrique de certitude attachée à l’intervalle numérique spécifique qui vient d’être extrait de l’échantillon clinique. Dès l’instant où l’expérimentateur a achevé ses calculs arithmétiques et transcrit les frontières $[0{,}2545 ,;, 0{,}4592]$, la mécanique probabiliste a cessé d’agir sur cet objet : le paramètre populationnel inconnu $p$ (la véritable proportion de déficits exécutifs chez l’ensemble des patients) est un nombre scalaire déterministe invariable. Par voie de conséquence, soit ce nombre réside entre $0{,}2545$ et $0{,}4592$, soit il réside hors de cette fourchette.
L’indice de 95 % est un attribut de la procédure globale d’échantillonnage et de calcul, et non du résultat particulier produit. La véritable posture intellectuelle requise consiste à affirmer : « Nous appliquons ici un algorithme décisionnel qui, sur le long terme d’une multitude indéfinie d’expérimentations indépendantes analogues, génère des intervalles capturant le paramètre cible dans 95 % des situations et échouant dans 5 % des cas. Notre confiance repose exclusivement sur la fiabilité démontrée du procédé technique, et non sur une propriété intrinsèque des bornes observées ». L’adhésion au fréquentisme exige d’accepter cette forme d’ascèse interprétative, excluant toute assignation probabiliste directe au résultat singulier.
8.2 Erreurs conceptuelles majeures identifiées dans la littérature
Une vaste littérature métascientifique, initiée notamment par Haller et Krauss (2002) ou Hoekstra et al. (2014), documente que même parmi les enseignants-chercheurs chevronnés en psychologie, une majorité écrasante commet des contresens majeurs lors de l’explicitation verbale d’un intervalle de confiance. Trois écueils prédominent très nettement :
- L’écueil bayésien rétrograde : affirmer qu’« il y a 95 % de probabilité que la vraie proportion de la population soit comprise entre 25,45 % et 45,92 % ». Cette assertion est rigoureusement fausse dans le cadre fréquentiste classique : assigner une probabilité continue à un paramètre fixe nécessiterait de le modéliser comme une variable aléatoire dotée d’une distribution a priori subjective, démarche relevant exclusivement du paradigme bayésien (intervalle de crédibilité).
- La confusion entre estimation et prédiction : prétendre que « 95 % des futurs échantillons examinés présenteront une proportion empirique $\hat{p}$ comprise dans cet intervalle ». Un intervalle de confiance n’est pas un intervalle de prédiction. La distribution des proportions d’échantillons ultérieurs présente une dispersion propre accrue, car elle conjugue l’incertitude quant à la position du paramètre à la variance d’échantillonnage de la réplication future.
- L’illusion de certitude centrale : croire que la véritable proportion $p$ a obligatoirement plus de chances de se trouver au centre mathématique de l’intervalle qu’à proximité immédiate de ses bornes. Dans l’intervalle de Wald, le centre n’est que la réalisation empirique ponctuelle d’un estimateur bruité, tandis que dans l’intervalle de Wilson, le centre est artificiellement translaté par une régularisation algébrique. L’intervalle fréquentiste ne fournit aucune fonction de densité de plausibilité interne sur les valeurs qu’il délimite.
8.3 Formulation narrative adéquate des résultats
Afin de prévenir tout refus de soumission éditoriale ou toute critique légitime lors de la revue par les pairs, le chercheur doit adopter des gabarits discursifs conformes à la logique probabiliste orthodoxe. Les syntaxes narratives suivantes illustrent l’expression académique optimale des résultats obtenus lors du protocole neuropsychologique précédent :
Formulation recommandée 1 (standard formel) : « Au sein de notre cohorte de patients présentant une plainte mnésique ($N = 80$), la proportion de profils présentant un déficit exécutif sévère est estimée à 35,00 % (28/80). L’intervalle de confiance de Wilson calculé au seuil de 95 % s’étend de 25,45 % à 45,92 %. Cette estimation indique que nos données d’échantillon sont compatibles, sous une procédure d’estimation garantissant 95 % de couverture à long terme, avec une prévalence populationnelle comprise entre un quart et près de la moitié des patients consultants ».
Formulation recommandée 2 (focalisée sur la précision) : « Le taux d’altération exécutive observé s’établit à 35,00 %, 95 % IC Wilson [25,45, 45,92]. L’amplitude substantielle de l’intervalle d’estimation (environ 20 points de pourcentage de largeur) reflète une précision méthodologique modérée, attribuable à la dimension finie de la cohorte étudiée, incitant à la prudence avant toute généralisation épidémiologique non régulée ».
Ces formulations intègrent explicitement la double nature de l’information : la localisation empirique ponctuelle et la reconnaissance transparente de la marge d’incertitude géométrique qui l’enveloppe.
9. Détermination de la taille d’échantillon requise et gestion de la précision
L’une des étapes les plus stratégiques de la conception d’un devis de recherche consiste à planifier en amont la puissance statistique et la résolution de l’étude, afin de calibrer l’effectif expérimental aux exigences de précision attendues.
9.1 Dérivation mathématique de la taille d’échantillon cible
Dans de nombreux protocoles de recherche appliquée, l’objectif fondamental n’est pas de rejeter une hypothèse nulle stérile, mais d’obtenir une estimation d’une proportion avec un degré d’incertitude préalablement fixé par le cahier des charges méthodologique. Le chercheur souhaite pouvoir affirmer : « Nous voulons estimer la prévalence $p$ avec une marge d’erreur maximale $E$ tolérée (par exemple $\pm 3,%$, soit $E = 0{,}03$) au seuil de confiance bilatéral de 95 % ».
Pour dériver l’effectif théorique $n$ nécessaire à la réalisation de cet impératif, il suffit de procéder à l’inversion algébrique de la fonction de marge d’erreur de Wald :
$$E = z_{1 – alpha/2} \sqrt{\frac{p(1 – p)}{n}}$$
Élevons l’ensemble des membres de cette relation d’égalité au carré pour nous affranchir de l’opérateur de radical :
$$E^2 = z_{1 – alpha/2}^2 \frac{p(1 – p)}{n}$$
Par un échange élémentaire entre les scalaires $n$ et $E^2$, nous isolons la formulation canonique du dimensionnement d’échantillon pour une proportion :
$$n = \frac{z_{1 – alpha/2}^2 \cdot p(1 – p)}{E^2}$$
L’observation de cette structure analytique met en exergue une dépendance quadratique impitoyable vis-à-vis de l’exigence de précision $E$ positionnée au dénominateur. Si un chercheur décide de doubler la précision de son étude en réduisant la marge d’erreur tolérée de $E = 0{,}06$ à $E = 0{,}03$, l’effectif requis n’est pas multiplié par deux, mais quadruple instantanément ($(\frac{0{,}06}{0{,}03})^2 = 2^2 = 4$). Par ailleurs, la dimension calculée $n$ aboutissant quasi systématiquement à un nombre réel non entier, une règle impérative de biostatistique impose d’arrondir systématiquement le résultat arithmétique à l’entier supérieur (fonction plafond), afin de ne jamais compromettre la borne d’erreur maximale convenue.
9.2 Stratégies d’assignation de la proportion préalable
La mise en œuvre de la formule de dimensionnement révèle un paradoxe logique apparent : pour calculer la taille d’échantillon $n$ nécessaire à l’estimation d’une proportion inconnue $p$, la formule requiert d’injecter au numérateur la valeur même de ce paramètre $p$ non encore mesuré ! Face à cette contrainte autoréférentielle, les chercheurs déploient deux grandes stratégies méthodologiques :
- La stratégie conservatrice du pire scénario (approche « minimax ») : en l’absence intégrale de données antérieures sur le phénomène examiné, le statisticien attribue à la proportion préalable la valeur $p = 0{,}50$. Comme nous l’avons théoriquement explicité à la section 3.3, le polynôme $p(1 – p)$ atteint son extremum théorique maximal en 0,50, valant précisément 0,25. Cette stratégie pessimiste maximise le numérateur et garantit que la taille d’échantillon calculée sera mathématiquement suffisante pour satisfaire la marge d’erreur $E$, quelle que soit la proportion empirique qui sera découverte au terme de la collecte. Pour $E = 0{,}05$ et un niveau de 95 % ($z = 1{,}96$) :
$$n = \frac{1{,}96^2 \times 0{,}25}{0{,}05^2} = \frac{3{,}8416 \times 0{,}25}{0{,}0025} = \frac{0{,}9604}{0{,}0025} = 384{,}16 implies 385 \text{ participants}$$ - La stratégie empirique optimisée fondée sur la littérature ou une étude pilote : si des publications antérieures rigoureuses suggèrent que le phénomène présente une prévalence restreinte — par exemple dans le diagnostic d’une phobie sociale spécifique estimée aux alentours de 10 % ($p = 0{,}10$) —, le numérateur s’allège considérablement : $p(1 – p) = 0{,}10 \times 0{,}90 = 0{,}09$. L’application de la formule fournit alors :
$$n = \frac{1{,}96^2 \times 0{,}09}{0{,}05^2} = \frac{3{,}8416 \times 0{,}09}{0{,}0025} = \frac{0{,}345744}{0{,}0025} = 138{,}30 implies 139 \text{ participants}$$
Exploiter une estimation a priori permet ici d’économiser le recrutement de plus de 240 sujets, réduisant massivement le coût global de la recherche. Néanmoins, cette stratégie comporte un risque : si la véritable prévalence s’avère finalement être de 30 %, l’échantillon de 139 participants sera sous-dimensionné et la marge d’erreur finale observée sera plus large que les 5 % initialement escomptés.
9.3 Contraintes pratiques et faisabilité en recherche comportementale
Dans l’écosystème concret des laboratoires de psychologie, le dimensionnement théorique dérivé de la formule mathématique se heurte inévitablement à l’écueil de l’attrition expérimentale. Dans tout protocole nécessitant un suivi temporel — qu’il s’agisse de mesurer la proportion d’individus maintenant une abstinence tabagique à six mois ou la rétention d’acquis cognitifs post-remédiation —, une fraction substantielle des participants recrutés initialement est inévitablement perdue de vue (déménagements, retraits de consentement, abandons thérapeutiques).
Pour prémunir le devis expérimental contre ce risque d’érosion, il est impératif d’anticiper le taux d’attrition attendu (noté $R_{\text{perte}}$, exprimé en pourcentage) et d’ajuster le contingent initial de recrutement $n_{\text{recrutement}}$ selon la correction proportionnelle :
$$n_{\text{recrutement}} = \frac{n_{\text{cible}}}{1 – R_{\text{perte}}}$$
Si la formule de précision prescrit formellement un effectif analysable minimal de $n_{\text{cible}} = 385$ sujets, et que l’expérience clinique de l’équipe anticipe un taux d’abandon longitudinal moyen de 20 % ($R_{\text{perte}} = 0{,}20$), la cohorte initiale enrolée au temps zéro doit obligatoirement être rehaussée à :
$$n_{\text{recrutement}} = \frac{385}{1 – 0{,}20} = \frac{385}{0{,}80} = 481{,}25 implies 482 \text{ participants}$$
Négliger cette planification préalable expose le protocole au danger d’un sous-dimensionnement final, dégradant la marge d’erreur au-delà du seuil de tolérance acceptable et fragilisant l’assise inférentielle de l’ensemble de la recherche.
10. Applications spécifiques dans les sous-disciplines de la psychologie
La polyvalence de l’inférence sur les proportions se manifeste à travers la diversité des paradigmes de recherche composant l’espace académique des sciences du comportement.
10.1 Épidémiologie psychiatrique et estimation de la morbidité
L’épidémiologie psychiatrique s’appuie de manière critique sur l’estimation de proportions pour établir les indicateurs de santé mentale à l’échelle de populations régionales ou nationales. Deux indices cardinaux font l’objet d’une surveillance continue : la prévalence ponctuelle (la proportion d’individus présentant un trouble diagnostiqué à un moment précis dans le temps) et la prévalence sur la vie entière (la proportion de personnes ayant satisfait aux critères du trouble à un moment quelconque de leur existence).
Dans les enquêtes épidémiologiques de grande envergure, comme celles diligentées par l’Organisation Mondiale de la Santé (OMS) à travers l’initiative World Mental Health Surveys, la représentativité est assurée par des plans de sondage stratifiés à plusieurs degrés. L’estimation d’une proportion de prévalence — par exemple la proportion de cas d’épisodes dépressifs majeurs caractérisés chez les adolescents — exige non seulement le calcul d’intervalles de confiance rigoureux, mais également le contrôle d’éventuels biais d’échantillonnage liés à la non-réponse. Si les sujets souffrant des formes dépressives les plus sévères refusent systématiquement de répondre aux enquêteurs, la proportion brute observée présentera un biais de sélection négatif. L’intervalle de confiance calculé doit alors être complété par des analyses de sensibilité et des pondérations par score de propension pour que les bornes de prévalence reflètent fidèlement la charge morbide sociétale.
10.2 Psychologie cognitive et taux de rétention mémorielle
Dans le domaine de la psychologie cognitive expérimentale, l’analyse des proportions est omniprésente dans l’exploration des mécanismes de traitement de l’information et d’architecture cognitive. Considérons un paradigme expérimental classique de détection de signaux ou de reconnaissance visuelle mnésique. Un participant est exposé à une série de 200 items cibles (mots ou visages), puis est confronté ultérieurement à un test de reconnaissance forcé comprenant les 200 items cibles intercalés avec 200 items distracteurs inédits.
Les métriques de performance fondamentales reposent sur des calculs de proportions conditionnelles :
- Le taux de reconnaissance correcte (Hits) : proportion de stimuli cibles correctement identifiés comme ayant été préalablement appris ($P(\text{Réponse « Ancien »} mid \text{Stimulus « Ancien »})$).
- Le taux de fausses alarmes (False Alarms) : proportion d’items distracteurs incorrectement identifiés comme familiers ($P(\text{Réponse « Ancien »} mid \text{Stimulus « Nouveau »})$).
L’encadrement par intervalle de confiance de ces proportions individuelles ou moyennées au niveau groupal permet d’évaluer la stabilité de l’indice de discrimination $d’$ et du critère de décision de réponse de la théorie de détection du signal. Dans les protocoles d’amorçage subliminal ou d’attention sélective, vérifier si la borne inférieure de l’intervalle de confiance du taux de réussite surclasse significativement le niveau du hasard théorique (par exemple 50 % dans une tâche à choix forcé binaire) constitue la preuve mathématique décisive de l’existence d’un traitement cognitif implicite sans conscience phénoménale explicite.
10.3 Psychologie sociale et conformité aux normes comportementales
La psychologie sociale expérimentale a forgé certaines de ses avancées théoriques majeures en quantifiant des proportions de conformisme et d’obéissance. Les célèbres protocoles initiés par Solomon Asch dans les années 1950 visaient précisément à mesurer la proportion d’individus acceptant de se conformer à un jugement visuel manifestement erroné formulé par une majorité unanime de compères complices. Les expériences historiques d’Asch rapportaient qu’environ 36,8 % des jugements critiques étaient conformistes, et que 75 % des participants se conformaient au moins une fois lors des essais critiques.
La réplication contemporaine de ces paradigmes fondamentaux illustre l’importance capitale de l’estimation par intervalle. L’enjeu des réplications modernes est de déterminer si les mutations socioculturelles survenues au fil des décennies ont altéré le degré de résistance des individus face à la pression normative de groupe. En calculant l’intervalle de confiance de la proportion d’actes de conformisme au sein d’une cohorte contemporaine et en le comparant aux données historiques d’Asch, les psychologues sociaux peuvent objectiver avec précision si le degré d’influence sociale demeure stable à travers les générations ou si des dynamiques d’émancipation individuelle ou de polarisation collective ont substantiellement modifié ces comportements.
11. Implémentation computationnelle sous R et Python
À l’ère de la science ouverte et de la reproductibilité computationnelle, la dérivation manuelle des intervalles de confiance cède le pas à l’exécution automatisée au sein de langages de programmation statistique dédiés tels que R et Python.
11.1 Traitement automatisé sous le langage R
Le langage R constitue le standard d’analyse statistique dans le monde universitaire et la recherche psychologique quantitative. Il propose nativement plusieurs fonctions optimisées pour l’inférence sur une proportion.
La fonction historique standard du paquet de base stats est prop.test(). Par défaut, cette commande implémente précisément l’intervalle de score de Wilson, en y adjoignant une correction de continuité de Yates destinée à compenser la discrétisation de la loi binomiale :
Pour exécuter l’estimation sur notre exemple empirique (28 succès sur 80 essais au seuil de 95 %) :
prop.test(x = 28, n = 80, conf.level = 0.95, correct = FALSE)
En désactivant la correction de continuité (correct = FALSE), la fonction renvoie exactement l’intervalle de Wilson asymptotique brut $[0{,}2545 ,;, 0{,}4592]$. Si l’argument est laissé à sa valeur par défaut correct = TRUE, R applique un décalage de $\frac{1}{2n}$ produisant des bornes légèrement plus conservatrices $[0{,}2493 ,;, 0{,}4650]$.
Pour obtenir l’intervalle exact de Clopper-Pearson, R fournit la fonction native binom.test() :
binom.test(x = 28, n = 80, conf.level = 0.95)
Cette commande exécute l’inversion par les quantiles de la loi Bêta et fournit un intervalle exact $[0{,}2471 ,;, 0{,}4634]$. Pour les utilisateurs désireux d’extraire simultanément l’ensemble des méthodes comparatives au sein d’une même matrice analytique, la bibliothèque spécialisée binom met à disposition la fonction exhaustive binom.confint() :
library(binom)
binom.confint(x = 28, n = 80, methods = c("wald", "wilson", "agresti-coull", "exact"))
Ce pipeline extrait en une ligne de code les résultats numériques complets pour les algorithmes de Wald, Wilson, Agresti-Coull et Clopper-Pearson, facilitant les arbitrages méthodologiques au sein de flux d’analyses psychométriques automatisés.
11.2 Programmation scientifique et inférence sous Python
Dans l’écosystème Python, largement plébiscité par les neurosciences computationnelles et les data scientists, les fonctionnalités d’inférence de proportions sont centralisées au sein du module statsmodels, en synergie étroite avec scipy et pandas.
L’implémentation repose principalement sur la fonction proportion_confint issue du sous-module statsmodels.stats.proportion. Cette routine accepte explicitement la spécification de la méthode algorithmique via l’argument method :
from statsmodels.stats.proportion import proportion_confint
# Paramètres de l'étude
k_succes = 28
n_total = 80
alpha_risque = 0.05
# Calcul selon l'intervalle de Wilson
ci_wilson = proportion_confint(count=k_succes, nobs=n_total, alpha=alpha_risque, method='wilson')
# Calcul selon l'intervalle d'Agresti-Coull
ci_agresti = proportion_confint(count=k_succes, nobs=n_total, alpha=alpha_risque, method='agresti_coull')
# Calcul selon l'intervalle exact de Clopper-Pearson (Beta)
ci_exact = proportion_confint(count=k_succes, nobs=n_total, alpha=alpha_risque, method='beta')
# Calcul selon l'intervalle classique de Wald
ci_wald = proportion_confint(count=k_succes, nobs=n_total, alpha=alpha_risque, method='normal')
Cette architecture computationnelle offre une modularité totale, permettant aux scripts d’analyse de données comportementales d’ingérer de vastes tableaux structurés sous Pandas et d’estimer en parallèle des centaines d’intervalles de confiance associés aux performances expérimentales d’utilisateurs distincts ou de conditions expérimentales croisées.
11.3 Représentation graphique rigoureuse de l’incertitude
La communication scientifique moderne privilégie la sémiotique graphique pour rendre compte de l’incertitude d’échantillonnage de manière intuitive et accessible. La restitution visuelle d’une proportion ne doit jamais se limiter à un graphique en barres unidimensionnel (diagramme en bâtons ou bar plot classique) coupant abruptement l’axe des ordonnées à la hauteur de l’estimation ponctuelle, ce qui induit visuellement une fausse impression de certitude déterministe (souvent dénoncé comme un écueil de « dynamite plot »).
Les bonnes pratiques de visualisation en psychologie requièrent la construction de graphiques de points d’estimation accompagnés de barres d’erreur explicites (forest plots ou diagrammes de dispersion avec barres d’erreur bilatérales). Sur le plan technique et déontologique, plusieurs prérequis doivent impérativement être honorés :
- L’intégrité de l’échelle d’affichage : l’axe représentant la proportion d’intérêt doit toujours être calibré de manière transparente. Lorsque les comparaisons portent sur des proportions substantielles, conserver l’échelle globale de 0 à 1 (ou 0 % à 100 %) prévient toute distorsion visuelle de grossissement artificiel des disparités. Si un zoom localisé est opéré pour illustrer des variations fines, cette troncature de l’axe doit être signalée de façon manifeste dans la légende graphique.
- L’annotation explicite de la nature des barres : tout graphique scientifique incorporant des segments de variabilité doit impérativement déclarer dans sa note textuelle le sens exact des barres dessinées : s’agit-il d’un écart-type (SD), d’une erreur type standard (SE), d’un intervalle de Wald à 95 % ou d’un intervalle de score de Wilson ? L’ambiguïté à cet égard demeure l’une des causes majeures de mélecture des figures dans les périodiques académiques.
- La clarté des contrastes de groupes : lorsque plusieurs sous-groupes cliniques sont juxtaposés sur le même panneau visuel, le chevauchement ou la disjonction spatiale des barres d’erreur de Wilson offre un premier diagnostic visuel de la significativité des contrastes, guidant le regard du lecteur vers les effets les plus robustes.
12. Intégration rédactionnelle selon les normes APA et perspectives avancées
L’aboutissement formel d’un travail d’investigation statistique réside dans sa transcription conforme aux standards de diffusion de la communauté scientifique, ainsi que dans son ouverture vers les modélisations inférentielles avancées.
12.1 Conformité avec les directives rédactionnelles de l’APA 7
La 7e édition du manuel de publication de l’American Psychological Association (APA 7) formule des exigences normatives strictes concernant la typographie, l’agencement textuel et la formalisation des résultats statistiques. Dans le corps du texte d’un article soumis aux revues à comité de lecture, la proportion empirique et son intervalle de confiance associé doivent être insérés selon une syntaxe parfaitement codifiée :
Règles typographiques de base de l’APA 7 :
- Les symboles statistiques représentés par des lettres latines doivent être composés en caractères italiques (par exemple, p pour la valeur-p, n pour la taille de l’échantillon, z pour le score centré réduit). En revanche, l’acronyme de l’intervalle de confiance « IC » (ou « CI » dans les publications en langue anglaise) reste en caractères romains droits majuscules.
- Le niveau de confiance choisi doit toujours être explicitement mentionné immédiatement devant l’acronyme : 95 % IC.
- Les bornes numériques de l’intervalle doivent être encapsulées entre des crochets droits, délimitées par une virgule (en anglais) ou un point-virgule (préféré en français pour éviter la confusion avec les virgules décimales), et suivies d’une espace :
[0{,}25 ; 0{,}46]. - Le nombre de décimales doit être rigoureusement homogène à travers le manuscrit, généralement calibré à deux décimales pour les proportions (trois décimales pour les p-valeurs).
Exemple canonique d’insertion textuelle en français académique :
« Au sein de notre échantillon de patients âgés de 60 à 75 ans présentant une plainte mnésique subjective (n = 80), la proportion de participants démontrant un profil d’altération exécutive cliniquement significatif s’établit à 35,00 %, 95 % IC [0,25 ; 0,46]. La méthode d’estimation utilisée repose sur l’inversion du score de Wilson sans correction de continuité ».
Lorsque les données inférentielles sont synthétisées dans un tableau récapitulatif, les directives de l’APA proscrivent la surcharge typographique. Il est vivement recommandé d’allouer une colonne distincte intitulée « 95 % IC » ou de placer l’intervalle entre crochets immédiatement sous l’estimation ponctuelle dans la cellule correspondante, en spécifiant en note de bas de tableau : « Note. IC = intervalle de confiance. Les bornes sont calculées selon la méthode de Wilson ».
12.2 Comparaison de deux proportions indépendantes
Dans la pratique courante de la recherche expérimentale, le chercheur s’intéresse rarement à une proportion isolée : il cherche le plus souvent à évaluer l’impact d’une intervention en comparant deux proportions observées au sein de deux groupes indépendants (par exemple, un groupe expérimental recevant une thérapie cognitive informatisée comparé à un groupe témoin sur liste d’attente).
Une tentation heuristique extrêmement répandue, mais fallacieuse sur le plan méthodologique, consiste à examiner visuellement les deux intervalles de confiance univariés calculés séparément pour chaque groupe. De nombreux auteurs concluent hâtivement : « Puisque les intervalles de confiance à 95 % du groupe expérimental et du groupe témoin se chevauchent partiellement, la différence entre les deux taux d’efficacité n’est pas statistiquement significative au seuil de 5 % ». Cette inférence informelle est mathématiquement erronée. Deux intervalles de confiance à 95 % peuvent tout à fait présenter un léger chevauchement géométrique alors que le test de comparaison formelle conclut à une différence statistiquement significative ($p < 0{,}05$). L'évaluation rigoureuse exige le calcul formel de l'intervalle de confiance de la différence de proportions :
$$\Delta = p_1 – p_2$$
L’estimateur ponctuel du contraste est la différence des proportions empiriques $\hat{p}_1 – \hat{p}_2$. Sous l’hypothèse d’indépendance mutuelle des deux échantillons de tailles respectives $n_1$ et $n_2$, la variance de cette différence est égale à la somme des variances d’échantillonnage individuelles :
$$\mathrm{Var}(\hat{p}_1 – \hat{p}_2) = \mathrm{Var}(\hat{p}_1) + \mathrm{Var}(\hat{p}_2) = \frac{p_1(1 – p_1)}{n_1} + \frac{p_2(1 – p_2)}{n_2}$$
L’intervalle de confiance asymptotique de Wald pour la différence de proportions prend la forme suivante :
$$\mathrm{IC}_{1 – \alpha}(p_1 – p_2) = \left[ (\hat{p}_1 – \hat{p}_2) – z_{1 – alpha/2} \sqrt{\frac{\hat{p}_1(1 – \hat{p}_1)}{n_1} + \frac{\hat{p}_2(1 – \hat{p}_2)}{n_2}} ; ; ; (\hat{p}_1 – \hat{p}_2) + z_{1 – alpha/2} \sqrt{\frac{\hat{p}_1(1 – \hat{p}_1)}{n_1} + \frac{\hat{p}_2(1 – \hat{p}_2)}{n_2}} \right]$$
Le critère décisionnel formel repose exclusivement sur la présence ou l’absence de la valeur zéro (l’hypothèse nulle d’égalité stricte des proportions) à l’intérieur de cet intervalle de contraste :
- Si la valeur 0 réside à l’intérieur de l’intervalle $\mathrm{IC}(p_1 – p_2)$, les données ne permettent pas de rejeter l’égalité des proportions au niveau de confiance considéré.
- Si l’intervalle exclut intégralement zéro (ses bornes étant toutes deux strictement positives ou toutes deux strictement négatives), le chercheur peut formellement conclure à l’existence d’une différence statistiquement significative entre les deux interventions ($p < \alpha$).
Pour des échantillons de taille modeste, l’analyste privilégiera des versions robustes adaptées aux deux groupes, telles que la méthode de Newcombe-Wilson ou l’extension d’Agresti-Caffo (qui préconise d’ajouter un succès et un échec à chacun des deux groupes, soit quatre pseudo-observations cumulées au total).
12.3 Regard comparatif avec l’intervalle de crédibilité bayésien
Pour parachever cette déconstruction épistémologique de l’intervalle de confiance pour une proportion, il est hautement instructif de mettre en miroir l’orthodoxie fréquentiste avec l’inférence bayésienne alternative. Dans le paradigme bayésien, le paramètre $p$ n’est plus considéré comme une constante inconnue inaccessible, mais comme une véritable variable aléatoire continue sur l’intervalle $[0, 1]$, caractérisée par une distribution de probabilité subjective reflétant l’état de connaissance et d’incertitude du chercheur.
L’analyste bayésien formalise son incertitude initiale préalablement au recueil des données à l’aide d’une distribution a priori. Pour modéliser une proportion binaire issue d’un processus binomial, la distribution a priori conjuguée naturelle par excellence est la loi Bêta, notée $\mathrm{B\eta}(\alpha_0, \beta_0)$, dont les hyperparamètres peuvent être interprétés comme des « pseudo-succès » ($\alpha_0$) et des « pseudo-échecs » ($\beta_0$) issus de connaissances scientifiques antérieures. Une loi $\mathrm{B\eta}(1, 1)$ équivaut à une densité uniforme plate sur $[0, 1]$, matérialisant une ignorance épistémique totale.
En vertu du théorème de Bayes, la distribution a posteriori combinant les connaissances préalables et la fonction de vraisemblance binomiale des données observées ($k$ succès parmi $n$ essais) s’obtient par une simple mise à jour analytique des hyperparamètres, sans nécessiter d’intégrations numériques complexes :
$$p mid (k, n) \sim \mathrm{B\eta}(\alpha_0 + k, ; \beta_0 + n – k)$$
À partir de cette distribution a posteriori continue, l’analyste dérive un intervalle de crédibilité bayésien à 95 % (typiquement l’intervalle de densité a posteriori maximale, Highest Posterior Density Interval – HPDI, ou l’intervalle à queues égales découpé sur les quantiles à 2,5 % et 97,5 %).
La divergence entre l’intervalle fréquentiste et l’intervalle bayésien est profondément épistémologique :
- L’intervalle de confiance fréquentiste évalue la performance à long terme d’un algorithme déterministe sur des échantillons imaginaires répétés issus d’un monde où $p$ est fixe. Il interdit toute affirmation de probabilité sur le paramètre lui-même au sein de l’intervalle calculé.
- L’intervalle de crédibilité bayésien autorise pleinement et rigoureusement le chercheur à affirmer : « Compte tenu des données recueillies et de nos connaissances préalables formalisées, il y a exactement 95 % de probabilité a posteriori que la véritable proportion $p$ réside entre ces deux bornes ».
L’intervalle d’Agresti-Coull ou l’intervalle de Wilson évoqués antérieurement peuvent d’ailleurs être interprétés mathématiquement comme des approximations empiriques directes d’estimateurs bayésiens adossés à une loi a priori non informative de type Jeffreys ($\mathrm{B\eta}(0{,}5 ,;, 0{,}5)$) ou uniforme ($\mathrm{B\eta}(1 ,;, 1)$). Cette convergence mathématique remarquable entre des formalismes épistémologiquement antagonistes démontre l’unité profonde de la théorie de la mesure : lorsqu’il s’agit de borner avec rigueur l’inconnu face au bruit d’échantillonnage, la régularisation mathématique s’impose invariablement comme la seule voie de salut scientifique.
Références
Agresti, A., & Coull, B. A. (1998). Approximate is better than « exact » for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Asch, S. E. (1956). Studies of independence and conformity: I. A minority of one against a unanimous majority. Psychological Monographs: General and Applied, 70(9), 1–70. https://doi.org/10.1037/h0093718
Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
Cohen, J. (1994). The earth is round (p < .05). American Psychologist, 49(12), 997–1003. https://doi.org/10.1037/0003-066X.49.12.997
Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
Haller, H., & Krauss, S. (2002). Misinterpretations of significance: A problem students share with their teachers? Methods of Psychological Research Online, 7(1), 1–20.
Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E. J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3
Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
Newcombe, R. G. (1998). Two-sided confidence intervals for the single proportion: Comparison of seven methods. Statistics in Medicine, 17(8), 857–872. <a href="https://doi.org/10.1002/(SICI)1097-0258(19980430)17:83.0.CO;2-E » target= »_blank » rel= »noopener noreferrer »>https://doi.org/10.1002/(SICI)1097-0258(19980430)17:83.0.CO;2-E
Wald, A. (1943). Tests of statistical hypotheses concerning several parameters when the number of observations is large. Transactions of the American Mathematical Society, 54(3), 426–482. https://doi.org/10.1090/S0002-9947-1943-0012401-3
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953