
Dans le vaste univers de l’analyse quantitative, de la modélisation statistique et de l’épistémologie scientifique, la distinction fondamentale entre interpolation et extrapolation constitue l’un des piliers méthodologiques les plus cruciaux et pourtant les plus fréquemment méconnus. Qu’il s’agisse d’évaluer les aptitudes cognitives d’un individu à travers une batterie de tests psychométriques, de modéliser l’évolution temporelle de signaux neurophysiologiques ou de prévoir des comportements sociodémographiques à grande échelle, le praticien et le chercheur sont sans cesse confrontés à des données lacunaires ou partielles. Dès lors qu’une fonction analytique ou un modèle empirique est ajusté sur un ensemble d’observations discrètes, la question de la validité des inférences déduites pour des points non directement échantillonnés devient primordiale.
Cette problématique ne relève pas d’une simple querelle sémantique ou d’un formalisme mathématique abstrait. Elle trace au contraire une frontière imperméable entre la reconstruction prudente et géométriquement contrainte d’un espace déjà exploré, d’une part, et la projection spéculative au sein d’un territoire inconnu, d’autre part. Confondre ces deux régimes d’inférence, ou minimiser la rupture épistémologique qui les sépare, revient à s’exposer à des erreurs d’interprétation massives, à des biais d’estimation incontrôlés et à des dérives décisionnelles majeures, particulièrement dans les sciences humaines et du comportement où la complexité des systèmes vivants défie toute linéarité simpliste.
Le présent article propose une analyse approfondie, rigoureuse et exhaustive des concepts d’interpolation et d’extrapolation. En explorant successivement leurs fondements mathématiques, leurs mécanismes statistiques de propagation de l’incertitude, leurs manifestations au sein des sciences cognitives et psychométriques, ainsi que les écueils cognitifs et méthodologiques qui jalonnent leur usage, nous établirons une grille de lecture robuste pour tout scientifique ou analyste de données soucieux de préserver l’intégrité de ses conclusions empiriques.
1. Introduction conceptuelle : Définir l’interpolation et l’extrapolation
1.1 Définition statistique de l’interpolation
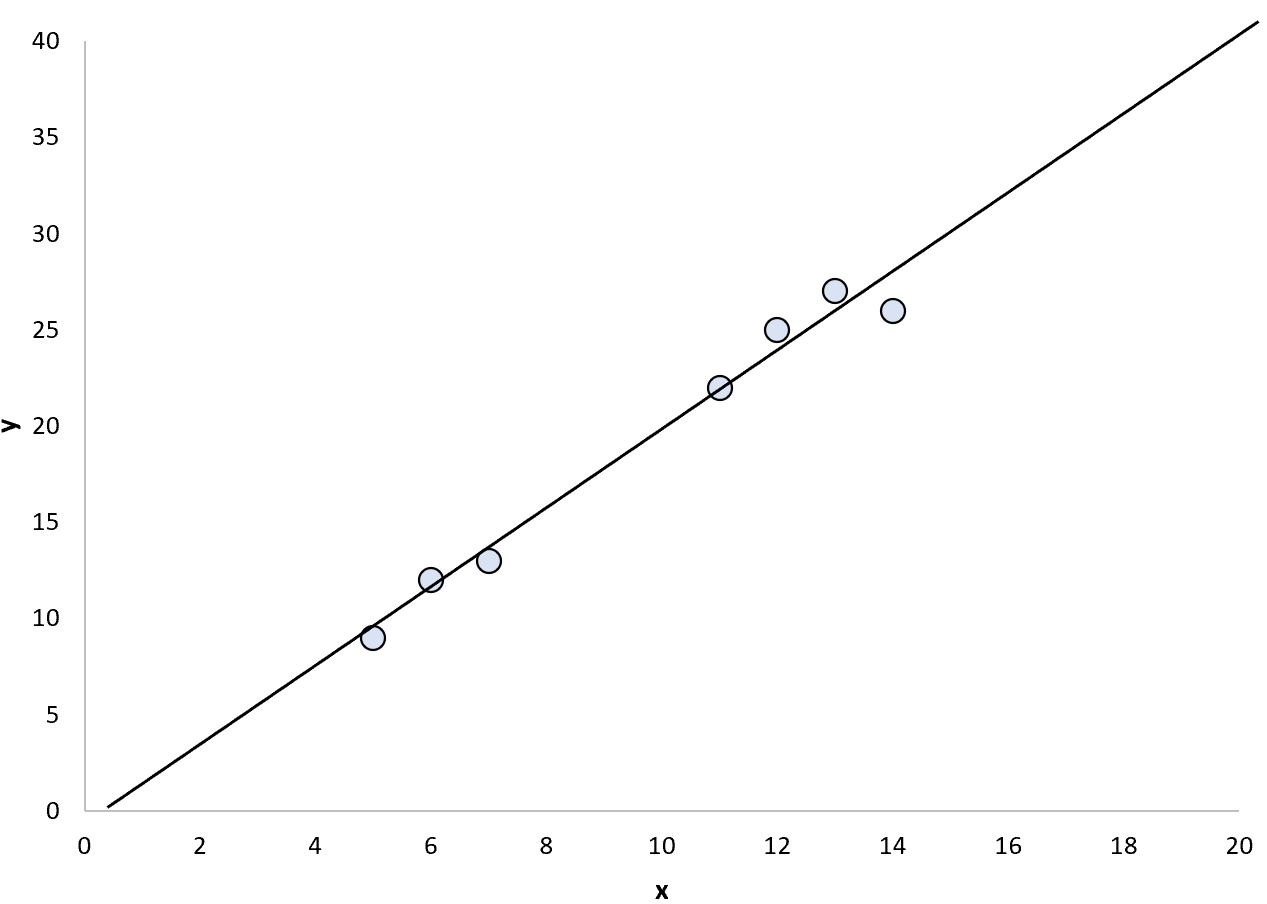
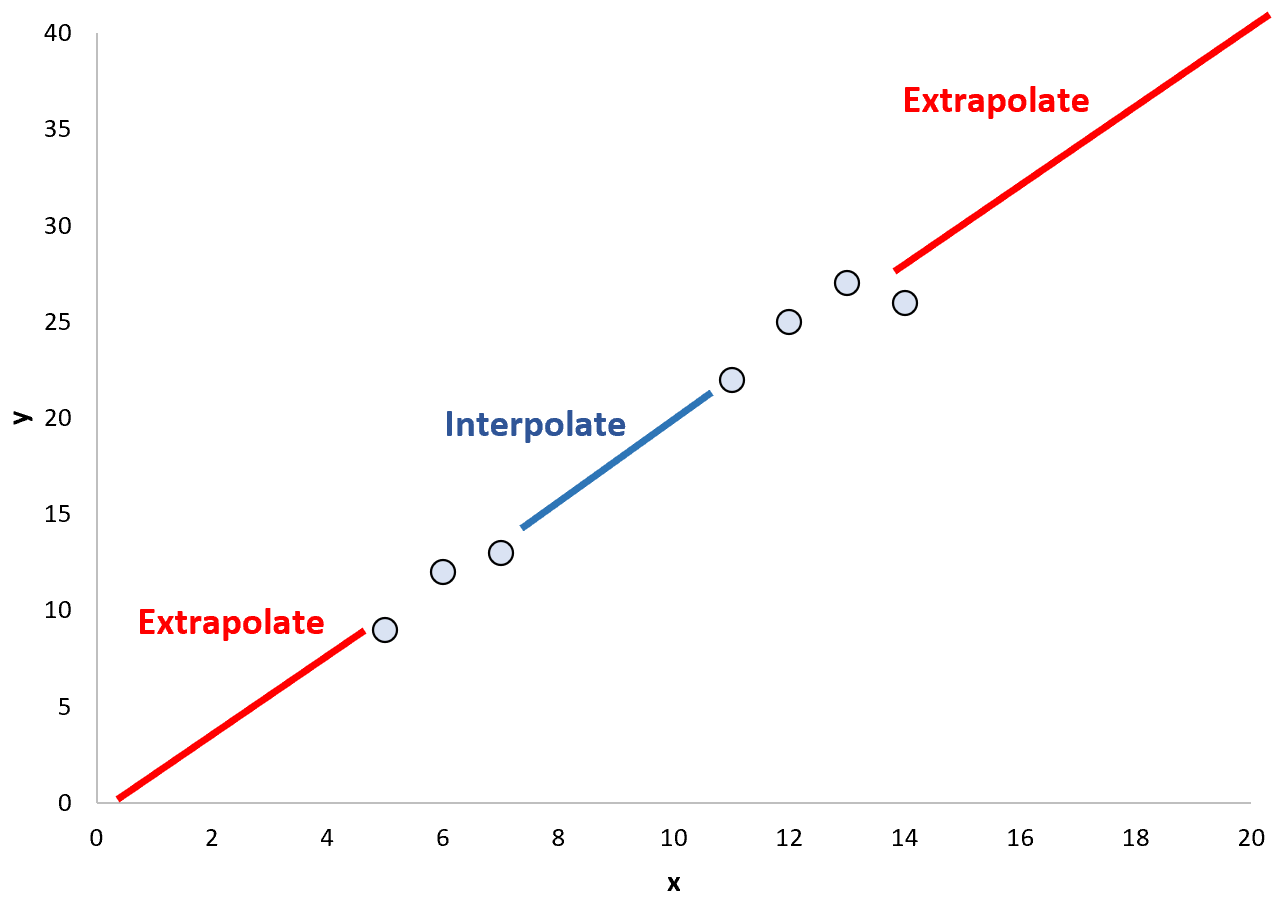
L’interpolation se définit rigoureusement, dans le cadre de l’analyse statistique et de l’analyse numérique, comme l’estimation ou la prédiction de valeurs inconnues d’une variable dépendante pour des valeurs de la variable explicative qui se situent strictement à l’intérieur de l’intervalle délimité par les observations empiriques les plus extrêmes du jeu de données. Formellement, si un ensemble d’observations discrètes est représenté par des couples ordonnés $(x_i, y_i)$ avec $i in {1, dots, n}$ tels que $x_1 < x_2 < dots < x_n$, toute inférence concernant une valeur $x^*$ appartenant à l'intervalle fermé $[x_1, x_n]$ relève formellement de l'interpolation. Ce paradigme repose sur le principe fondamental de la préservation de la structure locale des données observées : les points empiriques connus encadrent, bornent et contraignent mathématiquement l'espace des valeurs admissibles pour la quantité recherchée.
Sur le plan théorique, l’interpolation postule implicitement une hypothèse forte de continuité, de régularité et de différentiabilité du phénomène mesuré au sein des frontières explorées. L’analyste présume que la nature sous-jacente ne présente pas de discontinuités catastrophiques, de singularités aberrantes ou de fluctuations erratiques d’une magnitude disproportionnée entre deux points d’ancrage consécutifs. Dans le champ des sciences comportementales, un exemple archétypique d’interpolation se manifeste lorsqu’un chercheur souhaite déterminer le score moyen à un test d’aptitude cognitive pour des individus âgés de 24 ans et demi, alors que les tables d’étalonnage psychométriques n’ont consigné des données empiriques que pour des tranches d’âge fixes de 24 et 25 ans. En mobilisant une technique d’interpolation, le psychologue calcule une valeur intermédiaire en s’appuyant sur la proximité topologique des cohortes immédiatement adjacentes, réduisant ainsi drastiquement le risque d’erreur d’estimation.
Cette mécanique d’encadrement confère à l’interpolation une stabilité géométrique remarquable. Les données réelles jouent le rôle de tuteurs empiriques qui interdisent à la fonction d’ajustement de diverger arbitrairement vers l’infini ou d’adopter des trajectoires totalement découplées de la réalité observée, pourvu que la méthode d’interpolation sélectionnée soit adaptée au degré de lissage requis.
1.2 Définition statistique de l’extrapolation
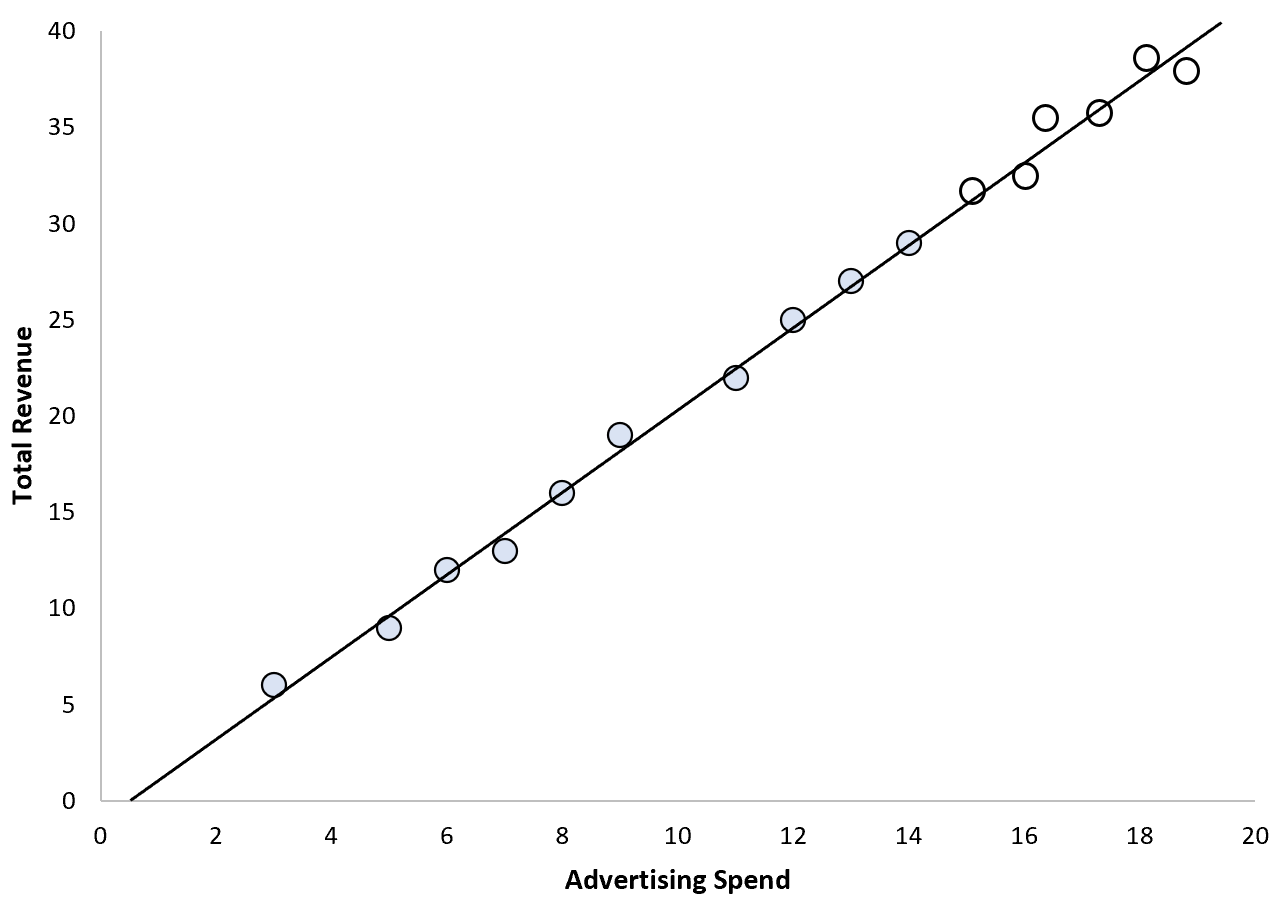
À l’opposé fondamental de l’interpolation, l’extrapolation désigne l’évaluation, la projection ou la prédiction de la valeur d’une fonction ou d’une variable dépendante au-delà du domaine empirique documenté par l’échantillon d’origine. En reprenant la formalisation précédente, l’extrapolation consiste à tenter d’estimer $y^*$ pour une valeur $x^*$ telle que $x^* x_n$. Dans cette configuration géométrique, le point ciblé n’est plus ceinturé par des observations réelles. Il flotte dans un espace d’inférence non corroboré empiriquement, où les mécanismes d’ancrage font totalement défaut.
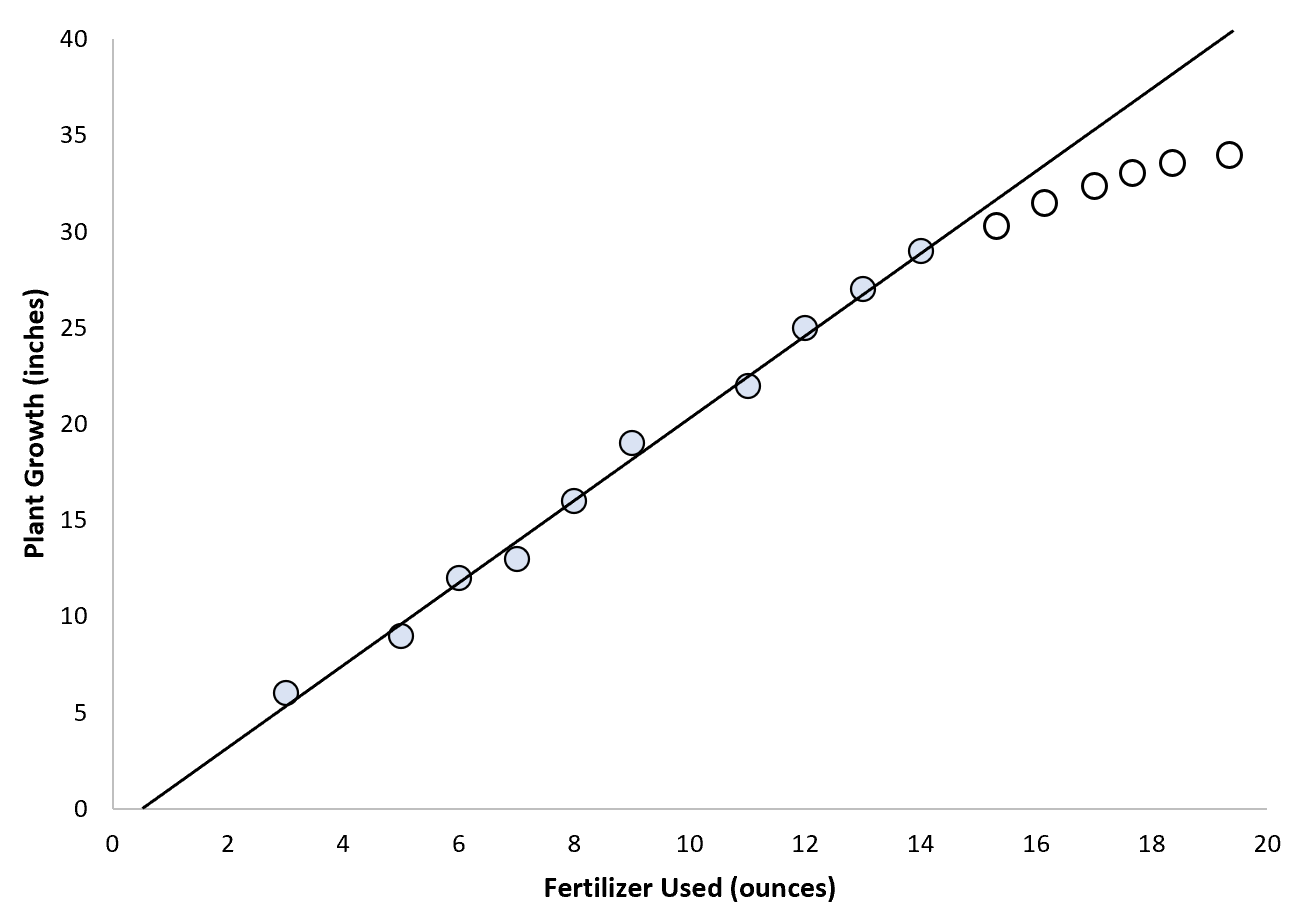
L’extrapolation dépend de manière critique, voire existentielle, de la validité universelle et invariante du modèle mathématique sous-jacent. Si l’interpolation peut tolérer des approximations fonctionnelles locales relativement grossières sans entraîner d’erreurs démesurées, l’extrapolation exige que la loi de distribution, l’équation différentielle ou le modèle de régression spécifié demeure parfaitement exact bien au-delà de la zone où il a été calibré. Le risque inhérent à cette démarche est immense : rien ne garantit théoriquement ni empiriquement que la dynamique observée dans l’intervalle $[x_1, x_n]$ persiste hors de ces bornes. Une relation linéaire apparente peut dissimuler une saturation asymptotique, une bascule exponentielle, ou un point d’inflexion biologique critique.
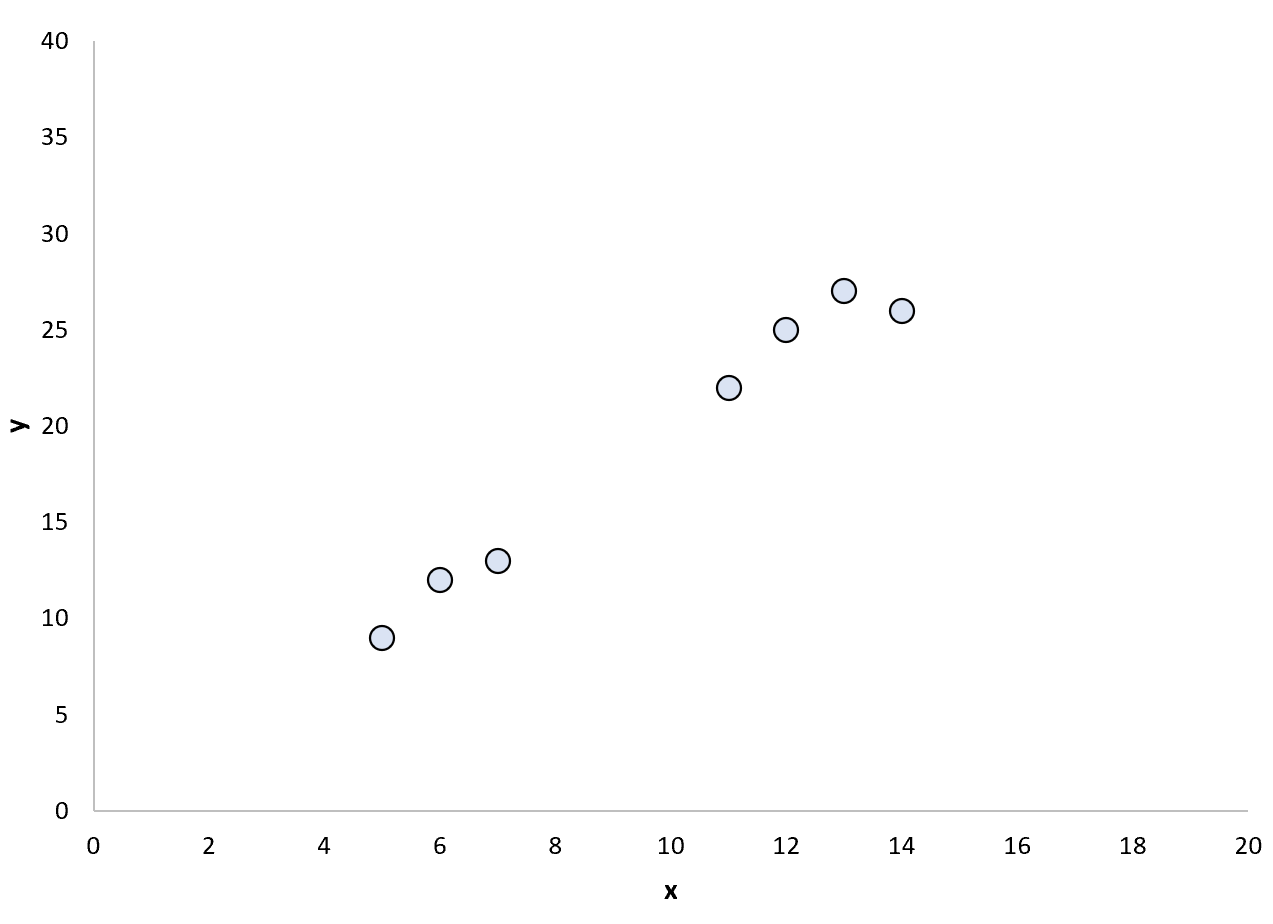
Une illustration classique en psychologie expérimentale concerne la prévision de trajectoires comportementales ou d’apprentissage à très long terme. Supposons qu’une étude mesure le taux de rétention mémorielle d’un protocole d’apprentissage sur une durée de 30 jours, constatant une décroissance logarithmique stable. Extrapoler ce modèle pour prédire le rappel d’informations chez un sujet à un horizon de vingt ans relève d’une spéculation statistique audacieuse. Des processus de sénescence cérébrale, des interférences cognitives ultérieures ou des remaniements synaptiques non modélisés au cours du premier mois viendront presque inévitablement démentir la projection mathématique brute.
1.3 L’importance de la distinction en recherche quantitative
L’importance d’opérer une césure rigide entre interpolation et extrapolation conditionne directement la robustesse, l’intégrité et la réplicabilité des inférences scientifiques. Dans les publications académiques à visée quantitative, l’assimilation confuse de l’extrapolation à une banale interpolation amplifiée constitue l’un des vecteurs majeurs de production de résultats erronés et d’effets artificiels non reproductibles. L’interpolation se situe au cœur de la démarche confirmatoire et descriptive : elle affine la mesure, comble les lacunes instrumentales et offre une cartographie continue d’un phénomène déjà balisé.
À l’inverse, l’extrapolation bascule instantanément dans le domaine de la conjecture prédictive et de l’heuristique théorique. Si elle s’avère parfois inévitable dans des contextes décisionnels d’urgence — qu’il s’agisse d’anticiper la propagation d’une crise sanitaire ou de prévoir les impacts de mutations sociologiques inédites —, elle ne possède jamais le même statut épistémologique que l’interpolation. L’extrapolation réclame une humilité méthodologique accrue, formalisée par l’explicitation systématique des postulats de stationnarité et l’élargissement substantiel des marges d’erreur.
En psychologie différentielle et clinique, la confusion entre ces deux régimes produit des conséquences palpables sur l’interprétation des effets marginaux. Déclarer qu’une intervention thérapeutique continue de produire des gains d’adaptation linéaires au-delà des doses ou des temporalités éprouvées cliniquement représente une dérive extrapolatoire susceptible de compromettre le bien-être des patients. La rigueur scientifique impose d’indiquer sans ambiguïté la nature de l’inférence produite, en s’interdisant de draper une extrapolation fragile sous les oripeaux de la précision rassurante propre à l’interpolation contrôlée.
2. Fondements mathématiques et géométriques de l’interpolation
2.1 L’interpolation linéaire et polynomiale
Sur le plan analytique, la forme la plus élémentaire d’interpolation est l’interpolation linéaire. Soit deux points connus consécutifs $(x_0, y_0)$ et $(x_1, y_1)$. L’estimation d’une valeur $y$ pour tout $x in [x_0, x_1]$ s’effectue via l’équation de la droite sécante reliant ces deux coordonnées :
$$y(x) = y_0 + \frac{y_1 – y_0}{x_1 – x_0}(x – x_0)$$
Cette formulation repose sur le calcul d’une pente locale constante sur le sous-intervalle considéré. Bien que d’une remarquable simplicité computationnelle et robuste face aux oscillations artificielles, l’interpolation linéaire souffre d’un manque criant de différentiabilité aux points d’ancrage ($x_i$), où la dérivée première présente des discontinuités brutales, rendant le modèle inadapté pour décrire des dynamiques biologiques ou psychologiques fluides.
Pour dépasser ces limitations et obtenir un lissage d’ordre supérieur, l’analyse numérique recourt aux polynômes de degré élevé, notamment via la formulation de l’interpolation polynomiale de Lagrange. Étant donné $n+1$ points distincts, il existe un unique polynôme $P(x)$ de degré au plus $n$ qui passe exactement par l’ensemble de ces points :
$$P(x) = \sum_{j=0}^{n} y_j L_{n,j}(x) \quad \text{a\vec} \quad L_{n,j}(x) = \prod_{substack{0 le k le n k \neq j}} \frac{x – x_k}{x_j – x_k}$$
Toutefois, l’augmentation aveugle du degré du polynôme pour tenter d’ajuster un grand nombre de données d’un seul bloc engendre un écueil mathématique sévère : le phénomène de Runge. Découvert par le mathématicien Carl Runge, ce problème se traduit par des oscillations d’amplitude divergente et croissante au voisinage des extrémités de l’intervalle d’interpolation, en particulier lorsque les nœuds d’échantillonnage sont équidistants. Dans les applications psychométriques impliquant des échelles de cotation continues (par exemple, des échelles de stress perçu ou d’anxiété normalisées), l’usage imprudent d’un polynôme de Lagrange d’ordre 8 ou 10 peut engendrer des valeurs prédites totalement absurdes aux marges du continuum, détruisant la cohérence psychologique du modèle sous un vernis d’ajustement formel parfait.
2.2 L’interpolation par splines cubiques
Afin de conjurer les artefacts oscillatoires du phénomène de Runge tout en garantissant une élégante régularité visuelle et mathématique, les statisticiens et analystes privilégient l’interpolation par splines, tout particulièrement les splines cubiques. L’approche consiste à abandonner la recherche d’un polynôme global unique pour lui substituer une construction par morceaux : entre chaque paire de nœuds adjacents $[x_i, x_{i+1}]$, on ajuste un polynôme cubique indépendant $S_i(x) = a_i + b_i(x – x_i) + c_i(x – x_i)^2 + d_i(x – x_i)^3$.
La puissance conceptuelle de la spline cubique réside dans ses conditions de raccordement aux nœuds intérieurs. Pour garantir une transition parfaitement fluide, on impose la continuité de la fonction elle-même, mais également celle de sa dérivée première (la pente) et de sa dérivée seconde (la courbure) :
$$S_{i-1}(x_i) = S_i(x_i), \quad S’_{i-1}(x_i) = S’_i(x_i), \quad S »_{i-1}(x_i) = S »_i(x_i)$$
Sur le plan variationnel, la spline cubique naturelle minimise l’intégrale de la dérivée seconde au carré sur tout le domaine, ce qui équivaut physiquement à minimiser l’énergie de courbure totale :
$$\int_{x_0}^{x_n} [S »(x)]^2 , dx to \min$$
Cette propriété de minimisation de la courbure globale s’avère particulièrement séduisante pour modéliser des trajectoires psychologiques et neurophysiologiques naturelles, telles que les transitions entre états de vigilance ou l’apprentissage perceptivo-moteur. Contrairement aux modèles polynomiaux globaux trop rigides ou excessivement réactifs, les splines cubiques procurent une excellente précision locale sans contraindre artificiellement l’allure des segments distants.
2.3 Gestion de l’erreur d’interpolation
L’estimation rigoureuse de la fidélité de l’interpolation repose sur l’analyse de son terme d’erreur. Dans le cas de l’interpolation polynomiale d’une fonction $f(x)$ suffisamment dérivable aux points $x_0, x_1, dots, x_n$, le théorème du reste de Cauchy-Taylor (ou reste d’interpolation) stipule que l’erreur commise en tout point $x$ de l’intervalle s’exprime sous la forme :
$$R_n(x) = f(x) – P_n(x) = \frac{f^{(n+1)}(\xi)}{(n+1)!} \prod_{i=0}^{n} (x – x_i)$$
où $xi$ est un point non déterminé appartenant à l’intervalle ouvert contenant l’ensemble des nœuds et le point d’évaluation $x$. Cette formalisation mathématique illustre immédiatement le rôle cardinal de la densité d’échantillonnage : à mesure que l’espacement maximal entre les nœuds tend vers zéro, le terme polynomial $\prod_{i=0}^{n} (x – x_i)$ s’amenuise considérablement, compressant mécaniquement l’erreur d’estimation globale.
Néanmoins, la réalité des mesures empiriques en sciences humaines introduit une vulnérabilité supplémentaire : la sensibilité au bruit de mesure stochastique. Lorsque les valeurs observées $y_i$ sont entachées d’erreurs aléatoires de mesure — ce qui est la norme constante en psychométrie —, forcer une fonction d’interpolation à passer strictement par chaque point observé conduit inévitablement à interpoler le bruit plutôt que le signal latent sous-jacent. C’est pourquoi, dans de nombreuses situations pratiques, on adjoint à l’interpolation pure des mécanismes de lissage pénalisé (smoothing splines), introduisant un compromis explicite entre l’adéquation exacte aux points d’ancrage et la régularité globale du tracé interpolé.
3. Mécanismes statistiques de l’extrapolation et propagation de l’incertitude
3.1 Projections linéaires et non linéaires
L’acte d’extrapoler consiste à propager l’expression analytique d’un modèle statistique ajusté au-delà de l’enveloppe délimitée par les données d’étalonnage. Dans le cadre d’un modèle de régression linéaire simple $y = \beta_0 + \beta_1 x + \varepsilon$, prolonger la droite de régression en dehors du domaine expérimental postule que le taux de variation marginal $\beta_1$ demeure parfaitement invariable, quelle que soit l’ampleur de l’incrémentation de $x$. Si cette hypothèse de rectitude peut paraître inoffensive sur de courtes distances, elle s’avère fréquemment désastreuse dès que l’éloignement s’accroît.
La situation devient encore plus volatile lorsque l’on manipule des modèles non linéaires. Un modèle polynomial d’ordre 2 ou 3 ($y = \beta_0 + \beta_1 x + \beta_2 x^2 + dots$), qui offre un ajustement descriptif remarquable sur l’intervalle $[x_{\min}, x_{\max}]$ en épousant subtilement une légère courbure des données, diverge avec une violence exponentielle dès que l’on franchit les frontières de l’échantillon. Selon le signe du terme de plus haut degré, la trajectoire extrapolée s’élancera vers des grandeurs positives ou négatives colossales, engendrant des prédictions délirantes dénuées de toute signification substantielle.
L’amplification des biais de spécification constitue la règle fondamentale de l’extrapolation hors échantillon. Une omission mineure de variable explicative ou une erreur infime dans le choix de la forme fonctionnelle (par exemple, modéliser une fonction logistique comme une droite sur son segment central quasi linéaire) passe souvent totalement inaperçue au sein du domaine d’interpolation. En revanche, cette approximation latente se déploie comme une faille béante dès lors que l’on s’aventure au-delà des points d’appui expérimentaux.
3.2 Explosion des intervalles de confiance
L’un des enseignements les plus cruciaux de la théorie statistique de l’inférence linéaire concerne la structure géométrique des bandes de confiance associées aux prédictions. Pour une valeur donnée $x_0$, la variance de la réponse moyenne prédite $\hat{\mu}_{Y|x_0}$ dans une régression linéaire ordinaire est donnée par la formule analytique :
$$operatorname{Var}(\hat{\mu}_{Y|x_0}) = \sigma^2 \left[ \frac{1}{n} + \frac{(x_0 – \bar{x})^2}{\sum_{i=1}^n (x_i – \bar{x})^2} \right]$$
Quant à la variance de prédiction d’une nouvelle observation individuelle isolée $\hat{y}_0$, elle intègre la variance intrinsèque du résidu :
$$operatorname{Var}(\hat{y}_0 – y_0) = \sigma^2 \left[ 1 + \frac{1}{n} + \frac{(x_0 – \bar{x})^2}{\sum_{i=1}^n (x_i – \bar{x})^2} \right]$$
Cette formulation mathématique met en évidence la structure hyperbolique inhérente aux intervalles de prédiction. L’incertitude est minimale au centre de gravité des données empiriques, c’est-à-dire au point moyen $\bar{x}$. Au fur et à mesure que le point ciblé $x_0$ s’éloigne de cette moyenne arithmétique, le terme quadratique $(x_0 – \bar{x})^2$ croît de manière inexorable. Dès lors que l’on bascule dans l’extrapolation, la marge d’erreur subit une inflation explosive, reflétant l’effondrement rapide de l’information statistique disponible.
Malheureusement, les logiciels statistiques modernes génèrent régulièrement des tableaux de prédiction ou des représentations visuelles linéaires qui peuvent masquer cette dégradation sous un affichage trompeur de précision numérique. L’analyste imprudent, observant une estimation ponctuelle nette, oublie trop souvent que l’intervalle de confiance à 95 % associé s’étend désormais sur un spectre si gigantesque qu’il englobe tout et son contraire, vidant la prédiction de toute valeur heuristique ou clinique concrète.
3.3 Hypothèse de stationnarité des processus sous-jacents
Extrapoler suppose obligatoirement la stationnarité, la permanence et l’invariance temporelle ou spatiale des lois probabilistes et physiques régissant le système à l’étude. Cette condition implique que la structure du réseau causal demeure strictement immuable en dehors du champ d’observation. Or, dans le domaine des sciences cognitives, de la psychologie différentielle et de la sociologie, une telle permanence relève de l’illusion théorique.
Les systèmes biologiques et psychologiques se caractérisent par l’existence de seuils de rupture critiques, de saturations métaboliques et de rétroactions homéostatiques complexes. Un traitement pharmacologique destiné à améliorer l’attention soutenue peut présenter un effet dose-réponse parfaitement linéaire entre 5 mg et 20 mg. Extrapoler cet effet à une dose de 100 mg conduira non pas à un niveau d’attention surhumain, mais potentiellement à une toxicité neurologique aiguë, à une inhibition paradoxale ou à des décompensations psychotiques. Le modèle linéaire n’a pas échoué parce que ses calculs internes étaient défaillants, mais parce que le principe de stationnarité de la relation physiologique a été anéanti par l’atteinte d’un plafond biologique.
Ce constat renvoie aux apories fondamentales du problème de l’induction identifié par le philosophe David Hume. L’inférence par extrapolation extrapole non seulement des chiffres, mais également le cadre ontologique des observations passées vers un avenir ou un espace inconnu, transformant un raisonnement empirique circonscrit en un pari épistémologique particulièrement périlleux.
4. Comparaison structurelle : Risques, précision et limites
4.1 Différence de fiabilité intrinsèque
La distinction opératoire majeure entre interpolation et extrapolation réside dans la mécanique de confinement de l’erreur d’ajustement. Dans le cadre de l’interpolation sur un ensemble compact, le comportement de la fonction estimée est encadré par les valeurs des points de données réels. Par application directe du théorème des valeurs intermédiaires et des principes de compacité topologique, la fonction d’interpolation est bornée supérieurement et inférieurement par les dynamiques locales de l’échantillon. L’erreur reste donc auto-limitée, son amplitude maximale dépendant directement de la distance séparant deux nœuds consécutifs et de la régularité supposée de la dérivée du phénomène.
À l’inverse, l’extrapolation se déploie au sein d’un horizon géométrique ouvert. Rien ne s’oppose formellement à ce qu’une fonction extrapolée prenne des valeurs théoriquement infinies ou diamétralement opposées à la vérité du terrain dès que l’on quitte le support des données. L’erreur d’extrapolation est potentiellement infinie et sans borne supérieure calculable sans nouvelles hypothèses restrictives.
Pour distinguer quantitativement l’extrapolation modérée de l’extrapolation extrême, les chercheurs s’appuient fréquemment sur le concept de distance d’éloignement standardisée, souvent formalisée par l’évaluation du rayon de convexité ou de la distance statistique relative par rapport au centroïde des données. Alors qu’une extrapolation mineure (à un pas d’échantillonnage infime au-delà de la borne) peut occasionnellement maintenir un niveau de biais résiduel acceptable, une projection lointaine équivaut méthodologiquement à une conjecture pure, indifférenciable du hasard sur le plan de la validation empirique formelle.
4.2 Sensibilité aux valeurs aberrantes (outliers)
L’architecture des estimateurs statistiques réagit de façon profondément asymétrique aux anomalies de mesure selon que l’on opère au centre ou à la périphérie des distributions. Les valeurs aberrantes situées aux marges extrêmes du jeu de données exercent une force disproportionnée sur les paramètres du modèle : en statistique linéaire, ces points sont qualifiés de points à fort levier (high leverage points). La mesure de cet effet d’entraînement s’évalue notamment par les coefficients de la matrice de projection (ou matrice chapeau $H$) et par la distance de Cook.
Dans un contexte d’interpolation locale, une donnée aberrante affectera principalement le sous-intervalle auquel elle appartient, perturbant le tracé sur une fenêtre spatiale restreinte, sans nécessairement corrompre l’ensemble de la fonction d’interpolation si celle-ci repose sur des splines locales ou des approches non paramétriques. En revanche, dans le cas de l’extrapolation, un point de levier périphérique modifie radicalement la trajectoire directionnelle du modèle tout entier. Une variation minime induite par un artefact de mesure sur le dernier point observé peut faire basculer la pente de prédiction globale de plusieurs degrés, orientant l’extrapolation dans une trajectoire totalement déviante à des kilomètres de la dynamique sous-jacente.
Les techniques de régression robuste, mobilisant des estimateurs de type M, des fonctions de perte de Huber ou la régression par quantiles, s’avèrent dès lors incontournables pour atténuer la vulnérabilité structurelle des modèles appelés à faire l’objet de projections tangentes aux bornes d’échantillonnage.
4.3 Comparaison sous l’angle du compromis biais-variance
Le compromis biais-variance (bias-variance tradeoff) fournit une grille de lecture fondamentale pour formaliser le contraste structurel entre les deux paradigmes d’inférence. L’erreur quadratique moyenne de prédiction se décompose canoniquement en trois composantes :
$$\mathbb{E}[(y_0 – \hat{f}(x_0))^2] = operatorname{Biais}[\hat{f}(x_0)]^2 + operatorname{Var}[\hat{f}(x_0)] + \sigma^2$$
À l’intérieur de l’espace d’interpolation, l’optimisation consiste généralement à trouver une complexité de modèle qui minimise simultanément le biais d’ajustement sans entraîner un surapprentissage délétère du bruit local. La variance de l’estimateur $operatorname{Var}[\hat{f}(x_0)]$ demeure relativement stable et maîtrisée du fait de la présence dense d’observations régulatrices dans le voisinage direct de chaque point de calcul.
Dès que l’on bascule dans l’espace extrapolé, ce compromis bascule dans une zone d’instabilité structurelle critique. Si le modèle est doté d’une forte flexibilité (par exemple, un réseau neuronal profond, un polynôme d’ordre élevé ou un algorithme non paramétrique libre), la variance de prédiction explose littéralement, entraînant des fluctuations erratiques pour le moindre décalage d’échantillon d’entraînement. À l’inverse, si l’on tente de rigidifier le modèle par le biais d’une contrainte linéaire stricte pour contenir cette variance, c’est le terme de biais empirique qui devient gargantuesque en cas de non-linéarité réelle du phénomène dans la zone inexplorée. Les stratégies modernes de régularisation mathématique (pénalités Ridge L2, Lasso L1 ou régularisation par processus gaussiens) visent précisément à contraindre cette expansion de la variance périphérique en imposant des a priori stricts sur la courbure admissible des trajectoires hors données.
5. Applications de l’interpolation en psychométrie et sciences du comportement
5.1 Imputation des données manquantes dans les enquêtes psychologiques
L’un des terrains d’élection de l’interpolation méthodologique concerne la résolution des non-réponses et des omissions dans l’administration des questionnaires psychométriques. Dans les études longitudinales impliquant la méthode d’échantillonnage des expériences vécues (Experience Sampling Method, ESM) ou le recueil écologique momentané (Ecological Momentary Assessment, EMA), les participants sont sollicités à de multiples reprises par jour pour coter leur état émotionnel, leur anxiété ou leur niveau d’épuisement. Il est fréquent que certains signaux temporels soient sporadiquement absents en raison d’oublis ou d’impératifs matériels.
Lorsque ces absences interviennent entre deux points d’évaluation effectifs dûment horodatés, l’interpolation temporelle (linéaire, polynomiale locale ou basée sur des modèles d’état-espace de Kalman) permet de reconstituer une dynamique continue du profil affectif sans altérer l’architecture temporelle du signal global. Cette approche est légitimée par la forte autocorrélation temporelle des états de l’humeur sur des échelles de quelques heures. Toutefois, la méthodologie psychométrique moderne prend soin de distinguer l’interpolation directe déterministe de l’imputation multiple bayésienne : alors que la première postule une trajectoire unique et certaine, la seconde génère une distribution probabiliste de valeurs plausibles à l’intérieur de l’intervalle, réinjectant l’incertitude liée à l’omission au sein du modèle structural final.
5.2 Étalonnage et normalisation des scores de tests cognitifs
La psychométrie différentielle fait un usage structurel de l’interpolation lors de l’établissement des barèmes et des normes standardisées pour les tests d’intelligence générale ou d’aptitudes spécifiques, à l’instar des échelles de Wechsler (WAIS, WISC). Lors de l’étalonnage national d’un instrument psychologique, il est matériellement et financièrement impossible d’échantillonner des effectifs représentatifs pour chaque sous-fraction d’âge de l’existence humaine (par exemple, chaque mois d’âge pour les enfants, ou chaque année précise chez les personnes d’âge mûr). Les concepteurs recueillent des données normatives auprès de cohortes d’âge discrètes, telles que des groupes de 8 ans et 0 mois, 8 ans et 6 mois, ou 9 ans et 0 mois.
Pour déterminer avec rigueur les percentiles, les rangs centiles et les scores dérivés (QI standard de moyenne 100 et d’écart-type 15) des individus situés chronologiquement entre ces tranches fixes, la modélisation statistique continue fait appel à des techniques d’interpolation de courbes de centiles, comme la méthode LMS de Cole et Green ou la régression quantile non paramétrique. Cette modélisation continue préserve la validité de construit en évitant les effets de seuil artificiels et arbitraires qu’engendrerait un découpage par paliers discontinus, assurant ainsi une transition fluide et biologiquement plausible des normes cognitives sur tout le spectre du développement intellectuel.
5.3 Analyse des séries temporelles en neurosciences
Dans le domaine des neurosciences cognitives, l’interpolation constitue un instrument de prétraitement incontournable pour le traitement des données électrophysiologiques à haute résolution temporelle, notamment l’électroencéphalographie (EEG) et la magnétoencéphalographie (MEG). Durant l’acquisition d’un tracé EEG, il arrive régulièrement qu’une ou plusieurs électrodes présentent des impédances inacceptables, des déconnexions transitoires ou des artefacts musculaires massifs qui corrompent l’enregistrement de manière irrécupérable.
Plutôt que d’éliminer l’intégralité de l’époque d’enregistrement ou de rejeter un participant précieux, les neuroscientifiques recourent à l’interpolation spatiale de l’activité corticale. En utilisant des algorithmes d’interpolation sphérique par splines tridimensionnelles basés sur la disposition topographique exacte du réseau d’électrodes, le voltage du canal défectueux est reconstitué mathématiquement à partir des signaux émis par les capteurs sains immédiatement adjacents sur la calotte crânienne. De manière analogue, au sein du domaine temporel, des interpolations par ondelettes permettent de gommer des artefacts de clignements oculaires sans rompre la cohérence de phase des oscillations cérébrales sous-jacentes (rythmes thêta, alpha ou gamma).
6. Les dérives de l’extrapolation dans la recherche psychologique
6.1 Extrapolation développementale et vieillissement
L’un des égarements méthodologiques les plus regrettables en psychologie du vieillissement a longtemps résidé dans l’extrapolation mécanique des trajectoires de déclin neurocognitif observées chez les personnes âgées de 60 à 75 ans pour décrire le fonctionnement cognitif des individus très âgés (le grand âge, au-delà de 85 ou 90 ans). Les modélisations linéaires transversales indiquaient fréquemment un affaissement constant et rapide de la mémoire de travail et de la vitesse de traitement de l’information au sein du troisième âge.
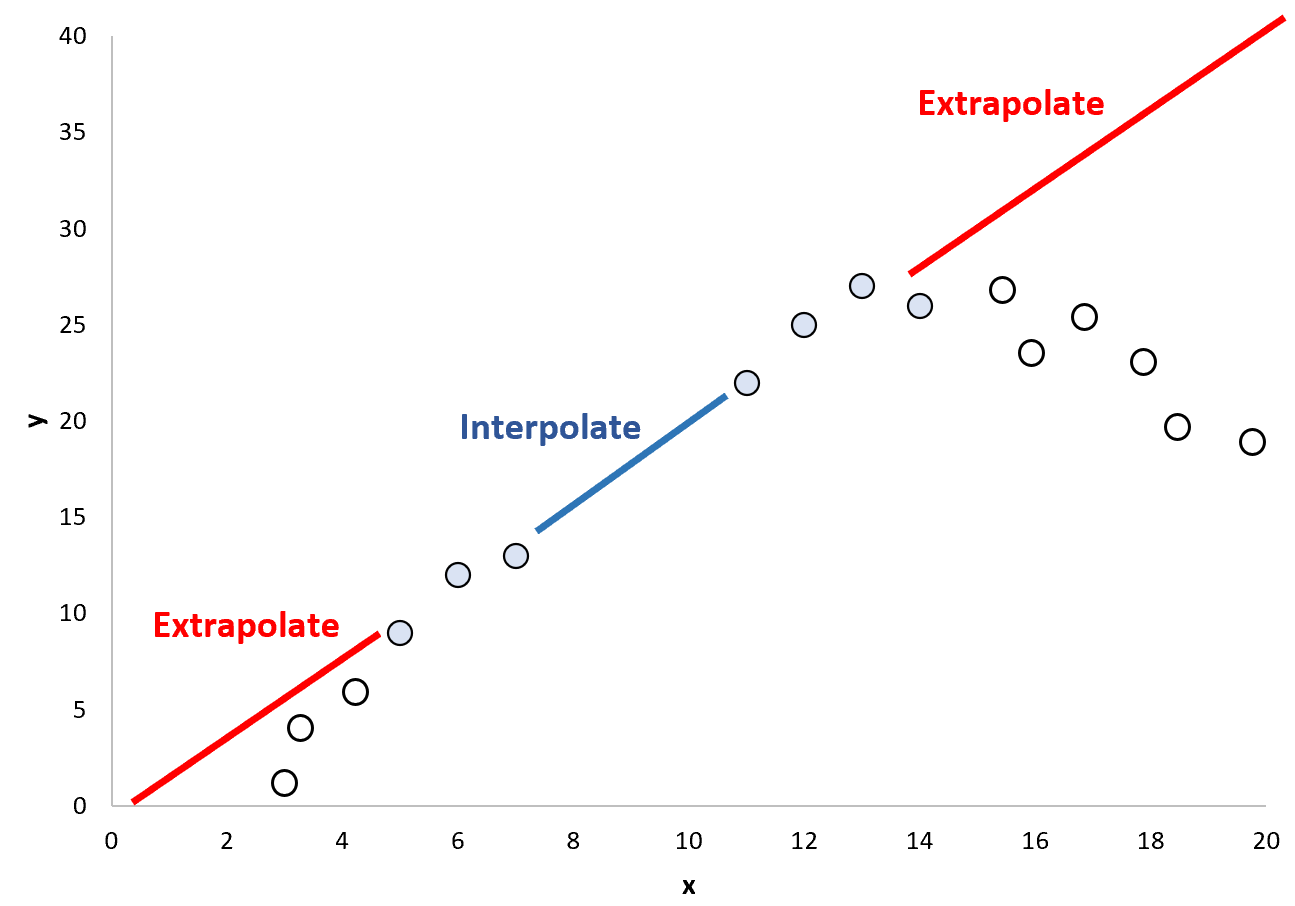
Extrapoler cette pente régressive brute aux nonagénaires et centenaires a conduit à la postulation théorique d’un effondrement cognitif universel et inéluctable. Or, les recherches contemporaines longitudinales sur la longévité exceptionnelle ont largement invalidé cette vision simpliste. Chez les sujets atteignant les âges les plus avancés sans démence neurodégénérative patente, on observe souvent une résilience neurobiologique remarquable, une stabilisation des fonctions exécutives basales ou la mise en œuvre de mécanismes compensatoires bilatéraux cérébraux (phénomène HAROLD : Hemispheric Asymmetry Reduction in Older Adults). L’extrapolation avait totalement ignoré le biais de survie sélective et l’existence d’états physiologiques stables alternatifs, générant une pathologisation indue et scientifiquement biaisée de la vieillesse extrême.
6.2 Prédiction des comportements dans des conditions extrêmes
Les armées, les agences aérospatiales et les organismes de sécurité civile ont fréquemment tenté d’anticiper le comportement, la prise de décision et la résistance psychologique des opérateurs humains placés dans des situations de survie ou de catastrophe extrême (missions spatiales de longue durée, combats intenses, environnements sous-marins profonds) en extrapolant les données issues de simulations de laboratoire modérément stressantes.
En laboratoire, il est éthiquement et techniquement impératif de limiter le stress imposé aux sujets d’expérience (par exemple, le test de stress social de Trier ou des tâches d’arithmétique sous privation légère de sommeil). Si la dégradation des performances cognitives suit une tendance contrôlée sous ces contraintes mesurées, postuler que la même équation prédictive s’appliquera sous une menace vitale directe ou une privation sensorielle absolue constitue un non-sens psychophysiologique. Sous des contraintes extrêmes, le système nerveux bascule hors des régulations autonomes ordinaires : l’inondation de l’amygdale par les catécholamines et les glucocorticoïdes fait franchir un point de rupture fonctionnel, déclenchant des réactions de sidération, de panique incontrôlée ou de dissociation péritraumatique. Ces ruptures de régimes dynamiques anéantissent purement et simplement les projections mathématiques construites en environnement universitaire sécurisé.
6.3 L’extrapolation transculturelle des modèles psychologiques
Sur le plan méthodologique et conceptuel, la crise de réplicabilité qui secoue les sciences comportementales trouve l’une de ses sources majeures dans l’extrapolation abusive de modèles psychologiques calibrés sur des cohortes hautement spécifiques à l’ensemble de l’humanité. Durant des décennies, la grande majorité des théories en psychologie cognitive, sociale et motivationnelle ont été échafaudées à partir d’échantillons qualifiés d’échantillons WEIRD (Western, Educated, Industrialized, Rich, Democratic), le plus souvent des étudiants de premier cycle universitaire nord-américains ou européens.
Étendre sans vérification préalable ces équations psychologiques à des populations issues de cultures collectivistes, de sociétés agraires ou de contextes socio-économiques précarisés relève formellement d’une extrapolation statistique et écologique non valide. Les biais d’attribution fondamentale, les styles attentionnels (holistiques versus analytiques) ou les dynamiques de valorisation de soi ne constituent pas des constantes mathématiques universelles invariant par translation culturelle. En assimilant implicitement un contexte anthropologique radicalement nouveau à une simple continuation de l’espace empirique familier, la recherche a produit des théories erronées et un ethnocentrisme méthodologique aux conséquences délétères pour la portée universelle des sciences de l’esprit.
7. Modélisation statistique : Comportement des modèles de régression
7.1 Le modèle linéaire classique face aux frontières de données
La régression linéaire par les moindres carrés ordinaires (MCO) demeure l’outil statistique le plus omniprésent en modélisation empirique. Sa formulation algébrique élégante, son interprétabilité immédiate et ses propriétés d’optimalité sous les conditions du théorème de Gauss-Markov en font le modèle de premier choix pour l’analyste. Au sein du domaine géométrique délimité par les données d’apprentissage, le modèle linéaire produit une interpolation globale qui s’avère particulièrement efficace pour résumer la tendance centrale d’une covariance multivariée.
Cependant, le modèle linéaire souffre d’une rigidité ontologique intrinsèque : il postule l’additivité universelle et la proportionalité stricte et illimitée des effets. Dès que l’on sollicite le modèle pour émettre une prédiction au-delà de l’enveloppe des données réelles, cette simplicité structurelle se transforme en un vecteur de défaillance majeure. Les coefficients angulaires $\beta$, ajustés pour minimiser l’erreur quadratique sur le support d’observation, projettent des trajectoires qui ignorent superbement les contraintes physiques ou biologiques réelles. La dégradation de la performance du modèle ne se fait pas de façon graduelle ; elle se révèle instantanée lorsque le processus réel intègre des régulations non linéaires ignorées par la droite de régression.
7.2 Modèles non linéaires et fonctions logistiques
Pour immuniser les extrapolations contre les aberrations manifestes inhérentes aux modèles linéaires (telles que la prédiction de probabilités négatives ou de scores de performance supérieurs au maximum théorique absolu), les statisticiens privilégient l’usage de modèles non linéaires contraints, au premier rang desquels figurent les fonctions logistiques et sigmoïdes. Dans l’analyse des apprentissages ou de la dynamique d’acquisition de compétences, l’équation logistique à quatre paramètres s’impose fréquemment :
$$y = D + \frac{A – D}{1 + \left(\frac{x}{C}\right)^B}$$
où $A$ représente l’asymptote inférieure théorique, $D$ l’asymptote supérieure (l’effet plafond), $C$ le point d’inflexion médiane et $B$ le taux de croissance relatif. L’immense supériorité de cette architecture fonctionnelle lors de projections périphériques réside dans son bornage asymptotique automatique. Alors qu’une modélisation polynomiale d’un processus d’apprentissage projettera que le score à un examen dépassera 150 % ou chutera en dessous de zéro avec l’augmentation du temps d’étude, la régression logistique contraint géométriquement l’extrapolation à demeurer captive de l’intervalle réaliste $[A, D]$.
Cette distinction est fondamentale pour préserver la cohérence des théories psychologiques. En reconnaissant que les capacités cognitives et les rendements comportementaux sont irrémédiablement soumis à des effets de plafond (saturation de la mémoire, limites motrices) et de plancher (performances imputables au simple hasard statistique), les fonctions sigmoïdes fournissent un cadre de projection infiniment plus résilient que n’importe quelle approximation polynomiale d’ordre élevé.
7.3 Modèles additifs généralisés (GAM) et lissage
Les Modèles Additifs Généralisés (Generalized Additive Models, GAM), introduits par Trevor Hastie et Robert Tibshirani, représentent le summum contemporain de la flexibilité statistique pour réconcilier modélisation non linéaire et interprétabilité. La formulation mathématique remplace la somme pondérée des prédicteurs linéaires par une somme de fonctions de lissage non paramétriques indéterminées $f_j(x_j)$ :
$$g(\mathbb{E}(Y)) = \beta_0 + \sum_{j=1}^{p} f_j(x_j)$$
Ces fonctions $f_j$ sont généralement estimées par le biais de bases de splines de régression pénalisées, où un paramètre de lissage $lambda$ arbitre mathématiquement entre l’ajustement aux données et la courbure de la fonction. À l’intérieur du nuage de points d’apprentissage, les GAM constituent les estimateurs d’interpolation les plus performants, épousant subtilement les formes fonctionnelles les plus complexes sans forcer de postulat paramétrique a priori rigide.
Néanmoins, cette flexibilité prodigieuse recèle un danger considérable dès que l’on atteint les frontières du support empirique. Par défaut, si l’on ne spécifie pas de contraintes additionnelles, les bases de splines non contraintes peuvent adopter des comportements hautement erratiques et imprévisibles au-delà du dernier point observé, s’enroulant brusquement vers le haut ou plongeant abruptement sous l’effet des conditions de fin de domaine. Pour neutraliser cette dérive lors de modélisations semi-extrapolatoires, les statisticiens emploient des splines naturelles pénalisées qui forcent la fonction de lissage à redevenir obligatoirement linéaire en dehors du domaine circonscrit par les nœuds extrêmes, stabilisant ainsi la projection au prix d’un postulat de rectitude locale.
8. Biais cognitifs et psychologie de l’extrapolation abusive
8.1 Le biais de linéarité dans le raisonnement humain
L’inclination récurrente des analystes, cliniciens et décideurs à préférer l’extrapolation naïve à la reconnaissance de l’incertitude plonge ses racines dans les biais cognitifs structurels de l’architecture cognitive humaine. Au centre de ces distorsions se trouve le biais de linéarité, une heuristique spontanée documentée par la psychologie cognitive selon laquelle l’esprit humain présume intuitivement que toute relation causale ou temporelle évolue selon une trajectoire proportionnelle, constante et rectiligne.
Ce biais mental a été mis en lumière de façon spectaculaire lors des travaux expérimentaux portant sur l’incompréhension des processus d’amplification géométrique ou exponentielle. Confrontés à une variable qui double de valeur à intervalle régulier, la quasi-totalité des individus sous-estiment radicalement l’explosion quantitative future, projetant mentalement une progression arithmétique simple. À l’inverse, face à un phénomène biologique atteignant une saturation asymptotique (comme l’effet d’un antidépresseur sur l’humeur en fonction du dosage), l’intuition clinique non régulée tend à croire qu’un doublement de la dose induira mécaniquement un doublement des bénéfices thérapeutiques. L’incapacité innée à visualiser intuitivement les dérivées secondes et les courbures complexes pousse le raisonnement humain à transformer toute tendance locale en une autoroute linéaire sans fin, rendant l’extrapolation abusive psychologiquement séduisante et cognitivement confortable.
8.2 L’illusion de certitude et l’effet de surconfiance
L’esprit humain abhorre le vide informatif et l’indétermination statistique. Cette intolérance psychologique à l’incertitude alimente puissamment ce que Daniel Kahneman et Amos Tversky ont conceptualisé comme le biais de surconfiance (overconfidence effect). Lorsqu’un individu est invité à émettre un jugement sur un cas ou une situation se trouvant en dehors de son périmètre d’expérience directe, son cerveau ne mobilise pas spontanément l’élargissement hyperbolique des marges d’erreur prescrit par la théorie statistique.
Au contraire, plus un professionnel acquiert un sentiment subjectif d’expertise dans son domaine (qu’il s’agisse de psychologie légale, de psychiatrie ou d’économie financière), plus il a tendance à produire des prédictions extrapolées péremptoires dotées d’une confiance subjective aveuglante. Ce phénomène est décuplé par la fabrication de récits narratifs cohérents : l’expert substitue à l’absence de données empiriques une histoire logique plausible expliquant pourquoi le mécanisme observé devrait continuer d’opérer hors de ses frontières d’épreuve. Cette construction discursive masque complètement l’ignorance objective et transforme une conjecture hasardeuse en une quasi-certitude perçue, annihilant la perception du risque statistique.
8.3 Heuristique de représentativité et extrapolation catégorielle
Le glissement insidieux entre interpolation et extrapolation se nourrit également de l’heuristique de représentativité. Lorsqu’un praticien examine un profil psychologique ou clinique présentant des caractéristiques exceptionnelles ou marginales (par exemple, un score de traumatisme ou de psychopathie situé à trois écarts-types au-dessus de la moyenne de l’échantillon normatif), l’automatisme cognitif consiste à rattacher immédiatement ce cas singulier aux propriétés du groupe normé d’étalonnage.
Ce faisant, le clinicien opère une extrapolation catégorielle abusive en appliquant au patient extrême les relations fonctionnelles et les pronostics dérivés du groupe majoritaire. Ce processus s’accompagne d’une négligence systématique des taux de base (base-rate fallacy) et de l’oubli pur et simple du phénomène mathématique de régression vers la moyenne. Parce que le cas extrême ressemble superficiellement aux membres de la catégorie documentée, l’évaluateur imagine pouvoir interpoler sa trajectoire à partir de la grille standard, ignorant qu’il navigue en réalité dans une zone d’extrapolation radicale où les mécanismes adaptatifs de survie peuvent différer qualitativement de ceux de la population générale.
9. Validité méthodologique : Validité interne vs validité externe
9.1 L’interpolation comme instrument de validité interne
Dans l’architecture de la méthode scientifique telle que formalisée par Campbell et Stanley, la validité interne d’une expérience désigne le degré de certitude avec lequel il est possible d’attribuer la variation de la variable dépendante à l’action exclusive de la variable indépendante manipulée, en éliminant toute interprétation concurrente ou variable confondante. Au sein de cet édifice épistémologique, l’interpolation opère comme un garant et un consolidateur de la validité interne.
En opérant strictement à l’intérieur du périmètre expérimental balisé, l’interpolation bénéficie de la stabilité du dispositif de contrôle des conditions ambiantes, de l’isolation des covariables et de la représentativité locale de l’échantillonnage. Tout point interpolé peut être soumis à une vérification empirique rigoureuse par partitionnement des données (data splitting) ou validation croisée : il suffit d’omettre temporairement une observation réelle, d’ajuster le modèle d’interpolation sur les points restants, et de quantifier l’erreur de restitution. Cette procédure d’audit continu confère aux déductions interpolées une assise méthodologique exceptionnellement solide, renforçant la cohésion interne du protocole scientifique.
9.2 L’extrapolation comme épreuve critique de la validité externe
La validité externe, quant à elle, questionne la légitimité avec laquelle les conclusions dégagées dans un cadre expérimental spécifique peuvent être généralisées à d’autres populations, d’autres contextes temporels, d’autres contextes géographiques ou des situations écologiquement plus complexes. Dès lors, l’extrapolation statistique et conceptuelle apparaît comme l’opérateur fondamental de la mise à l’épreuve de la validité externe.
Généraliser un protocole de remédiation cognitive conçu pour des étudiants en laboratoire à des résidents de maisons de retraite souffrant de troubles neurodégénératifs constitue une extrapolation au sens méthodologique le plus strict. Cette transition hors du sanctuaire expérimental exige une justification théorique substantielle qui dépasse de très loin la simple manipulation de chiffres dans un logiciel d’analyse. Pour être jugée scientifiquement recevable et valide, une extrapolation doit démontrer que le système hors du domaine de mesure partage la même architecture causale que le système d’entraînement. L’extrapolation est la véritable épreuve du feu pour toute théorie scientifique : elle teste si les mécanismes fondamentaux découverts possèdent une portée écologique universelle ou s’ils ne constituaient qu’un artefact d’un environnement expérimental hyper-contrôlé.
9.3 L’enveloppe convexe multivariée (Convex Hull)
L’un des défis les plus pernicieux et techniques de l’analyse multivariée moderne réside dans l’identification de ce que l’on nomme l’extrapolation cachée (hidden extrapolation). Dans une perspective univariée élémentaire impliquant une seule variable indépendante $x$, distinguer l’interpolation de l’extrapolation est trivial : il suffit de vérifier si la valeur $x^*$ se situe à l’intérieur de l’intervalle $[x_{\min}, x_{\max}]$. En revanche, dès que le modèle statistique intègre de multiples prédicteurs ($x_1, x_2, dots, x_p$), cette frontière géométrique cesse d’être triviale.
Le domaine d’interpolation valide en dimensions multiples est rigoureusement défini par l’enveloppe convexe (convex hull) de l’ensemble des données d’entraînement. L’enveloppe convexe représente le plus petit polygone convexe (en 2D) ou polyèdre (en dimension $p$) englobant l’intégralité du nuage de points expérimentaux. Le piège redoutable se présente lorsqu’un point d’évaluation présente des coordonnées individuelles qui tombent parfaitement à l’intérieur des marges univariées de chaque variable prise isolément, tout en se trouvant complètement en dehors de l’enveloppe convexe globale multivariée !
Imaginons une étude psychométrique observant deux variables : l’âge (allant de 18 à 70 ans) et le nombre d’années d’expérience professionnelle dans l’aviation militaire (allant de 0 à 40 ans). Un individu de 19 ans possédant 25 ans d’expérience dans l’aviation se situe parfaitement dans la plage univariée de l’âge (19 $in$ [18, 70]) et dans la plage univariée de l’expérience (25 $in$ [0, 40]). Pourtant, la combinaison simultanée de ces deux coordonnées est matériellement impossible et se situe à des années-lumière de l’enveloppe convexe réelle des données d’étalonnage. Appliquer un modèle statistique multivarié à ce point relève d’une extrapolation extrême dissimulée sous une fausse apparence d’interpolation marginale univariée. La détection de ces pièges impose la mise en œuvre systématique d’algorithmes géométriques de calcul d’enveloppe convexe ou l’évaluation continue de la distance de Mahalanobis.
10. Approches modernes en apprentissage automatique et modélisation avancée
10.1 Réseaux de neurones et extrapolation
L’essor vertigineux de l’apprentissage automatique profond (deep learning) a renouvelé de fond en comble les débats épistémologiques sur l’interpolation et l’extrapolation. Les réseaux de neurones profonds, opérant dans des espaces d’attributs de très haute dimension (plusieurs millions de paramètres libres), démontrent une capacité surhumaine à interpoler de manière ultra-précise et continue au sein des variétés de données d’apprentissage (manifold interpolation), défiant même les leçons classiques du compromis biais-variance grâce au phénomène moderne de double descente.
Toutefois, la fragilité structurelle de ces architectures face à l’extrapolation hors distribution (out-of-distribution generalization) demeure leur talon d’Achille fondamental. Lorsqu’un réseau de neurones est soumis à une sollicitation appartenant à une distribution probabiliste marginalement décalée de celle de ses données de calibrage, ses prédictions s’effondrent souvent de façon spectaculaire. Il peut assigner une probabilité de certitude de 99,9 % à une classification totalement erronée, démontrant qu’il n’a pas modélisé une loi causale universelle, mais un réseau complexe d’interpolations locales. Pour se prémunir contre ces défaillances critiques en intelligence artificielle appliquée à la santé mentale ou au diagnostic automatisé, les ingénieurs développent activement des algorithmes de détection d’anomalies afin de refuser systématiquement d’émettre des prédictions dès qu’une entrée se situe hors du domaine d’interpolation légitime de l’algorithme.
10.2 Arbres de décision et forêts aléatoires
Les algorithmes basés sur le partitionnement récursif de l’espace, tels que les arbres de classification et de régression (CART) et les forêts aléatoires (Random Forests), occupent une place prépondérante dans l’analyse prédictive en psychologie et sciences du comportement. Or, leur mécanique mathématique intrinsèque les rend structurellement et absolument incapables d’extrapoler au-delà du spectre des données d’entraînement.
Un arbre de décision segmente l’espace des attributs en hyperrectangles orthogonaux et assigne à toute nouvelle observation tombant dans une feuille terminale la moyenne des observations d’entraînement y résidant. Par conséquent, lorsqu’une observation extrapolée dépasse les seuils maximaux d’entraînement, elle se voit inévitablement assigner la valeur de la feuille la plus proche de la frontière. Les forêts aléatoires génèrent des prédictions sous forme de plateaux horizontaux constants hors de l’enveloppe de données d’origine. Si un modèle de forêt aléatoire est entraîné à prédire des scores d’anxiété sur des indices physiologiques ne dépassant pas un certain seuil de conductance cutanée, toute augmentation future de cette conductance au-delà des bornes connues recevra exactement la même prédiction plafonnée, masquant totalement une aggravation clinique réelle du patient.
10.3 Modélisation bayésienne et quantification de l’incertitude
Face aux carences manifestes des approches déterministes, la modélisation bayésienne et particulièrement les processus gaussiens (Gaussian Processes, GP) offrent le cadre le plus élégant, transparent et épistémologiquement honnête pour gérer la transition entre interpolation et extrapolation. Dans un modèle de régression par processus gaussien, on spécifie une distribution a priori sur un ensemble infini de fonctions possibles via une fonction de moyenne et une fonction de covariance ou noyau (kernel).
À l’intérieur de la zone où les données sont denses, le processus gaussien agit comme un interpolateur hautement précis : la fonction conditionnelle a posteriori épouse les données empiriques, et la variance de prédiction se contracte pour s’approcher de l’erreur instrumentale résiduelle. En revanche, à mesure que l’on s’éloigne des observations pour s’enfoncer dans l’espace d’extrapolation, la magie bayésienne opère avec une rigueur absolue : en l’absence d’information empirique locale, la fonction moyenne régresse automatiquement vers la moyenne a priori globale, tandis que l’incertitude épistémique (l’écart-type de prédiction) s’évase progressivement pour restaurer intégralement la variance de l’a priori originel. Le modèle exprime formellement son ignorance grandissante au fur et à mesure que l’extrapolation progresse, fournissant aux cliniciens une cartographie probabiliste limpide du niveau de risque attaché à chaque décision.
11. Études de cas comparatives et illustrations pratiques
11.1 L’effet Flynn : Interpolation historique vs projections extrapolées
L’effet Flynn, documenté de façon systématique par le chercheur James Flynn dans les années 1980, désigne la progression continue et séculaire des scores moyens aux tests d’intelligence générale observée dans de nombreux pays développés tout au long du XXe siècle, avec un gain moyen de l’ordre de 3 points de quotient intellectuel par décennie. Cet objet d’étude offre un terrain remarquable pour examiner le contraste entre la rigueur de l’interpolation historique et les aberrations méthodologiques de l’extrapolation mécanique.
L’estimation des performances moyennes de populations entre deux vagues d’étalonnage espacées de dix ou quinze ans par le biais de méthodes d’interpolation linéaire ou spline a fourni des résultats remarquablement fiables. Ces interpolations ont permis aux psychométriciens de recalibrer les scores de QI standardisés avec une exactitude clinique exemplaire pour les cohortes intermédiaires. En revanche, les dérives méthodologiques ont surgi lorsque des analystes ont tenté d’extrapoler cette tendance historique de façon linéaire, que ce soit vers le futur ou rétrospectivement vers le passé :
- L’extrapolation rétrospective séculaire : Si l’on prolonge la droite de l’effet Flynn à l’envers sur un siècle et demi, on aboutit à la conclusion mathématique absurde selon laquelle la moyenne des citoyens des nations industrialisées vers 1850 aurait affiché un quotient intellectuel moyen inférieur à 50 ou 60, ce qui correspond au seuil de la déficience intellectuelle modérée à sévère, incapable d’assurer le fonctionnement autonome d’une société humaine.
- L’extrapolation prospective : Prolongée sans frein vers le XXIe siècle, l’extrapolation linéaire postulait une ascension sans fin de l’intelligence humaine vers des sommets stratosphériques. Or, dès la fin des années 1990, de nombreuses études scandinaves et françaises ont documenté un effet Flynn négatif ou stagnant, révélant que la dynamique historique avait atteint un plateau d’asymptote sociologique et éducative non anticipé par le modèle statistique de base.
11.2 Modèles d’apprentissage et courbes de mémoire d’Ebbinghaus
Les travaux pionniers d’Hermann Ebbinghaus sur l’oubli et la rétention mémorielle illustrent à la perfection la supériorité de l’interpolation scientifique face aux impasses de l’extrapolation temporelle découplée de la physiologie cérébrale. Ebbinghaus mesura avec une méticulosité absolue le pourcentage d’économie cognitive lors du réapprentissage de listes de syllabes sans signification sur des intervalles temporels contrôlés s’échelonnant de 20 minutes à 31 jours.
L’ajustement mathématique d’une équation logarithmique exponentielle à décroissance rapide permit d’interpoler avec une fidélité quasi parfaite le taux d’oubli pour n’importe quel intervalle horaire intermédiaire au cours du premier mois (par exemple, estimer la rétention exacte à 48 heures ou à 14 jours). Cette réussite descriptive de l’interpolation a cimenté les lois fondamentales de la psychologie de la mémoire. Cependant, toute tentative d’extrapoler cette équation originale sur des durées de 10, 20 ou 40 ans sans réactivation conduit inéluctablement à prédire un oubli mathématique absolu et une amnésie complète de la matière étudiée.
Cette extrapolation échoue car elle ignore délibérément les mécanismes biologiques d’assimilation mnésique profonde, de consolidation synaptique et de sédimentation sémantique durable. Des pans entiers de compétences et de savoirs consolidés de manière récurrente s’ancrent dans ce que le psychologue Harry Bahrick a nommé le permastore, une structure mémorielle immunisée contre l’oubli ordinaire sur plusieurs décennies. L’extrapolation de la courbe à court terme d’Ebbinghaus ne peut en aucun cas capturer cette bascule de support neurophysiologique.
11.3 La relation stress-performance (Loi de Yerkes-Dodson)
La célèbre loi de Yerkes-Dodson, articulée pour la première fois en 1908 par Robert Yerkes et John Dillingham Dodson, postule que la relation entre le niveau d’éveil physiologique (ou de stress perçu) et l’efficacité de la performance cognitive ou motrice suit une trajectoire non linéaire modélisable par une courbe en U inversé. À un niveau d’éveil très bas, la somnolence et le désengagement nuisent à la performance ; à un niveau d’éveil optimal intermédiaire, la vigilance est maximale et la tâche est exécutée avec une précision supérieure ; au-delà de ce point de bascule, une activation physiologique excessive engendre de l’anxiété paralysante et une désorganisation cognitive rapide.
L’interpolation le long de cette trajectoire documentée expérimentalement permet aux spécialistes de l’ergonomie et de la psychologie du travail de cibler avec justesse la zone d’activation optimale pour différents types de tâches complexes. En revanche, l’histoire du management d’entreprise et de l’entraînement militaire est truffée de catastrophes induites par une extrapolation aveugle menée à partir de données tronquées dans la seule première phase ascendante de la courbe. Un gestionnaire observant qu’une augmentation de la pression temporelle et des exigences de production accroît la productivité d’une équipe lors des premières phases d’un projet extrapolate souvent naïvement cette causalité de manière linéaire : il en conclut qu’en augmentant indéfiniment le stress, la rentabilité continuera de croître proportionnellement. Cette extrapolation erronée précipite invariablement les collaborateurs dans la zone descendante de la courbe, déclenchant absentéisme, burn-out généralisé et effondrement brutal de la performance globale de l’organisation.
12. Guide méthodologique : Bonnes pratiques et arbre de décision pour les chercheurs
12.1 Protocole de vérification avant toute prédiction statistique
Afin de prémunir les chercheurs et analystes quantitatifs contre les pièges de l’inférence prédictive, il est impératif d’institutionnaliser un protocole méthodologique formel et rigoureux avant toute utilisation d’un modèle statistique à des fins d’estimation. Tout processus d’évaluation devrait impérativement débuter par l’application systématique des critères de contrôle suivants :
- Vérification formelle de l’appartenance à l’enveloppe convexe : Pour tout nouveau vecteur d’observation candidat à une prédiction, l’analyste doit déterminer par voie algorithmique si ce vecteur réside à l’intérieur du polyèdre délimité par les données d’entraînement. Si le cas relève de l’extrapolation, il doit être catégorisé comme prédiction à haute incertitude épistémique.
- Calcul des distances statistiques multivariées : L’évaluation de la distance de Mahalanobis permet de quantifier l’éloignement d’une observation par rapport au centroïde multivarié des données, pondérée par la structure de covariance globale. Une observation présentant une distance de Mahalanobis excédant le seuil critique d’une distribution du Chi-deux au degré de liberté approprié signale immédiatement une extrapolation dissimulée.
- Visualisation graphique obligatoire : Aucun calcul de prédiction numérique ne devrait être accepté sans une inspection visuelle préalable des nuages de points multivariés, des diagrammes de projection bi-dimensionnels et des cartes résiduelles. La visualisation spatiale demeure le rempart le plus instinctif et le plus efficace contre l’illusion de rectitude mathématique des sorties logicielles brutes.
12.2 Stratégies d’atténuation de l’incertitude prédictive
Lorsqu’un chercheur est placé dans la nécessité scientifique incontournable de formuler une estimation extrapolée — ce qui se présente régulièrement lors de travaux prospectifs en santé publique ou lors d’évaluations cliniques inédites —, des protocoles d’atténuation de l’incertitude doivent être obligatoirement activés pour préserver la déontologie scientifique de la démarche :
- Abandon définitif des prédictions ponctuelles isolées : Il est formellement contraire à la rigueur méthodologique de communiquer un chiffre unique estimé au-delà des bornes d’échantillonnage. Toute prédiction extrapolée doit obligatoirement être accompagnée de son intervalle de prédiction à 95 % ou 99 %, calculé selon des formules intégrant l’élargissement hyperbolique de l’erreur quadratique.
- Imposition de bornes fonctionnelles théoriques : Si le phénomène mesuré possède des propriétés physiques, biologiques ou conceptuelles avérées (non-négativité, bornes de scores de test, limites métaboliques humaines), le modèle mathématique doit être structurellement bridé par des fonctions de pénalité ou des transformations fonctionnelles adaptées interdisant toute violation de ces frontières ontologiques.
- Recours à la validation croisée hors-domaine : Pour quantifier empiriquement la capacité de transfert d’un modèle, l’analyste doit concevoir des protocoles de validation croisée spécifiques par partitionnement spatial ou temporel disjoint (blocked cross-validation). En observant comment le modèle se comporte lorsqu’il tente de prédire un groupe systématiquement décalé qu’il n’a jamais vu lors de l’ajustement, on obtient une évaluation objective du risque réel attaché aux extrapolations futures.
12.3 Éthique de la communication des résultats empiriques
L’intégrité de la science quantitative ne se limite pas à la justesse des calculs matriciels ; elle repose fondamentalement sur la clarté, l’honnêteté et la transparence épistémique avec lesquelles les conclusions empiriques sont rédigées et diffusées au public, aux pairs et aux décideurs politiques. Le transfert inadéquat de projections extrapolées non vérifiées vers la sphère médiatique ou sociétale peut induire des politiques publiques désastreuses ou alimenter des paniques morales injustifiées.
Conformément aux normes les plus exigeantes de rédaction scientifique, telles que stipulées par les manuels de publication de l’American Psychological Association (APA 7th edition), les auteurs d’articles de recherche ont l’obligation déontologique de tracer une ligne de démarcation explicite et univoque entre les résultats issus de l’interpolation empiriquement validée et les propositions relevant de l’extrapolation spéculative. Les sections méthodologiques et de discussion doivent nommer textuellement les limites intrinsèques de l’espace échantillonné, expliciter sans complaisance les postulats d’invariance et de stationnarité adoptés, et s’abstenir formellement d’employer des termes certificateurs pour des trajectoires non corroborées par les données du terrain.
Seule une telle discipline méthodologique et éthique permet de préserver la crédibilité des sciences humaines et du comportement face aux défis contemporains, en rappelant avec fermeté que si l’interpolation affine la connaissance d’un monde déjà exploré, l’extrapolation n’est qu’un regard hésitant jeté vers l’inconnu, qui ne saurait en aucun cas se substituer à la vérification empirique concrète.
Références
- Cole, T. J., & Green, P. J. (1992). Smoothing reference centile curves: The LMS method and penalized likelihood. Statistics in Medicine, 11(10), 1305–1319. https://doi.org/10.1002/sim.4780111005
- De Boor, C. (2001). A Practical Guide to Splines (Rev. ed.). Springer-Verlag. https://doi.org/10.1007/978-1-4612-6333-3
- Flynn, J. R. (1987). Massive IQ gains in 14 nations: What IQ tests really measure. Psychological Bulletin, 101(2), 171–191. https://doi.org/10.1037/0033-2909.101.2.171
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized Additive Models. Chapman & Hall/CRC.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-0-387-84244-6
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Kahneman, D. (2011). Thinking, Fast and Slow. Farrar, Straus and Giroux.
- Rasmussen, C. E., & Williams, C. K. I. (2006). Gaussian Processes for Machine Learning. MIT Press.
- Weisberg, S. (2014). Applied Linear Regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503