
La caractérisation quantitative de la biodiversité représente l’un des défis méthodologiques majeurs de l’écologie moderne, de la biogéographie et des sciences environnementales. Loin de se réduire à un simple dénombrement d’entités vivantes, l’évaluation de la structure d’une communauté biologique exige des outils mathématiques capables de capturer simultanément le nombre d’espèces en présence et l’uniformité de leur abondance relative au sein d’un biotope déterminé. Face à cette complexité multidimensionnelle, les chercheurs ont développé au cours du XXe siècle un ensemble d’indices statistiques d’hétérogénéité, parmi lesquels l’indice de diversité formulé par le statisticien britannique Edward H. Simpson occupe une place fondamentale.
Introduit initialement en 1949, l’indice de Simpson propose une approche probabiliste élégante et robuste pour appréhender la concentration écologique. Contrairement à des métriques exclusivement focalisées sur le répertoire taxonomique brut, cet indice évalue la probabilité que deux individus sélectionnés au hasard au sein d’un échantillon appartiennent au même taxon. Cette perspective combinatoire offre une sensibilité singulière à la dominance écologique, permettant d’identifier sans ambiguïté les situations où un petit nombre d’espèces prépondérantes monopolise les ressources énergétiques et spatiales d’un habitat. Sa formulation mathématique souple s’adapte aussi bien aux inventaires exhaustifs de petites parcelles expérimentales qu’aux modélisations asymptotiques appliquées à de très grands effectifs.
Au-delà de son berceau d’origine en écologie quantitative, l’indice de Simpson a conquis un spectre applicatif d’une remarquable transversalité. Les biostatisticiens, les généticiens des populations, mais également les psychologues cognitifs, les sociologues et les économistes mobilisent aujourd’hui ses variantes formalisées pour mesurer la variabilité des répertoires comportementaux, la répartition des profils psychométriques ou la concentration des compétences au sein d’organisations humaines. Cet article propose une exploration exhaustive, rigoureuse et didactique de l’indice de diversité de Simpson, articulant ses fondements probabilistes historiques, ses dérivations mathématiques précises, ses trois variantes fondamentales, des démonstrations pratiques pas à pas, ainsi que des recommandations critiques pour son implémentation computationnelle et sa restitution académique.
1. Introduction à l’indice de diversité de Simpson
1.1 Origine historique et publication fondatrice de 1949
L’émergence des métriques de diversité dans le champ de la statistique théorique s’inscrit dans un contexte post-Seconde Guerre mondiale marqué par une formalisation accrue des sciences empiriques. En 1949, le statisticien britannique Edward H. Simpson, alors en fonction au sein de l’université de Cambridge et collaborateur régulier de pionniers de la génétique statistique, publie dans la prestigieuse revue Nature un article bref mais révolutionnaire intitulé Measurement of Diversity. À travers cette contribution de moins de deux pages, Simpson ne cherche pas prioritairement à résoudre un dilemme écologique particulier, mais s’attache à poser les bases formelles d’une mesure générale de la concentration au sein d’une population divisée en catégories mutuellement exclusives.
Le problème conceptuel posé par Simpson répondait à une nécessité statistique croissante : comment quantifier l’hétérogénéité interne d’un système sans dépendre exclusivement de la taille totale de l’échantillon collecté ? À cette époque, la description quantitative des communautés reposait fréquemment sur des ratios rudimentaires reliant le nombre total de classes au nombre total d’individus observés. Ces méthodes présentaient d’importantes instabilités statistiques face aux fluctuations de l’effort de capture. Simpson a su dépasser cette limite en proposant un opérateur probabiliste élémentaire, fondé sur l’échantillonnage sans remise de paires d’éléments. Cette démarche novatrice permit de formaliser la notion d’hétérogénéité sous l’angle du risque de coïncidence catégorielle.
Rapidement, la communauté des biologistes et des botanistes a perçu l’immense potentiel de cette formulation pour l’analyse des écosystèmes. Sous l’impulsion de théoriciens de l’écologie quantitative tels que Robert MacArthur et Ramon Margalef au cours des années 1950 et 1960, l’indice de Simpson a été extrait de son cadre purement abstrait pour devenir un instrument de premier plan dans l’analyse de la structure des peuplements végétaux et animaux. L’outil s’est ainsi imposé comme une réponse directe au besoin d’évaluer l’impact des perturbations environnementales, de la fragmentation forestière et de la dynamique des successions écologiques sur la structure interne des communautés vivantes.
1.2 Définition conceptuelle de la diversité biologique et statistique
Pour appréhender la portée de l’indice de Simpson, il est indispensable de clarifier la distinction théorique fondamentale entre abondance totale et abondance relative. L’abondance totale reflète la biomasse brute ou le nombre global d’organismes présents au sein d’une unité spatio-temporelle donnée. En revanche, l’abondance relative renvoie à la proportion mathématique que représente chaque taxon ou modalité par rapport à l’ensemble du contingent étudié. Deux écosystèmes hébergeant rigoureusement le même volume d’individus peuvent présenter des profils d’abondances relatives diamétralement opposés, l’un se caractérisant par une répartition équitable des forces numériques et l’autre par l’écrasante suprématie d’une seule population pionnière ou opportuniste.
L’indice de Simpson repose sur le concept probabiliste de la détection conjointe : si un observateur extrait simultanément, ou successivement et sans remise, deux organismes distincts au sein d’une communauté biologique, quelle est la probabilité que ces deux entités appartiennent rigoureusement à la même catégorie taxonomique ? Lorsque cette probabilité s’avère élevée, l’observateur se trouve face à un système hautement homogène ou concentré, dominé par un groupe exclusif. Inversement, si cette probabilité s’avère minimale, le système manifeste une dispersion extrême de ses effectifs à travers de nombreuses catégories dissemblables, ce qui caractérise une hétérogénéité substantielle.
En tant qu’outil d’évaluation de la complexité des systèmes naturels et artificiels, cette métrique dépasse la simple taxonomie linnéenne. Elle modélise la manière dont les interactions intra-spécifiques et inter-spécifiques sont distribuées dans un espace de ressources. Dans une communauté où la probabilité d’occurrence conjointe de deux individus de même espèce est faible, les interactions directes entre congénères cèdent le pas à des interactions hétérospécifiques complexes, telles que la compétition diffuse, la facilitation, la prédation croisée ou le mutualisme. L’indice permet ainsi de quantifier l’architecture relationnelle d’un système écologique ou comportemental en synthétisant sa trame compositionnelle en un indice scalaire universellement intelligible.
1.3 Champ d’application et pertinence méthodologique
Dans le domaine de la biogéographie et de la biologie de la conservation, l’indice de diversité de Simpson constitue une composante indispensable des protocoles d’évaluation environnementale. Il est couramment mobilisé lors des inventaires floristiques et faunistiques afin de cartographier des gradients de biodiversité à l’échelle de corridors écologiques ou d’écorégions entières. Face aux perturbations anthropiques, telles que la pollution chimique des cours d’eau, l’eutrophisation ou la sylviculture intensive, les spécialistes observent généralement une contraction drastique de la diversité de Simpson. Ces stress écologiques tendent à éliminer les espèces sténoèces les plus sensibles tout en favorisant la prolifération incontrôlée de taxons tolérants ou invasifs, provoquant ainsi une flambée de la dominance écologique.
L’intérêt de cet indice ne se cantonne pas aux frontières des sciences naturelles. Au cours des trois dernières décennies, les chercheurs en psychométrie quantitative, en sociologie computationnelle et en éthologie humaine ont transposé l’équation de Simpson à l’analyse des systèmes comportementaux. En éthologie cognitive, l’indice permet de mesurer l’étendue du répertoire comportemental d’un individu soumis à des situations d’apprentissage ou de stress chronique, quantifiant le passage d’une flexibilité adaptative à des stéréotypies motrices rigides. En psychologie sociale des organisations, il sert à évaluer la dispersion démographique, culturelle ou cognitive au sein d’équipes de travail, offrant une mesure rigoureuse de la variété des compétences disponibles pour la prise de décision collective.
D’un point de vue méthodologique, l’indice de Simpson offre une robustesse remarquable pour la comparaison d’échantillons dont la taille brute présente une forte hétérogénéité. Là où d’autres métriques se révèlent excessivement dépendantes de la découverte fortuite d’espèces rares ou d’événements comportementaux exceptionnels, la formulation quadratique de Simpson concentre son pouvoir de résolution sur les catégories fonctionnellement significatives de l’assemblage. Cette propriété confère aux synthèses bibliographiques, aux méta-analyses quantitatives et aux suivis longitudinaux une reproductibilité statistique essentielle à la formulation de diagnostics robustes.
2. Fondements mathématiques et formulation théorique
2.1 Équation standard pour populations finies
L’application rigoureuse de l’indice de Simpson à un ensemble de données réelles impose une distinction fondamentale entre les échantillons finis, pour lesquels chaque prélèvement modifie la structure de la population résiduelle, et les espaces théoriques continus. Pour une communauté biologique discrète dont l’inventaire complet a dénombré un effectif global fini, la formulation mathématique classique s’énonce selon l’équation combinatoire suivante :
D = Σ [ni(ni – 1)] / [N(N – 1)]
Dans cette formulation canonique, la sommation s’étend sur l’ensemble des S espèces ou catégories présentes au sein de l’inventaire. Le terme ni désigne l’effectif observé pour la i-ième catégorie, c’est-à-dire le nombre absolu d’individus recensés appartenant à cette catégorie spécifique. Le terme N représente quant à lui la somme totale des effectifs observés toutes espèces confondues, satisfaisant ainsi l’égalité arithmétique N = Σ ni.
L’architecture de cette formule découle directement des principes du calcul combinatoire sans remise. Le produit ni(ni – 1) correspond au nombre exact de manières distinctes de sélectionner successivement deux individus appartenant spécifiquement à la catégorie i au sein d’un contingent de taille ni. De façon analogue, le dénominateur N(N – 1) quantifie le nombre total de combinaisons possibles de deux individus quelconques tirés au sein de la population globale N. Dès lors, le ratio constitue l’estimateur sans biais de la probabilité que deux éléments choisis consécutivement au hasard, sans remplacement, soient strictement conspécifiques. Cette correction par la soustraction de l’unité au numérateur et au dénominateur revêt une importance capitale dès lors que l’effectif global N est de taille modeste, neutralisant les surévaluations systématiques inhérentes aux tirages avec remise.
2.2 Formulation pour populations infinies ou très vastes
Lorsque la taille totale de l’échantillon N tend vers l’infini, ou dans les situations expérimentales où la communauté parente est si colossale que le prélèvement d’un individu n’exerce aucune influence mesurable sur les probabilités relatives des tirages subséquents, l’équation combinatoire converge asymptotiquement vers une expression simplifiée. Soit pi = ni / N la proportion relative, ou fréquence observée, de l’espèce i au sein de la communauté. L’équation de Simpson pour populations infinies s’établit dès lors sous la forme quadratique continue :
D = Σ pi2
Cette forme asymptotique démontre que l’indice de concentration s’obtient simplement en calculant la somme des carrés des fréquences relatives de chacune des espèces constitutives du système. La convergence mathématique entre la formule exacte pour populations finies et la version asymptotique est instantanée dès lors que N atteint des ordres de grandeur élevés. En effet, lorsque N devient grand, le rapport (ni – 1) / (N – 1) se rapproche asymptotiquement de la fraction ni / N, rendant le produit [ni / N] × [(ni – 1) / (N – 1)] quasi indiscernable de pi2.
Néanmoins, les analystes doivent faire preuve d’une grande prudence méthodologique quant à l’utilisation de cette formulation simplifiée. Dans les études de terrain où les effectifs totaux N sont restreints — par exemple dans le cadre de piégeages de micro-mammifères ou de relevés d’insectes dans des micro-habitats où N n’excède pas quelques dizaines ou centaines d’individus —, substituer la formule continue Σ pi2 à l’équation combinatoire finie introduit un biais d’estimation non négligeable. Ce biais conduit à une surestimation systématique de la probabilité de coïncidence taxonomique et, corrélativement, à une sous-évaluation de la diversité réelle du milieu.
2.3 Interprétation probabiliste du paramètre D
Sur le plan de la modélisation statistique, le paramètre fondamental D ne constitue pas, en dépit de son appellation courante, une mesure directe de la diversité. Il s’agit rigoureusement d’une mesure de concentration ou de dominance écologique. Sa signification probabiliste est univoque : D représente l’espérance mathématique que deux entités sélectionnées au hasard, de façon totalement indépendante et aléatoire au sein du collecteur de données, soient issues du même compartiment taxonomique ou comportemental.
En vertu des axiomes probabilistes fondamentaux, l’intervalle théorique au sein duquel fluctue le coefficient D est strictement borné par les limites d’un intervalle fermé ou semi-ouvert :
0 < D ≤ 1
L’atteinte de la valeur maximale unitaire (D = 1) correspond à une situation d’homogénéité absolue ou de monoculture parfaite. Dans ce cas de figure, l’ensemble des individus recensés au sein de l’échantillon appartient sans exception à une unique espèce dominante (n1 = N et ni = 0 pour tout i ≠ 1). Le produit combinatoire N(N – 1) au numérateur s’annule alors rigoureusement avec le dénominateur global, confirmant qu’il existe une certitude probabiliste absolue (100 %) que deux individus tirés appartiendront à la même espèce.
À l’opposé, la valeur de D s’approche de sa borne inférieure lorsque la communauté présente un nombre extrêmement élevé d’espèces représentées par des abondances rigoureusement équilibrées. Si une population théorique comporte S espèces parfaitement équiproportibles, chacune représentant une fréquence pi = 1 / S, la formule asymptotique indique que D = Σ (1 / S)2 = S × (1 / S2) = 1 / S. Dès lors, si le nombre S d’espèces tend vers l’infini, la valeur de D tend asymptotiquement vers 0, traduisant l’évanouissement presque complet de la probabilité de tirer consécutivement deux organismes de la même espèce.
3. Les trois variantes de l’indice de Simpson
3.1 L’indice de dominance de Simpson (D)
La formulation originale D, telle qu’établie par Simpson en 1949, est universellement qualifiée par les écologues modernes d’indice de dominance. Cette dénomination s’avère particulièrement appropriée en raison de la nature contre-intuitive de son gradient de variation : plus la valeur calculée de D est élevée, plus le système sous-jacent est biologiquement et écologiquement pauvre ou concentré. Cette relation inverse suscite fréquemment des erreurs d’interprétation chez les praticiens néophytes, qui associent intuitivement un indice élevé à une valeur écologique supérieure.
L’indice de dominance D tire sa sensibilité aiguë du calcul au carré des effectifs ou des fréquences. En effet, l’opération d’élévation à la puissance deux a pour conséquence mathématique de surpondérer exponentiellement les valeurs les plus fortes de la série statistique. Si une communauté comporte dix espèces, mais que l’une d’entre elles concentre à elle seule 80 % des individus, sa contribution au numérateur représentera à elle seule 0,802 = 0,64, reléguant la totalité des neuf autres espèces à une influence marginale sur l’indice final. L’indice de dominance est donc l’estimateur par excellence pour détecter les contextes d’altération environnementale où une espèce rudérale ou colonisatrice s’accapare l’essentiel de la niche écologique disponible.
Dans les rapports de diagnostic environnemental ou les études comportementales axées sur les pathologies d’inhibition ou de fixation, l’usage de D est précieux lorsqu’il s’agit de caractériser des déséquilibres structuraux. Un indice de dominance proche de 0,5 ou supérieur traduit immanquablement un assemblage sous tension ou simpliste, tandis qu’une valeur inférieure à 0,1 atteste de l’absence d’hégémonie au sein du peuplement étudié.
3.2 L’indice de diversité de Simpson (1 – D)
Afin de concilier la formulation mathématique rigoureuse de Simpson avec les impératifs de communication scientifique et la logique écologique, les chercheurs privilégient fréquemment une transformation linéaire élémentaire : le complément à l’unité de la dominance, noté 1 – D. Cette variante formalisée est couramment désignée dans la littérature anglo-saxonne sous l’appellation d’indice de diversité de Gini-Simpson, en référence aux travaux parallèles du statisticien italien Corrado Gini sur les mesures de variabilité des variables catégorielles.
L’indice 1 – D rétablit une corrélation strictement positive avec la diversité biologique. Son interprétation probabiliste s’avère d’une limpidité remarquable : il quantifie la probabilité exacte que deux individus sélectionnés au hasard et de manière indépendante au sein de la communauté étudiée appartiennent à des taxons ou des modalités différents. Dès lors, plus la valeur de 1 – D s’élève, plus l’hétérogénéité et la mixité du système s’affirment.
L’échelle numérique de cette variante est rigoureusement bornée dans l’intervalle semi-ouvert [0, 1[ :
- Une valeur de 0 indique une absence totale de diversité taxonomique : tous les individus étant identiques, la probabilité de sélectionner deux entités d’espèces distinctes est formellement nulle.
- Une valeur approchant 1 (par exemple 0,95 ou 0,98) reflète un écosystème d’une exceptionnelle complexité, au sein duquel chaque tirage offre la quasi-certitude de découvrir un organisme d’une nature différente du précédent.
Cette propriété probabiliste directe fait de 1 – D le choix standard dans les évaluations de durabilité écologique et les études comparatives portant sur la résilience des habitats perturbés face aux changements globaux.
3.3 L’indice réciproque de Simpson (1 / D)
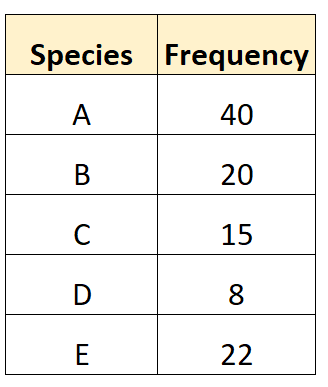
La troisième variante fondamentale issue de la dérivation mathématique de Simpson est l’indice réciproque, formulé par la fraction 1 / D. Popularisée par des écologues quantitatifs tels que David Mountford et Arthur Hill, cette transformation géométrique résout un inconvénient majeur de la variante 1 – D : la compression non linéaire des valeurs lorsque la diversité devient très substantielle. En effet, entre une diversité élevée et une diversité exceptionnelle, les valeurs de 1 – D ont tendance à s’agglutiner dans une marge étroite comprise entre 0,92 et 0,99, rendant les discriminations visuelles malaisées sur des graphiques conventionnels.
La caractéristique fondamentale de l’indice réciproque 1 / D réside dans son appartenance à la famille des « nombres équivalents d’espèces » ou « nombres effectifs » décrits théoriquement par Arthur Hill (1973). Contrairement à D et 1 – D qui s’expriment sous la forme de probabilités adimensionnelles restreintes à l’intervalle unitaire, 1 / D s’exprime directement en unités tangibles d’espèces. La valeur obtenue indique le nombre d’espèces d’abondances parfaitement égales qui seraient nécessaires pour générer le même niveau de concentration que celui observé dans la communauté empirique.
Les propriétés limites de l’indice réciproque apportent une lecture fonctionnelle directe de l’état du milieu :
- La valeur minimale théorique est strictement égale à 1,0, ce qui correspond à une monoculture absolue où l’écosystème ne possède fonctionnellement qu’une seule et unique espèce effective.
- La valeur maximale théorique est plafonnée par la richesse taxonomique réelle observée au sein de la communauté (S). Cette borne supérieure 1 / D = S n’est atteinte que dans la condition idéale où l’ensemble des S espèces recensées dispose d’un effectif rigoureusement identique.
Dès lors, un inventaire révélant 20 espèces mais générant un indice réciproque de Simpson de 1 / D = 3,4 alerte immédiatement le gestionnaire : bien que 20 taxons soient biologiquement présents, la communauté se comporte écologiquement et structurellement comme un assemblage de seulement 3 à 4 espèces prépondérantes, les 16 ou 17 autres ne subsistant qu’à l’état de reliquats démographiques.
4. Composantes fondamentales : Richesse spécifique et équitabilité
4.1 La richesse spécifique comme nombre de catégories
L’architecture fondamentale de la diversité biologique s’articule autour de deux piliers conceptuels distincts : la richesse spécifique d’une part, et l’équitabilité (ou régularité) d’autre part. La richesse spécifique, conventionnellement notée S, correspond au nombre brut de catégories taxonomiques, morphologiques ou comportementales identifiées au sein d’un échantillon déterminé. Bien qu’elle constitue la mesure la plus spontanée et la plus historiquement ancrée dans la démarche naturaliste, la richesse spécifique brute souffre de vulnérabilités méthodologiques majeures qui interdisent de l’utiliser comme descripteur exclusif d’un peuplement.
La limite critique de la richesse spécifique tient à son absolue insensibilité à la répartition quantitative des individus au sein des catégories dénombrées. Une communauté hébergeant 100 individus répartis à raison d’un unique organisme pour 9 espèces et de 91 individus pour une dixième espèce possède formellement une richesse S = 10. Or, un autre habitat abritant 10 espèces représentées chacune par rigoureusement 10 individus revendique également une richesse S = 10. Sur le plan fonctionnel, énergétique et évolutif, ces deux écosystèmes manifestent des structures radicalement dissemblables que le simple paramètre S est incapable de discerner.
En outre, la richesse brute dépend intrinsèquement de l’effort d’échantillonnage consenti. Plus le temps d’observation, la surface explorée ou le nombre d’individus capturés augmentent, plus la probabilité de rencontrer des espèces cryptiques, discrètes ou rarissimes s’accroît mécaniquement. Dès lors, fonder l’évaluation de la biodiversité sur la seule richesse S expose les études à des distorsions comparatives substantielles dès lors que la pression de prospection n’a pas été parfaitement standardisée d’une station de suivi à une autre.
4.2 L’équitabilité ou régularité de la répartition
Pour dépasser l’incomplétude de la richesse brute, l’écologie quantitative a forgé le concept d’équitabilité (traduction du terme anglo-saxon evenness). L’équitabilité modélise le degré d’uniformité avec lequel les individus observés se distribuent entre les différents taxons disponibles. Un système présente une équitabilité maximale lorsque l’ensemble des catégories abrite rigoureusement le même effectif démographique, illustrant une absence totale de hiérarchie ou d’hégémonie fonctionnelle. Inversement, l’équitabilité tend vers son nadir lorsqu’une seule catégorie concentre la quasi-totalité de l’effectif, reléguant les autres composantes au rang d’artefacts d’échantillonnage.
L’inégalité de répartition exerce un impact direct et prépondérant sur la métrique de Simpson. Alors que la richesse spécifique se contente d’enregistrer la présence binaire d’un taxon (présence ou absence), l’indice de Simpson intègre simultanément le répertoire S et l’équitabilité de la distribution. Plus les proportions relatives pi s’écartent de la moyenne théorique 1 / S, plus la somme des carrés Σ pi2 croît rapidement, réduisant l’indice de diversité 1 – D et diminuant le nombre effectif 1 / D.
Cette interaction étroite permet de dériver une mesure standardisée d’équitabilité fondée sur Simpson, fréquemment désignée par le coefficient ED. Cette métrique d’équitabilité de Simpson s’obtient en divisant l’indice réciproque par la richesse spécifique totale observée :
ED = (1 / D) / S
Ce ratio adimensionnel, strictement contraint entre une valeur approchant 0 et la valeur 1,0, élimine l’influence du nombre brut d’espèces pour isoler exclusivement la qualité de la répartition. Une valeur ED = 1,0 atteste d’une équipartition parfaite des effectifs au sein du peuplement, tandis qu’une valeur de 0,15 indique un affaissement sévère de la régularité structurale au profit d’un noyau restreint de taxons dominants.
4.3 Pondération différentielle des espèces abondantes
Le mécanisme algorithmique au cœur de l’indice de Simpson réside dans l’élévation des fréquences relatives à la puissance deux (forme quadratique). Cette formulation engendre une pondération mathématique différentielle très marquée : elle confère un poids disproportionné aux espèces à forte abondance, tout en étouffant quasi totalement l’influence des taxons rares ou marginaux sur le résultat numérique global.
Pour saisir ce phénomène avec acuité, examinons le comportement respectif de deux espèces au sein d’un échantillon théorique de 1 000 individus. Une espèce A très commune regroupe 500 individus (pA = 0,5), tandis qu’une espèce B très rare ne compte que 2 individus (pB = 0,002). Lors du calcul de la dominance asymptotique Σ pi2, la contribution de l’espèce commune s’élève à 0,52 = 0,25. En revanche, la contribution de l’espèce rare s’établit à 0,0022 = 0,000004. La contribution relative de l’espèce A au sein de l’indice de Simpson se révèle ainsi plus de 60 000 fois supérieure à celle de l’espèce B, alors même que son abondance absolue n’est que 250 fois plus importante.
Cette disproportion quadratique confère à l’indice de Simpson une résilience méthodologique remarquable face aux fluctuations stochastiques d’échantillonnage. Dans la plupart des écosystèmes naturels, l’observation d’espèces très rares dépend étroitement d’aléas environnementaux ponctuels, de mouvements migratoires erratiques ou de micro-hétérogénéités spatiales. En neutralisant mathématiquement le bruit de fond statistique induit par ces taxons sporadiques, l’indice de Simpson offre une évaluation stable, reproductible et robuste de l’état structurel moyen du système, focalisant son diagnostic sur les populations qui gouvernent les flux énergétiques dominants.
5. Exemple pratique pas à pas : Analyse d’un écosystème forestier
5.1 Étape 1 : Collecte des données et tableau d’effectifs
Pour illustrer de manière concrète et didactique les modalités pratiques de calcul de l’indice de Simpson et de ses variantes, développons une démonstration pas à pas fondée sur un cas d’école écologique réaliste. Imaginons un protocole d’inventaire dendrométrique conduit au sein d’une parcelle expérimentale de 2 hectares au cœur d’une forêt tempérée caducifoliée soumise à un régime de gestion sylvicole durable. L’ensemble des arbres vivants présentant un diamètre à hauteur de poitrine supérieur ou égal à 10 centimètres a fait l’objet d’un dénombrement exhaustif.
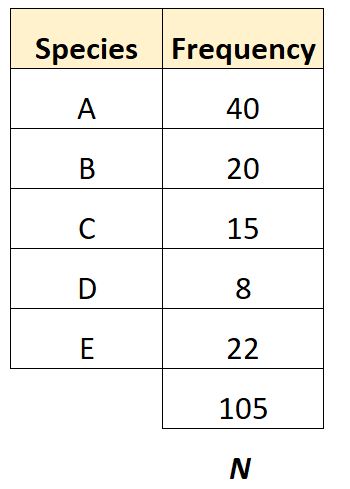
Le recensement sur le terrain a permis d’identifier formellement 5 espèces distinctes d’arbres, pour un effectif global totalisant précisément N = 100 individus arborescents. Les données brutes issues de l’inventaire se structurent de la façon suivante :
- Chênes sessiles (Quercus petraea) : n1 = 40 individus
- Hêtres communs (Fagus sylvatica) : n2 = 25 individus
- Bouleaux verruqueux (Betula pendula) : n3 = 15 individus
- Pins sylvestres (Pinus sylvestris) : n4 = 12 individus
- Érables champêtres (Acer campestre) : n5 = 8 individus
La somme arithmétique des effectifs catégoriels valide rigoureusement l’effectif global :
N = 40 + 25 + 15 + 12 + 8 = 100 individus
Nous nous trouvons ici dans la configuration idéale d’un ensemble fini dont l’effectif total N est modeste. L’analyse exige donc l’application de la formule combinatoire sans remise, garante d’une exactitude statistique irréprochable exempte des biais d’asymptote.
5.2 Étape 2 : Calcul des produits combinatoires individuels
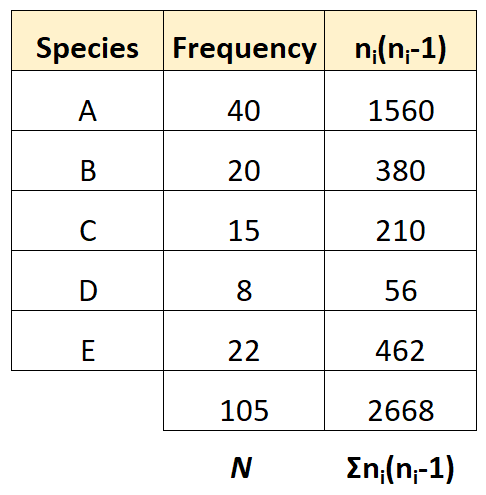
L’application rigoureuse de l’équation standard pour populations finies impose d’évaluer individuellement pour chaque taxon le produit combinatoire de la forme ni(ni – 1), lequel modélise le nombre de paires uniques de congénères qu’il est possible de constituer au sein de chaque espèce. Développons méticuleusement cette opération pour chacune des 5 espèces inventoriées :
- Pour les chênes sessiles : n1(n1 – 1) = 40 × (40 – 1) = 40 × 39 = 1 560
- Pour les hêtres communs : n2(n2 – 1) = 25 × (25 – 1) = 25 × 24 = 600
- Pour les bouleaux verruqueux : n3(n3 – 1) = 15 × (15 – 1) = 15 × 14 = 210
- Pour les pins sylvestres : n4(n4 – 1) = 12 × (12 – 1) = 12 × 11 = 132
- Pour les érables champêtres : n5(n5 – 1) = 8 × (8 – 1) = 8 × 7 = 56
Une fois ces termes calculés, l’étape suivante consiste à opérer la sommation algébrique méthodique de l’ensemble de ces produits combinatoires catégoriels afin de constituer le numérateur de notre équation générale :
Σ ni(ni – 1) = 1 560 + 600 + 210 + 132 + 56 = 2 558
Il convient ensuite d’évaluer le dénominateur global de l’équation, représentant le nombre total de paires distinctes susceptibles d’être extraites au sein des 100 arbres de la parcelle, sans considération de leur espèce :
N(N – 1) = 100 × (100 – 1) = 100 × 99 = 9 900
Nous disposons désormais des deux grandeurs fondamentales indispensables à la résolution des différentes variantes de l’indice : un numérateur combinatoire de 2 558 et un dénominateur combinatoire de 9 900.
5.3 Étape 3 : Résolution des trois variantes et conclusion écologique
À partir des valeurs combinatoires consolidées à l’étape précédente, procédons à la détermination chiffrée successive des trois variantes fondamentales de l’indice de Simpson :
1. Indice de dominance de Simpson (D) :
D = 2 558 / 9 900 ≈ 0,2584 (arrondi à 0,258)
Ce résultat démontre qu’il existe une probabilité de 25,8 % que deux arbres choisis au hasard au sein de cette parcelle forestière appartiennent rigoureusement à la même espèce. Cette valeur modérée indique une certaine concentration autour des chênes, mais sans hégémonie absolue.
2. Indice de diversité de Simpson (1 – D) :
1 – D = 1 – 0,2584 = 0,7416 (arrondi à 0,742)
Cette valeur rétablit une vision intuitive de l’état du système : il existe 74,2 % de chances que deux arbres tirés au hasard soient d’espèces différentes. Ce score atteste d’un niveau satisfaisant d’hétérogénéité biologique au sein du peuplement forestier.
3. Indice réciproque de Simpson (1 / D) :
1 / D = 1 / 0,2584 ≈ 3,87
L’interprétation de l’indice réciproque apporte une profondeur écologique majeure au diagnostic forestier. Bien que l’inventaire ait formellement dénombré 5 espèces d’arbres différentes sur le site (S = 5), l’asymétrie modérée de la distribution démographique — dominée par le tandem chêne-hêtre qui concentre à lui seul 65 % des tiges — confère à la forêt une dynamique fonctionnelle équivalente à celle d’une communauté théorique idéale constituée de 3,87 espèces d’abondances parfaitement égales.
Le calcul de l’équitabilité associée permet de clore l’analyse : ED = (1 / D) / S = 3,87 / 5 = 0,774. Cette équitabilité supérieure à 0,75 confirme que la gestion forestière a maintenu une distribution relative bien équilibrée, éloignée des écueils de la monoculture résineuse ou des dégradations sylvicoles sévères.
6. Étude comparative : Écosystème équilibré contre communauté déséquilibrée
6.1 Scénario A : Communauté hautement équitable
Pour mesurer pleinement la pertinence de l’indice de Simpson en tant qu’instrument de diagnostic structurel, il est particulièrement éclairant de comparer formellement deux écosystèmes théoriques présentant une richesse spécifique et un effectif global strictement identiques, mais affichant des patrons d’abondance relative opposés.
Considérons le Scénario A, incarnant un écosystème hautement équitable. Supposons une station biologique abritant un effectif cumulé de N = 100 organismes répartis entre 4 espèces d’invertébrés aquatiques, de façon parfaitement uniforme :
- Espèce 1 : n1 = 25 individus
- Espèce 2 : n2 = 25 individus
- Espèce 3 : n3 = 25 individus
- Espèce 4 : n4 = 25 individus
Évaluons les produits combinatoires individuels pour chacune des 4 espèces :
Pour chaque espèce : ni(ni – 1) = 25 × 24 = 600.
Le numérateur global s’obtient par sommation des 4 catégories identiques :
Σ ni(ni – 1) = 4 × 600 = 2 400.
Le dénominateur demeure inchangé avec un effectif de 100 individus : N(N – 1) = 100 × 99 = 9 900.
Calculons dès lors les trois indicateurs métriques :
- Indice de dominance : D = 2 400 / 9 900 ≈ 0,2424
- Indice de diversité : 1 – D = 1 – 0,2424 ≈ 0,7576
- Indice réciproque : 1 / D = 1 / 0,2424 ≈ 4,125 (ou 4,0 sous la formulation continue asymptotique 1 / Σ pi2 = 1 / [4 × 0,252])
Dans ce contexte de répartition uniforme, l’indice réciproque atteint rigoureusement son plafond théorique fixé par la richesse brute (1 / D = S = 4). L’équitabilité atteint son maximum absolu : ED = 1,0. La totalité des espèces contribue de manière symétrique aux flux trophiques du biotope.
6.2 Scénario B : Hyper-dominance d’un taxon pionnier
Examinons désormais le Scénario B, représentatif d’une communauté écologiquement dégradée ou soumise à un stress sélectif aigu. L’inventaire recense toujours un effectif total de N = 100 individus distribués entre S = 4 espèces. Toutefois, la structure démographique est ici marquée par l’hégémonie massive d’un taxon pionnier ultra-dominant :
- Espèce 1 : n1 = 91 individus
- Espèce 2 : n2 = 3 individus
- Espèce 3 : n3 = 3 individus
- Espèce 4 : n4 = 3 individus
Calculons méthodiquement les produits combinatoires sous cette configuration asymétrique :
- Pour l’espèce 1 : n1(n1 – 1) = 91 × 90 = 8 190
- Pour l’espèce 2 : n2(n2 – 1) = 3 × 2 = 6
- Pour l’espèce 3 : n3(n3 – 1) = 3 × 2 = 6
- Pour l’espèce 4 : n4(n4 – 1) = 3 × 2 = 6
La sommation des termes met immédiatement en lumière l’explosion du numérateur, gouverné de façon écrasante par l’espèce dominante :
Σ ni(ni – 1) = 8 190 + 6 + 6 + 6 = 8 208.
Le dénominateur global reste strictement constant à 9 900.
La résolution chiffrée dévoile des résultats saisissants :
- Indice de dominance : D = 8 208 / 9 900 ≈ 0,8291
- Indice de diversité : 1 – D = 1 – 0,8291 ≈ 0,1709
- Indice réciproque : 1 / D = 1 / 0,8291 ≈ 1,206
Bien que 4 espèces soient biologiquement observées sur le site, l’indice réciproque chute à seulement 1,21, signalant un système quasi monospécifique sur le plan opérationnel. L’équitabilité s’effondre à ED = 1,206 / 4 ≈ 0,30.
6.3 Synthèse critique des écarts observés
La confrontation objective de ces deux scénarios dissipe définitivement l’illusion naturaliste consistant à assimiler la richesse brute observée à un reflet fidèle de la santé écologique d’une communauté. Dans les deux cas d’étude, un chercheur se limitant à rapporter la richesse spécifique conclurait à une équivalence taxonomique absolue : S = 4 espèces pour 100 individus recensés.
L’indice de Simpson agit ici comme un analyseur spectral de la structure écologique. Dans le Scénario B, l’amplification quadratique révèle la précarité du système : la perte potentielle des trois espèces marginales — qui ne regroupent chacune que 3 individus — ne modifierait que de façon infinitésimale le fonctionnement énergétique global de l’écosystème, déjà entièrement sous la dépendance de l’espèce dominante. À l’inverse, dans le Scénario A, chaque espèce assure une fraction substantielle de l’équilibre communautaire, conférant au système une redondance fonctionnelle et des voies métaboliques alternatives multiples en cas de crise écologique.
Ces constats mettent en lumière la sensibilité spécifique de Simpson à la concentration. Alors qu’un indice purement équitable protège le milieu contre les effondrements en cascade, une hyper-dominance traduit souvent une régression écologique vers des stades pionniers ou perturbés, caractérisés par une faible résilience face aux invasions biologiques ou aux chocs climatiques exogènes.
7. Comparaison méthodologique avec l’indice de Shannon-Wiener
7.1 Origine théorique : Information contre probabilité
Dans l’arsenal méthodologique de l’écologue quantitatif, l’indice de diversité de Simpson partage le premier rang avec un autre descripteur fondamental : l’indice d’hétérogénéité de Shannon-Wiener, fréquemment abrégé en indice de Shannon et noté H’. Si ces deux outils sont souvent mobilisés de concert au sein des évaluations écologiques, leurs postulats axiomatiques et leurs fondements épistémologiques appartiennent à deux paradigmes scientifiques distincts.
L’indice de Shannon-Wiener puise ses fondements directs dans la théorie mathématique de la communication développée par Claude Shannon en 1948. L’équation canonique de Shannon, empruntée au formalisme de la mécanique statistique et de l’entropie de Boltzmann, s’énonce comme suit :
H’ = – Σ [pi × ln(pi)]
Dans cette formulation, l’indice H’ n’est pas conçu à l’origine comme une mesure combinatoire de coïncidence, mais comme une quantification de l’incertitude informationnelle. Il évalue la quantité d’information moyenne — exprimée en nats ou en bits selon la base du logarithme mobilisé — nécessaire pour prédire avec certitude l’identité taxonomique d’un individu tiré au sort au sein d’une communauté biologique donnée. Plus le milieu est complexe et diversifié, plus l’incertitude ressentie par l’observateur avant l’identification de l’organisme est grande, maximisant la valeur de H’.
L’indice de Simpson, à l’inverse, s’affranchit de toute référence à la théorie de l’information pour s’ancrer dans une stricte logique d’échantillonnage probabiliste. Il ne calcule pas une entropie, mais une probabilité finie de collision intra-catégorielle. Cette divergence fondamentale explique leurs comportements mathématiques contrastés face aux différentes composantes des peuplements.
7.2 Sensibilité comparée aux espèces rares
Le point de friction statistique le plus marqué entre Simpson et Shannon réside dans leur réactivité différentielle aux espèces rares et aux variations de la richesse taxonomique brute. Cette dissemblance s’explique par la nature des fonctions mathématiques qui pondèrent les abondances relatives respectives au sein de chaque formule.
L’indice de Shannon-Wiener s’articule autour de la fonction logarithmique ln(pi). Lorsque la fréquence relative pi d’un taxon tend vers zéro, son logarithme naturel plonge vers des valeurs négatives très élevées. Même si le terme multiplicatif pi tend également vers zéro, le produit pi × ln(pi) décroît à un rythme considérablement plus lent que le terme quadratique pi2 de Simpson. En conséquence directe, l’indice de Shannon accorde une sensibilité élevée à la présence des taxons rares, des singularités taxonomiques et des organismes représentés par un nombre restreint d’individus (singletons et doubletons).
L’indice de Simpson, dominé par son mécanisme d’élévation quadratique, adopte un comportement diamétralement opposé. Il est structurellement aveugle aux variations d’effectifs affectant les classes minoritaires dès lors que celles-ci représentent des proportions infinitésimales de l’échantillon. Un analyste soucieux de cartographier la biodiversité dans une optique de préservation de la flore patrimoniale — où chaque espèce rare possède une valeur de conservation critique — accordera sa préférence à l’indice de Shannon. En revanche, un chercheur étudiant la répartition des flux de biomasse, la dominance fonctionnelle ou l’impact d’une pollution majeure sur la simplification des chaînes trophiques privilégiera l’indice de Simpson pour sa neutralité face au bruit statistique des raretés démographiques.
7.3 Tableau récapitulatif des divergences d’interprétation
Afin de synthétiser les distinctions conceptuelles, statistiques et opérationnelles régissant ces deux géants de la métrique environnementale, le descriptif comparatif suivant éclaire leurs singularités méthodologiques fondamentales :
- Cadre théorique d’origine :
- Simpson : Probabilités combinatoires d’échantillonnage et analyse de concentration (Simpson, 1949).
- Shannon-Wiener : Théorie mathématique de l’information et calcul de l’entropie communicationnelle (Shannon, 1948).
- Échelle théorique de référence :
- Simpson (D) : Borné strictement entre 0 et 1 (sans dimension).
- Simpson (1 – D) : Borné strictement entre 0 et 1 (probabilité intuitive).
- Simpson (1 / D) : De 1,0 à S (exprimé en nombre effectif d’espèces équivalentes).
- Shannon (H’) : Échelle ouverte positive, typiquement comprise entre 0 (monoculture) et 4,5 voire 5,0 dans les forêts tropicales hyper-diverses (exprimé en nats par individu).
- Sensibilité à la richesse (espèces rares) :
- Simpson : Faible à très faible. Résistant aux taxons marginaux.
- Shannon : Forte à modérée. Sensible à l’apparition de nouveaux taxons rares.
- Sensibilité à l’équitabilité (dominance) :
- Simpson : Très élevée. Focalisé sur la monopolisation par les taxons les plus abondants.
- Shannon : Modérée. Intègre simultanément régularité et richesse sans focalisation exclusive.
- Robustesse face aux erreurs d’échantillonnage :
- Simpson : Exceptionnellement robuste face aux variations d’effort de capture.
- Shannon : Sensible au sous-échantillonnage des cortèges taxonomiques cryptiques.
Au vu de cette complémentarité dialectique, la communauté scientifique recommande formellement, dans le cadre des études d’impact environnemental et des bilans écologiques rigoureux, de ne jamais dissocier ces indicateurs mais de restituer conjointement le triplet : richesse brute S, indice de Shannon H’ et indice de diversité de Simpson 1 – D (ou son équivalent réciproque 1 / D).
8. Biais d’échantillonnage et corrections statistiques
8.1 Influence de la taille de l’échantillon sur la fiabilité de D
Bien que l’indice de Simpson soit reconnu pour sa robustesse relative, il n’échappe pas aux lois universelles de la théorie de l’échantillonnage statistique. L’estimation d’un indice de diversité à partir d’un prélèvement empirique constitue une inférence sur une communauté parente théorique. Lorsque la taille globale de l’échantillon N est excessivement réduite — par exemple moins de 30 ou 40 individus capturés au total —, les estimations de D manifestent une instabilité stochastique qui peut induire des erreurs d’interprétation notables.
L’utilisation de la formulation combinatoire sans remise D = Σ ni(ni – 1) / [N(N – 1)] constitue la première ligne de défense méthodologique contre ce biais. Comme l’a démontré Simpson dès sa publication originelle, cette formulation est rigoureusement non biaisée : l’espérance mathématique de l’estimateur d’échantillon coïncide exactement avec la concentration réelle Σ pi2 de la population parente, quelle que soit la petitesse de N. À l’inverse, l’usage erroné de la formule asymptotique continue sur de petits effectifs engendre un biais par excès systématique, pénalisant artificiellement la diversité calculée.
Pour s’assurer de la stabilité d’un calcul de Simpson face à l’effort de capture déployé, il est d’usage de recourir aux techniques de modélisation par courbes de raréfaction. En traçant l’évolution de la valeur calculée de 1 – D en fonction du nombre cumulé d’individus inventoriés, on observe une stabilisation asymptotique remarquablement précoce, survenant bien avant le plateau de saturation de la richesse spécifique brute S. Cette convergence rapide confirme la supériorité de l’indice de Simpson pour les analyses de comparaison inter-sites lorsque les protocoles de collecte ne permettent pas d’atteindre l’exhaustivité des inventaires floristiques ou faunistiques.
8.2 Problématique des espèces cryptiques et erreurs de dénombrement
Sur le terrain, la fiabilité des indices de diversité se heurte inévitablement aux contraintes de la taxonomie descriptive. Deux sources majeures de distorsion méthodologique méritent une attention particulière : la présence d’espèces cryptiques méconnues et les biais de sous-détection d’organismes particulièrement discrets ou enfouis.
L’existence de complexes d’espèces cryptiques — c’est-à-dire d’entités biologiquement isolées mais morphologiquement indiscernables à l’œil nu sans séquençage génétique — conduit fréquemment les observateurs à agréger par erreur plusieurs espèces sous un taxon générique unique. Une telle erreur d’agrégation gonfle artificiellement l’effectif ni de la classe combinée. En vertu de la puissance quadratique de la formule de Simpson, ce gonflement induit une surestimation brutale de l’indice de dominance D, masquant une diversité fonctionnelle sous-jacente bien réelle. À l’inverse, une sur-fragmentation taxonomique imputable à l’identification distincte de polymorphismes intraspécifiques tend à éroder artificiellement la dominance réelle de l’espèce considérée.
Pour contrôler l’incertitude générée par ces aléas d’observation et les erreurs de dénombrement inhérentes aux campagnes de terrain, les biostatisticiens mobilisent massivement les protocoles de rééchantillonnage non paramétrique par la méthode du bootstrap (Efron, 1979). En générant par tirage avec remise des milliers de pseudo-échantillons à partir de la matrice d’observation empirique initiale, il devient aisé de construire une distribution empirique de l’indice de Simpson. Ce procédé computationnel permet de calculer des intervalles de confiance robustes (typiquement à 95 %), garantissant que les différences de diversité constatées entre deux écosystèmes ou deux cohortes d’observation possèdent une significativité statistique avérée et ne relèvent pas de simples artefacts d’échantillonnage.
8.3 Échantillonnage continu et transects standardisés
La spatialisation des protocoles de prélèvement constitue un paramètre critique lors de l’application de l’indice de Simpson. Dans les écosystèmes réels, les organismes vivants ne se distribuent que très exceptionnellement selon un schéma aléatoire (distribution de Poisson). Ils manifestent au contraire des patrons agrégatifs marqués (distribution binomiale négative), induits par la disponibilité locale des nutriments, la micro-topographie ou des comportements de grégarisme social.
Si un protocole de terrain concentre ses observations sur un transect rectiligne trop court ou au sein de quadrats restreints, le collecteur risque d’intercepter par pur hasard un agrégat démographique massif d’une espèce donnée — par exemple une fourmilière, une talle clonale de graminée ou un banc d’alevins. Cette concentration locale fausse radicalement la représentativité de l’effectif ni pour cette espèce, catapultant artificiellement l’indice de dominance D à des sommets sans rapport avec la structure globale du paysage.
Pour prévenir ces biais d’agrégation spatiale, la démarche scientifique exige l’application d’un échantillonnage stratifié ou de transects standardisés de longueur adaptée, complétés par des réplications spatiales indépendantes. Avant de procéder au calcul de l’indice de Simpson, les données issues des différents sous-échantillons doivent faire l’objet d’une standardisation statistique rigoureuse, assurant que chaque unité de prospection bénéficie d’un poids équitable dans la matrice finale des abondances.
9. Applications interdisciplinaires en psychologie et sciences comportementales
9.1 Mesure de la diversité du répertoire comportemental
L’universalité mathématique de l’indice de Simpson autorise une transposition féconde hors du champ de la biologie des populations, notamment au sein de l’éthologie humaine et de la psychologie cognitive. Dans ce paradigme, les individus ou sujets observés ne sont plus assimilés à des organismes biologiques au sein d’un écosystème, mais chaque comportement ou action motrice émis par un même sujet est traité comme une entité discrète, classifiée au sein d’un répertoire comportemental fini regroupant S catégories fonctionnelles.
Cette approche quantitative permet d’évaluer de manière rigoureuse la flexibilité cognitive d’un individu placé en situation de résolution de problème ou sous condition d’apprentissage expérimental. Un sujet manifestant une grande agilité mentale diversifie ses démarches, explorant tour à tour différentes typologies de stratégies d’exploration ou de raisonnement (répartition équilibrée générant un 1 – D élevé et un D faible). À l’inverse, l’apparition d’un stress aigu, de lésions neurobiologiques préfrontales ou de psychopathologies spécifiques — telles que les troubles obsessionnels compulsifs (TOC) ou les troubles du spectre autistique — s’accompagne fréquemment d’une persévération comportementale et de stéréotypies motrices prononcées.
L’indice de dominance de Simpson D devient ainsi un bio-marqueur comportemental objectif du degré de rigidité cognitive. L’explosion de la valeur de D chez un sujet soumis à une épreuve neuropsychologique quantifie l’hyper-focalisation sur une routine d’action unique au détriment de l’exploration alternative, offrant une métrique scalaire sensible pour évaluer l’efficacité de thérapies cognitivo-comportementales ou de protocoles de remédiation neuro-développementaux.
9.2 Diversité cognitive et composition des groupes de travail
Au croisement de la psychologie du travail, de la théorie des organisations et des sciences managériales, la structuration optimale des équipes de prise de décision constitue un objet d’étude empirique majeur. Les chercheurs utilisent l’indice de diversité de Simpson — sous la dénomination de métrique d’hétérogénéité de Teachman ou de Blau — pour quantifier la composition des groupes humains selon des variables qualitatives telles que les profils de personnalité, les styles cognitifs (intuitif versus analytique), les trajectoires académiques ou les domaines d’expertise métier.
Les investigations en dynamique des groupes démontrent régulièrement qu’un niveau modéré à élevé de diversité de Simpson au sein des équipes de conception favorise l’innovation et la performance globale sur des tâches cognitives complexes. Lorsque les différentes typologies d’expertises sont équitablement distribuées (faible D, fort 1 – D), la variété des modèles mentaux mobilisés stimule la pensée divergente et améliore la robustesse de l’analyse des risques stratégiques.
Parallèlement, l’indice de concentration D constitue une arme de détection préventive contre le redoutable phénomène de « pensée de groupe » (groupthink), décrit initialement par Irving Janis. Une hyper-concentration des profils psychologiques ou idéologiques — objectivée par un score D avoisinant l’unité — favorise l’apparition de biais de confirmation systémiques, l’inhibition des opinions dissidentes et un aveuglement collectif face aux alternatives stratégiques. La régulation de l’indice de Simpson au sein des conseils d’administration ou des équipes de recherche constitue ainsi une démarche proactive d’hygiène cognitive et organisationnelle.
9.3 Hétérogénéité des réponses en psychométrie
Dans le domaine de la psychométrie quantitative, la conception et la validation de questionnaires standardisés constituent des étapes délicates où l’analyse de la dispersion des réponses joue un rôle de premier plan. Confrontés à des échelles d’évaluation ordonnées ou de type Likert comportant plusieurs modalités de réponse (par exemple de 1 à 5), les psychométriciens doivent s’assurer que l’instrument de mesure explore convenablement l’intégralité du continuum subjectif des répondants.
L’indice de diversité de Simpson 1 – D est ici mobilisé pour examiner l’hétérogénéité des réponses obtenues sur un item particulier au sein d’une cohorte clinique ou normative. Une valeur de diversité très basse sur un item d’évaluation indique qu’une proportion écrasante des répondants converge systématiquement vers la même modalité (effet plancher, effet plafond, ou puissant biais de désirabilité sociale). Un tel constat alerte le concepteur de l’échelle sur l’incapacité de l’énoncé à discriminer les variations subtiles du trait psychologique latent mesuré.
En outre, le calcul de D à l’échelle d’un individu à travers l’ensemble des questions d’une batterie de tests permet d’identifier des patrons de réponses atypiques. Un sujet présentant un indice de dominance extrême D > 0,90 sur un test multidimensionnel est fréquemment engagé dans une stratégie de réponse acquiescente compulsive (choix systématique de la modalité centrale ou d’un extrême), invalidant de facto la pertinence diagnostique de son profil individuel pour les analyses psychologiques ultérieures.
10. Implémentation computationnelle : R, Python et feuilles de calcul
10.1 Calcul automatisé sous tableur (Microsoft Excel, LibreOffice)
Pour de nombreux chercheurs de terrain et praticiens en agronomie ou en écologie appliquée, l’utilisation d’un tableur conventionnel tel que Microsoft Excel ou LibreOffice Calc constitue le vecteur le plus direct pour implémenter l’indice de diversité de Simpson sans nécessiter de compétences avancées en programmation. La structure tabulaire se prête idéalement à l’exécution séquentielle des calculs combinatoires pour populations finies.
Pour mettre en place une feuille de calcul automatisée et dynamique, la méthodologie opérationnelle se structure selon le protocole matriciel suivant :
- Organisation des colonnes brutes : Disposer en Colonne A la dénomination taxonomique ou la liste des catégories identifiées (lignes 2 à k+1, où k représente le nombre total d’espèces S). Renseigner dans la Colonne B contiguë les effectifs bruts observés ni associés à chaque espèce.
- Calcul des effectifs globaux : Insérer en fin de Colonne B (par exemple en cellule B10) la formule de sommation standard calculant l’effectif global cumulé :
=SOMME(B2:B9). Cette cellule matérialise le paramètre N. - Calcul des termes combinatoires catégoriels : Créer en Colonne C une série de calculs intermédiaires évaluant pour chaque ligne le terme ni(ni – 1). Dans la cellule C2, inscrire la syntaxe formelle :
=B2*(B2-1), puis étendre cette formule vers le bas jusqu’à la cellule C9 par glissement incrémentiel. - Sommation du numérateur et calcul du dénominateur : En cellule C10, calculer la somme des produits combinatoires catégoriels via la formule :
=SOMME(C2:C9), représentant Σ ni(ni – 1). En cellule B11, calculer la constante du dénominateur global :=B10*(B10-1). - Formulation finale des trois variantes :
- Indice de dominance (D) en cellule D2 :
=C10/B11 - Indice de diversité (1 – D) en cellule D3 :
=1-D2 - Indice réciproque (1 / D) en cellule D4 :
=1/D2
- Indice de dominance (D) en cellule D2 :
Cette architecture matricielle garantit une réactivité instantanée du tableur : toute modification ultérieure d’un effectif individuel ou l’adjonction de nouvelles catégories met à jour automatiquement et sans décalage l’ensemble des indicateurs de diversité consolidés.
10.2 Programmation en langage R avec le package vegan
Le langage de programmation R s’affirme comme le standard absolu pour l’analyse statistique des données écologiques et biogéographiques. Au sein de cet environnement, le package spécialisé vegan (dédié à l’écologie des communautés et aux analyses multivariées de végétation) offre une gamme d’outils optimisés permettant de manipuler sans friction des matrices d’abondances complexes multi-sites.
Au sein de la bibliothèque vegan, la fonction générique dédiée à l’évaluation des métriques d’hétérogénéité se nomme diversity(). Par défaut, cette fonction computationnelle opère sur la base des formulations asymptotiques Σ pi2, particulièrement adaptées aux vastes matrices d’écologie végétale :
Pour calculer directement l’indice de diversité de Simpson conventionnel (correspondant à la formulation 1 – D), l’utilisateur renseigne l’argument textuel explicite index = "simpson" au sein de l’instruction d’appel, comme le montre la syntaxe suivante :
diversity(vecteur_especes, index = "simpson")
Lorsque le projet de recherche commande l’extraction du nombre effectif d’espèces sous la forme de l’indice réciproque 1 / D, il suffit d’ajuster l’instruction de calcul en invoquant le paramètre index = "invsimpson" :
diversity(vecteur_especes, index = "invsimpson")
L’immense valeur ajoutée de l’environnement R réside dans son aptitude à traiter simultanément des tableaux d’abondances associant plusieurs dizaines de sites d’échantillonnage distincts à des centaines d’espèces répertoriées. L’application de la fonction diversity() sur une matrice rectangulaire d’abondance calcule instantanément le profil de diversité propre à chaque unité paysagère, autorisant l’enchaînement direct avec des modèles linéaires généralisés (GLM), des tests non paramétriques de Kruskal-Wallis ou des régressions spatialisées pour tester l’effet des gradients environnementaux sur la structure des peuplements.
10.3 Implémentation en Python avec NumPy et SciPy
Dans l’écosystème de la science des données modernes, le langage Python offre une flexibilité incomparable pour le traitement automatisé des données écologiques et la conception de pipelines analytiques de bio-informatique. Bien qu’il soit tout à fait aisé d’écrire une fonction purement algorithmique pour évaluer la combinatoire de Simpson sur des listes natives, les bibliothèques scientifiques spécialisées telles que NumPy et le package dédié à la génomique et à l’écologie microbienne scikit-bio fournissent des implémentations hautement performantes.
À travers la bibliothèque scikit-bio (module skbio.diversity.alpha), les calculs de diversité alpha intègrent des fonctions natives hautement documentées. La fonction simpson(counts) calcule l’indice de dominance D pour une série d’effectifs, tandis que la fonction simpson_e(counts) implémente des mesures d’équitabilité associées. La syntaxe sous-jacente s’appuie sur la manipulation vectorielle ultra-rapide permise par les tableaux multidimensionnels ndarray de NumPy.
L’intégration des résultats au sein de l’écosystème de visualisation Python — notamment via les bibliothèques Matplotlib et Seaborn — permet de déployer des représentations graphiques analytiques d’une grande élégance. Le couplage direct entre les scripts de calcul de diversité et les fonctions graphiques de distributions (telles que seaborn.boxplot ou seaborn.violinplot) facilite la génération automatisée de figures synthétiques prêtes pour la soumission éditoriale, illustrant la dispersion des indices de diversité de Simpson le long de chronoséquences écologiques ou entre différents groupes de traitement expérimental.
11. Avantages méthodologiques et limites analytiques
11.1 Forces distinctives de l’indice de Simpson
L’extraordinaire longévité et la popularité inaltérée de l’indice de diversité de Simpson s’expliquent par un faisceau d’avantages méthodologiques intrinsèques qui le distinguent avantageusement d’autres descripteurs quantitatifs :
- Clarté de l’interprétation probabiliste : Contrairement à l’indice de Shannon dont les unités logarithmiques (nats ou bits) demeurent abstraites et déconnectées de l’intuition physique, les variantes de Simpson (D et 1 – D) s’expriment rigoureusement en termes de probabilités d’occurrence. Pouvoir affirmer qu’il existe 78 % de chances que deux individus tirés au hasard soient conspécifiques ou hétérospécifiques confère au discours scientifique une limpidité pédagogique majeure pour la prise de décision publique.
- Focalisation fonctionnelle sur la dominance : Dans la grande majorité des écosystèmes, les processus écologiques vitaux — productivité primaire brute, cycles biochimiques du carbone et de l’azote, régulation hydrique — sont régis par les taxons démographiquement dominants. En amplifiant l’influence de ces taxons au détriment des raretés, Simpson offre un indicateur synthétique fidèle de l’état fonctionnel central du biome.
- Robustesse face au sous-échantillonnage : L’indice de Simpson présente une insensibilité structurelle salutaire aux fluctuations d’effectifs des espèces rares. Il est de facto très peu vulnérable aux variations stochastiques de capture, autorisant la comparaison rigoureuse de campagnes d’inventaire aux efforts d’échantillonnage modérément divergents.
- Simplicité de calcul : Sa dérivation mathématique directe — exempte de fonctions transcendantes telles que les logarithmes — autorise une exécution algorithmique rapide et une implémentation sans faille sur n’importe quel dispositif computationnel de terrain.
11.2 Limites intrinsèques et pièges d’interprétation
En dépit de ses indéniables atouts, l’indice de Simpson présente des limitations théoriques et des écueils opérationnels majeurs que tout chercheur rigoureux se doit d’anticiper :
- Invisibilisation de la crise de la biodiversité patrimoniale : Parce qu’il écrase quadratiquement la contribution des espèces rares, l’indice de Simpson est totalement inopérant pour détecter les signaux précurseurs d’extinction affectant des taxons discrets ou des espèces menacées d’intérêt communautaire. Une communauté peut perdre 40 % de ses espèces rarissimes sous l’impact d’un polluant chronique sans que l’indice de diversité 1 – D ne vacille de manière significative.
- Phénomène de saturation précoce : Dès lors qu’une communauté héberge un nombre appréciable d’espèces (par exemple S > 30) affichant une équitabilité raisonnable, les valeurs de 1 – D s’agglutinent de manière asymptotique à proximité immédiate de 1,0 (typiquement entre 0,95 et 0,99). Cette saturation non linéaire réduit considérablement le pouvoir discriminateur de l’indice pour comparer entre eux des écosystèmes complexes tels que les récifs coralliens ou les canopées équatoriales.
- Confusion sémantique et documentaire chronique : Il règne dans la littérature académique une déplorable confusion terminologique entre l’indice de dominance originel D et la forme complémentaire 1 – D. De nombreux articles mentionnent le calcul de l' »indice de Simpson » sans spécifier l’équation mathématique mobilisée, induisant des contresens dramatiques où des valeurs faibles sont tour à tour interprétées comme des sommets ou des déserts de biodiversité.
11.3 Bonnes pratiques pour éviter les biais analytiques
Pour garantir la validité scientifique et la reproductibilité des analyses fondées sur l’indice de Simpson, les praticiens doivent s’astreindre au respect strict d’un ensemble de bonnes pratiques méthodologiques :
La règle fondamentale absolue consiste à mentionner explicitement, dès la section Méthodes de tout rapport ou article scientifique, la formule mathématique rigoureuse exploitée et la convention de notation retenue : dominance D, diversité de Gini-Simpson 1 – D ou indice réciproque de Hill 1 / D. Il est impératif de stipuler si l’équation a été résolue sous sa formulation finie avec correction N(N – 1) ou sous sa formulation continue asymptotique Σ pi2.
En outre, un indice de Simpson ne doit jamais être interprété en vase clos. Il convient de l’adosser systématiquement à la restitution conjointe de la richesse spécifique brute observée (S), de l’indice d’équitabilité normalisé (ED), ainsi que d’une métrique logarithmique alternative telle que l’indice de Shannon. Enfin, toute confrontation comparative entre deux jeux de données impose de s’assurer scrupuleusement en amont de l’homogénéité des protocoles de capture, de la cohérence de la résolution taxonomique retenue et de la comparabilité des échelles spatiales d’observation.
12. Guide de restitution académique et publication scientifique
12.1 Standardisation de la section Méthodes dans un mémoire ou article
La crédibilité d’une publication académique repose sur la transparence intégrale de ses procédures méthodologiques. Lors de la rédaction d’un mémoire de recherche, d’une thèse de doctorat ou d’un manuscrit soumis à une revue internationale à comité de lecture, la sous-section dédiée aux analyses de diversité au sein du chapitre « Matériels et Méthodes » doit faire l’objet d’une formalisation irréprochable.
Le chercheur doit énoncer avec précision l’équation mathématique exacte appliquée, en citant nommément la publication séminale d’Edward H. Simpson (Nature, 1949). La définition opérationnelle de chaque variable (ni, N, S) doit être fournie sans ambiguïté. Si des seuils d’exclusion statistique ont été adoptés — par exemple l’élimination des échantillons présentant un effectif total inférieur à un seuil prédéfini ou le traitement particulier de spécimens immatures non déterminables à l’espèce —, ces filtres doivent être décrits de façon transparente et argumentée.
Enfin, la section se doit de spécifier explicitement l’environnement computationnel mobilisé pour exécuter les calculs. Il convient d’indiquer non seulement le nom du logiciel exploité (par exemple le logiciel R, Microsoft Excel ou la distribution Python), mais également son numéro de version exact, ainsi que la version des packages spécialisés mis à contribution (par exemple le package vegan version 2.6-4). Cette rigueur documentaire assure la parfaite réplicabilité des calculs par les pairs et rehausse le niveau de confiance accordé aux conclusions du travail de recherche.
12.2 Représentation graphique efficace des indices de diversité
La communication visuelle des résultats de diversité ne doit pas se réduire à la présentation de simples tableaux de chiffres arides. La conception de figures graphiques informatives, synthétiques et visuellement percutantes constitue un vecteur majeur pour valoriser la portée écologique ou comportementale d’une étude empirique.
Pour comparer la dispersion des indices de diversité de Simpson entre différents traitements expérimentaux, stades de succession forestière ou gradients de pollution, le diagramme en boîte (box-plot) associé à la superposition des points de dispersion individuels (strip-plot ou jitter) constitue la modalité de représentation privilégiée. Cette visualisation permet aux lecteurs de visualiser simultanément la médiane de la diversité, les quartiles de variabilité, ainsi que l’éventuelle présence de stations d’échantillonnage atypiques ou aberrantes (outliers).
Une démarche de publication particulièrement valorisée consiste à tracer des diagrammes de profils de diversité intégrés fondés sur la série des nombres effectifs d’espèces de Hill (1973). En reportant sur un graphique continu le profil de diversité qD en fonction de l’ordre d’amplification q — où q = 0 correspond à la richesse spécifique S, q = 1 correspond à l’exponentielle de l’indice de Shannon, et q = 2 correspond directement à l’indice réciproque de Simpson 1 / D —, le chercheur offre une vision panoramique et irréfutable de la structure de la communauté. L’incorporation systématique d’intervalles de confiance à 95 % sous forme d’enveloppes graphiques semi-transparentes, calculées par rééchantillonnage de bootstrap, apporte une caution statistique solide aux conclusions visuelles.
12.3 Formulation des conclusions et portée explicative
La rédaction de la section « Discussion » et la formulation des conclusions générales exigent de l’auteur une grande mesure épistémologique. L’un des écueils les plus fréquents dans les rapports de diagnostic environnemental consiste à formuler des jugements de valeur anthropomorphiques — tels que qualifier une valeur de diversité de « bonne » ou de « mauvaise » — en omettant de contextualiser la signification fonctionnelle des indices obtenus.
Un écosystème affichant un indice de diversité de Simpson modéré n’est pas intrinsèquement dégradé : certains biotopes extrêmes naturels ou remarquables (tourbières ombrotrophes acides, steppes salées, habitats périglaciaires) se caractérisent spontanément par une forte dominance écologique de quelques taxons hautement spécialisés. L’interprétation des variations de l’indice de Simpson doit impérativement s’inscrire dans le cadre écologique de référence de l’habitat considéré, en reliant directement les fluctuations de dominance constatées aux mécanismes biotiques et abiotiques sous-jacents (dynamique des perturbations, gradients de nutriments, pressions anthropiques ou processus de compétition inter-spécifique).
En conclusion, l’auteur doit s’attacher à définir les perspectives méthodologiques ouvertes par ses observations. Cela inclut la formulation de recommandations concrètes pour orienter les suivis écologiques ou les protocoles comportementaux futurs, le plaidoyer pour des études longitudinales à haute résolution temporelle et, le cas échéant, la préconisation d’actions de conservation ciblées visant la restauration de l’équitabilité fonctionnelle des écosystèmes menacés par les pressions globales.
Références
Efron, B. (1979). Bootstrap methods: another look at the jackknife. The Annals of Statistics, 7(1), 1-26. https://doi.org/10.1214/aos/1176344552
Gini, C. (1912). Variabilità e mutabilità. Tipografia di Paolo Cuppini.
Hill, M. O. (1973). Diversity and evenness: a unifying notation and its consequences. Ecology, 54(2), 427-432. https://doi.org/10.2307/1934352
Janis, I. L. (1972). Victims of groupthink: a psychological study of foreign-policy decisions and fiascoes. Houghton Mifflin.
MacArthur, R. H. (1965). Patterns of species diversity. Biological Reviews, 40(4), 510-534. https://doi.org/10.1111/j.1469-185X.1965.tb00815.x
Margalef, R. (1958). Information theory in ecology. General Systems, 3, 36-71.
Oksanen, J., Blanchet, F. G., Friendly, M., Kindt, R., Legendre, P., McGlinn, D., Minchin, P. R., O’Hara, R. B., Simpson, G. L., Solymos, P., Stevens, M. H. H., Szoecs, E., & Wagner, H. (2020). vegan: Community Ecology Package (Version 2.5-7). https://CRAN.R-project.org/package=vegan
Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Simpson, E. H. (1949). Measurement of diversity. Nature, 163(4148), 688. https://doi.org/10.1038/163688a0
Teachman, J. D. (1980). Analysis of population diversity: Measures of qualitative variation. Sociological Methods & Research, 8(3), 341-362. https://doi.org/10.1177/004912418000800305