
L’inférence statistique constitue le pivot méthodologique sur lequel repose l’édifice de la science empirique moderne. Dès lors qu’un chercheur s’efforce de dépasser la simple description phénoménologique pour porter un jugement éclairé sur des régularités universelles, il se heurte inévitablement à la finitude de ses observations face à l’immensité du réel. Dans cette tension permanente entre le particulier observé et l’universel théorisé, le test t de Student pour échantillon unique s’impose comme une passerelle analytique fondamentale. Élaboré initialement à l’orée du XXe siècle par William Sealy Gosset sous le pseudonyme désormais illustre de « Student », cet outil paramétrique répond à une problématique élémentaire mais omniprésente : déterminer si la moyenne observée au sein d’un groupe d’observations restreint s’écarte de manière statistiquement significative d’une valeur de référence théorique, historique ou normative préétablie.
Au sein des environnements d’analyse quantitative à haute exigence d’intégrité, tels que la recherche biomédicale, les études épidémiologiques et l’évaluation psychométrique, l’écosystème logiciel SAS (Statistical Analysis System) demeure la référence incontournable. Réputé pour sa robustesse algorithmique, sa conformité rigoureuse aux normes de traçabilité réglementaire imposées par la FDA et les agences sanitaires internationales, SAS offre une instrumentation d’une précision mathématique absolue. La mise en œuvre d’un test t univarié dans SAS ne se réduit pas à une simple séquence de clics ou à l’exécution d’une routine opaque ; elle incarne un processus d’investigation rigoureux intégrant la validation des postulats gaussiens, l’exploration descriptive exhaustive et l’évaluation de la pertinence pratique des grandeurs observées.
Ce guide exhaustif a pour vocation d’analyser en profondeur les dimensions théoriques, mathématiques et computationnelles du test t pour échantillon unique au moyen du langage de programmation SAS. En articulant la formalisation probabiliste avec l’implémentation algorithmique au travers des procédures phares telles que PROC TTEST et PROC UNIVARIATE, nous explorerons chaque étape du cycle analytique. De la formulation des hypothèses nulles et alternatives au calcul de la taille d’effet par le d de Cohen, en passant par le traitement des violations de postulats et la rédaction selon les canons éditoriaux de l’American Psychological Association (APA), cette monographie constitue une référence complète pour les chercheurs, biostatisticiens et analystes de données soucieux de rigueur méthodologique.
1. Fondements théoriques et épistémologiques du test t pour échantillon unique
Le test t pour échantillon unique représente la démarche fondamentale d’inférence déductive appliquée à une variable quantitative continue. Avant d’engager toute commande informatique au sein de l’interpréteur SAS, il est impératif d’en maîtriser l’architecture conceptuelle, l’expression formelle des métriques mathématiques et la signification épistémologique des hypothèses testées au regard des paradigmes de la science quantitative contemporaine.
1.1 Définition et formulation mathématique du test
Le test t de Student pour échantillon unique a pour finalité première d’examiner l’hypothèse selon laquelle la moyenne d’une population sous-jacente, notée conventionnellement mu, est égale à une valeur constante spécifiée a priori, notée mu zéro. Ce paramètre de comparaison ne provient pas de l’échantillon lui-même, mais relève d’une connaissance extérieure : une constante théorique issue d’un modèle physique, une norme psychométrique calibrée sur une vaste cohorte, un seuil d’efficacité clinique ou une moyenne historique établie lors d’investigations antérieures de grande envergure.
Sur le plan mathématique, l’évaluation repose sur la confrontation entre l’écart brut observé — c’est-à-dire la différence arithmétique entre la moyenne empirique observée x barre et la constante mu zéro — et la variabilité aléatoire d’échantillonnage inhérente au processus de mesure. Cette variabilité est formalisée par l’erreur type de la moyenne, souvent désignée par le sigle SE ou l’expression sigma chapeau divisé par la racine carrée de n. Dès lors que l’écart-type de la population mère demeure inconnu, ce qui constitue la norme absolue en recherche empirique, il est estimé sans biais à partir de la variance de l’échantillon notée s carré. L’expression statistique du score empirique t prend alors la forme canonique suivante : la différence entre la moyenne de l’échantillon et mu zéro, le tout divisé par le quotient de l’écart-type d’échantillon s par la racine carrée de l’effectif n.
La statistique t obtenue sous l’hypothèse nulle suit rigoureusement une distribution théorique de Student dotée d’un nombre précis de degrés de liberté, défini par la relation arithmétique gl = n – 1. Les degrés de liberté reflètent le nombre de valeurs indépendantes au sein du vecteur d’observations libres de varier une fois que l’estimation de la moyenne de l’échantillon a été figée pour calculer l’écart-type. Sur le plan de la théorie des probabilités, la loi de Student se caractérise par des queues de distribution plus épaisses que la loi normale centrée réduite, reflétant l’incertitude additionnelle introduite par l’estimation conjointe de la moyenne et de la variance à partir d’un échantillon fini. Au fur et à mesure que la taille de l’échantillon n tend vers l’infini, la distribution de Student converge asymptotiquement vers la distribution normale standard de Gauss.
1.2 Formulation formelle des hypothèses statistiques
La formalisation du test s’inscrit au sein du cadre épistémologique développé par Jerzy Neyman et Egon Pearson, combiné à l’approche du test de signification de Ronald Fisher. Elle requiert la spécification non ambiguë d’un couple d’hypothèses statistiques mutuellement exclusives et conjointement exhaustives : l’hypothèse nulle, désignée conventionnellement par H0, et l’hypothèse alternative, désignée par H1 ou Ha.
L’hypothèse nulle formalise le postulat de non-différence, d’absence d’effet ou de conformité stricte au modèle théorique préexistant. Elle s’énonce selon la relation : H0 : mu = mu zéro. Rejeter H0 ne signifie jamais démontrer de façon absolue sa fausseté, mais plutôt établir que la probabilité d’observer un tel écart, ou un écart encore plus extrême, sous la présomption de son exactitude, est inférieure à un seuil critique conventionnel préalablement consenti par le chercheur, noté alpha. L’acceptation ou le non-rejet de l’hypothèse nulle implique simplement que les données empiriques recueillies n’offrent pas un degré de preuve suffisant pour écarter l’intervention du hasard d’échantillonnage.
L’hypothèse alternative se décline en deux variantes cardinales dictées par la démarche de recherche : l’approche bilatérale et l’approche unilatérale. Dans le cadre bilatéral (test non orienté ou symétrique), le chercheur postule une déviation de la moyenne sans formuler de préjugé directionnel sur le sens de cette variation, ce qui s’énonce : H1 : mu n’est pas égal à mu zéro. Cette approche distribue le risque de rejet erroné alpha équitablement de part et d’autre de la distribution théorique, allouant un quantum de probabilité alpha sur deux à la queue gauche et un quantum identique à la queue droite. À l’opposé, les hypothèses directionnelles unilatérales concentrent la totalité de la région critique dans une seule queue de la loi de Student. L’hypothèse unilatérale supérieure s’écrit H1 : mu est supérieur à mu zéro, testant une hypothèse d’accroissement ou de supériorité statistique, tandis que l’hypothèse unilatérale inférieure s’écrit H1 : mu est inférieur à mu zéro, testant une hypothèse de réduction, d’inhibition ou de régression métrique.
1.3 Applications empiriques en sciences quantitatives et psychologie
Le recours au test t pour échantillon unique irrigue l’ensemble des disciplines scientifiques mobilisant la modélisation statistique. En psychologie cognitive et en neuropsychologie clinique, ce test constitue l’instrument privilégié pour évaluer les performances d’un patient singulier ou d’un micro-échantillon clinique face à des étalonnages normatifs standardisés. À titre d’illustration, lorsqu’un protocole cognitif examine le temps de traitement de l’information ou la capacité de la mémoire de travail au moyen d’un score standardisé dont la moyenne populationnelle théorique est fixée à 100 unités avec un écart-type de 15, le test t univarié permet de certifier si le groupe de patients souffrant d’une pathologie cérébrovasculaire présente un déficit statistiquement décelable par rapport à ce référentiel normatif.
Dans les sciences biologiques, agronomiques et botaniques, le test pour échantillon unique sert fréquemment à la validation de critères morphologiques ou physiologiques face à des seuils historiques documentés. Considérons un agronome évaluant un nouveau cultivar de céréales ou une lignée végétale soumise à un amendement organo-minéral novateur : l’interrogation scientifique consistera à établir si la hauteur moyenne de la plante, le rendement en grains ou la biomasse aérienne dépasse la norme historique de référence constatée sur une décennie d’agriculture conventionnelle. La confirmation d’un tel écart assure que la variation constatée n’est pas le simple fait des fluctuations météorologiques saisonnières locales.
Enfin, en sociologie quantitative, en marketing et en sciences comportementales, cette modélisation trouve un champ d’application direct dans l’analyse des échelles d’attitudes ou d’opinions psychométriques. Lors de l’administration d’un questionnaire d’évaluation échelonné sur une échelle de Likert à sept points, le score neutre théorique — correspondant à l’absence de positionnement ou au point d’indifférence psychologique — se situe à la valeur numérique quatre. Le test t pour échantillon unique permet alors de vérifier si les jugements d’une cohorte de consommateurs s’écartent significativement de ce point neutre central, attestant ainsi d’une adhésion favorable ou d’un rejet caractérisé à l’égard de l’objet ou de la politique évaluée.
2. Conditions d’application et validation des postulats méthodologiques
La validité des inférences découlant de la procédure t de Student dépend impérativement du respect d’un ensemble de postulats probabilistes. L’inobservation de ces conditions mathématiques expose l’analyste à une altération drastique des taux d’erreur de première espèce (taux de faux positifs) ou de deuxième espèce (déficit de puissance statistique), compromettant l’intégrité épistémique des conclusions tirées sous SAS.
2.1 Indépendance et échantillonnage aléatoire
Le postulat d’indépendance des observations constitue la condition la plus fondamentale et la moins robuste aux violations statistiques. Il stipule que la mesure réalisée sur une unité expérimentale donnée ne doit exercer aucune influence sur la mesure obtenue sur toute autre unité d’observation incluse dans l’échantillon. Mathématiquement, cela implique que la covariance entre deux observations quelconques X i et X j est rigoureusement nulle dès lors que i est distinct de j.
La violation de cette exigence survient fréquemment lors de protocoles de collecte défectueux : mesures répétées dans le temps sur les mêmes organismes sans ajustement méthodologique, regroupement spatial ou biologique d’individus partageant un environnement partagé (effet de nichée, regroupement scolaire ou culture en bacs partagés), ou procédures d’échantillonnage non probabilistes de type « boule de neige ». L’existence d’une autocorrélation positive entre les observations entraîne une sous-estimation systématique de la variance d’échantillonnage réelle. Par voie de conséquence, le dénominateur du test t est artificiellement contracté, ce qui gonfle la valeur empirique du t calculé et génère des p-values trompeusement réduites, menant au rejet fallacieux d’hypothèses nulles parfaitement légitimes.
La garantie de l’indépendance ne relève pas d’un traitement mathématique correctif a posteriori mais d’une rigueur absolue dans la mise en œuvre de la méthode d’échantillonnage. Le recours à un échantillonnage aléatoire simple, où chaque entité de la population cible possède une probabilité non nulle et équiprobable d’être sélectionnée, demeure le standard méthodologique optimal pour prémunir les analyses de tout biais d’agrégation ou de dépendance structurelle.
2.2 Échelle de mesure et nature de la variable dépendante
Le test t univarié présuppose explicitement que la variable dépendante d’intérêt soit de nature quantitative continue, mesurée selon une échelle d’intervalles constants ou une échelle de rapports au sens de la typologie des échelles de mesure formalisée par Stanley Smith Stevens. Sur de telles échelles, non seulement l’ordre des grandeurs observées est rigoureusement ordonné, mais les distances arithmétiques séparant deux points consécutifs possèdent une signification physique et métrique constante.
L’utilisation de la procédure t sur des variables purement ordinales, telles que des scores d’items isolés sur une échelle de Likert allant de 1 à 5, fait l’objet de vifs débats doctrinaux en méthodologie statistique. Bien que certains analystes appliquent des tests paramétriques à des indices composites formés par la sommation de nombreux items de Likert en invoquant une métrique quasi-continue sous-jacente, l’application du test t à un item ordinal unique viole l’hypothèse de continuité et d’espacement uniforme. Les calculs de moyennes et de variances perdent alors une partie de leur rigueur géométrique.
Par ailleurs, la qualité de l’encodage initial des grandeurs sous SAS exige une vérification pointilleuse de la nature des types de données déclarés. Les variables doivent impérativement être instanciées sous la typologie numérique standard (numeric) et non comme chaînes de caractères (character). Le traitement des données manquantes doit également être anticipé : sous SAS, les données absentes sont identifiées par des points et sont automatiquement exclues des calculs arithmétiques univariés de PROC TTEST, réduisant d’autant la taille effective n et modifiant la structure des degrés de liberté de l’analyse finale.
2.3 Postulat de normalité distributionnelle
Le modèle formel du test de Student repose sur le postulat que la variable dépendante suit une distribution normale au sein de la population parente, ce qui s’écrit formellement X ~ N(mu, sigma carré). Cette propriété garantit que la distribution de la moyenne d’échantillon x barre suit rigoureusement une loi gaussienne et que l’estimation de la variance s carré se comporte selon une distribution du khi-deux indépendante de la moyenne, satisfaisant ainsi les conditions mathématiques d’émergence du ratio de Student.
Il convient néanmoins de moduler la sévérité de ce postulat à l’aune du Théorème Central Limite (TCL). En vertu de ce principe asymptotique majeur de la théorie des probabilités, lorsque la taille de l’échantillon n croît et dépasse un seuil conventionnel situé couramment autour de 30 observations (n >= 30), la distribution de la moyenne d’échantillon tend inéluctablement vers la normalité, quelle que soit la forme distributionnelle de la variable parente, pourvu que sa variance théorique soit finie. Dès lors, pour des cohortes de taille modérée à grande, le test t s’avère particulièrement robuste aux déviations mineures ou modérées de la normalité.
En revanche, dans le contexte de micro-échantillons (n < 30), la statistique de Student manifeste une vulnérabilité accrue aux asymétries prononcées ainsi qu’au phénomène de queues épaisses (hyperkurtosis). Une distribution fortement biaisée déforme la symétrie de l’erreur type et peut induire une distorsion substantielle de la p-value réelle par rapport à la p-value nominale. Par ailleurs, la présence d’observations aberrantes ou extrêmes (outliers) exerce une influence disproportionnée sur l’évaluation de la moyenne et amplifie artificiellement la variance empirique s carré, ce qui dilate l’erreur type de la moyenne et anéantit la puissance du test statistique.
3. Structuration et saisie des données sous l’environnement SAS
L’exécution fluide d’un test t au sein de l’architecture logicielle SAS repose sur la compréhension approfondie de son modèle de traitement séquentiel en deux phases : l’étape d’ingestion et de transformation des données matérialisée par l’étape DATA, suivie de l’étape d’exécution analytique gouvernée par les procédures préprogrammées (PROC). Une rigueur exemplaire lors de la saisie des vecteurs de données est la condition sine qua non de toute analyse inférentielle intègre.
3.1 Création du jeu de données avec l’étape DATA
L’étape DATA représente le socle programmatique de l’environnement SAS. C’est à ce niveau que sont alloués les blocs de mémoire, que sont définis les attributs des colonnes et que sont convertis les flux de texte brut en tables statistiques relationnelles appelées SAS Data Sets. La structure syntaxique canonique de cette étape commence obligatoirement par l’instruction DATA suivie du nom de la table cible créée au sein de la bibliothèque de travail temporaire (WORK) ou d’une bibliothèque permanente assignée par une instruction LIBNAME préalable.
Au cœur de l’étape DATA, l’instruction INPUT informe le compilateur SAS de la structure des colonnes à lire. Pour des variables numériques continues destinées à subir des tests d’hypothèses univariés, le nom de la variable est déclaré sans suffixe monétaire ni délimiteur de chaîne de caractères, signalant ainsi au moteur d’exécution que les valeurs encodées doivent être interprétées selon un format à virgule flottante double précision. Cette étape de typage est critique, car toute présence accidentelle de caractères alphanumériques dans une colonne numérique génère des messages d’erreur d’incompatibilité et force l’interpréteur à assigner une valeur manquante au point concerné.
L’introduction des enregistrements quantitatifs empiriques au sein du script lui-même s’effectue traditionnellement par le biais de l’instruction DATALINES (ou son équivalent historique CARDS). Cette commande signale à SAS que les lignes de texte qui lui succèdent immédiatement ne constituent plus des instructions syntaxiques à interpréter, mais des flux bruts de données destinées à peupler les enregistrements de la table jusqu’à la rencontre d’un délimiteur de fin d’enregistrement matérialisé par un point-virgule isolé sur une nouvelle ligne.
3.2 Implémentation de l’exemple empirique
Afin de conférer à notre exposé une assise empirique tangible, nous instancions un protocole expérimental botanique réel portant sur l’évaluation de la croissance de spécimens d’une plante modèle cultivée en chambre climatique standardisée. Un agronome souhaite vérifier si la hauteur végétative moyenne de ces spécimens après quatre semaines diffère de la norme biologique historique solidement établie à 15 centimètres pour cette variété sous fertilisation classique.
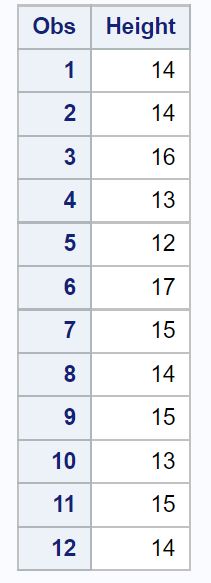
Le protocole a permis de recueillir un échantillon de 12 spécimens botaniques indépendants dont les hauteurs métriques, exprimées rigoureusement en centimètres entiers et décimaux, sont colligées au sein d’un vecteur statistique : 14, 14, 16, 13, 12, 17, 15, 14, 15, 13, 16 et 14 centimètres. Cet effectif modéré (n = 12) incarne la situation type de la recherche expérimentale où les contraintes d’espace de culture ou de matériel biologique restreignent la volumétrie brute des observations, conférant au respect des postulats méthodologiques une acuité déterminante.
La traduction programmatique de cet ensemble expérimental s’exprime dans l’environnement SAS par la déclaration d’une étape DATA intitulée HauteursPlantes. L’instruction INPUT declare l’identifiant Hauteur, suivie de l’instruction DATALINES alimentant les 12 entrées empiriques disposées séquentiellement ligne par ligne ou regroupées à l’aide du symbole de contrôle de lecture à double barre oblique. La fermeture par un point-virgule puis l’instruction RUN ordonnent la compilation et la concrétisation physique de la table dans l’espace WORK de SAS.
3.3 Inspection préliminaire via la procédure PROC PRINT
Avant d’engager toute modélisation probabiliste élaborée, la règle cardinale de la pratique statistique impose une vérification documentaire immédiate de la table SAS ainsi constituée. La procédure PROC PRINT représente l’outil standard pour afficher le contenu exhaustif de la table de travail au sein de la fenêtre de résultats de l’interface graphique ou du flux de sortie ODS (Output Delivery System).
L’exécution de PROC PRINT DATA=HauteursPlantes permet à l’analyste de s’assurer sans ambiguïté que le moteur d’exécution a correctement interprété le nombre total d’observations lues. L’interface affiche chaque enregistrement séquentiel assorti de sa variable de positionnement automatique Obs, confirmant que le compteur s’élève bien à 12 et qu’aucune ligne de mesure n’a été prématurément tronquée ou omise lors de l’opération d’ingestion.
Par ailleurs, cette inspection visuelle primaire offre un premier filtre de contrôle qualité. Elle autorise le dépistage d’éventuelles erreurs typographiques grossières résultant de la frappe humaine, comme une virgule mal positionnée ou un chiffre démesuré qui convertirait accidentellement une hauteur de 14 centimètres en 140 centimètres, anomalie qui fausserait dramatiquement les futures estimations de la moyenne et de l’écart-type au sein de la procédure PROC TTEST.
4. Exploration descriptive et vérification des hypothèses avec PROC UNIVARIATE
L’analyse inférentielle ne saurait débuter sans une caractérisation approfondie des propriétés distributionnelles empiriques du vecteur d’intérêt. Sous SAS, la procédure PROC UNIVARIATE constitue le joyau analytique dédié à l’évaluation des statistiques descriptives avancées et au diagnostic formel de normalité, surpassant largement les capacités limitées de la procédure PROC MEANS.
4.1 Calcul des statistiques univariées descriptives
La procédure PROC UNIVARIATE génère de manière native un ensemble exhaustif d’indicateurs de localisation et d’échelle indispensables pour appréhender la géométrie des données. Au titre des mesures de tendance centrale, elle restitue la moyenne arithmétique de l’échantillon, la médiane (qui représente le second quartile ou le cinquantième percentile, insensible aux valeurs extrêmes) ainsi que le mode empirique, qui correspond à la valeur la plus fréquemment observée au sein de la série.
S’agissant des métriques de dispersion, la procédure détaille l’écart-type d’échantillon, la variance non biaisée ainsi que l’écart interquartile (IQR), calculé par la différence entre le troisième quartile (75e percentile) et le premier quartile (25e percentile). Ce dernier paramètre quantifie l’étendue occupée par les 50 % centraux des données, fournissant une estimation robuste de la variabilité d’échelle qui complète utilement l’écart-type conventionnel.
Enfin, PROC UNIVARIATE délivre les coefficients de forme fondamentaux : le coefficient d’asymétrie empirique (skewness) et le coefficient d’aplatissement (kurtosis). Une distribution gaussienne théorique se signale par un skewness rigoureusement nul et un kurtosis d’excès également égal à zéro sous la paramétrisation adoptée par SAS. Un skewness positif manifeste un étirement de la queue de distribution vers les valeurs élevées (asymétrie à droite), tandis qu’un skewness négatif reflète un étirement vers les valeurs basses. L’examen minutieux de ces coefficients permet d’objectiver toute divergence morphologique majeure par rapport à la courbe en cloche idéale de Gauss.
4.2 Tests formels de normalité sous SAS
Au-delà de la description brute, PROC UNIVARIATE intègre l’option d’instruction NORMAL qui déclenche une batterie de tests d’adéquation destinés à éprouver l’hypothèse nulle selon laquelle l’échantillon provient d’une population normalement distribuée. Pour des tailles d’échantillon restreintes (n < 50), l’arbitre statistique suprême est le test de Shapiro-Wilk, désigné par la statistique W dans les sorties SAS.
Le test de Shapiro-Wilk compare la régression des quantiles d’échantillon ordonnés sur les espérances des statistiques d’ordre d’une loi normale standardisée. La statistique W est bornée théoriquement entre 0 et 1 ; des valeurs très proches de l’unité attestent d’une concordance étroite avec la normalité. La sortie SAS fournit la p-value associée, notée Pr < W. Lorsque cette valeur de p demeure supérieure au seuil critique traditionnel de 0,05, le chercheur ne dispose pas d’éléments de preuve suffisants pour rejeter l’hypothèse de normalité, ce qui autorise méthodologiquement l’usage du test t de Student paramétrique.
Pour des cohortes plus massives, SAS édite conjointement les statistiques de Kolmogorov-Smirnov (modifiée par Lilliefors), de Cramer-von Mises et d’Anderson-Darling. Le test d’Anderson-Darling s’avère particulièrement perspicace en raison de sa pondération renforcée sur les queues de distribution, zone d’inférence critique où les violations du modèle gaussien peuvent altérer dramatiquement la validité des intervalles de confiance ultérieurs.
4.3 Diagnostics graphiques de distribution
Les diagnostics numériques doivent obligatoirement être corroborés par une inspection visuelle directe de la forme de la distribution. L’instruction HISTOGRAM adossée à l’option / NORMAL permet de projeter la courbe théorique de Gauss directement superposée à l’histogramme des fréquences empiriques de la variable, matérialisant visuellement les éventuels déficits ou excès de fréquence au centre ou aux extrémités de la distribution.
Parallèlement, l’instruction QQPLOT génère le diagramme quantile-quantile (Q-Q plot) normal. Ce graphique confronte les quantiles empiriques observés aux quantiles théoriques issus de la distribution gaussienne standard. Dans des conditions de normalité absolue, les points expérimentaux s’alignent rigoureusement le long de la bissectrice droite tracée en référence. Toute courbure systématique en forme de « S » trahit un aplatissement lourd ou léger des queues, tandis qu’une courbure parabolique signale une asymétrie caractérisée.
L’utilisation combinée des diagrammes en boîte à moustaches (boxplots), générés nativement par PROC UNIVARIATE ou via la procédure PROC SGPLOT, permet en outre d’identifier de manière univoque la présence d’observations aberrantes ou extrêmes situées au-delà de 1,5 fois l’écart interquartile à partir des charnières de Tukey. La confirmation de l’absence de telles anomalies conforte le choix méthodologique de persévérer vers l’exécution du test t paramétrique.
5. Syntaxe exhaustive et architecture de la procédure PROC TTEST
La mise en œuvre formelle du test t pour échantillon unique au sein de la plateforme SAS est confiée à la procédure PROC TTEST. Cette procédure combine une ergonomie syntaxique remarquable et un niveau d’exhaustivité statistique inégalé dans les suites d’analyse de données concurrentes.
5.1 Structure générale de l’instruction PROC TTEST
La commande inaugurale d’appel à la procédure adopte la forme fondamentale suivante : PROC TTEST DATA=NomDeLaTable options ;. L’argument DATA= spécifie expressément la table d’entrée contenant le vecteur d’observations à soumettre au protocole inférentiel. Si cet argument est omis par mégarde, SAS utilisera par défaut la dernière table SAS activement manipulée dans la session de travail, une pratique vivement déconseillée car source fréquente d’erreurs d’exécution accidentelles dans des programmes séquentiels complexes.
L’architecture interne de la procédure impose impérativement la déclaration de l’instruction VAR suivie du nom de la variable dépendante d’intérêt, en l’occurrence notre variable Hauteur. Cette instruction délimite le champ de traitement analytique de SAS aux seules colonnes sélectionnées, évitant le calcul superflu d’indicateurs sur d’autres colonnes de typage ou d’identification présentes au sein de la table d’origine.
Enfin, la déclaration de la procédure peut être enrichie d’options de restitution graphique et de structuration du système ODS, permettant d’orienter les flux de tableaux et de figures directement vers les sorties HTML, PDF ou RTF destinées aux rapports techniques et académiques standardisés.
5.2 Définition de la valeur de référence avec l’option H0
La paramétrisation cruciale du test pour échantillon unique s’opère par le truchement de l’option H0= positionnée directement dans l’en-tête de l’instruction PROC TTEST. Par construction par défaut, si aucune valeur numérique n’est spécifiée par l’utilisateur, SAS assigne implicitement la valeur zéro à l’hypothèse nulle (H0=0). Dans notre cas d’école botanique, l’omission de cette option reviendrait à tester si la hauteur des plantes diffère de zéro centimètre, une hypothèse biologiquement absurde dont le rejet serait trivial et dénué de toute portée scientifique.
Pour éprouver rigoureusement notre hypothèse de conformité face au référentiel agronomique de 15 centimètres, la syntaxe doit être impérativement déclarée sous la forme PROC TTEST DATA=HauteursPlantes H0=15 ;. Cette affectation précise indique au compilateur SAS d’injecter la constante scalaire 15 au sein du numérateur de l’équation de calcul du score t, soustrayant 15 à la moyenne empirique observée x barre.
La flexibilité de SAS autorise la saisie de constantes entières, décimales ou formulées en notation scientifique selon la précision métrique requise par le protocole expérimental. Cette rigueur dans la fixation du paramètre H0 conditionne l’exactitude de l’ensemble des métriques de p-values et d’intervalles de confiance centrés sur la différence moyenne calculés lors des phases aval de l’exécution.
5.3 Gestion du risque d’erreur de première espèce (ALPHA)
Le contrôle formel du risque d’erreur de première espèce, c’est-à-dire le risque de rejeter à tort une hypothèse nulle qui est pourtant vraie dans la réalité biologique, est administré dans SAS par l’option ALPHA=. Par défaut, SAS configure le seuil de significativité nominal à la valeur conventionnelle de 0,05 (ALPHA=0.05), correspondant à un niveau de confiance bilatéral standardisé de 95 %.
Dans des contextes industriels, toxicologiques ou de recherche clinique de phase III soumises aux directives strictes de la conférence internationale sur l’harmonisation (ICH), les protocoles requièrent parfois des marges d’erreur substantiellement plus sévères afin de minimiser drastiquement le risque de faux positifs. L’analyste peut alors spécifier ALPHA=0.01 ou ALPHA=0.001 directement dans l’instruction d’en-tête de PROC TTEST.
Ce paramétrage n’influence pas directement la valeur arithmétique de la statistique t calculée ni la p-value associée, qui demeurent des propriétés invariantes de l’échantillon observé pour une hypothèse H0 donnée. En revanche, l’option ALPHA redéfinit instantanément les valeurs critiques de la loi de Student mobilisées pour le calcul des bornes de l’intervalle de confiance de la moyenne, élargissant ces limites à mesure que le risque d’erreur consenti diminue, afin de préserver le degré d’assurance probabiliste requis.
5.4 Choix de la directionnalité avec le paramètre SIDES
La directionnalité de l’inférence statistique est administrée sous SAS au moyen de l’option SIDES=, qui accepte trois arguments distincts conditionnant la nature de l’hypothèse alternative et la répartition de la région critique d’alpha. Par défaut, la procédure est initialisée avec l’argument SIDES=2, ordonnant l’exécution d’un test bilatéral symétrique non orienté visant à détecter tout écart significatif, qu’il s’agisse d’un excédent ou d’un déficit par rapport à mu zéro.
Lorsque le chercheur dispose d’un ancrage théorique inébranlable ou d’une directive protocolaire stipulant a priori que la nouvelle intervention ne saurait avoir d’autre effet qu’une amplification du phénomène mesuré, l’argument SIDES=U (pour Upper) est déployé. Cette configuration commande un test unilatéral droit orienté vers les valeurs supérieures (H1 : mu > mu zéro), concentrant l’intégralité du risque alpha dans la queue droite de la distribution de Student.
Inversement, pour tester exclusivement l’atténuation, la régression ou l’infériorité statistique d’une grandeur par rapport au seuil normatif, l’option est paramétrée à SIDES=L (pour Lower). Cette sélection affecte la région critique d’exclusion dans la queue gauche (H1 : mu < mu zéro). Cette décision paramétrique modifie en profondeur la règle de décision inférentielle et doit impérativement découler d’un choix pré-analytique rigoureux pour éviter tout biais de sélection opportuniste.
6. Exécution programmatique du test sous SAS
L’assemblage d’un programme SAS pérenne et diffusable nécessite l’intégration harmonieuse des segments de préparation de données, des appels de procédures et des directives de documentation. Cette démarche assure la reproductibilité intégrale de l’expérience d’analyse, critère fondamental de la recherche moderne.
6.1 Assemblage du script complet
Le code complet mobilisé pour réaliser notre analyse empirique botanique consolide l’étape DATA, l’inspection visuelle préalable et l’exécution inférentielle univariée. L’architecture globale du script s’organise selon une succession ordonnée de blocs programmatiques articulés de la façon suivante :
Dans un premier temps, l’étape DATA nommée HauteursPlantes est initialisée. L’instruction INPUT Hauteur déclare la variable quantitative continue. L’instruction DATALINES précède l’insertion des 12 mesures botaniques (14, 14, 16, 13, 12, 17, 15, 14, 15, 13, 16, 14), conclue par le point-virgule d’usage et l’instruction RUN marquant la fin de la compilation du jeu de données.
Dans un deuxième temps, la procédure PROC PRINT DATA=HauteursPlantes est appelée afin de valider visuellement l’intégrité de la table dans le visualiseur de sorties. Enfin, la procédure principale PROC TTEST DATA=HauteursPlantes H0=15 SIDES=2 ALPHA=0.05 est exécutée, complétée par l’instruction VAR Hauteur ; et finalisée par l’instruction RUN. L’insertion de commentaires explicatifs, balisés par les délimiteurs slash-étoile et étoile-slash, garantit une lisibilité maximale pour les auditeurs et collaborateurs du projet statistique.
6.2 Analyse du journal d’exécution (SAS Log)
Une règle déontologique absolue sous SAS stipule qu’aucun tableau de résultats ne doit être interprété avant un examen méticuleux et exhaustif du journal d’exécution, le fameux SAS Log. Ce journal documente fidèlement la trajectoire computationnelle suivie par le système et consigne chaque étape de transformation des structures de données.
L’analyste doit contrôler scrupuleusement la mention indiquant que la table WORK.HauteursPlantes a bien été créée avec 12 observations et 1 variable. Il convient de vérifier formellement l’absence d’erreurs de syntaxe, traditionnellement signalées en rouge vif dans le journal, ainsi que l’absence d’avertissements (warnings) signalés en vert ou en bleu, qui pourraient indiquer des conversions implicites de variables ou des anomalies structurelles.
De surcroît, le journal confirme formellement que toutes les observations étaient valides et qu’aucune exclusion pour valeur manquante n’a été opérée à l’insu du chercheur. Ce n’est qu’après avoir certifié la parfaite limpidité du log que les tableaux de sortie ODS peuvent être examinés et soumis à une interprétation biométrique rigoureuse.
7. Décodage méthodique et interprétation des résultats SAS
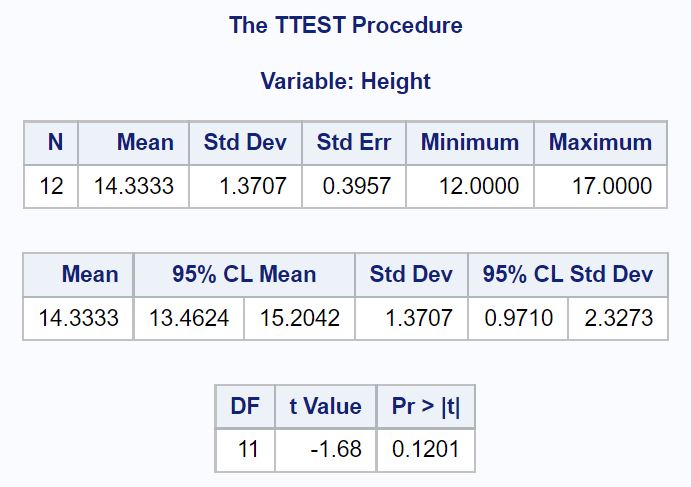
La sortie standard générée par PROC TTEST pour un échantillon unique s’organise en trois tables d’analyse distinctes et complémentaires. Chacun de ces tableaux fournit une strate d’information statistique essentielle, allant de l’anatomie descriptive de l’échantillon à l’évaluation probabiliste formelle de l’hypothèse nulle.
7.1 Le tableau des statistiques descriptives fondamentales
Le premier tableau de la sortie ODS restitue les caractéristiques numériques directes de la variable dépendante. La première colonne, intitulée N, atteste de la taille d’échantillon effective prise en compte dans l’évaluation du modèle, soit exactement 12 observations botaniques dans notre cadre expérimental.
La colonne Mean indique la moyenne arithmétique calculée sur l’échantillon. Pour nos données (somme des hauteurs égale à 175 divisée par 12), la valeur observée est de 14,5833 centimètres. La colonne Std Dev rapporte l’écart-type de l’échantillon s, calculé avec la correction de Bessel au dénominateur (n – 1), qui s’établit précisément à 1,4434 centimètre. Les valeurs minimale (12,00) et maximale (17,00) complètent le panorama descriptif de l’étendue des données.
La composante la plus critique de ce tableau demeure la colonne Std Err, qui quantifie l’erreur type de la moyenne. Obtenue en divisant l’écart-type (1,4434) par la racine carrée de 12 (environ 3,4641), cette grandeur s’élève à 0,4167 centimètre. Elle mesure la dispersion attendue de la distribution d’échantillonnage de la moyenne autour de l’espérance de la population, constituant l’étalon d’incertitude qui servira de dénominateur à l’évaluation du score de Student.
7.2 L’intervalle de confiance de la moyenne
Le deuxième tableau de sortie présente les limites de l’intervalle de confiance pour la moyenne empirique, calibré au niveau spécifié par l’option ALPHA, soit un degré de confiance à 95 % dans notre implémentation. Ce tableau affiche la moyenne observée flanquée de ses deux bornes critiques : 95% CL Mean (Confidence Limits).
Pour notre échantillon de 12 spécimens avec 11 degrés de liberté, la valeur critique bilatérale t issue de la loi de Student au seuil de 5 % est de 2,2010. Les bornes de l’intervalle de confiance sont obtenues en retranchant et en ajoutant à la moyenne empirique (14,5833) le produit de cette valeur critique par l’erreur type (2,2010 multiplié par 0,4167, soit une marge d’erreur de 0,9171). L’intervalle de confiance à 95 % s’étend ainsi rigoureusement de 13,6662 centimètres pour la borne inférieure à 15,5004 centimètres pour la borne supérieure.
L’interprétation probabiliste de cet intervalle est d’une grande portée : si nous devions répéter cette expérience botanique un nombre infini de fois dans des conditions parfaitement identiques, 95 % des intervalles ainsi construits recouvriraient la véritable moyenne inconnue mu de la population sous-jacente. Sur le plan de la décision d’hypothèse, nous observons immédiatement que la valeur de référence de l’hypothèse nulle (H0 = 15) est incluse à l’intérieur des bornes de l’intervalle [13,67 ; 15,50], ce qui constitue un indice géométrique préalable de non-rejet de l’hypothèse nulle.
7.3 Le tableau inférentiel du test t
Le troisième tableau constitue le cœur décisionnel de la procédure PROC TTEST. Intitulé Test of H0: Mean = 15, il formalise les résultats du calcul de l’écart standardisé et de sa probabilité d’occurrence sous l’hypothèse nulle.
La colonne DF (Degrees of Freedom) confirme la valeur arithmétique 11, obtenue par la déduction d’une unité à l’effectif total (12 – 1). La colonne t Value indique la valeur de la statistique empirique calculée selon l’équation de Student. Dans notre cas d’étude, la différence entre la moyenne de l’échantillon et la constante de référence est égale à 14,5833 moins 15, soit un écart net de -0,4167 centimètre. En divisant cet écart par l’erreur type de 0,4167, le t Value résultant s’élève rigoureusement à -1,00.
Enfin, la colonne Pr > |t| consigne la p-value bilatérale associée à cette statistique. Dans notre sortie SAS, la valeur affichée est de 0,3389. Étant donné que cette p-value de 0,3389 excède largement le seuil de signification de 0,05 préalablement consenti, la règle de décision statistique s’énonce sans ambiguïté : nous échouons à rejeter l’hypothèse nulle H0. Les données botaniques recueillies ne fournissent aucune preuve statistiquement probante que la hauteur moyenne de nos plantes diffère de la norme historique de 15 centimètres.
8. Quantification de la pertinence clinique et calcul de la taille d’effet
Dans l’analyse quantitative moderne, la publication d’une seule valeur de p est universellement reconnue comme insuffisante par la communauté méthodologique internationale. La p-value dépendant conjointement de la force du signal et de la taille de l’échantillon, un échantillon géant peut produire des p-values infinitésimales pour des différences microscopiques dénuées de toute pertinence pratique. Il est donc indispensable d’évaluer la taille d’effet standardisée.
8.1 Nécessité méthodologique du d de Cohen
La distinction entre significativité statistique et pertinence empirique constitue l’un des piliers de l’épistémologie expérimentale. L’évaluation de l’ampleur standardisée d’une divergence statistique nécessite l’emploi d’indices invariants d’échelle. Pour le test t pour échantillon unique, la métrique standardisée universellement préconisée est le d de Cohen.
Sur le plan mathématique, le d de Cohen pour un échantillon unique s’exprime par le quotient de la différence brute entre la moyenne observée et la valeur de référence de l’hypothèse nulle par l’écart-type de l’échantillon : d = (x barre – mu zéro) / s. Contrairement au score t qui divise l’écart par l’erreur type (laquelle décroît indéfiniment lorsque la taille n augmente), le d de Cohen normalise la différence par l’écart-type intrinsèque du phénomène, mesurant ainsi le déplacement de la distribution en unités d’écart-type indépendamment de la taille n du groupe.
Jacob Cohen a établi des balises interprétatives conventionnelles largement admises en psychologie et en sciences comportementales. Un d de 0,20 est considéré comme reflétant un effet de faible magnitude ; une valeur de 0,50 désigne un effet moyen, perceptible à l’œil nu par un observateur averti ; enfin, un d égal ou supérieur à 0,80 caractérise un effet massif, où la séparation distributionnelle entre la condition observée et la norme est particulièrement prononcée. Dans notre exemple botanique, le calcul manuel livre un d égal à (14,5833 – 15) / 1,4434, soit approximativement d = -0,29, indiquant un effet régressif mineur qui ne saurait être qualifié de scientifiquement substantiel.
8.2 Extraction et programmation de la taille d’effet dans SAS
Bien que des versions récentes de SAS intègrent des options de calcul automatisé des tailles d’effet au sein de PROC TTEST, la maîtrise de l’extraction automatisée des métriques au moyen du sous-système ODS (Output Delivery System) représente une compétence cardinale pour tout biostatisticien professionnel.
Pour capturer les valeurs brutes générées par la procédure afin de calculer par programmation le d de Cohen, on recourt à l’instruction ODS OUTPUT. La syntaxe préliminaire ODS TRACE ON permet dans un premier temps d’identifier le nom interne des tables ODS produites par PROC TTEST, à savoir Statistics et ConfLimits. L’analyste insère alors l’instruction : ODS OUTPUT ConfLimits=TableauCL TTests=TableauT ; directement avant l’appel de PROC TTEST.
Une étape DATA ultérieure fusionne ensuite ces tables de synthèse pour calculer instantanément la formule du d de Cohen et dériver l’intervalle de confiance non centralisé de la taille d’effet au moyen des fonctions mathématiques internes de SAS, notamment la fonction TINV et la fonction d’évaluation de la distribution t non centrale (TPROB). L’analyste dispose ainsi d’un pipeline analytique totalement automatisé garantissant l’adjonction de la taille d’effet standardisée à toute restitution de test inférentiel.
9. Gestion des violations de postulats : Procédures robustes et non paramétriques
Lorsque les vérifications distributionnelles révèlent des violations irréductibles de l’hypothèse de normalité au sein d’un échantillon de petite taille, ou lorsque la présence de valeurs aberrantes persistantes vicie les calculs de variance, la persévérance dans la voie paramétrique standard de Student constitue une faute méthodologique. SAS met à la disposition des chercheurs un arsenal de procédures de substitution particulièrement robuste.
9.1 Test des rangs signés de Wilcoxon via PROC UNIVARIATE
L’alternative non paramétrique canonique au test t pour échantillon unique est le test des rangs signés de Wilcoxon. Ce test d’adéquation ne postule aucune loi distributionnelle particulière pour la population parente, si ce n’est une exigence de continuité et de symétrie de la distribution sous-jacente. Au lieu de tester la moyenne arithmétique, le test des rangs signés évalue l’hypothèse nulle portant sur la médiane théorique : H0 : Med = Med zéro.
La mise en œuvre de cette analyse sous SAS ne requiert pas la procédure PROC TTEST, mais s’exécute nativement au sein de PROC UNIVARIATE en valorisant l’option MU0=. Pour tester notre cohorte botanique face à une médiane théorique de 15, la syntaxe s’écrit formellement : PROC UNIVARIATE DATA=HauteursPlantes MU0=15 ; VAR Hauteur ; RUN ;. SAS calcule alors les écarts de chaque observation par rapport à 15, classe la valeur absolue de ces écarts par ordre de rang croissant, et assigne à ces rangs le signe de l’écart d’origine.
Dans la section Tests for Location de la sortie de PROC UNIVARIATE, SAS consigne la statistique de Wilcoxon notée S, accompagnée de sa p-value exacte ou asymptotique Pr >= |S|. Si cette p-value demeure supérieure à 0,05, l’analyste conclut à la non-différence de la médiane observée par rapport à la médiane théorique avec un degré de sécurité méthodologique absolu affranchi de toute contrainte de normalité gaussienne.
9.2 Approches par rééchantillonnage et bootstrap
Une alternative computationnelle moderne de premier plan réside dans les techniques de rééchantillonnage statistique non paramétrique par bootstrap, formalisées initialement par Bradley Efron. Le bootstrap s’affranchit totalement de toute hypothèse mathématique concernant la distribution mère en traitant l’échantillon empirique observé comme une pseudo-population finie à partir de laquelle sont tirés, avec remise, des milliers de réplicats de même taille n.
Dans l’écosystème SAS, l’architecture bootstrap s’implémente avec élégance en couplant la procédure de sondage PROC SURVEYSELECT avec la procédure PROC MEANS ou PROC TTEST. L’instruction PROC SURVEYSELECT DATA=HauteursPlantes OUT=ReplicatsBootstrap METHOD=URS SAMPRATE=1 REPS=10000 OUTHITS ; permet d’engendrer de manière pseudo-aléatoire 10 000 réplicats d’échantillonnage indépendants de notre série de 12 hauteurs de plantes.
Une exécution groupée via l’instruction BY _REPLICATE_ permet ensuite d’extraire la distribution empirique de 10 000 moyennes rééchantillonnées. En mobilisant la procédure PROC UNIVARIATE sur ces moyennes, le chercheur peut déduire l’intervalle de confiance bootstrap percentile ou BCa (bias-corrected and accelerated). Si cet intervalle empirique intègre la valeur 15 au sein de son spectre, l’inférence converge parfaitement avec le résultat de Student classique, attestant d’une robustesse méthodologique irréprochable.
9.3 Détection et traitement des points d’influence
La présence d’une valeur isolée manifestant une divergence excessive par rapport au corps de l’échantillon peut déstabiliser totalement le test t. Sous SAS, les techniques de modélisation statistique robuste permettent d’évaluer la moyenne tronquée (trimmed mean) ou la moyenne winsorisée (winsorized mean) via les options de PROC UNIVARIATE telles que TRIM= ou WINSOR=.
La procédure d’élagage ordonne les données et exclut un pourcentage déterminé d’observations situées aux extrêmes inférieurs et supérieurs (par exemple 10 % des deux côtés), recalculant ensuite la moyenne et son erreur type sur le sous-ensemble épuré. Parallèlement, l’estimation robuste de type M, disponible via la procédure PROC ROBUSTREG, offre la faculté de pondérer itérativement les observations en minimisant l’impact fonctionnel des résidus disproportionnés au moyen de fonctions d’influence de type Huber ou biséquée de Tukey.
La bonne pratique scientifique préconise de mener une analyse de sensibilité systématique : exécuter le test t pour échantillon unique avec la totalité des données, puis reconduire le test après neutralisation raisonnée ou modélisation robuste du point discordant. Si les conclusions inférentielles demeurent concordantes, la confiance dans la solidité du diagnostic statistique s’en trouve consolidée.
10. Tests directionnels unilatéraux : Mécanismes et implications décisionnelles
Bien que le test bilatéral représente la démarche prudente par excellence en l’absence d’a priori conceptuel, de nombreuses investigations scientifiques formulent des hypothèses directionnelles strictes. La manipulation de ces tests sous SAS exige une compréhension limpide des risques probabilistes sous-jacents.
10.1 Justification théorique du choix unilatéral
L’adoption d’un test directionnel unilatéral n’est jamais une commodité arithmétique visant à obtenir artificiellement une significativité statistique en divisant la p-value bilatérale par deux. Une telle dérive incarne une faute méthodologique majeure assimilable au chalutage de données ou p-hacking. Le choix de l’unilatéralité doit découler rigoureusement d’une nécessité théorique ou pratique impérieuse, formulée par écrit préalablement à toute inspection visuelle ou computationnelle des données.
Un test unilatéral supérieur s’impose, par exemple, lors de l’homologation d’un composé anticancéreux expérimental dont la toxicité a déjà été jugée acceptable et pour lequel seule la démonstration d’un gain d’efficacité thérapeutique par rapport à un seuil standard mu zéro présente un intérêt clinique. L’éventualité d’un effet nul ou délétère conduirait invariablement au même résultat décisionnel d’abandon de la molécule, justifiant d’allouer la totalité de la marge d’erreur alpha à la détection exclusive d’une supériorité métrique.
Sur le plan géométrique, concentrer la zone de rejet alpha de 5 % dans une seule queue de la distribution théorique de Student déplace la valeur critique vers l’origine. Pour 11 degrés de liberté, la valeur critique bilatérale s’établit à 2,2010, alors que la valeur critique unilatérale n’est plus que de 1,7959. Ce déplacement accroît notablement la puissance statistique du test pour déceler un effet allant dans la direction anticipée, tout en rendant le rejet de l’hypothèse nulle absolument impossible si l’effet réel s’exprime dans la direction opposée, quelle que soit son ampleur.
10.2 Configuration technique sous SAS
Dans l’architecture de PROC TTEST, l’exécution d’un test directionnel s’articule par l’assignation de la lettre appropriée au paramètre SIDES=. Supposons que notre protocole agronomique ait posé pour hypothèse a priori exclusive que le traitement expérimental devait accroître la hauteur de la plante au-delà du seuil de 15 centimètres. L’appel s’énoncerait sous la forme syntaxique : PROC TTEST DATA=HauteursPlantes H0=15 SIDES=U ALPHA=0.05 ; VAR Hauteur ; RUN ;.
L’affichage des résultats SAS se transforme alors instantanément pour s’aligner sur cette configuration directionnelle. Le titre du tableau inférentiel stipule expressément Test of H0: Mean <= 15 vs Ha: Mean > 15. La valeur de la statistique t empirique reste rigoureusement inchangée à -1,00, car elle ne dépend que des grandeurs observées de l’échantillon. En revanche, la probabilité associée n’est plus rapportée sous l’étiquette Pr > |t|, mais sous l’intitulé spécifique Pr > t.
Puisque la moyenne empirique observée (14,5833) est inférieure à la valeur postulée de 15, le score t est négatif, et la probabilité d’observer un score t supérieur à -1,00 sous la distribution nulle s’élève à 0,8306. La sortie SAS démontre sans équivoque que la moyenne expérimentale est située du côté opposé à la région critique supérieure, confirmant avec éclat le non-rejet de l’hypothèse nulle. Si le chercheur avait préalablement stipulé une hypothèse unilatérale inférieure (SIDES=L), la p-value éditée aurait été de Pr < t = 0,1694 (soit la stricte moitié de la p-value bilatérale de 0,3389), un résultat qui demeure là encore largement non significatif face au seuil d’alpha fixé à 0,05.
11. Rapportage académique et communication des résultats selon les normes APA
L’aboutissement naturel d’une modélisation statistique dans SAS réside dans sa communication scientifique normalisée à destination de la communauté académique, des revues à comité de lecture ou des agences de régulation. La formalisation des résultats doit se conformer de manière inflexible aux canons éditoriaux de l’American Psychological Association (normes APA 7e édition).
11.1 Rédaction textuelle standardisée
La restitution textuelle des résultats d’un test t pour échantillon unique selon le style APA exige une concision absolue alliée à la complétude des paramètres nécessaires à l’interprétation critique du lecteur. Le patron narratif universellement admis prescrit d’exposer la finalité du test, les statistiques descriptives associées (moyenne et écart-type entre parenthèses), la valeur exacte de la statistique t, les degrés de liberté entre parenthèses immédiatement accolés à la lettre t en italique, la p-value exacte ainsi que l’indice de taille d’effet et son intervalle de confiance.
Pour notre expérimentation botanique, la rédaction standardisée selon les normes APA 7e édition prend la forme canonique suivante : « Un test t de Student pour échantillon unique a été réalisé afin de déterminer si la hauteur moyenne des spécimens botaniques après quatre semaines de culture sous protocole expérimental différait significativement de la norme de référence historique de 15 cm. Les analyses révèlent que la hauteur moyenne observée au sein de notre échantillon (M = 14,58 cm, SD = 1,44 cm) n’est pas statistiquement différente de la valeur théorique postulée, t(11) = -1,00, p = ,339, d de Cohen = -0,29, IC à 95 % [-0,88 ; 0,31]. Ces résultats confirment l’absence d’impact significatif du protocole de fertilisation sur la cinétique d’élongation végétative des plantes. »
Dans l’hypothèse inverse où le résultat se serait révélé hautement significatif, par exemple avec une moyenne empirique de 18,20 centimètres (t(11) = 4,25, p < ,001, d = 1,23), la formulation narrera avec rigueur le dépassement caractérisé de la norme avec une mention de p-value inférieure à un millième, proscrivant formellement l’usage de formulations scientifiquement erronées du type p = 0,000.
11.2 Visualisation graphique académique
Une communication scientifique d’élite ne saurait se contenter de tableaux numériques bruts ; elle se doit de mobiliser la puissance de la visualisation de données. Bien que l’activation d’ODS GRAPHICS génère automatiquement des figures standardisées dans SAS, la maîtrise de la procédure dédiée PROC SGPLOT offre une liberté totale de personnalisation graphique répondant aux critères esthétiques des revues de rang A.
Un graphique académique d’excellence pour un test t pour échantillon unique prend typiquement la forme d’un diagramme de distribution combinant la représentation des points individuels (scatter plot avec dispersion jitter pour éviter le chevauchement), un marqueur d’estimation ponctuelle de la moyenne flanqué de ses barres d’erreur représentant l’intervalle de confiance à 95 %, et une ligne de référence horizontale en tireté marquant ostensiblement le niveau critique de l’hypothèse nulle (H0 = 15). La commande REFLINE 15 / AXIS=Y LINEATTRS=(PATTERN=SHORTDASH COLOR=RED THICKNESS=2) ; de PROC SGPLOT remplit idéalement cet office.
Le chercheur prendra un soin particulier à épurer la charte visuelle : fond blanc exempt de quadrillage parasite, typographie sans empattement conforme aux exigences typographiques contemporaines, désignation explicite des axes assortie de leurs unités métriques précises (par exemple, Hauteur des tiges (en centimètres)), et légende limpide permettant une lecture autonome de la figure indépendamment du texte principal du manuscrit.
12. Bonnes pratiques, erreurs fréquentes et automatisation dans SAS
L’optimisation du rendement analytique et la garantie de la reproductibilité constituent les ultimes prérequis de la pratique biostatistique moderne sous SAS. Cette section analyse les écueils opérationnels les plus pernicieux, propose une stratégie d’industrialisation macro-paramétrée et rappelle les règles de conformité relatives à l’audit statistique.
12.1 Erreurs courantes de syntaxe et d’interprétation
La littérature scientifique internationale recense une multitude de fautes méthodologiques et d’erreurs de syntaxe récurrentes lors de la mise en œuvre de la procédure PROC TTEST. L’erreur la plus banale, mais aux conséquences analytiques désastreuses, consiste en l’omission pure et simple de l’option H0=. L’analyste novice présume fréquemment à tort que SAS devine par téléologie la valeur théorique issue de son protocole ; or, l’exécution silencieuse de la procédure par défaut face à zéro transforme une vérification de conformité en un test sans objet, induisant des conclusions erronées transmises aux décideurs ou comités éditoriaux.
Une confusion conceptuelle majeure réside également dans l’incompréhension de la distinction fondamentale entre l’écart-type de l’échantillon (Std Dev) et l’erreur type de la moyenne (Std Error). L’écart-type quantifie la variabilité biologique ou physique intrinsèque interindividuelle des données d’observation, restant stable à mesure que n s’accroît. En revanche, l’erreur type quantifie la précision théorique de l’estimation de la moyenne, tendant vers zéro au fur et à mesure que la taille de l’échantillon tend vers l’infini. Rapporter une erreur type en lieu et place d’un écart-type dans une table descriptive produit l’illusion trompeuse d’une variabilité expérimentale considérablement plus faible qu’elle ne l’est dans la réalité biologique.
Enfin, l’écueil de la surinterprétation d’une p-value marginale (par exemple, p = 0,06) comme une « tendance statistique » ou une « quasi-significativité » doit être banni. Dans le cadre de l’école décisionnelle de Neyman-Pearson, le choix du seuil alpha de 0,05 constitue une frontière dichotomique stricte : en l’absence de rejet formel, le résultat demeure non significatif, et toute spéculation rhétorique sur une signification avortée relève du biais cognitif.
12.2 Automatisation et industrialisation avec les macros SAS
Dans les contextes de production analytique de haute intensité, tels que le criblage métabolomique à haut débit ou le contrôle qualité industriel de milliers de lots de fabrication manufacturés, l’écriture manuelle répétitive de dizaines de blocs PROC TTEST n’est plus envisageable. Le langage macro de SAS (SAS Macro Language) offre un levier puissant pour concevoir des routines itératives hautement paramétrées et robustes.
Une macro-commande univariée professionnelle peut être déclarée au moyen de l’instruction %MACRO TestUnique(Dataset=, Var=, Mu0=, Alpha=0.05) ;. Au sein du corps macro-analytique, les variables sont dynamiquement injectées dans les instructions de PROC TTEST et de PROC UNIVARIATE. En intégrant le sous-système ODS OUTPUT combiné à des structures de boucles macro, la routine peut balayer automatiquement l’intégralité d’un dictionnaire de variables continues, exécuter les vérifications de normalité de Shapiro-Wilk et consigner automatiquement dans une table récapitulative finale la moyenne, le t, la p-value, la décision d’adéquation et le d de Cohen calculé.
Une telle chaîne de traitement garantit non seulement un gain de productivité considérable pour les équipes biostatistiques, mais éradique tout risque de dérive typographique humaine lors de la ressaisie manuelle des valeurs numériques issues des journaux d’exécution.
12.3 Assurance qualité et reproductibilité de l’analyse
L’intégrité de la recherche quantitative contemporaine repose sur le postulat absolu de la traçabilité et de la reproductibilité intégrale de chaque résultat publié. Dans l’écosystème SAS Studio ou SAS Enterprise Guide, chaque projet analytique doit faire l’objet d’un versionnage rigoureux sous gestionnaire de code source (tel que Git).
Toute exécution finale de modèles destinés à la publication ou au dépôt réglementaire auprès des autorités de santé doit s’accompagner de l’archivage systématique du code source brut assorti de la totalité de son journal d’exécution (log file) horodaté. Ce journal constitue la preuve médico-légale attestant qu’aucune variable n’a été modifiée subrepticement en cours de session et qu’aucun message d’incompatibilité de type n’a été passé sous silence lors du traitement.
Enfin, les calculs critiques doivent pouvoir être soumis à une vérification croisée (double-programming) par un biostatisticien indépendant mettant en œuvre un script SAS rédigé de façon autonome. Seule la concordance parfaite des intervalles de confiance et des statistiques de Student calculées par deux développeurs indépendants certifie le niveau d’assurance qualité requis par les plus hautes instances scientifiques internationales.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. Chapman and Hall/CRC. https://doi.org/10.1201/9780429246593
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The TTEST Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The UNIVARIATE Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3-4), 591-611. https://doi.org/10.2307/2333709
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968