
La modélisation par régression linéaire multiple constitue l’un des piliers méthodologiques les plus robustes et les plus largement exploités au sein des sciences quantitatives contemporaines, tout particulièrement en psychologie, en épidémiologie comportementale et en sociologie quantitative. Face à la complexité intrinsèque des conduites humaines et des processus neurocognitifs, la capacité d’isoler mathématiquement l’effet spécifique d’un facteur prédictif tout en maintenant constants les effets d’autres covariables représente une avancée épistémologique fondamentale. L’époque où l’inférence reposait exclusivement sur des analyses bivariées élémentaires a cédé la place à une exigence accrue de contrôle des facteurs de confusion et de quantification précise de la variance expliquée par des faisceaux de déterminants interconnectés.
Le progiciel d’analyse statistique SAS (Statistical Analysis System) demeure, depuis plusieurs décennies, une référence incontournable au sein des institutions de recherche académique, des agences de régulation biomédicale et des laboratoires d’évaluation psychométrique. Grâce à son architecture logicielle hautement optimisée, à sa rigueur algorithmique certifiée et à la puissance de ses procédures dédiées à la théorie du modèle linéaire général, SAS offre un environnement d’une précision analytique et d’une reproductibilité exemplaires. La maîtrise de ses procédures fondamentales, au premier rang desquelles figure la célèbre procédure PROC REG, est un prérequis indispensable pour tout chercheur aspirant à conduire des analyses multivariées conformes aux standards de publication internationaux les plus rigoureux.
Le présent traité méthodologique a été conçu comme un guide exhaustif d’analyse et de mise en œuvre pratique, articulant une justification théorique approfondie des postulats mathématiques sous-jacents et une démonstration pas à pas de la programmation sous SAS. À travers l’exploration détaillée des structures de syntaxe, des stratégies d’inspection des données, des diagnostics résiduels multivariés, de la gestion de la multicolinéarité et de la prise en compte des interactions, ce document propose une démarche intégrée permettant de transformer des données comportementales brutes en inférences scientifiques solides, documentées et directement transposables dans les publications respectant les normes de l’American Psychological Association.
1. Fondements théoriques de la régression linéaire multiple en sciences comportementales
1.1 Modélisation mathématique et formulation du modèle général
La régression linéaire multiple formalise la relation postulée entre une variable réponse continue, traditionnellement désignée par la variable dépendante ou critère noté Y, et un ensemble fini de variables explicatives ou prédicteurs, notés X1, X2, …, Xp. Sur le plan populationnel, cette modélisation s’exprime sous la forme d’une équation linéaire où chaque observation individuelle i (pour i variant de 1 à n) est décrite par l’expression mathématique : Yi = β0 + β1X1i + β2X2i + … + βpXpi + εi. Dans ce formalisme matriciel, le paramètre structural β0 représente l’ordonnée à l’origine, correspondant à la valeur conditionnelle attendue de la variable critère lorsque la totalité des covariables prédictives est rigoureusement égale à zéro, ce qui confère à cette constante un rôle d’ancrage fondamental au sein de l’espace vectoriel d’observation.
Les paramètres désignés par βj (pour j variant de 1 à p) constituent les coefficients de régression partielle. D’un point de vue conceptuel et statistique, chaque coefficient partiel βj quantifie l’amplitude et le sens du changement moyen attendu sur la variable dépendante Y pour une augmentation d’une unité sur le prédicteur spécifique Xj, sous la condition stricte que l’ensemble des autres variables explicatives incluses dans le modèle demeure rigoureusement constant, selon le principe classique du ceteris paribus. Cette propriété mathématique d’ajustement mutuel permet de décomposer la variance partagée et d’attribuer à chaque prédicteur une contribution unique, distincte de ses corrélations brutes potentielles avec les autres facteurs intégrés dans le système explicatif.
La formulation linéaire repose sur une hypothèse ontologique d’additivité et de proportionnalité des effets, signifiant que la trajectoire fonctionnelle reliant les covariables au critère ne subit pas d’inflexion non modélisée et que l’accumulation des influences individuelles produit un impact strictement cumulatif sur l’espérance mathématique de la variable dépendante. Enfin, le terme d’erreur stochastique, symbolisé par εi, rend compte de la part de variabilité individuelle non captée par la combinaison linéaire déterministe. Ce résidu non mesurable synthétise à la fois les fluctuations aléatoires inhérentes à l’échantillonnage, les erreurs de mesure non systématiques propres aux outils psychométriques et l’ensemble des déterminants causaux latents non observés dans le protocole expérimental.
1.2 Postulats classiques du modèle linéaire ordinaire
L’estimation des paramètres structuraux par la méthode des moindres carrés ordinaires (MCO), dont la puissance analytique est universellement reconnue, n’est optimale et valide au sens du théorème de Gauss-Markov que si un ensemble de postulats probabilistes fondamentaux est scrupuleusement respecté. En premier lieu, la distribution des termes d’erreur résiduelle conditionnelle doit satisfaire à l’hypothèse de normalité multidimensionnelle. Cela implique formellement que pour chaque vecteur de valeurs assigné aux prédicteurs, l’erreur stochastique se distribue selon une loi normale d’espérance nulle, condition sine qua non autorisant l’usage direct des distributions théoriques de Student et de Fisher-Snedecor pour les tests de significativité inférentielle.
En second lieu, l’hypothèse d’homoscédasticité, ou invariance de la variance conditionnelle des erreurs, requiert que la dispersion de la variable résiduelle demeure rigoureusement constante le long de l’ensemble du continuum des valeurs prédites. Une dispersion hétéroscédastique, caractérisée par une déformation en entonnoir de la variance d’erreur à mesure que les scores augmentent, compromet l’efficience des estimateurs MCO en induisant un biais dans le calcul de leurs erreurs-types respectives, ce qui fausse inexorablement les calculs de probabilités critiques et les seuils d’acceptation de l’hypothèse nulle.
En troisième lieu, les observations empiriques doivent impérativement satisfaire au postulat d’indépendance conditionnelle mutuelle, interdisant toute autocorrélation résiduelle entre les individus statistiques observés. Cette exigence est particulièrement mise à l’épreuve dans les protocoles de mesures répétées ou les échantillonnages en grappes où la proximité temporelle, géographique ou sociale engendre des corrélations intrasujets non modélisées. Enfin, le postulat d’exogénéité stricte postule que l’espérance conditionnelle des erreurs sachant les covariables est nulle, garantissant qu’aucune corrélation sous-jacente ne relie les prédicteurs au terme d’erreur stochastique, condition indispensable pour prémunir les estimations contre les biais d’endogénéité ou de confusion résiduelle.
1.3 Pertinence de la régression multiple dans la recherche psychologique
L’investigation scientifique des conduites humaines, des fonctions exécutives et des psychopathologies se heurte invariablement au caractère non expérimental ou quasi expérimental de nombreuses configurations empiriques. Dans ce contexte épistémologique précis, la régression linéaire multiple s’impose comme un instrument méthodologique prépondérant pour opérer un contrôle statistique sur des variables de confusion majeures telles que l’âge chronologique, le statut socio-économique, le niveau d’éducation ou l’exposition traumatique antérieure. En intégrant simultanément ces facteurs d’arrière-plan aux côtés des prédicteurs cibles, le chercheur neutralise mathématiquement les distorsions d’attribution et affine l’estimation des liens fonctionnels réels.
De surcroît, les modèles psychologiques modernes cherchent rarement à isoler un déterminant unique, mais s’attachent à hiérarchiser les contributions relatives de multiples composantes cognitives, affectives et contextuelles sur des indicateurs comportementaux ou académiques. La régression multiple offre le cadre quantitatif adéquat pour comparer, au moyen de coefficients paramétriques standardisés et de décompositions de variance partielles, l’impact différentiel d’aptitudes intellectuelles générales comparativement à des dimensions motivationnelles ou émotionnelles face à la performance scolaire ou au rendement professionnel.
Enfin, cette démarche statistique constitue la passerelle analytique indispensable permettant de dépasser la simple observation de covariations bivariées pour progresser vers une modélisation structurelle à visée explicative. Sans pour autant prétendre conférer automatiquement un statut de causalité absolue à des associations issues d’études transversales, la modélisation multivariée autorise l’élimination systématique de médiations fallacieuses et permet d’éprouver la plausibilité de théories psychologiques complexes en testant des agencements de prédicteurs articulés selon des schémas d’inférence probabiliste rigoureux.
2. Préparation de l’environnement SAS et structuration de la table de données
2.1 Création du jeu de données via l’étape DATA
Le point de départ de toute investigation quantitative au sein de l’architecture logicielle SAS repose sur la mise en œuvre rigoureuse de l’étape DATA, séquence de code impérative responsable de l’allocation mémoire, de la définition des attributs scalaires et de la vectorisation des observations. Pour concevoir une table analytique native, le praticien initie son script par l’instruction DATA suivie du nom assigné à la table, qu’elle soit destinée à résider dans l’espace temporaire ou dans un espace de stockage permanent. Cette instruction amorce le compilateur qui procède à la création du vecteur d’observation en mémoire vive, structure dénommée Program Data Vector (PDV).
La déclaration explicite des variables quantitatives s’effectue par l’intermédiaire de l’instruction INPUT, qui précise la liste séquentielle des identifiants et des métriques numériques assignées à chaque observation unitaire. Dans les contextes expérimentaux requérant l’incorporation directe de séries de données brutes au sein du fichier de programme, l’instruction DATALINES (ou son équivalent historique CARDS) signale au processeur SAS le passage immédiat de la compilation syntaxique à la lecture séquentielle des lignes d’enregistrements empiriques, chaque observation étant délimitée par des espaces standardisés ou des séparateurs conventionnels.
Il demeure capital d’assurer une gestion scrupuleuse des formats d’encodage et des types de données alloués par défaut. SAS considère par principe que toute variable non spécifiée avec le suffixe dollar ($) correspond à un nombre en virgule flottante double précision, garantissant une résolution arithmétique optimale pour l’exécution ultérieure des calculs matriciels de moindres carrés. De surcroît, le choix d’enregistrer la table résultante dans la bibliothèque temporaire WORK ou au sein d’une bibliothèque dédiée préalablement allouée via une instruction LIBNAME détermine la pérennité des données tout au long du cycle de vie du projet d’analyse statistique.
2.2 Importation de fichiers externes de recherche
Dans la pratique courante de la recherche contemporaine, les données psychométriques et comportementales sont massivement collectées via des plateformes d’évaluation numériques ou des tableurs, générant des fichiers aux extensions délimitées telles que CSV, TSV ou XLSX. La procédure SAS PROC IMPORT offre le moteur d’ingestion le plus flexible pour transformer ces sources d’information hétérogènes en tables relationnelles structurées conformes aux standards internes du logiciel. Sa syntaxe requiert l’indication du chemin d’accès absolu au fichier source via l’argument DATAFILE= et la spécification de la table SAS de destination via l’instruction OUT=.
Le paramétrage méthodique de l’option DBMS= permet à l’interpréteur d’adapter dynamiquement ses algorithmes de parsing selon la nature intrinsèque du support. Pour les fichiers de valeurs séparées par des virgules ou des points-virgules, l’adjonction de l’instruction DELIMITER= conjuguée à l’option GETNAMES=YES ordonne au compilateur d’extraire les libellés de la première ligne d’en-tête pour nommer les colonnes de données. Lors de l’ingestion de fichiers dont les désignations de colonnes comportent des caractères non conformes, l’activation de l’option système VALIDVARNAME=V7 ou ANY assure la préservation ou la conversion contrôlée de ces métadonnées structurelles.
Une fois l’opération d’ingestion exécutée, l’évaluation immédiate de la structure du jeu de données constitue une étape non négociable de l’assurance qualité scientifique. L’appel de la procédure PROC CONTENTS génère un répertoire analytique détaillé documentant les noms de variables, leurs longueurs d’enregistrement en octets, leurs étiquettes descriptives et les formats associés. Ce contrôle systématique permet de s’assurer qu’aucun artefact de troncature numérique n’a été introduit et que les variables catégorielles n’ont pas été confondues avec des échelles métriques lors de l’attribution automatique des types par le moteur d’importation.
2.3 Nettoyage préliminaire et traitement des valeurs manquantes
L’omniprésence de valeurs manquantes représente une vulnérabilité critique affectant l’intégrité inférentielle des études psychologiques et comportementales. Dans le système SAS, une observation numérique non documentée est conventionnellement représentée par un point (. ), équivalent fonctionnel d’une valeur nulle non définie. La détection exhaustive de ces valeurs s’avère indispensable pour apprécier si l’incomplétude relève d’un mécanisme purement aléatoire, qualifié de Missing Completely at Random (MCAR), ou si elle découle d’un mécanisme systématique (MAR ou MNAR) susceptible de biaiser l’échantillonnage représentatif.
Il importe de souligner avec la plus grande rigueur technique que la procédure d’estimation PROC REG applique par défaut la méthode d’omission par observation complète, fréquemment dénommée suppression par liste (listwise deletion). En vertu de ce mécanisme automatisé, la présence d’une seule valeur manquante sur une variable prédictive ou sur le critère entraîne le rejet intégral et immédiat de l’observation concernée hors du calcul des matrices de variance-covariance. Si le taux de non-réponse est dispersé sur de multiples variables, ce processus peut aboutir à une réduction drastique de la taille effective de l’échantillon, amoindrissant sévèrement la puissance statistique globale du protocole.
Pour parer à toute distorsion inattendue, le chercheur doit mettre en œuvre des filtres de sélection formels au sein d’étapes DATA de nettoyage ou au moyen d’instructions conditionnelles WHERE directement incorporées dans les procédures subséquentes. La documentation rigoureuse des cas exclus à cette étape garantit la transparence méthodologique et permet de quantifier précisément l’attrition de l’échantillon avant d’engager les étapes d’estimation des coefficients de régression.
3. Exploration statistique préliminaire et vérification des hypothèses sous SAS
3.1 Analyse descriptive et distributions univariées
L’estimation rigoureuse d’un modèle linéaire requiert impérativement une immersion exploratoire au cœur des propriétés distributionnelles de l’ensemble des variables sélectionnées. L’utilisation conjointe des procédures SAS PROC MEANS et PROC UNIVARIATE permet d’obtenir un profil univarié exhaustif. Alors que PROC MEANS fournit rapidement les statistiques centrales de dispersion incluant la moyenne arithmétique, la variance, l’écart-type et les extrêmes pour l’ensemble des covariables, PROC UNIVARIATE déploie une panoplie diagnostique bien plus approfondie, indispensable pour évaluer la forme des distributions sous-jacentes.
L’examen des moments d’ordre supérieur s’avère fondamental pour déceler les violations précoces des postulats du modèle linéaire. L’évaluation de l’asymétrie empirique (skewness) et de l’aplatissement (kurtosis) permet de vérifier si les distributions s’écartent substantiellement de la cloche gaussienne théorique. Des coefficients d’asymétrie excédant en valeur absolue le seuil critique de 2 ou des valeurs d’aplatissement dépassant 7 constituent des alertes méthodologiques sévères quant au risque de non-normalité des données métriques brutes, invitant le statisticien à envisager d’éventuelles transformations mathématiques préalables.
De surcroît, l’adjonction des instructions graphiques HISTOGRAM et QQPLOT au sein de l’environnement PROC UNIVARIATE permet d’adjoindre à l’évaluation numérique une inspection visuelle directe de la normalité. La superposition d’une densité normale théorique sur l’histogramme empirique et l’analyse de l’alignement des quantiles observés sur la droite de référence quantile-quantile fournissent une appréciation intuitive et fiable des écarts de distribution, particulièrement au niveau des queues de distribution où se concentrent fréquemment les artefacts métrologiques.
3.2 Matrice de corrélation bivariée avec PROC CORR
L’évaluation des relations de dépendance bivariée entre la variable critère et ses prédicteurs potentiels s’effectue au moyen de la procédure PROC CORR. Cette étape préliminaire permet de quantifier les coefficients de corrélation linéaire de Bravais-Pearson, offrant une première estimation de la force et de la direction des associations linéaires directes. Pour un chercheur en psychométrie, la mise en évidence d’une association bivariée statistiquement significative entre chaque covariable candidate et la variable dépendante constitue un prérequis logique avant l’inclusion de ces facteurs dans une équation explicative multidimensionnelle.
Cependant, la finalité majeure de la matrice de corrélation réside également dans le repérage précoce d’associations redondantes ou excessivement fortes entre les variables explicatives elles-mêmes. L’existence de corrélations inter-prédicteurs atteignant ou dépassant des magnitudes de 0,80 ou 0,85 constitue une alerte manifeste quant au risque imminent d’instabilité mathématique causée par la multicolinéarité. Cette situation pathologique affaiblit la capacité de l’algorithme des moindres carrés à séparer les effets singuliers de chaque facteur sur le critère étudié.
Pour parfaire cette cartographie préliminaire, la procédure dispose de l’option globale PLOTS=SCATTER ou PLOTS=MATRIX au sein de la syntaxe SAS ODS. Cette fonctionnalité automatise la génération d’une matrice complète de nuages de points croisés intégrant des ellipses de confiance bivariées. Ces visualisations permettent d’appréhender d’un coup d’œil l’architecture globale des covariations, de repérer d’éventuelles sous-populations hétérogènes et de détecter des données atypiques bivariées qui pourraient demeurer indétectables lors d’une simple analyse univariée.
3.3 Vérification de la linéarité des relations
Le postulat cardinal stipulant que la relation entre la variable dépendante et chaque facteur explicatif est de nature strictement linéaire exige une validation graphique et empirique scrupuleuse. La violation de ce postulat fondamental engendre une sous-estimation systématique de la véritable magnitude de l’effet univarié et introduit un biais structurel dans l’estimation de l’ensemble des coefficients partiels du modèle. L’inspection méticuleuse des formes fonctionnelles bivariées s’impose donc comme un impératif méthodologique préalable à tout ajustement linéaire conventionnel.
La procédure graphique avancée PROC SGPLOT offre un cadre particulièrement puissant pour ausculter ces relations. En combinant au sein d’une même instruction l’affichage des nuages de points par l’instruction SCATTER et l’ajustement non paramétrique par l’instruction LOESS, le chercheur superpose aux données réelles une courbe de lissage local robuste exempte de toute contrainte paramétrique a priori. La divergence sensible entre la trajectoire du lissage loess et une simple droite de régression linéaire met en exergue des phénomènes curvilignes, quadratiques ou asymptotiques sous-jacents.
Lorsqu’une non-linéarité substantielle est attestée par ces diagnostics visuels, l’analyste se trouve confronté à la nécessité d’adapter son modèle théorique avant d’exécuter la régression multiple standard. Cette remédiation peut consister en l’application d’une transformation non linéaire appropriée sur le prédicteur incriminé (telle que l’extraction de la racine carrée, l’inversion ou la transformation logarithmique), ou en l’incorporation explicite de termes polynomiaux d’ordre supérieur au sein de l’équation de régression générale.
4. Syntaxe fondamentale et exécution de la procédure PROC REG
4.1 Structure canonique de l’instruction MODEL
La procédure PROC REG constitue le cœur algorithmique historique de SAS pour l’ajustement des modèles linéaires de régression par les moindres carrés ordinaires. Sa structure syntaxique minimale repose sur une architecture extrêmement limpide mais rigoureusement contrainte. Le bloc analytique s’initialise par l’appel de l’instruction PROC REG DATA=nom_de_table; et se clôt impérativement par les commandes de pilotage séquentiel RUN; et QUIT;, cette dernière étant indispensable pour interrompre le mode d’exécution interactif propre à cette procédure fondamentale.
L’élément moteur de cette procédure réside dans l’instruction MODEL, dont la syntaxe cardinale respecte le schéma universel : MODEL variable_dependante = predicteur_1 predicteur_2 … predicteur_p / options;. La variable réponse continue est obligatoirement déclarée à la gauche immédiate de l’opérateur d’égalité, tandis que l’ensemble des variables prédictives quantitatives est énuméré de manière séquentielle à sa droite, séparé par de simples espaces typographiques. Cette formalisation indique au compilateur la composition exacte de la matrice de plan d’expérience X et du vecteur de réponse Y intervenant dans la résolution matricielle classique des équations normales.
Les paramètres placés après la barre oblique de démarcation contrôlent l’activation des algorithmes d’estimation avancés, la sélection des sorties analytiques affichées dans les rapports et la génération des matrices d’ajustement. L’utilisation correcte de cette syntaxe élémentaire déclenche le calcul de la table d’analyse de variance, la détermination du coefficient de détermination global et l’affichage des coefficients de régression non standardisés assortis de leurs tests d’inférence de Student.
4.2 Options avancées de l’instruction MODEL pour l’estimation
Au-delà des sorties fondamentales minimales, l’instruction MODEL intègre des options algorithmiques indispensables pour répondre aux exigences des revues académiques de premier plan. L’adjonction de l’option STB (Standardized parameter estimates) ordonne à la procédure d’exécuter l’estimation sur la base de données implicitement centrées et réduites. Cette option génère, aux côtés des coefficients métriques bruts, les coefficients standardisés désignés par la lettre grecque bêta, permettant d’évaluer la puissance relative d’impact de prédicteurs mesurés dans des unités scalaires incommensurables.
L’incorporation de l’option CLB (Confidence Limits for Parameters) force le calcul et la restitution des intervalles de confiance bilatéraux à 95% pour chaque paramètre partiel du modèle linéaire. Conformément aux recommandations institutionnelles en vigueur en psychologie expérimentale, l’interprétation exclusive de la valeur p doit être complétée par l’analyse de l’étendue et de la précision des intervalles de confiance, seuls indicateurs à même de renseigner sur la marge d’incertitude entourant l’estimation ponctuelle dans la population parente.
Enfin, l’évaluation approfondie de la contribution incrémentale de chaque variable explicative peut être enrichie par l’adjonction des options SS1 et SS2. Ces instructions génèrent respectivement les sommes des carrés de Type I (dites séquentielles ou hiérarchiques, dépendantes de l’ordre d’entrée des prédicteurs dans la ligne de commande) et les sommes des carrés de Type II (partielles, calculées pour chaque variable après ajustement sur toutes les autres mais en l’absence de termes d’ordre supérieur). Ces décompositions constituent une ressource analytique d’une grande finesse pour éprouver des hypothèses théoriques ordonnées ou emboîtées.
4.3 Personnalisation des graphiques ODS Graphics associés
L’intégration du système ODS (Output Delivery System) Graphics dans l’environnement SAS confère à PROC REG une capacité d’exploration visuelle hautement automatisée et conforme aux standards de l’art graphique scientifique. Pour libérer la puissance de ce sous-système, le script doit impérativement comporter l’instruction d’activation globale ODS GRAPHICS ON; avant le bloc de régression, complétée par ODS GRAPHICS OFF; une fois l’analyse achevée. Cette instruction informe le moteur graphique de construire en mémoire l’ensemble des matrices de tracés diagnostiques.
La commande graphique standard génère par défaut un ensemble complet de tracés diagnostiques résumant la qualité d’ajustement global, l’homoscédasticité, la normalité des erreurs et les points d’influence. Toutefois, pour éviter la surcharge de l’espace de sortie ou pour cibler précisément un ensemble particulier de graphiques dans le cadre d’une publication, le chercheur peut spécifier l’option PLOTS(ONLY)= directement au niveau de l’instruction PROC REG. Cette option permet de sélectionner exclusivement le graphique d’adéquation globale (FitPlot), le tracé des résidus studentisés contre les valeurs prédites ou encore le graphique quantile-quantile des résidus.
Pour répondre aux critères éditoriaux stricts des revues scientifiques, il est également possible de paramétrer finement la résolution, le format vectoriel et les dimensions des figures générées au moyen de l’instruction ODS GRAPHICS / RESET IMAGENAME=’Reg_Diagnostics’ IMAGEFMT=TIFF Dピ=300;. Ce contrôle programmable garantit que les représentations graphiques issues de l’environnement SAS possèdent la densité typographique et la clarté sémiologique requises pour l’évaluation par les pairs sans nécessiter de retouches manuelles externes.
5. Interprétation quantitative et substantielle des sorties de PROC REG
5.1 Évaluation globale du modèle d’analyse de variance
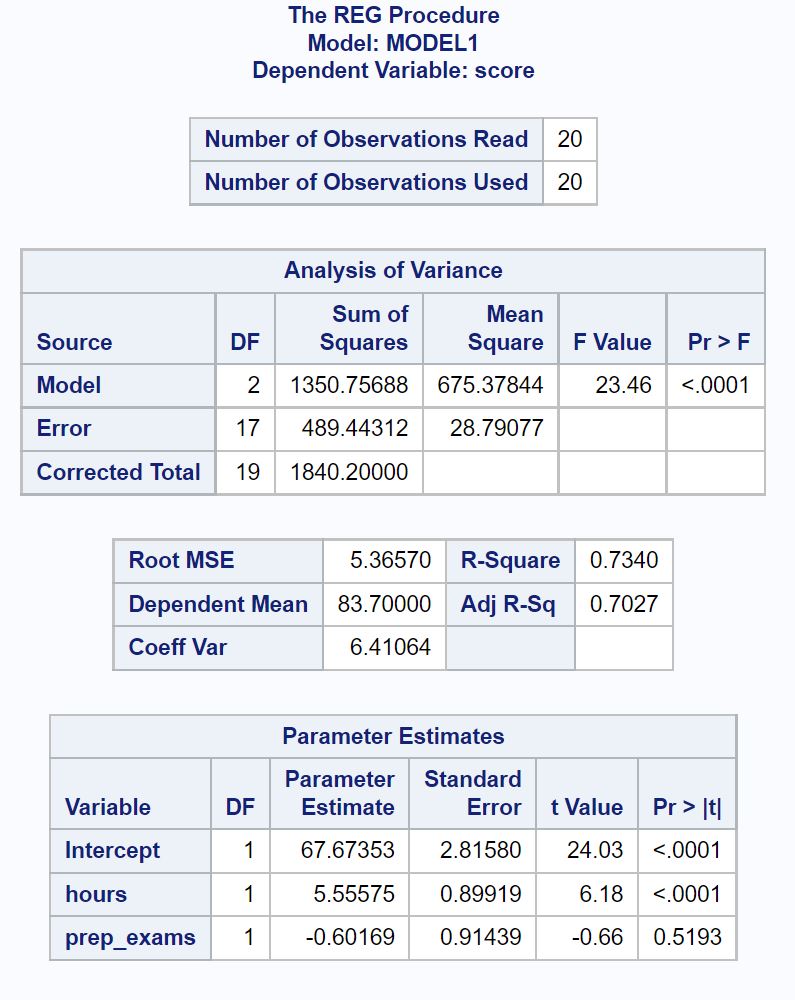
L’examen des sorties générées par PROC REG débute immanquablement par la table d’Analyse de Variance (ANOVA), qui documente l’évaluation omnibus de la plausibilité du modèle statistique proposé. Cette table formalise la partition rigoureuse de la dispersion totale de la variable critère en deux composantes fondamentales indépendantes : la Somme des Carrés du Modèle (Model Sum of Squares, notée SSM), quantifiant la variabilité captée par l’agencement linéaire des prédicteurs, et la Somme des Carrés des Erreurs (Error Sum of Squares, notée SSE), mesurant la dispersion non expliquée résidant dans les résidus d’observation.
Le rapport entre chaque somme des carrés et son nombre respectif de degrés de liberté (Degrees of Freedom, notés DF) conduit au calcul des Carrés Moyens (Mean Squares, MSM et MSE). Le carré moyen de l’erreur MSE correspond mathématiquement à l’estimateur sans biais de la variance conditionnelle des termes d’erreur populationnels (σ2). L’évaluation de l’efficacité prédictive globale du système s’incarne dans la statistique omnibus F de Fisher-Snedecor, définie par le ratio arithmétique : F = MSM / MSE. Ce test d’hypothèse composite éprouve formellement l’hypothèse nulle universelle H0 : β1 = β2 = … = βp = 0.
La lecture conjointe de la valeur empirique de la statistique F et de la probabilité critique associée, affichée sous la mention Pr > F, dicte la décision inférentielle globale. Lorsque cette p-valeur s’avère inférieure au seuil conventionnel alpha de 0,05 (ou 0,01 dans les protocoles conservateurs), le chercheur rejette catégoriquement l’hypothèse nulle d’indépendance globale. Ce rejet confirme avec une assise probabiliste contrôlée qu’au moins l’un des prédicteurs contribue de manière non aléatoire à la prédiction ou à l’explication substantielle des variations observées sur la variable dépendante.
5.2 Indices de qualité d’ajustement globale
Une fois la significativité omnibus formellement attestée, l’évaluation quantitative de la performance du modèle s’appuie sur des métriques de taille d’effet standardisées et absolues. Au premier rang de ces indicateurs trône le coefficient de détermination multiple, désigné par la mention R-Square (R2). Calculé par le ratio SSM / SST (où SST = SSM + SSE), le R2 quantifie la proportion exacte de variance de la variable critère directement imputable à l’action combinée des prédicteurs inclus dans l’équation. Exprimé sous forme de pourcentage, il fournit une mesure intuitive de la magnitude explicative du modèle global.
Cependant, le R2 présente une limite mathématique majeure : il constitue une fonction strictement monotone non décroissante du nombre de prédicteurs. L’ajout d’une nouvelle variable, même dénuée de toute pertinence conceptuelle, majore mécaniquement (ou maintient constant) le R2 ordinaire en raison de l’absorption stochastique de bruit dans l’échantillon. Pour pallier ce biais structurel d’optimisme, l’observateur doit porter son attention sur le Adjusted R-Square (R2 ajusté). Cet indice intègre une pénalité formelle fonction du nombre de paramètres estimés et de la taille de l’échantillon, offrant une estimation corrigée non biaisée de la variance expliquée généralisable à la population parente.
Enfin, la métrique libellée Root MSE (Racine du Carré Moyen de l’Erreur) restitue l’écart-type résiduel du modèle dans l’unité de mesure originale de la variable critère Y. Cette statistique d’erreur absolue revêt une signification clinique ou pratique essentielle : elle informe directement le praticien sur la marge moyenne d’imprécision affectant les prédictions individuelles générées par l’équation de régression. Un R2 élevé peut ainsi coexister avec un Root MSE cliniquement inacceptable si l’échelle originelle du phénomène présente une variabilité intrinsèque démesurée.
5.3 Significativité individuelle des prédicteurs
L’exploration des composantes spécifiques s’effectue dans la seconde section majeure de la sortie SAS, intitulée Parameter Estimates. Pour chaque variable prédictive, la première colonne documente le coefficient non standardisé B (estimateur des MCO). Ce coefficient métrique traduit la modification unitaire attendue sur Y pour chaque variation unitaire de X, dans les unités réelles d’échantillonnage. L’évaluation de l’ordonnée à l’origine (Intercept) fournit la valeur théorique de base projetée lorsque l’ensemble des prédicteurs est assigné à la valeur zéro.
La précision de cette estimation ponctuelle est garantie par l’erreur-type associée, rapportée sous l’étiquette Standard Error (SE). Le quotient du coefficient non standardisé par son erreur-type produit la statistique de test t de Student univariée (t = B / SE), testant l’hypothèse nulle spécifique H0 : βj = 0 sachant le maintien constant de l’ensemble des autres termes du modèle. La p-valeur correspondante (Pr > |t|) indique si la contribution isolée de cette covariable se distingue significativement du bruit aléatoire résiduel au seuil de risque préétabli.
Enfin, l’examen de la colonne issue de l’option STB, documentant les coefficients standardisés (Standardized Estimate ou bêta), s’avère indispensable pour comparer la force prédictive respective des variables. Exprimés en unités d’écart-type, ces coefficients bêta neutralisent les artefacts d’échelles de mesure divergentes : un prédicteur présentant un coefficient standardisé de 0,45 exerce ainsi un impact relatif substantiellement plus vigoureux sur le critère qu’un prédicteur dont le coefficient standardisé plafonne à 0,15, indépendamment de leurs unités métriques initiales.
6. Diagnostics d’erreurs et analyse approfondie des résidus
6.1 Génération et exportation des résidus
L’inférence statistique déduite des modèles de régression par les moindres carrés ordinaires repose sur la validité empirique des hypothèses postulées sur le comportement des erreurs. Puisque les erreurs théoriques εi sont par essence inobservables dans la population, le chercheur doit obligatoirement opérer sur leurs analogues empiriques : les résidus d’échantillonnage, définis pour chaque sujet par l’écart d’ajustement unitaire ei = Yi – Ŷi. L’instruction OUTPUT de la procédure PROC REG offre une flexibilité complète pour calculer et archiver ces métriques au sein d’une nouvelle table de données SAS spécifiée via l’argument OUT=.
La syntaxe de l’instruction OUTPUT permet d’extraire simultanément plusieurs typologies complémentaires de résidus. L’argument PREDICTED= (ou P=) extrait les valeurs prédites Ŷi calculées par l’équation linéaire pour chaque observation. L’argument RESIDUAL= (ou R=) sauvegarde les résidus bruts calculés dans l’unité du critère. Toutefois, ces résidus bruts présentent l’inconvénient d’avoir des variances théoriques inégales dépendantes de la position des prédicteurs dans l’espace multidimensionnel.
Pour éliminer cette distorsion géométrique, il est fortement recommandé d’exporter les résidus studentisés en exploitant les mots-clés STUDENT= pour les résidus studentisés internes, ou RSTUDENT= pour les résidus studentisés externes (résidus supprimés ou jackknife). Ces derniers sont obtenus en divisant chaque résidu par un estimateur de son écart-type calculé en excluant l’observation i du modèle, conférant ainsi à la métrique résultante une distribution exacte selon une loi de Student à (n – p – 1) degrés de liberté, outil parfait pour identifier les discordances de prédiction extrêmes.
6.2 Évaluation graphique des postulats sur les résidus
L’auscultation graphique des résidus studentisés constitue la démarche la plus efficace pour tester visuellement le respect de l’homoscédasticité et de la linéarité. Le tracé de référence fondamental superpose sur l’axe des ordonnées les résidus studentisés externes et sur l’axe des abscisses les valeurs prédites issues du modèle linéaire. Dans une configuration théorique satisfaisante, le nuage de points doit présenter une apparence de « ciel étoilé », c’est-à-dire une dispersion rectangulaire homogène et aléatoire s’étendant symétriquement de part et d’autre de la ligne horizontale d’ordonnée zéro.
L’émergence de motifs géométriques distincts trahit d’emblée la violation de postulats cardinaux. La présence d’une déformation systématique en forme d’entonnoir (qu’il soit divergent ou convergent) révèle indubitablement une hétéroscédasticité sous-jacente : la variance de l’erreur d’ajustement s’accroît ou s’amenuise en fonction du niveau prédit, invalidant l’exactitude des calculs d’erreurs-types et des tests de significativité. De même, la présence d’une courbure en forme de parabole ou de sinusoïde au sein du nuage résiduel indique l’omission d’une composante fonctionnelle non linéaire majeure dans la modélisation.
L’évaluation de la normalité de ces résidus s’appuie quant à elle sur l’analyse approfondie du diagramme quantile-quantile (Q-Q plot) généré au sein de la planche diagnostique ODS Graphics. Les quantiles standardisés de la distribution résiduelle empirique y sont confrontés aux quantiles théoriques d’une distribution normale standardisée. Tout décrochage substantiel ou déviation sigmoïde marquée par rapport à la droite de référence diagonale met en exergue des queues de distribution anormalement lourdes ou des distorsions d’asymétrie résiduelle incompatibles avec l’inférence paramétrique classique.
6.3 Tests formels de normalité et d’autocorrélation
Bien que l’inspection visuelle demeure incontournable, elle doit idéalement être étayée par des tests d’hypothèse formels confirmant l’acceptabilité statistique des propriétés d’erreurs. Une fois la table de résidus exportée via l’instruction OUTPUT, il devient aisé d’exécuter la procédure PROC UNIVARIATE NORMAL sur la variable des résidus studentisés. Cette commande génère les statistiques inférentielles de normalité universellement reconnues, au premier rang desquelles figurent le test de Shapiro-Wilk (hautement efficient pour les échantillons n < 2000) et le test de Kolmogorov-Smirnov adapté par Lilliefors pour les volumétries supérieures.
Une probabilité critique supérieure au seuil usuel alpha (p > 0,05) lors du test de Shapiro-Wilk conduit à retenir l’hypothèse de conformité à la normalité gaussienne. Concernant l’indépendance des observations et l’absence d’autocorrélation des résidus de premier ordre — postulat crucial lorsque les données sont ordonnées dans le temps ou issues de sessions expérimentales consécutives —, l’adjonction de l’option DW (Durbin-Watson) dans l’instruction MODEL de PROC REG automatise le calcul de la statistique de Durbin-Watson (notée d). Une valeur de d gravitant étroitement autour du point d’équilibre de 2 confirme l’absence d’autocorrélation linéaire sérielle.
Face à une hétéroscédasticité confirmée ou à des violations manifestes de normalité résiduelle, plusieurs stratégies de remédiation s’offrent au chercheur. Parmi celles-ci, l’activation des erreurs-types robustes à l’hétéroscédasticité d’Halbert White, accessible dans SAS via l’option ACOV ou via l’option HCCMETHOD= au sein de l’instruction MODEL, permet de restaurer la validité asymptotique des tests de Student sans requérir d’altération artificielle des données originelles.
7. Identification et traitement des observations aberrantes et influentes
7.1 Mesures de levier et éloignement multivarié
Une modélisation par régression linéaire multiple robuste requiert une vigilance absolue face aux observations extrêmes capables d’infléchir artificiellement la trajectoire du plan de régression. Il convient d’opérer une distinction conceptuelle fondamentale entre une observation aberrante sur la variable dépendante (caractérisée par un résidu de prédiction démesuré) et une observation présentant une valeur de levier élevée (leverage), définie par son positionnement atypique au sein du nuage multidimensionnel des covariables explicatives regroupées dans la matrice X.
La métrique mathématique universellement adoptée pour quantifier cet éloignement dans l’espace des prédicteurs correspond aux éléments diagonaux hii de la matrice de projection orthogonale, usuellement qualifiée de « matrice chapeau » (hat matrix, H = X(X’X)-1X’). Les valeurs hii, comprises structurellement entre 0 et 1, mesurent le degré auquel la valeur prédite Ŷi dépend de la valeur observée correspondante Yi. L’extraction de cette statistique s’opère dans SAS en insérant le mot-clé H= dans l’instruction OUTPUT de PROC REG.
La détection des points de fort levier s’appuie sur la comparaison des valeurs hii empiriques à des seuils d’alerte théoriques dérivés de la structure des données. La moyenne arithmétique des valeurs diagonales de la matrice chapeau étant rigoureusement égale à (p + 1) / n (où p désigne le nombre de prédicteurs et n la taille d’échantillon totale), la littérature méthodologique préconise d’examiner attentivement toute observation dont le levier hii excède le double (2(p + 1) / n), voire le triple (3(p + 1) / n) de cette valeur moyenne d’équilibre, signalant une anomalie multivariée dans le profil des covariables de ce participant.
7.2 Indices d’influence globale et locale
Une observation présentant un fort levier géométrique ne constitue pas nécessairement une menace pour le modèle si elle s’inscrit fidèlement dans la trajectoire linéaire générale impulsée par le reste de l’échantillon. En revanche, lorsqu’une valeur de fort levier s’associe à un résidu substantiel, elle devient un point influent, capable de modifier radicalement les estimations des paramètres MCO si elle venait à être extraite du calcul. La métrique reine pour quantifier cette influence globale est la Distance de Cook (Cook’s D), accessible via le mot-clé COOKD= de l’instruction OUTPUT.
La Distance de Cook synthétise l’amplitude du déplacement global subi par l’ensemble des valeurs prédites Ŷ lorsque l’observation i est omise du processus d’estimation. Bien que le seuil théorique historique d’alerte corresponde au percentile 50 de la distribution de Fisher F(p+1, n-p-1) — ce qui équivaut approximativement à une valeur critique de 1 —, de nombreux méthodologistes contemporains préconisent un seuil d’investigation plus conservateur formulé par le ratio 4 / (n – p – 1) pour déceler les influences disproportionnées au sein d’échantillons de taille modérée.
Pour disséquer plus finement l’influence locale d’une observation, SAS calcule deux indices diagnostiques additionnels d’une redoutable efficacité : le DFFITS et les DFBETAS (extraits via les commandes DFFITS= et DFBETAS=). Alors que le DFFITS mesure l’impact direct de la suppression d’un participant sur sa propre prédiction ajustée en unités d’erreur-type, la série des DFBETAS quantifie la fluctuation unitaire subie par chaque coefficient partiel βj pris individuellement. Toute valeur de |DFBETASij| excédant le critère analytique conventionnel 2 / √n révèle que l’estimation du paramètre pour ce prédicteur particulier dépend de manière critique de l’inclusion de ce seul participant.
7.3 Conduite scientifique face aux points d’influence
La découverte d’observations influentes ou aberrantes confronte le chercheur à un défi épistémologique et déontologique de premier ordre. Il est formellement proscrit de procéder à l’élimination machinale d’observations au simple motif qu’elles perturbent l’ajustement du modèle ou abaissent artificiellement le coefficient de détermination R2. La première démarche opérationnelle impose un retour minutieux aux sources empiriques afin d’écarter catégoriquement l’hypothèse d’une erreur d’encodage matériel, d’un dysfonctionnement d’appareillage expérimental ou d’une méconnaissance avérée des consignes par un sujet.
Si la validité formelle des données aberrantes est irréfutable, ces points atypiques constituent fréquemment des cas cliniques d’un intérêt substantiel, susceptibles de révéler les limites de validité de la théorie testée ou l’existence de sous-populations qualitatives singulières nécessitant un cadre théorique distinct. L’approche scientifique la plus rigoureuse et transparente repose sur la conduite d’une analyse de sensibilité comparée. Cette démarche consiste à exécuter et documenter intégralement l’analyse statistique selon deux approches parallèles : l’une incluant la cohorte intégrale et l’autre excluant les points hautement influents.
Lorsque les conclusions empiriques — c’est-à-dire la significativité, le sens et la magnitude relative des coefficients de régression — demeurent stables entre les deux configurations, le chercheur peut conclure à la robustesse intrinsèque de son modèle. Si, à l’inverse, l’exclusion d’un point influent fait basculer un résultat clé de la significativité statistique vers l’insignifiance, cette fragilité inférentielle doit être explicitement reconnue et discutée au sein de la publication scientifique comme une limitation inhérente au protocole.
8. Détection et prise en charge de la multicolinéarité
8.1 Origine et conséquences statistiques de la dépendance linéaire
La multicolinéarité survient au sein d’un modèle de régression linéaire multiple lorsque deux ou plusieurs variables explicatives présentent une forte interdépendance linéaire, traduisant un degré élevé de redondance informationnelle dans l’espace multidimensionnel des prédicteurs. Ce phénomène s’avère particulièrement prégnant en sciences comportementales et psychométriques, où différents sous-scores d’une même échelle cognitive ou des indicateurs psychologiques évaluant des construits apparentés (tels que la détresse psychologique, l’anxiété et la symptomatologie dépressive) partagent inévitablement une part massive de variance commune.
D’un point de vue purement mathématique, la multicolinéarité ne compromet pas formellement les propriétés asymptotiques sans biais des estimateurs des moindres carrés ordinaires, et n’altère en rien la capacité prédictive globale du modèle sur les données d’échantillonnage. En revanche, elle induit une pathologie algorithmique sévère matérialisée par le quasi-écroulement du déterminant de la matrice d’information (X’X). Cette quasi-singularité matricielle provoque un gonflement artificiel démesuré des erreurs-types associées aux coefficients de régression partielle estimés.
Ce gonflement direct des erreurs-types a pour conséquence immédiate d’amoindrir drastiquement les valeurs des statistiques t de Student univariées, précipitant une inflation dramatique du risque d’erreur de Type II : des prédicteurs théoriquement déterminants échouent à atteindre le seuil de significativité statistique conventionnel. Par ailleurs, la multicolinéarité engendre une instabilité phénoménale des coefficients de régression, dont le signe ou la magnitude peuvent osciller sauvagement à l’occasion de micro-variations dans la composition de l’échantillon ou lors de l’adjonction d’un prédicteur supplémentaire.
8.2 Indicateurs de colinéarité dans PROC REG
La procédure PROC REG intègre une batterie diagnostique de pointe pour dépister et quantifier avec précision le degré d’interdépendance linéaire au sein du système explicatif. L’outil diagnostique le plus usuel et le plus directement interprétable s’active en spécifiant l’option VIF (Variance Inflation Factor) à la suite de l’instruction MODEL. Pour chaque prédicteur Xj, le Facteur d’Inflation de la Variance est formellement défini par la fonction : VIFj = 1 / (1 – Rj2), où Rj2 désigne le coefficient de détermination issu de la régression auxiliaire de Xj sur l’ensemble de l’ensemble des autres variables indépendantes du modèle.
Un VIF égal à 1 reflète une absence absolue de corrélation linéaire entre ce prédicteur et les autres composantes de l’équation. À mesure que l’interdépendance croît, le VIF augmente exponentiellement. Bien que la littérature scientifique débatte de seuils universels, la convention méthodologique dominante identifie un VIF excédant la valeur 5 comme le signal d’une multicolinéarité préoccupante, tandis qu’un VIF supérieur à 10 atteste d’une redondance critique nécessitant une intervention corrective immédiate. L’option complémentaire TOL calcule la tolérance, inverse mathématique direct du VIF (1 / VIF), dont les valeurs inférieures à 0,10 ou 0,20 constituent l’exact équivalent des seuils critiques précédents.
Pour disséquer les structures de dépendance colinéaire complexes impliquant simultanément plus de deux variables, SAS offre l’option matricielle avancée COLLIN (ou COLLINOINT pour exclure l’ordonnée à l’origine). Cette commande procède à la décomposition spectrale des valeurs propres (eigenvalues) de la matrice X’X normalisée et calcule les indices de condition associés. Un indice de condition excédant 30, conjugué à une concentration de forte proportion de variance (supérieure à 0,50) sur deux ou plusieurs prédicteurs pour une même valeur propre, met en exergue avec une certitude absolue les faisceaux précis de variables engagés dans des liaisons de colinéarité dégénératives.
8.3 Solutions pratiques face à une forte colinéarité
Lorsqu’une multicolinéarité invalidante est formellement diagnostiquée au sein d’un modèle sous SAS, le chercheur doit adopter une stratégie de remédiation guidée par des considérations à la fois statistiques et conceptuelles. La résolution la plus élémentaire et la plus directe consiste en l’éviction raisonnée du prédicteur redondant le moins essentiel sur le plan théorique. Dès lors que deux échelles mesurent des facettes quasi indiscernables du même phénomène, l’exclusion délibérée de l’une d’elles allège le système matriciel, effondre les valeurs des VIF résiduels et restaure instantanément la stabilité statistique des coefficients du prédicteur conservé.
Une alternative méthodologique plus sophistiquée repose sur l’intégration préalable de techniques de réduction dimensionnelle. Face à un ensemble de covariables fortement intriquées, le chercheur peut recourir à la procédure PROC FACTOR ou PROC PRINCOMP afin d’extraire des composantes principales orthogonales non corrélées synthétisant l’essentiel de la variance commune. Les scores factoriels individuels ainsi obtenus peuvent subséquemment être insérés comme prédicteurs non biaisés dans PROC REG, garantissant par construction une orthogonalité géométrique parfaite et un VIF rigoureusement égal à 1 pour chaque facteur.
Enfin, lorsque l’omission de variables et la réduction dimensionnelle s’avèrent impossibles pour des motifs de préservation absolue de l’interprétabilité des échelles individuelles, le recours aux méthodes de régression régularisée constitue une solution de premier choix. La régression Ridge (accessible dans SAS via l’option RIDGE= de l’instruction PROC REG) introduit délibérément un léger paramètre de pénalisation λ sur les éléments diagonaux de la matrice (X’X + λI), acceptant un biais infinitésimal d’estimation en contrepartie d’une contraction spectaculaire de la variance d’échantillonnage et d’une stabilisation définitive des erreurs-types des coefficients.
9. Intégration de variables explicatives catégorielles et contrastes
9.1 Limites de PROC REG avec les prédicteurs discrets
Bien que la procédure PROC REG brille par son efficience pour l’ajustement des équations linéaires continues, elle présente une limitation structurelle historique : elle est intrinsèquement incapable de gérer de manière native et automatisée des variables indépendantes de nature qualitative ou catégorielle (telles que le groupe d’appartenance clinique, l’affiliation sociologique ou la typologie de prise en charge thérapeutique). Toute tentative d’insérer directement une variable discrète codée avec des entiers arbitraires (par exemple 1, 2 et 3) dans son instruction MODEL conduit l’algorithme à imposer une contrainte d’espacement métrique linéaire erronée entre les modalités.
Pour surmonter cette contrainte au sein de PROC REG, l’analyste doit impérativement précéder l’exécution de la régression d’une étape DATA dédiée au recodage manuel de la variable nominale en un ensemble de variables indicatrices binaires (fréquemment désignées sous l’anglicisme dummy variables). Pour un facteur qualitatif comportant k modalités distinctes, le chercheur est astreint à concevoir rigoureusement k – 1 variables indicatrices indépendantes, chaque variable binaire prenant la valeur 1 si l’individu appartient à la modalité ciblée, et 0 dans le cas contraire.
L’omission délibérée d’une modalité, dénommée modalité de référence, constitue une exigence mathématique absolue afin d’échapper au piège classique de la colinéarité parfaite (dummy variable trap). L’incorporation simultanée des k indicatrices aux côtés de l’ordonnée à l’origine engendrerait une somme vectorielle constante égale à 1, provoquant la singularité immédiate de la matrice de données. Dans cette formalisation manuelle, chaque coefficient partiel associé à une variable indicatrice binaire s’interprète précisément comme la différence moyenne observée sur le critère entre la catégorie ciblée et la modalité de référence maintenue sous silence.
9.2 Utilisation de PROC GLM pour l’encodage automatique
Conscients de la lourdeur et des risques d’erreurs inhérents au codage manuel préalable des indicatrices, les utilisateurs avancés de SAS se tournent préférentiellement vers la procédure PROC GLM (General Linear Model) dès lors que le modèle intègre un mélange de variables explicatives continues et qualitatives. La caractéristique architecturale majeure de PROC GLM réside dans la présence de l’instruction CLASS, qui automatise intégralement la paramétrisation matricielle des facteurs discrets sans nécessiter de modification préalable de la table source.
La syntaxe canonique s’articule de la manière suivante : l’instruction CLASS nom_facteur; précède immédiatement l’instruction MODEL variable_dependante = nom_facteur covariable_continue / SOLUTION;. L’adjonction fondamentale de l’option SOLUTION ordonne explicitement à la procédure d’afficher l’estimation individuelle des paramètres structuraux MCO, neutralisant le mode d’affichage par défaut de PROC GLM qui se limite conventionnellement aux seules tables d’analyse de variance et aux sommes des carrés de Type I et Type III.
Par défaut, l’algorithme de paramétrisation de PROC GLM adopte un schéma de codage singulier dans lequel la dernière modalité par ordre alphabétique ou numérique est automatiquement assignée comme catégorie de référence, recevant une valeur de paramètre contrainte à zéro. L’option syntaxique REF= adjointe à l’instruction CLASS permet toutefois à l’opérateur de spécifier librement n’importe quelle modalité empirique comme étalon de référence de base, harmonisant ainsi instantanément les sorties d’estimations avec les hypothèses conceptuelles du laboratoire de recherche.
9.3 Spécification de contrastes et comparaisons planifiées
L’un des avantages les plus décisifs de l’environnement PROC GLM réside dans sa capacité à tester des hypothèses de recherche complexes a priori par le truchement des instructions programmables CONTRAST et ESTIMATE. Alors qu’une lecture superficielle des coefficients de régression bruts ne permet d’évaluer que des différences bilatérales opposant chaque modalité à la référence arbitraire choisie, l’instruction ESTIMATE permet d’isoler n’importe quelle combinaison linéaire de paramètres pour en extraire la magnitude moyenne exacte, son erreur-type dédiée, son intervalle de confiance et sa valeur p afférente.
La syntaxe de l’instruction ESTIMATE requiert l’attribution d’un libellé textuel entre guillemets, suivi du nom du facteur classifiant et d’un vecteur pondérateur de coefficients arithmétiques respectant strictement la condition d’équilibre d’un contraste linéaire (somme des coefficients égale à zéro). Cette fonctionnalité autorise par exemple la comparaison directe de la moyenne pondérée de deux groupes de traitement distincts face à un groupe témoin unique, apportant une réponse inférentielle d’une précision inaccessible aux simples tests de Student ordinaires.
Pour sa part, l’instruction CONTRAST permet d’éprouver des hypothèses multidimensionnelles à plusieurs degrés de liberté simultanés en calculant la statistique F de Fisher partielle associée à un faisceau de comparaisons linéaires conjointes. L’utilisation conjuguée de ces instructions au sein du modèle linéaire généralisé évite la prolifération incontrôlée de tests post-hoc bivariés successifs, garantissant un contrôle rigoureux du taux d’erreur de famille (familywise error rate) et renforçant la crédibilité démonstrative des analyses de covariance (ANCOVA) publiées.
10. Modélisation des effets d’interaction et modération statistique
10.1 Concepts de modération et formulation du terme produit
Dans la recherche contemporaine sur le comportement et la cognition, les relations linéaires directes s’avèrent fréquemment dépendantes du contexte environnemental ou d’attributs individuels sous-jacents. L’examen des processus de modération statistique — formalisant l’hypothèse selon laquelle la force ou la direction de l’effet d’une variable indépendante X sur un critère Y varie systématiquement en fonction des niveaux pris par une troisième variable modératrice W — représente une démarche analytique de premier plan pour déchiffrer la complexité des systèmes psychologiques.
Sur le plan mathématique, la modélisation de cette dépendance conditionnelle s’opérationnalise par l’incorporation explicite d’un terme produit croisé au sein de l’équation de régression : Y = β0 + β1X + β2W + β3(X × W) + ε. Dans cette formulation, le coefficient d’interaction partiel β3 quantifie la variation marginale subie par la pente reliant X à Y pour chaque progression unitaire enregistrée sur le modérateur W. Le rejet de l’hypothèse nulle associée à β3 confirme formellement l’existence d’une modération statistiquement significative.
Un impératif méthodologique fondamental lors de l’intégration de prédicteurs continus réside dans le centrage préalable des variables X et W (soustraction de la moyenne arithmétique de l’échantillon à chaque score brut) avant de concevoir le produit d’interaction. Cette opération de transformation affine ne modifie en rien la significativité ou la magnitude de l’effet d’interaction β3, mais elle élimine la multicolinéarité non essentielle entre les termes constitutifs de base et le produit croisé, tout en conférant aux coefficients d’effets simples β1 et β2 une signification substantielle limpide au niveau des valeurs centrales de l’échantillon.
10.2 Interprétation des effets principaux conditionnels
La présence d’un terme d’interaction statistiquement significatif au sein d’un modèle linéaire sous SAS altère radicalement le statut épistémologique et l’interprétation sémantique des paramètres linéaires inférieurs β1 et β2. Dès lors que l’interaction (X × W) est incluse, les estimations rapportées pour X et W ne constituent plus des « effets principaux généraux » applicables à l’ensemble du continuum d’observation, mais deviennent des effets principaux conditionnels, dénommés techniquement des effets simples ou des pentes conditionnelles.
Précisément, le coefficient β1 associé à la variable X reflète désormais la pente de régression de X sur le critère Y exclusivement et rigoureusement au point précis où le modérateur W prend la valeur numérique zéro. C’est ici qu’apparaît toute l’importance du centrage préalable évoqué précédemment : si W a été convenablement centré sur sa moyenne, β1 correspond à la trajectoire d’impact de X pour un individu affichant un score parfaitement moyen sur la dimension modératrice. Si W n’a pas été centré, β1 traduirait un effet théorique hors-sol correspondant à un niveau nul de modérateur fréquemment impossible ou dénué de sens psychologique.
Pour décomposer l’effet d’interaction au-delà de cette estimation ponctuelle, le chercheur doit obligatoirement évaluer la pente conditionnelle de X à divers niveaux standardisés du modérateur. Cette décomposition s’effectue usuellement en observant la significativité de la relation à trois ancrages statistiques représentatifs de W : à sa moyenne (0 pour des variables centrées), à un niveau faible situé à un écart-type en deçà de la moyenne (-1 écart-type), et à un niveau élevé situé à un écart-type au-delà (+1 écart-type), conformément à la tradition analytique établie par Aiken et West.
10.3 Représentation graphique de la modération
La validation empirique d’une modération statistique ne saurait être pleinement assimilée et communiquée sans le support d’une représentation graphique soignée des pentes conditionnelles. La procédure PROC SGPLOT offre les fonctionnalités requises pour projeter avec une élégance visuelle optimale ces réseaux de droites de régression conditionnelles. L’utilisation combinée des instructions SERIES ou REG au sein d’une table intermédiaire contenant les valeurs estimées permet de matérialiser clairement la divergence angulaire des trajectoires.
L’affichage simultané des droites d’ajustement correspondant aux trois strates standards du modérateur (basse à -1 écart-type, moyenne, et haute à +1 écart-type) permet de déceler instantanément la nature de l’effet modérateur en présence : modération d’amplification (où la relation entre X et Y s’intensifie proportionnellement aux niveaux du modérateur), modération d’atténuation (où l’effet s’émousse jusqu’à disparaître), ou modération d’inversion complète (croisement franc où la relation change de signe selon le contexte modérateur).
Pour franchir un palier supérieur de rigueur méthodologique, les chercheurs déploient la technique de Johnson-Neyman. Contrairement à la méthode arbitraire des valeurs fixées à ± 1 écart-type, l’approche de Johnson-Neyman détermine par dérivation analytique la région exacte du continuum du modérateur au sein de laquelle la pente simple reliant le prédicteur au critère cesse d’être statistiquement significative au seuil alpha préétabli. Cette technique d’une puissance reconnue est directement accessible sous SAS par le biais de la macro-commande PROCESS ou via l’instruction avancée PLOTS=EFFECT de la procédure PROC PLM.
11. Sélection automatisée de variables et validation croisée
11.1 Algorithmes de sélection classiques dans PROC REG
Dans les contextes de modélisation prédictive ou d’exploration à large échelle impliquant un volume massif de covariables candidates, le chercheur peut ressentir la nécessité de rationnaliser la composition de son modèle au moyen d’algorithmes de sélection séquentielle de sous-ensembles de prédicteurs. La procédure PROC REG dispose d’une série d’options de pilotage automatisé intégrées à l’instruction MODEL via l’argument SELECTION=, orchestrant l’entrée et l’éviction itérative des paramètres sur la base de critères de significativité statistique définis par l’opérateur.
L’algorithme de sélection ascendante (SELECTION=FORWARD) débute avec une équation ne comportant que la constante et incorpore séquentiellement, une à une, la variable candidate apportant le gain de variance expliquée le plus important mesuré par la plus grande statistique F partielle, interrompant le processus lorsqu’aucun prédicteur résiduel ne satisfait au seuil d’entrée fixé par l’option SLENTRY=. À l’opposé, l’élimination descendante (SELECTION=BACKWARD) amorce l’ajustement avec la matrice intégrale de l’ensemble des prédicteurs et élimine successivement les composantes les moins contributives dont la valeur p excède le seuil d’expulsion configuré par SLSTAY=.
La régression pas à pas standardisée (SELECTION=STEPWISE) fusionne ces deux approches en un protocole itératif bidirectionnel : à chaque étape, l’algorithme évalue l’adjonction d’un nouveau prédicteur performant tout en réévaluant systématiquement la significativité marginale des variables antérieurement introduites, expulsant tout facteur dont la contribution deviendrait superflue en présence des nouveaux venus. Ce processus itératif se poursuit de manière convergente jusqu’à ce qu’aucune variable supplémentaire ne puisse être valablement intégrée ou exclue selon les seuils configurés.
11.2 Critères d’information pour la comparaison de modèles
Bien que les méthodes de sélection pas à pas basées sur les p-valeurs conservent une popularité historique indéniable, elles font l’objet de réserves méthodologiques sévères au sein de la communauté des statisticiens. La sélection guidée exclusivement par des valeurs p empiriques engendre un biais d’optimisme démesuré, sous-estime systématiquement les erreurs-types des coefficients finaux, gonfle les risques d’artefacts d’échantillonnage et viole les fondements épistémologiques de la déduction scientifique guidée par la théorie.
Pour asseoir la sélection de modèles sur une base d’évaluation plus équilibrée, il est impératif de privilégier des critères fondés sur la théorie de l’information pénalisant la complexité paramétrique. Les critères d’information d’Akaike (AIC) et le critère bayésien de Schwarz (BIC ou SBC) incarnent cet équilibre d’évaluation. Définis formellement à partir de la log-vraisemblance pénalisée par le nombre de paramètres libres, ces critères permettent de comparer des modèles concurrents, qu’ils soient ou non structurellement emboîtés : le modèle présentant la valeur AIC ou BIC la plus basse est désigné comme offrant le meilleur compromis de parcimonie entre adéquation empirique et simplicité formelle.
Un autre outil classique hautement informatif disponible dans PROC REG est le Cp de Mallows (accessible via l’option SELECTION=CP). Le critère Cp compare l’erreur quadratique moyenne totale du modèle restreint à celle du modèle complet incorporant la totalité des variables candidates. L’analyste recherchera prioritairement les modèles dont la valeur de Cp s’avère à la fois minimale et rigoureusement proche du nombre de paramètres p + 1 de l’équation candidate, signe incontestable que le modèle proposé minimise le biais d’omission tout en jugulant l’instabilité de variance liée à la surparamétrisation.
11.3 Validation croisée moderne avec la procédure PROC GLMSELECT
Pour s’émanciper définitivement des artefacts inhérents à l’inférence guidée par les données et prévenir le surajustement (overfitting), SAS a développé une procédure de modélisation avancée : PROC GLMSELECT. Conçue spécifiquement pour la sélection de modèles linéaires dans des environnements empiriques modernes, cette procédure transcende les limitations de PROC REG en associant la prise en charge native des variables de l’instruction CLASS à des algorithmes de sélection contemporains tels que la régression Lasso (Least Absolute Shrinkage and Selection Operator) ou le LARS (Least Angle Regression).
La force méthodologique majeure de PROC GLMSELECT réside dans l’intégration native de protocoles de validation croisée automatisés. Par l’intermédiaire de l’instruction PARTITION, le chercheur peut décomposer son jeu de données de manière stochastique en sous-ensembles indépendants : une cohorte d’apprentissage (TRAIN) destinée à l’estimation mathématique des coefficients, une cohorte de validation destinée à guider l’arrêt de la sélection algorithmique, et une cohorte de test (TEST) entièrement préservée permettant de quantifier l’erreur de généralisation réelle sur des données parfaitement neuves.
En outre, l’activation de la validation croisée à k-blocs (k-fold cross-validation) via l’option CVMETHOD=RANDOM(k) segmente dynamiquement l’échantillon en k partitions égales, entraînant et testant itérativement le modèle afin de maximiser la robustesse prédictive tout en minimisant la sensibilité aux fluctuations aléatoires du sous-échantillonnage. Cette approche algorithmique avancée constitue la garantie scientifique la plus irréfutable pour assurer la pérennité et la réplicabilité des modèles comportementaux publiés.
12. Restitution des résultats académiques selon les normes de l’APA et bonnes pratiques
12.1 Mise en forme des tableaux de régression
La synthèse des résultats issus d’une analyse de régression multiple doit impérativement se conformer aux standards de communication savante codifiés par le manuel de publication de l’American Psychological Association (APA, 7e édition). La pièce maîtresse de cette présentation formelle réside dans un tableau de synthèse rigoureusement épuré, dont la mise en page exclut conventionnellement tout quadrillage vertical au profit de lignes horizontales délimitant strictement les en-têtes de colonnes, les blocs de paramètres et la section des statistiques globales d’ajustement situées en pied de table.
L’architecture matricielle du tableau de régression APA requiert la présentation ordonnée des colonnes documentant, pour chaque variable explicative : le coefficient non standardisé métrique (symbolisé par la lettre latine B en italique), son erreur-type d’estimation dédiée (symbolisée par SE en italique), le coefficient standardisé (symbolisé par la lettre grecque minuscule β), la valeur empirique de la statistique de test (symbolisée par t en italique), et le niveau de significativité probabiliste exact ou balisé par des astérisques conventionnelles (* p < 0,05, ** p < 0,01, *** p < 0,001). L’adjonction des bornes inférieure et supérieure de l’intervalle de confiance à 95% pour le paramètre B est désormais prescrite de manière quasi systématique par les comités de lecture.
La section inférieure du tableau doit obligatoirement récapituler les indices macroscopiques synthétisant la performance du modèle global. Doivent y figurer la valeur du coefficient de détermination global (R2), celle du coefficient de détermination ajusté (R2 ajusté), la statistique globale d’adéquation de Fisher accompagnée de ses deux valeurs de degrés de liberté inscrits entre parenthèses, sous la formulation F(dfmodele, dferreur), ainsi que la mention de la significativité omnibus globale afférente.
12.2 Rédaction textuelle standardisée des conclusions
L’articulation rédactionnelle des résultats statistiques au sein du corps du manuscrit doit allier une concision exemplaire à une rigueur mathématique sans faille, évitant tout jargon inutile mais ne sacrifiant aucune des métriques inférentielles fondamentales. La narration débute invariablement par l’exposé formel de la performance omnibus du modèle de régression, informant le lecteur de la capacité explicative conjointe des prédicteurs sélectionnés sur la variance de la variable cible.
Une formulation narrative standardisée et conforme aux normes en vigueur s’articule typiquement de la manière suivante : « Une régression linéaire multiple a été réalisée afin d’évaluer dans quelle mesure les fonctions exécutives, l’anxiété de performance et le statut socio-économique permettent de prédire le niveau de réussite académique global. Le modèle de régression globale s’avère statistiquement significatif et permet d’expliquer une part substantielle de la variance observée, F(3, 146) = 18,42, p < 0,001, R2 = 0,275, R2 ajusté = 0,260. »
Dans un second temps, le texte dissèque méthodiquement la contribution de chaque prédicteur individuel en explicitant le sens fonctionnel, l’ampleur de l’effet et son intervalle d’incertitude : « L’analyse des paramètres partiels révèle que le niveau des fonctions exécutives constitue un prédicteur positif statistiquement significatif de la performance académique, B = 0,42, SE = 0,08, β = 0,38, t(146) = 5,25, p < 0,001, 95% IC [0,26, 0,58]. À l’inverse, l’anxiété de performance exerce un impact prédictif négatif indépendant significatif, B = -0,21, SE = 0,06, β = -0,24, t(146) = -3,50, p < 0,001, 95% IC [-0,33, -0,09]. »
12.3 Check-list méthodologique pour la reproductibilité sous SAS
L’exigence éthique et déontologique de reproductibilité computationnelle impose au chercheur une discipline d’archivage et de traçabilité irréprochable tout au long de sa chaîne d’analyse sous SAS. L’intégrité de la recherche repose sur la capacité d’un relecteur indépendant à réitérer intégralement le pipeline statistique, de la lecture des tables primaires brutes jusqu’à la compilation finale des tableaux de résultats, et d’obtenir des résultats rigoureusement identiques à la décimale près.
La première règle de bonne conduite réside dans l’inspection scrupuleuse et systématique du journal d’exécution SAS (SAS Log) à la suite de chaque commande soumise. Le journal ne doit comporter aucune erreur de syntaxe, et l’opérateur doit analyser méticuleusement chaque avertissement (WARNING) ou note méthodologique (NOTE). Des alertes signalant des observations omises pour valeurs manquantes, des divisions par zéro potentielles ou des matrices devenues quasi singulières représentent des signaux critiques devant être immédiatement investigués et documentés plutôt qu’ignorés.
Enfin, le script analytique final doit être structuré sous forme d’un programme modulaire, exhaustif et entièrement auto-documenté par des blocs de commentaires détaillant la justification rationnelle de chaque décision de traitement statistique. La déclaration explicite des graines aléatoires (seed) lors des partitions de validation croisée, l’archivage figé des versions logicielles utilisées et la préservation conjointe du code source et des fichiers journaux garantissent la transparence absolue de l’étude et immunisent le chercheur contre les aléas de l’audit scientifique international.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications. https://us.sagepub.com/en-us/nam/multiple-regression/book3395
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (2004). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall. https://conservancy.umn.edu/handle/11299/37076
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). The Guilford Press. https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin. https://www.mheducation.com
- SAS Institute Inc. (2018). SAS/STAT 15.1 User’s Guide: The REG procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/151/reg.pdf
- SAS Institute Inc. (2018). SAS/STAT 15.1 User’s Guide: The GLM procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/151/glm.pdf
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com