
L’inférence statistique paramétrique repose sur un ensemble de postulats théoriques fondamentaux qui garantissent la validité mathématique des conclusions tirées à partir d’échantillons empiriques. Parmi ces conditions préalables, l’hypothèse d’égalité des variances — couramment désignée sous les termes d’homoscédasticité ou d’homogénéité des variances selon les cadres de modélisation — occupe une place à la fois centrale et fréquemment sous-estimée. Trop souvent reléguée au statut de simple case méthodologique à cocher lors de la vérification routinière des prérequis, cette hypothèse conditionne pourtant directement la distribution exacte des statistiques de test fondamentales, à l’instar des ratios de Student et de Fisher-Snedecor. Lorsque cette condition est satisfaite, les estimateurs de la dispersion résiduelle convergent harmonieusement vers la variance populationnelle théorique, permettant un contrôle rigoureux du taux d’erreur de première espèce et garantissant une puissance statistique optimale.
Cependant, dans la pratique de la recherche scientifique — tout particulièrement au sein des sciences du comportement, de la psychologie quantitative, des neurosciences cognitives et de la médecine clinique —, les données empiriques se conforment rarement aux canons de l’homogénéité parfaite. Les processus psychologiques, développementaux ou psychopathologiques induisent intrinsèquement des asymétries de variabilité : les groupes cliniques manifestent fréquemment une dispersion accrue par rapport aux cohortes saines, les phases d’apprentissage génèrent une hétérogénéité temporelle de la performance, et les instruments psychométriques révèlent des effets d’échelle qui modulent artificiellement la variabilité des scores. Dans ces contextes, postuler naïvement que différents groupes ou différents niveaux de prédicteurs partagent une variance commune relève d’une simplification abusive susceptible de corrompre gravement l’édifice inférentiel.
L’objet de cet article encyclopédique est de disséquer de manière exhaustive la nature, les fondements mathématiques, les implications pratiques et les solutions contemporaines relatives à l’hypothèse d’égalité des variances. En explorant ses manifestations depuis le classique test t de comparaison de deux moyennes jusqu’aux raffinements de la régression linéaire multiple et des modèles mixtes, nous mettrons en lumière les conséquences concrètes de sa violation sur l’inflation du risque alpha et la dégradation de la puissance d’analyse. Enfin, nous proposerons un cadre décisionnel opérationnel et rigoureux, guidé par les recommandations contemporaines de la science ouverte et de la modélisation statistique robuste, afin de permettre aux chercheurs et analystes de traiter l’hétérogénéité des variances non pas comme un obstacle paralysant, mais comme une information substantielle sur leurs objets d’étude.
1. Cadre conceptuel et définition de l’hypothèse d’égalité des variances
1.1 Définition formelle de l’homoscédasticité et de l’hétéroscédasticité
Sur le plan sémantique et méthodologique, les termes « homogénéité des variances » et « homoscédasticité » désignent fondamentalement le même principe sous-jacent, mais leur emploi varie usuellement selon la nature du paradigme analytique mobilisé. Le vocable « homogénéité des variances » est traditionnellement privilégié dans le cadre des plans expérimentaux discrets, tels que les tests de comparaison de moyennes d’échantillons indépendants et les analyses de variance univariées ou multivariées (ANOVA). À l’inverse, le terme « homoscédasticité » — issu des racines grecques homo (même) et skedannumi (dispersion) — trouve son terrain de prédilection dans la modélisation linéaire générale, la régression par les moindres carrés ordinaires (OLS) et l’économétrie, où la dispersion des résidus est évaluée le long d’un continuum de valeurs prédictives continues.
Sur le plan formel, dans une configuration impliquant k populations indépendantes, l’hypothèse nulle d’homogénéité des variances postule l’équivalence stricte des variances populationnelles respectives. Mathématiquement, cela se formule de la manière suivante :
$$\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$$
Dans ce modèle, chaque sous-population j (pour j allant de 1 à k) possède une distribution théorique dont le second moment centré est rigoureusement identique à une constante commune $\sigma^2$, bien que leurs premiers moments respectifs (les moyennes populationnelles $\mu_j$) puissent diverger sous l’hypothèse alternative de l’investigateur.
Dans le contexte de la régression linéaire et de la modélisation conditionnelle, l’hétéroscédasticité se définit comme la non-constance de la variance conditionnelle des termes d’erreur stochastiques $\epsilon_i$ sachant le vecteur de régresseurs $X_i$. Formellement, la condition d’homoscédasticité s’écrit :
$$\text{Var}(\epsilon_i mid X_i) = \sigma^2 \quad \forall i in {1, dots, N}$$
Dès lors que cette variance conditionnelle n’est plus une constante scalaire mais devient une fonction dépendante des observations, des niveaux d’un prédicteur ou de variables exogènes latentes — de sorte que $\text{Var}(\epsilon_i mid X_i) = \sigma_i^2$ —, le modèle bascule dans l’hétéroscédasticité. Ce postulat constitue l’une des pierres angulaires de l’inférence paramétrique classique, car son respect garantit que le bruit de mesure ou la variabilité non expliquée opère avec une intensité homogène sur l’ensemble du domaine d’étude, autorisant ainsi une estimation globale et unifiée de l’incertitude.
1.2 Origine et rôle de l’hypothèse dans la théorie statistique classique
L’origine de l’hypothèse d’égalité des variances est intrinsèquement liée à la genèse même de la théorie de l’échantillonnage et de l’estimation optimale développée au cours du XIXe et du début du XXe siècle par des figures tutélaires telles que Carl Friedrich Gauss, William Sealy Gosset (sous le pseudonyme de Student) et Sir Ronald Aylmer Fisher. Dans la conceptualisation de la méthode des moindres carrés, Gauss a démontré que la combinaison linéaire optimale des observations nécessitait l’hypothèse que chaque résidu partageât la même dispersion d’erreur, condition sine qua non pour dériver la variance minimale des estimateurs.
Lorsque Gosset formalise la distribution t en 1908 pour résoudre le problème de l’inférence sur de petits échantillons dont la variance est inconnue, la mutualisation des variances devient un impératif de calcul. Pour estimer l’erreur-type de la différence entre deux moyennes empiriques sans supposer connue la variance de la population, il est mathématiquement indispensable de supposer une variance d’erreur unique. Cette étape permet d’agréger ou de regrouper (opération dite de pooling) les sommes de carrés des écarts des deux échantillons afin d’obtenir un estimateur quadratique moyen commun non biaisé, basé sur un nombre de degrés de liberté accru ($n_1 + n_2 – 2$).
Fisher, en étendant ces travaux à la comparaison simultanée de multiples groupes à travers l’invention de l’analyse de variance, a institutionnalisé cette nécessité. La dérivation exacte de la distribution F de Fisher-Snedecor repose expressément sur le ratio de deux variables aléatoires indépendantes suivant chacune une loi du Khi-carré ($\chi^2$), divisées par leurs degrés de liberté respectifs. Cette dérivation mathématique élégante n’est rigoureusement exacte que si le numérateur (variance intergroupe) et le dénominateur (variance intragroupe ou carré moyen résiduel) mesurent tous deux la même quantité fondamentale $\sigma^2$ sous l’hypothèse nulle. Si les variances sous-jacentes des groupes divergent, le dénominateur ne suit plus une distribution du Khi-carré standard divisée par ses degrés de liberté, ce qui fausse les propriétés distributionnelles exactes de la statistique de test et invalide les tables de probabilité associées.
1.3 Pertinence épistémologique et contextuelle en psychologie quantitative
Dans le domaine des sciences psychologiques, cognitives et comportementales, l’hypothèse d’homogénéité des variances acquiert une dimension épistémologique cruciale qui dépasse la simple mécanique mathématique. Les données recueillies dans les recherches quantitatives en psychologie s’écartent très fréquemment des idéaux gaussiens théoriques. Les échelles d’évaluation, qu’il s’agisse de questionnaires de personnalité, de mesures de bien-être subjectif ou de scores psychométriques de dépression, génèrent couramment des distributions marquées par une asymétrie substantielle et une variabilité hétérogène inhérente aux phénomènes mesurés.
Cette variabilité n’est pas un simple artefact statistique, mais reflète fréquemment une réalité substantielle : les populations cliniques (par exemple, des individus présentant un trouble du spectre de l’autisme, un épisode dépressif caractérisé ou une lésion cérébrale focale) manifestent typiquement une dispersion interindividuelle considérablement plus élevée que les populations témoins neurotypiques ou asymptomatiques. Dans un groupe témoin, les mécanismes de régulation ou les compétences cognitives de base tendent à concentrer les scores autour d’une moyenne normative, générant une variance restreinte. Dans le groupe clinique, l’hétérogénéité des étiologies, la sévérité variable des symptômes, les comorbidités et les mécanismes compensatoires individuels provoquent un étalement majeur de la distribution des performances, matérialisé par une variance substantiellement accrue.
Dans le cadre de la psychométrie et de la validation des instruments de mesure, ignorer ces disparités de variance expose les chercheurs à des erreurs diagnostiques majeures. Par exemple, lors de la normalisation d’un test ou de l’évaluation de l’invariance de mesure à travers différents sous-groupes démographiques (tels que le genre, les tranches d’âge ou le niveau socio-économique), la présence d’une hétéroscédasticité non contrôlée fausse les comparaisons de scores latents et conduit à rejeter à tort l’équivalence des construits mesurés. De surcroît, les effets d’intervention psychothérapeutique ou pharmacologique modifient souvent non seulement la moyenne du groupe traité, mais également sa dispersion — certains patients répondant magnifiquement tandis que d’autres stagnent —, rompant ainsi le postulat d’égalité indispensable aux analyses conventionnelles non ajustées.
2. L’hypothèse d’égalité des variances dans le test t de Student
2.1 Mécanisme mathématique de la variance combinée
Le test t de Student pour deux échantillons indépendants est conçu pour évaluer l’hypothèse nulle selon laquelle les moyennes de deux populations distinctes sont identiques ($H_0: \mu_1 = \mu_2$). Le calcul classique de la statistique t dépend intimement du concept de variance combinée ou pondérée, désignée dans la littérature sous l’anglicisme de pooled variance ($s_p^2$). Ce mécanisme repose sur le postulat formel selon lequel les deux groupes sont issus de populations partageant une même variance théorique $\sigma^2$, les variances d’échantillonnage $s_1^2$ et $s_2^2$ n’étant que des estimations fluctuantes de cette quantité unique.
La formule mathématique de la variance combinée s’exprime comme une moyenne des variances d’échantillons, pondérée par leurs degrés de liberté respectifs :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
Dans cette équation, $n_1$ et $n_2$ représentent les effectifs des deux échantillons, tandis que $n_1 + n_2 – 2$ correspond aux degrés de liberté totaux alloués à l’estimation de l’erreur résiduelle conjointe. L’erreur-type de la différence entre les deux moyennes empiriques ($\bar{X}_1 – \bar{X}_2$) est ensuite dérivée directement de cette variance combinée :
$$SE_{(\bar{X}_1 – \bar{X}_2)} = \sqrt{s_p^2 \left(\frac{1}{n_1} + \frac{1}{n_2}\right)}$$
La statistique t finale prend alors la forme canonique :
$$t = \frac{\bar{X}_1 – \bar{X}_2}{s_p \sqrt{\frac{1}{n_1} + \frac{1}{n_2}}}$$
La condition absolue de validité de cette statistique est que le ratio suive fidèlement une distribution théorique de Student à $n_1 + n_2 – 2$ degrés de liberté sous $H_0$. Cette convergence distributionnelle n’est garantie que si $s_p^2$ est un estimateur sans biais et efficace de l’erreur stochastique commune. Si la condition $\sigma_1^2 = \sigma_2^2$ est compromise, $s_p^2$ cesse de représenter adéquatement l’incertitude spécifique associée à chaque groupe, ce qui déstabilise le dénominateur de la statistique t et altère sa distribution de référence.
2.2 Impact des tailles d’échantillons sur la robustesse du test t
L’impact de la violation de l’homogénéité des variances sur le test t classique dépend de manière critique de l’équilibre des effectifs entre les deux groupes étudiés. Il s’agit de l’un des phénomènes les plus remarquables de la théorie des tests statistiques : l’existence d’une interaction majeure entre la disparité des variances et le rapport des tailles d’échantillons ($n_1 / n_2$).
Lorsque le plan expérimental est rigoureusement équilibré, c’est-à-dire lorsque $n_1 = n_2$, le test t de Student traditionnel démontre une remarquable robustesse intrinsèque face aux entorses à l’égalité des variances. Dans ce cas spécifique, la formule de la variance combinée attribue un poids strictement égal aux deux variances d’échantillon. Même si une population présente une variance deux, trois ou quatre fois supérieure à l’autre, le taux d’erreur de première espèce réel (le taux $\alpha$ empirique) demeure remarquablement proche du seuil nominal conventionnel de 5 % (variant typiquement entre 0,045 et 0,065 selon l’ampleur du déséquilibre de variance), à condition que la distribution des données ne présente pas d’asymétrie sévère.
En revanche, dès lors que le plan expérimental devient déséquilibré ($n_1 \neq n_2$), la robustesse du test t classique s’effondre littéralement, donnant lieu à deux scénarios hautement problématiques :
- Le cas de l’appariement positif : La taille d’échantillon la plus grande est associée à la population présentant la plus grande variance ($n_{\text{grand}} \rightarrow \sigma_{\text{grand}}^2$). Dans cette situation, la formule de pooling surestime largement la variance résiduelle globale en la tirant vers la valeur du grand groupe. L’erreur-type conjointe est alors artificiellement gonflée, ce qui réduit drastiquement la statistique t calculée. Le test devient hyper-conservateur : le risque d’erreur de première espèce chute bien en deçà du seuil nominal (souvent en dessous de 1 %), au prix d’une perte catastrophique de puissance statistique (erreur de type II).
- Le cas de l’appariement négatif : La taille d’échantillon la plus faible est associée à la population présentant la plus grande variance ($n_{\text{petit}} \rightarrow \sigma_{\text{grand}}^2$). Il s’agit du scénario le plus destructeur pour l’intégrité scientifique. La variance combinée est principalement déterminée par le grand échantillon à faible variance ; elle sous-estime tragiquement l’incertitude réelle pesant sur la différence de moyennes. Le dénominateur de la statistique t est anormalement contracté, catapultant la statistique t vers des valeurs extrêmes. Le taux de faux positifs s’envole alors de manière dramatique, atteignant fréquemment 15 %, 25 % voire 40 % pour un seuil nominal fixé à 5 %. Le chercheur conclut ainsi à une découverte statistiquement significative qui ne reflète qu’un artefact d’hétéroscédasticité.
2.3 Distinction entre test unilatéral et bilatéral face à l’hétérogénéité
L’asymétrie induite par des variances inégales n’exerce pas les mêmes ravages selon que le chercheur formule une hypothèse directionnelle (test unilatéral) ou non directionnelle (test bilatéral). Dans un test bilatéral, le risque d’erreur de première espèce nominal de 5 % est réparti équitablement aux deux extrémités de la distribution théorique (2,5 % dans chaque queue). Bien que le taux d’erreur global cumulé soit déformé en cas d’appariement négatif ou positif, la symétrie de la règle de décision bilatérale permet de tempérer marginalement certaines distorsions unilatérales extrêmes.
À l’inverse, lors de la mise en œuvre d’un test unilatéral — démarche courante lorsqu’un clinicien postule a priori qu’un traitement expérimental ne peut que surpasser un placebo —, la sensibilité à l’hétéroscédasticité combinée à la forme des queues de distribution s’accroît considérablement. Si la population affectée par la plus forte variabilité correspond au groupe pour lequel on attend une moyenne plus élevée, la queue de distribution empirique située du côté de la région de rejet devient anormalement épaisse. Il en résulte que le seuil critique unilatéral est franchi avec une probabilité encore plus déséquilibrée que dans le scénario bilatéral.
Les simulations statistiques menées en méthodologie psychologique démontrent sans ambiguïté que les tests directionnels unilatéraux appliqués à des données hétéroscédastiques issues d’échantillons inégaux génèrent des taux d’erreur de première espèce totalement incontrôlables, pouvant dépasser les 30 % dans des contextes pourtant fréquents en laboratoire (par exemple un groupe contrôle de 50 participants opposé à un groupe expérimental clinique restreint de 20 participants). Par conséquent, la recommandation méthodologique moderne impose de proscrire rigoureusement le recours au test t de Student classique sous formulation unilatérale dès lors que l’égalité absolue des variances ne peut être démontrée formellement.
3. Le postulat d’homogénéité des variances dans l’ANOVA à un ou plusieurs facteurs
3.1 Décomposition de la variance et calcul du ratio F
L’analyse de variance à un facteur (ANOVA one-way) généralise la logique du test t à la comparaison simultanée de trois groupes ou davantage. Son principe algorithmique repose sur le théorème de décomposition de la somme des carrés : la variation totale observée dans les données ($SS_{\text{totale}}$) est scindée de façon orthogonale en une variation attribuable aux différences entre les moyennes des groupes ($SS_{\text{inter}}$ ou Between-groups sum of squares) et une variation attribuable aux fluctuations individuelles au sein de chaque groupe ($SS_{\text{intra}}$ ou Within-groups sum of squares, fréquemment dénommée somme des carrés résiduels, $SS_{\text{résiduelle}}$).
Chacune de ces composantes est divisée par ses degrés de liberté respectifs ($k – 1$ pour la composante intergroupe, et $N – k$ pour la composante intragroupe) afin d’obtenir des carrés moyens. Le carré moyen résiduel ($MS_{\text{résiduel}}$ ou $MS_{\text{intra}}$) constitue la pièce maîtresse du dispositif : il représente la moyenne arithmétique pondérée des variances d’échantillon de l’ensemble des k groupes :
$$MS_{\text{résiduel}} = \frac{\sum_{j=1}^k (n_j – 1)s_j^2}{N – k}$$
La statistique inférentielle calculée est le ratio F :
$$F = \frac{MS_{\text{inter}}}{MS_{\text{résiduel}}}$$
Pour que cette statistique F suive exactement la distribution théorique de Fisher-Snedecor avec les paramètres $k-1$ et $N-k$, il est impératif que les erreurs au sein de chaque niveau de traitement soient des variables aléatoires indépendantes et identiquement distribuées suivant une loi normale d’espérance nulle et de variance identique $\sigma^2$. En cas de violation de l’homogénéité des variances ($\sigma_1^2 \neq \sigma_2^2 \neq dots \neq \sigma_k^2$), le carré moyen résiduel cesse de suivre une loi du Khi-carré standardisée unifiée. Le numérateur et le dénominateur cessent de satisfaire aux critères théoriques d’indépendance et d’échelles de dispersion conjointe. Il s’ensuit une distorsion majeure de la fonction de densité de probabilité du ratio F, rendant les p-valeurs tabulées hautement fallacieuses.
3.2 Plans factoriels et interactions complexes
La complexité de l’hétérogénéité des variances s’amplifie considérablement lorsque l’on quitte le cadre univarié à un facteur pour explorer des plans factoriels croisés (plans de type $2 \times 2$, $3 \times 2$, ou $2 \times 2 \times 2$). Dans ces dispositifs, l’attention du chercheur ne se focalise pas uniquement sur les effets principaux des différents facteurs, mais sonde de manière prioritaire l’existence de termes d’interaction, c’est-à-dire l’évaluation de la manière dont l’effet d’une variable indépendante se module en fonction des modalités d’une autre.
Dans les plans factoriels déséquilibrés — où les cellules expérimentales comportent des effectifs inégaux —, l’hétéroscédasticité affecte de façon dissymétrique les effets principaux et les termes d’interaction. Des simulations approfondies ont mis en exergue que les tests portant sur les interactions sont fréquemment bien plus vulnérables aux distorsions d’égalité des variances que les tests d’effets principaux. Une hétérogénéité localisée dans une seule cellule expérimentale (par exemple, un sous-groupe combinant un niveau d’anxiété élevé et une privation de sommeil sévère manifestant un écroulement de l’homogénéité de sa performance) est capable de contaminer l’ensemble du terme d’erreur résiduel commun de l’ANOVA factorielle.
Cette contamination induit une cascade d’erreurs méthodologiques :
- Des interactions hautement significatives peuvent émerger de façon totalement fallacieuse par simple artéfact d’une variance démesurée dans une condition expérimentale particulière.
- Inversement, de véritables interactions théoriques peuvent être entièrement masquées en raison d’un gonflement artificiel du dénominateur $MS_{\text{résiduel}}$, induit par des cellules périphériques instables.
- Le recours habituel aux décompositions des sommes de carrés de Type II ou de Type III ne pallie en rien cette déficience, car ces ajustements ne corrigent que les dépendances structurelles liées au déséquilibre des effectifs sans réparer la rupture d’homoscédasticité sous-jacente.
3.3 Application spécifique aux mesures répétées et sphéricité
Lorsque les données recueillies reposent sur des plans intra-participants ou longitudinaux, dans lesquels les mêmes sujets sont mesurés à travers différentes conditions expérimentales ou points temporels, le concept d’égalité des variances mute pour adopter une forme multidimensionnelle plus exigeante : la sphéricité. Dans l’ANOVA à mesures répétées, l’hypothèse d’homogénéité des variances univariée est insuffisante en raison de l’interdépendance structurelle des observations issues d’un même individu.
La condition de sphéricité — formalisée mathématiquement par l’hypothèse de Mauchly — exige l’égalité absolue des variances de toutes les différences possibles entre les paires de conditions intra-sujets. Soient trois conditions répétées $A$, $B$ et $C$. L’hypothèse de sphéricité impose la condition stricte suivante :
$$\text{Var}(Y_A – Y_B) = \text{Var}(Y_A – Y_C) = \text{Var}(Y_B – Y_C) = \text{constante}$$
La sphéricité représente une condition moins restrictive que celle de symétrie composée (qui requerrait à la fois l’égalité exacte de toutes les variances individuelles des conditions et l’égalité parfaite de toutes les covariances entre paires de conditions). Néanmoins, dans la pratique empirique en psychologie et en neuro-imagerie, la sphéricité est quasi systématiquement violée dès lors que le nombre de niveaux du facteur répété dépasse deux. Les points temporels plus rapprochés manifestent presque toujours une corrélation supérieure à celle unissant des points éloignés, ce qui fait inévitablement fluctuer la variance des différences.
La violation de la sphéricité a pour conséquence inéluctable une inflation substantielle du risque d’erreur de première espèce pour les tests F intra-sujets. L’analyste se voit contraint d’abandonner la statistique F usuelle au profit de versions pénalisées réduisant mathématiquement les degrés de liberté du numérateur et du dénominateur via le facteur d’ajustement epsilon ($epsilon$), tel que proposé par Greenhouse et Geisser (procédure très conservatrice) ou par Huynh et Feldt (procédure plus libérale adaptée aux valeurs d’epsilon proches de l’unité).
4. L’hypothèse d’homoscédasticité dans la régression linéaire ordinaire (OLS)
4.1 Le théorème de Gauss-Markov et les propriétés BLUE
Dans l’architecture de la régression linéaire univariée ou multiple estimée par la méthode des moindres carrés ordinaires (Ordinary Least Squares ou OLS), l’hypothèse d’égalité des variances des résidus constitue l’un des piliers du vénérable théorème de Gauss-Markov. Ce théorème fondamental établit les conditions sous lesquelles les estimateurs OLS des coefficients de régression $\hat{\beta}$ sont qualifiés de BLUE (Best Linear Unbiased Estimator), c’est-à-dire les meilleurs estimateurs linéaires sans biais.
Pour qu’un estimateur mérite l’attribut « Best » (meilleur), il doit présenter la variance d’échantillonnage minimale au sein de l’ensemble de la classe des estimateurs linéaires sans biais. Le théorème de Gauss-Markov prouve mathématiquement que cette efficacité optimale n’est garantie que si la matrice de variance-covariance conditionnelle des erreurs stochastiques $\mathbf{\epsilon}$ est une matrice scalaire unitaire :
$$\text{Var}(\mathbf{\epsilon} mid \mathbf{X}) = \sigma^2 \mathbf{I}_N$$
Cette condition implique deux réquisits distincts : l’absence d’autocorrélation entre les résidus (les éléments extradiagonaux de la matrice sont nuls) et l’homoscédasticité parfaite (tous les éléments de la diagonale principale sont rigoureusement égaux à une constante unique $\sigma^2$).
Il est capital de comprendre une nuance théorique majeure souvent mal comprise : la violation du postulat d’homoscédasticité n’induit aucun biais dans l’estimation ponctuelle des coefficients de régression. Les pentes estimées $\hat{\beta}_1, \hat{\beta}_2, dots, \hat{\beta}_p$ demeurent mathématiquement non biaisées : leur espérance reste rigoureusement égale aux vrais paramètres populationnels $\beta$, sous réserve que l’hypothèse d’exogénéité stricte ($E(\mathbf{\epsilon} mid \mathbf{X}) = 0$) soit satisfaite. Cependant, l’estimateur OLS perd sa propriété d’efficacité statistique maximale : il cesse d’être BLUE. Il existe alors d’autres familles d’estimateurs linéaires, notamment les moindres carrés pondérés ou généralisés, qui possèdent une variance d’échantillonnage strictement inférieure.
4.2 Impact sur l’estimation des erreurs-types des coefficients
Si la non-biaisitude des pentes est préservée en présence d’hétéroscédasticité, la mécanique inférentielle entourant ces coefficients est, quant à elle, totalement compromise. Dans le cadre OLS classique, la formule analytique consacrée pour estimer la matrice de variance-covariance des coefficients estimés repose expressément sur l’hypothèse d’homogénéité :
$$\text{Var}(\hat{\mathbf{\beta}}) = \sigma^2 (\mathbf{X}’\mathbf{X})^{-1}$$
Où $\sigma^2$ est estimé sans distinction par la variance résiduelle globale $s_e^2 = \frac{\mathbf{e}’\mathbf{e}}{N – p – 1}$. Or, si la véritable matrice de variance-covariance des perturbations est hétéroscédastique et prend la forme $\mathbf{\Omega} = \text{diag}(\sigma_1^2, \sigma_2^2, dots, \sigma_N^2)$, la structure exacte de dispersion des estimateurs répond en réalité à la formulation matricielle dite « en sandwich » :
$$\text{Var}(\hat{\mathbf{\beta}})_{\text{réelle}} = (\mathbf{X}’\mathbf{X})^{-1} (\mathbf{X}’ \mathbf{\Omega} \mathbf{X}) (\mathbf{X}’\mathbf{X})^{-1}$$
En employant aveuglément la formule standard au lieu de l’expression exacte, le logiciel d’analyse calcule des erreurs-types (standard errors, $SE(\hat{\beta}_j)$) qui sont biaisées de manière systématique. Dans la grande majorité des applications en sciences sociales, cette distorsion se traduit par une sous-estimation substantielle des véritables erreurs-types. En sous-estimant l’erreur-type, le ratio de Wald classique :
$$t = \frac{\hat{\beta}_j}{SE(\hat{\beta}_j)}$$
est artificiellement gonflé vers le haut, écrasant les p-valeurs et produisant des résultats fallacieusement significatifs. De plus, les intervalles de confiance à 95 % calculés autour des pentes de régression deviennent excessivement étroits : ils échouent à capturer la vraie valeur du paramètre dans 95 % des réplications théoriques, affichant parfois des taux de couverture effectifs chutant sous la barre des 80 %.
4.3 Formes courantes d’hétéroscédasticité en modélisation psychologique
L’hétéroscédasticité en modélisation psychologique et comportementale n’apparaît que rarement sous la forme d’un bruit blanc aléatoire ; elle s’organise le plus souvent selon des structures morphologiques conditionnées par la nature des processus étudiés. On répertorie trois configurations emblématiques particulièrement répandues dans la discipline :
- L’hétéroscédasticité monotone croissante (ou décroissante) liée aux apprentissages ou à la fatigue : Dans les protocoles chronométriques d’apprentissage moteur ou cognitif, la dispersion des temps de réaction est massive au début de l’expérimentation lorsque les participants explorent des stratégies divergentes. Au fur et à mesure des blocs d’essais, les performances s’automatisent et convergent, provoquant une contraction progressive et continue de la variance résiduelle à mesure que les valeurs prédites diminuent. Inversement, lors d’épreuves d’endurance cognitive prolongée, l’apparition asynchrone de la fatigue chez certains sujets génère un éclatement de la variance résiduelle pour les valeurs élevées de durée.
- L’hétérogénéité structurelle liée aux gradients développementaux ou démographiques : En psychologie du développement et en gérontologie cognitive, la variabilité interindividuelle des capacités cognitives (mémoire de travail, vitesse d’inhibition) augmente de façon structurelle avec l’âge chronologique. L’inclusion de participants s’étalant de l’enfance à l’âge adulte avancé induit systématiquement une variance résiduelle conditionnelle qui croît le long de l’axe des âges, dessinant une dispersion en éventail classique.
- Les effets de seuil (plancher et plafond) des instruments psychométriques : Lorsqu’une échelle d’auto-évaluation ou un test cognitif présente une difficulté inadaptée à la population échantillonnée, une fraction majeure des participants s’agglutine au score minimal ou maximal possible. Vers ces extrêmes de l’échelle de mesure, la dispersion des scores est mécaniquement comprimée à zéro par la borne de l’instrument, alors qu’elle s’exprime librement au milieu de l’échelle. Ce phénomène engendre une hétéroscédasticité en forme de fuseau ou de cloche inversée qui brise totalement l’hypothèse de variance constante.
5. Évaluation visuelle et exploratoire de l’égalité des variances
5.1 Diagrammes en boîte (boxplots) et représentations par dispersion
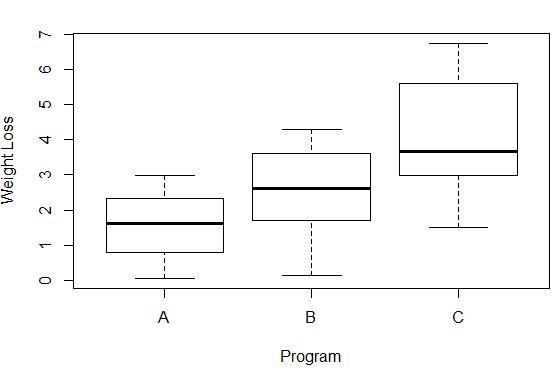
La première ligne de défense de l’analyste face aux écarts d’homogénéité réside dans l’analyse exploratoire et la visualisation graphique rigoureuse des données brutes. Pour les configurations d’échantillons indépendants ou d’ANOVA, le diagramme en boîte de Tukey (boxplot) constitue l’outil de criblage universel par excellence. L’examen attentif d’un boxplot offre une appréciation immédiate et robuste de la dispersion sans dépendre d’hypothèses distributionnelles restrictives.
L’évaluation repose principalement sur la hauteur de la boîte centrale, qui matérialise l’écart interquartile (IQR, délimité par le 25e et le 75e percentile et englobant 50 % des données centrales). Lorsque les hauteurs des boîtes diffèrent visuellement de manière flagrante d’un groupe à l’autre — par exemple si la boîte d’un groupe clinique est deux ou trois fois plus haute que celle du groupe témoin —, l’existence d’une violation de l’égalité des variances est hautement probable. Dans un second temps, l’analyste examine l’envergure totale des moustaches (qui s’étendent typiquement jusqu’à 1,5 fois l’IQR à partir des charnières) ainsi que le nombre et la distribution des valeurs considérées comme aberrantes ou atypiques (outliers).
Le boxplot permet également de dissocier simultanément la question de la dispersion et celle de la symétrie de la distribution : la position relative de la ligne médiane au sein de la boîte et l’égalité de longueur des moustaches supérieure et inférieure renseignent sur l’asymétrie (skewness). Pour un raffinement supérieur, la superposition d’un nuage de points individualisés avec instabilité horizontale aléatoire (jittered stripchart) ou le recours aux diagrammes en violon (violin plots) combinant l’estimation de densité par noyau offre une transparence absolue sur l’étalement des données réelles.
5.2 Graphiques des résidus versus valeurs prédites (Residuals vs Fitted)
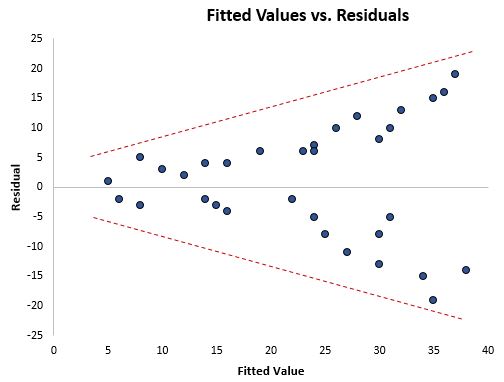
Dans le cadre de la modélisation linéaire et de la régression OLS, le graphique de diagnostic standard incontournable confronte les résidus ordinaires ou standardisés ($e_i$) portés sur l’axe des ordonnées aux valeurs prédites ou ajustées ($\hat{Y}_i$) portées sur l’axe des abscisses. Lorsque l’hypothèse d’homoscédasticité est scrupuleusement respectée dans la population étudiée, ce graphique affiche un nuage de points sans motif particulier, formant une bande horizontale régulière d’épaisseur constante tout au long de l’axe des ordonnées, répartie de manière symétrique et homogène de part et d’autre de la ligne horizontale horizontale $y = 0$.
L’expression graphique emblématique d’une violation de l’homoscédasticité réside dans l’apparition d’un motif caractéristique en cône ou en entonnoir (communément qualifié de fan shape ou cone shape). Dans cette configuration visuelle, les résidus sont très regroupés autour de zéro pour les faibles valeurs de $\hat{Y}$, puis s’écartent de plus en plus vigoureusement à mesure que $\hat{Y}$ progresse vers la droite, trahissant une variance d’erreur qui croît en fonction directe de la prédiction du modèle.
Ce graphique joue également un rôle capital de discrimination clinique entre deux violations distinctes : la non-linéarité et l’hétéroscédasticité. Une tendance curviligne (en forme de parabole, de U ou de S) tracée par les points ou par une courbe d’ajustement non paramétrique locale (LOESS) signale une défaillance de la spécification de la fonction moyenne (non-linéarité), qui peut coexister avec l’hétérogénéité des résidus ou en être la cause directe. L’isolation visuelle d’une simple dérive de l’épaisseur du nuage de points sans courbure de la ligne centrale confirme quant à elle une hétéroscédasticité pure.
5.3 Graphiques Scale-Location (Spread-Location)
Bien que le graphique des résidus bruts versus valeurs ajustées soit très populaire, il présente une limite perceptuelle humaine bien documentée : l’œil éprouve des difficultés à comparer rigoureusement la largeur d’un nuage de points lorsque la densité des observations varie le long de l’axe ou lorsque des asymétries unilatérales sont présentes. Pour surmonter cet écueil cognitif, le graphique Scale-Location (ou Spread-Location plot) propose une transformation élégante de l’axe vertical.
L’ordonnée de ce graphique affiche la racine carrée de la valeur absolue des résidus standardisés :
$$y_i = \sqrt{|\tilde{e}_i|}$$
Cette transformation mathématique produit deux effets cruciaux. D’une part, la prise de valeur absolue rabat l’ensemble des résidus dans le quadrant positif, éliminant la composante directionnelle du signe pour ne conserver que la pure magnitude de l’écart. D’autre part, l’application de la racine carrée tempère la courbure naturelle induite par les distributions des carrés et stabilise la variance de l’indicateur lorsque les résidus d’origine sont normaux. Sur ce graphique, l’hypothèse d’homoscédasticité se traduit par une ligne de lissage non paramétrique (LOESS) rigoureusement horizontale et plane.
Si la ligne rouge LOESS dévie de l’horizontale en adoptant une trajectoire ascendante continue, l’analyste dispose d’une preuve visuelle éclatante d’une augmentation de la dispersion des résidus corrélée aux valeurs ajustées. Si la ligne plonge aux extrémités ou forme une onde, cela révèle des zones localisées de sur-dispersion ou de sous-dispersion qui guideront le choix d’interventions ciblées.
6. Tests d’hypothèse formels pour l’évaluation de l’égalité des variances
6.1 Le test de Levene et ses variantes robustes (Brown-Forsythe)
Face aux subjectivités inhérentes à l’interprétation purement visuelle des graphiques, la communauté statistique a élaboré des tests d’hypothèse formels destinés à trancher statistiquement sur l’égalité des variances. Le test historiquement le plus préconisé dans les progiciels généralistes (SPSS, SAS) est le test de Levene (1960). L’intuition fondamentale d’Howard Levene a été de transformer le problème de l’évaluation de l’égalité des variances en une classique analyse de variance à un facteur appliquée non pas aux scores bruts, mais à une métrique d’écart individuel absolu.
Dans sa version originelle, le test de Levene calcule pour chaque individu $i$ appartenant au groupe $j$ la valeur absolue de l’écart à la moyenne de son groupe :
$$z_{ij} = |Y_{ij} – \bar{Y}_{\cdot j}|$$
L’analyse procède ensuite au calcul d’une ANOVA standard sur ces scores dérivés $z_{ij}$. Si les variances des groupes d’origine sont égales, l’espérance de ces distances absolues est identique entre les groupes, et le test F qui en résulte n’est pas significatif. Cependant, la formulation initiale de Levene s’est révélée hautement vulnérable aux violations de l’hypothèse de normalité : si les données brutes sont asymétriques ou présentent des queues épaisses (kurtosis prononcée), le test de Levene moyen génère un excès dramatique d’erreurs de première espèce.
Pour remédier à cette tare, Brown et Forsythe (1974) ont introduit une modification cruciale : substituer la médiane du groupe ($\tilde{Y}_{\cdot j}$) à la moyenne arithmétique lors du calcul des écarts absolus :
$$z_{ij}^* = |Y_{ij} – \tilde{Y}_{\cdot j}|$$
Le test de Brown-Forsythe qui en découle confère une robustesse exceptionnelle face aux distributions asymétriques et aux contaminations par des valeurs extrêmes. L’interprétation de la p-valeur suit la logique standard de l’inférence : un résultat significatif (typiquement $p < 0,05$) conduit au rejet de l'hypothèse nulle d'homogénéité des variances, intimant à l'expérimentateur d'adopter des méthodes correctrices.
6.2 Le test de Bartlett et le test de Fligner-Killeen
Antérieurement aux travaux de Levene, Maurice Bartlett avait proposé en 1937 un test d’égalité des variances dérivé de la théorie du rapport de vraisemblance (likelihood ratio test). Sous l’hypothèse formelle de normalité stricte des données dans chaque population parente, la statistique de Bartlett s’exprime comme suit :
$$K = \frac{(N – k) \ln(s_p^2) – \sum_{j=1}^k (n_j – 1) \ln(s_j^2)}{1 + \frac{1}{3(k – 1)} \left( \sum_{j=1}^k \left( \frac{1}{n_j – 1} \right) – \frac{1}{N – k} \right)}$$
Sous $H_0$, la statistique $K$ suit asymptotiquement une loi du Khi-carré à $k – 1$ degrés de liberté. Lorsque la condition de normalité parfaite est satisfaite, le test de Bartlett est le plus puissant disponible sur le plan théorique. Cependant, cette puissance exceptionnelle se paie au prix d’une fragilité devenue proverbiale dans la littérature statistique. Le test de Bartlett est hypersensible aux moindres déviations par rapport à la loi normale univariée : George Box a synthétisé cette faiblesse en écrivant avec ironie que « faire un test de Bartlett pour vérifier l’égalité des variances avant une ANOVA revient à prendre la mer dans un canot de sauvetage pour vérifier si les conditions météorologiques sont assez sûres pour un paquebot ».
À l’autre extrémité du spectre se trouve le test de Fligner-Killeen (1976). Il s’agit d’une procédure non paramétrique totalement affranchie de l’hypothèse de normalité, basée sur le classement par rangs des scores centrés par rapport à leurs médianes de groupe, auxquels on applique ensuite une transformation basée sur les quantiles de la loi normale. Le test de Fligner-Killeen s’avère l’un des outils les plus fiables et puissants lorsque les distributions sous-jacentes sont lourdement non-gaussiennes, bi-modales ou polluées par des valeurs aberrantes massives.
6.3 Limites inhérentes à l’utilisation exclusive des tests formels
Bien que les tests statistiques formels d’homogénéité offrent un confort psychologique certain aux chercheurs en fournissant un verdict binaire rassurant ($p > 0,05$ ou $p < 0,05$), la communauté méthodologique contemporaine s'accorde à condamner leur usage exclusif et non critique. Deux faiblesses statistiques fondamentales expliquent cette prise de position unanime :
- Le problème de la dépendance à la taille d’échantillon : Comme tout test de signification de l’hypothèse nulle (NHST), les tests de Levene, Bartlett ou Brown-Forsythe voient leur puissance statistique fluctuer drastiquement en fonction directe de la taille totale de l’échantillon ($N$). Dans les études à très grands effectifs (par exemple en épidémiologie ou dans les cohortes massives de psychologie en ligne avec $N > 2000$), le test formel détectera des divergences microscopiques et totalement triviales de variance entre les groupes (qui n’auraient strictement aucun impact délétère sur le test paramétrique sous-jacent) et affichera des p-valeurs hyper-significatives ($p 0,05$), berçant l’expérimentateur dans une fausse illusion de sécurité.
- Le paradoxe du pré-test (analyse en deux étapes) : Conditionner l’analyse principale (choisir entre le test t de Student et le test de Welch) sur le résultat formel d’un pré-test de Levene modifie et pollue le taux d’erreur de première espèce global du protocole analytique. Cette stratégie séquentielle en cascade introduit une dépendance statistique complexe qui altère les propriétés inférentielles de l’ensemble de la démarche.
7. Conséquences statistiques de la violation du postulat
7.1 Inflation ou déflation du taux d’erreur de première espèce (Type I)
L’impact le plus redoutable de la violation de l’hypothèse d’égalité des variances réside dans l’altération profonde du taux nominal d’erreur de première espèce ($\alpha$), traditionnellement calibré à la valeur consensuelle de 5 % ($\alpha = 0,05$). Dans un article séminal publié en 1954, George E. P. Box a modélisé mathématiquement les distorsions exactes subies par les tests inférentiels paramétriques lorsque les postulats sous-jacents sont brisés. Ses dérivations analytiques, corroborées depuis par des millions de simulations de Monte-Carlo, ont formalisé la dichotomie fondamentale entre inflation et déflation du risque d’erreur selon la structure de la covariance des données.
Comme évoqué précédemment, la distorsion prend des proportions alarmantes dans les plans déséquilibrés. Considérons un cas classique en recherche expérimentale : un chercheur compare un groupe témoin volumineux ($n_1 = 80$) et un groupe clinique rare ($n_2 = 20$). Si le groupe clinique manifeste une variabilité quatre fois supérieure à celle du groupe témoin ($\sigma_2^2 = 4\sigma_1^2$, soit un ratio d’écarts-types de 2:1), et que le chercheur utilise le test t de Student conventionnel ou l’ANOVA classique :
$$s_p^2 \approx \frac{79 s_1^2 + 19 (4s_1^2)}{98} = \frac{155}{98} s_1^2 \approx 1,58 s_1^2$$
Le calcul montre que la variance combinée est principalement régie par la variance du grand échantillon. Or, l’erreur-type réelle de la différence fait peser un poids massif sur le terme $s_2^2/n_2 = 4s_1^2/20 = 0,20 s_1^2$, alors que la formule combinée lui attribue artificiellement $s_p^2/n_2 \approx 1,58 s_1^2 / 20 \approx 0,079 s_1^2$. L’erreur-type est sous-estimée de plus de la moitié. Le taux d’erreur de première espèce réel explose pour atteindre approximativement 18 % à 22 % au lieu des 5 % supposés.
Dans un tel contexte, près d’une décision de rejet de l’hypothèse nulle sur cinq constitue une illusion statistique (un faux positif pur). Ce phénomène a constitué l’un des moteurs silencieux mais destructeurs de la crise de la reproductibilité qui a frappé la psychologie quantitative au cours de la dernière décennie.
7.2 Perte de puissance statistique et erreur de seconde espèce (Type II)
À l’autre extrémité du spectre d’interaction, le scénario de l’appariement positif ($n_{\text{grand}} \rightarrow \sigma_{\text{grand}}^2$) engendre une pathologie méthodologique tout aussi pernicieuse, bien que moins médiatisée que l’inflation des faux positifs : l’effondrement de la puissance statistique ($1 – \beta$) et l’explosion corrélative de l’erreur de type II (taux $\beta$).
Dans cette configuration, l’attribution d’un poids prépondérant à la forte variance du grand échantillon au sein de la variance combinée $s_p^2$ entraîne un gonflement massif du dénominateur du test t ou du carré moyen résiduel de l’ANOVA. En conséquence directe, le test statistique devient excessivement conservateur, son taux $\alpha$ effectif s’effondrant parfois sous la barre de 0,5 %. Dès lors, même en présence d’un effet expérimental réel, cliniquement ou théoriquement substantiel dans la population cible, le ratio empirique échoue systématiquement à dépasser la valeur critique tabulée.
Ce dysfonctionnement altère fondamentalement l’estimation de la taille d’effet standardisée. Le $d$ de Cohen classique, calculé à l’aide de la variance combinée déformée :
$$d = \frac{\bar{X}_1 – \bar{X}_2}{s_p}$$
se trouve substantiellement compressé vers zéro lorsque la variance combinée est surestimée par rapport à la dispersion propre de la population de référence. Il en résulte que les revues de littérature méta-analytiques intégrant ces estimations biaisées sous-évaluent systématiquement la magnitude réelle des phénomènes psychologiques étudiés, et que les calculs de puissance a priori réalisés pour dimensionner les études ultérieures sont faussés dès leur base.
7.3 Invalidation des comparaisons post-hoc multiples
Lorsqu’une analyse de variance à trois groupes ou plus révèle un effet omnibus significatif, la démarche expérimentale usuelle consiste à déployer une batterie de comparaisons par paires (tests post-hoc) afin de localiser précisément l’origine des contrastes significatifs tout en jugulant l’inflation globale du risque d’erreur de première espèce de la famille de tests (Family-Wise Error Rate, FWER). La grande majorité des procédures post-hoc canoniques, au premier rang desquelles trône le test de la plus petite différence significative honnête de Tukey (Tukey HSD), s’appuient directement sur le carré moyen résiduel unifié de l’ANOVA :
$$q = \frac{\bar{Y}_i – \bar{Y}_j}{\sqrt{\frac{MS_{\text{résiduel}}}{2} \left( \frac{1}{n_i} + \frac{1}{n_j} \right)}}$$
Cette architecture repose sur le postulat non négociable que chaque paire de sous-groupes partage la même dispersion d’erreur, valablement résumée par le terme global $MS_{\text{résiduel}}$. En cas de rupture de l’homogénéité des variances, cette mécanique s’effondre intégralement :
- Pour les paires de groupes dont les variances réelles sont intrinsèquement faibles par rapport aux autres conditions de l’étude, l’utilisation du $MS_{\text{résiduel}}$ (tiré vers le haut par les groupes très dispersés) produit des tests post-hoc excessivement conservateurs, incapables de détecter des contrastes réels manifestes.
- Inversement, pour les paires de groupes dont les variances empiriques sont les plus colossales de l’expérience, le dénominateur de Tukey sous-estime l’erreur propre à ce contraste spécifique, déclenchant une prolifération anarchique de fausses significations post-hoc.
- L’assurance mathématique d’un contrôle strict du FWER à exactement 5 % sur l’ensemble de la famille de tests n’est plus du tout garantie, ce qui invalide l’assise probabiliste des conclusions de l’article.
8. Solutions paramétriques directes : corrections et tests adaptés
8.1 Le test t de Welch pour deux échantillons indépendants
Face à la faillibilité prouvée du test t de Student classique en présence de variances hétérogènes, Bernard Lewis Welch a développé en 1938 et 1947 une alternative d’une élégance statistique remarquable : le test t de Welch (parfois baptisé test de Welch-Aspin ou test t à variances inégales). Le génie de la modélisation de Welch a été d’abandonner purement et simplement le principe du regroupement unifié des variances ($s_p^2$) au profit du calcul direct de l’erreur-type sans mise en commun :
$$SE_{(\bar{X}_1 – \bar{X}_2)} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
La statistique $t^*$ de Welch prend ainsi la forme :
$$t^* = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}}$$
Puisque les variances d’échantillonnage ne sont plus mutualisées, la distribution exacte de cette statistique ne correspond plus rigoureusement à une loi de Student standard basée sur $n_1 + n_2 – 2$ degrés de liberté. Pour surmonter cet obstacle théorique (connu sous le nom d’impasse de Behrens-Fisher), Welch a mobilisé l’approximation des degrés de liberté de Satterthwaite pour dériver une valeur ajustée fractionnaire des degrés de liberté ($\nu$ ou $df_{\text{Welch}}$) :
$$\nu = \frac{\left(\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}\right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
Cette équation ingénieuse ajuste dynamiquement les degrés de liberté en fonction du poids relatif des variances de chaque groupe. Si les variances sont rigoureusement identiques et les effectifs égaux, $\nu$ converge précisément vers $n_1 + n_2 – 2$. Si une variance domine de manière disproportionnée un petit effectif, $\nu$ s’effondre pour approcher les degrés de liberté du seul groupe instable, pénalisant adéquatement la valeur critique du test et maintenant le taux d’erreur de première espèce rigoureusement rivé à 5 %.
Une pléthore de travaux méthodologiques majeurs (Delacre, Lakens, & Leys, 2017 ; Ruxton, 2006) ont démontré de manière irréfutable que le test t de Welch présente des performances strictement équivalentes au test de Student lorsque les variances sont égales, tout en assurant une robustesse absolue lorsqu’elles divergent. Ces auteurs recommandent instamment d’adopter le test t de Welch comme option par défaut systématique pour l’ensemble des comparaisons de deux moyennes indépendantes, rendant obsolète la routine du pré-test de Levene.
8.2 L’ANOVA de Welch pour trois groupes et plus
De même que le test t de Welch surpasse son homologue classique pour deux groupes, l’ANOVA de Welch (1951) fournit la solution de premier plan pour tester les différences de moyennes entre trois groupes ou plus sous hétéroscédasticité avérée. L’ANOVA conventionnelle calcule une moyenne non pondérée des moyennes de groupes pour dériver le carré moyen intergroupe, et utilise une variance d’erreur globale commune. L’ANOVA de Welch brise cette symétrie en pondérant explicitement chaque moyenne de groupe par l’inverse de sa variance d’échantillonnage spécifique :
$$w_j = \frac{n_j}{s_j^2}$$
Cette formulation octroie un poids statistique prépondérant aux groupes dont la variabilité est la plus restreinte (ceux qui offrent l’information la plus stable et précise) et tempère proportionnellement l’influence des groupes dont la dispersion est erratique. La moyenne générale ajustée pondérée s’écrit alors :
$$\bar{X}^* = \frac{\sum_{j=1}^k w_j \bar{X}_j}{\sum_{j=1}^k w_j}$$
La statistique $F^*$ de Welch est calculée à partir de ces pondérations, et est évaluée face à une distribution de Fisher dont les degrés de liberté résiduels sont ajustés selon une formule d’approximation complexe analogue à celle de Satterthwaite. En complément direct de l’ANOVA de Welch, la procédure de comparaisons multiples de Games-Howell doit être systématiquement substituée au Tukey HSD. Le test de Games-Howell n’utilise aucun carré moyen commun : il applique la formule de Welch et l’approximation de Satterthwaite à chaque paire spécifique de groupes comparés, tout en intégrant un contrôle rigoureux du taux d’erreur global de la famille de contrastes basé sur la loi de l’étendue studentisée.
8.3 Le test de Brown-Forsythe pour les comparaisons multiples
Outre l’approche de Welch, une méthode paramétrique alternative remarquable pour remédier à l’hétérogénéité des variances au sein des analyses multigroupes a été proposée par Morton B. Brown et Alan B. Forsythe en 1974 : l’ANOVA de Brown-Forsythe modifiée. Contrairement à l’ANOVA de Welch qui module la moyenne générale par des pondérations inverses de la variance, la statistique $F^*$ de Brown-Forsythe conserve le calcul conventionnel de la somme des carrés intergroupes au numérateur, mais modifie profondément le dénominateur.
Le dénominateur de Brown-Forsythe n’est pas le $MS_{\text{résiduel}}$ unifié, mais une somme pondérée des variances d’échantillon individuelles :
$$\text{Dénominateur}_{BF} = \sum_{j=1}^k \left( 1 – \frac{n_j}{N} \right) s_j^2$$
Les degrés de liberté du dénominateur sont ensuite corrigés par une dérivation d’approximation de type Satterthwaite afin d’assurer que le ratio suive convenablement une loi F sous $H_0$. Les études de simulation comparatives révèlent que l’ANOVA de Welch et l’ANOVA de Brown-Forsythe sont toutes deux immensément supérieures à l’ANOVA classique dès que l’homogénéité des variances fait défaut. Cependant, de subtiles nuances opérationnelles les distinguent :
- L’ANOVA de Welch conserve une puissance statistique supérieure dans la vaste majorité des configurations expérimentales, en particulier lorsqu’une ou deux moyennes extrêmes coïncident avec des groupes à faible variance.
- L’ANOVA de Brown-Forsythe se révèle légèrement plus performante et robuste que celle de Welch dans un cas précis : lorsque le design expérimental comporte des groupes d’effectifs extrêmement inégaux combinés à des distributions modérément asymétriques ou leptokurtiques, ou lorsqu’un groupe déviant cumule à la fois une taille très réduite et une variance extrêmement faible.
9. Transformations de variables pour la stabilisation de la variance
9.1 Transformations mathématiques classiques et leurs cibles
Historiquement, avant la démocratisation de la puissance de calcul informatique et la généralisation logicielle des approximations de Welch et des estimateurs robustes, la réponse méthodologique standard face à des variances hétérogènes consistait à appliquer une transformation mathématique non linéaire à l’ensemble de la variable dépendante ($Y$). L’objectif mathématique d’une transformation stabilisatrice de variance est de modifier l’échelle de mesure de telle sorte que la dispersion des données cesse de corréler avec la grandeur de la moyenne.
Le choix de la transformation fonctionnelle optimale dépend intimement de la relation observée entre la moyenne du groupe ($\mu$) et sa variance ($\sigma^2$) :
- La transformation logarithmique ($ln(Y)$ ou $\log_{10}(Y + c)$) : Elle constitue la solution canonique lorsque l’écart-type est proportionnel à la moyenne ($\sigma_j propto \mu_j$), ce qui correspond à un coefficient de variation constant à travers les niveaux de facteurs. En psychologie cognitive, les données chronométriques (temps de réaction) présentent typiquement cette caractéristique : des réponses lentes génèrent une dispersion proportionnellement dilatée. Le logarithme comprime drastiquement les valeurs élevées tout en étirant les scores faibles, régularisant simultanément l’homogénéité des variances et réduisant l’asymétrie positive.
- La transformation racine carrée ($\sqrt{Y}$ ou $\sqrt{Y + 0,5}$) : Elle s’applique de manière privilégiée aux données de comptage d’occurrences discrètes, lesquelles suivent classiquement une distribution théorique de Poisson où la variance est intrinsèquement égale à la moyenne ($\sigma_j^2 = \mu_j$). C’est fréquemment le cas du nombre d’erreurs commises dans une tâche attentionnelle ou du nombre d’intrusions mnésiques.
- La transformation arc sinus de la racine carrée ($\arcsin(\sqrt{p})$) : Conçue pour stabiliser la variance des proportions, ratios ou pourcentages issus de processus binomiaux, où la variance dépend directement de la probabilité de succès : $\text{Var}(p) = \frac{\pi(1-\pi)}{n}$. La dispersion s’effondre naturellement vers les extrémités (0 et 1) et culmine à 0,5 ; la fonction angulaire étire les queues de distribution pour rétablir une variance conditionnelle plane.
9.2 La famille de transformations paramétriques Box-Cox
Plutôt que d’appliquer de manière empirique et discrétionnaire l’une des fonctions classiques évoquées ci-dessus, George Box et David Cox ont développé en 1964 une méthode formalisée permettant d’identifier algorithmiquement la transformation mathématique optimale au sein d’une famille continue de fonctions puissances. La transformation de Box-Cox est paramétrée par un exposant scalaire continu, généralement noté $lambda$ (lambda) :
$$Y^{(\lambda)} = \begin{\cases} \frac{Y^\lambda – 1}{\lambda} &a\mp; \text{si } \lambda \neq 0 \ln(Y) &a\mp; \text{si } \lambda = 0 \end{\cases}$$
La valeur numérique du paramètre $lambda$ est estimée par la méthode du maximum de vraisemblance (ou par maximisation du profil de log-vraisemblance) sur les données observées. Cette famille englobe un continuum de transformations usuelles : $lambda = 1$ correspond à l’absence de transformation (identité linéaire) ; $lambda = 0,5$ équivaut à la racine carrée ; $lambda = 0$ correspond au logarithme népérien ; $lambda = -1$ représente la transformation inverse ($1/Y$).
Une contrainte computationnelle absolue de la formulation classique de Box-Cox est qu’elle exige impérativement des valeurs brutes strictement positives ($Y_i > 0$). Pour étendre cette approche à des variables comportementales pouvant intégrer des zéros stricts ou des scores négatifs (comme des indices d’amorçage ou des variations de température corporelle), In-Kwon Yeo et Richard A. Johnson ont développé en 2000 une extension généralisée (la transformation de Yeo-Johnson), qui préserve les propriétés remarquables de stabilisation de variance de Box-Cox tout en autorisant le traitement sans rupture des valeurs négatives ou nulles.
9.3 Défis d’interprétation clinique et psychologique post-transformation
Bien que les transformations mathématiques résolvent avec efficacité les violations conjointes de normalité et d’homoscédasticité, leur implémentation en sciences humaines et médicales soulève des difficultés interprétatives et communicationnelles majeures que les analystes ne sauraient ignorer. Transformer une variable modifie fondamentalement l’unité de mesure et la nature substantielle de l’échelle psychologique sous-jacente.
Par exemple, si un chercheur applique une transformation logarithmique sur des scores d’anxiété mesurés par le questionnaire STAI, l’analyse inférentielle teste désormais l’égalité des moyennes des logarithmes des scores ($\overline{\ln(Y)}$), et non plus les moyennes des scores originaux. Les conclusions tirées portent dès lors sur une métrique compressée difficilement transposable au diagnostic clinique usuel. Pour restituer une intelligibilité descriptive, le chercheur procède souvent à une transformation inverse (dite back-transformation) par exponentiation des moyennes transformées. Or, en vertu de l’inégalité de Jensen, l’exponentielle de la moyenne d’une série de logarithmes ne restitue pas la moyenne arithmétique originale, mais correspond rigoureusement à la moyenne géométrique des données brutes, qui est systématiquement inférieure à la moyenne arithmétique :
$$\exp(E[\ln(Y)]) = \text{Moyenne Géométrique} le E[Y]$$
De surcroît, les contrastes, pentes de régression et intervalles de confiance transformés de nouveau dans l’échelle d’origine cessent d’être symétriques, complexifiant la présentation formelle des résultats. Dans le cadre de plans factoriels, appliquer une transformation non linéaire altère profondément la nature mathématique des interactions : une interaction multiplicative dans l’échelle brute peut être intégralement résorbée dans l’échelle logarithmique, ou inversement, une interaction totalement factice peut émerger par distorsion d’échelle. C’est pourquoi, face à ces écueils interprétatifs, la communauté statistique contemporaine privilégie désormais massivement les approches directes sans transformation d’échelle, fondées sur les tests de Welch ou les modèles linéaires robustes.
10. Approches avancées en régression : hétéroscédasticité et modélisation robuste
10.1 Erreurs-types robustes à l’hétéroscédasticité (estimateurs sandwich)
Dans la modélisation par régression linéaire multiple OLS, la stratégie contemporaine dominante pour neutraliser définitivement l’impact de l’hétéroscédasticité sans avoir recours à des transformations d’échelles déstabilisantes repose sur l’implémentation d’erreurs-types robustes à l’hétéroscédasticité (Heteroscedasticity-Consistent Standard Errors, ou estimateurs HC). Cette méthodologie a été initialement théorisée par Halbert White en 1980, qui a dérivé l’estimateur canonique baptisé HC0.
L’estimateur sandwich de White conserve intégralement les coefficients de régression originaux $\hat{\mathbf{\beta}}_{\text{OLS}}$, garantissant ainsi l’intelligibilité directe des pentes. Il substitue en revanche à la matrice de variance conventionnelle l’estimation empirique suivante :
$$\text{Var}_{\text{HC0}}(\hat{\mathbf{\beta}}) = (\mathbf{X}’\mathbf{X})^{-1} \left( \sum_{i=1}^N e_i^2 \mathbf{x}_i \mathbf{x}_i’ \right) (\mathbf{X}’\mathbf{X})^{-1}$$
Dans cette structure, les carrés des résidus individuels observés ($e_i^2$) servent d’estimateurs directs et non contraints des variances spécifiques conditionnelles $\sigma_i^2$. Bien que l’estimateur HC0 soit asymptotiquement parfait (convergeant rigoureusement vers la vraie variance lorsque $N to \infty$), des recherches ultérieures ont démontré qu’il manifeste un biais sévère sur des échantillons de taille modeste ($N < 250$), sous-estimant les erreurs-types et maintenant une inflation d'erreur de Type I.
Pour résoudre cette défaillance sur petits échantillons, une série de raffinements successifs a été modélisée :
- HC1 (MacKinnon & White, 1985) : Introduit une correction par les degrés de liberté en multipliant l’ensemble par le facteur scalaire $\frac{N}{N – p – 1}$, tempérant légèrement le biais sur petits effectifs.
- HC2 (MacKinnon & White, 1985) : Divise le carré de chaque résidu par la quantité $(1 – h_{ii})$, où $h_{ii}$ représente le levier statistique (leverage) de la $i$-ème observation issu de la matrice de projection chapeau ($\mathbf{H}$). Les points dotés d’un levier élevé voient ainsi leur influence résiduelle correctement réévaluée.
- HC3 (Davidson & MacKinnon, 1993) : Pénalise plus vigoureusement les points à fort levier en divisant chaque résidu au carré par $(1 – h_{ii})^2$. Les vastes simulations conduites par Long et Ervin (2000) ont consacré l’estimateur HC3 comme le standard d’excellence pour la recherche quantitative : il offre un contrôle irréprochable du taux d’erreur de première espèce, même avec de faibles effectifs ($N < 50$), indépendamment de la structure ou de la gravité de l'hétéroscédasticité présente.
- HC4 (Cribari-Neto, 2004) : Conçu spécifiquement pour juguler les effets délétères d’observations combinant à la fois un fort levier et une forte variance résiduelle, en exploitant un exposant modulé par le ratio de levier.
10.2 La régression par les moindres carrés pondérés (WLS)
Si les erreurs-types robustes HC corrigent parfaitement l’inférence (tests t et intervalles de confiance) sans altérer les coefficients OLS, elles ne restaurent pas l’efficacité statistique théorique : les estimateurs OLS demeurent sous-optimaux sur le plan de la variance d’échantillonnage minimale. Lorsque la forme précise de la variance conditionnelle des erreurs est connue ou peut être estimée de manière crédible, la méthode des moindres carrés pondérés (Weighted Least Squares, WLS) permet de recouvrer pleinement le statut de meilleur estimateur linéaire sans biais (BLUE).
Le principe fondamental de la régression WLS consiste à assigner à chaque observation $i$ un poids statistique ($w_i$) inversement proportionnel à sa variance d’erreur attendue :
$$w_i = \frac{1}{\sigma_i^2}$$
La minimisation mathématique ne porte plus sur la somme ordinaire des carrés des résidus, mais sur la somme pondérée de ces écarts :
$$\text{Minimiser } \sum_{i=1}^N w_i (Y_i – \hat{Y}_i)^2$$
Sur le plan géométrique et conceptuel, la méthode WLS rééchelonne l’espace des observations : les points appartenant à des segments où la dispersion résiduelle est colossale voient leur poids d’entraînement fortement atténué, évitant qu’ils ne tirent erratiquement la ligne de régression vers eux. À l’inverse, les observations collectées avec une précision microscopique (faible dispersion) reçoivent une influence prépondérante dans la détermination des pentes. L’estimateur analytique WLS s’exprime sous forme matricielle directe :
$$\hat{\mathbf{\beta}}_{\text{WLS}} = (\mathbf{X}’\mathbf{W}\mathbf{X})^{-1} \mathbf{X}’\mathbf{W}\mathbf{Y}$$
où $\mathbf{W}$ est une matrice diagonale contenant les poids $w_i$. Le défi majeur de l’implémentation WLS en pratique réside dans le fait que les véritables variances $\sigma_i^2$ sont généralement inconnues de l’investigateur. Elles doivent être estimées dans un premier temps en régressant le logarithme des résidus OLS au carré sur les variables explicatives suspectées de piloter l’hétérogénéité, démarche connue sous le nom de moindres carrés généralisés réalisables (Feasible Generalized Least Squares, FGLS). Si cette modélisation de la variance d’erreur est mal spécifiée, l’estimateur WLS peut paradoxalement s’avérer moins précis que le modèle OLS standard.
10.3 Modèles linéaires mixtes et modèles de localisation-échelle
L’essor de la modélisation statistique avancée a permis de transcender l’hétéroscédasticité en cessant de la considérer comme une simple nuisance à corriger, pour en faire une composante théorique noble du modèle. Les modèles linéaires mixtes (Linear Mixed Models, LMM), amplement exploités dans l’analyse de données hiérarchiques ou longitudinales, permettent de paramétrer explicitement et directement la structure de covariance des résidus intra-individuels ou inter-groupes.
Au sein des progiciels statistiques contemporains (comme le package nlme en langage R), des fonctions de variance explicites (telles que varIdent) permettent de déclarer que chaque sous-groupe d’un plan expérimental possède sa propre variance d’erreur résiduelle stochastique :
$$\text{Var}(\mathbf{\epsilon}_j) = \sigma^2 \mathbf{\Lambda}_j$$
Cette spécification permet d’estimer simultanément les paramètres de moyennes à effets fixes et les ratios d’écart-type propres à chaque modalité sans forcer un pooling artificiel de la variance. L’inférence sur les effets fixes est alors calculée en tenant compte de ces variances hétérogènes estimées par le maximum de vraisemblance restreint (REML).
L’aboutissement contemporain de cette démarche conceptuelle s’incarne dans les modèles de localisation-échelle (Location-Scale Models ou Double Generalized Linear Models, DGLM), popularisés notamment par Donald Hedeker en psychologie quantitative. Ces architectures sophistiquées estiment deux équations de régression simultanées et interconnectées à partir d’un même jeu de données :
- L’équation de localisation (Location) : Elle modélise la moyenne conditionnelle de la variable dépendante ($\mu_i = E[Y_i mid X_i]$) à travers une combinaison linéaire standard de régresseurs.
- L’équation d’échelle (Scale) : Elle modélise explicitement le logarithme de la variance résiduelle ($\ln(\sigma_i^2)$) en fonction d’un ensemble de covariables spécifiques.
Cette méthodologie ouvre des perspectives scientifiques révolutionnaires en psychologie différentielle : elle autorise l’expérimentateur à tester formellement si une intervention thérapeutique modifie l’instabilité ou la variabilité intra-individuelle des patients (l’hétérogénéité), indépendamment de son effet sur leur niveau moyen de performance cognitive ou affective.
11. Alternatives non paramétriques et approches par rééchantillonnage
11.1 Tests non paramétriques basés sur les rangs et leurs limites
Lorsqu’un chercheur observe que ses données violent simultanément les postulats de normalité univariée et d’homogénéité des variances, un réflexe méthodologique extrêmement répandu consiste à abandonner les tests paramétriques pour se réfugier dans l’arsenal des tests non paramétriques basés sur les rangs. Le test U de Mann-Whitney-Wilcoxon (pour deux échantillons) et le test de Kruskal-Wallis (pour trois groupes ou plus) sont ainsi couramment mobilisés sous l’assertion rassurante qu’ils sont exempts de toute contrainte distributionnelle.
Or, cette croyance relève d’une méconception théorique majeure dénoncée avec insistance par les mathématiciens statisticiens. Si les tests de Mann-Whitney et de Kruskal-Wallis ne requièrent effectivement aucune distribution gaussienne sous-jacente, leur utilisation en tant que tests stricts d’égalité des médianes ou des paramètres de position exige expressément l’hypothèse de formes distributionnelles identiques entre les populations comparées, ce qui inclut expressément l’égalité des variances.
Le test de Wilcoxon évalue en réalité l’hypothèse nulle de dominance stochastique :
$$H_0: P(X_1 > X_2) = 0,5$$
Si deux populations partagent une même médiane théorique mais possèdent des variances radicalement inégales, la distribution conjointe des rangs s’en trouve profondément déséquilibrée. Les travaux de simulation ont démontré que le test de Mann-Whitney-Wilcoxon appliqué à des groupes d’effectifs inégaux et de variances hétérogènes subit une inflation de l’erreur de Type I tout aussi cataclysmique que le test t de Student classique (le taux $\alpha$ dépassant régulièrement les 25 % en cas d’appariement négatif). Par conséquent, substituer un test sur les rangs classique au test t pour résoudre un problème d’hétéroscédasticité constitue une erreur de jugement statistique.
11.2 Méthodes de rééchantillonnage (Bootstrapping)
Face aux défaillances des méthodes analytiques fondées sur des hypothèses rigides d’homogénéité des variances, les techniques de calcul intensif par rééchantillonnage informatique, au premier plan desquelles s’impose le bootstrapping non paramétrique théorisé par Bradley Efron (1979), fournissent une voie de résolution empirique particulièrement puissante.
Le bootstrap s’affranchit de la nécessité de dériver une loi de distribution théorique fermée sous des postulats d’homogénéité stricte. Son principe opératoire consiste à traiter l’échantillon empirique initial comme une pseudo-population représentative, au sein de laquelle l’ordinateur tire par tirage avec remise des milliers de ré-échantillons (typiquement $B = 2000$ à $10,000$ itérations) de taille $n$. Pour chaque réplication bootstrap, la statistique d’intérêt — par exemple la différence brute de moyennes ($\bar{X}_1^* – \bar{X}_2^*$) ou une pente de régression $\hat{\beta}_j^*$ — est calculée et consignée.
La compilation ordonnée de ces milliers d’estimations empiriques trace la distribution d’échantillonnage directe du paramètre. L’inférence s’effectue ensuite par la construction d’intervalles de confiance empiriques :
- L’intervalle de confiance percentile bootstrap : Les bornes inférieure et supérieure à 95 % sont simplement définies par le 2,5e et le 97,5e percentile de la distribution empirique générée. Cet intervalle capture la variance intrinsèque spécifique de chaque échantillon sans rien postuler sur leur équivalence préalable.
- L’intervalle de confiance BCa (Bias-Corrected and Accelerated) : Il affine la méthode des percentiles en introduisant une correction mathématique formalisée pour l’asymétrie empirique (paramètre d’accélération $a$) et le biais médian (paramètre $z_0$). L’intervalle BCa démontre une précision de couverture remarquable face à des structures de variances hétérogènes conjuguées à des distributions fortement asymétriques.
En psychologie moderne, le bootstrap constitue l’étalon-or incontesté pour tester les effets indirects dans les modèles de médiation (Preacher & Hayes, 2008), où les distributions des produits de coefficients violent de manière structurelle les conditions canoniques d’homogénéité et de normalité.
11.3 Tests de permutation exacte et asymptotique
Les tests de randomisation ou de permutation, initialement conceptualisés par Ronald Fisher dans les années 1930, offrent une alternative non paramétrique rigoureuse pour l’évaluation de l’hypothèse nulle sans dépendance aux lois de probabilité classiques. Leur fondement logique repose sur le principe d’interchangeabilité (exchangeability) : sous l’hypothèse nulle d’absence totale d’effet ou de différence entre les traitements, les étiquettes assignant chaque observation à un groupe expérimental donné sont purement arbitraires.
L’algorithme de permutation réassigne aléatoirement les scores observés entre les différents groupes expérimentaux en préservant les tailles d’échantillons originelles, puis recalcule la statistique de divergence choisie à chaque itération. En évaluant la proportion de permutations réassignées qui affichent une statistique au moins aussi extrême que celle mesurée sur les données réelles, l’expérimentateur dérive une p-valeur exacte ou asymptotique exempte de toute approximation paramétrique.
Cependant, une mise en garde épistémologique cruciale s’impose : le principe fondamental d’interchangeabilité sous l’hypothèse nulle n’est rigoureusement satisfait que si les distributions des populations d’origine sont parfaitement identiques en tout point (même forme, même médiane, et même variance). Si les groupes manifestent des variances intrinsèquement distinctes, les observations ne sont plus théoriquement interchangeables sous $H_0$. Un test de permutation standard utilisant la différence brute de moyennes $(\bar{X}_1 – \bar{X}_2)$ comme statistique de pivot verra son taux d’erreur de première espèce sévèrement biaisé en cas d’effectifs inégaux et de variances hétérogènes.
Pour immuniser les tests de permutation face à l’hétérogénéité des variances, les statisticiens contemporains préconisent d’utiliser non pas une statistique brute, mais une statistique étudiante de Welch ($t^*$) comme métrique de permutation (procédure de permutation dite studentisée ou test de Welch permé). Cette hybridation algorithmique combine l’immunité structurelle de la correction de Welch face aux variances inégales et la flexibilité distributionnelle totale du rééchantillonnage exact.
12. Protocole décisionnel et bonnes pratiques de rapportage en recherche psychologique
12.1 Arbre décisionnel pour l’analyse des données quantitatives
Afin de traduire l’ensemble de ces impératifs théoriques en une pratique de laboratoire opérationnelle, reproductible et robuste, la formalisation d’un arbre décisionnel standardisé s’avère indispensable pour tout chercheur en psychologie quantitative. Ce protocole systématique s’articule en trois étapes séquentielles intégrées :
- Étape 1 : Exploration visuelle et descriptive préalable :
- Générer systématiquement des diagrammes en boîte enrichis (boxplots superposés aux points réels individuels) pour chaque modalité et condition. Examiner l’homogénéité de l’écart interquartile (hauteur des boîtes) et la symétrie des moustaches.
- En régression, inspecter rigoureusement le graphique des résidus versus valeurs prédites (recherche active d’un motif en entonnoir) ainsi que le graphique Scale-Location (horizontalité de la courbe LOESS).
- Calculer et rapporter le ratio des variances maximales et minimales ($s_{\text{\max}}^2 / s_{\text{\min}}^2$). Si ce ratio excède 1,5 avec des effectifs inégaux, ou s’il excède 4 avec des effectifs strictement égaux, une alerte méthodologique majeure doit être consignée.
- Étape 2 : Évaluation conjointe de la normalité et de l’équilibre des effectifs :
- Vérifier le ratio des tailles d’échantillons ($n_{\text{grand}} / n_{\text{petit}}$). Dès lors que ce ratio s’écarte de 1:1 (plans déséquilibrés), la tolérance de l’analyse classique face à l’hétérogénéité devient strictement nulle.
- En cas de doute sur la sévérité de la violation, calculer le test de Brown-Forsythe (Levene basé sur la médiane) ou de Fligner-Killeen en guise d’information diagnostique contextuelle, sans jamais faire dépendre l’analyse principale exclusivement de son franchissement binaire du seuil 0,05.
- Étape 3 : Sélection raisonnée et automatisée du modèle inférentiel :
- Comparaison de deux groupes : Appliquer de manière systématique et inconditionnelle le test t de Welch (avec degrés de liberté de Satterthwaite), indépendamment du résultat des pré-tests. Cette recommandation contemporaine garantit une protection absolue sans coût statistique réel.
- Comparaison de trois groupes ou plus : Privilégier l’ANOVA de Welch associée aux tests post-hoc de Games-Howell. En présence de violations conjointes de la normalité, mobiliser le bootstrap BCa ou des tests de permutation studentisés.
- Régression linéaire multiple : Implémenter de routine les erreurs-types robustes de type HC3 (ou HC4 en présence d’observations à fort levier) ou calibrer un modèle linéaire mixte incluant une fonction de variance explicite (
varIdent).
12.2 Normes de rapportage selon l’APA (American Psychological Association, 7e éd.)
L’intégrité de la communication scientifique impose une transparence absolue lors de la restitution des analyses statistiques dans les manuscrits soumis à publication. Selon les directives de l’American Psychological Association (APA, 7e édition, Section 6.44), le chercheur ne doit jamais masquer la présence d’hétérogénéité ni omettre d’expliciter les ajustements statistiques appliqués pour y répondre.
La restitution formelle de ces résultats répond à des conventions d’écriture typographiques et mathématiques standardisées très précises :
- Rapportage d’un test t de Welch : Il est impératif de mentionner explicitement que la correction de Welch pour variances inégales a été appliquée. La statistique t doit être rapportée avec les degrés de liberté fractionnaires réels issus de la formule d’approximation de Satterthwaite, sans jamais les arrondir arbitrairement à des entiers :
« L’hypothèse d’égalité des variances étant compromise, un test t de Welch pour échantillons indépendants a été conduit. La performance mnésique moyenne du groupe expérimental (M = 14,32, SD = 4,87) s’est avérée significativement supérieure à celle du groupe témoin (M = 11,05, SD = 2,12), t(34,28) = 2,84, p = 0,007, d = 0,86, IC à 95 % [0,94, 5,60]. » - Rapportage d’une ANOVA de Welch et contrastes associés :
« En raison d’une disparité substantielle de variabilité entre les trois cohortes, une ANOVA robuste de Welch a été mobilisée. L’effet omnibus du niveau d’anxiété s’est révélé significatif, F_Welch(2, 28,45) = 8,92, p < 0,001, omega^2 = 0,14. Les comparaisons par paires a posteriori conduites à l'aide de la procédure de Games-Howell ont indiqué que le groupe à anxiété sévère présentait des temps de réponse significativement plus élevés que le groupe asymptomatique (p = 0,002) et le groupe modéré (p = 0,028). » - Rapportage en régression linéaire robuste :
« Face à la présence avérée d’hétéroscédasticité diagnostiquée par l’inspection des résidus vs fitted, les paramètres de régression ont été estimés par la méthode OLS conjointe à l’estimateur d’erreurs-types robustes HC3 de Davidson-MacKinnon. Le score d’inhibition cognitive prédit significativement la fluidité verbale, B = 0,42, SE_HC3 = 0,11, t(118) = 3,82, p < 0,001, IC à 95 % [0,20, 0,64]. »
12.3 Transparence, science ouverte et reproductibilité computationnelle
Enfin, le traitement adéquat de l’égalité des variances s’inscrit au cœur du mouvement planétaire pour la science ouverte (Open Science) et la reproductibilité computationnelle. La flexibilité dont dispose l’analyste face au choix de ses méthodes de vérification de postulats et d’ajustements statistiques constitue une source majeure de degrés de liberté non documentés (researcher degrees of freedom), susceptibles d’alimenter des pratiques de recherche douteuses (QRP) telles que le p-hacking.
Naviguer entre le test t classique, le test de Welch, une transformation logarithmique ou un test non paramétrique jusqu’à ce que la p-valeur bascule opportunément sous le seuil symbolique de 0,05 corrompt l’édifice scientifique. Pour éradiquer ces biais systémiques, plusieurs pratiques vertueuses doivent être systématiquement adoptées :
- Le pré-enregistrement des analyses (Preregistration) : Les chercheurs doivent spécifier préalablement sur des plateformes dédiées (telles que le Center for Open Science – OSF) leur plan analytique d’investigation. Ce document doit consigner formellement la décision d’employer par défaut les procédures robustes (comme le test de Welch ou les erreurs-types HC3), coupant court à toute tentation d’arbitrage post-hoc.
- Le partage intégral des scripts computationnels : Les scripts d’analyse rédigés sous des environnements de programmation statistique ouverts (R, Python) ou des logiciels libres pilotés par menus transparents (JASP, Jamovi) doivent être déposés en accès public dans des dépôts pérennes. Le code source doit consigner sans fard l’intégralité du pipeline méthodologique : scripts de diagnostic visuel, calculs d’erreurs-types robustes et modélisations alternatives d’analyse de sensibilité.
- La publication d’analyses de sensibilité multivers : Lorsque la frontière entre homoscédasticité et hétéroscédasticité est ambiguë, rapporter en annexes ou en matériel supplémentaire la matrice complète des résultats obtenus sous différents prismes analytiques (test classique, test de Welch, régression robuste, bootstrap) confère aux conclusions de l’article une robustesse et une autorité empirique inébranlables.
Références
Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
Cribari-Neto, F. (2004). Asymptotic inference under heteroskedasticity of unknown form. Computational Statistics & Data Analysis, 45(2), 215–233. https://doi.org/10.1016/S0167-9473(02)00366-3
Davidson, R., & MacKinnon, J. G. (1993). Estimation and inference in econometrics. Oxford University Press.
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Fligner, M. A., & Killeen, T. J. (1976). Distribution-free two-sample tests for scale. Journal of the American Statistical Association, 71(353), 210–213. https://doi.org/10.1080/01621459.1976.10481517
Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.2307/1164979
Hedeker, D., Mermelstein, R. J., & Demirtas, H. (2008). An application of a mixed-effects location scale model for analysis of ecological momentary assessment (EMA) data. Biometrics, 64(2), 627–634. https://doi.org/10.1111/j.1541-0420.2007.00898.x
Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. https://doi.org/10.1016/0304-4076(85)90158-7
Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879
Ruxton, G. D. (2006). The unequal variance t-test is underused. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3/4), 350–362. https://doi.org/10.1093/biomet/29.3-4.350
Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Yeo, I. K., & Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. https://doi.org/10.1093/biomet/87.4.954