
Dans le vaste édifice de la statistique inférentielle contemporaine, peu de postulats occupent une position aussi centrale, et pourtant aussi fréquemment mal interprétée, que l’hypothèse de normalité. Pierre angulaire des modèles dits paramétriques, cette supposition mathématique postule que les données observées, ou plus rigoureusement les erreurs aléatoires associées à leur mesure, se distribuent selon la célèbre loi normale théorisée par Carl Friedrich Gauss et Pierre-Simon de Laplace. Qu’il s’agisse de comparer l’efficacité de deux protocoles psychothérapeutiques à l’aide d’un test t de Student, d’évaluer l’impact de multiples facteurs psychosociaux par une analyse de variance, ou de modéliser des trajectoires de développement cognitif via la régression linéaire, la normalité est omniprésente dans les manuels universitaires et les logiciels d’analyse de données.
Pourtant, la pratique de la recherche empirique, tout particulièrement en psychologie, en sciences cognitives et dans l’ensemble des sciences humaines et sociales, confronte quotidiennement les chercheurs à une réalité bien éloignée de l’abstraction mathématique. Les distributions de temps de réaction s’étirent invariablement vers la droite, les échelles cliniques mesurant la dépression ou l’anxiété s’accumulent au plancher chez les participants sains, et les comportements humains manifestent des régularités complexes que la symétrie parfaite d’une cloche gaussienne peine à encapsuler. Face à cette discordance entre l’idéal théorique et la rugosité du terrain empirique, l’analyste se trouve régulièrement confronté à des dilemmes majeurs : mon modèle est-il valide ? Les valeurs p affichées sur mon écran reflètent-elles la réalité scientifique ou ne sont-elles que des artéfacts d’une violation méthodologique ?
Comprendre en profondeur la nature de l’hypothèse de normalité ne relève donc pas d’une simple coquetterie académique, mais d’une exigence épistémologique et méthodologique incontournable pour quiconque souhaite produire des connaissances scientifiques robustes, reproductibles et éthiquement défendables. L’objectif de cet article de référence est d’explorer de manière exhaustive les fondements mathématiques, les implications inférentielles, les protocoles de diagnostic graphique et formel, ainsi que les stratégies de remédiation contemporaines liées à la normalité. En démystifiant les dogmes rigides et en dissipant les confusions pernicieuses, nous fournirons au chercheur et à l’étudiant avancé les repères théoriques et pratiques indispensables pour naviguer avec discernement dans l’univers de la modélisation statistique moderne.
1. Fondements théoriques : Définition et origine mathématique de l’hypothèse de normalité
1.1 Définition de la distribution gaussienne en statistique inférentielle
La loi normale, souvent qualifiée de distribution gaussienne ou de courbe en cloche, est une loi de probabilité continue fondamentale caractérisée par sa fonction de densité symétrique et unimodale. Mathématiquement définie sur l’ensemble des réels par une équation faisant intervenir la constante d’Euler et le nombre pi, elle se distingue par des propriétés analytiques d’une rare élégance. Au sommet de cette distribution, la moyenne arithmétique, la médiane (le point séparant l’échantillon en deux moitiés égales) et le mode (la valeur la plus fréquente) coïncident rigoureusement en un unique point central d’équilibre. Cette coïncidence parfaite traduit une symétrie axiale absolue : pour toute déviation positive d’une magnitude donnée par rapport au centre, il existe une probabilité rigoureusement identique d’observer une déviation négative de même amplitude.
Dans l’histoire des sciences du comportement et de la psychométrie, la distribution gaussienne a rapidement été investie d’une portée quasi ontologique. Dès les travaux pionniers d’Adolphe Quetelet et de Francis Galton, l’idée s’est imposée que les caractéristiques anthropométriques, puis les aptitudes cognitives et les traits de personnalité, devaient se conformer naturellement à ce modèle mathématique. Le modèle psychométrique classique postule ainsi que le score observé d’un individu à un test psychologique représente la sommation d’un score vrai latent et d’une infinité de micro-perturbations environnementales, physiologiques ou attentionnelles non contrôlées. Cette conception d’une variabilité humaine distribuée selon une cloche harmonieuse a forgé le développement des échelles d’intelligence standardisées (telles que le quotient intellectuel de David Wechsler) et structure encore aujourd’hui l’étalonnage de la quasi-totalité des instruments standardisés d’évaluation psychologique.
1.2 Le théorème central limite et son rôle explicatif
Pour comprendre pourquoi la loi normale s’immisce dans tant de phénomènes naturels et de procédures inférentielles, il est impératif d’examiner le théorème central limite (TCL), l’un des sommets intellectuels de la théorie des probabilités. Formulé dans ses versions modernes par Laplace, Aleksandr Lyapunov et Jarl Waldemar Lindeberg, le TCL énonce que la somme, ou de manière équivalente la moyenne arithmétique, d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées converge en loi vers une distribution normale, quelle que soit la forme de la distribution sous-jacente d’origine, pourvu que cette dernière possède une variance finie.
Une distinction conceptuelle capitale doit être opérée à ce stade entre la distribution de la population parente et la distribution d’échantillonnage de la moyenne. Si les observations individuelles prélevées dans une population peuvent présenter une distribution exponentielle, bimodalement polarisée ou uniformément plate, la moyenne calculée à partir d’échantillons répétés de taille suffisante adoptera inexorablement une allure gaussienne. Les conditions de validité du TCL dépendent intrinsèquement de la sévérité de l’écart à la normalité de la population mère. Pour des distributions modérément asymétriques, un effectif de 30 observations par groupe est traditionnellement considéré dans les manuels d’introduction comme suffisant pour garantir une approximation acceptable. Toutefois, face à des distributions sévèrement contaminées ou présentant des queues extrêmement lourdes, des effectifs de plusieurs centaines d’unités statistiques deviennent indispensables pour préserver l’intégrité de la convergence asymptotique.
1.3 Paramètres fondamentaux : Espérance, variance et dispersion
L’une des raisons majeures de la suprématie de la loi normale dans la modélisation statistique réside dans sa parcimonie paramétrique absolue : elle est intégralement déterminée par seulement deux paramètres mathématiques. Le premier est l’espérance mathématique, notée mu (μ), qui caractérise la tendance centrale ou le paramètre de position de la distribution. En l’absence de biais de mesure, μ fixe le barycentre des observations et détermine la localisation du sommet de la cloche sur l’axe des abscisses. Le second paramètre est la variance, notée sigma carré (σ²), dont la racine carrée positive constitue l’écart-type (σ), définissant le paramètre d’échelle ou de dispersion. Cet écart-type quantifie l’étalement horizontal de la courbe et gouverne la distance séparant l’axe de symétrie des deux points d’inflexion où la concavité de la fonction s’inverse.
Cette structure mathématique donne naissance à la célèbre règle empirique des trois sigmas, également désignée sous le vocable de règle 68-95-99.7. En vertu des propriétés de l’intégrale de Gauss, exactement 68,27 % de la masse de probabilité se concentre dans l’intervalle délimité par μ ± 1σ, 95,45 % s’inscrit dans l’intervalle μ ± 2σ (ou plus précisément 95 % entre μ ± 1,96σ), et 99,73 % des réalisations aléatoires demeurent circonscrites entre μ ± 3σ. Dans le champ de la psychométrie clinique et différentielle, cette propriété autorise la transformation directe des scores bruts en notes standardisées universelles : les scores z (de moyenne 0 et d’écart-type 1), les notes T (de moyenne 50 et d’écart-type 10) ou les échelles de QI standard (de moyenne 100 et d’écart-type 15). L’écart à la moyenne prend alors immédiatement une signification probabiliste directe relative à la rareté du profil cognitif ou psychopathologique évalué.
2. Pourquoi la normalité est-elle cruciale dans les modèles paramétriques ?
2.1 Le principe de l’inférence statistique et la validité de la généralisation
L’ambition première de la statistique inférentielle consiste à tirer des conclusions fiables et généralisables sur les caractéristiques inobservables d’une population globale à partir de l’observation fragmentaire d’un échantillon fini de sujets. Pour opérer ce saut inductif sans sombrer dans l’arbitraire, les modèles paramétriques reposent sur la formulation explicite d’une fonction de vraisemblance, c’est-à-dire un modèle probabiliste théorique spécifiant la probabilité conjointe d’obtenir les données observées en fonction des paramètres du modèle. La loi normale sert ici de matrice génératrice par excellence.
Lorsque la forme distributionnelle réelle s’écarte substantiellement du postulat gaussien postulé par le modèle mathématique, la fonction de vraisemblance devient erronée ou inadéquate. Il en résulte un risque majeur de biais d’inférence, menant à une estimation distordue de la précision des estimateurs. Plus critique encore, le calcul de la probabilité critique, la fameuse valeur p (ou p-value), repose intégralement sur l’adéquation entre la distribution d’échantillonnage théorique de la statistique de test (telle que la loi de Student ou la loi de Fisher-Snedecor) et sa distribution empirique réelle sous l’hypothèse nulle. Si l’hypothèse de normalité s’effondre sans que le théorème central limite ne vienne compenser cette rupture, les seuils critiques tabulés ne correspondent plus aux probabilités réelles d’occurrence des événements extrêmes, compromettant l’intégrité de l’arbitrage scientifique.
2.2 Préservation des taux d’erreur de type I et de type II
Dans le paradigme décisionnel formalisé par Jerzy Neyman et Egon Pearson, la validité d’une démarche de test repose sur le contrôle rigoureux de deux risques antagonistes : le risque d’erreur de type I (ou risque alpha, consistant à rejeter à tort une hypothèse nulle pourtant vraie) et le risque d’erreur de type II (ou risque bêta, consistant à échouer à détecter un effet ou une différence qui existe réellement dans la population). La puissance statistique d’une étude, quantifiée par le complémentaire 1 – β, dépend étroitement du respect des hypothèses sous-jacentes du modèle.
Une violation sévère de l’hypothèse de normalité produit des répercussions directes et insidieuses sur ces deux taux d’erreur. Lorsque les distributions présentent une asymétrie marquée combinée à une hétérogénéité des variances entre les groupes, le taux d’erreur alpha réel peut s’envoler dramatiquement au-delà du seuil conventionnel de 5 %, atteignant fréquemment 10 %, 15 % voire davantage. Le chercheur s’expose alors à déclarer faussement des découvertes scientifiques, alimentant la crise de la reproductibilité des résultats expérimentaux. Réciproquement, face à des distributions leptokurtiques ou polluées par des observations distantes, la variance des estimateurs augmente de façon démesurée, provoquant un effondrement de la puissance statistique. Dans ce cas de figure, des interventions thérapeutiques ou psychoéducatives authentiquement efficaces risquent d’être abandonnées prématurément par manque de sensibilité analytique.
2.3 Propriétés d’optimalité des estimateurs gaussiens
La primauté de l’hypothèse de normalité dans les sciences quantitatives découle également d’un ensemble de théorèmes fondamentaux garantissant l’excellence mathématique des estimateurs calculés sous cette hypothèse. Dans le cadre de l’estimation linéaire, le réputé théorème de Gauss-Markov établit que l’estimateur des moindres carrés ordinaires constitue le meilleur estimateur linéaire non biaisé (connu sous l’acronyme anglophone BLUE : Best Linear Unbiased Estimator), présentant la variance la plus faible parmi tous les estimateurs linéaires sans biais, même sans présupposer la normalité des termes d’erreur.
Cependant, lorsque l’hypothèse de normalité des erreurs est formellement satisfaite, cette propriété d’optimalité franchit un palier qualitatif déterminant : l’estimateur des moindres carrés devient alors équivalent à l’estimateur obtenu par la méthode du maximum de vraisemblance. Il atteint la borne inférieure de Cramér-Rao, devenant ainsi le meilleur estimateur non biaisé absolu (BUE), surpassant non seulement les estimateurs linéaires, mais également l’ensemble des estimateurs non linéaires concevables. Cette efficacité maximale confère une stabilité mathématique exemplaire aux intervalles de confiance construits autour des coefficients de régression ou des moyennes conditionnelles, assurant la largeur la plus resserrée possible pour un niveau de confiance fixé (habituellement 95 %).
3. Les tests statistiques fondés sur l’hypothèse de normalité
3.1 Les tests t de Student pour échantillons uniques et indépendants
Le test t de Student, développé à l’origine par William Sealy Gosset sous le pseudonyme de Student en 1908, constitue l’un des outils les plus omniprésents en recherche quantitative. Dans sa configuration pour échantillon unique ou pour deux échantillons indépendants, la construction mathématique de la variable pivotale t exige impérativement que la variable dépendante continue mesurée suive une loi normale au sein de chaque groupe ou population parente considérée. Cette condition permet au numérateur (la différence de moyennes) de suivre une loi gaussienne et au dénominateur (l’erreur standard estimée) d’être proportionnel à la racine carrée d’une distribution du chi-deux, garantissant que leur ratio obéisse fidèlement à la distribution théorique t de Student à n – 1 ou n1 + n2 – 2 degrés de liberté.
Dans les applications psychologiques classiques, comme la comparaison des scores moyens obtenus à une échelle d’évaluation de la mémoire de travail entre un groupe témoin et un groupe de patients ayant subi un traumatisme crânien, la vulnérabilité du test t s’accroît considérablement dès lors que les effectifs sont réduits (par exemple moins de 15 participants par condition) et que la distribution sous-jacente est asymétrique. En situation d’échantillons de petite taille, l’effet modérateur du théorème central limite ne peut s’exercer. Dès lors, si la condition de normalité est violée, l’incertitude sur l’estimation de l’écart-type échantillonnal est massivement accrue, faussant la largeur de l’intervalle de confiance et rendant caduque la signification probabiliste associée à la valeur p calculée.
3.2 Le test t pour mesures répétées
Le test t pour échantillons appariés, ou mesures répétées, intervient couramment dans les plans d’expérience longitudinaux ou intra-sujets, typiques de l’évaluation neuropsychologique ou clinique. On l’emploie classiquement pour mesurer l’évolution des symptômes d’un trouble obsessionnel-compulsif avant et après l’administration d’un protocole de thérapie comportementale et cognitive. Une confusion conceptuelle tenace règne fréquemment parmi les praticiens concernant la cible de l’hypothèse de normalité dans ce paradigme expérimental particulier.
En effet, il n’est nullement requis que la distribution des scores pré-thérapeutiques, ni celle des scores post-thérapeutiques, considérée isolément, soit normale. L’exigence mathématique porte de manière exclusive sur la distribution des différences intra-individuelles (c’est-à-dire la variable Δ = Xpost – Xpré). Il est tout à fait possible que les mesures brutes de départ et d’arrivée manifestent une forte asymétrie ou une allure bimodale, mais que les variations individuelles se distribuent de façon parfaitement gaussienne autour du gain thérapeutique moyen. À l’inverse, des scores initiaux et finaux approximativement normaux peuvent générer une distribution de différences fortement asymétrique si la dynamique du changement clinique diverge radicalement entre les répondeurs massifs et les non-répondeurs.
3.3 L’analyse de variance univariée et multivariée (ANOVA et MANOVA)
L’analyse de variance (ANOVA), généralisation élégante du test t développée par Ronald Aylmer Fisher, décompose la variabilité totale d’un ensemble de données en composantes inter-groupes (liées au traitement expérimental) et intra-groupes (variabilité résiduelle aléatoire). Le ratio de ces variances, désigné sous le nom de statistique F de Fisher, n’obéit formellement à la loi théorique de Fisher-Snedecor que si deux conditions distributionnelles majeures sont vérifiées : la normalité de la variable dépendante au sein de chaque niveau du facteur et l’homogénéité des variances entre les groupes (homoscédasticité).
Lorsque l’analyse s’élargit à plusieurs variables dépendantes simultanées au sein de la MANOVA, le postulat se complexifie substantiellement pour exiger la normalité multivariée au sein de chaque groupe expérimental. La normalité multivariée suppose non seulement que chaque variable prise isolément soit gaussienne, mais que toute combinaison linéaire de ces variables suive également une loi normale unidimensionnelle, avec une dispersion conjointe ellipsoïdale régie par la matrice de variance-covariance. L’interaction entre violation de la normalité et hétéroscédasticité est particulièrement néfaste : si les groupes ne sont pas strictement équilibrés en termes d’effectifs, une légère asymétrie conjointe à des variances inégales entraîne une déstabilisation totale du test F, menant soit à une explosion du taux de fausses alertes, soit à une perte dramatique de sensibilité empirique.
3.4 La régression linéaire ordinaire
La modélisation par régression linéaire ordinaire (OLS pour Ordinary Least Squares) constitue sans doute le cadre analytique le plus général et le plus utilisé pour investiguer les relations prédictives entre des variables indépendantes (continues ou catégorielles) et un critère continu. Dans le cadre de ce modèle, une incompréhension récurrente consiste à exiger que les variables prédictrices (X) ou la variable réponse (Y) suivent individuellement une loi normale dans leur distribution globale. Rien n’est plus inexact sur le plan théorique.
Les prédicteurs peuvent être des variables dichotomiques (comme le genre ou l’assignation à un groupe placebo versus molécule active), des distributions tronquées, ou des scores polytomiques sans que la légitimité du modèle ne soit compromise. La condition de normalité requise pour la validité des inférences statistiques (tests t sur la significativité des coefficients de régression, tests F d’adéquation globale du modèle R², calcul des intervalles de prédiction) concerne exclusivement la composante d’erreur aléatoire, c’est-à-dire le terme d’erreur stochastique inhérent au modèle mathématique. Les estimateurs des coefficients de régression conservent leur caractère non biaisé et convergent même en présence d’erreurs non normales, mais les inférences probabilistes associées ne sont exactes que sous condition de normalité résiduelle.
4. La distinction cruciale : Normalité des données brutes versus normalité des résidus
4.1 Erreurs conceptuelles fréquentes dans la recherche empirique
Dans la littérature scientifique publiée et les travaux de recherche doctoraux, il demeure extrêmement fréquent de constater que des auteurs évaluent la normalité de leur variable dépendante sur l’ensemble global de leur échantillon avant d’effectuer une régression ou une ANOVA, rejetant le modèle paramétrique au vu d’une valeur de p significative à un test de Shapiro-Wilk. Cette pratique repose sur une confusion méthodologique majeure entre distribution marginale et distribution conditionnelle.
Considérons une étude en psychologie cognitive portant sur les performances à une tâche attentionnelle en fonction de deux tranches d’âge contrastées : de jeunes adultes et des personnes âgées. Si l’on agrège l’ensemble des scores de performance pour tester leur normalité, la distribution globale sera vraisemblablement bimodale, étalée, et échouera inévitablement à tous les tests de normalité formels. Pourtant, cette non-normalité apparente n’est que la conséquence directe de l’effet de groupe (l’âge) que l’on cherche précisément à étudier. Tester la normalité sur les données brutes mélangées revient à ignorer la structure explicative du plan d’expérience, conduisant à des diagnostics erronés et à des prises de décision méthodologiques inadaptées.
4.2 L’évaluation de la normalité des erreurs et des résidus du modèle
Sur le plan mathématique formel, l’équation générale du modèle linéaire s’écrit sous la forme Y = Xβ + ε, où ε représente le vecteur des erreurs théoriques non observables. L’hypothèse de normalité stipule expressément que ces erreurs sont identiquement et indépendamment distribuées selon une loi normale centrée sur zéro et de variance constante : ε ~ N(0, σ²I). Comme les véritables erreurs de la population ne sont jamais directement accessibles à l’expérimentateur, celui-ci doit opérer sur leurs approximations empiriques : les résidus (notés e = Y – Ŷ), qui correspondent à la distance séparant chaque valeur observée de la valeur prédite par le modèle ajusté.
L’évaluation rigoureuse de la normalité s’effectue donc obligatoirement sur les résidus du modèle. Pour affiner ce diagnostic, il est recommandé d’examiner les résidus standardisés (divisés par leur écart-type résiduel) ou, mieux encore, les résidus studentisés, dans lesquels chaque résidu est divisé par un écart-type calculé en excluant l’observation concernée afin d’éviter qu’une valeur aberrante ne masque sa propre déviance par gonflement artificiel de l’erreur résiduelle globale. Ce sont exclusivement les propriétés distributionnelles de ces résidus qui conditionnent la validité des statistiques t et F calculées par les progiciels de statistique.
4.3 Distributions marginales versus distributions conditionnelles
La distinction entre distribution marginale (la distribution d’une variable prise isolément sur l’ensemble de la cohorte) et distribution conditionnelle (la distribution de la variable pour une valeur fixée des prédicteurs) constitue le pivot théorique de l’analyse linéaire avancée. Une variable dépendante continue peut afficher une distribution marginale hautement asymétrique, voire plurimodale, tout en présentant des distributions conditionnelles rigoureusement normales et homoscédastiques autour de l’hyperplan de régression.
À titre d’illustration, supposons que le revenu annuel soit modélisé en fonction du nombre d’années de formation universitaire. À l’échelle sociétale, la distribution marginale des revenus est universellement reconnue comme fortement étirée vers les valeurs supérieures (asymétrie positive prononcée). Néanmoins, si l’on examine la distribution des revenus conditionnellement à un niveau d’études déterminé (par exemple, uniquement parmi les détenteurs d’un master professionnel de psychologie clinique), la dispersion des revenus au sein de cette sous-population spécifique peut fort bien se répartir de manière quasi symétrique et gaussienne autour de la moyenne conditionnelle. Les logiciels statistiques contemporains permettent d’extraire directement les résidus d’un modèle spécifié, et c’est exclusivement sur ces séries résiduelles que doivent porter les vérifications de normalité préalables à l’interprétation des seuils de significativité.
5. Méthodes graphiques d’évaluation de la normalité
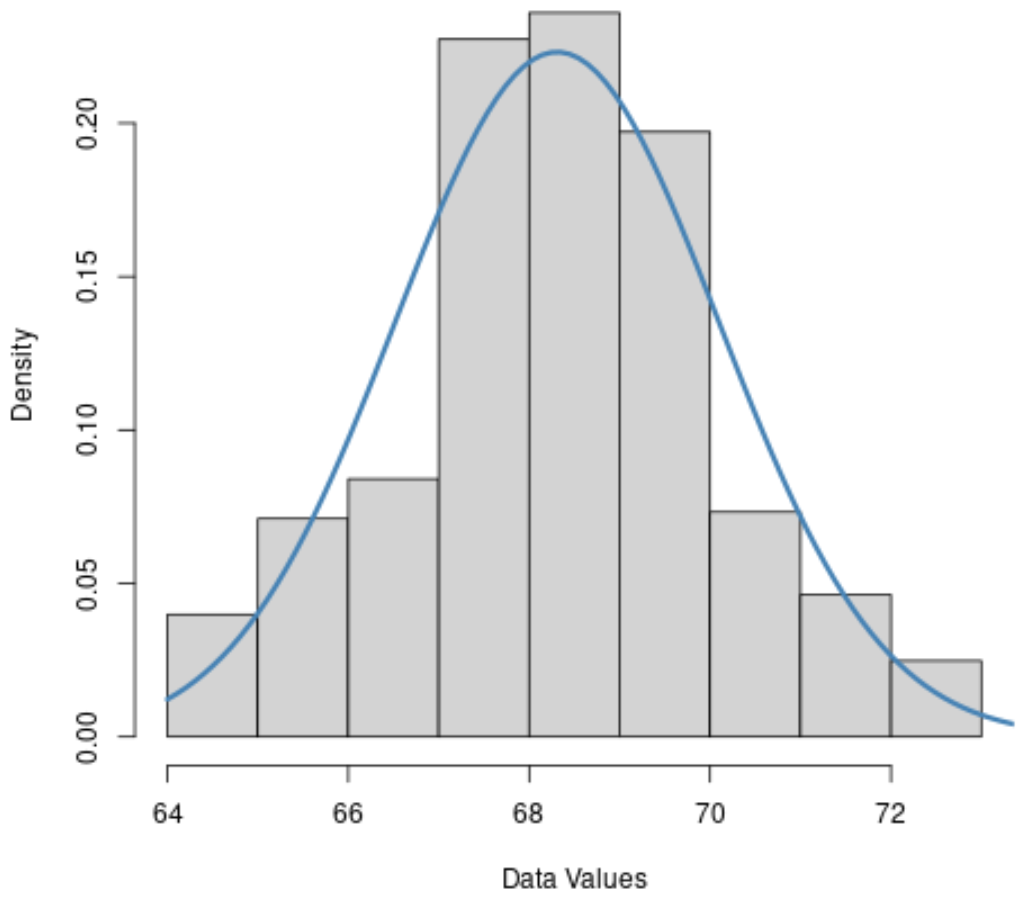
5.1 L’histogramme et la courbe de densité estimée
L’inspection visuelle constitue invariablement la première étape indispensable et incontournable du diagnostic distributionnel. Parmi les représentations graphiques classiques, l’histogramme de fréquences permet d’appréhender intuitivement la forme globale des données observées, la présence d’un pic central prédominant, ainsi que l’étalement symétrique des observations de part et d’autre de ce point central. Une distribution conforme à l’hypothèse de normalité doit présenter une morphologie régulière évoquant la cloche de Gauss, sans cassure abrupte ni discontinuité suspecte.
Cependant, l’interprétation de l’histogramme souffre d’une limitation méthodologique majeure : sa sensibilité critique au choix de la largeur des classes (le bin width) et à la fixation de leurs bornes d’origine. Un découpage trop lâche masque les asymétries et la multimodalité, tandis qu’un découpage trop étroit engendre un bruit graphique fragmenté rendant l’appréciation globale illisible. Pour pallier cette faiblesse, il est hautement recommandé de superposer à l’histogramme une courbe d’estimation de la densité par noyau (Kernel Density Estimation) ainsi que le tracé théorique de la fonction de densité gaussienne paramétrée avec la moyenne et la variance de l’échantillon. Cette confrontation graphique immédiate met en lumière les déficits de masse au centre ou les renflements suspects situés dans les régions intermédiaires de la distribution.
5.2 Le diagramme quantile-quantile (Q-Q plot)
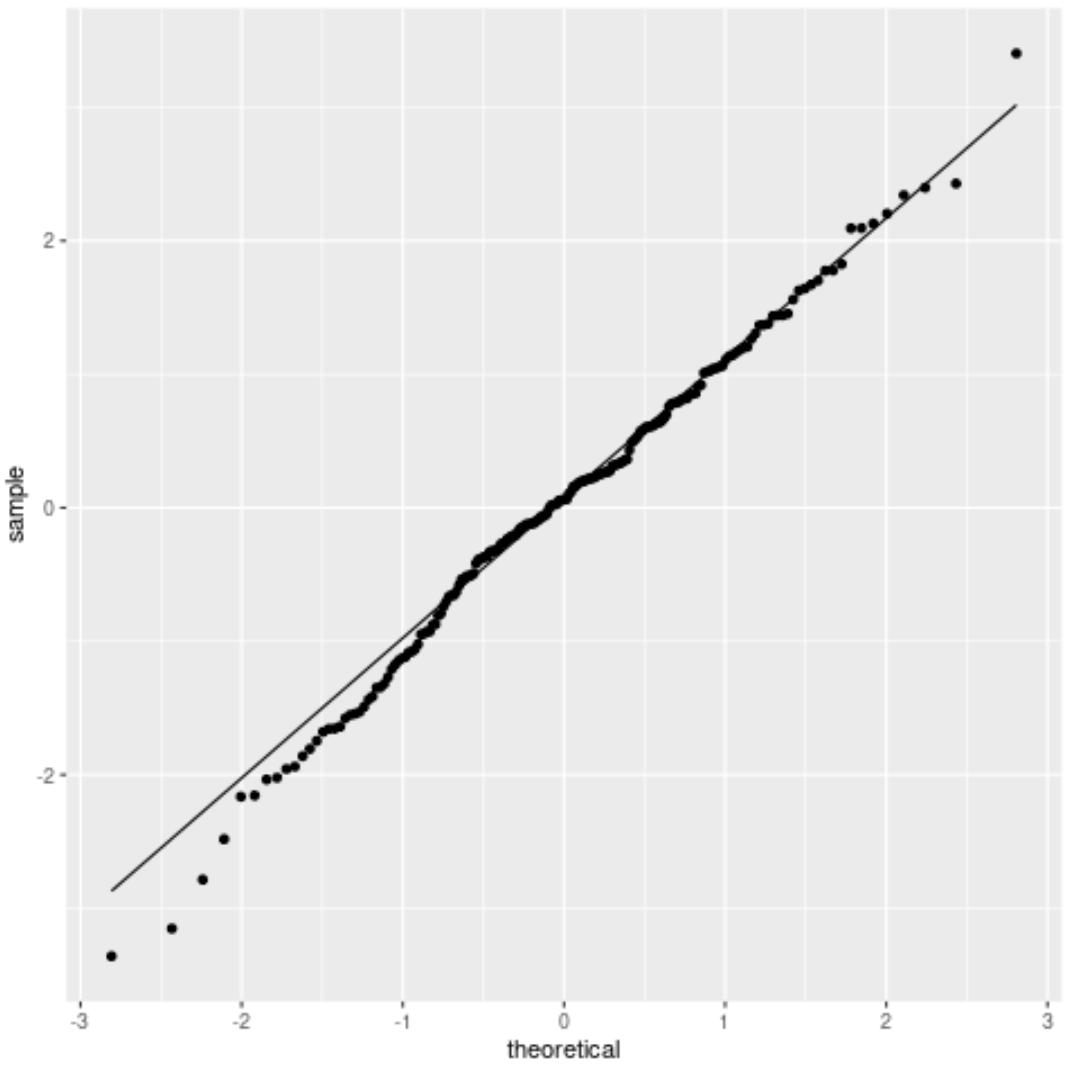
Parmi l’ensemble des outils diagnostiques disponibles, le diagramme quantile-quantile (communément désigné sous l’anglicisme de Q-Q plot) s’impose comme l’étalon-or graphique pour scruter la normalité d’une série de résidus. Le principe de ce graphique repose sur la mise en relation bi-dimensionnelle directe entre les quantiles empiriques observés dans l’échantillon (ordonnés par valeurs croissantes) et les quantiles théoriques que l’on obtiendrait de façon prévisible sous une loi normale standardisée parfaite de mêmes paramètres.
Si la distribution étudiée est rigoureusement normale, les points expérimentaux viennent se positionner de manière rectiligne le long de la première bissectrice idéale (la droite diagonale à 45 degrés). Toute déviation morphologique par rapport à cette droite révèle sans ambiguïté la nature précise de la non-normalité :
- Une courbure en forme de « S » inversé signale que les quantiles observés s’écartent plus rapidement dans les extrêmes que les valeurs théoriques attendues, attestant la présence de queues de distribution lourdes ou épaisses (phénomène de leptokurtose).
- Une courbure en « S » direct révèle à l’inverse une absence de variabilité dans les extrémités, caractéristique de queues courtes ou tronquées (platykurtose).
- Une concavité ou convexité monotone globale (forme en banane ou en parabole) trahit quant à elle une asymétrie systématique, qu’elle soit orientée vers la droite ou vers la gauche.
L’avantage analytique du Q-Q plot réside dans sa capacité à discriminer d’un coup d’œil clinique la présence d’une ou deux valeurs marginales isolées d’une déformation structurelle générale de l’ensemble de la série statistique.
5.3 Le diagramme P-P (Probability-Probability plot)
Moins fréquemment employé que le Q-Q plot mais particulièrement éclairant dans certaines configurations diagnostiques, le diagramme P-P (pour Probability-Probability plot) confronte directement la fonction de répartition empirique cumulée de l’échantillon analysé à la fonction de répartition théorique de la loi normale de référence. Chaque point du graphique associe ainsi la probabilité cumulée observée d’un score à sa probabilité cumulée attendue sous l’hypothèse de conformité gaussienne.
La particularité structurelle du diagramme P-P réside dans sa zone de sensibilité préférentielle. Tandis que le Q-Q plot accentue visuellement les discordances situées dans les queues de la distribution (les événements rares ou extrêmes), le diagramme P-P focalise son acuité analytique sur le cœur même de la distribution, c’est-à-dire autour de la moyenne et de la médiane. Par conséquent, si un chercheur s’interroge sur l’existence d’une multimodalité sous-jacente ou d’un aplatissement central sans être particulièrement préoccupé par les observations marginales, le diagramme P-P offre une perspective complémentaire de premier ordre, les déviations par rapport à la diagonale idéale se manifestant sous forme d’ondes ou d’ondulations régulières au centre du tracé.
5.4 La boîte à moustaches (Boxplot) et la détection d’asymétrie
Conçue par le mathématicien John Tukey dans le cadre de l’analyse exploratoire des données, la boîte à moustaches (ou boxplot) constitue un dispositif graphique synthétique exceptionnellement performant pour évaluer la symétrie d’une distribution et localiser les scores aberrants potentiels. La boîte centrale délimite l’intervalle interquartile (IQR), s’étendant du premier quartile (Q1, 25e percentile) au troisième quartile (Q3, 75e percentile), capturant ainsi les 50 % centraux des données observées, la ligne transversale interne figurant la médiane empirique.
L’évaluation de la normalité à travers le prisme de la boîte à moustaches requiert l’examen simultané de plusieurs indices de symétrie :
- La ligne médiane doit se situer au centre géométrique exact de la boîte interquartile ; un décalage prononcé vers le bas ou vers le haut signale immédiatement une asymétrie de distribution.
- Les moustaches, s’étendant classiquement jusqu’à la valeur la plus éloignée ne dépassant pas 1,5 fois l’intervalle interquartile au-delà des quartiles, doivent afficher des longueurs rigoureusement équivalentes à chaque extrémité.
- L’apparition d’observations individuelles matérialisées sous forme de points au-delà des clôtures de moustaches (les outliers) permet d’identifier instantanément les sources majeures de distorsion susceptibles d’altérer la normalité des résidus.
6. Tests statistiques formels de normalité : Procédures et algorithmes
6.1 Le test de Shapiro-Wilk
Parmi l’arsenal des procédures d’inférence dédiées à la conformité distributionnelle, le test développé par Samuel Sanford Shapiro et Martin Wilk en 1965 s’impose incontestablement comme le test formel de normalité le plus puissant et le plus universellement recommandé dans la littérature statistique contemporaine. Le fondement théorique du test de Shapiro-Wilk repose sur le calcul de la statistique W, qui mesure la corrélation linéaire au carré entre les observations ordonnées de l’échantillon et les espérances mathématiques des statistiques d’ordre issues d’une distribution normale standard.
La formulation des hypothèses se structure selon la logique classique des tests de conformité : l’hypothèse nulle (H0) pose que la population sous-jacente dont est extrait l’échantillon suit une loi normale de moyenne et variance indéterminées, tandis que l’hypothèse alternative (H1) affirme que la distribution s’écarte significativement de la normalité. La statistique W oscille structurellement entre 0 et 1, une valeur très proche de 1 attestant une concordance parfaite avec le modèle gaussien. De nombreuses simulations de Monte Carlo ont formellement démontré la supériorité statistique du test de Shapiro-Wilk face à un éventail très large d’alternatives non gaussiennes, particulièrement pour des effectifs restreints à modérés (allant de n = 10 à quelques centaines d’observations), ce qui en fait le choix privilégié pour la quasi-totalité des investigations expérimentales standards.
6.2 Le test de Kolmogorov-Smirnov et l’adaptation de Lilliefors
Le test de Kolmogorov-Smirnov (K-S) est historiquement l’une des premières méthodes non paramétriques générales conçues pour éprouver l’adéquation d’un échantillon à une distribution théorique continue quelconque. Son principe opérationnel réside dans la quantification de la distance verticale maximale absolue, notée D, séparant la fonction de répartition empirique par paliers Sn(x) et la fonction de répartition théorique continue F0(x). Bien que d’une grande élégance formelle, l’application directe du test K-S classique souffre d’une restriction majeure trop souvent méconnue : la distribution théorique de référence doit être entièrement connue a priori, paramètres de moyenne et de variance inclus.
Or, dans la pratique de la recherche, les paramètres μ et σ ne sont jamais connus d’avance et sont inévitablement estimés à partir des données mêmes de l’échantillon (via la moyenne empirique m et l’écart-type empirique s). Lorsque cette estimation intervient, le test de Kolmogorov-Smirnov standard devient extrêmement conservateur : la statistique D est artificiellement compressée vers le bas, et le taux d’erreur de type I s’effondre très en deçà du seuil nominal. Pour corriger cette défaillance systématique, Hubert Lilliefors a introduit en 1967 une table de valeurs critiques modifiée par simulations de Monte Carlo. Le test de Lilliefors autorise l’estimation conjointe de la moyenne et de la variance à partir des données. Malgré cet ajustement capital, la puissance du test de Kolmogorov-Lilliefors demeure notablement inférieure à celle de ses rivaux modernes, ce qui justifie son abandon progressif au profit de procédures plus sensibles.
6.3 Le test d’Anderson-Darling
Conçu par Theodore Wilbur Anderson et Donald A. Darling en 1952, le test d’Anderson-Darling (statistique A²) constitue une modification sophistiquée de la famille des tests basés sur la distance quadratique de Cramér-von Mises. Contrairement au test de Kolmogorov-Smirnov qui ne retient que la déviation ponctuelle la plus extrême sur l’ensemble de la fonction, le test d’Anderson-Darling intègre l’ensemble des écarts au carré pondérés entre la fonction empirique et la loi théorique sur tout le spectre des données.
La force singulière de l’algorithme d’Anderson-Darling réside dans sa fonction de pondération mathématique spécifique, qui attribue un poids délibérément plus lourd aux écarts constatés dans les queues de distribution, là où la fonction de répartition cumulée s’approche de 0 ou de 1. Cette caractéristique en fait un outil de détection d’une puissance exceptionnelle face aux distributions leptokurtiques ou contaminées par des valeurs extrêmes, qui constituent précisément les configurations les plus délétères pour l’estimation de la variance en inférence paramétrique. Dans les protocoles cliniques ou les évaluations psychométriques où la précision d’estimation aux confins des seuils pathologiques est cruciale, le test d’Anderson-Darling s’avère fréquemment un allié diagnostique supérieur à bien d’autres procédures formelles.
6.4 Le test de Jarque-Bera fondé sur les moments
Formulé à l’origine dans le champ de l’économétrie par Carlos Jarque et Anil Bera en 1980, le test de Jarque-Bera (JB) procède d’une philosophie analytique radicalement distincte de celle des tests basés sur les fonctions de répartition. Il évalue la normalité d’une série statistique en mesurant simultanément l’écart entre les moments empiriques d’ordre trois et quatre de l’échantillon et leurs contreparties théoriques gaussiennes.
La statistique JB synthétise dans une formule quadratique pondérée le coefficient d’asymétrie empirique (qui doit théoriquement être nul sous H0) et l’excès de kurtosis (qui doit théoriquement être nul sous convention gaussienne). Sous l’hypothèse nulle de normalité et pour des effectifs suffisamment larges, la statistique JB converge asymptotiquement vers une loi du chi-deux à 2 degrés de liberté (χ²(2)). Dès lors, une valeur calculée de JB supérieure au seuil critique de 5,99 entraîne le rejet formel de la normalité au seuil α = 0,05. Bien que d’une interprétation très directe pour les modélisateurs familiers de la théorie des moments, le test de Jarque-Bera souffre d’un déficit d’efficacité manifeste dès lors que la taille d’échantillon descend sous la centaine de participants, sa validité asymptotique requérant de grands volumes d’observations pour stabiliser la variance de ses moments d’ordre supérieur.
7. Limites et paradoxes des tests formels d’adéquation
7.1 Le piège de la sur-puissance dans les grands échantillons
L’utilisation aveugle et mécanisée des tests formels d’adéquation expose le chercheur à un paradoxe méthodologique majeur, directement tributaire des lois mathématiques gouvernant la puissance statistique. Tout test d’hypothèse nulle voit sa puissance croître de manière monotone avec l’augmentation de la taille de l’échantillon N. Par conséquent, lorsque l’on analyse de grands ensembles de données empiriques (comme c’est fréquemment le cas dans les enquêtes épidémiologiques, les cohortes de santé publique ou les bases de données d’apprentissage numérique regroupant des milliers de participants), les tests tels que Shapiro-Wilk ou Anderson-Darling acquièrent une puissance quasi absolue.
Dans ces conditions d’échantillonnage massif, la moindre déviation infinitésimale et totalement insignifiante sur le plan pratique par rapport à une perfection gaussienne idéale déclenchera inévitablement une valeur p hautement significative (par exemple, p < 0,001). Rejeter l’utilisation d’une régression linéaire ou d’une ANOVA sur la base de ce résultat formel constitue une erreur d’appréciation sévère : à des tailles d’échantillon aussi vastes, le théorème central limite opère avec une efficacité maximale, et la robustesse des estimateurs paramétriques est absolument inattaquable. Le test formel se transforme alors en piège méthodologique, incitant les chercheurs à abandonner des modèles paramétriques parfaitement légitimes au profit d’alternatives non paramétriques moins puissantes et conceptuellement inadaptées.
7.2 Le déficit de puissance statistique dans les petits échantillons
Si la sur-puissance menace les vastes études, la situation inverse prévaut dans les petits échantillons, générant un piège méthodologique tout aussi pernicieux. Dans de multiples protocoles expérimentaux d’imagerie cérébrale, de neuropsychologie clinique rare ou d’ergonomie cognitive où les effectifs oscillent fréquemment entre 8 et 20 participants par groupe, les tests de normalité formels souffrent d’un déficit dramatique de puissance statistique.
Face à des effectifs aussi resserrés, un test de Shapiro-Wilk s’avère structurellement incapable de distinguer une authentique distribution gaussienne d’une distribution exponentielle modérément asymétrique ou d’une loi uniforme. Le chercheur obtient alors une valeur de probabilité non significative (par exemple, p = 0,23) et conclut triomphalement que « la normalité a été formellement validée », s’autorisant à dérouler son analyse paramétrique en toute confiance. Cette déduction constitue une violation élémentaire de la logique de l’inférence neyman-pearsonienne : l’absence de preuve du rejet de l’hypothèse nulle n’équivaut en aucun cas à la preuve de sa véracité. Dans les petits échantillons, ce faux sentiment de sécurité expose le chercheur à exécuter des tests paramétriques dans les configurations distributionnelles les plus instables qui soient, là précisément où le théorème central limite ne peut jouer aucun rôle compensateur.
7.3 L’impératif du jugement d’expert face aux indicateurs automatisés
Ce double écueil met en lumière une réalité épistémologique fondamentale : la vérification des postulats distributionnels ne peut et ne doit jamais être déléguée passivement à un algorithme binaire de décision automatisée. La pratique statistique contemporaine exige l’exercice d’un jugement méthodologique expert, conjuguant de multiples sources de diagnostic convergentes au sein d’une approche holistique raisonnée.
L’analyste de données averti doit impérativement distinguer la significativité statistique de la non-normalité de son importance pratique ou substantive. Une violation modeste dans un échantillon de 500 sujets n’a rigoureusement aucune conséquence sur la validité des conclusions, tandis qu’une violation substantielle dans un échantillon de 18 sujets invalide totalement la portée des inférences, indépendamment des valeurs p affichées par les tests de normalité. C’est pourquoi les recommandations méthodologiques actuelles préconisent d’accorder la primauté absolue à l’examen conjoint des représentations graphiques (Q-Q plots en tête) et des coefficients quantitatifs de forme, reléguant les tests de significativité formels au rang de simples indicateurs consultatifs.
8. Mesures numériques de forme : Coefficients d’asymétrie et d’aplatissement
8.1 L’asymétrie (Skewness) : Calcul et interprétation clinique
Pour dépasser l’arbitraire des tests formels et objectiver la morphologie d’une distribution, l’analyste dispose des coefficients d’asymétrie (skewness), fondés sur le moment centré d’ordre trois standardisé. Ce paramètre sans dimension quantifie le degré d’écart à la symétrie axiale parfaite d’une loi continue. Dans le formalisme d’échantillonnage, le coefficient d’asymétrie non biaisé de Fisher-Pearson se calcule en divisant le moment centré empirique d’ordre trois par le cube de l’écart-type d’échantillon, assorti d’un terme de correction pour les degrés de liberté finis.
L’interprétation de l’orientation du skewness revêt une importance clinique et phénoménologique directe :
- Un coefficient d’asymétrie positif (skewness > 0) indique une queue de distribution s’étirant vers les valeurs élevées à droite, la masse des observations étant concentrée sur les valeurs faibles. Cette morphologie est typique des échelles mesurant des états psychopathologiques au sein de la population générale (comme le questionnaire de dépression de Beck ou les échelles d’anxiété de Spielberger), où l’immense majorité des participants sains rapportent des scores quasi nuls, tandis qu’une minorité clinique étire la traîne droite.
- Un coefficient d’asymétrie négatif (skewness < 0) traduit une queue de distribution s’étirant vers les valeurs faibles à gauche, la concentration des données se situant vers les scores maximaux. On retrouve typiquement cette configuration dans les tâches cognitives de reconnaissance simples où s’exerce un fort effet de plafond.
Une distribution rigoureusement gaussienne présente un skewness théorique de zéro absolu.
8.2 L’aplatissement (Kurtosis) : Épaisseur des queues et acuité du pic
Le second paramètre morphologique fondamental est le coefficient d’aplatissement (kurtosis), calculé à partir du moment centré d’ordre quatre standardisé. Bien qu’historiquement décrit comme une mesure de la « pointicité » ou de la hauteur relative du sommet de la cloche, les développements mathématiques modernes initiés notamment par Peter Westfall ont définitivement clarifié que le kurtosis quantifie principalement l’épaisseur et la lourdeur des queues de la distribution, c’est-à-dire la propension de la distribution à générer des événements distants et extrêmes par rapport à une loi normale.
Dans la quasi-totalité des progiciels statistiques contemporains (R, SPSS, SAS), la valeur rapportée est l’excès de kurtosis, calculé en retranchant 3 (la valeur du moment d’ordre quatre de la distribution normale standard) du kurtosis brut. Dès lors, une loi normale parfaite possède un excès de kurtosis égal à 0 :
- Les distributions leptokurtiques (kurtosis > 0) se caractérisent par des queues très lourdes et allongées, accumulant une proportion de données extrêmes bien supérieure à ce que postule la loi gaussienne. Cette configuration est particulièrement dangereuse pour la variance empirique car elle génère des instabilités d’échantillonnage sévères.
- Les distributions platykurtiques (kurtosis < 0) se distinguent à l’inverse par des queues fines, courtes ou artificiellement tronquées, les données étant distribuées de façon plus diffuse sur un intervalle borné sans générer de points périphériques distants.
8.3 Seuils heuristiques et critères de tolérance en sciences humaines
Confrontés à l’inéluctable imperfection des données empiriques recueillies sur des êtres humains, les méthodologistes et psychométriciens ont formulé des recommandations opérationnelles pragmatiques afin de déterminer le niveau d’écart distributionnel au-delà duquel les modèles paramétriques cessent d’être fiables. Les travaux de référence de Rex Kline, de Patrick Curran, Stephen West et John Finch, ainsi que de Darren George et Paul Mallery, font autorité dans ce domaine.
Un consensus robuste émerge au sein de la littérature quant aux seuils de tolérance opérationnels :
- Pour une normalité stricte ou quasi idéale : Les valeurs de skewness et de kurtosis comprises entre -1,0 et +1,0 sont considérées comme reflétant une conformité distributionnelle excellente ne nécessitant aucun ajustement.
- Pour les modèles linéaires généraux univariés standards (ANOVA, régressions OLS) : Un coefficient d’asymétrie en valeur absolue inférieur à 2,0 (|Skewness| < 2) et un excès de kurtosis en valeur absolue inférieur à 7,0 (|Kurtosis| < 7) sont largement admis comme n’altérant pas significativement le taux d’erreur de type I ni la robustesse générale du modèle.
- Pour la modélisation par équations structurelles (SEM) et l’estimation du maximum de vraisemblance standard : Les contraintes sont sensiblement plus exigeantes : tout kurtosis excédant une valeur absolue de 5,0 à 7,0 impose le recours systématique à des estimateurs robustes (tels que l’estimateur Satorra-Bentler ou MLR) pour éviter une inflation dramatique de la statistique d’ajustement du chi-deux.
Ces seuils fournissent aux chercheurs un repère quantitatif tangible, infiniment plus informatif que la simple lecture d’une valeur p d’adéquation binaire.
9. Conséquences empiriques de la violation de l’hypothèse de normalité
9.1 Dégradation de la robustesse des tests de comparaison
L’affirmation courante selon laquelle les tests paramétriques tels que le test t de Student ou l’ANOVA seraient « universellement robustes » aux violations de l’hypothèse de normalité constitue une simplification pédagogique potentiellement trompeuse. La robustesse de ces procédures est conditionnelle et dépend dramatiquement de la configuration conjointe du design expérimental et des variances sous-jacentes.
L’effet le plus dévastateur survient lorsque la non-normalité (typiquement une asymétrie marquée) se conjugue à un déséquilibre des effectifs entre les groupes (plans non orthogonaux) et à une hétérogénéité des variances (hétéroscédasticité). Si le groupe possédant le plus petit effectif affiche simultanément la variance la plus élevée (fréquent dans les populations cliniques pathologiques comparées à des témoins sains), le taux de rejet à tort de l’hypothèse nulle sous le test de Student peut s’envoler pour atteindre 20 % ou 30 % au lieu des 5 % nominaux ! À l’inverse, si le groupe de grande taille présente la variance la plus forte, le test devient ultra-conservateur, sa puissance statistique s’effondrant à des niveaux rendant la détection de tout effet expérimental quasi impossible. La robustesse paramétrique n’est donc pas une propriété magique intrinsèque : elle n’opère efficacement que si les effectifs par groupe sont rigoureusement équilibrés et les variances raisonnablement homogènes.
9.2 Distorsion des intervalles de confiance et de la puissance
Au-delà de la distorsion de la valeur p, la non-respect de la normalité produit des dommages directs sur l’estimation des intervalles de confiance associés aux tailles d’effet (comme le d de Cohen ou le coefficient de détermination R²). La construction classique de ces intervalles repose sur la symétrie de la loi normale ou de lois associées non centrales. En présence d’une asymétrie résiduelle substantielle, les intervalles de confiance paramétriques deviennent asymétriquement distordus : ils recouvrent mal la véritable valeur du paramètre populationnel d’un côté de la distribution tout en étant excessivement lâches de l’autre.
De surcroît, la perte d’efficacité des estimateurs sous distributions non normales engendre un gaspillage méthodologique massif. Dans des contextes où les queues de distribution sont épaisses, la moyenne arithmétique devient un estimateur très instable, hautement sensible aux aléas d’échantillonnage. Dès lors, le chercheur sous-estime systématiquement la taille d’effet standardisée réelle dans la population, ce qui se traduit par une chute drastique de la probabilité de réplication lors de tentatives de reproduction indépendantes par d’autres laboratoires scientifiques.
9.3 Rôle délétère des valeurs aberrantes extrêmes (outliers)
Dans la pratique concrète de l’analyste, les déviations majeures de normalité observées dans les résidus ne résultent que très rarement d’une nature fondamentalement exotique de la population sous-jacente ; elles sont la conséquence directe de la présence d’une poignée de valeurs aberrantes extrêmes (les fameux outliers). En raison du rôle exponentiel des puissances d’ordre trois et quatre dans le calcul des moments statistiques, l’existence d’une unique observation atypique située à quatre ou cinq écarts-types de la moyenne suffit à désaxer complètement le skewness et à doubler artificiellement le kurtosis d’un échantillon entier de cinquante sujets.
Dans le cadre de l’ajustement d’une droite de régression linéaire, de tels points exercent un effet de levier (leverage) disproportionné, infléchissant la pente du modèle vers eux au détriment de l’ajustement optimal de l’ensemble des autres participants. Une distinction méthodologique rigoureuse s’impose alors impérativement :
- S’agit-il d’une erreur triviale de saisie informatique ou de transcription d’encodage ? Dans ce cas, la correction ou la suppression immédiate est une évidence déontologique.
- S’agit-il d’un artéfact lié à une consigne mal comprise par le sujet lors de la passation expérimentale ?
- Ou reflète-t-il l’expression authentique d’une variabilité phénotypique rare mais biologiquement et cliniquement valide issue d’une sous-population marginale ?
L’analyste ne peut traiter ces trois réalités sur un pied d’égalité sous peine de corrompre gravement la signification scientifique de son investigation.
10. Stratégies méthodologiques curatives face à la non-normalité
10.1 Transformations mathématiques des variables continues
Face au constat empirique d’une déviation prononcée de la normalité menaçant l’intégrité de l’analyse, l’approche curative classique historiquement privilégiée réside dans l’application d’une transformation mathématique continue aux données brutes avant l’ajustement du modèle. L’objectif de cette opération consiste à comprimer les intervalles étendus et à étirer les zones denses pour restaurer artificiellement la symétrie et la stabilité de la variance.
Les transformations les plus couramment mobilisées répondent à des profils morphologiques bien identifiés :
- La transformation logarithmique : x‘ = ln(x) ou log10(x + c), exceptionnellement efficace pour corriger une asymétrie positive sévère (temps de réaction en psychologie expérimentale, concentrations hormonales salivaires de cortisol).
- La transformation racine carrée : x‘ = √x, particulièrement appropriée pour stabiliser la dispersion de données issues de processus de comptage discrets (nombre de comportements d’évitement observés, nombre d’erreurs commises à un labyrinthe).
- La transformation inverse : x‘ = 1 / x, dédiée aux asymétries positives extrêmement prononcées, convertissant par exemple des temps de latence en vitesse d’exécution.
- La famille paramétrique optimale de Box-Cox : Cette procédure algorithmique générale explore par maximum de vraisemblance la valeur optimale d’un paramètre λ au sein d’une transformation continue de la forme (xλ – 1) / λ, identifiant automatiquement la fonction mathématique la plus susceptible de normaliser simultanément les résidus du modèle linéaire.
10.2 Gestion rigoureuse et éthique des données aberrantes
Lorsque la distorsion de la normalité est imputable à la présence circonscrite d’observations extrêmes isolées, l’analyste doit mettre en œuvre une stratégie de traitement formalisée et dénuée d’arbitraire. La détection statistique repose sur des critères univariés standardisés (scores z résiduels supérieurs en valeur absolue à 3 ou 3,29) ou des critères robustes basés sur la distance médiane absolue (MAD) ou la distance de Cook pour les effets de levier multivariés.
Plutôt que d’éliminer unilatéralement et définitivement les observations problématiques — une pratique qui réduit la puissance statistique et s’apparente fréquemment à du tri opportuniste de données (p-hacking) —, des méthodes alternatives conservatrices sont hautement préférables :
- La winsorisation : Cette technique consiste à remplacer la valeur extrême par le score valide le plus proche situé au seuil acceptable (par exemple, assigner à toute valeur supérieure au 95e percentile la valeur exacte dudit 95e percentile). La structure ordinale des rangs est ainsi rigoureusement préservée tout en anéantissant l’impact délétère de l’éloignement extrême sur le calcul des moments d’ordre 3 et 4.
- L’élagage contrôlé (trimmed means) : Procédure consistant à calculer des moyennes tronquées en supprimant un pourcentage symétrique fixe (généralement 10 % ou 20 %) aux deux extrémités de la distribution, immunisant totalement l’estimateur contre la contamination périphérique.
Quelle que soit la stratégie retenue, l’éthique de la recherche exige que l’ensemble des critères d’identification, d’ajustement ou d’exclusion soit consigné avec une transparence absolue dans le protocole méthodologique initial.
10.3 Controverses liées à l’interprétation des variables transformées
Bien que mathématiquement séduisantes, les transformations de variables font l’objet de critiques méthodologiques sévères et d’une méfiance croissante dans la recherche translationnelle contemporaine. L’inconvénient majeur réside dans la perte directe d’intelligibilité substantielle des unités de mesure. En psychométrie clinique, interpréter une différence moyenne de 0,35 en logarithme de score au questionnaire d’Inventaire de Dépression de Beck n’a aucune signification concrète pour le médecin ou le psychologue praticien, qui raisonne exclusivement en unités naturelles de points d’échelle.
Plus pernicieux encore, les transformations non linéaires altèrent profondément la nature même des hypothèses scientifiques testées :
- Une transformation logarithmique modifie un modèle additif originel en un modèle multiplicatif sous-jacent.
- La structure des termes d’interaction dans une ANOVA multifactorielle est profondément altérée : une interaction initialement significative sur l’échelle brute peut disparaître purement et simplement après transformation non linéaire, et réciproquement, une fausse interaction peut être artificiellement créée par la distorsion d’échelle.
- La comparaison des moyennes conditionnelles transformées reflète en réalité l’évaluation de moyennes géométriques et non plus arithmétiques, introduisant des glissements d’interprétation fréquemment ignorés par les auteurs.
Ces limitations substantielles expliquent pourquoi la statistique moderne privilégie désormais l’utilisation de modèles probabilistes spécifiant directement la vraie loi de distribution plutôt que de distordre artificiellement les données pour les faire entrer de force dans le moule gaussien.
11. Alternatives non paramétriques et approches computationnelles modernes
11.1 Les tests non paramétriques basés sur les rangs
Lorsque la violation de la normalité est indéniable, que les échantillons sont de taille restreinte et que toute transformation s’avère indésirable, la méthodologie classique oriente traditionnellement le chercheur vers les tests non paramétriques dits sans distribution (distribution-free tests). Ces procédures s’affranchissent totalement de l’hypothèse de normalité en substituant aux grandeurs métriques continues des observations leurs simples positions ordinales relatives : les rangs.
Les équivalences canoniques s’articulent selon les correspondances suivantes :
- Le test U de Mann-Whitney (ou test de la somme des rangs de Wilcoxon) se substitue au test t pour deux échantillons indépendants. Il évalue si la probabilité qu’une observation issue de la population A surpasse une observation de la population B est égale à 0,5.
- Le test des rangs signés de Wilcoxon remplace le test t pour mesures répétées, analysant la symétrie des rangs des différences positives et négatives intra-sujets.
- Le test de Kruskal-Wallis et le test de Friedman constituent respectivement les équivalents non paramétriques de l’ANOVA à un facteur pour échantillons indépendants et pour mesures répétées.
Cependant, l’analyste ne doit jamais oublier que ces tests ne comparent pas des moyennes arithmétiques. Ils ne testent l’égalité des médianes que sous l’hypothèse stricte que les distributions des deux groupes partagent rigoureusement la même forme et la même dispersion géométrique. En présence de formes dissymétriques divergentes entre groupes, les tests de rangs deviennent des tests de dominance stochastique globale, ce qui modifie la teneur théorique de la conclusion scientifique.
11.2 Méthodes de rééchantillonnage : Bootstrap et permutations
Grâce à la démultiplication exponentielle de la puissance de calcul informatique, les méthodes computationnelles de rééchantillonnage se sont imposées comme la réponse contemporaine la plus puissante, élégante et robuste face aux ruptures de normalité. Parmi elles, le bootstrap non paramétrique, formalisé par Bradley Efron en 1979, occupe une place prééminente.
Le principe fondamental du bootstrap repose sur une idée d’une grande audace épistémologique : traiter l’échantillon empirique observé comme s’il était la meilleure représentation accessible de la population globale inconnue. En procédant à un très grand nombre de tirages aléatoires avec remise au sein de cet échantillon (par exemple 2 000, 5 000 ou 10 000 itérations indépendantes d’effectif N identique à l’échantillon initial), l’ordinateur reconstitue de manière purement empirique la véritable distribution d’échantillonnage de la statistique d’intérêt (différence de moyennes, coefficient de régression, coefficient de corrélation, médiation indirecte).
Le chercheur s’affranchit ainsi de tout postulat préalable imposant la forme gaussienne aux résidus. Pour la construction des intervalles de confiance, l’utilisation de la méthode de l’intervalle bootstrap corrigé du biais et accéléré (BCa) est tout particulièrement recommandée. Cet algorithme sophistiqué ajuste automatiquement les bornes de l’intervalle en intégrant un facteur de correction d’asymétrie empirique et un facteur de centrage, délivrant des seuils de significativité d’une précision exemplaire même face à des distributions atypiques ou polymorphiques.
11.3 Les modèles linéaires généralisés (GLM) et distributions alternatives
La véritable rupture paradigmatique accomplie par la statistique méthodologique au cours des trois dernières décennies réside dans l’essor des modèles linéaires généralisés (conçus par John Nelder et Robert Wedderburn). Plutôt que de contraindre la variable dépendante à s’ajuster à un modèle gaussien rigide par des transformations artificielles, les GLM élargissent le cadre de la modélisation à l’ensemble de la famille exponentielle de distributions probabilistes.
L’analyste dispose désormais de la flexibilité théorique d’aligner son outil analytique sur la nature physique et phénoménologique exacte de son objet psychologique :
- Pour des données continues strictement positives présentant une variance croissant avec la moyenne (comme les temps de réponse ou les coûts de santé) : La loi Gamma ou la loi Log-Normale s’ajustent avec un naturel parfait.
- Pour des données de comptage manifestant une sur-dispersion marquée (fréquence d’apparition de tics, d’actes d’automutilation, d’absences scolaires) : La régression binomiale négative ou les modèles de Poisson gonflés en zéros (Zero-Inflated Poisson) modélisent conjointement la probabilité d’occurrence nulle et la fréquence des événements sans distorsion d’échelle.
- Pour des taux, des ratios ou des proportions contraints entre 0 et 1 (scores d’exactitude normalisés) : La régression Bêta offre une adéquation mathématique optimale.
Grâce à une fonction de lien explicite (logarithmique, logit, identité) reliant l’espérance conditionnelle au prédicteur linéaire, le modèle linéaire généralisé rend définitivement obsolète le réflexe archaïque consistant à tout ramener à la normalité par défaut de solutions algorithmiques alternatives.
12. Guide méthodologique décisionnel pour la recherche en psychologie
12.1 Arbre de décision séquentiel pour l’analyste de données
Afin de guider l’expérimentateur et l’étudiant à travers le dédale des choix méthodologiques et de dissiper l’hésitation face à l’écran de traitement informatique, nous formalisons ci-dessous un arbre de décision séquentiel et pragmatique, structuré en quatre étapes rigoureuses :
Étape 1 : Examen du plan d’expérience et de la volumétrie échantillonnale
Identifier clairement la structure du plan (groupes indépendants, mesures répétées, modèle mixte). Évaluer l’effectif total N et l’équilibre des sous-groupes (ratios de tailles d’échantillons). Si N est très volumineux (plusieurs centaines d’individus) et les groupes équilibrés, le théorème central limite garantit une robustesse considérable des moyennes ; la prudence reste toutefois requise si l’on s’intéresse à la modélisation des événements extrêmes individuels.
Étape 2 : Spécification du modèle et diagnostic graphique des résidus
Ajuster le modèle linéaire théorique envisagé (ANOVA ou régression) et extraire les résidus studentisés. Générer immédiatement un histogramme assorti de l’estimation de densité, complété par un diagramme Q-Q plot des résidus. Inspecter méticuleusement le Q-Q plot : l’alignement sur la diagonale est-il raisonnablement respecté sur l’intervalle [-2 ; +2] ? Détecte-t-on une courbure globale en forme de parabole (asymétrie) ou un décrochage sévère en « S » aux extrémités (queues épaisses) ? Repérer l’existence d’éventuels résidus isolés dépassant la bande critique des ± 3 écarts-types.
Étape 3 : Quantification de la forme et confirmation indicative
Calculer les coefficients d’asymétrie (Skewness) et d’aplatissement (Excès de Kurtosis) sur les résidus studentisés. Vérifier si |Skewness| < 2 et |Kurtosis| < 7 pour un modèle linéaire classique univarié. Si l’effectif par groupe est restreint (n < 50), solliciter à titre indicatif le test de Shapiro-Wilk, sans subordonner dogmatiquement sa décision au couperet du seuil p = 0,05, mais en l’intégrant comme un signal d’alerte supplémentaire concordant avec les déviations constatées sur le Q-Q plot.
Étape 4 : Sélection et justification de la stratégie analytique
- Configuration A (Résidus approximativement normaux ou déviations légères sous effectifs stables) : Maintien confiant du modèle paramétrique classique (ANOVA standard, régression linéaire OLS).
- Configuration B (Déviations modérées à fortes, préservation des unités de mesure primordiale) : Recours privilégié aux méthodes computationnelles modernes de rééchantillonnage par bootstrap BCa pour dériver des intervalles de confiance et des inférences non paramétriques stables sur les paramètres d’intérêt originaux.
- Configuration C (Processus générateur physiquement non gaussien : comptages, proportions, temps de réponse) : Déploiement d’un modèle linéaire généralisé (GLM) spécifiant formellement la loi adaptée (Poisson, Gamma, Bêta).
- Configuration D (Échantillons très faibles [n < 15], violations flagrantes, rejet du bootstrap par manque de matière rééchantillonnable) : Repli sur les tests non paramétriques basés sur les rangs (Mann-Whitney, Wilcoxon, Kruskal-Wallis) en explicitant rigoureusement la reformulation de l’hypothèse testée en termes de position relative ordinale.
12.2 Bonnes pratiques de rapportage selon les normes académiques et APA
L’exigence de transparence méthodologique et de reproductibilité scientifique, promue par les directives éditoriales de l’American Psychological Association (normes APA 7e édition), impose aux auteurs de rendre compte explicitement et rigoureusement des démarches d’évaluation des postulats statistiques au sein de la section « Méthode / Analyses de données » de leurs manuscrits.
Il ne suffit plus d’affirmer de manière lapidaire que « les postulats de normalité ont été testés et validés ». Les bonnes pratiques académiques requièrent :
- De nommer explicitement la nature des données soumises à vérification (souligner formellement que l’évaluation a porté sur les résidus du modèle linéaire et non sur les variables brutes agrégées).
- De rapporter de manière transparente les indices numériques de forme (valeurs ponctuelles du Skewness et du Kurtosis des résidus) et, le cas échéant, la statistique W du test de Shapiro-Wilk accompagnée de sa probabilité critique exacte.
- D’attester formellement de la consultation des diagrammes de diagnostic graphique (Q-Q plots).
- En cas de déviation substantielle ayant motivé un arbitrage alternatif, d’expliciter sans ambiguïté les fondements de ce choix : détailler les paramètres du bootstrap (nombre de rééchantillonnages, type d’intervalles BCa), la spécification de la famille et de la fonction de lien du modèle linéaire généralisé, ou les raisons du repli sur une procédure basée sur les rangs.
Cette clarté narrative renforce substantiellement la crédibilité scientifique du manuscrit, désamorce d’emblée les objections critiques des relecteurs (peer reviewers), et garantit l’intégrité déontologique de la diffusion des connaissances.
12.3 Synthèse critique et vision intégrative
Au terme de cette exploration transversale des fondements, des diagnostics et des enjeux méthodologiques de l’hypothèse de normalité, une conclusion épistémologique majeure s’impose au chercheur en sciences humaines et du comportement : la loi normale n’est pas une loi universelle immanente de la nature psychologique, mais un modèle mathématique d’approximation commode et d’une remarquable fécondité théorique. Comme le formulait avec une élégante ironie le statisticien George Box : « Tous les modèles sont faux, mais certains sont utiles. »
La recherche éperdue d’une perfection gaussienne absolue dans les données empiriques relève d’une illusion positiviste désuète. L’expérimentateur moderne ne doit pas se demander avec anxiété si ses données sont « parfaitement normales » — elles ne le sont rigoureusement jamais dans le monde réel des phénomènes perceptifs, affectifs et sociaux. La seule interrogation méthodologique pertinente et féconde consiste à déterminer dans quelle mesure la déviation distributionnelle observée est susceptible de compromettre la validité substantive, la précision numérique et la stabilité prédictive des inférences scientifiques formulées.
L’affranchissement vis-à-vis des dogmes rigides du passé, combiné à l’assimilation réfléchie des diagnostics graphiques résiduels, des outils de rééchantillonnage algorithmique par bootstrap et de la modélisation linéaire généralisée, autorise le chercheur contemporain à concevoir sa pratique statistique non plus comme une soumission passive à des contraintes logicielles mécaniques, mais comme un dialogue dynamique, nuancé et lucide avec la complexité empirique du psychisme humain. C’est à ce prix, et à ce prix seulement, que s’édifiera une science psychologique et cognitive véritablement robuste, cumulable et émancipée de ses propres artéfacts de mesure.
Références
- Anderson, T. W., & Darling, D. A. (1952). Asymptotic theory of certain « goodness of fit » criteria based on stochastic processes. The Annals of Mathematical Statistics, 23(2), 193-212. https://doi.org/10.1214/aoms/1177729437
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-252. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16-29. https://doi.org/10.1037/1082-989X.1.1.16
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1-26. https://doi.org/10.1214/aos/1176344552
- George, D., & Mallery, P. (2020). IBM SPSS Statistics 26 Step by Step: A Simple Guide and Reference (16th ed.). Routledge. https://doi.org/10.4324/9780429056765
- Jarque, C. M., & Bera, A. K. (1980). Efficient tests for normality, homoscedasticity and serial independence of regression residuals. Economics Letters, 6(3), 255-259. https://doi.org/10.1016/0165-1765(80)90024-5
- Kline, R. B. (2016). Principles and Practice of Structural Equation Modeling (4th ed.). The Guilford Press.
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399-402. https://doi.org/10.1080/01621459.1967.10482916
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156-166. https://doi.org/10.1037/0033-2909.105.1.156
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21-33.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Westfall, P. H. (2014). Kurtosis as peakedness, 1905–2014. R.I.P. The American Statistician, 68(3), 191-195. https://doi.org/10.1080/00031305.2014.917055
- Wilcox, R. R. (2022). Introduction to Robust Estimation and Hypothesis Testing (5th ed.). Academic Press. https://doi.org/10.1016/C2019-0-03820-2