
L’analyse de variance, introduite par le statisticien et généticien Ronald A. Fisher au début du XXe siècle, constitue l’un des piliers méthodologiques les plus fondamentaux de l’inférence statistique moderne. Dans les sciences du comportement, la biomédecine, la psychologie expérimentale et les sciences de l’éducation, ce cadre analytique permet d’évaluer si les variations observées entre plusieurs conditions expérimentales résultent de réelles divergences populationnelles ou de simples fluctuations d’échantillonnage aléatoires. En décomposant la variabilité globale en sources distinctes, le test d’ANOVA fournit une décision globale relative à l’hétérogénéité des groupes. Cependant, cette puissance d’agrégation recèle une limite fonctionnelle majeure : elle ne précise jamais quelles moyennes diffèrent les unes des autres.
Lorsqu’un chercheur est confronté au rejet de l’hypothèse nulle globale à la suite d’un test F significatif, la question théorique centrale reste souvent non résolue. S’agit-il d’une divergence isolée entre une condition témoin et un traitement particulier, d’un effet dose-réponse monotone, ou d’une scission binaire entre deux sous-ensembles de conditions ? C’est précisément à cette jonction critique que les tests de comparaisons multiples, couramment désignés sous le vocable de tests post hoc, deviennent indispensables. Leur mission consiste à explorer la matrice des différences intergroupes tout en neutralisant rigoureusement l’accroissement vertigineux des erreurs d’inférence induit par la multiplication des évaluations statistiques simultanées.
Ce guide propose une analyse exhaustive, rigoureuse et ancrée dans la pratique contemporaine de la recherche sur les procédures post hoc associées à l’ANOVA. En combinant modélisation théorique, formulation mathématique, diagnostics des postulats et mise en œuvre computationnelle, cet ouvrage offre aux chercheurs et praticiens une référence complète pour naviguer parmi l’abondance d’algorithmes disponibles. De la préservation du taux d’erreur par famille aux arbitrages subtils entre puissance statistique et conservatisme, ce manuel éclaire les mécanismes sous-jacents aux décisions méthodologiques qui conditionnent la validité et la reproductibilité des inférences scientifiques.
1. Fondements théoriques de l’ANOVA et nécessité méthodologique des tests post hoc
1.1 Le principe du test F et la nature du test omnibus
L’analyse de variance à un facteur repose sur une modélisation linéaire fondamentale où la valeur d’une observation individuelle est conçue comme la résultante de trois composantes : une moyenne générale, l’effet spécifique du groupe d’appartenance et un terme d’erreur aléatoire non contrôlé. L’hypothèse nulle globale, traditionnellement notée H₀, stipule une égalité parfaite et simultanée des paramètres moyens au sein de l’ensemble des k populations étudiées :
H₀ : μ₁ = μ₂ = … = μₖ
L’hypothèse alternative H₁ ne formule aucune trajectoire directionnelle particulière ; elle se borne à poser qu’au moins une des moyennes diffère de l’une des autres, ce qui s’exprime formellement par l’existence d’au moins une paire (i, j) telle que μᵢ ≠ μⱼ. Pour évaluer la plausibilité de cette hypothèse nulle, Fisher a développé le mécanisme de décomposition de la somme des carrés des écarts totaux (SS_total) en deux grandeurs constitutives mutuellement exclusives : la somme des carrés intergroupes (SS_between) et la somme des carrés intragroupe ou résiduelle (SS_within ou SS_error).
Le ratio de Fisher, ou statistique F, est défini par le quotient des carrés moyens correspondants :
F = MS_between / MS_within = (SS_between / df_between) / (SS_within / df_within)
où df_between = k – 1 et df_within = N – k, avec N représentant l’effectif total cumulé sur l’ensemble des groupes. Sous l’hypothèse nulle d’égalité stricte des moyennes, ce ratio suit une distribution de Fisher-Snedecor avec (k – 1, N – k) degrés de liberté. Sa valeur attendue théorique oscille autour de 1 si les variances sont purement résiduelles. Une déviation substantielle au-delà de la valeur critique tabulée pour un seuil α donné signale que la variabilité attribuable aux différences de moyennes entre les groupes est significativement supérieure à ce que le hasard de l’échantillonnage pourrait produire.
Sur le plan épistémologique, la statistique F possède une nature intrinsèquement « omnibus », c’est-à-dire globale. Elle agrège l’intégralité des variations intergroupes en un scalaire unique. Par conséquent, le rejet de l’hypothèse nulle globale délivre une information macroscopique : la variabilité observée entre les centres de gravité des groupes n’est pas réductible au bruit résiduel. En revanche, le test omnibus est par essence incapable de localiser la provenance de cette divergence. Un test F hautement significatif (par exemple, p < 0,0001) ne permet en aucun cas de certifier si tous les groupes se distinguent mutuellement, si un sous-groupe unique se détache d’un ensemble homogène, ou si un gradient continu structure la population étudiée.
1.2 La transition conceptuelle de l’effet global aux comparaisons multiples
L’obtention d’une valeur p inférieure au seuil conventionnel de 5 % au terme du calcul de l’ANOVA marque le commencement, et non l’aboutissement, du travail d’élucidation statistique. Dans les protocoles expérimentaux réels — qu’il s’agisse de mesurer l’impact de quatre molécules psychotropes sur l’atténuation de symptômes anxieux ou de comparer cinq stratégies didactiques sur l’acquisition de la numératie —, l’objectif scientifique réside dans la caractérisation fine des contrastes thérapeutiques ou éducatifs. L’interruption de la démarche analytique au stade du test F constituerait un inachèvement méthodologique majeur, privant le chercheur d’une compréhension structurelle de ses résultats.
La transition conceptuelle du niveau omnibus au niveau granulaire requiert le déploiement de comparaisons appariées ou de contrastes complexes. Cependant, cette démarche d’investigation locale expose immédiatement l’analyste à un paradoxe déductif. Alors que le test omnibus fournissait un cadre décisionnel binaire unifié à un risque d’erreur consenti α, la décomposition en multiples sous-évaluations engendre un ensemble d’inférences interconnectées. Si un plan comporte k = 4 groupes, il existe six comparaisons par paires distinctes ; pour k = 6, ce nombre s’élève à quinze. Si le chercheur applique de manière simpliste des tests t de Student indépendants à chacune de ces paires sans ajustement spécifique, il altère gravement l’intégrité probabilisticoclinique de son dispositif.
Le risque inhérent à une transition mal maîtrisée réside dans l’illusion de précision. Un praticien non averti pourrait considérer qu’une probabilité d’erreur nominale de 5 % attachée à chaque paire individuelle protège adéquatement ses conclusions. En réalité, cette multiplicité déstructure le filet de protection statistique, générant une cascade de faux positifs que l’on qualifie d’inflation de l’erreur globale. Il est donc impératif d’appréhender les tests post hoc non pas comme de simples calculs d’appoint, mais comme des outils d’inférence conditionnelle spécifiquement conçus pour résoudre la tension entre le besoin d’investigation fine et le contrôle impérieux des incertitudes probabilistes.
1.3 Distinction fondamentale entre contrastes a priori et analyses a posteriori
L’architecture méthodologique d’une recherche expérimentale impose une dichotomie formelle entre deux stratégies comparatives : les comparaisons planifiées (dites a priori) et les analyses exploratoires non planifiées (dites a posteriori ou post hoc). Cette différenciation ne relève pas d’une préférence stylistique, mais découle de la chronologie de formulation des hypothèses et gouverne la puissance statistique tout autant que le calibrage des seuils de rejet.
Les contrastes a priori sont déduits directement du cadre théorique antérieur au recueil des données empiriques. Le chercheur formalise un nombre restreint d’hypothèses directes, motivées par la littérature existante. Par exemple, il peut prédire précisément qu’un nouveau protocole thérapeutique surpassera le traitement standard, sans s’intéresser aux fluctuations secondaires entre divers groupes témoins. Dans ce contexte déductif, le nombre de contrastes calculés est limité — idéalement restreint à un système de contrastes dits orthogonaux, où l’information portée par chaque comparaison est statistiquement indépendante des autres. La limitation quantitative des tests permet de préserver une puissance d’analyse élevée, autorisant fréquemment le recours à des ajustements modérés, voire à l’absence de correction lourde lorsque les hypothèses sont strictement pré-enregistrées.
À l’inverse, les tests post hoc s’inscrivent dans une démarche fondamentalement inductive ou exploratoire. Face aux données collectées et après avoir constaté la significativité de l’effet omnibus, le scientifique ausculte l’ensemble des permutations possibles pour détecter quelles conditions génèrent le signal statistique. Aucune contrainte d’orthogonalité ou de parcimonie ne vient restreindre l’investigation : toutes les paires sont évaluées, y compris celles dont la divergence n’avait pas été théorisée en amont. Cette posture exploratoire, indispensable à la découverte scientifique, s’accompagne d’une charge méthodologique lourde. L’analyste examine des données qui ont déjà servi à calculer la variance globale ; il sélectionne visuellement ou algorithmiquement les écarts maximaux observés dans l’échantillon. Pour que cette exploration conserve une validité inférentielle et ne se réduise pas à la réification du hasard, des pénalités mathématiques sévères doivent être appliquées afin de recalculer les valeurs critiques nécessaires au rejet de H₀.
2. Le problème de l’inflation de l’erreur de type I (Family-Wise Error Rate)
2.1 Mécanisme probabiliste de l’accumulation de l’erreur alpha
L’erreur de type I, conventionnellement désignée par la lettre grecque α, représente la probabilité de rejeter à tort une hypothèse nulle qui est en réalité vraie dans la population parente — soit la déclaration d’un effet ou d’une différence là où ne s’exprime que le bruit stochastique. Lorsque l’on fixe conventionnellement ce seuil à α = 0,05 pour un test d’hypothèse unique, la probabilité complémentaire de ne pas commettre d’erreur de type I (c’est-à-dire de conserver à juste titre l’hypothèse nulle) est de 1 – α = 0,95.
Le problème de l’inflation apparaît dès lors que plusieurs tests statistiques sont menés au sein d’une même expérience. Supposons un ensemble de c tests statistiques indépendants, chacun calibré au seuil nominal α. Par application de la règle de multiplication des probabilités d’événements mutuellement indépendants, la probabilité d’obtenir zéro faux positif sur l’intégralité de la série d’évaluations équivaut à (1 – α)ᶜ. Dès lors, la probabilité cumulée de commettre au moins une erreur de type I sur l’ensemble de ces c comparaisons — que l’on nomme le taux d’erreur par famille d’hypothèses — s’exprime mathématiquement par l’équation canonique :
P(au moins une erreur de type I) = 1 – (1 – α)ᶜ
Le nombre total de comparaisons par paires possibles entre k groupes expérimentaux correspond au coefficient binomial désignant le nombre de combinaisons de 2 éléments parmi k, soit :
c = k(k – 1) / 2
L’insertion de cette valeur dans la formule met en évidence l’explosion non linéaire du risque d’erreur d’inférence au fur et à mesure que le plan expérimental s’élargit :
- Pour k = 3 groupes : c = 3(2)/2 = 3 comparaisons. Le risque global devient : 1 – (1 – 0,05)³ = 1 – 0,8574 = 0,1426, soit environ 14,3 %.
- Pour k = 4 groupes : c = 4(3)/2 = 6 comparaisons. Le risque s’élève à : 1 – (1 – 0,05)⁶ = 1 – 0,7351 = 0,2649, soit 26,5 %.
- Pour k = 5 groupes : c = 5(4)/2 = 10 comparaisons. Le risque atteint : 1 – (1 – 0,05)¹⁰ = 1 – 0,5987 = 0,4013, soit 40,1 %.
- Pour k = 10 groupes : c = 45 comparaisons. Le risque global bondit à 90,1 %.
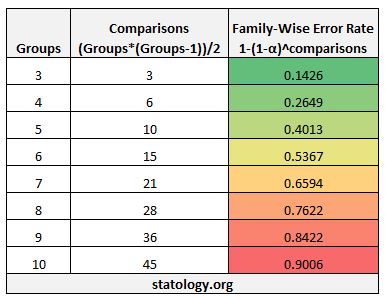
Cette démonstration algébrique établit sans ambiguïté qu’en l’absence de correction, un chercheur comparant cinq conditions expérimentales possède quatre chances sur dix de proclamer triomphalement l’existence d’une différence hautement significative là où ne règne qu’une égalité absolue. Dans un contexte de comparaisons multiples, les statistiques individuelles ne sont pas strictement indépendantes puisqu’elles partagent des termes de variance et de moyennes communes, mais cette interdépendance ne réduit que marginalement l’ampleur du problème. L’absence de régulation méthodologique transforme la démarche scientifique en une machine à fabriquer des artefacts statistiques.
2.2 Différenciation entre Per-Comparison Error Rate et Family-Wise Error Rate
Pour formaliser la régulation statistique, la théorie des tests d’hypothèses multiples a introduit une distinction terminologique et conceptuelle rigoureuse entre deux indices de contrôle des risques : le taux d’erreur par comparaison individuelle (en anglais, Per-Comparison Error Rate ou PCER) et le taux d’erreur par famille (Family-Wise Error Rate ou FWER).
Le PCER désigne la probabilité de commettre une erreur de type I lors de l’exécution d’un test spécifique isolé, indépendamment du statut de toutes les autres évaluations statistiques réalisées dans le cadre du même protocole ou du même manuscrit. Si un chercheur évalue un contraste particulier avec un seuil de significativité nominal fixé à α = 0,05, le PCER de ce test unitaire est exactement égal à 0,05. Si l’on applique ce seuil de façon indifférenciée à vingt contrastes consécutifs, le PCER demeure invariant pour chacun d’eux, mais l’accumulation globale de risque n’est aucunement régulée.
Le FWER, à l’inverse, appréhende la démarche inférentielle sous un angle systémique. Il est défini comme la probabilité qu’au moins une fausse découverte (au moins une décision erronée de rejet de l’hypothèse nulle vraie) survienne au sein de l’ensemble — ou famille — de tous les contrastes statistiques évalués simultanément. Le contrôle strict du FWER au niveau conventionnel α = 0,05 implique que, quelle que soit la quantité de combinaisons calculées (qu’il y ait trois, dix ou cinquante comparaisons), la probabilité globale d’introduire un résultat erroné dans le corpus de connaissances ne dépasse jamais la barrière des 5 %.
La délimitation de la notion de « famille » soulève d’importantes questions épistémologiques et pratiques. S’agit-il de l’ensemble des contrastes par paires découlant d’un facteur unique d’une ANOVA ? De l’ensemble des effets principaux et d’interaction d’un plan factoriel ? De l’intégralité des analyses présentées dans un article scientifique ? Dans la pratique méthodologique établie, la famille est universellement définie comme le faisceau de toutes les comparaisons analytiques dérivées de la décomposition d’un effet omnibus particulier au sein d’une même expérience. C’est sur ce périmètre que s’appliquent l’ensemble des corrections d’ajustement algorithmiques.
2.3 Implications pour la crise de la reproductibilité en psychologie
La sous-estimation systématique de l’inflation de l’erreur de type I a joué un rôle historique prépondérant dans l’émergence de la « crise de la reproductibilité », qui a secoué la psychologie expérimentale et les sciences biomédicales à partir du début des années 2010. Les travaux pionniers de méthodologistes tels que John Ioannidis ou Simmons, Nelson et Simonsohn ont mis en lumière la manière dont les degrés de liberté des chercheurs (researcher degrees of freedom) favorisaient la prolifération de résultats fallacieux.
Parmi ces libertés méthodologiques délétères, la pratique consistant à exécuter des dizaines de comparaisons de moyennes non contrôlées tout en ne rapportant dans le texte final que les seules paires ayant franchi le seuil arbitraire de p < 0,05 constituait une source majeure de pollution scientifique. En multipliant les conditions expérimentales, en subdivisant les cohortes en sous-groupes arbitraires et en omettant les pénalités d’ajustement associées au FWER, des expérimentateurs ont alimenté la littérature de corrélations illusoires, d’effets d’amorçage comportementaux impossibles à répliquer et d’interactions thérapeutiques fantômes.
Sous la pression des initiatives pour la science ouverte (Center for Open Science), les revues internationales à comité de lecture imposent désormais des normes de conformité statistique rigoureuses. Les rédacteurs en chef et évaluateurs exigent dorénavant la déclaration transparente de tous les contrastes calculés, le pré-enregistrement des plans analytiques et l’implémentation de procédures post hoc adaptées, assorties de corrections formelles pour les comparaisons multiples. Le choix d’une méthode de contrôle du FWER n’est donc plus un simple raffinement mathématique ; c’est un gage de probité garantissant la pérennité et la réplicabilité des édifices conceptuels en sciences humaines et biologiques.
3. Conditions préalables et critères d’application des tests post hoc
3.1 La règle conditionnelle de la significativité du test omnibus
L’orthodoxie statistique classique subordonne l’exécution des tests post hoc à une condition liminaire stricte : la significativité statistique préalable du test F omnibus au seuil α prédéterminé. Ce prérequis structure ce que l’on nomme les procédures de tests « protégés ». Dans cette architecture hiérarchisée, si le test F échoue à rejeter l’hypothèse nulle globale (par exemple, p = 0,12), la démarche inférentielle doit s’interrompre immédiatement. Aucune comparaison par paire ne peut être menée sous l’angle post hoc, quand bien même l’écart arithmétique entre la valeur la plus basse et la valeur la plus haute de l’échantillon semblerait spectaculaire à première vue.
Cette contrainte s’explique par les mécanismes mathématiques de l’ANOVA : le test omnibus apporte une garantie globale contre l’erreur de type I. Si la variance intergroupes globale ne dépasse pas l’espérance du bruit d’échantillonnage, la recherche effrénée d’une divergence appariée au sein de ce même ensemble constitue une entorse méthodologique assimilable à de la sélection opportune de données (cherry-picking). Le non-respect de ce verrouillage hiérarchique annule le contrôle théorique du FWER offert par certaines approches séquentielles traditionnelles.
Il existe néanmoins un débat technique relatif aux procédures qui n’ont pas besoin de cette protection omnibus. Des tests hautement rigoureux, tels que le test HSD de Tukey ou la méthode de Scheffé, intègrent intrinsèquement le contrôle du FWER pour l’ensemble exhaustif des comparaisons sans dépendre mathématiquement du résultat de la statistique F globale. Certains auteurs soutiennent qu’un chercheur pourrait appliquer la procédure de Tukey même si le test F est marginalement non significatif. Toutefois, dans la pratique académique standard et selon les consignes éditoriales dominantes, l’adhésion à la règle séquentielle — F omnibus significatif d’abord, tests post hoc ensuite — demeure le paradigme consensuel assurant la cohérence formelle de la démarche scientifique.
3.2 Évaluation de la normalité distributionnelle intragroupe
L’ANOVA paramétrique et les procédures de comparaisons multiples qui en découlent reposent sur le postulat que la variable dépendante suit une distribution normale au sein de chaque population parente représentée par un groupe, ce qui équivaut à postuler que les erreurs résiduelles du modèle linéaire suivent une loi gaussienne centrée sur zéro :
εᵢⱼ ~ N(0, σ²)
Le diagnostic de cette condition préalable doit être réalisé de manière systématique avant de valider la métrique des tests post hoc. Les méthodes formelles d’évaluation incluent le test d’adéquation de Shapiro-Wilk — reconnu pour son excellente sensibilité statistique face à des échantillons de petite à moyenne taille — et le test de Kolmogorov-Smirnov assorti de la correction de Lilliefors. Toutefois, les tests d’adéquation d’hypothèse nulle souffrent d’une limitation récurrente : pour de petits échantillons, ils manquent de puissance pour déceler des non-normalités dommageables, tandis que pour de très grands échantillons, ils deviennent inutilement hypersensibles à des déviations infinitésimales et sans conséquence pratique.
Par conséquent, l’évaluation de la normalité doit impérativement combiner ces tests formels avec un diagnostic graphique approfondi. L’inspection des diagrammes quantile-quantile (Q-Q plots) permet de visualiser directement l’alignement des résidus standardisés sur la diagonale théorique. L’apparition d’asymétries marquées (skewness) ou de queues de distribution excessivement épaisses (kurtosis) signale des perturbations susceptibles de fausser le calibrage des valeurs p des tests post hoc standard.
Il convient de rappeler que le théorème central limite confère à l’ANOVA une robustesse substantielle face aux écarts modérés à la normalité lorsque les effectifs de chaque groupe sont équilibrés et dépassent une trentaine de sujets par cellule (n > 30). Cependant, cette tolérance ne se transpose pas de manière identique à l’ensemble des tests post hoc. Certaines procédures fondées sur l’amplitude maximale des écarts sont particulièrement sensibles à la présence de valeurs aberrantes (outliers) et à la lourdeur des queues de distribution, ce qui nécessite un diagnostic méticuleux de ces anomalies.
3.3 Diagnostic rigoureux de l’homogénéité des variances (homoscédasticité)
Le postulat d’homogénéité des variances — ou homoscédasticité — postule que la variance résiduelle de la variable d’intérêt est strictement identique au sein de l’ensemble des populations sous-jacentes :
σ₁² = σ₂² = … = σₖ² = σ²
Cette condition structurelle est capitale : l’ensemble de la décomposition canonique de l’ANOVA repose sur l’hypothèse d’une unique variance d’erreur commune, dont l’estimateur sans biais est le carré moyen de l’erreur (MS_within ou MS_error). Les tests post hoc paramétriques conventionnels exploitent cette variance résiduelle agrégée pour calculer l’erreur type de la différence des moyennes, optimisant ainsi les degrés de liberté mobilisés.
L’évaluation statistique de l’homoscédasticité s’effectue usuellement par le test de Levene, dont la formulation moderne calcule les déviations des observations non pas par rapport aux moyennes des groupes, mais par rapport à leurs médianes respectives, conférant ainsi au test une excellente robustesse face aux déviations de la normalité. Le test de Bartlett offre une alternative de haute puissance mathématique mais souffre d’une extrême sensibilité au non-respect de la loi normale, ce qui restreint son usage aux contextes de gaussianité vérifiée.
Les conséquences d’une violation de l’homoscédasticité (hétéroscédasticité) sont asymétriques et potentiellement dévastatrices pour l’intégrité de la décision statistique :
- Si les variances sont hétérogènes et que les tailles d’échantillons sont égales (n₁ = n₂ = … = nₖ), les tests demeurent relativement robustes, bien qu’une légère perte de contrôle du FWER puisse apparaître.
- Si l’hétérogénéité des variances se conjugue à un déséquilibre d’effectifs (designs non équilibrés), la validité de l’inférence s’effondre :
- Lorsque les groupes aux effectifs les plus réduits affichent les variances les plus volumineuses, le test statistique devient excessivement libéral, générant une inflation exponentielle des faux positifs bien au-delà du seuil α consenti.
- Lorsque les groupes les plus fournis présentent les variances les plus importantes, le test devient conservateur à l’excès, provoquant une chute drastique de la puissance statistique et une incapacité chronique à identifier des différences réelles (inflation de l’erreur de type II).
Le diagnostic de l’homogénéité des variances agit ainsi comme un carrefour décisionnel impératif. Lorsque l’homoscédasticité est formellement rejetée par le test de Levene, l’analyste se trouve dans l’obligation méthodologique absolue de renoncer aux procédures post hoc paramétriques classiques (telles que Tukey ou Scheffé) pour s’orienter vers des algorithmes robustes spécifiquement programmés pour les variances inégales, tels que les tests de Games-Howell ou de Dunnett T3.
4. Les tests post hoc paramétriques sous hypothèse d’homogénéité des variances
4.1 Le test HSD de Tukey (Honestly Significant Difference)
Le test HSD de Tukey constitue la procédure de référence la plus employée dans le monde académique pour réaliser l’ensemble exhaustif des comparaisons par paires lorsque le postulat d’homogénéité des variances est respecté. Élaboré par le statisticien américain John W. Tukey, cet algorithme résout avec élégance l’arbitrage entre puissance d’analyse et régulation de l’erreur globale.
Le fondement théorique de la méthode de Tukey ne repose pas sur la distribution standard de Student, mais sur la Studentized Range Distribution (la loi de l’étendue studentisée, caractérisée par la statistique q). Cette distribution modélise formellement l’écart relatif entre la valeur maximale et la valeur minimale observées au sein d’un ensemble de moyennes issues d’une même distribution normale. La statistique de test s’écrit de la manière suivante :
q = (Ȳ_max – Ȳ_min) / SE
où SE représente l’erreur type de l’étendue, calculée à partir du carré moyen résiduel de l’ANOVA :
SE = √(MS_error / n)
Dans sa formulation opérationnelle pour comparer deux moyennes spécifiques quelconques Ȳᵢ et Ȳⱼ, la différence observée est déclarée statistiquement significative au niveau global α si elle excède la valeur critique de la « différence honnêtement significative » :
HSD = q_(crit; k, df_error) * √(MS_error / n)
où q_(crit) est la valeur critique tabulée de l’étendue studentisée dépendant du nombre total de groupes k dans l’ANOVA, des degrés de liberté résiduels df_error et du seuil α global désiré (généralement 0,05).
Lorsque les tailles d’échantillons des groupes sont inégales (nᵢ ≠ nⱼ), la procédure originale de Tukey ne peut s’appliquer sous sa forme brute. Elle bénéficie alors d’une modification structurelle validée conjointement par Tukey et Clyde Kramer : la méthode de Tukey-Kramer. L’adaptation remplace l’effectif constant n par la moyenne harmonique des tailles des deux groupes considérés dans le calcul de l’erreur type du contraste :
SE_(i-j) = √( (MS_error / 2) * (1/nᵢ + 1/nⱼ) )
Cette formulation garantit que le FWER demeure strictement inférieur ou égal au seuil nominal consenti, même sous de forts déséquilibres d’effectifs, pourvu que les variances restent homogènes. Le test HSD de Tukey excelle par son équilibre méthodologique : il offre une puissance maximale pour détecter des divergences par paires tout en assurant une protection globale constante contre l’apparition de faux positifs.
4.2 La méthode hautement conservatrice de Scheffé
Conçue par Henry Scheffé, cette approche propose un cadre analytique aux propriétés mathématiques remarquables, dont l’amplitude opérationnelle surpasse celle de l’ensemble des autres tests paramétriques. Alors que la technique de Tukey est circonscrite aux seules comparaisons par paires simples (μᵢ contre μⱼ), la méthode de Scheffé permet d’évaluer, sans aucune altération du FWER, l’infinité potentielle de l’ensemble des contrastes linéaires, qu’ils soient simples ou complexes.
Un contraste linéaire L est défini par une combinaison pondérée des moyennes de groupes :
L = ∑ cᵢ μᵢ avec ∑ cᵢ = 0
Un contraste simple oppose deux groupes isolés (c₁ = 1, c₂ = -1, c₃ = 0). En revanche, un contraste complexe permet d’opposer la moyenne combinée de deux conditions expérimentales à un groupe témoin unique (c₁ = 0,5, c₂ = 0,5, c₃ = -1), ou d’explorer des tendances polynomiales non prévues initialement.
La statistique de Scheffé est directement rattachée à la distribution de Fisher. Pour un contraste estimé L̂ = ∑ cᵢ Ȳᵢ, sa variance estimée est donnée par :
V(L̂) = MS_error * ∑ (cᵢ² / nᵢ)
La valeur critique de la différence de Scheffé permettant de rejeter l’hypothèse nulle d’un contraste s’établit selon la formulation :
S = √[ (k – 1) * F_(crit; k – 1, N – k) ] * √(V(L̂))
Cette architecture confère au test une cohérence formelle absolue avec le test F omnibus de l’ANOVA : un contraste de Scheffé significatif existe mathématiquement si, et seulement si, le test F global est lui-même statistiquement significatif. Aucune incohérence d’inférence n’est possible dans ce cadre.
Cependant, cette polyvalence conceptuelle s’accompagne d’un coût très élevé en matière de puissance statistique. En protégeant l’analyste contre l’erreur de type I pour l’univers complet de tous les contrastes concevables, Scheffé s’avère particulièrement pénalisant lorsqu’il est restreint à de banales comparaisons par paires simples. La probabilité d’erreur de type II y est nettement accrue par rapport à la méthode de Tukey. Dès lors, l’emploi de Scheffé ne se justifie méthodologiquement que dans les situations où la recherche requiert une exploration libre, non planifiée et intensive de regroupements complexes de modalités au sein de grands dispositifs d’expérimentation.
4.3 Les procédures séquentielles par étapes : Newman-Keuls et REGWQ
Pour optimiser la puissance statistique par rapport à l’approche à seuil d’amplitude unique de Tukey, des théoriciens ont élaboré des procédures dites séquentielles par étapes ou étagées (stepwise procedures). Ces méthodes ordonnent au préalable les moyennes des échantillons de la plus faible à la plus élevée, puis appliquent des valeurs critiques dynamiques modulées selon le nombre de rangs séparant les moyennes soumises à évaluation.
La méthode historiquement pionnière de cette famille est le test de Student-Newman-Keuls (SNK). Dans l’algorithme SNK, les moyennes sont classées par ordre croissant : Ȳ₍₁₎ ≤ Ȳ₍₂₎ ≤ … ≤ Ȳ₍ₖ₎. Si l’on compare deux moyennes séparées par un intervalle de r rangs (pour les extrêmes, r = k ; pour deux moyennes adjacentes, r = 2), le seuil critique mobilisé fait intervenir l’étendue studentisée q indexée sur la distance d’étape r plutôt que sur le total k des groupes. Ainsi, le seuil d’exigence statistique s’allège à mesure que l’écart spatial entre les moyennes se resserre.
Bien que séduisant par sa sensibilité accrue, le test de Newman-Keuls souffre d’un défaut conceptuel rédibitoire mis en évidence par la statistique contemporaine. Il échoue formellement à contrôler le FWER dès lors que le nombre de groupes atteint ou dépasse k = 4. Dans des configurations où l’hypothèse nulle globale n’est que partiellement vraie (par exemple, si deux moyennes sont identiques entre elles, mais distinctes des deux autres), le test SNK génère une inflation massive du taux d’erreur de type I, pouvant culminer à des valeurs de 20 % à 30 %. En conséquence, la littérature méthodologique actuelle recommande l’abandon de la procédure de Student-Newman-Keuls.
Pour remédier à cette instabilité sans abandonner le gain de sensibilité des approches séquentielles, Ryan, Einot, Gabriel et Welsch ont mis au point la procédure perfectionnée REGWQ (fondée sur l’étendue studentisée de Ryan-Einot-Gabriel-Welsch). Cet algorithme calcule, pour chaque amplitude d’étape r, un seuil ajusté αᵣ assurant une régulation mathématique sans faille :
αᵣ = 1 – (1 – α)^(r/k) pour r < k – 1
et
αᵣ = α pour r = k ou r = k – 1
Le test REGWQ offre l’un des meilleurs compromis statistiques disponibles : il préserve scrupuleusement le taux d’erreur par famille au niveau nominal choisi tout en délivrant une puissance systématiquement supérieure à celle du test HSD de Tukey pour les paires de moyennes géographiquement proches sur l’axe des rangs. Son utilisation est toutefois strictement subordonnée au respect rigoureux de l’homogénéité des variances et impose des effectifs rigoureusement équilibrés au sein de chaque groupe.
5. Les méthodes d’ajustement du seuil alpha et approches par bonferronisation
5.1 La correction classique de Bonferroni
L’approche conçue d’après les travaux de la mathématicienne Carlo Emilio Bonferroni repose sur une application directe de l’inégalité de Boole en théorie des probabilités. Cette inégalité postule que pour toute suite d’événements probabilistes, la probabilité de l’union d’événements est inférieure ou égale à la somme arithmétique de leurs probabilités individuelles respectives :
P(∪ Eᵢ) ≤ ∑ P(Eᵢ)
Transposé au problème des comparaisons statistiques multiples, ce théorème indique que si un chercheur mène c tests d’hypothèses distincts, chacun calibré à un seuil nominal d’erreur α_indiv, le FWER ne dépassera jamais la somme de ces seuils individuels. Dès lors, pour garantir un taux d’erreur par famille borné supérieurement par une valeur cible globale (typiquement α_global = 0,05), la règle de décision de Bonferroni consiste à diviser le seuil nominal par le volume total des comparaisons envisagées :
α_corrigé = α_global / c
De façon strictement équivalente, les logiciels contemporains multiplient usuellement la valeur p empirique observée (p_brute) par le nombre de tests c :
p_ajustée = min(1, c * p_brute)
L’universalité constitue le bénéfice premier de cette méthode. L’ajustement de Bonferroni ne formule aucun prérequis quant à la structure distributionnelle des données, à la normalité des résidus, à l’égalité des variances ou à l’orthogonalité des hypothèses. Il s’applique avec la même simplicité calculatoire à des tests t, des tests non paramétriques (Mann-Whitney), des régressions logistiques ou des coefficients de corrélation.
Cette rusticité opératoire induit en contrepartie une faiblesse majeure : un conservatisme excessif. L’inégalité de Boole constitue une borne supérieure lâche qui ignore totalement la dépendance statistique inévitable liant des comparaisons multiples calculées à partir de groupes partagés. Plus le nombre de contrastes c s’élève, plus le seuil d’acceptabilité de la preuve devient pénalisant. Par exemple, avec 10 comparaisons, une différence de moyennes doit atteindre une valeur p inférieure à 0,005 pour être reconnue significative. Ce laminage de la puissance statistique propulse l’erreur de type II à des niveaux préjudiciables, conduisant régulièrement les chercheurs à rejeter des avancées théoriques prometteuses faute d’une taille d’échantillon monumentale.
5.2 La procédure séquentielle descendante de Holm-Bonferroni
Pour éliminer le conservatisme disproportionné de la bonferronisation classique sans sacrifier sa flexibilité universelle, le statisticien suédois Sture Holm a développé en 1979 une alternative séquentielle descendante (step-down) connue sous le nom de procédure de Holm-Bonferroni. Cette méthode surpasse mathématiquement la correction classique de Bonferroni en tout point : elle offre une puissance statistique systématiquement supérieure tout en assurant un contrôle du FWER tout aussi strict.
L’algorithme de Holm procède selon les étapes ordonnées suivantes :
- L’ensemble des c valeurs p brutes obtenues par le calcul des différents contrastes sont ordonnées de la plus faible à la plus élevée :
p₍₁₎ ≤ p₍₂₎ ≤ … ≤ p₍꜀₎
Chaque valeur p se voit attribuer un rang i allant de 1 à c. - Chaque probabilité observée p₍ᵢ₎ est évaluée séquentiellement face à un seuil critique dynamique ajusté à son rang :
α₍ᵢ₎ = α_global / (c – i + 1) - L’algorithme débute par le rang i = 1. Si p₍₁₎ < α / c, la comparaison est déclarée statistiquement significative, et l’analyste procède à l’évaluation du rang i = 2 face au seuil assoupli α / (c – 1).
- Le processus d’évaluation descendante se poursuit tant que la condition p₍ᵢ₎ < α₍ᵢ₎ est remplie. Dès qu’une valeur p échoue à franchir le seuil correspondant à son étape, la procédure s’interrompt définitivement : cette comparaison ainsi que toutes les suivantes sont déclarées non significatives.
Le tableau suivant illustre le mécanisme de Holm-Bonferroni comparé à la correction classique de Bonferroni pour une famille de c = 5 tests avec un seuil global fixé à α = 0,05 :
- Rang 1 : seuil de Bonferroni = 0,0100 | seuil de Holm = 0,05 / (5 – 1 + 1) = 0,0100
- Rang 2 : seuil de Bonferroni = 0,0100 | seuil de Holm = 0,05 / (5 – 2 + 1) = 0,0125
- Rang 3 : seuil de Bonferroni = 0,0100 | seuil de Holm = 0,05 / (5 – 3 + 1) = 0,0167
- Rang 4 : seuil de Bonferroni = 0,0100 | seuil de Holm = 0,05 / (5 – 4 + 1) = 0,0250
- Rang 5 : seuil de Bonferroni = 0,0100 | seuil de Holm = 0,05 / (5 – 5 + 1) = 0,0500
On constate que pour la dernière comparaison, le seuil d’évaluation rejoint le seuil nominal non corrigé de 0,05. La démonstration mathématique ayant attesté que la méthode de Holm protège intégralement le FWER sous n’importe quelle configuration sans exiger d’indépendance statistique, l’utilisation de la correction de Bonferroni brute pour des tests post hoc n’est plus justifiée : la procédure de Holm-Bonferroni doit systématiquement lui être préférée.
5.3 L’ajustement de Šidák et ses variantes séquentielles
L’approche formulée par le mathématicien Zbyněk Šidák en 1967 repose sur une dérivation probabiliste plus précise que la borne linéaire de Boole, sous le postulat d’indépendance statistique mutuelle entre les tests d’hypothèses. En reprenant l’expression du risque cumulé d’erreur, 1 – (1 – α_indiv)ᶜ = α_global, l’isolation algébrique du seuil unitaire requis aboutit à l’équation de correction de Šidák :
α_Šidák = 1 – (1 – α_global)^(1/c)
De manière symétrique, le calcul de la probabilité ajustée à partir d’une valeur p brute s’énonce ainsi :
p_ajustée = 1 – (1 – p_brute)ᶜ
Dans la mesure où l’expression polynomiale de Šidák découle directement des axiomes fondamentaux des probabilités appliqués aux événements non dépendants, elle fournit un seuil critique systématiquement moins restrictif que le découpage arithmétique de Bonferroni. Par exemple, pour un dispositif intégrant c = 6 comparaisons au seuil global de 5 %, la correction de Bonferroni requiert α = 0,05 / 6 = 0,00833, tandis que la formule de Šidák attribue le seuil α = 1 – (0,95)^(1/6) = 0,00851.
Ce gain de sensibilité, bien que marginal pour de petits volumes de tests, tend à s’amplifier lors de plans factoriels étendus. Tout comme l’ajustement de Bonferroni a été perfectionné par Holm, la procédure de Šidák a été convertie en un algorithme séquentiel par étapes par Jean-Marie Holland et Margaret Copenhaver (méthode de Holm-Šidák), qui remplace le seuil statique par un étagement dynamique :
α₍ᵢ₎ = 1 – (1 – α_global)^(1 / (c – i + 1))
L’utilisation de Šidák et de ses déclinaisons par étapes requiert toutefois une réserve d’application : son fondement probabiliste exige formellement l’indépendance statistique des statistiques de test, ou une condition d’indépendance conjointe positive. Si des corrélations négatives importantes lient les comparaisons au sein de structures résiduelles particulières, l’inégalité de Šidák peut théoriquement se révéler légèrement sous-conservatrice, situation dans laquelle l’algorithme de Holm demeure la protection de référence.
6. Les tests post hoc en contexte d’hétérogénéité des variances (hétéroscédasticité)
6.1 Le test de Games-Howell : la référence robuste
Lorsque le diagnostic préalable par le test de Levene établit l’hétérogénéité des variances résiduelles (p < 0,05), les hypothèses fondamentales sous-jacentes aux procédures classiques de Tukey ou Scheffé sont invalidées. L’usage d’un carré moyen de l’erreur unique (MS_error) agrégé sur l’ensemble des cellules fausse l’estimation de l’erreur type. Pour résoudre cette impasse sans recourir à des transformations de données parfois destructrices d’interprétabilité, Paul Games et John Howell ont développé en 1976 le test de Games-Howell, largement considéré comme l’algorithme robuste par excellence.
La structure mathématique de Games-Howell s’émancipe de la variance globale agrégée. Pour chaque contraste apparié opposant le groupe i au groupe j, la statistique de test mobilise les variances d’échantillon spécifiques (sᵢ² et sⱼ²) et leurs effectifs respectifs (nᵢ et nⱼ) :
q = |Ȳᵢ – Ȳⱼ| / √( (sᵢ² / nᵢ + sⱼ² / nⱼ) / 2 )
Pour déterminer la valeur critique de l’étendue studentisée appropriée, le test renonce aux degrés de liberté résiduels globaux de l’ANOVA (N – k) et calcule des degrés de liberté effectifs ajustés (df’), dérivés de l’approximation historique de Welch-Satterthwaite :
df’ = (sᵢ² / nᵢ + sⱼ² / nⱼ)² / [ ((sᵢ² / nᵢ)² / (nᵢ – 1)) + ((sⱼ² / nⱼ)² / (nⱼ – 1)) ]
Cette formulation permet à la procédure d’ajuster le seuil critique à l’asymétrie propre à chaque paire de conditions. Si l’un des groupes présente une variance substantielle et un effectif modeste, les degrés de liberté sont fortement réduits, relevant automatiquement l’exigence statistique pour déclarer la significativité.
En psychométrie expérimentale, en neuropsychologie et dans les recherches cliniques évaluant des pathologies sévères, les variances des scores sont structurellement instables : les cohortes cliniques manifestent couramment une variabilité comportementale décuplée par rapport aux cohortes saines. Face à de telles données, les simulations de Monte Carlo ont prouvé la supériorité de Games-Howell. Ce test maintient le FWER rigoureusement proche du seuil théorique de 5 %, y compris sous de violentes distorsions d’homoscédasticité couplées à des designs expérimentaux hautement déséquilibrés, sans sacrifier indûment la puissance statistique. Il doit cependant être manipulé avec circonspection si les effectifs de cellules deviennent extrêmement faibles (n < 6), configuration dans laquelle il peut manifester une légère tendance au libéralisme.
6.2 Les tests T3 et C de Dunnett pour variances inégales
En parallèle des travaux de Games et Howell, Charles Dunnett a proposé en 1980 deux méthodes alternatives dédiées aux contextes d’hétérogénéité des variances : le T3 de Dunnett et le test C de Dunnett. Ces algorithmes partagent avec Games-Howell l’abandon du postulat de variance commune au profit des estimateurs empiriques propres à chaque cellule, mais s’en séparent par la distribution de référence sélectionnée pour le calibrage des valeurs critiques.
Le test T3 de Dunnett est élaboré à partir de la distribution modulaire maximale de Student (Student’s Maximum Modulus Distribution). La statistique de test correspond au ratio de Welch unitaire :
t = |Ȳᵢ – Ȳⱼ| / √( sᵢ² / nᵢ + sⱼ² / nⱼ )
Cette valeur est comparée à une borne issue de la loi modulaire maximale de paramètres k* (le nombre total de comparaisons par paires, c = k(k – 1)/2) et df’ (les degrés de liberté effectifs de Welch-Satterthwaite calculés pour la paire considérée). Le test C de Dunnett simplifie ce traitement en substituant aux degrés de liberté effectifs de Welch une combinaison linéaire des valeurs critiques de l’étendue studentisée pondérées par les variances des deux échantillons, se dispensant ainsi du calcul dynamique des degrés de liberté continus.
La confrontation empirique des performances met en évidence une démarcation nette :
- Le test T3 de Dunnett est caractérisé par un conservatisme prononcé. Il garantit que le FWER ne dépasse jamais le seuil α nominal, quelles que soient l’intensité de l’hétérogénéité des variances ou la disparité des effectifs. Ce rempart statistique robuste s’avère particulièrement protecteur face à de très petits échantillons (n < 15), situation précise dans laquelle le test de Games-Howell peut être pris en défaut.
- Le test C de Dunnett manifeste une tendance conservatrice encore plus marquée, réduisant considérablement la puissance d’analyse lors de designs complexes.
Dans la pratique scientifique, pour des échantillons d’effectifs moyens à larges (n > 30 par groupe), Games-Howell demeure la recommandation dominante en raison de sa puissance supérieure. Néanmoins, lorsque la taille des cohortes expérimentales est restreinte et que l’hétérogénéité des variances menace la validité des inférences, le T3 de Dunnett représente l’alternative la plus sécurisée.
6.3 Le test T2 de Tamhane et ses compromis statistiques
Le test T2 de Tamhane, formalisé par Ajit Tamhane en 1979, propose une stratégie alternative pour sécuriser les comparaisons de moyennes en situation d’hétéroscédasticité avérée. Cette méthode repose sur une synthèse entre l’inégalité probabiliste de Šidák et le test t de Welch pour échantillons indépendants à variances inégales.
Le déroulement mathématique du T2 de Tamhane implique le calcul de la statistique de Welch usuelle pour chaque paire, couplée à un calcul des degrés de liberté ajustés selon la formule classique de Satterthwaite. L’ajustement pour la multiplicité des tests ne recourt ni à l’étendue studentisée ni à la distribution modulaire maximale : il applique directement une valeur critique de Student bilatérale, évaluée à un niveau de risque unitaire α* ajusté par l’exposant conservateur de Šidák :
α* = 1 – (1 – α_global)^(1 / c)
Le test T2 de Tamhane constitue l’une des procédures les plus conservatrices de l’arsenal statistique robuste. En superposant la pénalité distributive de Šidák à la réduction des degrés de liberté de l’approximation de Welch, il crée un verrou inférentiel particulièrement rigide. Le risque de proclamer un faux positif y est presque nul, restant souvent bien en deçà du seuil nominal consenti.
Ce niveau de protection présente une contrepartie inévitable : le T2 de Tamhane s’avère considérablement moins puissant que le test de Games-Howell pour déceler des différences de moyennes moyennes ou faibles. Son usage méthodologique se justifie principalement dans des contextes confirmatoires de haute sécurité — par exemple lors de tests toxicologiques ou d’essais cliniques préliminaires portant sur des paramètres d’innocuité où toute fausse déclaration d’efficacité relative doit être systématiquement évitée, même au prix d’une perte sensible de sensibilité statistique.
7. Comparaisons spécifiques contre un groupe témoin : le test de Dunnett
7.1 Architecture théorique du test de Dunnett
Dans un grand nombre d’expérimentations en psychologie appliquée, en pharmacologie ou en ergonomie cognitive, la problématique de recherche ne requiert nullement l’évaluation exhaustive de toutes les paires possibles. L’expérimentateur n’a que faire de savoir si la dose pharmacologique B diffère de la dose C ; la seule question substantielle consiste à déterminer si chacune des doses expérimentales démontre une efficacité distincte par rapport à une condition de référence commune — typiquement un groupe témoin ou un groupe sous placebo. Ce type d’architecture est désigné sous l’appellation d’inférence de type Many-to-One.
Le statisticien canadien Charles Dunnett a formalisé en 1955 une procédure d’une efficacité mathématique remarquable, spécifiquement calibrée pour ce scénario expérimental. Au lieu de subir la pénalité de multiplicité attachée aux c = k(k – 1)/2 comparaisons d’un test comme celui de Tukey, le test de Dunnett restreint formellement le faisceau des évaluations aux seuls contrastes reliant les k – 1 groupes expérimentaux à l’unique condition de contrôle :
Nombre de comparaisons = k – 1
Par exemple, au sein d’un plan comprenant six groupes expérimentaux, une exploration par paires classique impose de corriger pour 15 comparaisons. Le test de Dunnett, lui, limite le calibrage statistique à 5 contrastes ciblés. Cette économie structurelle transforme l’équation de la puissance statistique. L’algorithme intègre la structure de corrélation intrinsèque liant ces contrastes, puisque la moyenne du groupe témoin intervient dans chacun d’eux. En utilisant une distribution multivariée de Student dédiée, le test de Dunnett délivre une puissance statistique nettement supérieure à toute autre méthode pour identifier des divergences vis-à-vis du contrôle, tout en garantissant un contrôle rigoureux du FWER.
7.2 Formulations unilatérale et bilatérale du test
L’une des spécificités majeures du test de Dunnett réside dans sa capacité à être formulé rigoureusement sous une modalité bilatérale (two-sided) ou sous une modalité unilatérale (one-sided), offrant un avantage inférentiel stratégique lorsque les hypothèses théoriques le justifient formellement.
La version bilatérale teste simplement l’absence de différence directionnelle entre les traitements expérimentaux et le contrôle (H₀ : μᵢ = μ_témoin contre H₁ : μᵢ ≠ μ_témoin). Elle s’applique lorsque les interventions peuvent indifféremment induire une amélioration ou une détérioration de la performance, ce qui est le cas lors de l’évaluation de nouvelles molécules dont on craint d’éventuels effets secondaires négatifs.
La formulation unilatérale devient opératoire lorsque la direction de l’effet attendu est conceptuellement et théoriquement verrouillée en amont de l’expérimentation. Dans un protocole d’intervention en remédiation cognitive, par exemple, la finalité scientifique est d’établir si les thérapies augmentent les scores de mémoire de travail par rapport au groupe sans traitement (H₀ : μᵢ ≤ μ_témoin contre H₁ : μᵢ > μ_témoin). En concentrant la zone de rejet dans une queue unique de la distribution multivariée de Student, le test de Dunnett unilatéral abaisse considérablement le seuil critique requis pour conclure à la supériorité du traitement, maximisant ainsi la puissance d’analyse sans compromettre le contrôle du risque α.
Cette approche unilatérale exige toutefois une discipline méthodologique rigoureuse. Elle doit être spécifiée dans le protocole expérimental pré-enregistré. Si l’intervention induit de manière inattendue un effet délétère majeur, l’analyste se trouve méthodologiquement interdit de basculer a posteriori vers une évaluation bilatérale pour tenter de repêcher un résultat statistique.
7.3 Variantes robustes face aux écarts de variances
Le test standard de Dunnett assume, au même titre que l’ANOVA classique, l’homoscédasticité parfaite des variances résiduelles entre toutes les conditions. Toutefois, dans les protocoles biomédicaux et cliniques, il est fréquent que le groupe témoin (constitué d’individus sains ou non traités) manifeste une variance physiologique modérée, tandis que les groupes pathologiques traités manifestent une dispersion très marquée consécutive à des hétérogénéités de réponse au traitement.
Pour prévenir la perte de contrôle de l’erreur de type I induite par ces distorsions, des formulations robustes du test de Dunnett ont été intégrées aux environnements computationnels modernes. Ces algorithmes adaptent la métrique de l’erreur type en incorporant des corrections d’approximation semblables à celles de Welch, calculant pour chaque confrontation au témoin :
SE_(i-témoin) = √( sᵢ² / nᵢ + s_témoin² / n_témoin )
Le calcul des degrés de liberté suit l’estimation locale de Welch-Satterthwaite, ce qui ajuste la distribution de référence à chaque couple d’évaluation.
Une règle méthodologique cruciale d’optimisation expérimentale s’applique aux plans destinés à être analysés par le test de Dunnett : le ratio d’échantillonnage optimal. Alors que pour les comparaisons par paires de Tukey, des effectifs égaux par cellule (n₁ = n₂ = … = nₖ) constituent la configuration optimale, le modèle mathématique de Dunnett préconise d’augmenter substantiellement l’effectif du groupe témoin. Le dimensionnement optimal de la cohorte de contrôle respecte approximativement la relation mathématique :
n_témoin ≈ n_expérimental * √(k – 1)
En affectant davantage de sujets au groupe témoin pivot, l’expérimentateur réduit la variance d’échantillonnage sur le terme commun à l’ensemble des contrastes, augmentant ainsi mécaniquement la puissance statistique de l’ensemble du dispositif analytique.
8. Tests post hoc pour plans factoriels et ANOVA à mesures répétées
8.1 Décomposition des interactions significatives (analyse des effets simples)
Dans les plans factoriels intégrant deux variables indépendantes ou plus (par exemple, un plan 2 × 3 croisant le Type d’intervention et le Niveau de stress initial), la survenue d’une interaction statistiquement significative (F_(A × B) significatif) modifie fondamentalement la trajectoire analytique. Les tests post hoc portant sur les effets principaux marginaux deviennent conceptuellement caducs, voire trompeurs. Déclarer qu’un traitement A est supérieur au traitement B « en moyenne » n’a aucun sens si l’interaction indique que la supériorité s’exprime exclusivement chez les sujets à haut niveau de stress et s’inverse chez les individus à bas niveau de stress.
La méthodologie prescrit dans cette configuration le déploiement d’une analyse des effets principaux simples (simple main effects). Cette procédure consiste à décomposer le plan factoriel bidimensionnel en sous-ensembles conditionnels unidimensionnels :
- On étudie l’effet du facteur A à chaque niveau fixé du facteur B (par exemple, évaluer la différence entre traitements uniquement chez les sujets à haut stress, puis chez les sujets à stress modéré, etc.).
- Alternativement, on étudie l’effet du facteur B à chaque niveau fixé du facteur A.
Dès lors que ces familles d’effets simples sont isolées, le calcul des tests post hoc par paires intervient pour départager les modalités si le facteur conditionnel comporte au moins trois niveaux. La difficulté méthodologique réside dans le calibrage de l’erreur type résiduelle. Deux approches s’opposent :
- L’utilisation du terme d’erreur résiduelle global du modèle factoriel complet (MS_residual de l’ANOVA factorielle), qui offre un maximum de degrés de liberté sous réserve d’une homoscédasticité absolue entre toutes les cellules de la matrice croisée.
- L’estimation de variances d’erreurs locales restreintes aux seules sous-populations conditionnelles examinées, approche recommandée lorsque la dispersion des scores fluctue selon les combinaisons expérimentales.
Le contrôle de l’inflation de l’erreur de type I doit s’appliquer à chaque famille d’effets simples à l’aide de méthodes séquentielles comme Holm-Bonferroni ou Tukey, garantissant que la granularité de l’interprétation ne s’accompagne pas d’une prolifération artificielle de faux effets conditionnels.
8.2 Spécificités des comparaisons multiples en mesures répétées
L’ANOVA à mesures répétées (plans intra-sujets) introduit une complexité absente des plans indépendants : la covariance sérielle des observations. Chaque participant agissant comme son propre témoin à travers les différentes conditions ou étapes temporelles, les scores mesurés au sein d’une même ligne expérimentale sont intrinsèquement corrélés. Cette architecture implique le postulat de sphéricité (analysé via le test de Mauchly), qui stipule l’égalité parfaite des variances de l’ensemble des différences possibles entre chaque paire de modalités intra-sujets.
Lorsque la sphéricité est violée — situation quasi omniprésente dans les suivis longitudinaux prolongés —, des facteurs de correction d’ajustement des degrés de liberté (Greenhouse-Geisser ou Huynh-Feldt) sont appliqués au test omnibus. Cependant, cette correction globale ne protège pas automatiquement les comparaisons post hoc ultérieures.
Une erreur méthodologique particulièrement courante consiste à employer le carré moyen d’erreur résiduel agrégé issu de l’ANOVA à mesures répétées (MS_error(within)) comme dénominateur unique pour calculer les tests post hoc de Tukey. Le statisticien Geoffrey Loftus et de nombreux méthodologistes ont démontré que ce procédé produit des résultats biaisés dès lors que la sphéricité n’est pas rigoureusement respectée. Dans les plans intra-sujets, la variance de la différence entre la condition 1 et la condition 2 est rarement identique à la variance de la différence entre la condition 2 et la condition 3.
La pratique recommandée consiste à abandonner l’erreur résiduelle agrégée au profit de termes d’erreurs résiduelles spécifiques par paire. Pour chaque comparaison, l’analyste calcule la variable de différence individuelle (D = X_condition1 – X_condition2) et applique un test t apparié muni d’une correction séquentielle de Holm-Bonferroni. Cette stratégie neutralise l’impact de la violation de la sphéricité et garantit des conclusions robustes au sein des designs intra-sujets.
8.3 Procédures post hoc appliquées aux plans mixtes (Split-Plot ANOVA)
Les plans d’expérience mixtes combinent au moins un facteur inter-sujets (par exemple, Groupe Clinique vs Groupe Contrôle) et au moins un facteur intra-sujets ou longitudinal (par exemple, Pré-test, Post-test immédiat et Suivi à 6 mois). Cette architecture méthodologique génère une partition de la variance d’erreur en deux composantes indépendantes :
- L’erreur résiduelle inter-sujets (liée aux variations individuelles globales entre les participants).
- L’erreur résiduelle intra-sujets (liée aux fluctuations individuelles temporelles ou conditionnelles).
La réalisation de tests post hoc dans un plan mixte exige une vigilance méthodologique extrême quant au choix du terme d’erreur à intégrer au dénominateur statistique des contrastes. Lorsque l’on compare les niveaux du facteur intra-sujets au sein d’un même groupe clinique, c’est l’erreur résiduelle intra-sujets qui doit être mobilisée. En revanche, lorsque l’on compare le groupe clinique au groupe témoin à un instant précis donné (effet simple inter-groupes à l’étape Post-test), l’analyste se trouve confronté à un mélange d’erreurs inter- et intra-sujets.
L’approche classique nécessite le calcul de l’erreur type combinée selon la formule de Fisher-Behrens, pondérant les carrés moyens inter et intra, associée à une approximation des degrés de liberté selon Satterthwaite. En raison de cette complexité arithmétique et de la rigidité des postulats sous-jacents, la communauté statistique contemporaine encourage le remplacement de l’ANOVA mixte par les modèles linéaires mixtes (Linear Mixed Models ou modèles multiniveaux). Ces modèles gèrent nativement les corrélations sérielles, tolèrent les données manquantes aléatoires et permettent de dériver des comparaisons par paires robustes via les moyennes marginales estimées (Estimated Marginal Means) assorties de corrections de multiplicité rigoureuses.
9. Arbre décisionnel pour sélectionner le test post hoc optimal
9.1 Évaluation du design expérimental et de l’équilibre des effectifs
La sélection du test post hoc le plus adapté ne saurait être le fruit d’une habitude empirique ou d’une sélection par défaut dans un logiciel ; elle procède d’un arbitrage méthodologique dépendant de la géométrie du plan expérimental, du respect des postulats distributionnels et des objectifs scientifiques poursuivis.
Le premier paramètre décisionnel concerne l’équilibre des effectifs par cellule. Si les échantillons sont rigoureusement équilibrés (n₁ = n₂ = … = nₖ) et que l’homoscédasticité est confirmée, les méthodes traditionnelles opérant sur l’étendue studentisée expriment leur plein potentiel :
- Le test HSD de Tukey représente le choix standard, combinant simplicité, stabilité et puissance pour toutes les comparaisons par paires.
- La procédure REGWQ constitue l’alternative de choix si l’expérimentateur privilégie une puissance accrue pour les paires de moyennes adjacentes, sous réserve d’une conformité stricte des données à la normalité.
Dès lors que les effectifs deviennent inégaux (plans non équilibrés), la formule originelle de Tukey doit obligatoirement être substituée par l’ajustement de Tukey-Kramer. Cet algorithme calcule la moyenne harmonique des tailles d’échantillons de chaque paire, rétablissant la validité formelle du FWER. Lorsque le déséquilibre d’effectif est délibéré — notamment dans le cadre de plans optimisés pour comparer des traitements à un groupe témoin surdimensionné —, le test de Dunnett s’impose comme l’architecture méthodologique incontournable.
9.2 Arbitrage entre rigueur conservatrice et préservation de la puissance
Le second axe décisionnel oppose le conservatisme à la puissance statistique. Ces deux notions sont intrinsèquement antagonistes : toute diminution du risque de commettre une erreur de type I (faux positif) s’accompagne inévitablement d’une augmentation proportionnelle du risque d’erreur de type II (faux négatif, désigné par la lettre β), abaissant la puissance statistique (1 – β) du test.
Le spectre des procédures post hoc peut être ordonné le long d’un continuum objectif de rigueur méthodologique croissant :
- Tests libéraux : Le test LSD de Fisher (à éviter dès que k ≥ 4) et le test de Newman-Keuls (à proscrire en raison de son absence de contrôle du FWER sous hypothèse nulle partielle).
- Tests équilibrés à haute puissance : Tukey HSD / Tukey-Kramer, REGWQ, Dunnett (pour la comparaison au témoin). Ces méthodes régulent le FWER exactement au seuil nominal consenti (généralement 5 %) sans excédent de conservatisme.
- Tests modérément conservateurs : La méthode séquentielle de Holm-Bonferroni et celle de Holm-Šidák. Elles offrent une régulation universelle sans postulat lourd, avec une perte de puissance très mesurée par rapport à la bonferronisation classique.
- Tests hyper-conservateurs : La correction classique de Bonferroni, le T2 de Tamhane et la méthode de Scheffé (lorsque cette dernière est employée pour de simples comparaisons par paires).
L’arbitrage doit être guidé par la visée de l’étude. Dans le cadre d’études exploratoires ou de phases pilotes (screening studies) visant à identifier de potentielles cibles thérapeutiques ou des pistes de recherche innovantes, l’utilisation de méthodes modérément puissantes (Holm-Bonferroni ou Tukey) est conseillée afin de ne pas masquer prématurément de réels signaux expérimentaux. En revanche, dans le cadre de recherches confirmatoires, d’essais cliniques de phase III ou d’études d’enregistrement soumises aux directives d’agences réglementaires (EMA, FDA), un conservatisme strict et un verrouillage absolu du FWER sont impératifs.
9.3 Schéma synthétique d’orientation méthodologique
Pour formaliser de manière opérationnelle le processus de sélection, la trajectoire décisionnelle du chercheur peut être formalisée par l’algorithme suivant :
- Étape 1 : Vérification des prérequis fondamentaux
- Le test F omnibus de l’ANOVA est-il statistiquement significatif (p < α) ? Si non, interrompre la démarche post hoc standard (sauf planification d’analyses de contrastes spécifiques pré-enregistrés).
- Les résidus sont-ils distribués selon une loi normale ou la taille des échantillons par groupe dépasse-t-elle le seuil pragmatique de robustesse (n ≥ 30) ? Si la déviation est extrême sur de très petits groupes, basculer vers des procédures non paramétriques (Kruskal-Wallis assorti de tests de Dunn avec correction de Holm).
- Étape 2 : Évaluation de l’homogénéité des variances
- Exécution du test de Levene (basé sur la médiane).
- Si le postulat d’homoscédasticité est validé (p ≥ 0,05) :
- Objectif A : Comparaison exhaustive de toutes les paires
→ Si effectifs rigoureusement égaux : REGWQ ou Tukey HSD.
→ Si effectifs inégaux : Tukey-Kramer. - Objectif B : Comparaison d’un ensemble de traitements face à un groupe témoin unique
→ Test de Dunnett (bilatéral ou unilatéral selon les prédictions théoriques préalables). - Objectif C : Exploration de contrastes linéaires complexes non planifiés
→ Méthode de Scheffé.
- Objectif A : Comparaison exhaustive de toutes les paires
- Si le postulat d’homoscédasticité est rejeté (p < 0,05) :
- Effectifs par groupe modérés à larges (n > 15) :
→ Test de Games-Howell (référence polyvalente et robuste). - Effectifs par groupe restreints (n ≤ 15) :
→ Test T3 de Dunnett (garantie de non-gonflement de l’erreur de type I). - Nécessité de sécurité absolue face au faux positif :
→ Test T2 de Tamhane.
- Effectifs par groupe modérés à larges (n > 15) :
Ce protocole garantit une rigueur méthodologique constante et prémunit le chercheur contre les biais d’analyse opportuniste lors de la valorisation de ses résultats.
10. Implémentation computationnelle et interprétation des résultats numériques
10.1 Exécution et analyse sous R (emmeans, multcomp, rstatix)
L’environnement statistique open-source R constitue aujourd’hui la plateforme de référence pour l’analyse des données de recherche, offrant un écosystème de paquets d’une précision et d’une flexibilité supérieures aux logiciels commerciaux conventionnels.
Le paquet emmeans (Estimated Marginal Means) est la solution de pointe pour la décomposition des modèles linéaires généraux et mixtes. Il calcule les moyennes marginales de chaque condition en réajustant le cas échéant les covariables, puis génère l’ensemble des contrastes d’intérêt. L’exécution d’un modèle d’ANOVA s’effectue usuellement via la fonction aov() ou lm() :
modele <- lm(Score ~ Groupe, data = donnees)
L’appel de la fonction emmeans() extrait les moyennes ajustées, et la fonction associée pairs() exécute l’ensemble exhaustif des comparaisons par paires. L’argument adjust = "tukey" active la méthode HSD de Tukey (adaptée automatiquement en Tukey-Kramer pour les échantillons inégaux), tandis que adjust = "holm" ou adjust = "bonferroni" configurent instantanément les corrections correspondantes. Pour une configuration de type Many-to-One, l’instruction contrast(..., method = "trt.vs.ctrl", ref = 1) implémente le test de Dunnett en fixant le groupe de contrôle de référence.
Le paquet multcomp fournit quant à lui la fonction glht() (General Linear Hypotheses), qui permet de définir des matrices de contrastes personnalisées d’une complexité arbitraire tout en exploitant la distribution multivariée normale ou de Student pour ajuster les valeurs critiques. Le paquet rstatix, parfaitement intégré à la philosophie du tidyverse, propose des fonctions plus directes adaptées aux débutants, telles que tukey_hsd() ou games_howell_test(), délivrant directement des tableaux ordonnés prêts pour la publication.
10.2 Traitement des sorties logicielles sous SPSS et Jamovi
L’exécution des tests post hoc dans des environnements reposant sur des interfaces graphiques — qu’il s’agisse de suites propriétaires comme IBM SPSS Statistics ou d’outils ouverts comme Jamovi — repose sur une formalisation commune de l’organisation des résultats.
Dans SPSS, la fenêtre d’ANOVA à un facteur (One-Way ANOVA) propose une boîte de dialogue secondaire dédiée intitulée « Post Hoc ». Celle-ci est explicitement partitionnée en deux compartiments distincts : « Variances égales supposées » (regroupant Tukey, Scheffé, Bonferroni, Sidak, Dunnett, SNK, REGWQ) et « Variances égales non supposées » (regroupant Games-Howell, Dunnett T3, Dunnett C, Tamhane T2). Cette séparation graphique invite l’analyste à ne jamais cocher simultanément un test de chaque bloc, mais à subordonner son choix au résultat du test d’homogénéité de Levene calculé dans les options.
L’analyse des sorties logicielles sous SPSS et Jamovi s’articule autour de deux représentations tabulaires fondamentales :
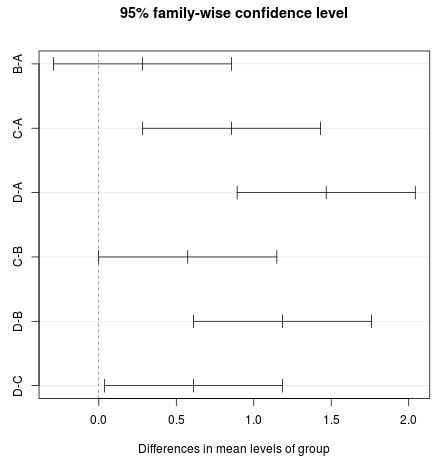
- Le tableau des comparaisons multiples : Ce tableau exhaustif recense l’ensemble des paires de groupes possibles. Pour chaque comparaison entre une condition (I) et une condition (J), il affiche la différence brute des moyennes (I – J), l’erreur type associée, la valeur p ajustée et les bornes inférieure et supérieure de l’intervalle de confiance ajusté à 95 %.
- Le tableau des sous-ensembles homogènes (spécifique à certains tests paramétriques sous homoscédasticité tels que Tukey ou SNK) : Ce tableau organise les moyennes par ordre croissant en colonnes de regroupement. Les conditions expérimentales dont les moyennes ne diffèrent pas significativement entre elles sont agrégées au sein d’une même colonne numérique (sous-ensemble). L’appartenance d’un groupe à deux sous-ensembles adjacents met en évidence les zones de transition où la différence statistique n’atteint pas le seuil de rejet.
L’écueil fréquent dans SPSS réside dans la sélection de la procédure LSD (Least Significant Difference). Située tout en haut de la liste, elle est régulièrement cochée par inadvertance par des utilisateurs qui ignorent qu’elle n’applique strictement aucun ajustement pour comparaisons multiples, exposant l’analyste à l’inflation brute de l’erreur de type I.
10.3 Décodage statistique des sorties tabulaires
La lecture critique d’un tableau de comparaisons multiples requiert une interprétation simultanée de plusieurs grandeurs numériques qui s’éclairent mutuellement. Prenons pour illustration une ligne de résultat comparant un groupe de Traitement A (M = 45,2) à un groupe Témoin (M = 38,1) :
- La différence moyenne brute (I – J) affiche une valeur de +7,10. Le signe positif atteste que la moyenne du premier groupe est arithmétiquement supérieure à celle du second groupe de référence.
- L’erreur type (Standard Error) mesure la précision de cette estimation différentielle compte tenu de la variance résiduelle et de la taille des échantillons analysés. Si l’erreur type s’élève à SE = 2,15, le ratio signal-bruit empirique se situe autour de 7,10 / 2,15 = 3,30.
- La valeur p ajustée (souvent annotée « Sig. » dans les interfaces anglo-saxonnes) représente la probabilité d’observer un tel écart par le simple fait de l’échantillonnage aléatoire sous l’hypothèse nulle globale que tous les groupes sont issus d’une même population parente. Si p_ajustée = 0,012, et que le seuil de significativité nominal a été préalablement fixé à α = 0,05, l’analyste rejette formellement l’égalité des deux moyennes au niveau de risque consenti.
- L’intervalle de confiance ajusté à 95 % de la différence : Dans notre exemple, il s’étend de [+1,62 ; +12,58]. L’interprétation de cet intervalle est fondamentale : dans la mesure où la valeur zéro (qui représente l’égalité stricte μᵢ – μⱼ = 0) ne se trouve pas comprise entre la borne inférieure et la borne supérieure, la conclusion de significativité est confortée. De plus, l’intervalle apporte une information quantitative absente de la seule valeur p : il informe le chercheur sur l’amplitude plausible du bénéfice thérapeutique réel, situé dans le pire des cas à +1,62 unité et dans le meilleur des cas à +12,58 unités, guidant ainsi l’évaluation de la pertinence clinique pratique au-delà du seul formalisme statistique.
11. Tailles d’effet des contrastes et reporting selon les normes APA
11.1 Calcul de la taille d’effet pour les comparaisons par paires
La déclaration isolée de la significativité statistique d’un test post hoc (par l’intermédiaire d’une valeur p inférieure à 0,05) est désormais jugée scientifiquement insuffisante par la communauté académique. La valeur p dépendant intrinsèquement de la taille de l’échantillon, un échantillon massif peut rendre statistiquement significative une différence infinitésimale et dénuée de tout intérêt clinique ou pratique. Il est donc impératif d’adjoindre à chaque contraste une métrique standardisée d’estimation de la force de la relation : la taille d’effet.
Pour les comparaisons par paires faisant suite à une ANOVA paramétrique, la métrique canonique est le d de Cohen. Dans un dispositif de comparaisons multiples sous hypothèse d’homogénéité des variances, l’estimation la plus robuste et la moins biaisée du d de Cohen ne mobilise pas l’écart-type restreint aux deux seuls groupes évalués, mais exploite la racine carrée du carré moyen de l’erreur issu de l’ANOVA globale (s_pooled = √(MS_error)) :
d = (Ȳᵢ – Ȳⱼ) / √(MS_error)
L’utilisation de la variance d’erreur agrégée stabilise substantiellement l’estimation en s’appuyant sur l’ensemble des degrés de liberté du protocole expérimental complet.
Toutefois, lorsque la taille des échantillons analysés est modeste (par exemple, n < 20 par cellule), le d de Cohen standard souffre d’un biais systématique qui tend à surestimer la taille d’effet réelle au sein de la population. Il convient alors de lui substituer le g de Hedges, qui applique un terme multiplicatif de correction du biais :
g = d * [ 1 – (3 / (4 * df – 1)) ]
où df correspond aux degrés de liberté résiduels associés à l’estimation de la variance.
Selon les grilles de lecture heuristiques établies par Jacob Cohen dans les sciences comportementales :
- d ≈ 0,20 signale un effet de faible amplitude.
- d ≈ 0,50 signale un effet de taille moyenne.
- d ≈ 0,80 signale un effet de forte amplitude.
Ces balises descriptives ne doivent pas être interprétées de manière dogmatique : en médecine préventive ou en éducation, un effet de d = 0,25 peut représenter un bénéfice sociétal substantiel, tandis qu’en psychologie de laboratoire mesurant des temps de réaction automatisés, des effets supérieurs à d = 1,00 sont fréquents.
11.2 Normes typographiques et rédactionnelles de l’APA (7e édition)
L’American Psychological Association (APA 7e édition) encadre la restitution textuelle et typographique des résultats statistiques. Les directives visent à garantir la transparence absolue, la traçabilité des algorithmes employés et l’exhaustivité des paramètres déductifs.
Les règles typographiques fondamentales imposent que toutes les lettres latines utilisées pour désigner des symboles statistiques (tels que M pour la moyenne, SD pour l’écart-type, F pour le test omnibus, p pour la valeur de significativité, t pour les contrastes de Student et d pour la taille d’effet) soient systématiquement composées en italique. En revanche, les lettres grecques (telles que α ou β) et les indices typographiques conservent un style romain droit. Les valeurs décimales ne pouvant mathématiquement pas excéder l’unité (comme les probabilités p) ne doivent jamais être précédées d’un zéro initial avant la virgule ou le point décimal (on écrit p = .012 et non p = 0.012 dans le format strict anglophone ; dans l’usage francophone académique, la virgule décimale est retenue avec maintien fréquent de la formulation canonique sans zéro ou avec zéro selon les revues : p < ,001 ou p < 0,001).
Un rapport méthodologique irréprochable doit toujours introduire le résultat omnibus avant de détailler la cascade des analyses post hoc. Voici deux modèles narratifs de reporting rigoureux conformes aux standards académiques internationaux :
Exemple 1 (Tukey HSD sous homoscédasticité) :
« L’analyse de variance à un facteur a révélé un effet principal significatif du type d’entraînement cognitif sur les performances mnésiques, F(3, 116) = 8,45, p < 0,001, η²_p = 0,18. Les comparaisons post hoc par paires réalisées à l’aide du test HSD de Tukey indiquent que les participants assignés à l’entraînement intensif (M = 78,4, SD = 6,2) obtiennent des scores significativement plus élevés que ceux du groupe sous entraînement standard (M = 71,2, SD = 5,8), p_ajusté = 0,002, d = 0,81, IC 95 % [2,45 ; 11,95], ainsi que par rapport au groupe témoin passif (M = 68,1, SD = 6,5), p_ajusté < 0,001, d = 1,15, IC 95 % [5,55 ; 15,05]. En revanche, aucune différence statistiquement significative n’a été détectée entre l’entraînement standard et le groupe témoin, p_ajusté = 0,248, d = 0,34, IC 95 % [-1,65 ; 7,85]. »
Exemple 2 (Games-Howell face à l’hétéroscédasticité) :
« Le test de Levene ayant révélé une violation significative du postulat d’homogénéité des variances, F(2, 45) = 6,82, p = 0,003, les comparaisons multiples ont été conduites à l’aide de la procédure robuste de Games-Howell. L’analyse met en évidence une baisse significative de l’indice de symptomatologie au sein de la cohorte ayant bénéficié de la nouvelle psychothérapie (M = 22,3, SD = 8,9) par rapport au groupe sous prise en charge médicamenteuse exclusive (M = 31,8, SD = 3,4), t(21,4) = 3,92, p_ajusté = 0,002, g = 1,41, IC 95 % [3,85 ; 15,15]. »
11.3 Visualisation graphique rigoureuse des comparaisons multiples
La transmission visuelle des résultats comparatifs constitue un aspect essentiel de la communication scientifique. Une représentation graphique mal conçue peut masquer des asymétries de dispersion critiques ou induire des conclusions hâtives quant à la significativité des contrastes.
La pratique traditionnelle consistant à publier des diagrammes en barres simples (souvent nommés graphiques « dynamite » lorsqu’ils sont surmontés d’une demi-barre d’écart-type) est aujourd’hui découragée par les éditeurs scientifiques. Ces représentations dissimulent la densité réelle des données et peuvent conférer une impression de précision trompeuse. La visualisation contemporaine privilégie les graphiques de dispersion avec moyennes et intervalles de confiance ajustés, les diagrammes en violon (violin plots) ou les boîtes à moustaches enrichies de points individuels (jittered points), qui exposent simultanément l’emplacement des centres de gravité et la distribution brute des mesures.
Pour matérialiser visuellement les résultats des tests post hoc sur une figure sans surcharger l’espace d’une multitude de barres d’accolades horizontales surmontées d’étoiles, la méthodologie recommande l’utilisation du système de lettrage compact (Compact Letter Display ou CLD). Ce formalisme obéit à une règle simple : deux groupes ne différant pas statistiquement au seuil choisi partagent une même lettre minuscule située au-dessus de leur marqueur graphique :
- Un groupe surmonté de la lettre « a » diffère significativement de tout groupe surmonté de la lettre « b ».
- Un groupe surmonté de la combinaison « ab » présente une moyenne statistiquement intermédiaire : il ne se distingue ni du groupe « a », ni du groupe « b ».
- Un groupe distant présentant des divergences avec tous les autres reçoit la lettre exclusive « c ».
Lors de l’utilisation de barres d’erreur classiques, il est primordial de préciser explicitement en légende si celles-ci représentent l’écart-type des observations (SD), l’erreur type de la moyenne (SEM) ou l’intervalle de confiance à 95 %. Il convient de rappeler aux lecteurs une règle fondamentale d’inférence visuelle : la non-superposition de deux intervalles de confiance à 95 % bilatéraux calculés isolément pour deux moyennes est une condition suffisante, mais nullement nécessaire, pour déclarer une différence significative. Pour évaluer graphiquement une divergence post hoc avec précision, seuls les intervalles de confiance construits spécifiquement sur la différence des moyennes intégrant l’ajustement pour multiplicité permettent une déduction rigoureuse.
12. Pièges méthodologiques, controverses et alternatives statistiques contemporaines
12.1 Le piège persistant du test LSD de Fisher (Least Significant Difference)
Parmi l’arsenal des techniques de comparaisons multiples, le test LSD de Fisher (Plus Petite Différence Significative) occupe une place singulière : c’est la méthode historiquement la plus ancienne, mais aussi l’une des plus susceptibles d’induire des erreurs d’interprétation lorsqu’elle est mal employée.
Dans sa modalité initiale formulée en 1935, le « LSD protégé » est structuré selon une règle hiérarchique à deux degrés :
- L’expérimentateur calcule d’abord le test F omnibus de l’ANOVA. Si celui-ci n’est pas statistiquement significatif (p ≥ 0,05), l’analyse s’interrompt.
- Si le test F est significatif, le chercheur s’autorise à exécuter des tests t de Student standards non corrigés (au seuil α = 0,05 nominal) entre toutes les paires possibles, en mobilisant simplement l’erreur résiduelle globale (MS_error) au sein de la statistique :
LSD = t_(crit; df_error) * √( MS_error * (1/nᵢ + 1/nⱼ) )
L’argument historique en faveur du LSD protégé stipulait que le test F préliminaire fournissait un rempart complet contre le risque d’erreur de type I. Cette allégation est mathématiquement exacte uniquement et exclusivement lorsque le plan expérimental comprend précisément k = 3 groupes. Pour trois conditions, les théoriciens ont démontré que le filtrage par le test omnibus limite le taux d’erreur par famille global à un niveau qui ne dépasse jamais les 5 % nominaux.
Le piège méthodologique survient dès lors que k ≥ 4. Dans un dispositif à quatre conditions ou davantage, le test F omnibus peut être rendu significatif par l’écart spectaculaire séparant les deux groupes extrêmes, tandis que les deux groupes intermédiaires proviennent en réalité d’une distribution strictement identique. Le test F franchit alors le seuil de rejet et « déverrouille » la protection globale. L’expérimentateur exécute ensuite ses tests t non corrigés sur les groupes intermédiaires et rejette indûment l’égalité avec un taux d’erreur de type I réel pouvant culminer à 15 % ou 20 % pour cette paire. Dès lors, le consensus contemporain de la communauté statistique réclame l’abandon systématique du test LSD dès que l’expérience comporte quatre conditions ou plus, au bénéfice de procédures régulatrices stables comme Tukey ou Holm-Bonferroni.
12.2 Pratiques douteuses de recherche : le P-hacking appliqué aux tests post hoc
La multiplicité des procédures post hoc disponibles dans les logiciels a ouvert la voie à des dérives méthodologiques qualifiées de p-hacking ou de pratiques de recherche douteuses (Questionable Research Practices, QRP). Ces comportements consistent à tester de manière opportuniste diverses méthodes d’ajustement jusqu’à trouver celle qui fait basculer artificiellement un seuil de significativité sous la ligne magique de p < 0,05.
Le cycle typique de cette distorsion se déroule souvent ainsi :
- Un expérimentateur lance initialement un test HSD de Tukey pour explorer l’ensemble de ses contrastes. Le résultat de la paire clé de son hypothèse affiche p = 0,068 (non significatif).
- Plutôt que d’accepter ce résultat, le chercheur réexécute l’analyse avec la correction de Newman-Keuls ou le test LSD de Fisher, plus permissifs, jusqu’à obtenir p = 0,041.
- Dans la rédaction finale de son article, il omet de mentionner la première étape et ne rapporte que le test ayant délivré le seuil désiré, sous le prétexte fallacieux d’un « choix stylistique d’analyse ».
- Une dérive symétrique consiste à omettre délibérément du manuscrit final deux des conditions initialement mesurées pour réduire la valeur de k, allégeant ainsi la pénalité de Bonferroni ou de Tukey pour faire émerger des résultats significatifs sur les groupes conservés.
Pour contrecarrer ces altérations de l’intégrité scientifique, le mouvement pour la science ouverte préconise le pré-enregistrement formel des protocoles expérimentaux (Preregistration) et les rapports enregistrés (Registered Reports). Dans ces dispositifs institutionnels, les chercheurs s’engagent par écrit, avant toute collecte de données, sur la liste exacte des comparaisons prévues, la nature des hypothèses (a priori vs post hoc) et les algorithmes précis de correction qui seront mobilisés (par exemple, « Les comparaisons exhaustives par paires seront conduites par le test de Games-Howell au seuil α = 0,05 en raison du risque d’hétéroscédasticité »). Cet ancrage préalable neutralise les tentations d’exploration opportuniste et restaure la valeur probatoire des inférences statistiques publiées.
12.3 Perspectives alternatives : approches bayésiennes et tests d’équivalence
Face aux limites conceptuelles inhérentes au cadre fréquentiste classique — notamment la fixation rigide sur le seuil arbitraire de 5 % et l’impossibilité d’apporter la preuve de l’égalité stricte des moyennes —, la statistique contemporaine a développé deux courants alternatifs complémentaires d’un intérêt méthodologique majeur pour l’analyse des contrastes.
Le premier courant repose sur l’inférence bayésienne. Plutôt que de s’enfermer dans le calcul de valeurs p pénalisées, l’approche bayésienne calcule des facteurs de Bayes (notés BF₁₀ ou BF₀₁) pour chaque paire de moyennes sous examen. Le facteur de Bayes quantifie directement le rapport de vraisemblance des données empiriques sous le modèle alternatif (différence réelle) par rapport au modèle nul (absence d’effet) :
- Un BF₁₀ = 15 indique que les données recueillies sont 15 fois plus probables sous l’hypothèse d’une réelle différence de moyennes que sous l’hypothèse d’égalité.
- Inversement, un BF₀₁ = 8 permet d’affirmer qu’il y a 8 fois plus d’évidence empirique en faveur de l’absence d’effet (égalité des groupes), conclusion qu’une valeur p > 0,05 fréquentiste est par nature impuissante à formuler.
De surcroît, les estimations des paramètres par les intervalles de crédibilité bayésiens fournissent une distribution de probabilité directe de la différence moyenne réelle, affranchie de la dépendance structurelle aux règles d’arrêt d’échantillonnage de la statistique fréquentiste.
Le second courant novateur est représenté par les tests d’équivalence, formalisés dans la procédure des deux tests unilatéraux combinés (Two One-Sided Tests ou TOST), largement popularisée par Daniël Lakens. Dans de nombreuses expérimentations, le but scientifique réside dans la démonstration que deux conditions sont cliniquement ou fonctionnellement équivalentes (par exemple, prouver qu’une intervention en téléconsultation génère des effets substantiellement comparables à une intervention en présentiel). L’échec d’un test post hoc de Tukey à atteindre la significativité ne prouve jamais l’équivalence ; il signale simplement une absence de preuve d’une différence.
La méthodologie TOST impose à l’expérimentateur de définir a priori une borne d’équivalence minimale (Smallest Effect Size of Interest ou SESOI), par exemple une marge de Δ = ±0,30 écart-type. La procédure évalue ensuite formellement si la différence observée entre les conditions se situe entièrement à l’intérieur de cet intervalle de tolérance. Si les deux tests unilatéraux sont rejetés, l’analyste peut alors certifier avec une garantie statistique rigoureuse que les deux interventions sont statistiquement équivalentes. L’intégration conjointe des contrastes de supériorité post hoc traditionnels et des tests d’équivalence enrichit considérablement le registre analytique de l’expérimentateur moderne, assurant des conclusions méthodologiques d’une robustesse et d’une lucidité scientifique optimales.
Références
- Bonferroni, C. E. (1936). Teoria statistica delle classi e calcolo delle probabilità. Pubblicazioni del R. Istituto Superiore di Scienze Economiche e Commerciali di Firenze, 8, 3–62.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Dunnett, C. W. (1980). Pairwise multiple comparisons in the unequal variance case. Journal of the American Statistical Association, 75(372), 796–800. https://doi.org/10.1080/01621459.1980.10477552
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Ioannidis, J. P. A. (2005). Why most published research findings are false. PLOS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001466
- Lakens, D. (2017). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
- Loftus, G. R., & Masson, M. E. (1994). Using confidence intervals in within-subject designs. Psychonomic Bulletin & Review, 1(4), 476–490. https://doi.org/10.3758/BF03210951
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3e éd.). Routledge.
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1/2), 87–104. https://doi.org/10.2307/2333100
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Tamhane, A. C. (1979). A comparison of procedures for multiple comparisons of means with unequal variances. Journal of the American Statistical Association, 74(366), 471–480. https://doi.org/10.1080/01621459.1979.10482539
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Wagenmakers, E.-J., Love, J., Marsman, M., Jamil, T., Ly, A., Verhagen, J., Selker, R., Gronau, Q. F., Dropmann, D., Boutin, B., Meerhoff, F., Knight, P., Raj, A., van Kesteren, E.-J., van Doorn, J., Šmíra, M., Epskamp, S., Etz, A., & Morey, R. D. (2018). Bayesian inference for psychology. Part II: Example applications with JASP. Psychonomic Bulletin & Review, 25(1), 58–76. https://doi.org/10.3758/s13423-017-1323-7