
L’analyse des données multivariées constitue aujourd’hui la clé de voûte de la recherche empirique dans les sciences du comportement, en psychométrie et dans les sciences sociales. Lorsque les chercheurs sont confrontés à de vastes ensembles d’indicateurs empiriques, tels que des batteries d’items mesurant des traits de personnalité, des échelles d’attitudes ou des tests d’aptitudes cognitives, le premier défi analytique consiste à vérifier si ces variables partagent une variance commune suffisante pour justifier une réduction de dimensionnalité. Tenter d’extraire des facteurs latents ou des composantes principales à partir de données qui ne présentent aucune corrélation sous-jacente équivaut à modéliser du bruit blanc stochastique, conduisant inévitablement à des artefacts statistiques fallacieux et à des conclusions scientifiques dénuées de validité.
Dans cet arsenal méthodologique préparatoire, le test de sphéricité de Bartlett occupe une place prépondérante. Développé au milieu du XXe siècle par le statisticien britannique Maurice Stevenson Bartlett, ce test statistique inférentiel examine la structure globale d’une matrice de corrélation pour déterminer si les variables observées sont mutuellement indépendantes ou si elles présentent des interdépendances significatives. Sur le plan géométrique, l’indépendance totale entre variables standardisées se traduit par une distribution hypersphérique dans l’espace multidimensionnel, configuration au sein de laquelle aucune direction privilégiée ne peut être isolée. Rejeter l’hypothèse de sphéricité est donc le prérequis absolu à toute tentative de condensation informationnelle.
Le présent guide a pour vocation d’offrir une exploration exhaustive, théorique et opérationnelle du test de sphéricité de Bartlett. Conçu pour les chercheurs, psychométriciens, statisticiens et étudiants avancés, cet ouvrage didactique détaille les fondements algébriques du test, clarifie les ambiguïtés sémantiques persistantes dans la littérature, explicite les étapes de calcul computationnel et présente des protocoles rigoureux de mise en œuvre logicielle sous R, Python, SPSS et JASP. En analysant scrupuleusement ses postulats, ses limites face aux grands échantillons et sa complémentarité avec l’indice de Kaiser-Meyer-Olkin (KMO), nous fournirons les clés méthodologiques nécessaires pour intégrer ce test selon les standards académiques les plus exigeants de l’American Psychological Association (APA).
1. Introduction et fondements théoriques du test de sphéricité de Bartlett
1.1 Origine historique et contextualisation statistique
L’émergence des techniques multivariées au cours du XXe siècle a profondément transformé le paysage de la statistique appliquée. C’est dans ce contexte d’effervescence méthodologique que le statisticien britannique Maurice Stevenson Bartlett formula en 1950 une contribution majeure à l’analyse factorielle naissante dans son article princeps intitulé Tests of significance in factor analysis, publié dans le British Journal of Statistical Psychology. À cette époque, les psychologues et psychométriciens, marchant dans les pas de Charles Spearman, Louis Leon Thurstone et Cyril Burt, cherchaient à conceptualiser l’intelligence et la personnalité à travers l’analyse factorielle exploratoire. Cependant, les praticiens se heurtaient à une difficulté méthodologique majeure : comment distinguer une corrélation empirique authentique, reflétant une entité latente véritable, d’une simple fluctuation d’échantillonnage apparue au sein de variables totalement indépendantes dans la population parente ?
Bartlett s’attela à résoudre cette lacune en développant un critère du rapport de vraisemblance capable de tester l’hypothèse selon laquelle les variables observées proviendraient d’une population normale multivariée au sein de laquelle toutes les corrélations inter-variables seraient nulles. L’évolution de ce test au fil des décennies l’a fermement ancré dans le corpus de la validation des construits en psychologie différentielle et clinique. La validation d’échelles de mesure repose sur la démonstration d’une structure interne cohérente. Avant même de pouvoir débattre de l’unidimensionnalité ou de la multidimensionnalité d’un inventaire clinique ou d’un test psychotechnique, le chercheur contemporain doit établir que l’espace vectoriel engendré par les items ne se résume pas à une dispersion anarchique. L’apport historique de Maurice Stevenson Bartlett réside ainsi dans l’introduction d’un garde-fou formel, transformant ce qui n’était jusqu’alors qu’une intuition visuelle des tables de corrélation en une décision inférentielle probabiliste et reproductible.
1.2 Objectif premier du test en analyse multivariée
L’objectif fondamental du test de sphéricité de Bartlett est d’évaluer l’interdépendance globale régnant au sein d’un ensemble de variables quantitatives continues ou quasi-continues. Dans le cadre de l’investigation empirique, ce test répond à une interrogation liminaire : le degré de redondance informationnelle entre les variables observées est-il suffisant pour autoriser une réduction de dimensionnalité sans sacrifier de l’information structurante ? En d’autres termes, il s’agit de tester la factorisabilité globale de la matrice de données. Si les variables mesurées n’entretiennent aucune relation statistique linéaire entre elles, chaque variable constitue une dimension propre et irréductible ; toute tentative de réduction dimensionnelle par analyse factorielle ou par analyse en composantes principales est alors dépourvue de fondement théorique et empirique.
En psychométrie, les indicateurs observés sont généralement conçus pour capturer des manifestations comportementales, émotionnelles ou cognitives d’un trait latent non observable directement. Ces manifestations partagent nécessairement une variance commune. Dès lors, le test de Bartlett opère comme un filtre diagnostique rigoureux. En comparant la distribution empirique des données à un modèle théorique dans lequel aucune redondance n’existerait, il permet de certifier que la structure de covariation observée s’écarte significativement d’un agencement aléatoire. La détection de cette redondance est une étape sine qua non : elle garantit que les algorithmes d’extraction ne fabriqueront pas des construits chimériques fondés sur les seules fluctuations aléatoires inhérentes à tout échantillon fini.
1.3 Importance méthodologique pour la recherche psychologique
Dans l’architecture de la recherche en psychologie et en sciences du comportement, l’usage rigoureux d’échelles de mesure standardisées constitue le socle de l’inférence scientifique. Qu’il s’agisse d’évaluer la dépression, l’anxiété-trait, l’extraversion ou l’engagement professionnel, les données recueillies sont intrinsèquement vulnérables aux bruits d’échantillonnage et aux erreurs de mesure. L’importance méthodologique du test de sphéricité de Bartlett se manifeste dès lors comme un prérequis incontournable avant toute formalisation factorielle. L’omission de cette étape de validation préalable expose la communauté des chercheurs à un risque épistémologique majeur : la réification d’artéfacts d’extraction. En effet, les algorithmes de décomposition spectrale ou d’estimation par maximum de vraisemblance produiront toujours des composantes et des saturations factorielles, y compris sur des matrices de nombres purement aléatoires.
Le recours systématique au test de Bartlett permet de prémunir les investigateurs contre de telles dérives interprétatives. En attestant formellement de la présence d’une interdépendance globale non stochastique, il fournit la justification empirique initiale nécessaire au déploiement des protocoles psychométriques avancés. De surcroît, la standardisation des protocoles d’investigation psychométrique impose la transparence dans les étapes exploratoires. Rapporter le test de Bartlett, conjointement avec d’autres indices d’adéquation, s’inscrit pleinement dans le cadre des lignes directrices méthodologiques contemporaines promues par l’American Psychological Association. Cela garantit à la communauté scientifique que les échelles psychologiques développées ne reposent pas sur des agrégations arbitraires, mais bien sur une architecture corrélationnelle robuste et statistiquement défendable.
2. Distinction épistémologique : Sphéricité versus Égalité des variances
2.1 Nature de la confusion récurrente dans la littérature
Une confusion sémantique et conceptuelle particulièrement prégnante traverse la littérature méthodologique en sciences humaines : l’amalgame entre le test de sphéricité de Bartlett et le test d’homogénéité des variances, également attribué à Maurice Stevenson Bartlett. Cette homonymie statistique est la source de nombreuses erreurs chez les analystes débutants et dans certains rapports de recherche. Les deux procédures procèdent de travaux menés par le même auteur britannique, mais répondent à des problématiques mathématiques radicalement disjointes et s’inscrivent dans des paradigmes expérimentaux totalement différents.
D’un côté, l’homogénéité des variances, ou homoscédasticité, concerne l’analyse univariée ou la modélisation linéaire de groupes indépendants, où l’on vérifie si plusieurs sous-populations partagent une même dispersion autour de leur moyenne respective. De l’autre côté, la sphéricité d’une matrice de corrélation renvoie à la géométrie de l’espace multivarié et à l’absence de covariation entre différentes variables mesurées sur un échantillon unique. La substitution erronée de ces concepts dans les protocoles d’analyse témoigne d’une méconnaissance des postulats sous-jacents : appliquer une formule de comparaison de variances inter-groupes alors que l’on souhaite justifier une factorisation d’items invalide l’ensemble de la démarche déductive. Il est donc fondamental de dissocier de manière étanche ces deux édifices conceptuels.
2.2 Le test d’égalité des variances (homoscédasticité)
Le test de Bartlett pour l’égalité des variances, formulé en 1937 dans son article Properties of sufficiency and statistical tests publié dans les Proceedings of the Royal Society of London, a pour finalité exclusive d’éprouver l’hypothèse nulle selon laquelle k groupes indépendants possèdent des variances résiduelles rigoureusement identiques :
H0 : σ12 = σ22 = … = σk2
Cette vérification représente un postulat fondamental de l’analyse de variance univariée (ANOVA) et des modèles de régression linéaire. Si les variances au sein des traitements ou des sous-groupes expérimentaux divergent de manière significative, la statistique de Fisher classique perd sa robustesse, gonflant indûment le taux d’erreur de type I. Cependant, le test d’homoscédasticité de Bartlett souffre d’une hypersensibilité notoire aux violations de la normalité univariée : si les données s’écartent ne serait-ce que modérément d’une distribution gaussienne (asymétrie ou leptocurticité), le test a tendance à rejeter l’hypothèse nulle d’égalité des variances, non pas en raison d’une véritable hétéroscédasticité, mais uniquement sous l’effet de la non-normalité. Pour cette raison pratique, les chercheurs en psychologie lui préfèrent couramment le test de Levene ou le test de Brown-Forsythe pour tester l’homoscédasticité univariée.
2.3 Le test de sphéricité des matrices de corrélation
À l’opposé de cette problématique univariée inter-groupes, le test de sphéricité de Bartlett appliqué aux matrices de corrélation, introduit en 1950, intervient au sein d’un espace vectoriel multivarié à p dimensions. Ici, il n’existe pas plusieurs sous-groupes expérimentaux à comparer, mais un ensemble de p variables observées collectées sur une cohorte de n observations. L’objet d’analyse n’est pas un scalaire de variance résiduelle, mais la matrice de corrélation empirique R de dimension p × p. L’objectif consiste à comparer cette matrice globale à une matrice théorique de non-corrélation, nommée matrice identité.
L’appellation géométrique de « sphéricité » découle directement de la forme que prend la distribution conjointe des données dans l’hyperespace. Si toutes les variables sont standardisées (variance égale à 1) et totalement décorrélées (corrélations nulles), les iso-contours de la fonction de densité normale multivariée forment une hypersphère parfaite à p dimensions. À l’inverse, si des corrélations existent, les iso-contours s’étirent selon des axes privilégiés pour former un hyperellipsoïde, signalant l’existence d’une structure sous-jacente. Il apparaît ainsi clairement que la sphéricité en analyse factorielle renvoie à l’isotropie de la distribution des données multivariées, un concept sans rapport avec l’homogénéité des variances scalaires d’une ANOVA.
3. Algèbre matricielle sous-jacente : Matrice de corrélation et matrice identité
3.1 Structure et propriétés de la matrice de corrélation observée
L’évaluation mathématique de la factorisabilité requiert une immersion dans l’algèbre linéaire multivariée. Soit un tableau de données empiriques regroupant n individus mesurés sur p variables quantitatives. Après centrage et réduction de ces variables (soustraction de la moyenne empirique et division par l’écart-type d’échantillon), nous obtenons la matrice des variables standardisées Z de dimension n × p. La matrice de corrélation empirique, notée R, se définit formellement par le produit tensoriel normalisé :
R = (1 / (n – 1)) × ZTZ
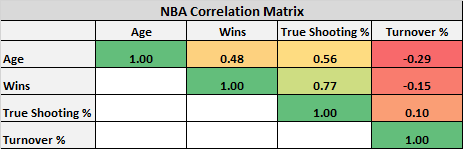
Cette matrice carrée de dimension p × p possède des propriétés algébriques fondamentales. Elle est symétrique par rapport à sa diagonale principale, dans la mesure où le coefficient de corrélation linéaire de Pearson entre la variable j et la variable k est identique à celui liant la variable k à la variable j (rjk = rkj). Sa diagonale principale est exclusivement composée de 1, reflétant la corrélation unitaire de chaque variable avec elle-même (rjj = 1). Par conséquent, la trace de la matrice, qui est la somme de ses éléments diagonaux, est strictement égale au nombre de variables : tr(R) = p. De plus, R est une matrice semi-définie positive (et généralement définie positive en l’absence de colinéarité exacte), ce qui implique que l’ensemble de ses p valeurs propres (λ1, λ2, …, λp) sont des réels positifs ou nuls dont la somme équivaut également à p.
3.2 La matrice identité comme modèle nul de non-corrélation
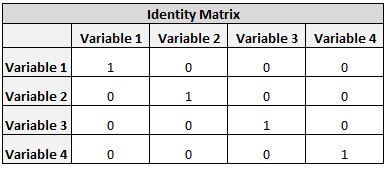
Dans l’espace théorique de l’hypothèse nulle, le modèle de référence absolu est représenté par la matrice identité de dimension p, notée Ip. Cette matrice possède la particularité structurelle d’avoir des 1 sur toute sa diagonale principale et des zéros absolus sur l’intégralité de ses positions extradiagonales. Algébriquement, elle s’exprime sous la forme du symbole de Kronecker : δjk = 1 si j = k, et δjk = 0 si j ≠ k.
Sur le plan géométrique et statistique, la matrice identité incarne l’orthogonalité parfaite des axes de mesure au sein de la population. Dans une telle configuration, les p variables observées sont totalement indépendantes les unes des autres sur le plan linéaire ; la covariance entre toute paire d’items est rigoureusement nulle. Si les données empiriques suivaient une distribution conforme à la matrice identité, chaque variable apporterait une information totalement hermétique et isolée de celle des autres. L’espace vectoriel des réponses psychologiques serait alors dépourvu de toute redondance. Il en résulterait une impossibilité géométrique de compresser les données : aucune combinaison linéaire des variables ne pourrait capturer une variance supérieure à celle d’une simple variable isolée, car toutes les valeurs propres de Ip sont uniformément égales à 1 (λ1 = λ2 = … = λp = 1).
3.3 Divergence entre structure observée et matrice d’identité
L’évaluation quantitative du désaccord entre la matrice empirique R et la matrice identité Ip repose sur un outil central de l’algèbre matricielle : le déterminant de la matrice de corrélation, noté det(R) ou |R|. Sur le plan géométrique, le déterminant d’une matrice symétrique définie positive mesure le volume de l’hyperparallélépipède engendré par les vecteurs colonnes des variables dans l’espace euclidien standardisé. Ce déterminant est mathématiquement borné entre 0 et 1 :
0 ≤ |R| ≤ 1
Lorsque les variables sont mutuellement indépendantes, c’est-à-dire lorsque R = Ip, les vecteurs sont parfaitement orthogonaux les uns aux autres. Le volume de l’hypercube unitaire est maximal et son déterminant atteint sa borne supérieure : |Ip| = 1. À mesure que les variables s’intercorrèlent, les vecteurs se rapprochent géométriquement, l’hyperparallélépipède s’aplatit, et le déterminant |R| décroît inexorablement vers zéro. Si deux variables sont parfaitement colinéaires, ou si une variable est une combinaison linéaire exacte des autres, la matrice devient singulière et son volume s’effondre : |R| = 0. Le déterminant mesure également le produit de toutes les valeurs propres de la matrice :
|R| = ∏j=1p λj
Si la dispersion est sphérique, le produit des valeurs propres vaut 1 × 1 × … × 1 = 1. Si une structure factorielle émerge, certaines valeurs propres deviennent largement supérieures à 1 (capturant les dimensions latentes), ce qui contraint les autres valeurs propres à devenir nettement inférieures à 1 pour maintenir la somme égale à p, précipitant la chute de leur produit global vers zéro. Le logarithme népérien de ce déterminant, ln(|R|), sert de fondement computationnel direct au test de Bartlett.
4. Formulation des hypothèses statistiques et interprétation probabiliste
4.1 L’hypothèse nulle (H0) : Absence d’intercorrélation
Dans le paradigme de l’inférence statistique classique par test de signification d’hypothèse nulle (NHST), la formulation mathématique rigoureuse de l’hypothèse de base testée par la procédure de Bartlett s’énonce comme suit :
H0 : P = Ip
où P (la lettre grecque Rhô majuscule) représente la matrice de corrélation de la population théorique parente dont est issu l’échantillon, et Ip désigne la matrice identité de dimension p. Cette égalité matricielle équivaut à formuler simultanément un système de p(p – 1) / 2 hypothèses nulles bivariées : ρjk = 0 pour tout couple d’indices (j, k) tel que j ≠ k.
La traduction conceptuelle de cette hypothèse nulle est l’indépendance stochastique linéaire complète de l’ensemble des indicateurs mesurés au sein de la population. Sous H0, la matrice observée R ne diffère de la matrice identité que par l’effet de fluctuations d’échantillonnage aléatoires et inévitables. Sur le plan psychométrique, le maintien de H0 signifie qu’il n’existe aucune dimension sous-jacente ou facteur commun liant les réponses des sujets : chaque item mesure une facette strictement idiosyncrasique ou du bruit pur. Dans une telle situation, la mise en œuvre d’une analyse factorielle exploratoire ou d’une analyse en composantes principales est formellement prohibée, car les facteurs extraits ne posséderaient aucune réalité substantielle.
4.2 L’hypothèse alternative (H1) : Présence d’une structure factorielle
À l’opposé du modèle de non-corrélation, l’hypothèse alternative s’énonce formellement par la négation de l’identité matricielle :
H1 : P ≠ Ip
Cette formulation n’exige pas que l’intégralité des corrélations de la matrice soient différentes de zéro, mais stipule qu’au moins une corrélation de population ρjk (avec j ≠ k) s’écarte significativement de la valeur zéro. En pratique, le rejet de l’hypothèse nulle signifie que les covariations observées dans l’échantillon présentent une densité statistique trop élevée pour être imputable au seul hasard de l’échantillonnage.
Sur le plan épistémologique, l’acceptation de H1 atteste de l’existence d’une interdépendance globale entre les variables mesurées. Cela implique que l’information véhiculée par les p indicateurs présente une redondance structurelle, ce qui légitime la tentative de compression dimensionnelle de rang inférieur. En psychométrie, la confirmation de H1 constitue l’autorisation méthodologique ouvrant la voie à la modélisation en traits latents. L’analyste peut alors émettre l’hypothèse théorique qu’une portion substantielle de la variance observée est régie par un nombre réduit de variables inobservables communes, justifiant la décomposition subséquente de la matrice.
4.3 Seuils décisionnels et erreurs d’inférence (Type I et Type II)
La prise de décision statistique dans le cadre du test de Bartlett repose sur la confrontation de la p-valeur calculée avec un seuil de signification conventionnel α, traditionnellement fixé à 0,05 ou 0,01. Si la p-valeur associée à la statistique observée est strictement inférieure à α (p < 0,05), l’hypothèse nulle H0 est rejetée au profit de H1, concluant que la matrice de corrélation n’est pas une matrice identité. Si p ≥ 0,05, le chercheur échoue à rejeter l’hypothèse nulle et doit suspendre toute procédure de factorisation dimensionnelle.
Cette dichotomie décisionnelle est soumise aux risques inhérents à l’inférence statistique :
- L’erreur de première espèce (Type I) : Elle consiste à rejeter H0 alors qu’elle est en réalité vraie dans la population (conclure faussement à l’existence de corrélations). Dans le cas du test de Bartlett, cette erreur survient avec une probabilité démesurée lorsque la taille de l’échantillon n est exceptionnellement vaste, ou lorsque l’hypothèse de normalité multivariée est violée par une forte leptocurticité des données.
- L’erreur de seconde espèce (Type II) : Elle consiste à ne pas rejeter H0 alors que de véritables corrélations existent dans la population parente. Cette situation se produit principalement en présence de très petits échantillons (faible puissance statistique) ou lorsque les corrélations réelles sont de très faible intensité mais conceptuellement réelles. Échouer à rejeter H0 dans un contexte où une structure latente sous-tend effectivement les items conduit à l’abandon injustifié d’une recherche prometteuse.
5. Formalisation mathématique et calcul de la statistique de test
5.1 Équation de Bartlett et transformation logarithmique
La statistique élaborée par Maurice Bartlett dérive directement du principe du test du rapport de vraisemblance (Likelihood Ratio Test) sous l’hypothèse d’une distribution normale multivariée Νp(μ, Σ). Sous cette prémisse, le rapport des fonctions de vraisemblance maximisées sous H0 et sous H1 est une fonction directe du déterminant de la matrice de corrélation de l’échantillon, noté |R|. Pour de très grands échantillons, le double du logarithme négatif de ce rapport suit asymptotiquement une distribution du khi-deux (χ2). Cependant, pour améliorer l’approximation distributionnelle sur des échantillons de taille finie, Bartlett (1950) a introduit un facteur correctif d’ordre supérieur dépendant du nombre de variables p.
La formule canonique de la statistique de test de Bartlett s’énonce mathématiquement comme suit :
χ2 = – [ n – 1 – (2p + 5) / 6 ] × ln(|R|)
Dans cette équation élégante, chaque terme remplit une fonction statistique précise :
- n représente la taille effective de l’échantillon, c’est-à-dire le nombre d’observations complètes.
- p désigne le nombre de variables ou d’items inclus dans l’analyse multivariée.
- Le terme d’ajustement [ n – 1 – (2p + 5) / 6 ] constitue le multiplicateur de correction pour échantillon fini conçu par Bartlett pour compenser le biais de l’asymptotisme standard.
- |R| représente le déterminant matriciel de la matrice de corrélation empirique.
- ln désigne la fonction logarithme népérien (naturel).
L’analyse dynamique de cette formule révèle son comportement mathématique. Puisque le déterminant |R| est strictement compris entre 0 et 1 pour toute matrice non singulière présentant des corrélations modérées à fortes, son logarithme népérien ln(|R|) est systématiquement une valeur négative ou nulle (ln(1) = 0). Le signe négatif placé devant la formule transforme ainsi cette quantité en un scalaire strictement positif. Si la matrice observée s’approche de la matrice identité, |R| tend vers 1, ce qui conduit ln(|R|) vers 0, et produit une statistique χ2 très faible, non significative. Inversement, dès lors que les variables s’intercorrèlent intensément, le déterminant chute vers zéro, propulsant le terme ln(|R|) vers des valeurs négatives très élevées en valeur absolue, ce qui génère une statistique χ2 de grande magnitude, hautement significative.
5.2 Calcul analytique des degrés de liberté
Toute variable aléatoire suivant une loi du khi-deux théorique est caractérisée par son paramètre de degrés de liberté (df), qui conditionne la forme géométrique de sa densité de probabilité, son espérance mathématique et sa variance. Dans le cadre du test de sphéricité de Bartlett, le nombre de degrés de liberté correspond précisément au nombre de contraintes paramétriques indépendantes imposées par l’hypothèse nulle sur la matrice de corrélation.
Une matrice de corrélation R de dimension p × p comporte p2 éléments au total. Sa diagonale principale contenant p valeurs fixes triviales (les variances standardisées égales à 1), il reste p2 – p éléments extradiagonaux représentant les corrélations bivariées. En vertu de la symétrie parfaite de la matrice (rjk = rkj), la moitié de ces éléments hors diagonale est rigoureusement redondante. Par conséquent, le nombre d’éléments non diagonaux uniques et indépendants à estimer se déduit de la formule combinatoire :
df = (p2 – p) / 2 = p(p – 1) / 2
L’impact de l’augmentation du nombre de variables p sur les degrés de liberté suit une progression quadratique. Pour une échelle comprenant 5 items, le test engage 5(4) / 2 = 10 degrés de liberté. Pour un questionnaire comportant 20 items, le nombre de degrés de liberté bondit à 20(19) / 2 = 190. Pour une batterie cognitive de 50 variables, il atteint 1 225 degrés de liberté. Cette inflation géométrique des degrés de liberté modifie substantiellement le seuil critique du χ2 requis pour rejeter l’hypothèse nulle et confère au test une puissance statistique exponentielle à mesure que le nombre d’indicateurs s’élargit.
5.3 Distribution asymptotique sous l’hypothèse nulle
Sous la validité rigoureuse de l’hypothèse nulle (P = Ip) et en présumant que l’échantillon de taille n est issu d’une population parente normale multivariée, la quantité χ2 calculée selon la formule corrigée de Bartlett converge en loi, lorsque n tend vers l’infini, vers une distribution théorique du Khi-deux central à df degrés de liberté :
χ2Bartlett ∼ χ2(df = p(p – 1) / 2)
L’espérance mathématique théorique de cette distribution est égale à son nombre de degrés de liberté : E[χ2] = df, et sa variance vaut Var(χ2) = 2 × df. La p-valeur associée à la statistique observée s’obtient en intégrant la queue supérieure de la fonction de densité de probabilité du khi-deux au-delà de la valeur calculée χ2obs :
p = P(χ2 ≥ χ2obs | H0)
Il est capital de souligner que cette propriété asymptotique repose de manière critique sur l’hypothèse de multinormalité des observations empiriques. Si la distribution sous-jacente des données présente des déviations majeures par rapport au modèle gaussien (en particulier une kurtosis multivariée anormale), la distribution empirique de la statistique sous H0 diverge lourdement de la loi du Khi-deux théorique, ce qui conduit à une sous-estimation systématique de la p-valeur réelle et à des décisions d’inférence biaisées.
6. Conditions préalables et sensibilité méthodologique
6.1 Exigence de normalité multivariée et tests de conformité
Le test de sphéricité de Bartlett est un test paramétrique dont la dérivation mathématique repose sur l’hypothèse selon laquelle les variables observées suivent conjointement une distribution normale multivariée. Cette condition est beaucoup plus exigeante que la simple normalité univariée de chaque variable prise isolément. La normalité multivariée postule que toute combinaison linéaire des variables suit une loi normale et que les relations conditionnelles entre toutes les paires d’indicateurs sont strictement linéaires et homoscédastiques.
La sensibilité du test de Bartlett aux violations de la multinormalité constitue l’un de ses points de vulnérabilité les plus documentés en statistique théorique. Des coefficients d’aplatissement (kurtosis) excessifs, en particulier une leptocurticité multivariée marquée (distributions à queues lourdes), provoquent un gonflement artificiel majeur de la statistique du χ2. Dans une telle configuration, le test produit une p-valeur extrêmement faible et rejette formellement la matrice identité non pas en raison de la présence de corrélations factorielles substantielles, mais uniquement sous l’effet de l’excès d’aplatissement des variables. Avant d’interpréter le test de Bartlett, il est donc impératif de soumettre les données à un test de conformité multivariée, tel que le test de kurtosis et de symétrie multivariée de Mardia, disponible dans la plupart des progiciels d’analyse factorielle.
6.2 Sensibilité exacerbée à la taille de l’échantillon (N)
À l’instar de la majorité des tests basés sur le rapport de vraisemblance et la distribution du khi-deux, la statistique de Bartlett est directement proportionnelle à la taille de l’échantillon n. L’examen de la formule analytique χ2 ≈ -(n – 1) × ln(|R|) démontre de façon indiscutable que la statistique de test s’accroît de manière linéaire avec n pour un déterminant matriciel |R| constant.
Cette dépendance algorithmique confère au test une puissance statistique colossale dès lors que la taille de l’échantillon dépasse quelques centaines d’observations (typiquement pour n > 300 ou n > 500), une situation très fréquente dans les enquêtes psychométriques et les études épidémiologiques contemporaines. Dans ces conditions de grand échantillon, des corrélations bivariées absolument triviales sur le plan psychologique (par exemple des coefficients de l’ordre de r = 0,05 ou 0,08) suffisent mathématiquement à induire un rejet catégorique de l’hypothèse nulle avec un résultat affichant p < 0,0001. Il devient alors indispensable pour le psychométricien averti de décorréler la significativité statistique de la pertinence substantielle. Le fait que la matrice R diffère statistiquement de la matrice identité n’implique nullement que les corrélations soient assez denses pour extraire des facteurs latents stables, fiables et interprétables au sens pratique.
6.3 Nature et niveau de mesure des variables psychométriques
Les fondements matriciels du test de Bartlett présupposent que les données sont mesurées sur une échelle continue d’intervalles ou de rapports, condition requise pour le calcul légitime des coefficients de corrélation produit-moment de Bravais-Pearson. Or, dans la pratique empirique des sciences psychologiques, les données proviennent majoritairement d’échelles de cotation ordinale de type Likert (souvent échelonnées sur 4, 5 ou 7 points d’accord) ou d’items dichotomiques (réponses vrai/faux, présence/absence de symptômes).
L’utilisation brute de matrices de corrélation de Pearson sur des variables ordinales discrètes ou dichotomiques génère une atténuation mécanique des coefficients de corrélation et biaise la distribution du déterminant |R|. Si l’échelle comprend au moins cinq à sept catégories ordonnées et que les distributions ne présentent pas d’asymétrie sévère, le biais demeure empiriquement contenu, permettant l’application du test classique. En revanche, lorsque les variables sont dichotomiques ou ordinales à échelle courte (2 à 4 modalités), l’estimation de la sphéricité doit impérativement s’effectuer sur la base d’une matrice de corrélations polychoriques (ou tétrachoriques pour le cas binaire). L’application naïve de la formule standard de Bartlett sur des corrélations de Pearson appliquées à de tels indicateurs altère dramatiquement la validité inférentielle du test.
7. Rôle dans la réduction dimensionnelle : ACP et Analyse Factorielle
7.1 Critère de passage obligatoire pour l’Analyse en Composantes Principales (ACP)
L’Analyse en Composantes Principales (ACP), formalisée par Harold Hotelling, vise à transformer un ensemble de p variables corrélées en un ensemble de composantes orthogonales non corrélées ordonnées par ordre décroissant de variance expliquée. Sur le plan de la géométrie vectorielle, l’ACP opère une rotation orthogonale rigide du système de coordonnées cartésiennes afin de faire coïncider les nouveaux axes avec les axes d’élongation maximale de l’ellipsoïde de dispersion des données.
Dans ce cadre géométrique, le test de sphéricité de Bartlett constitue le critère de passage matriciel obligatoire. Si l’hypothèse nulle de sphéricité est vérifiée (R = Ip), l’ellipsoïde de dispersion est une sphère parfaite. Dans une hypersphère, il n’existe aucune direction privilégiée ou allongée : tous les diamètres ont une longueur rigoureusement identique, ce qui se traduit algébriquement par l’égalité stricte de toutes les valeurs propres de la matrice (λ1 = λ2 = … = λp = 1). Par conséquent, la recherche d’axes principaux devient mathématiquement arbitraire et indéterminée. Effectuer une ACP sur une matrice sphérique constitue une non-sens méthodologique : la première composante principale n’expliquera pas plus de variance (1 / p) que n’importe quelle variable d’origine prise isolément, rendant la réduction dimensionnelle parfaitement inutile.
7.2 Application dans l’Analyse Factorielle Exploratoire (AFE)
Alors que l’ACP vise la simple condensation de la variance totale, l’Analyse Factorielle Exploratoire (AFE), ancrée dans le modèle des variables latentes, postule que la variance totale de chaque variable observée se décompose en une variance commune (expliquée par les facteurs sous-jacents) et une variance unique (spécifique à l’item et incluant l’erreur de mesure) :
σi2 = hi2 + ui2
où hi2 représente la communauté et ui2 l’unicité. Le test de sphéricité de Bartlett intervient en AFE pour valider l’existence même d’une variance commune partagée avant toute décomposition matricielle. Si les variables ne présentent pas de corrélations de population, l’unicité de chaque variable s’élève à 100 % (ui2 = 1) et les communautés tombent uniformément à zéro (hi2 = 0).
Tenter d’extraire des facteurs latents à partir d’une matrice qui ne rejette pas l’hypothèse de sphéricité de Bartlett aboutit inéluctablement à l’extraction de facteurs parasites ou d’artefacts d’échantillonnage. Les algorithmes d’extraction factorielle (tels que l’analyse en facteurs principaux ou le maximum de vraisemblance) continueront d’itérer et convergeront vers des solutions mathématiques formelles, mais ces facteurs n’auront aucune substance théorique et s’évaporeront lors de toute tentative de réplication indépendante. Le test de Bartlett protège ainsi le chercheur contre l’illusion cognitive de découvrir des traits latents là où la nature n’a déposé que des fluctuations stochastiques.
7.3 Positionnement séquentiel dans le flux d’analyse psychométrique
L’intégration du test de sphéricité de Bartlett au sein d’une chaîne de traitement psychométrique rigoureuse doit suivre un ordre séquentiel strictly hiérarchisé. La méthodologie psychométrique moderne prescrit l’articulation suivante :
- Étape 1 : Nettoyage et vérification des prérequis univariés et multivariés. Détection des données manquantes, traitement des valeurs aberrantes multivariées (distance de Mahalanobis), analyse de l’asymétrie et de la kurtosis, et test de multinormalité de Mardia.
- Étape 2 : Évaluation formelle de la factorisabilité. Exécution simultanée du test de sphéricité de Bartlett et du calcul de l’indice d’adéquation d’échantillonnage Kaiser-Meyer-Olkin (KMO). Si le test de Bartlett n’est pas statistiquement significatif (p ≥ 0,05), l’analyse factorielle est formellement arrêtée à cet instant précis.
- Étape 3 : Détermination du nombre de facteurs à extraire. Déploiement de l’analyse parallèle de Horn et de l’examen du graphique des éboulis (scree plot de Cattell). Ces analyses ne doivent jamais être conduites si la matrice n’a pas préalablement réussi le test de factorisabilité.
- Étape 4 : Extraction et rotation des facteurs. Extraction via les moindres carrés non pondérés ou le maximum de vraisemblance, suivie d’une rotation oblique (Promax, Oblimin) ou orthogonale (Varimax).
- Étape 5 : Évaluation de la fidélité et de la validité. Calcul des indices de consistance interne (α de Cronbach, ω de McDonald) et examen des validités convergente et discriminante.
Cette rigueur chronologique garantit que chaque transformation algébrique s’appuie sur une validation empirique préalable, prévenant l’empilement de décisions statistiques infondées.
8. Complémentarité fondamentale avec l’indice Kaiser-Meyer-Olkin (KMO)
8.1 Fondements et calcul de l’adéquation d’échantillonnage KMO
En dépit de sa rigueur mathématique, le test de sphéricité de Bartlett ne saurait être employé comme critère d’évaluation exclusif de la factorisabilité d’une matrice. Il forme un couple méthodologique indissociable avec la mesure d’adéquation de l’échantillonnage de Kaiser-Meyer-Olkin (KMO), développée par Henry Kaiser et perfectionnée par Kaiser et Rice en 1974. Alors que le test de Bartlett compare la matrice R à l’identité sur la base des corrélations brutes de Pearson, le KMO examine la structure fine des corrélations partielles entre les variables après contrôle mutuel de l’ensemble des autres variables du système.
L’indice KMO global s’exprime à travers le ratio des sommes des carrés des corrélations bivariées par rapport à la somme combinée des corrélations bivariées et des corrélations partielles :
KMO = [ ∑∑j≠k rjk2 ] / [ ∑∑j≠k rjk2 + ∑∑j≠k ajk2 ]
où rjk désigne le coefficient de corrélation empirique de Pearson entre les variables j et k, et ajk représente le coefficient de corrélation partielle entre les mêmes variables conditionnellement à toutes les autres variables du modèle. Si les variables partagent des facteurs latents communs sous-jacents, l’effet de ces facteurs est prédominant dans les corrélations bivariées (rjk élevés), tandis que les corrélations partielles conditionnelles ajk chutent vers zéro (l’association entre deux items disparaissant une fois le facteur contrôlé). Dans cette hypothèse favorable, le dénominateur de la formule s’aligne sur le numérateur et l’indice KMO s’approche de 1,00.
Henry Kaiser a formalisé le barème qualitatif suivant pour interpréter la valeur scalaire du KMO :
- 0,90 à 1,00 : Remarquable (Marvelous)
- 0,80 à 0,89 : Méritoire (Meritorious)
- 0,70 à 0,79 : Moyen / Convenable (Middling)
- 0,60 à 0,69 : Médiocre / Faible (Mediocre)
- 0,50 à 0,59 : Inacceptable / Misérable (Miserable)
- Moins de 0,50 : Inadéquat pour toute factorisation (Unacceptable)
8.2 Comparaison fonctionnelle : Test de Bartlett vs Indice KMO
La distinction fonctionnelle entre le test de sphéricité de Bartlett et l’indice KMO est fondamentale dans le diagnostic psychométrique :
- Nature mathématique : Le test de Bartlett est un test d’hypothèse probabiliste binaire (rejet ou non-rejet fondé sur une distribution du χ2 et une p-valeur), tandis que le KMO est une mesure descriptive continue de régularité psychométrique bornée entre 0 et 1.
- Niveau d’analyse structurelle : Bartlett évalue la matrice dans sa globalité sans distinguer si les associations sont diffuses ou regroupées par grappes nettes. Le KMO sonde la pureté factorielle en pénalisant la variance résiduelle spécifique via les corrélations partielles.
- Comportement face à l’échantillon : Le test de Bartlett est extrêmement dépendant de N (rejet systématique de H0 dès que N est important, même sur des corrélations infimes). L’indice KMO, quant à lui, est remarquablement résistant et stable vis-à-vis des augmentations de la taille d’échantillon, reflétant fidèlement l’architecture interne des intercorrélations.
Le tableau suivant met en lumière la synergie méthodologique entre ces deux approches diagnostiques incontournables :
| Caractéristique | Test de sphéricité de Bartlett | Indice Kaiser-Meyer-Olkin (KMO) |
|---|---|---|
| Objectif principal | Prouver que la matrice n’est pas une identité (interdépendance globale) | Quantifier la proportion de variance commune par rapport à la variance partielle |
| Format du résultat | Statistique χ2, degrés de liberté (df), et p-valeur | Indice scalaire continu borné entre 0,00 et 1,00 |
| Sensibilité à la taille (N) | Très forte (risque élevé d’inflation du χ2 sur grands échantillons) | Très faible (stabilité asymptotique de la métrique) |
| Critère de réussite | p < 0,05 (ou p < 0,001) | KMO ≥ 0,60 (idéalement ≥ 0,80) |
| Diagnostic au niveau item | Non (mesure exclusivement matricielle globale) | Oui (mesure individuelle d’adéquation : KMO MSA par item) |
8.3 Scénarios diagnostiques divergents et résolutions
L’utilisation combinée des deux métriques conduit fréquemment à des configurations diagnostiques asymétriques que le statisticien doit savoir décrypter et résoudre.
Scénario 1 : Test de Bartlett hautement significatif (p < 0,001) et KMO médiocre ou inacceptable (< 0,60).
Cette configuration est très fréquente lors de l’analyse de cohortes massives (N > 1 000) mesurant un grand nombre de variables faiblement corrélées entre elles (par exemple des coefficients oscillant tous entre 0,05 et 0,15). La puissance statistique colossale de l’échantillon force le χ2 de Bartlett à exploser vers la significativité, rejetant l’identité mathématique. Cependant, l’absence de regroupements structurés et la présence de nombreuses corrélations partielles résiduelles provoquent l’effondrement du KMO. Résolution méthodologique : L’analyste ne doit pas lancer d’analyse factorielle globale. Il convient d’examiner la diagonale de la matrice anti-image (les indices KMO individuels dits MSA pour Measure of Sampling Adequacy) et d’éliminer itérativement les items dont le MSA unitaire est inférieur à 0,50, ou d’accepter que les données ne se prêtent à aucune modélisation factorielle robuste.
Scénario 2 : Test de Bartlett non significatif (p > 0,05) et KMO acceptable (> 0,70).
Cette situation paradoxale découle presque exclusivement d’un échantillon critique en sous-effectif flagrant (par exemple N = 25 observations pour p = 15 variables). Les corrélations réelles peuvent être substantielles, ce qui valorise l’équation du KMO, mais l’erreur standard des coefficients d’échantillonnage est si démesurée que le test de Bartlett échoue à rejeter formellement l’hypothèse nulle d’indépendance matricielle par déficit de puissance. Résolution méthodologique : Aucune factorisation définitive ne peut être légitimée. Le chercheur doit impérativement augmenter substantiellement la taille de son échantillon avant toute modélisation dimensionnelle.
9. Mise en œuvre computationnelle avec R et Python
9.1 Implémentation sous R avec le package psych
Dans l’écosystème open-source du logiciel d’analyse statistique R, la référence absolue pour le traitement psychométrique est le package psych, développé par William Revelle. Ce package intègre nativement la fonction cortest.bartlett(), spécifiquement programmée pour exécuter le test de sphéricité de Bartlett avec la correction pour échantillon fini sur une matrice de données brutes ou directement sur une matrice de corrélation précalculée.
Pour exécuter le test à partir d’un ensemble de données psychologiques, le script s’articule selon une séquence d’instructions claires :
Tout d’abord, l’utilisateur charge la bibliothèque requise :
library(psych)
Considérons un tableau de données empiriques intitulé donnees_psy regroupant 400 participants ayant répondu à 10 items mesurés sur échelle de Likert. L’évaluation directe s’effectue par la ligne de commande :
resultat_bartlett <- cortest.bartlett(donnees_psy)
Il est également possible de fournir en argument direct la matrice de corrélation de Pearson calculée sur les données, sous réserve de stipuler impérativement la taille de l’échantillon via l’argument n afin de permettre le calcul du Khi-deux :
mat_cor <- cor(donnees_psy, use = "complete.obs")
resultat_bartlett <- cortest.bartlett(mat_cor, n = 400)
L’affichage de l’objet produit une sortie textuelle synthétique structurée :
print(resultat_bartlett)
La console renvoie trois valeurs fondamentales : $chisq (la statistique du khi-deux calculée), $p.value (la probabilité exacte associée sous l’hypothèse nulle), et $df (le nombre de degrés de liberté p(p – 1) / 2). Par exemple, pour 10 items, la sortie affichera 45 degrés de liberté.
9.2 Implémentation sous Python avec factor_analyzer
Dans l’écosystème de programmation Python dédié à la science des données, le calcul du test de sphéricité de Bartlett s’appuie principalement sur la bibliothèque spécialisée factor_analyzer, qui transpose fidèlement les algorithmes de la psychométrie traditionnelle au sein des structures de données pandas et numpy.
Le module met à disposition la fonction calculate_bartlett_sphericity. La mise en œuvre computationnelle s’articule comme suit :
On importe en préambule les bibliothèques d’analyse :
import pandas as pd
from factor_analyzer.factor_analyzer import calculate_bartlett_sphericity
Après avoir importé le fichier de données dans un DataFrame pandas (par exemple df_items) et s’être assuré de l’élimination préalable des enregistrements contenant des valeurs manquantes :
chi_square_value, p_value = calculate_bartlett_sphericity(df_items)
L’exécution de cette fonction extrait un tuple contenant deux éléments flottants : la statistique exacte du Khi-deux de Bartlett et la p-valeur asymptotique correspondante. L’utilisateur peut formaliser un affichage standardisé :
print(f"Statistique Chi-deux : {chi_square_value:.3f}")
print(f"Valeur de p : {p_value:.6e}")
La fonction calculate_bartlett_sphericity calcule automatiquement le déterminant matriciel de la matrice de corrélation interne et applique rigoureusement le coefficient multiplicateur d’échantillon fini de Bartlett, garantissant une parfaite convergence des résultats avec ceux obtenus sous R ou IBM SPSS.
9.3 Automatisation et vérifications préalables des données
Dans le cadre d’un pipeline d’analyse de données reproductible et professionnel, le calcul du test de Bartlett ne doit jamais être exécuté de manière isolée sans une batterie de contrôles préalables automatisés du statut de la matrice de corrélation. Deux diagnostics critiques méritent une implémentation scriptée systématique :
1. Diagnostic de singularité et colinéarité extrême.
Si deux variables sont parfaitement corrélées (r = 1,00) ou si une variable est une dépendance linéaire exacte d’autres prédicteurs, le déterminant |R| devient égal à zéro. Or, le logarithme de zéro n’est pas défini (ln(0) = -∞). Les progiciels génèrent alors soit un plantage du script, soit une valeur NaN ou un Khi-deux infini. Il convient de tester programmatiquement le déterminant avant l’appel à la fonction de Bartlett :
det_val <- det(cor(donnees))
if (det_val <= 1e-15) { stop("Erreur critique : Matrice singulière ou colinéarité parfaite.") }
2. Diagnostic de la multinormalité.
Afin d’éviter les décisions fallacieuses causées par une leptocurticité multivariée, il est recommandé d’automatiser l’exécution conjointe du test de Mardia, par exemple sous R avec le package MVN :
library(MVN)
mvn_result <- mvn(donnees_psy, mvnTest = "mardia")
Si la kurtosis multivariée viole sévèrement le seuil critique (p < 0,001), le pipeline d’analyse doit émettre un avertissement invitant le statisticien à interpréter la significativité du test de Bartlett avec une circonspection accrue.
10. Mise en œuvre pratique sous SPSS et JASP
10.1 Procédure pas à pas dans IBM SPSS Statistics
IBM SPSS Statistics demeure l’un des environnements graphiques les plus répandus pour l’analyse factorielle en sciences sociales. L’exécution du test de sphéricité de Bartlett y est intégrée de façon indissociable au protocole de réduction dimensionnelle.
Pour lancer la procédure sous SPSS, l’utilisateur suit le cheminement suivant au sein de l’interface graphique :
- Cliquez sur le menu principal Analyse (Analyze).
- Déroulez le sous-menu Réduction des dimensions (Dimension Reduction), puis sélectionnez Facteur… (Factor…).
- Dans la fenêtre principale, transférez l’ensemble des variables ou items d’intérêt de la liste de gauche vers la zone de droite intitulée Variables.
- Cliquez sur le bouton Descriptifs… (Descriptives) situé dans le panneau latéral droit.
- Dans la section intitulée « Matrice de corrélation », cochez impérativement la case nommée KMO et test de sphéricité de Bartlett (KMO and Bartlett’s test of sphericity). Cliquez ensuite sur Poursuivre (Continue).
- Cliquez sur OK pour générer les sorties dans la fenêtre des résultats.
Dans l’output produit par SPSS, le logiciel génère un tableau unique regroupant les métriques liminaires, intitulé KMO and Bartlett’s Test. La table présente verticalement la mesure de précision de l’échantillonnage de Kaiser-Meyer-Olkin, puis les statistiques du test de sphéricité de Bartlett : la valeur du Khi-deux approximé (Approx. Chi-Square), le nombre de degrés de liberté (df) et la significativité statistique exacte (Sig.), affichée comme < ,001 lorsque la p-valeur est extrêmement faible.
10.2 Exécution et analyse sous JASP
JASP (Jeffrey’s Amazing Statistics Program), logiciel libre et gratuit développé par l’Université d’Amsterdam, offre une alternative moderne et dynamique à SPSS pour la recherche académique en psychométrie. La vérification de la sphéricité y est particulièrement intuitive.
Le protocole opératoire sous JASP se déploie comme suit :
- Dans la barre d’outils supérieure, cliquez sur le module Factor, puis choisissez Exploratory Factor Analysis (Analyse Factorielle Exploratoire) ou Principal Component Analysis.
- Sélectionnez les variables numériques à analyser dans le panneau de gauche et insérez-les dans le champ Included Variables.
- Dans les options situées en dessous, déroulez la section intitulée Assumption Checks (Vérification des postulats).
- Cochez la case KMO and Bartlett’s test.
Instantanément et en temps réel, le panneau des résultats situé à droite de l’écran met à jour un tableau standardisé intitulé Assumption Checks. JASP y reporte avec une précision décimale rigoureuse la valeur globale du KMO ainsi que la ligne relative au Bartlett’s test of sphericity, indiquant la valeur χ2, les degrés de liberté df et la p-valeur associée. L’environnement JASP présente l’avantage majeur d’afficher les résultats selon une typographie directement conforme aux standards stylistiques de l’APA.
10.3 Pièges courants lors de l’utilisation des logiciels GUI
L’utilisation des logiciels à interface graphique utilisateur (GUI) recèle plusieurs chausse-trappes méthodologiques qui échappent fréquemment à la vigilance des chercheurs :
1. Le piège du traitement des données manquantes.
Par défaut, SPSS et d’autres logiciels appliquent souvent la suppression par liste (listwise deletion) pour l’analyse factorielle, éliminant toute observation présentant ne serait-ce qu’une seule valeur manquante sur l’ensemble des items. Si l’utilisateur bascule sans précaution vers l’option d’exclusion par paire (pairwise deletion) dans les options de la matrice de corrélation, la matrice empirique R est construite à partir de coefficients calculés sur des effectifs N discordants selon les paires d’items. Cette pratique brise le statut défini positif de la matrice et fausse intégralement la validité mathématique du déterminant |R|, conduisant à une statistique de Bartlett mathématiquement erronée.
2. L’oubli de la nature ordinale des variables.
Les menus par défaut de SPSS calculent mécaniquement les corrélations produit-moment de Pearson, y compris lorsque les variables introduites sont des échelles d’attitudes discrètes à 3 ou 4 points. Rien dans l’interface ne bloque cette exécution, mais les résultats du test de Bartlett obtenus sur de tels indicateurs sont méthodologiquement dégradés. L’analyste doit avoir la rigueur théorique de vérifier ses distributions préalablement à toute validation par clic.
11. Interprétation des résultats et rédaction académique aux normes APA
11.1 Guide d’interprétation statistique des outputs
L’analyse d’un output du test de sphéricité de Bartlett exige une lecture croisée et critique de ses trois composantes statistiques cardinales :
1. La statistique du Khi-deux (χ2) : Cette grandeur mesure l’amplitude globale de l’écart géométrique entre la matrice empirique et la matrice identité. Une valeur χ2 très modeste, proche du nombre de degrés de liberté, signale que les données ne s’écartent que marginalement de l’indépendance statistique.
2. Les degrés de liberté (df) : Ils doivent obligatoirement être vérifiés par l’analyste afin de s’assurer de l’absence d’erreurs dans l’inclusion des indicateurs. Si p variables sont incluses, la valeur doit rigoureusement concorder avec p(p – 1) / 2.
3. La significativité probabiliste (p-valeur) : Pour statuer formellement sur la factorisabilité, la p-valeur doit être strictement inférieure au seuil conventionnel α = 0,05 (et fréquemment p < 0,001 en psychométrie). Toutefois, si la taille de l’échantillon N est gigantesque, la significativité probabiliste doit être relativisée par l’examen minutieux de l’amplitude moyenne des coefficients de corrélation figurant dans la matrice R : au moins un nombre substantiel de coefficients doivent franchir le cap de |r| ≥ 0,30 pour garantir que la structure factorielle dispose d’une assise solide.
11.2 Protocole de rédaction selon les normes de l’APA (7e édition)
La communication scientifique rigoureuse impose la conformité intégrale avec les directives du manuel de publication de l’APA (7e édition). La présentation des résultats du test de Bartlett doit respecter des règles typographiques et d’agencement strictes :
- Les symboles statistiques alphabétiques et grecs s’écrivent obligatoirement en italique lorsqu’ils désignent des variables ou des statistiques : N, p, df, et χ2 (la lettre grecque khi porte l’exposant deux).
- Les parenthèses encadrent les degrés de liberté immédiatement après le symbole du khi-deux : χ2(df).
- La p-valeur est rapportée avec une précision de trois décimales sans zéro initial (ex. : p < ,001 ou p = ,024), car une probabilité ne peut jamais excéder 1,00.
- L’insertion du résultat de Bartlett doit toujours être articulée conjointement avec le score obtenu à l’indice KMO au sein de la sous-section Analyses préliminaires ou Validité de construit.
Un modèle syntaxique académique standardisé s’énonce comme suit :
« Préalablement à l’extraction factorielle, l’adéquation de la matrice de corrélation pour la factorisation a été formellement évaluée. L’indice d’adéquation d’échantillonnage de Kaiser-Meyer-Olkin s’est révélé très satisfaisant (KMO = ,84), et le test de sphéricité de Bartlett a atteint le seuil de significativité statistique, χ2(45) = 874,32, p < ,001, confirmant que les intercorrélations entre les items sont significativement différentes d’une matrice identité et autorisant le déploiement de l’analyse factorielle exploratoire. »
11.3 Exemples concrets de rédaction pour des échelles psychologiques
Afin d’illustrer la déclinaison pratique de ce formalisme académique, examinons deux contextes empiriques réels rencontrés en recherche psychologique :
Exemple 1 : Validation d’un inventaire de personnalité (Cas de confirmation structurelle).
« Afin de vérifier la factorisabilité des 20 items de l’échelle d’évaluation de la Régulation Émotionnelle auprès de notre cohorte d’étudiants (N = 340), les tests de prérequis multivariés ont été appliqués. L’indice KMO global a atteint une valeur de ,88, témoignant d’une excellente compacité corrélationnelle. Le test de sphéricité de Bartlett s’est révélé hautement significatif, χ2(190) = 2415,80, p < ,001. L’examen des indices MSA individuels a confirmé que chaque item dépassait le seuil minimal requis de ,70. Ces indicateurs valident conjointement la présence d’une variance partagée substantielle et justifient l’extraction subséquente des facteurs par la méthode de factorisation en axes principaux avec rotation Promax. »
Exemple 2 : Évaluation d’une échelle comportementale courte (Cas de violation des seuils).
« La factorisabilité des 6 items mesurant l’adhésion thérapeutique au sein de l’échantillon clinique (N = 65) a été éprouvée. Bien que l’indice de Kaiser-Meyer-Olkin ait affiché une valeur marginale acceptable (KMO = ,61), le test de sphéricité de Bartlett a échoué à atteindre le seuil de signification conventionnel, χ2(15) = 21,34, p = ,126. Ce résultat indique que la structure de covariation observée ne s’écarte pas de manière probabiliste d’une matrice identité, la faible amplitude des intercorrélations étant attribuable aux fluctuations aléatoires inhérentes à la taille restreinte de l’échantillon. En conséquence, l’analyse factorielle exploratoire a été suspendue, et les items ont été analysés sous forme de variables descriptives individuelles conformément aux recommandations psychométriques. »
12. Limites critiques, controverses et alternatives méthodologiques
12.1 Limites intrinsèques du test dans la recherche moderne
Malgré sa longévité et son statut d’outil incontournable dans les progiciels statistiques commerciaux, le test de sphéricité de Bartlett fait l’objet de critiques méthodologiques sévères de la part des théoriciens contemporains de la psychométrie. Le reproche épistémologique premier concerne la nature même de son hypothèse nulle : H0 : P = Ip. Dans les sciences humaines et sociales, postuler que p variables mesurant des aspects connexes du comportement humain ou de la personnalité partagent rigoureusement une corrélation nulle dans la population parente relève d’une fiction théorique totale. En psychologie, presque tout est au moins marginalement corrélé avec tout (le fameux crud factor conceptualisé par Paul Meehl).
Par voie de conséquence, dès lors que l’analyste réunit un échantillon d’une taille statistique confortable (N > 500), le rejet de cette hypothèse nulle irréaliste devient une quasi-certitude mathématique garantie d’avance, privant le test d’une grande partie de sa valeur diagnostique sélective. De surcroît, le test de Bartlett est une mesure aveugle : il est incapable d’indiquer si la matrice contient un seul facteur général, une structure hiérarchique complexe ou une constellation de grappes locales sans unité. Il atteste simplement que les variables « bougent ensemble » d’une manière non orthogonale, sans pouvoir juger si cette interdépendance est de nature à produire une réduction dimensionnelle scientifiquement intelligible.
12.2 Alternatives et approches robustes pour données non normales
Face à la vulnérabilité démontrée du test classique de Bartlett face à la non-normalité multivariée et aux formats de réponse discrets, les statisticiens ont formalisé plusieurs voies de contournement méthodologique :
1. Tests basés sur les matrices de corrélation polychoriques.
Pour les échelles de Likert et les questionnaires à items catégoriels, l’estimation des corrélations latentes sous-jacentes via les matrices polychoriques permet de corriger le biais d’atténuation. Des variantes adaptées du test de Bartlett intégrant les erreurs standard asymptotiques des corrélations polychoriques permettent de tester la sphéricité sans violer les postulats de continuité.
2. Approches par rééchantillonnage (Bootstrap empirique).
Lorsque la distribution des données présente une asymétrie sévère ou une kurtosis anormale invalidant la référence à la loi du χ2 théorique, le recours aux procédures de rééchantillonnage par bootstrap constitue une alternative méthodologique de premier ordre. En générant des milliers de réplicats de l’échantillon sous l’hypothèse nulle d’orthogonalité (par exemple par permutation indépendante des scores de chaque variable), le chercheur peut dériver la distribution d’échantillonnage empirique exacte du déterminant |R| et obtenir une p-valeur robuste exempte de toute présomption paramétrique de multinormalité.
12.3 Recommandations contemporaines pour les psychométristes
À la lumière des avancées méthodologiques de ces dernières décennies, la pratique psychométrique moderne assigne au test de sphéricité de Bartlett un rôle de filtre liminaire nécessaire mais formellement insuffisant. Les psychométristes contemporains s’accordent sur un ensemble de directives intégratives pour guider la réduction factorielle :
- Subordination méthodologique : Le test de Bartlett ne doit jamais être utilisé comme l’unique juge de la factorisabilité. Il doit être obligatoirement subordonné à l’analyse de l’indice KMO global et des indices KMO individuels (MSA) par variable. Un test de Bartlett significatif associé à un KMO global inférieur à 0,60 interdit toute factorisation.
- Priorisation de l’analyse parallèle : Pour déterminer la viabilité d’une réduction dimensionnelle, l’analyse parallèle de Horn surmonte magistralement les limites du test de Bartlett. En comparant les valeurs propres de l’échantillon empirique à celles générées par des matrices de bruit aléatoire de dimensions strictement identiques, l’analyse parallèle teste l’émergence réelle des dimensions avec une précision statistique incomparablement supérieure.
- Examen qualitatif de la matrice : Aucune statistique globale ne remplace l’inspection visuelle et théorique directe du tableau des intercorrélations. Le chercheur doit vérifier la présence substantielle de corrélations excédant les seuils de pertinence pratique (|r| > 0,30) alignées avec les hypothèses théoriques du construit mesuré.
En adoptant cette perspective intégrative et réflexive, le chercheur s’assure que le test de sphéricité de Bartlett remplit avec rigueur sa fonction fondatrice : être le premier rempart mathématique contre la modélisation d’artéfacts aléatoires, validant avec certitude le socle empirique sur lequel s’érigera l’édifice de la mesure psychologique.
Références
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A – Mathematical and Physical Sciences, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85. https://doi.org/10.1111/j.2044-8317.1950.tb00285.x
- Bartlett, M. S. (1951). A further note on tests of significance in factor analysis. British Journal of Statistical Psychology, 4(1), 1–2. https://doi.org/10.1111/j.2044-8317.1951.tb00299.x
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Kaiser, H. F. (1970). A second generation little jiffy. Psychometrika, 35(4), 401–415. https://doi.org/10.1007/BF02291817
- Kaiser, H. F., & Rice, J. (1974). Little Jiffy, Mark IV. Educational and Psychological Measurement, 34(1), 111–117. https://doi.org/10.1177/001316447403400115
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- Revelle, W. (2024). psych: Procedures for Personality and Psychological Research. Northwestern University, Evanston, Illinois. R package version 2.4.3. https://CRAN.R-project.org/package=psych
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7e éd.). Pearson.