
L’analyse de régression linéaire multiple constitue depuis plus d’un siècle l’un des piliers méthodologiques fondamentaux de la recherche empirique, irriguant les sciences exactes tout comme les sciences sociales, l’économétrie, la biométrie et la psychométrie. Fondée sur le paradigme de la modélisation des relations fonctionnelles entre un ensemble de variables prédictives et une variable critère continue, cette approche repose sur un édifice mathématique rigoureux formalisé par le théorème de Gauss-Markov. Cet appareil théorique garantit que, sous un ensemble précis de postulats axiomatiques, la méthode des moindres carrés ordinaires produit des estimateurs linéaires sans biais dotés d’une variance minimale. Néanmoins, la validité interne, la précision inférentielle et l’interprétabilité des paramètres estimés dépendent de manière critique du respect scrupuleux de ces conditions sous-jacentes, au premier rang desquelles figure l’absence de dépendance linéaire exacte ou approchée entre les prédicteurs.
Dans la pratique de la recherche contemporaine, singulièrement au sein des disciplines confrontées à la complexité des systèmes comportementaux et cognitifs, la condition d’indépendance linéaire des régresseurs est fréquemment compromise. Ce phénomène, désigné sous le vocable de multicolinéarité, émerge dès lors que deux ou plusieurs variables explicatives partagent une fraction substantielle de leur variance, manifestant ainsi un chevauchement informationnel aigu au sein de l’espace vectoriel d’échantillonnage. Loin de constituer une anomalie binaire triviale, la colinéarité représente un continuum de dégradation structurelle des données. Si la multicolinéarité parfaite conduit à une impasse computationnelle immédiate par singularité de la matrice des données, la multicolinéarité imparfaite s’avère bien plus insidieuse : elle autorise le calcul des coefficients tout en contaminant silencieusement l’estimation statistique par une instabilité numérique pathologique, une inflation dramatique des erreurs-types et une érosion sévère de la puissance statistique des tests d’hypothèse bilatéraux.
Face à ce défi méthodologique récurrent, la communauté scientifique a développé des outils diagnostiques sophistiqués destinés à évaluer l’ampleur de la redondance et son impact sur la matrice d’information. Parmi ces instruments, le facteur d’inflation de la variance, universellement abrégé par l’acronyme anglophone VIF (Variance Inflation Factor), et son corollaire immédiat, la tolérance statistique, occupent une position centrale dans les protocoles de validation des modèles de régression. Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements mathématiques, les répercussions inférentielles, les techniques d’évaluation diagnostique et les stratégies de remédiation relatives à la multicolinéarité. Conçu à l’intention des chercheurs, des méthodologistes et des analystes de données, il propose une déconstruction systématique des concepts, éclairée par les exigences contemporaines de réplicabilité et de rigueur analytique.
1. Introduction aux fondements de la régression linéaire et à l’hypothèse de non-colinéarité
1.1 Le modèle de régression linéaire multiple et ses hypothèses classiques
Le modèle canonique de régression linéaire multiple exprime une variable dépendante scalaire Y comme une combinaison linéaire de p variables explicatives mesurées sur n observations, modulée par un terme d’erreur stochastique résiduelle. Sous sa formulation matricielle synthétique, le système s’énonce :
Y = Xβ + ε
Dans cette formalisation vectorielle, Y représente un vecteur colonne de dimension (n × 1), X figure une matrice de dessin de dimension (n × (p + 1)) dont la première colonne est traditionnellement composée de constantes unitaires dédiées à l’ordonnée à l’origine, β constitue le vecteur ((p + 1) × 1) des paramètres de régression inconnus à estimer, et ε désigne le vecteur (n × 1) des perturbations aléatoires inobservables. L’ensemble de la dérivation analytique des Moindres Carrés Ordinaires (MCO) repose sur l’optimisation quadratique minimisant la somme des résidus au carré, aboutissant à la relation fermée classique :
β̂ = (X’X)-1X’Y
Le célèbre théorème de Gauss-Markov établit formellement que l’estimateur MCO β̂ est le meilleur estimateur linéaire non biaisé (BLUE, pour Best Linear Unbiased Estimator), sous réserve de la validation stricte d’un ensemble de postulats fondamentaux :
- Espérance conditionnelle nulle des erreurs : E(ε|X) = 0, certifiant l’absence d’omission de prédicteurs pertinents corrélés avec les variables incluses et la linéarité intrinsèque de la spécification fonctionnelle.
- Homoscédasticité des résidus : Var(εi|X) = σ2 pour toute observation i, imposant une dispersion constante du terme d’erreur le long du continuum des valeurs prédites.
- Absence d’autocorrélation temporelle ou spatiale : Cov(εi, εj|X) = 0 pour tout i ≠ j, assurant l’indépendance stochastique mutuelle des résidus d’échantillonnage.
- Exogénéité stricte : La matrice X est déterministe ou, si elle est stochastique, elle est indépendante du terme d’erreur ε.
- Absence de colinéarité parfaite : Le rang de la matrice X est égal à (p + 1), garantissant que le produit matriciel X’X est non singulier et inversible.
Lorsque ces postulats sont scrupuleusement honorés, la variance de l’estimateur β̂ s’exprime par le produit matriciel Cov(β̂) = σ2(X’X)-1. Dès lors qu’une violation de l’hypothèse de non-colinéarité se manifeste, quand bien même les autres postulats demeureraient intacts, la matrice X’X tend vers une quasi-singularité mathématique. Les propriétés optimales garanties par le cadre de Gauss-Markov s’effondrent sur le plan de la variance pratique : bien que l’estimateur conserve théoriquement son caractère asymptotiquement sans biais, sa variance d’échantillonnage explose de manière exponentielle, rendant les estimations instables, imprécises et hautement erratiques sous réplication empirique.
1.2 L’exigence d’indépendance linéaire entre variables explicatives
L’exigence d’indépendance linéaire entre les régresseurs transcende une simple contrainte de calcul numérique ; elle conditionne la structure logique de la modélisation statistique. Sur le plan algébrique, requérir que la matrice de dessin X soit de rang plein signifie qu’aucune des colonnes de X ne peut être générée sous la forme d’une combinaison linéaire exacte des autres colonnes du système. En termes de géométrie vectorielle hilbertienne, chaque prédicteur doit projeter un vecteur qui n’appartient pas au sous-espace vectoriel engendré par les p – 1 autres régresseurs. Cette condition est indispensable pour garantir l’unicité de la décomposition orthogonale de la projection du vecteur dépendant Y sur le sous-espace défini par les colonnes de X.
D’un point de vue conceptuel et substantiel, l’analyse de régression cherche à délimiter l’apport informatif unique de chaque variable explicative. La signification statistique du coefficient de régression partiel βj repose intrinsèquement sur la clause d’équivalence ceteris paribus : il quantifie l’espérance de variation de la variable dépendante Y consécutive à une élévation unitaire du régresseur Xj, tandis que l’ensemble des autres covariables Xk (k ≠ j) sont maintenues à un niveau rigoureusement constant. Or, si les variables explicatives manifestent une interdépendance empirique dense ou une corrélation élevée, cette abstraction méthodologique perd toute cohérence empirique.
Dans un contexte où les prédicteurs covarient de façon substantielle dans la population échantillonnée, contraindre statistiquement une variable à demeurer immobile tandis qu’une variable corrélée varie viole les dynamiques observables du phénomène sous examen. L’opération d’isolation du résidu partiel revient à tenter d’extraire la variance propre d’un facteur au sein d’une zone de chevauchement où l’information est intrinsèquement partagée. En conséquence, l’estimation des pentes partielles par MCO se heurte à une indétermination empirique : l’algorithme ne peut attribuer avec certitude la responsabilité de la variation de Y à une composante spécifique, aboutissant à une incertitude analytique qui dégrade directement l’interprétabilité des paramètres structurels.
1.3 Pertinence méthodologique en psychométrie et sciences comportementales
La question de la colinéarité se pose avec une acuité particulière dans le champ de la psychométrie, de la neuropsychologie et des sciences comportementales en raison de la nature phénoménologique des construits évalués. Contrairement aux grandeurs physiques directement quantifiables, les entités psychologiques telles que l’intelligence fluide, la mémoire de travail, l’affectivité négative ou l’anxiété sociale constituent des construits latents inobservables, mesurés indirectement par l’entremise de batteries d’items, de temps de réaction ou d’échelles de Likert. Cette architecture de mesure induit structurellement un niveau élevé d’intercorrélation : les dimensions psychologiques partagent de manière récurrente des strates substantielles de variance cognitive, comportementale ou affective.
Dans ce contexte disciplinaire, il est impératif d’opérer une distinction méthodologique entre la régression purement prédictive et la modélisation explicative ou causale. En modélisation prédictive orientée vers le génie logiciel ou l’aide au diagnostic clinique automatisé, l’objectif primordial réside dans la maximisation de la précision du pronostic d’un statut pathologique ou d’une performance ultérieure. Dès lors que l’on se cantonne à cet objectif, la multicolinéarité entre les variables d’évaluation n’altère pas l’ajustement global du modèle, ni la valeur de son coefficient de détermination multiple R2, pour autant que la matrice de covariance de la population future demeure semblable à celle de l’échantillon d’apprentissage.
À l’inverse, dès que la démarche scientifique poursuit une finalité explicative — par exemple, lorsqu’il s’agit d’identifier la contribution étiologique propre de la régulation émotionnelle par rapport au névrosisme dans l’apparition d’épisodes dépressifs majeurs —, la présence de colinéarité devient particulièrement problématique. L’évaluation de dimensions psychologiques imbriquées confronte le chercheur au risque d’inférences fallacieuses. Sous l’effet du chevauchement de variance, des prédicteurs dont la validité de construit et la pertinence théorique sont incontestables peuvent afficher des coefficients partiels statistiquement non significatifs, ou pire, des signes algébriques inversés défiant le consensus théorique. Une telle distorsion méthodologique compromet la confirmation des modèles théoriques et menace l’élaboration d’interventions ciblées fondées sur les données probantes.
2. Définition et nature mathématique de la multicolinéarité
2.1 Définition formelle de la dépendance linéaire en régression
Sur le plan de l’analyse matricielle et de la théorie des espaces vectoriels, la multicolinéarité caractérise une situation où les vecteurs colonnes de la matrice de données X présentent une dépendance linéaire exacte ou approximative. Soit un ensemble de p vecteurs colonnes X1, X2, …, Xp appartenant à l’espace euclidien ℜn. La dépendance linéaire exacte s’établit formellement s’il existe une collection de scalaires réels c1, c2, …, cp, non tous simultanément nuls, satisfaisant rigoureusement l’égalité suivante :
∑j=1p cjXj = 0
Cette configuration algébrique implique qu’au moins un des régresseurs peut être calculé sans aucune erreur comme une fonction linéaire exacte des autres prédicteurs du modèle. En pratique empirique, l’occurrence d’une dépendance absolue demeure rare, en dehors des fautes de spécification algorithmique. La problématique courante réside dans la dépendance linéaire approximative ou quasi-colinéarité, formalisée par l’existence d’une relation où le produit pondéré converge vers un vecteur d’erreur stochastique v dont la norme euclidienne est remarquablement restreinte par rapport à la dispersion propre des données :
∑j=1p cjXj = v, avec ||v||2 ≈ 0
Il est fondamental de dissiper une confusion fréquente qui consiste à assimiler la multicolinéarité à la seule existence de coefficients de corrélation bivariée élevés au sein de la matrice de corrélation de Pearson. La colinéarité est une propriété multivariée d’un espace de dimension supérieure. Si une corrélation de Pearson élevée entre deux régresseurs engendre incontestablement une colinéarité bivariée, l’absence de fortes corrélations par paires n’immunise aucunement le système contre la multicolinéarité multivariée. Un prédicteur Xj peut présenter des corrélations bivariées très faibles ou modérées avec X1, X2 et X3 individuellement, tout en étant parfaitement ou presque parfaitement prédit par la combinaison linéaire conjointe de ces trois variables. La multicolinéarité reflète donc la redondance vectorielle globale d’un hyperplan, inaccessible par le simple examen des paires de variables isolées.
2.2 Origine et causes structurelles de la multicolinéarité
L’émergence de la multicolinéarité au sein des plans d’expérience observationnels ou quasi-expérimentaux s’enracine dans des mécanismes structurels diversifiés, que l’analyste se doit de diagnostiquer en amont de toute prise de décision méthodologique :
- Surparamétrisation du modèle économétrique ou psychométrique : L’inclusion systématique et non théorisée d’une multitude de variables régulatrices, de covariables sociodémographiques et d’indicateurs comportementaux augmente mécaniquement la probabilité que le sous-espace des prédicteurs présente des redondances géométriques, réduisant le volume informatif unique de chaque dimension.
- Biais d’échantillonnage et contraintes intrinsèques aux données : Il arrive fréquemment que, dans la population cible, deux processus distincts ne soient pas nécessairement corrélés, mais que le protocole de recrutement des participants restreigne la variance d’échantillonnage à une zone spécifique de l’espace des attributs. Par exemple, l’évaluation du statut socioéconomique et du niveau de diplôme au sein d’un échantillon ciblant exclusivement des cadres supérieurs produira une corrélation artificielle très supérieure à celle observée en population générale.
- Redondance conceptuelle inhérente aux instruments de mesure : Dans les batteries de tests psychométriques standardisés, plusieurs sous-échelles exploitent des formulations d’items convergentes pour capturer des facettes proches d’un même phénomène latent. Cette fidélité interne élevée conduit inévitablement à ce que les scores bruts partagent une variance commune massive.
- Tendances temporelles et dynamiques longitudinales partagées : Dans les séries chronologiques ou les devis longitudinaux, de nombreux indicateurs macroéconomiques ou psychologiques (comme le stress au travail et l’épuisement cognitif) affichent des trajectoires monotones partagées au fil du temps, induisant des corrélations fallacieuses découlant de leur co-évolution temporelle plutôt que d’une relation directe.
2.3 Multicolinéarité structurelle versus multicolinéarité liée aux données
Une distinction méthodologique essentielle consiste à scinder le phénomène selon son étiologie fondamentale : la colinéarité structurelle d’une part, et la colinéarité liée aux données (ou colinéarité empirique) d’autre part. Cette typologie détermine directement la stratégie d’analyse et la viabilité des solutions statistiques à déployer.
La multicolinéarité structurelle résulte d’une manipulation computationnelle orchestrée par le modélisateur lors de la construction du modèle de régression. Le cas le plus emblématique réside dans l’intégration de puissances polynomiales (par exemple, modéliser une fonction quadratique incluant X et X2) ou de termes d’interaction multiplicative (modéliser les effets de modération sous la forme du produit de deux prédicteurs continus X1 × X2). Dès lors que les échelles brutes sont préservées, le terme de puissance ou de produit est mathématiquement corrélé aux prédicteurs de premier ordre qui le composent. Cette colinéarité n’est pas un artefact de l’échantillon mais une propriété inhérente à la transformation algébrique opérée. Heureusement, elle peut être corrigée par des techniques standardisées de centrage sur la moyenne ou d’orthogonalisation polynomiale sans altérer les propriétés prédictives du modèle.
À l’opposé, la multicolinéarité liée aux données (ou colinéarité échantillonnale) constitue une caractéristique intrinsèque et non provoquée de la matrice empirique recueillie. Elle traduit le fait que les phénomènes observables sous-jacents sont inextricablement entrelacés dans l’environnement naturel ou dans la cohorte évaluée. Dans cette configuration, aucune transformation algébrique triviale ne permet de séparer la variance partagée sans modifier substantiellement la nature des variables explicatives ou la formulation théorique du problème. La résolution de ce type de colinéarité requiert alors des arbitrages épistémologiques délicats, allant de l’exclusion raisonnée de régresseurs à l’emploi de méthodes d’estimation pénalisée ou de modélisation à variables latentes.
3. Multicolinéarité parfaite versus multicolinéarité imparfaite
3.1 Multicolinéarité parfaite : singularité matricielle et indétermination
La multicolinéarité parfaite correspond à l’état extrême d’invalidation de l’hypothèse de rang plein du modèle linéaire général. Dans ce scénario, le rang de la matrice de dessin X de dimension n × (p + 1) est strictement inférieur à son nombre de colonnes : rang(X) < (p + 1). Par voie de conséquence directe, la matrice symétrique carrée d’information de Fisher ou des produits croisés (X’X) de dimension ((p + 1) × (p + 1)) possède un déterminant rigoureusement nul :
det(X’X) = 0
Sur le plan de l’algèbre linéaire, une matrice dont le déterminant est nul est dite singulière ; elle ne possède pas d’inverse multiplicatif canonique au sens classique. Par conséquent, l’équation normale des moindres carrés (X’X)β̂ = X’Y ne peut pas être résolue par la formule canonique β̂ = (X’X)-1X’Y, car l’opération d’inversion est mathématiquement indéfinie. L’espace nul (ou noyau) de la matrice X’X n’étant pas réduit au vecteur zéro, il existe une infinité de vecteurs β̂ capables de minimiser strictement au même degré la somme des carrés des écarts résiduels.
Cette impasse analytique se rencontre traditionnellement dans les cas d’inadvertance de programmation statistique, par exemple lors de l’écueil classique désigné sous le terme de « piège de la variable muette » (dummy variable trap). Ce biais survient lorsqu’un chercheur code une variable nominale polytomique à k modalités au moyen de k variables binaires indicatrices, tout en incluant simultanément une constante d’ordonnée à l’origine dans la régression. La somme des k indicatrices étant égale à l’unité pour chaque observation, elle reproduit identiquement le vecteur colonne de la constante, créant une combinaison linéaire parfaite. L’analyste se heurte à une indétermination totale : les logiciels d’analyse interrompent brutalement l’opération ou excluent arbitrairement l’une des colonnes pour forcer l’inversion matricielle.
3.2 Multicolinéarité imparfaite : quasi-singularité et instabilité numérique
La multicolinéarité imparfaite, ou quasi-colinéarité, représente le scénario le plus prévalent et le plus insidieux dans les investigations quantitatives empiriques. Dans cette configuration, les colonnes de la matrice X demeurent formellement indépendantes au sens de la théorie des ensembles : le déterminant de (X’X) est strictement positif, det(X’X) > 0, confirmant que le rang de la matrice est théoriquement plein. Dès lors, l’inversion matricielle (X’X)-1 est computationnellement réalisable, et les algorithmes d’optimisation numérique convergent vers une solution unique pour le vecteur de paramètres β̂.
Cependant, la matrice X’X est dite mal conditionnée ou quasi-singulière. Le déterminant, bien que non nul, prend une valeur infinitésimale approchant les limites de précision de la machine à virgule flottante. La conséquence directe de cet état de quasi-singularité est une hypersensibilité numérique des estimateurs. Les coefficients de régression deviennent extrêmement fragiles, oscillant de façon disproportionnée en réponse à des perturbations minimes apportées aux données d’échantillonnage, telles que l’ajout ou la suppression d’une seule observation, ou une variation marginale liée à des erreurs d’arrondi lors du recueil expérimental.
La frontière séparant une corrélation acceptable d’une colinéarité pathologique s’avère particulièrement diffuse. Il n’existe pas de discontinuité mathématique abrupte au sein de l’opérateur matriciel, mais plutôt un continuum de dégradation progressive de la précision inférentielle. À mesure que le conditionnement de la matrice se détériore, les projections géométriques des gradients d’erreur perdent leur orthogonalité opérationnelle. La topologie de la surface de la somme des carrés résiduels ne forme plus une cuvette parabolique nette, mais se transforme en une vallée étroite, allongée et quasiment plate, le long de laquelle une infinité de combinaisons distinctes de coefficients procurent un niveau de résidus virtuellement indiscernable pour l’ordinateur.
3.3 Illustrations concrètes en modélisation psychologique
Pour matérialiser les répercussions pratiques de ces configurations géométriques, considérons plusieurs situations caractéristiques issues des protocoles d’évaluation psychologique et neuropsychologique. Un cas classique de multicolinéarité quasi-parfaite advient lorsqu’un chercheur intègre au sein d’une même équation de régression les scores dérivés de plusieurs sous-échelles d’un test psychométrique parallèlement au score global composite de ce même instrument. Par construction psychométrique, le score global n’est autre que la sommation linéaire ou une moyenne pondérée directe des sous-échelles :
Score Total = ∑k=1m Sous-Échellek
L’introduction simultanée du score composite et de ses composants constitue une forme explicite de colinéarité structurelle parfaite conduisant à la singularité immédiate de la matrice (X’X). Bien que les manuels de méthodologie mettent en garde contre cette pratique, des variantes plus diffuses continuent de parasiter la littérature scientifique. Par exemple, l’évaluation de la vitesse de traitement de l’information par le biais de temps de réaction mesurés dans des conditions expérimentales parallèles (telles que des tâches de Stroop congruent, incongruent et neutre) produit des matrices où les corrélations inter-prédicteurs dépassent régulièrement r = 0,90 ou r = 0,95.
De même, dans les protocoles de validation croisée de batteries de personnalité, l’incorporation concomitante des facettes d’un modèle en cinq facteurs (Big Five) et de scores d’un inventaire concurrent mesurant des construits analogues (par exemple, l’échelle d’anxiété de Spielberger couplée à la sous-dimension névrosisme du NEO-PI-R) sature le système d’équations de variances partagées. Dans de telles conditions, le système statistique peine à dissocier la part de variance imputable à chaque facette, aboutissant à une incohérence des estimations où des prédicteurs conceptuellement majeurs voient leur significativité statistique s’évanouir dans les tableaux de résultats.
4. Les conséquences théoriques et statistiques de la multicolinéarité
4.1 Gonflement des erreurs-types des coefficients de régression
La conséquence mathématique la plus directe et la plus dommageable de la multicolinéarité réside dans l’accroissement démesuré de la variance d’échantillonnage associée aux coefficients de régression partiels. Pour appréhender ce phénomène avec rigueur, il convient d’examiner l’expression analytique exacte de la variance de l’estimateur de pente β̂j dans le cadre d’un modèle de régression multiple comportant p variables explicatives :
Var(β̂j) = σ2 / [ ∑i=1n (Xij – X̄j)2 × (1 – Rj2) ]
Dans cette formulation fondamentale, σ2 désigne la variance du terme d’erreur résiduel, ∑(Xij – X̄j)2 quantifie la somme totale des carrés des écarts (la dispersion brute) de la variable Xj, et Rj2 représente le coefficient de détermination multiple issu d’une régression auxiliaire au sein de laquelle Xj est prédite par l’ensemble des p – 1 autres variables explicatives incluses dans le modèle principal. Dès lors que la corrélation multivariée entre Xj et les autres prédicteurs s’intensifie, le terme Rj2 converge inexorablement vers la valeur 1.
En conséquence immédiate, le dénominateur de la fraction, gouverné par le terme (1 – Rj2), se rapproche asymptotiquement de zéro, entraînant une divergence à l’infini de la variance estimée Var(β̂j). L’erreur-type du coefficient, définie comme la racine carrée de cette variance d’échantillonnage, SE(β̂j) = √(Var(β̂j)), subit un gonflement disproportionné. Ce phénomène se traduit par un élargissement considérable des intervalles de confiance associés aux pentes de régression :
IC1-α(βj) = β̂j ± tα/2, n-p-1 × SE(β̂j)
Il est crucial de souligner que ce gonflement des erreurs-types n’induit aucun biais dans l’estimation ponctuelle moyenne des paramètres : l’estimateur MCO conserve formellement son espérance mathématique E(β̂) = β. Néanmoins, il perd totalement son efficacité statistique (au sens de la borne minimale de Cramer-Rao). Les coefficients estimés deviennent hautement volatils, rendant la quantification de l’effet d’une imprécision telle qu’elle prive l’inférence de toute utilité scientifique pratique.
4.2 Chute de la puissance statistique et erreurs d’inférence
L’inflation démesurée des erreurs-types engendre une détérioration directe des procédures de test d’hypothèse inférentielle. La statistique empirique du test t de Student, mobilisée pour éprouver l’hypothèse nulle d’absence d’effet partiel H0: βj = 0 par rapport à l’hypothèse alternative bilatérale H1: βj ≠ 0, est calculée selon le ratio classique :
tstat = β̂j / SE(β̂j)
Dans un contexte d’interdépendance sévère des prédicteurs, l’augmentation substantielle du dénominateur SE(β̂j) provoque un effondrement mécanique de la valeur absolue de la statistique t calculée. Même dans l’éventualité où la magnitude réelle de la pente dans la population générale sous-jacente est d’une intensité notable, la valeur empirique de tstat échoue fréquemment à franchir le seuil de signification critique conditionné par le niveau d’erreur de première espèce (généralement α = 0,05). Le chercheur se trouve confronté à une élévation drastique du risque d’erreur de type II (non-rejet d’une hypothèse nulle pourtant empiriquement fausse), ce qui équivaut à une chute majeure de la puissance statistique de l’analyse.
Ce mécanisme pernicieux conduit au masquage d’effets réels, pourtant validés par la littérature théorique et clinique. Des prédicteurs essentiels à la compréhension d’une pathologie cognitive ou d’un comportement social peuvent être prématurément relégués au rang de variables non contributives, simplement en raison de l’impossibilité algorithmique d’isoler leur contribution marginale au sein de l’enchevêtrement des covariables incluses dans la modélisation.
4.3 Inversion paradoxale des signes des coefficients estimés
L’un des symptômes les plus déroutants induits par la multicolinéarité concerne l’inversion paradoxale du signe des coefficients partiels estimés par rapport au signe de leur corrélation bivariée d’origine avec le critère. Il est fréquent d’observer une situation empirique où une variable explicative Xj manifeste une corrélation de Pearson positive et hautement significative avec la variable dépendante Y (rY, Xj > 0, p < 0,001), mais affiche, au sein du tableau de régression linéaire multiple, un coefficient de pente partiel β̂j négatif et parfois statistiquement significatif.
Cette divergence déconcertante renvoie à des configurations particulières d’algèbre multidimensionnelle, parmi lesquelles figurent les phénomènes de suppression statistique et des variantes locales du paradoxe de Simpson. Lorsqu’une variable explicative fortement corrélée à une autre variable partage de la variance non pertinente (variance d’erreur ou variance spécifique non liée au critère), l’ajustement simultané des deux régresseurs peut contraindre l’une des pentes à adopter une trajectoire compensatoire artificielle. Le coefficient ne reflète plus l’action propre du construit, mais opère un ajustement mécanique visant à purger l’autre régresseur de sa composante résiduelle.
Pour le chercheur en psychologie ou en sciences médicales, ce phénomène engendre des défis interprétatifs considérables. L’analyste se trouve contraint de proposer des rationalisations théoriques ad hoc alambiquées pour expliquer pourquoi un facteur protecteur documenté semble subitement se muer en un facteur de vulnérabilité clinique au sein du modèle multivarié. Ces acrobaties herméneutiques reposent fréquemment sur une mauvaise lecture des données : l’inversion de signe n’est pas le reflet d’une dynamique psychologique sous-jacente, mais l’artefact mathématique direct de la projection instable d’un espace vectoriel colinéaire.
4.4 Préservation de la capacité prédictive globale du modèle
Au milieu des perturbations qu’elle inflige aux paramètres individuels, la multicolinéarité présente une propriété mathématique remarquable, souvent méconnue des praticiens : elle n’altère en rien l’aptitude prédictive globale de l’équation de régression, ni la validité d’ajustement du coefficient de détermination R2, pour autant que les prédictions soient cantonnées à l’intérieur du domaine d’observation de l’échantillon d’origine.
L’estimation de la valeur prédite Ŷ = Xβ̂ correspond à la projection orthogonale du vecteur Y sur le sous-espace vectoriel Col(X) engendré par les colonnes de X. Or, la structure géométrique de cet hyperplan dépend uniquement de la couverture dimensionnelle globale de la matrice, et demeure insensible à la façon dont la base vectorielle est paramétrée. Même si les coefficients β̂j individuels sont instables et que leurs erreurs-types sont démesurées, leurs covariances d’échantillonnage négatives se compensent de façon synchrone lors de la sommation pondérée. Le modèle parvient ainsi à prédire la valeur attendue Ŷ avec une précision et un niveau de résidus globaux inchangés.
Cette propriété scelle une dissociation nette entre performance prédictive et validité explicative :
- Dans une perspective purement orientée vers la prédiction (machine learning empirique, ingénierie pronostique), la présence d’une colinéarité substantielle peut être tolérée sans dommage majeur, à condition que la structure de dépendance entre prédicteurs demeure rigoureusement invariante dans les nouvelles populations cibles.
- Dans une perspective d’inférence causale ou d’explication théorique, la colinéarité s’avère particulièrement préjudiciable : elle déconstruit l’interprétabilité des paramètres structurels, rendant impossible toute attribution causale individualisée quant au rôle spécifique de chaque mécanisme mesuré.
5. L’impact de la multicolinéarité sur l’interprétation en recherche psychologique
5.1 Altération de la validité de construit et du contrôle statistique
L’une des finalités cardinales de la modélisation statistique en psychologie réside dans l’exercice du contrôle méthodologique : neutraliser l’influence d’un facteur confondant afin d’isoler l’impact spécifique du construit d’intérêt. La présence d’une forte multicolinéarité frappe cette démarche au cœur de sa validité méthodologique. Lorsque le construit opérationnel cible et la variable de contrôle partagent une fraction prépondérante de leur variance respective, le processus mathématique d’orthogonalisation inhérent aux MCO élimine non seulement la variance parasite, mais soustrait également la substance même du construit théorique sous évaluation.
Cette dérive méthodologique est fréquente dans les protocoles explorant les dynamiques cognitives et affectives, notamment dans la distinction entre les antécédents distaux et les médiateurs proximaux. Si un chercheur tente de modéliser les scores d’adaptation psychosociale en intégrant concurremment des mesures de coping adaptatif, de résilience psychologique et de sentiment d’auto-efficacité générale, la convergence conceptuelle et psychométrique de ces échelles conduira inévitablement à un échec du contrôle statistique traditionnel. L’ajustement multivarié classique ne parvient plus à distinguer la spécificité des processus, aboutissant à une dissolution de la validité de construit dans le modèle final.
De plus, cette indistinction favorise l’apparition de conclusions fallacieuses où l’absence de significativité statistique d’une covariable est interprétée comme la démonstration de son insignifiance écologique, alors que ce résultat n’est que la conséquence de la cannibalisation de sa variance par une variable tierce colinéaire.
5.2 Distorsion de l’attribution d’importance relative aux prédicteurs
Dans la pratique analytique courante, les chercheurs s’appuient fréquemment sur la magnitude relative des coefficients de régression standardisés, communément désignés sous l’appellation de poids bêta (β*), pour hiérarchiser l’influence relative des prédicteurs sur la variable dépendante. La multicolinéarité invalide profondément ce protocole d’inférence. En redistribuant arbitrairement la variance partagée entre les colonnes dépendantes de la matrice de dessin, les MCO confèrent des poids standardisés totalement asymétriques à des variables dont la relation bivariée avec le critère est pourtant d’intensité identique.
Cette fragilité méthodologique affecte également les stratégies d’analyse séquentielle, telles que la régression hiérarchique par blocs de variables. L’ordre d’introduction des régresseurs dans l’algorithme conditionne de manière disproportionnée le pourcentage incrémental de variance expliquée (ΔR2). Le premier prédicteur ou bloc colinéaire intégré dans l’équation s’accapare l’intégralité du socle d’information partagée, laissant aux blocs ultérieurs une part de variance résiduelle infinitésimale. Dès lors, le chercheur attribue de façon erronée une suprématie explicative au premier facteur introduit, alors qu’une permutation rigoureusement inverse de l’ordre d’entrée hiérarchique inverserait totalement la structure des conclusions substantielles.
Ce biais rend particulièrement précaires les tentatives d’établissement de priorités prédictives ou de recommandations ciblées, l’ordonnancement empirique des facteurs étant dominé par des artefacts de corrélation plutôt que par la réalité fonctionnelle du phénomène.
5.3 Fragilisation de la réplicabilité des résultats empiriques
La communauté scientifique fait face depuis plus d’une décennie à une réflexion majeure sur la robustesse de ses protocoles, souvent qualifiée de « crise de la reproductibilité ». Si les discussions se focalisent fréquemment sur le sous-dimensionnement des échantillons, le biais de publication ou le « p-hacking », la présence non maîtrisée de multicolinéarité au sein des modèles multivariés représente un facteur technique contributif d’une importance sous-estimée.
Du fait de l’extrême volatilité des estimateurs caractérisant les matrices mal conditionnées, des variations minimes de composition d’échantillonnage entre deux cohortes empiriques distinctes, bien que toutes deux extraites d’une même population parente selon des protocoles rigoureux, génèrent des estimations de coefficients spectaculairement divergentes. Une étude inaugurale pourra observer un coefficient β̂1 = +0,45 (statistiquement significatif à p < 0,01) tandis qu’un second régresseur colinéaire affichera β̂2 = -0,05 (non significatif). Une tentative d’exacte réplication méthodologique sur un échantillon indépendant de taille équivalente pourra aisément produire des résultats inversés : β̂1 = +0,02 (non significatif) et β̂2 = +0,41 (significatif).
Ces fluctuations, purement imputables à la morphologie géométrique de l’espace d’estimation et à l’inflation des erreurs-types, conduisent souvent les analystes à postuler l’existence d’hétérogénéités contextuelles ou de modérations latentes non observées, alors même qu’aucun changement fonctionnel réel n’a eu lieu. La multicolinéarité non identifiée érode ainsi la stabilité des modèles explicatifs et entrave la convergence cumulative des données empiriques nécessaires à la maturation théorique des disciplines comportementales.
6. Méthodes diagnostiques préliminaires : matrices de corrélation et déterminant
6.1 Examen de la matrice de corrélation bivariée
L’étape initiale de tout protocole d’évaluation diagnostique consiste en une analyse exploratoire scrupuleuse de la matrice de corrélation bivariée de Pearson reliant l’ensemble des prédicteurs candidats. Cette approche heuristique permet de détecter sans délai les colinéarités directes et manifestes au sein de l’espace des données. La littérature méthodologique a consacré divers seuils d’alerte empiriques :
- Des coefficients de corrélation par paires |r| ≥ 0,80 signalent conventionnellement un niveau critique de redondance bivariée susceptible d’affecter gravement la stabilité des moindres carrés.
- Certains auteurs préconisent un seuil plus conservateur dès |r| ≥ 0,70, estimant qu’un partage de près de 50 % de la variance entre deux régresseurs altère déjà notablement la précision de l’estimation conjointe.
Néanmoins, la confiance exclusive en l’inspection de la matrice de corrélation bivariée représente une erreur méthodologique classique. L’absence totale de corrélations de Pearson élevées entre les paires de prédicteurs ne garantit en aucun cas l’absence de multicolinéarité sévère. La dépendance linéaire peut se disséminer sous forme d’une toile multivariée : une variable spécifique peut présenter une corrélation modeste avec trois autres régresseurs individuellement (par exemple, des valeurs d’environ r = 0,35 à r = 0,40), tout en étant quasi parfaitement expliquée par la combinaison conjointe de ces trois facteurs dans l’espace multidimensionnel. L’examen des corrélations bivariées s’avère donc une condition nécessaire mais non suffisante pour exclure le risque de colinéarité.
6.2 Évaluation du déterminant de la matrice de corrélation
Pour dépasser l’écueil de l’analyse bivariée fragmentée et appréhender la structure relationnelle dans son ensemble, le calcul du déterminant de la matrice de corrélation R constitue une métrique globale essentielle. Sur le plan mathématique, le déterminant det(R) quantifie le volume généralisé de l’ellipsoïde d’échantillonnage sous-tendu par les prédicteurs au sein de l’espace vectoriel à p dimensions. Les propriétés structurelles de cet indice se décomposent comme suit :
- Dans la condition idéale d’orthogonalité absolue, où chaque prédicteur est totalement décorrélé de tous les autres (rjk = 0 pour tout j ≠ k), la matrice R équivaut rigoureusement à la matrice d’identité Ip, et son déterminant atteint son plafond théorique : det(R) = 1.
- Dans l’éventualité d’une dépendance linéaire parfaite, le volume de l’hyper-ellipsoïde s’aplatit totalement, entraînant l’annulation stricte du déterminant : det(R) = 0.
- Dans les configurations empiriques courantes, un déterminant approchant de zéro (par exemple, det(R) < 0,00001) signale la présence d’une quasi-singularité globale et d’une interdépendance prononcée au sein du faisceau des prédicteurs.
Dans ce cadre diagnostique, le test de sphéricité de Bartlett est parfois détourné de son usage initial en analyse factorielle pour être employé comme indicateur préliminaire en régression. Ce test confronte l’hypothèse nulle selon laquelle la matrice de corrélation de la population équivaut à une matrice d’identité (H0: R = I). Bien qu’un test de Bartlett non significatif constitue une indication rassurante quant à l’absence de corrélation globale, un résultat hautement significatif (p < 0,001) s’avère extrêmement fréquent avec des échantillons de taille moderne et confirme simplement l’existence d’une structure de corrélation non nulle, imposant la mobilisation de métriques diagnostiques plus ciblées.
6.3 Inspection conjointe des tests F globaux et des tests t individuels
L’un des signaux d’alerte les plus révélateurs de la multicolinéarité lors de l’examen initial des tableaux de modélisation réside dans l’émergence d’une divergence flagrante entre la significativité omnibus de l’ajustement global et la non-significativité des coefficients partiels. Cette configuration paradoxale se formalise de la manière suivante :
- Le modèle de régression globale affiche une statistique de Fisher (test F global) hautement significative à des seuils rigoureux (par exemple, F(p, n-p-1) = 45,8, p < 0,0001), attestant sans équivoque qu’au moins un des régresseurs exerce un impact prédictif non nul sur la variable dépendante.
- Simultanément, le coefficient de détermination R2 indique un niveau élevé de variance expliquée (par exemple, R2 = 0,65).
- Cependant, l’examen des statistiques t de Student associées à chaque variable explicative individuelle révèle qu’aucun prédicteur (ou une infime minorité d’entre eux) ne parvient à franchir le seuil conventionnel de significativité statistique (p > 0,05 pour tous les β̂j).
Ce hiatus statistique s’explique directement par la géométrie de la colinéarité : le test F omnibus évalue si l’espace vectoriel sous-tendu par la collection conjointe des prédicteurs intercepte de façon significative la variance du critère Y, ce qui est avéré. En revanche, les tests t évaluent la contribution marginale unique résiduelle apportée par chaque prédicteur au-delà de la variance déjà capturée par ses pairs. En présence de redondance substantielle, cette fraction d’information unique résiduelle est quasi nulle pour chaque variable prise isolément, induisant l’effondrement des statistiques t. La survenue de ce patron de résultats constitue un indicateur diagnostique direct incitant à un examen approfondi des métriques d’inflation de variance.
7. Le facteur d’inflation de la variance (VIF) : fondements et calculs
7.1 Dérivation mathématique et formule générale du VIF
Pour dépasser le cadre descriptif des méthodes heuristiques et quantifier avec exactitude l’impact de la redondance linéaire sur chaque variable explicative, le facteur d’inflation de la variance (VIF) constitue l’étalon diagnostique privilégié de la modélisation linéaire. Le VIF s’enracine directement dans la décomposition spectrale de la variance de chaque paramètre estimé.
Considérons un modèle de régression contenant p variables explicatives. Pour chaque prédicteur Xj (j ∈ {1, 2, …, p}), on procède à l’estimation d’un modèle de régression auxiliaire par les moindres carrés ordinaires, dans lequel Xj est positionné en variable dépendante et régressé sur la totalité des p – 1 autres variables explicatives restantes :
Xj = α0 + ∑k ≠ j αkXk + ej
De cette régression auxiliaire, on extrait le coefficient de détermination partiel, désigné par la notation Rj2. Cet indice capture scrupuleusement la proportion de variance de la variable Xj qui est partagée avec l’ensemble des autres régresseurs du système. La formule générale du facteur d’inflation de la variance pour ce prédicteur s’exprime alors rigoureusement par la fonction rationnelle :
VIFj = 1 / (1 – Rj2)
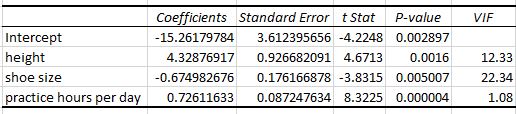
L’analyse des propriétés analytiques et du comportement asymptotique de cette fonction éclaire directement sa logique opérationnelle :
- Lorsque le prédicteur Xj est rigoureusement orthogonal à tous les autres covariables du modèle, l’ensemble des coefficients de la régression auxiliaire s’annule, aboutissant à Rj2 = 0. Dans cette condition d’indépendance parfaite, VIFj = 1 / (1 – 0) = 1. La valeur 1 constitue donc le plancher absolu du VIF, indiquant une absence totale de contamination par la colinéarité.
- À mesure que les interrelations se renforcent, Rj2 progresse au sein de l’intervalle ouvert [0, 1[. Si Rj2 = 0,80, le dénominateur devient égal à 0,20, engendrant un VIFj = 1 / 0,20 = 5.
- Au fur et à mesure que la corrélation multivariée devient quasi parfaite, le terme Rj2 tend vers l’unité, de sorte que le dénominateur s’approche de zéro. La fonction présente une singularité asymptotique : limRj2 → 1 VIFj = +∞. Le VIF tend vers l’infini, reflétant l’indétermination mathématique de l’estimation.
7.2 Interprétation substantielle de l’inflation de variance
Le facteur d’inflation de la variance ne se résume pas à un indicateur sans dimension arbitraire ; il possède une signification opérationnelle directe relative à la précision de l’inférence. Le VIF quantifie précisément le facteur d’accroissement de la variance d’échantillonnage du coefficient de régression β̂j comparativement à la variance qui aurait été obtenue si cette même variable Xj avait été rigoureusement orthogonale à toutes les autres variables explicatives de l’équation.
Dans la mesure où l’erreur-type du coefficient de régression SE(β̂j) est fonction de la racine carrée de sa variance d’échantillonnage, la métrique √(VIFj) capture le facteur d’élargissement direct de l’erreur-type. Ce multiplicateur d’incertitude indique de combien d’unités d’écart l’intervalle de confiance est artificiellement distendu par l’entrelacement des prédicteurs. Le tableau synoptique suivant met en évidence cette correspondance mathématique stricte :
- Pour un VIF = 1 (Rj2 = 0,00) : Facteur de dilatation de l’erreur-type √(1) = 1,00. Aucune altération de la précision inférentielle.
- Pour un VIF = 4 (Rj2 = 0,75) : Facteur de dilatation de l’erreur-type √(4) = 2,00. L’erreur-type est multipliée par deux ; pour retrouver la précision d’un devis orthogonal, il faudrait quadrupler la taille de l’échantillon.
- Pour un VIF = 9 (Rj2 ≈ 0,89) : Facteur de dilatation de l’erreur-type √(9) = 3,00. L’intervalle de confiance est trois fois plus large que sous orthogonalité stricte.
- Pour un VIF = 10 (Rj2 = 0,90) : Facteur de dilatation de l’erreur-type √(10) ≈ 3,16. La statistique de test t est divisée par plus de 3, diminuant substantiellement la probabilité d’isoler un effet statistiquement valide.
7.3 Procédure d’implémentation pratique et décomposition étape par étape
Pour illustrer de manière concrète l’architecture computationnelle du calcul du VIF et son application déterministe, décortiquons le traitement manuel pas à pas d’un système à trois régresseurs dans un contexte d’analyse expérimentale. Supposons qu’un chercheur souhaite modéliser l’intensité du bien-être psychologique (Y) à l’aide de trois variables explicatives : l’estime de soi (X1), le sentiment d’efficacité personnelle (X2) et l’optimisme dispositionnel (X3).
L’algorithme de dérivation séquentielle des indices s’opère selon les phases suivantes :
Étape 1 : Diagnostic du prédicteur X1 (Estime de soi). On réalise la régression auxiliaire où X1 devient le critère :
X1 = a0 + a2X2 + a3X3 + e1
L’estimation des moindres carrés fournit un coefficient de détermination auxiliaire égal à R12 = 0,82. Le calcul du facteur d’inflation de variance s’ensuit immédiatement :
VIF1 = 1 / (1 – 0,82) = 1 / 0,18 ≈ 5,56
L’erreur-type associée au coefficient partiel de l’estime de soi dans le modèle complet est ainsi dilatée d’un facteur √(5,56) ≈ 2,36 par rapport à une situation théorique de non-corrélation avec X2 et X3.
Étape 2 : Diagnostic du prédicteur X2 (Auto-efficacité). On estime la seconde équation auxiliaire :
X2 = b0 + b1X1 + b3X3 + e2
Supposons que cette régression auxiliaire aboutisse à un coefficient R22 = 0,88. L’évaluation du VIF donne :
VIF2 = 1 / (1 – 0,88) = 1 / 0,12 ≈ 8,33
Ce niveau de 8,33 traduit une vulnérabilité inférentielle marquée, l’erreur-type de l’auto-efficacité étant amplifiée de près de 2,89 fois.
Étape 3 : Diagnostic du prédicteur X3 (Optimisme). On procède à l’estimation de la dernière équation :
X3 = c0 + c1X1 + c2X2 + e3
Si la modélisation produit un R32 = 0,55, on dérive le score diagnostique suivant :
VIF3 = 1 / (1 – 0,55) = 1 / 0,45 ≈ 2,22
L’analyste dispose ainsi d’un profil diagnostique complet et individualisé. Alors que l’optimisme (X3) présente une stabilité d’estimation satisfaisante avec un VIF de 2,22, l’estime de soi et l’efficacité personnelle manifestent une redondance prononcée qui compromet la précision de leurs coefficients respectifs dans le modèle global.
8. La tolérance statistique et son rapport direct avec le VIF
8.1 Définition mathématique et conceptuelle de la tolérance
Parallèlement au facteur d’inflation de la variance, la littérature statistique et les logiciels d’analyse mobilisent couramment un indice jumeau désigné sous l’appellation de tolérance statistique (souvent abrégée TOL). La tolérance constitue l’expression directe du complément à l’unité du coefficient de détermination multiple issu des régressions auxiliaires. Pour le prédicteur Xj, son équation formelle s’énonce :
Tolérancej = 1 – Rj2
Il découle de cette formulation une relation de réciprocité mathématique absolue entre la tolérance et le facteur d’inflation de la variance, les deux métriques constituant simplement les deux faces inverses d’un même phénomène géométrique :
Tolérancej = 1 / VIFj ⇔ VIFj = 1 / Tolérancej
Sur le plan conceptuel et interprétatif, la tolérance offre une lecture immédiate et intuitive de la structure d’information. Elle représente rigoureusement la proportion ou le pourcentage de la variance totale de la variable explicative Xj qui n’est pas expliquée par la combinaison de tous les autres prédicteurs présents dans le modèle. Une tolérance de 0,25 indique qu’exactement 25 % de la variance de ce régresseur lui est strictement propre et spécifique, tandis que les 75 % restants sont redondants avec les autres covariables. La tolérance est bornée sur l’intervalle fermé standardisé [0, 1], où 1 figure une indépendance absolue et 0 une dépendance linéaire complète.
8.2 Évaluation conjointe de la tolérance et du VIF dans les logiciels
Les environnements logiciels d’analyse statistique de référence, qu’il s’agisse de suites commerciales propriétaires comme IBM SPSS Statistics et SAS, ou d’écosystèmes libres et modernes tels que R (notamment via le package car et sa fonction vif()) ou Jamovi, intègrent de manière standardisée ces deux indicateurs au sein des modules de régression sous la rubrique « Diagnostics de colinéarité ».
Généralement, les sorties logicielles présentent une colonne dédiée à la tolérance immédiatement juxtaposée à la colonne du VIF. Cette cohabitation impose au chercheur une vigilance méthodologique pour éviter les erreurs d’interprétation dues à l’inversion d’échelle :
- Dans le cas du VIF, les valeurs pathologiques se situent aux bornes supérieures : plus l’indice est élevé au-delà de 1, plus la colinéarité est critique.
- À l’inverse, pour la tolérance, la dégradation structurelle se signale par une chute vers zéro : plus l’indice est restreint et converge vers 0, plus la variable est compromise par la redondance multivariée.
Il est donc capital de s’assurer de la parfaite cohérence interne du rapportage méthodologique : affirmer qu’une tolérance est « élevée » constitue un signal positif quant à la robustesse du régresseur, alors qu’affirmer qu’un VIF est « élevé » dénote une instabilité structurelle prononcée. Les deux indices synthétisent exactement la même réalité computationnelle sous des perspectives métriques inverses.
8.3 Application psychométrique : part de variance unique des inventaires
Dans l’évaluation psychométrique et le développement d’instruments de mesure psychologiques, la tolérance constitue un indicateur précieux pour juger de la pertinence incrémentale d’un inventaire ou d’une sous-dimension d’un test. Lorsqu’un chercheur conçoit une nouvelle échelle d’évaluation clinique et tente de démontrer sa valeur ajoutée par rapport aux instruments préexistants, la tolérance offre une métrique directe de sa non-redondance empirique.
Si une nouvelle mesure proposée présente une tolérance inférieure à 0,10 lorsqu’elle est mise en compétition avec une batterie standard éprouvée, cela démontre qu’au moins 90 % de son information est déjà capturée par les instruments conventionnels. Dès lors, le chercheur doit s’interroger sur la validité incrémentale réelle du nouvel instrument : les items mesurent-ils une facette spécifique inexplorée, ou ne font-ils que répliquer sous une formulation différente des construits préexistants ? La tolérance permet de discriminer entre l’apport d’une variance spécifique cliniquement utile et la simple accumulation de bruit de mesure partagé, fournissant un critère statistique pour l’élagage des batteries diagnostiques volumineuses.
9. Seuils critiques d’interprétation du VIF et controverses empiriques
9.1 Les règles empiriques classiques et leurs origines historiques
La question des seuils décisionnels régissant l’interprétation du VIF a suscité de nombreux débats méthodologiques. Historiquement, une règle empirique très largement diffusée dans les manuels de statistique appliquée a établi le seuil critique de gravité à la valeur de 10 :
Seuil libéral traditionnel : VIF ≥ 10 ⇔ Tolérance ≤ 0,10
Ce point de rupture fixé à 10 correspond au franchissement d’un Rj2 auxiliaire de 0,90. Selon ce critère, tant que moins de 90 % de la variance d’un prédicteur est partagée avec le reste du modèle, la colinéarité est considérée comme tolérable. Parallèlement, une recommandation intermédiaire plus vigilante, positionnant le seuil d’intervention méthodologique à un niveau de VIF ≥ 5 (équivalant à un Rj2 ≥ 0,80 et une tolérance inférieure ou égale à 0,20), s’est consolidée dans de nombreux champs de recherche.
Toutefois, la majorité des méthodologistes contemporains critiquent vigoureusement l’arbitraire de ces valeurs couperets décontextualisées. Ces seuils de 10 ou 5 ont émergé historiquement dans le cadre de disciplines industrielles ou macroéconomiques caractérisées par de vastes bases de données et des effets de grande magnitude. L’application mécanique de ces règles empiriques à des domaines de recherche aux configurations différentes génère souvent un faux sentiment de sécurité analytique.
9.2 Vers des seuils plus rigoureux en psychologie et sciences sociales
Dans le domaine des sciences psychologiques, comportementales et médicales, les conditions expérimentales diffèrent notablement des standards économétriques : les tailles d’échantillons sont fréquemment restreintes par des contraintes budgétaires ou cliniques, les erreurs de mesure associées aux construits sont substantielles, et les tailles d’effet réelles observables oscillent le plus souvent entre des amplitudes petites à modérées (par exemple, f2 de Cohen compris entre 0,02 et 0,15).
Dans ce contexte particulier, plusieurs méthodologistes plaident pour l’adoption de seuils diagnostiques nettement plus conservateurs et rigoureux :
Seuils rigoureux en sciences sociales : VIF ≥ 2,5 ou 3,3 ⇔ Tolérance ≤ 0,40 ou 0,30
Un facteur d’inflation de variance atteignant seulement 3,3 traduit le fait que 70 % de la variance du régresseur est absorbée par les autres covariables, ce qui double la variance d’échantillonnage de l’estimateur par rapport à un état orthogonal. Combinée à un échantillon modeste (par exemple n = 80 ou n = 120), une telle inflation suffit à anéantir la puissance statistique des tests de Student pour des effets partiels subtils mais cliniquement déterminants. Tolérer un VIF de 5 ou de 8 dans un échantillon de taille limitée conduit inexorablement à une multiplication des erreurs d’inférence de type II.
9.3 Approche contextuelle du VIF : au-delà des valeurs couperets fixes
La recherche méthodologique contemporaine converge vers le rejet d’une doctrine purement fondée sur des critères rigides en faveur d’une approche contextuelle et multidimensionnelle du diagnostic de colinéarité. La dangerosité d’un VIF donné ne peut être appréciée de manière isolée ; elle interagit directement avec d’autres paramètres architecturaux du modèle statistique, synthétisés dans le tableau méthodologique ci-dessous :
| Paramètre d’interaction | Configuration protectrice (Atténuation de l’impact) | Configuration aggravante (Amplification de l’impact) |
|---|---|---|
| Taille de l’échantillon (n) | Grands échantillons (n > 1 000). L’erreur-type de base est minuscule ; un VIF de 6 peut rester sans impact sur la significativité. | Petits échantillons (n < 100). L’erreur-type de base est déjà large ; un VIF de 2,5 peut détruire la puissance de test. |
| Dispersion du prédicteur | Forte variance brute observée ∑(Xij – X̄j)2. Le dénominateur de la variance demeure substantiel. | Faible variance d’échantillonnage de Xj. Effet cumulatif désastreux sur le gonflement de l’erreur-type. |
| Magnitude du R2 global du modèle | Coefficient global très élevé (R2 > 0,80). La variance résiduelle σ2 au numérateur est très faible. | Coefficient global faible à modéré (R2 < 0,25). La variance résiduelle σ2 au numérateur est substantielle. |
| Objectif de recherche | Orientation purement prédictive sans interprétation des coefficients β individuels. | Orientation explicative, inférence causale, ou régression hiérarchique avec interprétation des poids β. |
Une directive d’évaluation contextuelle reconnue stipule qu’un VIF élevé est d’autant plus critique qu’il outrepasse la capacité explicative générale de l’équation. Certains auteurs recommandent ainsi de comparer systématiquement le VIF individuel au coefficient d’ajustement global selon la règle : VIFj > 1 / (1 – Rglobal2). Si le VIF d’un prédicteur surpasse cette borne, cela démontre que la colinéarité propre à cette variable excède le niveau d’explication globale atteint par le modèle, exigeant une intervention méthodologique.
10. Diagnostics avancés : valeurs propres et décomposition de la variance
10.1 Analyse spectrale de la matrice X’X et valeurs propres
Bien que le VIF identifie avec clarté quels régresseurs subissent une inflation de variance, il s’avère incapable d’éclairer la dynamique interne de la dépendance multivariée lorsque plusieurs relations linéaires s’entremêlent au sein d’un même modèle. Pour surmonter cette limite, la décomposition spectrale avancée de la matrice des prédicteurs, initialement formalisée par David Belsley, Edwin Kuh et Roy Welsch, fournit le protocole diagnostique le plus approfondi de la géométrie linéaire des données.
Cette méthodologie repose sur l’analyse spectrale de la matrice de dessin standardisée et normalisée (ou matrice des corrélations sans constante intégrée) X*‘X*. Par décomposition en valeurs propres (eigenvalues), la matrice est factorisée sous la forme :
X*‘X* = V Λ V’
Dans cette équation, Λ constitue une matrice diagonale logeant les p + 1 valeurs propres positives λ1 ≥ λ2 ≥ … ≥ λp+1 ≥ 0, ordonnées par ordre décroissant de magnitude, tandis que V représente la matrice unitaire orthogonale des vecteurs propres associés. Les valeurs propres reflètent la longueur des axes principaux de l’ellipsoïde des variables explicatives :
- Dans un système parfaitement orthogonal, toutes les valeurs propres sont strictement égales à l’unité : λ1 = λ2 = … = λp+1 = 1.
- La présence de multicolinéarité induit un aplatissement de l’ellipsoïde selon certaines directions de l’espace, se traduisant par la coexistence d’une ou plusieurs valeurs propres dominantes et d’une ou plusieurs valeurs propres infimes, convergeant vers zéro (λ ≈ 0).
Le nombre de valeurs propres s’approchant de zéro quantifie avec une exactitude mathématique le nombre précis de relations quasi colinéaires indépendantes qui coexistent et s’entrecroisent au sein de la matrice empirique.
10.2 L’indice de condition et le nombre de condition de Belsley
Pour operationaliser l’écart séparant l’axe dimensionnel dominant des axes dégénérés par la colinéarité, l’approche de Belsley, Kuh et Welsch recourt à l’indice de condition (Condition Index, CI). Pour chaque dimension k issue de la décomposition spectrale, son indice de condition ηk est défini par la racine carrée du ratio entre la valeur propre maximale λmax et la valeur propre spécifique λk associée à cette dimension :
ηk = √( λmax / λk )
Le nombre de condition global du système (Condition Number, CN) correspond à la valeur extrême de cette série, soit le ratio calculé à partir de la valeur propre minimale absolue : CN = ηmin = √( λmax / λmin ). Cet indice constitue une métrique globale d’instabilité computationnelle. Les critères de gradation établis par les travaux de Belsley font autorité dans la pratique méthodologique internationale :
- Indice de condition η < 10 : Absence de dépendance colinéaire substantielle. L’inversion matricielle s’opère dans des conditions de stabilité satisfaisantes.
- Indice de condition compris entre 15 et 30 (15 ≤ η ≤ 30) : Présence d’une colinéarité débutante à modérée. L’analyste doit inspecter les coefficients associés pour vérifier le niveau de dégradation des erreurs-types.
- Indice de condition supérieur à 30 (η > 30) : Présence d’une multicolinéarité sévère et destructrice. La matrice est mal conditionnée ; les coefficients de régression sont sujets à une instabilité numérique majeure et les estimations ponctuelles ne peuvent plus être considérées comme fiables.
10.3 Proportions de décomposition de la variance des coefficients
L’apport déterminant de la méthode développée par Belsley et ses collaborateurs réside dans le croisement systématique de l’indice de condition avec la matrice des proportions de décomposition de la variance des coefficients. La variance de chaque estimateur Var(β̂j) peut être décomposée de manière analytique selon la somme orthogonale de ses composantes associées à chacune des p + 1 valeurs propres ou dimensions spectrales. On calcule ainsi la proportion πkj de la variance d’échantillonnage du coefficient j qui est attribuable à la dimension k, avec la propriété de sommation unitaire ∑k=1p+1 πkj = 1 pour chaque régresseur.
Cette décomposition aboutit à une règle de décision opérationnelle particulièrement puissante : une multicolinéarité dégradante est diagnostiquée formellement dès lors qu’une dimension spécifique présente un indice de condition élevé (ηk > 30) conjointement à de fortes proportions de variance (πkj > 0,50) pour au moins deux coefficients de régression distincts.
Ce protocole analytique résout une faiblesse majeure du VIF : il permet d’isoler avec exactitude la morphologie de la dépendance multivariée. Par exemple, si une sortie logicielle révèle un indice de condition de 38,2 sur la dimension 4, et que les proportions de décomposition de variance associées sont de 0,89 pour le prédicteur X2, 0,92 pour le prédicteur X5, mais de seulement 0,04 pour les autres variables, le chercheur sait sans ambiguïté que la colinéarité détectée provient exclusivement d’une quasi-redondance linéaire articulée entre X2 et X5. Ce diagnostic ciblé permet d’éviter l’altération indue des autres variables du modèle.
11. Stratégies méthodologiques et remèdes face à la multicolinéarité
11.1 Élagage parcimonieux et sélection théorique des prédicteurs
Face à une multicolinéarité sévère et confirmée, la réponse méthodologique la plus intuitive et la plus fréquente consiste à procéder à l’élimination sélective d’une ou de plusieurs variables redondantes. Toutefois, cet élagage ne doit jamais être conduit de façon mécanique ou purement opportuniste ; il doit impérativement s’adosser à des critères théoriques et psychométriques préétablis.
Le chercheur confronté à deux prédicteurs fortement colinéaires (par exemple, VIF > 8) doit prioriser le maintien de la variable présentant :
- La fidélité de mesure la plus solide au sens psychométrique (meilleure consistance interne, coefficient oméga de McDonald ou alpha de Cronbach plus élevé).
- La validité conceptuelle la plus directe et la mieux étayée au regard du cadre théorique sous-jacent.
- Une sensibilité écologique supérieure ou une facilité d’évaluation clinique plus avantageuse pour les praticiens de terrain.
Dans ce contexte, il est impératif de proscrire formellement le recours aux algorithmes automatisés de sélection pas à pas, tels que les régressions stepwise (ascendantes, descendantes ou bidirectionnelles). L’emploi de la sélection pas à pas en présence de colinéarité constitue l’un des écueils méthodologiques les plus documentés. En raison des fluctuations infimes des erreurs-types et de la quasi-égalité des corrélations partagées, l’algorithme informatique sélectionne ou rejette des prédicteurs sur la base de variations résiduelles purement stochastiques (de simples artefacts d’échantillonnage). Ce processus aboutit à des modèles sur-ajustés (overfitted), non réplicables et conceptuellement incohérents, en éliminant des variables théoriquement capitales au profit de covariables secondaires introduites de manière opportuniste.
11.2 Agrégation de variables et réduction de dimensionnalité
Lorsque les variables explicatives colinéaires possèdent une légitimité théorique équivalente et participent d’un même phénomène psychologique ou physiologique sous-jacent, la suppression de l’une d’entre elles entraîne une perte regrettable d’information empirique. Dans cette situation, la stratégie méthodologique privilégiée réside dans l’agrégation raisonnée des indicateurs colinéaires au sein d’une métrique composite unique ou la modélisation à variables latentes.
Sur le plan psychométrique classique, l’analyste peut procéder à la standardisation préalable des prédicteurs corrélés suivie de leur sommation ou de leur moyennage pondéré pour ériger un score global plus robuste et généralement doté d’une fidélité de mesure supérieure à celle de ses composantes isolées. Sur le plan algorithmique, une approche fréquemment mobilisée consiste en la Régression sur Composantes Principales (PCR, pour Principal Component Regression). Cette méthode s’articule selon une séquence en deux temps :
- On extrait les axes factoriels principaux issus de l’analyse en composantes principales (ACP) appliquée exclusivement sur la matrice des prédicteurs X.
- Ces composantes orthogonales (par définition rigoureusement non corrélées entre elles, garantissant des VIF = 1) sont ensuite utilisées comme nouveaux régresseurs pour prédire le critère Y.
Bien que la PCR neutralise définitivement toute instabilité colinéaire, elle présente l’inconvénient notable d’altérer la lisibilité théorique des coefficients, les composantes principales représentant des mélanges synthétiques parfois difficiles à interpréter. C’est pourquoi, dans les paradigmes contemporains des sciences comportementales, l’alternative de choix consiste à migrer vers la modélisation en équations structurelles (SEM). En spécifiant formellement un construit latent inobservable dont les variables colinéaires constituent les indicateurs manifestes réflexifs, la SEM sépare la variance commune vraie du construit de la variance d’erreur spécifique, résolvant le problème de la colinéarité tout en modélisant explicitement l’erreur de mesure.
11.3 Régression pénalisée et méthodes de régularisation
Lorsque le chercheur est contraint de préserver l’ensemble des prédicteurs individuels sous leur forme initiale au sein du modèle (par exemple en présence d’un ratio restreint du nombre d’observations sur le nombre de paramètres n / p), l’inférence par les moindres carrés ordinaires s’avère inadaptée. Il convient alors de mobiliser les méthodes de régularisation et de régression pénalisée issues de l’apprentissage statistique, qui stabilisent l’estimation par l’introduction d’un biais contrôlé.
La régression Ridge (ou régression par arête), théorisée initialement par Hoerl et Kennard, constitue la réponse mathématique par excellence au problème du mauvais conditionnement matriciel. L’optimisation Ridge modifie l’estimation des moindres carrés en adjoignant à la minimisation des résidus une pénalité quadratique proportionnelle au carré de la norme L2 des coefficients :
β̂Ridge = argminβ [ ∑i=1n (Yi – Xiβ)2 + λ ∑j=1p βj2 ]
Cette formulation se traduit sur le plan matriciel par une modification directe du produit croisé avant inversion :
β̂Ridge = (X’X + λ I)-1 X’Y
L’adjonction d’une constante positive scalaire λ sur la diagonale principale de la matrice X’X augmente artificiellement ses valeurs propres, écartant définitivement la matrice de toute zone de singularité. Les erreurs-types des coefficients diminuent considérablement. En contrepartie de cette stabilisation de la variance, l’estimateur Ridge n’est plus rigoureusement sans biais : il accepte un biais systématique modéré mais permet une réduction globale substantielle de l’erreur quadratique moyenne (arbitrage biais-variance).
D’autres approches régularisées méritent d’être soulignées :
- La régression Lasso (Least Absolute Shrinkage and Selection Operator) : Elle mobilise une pénalité fondée sur la norme L1 absolue (λ ∑ |βj|). Sa particularité géométrique lui permet d’annuler strictement certains coefficients, réalisant simultanément une sélection parcimonieuse de variables. Toutefois, en présence de prédicteurs présentant une forte colinéarité de groupe, le Lasso a tendance à sélectionner arbitrairement une variable au sein du cluster et à écraser toutes les autres à zéro.
- La régression Elastic Net : Elle combine de façon pondérée les pénalités L1 et L2, ce qui lui confère les avantages des deux approches : elle préserve l’effet de regroupement (grouping effect) propre à Ridge face aux variables colinéaires tout en réalisant l’élagage parcimonieux permis par le Lasso.
11.4 Techniques de centrage pour la colinéarité structurelle
Dans les situations où le diagnostic de multicolinéarité découle de choix de modélisation spécifiques — notamment l’intégration de termes d’interaction multiplicative continus pour modéliser des effets de modération (X1 × X2) ou de puissances polynomiales (X2, X3) pour capturer des trajectoires non linéaires —, la mise en œuvre de transformations simples permet de résorber le problème.
Dans sa configuration brute, le produit arithmétique de deux variables continues positives X1 et X2 est inévitablement corrélé de manière étroite à ses deux termes constitutifs, générant des VIF souvent supérieurs à 10 ou 15 pour les effets principaux comme pour l’interaction. La méthode de correction préconisée par Aiken et West consiste à opérer un centrage sur la moyenne d’échantillon préalable des variables continues avant de calculer le terme de produit multiplicatif :
X̃1 = X1 – X̄1 et X̃2 = X2 – X̄2
Le terme d’interaction intégré dans le modèle de régression s’établit alors sous la forme :
Terme d’interaction centré = X̃1 × X̃2
Cette opération modifie la structure de covariance du produit par rapport aux composantes linéaires d’origine, réduisant le VIF du terme d’ordre supérieur à des niveaux modestes. Sur le plan statistique, le centrage ne modifie en rien la valeur du coefficient du terme d’interaction de plus haut degré, ni sa significativité statistique, ni l’ajustement global R2 du modèle. Son utilité réside dans la clarification de l’interprétation des effets de premier ordre : les pentes partielles β1 et β2 ne représentent plus l’effet hypothétique d’une variable lorsque l’autre est égale à un zéro absolu souvent impossible dans les données, mais quantifient l’effet de cette variable conditionné au niveau moyen de l’autre modérateur.
12. Bonnes pratiques de rapportage méthodologique et synthèse pour la recherche
12.1 Normes de rapportage statistique conformes aux standards APA
La transparence analytique constitue un impératif épistémologique au sein des protocoles de publication évalués par les pairs. Conformément aux directives édictées par les normes de l’American Psychological Association (APA 7th edition) et les recommandations du groupe de travail JARS (Journal Article Reporting Standards), les chercheurs se doivent d’expliciter avec rigueur les procédures diagnostiques mises en œuvre pour vérifier les postulats des modèles d’inférence multivariés.
La simple mention laconique stipulant que « les hypothèses de la régression linéaire ont été vérifiées et respectées » est jugée insuffisante. Les manuscrits empiriques doivent présenter un compte rendu structuré intégrant :
- La publication préalable de la matrice complète des corrélations bivariées de Pearson inter-prédicteurs, accompagnée des moyennes et des écarts-types d’échantillonnage de chaque variable explicative.
- La présentation formelle des indices de colinéarité individualisés (le VIF et la tolérance) sous forme de colonnes dédiées insérées au sein du tableau synoptique principal de régression, aux côtés des coefficients non standardisés (B), des erreurs-types associées (SE B) et des coefficients standardisés (β*).
- La justification explicite des seuils décisionnels retenus au vu de la taille de l’échantillon (par exemple, expliciter pourquoi un VIF seuil de 3 a été mobilisé en raison d’un effectif modéré).
- La description détaillée de tout protocole de remédiation entrepris en cas d’alerte diagnostique (procédure d’agrégation d’échelles, centrage sur la moyenne pour les modérations, ou migration vers une régression pénalisée), garantissant ainsi la parfaite traçabilité et la reproductibilité des résultats.
12.2 Protocole décisionnel séquentiel pour le chercheur
Afin de structurer la démarche méthodologique du chercheur depuis l’étape d’exploration initiale des données jusqu’à l’inférence finale, un protocole décisionnel séquentiel en cinq phases logiques est recommandé :
- Phase 1 : Inspection préliminaire des distributions. Examiner la matrice de corrélation bivariée. Repérer les paires de prédicteurs affichant des coefficients |r| ≥ 0,70. Calculer le déterminant de la matrice de corrélation pour déceler d’éventuels aplatissements multidimensionnels globaux.
- Phase 2 : Estimation du modèle complet et calcul du VIF. Extraire le facteur d’inflation de la variance (VIF) et la tolérance pour chaque régresseur. En présence de VIF ≤ 2,5, conclure à l’innocuité de la colinéarité et poursuivre l’interprétation inférentielle standard.
- Phase 3 : Évaluation approfondie des anomalies. Si un ou plusieurs prédicteurs manifestent un VIF > 3 ou VIF > 5, coupler l’analyse avec la décomposition spectrale de Belsley. Vérifier si un indice de condition élevé (η > 30) est associé à de fortes proportions de variance partagée (π > 0,50) pour les variables suspectées.
- Phase 4 : Diagnostic étiologique de la redondance.
- S’il s’agit d’une colinéarité structurelle induite par des interactions ou des polynômes : appliquer immédiatement le centrage sur la moyenne et recalculer le modèle.
- S’il s’agit d’une colinéarité liée aux données issue d’un chevauchement d’instruments ou d’items : arbitrer entre l’élagage raisonné du régresseur le moins fiable ou son agrégation au sein d’un score composite unique.
- Phase 5 : Mobilisation d’alternatives robustes si nécessaire. Si les régresseurs colinéaires doivent impérativement être maintenus sous leur forme propre pour tester des hypothèses théoriques divergentes : recourir aux régressions pénalisées (Ridge ou Elastic Net) ou à la modélisation structurelle en variables latentes (SEM).
12.3 Synthèse prospective : concilier complexité théorique et rigueur statistique
L’émergence récurrente de la multicolinéarité au sein des devis de recherche ne doit pas être appréhendée comme une défaillance accidentelle ou une négligence méthodologique des chercheurs, mais comme le reflet naturel de la complexité des systèmes psychologiques, sociologiques et biologiques. Les processus sous-jacents aux conduites humaines n’évoluent pas dans des compartiments étanches ; ils interagissent, co-évoluent et partagent structurellement de la variance informationnelle au sein des écosystèmes naturels.
Le défi majeur de la modélisation statistique contemporaine consiste à éviter deux écueils symétriques :
- D’une part, l’aveuglement méthodologique, consistant à ignorer les diagnostics de colinéarité et à sur-interpréter naïvement des coefficients partiels gonflés, inversés ou instables, ce qui contribue à la fragilisation des savoirs scientifiques et à l’impasse de la non-reproductibilité.
- D’autre part, un réductionnisme statistique excessif, qui conduirait à mutiler arbitrairement les modèles théoriques en éliminant des covariables écologiquement capitales au seul motif qu’elles corrèlent entre elles, appauvrissant ainsi la portée heuristique de l’investigation.
La conciliation harmonieuse entre complexité théorique et rigueur statistique impose une compréhension approfondie des mécanismes matriciels sous-jacents et une lucidité constante quant aux objectifs ultimes de la démarche analytique. En distinguant avec acuité la modélisation prédictive de l’inférence causale, en mobilisant de façon éclairée le facteur d’inflation de la variance, la tolérance et la décomposition spectrale, et en déployant les stratégies de remédiation les plus adaptées à la nature de la colinéarité observée, le chercheur contemporain se donne les moyens de transformer ce qui constituait jadis un écueil technique paralysant en un levier d’approfondissement de la structure géométrique de ses données.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J., & Monette, G. (1992). Generalized collinearity diagnostics. Journal of the American Statistical Association, 87(417), 178–183. https://doi.org/10.1080/01621459.1992.10475190
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Mansfield, E. R., & Helms, B. P. (1982). Detecting multicollinearity. The American Statistician, 36(3), 158–160. https://doi.org/10.1080/00031305.1982.10482818
- Mason, R. L., Gunst, R. F., & Webster, J. T. (1975). Regression analysis and problems of multicollinearity. Communications in Statistics, 4(3), 277–292. https://doi.org/10.1080/03610927508827246
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x