
Dans le paysage contemporain de l’analyse quantitative et de l’ingénierie des données, la prise de décision fondée sur des preuves empiriques constitue la pierre angulaire de la méthode scientifique. Qu’il s’agisse de valider l’efficacité clinique d’une nouvelle molécule thérapeutique, d’évaluer l’impact pédagogique d’un dispositif d’apprentissage ou de mesurer les retombées d’une refonte ergonomique sur le taux de conversion d’une plateforme numérique, les analystes sont perpétuellement confrontés au défi de distinguer les variations purement aléatoires des effets réels et systématiques. Dans cette quête de rigueur inférentielle, le test t de Student s’impose depuis plus d’un siècle comme l’une des procédures comparatives les plus robustes, polyvalentes et universellement adoptées de la statistique paramétrique.
Bien que des logiciels spécialisés tels que R, SAS, Stata ou IBM SPSS dominent les environnements de recherche fondamentale de pointe, Microsoft Excel demeure incontestablement l’environnement matriciel et analytique le plus ubiquitaire au sein des entreprises, des administrations publiques et des laboratoires de recherche appliquée. Doté de son puissant module complémentaire, l’Utilitaire d’analyse (Analysis ToolPak), le tableur permet d’exécuter des tests d’hypothèses sophistiqués en quelques clics. Toutefois, la facilité d’exécution technique masque fréquemment un écueil épistémologique majeur : la production automatisée d’un tableau de sortie statistique ne garantit en rien la validité conceptuelle de son interprétation. Une lecture erronée d’un seuil critique, une confusion entre hypothèses unilatérales et bilatérales ou l’ignorance des postulats sous-jacents d’homoscédasticité peuvent conduire à des conclusions fallacieuses et des décisions opérationnelles désastreuses.
Ce guide exhaustif a été conçu pour combler le fossé entre la mécanique calculatoire d’Excel et l’exigence d’une interprétation méthodologique irréprochable. En décortiquant chaque ligne, paramètre et coefficient généré par le tableur, ce document propose une déconstruction minutieuse des fondements théoriques, des choix paramétriques préalables, des métriques inférentielles fondamentales (t observé, p-valeur, degrés de liberté) et des prolongements indispensables tels que le calcul de la taille d’effet et la formalisation selon les standards académiques internationaux. Destiné aux chercheurs, analystes décisionnels, universitaires et professionnels de la donnée, ce manuel de référence fournit l’arsenal conceptuel et pratique nécessaire pour transformer des sorties numériques brutes en conclusions scientifiques rigoureuses et inattaquables.
1. Fondements théoriques du test t de Student dans la recherche empirique
1.1 Origine et utilité méthodologique du test t
L’émergence historique du test t constitue l’un des chapitres les plus fascinants de la statistique industrielle et appliquée moderne. Élaboré au tout début du XXe siècle par William Sealy Gosset, chimiste et mathématicien en poste au sein de la célèbre brasserie Guinness à Dublin, ce test répondait à une contrainte opérationnelle stricte : évaluer la qualité des matières premières, notamment les rendements des variétés d’orge et la concentration des levures, à partir d’échantillons de taille extrêmement restreinte. En raison des clauses de confidentialité draconiennes imposées par son employeur interdisant toute publication scientifique susceptible de divulguer des procédés de fabrication industriels, Gosset publia ses travaux fondateurs en 1908 dans la revue Biometrika sous le pseudonyme modeste de « Student ». La distribution de Student venait de naître, révolutionnant l’inférence statistique en palliant les insuffisances fondamentales de la loi normale lorsque l’écart-type de la population générale demeure inconnu et doit être estimé à partir de faibles effectifs.
Sur le plan méthodologique, la finalité comparative du test t réside dans la vérification de l’hypothèse selon laquelle deux moyennes échantillonnales proviennent, ou non, de populations mères présentant des caractéristiques identiques. Dans le paradigme expérimental classique, le test permet d’isoler l’effet d’une variable indépendante manipulée (le traitement) sur une variable dépendante continue, en évaluant si l’écart constaté entre le groupe expérimental et le groupe témoin peut raisonnablement être attribué aux fluctuations d’échantillonnage aléatoires ou s’il traduit un phénomène systématique sous-jacent. Cette approche est tout aussi indispensable dans les dispositifs quasi-expérimentaux et observationnels prévalant en psychologie, en sociologie quantitative, en épidémiologie ou en gestion, où l’assignation aléatoire parfaite est parfois impossible, mais où la comparaison rigoureuse de sous-groupes naturels (par exemple, hommes contre femmes, novices contre experts, organisations certifiées contre non certifiées) demeure essentielle.
Au cœur de cette démarche comparative se situe la distinction épistémologique fondamentale entre la variation intra-groupe (au sein de chaque sous-groupe) et la variation inter-groupes (entre les sous-groupes). La variation intra-groupe reflète le « bruit » de fond statistique, c’est-à-dire l’hétérogénéité naturelle inhérente aux sujets, les erreurs de mesure instrumentales et les facteurs contextuels non contrôlés. À l’inverse, la variation inter-groupes capture le « signal », c’est-à-dire l’écart généré par l’appartenance aux différentes conditions expérimentales. Le test t formalise précisément cette confrontation dialectique : il calcule un ratio normalisé où le numérateur exprime la magnitude du signal observé tandis que le dénominateur modélise l’ampleur du bruit ambiant pondéré par la taille des échantillons étudiés.
1.2 Formulation formelle des hypothèses statistiques
L’armature logique sur laquelle repose l’interprétation de tout test t s’articule autour de la confrontation binaire de deux hypothèses mutuellement exclusives et collectivement exhaustives : l’hypothèse nulle, traditionnellement désignée par la notation formelle H₀, et l’hypothèse alternative, formalisée par H₁ ou H_a. L’hypothèse nulle constitue la prémisse conservatrice du scepticisme scientifique. Elle postule l’absence absolue de différence réelle entre les paramètres populationnels des groupes investigués, signifiant que toute divergence observée entre les moyennes empiriques des échantillons n’est qu’un artéfact stochastique, un simple accident d’échantillonnage attribuable aux aléas du tirage au sort des sujets d’étude. Algébriquement, pour deux populations présentant des moyennes respectives notées μ₁ et μ₂, l’hypothèse nulle s’écrit conventionnellement sous la forme stricte :
H₀ : μ₁ – μ₂ = 0 (ou μ₁ = μ₂)
À l’opposé, l’hypothèse alternative incarne la conjecture substantielle du chercheur, affirmant l’existence d’une divergence systématique non attribuable au seul hasard. Cette hypothèse peut adopter deux configurations géométriques et probabilistes distinctes : bilatérale (non-directionnelle) ou unilatérale (directionnelle). L’hypothèse bilatérale se contente de postuler une inégalité sans préjuger du sens du différentiel observé (H₁ : μ₁ ≠ μ₂). Elle est privilégiée en recherche exploratoire ou lorsque la littérature théorique ne permet pas de prédire avec certitude la supériorité d’un traitement sur un autre. L’hypothèse unilatérale, quant à elle, spécifie a priori la direction de l’effet attendu, affirmant soit que la moyenne du premier groupe surpasse celle du second (H₁ : μ₁ > μ₂), soit l’inverse (H₁ : μ₁ < μ₂). Ce choix directionnel a un impact profond sur la répartition de la zone de rejet dans la loi de probabilité sous-jacente.
Le processus décisionnel inhérent au test statistique implique une gestion rigoureuse des risques probabilistes, au premier rang desquels figure le risque d’erreur de première espèce, universellement désigné par la lettre grecque alpha (α). Ce seuil de signification, conventionnellement fixé à 0,05 (soit 5 %) dans les sciences sociales et biologiques, représente la probabilité maximale que le chercheur accepte de tolérer quant au rejet erroné de l’hypothèse nulle alors que celle-ci est en réalité vraie dans la population cible. Contrôler rigoureusement α permet de préserver la communauté scientifique contre l’illusion de découvertes fortuites, tout en établissant une frontière quantitative claire pour déclarer un résultat comme « statistiquement significatif ».
1.3 Typologie des tests t disponibles pour l’analyse de données
L’écosystème méthodologique du test t se décompose en trois architectures procédurales distinctes, dont le choix dépend impérativement du design expérimental et de la structure relationnelle liant les unités d’échantillonnage observées. La première modalité correspond au test t à échantillon unique (one-sample t-test). Cette variante permet de comparer la moyenne empirique issue d’un groupe unique d’observations à une valeur théorique, historique ou normative préalablement déterminée. Ce modèle est largement mobilisé dans le contrôle qualité industriel pour vérifier la conformité d’un lot de production par rapport à un standard de tolérance prédéfini, ou en recherche biomédicale pour comparer un échantillon clinique à une constante épidémiologique établie au sein de la population générale.
La deuxième modalité, omniprésente dans les études comparatives, est le test t pour échantillons indépendants (independent two-sample t-test). Ce modèle est mobilisé lorsque l’analyste compare deux groupes formés d’individus ou d’unités expérimentales distincts, mutuellement exclusifs, où l’assignation d’un sujet à un groupe n’exerce aucune influence directe ou indirecte sur l’assignation ou la réponse des sujets appartenant au second groupe. C’est typiquement le cas des protocoles randomisés en double aveugle opposant un groupe sous traitement actif à un groupe sous placebo. Dans cette catégorie, une bifurcation statistique cruciale intervient selon que l’on postule l’égalité des variances des deux populations sous-jacentes (test de Student classique) ou que l’on renonce à cette contrainte au profit d’une modélisation adaptée aux variances inégales (test de Welch).
La troisième modalité majeure est le test t pour mesures répétées, communément désigné sous les appellations de test t apparié ou test t pour échantillons dépendants (paired samples t-test). Ce protocole analytique intervient lorsque les deux séries de données numériques proviennent des mêmes unités d’analyse mesurées à deux moments temporels distincts (par exemple, un design pré-test et post-test évaluant les compétences avant et après une formation) ou lorsqu’il existe un appariement méthodologique strict entre les paires de sujets (par exemple, des jumeaux homozygotes, des couples mariés, ou des cas cliniques appariés à des témoins selon des variables de confusion rigoureusement contrôlées telles que l’âge et l’indice de masse corporelle). La force mathématique de cette approche repose sur l’élimination de la variabilité interindividuelle globale, l’analyse se focalisant exclusivement sur la distribution des différences calculées au sein de chaque paire appariée.
2. Préparation technique et exécution de l’analyse dans Microsoft Excel
2.1 Activation et configuration de l’Utilitaire d’analyse
Pour exploiter les capacités inférentielles de Microsoft Excel, il est impératif de s’assurer préalablement de la disponibilité des algorithmes dédiés aux statistiques avancées. Par défaut, lors d’une installation standard de la suite bureautique, le module spécialisé n’est pas toujours activé de manière visible dans le ruban supérieur de navigation. L’analyste doit inspecter l’onglet « Données » de son interface : si le groupe contextuel « Analyse », abritant l’icône « Utilitaire d’analyse » (ou Data Analysis dans les versions anglophones), n’apparaît pas à l’extrême droite du ruban, une procédure formelle d’initialisation de ce complément natif s’avère indispensable.
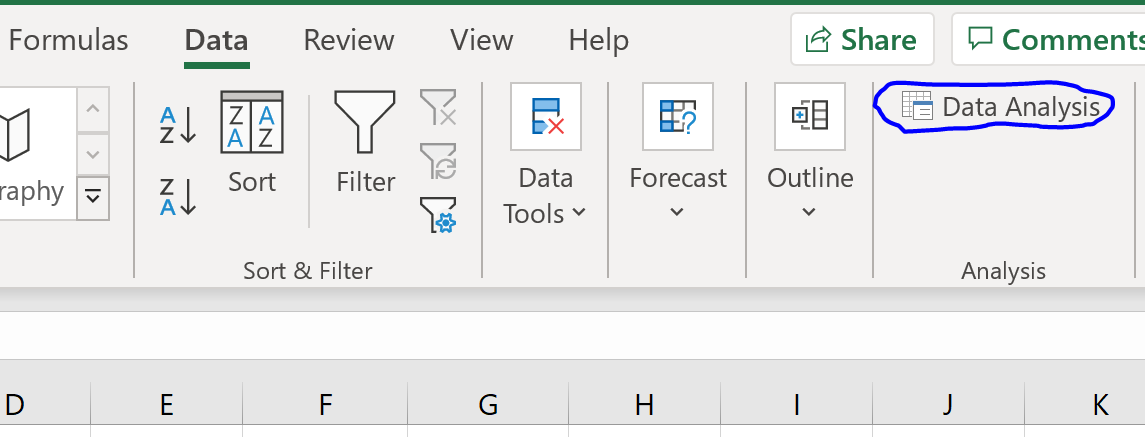
Sous l’environnement Windows, l’activation du complément requiert une séquence opératoire standardisée. Il convient de cliquer sur l’onglet principal « Fichier », de sélectionner le menu « Options » situé au bas de la barre latérale gauche, puis de naviguer jusqu’à la section « Compléments » (Add-ins). Dans la partie inférieure de cette fenêtre de dialogue, le menu déroulant intitulé « Gérer » doit être positionné sur la valeur « Compléments Excel », avant de valider l’action par un clic sur le bouton « Atteindre… ». Une boîte modale répertorie alors les composants intégrés disponibles. Il est impératif de cocher la case relative à l’« Utilitaire d’analyse » (l’analyste peut également activer l’option « Utilitaire d’analyse – VBA » s’il projette d’automatiser ses requêtes par script), puis de confirmer par « OK ». L’icône correspondante s’intègre instantanément dans le ruban Données.
Sur macOS, l’arborescence des commandes diverge légèrement en raison des spécificités ergonomiques du système d’exploitation d’Apple. L’utilisateur doit accéder au menu supérieur « Outils » de l’application Excel, sélectionner « Compléments Excel… », cocher la ligne correspondante au module d’analyse statistique et valider. En cas de dysfonctionnement récurrent ou d’absence persistante du bouton d’analyse, il convient de vérifier l’intégrité de la licence Office, de s’assurer que les stratégies de groupe institutionnelles (dans un contexte d’entreprise) ne bloquent pas le chargement des extensions XLL/DLL, ou d’envisager une réparation de l’installation de la suite logicielle via le panneau de configuration système.
2.2 Structuration optimale du jeu de données matriciel
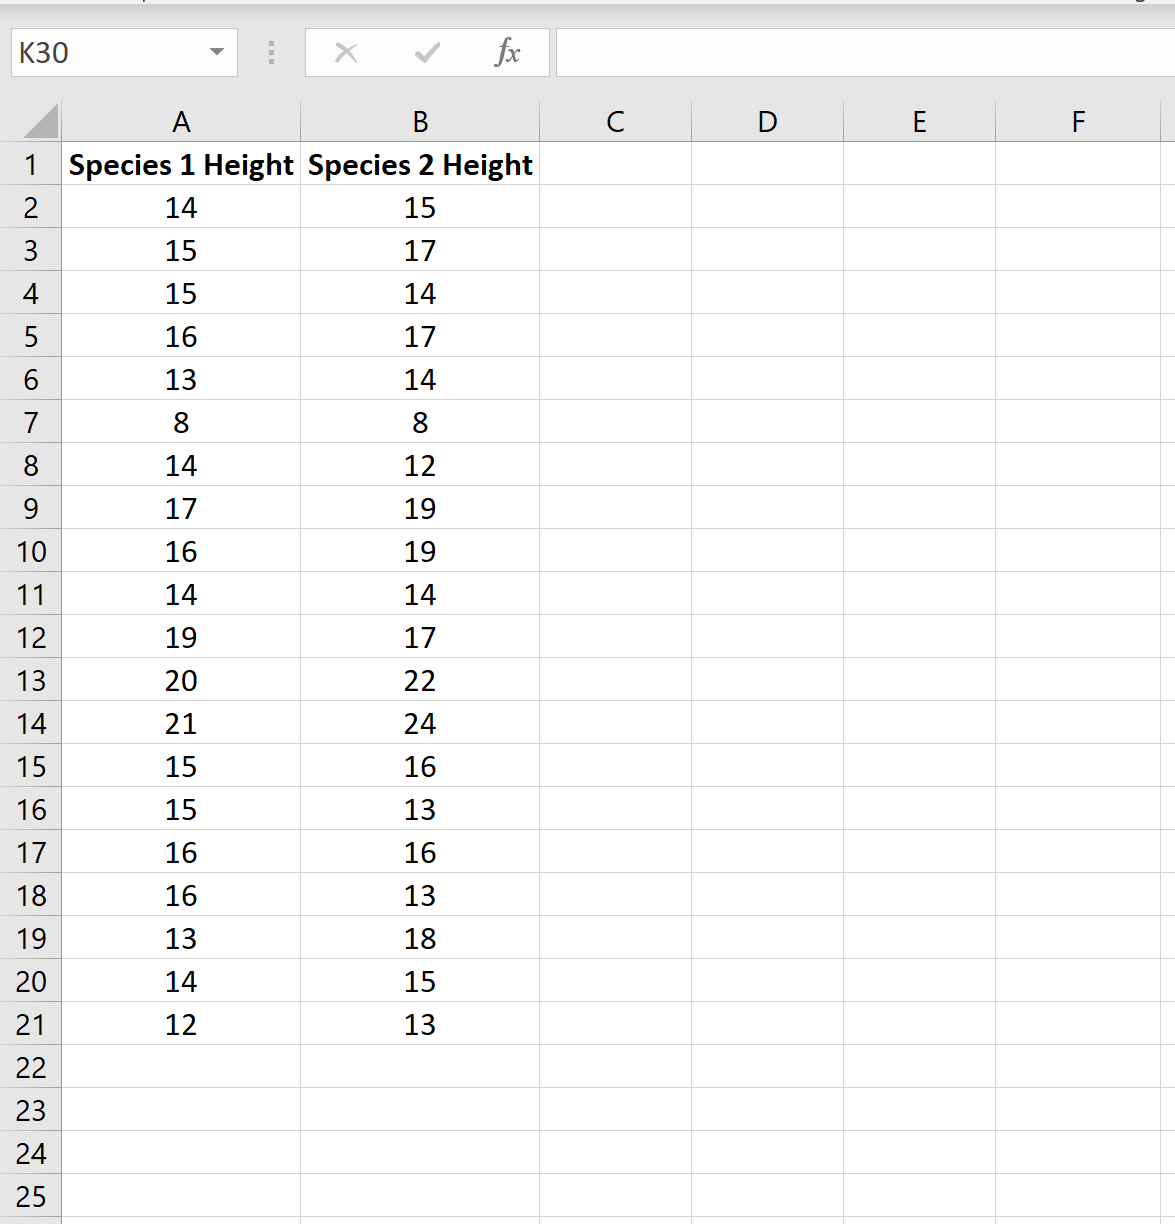
La fiabilité de l’exécution mathématique dépend étroitement de la propreté structurale de la matrice de données au sein de la feuille de calcul. Contrairement à des logiciels comme SPSS qui imposent une structure « longue » (une colonne identifiant le groupe et une colonne recueillant la mesure quantitative), l’Utilitaire d’analyse d’Excel pour les tests t indépendants requiert impérativement une organisation « large ». Cela implique que les données relatives au premier groupe doivent être consignées dans une colonne dédiée et contiguë à la colonne regroupant les données du second groupe. Chaque ligne de ces colonnes représente la mesure observée pour une unité expérimentale donnée.
Une rigueur absolue doit être accordée à la première ligne de chaque colonne, qui doit impérativement accueillir une étiquette textuelle explicite et descriptive (par exemple, « Groupe_Controle » et « Groupe_Traitement_A »). L’omission d’en-têtes informatifs ou l’utilisation de désignations cryptiques multiplie exponentiellement le risque d’erreur d’interprétation lors de la lecture des résultats générés. Parallèlement, le nettoyage préalable du jeu de données doit faire l’objet d’une vigilance méticuleuse : les valeurs manquantes doivent être identifiées avec précision. Si des cellules vides existent, Excel gère généralement l’inégalité des effectifs dans le test pour variances inégales, mais la présence d’espaces masqués, de caractères non numériques, de séparateurs décimaux erronés (mélange de virgules et de points selon les paramètres régionaux) ou d’erreurs de type #VALEUR! interrompra brutalement le calcul ou générera des sorties corrompues.
Sur le plan métrologique, l’analyste doit veiller à respecter les critères d’effectifs minimaux par cellule expérimentale. Bien que le test t de Gosset ait été formellement mathématisé pour compenser les distorsions propres aux très petits échantillons, descendre sous le seuil critique de n = 5 à n = 10 observations par groupe dégrade considérablement la puissance statistique du test, réduisant dramatiquement la probabilité de détecter un effet réel existant (risque accru d’erreur de type II). Une taille minimale de 20 à 30 observations par groupe est vivement conseillée pour bénéficier pleinement des propriétés asymptotiques du théorème central limite et garantir la stabilité des estimations variance-moyenne.
2.3 Paramétrage précis de la boîte de dialogue du test t
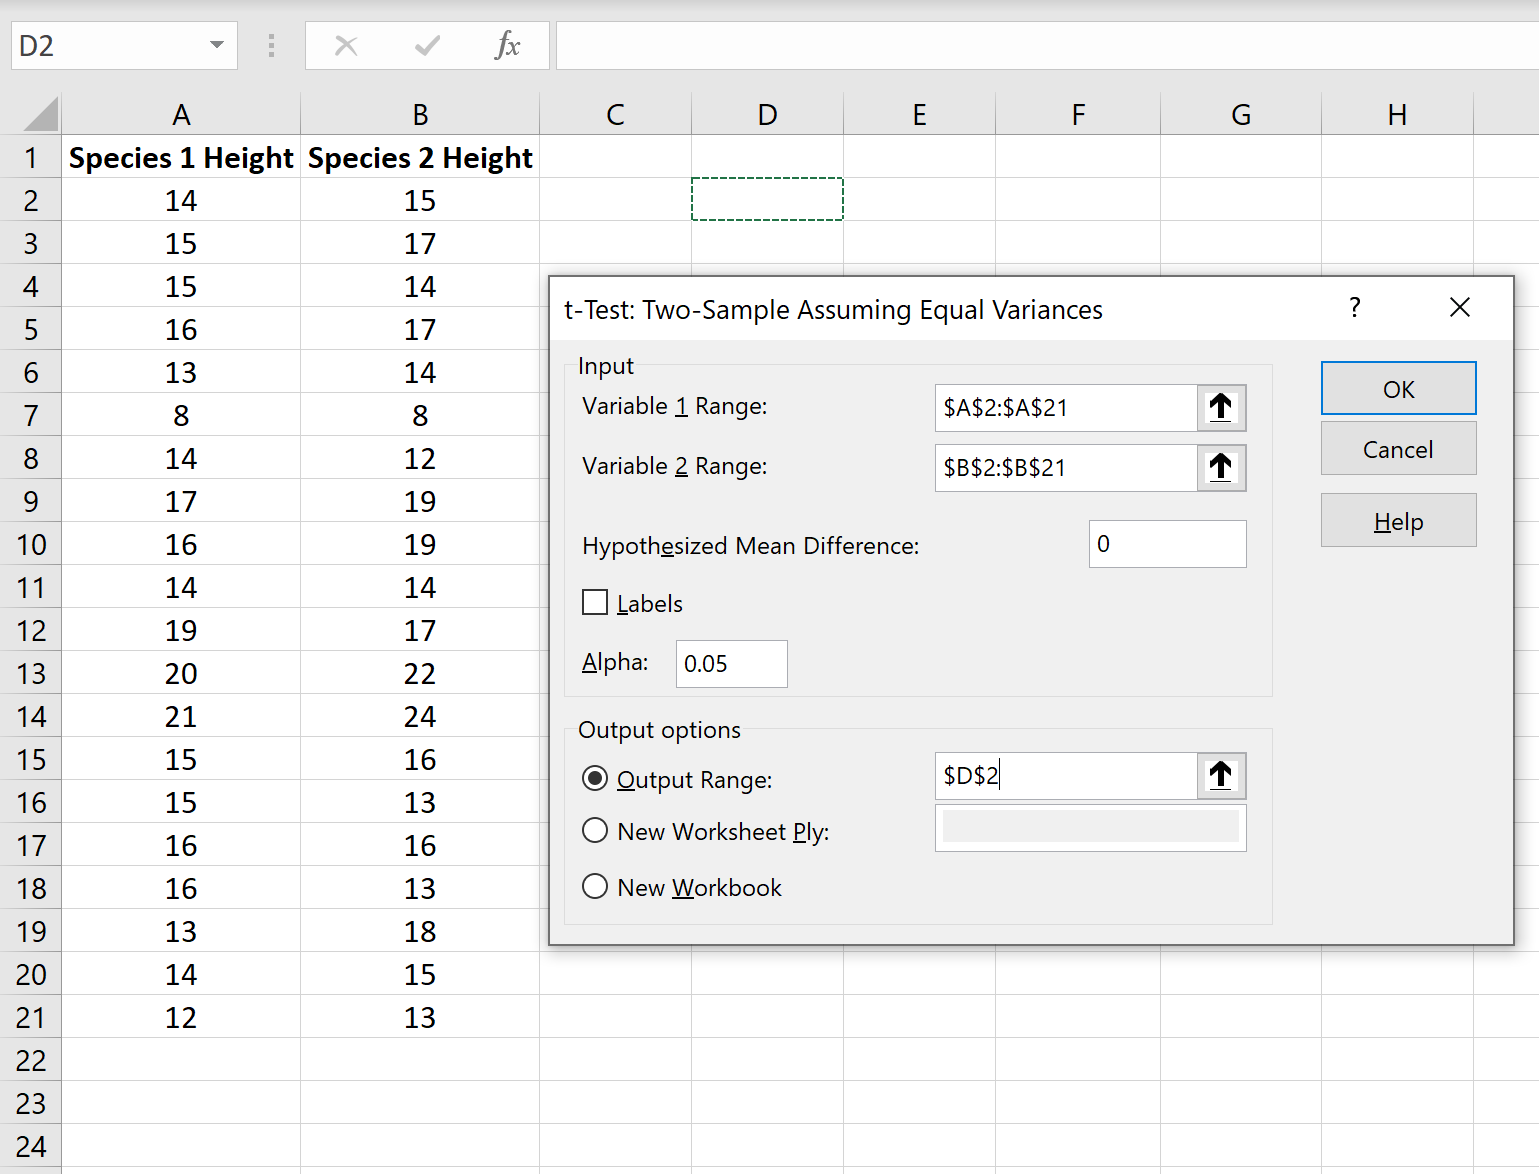
Une fois l’Utilitaire d’analyse lancé via le bouton dédié, l’utilisateur est confronté à une boîte de dialogue déroulante énumérant diverses procédures statistiques. Pour effectuer la comparaison de deux moyennes indépendantes, il convient de sélectionner selon le modèle théorique retenu : soit « Test d’égalité de deux moyennes pour les variables de variance égale », soit « Test d’égalité de deux moyennes pour les variables de variance inégale ». Dès validation du choix, la fenêtre de configuration paramétrique spécifique s’affiche, requérant des arbitrages opérationnels précis.
La première exigence opératoire consiste à renseigner avec exactitude les plages d’entrée matricielles. La zone de saisie « Plage de la variable 1 » doit englober l’ensemble des coordonnées cellulaires de la première colonne (par exemple, $A$1:$A$45), tandis que la « Plage de la variable 2 » accueille les références de la seconde colonne (par exemple, $B$1:$B$40). Si la sélection a scrupuleusement intégré les en-têtes textuels situés sur la ligne 1, il est absolument capital de cocher sans faute la case « Intitulés » (ou Labels). Si cette case est négligée alors que du texte est présent, le moteur d’évaluation d’Excel renverra un message d’erreur d’incompatibilité de type d’argument ; inversement, si la case est cochée alors que la plage ne contient que des chiffres, la première observation empirique sera arbitrairement exclue de l’échantillon et traitée comme un label alphabétique, tronquant ainsi les résultats.
La boîte de dialogue comporte également un champ intitulé « Différence hypothétique des moyennes ». Dans l’écrasante majorité des protocoles expérimentaux conventionnels visant à tester l’hypothèse nulle classique de stricte égalité entre les groupes, cette case doit être laissée entièrement vide ou renseignée avec la valeur numérique « 0 ». Renseigner une valeur non nulle n’est pertinent que dans des contextes très spécifiques d’essais d’équivalence ou de non-infériorité, où l’on cherche à démontrer que l’écart entre les populations surpasse un seuil d’intérêt clinique minimal prédéfini (Δ₀). Enfin, l’utilisateur doit stipuler la destination spatiale du tableau de résultat : insertion dans une zone délimitée de la feuille active, création automatique d’un nouvel onglet de calcul, ou exportation vers un classeur entièrement vierge.
3. Vérification des postulats statistiques préalables à l’interprétation
3.1 Postulat de normalité des distributions
L’édifice mathématique du test t de Student repose sur le postulat fondamental selon lequel la variable dépendante continue suit une distribution normale au sein de chacune des populations mères dont sont extraits les deux groupes d’échantillons. Cette condition de normalité garantit que la distribution d’échantillonnage de la différence entre les deux moyennes s’ajuste rigoureusement à la densité théorique de Student. Si cette hypothèse de distribution gaussienne est violée de manière flagrante, les probabilités associées aux statistiques de test peuvent se révéler biaisées, conduisant à des déductions inférentielles infondées.
L’évaluation de la normalité requiert une approche séquentielle, combinant inspections graphiques et diagnostics analytiques. Dans Excel, l’analyste peut générer des histogrammes de fréquence pour chacun des sous-groupes afin d’évaluer visuellement la symétrie de la cloche de Gauss et l’épaisseur des queues de distribution. Pour une évaluation plus raffinée, la construction de diagrammes quantile-quantile (Q-Q plots) permet de confronter les quantiles observés dans les données empiriques aux quantiles théoriques attendus sous une loi normale parfaite. Un alignement linéaire étroit des points le long de la diagonale confirme l’adéquation au modèle gaussien, tandis que des courbures marquées révèlent une asymétrie (skewness) ou un aplatissement anormal (kurtosis).
Fort heureusement pour le praticien, le théorème central limite confère au test t une robustesse statistique exceptionnelle face aux déviations modérées de la normalité dès lors que les tailles d’échantillons atteignent un niveau suffisant. En règle générale, lorsque chaque groupe compte au moins 30 observations (n₁ ≥ 30 et n₂ ≥ 30), les propriétés de convergence asymptotique garantissent que la distribution des moyennes échantillonnales s’approche de la normalité, rendant le test t hautement fiable même en présence d’une asymétrie modérée. Néanmoins, face à des distributions sévèrement leptokurtiques ou en présence d’échantillons réduits (n < 15) présentant une asymétrie extrême et contaminés par des points aberrants incontestables, le recours à des alternatives non paramétriques (telles que le test U de Mann-Whitney) s’impose impérativement pour préserver la validité de l’inférence.
3.2 Postulat d’homogénéité des variances (homoscédasticité)
Le second postulat prépondérant pour la sélection du modèle paramétrique adéquat est l’homogénéité des variances, concept technique désigné sous le terme d’homoscédasticité. Cette propriété théorique postule que la dispersion des données individuelles autour de leur moyenne respective est structurellement équivalente dans les deux populations sources (σ₁² = σ₂²). Lorsque cette égalité de variance fait défaut, la distribution des données est qualifiée d’hétéroscédastique (σ₁² ≠ σ₂²), ce qui altère profondément les propriétés mécaniques du dénominateur du test de Student standard.
Afin de diagnostiquer formellement la présence ou l’absence d’homoscédasticité au sein de l’environnement Excel, l’analyste doit mobiliser un autre outil statistique intégré dans l’Utilitaire d’analyse : le « Test F pour deux échantillons d’analyse de variance ». Ce test confronte directement les variances observées des deux colonnes via le calcul d’un ratio de Fisher-Snedecor (F = s₁² / s₂², en plaçant par convention analytique la variance empirique la plus élevée au numérateur). Si la p-valeur découlant de ce test F est supérieure au seuil conventionnel de 0,05, l’hypothèse de variances homogènes ne peut être rejetée, autorisant ainsi l’application sereine du test t standard pour variances égales. Dans le cas inverse (p ≤ 0,05), l’hétérogénéité des variances est empiriquement avérée.
L’impact de l’hétéroscédasticité sur la validité des conclusions statistiques ne doit jamais être sous-estimé. Lorsque les variances sont inégales et que, simultanément, la taille des groupes d’échantillons est fortement asymétrique (n₁ ≠ n₂), le test t de Student standard subit de graves distorsions. Si le groupe présentant le plus petit effectif possède la variance la plus forte, le taux d’erreur de première espèce s’envole bien au-delà de la limite nominale de 5 %, induisant une inflation massive de faux positifs. Inversement, si le grand échantillon présente la dispersion la plus prononcée, le test devient excessivement conservateur, écrasant la puissance statistique et générant une avalanche d’erreurs de type II. D’où la nécessité absolue d’arbitrer entre l’approche classique de Gosset et l’ajustement robuste de Welch.
3.3 Indépendance des observations et nature de la mesure
Le postulat méthodologique le plus intangible et le moins tolérant vis-à-vis des violations statistiques concerne la nature de la mesure et l’indépendance stricte des observations recueillies. En premier lieu, la variable dépendante mesurée doit obligatoirement relever d’une échelle métrique quantitative, qu’il s’agisse d’une échelle d’intervalle (comme la température en degrés Celsius ou les scores standardisés à des tests psychométriques validés) ou d’une échelle de rapport possédant un zéro absolu naturel (telle que la masse, la distance, le temps de réaction, le chiffre d’affaires ou la concentration sérique). L’application d’un test t à des variables purement qualitatives nominales ou à des échelles ordinales courtes (comme des échelles de Likert en trois ou cinq points dépourvues de continuité métrique réelle) constitue un abus statistique qui expose à des interprétations mathématiquement illégitimes.
En second lieu, la garantie méthodologique de l’indépendance des observations conditionne l’ensemble de la validité de l’inférence. Dans le cadre du test pour échantillons indépendants, la sélection et le comportement d’un participant au sein d’un groupe ne doivent exercer absolument aucune influence causale, corrélationnelle ou environnementale sur les réponses des autres participants du même groupe ou du groupe opposé. Ce postulat d’indépendance est directement adossé à la rigueur du protocole d’échantillonnage probabiliste et de randomisation expérimentale mis en place lors de la phase de collecte.
La violation de ce postulat survient fréquemment dans des protocoles expérimentaux mal conduits : mesures d’élèves interagissant librement au sein d’une même classe (effet de grappe ou de contagion), réponses fournies par des membres d’une même famille, ou mesures itératives répétées au fil du temps sur un unique sujet répertoriées par erreur dans deux colonnes distinctes. Dans cette dernière circonstance d’observations longitudinales intrapersonnelles ou de paires appariées selon des critères externes, le recours au modèle pour échantillons indépendants est formellement prohibé : l’analyste doit impérativement réorienter son choix méthodologique vers le « Test d’égalité de deux moyennes pour les variables appariées », lequel neutralise mathématiquement la covariance intra-sujet.
4. Sélection du modèle adéquat dans Excel : Variances égales ou inégales
4.1 Test t : deux échantillons en supposant des variances égales
Le modèle classique du test t de Student pour deux échantillons indépendants part du postulat d’homoscédasticité, postulant que les deux populations partagent une variance résiduelle unique et commune (σ²). Pour maximiser l’efficience de l’estimation de ce paramètre inconnu, le test ne calcule pas deux variances disjointes, mais opère une synthèse probabiliste en procédant au calcul d’une variance combinée ou pondérée, universellement désignée sous le vocable technique de pooled variance. Cette approche permet de mutualiser l’ensemble des données résiduelles pour calibrer l’erreur type avec un maximum de précision mathématique.
Ce test déploie une efficacité optimale et une robustesse statistique remarquable principalement lorsque le plan expérimental est rigoureusement équilibré, c’est-à-dire lorsque les effectifs d’échantillons sont strictement égaux (n₁ = n₂). Sous cette condition de parité numérique, le test t classique conserve une résilience remarquable même si l’hypothèse d’homoscédasticité subit de légères entorses. La variance groupée agit alors comme un barycentre parfait entre les deux dispersions observées.
Cependant, la sensibilité de ce test s’avère critique dès lors que la parité des effectifs est rompue (n₁ ≠ n₂) en présence d’une hétérogénéité sous-jacente des variances. L’estimation combinée devient alors asymétriquement biaisée en faveur de la variance du groupe le plus nombreux, ce qui fausse intégralement l’étalonnage du dénominateur du ratio t. Dans une telle situation, la probabilité théorique de commettre une erreur d’inférence s’écarte substantiellement du seuil nominal d’erreur α fixé par le chercheur, exposant l’expérimentateur soit à une cécité statistique face à un résultat substantiel, soit à l’affirmation trompeuse d’un effet illusoire.
4.2 Test t : deux échantillons en supposant des variances inégales (Test de Welch)
Face aux périls méthodologiques inhérents aux violations d’homoscédasticité, la statistique mathématique a développé une parade robuste : le test t de Welch (ou procédure de Welch-Aspin). Disponible au sein de l’Utilitaire d’analyse d’Excel sous la dénomination explicite « Test d’égalité de deux moyennes pour les variables de variance inégale », ce protocole abandonne définitivement l’hypothèse contraignante d’une variance commune. Au lieu de combiner les variances, le test calcule l’erreur type de la différence de manière directe en sommant les variances d’échantillonnage estimées pour chacun des groupes (s₁²/n₁ + s₂²/n₂).
Pour compenser la perte de l’hypothèse de variance partagée et préserver l’adéquation distributionnelle, le modèle applique la fameuse correction d’ajustement de Welch-Satterthwaite sur les degrés de liberté. Cet algorithme recalibre dynamiquement le nombre de degrés de liberté de la distribution de référence à un niveau inférieur ou égal à la somme arithmétique standard des tailles d’échantillons moins deux (df ≤ n₁ + n₂ – 2). Ce réajustement formel a pour conséquence mécanique d’épaissir les queues de la distribution t théorique, rendant le test plus rigoureux et conservateur lorsque les conditions d’incertitude sur la variance sont exacerbées.
Dans la littérature méthodologique contemporaine la plus autorisée, une recommandation fait désormais consensus au sein de la communauté des statisticiens : l’utilisation systématique du test de Welch par défaut. En effet, lorsque les variances des populations sont en réalité parfaitement égales, le test de Welch fournit des performances de puissance statistique quasiment indiscernables de celles du test classique de Student, avec une perte de sensibilité infinitésimale. En revanche, lorsque les variances sont inégales, seul le test de Welch maintient le taux d’erreur de première espèce au niveau strict de 0,05. Ainsi, l’analyste pragmatique sécurise systématiquement son protocole inférentiel en privilégiant cette variante.
4.3 Arbre décisionnel pour le choix du test dans Excel
Afin de structurer avec clarté la démarche opératoire de l’analyste au sein de l’environnement Excel, la mise en œuvre d’un protocole séquentiel standardisé permet de sélectionner le modèle optimal sans ambiguïté. La trajectoire d’arbitrage décisionnelle doit articuler des critères statistiques objectifs déduits des vérifications préalables, comme le formalise la grille séquentielle suivante :
- Étape 1 : Vérification de la structure d’appariement. Les données résultent-elles d’un design longitudinal avant-après ou de paires d’individus appariés ? Si oui, sélectionner sans hésitation « Test d’égalité de deux moyennes pour les variables appariées ». Si non, poursuivre vers l’Étape 2.
- Étape 2 : Vérification de la métrique et de la distribution. La variable est-elle continue et les distributions sous-groupes présentent-elles une symétrie acceptable (ou des effectifs n₁, n₂ ≥ 30) ? Si oui, poursuivre l’analyse paramétrique. Si non, envisager une transformation des données (logarithmique, racine carrée) ou basculer vers un test non paramétrique hors Excel standard.
- Étape 3 : Évaluation formelle de l’homoscédasticité. Exécuter le « Test F pour deux échantillons d’analyse de variance ». Examiner scrupuleusement la p-valeur du test F.
- Si p > 0,05 : L’hypothèse de variances égales n’est pas rejetée. On peut valablement sélectionner « Test d’égalité de deux moyennes pour les variables de variance égale ».
- Si p ≤ 0,05 : Hétérogénéité avérée des variances. Sélectionner impérativement « Test d’égalité de deux moyennes pour les variables de variance inégale » (test de Welch).
- Étape 4 : Règle empirique de précaution (ratio des variances). Même si le test F n’atteint pas formellement le seuil de signification, si le ratio de la plus grande variance sur la plus petite (s²_max / s²_min) excède un rapport de 1,5 à 2, particulièrement avec des tailles d’échantillons inégales, privilégier prudemment le modèle à variances inégales.
Quel que soit le chemin décisionnel emprunté, l’analyste rigoureux doit obligatoirement consigner et justifier cette démarche au sein de la section méthodologique de son rapport d’analyse. Indiquer que « le choix entre le test t de Student classique et l’approximation de Welch a été guidé par une évaluation préalable de l’homoscédasticité via le ratio des variances d’échantillonnage » témoigne d’une intégrité scientifique exemplaire et assure la reproductibilité intégrale des résultats.
5. Décryptage des statistiques descriptives dans le tableau de sortie
5.1 Ligne Moyenne (Mean) : Tendance centrale des groupes
Lorsqu’Excel achève le traitement computationnel du test t sélectionné, il projette sur la feuille de calcul un tableau matriciel structuré. Les premières lignes de ce récapitulatif synthétisent les statistiques descriptives fondamentales relatives à chacun des deux ensembles de données examinés. La première ligne, invariablement intitulée « Moyenne » (ou Mean), rapporte la tendance centrale empirique calculée pour chaque colonne d’entrée via la formule arithmétique standard de la somme des observations divisée par leur effectif respectif.
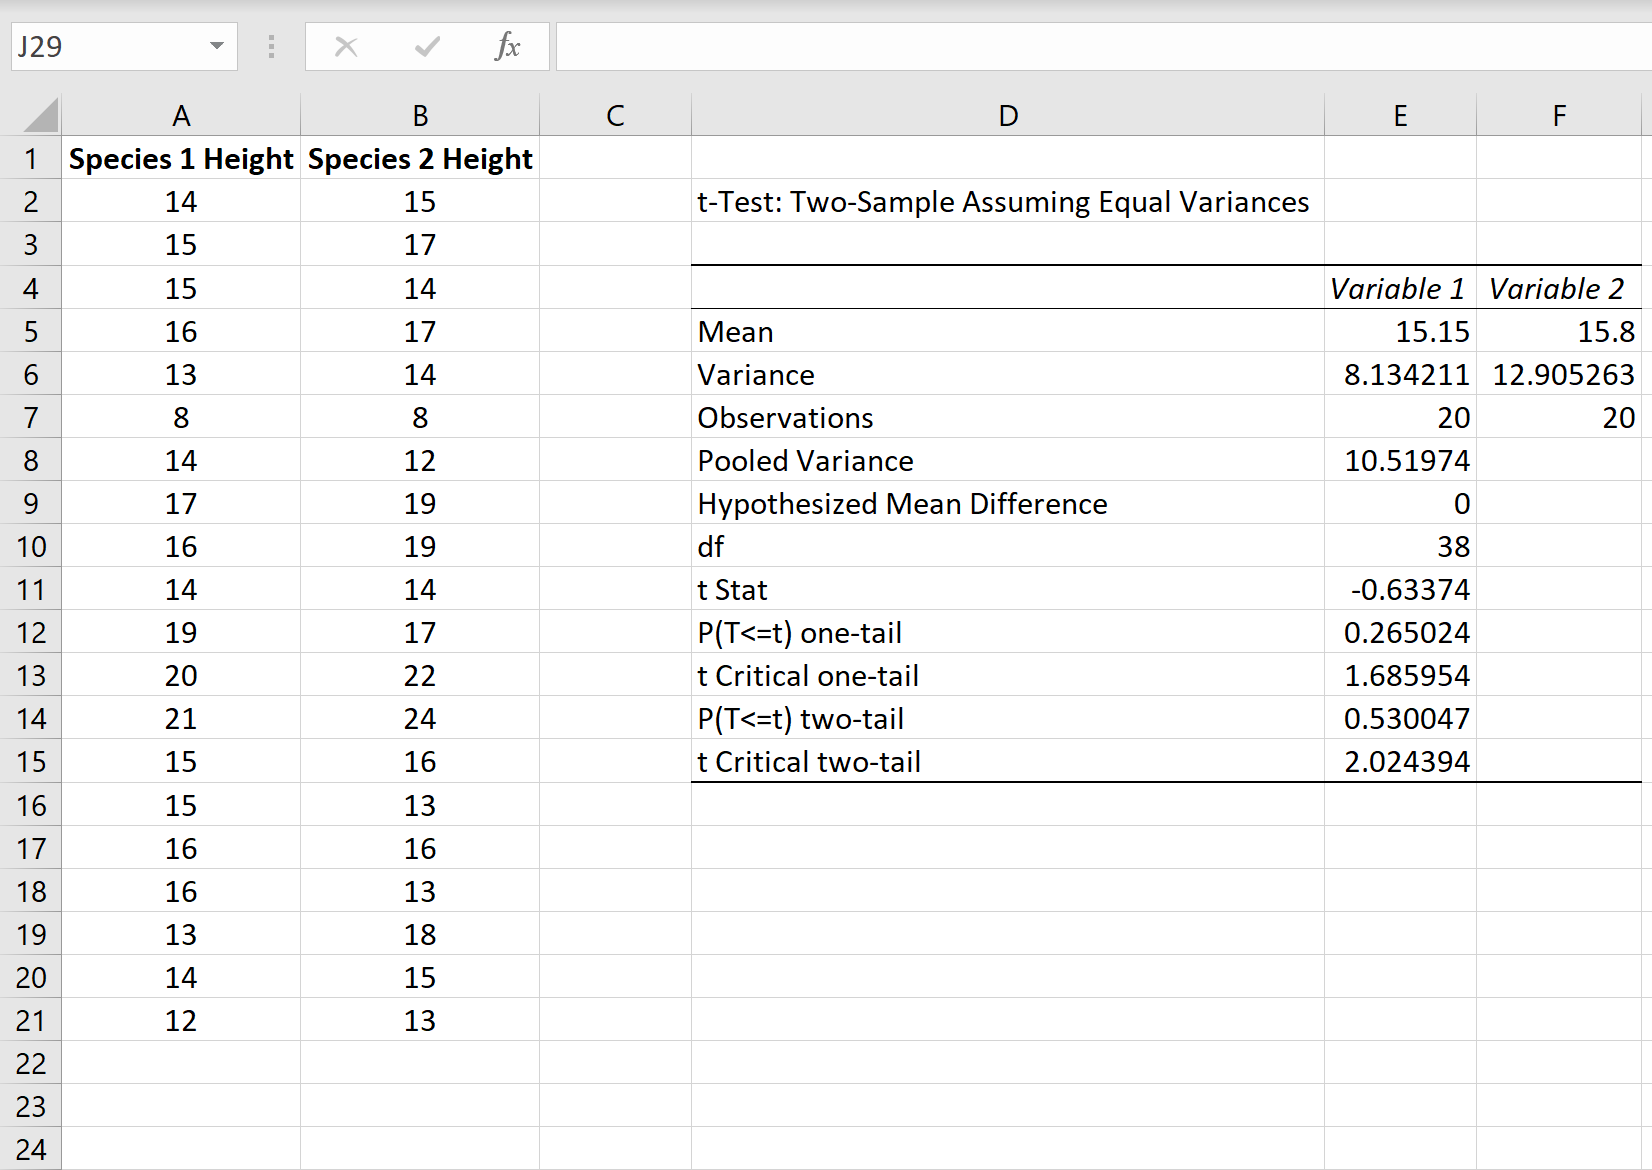
L’observation préliminaire de ces moyennes permet de saisir la magnitude absolue et le sens clinique ou opérationnel de l’effet étudié. L’analyste identifie immédiatement le groupe affichant la performance métrique la plus élevée ou la plus basse. L’écart brut entre ces deux moyennes (x̄₁ – x̄₂) incarne l’estimation ponctuelle sans biais de l’ampleur de la divergence causale ou corrélationnelle qui sépare les deux populations mères. Par exemple, dans une étude clinique évaluant l’efficacité d’un agent antihypertenseur, si le groupe sous traitement présente une moyenne de pression artérielle systolique de 125,4 mmHg contre 138,2 mmHg pour le groupe témoin, l’écart brut de -12,8 mmHg constitue le signal clinique primaire à interpréter.
Il importe toutefois de tempérer immédiatement l’enthousiasme quant à la seule contemplation de ces moyennes empiriques. La moyenne arithmétique est par définition une métrique hypersensible aux perturbations introduites par les valeurs aberrantes (outliers) et l’asymétrie distributionnelle. Une valeur extrême isolée au sein d’un groupe d’échantillons réduit peut déplacer artificiellement la moyenne vers le haut ou vers le bas, créant une illusion d’écart entre les sous-populations. C’est pourquoi l’analyste aguerri examine toujours ces moyennes à la lumière directe des paramètres de dispersion qui leur succèdent immédiatement dans le tableau de bord d’Excel.
5.2 Ligne Variance : Dispersion des données individuelles
La deuxième ligne du tableau analytique renseigne la « Variance » estimée pour chaque variable. Cette statistique mesure le degré de dispersion ou d’étalement des données individuelles autour de leur moyenne arithmétique de groupe respective. Sur le plan formel, la variance d’échantillon fournie par Excel correspond à la somme des carrés des écarts à la moyenne divisée par ses degrés de liberté locaux (n – 1), assurant ainsi une estimation non biaisée de la variance populationnelle correspondante (s²).
La variance s’avère particulièrement instructive pour évaluer la représentativité de la moyenne de chaque échantillon. Une variance exceptionnellement élevée témoigne d’une grande hétérogénéité interne parmi les sujets composant le groupe d’étude, signifiant que les individus réagissent de manière contrastée ou que le contrôle des variables parasites durant l’expérimentation a manqué de rigueur. Sur le plan calculatoire, la relation mathématique liant la variance à l’écart-type est directe : l’écart-type d’échantillon (s ou SD pour Standard Deviation) s’obtient simplement en calculant la racine carrée arithmétique de la cellule de variance (s = √s²).
La comparaison relative des deux cellules de variance permet également à l’analyste de procéder à une ultime vérification intuitive de l’homogénéité des dispersions. Si la variance du Groupe 1 s’établit à 24,5 tandis que celle du Groupe 2 culmine à 189,3, cette disproportion spectaculaire valide a posteriori la pertinence méthodologique d’avoir sélectionné le modèle du test de Welch à variances inégales. L’analyste visualise ainsi instantanément si les sous-populations présentent des niveaux de variabilité intrinsèque fondamentalement dissemblables.
5.3 Ligne Observations : Effectifs échantillonnaux
La troisième ligne de la section descriptive, libellée « Observations », délivre le dénombrement précis des unités expérimentales, participants ou cas validés pris en charge par l’algorithme computationnel pour chaque groupe d’étude. Bien que cette information puisse paraître rudimentaire au premier regard, son inspection minutieuse constitue un garde-fou méthodologique indispensable dans le protocole de vérification analytique.
En premier lieu, l’analyste doit confronter ces valeurs numériques avec les effectifs initialement prévus dans le plan expérimental ou le carnet d’observations. Toute discordance entre l’effectif théorique attendu et le chiffre rapporté par Excel trahit une anomalie technique sous-jacente : présence de cellules vides résultant d’abandons de sujets (dropouts), cellules encodées sous un format texte invisible (comme un chiffre précédé d’une apostrophe), ou sélection accidentellement tronquée de la plage de données lors de la saisie dans la boîte de dialogue. La détection précoce d’une telle omission permet de rectifier l’analyse avant toute diffusion des résultats.
En second lieu, la taille des effectifs exerce un levier mathématique déterminant sur l’ensemble des métriques inférentielles subséquentes. La précision avec laquelle une moyenne échantillonale estime la moyenne populationnelle réelle est inversement proportionnelle à la racine carrée de son effectif, un concept central formalisé par l’erreur type de la moyenne (SEM = s / √n). Plus l’effectif rapporté sur la ligne « Observations » est conséquent, plus l’intervalle d’incertitude rétrécit, décuplant ainsi la capacité de l’outil statistique à distinguer un signal expérimental infime au milieu du bruit de fond ambiant.
6. Compréhension des paramètres intermédiaires générés par Excel
6.1 Ligne Variance groupée (Pooled Variance)
Lors de l’exécution d’un test t formulé sous l’hypothèse de variances égales, une ligne spécifique apparaît au sein de la matrice de sortie d’Excel : la « Variance groupée » (ou Pooled Variance, notée mathématiquement s_p²). Ce paramètre intermédiaire est le pivot calculatoire du modèle classique de Student. Il synthétise les variances distinctes des deux échantillons en une estimation unifiée unique, pondérée par leurs contributions respectives en termes de degrés de liberté.
L’équation formelle gouvernant le calcul de cette variance groupée s’exprime comme la somme pondérée des sommes des carrés des écarts :
s_p² = [ (n₁ – 1)s₁² + (n₂ – 1)s₂² ] / (n₁ + n₂ – 2)
Cette formulation élégante illustre clairement que si un groupe dispose d’une taille d’échantillon deux fois supérieure à l’autre, sa variance individuelle exercera un poids proportionnellement double dans la détermination de la variance groupée finale. Cette métrique intermédiaire est directement injectée par Excel dans le dénominateur de l’équation du ratio t pour calculer l’erreur type commune de la différence de moyenne :
SE_(x̄₁ – x̄₂) = √[ s_p² ( (1/n₁) + (1/n₂) ) ]
Il est crucial de noter que cette ligne de « Variance groupée » brille par son absence intégrale lorsque l’analyste exécute le modèle pour variances inégales (test de Welch). Cette disparition est parfaitement cohérente avec la théorie statistique, puisque le modèle de Welch réfute expressément l’existence d’une variance commune et calcule séparément l’erreur d’échantillonnage de chaque population sans jamais tenter de les fusionner artificiellement.
6.2 Ligne Différence hypothétique des moyennes
La ligne intitulée « Différence hypothétique des moyennes » répercute simplement la constante théorique assignée par l’analyste lors de l’étape de configuration dans la boîte de dialogue paramétrique. Dans la quasi-totalité des analyses standards menées sous l’égide du paradigme de test d’hypothèse nulle classique (NHST), cette cellule consigne invariablement la valeur numérique « 0 ».
Ce chiffre zéro formalise l’énoncé de l’hypothèse nulle H₀ : il stipule mathématiquement qu’en l’absence de tout effet substantiel ou manipulation causale réelle, l’espérance mathématique de la différence entre les deux moyennes de populations sous-jacentes est strictement nulle (μ₁ – μ₂ = 0). Ce paramètre joue un rôle direct et indispensable dans le calcul du numérateur de la statistique de Student observée, qui correspond exactement à la soustraction suivante :
Numérateur = (x̄₁ – x̄₂) – Δ₀
Lorsque la différence hypothétique (Δ₀) est ancrée à zéro, le numérateur se résume simplement à la différence brute constatée entre les deux moyennes échantillonnales. En revanche, si un chercheur configure délibérément ce champ avec une valeur non nulle (par exemple, 5 unités) pour vérifier si le nouveau médicament améliore le score d’au moins 5 points par rapport au comparateur standard, Excel retranchera cette constante de la différence empirique observée, testant ainsi une hypothèse nulle déplacée (H₀ : μ₁ – μ₂ = 5).
6.3 Ligne Degré de liberté (df)
Sous la désignation abrégée « df » (pour l’anglais degrees of freedom) ou son équivalent français « Degré de liberté », Excel consigne une valeur numérique déterminante pour l’ensemble du calcul des probabilités inférentielles. Les degrés de liberté incarnent le nombre d’observations indépendantes qui demeurent libres de varier après que les paramètres descriptifs (ici, les moyennes d’échantillons) ont été contraints par l’estimation statistique.
Dans le cadre du test t supposant des variances égales, le calcul des degrés de liberté obéit à une arithmétique simple et linéaire, correspondant à la somme des effectifs totaux des deux groupes minorée de deux unités (une pour chaque moyenne calculée) :
df = n₁ + n₂ – 2
Cette valeur est obligatoirement un nombre entier. En revanche, lorsque l’analyse bascule sous le paradigme du test de Welch à variances inégales, le tableau de bord d’Excel affiche un comportement singulier qui déconcerte fréquemment les néophytes : la ligne « df » présente fréquemment un nombre tronqué ou décimal (selon les options d’affichage et versions du tableur). Ce phénomène découle directement de l’équation de Welch-Satterthwaite :
df_Welch = [ (s₁²/n₁ + s₂²/n₂) ]² / [ ( (s₁²/n₁)² / (n₁ – 1) ) + ( (s₂²/n₂)² / (n₂ – 1) ) ]
Ce calcul non linéaire pénalise les degrés de liberté en proportion directe de la sévérité du déséquilibre entre les variances et les tailles des groupes. Sur le plan théorique, la valeur des degrés de liberté dicte précisément la morphologie géométrique de la courbe de distribution t de Student : plus les degrés de liberté sont élevés, plus la loi de Student s’amincit au niveau de ses extrémités pour converger asymptotiquement vers la loi normale centrée réduite standard (Z).
7. Interprétation du t statistique observé (t Stat)
7.1 Signification mathématique et conceptuelle de « t Stat »
La cellule répertoriée sous l’intitulé « t Stat » (ou Statistique t) représente le cœur mathématique et la résultante synthétique du calcul inférentiel exécuté par Microsoft Excel. Sur le plan conceptuel, le t Stat est un ratio sans unité qui quantifie l’écart standardisé séparant la différence de moyennes observée empiriquement de la différence théorique postulée sous l’hypothèse nulle. C’est l’expression numérique rigoureuse de la confrontation entre le « signal » d’intérêt expérimental et le « bruit » résiduel aléatoire :
t Stat = (Signal) / (Bruit) = ( (x̄₁ – x̄₂) – Δ₀ ) / SE_(différence)
Une lecture intuitive et rigoureuse de cette statistique invite à la concevoir comme une mesure d’éloignement exprimée en unités d’erreur standard. Un t Stat de 3,45 signifie que la différence mesurée entre les deux moyennes échantillonnales se situe à exactement 3,45 erreurs types au-delà de la valeur zéro attendue sous l’hypothèse nulle. Plus la valeur absolue du t Stat est substantielle, plus la divergence constatée entre les deux groupes expérimentaux dépasse ce que le simple hasard de l’échantillonnage produit habituellement dans un univers où l’hypothèse nulle serait strictement vérifiée.
À l’inverse, une valeur de t Stat oscillant autour de zéro, ou comprise dans un intervalle étroit entre -1,0 et +1,0, indique que l’écart séparant les deux groupes est d’un ordre de grandeur parfaitement comparable à la fluctuation aléatoire attendue au sein d’échantillons de ces dimensions. Dans cette dernière circonstance, le signal expérimental est littéralement noyé dans le bruit de mesure, interdisant toute déduction quant à l’existence d’une divergence systématique entre les populations investiguées.
7.2 Interprétation de la polarité (signe positif ou négatif)
La présence récurrente d’un signe arithmétique négatif précédant la valeur numérique du t Stat constitue une source majeure de désarroi chez les analystes débutants, conduisant fréquemment à des interrogations superflues quant à la validité globale de l’analyse. Il convient d’affirmer avec force que la polarité (positive ou négative) du t Stat n’a strictement aucune incidence sur la puissance statistique de l’effet ni sur sa significativité probabiliste fondamentale.
Le signe de la statistique observée découle purement et simplement de l’ordre spatial arbitraire selon lequel les colonnes de données ont été sélectionnées dans la boîte de dialogue d’Excel. L’algorithme opère invariablement la soustraction suivante :
Différence = Moyenne de la Variable 1 – Moyenne de la Variable 2
Par conséquent, si la moyenne empirique de la série de données renseignée dans la boîte « Plage de la variable 1 » s’avère numériquement inférieure à celle assignée à la « Plage de la variable 2 », le numérateur devient négatif, conférant immédiatement un signe négatif à la statistique t finale. Si l’analyste avait inversé l’ordre de sélection des plages lors du paramétrage initial en désignant la seconde colonne comme Variable 1, le t Stat obtenu afficherait exactement la même valeur absolue, mais dotée d’une polarité positive.
Lors de la confrontation du t Stat avec les tables ou seuils critiques, il est impératif de considérer sa valeur absolue, formalisée par la notation mathématique |t Stat|. L’unique pertinence interprétative du signe réside dans sa cohérence avec l’orientation substantielle d’une hypothèse de recherche unilatérale : l’analyste doit simplement s’assurer que le sens du différentiel observé (positif ou négatif) concorde scrupuleusement avec la direction prédite a priori dans son cadre conceptuel théorique.
7.3 Relation entre t Stat et l’erreur type de mesure
Pour approfondir la compréhension diagnostique de la métrique t Stat, il est instructif de décortiquer les dynamiques biométriques et échantillonnales qui conditionnent sa magnitude finale. La formule fondamentale révèle que le t Stat est le produit de deux forces d’interaction : l’amplitude brute de l’effet d’une part, et l’erreur type de mesure d’autre part. L’erreur type (SE), logée au dénominateur, intègre à la fois la dispersion intrinsèque des observations et les effectifs d’échantillonnage :
SE = √(s₁²/n₁ + s₂²/n₂)
Cette relation analytique met en exergue deux mécanismes cruciaux :
- L’impact de la dispersion intra-groupe : Si la variabilité interne des sujets est massive (fortes variances s₁² et s₂²), le dénominateur croît exponentiellement, écrasant littéralement la valeur de t Stat vers zéro. Le bruit masque alors totalement le signal, rendant impossible la mise en évidence d’un effet pourtant réel dans la nature.
- L’effet multiplicateur de la taille d’échantillon : Puisque les effectifs n₁ et n₂ figurent aux dénominateurs des fractions de variance, l’augmentation du nombre de sujets réduit mécaniquement l’erreur type de manière proportionnelle à √n. En conséquence directe, avec un échantillon colossal de 10 000 sujets, un écart infinitésimal et dénué de tout intérêt clinique ou pratique entre deux moyennes peut générer un t Stat spectaculairement élevé.
Cette réalité arithmétique rappelle la distinction épistémologique formelle qui sépare la significativité statistique de l’importance substantielle ou clinique d’un résultat empirique. Un t Stat astronomique garantit que la divergence observée n’est pas le fruit du hasard, mais il ne certifie en aucun cas que cette divergence possède une utilité opérationnelle réelle dans le monde tangible.
8. Analyse des seuils décisionnels : Les valeurs critiques de Student
8.1 Ligne t Critique (unilatéral) / t Critical one-tail
Dans la zone inférieure du tableau récapitulatif généré par Excel, deux lignes sont dévolues à l’indication des « valeurs critiques ». La première d’entre elles s’intitule « t Critique (unilatéral) » ou t Critical one-tail dans la déclinaison anglaise de la suite bureautique. Cette valeur numérique représente le point de rupture géographique exact délimitant la frontière de la région de rejet de l’hypothèse nulle sous la condition expresse d’une distribution probabiliste unilatérale à une seule extrémité (queue).
Cette borne critique est fonction de deux paramètres statistiques : le seuil de signification alpha (α, calibré par défaut à 0,05 dans les algorithmes d’Excel) et le nombre de degrés de liberté (df). Dans un test unilatéral, l’intégralité du risque d’erreur de première espèce de 5 % est massivement concentrée sur une unique extrémité de la courbe symétrique de Student. La valeur critique indique le nombre d’erreurs types dont le t Stat doit impérativement s’éloigner de zéro dans la direction prédite pour pouvoir décréter le rejet formel de H₀.
La règle décisionnelle classique s’énonce de la manière suivante : si la valeur absolue du t statistique observé surpasse strictement la borne du t critique unilatéral (|t Stat| > t Critique), et sous réserve que le signe de la statistique concorde avec la direction stipulée dans l’hypothèse de recherche, l’hypothèse nulle est réfutée au profit de l’hypothèse alternative directionnelle. Toutefois, l’usage de cette ligne critique requiert une justification méthodologique préalable inattaquable : l’orientation du test devait être formulée avant la collecte des données et adossée à une certitude théorique documentée.
8.2 Ligne t Critique (bilatéral) / t Critical two-tail
La ligne suivante, intitulée « t Critique (bilatéral) » ou t Critical two-tail, consigne le seuil d’inférence le plus universellement mobilisé au sein de la recherche expérimentale et des publications académiques internationales. Dans le paradigme du test bilatéral (non directionnel), le risque de première espèce de 5 % (α = 0,05) est équitablement scindé en deux segments d’égale superficie probabiliste de 2,5 % (α/2 = 0,025) positionnés symétriquement à chacune des deux extrémités extrêmes de la courbe de Student.
En vertu de cette répartition bilatérale du risque statistique, le seuil critique s’éloigne mathématiquement de zéro comparativement à la borne unilatérale. Pour un nombre infini de degrés de liberté, la valeur critique bilatérale converge vers la constante universelle z de 1,96 (tandis que le seuil unilatéral s’établit à 1,645). Pour des degrés de liberté plus restreints, par exemple df = 20, le seuil bilatéral calculé par Excel s’élèvera à 2,086. Ce seuil définit un intervalle géométrique d’acceptation compris entre -t_critique et +t_critique. Si le t Stat calculé échoue à s’extraire de ce corridor (par exemple, si t Stat = 1,45 face à un seuil critique de 2,086), le résultat est déclaré non significatif.
Inversement, dès lors que le t statistique observé s’aventure au-delà des frontières critiques (t Stat > 2,086 ou t Stat < -2,086, soit |t Stat| > t Critique (bilatéral)), l’analyste pénètre dans la zone de rejet de l’hypothèse nulle. Cette règle de décision constitue le standard de rigueur académique minimal : elle certifie que la divergence empirique entre les deux groupes d’échantillons est suffisamment prononcée pour qu’il soit extrêmement improbable de l’observer sous les auspices du seul hasard.
8.3 Concordance entre la méthode des valeurs critiques et celle des p-valeurs
L’Utilitaire d’analyse d’Excel offre simultanément deux prismes de lecture distincts pour trancher le sort de l’hypothèse nulle : l’évaluation par comparaison des statistiques aux valeurs critiques (t Stat versus t Critique) d’une part, et l’évaluation par analyse probabiliste de la p-valeur (P(T<=t)) d’autre part. Il est capital de souligner que ces deux approches méthodologiques sont rigoureusement équivalentes sur le plan formel : elles constituent les deux faces géométriques et algébriques d’une même vérité inférentielle.
Cette équivalence parfaite s’articule autour des constats mathématiques suivants :
- Chaque fois que la valeur absolue de la statistique observée excède strictement la valeur critique (|t Stat| > t Critique), la p-valeur associée est systématiquement et obligatoirement inférieure ou égale au seuil de risque (p ≤ 0,05). Dans ces conditions invariables, la décision formelle est le rejet de l’hypothèse nulle.
- Inversement, dès lors que la statistique observée échoue à atteindre le seuil critique (|t Stat| ≤ t Critique), la p-valeur calculée sera mathématiquement supérieure au niveau alpha (p > 0,05). La décision procédurale qui s’impose est le non-rejet de l’hypothèse nulle.
Si la méthode géométrique de la valeur critique présente une vertu pédagogique indéniable pour visualiser la distribution d’échantillonnage et les zones de rejet, la pratique éditoriale contemporaine lui préfère massivement la communication de la p-valeur exacte. La p-valeur délivre une information continue sur la force des preuves empiriques accumulées contre H₀, tandis que le simple test par valeur critique se borne à une décision dichotomique aveugle au degré de proximité avec la frontière de rejet.
9. L’interprétation rigoureuse de la p-valeur : P(T<=t)
9.1 Distinction entre P(T<=t) unilatéral et bilatéral
Dans la taxonomie textuelle adoptée par Microsoft Excel, la probabilité critique, universellement connue sous l’appellation de p-valeur (p-value), est répertoriée sous la désignation formalisée « P(T<=t) unilatéral » et « P(T<=t) bilatéral » (ou P(T<=t) one-tail et P(T<=t) two-tail). Sur le plan épistémologique, la p-valeur quantifie la probabilité exacte d’observer, dans une population où l’hypothèse nulle H₀ serait rigoureusement vraie, un différentiel entre les moyennes empiriques au moins aussi extrême ou spectaculaire que celui effectivement constaté au sein des échantillons de l’étude.
La ligne « P(T<=t) unilatéral » intègre la masse de probabilité sous-tendue par la loi de Student sur une seule queue de distribution, correspondant à la zone située au-delà de la coordonnée définie par |t Stat|. Cette ligne ne doit être mobilisée que si le protocole expérimental a formalisé une hypothèse purement directionnelle et que les données empiriques ont progressé dans le sens exact de cette prédiction. Dans tous les autres contextes exploratoires ou standard, c’est impérativement la ligne « P(T<=t) bilatéral » qui doit faire autorité.
La relation arithmétique unissant ces deux métriques est d’une remarquable simplicité, découlant directement de la symétrie de la distribution t de Student : la p-valeur bilatérale est rigoureusement égale au double de la p-valeur unilatérale :
P(T<=t) bilatéral = 2 × P(T<=t) unilatéral
Cette relation d’amplification mécanique démontre la pénalité statistique imposée par la prudence du modèle bilatéral : une différence de moyennes affichant une significativité séduisante de 0,03 en unilatéral basculera à 0,06 en bilatéral, franchissant la frontière de rejet et imposant de déclarer le résultat non significatif selon les standards académiques conventionnels.
9.2 Règles de décision statistique formelles
Le traitement interprétatif de la p-valeur bilatérale obéit à une heuristique rigoureuse standardisée régie par la confrontation directe avec le seuil conventionnel α = 0,05. Deux configurations exclusives s’offrent alors à l’analyste :
- Configuration 1 : La p-valeur est inférieure ou égale à 0,05 (p ≤ 0,05). L’analyste conclut formellement au rejet de l’hypothèse nulle au profit de l’hypothèse alternative. Il est légitime d’affirmer que les deux moyennes empiriques présentent une différence « statistiquement significative ». Les données empiriques réunies fournissent un faisceau de preuves jugé suffisamment convaincant pour juger peu plausible que cet écart provienne du seul hasard d’échantillonnage.
- Configuration 2 : La p-valeur est strictement supérieure à 0,05 (p > 0,05). L’analyste conclut au non-rejet de l’hypothèse nulle. Il est alors rigoureusement impératif d’affirmer que « les données ne permettent pas de mettre en évidence une différence statistiquement significative entre les deux groupes ».
À ce stade, une mise en garde méthodologique fondamentale s’impose contre une erreur de formulation dramatiquement répandue : le non-rejet de l’hypothèse nulle n’équivaut absolument jamais à son acceptation ou à la preuve de sa vérité. Déclarer qu’une p-valeur de 0,23 prouve que les deux populations sont identiques constitue une hérésie scientifique majeure. L’absence de preuve statistique n’est pas la preuve de l’absence d’effet. Un résultat non significatif traduit simplement le fait que les données empiriques recueillies, compte tenu de leur dispersion et de la taille de l’échantillon, ne disposent pas d’une puissance statistique suffisante pour répudier l’hypothèse nulle avec une marge d’erreur maîtrisée.
Par ailleurs, la pratique consistant à surinterpréter les résultats affichant des p-valeurs dites « marginales » (typiquement comprises entre 0,051 et 0,099) en recourant à des formules de complaisance telles que « tendance vers la significativité » est fermement réprouvée par les méthodologistes les plus stricts. Sauf justification exploratoire expressément contextualisée, un seuil fixé à 0,05 demeure infranchissable, et toute probabilité supérieure à ce seuil doit être traitée comme non significative.
9.3 Gestion de la notation scientifique dans Excel
L’un des pièges informatiques les plus pernicieux de Microsoft Excel réside dans sa manière d’afficher les probabilités infinitésimales. Lorsqu’une différence de moyennes est extraordinairement prononcée, la p-valeur générée peut comporter un nombre considérable de zéros après la virgule (par exemple 0,0000345). Pour économiser l’espace visuel des cellules sans élargir démesurément les colonnes, le tableur bascule automatiquement l’affichage vers la notation scientifique exponentielle internationale.
Dans cette configuration, l’analyste découvrira dans la cellule P(T<=t) une chaîne de caractères telle que 3,45E-05 (ou 3,45e-05). Une méconnaissance de ce mode d’affichage engendre régulièrement des erreurs de lecture aux conséquences tragiques : l’utilisateur inexpérimenté, focalisant son attention sur les chiffres initiaux « 3,45 », interprète ce résultat comme un chiffre largement supérieur à 0,05 et en déduit à tort l’absence de significativité. En réalité, le suffixe E-05 (pour 10⁻⁵) commande de translater le séparateur décimal de cinq crans vers la gauche :
3,45E-05 = 3,45 × 10⁻⁵ = 0,0000345
Cette probabilité est colossalement inférieure au seuil de 0,05, signalant un niveau de significativité statistique écrasant. Pour éviter toute confusion visuelle, il est vivement recommandé de modifier le formatage de la cellule dans Excel en passant par le clic droit, « Format de cellule », puis en sélectionnant la catégorie « Nombre » en spécifiant quatre à six décimales. Lors de la transcription ultérieure de ce résultat dans un article de recherche ou un rapport d’entreprise, il est formellement proscrit de retranscrire la notation brute 3,45E-05 ou p = 0,000 : la convention académique universelle exige d’inscrire la formule standardisée p < 0,001.
10. Au-delà de la significativité : Calcul et interprétation de la taille d’effet
10.1 Limites inhérentes à la seule p-valeur
Au cours des dernières décennies, les instances méthodologiques internationales, à l’instar de l’American Psychological Association (APA) et de l’American Statistical Association (ASA), ont multiplié les avertissements formels contre la dépendance exclusive de la recherche envers la seule significativité dichotomique guidée par la p-valeur. La vulnérabilité cardinale de la p-valeur réside dans sa sensibilité intrinsèque à la taille d’échantillon (N). Dès lors que l’effectif d’étude franchit des seuils massifs (plusieurs milliers de cas), l’erreur standard tend asymptotiquement vers zéro, conférant une significativité statistique étincelante (p < 0,001) à des différences brutes infinitésimales totalement dénuées de toute utilité pratique ou clinique.
Inversement, dans des études pionnières caractérisées par des cohortes restreintes mais un protocole d’une méticulosité exemplaire, un effet interventionnel d’une puissance thérapeutique colossale peut échouer à atteindre le seuil couperet de p ≤ 0,05 en raison d’un manque de puissance d’échantillonnage, conduisant au rejet injustifié d’innovations porteuses. La p-valeur informe l’analyste sur la probabilité que le signal provienne du hasard, mais ne fournit rigoureusement aucun indice sur l’amplitude substantive de ce signal.
Pour s’émanciper de cet écueil et répondre aux exigences éditoriales des comités de lecture scientifiques contemporains, l’analyste ne peut se contenter d’extraire les sorties brutes d’Excel. Il doit obligatoirement compléter son diagnostic par l’estimation standardisée de la taille d’effet (effect size), métrique invariante et insensible à la taille d’échantillon qui quantifie la force intrinsèque de la divergence étudiée.
10.2 Calcul du d de Cohen à partir des résultats d’Excel
L’indicateur le plus universel et standardisé pour mesurer la taille d’effet entre deux moyennes indépendantes est le d de Cohen (Jacob Cohen, 1988). Bien que l’Utilitaire d’analyse d’Excel ne génère pas nativement cet indice dans son tableau de sortie standard, l’utilisateur avisé peut l’extraire immédiatement via une formule élémentaire en mobilisant les cellules produites par le test t.
La formulation algébrique originelle du d de Cohen exprime l’écart brut entre les moyennes rapporté à l’écart-type combiné :
d = (x̄₁ – x̄₂) / s_combiné
Dans le cas du modèle pour variances égales, l’écart-type combiné s’obtient directement par la racine carrée arithmétique de la cellule « Variance groupée ». Dès lors, dans la feuille Excel, l’analyste peut insérer la formule suivante (en supposant que les moyennes figurent en B4 et C4, et la variance groupée en B7) :
=ABS(B4-C4)/RACINE(B7)
Alternativement, une méthode élégante permet d’extraire le d de Cohen sans recourir aux statistiques descriptives brutes, en mobilisant exclusivement la statistique t et les degrés de liberté figurant dans la sortie :
d = (2 × |t Stat|) / √df
Dans la situation où le modèle pour variances inégales (test de Welch) a été retenu, l’utilisation de la variance groupée devient caduque. L’analyste doit alors calculer l’écart-type composite moyen en employant la formule adaptée :
s_moyen = √[ (s₁² + s₂²) / 2 ]
Le différentiel des moyennes divisé par ce diviseur fournit l’estimation rigoureuse de la taille d’effet sous hétéroscédasticité, garantissant une communication métrologique irréprochable.
10.3 Interprétation des repères conventionnels de Cohen
Une fois le coefficient d extrait et documenté, son interprétation quantitative s’appuie sur la taxonomie standardisée établie par Jacob Cohen, laquelle fournit des repères empiriques conventionnels largement adoptés par la communauté scientifique :
- Effet négligeable ou trivial : |d| < 0,20. La différence entre les deux distributions est imperceptible à l’œil nu ; le chevauchement des deux populations dépasse 92 %. L’effet, même s’il s’avère statistiquement significatif sur un très vaste échantillon, n’a que peu d’impact pratique.
- Effet faible (small effect) : 0,20 ≤ |d| < 0,50. L’écart commence à présenter une substance concrète, typique d’interventions sociologiques ou éducatives complexes où de multiples covariables inobservées diluent l’impact direct du traitement.
- Effet moyen (medium effect) : 0,50 ≤ |d| < 0,80. L’effet est clairement visible à l’échelle d’une population et engendre des conséquences diagnostiques ou opérationnelles majeures. C’est l’ordre de grandeur recherché par la plupart des essais cliniques ciblant une réponse clinique nette.
- Effet fort (large effect) : |d| ≥ 0,80. La divergence entre les populations est manifeste et robuste, traduisant une rupture nette sous l’influence du facteur expérimental. Un indice d = 1,00 signifie que la moyenne du groupe expérimental se situe à un écart-type complet au-dessus de celle du groupe contrôle.
Toutefois, une contextualisation critique demeure impérative : un effet qualifié de « faible » selon la nomenclature abstraite de Cohen (d = 0,20) peut s’avérer monumental à l’échelle de la santé publique s’il concerne une réduction de la mortalité cardiovasculaire induite par une prescription préventive massive. De surcroît, le calcul de la taille d’effet gagne à être enrichi par la construction de son intervalle de confiance à 95 % (IC 95 %), délimitant la plage de plausibilité de l’effet dans la population générale.
11. Rédaction et communication des résultats selon les normes académiques (APA 7)
11.1 Structure textuelle d’un compte rendu statistique complet
La transcription des analyses de données dans un article scientifique, une thèse de doctorat ou un rapport d’évaluation stratégique ne tolère aucune improvisation terminologique. L’Association Américaine de Psychologie a standardisé dans sa 7e édition (APA 7) un protocole de formalisation typographique et syntaxique strict, adopté à l’échelle planétaire dans les sciences du comportement, la médecine, le management et l’ingénierie humaine. La communication formelle d’un test t ne se résume jamais à la simple juxtaposition d’une p-valeur dans un texte narratif.
Un compte rendu conforme aux standards de rigueur exige l’incorporation conjointe et ordonnée de cinq composants statistiques incontournables :
- Les statistiques descriptives complètes de chaque groupe d’étude, spécifiant impérativement la moyenne arithmétique (M) et l’écart-type (SD pour Standard Deviation), impérativement arrondis à deux décimales après la virgule.
- L’identifiant formel de la distribution d’échantillonnage, matérialisé par la lettre t inscrite en italique minuscule, immédiatement suivie de la valeur des degrés de liberté consignée entre parenthèses : t(df).
- La valeur numérique de la statistique observée t Stat, arrondie à deux décimales, précédée du signe égal sans espace et assortie de sa polarité intrinsèque.
- La p-valeur exacte arrondie à trois décimales, inscrite avec la lettre p en italique (par exemple p = ,024 ; la norme anglophone omettant le zéro avant la virgule pour les bornes limitées à 1, tandis que l’usage francophone tolère p = 0,024). Si la probabilité est inférieure à 0,001, on inscrit rigoureusement p < ,001.
- L’indice standardisé de la taille d’effet, incarné par le d de Cohen en italique, rapporté à deux décimales.
11.2 Exemples concrets de rédaction académique
Pour illustrer la mise en application immédiate de cette armature formelle au départ des données produites par Microsoft Excel, examinons deux cas de figure méthodologiques fréquemment rencontrés dans la pratique de recherche.
Exemple 1 : Cas d’un test statistiquement significatif (rejet de l’hypothèse nulle).
Imaginons un protocole opposant une méthode d’apprentissage immersive (Groupe Expérimental, n = 35) à une méthode conventionnelle (Groupe Témoin, n = 35). Le tableau d’Excel rapporte : Moyennes de 78,45 contre 69,12 ; Variances de 121,30 et 114,80 ; df = 68 ; t Stat = 3,59 ; P(T<=t) bilatéral = 0,00062 ; d = 0,86. La rédaction académique s’articule ainsi :
« Un test t de Student pour échantillons indépendants a été mené afin de comparer les performances d’acquisition entre les deux modalités pédagogiques. Les analyses révèlent une différence statistiquement significative en faveur de la méthode immersive, qui engendre des scores moyens d’apprentissage significativement supérieurs (M = 78,45, SD = 11,01) à ceux enregistrés au sein du groupe conventionnel (M = 69,12, SD = 10,71), t(68) = 3,59, p < ,001, d = 0,86. Conformément aux critères de Cohen, cette divergence traduit une taille d’effet forte, démontrant l’efficacité substantielle du dispositif immersif. »
Exemple 2 : Cas d’un test non significatif (non-rejet de l’hypothèse nulle avec test de Welch).
Considérons une évaluation ergonomique opposant deux interfaces web avec variances inégales : Moyennes de 14,20 s contre 15,10 s ; df = 41,2 ; t Stat = -1,15 ; P(T<=t) bilatéral = 0,256 ; d = 0,34. La rédaction adéquate se structure de la manière suivante :
« Un test t de Welch pour échantillons indépendants avec correction pour hétéroscédasticité a été conduit pour déterminer l’impact de la version de l’interface sur le temps d’exécution de la tâche. Aucune différence statistiquement significative n’a pu être mise en évidence entre l’interface alternative (M = 14,20, SD = 3,10) et l’interface standard (M = 15,10, SD = 2,15), t(41,2) = -1,15, p = ,256, d = 0,34. Les données empiriques actuelles ne permettent pas de rejeter l’hypothèse nulle d’équivalence opérationnelle entre les deux environnements numériques. »
11.3 Conception de tableaux et graphiques récapitulatifs dans Excel
L’argumentation scientifique gagne une force démonstrative considérable lorsqu’elle s’appuie sur une synthèse visuelle épurée et normalisée. Microsoft Excel permet de concevoir des représentations graphiques parfaitement adaptées aux exigences des publications scientifiques, à condition de bannir formellement les formats par défaut encombrés d’artifices visuels inutiles (effets 3D, ombrages, quadrillages denses et dégradés de couleurs criards).
Le standard académique préconise la création d’un diagramme en colonnes (ou bâtons) représentant la moyenne de chaque condition expérimentale sur l’axe vertical des ordonnées, complété par l’insertion systématique de barres d’erreur (error bars). L’analyste doit choisir de manière délibérée et explicite l’indicateur métrologique ancré sur ces barres :
- L’écart-type de l’échantillon (SD), calculé via la racine carrée des variances, qui renseigne le lecteur sur la variabilité biologique ou comportementale réelle existant au sein de chaque groupe.
- L’erreur standard de la moyenne (SEM), correspondant à SD / √n, qui focalise le message visuel sur la précision de l’estimation de la moyenne par échantillonnage.
- L’intervalle de confiance à 95 % (IC 95 %), calculé via la fonction Excel
=INTERVALLE.CONFIANCE.T(0,05; SD; n), qui constitue la représentation visuelle la plus puissante : l’absence de chevauchement visuel entre les barres d’erreur de deux groupes constitue souvent un indicateur immédiat d’une forte probabilité de significativité statistique bilatérale.
Sur le plan tabulaire, un tableau récapitulatif APA dans Excel doit adopter une sobriété spartiate : présence stricte de trois lignes horizontales noires de délimitation (une sous le titre du tableau, une sous la ligne d’en-tête de colonnes et une clôturant le bas du tableau avant les notes de bas de page), et proscription totale des bordures verticales séparatrices de cellules.
12. Erreurs courantes, pièges méthodologiques et bonnes pratiques
12.1 Confusions conceptuelles fréquentes lors de l’interprétation
L’analyse des pratiques au sein des laboratoires et des services d’études statistiques révèle la persistance de confusions épistémologiques récurrentes lors de l’interprétation des sorties informatisées. La première d’entre elles réside dans la confusion pernicieuse entre l’écart-type de l’échantillon et l’erreur type de la moyenne. Si l’écart-type quantifie la variance phénoménologique réelle et incompressible propre aux individus composant l’échantillon, l’erreur standard n’est qu’un artéfact probabiliste reflétant la fluctuation de notre propre estimation mathématique sous l’effet de la taille de la cohorte. Confondre ces deux notions conduit soit à minimiser artificiellement la dispersion des sujets, soit à mal étalonner les intervalles de plausibilité de l’effet.
La deuxième dérive conceptuelle concerne la nature probabiliste exacte de la p-valeur. Une proportion considérable de praticiens continue d’affirmer à tort que la p-valeur quantifie « la probabilité que l’hypothèse nulle soit vraie » ou « la probabilité que les résultats observés soient le fruit pur du hasard ». Il s’agit d’une inversion conditionnelle majeure (le sophisme de la transposition de conditionnelle). En logique inférentielle fréquentiste, l’hypothèse nulle n’est pas une variable aléatoire dotée d’une distribution : elle est fixée comme une certitude opérationnelle a priori. La p-valeur calcule exclusivement la probabilité d’observer les données conditionnellement à la vérité absolue de H₀, formellement exprimée par P(Données | H₀), et non la probabilité inverse P(H₀ | Données), laquelle ne peut être calculée que dans le cadre d’une modélisation bayésienne.
Enfin, une vigilance critique doit être portée sur la tentation immorale du p-hacking par l’emploi opportuniste de tests unilatéraux non justifiés. Découvrir une p-valeur bilatérale de 0,07 et décider rétroactivement de basculer sur la ligne « P(T<=t) unilatéral » (divisant ainsi artificiellement le chiffre par deux pour atteindre 0,035 et clamer une victoire expérimentale) constitue une faute déontologique sévère. Le choix d’un test unilatéral doit être gravé dans le marbre du protocole pré-expérimental avant la saisie de la moindre donnée numérique dans Excel.
12.2 Biais techniques spécifiques à l’environnement Excel
Au-delà des méprises théoriques, Microsoft Excel présente des singularités ergonomiques et logicielles susceptibles d’induire en erreur le praticien non averti. Le premier piège réside dans le caractère statique de l’Utilitaire d’analyse. Contrairement aux formules dynamiques usuelles du tableur (telles que =MOYENNE() ou =SOMME()), les tableaux générés par l’Utilitaire d’analyse ne se recalculent jamais automatiquement en cas de mise à jour, de correction ou d’adjonction de données au sein des colonnes sources.
Si l’analyste rectifie une valeur aberrante en cellule A12 ou incrémente son jeu de données de dix nouveaux participants, le tableau matriciel affichant le t Stat et la p-valeur demeure figé dans son état initial. Toute diffusion de ces résultats non actualisés engendre la propagation d’erreurs matérielles substantielles. Dès lors qu’une modification intervient sur la matrice brute, l’analyste doit impérativement relancer l’outil d’analyse et écraser le tableau récapitulatif précédent.
Un deuxième écueil technique concerne la gestion silencieuse des cellules non conformes. Si une plage sélectionnée intègre des cellules contenant des espaces typographiques insoupçonnés, des chaînes de caractères masquées ou des valeurs nulles encodées par erreur textuelle, Excel peut, selon les versions, exclure silencieusement ces lignes du décompte des « Observations » sans émettre le moindre avertissement visuel explicite. Il en résulte une perte insidieuse de puissance statistique et une altération imperceptible du calcul des degrés de liberté. Une inspection rigoureuse de la ligne Observations par comparaison directe avec la fonction =NB() appliquée aux colonnes brutes doit être systématiquement opérée.
12.3 Guide de contrôle systématique avant validation des résultats
Pour prémunir l’analyste contre toute bévue méthodologique et sécuriser l’intégrité de ses conclusions avant la dissémination publique ou institutionnelle de ses travaux, la grille d’audit de qualité suivante récapitule les contrôles préalables impératifs :
- Audit 1 : Cohérence des effectifs. Le nombre consigné sur la ligne « Observations » correspond-il strictement au volume d’individus effectivement recrutés, nettoyés et validés par le protocole expérimental initial ?
- Audit 2 : Recoupement des moyennes descriptives. Les moyennes générées dans le tableau récapitulatif concordent-elles au centième près avec l’exécution parallèle des formules natives
=MOYENNE(plage)appliquées manuellement sur les données d’origine ? - Audit 3 : Justification formelle du modèle de variance. Le choix entre l’outil « variances égales » et « variances inégales » repose-t-il sur un diagnostic empirique documenté (test F préalable ou ratio systématique des variances observées) ?
- Audit 4 : Vérification de la polarité et de l’orientation. Le signe du t Stat a-t-il été interprété en stricte adéquation avec l’ordre de désignation des plages de variables ? L’analyste s’est-il abstenu de considérer un t Stat négatif comme un indicateur d’invalidité ?
- Audit 5 : Répudiation de la notation scientifique brute. Les cellules P(T<=t) ont-elles fait l’objet d’un examen minutieux pour détecter d’éventuels suffixes exponentiels (ex.
E-04), interdisant toute confusion visuelle lors de la rédaction finale ? - Audit 6 : Intégration systématique de la taille d’effet. La p-valeur a-t-elle été scrupuleusement assortie du calcul explicite du d de Cohen et de son intervalle de plausibilité afin de renseigner sur la pertinence pratique de la découverte ?
La mise en œuvre consciencieuse et systématique de cette procédure de vérification garantit l’excellence des inférences tirées de Microsoft Excel, transformant un simple outil de bureautique en un instrument d’analyse statistique d’une fiabilité et d’une crédibilité scientifique incontestables.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92-101. https://doi.org/10.5334/irsp.82
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Microsoft Corporation. (2023). Utiliser l’Utilitaire d’analyse pour effectuer des analyses statistiques complexes. Support Microsoft. https://support.microsoft.com/fr-fr/office/utiliser-l-utilitaire-d-analyse
- Rasch, D., Kubinger, K. D., & Moder, K. (2011). The two-sample t-test: Pre-testing its assumptions does not pay off. Statistical Papers, 52(1), 219-231. https://doi.org/10.1007/s00362-009-0224-x
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108