
L’inférence statistique contemporaine au sein des sciences du comportement et de la neuropsychologie clinique repose sur un équilibre subtil entre exigences théoriques et contingences matérielles. Alors que les modèles gaussiens classiques postulent une connaissance préalable de la variance populationnelle ou des cohortes d’une envergure suffisante pour invoquer le théorème central limite, les praticiens et chercheurs en psychologie sont quasi systématiquement confrontés à des échantillons d’effectifs restreints. Qu’il s’agisse de documenter l’efficacité d’une remédiation cognitive auprès de patients cérébrolésés, de quantifier les temps de réaction sous stress aigu ou d’évaluer les marqueurs neurophysiologiques de troubles rares, la contrainte de recrutement impose un paradigme probabiliste rigoureux capable d’intégrer formellement l’incertitude induite par l’estimation conjointe de la moyenne et de la dispersion.
Dans ce contexte méthodologique exigeant, la loi de Student s’impose non pas comme un simple substitut d’approximation, mais comme la clé de voûte de l’inférence paramétrique sur petits échantillons. Formalisée pour pallier l’inadéquation de la loi normale lorsque l’écart-type de la population demeure inconnu et doit être estimé à partir des données empiriques, cette distribution incorpore directement la variance d’échantillonnage dans la géométrie de ses probabilités. L’avènement des environnements computationnels modernes, singulièrement l’écosystème scientifique articulé autour du langage Python avec SciPy, NumPy et Pandas, confère aujourd’hui aux chercheurs une puissance de modélisation, de simulation et de diagnostic statistique sans précédent.
Le présent traité méthodologique propose une exploration exhaustive, rigoureuse et concrète de l’utilisation de la distribution t de Student sous Python. Conçu pour les statisticiens appliqués, les chercheurs en psychométrie et les scientifiques des données comportementales, ce document articule les fondements mathématiques indispensables de la distribution aux techniques de programmation les plus avancées. De la modélisation formelle des densités aux tests robustes face aux déviations de normalité, en passant par le calcul exact des valeurs p, la calibration d’intervalles de confiance non biaisés et la formalisation des résultats selon les normes éditoriales de l’American Psychological Association (APA 7ème édition), ce guide constitue une référence intégrale pour l’analyse inférentielle moderne.
1. Fondements théoriques de la distribution t de Student en recherche psychologique
1.1 Origine mathématique et nécessité en sciences comportementales
L’émergence de la distribution t de Student découle directement des contraintes empiriques auxquelles fut confronté le chimiste et statisticien britannique William Sealy Gosset au début du XXe siècle, alors qu’il travaillait pour les brasseries Guinness. Contraint par une clause de confidentialité industrielle stricte l’empêchant de publier sous sa véritable identité, Gosset choisit en 1908 le pseudonyme de « Student » pour divulguer ses travaux pionniers. Son problème fondamental résidait dans l’évaluation de la qualité des matières premières agricoles à partir d’échantillons extrêmement restreints, une situation où l’écart-type de la population globale était inconnaissable et ne pouvait être que grossièrement approximé par l’écart-type de l’échantillon.
En sciences du comportement et en recherche clinique, cette problématique demeure omniprésente. Lorsqu’un protocole expérimental vise à mesurer l’effet d’une molécule psychoactive novatrice ou l’impact d’une psychothérapie ciblée chez des individus présentant une pathologie rare, le recrutement excède rarement quelques dizaines, voire une quinzaine de sujets. Sous de telles contraintes d’échantillonnage, substituer aveuglément l’écart-type empirique corrigé à l’écart-type théorique au sein d’une statistique z conduit à une sous-estimation dramatique de la dispersion réelle de l’estimateur de la moyenne.
Le théorème central limite garantit certes que la moyenne d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées converge vers une distribution normale. Néanmoins, pour des tailles d’échantillon faibles, la variabilité inhérente à l’estimation de l’écart-type empirique se combine à la variabilité de la moyenne elle-même. La loi de Student émerge mathématiquement comme le quotient exact d’une variable normale centrée réduite et de la racine carrée d’une variable distribuée selon une loi du khi-deux divisée par ses degrés de liberté. Elle absorbe ainsi structurellement le surcroît d’incertitude induit par l’absence d’information populationnelle sur la variance.
1.2 Comparaison structurelle : Distribution t versus Loi Normale centrée réduite
D’un point de vue morphologique, la distribution t de Student présente une silhouette en cloche symétrique autour de son espérance mathématique nulle, similaire en apparence à la loi normale centrée réduite standardisée z. Cependant, une analyse structurelle plus fine révèle des différences topologiques fondamentales qui conditionnent directement la fiabilité des inférences statistiques en neuropsychologie et en sciences cognitives. La divergence majeure réside dans le phénomène des queues épaisses ou heavy tails, caractérisé par un excès d’aplatissement (kurtosis) rigoureusement supérieur à zéro.
Dans la loi de Student, la densité de probabilité au centre de la distribution est inférieure à celle d’une loi normale, tandis que la densité allouée aux zones distales — les queues de distribution — est nettement plus substantielle. Ce différentiel implique qu’une déviation de deux ou trois écarts-types par rapport à la moyenne présente une probabilité d’occurrence intrinsèquement plus élevée sous une loi t que sous une loi normale. En neuropsychologie expérimentale, où les temps de réponse et les mesures d’inhibition cognitive manifestent une sensibilité exacerbée aux observations atypiques, postuler une loi normale sur de petits échantillons induit un taux d’erreur de première espèce substantiellement plus élevé que le seuil théorique nominal.
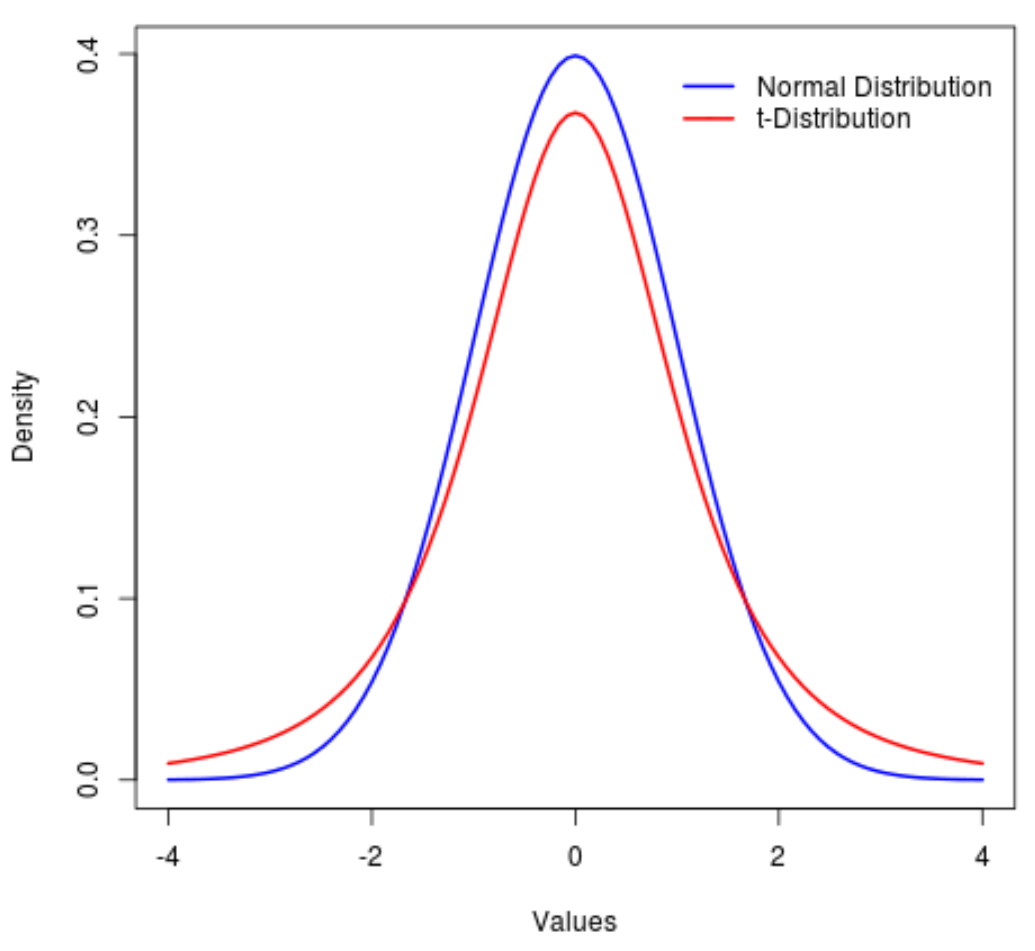
À mesure que la taille d’échantillon croît, l’estimation de l’écart-type gagne en consistance et en stabilité. Sur le plan asymptotique, la distribution t converge vers la distribution z normale lorsque ses degrés de liberté tendent vers l’infini. En pratique méthodologique, pour des degrés de liberté supérieurs à une centaine, l’écart entre les quantiles critiques des deux lois devient marginal. Toutefois, pour des protocoles restreints où n oscille entre 8 et 25 participants, négliger les queues épaisses de la loi de Student fausse lourdement le calcul de l’erreur type et expose le chercheur à rejeter indûment l’hypothèse nulle en présence de fluctuations purement aléatoires.
1.3 Le concept central des degrés de liberté (df)
Le paramètre structural unique régissant l’exacte configuration géométrique de la distribution t de Student standardisée est constitué par ses degrés de liberté, désignés par l’abréviation df (pour l’anglais degrees of freedom) ou par la lettre grecque nu. Mathématiquement, dans le cadre d’un échantillon indépendant de taille n destiné à estimer une moyenne, les degrés de liberté correspondent au nombre de valeurs indépendantes au sein du vecteur de données qui demeurent libres de varier après que l’estimateur de la moyenne a été calculé. Puisque le calcul de la somme des écarts à la moyenne empirique impose une contrainte arithmétique stricte (leur somme devant être nulle), un degré de liberté est mécaniquement consommé, fixant le nombre de degrés de liberté résiduels à n – 1.
L’influence de ce paramètre sur la morphologie de la courbe de densité est déterminante. Lorsque le paramètre df est très faible, par exemple égal à 2 ou 3, la distribution se caractérise par des queues excessivement lourdes et une base très étalée, traduisant une imprécision extrême sur la variance sous-jacente. Au fur et à mesure que les degrés de liberté augmentent, la probabilité se concentre progressivement autour du mode central, et les quantiles extrêmes se rapprochent des valeurs canoniques de la courbe de Gauss.
Le rôle opérationnel des degrés de liberté dans le contrôle de l’inflation de l’erreur alpha est capital en méthodologie scientifique. Fixer un seuil de significativité conventionnel à 5 % implique de localiser les quantiles bilatéraux délimitant 2,5 % de chaque côté de la distribution. Pour une loi normale, cette valeur critique se situe invariablement à 1,96. En revanche, pour une loi t dotée de 5 degrés de liberté (représentant une cohorte clinique de 6 sujets), la valeur critique s’élève à environ 2,571. Cette élévation automatique de l’exigence statistique ajuste l’incertitude mathématique et empêche une fausse découverte découlant de la petitesse de la cohorte observée.
2. Configuration de l’environnement Python pour l’inférence statistique
2.1 Écosystème scientifique : SciPy, NumPy et Pandas
L’analyse inférentielle moderne en psychologie quantitative exige un écosystème logiciel alliant rigueur calculatoire, traçabilité et reproductibilité intégrale. Au sein de la programmation en Python, ce socle repose sur l’articulation coordonnée de trois bibliothèques fondamentales du calcul scientifique. La bibliothèque NumPy fournit les structures de données sous-jacentes via des tableaux multidimensionnels homogènes optimisés, autorisant une manipulation vectorisée ultrarapide des matrices de scores psychométriques et des latences de réponse expérimentales.
En amont de toute modélisation probabiliste, la bibliothèque Pandas s’avère indispensable pour l’ingestion, le nettoyage, le filtrage et la structuration des cohortes expérimentales. Les structures tabulaires de type DataFrame permettent d’ordonner les variables indépendantes (telles que les groupes thérapeutiques ou les conditions d’amorçage cognitif) et les variables dépendantes continues, tout en offrant une traçabilité explicite lors du traitement des données manquantes, un impératif méthodologique récurrent en psychologie clinique.
Enfin, le sous-module spécialisé scipy.stats de la bibliothèque SciPy constitue le véritable moteur inférentiel pour l’analyse des distributions de probabilité continues et discrètes. Il intègre des dizaines de lois statistiques formalisées sous forme de classes génériques hautement optimisées, au sein desquelles la loi t de Student occupe une position centrale. Pour garantir la pérennité et la reproductibilité des protocoles computationnels, il est primordial de figer les versions de ces bibliothèques au moyen d’environnements virtuels isolés (via venv ou conda) documentés par des fichiers de dépendances stricts.
2.2 Importation et exploration de l’objet de distribution scipy.stats.t
Au sein de la bibliothèque SciPy, la distribution de Student est instanciée via l’objet scipy.stats.t. Cet objet hérite des fonctionnalités de la classe de base des variables aléatoires continues de SciPy, ce qui lui confère une interface cohérente et standardisée. L’importation s’effectue généralement de manière explicite depuis le sous-module statistique, permettant d’accéder directement à un ensemble étendu de méthodes analytiques et génératives sans introduire d’ambiguïté dans l’espace de noms du script d’analyse.
La paramétrisation de l’objet scipy.stats.t repose sur trois arguments structuraux essentiels. Le premier, df, représente les degrés de liberté, qui doivent être strictement positifs. Les deux paramètres additionnels, désignés par loc et scale, correspondent respectivement au paramètre de centrage (qui décale l’espérance mathématique de la distribution) et au paramètre d’échelle (qui dilate ou contracte l’axe des abscisses). Par défaut, loc=0 et scale=1, ce qui correspond à la loi t standardisée de Student. Dès lors qu’une moyenne empirique et une erreur type sont injectées dans ces paramètres, l’objet modélise directement la distribution d’échantillonnage non standardisée.
L’objet t expose un ensemble exhaustif de méthodes analytiques vectorisées, notamment rvs (pour la génération d’échantillons aléatoires), pdf (fonction de densité de probabilité), cdf (fonction de répartition cumulative), sf (fonction de survie), ppf (fonction quantile) et interval (calcul des bornes de confiance). L’implémentation algorithmique de ces fonctions repose sur des liaisons sous-jacentes compilées en C et Fortran, garantissant une stabilité numérique optimale en double précision à virgule flottante (standard IEEE 754), ce qui évite les phénomènes de sous-dépassement arithmétique dans l’estimation des probabilités d’événements extrêmes.
3. Génération de variables aléatoires suivant la distribution t
3.1 Utilisation pratique de la fonction t.rvs()
La génération de nombres pseudo-aléatoires distribués selon une loi de Student constitue un instrument indispensable pour la modélisation statistique avancée, l’analyse de puissance a priori par simulations et le développement de procédures d’étalonnage psychométrique. Sous SciPy, cette tâche est assurée par la méthode t.rvs(). Cette fonction accepte en paramètres obligatoires les degrés de liberté df, ainsi que les arguments optionnels de centrage loc, d’échelle scale et de dimensionnalité de sortie size.
Dans un contexte expérimental où l’on cherche à simuler des trajectoires comportementales d’individus sous protocole, la fixation rigoureuse de la reproductibilité algorithmique est un impératif déontologique et scientifique. Pour ce faire, il convient de proscrire l’usage des générateurs globaux dépréciés et d’exploiter l’argument random_state, auquel on transmet soit un entier faisant office de graine déterministe, soit une instance explicite de numpy.random.default_rng(), représentant le générateur moderne de permutations par congruence linéaire ou de type PCG64.
L’analyse descriptive des tenseurs générés permet de confronter immédiatement la structure empirique du tirage synthétique aux propriétés formelles du modèle théorique. Lorsque l’on extrait un vecteur unidimensionnel de scores synthétiques, l’application conjointe des méthodes numpy.mean() et numpy.std(ddof=1) permet de vérifier que, pour une taille d’échantillon suffisante, les estimateurs non biaisés oscillent harmonieusement autour des valeurs programmées pour loc et scale, tout en révélant l’instabilité typique inhérente aux petits tirages.
3.2 Simulation empirique de données psychologiques sous contrainte d’échantillon
Considérons un paradigme expérimental en neuropsychologie clinique dans lequel un chercheur souhaite modéliser les scores de réactivité au stress (mesurés par la variation du taux de cortisol salivaire en nanomoles par litre) au sein d’un échantillon clinique restreint de 12 patients souffrant de trouble de stress post-traumatique (TSPT). Dans ce scénario, n = 12 implique un paramètre de degrés de liberté df = 11. Supposons que l’échelle clinique standard établisse un score moyen de centrage de 25 unités avec une variabilité d’échelle calibrée à 4 unités.
Si l’on génère deux cohortes virtuelles de même dimension — l’une issue d’une distribution gaussienne pure via norm.rvs(loc=25, scale=4, size=12) et l’autre provenant d’une distribution de Student via t.rvs(df=11, loc=25, scale=4, size=12) —, la comparaison de leurs structures de dispersion s’avère hautement instructive. Dans le tirage gaussien, les observations se regroupent de manière dense autour de l’espérance, et l’apparition de scores dépassant trois écarts-types est quasi inexistante.
À l’inverse, l’échantillon généré selon la loi de Student manifeste une instabilité nettement plus représentative des réalités cliniques de terrain. En raison de la leptocurticité de la distribution parente, la probabilité d’enregistrer des observations isolées s’écartant sensiblement du noyau central est nettement plus élevée. Cette modélisation permet aux chercheurs d’anticiper la vulnérabilité de leurs indicateurs inférentiels face à l’émergence d’individus hypersensibles ou réfractaires, sans devoir invoquer immédiatement l’existence d’une sous-population pathologique distincte pour justifier la présence de scores extrêmes.
3.3 Validation de l’ajustement distributionnel des tirages
La conformité théorique d’un processus génératif basé sur t.rvs() nécessite une vérification rigoureuse au-delà de la simple inspection des moments du premier et du second ordre (moyenne et variance). Il est impératif d’évaluer les moments statistiques d’ordre supérieur, singulièrement le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Pour une distribution t de Student symétrique centrée en zéro avec df degrés de liberté, l’asymétrie théorique est rigoureusement nulle dès lors que df > 3, tandis que l’excès de kurtosis théorique est donné par l’expression analytique 6 / (df – 4) pour toute valeur de df > 4.
Sous Python, ces indicateurs peuvent être calculés sur des échantillons de grande envergure générés par simulation au moyen des fonctions scipy.stats.skew() et scipy.stats.kurtosis() (cette dernière calculant par défaut l’excès par rapport à la valeur gaussienne de 3). Lorsque df s’établit par exemple à 8, l’excès de kurtosis théorique vaut 6 / (8 – 4) = 1,5. En simulant un million de réalisations de cette variable, la kurtosis empirique converge avec une extrême fidélité vers cette valeur cible, démontrant la précision algorithmique de SciPy.
Pour des échantillons de taille modeste représentatifs d’une étude comportementale unique, la validation distributionnelle ne peut s’appuyer sur la convergence des moments en raison d’une variance d’échantillonnage excessive de ces statistiques d’ordre élevé. Dans ce cadre, la validation d’adéquation s’effectue via des tests statistiques non paramétriques d’adéquation de fonction de répartition, tels que le test de Kolmogorov-Smirnov implémenté dans scipy.stats.kstest(), en comparant les données observées à la fonction de répartition cumulative théorique de la loi de Student calibrée avec les mêmes degrés de liberté.
4. Calcul de probabilités cumulées : La fonction de répartition (t.cdf)
4.1 Principes mathématiques de la fonction de répartition cumulative
La fonction de répartition cumulative (désignée sous l’acronyme anglais CDF pour Cumulative Distribution Function) constitue l’outil probabiliste central pour déterminer la probabilité qu’une variable aléatoire continue prenne une valeur inférieure ou égale à un seuil d’observation donné. Sur le plan mathématique formel, la CDF de la distribution de Student correspond à l’intégrale définie de sa fonction de densité de probabilité, calculée depuis moins l’infini jusqu’à la statistique t observée. Cette intégrale ne possédant pas de primitive analytique élémentaire close pour des degrés de liberté arbitraires, son évaluation numérique mobilise la fonction bêta incomplète régularisée.
Dans la pratique de l’évaluation neuropsychologique, la valeur issue de la fonction de répartition possède une signification immédiate : elle représente le rang percentile théorique associé à une performance observée sous l’hypothèse de validité du modèle sous-jacent. L’implémentation dans SciPy s’opère via la méthode t.cdf(x, df, loc=0, scale=1). Lorsque l’on injecte une statistique standardisée issue d’un devis empirique, la fonction retourne un nombre réel compris dans l’intervalle semi-ouvert ]0, 1[.
La robustesse algorithmique de scipy.stats.t.cdf est garantie par l’intégration d’algorithmes d’approximation de fractions continues de haute précision. Même lorsque la valeur de x s’égare profondément dans les extrémités de la courbe (par exemple pour des scores t inférieurs à -8 ou supérieurs à 8), la fonction gère la décroissance asymptotique sans souffrir d’annulations catastrophiques, assurant ainsi une base computationnelle inébranlable pour le calcul des probabilités d’erreur de première espèce.
4.2 Calcul de la valeur p pour un test unilatéral à gauche
Dans de nombreuses investigations cliniques en psychologie de la santé ou en psychiatrie translationnelle, les hypothèses opérationnelles sont intrinsèquement directionnelles. Imaginons un essai clinique contrôlé évaluant une psychothérapie brève destinée à réduire la sévérité d’un trouble anxieux généralisé. L’hypothèse alternative du chercheur stipule expressément que le score moyen d’anxiété post-traitement du groupe expérimental sera inférieur à la norme pré-thérapeutique établie dans la population. Dès lors, le devis expérimental impose un test d’hypothèse unilatéral à gauche.
Après standardisation de la différence moyenne observée chez 16 patients (df = 15), le chercheur obtient une statistique t empirique négative, disons t_calc = -2,13. La valeur p unilatérale à gauche correspond rigoureusement à la probabilité cumulée d’observer, sous l’hypothèse nulle d’absence d’effet clinique, une statistique t au moins aussi extrême (c’est-à-dire inférieure ou égale) que la valeur observée. Sous SciPy, ce calcul s’exécute de manière directe :
L’exécution de l’instruction scipy.stats.t.cdf(-2.13, df=15) produit un résultat numérique d’environ 0,0251. Ce chiffre traduit précisément le risque d’erreur de première espèce encouru si l’on rejette l’hypothèse nulle pour conclure à l’efficacité du traitement : il n’y a que 2,51 % de chances que de telles données se manifestent sous l’effet du seul hasard d’échantillonnage. Dans le cadre d’un seuil alpha pré-spécifié à 0,05, le chercheur rejette formellement l’hypothèse nulle.
4.3 Calcul de la valeur p pour un test unilatéral à droite
À l’opposé, certains protocoles en neurosciences cognitives émettent l’hypothèse d’une amélioration ou d’un gain de performance consécutif à un entraînement spécifique. Considérons un protocole visant à tester si un entraînement de la mémoire de travail basé sur une tâche n-back permet d’accroître l’empan mnésique visuo-spatial chez des enfants présentant un trouble déficitaire de l’attention. L’hypothèse de recherche est ici unilatérale à droite : le chercheur postule que la moyenne de l’échantillon surpassera la moyenne normative.
Supposons qu’au terme de l’expérimentation conduite auprès de 20 participants (df = 19), la statistique t calculée s’élève à +1,85. La probabilité associée correspond à la surface située sous la courbe à droite de 1,85, soit l’intégrale de 1,85 à plus l’infini. Une première approche en programmation consiste à déduire la probabilité cumulée de l’unité intégrale, via la formule arithmétique : 1.0 - scipy.stats.t.cdf(1.85, df=19).
Cependant, sur le plan de la précision numérique en virgule flottante, cette formulation par soustraction souffre d’une perte d’information majeure (perte de chiffres significatifs) dès lors que la statistique t est exceptionnellement élevée et que la probabilité cumulée approche l’unité à un niveau microscopique. Pour pallier cette faiblesse, SciPy intègre nativement la fonction de survie (Survival Function), accessible via t.sf(x, df), qui calcule directement l’intégrale de la queue droite sans passer par le complémentaire à l’unité. L’appel scipy.stats.t.sf(1.85, df=19) retourne environ 0,0399 avec une stabilité analytique supérieure, particulièrement critique dans les protocoles d’imagerie cérébrale où des corrections pour comparaisons multiples exigent des valeurs p infinitésimales.
5. Calcul rigoureux des valeurs p bilatérales en sciences humaines
5.1 Justification de l’approche bilatérale en méthodologie clinique
Bien que les chercheurs soient fréquemment animés par des intuitions directionnelles étayées par la littérature, la méthodologie de la recherche clinique contemporaine privilégie massivement le recours aux tests d’hypothèse bilatéraux (ou non-directionnels). Cette exigence épistémologique s’explique par la nécessité d’adopter une posture d’impartialité totale face aux données empiriques. En psychopharmacologie ou lors de l’évaluation d’interventions comportementales, il n’est jamais exclu qu’un traitement induise des effets délétères inattendus, une détérioration symptomatique ou des réponses paradoxales.
Opter a priori pour un test unilatéral interdit structurellement de détecter une régression significative, le chercheur s’engageant mathématiquement à ignorer tout résultat situé dans la direction opposée à son intuition initiale, aussi extrême soit-il. Cette pratique favorise insidieusement le biais de confirmation et altère la reproductibilité de la littérature scientifique. Les comités d’éthique institutionnels et les comités de relecture des revues internationales de premier rang exigent donc l’adoption par défaut d’une démarche bilatérale, sauf cas exceptionnels minutieusement argumentés avant toute collecte d’observations.
Ce choix implique toutefois une contrepartie mécanique en termes de puissance statistique. En répartissant le risque d’erreur de première espèce alpha (généralement 5 %) de manière équitable sur les deux queues de la distribution (soit 2,5 % à chaque extrémité), le test bilatéral rehausse la valeur critique minimale requise pour déclarer un résultat statistiquement significatif. Pour un échantillon donné, il s’avère donc plus difficile de rejeter l’hypothèse nulle en bilatéral qu’en unilatéral, ce qui exige de dimensionner les cohortes avec une vigilance accrue.
5.2 Mise en œuvre du calcul bilatéral en Python
La morphologie de la distribution t de Student étant rigoureusement symétrique par rapport à son paramètre de centrage (qui est égal à zéro sous l’hypothèse nulle standard), la surface de la région de rejet bilatérale est équivalente au double de la surface présente dans l’une des extrémités extrêmes. Cette propriété simplifie considérablement la formalisation algorithmique de la valeur p bilatérale en Python.
Quelle que soit la valeur algébrique de la statistique t observée (positive ou négative), l’approche la plus robuste consiste à prendre la valeur absolue de la statistique, à évaluer la probabilité d’obtenir une valeur supérieure ou égale à cette amplitude dans la queue droite via la fonction de survie, puis à multiplier ce résultat par deux. L’expression canonique s’écrit donc en Python de la façon suivante :
p_valeur = 2 * scipy.stats.t.sf(abs(t_statistique), df=degres_de_liberte)
Une syntaxe équivalente reposant sur la fonction de répartition cumulative utilise la symétrie à gauche : p_valeur = 2 * scipy.stats.t.cdf(-abs(t_statistique), df=degres_de_liberte). Ces deux implémentations sont rigoureusement interchangeables sur le plan mathématique. En revanche, l’utilisation de 2 * (1 - scipy.stats.t.cdf(abs(t_statistique), df)) doit être évitée lors du traitement de très grandes statistiques t (t > 10), car l’imprécision inhérente à la soustraction en virgule flottante produit fréquemment une troncature erronée à zéro (floating-point underflow).
5.3 Évaluation du seuil alpha et décision statistique
Une fois la valeur p bilatérale extraite du moteur computationnel de SciPy, l’étape suivante consiste à formaliser la décision statistique en confrontant ce résultat scalaire au risque d’erreur alpha consenti a priori par le protocole de recherche. Traditionnellement, les seuils fixés par convention sont de 0,05 (significativité marginale ou standard), 0,01 (significativité forte) et 0,001 (significativité hautement conservatrice). Si la valeur p est strictement inférieure à alpha, la décision algorithmique consiste à rejeter l’hypothèse nulle (H0) au profit de l’hypothèse alternative (H1).
Cependant, la communauté contemporaine des méthodologistes en psychologie met fermement en garde contre une lecture naïve et dichotomique du résultat inférentiel. Une valeur p de 0,049 et une valeur p de 0,051 reflètent une quantité de preuve quasi identique contre le modèle de l’hypothèse nulle, mais une catégorisation binaire arbitraire induit souvent des conclusions interprétatives radicalement opposées dans les manuscrits scientifiques.
De surcroît, il est méthodologiquement impératif de dissocier la significativité statistique de la pertinence clinique ou comportementale. Dans une cohorte de grande dimension, une différence infime dépourvue de tout intérêt thérapeutique peut atteindre un p < 0,001. Inversement, dans une étude clinique restreinte portant sur un protocole novateur contre la dépression sévère, un effet clinique substantiel peut afficher un p = 0,06 en raison d’un manque de puissance d’échantillonnage. La valeur p issue de la loi t de Student ne doit donc jamais être interprétée de façon isolée, mais systématiquement contextualisée par des indicateurs de magnitude de l’effet et des intervalles de précision.
6. Modélisation de la densité et visualisations graphiques avancées
6.1 Calcul de la densité de probabilité via t.pdf()
La fonction de densité de probabilité (désignée par l’acronyme PDF pour Probability Density Function) décrit la loi régissant la probabilité relative pour une variable aléatoire continue d’adopter une valeur donnée le long de son continuum de réalisation. Pour la distribution t de Student, la formule analytique exacte de la densité s’exprime par le biais de la fonction Gamma d’Euler : elle incorpore un facteur d’échelle multiplicatif dépendant des degrés de liberté, divisé par le terme (1 + (x^2 / df))^((df + 1) / 2).
Au sein de SciPy, cette fonction est exécutée via scipy.stats.t.pdf(x, df, loc=0, scale=1). Il importe de rappeler un principe fondamental du calcul des probabilités : la valeur renvoyée par la fonction de densité n’est pas une probabilité brute (celle-ci étant nulle pour tout point isolé dans une distribution continue), mais bien une hauteur de densité par unité d’abscisse. L’intégration de cette densité sur un intervalle infinitésimal [x, x + dx] représente la probabilité réelle que la variable s’y matérialise.
Pour modéliser numériquement et graphiquement la distribution de Student sur un domaine continu, la démarche canonique en Python repose sur la création vectorisée d’un tableau d’abscisses régulières au moyen de numpy.linspace(), s’étendant typiquement de -4 à +4 écarts-types. La transmission de ce vecteur complet à t.pdf() opère une évaluation vectorisée sans boucle explicite, générant instantanément le vecteur de densités correspondant prêt pour le rendu graphique.
6.2 Visualisation comparative sous Matplotlib et Seaborn
La mise en évidence de la divergence structurelle entre la loi normale et les lois t dotées de différents degrés de liberté constitue une étape pédagogique et analytique majeure dans l’exploration de données comportementales. En combinant les bibliothèques Matplotlib et Seaborn, il devient aisé de tracer sur un même canevas graphique la courbe gaussienne théorique face à des distributions de Student calibrées pour diverses tailles d’échantillons (par exemple df = 2, df = 5 et df = 30).
Sur un tel graphique comparatif, la topologie des courbes illustre sans ambiguïté la transition asymptotique. Pour df = 2, la courbe t se singularise par une dépression marquée au sommet (mode inférieur à 0,40) et un relèvement très substantiel des queues de distribution au-delà de 2 écarts-types, témoignant d’une variance d’échantillonnage critique. À df = 5, la courbe se rapproche visiblement du patron gaussien, tout en maintenant une épaisseur périphérique décelable. Pour df = 30, la superposition avec la courbe de la loi normale est quasiment absolue à l’échelle visuelle standard.
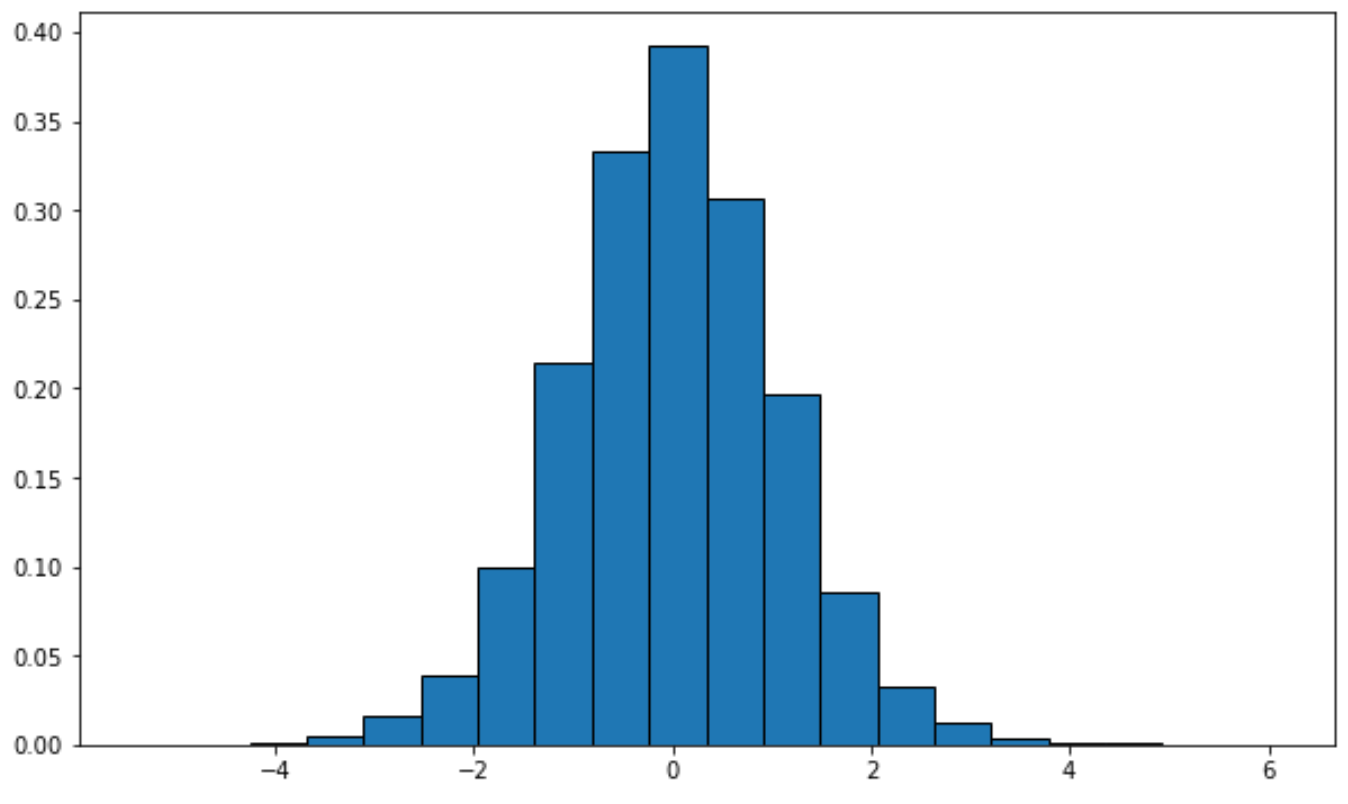
Le paramétrage esthétique selon les normes académiques internationales implique l’utilisation d’une typographie lisible, de palettes de couleurs adaptées aux personnes daltoniennes (telles que les palettes colorblind de Seaborn), d’une grille cartésienne discrète et d’une légende exhaustive positionnée stratégiquement. Une telle représentation graphique permet de communiquer immédiatement aux évaluateurs d’un manuscrit les fondements de la conservativité accrue des tests statistiques mis en œuvre sur petits échantillons.
6.3 Ombrage des zones critiques et de la valeur p observée
L’une des représentations les plus percutantes pour documenter l’aboutissement d’un test statistique consiste à ombrer graphiquement les régions de rejet de l’hypothèse nulle, ainsi que la fraction exacte de la surface correspondant à la statistique t empirique obtenue dans l’expérience. Cette opération graphique est hautement facilitée par la méthode plt.fill_between() de Matplotlib.
Pour illustrer un test bilatéral, le script calcule en premier lieu les quantiles critiques théoriques correspondant au seuil alpha fixé (via t.ppf(0.025, df) et t.ppf(0.975, df)). Un masque booléen appliqué sur le vecteur d’abscisses permet ensuite d’ombrer en rouge semi-transparent les surfaces situées au-delà de ces quantiles critiques, délimitant ainsi les frontières spatiales du rejet de H0.
Conjointement, l’insertion d’une ligne verticale pointillée indiquant la valeur t_calc observée lors de l’expérience, combinée à une coloration bleue hachurée de la surface située au-delà de cette coordonnée, explicite visuellement la nature de la valeur p. Si la zone hachurée pénètre profondément dans la zone rouge critique, le lecteur appréhende instantanément l’issue concluante de l’expérimentation. L’exportation de ces diagrammes vectoriels au format SVG ou PDF garantit une fidélité graphique maximale pour les publications scientifiques.
7. Détermination des valeurs critiques et quantiles avec t.ppf et t.isf
7.1 Calcul des quantiles théoriques avec la fonction t.ppf()
Alors que la fonction de répartition cumulative calcule une probabilité à partir d’un quantile, le problème inverse se pose continuellement lors de la planification expérimentale : identifier la valeur critique t délimitant une probabilité d’erreur donnée. Cette fonction réciproque s’intitule la fonction quantile ou Percent Point Function, et se trouve matérialisée dans SciPy par la méthode scipy.stats.t.ppf().
Pour un chercheur planifiant une étude comportementale avant toute collecte empirique, le calcul des bornes critiques de rejet constitue le cœur de la méthodologie hypothético-déductive. Si un protocole clinique engage 15 participants soumis à une évaluation pré-post (impliquant df = 14) et que le seuil de décision bilatéral est verrouillé à alpha = 0,05, le chercheur doit calculer le quantile correspondant à une probabilité cumulée de 0,975 pour la borne droite.
L’instruction scipy.stats.t.ppf(0.975, df=14) renvoie la valeur 2,1448. Cela signifie rigoureusement que la statistique t expérimentale devra dépasser 2,1448 (ou être inférieure à -2,1448) pour que la différence observée soit déclarée statistiquement significative. Dans le cas d’un test unilatéral à droite au même seuil global de 5 %, la probabilité cumulée injectée s’élève à 0,95, ce qui donne via scipy.stats.t.ppf(0.95, df=14) une valeur critique abaissée à 1,7613. La maîtrise de ces calculs permet d’éviter l’écueil consistant à mémoriser des tables statistiques imprimées désuètes au profit d’une détermination dynamique et exacte intégrée dans les flux computationnels.
7.2 Exploitation de la fonction inverse de survie t.isf()
En miroir direct de la fonction de survie t.sf(), la bibliothèque SciPy propose une méthode complémentaire dédiée au calcul inverse des quantiles supérieurs : la fonction inverse de survie ou t.isf() (pour Inverse Survival Function). Son rôle mathématique consiste à renvoyer la valeur critique d’abscisse qui laisse une probabilité alpha exactement spécifiée dans la queue droite de la distribution.
D’un point de vue de l’élégance syntaxique et de la clarté du code en psychométrie computationnelle, t.isf(0.05, df) élimine la nécessité d’effectuer mentalement l’opération complémentaire t.ppf(1 - 0.05, df). Les deux instructions retournent rigoureusement le même résultat arithmétique pour des seuils standards, mais t.isf() s’avère algorithmiquement supérieure lorsque l’on manipule des probabilités d’erreur extrêmement ténues (par exemple alpha = 10^-7), telles que celles imposées par les corrections de Bonferroni sur des matrices de corrélation fonctionnelle par résonance magnétique (IRMf).
Cette méthode est particulièrement exploitée lors de la calibration d’échelles de sévérité diagnostique. Lorsqu’un outil psychométrique vise à dépister une altération cognitive pathologique définie comme le percentile 95 supérieur d’une échelle de détérioration, t.isf(0.05, df, loc=moyenne_normative, scale=dispersion_normative) calcule immédiatement le seuil clinique de coupure opérationnel sous les hypothèses de Student.
7.3 Normalisation et standardisation des scores psychométriques
Dans l’évaluation psychologique et neuropsychologique, les scores bruts collectés lors de la passation de batteries de tests (comme les échelles de mémoire ou les matrices d’intelligence) ne possèdent aucune métrique intrinsèque universelle. Pour les interpréter cliniquement, il est indispensable de les convertir en scores standardisés permettant de situer l’individu par rapport à un échantillon d’étalonnage représentatif de sa classe d’âge ou de son niveau socioculturel.
Lorsque la cohorte d’étalonnage d’un sous-groupe spécifique est de taille restreinte (par exemple, un échantillon normatif pédiatrique de 25 enfants d’un âge développemental précis), standardiser les performances individuelles en utilisant la loi normale théorique introduit un biais systématique de diagnostic. En supposant une dispersion gaussienne, les cliniciens ont tendance à sous-estimer la rareté des scores situés aux extrêmes inférieurs et supérieurs de l’échelle cognitive.
En mobilisant la fonction de répartition t.cdf() de la loi de Student ajustée sur les degrés de liberté réels du groupe d’étalonnage, le psychomètre convertit les scores z d’échantillon en véritables rangs percentiles corrigés pour l’incertitude de la taille de référence. Par la suite, si nécessaire, ces percentiles corrigés peuvent être rétro-projetés vers des métriques standardisées classiques (comme les notes standards de moyenne 10 et d’écart-type 3, ou les notes T de moyenne 50 et d’écart-type 10). Cette chaîne de normalisation basée sur la distribution de Student garantit une équité d’évaluation exemplaire, évitant de diagnostiquer à tort un déficit cognitif chez des patients se situant simplement dans les fluctuations normales des queues lourdes de la distribution d’échantillonnage.
8. Construction d’intervalles de confiance basés sur la loi t
8.1 Théorie de l’estimation par intervalle pour les petits échantillons
L’estimation ponctuelle d’une moyenne empirique — aussi non biaisée soit-elle — ne fournit aucune indication sur le degré de précision de la mesure observée. En recherche scientifique, l’estimation par intervalle de confiance s’impose comme une alternative indispensable ou un complément obligatoire aux tests d’hypothèse nuls. Un intervalle de confiance à (1 – alpha) % délimite une plage de valeurs plausibles qui, sous réplication infinie du protocole expérimental dans des conditions identiques, couvrira la véritable moyenne inconnue de la population dans exactement (1 – alpha) % des cas.
Pour les échantillons de grande dimension où la variance d’échantillonnage est parfaitement maîtrisée, la construction de cet intervalle fait intervenir la valeur critique gaussienne z_alpha/2. Cependant, sur petits échantillons où la variance de la population est inconnue, l’intervalle doit être obligatoirement élargi en substituant le quantile critique t_(df, alpha/2) au multiplicateur normal, et en intégrant l’erreur type de la moyenne estimée : SEM = s / sqrt(n), où s représente l’écart-type empirique corrigé.
Cet élargissement mécanique de l’intervalle est la conséquence directe de la géométrie de la distribution t. Il traduit fidèlement l’incertitude épistémique accrue pesant sur l’expérimentateur en contexte d’échantillonnage restreint. Sous condition que la distribution de la variable au sein de la population mère soit approximativement normale, l’intervalle de confiance dérivé de la loi de Student garantit des propriétés de couverture empirique exactes, immunisant le chercheur contre les illusions de précision engendrées par l’utilisation abusive de l’estimateur gaussien.
8.2 Automatisation du calcul via scipy.stats.t.interval
Bien que le calcul manuel de l’intervalle de confiance soit aisé à mettre en œuvre via la combinaison de numpy.mean(), scipy.stats.sem() et t.ppf(), la bibliothèque SciPy fournit une abstraction analytique hautement performante et élégante : la méthode scipy.stats.t.interval(). Cette méthode prend en charge l’ensemble des intégrations sous-jacentes et prévient toute erreur d’assignation des bornes bilatérales.
La signature de la fonction exige la spécification du niveau de confiance requis (paramètre confidence, par exemple 0.95 ou 0.99), des degrés de liberté résiduels df, ainsi que des paramètres de décalage et d’échelle. Pour modéliser l’intervalle d’une moyenne empirique, le paramètre loc reçoit la moyenne de l’échantillon, tandis que le paramètre scale doit impérativement recevoir l’erreur type de la moyenne (obtenue via scipy.stats.sem(donnees)) et non l’écart-type de l’échantillon :
borne_inf, borne_sup = scipy.stats.t.interval(confidence=0.95, df=len(donnees)-1, loc=np.mean(donnees), scale=scipy.stats.sem(donnees))
Cette syntaxe retourne un tuple contenant les deux bornes réelles encadrant la moyenne estimée. La vectorisation intrinsèque de cette fonction autorise également son application sur des tableaux matriciels multidimensionnels NumPy, permettant de calculer simultanément et instantanément les intervalles de confiance associés à des dizaines de canaux d’électroencéphalographie (EEG) ou à de multiples conditions d’amorçage psychologique sans recourir à des itérations explicites.
8.3 Application concrète : Évaluation de temps de latence cognitive
Afin d’illustrer la pertinence de cette modélisation, analysons un protocole en neuropsychologie expérimentale évaluant l’efficacité d’un programme d’entraînement attentionnel de 8 semaines chez 12 patients cérébrolésés (n = 12, d’où df = 11). La variable mesurée est le temps de latence cognitive médian (en millisecondes) lors d’une tâche de détection de cible de type Go/No-Go. Les évaluations sont conduites avant l’intervention (T0) puis à l’issue du protocole (T1).
Supposons que les données recueillies à T0 indiquent une latence moyenne de 485 ms avec une erreur type SEM de 18 ms, tandis qu’à T1, la latence moyenne descend à 410 ms avec une SEM de 15 ms. Le calcul automatisé via t.interval(confidence=0.95, df=11, loc=485, scale=18) délimite pour la condition pré-entraînement un intervalle [445,38 ms ; 524,62 ms]. Pour la condition post-entraînement, l’intervalle à 95 % est borné par [377,00 ms ; 443,00 ms].
L’inspection des résultats met en évidence une absence totale de chevauchement entre l’intervalle de confiance pré-test et l’intervalle post-test (la borne supérieure post-test de 443,00 ms demeurant strictement inférieure à la borne inférieure pré-test de 445,38 ms). Cette non-intersection fournit une confirmation visuelle et quantitative immédiate de la robustesse clinique de l’intervention, qui se traduira graphiquement par des barres d’erreur basées sur la loi t non recouvrantes lors de la conception des figures de publication sous Matplotlib.
9. Mise en œuvre du test t à un échantillon : scipy.stats.ttest_1samp
9.1 Cadre d’application du test t à un échantillon en psychologie
Le test t à un échantillon constitue l’une des architectures inférentielles les plus emblématiques de la recherche en sciences comportementales. Son objectif méthodologique est d’éprouver formellement l’hypothèse selon laquelle la moyenne inconnue d’une population d’intérêt dont est extrait un échantillon empirique est égale à une valeur de référence théorique pré-établie, notée mu_0. Cette valeur de référence peut représenter une constante normative issue d’une vaste population de référence, le niveau de performance attendu sous l’effet du pur hasard (comme un score de 50 % dans une tâche de choix forcé à deux alternatives), ou un seuil d’invariance cognitive.
L’hypothèse nulle stipule invariablement que l’espérance mathématique de l’échantillon est égale à la constante théorique (H0: mu = mu_0), tandis que l’hypothèse alternative affirme que la moyenne s’en écarte de façon statistiquement significative (H1: mu != mu_0 dans un cadre bilatéral). Le dénominateur de la statistique de test modélise l’erreur type de l’échantillon, estimée sans biais en divisant l’écart-type de l’échantillon par la racine carrée de sa taille.
Dans ce paradigme, la sensibilité aux données aberrantes (outliers) est maximale. Puisque la moyenne arithmétique et la variance empirique présentent toutes deux un point de rupture égal à zéro (une seule valeur aberrante pouvant biaiser indéfiniment l’estimation), l’émergence d’une contamination accidentelle au sein d’une petite cohorte clinique peut soit gonfler artificiellement la statistique t et induire un faux positif, soit dilater considérablement l’erreur type au dénominateur et masquer l’émergence d’un effet réel, conduisant à une erreur de deuxième espèce (bêta).
9.2 Exécution informatique et extraction des métriques
L’implémentation opérationnelle du test t à un échantillon sous Python est exécutée de façon unifiée par la fonction scipy.stats.ttest_1samp(). Cette méthode prend en entrée un tableau de données unidimensionnel ou multidimensionnel, la valeur de référence popmean, ainsi que des paramètres optionnels hautement stratégiques, notamment le paramètre alternative qui accepte les chaînes 'two-sided' (par défaut), 'less' ou 'greater'.
Considérons l’analyse d’un groupe expérimental de 14 adolescents soumis à un protocole de méditation de pleine conscience, chez qui l’on évalue l’indice de flexibilité attentionnelle. La valeur normative établie chez les sujets témoins dans la littérature est fixée à une constante popmean = 50. Après importation et structuration des scores sous forme de tableau NumPy, l’exécution de l’analyse s’opère comme suit :
statistique_t, p_valeur = scipy.stats.ttest_1samp(scores_attention, popmean=50, alternative='two-sided')
L’objet retourné contient directement la valeur de la statistique t et la valeur p associée, calculée avec df = n – 1 degrés de liberté. Afin de compléter obligatoirement ce rapport conformément aux standards métrologiques modernes, il est impératif de quantifier la magnitude de l’effet. Le d de Cohen pour un échantillon unique se formalise par la différence entre la moyenne observée et la valeur de référence, divisée par l’écart-type empirique de l’échantillon (ddof=1). Un d > 0,80 signalera un effet de grande envergure, contextualisant la significativité de la valeur p extraite.
9.3 Vérification des conditions de validité
L’application rigoureuse du test t à un échantillon repose sur deux postulats fondamentaux : l’indépendance statistique des observations individuelles et la normalité de la distribution de la variable au sein de la population parente. L’indépendance découle exclusivement du plan expérimental : elle exige qu’aucun sujet ne soit mesuré plusieurs fois et qu’aucune interaction mutuelle n’ait influencé les performances au cours de la collecte.
Le postulat de normalité nécessite, pour sa part, un diagnostic statistique formel en amont de toute inférence. Sur de petits échantillons (n < 30), les histogrammes sont trompeurs en raison d’un nombre insuffisant de classes d’intervalles. Deux instruments diagnostiques sous Python s’avèrent indispensables : le test d’adéquation de Shapiro-Wilk et l’inspection visuelle du diagramme quantile-quantile (Q-Q plot).
La fonction scipy.stats.shapiro(scores) évalue formellement l’hypothèse nulle de distribution gaussienne des données. Une valeur p issue de Shapiro-Wilk strictement inférieure à 0,05 conduit au rejet de la normalité et impose une réorientation méthodologique. Conjointement, l’instruction scipy.stats.probplot(scores, dist="norm", plot=plt) permet de générer un diagramme Q-Q sous Matplotlib. Si les scores empiriques s’alignent fidèlement le long de la diagonale théorique sans divergence curviligne marquée aux extrémités, la condition de normalité est réputée raisonnablement respectée, autorisant le recours serein à ttest_1samp().
10. Tests t pour échantillons indépendants et appariés
10.1 Comparaison de deux groupes indépendants : ttest_ind
L’expérimentation factorielle inter-sujets en psychologie repose sur la comparaison de deux groupes d’individus distincts assignés aléatoirement à des conditions distinctes (par exemple, un groupe témoin recevant un placebo versus un groupe expérimental recevant un protocole de remédiation cognitive). L’outil statistique dédié à cette architecture sous SciPy est la fonction scipy.stats.ttest_ind().
Historiquement, le test de Student standard pour deux échantillons postule l’homogénéité des variances entre les deux populations mères (hypothèse d’homoscédasticité). Cependant, les méthodologistes statisticiens ont amplement démontré que l’égalité parfaite des variances est rarissime en pratique expérimentale, singulièrement lorsque les interventions cliniques accroissent la variabilité intra-groupe chez les répondeurs thérapeutiques. L’application du test classique de Student en présence de variances hétérogènes (hétéroscédasticité) et d’effectifs inégaux corrompt lourdement le taux d’erreur de première espèce.
En conséquence, la bonne pratique méthodologique en programmation statistique consiste à délaisser le test classique et à mobiliser systématiquement le test de Welch. Ce dernier s’active sous SciPy en spécifiant obligatoirement l’argument equal_var=False au sein de la fonction :
res = scipy.stats.ttest_ind(groupe_exp, groupe_temoin, equal_var=False)
Le test de Welch adapte le dénominateur de la statistique de test et ajuste les degrés de liberté résiduels via l’équation de Welch-Satterthwaite. Les degrés de liberté qui en résultent ne sont plus des nombres entiers mais des valeurs décimales fractionnaires reflétant l’hétérogénéité des dispersions des deux groupes, préservant ainsi scrupuleusement l’intégrité du seuil d’erreur alpha nominal.
10.2 Mesures répétées et plans intra-sujets : ttest_rel
Les plans d’expérience intra-sujets (ou à mesures répétées) évaluent les mêmes individus à travers deux conditions temporelles ou expérimentales distinctes (par exemple, condition Pré-Test versus Post-Test, ou condition Tâche Neutre versus Tâche Émotionnelle). Dans cette configuration, les observations recueillies au sein des deux vecteurs de scores ne sont pas indépendantes : elles sont structurellement corrélées par les caractéristiques individuelles stables des participants (traits de personnalité, vitesse de traitement basale, niveau intellectuel).
Exploiter un test pour échantillons indépendants sur des données appariées constituerait une faute méthodologique majeure : cela conduirait à surévaluer le bruit expérimental en y intégrant la variance interindividuelle globale, diminuant ainsi drastiquement la puissance statistique du test. La méthode adaptée est le test t pour échantillons appariés, implémenté sous SciPy via scipy.stats.ttest_rel() (pour related samples).
Sur le plan computationnel, ttest_rel(vecteur_post, vecteur_pre) opère en soustrayant point par point les observations appariées pour générer un vecteur unique de scores différentiels individuels (D_i = X_post_i – X_pre_i), puis exécute un test t à un échantillon unique sur ces scores de différence en testant l’hypothèse d’une moyenne nulle (mu_D = 0). Les degrés de liberté associés correspondent à n – 1, où n représente le nombre total de paires de mesures, offrant une sensibilité statistique décuplée pour identifier des variations longitudinales fines.
10.3 Calcul exhaustif des tailles d’effet sous Python
La publication d’une valeur p, qu’elle émane de ttest_ind ou de ttest_rel, ne saurait clore l’analyse scientifique. La quantification de la force de l’association requiert l’estimation rigoureuse de la taille d’effet standardisée. Pour des échantillons indépendants de variances comparables, le d de Cohen standardise la différence des moyennes en la divisant par l’écart-type combiné pondéré (pooled standard deviation). Néanmoins, lorsque les échantillons sont de très faible dimension (n < 20 par groupe), le d de Cohen présente un biais d’estimation systématique en surestimant légèrement la magnitude réelle de l’effet dans la population.
Pour corriger cette distorsion, les statisticiens emploient la correction de Hedges, dénommée g de Hedges. Elle consiste à multiplier le d de Cohen empirique par un facteur de correction polynomial exact dépendant des degrés de liberté totaux : J = 1 – (3 / (4 * df – 1)). Pour un plan de recherche apparié, le d de Cohen doit également être ajusté pour tenir compte de la corrélation intra-sujet r entre les deux séries de mesures, évitant les confusions courantes d’interprétation.
Pour automatiser intégralement ces calculs sans redévelopper l’ensemble des équations analytiques, l’écosystème Python dispose de la bibliothèque spécialisée Pingouin, qui s’intègre harmonieusement avec SciPy et Pandas. L’exécution de pingouin.ttest(groupe_a, groupe_b, paired=False, correction=True) renvoie un tableau récapitulatif complet intégrant la statistique t, les degrés de liberté ajustés, la valeur p, le g de Hedges non biaisé ainsi que son intervalle de confiance exact à 95 % dérivé de distributions t non centrales.
11. Robustesse de la distribution t et alternatives face aux violations
11.1 Sensibilité de la loi t face aux distributions asymétriques
Bien que la littérature méthodologique qualifie fréquemment le test t de Student de statistique « robuste » face aux écarts modérés par rapport au postulat de normalité lorsque les effectifs sont substantiels, cette tolérance s’effondre dramatiquement dès lors que deux conditions délétères se conjuguent : de petits effectifs d’échantillonnage et une forte asymétrie de la distribution d’origine (skewness marquée). En psychologie expérimentale, les variables telles que les temps de latence, les scores de détresse psychologique ou les indices de consommation addictive adoptent structurellement des distributions étirées vers la droite de type log-normale ou Gamma.
Des simulations systématiques de type Monte Carlo démontrent qu’en présence d’une asymétrie substantielle au sein d’échantillons de taille n < 15, la distribution d’échantillonnage de la statistique t cesse d’épouser la géométrie symétrique de Student. La distribution de la statistique devient elle-même asymétrique, ce qui a pour conséquence immédiate de distordre les probabilités d’erreur dans les queues. Le taux d’erreur unilatéral réel peut ainsi s’élever au double ou au triple du seuil nominal alpha dans l’une des extrémités, tout en s’effondrant à zéro dans l’autre.
De surcroît, la présence de valeurs aberrantes isole des scores résiduels colossaux qui dilatent artificiellement l’écart-type d’échantillon au dénominateur, effondrant la statistique t observée et détruisant la puissance statistique du test. Si l’asymétrie empirique calculée via scipy.stats.skew() dépasse la valeur absolue de 1,0, le chercheur doit proscrire le test t conventionnel et orienter sa chaîne analytique vers des algorithmes robustes d’estimation ou des procédures non paramétriques.
11.2 Ajustements robustes : Moyennes tronquées et M-estimateurs
Face à la vulnérabilité de la moyenne arithmétique et de l’écart-type conventionnels, les statistiques robustes développées par Rand Wilcox fournissent des solutions d’une efficacité mathématique remarquable. La méthodologie la plus reconnue repose sur le test t de Yuen appliqué aux moyennes tronquées (trimmed means). Contrairement à l’élimination arbitraire et discutable de points de données spécifiques, la troncature symétrique élimine une proportion gamma constante (typiquement 10 % ou 20 %) des valeurs les plus basses et les plus hautes de chaque distribution avant d’opérer la comparaison.
Sous Python, le calcul de la moyenne tronquée s’effectue via la méthode scipy.stats.trim_mean(vecteur, proportiontocut=0.2). Pour comparer deux groupes selon la méthode de Yuen, l’estimation de l’erreur type s’appuie sur la variance « winsorisée », dans laquelle les scores extrêmes situés dans les quantiles de troncature sont remplacés par la valeur valide la plus proche au lieu d’être simplement ignorés.
L’implémentation de la procédure de Yuen sous Python au moyen de la bibliothèque Pingouin (via pingouin.yuen()) ajuste automatiquement les degrés de liberté résiduels en fonction du degré de troncature appliqué. Cette approche préserve rigoureusement le taux d’erreur nominal alpha même sous des distributions hautement contaminées par des artéfacts de mesure, tout en offrant une puissance statistique très supérieure au test t classique en présence de queues épaisses empiriques.
11.3 Approches non paramétriques et rééchantillonnage bootstrap
Lorsque les postulats distributionnels sont irrémédiablement violés et que la modélisation paramétrique de Student ne peut être raisonnablement maintenue, deux grandes classes d’alternatives s’offrent au chercheur. La première consiste à abandonner l’échelle métrique continue au profit d’une analyse des rangs : il s’agit du test des rangs signés de Wilcoxon pour les mesures appariées (scipy.stats.wilcoxon) et du test U de Mann-Whitney pour les échantillons indépendants (scipy.stats.mannwhitneyu). Bien que très robustes face aux valeurs aberrantes, ces tests modifient l’hypothèse scientifique sous-jacente en testant une équivalence stochastique ou une égalité de médianes plutôt qu’une différence de moyennes.
La seconde alternative, méthodologiquement supérieure pour préserver l’inférence directe sur les moyennes sans supposer de normalité théorique, est la méthode du bootstrap. Cette approche computationnelle génère par rééchantillonnage intensif avec remise (par exemple 10 000 itérations) une distribution empirique de la statistique d’intérêt directement issue des observations collectées. L’estimation d’intervalles de confiance bootstrap corrigés pour le biais et l’accélération (intervalles BCa) fournit une quantification de l’incertitude affranchie de toute contrainte paramétrique.
Pour exécuter un test bootstrap de la différence des moyennes en Python, le sous-module statistique fournit l’outil de référence scipy.stats.bootstrap(). En lui passant le tableau de données, la fonction statistique cible (telle que numpy.mean) et en spécifiant method='BCa', le script génère un intervalle de confiance empirique hautement fiable. Si cet intervalle empirique bootstrap ne contient pas la valeur zéro, le chercheur peut rejeter l’hypothèse nulle d’égalité avec une validité méthodologique irréprochable, confirmant ainsi de façon non paramétrique les indications préliminaires de la distribution de Student.
12. Restitution académique des résultats et conformité aux normes APA
12.1 Formatage typographique et statistique selon les normes APA 7ème édition
La diffusion des résultats inférentiels au sein des revues scientifiques internationales de psychologie et de neurosciences est strictement encadrée par les normes éditoriales de l’American Psychological Association (manuel APA, 7ème édition). Cette standardisation vise à garantir une transparence absolue, une exhaustivité quantitative et une homogénéité formelle facilitant les futures méta-analyses. L’écriture d’un résultat issu d’une analyse par distribution t répond à un canevas syntaxique et typographique d’une précision chirurgicale.
La règle fondamentale stipule que la lettre identifiant la statistique doit être en italique, immédiatement suivie des degrés de liberté placés entre parenthèses sans espace : t(df). L’égalité est encadrée d’espaces, et la valeur numérique de la statistique t est rapportée avec exactement deux décimales après la virgule. De même, la valeur p est introduite par un p en italique, rapporté avec deux ou trois décimales. Une spécificité typographique cruciale des normes APA réside dans l’omission du zéro initial précédant la virgule ou le point décimal lorsque la métrique considérée ne peut mathématiquement jamais excéder l’unité : on écrit donc impérativement p = .023 et jamais p = 0.023.
Si la valeur p renvoyée par le moteur de calcul SciPy est infinitésimale (par exemple 0.000042), il est formellement prohibé d’écrire p = .000, cette notation suggérant une probabilité nulle mathématiquement impossible dans un continuum infini. La formulation réglementaire impose d’écrire p < .001. En outre, la déclaration de la taille d’effet standardisée (généralement le d de Cohen ou le g de Hedges, tous deux en italique) est obligatoire, accompagnée idéalement de son intervalle de confiance à 95 % : d = 0.65, IC à 95 % [0.12, 1.18]. Une formulation type en langue française s’énonce ainsi : « Les résultats indiquent une baisse statistiquement significative des scores de stress entre l’évaluation pré-test et post-test, t(14) = 2.45, p = .028, d = 0.63. »
12.2 Automatisation du reporting statistique avec Python
Afin d’éradiquer les erreurs de transcription manuelles entre les sorties de console Python et le corps des manuscrits scientifiques, il est hautement recommandé d’implémenter des fonctions logicielles dédiées à la génération automatisée de chaînes de texte pré-formatées en conformité stricte avec les exigences APA 7. Une fonction de reporting statistique bien structurée reçoit en argument l’objet résultat issu de SciPy ou Pingouin, extrait la statistique t, les degrés de liberté et la valeur p, puis formate la syntaxe textuelle de manière algorithmique.
Cette approche permet de gérer dynamiquement les conditions d’affichage du zéro initial, d’arrondir rigoureusement les métriques aux décimales requises au moyen des chaînes de formatage avancées (f-strings), et d’insérer automatiquement l’opérateur d’inégalité stricte si la probabilité franchit le plancher de .001. Les chaînes générées peuvent être injectées directement dans des documents Markdown, exportées vers des tableaux académiques en syntaxe LaTeX ou converties en documents Word via des modules tels que python-docx.
L’intégration de ces générateurs au cœur de carnets interactifs de type Jupyter Notebooks garantit une reproductibilité expérimentale totale. Lorsqu’une cohorte clinique est mise à jour avec de nouveaux participants, la ré-exécution du carnet met à jour instantanément la statistique, le seuil p, la taille d’effet et les paragraphes de conclusion du manuscrit sans intervention humaine, assurant une parfaite cohérence interne entre les données brutes et les assertions discursives publiées.
12.3 Arbre de décision méthodologique pour le chercheur
Pour naviguer sereinement à travers la richesse des méthodes paramétriques et computationnelles articulées autour de la loi de Student en Python, le chercheur doit formaliser un parcours décisionnel méthodique préalablement à toute analyse inférentielle. Cet arbre décisionnel synthétise les arbitrages opérationnels requis pour garantir l’intégrité de la démarche scientifique :
- Étape 1 : Caractérisation du devis et de la taille d’échantillon. Identifier clairement la structure des données : comparaison d’un groupe unique à une norme théorique (
ttest_1samp), comparaison de deux échantillons indépendants (ttest_ind) ou comparaison de mesures répétées appariées (ttest_rel). Noter les degrés de liberté théoriques associés. - Étape 2 : Évaluation formelle des conditions d’application. Tester la normalité au sein de chaque modalité via le test de Shapiro-Wilk (
scipy.stats.shapiro) et l’inspection visuelle sur diagrammes Q-Q. Si n < 30 et que l’asymétrie empirique est sévère (|skewness| > 1), délaisser le test t classique au profit de la comparaison de moyennes tronquées de Yuen (pingouin.yuen) ou du bootstrap BCa (scipy.stats.bootstrap). - Étape 3 : Gestion rigoureuse de l’homoscédasticité. Dans le cadre d’échantillons indépendants, supposer systématiquement l’inégalité des variances et activer impérativement le test de Welch via le paramètre
equal_var=Falseau sein dettest_ind, neutralisant ainsi tout risque d’inflation de l’erreur alpha induit par l’hétéroscédasticité. - Étape 4 : Détermination des bornes et probabilités exactes. Exécuter le test de manière bilatérale par défaut (
alternative='two-sided'). En cas d’hypothèse directionnelle clinique dûment enregistrée a priori, paramétrer avec vigilance'less'ou'greater'. Dériver les intervalles de confiance exacts basés sur la loi t au niveau 95 % viascipy.stats.t.interval. - Étape 5 : Calcul systématique de la taille d’effet. Conclure l’extraction en calculant la taille d’effet corrigée pour les petits échantillons (g de Hedges) ainsi que son intervalle de confiance empirique. Rédiger le compte rendu académique en conformité intégrale avec les canons typographiques de l’APA 7ème édition.
Au terme de ce parcours, il convient d’envisager les perspectives méthodologiques modernes. Bien que la distribution t de Student demeure le pivot universel des tests différentiels bivariés sur petits échantillons, la psychologie scientifique s’oriente résolument vers des architectures d’analyse plus englobantes. La transition vers le modèle linéaire général (GLM), les modèles mixtes à effets aléatoires pour données longitudinales, et l’inférence bayésienne — où la loi t intervient fréquemment comme fonction de vraisemblance robuste capable d’absorber naturellement les valeurs atypiques — constitue la suite logique de la formation du chercheur quantitatif moderne. Maîtriser la distribution de Student sous Python offre ainsi le socle conceptuel et computationnel indispensable pour appréhender avec rigueur l’ensemble de la modélisation statistique avancée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Rossum, G. van, & Drake, F. L. (2009). Python 3 Reference Manual. CreateSpace.
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Vallat, R. (2018). Pingouin: statistics in Python. Journal of Open Source Software, 3(31), 1026. https://doi.org/10.21105/joss.01026
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press.