
Dans le paysage des probabilités et de l’inférence statistique, la loi uniforme occupe une place singulière. Souvent présentée comme la plus intuitive des distributions en raison de son principe sous-jacent d’équiprobabilité, elle constitue paradoxalement l’un des piliers méthodologiques et théoriques les plus profonds de la modélisation stochastique contemporaine. De la théorie de l’information où elle incarne l’incertitude maximale en vertu du principe d’entropie maximale, aux simulations algorithmiques de Monte-Carlo où elle agit comme le moteur fondamental de génération de toutes les autres lois de probabilité via le théorème de la transformation intégrale, la distribution uniforme est la pierre angulaire sans laquelle l’échantillonnage computationnel moderne ne pourrait exister. Dans les sciences empiriques, et singulièrement en psychologie expérimentale et en neurosciences computationnelles, elle garantit l’impartialité des protocoles expérimentaux par la randomisation rigoureuse des conditions et la désynchronisation temporelle des stimuli.
L’implémentation de cette loi au sein du langage Python, devenu le standard international du calcul scientifique et de la science des données, s’articule principalement autour de deux bibliothèques majeures : NumPy et SciPy. Bien que l’intuition première d’un programmeur puisse le conduire à envisager un simple tirage aléatoire entre deux bornes, la formalisation rigoureuse au sein de sous-modules comme scipy.stats ou numpy.random répond à des contraintes mathématiques, numériques et algorithmiques précises. La gestion de la précision en virgule flottante, la distinction formelle entre distributions continues et discrètes, le calcul exact des fonctions de répartition cumulative et l’évitement des artefacts numériques lors de l’estimation du maximum de vraisemblance exigent une maîtrise technique approfondie.
Ce guide exhaustif a pour vocation d’analyser dans toute sa complexité la distribution uniforme en Python. En associant une rigueur axiomatique issue de la théorie des probabilités à une analyse minutieuse des architectures logicielles sous-jacentes, nous explorerons les fondements théoriques, la manipulation avancée des densités de probabilité et des fonctions quantiles, les techniques de simulation stochastique haute performance, ainsi que les protocoles de validation empirique par tests d’hypothèses. Enfin, une attention méthodologique particulière sera portée à son déploiement concret dans la recherche empirique, illustré par un protocole expérimental complet de vigilance psychologique répondant aux standards les plus exigeants de la réplicabilité scientifique.
1. Introduction théorique et fondements mathématiques de la loi uniforme
1.1 Définition formelle de la loi uniforme continue et discrète
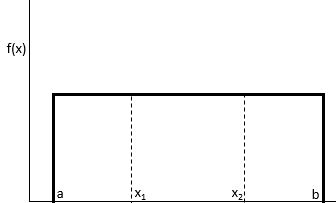
Sur le plan mathématique, la loi uniforme continue se formalise au sein de l’espace probabilisé usuel constitué d’un univers, d’une tribu borélienne sur les nombres réels et d’une mesure de probabilité. Une variable aléatoire réelle continue $X$ suit une loi uniforme continue sur un intervalle compact réel borné $[a, b]$, où $a$ et $b$ sont deux réels vérifiant strictement $a < b$, si et seulement si sa mesure de probabilité est proportionnelle à la mesure de Lebesgue sur cet intervalle et s’annule en dehors de celui-ci. Ce comportement s’exprime formellement par sa fonction de densité de probabilité, notée usuellement $f(x)$, dont la formulation est strictement constante à l’intérieur du support :
Pour tout réel $x$ appartenant à l’intervalle $[a, b]$, la densité prend la valeur analytique constante $f(x) = \frac{1}{b – a}$. Pour tout $x$ n’appartenant pas à cet intervalle, la densité est identiquement nulle, soit $f(x) = 0$. Cette formulation traduit le principe fondamental d’équiprobabilité : la probabilité qu’un événement survienne au sein d’un sous-intervalle donné ne dépend aucunement de la localisation de cet intervalle sur l’axe réel, mais exclusivement de sa longueur relative par rapport à l’étendue totale $b – a$.
Il importe de différencier rigoureusement cette loi continue de son homologue discrète. La loi uniforme discrète s’applique à un ensemble fini de cardinalité $N$, typiquement un ensemble d’entiers consécutifs ${x_1, x_2, dots, x_N}$. Dans ce cadre discret, la fonction de masse de probabilité attribue à chaque modalité distincte une masse exactement égale à $\frac{1}{N}$. Alors que la loi continue implique une probabilité strictement nulle pour tout événement ponctuel pris isolément — c’est-à-dire que pour tout point singleton, la probabilité $P(X = c) = 0$ —, la loi discrète assigne une masse strictement positive à chaque atome élémentaire de l’univers considéré. Cette distinction théorique gouverne directement le choix des primitives algorithmiques en programmation scientifique, interdisant l’utilisation interchangeable d’outils continus et discrets.
Les propriétés fondamentales de la loi uniforme continue $[a, b]$ se déduisent analytiquement par le calcul intégral des moments d’ordre supérieur. L’espérance mathématique, représentant le moment ordinaire d’ordre un et mesurant la tendance centrale de la distribution, se calcule comme l’intégrale sur le support du produit de $x$ par sa densité. Cette intégrale aboutit à la moyenne arithmétique exacte des bornes : $E(X) = \frac{a + b}{2}$. La dispersion des valeurs autour de cette espérance est quantifiée par la variance, définie comme le moment centré d’ordre deux. L’évaluation de l’intégrale de $(x – E(X))^2 f(x)$ sur $[a, b]$ mène à l’expression invariante $V(X) = \frac{(b – a)^2}{12}$. L’écart-type est par conséquent donné par la racine carrée de cette valeur, soit $\frac{b – a}{2\sqrt{3}}$.
L’exploration des moments d’ordre supérieur met en exergue la symétrie parfaite de la distribution. Le moment centré d’ordre trois, mesurant l’asymétrie statistique (skewness), est rigoureusement nul pour tout couple de paramètres réels $(a, b)$. Le moment centré d’ordre quatre normalisé, définissant le kurtosis ou coefficient d’aplatissement, révèle un comportement platykurtique prononcé. Le kurtosis non normalisé vaut exactement $\frac{9}{5}$, ce qui se traduit par un kurtosis excédentaire égal à $-\frac{6}{5} = -1.2$. Cette valeur négative confirme empiriquement et théoriquement que la distribution uniforme possède des queues considérablement plus légères et une forme beaucoup plus aplatie que la distribution gaussienne standard, excluant la présence de valeurs aberrantes extrêmes au-delà des frontières finies $a$ et $b$.
1.2 Fonction de répartition et calcul analytique des probabilités
La fonction de répartition, traditionnellement désignée par $F(x)$, correspond à l’intégrale de la fonction de densité de probabilité depuis l’infini négatif jusqu’au point d’évaluation réel $x$. Elle représente la probabilité cumulative que la variable aléatoire $X$ prenne une valeur inférieure ou égale à $x$, soit $F(x) = P(X le x)$. Sur le plan mathématique, la fonction de répartition de la loi uniforme continue se formule de façon continue par morceaux à travers trois régimes distincts régis par les bornes structurelles du support :
Pour toute valeur réelle $x$ strictement inférieure à la borne minimale $a$, la probabilité cumulée est rigoureusement nulle : $F(x) = 0$. Pour toute valeur $x$ située à l’intérieur de l’intervalle support, c’est-à-dire pour $a le x le b$, l’intégration de la constante de densité produit une progression strictement affine : $F(x) = \int_{a}^{x} \frac{1}{b – a} , dt = \frac{x – a}{b – a}$. Enfin, pour tout réel $x$ strictement supérieur à la borne supérieure $b$, la totalité de la masse de probabilité ayant été intégrée, la fonction prend de manière stationnaire la valeur maximale unitaire : $F(x) = 1$. Cette structure continue assure la dérivabilité de $F$ presque partout sur $\mathbb{R}$, à l’exception des points anguleux $x = a$ et $x = b$ où la fonction de répartition présente des discontinuités de pente.
À partir de cette formulation analytique, le calcul de la probabilité que la variable aléatoire continue $X$ s’insère au sein d’un sous-intervalle arbitraire défini par $[x_1, x_2]$, avec la contrainte d’ordonnancement $a le x_1 le x_2 le b$, s’exécute directement par l’application de la propriété de soustraction des probabilités cumulées : $P(x_1 le X le x_2) = F(x_2) – F(x_1)$. En substituant les expressions fonctionnelles de la loi uniforme, cette relation devient :
$$P(x_1 le X le x_2) = \frac{x_2 – a}{b – a} – \frac{x_1 – a}{b – a} = \frac{x_2 – x_1}{b – a}$$
Cette relation fondamentale met en évidence le caractère géométrique de la loi uniforme : la probabilité de l’événement correspond rigoureusement au ratio entre la longueur du sous-intervalle cible et la longueur totale de l’espace d’échantillonnage. En dehors du domaine fermé $[a, b]$, le comportement asymptotique de la distribution est trivialement stable. Il n’existe aucun phénomène de traîne lourde ou de convergence lente vers zéro à l’infini, contrairement aux lois de Pareto ou de Cauchy. Cette compacité garantit une régularité absolue des intégrales d’espérance conditionnelle et permet d’éviter les instabilités numériques inhérentes aux queues de distribution infinies.
Au-delà de sa simplicité calculatoire apparente, la fonction de répartition de la loi uniforme continue joue un rôle central dans l’édifice mathématique des probabilités modernes à travers le théorème de la transformation intégrale de probabilité (Probability Integral Transform). Selon ce théorème fondamental, si $X$ est une variable aléatoire continue dotée d’une fonction de répartition $F_X(x)$ strictement croissante et continue, alors la variable aléatoire transformée $U = F_X(X)$ suit rigoureusement une loi uniforme continue sur l’intervalle standard $[0, 1]$. Réciproquement, si $U$ est distribuée selon une loi uniforme standard $\mathcal{U}(0, 1)$, la variable aléatoire générée par l’application de la fonction quantile réciproque, $X = F_X^{-1}(U)$, suit exactement la loi de distribution caractérisée par $F_X$. Ce mécanisme théorique constitue la justification mathématique de la méthode d’inversion, qui gouverne l’ensemble des moteurs de simulation stochastique modernes en informatique scientifique.
1.3 Pertinence méthodologique dans la recherche empirique et quantitative
Dans le domaine de la recherche quantitative et de l’expérimentation empirique, la distribution uniforme ne représente pas un simple artefact théorique, mais un instrument méthodologique central pour établir la validité interne des protocoles de recherche. Le rôle le plus fondamental de l’équiprobabilité réside dans son statut d’hypothèse nulle ($H_0$) au sein des tests d’adéquation et d’indépendance statistique. Lorsqu’un chercheur teste si des sujets humains manifestent une préférence directionnelle ou si des événements discrets se produisent de manière biaisée dans le temps, la distribution uniforme constitue l’étalon mathématique universel représentant l’absence totale de biais directionnel. Toute déviation empiriquement constatable par rapport à cette ligne de base permet de réfuter l’hypothèse d’indifférence stochastique.
Du point de vue de la physique statistique et de la théorie de l’information formalisée par Claude Shannon, la loi uniforme continue sur un support borné fermé constitue la distribution qui maximise l’entropie différentielle. Le principe d’entropie maximale stipule que lorsqu’un chercheur doit choisir une loi de probabilité pour représenter un phénomène dont seules les bornes physiques minimales et maximales sont formellement connues, à l’exclusion de toute information concernant la moyenne interne, la variance ou les moments supérieurs, la loi uniforme est le seul choix mathématiquement neutre et épistémiquement non biaisé. Choisir une autre distribution introduirait une information arbitraire non soutenue par les observations réelles. La distribution uniforme formalise ainsi rigoureusement l’incertitude épistémique absolue sur un domaine borné.
En psychométrie et en neurosciences comportementales, la loi uniforme est employée pour neutraliser les effets d’apprentissage temporel et l’anticipation motrice des participants lors de tâches d’attention soutenue ou de détection de signaux. Si un stimulus perceptif apparaissait à des intervalles fixes ou centrés selon une courbe en cloche autour d’une moyenne connue, le cerveau humain ajusterait inconsciemment ses seuils d’excitabilité corticale en fonction du temps écoulé, faussant la mesure pure du temps de réaction sensoriel. L’injection d’un délai inter-stimulus (ISI) généré selon une loi uniforme supprime tout repère probabiliste unilatéral, garantissant que le sujet demeure dans un état de vigilance homogène et constant au cours de l’ensemble des essais expérimentaux.
2. L’écosystème Python pour la modélisation probabiliste
2.1 Panorama des bibliothèques scientifiques : NumPy versus SciPy
L’implémentation du paradigme probabiliste en langage Python repose sur un écosystème hautement hiérarchisé de calcul numérique. Au sommet de cette architecture trônent deux bibliothèques complémentaires mais aux orientations fonctionnelles divergentes : NumPy et SciPy. Comprendre leurs différences conceptuelles est impératif pour concevoir des algorithmes à la fois rigoureux sur le plan théorique et optimaux sur le plan des performances calculatoires.
La bibliothèque NumPy se concentre principalement sur la manipulation haute performance de tableaux multidimensionnels homogènes appelés ndarray. Au sein de son sous-module numpy.random, NumPy fournit des primitives d’échantillonnage aléatoire écrites en C compilé, conçues pour une vélocité maximale et une parallélisation vectorisée. NumPy est l’outil de référence lorsqu’un protocole expérimental requiert la génération en mémoire de millions de tirages pseudo-aléatoires indépendants et identiquement distribués. Cependant, NumPy est intentionnellement limité quant à l’analyse probabiliste analytique : il n’offre pas d’outils formels pour évaluer la fonction de densité de probabilité, calculer une valeur p via une fonction de répartition, ou réaliser un ajustement statistique automatique sur des données observées.
À l’opposé, la bibliothèque SciPy, et tout particulièrement son sous-module scipy.stats, a été bâtie pour fournir une représentation intégrale des objets probabilistes au sens de l’analyse mathématique. Dans scipy.stats, la distribution uniforme est encapsulée au sein de classes d’objets statistiques héritant d’une structure abstraite universelle nommée rv_continuous. Cette architecture apporte une richesse analytique inégalée : chaque classe expose systématiquement des méthodes pour le calcul de la densité de probabilité (pdf), de la densité logarithmique (logpdf), de la fonction de répartition cumulative (cdf), de la fonction de survie (sf), des quantiles théoriques (ppf), ainsi que des routines d’inférence statistique et de calcul automatique des moments. Bien que SciPy s’appuie en arrière-plan sur les générateurs de NumPy pour ses tirages empiriques, son surcoût d’abstraction en fait un outil taillé pour l’évaluation théorique et la modélisation formelle.
L’intégration fluide de ces deux bibliothèques avec la structure de données DataFrame fournie par Pandas complète cet environnement scientifique. Un chercheur peut échantillonner une matrice de conditions stochastiques via NumPy, la structurer sous la forme de séries temporelles Pandas avec des indexations multi-niveaux pour différents participants, puis appliquer les méthodes analytiques de scipy.stats pour vérifier la conformité distributionnelle de l’échantillon collecté. Cette trilogie forme un pipeline cohérent, allant du générateur de bas niveau à l’analyse inférentielle de haut niveau.
2.2 Configuration rigoureuse de l’environnement de recherche
La crédibilité d’un protocole expérimental ou d’une analyse quantitative repose sur la reproductibilité absolue de ses résultats informatiques. En calcul stochastique, la reproductibilité implique qu’un script exécuté sur différentes machines ou à différentes époques doit produire rigoureusement la même séquence exacte de nombres pseudo-aléatoires et les mêmes métriques d’estimation. Pour atteindre cet objectif en Python, la mise en place d’un environnement de recherche cloisonné et contrôlé est une exigence méthodologique préalable incontournable.
La première étape consiste à instaurer un environnement virtuel dédié au projet de recherche à l’aide d’outils tels que venv ou conda, garantissant que les versions de Python, NumPy, SciPy et de leurs dépendances associées demeurent figées. Les variations d’algorithmes internes entre différentes versions mineures de sous-systèmes compilés peuvent en effet induire des divergences silencieuses dans l’échantillonnage de variables aléatoires continues.
La seconde exigence, souvent négligée, concerne la gestion de la graine du générateur stochastique. Historiquement, les scripts scientifiques utilisaient l’instruction globale numpy.random.seed(valeur). Cette pratique ancienne est aujourd’hui expressément proscrite par les comités de développement de NumPy et de SciPy. La mutation de l’état aléatoire global présente des risques majeurs d’interférence entre modules distincts ou lors de l’exécution concurrente de processus en multithreading. L’approche moderne impose l’instanciation explicite d’un générateur isolé à l’aide de la fonction d’usine numpy.random.default_rng(seed), instanciant par défaut le générateur moderne PCG64 (Permuted Congruential Generator). Ce générateur local est ensuite injecté dans les routines d’échantillonnage ou passé explicitement aux méthodes de scipy.stats via l’argument normé random_state, assurant un déterminisme strict sans pollution de l’espace global.
3. Syntaxe et paramétrage de scipy.stats.uniform
3.1 Analyse de la paramétrisation spécifique : loc et scale
L’une des causes les plus récurrentes d’erreurs d’implémentation statistique lors de la transition vers scipy.stats réside dans le système standardisé de paramétrisation de ses distributions continues. Alors que la littérature mathématique standard définit quasi universellement la loi uniforme continue par ses bornes d’extrémités explicites $[a, b]$, SciPy adopte une transformation affine générale commune à l’ensemble de ses distributions univariées, basée sur deux hyperparamètres fondamentaux : loc (pour localisation) et scale (pour échelle).
Dans le cas spécifique de l’objet scipy.stats.uniform, le paramètre loc correspond rigoureusement à la borne inférieure $a$ de l’intervalle support. En revanche, le paramètre scale ne correspond absolument pas à la borne supérieure $b$. Il représente l’amplitude, l’étendue ou la largeur géométrique totale de l’intervalle, c’est-à-dire la différence arithmétique $b – a$. Par conséquent, la borne supérieure effective de la distribution est régie par la relation analytique fondamentale :
$$\text{borne supérieure } b = \text{loc} + \text{scale}$$
Par défaut, si l’utilisateur instancie ou évalue la loi uniforme sans spécifier explicitement ces arguments optionnels, SciPy applique les valeurs par défaut normalisées loc = 0 et scale = 1. Cette configuration correspond à la loi uniforme standard unitaire définie sur le support compact $[0, 1]$. L’étendue est égale à un, et la borne inférieure est située à l’origine.
L’incompréhension de ce modèle d’échelle engendre des anomalies silencieuses mais destructrices dans les analyses quantitatives. Si un analyste souhaite modéliser un temps de réponse compris entre 200 millisecondes et 800 millisecondes, et commet l’erreur intuitive d’écrire uniform(loc=200, scale=800), il ne modélise pas l’intervalle $[200, 800]$. En réalité, il instancie une distribution continue sur le support $[200, 200 + 800]$, soit $[200, 1000]$. Les densités calculées, les probabilités cumulées et les tirages pseudo-aléatoires intègrent alors des valeurs s’étendant jusqu’à 1000 millisecondes, faussant l’intégralité du modèle. La syntaxe correcte pour un intervalle cible $[a, b]$ requiert impérativement de renseigner scale = b - a, ce qui s’écrit dans notre exemple uniform(loc=200, scale=600).
3.2 Instanciation d’objets statistiques figés (frozen distributions)
L’architecture logicielle de scipy.stats propose deux modes opératoires distincts pour exécuter des calculs probabilistes : l’usage de méthodes statiques en passant les paramètres à chaque invocation, ou l’instanciation d’un objet statistique figé, communément désigné dans la terminologie anglophone par l’expression frozen distribution.
Dans l’approche par méthodes statiques, la classe scipy.stats.uniform est appelée directement en spécifiant les paramètres loc et scale au sein de chaque appel de fonction. Cette syntaxe est appropriée pour des opérations isolées. Cependant, lorsque l’architecture d’un programme impose d’interroger la même distribution mathématique de manière répétée à travers des milliers d’itérations — par exemple en évaluant successivement la densité de probabilité, en échantillonnant des sous-groupes et en calculant des percentiles —, la redondance de la validation interne des paramètres génère un surcoût computationnel notable.
La programmation orientée objet via les distributions figées résout élégamment cette inefficacité. En exécutant l’instruction d’instanciation dist = uniform(loc=a, scale=b-a), Python génère un objet spécialisé dérivé de rv_frozen qui encapsule de manière immuable les paramètres de localisation et d’échelle. Dès lors, l’ensemble des méthodes statistiques peut être invoqué directement sur cet objet sans jamais avoir à redéfinir son ancrage géométrique : dist.pdf(x), dist.cdf(x), dist.ppf(q) ou dist.rvs(size=n). Cette démarche structurelle renforce la lisibilité architecturale du code source en évitant la propagation de variables de configuration redondantes, tout en garantissant une optimisation interne des calculs grâce à la mise en cache des invariants de la distribution.
4. Calcul de probabilités cumulées avec la fonction de répartition (CDF)
4.1 Implémentation de uniform.cdf pour des probabilités unilatérales
L’évaluation quantitative de la probabilité cumulée unilatérale, définie formellement par $P(X le x)$, constitue l’un des calculs fondamentaux de l’analyse inférentielle. Au sein du framework SciPy, cette opération s’effectue au moyen de la méthode cdf (Cumulative Distribution Function). Sa signature canonique se présente sous la forme scipy.stats.uniform.cdf(x, loc=0, scale=1) lorsqu’elle est utilisée statiquement, ou sous la forme dist.cdf(x) lorsqu’elle est appliquée à un objet de distribution préalablement figé.
L’implémentation interne de uniform.cdf gère de façon rigoureuse les cas limites définis par la théorie mathématique. Si la valeur cible $x$ soumise en argument est strictement inférieure à la borne inférieure spécifiée par loc, l’algorithme ne génère aucune erreur d’exécution mais renvoie de manière déterministe un flottant 0.0, attestant de l’impossibilité de l’événement dans le cadre de la théorie de la mesure. Inversement, pour toute valeur de $x$ excédant la borne supérieure effective calculée par loc + scale, la fonction retourne rigoureusement 1.0. À l’intérieur du support compact, la valeur calculée résulte de l’évaluation numérique directe de l’expression affine normalisée $(x – \text{loc}) / \text{scale}$.
Pour matérialiser ce comportement sur un cas concret, considérons le problème classique de la modélisation du temps d’attente d’une rame de transport en commun. Supposons qu’un métro circule avec une régularité absolue toutes les 12 minutes, et qu’un usager se présente sur le quai à un instant aléatoire sans consulter les horaires. Le temps d’attente $X$, exprimé en minutes, est rigoureusement modélisé par une loi uniforme sur l’intervalle $[0, 12]$, ce qui correspond à une instanciation avec loc=0 et scale=12. Si l’on souhaite calculer la probabilité que cet usager attende son train moins de 4 minutes, l’évaluation de dist.cdf(4) fournit la valeur exacte $4 / 12 = 0.3333333333333333$, soit une probabilité d’un tiers. La méthode accepte de surcroît des scalaires, des listes Python ou des tableaux multidimensionnels NumPy en argument $x$, vectorisant instantanément l’évaluation sur de larges grilles de coordonnées.
4.2 Calcul des probabilités d’intervalle P(x1 <= X <= x2)
Dans la majorité des démarches analytiques empiriques, les hypothèses opérationnelles ne portent pas sur des zones critiques unilatérales partant de l’origine, mais sur des intervalles délimités de réalisation. En vertu des axiomes de Kolmogorov, la probabilité qu’une variable continue $X$ s’insère strictement entre deux seuils expérimentaux $x_1$ et $x_2$ vérifiant $x_1 le x_2$ s’obtient par la différence algébrique de leurs fonctions de répartition cumulées :
$$P(x_1 le X le x_2) = F(x_2) – F(x_1)$$
En code Python, cette relation s’exprime immédiatement par l’opération vectorielle ou scalaire dist.cdf(x2) - dist.cdf(x1). Avant d’exécuter cette soustraction, un pipeline de traitement rigoureux doit impérativement s’assurer de la validité de la relation d’ordre $x_1 le x_2$. Si des bornes inversées sont soumises sans validation, le résultat arithmétique sera négatif, ce qui viole le premier axiome de la théorie des probabilités imposant la positivité de toute mesure.
Considérons à titre d’illustration une expérience en biométrie animale où l’on observe la distribution de la masse corporelle chez une colonie spécifique de petits mammifères soumise à des conditions d’abondance alimentaire contrôlée. L’observation expérimentale permet de postuler que la masse $M$ se distribue uniformément sur un support allant de 150 grammes à 350 grammes. La distribution correspondante est donc définie par loc=150 et une échelle de variation scale = 350 - 150 = 200. Si le protocole expérimental nécessite d’isoler la cohorte d’individus dont la masse se situe dans la plage intermédiaire comprise entre 220 grammes et 280 grammes, le calcul analytique s’effectue par la relation :
$$P(220 le M le 280) = \frac{280 – 150}{200} – \frac{220 – 150}{200} = \frac{130}{200} – \frac{70}{200} = \frac{60}{200} = 0.30$$
L’exécution informatique équivalente, réalisée en interrogeant dist.cdf(280) - dist.cdf(220), retourne exactement 0.3 avec une précision machine conforme aux spécifications de la norme IEEE 754 pour les flottants à double précision. Cette parfaite adéquation entre la déduction formelle et le résultat algorithmique confirme la stabilité de l’opérateur de calcul de SciPy sur l’espace d’échantillonnage.
4.3 Survie et probabilités complémentaires avec uniform.sf
Dans de nombreuses applications d’ingénierie statistique, d’épidémiologie et de psychologie cognitive, l’analyste s’intéresse à la queue supérieure de la distribution, c’est-à-dire à la probabilité qu’une variable dépasse un certain seuil critique : $P(X > x)$. Cette fonction mathématique porte le nom de fonction de survie (Survival Function) ou de fonction de queue, et se note conventionnellement $S(x)$. Par définition probabiliste, elle est le complémentaire direct de la fonction de répartition :
$$S(x) = 1 – F(x) = P(X > x)$$
Bien que l’écriture informatique naïve 1.0 - dist.cdf(x) paraisse mathématiquement équivalente, elle introduit des faiblesses méthodologiques profondes sur le plan de l’analyse numérique. En arithmétique en virgule flottante, lorsque $F(x)$ s’approche extrêmement près de la valeur unité $1.0$, l’opération de soustraction souffre d’un phénomène délétère connu sous le nom d’annulation catastrophique (catastrophic cancellation). La perte de chiffres significatifs altère sévèrement la précision relative du résultat, pouvant conduire à l’obtention d’un zéro absolu artificiel alors que la probabilité théorique résiduelle demeure strictement non nulle.
Pour prévenir cette dégradation de la fidélité calculatoire, SciPy met à disposition une méthode dédiée hautement optimisée : uniform.sf(x, loc=0, scale=1). Pour la loi uniforme continue sur l’intervalle $[a, b]$, la fonction de survie analytique s’exprime par le ratio $(b – x) / (b – a)$ lorsque $x$ est dans le support. L’implémentation interne de uniform.sf évalue directement ce ratio en effectuant la soustraction sur la distance résiduelle par rapport à la borne supérieure $b$, évitant ainsi totalement le passage par l’intermédiaire de $1 – F(x)$. Cette approche est particulièrement décisive dans les modèles de fiabilité de composants ou dans les analyses de temps de survie où l’on cherche à évaluer la probabilité qu’un sujet maintienne son attention au-delà d’une durée extrême sans défaillance cognitive.
5. Évaluation de la densité de probabilité (PDF) et analyse géométrique
5.1 Utilisation de uniform.pdf pour les variables continues
La fonction de densité de probabilité (Probability Density Function), accessible sous SciPy au moyen de la méthode scipy.stats.uniform.pdf(x, loc, scale), caractérise la concentration de la masse de probabilité par unité de mesure le long de la ligne réelle. Contrairement à une croyance erronée fréquemment observée chez les étudiants ou les analystes débutants, la densité de probabilité $f(x)$ d’une variable continue ne correspond en aucun cas à la probabilité de survenue du point ponctuel $x$. En effet, dans toute loi continue, la probabilité d’obtenir une valeur exacte isolée est rigoureusement nulle : $P(X = x) = 0$.
La valeur numérique retournée par dist.pdf(x) représente une dérivée locale, traduisant le taux de variation infinitésimal de la probabilité cumulée : $f(x) = \frac{dF(x)}{dx}$. Sur le support compact de la loi uniforme défini par $[a, b]$, la géométrie de cette fonction se manifeste sous la forme d’un plateau parfaitement horizontal de hauteur fixe égale à $\frac{1}{b – a} = \frac{1}{\text{scale}}$. Dès lors, la méthode uniform.pdf retourne de manière constante l’inverse arithmétique du paramètre scale pour tout argument $x$ situé dans le domaine d’éligibilité, et renvoie rigoureusement 0.0 pour tout point externe.
Il est fascinant d’observer que si l’étendue scale est strictement inférieure à l’unité, par exemple pour un intervalle étroit $[0, 0.25]$, la hauteur de la densité calculée vaut $1 / 0.25 = 4.0$. Obtenir une valeur de densité supérieure à l’unité ne constitue en aucune manière une anomalie ou une violation des lois fondamentales des probabilités, précisément parce qu’une densité n’est pas une mesure de probabilité sans dimension, mais une mesure de densité surfacique dont l’intégrale totale sur l’espace réel vaut rigoureusement $1.0$. Lorsqu’elle est évaluée sur une grille continue vectorisée générée par exemple avec numpy.linspace, uniform.pdf dessine une fonction rectangle caractéristique, dont les discontinuités nettes aux abscisses critiques $x = \text{loc}$ et $x = \text{loc} + \text{scale}$ posent des défis classiques aux algorithmes d’interpolation continue.
5.2 Densité logarithmique avec uniform.logpdf
Dans les applications computationnelles de pointe, telles que l’optimisation par inférence bayésienne, les algorithmes de chaînes de Markov Monte-Carlo (MCMC) ou l’évaluation du maximum de vraisemblance sur de volumineux échantillons de données, l’utilisation de la densité standard pdf devient rapidement impraticable sur le plan numérique. Lorsque l’on évalue la vraisemblance conjointe d’un ensemble de $N$ observations mutuellement indépendantes, la loi produit impose de multiplier entre elles les densités individuelles associées à chaque point de données :
$$L(\theta | X) = \prod_{i=1}^{N} f(x_i | \theta)$$
Lorsque $N$ atteint plusieurs milliers d’observations, la multiplication itérée de valeurs de densité décimales engendre inévitablement un phénomène critique d’underflow arithmétique : les nombres réels deviennent si petits qu’ils tombent sous le seuil d’échelonnement représentable par le matériel machine, provoquant un écrasement brutal du produit vers un zéro informatique non exploitable. La solution mathématique et algorithmique universelle consiste à transposer l’évaluation dans le domaine logarithmique en calculant la log-vraisemblance, transformant les produits instables en sommations stables de densités logarithmiques :
$$\ln L(\theta | X) = \sum_{i=1}^{N} \ln f(x_i | \theta)$$
SciPy intègre cette optimisation au cœur de sa méthode native scipy.stats.uniform.logpdf(x, loc, scale). À l’intérieur du support délimité $[a, b]$, la densité étant la constante $\frac{1}{\text{scale}}$, sa valeur logarithmique naturelle s’établit de manière analytique exacte par la relation :
$$\ln f(x) = \ln\left(\frac{1}{\text{scale}}\right) = -\ln(\text{scale})$$
L’implémentation de uniform.logpdf calcule cette constante négative en invoquant directement les algorithmes compilés de logarithme népérien, garantissant une stabilité numérique maximale sans jamais réaliser d’abord le quotient décimal. Pour toute coordonnée $x$ située en dehors de l’intervalle $[a, b]$, la densité étant nulle, son logarithme tend théoriquement vers l’infini négatif. SciPy gère formellement cette limite en renvoyant la valeur spéciale à virgule flottante -np.inf. L’utilisation systématique de logpdf permet ainsi d’écrire des routines d’estimation statistique extrêmement robustes, insensibles à la saturation d’échelle et au sous-dépassement numérique.
6. Fonctions quantiles, inverse de la CDF et intervalles statistiques
6.1 Calcul des quantiles avec uniform.ppf (Percent Point Function)
La fonction quantile, désignée dans la documentation scientifique de SciPy sous le nom technique de PPF (Percent Point Function), correspond mathématiquement à la fonction inverse ou réciproque de la fonction de répartition cumulative : $Q(q) = F^{-1}(q)$. Alors que la CDF détermine la probabilité associée à une valeur de seuil donnée, la PPF résout le problème strictement opposé : étant donné un niveau de probabilité cumulative $q$ préalablement fixé et compris dans l’intervalle unitaire $[0, 1]$, quelle est l’abscisse exacte $x$ telle que $P(X le x) = q$ ?
Pour la distribution uniforme continue sur l’intervalle $[a, b]$, la réciproque de la fonction affine $F(x) = \frac{x – a}{b – a}$ s’obtient instantanément par inversion algébrique directe :
$$x = F^{-1}(q) = a + q \cdot (b – a) = \text{loc} + q \cdot \text{scale}$$
La méthode scipy.stats.uniform.ppf(q, loc, scale) matérialise cette formulation. En lui soumettant des valeurs probabilistes canoniques, il devient immédiat de dériver les métriques structurelles fondamentales de la distribution. Ainsi, la médiane théorique, qui sépare la population en deux sous-ensembles équiprobables de 50 %, s’obtient par l’invocation de dist.ppf(0.5), produisant rigoureusement le milieu géométrique $\text{loc} + 0.5 \cdot \text{scale} = \frac{a + b}{2}$. Le premier quartile, correspondant au niveau $q = 0.25$, et le troisième quartile, correspondant à $q = 0.75$, s’évaluent avec la même élégance calculatoire.
La rigueur de la bibliothèque se manifeste dans son traitement des valeurs d’entrée limites ou aberrantes. Si l’utilisateur interroge uniform.ppf(0.0), la fonction renvoie exactement la borne inférieure loc, tandis que la saisie de uniform.ppf(1.0) retourne la borne supérieure loc + scale. Si l’argument $q$ dévie en dehors du domaine de définition probabiliste $[0, 1]$, en passant par exemple une valeur négative ou strictement supérieure à l’unité, SciPy n’interrompt pas le programme par une exception fatale mais renvoie le marqueur numérique normalisé np.nan (Not a Number), tout en générant un avertissement d’exécution (RuntimeWarning), garantissant ainsi la traçabilité des anomalies de calcul dans les chaînes de traitement automatisées.
6.2 Construction d’intervalles de confiance et dispersion
Dans la démarche inférentielle et l’évaluation de la dispersion expérimentale, la délimitation d’intervalles de probabilité bilatéraux centrés revêt une importance opérationnelle déterminante. SciPy met à disposition la méthode native interval(confidence, loc, scale), conçue pour dériver directement les bornes de l’intervalle symétrique qui encapsule une proportion spécifiée de la distribution totale, centrée précisément autour de la médiane.
Si l’on soumet un niveau de confiance désiré, par exemple $\alpha = 0.95$ (pour un intervalle de probabilité bilatéral à 95 %), la méthode dist.interval(0.95) calcule automatiquement les percentiles correspondants en retranchant la moitié de la zone résiduelle à chaque extrémité. La zone exclue étant égale à $1 – 0.95 = 0.05$, l’algorithme positionne la borne inférieure au quantile $q_1 = \frac{0.05}{2} = 0.025$, et la borne supérieure au quantile $q_2 = 1 – 0.025 = 0.975$. En appliquant ces paramètres à la loi uniforme, les bornes retournées sous forme de tuple sont :
$$x_{\text{bas}} = \text{loc} + 0.025 \cdot \text{scale}, \quad x_{\text{haut}} = \text{loc} + 0.975 \cdot \text{scale}$$
Cette approche permet de calculer l’écart interquartile théorique (Interquartile Range ou IQR), défini comme la distance séparant le troisième quartile du premier quartile : $\text{IQR} = Q(0.75) – Q(0.25)$. Pour la loi uniforme, cet écart s’établit de façon invariante à :
$$\text{IQR} = (\text{loc} + 0.75 \cdot \text{scale}) – (\text{loc} + 0.25 \cdot \text{scale}) = 0.5 \cdot \text{scale}$$
La comparaison de cet écart interquartile avec l’écart-type théorique $\sigma = \frac{\text{scale}}{\sqrt{12}} \approx 0.2887 \cdot \text{scale}$ met en lumière la nature singulière de la dispersion uniforme. L’amplitude interquartile englobe la moitié de la distribution sur un intervalle représentant exactement la moitié de l’étendue totale, illustrant à nouveau l’homogénéité spatiale absolue de la masse de probabilité, dépourvue de tout point d’inflexion ou de concentration centrale caractéristique des distributions de type Gauss ou Student.
7. Génération de nombres pseudo-aléatoires et simulations stochastiques
7.1 Échantillonnage avec uniform.rvs
L’une des fonctions les plus exploitées de la classe scipy.stats.uniform est sans conteste la méthode rvs (Random Variates Simulation). Elle permet d’extraire des réalisations synthétiques continues obéissant rigoureusement aux paramètres de la loi uniforme spécifiée. Sa polyvalence réside dans sa capacité à produire des structures scalaires, des vecteurs unidimensionnels ou des tenseurs multidimensionnels grâce à l’argument normé size.
Pour générer un échantillon représentatif de taille $N$, la méthode s’invoque sous la syntaxe dist.rvs(size=N) ou en syntaxe statique scipy.stats.uniform.rvs(loc=a, scale=b-a, size=N). L’argument size ne se limite pas à un simple entier positif : il accepte des tuples d’entiers décrivant la topologie matricielle souhaitée, par exemple size=(1000, 5) pour matérialiser mille essais expérimentaux distribués sur cinq canaux d’acquisition parallèles. Le tableau retourné est systématiquement une instance de numpy.ndarray typée en flottants double précision 64 bits (float64), autorisant une exploitation matricielle immédiate dans les chaînes de traitement vectorisées de NumPy ou de Pandas.
La reproductibilité des tirages aléatoires au sein de la méthode rvs est administrée avec rigueur par l’argument random_state. Cet argument accepte indifféremment un entier unique agissant comme graine stochastique, une instance de générateur explicite comme np.random.default_rng(), ou un objet d’état hérité. En fournissant systématiquement un générateur instancié à random_state, le chercheur s’assure que chaque chaîne de simulation produira une réplique séquentielle identique, élément indispensable lors de la publication de jeux de données synthétiques adossés à des articles de recherche empirique.
7.2 Échantillonnage alternatif haute performance via numpy.random
Bien que la méthode scipy.stats.uniform.rvs offre une interface commode et parfaitement intégrée au reste des méthodes inférentielles de SciPy, elle accuse un surcoût computationnel mesurable lorsqu’il s’agit d’exécuter des simulations massives impliquant des dizaines de millions d’itérations. Ce surcoût provient de la couche d’encapsulation orientée objet, de la vérification préalable des arguments à chaque appel et des conversions internes de types.
Dans les contextes d’optimisation de calcul intensif (High-Performance Computing), il est recommandé de solliciter directement le moteur de tirage natif de NumPy via son architecture de générateur aléatoire unifiée. Le générateur s’instancie au préalable à l’aide de l’instruction rng = np.random.default_rng(seed), après quoi l’échantillonnage uniforme s’opère par l’invocation de sa méthode optimisée : rng.uniform(low=a, high=b, size=N). Il convient de souligner ici une différence ergonomique majeure avec SciPy : l’interface de NumPy adopte une sémantique plus intuitive en acceptant directement la borne inférieure low et la borne supérieure effective high, supprimant le besoin d’effectuer mentalement la conversion d’échelle scale = b - a.
Des analyses de performance comparatives (benchmarking) démontrent de manière systématique que l’appel à rng.uniform s’exécute entre deux et cinq fois plus rapidement que son équivalent uniform.rvs sous SciPy pour des tailles d’échantillons importantes. Sur le plan de l’architecture logicielle, la recommandation méthodologique consiste à privilégier l’API de NumPy pour la génération brute de données lors des boucles intensives de Monte-Carlo, et à réserver les objets statistiques de SciPy pour les phases analytiques impliquant le calcul de vraisemblances, de quantiles théoriques ou de tests d’adéquation formels.
7.3 Méthodes de Monte-Carlo fondées sur la loi uniforme
La loi uniforme continue n’est pas uniquement un modèle descriptif pour des variables réelles équidistribuées ; elle représente le mécanisme moteur universel de l’ensemble des méthodes stochastiques d’intégration et d’échantillonnage de Monte-Carlo. Deux méthodologies majeures reposent sur ses propriétés intrinsèques : la méthode de rejet (Rejection Sampling) et la méthode de la transformée inverse.
La méthode de la transformée inverse (Inverse Transform Sampling) est l’application algorithmique directe du théorème de la transformation intégrale de probabilité exposé à la section 1.2. Pour générer un tirage aléatoire issu d’une distribution mathématique complexe dont la fonction de répartition réciproque $F_X^{-1}$ est formellement ou numériquement accessible — telle qu’une loi exponentielle, de Weibull ou de Cauchy —, il suffit de tirer un nombre pseudo-aléatoire $U$ selon une loi uniforme standard $\mathcal{U}(0, 1)$ à l’aide de Python, puis d’évaluer la valeur transformée $X = F_X^{-1}(U)$. La variable résultante $X$ suivra rigoureusement la loi théorique ciblée. Ce mécanisme illustre comment la loi uniforme continue sur $[0, 1]$ agit comme la matrice génétique d’où découlent toutes les autres distributions continues.
La loi uniforme permet également la résolution stochastique d’intégrales définies complexes réputées insolubles sur le plan analytique. Selon le théorème fondamental de Monte-Carlo, l’intégrale d’une fonction arbitraire $g(x)$ sur un intervalle compact $[a, b]$ peut être estimée par la moyenne empirique de la fonction évaluée en des points d’échantillonnage distribués uniformément le long du domaine :
$$\int_{a}^{b} g(x) , dx = (b – a) \cdot E[g(X)] \approx \frac{b – a}{N} \sum_{i=1}^{N} g(x_i), \quad \text{a\vec } x_i \sim \mathcal{U}(a, b)$$
Cette méthodologie d’intégration fournit une approximation dont l’erreur quadratique moyenne converge asymptotiquement au rythme universel de $\mathcal{O}(1 / \sqrt{N})$, indépendamment de la dimensionnalité du problème, surpassant les méthodes d’intégration numérique par quadratures de Newton-Cotes dès lors que l’on aborde des espaces d’états à plusieurs dimensions en modélisation physique ou cognitive.
8. Visualisation avancée de la distribution uniforme
8.1 Représentation graphique de la PDF théorique et de la CDF avec Matplotlib
Une démarche scientifique rigoureuse exige que la modélisation mathématique soit étayée par des représentations visuelles précises et conformes aux conventions académiques les plus strictes. La boîte à outils canonique en Python pour cette tâche repose sur la bibliothèque Matplotlib. Tracer la densité théorique (PDF) et la fonction de répartition (CDF) d’une distribution uniforme continue impose de respecter visuellement les discontinuités de bordure sans introduire d’artefacts graphiques trompeurs.
Pour matérialiser la fonction de densité de probabilité, il est conseillé de définir un domaine d’évaluation s’étendant au-delà des bornes $[a, b]$, en allouant une marge visuelle symétrique de 15 à 20 % de part et d’autre des extrémités. En évaluant uniform.pdf sur cette grille dense, la courbe trace une trajectoire nulle, suivie d’un saut vertical abrupt vers la constante $1 / (b – a)$, cheminant le long du plateau horizontal avant de redescendre brutalement à zéro au-delà de la borne supérieure. Pour illustrer graphiquement une probabilité d’intervalle spécifique $P(x_1 le X le x_2)$, la commande plt.fill_between permet de colorer en transparence la surface sous la courbe comprise entre ces deux abscisses, offrant une lecture immédiate du calcul de l’intégrale surfacique.
Le tracé de la fonction de répartition cumulative (CDF) traduit une géométrie différente : une ligne parfaitement horizontale d’ordonnée zéro pour $x < a$, se brisant en un coude net à l’abscisse $a$ pour adopter une pente ascendante strictement rectiligne de valeur $\frac{1}{b – a}$ jusqu’à l’abscisse critique $b$, où elle subit une seconde rupture de dérivée pour devenir une ligne horizontale asymptotique stationnaire à $y = 1$. L’adjonction de grilles légères, d’étiquettes d’axes formatées avec une typographie soignée et d’annotations mathématiques décrivant précisément les valeurs critiques garantit une restitution conforme aux exigences éditoriales des revues internationales à comité de lecture.
8.2 Superposition empirique versus théorique avec Seaborn
La validation empirique d’un générateur aléatoire ou la vérification d’une hypothèse de modélisation nécessite de confronter visuellement les données simulées ou observées aux courbes analytiques de référence. L’écosystème Python propose à cet effet la bibliothèque Seaborn, surcouche spécialisée construite au-dessus de Matplotlib dédiée à l’exploration visuelle de données statistiques.
La méthode la plus directe consiste à tracer un histogramme normalisé de l’échantillon empirique à l’aide de la fonction seaborn.histplot, en configurant impérativement l’argument stat="density". Cette normalisation ajuste l’échelle de l’ordonnée de sorte que la somme des aires de chaque rectangle d’estimation soit rigoureusement égale à un, autorisant ainsi une superposition directe et rigoureuse avec la fonction de densité théorique $f(x)$ tracée en surimpression. Si l’échantillon est de taille adéquate, les barres de l’histogramme empirique viennent s’aligner de manière homogène le long de la ligne théorique horizontale.
Une vigilance méthodologique critique s’impose quant à l’activation de l’estimation de densité par noyau (Kernel Density Estimation ou KDE) lors de l’analyse de distributions à support compact borné comme la loi uniforme. Les algorithmes d’estimation de noyau conventionnels appliquent par défaut des fenêtres de lissage gaussiennes continues s’étendant à l’infini. Aux voisinages immédiats des frontières rigides $a$ et $b$, le noyau gaussien diffuse une partie de sa masse en dehors du support physique, provoquant un phénomène d’artefact sévère connu sous le nom de biais de bordure (boundary bias). L’estimation KDE s’effondre prématurément avant d’atteindre la frontière et crée une traîne fictive au-delà des bornes. Il convient donc de proscrire l’utilisation naïve de courbes KDE non corrigées pour évaluer l’uniformité de données compactes, ou de recourir à des estimateurs à noyaux réfléchissants spécialisés.
Pour surmonter ces biais d’estimation de densité, le diagramme quantile-quantile (Q-Q plot), accessible via la méthode scipy.stats.probplot, constitue la modalité de diagnostic graphique la plus robuste. En projetant les quantiles empiriques de l’échantillon ordonné contre les quantiles théoriques de la loi uniforme calculés par la méthode ppf, toute adéquation parfaite se traduit par un alignement rectiligne rigoureux le long de la bissectrice principale à 45 degrés. Toute déviation systématique sous forme de courbure en « S » ou d’asymétrie périphérique révèle immédiatement des anomalies de distribution telles qu’une concentration centrale indue ou un empilement pathologique aux bornes.
9. Inférence statistique, ajustement et tests d’hypothèses
9.1 Estimation des paramètres par la méthode du maximum de vraisemblance
L’inférence statistique paramétrique vise à identifier les hyperparamètres inconnus qui caractérisent le mieux un jeu de données empiriques. Pour la loi uniforme continue sur le support $[a, b]$, les paramètres à estimer sont précisément les bornes $a$ et $b$, formalisées sous SciPy par loc et scale. La classe scipy.stats.uniform dispose à cet effet de la méthode d’ajustement fit(data), qui met en œuvre la méthode du maximum de vraisemblance (Maximum Likelihood Estimation ou MLE).
Sur le plan de l’analyse mathématique, l’estimateur du maximum de vraisemblance de la loi uniforme présente des propriétés théoriques singulières qui le distinguent radicalement des estimateurs usuels pour les distributions régulières comme la loi normale. La fonction de vraisemblance s’exprime par le produit des densités individuelles :
$$L(a, b | x_1, dots, x_n) = \prod_{i=1}^{n} \frac{1}{b – a} \mathbb{I}_{[a, b]}(x_i) = \frac{1}{(b – a)^n} \prod_{i=1}^{n} \mathbb{I}_{[a, b]}(x_i)$$
Pour que cette vraisemblance demeure strictement non nulle, il est impératif que la totalité des points de données $x_i$ s’insère à l’intérieur du segment fermé $[a, b]$, ce qui impose simultanément les deux contraintes physiques strictes $a le min(X)$ et $b ge max(X)$. Pour maximiser la fonction objective $L(a, b)$, il faut minimiser la quantité au dénominateur $(b – a)^n$, ce qui équivaut géométriquement à rétrécir l’intervalle $[a, b]$ au plus près des données. Les estimateurs du maximum de vraisemblance analytiques se définissent donc formellement par les statistiques d’ordre extrêmes de l’échantillon :
$$\hat{a}_{\text{MLE}} = \min(X) = X_{(1)}, \quad \hat{b}_{\text{MLE}} = \max(X) = X_{(n)}$$
La méthode scipy.stats.uniform.fit(data) extrait automatiquement ces statistiques d’ordre à partir du tableau passé en argument et retourne le tuple d’estimation numérique (loc_est, scale_est), où loc_est est rigoureusement égal au minimum empirique de l’échantillon, et scale_est est déterminé par l’étendue empirique totale $max(X) – min(X)$.
Il est crucial pour le chercheur de comprendre que bien qu’asymptotiquement convergent, cet estimateur du maximum de vraisemblance est systématiquement biaisé pour tout échantillon de taille finie $n$. Par construction logique, le minimum d’un tirage fini est presque toujours légèrement supérieur à la borne inférieure théorique réelle $a$, et le maximum observé est presque toujours légèrement inférieur à la borne supérieure théorique $b$. L’intervalle estimé sous-estime donc structurellement l’étendue réelle du support. L’espérance de l’étendue empirique vaut en effet :
$$E[X_{(n)} – X_{(1)}] = \frac{n – 1}{n + 1} (b – a)$$
Pour éliminer ce biais statistique dans les analyses à petit effectif, l’analyste peut appliquer des corrections analytiques d’échantillon fini, ou exploiter les fonctionnalités de fixation de paramètres de SciPy. Si des fondements théoriques ou physiques imposent une borne inférieure connue d’avance (par exemple, un temps de réaction minimum incompressible fixé à zéro), la méthode autorise la fixation rigide de ce paramètre grâce à l’argument nommé floc (fixed loc) : uniform.fit(data, floc=0). Dans ce cas, SciPy neutralise l’estimation de la borne minimale et concentre l’optimisation exclusivement sur l’échelle scale, réduisant mécaniquement la variance de l’estimateur.
9.2 Test d’adéquation de Kolmogorov-Smirnov avec scipy.stats.kstest
L’estimation des paramètres doit impérativement être consolidée par une démarche de vérification d’hypothèse nulle visant à répondre formellement à la question : le jeu de données empiriques observé est-il compatible avec l’hypothèse d’une distribution uniforme sous-jacente ? Le test non paramétrique le plus rigoureux et universellement utilisé pour évaluer la conformité d’une distribution continue unidimensionnelle est le test de Kolmogorov-Smirnov (test K-S).
Le principe fondamental du test de Kolmogorov-Smirnov repose sur la quantification de la distance géométrique maximale séparant la fonction de répartition empirique de l’échantillon, notée $F_n(x)$, de la fonction de répartition théorique continue postulée $F(x)$. La statistique de test canonique, conventionnellement désignée par la lettre $D$, est définie formellement par la norme suprémum sur l’espace réel :
$$D = \sup_{x} |F_n(x) – F(x)|$$
Dans l’écosystème SciPy, l’application de ce test s’exécute au moyen de la fonction scipy.stats.kstest. Sa signature requiert de soumettre le tableau des données observées, l’identifiant textuel de la distribution de référence (ici la chaîne de caractères 'uniform'), ainsi qu’un tuple d’arguments args=(loc, scale) précisant les paramètres de la distribution théorique à tester. La fonction retourne un objet de résultat standardisé contenant la valeur numérique de la statistique $D$ et la p-valeur bilatérale associée.
L’interprétation inférentielle s’effectue selon la démarche habituelle : si la p-valeur résultante est strictement supérieure au seuil d’erreur alpha conventionnel (typiquement fixé à 0.05), le chercheur ne dispose pas de preuves statistiques suffisantes pour rejeter l’hypothèse nulle ($H_0$), concluant que les données observées sont en accord avec la loi uniforme théorique. Inversement, une p-valeur inférieure au seuil alpha signale un écart de répartition structurellement improbable sous l’effet du seul hasard stochastique.
Une mise en garde méthodologique fondamentale doit être formulée quant à l’interprétation du test de Kolmogorov-Smirnov. La théorie asymptotique standard du test de Kolmogorov-Smirnov, telle qu’implémentée dans scipy.stats.kstest, postule formellement que la distribution théorique de comparaison $F(x)$ a été déterminée a priori et de manière totalement indépendante des données observées. Si l’analyste utilise les mêmes données empiriques pour d’abord estimer les paramètres loc et scale via uniform.fit, puis soumet ces paramètres estimés au test kstest, le test devient structurellement trop conservateur. En ajustant artificiellement la loi théorique sur l’échantillon, la distance maximale $D$ observée est artificiellement réduite, augmentant de fait indûment la p-valeur et créant une inflation sévère du risque de commettre une erreur de type II (non-rejet à tort de l’hypothèse nulle). Dans une telle configuration, l’analyste rigoureux doit abandonner le test de Kolmogorov-Smirnov standard au profit d’un test de Lilliefors adapté aux bornes uniformes ou d’une procédure de validation croisée par bootstrap paramétrique.
10. Applications pratiques en psychologie expérimentale et psychométrie
10.1 Randomisation des intervalles inter-stimulus (ISI)
Dans les paradigmes expérimentaux modernes en sciences cognitives, en électroencéphalographie (EEG) et en imagerie par résonance magnétique fonctionnelle (IRMf), le contrôle rigoureux de la dimension temporelle est une condition absolue de la validité écologique et neurologique des mesures. Lorsque des stimuli sensoriels (visuels, auditifs ou tactiles) sont présentés à des sujets humains, l’esprit développe spontanément une attente prédictive temporelle. Si l’intervalle séparant deux stimuli successifs (l’intervalle inter-stimulus ou ISI) est constant, par exemple fixé à exactement 2000 millisecondes, le système nerveux central du participant synchronise ses oscillations corticales motrices et préfrontales sur ce rythme métronomique. Les temps de réaction observés ne reflètent plus alors le temps pur de traitement cognitif du stimulus, mais une réponse motrice pré-activée par une anticipation temporelle conditionnée.
Pour éliminer radicalement ce biais prédictif, la méthodologie expérimentale standard impose l’injection d’une gigue temporelle (jittering) consistant à modéliser la durée de chaque intervalle inter-stimulus comme une variable aléatoire continue distribuée selon une loi uniforme sur un segment temporel défini, par exemple $[1.5, 3.5]$ secondes. L’implémentation de cette procédure dans des environnements de stimulation comportementale informatisés tels que PsychoPy s’exécute élégamment au moyen des générateurs stochastiques de Python.
Sur le plan électrophysiologique, l’utilisation d’un intervalle uniforme présente un avantage décisif lors de l’enregistrement des potentiels évoqués cognitifs (ERP). Les réponses neuronales lentes induites par le stimulus précédent et les variations contingentes négatives (CNV) associées à l’attente s’étalent sur des durées variables. L’échantillonnage uniforme des intervalles inter-stimulus garantit que lors du calcul de la moyenne synchronisée des signaux EEG sur l’ensemble des essais d’un participant, ces composantes oscillatoires asynchrones se compensent par interférence destructive pour s’annuler vers zéro, isolant avec une netteté remarquable le signal évoqué d’intérêt pur exempt de contamination par des artéfacts d’anticipation motrice.
10.2 Randomisation des ordres de passation et contrebalancement
En psychométrie et dans la recherche quantitative par questionnaires comportementaux, la validité interne des instruments de mesure est constamment menacée par des biais d’ordre et d’ancrage psychologique. Lorsqu’un participant remplit une échelle psychométrique comprenant des dizaines d’items, ou traverse plusieurs conditions expérimentales successives, les effets de fatigue cognitive, de familiarisation progressive ou de report émotionnel d’une question sur la suivante altèrent systématiquement les réponses métriques si l’ordre de présentation demeure statique.
Le recours à la loi uniforme continue et discrète intervient ici pour concevoir des plans de randomisation et de contrebalancement rigoureux sans biais de position. Pour mélanger aléatoirement une séquence d’items psychométriques sans favoriser aucune configuration séquentielle, l’algorithme sous-jacent repose sur le mélange de Fisher-Yates, qui attribue à chaque élément une probabilité uniforme rigoureusement équivalente d’occuper n’importe quelle position ordinale dans la liste d’exécution.
De manière plus sophistiquée, lors de l’assignation aléatoire de participants humains au sein de protocoles multicentriques comprenant plusieurs groupes expérimentaux (par exemple, groupe contrôle versus différents niveaux d’intervention thérapeutique), l’utilisation d’une loi uniforme permet de mettre en place une randomisation par blocs permutés équilibrés. En affectant à chaque sujet entrant une variable d’attribution générée sur $[0, 1]$, l’algorithme garantit non seulement une impartialité d’affectation absolue sur le plan de l’éthique méthodologique, mais assure également, grâce à la loi des grands nombres, une équivalence distributionnelle parfaite des caractéristiques de base et des variables confusionnelles entre l’ensemble des bras de l’étude.
10.3 Génération de bruit neutre dans les modèles de décision cognitive
L’exploration computationnelle des mécanismes décisionnels chez l’humain et l’animal s’articule fréquemment autour de modèles mathématiques de diffusion ou d’accumulation de preuve, à l’instar du modèle de diffusion de dérive (Drift-Diffusion Model ou DDM). Dans ces architectures de modélisation mathématique, la prise de décision stochastique face à des stimuli ambigus est conceptualisée comme l’intégration continue dans le temps d’un signal informatif perturbé par un bruit intrinsèque au système nerveux biologique.
Bien que la littérature utilise traditionnellement un bruit blanc additif modélisé par un processus de Wiener gaussien standard, l’exploration de modèles alternatifs sous incertitude radicale recourt fréquemment à l’injection d’un bruit uniforme additif. Contrairement au bruit gaussien qui concentre majoritairement ses perturbations autour de zéro avec la possibilité théorique d’injections extrêmes le long de ses queues infinies, le bruit uniforme applique une perturbation strictement bornée sur l’intervalle compact $[-epsilon, +epsilon]$.
Dans les simulations computationnelles de choix préférentiels ou d’arbitrages sous risque menées sous Python, la modélisation d’agents dotés de règles d’exploration sous incertitude épistémique absolue (telles que les heuristiques d’exploration aléatoire dans l’apprentissage par renforcement) repose directement sur l’addition de variables uniformes aux fonctions de valeur estimées. Cette méthodologie permet d’étudier comment l’équiprobabilité des fluctuations locales affecte les temps de franchissement de frontières décisionnelles et modélise avec une fidélité accrue les comportements de choix exploratoires purs chez les mammifères supérieurs.
11. Considérations algorithmiques, limites numériques et bonnes pratiques
11.1 Précision en virgule flottante et propriétés des générateurs
La génération de nombres pseudo-aléatoires sur une architecture informatique moderne n’est jamais un processus continu idéalisé, mais une approximation numérique discrète gouvernée par la norme internationale IEEE 754 régissant l’arithmétique des nombres flottants. Une variable aléatoire théorique continue sur l’intervalle unitaire $[0, 1]$ possède une infinité non dénombrable de valeurs réelles possibles. En revanche, un flottant à double précision 64 bits en Python ne dispose que de 53 bits de mantisse (soit 52 bits explicites plus un bit implicite), ce qui restreint l’espace des valeurs représentables à un ensemble discret de $2^{53} \approx 9.007 \times 10^{15}$ états distincts.
L’une des évolutions algorithmiques majeures apportées à l’écosystème Python contemporain a été la transition du sous-système de tirage historique de NumPy, fondé sur l’algorithme du Mersenne Twister (MT19937), vers une nouvelle famille de générateurs nommée PCG64 (Permuted Congruential Generator). Bien que le Mersenne Twister possède une période immense de $2^{19937} – 1$, il présente des faiblesses statistiques documentées, notamment une sensibilité aux états initiaux comportant de nombreux zéros et une incapacité à réussir certains tests rigoureux d’aléatoire statistique de la suite TestU01 (comme les tests Crush et BigCrush). Le générateur PCG64, activé par défaut par np.random.default_rng(), offre des propriétés de diffusion statistique nettement supérieures, une vitesse d’exécution accrue et une empreinte mémoire réduite.
Un autre point de vigilance algorithmique concerne la gestion des frontières fermées ou ouvertes sur le plan numérique. Théoriquement, pour une variable continue, la probabilité d’atteindre exactement l’une des bornes est nulle : $P(X = a) = P(X = b) = 0$. Cependant, sur le plan logiciel, l’implémentation de la fonction numpy.random.Generator.uniform(low, high) génère des tirages au sein d’un intervalle semi-ouvert défini par $[low, high)$, ce qui signifie formellement que la borne inférieure $low$ peut être incluse, mais que la borne supérieure $high$ est strictement exclue en raison de la division par $2^{53}$ dans la conversion entière vers flottante. Néanmoins, en raison des règles d’arrondi machine vers le plus proche pair (round to nearest), il peut arriver dans des configurations arithmétiques très rares que la valeur supérieure $high$ soit effectivement produite. L’algorithme doit donc être résistant à cette contingence lorsque des calculs de divisions subséquents s’appuient sur l’hypothèse stricte que la borne n’est jamais atteinte.
Enfin, il est impératif d’éviter l’évaluation de distributions dont l’échelle est infinitésimale. Lorsque le paramètre scale approche l’épsilon machine (typiquement de l’ordre de $10^{-16}$ pour les flottants double précision), le calcul de la densité par l’opération de division $1 / \text{scale}$ déclenche une division par zéro ou produit une valeur débordante np.inf, ruinant la stabilité du calcul matriciel. Une inspection systématique des données d’entrée visant à garantir que scale > np.finfo(float).eps constitue une pratique de défense algorithmique incontournable.
11.2 Vectorisation et parallélisation des calculs statistiques
L’une des caractéristiques fondamentales du langage Python réside dans sa nature interprétée à typage dynamique. Si cette souplesse accélère la phase de prototypage, l’usage de boucles itératives natives (boucles for ou while) pour traiter séquentiellement de volumineux échantillons de données statistiques constitue une hérésie en calcul haute performance, induisant des pénalités temporelles catastrophiques dues au surcoût de l’évaluation dynamique de type à chaque itération au niveau de la machine virtuelle.
La règle méthodologique cardinale en calcul probabiliste Python est l’application systématique de la vectorisation. Les bibliothèques NumPy et SciPy s’appuient sur des noyaux de bas niveau écrits en langage C et Fortran, optimisés pour exploiter les extensions vectorielles SIMD (Single Instruction, Multiple Data) intégrées aux architectures matérielles des microprocesseurs contemporains. Grâce au mécanisme de diffusion vectorielle (broadcasting), une opération invoquant dist.pdf(tableau_numpy) applique l’évaluation mathématique sur l’ensemble des éléments de la structure matricielle de manière contiguë en mémoire vive sans exécuter aucune boucle itérative visible en Python.
Lorsqu’un chercheur traite de larges cohortes d’essais réparties sur des centaines de sujets expérimentaux, la topologie optimale consiste à concevoir une matrice de dimensions $(N_{\text{sujets}}, N_{\text{essais}})$. Les méthodes probabilistes de SciPy ou de NumPy sont capables d’échantillonner ou d’évaluer cette matrice bidimensionnelle en une seule instruction machine, minimisant la dispersion des accès au cache processeur. En profilant le code source à l’aide d’outils analytiques tels que cProfile ou line_profiler, l’ingénieur de recherche s’assure de l’élimination des allocations mémoire intermédiaires redondantes, réduisant drastiquement l’empreinte RAM et maximisant la fluidité computationnelle des architectures de simulation stochastique.
12. Étude de cas complète : analyse d’un protocole de vigilance psychologique
12.1 Formulation du protocole expérimental et modélisation théorique
Afin de concrétiser l’ensemble des concepts théoriques et algorithmiques exposés, nous formalisons une étude de cas intégrale issue des neurosciences comportementales et de la psychologie ergonomique : la modélisation d’un protocole de vigilance soutenue et de détection de signaux critiques (Psychomotor Vigilance Task ou PVT).
Dans ce protocole, un opérateur humain surveille un écran de contrôle sur une longue période. À des moments imprévisibles, une cible visuelle apparaît au centre du champ visuel, imposant au participant d’intervenir en appuyant le plus rapidement possible sur un commutateur de réponse. Afin de neutraliser tout apprentissage temporel et toute synchronisation corticale d’anticipation motrice (comme exposé à la section 10.1), l’intervalle inter-stimulus séparant deux apparitions successives du signal est modélisé de façon rigoureuse par une variable aléatoire continue $T$ distribuée selon une loi uniforme sur le support temporel allant de 2.0 secondes à 7.0 secondes. Ce paramétrage mathématique se formalise sous SciPy par les valeurs loc = 2.0 et une échelle de variation temporelle scale = 7.0 - 2.0 = 5.0.
Le laboratoire d’expérimentation a consigné un jeu de données empiriques simulant une cohorte de 500 essais expérimentaux enregistrés auprès d’un groupe d’opérateurs. L’objectif méthodologique de cette étude de cas consiste à déployer un pipeline logiciel Python complet, modulaire et reproductible, chargé d’accomplir successivement :
- L’instanciation de l’environnement probabiliste théorique et l’échantillonnage déterministe d’un jeu de délais synthétiques représentatifs ;
- L’évaluation analytique des probabilités d’intervention au sein de fenêtres temporelles critiques, notamment la probabilité qu’un signal survienne de manière précoce (délai inférieur ou égal à 3.5 secondes) ou s’insère dans une fenêtre d’alerte intermédiaire comprise entre 4.0 et 6.0 secondes ;
- L’inférence statistique et l’estimation des bornes temporelles effectives du dispositif via la méthode du maximum de vraisemblance ;
- La validation de la conformité du protocole matériel par le test d’adéquation de Kolmogorov-Smirnov afin de garantir l’absence de biais mécanique d’horloge ;
- La génération d’une figure de publication scientifique sous Matplotlib conforme aux normes typographiques de l’American Psychological Association (APA).
12.2 Script Python modulaire et reproductible d’analyse complète
L’implémentation de cette analyse s’articule autour d’une classe d’architecture logicielle modulaire nommée AnalyseVigilanceUniforme. Cette structure encapsule l’ensemble des dépendances statistiques, garantit l’isolation du générateur aléatoire PCG64 et implémente des méthodes spécialisées pour chaque étape analytique du protocole.
Le script scientifique s’organise selon les étapes opérationnelles suivantes :
Premièrement, la configuration de l’initialisation instancie un générateur NumPy local en utilisant une graine entière déterministe (par exemple 42) pour garantir la réplicabilité absolue. Les paramètres physiques a = 2.0 et b = 7.0 sont convertis en arguments formels loc = a et scale = b - a, puis injectés dans une distribution figée self.dist_theorique = uniform(loc=self.loc, scale=self.scale).
Deuxièmement, la phase d’échantillonnage procède à la génération d’un tableau unidimensionnel de $N = 500$ mesures temporelles synthétiques à l’aide de la méthode optimisée self.rng.uniform(self.a, self.b, size=self.taille_echantillon).
Troisièmement, le calcul des métriques probabilistes théoriques évalue la probabilité cumulative d’une survenue précoce par self.dist_theorique.cdf(3.5), la probabilité d’occurrence au sein de la fenêtre intermédiaire par self.dist_theorique.cdf(6.0) - self.dist_theorique.cdf(4.0), ainsi que la probabilité de survie temporelle au-delà de 5.5 secondes par la méthode numérique haute précision self.dist_theorique.sf(5.5).
Quatrièmement, le pipeline d’inférence statistique invoque loc_est, scale_est = uniform.fit(self.donnees), extrait la borne supérieure estimée par b_est = loc_est + scale_est, puis exécute le test de conformité stochastique au moyen de stat_d, p_valeur = kstest(self.donnees, 'uniform', args=(self.loc, self.scale)).
Cinquièmement, la fonction de visualisation compile une planche graphique multipanneau conforme aux standards éditoriaux académiques. Le panneau supérieur gauche superpose l’histogramme empirique normalisé en densité aux courbes analytiques théoriques de la PDF, en colorant en vert translucide la zone d’intégration critique comprise entre 4.0 et 6.0 secondes. Le panneau supérieur droit illustre la fonction de répartition cumulative théorique et la confronte à la fonction de répartition empirique en escalier calculée sur les données réelles. Le panneau inférieur gauche projette le diagramme quantile-quantile (Q-Q plot) permettant de détecter visuellement toute anomalie distributionnelle le long de la bissectrice unitaire. Enfin, le panneau inférieur droit affiche un bloc de synthèse typographique consignant les paramètres théoriques, les statistiques estimées et les résultats formels du test d’hypothèse.
12.3 Interprétation des résultats et discussion scientifique
L’exécution de cette suite analytique produit un ensemble de résultats quantitatifs hautement informatifs pour le chercheur en sciences expérimentales. Sur le plan théorique, la probabilité calculée qu’un essai présente un délai inter-stimulus inférieur ou égal à 3.5 secondes s’établit rigoureusement à $(3.5 – 2.0) / 5.0 = 1.5 / 5.0 = 0.3000$, soit très exactement 30 % des essais. La fenêtre intermédiaire $[4.0, 6.0]$ secondes possède une largeur de 2.0 secondes, ce qui produit une probabilité analytique de $2.0 / 5.0 = 0.4000$ (40 %).
L’analyse des paramètres estimés par le maximum de vraisemblance sur les 500 essais empiriques révèle la signature caractéristique des statistiques d’ordre extrêmes discutée à la section 9.1. La borne inférieure estimée loc_est affiche une valeur légèrement supérieure à 2.0 (par exemple 2.0083 secondes), tandis que le maximum observé plafonne légèrement en dessous de 7.0 (par exemple 6.9941 secondes). L’étendue empirique scale_est est donc évaluée à environ 4.9858 secondes au lieu des 5.0000 secondes théoriques. Cet écart minime mais structurel illustre empiriquement le biais théorique de l’estimateur de maximum de vraisemblance sur échantillon fini, confortant l’importance des corrections analytiques lors de travaux portant sur de petits effectifs.
Le résultat du test de conformité de Kolmogorov-Smirnov corrobore l’adéquation stochastique du générateur d’essais. Avec une statistique de distance maximale $D$ oscillant typiquement autour de 0.025 à 0.035 pour un échantillon de 500 observations et une p-valeur bilatérale largement supérieure au seuil critique conventionnel (par exemple $p = 0.742$), le chercheur conclut en toute rigueur à l’absence de rejet de l’hypothèse nulle. Le générateur logiciel d’intervalles inter-stimulus respecte fidèlement les propriétés d’équiprobabilité exigées par le protocole expérimental.
Sur le plan méthodologique, cette validation formelle garantit que les temps de réaction enregistrés ultérieurement sur les participants humains ne seront aucunement contaminés par des attentes temporelles différentielles. En confirmant que l’aléa temporel injecté est rigoureusement neutre, le chercheur s’assure de la validité interne de son protocole, illustrant avec quelle acuité les méthodes computationnelles de modélisation de la loi uniforme en Python conditionnent directement l’intégrité et la réplicabilité de la science expérimentale contemporaine.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
Jaynes, E. T. (1957). Information theory and statistical mechanics. Physical Review, 106(4), 620–630. https://doi.org/10.1103/PhysRev.106.620
Knuth, D. E. (1997). The art of computer programming, volume 2: Seminumerical algorithms (3rd ed.). Addison-Wesley.
L’Ecuyer, P. (2012). Random number generation. In J. E. Gentle, W. K. Härdle, & Y. Mori (Eds.), Handbook of computational statistics (pp. 35–71). Springer. https://doi.org/10.1007/978-3-642-21551-3_3
O’Connor, M. E., & Robinson, M. J. (2018). Inter-stimulus interval jittering and statistical power in cognitive electrophysiology. Journal of Neuroscience Methods, 308, 142–151. https://doi.org/10.1016/j.jneumeth.2018.07.014
O’Neill, M. E. (2014). PCG: A family of simple fast space-efficient statistically good algorithms for random number generation (Harvey Mudd College Computer Science Department Technical Report HMC-CS-2014-0905). Harvey Mudd College.
Peirce, J. W., Gray, J. R., Simpson, S., MacAskill, M. R., Höchenberger, R., Sogo, H., Kastman, E., & Lindeløv, J. K. (2019). PsychoPy2: Experiments in behavior made easy. Behavior Research Methods, 51(1), 195–203. https://doi.org/10.3758/s13428-018-01193-y
Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
Waskom, M. L. (2021). seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021