
Dans le domaine de la psychologie empirique, des sciences comportementales et de la modélisation statistique avancée, la visualisation des données ne constitue pas un simple appendice illustratif, mais un vecteur central de communication épistémologique. L’avènement de l’écosystème ggplot2, articulé autour des préceptes théoriques formalisés par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics et réinterprété pour l’environnement de programmation statistique R par Hadley Wickham, a profondément transformé la production graphique en introduisant une structure sémantique stricte. Au sein de cette armature graphique, le titre occupe une position charnière : loin d’être un simple libellé esthétique, il agit comme la passerelle cognitive principale entre l’architecture quantitative brute des données et l’appareil interprétatif du lecteur scientifique.
Le traitement des métadonnées textuelles dans les figures publiables requiert une maîtrise qui dépasse la simple invocation d’une fonction de base. Les exigences méthodologiques contemporaines, dictées notamment par les standards de l’American Psychological Association (APA) et les impératifs de la science ouverte, imposent une rigueur absolue dans la transmission des paramètres d’inférence, de la significativité statistique, des intervalles de confiance et de la traçabilité des cohortes. Le titre, dans ses interactions avec le sous-titre, les légendes et la zone de traçage géométrique, structure le flux visuel et hiérarchise les charges informationnelles. Une mauvaise configuration typographique, un désalignement spatial ou un manque de contextualisation sémantique peuvent altérer substantiellement la perception d’un effet psychométrique ou masquer des nuances analytiques indispensables.
Ce guide propose une analyse exhaustive et rigoureuse de la conception, de la manipulation et de l’optimisation des titres au sein de ggplot2. En articulant sémiotique visuelle, psychologie cognitive de l’attention, mécanique computationnelle sous-jacente du moteur vectoriel grid et contraintes typographiques académiques, cet article détaille les techniques fondamentales et avancées nécessaires à l’élaboration de figures d’une précision irréprochable. De la dialectique fonctionnelle entre ggtitle() et labs() jusqu’au rendu dynamique de formules mathématiques complexes et à l’harmonisation d’architectures multi-panneaux, chaque section décortique les mécanismes théoriques et pratiques régissant la couche textuelle supérieure de vos visualisations quantitatives.
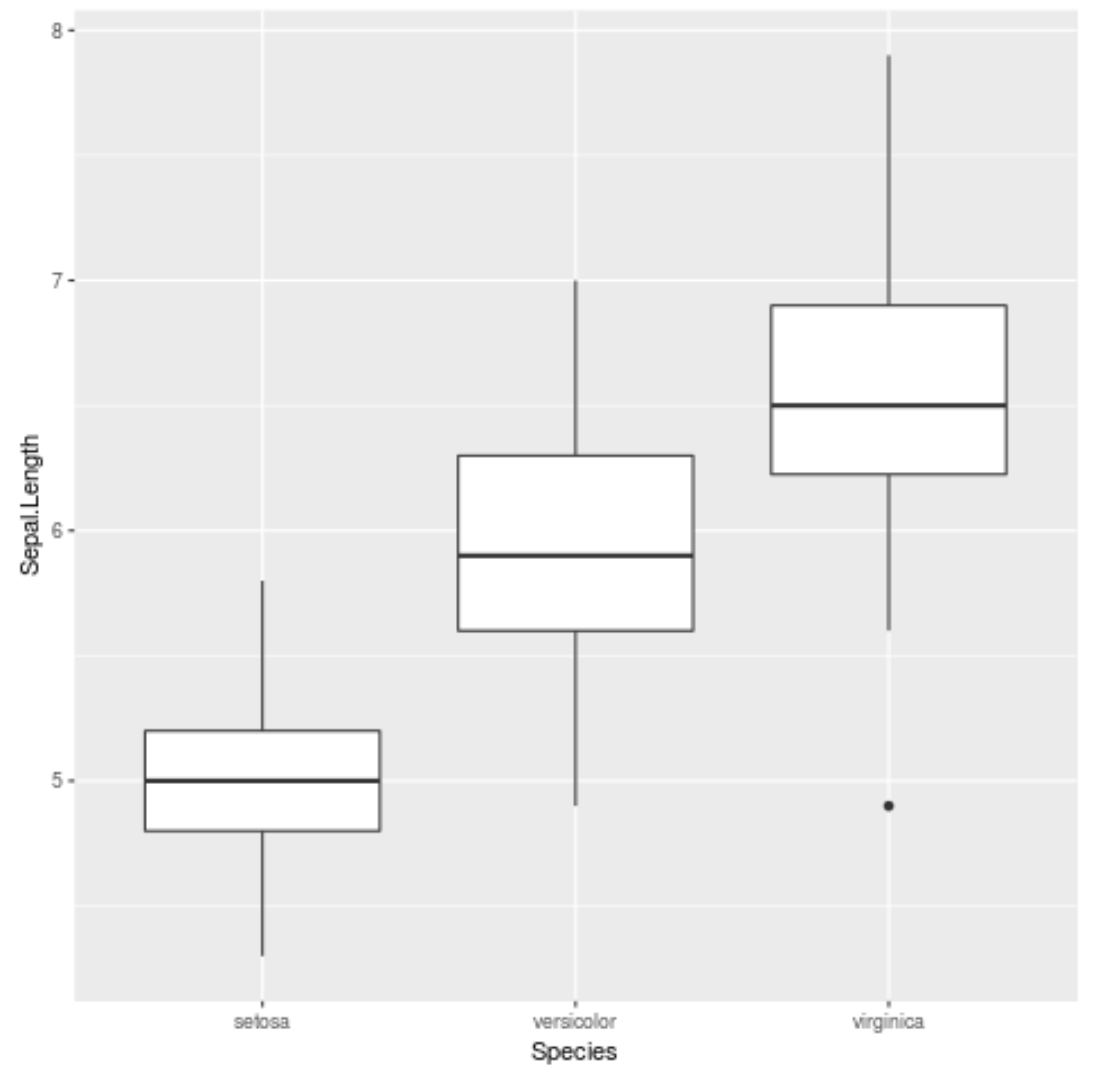
1. Introduction à la sémiotique des titres dans la visualisation de données psychologiques avec ggplot2
1.1 Le rôle cognitif du titre dans la transmission de résultats quantitatifs
L’appréhension visuelle d’un artefact graphique complexe sollicite l’attention sélective et la mémoire de travail du chercheur à travers des processus cognitifs à la fois ascendants (bottom-up), guidés par la saillance sensorielle des géométries, et descendants (top-down), dirigés par les attentes conceptuelles et l’expertise théorique. Dans ce cadre, la formulation et le positionnement du titre assument une fonction déterminante pour la minimisation de la charge cognitive extrinsèque, telle que définie dans la théorie de la charge cognitive de John Sweller. Lorsque le lecteur examine pour la première fois une distribution de scores composites, un diagramme de dispersion ou un tracé de trajectoires longitudinales, le titre fournit l’armature interprétative initiale qui préconfigure l’analyse des axes géométriques et des encodages visuels comme la couleur, la forme ou la saturation.
Sur le plan de la sémiotique cognitive, le titre produit un effet d’ancrage sémantique majeur. En psychométrie, où les variables latentes (telles que le neuroticisme, l’anxiété-trait ou le sentiment d’efficacité personnelle) sont opérationnalisées par des indicateurs mathématiques indirects, le libellé textuel précise immédiatement la nature du construit psychologique mesuré. Sans cette contextualisation textuelle préliminaire, le lecteur est contraint d’effectuer des allers-retours oculomoteurs épuisants entre les étiquettes des axes, la légende et le corps du texte méthodologique pour déduire la directionnalité de l’effet observé, ce qui disperse les ressources attentionnelles indispensables à l’évaluation critique de la validité interne des données présentées.
Il convient de distinguer formellement trois postures stylistiques et épistémologiques dans la rédaction des titres en psychologie expérimentale : le titre descriptif, le titre interrogatif et le titre conclusif. Le titre descriptif se limite à l’énumération neutre des variables mises en relation (par exemple, « Relation entre le chronotype et les performances mnésiques chez l’adulte jeune »). S’il présente l’avantage de la neutralité axiomatique, il impose un travail déductif supérieur. Le titre interrogatif (par exemple, « Le niveau d’anxiété module-t-il la flexibilité cognitive sous stress aigu ? ») cible la problématique sans préjuger du sens de la relation empirique, stimulant l’investigation visuelle des données. Enfin, le titre conclusif ou déclaratif (tel que « La privation de sommeil altère sélectivement le contrôle inhibiteur préfrontal ») synthétise directement l’inférence statistique majeure. Cette dernière approche, de plus en plus plébiscitée dans les revues à fort impact, maximise la vitesse d’assimilation mais requiert une prudence méthodologique absolue afin d’éviter toute surinterprétation causale d’associations purement corrélationnelles.
Au sein de la grammaire des graphiques de ggplot2, l’absence délibérée de titre généré par défaut constitue un choix architectural hautement significatif. Contrairement aux systèmes graphiques automatisés d’autres logiciels qui injectent machinalement les noms des colonnes du tableau de données, ggplot2 contraint l’analyste à une explicitation intentionnelle de son message. Cette absence native découle du principe selon lequel aucune métadonnée textuelle ne peut être assignée sans une intervention raisonnée du statisticien, garantissant ainsi que l’ancrage sémantique résulte d’un arbitrage délibéré plutôt que d’un automatisme algorithmique non contextualisé.
1.2 Fondements théoriques de l’écosystème ggplot2 et de la grammaire des graphiques
L’implémentation de la visualisation de données dans le formalisme conçu par Hadley Wickham repose sur une décomposition orthogonale rigoureuse des constituants du graphique. Au cœur de cette philosophie, on observe une dissociation stricte entre la couche des données brutes, l’application de transformations statistiques, la projection au sein d’un système de coordonnées géométriques (aesthetics mapping) et l’adjonction de métadonnées contextuelles textuelles. Le titre d’un graphique n’est pas lié de manière intrinsèque aux géométries vectorielles comme les barres, les points ou les lignes lissées ; il appartient à la strate thématique et annotationnelle, opérant à un méta-niveau structurel qui surplombe l’espace euclidien des données.
Pour appréhender la mécanique d’affichage des titres, il est fondamental de comprendre le fonctionnement interne de l’infrastructure graphique de bas niveau de R, pilotée par le moteur grid. Lors de la compilation d’un objet ggplot, celui-ci n’est pas immédiatement matérialisé sous forme de pixels matriciels ou de tracés vectoriels figés. Il est converti en une table géométrique d’éléments graphiques appelée gtable, composée d’objets graphiques élémentaires nommés grobs (abréviation de graphical objects). Dans cette hiérarchie spatiale matricielle, le titre principal correspond à un grob textuel spécifique (titleGrob) assigné à une cellule dédiée située au sommet de la grille structurelle du canevas, indépendante des cellules allouées aux marges intérieures, aux axes cartésiens et aux facettes.
Ce principe de modularité absolue présente des implications déterminantes pour l’analyste de données quantitatives. Dans la mesure où le titre constitue un grob autonome, sa manipulation stylistique, dimensionnelle et spatiale s’opère sans induire de déformation directe sur le ratio d’aspect des coordonnées de données. Le moteur de rendu calcule dynamiquement les dimensions nécessaires pour accueillir la boîte englobante (bounding box) du titre, puis réajuste les dimensions relatives du panneau principal contenant les données. Cette isolation garantit que la modification de la police, l’accroissement de la taille des caractères ou l’insertion de retours à la ligne n’altère en rien l’intégrité métrique de la représentation des variables continues ou discrètes, préservant ainsi l’exactitude des proportions statistiques visualisées.
2. Mécanismes fondamentaux d’insertion textuelle : ggtitle() versus labs()
2.1 La syntaxe dédiée de la fonction ggtitle()
Dans l’arsenal syntaxique de ggplot2, la commande historique destinée à l’injection d’un intitulé sommital est la fonction spécialisée ggtitle(). Conçue initialement comme un raccourci direct et sans ambiguïté pour les utilisateurs migrant depuis les fonctions graphiques de base de R, sa signature formelle accepte principalement un argument textuel central (label), suivi d’un second argument optionnel nommé subtitle. L’utilisation canonique repose sur l’adjonction de cette fonction à l’aide de l’opérateur de composition additive propre à l’écosystème, permettant de greffer la composante textuelle au sommet du graphe sans interagir avec la configuration des échelles ou des axes.
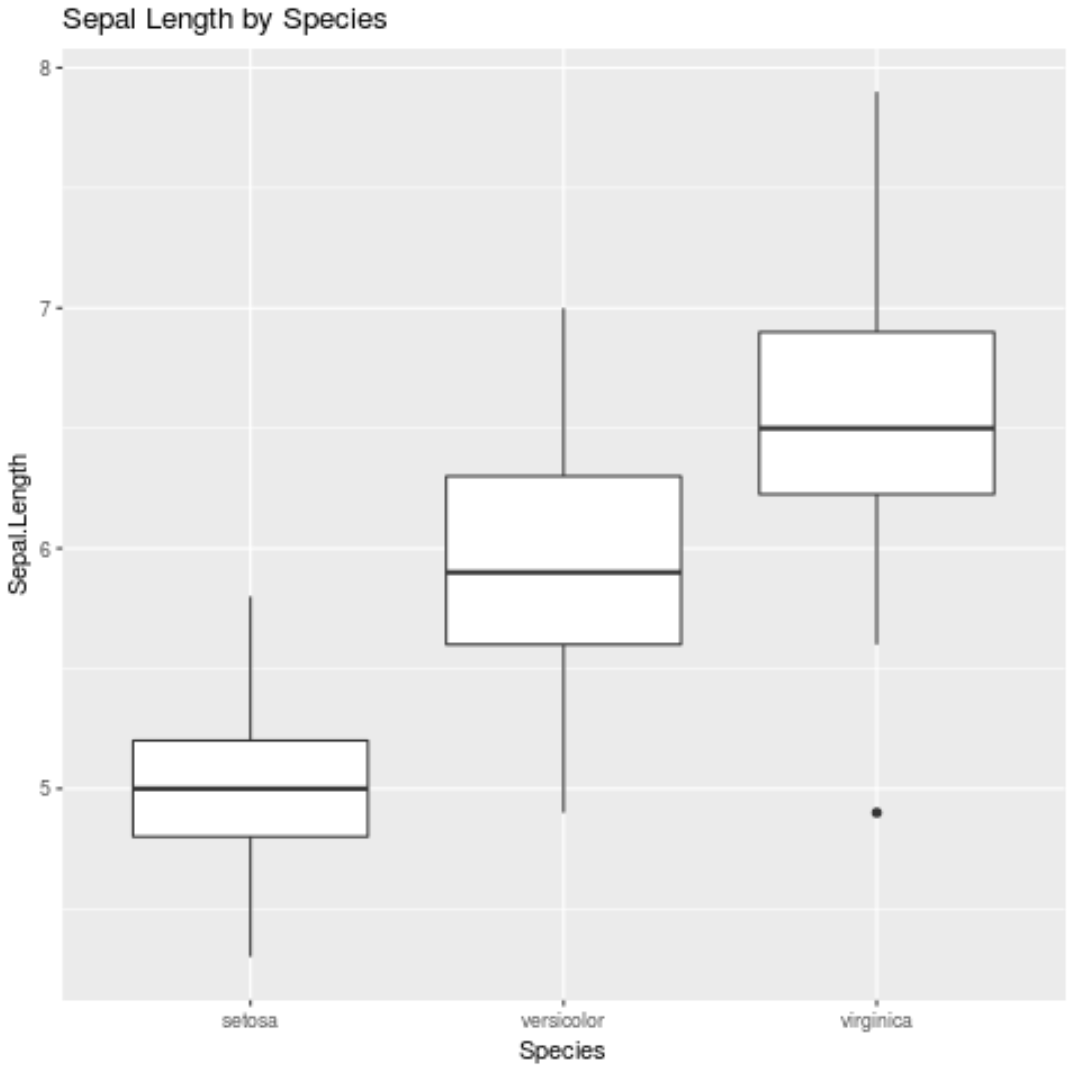
Bien que son implémentation soit d’une simplicité désarmante pour des visualisations exploratoires immédiates, la fonction ggtitle() révèle rapidement des limites fonctionnelles rédhibitoires dès lors que la structure du manuscrit scientifique requiert une orchestration documentaire complexe. En cantonnant strictement son champ d’application au titre principal et à son sous-titre immédiat, elle segmente la déclaration des métadonnées du graphique. L’analyste se trouve alors contraint de multiplier les déclarations périphériques pour nommer les axes d’ordonnées et d’abscisses, définir les libellés de légendes des variables catégorielles et insérer des renvois méthodologiques en bas de page.
Cette fragmentation syntaxique pose un problème notable d’homogénéité et de lisibilité du code source. Dans les projets de recherche collaboratifs ou les scripts d’analyse psychométrique à grande échelle, la dispersion des annotations textuelles dans des appels fonctionnels distincts nuit à la maintenabilité logicielle. L’utilisation isolée de ggtitle() demeure acceptable pour un diagnostic visuel préliminaire au sein de la console R interactive, mais elle s’avère nettement sous-optimale pour la conception d’un pipeline de production de figures destinées à la publication dans des revues internationales à comité de lecture.
2.2 La polyvalence systémique de la fonction labs()
Pour pallier l’éparpillement syntaxique des métadonnées, la fonction labs() constitue le standard contemporain d’excellence dans l’architecture ggplot2. Sa conception unifiée offre un point d’accès centralisé et universel à l’ensemble des éléments sémantiques de la figure. Par le biais d’une interface d’arguments nommés d’une grande clarté, labs() permet de définir conjointement le titre principal (title), le sous-titre contextuel (subtitle), le renvoi méthodologique inférieur (caption), le surtitre supérieur de regroupement (tag), ainsi que la totalité des libellés associés aux projections esthétiques, incluant les axes cartésiens (x, y) et les échelles dimensionnelles de couleur (color ou colour), de remplissage (fill), de forme de points (shape), de taille (size) et d’opacité (alpha).
Cette centralisation transforme radicalement la lisibilité du code source dans une optique de recherche reproductible. Le regroupement méthodique de l’intégralité du corpus textuel dans un bloc unique permet aux co-auteurs et aux relecteurs d’appréhender d’un seul coup d’œil l’ensemble des définitions opérationnelles du graphique sans devoir explorer les méandres des spécifications géométriques. De plus, labs() s’adapte automatiquement à l’évolution des couches graphiques : si une variable psychologique initialement mappée sur la couleur d’un nuage de points est réassignée au type de trait ou au niveau de gris, la modification correspondante du libellé s’opère dans la même section syntaxique unifiée, réduisant substantiellement le risque de discordance d’étiquetage.
Du point de vue des performances d’exécution, la compilation interne opérée par ggplot2 convertit de toute manière les appels à ggtitle() en une structure sémantique équivalente à celle produite par labs(). Dès lors, le choix de labs() ne présente aucun coût computationnel additionnel, tout en maximisant la robustesse architecturale du script. La standardisation autour de labs() s’impose donc comme une règle de bonne pratique indispensable pour quiconque souhaite pérenniser ses protocoles de traitement quantitatif et garantir une parfaite conformité avec les critères de clarté logicielle exigés par les comités de rédaction scientifique.
2.3 Écrasement et priorité des couches textuelles
La nature modulaire et déclarative de ggplot2 autorise la superposition séquentielle d’instructions via l’opérateur d’addition. Cette caractéristique fondamentale implique l’existence de règles déterministes d’évaluation et de préséance lorsque plusieurs directives contradictoires sont invoquées dans la même chaîne de traitement graphique. Dans l’éventualité où une fonction ggtitle() primitive est initialement greffée à un tracé, puis suivie en aval de la chaîne de compilation par un appel à labs(title = ...), le moteur syntaxique applique invariablement une logique de réécriture chronologique : la dernière occurrence assignée à un paramètre donné supplante l’ensemble des valeurs antérieurement instanciées.
Ce mécanisme d’écrasement dynamique s’avère particulièrement fécond dans les environnements de factorisation logicielle. Dans le cadre de protocoles expérimentaux d’envergure, il est fréquent d’encapsuler la génération d’une trame graphique de base dans une fonction utilisateur personnalisée, délivrant un graphique doté d’un titre standardisé. Un chercheur souhaitant adapter cette visualisation générique pour une sous-population clinique spécifique peut invoquer l’objet de base et y concaténer un nouvel appel à labs(). Cette réécriture ciblée redéfinit instantanément le titre principal sans altérer les couches sous-jacentes de données, d’échelles chromatiques ou de configurations géométriques préalablement compilées.
Il importe néanmoins d’exercer une vigilance méthodologique accrue lors de l’orchestration de ces redéfinitions successives. Une mauvaise appréhension de l’ordre d’évaluation séquentielle peut générer des comportements inattendus, notamment lorsqu’un thème complet appliqué tardivement vient réinitialiser l’alignement ou la visibilité d’un titre défini plus tôt. L’analyste doit veiller à structurer ses scripts en séparant rigoureusement la déclaration des sources de données, la stratification des géométries d’encodage, l’injection des libellés sémantiques via labs(), et en dernier ressort, le calibrage typographique fin au moyen de la commande theme().
3. Typographie et hiérarchie visuelle : personnalisation via element_text()
3.1 Modification des familles de polices et compatibilité multiplateforme
L’esthétique typographique d’une publication savante ne relève pas d’une coquetterie ornementale, mais d’un impératif de lisibilité et de respect des normes éditoriales académiques. Au sein de l’environnement ggplot2, l’ensemble des propriétés stylistiques des composants textuels est gouverné par la fonction modificatrice element_text(), imbriquée dans l’instruction de contrôle thématique theme(). Pour altérer la police du titre, l’analyste cible l’élément structurel plot.title en lui affectant une instance configurée de cette fonction. Le paramètre family commande directement le choix de la fonte typographique employée par le moteur de rendu graphique vectoriel.
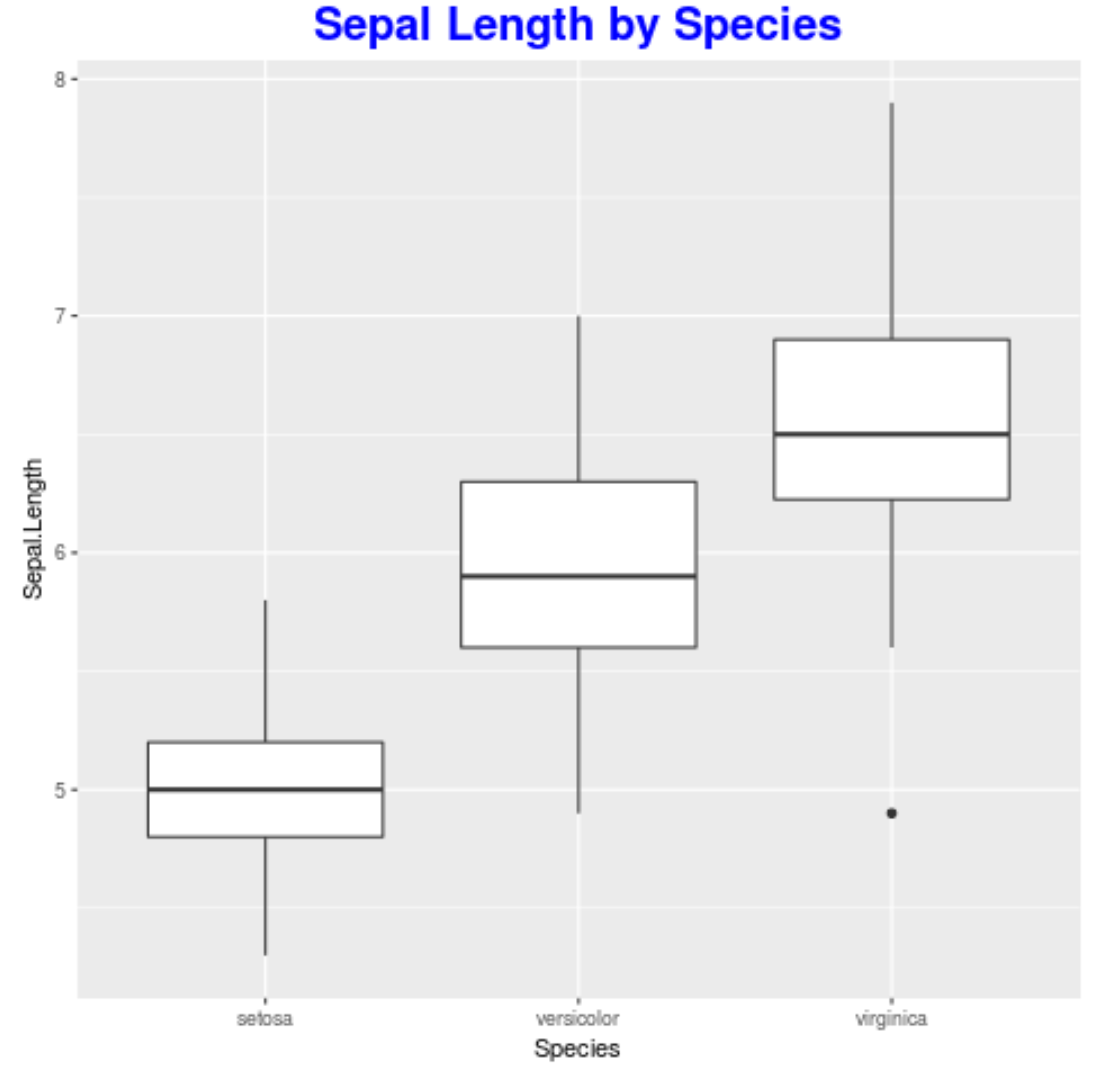
Cependant, l’interaction entre R, le système d’exploitation hôte (qu’il s’agisse de Windows, macOS ou d’une distribution Linux) et les pilotes de périphériques graphiques constitue un terrain historiquement propice aux frictions techniques. L’invocation d’un nom de police système conventionnelle telle que Times New Roman, Arial ou Helvetica peut échouer silencieusement ou générer des erreurs de substitution visuelle si la police n’est pas convenablement déclarée dans la table de polices du moteur graphique interne. Pour surmonter cet écueil et garantir une reproductibilité parfaite sur l’ensemble des stations de travail d’un consortium de recherche, l’utilisation de packages spécialisés tels que extrafont ou le très performant showtext est vivement préconisée.
L’exploitation de l’extension showtext s’avère particulièrement robuste dans la mesure où elle intercepte les instructions de glyphes vectoriels émis par R pour les transformer directement en tracés géométriques indépendants des pilotes typographiques locaux. Cette approche garantit que la police requise par les directives éditoriales de l’APA (comme Times New Roman en 12 points pour les manuscrits classiques ou Calibri / Arial pour les présentations numériques) sera restituée avec une fidélité absolue, que la figure soit compilée sur un serveur distant d’intégration continue ou sur la machine de bureau d’un analyste individuel.
3.2 Modulation de la taille, de la graisse et du style
L’établissement d’une hiérarchie visuelle intuitive repose sur un étalonnage rigoureux des contrastes de taille et de graisse typographique entre les différents étages textuels du graphique. Au sein de element_text(), le paramètre size pilote la dimension absolue du titre, traditionnellement exprimée en points typographiques. Toutefois, dans une perspective d’ingénierie graphique adaptative, il est souvent préférable de recourir à l’opérateur rel(). Cet opérateur permet de définir la taille du titre sous forme d’une proportion relative par rapport à la taille de base configurée au niveau global du thème (instanciée par exemple via theme_minimal(base_size = 11)). En affectant une valeur telle que rel(1.3) à plot.title, l’analyste s’assure que si la taille de base de la figure est modifiée pour s’adapter à un format d’impression particulier, l’équilibre proportionnel entre le titre principal, les titres d’axes et les annotations internes demeurera préservé de manière homogène.
L’accentuation sémantique s’articule également autour de l’argument face, qui accepte des valeurs scalaires standardisées telles que « bold » (gras), « italic » (italique), « plain » (romain ordinaire) ou « bold.italic » (gras-italique). Dans la tradition des publications en psychologie quantitative, la graisse typographique est généralement réservée au titre principal afin de capter prioritairement l’ancrage visuel, tandis que le sous-titre est maintenu dans une graisse normale ou légèrement affaiblie pour éviter toute concurrence perceptive frontale. L’usage de l’italique doit être réservé aux conventions internationales reconnues, telles que la mention d’espèces taxonomiques, d’emprunts lexicaux étrangers ou, plus communément en statistique, la spécification d’indices formels comme les coefficients de corrélation de Pearson ou les tailles d’effet.
L’équilibre dimensionnel global doit faire l’objet d’un dimensionnement scrupuleux. Un titre d’une magnitude démesurée comprime la zone allouée au panneau de données effectif, induisant une distorsion cognitive en réduisant l’espace alloué à l’affichage des données géométriques. À l’inverse, un titre d’une taille excessivement réduite, noyé au milieu d’axes surchargés, échoue à remplir son rôle d’ancrage sémantique immédiat. La règle d’or consiste à maintenir un facteur d’échelle oscillant entre 1,2 et 1,4 fois la taille des étiquettes d’axes, conférant ainsi au titre une prééminence visuelle nette sans jamais empiéter sur la surface de traçage statistique.
3.3 Attribution chromatique et accessibilité visuelle
Le paramétrage chromatique de l’élément textuel du titre s’effectue au moyen de l’argument colour (ou son alias américain color) inséré dans element_text(). Si le choix par défaut dans ggplot2 incline vers des nuances de gris très foncé (comme le classique "#333333") pour adoucir le contraste visuel par rapport à un noir absolu perçant, la manipulation de la chromaticité textuelle doit obéir à des règles fonctionnelles et d’accessibilité strictes, dictées notamment par les recommandations internationales du Web Content Accessibility Guidelines (WCAG).
Dans un contexte d’édition académique et de diffusion scientifique universelle, il est impératif que le ratio de contraste de luminance entre la couleur du texte du titre et le fond d’arrière-plan de la figure atteigne au minimum le seuil de 4,5:1 pour le corps de texte normal et de 3:1 pour les titres imposants, afin de demeurer parfaitement déchiffrable pour les individus présentant des déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie) ou visualisant le document sur des terminaux aux écrans sous-calibrés. Les teintes chromatiques vives ou excessivement saturées doivent être proscrites au profit de noirs profonds, de gris anthracite ou, dans des scénarios de design très spécifiques, de nuances sombres issues directement de la palette thématique principale du laboratoire.
Une attention méticuleuse doit également être accordée au comportement de la figure lors de sa reproduction dans des supports physiques imprimés monochromes ou des monographies distribuées sous forme de tirages en niveaux de gris. Un titre configuré dans une nuance intermédiaire de bleu ou de vert cyan, bien que lisible sur un moniteur RGB rétroéclairé, peut se dégrader considérablement lors de la rastérisation en demi-teintes d’une presse offset ou d’une imprimante laser universitaire, voyant son contraste s’effondrer jusqu’à l’illisibilité. L’évaluation préventive de la composition graphique à travers des filtres de simulation de conversion monochrome constitue une étape obligatoire avant toute validation éditoriale définitive.
4. Alignement et géométrie spatiale : maîtrise approfondie de hjust et vjust
4.1 Compréhension mathématique des paramètres d’ajustement vectoriel
L’agencement des éléments textuels dans l’espace bidimensionnel du canevas repose sur deux opérateurs de translation normalisée : hjust (ajustement horizontal) et vjust (ajustement vertical). Loin de correspondre à de simples commutateurs catégoriels (gauche, centre, droite), ces paramètres sont des scalaires continus définis sur un référentiel orthonormé relatif, où la valeur 0 représente l’origine vectorielle de la boîte englobante du texte, et la valeur 1 correspond à son extrémité opposée le long de l’axe considéré.
Pour le positionnement horizontal hjust, la convention cartésienne adoptée par le système grid s’articule comme suit :
hjust = 0ancre l’extrémité gauche du texte sur le point d’ancrage de coordonnées, provoquant un alignement du texte vers la droite de cette borne.hjust = 0.5positionne le centre géométrique exact de la chaîne de caractères sur l’axe de projection de l’ancrage.hjust = 1adosse la bordure droite du bloc textuel sur le repère spatial, produisant un alignement strict sur la marge de droite.
Il est fondamental de noter que l’échelle des ajustements vectoriels n’est pas hermétiquement bornée à l’intervalle unitaire standard [0, 1]. L’affectation de valeurs extraconventionnelles négatives (par exemple hjust = -0.2) ou supérieures à l’unité (comme hjust = 1.2) est formellement acceptée par le moteur de rendu, induisant une déportation spatiale proportionnelle du bloc textuel en dehors de sa boîte englobante naturelle. Toutefois, l’usage de telles valeurs extrapolées doit être manipulé avec une extrême circonspection, car elles fragilisent la robustesse d’affichage lors de variations de dimensions d’exportation.
L’introduction d’un paramètre de rotation angulaire au travers de l’argument angle (exprimé en degrés trigonométriques) modifie en profondeur l’orientation des vecteurs d’ajustement. Lorsqu’un titre subit une rotation, les axes hjust et vjust ne demeurent pas immobiles par rapport au référentiel d’affichage global du moniteur : ils tournent de concert avec la boîte de glyphes typographiques. Dès lors, le réglage fin de l’alignement d’un texte incliné requiert une modélisation mentale rigoureuse de la réorientation de ces axes locaux pour prévenir tout décrochage spatial inesthétique.
4.2 Le choix paradigmatique du centrage textuel
L’histoire de l’alignement textuel dans ggplot2 illustre une évolution paradigmatique majeure dans le champ du design d’information statistique. Durant les premières versions de la bibliothèque logicielle, le comportement par défaut assignait un alignement systématiquement centré au titre principal (hjust = 0.5). Cependant, lors de la publication de la version majeure ggplot2 2.2.0 en 2016, Hadley Wickham a opéré une refonte stylistique notable en adoptant par défaut l’alignement à gauche strict (hjust = 0). Cette décision architecturale s’appuie sur de solides arguments de psychologie de la perception et d’ergonomie de lecture : l’œil d’un lecteur occidental balaie naturellement une page de haut en bas et de gauche à droite selon un balayage en F ou en Z. L’alignement à gauche établit une ligne directrice visuelle continue débutant au titre, traversant le sous-titre et se prolongeant naturellement le long de l’axe vertical des ordonnées.
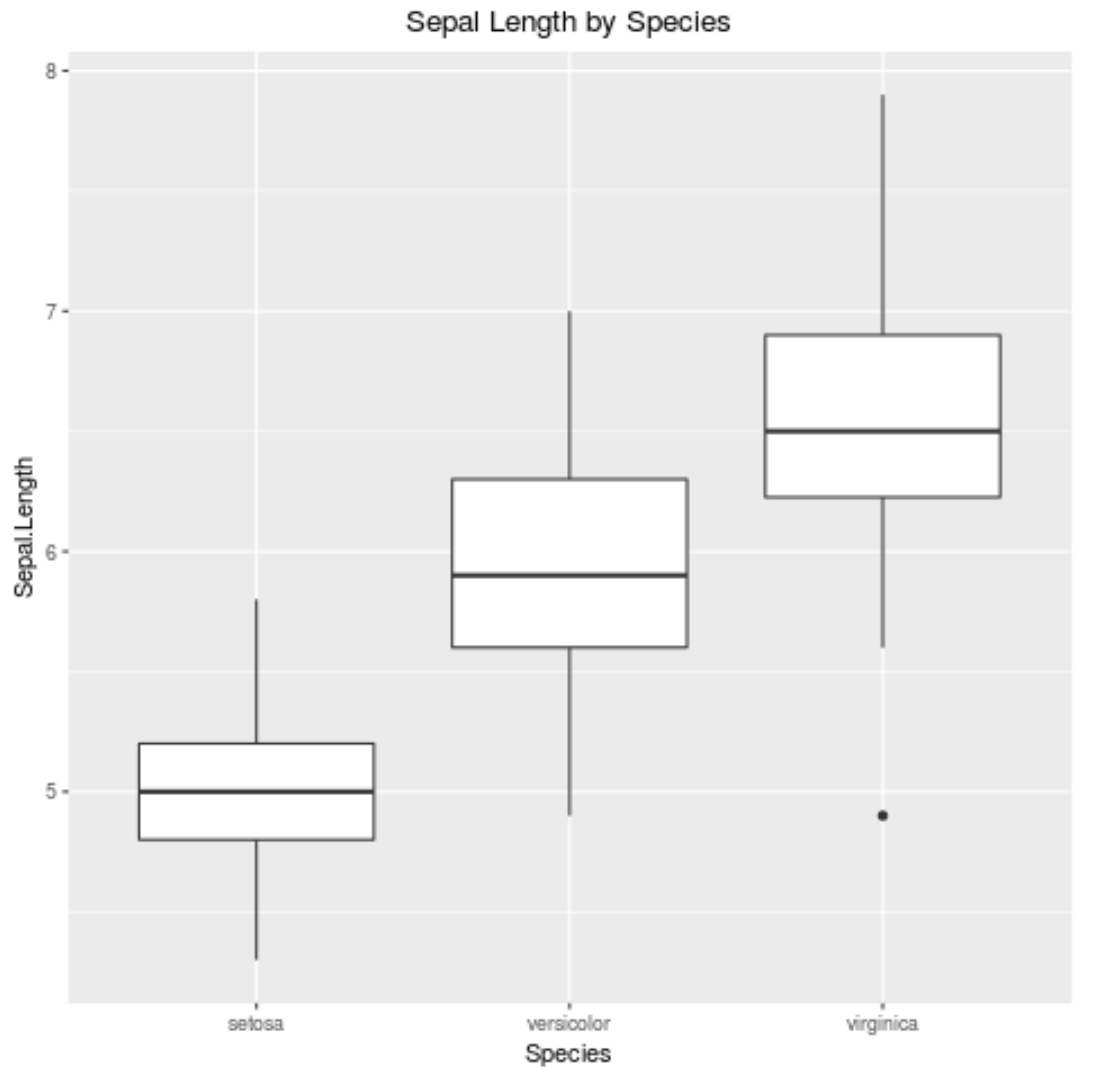
Néanmoins, certaines traditions de publication savante et les exigences spécifiques de certaines revues biomédicales ou psychologiques imposent le maintien d’une esthétique symétrique classique. Pour restaurer un centrage absolu du titre principal, l’opérateur doit spécifier explicitement la commande suivante au sein de l’arborescence du thème graphique :
theme(plot.title = element_text(hjust = 0.5))
Une distinction fondamentale mérite d’être soulignée quant au référentiel d’ancrage utilisé pour ce centrage. Par défaut, dans les configurations historiques de ggplot2, l’opération de centrage spatial s’effectuait par rapport à l’ensemble du canevas de la figure (plot), incluant les marges latérales externes et l’espace réservé aux légendes. Cela se traduisait fréquemment par un centrage optique faussé : si la figure intégrait une large légende sur le flanc droit, le titre apparaissait décalé vers la droite par rapport au panneau effectif des données géométriques. La maîtrise conjointe de hjust et de l’argument moderne plot.title.position (que nous explorerons exhaustivement dans la section 10) est impérative pour arbitrer entre un centrage géométrique par rapport à l’image intégrale et un centrage focalisé strictement au-dessus du panneau des données.
4.3 Contrôle des marges contextuelles via la fonction margin()
L’un des écueils les plus fréquents dans la composition de figures quantitatives sous ggplot2 réside dans l’effet d’étouffement spatial, matérialisé par une proximité excessive entre le titre principal, les tracés de sous-titres et la bordure supérieure du système de coordonnées. Pour aérer la composition visuelle et instaurer un rythme respiratoire harmonieux au sein de la page, il est essentiel de manipuler l’argument margin au moyen de la fonction constructrice dédiée margin().
La fonction margin() obéit à une convention mnémotechnique directionnelle cardinale bien établie : l’ordre des paramètres correspond au sens horaire débutant par le haut (Top, Right, Bottom, Left, d’où l’acronyme TRBL). La syntaxe canonique s’exprime sous la forme margin(t = ..., r = ..., b = ..., l = ..., unit = ...), où l’argument unit permet de s’affranchir des pixels relatifs en sélectionnant des grandeurs physiques pérennes comme les points ("pt"), les millimètres ("mm"), les centimètres ("cm") ou les pouces anglo-saxons ("in").
Dans la majorité des cas d’usage académiques, la gestion de la marge inférieure (b, pour bottom) du titre s’avère stratégique. En accordant un dégagement vertical contrôlé (par exemple, margin(b = 10, unit = "pt")), l’analyste crée une séparation visuelle franche qui empêche les glyphes de la ligne de titre d’entrer en collision avec les accents ou les jambages supérieurs des caractères du sous-titre, ou de heurter la ligne de crête des étiquettes numériques de l’axe supérieur lorsque des échelles secondaires y sont projetées. De même, l’insertion d’une légère marge sommitale (t) évite que les hampes des lettres majuscules ne soient tranchées net lors de l’exportation du graphique aux limites extrêmes du canevas vectoriel.
5. Gestion des titres volumineux : sauts de ligne et découpage dynamique
5.1 Insertion manuelle de retours chariot
Dans la communication de protocoles expérimentaux hautement spécifiques, les intitulés de figures doivent souvent concilier concision et exhaustivité descriptive. Face à des libellés scientifiques étendus, l’affichage sur une ligne unique continue constitue une faute de composition majeure : le texte s’étire au-delà des bornes physiques latérales de l’image, subit une troncature destructrice ou compresse drastiquement la largeur disponible du panneau de données. L’approche élémentaire la plus directe pour circonscrire ce problème réside dans l’injection délibérée du caractère d’échappement universel de nouvelle ligne n au sein de la chaîne de caractères transmise à l’argument textuel.
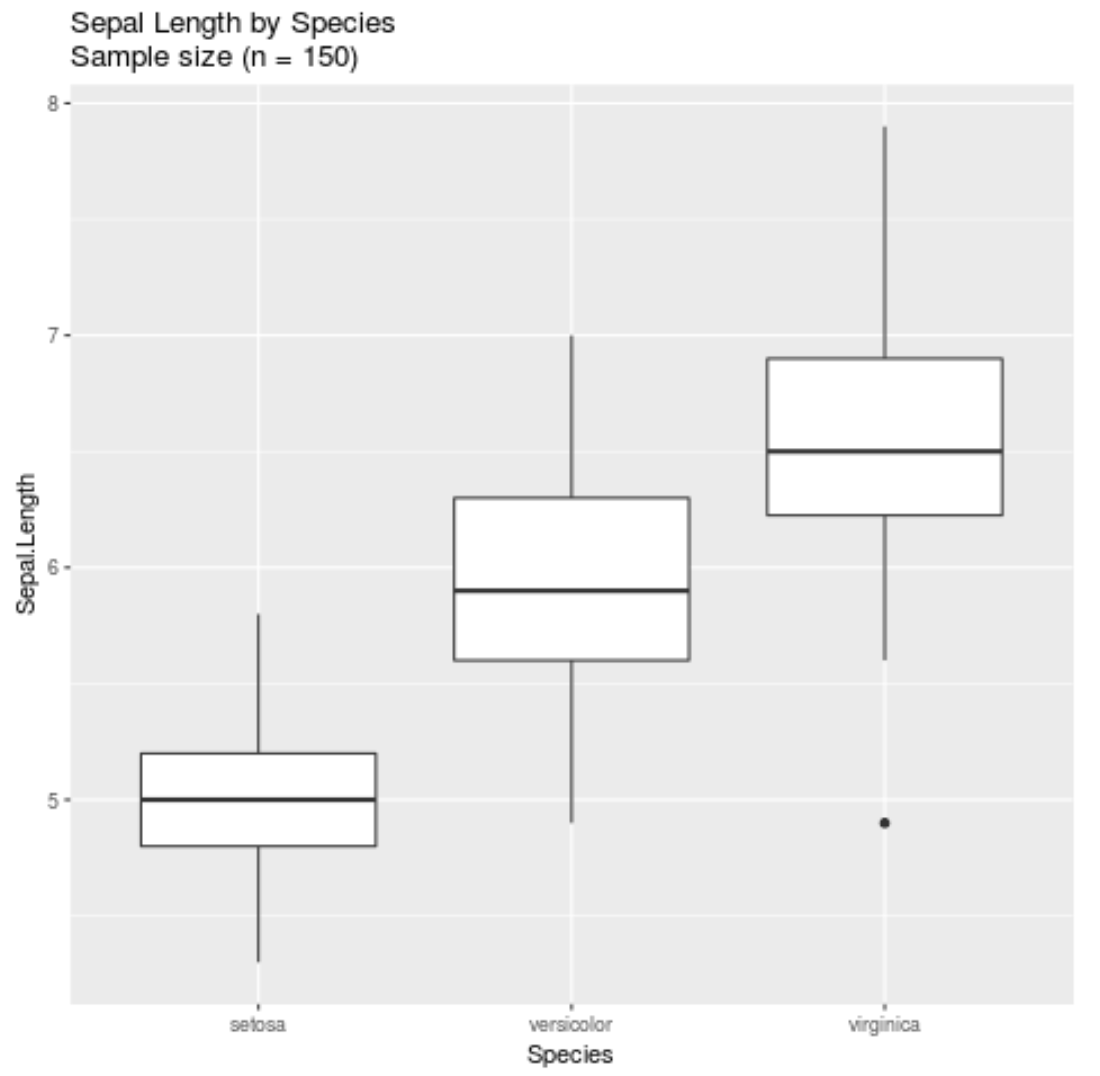
Dès l’instant où un titre est scindé en un bloc multiligne par le biais de retours à la ligne explicites, une nouvelle dimension typographique requiert l’intervention de l’analyste : l’interligne, paramétré par l’argument lineheight au sein de element_text(). Cet argument accepte un multiplicateur scalaire relatif (dont la valeur standard oscille couramment entre 0,9 et 1,2). Un interligne mal calibré peut considérablement dégrader la gestalt graphique du titre : s’il est excessivement resserré, les éléments diacritiques descendants (les jambages des p, q, y) viendront heurter les capitales de la ligne inférieure ; à l’inverse, un espacement démesuré brisera l’unité sémiotique du titre, incitant le cerveau du lecteur à appréhender les fragments disjoints comme deux entités informationnelles indépendantes.
Il importe d’alerter sur les vulnérabilités inhérentes aux découpages textuels manuels codés « en dur ». Si le chercheur modifie ultérieurement la dimension de sortie de sa figure (par exemple en basculant d’un format de présentation pour écran large à une colonne étroite d’un article au format double colonne imprimé), les points de rupture manuels instanciés par les balises n ne correspondront plus à l’optimum géométrique. Des fragments de phrases se retrouveront orphelins sur des lignes raccourcies, engendrant des déséquilibres esthétiques criants qui imposent une reprise manuelle fastidieuse du code source.
5.2 Automatisation du découpage textuel avec stringr
Pour s’émanciper des aléas des retours à la ligne manuels et bâtir des flux de travail véritablement programmatiques et pérennes, le couplage fonctionnel entre ggplot2 et la boîte à outils de traitement textuel stringr s’avère indispensable. La fonction stringr::str_wrap() implémente l’algorithme d’enroulement textuel optimal de Knuth-Plass, analysant la composition lexicale d’une longue chaîne pour y intercaler dynamiquement les caractères n en fonction d’un plafond strict de largeur exprimé en nombre de caractères typographiques via l’argument width.
L’intégration de cette automatisation s’opère directement au sein de la déclaration des étiquettes dans ggplot2, adoptant le patron idiomatique suivant :
labs(title = stringr::str_wrap("Effet longitudinal des interventions basées sur la pleine conscience sur la régulation émotionnelle chez des patients souffrant de douleurs chroniques", width = 50))
Grâce à ce mécanisme, le texte est découpé de façon intelligente sans jamais rompre l’intégrité lexicale interne des mots. La chaîne s’adapte avec souplesse aux exigences de gabarits éditoriaux variés : si l’article est destiné à une publication monoclonale nécessitant une compacité accrue, il suffit d’abaisser l’argument width à 35 ou 40 caractères au sein de la fonction d’automatisation pour que l’ensemble du titre se reconfigure instantanément de façon parfaitement équilibrée.
Une vigilance particulière demeure cependant nécessaire lors de l’application de str_wrap() à des terminologies psychométriques complexes. Les termes scientifiques composés reliés par des traits d’union, les abréviations formelles d’inventaires psychologiques (telles que BDI-II, STAI-Y ou WAIS-IV) et les notations statistiques combinées risquent d’être scindées de façon inappropriée si le seuil de coupure tombe précisément sur leurs caractères séparateurs. L’analyste rigoureux prendra soin d’associer le découpage dynamique à des expressions régulières de protection (par exemple en insérant des espaces insécables préalables) afin de prémunir les acronymes fondamentaux de toute partition dommageable.
6. Articulation sémantique des sous-titres et des légendes explicatives
6.1 Le rôle méthodologique du sous-titre (subtitle)
Tandis que le titre principal assume une mission d’ancrage conceptuel macroscopique ou d’énonciation de la thèse inférentielle centrale, le sous-titre (gouverné par l’argument subtitle dans labs() et stylisé via plot.subtitle dans theme()) opère comme un relai méthodologique d’une importance stratégique. En psychologie expérimentale et dans les sciences du comportement, c’est précisément dans cet espace interstitiel que doivent être consignées les spécifications opérationnelles immédiates indispensables à la contextualisation des résultats visualisés.
Le sous-titre permet d’expliciter sans ambiguïté les conditions expérimentales sous-jacentes, les paradigmes de tâche cognitive appliqués (par exemple, « Tâche de Stroop informatisée sous condition de privation de sommeil aiguë ») ainsi que la puissance effective du dispositif d’observation, matérialisée par la mention de la taille définitive de l’échantillon analysé (N = 248) après exclusion des observations aberrantes ou non conformes. L’évacuation de ces éléments critiques hors du titre principal préserve la pureté conceptuelle de ce dernier tout en offrant aux pairs évaluateurs un accès immédiat aux balises de validité externe de l’étude.
Sur le plan de la grammaire typographique, le sous-titre doit impérativement marquer une déférence visuelle claire vis-à-vis du titre dominant. Cette hiérarchisation s’obtient couramment par une conjonction de trois modifications coordonnées : l’application d’un corps de fonte réduit d’environ 15 à 25 % (via size = rel(0.9)), l’usage d’une graisse neutre ou allégée (face = "plain") contrastant avec le gras du titre supérieur, et l’emploi d’une valeur chromatique légèrement atténuée vers les gris intermédiaires. Cet aménagement perceptif guide l’attention du lecteur selon un flux descendant ordonné : découverte de l’effet central dans le titre, assimilation du cadre méthodologique dans le sous-titre, puis examen approfondi des données au cœur du panneau graphique.
6.2 L’utilisation de la légende inférieure (caption) pour la traçabilité des données
Positionnée traditionnellement au pied de l’artefact graphique, la légende inférieure (accessible via le paramètre caption dans la commande labs()) remplit un rôle épistémologique capital dans l’écosystème de la recherche ouverte et reproductible. Alors que le titre oriente et que le sous-titre contextualise, la caption atteste et documente la traçabilité des données empiriques représentées.
Cet encart textuel inférieur est le réceptacle privilégié pour inscrire les identifiants pérennes de données, tels que les identifiants d’enregistrement sur l’Open Science Framework (OSF), les codes DOI des répertoires de données brutes ou les références aux protocoles préenregistrés. Par ailleurs, la rigueur métrologique impose d’y consigner systématiquement les clés de décodage des métriques d’erreur affichées sur les géométries : mention explicite de la nature des barres d’erreur (écart-type, erreur standard de la moyenne ou intervalles de confiance bootstrappés à 95 %), déclaration formelle des seuils d’ajustement de la significativité statistique (alpha corrigé par la procédure de Bonferroni ou taux de fausse découverte FDR) et précision des critères d’élagage des données extrêmes.
En conformité avec les conventions typographiques dominantes de l’édition scientifique, l’élément thématique plot.caption est paramétré avec un alignement spontané calé sur l’extrémité droite (hjust = 1), adoptant une taille de caractères miniaturisée (size = rel(0.75)) et un style fréquemment incliné en italique. Cet effacement spatial et stylistique garantit que les métadonnées de contrôle méthodologique demeurent consultables par le spécialiste scrupuleux sans jamais perturber la trajectoire oculaire globale de l’observateur.
6.3 Cohérence esthétique tripartite : titre, sous-titre et caption
L’articulation harmonieuse du triptyque textuel (titre, sous-titre et légende inférieure) conditionne la réussite formelle de la figure. Une discordance stylistique entre ces trois strates engendre une sensation immédiate de désordre graphique, susceptible de jeter un discrédit involontaire mais bien réel sur la rigueur de l’analyse statistique sous-jacente. L’objectif de l’analyste consiste à orchestrer une continuité géométrique et typographique fluide au travers d’une gestion intégrée des marges et des alignements dans la fonction theme().
Considérons, à titre d’illustration méthodologique, la restitution visuelle des résultats d’une analyse de variance (ANOVA) factorielle mixte ou d’un modèle d’équations structurelles évaluant l’impact de l’exposition au stress perçu sur la mémoire de travail en fonction de profils génétiques distincts. La conception tripartite optimale s’articulera ainsi :
- Titre (plot.title) : Porteur du constat inférentiel majeur (« L’allèle Met du gène BDNF potentialise la baisse des performances de mémoire de travail sous stress aigu »), aligné à gauche, en typographie sans empattement vigoureuse et contrastée.
- Sous-titre (plot.subtitle) : Précision des dimensions d’échantillonnage et de la méthodologie (« ANOVA mixte 2×3, N = 180, comparaison de groupes randomisés avec mesure pré/post-induction du test de stress de Trier »), aligné à gauche en alignement vertical parfait avec le titre, corps textuel intermédiaire.
- Légende inférieure (plot.caption) : Déclaration des métriques de précision et de reproductibilité (« Barres d’erreur : IC à 95 % ajustés selon Morey (2008). Données et scripts OSF : 10.17605/OSF.IO/XXXXX. *** p < .001 »), disposée en bas, en marge extérieure, typographie sobre et discrète.
La synchronisation fine des marges verticales entre ces trois blocs s’avère indispensable : la marge inférieure du titre principal doit être subtilement réduite pour le souder visuellement au sous-titre méthodologique, tandis qu’un espacement vertical plus franc doit isoler ce tandem supérieur du panneau géométrique principal afin de matérialiser clairement la frontière entre métadonnées conceptuelles et distributions empiriques.
7. Intégration d’expressions mathématiques et de notations statistiques
7.1 Exploitation du moteur d’équations avec expression()
Dans la communication des sciences quantitatives, les métadonnées graphiques doivent fréquemment s’enrichir d’écritures mathématiques formalisées : symboles grecs désignant des coefficients de régression standardisés ($\beta$), variances résiduelles ($\sigma^2$), paramètres de fiabilité psychométrique (l’alpha de Cronbach $\alpha$ ou l’oméga de McDonald $\omega$), ainsi que des équations de modélisation structurelle. L’environnement R intègre nativement un puissant processeur mathématique fondé sur la fonctionnalité plotmath, mobilisable directement au travers de la primitive expression().
La déclaration d’une formule mathématique dans un titre ggplot2 s’effectue en substituant à la chaîne de caractères littérale conventionnelle un conteneur d’expressions formelles. Par exemple, l’inclusion d’une valeur moyenne et d’un écart-type s’articule comme suit :
labs(title = expression(paste("Évolution du score d'anxiété pour le groupe expérimental (", mu, " = 45.2, ", sigma, " = 6.1)")))
La syntaxe interne de plotmath obéit à des conventions lexicales strictes et idiosyncratiques : les symboles alphabétiques grecs sont invoqués par leur appellation textuelle brute (alpha, beta, gamma, theta), la création d’exposants met en œuvre l’opérateur chapeau standard (^), tandis que les indices utilisent les crochets syntaxiques (beta[0]). Les liaisons spatiales entre des termes littéraux statiques et des expressions formelles exigent l’emploi d’opérateurs de juxtaposition dédiés : le symbole tilde (~) insère une espace insécable standard, tandis que l’étoile (*) concatène deux entités typographiques contiguës sans aucun interstice spatial.
Néanmoins, la manipulation de expression() se heurte rapidement à une rigidité structurelle notoire dès lors que l’on tente d’entrelacer de longs fragments textuels narratifs avec des expressions statistiques ponctuelles. La complexification de la syntaxe induit une surcharge de guillemets, d’appels récursifs à paste() et d’opérateurs de collage qui rend le code source particulièrement opaque et hautement vulnérable aux erreurs d’analyse lexicale lors de la compilation.
7.2 Interpolation dynamique avec la fonction bquote()
Lorsque la figure s’inscrit au sein d’un pipeline d’analyse quantitative industrialisé, les valeurs numériques statistiques (telles que le coefficient de détermination ajusté $R^2$, la statistique de Fisher $F$, la $p$-valeur ou l’indice de taille d’effet comme le $d$ de Cohen) ne sont jamais rédigées manuellement, mais extraites directement des structures d’objets statistiques générées par les modèles (objets de classe lm, aov, ou lavaan). Dans ce contexte, la primitive expression() s’avère incapable d’évaluer directement des variables dynamiques en mémoire. La solution canonique consiste alors à mobiliser la fonction d’interpolation syntaxique bquote().
Le fonctionnement de bquote() repose sur le concept de quasi-citation (quasiquotation) : l’intégralité du contenu transmis à la fonction est traitée comme une expression mathématique différée, à l’exception impérative de tout fragment textuel ou scalaire encapsulé à l’intérieur de l’opérateur d’évaluation différée .(). Cet opérateur signale à l’interpréteur R d’extraire la variable de l’environnement d’exécution, d’effectuer son évaluation computationnelle et d’injecter le résultat formaté au sein de l’expression graphique globale.
Considérons l’exemple d’une modélisation linéaire psychométrique où les métriques d’inférence ont été calculées et assignées à des variables d’environnement. L’insertion dynamique et rigoureuse s’orchestrera ainsi :
r_val <- 0.6843

p_val <- 0.0012

labs(title = bquote("Modèle de régression : " ~ R^2 == .(formatC(r_val, digits = 2, format = "f")) ~ " avec " ~ italic(p) == .(formatC(p_val, digits = 3, format = "f"))))
Cette approche élimine intégralement les risques d’incohérence entre les données tabulées dans les modèles inférentiels et les valeurs annotées sur la figure graphique, réduisant le facteur d’erreur humaine inhérent aux transferts manuels de constantes statistiques. Le couplage systématique de bquote() avec des fonctions d’arrondi typographique rigoureuses comme formatC() ou sprintf() garantit la conformité stricte du nombre de décimales prescrit par les normes éditoriales académiques (exigeant typiquement deux décimales pour les tailles d’effet et trois pour les niveaux de significativité empirique).
7.3 Rendu avancé par le biais du package ggtext
En dépit de leur puissance, les solutions natives basées sur plotmath et bquote() souffrent d’une lacune majeure : l’incapacité d’appliquer des stylisations typographiques complexes, mixtes et sélectives à l’intérieur d’un même flux de phrase continue (comme colorer un mot spécifique pour faire écho à une couleur de groupe dans la légende, ou appliquer du gras à une seule partie du titre). Pour combler ce vide fonctionnel majeur, le package ggtext, développé par Claus O. Wilke, constitue une révolution ergonomique incontournable pour l’écosystème ggplot2.
Le package ggtext introduit un nouvel élément de thème textuel baptisé element_markdown(), qui s’instancie en lieu et place de l’habituel element_text(). En activant ce moteur, ggplot2 devient capable d’analyser et de restituer dynamiquement un sous-ensemble riche et standardisé de balises Markdown et de syntaxes HTML/CSS intégrées directement dans les chaînes de caractères littérales fournies à labs().
L’apport de cette technologie est particulièrement spectaculaire pour la réduction de la charge cognitive liée à la lecture des légendes conventionnelles. En colorant directement les termes textuels du titre avec les codes hexadécimaux exacts associés aux modalités expérimentales des données, l’analyste peut s’émanciper totalement de la légende extérieure. Par exemple :
labs(title = "Comparaison des temps de réaction entre le <span style='color:#0072B2;'>Groupe Contrôle</span> et le <span style='color:#D55E00;'>Groupe Clinique</span>") +

theme(plot.title = ggtext::element_markdown())
Ce procédé élégant, qualifié d’incorporation sémantique chromatique, permet au regard du chercheur d’établir une association mnésique instantanée entre l’intitulé conceptuel et les distributions visualisées, sans qu’aucun mouvement oculaire saccadé vers une légende périphérique ne soit requis. De surcroît, le support complet des balises de saut de ligne HTML (<br>), d’italique (*texte*) et de gras (**texte**) simplifie radicalement la structuration des titres multiaxes au sein des articles savants.
8. Génération dynamique et programmatique de titres paramétrés
8.1 Concaténation robuste à l’aide des fonctions paste() et glue
L’automatisation de la production de rapports visuels massifs, courante lors de l’exploitation de cohortes longitudinales ou de batteries psychométriques explorant des dizaines d’échelles concomitantes, impose d’ériger des mécanismes fiables de génération programmatique de métadonnées textuelles. Historiquement, l’environnement de base R proposait les fonctions paste() et paste0() pour assembler des chaînes de caractères statiques et des valeurs vectorielles dynamiques. Toutefois, dans des contextes de composition sémantique dense, la multiplication des virgules, des guillemets d’échappement et des gestionnaires d’espaces confère aux expressions paste() une vulnérabilité extrême aux erreurs de syntaxe.
Le standard moderne et incontesté de l’ingénierie logicielle au sein de l’écosystème Tidyverse repose sur le recours au package glue. Conçu selon les principes de l’interpolation de chaînes de caractères (string interpolation), glue permet d’imbriquer directement des variables ou des expressions de programmation R au cœur d’un bloc de texte littéral, en les isolant simplement au moyen d’accolades syntaxiques { }.
Cette méthodologie déploie toute sa pertinence lorsqu’elle est intégrée au sein de boucles itératives ou de pipelines fonctionnels pilotés par le package purrr. L’architecture de génération prend la forme suivante :
nom_variable <- "Anxiété Somatique"

valeur_n <- 342

coeff_alpha <- 0.89

labs(title = glue::glue("Évaluation psychométrique : {nom_variable}"),

     subtitle = glue::glue("Cohorte clinique (N = {valeur_n}) — Consistance interne α = {coeff_alpha}"))
La supériorité de glue réside dans sa lisibilité naturelle et dans sa capacité à prévenir les bugs insidieux d’évaluation différée (lazy evaluation) qui surviennent fréquemment lorsque des graphiques ggplot2 sont instanciés au sein de fonctions itératives personnalisées et évalués tardivement lors de leur impression sur le canevas.
8.2 Conception de titres adaptatifs pour les analyses en sous-groupes
La recherche contemporaine en psychologie différentielle et en neuropsychologie s’intéresse particulièrement à l’hétérogénéité des profils cliniques, exigeant la stratification régulière des analyses par sous-groupes démographiques, tranches d’âge ou scores de propension. La conception d’une fonction de visualisation paramétrée capable de construire des représentations adaptées nécessite un calibrage dynamique des métadonnées du titre en fonction des attributs spécifiques de chaque strate analysée.
Dans un tel pipeline, la fonction de traçage extrait algorithmiquement les descripteurs essentiels du sous-ensemble de données qui lui est passé en argument : le nom de la modalité catégorielle, le nombre d’observations effectives valides après exclusion, la moyenne et l’écart-type de la variable d’intérêt, ainsi que des marqueurs de représentativité démographique. Le titre et le sous-titre se reconfigurent automatiquement pour intégrer ces paramètres descriptifs, garantissant une étanchéité absolue entre les graphiques séquentiels compilés pour des cohortes distinctes.
Cette approche modulaire prévient le danger d’écrasement ou d’interversion accidentelle d’étiquettes, écueil critique pouvant conduire à l’inversion désastreuse de diagnostics cliniques lors de la publication d’analyses en sous-groupes. La figure cesse d’être une illustration statique pour s’ériger en une vue computationnelle adaptative, où l’intégrité de la couche textuelle supérieure est dynamiquement certifiée par l’état exact des données sous-jacentes.
9. Standardisation selon les normes typographiques de l’APA (7e édition)
9.1 Règles strictes de l’American Psychological Association pour les figures
La publication d’articles empiriques dans les revues affiliées à l’American Psychological Association obéit aux directives scrupuleusement codifiées de la 7e édition du manuel de publication de l’APA. Historiquement, la 6e édition imposait une séparation stricte : le graphique vectoriel devait être délivré vierge de tout titre interne, l’ensemble des indications textuelles étant déporté à l’extérieur, sous la figure, dans une légende éditoriale intitulée « Figure X. Caption… ». Cette contrainte historique créait des figures orphelines sitôt qu’elles étaient extraites de leur manuscrit textuel (par exemple lors de présentations en conférences ou de partages sur des archives ouvertes).
La 7e édition de l’APA a harmonisé et modernisé ce protocole de façon spectaculaire. Désormais, chaque figure doit comporter :
- Un numéro d’identification d’ordre (par exemple « Figure 1 »), disposé au sommet du graphique, aligné à gauche et mis en valeur en caractères gras.
- Un titre de figure concis mais hautement descriptif, positionné immédiatement sous le numéro de figure sur une nouvelle ligne, configuré en italique standard (non gras) et rédigé selon la convention typographique anglo-saxonne du Title Case (majuscule au début de chaque mot lexical significatif).
- Une séparation claire d’avec les notes de bas de figure (Notes), introduites en italique en bas à gauche de la zone graphique pour consigner les définitions d’abréviations, les clés de symboles et la signification des astérisques de probabilité.
Ce basculement normatif redéfinit la manière d’envisager la construction d’un tracé ggplot2 destiné à l’APA 7. Deux voies architecturales s’offrent désormais au statisticien : composer le numéro et le titre dans le logiciel de traitement de texte éditorial (comme LaTeX ou Microsoft Word) en conservant le graphique pur, ou — solution de plus en plus privilégiée pour la diffusion numérique — sculpter l’architecture textuelle interne de ggplot2 pour reproduire à la perfection l’empilement normatif prescrit par le manuel de l’APA.
9.2 Construction d’un thème ggplot2 personnalisé conforme à l’APA
Pour implémenter avec une rigueur absolue les standards visuels de l’APA 7e édition au sein de ggplot2, l’approche la plus efficiente et reproductible réside dans la confection d’une fonction de thème utilisateur dédiée. Ce thème personnalisé hérite des bases structurelles épurées de theme_classic() tout en modélisant précisément l’empilement typographique requis.
Dans cette architecture thématique normalisée, nous exploitons la flexibilité conjointe du titre (pour incarner la ligne en gras « Figure 1 ») et du sous-titre (pour matérialiser le titre conceptuel en italique), tout en veillant à modifier le référentiel de projection spatiale pour ancrer le texte sur l’alignement extérieur de l’image complète :
theme_apa7 <- function(base_size = 11, base_family = "sans") {

  theme_classic(base_size = base_size, base_family = base_family) +

  theme(

    plot.title.position = "plot",

    plot.caption.position = "plot",

    plot.title = element_text(

      face = "bold",

      size = rel(1.0),

      hjust = 0,

      margin = margin(b = 4, unit = "pt")

    ),

    plot.subtitle = element_text(

      face = "italic",

      size = rel(1.0),

      hjust = 0,

      margin = margin(b = 12, unit = "pt")

    ),

    plot.caption = element_text(

      face = "plain",

      size = rel(0.85),

      hjust = 0,

      margin = margin(t = 10, unit = "pt")

    )

  )

}
En encapsulant cette configuration au sein d’un script d’infrastructure de laboratoire ou d’un package R interne d’équipe, l’ensemble des collaborateurs dispose d’un instrument de standardisation immédiat. L’application de ce thème assure que chaque figure produite pour un manuscrit respecte au millimètre près les épaisseurs de lignes, les hiérarchies de corps de texte et les marges spatiales exigées par les comités de lecture les plus intransigeants.
10. Alignement contextuel à la zone de traçage versus aux limites de la figure
10.1 Comportement de l’argument plot.title.position
L’une des avancées les plus déterminantes introduites dans les versions contemporaines de ggplot2 (à partir de la version 3.3.0) réside dans l’intégration de l’argument plot.title.position au sein de la fonction theme(). Auparavant, lorsqu’un analyste spécifiait un alignement à gauche via hjust = 0, le moteur vectoriel alignait la bordure gauche du texte sur la bordure gauche du panel (la zone rectangulaire délimitée par les axes cartésiens et contenant les géométries de données).
Ce comportement historique, bien que géométriquement logique, génère fréquemment une asymétrie visuelle discordante dans les rapports statistiques. En effet, sur le flanc gauche du panneau se déploient les graduations numériques de l’axe vertical ainsi que le titre textuel de l’axe des ordonnées. Lorsque ces étiquettes sont volumineuses (par exemple des scores psychométriques bruts à trois chiffres ou des pourcentages longs), le décalage vers la droite du point d’ancrage du titre devient manifeste. Le titre semble « flotter » au-dessus du centre-gauche de la figure plutôt que de border l’artefact graphique dans son ensemble.
Pour résoudre ce dilemme d’ordonnancement géométrique, plot.title.position accepte deux valeurs canoniques distinctes :
"panel": Représente le comportement patrimonial historique. L’alignement horizontal (piloté parhjust) est calculé exclusivement par rapport aux coordonnées de la boîte englobante de la grille interne de données."plot": Constitue le standard moderne de composition graphique. L’alignement horizontal est calculé en prenant pour repère la marge extérieure absolue de la figure intégrale, incluant l’emprise spatiale des titres et étiquettes de l’axe des ordonnées.
L’assignation de la directive theme(plot.title.position = "plot") aligne rigoureusement le titre principal et le sous-titre sur l’extrême bordure gauche du graphique global. Ce calage crée une ligne de référence visuelle impeccable avec le reste de la page éditoriale, résolvant instantanément le problème des titres décalés et harmonisant l’équilibre architectural des planches de données psychométriques.
10.2 Application similaire avec plot.caption.position
Suivant une logique structurelle parfaitement symétrique à celle régissant le titre sommital, la gestion spatiale des notes inférieures bénéficie du paramètre thématique plot.caption.position. Traditionnellement, l’alignement à droite de la légende inférieure (hjust = 1) ancrait le bloc de texte sur la bordure droite du panneau géométrique interne (panel). Dans une composition présentant une légende catégorielle positionnée sur le flanc droit de la figure, cette disposition contraignait la caption à s’intercaler sous le panneau des données, laissant un vide inesthétique sous la boîte de la légende.
En basculant le paramètre de configuration sur plot.caption.position = "plot", l’analyste décrète que l’espace vectoriel assigné à la légende inférieure s’étend désormais sur l’intégralité du canevas de sortie de l’image. Dès lors :
- Si
hjust = 1, la légende inférieure glisse élégamment vers le coin inférieur droit absolu de la figure, venant s’aligner sous la bordure externe des légendes périphériques les plus avancées. - Si
hjust = 0(conformément aux exigences strictes de l’APA 7 imposant d’aligner les notes explicatives sur la marge gauche), la note commence à la bordure gauche absolue du document graphique, s’alignant au millimètre près sur la trajectoire verticale initiée au sommet par le titre et le sous-titre.
Cette maîtrise de l’enveloppe globale de traçage est indispensable lors de la composition de planches de données élaborées destinées à des revues biomédicales ou neuropsychologiques de premier plan, où la cohérence des marges et l’alignement rigoureux des blocs d’information témoignent du professionnalisme méthodologique des auteurs.
11. Gestion des titres dans les compositions multi-panneaux
11.1 Coordination des supratitres avec le package patchwork
L’évaluation rigoureuse de protocoles expérimentaux complexes impose fréquemment de juxtaposer plusieurs visualisations au sein d’une même planche illustrative (par exemple, présenter en sous-panneau A la cinétique temporelle d’un biomarqueur, en B la corrélation psychométrique transversale et en C les densités marginales de distributions). Dans ce contexte architectural polycentrique, l’emploi de titres individuels non régulés engendre rapidement une cacophonie visuelle épuisante. L’utilisation du package moderne patchwork s’impose aujourd’hui comme le standard d’excellence pour orchestrer ces compositions composites.
Le génie structurel de patchwork repose sur son opérateur de composition déclarative et sur sa fonction intégrée plot_annotation(). Cette dernière permet de coiffer l’ensemble de l’assemblage multi-panneaux d’un supratitre unifié (super-title), doté de son propre sous-titre synthétique et d’une légende inférieure commune, tout en orchestrant de manière automatisée l’étiquetage alphabétique distinctif de chaque sous-graphique élémentaire (via l’argument tag_levels = 'A') :
planche_composite <- (graph_a | graph_b) / graph_c

planche_composite + plot_annotation(

  title = "Impact multidimensionnel du stress psychosocial sur les fonctions exécutives",

  subtitle = "Analyses intégrant marqueurs neuroendocriniens (A), temps d'inhibition (B) et taux de rechute (C)",

  caption = "Étude clinique longitudinale N = 412. Données standardisées selon les normes cliniques internationales.",

  tag_levels = 'A'

) & theme(

  plot.title.position = "plot",

  plot.title = element_text(face = "bold", size = 14)

)
Il importe de souligner l’emploi fondamental de l’opérateur perluète & dans l’instruction terminale, en lieu et place du classique opérateur plus +. Dans la syntaxe de patchwork, le + n’applique une altération thématique qu’au dernier sous-graphique déclaré, tandis que le & applique récursivement la configuration de style et d’alignement à l’ensemble des graphiques constitutifs et à l’annotation supratitrale globale, garantissant une cohérence typographique irréprochable sur l’ensemble de la planche composite.
11.2 Assemblage textuel avec cowplot et ggpubr
Avant la généralisation de patchwork, et toujours de manière très pertinente pour certaines exigences de mise en page hautement spécifiques, les packages cowplot et ggpubr ont jeté les bases méthodologiques de la manipulation des objets graphiques composés en R. Ces environnements abordent la planche de figures sous l’angle de la grille de bas niveau, offrant des leviers de contrôle absolu sur le positionnement micrométrique des étiquettes et des supratitres.
Dans cowplot, l’injection d’un titre commun au-dessus d’une matrice de figures assemblées via plot_grid() repose sur l’instanciation préalable d’un grob textuel dédié généré par la fonction draw_label(). L’analyste structure ensuite un empilement vertical où ce titre isolé constitue une ligne indépendante dans une grille globale :
titre_grob <- cowplot::ggdraw() +

  cowplot::draw_label(

    "Méta-analyse visuelle des tailles d'effet du traitement par remédiation cognitive",

    fontface = 'bold', x = 0, hjust = 0

  )

cowplot::plot_grid(titre_grob, matrice_graphiques, ncol = 1, rel_heights = c(0.1, 1))
Cette approche par instanciation explicite de grobs textuels procure une liberté totale quant à la gestion spatiale des coordonnées relatives (coordonnées normalisées entre 0 et 1). Elle permet notamment d’insérer des logos d’institutions, des séparateurs verticaux vectoriels ou des annotations transversales chevauchant plusieurs panneaux, ce qui s’avère particulièrement utile lors de la finalisation de planches de synthèse pour des méta-analyses visuelles ou des posters scientifiques de grand format.
De son côté, le package ggpubr propose une abstraction ergonomique intermédiaire très populaire au travers de sa fonction annotate_figure(). En enrobant une grille générée par ggarrange(), cette fonction permet de greffer en une ligne de code un titre sommital unifié (argument top) stylisé à l’aide de la fonction auxiliaire text_grob(). Bien que cette approche soit moins extensible que l’écosystème patchwork pour des architectures asymétriques très imbriquées, elle offre une rapidité d’exécution remarquable pour les compositions classiques de deux à quatre panneaux.
12. Diagnostic des anomalies, débogage et optimisation à l’exportation
12.1 Résolution des problèmes de troncature lors de l’export avec ggsave()
L’un des traumatismes techniques les plus récurrents pour le chercheur réside dans le constat d’une divergence flagrante entre l’apparence d’une figure au sein de la fenêtre graphique interactive de RStudio et le document matriciel ou vectoriel final exporté sur le disque dur. La pathologie la plus courante concerne la troncature des ascendantes ou des extrémités latérales du titre principal : des tildes, des accents circonflexes ou des lettres marginales se retrouvent tranchés de manière irréversible par la bordure extérieure du canevas physique.
Ce dysfonctionnement structurel découle d’une incompréhension de l’interaction entre les paramètres de dimensionnement physique de la fonction d’exportation ggsave() et l’infrastructure de rastérisation graphique :
- Interdépendance dimensionnelle : L’invocation de
ggsave("figure1.pdf", width = 16, height = 12, units = "cm")fige une surface géométrique absolue. Si la taille typographique (exprimée en points) a été calibrée pour une figure de grande dimension mais que la taille globale d’exportation spécifiée en centimètres est trop restreinte, le rapport de proportionnalité s’effondre. Le texte refuse de rétrécir proportionnellement à la surface physique allouée et finit par déborder des limites matérielles du document. - Résolution et lissage (DPI) : Pour les exports matriciels destinés à l’impression scientifique (formats TIFF ou PNG haute définition), la spécification de l’argument
dpi = 300(voire 600 DPI pour les schémas au trait) est incontournable pour satisfaire aux exigences des maisons d’édition académiques. - Choix du format de fichier : Pour prévenir toute perte de fidélité géométrique et s’affranchir des contraintes de crénelage, l’exportation sous forme vectorielle (PDF ou SVG) doit toujours être privilégiée pour les revues à comité de lecture. Les polices typographiques y sont encodées sous forme d’instructions vectorielles pérennes, préservant la netteté absolue des glyphes quel que soit le niveau d’agrandissement opéré par l’imprimeur.
Pour immuniser définitivement vos figures contre les amputations accidentelles de glyphes, la solution de sécurité consiste à injecter une marge de dégagement extérieure globale au niveau de la figure. En spécifiant au sein du thème la commande theme(plot.margin = margin(t = 15, r = 15, b = 10, l = 10, unit = "pt")), vous matérialisez un corridor respiratoire protecteur le long des quatre bordures périphériques du canevas, garantissant que le titre sommital disposera toujours du débattement vertical nécessaire pour déployer ses hampes les plus élevées sans jamais entrer en collision avec le bord tranché de l’image.
12.2 Détection des conflits thématiques et écrasements accidentels
Une source fréquente d’incompréhension et de frustration lors de l’apprentissage approfondi de ggplot2 découle de la disparition inexpliquée des réglages stylistiques fins préalablement affectés au titre. Un analyste configure scrupuleusement l’alignement de son titre au travers d’une instruction telle que theme(plot.title = element_text(hjust = 0.5, face = "bold")), pour constater avec stupeur lors du rendu final que le titre apparaît obstinément aligné à gauche et dans une police romane ordinaire.
Cette anomalie est systématiquement le fruit d’un non-respect de la règle de préséance séquentielle impérative de ggplot2. Si, dans la chaîne de compilation graphique, l’appel à un thème complet prédéfini (tel que theme_bw(), theme_minimal() ou theme_light()) est positionné après la déclaration de l’instruction theme() personnalisée, le thème complet opère une réinitialisation intégrale et destructrice de l’ensemble des éléments typographiques de la figure. Ces fonctions prédéfinies ne se contentent pas d’ajuster le fond du graphique : elles contiennent des dictionnaires complets qui écrasent méthodiquement toutes les personnalisations antérieures portant sur plot.title, plot.subtitle ou les marges spatiales.
Pour éliminer définitivement ce risque lors de la conception de vos visualisations, il est recommandé d’adopter une checklist d’ordonnancement canonique stricte pour vos blocs de code ggplot2 :
- Initialisation et données : Déclaration de la fonction
ggplot(), passage de la structure de données et mappage esthétique de base (aes()). - Couches géométriques et statistiques : Empilement des couches vectorielles de représentation (
geom_point(),geom_smooth(),geom_boxplot(), etc.). - Systèmes de coordonnées et échelles : Définition des coordonnées (
coord_cartesian()) et calibration des échelles cartésiennes ou chromatiques (scale_x_continuous(),scale_color_manual()). - Injection sémantique globale : Centralisation méthodique de l’intégralité du corpus textuel au moyen de la fonction unique
labs(). - Thème macroscopique structurel : Application du thème d’ambiance complet de base (par exemple
theme_classic()ou un thème APA dédié). - Micro-typographie et calibrage spatial : Application terminale de la fonction
theme()pour ajusterplot.title,plot.title.position, les marges contextuelles (margin()) et les éventuelles instructionselement_markdown().
En observant rigoureusement cette discipline de programmation déclarative, vous vous prémunirez contre toute régression stylistique accidentelle et garantirez que vos visualisations quantitatives conjugueront une clarté sémiotique remarquable, une rigueur méthodologique sans faille et une élégance esthétique digne des plus hautes exigences de la publication scientifique internationale.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Pedersen, T. L. (2020). patchwork: The Composer of Plots (R package version 1.1.1). https://CRAN.R-project.org/package=patchwork
- Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The Psychology of Learning and Motivation: Cognition in Education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387691-1.00002-8
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media. https://clauswilke.com/dataviz/
- Wilke, C. O. (2020). ggtext: Improved Text Rendering Support for ‘ggplot2’ (R package version 0.1.2). https://CRAN.R-project.org/package=ggtext
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0