
Dans le champ de l’analyse exploratoire des données, conceptualisée avec vigueur par John Tukey dès les années 1970, l’étape initiale consistant à observer visuellement la morphologie d’une variable quantitative conditionne l’ensemble de la démarche inférentielle ultérieure. Avant même de calculer des estimateurs de position comme la moyenne arithmétique ou la médiane, ou des indices de dispersion tels que la variance et l’écart-type, le statisticien doit appréhender la topographie de ses observations. Deux représentations graphiques se partagent traditionnellement cette tâche fondamentale : le graphique à points (couramment désigné sous le terme anglo-saxon de dot plot) et l’histogramme. Bien que tous deux visent à traduire la distribution empirique d’une variable unidimensionnelle, ils reposent sur des axiomes géométriques, sémiotiques et computationnels fondamentalement divergents.
Le choix entre un graphique à points et un histogramme ne relève nullement d’une simple préférence esthétique ou cosmétique ; il engage directement la fidélité de la transmission de l’information quantitative. Alors que le graphique à points privilégie une granularité maximale en matérialisant chaque observation individuelle par une entité discrète le long d’une échelle graduée, l’histogramme opère une réduction dimensionnelle en condensant les mesures continues dans des intervalles contigus appelés classes ou casiers (bins). Cette dichotomie entre préservation nominale du cas individuel et modélisation synthétique d’une fonction de masse ou de densité constitue le cœur conceptuel de notre analyse comparative.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes structurels, les propriétés mathématiques et les implications perceptives de ces deux représentations graphiques emblématiques. À travers le prisme des sciences comportementales, de la psychométrie et de la statistique inférentielle, nous explorerons leurs fondements théoriques, évaluerons leur comportement face aux variations d’échantillonnage, disséquerons un exemple empirique concret et fournirons une grille décisionnelle rigoureuse destinée aux chercheurs et analystes soucieux de concilier intégrité graphique et clarté communicative.
1. Fondements épistémologiques de la visualisation des distributions
1.1 Le rôle de la distribution dans l’analyse quantitative
L’inspection visuelle des données constitue le rempart primordial contre les erreurs méthodologiques majeures en recherche quantitative. L’histoire de la statistique regorge d’exemples frappants, au premier rang desquels figure le célèbre quartet d’Anscombe, démontrant de façon irréfutable que des jeux de données aux paramètres descriptifs identiques (moyenne, variance, coefficient de corrélation, droite de régression) peuvent correspondre à des distributions spatiales totalement discordantes. Se contenter d’indicateurs numériques agrégés sans sonder visuellement la distribution revient à postuler une régularité géométrique que la réalité empirique dément fréquemment.
Dans les études empiriques, l’évaluation de la normalité et le respect des postulats paramétriques (tels que la symétrie, l’absence d’hétéroscédasticité ou la normalité des résidus dans les modèles linéaires généraux) requièrent impérativement une analyse de distribution soignée. Bien que des tests formels d’hypothèse existent — à l’instar des épreuves de Shapiro-Wilk ou de Kolmogorov-Smirnov —, ces outils souffrent paradoxalement d’une puissance excessive sur les grands échantillons, où la moindre déviation triviale devient statistiquement significative, et d’un manque criant de sensibilité sur les petits échantillons où le risque d’erreur de type II est maximal. La sémiotique graphique vient combler cette béance en permettant à l’analyste de qualifier la nature exacte de la déviation : lourdeur des queues (kurtosis), asymétrie marquée (skewness) ou présence d’irrégularités locales.
Le passage de l’observation brute à la représentation synthétique des comportements constitue l’essence même de l’inférence scientifique. La façon dont une distribution empirique est visualisée influence de manière prépondérante la formulation des hypothèses exploratoires, la décision d’appliquer une transformation mathématique (logarithmique, racine carrée, Box-Cox) et l’orientation vers des modélisations robustes ou non paramétriques. Le choix graphique est donc un acte épistémologique : il détermine la lentille à travers laquelle le phénomène naturel ou psychologique est interprété.
1.2 Définition synthétique : graphique à points versus histogramme
Le graphique à points se définit formellement comme une méthode de visualisation de données univariées où chaque observation est représentée par un symbole géométrique ponctuel (généralement un cercle ou un disque) positionné le long d’un axe horizontal continu. Lorsque plusieurs observations partagent une valeur numérique identique ou approchée selon un seuil de résolution prédéfini, les points sont méthodiquement empilés à la verticale de manière orthogonale à l’axe des mesures. La hauteur de la colonne de points exprime ainsi la fréquence absolue exacte des occurrences sans jamais altérer l’intégrité de la mesure sous-jacente.
À l’inverse, l’histogramme, introduit dans sa formalisation moderne par Karl Pearson à la fin du XIXe siècle, est un outil d’agrégation conçu pour résumer des variables continues par le découpage de l’espace de données en intervalles réguliers ou non, fermés et contigus. Au sein de chaque classe, les identités numériques singulières des observations sont oblitérées au profit d’un calcul de fréquence ou de densité, matérialisé par la surface d’un rectangle érigé au-dessus de l’intervalle. L’histogramme ne présente pas des entités individuelles mais modélise la fonction de répartition de l’échantillon global.
La distinction conceptuelle repose ainsi sur le niveau d’échelle et la granularité descriptive. Le graphique à points opère au niveau micro-analytique, préservant la nature discrète de l’acte de mesure et permettant la réversibilité parfaite (on peut reconstruire le jeu de données exact à partir du graphique). L’histogramme se situe à un niveau macro-analytique de lissage statistique, générant une réduction volontaire du volume d’information afin de faire émerger la morphologie globale de la population parente. Dans l’arsenal du chercheur, ces deux instruments ne s’excluent pas mutuellement ; ils incarnent deux compromis analytiques complémentaires le long du continuum reliant l’observation brute à la modélisation probabiliste abstraite.
1.3 La pertinence du choix graphique en sciences comportementales
Les disciplines relevant des sciences du comportement, notamment la psychométrie, la psychologie expérimentale et la neuropsychologie, sont confrontées à des défis méthodologiques singuliers quant à la nature de leurs métriques. Les données y oscillent continuellement entre des variables à support discret restreint — telles que les scores sommatifs sur échelles de Likert (allant souvent de 1 à 5 ou de 1 à 7) ou les comptes d’erreurs commises lors d’une tâche d’attention soutenue — et des mesures strictement continues telles que les temps de réaction exprimés en millisecondes ou les latences d’activation électrophysiologique.
Le recours inapproprié à un histogramme sur des scores psychométriques à support discret engendre systématiquement des artefacts visuels trompeurs. Si la largeur des classes choisie par l’analyste ou par les paramètres par défaut d’un logiciel ne concorde pas parfaitement avec le pas de graduation de l’échelle d’évaluation, des discontinuités artificielles ou des amalgames fallacieux apparaissent, simulant des modes inexistants ou masquant des singularités réelles de réponse. De même, sur les temps de réaction caractérisés par des distributions ex-gaussiennes à longue traîne, l’utilisation d’intervalles trop étirés dissimule les dynamiques attentionnelles sous-jacentes au niveau des réponses ultra-rapides.
Par ailleurs, la crise de la reproductibilité qui traverse les sciences comportementales a placé au premier plan les considérations éthiques relatives à la transparence des données rapportées. Les conventions traditionnelles, consistant à résumer des groupes de participants par des diagrammes en barres flanqués de barres d’erreur (les fameux dynamite plots), font aujourd’hui l’objet d’un rejet unanime dans la communauté scientifique internationale. Le graphique à points, en révélant sans fard la taille réelle de l’échantillon, la présence de doublons suspects, les lacunes distributionnelles et l’hétérogénéité des sujets, incarne une exigence de probité méthodologique et de visibilité brute que l’histogramme, de par sa nature intrinsèquement condensée, tend à éluder lorsqu’il est employé sur des effectifs limités.
2. Anatomie et fonctionnement structurel du graphique à points (Dot Plot)
2.1 Principes de construction et disposition des axes
La structure géométrique d’un graphique à points repose sur une économie de moyens visuels poussée à son paroxysme. L’élément structurant majeur est l’axe horizontal, rigoureusement gradué selon l’unité de mesure de la variable étudiée. Chaque donnée issue de l’échantillon brut est projetée perpendiculairement sur cet axe en fonction de sa valeur scalaire réelle. Il n’existe, dans la version fondamentale du dispositif, aucune transformation non linéaire ou opération de lissage préalable susceptible d’altérer la métrique d’origine.
Lorsque plusieurs observations présentent la même valeur numérique exacte, elles sont positionnées sur une même colonne verticale, empilées les unes sur les autres à équidistance régulière. Cette disposition spatiale orthogonale permet de convertir instantanément une fréquence d’occurrence absolue en une dimension spatiale : la hauteur verticale de la pile de marqueurs. Contrairement aux graphiques cartésiens conventionnels, l’axe vertical n’a pas nécessairement besoin d’une échelle formellement graduée, car chaque point constitue lui-même sa propre unité de compte discrète.
Cette propriété de conservation intégrale de l’identité de chaque donnée confère au dot plot une valeur diagnostique inégalée. Chaque point correspond de manière bijective à une unité expérimentale (un participant, une mesure de laboratoire, un essai). L’analyste conserve ainsi un contact direct et tangible avec l’intégralité du corpus d’observations, ce qui facilite l’identification immédiate d’anomalies de saisie ou de motifs de réponse inhabituels sans intermédiaire algorithmique.
2.2 Propriétés graphiques et lisibilité intrinsèque
La lisibilité d’un graphique à points découle directement de sa capacité à traduire des propriétés numériques complexes en configurations topologiques évidentes pour le système visuel humain. La détection des concentrations ponctuelles est immédiate : un groupe dense d’observations produit une colonne élevée ou un chapelet compact de points, signalant instantanément le mode statistique de la série. À l’inverse, l’étendue empirique réelle de la variable — bornée par le minimum et le maximum stricts observés — apparaît sans ambiguïté sur l’axe des abscisses, sans être artificiellement étendue par les bornes externes arbitraires d’un intervalle de classe.
Un autre atout fonctionnel déterminant réside dans l’exposition flagrante des lacunes intermédiaires (gaps). Si, au sein d’une distribution allant de 10 à 50, aucune observation n’apparaît entre les valeurs 25 et 35, cette absence se manifeste visuellement par un espace totalement vierge sur l’axe. Cette information négative — l’absence d’occurrences — est un indicateur crucial pour déceler une discontinuité dans le phénomène mesuré ou un biais d’échantillonnage, alors qu’elle peut se trouver masquée dans un histogramme dont les classes engloberaient à la fois des valeurs observées et des valeurs absentes.
Néanmoins, la construction d’un dot plot exige une rigueur géométrique sans faille. Le diamètre des points, l’espacement vertical entre deux éléments d’une même pile et la résolution spatiale globale doivent être calibrés avec précision. Si les points sont surdimensionnés par rapport à l’étendue de l’axe, des chevauchements indésirables surviennent rapidement, dégradant la lisibilité et introduisant une distorsion perceptive dans l’évaluation des fréquences relatives. Le graphique à points exige donc un équilibre subtil entre résolution graphique et densité informationnelle.
2.3 Variantes méthodologiques du dot plot
La formalisation du graphique à points s’est enrichie au fil des décennies de contributions méthodologiques majeures, au premier rang desquelles figure celle de Leland Wilkinson. Le dot plot de Wilkinson, décrit dans son ouvrage fondateur The Grammar of Graphics, a systématisé l’algorithme d’empilement par la mise en place d’un procédé d’agrégation locale (local binning) à très haute résolution. Lorsque les données sont continues et que les valeurs exactes diffèrent par des fractions infimes, l’algorithme de Wilkinson regroupe les points voisins à l’intérieur d’un rayon de tolérance infinitésimal prédéfini afin de permettre leur empilement vertical propre tout en préservant leur position centrale, conciliant ainsi rigueur d’empilement et précision métrique.
Une seconde déclinaison majeure est le dot plot de Cleveland, théorisé par William S. Cleveland. Contrairement à la variante de distribution univariée brute, le graphique de Cleveland est pensé pour remplacer avantageusement les diagrammes en barres horizontales lors de la présentation de données récapitulatives par catégories. Dans cette approche, un point unique est placé sur l’axe continu pour chaque modalité d’une variable nominale ou ordinale, permettant une comparaison perceptuelle d’une exactitude largement supérieure à celle autorisée par l’évaluation des longueurs de rectangles, tout en réduisant considérablement la surcharge d’encre inutile.
Enfin, dans le traitement contemporain des données expérimentales, les praticiens recourent fréquemment à la technique du jittering (adjonction d’un bruit aléatoire contrôlé). Appliquée au graphique à points — souvent nommé alors strip plot ou diagramme de dispersion univarié —, cette méthode introduit une dispersion mineure le long de l’axe vertical pour éviter la superposition exacte de points partageant la même abscisse. Le jittering s’avère particulièrement fécond pour explorer des distributions dont l’effectif commence à saturer la capacité d’empilement vertical vertical classique, bien qu’il sacrifie l’alignement rigoureux propre au dot plot canonique.
3. Architecture mathématique et caractéristiques de l’histogramme
3.1 Partitionnement de l’espace de données : la notion de classes (bins)
L’histogramme repose sur un paradigme statistique radicalement différent : la discrétisation d’un continuum mathématique. La première étape algorithmique de sa construction consiste à délimiter l’étendue totale des données, définie par la différence entre la valeur maximale et la valeur minimale observées, puis à subdiviser cet intervalle en une succession de sous-intervalles contigus, disjoints et mutuellement exclusifs, communément appelés classes ou casiers (bins). Formellement, si la variable aléatoire continue $X$ évolue sur l’intervalle $[x_{\min}, x_{\max}]$, le domaine est scindé en $k$ classes du type $[b_{i-1}, b_i[$ pour $i in {1, dots, k}$.
Le paramètre architectural fondamental de l’histogramme réside dans la détermination de la largeur de ces classes, notée $h$ (où $h_i = b_i – b_{i-1}$). Lorsque les classes possèdent une amplitude constante, la largeur $h$ détermine unilatéralement le degré de résolution de la représentation. Une classe trop large provoque une hypo-segmentation désastreuse, agrégeant des dynamiques distributionnelles distinctes et lissant artificiellement les variations locales ; inversement, une classe excessivement étroite génère une hyper-segmentation fragmentée où la variance d’échantillonnage produit un bruit chaotique empêchant toute appréhension de la forme sous-jacente.
Sur le plan ontologique, l’insertion des données dans ces classes entraîne l’oblitération complète de l’identité numérique des points individuels. Dès lors qu’une observation est assignée à un intervalle donné, sa coordonnée précise disparait de la représentation visuelle au bénéfice exclusif de la quantification collective. L’observateur est alors informé du nombre exact de sujets ayant obtenu une valeur comprise dans la classe, mais demeure dans l’incapacité totale de déterminer si ces valeurs se concentrent au centre de l’intervalle, s’étalent uniformément ou s’agglutinent à l’une de ses frontières.
La transcription graphique de cette agrégation se traduit par l’érection de rectangles adjacents au-dessus de chaque classe. La propriété géométrique cardinale de l’histogramme — souvent ignorée des néophytes — réside dans le fait que c’est la surface du rectangle, et non pas simplement sa hauteur, qui est directement proportionnelle à la fréquence des observations contenues dans la classe. Lorsque toutes les classes ont une largeur identique, la hauteur devient proportionnelle à l’effectif, mais dès lors que des classes de largeurs inégales sont employées, la hauteur doit impérativement être recalculée pour représenter la densité d’effectif (fréquence divisée par la largeur de classe), sous peine d’induire en erreur le lecteur sur le poids relatif des différents segments de la distribution.
3.2 Règles algorithmiques de discrétisation
Afin d’extraire la détermination de la largeur de classe de l’arbitraire subjectif du chercheur, les statisticiens ont formalisé plusieurs règles mathématiques prédictives. La plus ancienne et la plus largement diffusée dans les logiciels commerciaux est la règle de Sturges, formulée en 1926. Fondée sur l’approximation binomiale de la loi normale, elle établit que le nombre idéal de classes $k$ pour un échantillon de taille $n$ est donné par la formule :
$$k = 1 + \log_2(n) \approx 1 + 3{,}322 \times \log_{10}(n)$$
Bien qu’extrêmement simple d’application, la formule de Sturges repose sur le postulat implicite d’une distribution parfaitement symétrique et gaussienne. Dès lors que l’échantillon présente une forte asymétrie ou des queues de distribution épaisses, cette règle sous-estime dramatiquement le nombre optimal de classes, induisant un sur-lissage sévère qui masque fréquemment la multimodalité ou l’étirement des données.
Pour pallier ces déficiences, David Scott a introduit en 1979 une formule asymptotiquement optimale fondée sur la minimisation de l’erreur quadratique moyenne intégrée (MISE, Mean Integrated Squared Error) entre l’histogramme empirique et la véritable densité théorique. La règle de Scott calcule la largeur de classe optimale $h$ par l’expression :
$$h = \frac{3{,}49 \times s}{n^{1/3}}$$
où $s$ représente l’écart-type de l’échantillon et $n$ la taille de la cohorte. Cette approche tient rigoureusement compte de la dispersion métrique globale des données, conférant aux représentations une robustesse accrue pour les échantillons gaussiens de taille moyenne à grande.
Cependant, en présence de valeurs atypiques ou de contaminations extrêmes dans le jeu de données, l’estimateur de l’écart-type $s$ se trouve gonflé de manière disproportionnée, conduisant à des classes artificiellement élargies. C’est précisément pour neutraliser cette sensibilité aux valeurs extrêmes que David Freedman et Persi Diaconis ont publié en 1981 la règle de Freedman-Diaconis, devenue le standard le plus rigoureux en science statistique. Elle substitue à l’écart-type une mesure de dispersion non paramétrique éminemment résistante : l’intervalle interquartile (IQR, calculé comme le 75e percentile moins le 25e percentile). La largeur de classe y est définie par :
$$h = \frac{2 \times \text{IQR}(X)}{n^{1/3}}$$
Cette formulation isole efficacement le cœur de la distribution des perturbations induites par les queues d’asymétrie extrême, garantissant un découpage équilibré capable de restituer fidèlement la structure du noyau central des observations sans être distordu par un point aberrant isolé.
Il n’en demeure pas moins que, quelle que soit la formule algorithmique sélectionnée, l’observateur humain demeure captif de l’emplacement arbitraire de l’origine du premier intervalle (le point d’ancrage $b_0$). Une simple translation de la grille de discrétisation vers la gauche ou vers la droite d’une fraction de millimètre, sans changer la largeur des classes, peut altérer drastiquement la configuration des barres, transformant une silhouette unimodale apparente en profil bimodal sans qu’aucune donnée n’ait été modifiée dans le corpus initial.
3.3 Propriétés géométriques et continuité visuelle
Sur le plan de la sémiologie graphique, l’histogramme se distingue par une exigence impérative : l’adjacence rigoureuse des barres rectangulaires. Contrairement au diagramme en bâtons destiné aux variables qualitatives ou catégorielles — où des espaces vides interstitiels sont insérés de manière délibérée entre les colonnes pour marquer l’étanchéité ontologique des catégories (par exemple : nationalités, groupes sanguins) —, les rectangles d’un histogramme doivent impérativement se toucher sans aucune marge de séparation.
Cette continuité spatiale traduit visuellement la nature mathématique de la variable sous-jacente, qui évolue sur un continuum géométrique dense où chaque valeur frontière constitue simultanément la limite supérieure d’une classe et la borne inférieure de la suivante. Insérer des espacements entre les barres d’un histogramme constitue une faute d’expression statistique majeure, car cela instille dans l’esprit du lecteur l’illusion d’une variable à support discret ou d’une interruption illégitime dans l’espace des mesures mesurables.
Enfin, l’histogramme possède la faculté d’être normalisé en densité relative. En divisant les hauteurs des barres par le produit de l’effectif total $n$ et de la largeur de classe $h$, l’aire totale cumulée de l’ensemble des rectangles devient strictement égale à 1. Cette conversion confère à l’histogramme une compatibilité théorique immédiate avec le calcul infinitésimal et la théorie des probabilités : il s’érige ainsi en estimateur empirique non paramétrique de la véritable fonction de densité de probabilité $f(x)$ de la population d’origine, autorisant la comparaison directe entre des échantillons de tailles profondément divergentes ou la superposition d’une courbe de Gauss théorique de référence.
4. Comparaison technique directe : Données discrètes contre données continues
4.1 Traitement des échelles discrètes et ordinales
Le traitement graphique d’une variable quantitative est tributaire de sa structure mathématique intrinsèque. Lorsque l’analyste manipule des données discrètes ou ordinales — typiquement rencontrées en psychométrie sous la forme d’échelles d’attitudes de Likert graduées en cinq, sept ou neuf échelons entiers —, le graphique à points constitue un dispositif d’une élégance et d’une adéquation naturelles. Puisque l’ensemble des valeurs admissibles est fini et composé d’entiers naturels, chaque valeur distincte se voit assigner un point fixe sur l’axe horizontal, et les observations s’empilent sans aucune déformation de la granularité.
L’utilisation de l’histogramme sur ce type de données discrètes engendre des aberrations morphologiques considérables. Si l’on applique machinalement un algorithme de binning automatique à des scores discrets (par exemple : 1, 2, 3, 4, 5), le logiciel de traitement statistique peut définir des classes continues de type $[0{,}8 ; 1{,}6[$, $[1{,}6 ; 2{,}4[$, ou $[2{,}4 ; 3{,}2[$. De telles frontières n’ont aucun sens sémiotique pour une métrique où les fractions de points n’existent pas dans le protocole expérimental. Les barres de l’histogramme semblent suggérer l’existence d’un espace continu sous-jacent, induisant une confusion perceptive sur la nature ontologique des données recueillies.
De surcroît, le graphique à points restitue fidèlement les fréquences absolues de comptage sans aucune distorsion liée aux arrondis de calcul de classe. Sur une distribution de scores d’erreurs cognitives restreinte à des petites valeurs (0, 1, 2, 3 erreurs), un dot plot permet de dénombrer individuellement les participants sans effort mnésique. L’histogramme, quant à lui, impose au lecteur de reporter continuellement son regard vers l’axe des ordonnées pour tenter d’inférer la valeur de l’effectif via la hauteur de chaque colonne, augmentant inutilement la charge cognitive nécessaire à la lecture de la distribution.
4.2 Traitement des variables strictement continues
La situation méthodologique s’inverse dès lors que la variable quantitative sous examen possède un support strictement continu, où les valeurs réelles sont mesurées sur une échelle infiniment divisible (par exemple, la concentration d’un biomarqueur plasmatique, la résistance cutanée mesurée en micro-siemens, ou le temps de latence oculaire exprimé avec une précision sub-milliseconde). Sur de tels continua, la probabilité que deux observations expérimentales indépendantes possèdent rigoureusement la même coordonnée au milliardième près tend mathématiquement vers zéro.
Dans ce contexte continu, le graphique à points élémentaire atteint rapidement ses limites géométriques intrinsèques : comme chaque mesure possède une valeur singulière, aucune superposition exacte ne se produit le long de l’axe. Les points ont alors tendance à s’éparpiller de manière horizontale le long d’une ligne unique sans jamais s’empiler, créant un phénomène de saturation linéaire où la densité locale devient très malaisée à évaluer à l’œil nu. Même avec l’adjonction d’un algorithme d’empilement par tolérance locale (Wilkinson), le dot plot finit par se métamorphoser en une juxtaposition complexe de colonnettes d’un ou deux points d’épaisseur, perdant une large partie de son pouvoir de synthèse.
L’histogramme s’impose alors comme l’outil privilégié de modélisation continue. En partitionnant délibérément l’espace continu en classes englobantes, il transcende l’extrême variabilité singulière de chaque mesure continue pour faire émerger une silhouette statistique globale. L’histogramme préfigure conceptuellement les méthodes modernes d’estimation par noyau (Kernel Density Estimation ou KDE), qui consistent à appliquer une fonction de lissage gaussienne glissante sur l’ensemble du domaine pour estimer une fonction de densité différentiable sans les discontinuités anguleuses propres aux frontières rectangulaires de l’histogramme.
4.3 Évaluation comparative de la granularité de l’information
Le dilemme fondamental qui oppose le graphique à points et l’histogramme s’énonce en termes de compromis entre granularité et abstraction statistique. Le tableau conceptuel ci-après formalise les caractéristiques distinctives de chaque approche vis-à-vis du spectre de l’information :
- Le graphique à points comme miroir fidèle des données : Il adhère rigoureusement au principe d’invariance des observations. Aucune information numérique n’est sacrifiée lors de sa génération. La matrice originelle des données peut être mentalement ou manuellement extraite du graphique par un simple inventaire visuel des coordonnées de chaque marqueur. C’est un instrument d’une granularité unitaire (ratio 1:1 entre l’observation et le symbole graphique).
- L’histogramme comme modèle d’abstraction et de lissage : Il applique une réduction volontaire du volume d’information. En troquant les coordonnées précises des observations contre une valeur d’aire représentative de classe, il sacrifie la fidélité locale au bénéfice exclusif de la lisibilité globale. L’opération est irréversible : l’observateur ne peut plus déduire la matrice originelle à partir de l’histogramme sans faire d’hypothèses invérifiables quant à la répartition interne des données au sein de chaque rectangle.
Ce compromis méthodologique reflète une tension séculaire en théorie de la mesure : faut-il privilégier l’honnêteté descriptive de la dispersion empirique brute, quitte à exposer le lecteur à l’hétérogénéité chaotique d’un petit échantillon, ou faut-il privilégier la régularisation statistique pour orienter le regard vers la loi générale postulée, au risque d’occulter des singularités structurelles majeures ? Le choix de l’instrument découle directement de la réponse apportée à cette question fondamentale.
5. Démonstration pratique sur un jeu de données psychométriques identique
5.1 Présentation de l’échantillon empirique de test
Pour dissiper tout flou théorique, examinons rigoureusement la transposition de ces deux méthodes de visualisation sur un corpus expérimental concret. Considérons une cohorte de 18 sujets humains participant à un protocole de psychologie cognitive évaluant la réactivité émotionnelle après une épreuve standardisée d’induction de stress social (Trier Social Stress Test). À l’issue de l’épreuve, chaque participant renseigne une échelle validée d’anxiété subjective dont le score total est un entier compris entre 1 (apaisement parfait) et 10 (anxiété paroxystique).
Les 18 scores recueillis lors de la session se répartissent textuellement comme suit :
$$\mathcal{D} = {1, 1, 1, 1, 2, 2, 2, 3, 4, 5, 5, 6, 6, 6, 6, 7, 8, 10}$$
Un examen descriptif rapide de cette distribution brute indique une étendue totale de 9 points (allant de $x_{\min}=1$ à $x_{\max}=10$). La médiane empirique de l’échantillon s’établit à 4,5, tandis que la moyenne arithmétique s’élève à 4,22. Fait marquant, la distribution présente deux modes lexicaux jumeaux : le score 1 et le score 6, chacun étant représenté par exactement 4 observations distinctes. Enfin, une valeur isolée, le score 10, semble matérialiser une réaction émotionnelle extrême chez un sujet unique.
5.2 Construction détaillée et lecture du graphique à points
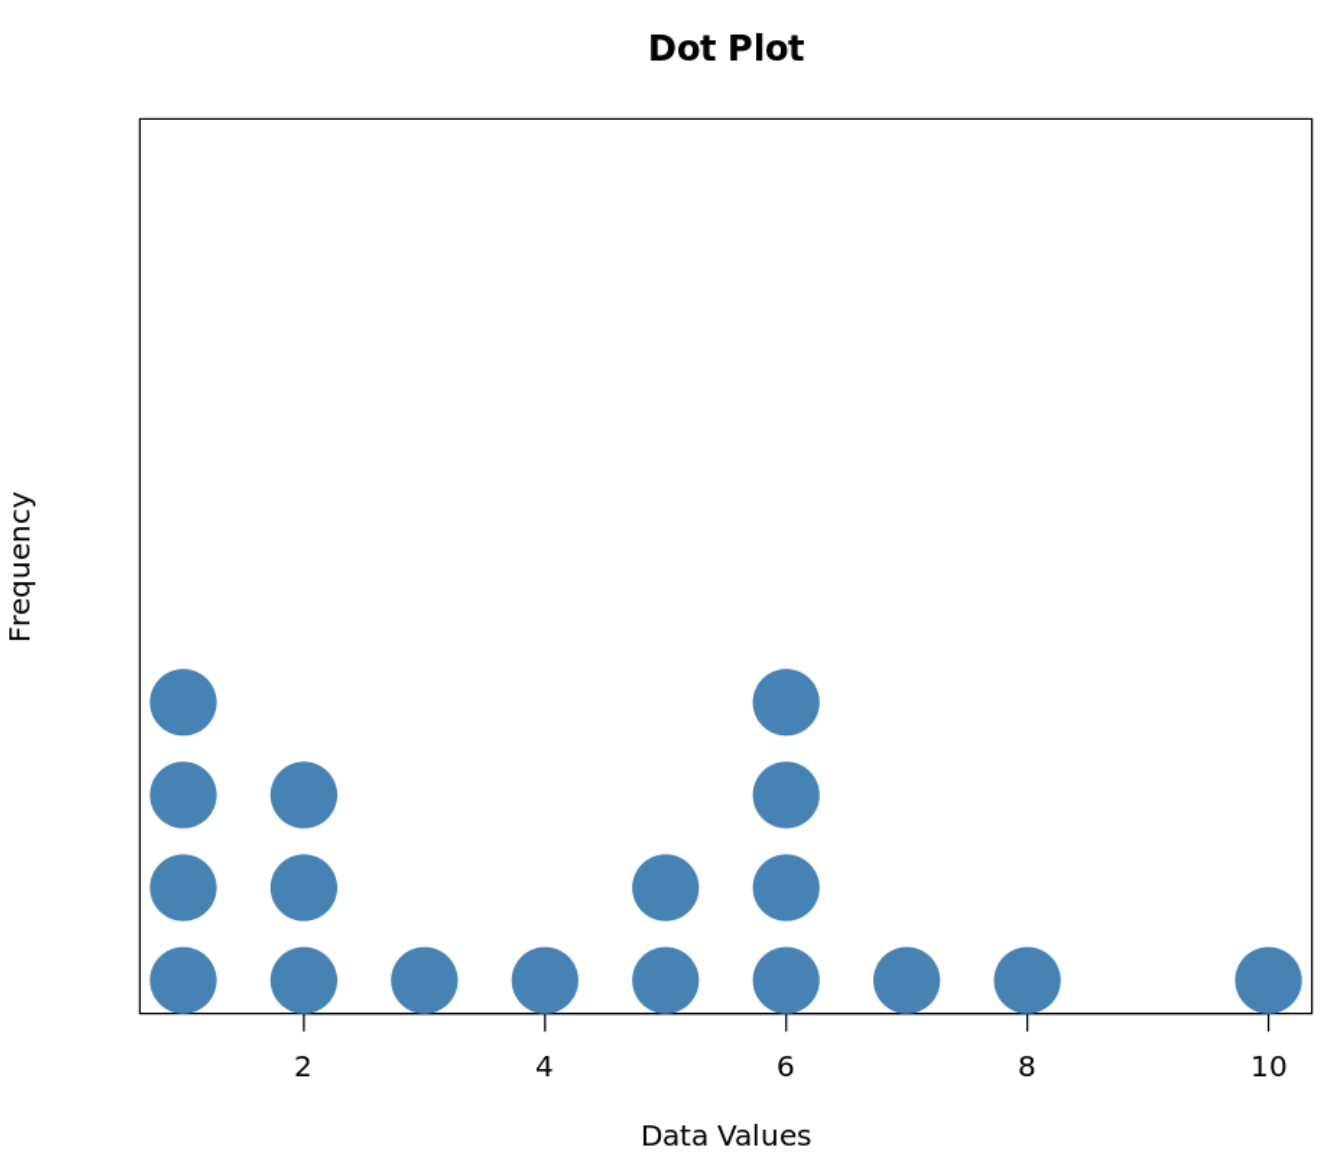
Traçons à présent mentalement le graphique à points univarié correspondant à cet échantillon $\mathcal{D}$. L’axe horizontal est gradué de 1 à 10 par incréments unitaires stricts. Au-dessus de la valeur 1 s’élève une colonne verticale formée de quatre points parfaitement équidistants. Immédiatement adjacente, au-dessus de la valeur 2, s’érige une pile de trois points. Les valeurs 3 et 4 reçoivent chacune un point isolé.
La valeur 5 supporte une colonne de deux points, immédiatement suivie de la valeur 6, sur laquelle vient s’empiler une nouvelle colonne massive de quatre points, rigoureusement égale en hauteur à celle observée sur le score 1. Les valeurs 7 et 8 reçoivent un point unitaire chacune. Vient ensuite la valeur 9 : l’espace au-dessus de cette graduation demeure rigoureusement vierge de tout marqueur. Enfin, un point unique trône au sommet de la valeur 10.
La lecture de ce graphique à points délivre une moisson analytique d’une limpidité absolue :
- Les modes jumeaux (1 et 6) sautent instantanément aux yeux du lecteur sans l’ombre d’une équivoque, mettant en lumière une structure potentiellement bimodale au sein de l’échantillon (un groupe d’individus totalement résilients au stress et un groupe réagissant par une anxiété modérément élevée).
- La lacune structurale au score 9 est immédiatement palpable : le lecteur constate visuellement qu’aucun sujet ne se situe à ce niveau d’intensité, ce qui isole catégoriquement le score 10 comme une réponse singulière et atypique.
- L’intégrité de l’échantillon de 18 individus est instantanément vérifiable : un simple comptage permet de s’assurer du volume exhaustif des participants testés.
5.3 Construction détaillée et lecture de l’histogramme
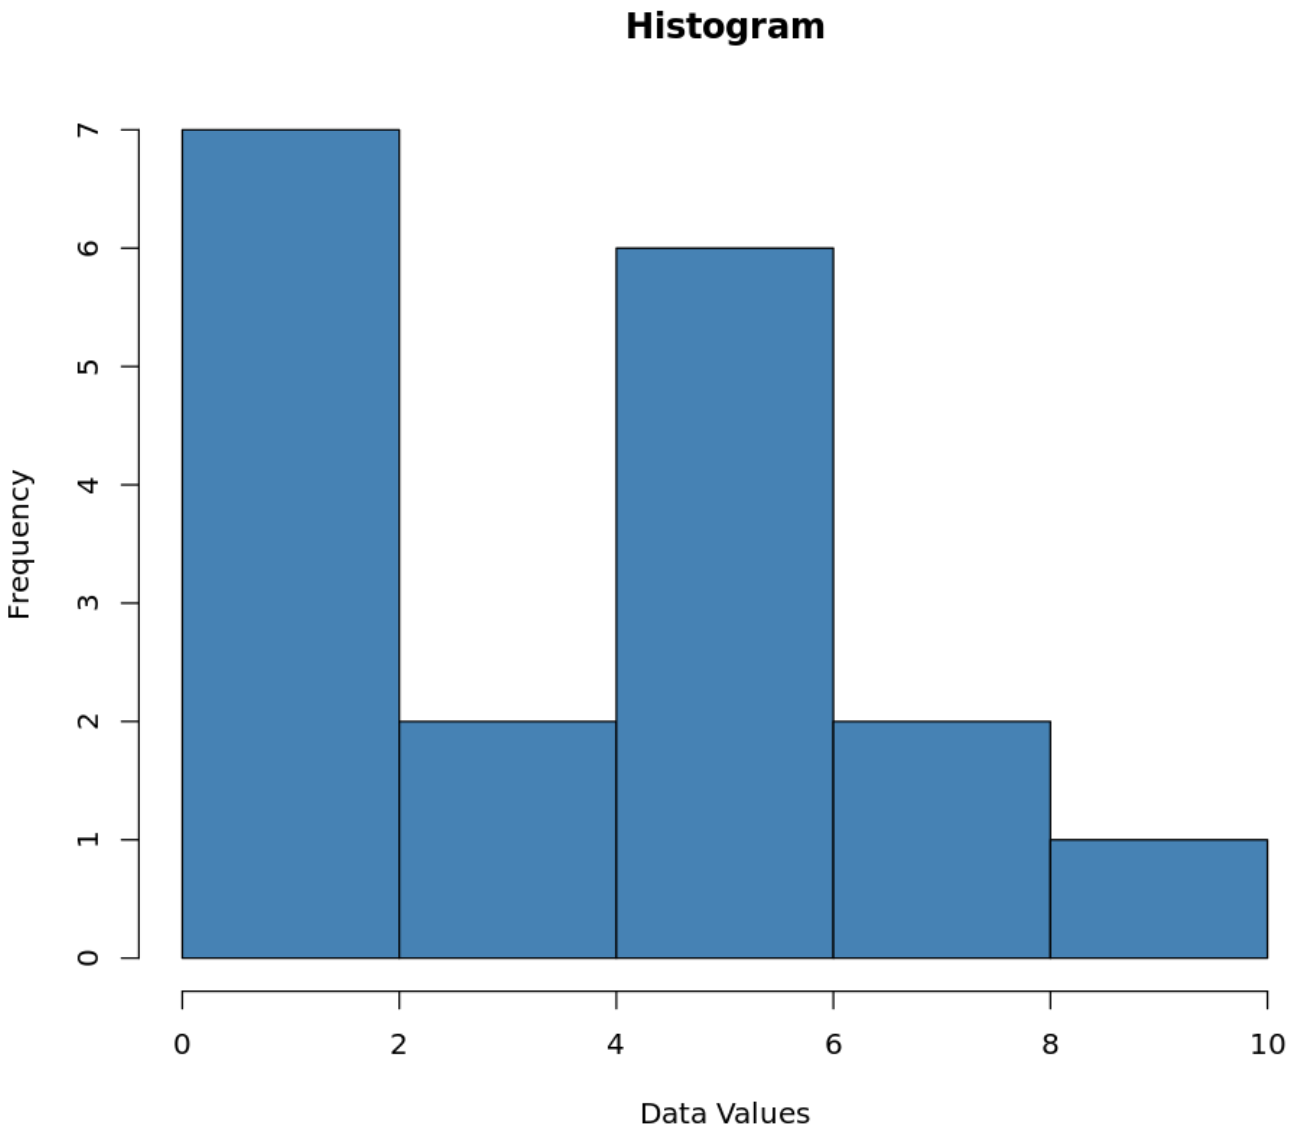
Appliquons à présent la logique de l’histogramme à ce même jeu de données. Choisissons un découpage méthodique très usuel reposant sur une largeur de classe de 2 unités ($h = 2$), générant cinq classes contiguës recouvrant l’ensemble du domaine de mesure : $[1 ; 3[$, $[3 ; 5[$, $[5 ; 7[$, $[7 ; 9[$ et $[9 ; 11[$.
Agrégeons les observations au sein de chacune de ces tranches :
- La classe $[1 ; 3[$ regroupe l’ensemble des scores 1 (4 occurrences) et des scores 2 (3 occurrences), soit un effectif total agrégé de 7 observations.
- La classe $[3 ; 5[$ contient le score 3 (1 occurrence) et le score 4 (1 occurrence), totalisant un effectif de 2 observations.
- La classe $[5 ; 7[$ englobe les scores 5 (2 occurrences) et les scores 6 (4 occurrences), totalisant un effectif combiné de 6 observations.
- La classe $[7 ; 9[$ regroupe les scores 7 (1 occurrence) et 8 (1 occurrence), soit 2 observations.
- La classe $[9 ; 11[$ ne contient que le score 10 (1 occurrence), matérialisant 1 observation.
Sur le plan géométrique, l’histogramme résultant présente un rectangle colossal de hauteur 7 sur le premier intervalle, suivi d’une chute brutale à une hauteur de 2 sur le second rectangle, d’un rebond marqué à une hauteur de 6 sur le troisième rectangle, d’un affaissement à 2 sur le quatrième et d’un rectangle résiduel de hauteur 1 sur le dernier segment.
Que s’est-il produit lors de cette transition graphique ? La distinction cruciale entre les scores basaux 1 et 2 a été purement et simplement anéantie par l’opération de regroupement. Le lecteur ignore totalement que le score 1 représentait un mode absolu et que le score 2 était en réalité moins fréquent. De même, l’amalgame des scores 5 et 6 dans un même rectangle confère artificiellement à cet intervalle un effectif de 6, sans laisser paraître que le score 6 était un mode deux fois plus massif que le score 5. Pire encore, la barre érigée sur l’intervalle $[9 ; 11[$ s’étale uniformément sur deux unités d’axe, occultant totalement le vide absolu constaté au score 9 et laissant imaginer que des observations pourraient exister à la fois en 9 et en 10.
5.4 Confrontation critique des enseignements tirés des deux figures
La confrontation directe de ces deux visualisations issues d’une même matrice empirique constitue une leçon de méthodologie graphique. Ce que le graphique à points révèle avec une acuité chirurgicale — la bimodalité stricte en 1 et 6, le vide complet au score 9, et l’isolement du score 10 —, l’histogramme le masque sous un voile d’agrégation arbitraire. L’histogramme a lissé la topographie locale au profit d’un profil ondulatoire en deux vagues $[1 ; 3[$ et $[5 ; 7[$, modifiant la perception fondamentale de la composition de l’échantillon.
Cependant, pour un regard non averti ou une audience recherchant uniquement une synthèse décisionnelle ultra-rapide, l’histogramme offre une structure géométrique compacte. L’œil n’a pas à traiter 18 micro-symboles individuels, mais perçoit immédiatement trois blocs majeurs : une concentration massive de sujets dans les scores faibles, un second groupe médian significatif et une traîne d’extinction progressive. L’effort cognitif requis pour saisir la masse générale est allégé, mais cet allègement s’opère au détriment de l’exactitude scientifique.
Pour le chercheur en sciences comportementales, l’occultation du vide en 9 et l’écrasement des modes singuliers par l’histogramme constituent une perte analytique inacceptable à cette échelle d’échantillon. Le graphique à points s’impose ici comme le seul vecteur capable d’assurer la transparence des résultats sans injecter d’artefacts structurels liés au choix du découpage.
6. L’influence déterminante de la taille de l’échantillon (N)
6.1 Performance sur petits échantillons (N < 30)
L’effectif global d’un échantillon (usuellement formalisé par la lettre $N$) constitue le paramètre régulateur suprême dans l’arbitrage entre graphique à points et histogramme. Lorsque les études portent sur de petits effectifs — situation récurrente dans les recherches cliniques de pointe, les études en neuro-imagerie fonctionnelle (IRMf), les protocoles avec modèles animaux ou les phases pilotes d’expérimentations comportementales, où $N < 30$ —, l’histogramme se révèle méthodologiquement inadapté et potentiellement trompeur.
À de faibles niveaux de $N$, l’histogramme est assujetti à une instabilité critique. Le déplacement d’une seule observation d’une unité de mesure le long de l’axe peut faire basculer ce point d’une classe à l’autre, modifiant de manière drastique les hauteurs relatives des barres et bouleversant entièrement la silhouette perçue. L’observateur est alors exposé à un risque majeur de surinterprétation : un creux fortuit généré par le simple aléa d’échantillonnage sur un effectif squelettique est interprété à tort comme une bimodalité théorique fondamentale, tandis qu’un pic isolé d’une barre de hauteur 3 est érigé en mode caractéristique de la population.
Dans ce régime de faible puissance, le graphique à points s’avère infiniment supérieur. Il expose la précarité structurelle de l’échantillon avec une honnêteté intellectuelle intégrale. Les points isolés ne prétendent pas combler l’espace géométrique comme le ferait un rectangle de surface volumineuse ; ils témoignent sans fard de la sparsité des données. Le chercheur et ses pairs peuvent ainsi juger immédiatement de la solidité des inférences statistiques tirées d’un corpus restreint, écartant tout mirage de modélisation continue prématurée.
6.2 Zones de transition et échantillons intermédiaires (30 ≤ N ≤ 100)
La zone comprise entre $N = 30$ et $N = 100$ constitue une phase de transition méthodologique où les forces et les contraintes des deux outils s’équilibrent de façon dynamique. À mesure que l’effectif s’accroît dans cette tranche intermédiaire, le graphique à points commence à être confronté au spectre de l’encombrement graphique (overplotting). Si la variable présente une variabilité restreinte ou un support discret resserré, les piles verticales de points s’élèvent de façon vertigineuse, menaçant de saturer la hauteur du cadre graphique ou obligeant à réduire le diamètre des marqueurs à des dimensions microscopiques qui nuisent à leur lisibilité.
Simultanément, l’histogramme acquiert dans cette plage d’effectifs une première assise de stabilité statistique. Avec un effectif avoisinant 80 ou 100 participants, l’application de la règle de Freedman-Diaconis ou de Scott génère un nombre suffisant de classes peuplées de manière assez consistante pour que la silhouette commence à s’affranchir du bruit d’échantillonnage brut. La distribution empirique se stabilise et converge progressivement vers une approximation raisonnable de la loi de densité sous-jacente.
Dans cette zone grise, le choix relève de la pondération pragmatique des objectifs de communication. Si le chercheur désire effectuer une analyse diagnostique interne de ses données en phase de nettoyage (data cleaning), le dot plot — éventuellement enrichi d’un léger jittering ou d’un tracé de Wilkinson — demeure irremplaçable pour débusquer les anomalies locales. En revanche, pour une communication synthétique destinée à un public non spécialiste au sein d’un rapport exécutif, l’histogramme devient une option défendable, à condition expresse de vérifier la robustesse de sa morphologie à travers différentes configurations de découpage.
6.3 Comportement sur grands échantillons (N > 1000)
Dès lors que l’échantillonnage franchit le seuil des grands volumes pour atteindre des centaines ou des milliers d’observations ($N > 1000$) — comme c’est le cas dans les cohortes épidémiologiques, les données de télémétrie numérique, l’exploitation de bases médico-administratives ou les enquêtes psychométriques transnationales standardisées —, le graphique à points s’effondre sous le poids de sa propre saturation graphique.
Sur un échantillon de 5000 observations, empiler individuellement des disques ou des cercles aboutit inéluctablement à un amas d’encre opaque ou à un chevauchement inextricable (effet dit de « rideau de fer »). L’individualisation de chaque observation n’a plus aucun sens analytique à cette échelle : ce ne sont plus les idiosyncrasies de l’individu numéro 437 qui intéressent l’investigateur, mais le comportement asymptotique de la population dans sa globalité. La tentative de préserver la granularité unitaire vire à l’obstination graphique contre-productive, alourdissant le fichier informatique vectoriel sans apporter le moindre gain d’intelligibilité.
C’est dans ce domaine des grands effectifs que l’histogramme triomphe sans conteste. Grâce à la loi des grands nombres, la variance d’échantillonnage qui affectait les classes sur de petits effectifs s’évanouit. L’histogramme se métamorphose en une approximation géométrique quasi parfaite de la fonction de densité théorique $f(x)$. En combinant une discrétisation fine autorisée par la taille colossale de la cohorte avec une normalisation en densité, l’histogramme capture avec une élégance et une fluidité remarquables les plus subtiles inflexions de la distribution parentale, tout en optimisant drastiquement l’espace d’affichage et l’économie cognitive de l’observateur.
7. Détection des valeurs atypiques, asymétries et multimodalités
7.1 Localisation et diagnostic des valeurs aberrantes (Outliers)
L’un des rôles majeurs dévolus à la visualisation descriptive préliminaire est le diagnostic précoce des valeurs atypiques, aberrantes ou isolées (outliers). Sur ce terrain d’investigation critique, le graphique à points offre une supériorité opérationnelle éclatante. En projetant chaque point sur son abscisse exacte, un score isolé à l’extrémité du domaine apparaît comme une entité spatiale autonome, détachée du corps principal de la distribution par un vide linéaire explicite.
Cette visibilité chirurgicale permet au chercheur d’engager immédiatement un diagnostic qualitatif approfondi : s’agit-il d’une faute de frappe typographique (par exemple, la saisie d’un score de 100 sur une échelle bornée à 10), d’un dysfonctionnement d’un capteur de mesure physiologique, ou d’une observation cliniquement authentique émanant d’un sujet aux caractéristiques psychologiques véritablement exceptionnelles ? Le point étant isolé et identifiable, il renvoie directement à la ligne correspondante dans la matrice brute sans ambiguïté.
À l’inverse, l’histogramme recèle un danger structurel majeur d’absorption ou d’invisibilisation des valeurs atypiques. Si la largeur de classe est paramétrée de façon trop généreuse, une valeur aberrante unique peut se retrouver amalgamée au sein de la classe terminale de l’histogramme, se fondant anonymement dans un effectif de quelques unités. Le rectangle résultant masque l’isolement du point en lui conférant une assiette continue partagée avec d’autres observations plausibles. À l’autre extrême, si l’intervalle est étroit, un outlier unique dressera une minuscule barre d’une unité à des kilomètres géométriques du reste du graphique, écrasant l’ensemble de la distribution principale dans une bande étroite et comprimée afin d’inclure cette excroissance dans le cadre graphique, anéantissant ainsi la résolution visuelle du corps central des données.
7.2 Appréciation du skewness (asymétrie positive et négative)
La détection de l’asymétrie d’une distribution — le skewness — est déterminante pour juger de l’opportunité d’appliquer des modèles statistiques paramétriques qui reposent sur le postulat d’une dispersion symétrique autour du centre de gravité. Dans les études comportementales, les distributions sont très fréquemment asymétriques à droite (asymétrie positive), à l’instar des temps de réponse ou des salaires, ou asymétriques à gauche (asymétrie négative), comme les scores de performance à un examen trop aisé exhibant un effet plafond massif.
L’histogramme s’avère particulièrement intuitif pour apprécier la silhouette globale d’une asymétrie lorsque la taille d’échantillon est suffisante. L’étirement progressif de la traîne de rectangles décroissants vers la droite ou vers la gauche offre une transcription visuelle directe de la queue de distribution. Cependant, cette appréciation reste étroitement dépendante du choix de la largeur des classes : un sur-dimensionnement de la largeur des bins a tendance à émousser la queue de distribution, la faisant paraître artificiellement abrupte et masquant l’ampleur réelle de l’asymétrie.
Le graphique à points, pour sa part, expose la traîne de distribution par un espacement horizontal de plus en plus lâche entre les points à mesure que l’on s’éloigne du mode. Il permet de discerner avec une exactitude incomparable l’émergence des effets plancher (amassement dense de points sur la borne inférieure gauche de l’axe sans possibilité de descendre plus bas) ou des effets plafond. Il permet en outre d’évaluer si l’étalement de la queue de distribution est constitué d’une suite ininterrompue de points de plus en plus rares mais contigus, ou s’il s’agit en réalité d’une distribution symétrique polluée par deux ou trois observations erratiques distantes.
7.3 Révélation de la multimodalité et des sous-populations
La présence d’une multimodalité au sein d’une distribution constitue l’un des signaux les plus cruciaux en analyse exploratoire. Elle révèle presque invariablement l’existence de sous-populations hétérogènes dissimulées au sein de la cohorte analysée (par exemple, la conjonction de deux sous-groupes diagnostiques différents, d’une divergence liée au genre, ou de l’application de stratégies cognitives qualitativement distinctes face à un même problème expérimental).
Le graphique à points excelle à révéler les micro-concentrations disjointes de données. Même au sein d’un effectif modeste de quelques dizaines d’individus, la formation de deux ou trois grappes de points nettement espacées par un vallon désert constitue une signature visuelle indéniable. L’analyste est instantanément averti de la non-pertinence d’un résumé statistique unifié (comme une moyenne globale) et est incité à stratifier ses analyses selon des variables modératrices sous-jacentes.
Dans l’histogramme, en revanche, la détection de la multimodalité est suspendue au fil du rasoir du paramétrage des classes. Un choix malheureux de largeur ou d’origine d’intervalle peut complètement occulter un profil bimodal : si une frontière de classe est malencontreusement positionnée précisément au sommet d’un des modes ou si la largeur de classe est égale à la distance séparant les deux pics, les deux modes peuvent se retrouver absorbés dans une unique et large barre centrale, transformant une distribution fondamentalement bimodale en une colline unimodale parfaitement trompeuse. C’est l’un des pièges les plus insidieux de la modélisation par intervalles contigus.
8. Psychologie cognitive et sémiotique visuelle du chercheur
8.1 Charge cognitive et théorie de la charge perceptive de Sweller
L’efficacité d’un format graphique ne s’évalue pas exclusivement à l’aune de ses propriétés mathématiques formelles ; elle doit être analysée à travers le prisme de la psychologie cognitive et des contraintes intrinsèques au système de traitement visuel de l’observateur humain. La théorie de la charge cognitive, formalisée par John Sweller, nous enseigne que la mémoire de travail humaine possède une capacité limitée dans le traitement simultané des éléments d’information visuelle non automatisés.
Lorsqu’un chercheur observe un graphique à points, il est confronté à une multiplicité d’entités discrètes. Si l’échantillon est restreint ($N < 40$), la charge cognitive demeure faible car le système perceptif humain bénéficie du phénomène de subitizing (la capacité d’estimer instantanément et sans effort de comptage le nombre d’éléments dans un petit ensemble) et d’une intégration spatiale immédiate. Toutefois, si le nombre de points devient colossal, la charge cognitive extrinsèque s’accroît exponentiellement : le cerveau est sollicité pour délimiter les contours d’une masse indéfinie d’éléments fragmentés, ce qui ralentit la vitesse d’extraction de la tendance centrale et de la dispersion globale.
L’histogramme, à l’inverse, opère une pré-digestion structurelle de l’information quantitative. En substituant aux dizaines ou centaines d’occurrences ponctuelles un nombre réduit de polygones rectangulaires (généralement entre 5 et 15 barres), il abaisse dramatiquement la charge cognitive de traitement élémentaire. L’observateur n’a plus à appréhender une myriade d’individualités, mais une silhouette d’ensemble (la gestalt générale). Néanmoins, cette économie perceptive s’accompagne d’un coût intellectuel indirect : l’analyste doit allouer des ressources cognitives pour décoder l’échelle des ordonnées, mentaliser la largeur des classes et garder à l’esprit que la continuité affichée peut être un artefact algorithmique du logiciel.
8.2 Principes de la Gestalt appliqués à la perception des groupements
Les théories de la Gestalt explicitent avec force les mécanismes par lesquels notre système visuel organise les stimuli graphiques en unités porteuses de sens. Deux lois gestaltistes régissent prioritairement la lecture de ces instruments : la loi de proximité et la loi de clôture/continuité.
Dans le graphique à points, la loi de proximité opère au premier degré : les points situés à proximité spatiale immédiate le long de l’axe des abscisses et empilés verticalement sont spontanément regroupés par notre cerveau en une entité unifiée, perçue comme un foyer de densité ou un mode. Cependant, en l’absence de contours rigides enserrant ces groupes, la perception reste ouverte et non contraignante : l’œil conserve la faculté de basculer instantanément de la vision macroscopique (la forme générale du nuage) à la vision microscopique (le point individuel situé à la périphérie).
Dans l’histogramme, c’est la loi de clôture et la loi de continuité qui dominent sans partage. Les contours rectilignes fermés de chaque barre créent une ségrégation spatiale tranchée : ce qui est à l’intérieur du rectangle est immédiatement perçu comme homogène et indissociable, tandis que ce qui est à l’extérieur en est exclu. Cette clôture géométrique artificielle instille un biais perceptif puissant : le cerveau de l’observateur projette une densité uniforme à l’intérieur de chaque classe (illusion de distribution homogène interne) et perçoit une barrière étanche au niveau des frontières de classe, là où la nature ne présente souvent qu’une transition statistique douce et continue.
8.3 Recommandations de Tufte : efficacité de l’encre et intégrité
Edward R. Tufte, pionnier de l’esthétique et de l’intégrité de la visualisation scientifique, a introduit dans son ouvrage classique The Visual Display of Quantitative Information le concept fondamental de ratio données-encre (data-ink ratio), défini comme la proportion d’encre utilisée pour afficher l’information quantitative réelle par rapport à l’encre totale mobilisée par la figure. Le précepte normatif de Tufte stipule qu’une visualisation scientifique rigoureuse doit maximiser ce ratio en éliminant impitoyablement tout ornement superflu, quadrillage redondant ou artéfact non informatif (désigné sous le terme de chartjunk).
Analysé à travers ce crible théorique, le graphique à points de distribution affiche un ratio données-encre d’une pureté exemplaire. Chaque marqueur imprimé sur le papier ou projeté sur l’écran code rigoureusement une unité empirique réelle. L’espace vide code l’absence de données. Il n’existe aucun remplissage de surface arbitraire, aucune frontière imaginaire. L’intégrité graphique y est totale car le facteur de distorsion (le rapport entre la variation apparente dans le graphique et la variation réelle dans les données) est rigoureusement égal à 1.
L’histogramme présente quant à lui un ratio données-encre plus contestable sur le plan tuftien, en particulier lorsqu’il est appliqué à des échantillons d’ampleur limitée. La surface encrée massive des grands rectangles consomme une quantité considérable d’encre pour transmettre une information qui se résume, en substance, à un simple chiffre scalaire (le compte d’effectif de la classe). Tufte a souvent fustigé l’utilisation de surfaces bidimensionnelles pour figurer des quantités unidimensionnelles élémentaires, mettant en garde contre le pouvoir déformateur des aplats de couleur qui accordent un poids perceptif démesuré aux classes centrales élargies au détriment des zones marginales clairsemées mais potentiellement décisives pour l’analyse scientifique.
9. Applications ciblées dans la recherche psychologique
9.1 Évaluation psychométrique et analyse d’items
L’ingénierie psychométrique, dévolue à la conception et à la validation d’outils de mesure psychologique, constitue un terrain d’élection où la distinction entre ces deux visualisations prend une dimension méthodologique fondamentale. Lors de la phase d’étalonnage et d’analyse des items d’une nouvelle échelle diagnostique (qu’il s’agisse de mesurer la symptomatologie dépressive, l’anxiété-trait ou un trait de personnalité du modèle Big Five), le psychomètre analyse les patterns de distribution des réponses fournies à chaque proposition isolée.
Le graphique à points se révèle ici d’une rentabilité clinique exceptionnelle. Appliqué aux scores d’un item gradué de 0 à 4, il met immédiatement en lumière d’éventuels effets d’acquiescement (les sujets qui cochent systématiquement l’option médiane ou la modalité la plus positive), des distributions asymétriques en J ou des taux de non-réponse. L’analyste visualise en un coup d’œil si un item spécifique présente un pouvoir discriminant suffisant ou si sa variance est entièrement annihilée par un regroupement exclusif sur les modalités extrêmes.
L’histogramme reprend ses droits légitimes dès lors que l’investigation s’élève de l’analyse d’item unitaire vers l’étude du score global composite issu de la sommation d’une batterie d’items (pouvant totaliser des scores continus s’étalant de 0 à 100). Lors de l’étalonnage normatif d’un test standardisé sur un échantillon représentatif de standardisation nationale comprenant des milliers de participants, l’histogramme normalisé constitue la pièce maîtresse permettant de superposer la courbe de référence en cloche de Gauss et de définir graphiquement les percentiles, les rangs tétrachoriques et les seuils de rupture clinique (cut-off points) servant au diagnostic en santé mentale.
9.2 Psychologie cognitive expérimentale et temps de réaction
En psychologie cognitive fondamentale, l’analyse chronométrique des processus mentaux via l’enregistrement des temps de réaction (TR) à des tâches informatisées de discrimination ou d’inhibition motrice (tâche de Stroop, tâche de Simon, paradigme de Posner) génère des jeux de données d’une nature mathématique très spécifique. Les temps de réaction sont des variables continues positives présentant structurellement une distribution ex-gaussienne (résultant de la convolution d’une composante normale représentant les processus moteurs sensoriels et d’une composante exponentielle incarnant les processus attentionnels et décisionnels décisionnels délibératifs).
Dans ce contexte, l’histogramme est l’instrument traditionnel mobilisé pour cartographier la silhouette de cette fonction ex-gaussienne au sein d’une cohorte expérimentale élargie. Grâce à un découpage fin (par exemple, par intervalles réguliers de 25 ou 50 millisecondes sur une étendue s’étalant de 200 à 1500 ms), il met majestueusement en scène la traîne asymétrique droite caractéristique des processus d’abandon attentionnel (attentional lapses).
Toutefois, lors de l’inspection diagnostique individuelle à l’intérieur d’un protocole intra-sujet (analysant par exemple les 40 essais d’un patient unique atteint d’un déficit fronto-pariétal), le graphique à points redevient souverain. Il permet au chercheur de repérer instantanément les réponses anticipées invalides (temps de réaction aberrants inférieurs à 150 ms, physiologiquement incompatibles avec le temps d’intégration rétinienne et de commande motrice corticale) ou les erreurs d’inattention isolées au-delà de 2000 ms. L’analyste peut ainsi valider visuellement ses critères stricts d’élagage des données (data trimming) avant d’engager le calcul de la moyenne épurée ou de la médiane individuelle.
9.3 Neurosciences comportementales et données physiologiques
Les protocoles contemporains en neurosciences comportementales mobilisent de manière croissante des mesures biologiques continues et hautement volatiles : concentrations salivaires de cortisol diurne, taux d’interleukines pro-inflammatoires, indices de variabilité de la fréquence cardiaque (HF-HRV) ou amplitudes des potentiels évoqués cognitifs (comme l’onde P300 en électroencéphalographie). En raison des contraintes logistiques, financières et éthiques inhérentes à ce type d’investigation, les effectifs expérimentaux sont fréquemment réduits à quelques unités par groupe (par exemple, 8 rongeurs par condition pharmacologique, ou 12 patients dans un groupe clinique de pathologie rare).
Au cours de la dernière décennie, les revues scientifiques d’excellence ont mené une croisade méthodologique contre l’utilisation abusive des diagrammes en barres dans ces contextes de neurosciences à petits effectifs. Des articles fondateurs, à l’image du manifeste de Tracey Weissgerber et ses collaborateurs (2015), ont démontré que les barres agrégeant moyenne et barre d’erreur dissimulent des distributions totalement disparates, masquant des distributions bimodales ou des outliers colossaux qui expliquent à eux seuls l’apparition d’un effet statistique faussement attribué à une manipulation moléculaire.
Dans ce cadre normatif renouvelé, le graphique à points (sous sa forme de strip plot ou de dot plot univarié annoté des quantiles) est devenu une exigence de publication incontournable. Il assure la reproductibilité des résultats en affichant publiquement le statut biologique réel de chaque sujet de l’échantillon. Un chercheur ne peut plus masquer un échec de manipulation sous une barre d’histogramme opaque ou un diagramme en barres : chaque animal, chaque prélèvement sérique est matérialisé par un point, permettant à la communauté scientifique d’évaluer visuellement et sans filtre la réalité de la dispersion physiologique.
10. Erreurs méthodologiques courantes et pièges d’interprétation
10.1 Le piège du bin width dans l’histogramme
Le piège méthodologique le plus redoutable et le plus universellement documenté de l’histogramme réside dans l’arbitraire sous-jacent à la fixation de la largeur de classe (bin width) et de l’origine d’implantation de la grille. Par une sélection intentionnelle ou un réglage logiciel aveugle, un analyste peut littéralement manipuler à dessein l’apparence formelle d’une distribution sans jamais altérer une seule ligne du jeu de données brut.
En sur-élargissant les classes, on génère un phénomène délétère de sur-lissage. Deux concentrations bimodales nettes peuvent se fondre sous une barre unique commune, éradiquant un creux pourtant fondamental pour la théorisation du phénomène. Ce lissage artificiel peut donner une illusion trompeuse de normalité à une distribution qui s’avère en réalité profondément hétérogène et fragmentée. Ce processus anesthésie l’esprit critique du lecteur, qui acceptera sans réserve les hypothèses d’un modèle paramétrique appliqué à tort.
À l’extrême opposé, un sous-dimensionnement radical des intervalles provoque une hyper-fragmentation. L’histogramme se décompose en un peigne hérissé d’intervalles vides et de barres de hauteur unitaire, reflétant le bruit stochastique résiduel d’échantillonnage plutôt que la forme de la population sous-jacente. Pour se prémunir contre ces artefacts visuels, le chercheur rigoureux ne doit jamais se fier à un affichage unique : il est impératif d’évaluer la distribution sous au moins trois ou quatre largeurs de classes divergentes (ou d’expérimenter une translation de l’origine des intervalles) pour s’assurer que les conclusions tirées sur la structure de la distribution ne sont pas des illusions d’optique nées d’une contingence algorithmique.
10.2 Confusion pernicieuse entre bar chart et histogramme
L’une des confusions taxonomiques et conceptuelles les plus tenaces dans l’enseignement universitaire de la statistique concerne l’assimilation erronée du diagramme en barres (bar chart) à un histogramme. Bien que ces deux représentations partagent l’usage géométrique de rectangles, leurs fondements mathématiques respectifs sont aux antipodes l’un de l’autre.
Le diagramme en barres est exclusivement destiné aux variables qualitatives, nominales ou catégorielles. L’axe horizontal ne comporte aucune métrique spatiale continue : il répertorie une suite de modalités textuelles discrètes (par exemple : les départements géographiques, les orientations professionnelles ou les types de traitement). L’ordre des catégories le long de l’axe est fréquemment interchangeable sans altérer le sens de la figure, et les barres doivent impérativement être séparées par des espaces vides interstitiels pour marquer cette discontinuité catégorielle.
L’histogramme, quant à lui, est assujetti à un axe quantitatif continu rigide. L’ordre des valeurs ne peut sous aucun prétexte être transposé ou réarrangé : la valeur 12 doit obligatoirement succéder à 11 et précéder 13. Les rectangles se touchent pour traduire la nature physique ou conceptuelle du continuum sous-jacent. Insérer des espaces blancs entre les colonnes d’un histogramme ou tracer un histogramme sur des catégories de variables nominales constitue un non-sens sémiologique qui dégrade instantanément la crédibilité scientifique du document de recherche.
10.3 Mauvaise utilisation du graphique à points sur données massives
Si l’histogramme possède ses zones de fragilité sur les petits effectifs, le graphique à points présente des risques méthodologiques tout aussi critiques dès lors qu’il est appliqué inconsidérément à des cohortes de grand volume. La manifestation la plus spectaculaire de cette mauvaise utilisation est ce que les sémioticiens du graphique désignent sous le nom d’effet rideau ou de mur opaque.
Lorsqu’un chercheur projette plusieurs milliers de points sur une échelle d’abscisses restreinte sans recourir à des ajustements de transparence (alpha-blending) ou à une réduction drastique de la taille des glyphes, les marqueurs fusionnent visuellement en un aplat monochrome dense. À partir d’un certain seuil d’empilement ou de recouvrement horizontal, l’œil humain devient incapable de distinguer si une région du graphique contient 50 observations superposées ou 5 000. L’intérêt métrologique fondamental du graphique à points — préserver la précision de la fréquence et l’identité des cas individuels — est alors totalement anéanti.
De surcroît, cette inflation graphique induit des contraintes computationnelles disproportionnées. L’inclusion d’un dot plot vectoriel intégrant 50 000 points individuels dans un manuscrit génère des fichiers PDF d’une lourdeur extrême, ralentit considérablement les moteurs de rendu graphique et peut poser des problèmes sévères d’impression papier lors du processus éditorial. Dans ce domaine volumétrique, refuser l’abstraction statistique de l’histogramme relève d’un contresens méthodologique majeur.
11. Solutions hybrides, extensions modernes et outillage informatique
11.1 Alternatives contemporaines : du Raincloud plot au Violin plot
Face aux limites inhérentes à l’usage exclusif de l’un ou l’autre de ces deux paradigmes traditionnels, la communauté de la science ouverte (Open Science) a développé des visualisations hybrides sophistiquées, conçues pour combiner harmonieusement les vertus de granularité du dot plot et la puissance de synthèse morphologique des représentations continues.
L’innovation la plus emblématique de ces dernières années est incontestablement le Raincloud plot (graphique en nuage de pluie), théorisé et popularisé par Micah Allen et ses collègues (2019). Cette architecture intègre simultanément trois couches graphiques superposées :
- Un demi-violin plot supérieur (analogue à un histogramme lissé via un estimateur de densité par noyau, le KDE), qui déploie la silhouette continue globale de la population (le « nuage »).
- Une boîte à moustaches médiane (box plot de Tukey) ultra-compacte, explicitant les paramètres de position et de dispersion non paramétriques (médiane, quartiles, étendue interquartile).
- Un strip plot ou dot plot jitterisé inférieur, matérialisant chaque observation individuelle par un point projeté sous la distribution (les « gouttes de pluie »).
Le Raincloud plot résout magistralement le dilemme épistémologique historique : le lecteur a accès d’un seul coup d’œil à la masse générale de la distribution, aux indices statistiques normés et à l’intégralité du corpus de données brutes sans aucune dissimulation.
Une autre alternative contemporaine très répandue est le violin plot (graphique en violon), introduit par Hintze et Nelson en 1998. Il consiste en une boîte à moustaches conventionnelle enrobée de part et d’autre d’une courbe de densité miroir bilatérale. Bien que visuellement attrayant pour comparer de multiples cohortes côte à côte, le violin plot partage les fragilités de l’histogramme : sur de très petits effectifs ($N < 20$), la fonction d’estimation par noyau extrapole artificiellement une continuité trompeuse là où il n’existe que quelques observations éparses. Son utilisation doit donc impérativement être réservée à des effectifs suffisants ou complétée systématiquement par l’affichage des points réels en surimpression.
11.2 Implémentation sous les principaux logiciels de psychologie
La mise en œuvre pratique de ces concepts visuels dépend intimement des logiciels d’analyse statistique mobilisés par les équipes de recherche. Dans l’écosystème open-source R, l’incontournable bibliothèque graphique ggplot2 (conçue par Hadley Wickham sur les préceptes de Wilkinson) offre deux fonctions fondamentales dédiées :
geom_dotplot()permet d’implémenter l’algorithme d’empilement univarié avec réglage strict de la tolérance locale (paramètresbinwidth,dotsizeetstackdir).geom_histogram()gère l’agrégation continue classique, autorisant un contrôle micrométrique de la discrétisation via le nombre de divisions (bins) ou la largeur absolue (binwidth).
Dans l’univers Python, les bibliothèques scientifiques Matplotlib et Seaborn fournissent des équivalents hautement standardisés : la fonction seaborn.stripplot() génère des graphiques à points enrichis d’un jittering hautement paramétrable, tandis que seaborn.histplot() permet de générer des histogrammes rigoureux avec calcul automatisé des largeurs de classes optimales (méthodes de Scott, Freedman-Diaconis ou Sturges configurables en argument) et possibilité d’ajouter la courbe KDE en surimpression.
Pour les chercheurs privilégiant des interfaces utilisateur graphiques sans programmation, les logiciels contemporains dédiés aux sciences comportementales tels que JASP et Jamovi (fondés sur R) ont nativement intégré ces impératifs de transparence : ils permettent de cocher en un clic l’affichage simultané des points réels sous les densités ou les histogrammes. Le logiciel propriétaire conventionnel SPSS offre également ces options au sein de son générateur de graphiques, bien que ses rendus par défaut requièrent souvent une reconfiguration éditoriale minutieuse pour satisfaire aux critères de haute résolution vectorielle (fichiers TIFF à 300 DPI ou SVG vectoriels) imposés par les revues internationales de l’American Psychological Association (APA).
11.3 Interactivité et inspection dynamique des distributions
L’essor fulgurant des technologies web intégrées à la recherche (notamment via les packages Plotly, Bokeh, ou les environnements computationnels reproductibles sous forme de notebooks Jupyter et de documents Quarto) a ouvert une dimension d’exploration interactive jusque-là inaccessible aux supports papier statiques.
L’inspection dynamique permet désormais à l’investigateur de manipuler un curseur interactif faisant varier en temps réel la largeur de classe d’un histogramme. Cette exploration fluide permet d’éprouver immédiatement la robustesse d’un creux distributionnel à travers une gamme continue d’intervalles de discrétisation, désamorçant le piège du bin width subjectif. Si un mode persiste invariablement à travers toutes les variations d’amplitudes de classes, le chercheur acquiert une certitude quasi mathématique quant à sa réalité structurelle.
Parallèlement, l’interaction dynamique appliquée au graphique à points autorise le survol sélectif (hovering) : en positionnant le curseur de sa souris sur un point isolé ou une observation aberrante, l’analyste peut faire surgir une info-bulle contextuelle révélant l’ensemble des métadonnées du sujet correspondant (identifiant du participant, âge, sexe, score de dépression associé, date de passation). Cette imbrication de l’exploration quantitative microscopique et du contexte qualitatif enrichit considérablement la démarche herméneutique de l’investigateur, abolissant la frontière traditionnelle entre la donnée anonymisée agrégée et l’individu singulier.
12. Matrice de décision méthodique et synthèse pour le chercheur
12.1 Arbre décisionnel pour le choix du format graphique
Afin de guider rationnellement le praticien dans la sélection du format graphique optimal pour son protocole d’analyse ou son manuscrit scientifique, la démarche peut être formalisée à travers une séquence rigoureuse d’arbitrages conditionnels :
- Étape 1 : Analyse de l’échelle de mesure sous-jacente
- La variable est-elle qualitative, catégorielle ou ordinale pure ? 👉 Exclusion absolue de l’histogramme. Privilégiez un diagramme en barres séparées pour les catégories, ou un graphique à points pour les échelles de Likert à support discret.
- La variable est-elle quantitative continue ou pseudo-continue ? 👉 Passez à l’étape 2.
- Étape 2 : Quantification du volume de l’échantillon ($N$)
- $N < 30$ 👉 Graphique à points impératif (Wilkinson dot plot ou strip plot annoté de la médiane et de l’IQR). Rejetez l’histogramme dont les barres génèrent une illusion d’échantillonnage continu.
- $30 le N le 100$ 👉 Approche hybride fortement recommandée (Raincloud plot ou strip plot jitterisé associé à un boxplot). L’histogramme est envisageable à titre exploratoire mais nécessite une justification formelle du choix des classes.
- $N > 1000$ 👉 Histogramme normalisé ou densité KDE impératif. Le graphique à points élémentaire doit être écarté en raison de la saturation spatiale (effet rideau).
- Étape 3 : Définition de l’objectif communicationnel
- L’objectif est l’audit méthodologique interne, la détection des valeurs aberrantes ou le nettoyage des données brutes ? 👉 Privilégiez le graphique à points pour conserver un accès unitaire à chaque observation.
- L’objectif est l’illustration synthétique d’une population générale dans un support de vulgarisation ou un résumé de politiques publiques ? 👉 Privilégiez l’histogramme pour alléger la charge cognitive extrinsèque du lecteur.
- Étape 4 : Suspicion d’anomalies structurelles ou de sous-populations
- Si une bimodalité ou la présence d’outliers isolés est suspectée, confrontez systématiquement l’histogramme à un graphique à points ou testez la variabilité dynamique de la largeur des classes avant d’arrêter une conclusion formelle.
12.2 Tableau récapitulatif des compromis analytiques
Le tableau analytique suivant synthétise de manière comparative l’ensemble des dimensions méthodologiques, statistiques et perceptives caractérisant les deux familles d’instruments :
| Dimension d’évaluation | Graphique à points (Dot Plot) | Histogramme (Histogram) |
|---|---|---|
| Échelle de mesure privilégiée | Variables discrètes, ordinales, échelles de Likert et petits continua | Variables strictement continues et mesures physiques réelles |
| Granularité de l’information | Absolue : préservation intégrale de la coordonnée de chaque donnée | Réduite : discrétisation par agrégation et perte des coordonnées individuelles |
| Sensibilité aux effectifs réduits ($N < 30$) | Excellente : honnêteté descriptive totale sans artefact | Médiocre : instabilité structurelle majeure des barres |
| Comportement sur grands échantillons ($N > 1000$) | Saturation visuelle sévère (sur-encrage, effet rideau opaque) | Performance optimale : convergence visuelle vers la densité théorique |
| Diagnostic des valeurs aberrantes | Immédiat et sans équivoque (points isolés dans l’espace vierge) | Mitigé : risque d’absorption dans une classe ou déformation d’échelle |
| Sensibilité aux choix de paramétrage | Nulle à très faible (position fixée par l’abscisse de la donnée) | Critique : dépendance aiguë à la largeur de classe et au point d’ancrage |
| Charge cognitive pour l’observateur | Variable : très faible sur petit $N$, très élevée sur grand corpus | Faible et constante : pré-digestion des données en un nombre fini de barres |
| Conformité aux exigences Open Science actuelles | Exemplaire : transparence intégrale sur la structure de l’échantillon | Partielle : lissage abstractionniste pouvant masquer des hétérogénéités |
12.3 Recommandations finales pour la pratique de recherche
Au terme de cette analyse comparée, une vérité méthodologique s’impose avec évidence : la supériorité absolue d’une méthode graphique sur l’autre n’existe pas in abstracto. L’histogramme et le graphique à points incarnent deux philosophies complémentaires du traitement de l’information empirique. L’excellence de la pratique de recherche réside dans l’adéquation méthodique du véhicule visuel aux propriétés numériques réelles du corpus analysé.
Nous recommandons instamment aux chercheurs et analystes de rompre définitivement avec les automatismes logiciels consistant à générer aveuglément les graphiques par défaut proposés par les progiciels statistiques. Pour l’immense majorité des travaux conduits en psychologie, en neurosciences cognitives et en sciences de l’éducation sur des cohortes expérimentales réduites ou modérées ($N le 60$), le graphique à points — ou ses déclinaisons hybrides contemporaines que sont les Raincloud plots — doit impérativement devenir le premier réflexe méthodologique, garantissant une exposition probe et vérifiable de la réalité empirique.
Lorsque la taille colossale des cohortes impose le recours à l’histogramme, ce dernier ne doit plus être présenté comme une entité absolue et immuable, mais comme une modélisation statistique contingente. Le chercheur méticuleux doit systématiquement consigner dans la légende de ses figures ou dans sa section méthodologique la justification algorithmique ayant présidé au calibrage de ses classes (Scott, Freedman-Diaconis ou Sturges), attestant qu’aucun artefact n’a été insidieusement introduit pour façonner artificiellement la morphologie de la distribution.
Enfin, conformément aux principes directeurs FAIR (Facile à trouver, Accessible, Interopérable et Réutilisable) qui régissent la recherche scientifique contemporaine, le choix de la visualisation graphique ne saurait exonérer l’auteur de son devoir de partage des données sources. En publiant les matrices numériques ouvertes (open data) aux côtés des manuscrits évalués par les pairs, la communauté scientifique permet à chacun de re-projeter les distributions, de tester des découpages alternatifs et de perpétuer l’idéal de réfutabilité et d’intégrité qui fonde l’entreprise scientifique moderne.
Références
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cleveland, W. S. (1984). Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging. The American Statistician, 38(4), 270–280. https://doi.org/10.1080/00031305.1984.10483204
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181–184. https://doi.org/10.1080/00031305.1998.10480559
- Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Sweller, J. (2011). Cognitive load theory. Dans J. P. Mestre & B. H. Ross (Éds.), The psychology of learning and motivation: Cognition in education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387691-1.00002-8
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128
- Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276–283. https://doi.org/10.1080/00031305.1999.10474474
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer. https://doi.org/10.1007/0-387-28695-0