
Dans l’écosystème contemporain de l’ingénierie des données et de la modélisation décisionnelle, Google Sheets s’est imposé comme un vecteur de calcul infonuagique omniprésent, conjuguant flexibilité collaborative et puissance algorithmique distribuée. Au cœur de toute manipulation matricielle réside une opération fondamentale mais souvent sous-estimée : la vérification de l’appartenance d’un scalaire élémentaire à un ensemble délimité de coordonnées tabulaires. Cette problématique, en apparence triviale pour l’opérateur néophyte, soulève en réalité des enjeux théoriques et pratiques substantiels touchant à la théorie des ensembles, à l’algèbre relationnelle et à l’optimisation des temps d’exécution au sein d’environnements virtualisés à ressources contraintes.
Déterminer avec une certitude mathématique absolue si un identifiant alphanumérique, une grandeur monétaire ou une estampille temporelle préexiste dans une plage de référence constitue la pierre angulaire de l’intégrité référentielle au sein des tableurs. Qu’il s’agisse de rapprocher des registres comptables hétérogènes, de dédoubler des catalogues de références commerciales ou d’automatiser des pipelines d’ingestion de données brutes, l’analyste se trouve confronté à une multiplicité de paradigmes fonctionnels. L’éventail des solutions offertes par le moteur d’évaluation de Google Sheets oscille entre des fonctions de recherche par correspondance exacte, des opérateurs de dénombrement statistique conditionnel, des mécanismes d’interception d’exceptions d’exécution et des structures vectorielles avancées de type tableau dynamique.
Le présent traité propose une analyse exhaustive et rigoureuse des méthodologies consacrées à la vérification d’appartenance au sein de Google Sheets. À travers une déconstruction systématique des arbres d’évaluation syntaxique, une analyse comparative de la complexité algorithmique temporelle et spatiale, ainsi qu’une exploration des singularités computationnelles telles que la sensibilité à la casse, le polymorphisme des types de données et le comportement en présence de valeurs nulles, cette étude fournit aux architectes de données et aux analystes avancés les fondements conceptuels et les implémentations pratiques nécessaires à l’élaboration de modèles de calcul robustes, pérennes et hautement performants.
1. Cadre conceptuel et fondements de la vérification d’appartenance dans Google Sheets
1.1 Définition de l’appartenance d’une valeur à une plage matricielle
L’appartenance d’une valeur à une plage matricielle au sein de l’environnement Google Sheets relève formellement de la théorie naïve des ensembles appliquée aux structures de données tabulaires bidimensionnelles. Dans ce cadre, une plage de cellules définie par des coordonnées cartésiennes, telle que A1:B50, ne constitue pas simplement un arrangement spatial d’éléments graphiques, mais une matrice ordonnée de scalaires typés. Chaque cellule héberge une valeur appartenant à un domaine de définition restreint, principalement articulé autour des types fondamentaux que sont les réels à virgule flottante double précision conformes au standard IEEE 754, les chaînes de caractères encodées en UTF-8, les booléens purs issus de l’algèbre de Boole binaire, ainsi que des types dérivés ou composites tels que les dates et heures, lesquelles sont en réalité stockées sous forme de numéros de série séquentiels décimaux rapportés à une date époque conventionnelle.
Du point de vue de l’inclusion mathématique, vérifier si une valeur scalaire x appartient à un ensemble matriciel M revient à évaluer la proposition logique d’existence :
∃ i ∈ [1, n], ∃ j ∈ [1, m] tel que M(i, j) = x
Cette formulation implique immédiatement l’étude de la cardinalité de l’ensemble sous-jacent. Si la cardinalité de l’intersection entre le singleton {x} et l’ensemble des éléments de M est strictement supérieure ou égale à un, l’appartenance est validée au sens logique. Cependant, dans la pratique de l’ingénierie des données, il convient de distinguer avec une extrême rigueur épistémologique trois concepts fréquemment confondus par les praticiens : l’existence pure, la position relative et la fréquence d’occurrence. L’existence se réduit à un prédicat binaire (vrai ou faux). La position relative introduit la notion d’ordre lexicographique ou séquentiel au sein du vecteur ou de la matrice, identifiant les coordonnées d’indice (i, j) de la première occurrence rencontrée selon le parcours algorithmique standard. Enfin, la fréquence d’occurrence quantifie le nombre total d’instanciations de l’élément recherché au sein de l’espace d’échantillonnage matriciel, transformant le problème logique binaire en une métrique de cardinalité discrète.
Cette distinction s’avère déterminante lorsque le modèle de données fait face à des structures hétérogènes où cohabitent des valeurs vides, des chaînes de caractères de longueur nulle (souvent issues de formules conditionnelles antérieures renvoyant des guillemets vides) et des états d’erreur de typage. L’égalité structurelle stricte dépend intrinsèquement des mécanismes de coercition de type implémentés dans le moteur d’exécution JavaScript sous-jacent à Google Sheets, lequel peut, dans certains contextes, assimiler le nombre zéro au booléen faux ou interpréter une chaîne numérique comme un entier arithmétique, modifiant ainsi l’espace d’appartenance théorique.
1.2 Implications de la validation des données sur la modélisation informationnelle
L’acte d’interroger la présence d’une valeur dans une plage de référence ne se limite pas à un simple calcul ad hoc ; il engage directement l’intégrité référentielle de l’architecture informationnelle globale du classeur. Dans les systèmes de gestion de bases de données relationnelles traditionnels (SGBDR), l’intégrité référentielle est garantie au niveau du schéma par des contraintes de clés étrangères explicites, interdisant formellement l’insertion d’un enregistrement enfant dont l’identifiant n’existerait pas dans la table parente. À l’inverse, dans un tableur collaboratif flexible comme Google Sheets, la grille bidimensionnelle offre une liberté structurelle totale qui, en l’absence de mécanismes de vérification rigoureux, conduit inexorablement à une entropie informationnelle élevée et à la corruption silencieuse des jeux de données.
La mise en place de tests d’appartenance robustes permet de circonscrire cette dérive en instaurant des barrières de contrôle automatisées à l’entrée des pipelines analytiques. Lors de la saisie manuelle ou de l’ingestion asynchrone d’informations via des connecteurs d’interfaces de programmation d’applications (Google Sheets API) ou des formulaires externes, la vérification d’existence préalable constitue une étape indispensable de validation croisée. Elle réduit substantiellement le taux d’erreur cognitive imputable aux opérateurs humains, en signalant immédiatement les discordances de nomenclature, les fautes de frappe typographiques, les tronquages d’identifiants uniques ou les anomalies de formatage de données critiques telles que les codes d’identification bancaire internationale (IBAN), les numéros de sécurité sociale ou les identifiants d’inventaire (SKU).
En outre, l’automatisation du contrôle de cohérence au moyen de formules d’appartenance conditionnelle participe à la fiabilisation des modèles financiers et prédictifs en éliminant les faux positifs en amont des chaînes de consolidation. Un modèle informationnel pérenne exige que chaque flux entrant soit soumis à une séquence d’assertions logiques évaluant son appartenance à des tables de correspondances dimensionnelles d’autorité. Cette formalisation méthodologique assure une idempotence des calculs subséquents : quelle que soit l’instabilité de l’environnement opérationnel ou la fréquence de mise à jour des données brutes, le modèle conserve une trajectoire d’évaluation déterministe, exempte de ruptures de chaînage induites par des clés orphelines.
2. La méthode canonique : combinaison des fonctions EQUIV, ESTERREUR et SI
2.1 Mécanisme interne de la fonction EQUIV (MATCH)
La fonction EQUIV (dénommée MATCH dans la nomenclature anglo-saxonne standardisée) constitue l’opérateur canonique par excellence dédié à la recherche séquentielle et indiciaire au sein des environnements de feuilles de calcul. Sa signature formelle s’articule autour de trois arguments distincts : la valeur recherchée (qui peut être un littéral scalaire ou une référence directe de cellule), la plage de recherche (définie impérativement comme un vecteur unidimensionnel, qu’il soit vertical ou horizontal), et le type de correspondance, formalisé sous la forme d’un indicateur numérique borné à l’ensemble {-1, 0, 1}.
D’un point de vue algorithmique, l’argument de type de correspondance gouverne l’heuristique de recherche déployée par le moteur de Google Sheets. Lorsque le type est fixé à zéro (0), la fonction instancie une procédure de correspondance exacte stricte. Dans ce mode d’exécution, le moteur parcourt séquentiellement les éléments du vecteur cible à partir de la première cellule de coordonnées jusqu’à identifier une valeur dont l’égalité s’avère vérifiée. Dès que cette première correspondance est isolée, l’algorithme interrompt son exploration et retourne immédiatement la position ordinale relative de l’élément au sein du vecteur considéré, sous la forme d’un entier strictement positif supérieur ou égal à l’unité. Il est capital de souligner que cette valeur de retour ne reflète pas le numéro absolu de la ligne ou de la colonne de la grille de calcul, mais l’indice intrinsèque de la cellule au sein de la plage vectorielle déclarée.
Lorsque la valeur cible s’avère totalement absente de la plage de référence, la fonction EQUIV ne renvoie pas une valeur scalaire nulle ou négative, mais interrompt brutalement son flux d’évaluation standard pour propager une erreur structurelle d’indisponibilité, typée sous la dénomination normalisée #N/A (signifiant Not Available ou Non Disponible). Cette émission d’erreur n’est pas un accident de programmation, mais un comportement déterministe formalisé : l’absence d’évaluation possible dans le domaine des nombres entiers force le moteur à notifier l’interruption de la chaîne de calcul par un état d’exception.
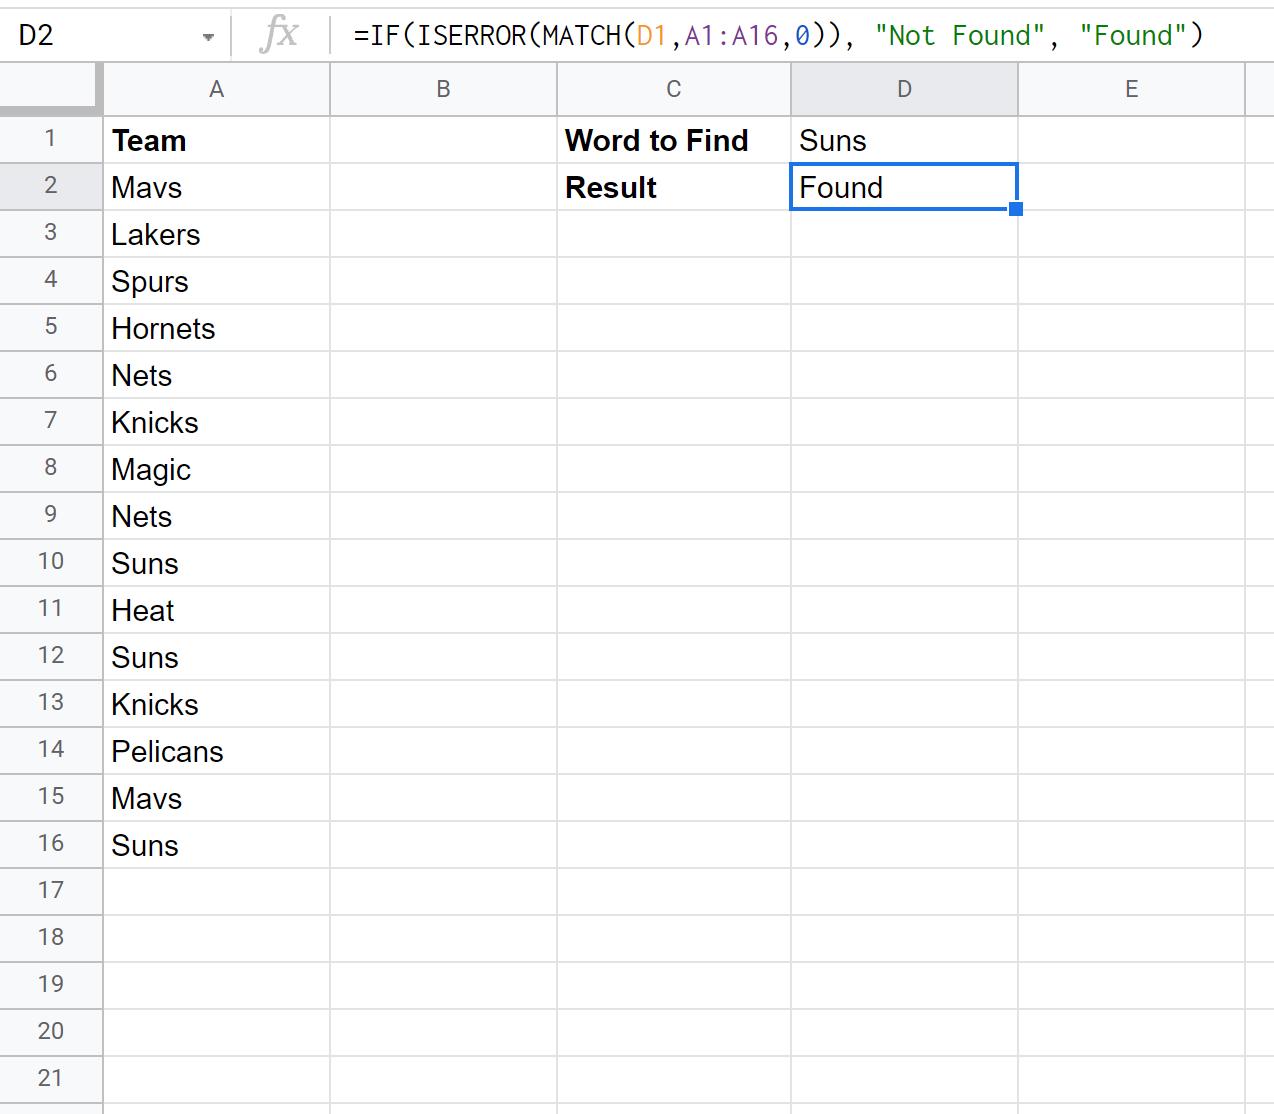
2.2 Interception de l’erreur via ESTERREUR (ISERROR) et ESTNA (ISNA)
La gestion élégante et fonctionnelle de l’exception #N/A requiert son encapsulation au sein d’une fonction de prédicat booléen capable d’intercepter l’anomalie sans provoquer la suspension de la chaîne de calcul globale de la feuille. Deux opérateurs distincts sont traditionnellement mobilisés à cet effet dans la syntaxe de Google Sheets : la fonction ESTERREUR (correspondant à ISERROR) et la fonction plus spécifique ESTNA (correspondant à ISNA). La distinction entre ces deux fonctions n’est point sémantiquement neutre, car elle affecte directement la résilience structurelle de la formule face à des dysfonctionnements inattendus.
La fonction ESTERREUR adopte un champ de capture maximaliste : elle évalue à la valeur booléenne VRAI n’importe quelle catégorie d’erreur émise par le processeur de formule, incluant indistinctement #N/A, #VALEUR!, #REF!, #DIV/0!, #NUM!, #NOM? et #NUL!. Bien que commode en première approche, l’utilisation de ESTERREUR présente un risque d’occultation diagnostique majeur. Si, par exemple, la plage de recherche référencée dans la fonction EQUIV pointe vers un onglet supprimé (générant une erreur #REF!) ou si le nom de la fonction comporte une coquille typographique (induisant une erreur #NOM?), la fonction ESTERREUR convertira aveuglément cette anomalie d’infrastructure en une fausse affirmation d’inexistence de la valeur.
À l’opposé, la fonction ESTNA se focalise exclusivement sur l’état d’absence de données #N/A. Si la fonction EQUIV échoue à trouver la valeur cible au terme d’une recherche syntaxiquement irréprochable au sein d’une plage valide, ESTNA intercepte l’erreur #N/A et renvoie VRAI. En revanche, si une erreur de référence spatiale ou de typage matriciel survient, ESTNA laissera propager l’erreur critique correspondante à travers l’arbre d’évaluation, permettant à l’analyste d’identifier immédiatement la défaillance structurelle sous-jacente du classeur. Par conséquent, dans une perspective d’ingénierie logicielle rigoureuse, la combinaison NON(ESTNA(EQUIV(...))) s’avère intrinsèquement supérieure à l’utilisation indifférenciée de ESTERREUR.
2.3 Encapsulation finale avec la fonction logique SI (IF)
L’étape de synthèse de cette approche canonique consiste à insérer le prédicat d’interception d’erreur au sein de la structure de contrôle conditionnelle élémentaire offerte par la fonction SI (correspondant à IF). La formulation intégrale prend alors la forme classique suivante :
=SI(ESTNA(EQUIV("ValeurCible", A1:A100, 0)), "Absent", "Présent")
Ou, de manière alternative en inversant la polarité logique par l’emploi de la négation ou la permutation des branches d’évaluation :
=SI(NON(ESTNA(EQUIV("ValeurCible", A1:A100, 0))), "Présent", "Absent")
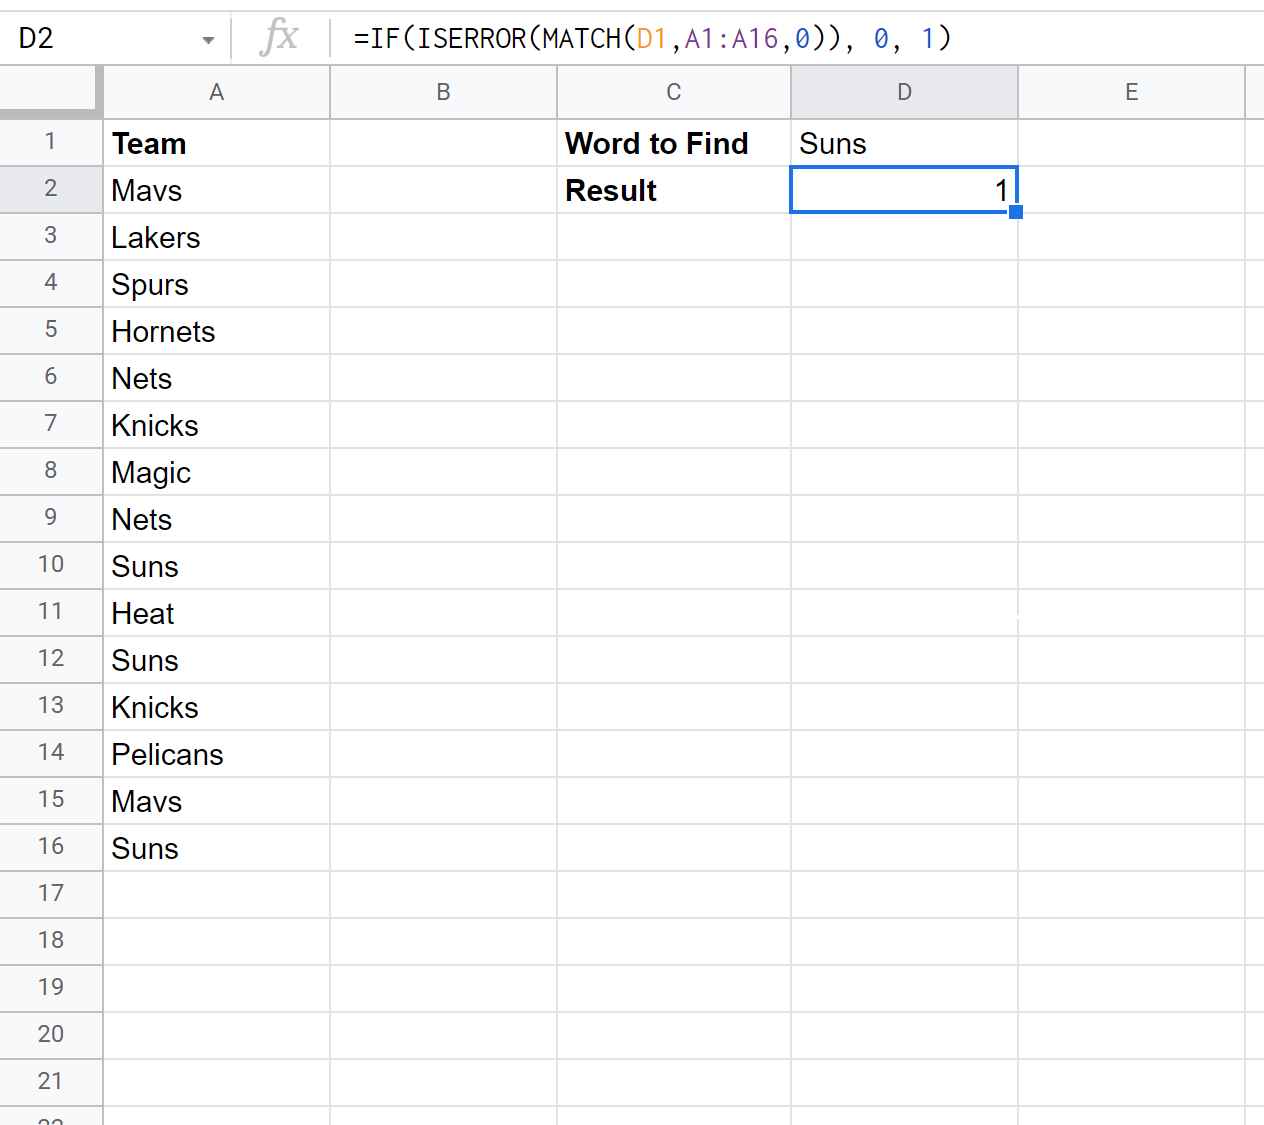
Dans les contextes d’intégration algorithmique où le résultat de cette vérification est destiné à alimenter des calculs arithmétiques ultérieurs, des agrégations matricielles ou des pondérations de score, il est fortement recommandé de proscrire les littéraux textuels arbitraires au profit d’une sortie booléenne pure ou d’un encodage binaire discret sous la forme de l’entier 1 pour la présence et de l’entier 0 pour l’absence. L’évaluation booléenne directe s’obtient avec une concision remarquable en se passant totalement de l’appel à la fonction SI :
=NON(ESTNA(EQUIV("ValeurCible", A1:A100, 0)))
Cette expression renvoie intrinsèquement VRAI ou FAUX, deux entités logiques que le moteur de Google Sheets peut spontanément coercer en entiers d’Arithmétique de Boole (1 et 0) dès lors qu’elles sont soumises à un opérateur unaire double négatif ou à une addition élémentaire :
=--NON(ESTNA(EQUIV("ValeurCible", A1:A100, 0)))
Le traitement des cas limites requiert une vigilance accrue. Dans l’éventualité où la cellule contenant la valeur cible recherchée est strictement vide, la fonction EQUIV peut générer un comportement indéterminé ou tenter de faire correspondre un zéro numérique ou une chaîne vide préexistante dans la plage de référence. Il convient donc de prémunir l’architecture contre ce biais en adjoignant un test de vacuité préliminaire :
=SI(ESTVIDE(B1), "Cellule cible vide", SI(NON(ESTNA(EQUIV(B1, A1:A100, 0))), "Présent", "Absent"))
3. La méthode quantitative : exploitation de la fonction NB.SI (COUNTIF)
3.1 Principe de dénombrement conditionnel appliqué à l’existence
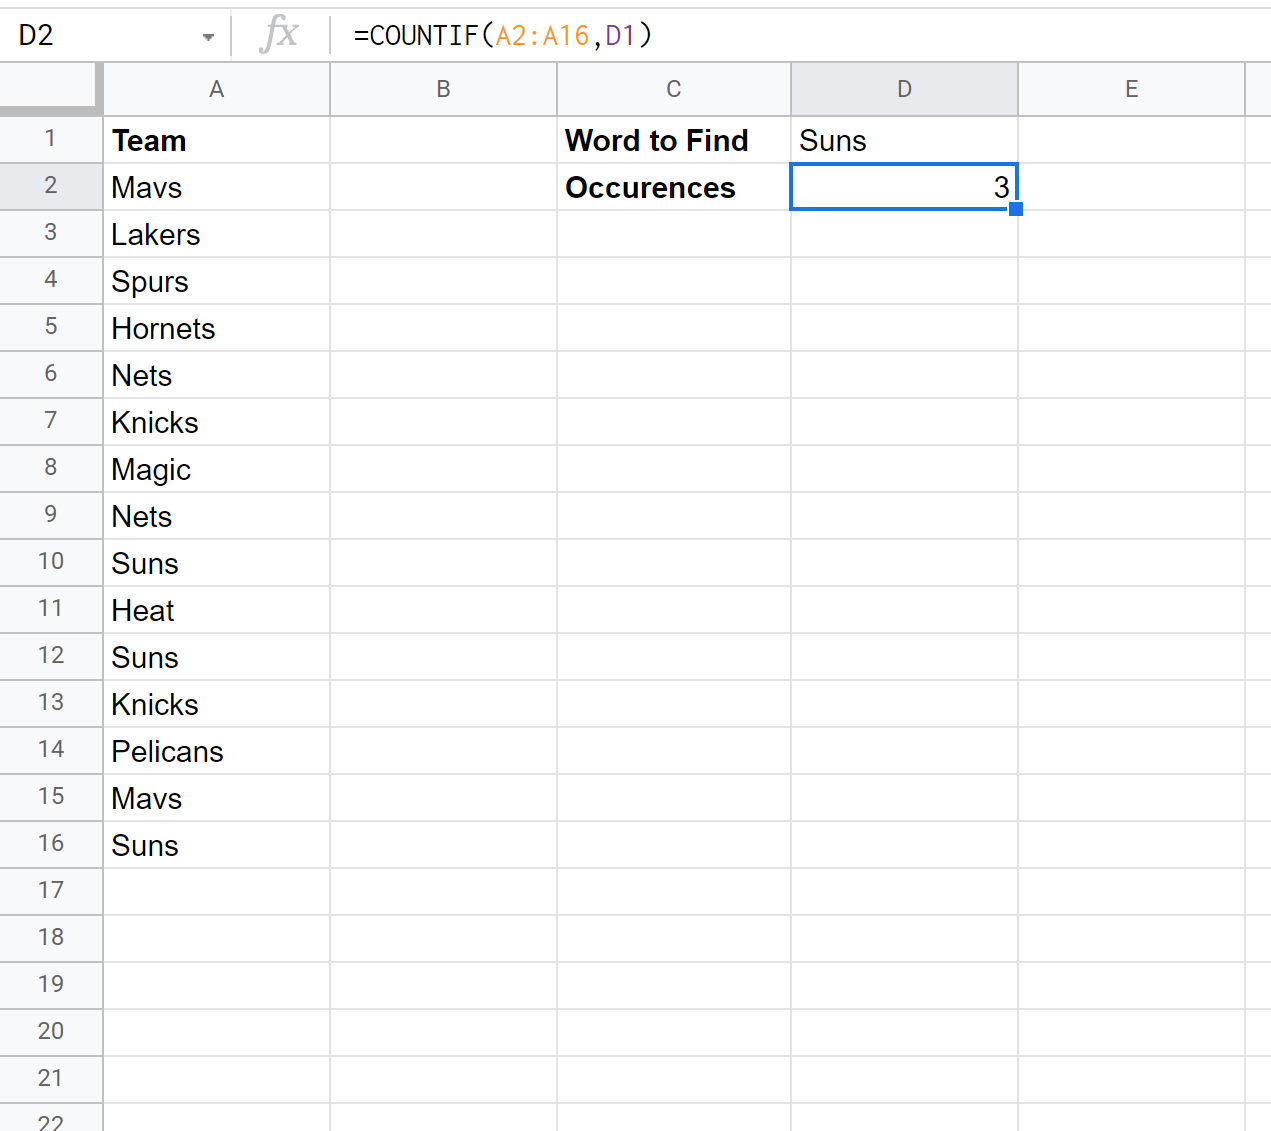
Tandis que la méthode canonique articulée autour de EQUIV procède d’une logique d’indexation positionnelle court-circuitée, l’approche quantitative repose sur la mobilisation de la fonction NB.SI (dénommée COUNTIF dans l’environnement international). Cette fonction statistique élémentaire est spécifiquement conçue pour parcourir une plage déterminée et quantifier le volume précis d’enregistrements satisfaisant à un critère logique ou textuel explicitement défini. Sa syntaxe standardisée mobilise deux paramètres obligatoires : la plage d’investigation (qui, à la différence de EQUIV, peut être bidimensionnelle et englober plusieurs lignes et colonnes simultanément, telle que A1:D100) et le critère de comparaison.
L’application de NB.SI à la problématique de la simple vérification d’existence repose sur une translation conceptuelle directe : si le cardinal du sous-ensemble des éléments correspondant au critère est supérieur ou égal à un, alors la preuve formelle de l’existence de ladite valeur est irréfutablement apportée. L’immense avantage syntaxique de cette méthode réside dans sa robustesse native face aux anomalies d’absence. Contrairement à EQUIV ou aux fonctions de recherche matricielle qui interrompent leur calcul en émettant une erreur d’arrêt #N/A dès lors qu’un scalaire n’est pas localisé, NB.SI conserve une intégrité d’évaluation absolue en retournant simplement la valeur scalaire entière zéro (0).
Cette particularité structurelle élimine d’emblée la nécessité de recourir à des fonctions d’encapsulation d’interception d’erreur telles que ESTERREUR, ESTNA ou SIERREUR. Le code de la formule gagne ainsi en compacité, en lisibilité pour les collaborateurs tiers et en élégance procédurale, en réduisant la profondeur de l’arbre syntaxique abstrait généré lors de la phase de compilation interne de l’interpréteur de Google Sheets.
3.2 Structuration logique par comparaison arithmétique
La structuration de la vérification au moyen de NB.SI s’opère par l’adjonction d’un opérateur de comparaison arithmétique strict vis-à-vis du seuil de nullité. La formulation conventionnelle encapsulée dans une structure décisionnelle prend l’aspect suivant :
=SI(NB.SI(A1:A100, "ValeurRecherchée") > 0, "Présent", "Absent")
Toutefois, à l’instar de la méthode indiciaire, il est mathématiquement plus direct et computationnellement plus pur d’extraire directement la proposition booléenne sans transiter par l’arborescence dichotomique de la fonction SI. L’expression :
=(NB.SI(A1:A100, "ValeurRecherchée") > 0)
génère de manière autonome la valeur de vérité fondamentale VRAI ou FAUX. Cette construction booléenne brute optimise le stockage mémoire temporaire du moteur de calcul et facilite les chaînages conditionnels complexes au sein d’opérateurs logiques conjonctifs tels que ET ou disjonctifs comme OU.
Néanmoins, l’analyste rigoureux doit impérativement appréhender les contreparties algorithmiques de cette élégance de surface. La fonction NB.SI est par essence une fonction d’agrégation exhaustive. Cela signifie que son algorithme interne d’exécution ne met en œuvre aucun mécanisme de terminaison anticipée (communément qualifié de short-circuit evaluation). Là où la fonction EQUIV(..., 0) s’interrompt instantanément dès qu’elle rencontre la première occurrence valide (par exemple dès la ligne 2 d’une plage qui en compte un million), la fonction NB.SI poursuit inexorablement son itération séquentielle jusqu’à l’évaluation de la dernière cellule de la plage spécifiée, afin de certifier l’exactitude de son dénombrement cumulatif. Sur des plages de dimensions colossales ou au sein de classeurs comprenant des dizaines de milliers de formules redondantes, l’utilisation systématique de NB.SI à des fins de vérification binaire peut ainsi induire une latence de calcul non négligeable comparativement à un algorithme court-circuité.
4. Approches basées sur les fonctions de recherche : RECHERCHEV et RECHERCHEX
4.1 Vérification via RECHERCHEV (VLOOKUP) et détection d’erreurs
La fonction RECHERCHEV (ou VLOOKUP dans le standard technique anglophone) représente historiquement l’instruction de recherche la plus largement disséminée au sein des environnements de tableurs bureautiques. Conçue initialement pour extraire une information satellite située dans une colonne adjacente à partir d’une clé d’indexation primaire, RECHERCHEV est fréquemment détournée par les praticiens pour attester de la présence intrinsèque d’une valeur au sein d’une colonne vectorielle de données. Sa signature classique comprend la clé de recherche, la plage matricielle de référence, l’indice numérique de la colonne à renvoyer (fixé à 1 dans le contexte d’une auto-vérification), et le drapeau booléen déterminant le mode d’appariement (fixé rigoureusement à FAUX pour exiger une correspondance exacte sans tri préalable).
La formulation typique pour tester l’appartenance d’un élément présent en B1 au sein de la colonne vectorielle A1:A100 se présente ainsi :
=SIERREUR(SI(RECHERCHEV(B1, A1:A100, 1, FAUX) = B1, "Présent", "Absent"), "Absent")
Ou, de manière plus condensée en exploitant directement l’interception de l’exception :
=NON(ESTNA(RECHERCHEV(B1, A1:A100, 1, FAUX)))
Cette approche souffre toutefois de lourdes contraintes inhérentes à la géométrie de son implémentation originelle. D’une part, RECHERCHEV est structurellement asymétrique et directionnelle : elle contraint la colonne d’indexation à occuper impérativement la position la plus à gauche de la matrice déclarée, interdisant toute recherche vectorielle libre sans recomposition matricielle artificielle. D’autre part, la verbosité syntaxique imposée par l’encapsulation dans la fonction SIERREUR ou ESTNA alourdit considérablement la maintenance du code. Enfin, sur le plan computationnel, forcer l’extraction et la ré-allocation en mémoire de la valeur trouvée simplement pour valider son existence constitue une dépense de cycles processeur totalement superfétatoire.
4.2 Modernisation procédurale avec la fonction RECHERCHEX (XLOOKUP)
Afin de pallier les limitations architecturales chroniques de ses prédécesseurs historiques, Google Sheets a intégré la fonction RECHERCHEX (standardisée sous l’appellation internationale XLOOKUP). Cette instruction de dernière génération réinvente le paradigme de la recherche tabulaire en séparant distinctement le vecteur de recherche du vecteur de restitution, et en incorporant nativement des mécanismes de traitement des exceptions qui rendaient jusqu’alors obligatoire l’usage de fonctions satellites imbriquées.
L’argumentaire d’appel de RECHERCHEX intègre de façon standardisée un paramètre optionnel de substitution en cas d’absence avérée de la valeur (le paramètre formel si_non_trouvé ou if_not_found). Cette caractéristique transforme radicalement la vérification d’appartenance en une opération autonome ne nécessitant aucune encapsulation logicielle périphérique. La syntaxe canonique de vérification s’énonce comme suit :
=RECHERCHEX(B1, A1:A100, VRAI, FAUX, 0)
Dans cette formulation remarquablement optimisée, la fonction recherche la valeur de la cellule B1 au sein du vecteur A1:A100. Si l’élément est identifié avec une correspondance exacte (pilotée par l’argument 0), la fonction renvoie la valeur booléenne constante VRAI spécifiée dans le troisième argument de retour. À l’inverse, si l’algorithme d’exploration de la plage échoue à localiser l’occurrence, il court-circuite l’émission standard de l’erreur #N/A et renvoie immédiatement l’alternative spécifiée dans son quatrième argument, à savoir le booléen pur FAUX.
L’élimination formelle des fonctions d’interception d’erreurs externes telles que SIERREUR assainit la structure du modèle. De surcroît, RECHERCHEX autorise une granularité de configuration inégalée en permettant de paramétrer le sens d’exploration séquentielle (du premier au dernier élément, ou inversement du dernier au premier élément via l’argument de mode de recherche positionné à -1), ce qui permet à l’architecte de données d’optimiser le temps d’accès s’il possède une connaissance a priori de la distribution spatiale des enregistrements les plus fréquemment consultés.
4.3 Comparaison de performance analytique entre les paradigmes de recherche
L’arbitrage entre l’usage d’une chaîne EQUIV, d’un appel à NB.SI ou d’une instruction moderne RECHERCHEX ne saurait se réduire à des préférences esthétiques ou stylistiques ; il doit impérativement procéder d’une analyse rigoureuse des structures de données sous-jacentes et de la gestion de la mémoire volatile par le moteur de rendu de Google Sheets. Le tableau suivant synthétise les propriétés opérationnelles fondamentales de ces différents paradigmes d’appartenance :
- EQUIV (MATCH) : Approche unidimensionnelle séquentielle court-circuitée. Complexité temporelle minimale dans les cas favorables où l’élément se situe en tête de matrice. Interruption immédiate dès la première capture d’indice. Nécessite une encapsulation booléenne via
ESTNA. Recommandée pour les environnements à forte densité computationnelle. - NB.SI (COUNTIF) : Approche multidimensionnelle exhaustive sans court-circuit. Parcourt l’intégralité de la matrice quoi qu’il advienne. Complexité temporelle strictement proportionnelle à la taille absolue de la zone mémoire allouée (O(N)). Évite les exceptions d’exécution en renvoyant zéro par défaut. Idéale pour les validations rapides sur des plages restreintes ou non linéaires (lignes et colonnes combinées).
- RECHERCHEX (XLOOKUP) : Paradigme unifié de recherche vectorielle isolée. Offre le traitement natif de l’absence sans surcharge de wrappers d’erreur. Découplage structurel parfait entre l’espace de recherche et l’espace de résultat. Stabilité référentielle absolue en cas de modification dynamique de la disposition des colonnes environnantes.
Un critère déterminant de robustesse réside dans l’immunité structurelle face aux manipulations dimensionnelles des feuilles de calcul. Dans les anciens modèles fondés sur RECHERCHEV, l’insertion accidentelle d’une colonne au milieu de la plage de sélection faussait irrémédiablement l’index d’extraction numérique statique, provoquant des faux négatifs ou des erreurs de projection typologique. RECHERCHEX et EQUIV, opérant exclusivement sur des plages vectorielles indépendantes, garantissent une intégrité d’évaluation totale et pérenne quelles que soient les mutations topologiques opérées sur la feuille de calcul par les équipes d’exploitation.
5. Exploitation des fonctions de filtrage et de requête : FILTER et QUERY
5.1 Application de la fonction FILTER pour extraire la preuve d’existence
Pour les architectes de systèmes d’information opérant au sein de Google Sheets, la fonction FILTER constitue un outil déclaratif de sélection particulièrement expressif. Contrairement aux opérateurs de recherche indiciaire qui s’efforcent d’isoler un scalaire ou sa position, FILTER est programmée pour segmenter dynamiquement une matrice selon un ensemble d’assertions logiques booléennes vectorielles, générant en sortie une sous-matrice contenant exclusivement les enregistrements validant l’ensemble des conditions. Sa signature de base s’énonce : FILTER(plage, condition1, [condition2, ...]).
L’utilisation de la fonction FILTER pour vérifier l’appartenance d’un élément spécifique s’articule autour de l’évaluation d’un vecteur logique d’égalité stricte :
=FILTER(A2:A100, A2:A100 = "ValeurCible")
Si la valeur est présente au sein de la plage examinée, la formule génère un étalement dynamique (souvent qualifié de spill) de l’ensemble des occurrences correspondantes sur les cellules sous-jacentes. Afin de circonscrire ce comportement matriciel expansif susceptible de générer des erreurs de collision spatiale (#REF! induites par l’écrasement de données contiguës existantes), il est impératif de conditionner et de quantifier la dimension du flux sortant.
L’encapsulation de FILTER au sein d’opérateurs dimensionnels d’inspection tels que LIGNES (correspondant à ROWS) ou de prédicats de vacuité permet d’obtenir un indicateur d’appartenance unitaire et stable :
=SIERREUR(LIGNES(FILTER(A2:A100, A2:A100 = "ValeurCible")) > 0, FAUX)
Dans ce schéma opératoire sophistiqué, si l’évaluation de FILTER échoue à capturer la moindre correspondance, le moteur génère une exception #N/A indiquant qu’aucune ligne ne correspond aux filtres déclarés. La fonction périphérique SIERREUR intercepte ce signal d’invisibilité et substitue immédiatement la valeur booléenne FAUX. En cas de détection d’au moins une cellule homologue, la fonction LIGNES quantifie la hauteur de la matrice vectorielle résultante, validant la condition supérieure à zéro et retournant l’état booléen VRAI avec une imperméabilité totale aux débordements d’affichage.
5.2 Implémentation du langage déclaratif via QUERY
Google Sheets se distingue de l’ensemble de ses concurrents bureautiques traditionnels par l’intégration native d’un interpréteur déclaratif d’inspiration SQL via sa fonction emblématique QUERY. Cet opérateur convoque le formalisme de l’API de visualisation de Google pour exécuter des requêtes relationnelles structurées directement sur des plages matricielles internes. La structure d’appel requiert la matrice de données source, une chaîne textuelle de commande formulée selon une syntaxe quasi-SQL standardisée, et un paramètre optionnel spécifiant le nombre de lignes d’en-tête de la structure.
Pour vérifier l’appartenance d’un élément alphanumérique sans autoriser la génération de données parasites sur les axes secondaires de la feuille, la formulation QUERY déploie des clauses de projection et de restriction optimisées :
=QUERY(A2:A100, "SELECT A WHERE A = '" & B1 & "' LIMIT 1", 0)
L’introduction explicite de la directive LIMIT 1 au sein de la clause relationnelle constitue une pratique d’ingénierie logicielle d’une importance capitale. Elle contraint l’interpréteur de requêtes à suspendre l’interrogation matricielle dès la résolution de la première occurrence correspondante, évitant ainsi l’allocation dynamique de plages d’étalement multidimensionnelles et bornant la sortie à une cellule unique. La validation de la présence s’effectue ensuite en interceptant l’éventuelle émission de résultat vide via la fonction ESTVIDE ou SIERREUR :
=NON(ESTVIDE(SIERREUR(QUERY(A2:A100, "SELECT A WHERE A = '" & B1 & "' LIMIT 1", 0))))
Il est fondamental de noter que l’interpréteur de la fonction QUERY repose sur un mécanisme strict d’inférence de type par colonne. Si une colonne de référence héberge un profil typologique mixte (par exemple, 80 % de valeurs numériques entières et 20 % de chaînes de caractères textuelles), le moteur d’inférence statistique attribuera unitairement le type numérique à l’ensemble de la colonne. Par voie de conséquence, toutes les valeurs textuelles résiduelles seront silencieusement ignorées et converties en valeurs nulles lors de l’exécution de la requête, conduisant à des faux négatifs d’appartenance absolument indétectables par les mécanismes usuels. Ce comportement particulier disqualifie formellement l’usage de QUERY au profit de EQUIV ou NB.SI sur les ensembles de données non nettoyés ou dépourvus d’un typage homogène rigoureux.
6. Vectorisation et calcul dynamique avec ARRAYFORMULA
6.1 Vérification simultanée d’une pluralité de valeurs cibles
Dans les architectures de traitement de données volumineuses, la confrontation individuelle d’un scalaire unique à une table de référence ne constitue qu’une fraction marginale des cas d’usage réels. L’analyste se trouve bien plus fréquemment confronté à l’obligation de valider l’appartenance d’un flux vectoriel continu de requêtes simultanées (par exemple, confronter une colonne d’entrées de transactions C2:C50000 à un registre de comptes autorisés A2:A1000). La réplication mécanique d’une formule scalaire unitaire par étirement manuel ou par copie de cellules engendre une prolifération anarchique de calculs autonomes qui dégrade dramatiquement les performances d’exécution du navigateur et gonfle inutilement l’empreinte mémoire du document.
La vectorisation via l’opérateur structurel ARRAYFORMULA permet de subvertir cette limitation fondamentale en soumettant un vecteur complet à une opération de traitement par lot déterministe. En encapsulant la méthode quantitative au sein de ARRAYFORMULA, il devient possible de projeter l’évaluation d’appartenance sur l’intégralité d’un axe vertical à l’aide d’une instruction unique localisée dans la cellule d’en-tête :
=ARRAYFORMULA(SI(ESTVIDE(C2:C), "", SI(NB.SI(A2:A100, C2:C) > 0, "Présent", "Absent")))
Dans ce contexte vectorisé, la fonction NB.SI ne reçoit plus un paramètre de critère unitaire, mais le vecteur dynamique C2:C. L’opérateur ARRAYFORMULA ordonne alors au moteur d’itérer mathématiquement le prédicat sur chaque composant scalaire du vecteur sans rupture de contexte d’exécution. L’adjonction de la condition préalable ESTVIDE(C2:C) est hautement stratégique : elle permet de neutraliser dynamiquement le calcul sur les lignes du classeur non encore renseignées, empêchant la formule de propager stérilement des chaînes de caractères « Absent » jusqu’à la limite absolue de dix millions de cellules de la grille de calcul de Google Sheets.
6.2 Utilisation de MAP et LAMBDA pour des vérifications itératives modulaires
L’avènement des fonctions d’ordre supérieur basées sur le calcul lambda au sein de Google Sheets a ouvert de nouveaux horizons d’abstraction fonctionnelle, rendant obsolètes certaines constructions vectorielles complexes à base de produits matriciels ou de concaténations forcées. Grâce à la combinaison des fonctions MAP et LAMBDA, l’opérateur bénéficie de la puissance itérative des langages de programmation fonctionnelle purs au sein même de la grille tabulaire.
La signature de MAP applique une fonction LAMBDA personnalisée à chaque élément d’un ou plusieurs tableaux matriciels pour composer une matrice de résultat homogène. L’architecture d’une vérification d’appartenance itérative et modulaire se structure de la façon suivante :
=MAP(C2:C100, LAMBDA(cle, SI(cle="", "", NON(ESTNA(EQUIV(cle, A2:A50, 0))))))
Cette approche apporte des gains conceptuels considérables par rapport aux vectorisations traditionnelles :
- Isolation des variables locales : Le paramètre
cleagit comme une variable formelle strictement isolée dans la portée lexicale de la fonction anonyme, éliminant tout risque d’interférence référentielle globale avec d’autres zones du classeur. - Comportement sans distorsion matricielle : Certaines fonctions natives de Google Sheets (à l’image de
RECHERCHEXouEQUIV) réagissent parfois de façon imprévisible ou refusent d’itérer naturellement lorsqu’elles sont insérées à l’intérieur d’unARRAYFORMULAtraditionnel. L’emploi explicite deMAPforce l’interpréteur à décomposer le calcul de façon unitaire et déterministe, garantissant une conformité d’exécution absolue quel que soit l’opérateur de recherche encapsulé. - Lisibilité algorithmique supérieure : La structure de la formule reflète exactement le schéma cognitif de traitement par lot (batch processing), facilitant les opérations d’auditabilité par des tiers et la documentation formelle des chaînes de valeur de données.
7. Contrôle de la sensibilité à la casse (majuscules et minuscules)
7.1 Insensibilité par défaut des fonctions usuelles de Google Sheets
L’un des pièges les plus redoutables pour les auditeurs et analystes de données réside dans le principe d’insensibilité à la casse textuelle (case-insensitivity) implémenté par défaut dans la grande majorité des fonctions standards d’interrogation de Google Sheets. Par convention ergonomique d’accessibilité bureautique, les fonctions fondamentales que sont EQUIV, NB.SI, RECHERCHEV ou RECHERCHEX traitent les représentations typographiques de bas de casse et de haut de casse de manière indifférenciée. Ainsi, pour l’interpréteur de calcul, les chaînes scalaires "PARIS", "Paris" et "paris" sont rigoureusement équivalentes et possèdent une égalité sémantique absolue.
Si cette commodité logicielle est louable pour traiter des saisies approximatives de noms patronymiques ou de localités géographiques, elle s’avère extrêmement néfaste dans des contextes technologiques normés où la casse constitue un vecteur d’information discriminant. C’est notamment le cas lors de la confrontation de :
- Clés de hachage cryptographiques (empreintes SHA-256, jetons de sécurité JWT ou identifiants encodés en base64) où une permutation typographique altère radicalement l’authenticité de la chaîne ;
- Identifiants de suivi logistique normalisés ou références de pièces industrielles complexes au sein desquelles les préfixes majuscules identifient des catégories structurellement différentes de leurs pendants minuscules ;
- Identificateurs uniques universels ou codes d’inventaire sensibles à la typographie d’enregistrement dans des bases de données transactionnelles externes synchronisées par API.
Dans ces configurations hautement critiques, accorder une validation d’appartenance à un élément sur la simple foi d’un test NB.SI traditionnel engendre des faux positifs d’une gravité substantielle, susceptibles de corrompre des bases de données maîtresses et d’entraîner des dysfonctionnements opérationnels majeurs dans les couches logicielles aval.
7.2 Intégration de la fonction EXACT pour une vérification rigoureuse
Pour restaurer l’intégrité de la vérification orthographique absolue et contraindre le moteur de Google Sheets à respecter scrupuleusement la table de codage de caractères UTF-8, il est impératif de faire intervenir la fonction binaire EXACT. La fonction EXACT(chaîne1, chaîne2) compare deux chaînes de texte de manière binaire stricte et ne retourne la valeur booléenne VRAI que si et seulement si chaque glyphe des deux opérandes présente une parité typographique totale au niveau de sa représentation binaire de casse.
Puisque la fonction EXACT n’est nativement capable d’évaluer que des scalaires unitaires deux à deux, son déploiement à l’échelle d’une plage matricielle de référence exige son hybridation avec des opérateurs d’agrégation d’arithmétique matricielle. La méthode de référence consiste à combiner EXACT avec la fonction SOMMEPROD (ou SUMPRODUCT) :
=SOMMEPROD(EXACT(A2:A100, "ValeurSensible")) > 0
Dans cette architecture computationnelle, l’instruction EXACT(A2:A100, "ValeurSensible") effectue une projection vectorielle, confrontant la valeur cible à chacune des cellules du vecteur de référence. Cette opération génère en mémoire un tableau transitoire de booléens {FAUX; FAUX; VRAI; ...}. La fonction SOMMEPROD force la coercition arithmétique de ces états logiques en valeurs numériques discrètes (1 pour VRAI, 0 pour FAUX) et procède à leur sommation globale.
Si la somme cumulée qui en résulte est strictement supérieure à zéro, la présence exacte et sensible à la casse est mathématiquement attestée. Alternativement, au sein des environnements modernes intégrant le calcul lambda, l’expression peut se formuler avec une élégance syntaxique irréprochable via la fonction OU combinée à MAP :
=OU(MAP(A2:A100, LAMBDA(elem, EXACT(elem, "ValeurSensible"))))
Cette seconde formulation possède l’immense avantage d’exécuter un court-circuit d’évaluation logique par disjonction dès la première concordance absolue isolée, préservant ainsi les ressources computationnelles du serveur lors des traitements sur des vecteurs à forte cardinalité.
8. Recherche par motifs, caractères génériques et expressions régulières
8.1 Utilisation des caractères génériques avec NB.SI et EQUIV
Il est des contextes analytiques où la vérification d’appartenance ne peut s’encombrer d’une exigence d’identité parfaite, mais doit au contraire autoriser une flexibilité morphologique délimitée afin d’identifier des fragments textuels, des préfixes sémantiques ou des variations typographiques encadrées. À cette fin, Google Sheets intègre au sein de ses fonctions d’appariement traditionnelles (telles que NB.SI, EQUIV ou RECHERCHEV) un système standardisé de caractères génériques (communément désignés sous le terme anglais de wildcards).
Ce formalisme repose sur l’assignation sémantique de trois symboles de contrôle élémentaires :
- Le point d’interrogation (?) : Représente strictement un caractère unitaire quelconque, quelle que soit sa nature littérale ou numérique. Ainsi, la recherche du motif
"REF???"vérifiera l’existence de toute chaîne débutant par « REF » et suivie d’exactement trois glyphes arbitraires. - L’astérisque (*) : Modélise une chaîne arbitraire de caractères d’une longueur indéterminée, pouvant aller d’une suite indéfinie de glyphes jusqu’à l’absence totale de caractère (longueur zéro). L’expression
NB.SI(A2:A100, "*alpha*") > 0permet dès lors d’attester de la présence d’une cellule encapsulant la sous-chaîne « alpha », qu’elle se situe au préfixe, au cœur ou au suffixe de l’enregistrement textuel. - Le tilde (~) : Agit en tant qu’opérateur d’échappement syntaxique. Si la valeur cible recherchée au sein de la plage matricielle comporte littéralement un astérisque, un point d’interrogation ou un tilde, ces caractères doivent être obligatoirement préfixés par un tilde d’échappement (par exemple
"TOTAL~*") pour inhiber leur comportement générique et contraindre le moteur à une comparaison littérale stricte.
La formulation pratique d’une recherche d’appartenance par sous-chaîne dynamique s’exécute ainsi avec une grande fluidité syntaxique :
=(NB.SI(A2:A100, "*" & B1 & "*") > 0)
Cette instruction vérifie sans ambiguïté si le fragment contenu dans la variable de contrôle B1 se trouve disséminé au sein de l’un quelconque des nœuds d’information de la plage cible A2:A100.
8.2 Vérification avancée d’existence via REGEXMATCH
Bien que les caractères génériques fournissent une solution d’appoint convenable pour des filtres morphologiques basiques, ils se révèlent dramatiquement impuissants face à des structures de données complexes exigeant des contraintes syntaxiques sophistiquées (telles que la validation d’adresses de courrier électronique normalisées selon les standards RFC, de numéros de téléphone internationaux ou de formats stricts de numéros de traçabilité alphanumériques). Pour franchir ce palier d’exigence méthodologique, Google Sheets met à disposition son moteur d’évaluation d’expressions régulières conformes au standard Google RE2, incarné par la fonction REGEXMATCH.
La fonction REGEXMATCH(texte, expression_régulière) évalue si une chaîne scalaire concorde avec un motif d’expression régulière formel et renvoie un booléen pur. Appliquée à une plage matricielle entière pour certifier l’existence d’au moins un élément répondant à un format normé complexe, elle s’associe avantageusement à des techniques d’aplatissement ou d’itération par ordre supérieur :
=OU(ARRAYFORMULA(SI(ESTVIDE(A2:A100), FAUX, REGEXMATCH(A2:A100, "^[A-Z]{3}-d{4}$"))))
Dans cet exemple, la formule parcourt vectoriellement la plage A2:A100 pour valider si au moins une cellule respecte rigoureusement la syntaxe d’un identifiant composé de trois lettres capitales, suivies d’un trait d’union et de quatre chiffres consécutifs.
Une méthode de contournement extrêmement puissante pour valider l’existence instantanée d’une valeur au sein d’une plage sans générer de tableau dynamique intermédiaire consiste à fusionner la plage cible à l’aide de la fonction JOINDRE.TEXTE (ou TEXTJOIN) préalablement à l’évaluation régulière :
=REGEXMATCH(JOINDRE.TEXTE(CAR(9), VRAI, A2:A100), "b" & B1 & "b")
En agrégeant l’intégralité du vecteur matriciel au sein d’une chaîne de texte unique consolidée en mémoire vive, séparée par des caractères de tabulation insécables CAR(9), l’assertion régulière b (marquant la frontière de mot) permet d’attester de la présence du terme de façon quasi instantanée. Cette architecture réduit l’arbre d’évaluation à un calcul unitaire unique, soulageant le processeur d’affichage au prix d’une utilisation éphémère de la pile textuelle.
9. Visualisation et ergonomie cognitive : la mise en forme conditionnelle
9.1 Traduction visuelle de l’appartenance à une plage
L’exploitation analytique de la vérification d’appartenance ne s’exprime pas exclusivement par la génération de scalaires ou de vecteurs de vérité abstraits ; elle trouve un prolongement opérationnel indispensable dans la sémiologie graphique des interfaces de calcul via le moteur de mise en forme conditionnelle de Google Sheets. L’objectif ergonomique consiste à transposer immédiatement une correspondance mathématique sous-jacente en un signal perceptif visuel univoque (surlignage chromatique d’arrière-plan, modification de la police typographique ou apparition de bordures distinctives), permettant à l’utilisateur d’isoler visuellement les concordances ou les discordances au sein de volumes considérables d’informations.
Pour mettre en place une telle instrumentation cognitive, il convient de définir une règle de mise en forme conditionnelle personnalisée fondée sur une formule dédiée. Par convention architecturale, la règle conditionnelle personnalisée s’applique sur une plage géométrique donnée (par exemple A2:A100) et attend une expression qui, une fois résolue pour la cellule pivot de référence supérieure gauche, s’évalue strictement à la valeur logique VRAI.
L’instruction type pour mettre en exergue visuellement n’importe quel enregistrement de la plage active A2:A100 préexistant au sein d’une table d’exclusion ou d’une liste de contrôle externe située en F2:F50 s’énonce comme suit :
=NB.SI($F$2:$F$50, A2) > 0
L’introduction d’un tel repère visuel dynamique modifie profondément la dynamique de travail des gestionnaires de flux de données. Au lieu de contraindre l’analyste à une scrutation fastidieuse de colonnes parallèles pour traquer manuellement des doublons ou des omissions d’appariement, la couleur s’impose comme une métrique d’alerte en temps réel. La charge mentale de traitement de l’information est substantiellement allégée, limitant drastiquement les biais d’inattention et autorisant un pilotage par exception particulièrement performant dans les environnements de reporting collaboratif à haute fréquence d’actualisation.
9.2 Gestion des références absolues et relatives dans les règles conditionnelles
Le paramétrage des règles de validation visuelle par formule personnalisée constitue l’un des terrains d’erreur les plus récurrents, en raison de la manipulation complexe de la relativité des coordonnées de cellules au sein du moteur d’évaluation conditionnelle. Lors de l’écriture d’une règle personnalisée, Google Sheets applique la formule à la première cellule de la plage de sélection, puis procède à une translation virtuelle de ses indices pour chaque cellule ultérieure incluse dans le champ d’application, mimant fidèlement le comportement d’un étirement de formule conventionnel.
Il est donc d’une nécessité absolue d’ancrer de façon immuable la plage de référence externe à l’aide de l’opérateur de verrouillage dollar ($) pour neutraliser tout décalage dimensionnel parasite. Considérons la formule de validation susmentionnée :
=NB.SI($F$2:$F$50, A2) > 0
L’utilisation de la référence absolue $F$2:$F$50 fige définitivement les frontières spatiales du périmètre de contrôle. Si l’opérateur omettait par inadvertance ces dollars structuraux en écrivant F2:F50, le moteur décalerait la plage d’investigation d’un pas vers le bas pour chaque ligne parcourue : lors de l’évaluation de la cellule A3, la vérification s’opérerait sur F3:F51, et pour A10, sur F10:F58. Ce glissement d’indice invisible engendre une hécatombe analytique, excluant arbitrairement les premiers éléments de la liste de contrôle et générant une multitude de faux négatifs impossibles à détecter sans un audit approfondi de la grille.
Inversement, le second argument A2 doit impérativement conserver une référence de ligne relative (ou semi-relative) pour autoriser le processeur d’affichage à faire correspondre le critère avec la valeur intrinsèque de la cellule actuellement inspectée. Si l’on applique la mise en forme conditionnelle à une matrice complète englobant plusieurs colonnes (par exemple A2:D100) et que l’on désire surligner l’intégralité d’une ligne dès lors que la valeur située dans sa première colonne A appartient à la liste de référence, il convient d’adopter une référence mixte en verrouillant uniquement la colonne :
=NB.SI($F$2:$F$50, $A2) > 0
Ce verrouillage unilatéral garantit que les cellules B2, C2 et D2 évalueront systématiquement le contenu de A2, provoquant le surlignage horizontal unitaire et cohérent de toute la rangée informationnelle.
10. Vérification croisée, multi-critères et plages non contiguës
10.1 Détection d’existence sous conditions multiples (NB.SI.ENS)
Dans les architectures de données relationnelles complexes, la notion d’appartenance univariée se révèle souvent insuffisante pour caractériser l’existence d’une entité informationnelle. L’analyste se voit fréquemment contraint de vérifier si une entité existe au confluent de multiples dimensions interdépendantes (par exemple, attester de l’existence d’une transaction financière impliquant simultanément un client spécifique, un code de devise déterminé et un statut comptable validé). Cette vérification relève formellement de la conjonction logique stricte (opérateur ET) appliquée à l’appartenance.
Pour résoudre cette problématique sans complexifier inutilement le classeur par l’adjonction de colonnes de concaténation physiques, la fonction NB.SI.ENS (ou COUNTIFS) constitue l’outil de prédilection. Sa signature autorise la spécification séquentielle de multiples couples d’arguments composés chacun d’une plage vectorielle et de son critère associé :
=SI(NB.SI.ENS(Clients, "Client_A", Devises, "EUR", Statuts, "Validé") > 0, "Ensemble identifié", "Inexistant")
Dans ce modèle d’exécution, la fonction ne comptabilise que les occurrences pour lesquelles l’ensemble des prédicats s’avère concomitamment satisfait au même indice de ligne. La transformation de cette instruction en prédicat booléen pur s’opère par l’inégalité arithmétique habituelle :
=(NB.SI.ENS(Clients, "Client_A", Devises, "EUR", Statuts, "Validé") > 0)
À l’inverse, lorsque la problématique analytique relève de la disjonction logique (l’opérateur OU), exigeant d’attester de la présence d’une valeur dans au moins un sous-ensemble parmi plusieurs domaines indépendants, la structure de calcul se décline par la sommation arithmétique de plusieurs fonctions de dénombrement unilatérales :
=( (NB.SI(Catalogue_Printemps, "Ref_X") + NB.SI(Catalogue_Ete, "Ref_X")) > 0 )
Cette algébrisation de la disjonction repose sur le postulat fondamental de l’arithmétique booléenne : la somme de deux grandeurs positives ou nulles est strictement supérieure à zéro si et seulement si au moins l’un des deux termes contributifs est strictement positif. Cette formulation évite les imbrications tortueuses de fonctions OU(NB.SI(...)>0, NB.SI(...)>0) et s’avère computationnellement plus rapide à évaluer pour le moteur JavaScript de la plateforme.
10.2 Recherche au sein de plages disjointes et d’onglets multiples
L’une des limitations historiques les plus contraignantes des tableurs réside dans l’incapacité native de fonctions traditionnelles comme NB.SI ou EQUIV à recevoir des plages spatialement disjointes et disséminées sur des coordonnées matricielles discontinues (telles que la collection non attenante (A2:A50, C2:C50, F2:F50)). Tenter de transmettre une telle énumération d’arguments à NB.SI déclenche une erreur syntaxique immédiate d’incompatibilité de signature.
Pour contourner élégamment cet obstacle sans altérer la topologie de la feuille, Google Sheets offre un mécanisme d’agrégation matricielle en mémoire vive matérialisé par les opérateurs d’accolades littérales { }. Ces délimiteurs permettent de concaténer virtuellement plusieurs fragments vectoriels discontinus au sein d’une matrice synthétique unique unifiée. La formulation se structure selon l’axe d’empilement :
- Le point-virgule (
;) empile les vecteurs verticalement (concaténation de lignes successives) ; - La barre oblique inversée (
) ou la virgule selon la configuration régionale des séparateurs accole les vecteurs horizontalement.
Dès lors, pour rechercher l’appartenance d’un scalaire au sein de trois colonnes éparses au moyen de EQUIV, il suffit de recomposer l’espace de recherche en un méta-vecteur virtuel vertical :
=NON(ESTNA(EQUIV("ValeurCible", {A2:A50; C2:C50; F2:F50}, 0)))
Cette technique démontre une puissance d’application redoutable lorsqu’il s’agit d’exécuter des vérifications d’existence réparties à travers une constellation d’onglets multiples au sein d’un même classeur (par exemple, vérifier si un identifiant client est présent dans l’onglet 'Q1_2023'!A2:A, 'Q2_2023'!A2:A ou 'Q3_2023'!A2:A). En agrégeant ces dimensions distantes :
=NON(ESTNA(EQUIV("ValeurCible", {'Q1_2023'!A2:A; 'Q2_2023'!A2:A; 'Q3_2023'!A2:A}, 0)))
Il demeure toutefois impératif de veiller à ce que chaque sous-vecteur agrégé possède rigoureusement la même largeur dimensionnelle (en l’occurrence ici une colonne unitaire unique), sous peine de provoquer une erreur critique d’incohérence dimensionnelle matricielle (erreur #VALEUR! indiquant l’échec de la concaténation de tableaux aux dimensions discordantes).
11. Optimisation computationnelle pour les jeux de données volumineux
11.1 Analyse du coût algorithmique des fonctions de recherche
Dans les feuilles de calcul d’entreprise dont la volumétrie dépasse couramment plusieurs centaines de milliers d’enregistrements, l’efficience algorithmique des fonctions de vérification d’appartenance cesse d’être une préoccupation théorique secondaire pour devenir un impératif critique de performance. Chaque recalcul de la grille monopolise des cycles de calcul au sein de l’interpréteur, et l’ignorance des principes de la complexité computationnelle (notée sous le formalisme de Landau O(…)) engendre inévitablement des blocages d’interface, des dépassements de quotas d’exécution et des temps de latence prohibitifs.
La recherche linéaire exacte mise en œuvre par les fonctions traditionnelles telles que EQUIV(..., 0), NB.SI(...) ou RECHERCHEX(..., mode_recherche=1) sans tri préalable relève d’une classe de complexité temporelle linéaire, soit O(N), où N représente le nombre absolu de cellules inspectées. Dans le pire des scénarios computationnels (lorsque la valeur cible est absente ou localisée à la terminaison ultime de la matrice), l’algorithme est forcé de procéder à N comparaisons élémentaires en mémoire vive. Si un classeur effectue cette vérification unitaire pour M requêtes simultanées (par exemple 50 000 lignes vérifiant leur appartenance à une table de 100 000 entrées), la complexité cumulée du système culmine à O(M × N), soit l’exécution astronomique de 5 milliards de comparaisons matricielles.
Pour transcender ce goulet d’étranglement structurel, il est indispensable de migrer vers des algorithmes de recherche binaire ou dichotomique, caractérisés par une complexité temporelle logarithmique de classe O(log N). Dans Google Sheets, ce mode de calcul ultra-rapide est activé en ordonnant scrupuleusement la plage de référence par ordre croissant, puis en assignant la valeur 1 à l’argument de type de correspondance de la fonction EQUIV ou RECHERCHEX :
=SI(EQUIV(B1, PlageTriée, 1) > 0, SI(INDEX(PlageTriée, EQUIV(B1, PlageTriée, 1)) = B1, "Présent", "Absent"), "Absent")
Bien que cette construction paraisse plus verbeuse, son exécution sur une liste de 100 000 éléments n’exige qu’un maximum infinitésimal d’environ 17 comparaisons dichotomiques successives (puisque 217 ≈ 131 072), comparativement aux 100 000 opérations systématiques imposées par la recherche linéaire non triée. Le différentiel de vélocité computationnelle atteint ainsi plusieurs ordres de grandeur.
11.2 Stratégies d’architecture pour minimiser les recalculs
Au-delà du strict choix algorithmique unitaire, la préservation de la fluidité des modèles matriciels massifs exige l’application de principes directeurs d’ingénierie logicielle visant à neutraliser l’évaluation redondante des nœuds de calcul :
- Externalisation en colonnes auxiliaires dédiées : L’une des hérésies les plus répandues en modélisation consiste à ré-exécuter une recherche d’appartenance identique au sein de multiples formules satellites pour des besoins d’affichage conditionnel, de filtrage et d’extraction conjointe. L’analyste rigoureux instanciera systématiquement une colonne auxiliaire unique chargée d’effectuer la vérification d’existence une fois pour toutes, stockant le résultat booléen brut. Les formules périphériques se borneront ensuite à référencer ce bit d’information pré-calculé, réduisant la charge de travail globale du processeur à une simple consultation mémoire en O(1).
- Proscription absolue des fonctions volatiles au sein des critères : L’insertion de fonctions dites volatiles (telles que
MAINTENANT(),AUJOURDHUI(),ALEA()ouINDIRECT()) à l’intérieur des arguments de comparaison d’appartenance est catastrophique. Ces fonctions forcent le moteur d’évaluation à invalider la totalité de son cache computationnel à la moindre frappe au clavier sur le classeur, redéclenchant l’intégralité des millions de tests de recherche sur toute la feuille, quand bien même les données sources n’auraient subi aucune altération. - Élagage chirurgical des dimensions de plages : L’usage indiscriminé de colonnes ouvertes infinies de type
A:Aau sein des opérateurs de dénombrement commeNB.SIcontraint parfois l’interpréteur à balayer des centaines de milliers de lignes vierges allouées en mémoire vive. Délimiter expressément les frontières de calcul via des plages dynamiques bornées ou des coordonnées fermées (par exempleA2:A15000) allège instantanément l’empreinte de la pile d’exécution du navigateur web hôte.
12. Dépannage systématique, typologie des erreurs et guides de bonnes pratiques
12.1 Diagnostic des échecs de correspondance et faux négatifs
La défaillance d’une formule de vérification d’appartenance se manifeste presque invariablement sous la forme d’un faux négatif : la valeur est optiquement présente aux yeux de l’analyste au sein de la plage de consultation, mais l’algorithme persiste inexorablement à renvoyer FAUX, 0 ou l’exception #N/A. Cette divergence découle presque toujours d’une altération de surface ou d’une incompatibilité de typage sous-jacente que l’analyste doit diagnostiquer selon un protocole rigoureux.
Le tableau méthodique suivant inventorie les principales pathologies d’appariement rencontrées au sein de Google Sheets, leur mécanisme causal intrinsèque et le protocole curatif correspondant :
| Pathologie observée | Mécanisme causal sous-jacent | Protocole curatif standardisé |
|---|---|---|
| Espaces résiduels invisibles | Présence de caractères d’espacement ordinaires (code ASCII 32) situés en préfixe ou suffixe de la chaîne textuelle, souvent issus d’un copier-coller hâtif. | Encapsuler la référence de recherche et la plage cible au sein de la fonction d’élagage : =SUPPRESPACE(cellule) (ou TRIM). |
| Espaces insécables web | Importation de données web contenant des espaces insécables normalisés sous le code HTML (code ASCII/Unicode 160), totalement insensibles à la fonction standard SUPPRESPACE. |
Substituer agressivement le caractère avant la comparaison : =SUBSTITUE(A1, CAR(160), " ") combiné à SUPPRESPACE. |
| Discordance de typage nombre/texte | Une cellule héberge un nombre pur (valeur numérique alignée à droite) tandis que l’autre stocke une chaîne de chiffres typée comme texte (souvent préfixée d’une apostrophe invisible). | Forcer l’harmonisation de typage par coercition : utiliser CNUM(valeur) pour convertir le texte en nombre, ou TEXTE(valeur, "@") pour transmuer le nombre en chaîne. |
| Caractères non imprimables | Présence de retours chariot, de sauts de ligne ou de glyphes de commande système issus d’exports ERP corrompus. | Appliquer la fonction d’assainissement EPURAGE(cellule) (ou CLEAN) pour expurger les codes ASCII 0 à 31 préalablement au test d’existence. |
| Divergence d’arrondi flottant | Deux valeurs décimales calculées semblent identiques à l’écran mais diffèrent au-delà de la 12e décimale en vertu des approximations de l’arithmétique IEEE 754. | Imposer un arrondissement déterministe préalable sur les deux opérandes au moyen de la fonction ARRONDI(valeur, 2) avant d’exécuter la recherche d’égalité. |
12.2 Protocole d’audit et recommandations pour modèles pérennes
L’industrialisation pérenne de modèles de calcul au sein d’équipes pluridisciplinaires requiert une standardisation formelle des patterns de vérification d’appartenance. L’arbitraire consistant à laisser chaque collaborateur déployer sa propre variante de formule au gré de ses affinités techniques dégrade gravement la maintenabilité du patrimoine informationnel de l’entreprise. Il est donc hautement recommandé d’instaurer une charte de modélisation énonçant les règles prescriptives suivantes :
- Standardiser les architectures scalaires autour de
EQUIVetESTNA: Pour les vérifications d’appartenance unilatérales isolées, privilégier universellement la constructionNON(ESTNA(EQUIV(cible, plage, 0))). Cette formulation garantit un court-circuit algorithmique immédiat, expose immédiatement les erreurs de référence critiques sans les occulter aveuglément, et affiche la compatibilité rétroactive la plus élevée avec les systèmes tiers. - Documenter les intentions algorithmiques complexes : Lorsqu’une formule d’appartenance intègre des manipulations matricielles non triviales (telles que des assertions sensibles à la casse via
EXACTou des concaténations vectorielles par accolades), expliciter impérativement la finalité du calcul par l’insertion de commentaires de cellule structurés ou par l’adjonction de métadonnées documentaires intégrées via la fonction neutreN():
=NON(ESTNA(EQUIV(B1, A2:A100, 0))) + N("Vérification d'appartenance exacte insensible à la casse") - Privilégier la modularité fonctionnelle nommée : Exploiter l’écosystème des fonctions nommées de Google Sheets (accessibles via le menu Données > Fonctions nommées) pour encapsuler ces logiques au sein d’opérateurs métiers déclaratifs réutilisables. Définir une fonction nominale d’entreprise telle que
EST_DANS_PLAGE(valeur, matrice)dissimulant l’arborescence complexe deEQUIVouMAPpermet d’assainir la formule visible pour les utilisateurs finaux, tout en garantissant qu’une optimisation algorithmique future déployée sur la fonction centrale se propage instantanément à travers l’ensemble des classeurs organisationnels.
En respectant rigoureusement ces préceptes d’architecture logicielle, les organisations garantissent à leurs modèles décisionnels une robustesse mathématique irréprochable, une vélocité de traitement optimale et une résilience totale face aux défis constants de la montée en charge des données professionnelles.
Références
- Google. (s. d.). Aide Google Sheets : Utilisation des fonctions de recherche et de matrices. Centre d’aide Google Docs. Consulté le 15 octobre 2023, sur https://support.google.com/docs/answer/6000292
- Google. (s. d.). Fonction RECHERCHEX (XLOOKUP). Centre d’aide Google Docs. Consulté le 18 octobre 2023, sur https://support.google.com/docs/answer/9924978
- Google. (s. d.). Fonction QUERY : Syntaxe du langage de requête. Centre d’aide Google Docs. Consulté le 22 octobre 2023, sur https://support.google.com/docs/answer/3093343
- Google. (s. d.). Fonctions LAMBDA et MAP dans Google Sheets. Centre d’aide Google Docs. Consulté le 25 octobre 2023, sur https://support.google.com/docs/answer/12569915
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE Standards Association. https://standards.ieee.org/ieee/754/6020/
- Walkenbach, J. (2015). Excel 2016 Formulas. John Wiley & Sons.