
La visualisation des données quantitatives constitue un pilier fondamental de la démarche scientifique contemporaine, assurant l’interface critique entre les abstractions numériques matricielles et les capacités interprétatives du système cognitif humain. Dans le cadre de l’analyse exploratoire et confirmatoire, le recours à des représentations graphiques rigoureuses conditionne la capacité du chercheur ou du praticien à discerner des structures sous-jacentes, des régularités morphologiques et des distributions asymétriques. L’outil tableur infonuagique Google Sheets s’est imposé comme une plateforme ubiquitaire de calcul et de modélisation visuelle, démocratisant l’accès à des fonctions d’encodage graphique sophistiquées tout en exigeant une rigueur méthodologique sans faille pour prévenir les distorsions sémiotiques et les biais interprétatifs.
Parmi les artefacts visuels disponibles dans l’arsenal de Google Sheets, le graphique à barres empilées occupe une position épistémologique singulière en articulant simultanément l’évaluation de la magnitude globale d’une observation et la décomposition structurelle de ses éléments constitutifs. Contrairement aux diagrammes à barres simples ou groupées, qui privilégient la comparaison linéaire ou multidimensionnelle d’entités discrètes indépendantes, la segmentation cumulative inhérente au diagramme empilé superpose des sous-dimensions au sein d’une enveloppe spatiale partagée. Cette configuration sollicite des mécanismes psychophysiques spécifiques liés à l’estimation des longueurs, des surfaces et des positions relatives, faisant de sa conception un exercice d’ingénierie visuelle où la rigueur algorithmique doit s’harmoniser avec les principes universels de la sémiologie graphique.
Le présent traité méthodologique propose une exploration exhaustive des fondements théoriques, des protocoles opératoires et des exigences de personnalisation avancée présidant à la genèse d’un graphique à barres empilées au sein de Google Sheets. À travers une progression didactique articulée autour de douze sections critiques, nous disséquerons les contraintes d’architecture matricielle, les mécanismes de normalisation relative, les implications psychophysiques de la palette chromatique, ainsi que les stratégies de diagnostic face aux anomalies de distribution. L’objectif est d’équiper le lecteur d’un cadre conceptuel et opérationnel irréprochable, conforme aux standards les plus exigeants de la communication scientifique et de l’analyse empirique rigoureuse.
1. Introduction théorique et définition du graphique à barres empilées dans Google Sheets
1.1 Fondements conceptuels du graphique à barres empilées
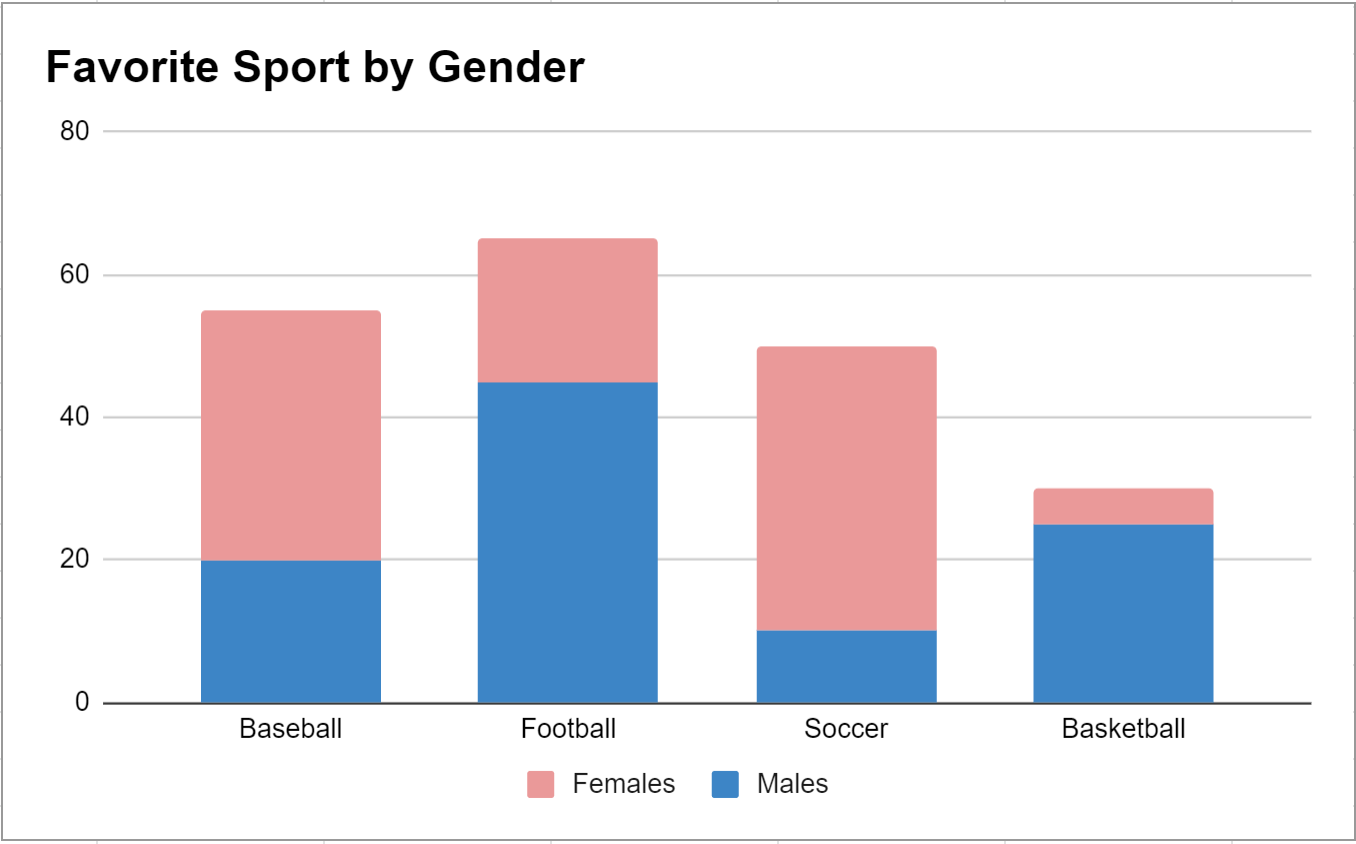
D’un point de vue sémiotique, le graphique à barres empilées repose sur l’utilisation de la barre segmentée en tant qu’unité géométrique de mesure cumulative. Dans ce paradigme, une dimension spatiale unidirectionnelle — traditionnellement la hauteur le long de l’axe vertical des ordonnées ou la longueur le long de l’axe horizontal des abscisses — encode la somme algébrique d’un vecteur de variables quantitatives positives rattachées à une modalité catégorielle déterminée. La morphologie de la barre se trouve ainsi subdivisée en sous-rectangles contigus dont l’étendue surfacique et la portée linéaire traduisent fidèlement la quote-part de chaque sous-composante analytique. Cette construction se distingue formellement des graphiques à barres groupées, où chaque sous-variable se voit assigner une position d’ancrage autonome alignée sur une ligne de base commune, favorisant la comparaison inter-séries au détriment de l’appréciation synthétique du volume total.
Sur le plan des principes de la perception visuelle, formalisés notamment par les travaux fondateurs de William S. Cleveland et Robert McGill sur l’encodage graphique des données quantitatives, le graphique empilé sollicite une hiérarchie cognitive complexe. Tandis que l’évaluation du segment inférieur bénéficie d’un alignement parfait sur une ligne de base commune à coordonnées nulles — garantissant une précision d’estimation optimale équivalente à celle d’une barre standard —, les segments intermédiaires et terminaux sont perçus comme des grandeurs flottantes privées d’origine géométrique partagée. L’observateur doit alors mobiliser une appréciation de la longueur relative décontextualisée de la position absolue, ce qui augmente substantiellement la charge cognitive et la variance des jugements estimatifs.
Néanmoins, la pertinence sémiologique du graphique à barres empilées demeure inégalée lorsqu’il s’agit de modéliser les relations de la partie au tout (*part-to-whole relationships*). Il offre un modèle mental immédiat pour appréhender simultanément deux niveaux de réalité statistique : l’évolution de la magnitude intégrale d’une unité d’observation et la dynamique de recomposition interne de ses strates sous-jacentes. Cette double vocation analytique en fait un instrument privilégié pour les corpus où la conservation de la masse globale constitue une donnée signifiante au même titre que ses subdivisions internes.
1.2 Typologie des variables adaptées à la visualisation cumulative
L’application d’un empilement graphique exige une stricte adéquation entre la nature ontologique des variables mobilisées et les postulats géométriques du modèle additif. Sur l’axe primaire d’ordonnancement, le modèle accueille des variables catégorielles qualitatives, qu’elles soient de nature nominale (comme des zones géographiques ou des catégories de produits dénuées de hiérarchie intrinsèque) ou ordinale (telles que des cohortes chronologiques, des tranches d’âge ou des niveaux de scolarité gradués). Pour ces dernières, l’agencement spatial des barres doit impérativement respecter la transitivité et l’ordre intrinsèque des modalités pour ne pas induire en erreur l’appareil cognitif du lecteur.
À l’intérieur de chaque barre, les sous-segments doivent obligatoirement dériver de métriques quantitatives absolues, discrètes ou continues, possédant une unité de mesure homogène et sommable. Il est méthodologiquement erroné d’agréger des ratios hétérogènes, des moyennes arithmétiques non pondérées ou des indices composites dont la sommation mathématique ne correspond à aucun construit physique ou économique réel. De surcroît, le concepteur doit surveiller la granularité de la décomposition : la prolifération excessive des strates sous-jacentes — généralement au-delà de cinq à sept segments distincts — engendre une surcharge visuelle incapacitante et rend quasiment impossible l’identification et la comparaison des couches supérieures flottantes.
Une limite théorique majeure de la visualisation cumulative réside dans l’incapacité structurelle du modèle géométrique standard à traiter harmonieusement la coexistence de valeurs scalaires positives et négatives au sein d’une même pile matricielle. Si Google Sheets parvient à projeter algorithmiquement les valeurs négatives en deçà de la ligne de base zéro, l’intégrité de la sommation visuelle globale s’en trouve profondément compromise, détruisant la lisibilité immédiate de la magnitude cumulative et introduisant des ruptures de contiguïté spatiale qui dénaturent l’interprétation des rapports de proportions.
1.3 Objectifs analytiques et cas d’usage en sciences quantitatives
Dans le périmètre des sciences quantitatives, le graphique à barres empilées constitue une solution de choix pour la comparaison longitudinale des structures proportionnelles au sein d’un échantillon stratifié. En sociologie démographique ou en économie du travail, par exemple, le suivi temporel de la répartition des actifs selon le niveau de qualification ou le statut contractuel permet de mettre en exergue non seulement l’expansion ou la contraction de la population active totale, mais également les glissements structurels imperceptibles sur une base d’analyse purement univariée. La superposition ordonnée des strates chronologiques révèle les phénomènes de substitution et les transitions de cohorte avec une acuité visuelle remarquable.
Un autre cas d’usage paradigmatique concerne le dépouillement et la restitution d’enquêtes psychométriques mobilisant des échelles de mesure comportementales de type Likert. La distribution des fréquences de réponses articulées autour d’items gradés (allant de « tout à fait en désaccord » à « tout à fait d’accord ») se prête admirablement à l’empilement, en particulier dans sa déclinaison normalisée ou divergente. Cette disposition offre un aperçu immédiat de la polarisation des attitudes, du consensus ou de l’indécision d’une population cible vis-à-vis d’un ensemble standardisé de propositions stimulantes.
Enfin, dans l’économie générale des publications scientifiques, où la densité d’information par centimètre carré d’espace imprimé représente un critère éditorial critique, le diagramme empilé optimise l’espace visuel d’une manière exemplaire. En synthétisant dans un cadre cartésien unique des métriques qui nécessiteraient autrement la juxtaposition fastidieuse de multiples diagrammes univariés ou de tableaux d’effectifs arides, il préserve l’attention du chercheur et facilite l’extraction immédiate d’inférences descriptives sans compromettre la traçabilité des volumes absolus sous-jacents.
2. Préparation et structuration rigoureuse des données sources
2.1 Architecture matricielle requise dans la feuille de calcul
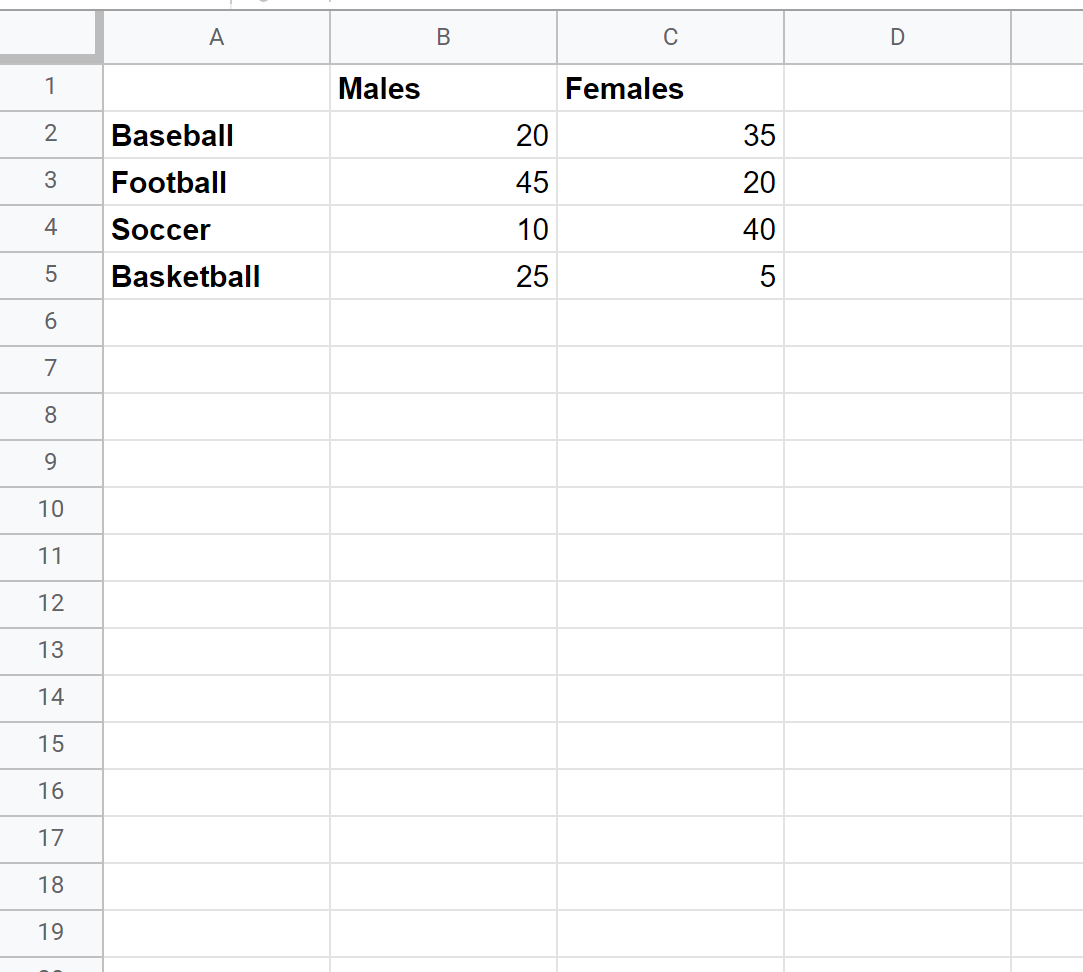
L’efficacité algorithmique du moteur d’inférence graphique de Google Sheets dépend directement de la conformité structurelle de la matrice de données sous-jacente. Pour générer un diagramme à barres empilées sans friction, la structure de la table doit respecter une disposition orthogonale stricte : les unités catégorielles destinées à structurer l’axe principal doivent occuper la première colonne verticale, tandis que les diverses sous-composantes ou variables sommables doivent s’aligner horizontalement sous forme de colonnes adjacentes successives. Cette géométrie bidimensionnelle permet au moteur de feuille de calcul de partitionner immédiatement les dimensions scalaires et les dimensions d’encodage thématique.
Les intitulés d’en-tête situés sur la première ligne doivent faire l’objet d’une standardisation lexicale rigoureuse. Chaque colonne de données doit comporter une étiquette textuelle unique, concise et dénuée d’ambiguïté conceptuelle, car ces intitulés seront automatiquement ingérés par le logiciel pour générer les entrées nominales de la légende graphique. L’homogénéité dimensionnelle est tout aussi capitale : toutes les cellules de la grille matricielle doivent partager une unité de mesure strictement identique (fréquences absolues, devises monétaires, masses pondérées ou unités temporelles), toute disparité métrique invalidant de facto la pertinence additive de la pile géométrique.
Une contrainte technique rédhibitoire souvent sous-estimée concerne la présence de cellules fusionnées (*merged cells*) dans le périmètre d’extraction. Le recours à la fusion de cellules, bien que répandu pour des motifs de mise en page tabulaire humaine, altère l’indexation cartésienne des lignes et colonnes au sein du modèle objet de Google Sheets. Une telle anomalie structurelle désynchronise le mappage automatique des séries de données, induit des discontinuités de lecture algorithmique et débouche systématiquement sur des erreurs de projection spatiale lors de l’instanciation de l’objet graphique.
2.2 Nettoyage et validation des données quantitatives
Préalablement à toute démarche de virtualisation graphique, une phase méticuleuse de nettoyage et d’audit typologique des données quantitatives s’avère indispensable. L’un des pièges les plus insidieux dans l’environnement Google Sheets découle du formatage accidentel de données chiffrées sous la forme de chaînes de caractères textuelles (souvent causé par des espaces insécables résiduels ou des séparateurs décimaux inadéquats importés de bases de données hétérogènes). De telles cellules sont traitées par le moteur de rendu comme des valeurs non quantifiables, générant des lacunes visuelles inexpliquées ou neutralisant purement et simplement la construction de la série au sein de la pile. L’application systématique de la fonction de validation `ESTNUM` permet d’attester sans équivoque de la conformité arithmétique de chaque enregistrement scalaire.
Le traitement des valeurs nulles et des observations manquantes exige une clarification méthodologique rigoureuse. Une valeur nulle (chiffrée explicitement à 0) traduit la mesure effective d’un phénomène dont l’occurrence est absente pour la catégorie considérée, tandis qu’une cellule vide dénote une carence d’observation, une omission de saisie ou un refus de réponse. Si Google Sheets attribue par défaut une dimension géométrique nulle à ces deux états, leur interprétation théorique diverge radicalement. Le praticien veillera donc à renseigner explicitement les zéros canoniques et à définir un protocole formel pour le traitement ou l’imputation contrôlée des données manquantes.
Enfin, l’ordre séquentiel des modalités de la variable primaire doit être stabilisé en amont au sein même de la grille tabulaire. Pour les variables ordinales, les lignes doivent être physiquement ordonnées selon le gradient d’intensité du phénomène mesuré ; pour les variables nominales, un tri préalable fondé sur la magnitude descendante de la somme globale marginale permet de prévenir l’apparition de profils anarchiques et garantit que le rendu final guidera l’œil du lecteur du pôle le plus volumique vers le moins prépondérant.
2.3 Exemple d’application empirique : Enquête comportementale standardisée
Afin de concrétiser les principes de structuration énoncés ci-dessus, considérons le jeu de données empirique suivant, issu d’une étude d’ergonomie comportementale mesurant l’intensité de satisfaction des utilisateurs vis-à-vis d’une plateforme d’apprentissage numérique, segmentée selon quatre tranches d’âge démographiques distinctes. Les observations quantitatives correspondent aux effectifs absolus d’individus recensés pour chaque profil d’attitude, attestant d’une distribution de fréquences pures :
Tableau 1. Répartition matricielle des scores de satisfaction par cohorte d’âge :
- Cohorte 18-25 ans : Insatisfait = 120, Neutre = 85, Satisfait = 310, Très satisfait = 485 (Total marginal = 1 000)
- Cohorte 26-40 ans : Insatisfait = 195, Neutre = 140, Satisfait = 420, Très satisfait = 345 (Total marginal = 1 100)
- Cohorte 41-60 ans : Insatisfait = 280, Neutre = 210, Satisfait = 290, Très satisfait = 120 (Total marginal = 900)
- Cohorte 61 ans et plus : Insatisfait = 150, Neutre = 180, Satisfait = 110, Très satisfait = 60 (Total marginal = 500)
Ce corpus de données présente toutes les propriétés nécessaires à une restitution cumulative de haute précision. La variable indépendante catégorielle ordinale (« Cohorte d’âge ») assure l’agencement logique des catégories sur l’axe primaire, tandis que les quatre modalités d’opinion constituent des séries quantitatives discrètes mutuellement exclusives. La somme marginale de chaque ligne reflète fidèlement la représentativité effective de chaque sous-échantillon dans l’étude, offrant à l’analyste la possibilité de basculer sans distorsion cognitive entre l’évaluation de la participation globale des cohortes et l’analyse comparée de leur gradient de satisfaction.
L’intégrité de la table est garantie par l’absence totale d’irrégularités textuelles, d’amalgames dimensionnels ou d’interpolations hasardeuses. Chaque colonne sous-jacente (« Insatisfait », « Neutre », « Satisfait », « Très satisfait ») représente une part rigoureusement délimitée du phénomène total. Nous disposons ainsi de la matière première idéale pour engager la phase instrumentale de matérialisation graphique dans l’environnement applicatif de Google Sheets.
3. Procédure pas à pas : Insertion et sélection initiale des données
3.1 Sélection de la plage matricielle et appel de l’outil
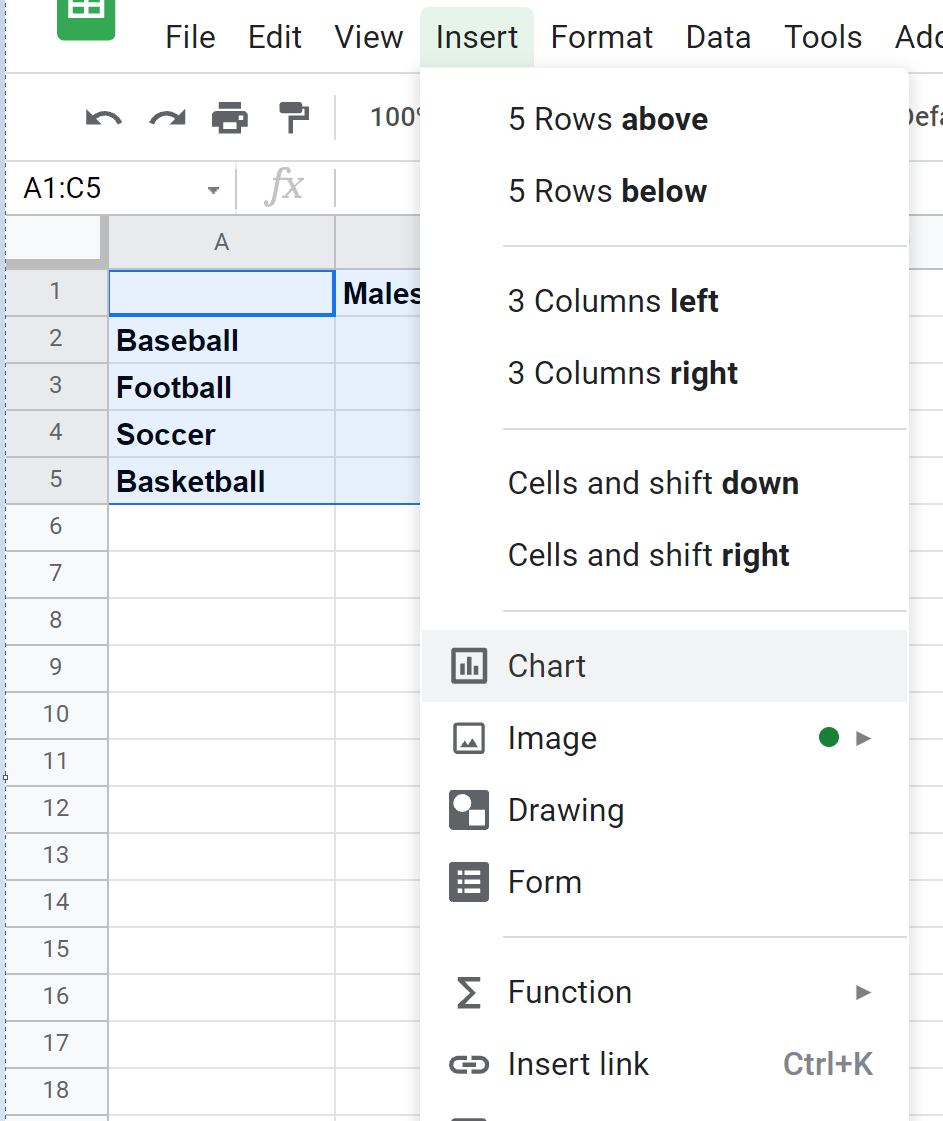
L’amorce de la chaîne opératoire exige une délimitation spatiale rigoureuse de la plage matricielle au sein de la feuille de calcul. L’analyste doit effectuer une sélection par glissement ou au clavier en veillant scrupuleusement à englober la ligne d’en-tête contenant les libellés sémantiques des séries ainsi que la colonne initiale abritant les étiquettes catégorielles. Pour notre matrice de référence, cela correspond par exemple à l’intervalle cartésien `A1:E5`. Toute omission de la ligne supérieure contraindra le logiciel à inventer des désignations génériques dénuées de sens du type « Série 1, Série 2 », tandis que l’omission de la colonne d’ancrage privera l’axe principal de son assise qualitative.
Une fois la matrice circonscrite, l’activation du générateur graphique peut s’effectuer via deux vecteurs d’interface équivalents au sein de l’environnement Google Sheets : d’une part, par le biais de la barre d’outils supérieure via le menu textuel déroulant Insertion, en sélectionnant expressément l’élément opérationnel Graphique ; d’autre part, en cliquant sur l’icône vectorielle correspondante située sur le ruban d’outils contextuel. Cette action déclenche l’exécution des routines d’inférence visuelle du moteur tableur.
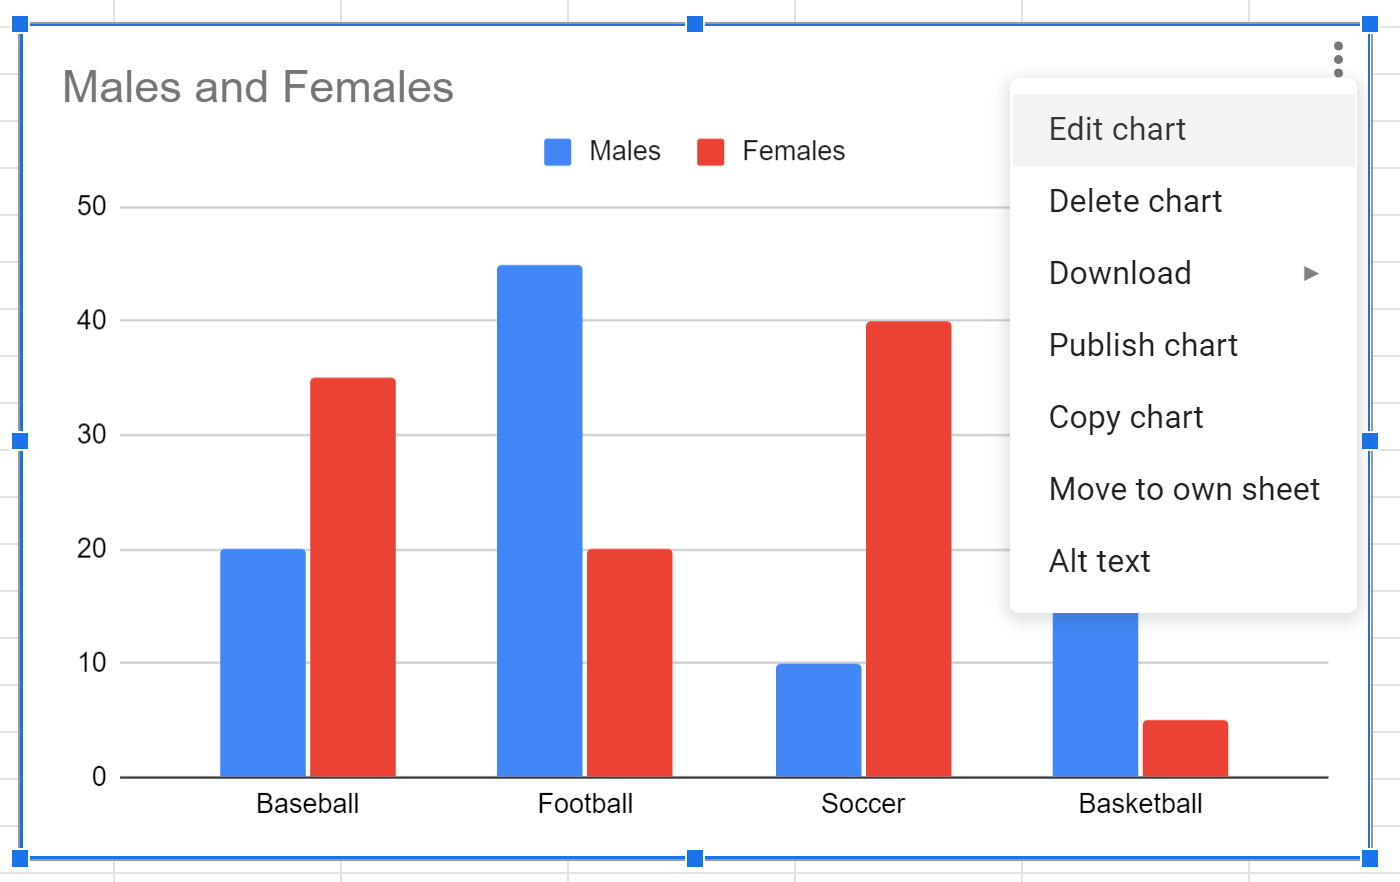
Par défaut, l’intelligence algorithmique intégrée de Google Sheets analyse la morphologie des données soumises et génère automatiquement un graphique estimé standard. Dans la majorité des configurations matricielles comprenant plusieurs colonnes scalaires adjacentes, le système instancie par présomption un graphique à colonnes groupées standard (*grouped column chart*). Cette matérialisation première, bien qu’inadaptée à nos objectifs de sommation cumulative, confirme que le logiciel a correctement indexé la pluralité des séries de données et prépare le terrain pour l’ajustement structurel des paramètres d’agrégation.
3.2 Accès et navigation dans l’éditeur de graphiques
Dès l’insertion de l’artefact visuel sur le canevas de la feuille active, l’interface utilisateur déploie automatiquement un volet latéral d’ingénierie dénommé l’Éditeur de graphiques. Si ce panneau venait à se fermer par inadvertance lors de manipulations annexes, sa réactivation immédiate demeure triviale : il suffit d’effectuer un double-clic directement sur le corps du graphique ou de cliquer sur le menu contextuel symbolisé par trois points verticaux alignés dans le coin supérieur droit du cadre graphique, puis de sélectionner la commande Modifier le graphique.
L’éditeur de graphiques s’organise selon une dichotomie fonctionnelle fondamentale matérialisée par deux onglets directeurs : l’onglet Configuration et l’onglet Personnaliser. Le premier gouverne la logique structurelle, relationnelle et computationnelle de l’objet graphique. C’est en son sein que s’opèrent le choix de la famille morphologique du tracé, l’assignation des axes, l’agrégation des séries, la désignation des plages de cellules d’ancrage et la sélection des modes mathématiques d’empilement.
L’onglet Personnaliser régit quant à lui la dimension sémiotique, stylistique et esthétique de la visualisation. Il offre un contrôle granulaire sur les palettes chromatiques, l’opacité des encres numériques, la typographie institutionnelle, la modélisation des bordures, le positionnement de la légende, ainsi que le calibrage précis des axes et des quadrillages cartésiens. La maîtrise opératoire du graphique à barres empilées impose de naviguer de manière coordonnée et méthodique entre ces deux univers d’ajustement technique.
4. Configuration du paramètre d’empilement dans l’éditeur de graphiques
4.1 Sélection du mode d’empilement standard
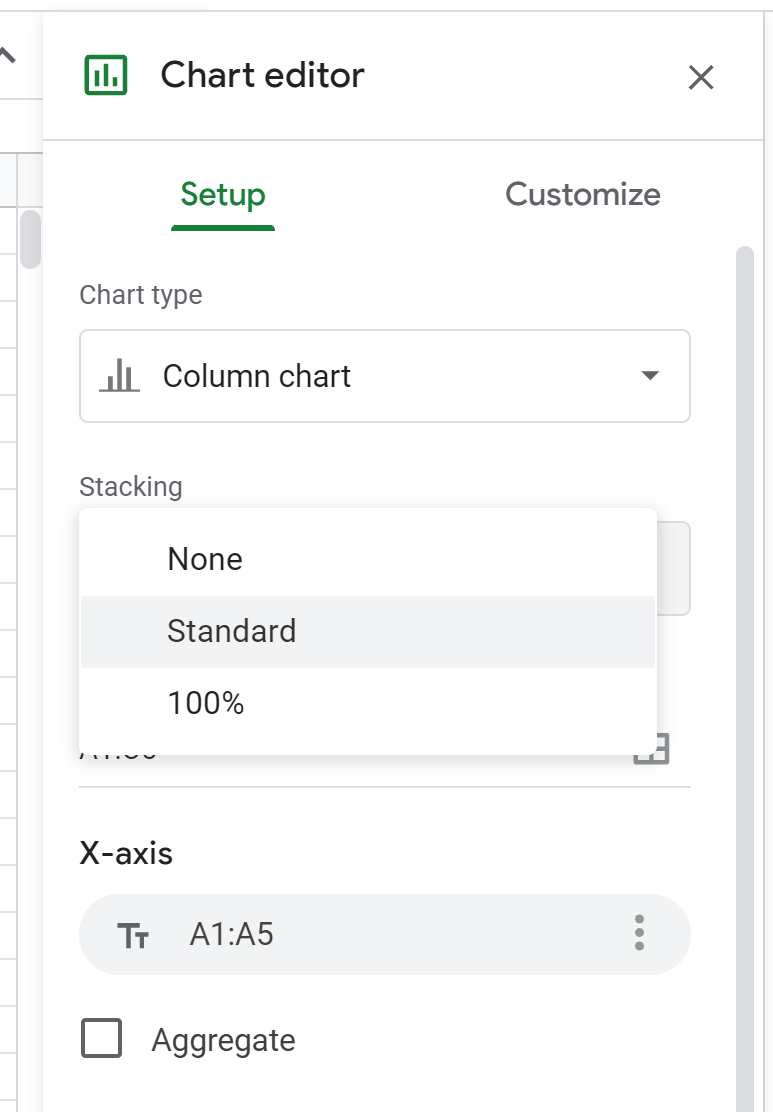
Pour convertir le graphique préliminaire en une structure véritablement cumulative, le praticien doit intervenir au niveau de la section Configuration du volet latéral. Sous le menu déroulant intitulé Type de graphique, l’utilisateur a la possibilité d’opter directement pour le pictogramme désignant le Graphique à colonnes empilées ou le Graphique à barres empilées. Alternativement, si un type de colonnes simples est initialement sélectionné, il convient de localiser plus bas dans le panneau la propriété nommée spécifiquement Empiler (*Stacking*), qui propose un sélecteur à options multiples.
Par défaut, ce sélecteur est assigné à l’état Aucun, maintenant les séries dans une contiguïté latérale disséquée. En activant l’option Standard, l’utilisateur ordonne au moteur de calcul de modifier la géométrie spatiale de la scène visuelle. Google Sheets recalcule alors instantanément les coordonnées cartésiennes des polygones de données : au lieu de partager la coordonnée zéro de la ligne de base pour chaque série, chaque segment voit son point d’origine vertical calé sur la valeur cumulative sommitale du segment qui le précède immédiatement dans la hiérarchie matricielle.
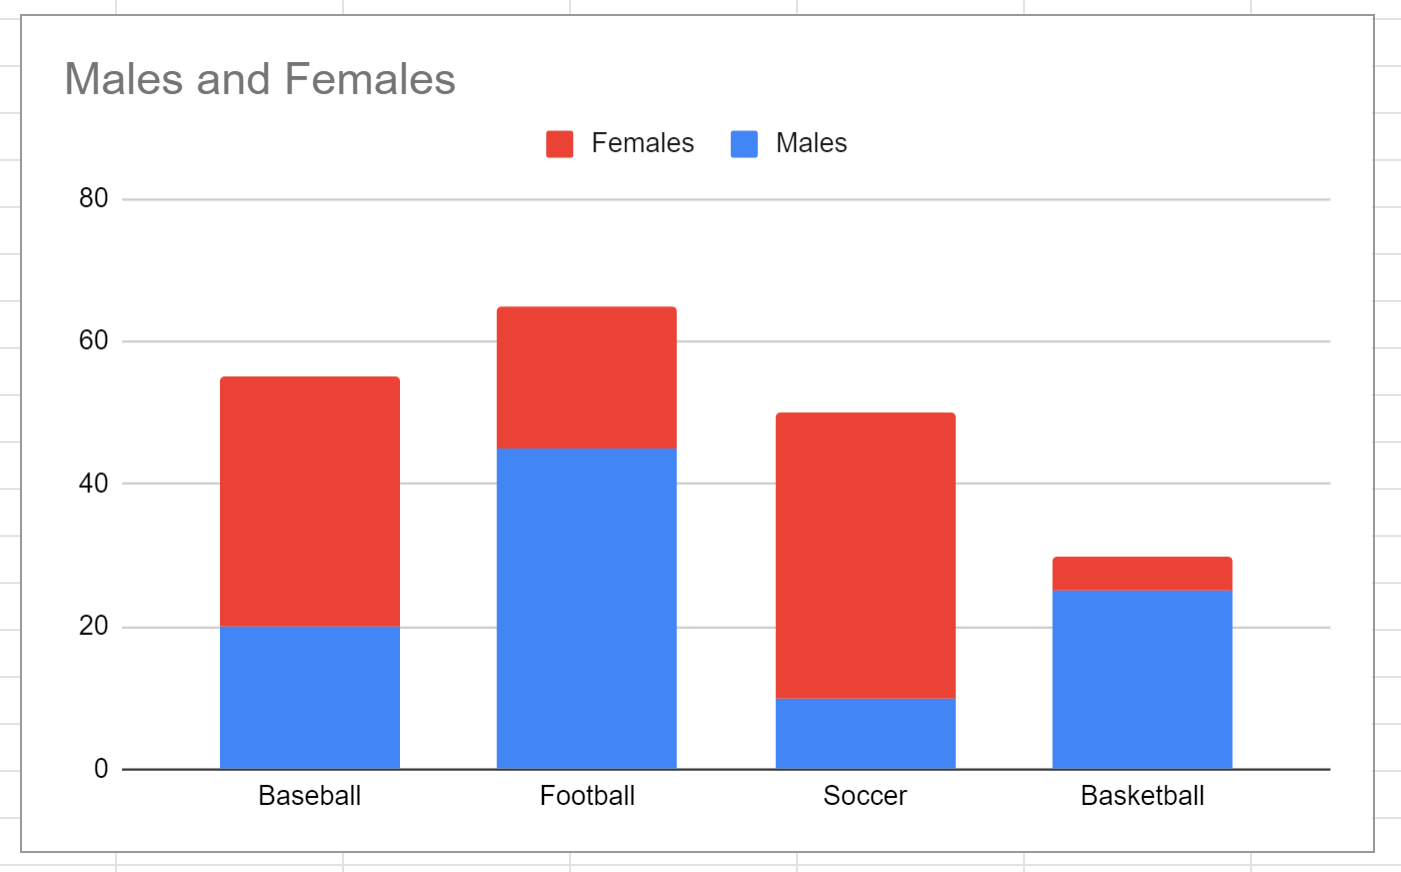
Cette transformation géométrique produit une mutation visuelle radicale. Les rectangles de couleur se hissent les uns au-dessus des autres pour composer une colonne segmentée unifiée par catégorie. La hauteur globale atteinte par le sommet de la pile représente désormais fidèlement la résultante arithmétique de la somme des composantes. Le chercheur doit valider visuellement cette phase en vérifiant que la valeur plafond de l’axe quantitatif s’est automatiquement ajustée pour absorber la somme marginale maximale de l’échantillon.
4.2 Inversion et permutation des axes selon la perspective analytique
Une étape conceptuelle décisive consiste à déterminer l’orientation géométrique optimale du tracé : orientation verticale (communément appelée « graphique à colonnes empilées ») ou orientation horizontale (désignée au sens strict sous le terme de « graphique à barres empilées »). Ce basculement s’opère instantanément dans le menu de sélection morphologique de Google Sheets. Le choix d’une disposition horizontale s’avère particulièrement préconisé dès lors que les libellés de la variable catégorielle primaire possèdent une longueur lexicale conséquente, évitant ainsi les troncatures textuelles disgracieuses ou les inclinaisons d’étiquettes à 45 ou 90 degrés qui entravent la vitesse de lecture séquentielle.
Parallèlement, la zone inférieure de l’onglet Configuration présente deux cases à cocher aux implications analytiques profondes : Intervertir les lignes et les colonnes (*Switch rows / columns*) et Utiliser la ligne 1 comme en-têtes / Utiliser la colonne A comme libellés. L’activation de la commande d’interversion modifie radicalement l’angle d’attaque sémiotique. Dans notre exemple de recherche, elle commuterait instantanément le graphique d’une structure comparant « les cohortes d’âge décomposées par niveau de satisfaction » vers une structure comparant « les niveaux de satisfaction décomposés par cohorte d’âge ».
Cette permutation n’est pas neutre : elle déplace le focus perceptif de l’évaluation des segments socio-démographiques vers l’évaluation structurelle des polarités d’opinion. L’analyste doit s’assurer avec une vigilance intransigeante que l’axe catégoriel primaire reflète scrupuleusement la variable indépendante fondamentale de son hypothèse de travail, évitant d’imposer au lecteur des contorsions interprétatives inutiles.
5. Distinction conceptuelle : Empilement standard versus Empilement à 100 %
5.1 L’empilement standard : Préservation des grandeurs absolues
L’empilement qualifié de « standard » au sein de Google Sheets ancre sa valeur heuristique dans la préservation inconditionnelle des grandeurs métriques absolues. Dans ce modèle, la hauteur physique totale de chaque colonne segmentée équivaut à la somme mathématique réelle des valeurs unitaires qui la constituent. Cette caractéristique autorise une lecture bi-scalaire : d’une part, l’observateur évalue les différentiels de masse totale entre les catégories grâce à l’alignement rigoureux des sommets sur l’échelle continue de l’axe principal ; d’autre part, il perçoit la contribution volumique brute apportée par chaque strate.
Cette modalité s’avère méthodologiquement indispensable lorsque la magnitude brute de la population observée constitue une variable d’intérêt primordiale dans l’interprétation des faits empiriques. À titre d’illustration, dans le reporting de budgets institutionnels ou l’analyse des dépenses énergétiques ventilées par source de combustible, il est impératif de visualiser non seulement l’évolution de la part relative du gaz ou du solaire, mais également l’expansion ou la réduction de l’empreinte de consommation globale au fil des exercices budgétaires.
Le tribut cognitif inhérent à ce choix réside toutefois dans la difficulté structurelle d’estimer les ratios internes lorsque les totaux marginaux des barres fluctuent fortement d’une unité à l’autre. Une strate quantitativement stable en volume absolu peut sembler optiquement se comprimer ou se dilater selon que le volume global de la colonne dans laquelle elle s’insère diminue ou progresse de manière abrupte, exposant le lecteur à des illusions géométriques d’écrasement ou d’amplification disproportionnée.
5.2 L’empilement à 100 % : Normalisation des proportions relatives
En activant l’option alternative désignée sous le vocable Empilé à 100 % dans le sélecteur d’empilement de Google Sheets, l’analyste applique un algorithme de transformation probabiliste à la matrice sous-jacente. Le moteur calcule dynamiquement la somme marginale de chaque ligne vectorielle, puis divise la valeur scalaire de chaque cellule par cette somme marginale avant d’opérer la mise à l’échelle graphique. Visuellement, toutes les barres adoptent instantanément une longueur géométrique strictement uniforme correspondant à la totalité unitaire de 100 % (ou 1,0 en valeur décimale standard).
L’avantage analytique majeur de ce paradigme réside dans l’optimisation spectaculaire de la comparaison structurelle interne. En éliminant l’hétérogénéité des tailles globales d’échantillons ou des volumes totaux, l’empilement à 100 % permet de confronter directement les compositions proportionnelles de groupes sociologiques ou d’unités expérimentales hétérogènes sur un pied d’égalité visuel parfait. C’est l’instrument d’excellence pour valider des hypothèses de glissement proportionnel ou des distributions de profils d’attitude.
Néanmoins, cette abstraction géométrique s’accompagne d’un coût épistémologique substantiel : l’effacement total de l’information relative à la magnitude absolue de l’échantillon. Une cohorte marginale ne comptant que 50 répondants présentera exactement la même emprise spatiale qu’une cohorte robuste regroupant 5 000 individus. Sans une mention contextuelle rigoureuse ou une annotation textuelle explicite du `N` total associé à chaque barre, le graphique empilé à 100 % peut induire une illusion d’équivalence statistique hautement trompeuse pour la communauté des pairs ou les décideurs publics.
5.3 Critères décisionnels de sélection du mode d’empilement
Le choix entre l’empilement standard et l’empilement à 100 % ne saurait relever d’une simple préférence cosmétique ; il doit résulter d’un arbitrage méthodologique fondé sur la primauté des questions de recherche :
Tableau 2. Matrice d’arbitrage méthodologique pour la sélection du mode d’empilement :
- Objectif scientifique : Démonstration de l’expansion d’une capacité globale ou d’une masse volumique. Option recommandée : Empilement Standard (car la hauteur cumulée reflète l’échelle réelle des stocks ou des flux).
- Objectif scientifique : Analyse de la reconfiguration sociologique ou morphologique interne indépendamment du volume global. Option recommandée : Empilement à 100 % (car la standardisation relative supprime le bruit lié aux tailles d’échantillons inégales).
- Risque d’artefact statistique : Échantillons aux effectifs marginaux excessivement disparates (ex. groupe A = 10 000, groupe B = 12). Recommandation formelle : Recourir à l’empilement standard ou expliciter impérativement les effectifs totaux bruts au sommet ou au pied des barres normalisées pour prévenir toute surinterprétation des micro-variations de strates sous-échantillonnées.
En définitive, si l’analyse vise à répondre à la question « Comment évolue le volume total et comment se répartissent ses composantes ? », l’empilement standard s’impose sans réserve. Si la problématique centrale se résume à « Quelle est la distribution interne relative des composantes au sein de chaque groupe considéré isolément ? », l’empilement normalisé à 100 % constitue l’outil de formalisation le plus pertinent et le plus rigoureux sur le plan démonstratif.
6. Personnalisation avancée des séries et de la palette chromatique
6.1 Choix épistémologique et psychophysique des couleurs
L’assignation chromatique au sein d’un graphique à barres empilées dépasse largement les considérations d’ordre esthétique pour engager directement les principes de la psychophysique de la vision humaine. Dans la mesure où les segments de données sont physiquement contigus et accolés le long d’une même pile, l’effet de contraste simultané théorisé par Michel-Eugène Chevreul peut induire des altérations perceptives majeures de la teinte et de la clarté apparente d’un segment en fonction de la couleur du rectangle qui le jouxte immédiatement. Une conception rigoureuse exige le recours à des palettes dites perceptuellement uniformes.
Il convient d’adopter une stratégie chromatique strictement alignée sur le statut métrique des sous-séries. Dans le cas d’une variable ordinale gradée (telle que notre échelle de satisfaction allant d’« Insatisfait » à « Très satisfait »), l’encodage le plus performant réside dans le déploiement d’une palette séquentielle monochrome ou à double divergence thermique (par exemple, une transition continue allant de l’ambre sombre vers le sarcelle profond en passant par des teintes neutres insaturées). L’utilisation de couleurs qualitatives aléatoires et bigarrées pour des concepts gradués génère une dissonance cognitive aiguë en suggérant des ruptures ontologiques là où n’existe qu’une variation d’intensité continue.
Par ailleurs, les exigences d’accessibilité universelle et d’inclusivité imposent de tester systématiquement la lisibilité de la palette vis-à-vis des diverses formes de dyschromatopsie (notamment la deutéranopie et la protanopie, qui affectent une proportion significative de la population masculine). Il est impératif de proscrire formellement l’antagonisme binaire classique « rouge versus vert » lorsqu’il encode des strates contiguës critiques, au profit de combinaisons plus robustes telles que les contrastes bleu-orange ou violet-jaune, perceptibles sans ambiguïté à travers l’ensemble des spectres visuels humains.
6.2 Modification manuelle de chaque sous-série
L’intervention sur les caractéristiques chromatiques individuelles des séries s’opère au sein de l’onglet Personnaliser de l’éditeur de graphiques, dans la section dédiée intitulée Séries. Google Sheets offre une granularité de contrôle remarquable : en activant le sélecteur de série déroulant (qui affiche par défaut la mention globale Appliquer à toutes les séries), le praticien peut isoler une sous-composante spécifique pour en modifier les attributs géométriques et visuels sans impacter les autres strates du diagramme.
Pour chaque série sélectionnée, l’utilisateur a la possibilité de redéfinir la Couleur de remplissage via un nuancier matriciel étendu ou par l’injection directe de codes hexadécimaux normalisés conformes à la charte graphique de son institution de recherche. Au-delà de la teinte pure, le réglage du paramètre d’Opacité du remplissage (idéalement calibré entre 80 % et 90 %) permet de tempérer l’agressivité visuelle des aplats massifs tout en conservant une netteté de contour parfaite, minimisant ainsi la fatigue oculaire lors de l’examen prolongé de figures statistiques denses.
Un raffinement technique d’une importance capitale dans les graphiques à barres empilées réside dans la configuration de la Couleur du trait (ou bordure de segment). L’application d’un liseré périphérique discret, décliné dans une nuance neutre (blanc pur `#FFFFFF` pour des arrière-plans clairs, ou gris ardoise très sombre pour des interfaces sombres) avec une épaisseur minimale de 1 point, matérialise des frontières géométriques d’une précision cristalline entre les strates adjacentes. Ce partitionnement évite que des teintes contiguës de saturation similaire ne fusionnent optiquement, garantissant une résolution spatiale irréprochable des segments.
6.3 Harmonisation esthétique globale et lisibilité institutionnelle
La production d’une figure scientifique répond au principe fondamental de sobriété sémiotique énoncé par Edward Tufte sous la notion de maximisation du « ratio encre-données » (*data-ink ratio*). Toute fioriture graphique non porteuse de sens — communément désignée sous le terme péjoratif de *chartjunk* — doit être impitoyablement bannie. Dans Google Sheets, cela implique l’élimination systématique des effets d’ombrage portés, des bordures de cadre extérieures épaisses et surtout des déformations tridimensionnelles (options 3D disponibles dans le menu Style de graphique), dont l’aberration perspective fausse irrémédiablement l’estimation des volumes et viole les principes directeurs de l’infographie savante.
L’arrière-plan du graphique doit être conservé dans un état de neutralité absolue, privilégiant une transparence totale ou un blanc immaculé (`#FFFFFF`). Cette disposition favorise une intégration sans heurt du canevas visuel dans le corps rédactionnel d’un article universitaire ou d’un rapport institutionnel, sans créer de rupture visuelle artificielle au sein de la page.
Enfin, la cohérence typographique participe directement de l’autorité académique du document. Dans la section Style de graphique, l’analyste sélectionnera une police sans empattement (*sans-serif*) à forte lisibilité telle que Roboto, Arial ou Calibri, et veillera à harmoniser rigoureusement cette police sur l’ensemble des composantes textuelles du visuel (titres, étiquettes d’axes, mentions de légende et marqueurs de données), maintenant ainsi une unité formelle garante d’une expérience de lecture professionnelle.
7. Configuration et optimisation des axes et de l’échelle métrique
7.1 Paramétrage de l’axe quantitatif vertical
L’intégrité déontologique de la représentation statistique repose en premier lieu sur le paramétrage rigoureux de l’axe quantitatif cartésien (l’axe vertical dans une configuration en colonnes, l’axe horizontal dans une disposition en barres). Dans l’onglet Personnaliser, sous la rubrique Axe vertical, il est formellement exigé de fixer la valeur minimale de l’échelle à zéro absolu. Tronquer l’axe quantitatif pour commencer à une valeur arbitraire non nulle constitue une manipulation visuelle sévère : cette troncature amplifie démesurément les écarts relatifs entre les barres et oblitère totalement la fidélité de l’évaluation surfacique de la partie au tout, altérant fondamentalement la probité de la démonstration scientifique.
La valeur maximale de l’échelle gagne à être définie de façon délibérée plutôt que d’être laissée à l’arbitrage dynamique de l’algorithme. Pour un empilement standard, fixer un plafond légèrement supérieur à la somme marginale la plus élevée permet de dégager une zone de respiration spatiale au sommet des barres, évitant que le rectangle le plus haut ne heurte agressivement la bordure supérieure du canevas. Pour un graphique empilé à 100 %, l’analyste fixera rigoureusement la borne maximale à 1 (ou 100 %), neutralisant ainsi toute velléité d’extension erratique de l’échelle au-delà du seuil totalitaire.
Le réglage du formatage numérique affine l’intelligibilité des repères de lecture. Google Sheets permet d’appliquer des facteurs d’échelle (milliers, millions) ou d’imposer des masques de formatage personnalisé. Il convient de bannir les décimales superflues qui surchargent visuellement l’axe vertical sans apporter de gain informationnel significatif : des graduations entières rondes (par exemple des incréments de 200 unités ou de 20 %) garantissent un balayage oculaire fluide et instantané des amplitudes numériques.
7.2 Aménagement de l’axe qualitatif horizontal
L’ordonnancement et la lisibilité spatiale de l’axe catégoriel primaire conditionnent la transmission du sens conceptuel de la modélisation. Accessible sous la section Axe horizontal, le traitement des libellés textuels réclame une vigilance particulière. Par défaut, lorsque le nombre de catégories est élevé ou que les dénominations s’avèrent étendues, Google Sheets peut tronquer certains mots ou opérer une sélection alternée en omettant arbitrairement une catégorie sur deux. Cette dégradation ergonomique inacceptable doit être jugulée en calibrant l’angle de rotation des étiquettes (en optant pour une disposition horizontale stricte, ou à défaut une inclinaison standardisée à 30 ou 60 degrés) ou en convertissant le tracé vers une orientation horizontale à barres latérales.
L’agencement des modalités catégorielles ne doit jamais être abandonné au hasard de la saisie matricielle initiale. Trois logiques de tri ordonné s’imposent selon les caractéristiques de l’enquête :
- Le tri chronologique ou séquentiel : Incontournable pour les variables temporelles ou les échelles de cohortes progressives (ex. 18-25 ans, 26-40 ans, etc.), respectant la flèche vectorielle de l’expérience humaine.
- Le tri par magnitude marginale globale : Recommandé pour les variables nominales indépendantes, classant les unités de la plus volumineuse à la plus restreinte pour faciliter l’identification instantanée des pôles de dominance empirique.
- Le tri normatif ou taxonomique : Justifié lorsque l’analyse s’adosse à une nomenclature scientifique officielle (classification internationale des maladies, nomenclature d’activités économiques standardisée).
En aucun cas l’analyste ne tolérera un ordonnancement alphabétique fortuit imposé par la base de données lorsque celui-ci entre en conflit direct avec la rationalité intrinsèque de la variable étudiée.
7.3 Traitement des quadrillages et repères visuels
Le quadrillage cartésien joue un rôle de guide géométrique destiné à compenser la difficulté naturelle de l’œil humain à projeter mentalement la coordonnée sommitale d’une barre vers l’axe de référence numérique distant. Dans la section Quadrillage et graduations de l’éditeur, l’ingénierie visuelle commande un réglage d’une grande subtilité quantométrique : les lignes de quadrillage principales (*major gridlines*) doivent être maintenues, mais leur intensité optique doit être drastiquement atténuée au moyen d’un gris perle extrêmement pâle (`#E0E0E0` ou `#EEEEEE`), avec un tracé filiforme ne dépassant pas un demi-point d’épaisseur.
Cette discrétion structurelle garantit que le quadrillage assume pleinement sa fonction utilitaire de repérage spatial sans entrer en compétition perceptive avec les segments volumiques colorés du diagramme. À l’inverse, les lignes de quadrillage secondaires (*minor gridlines*) constituent presque invariablement une pollution visuelle dispensable qui fragmente inutilement l’espace graphique ; leur désactivation pure et simple constitue une bonne pratique standard en typographie statistique.
Enfin, l’activation discrète des petits repères de graduation (*tick marks*) extérieurs le long de l’axe quantitatif apporte un ancrage supplémentaire bienvenu. Ces marqueurs minuscules définissent l’emplacement exact de chaque palier numérique sur la ligne d’axe, assurant une lecture métrologique sans équivoque des grandeurs observées.
8. Ajout et mise en forme des étiquettes de données et légendes
8.1 Positionnement et calibrage des étiquettes numériques internes
L’intégration d’étiquettes de données (*data labels*) numériques au cœur même des segments géométriques transforme une visualisation purement comparative en un instrument de mesure directe, affranchissant l’observateur d’un va-et-vient fastidieux vers l’axe des ordonnées. Dans Google Sheets, l’activation de cette fonctionnalité s’exécute au sein de la rubrique Séries, en cochant la case idoine Libellés de données. L’analyste peut choisir d’appliquer cette mesure globalement à l’ensemble du canevas ou de la réserver sélectivement à certaines strates hautement stratégiques.
La question du placement géométrique de ces étiquettes textuelles s’avère critique : les options d’ancrage incluent le Centre, la Base intérieure ou l’Extrémité intérieure du segment. Pour un graphique empilé, le centrage absolu au sein de chaque polygone élémentaire offre généralement l’équilibre morphologique le plus stable. La contrainte majeure réside toutefois dans la gestion des strates à faible magnitude : lorsqu’un segment présente une épaisseur infime, le libellé numérique excède l’enveloppe spatiale disponible et déborde disgracieusement sur les strates contiguës, induisant un brouillage visuel particulièrement néfaste.
Pour surmonter cet écueil, le praticien veillera à ajuster rigoureusement la taille typographique (optant pour un corps de caractère réduit mais parfaitement net, typiquement entre 8 et 10 points) et à définir une couleur textuelle offrant un contraste chromatique intransigeant (idéalement le blanc pur `#FFFFFF` sur des segments denses et saturés, ou le noir d’encre `#000000` sur des segments pastels). Si la densité de la matrice rend les chevauchements inévitables, il est méthodologiquement plus sain de renoncer aux étiquettes internes et de privilégier un tableau synoptique annexe ou de ne matérialiser textuellement que les valeurs des strates primordiales.
8.2 Configuration sémiotique de la légende
La légende d’un graphique segmenté constitue la clé de décodage sémiotique indispensable à l’attribution du sens fonctionnel de chaque strate chromatique. Sa localisation spatiale, gouvernée par la section Légende du menu de personnalisation, conditionne l’efficience de la trajectoire oculaire du lecteur. Si Google Sheets propose diverses positions préétablies (haut, bas, gauche, droite), le positionnement au sommet horizontal ou sur le flanc droit représente la norme la plus robuste sur le plan de l’ergonomie visuelle.
Un impératif ergonomique fondamental trop souvent violé concerne la conformité stricte de l’ordre d’énonciation : l’agencement séquentiel des éléments de la légende doit impérativement reproduire à l’identique l’ordre physique d’empilement spatial des séries au sein des colonnes. Si la série « Très satisfait » trône au sommet de la pile physique de données, elle doit figurer en première position (ou au sommet de la liste verticale) au sein de la boîte de légende. Tout déphasage entre la séquence spatiale des barres et la séquence lexicale de la légende impose une gymnastique mentale superflue à l’observateur, retardant le décodage analytique de l’information.
Les formulations textuelles de la légende doivent briller par leur concision chirurgicale. Les descripteurs verbeux issus des intitulés de requêtes SQL ou de bases de données brutes doivent être nettoyés et abrégés en étiquettes synthétiques de un à deux mots, éliminant tout bruit textuel susceptible d’encombrer inutilement la périphérie du canevas analytique.
8.3 Formulation des titres et annotations explicatives
L’autonomie fonctionnelle d’un graphique scientifique exige que celui-ci puisse être pleinement appréhendé sans qu’il soit obligatoirement nécessaire de se reporter au corps du texte environnant. Ce principe d’auto-suffisance repose sur une architecture textuelle rigoureuse configurée dans la section Titres des graphiques et des axes de Google Sheets. Le titre principal ne doit pas se borner à une description tautologique superficielle (telle que « Graphique des résultats »), mais énoncer clairement la nature du phénomène modélisé, l’échantillon ou le champ géographique considéré ainsi que la temporalité de l’observation empirique.
Le recours à un Sous-titre du graphique permet de délester l’en-tête principal en y consignant les spécifications métrologiques cruciales : l’unité de mesure exacte (ex. « Effectifs bruts recensés », « Pourcentages relatifs normalisés ») ainsi que la taille totale de l’échantillon d’étude (la métrique `N`). Cette standardisation offre au lecteur un ancrage immédiat pour calibrer son niveau de certitude statistique face aux distributions visualisées.
Enfin, l’insertion de mentions de bas de graphique — sous forme d’étiquettes de données complémentaires ou d’annotations textuelles intégrées — s’avère indispensable pour documenter les sources primaires des données (« Source : Enquête Ergonomie & Interfaces, Q3 2023 »), expliciter le statut dérogatoire éventuel de certaines observations aberrantes ou signaler des ruptures de séries méthodologiques. Cette transparence documentaire constitue le gage suprême de l’honnêteté et de la reproductibilité scientifique du travail de recherche présenté.
9. Gestion des données manquantes, aberrantes et des variables nulles
9.1 Incidence structurelle des valeurs nulles dans la pile
Dans l’architecture mécanique d’un graphique à barres empilées, la survenue d’une valeur arithmétique rigoureusement égale à zéro (`0`) au sein d’une série matricielle requiert une appréhension géométrique précise. Lorsqu’une cellule renvoie zéro, Google Sheets attribue une hauteur scalaire nulle au polygone correspondant : le segment n’occupe aucun espace linéaire le long de la coordonnée cartésienne. La pile continue de s’élever sans interruption en reliant directement la strate inférieure précédente à la strate supérieure subséquente, préservant la continuité spatiale générale de la colonne.
Néanmoins, si cette neutralité géométrique garantit l’exactitude de la sommation cumulative marginale, elle peut susciter des interrogations interprétatives légitimes chez le lecteur néophyte, qui constatera la disparition apparente d’une couleur thématique au sein de la barre considérée. L’analyste doit veiller à ce que cette absence visuelle ne soit pas interprétée à tort comme une défaillance technique d’affichage ou une corruption du tracé matriciel.
Dans les rapports d’audit statistique à haut niveau de contrôle, il est de bonne pratique d’assortir le graphique d’une mention d’annotation spécifique ou d’une note de bas de page précisant formellement que l’absence de certains segments colorés au sein d’une cohorte donnée correspond à une fréquence observée strictement nulle (`n = 0`), dissipant toute ambiguïté sur la complétude du protocole de recueil des données.
9.2 Traitement des données non renseignées ou lacunaires
Une distinction épistémologique et informatique capitale doit être opérée entre une cellule matricielle contenant la valeur zéro et une cellule vide résultant d’une omission de mesure ou d’une non-réponse. Dans l’architecture interne de Google Sheets, les cellules vides ou contenant des valeurs non numériques (comme des chaînes de texte résiduelles) ne sont pas sommables. Si le moteur graphique gère généralement la cellule vide en lui affectant temporairement une magnitude nulle pour ne pas interrompre le rendu de la pile, des discontinuités algorithmiques plus pernicieuses peuvent survenir lors de l’application de fonctions conditionnelles matricielles.
Contrairement aux graphiques linéaires continus — qui proposent une option explicite pour combler les lacunes d’échantillonnage par interpolation linéaire (*interpolate missing data*) —, le graphique à barres empilées ne tolère aucune interpolation géométrique : chaque barre reflète exclusivement la réalité ponctuelle de son agrégat catégoriel. Si une cellule demeure non documentée au sein d’un vecteur sous-jacent, le segment correspondant est simplement escamoté, ce qui entraîne une sous-estimation artificielle du volume marginal total de la catégorie concernée si la cellule vide dissimulait une valeur réelle non mesurée.
Le protocole méthodologique impose donc d’assainir la matrice en amont : soit en imputant les valeurs manquantes via des algorithmes statistiques contrôlés (moyennes pondérées de sous-groupes, modélisation par régression) avant la projection graphique, soit en consignant formellement une modalité d’attente explicite nommée « Non déterminé » ou « Données manquantes » dotée de son propre volume effectif, garantissant ainsi que le périmètre arithmétique de l’échantillon demeure d’une totale intégrité mathématique.
9.3 Gestion des ordres de grandeur asymétriques
L’un des défis morphologiques les plus redoutables posés par l’empilement graphique concerne l’extrême asymétrie de distribution des ordres de grandeur au sein d’une même pile. Lorsqu’une composante ultra-majoritaire (captant par exemple 95 % de la masse marginale) cohabite avec une pluralité de sous-composantes marginales résiduelles (pesant chacune moins de 1 %), ces dernières se trouvent écrasées en des strates linéaires micrométriques quasi invisibles à l’œil nu. L’encodage par la longueur perd alors toute son efficacité perceptive, transformant ces strates minoritaires en de simples artefacts chromatiques indéchiffrables.
Face à cette contrainte géométrique irréductible, plusieurs solutions de contournement s’offrent au concepteur averti :
- L’agrégation analytique résiduelle : Fusionner méthodologiquement l’ensemble des séries à très faible magnitude au sein d’une classe unifiée dénommée explicitement « Autres » ou « Divers », dont la masse combinée atteint un seuil de visibilité graphique suffisant pour être appréhendé sans distorsion.
- La dissociation focale par graphique dérivé : Conserver les composantes dominantes au sein du graphique principal et produire un graphique secondaire détaillé (diagramme à barres agrandi ou vue transversale focalisée) dédié à la dissection microscopique de la classe résiduelle.
- La proscription absolue de la transformation logarithmique : S’interdire formellement l’usage d’une échelle logarithmique sur l’axe vertical d’un graphique empilé. Si l’échelle log permet d’exalter les micro-grandeurs dans un tracé simple, la propriété mathématique `log(A + B) ≠ log(A) + log(B)` rend l’empilement géométrique sur une échelle logarithmique strictement faux et arithmétiquement incohérent.
Le maintien de la probité scientifique exige d’adapter la structure des variables plutôt que de tordre les lois de la géométrie euclidienne au détriment de la vérité des données.
10. Erreurs méthodologiques fréquentes et diagnostics de dépannage
10.1 Écueils d’inversion des axes et de mauvaise ségrégation des séries
L’une des anomalies les plus courantes rencontrées lors de l’instanciation automatique d’un graphique empilé dans Google Sheets réside dans l’inversion involontaire du système d’axes. Ce phénomène se manifeste lorsque le logiciel méconnaît la dimension directrice principale et regroupe les données sous un format aberrant où, par exemple, chaque barre représente une strate d’opinion tandis que les tranches d’âge se retrouvent empilées les unes sur les autres. Ce désalignement détruit la trajectoire démonstrative initiale en substituant la variable dépendante à la variable indépendante sur l’axe primaire d’exposition.
Le diagnostic de ce dysfonctionnement est immédiat à l’examen de l’axe horizontal. Pour restaurer l’intégrité de la structure analytique, l’utilisateur doit intervenir dans l’onglet Configuration de l’éditeur de graphiques :
- Vérifier et cocher ou décocher la case fonctionnelle Intervertir les lignes et les colonnes jusqu’à rétablir la variable pivot souhaitée sur l’axe primaire des abscisses.
- S’assurer que la case Utiliser la ligne 1 comme en-têtes est explicitement activée afin que les dénominations qualitatives des séries ne soient pas amalgamées à des observations numériques ordinaires.
- Confirmer l’activation de la case Utiliser la colonne A comme libellés, garantissant que les identifiants d’observation structurent la segmentation de l’axe catégoriel.
Ce réalignement instantané réassigne les séries matricielles dans leurs fuseaux orthogonaux légitimes, restaurant la validité fonctionnelle de la visualisation cumulative.
10.2 Biais cognitifs induits par l’évaluation des segments non alignés
Comme l’ont magistralement démontré Cleveland et McGill dans leurs traités expérimentaux sur la cognition graphique, l’être humain est remarquablement performant pour évaluer la position relative d’éléments alignés sur une échelle commune, mais accuse un taux d’erreur statistique significatif dès lors qu’il doit juger de la longueur de segments « flottants » dépourvus d’ancrage basal direct. Dans un graphique empilé comportant plus de trois séries, les strates intermédiaires souffrent structurellement de ce biais perceptif : leurs limites inférieures et supérieures ondulant au gré des variations des strates qui les soutiennent, l’observateur est incapable d’estimer avec précision si le segment lui-même grandit, régresse ou stagne d’une catégorie à la suivante.
Pour atténuer ce biais cognitif inhérent à la morphologie du diagramme empilé, l’analyste rigoureux mettra en œuvre des palliatifs méthodologiques ciblés :
- Le positionnement stratégique sur la ligne de base : Placer impérativement la série dont la comparaison exacte constitue la question scientifique prioritaire en toute première position de la matrice (tout en bas de la pile), là où elle bénéficie d’un ancrage parfait sur la ligne zéro partagée.
- L’adjonction sélective des libellés numériques : Intégrer les valeurs textuelles précises au sein des segments flottants pour désamorcer l’illusion optique par une lecture métrique objective immédiate.
- L’arbitrage vers des visualisations alternatives : Si l’objectif principal réside dans la comparaison chirurgicale et fine de chaque série individuelle à travers les groupes plutôt que dans l’évaluation du volume global cumulé, renoncer à l’empilement au profit d’un graphique à barres groupées standard ou d’une matrice de petits multiples (*small multiples*), infiniment plus respectueux de la fidélité comparative inter-séries.
L’honnêteté intellectuelle du statisticien s’incarne dans cette lucidité face aux limites perceptives intrinsèques des outils qu’il déploie.
10.3 Dysfonctionnements de mise à jour dynamique et ruptures de liens
Un dysfonctionnement technique récurrent au sein de Google Sheets concerne la désynchronisation de l’objet graphique lors de l’adjonction subséquente de nouvelles lignes d’observations ou de nouvelles colonnes de variables au sein de la feuille de calcul. Dans sa configuration initiale, l’étendue matricielle saisie par le logiciel se fige sur des coordonnées cartésiennes fermées (par exemple `A1:E5`). Tout enregistrement inséré subséquemment à la ligne 6 ou à la colonne F demeure purement et simplement exclu de la projection visuelle, conduisant à des analyses fondées sur des jeux de données périmés ou tronqués.
Pour immuniser durablement le graphique contre ce risque de rupture de chaîne opérationnelle, il convient de modifier la définition de la Plage de données dans l’onglet Configuration en adoptant une syntaxe d’adressage matriciel ouverte. Remplacer une référence rigide `A1:E5` par une notation dynamique non bornée verticalement du type `A1:E` garantit que toute insertion nouvelle dans les lignes inférieures sera instantanément ingérée par le moteur graphique et intégrée à la pile sans nécessiter de reconfiguration manuelle ultérieure.
Par ailleurs, dans le cas d’anomalies résiduelles d’affichage consécutives à des modifications de formules complexes ou à des importations volumineuses, un simple rafraîchissement du cache de calcul — opéré en modifiant temporairement une cellule quelconque puis en l’annulant, ou en forçant le rechargement de la page de navigation — permet de purger les descripteurs graphiques internes et d’assurer une réplication visuelle conforme à l’état réel de la mémoire matricielle.
11. Applications analytiques avancées et interactivité dynamique
11.1 Alimentation dynamique via des tableaux croisés dynamiques
Dans les architectures de données contemporaines, les données sources se présentent rarement sous la forme de matrices bidimensionnelles préalablement consolidées, mais plutôt sous l’aspect de tables relationnelles brutes dites « plates » ou transactionnelles, où chaque ligne consigne un événement élémentaire horodaté comportant une multitude d’attributs qualitatifs et de mesures continues. Pour alimenter un graphique à barres empilées à partir d’un tel lac de données sans recourir à des agrégations manuelles fastidieuses, l’interfaçage avec un Tableau croisé dynamique (TCD) constitue la démarche méthodologique la plus robuste.
L’opération se déploie avec une rigueur systématique :
- L’analyste sélectionne la table transactionnelle brute et appelle l’outil de création de TCD via le menu Données > Tableau croisé dynamique, de préférence sur une feuille de calcul dédiée.
- Dans l’éditeur de tableau croisé dynamique, la variable explicative catégorielle primaire est assignée au compartiment des Lignes, matérialisant les futurs piliers verticaux du diagramme.
- La dimension qualitative secondaire régissant les sous-strates est insérée dans la section des Colonnes, générant l’éclatement horizontal des futures séries empilées.
- La métrique quantitative d’intérêt est déposée dans le compartiment des Valeurs, en sélectionnant la fonction d’agrégation mathématique adéquate (somme arithmétique `SOMME`, effectif unitaire `NB` ou moyenne pondérée).
Une fois cette matrice de contingence dynamique formalisée, il suffit d’insérer le graphique empilé en pointant directement sur la plage couverte par le TCD (en veillant à exclure scrupuleusement la ligne et la colonne réservées aux totaux généraux pour ne pas doubler artificiellement l’échelle cumulative). Toute nouvelle transaction ajoutée à la base de données brute viendra instantanément actualiser le TCD, dont la répercussion sur le graphique empilé sera absolument immédiate et transparente, assurant un pipeline de restitution analytique pérenne et automatisé.
11.2 Couplage avec des fonctions de requêtage et de filtrage
Pour repousser les frontières fonctionnelles de Google Sheets et ériger de véritables tableaux de bord interactifs de niveau décisionnel, l’association du graphique à barres empilées avec la formidable puissance de la fonction relationnelle `QUERY` ouvre des horizons analytiques considérables. En exploitant la syntaxe quasi-SQL de `QUERY`, l’analyste peut générer une matrice de données intermédiaire entièrement automatisée et assujettie à des conditions logiques complexes et des filtres paramétriques stricts.
Considérons une expression programmatique matricielle typique déployée dans la cellule d’ancrage d’une feuille de synthèse :
=QUERY(DonneesBrutes!A1:G10000; "SELECT A, SUM(D), SUM(E), SUM(F) WHERE B = 'Zone Nord' GROUP BY A ORDER BY A LABEL SUM(D) 'Niveau 1', SUM(E) 'Niveau 2', SUM(F) 'Niveau 3'"; 1)
Cette formule interroge un registre de dix mille entrées, filtre sélectivement les observations afférentes à un segment géographique unitaire, agrège les composantes continues sous forme de sommes groupées par cohorte, ordonne la séquence logique et standardise les en-têtes nominaux des séries en une seule passe algorithmique. Le graphique à barres empilées adossé à cette cellule pivot se transforme dès lors en un visualiseur analytique adaptatif de haute volée.
Pour doter cette architecture d’une interactivité conviviale sans nécessiter l’écriture de code de programmation complexe pour l’utilisateur final, l’analyste peut insérer des Segments (*Slicers*) via le menu Données > Ajouter un segment. Ces contrôles d’interface utilisateur flottants permettent aux réviseurs de filtrer dynamiquement le jeu de données selon diverses variables modératrices (dates, statuts, régions) par de simples clics contextuels, recalculant instantanément les strates matricielles et animant la morphologie du graphique empilé en temps réel sous leurs yeux.
11.3 Intégration de formules matricielles pour le calcul automatique des totaux
Bien que le graphique à barres empilées standard traduise visuellement l’amplitude du volume total par la hauteur sommitale de chaque pilier géométrique, Google Sheets ne dispose pas nativement d’une fonction unifiée permettant d’afficher à la fois les étiquettes de données à l’intérieur de chaque sous-segment ET le score total global au sommet de la colonne. Pour pallier cette carence logicielle majeure sans introduire de redondances manuelles, le recours aux formules matricielles dynamiques s’impose comme une élégante astuce d’ingénierie tabulaire.
En mobilisant la fonction d’expansion automatique `ARRAYFORMULA`, l’utilisateur peut insérer une colonne marginale adjacente à sa matrice de données sous-jacente calculant en temps réel la somme vectorielle de chaque ligne :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; SOMME.SI.ENS(...))) ou de façon plus élémentaire : =ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; B2:B + C2:C + D2:D + E2:E))
Une fois cette colonne de sommation dynamique matérialisée dans la grille, une technique de rendu graphique sophistiquée consiste à incorporer cette série supplémentaire au sein du graphique et à modifier sa morphologie individuelle dans l’onglet Personnaliser > Séries : en configurant ce composant d’agrégation marginale non pas comme une strate de barre empilée, mais comme une série combinée de type linéaire (*Ligne*) dont la couleur de tracé est rendue strictement invisible (opacité fixée à 0 %), l’analyste peut activer l’étiquette de données de cette série fantôme positionnée en son sommet. Le résultat optique est parfait : la valeur numérique de la magnitude totale trône au-dessus de chaque colonne cumulée, coiffant harmonieusement la segmentation interne sans polluer le calcul géométrique des strates sous-jacentes.
12. Synthèse méthodologique et bonnes pratiques pour la communication scientifique
12.1 Critères d’évaluation de la conformité aux normes académiques
La formalisation finale d’un graphique à barres empilées destiné à intégrer le corpus d’un mémoire doctoral, d’une monographie de recherche ou d’un article soumis aux revues à comité de lecture doit répondre à des critères d’évaluation drastiques calqués sur les canons internationaux de publication, notamment ceux édictés par l’American Psychological Association (normes APA, 7e édition). La figure doit faire preuve d’une autonomie sémiotique intégrale : un chercheur étranger au manuscrit doit être en mesure d’en déchiffrer la substantifique moelle sans devoir obligatoirement explorer la prose narrative du document.
Cette exigence de rigueur impose le respect scrupuleux de plusieurs impératifs déontologiques :
- La sobriété topologique : Proscription inconditionnelle des artifices pseudo-tridimensionnels, des textures moirées ou des dégradés agressifs qui déforment la géométrie surfacique et distordent la perception des grandeurs.
- L’explicitation métrologique absolue : Présence impérative de l’ensemble des descripteurs dimensionnels, des unités de mesure précises le long de l’axe quantitatif et de la mention exhaustive des effectifs totaux au sein de la figure ou de sa note explicative.
- La traçabilité méthodologique : Adjonction systématique d’une note de figure normalisée détaillant la provenance empirique des données, le niveau de significativité statistique des sous-groupes présentés et, le cas échéant, le protocole d’imputation mobilisé pour traiter les valeurs atypiques ou manquantes.
Le diagramme n’a pas pour mission d’enjoliver la réalité expérimentale mais d’en restituer l’architecture latente avec la plus froide et la plus parfaite lucidité arithmétique.
12.2 Protocoles d’exportation et d’intégration documentaire
L’intégration d’un artefact graphique conçu dans Google Sheets au sein d’une suite de traitement de texte académique (qu’il s’agisse de Google Docs, de Microsoft Word ou de suites typographiques professionnelles comme LaTeX) soulève des enjeux techniques critiques relatifs à la résolution optique et à la préservation de l’intégrité vectorielle des tracés. Google Sheets propose plusieurs protocoles d’exportation accessibles via le menu contextuel à trois points verticaux de l’objet graphique, sous la rubrique Télécharger.
Pour les environnements de publication électronique ou imprimée de haute précision, le recours aux formats d’exportation vectoriels — spécifiquement le format Graphique vectoriel adaptable (.svg) ou le format Document PDF (.pdf) — s’avère infiniment supérieur aux formats d’images matricielles tramées classiques (.png ou .jpg). Contrairement aux matrices de pixels qui se pixellisent, se floutent et perdent leur netteté lors des redimensionnements ou des impressions haute résolution à 300 ou 600 DPI, les formats vectoriels conservent la perfection mathématique des équations de courbes et des tracés de polices typographiques, garantissant une acuité visuelle chirurgicale, quelle que soit l’échelle finale de mise en page.
Dans le cas d’une production collaborative au sein de l’écosystème Google Workspace, l’insertion du graphique au sein d’un document Google Docs via la commande Insertion > Graphique > À partir de Sheets autorise la mise en place d’un lien relationnel vivant (*linked chart*). Cette liaison dynamique confère un avantage fonctionnel majeur : lorsque les données matricielles sources subissent un ajustement au sein du tableur, un bouton contextuel d’actualisation apparaît automatiquement sur la figure intégrée dans le traitement de texte, permettant de synchroniser instantanément le visuel éditorial avec le dernier état de la base scientifique sans rompre la chaîne de révision typographique.
12.3 Grille d’audit final avant diffusion
Préalablement à toute dissémination publique ou institutionnelle d’un graphique à barres empilées, l’analyste se doit de soumettre son artefact à une grille d’audit qualité méthodologique exhaustive. Ce contrôle ultime garantit l’élimination systématique de toute coquille opératoire ou de tout biais visuel susceptible d’altérer la crédibilité du chercheur :
Tableau 3. Grille d’audit formel de la qualité graphique et statistique :
- Dimension métrique : L’axe quantitatif commence-t-il obligatoirement à la valeur zéro ? Les incréments sont-ils réguliers, équidistants et dépourvus de décimales superflues ? Validation impérative : Oui.
- Dimension sémiotique : L’ordre des éléments au sein de la légende correspond-il exactement à la disposition spatiale physique des séries empilées dans les barres ? Les couleurs choisies résistent-elles à un test de simulation de daltonisme et à une impression en nuances de gris ? Validation impérative : Oui.
- Dimension arithmétique : Pour un graphique empilé standard, la hauteur maximale coïncide-t-elle rigoureusement avec les totaux marginaux calculés ? Pour un empilement à 100 %, l’ensemble des colonnes culmine-t-il avec une égalité géométrique parfaite au palier 100 % ? Validation impérative : Oui.
- Dimension contextuelle : Le titre renseigne-t-il sans équivoque la variable, l’échantillon et la temporalité ? L’effectif total `N` et l’unité de mesure sont-ils clairement explicités dans le sous-titre ou la légende ? Validation impérative : Oui.
- Dimension d’ergonomie cognitive : Le nombre de strates sous-jacentes est-il contenu (idéalement inférieur ou égal à cinq) afin de préserver la lisibilité des segments flottants ? Les étiquettes textuelles sont-elles lisibles sans nécessiter de contorsions oculaires incongrues ? Validation impérative : Oui.
Seule la validation scrupuleuse et sans concession de l’ensemble de ces points de contrôle autorise l’analyste à considérer sa visualisation comme un instrument de communication scientifique achevé, digne de contribuer au progrès de la connaissance empirique et à l’éclairage de la décision rationnelle.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars / Éditions de l’École des Hautes Études en Sciences Sociales. https://catalogue.bnf.fr/ark:/12148/cb32920800d
- Cleveland, W. S., & McGill, R. (1984). Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Google. (2023). Types de graphiques disponibles dans Google Sheets. Centre d’aide Google Docs Editors. https://support.google.com/docs/answer/190718
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- Ware, C. (2012). Information Visualization: Perception for Design (3rd ed.). Morgan Kaufmann. https://doi.org/10.1016/C2009-0-62325-1
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media. https://clauswilke.com/dataviz/