
L’écosystème contemporain du traitement de données au sein des tableurs infonuagiques a connu une mutation paradigmatique majeure avec l’avènement de fonctionnalités d’interrogation déclaratives avancées. Parmi ces instruments de calcul, la fonction QUERY de Google Sheets s’impose comme le dispositif le plus puissant et le plus polyvalent pour la manipulation, le filtrage et la restructuration d’ensembles d’enregistrements complexes. En intégrant la syntaxe et la logique du langage d’interrogation de l’API Google Visualization, cette fonction émule la puissance de l’algèbre relationnelle et du langage SQL (Structured Query Language) au sein d’une simple cellule matricielle, affranchissant l’analyste des imbrications fastidieuses de filtres conditionnels traditionnels.
Au cœur de cette architecture d’interrogation réside la problématique récurrente de l’extraction textuelle ciblée, et plus particulièrement la sélection des rangées satisfaisant un critère d’inclusion de sous-chaîne. Alors que l’égalité stricte s’avère fréquemment inopérante face à des corpus textuels hétérogènes, des descriptions qualitatives, des libellés logistiques ou des identifiants composites, l’opérateur CONTAINS constitue la clef de voûte du filtrage partiel. Cet opérateur permet d’isoler des données signifiantes sans exiger une correspondance intégrale du champ textuel, ouvrant ainsi la voie à des méthodologies d’analyse de données d’une finesse algorithmique remarquable.
Cependant, la manipulation de l’opérateur CONTAINS dans Google Sheets ne saurait se résumer à une simple application mécanique de formules génériques. L’évaluation sémantique opérée par le moteur sous-jacent implique une compréhension rigoureuse du typage des données, de la sensibilité à la casse typographique, de la gestion des valeurs nulles, ainsi que des interactions complexes entre les opérateurs booléens de conjonction et de disjonction. Une mauvaise appréhension de ces mécanismes formels expose inévitablement l’analyste à des pertes silencieuses de données, à des erreurs de compilation syntaxique ou à des biais analytiques substantiels. L’objet de cet article est de disséquer de manière exhaustive les fondements, la syntaxe, les cas limites et les applications avancées de la sélection de lignes par inclusion de chaîne avec la fonction QUERY.
1. Fondements et architecture syntaxique de la fonction QUERY
1.1 Anatomie structurelle de la formule =QUERY()
L’invocation canonique de la fonction d’interrogation au sein de la grille de calcul s’articule autour de la signature ternaire formelle : =QUERY(données; requête; [en-têtes]). Chacun de ces paramètres remplit un rôle algorithmique strictement délimité au sein du cycle de vie du calcul matriciel. Le premier argument, données, désigne la plage de cellules bidimensionnelle sur laquelle l’opération de projection et de sélection s’exécute. Cette plage peut être référencée sous une forme continue classique, telle que A1:F1000, ou sous la forme d’un tableau virtuel issu d’une formule matricielle encapsulée entre accolades, ce qui modifie alors profondément la dénomination structurelle des colonnes sous-jacentes.
Le second argument, requête, se matérialise sous la forme d’une chaîne de caractères représentant l’instruction textuelle exécutable. Cette clause de commande, obligatoirement entourée de guillemets doubles droits, formalise les opérations de sélection (SELECT), de restriction logique (WHERE), d’agrégation (GROUP BY), de tri (ORDER BY) ou de formatage (FORMAT). Lorsque le moteur d’évaluation de la feuille de calcul analyse cet argument, il délègue l’interprétation syntaxique à un processeur spécialisé. Toute défaillance de fermeture de guillemets ou toute omission de séparateur logique entraîne une rupture précoce de la phase d’analyse lexicale, générant une exception structurelle qui bloque l’affichage des données.
Le troisième argument, en-têtes, bien que facultatif selon la spécification de base, exerce une fonction déterminante pour préserver l’intégrité métadonnée du système. Il s’agit d’un nombre entier non négatif indiquant la quantité de rangées situées au sommet de la plage qui doivent être considérées comme des libellés descriptifs et non comme des observations empiriques. L’omission délibérée de ce paramètre force le compilateur à formuler une conjecture probabiliste basée sur le typage dominant des premières lignes. Cette heuristique automatique introduit une vulnérabilité majeure : si une colonne textuelle possède une ligne d’en-tête alphabétique suivie d’enregistrements textuels, l’algorithme peut fusionner indûment les premières rangées ou interpréter la ligne de titre comme une valeur de données, corrompant de facto la validité des sélections ultérieures basées sur la clause WHERE.
1.2 Origine et spécificités du langage Google Visualization API
Bien que la syntaxe apparente de la fonction évoque immédiatement le dialecte ANSI SQL standardisé utilisé au sein des systèmes de gestion de bases de données relationnelles, son implémentation repose intégralement sur le langage d’interrogation de l’API Google Visualization. Cette filiation confère au moteur de calcul des propriétés sémantiques uniques, mais impose également des contraintes opérationnelles rigides que tout praticien se doit d’assimiler pour éviter des comportements anormaux.
La divergence conceptuelle la plus critique réside dans l’obligation d’un typage strict et exclusif au niveau colonnaire. Dans un système de base de données relationnelle traditionnel, le schéma impose un type invariable (tel qu’entier, chaîne de caractères ou date) pour chaque champ dès la création de la table. Dans un environnement de tableur ouvert tel que Google Sheets, la liberté de saisie permet la coexistence anarchique de chaînes de caractères, de nombres réels et de dates sérialisées au sein d’une même coordonnée verticale. Face à cette hétérogénéité, l’API Google Visualization déploie un algorithme de détermination typologique basé sur la règle de majorité statistique.
Le moteur examine un échantillon représentatif des valeurs contenues dans la colonne cible pour déterminer son type dominant. Dès lors que cette identité typologique est fixée (par exemple, le type numérique), toute valeur discordante appartenant à un type minoritaire (par exemple, une chaîne de caractères alphabétique explicative saisie au sein d’une colonne de montants monétaires) est immédiatement et silencieusement transformée en valeur nulle (null). Cette coercition implicite produit des répercussions directes et souvent dévastatrices sur les filtres textuels : si une colonne est catégorisée comme numérique par le moteur, l’application d’un prédicat de recherche textuelle via CONTAINS échouera irrémédiablement, non pas en déclenchant un message d’erreur explicite, mais en excluant l’intégralité des cellules discordantes qui auront été éradiquées en mémoire vive lors de la phase de normalisation préalable.
1.3 Intégration méthodologique de la clause WHERE
La clause WHERE remplit le rôle d’opérateur de sélection restreinte dans le formalisme de l’algèbre relationnelle. Sur le plan fonctionnel, elle agit comme un prédicat booléen appliqué individuellement et séquentiellement à chaque rangée de la table source. Seuls les tuples d’enregistrements pour lesquels l’évaluation globale de la condition produit la valeur logique TRUE sont acheminés vers le flux de sortie de la requête pour être ensuite projetés par la clause SELECT.
L’évaluation des requêtes au sein du moteur obéit à un ordre d’exécution logique strict qui diffère notablement de l’ordre lexical dans lequel la commande est rédigée. Alors que l’instruction débute formellement par le mot-clé SELECT, le processeur exécute d’abord l’identification de la source de données, puis applique immédiatement la clause WHERE afin d’élaguer l’espace dimensionnel de recherche. Les opérations subséquentes, telles que le regroupement par GROUP BY, le filtrage des agrégats via HAVING, le classement ordonné via ORDER BY et le plafonnement via LIMIT, ne sont appliquées qu’exclusivement au sous-ensemble des données ayant franchi avec succès le crible du prédicat de restriction.
Dans ce paradigme séquentiel, la définition de la valeur de vérité booléenne pour chaque enregistrement dépend entièrement de la résolution d’expressions logiques unaires ou binaires. Lorsqu’un opérateur textuel est invoqué dans le prédicat, le moteur évalue la relation entre le contenu physique de la cellule inspectée et le littéral spécifié dans la requête. Si la cellule contient une valeur nulle ou si le type sous-jacent est jugé incompatible avec l’opération demandée, la valeur booléenne résultante bascule vers un état indéterminé qui est systématiquement assimilé à FALSE dans le cadre du filtrage standard, neutralisant de facto la rangée correspondante.
2. L’opérateur CONTAINS : Définition, sémantique et fonctionnement interne
2.1 Mécanisme d’évaluation de la sous-chaîne textuelle
L’opérateur CONTAINS constitue un comparateur relationnel binaire conçu spécifiquement pour tester la présence d’une séquence de caractères continue au sein d’un champ textuel cible. Contrairement à l’égalité formelle qui exige une superposition isomorphique exacte entre la valeur de la cellule et le critère de recherche, CONTAINS résout l’assertion suivante : la chaîne recherchée est-elle un sous-ensemble séquentiel ordonné de la chaîne examinée ? Mathématiquement, pour une cellule contenant la chaîne $S$ et un littéral de recherche $L$, l’expression retourne TRUE s’il existe deux chaînes quelconques, éventuellement vides, $u$ et $v$, telles que la concaténation $u \cdot L \cdot v = S$.
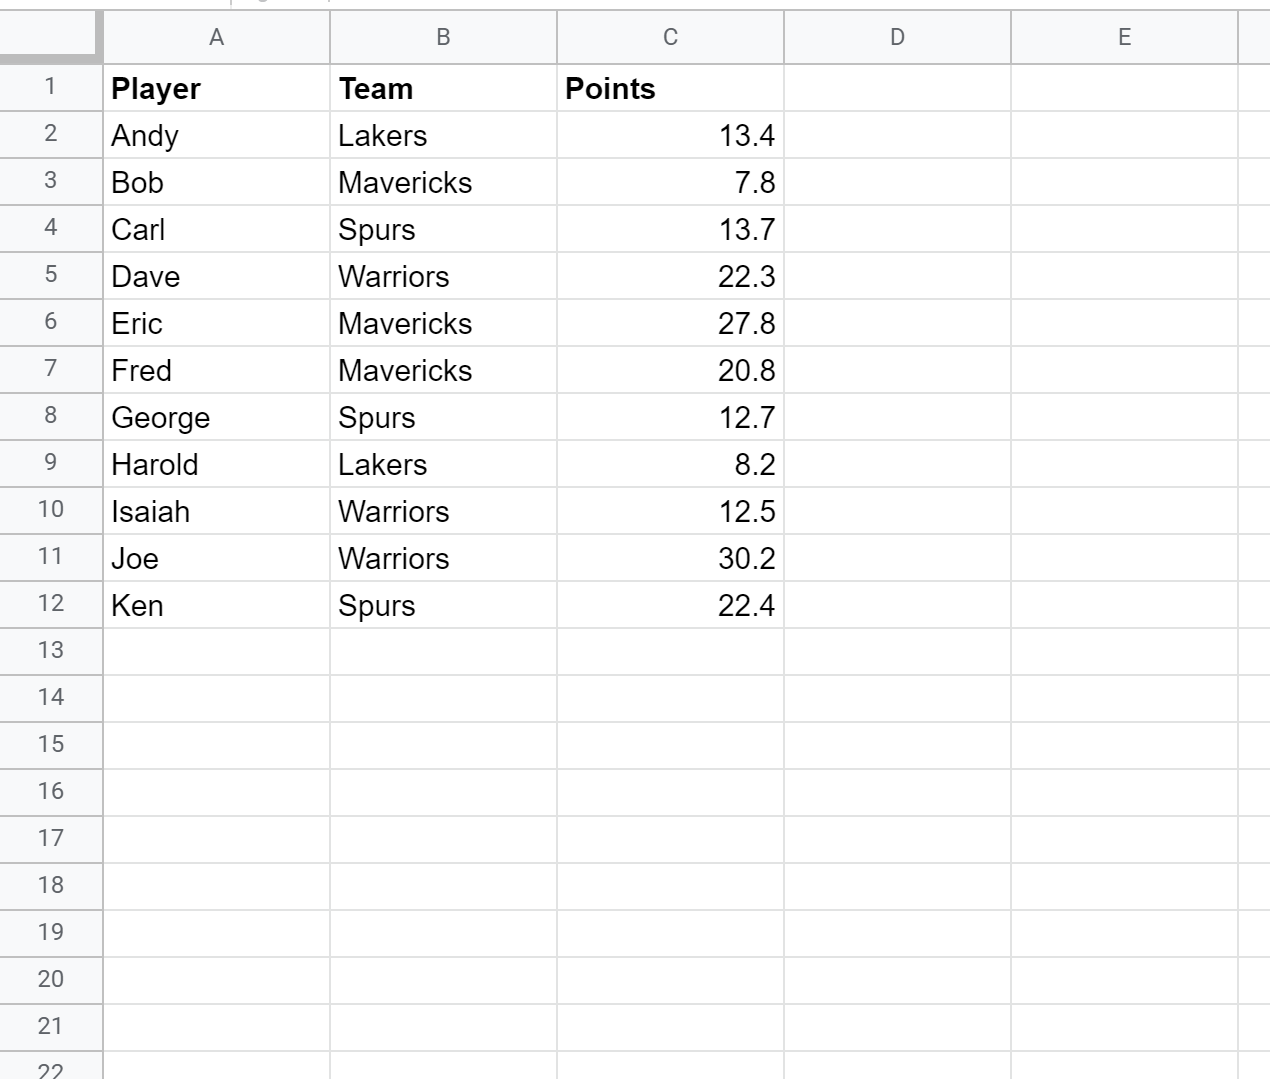
Ce mode opératoire confère une flexibilité d’analyse fondamentale. La sous-chaîne peut se situer au tout début de la cellule (préfixe), au cœur de celle-ci (inframot), ou à sa terminaison immédiate (suffixe). De surcroît, le moteur traite avec une indifférence mathématique les délimiteurs textuels ordinaires, tels que les espaces simples, les traits d’union, les barres obliques ou les ponctuations, pour autant qu’ils ne fassent pas partie intégrante de la définition formelle de l’argument de recherche.
Sur le plan syntaxique, la directive impose l’encadrement impératif du terme cible au moyen d’apostrophes simples droites ('terme'). Cette délimitation permet au parseur de distinguer formellement les chaînes littérales pures des identifiants de colonnes (tels que A, B, Col1, Col2) ou des mots-clés réservés du langage. Tout oubli de ces apostrophes simples provoque l’émission immédiate d’une erreur de compilation de type PARSE_ERROR, le compilateur tentant vainement d’interpréter le terme de recherche comme une variable colonnaire inexistante dans le schéma relationnel de la feuille de calcul.
2.2 Sensibilité stricte à la casse (Case Sensitivity)
La caractéristique technique la plus déterminante, et simultanément la plus piégeuse, de l’opérateur CONTAINS réside dans sa sensibilité stricte et immuable à la casse typographique. Pour le moteur de l’API Google Visualization, les caractères majuscules et minuscules correspondent à des points de code Unicode rigoureusement distincts. En conséquence directe, le terme 'CLIENT', le terme 'Client' et le terme 'client' représentent trois entités sémantiques mutuellement disjointes.
Cette stricte séparation binaire induit des failles analytiques considérables lors du traitement de jeux de données issus de saisies humaines non normalisées ou de flux d’importation hétérogènes. Considérons une colonne colligeant des statuts de réclamation logistique : si un opérateur consigne manuellement la mention « Colis endommagé », tandis qu’un second inscrit « colis endommagé » et qu’un troisième utilise le sigle typographique « COLIS ENDOMMAGÉ », une requête formulée sous la condition restrictive where A contains 'Colis' éliminera arbitrairement les deux dernières variantes d’enregistrement. Les enregistrements correspondants ne figureront pas dans le tableau résultant, faussant drastiquement les agrégations ou les métriques volumétriques déduites.
Cette sensibilité mécanique impose donc à l’analyste méthodologique une vigilance permanente. Il devient impératif, dès lors que la source de données n’est pas assujettie à une validation stricte à l’entrée par menu déroulant ou règles de masquage, d’anticiper cette disparité soit par des procédures préalables de nettoyage et d’uniformisation du corpus brut, soit par la mise en œuvre de stratagèmes syntaxiques d’insensibilisation intégrés au cœur même de la formule d’interrogation.
2.3 Comparaison conceptuelle : CONTAINS, LIKE et l’égalité stricte
Le tableau comparatif suivant synthétise les comportements et les spécificités structurelles des trois principaux opérateurs de filtrage textuel disponibles dans Google Sheets :
- Opérateur d’égalité stricte (
=) : Exige une identité intégrale et absolue entre la cellule examinée et la chaîne de référence. La présence d’un seul espace typographique initial ou terminal dans la cellule suffit à invalider l’évaluation booléenne. Cet opérateur s’avère idéal pour les clés primaires, les codes normalisés ou les identifiants uniques discrets, mais totalement inopérant pour l’exploration de texte libre. - Opérateur de sous-chaîne (
CONTAINS) : Détecte la présence d’une séquence textuelle fixe arbitrairement positionnée au sein du champ récepteur. Aucune configuration de caractères génériques n’est requise. Son exécution est algorithmiquement fluide, hautement lisible, mais limitée par son incapacité structurelle à interpréter des masques de saisie variables ou des motifs positionnels précis. - Opérateur de comparaison par motif (
LIKE) : Emprunté directement aux standards des moteurs SQL traditionnels,LIKErepose sur l’utilisation explicite de métacaractères de substitution. Le symbole pourcentage (%) représente une suite quelconque de zéro, un ou plusieurs caractères, tandis que le trait de soulignement (_) se substitue à un caractère unique et obligatoire.
Le choix méthodologique entre CONTAINS et LIKE découle de l’arbitrage entre concision syntaxique et expressivité algorithmique. L’instruction where A contains 'rapport' équivaut fonctionnellement à l’expression where A like '%rapport%'. Dès lors qu’une condition ne requiert aucun ancrage directionnel strict (comme exiger qu’une chaîne commence impérativement par une particule précise sans autoriser sa présence médiane), CONTAINS offre une structure plus compacte et moins sujette aux erreurs d’échappement typographique. En revanche, si la logique d’affaires impose qu’un numéro de dossier commence par « D- » suivi de trois caractères quelconques et s’achève par « FR », LIKE s’impose par sa capacité à contraindre la topologie du texte via la formulation where A like 'D-___FR'.
3. Extraction unitaire : Sélection de lignes contenant une chaîne unique
3.1 Formulation élémentaire de la clause WHERE avec CONTAINS
L’implémentation opérationnelle fondamentale de l’extraction par sous-chaîne textuelle repose sur l’assemblage standard d’une projection et d’une restriction unitaire. Considérons un registre matriciel d’incidents informatiques documenté au sein de la plage A2:D500, dans lequel la colonne A collige les numéros de ticket, la colonne B le service émetteur, la colonne C la description narrative du dysfonctionnement et la colonne D le niveau de sévérité attribué.
Si la finalité de l’investigation consiste à isoler l’intégralité des dysfonctionnements matériels affectant spécifiquement les disques de stockage, la formule se structure de la manière suivante :
=QUERY(A2:D500; "SELECT A, B, C WHERE C CONTAINS 'disque'"; 0)
Dans ce schéma élémentaire, l’analyste fait le choix d’exclure délibérément la colonne D du flux de restitution en spécifiant SELECT A, B, C, allégeant ainsi la charge cognitive de lecture tout en extrayant uniquement les attributs requis. Lors de l’évaluation séquentielle de chaque tuple d’enregistrement, le compilateur procède à une analyse textuelle approfondie de la cellule correspondante dans la colonne C. Si la suite de caractères alphabétiques d-i-s-q-u-e est repérée en position préfixe (ex. : « disque saturé »), médiane (ex. : « remplacement disque nécessaire ») ou terminale (ex. : « panne sur le disque »), le prédicat est validé et la rangée est restituée.
Il importe de souligner l’intérêt analytique d’une telle extraction unitaire. Elle permet d’opérer un forage vertical immédiat au sein de gisements de commentaires libres non structurés, révélant des patterns lexicaux récurrents sans exiger la mise en œuvre préalable d’algorithmes complexes de traitement automatique du langage naturel.
3.2 Gestion des caractères spéciaux et des apostrophes dans le terme cible
Une complexité technique majeure surgit lorsque la chaîne littérale ciblée pour l’extraction intègre elle-même un caractère structurellement utilisé par le moteur d’interprétation pour délimiter les paramètres, en premier lieu l’apostrophe droite simple (caractère ASCII 39). Dans la langue française, l’élision grammaticale et l’usage fréquent d’articles contractés (tels que « l’ordinateur », « d’exploitation », « l’accès ») rendent cette situation omniprésente.
Si l’analyste rédige sans précaution l’expression suivante :
=QUERY(A2:D500; "WHERE C CONTAINS 'l'accès'"; 0)
Le parseur lexical identifie l’apostrophe située immédiatement après la lettre l comme la balise fermant la chaîne littérale ouverte avant cette même lettre. En conséquence, les caractères subséquents accès' sont interprétés comme des éléments d’instruction syntaxique non reconnus, brisant instantanément la compilation et renvoyant une erreur de syntaxe irrémédiable de type INVALID_QUERY.
Pour contourner cet écueil architectural, plusieurs protocoles formels existent. Le premier consiste à échapper le caractère conflictuel en le faisant précéder d’une barre oblique inversée (') au sein de la chaîne de commande, signalant ainsi explicitement au compilateur que l’apostrophe doit être traitée comme un caractère littéral brut et non comme un opérateur d’encadrement sémantique. Une seconde technique, particulièrement robuste lors de la génération dynamique de chaînes, consiste à recourir à la fonction de manipulation textuelle SUBSTITUTE ou à scinder la chaîne globale en concaténant explicitement les guillemets et apostrophes via la fonction CHAR(39).
Concernant les caractères diacritiques propres à la langue française (accents aigus, graves, circonflexes, cédilles, trémas), le moteur de l’API Google Visualization les traite avec une fidélité binaire absolue basée sur la table Unicode. En pratique, la lettre e, la lettre é et la lettre è sont morphologiquement et numériquement indépendantes. L’exécution de where C contains 'systeme' n’extraira sous aucun prétexte les cellules consignant « système ». Cette rigueur impose une synchronisation diacritique parfaite entre le terme formulé dans la requête et l’orthographe réelle des enregistrements sous surveillance.
3.3 Comportement du moteur face aux cellules vides et aux non-occurrences
L’une des caractéristiques les plus déroutantes de la fonction QUERY pour les utilisateurs non initiés réside dans son protocole de restitution lorsque aucun enregistrement ne valide le prédicat de la clause WHERE. Contrairement aux fonctions classiques de recherche (telles que VLOOKUP ou MATCH) qui lèvent immédiatement l’exception d’erreur #N/A lorsqu’une recherche est infructueuse, QUERY adopte un comportement purement relationnel : elle renvoie un ensemble vide.
Toutefois, la matérialisation physique de cet ensemble vide dans l’interface de Google Sheets dépend étroitement du troisième argument de la formule relatif aux en-têtes. Si la formule a spécifié la présence de lignes d’en-tête (par exemple 1), le résultat visible se bornera à dupliquer les étiquettes de colonnes au point d’insertion, sans qu’aucune ligne de données n’apparaisse sous celles-ci. Si le paramètre d’en-tête a été fixé à 0 et qu’aucune ligne ne correspond au critère CONTAINS, la cellule réceptrice demeure visuellement immaculée ou génère parfois une exception textuelle d’absence d’éléments.
Pour prévenir la désorientation des utilisateurs finaux et consolider l’expérience applicative au sein de tableaux de bord de production, il est fortement préconisé d’encapsuler la formule d’extraction textuelle au sein d’une structure conditionnelle préventive de type IFERROR, complétée par un test dimensionnel. Par exemple :
=IFERROR(QUERY(A2:D500; "SELECT * WHERE C CONTAINS 'matériel'"; 0); "Aucune occurrence identifiée")
Ce patron de conception garantit qu’en cas de non-occurrence intégrale, l’application ne laissera pas une plage d’affichage ambiguë mais affichera explicitement un message de substitution informant l’opérateur de la vacuité sémantique des résultats pour le critère considéré.
4. Logique d’exclusion : Filtrage des lignes ne contenant pas une chaîne
4.1 Syntaxe de la négation logique avec NOT CONTAINS
L’inversion de la polarité logique d’une extraction textuelle répond à des nécessités analytiques tout aussi impératives que la sélection positive. Il s’agit alors de retrancher d’un corpus d’observations l’ensemble des enregistrements renfermant un marqueur textuel identifié comme non pertinent, obsolète ou parasitaire. Dans le langage de Google Visualization, cette opération est orchestrée par l’application de l’opérateur unaire de négation NOT.
La morphologie syntaxique impose un positionnement rigoureux de l’opérateur en amont immédiat du prédicat qu’il altère. La construction canonique s’articule ainsi :
=QUERY(A2:D500; "SELECT * WHERE NOT C CONTAINS 'annulé'"; 0)
Il convient de noter une tolérance structurelle dans le formalisme du moteur : l’analyste peut également positionner l’opérateur avant l’identifiant de colonne, ou encadrer l’expression affirmative entre parenthèses précédées de la négation, sous la forme WHERE NOT (C CONTAINS 'annulé'). Cette dernière formulation est d’ailleurs hautement recommandée par les canons de la clarté algorithmique, dans la mesure où elle lève toute ambiguïté théorique quant au champ d’application de l’inversion booléenne.
Sur le plan de la logique des prédicats, la table de vérité associée est rigoureusement inversée : toute ligne dont le contenu de la colonne examinée contient la séquence textuelle cible génère une valeur interne TRUE lors de l’évaluation du sous-bloc CONTAINS, valeur qui est immédiatement transmutée en FALSE par l’opérateur NOT, prononçant l’expulsion irrévocable de la ligne du jeu de résultats final.
4.2 Traitement des valeurs nulles et cellules vides sous négation
L’usage de la négation logique via NOT CONTAINS recèle l’un des pièges les plus insidieux et les plus mal documentés du moteur d’évaluation de Google Sheets : la disparition silencieuse des cellules vides ou non renseignées. Ce phénomène découle directement de la logique tri-valuée inhérente aux systèmes relationnels manipulant le concept d’inconnu ou de valeur nulle (NULL).
Lorsqu’une cellule de la colonne cible est rigoureusement vide, son état sémantique pour le moteur n’est pas une chaîne de caractères de longueur zéro, mais une absence de valeur. Lorsque l’expression C CONTAINS 'annulé' est confrontée à une telle cellule, le résultat de la comparaison ne peut être ni TRUE ni FALSE, car aucune comparaison textuelle n’est matériellement possible sur le vide absolu. L’opération renvoie donc un état logique indéterminé (NULL). Or, en application des théorèmes fondamentaux de la logique relationnelle, l’application de l’opérateur unaire NOT à un état NULL renvoie invariablement l’état NULL.
Le filtrage de la clause WHERE rejetant sans exception toute rangée dont l’évaluation globale ne produit pas explicitement la constante booléenne TRUE, toutes les lignes comportant une cellule vide dans la colonne cible sont impitoyablement purgées du résultat final. L’analyste croyant naïvement avoir sélectionné « toutes les commandes non annulées » s’apercevra rétrospectivement qu’il a également exclu l’intégralité des commandes n’ayant fait l’objet d’aucun commentaire textuel explicatif.
Pour restaurer l’intégrité de l’extraction et préserver la complétude des données, il est méthodologiquement impératif d’intégrer une clause de réhabilitation explicite des cellules vides au moyen de l’opérateur spécialisé IS NULL, encapsulé au sein d’une disjonction logique :
=QUERY(A2:D500; "SELECT * WHERE (NOT C CONTAINS 'annulé') OR C IS NULL"; 0)
Cette architecture conjonctive blindée assure que la rangée sera retenue soit si elle contient un texte explicite exempt du terme proscrit, soit si elle n’a fait l’objet d’aucune saisie textuelle, protégeant ainsi l’échantillon d’une atrophie quantitative injustifiée.
4.3 Distinction analytique entre non-contenance et non-égalité
Il s’avère fondamental d’établir une ligne de démarcation épistémologique nette entre l’opérateur de non-égalité (!= ou <>) et l’instruction de non-contenance (NOT ... CONTAINS). Bien que ces deux instruments poursuivent une intention générale de rejet, leur périmètre d’action sur le volume de données diverge radicalement.
Considérons un échantillon d’enregistrements logistiques où une colonne consigne la localisation des entrepôts sous des libellés tels que « Paris-Nord », « Paris-Sud », « Lyon-Centre » et « Marseille-Port ». Si l’on applique le critère de non-égalité WHERE A != 'Paris', l’intégralité des enregistrements mentionnés sera restituée dans le tableau de sortie. En effet, la chaîne « Paris-Nord » étant physiquement différente de la chaîne isolée « Paris », l’assertion d’inégalité est rigoureusement exacte pour chaque enregistrement.
À l’inverse, l’application de la non-contenance WHERE NOT A CONTAINS 'Paris' procède à un balayage sous-jacent beaucoup plus intrusif. Elle identifiera l’inclusion lexicale de la particule « Paris » au sein de « Paris-Nord » et de « Paris-Sud », prononçant l’éviction de ces deux classes d’observations pour ne conserver strictement que « Lyon-Centre » et « Marseille-Port ».
Cette divergence démontre que l’opérateur de non-égalité ne peut traiter que des catégories conceptuellement discrètes et uniformisées, tandis que la non-contenance opère au niveau infra-catégoriel, ce qui la rend indispensable pour purger des données contenant des variantes combinatoires ou des commentaires additifs non standardisés.
5. Combinaisons disjonctives : Inclusion de plusieurs chaînes potentielles (OR)
5.1 Construction d’arborescences logiques à l’aide de l’opérateur OR
L’exploration analytique de corpus volumineux exige fréquemment la sélection d’observations satisfaisant au moins une condition parmi une pluralité d’options textuelles prédéfinies. Dans le langage de requête de Google Sheets, cette flexibilité est médiée par l’opérateur logique disjonctif OR. Sa vocation est d’élargir l’ensemble de sortie en agrégeant les enregistrements validant l’un quelconque des prédicats formulés.
La règle d’or régissant l’écriture des clauses disjonctives au sein de l’API Google Visualization stipule la répétition formelle et obligatoire de l’opérande colonnaire pour chaque membre de la disjonction. Une formulation abrégée calquée sur le langage naturel, telle que l’aberration syntaxique WHERE A CONTAINS 'Alpha' OR 'Bêta', est catégoriquement rejetée par le parseur lexical et génère une erreur d’analyse fatale. La syntaxe canonique exige une déclaration symétrique intégrale :
=QUERY(A2:D500; "SELECT * WHERE A CONTAINS 'Alpha' OR A CONTAINS 'Bêta'"; 0)
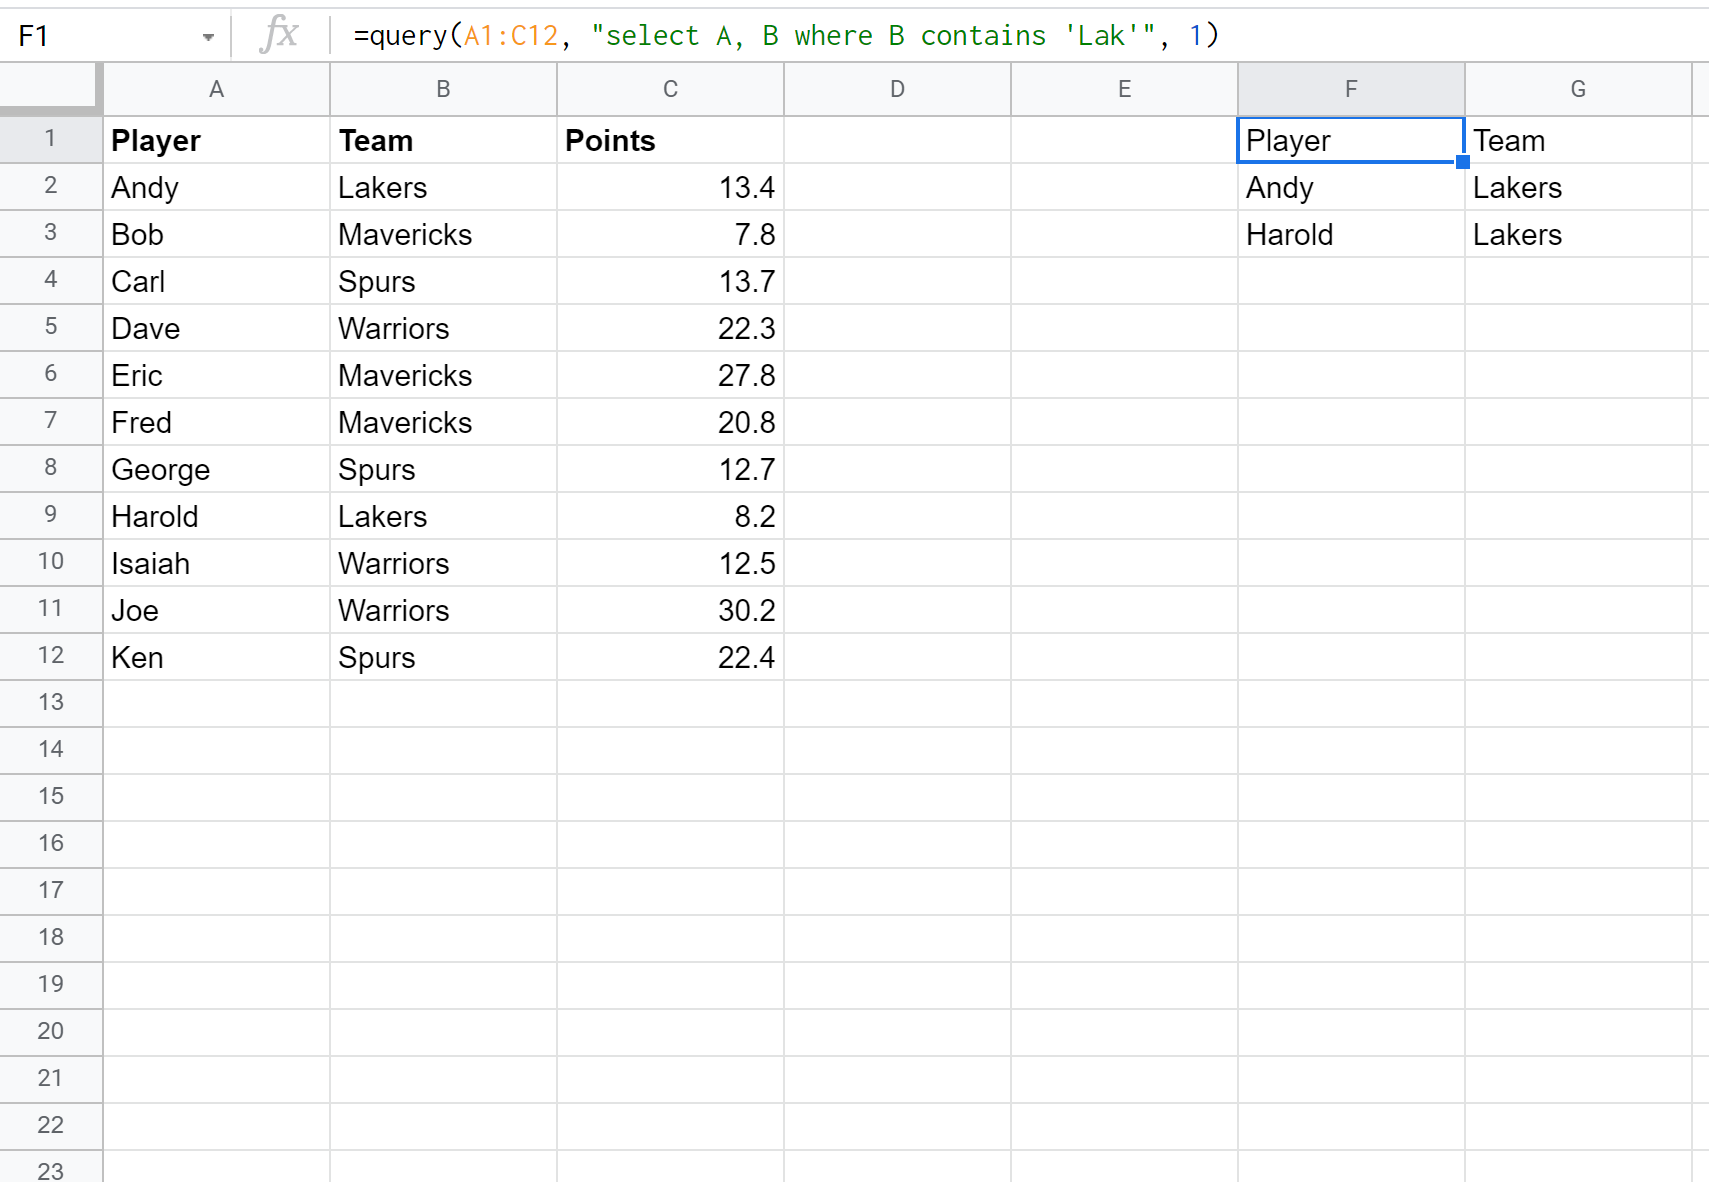
Lors du cycle d’exécution, le moteur traite ces prédicats selon le principe computationnel de l’évaluation court-circuitée (short-circuit evaluation). Pour un enregistrement donné, le compilateur évalue d’abord le prédicat primaire A CONTAINS 'Alpha'. Si cette condition est résolue par la valeur de vérité TRUE, le moteur valide immédiatement l’admissibilité de la ligne sans procéder à l’évaluation computationally coûteuse du second prédicat A CONTAINS 'Bêta', puisque la présence d’un seul terme vrai suffit à satisfaire la table de vérité de la disjonction. Ce mécanisme optimise substantiellement la vitesse de calcul lors du traitement de dizaines de milliers d’enregistrements.
5.2 Règles de précédence et parenthétisation rigoureuse
Dès lors qu’une requête entremêle des opérateurs de disjonction (OR) et des opérateurs de conjonction (AND), l’analyste pénètre sur un terrain à haut risque méthodologique en raison des lois de précédence des opérateurs booléens. Conformément aux principes universels de l’algèbre de Boole, l’opérateur AND dispose d’une priorité hiérarchique absolue sur l’opérateur OR. Il agit conceptuellement comme une multiplication logique, tandis que l’opérateur disjonctif opère comme une addition logique.
Considérons l’instruction suivante, rédigée sans précautions typographiques particulières :
=QUERY(A2:D500; "SELECT * WHERE A CONTAINS 'France' OR A CONTAINS 'Espagne' AND B CONTAINS 'Validé'"; 0)
En raison de la précédence native de l’opérateur AND, le compilateur regroupe structurellement les prédicats sous la forme implicite suivante : « Sélectionner toutes les lignes concernant la France, quelle que soit leur validation, ainsi que toutes les lignes concernant l’Espagne qui sont simultanément validées ». L’analyste qui escomptait extraire les dossiers validés pour l’un ou l’autre de ces deux territoires géographiques verra son jeu de données lourdement vicié par l’incorporation de dossiers français rejetés ou en cours de traitement.
L’unique rempart méthodologique contre cette dérive interprétative réside dans la parenthétisation explicite, préventive et systématique des blocs disjonctifs. La formulation rigoureuse devient impérativement :
=QUERY(A2:D500; "SELECT * WHERE (A CONTAINS 'France' OR A CONTAINS 'Espagne') AND B CONTAINS 'Validé'"; 0)
En encapsulant les deux conditions géographiques au sein de parenthèses fermées, l’analyste force le compilateur à résoudre la disjonction en tant qu’entité logique unitaire préalable, dont la valeur de vérité globale est ensuite transmise à l’opérateur conjonctif, rétablissant ainsi la conformité rigoureuse du filtrage avec l’intention analytique initiale.
5.3 Factorisation et lisibilité des requêtes disjonctives complexes
Lorsque le protocole de sélection requiert le filtrage simultané d’une vaste taxonomie lexicale (par exemple, identifier la présence d’une dizaine ou d’une vingtaine de mots-clés alternatifs au sein d’une même colonne), la syntaxe basée sur l’accumulation sérielle d’opérateurs OR engendre une dégradation dramatique de la lisibilité et de la maintenabilité du code applicatif. La formule prend alors une ampleur hypertrophiée :
WHERE A CONTAINS 'terme1' OR A CONTAINS 'terme2' OR A CONTAINS 'terme3' ... OR A CONTAINS 'termeN'
Cette verbosité excessive multiplie exponentiellement le risque d’erreurs d’inattention, telles que l’omission d’une apostrophe de fermeture ou la substitution erronée d’un délimiteur logique. De surcroît, toute modification ultérieure de la taxonomie impose une intervention chirurgicale et périlleuse au sein de la longue chaîne de caractères de la formule.
Face à ce goulet d’étranglement ergonomique, l’analyste dispose de deux alternatives de conception avancées. La première consiste à extraire la chaîne de condition vers une cellule matricielle dédiée, au sein de laquelle la clause textuelle est dynamiquement synthétisée au moyen de fonctions de concaténation de listes, telles que JOIN ou TEXTJOIN. La seconde alternative, hautement supérieure sur le plan de la compacité algorithmique, consiste à abandonner l’opérateur CONTAINS au profit de l’opérateur d’expression régulière MATCHES, dont la structure supporte nativement l’alternative par métacaractère sans exiger la réitération redondante des identifiants colonnaires.
6. Combinaisons conjonctives : Critères de contenance simultanés (AND)
6.1 Intersection textuelle sur une même colonne d’observation
L’intersection conjonctive textuelle matérialisée par l’opérateur AND répond à un impératif analytique d’une grande rigueur : isoler exclusivement les observations qui concentrent simultanément une pluralité de marqueurs sémantiques distincts au sein d’un même champ textuel. Cette technique trouve une utilité de premier ordre dans l’analyse de questions ouvertes, d’enquêtes de satisfaction, de dossiers d’audit ou de flux d’actualités financières.
Considérons une situation où un auditeur cherche à isoler les comptes-rendus d’évaluation faisant état de difficultés techniques liées spécifiquement à la bande passante du réseau de télécommunication. Si l’on recherche uniquement le terme « réseau », l’extraction sera excessivement polluée par des mentions organisationnelles (« réseau de distribution », « réseau de compétences »). Si l’on recherche isolément « bande passante », on risque d’omettre des formulations elliptiques. La conjonction textuelle apporte la solution :
=QUERY(A2:D500; "SELECT * WHERE C CONTAINS 'réseau' AND C CONTAINS 'saturation'"; 0)
Ce schéma syntaxique contraint le moteur à soumettre chaque enregistrement à une double inspection séquentielle. Seules les rangées dont la cellule correspondante intègre l’occurrence « réseau » et l’occurrence « saturation » franchiront le prédicat, indépendamment de leur ordre d’apparition respectif dans la cellule et de la distance lexicale séparant ces deux vocables. Cette indépendance topologique confère à la conjonction textuelle une robustesse considérablement accrue par rapport à la recherche d’une phrase figée.
6.2 Filtrage croisé à travers des colonnes multidimensionnelles
La puissance d’investigation relationnelle de la clause conjonctive s’illustre particulièrement lors du croisement de variables qualitatives distribuées sur des axes dimensionnels distincts de la base de données. Dans cette configuration, le filtre agit comme un dispositif de sélection matricielle croisée permettant de tester des hypothèses de recherche complexes.
Imaginons une base de données d’essais cliniques multicentriques structurée selon les coordonnées suivantes : colonne A désignant le centre hospitalier de rattachement, colonne B colligeant le protocole thérapeutique administré, colonne C documentant les effets secondaires indésirables déclarés et colonne D répertoriant les antécédents médicaux du patient. Une étude méthodologique visant à évaluer les manifestations allergiques cutanées chez des patients recevant une molécule spécifique au sein d’un pôle hospitalier défini s’articulera formellement ainsi :
=QUERY(A2:D5000; "SELECT A, B, C, D WHERE A CONTAINS 'Bordeaux' AND B CONTAINS 'Molécule-X' AND C CONTAINS 'cutané'"; 0)
Du point de vue du coût computationnel, il est stratégiquement avantageux de positionner en tête de chaîne conjonctive les prédicats portant sur les colonnes présentant le plus fort pouvoir discriminant ou le taux de cardinalité le plus restreint. Bien que l’optimiseur de requêtes de Google Visualization applique ses propres mécanismes de rationalisation, le rejet précoce d’enregistrements volumineux lors des premiers tests conjonctifs allège la charge de traitement des sous-chaînes sur les colonnes narratives subséquentes, garantissant une fluidité de recalcul optimale au sein du classeur.
6.3 Gestion des incompatibilités logiques et des ensembles vides
L’accumulation effrénée de contraintes conjonctives expose inévitablement l’analyste à l’émergence d’incompatibilités sémantiques ou de conditions mutuellement exclusives aboutissant à la genèse systématique d’ensembles de données vides. Il convient de distinguer avec une extrême rigueur la vacuité logique résultant de l’incompatibilité des critères et l’erreur d’exécution découlant d’une anomalie syntaxique.
Considérons le prédicat contradictoire suivant :
WHERE A CONTAINS 'Statut: Clos' AND A CONTAINS 'Statut: Ouvert'
Si le processus métier sous-jacent consigne le statut sous la forme d’une valeur textuelle unitaire et exclusive à l’intérieur de la colonne A, aucune observation empirique ne pourra simultanément héberger ces deux séquences de caractères concurrentes. Le moteur renverra inéluctablement un jeu d’enregistrements vide. Face à un écran sans données, l’analyste inexpérimenté suspectera fréquemment, à tort, une corruption de la formule ou un dysfonctionnement de la feuille de calcul, alors que le moteur relationnel a exécuté avec une fidélité mathématique impeccable une commande logiquement contradictoire.
Le diagnostic de ces anomalies méthodologiques requiert la mise en œuvre d’un protocole de validation déconstructive pas-à-pas. L’opérateur doit scinder temporairement l’instruction conjonctive en requêtes unitaires indépendantes : tester isolément WHERE A CONTAINS 'Statut: Clos' dans une cellule témoin, puis tester WHERE A CONTAINS 'Statut: Ouvert' dans une cellule contiguë. L’observation des volumes partiels restitués permet d’identifier l’étape d’effondrement dimensionnel et de corriger l’architecture logique, le plus souvent en convertissant une conjonction illégitime (AND) en une disjonction appropriée (OR).
7. Neutralisation de la sensibilité à la casse (Case-Insensitive Filtering)
7.1 Normalisation syntaxique via LOWER et UPPER
Comme démontré précédemment, la sensibilité intrinsèque de l’opérateur CONTAINS aux majuscules et minuscules constitue un handicap sévère pour l’extraction de données textuelles non assainies. Pour pallier cette rigidité sans corrompre physiquement la typographie du jeu de données source, le formalisme de l’API Google Visualization met à la disposition des praticiens deux fonctions de transformation scalaire : lower() et upper().
Le protocole d’insensibilisation repose sur un principe mathématique élémentaire de projection homomorphe : convertir unilatéralement l’intégralité du texte de la colonne observée dans un registre typologique unique (les minuscules par exemple), tout en veillant à fournir au comparateur un terme cible formulé strictement dans ce même registre. Le schéma d’implémentation opérationnel prend la forme suivante :
=QUERY(A2:D500; "SELECT * WHERE lower(C) CONTAINS 'maintenance'"; 0)
Analysons avec minutie la cinétique computationnelle de cette instruction :
- Pour chaque rangée traitée, le compilateur extrait temporairement en mémoire tampon le contenu textuel de la cellule
C. - La fonction
lower(C)transfigure immédiatement chaque glyphe majuscule en son équivalent minuscule standardisé, sans altérer la donnée inscrite dans la cellule source. - L’opérateur
CONTAINSconfronte alors cette représentation normalisée au littéral de recherche, obligatoirement saisi en minuscules :'maintenance'.
Dès lors, que la cellule source contienne « MAINTENANCE », « Maintenance », « mAiNtEnAnCe » ou « maintenance préventive », la concordance devient totale et inaltérable. L’invariance d’échelle typologique est ainsi garantie avec une rigueur absolue, éliminant d’un coup l’ensemble des faux négatifs imputables aux aléas de la saisie.
7.2 Impacts sur les performances de calcul des tables massives
Si la standardisation dynamique par lower() ou upper() s’impose par sa suprématie logique, elle induit néanmoins un tribut computationnel non négligeable qu’il convient d’évaluer avec lucidité lors de la manipulation de matrices de données massives (dépassant plusieurs dizaines de milliers d’enregistrements).
Dans une requête statique native de type WHERE C CONTAINS 'terme', le moteur d’évaluation peut exploiter des mécanismes d’indexation interne et de recherche séquentielle directe optimisée en mémoire bas niveau. En revanche, l’introduction de la fonction scalaire lower(C) force le processeur de calcul à exécuter une transformation dynamique caractère par caractère sur chaque enregistrement de la colonne considérée préalablement au test d’inclusion séquentiel. Cette opération multiplie substantiellement le nombre de cycles CPU réclamés pour finaliser le rendu matriciel.
Sur des corpus particulièrement imposants ou des classeurs interconnectés subissant des rafraîchissements constants, cette surcharge algorithmique se traduit par une latence d’affichage sensible et l’apparition récurrente de l’icône de progression du calcul en boucle. Dans ce cas de figure extrême, la meilleure pratique d’ingénierie des données consiste à déporter le coût de standardisation typologique hors de la formule QUERY : on adjoindra en amont à la table brute une colonne auxiliaire normalisée calculée via la formule matricielle =ARRAYFORMULA(LOWER(C2:C)). Il suffit alors de pointer l’opérateur direct CONTAINS sur cette colonne pré-calculée, restaurant instantanément une vitesse d’exécution optimale.
7.3 Alternatives fonctionnelles pour la recherche insensible
Au-delà de la manipulation structurelle par lower(), il existe des trajectoires alternatives au sein de Google Sheets pour neutraliser la contrainte de casse lors d’extractions complexes. La voie la plus puissante réside dans l’exploitation de l’opérateur d’expression régulière MATCHES couplé à un drapeau de configuration (flag) d’insensibilité typographique.
En substituant la syntaxe d’expression régulière à l’opérateur de sous-chaîne direct, la requête prend la forme suivante :
=QUERY(A2:D500; "SELECT * WHERE C MATCHES '(?i).*audit.*'"; 0)
Le préfixe régulier (?i) instruit formellement le moteur d’expression régulière de faire abstraction intégrale de la distinction majuscule/minuscule pour l’ensemble du motif qui lui succède. Cette approche technique présente l’immense avantage de s’exécuter sans exiger l’appel explicite à la fonction scalaire d’encapsulation lower() sur la variable colonnaire, offrant une lisibilité algorithmique remarquable pour les praticiens aguerris au formalisme des regex.
Néanmoins, cette flexibilité accrue a pour contrepartie d’engager le moteur de calcul sur un algorithme d’automates finis non déterministes inhérent aux expressions régulières, dont l’empreinte mémoire peut se révéler supérieure à celle d’une simple vérification de sous-chaîne standard sur des chaînes de caractères extrêmement denses.
8. Dynamisation des critères par injection de références cellulaires
8.1 Principes de concaténation de chaînes dans la formule QUERY
L’édification de tableaux de bord analytiques interactifs et d’outils d’exploration flexibles exige d’affranchir la requête de ses valeurs littérales figées afin de lier organiquement les critères de sélection aux interactions de l’utilisateur final. Cela requiert l’injection dynamique du contenu de cellules de commande externes au cœur de la clause textuelle de la fonction QUERY.
Cette technique opérationnelle repose sur le mécanisme de segmentation et de concaténation de chaînes textuelles au moyen de l’opérateur esperluette (&). Pour insérer la valeur d’une cellule réceptrice — désignons arbitrairement la cellule G1 — au sein du prédicat CONTAINS, l’analyste doit impérativement maîtriser la topologie de l’imbrication des délimiteurs typographiques. La construction rigoureuse s’articule selon la séquence séquentielle exacte :
=QUERY(A2:D500; "SELECT * WHERE C CONTAINS '" & G1 & "'"; 0)
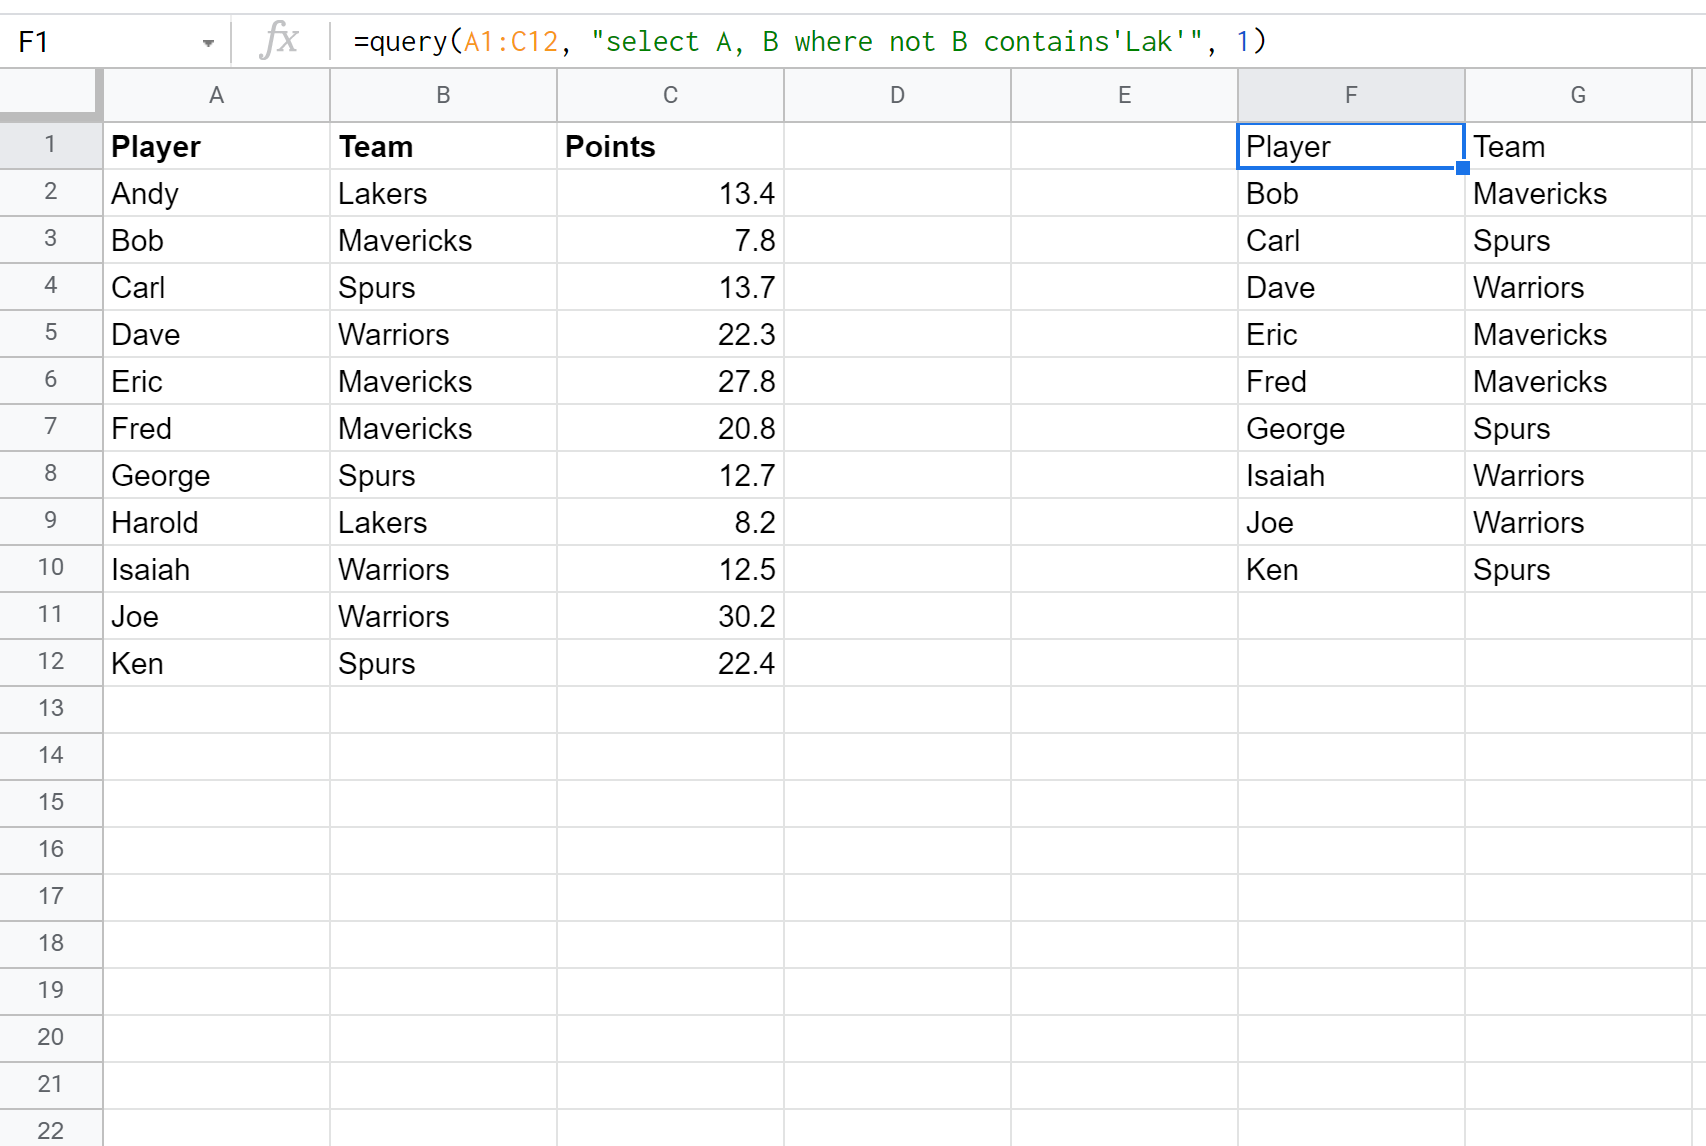
La décomposition analytique pas-à-pas de cette séquence s’avère indispensable pour en saisir la mécanique formelle :
- Le premier segment textuel
"SELECT * WHERE C CONTAINS '"ouvre la chaîne de commande principale entre guillemets doubles, pose le mot-cléCONTAINSet prépare l’ouverture de l’apostrophe simple requise par l’API pour encapsuler le futur littéral. - Le premier guillemet double met temporairement fin à la chaîne de commande brute pour autoriser l’intervention du moteur de calcul du tableur.
- Le premier opérateur de concaténation
&capture la valeur résidente de la coordonnéeG1et la convertit en chaîne de caractères. - Le second opérateur
&raccorde cette valeur au dernier segment textuel"'". - Le dernier segment, ouvert par un guillemet double, renferme l’apostrophe simple fermante indispensable pour clore le terme de recherche aux yeux du compilateur Google Visualization, avant d’être lui-même scellé par l’ultime guillemet double.
Toute déviation typographique minime dans cette alternance méticuleuse de guillemets doubles et d’apostrophes simples engendre inéluctablement une erreur de compilation textuelle immédiate.
8.2 Sécurisation contre les caractères déstabilisateurs et l’injection
L’ouverture d’une requête dynamique aux saisies libres d’opérateurs tiers introduit une vulnérabilité logicielle majeure : le phénomène d’injection involontaire ou déstabilisatrice de syntaxe. Si l’utilisateur consigne dans la cellule de commande G1 un vocable incorporant une apostrophe simple (par exemple le mot l'alerte), cette saisie innocente va briser instantanément l’architecture concaténée de la formule.
En reprenant la formule standard :
"SELECT * WHERE C CONTAINS '" & G1 & "'"
L’injection textuelle produira la chaîne finale compilée suivante :
SELECT * WHERE C CONTAINS 'l'alerte'
Le compilateur interprète la seconde apostrophe comme la terminaison lexicale du critère et tente d’interpréter le fragment résiduel alerte' comme un opérateur d’instruction, ce qui fait échouer instantanément la formule avec l’affichage d’un message d’erreur d’analyse cryptique pour l’utilisateur final.
Pour immuniser l’outil décisionnel contre cette fragilité structurelle, l’ingénierie des données prescrit d’assainir systématiquement l’entrée cellulaire au moyen de la fonction textuelle SUBSTITUTE avant sa fusion au sein du flux d’interrogation. Le patron de conception sécurisé s’établit comme suit :
=QUERY(A2:D500; "SELECT * WHERE C CONTAINS '" & SUBSTITUTE(G1; "'"; "'") & "'"; 0)
Ce blindage computationnel intercepte chaque occurrence d’apostrophe brute saisie dans la cellule de pilotage et lui adjoint préventivement une barre oblique d’échappement. Ainsi transmise au compilateur, la valeur conflictuelle est neutralisée dans sa dimension structurelle et traitée exclusivement comme un composant littéral inoffensif, préservant la stabilité absolue de l’interface d’interrogation.
8.3 Conception d’interfaces de recherche et tableaux de bord interactifs
L’intégration d’une extraction dynamique par CONTAINS au cœur d’un tableau de bord décisionnel interactif soulève une exigence fonctionnelle critique : la gestion rigoureuse de l’état vacant de la cellule de commande. Dans la plupart des architectures de tableaux de bord, lorsque la cellule de saisie de recherche (G1) est purgée de tout contenu par l’utilisateur, l’intention sous-jacente est d’afficher l’intégralité du jeu d’enregistrements disponible, et non de restituer une page vide.
Or, si la cellule G1 est vide, l’expression CONTAINS '""' recherche formellement la sous-chaîne vide. Si cette condition peut théoriquement valider l’ensemble des cellules textuelles, elle risque de se comporter de façon imprévisible ou d’exclure les enregistrements comportant des valeurs nulles. Pour orchestrer un comportement ergonomique sans faille, il convient d’associer la fonction QUERY à une structure conditionnelle préalable IF évaluant l’état de vacuité de la cellule de commande via ISBLANK :
=IF(ISBLANK(G1); QUERY(A2:D500; "SELECT *"; 0); QUERY(A2:D500; "SELECT * WHERE lower(C) CONTAINS '" & LOWER(SUBSTITUTE(G1; "'"; "'")) & "'"; 0))
Dans ce modèle de conception applicative :
- Si la cellule de recherche
G1ne renferme aucune saisie textuelle, la première branche conditionnelle exécute une sélection intégrale de la plage sans appliquer la moindre clause de restrictionWHERE, garantissant l’affichage sans entrave de l’ensemble des tuples de données. - Dès lors qu’un opérateur consigne un terme de recherche, la seconde branche s’active dynamiquement, appliquant l’assainissement anti-apostrophe et la normalisation en minuscules pour délivrer une sélection chirurgicale insensible à la casse.
Cette approche méticuleuse transforme une simple feuille de calcul en une interface d’interrogation semi-professionnelle robuste et hautement tolérante aux manipulations exploratoires.
9. Extension avancée : Transition vers l’opérateur MATCHES et les REGEX
9.1 Limites intrinsèques de CONTAINS face aux motifs complexes
En dépit de son élégance syntaxique indéniable, l’opérateur CONTAINS présente des limites conceptuelles strictes dès lors que la logique de filtrage dépasse la simple inclusion d’une séquence linéaire de caractères fixes. Par conception même, CONTAINS s’avère incapable d’interpréter le contexte structural ou syntaxique entourant la sous-chaîne recherchée.
La première limitation rédhibitoire concerne l’absence totale de reconnaissance des frontières de mots (word boundaries). Si l’analyste recherche l’occurrence du mot « car » (au sens de véhicule automobile) via l’instruction WHERE A CONTAINS 'car', le moteur extraira aveuglément les rangées mentionnant « carte », « placard », « carrelage », « écart », « anachorète » ou « brancardier ». La sous-chaîne étant physiquement présente dans chacun de ces termes sans lien sémantique avec le concept visé, l’échantillon extrait se trouvera lourdement parasité par un bruit lexical prohibitif.
La seconde limitation majeure a trait à l’incapacité d’imposer des ancrages topologiques stricts (exiger que la séquence apparaisse exclusivement au tout début ou à l’extrême fin de la chaîne) ou de gérer des motifs probabilistes (tels que la présence d’une séquence de chiffres d’un format spécifique). Face à de telles exigences d’ingénierie textuelle, l’abandon méthodologique de CONTAINS au profit de l’opérateur MATCHES devient un impératif technique catégorique.
9.2 Syntaxe de l’expression régulière équivalente à CONTAINS
L’opérateur MATCHES exploite l’expressivité intégrale des expressions régulières (standard Java Regex implémenté au sein de l’API Google Visualization). Cependant, une disparité d’évaluation fondamentale doit être impérativement assimilée : alors que CONTAINS teste l’existence d’une sous-chaîne locale, l’opérateur MATCHES exige que l’expression régulière décrive et englobe l’intégralité textuelle absolue de la cellule examinée, du premier au dernier caractère.
En conséquence, pour concevoir avec MATCHES un filtre fonctionnellement strictement équivalent à CONTAINS 'terme', il est indispensable d’adjoindre des motifs d’absorption universels de part et d’autre de la cible. Le schéma s’établit formellement comme suit :
=QUERY(A2:D500; "SELECT * WHERE C MATCHES '.*terme.*'"; 0)
Dans ce formalisme régulier, le métacaractère point (.) représente n’importe quel caractère arbitraire, tandis que l’astérisque quantificateur (*) autorise la répétition de ce caractère de zéro à une infinité de fois. L’expression .* située en amont et en aval de la cible autorise l’existence de n’importe quel préfixe ou suffixe textuel, émulant ainsi à la perfection le comportement de base de CONTAINS.
L’avantage décisif de cette transition réside dans l’immense flexibilité subsidiaire immédiatement déverrouillée :
- Alternative compacte :
C MATCHES '.*(Alpha|Bêta|Gamma).*'permet de remplacer élégamment une cascade interminable de clausesOR CONTAINS. - Frontières de mots strictes :
C MATCHES '.*bcarb.*'isole strictement le mot « car » en tant qu’entité lexicale autonome, éliminant radicalement « carte » ou « placard ». - Insensibilité native à la casse : L’adjonction initiale du drapeau
(?i), sous la formeC MATCHES '(?i).*terme.*', garantit une neutralisation typographique totale sans nécessiter l’appel à la fonctionlower().
9.3 Évaluation comparative des performances : CONTAINS contre MATCHES
L’accroissement de la puissance expressive apporté par MATCHES s’accompagne d’une complexité algorithmique intrinsèquement supérieure qu’il convient de jauger avec discernement dans l’arbitrage architectural de vos modèles de données.
L’opérateur CONTAINS repose sur des algorithmes d’analyse sous-textuelle déterministes hautement spécialisés (de la classe des algorithmes de type Boyer-Moore ou Knuth-Morris-Pratt). Ces algorithmes effectuent des sauts optimisés au sein du flux de caractères de chaque cellule sans maintenir d’états d’exécution complexes. La consommation de mémoire vive et la charge d’instruction processeur demeurent par conséquent remarquablement réduites.
À l’opposé, l’opérateur MATCHES mobilise un moteur complet d’analyse d’expressions régulières compilant des automates à états finis. Dès lors que l’expression intègre des quantificateurs universels gloutons (tels que .*) couplés à des alternatives multiples, le processeur peut être contraint d’opérer des retours sur trace substantiels (backtracking) lorsque la chaîne examinée s’avère longue et complexe. Sur un tableau de bord sollicitant des milliers de rangées, le recours aveugle et indiscriminé à MATCHES en lieu et place d’un simple CONTAINS peut induire une dégradation mesurable du temps de restitution global du document.
La doctrine méthodologique préconise donc une approche hiérarchisée : privilégier systématiquement la frugalité computationnelle et la clarté syntaxique de CONTAINS pour toutes les opérations ordinaires de filtrage de sous-chaînes linéaires, et réserver l’arsenal de MATCHES exclusivement aux cas d’usage démontrant une réelle nécessité de reconnaissance de motifs variables ou d’alternances lexicales massives.
10. Gestion des anomalies de typage et robustesse des données
10.1 La règle de la majorité typologique dans les colonnes Google Sheets
L’un des vecteurs les plus insidieux de corruption silencieuse des extractions réside dans l’hétérogénéité des types de données au sein d’une même coordonnée colonnaire. Comme esquissé lors des développements théoriques préliminaires, l’API Google Visualization applique de manière coercitive la règle de la majorité typologique pour déterminer le contrat de service applicable à chaque colonne de la plage données.
Supposons une colonne colligeant des codes d’inventaire d’équipements au sein de laquelle 80 % des entrées sont rigoureusement numériques (ex. : 104928, 205839), tandis que 20 % des enregistrements récents intègrent des lettres alphabétiques en raison d’une modification de nomenclature (ex. : REF-3049, REF-8921). Lors de la compilation de la requête, le moteur analyse la colonne et décrète, sur la base de la prépondérance statistique des premières rangées, que l’attribut est de nature exclusivement numérique.
La conséquence opérationnelle est irrévocable : lors de la phase d’ingestion des données en mémoire, tous les enregistrements alphanumériques (REF-3049, etc.) sont détruits et remplacés par des valeurs nulles (null). Si l’analyste formule par la suite une requête d’inspection textuelle :
=QUERY(A2:D500; "SELECT * WHERE A CONTAINS 'REF'"; 0)
Le résultat ne restituera absolument aucune ligne. L’analyste sera alors induit dans l’erreur tragique de croire que la base de données ne contient aucun équipement correspondant à la nouvelle nomenclature, alors même que ces enregistrements existent physiquement dans la grille de calcul, mais ont été vaporisés par le moteur d’évaluation en amont même de l’exécution du filtre WHERE.
10.2 Filtrage textuel de colonnes contenant des valeurs numériques ou dates
La règle typologique interdit formellement d’appliquer directement l’opérateur CONTAINS à une colonne dont le type dominant est numérique ou temporel. Si une colonne collige des codes postaux, des dates de transaction ou des montants de facturation catégorisés comme nombres par le tableur, l’expression WHERE A CONTAINS '75' déclenchera une rupture immédiate de type PARSE_ERROR, le compilateur signalant l’impossibilité sémantique d’appliquer un opérateur de sous-chaîne textuelle à une valeur scalaire numérique.
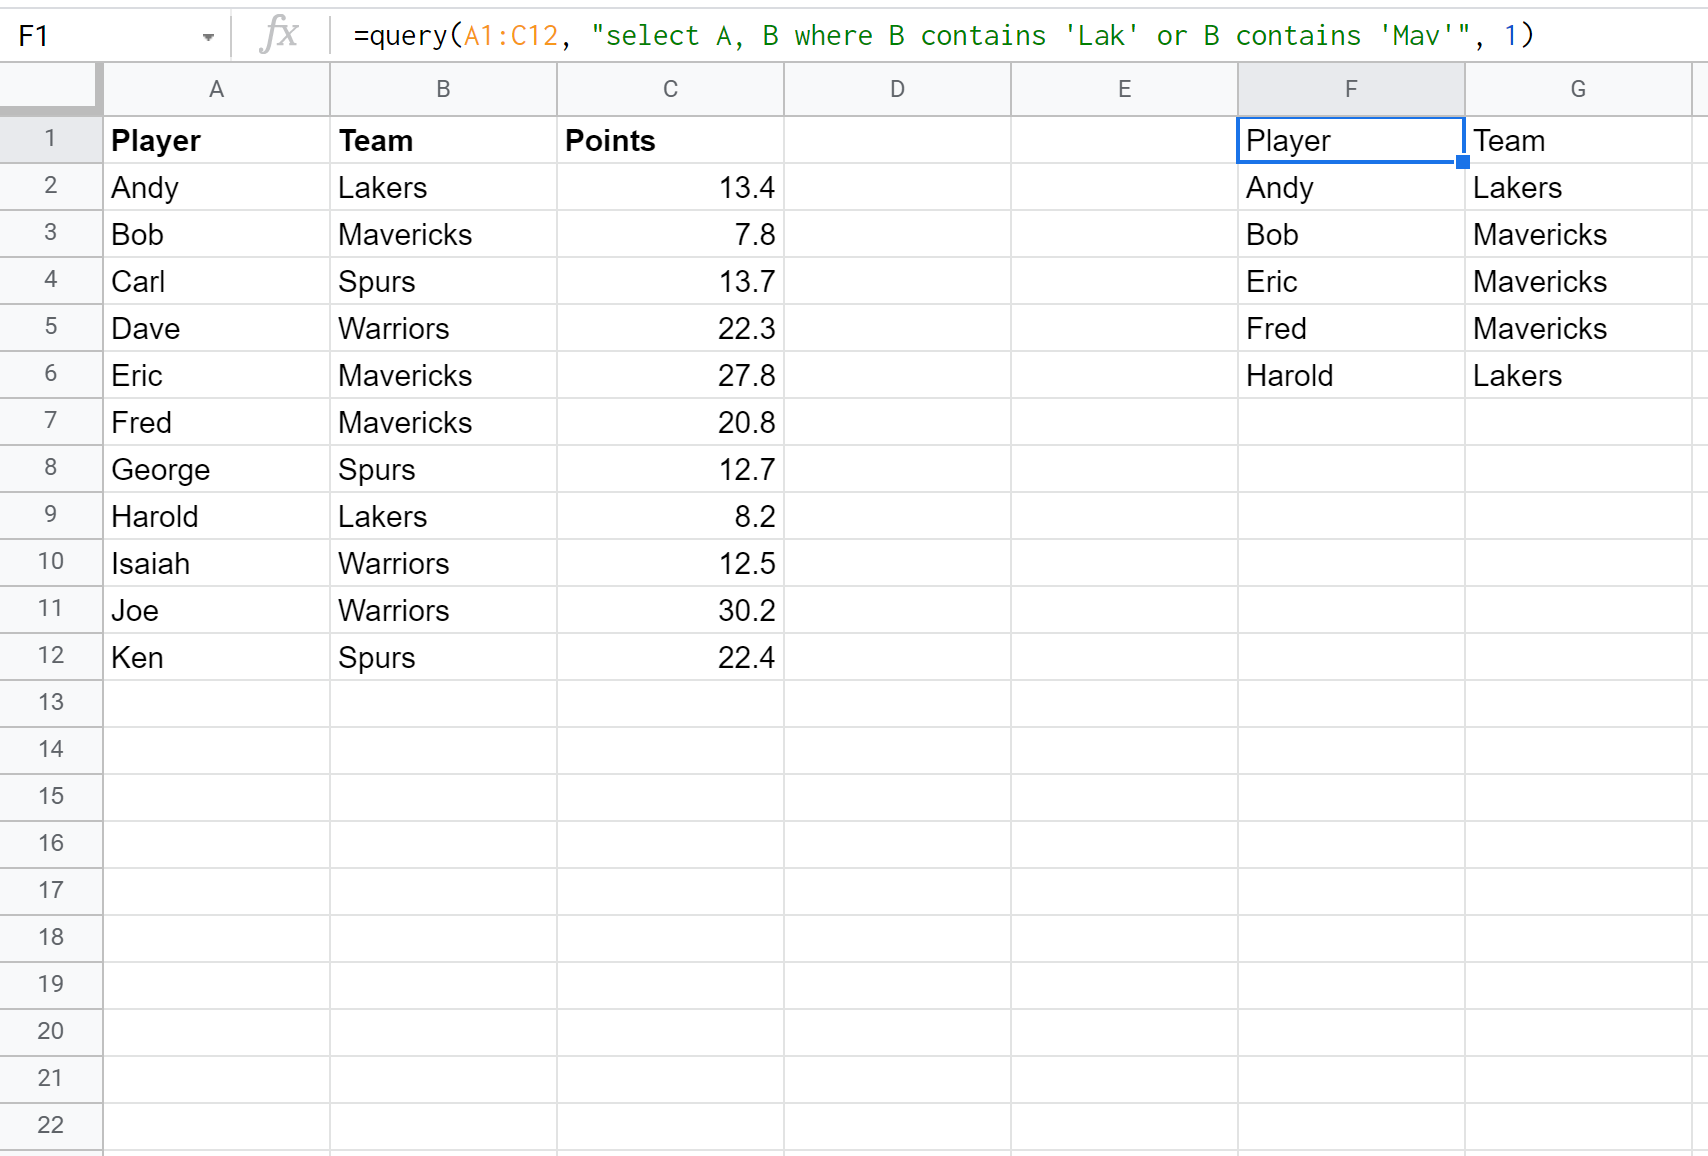
Pour contourner ce verrou structurel et autoriser la recherche de sous-chaînes au sein de données chiffrées sans devoir reconfigurer manuellement l’intégralité du classeur source, il convient de forcer une coercition de type universelle en amont de l’injection dans la fonction QUERY. Cette métamorphose est opérée en encapsulant la plage source au sein d’une transformation matricielle via la fonction TO_TEXT :
=QUERY(INDEX(TO_TEXT(A2:D500)); "SELECT Col1, Col2 WHERE Col1 CONTAINS '75'"; 0)
Ce patron de conception technique impose deux ajustements fondamentaux :
- L’association de
INDEX(TO_TEXT(...))opère une conversion instantanée de l’intégralité des cellules de la plage en chaînes de caractères pures en mémoire vive, neutralisant la règle de la majorité typologique et homogénéisant l’ensemble du corpus sur le type textuel. - La plage n’étant plus une référence directe de cellules mais un tableau virtuel généré en mémoire, la syntaxe de désignation des colonnes bascule obligatoirement de la notation par lettres alphabétiques standard (
A,B,C) vers la notation positionnelle formaliséeCol1,Col2,Col3. L’usage accidentel des lettres au sein d’une plage virtuelle transformée lèverait une exception de colonne introuvable.
10.3 Résolution des conflits de formatage et de standardisation
Même au sein de colonnes rigoureusement textuelles, la présence d’artéfacts de saisie imperceptibles à l’œil nu constitue une cause permanente de défaillance des critères CONTAINS. Les pollutions typographiques les plus fréquentes sont les espaces périphériques superflus (espaces insécables ou espaces simples placés en tête ou en queue de texte) et les retours à la ligne résiduels issus d’opérations de copier-coller depuis des systèmes externes.
Si la cellule contient la chaîne " Rapport " (environnée de deux espaces) et que l’analyste injecte dynamiquement un critère rigoureusement nettoyé "Rapport", l’opérateur CONTAINS validera la concordance. Toutefois, la situation inverse s’avère hautement préjudiciable : si la cellule de recherche utilisateur comporte par mégarde un espace terminal involontaire ("Rapport ") alors que les données de la base n’intègrent aucun espace subséquent ("Rapport financier" est validé, mais "Rapport" isolé en fin de cellule échouera), le prédicat rejettera les enregistrements valides.
L’assainissement systématique du flux de travail analytique requiert la mise en place d’un protocole d’audit de qualité préalable. Il est hautement recommandé d’assainir la saisie des cellules de commande via l’adjonction de la fonction d’élagage TRIM :
=QUERY(A2:D500; "SELECT * WHERE lower(C) CONTAINS '" & LOWER(TRIM(G1)) & "'"; 0)
Cette mesure prophylactique supprime instantanément toute scorie d’espacement au début ou à la fin de la chaîne de recherche injectée, fiabilisant considérablement le comportement de l’infrastructure d’interrogation face aux inadvertances ergonomiques de l’utilisateur final.
11. Diagnostic, débogage et résolution des erreurs de requête
11.1 Déchiffrage des messages d’erreur textuels de QUERY
La mise au point de requêtes complexes confronte inéluctablement l’analyste à des alertes d’interruption générées par le moteur d’exécution. L’interprétation rigoureuse de ces diagnostics textuels constitue le prérequis absolu à toute résolution méthodologique efficiente.
Les messages d’erreur les plus prévalents dans l’usage de CONTAINS s’ordonnent selon la typologie suivante :
#VALUE!avec mentionPARSE_ERROR: Ce diagnostic signale une rupture lexicale irréversible au sein de la chaîne de requête. Les causes fondamentales en sont quasi-exclusivement l’absence d’apostrophe fermante autour d’un littéral de recherche, l’omission d’un opérateur de liaison (tel que l’oubli deANDou deORentre deux assertions), ou la présence d’une apostrophe brute non échappée au sein du terme cible.#VALUE!avec mentionNO_COLUMN: Cette erreur survient lorsque la clauseWHEREou la clauseSELECTsollicite un identifiant colonnaire inconnu du schéma d’exécution. Les scénarios typiques impliquent l’utilisation d’une lettre alphabétique (ex. :WHERE A CONTAINS...) au sein d’une plage matricielle calculée entre accolades qui n’admet que la notationCol1, ou l’utilisation d’une lettre excédant la largeur physique de la plage déclarée dans le premier argument (par exemple désignerEalors que la plage s’arrête àD500).- Absence totale d’erreur avec restitution d’un résultat vide : Comme démontré précédemment, cette situation ne traduit pas une anomalie syntaxique, mais une vacuité relationnelle découlant d’une sensibilité à la casse non prise en charge, d’une exclusion silencieuse par négation sur valeurs nulles, ou de l’application de
CONTAINSsur une colonne classifiée numérique par la règle de la majorité.
11.2 Procédures systématiques de débogage des requêtes complexes
Face à une formule complexe récalcitrante entremêlant sélections multiples, conjonctions, disjonctions et insensibilisations typographiques, la tentative de correction aveugle au sein de la cellule de calcul finale constitue une faute méthodologique majeure. Il convient d’appliquer une procédure d’isolation progressive descendante hautement formalisée.
La première phase de ce protocole consiste à déporter la chaîne de requête textuelle hors de la formule QUERY en l’isolant dans une cellule de test adjacente (par exemple Z1). On inscrit dans cette cellule la formule de concaténation brute :
="SELECT * WHERE lower(C) CONTAINS '" & LOWER(TRIM(G1)) & "'"
Cette dissociation permet à l’analyste de visualiser visuellement la chaîne de commande exactement telle qu’elle sera soumise au compilateur de l’API Google Visualization, rendant instantanément évidentes les défaillances d’apostrophes, les ruptures de guillemets ou les concaténations aberrantes.
La seconde phase repose sur la décomposition modulaire de la clause WHERE. L’opérateur réduit initialement la requête à sa plus simple expression fonctionnelle :
=QUERY(A2:D500; "SELECT *"; 0)
Si cette projection de base fonctionne, l’analyste intègre individuellement le premier prédicat WHERE C CONTAINS 'valeur'. Une fois ce prédicat unitaire validé, il lui adjoint la normalisation scalaire lower(), puis réintègre une à une les clauses conditionnelles subséquentes reliées par AND ou OR. Cette incrémentation séquentielle permet d’identifier à la milliseconde près le fragment syntaxique précis qui provoque la rupture du moteur de compilation.
11.3 Sécurisation et maintenance préventive du modèle de données
La viabilité opérationnelle à long terme d’un classeur d’entreprise reposant sur des requêtes QUERY complexes exige l’adoption d’un ensemble de mesures d’ingénierie préventives visant à immuniser les formules contre les altérations structurelles courantes de la grille de calcul.
Le risque structurel prédominant réside dans l’insertion ou la suppression inopinée de colonnes par des intervenants tiers au sein de la feuille de calcul source. Si une formule référence en dur les colonnes alphabétiques (SELECT A, C WHERE B CONTAINS 'terme') et qu’un utilisateur intercale une nouvelle colonne entre les attributs existants, les désignations textuelles figées à l’intérieur des guillemets de la chaîne de requête ne s’adapteront pas dynamiquement. La colonne B continuera d’être inspectée alors qu’elle héberge désormais un tout autre attribut, ruinant la fiabilité de l’extraction.
Pour prévenir cette obsolescence accidentelle, deux architectures de haute disponibilité peuvent être déployées :
- Virtualisation systématique par accolades : En déclarant la plage sous la forme
{A2:D500}et en basculant l’ensemble de la syntaxe sous la notationCol1, Col2, Col3, on standardise l’interrogation sur un ordre ordinal invariant, particulièrement adapté si la source est une table de base de données importée dont le schéma est rigide. - Documentation des prédicats et figeage des en-têtes : L’interdiction formelle de modifier la structure des en-têtes de colonnes, couplée à la spécification systématique et explicite du troisième argument de la formule (au lieu de laisser le moteur le déduire), empêche toute corruption opportuniste de l’extraction lors des opérations courantes d’actualisation de la grille.
12. Applications méthodologiques et protocoles d’analyse textuelle
12.1 Codage et catégorisation thématique de corpus qualitatifs
L’extraction de sous-chaînes au moyen de la fonction QUERY trouve un champ d’application méthodologique d’une puissance insoupçonnée dans le traitement systématique de matériaux textuels semi-structurés, tels que les transcriptions d’entretiens qualitatifs, les retours d’expérience d’utilisateurs ou les verbatim de questionnaires ouverts. Dans ces disciplines de recherche, le chercheur ou l’analyste est constamment confronté au défi de catégoriser de vastes flux lexicaux en classes sémantiques ordonnées.
En lieu et place de procédures manuelles d’annotation fastidieuses et sujettes à l’épuisement cognitif, l’analyste peut élaborer un banc d’extraction automatisé ventilant dynamiquement les réponses selon un dictionnaire de concepts contrôlés. Supposons un corpus d’évaluations qualitatives colligé dans la colonne B : l’analyste peut cartographier l’émergence d’une thématique liée à la tarification en déployant une formule dédiée au sein d’un onglet de synthèse :
=QUERY('Données Brutes'!A2:C1000; "SELECT Col1, Col2 WHERE lower(Col2) CONTAINS 'prix' OR lower(Col2) CONTAINS 'tarif' OR lower(Col2) CONTAINS 'coût' OR lower(Col2) CONTAINS 'cherté'"; 0)
Cette disposition algorithmique permet d’isoler en temps réel un sous-ensemble homogène d’extraits textuels répondant au champ lexical monétaire. La même procédure pouvant être répétée parallèlement pour les dimensions relationnelles, techniques ou ergonomiques, la feuille de calcul se métamorphose en un outil d’analyse lexicométrique semi-automatisé capable de traiter des milliers de lignes de verbatim avec une fidélité conceptuelle absolue et reproductible.
12.2 Segmentation comportementale et textuelle de bases d’observations
Dans le domaine des études quantitatives et de l’analyse comportementale, la capacité à segmenter des populations d’individus ou de transactions selon des attributs narratifs combinés constitue un atout méthodologique déterminant. La fonction QUERY et l’opérateur CONTAINS permettent de créer des cohortes hautement ciblées à l’intersection de multiples variables qualitatives.
Considérons une base d’observations expérimentales répertoriant les réponses d’usagers soumis à divers protocoles de stimulation en sciences comportementales. La colonne A consigne l’identifiant du sujet, la colonne B les annotations descriptives émises par les observateurs, la colonne C les mesures quantitatives associées et la colonne D les métadonnées de cohorte démographique. Pour isoler spécifiquement la cohorte d’individus ayant manifesté des réactions textuellement qualifiées d’anxiété ou d’hésitation motrice, tout en éliminant les participants ayant reçu un traitement préalable neutralisant, l’équation s’articule ainsi :
=QUERY(A2:D; "SELECT A, C WHERE (lower(B) CONTAINS 'anxiété' OR lower(B) CONTAINS 'hésitation') AND NOT lower(B) CONTAINS 'placebo'"; 1)
Cette approche méthodologique permet aux chercheurs de vérifier avec une réactivité instantanée des hypothèses de corrélation statistique entre des manifestations cliniques documentées sous forme textuelle et des métriques numériques observées, illustrant la fécondité du couplage entre l’algèbre relationnelle et l’investigation empirique dans les feuilles de calcul.
12.3 Matrice de référence syntaxique pour l’opérateur CONTAINS
Le tableau de synthèse méthodologique ci-après rassemble les principales configurations opératoires de l’opérateur CONTAINS, constituant un répertoire de référence rapide pour la conception et l’audit de formules au sein de vos systèmes d’information :
| Objectif Analytique | Modèle Syntaxique de Référence | Spécificités et Vigilances Critiques |
|---|---|---|
| Inclusion unitaire simple | WHERE A CONTAINS 'terme' |
Sensibilité stricte à la casse typographique. Échec si la cellule est de type numérique majoritaire. |
| Inclusion insensible à la casse | WHERE lower(A) CONTAINS 'terme' |
Garantit la détection quelle que soit la typographie. Le terme cible doit impérativement être saisi en minuscules. |
| Exclusion unitaire pure | WHERE NOT A CONTAINS 'terme' |
Attention : Élimine silencieusement toutes les cellules vides ou nulles de la colonne examinée. |
| Exclusion robuste sécurisée | WHERE (NOT A CONTAINS 'terme') OR A IS NULL |
Réhabilite explicitement les cellules non renseignées, préservant la complétude volumétrique de l’échantillon. |
| Disjonction lexicale (OU) | WHERE A CONTAINS 'X' OR A CONTAINS 'Y' |
L’identifiant colonnaire doit obligatoirement être répété pour chaque terme. Évaluation court-circuitée. |
| Conjonction simultanée (ET) | WHERE A CONTAINS 'X' AND A CONTAINS 'Y' |
Valide uniquement si les deux chaînes coexistent dans la cellule, indépendamment de leur disposition ordonnée. |
| Injection dynamique d’une cellule | WHERE A CONTAINS '" & G1 & "' |
Rupture fatale si G1 contient une apostrophe. Doit être protégée par la fonction SUBSTITUTE. |
| Recherche textuelle sur nombres/dates | WHERE Col1 CONTAINS '99' (avec INDEX(TO_TEXT())) |
Exige la transformation préalable par TO_TEXT et le basculement obligatoire en notation ColX. |
| Alternative par motif complexe | WHERE A MATCHES '(?i).*terme.*' |
Mobilise le moteur d’expressions régulières. Équivalent à CONTAINS insensible avec une empreinte calculatoire accrue. |
Avant toute exploitation définitive de résultats extraits par ces mécanismes au sein de publications, rapports d’activité ou prises de décision organisationnelles critiques, il est vivement préconisé de valider la conformité de l’interrogation au moyen de la liste de contrôle méthodologique suivante :
- Le troisième paramètre (
en-têtes) est-il formellement renseigné par une constante entière explicite pour empêcher les conjectures hasardeuses du moteur ? - La colonne inspectée présente-t-elle un typage textuel majoritaire homogène exempt de corruptions scalaires par des valeurs numériques pures ?
- La sensibilité à la casse a-t-elle été préventivement neutralisée via
lower()si la source découle d’une saisie humaine libre non normalisée ? - En cas d’application de la négation (
NOT CONTAINS), la préservation des enregistrements vides a-t-elle été expressément assurée par la clauseOR Col IS NULL? - Les blocs logiques entremêlant
ANDetORsont-ils rigoureusement compartimentés par des parenthèses fermées pour juguler la priorité mathématique naturelle de la conjonction ? - Les chaînes de caractères injectées depuis des coordonnées de pilotage externes sont-elles convenablement élaguées par
TRIMet expurgées de toute apostrophe déstabilisatrice parSUBSTITUTE?
La mise en œuvre assidue de ces préceptes garantit une exploitation hautement sécurisée, performante et scientifiquement reproductible des capacités d’interrogation textuelle offertes par l’écosystème Google Sheets, consolidant ainsi la crédibilité et l’efficience de vos infrastructures d’analyse de données relationnelles.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Google Developers. (2023). Google Visualization API Query Language (Version 0.7). Google Workspace Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
- Google Support. (2024). Fonction QUERY : Référence officielle des formules Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/3093343
- International Organization for Standardization. (2016). Information technology — Database languages — SQL (ISO/IEC standard n° 9075:2016). ISO/IEC. https://www.iso.org/standard/63555.html
- The Unicode Consortium. (2023). The Unicode Standard, Version 15.0. Mountain View, CA: The Unicode Consortium. https://unicode.org/standard/standard.html