
Dans l’écosystème contemporain de l’analyse décisionnelle et de la science des données, la feuille de calcul a transcendé son statut historique de simple registre comptable pour s’ériger en un environnement de modélisation dynamique et d’exploration visuelle de premier plan. Au sein de ce paradigme, Google Sheets s’est imposé comme un vecteur d’intelligence collective d’une efficacité redoutable, favorisant la collaboration synchrone et l’interopérabilité au sein d’architectures informationnelles distribuées. Cependant, la complexité intrinsèque des données d’entreprise modernes défie fréquemment les structures tabulaires linéaires conventionnelles. Les analystes se heurtent de manière récurrente à des contextes où les indicateurs critiques ne résident pas au sein d’une matrice contiguë unique, mais se trouvent disséminés à travers des segments de colonnes asymétriques, des plages de cellules disjointes ou des feuilles de calcul distinctes.
La synthèse graphique de ces fragments hétérogènes constitue un défi méthodologique et technique substantiel. Établir une représentation visuelle cohérente à partir de sources disparates requiert une compréhension profonde de la sémantique sous-jacente des séries matricielles, des mécanismes d’indexation vectorielle du moteur d’exécution de Google Workspace, ainsi que des principes fondamentaux de la psychologie cognitive appliquée à la sémiologie graphique. Une configuration erronée des plages de données engendre immanquablement des distorsions herméneutiques, des ruptures d’échelle ou des représentations fallacieuses susceptibles de compromettre l’intégrité des processus d’arbitrage stratégique au plus haut niveau organisationnel.
Cet article propose un traité d’ingénierie analytique exhaustif consacré à la conception, la normalisation, la configuration et l’automatisation de visualisations avancées exploitant des plages de données multiples au sein de Google Sheets. À travers un parcours didactique rigoureux, nous disséquerons les fondements théoriques de la perception visuelle, les méthodes d’assainissement dimensionnel, les syntaxes de sélection disjointe, la maîtrise de l’axe vertical secondaire, l’orchestration de tableaux virtuels par des formules matricielles et le déploiement programmatique via Google Apps Script. Ce guide ambitionne de fournir aux professionnels de la donnée un corpus de connaissances exhaustif, alliant rigueur théorique et applicabilité opérationnelle absolue.
1. Fondements théoriques de la visualisation multi-sources dans Google Sheets
Avant d’aborder les manipulations logicielles, il s’avère indispensable de circonscrire les fondements épistémologiques et cognitifs qui régissent l’agrégation graphique de jeux de données distribués. La visualisation multi-sources n’est pas un simple artifice d’affichage ; elle incarne un processus d’intégration conceptuelle dont la validité repose sur des règles précises de traitement de l’information.
1.1 Perception visuelle et traitement cognitif des séries multiples
L’interprétation conjointe de plusieurs flux de données superposés sollicite intensément le système perceptif humain. L’analyse de la charge cognitive, telle que formalisée par la théorie de la charge cognitive, révèle que la juxtaposition de séries temporelles concurrentes au sein d’un même espace géométrique s’accompagne d’un coût mental extrinsèque élevé. Lorsque l’œil parcourt des courbes oscillantes ou des histogrammes entremêlés, la mémoire de travail doit simultanément segmenter les stimuli, associer chaque élément à sa légende respective et synthétiser les différentiels cinétiques ou volumétriques.
Les principes fondamentaux de la psychologie de la Gestalt — en particulier les lois de continuité, de proximité et de similitude — constituent le cadre régulateur de la différenciation visuelle. Selon ces préceptes, l’esprit humain regroupe spontanément les éléments partageant des caractéristiques morphologiques homogènes. L’attribution judicieuse de marqueurs géométriques distincts (disques, losanges, triangles) et de typologies de tracés spécifiques permet de contrecarrer la tendance naturelle à l’amalgame cognitif lorsque deux trajectoires quantitatives se croisent.
La capacité de traitement visuel instantané de l’être humain étant strictement bornée, la mémoire de travail subit un phénomène de saturation rapide dès lors que le nombre de séries concurrentes franchit le seuil critique de quatre à cinq dimensions. Au-delà de cette frontière, le phénomène d’« encombrement visuel » dégrade substantiellement l’exactitude de l’extraction d’information, transformant un outil de discernement stratégique en un bruit graphique impénétrable.
1.2 Typologie architecturale des données tabulaires
D’un point de vue architectural, les données tabulaires traitées au sein d’une feuille de calcul numérique se scindent en deux configurations spatiales majeures : les plages contiguës et les plages discontinues. Une plage contiguë correspond à un bloc matriciel continu défini par une coordonnée d’origine et une coordonnée terminale, au sein duquel chaque cellule partage une frontière mitoyenne avec ses adjacentes. Inversement, les plages discontinues ou disjointes se composent de sous-ensembles géographiquement isolés au sein de la grille spatiale, séparés par des colonnes intercalaires, des totaux partiels ou des lignes de métadonnées.
La formalisation matricielle impose une distinction stricte entre les dimensions axiales : les lignes correspondent typiquement aux observations (unités statistiques ou pas d’échantillonnage temporel), tandis que les colonnes incarnent les variables (mesures quantitatives ou catégorielles). Dans Google Sheets, la conservation de cet isomorphisme est indispensable. L’analyste doit veiller à ce que la structure des plages disjointes sélectionnées présente une parité dimensionnelle absolue en termes d’orientations et de cardinalités d’échantillons.
L’alignement typologique des données conditionne directement la viabilité de l’agrégation graphique. Une série de données ne peut être agrégée à une autre que si leurs domaines de définition s’avèrent compatibles. Toute asymétrie dans la nature des variables — par exemple l’association directe d’une variable cumulative avec une variable instantanée sans transformation préalable — engendre une fracture sémantique qui altère l’intégrité du rendu visuel final.
1.3 Avantages de la modélisation à sources plurielles
L’intégration de plages multiples au sein d’une composition graphique unifiée déverrouille des perspectives analytiques inaccessibles via des diagrammes isolés. L’un des bénéfices majeurs réside dans l’analyse comparative longitudinale de cohortes indépendantes sur un intervalle chronologique unifié. Cette technique permet, par exemple, de superposer les trajectoires d’acquisition d’utilisateurs issues de campagnes marketing distinctes exécutées à des périodes asynchrones, en réalignant leur origine temporelle sur un axe normalisé.
Par ailleurs, la modélisation à sources plurielles autorise la corrélation dynamique de métriques capturées par des systèmes d’enregistrement disparates. Il devient ainsi envisageable de corréler des flux de trésorerie consolidés dans un onglet financier avec des volumes d’activité opérationnelle saisis au sein d’un onglet logistique distant, sans requérir de fusion préalable des tables de données.
Enfin, cette approche optimise la compacité de l’écosystème d’information en éliminant la redondance structurelle. En évitant la duplication artificielle de colonnes de référence (telles que les axes temporels) à seule fin de satisfaire aux contraintes d’une sélection contiguë, l’analyste préserve la pureté architecturale de son modèle relationnel et réduit la surface de vulnérabilité aux erreurs de saisie.
2. Préparation rigoureuse et normalisation des plages de données
L’exactitude d’une restitution graphique est consubstantielle à la rigueur de la phase de préparation des données. L’adage fondamental des sciences informatiques — garbage in, garbage out — s’applique avec une acuité particulière à la visualisation multi-sources. Toute négligence dans la standardisation des vecteurs ou le traitement des valeurs lacunaires se répercute de manière amplifiée sur le plan cartésien du graphique.
2.1 Standardisation dimensionnelle des séries matricielles
La synchronisation vectorielle requiert une uniformisation irréprochable de la longueur des séries de données destinées à être comparées. Si une plage de référence temporelle s’étend sur cinquante lignes, chaque série de mesure associée doit impérativement afficher une hauteur vectorielle équivalente. Une asymétrie dans l’indexation matricielle génère des décalages d’alignement ou des erreurs d’exécution au sein du moteur géométrique de Google Sheets, induisant des biais d’échantillonnage préjudiciables.
La gestion des pas temporels réguliers représente un enjeu critique face à des enregistrements hétérogènes. Lorsqu’une série est capturée sur une fréquence quotidienne tandis qu’une autre n’est renseignée que de façon hebdomadaire ou sporadique, une normalisation chronologique préalable s’impose. Cette homogénéisation peut s’effectuer via un rééchantillonnage systématique s’appuyant sur les recommandations internationales de l’organisation ISO 8601 pour la standardisation des formats temporels.
Le traitement des métadonnées d’en-tête constitue le troisième pilier de la standardisation dimensionnelle. Chaque plage, qu’elle soit isolée ou contiguë, doit posséder une cellule d’en-tête explicite, rigoureusement typée en format textuel standard. Ces étiquettes textuelles constituent les ancres sémantiques que le générateur de graphiques utilisera automatiquement pour instancier les légendes et indexer les variables associées.
2.2 Assainissement des variables et gestion des données manquantes
Dans un contexte multi-plages, le traitement des lacunes d’observation — les cellules vides ou nulles — nécessite un arbitrage méthodologique avisé. L’analyste est confronté à deux stratégies divergentes : l’imputation numérique (par interpolation linéaire, maintien de la dernière valeur observée ou assignation de la moyenne mobile) versus la préservation stricte de la cellule vide. L’imputation artificielle risque d’induire en erreur quant à la réalité du phénomène observé, tandis que la présence de cellules vides non paramétrées peut briser la continuité des tracés linéaires.
Il convient de porter une attention méticuleuse à l’uniformité du typage des données. L’un des écueils les plus fréquents dans Google Sheets réside dans l’existence pernicieuse de valeurs numériques encodées sous forme de chaînes de caractères textuelles, souvent issues d’exports CSV imparfaits. Une simple espace insécable ou l’usage inadéquat du point décimal à la place de la virgule locale prive la cellule de sa nature arithmétique, la contraignant à être ignorée par le moteur de rendu ou reléguée à une valeur nulle arbitraire.
Enfin, le dépistage des valeurs aberrantes ou extrêmes (outliers) est impératif. Dans un graphique combinant plusieurs plages indépendantes, une anomalie ponctuelle au sein d’une seule série entraîne un écrasement immédiat de l’échelle verticale globale, anéantissant la granularité visuelle de l’ensemble des autres séries tracées sur le même axe.
2.3 Organisation spatiale au sein du classeur
L’agencement topologique des données au sein du classeur exerce une influence déterminante sur la pérennité de l’infrastructure analytique. Deux philosophies d’organisation spatiale s’affrontent couramment : la structuration sur feuille unique et l’architecture multi-onglets distribuée. L’approche sur feuille unique regroupe l’intégralité des tableaux sur le même plan, ce qui simplifie le repérage visuel direct au détriment potentiel de la clarté lorsque les tables prolifèrent.
À l’inverse, l’architecture multi-onglets distribue les plages de données selon des découpages thématiques, géographiques ou chronologiques. Cette approche requiert l’adoption d’une convention de nommage rigoureuse et standardisée pour chaque onglet (par exemple, DATA_FINANCE_2023 ou METRICS_OPS_Q1). Cette discipline évite les ruptures de syntaxe lors du référencement manuel de plages externes au sein de l’éditeur de graphiques.
Il est vivement recommandé d’aménager des zones d’isolation documentaire dédiées aux métadonnées. Ces blocs documentaires, idéalement positionnés en périphérie ou au sommet des structures de données, consignent formellement la source d’extraction, l’horodatage de la dernière synchronisation, l’auteur de la saisie ainsi que les unités de mesure sous-jacentes. Cette démarche garantit une traçabilité intégrale, indispensable à la maintenance collaborative des visualisations complexes.
3. Création initiale du graphique à partir de plages contiguës
Avant d’aborder la complexité des configurations discontinues, il est indispensable de maîtriser la genèse d’un graphique à partir d’une matrice contiguë standard. Cette démarche permet de décortiquer les automatismes exécutés par l’algorithme d’inférence de Google Sheets lors de l’attribution initiale des dimensions.
3.1 Sélection matricielle exhaustive et insertion primitive
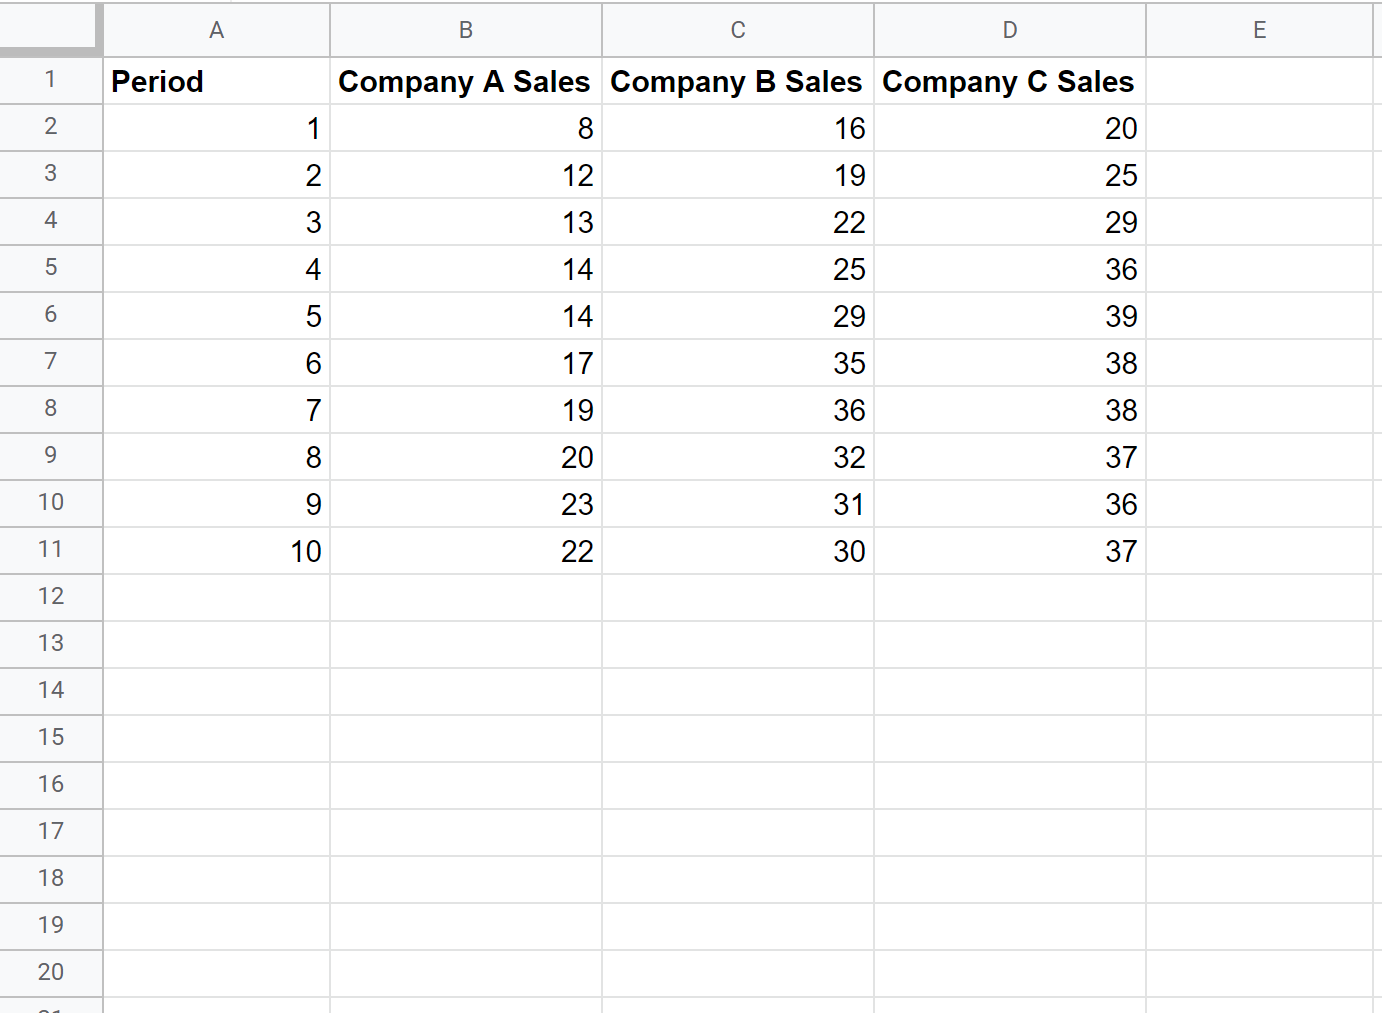
La procédure d’initialisation classique débute par la délimitation d’un bloc de données contigu, tel que la plage matricielle A1:D11, englobant une colonne d’indexation chronologique et trois colonnes d’indicateurs quantitatifs. Cette sélection peut être réalisée via les périphériques d’entrée standard, ou plus efficacement au moyen de raccourcis clavier de navigation directionnelle (par exemple, la combinaison des touches Ctrl, Maj et des flèches sous Windows ou Commande, Maj et flèches sous macOS).
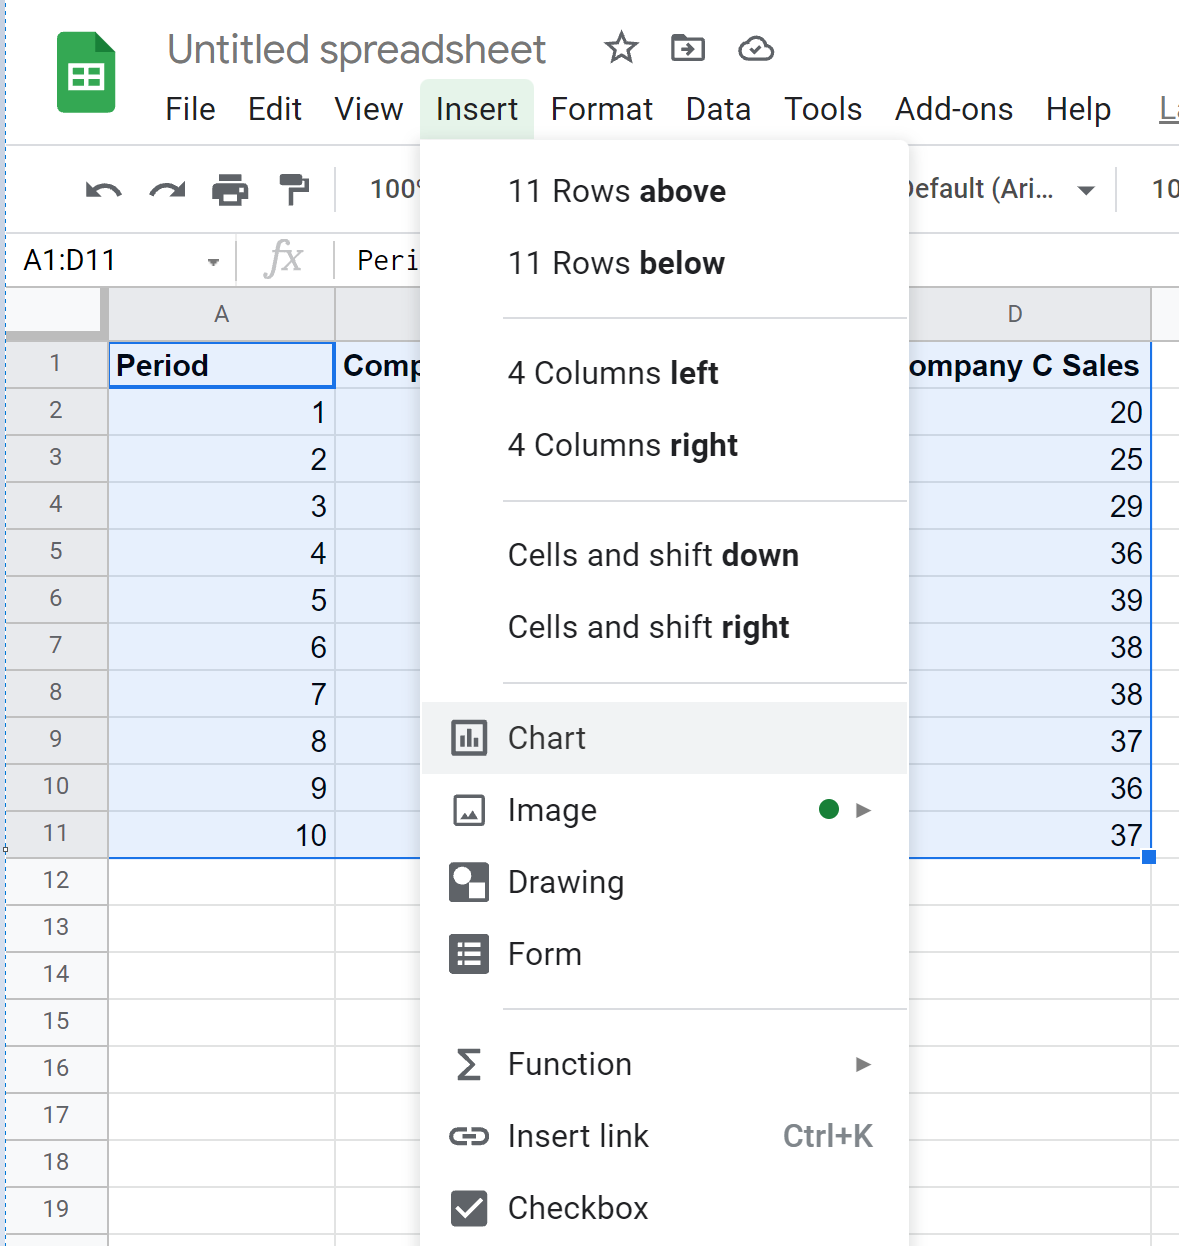
Une fois la matrice circonscrite, l’insertion du canevas visuel s’opère soit en accédant au menu principal via la séquence Insertion > Graphique, soit par l’activation directe du pictogramme idoine situé sur la barre d’outils contextuelle. Cette action sollicite le moteur heuristique de Google Sheets, qui injecte instantanément un composant graphique flottant sur la feuille active tout en ouvrant le panneau latéral dédié : l’Éditeur de graphiques.
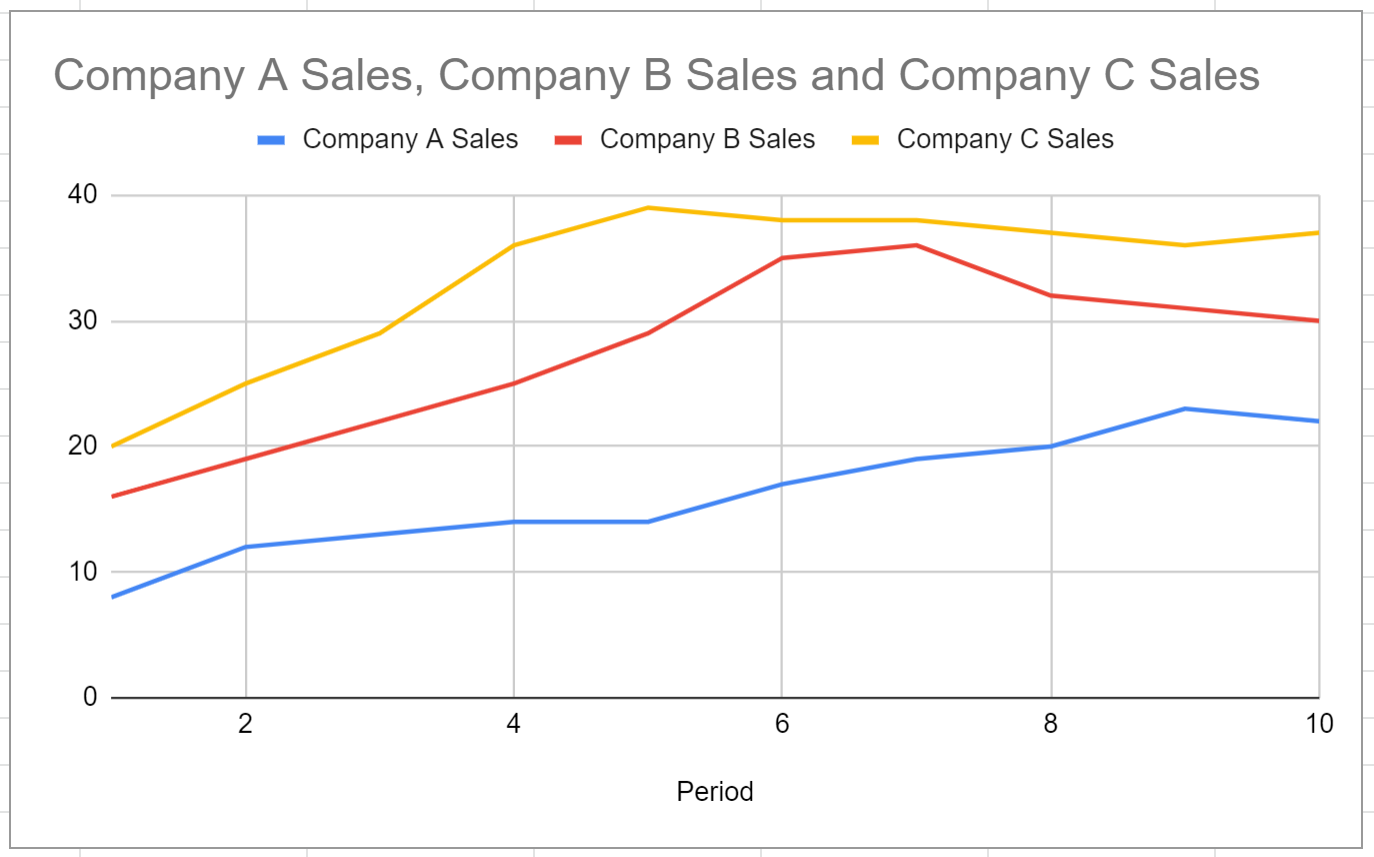
Par défaut, l’environnement évalue les types de données en présence et génère le diagramme qu’il juge le plus représentatif de la structure sous-jacente — fréquemment un graphique linéaire ou un histogramme à colonnes groupées si une variable temporelle ou ordinale est identifiée en tête de matrice.
3.2 Déconstruction du moteur d’attribution automatique
Le moteur d’intelligence analytique sous-jacent applique un ensemble de règles déterministes pour convertir la table brute en objets géométriques vectoriels. La colonne située à l’extrême gauche de la sélection (dans notre cas, la colonne A) est quasi systématiquement assignée au rôle d’abscisse (Axe horizontal ou Axe X). Le moteur présume qu’elle représente la variable indépendante de référence, servant de fil conducteur pour le balayage visuel.
Les colonnes contiguës subséquentes (colonnes B, C et D) sont automatiquement métamorphosées en séries de données ordonnées. Chacune d’entre elles se voit allouer une couche vectorielle distincte, assortie d’un code chromatique différentiel prélevé sur la palette thématique active du document de travail.
Simultanément, le système analyse la première ligne de la sélection. Si cette dernière contient des chaînes textuelles alors que les cellules inférieures contiennent des entiers ou des flottants, Google Sheets interprète irrévocablement cette première ligne comme étant la strate des en-têtes de séries. Elle est alors retranchée de l’espace de traçage quantitatif pour être convertie en étiquettes de légende textuelles.
3.3 Validation préliminaire de la représentation vectorielle
Dès l’apparition du tracé, une phase d’audit critique est requise afin de s’assurer de l’adéquation entre l’intention d’analyse et le rendu géométrique effectif. L’analyste doit effectuer un contrôle de cohérence rigoureux entre les amplitudes numériques de la matrice d’origine et les coordonnées projetées sur l’axe des ordonnées (Axe vertical ou Axe Y). Un aplatissement inattendu ou des discontinuités géométriques non représentatives du phénomène réel signalent une méprise algorithmique.
Il convient ensuite de vérifier la trajectoire de chaque courbe de performance pour identifier d’éventuels chevauchements anormaux ou des inversions polaires. Les erreurs de transcription d’échelles ou de granularités temporelles dégradent instantanément la pertinence de la restitution.
L’un des désagréments algorithmiques récurrents réside dans l’inversion inopinée des axes par le système, qui transmute la matrice par rotation orthogonale (interversion des lignes et des colonnes). Si le graphique trace dix séries d’observations temporelles à la place de trois lignes d’évolution diachronique, une intervention manuelle corrective s’avère immédiatement indispensable au sein du module de contrôle de configuration.
4. Intégration de plages de données discontinues et non contiguës
L’analyse opérationnelle impose fréquemment de confronter des indicateurs hébergés dans des segments spatiaux non mitoyens. Cette séparation spatiale résulte souvent de la présence de colonnes de travail intermédiaires, de calculs préliminaires non destinés à la visualisation ou d’une distribution thématique éclatée au sein du tableur.
4.1 Techniques de sélection manuelle disjointe
La sélection directe de plages disjointes requiert l’emploi combiné de périphériques de pointage et de touches modificatrices du système d’exploitation. Sous l’environnement Windows et ChromeOS, l’opérateur doit maintenir la touche Ctrl enfoncée pendant qu’il effectue le surlignage successif des blocs spatiaux non mitoyens. Sur l’écosystème macOS, cette fonction est assurée par la touche Commande (Cmd).
Cette manipulation requiert une discipline gestuelle rigoureuse. Une règle fondamentale de parallélisme structurel prévaut : les sélections disjointes doivent impérativement présenter des dimensions synchrones et des bornes d’indexation vertébrales parfaitement alignées. Par exemple, si la plage temporelle maîtresse couvre le segment A2:A50, toute sélection complémentaire doit débuter précisément à la ligne 2 et s’achever à la ligne 50 (par exemple, C2:C50 et F2:F50).
Le non-respect de ce parallélisme engendre l’erreur redoutée dite de discordance morphologique (dimension mismatch). Dans ce scénario, Google Sheets tente d’associer un vecteur de 49 observations à un second vecteur n’en dénombrant que 35, ce qui provoque l’avortement de l’opération ou l’insertion de distorsions géométriques irrécupérables au sein du graphique.
4.2 Syntaxe manuelle de référence de plages multiples
Au-delà de la manipulation graphique directe à l’aide de la souris, l’Éditeur de graphiques autorise l’injection programmée ou textuelle directe des références matricielles au sein de son champ dédié « Sélectionner une plage de données ». Cette méthode présente un degré de fiabilité nettement supérieur pour la gestion de classeurs denses ou de grande envergure.
La formalisation syntaxique de cette opération repose sur l’énumération séquentielle des plages, séparées par des délimiteurs dont la nature dépend des conventions régionales configurées dans les paramètres de votre feuille de calcul. Dans les environnements anglophones, la virgule constitue le séparateur standard, tandis que dans la majorité des paramètres régionaux francophones, l’analyste doit impérativement employer le point-virgule afin d’éviter toute confusion syntaxique avec la décimale arithmétique :
- Configuration internationale standard :
Feuille1!A1:A20, Feuille1!C1:C20, Feuille1!F1:F20 - Configuration régionale francophone :
Feuille1!A1:A20; Feuille1!C1:C20; Feuille1!F1:F20
Cette approche permet de fusionner des séries distantes au sein d’une déclaration unique et compacte. L’éditeur interprète chaque segment délimité comme une entité vectorielle indépendante, venant se greffer harmonieusement sur l’échafaudage géométrique de la visualisation sans exiger la contiguïté spatiale des cellules sources.
4.3 Consolidation de fragments distants au sein de la feuille
Face à des architectures tabulaires excessivement fragmentées, l’analyste avisé peut juger opportun de s’abstraire d’une sélection disjointe complexe en édifiant une zone de consolidation intermédiaire, souvent désignée sous le vocable de table tampon ou staging area. Cette zone technique a pour vocation de rassembler, par projection de références directes, les différentes colonnes dispersées en une matrice contiguë harmonieuse.
L’arbitrage entre sélection directe et table de consolidation tampon implique des compromis d’ingénierie distincts :
- Sélection disjointe directe : Évite la prolifération de cellules de calcul annexes, économise l’empreinte mémoire du classeur, mais accroît la complexité de reconfiguration manuelle lors de modifications architecturales ultérieures.
- Table tampon consolidée : Introduit une redondance de pointeurs par formules directes (par exemple
=Feuille2!D5), mais offre une lisibilité exemplaire, facilitant l’application de formats conditionnels préalables et assurant une pérennité absolue aux liaisons de données du graphique.
Sur le long terme, la centralisation des flux au sein d’une table dédiée optimise considérablement la maintenabilité du modèle opérationnel, particulièrement lorsque les données sources proviennent de systèmes transactionnels hétérogènes subissant des refontes structurelles récurrentes.
5. Configuration avancée de l’Éditeur de graphiques (Onglet Configuration)
L’onglet Configuration de l’Éditeur de graphiques constitue le cockpit d’ingénierie où s’orchestrent l’indexation matricielle et la distribution des flux d’information sur les axes cartésiens. Une navigation maîtrisée au sein de cette interface est indispensable pour corriger les automatismes défaillants et assigner chirurgicalement chaque série à son vecteur de destination.
5.1 Paramétrage chirurgical de l’axe horizontal (Axe X)
L’attribution de l’axe des abscisses détermine le squelette chronologique ou catégoriel de la représentation. Dans le cadre d’un graphique multi-plages, Google Sheets peut éprouver des difficultés à identifier spontanément le vecteur directeur. L’opérateur doit alors cliquer sur l’icône de grille matricielle nichée au sein du champ « Axe X » afin de désigner manuellement la plage de cellules hébergeant les étiquettes temporelles ou les descripteurs qualitatifs, qu’ils résident sur la feuille en cours ou sur un onglet distant.
L’éditeur propose une case à cocher déterminante intitulée « Agréger les données de l’axe X ». L’activation de cette option enclenche un moteur de regroupement algorithmique semblable à un tableau croisé dynamique, condensant les occurrences identiques de dates ou de catégories par la sommation ou le moyennage des valeurs associées. Si cette fonction s’avère puissante pour traiter des séries d’observations irrégulières, elle doit être désactivée lorsqu’on cherche à tracer des séries temporelles continues avec fidélité brute.
Un traitement différencié s’impose selon que l’axe X héberge une variable continue (dates continues, grandeurs physiques scalaires) ou une suite d’étiquettes textuelles discrètes. L’analyste doit s’assurer que le système interprète les horodatages sous forme d’échelle temporelle proportionnelle continue plutôt que sous forme de catégories textuelles équidistantes, ce qui déformerait l’appréciation des durées relatives séparant les événements.
5.2 Ajout, modification et suppression granulaire de séries
Le compartiment « Séries » de l’onglet Configuration permet de bâtir couche par couche l’édifice comparatif de la visualisation. L’adjonction d’un nouvel indicateur quantitatif s’opère par l’actionnement de la commande « Ajouter une série ». Un menu interactif propose alors les colonnes contiguës immédiatement disponibles, mais offre également un bouton de sélection matricielle manuelle permettant de cibler n’importe quel segment isolé du classeur actif.
La hiérarchie verticale des séries au sein de ce panneau n’est pas neutre : elle dicte la chronologie de superposition des éléments graphiques sur le plan de travail. La série culminant au sommet de la liste sera dessinée en premier plan, tandis que les séries sous-jacentes s’empileront en arrière-plan. L’agencement de cet ordre par glisser-déposer ou via les options contextuelles permet de désenchevêtrer des tracés et d’éviter que des surfaces pleines ne masquent des courbes plus ténues.
Au bas de l’onglet Configuration figurent plusieurs commutateurs d’interversion fondamentaux :
- Changer les lignes et les colonnes : Transmute intégralement l’orientation d’interprétation de la matrice de données.
- Utiliser la ligne N comme en-têtes : Impose au moteur de reconnaître la rangée spécifiée comme réservoir des étiquettes sémantiques.
- Utiliser la colonne X comme étiquettes : Force l’attribution d’une dimension spécifique en guise de référentiel descriptif.
5.3 Gestion des options d’interprétation des en-têtes
La reconnaissance précise des en-têtes est indispensable pour prévenir la pollution des échelles graphiques par des chaînes de caractères orphelines. En cochant la directive « Utiliser la ligne 1 comme en-têtes », l’analyste consacre explicitement la première ligne de ses plages sélectionnées comme vecteur métacognitif, destiné exclusivement à alimenter la légende et les cartouches d’outils interactifs (tooltips).
Si la plage matricielle fournie par l’utilisateur ne comporte aucun intitulé textuel initial — cas fréquent lors de l’extraction de tables de données brutes non documentées —, la validation de cette option conduit Google Sheets à confisquer la première rangée de valeurs numériques légitimes pour la métamorphoser indûment en noms de séries. Dans cette conjoncture, la case doit impérativement être décochée, ce qui incite l’éditeur à générer des étiquettes génériques (telles que Série 1, Série 2) qu’il sera loisible de renommer ultérieurement.
Une rigueur similaire prévaut lors de l’intégration de colonnes d’étiquettes textuelles intercalaires. Une mauvaise déclaration dans ces options d’interprétation provoque couramment l’apparition de messages d’erreur signalant l’impossibilité d’évaluer arithmétiquement des segments qualitatifs au sein d’axes dévolus aux grandeurs métriques continues.
6. Personnalisation sémantique et ergonomique (Onglet Personnaliser)
La rigueur structurelle d’une composition multi-plages doit être parachevée par une modélisation visuelle soignée. L’onglet Personnaliser concentre les leviers typographiques, chromatiques et topologiques permettant de convertir une accumulation d’indicateurs composites en un artefact de communication décisionnelle limpide et élégant.
6.1 Hiérarchisation textuelle et typographie scientifique
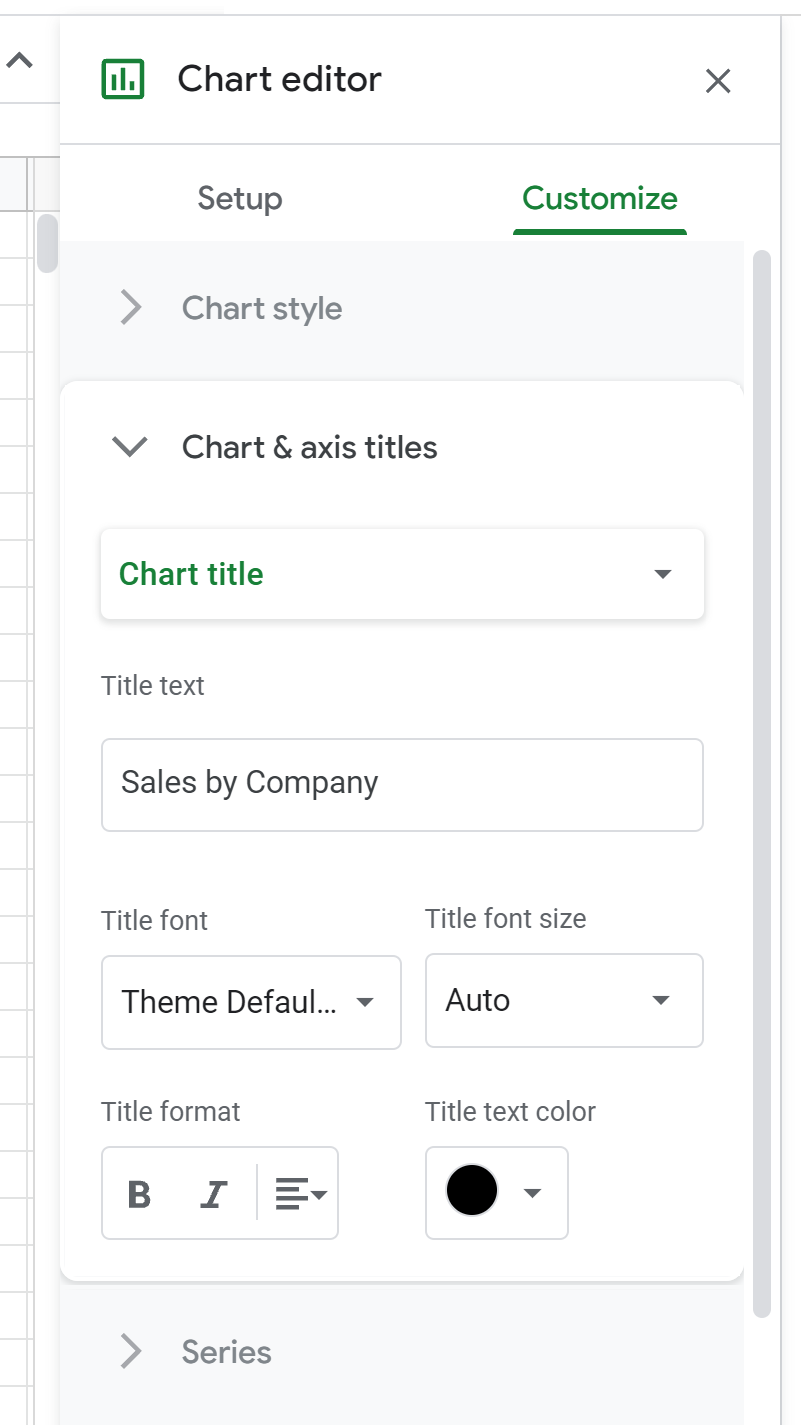
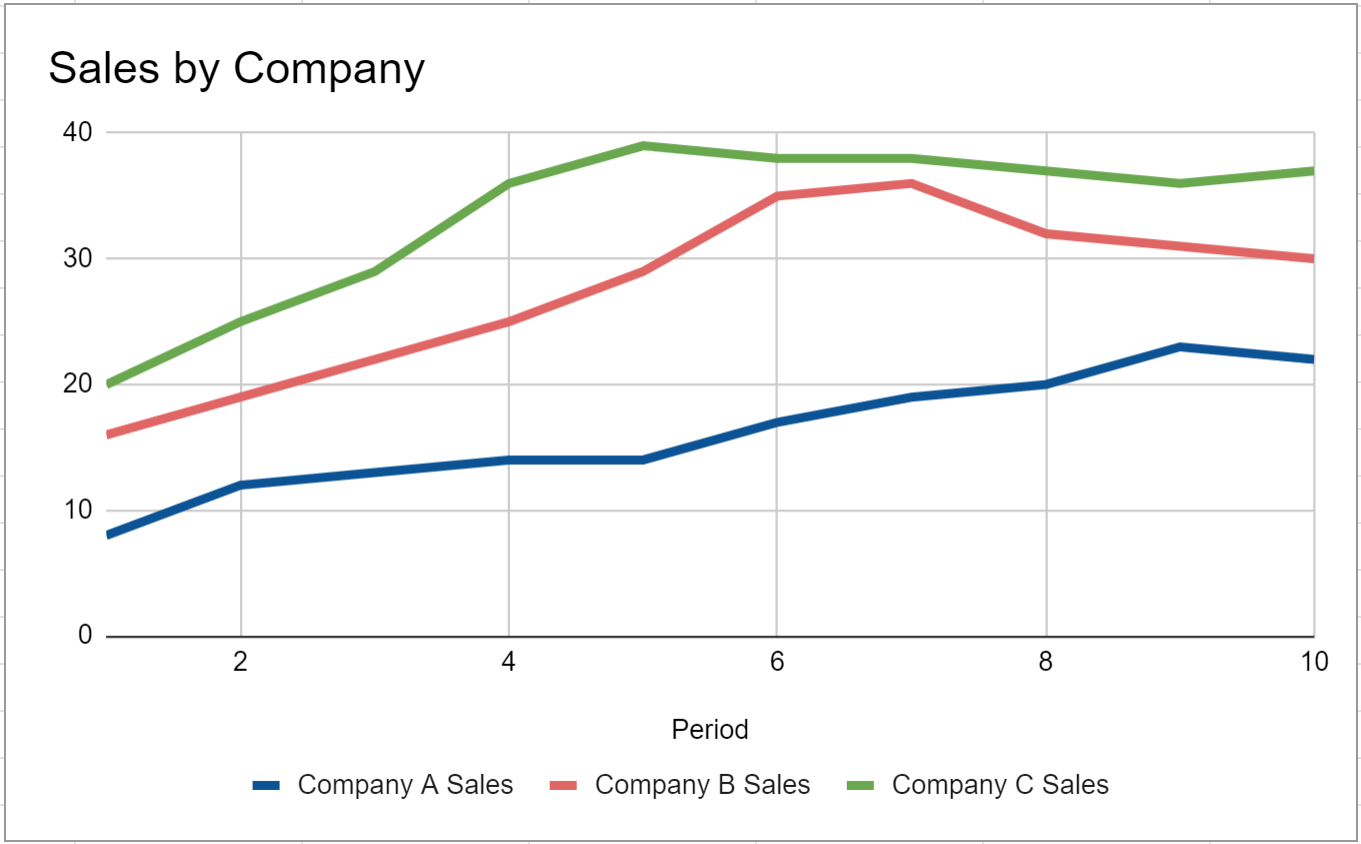
L’intelligibilité d’une planche d’analyse multi-séries repose sur une architecture textuelle explicite. Le titre général du graphique ne doit pas se cantonner à une nomenclature descriptive passive ; il convient d’y énoncer précisément l’objet de l’arbitrage analytique, enrichi de la couverture temporelle et spatiale du périmètre examiné. Les standards de documentation scientifique préconisent des formulations denses et informatives.
La désignation des axes de coordonnées ne tolère aucune équivoque. L’axe des ordonnatrices doit systématiquement mentionner la nature de la grandeur physique ou financière mesurée ainsi que son unité de standardisation entre parenthèses, à l’instar de Flux de trésorerie opérationnel (k€) ou Délai moyen d’intervention (Heures). L’omission des unités de mesure dans un environnement graphique multi-courbes constitue l’une des sources majeures d’erreur d’interprétation managériale.
Le choix typographique s’orientera vers des polices neutres, hautement lisibles et sans empattement, telles que Roboto, Arial ou Inter. L’analyste veillera à calibrer minutieusement le corps des polices selon une cascade hiérarchique décroissante : titre principal à 14-16 points, titres d’axes à 12 points et valeurs de graduation numérique à 10 points. Cette gradation garantit la lisibilité des détails sans saturer l’espace utile réservé au dessin géométrique.
6.2 Différenciation chromatique et encodage sélectif
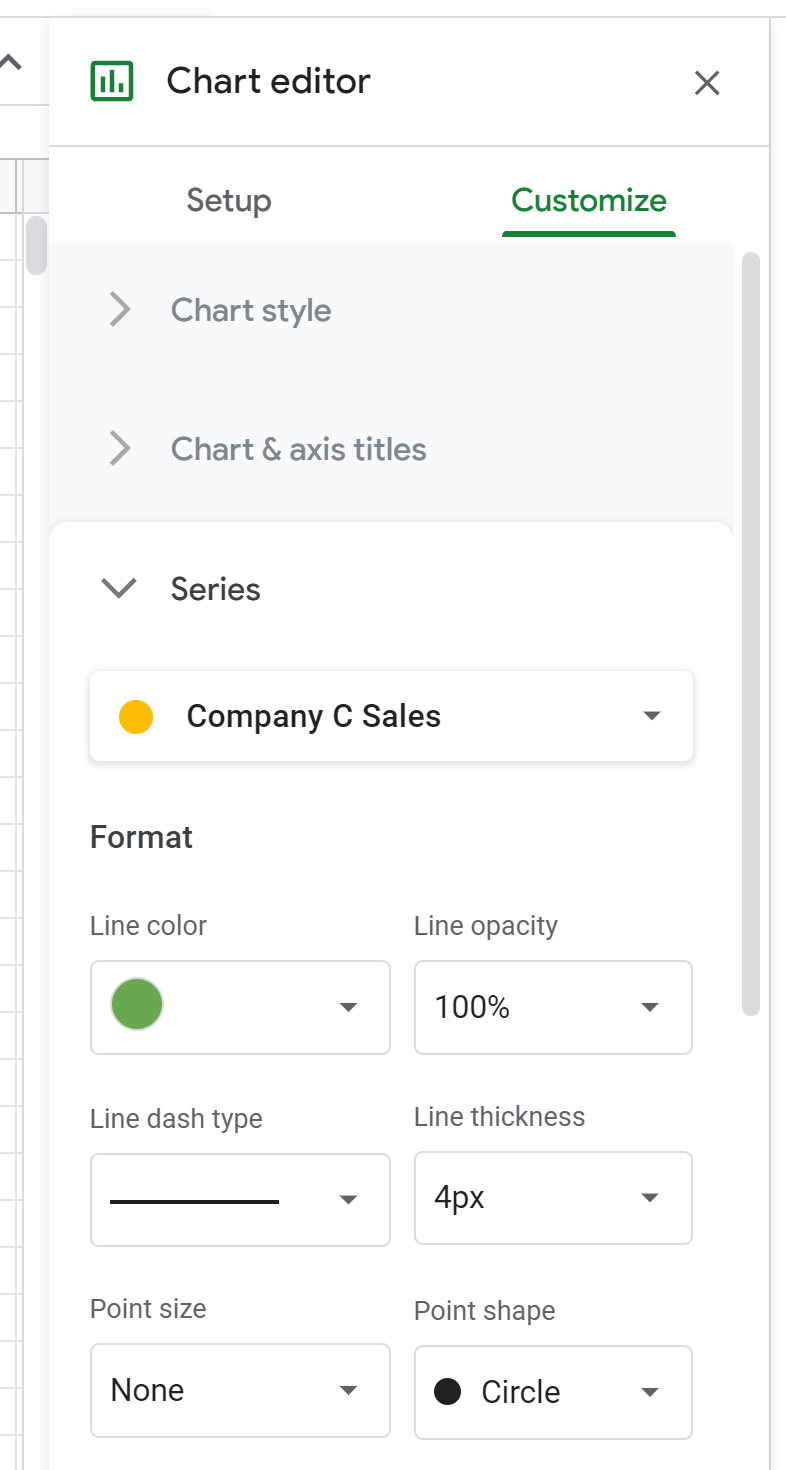
L’attribution des teintes chromatiques au sein d’un graphique multi-plages doit transcender les considérations purement esthétiques pour s’aligner sur les exigences de l’ergonomie visuelle. Il est primordial d’adopter des palettes chromatiques compatibles avec les différentes formes de déficience de perception des couleurs (notamment le daltonisme sous ses formes deutéranope et protanope). L’emploi simultané de vert et de rouge pour différencier deux séries concurrentes doit être formellement banni de tout document d’entreprise professionnel.
Pour démultiplier l’accessibilité sémiotique au-delà du seul spectre colorimétrique, il convient d’exploiter la plasticité morphologique des tracés. Google Sheets autorise l’altération individuelle du style de ligne pour chaque série isolée. L’analyste averti combinera :
- Un tracé plein continu d’épaisseur 3 pixels pour la série directrice principale.
- Un tracé discontinu en pointillés pour une série de référence historique ou budgétaire.
- Un tracé alterné en tirets longs pour une projection algorithmique ou un consensus prévisionnel.
Cette différenciation vectorielle est parachevée par l’assignation de symboles géométriques discriminants au niveau de chaque nœud d’observation : cercles pleins, losanges, carrés ou étoiles. Ainsi, même en cas de reprographie monochrome ou d’altération de l’écran de projection, la dissociation cognitive des courbes demeure instantanée et infaillible.
6.3 Agencement stratégique de la légende
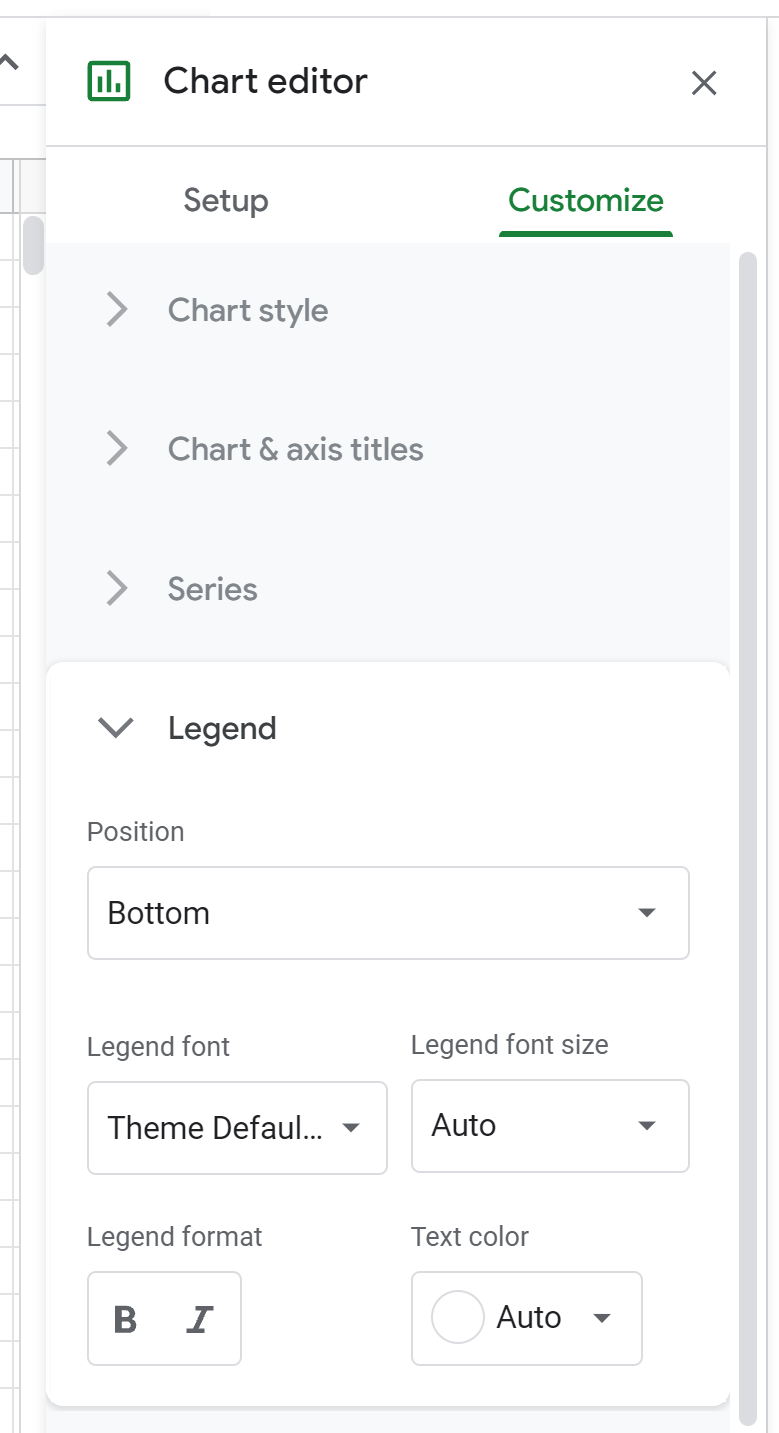
La légende constitue le dictionnaire sémantique par lequel l’observateur décode les composantes du graphique. Son positionnement spatial exerce un impact direct sur l’efficience oculaire, mesurée par le nombre de saccades visuelles nécessaires à la mise en correspondance d’un point de courbe avec sa désignation nominative. Dans la mesure du possible, l’implantation de la légende au sommet du graphique ou ancrée sur son flanc droit s’avère supérieure au positionnement inférieur classique, qui contraint l’œil à des allers-retours verticaux fatigants.
L’optimisation des contrastes et de la compacité de la légende implique d’épurer drastiquement les libellés de variables en amont, au niveau des en-têtes tabulaires. Les intitulés kilométriques doivent être tronqués ou résumés sous la forme d’acronymes normalisés préalablement définis au sein du bloc documentaire de la feuille.
Dans certaines configurations avancées de tracés linéaires longitudinaux, la démarche d’excellence consiste à désactiver totalement la légende globale au profit d’un étiquetage direct positionné à l’extrémité terminale de chaque courbe. Quoique cette pratique exige un travail de paramétrage minutieux via l’ajout de colonnes d’annotations dédiées, elle supprime l’effort mental de découplage pour offrir une lisibilité ergonomique optimale.
7. Traitement des échelles hétérogènes : L’axe vertical secondaire
La confrontation de séries issues de plages hétérogènes fait surgir un obstacle mathématique récurrent : l’incommensurabilité des échelles de mesure. La juxtaposition non calibrée d’une série exprimée en dizaines de millions d’unités avec un ratio oscillant entre zéro et un engendre inévitablement la neutralisation visuelle de la seconde. La maîtrise de l’axe vertical secondaire apporte une réponse géométrique élégante à cette aporie.
7.1 Fondement mathématique de la dissociation d’échelles
L’écrasement visuel est la conséquence directe d’une disparité substantielle dans les ordres de grandeur des grandeurs comparées. Lorsqu’un algorithme de rendu graphique calcule l’amplitude d’un axe vertical unique pour englober à la fois le chiffre d’affaires d’une multinationale (plage 1 : échelle de $10^6$ à $10^8$) et son taux de marge opérationnelle (plage 2 : échelle de $10^{-2}$ à $10^{-1}$), la série marginale est mécaniquement confinée à une bande linéaire imperceptible plaquée contre la ligne de base zéro.
Cette coexistence de métriques absolues et relatives incarne le cas d’usage par excellence de la binarité axiale. Cependant, l’usage de doubles axes verticaux introduit des risques cognitifs considérables. L’observateur non averti a tendance à comparer instinctivement la hauteur relative des courbes ou l’emplacement géométrique de leurs intersections. Or, ces intersections sont totalement arbitraires, car dépendantes des étalonnages d’échelles indépendamment choisis pour chaque axe.
L’analyste doit donc faire preuve d’une grande prudence intellectuelle pour s’assurer que l’intégration d’un axe vertical de droite n’induit pas de biais herméneutiques fallacieux ni ne suggère de corrélations fallacieuses entre deux phénomènes dépourvus de lien causal sous-jacent.
7.2 Attribution technique d’une série à l’axe secondaire
Pour transférer l’ancrage spatial d’un vecteur de données vers le bord droit du plan cartésien, l’opérateur se rend dans l’onglet Personnaliser de l’Éditeur de graphiques et déploie l’accordéon intitulé Série. Il convient alors d’abandonner le mode global « Appliquer à toutes les séries » pour sélectionner nominativement la série spécifique nécessitant la translation d’échelle.
Au sein des paramètres individuels de la série cible apparaît un commutateur déroulant fondamental intitulé « Axe ». Par défaut assigné à la valeur « Axe de gauche », il suffit de basculer ce paramètre vers l’option « Axe de droite ». Instantanément, le moteur de Google Sheets génère une seconde échelle graduée sur la frontière droite du graphique et projette les coordonnées de la série sélectionnée sur ce nouveau système de référence.
La démarche doit impérativement être complétée par l’ajustement des bornes limites de l’axe nouvellement instancié. Dans le volet « Axe vertical de droite », l’analyste explicitera les valeurs minimale et maximale afin d’éviter que le zéro mathématique ne soit tronqué de façon insidieuse, ce qui exagérerait artificiellement des fluctuations marginales sans réelle signification statistique.
7.3 Harmonisation graphique des échelles jumelées
L’écueil ergonomique majeur du graphique à double axe réside dans la confusion quant à l’attribution de chaque série à son axe de lecture légitime. Pour conjurer cette ambiguïté, l’analyste appliquera un principe strict de synchronisation chromatique : la couleur de la graduation, du libellé et du titre de l’axe vertical de droite doit être strictement identique à la couleur de tracé de la série vectorielle qu’il quantifie.
Un autre défi réside dans la prolifération désordonnée des quadrillages horizontaux. Lorsque l’axe de gauche et l’axe de droite génèrent simultanément des lignes de grille selon des pas arithmétiques désynchronisés, le graphique se transforme en un treillis visuel chaotique. Il convient de neutraliser les lignes de quadrillage de l’axe secondaire et de calibrer le nombre de divisions majeures de l’axe de gauche pour préserver une trame épurée.
Enfin, la présence de cartouches de titrage explicites apposés directement à l’extérieur des marges verticales de gauche et de droite parachève la composition, en spécifiant de part et d’autre les dénominations d’unités de manière parfaitement symétrique et sans équivoque possible pour le lecteur.
8. Combinaison de types de graphiques pour plages hétérogènes
La représentation simultanée de plusieurs plages de données gagne fréquemment en clarté lorsque l’on diversifie les morphologies graphiques au sein de la même interface visuelle. L’hybridation des formes géométriques au moyen du graphique combiné permet d’opérer une ségrégation immédiate entre des typologies d’indicateurs fondamentalement divergentes.
8.1 Mise en œuvre du graphique combiné (Combo Chart)
Le modèle du graphique combiné (désigné sous le terme Combo Chart dans la nomenclature logicielle) offre la possibilité d’associer, sur un système d’axes cartésiens commun, des éléments spatiaux volumétriques et des éléments linéaires continus. Pour l’activer, l’analyste sélectionne « Graphique combiné » dans la bibliothèque de modèles de l’onglet Configuration.
L’utilisation canonique de ce formalisme réside dans l’attribution du format en barres ou colonnes verticales pour les données physiques volumétriques brutes (telles que le chiffre d’affaires brut généré, le nombre d’incidents recensés ou les volumes d’heures prestées). Ces variables sont issues de cumuls discrets par période et bénéficient de l’ancrage au sol que confère la barre verticale.
Inversement, le format linéaire continu est systématiquement réservé aux métriques exprimant des ratios d’efficience, des objectifs théoriques continus, des moyennes mobiles d’atténuation ou des lignes de tendance macro-économiques. Cette démarcation morphologique prévient toute assimilation erronée entre des grandeurs de flux cumulatifs et des grandeurs d’état ou d’intensité.
8.2 Ajustement morphologique des éléments géométriques
L’hybridation des types graphiques impose un calibrage chirurgical de la saillance perceptuelle des composants afin d’éviter la congestion visuelle. L’analyste se rendra dans le sous-menu de personnalisation de chaque série pour affiner les propriétés géométriques respectives des tracés et des barres.
L’épaisseur des courbes linéaires doit être proportionnée de sorte qu’elles se détachent nettement des colonnes arrière-plans sans toutefois masquer les sommets de ces dernières. Une épaisseur de 2 à 4 pixels représente l’optimum opérationnel usuel. Pour les colonnes verticales, l’ajustement de l’opacité de remplissage (idéalement calibrée entre 65 % et 80 %) permet d’adoucir leur présence visuelle et de rendre discernables les tracés linéaires qui les traversent de part en part.
Il importe également de surveiller l’espacement inter-barres (la largeur de l’intervalle catégoriel). Un espacement insuffisant génère un bloc compact étouffant, tandis qu’un espacement excessif fragmente inutilement le balayage latéral de l’œil le long de la progression de la variable indépendante.
8.3 Critères de validité empirique des graphiques hybrides
La puissance expressive du graphique combiné recèle des pièges herméneutiques majeurs. L’un des écueils réside dans l’accumulation débridée de couches visuelles. L’analyste rigoureux s’astreindra à une limitation déontologique stricte : un graphique combiné ne devrait jamais excéder l’assemblage de deux séries de colonnes et de deux courbes linéaires concurrentes. Au-delà de cette frontière de complexité, l’illisibilité l’emporte invariablement sur la synthèse informationnelle.
La validité empirique d’un montage hybride repose sur une adéquation conceptuelle indiscutable entre la nature ontologique de la variable observée et sa géométrie de projection. Tracer un indice boursier continu sous la forme d’un empilement de barres verticales disjointes constitue une maladresse sémiologique, tout comme projeter des volumes de production ponctuels sous la forme d’une ligne sinueuse laissant supposer l’existence d’une continuité physique inexistante entre deux relevés.
Enfin, tout artefact graphique combiné doit être soumis à l’épreuve de l’audit de robustesse : le test d’interprétabilité par un tiers non-initié. Si un cadre dirigeant ou un auditeur externe est incapable de décrypter en moins de dix secondes les axes et les natures des grandeurs visualisées sans assistance oratoire, la visualisation doit être simplifiée ou fractionnée en visualisations univariées dédiées.
9. Agrégation dynamique de plages via fonctions matricielles
Lorsque la structure spatiale des données est si disséminée qu’elle défie les capacités de sélection directe de l’éditeur graphique, l’analyste chevronné fait appel à la puissance des formules matricielles. Google Sheets intègre des mécanismes de virtualisation matricielle sophistiqués permettant de recomposer, filtrer et transcender les données dynamiquement avant d’alimenter le composant graphique.
9.1 Emploi de la notation entre accolades pour tableaux virtuels
L’un des atouts les plus redoutables de Google Sheets réside dans l’usage syntaxique des accolades pour forger des matrices virtuelles ad hoc, désignées sous le vocable de tableaux littéraux matriciels. Cette syntaxe offre le pouvoir d’assembler des segments de colonnes distants ou non contigus comme s’ils résidaient sur une table spatiale unifiée, sans altérer l’intégrité de la feuille d’origine.
La distinction entre juxtaposition horizontale et concaténation verticale repose sur l’usage précis des délimiteurs conventionnels :
- La juxtaposition horizontale : Permet d’adosser deux colonnes disjointes en une matrice à deux colonnes mitoyennes. Selon vos paramètres linguistiques, la syntaxe s’exprime par
{Plage1, Plage2}ou{Plage1Plage2}. Par exemple, la formule={A2:A10, D2:D10}génère instantanément un bloc virtuel unifiant les dates de la colonne A et les montants de la colonne D. - La concaténation verticale : Permet d’empiler des séries d’enregistrements identiques provenant d’onglets distincts à la suite les uns des autres via le point-virgule :
={Feuille1!A2:B50; Feuille2!A2:B50}.
Cette matrice virtuelle résultante peut être hébergée au sein d’une feuille de travail technique ou, dans certains contextes d’interfaçage, directement liée au graphique, conférant une souplesse de conception inégalée au processus d’intégration.
9.2 Interfaçage avec les fonctions QUERY et FILTER
L’emploi conjoint de matrices virtuelles avec les fonctions de manipulation algébrique avancées comme QUERY ou FILTER propulse la visualisation multi-plages dans une dimension supérieure d’adaptabilité. La fonction Google Visualization API Query Language intégrée via QUERY permet d’exécuter des sélections relationnelles pseudo-SQL sur des agrégations multi-sources éclatées :
=QUERY({DATA_NORD!A2:E100; DATA_SUD!A2:E100}; "SELECT Col1, SUM(Col3), AVG(Col5) WHERE Col2 = 'Qualifié' GROUP BY Col1 ORDER BY Col1 ASC")
Cette directive consolide deux plages distribuées, applique un filtrage logique rigoureux sur les critères qualitatifs, agrège les valeurs selon la dimension temporelle et ordonne la séquence finale. Le graphique indexé sur la table dérivée résultante bénéficie d’une source parfaitement normalisée, immunisée contre les bruits parasites des saisies opérationnelles brutes.
La réactivité en temps réel constitue la force maîtresse de cette architecture : dès lors qu’un collaborateur modifie ou incrémente une valeur sur l’un des onglets opérationnels distants, la chaîne de requêtes matricielles recalcule les condensats et actualise instantanément le graphique sans nécessiter la moindre reconfiguration manuelle.
9.3 Modélisation adaptative par plages de dimensions variables
L’un des défis majeurs dans l’exploitation de visualisations décisionnelles réside dans l’obsolescence programmée des bornes de sélection à mesure que de nouveaux enregistrements s’ajoutent au fil des jours. L’assignation de plages rigides telles que A1:D30 condamne l’analyste à un travail de mise à jour manuelle perpétuel sous peine de voir ses graphiques amputer les périodes les plus récentes.
Pour octroyer une plasticité adaptative totale aux graphiques multi-plages, on combinera les fonctions matricielles de délimitation dynamique, notamment par l’usage des notations ouvertes ou l’emploi synergique des fonctions DECALER et NBVAL. L’écriture A2:INDEX(A:A; NBVAL(A:A)) permet de recalculer dynamiquement la borne inférieure du vecteur pour épouser précisément le nombre effectif de lignes renseignées.
L’usage avisé de ces formulations dynamiques garantit la pérennité du traçage sans alourdir indûment le moteur d’exécution JavaScript Google V8 sous-jacent. L’évitement des colonnes ouvertes infinies non conditionnées (telles que A:D sans filtrage) prévient l’allocation inutile de ressources serveur et l’apparition de milliers de points nuls fantômes au sein du composant visuel.
10. Diagnostic et résolution des anomalies de rendu graphique
Même les analystes les plus rigoureux se heurtent parfois à des comportements aberrants du moteur de visualisation de Google Sheets. La compréhension des mécanismes d’échec et la possession d’un protocole de diagnostic méthodique permettent de résoudre promptement les pannes de rendu sans devoir reconstruire l’artefact graphique dans son intégralité.
10.1 Discontinuités et ruptures de lignes dans les séries
L’une des anomalies les plus fréquemment déplorées réside dans l’apparition de lignes brisées, discontinues ou fragmentées en îlots isolés au sein de graphiques linéaires chronologiques. Cette pathologie visuelle découle directement de la présence de valeurs nulles ou de cellules vides intercalaires au sein des plages sources sélectionnées.
Google Sheets propose un paramètre correctif fondamental logé au sein de l’onglet Personnaliser, sous la section Graphique : le menu contextuel intitulé « Tracer les cellules vides ». L’analyste dispose de trois arbitrages fonctionnels distincts :
- Espace (Interruption) : Le moteur cesse de tracer le trait au niveau de la cellule absente et le reprend à l’observation valide suivante, illustrant la carence informationnelle avec fidélité au détriment de l’esthétique continue.
- Zéro : Le système convertit arbitrairement la vacuité de la cellule en une valeur arithmétique nulle (0), provoquant un décrochage vertical brutal de la courbe vers la ligne de base, ce qui introduit une fausseté analytique si le phénomène mesuré n’était pas réellement nul.
- Interpoler : L’algorithme calcule une trajectoire de raccordement rectiligne directe entre le dernier point valide et le point valide suivant, rétablissant la continuité visuelle sans falsifier la moyenne générale de la série.
Il importe en outre de débusquer les espaces invisibles résiduels. Une cellule paraissant visuellement vide mais abritant en réalité un caractère d’espacement textuel est interprétée comme une chaîne alphanumérique non interpolable, bloquant le moteur de raccordement automatique de Google Sheets.
10.2 Discordance structurelle des dimensions de plages
L’irruption d’un message d’alerte écarlate proclamant l’impossibilité de tracer le graphique consacre typiquement une incompatibilité dimensionnelle entre les vecteurs matriciels assignés. Ce phénomène survient dès lors que l’analyste sélectionne des séries de données présentant un nombre disparate de lignes d’échantillonnage.
La résolution exige un réalignement synchronisé des bornes d’indexation. Si la série A s’étend de la ligne 2 à la ligne 150, toute série B, C ou D additionnée au sein du même conteneur graphique doit impérativement débuter à la ligne 2 et s’achever rigoureusement à la ligne 150. L’existence d’une ligne de totalisation intermédiaire insérée malencontreusement au sein d’une seule des colonnes suffit à rompre la parité mathématique requise par le moteur.
Il convient également d’auditer l’homogénéité interne des types de variables composant chaque vecteur. La présence sporadique de chaînes de caractères au sein d’une colonne typée en nombres à virgule flottante perturbe l’algorithme d’inférence de Google Sheets, qui bascule parfois inopinément le typage global de la série vers une échelle catégorielle discontinue.
10.3 Bugs d’actualisation et instabilités du cache navigateur
Dans un contexte de collaboration multi-utilisateurs en temps réel, Google Sheets fait intervenir des couches de mise en cache locales asynchrones au sein du navigateur web pour assurer la fluidité de l’interface. Il arrive que ces mécanismes entrent en collision lors de la manipulation complexe de plages de données multiples et distantes, engendrant un figeage du rendu graphique qui ne reflète plus les mutations tabulaires sous-jacentes.
Pour dissiper ces dysfonctionnements éphémères sans corrompre le modèle d’analyse, on procèdera à une réinitialisation de l’évaluation du classeur. Cette opération s’accomplit en modifiant temporairement une cellule quelconque pour contraindre le moteur de dépendances à recalculer l’arbre complet des formules, ou en effectuant un rechargement forcé de la page web via le raccourci Ctrl+F5 ou Cmd+Shift+R.
Si le graphique demeure réfractaire à l’actualisation, une procédure de découplage propre consiste à découper le graphique (via l’instruction Couper ou Ctrl+X), rafraîchir l’onglet du navigateur, puis réinjecter le composant (Coller ou Ctrl+V). Cette manœuvre réinitialise l’instance du conteneur vectoriel au sein du DOM de l’application sans obliger l’utilisateur à redéfinir la constellation complexe de ses plages et options de personnalisation.
11. Automatisation de graphiques multi-plages via Google Apps Script
L’excellence analytique culmine dans la capacité à s’affranchir des manipulations manuelles pour orchestrer la génération et la mise à jour des visualisations par voie programmatique. L’environnement d’exécution de développement Google Apps Script, fondé sur une implémentation moderne du langage ECMAScript, confère une maîtrise absolue sur l’infrastructure de visualisation du tableur.
11.1 Architecture du modèle objet ChartBuilder
L’instanciation logicielle d’un composant visuel repose sur le paradigme de conception Builder, formalisé au sein de l’API de Google Sheets par la classe native EmbeddedChartBuilder. Accessible depuis l’objet d’encapsulation de la feuille de calcul active, ce constructeur expose un ensemble d’interfaces méthodologiques fluides permettant d’assembler pas à pas les dimensions du graphique.
La commande pivot pour l’adjonction de sources plurielles réside dans la méthode itérative addRange(). Contrairement aux interfaces graphiques qui peinent parfois à synthétiser des sélections asymétriques, l’environnement de script permet d’appeler séquentiellement cette méthode autant de fois que nécessaire, en lui passant en argument des instances de type Range prélevées sur des zones géographiquement isolées ou sur des onglets entièrement disjoints du classeur.
L’assignation de la morphologie graphique s’effectue au moyen de l’énumération fortement typée Charts.ChartType, qui permet de basculer dynamiquement le rendu vers des formes complexes telles que COMBO, LINE, COLUMN ou SCATTER, ouvrant la voie à une génération industrielle de tableaux de bord entièrement décorrélée de toute contrainte d’interface utilisateur.
11.2 Script de consolidation automatisée de plages hétérogènes
Afin d’illustrer la concrétisation empirique de cette architecture logicielle, considérons le développement d’un script d’automatisation d’entreprise. L’objectif de ce fragment de code consiste à détecter automatiquement l’altitude matricielle effective sur trois onglets régionaux distincts, d’en extraire les plages d’indicateurs correspondantes et d’ériger un graphique comparatif consolidé doté d’en-têtes et de configurations ergonomiques personnalisées :
L’algorithme débute par l’acquisition du classeur maître via SpreadsheetApp.getActiveSpreadsheet(). Il interroge ensuite les feuilles opérationnelles cibles afin d’en scruter les dernières lignes actives au moyen de la méthode getLastRow(). Cette précaution garantit que seules les cellules effectivement occupées par des données fraîches sont incluses dans les vecteurs vectoriels, prévenant l’injection de plages vides démesurées.
Le script assemble ensuite la plage temporelle maîtresse et les deux plages de valeurs quantitatives disjointes au sein d’un composant graphique émergent. L’injection d’options sémantiques s’opère par l’intermédiaire de la méthode setOption(), qui autorise la manipulation programmatique des propriétés d’affichage les plus granulaires, depuis l’inversion d’axes jusqu’à l’ajustement des marges intérieures du canevas de dessin. Enfin, l’objet visuel parachevé est ancré spatialement au sein d’une feuille de synthèse dédiée via la commande insertChart().
11.3 Déploiement de déclencheurs d’actualisation événementielle
La valeur ajoutée d’un script d’automatisation se décuple lorsqu’il est arrimé à des déclencheurs événementiels (triggers). L’implémentation de la fonction événementielle simple onEdit(e) permet de surveiller en arrière-plan les modifications structurelles opérées au sein du classeur. Dès lors qu’une modification intervient au sein des colonnes surveillées, le déclencheur recalcule les emprises matricielles et redéfinit instantanément les séries associées au graphique sans aucune intervention active de l’analyste.
Pour les infrastructures de données plus vastes soumises à des flux d’intégration asynchrones par API tierces, le déploiement d’un menu personnalisé constitue une bonne pratique ergonomique. Par l’adjonction d’un bloc d’instructions au sein de la fonction onOpen(), l’équipe d’ingénierie peut enrichir la barre de menus standard de Google Sheets d’une entrée dédiée permettant de régénérer intégralement le parc de graphiques décisionnels d’un simple clic.
Il conviendra de veiller scrupuleusement à l’optimisation des temps de calcul et au respect des quotas d’exécution imposés par l’écosystème Google Apps Script. L’analyste évitera les appels répétitifs et non temporisés aux services de l’API Spreadsheet, en favorisant la lecture en bloc des structures de données en mémoire afin de préserver une expérience de collaboration fluide et réactive.
12. Synthèse méthodologique et critères d’excellence analytique
L’élaboration d’une visualisation multi-plages ne saurait s’achever sur la seule réussite technique de son tracé cartésien. L’artefact produit doit être soumis à une évaluation rigoureuse de son efficience communicationnelle et s’intégrer harmonieusement dans les processus documentaires et décisionnels de l’organisation.
12.1 Grille d’évaluation qualitative de la visualisation multi-séries
L’évaluation épistémologique d’un graphique s’articule autour des principes d’excellence formulés par Edward Tufte, au premier rang desquels figure la maximisation du ratio données-encre (Data-Ink Ratio). Ce ratio postule que chaque élément graphique projeté — ligne, barre, graduation, étiquette — doit être strictement justifié par la transmission d’une quantité d’information indispensable. Tout ornement superflu, quadrillage redondant ou effet d’ombrage tridimensionnel artificiel relève de la pollution cognitive (chartjunk) et doit être éliminé.
L’intégrité contextuelle constitue le second garde-fou déontologique de l’analyste. Un graphique multi-plages doit restituer les données dans leur perspective historique et structurelle authentique, sans manipulation pernicieuse des échelles visant à accentuer artificiellement une corrélation ou à dissimuler une inflexion préjudiciable. La distorsion optique délibérée constitue une faute déontologique majeure en science de la décision.
Enfin, la robustesse opérationnelle d’un graphique décisionnel se mesure par la règle empirique des cinq secondes. Présenté devant un collège de décideurs non avertis, l’artefact visuel doit être en mesure de livrer son message directeur, d’expliciter ses variables fondamentales et de clarifier ses ordres de grandeur dans cet intervalle de temps minimal. Tout artefact échouant à cette épreuve de fluidité immédiate requiert une restructuration typologique ou un élagage dimensionnel immédiat.
12.2 Protocole de documentation et de pérennité des feuilles de calcul
Dans un contexte organisationnel où les collaborateurs se succèdent au chevet des modèles analytiques, la documentation formelle constitue le rempart ultime contre la dégradation des classeurs. L’analyste diligent accompagnera impérativement chaque graphique multi-plages complexe d’un dictionnaire de données exhaustif, répertoriant méticuleusement la localisation géographique exacte de chaque plage source, la signification opérationnelle de chaque variable ainsi que les formules d’agrégation éventuellement appliquées.
La résilience du classeur face aux fausses manœuvres involontaires est garantie par l’instauration de politiques de protection granulaire. Google Sheets autorise le verrouillage nominatif de cellules et de plages de configuration spécifiques. En sanctuarisant les zones de données sources, les tables tampons de consolidation et les colonnes d’indexation chronologique contre l’édition non autorisée, on préserve l’intégrité des liaisons matricielles alimentant le moteur visuel.
Enfin, l’élaboration d’un protocole de transmission documenté et formalisé garantit la pérennité de l’infrastructure informationnelle. Ce guide de maintenance synthétique détaille les procédures d’intégration de nouvelles périodes d’échantillonnage, la conduite à tenir en présence de données manquantes et le mode d’emploi des scripts d’actualisation automatisée.
12.3 Perspectives d’intégration dans des écosystèmes décisionnels étendus
La visualisation multi-plages au sein de Google Sheets ne constitue fréquemment qu’un maillon d’une chaîne décisionnelle plus vaste. L’un des atouts distinctifs de l’écosystème collaboratif réside dans la capacité d’exporter dynamiquement les graphiques ainsi confectionnés vers d’autres supports de communication d’entreprise, tels que Google Docs ou Google Slides, au moyen de liaisons d’ancrage synchronisées en temps réel.
Pour les besoins analytiques exigeant un degré supérieur d’interactivité multidimensionnelle, de filtrage dynamique croisé ou de volumétrie massive de données (Big Data), Google Sheets sert fréquemment de laboratoire de prototypage rapide avant l’interfaçage avec des solutions dédiées de Business Intelligence, au premier rang desquelles figure Looker Studio. Les plages de données assainies et normalisées au sein de la feuille de calcul s’injectent alors de manière transparente dans ces moteurs analytiques industriels.
Néanmoins, l’analyste pragmatique saura identifier avec lucidité les frontières intrinsèques de Google Sheets. Dès lors que les jeux de données franchissent le cap de plusieurs centaines de milliers de lignes matricielles, ou que les nécessités de modélisation relationnelle imposent des jointures en étoile excessivement imbriquées, la feuille de calcul doit s’effacer avec humilité devant des entrepôts de données relationnels modernes (tels que BigQuery, Snowflake ou PostgreSQL) couplés à des couches d’orchestration sémantique dédiées.
Références
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Google Workspace Support. (2023). Add and edit a chart or graph in Google Sheets. Google Help Center. https://support.google.com/docs/answer/63824
- Google Developers. (2023). Class EmbeddedChartBuilder in Google Apps Script. Google Developers Reference. https://developers.google.com/apps-script/reference/spreadsheet/embedded-chart-builder
- International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
- Kosslyn, S. M. (2006). Graph design for the eye and mind. Oxford University Press.
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Ware, C. (2019). Information visualization: Perception for design (4th ed.). Morgan Kaufmann.