
L’édifice de la statistique moderne repose sur une tension permanente entre la simplification réductrice nécessaire à la compréhension globale des phénomènes et la préservation de la complexité inhérente aux interactions du monde réel. Lorsque les chercheurs observent des entités au sein de populations diversifiées, qu’il s’agisse de sujets humains en psychologie cognitive, de patients au sein de structures épidémiologiques ou de comportements électoraux en sociologie politique, l’analyse d’une seule caractéristique isolée s’avère rapidement insuffisante pour capturer la dynamique des processus sous-jacents. L’approche univariée, bien qu’essentielle pour établir des paramètres de position ou de dispersion fondamentaux, ignore délibérément la manière dont les différentes dimensions d’un phénomène s’articulent, s’influencent et coexistent au sein des mêmes unités statistiques d’observation.
C’est précisément pour dépasser cette myopie analytique que la statistique bivariée déploie ses outils méthodologiques fondamentaux, au cœur desquels trône le concept de fréquence conjointe. Loin d’être un simple artifice calculatoire réservé aux praticiens des mathématiques appliquées, la fréquence conjointe constitue le point d’ancrage fondamental permettant de quantifier la co-occurrence de deux modalités appartenant à des variables catégorielles distinctes. Elle incarne la réponse empirique immédiate à la question de savoir combien d’individus ou d’objets d’étude partagent simultanément deux critères qualitatifs donnés. Sans la maîtrise rigoureuse de cette notion, toute tentative de modéliser les relations fonctionnelles, les corrélations non linéaires ou les structures d’association complexes dans les sciences empiriques se trouve condamnée à l’imprécision conceptuelle.
L’exploration approfondie de la fréquence conjointe invite à un parcours à la fois mathématique, épistémologique et appliqué. Elle exige de distinguer avec une méticulosité absolue ce qui relève de l’observation brute au sein d’un échantillon fini de ce qui renvoie à la probabilité conjointe théorique régissant l’univers des possibles. De plus, elle impose de clarifier sans ambiguïté les frontières théoriques qui la séparent des fréquences marginales, issues de l’agrégation unilatérale, et des fréquences conditionnelles, fondées sur une restriction intentionnelle du cadre de référence. Cet article se propose de disséquer de manière exhaustive la nature des fréquences conjointes, de leur formalisation matricielle au sein des tables de contingence jusqu’à leurs prolongements dans les tests d’inférence statistique tels que le test du Chi-deux de Pearson, la modélisation log-linéaire et l’évaluation psychométrique contemporaine.
1. Introduction conceptuelle à la fréquence conjointe en statistiques
1.1 Définition formelle de la fréquence conjointe
Sur le plan de l’analyse combinatoire et de la statistique descriptive, la fréquence conjointe se définit formellement comme le dénombrement absolu des unités statistiques qui présentent simultanément deux modalités spécifiques associées à deux variables distinctes. Considérons une population ou un échantillon d’individus mesurés selon deux critères qualitatifs discrets, par exemple la variable $X$ possédant un ensemble fini de modalités exclusives notées ${A_1, A_2, dots, A_r}$ et la variable $Y$ déclinée en modalités notées ${B_1, B_2, dots, B_c}$. La fréquence conjointe, conventionnellement désignée par la notation $n_{ij}$, correspond au cardinal de l’ensemble des éléments appartenant à l’intersection formelle des sous-populations caractérisées par la modalité $A_i$ d’une part et par la modalité $B_j$ d’autre part.
Cette caractérisation en tant que co-occurrence au sein d’une population donnée possède une signification épistémologique de premier ordre. Elle matérialise le passage d’une vision atomique des attributs à une vision structurelle de la réalité empirique. Observer une fréquence conjointe ne revient pas simplement à constater l’existence isolée d’un trait, mais à saisir empiriquement l’entrelacement de deux réalités conceptuelles au niveau de l’unité fondamentale de mesure. Il importe toutefois d’introduire dès ce stade une démarcation fondamentale entre l’observation brute issue du comptage empirique et la notion sous-jacente de probabilité conjointe. Alors que la fréquence conjointe absolue relève du constat d’effectif au sein d’une collection déterminée de données, la probabilité conjointe représente une construction théorique régie par les axiomes de Kolmogorov, modélisant la propension intrinsèque d’un phénomène aléatoire à manifester simultanément deux événements.
Dans la théorie des ensembles, la fréquence conjointe est intrinsèquement liée à l’opération d’intersection logique. Pour deux événements discrets définis sur un univers probabilisable $\Omega$, l’événement conjoint est représenté par l’intersection $A cap B$. L’évaluation de la fréquence conjointe repose sur la quantification stricte du nombre d’éléments appartenant sans ambiguïté à cet ensemble d’intersection. Si l’un des critères fait défaut, ou si l’attribution catégorielle s’avère floue, l’appartenance à l’intersection est révoquée, ce qui souligne la dépendance absolue de la fréquence conjointe envers la rigueur taxonomique initiale des variables sous observation.
1.2 Rôle épistémologique dans l’analyse bivariée
L’analyse statistique univariée opère une simplification nécessaire en s’intéressant isolément à la répartition d’une seule variable à la fois. Toutefois, cette démarche atomistique laisse dans l’ombre les dynamiques d’interaction, les dépendances mutuelles et les phénomènes d’association qui caractérisent les systèmes réels. La transition analytique vers la statistique descriptive bivariée s’opère précisément grâce à l’introduction des fréquences conjointes, qui agissent comme le ciment observationnel liant deux dimensions distinctes d’un même ensemble de sujets.
Cette transition permet l’identification méthodique de patrons comportementaux ou phénoménologiques qui demeureraient totalement indétectables par le simple examen des distributions marginales séparées. Deux populations peuvent en effet afficher des distributions marginales strictement identiques pour deux variables données tout en présentant des organisations de fréquences conjointes radicalement opposées. Par exemple, une répartition paritaire entre hommes et femmes d’un côté, et une répartition égale entre partisans de deux options politiques de l’autre, ne révèlent rien de la manière dont les affiliations politiques se polarisent ou se neutralisent selon le genre. Seule la structure interne des fréquences conjointes met en lumière la présence d’une ségrégation parfaite ou, au contraire, d’une homogénéité distributive transversale.
Dans le domaine des sciences sociales, la fréquence conjointe constitue le point de départ de l’évaluation rigoureuse des hypothèses d’association. Les théories sociologiques, qu’elles concernent la reproduction sociale, la stratification culturelle ou la sociologie des organisations, formulent rarement des prédictions sur des attributs isolés. Elles postulent l’existence de co-occurrences privilégiées entre des positions sociales et des choix d’existence. Le dénombrement des fréquences conjointes fournit la matière empirique primaire indispensable à partir de laquelle il devient possible de calculer si deux dimensions de la réalité sociale interagissent de manière significative ou si elles se déploient dans une indépendance mutuelle absolue.
1.3 Place des fréquences conjointes en psychologie quantitative
La psychologie quantitative accorde une place centrale aux fréquences conjointes, car la mesure des construits psychologiques repose très souvent sur des instruments de mesure générant des données catégorielles ou ordinales discrétisées. Dans l’administration des inventaires de personnalité multidimensionnels, par exemple, les réponses croisées à deux items distincts — tels que le niveau d’introversion perçu et la tendance à l’évitement social — sont directement représentées sous forme de fréquences conjointes au sein de l’échantillon de standardisation normatif.
Ces distributions de fréquences conjointes sont également fondamentales lors de l’analyse de la concordance inter-juges dans le cadre d’évaluations cliniques. Lorsque deux praticiens indépendants examinent une même cohorte de patients afin d’établir un diagnostic psychopathologique selon les nomenclatures du DSM-5 ou de la CIM-11, la table des fréquences conjointes constitue l’outil par excellence pour observer la distribution empirique des accords et des désaccords diagnostiques. Chaque cellule conjointe de la diagonale principale reflète le nombre de cas pour lesquels les cliniciens convergent vers le même diagnostic, tandis que les cellules hors diagonale révèlent la nature et la fréquence exacte des discordances diagnostiques.
Enfin, l’étude épidémiologique des comorbidités symptomatiques chez des cohortes cliniques définies dépend entièrement de l’analyse minutieuse des fréquences conjointes. La coexistence de deux troubles distincts, comme le trouble dépressif caractérisé et le trouble d’anxiété généralisée, ne peut être estimée ni comprise sans quantifier avec précision la fréquence conjointe d’individus manifestant simultanément les deux constellations de critères diagnostiques. C’est à partir de cette fréquence de co-occurrence que les psychopathologues quantitatifs peuvent inférer l’existence possible de facteurs étiologiques communs, de causalités réciproques ou de syndromes transdiagnostiques plus vastes.
2. Fondements méthodologiques : Le tableau de contingence à double entrée
2.1 Architecture et structure des données croisées
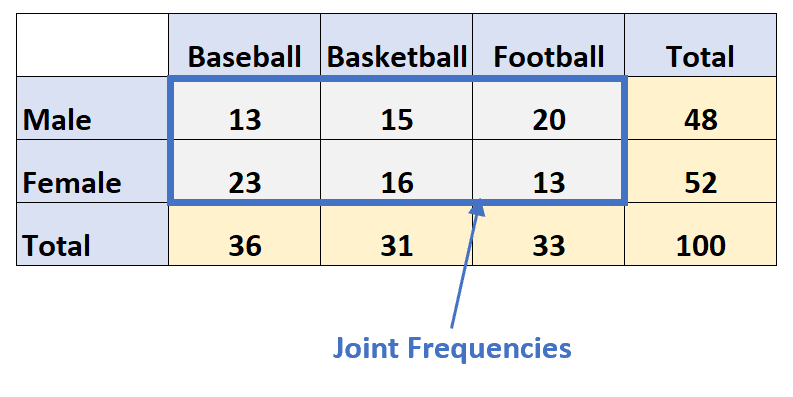
Pour organiser de manière rationnelle les données bivariées qualitatives, les statisticiens recourent à un dispositif matriciel fondamental : le tableau de contingence à double entrée, également nommé tableau croisé. L’architecture formelle de cet outil repose sur le croisement spatial de deux axes d’analyse orthogonaux. Le premier axe, disposé horizontalement sous forme de lignes, accueille les différentes modalités de la première variable qualitative, tandis que le second axe, structuré verticalement sous forme de colonnes, segmente les modalités de la seconde variable.
Cette disposition génère un quadrillage régulier dont les intersections définissent des réceptacles élémentaires désignés sous le terme de cellules internes. Chacune de ces cellules internes possède une vocation univoque : elle héberge exclusivement l’effectif conjoint correspondant aux sujets qui présentent à la fois la modalité stipulée en tête de ligne et celle désignée en tête de colonne. La structure est dite bidimensionnelle standardisée lorsque l’ensemble des modalités est exhaustif et que chaque case interne du tableau représente une combinaison spécifique de critères, ne laissant place à aucune ambiguïté quant à l’affectation spatiale de chaque observation empirique.
L’avantage cognitif et computationnel de cette standardisation réside dans la transparence immédiate qu’elle offre sur la distribution du phénomène étudié. Plutôt que de manipuler une liste brute de paires d’observations individuelles difficilement déchiffrable à l’œil nu, le chercheur condense l’information empirique en une représentation compacte. Cette forme synthétique respecte scrupuleusement la topologie logique des données sans opérer la moindre perte d’information quant aux effectifs de chaque configuration bivariée existante.
2.2 Conventions de notation matricielle en sciences empiriques
La rigueur de la communication scientifique et de l’analyse computationnelle exige l’adoption d’un système de notation mathématique universel et cohérent. Dans une table de contingence de dimensions $r \times c$, où la variable de ligne comporte $r$ modalités distinctes et la variable de colonne en comprend $c$, chaque cellule interne est repérée de manière univoque par un couple d’indices formels noté $(i, j)$. Par convention internationale admise dans les sciences empiriques, l’indice $i$ (variant de $1$ à $r$) indexe systématiquement la ligne, tandis que l’indice $j$ (variant de $1$ à $c$) renvoie à la colonne.
La valeur numérique abritée au sein de la cellule $(i, j)$ est notée $n_{ij}$. Elle représente l’effectif conjoint exact, c’est-à-dire le nombre précis d’unités statistiques observées qui satisfont concomitamment à la modalité $i$ de la première variable et à la modalité $j$ de la seconde variable. Cette notation indicielle permet de désigner sans aucune ambiguïté chaque composante locale de l’ensemble d’observations. Par exemple, la valeur $n_{12}$ désigne sans équivoque la fréquence conjointe de la première modalité de ligne associée à la seconde modalité de colonne.
Le symbolisme opératoire s’étend naturellement à la taille globale de l’échantillon ou de la population sous examen, unanimement désignée par la lettre majuscule $N$. Sur le plan arithmétique, la valeur scalaire de $N$ correspond à la sommation bidimensionnelle exhaustive de toutes les fréquences conjointes présentes dans la matrice :
$$N = \sum_{i=1}^{r} \sum_{j=1}^{c} n_{ij}$$
Cette sommation double atteste que chaque individu recensé est comptabilisé dans le bilan général et que la structure matricielle préserve l’intégrité numérique complète du protocole expérimental ou observationnel initial.
2.3 Critères d’exhaustivité et d’exclusivité catégorielle
Pour qu’un tableau de contingence possède une validité statistique et méthodologique irréprochable, les variables qualitatives retenues doivent obéir scrupuleusement aux principes de la taxonomie formelle, articulés autour de deux critères indissociables : l’exclusivité catégorielle et l’exhaustivité catégorielle. Ces impératifs garantissent que l’espace des modalités forme une partition mathématique rigoureuse de l’univers du discours.
L’exclusivité catégorielle exige que les modalités d’une même variable soient mutuellement hermétiques, ne tolérant aucun chevauchement conceptuel ou empirique. Un sujet statistique ne peut en aucun cas appartenir à deux modalités différentes d’une même variable. Si une personne pouvait être classée simultanément dans deux catégories de lignes distinctes, l’attribution matricielle de la fréquence conjointe deviendrait indéterminée, violant l’unicité de l’affectation dans une cellule $(i, j)$ singulière et générant un double comptage artificiel faussant la taille globale $N$.
L’exhaustivité impose quant à elle que le répertoire des modalités couvre l’intégralité des configurations envisageables au sein de la population. Aucune unité statistique ne doit se trouver dénuée de catégorie d’affectation. L’omission d’une catégorie potentielle, ou le défaut de prévision d’une modalité résiduelle clairement délimitée, aboutit à l’exclusion silencieuse de certains sujets, réduisant artificiellement la taille de l’échantillon et introduisant des biais structurels majeurs dans les fréquences conjointes observées. Une catégorisation déficiente détruit la fidélité de la mesure et compromet irrémédiablement la validité interne de toute conclusion issue des analyses d’association subséquentes.
3. Fréquence conjointe versus fréquence marginale : Démarcation théorique
3.1 Définition et calcul des marges de tableau
Tandis que les cellules internes d’une table de contingence capturent l’intersection des attributs, les marges du tableau remplissent une fonction de sommation vectorielle le long des axes dimensionnels. Les fréquences marginales s’obtiennent par l’opération arithmétique de marginalisation, consistant à projeter la distribution bidimensionnelle sur l’un des deux axes isolés, en neutralisant complètement l’influence différentielle de l’autre variable.
Formellement, le total marginal d’une ligne donnée $i$, noté $n_{i\cdot}$ (ou parfois $n_{i+}$ dans la littérature mathématique francophone), représente la somme de l’ensemble des fréquences conjointes alignées sur cette même ligne, balayant toutes les colonnes possibles :
$$n_{i\cdot} = \sum_{j=1}^{c} n_{ij}$$
De manière parfaitement symétrique, le total marginal d’une colonne donnée $j$, noté $n_{\cdot j}$ (ou $n_{+j}$), s’obtient par la sommation verticale de toutes les cellules conjointes appartenant à cette colonne, balayant l’ensemble des lignes :
$$n_{\cdot j} = \sum_{i=1}^{r} n_{ij}$$
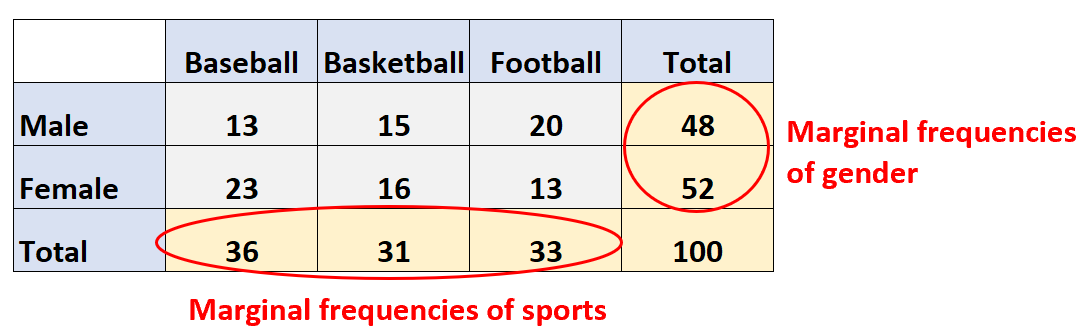
Ces totaux marginaux, consignés dans les marges droite et inférieure du tableau de contingence, ne constituent rien d’autre que la restitution exacte de la distribution univariée isolée de chaque variable prise indépendamment de l’autre. Le passage des cellules conjointes aux marges illustre une perte délibérée d’information relationnelle au profit d’un bilan macroscopique unilatéral.
3.2 Analyse comparative conjointe et marginale
La distinction conceptuelle entre fréquence conjointe et fréquence marginale relève d’une différence de granularité analytique fondamentale. La fréquence marginale fonctionne comme une lentille agrégative qui ignore volontairement la structure interne des relations bivariées. Lorsqu’un analyste examine le total marginal d’une modalité particulière de la variable $X$, il prend délibérément le parti d’ignorer la manière dont les individus porteurs de cette caractéristique se subdivisent selon les modalités de la variable $Y$. Cette opération d’effacement permet d’appréhender le poids global d’un attribut au sein de l’échantillon, mais elle oblitère totalement l’interaction locale.
À l’inverse, la fréquence conjointe agit comme le révélateur spécifique de l’interaction. Elle conserve intacte l’information sur la co-présence des traits, permettant de déceler des affinités préférentielles ou des répulsions structurelles entre catégories. Deux modalités peuvent posséder des fréquences marginales très élevées à l’échelle de la population tout en affichant une fréquence conjointe nulle ou extrêmement faible, mettant en lumière une incompatibilité empirique que l’inspection des seules marges univariées masquerait irrémédiablement.
Il existe néanmoins une dépendance structurelle stricte entre les marges et le corps du tableau : la somme des fréquences conjointes composant un sous-ensemble linéaire doit impérativement converger vers le total marginal correspondant. Cette contrainte arithmétique signifie que les fréquences marginales définissent les limites supérieures infranchissables des fréquences conjointes. Pour toute cellule, on observe nécessairement que $n_{ij} le n_{i\cdot}$ et $n_{ij} le n_{\cdot j}$. L’espace des fréquences conjointes possibles est ainsi rigidement borné par les distributions marginales sous-jacentes.
3.3 Interprétation contextuelle des proportions globales
Au-delà du décompte en nombres entiers, l’interprétation comparative des structures de données impose fréquemment la conversion des effectifs conjoints absolus en fréquences relatives globales. Cette normalisation scalaire s’effectue en divisant chaque fréquence conjointe $n_{ij}$ par l’effectif global $N$ de l’échantillon étudié. On obtient ainsi la proportion conjointe, conventionnellement désignée par la notation $f_{ij}$ :
$$f_{ij} = \frac{n_{ij}}{N}$$
Sur le plan de la théorie de la mesure et de la modélisation statistique, cette quantité $f_{ij}$ s’interprète comme l’estimation ponctuelle empirique de la probabilité conjointe sous-jacente, c’est-à-dire la probabilité qu’une unité statistique prélevée de manière strictement aléatoire au sein de la population cible appartienne de manière simultanée à la catégorie $A_i$ et à la catégorie $B_j$. Cette transformation d’échelle libère l’analyste des contraintes liées à la taille arbitraire de l’échantillon, facilitant les comparaisons directes entre différentes études ou différents pays.
Cette distribution de proportions conjointes est rigoureusement soumise aux contraintes axiomatiques de la théorie des probabilités. La sommation de toutes les proportions conjointes sur l’ensemble de la grille bidimensionnelle doit restituer exactement l’unité :
$$\sum_{i=1}^{r} \sum_{j=1}^{c} f_{ij} = 1$$
Toute déviation par rapport à cette valeur unitaire signale une erreur computationnelle d’arrondi ou une faille méthodologique dans l’exhaustivité de la partition catégorielle initiale.
4. Distinction critique : Fréquences conjointes et fréquences conditionnelles
4.1 Fondements théoriques du conditionnement
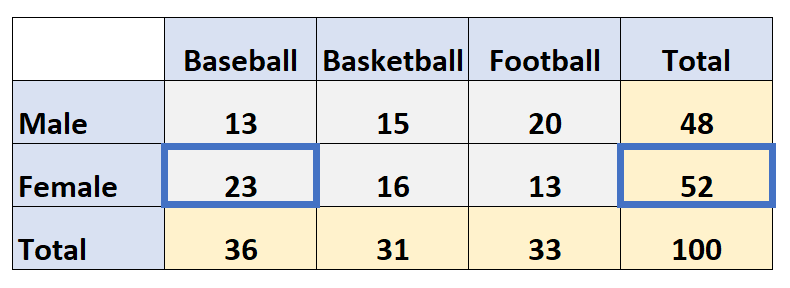
L’une des confusions les plus récurrentes et méthodologiquement dommageables en statistique appliquée consiste à amalgamer la fréquence conjointe et la fréquence conditionnelle. La clarification conceptuelle de cette frontière requiert de s’intéresser au dénominateur mobilisé lors du calcul de la proportion. Alors que la fréquence conjointe relative rapporte l’effectif d’une cellule à la population globale $N$, la fréquence conditionnelle opère une restriction volontaire du référentiel à un sous-ensemble marginal particulier.
Calculer une fréquence conditionnelle revient à poser la question : parmi les individus appartenant déjà à une catégorie déterminée (par exemple la modalité de ligne $A_i$), quelle proportion présente également la modalité de colonne $B_j$ ? Le calcul implique donc de diviser l’effectif conjoint $n_{ij}$ non pas par $N$, mais par la fréquence marginale de référence, ici $n_{i\cdot}$ pour une fréquence conditionnelle en ligne :
$$f_{j|i} = \frac{n_{ij}}{n_{i\cdot}}$$
Sur le plan sémantique et linguistique, cette distinction correspond à la frontière formelle séparant la conjonction de coordination « et » du syntagme conditionnel « sachant que ». La proposition « la proportion de personnes qui sont anxieuses et sportives » (perspective conjointe) mobilise l’ensemble de la population comme étalon de référence, tandis que la proposition « la proportion de personnes sportives sachant qu’elles sont anxieuses » (perspective conditionnelle) restreint d’emblée l’univers du discours aux seuls individus manifestant des symptômes anxieux.
4.2 Implications psychologiques et interprétatives
Les conséquences pratiques d’une confusion entre fréquence conjointe et fréquence conditionnelle sont particulièrement aiguës dans le jugement humain et l’évaluation diagnostique. Les travaux précurseurs en psychologie cognitive conduits par Daniel Kahneman et Amos Tversky ont démontré que l’esprit humain utilise fréquemment des heuristiques de représentativité qui abolissent spontanément la prise en compte rigoureuse des dénominateurs statistiques. Les cliniciens non avertis courent fréquemment le risque de commettre ce biais interprétatif majeur.
Considérons l’évaluation de la prévalence d’un trouble psychopathologique rare, comme la schizophrénie, au sein d’une population manifestant un comportement atypique particulier. La fréquence conjointe d’individus à la fois schizophrènes et auteurs d’actes de violence extrême est statistiquement infime à l’échelle de la population générale, car ces deux événements sont intrinsèquement rares. Pourtant, lorsqu’un clinicien évalue un patient présentant déjà des antécédents de passage à l’acte, la fréquence conditionnelle de la pathologie sachant le comportement violent peut devenir l’objet d’une surestimation massive si l’on oublie le faible taux de base de la pathologie dans la population globale.
Ce phénomène trouve un écho retentissant dans le domaine médico-légal à travers le piège bien documenté de l’erreur du procureur. Cette faute de logique consiste à substituer indûment la probabilité conditionnelle d’observer une concordance génétique chez un individu innocent avec la probabilité conjointe ou inverse que l’accusé soit innocent sachant que son profil génétique correspond à l’échantillon prélevé sur la scène de crime. Une telle confusion épistémologique inverse le conditionnement logique et conduit à des condamnations judiciaires erronées fondées sur une mauvaise interprétation des effectifs conjoints rapportés à des sous-populations spécifiques.
4.3 Formulations probabilistes associées
La traduction mathématique rigoureuse de ces distinctions s’exprime dans le formalisme des probabilités discrètes. Soit deux événements aléatoires discrets $A$ et $B$. La probabilité conjointe, qui quantifie la survenue simultanée des deux attributs, se note $P(A cap B)$. Elle se distingue catégoriquement de la probabilité conditionnelle notée $P(A|B)$, qui exprime la probabilité de survenue de l’événement $A$ sous la condition stricte que l’événement $B$ soit déjà réalisé.
La passerelle analytique unissant ces concepts est formulée par la définition même de la probabilité conditionnelle sous la théorie de Kolmogorov :
$$P(A|B) = \frac{P(A \cap B)}{P(B)} \quad \text{a\vec } P(B) > 0$$
À partir de cette relation élémentaire, le théorème de Bayes permet le rétro-calcul des probabilités conjointes et conditionnelles inverses en décomposant les intersections au moyen des produits de probabilités conditionnelles et de probabilités marginales préalables :
$$P(A \cap B) = P(A|B) \times P(B) = P(B|A) \times P(A)$$
Une propriété fondamentale mérite une mise en exergue appuyée : la probabilité et la fréquence conjointe sont strictement symétriques, c’est-à-dire que l’intersection ensembliste est commutative :
$$P(A \cap B) = P(B \cap A) \quad \text{et} \quad n_{ij} = n_{ji}^{top}$$
À l’opposé, la fréquence conditionnelle est intrinsèquement asymétrique : en règle générale, la probabilité d’être $A$ sachant $B$ ne présente aucune équivalence numérique avec la probabilité d’être $B$ sachant $A$ ($P(A|B) ne P(B|A)$ dès lors que $P(A) ne P(B)$). Oublier cette asymétrie revient à inverser la relation d’attribution logique des prédicats.
5. Exemple empirique standard : Analyse de données d’enquête
5.1 Présentation du protocole expérimental et de l’échantillon
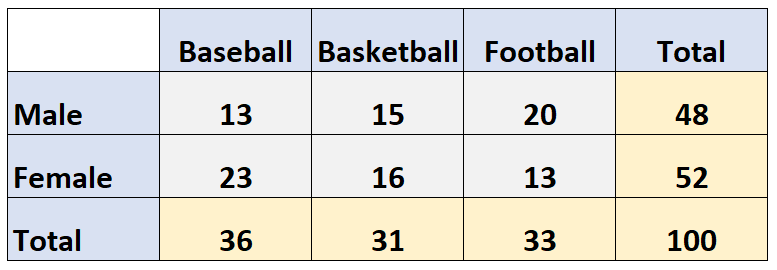
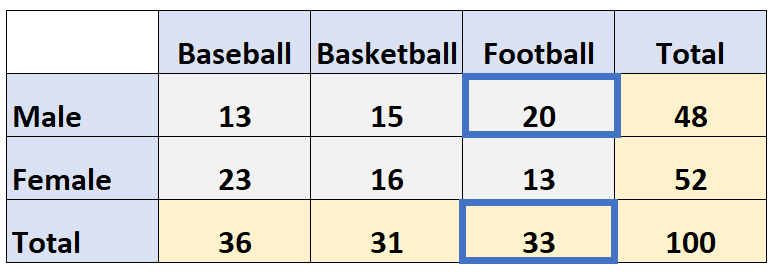
Afin de concrétiser les développements théoriques précédents à l’aide d’une illustration pédagogique et méthodologiquement transparente, considérons un protocole d’enquête empirique mené auprès d’un panel de sujets représentatifs. Une équipe de recherche en psychologie sociale s’intéresse aux préférences relatives aux pratiques de loisirs sportifs en fonction du genre auto-déclaré des participants. Le protocole implique un échantillon contrôlé de exactement cent répondants ($N = 100$), ce qui confère à chaque effectif absolu une conversion directe et immédiate en pourcentage, facilitant l’appréhension intuitive des calculs.
L’espace des variables est rigoureusement circonscrit de façon bidimensionnelle. La première variable, disposée en ligne, correspond au Genre du répondant et comprend deux modalités exclusives : Homme et Femme. La seconde variable, disposée en colonne, capture le Sport de prédilection déclaré parmi une sélection contrainte de trois disciplines populaires aux États-Unis : le Baseball, le Basketball et le Football américain. Chaque sujet interrogé a l’obligation méthodologique de choisir une et une seule discipline sportive préférée, garantissant le respect strict des principes de partition catégorielle, d’exhaustivité et d’exclusivité mutuelle.
L’objectif de cette étude descriptive consiste à cartographier sans distorsion la configuration des préférences sportives au sein de cet échantillon, d’examiner si certaines disciplines attirent préférentiellement un genre spécifique et de fournir une base de calcul accessible pour illustrer l’articulation arithmétique entre fréquences conjointes internes et marges globales du tableau croisé.
5.2 Revue systématique des fréquences conjointes observées
L’administration rigoureuse du questionnaire auprès des cent répondants permet de recueillir les observations empiriques et de dénombrer systématiquement les effectifs conjoints pour chacune des six cellules formées par le croisement des deux variables. L’analyse détaillée de ces co-occurrences observées au sein du segment masculin révèle les effectifs conjoints suivants :
- Exactement treize répondants masculins déclarent préférer le Baseball, ce qui correspond à la fréquence conjointe $n_{11} = 13$ (soit une fréquence conjointe relative de $13%$ par rapport à l’échantillon global).
- Exactement quinze participants masculins portent leur choix sur le Basketball, matérialisant l’effectif conjoint $n_{12} = 15$ (représentant une proportion globale de $15%$).
- Exactement vingt sujets masculins sélectionnent le Football américain comme leur discipline de prédilection, établissant la fréquence conjointe $n_{13} = 20$ (soit $20%$ de la population totale).
De manière parallèle, le décompte systématique des co-occurrences parmi les participantes composant le sous-groupe féminin du panel met en évidence la répartition suivante :
- Exactement seize femmes interrogées expriment une préférence dominante pour le Baseball, générant la fréquence conjointe $n_{21} = 16$ ($16%$ du total global).
- Exactement vingt-deux répondantes féminines désignent le Basketball comme leur sport récréatif favori, correspondant à la fréquence conjointe $n_{22} = 22$ ($22%$ de l’échantillon).
- Exactement quatorze participantes féminines choisissent le Football américain, constituant la fréquence conjointe $n_{23} = 14$ ($14%$ du total des répondants).
Chacune de ces six valeurs quantifie un segment exclusif de l’échantillon et atteste de la co-occurrence observable des deux critères examinés.
5.3 Agrégation marginale et cohérence arithmétique
Une fois les fréquences conjointes répertoriées au sein des cellules internes, l’étape impérative consiste à procéder aux sommations horizontales et verticales afin de dériver les totaux marginaux et de certifier la parfaite cohérence interne de la matrice de données. La sommation horizontale de la première ligne, dédiée au genre masculin, produit :
$$n_{1\cdot} = n_{11} + n_{12} + n_{13} = 13 + 15 + 20 = 48$$
L’échantillon compte donc quarante-huit hommes au total. La sommation de la seconde ligne, correspondant au genre féminin, donne :
$$n_{2\cdot} = n_{21} + n_{22} + n_{23} = 16 + 22 + 14 = 52$$
Le groupe féminin réunit ainsi cinquante-deux participantes. L’examen des totaux de lignes valide la répartition démographique univariée du genre au sein de l’étude.
De manière complémentaire, l’agrégation vectorielle descendante le long des colonnes permet d’établir la distribution marginale univariée des préférences sportives, indépendamment de toute considération liée au genre des individus :
- Pour le Baseball : $n_{\cdot 1} = n_{11} + n_{21} = 13 + 16 = 29$ personnes.
- Pour le Basketball : $n_{\cdot 2} = n_{12} + n_{22} = 15 + 22 = 37$ répondants.
- Pour le Football américain : $n_{\cdot 3} = n_{13} + n_{23} = 20 + 14 = 34$ participants.
Enfin, la sommation globale des marges horizontales ($48 + 52 = 100$) et la sommation globale des marges verticales ($29 + 37 + 34 = 100$) convergent rigoureusement vers l’effectif total attendu de cent observations ($N = 100$). La clôture arithmétique est scellée sans défaut.
6. Applications empiriques en psychométrie et évaluation clinique
6.1 Taxonomie diagnostique et comorbidités
L’évaluation des comorbidités en nosologie psychiatrique moderne repose sur la modélisation rigoureuse des fréquences conjointes. Lorsqu’une cohorte clinique de grande ampleur est soumise à une batterie diagnostique standardisée, la classification croisée de deux troubles majeurs — comme le trouble dépressif caractérisé et le trouble d’anxiété généralisée — génère un tableau quatre cases ($2 \times 2$) révélant la distribution des états morbides isolés et concomitants.
La fréquence conjointe de la cellule correspondant à la présence simultanée des deux troubles diagnostiqués met en lumière l’ampleur exacte du syndrome comorbide au sein de l’institution hospitalière ou de la cohorte suivie. La présence d’un effectif conjoint substantiellement élevé dans cette cellule mixte fournit des indications quantitatives primordiales pour réévaluer la validité discriminante des catégories nosographiques utilisées. Si la quasi-totalité des individus souffrant de dépression se retrouve également dans la cellule conjointe des personnes souffrant d’anxiété, la pertinence d’un découpage de ces troubles en entités étanches devient cliniquement contestable.
En outre, l’identification de ces profils mixtes via le dénombrement de leurs fréquences conjointes oriente directement la stratégie thérapeutique. Les trajectoires de réponse pharmacologique et psychothérapeutique des patients appartenant à la cellule conjointe comorbide diffèrent fréquemment de celles des patients logés dans les cellules de monopahologie. L’estimation précise de ces effectifs conjoints permet ainsi d’optimiser l’allocation des ressources soignantes spécialisées et de concevoir des protocoles de prise en charge intégrés.
6.2 Validation croisée des items psychologiques
En psychométrie, le développement et la validation d’échelles de mesure quantitatives exigent un examen scrupuleux du comportement individuel et conjoint des items qui composent les questionnaires. Lors de la phase de purification d’une échelle psychologique, les réponses dichotomiques de type accord/désaccord ou présent/absent fournies par un large échantillon de sujets à deux items distincts sont compilées sous la forme d’un tableau croisé.
La fréquence conjointe d’endossement simultané des deux items permet de traquer d’éventuelles redondances sémantiques triviales. Si la cellule conjointe d’accord bilatéral concentre l’écrasante majorité des répondants au détriment des cellules mixtes de désaccord unilatéral, les deux items partagent une proximité conceptuelle excessive qui n’apporte aucune valeur discriminante supplémentaire à l’instrument de mesure. L’un des items s’avère alors superflu et peut être éliminé au profit de la parcimonie du test.
Inversement, si deux items formulés pour refléter une même dimension latente (comme la détresse psychologique) présentent une fréquence conjointe d’accord quasi nulle au sein d’une population cible, cette divergence observationnelle indique une défaillance de cohérence interne ou une ambiguïté dans la formulation linguistique. L’analyse des patrons de fréquences conjointes sert ainsi de tamis préliminaire indispensable avant toute démarche plus sophistiquée d’analyse factorielle confirmatoire ou de modélisation par la théorie des réponses aux items.
6.3 Évaluation de la fidélité inter-évaluateurs
La recherche clinique et psychologique contemporaine impose de garantir que les évaluations diagnostiques ou comportementales ne soient pas tributaires de la subjectivité idiosyncrasique de l’observateur. L’analyse de la fidélité inter-évaluateurs consiste à faire coder de manière indépendante une série de sujets par au moins deux juges distincts, puis à consigner leurs décisions concordantes et discordantes au sein d’une matrice de contingence carrée.
Les cellules de la diagonale principale de cette matrice hébergent les fréquences conjointes d’accord parfait : cas où les deux cliniciens attribuent simultanément la catégorie normale, ou cas où ils posent tous deux le même diagnostic pathologique. La sommation de ces fréquences conjointes diagonales rapportée à l’effectif global $N$ fournit l’indice d’accord global brut observé, élément empirique primaire de la concordance.
Toutefois, la manipulation des fréquences conjointes observées ne suffit pas à elle seule pour juger de la fiabilité métrologique du protocole, car une part non négligeable de cet accord peut survenir par pure coïncidence stochastique. L’évaluation rigoureuse requiert de comparer la fréquence conjointe d’accord observée avec la fréquence conjointe théorique attendue sous l’hypothèse que les jugements des deux évaluateurs s’opéreraient de façon mutuellement indépendante. Cette confrontation fondamentale entre le conjoint observé et le conjoint aléatoire constitue le fondement même du calcul du coefficient Kappa de Cohen.
7. Fréquences conjointes et théorie de l’indépendance statistique
7.1 Définition formelle de l’indépendance bivariée
Le concept d’indépendance statistique représente la clé de voûte de l’inférence bivariée. Sur le plan théorique fondamental, deux variables qualitatives $X$ et $Y$ sont déclarées rigoureusement indépendantes si, et seulement si, la réalisation d’une modalité particulière de l’une d’entre elles ne modifie en rien la distribution de probabilité des modalités de l’autre. Autrement dit, l’information quant à l’état de la première variable n’apporte strictement aucun pouvoir prédictif sur l’état de la seconde.
Dans le langage de la théorie axiomatique des probabilités, cette absence totale d’association se traduit par la célèbre propriété de factorisation multiplicative : pour tout couple de modalités $(A_i, B_j)$, la probabilité conjointe de leur co-occurrence est strictement égale au produit algébrique de leurs probabilités marginales respectives :
$$P(A_i \cap B_j) = P(A_i) \times P(B_j)$$
Ce postulat d’indépendance implique que toute relation de conditionnement s’effondre vers la distribution marginale simple : $P(A_i|B_j) = P(A_i)$ pour tout $j$, et réciproquement $P(B_j|A_i) = P(B_j)$ pour tout $i$. Au niveau populationnel, l’indépendance statistique désigne ainsi une absence absolue d’effet d’interaction ou d’attraction structurelle entre les critères observés, établissant une forme d’orthogonalité distributionnelle parfaite.
7.2 Calcul des fréquences conjointes attendues (théoriques)
Pour transposer le postulat théorique de l’indépendance statistique dans le champ opératoire d’une table de contingence empirique, les statisticiens doivent calculer les fréquences conjointes théoriques (également désignées sous le vocable d’effectifs attendus ou théoriques), notées conventionnellement $e_{ij}$ ou $E_{ij}$. Ces effectifs incarnent les valeurs exactes que l’on observerait dans chaque cellule interne si l’hypothèse d’indépendance stricte était parfaitement vérifiée tout en maintenant inchangées les distributions marginales empiriques observées.
La formulation analytique permettant d’isoler cette valeur théorique découle directement de la substitution des probabilités marginales par leurs estimateurs empiriques :
$$e_{ij} = N \times \left( \frac{n_{i\cdot}}{N} \times \frac{n_{\cdot j}}{N} \right) = \frac{n_{i\cdot} \times n_{\cdot j}}{N}$$
Cette règle de trois élégante stipule que la fréquence conjointe attendue pour la cellule $(i, j)$ est rigoureusement égale au produit arithmétique de son total marginal de ligne par son total marginal de colonne, le tout divisé par la taille globale de l’échantillon $N$.
La signification théorique de cette grandeur est primordiale : elle constitue le standard contrefactuel de référence. Toute comparaison ultérieure menée dans le cadre de l’inférence statistique reposera sur la confrontation directe entre la fréquence conjointe empirique effectivement observée dans le monde réel ($n_{ij}$) et la fréquence conjointe théorique déduite mécaniquement du modèle de l’indépendance statistique ($e_{ij}$).
7.3 Écarts empiriques et interprétation clinique
L’intérêt de la modélisation bivariée réside dans l’analyse critique de la divergence observée entre l’effectif conjoint réel et l’effectif conjoint théorique attendu ($n_{ij} – e_{ij}$). Cette différence algébrique fournit une estimation immédiate de la direction et de l’intensité de l’association locale unissant les deux modalités considérées.
Lorsqu’une cellule conjointe présente un effectif observé substantiellement supérieur à sa valeur attendue ($n_{ij} > e_{ij}$), la cellule est dite en situation de surreprésentation conjointe positive ou d’attraction. Cela signale que les deux attributs se manifestent conjointement avec une intensité plus vigoureuse que celle prédite par le simple jeu du hasard stochastique. En psychologie clinique, une telle surreprésentation entre un trait de personnalité spécifique (par exemple, un perfectionnisme inadapté élevé) et un trouble psychopathologique (comme l’anorexie mentale) valide l’hypothèse d’une affinité psychopathologique méritant une exploration étiologique approfondie.
À l’inverse, lorsqu’une fréquence conjointe observée s’avère nettement inférieure à son effectif attendu sous indépendance ($n_{ij} < e_{ij}$), la cellule révèle un phénomène de sous-représentation conjointe ou d'incompatibilité relative. Les deux caractéristiques semblent s'exclure mutuellement dans une certaine mesure au sein de la dynamique populationnelle observée. L'interprétation clinique ou sociologique de ces déficits de co-occurrence est tout aussi cruciale que celle des surreprésentations, car elle permet d'identifier des facteurs protecteurs potentiels ou des mécanismes d'inhibition comportementale mutuelle.
8. Rôle de la fréquence conjointe dans le test du Chi-deux d’indépendance
8.1 Construction de la statistique du Chi-deux
La statistique du test d’indépendance développé à la fin du XIXe siècle par Karl Pearson repose précisément sur une métrique globale d’agrégation des divergences existant entre les fréquences conjointes observées et les fréquences conjointes théoriques attendues sous l’hypothèse nulle ($H_0$) d’indépendance bivariée.
La construction mathématique de la statistique de Pearson, désignée par le symbole $\chi^2$, consiste à calculer la somme sur l’ensemble des cellules internes du tableau de contingence des écarts quadratiques standardisés entre les effectifs observés $n_{ij}$ et théoriques $e_{ij}$ :
$$\chi^2 = \sum_{i=1}^{r} \sum_{j=1}^{c} \frac{(n_{ij} – e_{ij})^2}{e_{ij}}$$
L’élévation au carré garantit la positivité de chaque contribution locale tout en sanctionnant plus lourdement les déviations massives, tandis que la division par la fréquence conjointe attendue $e_{ij}$ assure une pondération relative conforme à la variance asymptotique attendue de la distribution poissonnienne de chaque cellule.
Cette formulation met en lumière l’extrême sensibilité du test global aux fluctuations locales des fréquences conjointes. Si l’ensemble des fréquences conjointes observées s’aligne fidèlement sur les effectifs attendus, le numérateur de chaque terme s’annule, aboutissant à une statistique $\chi^2$ proche de zéro et conduisant au maintien de l’hypothèse d’indépendance. En revanche, l’émergence d’anomalies distributives majeures au sein d’une ou plusieurs cellules conjointes suffit à faire croître la valeur scalaire globale du Chi-deux au-delà du seuil critique fixé par les degrés de liberté $((r-1)(c-1))$, provoquant le rejet statistique franc de l’indépendance.
8.2 Règle de Cochran et contraintes d’effectifs
L’utilisation de la statistique du Chi-deux de Pearson repose sur une approximation distributionnelle continue asymptotique qui n’est méthodologiquement valide que sous certaines contraintes strictes régissant les fréquences conjointes du tableau. Lorsque les effectifs sont trop faibles, l’approximation de la loi discrète par la loi continue du $\chi^2$ perd sa robustesse et gonfle artificiellement le risque d’erreur de première espèce (rejet erroné de l’hypothèse nulle).
Le biostatisticien William Gemmell Cochran a formalisé des critères directeurs universally reconnus sous le nom de règles de Cochran pour statuer sur la validité du test :
- Aucune cellule conjointe théorique ne doit comporter une valeur attendue strictement inférieure à $1$ ($e_{ij} ge 1$ pour tout couple $(i, j)$).
- Au moins $80%$ de l’ensemble des cellules conjointes internes du tableau doivent présenter une fréquence théorique attendue supérieure ou égale à cinq ($e_{ij} ge 5$).
Lorsque ces conditions ne sont pas honorées, notamment en présence de cellules internes affichant des effectifs conjoints quasi-vides ou clairsemés, le chercheur doit proscrire l’application directe du Chi-deux standard. Deux solutions méthodologiques s’imposent alors : procéder au regroupement rationnel de certaines modalités catégorielles connexes pour densifier artificiellement les marges et les cellules, ou recourir à des procédures d’inférence non paramétriques exactes, telles que le test exact de Fisher (généralisé aux tables $r \times c$ par l’algorithme de Mehta et Patel), qui évalue la probabilité exacte d’observer la configuration conjointe sous la loi hypergéométrique multivariée conditionnellement aux marges fixées.
8.3 Interprétation des résidus standardisés ajustés
L’obtention d’une valeur de Chi-deux globalement significative informe le praticien de l’existence d’une dépendance statistique entre les deux variables, mais ce test omnidirectionnel demeure muet quant à l’identification précise des cellules conjointes responsables de ce rejet. Pour contourner cette limite d’interprétation, l’analyse diagnostique post-hoc s’appuie sur le calcul des résidus standardisés ajustés, initialement théorisés par Shelby Haberman.
Le résidu standardisé brut d’une cellule conjointe se définit par le rapport $(n_{ij} – e_{ij}) / \sqrt{e_{ij}}$. Bien qu’informatif, ce résidu n’a pas une variance unitaire exacte. Le résidu ajusté résout cette imperfection en divisant l’écart d’observation par l’estimation standard exacte de son erreur-type, qui prend rigoureusement en compte le poids marginal des lignes et des colonnes :
$$d_{ij} = \frac{n_{ij} – e_{ij}}{\sqrt{e_{ij} \left(1 – \frac{n_{i\cdot}}{N}\right) \left(1 – \frac{n_{\cdot j}}{N}\right)}}$$
Ces résidus ajustés suivent asymptotiquement une loi normale centrée réduite $\mathcal{N}(0, 1)$ sous l’hypothèse nulle d’indépendance. Dès lors, le chercheur dispose d’une métrique probabiliste standardisée : toute cellule conjointe dont le résidu ajusté présente une valeur absolue supérieure à $1{,}96$ indique une anomalie locale statistiquement significative au seuil de $\alpha = 0{,}05$ (ou supérieure à $2{,}58$ pour $\alpha = 0{,}01$). Cette méthode permet de cartographier avec une extrême précision chirurgicale les associations locales positives ou négatives qui sous-tendent la signification globale du tableau croisé.
9. Mesures de taille d’effet dérivées des fréquences conjointes
9.1 Le coefficient Phi pour les tables deux par deux
Si la statistique du Chi-deux renseigne sur l’existence probante d’une déviation par rapport au hasard, elle demeure dépendante de la taille de l’échantillon $N$. Pour quantifier la magnitude ou l’intensité intrinsèque de l’association, la recherche empirique doit impérativement rapporter des mesures de taille d’effet standardisées. Dans le cadre fondamental des matrices de contingence $2 \times 2$ réunissant deux variables strictement dichotomiques, la mesure d’association privilégiée est le coefficient Phi, désigné par la lettre grecque $phi$.
Ce coefficient s’obtient directement en divisant la statistique du $\chi^2$ par la taille globale de l’échantillon puis en extrayant la racine carrée du quotient :
$$\phi = \sqrt{\frac{\chi^2}{N}}$$
Exprimé directement à partir des quatre fréquences conjointes absolues d’un tableau composé des cellules $a, b, c, d$ (où la première ligne contient $a = n_{11}$ et $b = n_{12}$, et la seconde ligne $c = n_{21}$ et $d = n_{22}$), le coefficient Phi se calcule sous sa forme algébrique matricielle déterminantale :
$$\phi = \frac{ad – bc}{\sqrt{(a+b)(c+d)(a+c)(b+d)}}$$
Sur le plan métrologique, le coefficient $phi$ est rigoureusement équivalent au coefficient de corrélation produit-moment de Bravais-Pearson calculé entre deux variables binaires codées $0$ et $1$. Il oscille dans un intervalle compris entre $-1$ et $+1$ dans les tables symétriques équilibrées. En recherche psychologique et comportementale, des valeurs de l’ordre de $0{,}10$, $0{,}30$ et $0{,}50$ sont conventionnellement interprétées selon les repères de Jacob Cohen comme matérialisant respectivement des effets de taille faible, moyenne et forte.
9.2 Le V de Cramér pour les tables de dimensions supérieures
Lorsque la structure matricielle s’élargit pour accueillir des variables polytomiques comportant plus de deux modalités, le tableau de contingence atteint des dimensions $r \times c$ supérieures à deux. Dans cette configuration, le coefficient Phi perd son calibrage normatif et peut mathématiquement dépasser l’unité, ce qui interdit toute interprétation analogique à un coefficient de corrélation standardisé. Le statisticien Harald Cramér a pallié cette carence en forgeant une extension standardisée universelle : le V de Cramér.
Le calcul du V de Cramér introduit un terme d’ajustement correctif qui intègre le nombre minimal de lignes ou de colonnes diminué d’une unité, désigné par la quantité $k = min(r – 1, c – 1)$ :
$$V = \sqrt{\frac{\chi^2}{N \times \min(r – 1, c – 1)}}$$
Grâce à cette normalisation mathématique rigoureuse, le V de Cramér est strictement borné à l’intervalle canonique $[0, 1]$, quelle que soit la complexité dimensionnelle ou l’asymétrie rectangulaire de la table de contingence étudiée. Une valeur de zéro atteste d’une indépendance bivariée absolue, traduisant une concordance parfaite entre fréquences conjointes observées et attendues. Une valeur de $1$ consigne au contraire une association parfaite, dans laquelle la connaissance de la modalité de ligne détermine entièrement la modalité de colonne sans la moindre incertitude.
L’intérêt épistémologique majeur du V de Cramér réside dans la comparabilité transversale qu’il autorise. Un chercheur peut ainsi comparer de façon méthodologiquement saine la force d’association entre des études empiriques mobilisant des échantillons d’amplitudes divergentes et des découpages de catégories aux nombres de modalités dissemblables.
9.3 Rapport de cotes (Odds Ratio) et risque relatif
En épidémiologie psychiatrique, en génétique comportementale et dans les études cliniques cas-témoins, la quantification de l’association entre une exposition à un facteur de vulnérabilité et la survenue d’une entité nosologique s’exprime préférentiellement à travers le rapport de cotes, internationalement désigné sous l’anglicisme Odds Ratio ($OR$). Cette métrique fondamentale dérive directement des fréquences conjointes des diagonales d’une matrice $2 \times 2$.
En reprenant la désignation formelle des quatre cellules conjointes de la matrice binaire ($a = n_{11}, b = n_{12}, c = n_{21}, d = n_{22}$), l’Odds Ratio se définit comme le rapport des produits croisés de ces fréquences internes :
$$OR = \frac{a \times d}{b \times c}$$
Cette formulation quantifie le ratio entre la cote de survenue de l’événement chez les sujets exposés ($a / b$) et la cote de survenue de ce même événement chez les sujets non exposés ($c / d$).
L’interprétation quantitative du rapport de cotes est particulièrement lisible :
- Une valeur de $OR = 1$ indique que l’exposition n’altère en rien la probabilité de développer l’affection, traduisant une indépendance statistique des fréquences conjointes.
- Une valeur de $OR > 1$ indique un sur-risque statistiquement quantifiable, l’exposition agissant comme un facteur favorisant ou de vulnérabilité avéré.
- Une valeur de $OR < 1$ signale au contraire un rôle de facteur protecteur, la co-occurrence entre l'attribut protecteur et la morbidité étant structurellement amoindrie.
Dans les protocoles longitudinaux de cohortes prospectives, on lui adjoint fréquemment le risque relatif ($RR$), défini par le rapport des fréquences conditionnelles incidentes $(a / (a+b)) / (c / (c+d))$. Alors que le risque relatif nécessite la maîtrise des incidences réelles dans le temps, l’Odds Ratio présente l’immense flexibilité d’être calculable directement sur des études rétrospectives d’archives à partir des fréquences conjointes d’échantillons stratifiés.
10. Modélisation avancée : Tables de contingence multidimensionnelles
10.1 Extension aux fréquences conjointes à trois variables ou plus
La réalité psychologique et sociale se caractérise rarement par des configurations bivariées isolées du reste du monde. Les phénomènes réels impliquent couramment des réseaux complexes de variables en interaction simultanée. La statistique catégorielle avancée étend l’architecture des tableaux de contingence pour intégrer une troisième, voire une quatrième dimension analytique, donnant naissance à des structures spatiales matricielles désignées sous le nom d’hypercubes de contingence ou de tables stratifiées.
Considérons l’adjonction d’une variable modératrice $Z$, découpée en $K$ strates distinctes (telles que des tranches d’âge ou des niveaux de sévérité symptomatique). La notation formelle de la fréquence conjointe se complexifie naturellement par l’introduction d’un troisième indice indiciel univoque : $n_{ijk}$. Cette notation quantifie le dénombrement précis des sujets qui manifestent simultanément la modalité $i$ de la première variable, la modalité $j$ de la seconde variable, au sein du sous-groupe défini par la modalité $k$ de la troisième variable.
L’analyse d’une telle matrice tridimensionnelle se déploie à travers des coupes bidimensionnelles transversales désignées sous l’appellation de tableaux partiels. L’évaluation minutieuse de ces cellules conjointes multidimensionnelles permet aux chercheurs de vérifier si la relation observée initialement entre $X$ et $Y$ se maintient de façon invariante à travers l’ensemble des strates de $Z$, ou si l’intensité et la direction de cette association sont modulées par l’appartenance catégorielle à la variable régulatrice, attestant d’un effet d’interaction statistique d’ordre supérieur.
10.2 Le paradoxe de Simpson et pièges d’agrégation
L’une des manifestations les plus spectaculaires de l’impérieuse nécessité d’examiner les fréquences conjointes au niveau désagrégé réside dans le célèbre piège méthodologique nommé paradoxe de Simpson. Cette anomalie apparente survient lorsqu’une tendance associative observée de façon homogène au sein de plusieurs sous-tableaux de fréquences conjointes désagrégées se trouve complètement inversée lorsque l’analyste commet l’erreur d’agréger ces données en une seule table de contingence bivariée globale.
Ce phénomène n’a rien de magique : il s’explique mathématiquement par la présence d’une variable de confusion cachée qui entretient des relations asymétriques fortes tant avec la variable d’exposition qu’avec la variable de résultat. Lorsqu’on fusionne les strates sans précaution, la pondération inégale des effectifs marginaux de chaque sous-groupe biaise mécaniquement la composition des cellules conjointes agrégées, produisant une distorsion statistique majeure où une corrélation conditionnelle systématiquement positive au sein de chaque strate se métamorphose en une association conjointe globalement négative dans le tableau réuni.
Cette distorsion souligne de manière éclatante qu’une fréquence conjointe bidimensionnelle brute ne doit jamais être considérée comme une vérité étiologique absolue lorsqu’il existe des soupçons légitimes quant à l’action de covariables sous-jacentes. Seule l’inspection rigoureuse des fréquences conjointes stratifiées multidimensionnelles permet de dissiper ces mirages agrégatifs et d’accéder à une compréhension structurellement fidèle de la causalité probabiliste.
10.3 Introduction aux modèles log-linéaires
Pour formaliser, décomposer et tester mathématiquement les multiples interactions qui se nouent au sein des tables de contingence multidimensionnelles, la statistique paramétrique catégorielle a mis au point la modélisation log-linéaire. Cette famille de modèles statistiques avancés, formalisée notamment par Yvonne Bishop, Stephen Fienberg et Paul Holland, contourne la contrainte de positivité stricte des effectifs en modélisant le logarithme népérien des fréquences conjointes théoriques attendues.
Pour un tableau bivarié fondamental, le modèle log-linéaire saturé décompose le logarithme de chaque cellule attendue $m_{ij}$ en une sommation d’effets analogiques à ceux d’une analyse de variance factorielle classique (ANOVA) :
$$\ln(m_{ij}) = \lambda + \lambda_i^X + \lambda_j^Y + \lambda_{ij}^{XY}$$
Dans cette formulation élégante :
- $lambda$ représente la constante d’échelle globale, régie par la taille totale de l’échantillon $N$.
- $\lambda_i^X$ capture l’effet principal de la $i$-ème modalité de la variable de ligne, reflétant sa fréquence marginale univariée.
- $\lambda_j^Y$ capture l’effet principal de la $j$-ème modalité de la variable de colonne.
- $\lambda_{ij}^{XY}$ représente le terme d’interaction conjointe spécifique entre les modalités $i$ et $j$.
Si l’hypothèse d’indépendance statistique entre les deux variables est empiriquement exacte, l’ensemble des termes d’interaction $\lambda_{ij}^{XY}$ s’annule rigoureusement ($\lambda_{ij}^{XY} = 0$ pour tout couple $(i, j)$), réduisant le modèle à la simple juxtaposition de ses composantes marginales. L’extension naturelle de ce formalisme aux hypercubes à trois dimensions ($XYZ$) permet d’isoler des termes d’interaction d’ordre trois ($\lambda_{ijk}^{XYZ}$), offrant un outil d’une puissance computationnelle sans égal pour tester des réseaux complexes d’interdépendances sans imposer arbitrairement une distinction directionnelle rigide entre variable dépendante et variable indépendante.
11. Erreurs méthodologiques et pièges d’interprétation
11.1 Confusion entre corrélation catégorielle et causalité
L’observation d’une fréquence conjointe exceptionnellement élevée ou d’un coefficient d’association statistique hautement significatif entre deux modalités qualitatives ne permet en aucun cas de déduire l’existence d’un lien de causalité directe entre elles. L’adage épistémologique fondamental de la recherche quantitative s’applique avec une rigueur absolue aux données catégorielles : la co-occurrence empirique n’établit pas la genèse causale.
La présence d’un effectif conjoint proéminent dans une cellule interne peut parfaitement résulter de multiples mécanismes alternatifs ne relevant d’aucune influence mutuelle directe. Il peut s’agir d’une relation fallacieuse régie en sous-main par une variable confondante commune non mesurée dans le protocole. Par exemple, observer une co-occurrence fréquente entre le port de vêtements épais et la consommation de boissons chaudes ne signifie pas que le port de tissus thermiques déclenche la soif de liquides chauffés : ces deux comportements sont simplement des réponses comportementales conjointes provoquées par une cause tierce exogène, à savoir la température météorologique hivernale.
Les chercheurs doivent faire preuve d’une réserve méthodologique vigilante lors de la rédaction des conclusions de leurs travaux observationnels. Sans manipulation expérimentale contrôlée avec randomisation stricte ou sans devis longitudinal permettant d’établir de façon irréfutable l’antériorité temporelle de la cause postulée sur son effet présumé, toute interprétation causale extrapolée à partir d’une simple table de fréquences conjointes relève d’une spéculation non étayée.
11.2 Biais d’échantillonnage et validité externe
La crédibilité intrinsèque des fréquences conjointes compilées dans une table de contingence dépend viscéralement de la qualité de la procédure d’échantillonnage mise en œuvre. Si le recrutement des participants s’opère selon des logiques non probabilistes ou s’il se trouve contaminé par des filtres de sélection implicites, la représentativité des cellules internes s’effondre, compromettant gravement la validité externe des conclusions scientifiques.
Un cas d’école épidémiologique est illustré par le biais de Berkson (ou paradoxe de Berkson). Ce biais d’échantillonnage surgit lorsque le recrutement de la cohorte est effectué exclusivement en milieu intrahospitalier. Les individus hospitalisés présentent structurellement une probabilité accrue de cumuler plusieurs affections chroniques en comparaison des individus vivant dans la communauté générale. En conséquence, les tableaux de contingence dressés à partir de ces échantillons cliniques exhibent des fréquences conjointes de comorbidité artificiellement hypertrophiées, créant des associations fallacieuses entre des pathologies qui s’avèrent totalement indépendantes au sein de la population globale.
La généralisation indue de régularités bivariées déduites d’échantillons de convenance (comme les cohortes d’étudiants en psychologie fréquemment mobilisées dans les études académiques universitaires) constitue un autre écueil classique. Si un groupe sociodémographique est massivement sous-représenté dans l’échantillonnage initial, les fréquences conjointes impliquant ses caractéristiques seront anémiques ou inexistantes, interdisant toute inférence valide quant aux dynamiques régissant ces populations dans le monde réel.
11.3 Gestion des cellules sans effectif (zéros structurels vs aléatoires)
L’une des complexités computationnelles et analytiques les plus redoutables lors du traitement des tables de contingence concerne l’apparition de cellules internes dont la fréquence conjointe observée est rigoureusement égale à zéro ($n_{ij} = 0$). Face à un effectif nul, le méthodologue doit impérativement opérer une distinction épistémologique cruciale entre ce que la littérature nomme les zéros aléatoires (ou zéros d’échantillonnage) et les zéros structurels.
Un zéro aléatoire reflète une absence fortuite d’observation temporaire imputable aux contraintes de taille de l’échantillon ou à la rareté relative de la conjonction étudiée. La cellule conjointe possède une probabilité sous-jacente non nulle ($P(A_i \cap B_j) > 0$), mais aucun individu ne s’est trouvé capturé dans cette configuration lors de la collecte. À l’opposé, un zéro structurel (ou zéro biologique/logique) matérialise une impossibilité intrinsèque fondamentale : l’événement conjoint ne peut conceptuellement pas se produire dans le monde réel (par exemple, la cellule croisant le diagnostic d’adénome prostatique et le genre anatomique féminin). La probabilité de cette intersection est axiomatiquement fixée à zéro ($P(A_i \cap B_j) = 0$).
Les répercussions algorithmiques de ces zéros sont profondes. La présence d’un zéro aléatoire rend indéterminé le calcul direct de métriques comme l’Odds Ratio, générant une division interdite par zéro. Pour stabiliser ces estimations sur données éparses sans introduire de biais de modélisation outranciers, les biostatisticiens emploient des corrections formelles, telles que la correction d’Haldane-Anscombe, qui consiste à adjoindre une pseudo-constante de $0{,}5$ à l’ensemble des cellules internes, ou recourent à des méthodes d’estimation bayésienne incorporant des lois a priori régularisatrices.
12. Implémentation computationnelle sous logiciels statistiques
12.1 Extraction et traitement des tableaux croisés sous R
Dans l’écosystème open-source du logiciel et langage de programmation statistique R, le dénombrement, la manipulation et la modélisation des fréquences conjointes s’effectuent au moyen de fonctions vectorielles hautement optimisées. La commande élémentaire native de référence pour agréger des vecteurs de données catégorielles en un tableau croisé de contingence est la fonction table(), complétée par la formule plus générale xtabs() :
La syntaxe opératoire standard prend la forme suivante :
tableau_brut <- table(donnees$Genre, donnees$Sport)
Cette instruction génère instantanément une matrice bidimensionnelle contenant l’ensemble des fréquences conjointes absolues $n_{ij}$. Pour dériver sans effort les proportions conjointes relatives normalisées par rapport à l’effectif global $N$, l’analyste imbrique ce premier résultat dans la fonction prop.table() en omettant tout argument de marge :
proportions_conjointes <- prop.table(tableau_brut)
Pour inspecter la distribution de ces fréquences et vérifier les hypothèses d’indépendance, le praticien sollicite directement la fonction chisq.test(tableau_brut), laquelle extrait les effectifs conjoints observés, les effectifs théoriques attendus (accessibles via l’attribut $expected), ainsi que les résidus standardisés ajustés de Haberman (accessibles via $stdres). Enfin, la traduction graphique multidimensionnelle des fréquences conjointes s’effectue avec raffinement à l’aide des diagrammes en mosaïque générés par la fonction native mosaicplot() ou par le package spécialisé vcd, où la surface géométrique de chaque polygone est rigoureusement proportionnelle à la fréquence conjointe de la cellule correspondante.
12.2 Procédures d’analyse automatisées sous IBM SPSS
Au sein des laboratoires de psychologie quantitative et de sciences de l’éducation, le logiciel commercial IBM SPSS Statistics demeure une plateforme largement répandue pour le traitement des enquêtes et la passation de tests d’association catégorielle. L’accès aux matrices de fréquences conjointes s’opère de manière fluide à travers l’interface graphique en parcourant l’arborescence du menu : Analyser > Statistiques descriptives > Tableaux croisés (Crosstabs).
Au sein de la boîte de dialogue principale, le chercheur assigne ses variables de catégorisation aux axes de Lignes et de Colonnes. L’ouverture du sous-menu Cellules (Cells) offre un contrôle granulaire sur les métriques affichées au sein de chaque alvéole interne de la table de contingence :
- Sélection de l’option Observés pour visualiser les fréquences conjointes empiriques directes ($n_{ij}$).
- Sélection de l’option Théoriques pour commander le calcul automatique des fréquences conjointes attendues sous condition d’indépendance ($e_{ij}$).
- Sélection des Pourcentages du total pour obtenir la projection des proportions conjointes globales ($f_{ij} = n_{ij}/N$).
- Sélection des Résidus ajustés standardisés pour identifier immédiatement les cellules conjointes significativement discordantes.
Le sous-menu Statistiques permet d’ordonner l’exécution conjointe du test de Chi-deux de Pearson, de la correction de continuité de Yates, et d’extraire les métriques de force d’association comme le coefficient Phi et le V de Cramér. La table finale générée dans la fenêtre de sortie fournit une mise en page standardisée conforme aux normes académiques, facilitant son exportation directe vers les manuscrits scientifiques.
12.3 Traitement de données catégorielles avec Python et Pandas
Dans le domaine contemporain de la science des données, de l’apprentissage automatique et du calcul scientifique computationnel, le langage Python associé à la bibliothèque logicielle Pandas s’impose comme un standard industriel pour l’ingestion et la manipulation de données multidimensionnelles. La génération d’une table de fréquences conjointes s’opère de façon directe grâce à l’implémentation de la fonction dédiée pandas.crosstab() :
import pandas as pd
matrice_conjointe = pd.crosstab(index=df['Genre'], columns=df['Sport'])
Pour étendre cette structure descriptive et y intégrer instantanément les sommes marginales de lignes et de colonnes, la fonction propose un argument booléen extrêmement utile nommé margins, accompagné de l’étiquetage personnalisé de ces marges :
matrice_complete = pd.crosstab(index=df['Genre'], columns=df['Sport'], margins=True, margins_name="Total")
Si l’analyste requiert l’expression des fréquences conjointes sous la forme de proportions relatives globales, il suffit de configurer le paramètre de normalisation globale au moyen de l’argument normalize='all' (tandis que normalize='index' ou normalize='columns' produirait respectivement les tables de fréquences conditionnelles de lignes ou de colonnes).
Enfin, pour conférer une dimension visuelle immédiatement interprétable aux matrices de fréquences conjointes volumineuses, la bibliothèque de visualisation statistique Seaborn permet de transformer ces grilles de chiffres en cartes thermiques (heatmaps) chromatiques :
import seaborn as sns
import matplotlib.pyplot as plt
sns.heatmap(matrice_conjointe, annot=True, fmt='d', cmap='Blues')
plt.show()
Ce rendu cartographique attribue une nuance colorimétrique progressive dont la densité spectrale est indexée sur la magnitude des fréquences conjointes hébergées dans chaque cellule, offrant un décodage perceptif instantané des zones d’attraction ou de désertion statistique au sein des données massives.
Références
Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
Bishop, Y. M., Fienberg, S. E., & Holland, P. W. (2007). Discrete multivariate analysis: Theory and practice. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-72806-3
Cochran, W. G. (1952). The $\chi^2$ test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
Cochran, W. G. (1954). Some methods for strengthening the common $\chi^2$ tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical methods for rates and proportions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471445428
Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
Kahneman, D., Slovic, S. P., & Tversky, A. (Eds.). (1982). Judgment under uncertainty: Heuristics and biases. Cambridge University Press. https://doi.org/10.1017/CBO9780511809477
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x