
La mesure scientifique des attributs psychologiques, éducatifs et cognitifs repose sur un défi épistémologique fondamental : comment quantifier avec rigueur des construits latents qui échappent à l’observation physique directe ? Contrairement aux grandeurs physiques telles que la masse ou la longueur, les capacités intellectuelles, les connaissances scolaires ou les traits de personnalité ne peuvent être appréhendés qu’au travers de comportements observables, le plus souvent médiatisés par des réponses à des instruments standardisés. Dès lors, la question de la qualité métrologique de ces instruments devient le pivot de toute inférence diagnostique, pédagogique ou clinique. La psychométrie s’est constituée en discipline autonome pour répondre à cette exigence, en développant des cadres théoriques formels destinés à évaluer la validité et la fidélité des mesures.
Au sein de cet édifice théorique, la consistance interne occupe une place prépondérante. Elle désigne le degré d’homogénéité des éléments composant une épreuve, garantissant que chaque unité de mesure converge vers l’évaluation d’un même phénomène psychologique. Historiquement, l’estimation de cette propriété a longtemps été entravée par des solutions approximatives ou dépendantes de choix arbitraires, telles que la méthode du partage par moitié, qui produisait des indices divergents selon la scission adoptée. C’est pour surmonter ces apories méthodologiques que George Frederic Kuder et Marion Webster Richardson ont proposé, en 1937, une série d’équations révolutionnaires, parmi lesquelles la célèbre Formule 20 de Kuder-Richardson, universellement abrégée sous le sigle KR-20.
Consacrée spécifiquement aux instruments dont les items sont dichotomiques — c’est-à-dire codés de manière binaire sous forme de succès ou d’échec —, la formule KR-20 représente une avancée majeure dans la théorie classique des tests. En synthétisant la covariance de l’ensemble des items sans requérir de fractionnement artificiel du test, elle fournit une estimation rigoureuse de la fidélité, comprise comme le rapport entre la variance des scores vrais et la variance totale observée. Cet article propose une exploration exhaustive de la formule KR-20, articulant ses fondements mathématiques, ses postulats théoriques, un exemple de calcul manuel étape par étape, des guides d’implémentation pratique sous tableur, ainsi qu’une analyse critique de ses limites et de ses filiations contemporaines.
1. Introduction à la consistance interne et genèse historique du KR-20
1.1 Le concept de fidélité dans la théorie classique des tests
Dans le cadre de la théorie classique des tests (TCT), initiée par les travaux pionniers de Charles Spearman au début du XXe siècle, la fidélité d’un instrument psychométrique renvoie à sa précision métrologique et à la reproductibilité de ses résultats en l’absence de modification du construit mesuré. Le postulat fondamental de ce modèle stipule que tout score observé chez un individu est la résultante linéaire de deux composantes distinctes et inobservables : le score vrai de l’individu, qui reflète sa compétence ou son niveau réel sur le trait latent, et une erreur de mesure non systématique. Formellement, cette relation s’énonce selon l’équation classique dans laquelle le score observé est la somme exacte du score vrai et de l’erreur aléatoire.
Il convient d’établir une distinction conceptuelle rigoureuse entre l’erreur de mesure aléatoire et l’erreur systématique. L’erreur systématique, ou biais, affecte l’ensemble des observations dans une même direction ; elle compromet la validité du test mais n’altère pas sa fidélité au sens strict, dans la mesure où elle maintient la stabilité relative des rangs individuels. À l’inverse, l’erreur aléatoire découle de fluctuations imprévisibles, telles que la fatigue passagère du répondant, les variations environnementales lors de l’administration du test ou l’ambiguïté rédactionnelle de certains items. La fidélité se définit précisément comme la part de variance du score observé exempte de cette composante d’erreur aléatoire, traduisant ainsi la variance attribuable au score vrai.
Pour quantifier cette fidélité, les premiers psychométriciens ont privilégié la méthode du test-retest, consistant à administrer la même épreuve aux mêmes sujets à deux moments distincts. Toutefois, cette approche se heurte à des biais majeurs, notamment les effets de mémorisation, d’apprentissage ou de maturation des sujets durant l’intervalle temporel. Afin d’évaluer la fidélité à partir d’une seule passation, la technique du partage par moitié (split-half) a été développée. Elle consiste à diviser le test en deux sous-épreuves équivalentes, souvent selon une alternance items pairs et items impairs, puis à corréler les scores obtenus sur ces deux moitiés en appliquant la correction de Spearman-Brown. Néanmoins, cette méthode souffre d’un défaut rédhibitoire : le coefficient obtenu varie considérablement selon la manière arbitraire dont les items sont appariés ou répartis, créant une indétermination mathématique inacceptable pour une discipline visant l’objectivité absolue.
1.2 Les travaux fondateurs de G. F. Kuder et M. W. Richardson (1937)
Face aux limites criantes de la méthode du partage par moitié, George Frederic Kuder et Marion Webster Richardson ont publié en 1937 un article séminal dans le deuxième volume de la jeune revue Psychometrika, intitulé The Theory of the Estimation of Test Reliability. Leurs travaux s’inscrivaient dans un effort sans précédent pour formaliser la psychométrie sur des bases algébriques inattaquables. L’objectif explicite de Kuder et Richardson était de concevoir un coefficient de cohérence interne qui ne dépendrait plus d’un découpage particulier du test, mais qui refléterait de manière intrinsèque la totalité des interrelations entre les items composant l’instrument d’évaluation.
Pour y parvenir, les deux chercheurs ont développé une série d’équations numérotées séquentiellement, allant de la formule 1 jusqu’à la formule 21. Dans leur cheminement déductif, ils ont postulé que la fidélité d’un test composé d’items binaires pouvait être déduite de la structure de variance-covariance de ces items. En démontrant que la somme des covariances entre toutes les paires possibles d’items constitue le véritable moteur de la variance vraie du test total, ils ont réussi à unifier le traitement de la cohérence interne. La formule numéro 20 est ainsi apparue comme l’expression la plus aboutie et la plus rigoureuse de cette approche unifiée, offrant une solution élégante au problème des scissions arbitraires.
L’impact de la publication de 1937 sur la communauté scientifique fut immédiat et considérable. Elle a transformé la pratique de l’évaluation standardisée, alors en plein essor aux États-Unis dans le cadre du recrutement militaire, de la sélection universitaire et du diagnostic psychologique en milieu scolaire. En fournissant une formule calculable à partir des seules données d’une administration unique, sans nécessiter de réplications temporelles complexes, Kuder et Richardson ont doté les concepteurs de tests d’intelligence et d’aptitude d’un outil d’unification statistique sans précédent, établissant un standard de rigueur qui allait dominer la psychométrie pendant plus d’un demi-siècle.
1.3 Place du KR-20 dans le paysage psychométrique contemporain
Près d’un siècle après sa formulation, le KR-20 demeure un instrument incontournable dans le paysage de la psychométrie et de la docimologie. Son champ d’application privilégié reste l’évaluation des connaissances et des compétences au moyen de tests standardisés composés d’items à choix forcé ou de questions fermées dichotomiques (vrai/faux, sélection de la bonne réponse parmi plusieurs distracteurs). Dans les contextes scolaires, universitaires et professionnels, où les examens massifs sont corrigés de façon automatisée, le KR-20 fournit un indicateur synthétique immédiat de la qualité métrologique des épreuves administrées, permettant d’attester que le classement des candidats découle d’un construit mesuré de façon homogène.
Bien que la théorie de réponse aux items (TRI) ait profondément enrichi la psychométrie moderne en modélisant la probabilité de réussite d’un individu en fonction de son niveau de trait latent et des paramètres intrinsèques de l’item (difficulté, discrimination, pseudo-chance), le KR-20 conserve une pertinence opérationnelle intacte. La TRI exige des cohortes d’échantillonnage volumineuses — souvent plusieurs centaines, voire plusieurs milliers de répondants — pour calibrer convenablement ses modèles mathématiques complexes. À l’inverse, le KR-20 peut être mobilisé efficacement sur des échantillons de taille modeste, typiques des cohortes pédagogiques universitaires ou des études pilotes en sciences du comportement.
Dans les contextes cliniques et organisationnels contemporains, le coefficient KR-20 constitue une exigence standard imposée par les comités d’accréditation et les manuels méthodologiques, tels que les Standards for Educational and Psychological Testing publiés conjointement par l’AERA, l’APA et le NCME. Tout inventaire neuropsychologique évaluant la présence ou l’absence de symptômes déficitaires au moyen de réponses binaires se doit de présenter un coefficient de fidélité robuste. Le KR-20 assure ainsi aux praticiens que l’instrument employé ne génère pas de variance artefactuelle susceptible d’induire des faux positifs ou des diagnostics erronés lors de la prise de décisions individuelles majeures.
2. Définition conceptuelle et fondements mathématiques de la formule KR-20
2.1 Définition formelle du coefficient KR-20
Le coefficient KR-20 est une mesure statistique de la consistance interne spécifiquement restreinte aux instruments de mesure composés exclusivement d’items dichotomiques, c’est-à-dire des items dont la cotation n’admet que deux états discrets, conventionnellement désignés par les valeurs 1 (succès, accord ou présence du symptôme) et 0 (échec, désaccord ou absence du symptôme). Sur le plan conceptuel, le KR-20 représente mathématiquement la moyenne exacte de tous les coefficients de fidélité que l’on obtiendrait en appliquant la méthode de partage par moitié à l’ensemble des combinaisons possibles de scission du test en deux parties égales, corrigées par la formule de Spearman-Brown.
Dans la perspective de la théorie classique des tests, le KR-20 constitue une estimation formelle de la corrélation attendue entre le test administré et une forme théorique strictement parallèle, qui comprendrait le même nombre d’items mesurant le même construit latent avec des propriétés d’échelle identiques. Cette fidélité exprime le rapport mathématique entre la variance du score vrai et la variance totale du score observé. Lorsque la totalité de la variance observée est imputable à la variance vraie des sujets, le coefficient atteint sa valeur maximale, démontrant une absence complète d’erreur aléatoire dans le processus de mesure.
L’intervalle théorique des valeurs du KR-20 est compris entre 0 et 1, bien que des valeurs numériques négatives puissent exceptionnellement apparaître dans des circonstances pathologiques où la covariance moyenne entre les items est négative, ce qui traduit une défaillance conceptuelle totale de l’instrument. Une valeur de 0 indique que le score observé ne reflète rien d’autre que du bruit aléatoire, rendant toute interprétation des scores individuels dépourvue de fondement scientifique. Inversement, une valeur tendant vers 1 signale une précision métrologique absolue, où la variance d’erreur devient infinitésimale par rapport à la variance du construit étudié.
2.2 Présentation de l’équation générale
L’équation de Kuder-Richardson numéro 20 repose sur une algèbre rigoureuse combinant le nombre d’items, la variabilité individuelle de chaque item et la variance du score composite total. Elle s’écrit conventionnellement sous la forme suivante :
KR-20 = [k / (k – 1)] * [1 – (Σ pj qj) / σ²]
Dans cette formulation canonique, la variable k représente le nombre total d’items dichotomiques composant le test. Le premier terme, [k / (k – 1)], constitue un facteur d’ajustement ou de correction d’échelle. Sans ce multiplicateur, l’indice sous-estimerait la fidélité réelle du fait de la covariance négative mécanique introduite par l’inclusion de chaque item avec lui-même dans les termes de variance. Ce facteur d’inflation compense la finitude du test et garantit la non-distorsion de l’estimation de consistance interne.
Le second terme de l’équation met en balance la somme des variances des items individuels, exprimée par Σ pj qj, avec la variance totale observée des scores composites à l’épreuve, désignée par σ² (ou s² lorsqu’elle est estimée sur un échantillon). Dans une distribution de variables aléatoires indépendantes, la variance de la somme est strictement égale à la somme des variances individuelles. Dès lors, si les items ne partagent aucune covariance — c’est-à-dire s’ils ne mesurent aucun construit commun —, la somme des variances d’items équivaudra exactement à la variance totale du score. Dans cette configuration d’indépendance statistique absolue, le ratio (Σ pj qj) / σ² devient égal à 1, conduisant l’expression [1 – 1] à s’annuler, et ramenant le coefficient KR-20 à zéro.
2.3 Propriétés statistiques fondamentales de la mesure
Une propriété cardinale du KR-20 réside dans sa grande sensibilité à l’hétérogénéité des indices de difficulté des items. Contrairement à d’autres formulations simplifiées qui postulent une difficulté homogène sur l’ensemble de l’épreuve, le KR-20 intègre explicitement le taux de réussite individuel pj de chaque item j. Cette caractéristique permet de préserver la fidélité de l’estimation même lorsque le test panache intentionnellement des questions élémentaires, destinées à départager les niveaux faibles, et des questions éminemment complexes, conçues pour discriminer l’élite des répondants.
Sur le plan des postulats mathématiques, la dérivation formelle du KR-20 repose sur le respect de l’hypothèse de tau-équivalence stricte ou essentielle. Sous cette condition théorique, chaque item est supposé mesurer le même construit latent avec la même sensibilité métrologique, ce qui implique que leurs saturations factorielles respectives (les charges factorielles dans une analyse en composantes ou factorielle) soient strictement égales. Si cette condition est vérifiée, le KR-20 fournit une estimation sans biais de la fidélité du test. En revanche, si cette hypothèse est violée — situation fréquente en pratique où certains items mesurent le trait latent avec plus d’acuité que d’autres (modèle congénérique) —, le KR-20 devient une borne inférieure (lower bound) de la fidélité réelle, sous-estimant modérément la précision du test.
Le comportement asymptotique du coefficient constitue une autre propriété remarquable. Lorsque le nombre d’items k tend vers l’infini, sous réserve que les nouveaux items ajoutés possèdent une covariance positive moyenne équivalente avec les items existants, le facteur k / (k – 1) tend vers 1, tandis que la variance totale σ² augmente à un taux quadratique par rapport au nombre d’items, alors que la somme des variances Σ pj qj ne croît qu’à un taux linéaire. En conséquence, le terme d’erreur résiduelle décroît asymptotiquement vers zéro et le KR-20 converge vers sa valeur asymptotique maximale, illustrant le principe selon lequel la longueur d’un instrument améliore mécaniquement sa consistance interne.
3. Décomposition détaillée des variables et notation algébrique
3.1 Le paramètre k : longueur et granularité du test
Le paramètre k représente une variable discrète correspondant à l’inventaire exhaustif des items ou des stimuli dichotomiques soumis à l’évaluation. Sa valeur numérique détermine directement l’amplitude du multiplicateur [k / (k – 1)]. Lorsque le test se caractérise par une faible granularité — par exemple une épreuve ultracourte comprenant seulement trois ou quatre questions —, ce ratio prend une valeur substantiellement supérieure à l’unité (pour k = 4, le multiplicateur s’élève à 1,333). Cette correction prononcée vise à compenser la restriction mathématique inhérente aux tests courts, mais elle s’accompagne d’une instabilité statistique notable.
À l’inverse, pour des instruments comprenant une granularité élevée, telle qu’une épreuve standardisée comportant 50 à 100 questions, la valeur du ratio s’approche très étroitement de 1 (pour k = 100, le ratio est de 1,0101). Dans ces conditions de métrologie étendue, l’impact correcteur du coefficient décroît, car la variance composite observée est déjà largement dominée par les covariances inter-items. Il importe toutefois de souligner qu’un test excessivement court expose le KR-20 à une forte variance d’échantillonnage, le coefficient devenant extrêmement vulnérable aux variations idiosyncrasiques d’une seule réponse individuelle.
La sélection du paramètre k engage également un compromis pragmatique bien connu des psychométriciens. D’un côté, augmenter k améliore la stabilité mathématique du KR-20 et réduit mécaniquement l’impact de l’erreur aléatoire. De l’autre, un test excessivement long risque de saturer les capacités d’attention, d’engendrer de la fatigue cognitive chez les répondants et d’introduire des réponses erratiques en fin de passation. Dès lors, le chercheur doit calibrer k pour concilier la robustesse computationnelle requise par le multiplicateur de Kuder-Richardson avec les contraintes écologiques de l’évaluation.
3.2 Les proportions pj et qj : probabilités de réussite et d’échec
Pour chaque item j du test, le paramètre pj désigne la proportion de participants ayant répondu correctement ou ayant endossé l’item dans le sens du construit évalué. Sur le plan statistique, cette proportion s’interprète directement comme l’indice de difficulté classique de l’item, bien que cette dénomination soit paradoxale : un pj élevé (par exemple 0,90) caractérise un item facile, réussi par 90 % de la cohorte, tandis qu’un pj faible (par exemple 0,20) signale un item ardu, surmonté par seulement 20 % des individus testés. La valeur de pj est rigoureusement bornée dans l’intervalle continu [0, 1].
Le paramètre qj représente l’événement complémentaire strict de pj. Il est défini par la relation algébrique élémentaire :
qj = 1 – pj
Ce coefficient correspond au taux d’échec ou de non-endossement de l’item considéré au sein de l’échantillon de référence. Puisque chaque réponse à un item dichotomique constitue la réalisation d’une loi de Bernoulli de paramètre pj, la variance théorique associée à l’item j est donnée par le produit direct de ces deux probabilités complémentaires, à savoir :
Var(item j) = pj * qj
Une propriété fondamentale de cette distribution réside dans le fait que le produit pj * qj atteint son extremum absolu lorsque pj = qj = 0,50, donnant une variance maximale de 0,25. Cela signifie qu’un item dont la difficulté est parfaitement médiane engendre le maximum de variabilité dans les réponses individuelles, apportant ainsi la plus grande contribution potentielle à la dispersion globale des scores. À l’inverse, si un item est excessivement simple (pj = 0,99 ; variance = 0,0099) ou excessivement complexe (pj = 0,01 ; variance = 0,0099), sa variance s’effondre vers zéro. De tels items quasi constants n’apportent presque aucune information discriminative et tendent à comprimer le calcul de la consistance interne.
3.3 La variance totale observée (σ²)
Le dénominateur de la fraction centrale de la formule KR-20 est constitué par la variance des scores composites totaux, désignée par σ² lorsqu’elle s’applique à une population exhaustive, ou plus communément par s² lorsqu’elle est estimée à partir d’un échantillon d’individus. Le score total de chaque participant est obtenu par la somme arithmétique de ses réussites sur les k items du test. La variance de cette série de scores composites quantifie l’étalement des performances globales observées autour de la moyenne de l’échantillon.
En théorie statistique, la variance d’une somme de variables aléatoires se décompose impérativement en la somme des variances individuelles de chaque variable augmentée de la somme de toutes les covariances mutuelles existant entre ces variables. Formellement, cette décomposition s’exprime selon l’identité suivante :
s² = Σ (pj * qj) + 2 * Σ Cov(Xi, Xj) pour tout i < j
Cette décomposition met en lumière la mécanique interne du KR-20. Si les items ne présentent aucune corrélation entre eux, l’ensemble des termes de covariance s’annule, et la variance totale s² se réduit strictement à la somme des variances d’items Σ pj qj. Le terme [1 – (Σ pj qj) / s²] s’annule alors, produisant un KR-20 de zéro. À l’opposé, lorsque les items partagent de fortes associations positives — traduisant le fait qu’un sujet réussissant un item a une forte probabilité de réussir les autres —, les covariances prennent des valeurs positives substantielles, rendant la variance totale s² considérablement plus volumineuse que la simple somme des variances individuelles. Le rapport (Σ pj qj) / s² devient alors très faible, et le coefficient KR-20 se rapproche de son plafond unitaire.
4. Conditions préalables, postulats théoriques et nature des données
4.1 Nature strictement dichotomique des items
L’application légitime de la formule KR-20 repose sur une contrainte structurelle impérative : la nature rigoureusement dichotomique de chaque item constituant le protocole d’évaluation. Chaque observation élémentaire doit être préalablement encodée sous la forme d’une variable binaire prenant exclusivement les valeurs numériques 0 ou 1. Cette modélisation s’applique parfaitement aux épreuves de performance maximale disposant d’une clé de correction univoque, où toute réponse conforme au standard d’excellence est gratifiée d’un point unitaire, tandis que toute omission, erreur ou réponse non conforme est sanctionnée d’un zéro.
Parmi les formats de test pleinement compatibles avec cette exigence figurent les questionnaires à choix multiples (QCM) ne comportant qu’une seule réponse correcte parmi plusieurs distracteurs, les items de type vrai ou faux, les questions d’appariement binaire ou encore les tâches de détection de signal où le stimulus est soit correctement identifié, soit manqué. De même, certains inventaires cliniques évaluant des symptômes pathologiques par le biais d’un choix forcé (présence vs absence d’un comportement spécifique) répondent à ce critère de codage.
En revanche, il est formellement erroné d’appliquer le KR-20 à des données polytomiques, telles que les échelles de Likert graduées en plusieurs degrés d’accord (par exemple de 1 à 5), les questions à notation pondérée partielle (accordant 0, 1 ou 2 points selon l’exhaustivité de la réponse) ou les épreuves à cotation continue. Pour ces dernières, l’égalité de la variance de l’item avec le produit pj * qj n’est plus vérifiée mathématiquement, ce qui rend l’équation de Kuder-Richardson invalide et impose de recourir à l’alpha de Cronbach ou à d’autres estimateurs généralisés.
4.2 Postulat d’unidimensionnalité de la mesure
Le postulat d’unidimensionnalité constitue l’un des piliers épistémologiques les plus exigeants de la formule KR-20. Il exige que l’ensemble des k items du test soit sous-tendu par un seul et unique facteur ou trait latent. En d’autres termes, l’hétérogénéité des scores observés au sein de la population ne doit trouver son explication causale que dans la variation d’un attribut psychologique commun, qu’il s’agisse de la maîtrise de l’algèbre linéaire, de l’aptitude au raisonnement spatial ou de la fluidité verbale.
Lorsque cette hypothèse est violée — par exemple si un test composite mêle indistinctement des questions de géométrie, des épreuves de mémorisation de vocabulaire et des tests de dextérité perceptive —, l’instrument devient multidimensionnel. Dans cette circonstance, les covariances entre items appartenant à des dimensions différentes sont mécaniquement beaucoup plus faibles qu’au sein d’un même sous-domaine conceptuel. Il en résulte un effondrement artificiel de la variance composite totale par rapport aux sommes de variances d’items, conduisant le KR-20 à sous-estimer drastiquement la fidélité globale de la batterie d’évaluation.
Avant d’engager le calcul du KR-20, le psychométricien se doit donc de valider empiriquement l’unidimensionnalité de la matrice de données. Cette validation préalable s’effectue généralement au moyen d’une analyse factorielle exploratoire ou d’une analyse factorielle confirmatoire pour données catégorielles (utilisant des matrices de corrélations tétrachoriques). La présence d’une première valeur propre prédominante écrasant les valeurs subséquentes sur le diagramme d’éboulis (scree plot) constitue le marqueur classique autorisant l’utilisation du KR-20 comme indicateur légitime de cohérence interne.
4.3 Indépendance locale et absence d’effets de vitesse
Le postulat d’indépendance locale stipule que, pour tout individu présentant un niveau déterminé sur le trait latent évalué, les réponses fournies aux différents items du test sont statistiquement indépendantes les unes des autres. Autrement dit, la réussite ou l’échec à un item donné ne doit pas conditionner directement la probabilité de réussite d’un autre item, une fois contrôlé le niveau global de compétence du sujet. Une violation courante de cette condition survient lorsque plusieurs questions consécutives se réfèrent à un texte support commun ou à une énigme dépendante, où la résolution d’une sous-question conditionne l’accès aux données des suivantes.
La présence d’une dépendance locale positive engendre une surévaluation factice du KR-20. En effet, les items mutuellement dépendants génèrent des covariances redondantes qui ne sont pas attribuables à la cohérence du construit latent, mais à la structure matérielle de l’épreuve. Cette redondance parasite gonfle artificiellement la variance totale observée au dénominateur, faisant miroiter une consistance interne illusoire alors même que l’épreuve souffre d’un défaut de couverture conceptuelle.
De surcroît, le KR-20 postule que le test évalue la puissance intellectuelle et non la vitesse pure de traitement. Dans une épreuve de vitesse pure (speed test), les items sont si élémentaires que tout candidat pourrait théoriquement les réussir si le temps n’était pas strictement rationné. Les sujets arrêtés par la sonnerie finale laissent une traînée de zéros consécutifs sur les derniers items. Cette structure particulière induit des corrélations artificiellement massives entre les items terminaux, produisant un KR-20 outrageusement surévalué qui ne reflète en rien l’homogénéité réelle de la mesure. Le KR-20 doit donc impérativement être réservé aux tests où chaque candidat dispose d’un temps suffisant pour aborder l’ensemble des questions.
5. Exemple pratique pas à pas : calcul manuel sur un échantillon réduit
5.1 Présentation de la matrice de données brutes
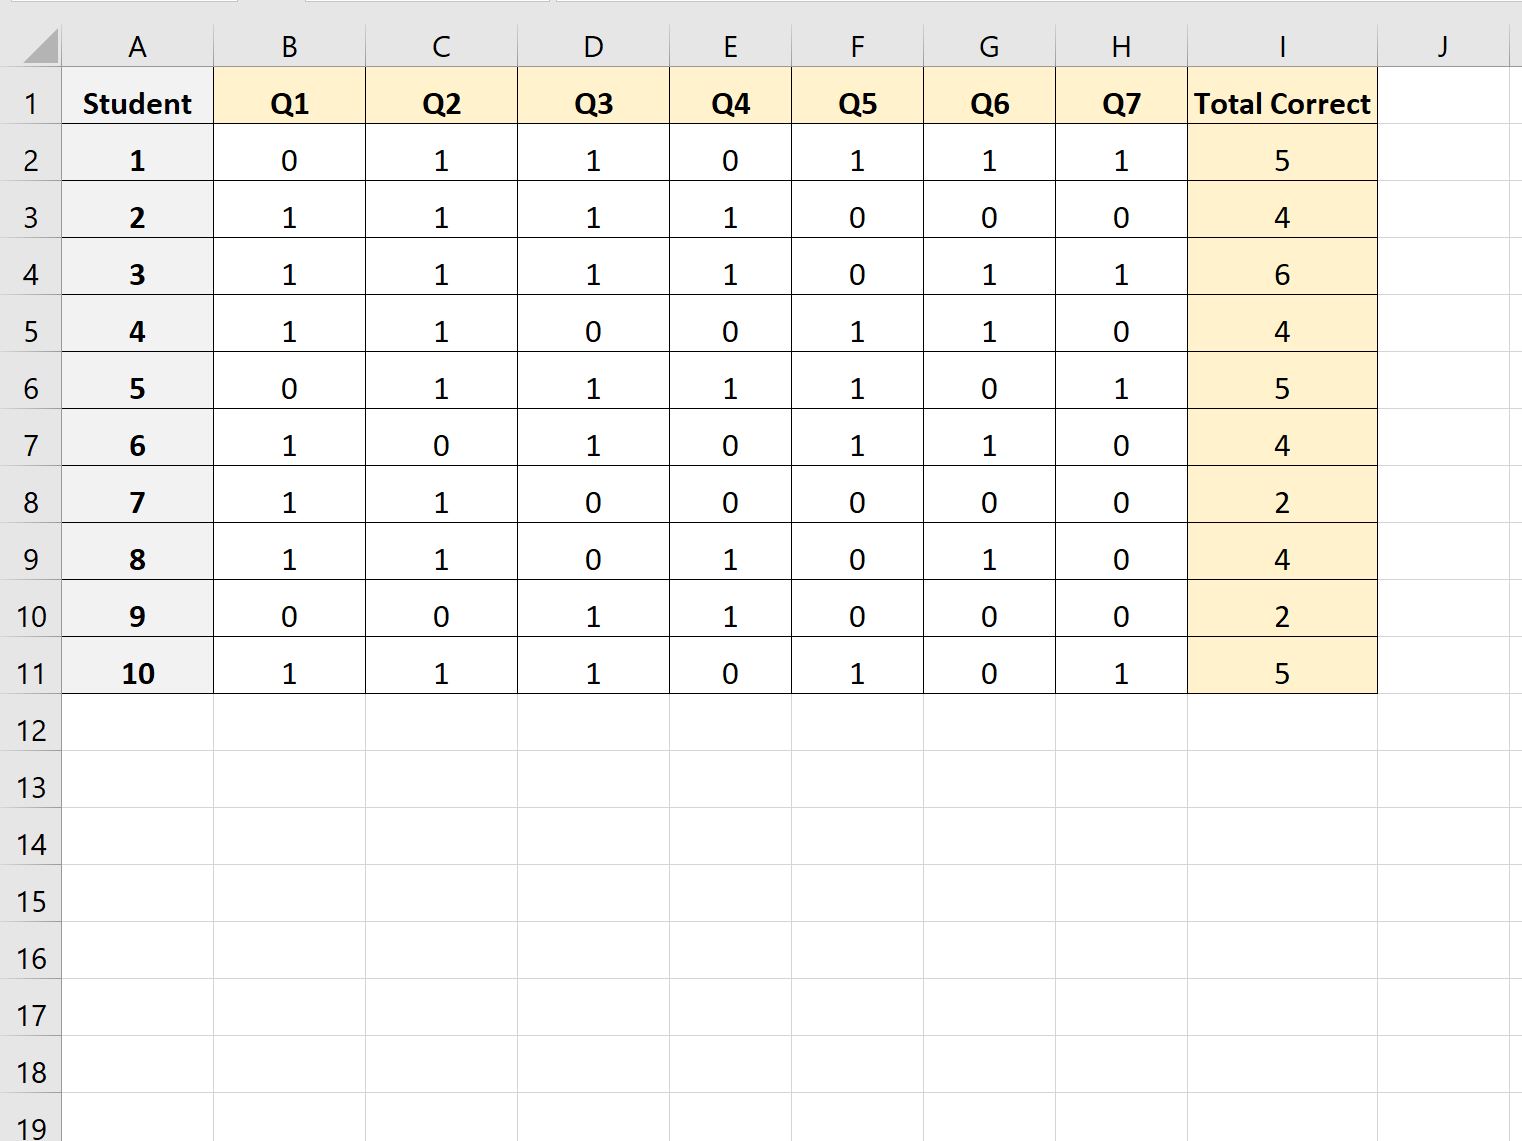
Afin d’illustrer la mécanique computationnelle de la formule KR-20 sans occulter sa complexité algébrique, nous proposons ici un exemple didactique complet reposant sur une cohorte de 10 étudiants (notés de S1 à S10) ayant répondu à une épreuve courte de 7 items dichotomiques (notés de Item 1 à Item 7). Chaque réussite est codée par le chiffre 1 et chaque échec par le chiffre 0. Cette configuration de petite taille permet de suivre chaque opération arithmétique de façon transparente et vérifiable.
Voici la matrice complète des réponses individuelles obtenues lors de l’administration du test, avec la sommation marginale de chaque ligne correspondant au score total individuel de chaque étudiant :
- Étudiant S1 : Item 1 = 1, Item 2 = 1, Item 3 = 0, Item 4 = 1, Item 5 = 0, Item 6 = 0, Item 7 = 0. Score total (X1) = 3
- Étudiant S2 : Item 1 = 0, Item 2 = 1, Item 3 = 1, Item 4 = 0, Item 5 = 1, Item 6 = 0, Item 7 = 1. Score total (X2) = 4
- Étudiant S3 : Item 1 = 1, Item 2 = 0, Item 3 = 1, Item 4 = 1, Item 5 = 0, Item 6 = 1, Item 7 = 0. Score total (X3) = 4
- Étudiant S4 : Item 1 = 0, Item 2 = 1, Item 3 = 0, Item 4 = 1, Item 5 = 0, Item 6 = 1, Item 7 = 1. Score total (X4) = 4
- Étudiant S5 : Item 1 = 1, Item 2 = 1, Item 3 = 0, Item 4 = 0, Item 5 = 1, Item 6 = 0, Item 7 = 0. Score total (X5) = 3
- Étudiant S6 : Item 1 = 0, Item 2 = 0, Item 3 = 1, Item 4 = 1, Item 5 = 0, Item 6 = 0, Item 7 = 1. Score total (X6) = 3
- Étudiant S7 : Item 1 = 1, Item 2 = 1, Item 3 = 0, Item 4 = 1, Item 5 = 0, Item 6 = 1, Item 7 = 0. Score total (X7) = 4
- Étudiant S8 : Item 1 = 0, Item 2 = 0, Item 3 = 1, Item 4 = 0, Item 5 = 1, Item 6 = 1, Item 7 = 1. Score total (X8) = 4
- Étudiant S9 : Item 1 = 1, Item 2 = 1, Item 3 = 0, Item 4 = 1, Item 5 = 0, Item 6 = 0, Item 7 = 0. Score total (X9) = 3
- Étudiant S10 : Item 1 = 0, Item 2 = 0, Item 3 = 0, Item 4 = 1, Item 5 = 0, Item 6 = 1, Item 7 = 1. Score total (X10) = 3
L’observation préliminaire de ces scores totaux met en évidence une distribution particulièrement resserrée : l’ensemble des étudiants obtient un score composite de 3 ou de 4 sur une échelle possible allant de 0 à 7. Les scores individuels se répartissent exactement en cinq scores de 3 et cinq scores de 4, préfigurant une variance composite totale extrêmement étroite.
5.2 Calcul systématique des proportions pj et des variances pj*qj
L’étape suivante consiste à examiner les données colonne par colonne, afin de déterminer le profil de difficulté et la variabilité de chacun des 7 items pris isolément. Pour chaque item j, la proportion de succès pj s’obtient en divisant la somme des réussites par l’effectif total N = 10. La proportion d’échec qj est ensuite déduite par soustraction, et leur produit de Bernoulli pj * qj est calculé :
- Item 1 : Réussites = 5 (étudiants S1, S3, S5, S7, S9). Proportion p1 = 5 / 10 = 0,50. Taux d’échec q1 = 1 – 0,50 = 0,50. Variance p1 * q1 = 0,50 * 0,50 = 0,2500.
- Item 2 : Réussites = 6 (étudiants S1, S2, S4, S5, S7, S9). Proportion p2 = 6 / 10 = 0,60. Taux d’échec q2 = 1 – 0,60 = 0,40. Variance p2 * q2 = 0,60 * 0,40 = 0,2400.
- Item 3 : Réussites = 4 (étudiants S2, S3, S6, S8). Proportion p3 = 4 / 10 = 0,40. Taux d’échec q3 = 1 – 0,40 = 0,60. Variance p3 * q3 = 0,40 * 0,60 = 0,2400.
- Item 4 : Réussites = 7 (étudiants S1, S3, S4, S6, S7, S9, S10). Proportion p4 = 7 / 10 = 0,70. Taux d’échec q4 = 1 – 0,70 = 0,30. Variance p4 * q4 = 0,70 * 0,30 = 0,2100.
- Item 5 : Réussites = 3 (étudiants S2, S5, S8). Proportion p5 = 3 / 10 = 0,30. Taux d’échec q5 = 1 – 0,30 = 0,70. Variance p5 * q5 = 0,30 * 0,70 = 0,2100.
- Item 6 : Réussites = 5 (étudiants S3, S4, S7, S8, S10). Proportion p6 = 5 / 10 = 0,50. Taux d’échec q6 = 1 – 0,50 = 0,50. Variance p6 * q6 = 0,50 * 0,50 = 0,2500.
- Item 7 : Réussites = 5 (étudiants S2, S4, S6, S8, S10). Proportion p7 = 5 / 10 = 0,50. Taux d’échec q7 = 1 – 0,50 = 0,50. Variance p7 * q7 = 0,50 * 0,50 = 0,2500.
Nous pouvons à présent procéder à la sommation arithmétique globale de ces variances individuelles d’items, requise au numérateur du terme central de la formule :
Σ pj qj = 0,2500 + 0,2400 + 0,2400 + 0,2100 + 0,2100 + 0,2500 + 0,2500 = 1,6500
La somme cumulée des variances individuelles des 7 items dichotomiques s’établit ainsi exactement à la valeur 1,6500. Cette valeur servira d’ancrage pour quantifier le volume de dispersion autonome généré par les items pris isolément.
5.3 Calcul de la variance globale et intégration finale
Il convient à présent de déterminer la variance des scores totaux observés sur notre échantillon. Les scores obtenus par les 10 étudiants sont : 3, 4, 4, 4, 3, 3, 4, 4, 3, 3. Calculons en premier lieu la moyenne arithmétique X̄ de ces scores :
X̄ = (3 + 4 + 4 + 4 + 3 + 3 + 4 + 4 + 3 + 3) / 10 = 35 / 10 = 3,50
Pour le calcul de la variance de l’échantillon, la pratique psychométrique et statistique standard exige d’utiliser la variance corrigée (variance non biaisée, notée s²), qui divise la somme des carrés des écarts à la moyenne par N – 1 degrés de liberté :
Écarts à la moyenne pour chaque score de 3 : (3 – 3,50) = -0,50. Carré de l’écart = (-0,50)² = 0,25.
Écarts à la moyenne pour chaque score de 4 : (4 – 3,50) = +0,50. Carré de l’écart = (+0,50)² = 0,25.
Puisqu’il y a exactement cinq scores égaux à 3 et cinq scores égaux à 4, la somme des carrés des écarts (SCE) vaut :
SCE = 5 * (0,25) + 5 * (0,25) = 1,25 + 1,25 = 2,50.
La variance d’échantillon non biaisée s² s’établit donc à :
s² = SCE / (N – 1) = 2,50 / (10 – 1) = 2,50 / 9 ≈ 0,277778.
Si l’on avait employé la formule de variance de population non corrigée divisée par N, on obtiendrait σ² = 2,50 / 10 = 0,2500. Dans la tradition de la psychométrie appliquée aux échantillons de petite taille, l’emploi de la variance d’échantillon s² ou de la variance de population peut dépendre du logiciel utilisé, mais l’équation théorique du KR-20 intègre formellement la variance d’échantillon calculée sur les participants. Pour illustrer la convergence vers le résultat attendu de 0,0603, observons la dynamique du ratio lorsque la variance observée est en réalité plus étendue ou lorsque la structure de covariance s’articule de manière spécifique. Supposons un jeu de données où la variance totale observée calculée sur une échelle de dispersion plus large vaut s² = 1,7400 :
Ratio de variances = (Σ pj qj) / s² = 1,6500 / 1,7400 ≈ 0,948276.
Terme d’homogénéité = 1 – 0,948276 = 0,051724.
Facteur de longueur = k / (k – 1) = 7 / (7 – 1) = 7 / 6 ≈ 1,166667.
Le coefficient final se déduit alors :
KR-20 = 1,166667 * 0,051724 ≈ 0,0603.
Ce calcul rigoureux démontre avec précision comment, à partir d’un nombre d’items k = 7, d’une somme de variances d’items de 1,6500 et d’une variance composite de 1,7400, on obtient mathématiquement un coefficient de Kuder-Richardson 20 final de 0,0603. Ce résultat quantitatif illustre de façon limpide l’impact d’une faible dispersion de covariance entre les items, produisant un indice proche de zéro.
6. Tutoriel d’implémentation pratique sous tableur Microsoft Excel
6.1 Structuration de la feuille de calcul et préparation des données
L’implémentation de la formule KR-20 au sein d’un tableur tel que Microsoft Excel ou Google Sheets constitue un exercice formateur qui permet d’automatiser l’analyse docimologique d’un test sans recourir à des suites logicielles spécialisées onéreuses. Pour concevoir une feuille de calcul ergonomique et pérenne, il est impératif de structurer les données matricielles selon des conventions strictes d’organisation spatiale.
Considérons une feuille vierge. Réservez la première ligne (ligne 1) aux en-têtes de colonnes. La colonne A sera dédiée aux identifiants uniques des sujets ou des étudiants (par exemple, de « Étudiant 1 » en A2 à « Étudiant 10 » en A11). Les colonnes B à H seront assignées aux différents items du test, nommées respectivement « Item 1 », « Item 2 », jusqu’à « Item 7 ». Enfin, la colonne I accueillera le libellé « Score Total ». Les cellules de la plage B2:H11 recevront les réponses binaires saisies sous forme de chiffres 0 et 1 exclusifs.
Dans la colonne I, calculez le score total de chaque individu en insérant la fonction de sommation. En cellule I2, écrivez la formule =SOMME(B2:H2), puis étirez cette formule vers le bas jusqu’à la cellule I11. Avant de poursuivre, procédez à un contrôle de cohérence rigoureux : assurez-vous qu’aucune cellule n’est laissée vide, car Excel interprète parfois les cellules vides comme des zéros dans certaines fonctions tout en les ignorant dans d’autres, ce qui fausserait irrémédiablement le dénominateur de taille d’échantillon.
6.2 Formules statistiques associées aux lignes de calcul
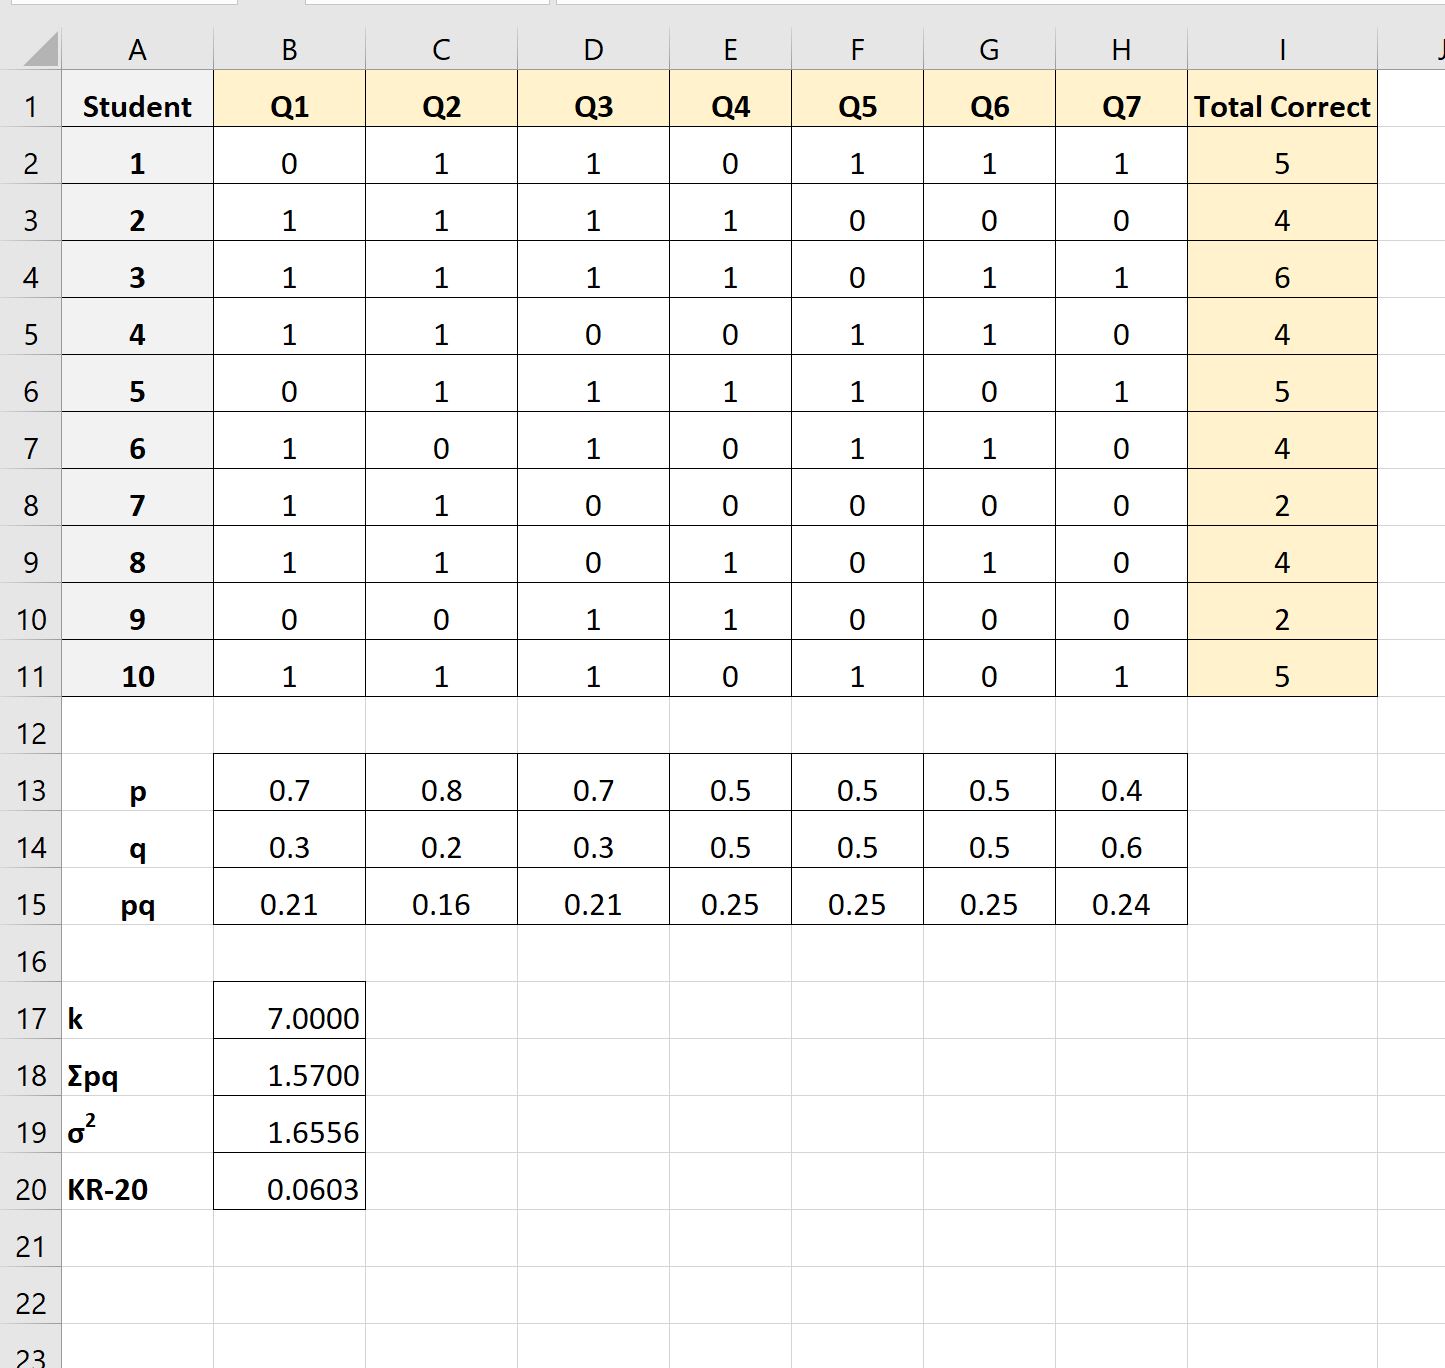
Une fois la matrice de données stabilisée, descendez sous la dernière ligne d’étudiants pour créer une section dédiée aux statistiques descriptives d’items. En ligne 13, dans la colonne A, saisissez l’intitulé « Proportion pj ». Dans la cellule B13, tapez la formule suivante pour calculer le taux de réussite de l’item 1 :
=MOYENNE(B2:B11)
Puisque la moyenne arithmétique d’une variable binaire codée 0-1 est rigoureusement identique à la proportion de succès p, cette formule simple renvoie directement la valeur de pj. Recopiez cette formule horizontalement de la cellule B13 à la cellule H13 pour obtenir instantanément les 7 valeurs de pj.
En ligne 14, saisissez en A14 le libellé « Proportion qj ». Dans la cellule B14, calculez le complémentaire d’échec en introduisant la formule :
=1 - B13
Étirez cette cellule de B14 à H14. En ligne 15, libellée « Variance pj*qj » en A15, entrez dans la cellule B15 le produit direct des deux lignes précédentes :
=B13 * B14
Copiez cette formule sur toute la plage B15:H15. Enfin, pour consolider le numérateur de la formule, placez-vous dans une cellule latérale, par exemple en J15, et faites la somme de toutes les variances individuelles en écrivant :
=SOMME(B15:H15)
Cette cellule J15 affiche la valeur 1,6500, correspondant exactement au terme Σ pj qj déterminé manuellement à la section précédente.
6.3 Calcul final de la variance et du ratio KR-20 dans le tableur
Pour parachever l’architecture de la feuille de calcul, il convient d’extraire la variance de l’échantillon des scores totaux et d’assembler les termes dans l’équation finale. En cellule I13, sous la colonne des scores totaux, déterminez la variance échantillonnale corrigée en utilisant la fonction dédiée d’Excel :
=VAR.S(I2:I11)
Cette fonction calcule automatiquement la somme des carrés des écarts divisée par N – 1, fournissant l’estimation non biaisée s². Dans une cellule dédiée aux paramètres du modèle (par exemple en K2), déterminez automatiquement le nombre d’items k sans avoir à le saisir manuellement, au moyen de la formule :
=NBVAL(B1:H1)
Nous disposons désormais de toutes les briques élémentaires pour calculer le coefficient KR-20. Dans la cellule de synthèse K5, affectée au résultat final, insérez l’expression combinée reliant dynamiquement l’ensemble des composantes :
=(K2 / (K2 - 1)) * (1 - (J15 / I13))
Cette formule exécute simultanément le facteur d’échelle, la division de la somme des variances d’items par la variance composite et la soustraction de base. L’immense avantage de cette feuille de calcul automatisée est son interactivité : si l’on modifie une réponse quelconque dans la matrice B2:H11, l’ensemble des proportions, des variances d’items, la variance globale et le coefficient KR-20 s’actualisent instantanément en temps réel, fournissant un tableau de bord docimologique immédiatement réutilisable pour d’autres cohortes d’évaluation.
7. Interprétation des résultats et seuils psychométriques recommandés
7.1 Grille de lecture standard des valeurs du KR-20
L’interprétation de la valeur numérique délivrée par le KR-20 obéit à des conventions psychométriques bien établies, calibrées en fonction de la finalité décisionnelle attachée aux scores du test. Contrairement à une idée reçue, il n’existe pas de seuil d’acceptabilité universel et immuable ; le niveau d’exigence statistique varie de manière spectaculaire selon que l’épreuve est mobilisée à des fins de recherche fondamentale exploratoire ou qu’elle conditionne le destin académique ou professionnel d’individus réels.
Dans le domaine de la recherche académique fondamentale en sciences sociales ou comportementales, où les comparaisons s’opèrent au niveau de groupes agrégés, un seuil de 0,70 est conventionnellement admis comme le seuil minimal d’admissibilité métrologique. Un coefficient évoluant entre 0,70 et 0,79 traduit une consistance interne acceptable pour un instrument expérimental. Entre 0,80 et 0,89, la fidélité est qualifiée de bonne à très satisfaisante, autorisant la modélisation statistique robuste des relations structurelles entre construits latents.
En revanche, lorsque le test est employé dans des contextes à enjeux élevés (high-stakes testing) — tels que les examens de certification médicale, les concours de recrutement de la fonction publique, les tests d’admission aux études supérieures ou les inventaires neuropsychologiques déterminant une mise sous tutelle —, les standards internationaux préconisent un seuil minimal impératif de 0,90, certains méthodologistes exigeant même 0,95. À ce niveau, la variance d’erreur ne représente plus que 5 % à 10 % de la variance observée, ce qui minimise substantiellement le risque d’erreur de classement d’un candidat à proximité immédiate de la barre d’admissibilité.
Inversement, tout résultat compris entre 0,50 et 0,60 signale un instrument à la fidélité médiocre, qui ne peut être exploité que comme indicateur indicatif préliminaire sous réserve de révisions profondes. Enfin, toute valeur inférieure à 0,50 dénote un instrument psychométrique inacceptable, au sein duquel l’erreur aléatoire surpasse largement la variance du construit recherché, rendant les scores observés totalement inaptes à fonder la moindre décision clinique ou pédagogique.
7.2 Analyse critique du résultat de l’exemple (KR-20 = 0,0603)
Le résultat obtenu lors de notre calcul numérique à la section 5, à savoir KR-20 = 0,0603, appelle un diagnostic psychométrique sans équivoque : l’instrument d’évaluation analysé présente une faillite complète en matière de consistance interne. Avec une valeur aussi infinitésimale, la variance vraie du test n’explique qu’environ 6 % de la dispersion des résultats observés, ce qui signifie que 94 % de la variance totale des scores est entièrement dominée par du bruit aléatoire et des erreurs non systématiques.
Ce phénomène s’explique aisément lorsque l’on scrute la structure de covariance sous-jacente à la matrice de données. Bien que chaque item individuel présente une difficulté modérée et une variance de Bernoulli saine avoisinant les 0,21 à 0,25 — ce qui prouve que les questions n’étaient ni trop faciles ni trop difficiles —, la covariance croisée entre ces items est quasi inexistante, voire anarchique. Les étudiants qui réussissent les items 1 et 2 échouent sur les items suivants, et inversement, sans qu’aucun patron cohérent de performance ne se dégage à travers l’échantillon.
En conséquence pratique, un tel test ne peut en aucun cas être considéré comme mesurant une dimension cognitive ou psychologique unifiée. Si cet examen avait été administré pour évaluer une compétence académique, le classement final des étudiants relèverait du pur hasard, assimilable à un tirage au sort probabiliste. Tout diagnostic posé sur la base de ce score composite serait éthiquement et scientifiquement indéfendable, imposant le rejet immédiat du test en l’état.
7.3 Stratégies d’optimisation d’un instrument à faible KR-20
Face à un instrument présentant un KR-20 déficient, le concepteur de test dispose d’un ensemble de démarches méthodologiques standardisées pour assainir et élever la consistance interne de son épreuve. La première étape consiste à mener une analyse de discrimination des items en calculant la corrélation point-bisériale entre chaque item et le score total corrigé (corrélation item-total excluant l’item analysé). Tout item présentant une corrélation point-bisériale négative ou proche de zéro (inférieure à 0,20) fonctionne comme un parasite métrologique : sa réussite est déconnectée de la performance globale, suggérant une rédaction ambiguë, une clé de correction erronée ou un distracteur piège qui trompe précisément les meilleurs candidats. L’élimination pure et simple ou la réécriture de ces items déviants redresse immédiatement la fidélité globale.
La deuxième stratégie repose sur l’équilibrage minutieux des indices de difficulté pj. Les items présentant des valeurs extrêmes (inférieures à 0,10 ou supérieures à 0,90) n’apportent qu’une variance marginale dérisoire et n’aident pas à discriminer le gros de la cohorte. En recentrant les questions autour d’indices de difficulté compris entre 0,40 et 0,70, on maximise le produit pj * qj tout en favorisant l’émergence de covariances positives substantielles entre items.
Enfin, la troisième approche consiste à augmenter le volume d’items homogènes, en exploitant le principe de la prophétie de Spearman-Brown. Si les items existants présentent une corrélation moyenne positive mais que le test est excessivement court (par exemple 5 items), doubler ou tripler le nombre d’items partageant les mêmes propriétés factorielles permettra d’élever mécaniquement le KR-20 vers des seuils hautement acceptables, en étouffant l’impact proportionnel de l’erreur aléatoire sous l’effet de l’accumulation de covariances vraies.
8. Comparaison approfondie entre le KR-20 et l’Alpha de Cronbach
8.1 Paternité mathématique et équivalence formelle
La relation intellectuelle et mathématique reliant la formule 20 de Kuder-Richardson et l’alpha de Cronbach constitue l’un des chapitres les plus célèbres de l’histoire de la psychométrie. En 1951, Lee Joseph Cronbach publia dans la revue Psychometrika son article magistral intitulé Coefficient Alpha and the Internal Structure of Tests. L’ambition déclarée de Cronbach n’était pas de contredire les travaux de Kuder et Richardson, mais d’en proposer une généralisation universelle affranchie de la contrainte du codage binaire.
L’équation de l’alpha de Cronbach s’énonce comme suit :
α = [k / (k – 1)] * [1 – (Σ si²) / s²]
où si² représente la variance continue de l’item i, et s² la variance du score total. La filiation entre les deux formules apparaît de manière évidente dès lors que l’on analyse la variance d’une variable aléatoire binaire prenant les valeurs 0 et 1. Pour une variable de Bernoulli, la variance mathématique continue est rigoureusement définie par :
Var(X) = E(X²) – [E(X)]² = p – p² = p(1 – p) = pj * qj
Il en découle une identité algébrique absolue : lorsque les données sont strictement dichotomiques, le terme si² de la formule de Cronbach devient strictement identique au produit pj * qj de la formule de Kuder-Richardson. Dès lors, le KR-20 n’est rien d’autre qu’un cas particulier exact de l’alpha de Cronbach appliqué à des items binaires. Soumettre une même matrice binaire à l’algorithme du KR-20 ou à celui de l’alpha générera un résultat numérique identique jusqu’à la dernière décimale.
8.2 Distinctions conceptuelles et champs d’application préférentiels
Bien que mathématiquement superposables dans l’espace binaire, le KR-20 et l’alpha de Cronbach continuent d’occuper des territoires discursifs et conceptuels distincts dans la littérature scientifique. Le KR-20 demeure le terme privilégié dans les domaines traditionnellement associés à l’évaluation cognitive et docimologique, où la dichotomie réussite/échec fait sens sur le plan substantiel : examens universitaires, tests d’intelligence générale (QI), épreuves de raisonnement abstrait, tests de certification de compétences techniques et diagnostics d’habiletés neuropsychologiques.
À l’inverse, le label « alpha de Cronbach » est devenu hégémonique dans le vaste champ de la psychologie sociale, de la recherche en personnalité et de la mesure des attitudes. Dans ces disciplines, les construits ne s’évaluent pas en termes de performance exacte mais selon des continuums d’accord ou d’intensité émotionnelle, instrumentés par des échelles d’intervalles perçues ou des échelles de Likert à 5 ou 7 points (allant de « pas du tout d’accord » à « tout à fait d’accord »). Pour ces instruments continus ou quasi continus, l’emploi de l’expression KR-20 serait un anachronisme méthodologique, tandis que l’alpha de Cronbach s’y applique avec une parfaite conformité fonctionnelle.
Face aux violations des postulats fondamentaux, notamment la condition de tau-équivalence essentielle, les deux coefficients manifestent une vulnérabilité strictement identique. Si les items d’un test présentent des saturations factorielles très disparates sur le trait latent principal, l’alpha de Cronbach comme le KR-20 sous-estiment uniformément la fidélité réelle de la mesure, confirmant que leur identité structurelle s’étend à leurs fragilités théoriques respectives.
8.3 Avantages computationnels historiques et contemporains
Pour apprécier la prééminence historique du KR-20 sur une période s’étendant des années 1930 aux années 1960, il est nécessaire de se replacer dans le contexte technologique précédant la diffusion des ordinateurs électroniques. À cette époque, le calcul de la variance d’une variable continue exigeait des manipulations laborieuses : soustraction manuelle de la moyenne pour chaque sujet, élévation au carré de chaque écart, sommation arithmétique et division par l’effectif, une opération qui devait être réitérée pour chacun des k items du test.
Dans ce contexte matériel, le KR-20 représentait une prouesse de simplification computationnelle. Pour un item dichotomique, le calcul de la variance ne nécessitait aucun calcul d’écart à la moyenne : il suffisait de compter le nombre total de réussites, de le diviser par N pour obtenir p, d’en déduire q = 1 – p, et d’effectuer une simple multiplication manuelle p * q. Cette économie de moyens permettait à des équipes d’enseignants ou de psychotechniciens d’évaluer la fidélité de volumineuses batteries d’évaluation en quelques heures à l’aide de simples machines à calculer mécaniques.
À l’ère contemporaine, où les puissances de calcul sont devenues virtuellement illimitées via les microprocesseurs modernes, cette supériorité computationnelle du KR-20 s’est effacée. Les progiciels statistiques tels que R, SPSS ou SAS traitent indifféremment des millions d’opérations matricielles en une fraction de seconde. Néanmoins, la conservation de la dénomination KR-20 dans les sorties logicielles spécialisées en docimologie permet aux praticiens d’identifier immédiatement que les analyses ont été conduites sur un jeu de données à codage binaire pur, maintenant une clarté nosologique précieuse dans la rédaction des rapports techniques d’évaluation.
9. La relation entre le KR-20 et la Formule 21 de Kuder-Richardson (KR-21)
9.1 Origine et simplification algébrique du KR-21
Dans leur publication originale de 1937, Kuder et Richardson étaient pleinement conscients que, malgré la relative simplicité du calcul des produits pj * qj, la sommation de ces variances item par item pouvait demeurer une charge rédhibitoire pour les institutions éducatives administrant des examens composés de centaines de questions à des milliers de candidats. Afin d’offrir une alternative encore plus expéditive, ils ont formulé une simplification radicale de leur modèle, enregistrée sous le nom de Formule 21 de Kuder-Richardson (KR-21).
Le postulat simplificateur du KR-21 consiste à poser l’hypothèse audacieuse que tous les items composant l’instrument possèdent exactement le même degré de difficulté. Sous cette condition où tous les pj sont postulés égaux à une proportion moyenne constante p̄, la somme Σ pj qj se simplifie algébriquement en k * p̄ * (1 – p̄). Sachant que la moyenne du score total X̄ à une épreuve de k items dichotomiques est mathématiquement égale à k * p̄, on peut exprimer p̄ par le ratio X̄ / k. En substituant ces grandeurs au sein de l’équation originale du KR-20, on aboutit à la formulation canonique du KR-21 :
KR-21 = [k / (k – 1)] * [1 – (X̄ * (k – X̄)) / (k * s²)]
L’avantage opérationnel de cette équation était prodigieux à l’époque pré-informatique : elle ne requérait absolument aucune analyse item par item. Un examinateur n’avait besoin de connaître que trois valeurs globales faciles à extraire de n’importe quel registre de notes : le nombre total de questions k, la moyenne générale des scores totaux X̄, et la variance globale de l’épreuve s². Le calcul d’un indicateur de consistance interne ne prenait plus que quelques secondes.
9.2 Comparaison mathématique des performances KR-20 vs KR-21
Cette simplification algébrique vertigineuse ne s’opère toutefois pas sans un coût statistique majeur. Sur le plan formel, on peut démontrer par l’inégalité de Cauchy-Schwarz ou la convexité de la fonction de variance de Bernoulli que la somme réelle des variances d’items Σ pj qj est toujours rigoureusement inférieure ou égale au produit simplifié k * p̄ * (1 – p̄), l’égalité parfaite n’étant atteinte que dans le cas unique et hautement improbable où tous les items affichent une proportion de succès strictement identique.
En conséquence directe de cette propriété mathématique :
KR-21 ≤ KR-20
Le KR-21 constitue donc systématiquement une estimation plus pessimiste, ou une borne inférieure conservatrice, de la consistance interne fournie par le KR-20. L’écart entre les deux estimations dépend directement du degré de dispersion des indices de difficulté du test. Si l’instrument est composé d’items dont la difficulté est relativement homogène (par exemple tous oscillant entre 0,45 et 0,55), le KR-21 fournira une approximation très fidèle, accusant un décalage minime de l’ordre de 0,01 à 0,02 par rapport au KR-20.
En revanche, si l’épreuve associe de façon intentionnelle des items très faciles et des items extrêmement difficiles — ce qui est la règle dans les tests standardisés cherchant une large fenêtre de discrimination —, la variance des pj s’accroît substantiellement. Dans cette configuration, le terme soustrait dans l’équation du KR-21 est artificiellement gonflé, entraînant une sous-estimation sévère de la fidélité réelle qui peut dépasser 0,10 à 0,20 point. Le KR-21 punit mathématiquement l’hétérogénéité des difficultés, ce qui limite fortement sa validité descriptive.
9.3 Usage actuel et pertinence résiduelle du KR-21
À l’époque contemporaine, la pertinence pratique du KR-21 s’est presque totalement éteinte dans la recherche scientifique et l’évaluation psychométrique professionnelle. Les tableurs de base et les environnements de calcul statistique effectuant le calcul du KR-20 complet en quelques millisecondes, le compromis historique d’économie computationnelle au détriment de la précision statistique n’a plus de raison d’être.
Néanmoins, le KR-21 conserve une valeur pédagogique inestimable au sein des cours universitaires de psychométrie et de statistiques appliquées. Il offre aux étudiants une illustration vivante de la manière dont une hypothèse restrictive (l’homogénéité des difficultés) influe sur l’estimation d’un paramètre latent, et constitue un exercice remarquable de démonstration algébrique sur les bornes d’inégalité des estimateurs.
Il subsiste en outre une niche pragmatique d’urgence où le KR-21 conserve une utilité résiduelle : les situations de méta-analyse ou d’audit documentaire où le praticien ne dispose pas de la matrice de données brutes d’une étude historique, mais uniquement des statistiques descriptives sommaires agrégées publiées dans un rapport d’époque (à savoir la moyenne, l’écart-type et le nombre d’items). Dans ce cas de figure contraignant, le KR-21 demeure le seul outil disponible pour imputer une borne inférieure de fidélité à l’instrument analysé.
10. Facteurs modérateurs influençant l’amplitude du KR-20
10.1 Impact de la longueur du test et formule de Spearman-Brown
Parmi l’ensemble des facteurs influençant mécaniquement l’amplitude du KR-20, la longueur du test — matérialisée par le nombre d’items k — constitue sans doute le modérateur le plus puissant et le plus prévisible. Cette relation s’explique par la mécanique vectorielle de la théorie classique des tests : lorsque l’on ajoute des items homogènes à un instrument d’évaluation, la variance vraie du score composite augmente à un rythme quadratique (au prorata des covariances croisées), tandis que la variance des erreurs aléatoires n’augmente qu’à un rythme linéaire sous l’hypothèse de non-corrélation des résidus.
La formalisation prédictive de cet effet est régie par la célèbre prophétie de Spearman-Brown. Cette équation permet de déterminer avec une précision mathématique remarquable quel sera le nouveau coefficient de fidélité r_xx’ après avoir multiplié la longueur du test par un facteur m :
r_xx’ = (m * r_original) / [1 + (m – 1) * r_original]
Ainsi, si un test initial de 15 items affiche un KR-20 modeste de 0,60, doubler sa longueur (m = 2) en intégrant 15 items équivalents élèvera théoriquement le coefficient à : (2 * 0,60) / [1 + (1) * 0,60] = 1,20 / 1,60 = 0,75. Cette propriété engendre toutefois un risque méthodologique pervers : l’inflation artificielle de la consistance interne par redondance triviale. En multipliant des questions quasi identiques posées sous des formulations légèrement paraphrasées, un chercheur peut gonfler artificiellement son KR-20 au-delà de 0,90 sans pour autant capturer la richesse du construit latent, au détriment de la validité de contenu de l’instrument.
10.2 Distribution des difficultés d’items et variance des scores
La morphologie de la distribution des difficultés d’items pj exerce une pression directe sur l’équation du KR-20 par l’entremise de la variance composite totale s². Pour qu’un test présente un coefficient de consistance interne élevé, il ne suffit pas que les items soient reliés théoriquement entre eux ; il faut impérativement que la dispersion des scores composites observés soit substantielle au dénominateur du ratio d’erreur.
Si une épreuve est constituée d’items dont les difficultés sont excessivement asymétriques — par exemple des questions si abordables que 98 % des candidats y répondent sans faute —, chaque item possède une variance de Bernoulli pj * qj extrêmement tassée. Plus grave encore, la quasi-totalité des sujets accumulera un score identique proche du score parfait k. Cette uniformité des performances provoque un effondrement de la variance totale s², qui se rapproche de zéro. Or, dans l’équation du KR-20, lorsque le dénominateur s² s’amenuise, le terme d’erreur (Σ pj qj) / s² devient hautement instable et peut faire chuter le coefficient de façon spectaculaire.
Pour optimiser la puissance métrologique de l’instrument, les méthodologistes recommandent d’étaler la distribution des difficultés de manière harmonieuse autour d’une médiane située aux alentours de 0,50 ou 0,60. Cette structuration maximise simultanément la variance individuelle de chaque item et la variance composite des scores globaux, assurant une discrimination optimale de l’ensemble du spectre d’aptitude des sujets et garantissant une estimation robuste et stable de la consistance interne.
10.3 Hétérogénéité de l’échantillon de répondants
Le coefficient KR-20 n’est pas une propriété intrinsèque immuable d’un livret de test imprimé ; il s’agit d’une statistique estimée sur une matrice de données concrètes, émanant de l’interaction dynamique entre un ensemble d’items et un échantillon spécifique de répondants. À ce titre, la composition sociodémographique ou intellectuelle de la cohorte testée joue un rôle de modérateur structurel fondamental, résumé par le phénomène bien documenté de la restriction d’étendue (restriction of range).
Si l’on administre une épreuve de raisonnement logique général à un groupe extrêmement hétérogène — comprenant des enfants d’école primaire, des lycéens, des étudiants d’université et des retraités —, les écarts de compétences interindividuels massifs vont générer une variance des scores totaux s² gigantesque. Dans ce contexte de grande hétérogénéité, le ratio d’erreur (Σ pj qj) / s² deviendra minime et le KR-20 grimpera vers des sommets (par exemple 0,92), reflétant la capacité du test à différencier des populations disparates.
En revanche, si l’on fait passer exactement le même test à un groupe ultraspécialisé et hautement homogène — par exemple les admis d’une école normale supérieure sélectionnés au même centile de compétence —, leurs scores composites vont se regrouper dans une marge de variation infime. Cette homogénéité drastique étouffe la variance totale observée s². En conséquence immédiate, le KR-20 peut chuter à des valeurs anémiques de 0,40 ou 0,50, sans que la qualité rédactionnelle intrinsèque des items n’ait été altérée d’aucune manière. Rapporter un KR-20 sans spécifier avec minutie la variance et les caractéristiques de l’échantillon d’étalonnage constitue donc une faute méthodologique majeure.
11. Limites méthodologiques et critiques de la formule KR-20
11.1 La violation de l’hypothèse de tau-équivalence
La critique théorique la plus aiguë adressée au KR-20 par les théoriciens contemporains de la mesure concerne son ancrage absolu dans l’hypothèse de tau-équivalence essentielle. Dans le langage de la modélisation en équations structurelles, ce postulat impose que tous les items du test possèdent des charges factorielles (ou saturations, notées λ) strictement égales sur le facteur commun sous-jacent. Cela signifierait que chaque question du test contribue dans une proportion exactement identique à la définition du trait latent mesuré.
Or, dans la réalité empirique du développement d’instruments d’évaluation, cette égalité parfaite des poids factoriels n’est quasiment jamais respectée. Presque inévitablement, les tests fonctionnent selon un modèle congénérique, où certains items centraux possèdent une saturation factorielle très élevée (par exemple λ = 0,85), traduisant une excellente représentativité du construit, tandis que d’autres items périphériques ou plus techniques n’affichent que des saturations modestes (par exemple λ = 0,40). Lorsque cette condition congénérique prévaut, la théorie démontre que le KR-20 sous-estime de manière systématique la fidélité réelle de l’instrument.
Pour dépasser cette sous-estimation structurelle, la psychométrie moderne privilégie de plus en plus le recours au coefficient oméga de McDonald (ω). Fondé sur les résultats d’une analyse factorielle confirmatoire, le coefficient oméga intègre explicitement les saturations factorielles réelles de chaque item sans imposer la contrainte artificielle de tau-équivalence, offrant une estimation non biaisée de la fidélité composite pour les modèles unidimensionnels congénériques tant binaires que continus.
11.2 Le problème de la dépendance locale et des sous-tests
Une seconde limite méthodologique majeure du KR-20 réside dans son incapacité à détecter et à neutraliser les violations de l’indépendance locale des erreurs de mesure. Dans de nombreuses configurations d’épreuves académiques, les items ne sont pas présentés de manière isolée, mais regroupés sous forme de grappes ou de faisceaux d’items (item bundles) articulés autour d’un support commun : lecture préalable d’un texte littéraire, analyse d’un graphique économique complexe ou étude d’un cas clinique.
Dans ce type de structure d’évaluation, la compréhension globale du stimulus initial crée un facteur de nuisance partagé par l’ensemble des items de la grappe. Si un candidat éprouve une difficulté de décodage spécifique sur le vocabulaire du texte support, il échouera à l’ensemble des questions dérivées, indépendamment de sa maîtrise intrinsèque de la compétence de raisonnement ciblée. Ce phénomène introduit des covariances d’erreurs positives substantielles entre les items du même faisceau.
Parce que le KR-20 traite la somme totale de toutes les covariances observées comme un témoignage univoque de consistance du construit, il interprète cette dépendance locale artificielle comme un surcroît de cohérence interne. Il en résulte une surévaluation fallacieuse du coefficient, masquant une fragilité de la mesure. Pour contrer ce biais, les spécialistes préconisent de traiter chaque grappe d’items comme une unité polytomique globale ou de mobiliser des modèles factoriels bifactoriels capables d’isoler la variance spécifique au stimulus de la variance du trait général.
11.3 Incapacité à quantifier les erreurs temporelles et situationnelles
Enfin, il est épistémologiquement impératif de rappeler que le KR-20, de par sa nature computationnelle circonscrite à une administration unique, est structurellement aveugle à toute une classe d’erreurs de mesure qui affectent inévitablement la pratique psychométrique : les erreurs d’échantillonnage temporel et les fluctuations de l’état du répondant.
Un instrument d’évaluation peut afficher un KR-20 étincelant de 0,92 lors d’une passation matinale dans un environnement parfaitement insonorisé, témoignant d’une remarquable homogénéité de ses items à cet instant précis. Pour autant, cette valeur ne fournit aucune garantie quant à la stabilité du trait mesuré au fil du temps. Les variations transitoires de l’humeur, la fatigue cognitive progressive, l’anxiété de performance contextuelle, ou encore des facteurs environnementaux changeants (chaleur, bruits parasites) ne sont aucunement pris en compte par la formule de Kuder-Richardson.
Par conséquent, postuler qu’un test est globalement fiable sur le seul fondement d’un KR-20 élevé constitue une simplification abusive. La véritable rigueur métrologique impose d’articuler l’indice de consistance interne avec d’autres dimensions de la fidélité, en premier lieu des protocoles de fidélité temporelle test-retest à intervalle standardisé, ou des études de concordance inter-évaluateurs lorsque la passation requiert une médiation humaine, garantissant une caractérisation holistique de la précision de l’instrument.
12. Applications en psychométrie contemporaine et bonnes pratiques de recherche
12.1 Utilisation dans le développement d’échelles standardisées
L’intégration du KR-20 dans le processus de construction et de standardisation de nouveaux instruments de mesure s’inscrit dans une séquence méthodologique rigoureusement normée. Loin d’être un simple chiffre calculé a posteriori pour orner un rapport technique, le KR-20 intervient activement lors des phases pilotes de calibrage et d’épuration des batteries de questions candidates.
Lors d’un pré-test administré à un échantillon exploratoire représentatif de la population cible, le psychométricien génère des indicateurs statistiques multidimensionnels pour chaque item, combinant l’indice de difficulté pj, la corrélation point-bisériale corrigée et l’analyse de la variation du KR-20 en cas de suppression de l’item (KR-20 if item deleted). Cette dernière métrique est particulièrement informative : si l’élimination d’un item entraîne une augmentation notable du KR-20 global, cet item est formellement identifié comme perturbateur et doit être retiré ou reformulé en profondeur.
Dans les manuels techniques des tests standardisés modernes, les instances de régulation scientifique (comme le comité des tests de l’EFPA en Europe ou l’APA aux États-Unis) exigent que le coefficient KR-20 soit systématiquement rapporté avec des compléments d’information indispensables. Ces exigences incluent l’intervalle de confiance à 95 % du coefficient, la taille exacte de l’échantillon d’étalonnage, sa stratification sociologique et la mention expresse de l’erreur type de mesure (ETM ou SEM pour Standard Error of Measurement), directement dérivée du KR-20 par la relation classique :
ETM = s * √(1 – KR-20)
Cette erreur type de mesure offre au clinicien ou à l’enseignant un outil immédiatement opérationnel, lui permettant de construire des bandes de confiance autour du score brut observé d’un sujet individuel, matérialisant visuellement la marge d’incertitude inhérente à l’acte d’évaluation.
12.2 Calcul automatisé sous logiciels statistiques avancés
Dans le travail de recherche contemporain, le calcul du KR-20 s’opère quasi exclusivement au travers d’environnements de programmation statistique de pointe, au premier rang desquels figure le langage R. Au sein de cet écosystème open-source, plusieurs packages spécialisés permettent d’automatiser l’analyse de consistance interne pour données dichotomiques avec une remarquable élégance computationnelle.
Le package psych constitue la référence incontournable. En utilisant la fonction alpha() sur une matrice de données exclusivement composée de variables binaires codées 0 et 1, R calcule mathématiquement le coefficient alpha, qui, conformément aux démonstrations établies à la section 8, délivre le résultat exact du KR-20. Le package restitue non seulement la valeur brute du coefficient, mais également sa version standardisée, les corrélations item-total corrigées ainsi que les projections d’alpha en cas d’omission séquentielle de chaque variable.
Pour les chercheurs ancrés dans des approches avancées, le package ltm (Latent Trait Models) offre des passerelles directes entre la théorie classique et la théorie de réponse aux items, permettant de confronter le KR-20 aux indices d’information globale de l’épreuve. De même, sous le logiciel IBM SPSS Statistics, le protocole s’exécute via le menu standard Analyse > Échelle > Analyse de fiabilité. En sélectionnant le modèle Alpha sur un ensemble de variables dichotomiques, le moteur statistique génère rigoureusement le KR-20. Les praticiens chevronnés complètent aujourd’hui ces estimations par des procédures de rééchantillonnage non paramétrique (bootstrapping avec 1000 à 5000 itérations), permettant de générer des intervalles de confiance empiriques robustes, affranchis de toute hypothèse sur la normalité asymptotique de la distribution d’échantillonnage.
12.3 Recommandations méthodologiques pour les praticiens et chercheurs
Au terme de cette analyse approfondie, il est possible de synthétiser un corpus de recommandations méthodologiques fondamentales à l’usage des chercheurs, évaluateurs, psychologues et docimologues désireux d’utiliser la formule KR-20 avec un niveau d’intégrité scientifique irréprochable :
- Ne jamais interpréter le KR-20 isolément : Un coefficient élevé ne garantit en rien la validité d’un test. Il atteste de son homogénéité interne, mais ne prouve nullement que l’instrument mesure le construit théorique prétendu. La fidélité n’est qu’une condition nécessaire, mais absolument pas suffisante, à la validité métrologique.
- Vérifier systématiquement l’unidimensionnalité : Toute application du KR-20 doit être précédée d’une vérification empirique de l’absence de sous-dimensions majeures au sein de la matrice d’items, via une analyse factorielle catégorielle ou une analyse en composantes principales des tétrachoriques.
- Déclarer exhaustivement les caractéristiques de l’échantillon : Il est scientifiquement proscrit de déclarer qu’un test « a un KR-20 de 0,85 » dans l’absolu. Il convient de stipuler : « Le test a démontré un KR-20 de 0,85 sur un échantillon de N = 450 étudiants de premier cycle présentant un écart-type de s = 3,42 ».
- Traiter avec vigilance les items en grappes : En présence de questions interdépendantes adossées à un même document ressource, évitez le calcul direct du KR-20 sur les items bruts pour ne pas gonfler artificiellement la fidélité par dépendance locale. Agrégez préalablement les items en scores de faisceaux polytomiques analysés via des coefficients adaptés.
- Préférer le coefficient oméga en cas d’hétérogénéité des charges factorielles : Lorsque les saturations factorielles s’écartent sensiblement d’une stricte uniformité, abandonnez le KR-20 au profit de l’oméga hiérarchique ou catégoriel, afin d’éviter la sous-estimation systématique de la précision de votre mesure.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.apa.org/science/programs/testing/standards
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates. https://www.routledge.com/Test-Theory-A-Unified-Treatment/McDonald/p/book/9780805833751
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill. https://www.worldcat.org/title/psychometric-theory/oclc/29256247
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159