
Dans le vaste édifice de la théorie des probabilités et de la statistique mathématique, la modélisation de l’incertitude repose sur des structures formelles rigoureuses destinées à quantifier l’aléatoire. Lorsque l’espace des états envisageables au sein d’une expérience stochastique est intrinsèquement morcelé, discontinu ou dénombrable, l’analyste fait face à des configurations où chaque réalisation individuelle possède une charge probabiliste identifiable. C’est précisément pour gouverner cette architecture discrète que s’impose la fonction de masse de probabilité, universellement désignée sous son acronyme anglais PMF (Probability Mass Function). Véritable pierre angulaire de l’analyse discrète, elle constitue la clef d’accès à la distribution sous-jacente qui régit le comportement de variables non continues, depuis les processus de comptage jusqu’aux sondages d’opinion et aux mesures psychométriques.
Historiquement forgée au confluent de l’analyse combinatoire et des axiomes formalisés par Andreï Kolmogorov, la fonction de masse transcende la simple description de fréquences empiriques pour devenir un opérateur mathématique souverain. Contrairement aux grandeurs continues dont l’infinité indénombrable réduit la probabilité ponctuelle à néant, l’univers discret attribue à des points isolés une masse concrète, un poids arithmétique qui matérialise la vraisemblance exacte d’un événement élémentaire. Comprendre la mécanique interne de la PMF, c’est appréhender la manière dont la théorie moderne de l’inférence attribue, conserve et distribue la certitude globale au sein d’un univers fractionné en entités distinctes.
Le présent article propose une analyse exhaustive, méthodique et mathématiquement rigoureuse de la fonction de masse de probabilité. Il s’agira d’explorer ses fondations axiomatiques, ses propriétés analytiques intrinsèques, ses convergences et divergences vis-à-vis des densités continues, ainsi que les lois canoniques qu’elle anime. Nous examinerons également ses répercussions pratiques fondamentales dans la quantification des sciences comportementales et psychométriques, tout en dévoilant les procédures d’estimation inférentielle et d’adéquation qui permettent de confronter la perfection du formalisme probabiliste à l’âpreté des données du monde réel.
1. Introduction fondamentale à la fonction de masse de probabilité (PMF)
La théorie moderne des probabilités s’articule autour de la caractérisation précise des variables stochastiques, dont la nature détermine fondamentalement la structure des outils d’analyse requis. Au sein de cet environnement formel, la fonction de masse de probabilité s’érige en mécanisme cardinal pour toute phénoménologie discrète.
1.1 Définition axiomatique et rôle dans l’analyse stochastique
D’un point de vue axiomatique, la fonction de masse de probabilité opère comme une application fondamentale chargée de faire correspondre à chaque valeur discrète admissible d’un espace d’états une mesure probabiliste précise et non nulle. Dans le formalisme classique de la théorie des probabilités, lorsqu’une expérience aléatoire se déploie sur un univers probabilisé, la fonction de masse sert d’opérateur d’assignation directe : elle fixe la probabilité que la variable aléatoire s’identifie ponctuellement et rigoureusement à une valeur scalaire assignée. Ce rôle d’attribution probabiliste ponctuelle distingue la fonction de masse de tout autre instrument de transfert stochastique, car elle confère une substance quantitative concrète à des états d’existence mathématique isolés.
La place de la PMF au sein du calcul des probabilités discret est proprement structurante. Elle intervient non pas comme une approximation ou une dérivation indirecte, mais comme la matrice génératrice d’où découle la totalité des attributs statistiques du système étudié. Par son entremise, l’analyse stochastique quitte le terrain de la simple conjecture qualitative pour embrasser une arithmétique rigoureuse des événements. Qu’il s’agisse de calculer des espérances conditionnelles, des covariances ou des transformations par des fonctions boréliennes, la fonction de masse offre l’ancrage primaire indispensable à tout déploiement computationnel.
Sur le plan épistémologique, il est crucial d’établir une ligne de démarcation imperméable entre la probabilité théorique articulée par la PMF et la distribution empirique des fréquences relatives constatée sur un échantillon matériel. Alors que la distribution empirique est par nature contingente, fluctuante et subordonnée aux aléas du recueil de données, la fonction de masse de probabilité constitue l’objet platonicien idéalisé, la loi invariante et universelle qui prescrit le comportement théorique asymptotique de la variable étudiée. Confondre la fréquence observée avec la masse de probabilité intrinsèque relèverait d’une méprise conceptuelle majeure entre le modèle stochastique génératif et ses instanciations expérimentales finies.
1.2 Variables aléatoires discrètes versus variables continues
L’architecture de la PMF est indissociable de la notion d’espace d’états dénombrable. En topologie et en théorie des ensembles, un ensemble est qualifié de discret ou de dénombrable lorsqu’il est possible d’établir une injection explicite entre ses éléments et le sous-ensemble des entiers naturels. Une variable aléatoire discrète est donc formellement restreinte à évoluer sur un support qui peut être soit strictement fini (comme les scores possibles sur une échelle bornée), soit infini dénombrable (à l’instar de l’ensemble des entiers naturels caractérisant un nombre d’arrivées dans une file d’attente sur un intervalle temporel donné).
Cette distinction engendre des disparités de mesurabilité profondes au regard de la théorie de l’intégration et de la théorie de la mesure de Lebesgue. Dans les espaces continus, le support de la variable aléatoire correspond à des sous-ensembles indénombrables de la droite réelle possédant la puissance du continu. Dès lors, la tribu des événements admissibles et la mesure de probabilité associée ne peuvent attribuer une valeur strictement positive à des singletons isolés sans briser instantanément l’axiome de sous-additivité unitaire. L’espace discret, en revanche, autorise la décomposition de tout événement en une somme disjointe de singletons mesurables portant chacun une masse propre.
Il en résulte une impossibilité théorique majeure : dans un cadre strictement continu, la probabilité ponctuelle d’observer n’importe quelle valeur exacte est rigoureusement nulle, contraignant le théoricien à raisonner exclusivement en termes de densités de probabilité sur des voisinages infinitésimaux. À l’inverse, l’univers discret gouverné par la fonction de masse repose précisément sur l’existence de ces « atomes » probabilistes, c’est-à-dire de points uniques dont la réalisation possède un poids stochastique strictement supérieur à zéro. Cette dichotomie conceptuelle structure l’ensemble de la modélisation statistique.
1.3 Importance de la PMF dans la modélisation statistique
Dans le domaine de la modélisation appliquée, la fonction de masse de probabilité fournit le cadre mathématique idoine pour encapsuler les phénomènes de tirage au sort, de sélection sous contrainte et d’échantillonnage combinatoire. Sans une définition exacte de la distribution des masses, la formalisation des protocoles d’inspection de qualité industrielle, des études de capture-recapture en écologie des populations ou encore du routage de paquets dans les télécommunications modernes demeurerait purement descriptive et privée de toute prédictibilité formelle.
De surcroît, la PMF constitue le socle indispensable à l’élaboration de la théorie de la décision et de la théorie des tests d’hypothèses statistiques. Lorsqu’un statisticien est mandaté pour valider ou rejeter une conjecture scientifique relative à une variable discrète, la structure de la PMF permet de calculer avec une précision analytique absolue les probabilités associées aux erreurs de première et de deuxième espèce. Les régions de rejet, les seuils critiques et les fonctions de puissance reposent directement sur la sommation ordonnée des masses de probabilité prescrites par le modèle théorique sous l’hypothèse nulle.
Enfin, au sein des sciences empiriques contemporaines — qu’il s’agisse de l’épidémiologie traquant les grappes de cas infectieux, de la linguistique quantitative dénombrant les fréquences lexicales ou de l’astrophysique comptabilisant les impacts photoniques — la PMF permet d’abstraire la réalité physique pour la projeter dans un cadre paramétrique manipulable. Elle offre aux chercheurs la capacité de résumer des dynamiques observationnelles extraordinairement complexes en un nombre restreint de paramètres directeurs, ouvrant ainsi la voie à une explication unifiée et parcimonieuse des régularités de la nature.
2. Définition formelle et fondements mathématiques
Pour dépasser l’intuition probabiliste et manipuler la fonction de masse avec l’exactitude requise par l’analyse moderne, il est nécessaire de formaliser son ancrage au sein des structures ensemblistes et fonctionnelles de l’analyse mathématique.
2.1 Notation canonique et formalisme probabiliste
Soit un espace probabilisé canonique dénoté par le triplet usuel $(\Omega, \mathcal{F}, P)$, où $\Omega$ représente l’univers des événements élémentaires possibles, $\mathcal{F}$ une tribu (ou $\sigma$-algèbre) d’événements construits sur cet univers, et $P$ une mesure de probabilité assignant un réel de l’intervalle $[0, 1]$ à tout élément de $\mathcal{F}$. Soit $X$ une variable aléatoire discrète définie comme une application mesurable de $\Omega$ dans l’espace métrique réel $(\mathbb{R}, \mathcal{B}(\mathbb{R}))$, où $\mathcal{B}(\mathbb{R})$ désigne la tribu borélienne standard.
La fonction de masse de probabilité de cette variable, conventionnellement notée $p_X$ ou parfois $f_X$, est formellement définie comme l’application scalaire :
$$p_X : \mathbb{R} to [0, 1]$$
telle que, pour tout réel $x$ appartenant à l’ensemble d’arrivée :
$$p_X(x) = P(X = x) = P\big({\omega in \Omega mid X(\omega) = x}\big)$$
Dans cette formulation, l’expression $X = x$ constitue un raccourci de notation élégant mais strict désignant l’image réciproque par $X$ du singleton ${x}$, c’est-à-dire l’événement élémentaire composite constitué par l’ensemble des éléments $\omega$ de l’espace fondamental $\Omega$ dont l’évaluation sous l’application $X$ est précisément égale au scalaire $x$.
La distinction typographique et sémantique entre la lettre majuscule $X$ et la lettre minuscule $x$ constitue un prérequis épistémologique capital. La majuscule $X$ désigne l’entité stochastique elle-même, c’est-à-dire une fonction mathématique dont la valeur effective demeure suspendue au déroulement de l’expérience aléatoire. À l’opposé, la minuscule $x$ incarne une réalisation spécifique, une valeur numérique déterminée et déterministe appartenant au spectre des valeurs numériques potentielles. La PMF évalue donc l’affinité probabiliste liant la variable générative $X$ à sa matérialisation scalaire ponctuelle $x$.
2.2 Le concept de support d’une variable aléatoire discrète
L’analyse rigoureuse d’une PMF exige la délimitation méticuleuse de son domaine de pertinence stochastique, universellement qualifié de support. Le support d’une variable aléatoire discrète $X$, traditionnellement noté $R_X$, $S_X$ ou $operatorname{supp}(X)$, est formellement défini comme le sous-ensemble de la droite réelle $\mathbb{R}$ pour lequel la fonction de masse assigne une probabilité strictement positive :
$$R_X = {x in \mathbb{R} mid p_X(x) > 0}$$
Ce support possède des caractéristiques topologiques particulières. Dans le cas discret, il s’agit obligatoirement d’un ensemble discret au sens topologique, composé exclusivement de points isolés sans point d’accumulation dans les configurations finies. Algébriquement, $R_X$ est au plus dénombrable : il peut consister en une suite finie d’éléments ${x_1, x_2, dots, x_n}$ ou en une séquence indexable infinie dénombrable ${x_1, x_2, dots, x_k, dots}$.
Pour tout point $y in \mathbb{R}$ n’appartenant pas à ce support ($y \notin R_X$), la fonction de masse de probabilité s’annule identiquement :
$$p_X(y) = 0$$
Cette propriété assure que la variable aléatoire ne possède aucune propension stochastique à se matérialiser en dehors des frontières de son support. La délimitation analytique exacte du support $R_X$ constitue une étape incontournable de tout calcul probabiliste, car l’extension indue des bornes de sommation vers des zones où la PMF est indéfinie ou nulle peut altérer la convergence des séries et générer des paradoxes calculatoires insolubles.
2.3 Fondations selon les axiomes de Kolmogorov
La validité mathématique d’une fonction de masse de probabilité découle de son adéquation parfaite avec le cadre formalisé par Kolmogorov en 1933 dans ses fondations de la théorie des probabilités. Le premier axiome stipule que pour tout événement $A in \mathcal{F}$, sa mesure doit être univoquement non négative : $P(A) ge 0$. Dans le cadre de la PMF, cet impératif se traduit immédiatement par la contrainte de non-négativité ponctuelle :
$$\forall x in R_X, \quad p_X(x) ge 0$$
Le deuxième axiome proclame la certitude de l’univers, imposant que la probabilité globale associée à l’événement certain $\Omega$ soit unitaire : $P(\Omega) = 1$. Puisque l’univers peut être partitionné en la disjonction dénombrable des événements élémentaires associés aux points du support, ce deuxième principe impose la condition de fermeture unitaire sur la masse globale :
$$\sum_{x in R_X} p_X(x) = P\left(\big\cup_{x in R_X} {X = x}\right) = P(\Omega) = 1$$
Enfin, le troisième axiome de Kolmogorov, consacré à la $\sigma$-additivité (ou additivité dénombrable), établit que la probabilité d’une union dénombrable d’événements mutuellement disjoints équivaut à la somme des séries de leurs probabilités respectives. Pour tout sous-ensemble borélien $B \subset \mathbb{R}$, l’événement composite $X in B$ s’exprime comme la réunion disjointe des singletons ${X = x}$ pour $x in B \cap R_X$. L’axiome garantit ainsi de manière indéfectible que :
$$P(X in B) = \sum_{x in B \cap R_X} p_X(x)$$
Cette relation fondamentale scelle la conformité de la fonction de masse aux canons de l’analyse stochastique moderne, érigeant la PMF en un pont mathématique parfait entre l’espace probabilisé sous-jacent et les mesures de probabilité définies sur la droite réelle.
3. Propriétés fondamentales d’une fonction de masse de probabilité
Toute fonction prétendant au statut de fonction de masse de probabilité doit se conformer à un corpus de propriétés arithmétiques et analytiques fondamentales. Ces contraintes garantissent que le modèle probabiliste respecte scrupuleusement les lois de conservation de l’incertitude.
3.1 La condition de non-négativité stricte
La première exigence imposée à une PMF réside dans son bornage structurel au sein du corps des réels. Pour toute valeur scalaire $x$, la masse de probabilité associée ne peut en aucun cas afficher une amplitude négative :
$$\forall x in \mathbb{R}, \quad 0 le p_X(x) le 1$$
Cette contrainte bilatérale n’est pas une simple convention graphique, mais une nécessité logique absolue. Une probabilité négative priverait le modèle de toute interprétabilité sémantique, tandis qu’une valeur excédant l’unité violerait la complétude du système stochastique en postulant un événement plus certain que la certitude elle-même.
Dans la perspective fréquentiste, où $p_X(x)$ incarne la limite vers laquelle converge le ratio entre le nombre d’occurrences de l’événement et la taille globale de l’échantillon lorsque cette dernière tend vers l’infini, la positivité découle mécaniquement de la nature intrinsèquement positive des opérations de dénombrement. Du point de vue bayésien, la masse $p_X(x)$ représente le degré de croyance rationnelle alloué à l’état $x$ en présence d’une information donnée ; ce degré de plausibilité, normalisé sur une échelle standard, récuse catégoriquement tout coefficient inférieur à la nullité absolue ou supérieur à la plénitude de la certitude.
3.2 La condition de normalisation unitaire
La deuxième condition sine qua non régissant la PMF concerne la conservation de la masse stochastique totale. Lorsque l’on procède à la sommation de l’ensemble des valeurs de la fonction de masse sur l’intégralité du support $R_X$, le résultat doit converger avec une exactitude arithmétique rigoureuse vers l’unité :
$$\sum_{x in R_X} p_X(x) = 1$$
Dans les configurations où le support $R_X$ est infini dénombrable, cette exigence implique non seulement la convergence de la série, mais plus spécifiquement sa convergence absolue. En vertu des théorèmes d’analyse réelle relatifs aux séries à termes positifs, l’ordre dans lequel les éléments du support sont sommés ne doit altérer ni l’existence ni la valeur de la somme limite, laquelle doit demeurer invariablement égale à 1.
Cette condition unitaire s’avère particulièrement opérationnelle lors de la calibration de modèles statistiques. Fréquemment, les physiciens ou les théoriciens des probabilités dérivent des fonctions de poids arbitraires $w(x) ge 0$ décrivant la propension relative d’un système à occuper l’état $x$. Pour transmuter ce système de poids en une PMF valide, il est indispensable de déterminer la constante de normalisation, couramment désignée sous le terme de fonction de partition en physique statistique, définie par :
$$Z = \sum_{x in R_X} w(x)$$
Dès lors, l’application renormalisée $p_X(x) = \frac{w(x)}{Z}$ satisfait de manière irréprochable au postulat unitaire et constitue une fonction de masse de probabilité parfaitement certifiée.
3.3 Comportement en dehors du support statistique
La rigueur analytique impose d’expliciter le statut mathématique de la PMF pour tout argument réel localisé en dehors du support formellement caractérisé. Si $x \notin R_X$, l’application de la fonction de masse délivre systématiquement :
$$p_X(x) = 0$$
Cette assignation systématique de la valeur zéro garantit la robustesse formelle des calculs lors de l’intégration stochastique par rapport à la mesure de comptage discrète. En considérant que la mesure discrète induite par $X$ est absolument continue par rapport à la mesure de comptage sur $\mathbb{R}$, la PMF apparaît formellement comme la dérivée de Radon-Nikodym de cette distribution probabiliste par rapport à ladite mesure de comptage.
Cette propriété évite par ailleurs les distorsions analytiques lors de l’intégration ou de la sommation sur des intervalles ouverts, semi-ouverts ou fermés. Par exemple, si une variable discrète ne prend que des valeurs entières paires, l’évaluation de sa fonction de masse sur un réel impair ou transcendant se solde invariablement par une annulation immédiate, garantissant qu’aucune charge probabiliste résiduelle ne vienne corrompre les évaluations intégrales sur des domaines continus arbitraires.
4. Illustration empirique : L’exemple paradigmatique du dé à six faces
Afin de matérialiser ces concepts abstraits dans une structure opérationnelle transparente, l’analyse d’un système mécanique classique constitue une illustration pédagogique et mathématique idéale.
4.1 Modélisation de l’expérience aléatoire
Considérons l’expérience probabiliste archétypale consistant en la projection unique d’un dé cubique régulier à six faces sur une surface plane exempte de frottements asymétriques. L’univers des résultats physiques possibles se formalise par l’ensemble fini des faces observables au repos :
$$\Omega = {\omega_1, \omega_2, \omega_3, \omega_4, \omega_5, \omega_6}$$
Définissons la variable aléatoire $X$ comme l’application associant à chaque face $\omega_i$ la valeur numérique du nombre de points gravés sur sa surface. Le support algébrique $R_X$ de cette variable stochastique est constitué de l’ensemble fini des entiers naturels consécutifs compris entre un et six :
$$R_X = {1, 2, 3, 4, 5, 6}$$
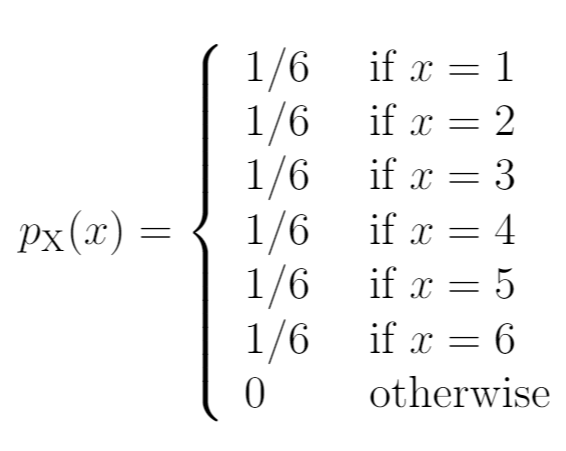
L’hypothèse d’équilibrage parfait de l’objet — impliquant une homogénéité de masse de la matière constitutive, une géométrie cubique stricte et un centre de gravité coïncidant rigoureusement avec le centre géométrique — invite à appliquer le principe d’indifférence de Laplace. En l’absence de tout biais physique privilégiant une orientation spatiale particulière, la symétrie géométrique impose d’attribuer à chaque événement élémentaire une potentialité d’occurrence rigoureusement identique.
4.2 Formulation analytique de la PMF uniforme discrète
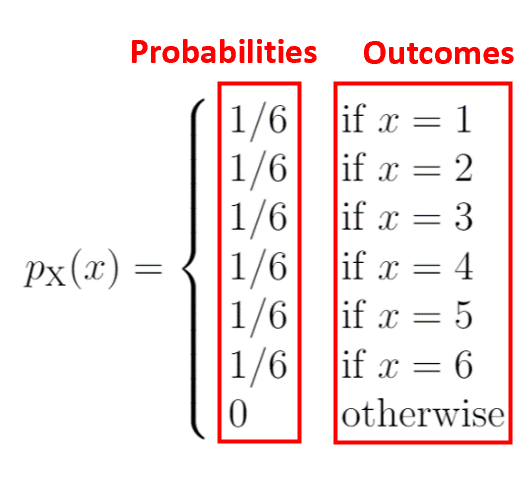
En vertu du postulat d’équiprobabilité découlant des propriétés physiques du système, la fonction de masse de probabilité régissant la variable aléatoire $X$ prend la forme analytique canonique d’une distribution uniforme discrète :
$$p_X(x) = P(X = x) = \begin{\cases} \frac{1}{6} &a\mp; \text{si } x in {1, 2, 3, 4, 5, 6} 0 &a\mp; \text{sinon} \end{\cases}$$
Cette formalisation concise peut être représentée sous forme tabulaire, offrant une cartographie complète et univoque de la distribution probabiliste du système :
- Réalisation ($x = 1$) : Masse théorique assignée : $p_X(1) = 1/6 \approx 0{,}1667$
- Réalisation ($x = 2$) : Masse théorique assignée : $p_X(2) = 1/6 \approx 0{,}1667$
- Réalisation ($x = 3$) : Masse théorique assignée : $p_X(3) = 1/6 \approx 0{,}1667$
- Réalisation ($x = 4$) : Masse théorique assignée : $p_X(4) = 1/6 \approx 0{,}1667$
- Réalisation ($x = 5$) : Masse théorique assignée : $p_X(5) = 1/6 \approx 0{,}1667$
- Réalisation ($x = 6$) : Masse théorique assignée : $p_X(6) = 1/6 \approx 0{,}1667$
- Toute autre valeur ($x \notin R_X$) : Masse théorique assignée : $p_X(x) = 0$
Ce tableau illustre parfaitement comment la fonction de masse partitionne la certitude totale en six portions scalaires infinitésimales mais strictement égales, projetant chaque élément de l’espace abstrait des états sur une échelle numérique quantifiable.
4.3 Vérification rigoureuse des propriétés axiomatiques
L’examen de cette distribution prototypique confirme la satisfaction intégrale des propriétés énoncées précédemment. Premièrement, la condition de positivité est universellement respectée puisque la valeur constante $1/6$ se situe de manière incontestable dans l’intervalle ouvert $]0, 1[$. Aucun état admissible ne présente de poids négatif ni de valeur asymptotique divergente.
Deuxièmement, la sommation finie des masses de probabilité sur le support $R_X$ valide rigoureusement la condition de normalisation unitaire :
$$\sum_{x=1}^{6} p_X(x) = p_X(1) + p_X(2) + p_X(3) + p_X(4) + p_X(5) + p_X(6) = \frac{1}{6} + \frac{1}{6} + \frac{1}{6} + \frac{1}{6} + \frac{1}{6} + \frac{1}{6} = \frac{6}{6} = 1$$
Troisièmement, la puissance de la PMF transparaît dès lors que l’on calcule la probabilité d’événements composés par simple additivité finie. Considérons, à titre d’exemple, l’événement $A$ défini par l’obtention d’un résultat pair, c’est-à-dire $A = {X in {2, 4, 6}}$. En exploitant la $\sigma$-additivité sur les singletons disjoints du support :
$$P(A) = \sum_{x in {2, 4, 6}} p_X(x) = p_X(2) + p_X(4) + p_X(6) = \frac{1}{6} + \frac{1}{6} + \frac{1}{6} = \frac{3}{6} = \frac{1}{2}$$
Cette arithmétique élémentaire confirme l’efficacité opératoire de la fonction de masse de probabilité, capable de résoudre les requêtes probabilistes les plus élaborées par la décomposition atomique des états du système.
5. Distinction conceptuelle : PMF, PDF et CDF
La maîtrise de la statistique mathématique requiert une dissociation conceptuelle limpide entre trois opérateurs de distribution fréquemment amalgamés par les praticiens : la fonction de masse de probabilité (PMF), la fonction de densité de probabilité (PDF) et la fonction de répartition cumulative (CDF).
5.1 Comparaison critique entre PMF et fonction de densité (PDF)
La confusion entre la fonction de masse de probabilité (PMF) et la fonction de densité de probabilité (communément désignée sous l’acronyme anglais PDF – Probability Density Function) représente l’un des écueils analytiques les plus pernicieux en statistique. Cette confusion procède généralement d’une analogie superficielle masquant une divergence ontologique et dimensionnelle fondamentale.
Tandis que la PMF délivre directement une probabilité adimensionnelle absolue comprise entre 0 et 1 pour un point singulier, la PDF — propre aux variables aléatoires continues — ne fournit en aucun cas une probabilité directe lorsqu’elle est évaluée en un point scalaire donné. La PDF représente le taux de concentration locale de probabilité par unité de mesure de la variable. Ses grandeurs numériques possèdent une dimensionnalité physique égale à l’inverse de la dimension de la variable sous-jacente ($[unité]^{-1}$) et peuvent, sans enfreindre la moindre loi probabiliste, atteindre des valeurs arbitrairement gigantesques voire diverger vers l’infini, pourvu que son intégrale sur la droite réelle demeure strictement unitaire.
Il en résulte une propriété paradoxale pour le néophyte : si $Y$ est une variable continue gouvernée par une PDF notée $f_Y$, la probabilité ponctuelle exacte d’observer n’importe quel réel spécifique $y_0$ est rigoureusement et universellement nulle :
$$P(Y = y_0) = \lim_{\epsilon to 0} \int_{y_0 – \epsilon}^{y_0 + \epsilon} f_Y(u),du = 0$$
Or, pour une variable discrète régie par une PMF, $p_X(x_0) > 0$ constitue la signature d’un point atomique appartenant au support. Amalgamer $f_Y(y)$ avec $P(Y=y)$ constitue donc un contre-sens mathématique destructeur, dissipé dès lors que l’on reconnaît la PMF comme une masse discrète concentrée en des points isolés et la PDF comme une nappe continue ne générant de probabilité que par intégration sur des intervalles de mesure non nulle.
5.2 La fonction de répartition cumulative (CDF) en contexte discret
La fonction de répartition cumulative, universellement formalisée par l’acronyme CDF (Cumulative Distribution Function) et notée $F_X(x)$, se positionne comme l’opérateur unificateur embrassant simultanément les mondes discret et continu. Par définition universelle, elle mesure la probabilité que la variable aléatoire $X$ prenne une valeur inférieure ou égale à un seuil réel assigné $x$ :
$$F_X(x) = P(X le x)$$
Dans le contexte exclusif d’une variable aléatoire discrète régie par sa fonction de masse $p_X$, la CDF s’obtient non pas par une opération d’intégration riemannienne, mais par une sommation discrète des masses de probabilité assignées aux points du support n’excédant pas la valeur cible :
$$F_X(x) = \sum_{k in R_X atop k le x} p_X(k)$$
Cette sommation par paliers confère à la CDF d’une variable discrète un profil géométrique éminemment distinctif : il s’agit d’une fonction en escalier, continue par morceaux, présentant une discontinuité de saut à chaque valeur appartenant au support $R_X$. Entre deux valeurs consécutives du support, la CDF demeure strictement horizontale et constante. Conformément aux théorèmes de l’analyse stochastique, la fonction de répartition discrète est continue à droite en tout point de son domaine et satisfait scrupuleusement aux limites asymptotiques canoniques régissant toute probabilité cumulative :
$$\lim_{x to -\infty} F_X(x) = 0 \quad \text{et} \quad \lim_{x to +\infty} F_X(x) = 1$$
5.3 Passage analytique bidirectionnel entre PMF et CDF
Il existe une correspondance bijective parfaite entre la fonction de masse de probabilité et la fonction de répartition cumulative d’une variable aléatoire discrète. Si la transition de la PMF vers la CDF s’opère par accumulation additive comme détaillé supra, l’extraction de la PMF à partir d’une CDF donnée s’effectue par l’évaluation exacte de l’amplitude de ses discontinuités de saut.
Formellement, si $x$ est un point d’accumulation potentiel du support, la masse de probabilité $p_X(x)$ coïncide rigoureusement avec la différence entre la valeur de la CDF évaluée en ce point et sa limite à gauche (notée traditionnellement $F_X(x^-)$) :
$$p_X(x) = F_X(x) – F_X(x^-) = F_X(x) – \lim_{t to x, , t < x} F_X(t)$$
Si la CDF est continue au point $x$, la limite à gauche équivaut à la valeur ponctuelle, confirmant ainsi que $p_X(x) = 0$ et attestant que $x$ est extérieur au support statistique. Cette relation de dérivation discrète revêt une importance capitale lors du traitement des inégalités strictes ou larges. Pour deux bornes $a$ et $b$ ($a < b$) appartenant à $\mathbb{R}$, le calcul des probabilités cumulées impose une rigueur extrême quant au traitement des frontières :
- $P(a < X le b) = F_X(b) – F_X(a)$
- $P(a le X le b) = F_X(b) – F_X(a) + p_X(a) = F_X(b) – F_X(a^-)$
- $P(a < X < b) = F_X(b^-) – F_X(a)$
Ces subtilités calculatoires, parfaitement triviales et indifférenciées au sein du calcul continu (où les probabilités de frontière sont rigoureusement nulles), s’avèrent hautement déterminantes lors de l’usage opérationnel d’une PMF, confirmant la nature éminemment granulaire des distributions discrètes.
6. Principales lois de probabilité discrètes et leurs PMF associées
Le corpus de la statistique mathématique abrite une taxonomie de lois discrètes standards dont les fonctions de masse ont été forgées pour capturer des régularités phénoménologiques récurrentes de l’univers physique et social.
6.1 La loi de Bernoulli et la distribution binomiale
À la base de toute la combinatoire stochastique réside l’expérience binaire prototypique théorisée par Jacques Bernoulli. Une variable aléatoire $X$ obéit à une loi de Bernoulli de paramètre $p in [0, 1]$ si son support est strictement binaire : $R_X = {0, 1}$, où $1$ encode conventionnellement le « succès » et $0$ l’« échec ». Sa fonction de masse de probabilité s’énonce sous une forme compacte analytique particulièrement ingénieuse :
$$p_X(x) = p^x (1 – p)^{1 – x} \quad \text{pour } x in {0, 1}$$
Lorsque cette expérience élémentaire est répétée $n$ fois de manière strictement indépendante et sous des conditions opératoires identiques, le nombre global de succès observés se modélise par la loi binomiale de paramètres $n in \mathbb{N}^*$ et $p in [0, 1]$, notée $\mathcal{B}(n, p)$. Le support s’étend alors sur les entiers $R_X = {0, 1, 2, dots, n}$. Sa PMF fait intervenir le coefficient binomial, chargé de dénombrer la multiplicité combinatoire des arrangements menant à exactement $x$ réalisations victorieuses :
$$p_X(x) = \binom{n}{x} p^x (1 – p)^{n – x} = \frac{n!}{x!,(n – x)!} , p^x (1 – p)^{n – x}$$
Cette expression formalise l’intersection de deux principes combinatoires majeurs : le terme $p^x (1 – p)^{n – x}$ quantifie la probabilité de survenue d’une trajectoire ordonnée singulière comportant $x$ succès et $n-x$ échecs, tandis que le préfacteur combinatoire somme les probabilités mutuellement disjointes de l’ensemble des permutations structurellement indistinguables produisant ce même décompte final.
6.2 La distribution de Poisson pour les événements rares
Lorsque le nombre d’épreuves $n$ croît vers l’infini tandis que la probabilité unitaire $p$ décroît vers zéro, de telle sorte que le produit $lambda = np$ demeure un scalaire fini et constant, la loi binomiale converge asymptotiquement vers la distribution de Poisson, modélisant l’occurrence d’événements aléatoires rares au sein d’un continuum temporel ou spatial continu.
Découverte par Siméon Denis Poisson, cette loi stochastique déploie un support infini dénombrable englobant l’intégralité des entiers naturels : $R_X = \mathbb{N} = {0, 1, 2, dots}$. Sa fonction de masse de probabilité est gouvernée par le paramètre d’intensité moyenne d’arrivée $lambda > 0$ et prend la forme structurelle exponentielle suivante :
$$p_X(x) = \frac{\lambda^x e^{-\lambda}}{x!} \quad \text{pour } x in \mathbb{N}$$
La normalisation unitaire de cette PMF s’établit avec une remarquable élégance mathématique par le déploiement de la série de Taylor de la fonction exponentielle standard :
$$\sum_{x=0}^{\infty} p_X(x) = \sum_{x=0}^{\infty} \frac{\lambda^x e^{-\lambda}}{x!} = e^{-\lambda} \sum_{x=0}^{\infty} \frac{\lambda^x}{x!} = e^{-\lambda} \cdot e^{\lambda} = e^0 = 1$$
La loi de Poisson constitue l’armature probabiliste maîtresse des processus de comptage purs, tels que la modélisation des flux d’appels entrants sur un commutateur téléphonique, la fréquence des mutations génétiques spontanées par segment d’ADN ou l’enregistrement des désintégrations de particules radioactives par un détecteur de Geiger.
6.3 Les lois géométrique, binomiale négative et hypergéométrique
Au-delà des processus poissoniens et binomiaux, d’autres contraintes expérimentales génèrent des fonctions de masse spécifiques. La loi géométrique quantifie le nombre d’essais bernoulliens indépendants nécessaires pour observer le tout premier succès. Pour un support défini sur les entiers strictement positifs $R_X = {1, 2, 3, dots}$, sa PMF s’écrit :
$$p_X(x) = (1 – p)^{x – 1} p$$
Cette loi est l’unique distribution discrète jouissant de la propriété d’absence de mémoire stochastique, signifiant que la probabilité d’obtenir le succès au prochain tirage demeure rigoureusement invariante face au nombre d’échecs préalablement endurés.
En généralisant cette logique à l’attente du $r$-ième succès ($r in \mathbb{N}^*$), on obtient la loi binomiale négative (ou loi de Pascal), dont la fonction de masse module le support $R_X = {r, r+1, r+2, dots}$ selon l’expression :
$$p_X(x) = \binom{x – 1}{r – 1} p^r (1 – p)^{x – r}$$
Enfin, lorsque l’échantillonnage s’opère sans remise au sein d’une population finie de taille $N$ contenant $K$ éléments possédant un attribut distinctif, les tirages successifs cessent d’être mutuellement indépendants. La distribution binomiale perd alors sa légitimité au profit de la loi hypergéométrique. Pour un prélèvement de taille $n$, la variable $X$ dénombrant les succès est contrainte par un support délimité par $max(0, n – (N – K)) le x le min(n, K)$ et sa PMF s’exprime par le ratio combinatoire :
$$p_X(x) = \frac{\binom{K}{x} \binom{N – K}{n – x}}{\binom{N}{n}}$$
Cette triade de distributions démontre la flexibilité analytique de la PMF, capable d’adapter ses termes combinatoires aux conditions d’indépendance, de dépendance ou d’attente imposées par le protocole stochastique.
7. Calcul des moments statistiques à partir de la PMF
Une fonction de masse de probabilité ne se borne pas à énoncer statiquement des potentialités d’occurrence ; elle permet de dériver l’ensemble des résumés caractéristiques de la distribution au moyen de l’opérateur d’intégration discrète des moments statistiques.
7.1 Espérance mathématique : le premier moment ordinaire
L’espérance mathématique, traditionnellement dénotée $E[X]$ ou $\mu$, représente le premier moment ordinaire de la distribution et matérialise la tendance centrale ou le barycentre probabiliste du support. Pour une variable aléatoire discrète régie par sa fonction de masse $p_X$, l’espérance se définit formellement comme la somme pondérée de toutes les réalisations scalaires possibles par leurs masses respectives :
$$E[X] = \sum_{x in R_X} x \cdot p_X(x)$$
Dans le cas d’un support infini dénombrable, l’existence formelle de cette grandeur est subordonnée au critère de sommabilité absolue :
$$\sum_{x in R_X} |x| \cdot p_X(x) < \infty$$
Si cette série diverge ou présente une semi-convergence dépendante de l’ordonnancement des termes (comme c’est le cas emblématique pour la loi de Cauchy discrète), l’espérance est déclarée indéfinie au sens strict de Lebesgue. Dès lors qu’elle converge, l’espérance bénéficie de la propriété souveraine de linéarité : pour toutes constantes réelles $a, b in \mathbb{R}$ et pour toute paire de variables aléatoires $X$ et $Y$ définies sur le même espace probabilisable :
$$E[aX + bY] = aE[X] + bE[Y]$$
Cette relation permet d’évaluer les comportements d’agrégats complexes sans exiger la dérivation préalable de la PMF de la somme, illustrant l’immense puissance opérationnelle du formalisme discret.
7.2 Variance et écart-type : dispersion autour du centre
Tandis que l’espérance localise l’ancrage central du système, la variance, notée $operatorname{Var}(X)$ ou $\sigma^2$, mesure le degré de dispersion stochastique des réalisations autour de cette valeur centrale. Elle se définit mathématiquement comme le deuxième moment centré, c’est-à-dire l’espérance de l’écart quadratique à la moyenne :
$$operatorname{Var}(X) = E\big[(X – E[X])^2\big]$$
L’application directe du théorème de transfert (ou loi du statisticien inconscient) permet de transposer cette espérance d’une fonction borélienne de la variable en une sommation discrète directe pondérée par la PMF originelle :
$$operatorname{Var}(X) = \sum_{x in R_X} (x – \mu)^2 \cdot p_X(x)$$
Pour fluidifier les calculs algébriques, les statisticiens exploitent universellement le théorème de König-Huygens, qui décompose la variance en la soustraction du carré de l’espérance au second moment ordinaire :
$$operatorname{Var}(X) = E[X^2] – (E[X])^2 = \left( \sum_{x in R_X} x^2 \cdot p_X(x) \right) – \left( \sum_{x in R_X} x \cdot p_X(x) \right)^2$$
L’écart-type $\sigma = \sqrt{operatorname{Var}(X)}$ restaure l’homogénéité dimensionnelle vis-à-vis de l’unité de mesure initiale de la variable, fournissant une métrique directe de l’incertitude absolue inhérente à la distribution décrite par la PMF.
7.3 Moments d’ordre supérieur : asymétrie et kurtosis
La caractérisation approfondie de la morphologie d’une distribution discrète requiert l’évaluation de moments centrés d’ordre supérieur. Le moment centré d’ordre $k$ d’une variable discrète s’exprime de manière générique par la relation :
$$\mu_k = E\big[(X – \mu)^k\big] = \sum_{x in R_X} (x – \mu)^k \cdot p_X(x)$$
Le troisième moment centré normalisé donne naissance au coefficient d’asymétrie de Pearson ($\gamma_1$), formulé par :
$$\gamma_1 = \frac{\mu_3}{\sigma^3} = \frac{\sum_{x in R_X} (x – \mu)^3 \cdot p_X(x)}{\left( \sum_{x in R_X} (x – \mu)^2 \cdot p_X(x) \right)^{3/2}}$$
Un coefficient $\gamma_1$ non nul indique une distorsion géométrique de la PMF : une valeur positive traduit un étalement de la masse vers les valeurs positives (queue de distribution orientée vers la droite), tandis qu’une valeur négative dénote une prépondérance des masses élevées avec une traîne s’étendant vers la gauche.
Le quatrième moment centré génère quant à lui le coefficient d’aplatissement ou kurtosis ($\beta_2$ ou son excès $\gamma_2 = \beta_2 – 3$), mesurant le poids relatif des queues de distribution et la propension de la PMF à générer des réalisations extrêmes (phénomène de leptocurticité) :
$$\beta_2 = \frac{\mu_4}{\sigma^4} = \frac{\sum_{x in R_X} (x – \mu)^4 \cdot p_X(x)}{\sigma^4}$$
Pour dériver l’ensemble infini de ces moments avec fluidité, les mathématiciens recourent fréquemment à la fonction génératrice des moments (MGF – Moment Generating Function), définie par l’espérance de l’exponentielle du produit scalaire :
$$M_X(t) = E\big[e^{tX}\big] = \sum_{x in R_X} e^{tx} \cdot p_X(x)$$
En différentiant formellement cette fonction $n$ fois par rapport à la variable réelle $t$ et en évaluant la dérivée résultante à l’origine ($t=0$), le statisticien extrait directement le moment d’ordre $n$ : $E[X^n] = M_X^{(n)}(0)$, condensant ainsi l’intégralité du profil stochastique gouverné par la PMF.
8. Représentations graphiques et géométrie de la PMF
La traduction visuelle d’une fonction de masse de probabilité requiert un strict respect de sa nature discrète. Toute extrapolation graphique inadaptée risque de conférer une illusion de continuité à des données fondamentalement discontinues.
8.1 Le diagramme en bâtons et le tracé en tiges
La transcription géométrique standardisée d’une fonction de masse de probabilité est le diagramme en bâtons (communément appelé lollipop chart ou stem plot en visualisation statistique moderne). Dans ce repère cartésien, l’axe des abscisses porte les réalisations scalaires disjointes $x_i$ appartenant au support $R_X$, tandis que l’axe des ordonnées calibre l’échelle des probabilités absolues comprises dans l’intervalle $[0, 1]$.
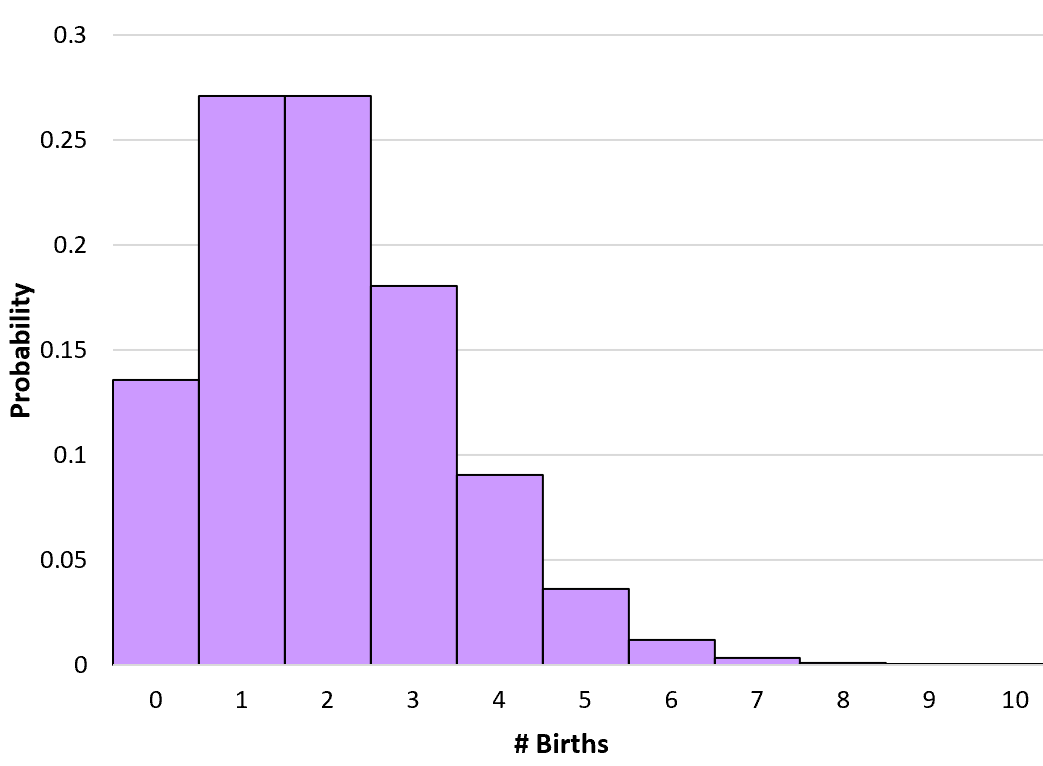
La règle sémiologique fondamentale de ce tracé impose de matérialiser chaque probabilité par un segment vertical émergeant de l’axe des abscisses au point $x_i$ pour s’élever jusqu’à une hauteur rigoureusement proportionnelle à $p_X(x_i)$, le sommet étant souvent ponctué par un point circulaire marquant la masse terminale. Le point saillant réside dans l’absence délibérée de toute largeur horizontale pour ces segments : la masse de probabilité est concentrée en un point mathématique unique sans étalement dimensionnel le long de l’axe des réels.
Cette modalité graphique fournit une appréciation perceptive immédiate de l’architecture distributionnelle. L’observateur identifie d’un simple coup d’œil le mode de la variable (la modalité correspondant à la tige la plus élevée, maximisant ponctuellement la fonction de masse), la dispersion périphérique du support, ainsi que l’asymétrie structurelle ou la symétrie parfaite des masses stochastiques réparties le long du spectre des possibles.
8.2 Différences structurales avec les histogrammes de densité
Une confusion graphique préjudiciable réside dans l’assimilation hâtive d’un diagramme en bâtons propre à une PMF à un histogramme de densité de probabilité continue. L’histogramme continuous juxtapose des rectangles contigus dont l’attribut probabiliste est véhiculé non pas par la hauteur, mais exclusivement par l’aire de chaque barre, calculée comme le produit de la base (la largeur de classe $\Delta x$) par la densité locale.
Transposer la logique des rectangles pleins à une PMF discrète constitue une faute méthodologique lourde. D’une part, attribuer une épaisseur visuelle arbitraire à des points atomiques induit l’illusion que les valeurs intermédiaires non entières ou hors support possèdent une existence physique probabiliste. D’autre part, dans un diagramme de PMF authentique, c’est la hauteur absolue du segment qui consigne l’information quantitative ($P(X = x)$), tandis que l’aire géométrique d’un segment de largeur strictement nulle est par définition nulle ($0 \times p_X(x) = 0$).
Le regroupement arbitraire de valeurs discrètes au sein de compartiments larges (le binning) comporte également le risque d’introduire des artefacts visuels trompeurs. Une discrétisation forcée peut masquer la présence de modes locaux singuliers ou effacer la signature arithmétique de la fonction de masse (comme la parité obligatoire de certains processus de saut), dénaturant ainsi l’interprétation théorique sous-jacente.
8.3 Interprétation de la masse physique comme analogie mécanique
Le choix sémantique du terme « masse » pour désigner la probabilité discrète n’est pas une métaphore fortuite ; il plonge ses racines dans une homologie mathématique formelle avec la mécanique rationnelle des systèmes discrets. Imaginons une tige rigide de masse nulle alignée le long de la droite réelle. En chaque point scalaire $x_i$ où la PMF attribue une probabilité non nulle, fixons une bille de plomb ponctuelle dont la masse pondérale équivaut rigoureusement à la grandeur stochastique $p_X(x_i)$.
Sous cette projection mécanique, les grandeurs fondamentales de la théorie des probabilités s’identifient immédiatement aux concepts newtoniens canoniques :
- La conservation de la masse totale unitaire $\sum p_X(x_i) = 1$ correspond à un système mécanique pesant de masse unitaire consolidée ($M_{\text{total}} = 1$).
- L’espérance mathématique $E[X] = \sum x_i p_X(x_i)$ correspond très précisément à la coordonnée du centre de gravité (ou barycentre) du système de points matériels. Si un pivot mécanique était inséré sous la droite réelle en ce point précis $\mu$, la tige demeurerait dans un équilibre horizontal parfait.
- La variance $operatorname{Var}(X) = \sum (x_i – \mu)^2 p_X(x_i)$ équivaut rigoureusement au moment d’inertie du système matériel en rotation autour de l’axe perpendiculaire passant par son centre de gravité. Une variance élevée dénote une dispersion mécanique centrifuge des masselottes vers les périphéries de la tige, augmentant sa résistance inertielle à l’accélération angulaire.
Cette analogie mécanique démontre la cohérence profonde de la fonction de masse, qui régit les points probabilistes exactement comme la mécanique newtonienne gouverne la distribution de matière discrète dans l’espace.
9. La PMF bivariée et multivariée : Distributions conjointes et marginales
Les phénomènes stochastiques du monde réel impliquent rarement des variables isolées. L’analyse simultanée de multiples grandeurs exige l’extension du concept de fonction de masse aux dimensions supérieures de l’algèbre vectorielle.
9.1 Fonction de masse conjointe de plusieurs variables
Lorsque deux variables aléatoires discrètes $X$ et $Y$ sont définies de concert sur un même espace probabilisé $(\Omega, \mathcal{F}, P)$, leur comportement stochastique commun est formalisé par la fonction de masse conjointe (ou bivariée), conventionnellement notée $p_{X,Y}$. Cette application fait correspondre à tout couple ordonné $(x, y) in \mathbb{R}^2$ la probabilité de l’intersection stochastique simultanée de leurs réalisations :
$$p_{X,Y}(x, y) = P(X = x \text{ et } Y = y) = P\big({X = x} \cap {Y = y}\big)$$
Le support bidimensionnel du couple stochastique, dénoté $R_{X,Y}$, est constitué du sous-ensemble du produit cartésien des supports individuels ($R_{X,Y} \subset R_X \times R_Y$) pour lequel la probabilité conjointe demeure strictement positive. Les deux axiomes fondamentaux de positivité et de normalisation s’étendent naturellement à cette structure par sommation bidimensionnelle :
$$\forall (x, y) in \mathbb{R}^2, \quad 0 le p_{X,Y}(x, y) le 1 \quad \text{et} \quad \sum_{x in R_X} \sum_{y in R_Y} p_{X,Y}(x, y) = 1$$
Pour des variables à supports finis comportant respectivement $m$ et $n$ états possibles, cette fonction de masse conjointe se matérialise analytiquement sous la forme d’une matrice de contingence stochastique de dimension $m \times n$, où la cellule à l’intersection de la ligne $x_i$ et de la colonne $y_j$ consigne la masse conjointe $p_{X,Y}(x_i, y_j)$, scellant ainsi l’interconnexion statistique des deux dimensions étudiées.
9.2 Lois marginales obtenues par sommation
Posséder la fonction de masse conjointe fournit une information totale sur le système bivarié, permettant d’en extraire sans perte la distribution individuelle de chacune des composantes par une procédure de marginalisation. La loi marginale de la variable $X$, notée $p_X(x)$, s’obtient en sommant l’ensemble des probabilités conjointes sur toutes les réalisations potentielles de la variable colatérale $Y$ le long de l’axe orthogonal :
$$p_X(x) = \sum_{y in R_Y} p_{X,Y}(x, y)$$
De manière parfaitement symétrique, la fonction de masse marginale de la variable $Y$ s’extrait par intégration discrète par rapport aux états admissibles de la variable $X$ :
$$p_Y(y) = \sum_{x in R_X} p_{X,Y}(x, y)$$
Cette opération d’écrasement dimensionnel obéit fidèlement au théorème des probabilités totales : en faisant varier $y$ sur l’ensemble de son support exhaustif $R_Y$, on déploie une partition de l’univers qui permet de reconstituer la masse univariée d’origine. Les lois marginales ainsi recalculées satisfont intrinsèquement à la condition unitaire univariée, garantissant que $\sum_{x in R_X} p_X(x) = 1$, et rétablissent les profils stochastiques individuels au départ de la matrice conjointe.
9.3 Probabilités conditionnelles et indépendance stochastique
La connaissance partielle de l’état pris par l’une des variables modifie l’attribution probabiliste de l’autre composante. La fonction de masse conditionnelle de $X$ sachant que la réalisation $Y = y$ est advenue (pourvu que $p_Y(y) > 0$) s’établit en accord avec la définition probabiliste fondamentale de Thomas Bayes :
$$p_{X|Y}(x mid y) = P(X = x mid Y = y) = \frac{p_{X,Y}(x, y)}{p_Y(y)} = \frac{p_{X,Y}(x, y)}{\sum_{t in R_X} p_{X,Y}(t, y)}$$
Pour un état conditionnant $y$ fixé, l’application $x \mapsto p_{X|Y}(x mid y)$ se comporte comme une authentique fonction de masse de probabilité univariée sur le support $R_X$ : elle est uniformément non négative et sa sommation par rapport à la variable active $x$ égale rigoureusement 1.
Ce formalisme conditionnel débouche sur le critère d’indépendance stochastique. Deux variables discrètes $X$ et $Y$ sont déclarées indépendantes si et seulement si leur fonction de masse conjointe se factorise exactement en le produit de leurs fonctions de masse marginales respectives sur la totalité du produit cartésien de leurs supports :
$$\forall (x, y) in R_X \times R_Y, \quad p_{X,Y}(x, y) = p_X(x) \cdot p_Y(y)$$
Lorsque cette égalité est satisfaite, la distribution conditionnelle se simplifie immédiatement en $p_{X|Y}(x mid y) = p_X(x)$, signifiant que la réalisation contingente de la variable conditionnante n’exerce aucune influence informative sur la répartition des masses de probabilité de l’autre variable.
10. Applications de la PMF en psychométrie et sciences du comportement
Dans l’investigation des conduites humaines et cognitives, la capture des données opère de façon prépondérante via des indicateurs quantifiés discrets. La fonction de masse de probabilité y constitue le socle modélisateur incontournable de la mesure.
10.1 Modélisation des échelles de Likert et réponses catégorielles
La recherche contemporaine en psychologie sociale et en sciences du comportement recourt massivement aux questionnaires structurés intégrant des échelles de Likert. Les items typiques invitent les participants à positionner leur niveau d’accord le long d’un spectre discret borné, usuellement indexé sur un support fini tel que $R_X = {1, 2, 3, 4, 5}$ (allant de « Pas du tout d’accord » à « Tout à fait d’accord »).
Le traitement statistique adéquat de ces scores exige de modéliser l’instrument au moyen d’une PMF polytomique discrète. Considérer ces échelles ordinales comme des variables continues gouvernées par une loi normale constitue une simplification abusive aux conséquences délétères. L’assignation d’une fonction de masse discrète propre permet de respecter scrupuleusement la nature granulaire des choix comportementaux, tout en intégrant des asymétries de réponse prononcées (biais d’acquiescement ou d’évitement des extrêmes) qui violent ouvertement la symétrie de la courbe en cloche continue de Gauss.
En calibrant des PMF catégorielles sur ces distributions, les psychométriciens évitent les erreurs systématiques d’estimation liées à l’assignation de probabilités à des valeurs décimales fantômes (par exemple, un score de $3{,}7$ qui n’a aucun sens physique sur une échelle de Likert stricte), garantissant une validité de construit irréprochable aux échelles d’évaluation de la personnalité et des attitudes.
10.2 Théorie de la réponse aux items (TRI) et variables discrètes
Dans l’évaluation moderne des compétences cognitives et des aptitudes scolaires, la Théorie de la Réponse aux Items (TRI) substitue à la théorie classique des scores des modèles probabilistes non linéaires sophistiqués. Lorsqu’un sujet tente de résoudre un item de test binaire (réussite encodée par 1, échec encodé par 0), la réponse est modélisée par une variable de Bernoulli dont la PMF dépend intrinsèquement d’un trait latent inobservable, traditionnellement noté $\theta$ (représentant la compétence ou l’habileté de l’individu).
Dans le modèle de Rasch à un paramètre, la fonction de masse de probabilité conditionnelle $p_X(x mid \theta)$ de l’item $i$ caractérisé par une difficulté $b_i in \mathbb{R}$ s’énonce selon la formulation logistique canonique :
$$P(X_i = 1 mid \theta) = \frac{e^{\theta – b_i}}{1 + e^{\theta – b_i}} \quad \text{et} \quad P(X_i = 0 mid \theta) = \frac{1}{1 + e^{\theta – b_i}}$$
La PMF de réponse à un test composite constitué de $K$ items indépendants devient le produit des fonctions de masse de Bernoulli individuelles conditionnées par le trait :
$$p_{\mathbf{X}}(\mathbf{x} mid \theta) = \prod_{i=1}^{K} \left( \frac{e^{\theta – b_i}}{1 + e^{\theta – b_i}} \right)^{x_i} \left( \frac{1}{1 + e^{\theta – b_i}} \right)^{1 – x_i}$$
Cette approche permet d’estimer avec une précision métrologique absolue la fonction d’information du test, isolant l’erreur type de mesure pour chaque niveau de compétence sur le continuum psychologique. La PMF discrète sert ainsi d’ancrage stochastique pour transformer des observations binaires rugueuses en une estimation continue raffinée de l’intelligence ou du savoir humain.
10.3 Comptage comportemental et modèles de décision
Les protocoles de neuropsychologie expérimentale et d’ergonomie cognitive génèrent fréquemment des variables stochastiques issues de l’observation de comportements discrets : décompte des omissions lors d’une tâche d’attention soutenue, nombre de fixations oculaires aberrantes lors de la lecture d’un texte ambigu ou comptage des conduites impulsives dans un labyrinthe décisionnel.
Ces données de comptage se prêtent idéalement à une modélisation par des PMF poissoniennes ou binomiales négatives. L’ajustement formel d’une fonction de masse de Poisson permet de dissocier le taux de base aléatoire de survenue d’un comportement d’une altération pathologique induite par une lésion cérébrale ou un stress environnemental. De même, les temps de réaction enregistrés dans les épreuves de choix forcé, bien qu’évoluant sur une échelle temporelle continue, sont souvent discrétisés en tranches temporelles (ou bins) de micro-intervalles successifs, permettant de modéliser la latence d’action via des PMF géométriques traduisant l’accumulation séquentielle de preuves perceptives jusqu’à l’atteinte d’un seuil déclencheur moteur.
Enfin, dans l’étude des modèles de décision économique et comportementale sous incertitude, le calcul de l’utilité espérée découle immédiatement de l’application de la PMF. Lorsqu’un sujet arbitre entre différentes loteries monétaires discrètes, sa décision rationnelle est prédite par l’espérance de la transformation non linéaire de ses gains, calculée via la sommation des utilités subjectives pondérées par les masses de probabilité objectives associées à chaque scénario :
$$U_{\text{globale}} = \sum_{x in R_X} u(x) \cdot p_X(x)$$
La PMF offre ainsi aux spécialistes des sciences cognitives l’opérateur arithmétique indispensable pour sonder la rationalité et la subjectivité humaine face au risque.
11. Estimation et inférence statistique liées à la PMF
Le théoricien des probabilités déduit le comportement d’un système à partir d’une PMF postulée a priori, mais le statisticien praticien est confronté au problème inverse : inférer la véritable fonction de masse génératrice à partir d’observations empiriques partielles et bruitées.
11.1 Estimation empirique de la fonction de masse
Soit un échantillon aléatoire de taille $n$ constitué de variables aléatoires i.i.d. (indépendantes et identiquement distribuées) $X_1, X_2, dots, X_n$ tirées selon une fonction de masse théorique inconnue $p_X$. L’estimateur non paramétrique canonique de la valeur de la PMF au point $x$, désigné sous le terme de fonction de masse empirique $\hat{p}_n(x)$, s’établit par le calcul de la fréquence relative de l’état au sein de l’échantillon :
$$\hat{p}_n(x) = \frac{1}{n} \sum_{i=1}^{n} \mathbb{I}(X_i = x)$$
où $\mathbb{I}(\cdot)$ représente la fonction indicatrice d’événement, valant 1 si l’égalité est satisfaite et 0 dans le cas contraire. Cet estimateur empirique possède des propriétés théoriques optimales :
- Absence de biais : Pour toute taille d’échantillon, son espérance mathématique coïncide rigoureusement avec la cible théorique : $E[\hat{p}_n(x)] = p_X(x)$.
- Variance décroissante : La variance de l’estimateur s’énonce comme celle d’une proportion binomiale : $operatorname{Var}(\hat{p}_n(x)) = \frac{p_X(x)(1 – p_X(x))}{n}$, tendant vers zéro lorsque la taille d’échantillon $n$ s’accroît indéfiniment.
- Convergence presque sûre : En vertu de la Loi Forte des Grands Nombres, la fonction de masse empirique converge presque sûrement vers la PMF théorique : $P\left(\lim_{n to \infty} \hat{p}_n(x) = p_X(x)\right) = 1$.
Lorsque le support comporte plusieurs modalités catégorielles disjointes, la variabilité conjointe du vecteur d’estimation empirique est gouvernée par une loi multinomiale. L’établissement d’intervalles de confiance simultanés requiert l’ajustement de corrections de multiplicité (telles que les corrections de Bonferroni ou les bandes de confiance de Goodman) pour préserver la couverture nominale sur l’intégralité du support estimé.
11.2 Estimation des paramètres par le maximum de vraisemblance (MLE)
Lorsqu’un modèle paramétrique est postulé pour la fonction de masse (par exemple, une loi de Poisson de paramètre inconnu $lambda$, ou une loi binomiale de succès $p$), l’estimation procède généralement par la méthode du Maximum de Vraisemblance (MLE – Maximum Likelihood Estimation). Pour un échantillon d’observations indépendantes $\mathbf{x} = (x_1, x_2, dots, x_n)$, la fonction de vraisemblance $L(\theta mid \mathbf{x})$ s’exprime comme le produit tensoriel des fonctions de masse individuelles conditionnées par le vecteur des paramètres $\theta$ :
$$L(\theta mid \mathbf{x}) = \prod_{i=1}^{n} p_X(x_i; \theta)$$
Pour simplifier l’optimisation mathématique, on applique le logarithme népérien afin de transformer le produit en une sommation séparable, définissant ainsi la fonction de log-vraisemblance :
$$ell(\theta mid \mathbf{x}) = \ln L(\theta mid \mathbf{x}) = \sum_{i=1}^{n} \ln\big(p_X(x_i; \theta)\big)$$
L’estimateur du maximum de vraisemblance $\hat{\theta}_{\text{MLE}}$ est localisé en résolvant l’équation de score vectorielle, annulant le gradient de la log-vraisemblance par rapport aux paramètres :
$$\nabla_\theta , ell(\theta mid \mathbf{x}) = \mathbf{0}$$
Sous réserve de régularité analytique de la PMF, les estimateurs ainsi dérivés bénéficient de propriétés asymptotiques royales : ils sont convergents, asymptotiquement normaux et asymptotiquement efficaces, atteignant la célèbre borne inférieure de Cramér-Rao gouvernée par la matrice d’information de Fisher.
11.3 Tests d’adéquation de lois discrètes (Goodness-of-Fit)
Une fois les paramètres d’une PMF théorique estimés, le praticien doit impérativement éprouver la validité de l’adéquation globale du modèle aux données expérimentales. Le test standardisé par excellence est le test d’adéquation du Chi-deux de Pearson ($\chi^2$).
Soit une partition du support discret en $k$ classes mutuellement disjointes. Dénotons par $O_j$ le nombre d’observations empiriques constatées dans la classe $j$, et par $E_j = n \cdot p_j(\hat{\theta})$ le décompte théorique prédit par l’évaluation de la PMF sous l’hypothèse nulle $H_0$. La statistique de divergence du Chi-deux s’établit par la métrique quadratique :
$$X^2 = \sum_{j=1}^{k} \frac{(O_j – E_j)^2}{E_j}$$
Sous l’hypothèse nulle d’adéquation de la PMF postulée, cette statistique converge asymptotiquement vers une loi du $\chi^2$ à $k – 1 – m$ degrés de liberté, où $m$ consigne le nombre de paramètres indépendants estimés sur l’échantillon par maximum de vraisemblance. Si la quantité observée $X^2$ excède le seuil critique pour un niveau de signification $\alpha$ donné, l’hypothèse stipulant que les données proviennent de la PMF théorique candidate est rejetée.
Dans les configurations d’échantillons restreints où les effectifs attendus $E_j$ descendent en deçà du seuil critique de 5 individus par modalité, le théorème central limite cesse de garantir la normalité asymptotique requise par Pearson. Le statisticien doit alors renoncer au test du Chi-deux asymptotique pour mobiliser des tests d’ajustement exacts fondés sur la loi multinomiale globale, ou implémenter des procédures non paramétriques intensives par bootstrap stochastique ou tests de Monte Carlo.
12. Synthèse méthodologique, limites et perspectives théoriques
L’emploi judicieux de la fonction de masse de probabilité impose d’en appréhender les contraintes intrinsèques, les frontières opérationnelles et les passerelles analytiques vers le calcul infinitésimal.
12.1 Sensibilité aux erreurs de catégorisation et biais de discrétisation
L’utilisation d’une PMF implique une sélection préalable drastique de son support. Si la discrétisation découle d’un phénomène discontinu authentique (comme le comptage de personnes ou d’événements physiques indivisibles), la PMF capture l’essence ontologique du système. En revanche, lorsque le statisticien discrétise artificiellement un processus physique ou psychologique sous-jacent continu (par exemple, en compressant des temps de réponse continus en catégories « rapides », « moyens » et « lents »), il introduit des biais de discrétisation sévères.
Cette opération de regroupement forcé induit une perte irréversible d’information fisherienne et rend le modèle hautement tributaire du positionnement arbitraire des frontières de coupure (effet MAUP – Modifiable Areal Unit Problem en statistique spatiale et catégorielle). Une légère translation d’une frontière de seuil peut altérer substantiellement la valeur relative des masses de probabilité attribuées aux différents barreaux du support.
Un autre écueil méthodologique récurrent concerne le phénomène de surdispersion (overdispersion) au sein des modèles de comptage. Fréquemment, les chercheurs postulent une fonction de masse de Poisson pour modéliser des effectifs, occultant la contrainte structurelle d’équidispersion stricte propre à cette PMF (qui impose l’égalité obligatoire $E[X] = operatorname{Var}(X) = \lambda$). Si la variance empirique dépasse substantiellement l’espérance — un phénomène omniprésent en biologie et en sociologie dû à l’hétérogénéité non observée des sujets —, l’ajustement d’une PMF de Poisson standard conduit à une sous-estimation massive des erreurs-types et à des conclusions fallacieusement significatives. Le recours à des PMF plus plastiques, telles que la loi binomiale négative (qui intègre un paramètre de dispersion autonome) ou des modèles de Poisson gonflés en zéros (Zero-Inflated Poisson), devient alors une exigence impérative pour préserver l’intégrité de l’inférence.
12.2 Approximations continues des lois discrètes
Bien que la PMF appartienne formellement à la sphère discrète, il est fréquent que les calculs de sommes combinatoires finies ou dénombrables deviennent analytiquement insolubles ou numériquement prohibitifs lorsque les paramètres scalaires croissent de façon démesurée. Dans ces régimes extrêmes, le statisticien recourt à des théorèmes limites pour approximer la PMF discrète par une fonction de densité continue (PDF).
Le prototype historique de cette passerelle est le théorème de De Moivre-Laplace, cas particulier pionnier du Théorème Central Limite. Ce théorème établit que lorsque la taille d’échantillon $n$ tend vers l’infini, la PMF d’une loi binomiale $\mathcal{B}(n, p)$ converge uniformément vers la densité d’une loi normale de moyenne $\mu = np$ et de variance $\sigma^2 = np(1-p)$ :
$$\lim_{n to \infty} P\left( \frac{X – np}{\sqrt{np(1-p)}} = z \right) \approx \frac{1}{\sqrt{2\pi}} e^{-z^2/2}$$
L’implémentation opérationnelle de cette approximation continue impose l’usage rigoureux d’une correction de continuité. Pour calculer la masse ponctuelle d’un entier $k$ ou d’un intervalle discret à l’aide de l’intégrale continue, il convient d’étendre artificiellement la frontière de sommation d’un demi-intervalle ($\pm 0{,}5$) :
$$P(X = k) \approx \int_{k – 0{,}5}^{k + 0{,}5} \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{(t – \mu)^2}{2\sigma^2} \right) dt$$
Les critères heuristiques classiques stipulent que cette approximation normale de la PMF binomiale n’est méthodologiquement recevable que si les conditions conjointes $np ge 5$ et $n(1-p) ge 5$ sont scrupuleusement satisfaites, garantissant une symétrie suffisante pour que la densité gaussienne se substitue sans déformation inadmissible au diagramme en bâtons discret.
12.3 Recommandations pratiques pour le praticien et le chercheur
Face à un jeu de données empiriques, le choix d’une fonction de masse de probabilité doit résulter d’une analyse déterministe rigoureuse dictée par les caractéristiques physiques de l’expérience et la topologie des variables collectées. L’arbre décisionnel suivant résume les règles de guidage méthodologique recommandées :
- Support binaire strict ($R_X = {0, 1}$) : La modélisation impose obligatoirement la PMF de Bernoulli. C’est l’atome élémentaire de toute décision bivalente ou item psychométrique binaire.
- Décompte d’occurrences sur des essais bornés fixes ($R_X = {0, 1, dots, n}$) : Si les épreuves sont indépendantes et avec remise, sélectionner la PMF binomiale. Si l’échantillonnage s’effectue sans remise au sein d’une population finie, la PMF hypergéométrique est formellement requise pour préserver la dépendance stochastique.
- Processus d’attente jusqu’au succès : Si l’on dénombre le nombre d’essais pour décrocher le premier succès, adopter la PMF géométrique. Si l’objectif concerne l’obtention d’un quota de $r$ succès, déployer la PMF binomiale négative.
- Décompte d’événements sans borne supérieure fixe ($R_X = \mathbb{N}$) : Pour des événements distribués uniformément dans le temps ou l’espace sans saturation apparente, la PMF de Poisson constitue le choix par défaut, sous réserve expresse de contrôler l’égalité de la moyenne et de la variance. En cas de surdispersion statistiquement avérée ($\sigma^2 > \mu$), basculer immédiatement vers une distribution binomiale négative ou un modèle quasi-Poisson.
Dans toute publication académique ou rapport d’ingénierie statistique, la transparence protocolaire impose de spécifier explicitement la formule de la PMF retenue, ses paramètres estimés accompagnés de leurs intervalles de confiance respectifs, les résultats des tests formels d’adéquation (Goodness-of-Fit), et de justifier analytiquement les raisons ayant motivé le choix d’une modélisation discrète de préférence à une approximation continue.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Categorical+Data+Analysis%2C+3rd+Edition-p-9780470463635
- Blitzstein, J. K., & Hwang, J. (2019). Introduction to probability (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429195976
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Kolmogorov, A. N. (1956). Foundations of the theory of probability (N. Morrison, Trans.; 2nd English ed.). Chelsea Publishing Company. (Ouvrage original publié en allemand en 1933 sous le titre Grundbegriffe der Wahrscheinlichkeitsrechnung).
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Papoulis, A., & Pillai, S. U. (2002). Probability, random variables, and stochastic processes (4th ed.). McGraw-Hill.
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danish Institute for Educational Research.
- Ross, S. M. (2014). A first course in probability (9th ed.). Pearson.
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7th ed.). Cengage Learning.