
La mesure en psychologie et en sciences sociales représente un défi épistémologique singulier : comment quantifier avec rigueur des entités qui échappent par nature à l’observation sensorielle directe ? Contrairement aux sciences physiques, où l’étalon du mètre ou du kilogramme repose sur des constantes universelles tangibles, la psychométrie doit appréhender des construits hypothétiques tels que l’intelligence, les traits de personnalité, l’anxiété ou les compétences cognitives. Dans cette quête d’objectivité métrologique, la valeur scientifique d’un instrument d’évaluation dépend inexorablement de deux piliers fondamentaux : sa validité et sa fidélité. Sans une fidélité irréprochable, toute inférence diagnostique ou prédictive devient caduque, exposant le praticien comme le chercheur au risque d’attribuer à des variations réelles de l’individu ce qui ne relève en réalité que du bruit de mesure.
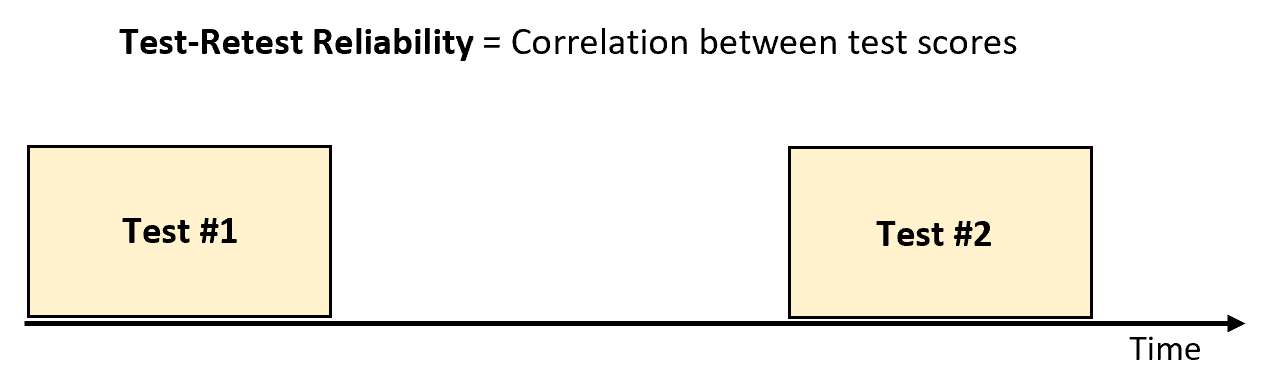
Parmi les multiples facettes de la fidélité psychométrique, la fidélité test-retest — souvent désignée sous le terme de stabilité temporelle — occupe une place prépondérante. Elle interroge directement la pérennité du score à travers le temps : si un individu est évalué au moyen du même instrument à deux moments distincts, dans des conditions similaires, obtiendra-t-il un résultat comparable ? Cette question, d’apparence élémentaire, soulève des enjeux méthodologiques et statistiques d’une rare complexité. Elle confronte la rigueur mathématique des modèles de corrélation aux aléas inhérents à la condition humaine, tels que la mémoire, la fatigue, l’apprentissage ou la maturation spontanée du sujet.
Le présent article propose une exploration exhaustive de la fidélité test-retest, depuis ses fondements théoriques enracinés dans la théorie classique des tests jusqu’à ses applications pratiques contemporaines en clinique, en éducation et dans la recherche biomédicale. Nous détaillerons les mécanismes algébriques qui sous-tendent son calcul, analyserons les critères d’interprétation des coefficients obtenus, examinerons les sources d’erreur susceptibles de biaiser les résultats et explorerons les alternatives statistiques modernes telles que le coefficient de corrélation intraclasse. À travers une démarche didactique et rigoureuse, ce guide constitue une référence approfondie pour quiconque souhaite maîtriser la métrologie des scores répétés.
1. Introduction fondamentale à la fidélité test-retest en psychométrie
1.1 Le rôle central de la fidélité dans la mesure psychologique
La psychométrie moderne se définit comme la discipline scientifique consacrée à l’élaboration, à l’évaluation et à l’application de techniques d’évaluation quantitative des caractéristiques psychologiques. Au cœur de cette discipline réside la nécessité d’opérationnaliser des construits latents, c’est-à-dire des variables théoriques inobservables directement qui sous-tendent les comportements manifestes des individus. Qu’il s’agisse de mesurer le niveau de raisonnement fluide d’un enfant, l’intensité d’un épisode dépressif caractérisé ou le degré d’extraversion d’un candidat à un poste, le psychologue ne dispose pas d’un accès direct à ces dimensions psychiques. Il doit concevoir des épreuves standardisées — questionnaires, batteries neuropsychologiques, tests de performance maximale — dont les scores bruts sont censés refléter l’ampleur du trait latent sous-jacent.
Dans ce contexte métrologique, une distinction primordiale s’impose entre la validité et la fidélité (ou fiabilité) d’un outil. La validité s’assure que le test mesure effectivement le construit psychologique qu’il prétend mesurer, et non une variable parasite. La fidélité, quant à elle, s’attache à la précision, à la consistance et à la reproductibilité de la mesure, indépendamment de ce qui est mesuré. Un instrument peut être remarquablement fidèle sans pour autant être valide ; en revanche, il est mathématiquement et logiquement impossible qu’un outil soit valide s’il n’est pas d’abord fidèle. En effet, si un thermomètre défectueux affiche des températures aléatoires oscillant de dix degrés d’une minute à l’autre sans changement thermique ambiant, la notion même de validité de sa mesure s’effondre.
Les conséquences de l’instabilité d’un instrument d’évaluation sont désastreuses, tant sur le plan clinique qu’expérimental. Dans une perspective diagnostique, un test manquant de fidélité temporelle peut conduire à classer erronément un patient au-dessus ou en deçà d’un seuil pathologique d’une semaine à l’autre, générant des faux positifs ou des faux négatifs dommageables pour la prise en charge thérapeutique. En recherche expérimentale, une faible fidélité dilue la puissance statistique des tests d’hypothèses, accroît la variance d’erreur et atténue artificiellement les coefficients de corrélation observés entre variables, masquant potentiellement des relations causales pourtant réelles. Les origines de cette réflexion remontent aux travaux pionniers de Charles Spearman au début du XXe siècle, qui formula les premiers axiomes de ce qui deviendra la théorie classique des tests, insistant sur le fait que tout score observé est inéluctablement entaché d’une part d’erreur aléatoire.
1.2 La notion de reproductibilité des scores dans le temps
Le principe cardinal de la fidélité test-retest repose sur le postulat d’invariance temporelle des attributs psychologiques stables. Lorsqu’une caractéristique individuelle est théorisée comme un trait durable — par opposition à un état passager —, l’outil censé la mesurer doit impérativement produire des résultats constants lorsque l’évaluation est réitérée dans des conditions rigoureusement identiques. Cette exigence de reproductibilité impose d’opérer une différenciation conceptuelle méticuleuse entre l’état (state) et le trait (trait), dichotomie largement popularisée par les travaux de Charles Spielberger dans le domaine de l’anxiété. L’anxiété-trait représente une disposition générale et pérenne de la personnalité à percevoir des situations comme menaçantes, tandis que l’anxiété-état renvoie à une réaction émotionnelle transitoire déclenchée par un stimulus immédiat.
Alors qu’il serait insensé d’exiger d’une échelle d’anxiété-état une stabilité temporelle élevée sur un intervalle de plusieurs semaines — puisque son objectif est précisément de capturer les fluctuations affectives en réponse à l’environnement —, un inventaire d’anxiété-trait ou un test de quotient intellectuel se doit d’exhiber une invariance remarquable des scores. Si un individu sain obtient un score de 115 à un test d’intelligence un lundi matin et un score de 95 le lundi suivant, en l’absence de tout événement neurologique ou traumatique, cette divergence spectaculaire ne peut être imputée à une baisse subite des capacités cognitives intrinsèques du sujet. Elle dénonce indubitablement la défaillance métrologique de l’instrument utilisé.
Pour garantir la validité de l’évaluation de la reproductibilité temporelle, des conditions d’administration hautement standardisées s’avèrent impératives lors des deux passations successives. Les consignes verbales, l’environnement physique (éclairage, niveau de bruit, température ambiante), le support de passation (papier-crayon ou informatisé) et l’attitude de l’examinateur doivent demeurer constants. La moindre altération de ces paramètres contextuels est susceptible d’induire des fluctuations environnementales immédiates qui s’incorporeront à la variance d’erreur, venant masquer la véritable stabilité intrinsèque du test étudié.
1.3 Objectifs et portée de l’analyse test-retest
L’objectif primordial de l’analyse de fidélité test-retest est d’estimer avec précision la robustesse d’un test face au simple passage du temps. Cette démarche permet aux concepteurs d’outils d’évaluation de quantifier la part de variance attribuable aux caractéristiques réelles des sujets par rapport à la variance imputable aux aléas temporels non contrôlés. En obtenant une estimation chiffrée de cette consistance, la communauté scientifique et les praticiens disposent d’un indicateur tangible leur permettant de déterminer si un instrument est apte à être déployé dans des contextes décisionnels critiques.
Dans le domaine des suivis longitudinaux, l’analyse test-retest revêt une portée stratégique majeure. Elle garantit l’équivalence métrique des scores au fil du temps, assurant que les évolutions constatées chez un individu ou une cohorte reflètent de véritables trajectoires de développement, des processus de réadaptation cognitive ou les bénéfices authentiques d’une intervention pharmacologique ou psychothérapeutique. Sans la démonstration préalable d’une haute stabilité test-retest, toute étude d’efficacité clinique devient vulnérable aux critiques méthodologiques, dans la mesure où l’effet présumé du traitement ne pourrait être distingué des oscillations spontanées de l’instrument de mesure.
Au-delà des aspects purement techniques, la fidélité test-retest comporte des implications éthiques et déontologiques fondamentales dans la pratique clinique, judiciaire et éducative. Lorsqu’un psychologue scolaire pose une indication d’orientation vers une structure d’enseignement spécialisé sur la base d’une batterie cognitive, ou lorsqu’un expert judiciaire évalue la responsabilité pénale d’un accusé en s’appuyant sur des échelles de psychopathologie, les conséquences sur la vie des individus sont considérables. Utiliser un outil dont la stabilité temporelle n’a pas été rigoureusement attestée expose le professionnel à émettre des jugements diagnostiques erratiques, compromettant la justice et la bienveillance inhérentes à l’acte psychologique.
2. Définition conceptuelle et théorique de la fidélité test-retest
2.1 Le postulat de la théorie classique des tests (TCT)
La formalisation théorique de la fidélité test-retest puise ses fondements directs dans la théorie classique des tests (TCT), initiée par Spearman et ultérieurement formalisée par Harold Gulliksen ainsi que par Frederic Lord et Melvin Novick. Selon le postulat fondamental de ce modèle axiomatique, tout score observé pour un individu à une mesure donnée (noté $X$) est la résultante linéaire de deux composantes distinctes et non corrélées : un score vrai (noté $T$, pour True score) et une erreur de mesure aléatoire (notée $E$, pour Error). Cette relation s’énonce selon l’équation élémentaire :
X = T + E
Le score vrai $T$ est défini sur le plan conceptuel comme l’espérance mathématique des scores observés si le sujet était évalué un nombre infini de fois dans des conditions parfaitement indépendantes et identiques. L’erreur de mesure $E$, quant à elle, représente la somme de toutes les perturbations contingentes, non prévisibles et éphémères qui viennent altérer le score lors d’une administration donnée. La TCT formule plusieurs hypothèses indispensables : l’erreur aléatoire possède une espérance nulle ($E(E) = 0$), ce qui signifie qu’elle ne favorise ni ne défavorise systématiquement le sujet ; la corrélation entre le score vrai et l’erreur de mesure est rigoureusement nulle ($r_{TE} = 0$) ; et les erreurs de mesure associées à deux passations distinctes sont indépendantes les unes des autres ($r_{E_1E_2} = 0$).
À partir de ces postulats d’indépendance, la variance totale des scores observés au sein d’une population ($\sigma^2_X$) se décompose de manière additive en variance des scores vrais ($\sigma^2_T$) et variance d’erreur ($\sigma^2_E$) :
σ2X = σ2T + σ2E
Dès lors, le coefficient de fidélité général ($\rho_{XX’}$) est formellement défini comme le rapport entre la variance des scores vrais et la variance totale des scores observés :
ρXX’ = σ2T / σ2X = 1 – (σ2E / σ2X)
Dans le cas spécifique de la fidélité test-retest, ce ratio métrologique s’incarne empiriquement sous la forme du coefficient de stabilité. Ce coefficient estime la proportion de la variance des scores observés qui demeure invariante au cours de l’intervalle séparant les deux sessions d’évaluation, attribuant toute divergence observée entre les passations successives à la seule variance d’erreur temporelle.
2.2 Stabilité temporelle et consistance des mesures
L’investigation de la stabilité temporelle interroge le degré d’homogénéité des réponses fournies par un même panel d’individus à deux temps distincts. Cependant, une distinction méthodologique fondamentale doit être opérée entre la stabilité absolue des scores et la stabilité relative (ou consistance du rang). La stabilité absolue exige que chaque individu obtienne rigoureusement la même valeur numérique lors de la seconde administration que lors de la première. À l’opposé, la consistance relative n’impose pas l’identité absolue des scores bruts, mais exige le maintien scrupuleux du positionnement ou du rang relatif des sujets au sein de la distribution du groupe de référence.
Cette distinction s’avère cruciale pour appréhender la nature des perturbations métriques. D’une part, les fluctuations aléatoires — telles que de légères variations d’attention chez certains participants ou des devinettes heureuses sur des items difficiles — affectent la consistance relative de manière imprévisible, introduisant du désordre dans l’ordonnancement des sujets et réduisant ainsi directement le coefficient de corrélation test-retest. D’autre part, les biais systématiques d’évaluation — comme un effet d’apprentissage uniforme qui ferait progresser l’ensemble de la cohorte de 5 points au retest — modifient la stabilité absolue des mesures sans nécessairement altérer leur consistance relative. La corrélation de Pearson standard, traditionnellement employée pour quantifier la fidélité test-retest, est exclusivement sensible à la consistance relative et s’avère parfaitement aveugle aux glissements constants de moyenne, une limitation méthodologique d’importance majeure que nous approfondirons ultérieurement.
2.3 Conditions d’application de la fidélité test-retest
L’estimation légitime de la fidélité test-retest repose sur des conditions prérequises strictes, dont le non-respect entraîne une falsification de l’indice de stabilité calculé. La première condition impérative réside dans l’hypothèse de constance absolue du construit psychologique sous-jacent durant la fenêtre temporelle sélectionnée. Si le trait évalué évolue naturellement au cours de cette période — par exemple, le développement rapide du vocabulaire chez un nourrisson ou le déclin cognitif accéléré dans une démence neurodégénérative sévère —, l’instabilité constatée des scores n’est en rien imputable aux imperfections de l’instrument, mais découle de la dynamique biologique ou psychologique du sujet lui-même.
En second lieu, le protocole expérimental exclut formellement toute survenue d’intervention thérapeutique, pédagogique, médicale ou environnementale significative entre les deux sessions. L’administration d’un traitement anxiolytique entre le test et le retest d’une échelle de phobie sociale fausserait intrinsèquement l’estimation de la fidélité de l’outil, confondant l’efficacité thérapeutique avec l’erreur métrologique. Enfin, la troisième condition impose le maintien rigoureux de conditions expérimentales identiques : même heure d’administration pour neutraliser les rythmes circadiens de vigilance, même environnement physique dénué de distractions sensorielles, et respect absolu de la standardisation des consignes transmises par les évaluateurs.
3. Les fondements statistiques : Calcul et coefficient de corrélation de Pearson
3.1 Le coefficient de corrélation linéaire de Pearson (r)
L’approche statistique conventionnelle pour quantifier la fidélité test-retest consiste à administrer un instrument à un échantillon représentatif de $N$ participants à un instant $T_1$, puis à réadministrer le même instrument à ces mêmes sujets à un instant ultérieur $T_2$. Les deux séries de scores continus ainsi obtenues, notées respectivement $X$ (scores au test) et $Y$ (scores au retest), font ensuite l’objet d’une analyse de corrélation bivariée au moyen du coefficient de corrélation produit-moment de Pearson, désigné par la lettre $r$.
Sur le plan mathématique, le coefficient de corrélation de Pearson est défini comme le rapport entre la covariance des deux séries de mesures et le produit de leurs écarts-types respectifs. La formule générale s’énonce comme suit :
rXY = Cov(X, Y) / (σX × σY) = ∑[(Xi – X̄)(Yi – Ȳ)] / √[∑(Xi – X̄)2 × ∑(Yi – Ȳ)2]
Les propriétés métriques du coefficient de Pearson imposent qu’il s’étende strictement à l’intérieur de l’intervalle fermé $[-1, +1]$. Dans le cadre de l’évaluation de la stabilité temporelle, la signification théorique des valeurs extrêmes est sans ambiguïté : un coefficient de $r = +1$ traduit une stabilité linéaire absolue et parfaite, où le rang et l’espacement relatif de tous les participants demeurent rigoureusement identiques d’une passation à l’autre ; une valeur de $r = 0$ dénote une absence totale de consistance temporelle, les scores du retest se distribuant de manière aléatoire par rapport à ceux du test initial ; enfin, une corrélation négative ($r < 0$) constituerait une anomalie psychométrique majeure, indiquant paradoxalement que les participants les plus performants à $T_1$ deviennent systématiquement les moins performants à $T_2$.
L’application rigoureuse du coefficient de Pearson requiert la satisfaction de plusieurs hypothèses statistiques fondamentales. Les données doivent être de nature continue (mesurées au moins sur une échelle d’intervalles) et obéir au postulat de normalité bivariée, signifiant que la distribution conjointe des variables $X$ et $Y$ suit une loi normale à deux dimensions. De surcroît, la relation unissant les scores du test à ceux du retest doit impérativement être linéaire et homoscédastique, c’est-à-dire que la dispersion des scores à $T_2$ doit demeurer homogène sur l’ensemble de l’éventail des scores obtenus à $T_1$.
3.2 Étapes algébriques du calcul du coefficient de stabilité
La mise en œuvre calculatoire du coefficient de stabilité temporelle se décompose en une suite ordonnée d’opérations algébriques élémentaires mais hautement rigoureuses. La première étape consiste à déterminer les moyennes arithmétiques respectives des scores obtenus lors de la session initiale ($\bar{X}$) et de la session ultérieure ($\bar{Y}$) :
X̄ = (1/N) × ∑ Xi et Ȳ = (1/N) × ∑ Yi
Dans un deuxième temps, le statisticien calcule les scores d’écart à la moyenne pour chaque individu, définis par $(X_i – \bar{X})$ et $(Y_i – \bar{Y})$. Ces écarts permettent de situer chaque participant par rapport au centre de gravité de la distribution de son groupe lors de chacune des deux sessions d’évaluation.
La troisième étape requiert le calcul de la somme des produits croisés de ces écarts centrés, quantité correspondant au numérateur de la formule de Pearson :
SP = ∑ [(Xi – X̄)(Yi – Ȳ)]
Cette somme mesure la tendance des variations individuelles à concorder entre les deux passations : une contribution positive émerge lorsqu’un sujet se situe simultanément au-dessus (ou en dessous) des moyennes respectives aux deux temps de mesure.
La quatrième étape consiste à calculer la variabilité totale au sein de chaque passation, via les sommes des carrés des écarts (notées respectivement $SCE_X$ et $SCE_Y$) :
SCEX = ∑ (Xi – X̄)2 et SCEY = ∑ (Yi – Ȳ)2
Enfin, la normalisation finale s’opère en divisant la somme des produits croisés par la racine carrée du produit des deux sommes des carrés :
rtest-retest = SP / √(SCEX × SCEY)
Cette normalisation algébrique garantit l’invariance d’échelle du coefficient obtenu, permettant de comparer directement la stabilité métrologique d’instruments exprimés dans des unités de mesure distinctes.
3.3 Alternatives non paramétriques pour données ordinales
Lorsque les scores recueillis ne satisfont pas aux exigences strictes de la métrique d’intervalles ou que les postulats de normalité bivariée sont manifestement violés — notamment en présence de distributions fortement asymétriques ou tronquées par des effets de plancher ou de plafond —, le recours au coefficient de corrélation linéaire de Pearson devient méthodologiquement discutable. Dans ces circonstances, des alternatives statistiques non paramétriques doivent être mobilisées.
La solution la plus couramment déployée est le coefficient de corrélation des rangs de Spearman, désigné par $rho$ (rho) ou $r_s$. Ce coefficient consiste à remplacer les scores quantitatifs bruts de chaque participant par leurs rangs respectifs au sein de l’échantillon pour chacune des deux passations, avant d’appliquer la formule de corrélation. Si aucune égalité de rang (ex æquo) n’est observée, la formule simplifiée de Spearman s’applique élégamment :
ρ = 1 – [6 × ∑ di2 / (N(N2 – 1))]
où $d_i = Rang(X_i) – Rang(Y_i)$ représente la différence entre les rangs attribués au sujet $i$ lors des sessions $T_1$ et $T_2$, et $N$ le nombre total de sujets. Lorsque les données comportent de nombreux ex æquo ou proviennent d’échantillons de taille modeste, le coefficient $tau$ (tau) de Kendall est généralement privilégié en raison de ses propriétés statistiques supérieures et de son interprétation probabiliste directe fondée sur les paires concordantes et discordantes.
Néanmoins, les méthodes fondées sur les rangs comportent une limitation conceptuelle majeure : elles sont intrinsèquement insensibles aux variations d’amplitude des scores bruts. Deux profils de données dont les distances absolues entre participants diffèrent drastiquement produiront un coefficient de Spearman rigoureusement identique dès lors que l’ordonnancement hiérarchique des sujets est conservé, occultant de facto de substantielles pertes d’information métrologique.
4. Exemple concret et étape par étape d’une étude de fidélité test-retest
4.1 Mise en place du protocole expérimental
Afin d’illustrer de manière pragmatique les mécanismes opératoires d’une étude de fidélité test-retest, considérons la démarche de validation d’un nouveau test standardisé mesurant le raisonnement logique non verbal chez l’adulte. L’équipe de recherche recrute une cohorte représentative de 50 participants adultes volontaires (25 femmes et 25 hommes, âgés de 20 à 45 ans, moyenne d’âge = 28,4 ans). Les participants sont présumés indemnes de tout trouble neurologique ou psychiatrique susceptible d’altérer la stabilité de leurs fonctions exécutives.
La première administration du test ($T_1$) a lieu le 1er mars dans un laboratoire universitaire dédié aux sciences cognitives. Chaque participant est installé dans un box insonorisé individuel, devant un écran calibré présentant les 40 items sous forme de matrices logiques. Les consignes verbales sont rigoureusement scriptées et lues par un examinateur certifié. L’heure de passation est systématiquement fixée entre 9h30 et 11h00 afin de standardiser les niveaux de vigilance matinale et de minimiser les effets de la fatigue cognitive.
La seconde session d’évaluation ($T_2$) est planifiée exactement un mois plus tard, le 1er avril. Ce choix temporel de quatre semaines est délibéré : il est jugé suffisamment long pour dissiper les effets de mémorisation mot à mot des items spécifiques, tout en demeurant assez court pour garantir l’absence de maturation cognitive ou de changements développementaux notables au sein de cette population adulte. L’ensemble des conditions physiques, logicielles et contextuelles est répliqué avec une précision chirurgicale.
4.2 Collecte et alignement des données appariées
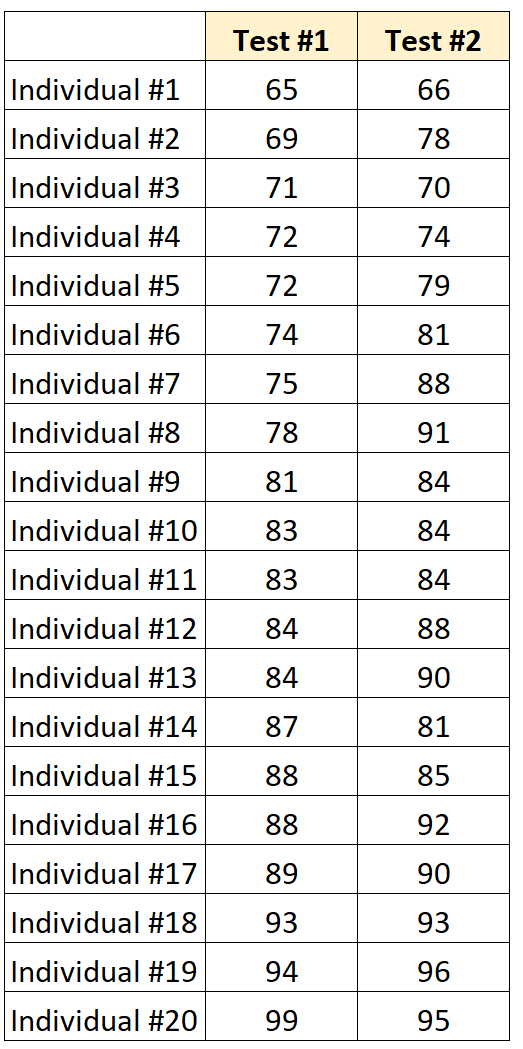
Au terme des deux sessions de mesure, les scores bruts sont enregistrés dans une matrice de données bivariée. Chaque ligne correspond à un sujet unique identifié par un code anonymisé, garantissant un appariement parfait entre la performance initiale à $T_1$ (variable $X$) et la performance au retest à $T_2$ (variable $Y$). Le test étant composé de 40 items dichotomiques (cotés 0 ou 1), le score total théorique oscille de 0 à 40 points.
Avant d’engager tout calcul inférentiel, une inspection visuelle des données appariées est effectuée via la génération d’un diagramme de dispersion (scatterplot). Ce nuage de points permet de vérifier graphiquement la linéarité de la trajectoire reliant les performances des deux sessions et de confirmer l’absence d’hétéroscédasticité manifeste. Cette étape exploratoire permet en outre d’identifier d’éventuels points aberrants ou discordances extrêmes de passation.
Supposons qu’un participant ait obtenu un score de 36/40 lors de la session initiale mais s’effondre à 12/40 lors du retest. Une telle anomalie métrique impose une vérification qualitative immédiate du journal d’expérimentation. Si l’interrogatoire révèle que ce participant souffrait d’une céphalée aiguë invalidante le jour de la seconde session ou que ses réponses ont été interrompues par un malaise vagal, la donnée doit être documentée comme invalide pour des motifs procéduraux indépendants de l’instrument lui-même. Dans notre cohorte de 50 sujets, aucune anomalie procédurale n’étant relevée, la matrice complète est retenue pour l’analyse computationnelle.
4.3 Résolution numérique et calcul de la corrélation
Les paramètres descriptifs calculés sur notre échantillon de $N = 50$ participants révèlent les valeurs globales suivantes :
- Moyenne des scores à $T_1$ : $\bar{X} = 26,40$
- Moyenne des scores à $T_2$ : $\bar{Y} = 27,80$
- Somme des carrés des écarts pour $T_1$ : $SCE_X = \sum (X_i – \bar{X})^2 = 1,245,60$
- Somme des carrés des écarts pour $T_2$ : $SCE_Y = \sum (Y_i – \bar{Y})^2 = 1,312,20$
- Somme des produits croisés des écarts : $SP = \sum [(X_i – \bar{X})(Y_i – \bar{Y})] = 1,125,40$
L’application directe de la formule de Pearson permet de dériver le coefficient empirique de corrélation test-retest :
rtest-retest = 1,125,40 / √(1,245,60 × 1,312,20) = 1,125,40 / √(1,634,476,32) = 1,125,40 / 1,278,46 ≈ 0,8803
Le coefficient de corrélation obtenu est donc de $r = 0,88$. Sur le plan psychométrique, ce résultat traduit une corrélation positive très forte et témoigne d’une remarquable consistance temporelle des scores de raisonnement non verbal au sein de cette cohorte sur une durée d’un mois. Bien qu’une légère hausse de la moyenne globale soit constatée entre les deux sessions ($\bar{Y} – \bar{X} = +1,40$ point), imputable à un effet de familiarisation modéré avec l’interface, l’ordonnancement relatif des participants est demeuré hautement stable, attestant de l’excellente fidélité temporelle du test.
5. Interprétation des seuils et critères de validité du coefficient
5.1 Les barèmes conventionnels en psychométrie
L’interprétation quantitative d’un coefficient de fidélité test-retest ne s’effectue pas dans un vide théorique ; elle obéit à des conventions normatives consolidées par des décennies de pratique psychométrique, largement documentées par des auteurs de référence tels que Jum Nunnally ou Anne Anastasi. Les seuils d’acceptabilité sont intrinsèquement tributaires de la finalité d’utilisation de l’instrument d’évaluation.
Dans le domaine de la recherche fondamentale et des études de groupes comparatives, un coefficient de fidélité modéré à satisfaisant, traditionnellement fixé à un seuil minimal de $r ge 0,70$, est généralement considéré comme acceptable. En effet, dans les protocoles de recherche expérimentale portant sur de grands échantillons, les erreurs de mesure individuelles ont tendance à se compenser mutuellement au sein des moyennes de groupe, ce qui atténue leur impact destructeur sur l’inférence statistique globale.
À l’inverse, lorsque l’outil est destiné à des applications cliniques individuelles, au diagnostic psychopathologique, à l’orientation scolaire ou à des décisions de sélection professionnelle à fort enjeu (high-stakes testing), les standards psychométriques deviennent drastiquement plus sévères. Les directives des sociétés savantes préconisent alors une fidélité minimale de $r ge 0,85$, voire idéalement de $r ge 0,90$. Un coefficient oscillant entre 0,60 et 0,79 révèle une instabilité temporelle problématique qui introduit une incertitude inacceptable dans le profil individuel du patient. Enfin, tout instrument dont le coefficient de fidélité test-retest s’avère inférieur à 0,60 doit être considéré comme métrologiquement défaillant pour évaluer un trait stable, son niveau de variance d’erreur dépassant substantiellement les seuils de tolérance scientifique.
5.2 Le calcul de l’Erreur Standard de Mesure (ESM)
Bien que le coefficient de corrélation fournisse une appréciation synthétique de la stabilité relative d’un instrument, il présente l’inconvénient d’être un nombre abstrait, sans unité, dépendant de l’hétérogénéité de l’échantillon évalué. Pour transposer cette fidélité dans l’échelle concrète des scores du test et appréhender la marge d’incertitude entourant le score d’un individu singulier, le psychométricien calcule l’Erreur Standard de Mesure (ESM, ou Standard Error of Measurement – SEM). L’ESM intègre simultanément l’écart-type de l’échantillon ($\sigma_X$) et le coefficient de fidélité obtenu ($r_{xx}$) selon la formule :
ESM = σX × √(1 – rxx)
L’ESM constitue l’estimation de l’écart-type de la distribution théorique des erreurs de mesure autour du score vrai d’un participant. Plus la fidélité $r_{xx}$ tend vers l’unité ($1,00$), plus le terme $\sqrt{1 – r_{xx}}$ s’amenuise, réduisant l’ESM vers zéro. À l’opposé, si la fidélité s’effondre à zéro, l’ESM devient strictement égale à l’écart-type total des scores bruts.
La maîtrise de l’ESM permet de délimiter rigoureusement les intervalles de confiance (généralement à 90 % ou 95 %) entourant le score observé d’un patient lors d’un examen clinique. Pour un intervalle de confiance à 95 %, l’estimation s’établit selon :
IC95% = X ± 1,96 × ESM
Cette approche rappelle concrètement au clinicien que le score brut d’un patient ne doit jamais être sanctuarisé comme une vérité absolue immuable, mais interprété comme une plage de plausibilité statistique reflétant la précision intrinsèque de l’instrument.
5.3 La différence minimale cliniquement importante (DMCI)
L’une des applications les plus décisives de la fidélité temporelle réside dans l’analyse des scores de changement lors des suivis longitudinaux ou après une psychothérapie. Lorsqu’un patient réévalué après un protocole thérapeutique affiche un score diminué de 6 points sur une échelle d’évaluation de la sévérité dépressive, comment savoir si cette amélioration traduit une véritable rémission symptomatique ou une simple oscillation aléatoire imputable à l’imprécision du test ?
Pour résoudre ce dilemme diagnostique, la méthode de l’Indice de Changement Fiable (Reliable Change Index – RCI), introduite par Jacobson et Truax en 1991, s’avère indispensable. Le RCI calcule le ratio de la différence observée entre les deux sessions par rapport à l’erreur standard de la différence ($S_{diff}$) :
RCI = (X2 – X1) / Sdiff où Sdiff = √(2 × ESM2)
Si la valeur absolue du RCI excède la valeur critique de 1,96 (au seuil bilatéral de $\alpha = 0,05$), le clinicien est habilité à affirmer avec un degré de confiance suffisant que la modification observée dépasse ce qui pourrait être raisonnablement attendu par le seul jeu des erreurs de mesure. Ce concept est intimement adossé à celui de la Différence Minimale Cliniquement Importante (DMCI), garantissant que les décisions de poursuite, de réorientation ou d’interruption d’une prise en charge reposent sur des fondements statistiques inattaquables.
6. L’influence critique de l’intervalle temporel entre les passations
6.1 Le dilemme du choix de la fenêtre temporelle
Le paramètre méthodologique le plus épineux lors de la conception d’un protocole test-retest réside indubitablement dans la sélection de la durée temporelle intercalée entre la passation initiale et la réévaluation. Ce choix confronte le chercheur à un dilemme permanent, matérialisé par un arbitrage complexe entre des contraintes épistémologiques contradictoires. Aucun intervalle universel n’existe dans l’absolu ; la fenêtre temporelle idéale varie continuellement en fonction de la nature ontologique du construit psychologique mesuré.
Dans la littérature psychométrique, les intervalles standards oscillent généralement entre deux semaines et trois mois. Pour des variables cognitives élémentaires ou des épreuves d’aptitudes physiques, des délais restreints (de 14 à 21 jours) sont fréquemment retenus afin de prévenir toute interférence liée à l’évolution développementale spontanée des sujets. Pour des inventaires de personnalité évaluant des dimensions macro-structurales présumées immuables à l’âge adulte (comme les modèles en cinq facteurs), des délais s’étirant de six mois à plusieurs années peuvent être légitimement explorés afin de tester la pérennité séculaire du trait.
Il est empiriquement documenté que la valeur du coefficient de corrélation test-retest manifeste une décroissance tendancielle continue à mesure que l’intervalle temporel s’allonge. Cette dégradation statistique progressive ne reflète pas nécessairement une défaillance métrologique de l’outil, mais traduit l’accumulation naturelle d’expériences de vie, de remaniements cognitifs et de fluctuations environnementales chez les participants. Il est par conséquent obligatoire, pour tout concepteur de test, de justifier rationnellement et théoriquement l’intervalle retenu dans le manuel technique de l’instrument.
6.2 Risques associés aux intervalles trop courts
La tentation d’opter pour un intervalle temporel excessivement resserré — par exemple quelques heures ou quelques jours — est fréquemment guidée par la volonté de limiter le taux d’abandon (attrition) des participants. Néanmoins, cette stratégie expose l’évaluation à deux menaces méthodologiques majeures : l’effet de mémoire résiduelle et l’effet de pratique (ou d’apprentissage).
L’effet de mémoire résiduelle intervient lorsqu’un participant se remémore distinctement les réponses précises qu’il a fournies lors de la passation initiale. Au lieu de réévaluer cognitivement chaque item de manière authentique lors de la seconde session, le sujet se borne à réitérer délibérément ses choix antérieurs par un réflexe de cohérence cognitive. Ce rappel conscient a pour conséquence néfaste de corréler artificiellement les termes d’erreur de mesure ($r_{E_1E_2} > 0$), violant ainsi le postulat axiomatique fondamental de la théorie classique des tests.
L’effet de pratique (practice effect) se manifeste plus particulièrement dans les tests de performance maximale et les batteries de vitesse ou de résolution de problèmes. Dès lors qu’un individu a déjà été exposé à la logique structurelle des énigmes, son anxiété face à la tâche s’amenuise, ses stratégies exécutives se raffinent et sa rapidité d’exécution s’accroît. Il en découle un gonflement artificiel des coefficients de corrélation observés et une élévation substantielle de la moyenne des scores au retest, sans que cette performance ne traduise une augmentation intrinsèque des compétences de fond.
6.3 Risques associés aux intervalles excessivement longs
À l’autre extrémité du continuum méthodologique, la sélection d’intervalles excessivement distendus — par exemple un an ou plus pour des échelles de fonctionnement affectif chez l’adolescent — introduit des facteurs de confusion encore plus déstabilisants pour l’analyse de fidélité. Le principal écueil réside dans l’interférence inévitable des processus de maturation psychologique, biologique et cognitive.
Chez les enfants et les populations vieillissantes, le système nerveux central et les schémas cognitifs subissent des remaniements constants. Une baisse de score à une épreuve de mémoire épisodique observée chez une personne âgée après un intervalle de dix-huit mois peut parfaitement résulter de l’amorce réelle d’un processus de déclin neurocognitif plutôt que d’un défaut de fidélité temporelle du test neuropsychologique. De même, des événements de vie significatifs (séparations, deuils, promotions professionnelles, thérapies) peuvent modifier authentiquement les scores d’un individu à un questionnaire mesurant le bien-être subjectif ou l’estime de soi.
De surcroît, les fenêtres temporelles prolongées exacerbent le phénomène de mortalité expérimentale ou attrition de l’échantillon. La déperdition de participants entre le test et le retest — consécutive aux déménagements, aux refus de poursuivre ou aux pertes de contact — n’est que très rarement aléatoire. Elle tend à éliminer de manière sélective les individus les plus vulnérables ou les moins rigoureux, introduisant un biais de sélection d’attrition susceptible de distordre lourdement l’estimation finale du coefficient de fidélité.
7. Sources de variance d’erreur et menaces à la stabilité temporelle
7.1 Facteurs internes liés aux participants
L’estimation de la fidélité test-retest part de la prémisse théorique selon laquelle le sujet évalué se présente dans une disposition biopsychologique équivalente lors des deux sessions d’investigation. Or, l’état interne d’un être humain est par essence dynamique et sujet à d’incessantes micro-oscillations. Parmi les facteurs internes les plus prégnants, l’état d’éveil et le niveau de fatigue physique ou cognitive occupent une place de choix. Un étudiant passant une épreuve de vitesse de traitement cognitif après une nuit de sommeil réparateur obtiendra des résultats sans commune mesure avec ceux enregistrés s’il se présente au retest en état de privation de sommeil sévère.
Les fluctuations affectives et motivationnelles représentent une autre source majeure de variance d’erreur aléatoire. Le niveau d’engagement volontaire dans la réalisation de l’épreuve, l’anxiété circonstancielle générée par la menace du stéréotype ou l’enjeu perçu de la situation évaluative peuvent varier substantiellement entre les deux passations. Un candidat très stressé à $T_1$ peut se présenter beaucoup plus détendu et confiant à $T_2$, modifiant radicalement l’efficacité de sa mémoire de travail et de ses capacités d’attention sélective.
Enfin, le recours à des stratégies cognitives divergentes lors de la réévaluation constitue un facteur de distorsion interne méconnu. Ayant pris conscience lors de la première passation du temps limité imparti pour accomplir le test, un sujet peut délibérément adopter une stratégie d’arbitrage vitesse-précision radicalement différente lors de la seconde administration, privilégiant la rapidité au détriment de l’exactitude des réponses fournies.
7.2 Facteurs externes liés aux conditions d’administration
Les variations relevant des conditions externes d’administration constituent des menaces directes pour la standardisation psychométrique. Même dans les protocoles les plus stricts, des disparités subtiles dans l’attitude, la tonalité de voix, le rythme d’énonciation des consignes ou les encouragements involontairement dispensés par l’examinateur peuvent introduire un bruit d’évaluation substantiel. C’est la raison pour laquelle de nombreuses recherches test-retest imposent que le même psychologue supervise systématiquement les deux sessions d’un même participant, ou, à l’inverse, contrebalancent les évaluateurs pour neutraliser les effets d’opérateur.
L’environnement physique immédiat influe tout autant sur la stabilité des performances. Des variations d’éclairage (lumière naturelle versus artificielle), la température thermique de la pièce, ou la présence de micro-nuisances acoustiques sporadiques (bruits de couloir, travaux de voirie) sont susceptibles d’interférer de façon asymétrique entre les passations. Lors de tests informatisés, des hétérogénéités matérielles — telles que des différences de sensibilité des souris, de résolution d’affichage ou de temps de latence des serveurs lors d’évaluations en ligne non supervisées — introduisent des artefacts techniques préjudiciables à la consistance des temps de réaction enregistrés.
7.3 Interaction entre réactivité du test et instabilité du construit
L’une des apories méthodologiques les plus redoutables dans l’analyse de la fidélité test-retest est le phénomène de réactivité du test. Il arrive que le simple fait de soumettre un individu à un instrument de mesure altère de manière irréversible le construit même que l’on cherche à quantifier. Par exemple, l’administration d’un questionnaire explorant en profondeur la rumination mentale peut déclencher chez le participant une prise de conscience introspective inédite de ses processus cognitifs, l’amenant à modifier substantiellement ses comportements et son regard sur lui-même avant la tenue de la seconde session.
Il en résulte une confusion fréquente et préjudiciable entre une supposée faiblesse psychométrique de l’outil et l’instabilité intrinsèque du construit latent chez le sujet. Lorsqu’une corrélation test-retest décevante est observée, il est souvent périlleux d’affirmer avec certitude si l’instrument est incapable de mesurer fidèlement la variable cible ou si c’est la variable cible elle-même qui a subi une métamorphose sous l’effet réactif de l’évaluation inaugurale. La modélisation de trajectoires développementales longitudinales complexes par des équations structurelles s’avère alors souvent indispensable pour dénouer cette imbrication empirique.
8. Comparaison méthodologique : Test-retest versus autres formes de fidélité
8.1 Test-retest versus cohérence interne
La théorie psychométrique classique distingue traditionnellement plusieurs modalités d’évaluation de la fidélité, chacune ciblant une source spécifique d’erreur de mesure. La comparaison entre la fidélité test-retest et la fidélité par cohérence interne est à cet égard hautement illustrative. La cohérence interne — quantifiée par des indices renommés tels que l’alpha de Cronbach ou l’oméga de McDonald — repose sur une administration transversale unique à un instant $t$. Elle évalue le degré d’homogénéité et de redondance partagée entre les différents items composant l’instrument, postulant que s’ils mesurent le même construit, les réponses qu’ils suscitent doivent fortement concorder.
Or, il s’agit de dimensions conceptuellement indépendantes : un instrument peut faire montre d’une consistance interne exceptionnelle tout en étant dénué de fidélité temporelle, et réciproquement. Considérons une échelle d’évaluation de l’humeur dépressive instantanée : les items explorant la tristesse ressentie « en ce moment même » afficheront une excellente cohérence interne au sein d’une passation unique. Pourtant, si le test est réadministré deux mois plus tard, la fidélité test-retest pourra s’effondrer légitimement vers 0,20 si les participants ont connu des événements de vie favorables. La cohérence interne informe sur la structure architecturale interne du test, alors que le test-retest sonde exclusivement son invariance chronologique.
8.2 Test-retest versus formes parallèles et alternées
Pour contourner les redoutables effets de mémorisation mot à mot et d’apprentissage inhérents à l’administration du même matériel lors du test et du retest, la méthode des formes parallèles (ou alternées) constitue une alternative méthodologique de premier ordre. Dans ce dispositif, deux versions formellement distinctes mais théoriquement équivalentes d’un même test (Forme A et Forme B) sont construites pour mesurer le même trait avec des questions dissemblables.
Si la Forme A est administrée à $T_1$ et la Forme B à $T_2$ avec un intervalle temporel intermédiaire, le coefficient de corrélation obtenu est qualifié de coefficient de stabilité et d’équivalence. Cette approche méthodologique cumule l’examen de la consistance temporelle et l’épreuve de la représentativité de l’échantillonnage d’items. Néanmoins, elle se heurte à des défis de calibrage colossaux : démontrer l’équivalence stricte de deux formes parallèles — en termes de moyennes, de variances, de niveaux de difficulté d’items et d’indices de discrimination — nécessite des protocoles de standardisation d’une extrême lourdeur logistique et financière.
8.3 Test-retest versus fidélité inter-juges
La fidélité inter-juges, enfin, s’adresse aux situations d’évaluation où la mesure dépend du jugement qualitatif subjectif d’un ou plusieurs observateurs, comme dans les grilles d’observation du comportement infantile, les entretiens cliniques semi-structurés ou les tests projectifs. L’analyse ne s’intéresse pas ici au temps, mais au degré de concordance ou d’agrément entre évaluateurs indépendants cotant simultanément les mêmes manifestations comportementales (à travers des statistiques comme le kappa de Cohen pour les données qualitatives ou le coefficient de corrélation intraclasse pour les données numériques).
Ces différentes facettes de la métrologie ne s’excluent nullement : elles se complètent au sein d’un faisceau convergent de preuves psychométriques. Le tableau synoptique suivant résume les caractéristiques différentielles de ces grandes approches de la fidélité :
| Forme de fidélité | Source d’erreur ciblée | Protocole requis | Statistiques usuelles |
|---|---|---|---|
| Test-retest | Fluctuations temporelles, instabilité circonstancielle | Même test, 2 passations distinctes dans le temps | Pearson $r$, Spearman $rho$, CCI |
| Cohérence interne | Hétérogénéité du contenu des items | Une seule passation d’un test multi-items | Alpha de Cronbach, Oméga de McDonald |
| Formes parallèles | Échantillonnage du contenu des items (± temps) | Deux versions distinctes (A et B) administrées | Corrélation linéaire, équivalence de Lord |
| Inter-juges | Subjectivité et biais propres aux évaluateurs | Au moins 2 observateurs cotant les mêmes sujets | Kappa de Cohen, Fleiss, CCI |
9. Le coefficient de corrélation intraclasse (CCI) : Une alternative robuste à Pearson
9.1 Les limitations structurelles du coefficient de Pearson
Bien que le coefficient de corrélation de Pearson soit historiquement la statistique la plus fréquemment mobilisée pour quantifier la fidélité test-retest, la psychométrie moderne souligne avec force ses carences structurelles intrinsèques. La faille la plus critique de la corrélation de Pearson réside dans son insensibilité absolue aux variations systématiques de moyenne entre les sessions d’évaluation. En effet, la formule mathématique de Pearson normalise systématiquement les données en soustrayant les moyennes respectives des deux séries de mesures.
Considérons un cas d’école saisissant : supposons qu’un échantillon de cinq patients évalués pour un déficit moteur obtienne les scores suivants à $T_1$ : ${10, 20, 30, 40, 50}$. Lors du retest à $T_2$, chaque participant voit son score augmenter de façon parfaitement uniforme et systématique de dix points, produisant les valeurs : ${20, 30, 40, 50, 60}$. Si l’on applique le coefficient de corrélation linéaire de Pearson à ces deux séries, le résultat obtenu sera rigoureusement égal à $r = 1,00$, suggérant une reproductibilité sans faille.
Pourtant, il est manifeste que les scores ne sont absolument pas reproductibles en valeur absolue, la moyenne du groupe ayant dérivé d’un écart considérable équivalent à un écart-type entier. En présence d’un effet d’apprentissage uniforme, d’une habituation ou d’une dérive d’étalonnage d’un appareil, Pearson masque totalement ce déplacement métrique systématique. Cette statistique quantifie exclusivement l’association linéaire et la consistance du rang, mais s’avère incapable d’évaluer le degré d’accord absolu (absolute agreement) entre les sessions, rendant son usage potentiellement trompeur dans les études cliniques et biomédicales.
9.2 Fondements et typologie des modèles de CCI
Pour pallier les insuffisances manifestes de Pearson, la modélisation moderne fait appel au Coefficient de Corrélation Intraclasse (CCI). Fondé sur le formalisme de l’analyse de variance (ANOVA) à mesures répétées, le CCI partitionne la variance totale observée non plus en un simple ratio bivarié, mais en décomposant rigoureusement les différentes sources de variance : la variance entre sujets ($\sigma^2_{sujets}$), la variance entre sessions d’évaluation ($\sigma^2_{sessions}$) et la variance d’erreur résiduelle non expliquée ($\sigma^2_{erreur}$).
Dans leur taxonomie fondamentale devenue la norme de référence internationale, Shrout et Fleiss (1979) ont catégorisé les coefficients de corrélation intraclasse en trois modèles distincts, subdivisés selon la finalité métrique recherchée :
- Modèle à 1 facteur à effets aléatoires (One-way random effects model – CCI 1,1) : Chaque sujet est évalué par un ensemble différent d’évaluateurs ou d’occasions sélectionnés aléatoirement. Ce modèle ne permet pas d’isoler l’effet spécifique de la session de l’erreur résiduelle.
- Modèle à 2 facteurs à effets aléatoires (Two-way random effects model – CCI 2,1) : Tous les sujets sont évalués aux mêmes occasions ou par les mêmes examinateurs, considérés comme un échantillon aléatoire représentatif d’une population plus large d’occasions ou d’examinateurs possibles. Ce modèle permet de généraliser les conclusions psychométriques au-delà des évaluateurs ou moments spécifiques de l’étude.
- Modèle à 2 facteurs à effets mixtes (Two-way mixed effects model – CCI 3,1) : Tous les sujets sont évalués aux mêmes occasions fixes (ici, précisément la session 1 et la session 2). Les sessions ne sont pas considérées comme un échantillon aléatoire, mais comme les seuls moments d’intérêt de l’étude.
Au sein de ces modèles, une distinction analytique primordiale doit être opérée entre le calcul de l’accord absolu et celui de la cohérence (consistency). Alors que l’estimation de cohérence ignore la variance systématique entre les sessions (se comportant de manière similaire à Pearson), l’estimation d’accord absolu incorpore explicitement la variance inter-sessions dans le dénominateur mathématique, pénalisant impitoyablement le coefficient si les moyennes dérivent entre le test et le retest. Enfin, le statisticien doit choisir entre la fidélité d’une mesure unique (cas typique de la clinique où l’on utilise un score individuel isolé) ou la fidélité d’une moyenne de plusieurs mesures.
9.3 Recommandations contemporaines pour le choix statistique
Dans le paysage métrologique contemporain, les comités de normalisation scientifique préconisent massivement l’abandon de Pearson au profit du CCI pour toute investigation rigoureuse de la fidélité test-retest. La formulation conventionnelle recommandée pour une étude standard de stabilité temporelle à deux sessions fixes est le CCI (3,1) à accord absolu pour mesure unique, dont la formulation algébrique issue de l’ANOVA s’exprime par :
CCI(3,1)accord = [CMS – CME] / [CMS + (k – 1) × CME + (k/n) × (CMT – CME)]
où $CM_S$ représente le carré moyen entre sujets, $CM_E$ le carré moyen de l’erreur résiduelle, $CM_T$ le carré moyen entre les sessions (temps), $n$ le nombre de sujets et $k$ le nombre de passations ($k=2$). Si un effet d’apprentissage substantiel se produit à la seconde session, le terme $CM_T$ croît dramatiquement, ce qui a pour effet direct de gonfler le dénominateur et d’abaisser le CCI résultant, alertant avec transparence sur l’absence de reproductibilité absolue des scores.
En neuropsychologie et dans les essais cliniques pharmacologiques, l’utilisation conjointe du CCI et de la méthode graphique de représentation de Bland et Altman est désormais considérée comme l’étalon-or (gold standard). Le diagramme de Bland-Altman projette la différence entre les deux mesures ($T_2 – T_1$) en fonction de leur moyenne, permettant d’objectiver instantanément le biais systématique moyen et les limites de concordance à 95 %.
10. Applications cliniques, éducatives et de recherche en psychologie
10.1 L’évaluation de la personnalité et des traits stables
Dans la sphère de l’évaluation de la personnalité, la fidélité test-retest constitue l’épreuve de vérité épistémologique par excellence. Des inventaires universellement reconnus tels que le NEO-PI-R ou le Big Five Inventory (BFI) — opérationnalisant les dimensions d’Extraversion, d’Agréabilité, de Conscienciosité, de Neuroticisme et d’Ouverture à l’expérience — postulent que la personnalité de l’adulte d’âge mûr est fondamentalement pérenne. Par conséquent, les protocoles de validation de ces échelles exigent l’administration répétée sur des intervalles de plusieurs mois, voire de plusieurs années, avec une attente théorique de coefficients de fidélité test-retest se maintenant au-delà de $r = 0,80$.
À l’opposé, les inventaires évaluant des dimensions psychopathologiques dynamiques, comme le State-Trait Anxiety Inventory (STAI) de Spielberger ou l’Inventaire de Dépression de Beck (BDI), doivent impérativement moduler leurs attentes en fonction du sous-construit exploré. Si l’échelle d’anxiété-trait du STAI conserve d’excellentes corrélations de stabilité à six semaines ($r > 0,85$), l’échelle d’anxiété-état présente des corrélations test-retest naturellement très basses ($r < 0,40$), confirmant que cette dernière est éminemment sensible aux variations circonstancielles de l'humeur, ce qui atteste paradoxalement de sa validité discriminante.
10.2 Les tests cognitifs et les batteries neuropsychologiques
L’évaluation des fonctions intellectuelles et neuropsychologiques — illustrée par les échelles d’intelligence pour enfants et adultes de Wechsler (WISC-V et WAIS-IV) — impose des exigences métrologiques d’une rigueur absolue. Dans ces batteries d’évaluation de la performance maximale, le score de Quotient Intellectuel Total (QIT) sert souvent de pivot pour l’attribution d’allocations de handicap ou d’orientations médico-sociales lourdes.
Or, les bilans neuropsychologiques successifs sont massivement pollués par les effets de pratique. Lorsqu’un patient est soumis à une sous-épreuve de blocs de Kohs ou d’assemblage d’objets, le fait d’avoir déjà manipulé le matériel confère un avantage exécutif considérable lors de la seconde confrontation. Les manuels psychométriques de la WAIS documentent avec précision ces gains d’apprentissage, qui peuvent atteindre de 3 à 8 points de QI au retest sur des délais courts de quelques semaines. Pour cette raison, les neuropsychologues imposent usuellement un intervalle minimal de carence de six mois à un an avant de réadministrer la même batterie à des fins diagnostiques.
De surcroît, le clinicien doit impérativement composer avec le phénomène statistique de régression vers la moyenne, initialement formalisé par Francis Galton. Tout individu présentant un score initial extrêmement bas ou extrêmement haut a une probabilité mathématique majeure de se rapprocher de la moyenne de la population lors du retest, sous le seul effet de la redistribution probabiliste des erreurs de mesure aléatoires. Ignorer ce mécanisme conduirait à interpréter faussement la rémission spontanée d’un score extrême comme le succès éclatant d’une thérapie expérimentale.
10.3 La mesure des compétences académiques et professionnelles
Dans l’ingénierie des examens scolaires, des tests d’aptitudes académiques (tels que le SAT ou le GRE aux États-Unis) et des processus de recrutement en psychologie organisationnelle, la fidélité test-retest se trouve au carrefour de la performance métrologique et de l’équité déontologique. Un test de sélection professionnelle dont la stabilité temporelle serait médiocre équivaudrait à sélectionner les futurs cadres dirigeants sur un coup de dé aléatoire.
L’assurance d’une stabilité temporelle irréprochable garantit l’équité de traitement (fairness) entre les candidats. Elle apporte la preuve légale et empirique que le résultat obtenu par un candidat dépend de son niveau de compétences stabilisées et non du hasard du calendrier ou des oscillations métrologiques du dispositif d’évaluation. Dans le secteur des habilitations de haute sécurité ou de l’aéronautique (sélection des pilotes de ligne), des coefficients de fidélité test-retest excédant systématiquement le seuil de 0,90 sont formellement requis pour autoriser l’usage d’une batterie d’aptitudes psychomotrices et décisionnelles.
11. Stratégies méthodologiques pour optimiser la fidélité test-retest
11.1 Standardisation rigoureuse des procédures de passation
L’optimisation de la fidélité temporelle d’un instrument d’évaluation repose en premier lieu sur la réduction intransigeante de la variance d’erreur externe, ce qui s’obtient par une standardisation méthodique de l’ensemble de la chaîne de passation. L’instrument doit s’accompagner d’un manuel d’administration exhaustif consignant à la virgule près les consignes verbales que l’examinateur est autorisé à formuler, proscrivant toute improvisation discursive ou reformulation subjective susceptible d’orienter le sujet.
La formation et l’accréditation des évaluateurs constituent un levier prépondérant. Dans les protocoles de recherche clinique multicentriques, des sessions régulières d’étalonnage et de calibrage croisé entre psychologues sont indispensables pour harmoniser les seuils de tolérance temporelle et les attitudes d’encouragement. Enfin, les conditions physiques de recueil — incluant la neutralité acoustique des locaux, le calibrage photométrique des éclairages et la concordance rigoureuse des créneaux horaires entre le test et le retest — doivent faire l’objet d’un contrôle scrupuleux consigné dans des registres d’audit métrologique.
11.2 Raffinement des items et de la structure du test
Une fidélité test-retest globale insatisfaisante prend fréquemment racine dans les ambiguïtés sémantiques ou structurelles des questions individuelles composant le test. L’analyse statistique fine d’items (item analysis) est indispensable lors de la phase pilote d’élaboration de l’outil pour identifier et éliminer impitoyablement les items dont la stabilité temporelle propre s’avère déficiente. Tout item formulé avec des doubles négations, des termes polysémiques ou faisant référence à des contextes temporels trop flous (ex. « ces derniers temps ») introduit un aléa interprétatif qui incite le participant à modifier erratiquement ses réponses d’une session à l’autre.
Par ailleurs, la théorie psychométrique enseigne — via la formule prophétique de Spearman-Brown — que la fidélité d’un test est fonction directe de sa longueur : à qualité d’items égale, un instrument comportant un plus grand nombre d’items tend mécaniquement à afficher une fidélité accrue, les erreurs aléatoires propres à chaque question ayant tendance à s’annuler mutuellement au sein de la somme composite. Toutefois, le concepteur doit concilier cette exigence statistique avec la réalité clinique : allonger démesurément un test accroît la fatigue et la démotivation du participant, générant en fin d’épreuve une variance d’erreur parasite qui anéantit le bénéfice théorique de l’ajout d’items.
11.3 Gestion proactive des effets de pratique
Pour neutraliser l’impact délétère de l’effet de pratique sur les évaluations répétées, plusieurs stratégies méthodologiques sophistiquées peuvent être déployées dès la phase de conception du test. La méthode la plus aboutie réside dans l’élaboration simultanée de formes parallèles strictement calibrées. En disposant de banques d’items distinctes mais présentant des paramètres de difficulté et de discrimination mathématiquement identiques (calibrés par exemple selon les modèles de la théorie de la réponse à l’item), l’examinateur peut alterner les formes entre les sessions successives, abolissant instantanément les biais de mémorisation mot à mot.
Une seconde approche consiste à intégrer au début de la première session des exercices d’entraînement préparatoires substantiels (warm-up trials). En familiarisant d’emblée le sujet avec le format des réponses, la gestion du chronomètre et les types d’interactions exigés, l’examinateur permet au participant de gravir la phase abrupte de sa courbe d’apprentissage avant même l’enregistrement des scores officiels. Enfin, lorsqu’il s’avère impossible d’annihiler totalement l’effet de pratique, les éditeurs de tests doivent impérativement calculer et publier dans leurs manuels des tables de correction de retest, permettant de déduire du score brut observé à $T_2$ le gain moyen empiriquement attendu au sein de la population générale pour un intervalle temporel donné.
12. Synthèse, directives de publication et perspectives psychométriques contemporaines
12.1 Lignes directrices pour la rédaction d’articles scientifiques (COSMIN)
L’exigence de rigueur méthodologique entourant la fidélité test-retest a conduit les instances scientifiques internationales à édicter des normes éditoriales strictes pour la documentation des propriétés psychométriques des outils de mesure. L’initiative de référence mondiale est incarnée par la grille COSMIN (COnsensus-based Standards for the selection of health Measurement INstruments). Les directives COSMIN imposent aux auteurs publiant des études de validation de respecter une transparence méthodologique absolue.
Concrètement, tout article scientifique se réclamant de ces standards doit explicitement rapporter :
- La description sociodémographique exhaustive de la cohorte et la justification de sa taille d’échantillon (un minimum de 50 à 100 participants étant universellement préconisé pour l’évaluation de la fidélité) ;
- L’intervalle temporel exact séparant les deux sessions, documenté non seulement par sa valeur moyenne ou médiane, mais également par son étendue minimale et maximale ;
- Les données descriptives complètes obtenues aux deux passations (moyennes, écarts-types, asymétrie) afin d’exposer clairement toute éventuelle dérive systématique ;
- Le modèle mathématique précis mobilisé pour le calcul de la fidélité, en rejetant l’usage exclusif du simple coefficient de Pearson et en précisant la formule exacte du Coefficient de Corrélation Intraclasse (ex. CCI modèle 2 ou 3, accord absolu versus cohérence) ;
- Le calcul explicite de l’Erreur Standard de Mesure (ESM) et des limites de concordance à 95 % (idéalement appuyées par un diagramme de Bland-Altman).
12.2 Apports de la théorie de la réponse à l’item (TRI) et de la généralisabilité
La psychométrie du XXIe siècle a profondément enrichi le paradigme classique en substituant ou en complétant les axiomes de la TCT par des approches probabilistes avancées, au premier rang desquelles figure la théorie de la réponse à l’item (TRI). Dans le cadre de la TRI, le concept traditionnel d’un « coefficient de fidélité global unique » valable uniformément pour tous les sujets est abandonné, car jugé simplificateur. La TRI démontre que la précision métrologique d’un test varie continuellement le long du continuum du trait latent mesuré ($\theta$).
Cette variabilité locale de la précision est modélisée par la fonction d’information du test : un instrument peut s’avérer extrêmement précis et fidèle pour différencier des individus situés dans la zone moyenne du spectre, mais perdre dramatiquement toute stabilité temporelle lorsqu’il est administré à des sujets présentant des niveaux exceptionnellement faibles ou élevés du trait. La modélisation en TRI permet d’anticiper avec une finesse computationnelle inédite la reproductibilité locale des scores.
Parallèlement, la théorie de la généralisabilité (G-Theory), développée par Lee Cronbach et ses collaborateurs, dépasse l’opposition dichotomique score vrai / erreur globale en utilisant les techniques d’analyse de variance multifactorielle pour décomposer l’erreur en multiples facettes simultanées (effets de l’examinateur, moments de passation, formes de questions, interactions sujet-moment). La G-Theory permet de quantifier avec une élégance analytique remarquable quelle proportion exacte de variance d’instabilité est imputable au temps par rapport à celle engendrée par les évaluateurs ou le choix des items.
12.3 Recommandations pratiques pour les praticiens et chercheurs
Pour le praticien de terrain — qu’il soit psychologue clinicien, neuropsychologue, conseiller d’orientation ou chercheur —, le choix d’un instrument psychométrique ne doit jamais reposer sur la seule renommée éditoriale ou sur la commodité de passation. Une liste de vérification méthodique s’impose avant tout déploiement sur le terrain :
- Vérifier dans le manuel technique si la fidélité test-retest a été formellement établie sur une population cible analogue à celle qui sera évaluée ;
- S’assurer que l’intervalle temporel utilisé lors des études de standardisation est compatible avec l’usage concret envisagé dans la pratique quotidienne ;
- Identifier la valeur du coefficient de stabilité et s’assurer qu’il atteint les seuils minimaux requis (idéalement $CCI ge 0,85$ pour toute décision clinique diagnostique individuelle) ;
- Rechercher systématiquement la valeur publiée de l’Erreur Standard de Mesure (ESM) afin de toujours formaliser les scores bruts sous forme d’intervalles de confiance rigoureux.
En conclusion, la fidélité test-retest n’est nullement une fin en soi ni une formalité statistique austère : elle incarne le garant indispensable de l’intégrité métrologique des sciences humaines. Toutefois, le praticien veillera à toujours maintenir une posture critique éclairée face au mirage d’une fidélité absolue : un instrument dont la stabilité temporelle approcherait artificiellement la perfection ($r = 0,99$) risquerait fort d’être un instrument excessivement rigide, incapable de détecter les véritables mutations et progrès psychologiques du patient. La métrologie d’excellence réside dans cet équilibre subtil et rigoureux : assurer une stabilité inaltérable face aux aléas de la mesure, tout en préservant une sensibilité aiguë aux évolutions authentiques de la vie psychique.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.apa.org/science/programs/testing/standards
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307-310. https://doi.org/10.1016/S0140-6736(86)90837-8
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297-334. https://doi.org/10.1007/BF02310555
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12-19. https://doi.org/10.1037/0022-006X.59.1.12
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155-163. https://doi.org/10.1016/j.jcm.2016.02.012
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Mokkink, L. B., Terwee, C. B., Patrick, D. L., Alonso, J., Stratford, P. W., Knol, D. L., Bouter, L. M., & de Vet, H. C. (2010). The COSMIN checklist for assessing the methodological quality of studies on measurement properties of health status measurement instruments: An international Delphi study. Quality of Life Research, 19(4), 539-549. https://doi.org/10.1007/s11136-010-9606-8
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420-428. https://doi.org/10.1037/0033-2909.86.2.420
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72-101. https://doi.org/10.2307/1412159