
La psychométrie moderne repose sur un impératif fondamental : s’assurer que les scores dérivés d’un instrument de mesure reflètent fidèlement le niveau réel d’un individu sur un trait latent ou une compétence, plutôt que des fluctuations aléatoires ou des erreurs méthodologiques. Dans cette quête de rigueur scientifique, la fidélité constitue l’un des piliers cardinaux de l’évaluation psychologique, éducative et clinique. Si la validité interroge la nature même de ce qui est mesuré, la fidélité examine la reproductibilité, la précision et la stabilité de la mesure. Au cœur des diverses approches d’estimation de la fidélité développées au sein de la théorie classique des tests, la fidélité par formes parallèles (ou formes équivalentes) occupe une place méthodologique d’exception.
Contrairement aux indices de consistance interne qui scrutent l’homogénéité des items au sein d’une seule passation, ou à la fidélité test-retest qui réadministre un test identique au risque d’induire de profonds biais de mémoire et d’apprentissage, la méthode des formes parallèles recourt à deux instruments distincts mais psychométriquement interchangeables. Cette approche offre une solution élégante au problème récurrent des réévaluations successives, qu’il s’agisse de mesurer l’efficacité d’une intervention thérapeutique en neuropsychologie, d’évaluer le progrès académique au fil d’une année scolaire ou d’organiser des sessions d’examens sécurisées à grande échelle sans risque de compromission des contenus.
Toutefois, la mise en œuvre d’une fidélité par formes parallèles ne se résume pas à rédiger deux questionnaires d’apparence similaire. Elle exige le respect d’exigences mathématiques et théoriques strictes, issues des postulats de la théorie classique des tests et des développements contemporains de la modélisation en équations structurelles et de la théorie de réponse aux items. Comprendre les fondements, les contraintes opérationnelles, les modèles mathématiques sous-jacents ainsi que les limites de cette méthodologie est indispensable pour tout chercheur ou praticien soucieux de la solidité empirique de ses évaluations.
1. Introduction fondamentale à la fidélité des formes parallèles en psychométrie
1.1 Définition conceptuelle de la fidélité par formes parallèles
La fidélité par formes parallèles désigne le degré auquel deux versions distinctes, développées indépendamment mais construites selon les mêmes devis de spécifications, produisent des résultats comparables lorsqu’elles sont administrées aux mêmes individus. L’objectif ultime est d’établir l’interchangeabilité de ces deux versions, de manière à ce qu’un individu obtienne, aux variations d’échantillonnage de l’erreur de mesure près, le même score observé, qu’il soit confronté à la Forme A ou à la Forme B.
Sur le plan terminologique, il convient d’opérer une distinction rigoureuse entre plusieurs notions souvent confondues dans la littérature francophone et internationale. Les formes parallèles (au sens strict de la psychométrie) répondent à des contraintes statistiques très précises : égalité des scores vrais, égalité des moyennes, homogénéité des variances observées et égalité des variances d’erreur. Les formes alternatives ou formes équivalentes renvoient à des acceptations plus souples, où les instruments partagent le même cadre conceptuel, le même nombre d’items et des caractéristiques de distribution proches, sans satisfaire obligatoirement à l’ensemble des postulats mathématiques d’un parallélisme strict.
Selon les Standards for Educational and Psychological Testing élaborés conjointement par l’American Educational Research Association (AERA), l’American Psychological Association (APA) et le National Council on Measurement in Education (NCME), l’estimation de la fidélité par formes alternées constitue la modalité la plus robuste pour documenter l’erreur de mesure liée à la fois à l’échantillonnage du contenu et aux fluctuations temporelles. Elle permet d’attester que l’instrument ne dépend pas d’un ensemble restreint de stimuli spécifiques, mais capture adéquatement le domaine conceptuel visé.
1.2 Origine historique et évolution dans la théorie classique des tests
L’ancrage théorique de la méthode des formes parallèles trouve sa genèse dans les travaux fondateurs de Charles Spearman au tout début du XXe siècle. Confronté aux imperfections inhérentes aux mesures des aptitudes intellectuelles, Spearman a formalisé l’idée que tout score brut se compose d’un score véritable et d’une composante aléatoire parasitaire. Pour quantifier l’impact de cette composante d’erreur, les pionniers de la psychométrie ont rapidement compris que la simple réadministration d’un test identique engendrait une contamination majeure des résultats.
Historiquement, l’essor des tests d’intelligence de masse lors de la Première Guerre mondiale (notamment les tests Army Alpha et Army Beta) a mis en lumière la nécessité absolue de disposer de variantes équivalentes d’une même épreuve pour prévenir la triche et limiter l’impact de la divulgation des questions. Des auteurs comme Truman Lee Kelley et Louis Leon Thurstone ont ensuite formalisé les principes statistiques permettant d’aligner les métriques de plusieurs versions d’un même examen.
Au fil des décennies, cette méthodologie est passée de protocoles artisanaux sur support papier-crayon, où deux listes de questions étaient appariées intuitivement par des enseignants, à des procédures algorithmiques ultra-sophistiquées intégrées aux plateformes informatisées contemporaines. Aujourd’hui, l’élaboration de formes parallèles mobilise des banques de questions calibrées par ordinateur et des procédures d’égalisation statistique automatisées, garantissant un niveau de comparabilité inaccessible aux premiers psychométriciens.
1.3 Rôle dans la réduction des biais de mesure
L’un des apports majeurs de la fidélité par formes parallèles réside dans sa capacité singulière à neutraliser l’effet d’entraînement (ou practice effect). Lorsqu’un participant est exposé à deux reprises aux mêmes énigmes cognitives ou aux mêmes énoncés d’un questionnaire de personnalité, une amélioration artificielle du score est quasi systématiquement observée lors de la seconde administration. Cette amélioration n’est pas le reflet d’un gain réel dans l’aptitude latente, mais provient de la familiarisation avec le format du test, de la levée de l’anxiété situationnelle initiale et du souvenir des réponses précédemment fournies.
Le biais de mémorisation est particulièrement critique dans les évaluations neuropsychologiques où la capacité d’apprentissage incident peut masquer des déficits réels de rétention mnésique. En présentant deux ensembles d’items non identiques mais sémantiquement et structurellement homologues, la méthode des formes parallèles réduit considérablement la récupération mnésique directe des réponses. Le sujet est ainsi contraint d’engager à chaque séance le processus cognitif authentique que le test entend mesurer.
Dans le domaine du diagnostic clinique et des études longitudinales pré- et post-traitement, cette approche préserve la neutralité psychométrique. Elle assure que l’évolution constatée entre la ligne de base et l’évaluation finale résulte exclusivement de la maturation développementale, de l’évolution pathologique ou de l’efficacité thérapeutique, éliminant ainsi l’artefact méthodologique induit par la réexposition aux mêmes stimuli.
2. Cadre théorique et postulats de la théorie classique des tests
2.1 Le modèle du score vrai et la variance d’erreur
La théorie classique des tests (TCT), largement formalisée par Lord et Novick (1968), repose sur une décomposition linéaire fondamentale. Pour un individu $i$ soumis à un instrument de mesure, le score observé $X_i$ est la résultante de la somme de son score vrai $T_i$ (l’espérance mathématique du score de cet individu s’il était testé une infinité de fois dans des conditions identiques) et d’une erreur de mesure aléatoire $E_i$ :
Xi = Ti + Ei
Dans ce paradigme, l’erreur de mesure $E$ est postulée comme étant une variable aléatoire de moyenne nulle, non corrélée avec le score vrai $T$, et non corrélée avec l’erreur de mesure sur une autre forme ou lors d’une autre passation. Lorsque l’on considère deux formes d’un test, notées respectivement $X_1$ et $X_2$, la variance des scores observés au sein de la population se décompose de la manière suivante :
σ2(X) = σ2(T) + σ2(E)
La fidélité d’un test, notée $\rho_{XX’}$, correspond au ratio de la variance du score vrai sur la variance totale observée : $\rho_{XX’} = \frac{\sigma^2(T)}{\sigma^2(X)}$. L’erreur de mesure sur la forme $X_1$ ($E_1$) et l’erreur sur la forme $X_2$ ($E_2$) étant théoriquement indépendantes, la covariance entre les deux formes observées est mathématiquement égale à la variance du score vrai : $Cov(X_1, X_2) = Cov(T + E_1, T + E_2) = \sigma^2(T)$. Par conséquent, la corrélation linéaire de Pearson entre deux formes strictement parallèles fournit une estimation directe et non biaisée du coefficient de fidélité.
De ce lien découle la détermination de l’erreur type de mesure (ETM ou SEM pour Standard Error of Measurement), formalisée par l’équation suivante :
SEM = σX √(1 – ρXX’)
Cette métrique statistique est primordiale pour la pratique clinique : elle permet de calculer les intervalles de confiance au sein desquels se situe le score vrai d’un individu avec un degré de certitude donné (habituellement 95 % ou 99 %). Plus la corrélation entre les deux formes parallèles est élevée, plus l’erreur type de mesure diminue, garantissant ainsi une précision diagnostique maximale.
2.2 Critères d’équivalence stricte entre deux formes
Pour que deux formes $X_1$ et $X_2$ soient qualifiées de strictement parallèles dans le cadre de la théorie classique des tests, elles doivent impérativement satisfaire quatre conditions mathématiques et psychométriques simultanées sur la population cible :
- Égalité des scores vrais : Pour tout individu $i$, le score vrai sur la première forme doit être rigoureusement identique au score vrai sur la seconde forme ($T_{1i} = T_{2i}$). Par extension, l’espérance mathématique des scores observés doit être strictement égale : $E(X_1) = E(X_2)$, ce qui se traduit par des moyennes d’échantillon statistiquement indiscernables ($\mu_{X_1} = \mu_{X_2}$).
- Homogénéité parfaite des variances observées : La dispersion des scores autour de la moyenne doit être rigoureusement équivalente entre les deux formes ($\sigma^2(X_1) = \sigma^2(X_2)$). Cela implique automatiquement l’égalité des variances d’erreur ($\sigma^2(E_1) = \sigma^2(E_2)$).
- Identité des corrélations externes : Pour tout critère externe $Y$ (qu’il s’agisse de la réussite scolaire, d’un biomarqueur ou d’une autre mesure psychologique), la corrélation entre $X_1$ et $Y$ doit être parfaitement égale à la corrélation entre $X_2$ et $Y$ : $\rho(X_1, Y) = \rho(X_2, Y)$.
- Invariance de la structure factorielle : Les deux versions doivent présenter une dimensionnalité identique, mobilisant les mêmes facteurs latents avec des saturations factorielles (charges factorielles) rigoureusement identiques pour les items équivalents.
Si l’une de ces conditions est substantiellement violée, le coefficient de corrélation obtenu entre les deux instruments ne reflétera plus fidèlement le coefficient de parallélisme théorique, mais intégrera une variance résiduelle parasite liée au défaut d’équivalence intrinsèque des versions.
3. Typologie des modèles de mesure et degrés de parallélisme
3.1 Modèle strictement parallèle
Le modèle strictement parallèle représente l’idéal psychométrique le plus exigeant de la théorie des tests. Dans ce modèle, chaque item ou sous-test homologue d’une forme à l’autre possède une charge factorielle (saturation $lambda$) identique vis-à-vis du construit sous-jacent, ainsi qu’une variance d’erreur résiduelle ($\theta$) rigoureusement égale. Sur le plan formel :
X1 = λ η + ε1 et X2 = λ η + ε2
avec Var(ε1) = Var(ε2)
Dans ce contexte, les deux tests sont purement interchangeables à tous les égards. Les praticiens peuvent employer l’une ou l’autre forme sans appliquer la moindre constante de correction, et l’interprétation des scores bruts s’effectue exactement sur la même échelle métrique. Cependant, dans la réalité de la recherche appliquée et de la clinique, l’adéquation empirique stricte à ce modèle est d’une rareté extrême. Obtenir simultanément des moyennes identiques, des variances égales et des erreurs de mesure indiscernables relève de l’exploit expérimental, ce qui a conduit les méthodologistes à concevoir des modèles plus souples et plus réalistes.
3.2 Modèle essentiellement tau-équivalent
Face à la difficulté d’atteindre un parallélisme absolu, le modèle essentiellement tau-équivalent (ou essentially tau-equivalent) propose une relaxation pragmatique de la contrainte d’égalité des scores vrais. Dans ce modèle, on admet que l’une des formes peut s’avérer globalement plus difficile ou plus indulgente que l’autre d’une valeur constante additive $\alpha$. La relation entre les scores vrais s’écrit alors :
T1i = T2i + α
Sous ce modèle, les charges factorielles restent strictement égales ($\lambda_1 = \lambda_2$), ce qui signifie que chaque forme mesure le trait latent avec exactement la même sensibilité et la même unité métrique. En revanche, les moyennes observées peuvent différer de la valeur de la constante $\alpha$ ($\mu_{X_1} = \mu_{X_2} + \alpha$). Les variances observées demeurent quant à elles théoriquement identiques car l’addition d’une constante n’affecte pas la dispersion : $\sigma^2(X_1) = \sigma^2(X_2)$.
Cette condition est particulièrement fréquente lorsque de nouveaux items sont introduits dans une épreuve : le niveau global de performance peut fluctuer légèrement, mais la hiérarchie relative des individus et la précision discriminante du test restent totalement préservées. L’ajustement nécessite simplement l’ajout ou la soustraction d’une constante de conversion lors de la comparaison des scores.
3.3 Modèle congénérique
Le modèle congénérique constitue le niveau d’équivalence le plus général et le moins contraignant admis pour considérer que deux épreuves évaluent le même construit latent. Dans un modèle congénérique, on abandonne à la fois l’exigence d’égalité des moyennes et celle de l’égalité des saturations factorielles et des variances d’erreur. La relation entre les deux formes s’exprime alors sous une forme linéaire affine :
X1 = α1 + λ1 η + ε1 et X2 = α2 + λ2 η + ε2
Ici, $\lambda_1$ n’est pas nécessairement égal à $\lambda_2$, et la variance de l’erreur $\epsilon_1$ peut être distincte de la variance de $\epsilon_2$. La seule contrainte formelle réside dans le fait que les deux formes sont parfaitement corrélées avec le même trait latent sous-jacent $eta$ (leur corrélation latente est égale à 1,00). Les deux formes ne partagent plus la même échelle d’origine ni la même unité de mesure.
Dès lors, la simple corrélation linéaire de Pearson entre les scores bruts sous-estime la fidélité réelle des instruments. Pour rendre ces formes utilisables de manière interchangeable, il devient indispensable de recourir à des modélisations statistiques avancées, telles que l’analyse factorielle confirmatoire ou des procédures complexes d’égalisation (equating), afin d’estimer les paramètres de conversion métrique entre les deux formes.
4. Méthodologie opérationnelle de calcul : Protocole en trois étapes
4.1 Étape 1 : Conception et partitionnement des versions équivalentes
L’édification de deux formes véritablement parallèles ne s’improvise pas ; elle exige une planification minutieuse dès la phase de rédaction des items. Le protocole démarre obligatoirement par la création d’une matrice de spécifications exhaustive, qui cartographie les facettes dimensionnelles du construit, les processus cognitifs sollicités, les formats de réponse, ainsi que les niveaux de complexité souhaités.
Pour chaque item de la Forme A, les concepteurs doivent créer un item homologue ou « jumeau psychométrique » destiné à la Forme B. Cet appariement ne se borne pas à une similarité superficielle ; il repose sur des critères empiriques rigoureux :
- L’indice de difficulté de l’item ($p$) : La proportion de participants réussissant l’item doit être quasi identique entre les deux versions ($p_A \approx p_B$).
- L’indice de discrimination ($D$ ou corrélation item-total corrigée) : Chaque item apparié doit discriminer les sujets de haut et de bas niveau avec une intensité analogue.
- L’équivalence linguistique et syntaxique : La longueur des énoncés, le registre de langue, la fréquence lexicale des termes employés (établie par exemple via des bases lexicales standardisées comme Lexique.org) et la structure grammaticale doivent être scrupuleusement contrôlés.
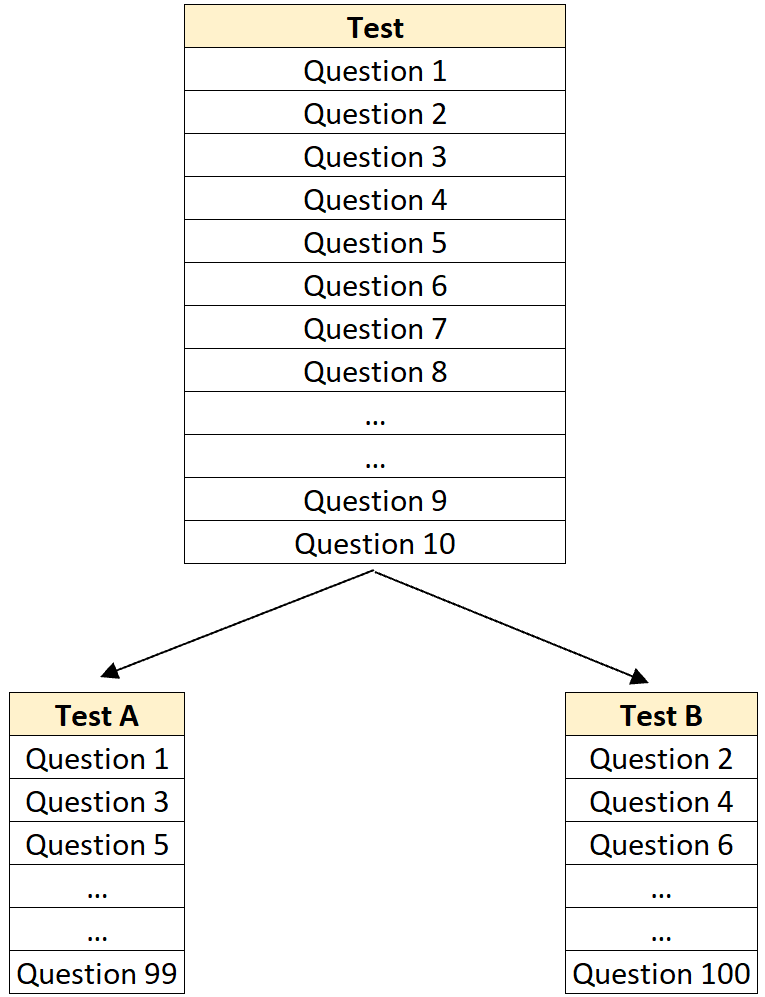
Une méthode fréquemment privilégiée par les laboratoires de psychométrie consiste à développer une banque élargie d’items pré-calibrés, puis à procéder à une scission aléatoire stratifiée (stratified random split), assurant ainsi une distribution mathématiquement équilibrée des paramètres statistiques au sein des deux sous-ensembles créés.
4.2 Étape 2 : Protocole d’administration séquentielle
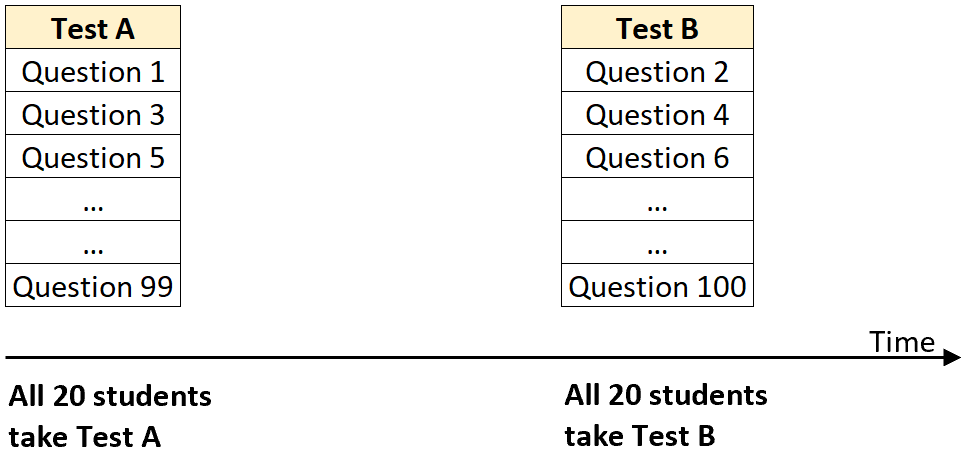
L’administration expérimentale de deux formes parallèles doit obéir à des règles méthodologiques drastiques pour prévenir les artefacts d’échantillonnage et les effets de contamination temporelle. La première décision concerne le choix du délai entre les passations. Ce délai peut être immédiat (les deux formes sont administrées au cours de la même session, séparées par une courte pause) ou différé (avec un intervalle allant de quelques jours à deux ou trois semaines).
Un intervalle immédiat maximise la stabilité du trait psychologique (évitant ainsi les effets de maturation ou de survenue d’événements de vie), mais augmente le risque de fatigue cognitive et de baisse de motivation. À l’inverse, un intervalle différé limite la fatigue mais expose l’estimation à une part de variance temporelle indésirable, confondant le défaut de fidélité des formes avec une fluctuation réelle de l’état du participant.
Pour neutraliser l’inévitable effet d’ordre, le recours à un plan d’expérience contrebalancé (ou cross-over design AB/BA) est impératif :
- Le groupe 1 (la moitié des participants, assignée aléatoirement) passe la Forme A en première session, puis la Forme B en seconde session.
- Le groupe 2 (la seconde moitié) passe la Forme B en première session, puis la Forme A en seconde session.
Ce contrebalancement strict permet de répartir uniformément l’impact de l’échauffement initial, de l’anxiété de situation et de la fatigue sur l’ensemble des scores des deux formes, garantissant une estimation non biaisée des paramètres d’équivalence.
4.3 Étape 3 : Estimation statistique de l’intercorrélation
Une fois les données collectées auprès d’un échantillon représentatif de la population de référence, la dernière étape consiste à procéder au traitement statistique des distributions de scores. La première exigence réside dans un appariement individuel sans faille : chaque participant doit être associé à son couple de scores bruts ($X_{A}, X_{B}$).
Avant d’engager tout calcul de corrélation, le chercheur doit tester les postulats distributionnels fondamentaux. La distribution conjointe des scores doit impérativement se conformer au postulat de normalité bivariée. Cette vérification s’opère par l’examen visuel des diagrammes de dispersion (scatterplots) à la recherche d’une configuration ellipsoïdale régulière, complété par des tests statistiques d’asymétrie (skewness), d’aplatissement (kurtosis) et par le test de Henze-Zirkler pour la normalité multivariée.
Le calcul du coefficient de corrélation linéaire adéquat est alors exécuté. La magnitude de ce coefficient synthétise le niveau d’accord entre les deux épreuves. Un coefficient élevé démontre que la variabilité des performances individuelles découle presque exclusivement des différences interindividuelles sur le construit latent, confirmant que l’erreur spécifique attachée à l’échantillonnage des items sur l’une ou l’autre des formes demeure résiduelle.
5. Analyses statistiques avancées et estimation des coefficients
5.1 Coefficient de corrélation linéaire de Pearson
Le paramètre central de quantification de la fidélité par formes parallèles est le coefficient de corrélation produit-moment de Bravais-Pearson ($r_{AB}$), calculé entre les scores observés obtenus à la Forme A et à la Forme B :
rAB = ∑ (XAi – X̄A)(XBi – X̄B) / [ √∑ (XAi – X̄A)2 √∑ (XBi – X̄B)2 ]
La valeur numérique de $r_{AB}$ est comprise entre -1,00 et +1,00. Dans le cadre de l’évaluation de la fidélité psychométrique, seules les valeurs positives élevées sont admises. Les seuils conventionnels retenus par la communauté scientifique établissent généralement qu’un coefficient de fidélité :
- Est considéré comme inacceptable en deçà de 0,70.
- Est jugé acceptable pour la recherche fondamentale entre 0,70 et 0,79.
- Est qualifié de bon pour des évaluations individuelles non critiques entre 0,80 et 0,89.
- Doit impérativement atteindre ou dépasser 0,90 (voire 0,95) dans les contextes à enjeux majeurs (décisions de placement scolaire, sélection professionnelle, diagnostic neuropsychologique ou expertises médico-légales).
Il importe de souligner que le coefficient de Pearson est extrêmement sensible à la restriction d’étendue (range restriction). Si l’échantillon d’étalonnage est trop homogène par rapport à la population générale, la variance observée sera artificiellement comprimée, entraînant une chute drastique du coefficient de corrélation calculé, sans que la fidélité intrinsèque du test ne soit nécessairement en cause. Pour pallier cette distorsion, des formules de correction statistique (comme la correction de Thorndike) doivent être appliquées si la variance de l’échantillon diverge substantiellement de celle de la population de référence.
Par ailleurs, pour communiquer la marge d’incertitude entourant l’estimation de l’échantillon, le calcul des intervalles de confiance est indispensable. La statistique $r_{AB}$ n’étant pas distribuée normalement, on applique la transformation en $Z$ de Fisher :
Zr = (1/2) · ln( (1 + rAB) / (1 – rAB) )
L’erreur type de $Z_r$ étant égale à $\frac{1}{\sqrt{N – 3}}$, il est possible de délimiter l’intervalle de confiance à 95 % avant d’effectuer la rétro-transformation en coefficients de corrélation originaux.
5.2 Formule de prophétie de Spearman-Brown
La fidélité d’un test dépend directement de sa longueur : plus un instrument comporte d’items homogènes, plus la variance d’erreur aléatoire s’annule au profit de la variance du score vrai. Lorsque deux formes parallèles sont élaborées en scindant un test complet en deux moitiés égales (procédure de split-half), chaque forme parallèle résultante contient exactement la moitié du nombre d’items de l’instrument original.
La simple corrélation de Pearson calculée entre les deux demi-tests estime avec précision la fidélité d’une forme courte isolée, mais elle sous-estime systématiquement la fidélité qu’aurait le test si l’on fusionnait les deux formes pour créer une épreuve unifiée deux fois plus longue. Pour estimer la fidélité d’un test dont la longueur est modifiée d’un facteur $k$, la formule de prophétie de Spearman-Brown s’applique :
ρ*XX’ = [ k · rAB ] / [ 1 + (k – 1) · rAB ]
Dans le cas d’une épreuve dont on double la taille en cumulant la Forme A et la Forme B ($k = 2$), l’équation prend la forme simplifiée suivante :
rtotal = [ 2 · rAB ] / [ 1 + rAB ]
Inversement, si un concepteur dispose d’un instrument unifié très robuste présentant une fidélité globale de 0,94 et souhaite commercialiser deux formes parallèles autonomes de taille moitié ($k = 0,5$), la formule permet de prédire avec exactitude la dégradation de la fidélité de chaque sous-forme, évitant ainsi le déploiement d’outils dont la précision diagnostique individuelle deviendrait déficiente.
5.3 Approches par modélisation d’équations structurelles (SEM)
Les avancées contemporaines de l’analyse multivariée ont progressivement supplanté la seule corrélation de Pearson au profit de l’Analyse Factorielle Confirmatoire (AFC) au sein des modèles d’équations structurelles (Structural Equation Modeling, SEM). Cette démarche permet de tester formellement les différents degrés de parallélisme par le biais de tests d’invariance de mesure emboîtés.
Le processus consiste à comparer successivement plusieurs modèles statistiques contraints :
- Invariance configurale : On vérifie d’abord que les deux formes présentent la même structure factorielle générale (par exemple, un modèle unidimensionnel ou à trois facteurs obliques).
- Invariance métrique (faible) : On impose l’égalité des saturations factorielles ($\lambda_{Ai} = \lambda_{Bi}$) pour chaque paire d’items homologues. La non-dégradation de l’ajustement valide le modèle congénérique ou tau-équivalent.
- Invariance scalaire (forte) : On force simultanément l’égalité des seuils ou des ordonnées à l’origine ($\nu_{Ai} = \nu_{Bi}$). Cette étape démontre l’absence de différentiel de difficulté systématique entre les formes.
- Invariance stricte : On ajoute l’égalité des variances d’erreur résiduelle ($\theta_{Ai} = \theta_{Bi}$). Si ce modèle ultime n’est pas rejeté statistiquement, le statut de parallélisme strict est empiriquement établi.
Pour juger de la recevabilité de ces modèles d’invariance, les psychométriciens s’appuient sur des indices d’ajustement globaux tels que le Root Mean Square Error of Approximation (RMSEA ≤ 0,06), le Comparative Fit Index (CFI ≥ 0,95) et le Tucker-Lewis Index (TLI ≥ 0,95), associés à des tests de différence de chi-carré ($\Delta\chi^2$) ou à l’observation de la dégradation marginale du CFI ($\Delta CFI le 0,01$).
6. Étude de cas détaillée : Exemple pratique d’évaluation psychologique
6.1 Contexte de l’évaluation cognitive de la mémoire de travail
Afin d’illustrer la mise en pratique opérationnelle de la fidélité par formes parallèles, examinons une étude clinique contrôlée menée auprès d’une cohorte de 60 adultes sains (âgés de 20 à 45 ans). L’objectif est d’étalonner deux formes parallèles d’un test cognitif de mémoire de travail verbale : l’Épreuve de Rétention Séquentielle de Mots Abstraits (ERS-MA).
Chaque forme (Forme A et Forme B) est constituée d’une série de 20 listes de mots présentées auditivement au rythme d’un mot par seconde, le participant devant restituer les mots dans l’ordre strict de présentation. Le score total de chaque participant correspond au nombre total d’items parfaitement rappelés (score théorique allant de 0 à 20).
Les critères linguistiques de jumelage des items entre la Forme A et la Forme B ont fait l’objet d’un contrôle rigoureux :
- Fréquence d’usage lexicale : Les listes appariées présentent une fréquence d’occurrence moyenne identique de 14,2 occurrences par million selon la base lexicale de référence.
- Longueur syllabique : Chaque mot homologue comporte exactement le même nombre de syllabes (strictement dissyllabiques).
- Indice d’imagerie et concrétude : Seuls des substantifs abstraits (amour, destin, concept, vertu, etc.) ayant une valeur de concrétude inférieure à 2,5 sur une échelle de 1 à 7 ont été sélectionnés, afin de neutraliser tout recours à des stratégies de codage visuel préférentiel.
Le protocole a mobilisé un plan contrebalancé AB/BA strict avec un intervalle de 48 heures entre les deux passations, réalisé dans une salle insonorisée à niveau d’éclairement constant.
6.2 Présentation des données brutes et calculs appliqués
Le tableau ci-dessous présente la synthèse des statistiques descriptives obtenues sur l’échantillon de 60 participants pour les deux formes expérimentales du test :
| Paramètre statistique | Forme A (Liste A) | Forme B (Liste B) | Différence / Comparaison |
|---|---|---|---|
| Taille de l’échantillon (N) | 60 | 60 | – |
| Moyenne observée (X̄) | 13,42 | 13,38 | Δ = 0,04 (p = 0,81) |
| Écart-type (s) | 3,18 | 3,22 | F-ratio = 1,025 (p = 0,92) |
| Variance (s2) | 10,11 | 10,37 | Homogénéité validée |
| Étendue des scores (Min – Max) | 6 – 19 | 6 – 20 | Distribution superposable |
| Asymétrie (Skewness) | -0,22 | -0,19 | Conformité normale |
Pour calculer le coefficient de corrélation produit-moment de Bravais-Pearson entre les deux séries de scores appariés, les sommes statistiques nécessaires ont été extraites du jeu de données :
- $\sum (X_{Ai} – \bar{X}_A)^2 = 596,64$
- $\sum (X_{Bi} – \bar{X}_B)^2 = 611,72$
- $\sum (X_{Ai} – \bar{X}_A)(X_{Bi} – \bar{X}_B) = 537,85$
L’application de la formule de Pearson donne :
rAB = 537,85 / √(596,64 × 611,72) = 537,85 / √(364976,62) = 537,85 / 604,13 = 0,8903
Le coefficient de fidélité par formes parallèles de l’épreuve ERS-MA s’établit donc à rAB = 0,89 (avec un intervalle de confiance à 95 % compris entre 0,82 et 0,93). Parallèlement, un test t de Student pour échantillons appariés a été mené pour vérifier l’égalité des moyennes : $t(59) = 0,24$, $p = 0,81$. L’absence de différence statistiquement significative entre les moyennes, couplée au test de Levene confirmant l’homogénéité des variances ($F = 0,01$, $p = 0,92$), valide empiriquement l’équivalence étroite des formes A et B.
6.3 Interprétation diagnostique des résultats
Un coefficient de fidélité de 0,89 témoigne d’une excellente cohérence psychométrique. Pour le neuropsychologue ou le chercheur en sciences cognitives, cette valeur permet de déterminer l’erreur type de mesure (SEM) en utilisant l’écart-type moyen des deux formes ($s_{moyen} = 3,20$) :
SEM = 3,20 × √(1 – 0,89) = 3,20 × √(0,11) = 3,20 × 0,3317 = 1,06 point
Cette donnée permet d’établir l’Indice de Changement Fiable (Reliable Change Index, RCI), formalisé par Jacobson et Truax (1991), indispensable pour déterminer si l’évolution d’un patient entre une évaluation initiale sous Forme A et un contrôle sous Forme B relève d’une réelle amélioration clinique ou du simple bruit de mesure. L’erreur type de la différence ($S_{diff}$) se calcule ainsi :
Sdiff = √(2 × SEM2) = √(2 × 1,062) = √(2,247) = 1,50 point
Pour qu’une modification de performance soit déclarée statistiquement significative au seuil bilatéral conventionnel de 5 % ($Z ge 1,96$), le score d’un sujet doit varier d’au moins :
Variation minimale = 1,96 × 1,50 = 2,94 points (soit 3 points)
Grâce au calibrage rigoureux de ces deux formes parallèles, le clinicien peut affirmer avec une certitude statistique de 95 % qu’un patient gagnant 3 points ou plus entre la Forme A et la Forme B a bénéficié d’un gain mnésique véritable lié à la remédiation cognitive, excluant formellement l’aléa de mesure et les artefacts d’apprentissage par répétition.
7. Applications pratiques dans les contextes académiques, cliniques et organisationnels
7.1 Milieu éducatif et examens à grande échelle
Dans l’enseignement supérieur et lors des certifications professionnelles de masse, l’administration simultanée d’examens identiques dans des amphithéâtres surpeuplés ou sur des fuseaux horaires multiples représente un risque majeur de compromission académique. L’élaboration de formes parallèles permet de distribuer des versions alternatives (Forme Verte, Forme Bleue) aux étudiants assis côte à côte, éradiquant instantanément les tentatives de plagiat visuel immédiat.
Par ailleurs, la gestion des sessions d’examens de rattrapage ou de remplacement constitue un défi logistique et éthique récurrent. Proposer l’examen initial aux étudiants absents compromet la sécurité de l’épreuve, tandis que créer une nouvelle épreuve sans calibrage psychométrique strict expose les candidats à une injustice flagrante (l’épreuve de rattrapage risquant d’être plus ardue ou plus facile). Le recours à des formes rigoureusement égalisées garantit une équité institutionnelle absolue, chaque étudiant étant évalué selon le même étalon de compétence indépendamment de la session à laquelle il participe.
Enfin, dans le suivi longitudinal des acquis scolaires (à l’instar des évaluations nationales de lecture ou de mathématiques menées par les ministères de l’Éducation), l’emploi de formes alternées au début et à la fin de l’année scolaire permet de mesurer la progression pédagogique réelle d’une cohorte sans que les élèves ne soient influencés par la réexposition aux mêmes énoncés d’exercices.
7.2 Neuropsychologie et essais cliniques longitudinaux
Le monitoring des fonctions cérébrales au cours du vieillissement normal et pathologique représente l’un des domaines les plus dépendants de la fidélité par formes parallèles. Dans le diagnostic précoce des troubles neurocognitifs majeurs, tels que la maladie d’Alzheimer, les batteries standardisées d’évaluation de la mémoire épisodique (comme le test de rappel libre/rappel indicé à 16 items de Grober et Buschke) doivent impérativement proposer plusieurs formes parallèles validées.
Lors des essais cliniques randomisés en double aveugle évaluant de nouvelles molécules pharmacologiques neuroprotectrices ou nootropiques, les patients sont soumis à des évaluations cognitives répétées (par exemple à la sélection, à 3 mois, à 6 mois et à 12 mois). Si le même protocole d’évaluation verbale ou spatiale était réadministré à chaque échéance, les gains procéduraux cumulés chez les patients des groupes placebo masqueraient l’effet thérapeutique éventuel du médicament ou, inversement, simuleraient une absence de déclin chez des patients en phase de dégénérescence active.
La disponibilité de trois à cinq formes parallèles métriquement équivalentes constitue ainsi une exigence réglementaire imposée par les agences du médicament (telles que l’EMA ou la FDA) pour valider l’efficacité neurocognitive de tout nouveau traitement.
7.3 Psychologie du travail et recrutement professionnel
Dans les processus de sélection des ressources humaines et les concours d’entrée aux fonctions publiques hautement sélectives, les tests de raisonnement logique, d’aptitude spatiale et de jugement situationnel sont soumis à une exposition massive sur les réseaux sociaux et les forums de préparation en ligne. Une banque de questions non renouvelée perd son pouvoir discriminant en quelques semaines en raison de la fuite des corrigés.
Les départements de recrutement des grandes entreprises conçoivent par conséquent des tests sous forme de variantes parallèles administrées dynamiquement. Les candidats d’une même vague d’embauche reçoivent des ensembles d’items distincts mais statistiquement interchangeables. Cette pratique assure l’étanchéité des processus d’embauche tout en maintenant une comparabilité des scores pour classer les postulants de manière équitable.
De surcroît, dans le secteur des métiers à haut risque (aviation civile, transport ferroviaire, contrôle nucléaire), l’évaluation périodique des réflexes psychomoteurs et de la vigilance sur simulateur repose impérativement sur des scénarios d’urgence parallèles. L’objectif est de s’assurer que l’opérateur est capable de mobiliser ses compétences face à des configurations d’incidents inédites, et non d’exécuter une séquence motrice préalablement mémorisée.
8. Analyse comparative : Formes parallèles versus autres indices de fidélité
8.1 Comparaison avec la fidélité test-retest
La fidélité test-retest évalue la stabilité temporelle d’un instrument en administrant le même test aux mêmes participants à deux moments distincts. Bien que conceptuellement intuitive, cette approche souffre d’une vulnérabilité intrinsèque majeure : elle est incapable de dissocier l’erreur de mesure réelle de l’effet de pratique et du rappel mnésique conscient. Les participants se souviennent souvent de leurs réponses antérieures, ce qui gonfle artificiellement le coefficient de corrélation observé.
La méthode des formes parallèles neutralise ce biais de mémorisation directe des réponses puisque les items sont physiquement différents. De plus, elle offre une flexibilité temporelle incomparable : l’administration des formes parallèles peut être réalisée au cours d’une seule et même journée, s’affranchissant ainsi de l’aléa lié aux événements de vie intervenant entre deux sessions de test-retest espacées de plusieurs semaines.
En contrepartie, la fidélité par formes parallèles impose un coût cognitif et financier de développement infiniment plus élevé. Alors que le test-retest ne requiert aucun item supplémentaire, les formes parallèles exigent la conception, la validation et l’étalonnage rigoureux d’un double contingent de stimuli.
8.2 Comparaison avec la cohérence interne (Alpha de Cronbach, Oméga de McDonald)
Les coefficients de consistance interne, dominés historiquement par le fameux Alpha de Cronbach ($\alpha$) et aujourd’hui par l’Oméga de McDonald ($\omega$), quantifient le degré d’intercorrélation entre l’ensemble des items composant un test unique administré en une seule séance. L’immense avantage de la cohérence interne réside dans son économie logistique : une seule passation suffit pour extraire le coefficient.
Cependant, la cohérence interne présente une cécité psychométrique notoire : elle est totalement incapable de capturer les sources d’erreur associées aux fluctuations temporelles de l’état psychologique des individus (fluctuations de l’attention, stress contextuel, fatigue). De surcroît, l’Alpha de Cronbach est notoirement sensible à la redondance lexicale : deux items formulés de manière quasi identique feront grimper mécaniquement la valeur de l’Alpha sans pour autant garantir une mesure précise et étendue du concept latent.
La méthode des formes parallèles, particulièrement lorsqu’elle intègre un bref délai entre les administrations, embrasse une perspective beaucoup plus complète de l’erreur de mesure : elle comptabilise simultanément l’erreur liée à l’échantillonnage spécifique des items et celle imputable aux variations d’état momentanées du sujet.
8.3 Comparaison avec la fidélité inter-juges
La fidélité inter-juges (estimée par le coefficient Kappa de Cohen ou les Coefficients de Corrélation Intraclasse – CCI) répond à une problématique distincte : elle évalue l’objectivité de la notation lorsque l’évaluation repose sur le jugement subjectif d’un observateur humain (grilles d’observation clinique, dissertations, épreuves orales). L’erreur de mesure traquée ici n’est pas logée dans les items du test, mais dans le système perceptif et d’évaluation de l’examinateur.
Toutefois, ces deux démarches s’articulent fréquemment de manière conjointe dans les protocoles d’évaluation complexes. Par exemple, lors d’un examen clinique structuré objectif (ECOS) en médecine, les étudiants peuvent être évalués à travers des stations cliniques parallèles impliquant des patients simulés distincts, la notation étant assurée par différents médecins évaluateurs. La fidélité globale du dispositif dépend alors à la fois du parallélisme des cas cliniques et de l’accord inter-juges.
| Méthode de fidélité | Sources d’erreur prises en compte | Biais principal | Coût logistique |
|---|---|---|---|
| Formes parallèles | Échantillonnage du contenu + Fluctuations temporelles | Incomplétude du parallélisme (pseudo-équivalence) | Très élevé (doublement des items et passations) |
| Test-retest | Fluctuations temporelles d’une séance à l’autre | Effet d’entraînement et souvenir mnésique direct | Modéré (deux passations du même test) |
| Cohérence interne (α, ω) | Hétérogénéité et échantillonnage des items | Inflation par redondance lexicale des items | Très faible (une seule passation d’un seul test) |
| Inter-juges | Subjectivité et sévérité différentielle de l’évaluateur | Effet de halo, biais de contraste entre juges | Modéré à élevé (mobilisation de multiples experts) |
9. Limites méthodologiques, défis logistiques et biais statistiques
9.1 Le coût élevé et la complexité de standardisation
L’obstacle prépondérant entravant la généralisation de la fidélité par formes parallèles réside dans la lourdeur colossale de son développement. Pour produire un test de 50 items sous deux formes strictement parallèles, une équipe de recherche doit rédiger initialement entre 150 et 200 items candidats afin de pouvoir écarter après pré-testage les items ne présentant pas les propriétés métriques requises.
Cette démarche exige une mobilisation budgétaire substantielle, des cohortes de plusieurs centaines de sujets pilotes pour l’étalonnage psychométrique, ainsi qu’un temps de développement souvent multiplié par deux ou trois par rapport à un instrument standard à version unique. Pour de nombreux laboratoires académiques ou éditeurs de tests disposant de ressources limitées, cet investissement est souvent jugé prohibitif, expliquant la prévalence écrasante de la cohérence interne dans la littérature publiée au détriment des formes parallèles.
En outre, l’épuisement des panels de testeurs lors des phases de standardisation constitue une source d’attrition non négligeable : les taux d’abandon entre la Forme A et la Forme B lors de protocoles différés peuvent atteindre 15 à 25 %, risquant d’introduire un biais de sélection systématique au sein de l’échantillon final de validation.
9.2 Le dilemme de la pseudo-équivalence
L’un des écueils théoriques les plus insidieux est celui de la pseudo-équivalence. Deux formes peuvent sembler rigoureusement jumelées sur le papier, partageant les mêmes longueurs de phrases et des thématiques identiques, tout en déclenchant chez les participants des processus de traitement cognitif profondément asymétriques.
Dans un test de mathématiques, par exemple, remplacer l’énoncé d’un problème géométrique impliquant le calcul de la surface d’un triangle rectangle par un autre triangle ayant des dimensions numériques différentes peut sembler neutre. Cependant, si le jeu de nombres de la Forme B introduit fortuitement une combinaison de chiffres facilitant le calcul mental direct ou requérant un report de retenue supplémentaire, la difficulté intrinsèque de l’épreuve s’en trouve altérée. L’hypothèse de parallélisme strict est violée, et les scores observés cessent d’être strictement comparables sans recalibrage statistique préalable.
Par ailleurs, les variations socioculturelles peuvent frapper asymétriquement deux formes. L’emploi d’un terme lexical particulier dans la Forme B, bien qu’ayant la même fréquence théorique moyenne dans la population générale, peut s’avérer beaucoup moins familier pour un sous-groupe régional ou sociodémographique donné, introduisant une erreur systématique parasite qui fausse l’équité de la mesure.
9.3 L’interférence des effets d’ordre et de transfert
Bien que le recours à des items différents élimine le souvenir direct des réponses spécifiques, il ne permet pas d’éradiquer totalement le transfert de stratégies cognitives (learning-to-learn effect). Lorsqu’un sujet découvre sur la Forme A un type de raisonnement inductif complexe inédit, le temps passé à décoder la consigne et à élaborer une heuristique efficace lui permet d’aborder la Forme B avec un schéma de résolution cognitif déjà prêt à l’emploi.
Il en résulte fréquemment une asymétrie de performance structurelle : les scores à la seconde passation sont statistiquement supérieurs à ceux de la première, indépendamment de la forme attribuée. Même si le plan de contrebalancement AB/BA permet de neutraliser cette déviation au niveau de la moyenne globale du groupe, il introduit une variance d’interaction intra-individuelle qui peut gonfler la variance d’erreur résiduelle.
De plus, l’anxiété d’évaluation diminue souvent de façon notable entre la première et la seconde séance, modifiant la réactivité émotionnelle du participant face au test. Les scores de la Forme B reflètent alors une performance cognitive moins polluée par le stress situationnel que ceux de la Forme A, créant une violation subtile de l’invariance des conditions d’évaluation.
10. Stratégies avancées de conception et calibrage des formes parallèles
10.1 Élaboration rigoureuse d’une matrice de spécifications
La prévention des asymétries de mesure commence par une formalisation multidimensionnelle du contenu via une table de spécifications croisées. Cette matrice opérationnelle répertorie l’intégralité des sous-domaines théoriques à couvrir et fixe le pourcentage précis d’items alloué à chaque domaine au sein des deux formes futures.
Par exemple, pour un test évaluant l’intelligence fluide, la matrice définira explicitement que la Forme A et la Forme B doivent comporter :
- 30 % de matrices visuo-spatiales avec rotation mentale continue.
- 30 % de séries de complétion numérique avec progression polynomiale.
- 20 % de problèmes d’analogies géométriques basés sur des règles d’exclusion.
- 20 % d’items de déduction relationnelle abstraite.
Chaque cellule de la matrice se voit assigner des contraintes strictes sur le format de réponse (nombre égal de distracteurs, absence de formulation négative ambigüe) et des règles d’isomorphisme conceptuel. Deux items sont déclarés isomorphes lorsqu’ils possèdent rigoureusement la même architecture logique, ne divergeant que par les attributs de surface des stimuli (tels que la forme des figures ou la nature des vecteurs de transformation).
10.2 Processus d’appariement psychométrique des items
Au-delà de l’isomorphisme qualitatif, la consolidation des formes parallèles contemporaines repose sur l’appariement empirique par paires d’items. Après administration d’une vaste banque de questions à un échantillon d’étalonnage représentatif, chaque item fait l’objet d’une analyse métrique approfondie.
Les items sont alors appariés un à un en fonction de leurs courbes caractéristiques :
- Le niveau de difficulté de l’item ($p$) ne doit pas diverger de plus de ± 0,03 entre deux items homologues.
- Le coefficient de corrélation bisériale de point ou l’indice de discrimination $D$ ne doit pas s’écarter de plus de ± 0,05.
- L’analyse de l’attractivité des distracteurs (pour les QCM) doit attester que les réponses incorrectes attirent les participants de bas niveau avec une proportion et une dispersion équivalentes sur les deux versions.
Cette phase d’appariement algorithmique est systématiquement soumise à un comité d’experts multidisciplinaire indépendant (comprenant des psychologues spécialistes du domaine, des linguistes et des psychométriciens) chargé de repérer d’éventuels biais qualitatifs invisibles sur le plan purement numérique.
10.3 Procédures d’égalisation statistique (Equating)
Même avec les stratégies de conception les plus rigoureuses, des écarts métriques résiduels minimes subsistent inévitablement entre deux formes indépendantes. Pour garantir une comparabilité absolue des scores sur l’ensemble de l’échelle, les psychométriciens déploient des méthodologies formelles d’égalisation statistique (test equating).
Les deux principales familles d’égalisation linéaire de la théorie classique des tests sont :
- La méthode d’égalisation linéaire de Tucker : Particulièrement adaptée lorsque les deux formes sont administrées à des échantillons qui ne sont pas strictement équivalents, en utilisant un ensemble d’items d’ancrage communs (anchor items) pour ajuster mathématiquement la moyenne et l’écart-type de la Forme B sur l’échelle de la Forme A :
XB_ajusté = ( σA / σB ) · ( XB – μB ) + μA
- La méthode d’égalisation linéaire de Levine : Plus robuste face aux erreurs d’échantillonnage, elle calibre la relation métrique en se fondant directement sur l’estimation des scores vrais sous-jacents plutôt que sur les seuls scores bruts observés.
Lorsque la relation entre les distributions n’est pas strictement linéaire (ce qui survient lorsque l’une des formes est légèrement plus discriminante vers les scores extrêmes), l’égalisation equipercentile est adoptée. Cette approche non linéaire fait correspondre les scores des deux formes qui possèdent le même rang centile dans la population de référence. Les scores bruts égalisés sont ensuite convertis en échelles standardisées universelles (scores Z, notes T à moyenne 50 et écart-type 10, ou Stanines) garantissant une équivalence d’interprétation pour les praticiens de terrain.
11. Apport de la théorie de réponse aux items (TRI) et tests adaptatifs
11.1 Dépassement des limites de la théorie classique
La théorie classique des tests présente une faiblesse théorique majeure : les paramètres d’un item (sa difficulté $p$ et son pouvoir discriminant $D$) dépendent intrinsèquement de l’échantillon sur lequel ils ont été mesurés. Si l’échantillon pilote est constitué d’individus très performants, les items sembleront faciles ; s’il est constitué de participants moins performants, les mêmes items sembleront difficiles.
La Théorie de Réponse aux Items (TRI ou Item Response Theory) affranchit la psychométrie de cette contrainte grâce à la propriété d’invariance des paramètres. Dans les modèles logistiques de la TRI (modèles de Rasch à 1 paramètre, modèles à 2 ou 3 paramètres), la probabilité qu’un sujet réussisse un item dépend de son niveau sur le trait latent ($\theta$) et des propriétés absolues de l’item : sa difficulté intrinsèque ($b$), sa discrimination ($a$) et la probabilité de réussite due au hasard ($c$) :
P(Xij = 1 | θi) = cj + [ (1 – cj) / ( 1 + e-aj(θi – bj) ) ]
Dans le paradigme de la TRI, la notion de fidélité globale uniforme est remplacée par le concept beaucoup plus fin de Fonction d’Information du Test (TIF ou Test Information Function), notée $I(\theta)$. L’erreur type d’estimation devient conditionnelle au niveau de trait du sujet :
SE(θ) = 1 / √I(θ)
Dès lors, deux formes sont définies comme rigoureusement parallèles si et seulement si leurs fonctions d’information sont strictement superposables sur l’ensemble du continuum du trait latent $\theta$, garantissant ainsi une précision de mesure équivalente quel que soit le niveau de compétence du participant.
11.2 Génération automatisée de formes parallèles dynamiques
L’intégration de la TRI aux technologies informatiques contemporaines a donné naissance à l’Assemblage Automatisé de Tests (Automated Test Assembly, ATA). Plutôt que de construire manuellement deux versions statiques, les ingénieurs psychométriciens programment des algorithmes d’optimisation mathématique (notamment la programmation linéaire mixte en nombres entiers).
Ces algorithmes puisent au sein de gigantesques banques d’items pré-calibrés pour construire à la volée des dizaines de formes parallèles distinctes. Le système informatique résout un système d’équations sous contraintes multiples :
- Contrainte d’alignement de la fonction d’information du test (qui doit épouser une cible prédéfinie avec une marge d’erreur inférieure à 1 %).
- Contraintes de contenu (respect absolu de la matrice de spécifications thématiques).
- Contraintes d’exposition des items (contrôle du taux de réutilisation des questions pour prévenir les fuites de contenus).
- Contraintes de structure syntaxique, de temps estimé de complétion et de parité des formats de réponse.
Grâce à l’ATA, chaque candidat peut se voir administrer une forme totalement unique du point de vue de sa composition d’items, tout en garantissant une comparabilité psychométrique parfaite de l’estimation de son score latent par rapport à tous les autres candidats.
11.3 Rôle dans les tests adaptatifs informatisés (CAT)
Le point d’orgue de cette évolution méthodologique réside dans les Tests Adaptatifs Informatisés (Computerized Adaptive Testing, CAT). Dans un test adaptatif, la notion traditionnelle de formes parallèles statiques fixes s’efface au profit d’un parallélisme dynamique individualisé.
Au cours de l’évaluation, l’algorithme sélectionne interactivement chaque item en fonction des réponses précédentes du sujet. Si le candidat réussit un item, un item de difficulté légèrement supérieure lui est soumis ; s’il échoue, un item plus accessible lui est présenté. Le test s’arrête dès que l’erreur type de mesure conditionnelle $SE(\theta)$ atteint un seuil de précision standardisé prédéterminé (par exemple $SE(\theta) le 0,20$, équivalant à une fidélité classique de 0,96).
Dans ce cadre, la fidélité n’est plus compromise par des décalages de difficulté entre des versions pré-imprimées : chaque individu bénéficie d’une précision de mesure maximale taillée sur mesure pour son niveau réel, tout en réduisant le temps total de passation de 50 à 70 % par rapport à un test conventionnel.
12. Recommandations déontologiques, reporting et perspectives de recherche
12.1 Normes de publication et transparence méthodologique
La publication scientifique et la commercialisation d’un instrument psychologique revendiquant l’existence de formes parallèles sont soumises à des obligations déontologiques strictes, codifiées par les instances de régulation internationales telles que l’APA et l’International Test Commission (ITC). Les manuels d’utilisation doivent consigner avec la plus grande transparence l’ensemble des données d’étalonnage :
- La composition détaillée des échantillons de validation croisée (taille, caractéristiques sociodémographiques, niveau d’éducation, répartition par sexe).
- Le protocole d’administration appliqué lors de l’étude d’équivalence (délai temporel précis entre les passations, détails du plan de contrebalancement).
- La divulgation intégrale des matrices de corrélation, des moyennes et des écarts-types observés pour chaque forme, ainsi que les indices d’ajustement factoriel (SEM) confirmant le parallélisme.
- La publication obligatoire de l’erreur type de mesure (SEM) et de l’intervalle de confiance associé pour chaque version de l’instrument.
L’omission de ces données fondamentales dans le manuel technique d’un test déchoit immédiatement l’instrument de sa validité scientifique et expose les praticiens l’utilisant à des risques de contestation médico-légale ou juridique de leurs conclusions diagnostiques.
12.2 Considérations éthiques et équité pour les participants
Sur le plan éthique, l’utilisation de formes parallèles engage la responsabilité directe de l’évaluateur vis-à-vis de l’équité de traitement accordée aux individus évalués. Il est inacceptable qu’un candidat ou un patient subisse un préjudice personnel, académique ou professionnel sous prétexte qu’il s’est vu attribuer par tirage au sort une forme de test qui s’avérerait marginalement plus difficile ou moins discriminante qu’une autre version.
Cette exigence impose la détection rigoureuse du Fonctionnement Différentiel des Items (DIF pour Differential Item Functioning). Une forme parallèle ne doit comporter aucun item favorisant systématiquement un groupe d’individus au détriment d’un autre (en fonction de l’origine ethnique, de l’identité de genre ou du statut socio-économique) à niveau d’aptitude latente égal. L’analyse du DIF, menée via des méthodes de régression logistique ou le test de Mantel-Haenszel, est incontournable avant la mise en circulation de toute forme alternative.
Enfin, pour les personnes en situation de handicap, l’adaptation d’une forme en version accessible (par exemple en braille ou avec agrandissement typographique) ne doit pas être traitée comme une simple formalité technique : elle nécessite une démonstration psychométrique formelle que l’aménagement n’a pas détruit le parallélisme de mesure par rapport à la forme standard.
12.3 Perspectives technologiques et utilisation de l’intelligence artificielle
Le champ de la psychométrie connaît une mutation sans précédent sous l’impulsion de l’intelligence artificielle et des modèles de traitement automatique du langage naturel (NLP). Les modèles de langage de grande taille (LLM) sont désormais exploités pour soutenir la génération automatique d’items (AIG pour Automatic Item Generation).
En introduisant des modèles sémantiques formels et des matrices de spécifications au sein d’invites algorithmiques spécialisées, les chercheurs sont capables de générer instantanément des centaines d’énoncés alternatifs présentant un isomorphisme linguistique et conceptuel quasi parfait. L’intelligence artificielle peut également procéder à la vérification automatisée de la lisibilité lexicale (indices de Flesch-Kincaid) et à la prédiction computationnelle de la difficulté de l’item ($p$) avant même qu’il ne soit soumis à un échantillon humain.
Toutefois, cette opportunité technologique s’accompagne de défis méthodologiques majeurs. L’automatisation ne saurait dispenser la communauté scientifique de la validation empirique sur le terrain. L’existence d’artefacts cognitifs imperceptibles pour les algorithmes génératifs réaffirme avec force l’impératif absolu d’appliquer les protocoles statistiques rigoureux de la fidélité par formes parallèles. Seule l’articulation harmonieuse entre puissance algorithmique et rigueur psychométrique garantira l’équité, la reproductibilité et la validité des évaluations psychologiques de demain.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.apa.org/science/programs/testing/standards
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006X.59.1.12
- Kolen, M. J., & Brennan, R. L. (2014). Test equating, scaling, and linking: Methods and practices (3rd ed.). Springer. https://doi.org/10.1007/978-1-4939-0317-7
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- van der Linden, W. J. (2005). Linear models for optimal test design. Springer. https://doi.org/10.1007/0-387-29054-0