
Dans l’univers de la psychométrie, de l’évaluation psychologique et des sciences du comportement, la question fondamentale qui se pose à tout concepteur ou utilisateur d’instrument d’évaluation est d’une désarmante simplicité : ce test mesure-t-il véritablement ce qu’il prétend mesurer, et surtout, permet-il de prendre des décisions éclairées et justes concernant les individus ? Face à l’abstraction inhérente aux construits psychologiques tels que l’intelligence, la dépression, les aptitudes managériales ou la motivation intrinsèque, les chercheurs ne peuvent se contenter d’intuitions subjectives. C’est ici qu’intervient la notion de validité de critère, pilier pragmatique et empirique de l’évaluation standardisée, qui établit un pont quantifiable entre un score abstrait obtenu à un test et une réalité tangible observable dans le monde réel.
La validité de critère ne s’embarrasse pas uniquement de modélisations conceptuelles pures ; elle plonge ses racines dans l’utilité pratique, l’efficience décisionnelle et la rigueur prédictive. Qu’il s’agisse de sélectionner les candidats les plus prometteurs pour un programme universitaire hautement sélectif, d’identifier les employés susceptibles de s’épanouir dans des fonctions à haute responsabilité, ou de diagnostiquer précocement un trouble psychiatrique invalidant, la validité de critère constitue l’étalon statistique par lequel la valeur appliquée d’un instrument est jugée. Elle répond au besoin impérieux de vérifier si un instrument de mesure psychologique peut servir de substitut fiable, économique et standardisé à l’observation directe de comportements souvent complexes, coûteux ou différés dans le temps.
Comprendre la validité de critère, c’est explorer l’un des domaines les plus fascinants de la méthodologie scientifique, où les mathématiques de la corrélation rencontrent la psychologie appliquée et l’éthique de la décision. Ce guide approfondi a pour vocation de déconstruire méthodiquement ce concept cardinal, en explorant ses fondements historiques, ses déclinaisons prédictive et concourante, ses soubassements statistiques, ainsi que les écueils méthodologiques qui guettent les praticiens. En démystifiant ses équations et en illustrant ses mécanismes par des situations concrètes issues de la clinique, de l’éducation et du monde professionnel, nous offrirons une grille de lecture exhaustive pour quiconque souhaite maîtriser l’évaluation psychologique moderne.
1. Introduction fondamentale à la validité de critère en psychométrie
1.1 Définition conceptuelle de la validité de critère
La validité de critère, parfois désignée sous le terme de validité empirique ou pragmatique, renvoie au degré d’efficacité avec lequel un score obtenu à un instrument d’évaluation (le prédicteur) permet d’estimer ou d’anticiper la performance d’un individu sur une mesure externe spécifique, nommée le critère. Sur le plan théorique, cette forme de validité examine la force et la direction de l’association statistique entre l’instrument de mesure et un résultat comportemental ou clinique observable de manière indépendante. Contrairement aux approches purement internalistes de la mesure, la validité de critère s’ancre dans l’extériorité : un test d’aptitude numérique n’a que peu de valeur pratique en soi si l’on ne peut prouver qu’un score élevé prédit avec régularité la capacité à analyser des états financiers complexes ou à réussir des examens avancés de comptabilité.
Cette approche justifie l’usage pragmatique d’un test dans la vie quotidienne des institutions et des cliniques. Dans de nombreuses situations professionnelles ou éducatives, il s’avère impossible ou excessivement coûteux d’observer directement le comportement final d’un individu avant de prendre une décision d’admission, d’embauche ou de traitement. La validité de critère autorise ainsi une inférence légitime : elle permet d’utiliser une mesure intermédiaire, rapide et standardisée, pour tirer des conclusions probables sur un événement futur ou sur un état latent plus difficile d’accès. Sans cette démonstration empirique formalisée, l’utilisation de tests psychométriques relèverait de la pure spéculation arbitraire, privant les praticiens de fondements scientifiques solides.
Il importe de distinguer rigoureusement la validité de critère de la validité apparente (dite aussi validité faciale). La validité apparente désigne simplement l’impression superficielle, pour le profane ou le répondant, que le test mesure ce qu’il prétend évaluer. Un questionnaire peut sembler extrêmement pertinent à la lecture de ses items tout en présentant une corrélation nulle avec la réalité du terrain. Inversement, un test psychomoteur ou projectif d’apparence nébuleuse peut démontrer une validité empirique exceptionnelle lorsqu’il est confronté à des indicateurs objectifs de rendement ou de diagnostic. La validité de critère transcende les apparences pour s’appuyer exclusivement sur des preuves quantitatives irréfutables.
Dans l’architecture globale de la validation d’un instrument psychologique, la validité de critère occupe un rôle nodal. Elle constitue la preuve ultime d’utilité selon les perspectives décisionnelles de la psychométrie. Un instrument doté d’une remarquable cohérence interne et d’une structure factorielle impeccable demeure un exercice intellectuel stérile s’il se montre incapable d’éclairer un comportement humain tangible ou d’améliorer la précision diagnostique par rapport aux méthodes conventionnelles déjà en vigueur.
1.2 Évolution historique de la notion de critère en psychologie
L’émergence formelle de la validité de critère s’inscrit au carrefour des nécessités socio-économiques du début du XXe siècle et des impératifs militaires des deux guerres mondiales. Dès les travaux pionniers d’Alfred Binet et de Théodore Simon en 1905, l’objectif était éminemment pratique : concevoir une échelle métrique capable d’identifier les enfants en échec scolaire nécessitant un enseignement spécialisé. Le critère initial était limpide et externe : le jugement des enseignants et la performance pédagogique réelle en classe. Cependant, c’est véritablement lors de l’entrée des États-Unis dans la Première Guerre mondiale, sous l’impulsion de Robert Yerkes et de ses collègues, que la sélection standardisée à grande échelle a pris son essor avec les célèbres tests Army Alpha et Army Beta, conçus pour affecter des millions de recrues selon leurs capacités intellectuelles à divers postes militaires.
Durant l’entre-deux-guerres et lors de la Seconde Guerre mondiale, l’industrialisation rapide et le besoin d’optimiser le capital humain ont conduit à une formalisation mathématique poussée des critères d’évaluation. Des pionniers de la psychométrie et de la statistique inférentielle, tels que Charles Spearman, Karl Pearson et plus tard Harold Gulliksen, ont élaboré le cadre formel de la théorie classique des tests. Durant cette période, la validité était presque exclusivement conçue comme une validité empirique : la valeur d’un test se résumait intégralement à sa corrélation brute avec un critère donné, qu’il s’agisse du nombre de pièces usinées sans défaut par heure ou de la réussite d’un pilote lors de son entraînement en vol militaire.
Toutefois, cette approche strictement utilitaire et parfois aveugle a révélé ses limites conceptuelles dès les années 1950. Réduire la validité à un simple coefficient statistique sans s’interroger sur la nature psychologique de ce qui était mesuré exposait la discipline au risque de créer des instruments aux corrélations fortuites ou instables dans le temps. C’est sous l’impulsion de méthodologistes visionnaires comme Lee Cronbach et Paul Meehl que s’est opérée la transition vers une intégration théorique structurée, positionnant le critère non plus comme une fin absolue et isolée, mais comme un élément constitutif du réseau explicatif d’un construit psychologique sous-jacent.
1.3 Place de la validité de critère dans l’évaluation psychologique moderne
Dans la pratique contemporaine de l’évaluation psychologique, l’administration d’un test engage directement la responsabilité déontologique et éthique du professionnel. Qu’il s’agisse d’orienter la scolarité d’un enfant, de décider de l’octroi d’une rente d’invalidité, de sélectionner un cadre supérieur ou de prononcer une mesure d’internement psychiatrique, les conséquences humaines, sociales et financières sont considérables. Les codes éthiques modernes, à l’instar de ceux de l’American Psychological Association ou de la Société Française de Psychologie, exigent formellement que chaque décision fondée sur un test repose sur des preuves documentées de validité de critère pour la population cible considérée.
L’impact de cette métrique sur la prise de décision organisationnelle et individuelle s’avère déterminant pour limiter l’arbitraire et la discrimination injuste. En milieu professionnel, par exemple, l’usage d’outils d’évaluation dépourvus de validité de critère démontrée expose les organisations à des risques juridiques majeurs pour discrimination indirecte. Si un processus de sélection exclut disproportionnellement certains groupes démographiques sans pouvoir prouver de manière irréfutable que le score prédit effectivement la compétence professionnelle recherchée, la pratique est jugée illégitime et scientifiquement infondée. La validité de critère agit dès lors comme un garant d’équité et d’efficience sociale.
De surcroît, les exigences scientifiques actuelles imposent une standardisation méticuleuse des procédures de mesure et une objectivité totale dans l’établissement des critères. Avec la prolifération des algorithmes d’apprentissage automatique, de l’analyse automatisée de données volumineuses et du profilage psychologique numérique, la recherche d’une validité de critère rigoureuse et exempte de biais de mesure n’a jamais été aussi cruciale. Elle demeure l’unique rempart méthodologique garantissant que nos technologies prédictives mesurent des compétences et des traits authentiques plutôt que des artefacts statistiques dénués de sens.
2. Les deux composantes clés : variable explicative et variable critère
2.1 La variable explicative : le score au test prédictif
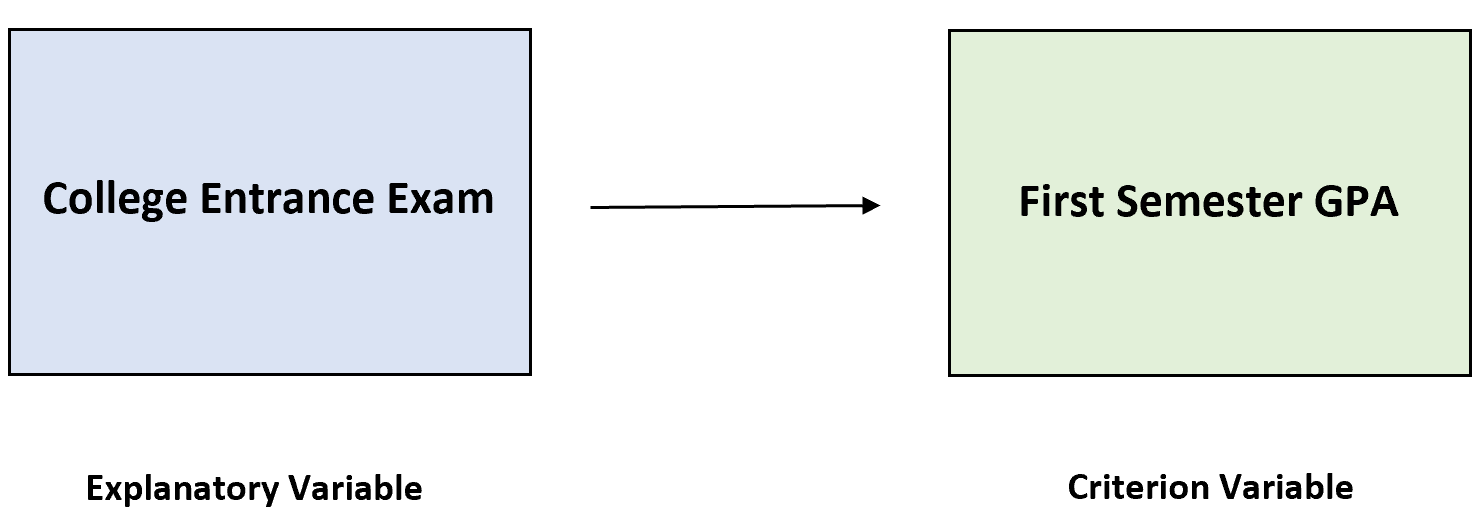
Au cœur de toute démarche d’analyse de validité de critère se trouve la variable explicative, traditionnellement qualifiée de prédicteur ou de variable indépendante dans le cadre de la modélisation statistique. Cette variable est constituée par le score brut ou standardisé obtenu par un sujet à l’issue de l’administration d’un instrument de mesure spécifique. Sur le plan métrologique, ce prédicteur opérationnalise une caractéristique psychologique ou comportementale donnée, en convertissant une série de réponses standardisées à des stimuli, des questions ou des épreuves en une valeur numérique continue ou catégorielle ordonnée.
L’opérationnalisation des scores exige une attention scrupuleuse aux conditions techniques de passation. Le prédicteur doit posséder des qualités psychométriques intrinsèques solides, au premier rang desquelles figure une fidélité (ou fiabilité) élevée. En vertu des axiomes de la théorie classique des tests, un instrument dont le score est instable, excessivement sensible aux erreurs aléatoires de mesure ou dénué de consistance interne ne pourra jamais manifester une corrélation robuste et reproductible avec un critère externe. En d’autres termes, une variable explicative bruitée limite mathématiquement la portée de toute inférence prédictive.
Les exemples canoniques de variables explicatives foisonnent dans la littérature scientifique contemporaine. On retrouve au premier chef les tests d’aptitude cognitive générale (comme les échelles de Wechsler), les inventaires de personnalité fondés sur le modèle des Big Five (tels que le NEO-PI), les épreuves standardisées de jugement situationnel utilisées en recrutement, ou encore les tests standardisés de connaissances académiques. Dans chacun de ces cas, le score agrégé constitue le point de départ empirique à partir duquel la trajectoire d’un individu va être extrapolée.
2.2 La variable critère : le comportement ou résultat cible
La variable critère représente le comportement, le rendement ou l’état clinique réel que l’on cherche à prédire, à expliquer ou à diagnostiquer à travers l’instrument d’évaluation. Elle fait office d’étalon de référence externe, incarnant la finalité pragmatique de la démarche psychométrique. Définir un critère pertinent nécessite de quitter le champ restreint du test pour interroger directement le contexte d’application : quel résultat comportemental concret justifie que l’on soumette des individus à cette passation ? La variable critère doit posséder une valeur écologique et fonctionnelle indéniable pour les parties prenantes du processus d’évaluation.
À l’instar de la variable explicative, la mesure critère doit elle-même répondre à des normes strictes de validité et de fidélité métrologiques. Si le critère retenu est erratique, imprécis ou sujet à d’importantes fluctuations aléatoires, la meilleure des épreuves prédictives échouera à établir une association statistique significative. Les critères classiques regroupent, selon les contextes, la moyenne académique générale pondérée sur un cycle universitaire, le volume des ventes trimestrielles ajusté pour un commercial, le taux d’accidents de travail sur une période de cinq ans chez des conducteurs de train, ou encore l’établissement formel d’un diagnostic d’état de stress post-traumatique au moyen d’un entretien structuré approfondi.
Une exigence méthodologique absolue réside dans l’indépendance intégrale entre l’administration du test prédicteur et l’évaluation du critère. Le processus d’obtention de la mesure critère ne doit sous aucun prétexte être influencé par la connaissance préalable du score obtenu au test. Tout chevauchement opérationnel ou toute contamination informationnelle entre ces deux pôles détruit la légitimité de l’inférence statistique en créant une corrélation artificielle qui ne reflète aucune réalité psychologique sous-jacente.
2.3 La nature de la relation fonctionnelle entre prédicteur et critère
L’analyse de la validité de critère postule l’existence d’une relation fonctionnelle, observable et reproductible, unissant le score du test et la performance mesurée par le critère. Sur le plan statistique, cette relation se formalise sous la forme d’une covariance empirique : les variations observées sur les scores du prédicteur doivent être systématiquement associées à des variations correspondantes sur la variable critère. Il s’agit de vérifier dans quelle mesure la distribution conditionnelle des scores critères varie en fonction des niveaux du prédicteur, autorisant une réduction de l’incertitude quant à l’évaluation du statut d’un individu.
La détermination du sens de l’influence et de la dynamique relationnelle suppose une distinction claire entre simple concomitance statistique et modélisation directionnelle. Bien que le calcul d’un coefficient de corrélation soit symétrique d’un point de vue purement algébrique, le modèle théorique sous-jacent est généralement asymétrique : le prédicteur est appréhendé comme l’antécédent logique ou temporel à partir duquel le résultat sur le critère est dérivé. La nature de ce lien peut être linéaire, les augmentations du score au test s’accompagnant d’augmentations proportionnelles du critère, ou présenter des non-linéarités, telles que des effets de seuil ou des rendements décroissants au-delà d’un certain niveau d’aptitude.
Il demeure fondamental d’adosser cette relation fonctionnelle à une justification théorique substantielle. Observer une association statistique robuste entre deux variables ne suffit pas à valider l’usage d’un test si aucun mécanisme psychologique plausible ne vient étayer ce lien. Le construit évalué par le prédicteur doit constituer une composante causale ou un corrélat fonctionnel avéré des compétences requises pour manifester le comportement critère. L’absence de fondation théorique condamne l’évaluateur à exploiter des corrélations fortuites, hautement vulnérables à l’instabilité d’échantillonnage et aux changements de contexte environnemental.
3. Les deux formes canoniques : validité prédictive et validité concourante
3.1 La validité prédictive : anticiper les résultats futurs
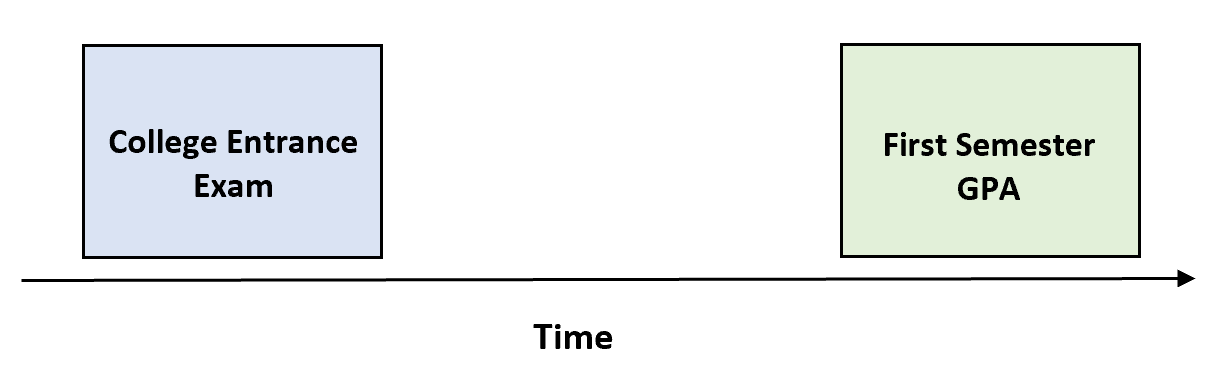
La validité prédictive représente la modalité la plus intuitive et la plus rigoureuse de la validité de critère. Son principe fondamental réside dans l’instauration délibérée d’un décalage temporel substantiel entre l’administration de l’instrument d’évaluation (le prédicteur) et le recueil ultérieur des données relatives au comportement cible (le critère). Le chercheur ou le praticien évalue une cohorte à l’instant t, conserve les scores sous scellés méthodologiques sans s’en servir pour modifier les conditions environnementales des participants, puis observe ces mêmes individus à l’instant t + k afin d’enregistrer leurs performances réelles. L’intensité de la corrélation calculée entre ces deux temps mesure la capacité prospective du test.
Cette approche revêt une utilité stratégique inestimable dans tous les processus d’orientation scolaire, de sélection universitaire et de recrutement professionnel. Elle permet d’éclairer des décisions d’investissement humain majeures où l’organisation s’engage sur le long terme sans possibilité de retour en arrière aisé. Par exemple, mesurer la validité prédictive d’un concours d’entrée aux grandes écoles d’ingénieurs implique de corréler les classements obtenus lors des épreuves d’admission avec la réussite professionnelle, les brevets déposés ou le salaire d’embauche cinq ou dix ans après l’obtention du diplôme. Le test agit ici comme un filtre anticipateur dont l’efficacité se vérifie sur la durée.
Néanmoins, les devis longitudinaux inhérents à la validité prédictive soulèvent des défis méthodologiques et logistiques ardus. Le coût financier de ces protocoles étalés sur plusieurs mois ou années, les difficultés liées à l’attrition de l’échantillon (sujets perdus de vue, démissions, abandons scolaires), ainsi que les variations historiques et contextuelles qui peuvent survenir durant l’intervalle de suivi compliquent singulièrement l’interprétation des résultats. Malgré ces obstacles, la validité prédictive demeure la référence scientifique suprême pour justifier tout processus de sélection prospective.
3.2 La validité concourante : corrélation simultanée
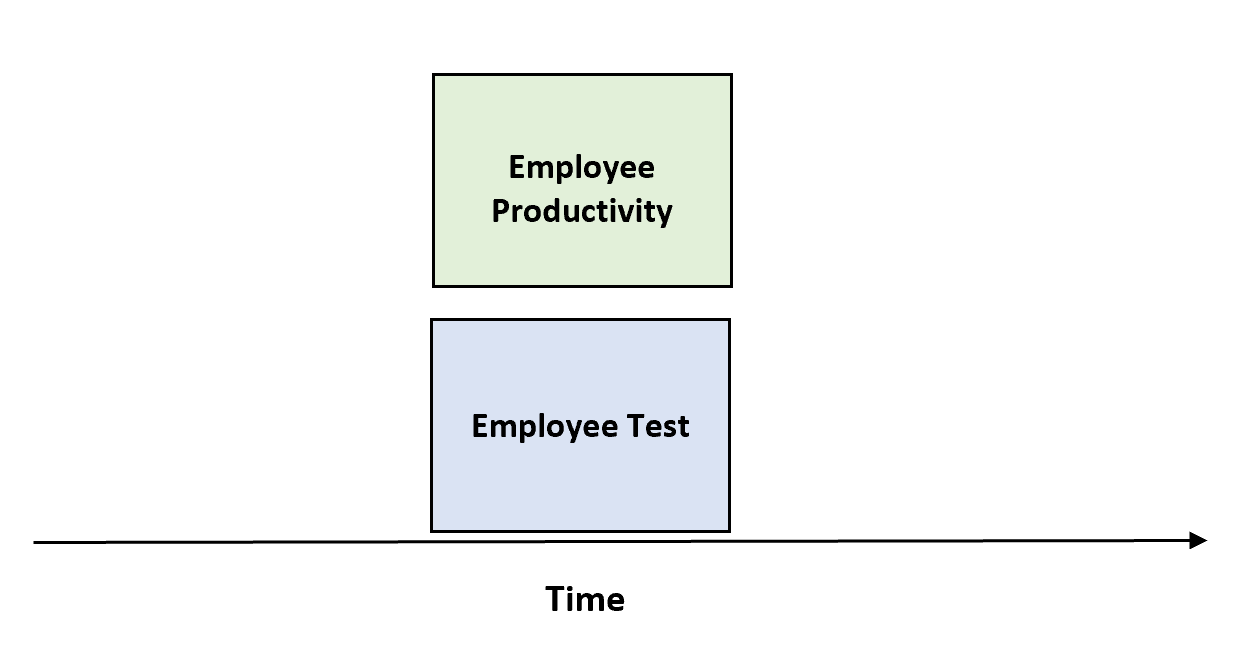
À la différence de la démarche prédictive, la validité concourante (également qualifiée de validité concomitante) se caractérise par l’administration quasi synchrone du nouvel instrument d’évaluation et de la mesure de référence externe. Dans ce dispositif méthodologique, le temps qui s’écoule entre le recueil des scores au test évalué et l’obtention des résultats au critère est nul ou négligeable. L’investigation cherche à déterminer si le score obtenu au nouvel outil concorde précisément avec le statut présent de l’individu tel qu’établi par une méthode diagnostique ou comportementale contemporaine.
L’application pratique majeure de la validité concourante réside dans le développement, la validation et l’étalonnage d’instruments de mesure alternatifs plus rapides, plus économiques ou moins invasifs que les outils traditionnels de référence. En milieu médical et psychiatrique, par exemple, un protocole diagnostique complet peut exiger plusieurs heures d’entretiens cliniques semi-structurés conduits par des praticiens seniors chevronnés. Valider une échelle auto-rapportée de vingt items en démontrant sa corrélation massive et synchrone avec le diagnostic clinique posé le jour même permet de doter les services d’urgence d’un outil de tri préliminaire d’une immense efficacité logistique.
Il existe toutefois une contrepartie épistémologique stricte à la rapidité de collecte offerte par le devis concourant. Par construction, ce dispositif élimine la dimension temporelle et s’avère incapable de prouver formellement la causalité ou le pouvoir de prédiction à long terme de l’instrument. Un test démontrant une excellente validité concourante chez des individus exerçant déjà un emploi depuis dix ans ne garantit pas automatiquement que le même test, administré à de jeunes candidats inexpérimentés, prédira avec succès leur adaptation future. Les effets d’apprentissage, d’habituation au poste ou de sélection naturelle du personnel peuvent altérer profondément la transférabilité des scores vers une perspective prospective.
3.3 Critères de décision entre devis prédictif et devis concourant
Le choix méthodologique entre un devis de validité prédictive et un devis de validité concourante découle prioritairement de la finalité fonctionnelle assignée à l’instrument d’évaluation. Lorsque le test a pour vocation d’opérer un tri prospectif pour des situations où les compétences ne sont pas encore stabilisées ou observées — à l’instar de l’octroi d’une bourse d’études, du recrutement de stagiaires ou de l’évaluation du potentiel de reconversion —, le recours au devis prédictif s’impose comme une nécessité absolue. En revanche, lorsque le test est conçu pour établir un diagnostic différentiel immédiat, évaluer un état psychopathologique aigu ou remplacer une mesure étalon lourde par un équivalent abrégé, le schéma concourant s’avère non seulement approprié mais méthodologiquement supérieur par son contrôle des variations temporelles.
Les contraintes matérielles, financières et institutionnelles exercent également un arbitrage déterminant dans la conception de l’étude. Très souvent, les organisations ne disposent ni du temps ni des ressources budgétaires nécessaires pour geler des données pendant deux ans avant d’autoriser l’usage d’un outil de sélection. Le devis concourant, en permettant de tester une cohorte actuelle d’employés ou d’étudiants dont les métriques de rendement sont déjà disponibles dans les bases de données institutionnelles, offre un gain d’efficience immédiat, souvent exploité comme validation préliminaire avant d’engager des travaux prospectifs à long terme.
Enfin, des considérations éthiques fondamentales dictent parfois l’arbitrage méthodologique. Dans le domaine de la psychologie clinique et de la suicidologie, par exemple, il serait impensable et déontologiquement inacceptable d’administrer une échelle évaluant le risque de passage à l’acte imminent puis d’attendre passivement plusieurs mois pour vérifier si les scores élevés correspondent effectivement à des suicides réels sans intervenir médicalement. L’évaluation du critère doit se faire de façon concourante face à des évaluations cliniques expertes indépendantes et synchrones, afin d’engager sans délai les mesures de protection nécessaires.
4. Études de cas et illustrations pratiques en contexte réel
4.1 Cas 1 : L’examen d’admission universitaire et la moyenne générale
Considérons l’exemple archétypal d’une faculté de médecine prestigieuse qui met en place une épreuve d’admission standardisée afin de départager plusieurs milliers de candidats pour un nombre très restreint de places. La variable explicative continue est représentée par le score global obtenu à cet examen d’entrée, qui évalue le raisonnement logique, la compréhension de textes scientifiques et la résolution de problèmes biochimiques. Pour vérifier empiriquement si cette épreuve remplit sa fonction sélective avec justesse, l’institution déploie une étude de validité prédictive à grande échelle.
La variable critère retenue est la moyenne générale pondérée obtenue par chaque étudiant à l’issue de sa première année académique complète, une mesure standardisée reflétant l’acquisition réelle des compétences médicales fondamentales. Les résultats de la modélisation statistique révèlent une corrélation positive statistiquement significative de r = 0,48 entre le score à l’examen d’admission et la moyenne de fin d’année. L’analyse démontre que les candidats situés dans le quartile supérieur de l’examen d’entrée affichent un taux de réussite aux examens de première année de 88 %, tandis que ceux du quartile inférieur admis par dérogation ne franchissent ce cap qu’à hauteur de 22 %.
Ces données de validité de critère permettent à l’administration universitaire de fixer des seuils de coupure scientifiquement justifiés, limitant considérablement les risques d’échec précoce tout en optimisant l’allocation des ressources d’encadrement pédagogique. De surcroît, ces éléments empiriques offrent une réponse tangible aux contestations juridiques relatives à l’équité institutionnelle, en prouvant que les notes au concours ne constituent pas une barrière arbitraire mais un prédicteur empiriquement vérifié de la performance académique ultérieure.
4.2 Cas 2 : Les tests psychotechniques en milieu professionnel
Dans le secteur de la logistique industrielle de haute précision, une multinationale recrute des opérateurs de maintenance automatisée. Le poste exige une vigilance visuelle constante, une dextérité manuelle fine et des capacités d’analyse mécanique sous contrainte temporelle. L’équipe des ressources humaines introduit une batterie de tests psychotechniques standardisés informatisés mesurant la vitesse de traitement de l’information et la rotation spatiale tridimensionnelle. Ce score composite constitue la variable explicative de l’étude de validation.
Pour définir la variable critère de manière rigoureuse et multifactorielle, l’organisation collecte, au terme des douze premiers mois de travail effectif, une combinaison standardisée de deux métriques : d’une part, le taux moyen de temps d’arrêt non planifié des machines par opérateur (indicateur objectif de productivité) et, d’autre part, une grille standardisée d’évaluation comportementale du rendement à la tâche remplie par le supérieur hiérarchique direct. Afin d’éviter la contamination du critère, les managers évaluent les salariés sans avoir aucunement accès aux résultats initiaux des tests psychotechniques.
L’analyse bivariée met en lumière un coefficient de validité de r = 0,41 (p < 0,001) entre la batterie psychotechnique et la métrique combinée de rendement professionnel. En intégrant ce test validé dans son entonnoir d’embauche, l’entreprise constate une réduction de 35 % des erreurs de recrutement au cours de l’année suivante, diminuant substantiellement les coûts liés aux pannes de lignes de production. L’objectivité des tests permet également d’atténuer les biais subjectifs d’évaluation managériale, tels que l’effet de halo ou le biais de similarité sociale lors des entretiens initiaux.
4.3 Cas 3 : Échelles d’évaluation en psychologie clinique
Dans le domaine de la santé mentale hospitalière, le diagnostic rapide de la dépression majeure constitue un enjeu de santé publique critique. Une équipe de chercheurs en psychiatrie développe une nouvelle échelle auto-rapportée, le « Questionnaire d’Auto-évaluation de l’Humeur » (QAH), composé de quinze questions concises cotées sur une échelle de Likert, conçu pour être administré en moins de cinq minutes en salle d’attente. La variable explicative est le score continu cumulatif obtenu par le patient à ce questionnaire.
Pour mesurer la validité concourante de ce nouvel outil, le critère de référence externe retenu est la passation, le jour même, de l’entretien clinique structuré international pour les troubles psychiatriques (MINI ou SCID), administré en aveugle par un psychiatre expert chevronné. Ce protocole clinique fournit un statut diagnostique dichotomique formel (présence ou absence d’un épisode dépressif majeur caractérisé selon les critères du DSM-5) ainsi qu’un score de sévérité globale sur l’échelle d’évaluation de la dépression de Hamilton (HAM-D).
La corrélation de Pearson entre le score au nouveau questionnaire (QAH) et les scores de l’échelle expertisée de Hamilton atteint r = 0,74, attestant d’une excellente concordance métrique synchrone. Par ailleurs, l’analyse par courbes ROC (Receiver Operating Characteristic) permet d’identifier un score de coupure optimal sur le QAH qui offre une sensibilité de 89 % et une spécificité de 84 % par rapport au diagnostic catégoriel posé par l’expert. Cette démarche clinique rigoureuse démontre que l’outil auto-rapporté peut être déployé avec confiance dans les services de première ligne pour le dépistage précoce des états dépressifs majeurs.
5. Méthodologie de mesure : le coefficient de corrélation de Pearson
5.1 Fondements mathématiques du coefficient de corrélation linéaire
L’estimation quantitative de la validité de critère repose traditionnellement sur la modélisation statistique de l’association entre deux distributions continues. L’outil mathématique par excellence utilisé à cette fin est le coefficient de corrélation linéaire produit-moment de Pearson, universellement désigné par la lettre r. Sur le plan formel, le coefficient r quantifie la covariance standardisée entre la variable explicative X (le score au test) et la variable critère Y (le résultat externe). Il mesure la proximité avec laquelle le nuage de points formé par les couples d’observations s’aligne le long d’une droite de régression linéaire parfaite.
La formule mathématique fondamentale du coefficient de corrélation de Pearson s’énonce comme le rapport entre la covariance des deux variables et le produit de leurs écarts-types respectifs :
rXY = Cov(X, Y) / (σX · σY)
Sous sa forme calculatoire appliquée aux scores observés d’un échantillon de taille N, elle s’exprime ainsi :
r = [ Σ(Xi – X̄)(Yi – Ȳ) ] / [ √Σ(Xi – X̄)² · √Σ(Yi – Ȳ)² ]
Cette métrique possède des propriétés remarquables : elle est adimensionnelle et strictement invariante face à toute transformation linéaire positive des variables, ce qui signifie que l’ajout d’une constante ou la multiplication par un facteur d’échelle ne modifie aucunement la valeur de la corrélation. La signification statistique du coefficient obtenu se vérifie au moyen d’un test de Student avec N – 2 degrés de liberté, permettant de tester l’hypothèse nulle d’une absence de corrélation dans la population sous-jacente.
5.2 Conditions d’application pour un calcul valide du r de Pearson
Le calcul et l’interprétation légitime du r de Pearson ne sauraient être appliqués sans discernement. Ils exigent le respect rigoureux de plusieurs postulats métrologiques et distributionnels sous-jacents. Premièrement, les deux variables, X et Y, doivent être mesurées sur des échelles quantitatives continues de niveau au moins d’intervalle ou de rapport. Appliquer le r de Pearson à des variables ordinales grossières aux échelons arbitraires risque de fausser lourdement les estimations de la force de la relation.
Deuxièmement, la validité de l’inférence repose sur l’hypothèse de normalité bivariée des distributions : pour chaque niveau de la variable explicative, la distribution conditionnelle des scores critères doit suivre une loi normale, et vice-versa. Troisièmement, la relation entre le prédicteur et le critère doit impérativement être de nature linéaire. L’inspection visuelle préalable d’un diagramme de dispersion (nuage de points) est une exigence méthodologique inaliénable : si la relation prend une forme curviligne (par exemple, la loi de Yerkes-Dodson reliant le niveau d’anxiété à la performance intellectuelle en forme de U inversé), le coefficient de corrélation linéaire de Pearson sous-estimera dramatiquement l’intensité réelle de l’interdépendance des deux variables, s’approchant potentiellement de zéro malgré une relation fonctionnelle quasi déterministe.
Enfin, le chercheur doit se prémunir contre la présence de valeurs aberrantes (outliers) et l’hétéroscédasticité des résidus. Une unique valeur extrême, isolée aux confins de la distribution, peut artificiellement gonfler ou anéantir un coefficient de corrélation au sein d’échantillons de taille modeste. La stabilité des estimations requiert des échantillons suffisamment volumineux et une variance résiduelle constante à travers tous les niveaux du prédicteur.
5.3 Alternatives statistiques pour données non métriques
Dans de nombreuses situations cliniques ou organisationnelles, les données disponibles ne répondent pas aux exigences d’une distribution métrique continue. Lorsque la variable critère ou le prédicteur se présente sous la forme de données ordinales (telles que des classements par rangs ou des échelles de Likert aux catégories restreintes ne respectant pas la normalité), le recours au coefficient de corrélation des rangs de Spearman (ρ) ou au tau de Kendall constitue l’alternative non paramétrique par excellence. Ces indices calculent la concordance monotone entre les rangs des individus, neutralisant les distorsions liées aux distributions asymétriques ou non linéaires.
Lorsque la variable critère est de nature strictement dichotomique réelle — c’est-à-dire qu’elle n’admet intrinsèquement que deux états exclusifs, tels que la survie versus le décès d’un patient, la réussite versus l’échec à un examen certifiant, ou l’admission versus le rejet —, le statisticien doit utiliser le coefficient de corrélation point-bisériale (rpb). Ce coefficient est une dérivation mathématique directe du r de Pearson appliquée à une variable continue et une variable indicatrice binaire (0 ou 1), mesurant l’ampleur de l’écart standardisé entre les moyennes du groupe codé 0 et du groupe codé 1 sur le test prédictif.
En revanche, lorsque la dichotomie observée sur le critère est arbitraire ou artificielle — c’est-à-dire qu’elle découle d’un découpage binaire forcé d’une réalité continue sous-jacente normalement distribuée (comme diviser des individus entre « performants » et « non-performants » selon un seuil de vente médian) —, il convient d’employer le coefficient de corrélation bisériale (rb). Le calcul du coefficient bisérial corrige mathématiquement la perte d’information et de variance induite par la dichotomisation forcée, fournissant une estimation non biaisée de ce qu’aurait été la corrélation si le critère avait pu être mesuré de façon parfaitement continue.
6. Interprétation statistique et pratique des coefficients de validité
6.1 L’échelle des valeurs de -1 à +1
L’interprétation de la magnitude d’un coefficient de validité de critère s’inscrit sur un continuum théorique borné entre -1,00 et +1,00. Un coefficient de validité atteignant exactement +1,00 traduirait une relation linéaire directe et parfaite : tout individu obtenant le score le plus élevé au test prédictif obtiendrait immanquablement le score le plus haut sur le critère, sans la moindre divergence. Bien qu’une telle perfection soit théoriquement séduisante, elle n’existe jamais dans les sciences humaines et du comportement en raison de la complexité intrinsèque de la psyché humaine, des erreurs inhérentes aux instruments de mesure et de la multiplicité des déterminants contextuels de la performance.
À l’inverse, un coefficient de validité de zéro indique une absence totale de relation linéaire entre le score au test et le comportement cible. Les variations observées sur le prédicteur ne fournissent strictement aucune information permettant de réduire l’incertitude quant aux résultats futurs sur le critère. L’utilisation d’un instrument affichant une validité de critère nulle équivaut, sur le plan décisionnel, à un tirage au sort probabiliste pur, privant la procédure de toute justification scientifique ou déontologique.
Une valeur négative, tendant vers -1,00, n’indique nullement une mauvaise métrique, mais signale une prédiction inverse parfaite : un score élevé sur le prédicteur est systématiquement associé à une valeur basse sur le critère. Ce cas de figure est très fréquent selon la façon dont sont opérationnalisées les variables. Par exemple, une échelle mesurant l’impulsivité ou les traits de personnalité névrotiques devrait théoriquement présenter une corrélation négative avec la longévité en entreprise ou le respect des consignes de sécurité industrielle. C’est donc la magnitude absolue du coefficient (|r|), et non son signe algébrique, qui renseigne sur l’intensité et la valeur prédictive de l’instrument.
6.2 Normes d’acceptabilité des coefficients en sciences psychologiques
L’évaluation de l’acceptabilité pratique d’un coefficient de validité de critère exige un réalisme méthodologique éclairé. Contrairement aux coefficients de fidélité test-retest ou de consistance interne (qui doivent généralement dépasser 0,80 voire 0,90 pour être jugés satisfaisants), les coefficients de validité de critère en psychologie dépassent très rarement 0,50 ou 0,60 dans les études de terrain non artificiellement gonflées. Cette différence d’ordre de grandeur s’explique simplement : un comportement humain complexe (le critère) est multidéterminé par une infinité de facteurs cognitifs, motivationnels, affectifs et environnementaux qu’un seul test ne saurait capturer exhaustivement.
Dans la littérature psychométrique de référence, les seuils d’interprétation conventionnels des coefficients de validité de critère observés s’établissent généralement de la manière suivante :
- Faible : Valeurs comprises entre 0,15 et 0,25. Bien que modestes, ces corrélations peuvent posséder une utilité pratique substantielle lorsqu’elles sont appliquées à de très grands effectifs.
- Modéré : Valeurs comprises entre 0,25 et 0,40. Il s’agit de la norme typique observée pour les bons prédicteurs standardisés en psychologie du personnel et en éducation.
- Fort : Valeurs supérieures à 0,40 ou 0,50. Ces scores témoignent d’une efficacité prédictive exceptionnelle, rarement dépassée dans des contextes écologiquement valides.
Il est capital de souligner qu’un coefficient perçu comme statistiquement faible (par exemple, r = 0,20) peut générer des gains économiques et décisionnels gigantesques. En vertu des modèles de rentabilité psychométrique (comme le modèle de Taylor et Russell ou le modèle de Naylor-Shine), l’utilité pratique d’un test dépend conjointement de sa validité, du taux de sélection (proportion de candidats retenus parmi les postulants) et du taux de base de réussite dans la population. Si une entreprise hautement sélective ne retient que 2 % des postulants parmi 10 000 candidats, l’usage d’un test même modérément valide (r = 0,25) augmentera de façon spectaculaire la probabilité de sélectionner des éléments exceptionnels par rapport à une sélection non structurée.
6.3 Le coefficient de détermination et la variance expliquée
Pour appréhender pleinement la signification mathématique d’un coefficient de validité de Pearson, il convient de calculer son coefficient de détermination, obtenu simplement en élevant le coefficient de validité au carré (noté r²). Le coefficient de détermination exprime rigoureusement la proportion ou le pourcentage de la variance totale de la variable critère qui est directement expliquée, partagée ou prédite par la variance de la variable explicative au sein du modèle linéaire.
Ce calcul induit souvent une prise de conscience brutale chez les praticiens non initiés. Un coefficient de validité de r = 0,30 — considéré comme tout à fait respectable et exploitable en psychologie organisationnelle — se traduit par un coefficient de détermination de :
r² = (0,30)² = 0,09
Cela signifie que le test n’explique en réalité que 9 % de la variance des performances futures observées sur le terrain. Les 91 % restants de la variance du critère demeurent totalement inexpliqués par cet instrument spécifique, dépendant d’autres dimensions individuelles (effort consenti, santé physique, traits relationnels) ou de contingences organisationnelles et environnementales échappant au testeur.
Même dans le cas d’une corrélation substantielle de r = 0,50, la variance expliquée n’atteint que 25 %, laissant les trois quarts de la variabilité du critère en dehors de l’équation prédictive. Cette réalité statistique rappelle l’impérieuse nécessité de faire preuve de modestie clinique et scientifique : aucun instrument psychométrique unique ne peut prétendre rendre compte de la totalité d’un comportement humain complexe. C’est précisément ce constat qui a conduit les chercheurs à dépasser les corrélations simples pour concevoir des modèles d’évaluation multidimensionnels.
7. Modélisation avancée : de la corrélation simple à la régression
7.1 Régression linéaire univariée comme outil de prédiction concrète
Si le coefficient de corrélation linéaire informe avec précision sur la force de l’association entre deux variables, il ne constitue pas en soi un algorithme opérationnel de prédiction individuelle. Pour concrétiser cette prédiction et estimer la note exacte qu’obtiendra un sujet sur la variable critère Y à partir de son score observé sur le prédicteur X, la psychométrie s’appuie sur la modélisation par régression linéaire simple. L’équation de la droite d’estimation des moindres carrés s’écrit formellement :
Ŷ = a + bX
Où Ŷ représente le score prédit sur le critère, b désigne la pente de régression (coefficient non standardisé calculé par Cov(X,Y) / Var(X)) et a constitue la constante à l’origine (la valeur théorique de Y lorsque X est nul). Cette équation matérialise la relation fonctionnelle directe en traçant la trajectoire prédictive optimale minimisant la somme des carrés des écarts entre les scores réels observés et les valeurs projetées.
Un paramètre statistique capital lors de l’utilisation de cette droite d’estimation est l’erreur type d’estimation (notée SEest), directement dérivée de l’écart-type de la variable critère et du coefficient de validité :
SEest = σY · √(1 – rXY²)
Cette erreur type quantifie la dispersion des scores réels observés autour de la droite de régression. Plus la validité de critère est élevée, plus le terme sous la racine s’amenuise, réduisant l’incertitude entourant l’estimation individuelle. L’erreur type permet aux psychométriciens de construire des intervalles de prédiction probabilistes (généralement à 95 %) autour du score estimé, évitant l’illusion déterministe d’une prédiction ponctuelle absolue et rappelant la marge d’erreur inhérente à toute inférence psychologique.
7.2 Régression multiple et utilisation conjointe de plusieurs prédicteurs
Puisqu’un prédicteur isolé n’explique souvent qu’une fraction modeste de la variance du critère, la démarche méthodologique la plus productive consiste à agréger plusieurs instruments d’évaluation complémentaires au sein d’une batterie de tests. La modélisation par régression linéaire multiple répond précisément à cet impératif en reliant mathématiquement un critère unique Y à un vecteur de plusieurs variables prédictives X1, X2, …, Xk :
Ŷ = a + b1X1 + b2X2 + … + bkXk
Cette approche vise à optimiser le coefficient de corrélation multiple (désigné par un R majuscule), qui exprime la corrélation globale entre la combinaison linéaire optimale de tous les prédicteurs et la variable critère. En élevant cette métrique au carré (R²), on obtient la variance totale du critère expliquée conjointement par l’ensemble de la batterie d’évaluation.
Cependant, la construction d’une équation de régression multiple performante exige une gestion méticuleuse du phénomène de colinéarité (ou multicolinéarité). Deux tests qui corrèlent extrêmement fort entre eux mesurent en réalité la même variance psychologique ; les combiner n’apporte que très peu d’informations nouvelles tout en surchargeant inutilement la procédure de passation. L’art du psychométricien consiste à sélectionner des prédicteurs qui présentent de fortes corrélations directes avec le critère, mais des corrélations mutuelles aussi faibles que possible, garantissant que chaque instrument explore une facette distincte et orthogonale du comportement ciblé.
7.3 La notion de validité incrémentielle
Directement issue des architectures de régression multiple, la notion de validité incrémentielle constitue l’un des principes décisionnels les plus rigoureux de l’évaluation contemporaine. Introduite théoriquement par Sechrest en 1963, la validité incrémentielle désigne le gain statistique mesurable apporté par l’adjonction d’un nouvel instrument de mesure au sein d’une batterie prédictive préexistante. Elle interroge formellement la valeur ajoutée de l’outil : ce nouveau test permet-il d’augmenter de manière statistiquement significative la variance expliquée du critère (hausse du ΔR²) au-delà de ce que prédisaient déjà les tests standardisés moins coûteux ou plus rapides ?
L’application classique de ce principe s’illustre dans le couplage des tests d’intelligence générale (facteur g) et des inventaires de personnalité mesurant le trait de Conscience. L’aptitude cognitive générale s’impose historiquement comme le prédicteur univarié le plus puissant du rendement professionnel. Néanmoins, l’intégration conjointe d’une échelle standardisée mesurant la méticulosité et la persévérance démontre de manière récurrente une augmentation substantielle du R² global. La personnalité apporte ici une validité incrémentielle authentique : elle capture des variations de la performance au travail qui échappent intégralement au champ de l’efficience cognitive pure.
Cette évaluation de la validité incrémentielle s’avère indispensable pour arbitrer les ratios coût-bénéfice des protocoles d’évaluation. L’administration de batteries de tests extensives engendre une fatigue pour les répondants et des coûts financiers pour les institutions. Si un test très sophistiqué ne génère qu’un gain incrémentiel dérisoire (ΔR² < 0,01) au regard de son coût d’acquisition ou de cotation, son maintien au sein du protocole s’avère scientifiquement et économiquement injustifié.
8. Défis méthodologiques et biais affectant la validité de critère
8.1 Le phénomène d’atténuation lié à la fidélité des mesures
L’un des théorèmes statistiques les plus fondamentaux de la psychométrie classique stipule que la validité de critère observée empiriquement sur le terrain est inexorablement plafonnée et comprimée par l’imperfection de la fidélité (ou fiabilité) des instruments utilisés. Toute mesure psychologique comporte une part irréductible d’erreur aléatoire. Si le score obtenu au prédicteur X contient de l’erreur de mesure, et que la mesure de la variable critère Y est elle-même polluée par des imprécisions d’enregistrement, la corrélation empirique brute observée entre ces deux variables sera mathématiquement inférieure à la corrélation théorique réelle qui unit les deux construits latents purs.
Ce phénomène porte le nom d’atténuation de la corrélation. Le théoricien Charles Spearman a formalisé ce principe en démontrant que la corrélation maximale observable entre deux variables ne peut jamais dépasser la racine carrée du produit de leurs coefficients de fidélité respectifs :
rXY(max) = √(rXX’ · rYY’)
Où rXX’ représente la fidélité du prédicteur et rYY’ la fidélité de la mesure critère. Pour pallier ce biais mécanique d’amenuisement statistique, les chercheurs appliquent la formule de correction pour atténuation de Spearman, qui permet d’estimer la corrélation réelle débarrassée de l’erreur de mesure :
rvrai = rXY(obs) / √(rXX’ · rYY’)
Cette distinction entre validité observée brute et validité théorique corrigée est vitale pour la recherche fondamentale. Elle évite d’abandonner prématurément un instrument conceptuellement brillant dont la corrélation apparente semblait médiocre simplement parce que la métrique du critère utilisée sur le terrain manquait de constance interne ou de fidélité test-retest.
8.2 L’effet pervers de la restriction de l’étendue
La restriction de l’étendue de la variance (restriction of range) représente le piège méthodologique le plus insidieux et le plus universellement rencontré lors des études empiriques de validation en contexte réel. Ce phénomène se produit de façon mécanique lorsqu’une étude de validité est conduite auprès d’un échantillon d’individus qui ont préalablement été triés, filtrés ou sélectionnés sur la base de la variable prédictive elle-même, ou sur une variable fortement corrélée à celle-ci.
Considérons l’évaluation de la validité d’un examen d’entrée à l’université : la faculté n’admet que les candidats ayant obtenu des scores remarquables au concours. Si les chercheurs mesurent ultérieurement la corrélation entre les notes du test d’entrée et les moyennes universitaires obtenues par les seuls étudiants admis, ils observeront une dispersion des scores extrêmement étroite et tronquée. La formule de Pearson étant hautement dépendante de la variance totale des distributions, cette amputation de la variabilité naturelle du groupe entraîne un effondrement dramatique du coefficient de corrélation observé, qui peut chuter artificiellement de r = 0,55 (dans la population complète des postulants) à r = 0,18 au sein du seul groupe restreint des admis.
Pour remédier à cette distorsion systématique qui conduit de nombreux praticiens à sous-estimer dramatiquement la valeur réelle de leurs outils, le psychométricien Robert Thorndike a développé une série d’équations correctives d’ajustement de la variance. En exploitant le ratio de l’écart-type de l’échantillon sélectionné sur l’écart-type de la population globale candidate non sélectionnée, ces formules permettent de restituer le véritable pouvoir prédictif du test tel qu’il s’exerce au moment même de l’acte décisionnel de tri initial.
8.3 La contamination et la déficience du critère
L’évaluation rigoureuse de la validité de critère est menacée par deux pathologies méthodologiques symétriques affectant la variable critère : la déficience et la contamination. La déficience du critère survient lorsque la mesure externe retenue est trop étriquée et omet des facettes substantielles et capitales du domaine de performance que l’on cherchait originellement à capturer. Par exemple, si l’on évalue l’efficacité professionnelle d’un enseignant universitaire uniquement à travers le nombre d’articles scientifiques publiés, le critère souffre d’une déficience flagrante puisqu’il ignore délibérément ses aptitudes pédagogiques en classe et son implication dans le tutorat des étudiants.
Inversement, la contamination du critère désigne l’inclusion pernicieuse d’éléments extérieurs non pertinents, d’erreurs systématiques ou de biais cognitifs au sein de la mesure du critère, polluant sa signification psychologique. La contamination peut être d’ordre contextuel — évaluer un vendeur automobile sans corriger le score par le pouvoir d’achat moyen de la région géographique où se situe sa concession — ou découler de distorsions subjectives des évaluateurs.
La forme la plus redoutable de contamination est sans conteste le biais de l’évaluateur induit par la connaissance préalable des résultats au prédicteur. Si un supérieur hiérarchique chargé d’attribuer les notes de performance annuelle sait qu’un employé a réalisé un score exceptionnel au test d’aptitude intellectuelle lors de son embauche, cette information influence inconsciemment son regard et conduit à une surévaluation systématique de son travail (prophétie autoréalisatrice). Pour assainir méthodologiquement la mesure de validité, la mise en place d’un protocole d’évaluation strictement conduit en double aveugle s’impose comme une règle absolue : l’évaluateur du critère ne doit jamais avoir accès aux scores prédictifs des sujets.
9. Sélection et opérationnalisation rigoureuse de la variable critère
9.1 La recherche du critère de référence ou étalon-or
Le fondement de toute validation empirique repose sur la prémisse implicite que la mesure externe choisie comme référence incarne une approximation fidèle et indiscutable de la réalité : c’est la quête méthodologique de l’étalon-or (ou gold standard). Dans les sciences biologiques ou physiques, l’étalon-or est souvent aisé à circonscrire au moyen d’analyses anatomopathologiques ou de constantes physiques immuables. En revanche, dans l’immense majorité des sous-domaines des sciences du comportement, l’étalon parfait relève d’une illusion théorique inaccessible.
L’utilisation d’un critère intrinsèquement imparfait contamine mécaniquement l’ensemble des inférences statistiques que l’on peut en tirer. Si l’étalon de référence lui-même ne possède qu’une validité discutable et une fidélité précaire, un coefficient de corrélation faible entre le nouveau test et ce critère ambigu ne permet pas d’établir si c’est le nouvel instrument qui est défaillant ou si c’est la mesure de référence qui est méthodologiquement incapable de servir de témoin. La faiblesse d’une corrélation peut indifféremment sanctionner la médiocrité du prédicteur ou la déliquescence du critère.
Face à cette aporie méthodologique, la pratique contemporaine préconise la triangulation de multiples indicateurs de référence au lieu d’assujettir la validation à un unique étalon fragile. En intégrant simultanément des mesures comportementales directes, des indicateurs physiologiques ou fonctionnels et des évaluations expertes standardisées, le chercheur génère un critère composite synthétique. Ce construit de référence agrégé compense les faiblesses propres à chaque modalité isolée et procure une assise nettement plus solide pour asseoir la validité du prédicteur.
9.2 Critères objectifs versus critères subjectifs
La littérature scientifique opère une dichotomie classique entre les critères de performance dits « objectifs » et les critères qualifiés de « subjectifs », chacun présentant des atouts et des vulnérabilités métrologiques spécifiques. Les critères objectifs reposent sur des enregistrements factuels, standardisés et quantifiables indépendamment de l’intervention directe du jugement humain. Dans le monde du travail et de l’éducation, ils englobent des métriques telles que le chiffre d’affaires généré, le nombre de brevets déposés, le taux d’absentéisme non motivé, la rapidité d’exécution sur chaîne automatisée ou les relevés de notes chiffrés à des examens standardisés.
Bien que ces critères objectifs bénéficient d’une réputation spontanée d’infaillibilité et d’objectivité totale, ils souffrent très fréquemment de déficiences graves et d’une sensibilité exacerbée aux facteurs environnementaux incontrôlables. Un volume de vente individuel dépend souvent de la localisation géographique ou de la dynamique sectorielle du marché bien plus que du talent intrinsèque de l’employé. Les critères subjectifs, quant à eux, reposent sur l’intervention humaine sous la forme d’évaluations par les pairs, de grilles d’appréciation managériale ou d’entretiens cliniques expertisés.
Si les critères subjectifs sont naturellement vulnérables aux biais cognitifs des évaluateurs (effets d’indulgence, sévérité excessive, biais de récence ou effets de stéréotypie), ils possèdent l’avantage irremplaçable d’appréhender le comportement dans toute sa complexité qualitative et contextuelle. Pour fiabiliser les critères subjectifs, la psychométrie moderne prescrit l’abandon des évaluations libres au profit d’échelles de notation comportementale ancrées (Behaviorally Anchored Rating Scales – BARS). En associant des descriptions d’actes observables spécifiques à chaque niveau de l’échelle et en formant rigoureusement les juges, on maximise la fidélité inter-juges, condition indispensable pour sécuriser la mesure du critère.
9.3 Stabilité temporelle et dynamique évolutive du critère
Une erreur épistémologique classique consiste à conceptualiser la variable critère comme une réalité statique, figée et invariante à travers les époques. Or, la performance humaine, qu’elle soit académique, organisationnelle ou clinique, constitue un phénomène intrinsèquement dynamique, assujetti aux processus d’apprentissage, à la maturation psychologique individuelle et aux transformations des contextes sociotechniques. Un score obtenu à un test d’efficience cognitive n’entretient pas nécessairement la même relation fonctionnelle avec la performance d’un individu lors de sa première semaine d’apprentissage qu’après cinq années d’expertise consolidée dans un poste de travail.
La théorie des phases d’apprentissage d’Ackerman formalise cette dynamique temporelle en démontrant que la nature des capacités prédisant la performance se transforme au fil de la pratique. Lors de la phase initiale d’acquisition des compétences (dite phase cognitive), les capacités intellectuelles générales et le raisonnement abstrait constituent les prédicteurs suprêmes du critère. En revanche, à mesure que les routines motrices et cognitives s’automatisent (phase procédurale), la validité de l’intelligence générale tend à régresser au profit des aptitudes psychomotrices et des traits de personnalité relatifs à la méticulosité et à l’endurance.
Il est donc impératif de calibrer avec une immense rigueur le moment optimal d’administration du critère après le test prédicteur. Mesurer la réussite professionnelle trop tôt capture l’adaptabilité au choc d’apprentissage initial plutôt que le rendement pérenne ; la mesurer trop tard expose l’étude à des contaminations massives liées aux aléas de carrière et aux politiques internes d’avancement des organisations. Les chercheurs doivent documenter formellement la dynamique temporelle de leur critère pour éviter de tirer des conclusions de validité trompeuses quant à la trajectoire réelle des individus.
10. Comparaison critique avec les autres facettes de la validité
10.1 Validité de critère versus validité de contenu
Pour appréhender la singularité de la validité de critère, il importe de la confronter méthodologiquement aux deux autres grandes facettes traditionnelles de l’évaluation : la validité de contenu et la validité de construit. La validité de contenu s’attache à vérifier dans quelle mesure les items, questions ou tâches qui composent un instrument psychométrique constituent un échantillon représentatif et exhaustif de l’univers de contenu du domaine de connaissances ou de compétences que l’on entend cartographier. Cette analyse repose fondamentalement sur des jugements d’experts qualitatifs, des tables de spécifications et des revues de littérature minutieuses.
La distinction méthodologique est radicale : alors que la validité de contenu est strictement intrinsèque, logique et déductive, la validité de critère est extrinsèque, inductive et éminemment empirique. Un examen d’histoire ou un examen d’obtention du permis de conduire peut jouir d’une validité de contenu irréprochable — en couvrant exhaustivement toutes les règles de signalisation et le code de la route — tout en présentant une validité de critère médiocre lorsqu’il s’agit d’anticiper le taux effectif d’accidents de la circulation des conducteurs au cours des dix années suivantes.
Ces deux formes de validité sont néanmoins appelées à se compléter harmonieusement. Concevoir un instrument purement basé sur une conformité de contenu sans jamais tester sa validité de critère expose à l’illusion qu’un test bien conçu prédit nécessairement des actes concrets. Inversement, privilégier exclusivement une validité de critère aveugle au mépris du contenu peut conduire à sélectionner des prédicteurs totalement dénués de pertinence pédagogique ou professionnelle mais accidentellement corrélés au critère au sein d’un échantillon donné.
10.2 Validité de critère versus validité de construit
La validité de construit représente le concept intégrateur ultime de la métrologie psychologique. Elle s’intéresse à l’exactitude de l’inférence selon laquelle un instrument mesure véritablement un trait psychologique abstrait particulier (comme l’extraversion, l’intelligence fluide ou l’anxiété-trait) tel que théoriquement défini par le modèle conceptuel sous-jacent. Elle s’établit par un vaste réseau de preuves convergentes, discriminantes, factorielles et expérimentales.
Dans ce cadre, la validité de critère n’est plus envisagée comme une entité isolée ou concurrente, mais comme un sous-ensemble empirique indispensable apportant sa pierre à l’édifice de la validité de construit. Dès 1955, Cronbach et Meehl ont formalisé le concept de réseau nomologique : un système entremêlé de lois théoriques reliant les construits observables et non observables entre eux. La corrélation d’un test avec un critère comportemental externe n’est rien d’autre que la mise à l’épreuve expérimentale d’une branche spécifique de ce réseau nomologique.
L’écueil suprême consisterait à pratiquer ce que l’on nomme « l’empirisme aveugle » (dustbowl empiricism) : rechercher des corrélations maximales entre des listes hétéroclites d’items et des critères externes sans disposer du moindre cadre théorique pour expliciter pourquoi une telle relation existe. Sans validité de construit, un coefficient de validité de critère n’a aucune garantie de robustesse : dès que l’environnement économique, social ou technique se modifie, la corrélation empirique inexpliquée s’effondre, laissant les praticiens désarmés face à des outils soudain inefficaces.
10.3 La vision unifiée de la validité selon Samuel Messick
L’évolution épistémologique de la psychométrie a culminé à la fin du XXe siècle sous l’impulsion théorique monumentale de Samuel Messick (1989, 1995). Messick a vigoureusement combattu la vision fragmentée et compartimentée dite de la « sainte trinité » de la validité, qui divisait artificiellement la métrique en trois compartiments étanches : contenu, critère et construit. Il a imposé au consensus scientifique international la perspective révolutionnaire d’une validité unifiée, centrée tout entière sur la validité de construit.
Dans le cadre messickien, la validité ne réside pas intrinsèquement dans l’instrument lui-même, mais dans la pertinence, la justesse et les conséquences sociales et éthiques des inférences et des actions décidées à partir des scores obtenus. Les données traditionnelles de validité de critère (prédictive ou concourante) cessent d’être considérées comme des « types » de validité autonomes pour devenir des sources spécifiques de preuves empiriques destinées à étayer l’interprétation du construit.
Cette vision unifiée intègre également la facette des conséquences sociales des tests (consequential validity). Il ne suffit plus qu’un test montre une corrélation statistique brute avec un critère pour que son emploi soit déclaré valide. Le psychométricien doit également s’interroger sur l’impact fonctionnel, les biais différentiels de sélection envers les minorités et les dérives sociétales potentielles induits par l’implémentation de cet outil à grande échelle. La validité de critère devient ainsi un élément empirique indissociable d’une démarche scientifique globale guidée par la responsabilité déontologique.
11. Applications pratiques dans les sous-domaines psychologiques
11.1 Psychologie du travail et des organisations
La psychologie du personnel et du travail constitue le champ d’application historique par excellence où la validité de critère déploie sa puissance mathématique et économique. Dans ce domaine, la modélisation s’est considérablement affinée, distinguant la performance à la tâche (l’exécution formelle des obligations prescrites par la fiche de poste) du rendement contextuel (les comportements de citoyenneté organisationnelle, tels que l’entraide entre collègues, le dévouement volontaire et la préservation du climat social). Chaque type de critère réclame ses propres prédicteurs psychométriques validés.
Les méta-analyses majeures conduites sur plusieurs décennies, notamment celles de Schmidt et Hunter (1998, actualisées en 2016), ont apporté un éclairage fondamental sur la hiérarchie de la validité de critère des instruments de sélection professionnelle. Elles ont démontré que les tests d’aptitude cognitive générale (facteur g) affichent la validité de critère prédictive la plus élevée et la plus universelle à travers tous les secteurs d’activité, atteignant des coefficients corrigés de r = 0,65 pour les emplois de haute complexité analytique.
Ces études ont également mis en évidence la supériorité éclatante des entretiens d’embauche hautement structurés (qui atteignent des validités de critère de l’ordre de r = 0,58) par rapport aux entretiens informels libres non standardisés (qui plafonnent souvent autour de r = 0,20). L’implémentation de batteries combinant raisonnement cognitif, jugement situationnel et épreuves de mise en situation concrète permet aux organisations multinationales de réduire de façon spectaculaire les coûts astronomiques liés au turnover, aux erreurs techniques d’usinage et aux démissions précoces, apportant une rentabilité économique démontrée à la démarche psychométrique.
11.2 Psychologie de l’éducation et contextes universitaires
Dans l’univers éducatif, scolaire et académique, l’évaluation de la validité de critère régit la conception des épreuves standardisées d’admission et d’orientation (telles que le SAT ou l’ACT aux États-Unis, ou les concours d’accès aux grandes filières européennes). L’enjeu central réside ici dans la détection précoce des candidats qui possèdent les ressources cognitives et conatives nécessaires pour persévérer dans des cursus d’études supérieures longs et éprouvants, réduisant ainsi le gaspillage académique et la souffrance psychologique liée aux décrochages massifs en cours d’études.
Les études empiriques montrent de manière consistante que les tests standardisés d’admission prédisent la moyenne générale universitaire avec des coefficients de corrélation oscillant entre r = 0,40 et r = 0,55. Plus remarquable encore, ces instruments conservent une validité prédictive substantielle pour anticiper le risque de désistement ou d’abandon dès la première année universitaire, attestant de leur capacité fonctionnelle à séparer les profils d’étudiants résilients de ceux en situation de fragilité méthodologique.
Toutefois, la psychologie de l’éducation contemporaine porte une attention scrupuleuse à l’invariance de la validité de critère à travers les sous-populations. Les équations de prédiction doivent impérativement être ajustées et contrôlées afin d’éviter tout phénomène de prédiction différentielle (differential prediction), qui verrait un même score prédictif sous-estimer systématiquement la performance réelle future d’étudiants issus de milieux défavorisés ou d’élèves présentant des besoins éducatifs particuliers (comme les troubles neurodéveloppementaux ou les troubles spécifiques du langage et des apprentissages). L’équité éducative repose sur une validité de critère méticuleusement équilibrée pour tous les segments démographiques.
11.3 Psychologie clinique, médicale et neuropsychologie
Dans les contextes médicaux et cliniques, la validité de critère revêt une importance littéralement vitale, où l’erreur d’évaluation engage directement l’intégrité physique et psychique du patient. Les instruments psychométriques doivent être étalonnés par rapport aux grandes classifications internationales des troubles mentaux, qu’il s’agisse du DSM de l’APA ou de la Classification Internationale des Maladies (CIM) édictée par l’Organisation Mondiale de la Santé. Un questionnaire évaluant l’anxiété généralisée, les attaques de panique ou les troubles de l’humeur n’acquiert sa légitimité médicale qu’à la condition de prouver sa validité concourante face à des entretiens psychiatriques structurés indépendants.
En neuropsychologie, la validité de critère des batteries d’évaluation cognitive (comme la détection de la maladie d’Alzheimer, des démences vasculaires ou des séquelles de traumatismes crâniens) est scrutée face à deux critères majeurs : d’une part, les marqueurs biologiques et d’imagerie cérébrale (IRM structurelle, TEP-scan mesurant la fixation des plaques amyloïdes), et d’autre part, le critère d’autonomie fonctionnelle au quotidien (mesuré par des échelles d’activités instrumentales de la vie journalière – IADL). Une batterie neuropsychologique hautement valide est celle qui corrèle intimement avec la dégradation réelle de la capacité du patient à gérer de manière autonome ses finances personnelles, ses rendez-vous ou sa prise médicamenteuse.
Dans ce paradigme clinique, la validité de critère s’opérationnalise prioritairement à travers les indices statistiques de la théorie de la détection du signal : la sensibilité (capacité du test à identifier correctement les individus réellement malades selon le critère étalon), la spécificité (capacité à écarter les sujets sains), ainsi que les valeurs prédictives positives et négatives. Les décisions de traitement pharmacologique ou de placement en institution spécialisée dépendent directement de la solidité de ces coefficients d’association avec le critère d’état morbide avéré.
12. Bonnes pratiques pour évaluer et documenter la validité de critère
12.1 Conformité avec les normes internationales de testage (AERA, APA, NCME)
L’administration et la commercialisation d’instruments de mesure psychologique et éducative ne peuvent être laissées au libre arbitre des concepteurs d’outils. Elles sont strictement encadrées au niveau international par un document normatif faisant autorité suprême : les Standards for Educational and Psychological Testing, corédigés et régulièrement actualisés par l’American Educational Research Association (AERA), l’American Psychological Association (APA) et le National Council on Measurement in Education (NCME). Tout éditeur de test a l’obligation statutaire de formaliser de manière exhaustive les preuves de validité de critère au sein du manuel technique d’utilisation accompagnant le matériel d’évaluation.
Les normes internationales imposent une transparence absolue concernant la composition sociodémographique, l’âge, le niveau de qualification et la représentativité de l’échantillon de validation initial ayant servi à établir les corrélations. Les manuels doivent formellement proscrire les extrapolations abusives : un coefficient de validité de critère calculé avec succès auprès d’un échantillon restreint de jeunes diplômés d’écoles de commerce européennes ne saurait être considéré comme automatiquement généralisable à un public d’opérateurs industriels seniors ou à des populations issues d’autres aires géoculturelles. Si l’instrument est transposé dans un nouveau contexte organisationnel ou culturel, des études de réplication locale sont méthodologiquement indispensables.
De plus, la validité de critère ne doit jamais être conçue comme un certificat d’infaillibilité acquis une fois pour toutes lors de la sortie commerciale du test. En raison de l’évolution permanente de la nature des emplois, des cursus scolaires et des modes de vie sociétaux, les coefficients de corrélation souffrent d’une érosion temporelle naturelle. Les normes éthiques recommandent une mise à jour périodique systématique des études de validation empirique (généralement tous les 10 à 15 ans) afin de vérifier la pérennité du pouvoir prédictif de l’outil.
12.2 Rapports statistiques rigoureux et transparence scientifique
Pour garantir la rigueur et la reproductibilité de la science de la mesure, la présentation des données de validité de critère au sein des revues scientifiques ou des rapports institutionnels doit satisfaire à des exigences méthodologiques intransigeantes. Il est rigoureusement inacceptable de se borner à rapporter une corrélation ponctuelle isolée sans fournir la taille précise de l’échantillon (N) et la valeur de la significativité statistique (valeur de p). Conformément aux standards de l’APA, l’affichage systématique des intervalles de confiance à 95 % entourant chaque coefficient de validité constitue désormais une obligation formelle, rappelant la marge d’incertitude induite par les erreurs d’échantillonnage.
Une transparence méthodologique totale est également requise quant aux données brutes et corrigées. Si les chercheurs appliquent des corrections statistiques pour l’atténuation de l’erreur de mesure (formule de Spearman) ou pour la restriction d’étendue (équations de Thorndike), ils ont l’obligation déontologique de rapporter d’abord et sans fard la corrélation brute réellement observée sur le terrain avant de mentionner la valeur théorique corrigée. Présenter exclusivement un coefficient corrigé en le faisant passer pour une métrique directement constatée auprès des répondants constitue une grave altération de l’intégrité scientifique.
Enfin, les praticiens doivent éradiquer impérativement la pratique délétère du « cherry-picking » (cueillette sélective des résultats), qui consiste à tester une dizaine d’indicateurs de critères hétéroclites et à ne publier que l’unique indicateur ayant fortuitement franchi le seuil de significativité par pur hasard statistique. Les chercheurs ont l’obligation d’enregistrer préalablement leurs hypothèses et de documenter l’intégralité des corrélations observées, y compris celles qui réfutent l’efficacité prédictive de l’instrument évalué.
12.3 Guide étape par étape pour planifier une étude de validité de critère
La conception et la réalisation d’une recherche empirique visant à établir la validité de critère d’un nouvel instrument d’évaluation doivent obéir à une séquence opératoire méthodique en quatre étapes fondamentales :
- Étape 1 : Formulation d’hypothèses théoriques précises liant prédicteur et résultat. Avant de recueillir la moindre donnée, l’évaluateur doit circonscrire avec minutie les mécanismes psychologiques qui justifient rationnellement pourquoi le test devrait prédire tel comportement cible spécifique. Il formule des hypothèses directionnelles claires, définissant la nature (positive ou négative) et l’amplitude attendue de l’association statistique au sein de son modèle conceptuel.
- Étape 2 : Choix rigoureux et validation préalable de la mesure critère. Le statisticien sélectionne un critère possédant une valeur fonctionnelle tangible, libre de toute contamination informationnelle avec le test. La mesure critère doit être elle-même soumise à une vérification rigoureuse de ses qualités psychométriques : sa fidélité doit être préalablement démontrée, et ses procédures de recueil d’observation doivent être strictement standardisées afin de minimiser les erreurs de variance résiduelle.
- Étape 3 : Détermination d’une taille d’échantillon garantissant une puissance adéquate. L’évaluateur réalise une analyse a priori de puissance statistique (power analysis) pour calibrer son effectif de participants. Pour détecter un coefficient de corrélation modeste mais typique de l’ordre de r = 0,30 avec une puissance statistique robuste de 80 % au seuil classique α = 0,05, un échantillon d’au moins 85 à 100 individus est mathématiquement requis. Les études reposant sur des cohortes squelettiques de 20 ou 30 sujets sont méthodologiquement fragiles et vouées à produire des coefficients instables.
- Étape 4 : Analyse, correction des biais connus et rédaction d’un rapport critique. Le protocole se conclut par l’administration des mesures selon un devis soigneusement déterminé (prédictif longitudinal ou concourant synchrone). Les données collectées sont soumises à l’analyse bivariée et à la modélisation par régression linéaire univariée ou multiple. Le chercheur quantifie scrupuleusement l’impact potentiel de l’atténuation ou de la restriction d’étendue, puis consigne ses conclusions dans un rapport scientifique transparent, stipulant explicitement les limites contextuelles d’utilisation de l’outil.
En respectant scrupuleusement ces jalons méthodologiques et éthiques, les spécialistes de l’évaluation psychologique et de la recherche comportementale transforment des scores bruts en leviers de décision fiables, équitables et scientifiquement irréfutables, consacrant la validité de critère comme le rempart méthodologique indépassable de la psychométrie appliquée contemporaine.
Références
American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.aera.net/Publications-Resources/Standards-for-Educational-Psychological-Testing
Binet, A., & Simon, T. (1905). Méthodes nouvelles pour le diagnostic du niveau intellectuel des anormaux. L’Année psychologique, 11, 191-244. https://doi.org/10.3406/psy.1904.3675
Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281-302. https://doi.org/10.1037/h0040957
Gulliksen, H. (1950). Theory of mental tests. John Wiley & Sons. https://doi.org/10.1037/13240-000
Messick, S. (1989). Validity. In R. L. Linn (Ed.), Educational measurement (3rd ed., pp. 13-103). Macmillan.
Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741-749. https://doi.org/10.1037/0003-066X.50.9.741
Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, 187, 253-318. https://doi.org/10.1098/rsta.1896.0007
Schmidt, F. L., & Hunter, J. E. (1998). The validity and utility of selection methods in personnel psychology: Practical and theoretical implications of 85 years of research findings. Psychological Bulletin, 124(2), 262-274. https://doi.org/10.1037/0033-2909.124.2.262
Sechrest, L. (1963). Incremental validity: A recommendation. Educational and Psychological Measurement, 23(1), 153-158. https://doi.org/10.1177/001316446302300113
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72-101. https://doi.org/10.2307/1412159
Taylor, H. C., & Russell, J. T. (1939). The relationship of validity coefficients to the practical effectiveness of tests in selection: Discussion and tables. Journal of Applied Psychology, 23(5), 565-578. https://doi.org/10.1037/h0057079
Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.