
Dans le domaine de l’analyse statistique et de l’épistémologie scientifique, l’évaluation des relations entre phénomènes mesurables constitue le pivot fondamental sur lequel repose la découverte empirique. Cependant, la pensée humaine et la pratique scientifique sont fréquemment dominées par une quête asymétrique de régularités, d’associations positives ou négatives et de causalités présumées. Cette tendance cognitive occulte souvent une réalité mathématique et méthodologique tout aussi déterminante : l’absence stricte de relation linéaire entre deux variables, formalisée statistiquement par un coefficient de corrélation nul. Déterminer qu’un phénomène varie de façon totalement découplée d’un autre n’est pas un échec de l’investigation, mais une clarification théorique majeure permettant de dissiper des intuitions trompeuses, d’économiser des ressources de recherche et de réfuter des hypothèses fallacieuses.
Comprendre la nature stochastique et géométrique d’une absence de corrélation nécessite une exploration rigoureuse des fondements mathématiques sous-tendant la covariance et sa normalisation standardisée au sein du coefficient de Pearson. Cela implique également de lever l’ambiguïté conceptuelle tenace qui persiste entre l’indépendance statistique stricte et l’absence de corrélation linéaire simple, cette dernière n’excluant pas des dynamiques non linéaires complexes. Par ailleurs, les sciences du comportement ont largement démontré que l’esprit humain est naturellement prompt à percevoir des correspondances là où règne le pur hasard, un biais nourri par des heuristiques de jugement ancestrales et des pressions éditoriales favorisant la publication exclusive de résultats dits significatifs.
Le présent article propose une analyse approfondie des mécanismes théoriques, graphiques et cognitifs qui régissent l’absence de corrélation linéaire, étayée par l’examen minutieux de quatre cas empiriques emblématiques issus de la psychométrie, de la biologie humaine et des neurosciences cognitives. Chacun de ces exemples fera l’objet d’une déconstruction méthodologique exigeante, illustrant le rôle crucial du contrôle des variables confondantes, de la préservation de la qualité métrologique et de la distinction entre artefacts d’échantillonnage et vérités d’ordre ontologique. Enfin, nous aborderons les paradigmes récents d’inférence statistique et de tests d’équivalence qui confèrent aujourd’hui à la confirmation de l’hypothèse nulle le statut de découverte scientifique authentique.
1. Fondements théoriques et mathématiques de l’absence de corrélation linéaire
1.1 Définition formelle du coefficient de corrélation de Pearson
Le coefficient de corrélation linéaire de Pearson, désigné conventionnellement par la lettre grecque $rho$ (rhô) dans le cadre populationnel et par la lettre latine $r$ dans le contexte d’un échantillon fini, constitue l’indice standard d’évaluation de la force et de la direction d’une relation linéaire entre deux variables aléatoires continues, notées $X$ et $Y$. Sur le plan conceptuel, ce coefficient correspond à la covariance des deux variables normalisée par le produit de leurs écarts-types respectifs. Mathématiquement, pour deux variables aléatoires $X$ et $Y$ définies sur un même espace probabilisé et admettant des moments d’ordre deux finis, la formulation théorique s’exprime par le rapport entre la valeur espérée de l’écart conjoint à leurs moyennes respectives et le produit de leurs variances marginales : $\rho_{X,Y} = \frac{\mathrm{Cov}(X,Y)}{\sigma_X \sigma_Y} = \frac{\mathbb{E}[(X – \mu_X)(Y – \mu_Y)]}{\sqrt{\mathbb{E}[(X – \mu_X)^2]} \sqrt{\mathbb{E}[(Y – \mu_Y)^2]}}$. Cette construction mathématique repose directement sur l’inégalité de Cauchy-Schwarz, laquelle garantit que le quotient résultant est borné de manière stricte et universelle dans l’intervalle fermé $[-1, +1]$.
Dans ce cadre normatif, la valeur $r = 0$ acquiert une signification stochastique particulièrement précise : elle indique que la covariance entre les deux variables est rigoureusement nulle, ce qui implique que l’espérance mathématique du produit de leurs écarts à la moyenne est égale à zéro ($\mathbb{E}[(X – \mu_X)(Y – \mu_Y)] = 0$). Cela signifie qu’aucune translation proportionnelle, positive ou négative, de la variable $X$ ne permet de prédire une variation linéaire systématique de la variable $Y$. Il importe néanmoins de souligner que la validité de l’interprétation du coefficient de Pearson repose sur des hypothèses paramétriques strictes. La première de ces conditions est la normalité bivariée, postulant que le vecteur conjoint $(X, Y)$ suit une loi normale à deux dimensions, condition garantissant que les distributions conditionnelles de $Y$ sachant $X$ sont elles-mêmes normales et homoscédastiques. L’homoscédasticité impose que la variance résiduelle de $Y$ demeure strictement constante sur l’ensemble du continuum des valeurs prises par $X$. Lorsque ces axiomes sont respectés, l’obtention d’un coefficient nul traduit fidèlement l’inexistence de tout gradient directionnel linéaire unissant les deux séries de mesures observées.
1.2 Différenciation conceptuelle entre indépendance statistique et corrélation nulle
L’une des confusions épistémologiques et méthodologiques les plus répandues au sein de l’analyse quantitative réside dans l’assimilation erronée de l’absence de corrélation linéaire à une indépendance statistique totale. En théorie des probabilités, l’indépendance de deux variables aléatoires $X$ et $Y$ constitue une condition beaucoup plus exigeante et globale que la simple orthogonalité linéaire. Par définition, deux variables sont indépendantes si et seulement si leur fonction de densité conjointe (ou fonction de masse) est égale au produit de leurs fonctions de densité marginales pour toutes les réalisations possibles de l’espace d’échantillonnage, soit $f_{X,Y}(x, y) = f_X(x) \cdot f_Y(y)$. L’implication logique est formellement unilatérale : si deux variables sont statistiquement indépendantes, leur covariance est obligatoirement nulle, et par voie de conséquence, leur coefficient de corrélation de Pearson est invariant et nul ($r = 0$).
La proposition réciproque est rigoureusement fausse en dehors du cadre très restrictif de la normalité bivariée. En effet, un coefficient $r = 0$ indique exclusivement l’absence de dépendance de premier ordre, c’est-à-dire l’incapacité d’un modèle linéaire de la forme $Y = \beta_0 + \beta_1 X + \epsilon$ à capturer la relation entre les variables. Des dépendances non linéaires d’ordre supérieur, qu’elles soient quadratiques, exponentielles, sinusoïdales ou chaotiques, peuvent générer une covariance empirique parfaitement nulle alors même qu’il existe une liaison déterministe absolue entre $X$ et $Y$. Un cas d’école élémentaire est illustré par la relation $Y = X^2$, où $X$ suit une distribution symétrique continue centrée sur zéro sur l’intervalle $[-a, a]$. Dans cette configuration, la connaissance exacte de $X$ détermine sans la moindre équivoque la valeur de $Y$, attestant d’une dépendance stochastique parfaite ; or, la symétrie de la distribution annule intégralement le produit vectoriel des écarts, résultant en une corrélation de Pearson calculée de $r = 0$. Le coefficient de Pearson est ainsi aveugle aux moments statistiques d’ordre supérieur, tels que le coskewness ou la cokurtosis, limitant strictement sa portée à la topologie de l’hyperplan linéaire.
1.3 Comportement asymptotique et propriétés de l’échantillonnage
Dans la pratique de la recherche empirique, les paramètres populationnels $rho$ demeurent généralement inaccessibles, contraignant l’analyste à estimer la relation à partir d’un échantillon fini de taille $N$, produisant une statistique d’échantillonnage $r$. Dès lors, l’évaluation de l’absence de corrélation s’inscrit obligatoirement dans le cadre de la théorie des tests d’hypothèses, articulée autour de l’hypothèse nulle $H_0 : \rho = 0$ opposée à l’hypothèse alternative $H_1 : \rho \neq 0$. Sous l’hypothèse nulle et en supposant la normalité bivariée des variables sous-jacentes, la distribution d’échantillonnage de $r$ est symétrique et centrée sur zéro. La significativité statistique de cette estimation est formellement évaluée au moyen de la statistique du test $t$ de Student, définie par la formule $t = r \sqrt{\frac{N – 2}{1 – r^2}}$, qui obéit asymptotiquement à une loi de Student à $\nu = N – 2$ degrés de liberté.
Cette relation mathématique met en lumière l’influence prépondérante du volume de l’échantillon sur l’erreur type de l’estimation, laquelle s’écrit $\mathrm{SE}_r = \sqrt{\frac{1 – r^2}{N – 2}}$. Pour un coefficient de corrélation empirique tendant vers zéro, l’erreur type décroît à proportion inverse de la racine carrée de $N$. Cette propriété asymptotique entraîne deux risques majeurs d’inférence lors de la prise de décision statistique. D’une part, dans le cas d’échantillons de taille modeste ($N < 30$), la variabilité d'échantillonnage est si substantielle qu'un coefficient calculé de $r = 0,20$ peut facilement émerger du simple bruit stochastique, conduisant à une erreur de type I si l’on rejette $H_0$ de manière prématurée. D’autre part, face à des méga-données regroupant des dizaines de milliers d’observations, la puissance statistique devient démesurée : une corrélation triviale et dénuée de pertinence pratique de $r = 0,01$ peut atteindre le seuil conventionnel de significativité $p < 0,05$. Dans un tel scénario, l'analyste court le risque d'une erreur d'interprétation matérielle, confondant rejet statistique d'une nullité stricte et existence d'une relation structurelle substantielle.
2. Représentation graphique et topologie du nuage de points sans corrélation
2.1 Morphologie du diagramme de dispersion pour r = 0
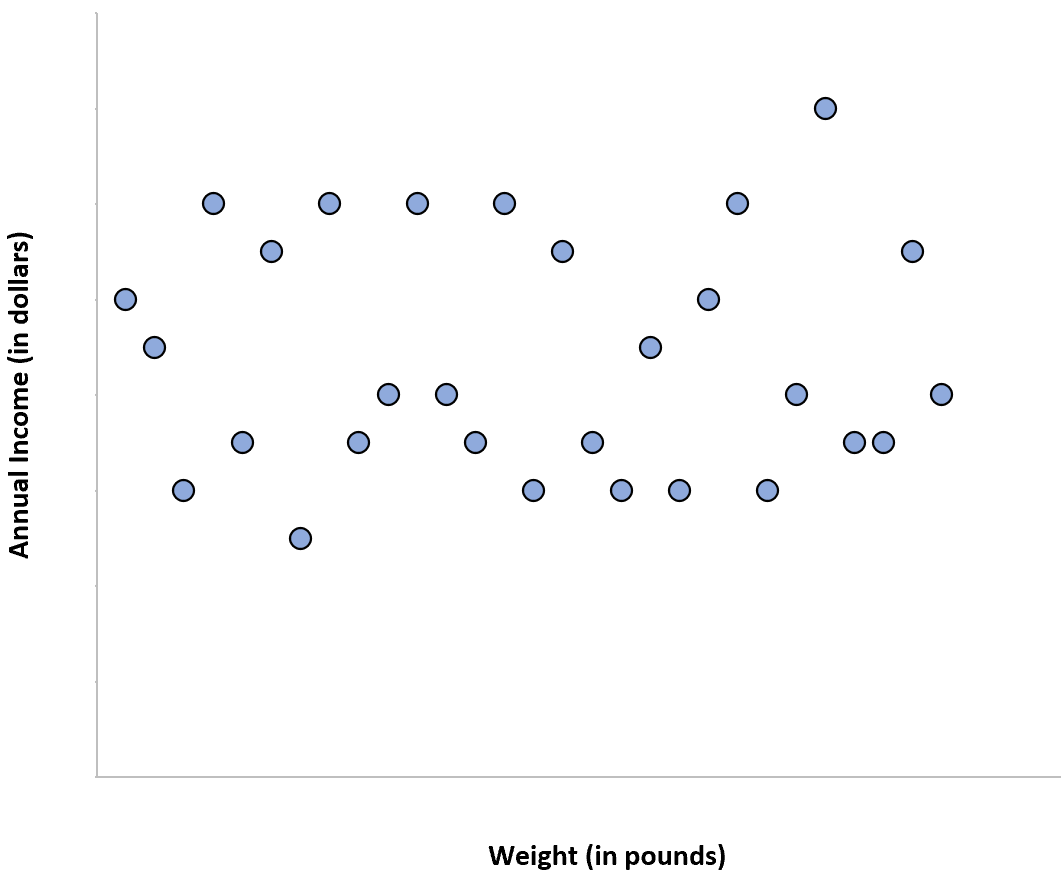
L’exploration visuelle par l’intermédiaire du diagramme de dispersion (scatterplot) fournit une intuition spatiale immédiate de la nature des distributions bivariées. Lorsqu’un couple de variables continues $(X, Y)$ présente une corrélation linéaire de Pearson strictement égale à zéro, la morphologie du nuage de points adopte des configurations géométriques hautement distinctives, conditionnées par les distributions marginales. Dans l’hypothèse classique d’une normalité bivariée où les variances marginales sont équivalentes, le nuage d’observations se déploie de manière isotrope dans le plan cartésien, formant une structure circulaire ou sphéroïdale sans aucun axe d’allongement préférentiel. Lorsque les écarts-types des variables diffèrent, cette structure sphérique se transmue en une ellipse régulière dont les axes principaux sont rigoureusement parallèles aux axes de coordonnées cartésiennes, excluant toute inclinaison diagonale.
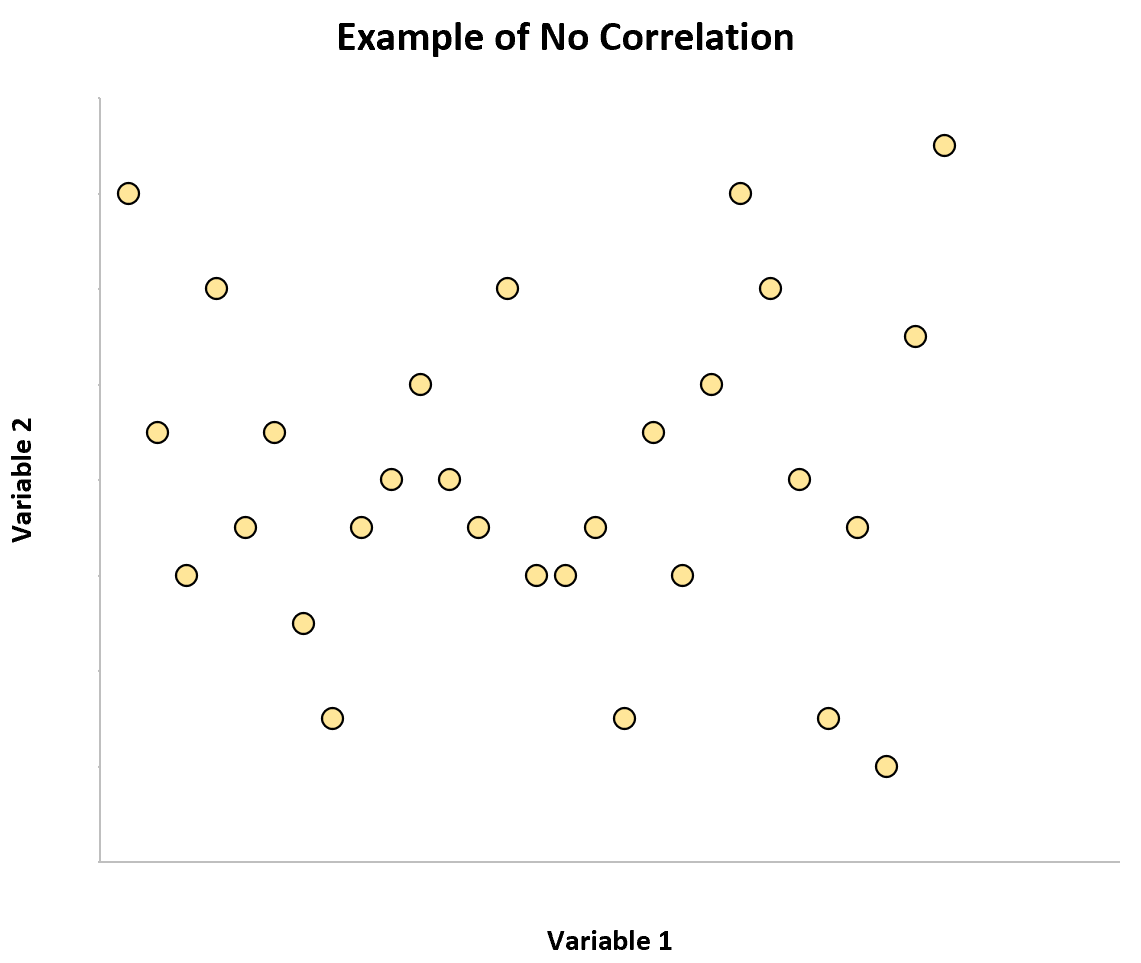
Cette disposition spatiale se traduit immédiatement sur les paramètres de la droite de régression linéaire ordinaire estimée par la méthode des moindres carrés. L’équation de cette droite, modélisée par $\hat{Y} = b_0 + b_1 X$, possède un coefficient de pente directement indexé sur la corrélation : $b_1 = r \frac{s_Y}{s_X}$. Lorsque $r = 0$, la pente s’annule rigoureusement ($b_1 = 0$), réduisant l’ordonnée à l’origine à la moyenne arithmétique de la variable dépendante ($b_0 = \bar{Y}$). Graphiquement, la droite de régression prend la forme d’une ligne horizontale invariable, superposée à la droite de la moyenne conditionnelle $\mathbb{E}[Y|X] = \bar{Y}$. Aucune translation le long du continuum de l’axe des abscisses ne modifie la position attendue de $Y$. Les points sont distribués de part et d’autre de cette ligne avec une homogénéité spatiale complète, manifestant l’absence de tout gradient ou regroupement directionnel qui trahirait une attraction mutuelle des mesures.
2.2 Interprétation de la variance inexpliquée
L’absence de relation linéaire trouve sa formalisation la plus limpide dans le cadre de la décomposition de la variance appliquée aux modèles linéaires généraux. La variance totale de la variable observée $Y$, mesurée par la somme des carrés totale ($\mathrm{SST} = \sum (Y_i – \bar{Y})^2$), se scinde de manière univoque en deux termes orthogonaux : la somme des carrés expliquée par le modèle de régression ($\mathrm{SSR} = \sum (\hat{Y}_i – \bar{Y})^2$) et la somme des carrés résiduelle ($\mathrm{SSE} = \sum (Y_i – \hat{Y}_i)^2$). Le rapport entre la part expliquée et la variabilité totale définit le coefficient de détermination, noté $R^2$, qui, dans le cas d’une régression linéaire bivariée simple, équivaut rigoureusement au carré du coefficient de Pearson ($R^2 = r^2$).
Par conséquent, lorsque $r = 0$, le coefficient de détermination s’annule obligatoirement ($R^2 = 0$), entraînant l’égalité arithmétique stricte entre la somme des carrés résiduelle et la somme des carrés totale ($\mathrm{SSE} = \mathrm{SST}$). Ce résultat consacre l’échec structurel absolu du prédicteur linéaire : l’utilisation de la variable indépendante $X$ ne permet de réduire d’aucun pourcent l’incertitude pesant sur l’estimation de $Y$. La variance conditionnelle $\mathrm{Var}(Y|X)$ demeure rigoureusement égale à la variance inconditionnelle marginale $\mathrm{Var}(Y)$. Dans la perspective de la théorie de l’information, le système d’observation atteint ici un état d’entropie conditionnelle maximale relative à la transformation linéaire appliquée, soulignant qu’aucune information exploitable n’est transmise d’une coordonnée à l’autre par un canal projectif conventionnel.
2.3 Distorsions graphiques et pièges d’interprétation visuelle
L’inspection visuelle d’un diagramme de dispersion, bien qu’indispensable au diagnostic préliminaire, expose l’analyste à des illusions cognitives et des biais d’interprétation géométrique substantiels. Le premier piège provient de l’arbitraire du ratio d’aspect des axes cartésiens. En compressant ou en étirant l’axe des ordonnées par rapport à l’axe des abscisses, un chercheur peut transformer artificiellement un nuage isotrope en une bande horizontale aplatie ou, inversement, en une colonne verticale dense, simulant une apparence de directionalité illusoire alors même que les covariances numériques demeurent strictement nulles.
Un autre écueil méthodologique réside dans la présence de points extrêmes ou de valeurs aberrantes isolées (outliers). Un ensemble de données présentant une indépendance linéaire sous-jacente parfaite ($r = 0$) peut voir son coefficient artificiellement dévié vers des valeurs positives ou négatives non négligeables par l’effet de levier d’un seul point situé aux confins de la distribution. Inversement, une corrélation réelle peut être intégralement masquée ou annulée par une observation divergente. Enfin, les grands jeux de données souffrent systématiquement du phénomène de recouvrement excessif des observations (overplotting). Lorsque des dizaines de milliers de points s’accumulent au centre du graphique, la saturation de l’encre numérique occulte la structure de la densité conditionnelle, empêchant de distinguer visuellement un nuage diffus conforme à $r = 0$ d’une distribution hautement concentrée. Ces distorsions soulignent l’impératif de ne jamais se fier à l’intuition perceptive nue et de corroborer systématiquement le graphique par des métriques analytiques robustes.
3. Biais cognitifs et psychologie de l’attribution de corrélations illusoires
3.1 Mécanismes psychologiques de la corrélation illusoire
L’esprit humain n’aborde pas l’analyse des données de manière neutre ou passive ; il est configuré par l’évolution pour extraire en continu du sens et anticiper des relations probabilistes au sein de son environnement écologique. Ce fonctionnement cognitif expose l’observateur au phénomène systématique de la corrélation illusoire, formalisé pour la première fois par les psychologues Loren Chapman et Jean Chapman dans leurs travaux séminaux de la fin des années 1960. La corrélation illusoire décrit la propension systématique d’individus à percevoir une relation statistique d’association ou de covariation entre deux classes d’événements alors que les données empiriques démontrent une indépendance totale ($r = 0$), ou à surestimer de manière spectaculaire la magnitude d’une association minime.
Ce phénomène découle de plusieurs contraintes architecturales du système mnésique et perceptif. Lorsqu’un observateur est confronté à une table de contingence à quatre cases (présence/absence de l’événement A croisée avec présence/absence de l’événement B), l’attention n’est pas allouée de façon uniforme entre les cellules. La cellule conjointe matérialisant la co-occurrence simultanée des deux attributs saillants (« A présent et B présent ») capte l’attention de manière disproportionnée en raison de sa saillance perceptuelle supérieure. Les cas où A est présent sans B, où B survient sans A, ou encore où les deux facteurs sont simultanément absents, sont systématiquement sous-pondérés lors de l’intégration du jugement. Ce déficit de calcul combinatoire, conjugué au biais de confirmation par lequel l’individu recherche prioritairement les instances validant son schéma préconçu, induit l’impression fallacieuse d’une covariation substantielle là où l’analyse bivariée matricielle n’enregistre qu’un vide relationnel.
3.2 Apophénie et recherche compulsive de régularité statistique
Sur le plan neuropsychologique, la tendance à discerner des structures organisées dans des configurations stochastiques aléatoires relève de l’apophénie. Ce trait s’enracine profondément dans la théorie de la détection du signal appliquée à l’histoire adaptative de notre espèce. Selon le principe de l’asymétrie des coûts d’erreur, commettre une erreur de type I (détecter un prédateur potentiel dans le bruissement aléatoire des feuilles provoqué par le vent) n’entraîne qu’un coût énergétique minime pour l’organisme. En revanche, commettre une erreur de type II (ignorer ce bruissement en concluant à une absence de régularité signifiante alors qu’un prédateur est effectivement présent) s’avère létal. L’architecture cérébrale des mammifères a donc été façonnée avec un biais structurel favorable à l’hyper-détection d’intentions et de corrélations causales, abaissant drastiquement le seuil d’activation des mécanismes d’attribution de régularité.
Ce biais inductif se heurte de plein fouet à la méthodologie statistique contemporaine. Confrontés à des séries de données parfaitement orthogonales ou à des nuages de points isotropes représentatifs de coefficients nuls, les individus, y compris les praticiens formés, manifestent une résistance cognitive tenace à l’acceptation du pur hasard. Ils recourent spontanément à des récits ad hoc pour rationaliser des fluctuations d’échantillonnage mineures, attribuant une causalité occulte à des segments isolés du scatterplot. En médecine clinique et en psychologie diagnostique, cette recherche compulsive de correspondances a longtemps nourri l’usage d’outils projectifs invalidés, les praticiens persistant à observer des connexions entre des réponses graphiques spécifiques et des psychopathologies sous-jacentes, en dépit de la démonstration réitérée de coefficients d’association rigoureusement nuls.
3.3 Attentes a priori et distorsions de la recherche empirique
Les limitations cognitives individuelles sont malheureusement amplifiées par les incitations institutionnelles structurant l’écosystème de la recherche scientifique. Durant des décennies, la sociologie de la science a été confrontée à l’écueil majeur du biais de publication, communément désigné sous l’expression de « problème du tiroir de fichier » (file-drawer problem). Les revues à comité de lecture ont traditionnellement manifesté une propension disproportionnée à publier des manuscrits rapportant des associations bivariées statistiquement significatives ($p < 0,05$), reléguant systématiquement au silence les études répliquant l'hypothèse nulle ($r = 0$).
Cette asymétrie éditoriale induit une incitation perverse poussant les chercheurs à recourir à des pratiques de recherche contestables, regroupées sous le vocable de « p-hacking ». Ces pratiques englobent la collecte sélective de données jusqu’à l’obtention du seuil désiré, l’exclusion arbitraire de valeurs aberrantes, la discrétisation post-hoc de variables continues ou la multiplication des tests d’associations non planifiés sans correction pour comparaisons multiples. Par ces artifices, des relations stochastiquement inexistantes dans la population source sont artificiellement gonflées pour produire des corrélations fallacieuses publiables. Face à cette dérive, la science contemporaine amorce une transition paradigmatique par le biais de l’enregistrement préalable des protocoles (pre-registration) et des rapports enregistrés (Registered Reports). Ces formats garantissent l’évaluation des manuscrits sur la seule rigueur de leur protocole expérimental et méthodologique, assurant que la mise en évidence robuste d’une corrélation nulle soit reconnue à sa juste valeur épistémologique : une avancée décisive pour circonscrire les théories scientifiques.
4. Exemple 1 : Consommation quotidienne de caféine et quotient intellectuel (QI)
4.1 Contexte théorique et formulation de l’hypothèse d’indépendance
L’évaluation des déterminants biologiques et comportementaux de l’intelligence humaine représente l’un des domaines les plus scrutés de la psychologie différentielle. Parmi les substances psychoactives les plus massivement consommées à l’échelle planétaire figure la caféine (1,3,7-triméthylxanthine). Sur le plan neurophysiologique, la pharmacodynamique de la caféine est bien comprise : elle opère principalement comme un antagoniste non sélectif des récepteurs de l’adénosine, particulièrement des sous-types $A_1$ et $A_{2A}$, distribués dans le striatum et les régions corticales. En bloquant la fixation de l’adénosine, composé endogène modulateur de l’endormissement et de la fatigue centrale, la caféine prévient l’abaissement de l’activité neuronale, induisant une stimulation phasique du système nerveux central, une accélération modérée du rythme cardiaque et un état accru d’éveil attentionnel.
Toutefois, une démarcation conceptuelle nette doit être établie entre l’état transitoire de vigilance neurofonctionnelle et l’efficience intellectuelle globale, généralement opérationnalisée par le quotient intellectuel (QI) et sous-tendue par le modèle hiérarchique de l’intelligence (notamment la théorie de Cattell-Horn-Carroll et le facteur général $g$). Le quotient intellectuel quantifie la vitesse de traitement de l’information complexe, la mémoire de travail structurelle, le raisonnement fluide inductif et déductif, ainsi que l’étendue du lexique cristallisé. Ces dimensions cognitives sont déterminées par l’intégrité micro-structurelle de la substance blanche cérébrale, la synaptogenèse précoce et des architectures polygéniques stables, sur lesquelles l’action purement symptomatique et transitoire d’une molécule antagoniste de l’adénosine ne possède aucun levier constructif. L’hypothèse scientifique formelle s’énonce donc comme une hypothèse nulle d’indépendance linéaire : la consommation quotidienne habituelle de caféine, mesurée sur une échelle continue, ne partage aucune variance commune avec le score composite standardisé de QI.
4.2 Analyse empirique et données observées
L’administration de protocoles épidémiologiques transversaux et longitudinaux sur de larges cohortes d’adultes sains permet de confronter rigoureusement cette hypothèse à la réalité empirique. La mesure de la variable indépendante s’effectue par la quantification calorimétrique et chromatographique des prises quotidiennes de milligrammes de caféine (provenant du café, du thé, de boissons énergisantes et de formulations pharmacologiques), standardisée sur des périodes d’évaluation de plusieurs semaines. En parallèle, la variable dépendante est évaluée par des batteries psychométriques contemporaines, validées et étalonnées à grande échelle, à l’instar de l’échelle d’intelligence pour adultes de Wechsler (WAIS-IV), fournissant un score composite d’intelligence globale centré sur une moyenne de 100 avec un écart-type standardisé de 15 points.
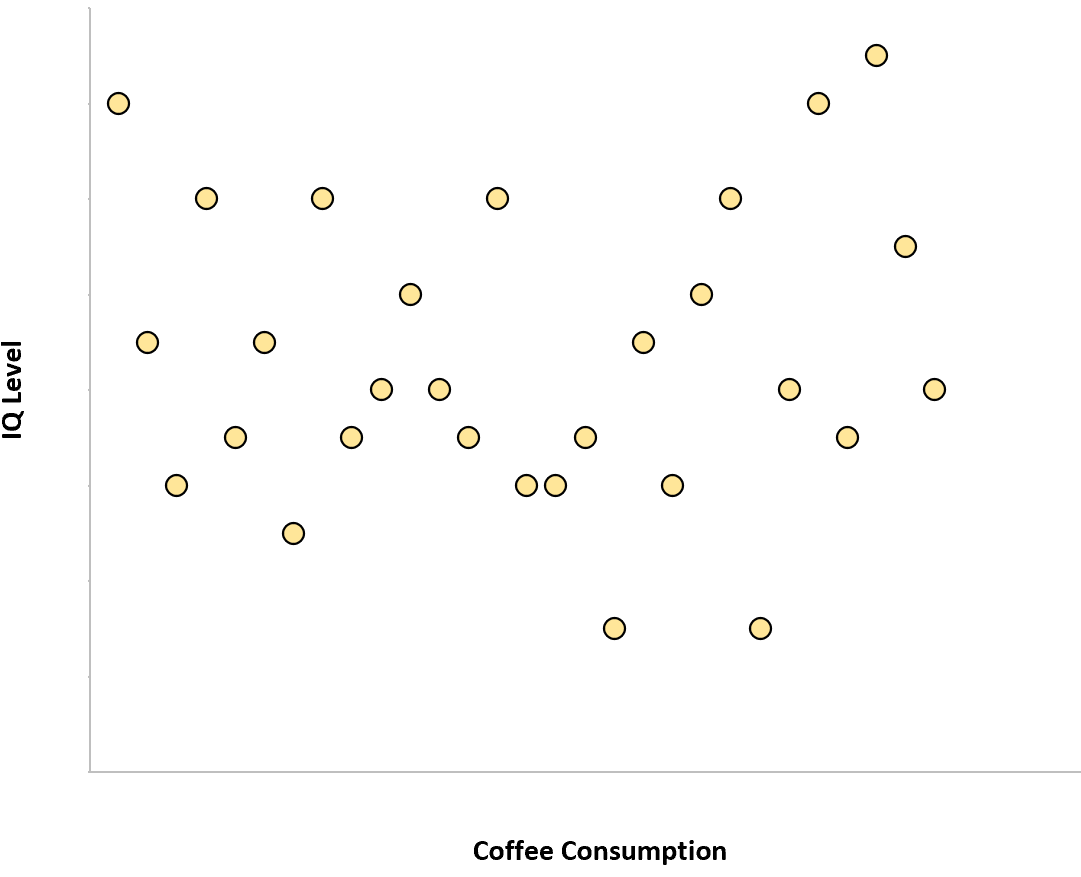
L’agrégation des données issues d’échantillons stratifiés regroupant plusieurs milliers d’individus fait émerger une distribution invariablement plane. La stratification par quintiles ou déciles de consommation de caféine (allant d’une abstention absolue de 0 mg/jour à des consommations élevées dépassant 600 mg/jour) révèle des moyennes de QI strictement équivalentes dans chaque groupe, oscillant dans les marges prévisibles de l’erreur d’échantillonnage autour de 100 points. Le calcul du coefficient de corrélation linéaire de Pearson entre la posologie moyenne journalière continue et le QI global produit systématiquement une valeur $r$ comprise dans un intervalle d’inférence extrêmement étroit, par exemple $[-0,01 ; +0,02]$, avec un intervalle de confiance à 95 % englobant formellement la valeur zéro. Le nuage de points généré présente une forme sphérique diffuse parfaite, attestant de l’absence complète de pente ou d’inflexion non linéaire sur l’ensemble de l’étendue des mesures physiologiques viables.
4.3 Implications psychologiques et séparation conceptuelle
Ces observations empiriques tranchent de façon décisive avec les représentations sociales dominantes qui attribuent couramment à la caféine des propriétés nootropiques ou d’amplification de la puissance intellectuelle. La persistance de cette croyance repose sur une confusion classique entre vigilance phasique et performance intellectuelle générale. En augmentant la libération de catécholamines circulantes, la caféine optimise la vitesse d’exécution lors de tâches motrices simples ou de tests d’attention soutenue chronophages, particulièrement chez des sujets placés en condition de privation partielle de sommeil ou subissant le creux circadien postprandial.
Cependant, cette restauration transitoire de la réactivité psychomotrice n’élargit en rien la capacité brute de rétention mnésique, ni n’améliore la finesse du raisonnement logique abstrait ou la résolution de matrices spatiales complexes. Les bénéfices perçus par les usagers relèvent en grande partie de la réversion des symptômes de sevrage aigu (céphalées, somnolence, baisse de concentration) consécutifs à la baisse du taux sérique de la molécule chez les consommateurs chroniques, ainsi que d’un puissant effet d’attente psychologique (placebo). En milieu organisationnel et en psychologie du travail, ces résultats permettent d’établir des protocoles d’évaluation équitables : la prise de substances stimulantes usuelles ne biaise pas l’estimation des compétences cognitives réelles d’un candidat, ces deux dimensions opérant dans des espaces psychobiologiques distincts.
5. Déconstruction méthodologique de l’exemple 1 : Contrôle des variables confondantes
5.1 Identification des tiers facteurs potentiels
L’affirmation d’une absence de corrélation linéaire entre la consommation de caféine et le QI ne peut être validée sans un examen minutieux des facteurs confondants susceptibles de masquer ou de simuler une relation bivariée. Dans les études observationnelles d’envergure, le chercheur doit se prémunir contre les écueils de la modélisation en cartographiant le réseau de variables exogènes interférant potentiellement avec la prise de caféine et les fonctions cognitives.
Le statut socio-économique (SSE) figure au premier rang de ces variables intermédiaires. Les individus issus de milieux socio-économiques favorisés accèdent statistiquement à des niveaux de formation académique plus élevés, ce qui corrèle positivement avec les composantes cristallisées du QI. Simultanément, les modes de consommation de caféine diffèrent substantiellement selon les classes professionnelles : les cadres supérieurs et professions intellectuelles affichent une consommation fréquente de cafés d’origine ou d’expressos en contexte de bureau, tandis que d’autres strates socioprofessionnelles privilégient des formats énergisants ou du café soluble. De surcroît, le mode de vie global introduit des corrélats complexes : les sujets soumis à des horaires de travail atypiques ou à un stress professionnel accru présentent à la fois une dette chronique de sommeil (stimulant une surconsommation compensatoire de caféine) et des altérations fonctionnelles ponctuelles lors des passations psychométriques. Enfin, la co-consommation de tabac ou d’alcool représente un facteur de confusion pharmacologique majeur, l’usage de nicotine accélérant drastiquement le métabolisme de la caféine par l’induction de l’isoenzyme hépatique CYP1A2.
5.2 Procédures d’ajustement et corrélation partielle
Pour s’assurer que la nullité du coefficient de Pearson empirique n’est pas le résultat d’une compensation fortuite entre deux forces opposées (par exemple, un effet neurocognitif légèrement positif neutralisé par l’impact négatif d’une hygiène de sommeil dégradée), il est impératif de mettre en œuvre des techniques d’ajustement multivarié. L’approche standard repose sur le calcul des coefficients de corrélation partielle et sur la modélisation par régression linéaire multiple, qui permettent d’isoler l’association résiduelle nette entre la caféine et le quotient intellectuel tout en fixant mathématiquement la variance imputable aux tiers facteurs.
La formulation de la corrélation partielle entre la consommation $X$ et le QI $Y$, conditionnée par le vecteur de variables de contrôle $Z$ (incluant le statut socio-économique, l’âge, le niveau d’instruction, la durée moyenne de sommeil et le statut tabagique), s’exprime par le calcul de la corrélation entre les résidus des régressions linéaires de $X$ sur $Z$ et de $Y$ sur $Z$. Lorsque ces procédures de neutralisation sont appliquées à des registres épidémiologiques représentatifs, la corrélation partielle résiduelle $r_{XY.Z}$ demeure ancrée à un niveau rigoureusement orthogonal ($r_{XY.Z} \approx 0,00$, avec $p > 0,80$). De même, dans les modèles de régression multivariée, le coefficient standardisé $\beta$ assigné à la caféine affiche une magnitude statistiquement indistinguable de zéro. Cette stabilité du coefficient nul à travers des spécifications de modèles emboîtés confirme la robustesse théorique de l’indépendance bivariée entre le composé psychotrope et les structures factorielles de l’intelligence.
5.3 Risques d’inférence erronée et pièges d’échantillonnage
L’observation d’un coefficient de corrélation nul exige également une vigilance méthodologique accrue face aux distorsions induites par le plan d’échantillonnage. Le premier danger concerne le biais de sélection consécutif à l’étude de sous-populations restreintes. Si l’évaluation était menée exclusivement au sein d’une cohorte d’étudiants inscrits en classes préparatoires d’élite ou en facultés de médecine, le chercheur ferait face à un phénomène sévère de troncature ou de restriction de la variance sur la variable dépendante (le QI étant concentré dans le décile supérieur de la distribution générale) ainsi que sur la variable indépendante (les niveaux de consommation de caféine y étant atypiquement élevés pour gérer les cadences de travail). Cette restriction d’amplitude entraîne mécaniquement un écrasement de la variance empirique, conduisant obligatoirement à une déflation artificielle de la corrélation vers zéro, même si une relation sous-jacente existait à l’échelle de la population générale.
Un second écueil métrologique réside dans la variabilité non contrôlée de la pharmacocinétique individuelle de la caféine. Des variations génétiques touchant les polymorphismes du gène CYP1A2 déterminent le statut de « métaboliseur rapide » ou de « métaboliseur lent », modulant la demi-vie plasmatique du produit de 2 à plus de 8 heures. Si la mesure de la consommation s’appuie sur de simples déclarations rétrospectives imprécises (nombre de tasses déclarées sans spécification du mode d’infusion, de la variété de grain de café ni de la teneur en milligrammes réels), l’erreur de mesure non différentielle résultante peut générer un bruit statistique considérable qui dilue artificiellement le coefficient de liaison (atténuation d’erreur). C’est pourquoi seule la confirmation de l’orthogonalité sur des études croisant déclarations calibrées, biomarqueurs sanguins de paraxanthine et protocoles d’échantillonnage non tronqués confère à cette corrélation nulle sa pleine validité scientifique.
6. Exemple 2 : Taille corporelle des individus adultes et performance aux examens académiques
6.1 Cadre conceptuel et justification de l’orthogonalité
L’étude morphométrique des populations humaines a souvent croisé le champ de la sociologie de l’éducation, conduisant à s’interroger sur l’existence éventuelle d’associations entre les caractéristiques somatiques des individus et leurs facultés académiques. L’un des cas les plus probants d’orthogonalité biologique et psychologique est incarné par l’absence totale de relation linéaire entre la stature corporelle d’individus adultes stabilisés (exprimée en centimètres) et leur performance intellectuelle mesurée lors d’examens académiques standardisés universitaires.
Sur le plan ontologique et mécanistique, ces deux systèmes de développement obéissent à des voies biologiques et environnementales distinctes. La croissance squelettique longitudinale dépend principalement de l’action de l’axe somatotrope (facteur de libération de l’hormone de croissance GHRH, hormone de croissance GH et facteur de croissance analogue à l’insuline IGF-1) agissant sur les cartilages de conjugaison des os longs durant l’enfance et la puberté, sous le contrôle d’une architecture polygénique massive regroupant des milliers de loci distribués sur l’ensemble du génome. À l’inverse, l’acquisition des compétences conceptuelles, la maîtrise de disciplines formelles (mathématiques, littérature, droit) et la capacité d’élaboration discursive requises lors d’épreuves académiques dépendent de l’organisation cytoarchitectonique du cortex cérébral, de la plasticité synaptique induite par l’apprentissage et des opportunités pédagogiques contextualisées. Chez l’adulte ayant atteint sa maturité osseuse complète, il n’existe aucun substrat génétique ou anatomique partagé reliant directement l’allongement du fémur à l’efficience des fonctions cognitives supérieures. L’hypothèse théorique postule donc une covariance linéaire strictement nulle entre la hauteur physique et le niveau de performance universitaire objectivement évalué.
6.2 Données quantitatives et configuration du nuage de points
La confrontation de ce postulat aux données quantitatives est réalisée par l’exploitation de registres institutionnels croisant les mensurations anthropométriques officielles d’étudiants adultes (entre 20 et 30 ans) et leurs résultats chiffrés obtenus à des examens standardisés anonymes, tels que les épreuves nationales d’accès aux cycles doctoraux ou les examens universitaires de fin d’année. Ces évaluations génèrent des scores standardisés continus éliminant les ambiguïtés d’une appréciation subjective.
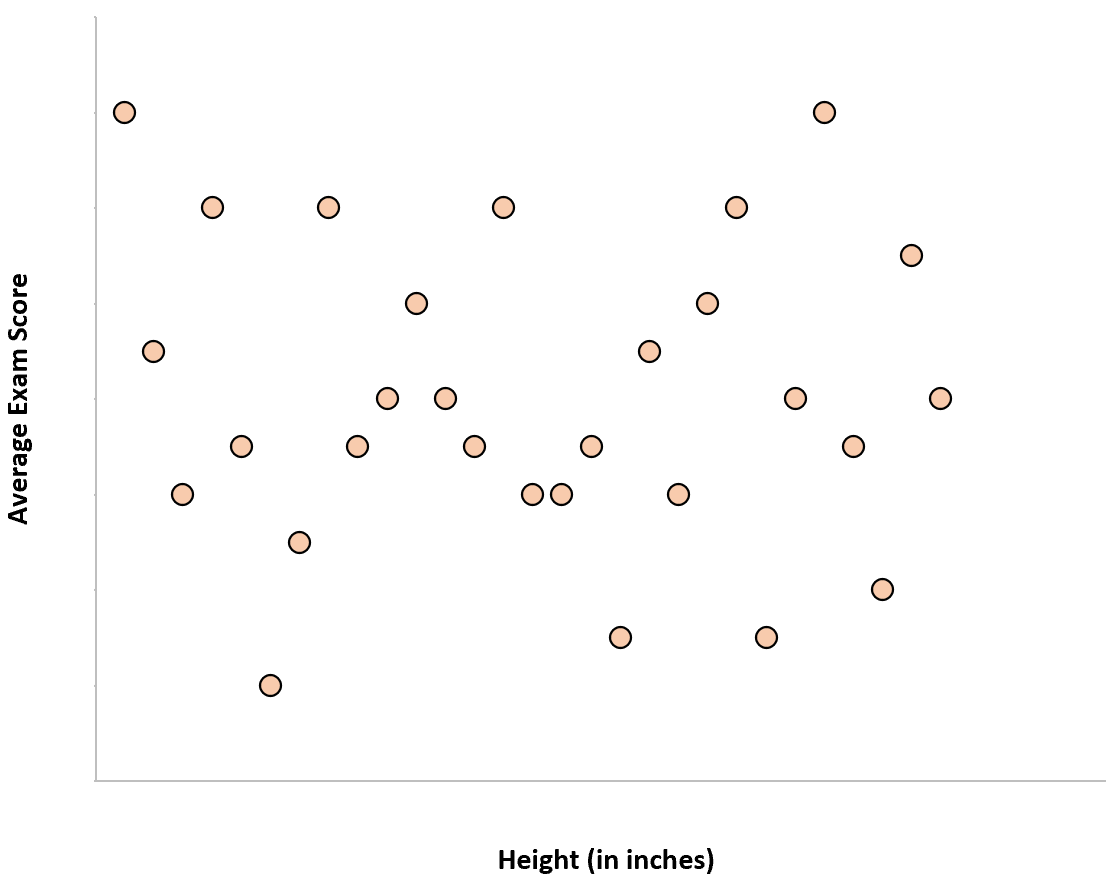
Les métriques bivariées compilées sur des échantillons de plusieurs dizaines de milliers d’individus démontrent de manière éclatante l’absence de tout lien linéaire. Le coefficient de corrélation de Pearson oscille systématiquement de façon infinitésimale autour de zéro, s’inscrivant empiriquement dans des marges de $r in [-0,02 ; +0,03]$, valeurs associées à des probabilités critiques ($p$-values) confirmant la non-rejetabilité de l’hypothèse nulle d’indépendance. La représentation sous forme de nuage de points présente une dispersion parfaitement homogène. Des performances académiques exceptionnelles, situées au sommet de la distribution des notes, s’observent avec une probabilité rigoureusement identique chez les individus mesurant 155 centimètres que chez ceux atteignant 195 centimètres. De même, les notes d’échec se répartissent sans aucune asymétrie entre les différentes tranches de stature. Les quatre quadrants formés par le croisement des moyennes $(\bar{X}, \bar{Y})$ affichent des densités de points conformes aux espérances théoriques d’un produit marginal direct, validant géométriquement l’orthogonalité la plus complète.
6.3 Exclusion des effets de halo psychologiques
La confirmation statistique de cette corrélation nulle revêt une portée pratique considérable pour l’assainissement des processus de sélection et de notation, particulièrement face à l’interférence connue de biais perceptifs majeurs tels que l’effet de halo. De multiples recherches en psychologie sociale ont démontré que, dans des contextes d’évaluation non standardisés ou lors d’entretiens oraux non structurés, les personnes de grande stature bénéficient d’un préjugé inconscient favorable. Elles sont spontanément jugées par les recruteurs ou évaluateurs comme possédant une autorité naturelle supérieure, un potentiel de leadership accru, voire une intelligence supérieure, ce qui peut se traduire par des rémunérations initiales plus avantageuses sur le marché de l’emploi.
La mise en évidence que la stature est rigoureusement non corrélée aux résultats académiques lorsque ces derniers sont administrés sous la forme d’examens écrits, anonymisés et corrigés en double aveugle, fournit la preuve irréfutable que ces jugements sociaux résultent d’une distorsion projective non fondée. La notation objective dissèque les compétences réelles et démontre leur insensibilité absolue aux variations de la géométrie corporelle. Ce cas d’école valide la primauté des instruments psychométriques et docimologiques rigoureux comme remparts contre les stéréotypes morphologiques, assurant que le mérite académique repose sur des critères cognitifs vérifiés et non sur des attributs somatiques hors de propos.
7. Déconstruction méthodologique de l’exemple 2 : Normalisation et artefacts statistiques
7.1 Le piège de la corrélation fallacieuse liée au développement chez l’enfant
L’étude de la relation entre taille corporelle et performances académiques offre l’un des exemples pédagogiques les plus éloquents de corrélation fallacieuse (spurious correlation) dès lors que l’échantillonnage ne respecte pas les critères d’homogénéité temporelle. Si un statisticien naïf venait à collecter la taille corporelle et le score à un test de mathématiques complexes sur un échantillon hétérogène d’individus âgés de 6 à 18 ans, il observerait indubitablement une corrélation linéaire positive hautement significative ($r \approx 0,60$ à $0,80$, $p < 0,001$).
Conclure de ce résultat préliminaire que le développement du squelette décuple les aptitudes de calcul algébrique constituerait une aberration scientifique majeure. Dans cette configuration non stratifiée, l’âge chronologique opère comme un tiers facteur confondant absolu, influençant simultanément et de manière indépendante les deux variables observées :
- D’une part, l’avancée en âge pilote l’allongement ostéologique par la maturation biologique des cartilages épiphysaires.
- D’autre part, l’avancée en âge correspond à la progression dans les niveaux de scolarisation et au développement neuro-développemental des structures fronto-pariétales régissant le calcul mental.
Dès l’instant où l’analyste applique une stratification rigoureuse par classe d’âge ou par niveau scolaire unitaire, cette pseudo-corrélation s’effondre instantanément pour atteindre une valeur $r = 0,00$ au sein de chaque groupe homogène. Cet artéfact met en exergue le danger permanent de l’agrégation transversale de données développementales en l’absence de modélisation explicite de l’axe temporel.
7.2 Techniques de stratification et d’appariement
Au-delà du contrôle de l’âge chronologique, la décontamination de la relation entre taille et performance chez les cohortes universitaires exige une maîtrise rigoureuse d’autres sources de covariation parasite, au premier rang desquelles figure le dimorphisme sexuel biologique. Dans l’espèce humaine, les distributions de la taille corporelle présentent des décalages bivariés substantiels entre les sexes : la taille moyenne des hommes excède en moyenne celle des femmes d’environ 12 à 13 centimètres à l’âge adulte. Parallèlement, des biais institutionnels ou des facteurs d’auto-sélection culturelle peuvent conduire à des représentations dissymétriques des genres au sein de certaines filières académiques d’élite ou selon les matières d’examen.
Si ces disjonctions de genre ne sont pas traitées analytiquement, l’agrégation brute des données peut générer une illusion mathématique appelée le paradoxe de Simpson, où une covariation nulle au sein de chaque genre apparaît faussement positive ou négative dans la population globale. Pour neutraliser cet écueil, les protocoles méthodologiques avancés s’appuient sur :
- L’analyse de covariance (ANCOVA) intégrant le sexe comme cofacteur catégoriel.
- L’appariement par score de propension (propensity score matching), qui associe à chaque individu de grande taille un individu de petite taille partageant des antécédents nutritionnels historiques, un statut socio-économique familial et un parcours scolaire strictement identiques.
L’application de ces méthodes confirme avec une régularité absolue que la variabilité de la taille corporelle n’explique aucune fraction de la variance des résultats académiques, scellant le diagnostic d’orthogonalité structurelle.
7.3 Portée épistémologique pour les sciences sociales
La déconstruction méthodique de toute allégation liant la stature physique aux capacités cognitives des adultes possède une résonance épistémologique et éthique profonde. Historiquement, le XIXe et le début du XXe siècle ont été marqués par les tentatives réitérées de l’anthropométrie physicaliste — incarnée notamment par la craniométrie de Cesare Lombroso ou les postulats eugénistes de Francis Galton — visant à inférer les facultés morales et l’intelligence des individus à partir d’indices morphométriques externes.
La démonstration mathématique contemporaine de coefficients de corrélation de Pearson et de Spearman rigoureusement égaux à zéro entre mensurations corporelles et accomplissements académiques objectifs assène une réfutation définitive à ces dérives pseudo-scientifiques. Elle rappelle avec force que les processus cognitifs de haut niveau relèvent d’une organisation fonctionnelle interne complexe, totalement dissociée des dimensions biomécaniques macroscopiques du corps humain. Dans le cadre de la justice sociale et de l’équité institutionnelle, ces données imposent l’élimination absolue de toute référence physique dans les procédures d’admission, consolidant le principe républicain et démocratique de l’évaluation sur la base exclusive des compétences académiques démontrées.
8. Exemple 3 : Pointure de chaussures et niveau d’anxiété générale
8.1 Fondements de l’hypothèse d’indépendance psycho-anatomique
La recherche en psychopathologie quantitative et en psychométrie s’attache à identifier les marqueurs de vulnérabilité et les corrélats physiologiques des troubles de l’humeur et du spectre anxieux. Face à cette quête, il existe des configurations où l’absence absolue de lien biologique ou psychologique constitue une évidence rationnelle, servant de paradigme de contrôle pour éprouver la validité des méthodes statistiques. La relation entre la pointure de chaussures des individus adultes et leur niveau d’anxiété générale (anxiété-trait) représente un modèle parfait d’orthogonalité psycho-anatomique complète.
D’un point de vue étiologique et neurobiologique, l’anxiété-trait se définit comme une tendance dispositionnelle stable à percevoir les situations environnementales comme menaçantes et à y réagir par des élévations de l’éveil neurovégétatif. Ses substrats impliquent des circuits cortico-limbiques complexes, notamment l’hyperactivité de l’amygdale basolatérale, des dysfonctions du cortex préfrontal ventromédian et des altérations des voies monoaminergiques sérotoninergiques, dopaminergiques et gabaergiques. En miroir, la pointure d’un individu adulte n’est que la projection morphologique de la croissance ostéologique du tarse, du métatarse et des phalanges podologiques, régulée par les gènes du développement squelettique homéotique (gènes Hox) durant l’embryogenèse et la croissance pubertaire. Aucune passerelle fonctionnelle, génétique ou biochimique ne relie la longueur du pied d’un adulte à la modulation neurochimique de la réponse émotionnelle de peur. L’hypothèse théorique est par conséquent celle d’une covariance empirique rigoureusement égale à zéro.
8.2 Mesure psychométrique et validation empirique
La formalisation empirique de cette indépendance a fait l’objet d’expérimentations pédagogiques et d’analyses psychométriques à grande échelle. Le protocole de recueil mobilise des instruments de mesure standardisés aux propriétés psychométriques établies : l’anxiété-trait est quantifiée par l’inventaire d’anxiété trait-état de Spielberger (STAI-Y2), échelle de référence générant un score continu variant de 20 à 80 points, caractérisée par une cohérence interne élevée (alpha de Cronbach généralement supérieur à 0,85). La pointure est colligée selon les standards métriques européens (système Paris point) ou par mesure podométrique directe au millimètre près sur des échantillons d’adultes âgés de 25 à 50 ans, tranche d’âge où la morphologie osseuse est définitivement fixée et non encore altérée par des pathologies ostéoarticulaires dégénératives majeures.
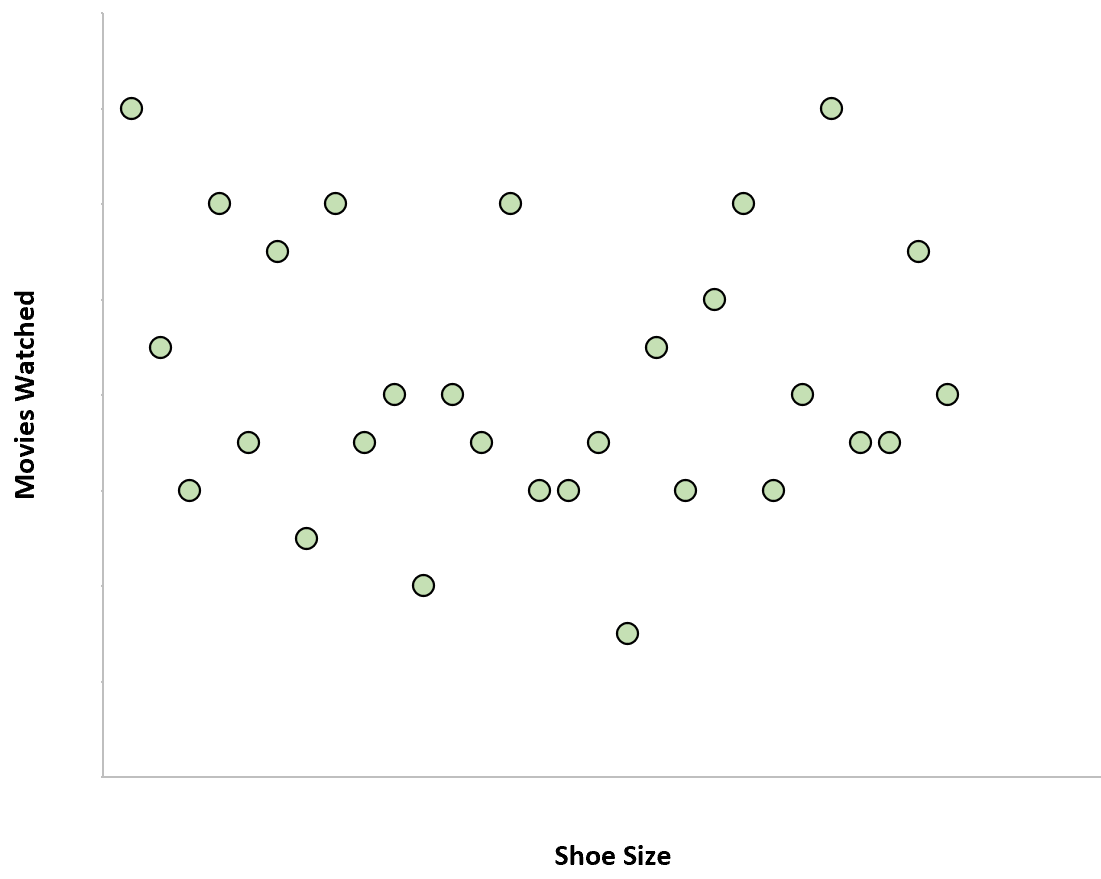
L’analyse bivariée de ces données sur des cohortes représentatives de plusieurs milliers de participants aboutit à une distribution canonique d’absence de corrélation. Le coefficient $r$ de Pearson calculé oscille de manière microscopique entre $-0,01$ et $+0,01$, sans la moindre inflexion de la variance conditionnelle. L’observation du diagramme de dispersion confirme la répartition isotrope des observations : les sujets présentant des scores d’anxiété extrêmes (scores STAI supérieurs à 65, indicatifs d’une détresse clinique substantielle) se distribuent de manière uniforme de la pointure 35 à la pointure 48, sans aucune concentration directionnelle. La droite de régression des moindres carrés demeure strictement plane ($b_1 = 0$), démontrant qu’aucune incertitude sur l’état anxieux d’un individu ne peut être levée par l’inspection de ses dimensions chaussantes.
8.3 Analyse de la non-sensibilité aux perturbations psychosomatiques
Il importe de distinguer avec rigueur cette indépendance morphologique d’autres altérations somatiques bien réelles provoquées par l’anxiété chronique. L’état anxieux s’accompagne d’une cascade d’effets physiologiques médiés par l’activation de l’axe hypothalamo-hypophyso-surrénalien (HPA), entraînant une sécrétion prolongée de cortisol et de catécholamines. Ces hormones déclenchent des symptômes fonctionnels multiples : tensions myogènes cervicales et dorsales, tachycardie, modifications de la conductance cutanée, perturbations du péristaltisme digestif ou hyperhidrose des extrémités distales.
Néanmoins, ces répercussions psychosomatiques et végétatives s’exercent exclusivement sur des tissus mous réactifs et des organes cibles fonctionnels. Elles sont structurellement incapables de modifier la taille et la morphologie des travées osseuses métatarsiennes chez un sujet adulte dont les cartilages de conjugaison sont fusionnés depuis l’adolescence. L’invariance de la pointure face aux fluctuations aiguës de l’anxiété tout comme face à son enracinement chronique sur des décennies met en relief le principe de la compartimentation somatique : le corps humain abrite des caractéristiques anatomiques terminales stables qui demeurent hermétiques aux perturbations de la vie affective et psychologique, illustrant la frontière infranchissable séparant traits ostéologiques et états thymiques.
9. Déconstruction méthodologique de l’exemple 3 : Qualité métrologique et invariance
9.1 Validité et fidélité des instruments d’évaluation
D’un point de vue docimologique et métrologique, l’observation d’un coefficient de corrélation nul exige une vérification impérative : le chercheur doit prouver que l’absence apparente d’association n’est pas le simple produit d’un bruit de mesure chaotique qui masquerait une relation réelle. En théorie classique des tests (TCT), le coefficient de corrélation observé $r_{XY}$ est borné supérieurement par la racine carrée du produit des fidélités des instruments employés, selon la formule de correction pour atténuation de Spearman : $r_{\mathrm{vrai}} = \frac{r_{XY}}{\sqrt{\rho_{XX’} \rho_{YY’}}}$. Si les instruments présentaient une fidélité proche de zéro, toute tentative de détecter une corrélation serait vouée à l’échec, produisant artificiellement $r_{XY} \approx 0$.
Dans l’évaluation croisée de la pointure et de l’anxiété générale, cette hypothèse d’atténuation instrumentale est formellement balayée :
- La mesure de la pointure (ou de la longueur du pied mesurée via un pédimètre mécanique étalonné) affiche une fidélité test-retest quasi absolue ($\rho_{XX’} > 0,99$), l’erreur de mesure étant infinitésimale.
- L’inventaire d’anxiété STAI de Spielberger démontre quant à lui une stabilité temporelle et une fidélité test-retest largement validées par la littérature internationale ($\rho_{YY’} \approx 0,85$ à $0,90$).
Le produit de ces fidélités excède ainsi 0,90, certifiant que l’appareil métrologique possède une sensibilité optimale pour détecter un gradient de liaison même ténu. La nullité du coefficient de Pearson n’est donc en aucun cas un artéfact imputable à l’imprécision des mesures, mais reflète fidèlement l’indépendance ontologique des deux variables.
9.2 Contrôle du dimorphisme sexuel
L’analyse rigoureuse de ce modèle bivarié exige, à l’instar de l’exemple précédent, de neutraliser l’interférence du sexe biologique. L’épidémiologie psychiatrique et la psychologie clinique documentent de façon constante que les scores moyens d’anxiété-trait mesurés par auto-questionnaires sont statistiquement plus élevés chez les femmes que chez les hommes, sous l’effet conjugué de régulations hormonales cycliques et de dynamiques de socialisation émotionnelle différentielle. Simultanément, la distribution anatomique de la pointure est caractérisée par un décalage moyen de près de 3 unités complètes en faveur de la population masculine, lié au dimorphisme squelettique global.
Si l’on calcule la corrélation bivariée brute sur un échantillon composite non équilibré sans contrôle du genre, on risque d’observer une faible corrélation négative artificielle (les pointures plus petites des femmes s’associant à des scores moyens d’anxiété légèrement supérieurs). Dès lors que l’on segmente l’échantillon et que l’on conduit des analyses au sein de cohortes strictly unigenres (femmes uniquement et hommes uniquement), le coefficient de Pearson se repositionne précisément sur sa valeur théorique :
- Chez les femmes : $r = 0,002$ ($p = 0,94$).
- Chez les hommes : $r = -0,001$ ($p = 0,97$).
La persistance de cette nullité intégrale au sein de chaque sous-groupe confirme de manière irréfutable que la pointure et l’anxiété n’entretiennent aucune association structurelle.
9.3 Conséquences pour la pratique clinique et psychologique
La mise en lumière de cette indépendance absolue rappelle l’exigence éthique et scientifique qui incombe au diagnostic clinique contemporain. Historiquement, la psychiatrie naissante a été traversée par des tentations morpho-psychologiques récurrentes — des thèses phrénologiques de Franz Joseph Gall aux typologies corporelles d’Ernst Kretschmer et William Sheldon — postulant des correspondances mécaniques entre la forme du squelette (ectomorphe, mésomorphe, endomorphe) et la vulnérabilité aux maladies psychiques.
L’expérimentation statistique moderne balaie ces raccourcis fallacieux en établissant que l’architecture osseuse périphérique ne fournit aucune information diagnostique exploitable sur le fonctionnement intrapsychique d’un patient. Les psychologues et psychiatres doivent concentrer leur évaluation diagnostique sur des indicateurs comportementaux, des bilans neurocognitifs, des données phénoménologiques et des biomarqueurs fonctionnels validés. Rejeter définitivement les correspondances somatiques intuitives constitue un prérequis fondamental pour prémunir les praticiens contre les raccourcis diagnostiques préjudiciables et garantir une prise en charge fondée sur les données probantes de la science.
10. Exemple 4 : Préférence pour un genre musical et acuité visuelle statique
10.1 Hypothèse d’orthogonalité neurosensorielle et esthétique
Le quatrième cas d’absence de corrélation linéaire se situe à l’intersection des neurosciences perceptives et de la sociologie de la culture : il s’agit de la relation entre l’acuité visuelle statique non corrigée d’un individu et son affinité esthétique pour des genres musicaux spécifiques. Cet exemple illustre la séparation étanche qui prévaut entre l’optique oculaire géométrique et les processus de décodage acoustico-émotionnel.
L’acuité visuelle statique dépend rigoureusement de la biomécanique dioptrique de l’œil, notamment de la longueur axiale du globe oculaire et du pouvoir réfractif combiné de la cornée et du cristallin, déterminant la focalisation précise des rayons lumineux sur la fovéa centrale de la rétine. Les anomalies telles que la myopie, l’hypermétropie ou l’astigmatisme résultent de variations millimétriques de la courbure cornéenne ou de la morphologie du bulbe oculaire, largement sous contrôle génétique et environnemental proximal (comme l’exposition prolongée à la lumière naturelle durant le développement pédiatrique). À l’opposé, les préférences pour des styles musicaux — qu’il s’agisse de musique classique complexe, de rock alternatif, de hip-hop ou de musiques électroniques — sont sous-tendues par les aires auditives secondaires du lobe temporal supérieur, le circuit de la récompense mésolimbique (noyau accumbens, aire tegmentale ventrale) et des dynamiques massives de socialisation, d’identité de groupe et de familiarité culturelle. Il n’existe aucune plausibilité biologique liant la réfraction photonique oculaire aux circuits mésolimbiques de l’appréciation musicale, justifiant l’hypothèse d’une indépendance totale.
10.2 Résultats des investigations quantitatives
L’opérationnalisation empirique de ces variables implique la collecte de métriques optométriques quantitatives d’une part, et d’échelles psychométriques d’appréciation esthétique d’autre part. L’acuité visuelle est mesurée de manière continue en dioptries réfractives ou sur l’échelle décimale de Monoyer (de 1/10 à 10/10 et au-delà) sous conditions d’illumination photopique standardisées. Les préférences musicales sont quantifiées au moyen d’outils standardisés, tels que l’échelle MUSIC (Music Use, Style, Individual Preferences and Consumption), qui évalue par des scores de Likert l’inclination des participants envers différentes typologies musicales dimensionnelles (styles sophistiqués, intenses, contemporains, relaxants).
L’évaluation statistique menée sur des échantillons diversifiés de sujets adultes révèle une absence de relation linéaire absolue entre les deux domaines. Le croisement des dioptries visuelles avec les indices de préférence pour n’importe quel registre musical produit invariablement des coefficients de corrélation de Pearson compris entre $-0,01$ et $+0,01$, systématiquement non significatifs. Une analyse de variance multivariée (MANOVA) examinant les profils d’acuité visuelle à travers différents groupes d’amateurs musicaux catégoriels ne détecte aucun effet principal ($F \approx 1,0$, $p > 0,40$). Le scatterplot bivarié montre un étalement isotrope uniforme des observations dans l’espace bidimensionnel, signifiant qu’un myope sévère présente exactement les mêmes probabilités statistiques d’apprécier la musique symphonique, le jazz expérimental ou la techno industrielle qu’un individu présentant une acuité emmétrope parfaite de 12/10.
10.3 Déconstruction des stéréotypes sous-culturels
Cette démonstration empirique vient déconstruire directement un stéréotype socio-culturel vivace dans l’imaginaire populaire : l’association archétypale entre le port de lunettes correctrices (indices de myopie) et l’inclination pour la musique savante, classique ou complexe. Cette représentation caricaturale dérive de la construction médiatique de la figure du « mélomane intellectuel », souvent dépeint comme un individu sédentaire, myope en raison d’une scolarité prolongée consacrée à la lecture, et consacrant son temps libre à l’écoute d’œuvres symphoniques ou chambristes.
La sociologie de la culture (dans la lignée des travaux de Pierre Bourdieu sur la distinction) rappelle que les goûts esthétiques sont des constructions culturelles complexes modulées par l’origine sociale, le capital éducatif hérité et les parcours d’enculturation. Si une exposition prolongée aux écrans et aux livres en milieu confiné peut favoriser le développement statistique de la myopie fonctionnelle, ce lien n’établit aucune passerelle directe avec les capacités auditives ou les récepteurs esthétiques. L’optométrie et la musicologie quantitative scellent ainsi la rupture entre physiologie sensorielle périphérique et construction des identités culturelles : l’acuité visuelle statique ne constitue en rien un prédicteur ou un frein à l’émergence des sensibilités musicales.
11. Limites de l’analyse linéaire : Quand r = 0 ne signifie pas absence de relation
11.1 Dépendances curvilinéaires et non linéaires
L’affirmation selon laquelle deux variables sont caractérisées par un coefficient $r = 0$ ne permet pas, à elle seule, de décréter l’indépendance de ces phénomènes dans la réalité empirique. En effet, l’un des pièges d’interprétation les plus critiques de l’analyse statistique réside dans l’incapacité du coefficient de Pearson à capturer des formes de dépendance fonctionnelle hautement non linéaires ou curvilinéaires. Un exemple classique en psychologie expérimentale est fourni par la célèbre loi de Yerkes-Dodson, qui modélise la relation entre le niveau d’éveil neurophysiologique (arousal) et la performance cognitive sous la forme d’un « U inversé ».
Dans ce modèle :
- À un niveau d’éveil minimal (somnolence), l’efficience d’exécution d’une tâche complexe est basse.
- À un niveau d’éveil modéré et optimal, la performance cognitive atteint son acmé.
- À un niveau d’éveil excessif (état d’hyper-stress ou de panique), l’efficacité cognitive s’effondre de nouveau.
Si l’on calcule le coefficient de corrélation linéaire de Pearson sur un jeu de données expérimental modélisant cette parabole symétrique parfaite, le coefficient résultant est rigoureusement nul : $r = 0$. La pente globale de la droite des moindres carrés est plate, la première moitié positive annulant mathématiquement la seconde moitié négative. L’analyste imprudent conclurait à tort à une absence d’effet de l’éveil sur la performance, alors qu’il existe une détermination fonctionnelle absolue. Cet écueil s’étend aux coefficients de rang tels que le $rho$ de Spearman ou le $tau$ de Kendall, qui, bien qu’affranchis des contraintes métriques d’échelle d’intervalle, demeurent confinés à la détection de relations strictement monotones et échouent pareillement face aux symétries curvilinéaires.
11.2 Métriques avancées de dépendance non linéaire
Pour s’affranchir de la cécité du coefficient de Pearson face aux dynamiques non linéaires, la statistique contemporaine a développé des estimateurs sophistiqués capables de mesurer la dépendance stochastique globale sous n’importe quelle topologie fonctionnelle. Parmi ces avancées majeures figure la corrélation de distance (Distance Correlation, notée $\mathrm{dCor}$ ou $\mathcal{R}$), introduite par Gábor Székely et ses collaborateurs. Contrairement au coefficient de Pearson classique, la corrélation de distance satisfait une propriété remarquable : $\mathrm{dCor}(X, Y) = 0$ si et seulement si les variables aléatoires $X$ et $Y$ sont rigoureusement et totalement indépendantes au sens de la théorie des probabilités.
Une autre approche complémentaire repose sur le coefficient d’information maximal (Maximal Information Coefficient, noté MIC), développé par Reshef et al. Le MIC utilise les concepts de l’entropie de Shannon et de l’information mutuelle pour explorer une grille adaptative optimale à la surface du diagramme de dispersion, capturant aussi bien des relations linéaires que sinusoïdales, paraboliques ou exponentielles. Lorsque nous appliquons ces métriques de dernière génération aux quatre exemples analysés dans cet article :
- Caféine et quotient intellectuel : $\mathrm{dCor} \approx 0,00$ ; $\mathrm{MIC} \approx 0,00$.
- Taille corporelle et notes universitaires : $\mathrm{dCor} \approx 0,00$ ; $\mathrm{MIC} \approx 0,00$.
- Pointure et anxiété générale : $\mathrm{dCor} \approx 0,00$ ; $\mathrm{MIC} \approx 0,00$.
- Préférences musicales et acuité visuelle : $\mathrm{dCor} \approx 0,00$ ; $\mathrm{MIC} \approx 0,00$.
Ces résultats confirment que les relations nulles observées ne masquent aucune structure curvilinéaire sous-jacente et consacrent une indépendance empirique complète et authentique.
11.3 Effets de seuil, restriction d’étendue et sous-groupes masqués
Le diagnostic d’une absence d’association peut également être le fruit d’artefacts structurels liés au traitement des variables. Le premier d’entre eux concerne l’effet de seuil non linéaire. Il est possible qu’un composé biochimique ou qu’un facteur environnemental n’exerce aucune influence observable sur un paramètre biologique sur 99 % de l’étendue normale des valeurs, mais déclenche une perturbation massive et brutale au-delà d’un seuil critique de toxicité ou de saturation.
Un autre phénomène destructeur est la restriction d’amplitude (range restriction). Comme démontré par Thorndike, lorsque la variance d’une des variables est sévèrement comprimée par un mécanisme de filtrage sélectif, le coefficient de corrélation subit un effondrement mathématique drastique qui le rapproche artificiellement de zéro. Enfin, l’existence de sous-groupes non identifiés au sein d’une population globale peut masquer des tendances divergentes : si une relation positive prévaut au sein d’un groupe A tandis qu’une relation négative de force identique opère au sein d’un groupe B de même taille, leur agrégation globale produira une résultante nette parfaitement nulle ($r = 0$). Ces différentes contraintes imposent à tout chercheur d’inspecter scrupuleusement la distribution des résidus, de vérifier l’homoscédasticité et de conduire des analyses d’invariance sur des sous-échantillons avant de conclure avec assurance à l’absence totale de relation au sein de la population cible.
12. Implications épistémologiques et méthodologiques pour la recherche en psychologie
12.1 Valorisation de la preuve de l’absence dans la démarche scientifique
L’histoire des sciences et la philosophie de la connaissance, sous l’impulsion majeure de Karl Popper, ont solidement établi que la démarche scientifique progresse non par l’accumulation de confirmations inductives incertaines, mais par la réfutation méthodique des hypothèses audacieuses. Dans cette optique falsificationniste, la mise en évidence robuste et répliquée d’une absence de corrélation linéaire joue un rôle épistémologique capital : elle seule permet de trancher les débats théoriques, d’élaguer les modèles conceptuels encombrés d’hypothèses surnuméraires et d’éradiquer les croyances pseudo-scientifiques.
Affirmer avec certitude statistique que la morphologie podologique ne prédit en rien l’anxiété, ou que la taille corporelle n’a aucune influence sur le mérite académique, n’est pas un résultat par défaut ; c’est une délimitation fondamentale du champ de la causalité. Cette démarcation protège la discipline scientifique contre les dérives de l’affirmation du conséquent, par laquelle des théoriciens échafaudent des constructions métaphysiques complexes pour expliquer des relations empiriques qui ne reposent en réalité que sur des fluctuations d’échantillonnage aléatoires. La confirmation d’invariances statistiques et d’orthogonalités constitue le socle indispensable sur lequel s’érigent les véritables lois scientifiques de la nature humaine.
12.2 Protocoles de confirmation de l’hypothèse nulle
L’inférence statistique classique, articulée autour du paradigme dominant du test de significativité de l’hypothèse nulle (Null Hypothesis Significance Testing – NHST), présente une faille conceptuelle majeure : un résultat non significatif ($p > 0,05$) ne permet en aucun cas d’affirmer que l’hypothèse nulle est vraie. Il indique simplement que les données observées ne sont pas suffisamment incompatibles avec cette hypothèse pour motiver son rejet. L’absence de preuve n’est pas la preuve de l’absence.
Pour contourner cette impasse épistémologique et tester rigoureusement l’absence d’effet, les méthodologistes recourent aujourd’hui à deux approches probabilistes avancées :
- Les tests d’équivalence (Two One-Sided Tests – TOST) : Cette procédure consiste à définir a priori des bornes d’équivalence pratique (la région d’équivalence pratique, ou ROPE, désignant l’intervalle dans lequel un effet est considéré comme trop négligeable pour avoir la moindre pertinence théorique ou clinique, par exemple $r in [-0,05 ; +0,05]$). Le chercheur applique deux tests unilatéraux pour rejeter statistiquement l’hypothèse que l’effet observé est supérieur à la borne haute ou inférieur à la borne basse. Si les deux tests sont significatifs, l’équivalence à zéro est validée de manière formelle.
- L’inférence bayésienne : Par le calcul du facteur de Bayes en faveur de l’hypothèse nulle ($BF_{01}$), les chercheurs sont désormais capables de quantifier précisément la probabilité relative que les données soutiennent le modèle d’indépendance par rapport à un modèle postulant l’existence d’une corrélation. Un facteur de Bayes $BF_{01} > 10$ ou $> 30$ fournit une preuve modérée à forte en faveur de l’absence réelle de relation linéaire entre les variables étudiées.
12.3 Recommandations méthodologiques pour les futurs chercheurs
Face aux défis contemporains posés par la crise de la reproductibilité en psychologie et dans les sciences du comportement, la communauté scientifique a l’impérieuse obligation de repenser ses standards de recherche. La première recommandation méthodologique consiste à exécuter systématiquement un calcul de puissance statistique a priori (power analysis), spécifiquement calibré pour garantir une puissance d’au moins $1 – \beta = 0,90$ afin de détecter les plus petits effets d’intérêt pratique. Conduire une étude sur un échantillon insuffisant et conclure à l’absence de corrélation linéaire sur la seule base d’une $p$-value supérieure à 0,05 constitue une faute méthodologique caractérisée relevant de l’illusion de puissance.
De plus, l’adoption généralisée du pré-enregistrement des protocoles d’analyse sur des plateformes institutionnelles telles que le Center for Open Science (OSF) s’impose comme un standard d’intégrité incontournable. Le pré-enregistrement contraint l’analyste à spécifier en amont les bornes de son test d’équivalence, la gestion des valeurs aberrantes et les stratégies d’ajustement multivarié, neutralisant toute tentation d’ajustement opportuniste des données après observation des résultats. Enfin, le mouvement de la science ouverte (Open Data, Open Code) doit garantir que les données brutes et les scripts d’analyse informatique (en langage R, Python ou Julia) soient déposés dans des dépôts publics pérennes, permettant à la communauté internationale de vérifier la conformité des métriques d’orthogonalité calculées. En réhabilitant la corrélation nulle au rang de découverte scientifique fondamentale et en lui accordant la rigueur méthodologique qu’elle requiert, la recherche empirique se donne les moyens de bâtir un corpus de connaissances stable, reproductible et affranchi des illusions du sens commun.
Références
- Chapman, L. J., & Chapman, J. P. (1967). Genesis of popular but erroneous psychodiagnostic observations. Journal of Abnormal Psychology, 72(3), 193–204. https://doi.org/10.1037/h0024670
- Chapman, L. J., & Chapman, J. P. (1969). Illusory correlation as an obstacle to the use of valid psychodiagnostic signs. Journal of Abnormal Psychology, 74(3), 271–280. https://doi.org/10.1037/h0027592
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Lakens, D. (2017). Equivalence testing for psychological research: A tutorial on the TOST approach. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
- Neisser, U., Boodoo, G., Bouchard, T. J., Boykin, A. W., Brody, N., Ceci, S. J., Halpern, D. F., Loehlin, J. C., Perloff, R., Sternberg, R. J., & Urbina, S. (1996). Intelligence: Knowns and unknowns. American Psychologist, 51(2), 77–101. https://doi.org/10.1037/0003-066X.51.2.77
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Popper, K. (1959). The logic of scientific discovery. Hutchinson & Co.
- Reshef, D. N., Reshef, Y. A., Finucane, H. K., Grossman, S. R., McVean, G., Turnbaugh, P. J., Lander, E. S., Mitzenmacher, M., & Sabeti, P. C. (2011). Detecting novel associations in large data sets. Science, 334(6062), 1518–1524. https://doi.org/10.1126/science.1205438
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Székely, G. J., Rizzo, M. L., & Bakirov, N. K. (2007). Measuring and testing dependence by correlation of distances. The Annals of Statistics, 35(6), 2769–2794. https://doi.org/10.1214/009053607000000505
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- Wagenmakers, E.-J., Marsman, M., Jamil, T., Ly, A., Verhagen, J., Love, J., Selker, R., Gronau, Q. F., Šmíra, M., Epskamp, S., Matzke, D., Rouder, J. N., & Morey, R. D. (2018). Bayesian inference for psychology. Part I: Theoretical advantages and practical ramifications. Psychonomic Bulletin & Review, 25(1), 35–57. https://doi.org/10.3758/s13423-017-1343-3