
Dans le champ de l’analyse quantitative contemporaine, l’exploration graphique ne constitue pas un simple préliminaire esthétique, mais s’affirme comme un impératif méthodologique incontournable. Face à la prolifération de jeux de données massifs et hétérogènes, le chercheur et le biostatisticien sont confrontés à l’obligation de sonder intimement la structure de leurs observations avant de formaliser la moindre inférence paramétrique. Le nuage de points, formalisé historiquement par John Herschel et enrichi par Francis Galton lors de ses travaux pionniers sur l’hérédité, demeure le vecteur visuel par excellence pour appréhender la covariation de deux dimensions numériques continues. Adjoint à une droite de régression ajustée selon le critère des moindres carrés ordinaires, il condense de façon magistrale la tendance directionnelle, l’intensité de la relation linéaire et l’amplitude de la dispersion résiduelle.
L’environnement logiciel SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme le standard de référence au sein des industries hautement régulées, telles que la recherche clinique et biopharmaceutique, l’économétrie et l’actuariat. Au sein de cet écosystème réputé pour sa rigueur algorithmique et sa conformité aux exigences réglementaires, la production de visualisations analytiques a connu une métamorphose profonde. L’avènement du système ODS Graphics (Output Delivery System) et, plus particulièrement, de la procédure PROC SGPLOT, a sonné le glas des architectures graphiques obsolètes pour instaurer un paradigme déclaratif moderne, puissant et hautement reproductible.
Ce traité exhaustif se propose d’explorer méthodiquement l’art et la technique de la modélisation visuelle bivariée sous SAS. De la rigueur de la préparation distributionnelle des données à la maîtrise chirurgicale des paramètres esthétiques et typographiques imposés par les comités de lecture des revues scientifiques internationales, chaque facette de l’instruction REG et des modules connexes de PROC SGPLOT sera disséquée. À travers une démarche alliant rigueur théorique et précision programmatique, ce guide ambitionne de fournir aux analystes les clés d’une communication graphique irréprochable et scientifiquement inattaquable.
1. Introduction théorique et utilité du nuage de points avec régression sous SAS
1.1 Fondements de l’analyse bivariée dans la recherche empirique
L’exploration des relations bivariées constitue la pierre angulaire de toute investigation empirique en sciences quantitatives, qu’il s’agisse de la pharmacovigilance, de l’épidémiologie clinique, de la psychométrie ou de l’économétrie appliquée. L’objectif fondamental réside dans l’élucidation de la nature, de la direction et de l’amplitude de la dépendance stochastique unissant une variable explicative indépendante, traditionnellement affectée à l’axe des abscisses, et une variable réponse dépendante, projetée sur l’axe des ordonnées. Lorsque ces dimensions appartiennent au domaine du continu et sont mesurées sur des échelles d’intervalle ou de rapport, l’investigateur doit impérativement cartographier leur espace conjoint pour dépasser les intuitions théoriques préliminaires.
L’impératif d’une inspection visuelle approfondie avant toute modélisation statistique formalisée a été brillamment illustré par le statisticien Francis Anscombe à travers son célèbre quartet d’Anscombe. Cet ensemble de quatre jeux de données artificiels partage des propriétés statistiques sommaires strictement identiques — moyennes, variances, coefficients de corrélation de Pearson et équations de régression linéaires rigoureusement confondues —, tout en décrivant des réalités structurelles diamétralement opposées : une relation linéaire classique, une dynamique purement parabolique, une dépendance linéaire parfaite compromise par un point aberrant, et une absence totale de corrélation altérée par un point de levier critique. Sans le secours de la représentation visuelle, l’analyste demeure aveugle à de telles dissemblances morphologiques fondamentales.
La représentation sous forme de nuage de points opère ainsi une dialectique féconde avec les indices paramétriques de corrélation. Si le coefficient de corrélation linéaire de Pearson offre une synthèse scalaire commode, oscillant entre les bornes unitaires négative et positive, il postule implicitement la linéarité du phénomène et l’absence de perturbations extrêmes. Le tracé graphique permet d’authentifier la légitimité de ce scalaire en révélant si la liaison observée résulte d’une véritable cohérence globale de l’échantillon ou si elle constitue un artefact imputable à une sous-population spécifique ou à des erreurs métrologiques. L’inférence moderne ne saurait donc dissocier la computation matricielle de l’examen visuel scrupuleux des topologies de dispersion.
1.2 Rôle heuristique de la droite de régression par les moindres carrés
L’adjonction d’une droite de régression par les moindres carrés ordinaires au sein d’un nuage de points confère à la visualisation une puissance heuristique substantielle. En substance, le modèle linéaire simple formalise la valeur espérée de la variable dépendante conditionnellement à la réalisation de la variable indépendante, sous la forme canonique d’une fonction affine paramétrée par une constante d’ordonnée à l’origine et un coefficient de pente. L’insertion de ce vecteur unidimensionnel transforme un agrégat de coordonnées discrètes en une trajectoire continue intelligible, permettant à l’œil humain de capter instantanément le sens de la covariation, son inclinaison marginale et l’espérance mathématique conditionnelle.
Au-delà de la matérialisation de cette tendance centrale, la droite de régression agit comme un étalon visuel fondamental vis-à-vis duquel s’évalue la variabilité résiduelle. L’observateur expérimenté ne focalise pas exclusivement son attention sur l’orientation de la ligne, mais jauge la compacité de la nébuleuse de points autour de celle-ci. Un resserrement dense des observations traduit une variance résiduelle minime et, corrélativement, un coefficient de détermination élevé signifiant que la variance de l’abscisse absorbe une part prépondérante de la variance de l’ordonnée. Inversement, un halo diffus et distendu signale une prédictibilité précaire ou l’interférence de covariables omises exerçant un bruit stochastique majeur.
Cette confrontation visuelle entre le modèle d’ajustement déterministe et les données brutes permet également un diagnostic préliminaire intuitif des violations des postulats gaussiens. Une configuration résiduelle asymétrique, caractérisée par une déviation systématique des points en forme de parabole ou de sinusoïde par rapport à la droite, met en échec l’hypothèse de linéarité intrinsèque. De surcroît, l’observation d’un élargissement progressif du nuage d’observations au fur et à mesure que les valeurs de l’abscisse croissent — configuration classiquement désignée sous le terme d’évasement en entonnoir — fournit une alerte visuelle précoce sur la présence d’hétéroscédasticité, remettant en cause l’homogénéité de la variance des résidus.
1.3 Positionnement et avantages de PROC SGPLOT dans l’écosystème SAS
L’architecture de production graphique du logiciel SAS a connu une révolution conceptuelle déterminante avec l’émergence du sous-système ODS Graphics. Durant plusieurs décennies, les utilisateurs de la plateforme ont composé avec les instructions complexes du module SAS/GRAPH, incarnées notamment par la procédure PROC GPLOT. Ce paradigme historique contraignait les statisticiens à définir laborieusement des instructions de bas niveau, telles que les énoncés SYMBOL, AXIS et PATTERN, imposant une volumétrie de code considérable pour des résultats visuels souvent archaïques, dépourvus de lissage vectoriel moderne et déconnectés des métadonnées analytiques.
La procédure PROC SGPLOT (Statistical Graphics Plot) s’inscrit en rupture avec cet héritage en proposant une syntaxe déclarative concise, modulaire et résolument orientée vers l’analytique moderne. Au lieu d’obliger le programmeur à dessiner laborieusement des primitives géométriques, SAS délègue désormais la compilation visuelle au moteur sous-jacent Graph Template Language (GTL). Cette abstraction de haut niveau permet de générer des figures d’une sophistication remarquable au moyen d’un nombre restreint de lignes de commande, en assurant une conformité typographique native avec les chartes graphiques les plus exigeantes des périodiques scientifiques internationaux.
L’un des atouts prééminents de PROC SGPLOT réside dans son aptitude à internaliser les opérations de calcul statistique lourd sans requérir l’exécution préalable d’étapes d’estimation procédurales. Alors que sous l’ancien système, l’insertion d’une droite de régression assistée de ses intervalles de confiance imposait une séquence itérative combinant PROC REG pour exporter des tables d’estimations (via ODS OUTPUT ou OUTPUT OUT=), suivie d’une jointure relationnelle au sein d’une étape DATA, puis de l’invocation de PROC GPLOT, l’instruction contemporaine REG réalise cette séquence de façon totalement transparente, synchronisant l’ajustement mathématique et le rendu visuel dans une élégance algorithmique absolue.
2. Prérequis méthodologiques et préparation des données dans l’environnement SAS
2.1 Structure et typologie des variables requises
La mise en œuvre d’un nuage de points enrichi d’un ajustement de régression suppose en premier lieu une conformité stricte des données sous-jacentes avec la théorie de la mesure. Les deux variables mobilisées doivent impérativement présenter un caractère métrique continu, répondant aux critères d’échelles d’intervalles (où la distance entre deux graduations successives conserve une signification invariante, à l’image de la température en degrés Celsius) ou d’échelles de rapport (caractérisées par l’existence d’un zéro absolu non arbitraire, telles que la masse corporelle, la pression artérielle ou le revenu monétaire). L’utilisation de variables qualitatives ordinales arbitrairement codées sous forme numérique induirait des distorsions d’interprétation critiques, tant pour le calcul de la pente que pour l’appréciation géométrique des écarts.
La gestion des observations incomplètes revêt également une importance méthodologique capitale au sein de l’environnement SAS. Par défaut, la procédure PROC SGPLOT applique un filtrage strict fondé sur la suppression cascadée par liste (listwise deletion) : toute observation présentant une valeur manquante sur l’abscisse ou sur l’ordonnée est exclue de l’ajustement de la régression linéaire et ne donne lieu à aucun tracé de point. Toutefois, si l’enregistrement possède des valeurs renseignées sur d’autres colonnes exploitées pour des tracés superposés, SAS peut maintenir l’échelle d’axe sans afficher l’observation déficiente, risquant d’altérer imperceptiblement l’échantillon effectif analysé. L’analyste rigoureux doit systématiquement dénombrer les données manquantes préalablement à l’appel graphique.
Dans certaines circonstances expérimentales, il s’avère hautement judicieux de procéder à une transformation ou à une standardisation préalable des variables au cours d’une étape DATA préliminaire. La centration des variables sur leur moyenne arithmétique respective, voire leur réduction par la division par leur écart-type empirique (calcul des scores Z), modifie l’interprétation de l’ordonnée à l’origine, laquelle correspond désormais à l’espérance mathématique de la réponse lorsque la variable explicative se situe à son niveau moyen. De telles transformations préparatoires neutralisent les effets d’échelle extrêmes susceptibles de dégrader la lisibilité visuelle des axes et facilitent la comparaison immédiate de plusieurs modèles de régression concurrents.
2.2 Exploration du jeu de données canonique SASHELP.CLASS
Afin d’illustrer la mécanique opérationnelle de SAS sans recourir à des dépendances externes ou à des jeux de données privatifs, la table canonique SASHELP.CLASS constitue un substrat expérimental irremplaçable. Intégrée nativement à toute installation SAS certifiée, cette table contient les métriques biométriques d’une cohorte de dix-neuf enfants et adolescents scolarisés, documentant pour chacun le prénom (variable textuelle Name), le genre biologique (variable catégorielle Sex), l’âge chronologique (variable discrète Age), ainsi que la stature (variable continue Height mesurée en pouces) et la masse pondérale (variable continue Weight mesurée en livres anglo-saxonnes).
Le couple de variables formé par la stature (Height) en variable explicative indépendante et la masse (Weight) en variable de réponse constitue le cas d’école idéal pour illustrer la covariation biométrique continue. Sur le plan ontologique, l’accroissement statural chez l’être humain en phase de croissance pubertaire engendre une augmentation conjointe de la masse somatique selon des dynamiques globalement cohérentes, bien que soumises à une variabilité interindividuelle notable. L’existence d’une corrélation positive substantielle couplée à un effectif restreint permet d’apprécier la précision des tracés, la disposition des points isolés et le comportement des intervalles de confiance sans subir de saturation visuelle.
Avant d’engager le rendu graphique, le protocole standard d’audit analytique SAS impose de soumettre la table à la procédure PROC CONTENTS. Cette étape de validation formelle garantit que les variables ciblées sont rigoureusement répertoriées sous le type Num (numérique) dans le dictionnaire de données SAS, écartant ainsi tout risque de rejet d’exécution lié à un typage textuel accidentel consécutif à une importation défectueuse. Elle permet en outre d’examiner les formats d’affichage associés et d’extraire la volumétrie exacte de l’échantillon, consolidant ainsi la traçabilité de l’analyse en aval.
2.3 Vérification des postulats distributionnels avant modélisation visuelle
L’adjonction d’une droite de régression ne saurait être appréhendée comme un acte mécanique dépourvu d’ancrage distributionnel. Le calcul de la droite des moindres carrés, bien que robuste sur le plan purement descriptif en vertu du théorème de Gauss-Markov, engage une inférence statistique dès lors que l’analyste prétend tracer des bandes de confiance ou interpréter la pertinence prédictive du modèle. L’évaluation de la normalité univariée de chaque dimension via la procédure PROC UNIVARIATE, au moyen des tests omnibus de Shapiro-Wilk ou d’Anderson-Darling, offre un premier rempart méthodologique contre les interprétations fallacieuses consécutives à des asymétries majeures.
Parallèlement à la normalité univariée, la détection précoce des observations aberrantes ou suspectes constitue une phase critique. Une observation présentant un écart résiduel colossal par rapport au barycentre du nuage peut exercer un effet de levier disproportionné sur la trajectoire de la droite de régression, modifiant artificiellement son orientation angulaire. L’examen des tables de percentiles extrêmes générées par PROC UNIVARIATE permet de localiser sans ambiguïté les sujets dont les mesures s’écartent de plus de trois écarts-types de la moyenne empirique, signalant la nécessité d’une attention accrue lors de l’agencement graphique.
D’un point de vue éthique et épistémologique, l’identification d’une observation aberrante ne saurait justifier sa suppression arbitraire du jeu de données pour contraindre le modèle à une linéarité factice. La déontologie de la recherche exige que toute donnée valide soit maintenue au sein de la figuration visuelle, sauf preuve manifeste d’une altération instrumentale ou d’une erreur d’encodage matérielle. L’optimisation du nuage de points sous SAS doit précisément permettre de rendre compte de cette hétérogénéité naturelle, en équipant le chercheur des outils nécessaires pour contextualiser visuellement ces singularités sans altérer la probité des données brutes.
3. Syntaxe fondamentale : Création d’un graphique de régression de base
3.1 Déclaration minimale de la procédure PROC SGPLOT
L’initialisation d’un environnement de rendu graphique sous SAS repose sur l’appel explicite de la procédure PROC SGPLOT, assortie impérativement de la désignation de la source de données via l’option standard DATA=. Dans sa structure déclarative la plus épurée, le bloc syntaxique s’ouvre par cette déclaration et se conclut invariablement par l’instruction RUN;, laquelle commande au processeur SAS d’exécuter la séquence d’instructions accumulées dans la mémoire tampon et de compiler la figure correspondante vers les destinations ouvertes du système ODS.
Le fonctionnement interne de PROC SGPLOT repose sur le concept architectural de couches superposées (layered rendering). À l’instar d’un logiciel de composition graphique assistée par ordinateur, la procédure traite les instructions séquentiellement : chaque énoncé analytique ou géométrique vient déposer un niveau d’information visuelle supplémentaire sur un canevas partagé. Ce mécanisme confère une modularité exceptionnelle au programmeur, qui peut ainsi empiler des points de dispersion, des droites analytiques, des courbes d’ajustement localisé et des annotations textuelles sans devoir redéfinir la géométrie générale des axes cartésiens.
Il est fondamental de souligner que PROC SGPLOT hérite dynamiquement de l’état des options globales de l’environnement SAS actif lors de son exécution. Les paramètres régissant le moteur ODS GRAPHICS, tels que l’allocation mémoire pour le rendu vectoriel ou le style graphique actif au sein du document hôte (par exemple le style HTMLBlue, Pearl ou Journal), impriment immédiatement leurs attributs chromatiques et typographiques au tracé élémentaire, assurant une cohérence esthétique par défaut sans nécessiter de micro-gestion stylistique dans le code initial.
3.2 L’instruction REG : syntaxe et paramètres obligatoires
Au cœur de l’instrumentation dédiée à l’analyse bivariée au sein de PROC SGPLOT figure l’instruction REG. Conçue spécifiquement pour la modélisation paramétrique linéaire, cette instruction synthétise en un seul énoncé la matérialisation des coordonnées discrètes et le calcul algorithmique de la droite optimale au sens des moindres carrés ordinaires. Sa syntaxe fondamentale exige la spécification de deux arguments cardinaux : le paramètre X= désignant la variable prédictive indépendante et le paramètre Y= identifiant la variable quantitative dépendante soumise à l’ajustement.
Lorsque le processeur SAS interprète l’instruction REG, il déclenche en arrière-plan un module d’ajustement analytique qui extrait l’estimateur de la pente et l’ordonnée à l’origine selon les formules matricielles classiques de l’inversion de la matrice d’information. Contrairement à une idée reçue, REG ne se contente pas de relier géométriquement deux points extrêmes de l’espace, mais calibre une modélisation mathématique rigoureuse qui se conforme aux propriétés statistiques théoriques de la distribution conjointe de l’échantillon analysé.
Il convient d’établir une distinction conceptuelle nette entre l’instruction REG et l’instruction générique SCATTER. Cette dernière se limite exclusivement à la transcription spatiale des coordonnées cartésiennes sans y associer la moindre fonction de lissage ou d’inférence linéaire. Si l’analyste peut théoriquement combiner une instruction SCATTER et une instruction SERIES alimentée par un fichier de prédictions issues d’un modèle externe, le recours direct à l’instruction REG supprime toute cette surcharge procédurale en unifiant la représentation du nuage brut et de sa composante structurelle au sein d’une sémantique déclarative d’une concision exemplaire.
3.3 Analyse du graphique généré par défaut
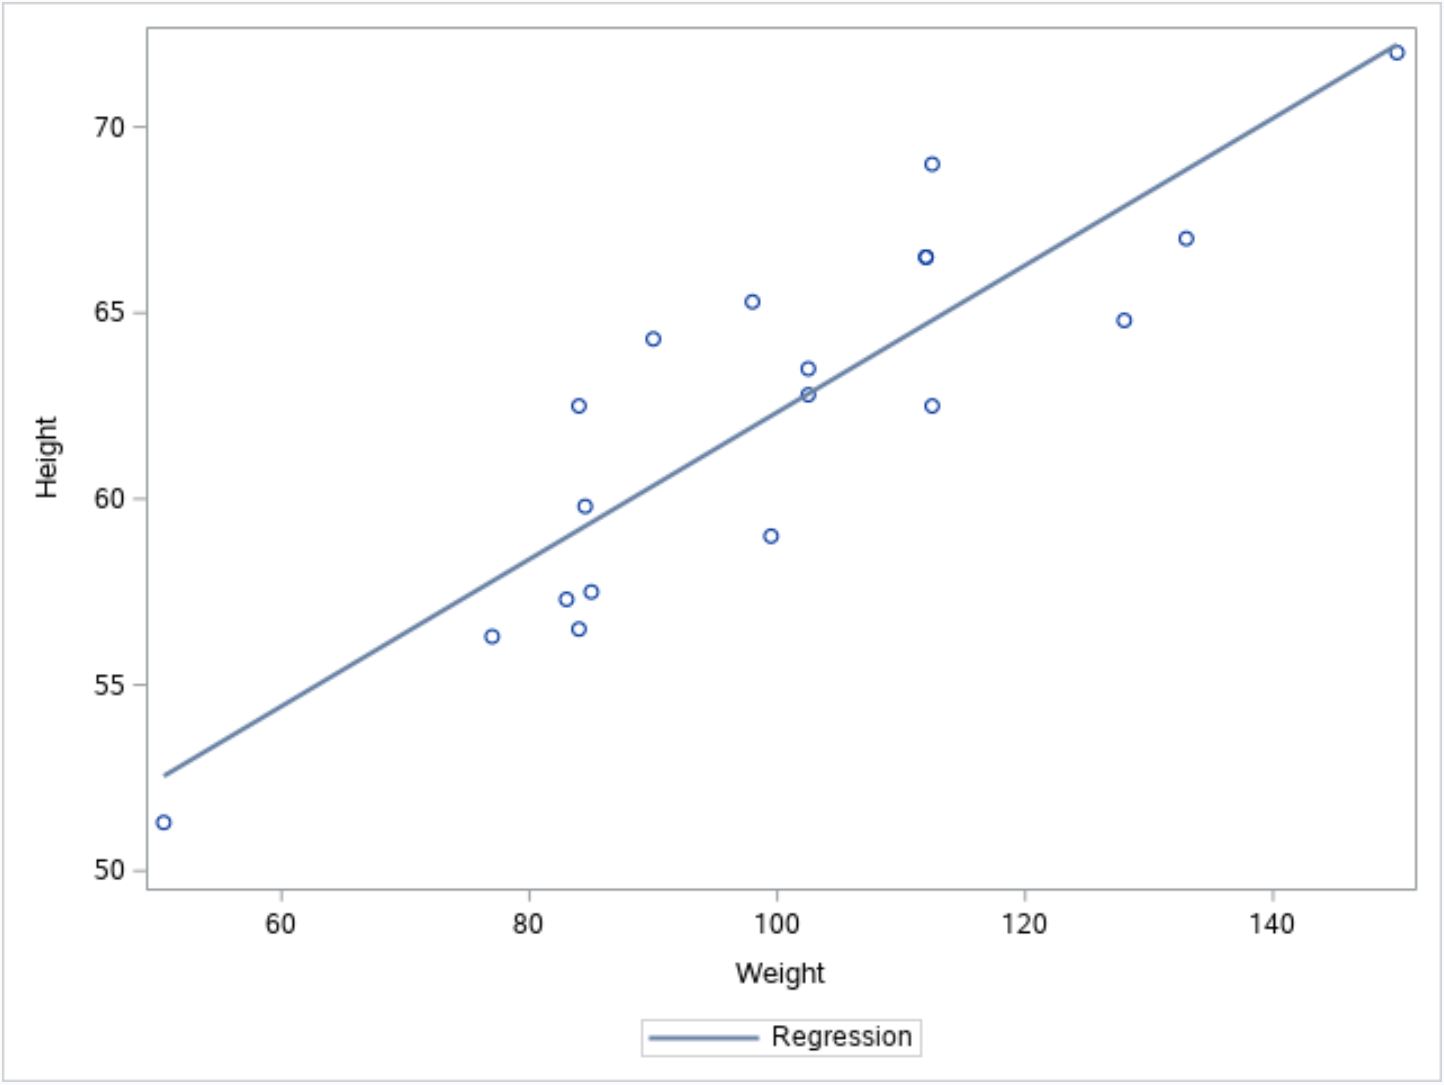
L’exécution d’une requête minimale mobilisant l’instruction REG sur le jeu de données SASHELP.CLASS génère une figure immédiatement exploitable, dont les propriétés par défaut méritent un décryptage technique attentif. Sous le style moderne HTMLBlue, les marqueurs incarnant les observations individuelles se matérialisent sous la forme de cercles d’un bleu mesuré, positionnés avec une rigueur géométrique absolue à l’intersection exacte des coordonnées dimensionnelles de chaque individu statistique.
La droite d’ajustement se déploie quant à elle sous l’aspect d’un segment linéaire continu d’une teinte bleue saturée, traversant l’intégralité du domaine expérimental couvert par la variable portée sur l’abscisse. SAS applique par défaut une politique graphique stricte : la droite ne s’extrapole pas indûment au-delà de la valeur minimale et de la valeur maximale observées pour la variable indépendante, sanctuarisant ainsi le modèle contre le risque de prédictions hasardeuses en dehors de la fenêtre empirique d’observation.
Enfin, le moteur ODS Graphics adjoint automatiquement un faisceau d’éléments périphériques structurants. Les axes horizontal et vertical sont indexés par le libellé officiel (LABEL) des variables ou, à défaut, par leur identifiant informatique brut, flanqués de graduations majeures équidistantes calculées par un algorithme d’optimisation de lisibilité numérique. Une légende automatique discrète est généralement disposée en marge inférieure du graphique, explicitant la nature de la droite de régression et des intervalles associés, achevant de conférer au résultat visuel brut une honorabilité académique immédiate.
4. Personnalisation avancée des marqueurs de dispersion (Markers)
4.1 Contrôle géométrique via l’option MARKERATTRS
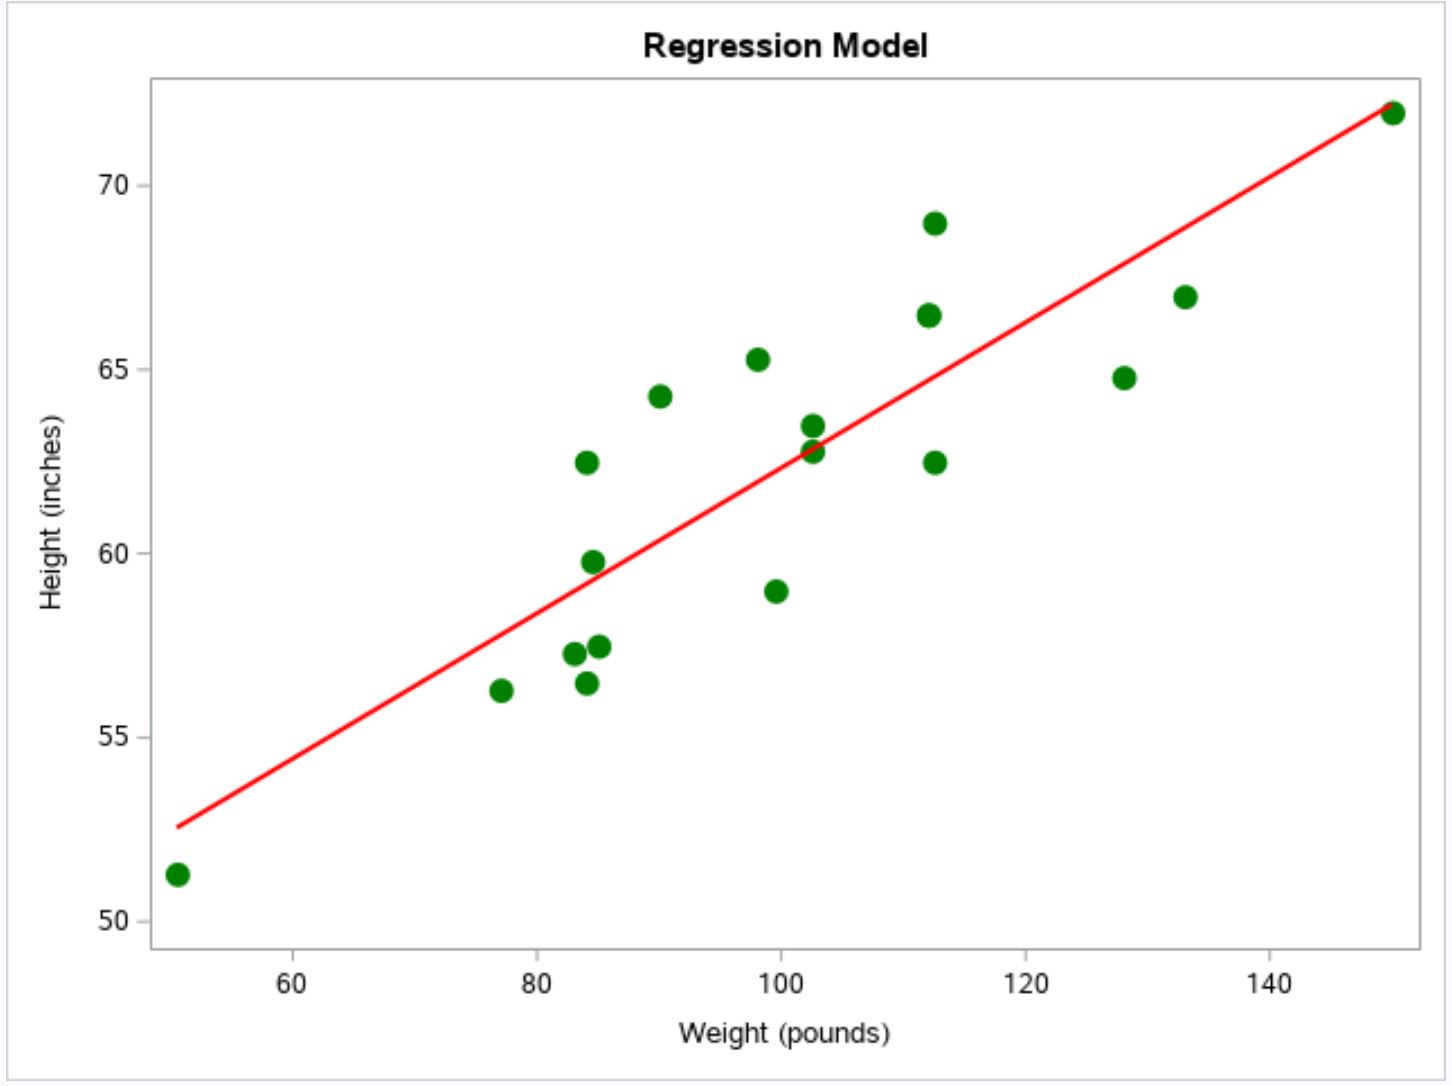
Bien que la configuration par défaut de SAS satisfasse aux exigences de l’exploration rapide, la communication scientifique rigoureuse impose fréquemment une maîtrise totale des propriétés visuelles des observations. L’option MARKERATTRS= intégrée à l’instruction REG permet de gouverner précisément la géométrie, la dimension et la structure des glyphes représentant les unités statistiques. Cette option encapsule un sous-ensemble de sous-options typographiques entre parenthèses, offrant une granularité de réglage absolue.
La typologie des symboles disponibles répond à une nomenclature rigoureusement documentée par SAS. L’analyste peut sélectionner des géométries pleines ou évidées à travers le paramètre SYMBOL=, en faisant appel à des descripteurs tels que Circle, CircleFilled, Square, SquareFilled, Triangle ou Diamond. Le recours à des formes pleines (CircleFilled) s’avère particulièrement recommandé en épidémiologie et en biométrie pour conférer une densité optique satisfaisante aux points de faible diamètre, tandis que les formes évidées révèlent leur pertinence lors de l’impression sur papier journal ou lors de la superposition dense d’observations.
Le dimensionnement des symboles s’opère via la sous-option SIZE=, laquelle accepte des valeurs numériques associées à des unités de mesure explicites telles que les pixels (px) ou les points typographiques (pt). En matière d’édition académique soumise à des normes de réduction dimensionnelle lors de la mise en page finale, un calibrage des marqueurs compris entre 6 et 8 points typographiques prévient efficacement la disparition des points à l’impression tout en évitant les phénomènes d’obstruction mutuelle qui altèrent l’estimation visuelle de la dispersion locale.
4.2 Gestion chromatique et contraste des points individuels
La sélection chromatique des marqueurs de dispersion ne répond pas seulement à des impératifs esthétiques, mais doit se conformer aux standards internationaux d’accessibilité visuelle (notamment pour les lecteurs présentant des déficiences de la vision des couleurs, telles que la protanopie ou la deutéranopie). Le paramètre COLOR= au sein de MARKERATTRS= autorise la spécification de teintes à l’aide de dénominations textuelles standardisées reconnues par SAS (telles que SteelBlue, DarkSlateGray ou Navy) ou par l’injection directe de codes hexadécimaux stricts sous la forme CXrrggbb (par exemple, CX2C3E50).
L’optimisation du contraste entre les marqueurs individuels et la ligne de régression constitue un facteur de lisibilité déterminant. Attribuer aux points une teinte neutre légèrement atténuée — tel qu’un gris anthracite ou un bleu ardoise foncé — tout en réservant une teinte vive et saturée pour la trajectoire linéaire permet d’instaurer une hiérarchie visuelle immédiate : le regard de l’évaluateur appréhende d’abord la macrostructure directionnelle avant de descendre dans l’analyse de la variance individuelle.
Dans les contextes d’édition où les contraintes budgétaires imposent une publication sous presse strictement monochrome, la gestion du contraste ne repose plus sur la saturation chromatique mais sur la luminance relative. L’emploi judicieux de marqueurs noirs intenses (CX000000) combinés à une droite de régression en gris médian (CX808080) assure une différentiation optimale des éléments sans ambiguïté interprétative, garantissant une transmission intégrale du message statistique indépendamment du support de reproduction physique.
4.3 Résolution des problèmes de superposition (Overplotting)
Lorsque le volume d’échantillonnage excède plusieurs centaines ou milliers d’enregistrements, le phénomène de chevauchement massif des marqueurs — techniquement désigné sous le terme d’overplotting — dégrade considérablement la qualité informative du nuage de points. Des dizaines d’observations coincidentes fusionnent visuellement en une tache d’encre unie, masquant la véritable distribution sous-jacente et annihilant la capacité de l’œil à percevoir les concentrations de densité locale au sein de l’espace multivarié.
Pour juguler cette dérive sans dénaturer la métrique des variables, l’activation du paramètre TRANSPARENCY= au niveau de l’instruction REG s’avère d’une efficacité redoutable. Ce paramètre accepte une valeur continue comprise entre 0.0 (opacité totale) et 1.0 (transparence intégrale). En fixant par exemple la transparence à 0.6 ou 0.7, chaque marqueur n’imprime qu’une fraction de son intensité sur le canevas ; ainsi, seules les régions géographiques concentrant un empilement substantiel de points atteignent une saturation visuelle marquée, générant une cartographie intuitive des gradients de densité bivariée.
Une alternative méthodologique complémentaire réside dans l’application contrôlée d’une dispersion artificielle des coordonnées, désignée sous l’anglicisme de jittering. Bien que l’instruction REG ne supporte pas nativement le jittering directement sur son tracé linéaire, il est aisé d’adjoindre un bruit aléatoire uniforme minime aux coordonnées discrètes dans l’étape DATA amont (via la fonction RAND(‘Uniform’)). Cette technique décolle visuellement les données chevauchantes sans dévoyer l’intégrité de la tendance centrale estimée par la régression, préservant ainsi l’exactitude de l’inférence.
5. Configuration stylistique de la droite de régression (Line Attributes)
5.1 Paramétrage précis via l’option LINEATTRS
La morphologie de la droite de régression doit faire l’objet d’un paramétrage minutieux pour équilibrer son autorité analytique sans occulter les variations fines de l’échantillon. L’option LINEATTRS= dédiée à l’instruction REG permet de sculpter l’apparence de cette ligne de tendance centrale à travers trois dimensions opérationnelles fondamentales : l’épaisseur du trait (THICKNESS=), la texture du motif de tracé (PATTERN=) et la signature chromatique (COLOR=).
L’épaisseur du segment doit être calibrée en stricte harmonie avec l’échelle générale de la planche graphique. Une ligne excessivement épaisse, paramétrée par exemple à plus de 4 pixels, introduit une incertitude visuelle dommageable en masquant les observations contiguës et en suggérant une précision déterministe illusoire. À l’inverse, un trait filiforme d’une largeur inférieure à 1 point typographique s’efface lors des processus de rastérisation numérique ou d’impression papier. Une valeur comprise entre 1.5 et 2.5 points constitue l’étalon académique optimal pour concilier visibilité et finesse documentaire.
Le catalogue des motifs de ligne sous SAS offre un répertoire étendu comprenant les états continu (PATTERN=Solid), tireté (PATTERN=Dash), pointillé (PATTERN=Dot) ou alterné (PATTERN=ShortDash). Dans le cadre d’une modélisation linéaire simple sans stratification de sous-groupes, la norme internationale prescrit l’utilisation exclusive d’une ligne continue rigoureuse pour incarner le modèle des moindres carrés. Les textures tiretées ou discontinues doivent impérativement être réservées à la signalisation des limites de confiance ou à des courbes d’ajustement concurrentes superposées, afin d’éviter toute ambiguïté sémiotique chez le lecteur spécialisé.
5.2 Désactivation ou maintien de la droite dans l’instruction REG
L’instruction REG offre une flexibilité architecturale singulière en permettant à l’analyste de dissocier les éléments géométriques qui la composent. Dans des protocoles de recherche spécifiques axés sur la comparaison séquentielle de modèles, il peut être souhaitable d’occulter totalement la représentation des points de dispersion individuels pour ne projeter sur la surface de rendu que la seule composante analytique. Cette manœuvre s’accomplit sans effort grâce à l’adjonction de l’option NOMARKERS au sein de la ligne de commande REG.
L’élimination sélective des marqueurs via NOMARKERS se révèle particulièrement fructueuse lorsque le chercheur souhaite superposer, au sein d’une unique figure PROC SGPLOT, plusieurs droites de régression issues de sous-échantillons distincts ou calibrées selon des spécifications algorithmiques alternatives. Le maintien concomitant de centaines de points issus de chaque strate risquerait de précipiter le graphique dans une saturation visuelle inextricable, alors que l’affichage exclusif des faisceaux de trajectoires linéaires met en lumière les écarts d’ordonnée à l’origine et les divergences de pente avec une clarté géométrique absolue.
D’un point de vue cognitif, la visibilité de la droite linéaire exerce un pouvoir de suggestion majeur sur l’esprit de l’évaluateur. En isolant le modèle théorique des données empiriques brutes via l’option NOMARKERS, l’auteur focalise délibérément l’attention sur les propriétés déterministes du système dynamique étudié ; à l’inverse, le maintien simultané des marqueurs ancre le discours dans l’humilité de la dispersion expérimentale. L’analyste doit opérer ce choix en conscience méthodologique, en regard des objectifs démonstratifs assignés à sa planche graphique.
5.3 Extrapolation et délimitation de la droite
L’un des postulats directeurs de l’analyse de régression linéaire classique réside dans l’interdiction méthodologique de l’extrapolation inconsidérée. Ajuster une fonction mathématique sur une fenêtre empirique bornée n’autorise en aucun cas l’observateur à déduire le comportement du système en deçà de la valeur minimale de l’abscisse observée, ni au-delà de son maximum historique. Le comportement naturel de SAS, qui borne rigoureusement le segment de régression entre l’étendue empirique des observations réelles ($[X_{\min}, X_{\max}]$), constitue une sécurité méthodologique essentielle.
Il existe néanmoins des cas d’usage expérimentaux où l’analyste requiert l’extension artificielle de la droite vers une valeur cible théorique, telle que l’abscisse d’origine zéro, afin de rendre visuellement palpable l’ordonnée à l’origine (intercept). Bien que l’instruction REG basique refuse d’étendre son tracé au-delà des coordonnées brutes contenues dans la variable d’entrée, il est possible de contourner rigoureusement cette limitation en insérant, au sein de l’étape DATA préliminaire, un enregistrement factice possédant la valeur cible en $X$ mais une valeur manquante en $Y$, ou en basculant vers des couches vectorielles modélisées via l’instruction VECTOR.
Toute tentative d’extension artificielle de la droite de régression impose un avertissement explicite dans le corps des notes de bas de page associées à la figure. L’analyste doit systématiquement rappeler que la prolongation linéaire hors du domaine d’observation procède d’une hypothèse d’homogénéité structurale purement inductive et ne saurait engager la certitude expérimentale, les processus naturels manifestant fréquemment des transitions de phase ou des seuils de saturation asymptotique rigoureusement invisibles dans l’intervalle d’échantillonnage immédiat.
6. Intégration et interprétation des bandes de confiance et de prédiction
6.1 Affichage des intervalles de confiance de la moyenne (CLM)
L’ajustement d’une droite de régression sur un échantillon aléatoire fini demeure assujetti à l’erreur d’échantillonnage. Si une infinité d’expériences identiques étaient répliquées, les valeurs de la pente et de l’ordonnée à l’origine fluctueraient selon une distribution conjointe régie par la variance résiduelle de la population source. L’activation de l’option CLM (Confidence Limits for Mean) au sein de l’instruction REG permet de matérialiser visuellement cette incertitude fondamentale en projetant une enveloppe curviligne continue encadrant la droite des moindres carrés.
Sur le plan géométrique et mathématique, cette bande de confiance ne présente pas des frontières strictement parallèles à la ligne de régression, mais arbore un profil hyperbolique concave caractéristique. L’écartement de l’enveloppe est minimal à la verticale exacte du barycentre des coordonnées $(\bar{X}, \bar{Y})$, là où l’estimation de l’espérance mathématique conditionnelle jouit de la variance d’échantillonnage la plus réduite. À mesure que l’on s’écarte de cette moyenne centrale vers les confins du domaine d’étude, l’incertitude liée à l’erreur sur la pente s’amplifie géométriquement, provoquant l’évasement hyperbolique des limites de confiance supérieures et inférieures.
Par défaut, l’instruction REG paramètre cette région d’incertitude au seuil de confiance nominal de 95% ($\alpha = 0.05$). L’analyste a toutefois l’entière liberté d’ajuster ce niveau d’exigence statistique à l’aide du modificateur syntaxique ALPHA= positionné dans l’instruction REG. La déclaration conjointe CLM ALPHA=0.01 resserrera les contraintes probabilistes en traçant une zone de confiance à 99%, traduisant un conservatisme accru parfaitement adapté aux essais cliniques pivotaux ou aux études toxicologiques soumises aux directives strictes de la Food and Drug Administration (FDA).
6.2 Visualisation des limites de prédiction individuelles (CLI)
Une confusion épistémologique fréquente parmi les chercheurs débutants consiste à amalgamer les limites de confiance sur la moyenne conditionnelle et les limites de prédiction applicables à une observation individuelle future. Pour cartographier cette seconde dimension stochastique, la procédure PROC SGPLOT propose l’activation conjointe ou exclusive de l’option CLI (Confidence Limits for Individual) au sein de l’instruction REG, ouvrant un champ d’interprétation prospectif essentiel.
La disparité théorique entre ces deux notions est monumentale. Tandis que l’option CLM ne quantifie que l’incertitude d’échantillonnage inhérente à l’estimation des paramètres directeurs du modèle moyen, l’option CLI incorpore une composante de variance supplémentaire et prépondérante : la dispersion résiduelle propre aux unités statistiques individuelles ($\sigma^2$). En conséquence mathématique directe, l’enveloppe générée par l’instruction CLI se déploie selon une amplitude considérablement plus vaste que la bande CLM, englobant théoriquement une proportion nominale prédéfinie (par exemple 95%) de l’ensemble des futures observations projetées dans les mêmes conditions d’expérience.
L’examen visuel des bandes CLI fournit un enseignement pragmatique sans équivalent sur la performance opérationnelle du modèle de régression. Alors qu’un test de significativité sur la pente peut afficher une p-valeur infinitésimale ($p < 0.0001$) attestant de la solidité formelle du lien statistique moyen sous-jacent (reflété par une bande CLM extrêmement étroite), la bande CLI peut révéler une largeur prohibitive traduisant l’inaptitude absolue de l’équation à prédire avec précision le score d’un individu isolé. Cette différenciation graphique immunise le praticien contre la surévaluation clinique ou décisionnelle de ses modèles explicatifs.
6.3 Personnalisation esthétique des bandes d’incertitude
L’activation brute des options d’intervalles d’incertitude peut rapidement détériorer la lisibilité graphique en générant des zones d’ombre opaques venant étouffer les points de dispersion sous-jacents. La maîtrise des options de raffinement esthétique CLMATTRS= et CLIATTRS= s’impose dès lors comme un prérequis pour préserver l’élégance et la clarté informative de la publication. Ces conteneurs d’attributs autorisent la modulation distincte de la couleur de remplissage (FILLATTRS=) et des caractéristiques des bordures linéaires délimitant les bandes.
Le réglage judicieux de l’opacité au moyen de la sous-option TRANSPARENCY= au sein de CLMATTRS= s’avère particulièrement fécond. En calibrant la transparence de la surface de confiance moyenne à une valeur substantielle (comprise entre 0.70 et 0.85), la bande prend l’aspect d’un voile diaphane élégant — souvent teinté d’une couleur ciel ou ardoise douce — à travers lequel les glyphes individuels demeurent parfaitement perceptibles dans toute leur intégrité spatiale. Cette stratification visuelle hiérarchise l’espace sans perte d’information brute.
Lorsque la méthodologie impose de superposer sur un même graphique la bande de confiance moyenne et la bande de prédiction individuelle, l’artifice graphique le plus épuré consiste à attribuer à la région CLM un remplissage translucide sans bordure marquée, tout en cantonnant la région CLI à des lignes délimitatrices externes sans aucun remplissage interne (via l’option OUTLINE combinée à un motif tireté fin). Cette stratégie d’ingénierie visuelle désamorce toute saturation chromatique et permet à l’évaluateur de distinguer sans le moindre effort cognitif l’estimation paramétrique de la dispersion globale attendue.
7. Optimisation des axes cartésiens et des échelles de mesure
7.1 Édition des libellés et des unités (XAXIS et YAXIS)
La rigueur d’une communication statistique repose pour une large part sur la clarté et l’exactitude de la métrologie exposée le long des axes de référence. Par défaut, SAS extrait les métadonnées préexistantes dans la table source, mais celles-ci demeurent fréquemment laconiques, tronquées ou cryptiques. L’emploi conjoint des instructions dédiées XAXIS et YAXIS au sein de PROC SGPLOT confère au programmeur la souveraineté absolue sur la transcription des échelles cartésiennes horizontale et verticale.
L’option primaire LABEL= intégrée à ces instructions permet d’écraser les désignations système par des intitulés explicites et académiquement irréprochables. La norme éditoriale internationale prescrit d’énoncer précisément le concept physiologique, physique ou économique mesuré, en le faisant suivre immédiatement de son unité de mesure normalisée scellée entre parenthèses ou crochets typographiques — par exemple LABEL= »Stature corporelle (centimètres) » et LABEL= »Masse somatique (kilogrammes) ». Cette rigueur sémantique prévient toute méprise lors de la manipulation de mesures étrangères au système métrique standard.
La typographie de ces libellés peut faire l’objet d’un contrôle chirurgical via l’option LABELATTRS=, laquelle permet d’harmoniser la police de caractères (FAMILY=), la taille du corps de texte (SIZE=) et la graisse (WEIGHT=) avec la maquette globale de la revue scientifique ciblée. De surcroît, l’orientation spatiale des graduations et libellés peut être optimisée au moyen de l’option VALUESROTATE= ou de la configuration de l’alignement sur l’axe des ordonnées pour empêcher le chevauchement disgracieux des chiffres d’échelles comportant un grand nombre de caractères significatifs.
7.2 Définition des étendues, intervalles et graduations
L’autorité d’un graphique de régression peut être insidieusement corrompue par des algorithmes d’ajustement d’axes automatiques générant des échelles disproportionnées ou induisant des illusions d’optique perverses. La maîtrise des paramètres dimensionnels au sein des blocs XAXIS et YAXIS constitue le garant méthodologique de la neutralité de la représentation. L’option fondamentale VALUES= autorise la fixation manuelle de la séquence complète des graduations majeures sous la forme d’une liste énumérée ou d’une séquence arithmétique rigoureuse (par exemple VALUES=(50 TO 150 BY 25)).
L’analyste doit veiller avec la plus grande circonspection à la problématique de la troncature des axes. Supprimer artificiellement l’origine zéro sur une variable de rapport sans justification méthodologique impérieuse peut induire une dramatisation excessive de la pente, faisant apparaître une variation insignifiante comme une transition vertigineuse. Si les impératifs de lisibilité de la dispersion locale imposent de borner l’axe au voisinage immédiat du domaine empirique au moyen des options MIN= et MAX=, cette décision d’ingénierie graphique doit être signalée de façon transparente pour ne pas abuser la perception du lecteur non averti.
La granularité des graduations secondaires (minor ticks) s’avère également paramétrable à travers l’option MINORTICKS. Bien que souvent proscrites par les chartes éditoriales minimalistes en raison du bruit visuel qu’elles peuvent générer, les graduations mineures conservent une pertinence technique indiscutable lorsque la figure est destinée à des applications d’étalonnage industriel ou de biométrie clinique nécessitant des lectures d’ordonnées rétrogrades d’une précision micrométrique sur support papier.
7.3 Transformations d’échelle et gestion des grilles d’arrière-plan
De nombreux phénomènes biologiques, pharmacologiques ou financiers obéissent à des dynamiques de prolifération multiplicative ou allométrique non réductibles à des géométries affines simples. Lorsque la relation bivariée manifeste une non-linéarité fondamentale due à une croissance exponentielle ou à des lois de puissance, forcer une droite des moindres carrés sur des axes arithmétiques bruts constitue une hérésie statistique. L’instruction XAXIS et l’instruction YAXIS intègrent la possibilité de commuter instantanément l’architecture métrique via l’option TYPE=LOG.
Cette transformation logarithmique native présente l’avantage immense de préserver les données brutes dans leur unité de compte naturelle tout en opérant une anamorphose spatiale rigoureuse de l’axe, étalonnée selon une base logarithmique prédéfinie (base 10, base 2 ou logarithme népérien via l’option LOGBASE=). L’adjonction de l’instruction REG sur un axe logarithmique recalcule et visualise immédiatement le modèle allométrique adapté, linéarisant le phénomène sous-jacent sans imposer de computations algébriques préalables au sein de la table de données.
Pour parachever l’ergonomie de lecture sur ces échelles transformées ou sur des repères cartésiens étendus, l’activation de l’option GRID au sein de XAXIS et YAXIS projette un maillage de lignes directrices traversant le champ graphique. Toutefois, pour ne pas enfreindre le principe fondamental d’économie visuelle cher à Edward Tufte, ce quadrillage d’arrière-plan doit demeurer résolument subordonné aux données ; il sera impérativement configuré au moyen de l’option GRIDATTRS= avec des motifs pointillés fins et une teinte d’un gris d’une extrême pâleur (par exemple COLOR=CXEEEEEE), assurant un appui géométrique sans parasiter la lecture des marqueurs.
8. Typographie, titrage et contrôle des légendes
8.1 Structuration des en-têtes et notes de bas de page
L’appareil textuel encadrant la représentation visuelle joue un rôle déterminant dans l’autonomie documentaire du graphique scientifique. Une figure d’analyse bivariée doit idéalement pouvoir être extraite de son manuscrit hôte et demeurer parfaitement intelligible par elle-même. Dans l’écosystème SAS, cette contextualisation formelle est orchestrée par les instructions déclaratives globales TITLE et FOOTNOTE, positionnées en amont immédiat de la procédure PROC SGPLOT.
L’élaboration des titres doit obéir à une hiérarchie typographique stricte. L’instruction TITLE1 reçoit l’énoncé canonique synthétisant la relation bivariée modélisée, en intégrant si nécessaire la caractérisation de la population observée, tandis que TITLE2 peut accueillir des précisions méthodologiques subsidiaires. SAS offre des modificateurs de style intégrés d’une grande puissance, tels que HEIGHT=, FONT=, JUSTIFY= (permettant un alignement rigoureux à gauche ou centré) et BOLD, pour modeler les en-têtes selon les exigences des comités de rédaction les plus stricts.
Les notes de bas de page dévolues à l’instruction FOOTNOTE doivent accueillir l’ensemble des métadonnées analytiques indispensables à l’authentification de la démarche empirique. C’est l’emplacement idoine pour consigner l’effectif effectif de l’échantillon analysé ($N$), la formulation littérale de l’équation de régression obtenue, la valeur exacte du seuil de significativité des tests d’hypothèse sous-jacents, ainsi que la mention explicite des filtres ou sélections opérés lors de la phase de préparation des données. Il convient de garder à l’esprit que les instructions TITLE et FOOTNOTE possèdent une portée globale dans la session SAS ; elles doivent être neutralisées immédiatement après l’exécution via des instructions TITLE; et FOOTNOTE; vides afin d’éviter toute contamination résiduelle sur les procédures analytiques ultérieures.
8.2 Gestion de la légende avec NOAUTOLEGEND et KEYLEGEND
La gestion des éléments de légende constitue souvent le talon d’Achille des figures scientifiques générées par ordinateur. Par défaut, dès lors qu’une instruction REG comporte des options d’intervalles de confiance ou fait appel à des attributs de stratification, la procédure PROC SGPLOT injecte automatiquement une légende standardisée en périphérie inférieure du tracé. Bien que fonctionnelle, cette disposition automatique consomme un espace précieux sur le canevas et produit fréquemment des libellés verbeux dégradant la pureté de la mise en page.
Lorsque la figure ne comporte qu’une régression univariée limpide et que l’identité de la droite et de ses bandes est explicitée sans équivoque dans le titre ou les notes d’accompagnement, la légende devient visuellement redondante. Sa désactivation intégrale s’opère de façon magistrale par l’adjonction de l’option globale NOAUTOLEGEND au sein même de l’instruction d’ouverture PROC SGPLOT. Cette suppression dégage instantanément l’assiette du tracé, permettant au nuage de points d’occuper l’intégralité du ratio d’aspect dévolu à la figure.
Si la complexité de l’agencement exige le maintien d’une table de correspondance explicative, l’instruction dédiée KEYLEGEND confère une flexibilité d’ingénierie absolue. Elle autorise la sélection nominative des seules composantes à documenter (en isolant par exemple la droite d’ajustement tout en ignorant les marqueurs de points triviaux), la disposition des entrées en colonnes ou en rangées harmonieuses via l’option DOWN= ou ACROSS=, ainsi que son relogement spatial stratégique. L’option POSITION=TOPRIGHT ou POSITION=BOTTOMRIGHT, couplée au modificateur LOCATION=INSIDE, permet ainsi d’enchâsser élégamment une légende compacte directement au sein d’un quadrant inoccupé du repère cartésien, maximisant la densité d’information utile.
8.3 Inclusion directe d’équations et d’annotations statistiques
L’un des apports majeurs de la sémiologie graphique contemporaine réside dans l’intégration synoptique des estimateurs numériques au cœur même de l’espace géométrique. L’observateur scientifique ne doit pas être contraint d’effectuer des allers-retours fastidieux entre la visualisation et des tableaux matriciels volumineux situés hors du champ visuel pour apprécier les métriques de la modélisation. À cette fin, l’instruction INSET de la procédure PROC SGPLOT constitue un vecteur d’annotation d’une sophistication remarquable.
Positionnée stratégiquement dans un quadrant vierge de données pour ne masquer aucun point de mesure expérimental (à l’aide de paramètres directeurs tels que POSITION=TOPLEFT ou POSITION=BOTTOMRIGHT), l’instruction INSET permet de matérialiser un encadré typographique épuré accueillant les scalaires fondamentaux de la régression : le coefficient d’aliénation ou de détermination $R^2$, l’erreur type d’estimation (Root MSE), l’effectif valide et la statistique $F$ d’ajustement global avec son niveau de significativité associé.
L’excellence éditoriale impose une standardisation méticuleuse de ces annotations numériques. Il est impératif d’éditer les coefficients d’ordonnée et de pente avec un nombre de décimales statistiquement cohérent au regard de la précision des instruments de mesure (généralement deux à trois décimales significatives, évitant l’affichage grotesque d’une dizaine de décimales flottantes résiduelles). L’encadré peut en outre être débarrassé de tout contour coercitif disgracieux au moyen de l’option NOBORDER, intégrant organiquement les paramètres de modélisation au blanc typographique du canevas analytique.
9. Stratification et analyse de sous-groupes (Groupes et Panels)
9.1 Comparaison de plusieurs droites via l’option GROUP
Dans l’immense majorité des applications empiriques, la population observée ne présente pas une nature strictement homogène, mais héberge des strates sous-jacentes — qu’il s’agisse du sexe biologique chez des patients, de la souche génétique dans les modèles animaux, ou du secteur d’activité en économétrie financière. L’instruction REG se dote d’une puissance démultipliée par l’adjonction de l’option factorielle GROUP=, laquelle scinde instantanément l’ajustement linéaire selon les modalités exclusives portées par une variable catégorielle discrète.
Sous l’effet de ce paramètre, SAS fragmente algorithmiquement l’échantillon global en sous-ensembles indépendants, calibre une régression linéaire univariée propre à chaque strate et projette simultanément sur le même repère cartésien les différentes droites d’ajustement et leurs faisceaux de marqueurs respectifs. Chaque groupe hérite d’une identité visuelle singulière régie par le style ODS actif, combinant des contrastes chromatiques distincts et des formes géométriques de marqueurs différenciées, permettant un examen comparatif immédiat des trajectoires démographiques ou biologiques.
Pour assurer une discrimination perceptive exempte de confusion, l’analyste doit toutefois veiller à ne pas saturer le graphique avec un nombre excessif de modalités factorielles. L’option GROUP= s’avère visuellement souveraine pour des partitions comportant deux à quatre sous-groupes identifiables (par exemple la dichotomie masculine/féminine dans la table SASHELP.CLASS). Au-delà de ce seuil critique, le croisement enchevêtré des segments linéaires et la multiplicité des marqueurs multicolores engendrent une cacophonie visuelle dommageable, dictant le recours à des modes de décomposition spatiale alternatifs.
9.2 Détection visuelle des interactions et modérations
La figuration conjointe de multiples droites de régression stratifiées via l’option GROUP transcende l’analyse bivariée simple pour pénétrer de plain-pied dans l’exploration graphique des effets d’interaction statistique et de modération. L’attention de l’analyste ne se focalise plus uniquement sur le déplacement vertical relatif des segments (reflétant l’effet principal de la variable catégorielle sur le niveau moyen de l’ordonnée), mais scrute prioritairement le parallélisme géométrique des pentes.
Des trajectoires parfaitement équidistantes et parallèles signalent visuellement l’absence d’interaction entre la variable explicative continue et le facteur de groupe : l’incidence marginale d’une unité additionnelle en $X$ sur l’espérance mathématique de $Y$ demeure invariante quelle que soit la strate considérée. À l’inverse, des segments présentant des angles d’inclinaison divergents, voire des trajectoires sécantes au sein de la fenêtre empirique, matérialisent de façon éclatante une interaction de premier ordre : l’amplitude, et potentiellement le sens, de l’effet de l’abscisse sur l’ordonnée se trouve conditionné et modéré par l’appartenance catégorielle du sujet.
Il importe toutefois de souligner les strictes limites épistémologiques de la seule détection oculaire face aux interactions statistiques. Une divergence visuelle de pente peut résulter d’une simple instabilité stochastique consécutive à un sous-effectif dans l’un des sous-groupes, sans revêtir la moindre significativité inférentielle. L’inspection visuelle sous PROC SGPLOT doit impérativement être corroborée en aval par l’estimation formelle d’un modèle linéaire généralisé sous PROC GLM ou PROC MIXED, incorporant le terme de produit croisé idoine pour tester rigoureusement l’hypothèse de nullité de l’interaction factorielle.
9.3 Multi-panneaux avec la procédure SGPANEL
Lorsque la stratification de l’échantillon implique des covariables complexes, des facteurs polytomiques à nombreuses modalités, ou lorsque l’analyste souhaite examiner simultanément les bandes de confiance individuelles pour chaque strate sans risquer un masquage mutuel des surfaces, la superposition sur un canevas unique avoue ses limites. L’écosystème SAS apporte une réponse architecturale d’une élégance méthodologique absolue à travers la procédure dédiée PROC SGPANEL.
Fonctionnant selon une logique conceptuelle identique à celle de PROC SGPLOT, PROC SGPANEL introduit l’instruction pivot PANELBY, laquelle ordonne la segmentation spatiale de l’affichage sous forme de panneaux en mosaïque (technique des trellis graphs ou petits multiples popularisée par William Cleveland). En renseignant par exemple PANELBY Sex; avant l’instruction REG X=Height Y=Weight;, le système dresse deux graphiques indépendants juxtaposés, hébergeant chacun le sous-ensemble empirique et la régression linéaire afférente à l’un des deux sexes.
Le raffinement majeur de la procédure PROC SGPANEL réside dans l’harmonisation et la synchronisation automatisées absolues des échelles d’axes entre les différents panneaux de la matrice visuelle. Les minima et maxima des abscisses et ordonnées sont invariablement alignés sur les mêmes métriques cartésiennes, prémunissant l’évaluateur contre les jugements hâtifs consécutifs à des échelles tronquées de façon asymétrique. Cette structure cognitive soulage la mémoire de travail de l’observateur et autorise des comparaisons morphologiques d’une rigueur absolue d’une facette à l’autre de la planche analytique.
10. Diagnostics de régression et vérification conjointe des résidus
10.1 Détection graphique de la violation de linéarité
Le postulat cardinal qui fonde la validité de la régression linéaire ordinaire réside dans l’adéquation ontologique de la fonction affine pour décrire le phénomène sous-jacent. Si la vraie nature de la relation exhibe un seuil de saturation, une cinétique enzymatique de Michaelis-Menten ou une oscillation cyclique, l’imposition aveugle d’une droite des moindres carrés constitue une erreur d’inférence majeure. L’œil exercé du biostatisticien exploite le nuage de points comme le premier instrument de détection de cette violation structurelle.
Une distorsion de linéarité se manifeste typiquement au sein de l’espace cartésien par une courbure résiduelle macroscopique : les observations individuelles ont tendance à se regrouper systématiquement au-dessus de la droite aux extrémités inférieure et supérieure du domaine d’observation, tout en plongeant sous la trajectoire linéaire dans la portion médiane du tracé (ou la configuration symétrique inverse). Cette distribution ordonnée des résidus témoigne de l’incapacité du modèle univarié du premier degré à capter l’énergie géométrique de la distribution empirique.
Pour authentifier formellement cette intuition visuelle, une pratique experte sous PROC SGPLOT consiste à confronter directement sur le même canevas la droite de régression paramétrique (via l’instruction REG) avec une courbe de lissage non paramétrique d’exploration libre, générée via l’instruction LOESS. Si la trajectoire souple du lissage LOESS s’écarte de façon substantielle et statistiquement significative du tracé rigide de la droite, le chercheur recueille un faisceau de preuves péremptoire lui dictant d’abandonner le modèle affine au profit d’une spécification polynomiale quadratique ou d’une transformation non linéaire appropriée.
10.2 Identification des points de levier et valeurs aberrantes
Dans l’arsenal des diagnostics statistiques régissant la modélisation bivariée, il est impératif de distinguer rigoureusement deux catégories d’observations discordantes dont l’impact graphique et inférentiel diffère radicalement : les valeurs aberrantes (outliers) et les observations à fort effet de levier (high leverage points). Le tracé conjoint du nuage de points et de la droite d’ajustement fournit une cartographie intuitive immédiate de ces anomalies structurales.
Une valeur aberrante pure se matérialise par une unité statistique dont la coordonnée en $X$ se situe dans la plage centrale standard de la distribution empirique, mais dont la coordonnée en $Y$ présente un écart résiduel spectaculaire par rapport à la droite de régression. Si cette observation tire modérément l’ordonnée à l’origine vers le haut ou vers le bas et dégrade la variance résiduelle globale (abaissant ainsi la valeur du $R^2$), elle n’exerce généralement qu’une influence marginale sur l’inclinaison de la pente d’ajustement.
À l’opposé, une observation à fort effet de levier se localise aux confins extrêmes de l’axe horizontal des abscisses, très loin du centre de gravité des données. Si cette observation s’écarte ne serait-ce que légèrement de la trajectoire attendue, elle agit à la manière d’une force mécanique démesurée sur un bras de levier, contraignant la droite de régression à basculer vers elle au détriment de l’ajustement sur l’ensemble des autres points de l’échantillon. L’analyste averti complétera systématiquement son examen visuel initial par la génération des graphiques de diagnostic standardisés sous la procédure PROC REG (via l’instruction PLOTS=DIAGNOSTICS), intégrant la mesure de la distance de Cook et l’estimation des résidus studentisés.
10.3 Analyse exploratoire de l’homoscédasticité
L’inférence paramétrique associée au modèle de régression par les moindres carrés — incluant le calcul de la statistique de Student pour la significativité de la pente et le tracé des limites de confiance CLM et CLI — repose sur l’hypothèse cruciale d’homoscédasticité, stipulant que la variance de l’aléa résiduel conditionnel demeure strictement constante sur l’intégralité du domaine de définition de la variable indépendante ($operatorname{Var}(\epsilon_i mid X_i) = \sigma^2$).
La représentation bivariée sous PROC SGPLOT constitue le premier baromètre de surveillance de cette contrainte. L’hétéroscédasticité se traduit graphiquement par une altération morphologique de la nébuleuse de points le long de l’axe horizontal. L’apparition d’une configuration dite en mégaphone ou en entonnoir — où les observations sont étroitement serrées autour de la droite d’ajustement pour les petites valeurs de l’abscisse, puis se dispersent selon une amplitude croissante au fur et à mesure que les valeurs de $X$ progressent — dénonce une instabilité flagrante de la variance de perturbation.
L’observation d’un tel profil visuel invalide immédiatement l’utilisation brute des bandes de confiance projetées par les options par défaut de l’instruction REG, ces dernières postulant l’homoscédasticité dans la composition analytique de leurs bornes. La découverte graphique de cette pathologie impose de réorienter la modélisation statistique vers l’estimation d’erreurs-types robustes à l’hétéroscédasticité (telles que les estimateurs sandwich de White ou de Huber-White sous PROC REG ou PROC SURVEYREG), ou de procéder à des transformations stabilisatrices de variance sur la variable dépendante (par exemple une transformation logarithmique ou la méthode de Box-Cox) avant de réitérer l’affichage graphique sur des bases méthodologiques assainies.
11. Exportation haute résolution et conformité aux normes éditoriales
11.1 Configuration des destinations ODS et résolution DPI
La production d’un graphique scientifiquement abouti au sein de l’environnement interactif de SAS ne constitue que la première étape de la chaîne éditoriale. Pour s’insérer avec succès dans le manuscrit final destiné à une revue scientifique arbitrée par les pairs, la figure doit être extraite sous une résolution géométrique irréprochable garantissant une absence totale d’artéfacts de pixellisation ou de flou lors de l’impression physique grand format. Ce processus de transfert est gouverné par l’instruction maîtresse ODS GRAPHICS.
Le paramètre déterminant pour calibrer la netteté intrinsèque d’une sortie matricielle réside dans la spécification de la résolution par l’option IMAGEFMT= combinée à DPI= (Dots Per Inch). Alors que l’affichage d’un moniteur de bureau standard se contente d’une densité de 72 à 96 DPI, les standards éditoriaux internationaux (imposés par des éditeurs majeurs tels qu’Elsevier, Springer-Nature ou l’IEEE) exigent formellement une résolution minimale de 300 DPI pour les représentations en demi-teintes chromatiques, et fréquemment de 600 DPI pour les tracés graphiques linéaires combinant texte fin et marqueurs vectoriels.
La maîtrise de la géométrie physique s’avère tout aussi capitale que la densité d’échantillonnage de pixels. L’analyste doit impérativement déclarer explicitement les dimensions spatiales absolues de l’image au sein de l’instruction ODS GRAPHICS ON au moyen des paramètres WIDTH= et HEIGHT=, en faisant usage d’unités physiques telles que les centimètres (cm) ou les pouces (in). En calquant rigoureusement la largeur du graphique SAS sur la largeur réelle d’une colonne de texte du périodique ciblé (par exemple 8.5 cm pour un format double colonne standard), on prévient tout redimensionnement anamorphique en aval lors de la composition typographique, préservant ainsi la lisibilité exacte des polices de caractères et l’épaisseur des traits.
11.2 Alignement sur les normes de publication académique (Style APA)
L’American Psychological Association (APA), dans sa septième édition normative, édicte des règles strictes relatives à la sobriété et à l’économie visuelle des figures scientifiques. Le style graphique généré nativement par certains thèmes SAS par défaut, saturé d’arrière-plans colorés, de bordures d’encadrement lourdes et d’effets d’ombrage numériques, se heurte de plein fouet à ces canons académiques épurés, lesquels proscrivent tout artifice visuel non porteur d’information statistique.
Pour hisser le rendu de PROC SGPLOT au niveau des exigences du style APA, le programmeur doit opérer une réinitialisation radicale des styles d’arrière-plan. Le canevas de dessin (WALL) et le conteneur externe du graphique (BORDER) doivent être débarrassés de tout contour géométrique fermé et de toute coloration de fond, imposant un blanc immaculé absolu. Ceci s’obtient élégamment en invoquant l’option de style ODS STYLE=JOURNAL ou en déclarant explicitement NOBORDER sur l’instruction PROC SGPLOT, tout en neutralisant le tracé des bordures d’axes superflues via XAXIS DISPLAY=(NOLINE).
L’uniformisation typographique constitue le second pilier de la conformité APA. La police de caractères mobilisée pour les axes cartésiens, les équations et les légendes doit appartenir de façon cohérente à la même famille typographique sans empattement (telle qu’Arial, Calibri ou Helvetica) que le corps de texte du manuscrit de recherche, avec une échelle de tailles strictement hiérarchisée (généralement entre 8 et 12 points typographiques). L’objectif intangible demeure l’élimination méticuleuse du « chartjunk », concentrant 100% de la charge cognitive du relecteur sur l’interaction fondamentale entre le nuage empirique et sa modélisation linéaire.
11.3 Exportation vectorielle vers les formats EPS, PDF et SVG
Si les formats de fichiers matriciels (tels que le PNG ou le TIFF non compressé) satisfont aux besoins de nombreux flux de production éditoriaux, ils demeurent structurellement limités par leur résolution figée à la compilation. Dans le cadre de la rédaction de thèses d’université, de monographies académiques ou de manuscrits de recherche rédigés sous le système de composition typographique LaTeX, le recours à des formats vectoriels s’impose comme la solution de référence absolue pour garantir une qualité visuelle pérenne.
Le moteur ODS Graphics de SAS permet d’exporter nativement les graphiques issus de PROC SGPLOT vers les standards vectoriels ouverts les plus renommés, au premier rang desquels figurent le format PDF vectoriel, le SVG (Scalable Vector Graphics) et le format historique EPS (Encapsulated PostScript). En déclarant l’instruction ODS GRAPHICS ON / IMAGEFMT=PDF; ou IMAGEFMT=SVG; associée à une destination ODS PDF ou ODS LISTING GPATH= »chemin_disque »;, le compilateur ne génère pas un réseau de points discrets, mais une collection d’instructions mathématiques vectorielles décrivant avec une exactitude infinie chaque segment de ligne, chaque glyphe et chaque contour de caractère.
L’avantage opérationnel de cette approche réside dans l’invariance d’échelle absolue : le document scientifique peut être soumis à un facteur d’agrandissement macroscopique arbitraire sans qu’aucune pixellisation ne vienne dégrader la pureté géométrique des marqueurs ou de la droite de régression. De surcroît, le moteur SAS garantit l’incorporation directe des polices vectorielles au sein du conteneur de sortie, immunisant l’auteur contre les déconvenues classiques de substitution de polices non autorisées lors de la phase finale de flashage numérique chez l’éditeur scientifique.
12. Erreurs courantes, alternatives de lissage et synthèse pratique
12.1 Diagnostics des erreurs de syntaxe fréquentes sous PROC SGPLOT
L’apprentissage de l’environnement graphique SAS s’accompagne inévitablement de déconvenues programmatiques consécutives à des erreurs de syntaxe ou à des conflits d’options au sein du processeur d’exécution. L’une des anomalies les plus fréquemment répertoriées dans le fichier journal (SAS LOG) réside dans l’injection d’options incompatibles au sein de l’instruction REG. Par exemple, tenter d’associer une instruction de lissage par spline pénalisée directement au sein de REG au lieu de déclarer l’instruction distincte PBSPLINE déclenchera immédiatement une notification d’erreur d’option non reconnue interrompant la compilation graphique.
Une autre source d’achoppement récurrente concerne la ponctuation rigide du langage SAS. L’omission accidentelle d’un simple point-virgule à la suite d’une instruction XAXIS ou MARKERATTRS a pour effet catastrophique de fusionner syntaxiquement deux instructions conceptuellement étanches. Le compilateur tentera alors d’interpréter le mot-clé subséquent (par exemple l’instruction YAXIS) comme un argument interne de l’instruction précédente, entraînant une cascade d’avertissements de syntaxe invalidant l’ensemble de la procédure.
Enfin, l’incompréhension des interactions entre les filtres de données et l’instruction REG génère de fréquents désagréments visuels. Tenter de tracer une régression sur une table comportant des valeurs textuelles résiduelles au sein d’une variable numérique déclarée provoque l’émission de notes d’erreur silencieuses relatives aux conversions de types, se traduisant à l’écran par la génération d’un canevas cartésien totalement désespérément vierge. Une lecture scrupuleuse et méthodique du journal d’exécution LOG demeure la boussole indispensable du programmeur pour traquer et résorber ces frictions de compilation.
12.2 Alternatives non paramétriques : LOESS et PBSPLINE
L’instruction REG, bien que souveraine pour formaliser les relations affines classiques, se trouve démunie face à des structures de données complexes refusant obstinément de s’inscrire dans le carcan d’un modèle paramétrique rigide du premier degré. Lorsque la vérification des postulats distributionnels et l’examen exploratoire préliminaire ont mis en lumière des torsions morphologiques indiscutables, l’analyste se doit de mobiliser des alternatives d’ajustement plus agiles proposées nativement par la procédure PROC SGPLOT.
La première alternative de choix est incarnée par l’instruction LOESS (Local Regression). Cette approche algorithmique non paramétrique modélise la tendance centrale sans postuler de fonction globale a priori, en ajustant des régressions linéaires ou quadratiques locales pondérées au sein d’un voisinage glissant de points le long de l’axe des abscisses. La courbe LOESS qui en résulte épouse fidèlement les singularités, les points d’inflexion et les ondulations sinueuses du nuage empirique, offrant un miroir fidèle de la véritable dynamique des données sans biaiser l’estimation par une hypothèse réductrice de linéarité globale.
La seconde alternative majeure s’incarne dans l’instruction PBSPLINE (Penalized B-Spline). Ce module de pointe recourt à la théorie des splines pénalisées pour draper les observations statistiques sous une courbe de régression lisse et continue, où le degré de flexibilité est rigoureusement régulé par un paramètre de pénalisation mathématique optimisé par le critère de validation croisée généralisée (GCV). Confronté à l’alternative entre la simplicité sémiotique et interprétative de la droite des moindres carrés (REG) et l’exactitude descriptive de la spline (PBSPLINE), l’analyste opérera un arbitrage scientifique rigoureux, dicté par l’équilibre recherché entre parcimonie théorique et fidélité empirique.
12.3 Grille récapitulative des meilleures pratiques de programmation SAS
L’industrialisation et la pérennisation des flux de travail graphiques au sein d’un département de biostatistique ou d’économétrie imposent une standardisation méthodologique rigoureuse du code source SAS. La production artisanale de graphiques isolés doit s’effacer au profit d’une approche d’ingénierie logicielle modulaire, reposant sur l’encapsulation des requêtes graphiques sous la forme de macro-programmes SAS paramétrés et hautement réutilisables. Cette stratégie garantit la stricte reproductibilité des analyses à travers le temps et les projets de recherche.
Dans cette perspective d’excellence opérationnelle, chaque script graphique de production doit intégrer une architecture standardisée séquentielle invariable : 1) initialisation formelle de l’environnement avec réinitialisation explicite des titres, notes et destinations ODS ; 2) configuration des paramètres de haute résolution via ODS GRAPHICS ON avec spécification métrique stricte ; 3) exécution de PROC SGPLOT mobilisant des variables dûment auditées, typées et labellisées ; 4) clôture systématique des destinations graphiques et vidage de la mémoire tampon des titres. L’incorporation de métadonnées programmatiques au moyen de macro-variables de session (&SYSUSERID, &SYSDATE9) au sein des notes de bas de page ancre en outre une traçabilité d’audit inestimable pour les organismes de réglementation.
Pour parachever ce protocole de rigueur scientifique, la grille de contrôle d’auto-évaluation ci-après consigne les points d’ancrage critiques à valider impérativement avant toute diffusion d’une planche de régression linéaire sous SAS :
- Examen des échelles et de la troncature : Vérification formelle que les étendues cartésiennes des axes horizontal et vertical ne tronquent arbitrairement aucune observation valide et ne dramatisent artificiellement la pente observée.
- Exactitude métrologique des libellés : Confirmation de la présence explicite des unités de mesure physiques normalisées au sein des intitulés d’axes générés par XAXIS et YAXIS.
- Hiérarchisation perceptive du contraste : Validation de la discernabilité géométrique et chromatique absolue entre les marqueurs d’observations brutes et le vecteur analytique de la droite de régression.
- Explicitation probabiliste des incertitudes : Mention non équivoque au sein des notes de bas de page de la nature exacte des bandes de variabilité représentées (distinction formelle entre confiance sur la moyenne CLM et prédiction individuelle CLI) ainsi que du niveau de confiance $\alpha$ retenu.
- Assainissement de la densité visuelle : Application rigoureuse de techniques de gestion de la transparence (TRANSPARENCY=) ou d’encapsulation sous forme de facettes multi-panneaux (PROC SGPANEL) dès lors que le volume d’échantillonnage sature la lisibilité spatiale.
- Reproductibilité de l’environnement de sortie : Vérification de l’adéquation de la résolution DPI déclarée (300 ou 600 DPI) aux critères contractuels de la destination éditoriale ciblée.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.2307/2682899
Cleveland, W. S. (1993). Visualizing data. Hobart Press.
Heath, D. (2017). Effective graphs for medical research: A guide for SAS users. SAS Institute Inc.
National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://doi.org/10.18434/M32189
SAS Institute Inc. (2016). SAS/GRAPH 9.4: Statistical Graphics Procedures Guide (6th ed.). SAS Institute Inc. https://support.sas.com/documentation/cdl/en/grstatproc/69716/HTML/default/viewer.htm
SAS Institute Inc. (2020). SAS 9.4 ODS Graphics: Procedures Guide (4th ed.). SAS Institute Inc.
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098