
L’analyse prédictive contemporaine repose sur la capacité des analystes et des chercheurs à modéliser des phénomènes complexes caractérisés par des interactions multifactorielles. Dans ce cadre épistémologique, la régression linéaire multiple s’impose comme une pierre angulaire des méthodes quantitatives, permettant d’isoler les contributions respectives de plusieurs variables prédictives sur une variable dépendante continue. Si des environnements de programmation statistique dédiés tels que R ou Python dominent la recherche computationnelle lourde, le tableur Microsoft Excel demeure une plateforme omniprésente, accessible et extraordinairement performante pour implémenter, auditer et déployer des architectures d’analyse prédictive rigoureuses.
L’intégration progressive de moteurs de calcul matriciel dynamique et de bibliothèques d’analyse statistique avancées au sein d’Excel a transformé ce logiciel bureautique en un laboratoire d’inférence statistique complet. Loin de se cantonner à de simples ajustements bivariés ou à des représentations graphiques rudimentaires, le praticien peut concevoir des systèmes de calcul prédictif intégrant le diagnostic d’homoscédasticité, l’évaluation de la multicolinéarité, l’estimation des intervalles de confiance de l’espérance conditionnelle et la projection d’intervalles de prédiction individuelle avec une rigueur mathématique égale à celle des progiciels spécialisés.
Ce guide méthodologique exhaustif a pour vocation d’articuler les fondements théoriques de l’estimation par les moindres carrés ordinaires avec leur concrétisation algorithmique et matricielle sous Excel. En parcourant les étapes successives de la préparation structurée des données, de l’estimation des coefficients par les formules natives et l’Utilitaire d’analyse, du diagnostic rigoureux des résidus et de l’automatisation prédictive, ce document fournit aux statisticiens, économistes et spécialistes des sciences comportementales les outils conceptuels et opérationnels indispensables pour transformer des données brutes en prédictions fiables, auditables et scientifiquement reproductibles.
1. Cadre conceptuel et fondements statistiques de la régression linéaire multiple
1.1 Définition mathématique et modélisation générale
La régression linéaire multiple étend le modèle linéaire simple en postulant que la variable dépendante continue, conventionnellement désignée par y, peut être formalisée comme une combinaison linéaire d’un ensemble de k variables explicatives ou prédictives, notées x1, x2, …, xk, pondérées par des paramètres de population inconnus et associée à un terme d’erreur stochastique résiduel. L’expression générale de ce modèle s’énonce mathématiquement sous la forme canonique suivante :
y = β0 + β1x1 + β2x2 + … + βkxk + ε
Dans cette formalisation fondamentale, le terme β0 représente l’ordonnée à l’origine, également qualifiée de constante ou d’intercepte. Sur le plan géométrique et conceptuel, il correspond à la valeur espérée de y lorsque l’ensemble des prédicteurs vectoriels du modèle adopte simultanément une valeur strictement égale à zéro. Les paramètres β1, β2, …, βk constituent les coefficients de régression partielle. Chacun d’eux quantifie la variation attendue de la variable réponse y consécutive à un incrément d’une unité de la variable explicative correspondante, sous l’hypothèse d’invariance absolue des autres covariables intégrées au système, selon le principe classique du ceteris paribus. Enfin, le terme résiduel ε désigne l’erreur non systématique, laquelle capture l’ensemble des influences non mesurées, le bruit aléatoire propre à l’échantillonnage et les imprécisions intrinsèques à la mesure des construits.
Il est impératif d’opérer une distinction formelle entre la simple corrélation bivariée de Pearson, la régression bivariée et le cadre multivarié. Tandis que le coefficient de corrélation linéaire se borne à évaluer l’intensité et le sens d’une liaison symétrique non causale entre deux axes de variance, la régression univariée introduit une relation asymétrique d’influence fonctionnelle orientée d’une variable indépendante vers une variable dépendante. La régression linéaire multiple franchit un palier d’abstraction supplémentaire en purgeant mathématiquement les liaisons observées des covariances croisées entre prédicteurs. Elle permet d’isoler l’effet unique et net de chaque régresseur sur le critère, répondant ainsi au double objectif épistémologique de l’analyse quantitative : décomposer et expliquer la variance globale d’un phénomène empirique tout en fournissant un moteur d’inférence capable de générer des projections prédictives quantitatives fiables pour de futures observations non incluses dans l’échantillon d’estimation initial.
1.2 Pertinence méthodologique en sciences quantitatives et comportementales
Dans les sciences empiriques, notamment l’économétrie, la psychométrie, la sociologie quantitative et la recherche clinique, les comportements et les états latents ne peuvent que très rarement être imputés à une cause isolée. La modélisation de construits psychologiques complexes, tels que la charge cognitive, le rendement académique ou l’adhésion thérapeutique, exige la prise en compte simultanée d’un faisceau de covariables issues de contextes cognitifs, dispositionnels ou environnementaux. L’intérêt méthodologique de la modélisation linéaire multiple réside dans sa propension à neutraliser les effets de confusion statistique et à contrôler statistiquement des facteurs exogènes qui, s’ils étaient omis, biaiseraient dramatiquement l’estimation des effets substantiels des variables focales.
L’utilisation d’un tableur accessible tel que Microsoft Excel dans le cadre académique et professionnel appliqué présente des avantages pédagogiques et analytiques substantiels. Contrairement aux environnements en ligne de commande ou aux logiciels boîte noire qui masquent les opérations intermédiaires derrière des fonctions préprogrammées rigides, la manipulation matricielle sous tableur force le chercheur à se confronter à la matérialité géométrique de ses données. La spatialisation des vecteurs de données, l’affichage explicite des matrices de covariances et le suivi déterministe de chaque étape de transformation concourent à une compréhension approfondie de la chaîne de traitement. Cette proximité opérationnelle avec les matrices élémentaires minimise le risque d’erreurs d’interprétation aveugle des résultats algorithmiques.
Néanmoins, le recours à un tableur dans un protocole d’analyse de pointe comporte des contraintes inhérentes que l’analyste doit impérativement circonscrire. La gestion de la mémoire vive face à des jeux de données massifs excédant plusieurs centaines de milliers de lignes devient rapidement prohibitive. De surcroît, l’absence de traçabilité native des modifications de code, typique des scripts sous R ou Python munis d’un système de contrôle de version, impose une discipline documentaire extrêmement stricte dans la structuration des classeurs. Enfin, l’implémentation de modèles non linéaires complexes ou de structures hiérarchiques emboîtées requiert des formulations matricielles particulièrement sophistiquées, qui rendent l’infrastructure du tableur vulnérable aux erreurs accidentelles de manipulation de cellules.
1.3 Objectifs de l’analyse prédictive appliquée
L’analyse prédictive appliquée ne vise pas exclusivement l’élucidation descriptive des mécanismes sous-jacents aux observations historiques ; son dessein cardinal consiste à inférer des états futurs ou inobservés à partir d’un ensemble structuré de métriques empiriques. Dans ce contexte, l’ajustement des moindres carrés permet d’extraire une fonction de transfert mathématique capable d’ingérer un vecteur de nouvelles caractéristiques observées chez un sujet ou une unité d’analyse afin de générer une estimation ponctuelle optimale de son score sur la variable critère. La qualité d’un tel dispositif prédictif ne s’évalue pas uniquement à l’aune de son adéquation à l’échantillon historique, mais principalement par sa robustesse lors du déploiement opérationnel sur de nouvelles cohortes de données.
Au cœur de cette démarche réside la quantification précise de l’erreur standard d’estimation, désignée formellement par l’abréviation se ou RMSE (Root Mean Square Error). Cette métrique statistique cristallise l’écart type de la distribution des perturbations résiduelles autour de l’hyperplan de régression multidimensionnel. En fournissant une échelle directe de dispersion des erreurs dans l’unité de mesure de la variable dépendante, l’erreur standard conditionne directement la largeur des intervalles de prédiction futurs et circonscrit le degré d’incertitude inhérent à toute projection prospective issue du modèle.
La conception d’un modèle prédictif hautement performant repose ainsi sur la recherche permanente d’un équilibre optimal entre la parcimonie structurelle et la puissance explicative globale, principe communément rattaché au rasoir d’Ockham. L’adjonction systématique et indiscriminée de prédicteurs additionnels dans un modèle de régression tend mécaniquement à accroître le coefficient de détermination R2 brut, donnant l’illusion trompeuse d’un raffinement de la qualité d’ajustement. Toutefois, cette pratique pernicieuse engendre invariablement une sur-paramétrisation délétère, laquelle dégrade la capacité de généralisation du modèle face à de nouvelles observations en capturant le bruit stochastique spécifique à l’échantillon d’entraînement. L’analyste prédictif sous Excel doit par conséquent déployer des métriques d’arbitrage rigoureuses pour sélectionner uniquement les régresseurs apportant un incrément d’information statisticable net.
2. Postulats statistiques préalables indispensables à la modélisation
2.1 Linéarité des relations et normalité des résidus
La validité des inférences statistiques issues de la régression linéaire multiple dépend impérativement du respect d’un ensemble de postulats fondamentaux connus sous l’appellation générique des conditions du théorème de Gauss-Markov. Le premier de ces prérequis exige que l’espérance conditionnelle de la variable dépendante soit une fonction strictement linéaire des variables explicatives. Si la véritable liaison sous-jacente s’avère polynomiale, exponentielle ou logarithmique, l’ajustement d’un hyperplan linéaire produira des estimations paramétriques biaisées et des erreurs de prédiction systématiques dans certaines régions de l’espace des covariables. L’évaluation de cette linéarité s’opère usuellement par l’inspection scrupuleuse de graphiques de dispersion croisant chaque prédicteur individuel avec la variable critère, ainsi que par la projection des résidus du modèle en fonction des valeurs prédites.
Le second postulat essentiel concerne les propriétés distributionnelles des résidus εi. Bien que l’obtention d’estimateurs linéaires sans biais à variance minimale (BLUE) n’exige pas formellement l’hypothèse de normalité, cette dernière s’avère rigoureusement indispensable pour légitimer les tests d’hypothèses classiques portant sur les coefficients individuels (tests t de Student), le test de significativité globale du modèle (test F de Fisher-Snedecor) et la dérivation des intervalles de confiance et de prédiction paramétriques. Les termes d’erreur résiduels doivent suivre une loi normale de moyenne nulle et d’écart-type constant σ, formalisée par ε ~ N(0, σ2).
Au sein de l’environnement Excel, la vérification de la normalité distributionnelle s’articule autour de diagnostics graphiques et tabulaires particulièrement rigoureux. L’élaboration d’un diagramme quantile-quantile (Q-Q plot) constitue l’approche méthodologique de référence. Ce tracé confronte les quantiles empiriques des résidus standardisés calculés aux quantiles théoriques d’une loi normale centrée réduite générés via la fonction native LOI.NORMALE.STANDARD.INVERSE.N. L’alignement étroit des points d’observation le long de la bissectrice confirme l’adhésion distributionnelle aux postulats gaussiens, tandis que des déviations sigmoïdes ou paraboliques trahissent respectivement la présence d’asymétrie ou d’un excès de kurtosis (queues de distribution lourdes) compromettant la robustesse des tests inférentiels.
2.2 Homoscédasticité et indépendance des observations
L’hypothèse d’homoscédasticité postule que la variance des termes d’erreur résiduels demeure strictement constante à travers l’ensemble des strates ou des niveaux formés par les combinaisons linéaires des prédicteurs. Formellement, cela implique que Var(εi | X) = σ2 pour tout indice d’observation i. Lorsque la variance résiduelle fluctue en fonction de la magnitude des prédictions ou de la valeur d’une covariable spécifique, le modèle souffre d’hétéroscédasticité. Sous hétéroscédasticité, bien que les coefficients estimés demeurent asymptotiquement sans biais, leurs erreurs types calculées par la méthode des moindres carrés ordinaires sont gravement biaisées, conduisant à des rejets ou à des non-rejets indus de l’hypothèse nulle lors de l’évaluation de la significativité statistique.
La détection graphique de l’hétéroscédasticité sous Excel repose sur l’examen d’un nuage de points confrontant sur l’axe des abscisses les valeurs ajustées par le modèle (ŷi) et sur l’axe des ordonnées les résidus bruts ou standardisés (ei). Une structure homoscédastique s’illustre visuellement par une bande rectangulaire diffuse et homogène de points distribués de manière purement aléatoire autour de l’axe horizontal zéro. À l’inverse, l’apparition d’un motif conique, en entonnoir ou en fuseau, signalant que la dispersion des résidus s’évase ou se rétracte à mesure que la valeur prédite croît, démontre incontestablement une rupture d’homogénéité de variance qui impose des corrections analytiques, telles que la transformation logarithmique de la variable dépendante ou le recours à des estimateurs des moindres carrés pondérés.
Concomitamment, le modèle suppose l’indépendance stricte des erreurs de mesure entre les différentes unités de l’échantillon, formalisée par Cov(εi, εj) = 0 pour tout i ≠ j. La violation de cette hypothèse d’absence d’autocorrélation résiduelle survient fréquemment dans les structures longitudinales ou les séries temporelles, où les perturbations associées à un pas de temps t conservent une mémoire inertielle de la perturbation survenue au pas t-1. Dans le cadre de données transversales, l’indépendance est généralement garantie par un schéma d’échantillonnage aléatoire simple évitant les effets de grappe ou de dépendance spatiale non modélisés.
2.3 Diagnostic de la multicolinéarité entre prédicteurs
La multicolinéarité désigne un phénomène d’interdépendance linéaire substantielle, voire quasi-parfaite, unissant deux ou plusieurs variables explicatives intégrées dans l’architecture du modèle. Si une colinéarité modérée est quasi-systématique dans les sciences comportementales et économiques en raison de la nature intriquée des réalités humaines, des niveaux de corrélation excessivement élevés entre prédicteurs induisent des dysfonctionnements computationnels et analytiques majeurs. Sur le plan matriciel, la matrice d’information XTX devient singulière ou quasi-singulière, rendant son inversion numérique extrêmement instable et hautement sensible à des fluctuations mineures de l’échantillon.
Le corollaire immédiat de cette instabilité computationnelle est une inflation massive des erreurs types associées aux coefficients de régression partielle. En conséquence, les statistiques t de Student s’effondrent artificiellement, amenant le chercheur à conclure faussement à la non-significativité de prédicteurs substantiellement cruciaux, alors même que le test global F de l’analyse de variance affiche une significativité éclatante et que le R2 atteint des sommets. De surcroît, les estimations ponctuelles des coefficients peuvent basculer vers des valeurs numériques aberrantes ou adopter des signes inverses à la réalité empirique du phénomène étudié, rendant caduque toute interprétation marginaliste des pentes individuelles.
Pour prévenir ces écueils sous Excel, le protocole diagnostique impératif débute par l’extraction d’une matrice de corrélation de Pearson couvrant l’ensemble des prédicteurs potentiels via l’outil dédié de l’Utilitaire d’analyse. Un coefficient de corrélation bivarié excédant la valeur critique de 0,70 ou 0,80 entre deux variables explicatives constitue un premier signal d’alarme indiscutable. Toutefois, la multicolinéarité pouvant résulter d’une combinaison linéaire complexe impliquant plus de deux régresseurs sans qu’aucune corrélation bivariée isolée n’apparaisse spectaculaire, il s’avère indispensable de quantifier le Facteur d’Inflation de la Variance (VIF, Variance Inflation Factor) pour chacun des prédicteurs, une opération réalisable sous tableur par le biais de régressions auxiliaires itératives.
3. Structuration matricielle et préparation rigoureuse des données sous Excel
3.1 Organisation tabulaire des variables explicatives et de réponse
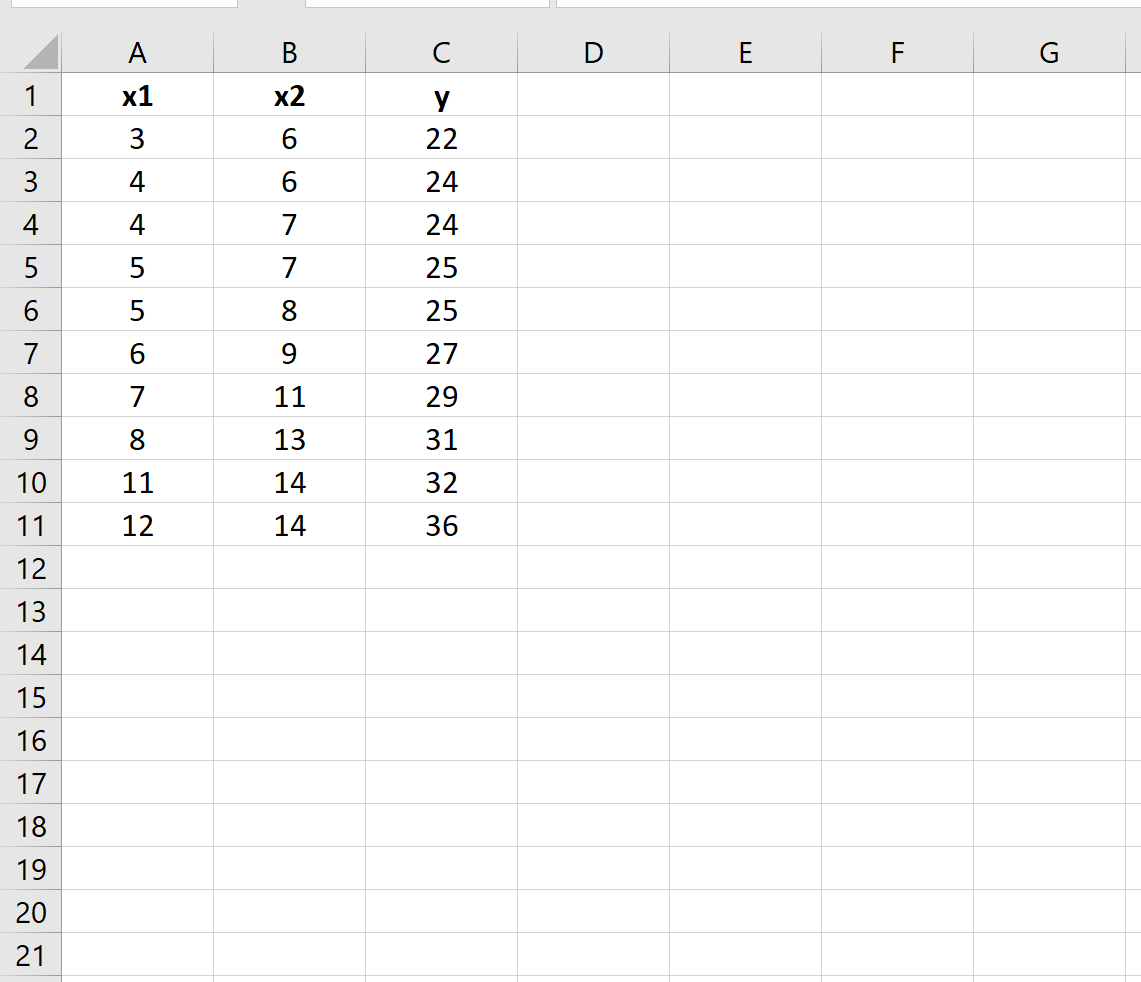
La réussite de l’implémentation de la régression multiple sous Excel est conditionnée par l’ordonnancement géométrique rigoureux des colonnes au sein de la feuille de calcul. L’algorithme de calcul matriciel de la fonction DROITEREG ainsi que le module de régression de l’Utilitaire d’analyse imposent que l’ensemble des variables explicatives indépendantes (x1, x2, …, xk) forme une plage de cellules strictement contiguë, sans aucune interruption par des colonnes intercalaires ou des espaces vides. Chaque variable indépendante doit occuper une colonne dédiée, identifiée par un en-tête univoque en première ligne, tandis que les lignes successives contiennent les mesures associées aux unités statistiques observées.
La variable dépendante ou critère continu (y) doit quant à elle être positionnée dans une colonne distincte, idéalement adjacente au bloc matriciel des prédicteurs, bien que cette proximité spatiale ne soit pas algorithmiquement obligatoire. Le typage des données doit être minutieusement validé : toutes les cellules de la zone d’apprentissage doivent contenir des valeurs numériques pures. L’insertion accidentelle de chaînes de caractères, de codes d’erreurs logiques ou d’espaces typographiques invisibles dans les plages désignées est une source récurrente d’échec d’exécution des fonctions matricielles ou de calculs corrompus silencieux.
Pour immuniser le modèle contre les décalages de plage de cellules lors de l’ajout ultérieur d’observations, il est fortement recommandé de convertir la plage de données conventionnelle en un Tableau Structuré Excel officiel (via la combinaison de touches Ctrl + L ou l’onglet Insertion > Tableau). L’attribution de noms structurés à ces ensembles de données fiabilise considérablement la maintenance des formules matricielles en substituant des références sémantiques robustes aux coordonnées rigides et périssables du type A2:D500.
3.2 Prétraitement, nettoyage et standardisation
La présence de valeurs manquantes (missing values) au sein de la matrice de modélisation exige une stratégie de traitement explicite avant tout calcul statistique. Par défaut, les fonctions matricielles de régression sous Excel renvoient des erreurs globales d’exécution dès lors qu’une seule cellule de la plage désignée contient une valeur nulle non numérique ou le code #N/A. Deux stratégies fondamentales s’offrent au praticien : la suppression par liste (listwise deletion), consistant à purger intégralement de la matrice toute ligne comportant au moins une valeur manquante, ou l’imputation de la moyenne arithmétique via des formules dynamiques. Si la suppression est méthodologiquement préférable lorsque les données manquantes surviennent de manière totalement aléatoire (MCAR), elle réduit mécaniquement la taille de l’échantillon effectif et donc la puissance statistique des tests ultérieurs.
L’étape subséquente du nettoyage statistique repose sur l’identification systématique des valeurs aberrantes (outliers) et des observations influentes. Une première approche analytique consiste à calculer le score centré réduit (score z) pour chaque variable du jeu de données en exploitant conjointement les fonctions MOYENNE et ECARTYPE.STANDARD. Les observations associées à une valeur absolue de z excédant le seuil de 3,0 ou 3,29 doivent être isolées et soumises à un examen méthodologique scrupuleux afin de déterminer si elles résultent d’erreurs de saisie instrumentale ou si elles traduisent des profils réels mais exceptionnels nécessitant un traitement robuste.
Enfin, la standardisation préalable de l’ensemble des variables (en soustrayant la moyenne de chaque colonne et en divisant le résultat par son écart-type respectif) constitue une pratique d’une immense valeur analytique lorsque les prédicteurs s’expriment dans des unités de mesure hétérogènes (par exemple, confronter un revenu annuel en dizaines de milliers d’euros à un âge mesuré en années). L’exécution du modèle sur des données préalablement standardisées permet d’obtenir directement des coefficients de régression standardisés (β standardisés), facilitant ainsi la comparaison objective de l’importance relative de chaque régresseur sur la variabilité du critère.
3.3 Création d’un jeu de données synthétique pour simulation
Afin de matérialiser les démonstrations techniques de ce traité, nous élaborons un jeu de données synthétique contrôlé simulant une recherche en psychologie du travail et ergonomie cognitive. L’objectif consiste à modéliser et prédire la performance opérationnelle globale d’employés (variable critère y, score continu variant conceptuellement de 0 à 100 points) à partir de deux prédicteurs psychométriques quantitatifs continus : le niveau de charge cognitive évalué sur une échelle objective (x1, variant de 1 à 10) et le nombre d’heures hebdomadaires d’entraînement pratique aux interfaces numériques (x2, variant de 0 à 20 heures).
Pour calibrer ce jeu d’essai sous Excel de manière déterministe tout en injectant une variance stochastique réaliste, les prédicteurs peuvent être générés sur une cohorte de cinquante sujets à l’aide de formules de génération pseudo-aléatoires telles que ALEA.ENTRE.BORNES(1; 10) pour x1 et ALEA.ENTRE.BORNES(2; 18) pour x2. La variable dépendante y est ensuite synthétisée en appliquant la fonction de transfert théorique suivante, à laquelle s’agrège une composante d’erreur aléatoire normale générée par la formule LOI.NORMALE.STANDARD.INVERSE.N(ALEA()) * 4 :
ythéorique = 45 – 2,8(x1) + 1,9(x2) + ε
Une fois les valeurs générées, il est d’usage d’effectuer un copier-coller des valeurs en lieu et place des formules dynamiques afin de figer définitivement le jeu d’apprentissage numérique. Ce processus garantit l’intégrité numérique du jeu d’essai, prévient la recalculation erratique des données stochastiques à chaque interaction avec la feuille et offre une base de vérification empirique rigoureuse pour les étapes d’estimation paramétrique subséquentes.
4. Estimation paramétrique via la fonction matricielle DROITEREG
4.1 Syntaxe, arguments et exécution dynamique de DROITEREG
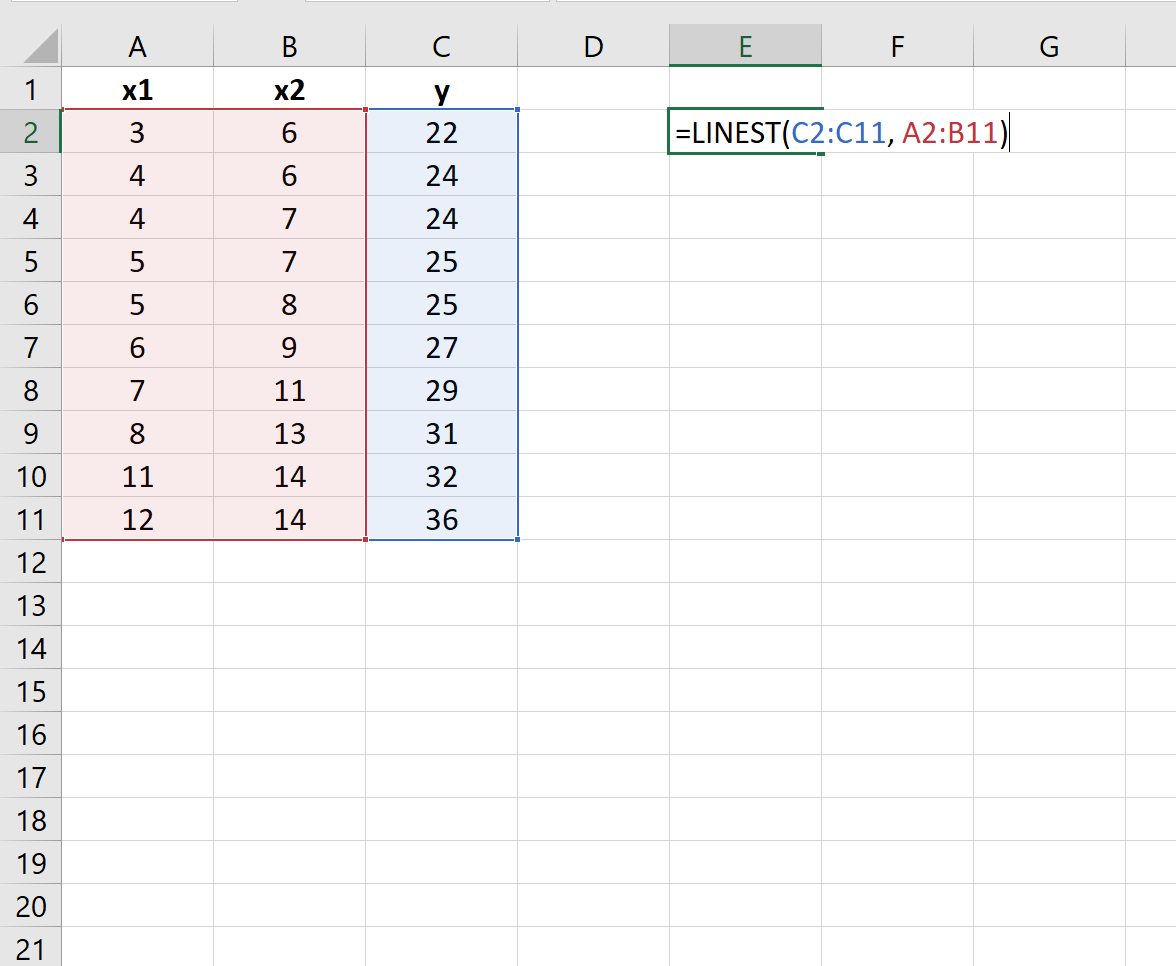
La fonction native DROITEREG constitue le moteur d’estimation paramétrique le plus puissant et complet intégré nativement au cœur du tableur Excel. Cette fonction implémente rigoureusement l’algorithme des moindres carrés ordinaires par décomposition QR ou inversion matricielle généralisée. Sa signature syntaxique formelle se structure autour de quatre arguments distincts : DROITEREG(y_connus; [x_connus]; [constante]; [statistiques]). L’argument y_connus désigne le vecteur colonne représentant la variable dépendante continue, tandis que x_connus spécifie la matrice rectangulaire contiguë des prédicteurs indépendants.
L’argument logique constante détermine le traitement réservé à l’ordonnée à l’origine : assigné à VRAI (ou omis par défaut), il ordonne le calcul classique de l’intercepte β0 ; assigné à FAUX, il force la droite de régression à passer strictement par l’origine mathématique (imposant β0 = 0), une contrainte théorique qui ne doit être mobilisée que dans des cadres phénoménologiques très spécifiques sous peine de biaiser lourdement le modèle. Enfin, l’argument logique statistiques est déterminant : lorsqu’il est configuré sur VRAI, la fonction ne se contente pas de renvoyer le vecteur des coefficients ponctuels, mais génère une matrice statistique exhaustive de cinq lignes sur k+1 colonnes encapsulant l’ensemble des grandeurs inférentielles nécessaires à l’audit du modèle.
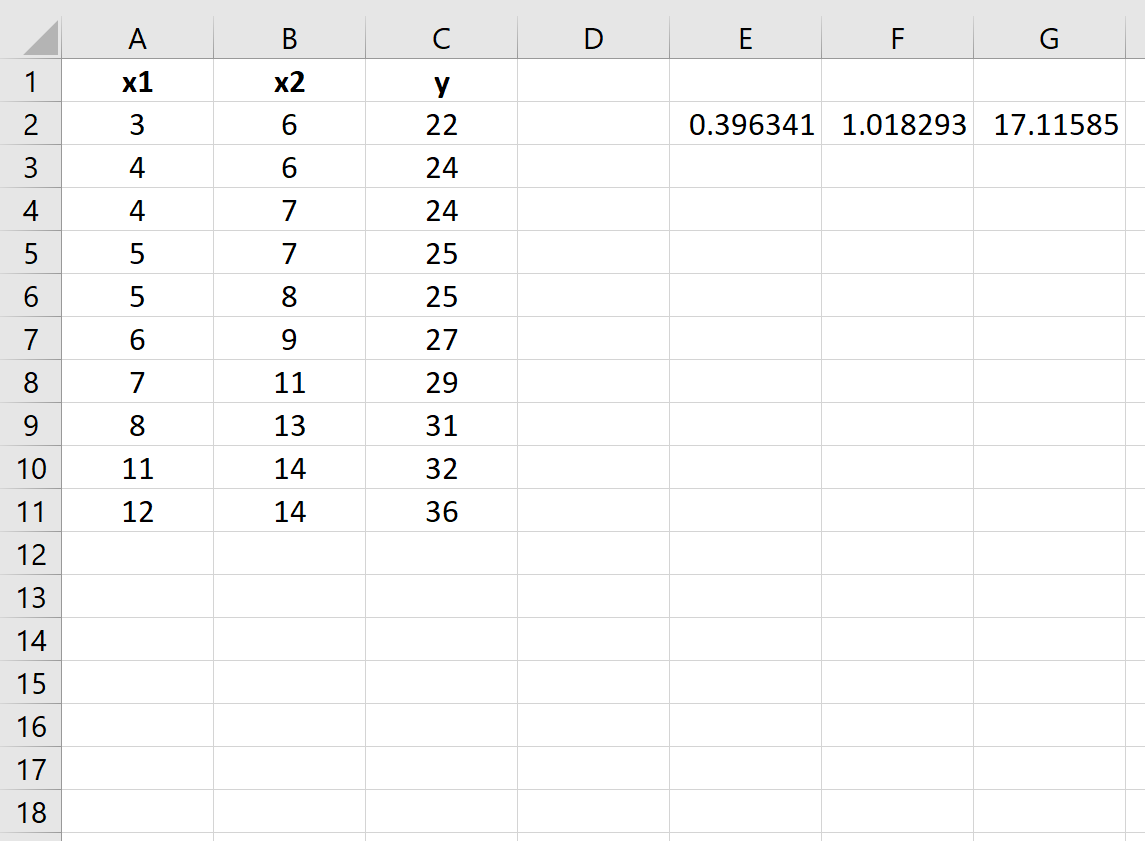
Sur le plan de l’ingénierie logicielle au sein d’Excel, l’exécution de DROITEREG a connu une mutation paradigmatique majeure avec l’introduction des tableaux dynamiques dans Microsoft 365 et les versions modernes d’Excel. Alors que les versions historiques du tableur contraignaient l’analyste à sélectionner préalablement une plage rectangulaire exacte de cinq lignes et k+1 colonnes puis à valider la formule via l’instruction matricielle héritée Ctrl + Maj + Entrée (formule CSE), les versions actuelles gèrent automatiquement le déversement matriciel dynamique (spill) depuis une unique cellule de départ validée par une frappe standard sur la touche Entrée. Il convient impérativement d’attirer l’attention du praticien sur une singularité algorithmique critique d’Excel : la fonction DROITEREG affiche l’ordre des coefficients de manière rigoureusement inverse à la disposition spatiale des colonnes sources, restituant ainsi les paramètres de droite à gauche sous la forme [βk, βk-1, …, β1, β0].
4.2 Lecture approfondie de la matrice de sortie statistique
L’extraction optimale des données produites par DROITEREG requiert une maîtrise parfaite de l’anatomie interne de la matrice de déversement à cinq lignes. La première ligne abrite, comme souligné précédemment, l’ensemble des estimateurs ponctuels des coefficients de régression partielle ordonnés de façon décroissante selon l’indice des prédicteurs, l’ultime cellule située à l’extrême droite accueillant l’intercepte β0. La deuxième ligne présente en miroir absolu les erreurs types associées à chacun de ces mêmes coefficients (SE(βk), …, SE(β0)), lesquelles quantifient la variabilité d’échantillonnage de chaque estimateur paramétrique.
La troisième ligne de la matrice bascule vers des grandeurs diagnostiques globales. Sa première cellule héberge le coefficient de détermination multiple R2, qui mesure la proportion de variance de la variable critère absorbée par le jeu combiné des prédicteurs. La seconde cellule consigne l’erreur type de régression (se), métrique cruciale exprimant la dispersion résiduelle dans l’échelle d’origine de la variable réponse. Les cellules suivantes de cette troisième ligne ne sont pas renseignées par le moteur et renvoient des codes d’indisponibilité conventionnels #N/A sans incidence opérationnelle.
La quatrième ligne fournit dans sa première colonne la statistique globale F de Fisher-Snedecor, conçue pour tester la significativité conjointe de l’ensemble des prédicteurs par rapport à un modèle nul ne comportant que la constante. Sa deuxième cellule indique le nombre de degrés de liberté résiduels (ddl = n – k – 1), un paramètre fondamental pour le calcul manuel des valeurs critiques et des p-valeurs associées. Enfin, la cinquième et dernière ligne expose l’arbitrage fondamental de l’analyse de variance : la première cellule contient la somme des carrés due à la régression (SSreg), tandis que la deuxième cellule consigne la somme des carrés résiduels (SSres), dont le ratio relatif permet de vérifier l’additivité arithmétique de la décomposition de la variance totale du critère.
4.3 Formules alternatives directes : PENTE, ORDONNEE.ORIGINE et INDICE
Face à la densité d’information générée par une matrice dynamique complète, certains besoins opérationnels requièrent l’extraction chirurgicale d’un coefficient particulier au sein d’une cellule isolée sans provoquer de déversement matriciel adjacent. De nombreux utilisateurs débutants tentent de mobiliser les fonctions natives PENTE ou ORDONNEE.ORIGINE ; toutefois, ces fonctions présentent la limitation structurelle rédhibitoire de ne tolérer strictement qu’une seule variable explicative vectorielle, rendant leur emploi rigoureusement impossible dans le cadre d’une modélisation multivariée.
La stratégie d’excellence pour capturer de manière autonome et dynamique un paramètre précis consiste à imbriquer l’appel de DROITEREG au sein de la fonction d’extraction positionnelle INDEX. Par exemple, pour extraire exclusivement l’intercepte β0 d’un modèle incorporant deux prédicteurs explicatifs, la formule s’énoncera ainsi dans la feuille de calcul :
=INDEX(DROITEREG(Plage_Y; Plage_X; VRAI; VRAI); 1; 3)
Dans cette structure syntaxique, les arguments de ligne 1 et de colonne 3 pointent directement vers la coordonnée hébergeant la constante au sein de la grille de sortie de DROITEREG. De la même manière, l’extraction de l’erreur type de régression ou du coefficient de détermination global s’opère en ajustant simplement les coordonnées de ciblage (respectivement ligne 3, colonne 2 pour l’erreur type, et ligne 3, colonne 1 pour le R2). Cette technique d’encapsulation permet de bâtir des tableaux de bord de synthèse décisionnelle d’une remarquable élégance, parfaitement autonomes et automatisés, éliminant tout risque de chevauchement matriciel au sein des interfaces de reporting exécutif.
5. Déploiement de l’Utilitaire d’analyse Excel : Extraction et analyse globale
5.1 Activation et configuration du complément Utilitaire d’analyse
Pour les analyses statistiques formelles requérant une lisibilité immédiate conforme aux standards académiques internationaux sans programmation matricielle manuelle, le module complémentaire officiel Utilitaire d’analyse (Analysis ToolPak) s’affirme comme une ressource inestimable. Par défaut, ce composant d’analyse avancée n’est pas activé lors d’une installation standard d’Excel. L’utilisateur doit se rendre dans le menu Fichier > Options > Compléments, sélectionner Compléments Excel dans le menu déroulant inférieur, cliquer sur Atteindre…, puis cocher l’option Utilitaire d’analyse avant de valider.
Une fois le module initialisé, l’accès s’opère depuis l’onglet Données du ruban, où trône désormais le bouton Utilitaire d’analyse. La sélection de l’outil Régression ouvre une boîte de dialogue hautement spécialisée requérant un paramétrage scrupuleux. La plage d’entrée Plage Y en entrée doit pointer sur la colonne de la variable dépendante continue, en veillant scrupuleusement à inclure la cellule d’en-tête textuel. La Plage X en entrée doit englober l’ensemble du bloc contigu des variables explicatives indépendantes, intégrant de façon synchrone leurs étiquettes respectives.
Il est impératif de cocher la case Intitulés afin de signifier au compilateur que la première ligne ne renferme pas des valeurs d’observations numériques mais des identifiants nominatifs de variables, ce qui permettra à Excel d’étiqueter lisiblement chaque ligne de coefficient dans le rapport final. Enfin, la boîte de dialogue permet de paramétrer un niveau de confiance personnalisé (usuellement 95 %, modifiable à 99 % pour des contraintes de significativité plus rigoureuses) et de cocher l’ensemble des modules d’exportation auxiliaires : résidus bruts, résidus standardisés, tracés de dispersion résiduelle et tracés de probabilité normale.
5.2 Interprétation du tableau récapitulatif de sortie
La validation de la boîte de dialogue génère un rapport analytique structuré de manière hiérarchique en trois blocs méthodologiques majeurs. Le premier bloc, intitulé Statistiques de la régression, expose les indices de performance macroscopique. Une attention critique doit être portée à la dichotomie fondamentale entre le Coefficient de détermination R² et le R² ajusté (ou corrigé). Si le R2 brut mesure la variance apparente expliquée, le R2 ajusté pénalise lourdement l’introduction de covariables additionnelles en fonction du ratio d’échantillonnage via la formule corrective de Wherry :
R2ajusté = 1 – [(1 – R2)(n – 1) / (n – k – 1)]
Cette distinction s’avère vitale lors du prototypage prédictif : un accroissement du R2 concomitant à une diminution du R2 ajusté indique indubitablement que la nouvelle variable introduite apporte une contribution informationnelle marginale inférieure à la dégradation statistique causée par la consommation d’un degré de liberté additionnel.
Le second bloc de sortie présente le tableau d’analyse de variance (ANOVA). Il décompose la somme totale des écarts à la moyenne (Total) en une part structurelle imputable au modèle d’ajustement (Régression) et une part d’incertitude irréductible (Résidus). Le diagnostic de validité globale repose sur la lecture de la colonne F et de sa probabilité critique associée, étiquetée F de signification (correspondant formellement à la p-valeur du test F de Fisher-Snedecor). Si cette valeur s’avère inférieure au seuil conventionnel de risque de première espèce α = 0,05, l’analyste rejette formellement l’hypothèse nulle globale selon laquelle l’ensemble des coefficients β1 = β2 = … = βk = 0, confirmant que le modèle capte une fraction de variance statistiquement significative de la réalité empirique.
Le troisième bloc détaille la décomposition paramétrique individuelle. Pour chaque ligne de variable explicative, le tableau restitue la valeur de l’estimation ponctuelle du coefficient, son erreur type standard, la statistique t de Student (quotient du coefficient par son erreur type) et la Valeur P associée à un test bilatéral de nullité paramétrique. Une p-valeur strictement inférieure à 0,05 atteste que le prédicteur considéré exerce un effet marginal partiel statistiquement discernable sur la variable réponse, sous condition expresse de maintien à niveau constant de tous les autres prédicteurs concomitants.
5.3 Analyse des intervalles de confiance des coefficients
L’interprétation inférentielle moderne ne saurait s’enfermer dans le seul diktat dichotomique de la significativité dicté par les valeurs p. L’examen des intervalles de confiance des coefficients de régression partielle constitue une étape indispensable pour apprécier l’incertitude paramétrique et l’ampleur substantielle des effets modélisés. Le rapport de l’Utilitaire d’analyse édite systématiquement les colonnes Borne inférieure 95% et Borne supérieure 95% pour chaque paramètre du système, délimitant la plage au sein de laquelle le véritable coefficient de population β a 95 % de chances de se situer sous l’hypothèse de répétition infinie de l’échantillonnage.
Le test visuel fondamental consiste à vérifier si l’intervalle de confiance calculé englobe ou non la valeur zéro. Si la valeur zéro est incluse entre la borne inférieure négative et la borne supérieure positive, il est formellement impossible de rejeter l’hypothèse nulle d’un effet marginal nul au seuil de risque consenti. Ce critère est rigoureusement équivalent au constat d’une valeur p supérieure à 0,05. À l’inverse, un intervalle excluant entièrement la valeur zéro démontre un effet statistiquement robuste et informe l’analyste sur l’orientation directionnelle stable de l’impact du prédicteur.
Au-delà de la significativité brute, la largeur intrinsèque de cet intervalle traduit directement la précision de l’estimation sous-jacente. Un intervalle de confiance démesurément large signale une faible puissance statistique imputable à une taille d’échantillon déficiente ou à une forte colinéarité entre régresseurs, alertant l’analyste sur la fragilité structurelle du modèle. Si les bornes oscillent entre des effets marginaux microscopiques et des impacts considérables, l’utilisabilité opérationnelle du modèle prédictif dans un cadre décisionnel à fort enjeu devient particulièrement hasardeuse.
6. Formulation mathématique de l’équation prédictive ajustée
6.1 Transcription formelle des coefficients calculés
L’achèvement de la phase d’estimation paramétrique permet de transposer les grandeurs numériques abstraites extraites des matrices en une équation prédictive opérationnelle. En intégrant les coefficients estimés (notés conventionnellement avec des chapeaux pour souligner leur nature empirique déduite d’un échantillon fini), la fonction de calcul prédictif s’énonce selon le gabarit algébrique universel :
ŷ = b0 + b1x1 + b2x2 + … + bkxk
Considérons l’application concrète issue de notre simulation comportementale au sein de laquelle les calculs de l’Utilitaire d’analyse ou de la fonction DROITEREG auraient fourni les estimations paramétriques suivantes : constante b0 = 44,82 ; coefficient de la charge cognitive b1 = -2,74 ; coefficient des heures d’entraînement b2 = +1,86. L’équation de prédiction individuelle de la performance opérationnelle se formalise rigoureusement ainsi :
Score_Performancê = 44,82 – 2,74 × (Charge_Cognitive) + 1,86 × (Heures_Entraînement)
L’évaluation substantielle de l’intercepte (44,82) exige un discernement théorique majeur. Sur le plan purement géométrique, elle représente le niveau de performance prédit pour un individu dont la charge cognitive s’élèverait à zéro et qui ne consacrerait aucune heure à l’entraînement numérique. Si, dans ce cas précis, une valeur d’entraînement nulle présente une signification physique concrète, une charge cognitive rigoureusement égale à zéro s’avère biologiquement et psychométriquement impossible sur une échelle standardisée débutant à 1. Dans de nombreuses configurations pratiques, l’intercepte ne possède ainsi aucune validité ontologique autonome ; il agit comme une constante d’ajustement mathématique garantissant que l’hyperplan passe exactement par le centroïde multidimensionnel des moyennes de l’échantillon d’apprentissage.
6.2 Interprétation quantitative des pentes partielles
L’interprétation statistique des pentes partielles constitue l’une des démarches les plus rigoureuses de l’analyse quantitative en raison de la clause restrictive d’invariance des autres variables qu’elle encapsule obligatoirement. Dans notre modèle calibré, la valeur de b1 (-2,74) indique que pour toute augmentation d’un point sur l’échelle de charge cognitive, la performance opérationnelle modélisée décroît en moyenne de 2,74 points, sous condition expresse que le volume d’entraînement pratique demeure strictement invariant d’un profil à l’autre.
Symétriquement, le coefficient b2 (+1,86) stipule que l’investissement d’une heure additionnelle d’entraînement hebdomadaire engendre un gain moyen attendu de 1,86 point de performance sur l’épreuve opérationnelle, toutes choses égales par ailleurs, c’est-à-dire à niveau de charge cognitive scrupuleusement identique. Cette spécification de contrôle statistique partiel constitue la force analytique fondamentale de la régression multiple : elle isole l’efficacité pédagogique de l’entraînement des effets potentiellement confondants d’une surcharge cognitive variable chez les opérateurs observés.
Cette lecture marginaliste linéaire repose néanmoins sur un postulat mécanique implicite : l’indépendance des effets partiels. Le modèle canonique postule en effet que l’impact d’une heure d’entraînement supplémentaire demeure rigoureusement identique que l’opérateur se trouve en condition de stress cognitif extrême (charge = 10) ou en condition de confort intellectuel (charge = 2). Si l’efficacité de l’entraînement fluctuait substantiellement selon la charge cognitive vécue par le sujet, le modèle nécessiterait l’incorporation d’un terme multiplicatif d’interaction (x1 × x2). En l’absence d’une telle variable d’interaction, les pentes partielles doivent être interprétées comme des effets additifs constants sur l’ensemble du domaine de validité de l’espace expérimental.
6.3 Documentation technique et traçabilité du modèle dans le classeur
Dans un contexte d’ingénierie statistique et d’assurance qualité des calculs décisionnels, consigner les résultats dans une cellule opaque sans mécanisme d’explication textuelle compromet la maintenabilité et la reproductibilité des analyses. Il est par conséquent hautement recommandé d’ériger une zone de restitution documentaire dédiée au sein de la feuille de calcul, générant dynamiquement l’équation de régression sous forme littérale lisible par n’importe quel auditeur externe.
L’élaboration d’une telle chaîne de caractères textuelle s’effectue aisément via la combinaison de la fonction de concaténation contemporaine et de la fonction TEXTE, laquelle assure la mise en forme des décimales sans rompre la chaîne textuelle. Supposons que l’intercepte soit consigné en cellule G1, la pente b1 en E1 et la pente b2 en F1. La formule d’assemblage dynamique s’articule comme suit :
="ŷ = " & TEXTE(G1; "0,00") & " + (" & TEXTE(E1; "0,00") & " * x₁) + (" & TEXTE(F1; "0,00") & " * x₂)"
Cette approche présente l’avantage décisif d’actualiser instantanément le texte descriptif du modèle dès lors que de nouvelles données viennent amender le tableau source et recalculer les paramètres par DROITEREG. La traçabilité scientifique impose d’adjoindre systématiquement à cette équation littérale des métadonnées contextuelles indispensables : date et heure de la calibration, identifiant de version du jeu d’apprentissage source, nombre d’observations effectives prises en compte (n) et taille des écarts types résiduels constatés.
7. Calcul prédictif pour de nouvelles observations : Méthodes de calcul sous Excel
7.1 Méthode par référence cellulaire directe
L’exploitation opérationnelle du modèle de régression réside dans sa capacité à produire des prédictions personnalisées lorsqu’un profil d’entrée inédit se présente. La méthode la plus intuitive, particulièrement adaptée aux interfaces de simulation unitaire simplifiées, repose sur le référencement direct des cellules dans une formule arithmétique élémentaire traduisant scrupuleusement l’équation ajustée.
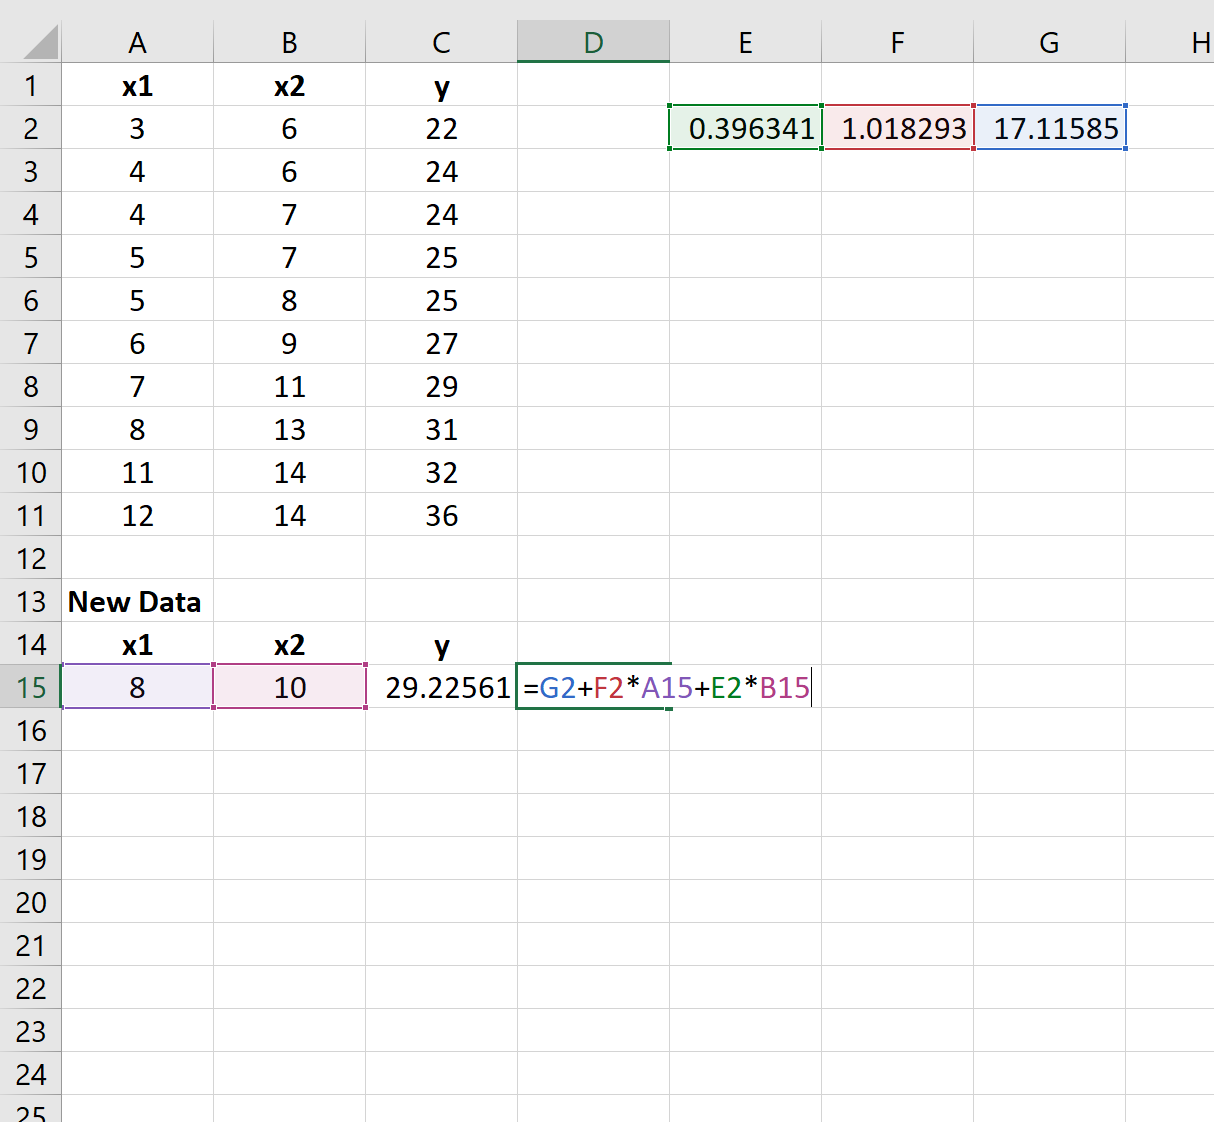
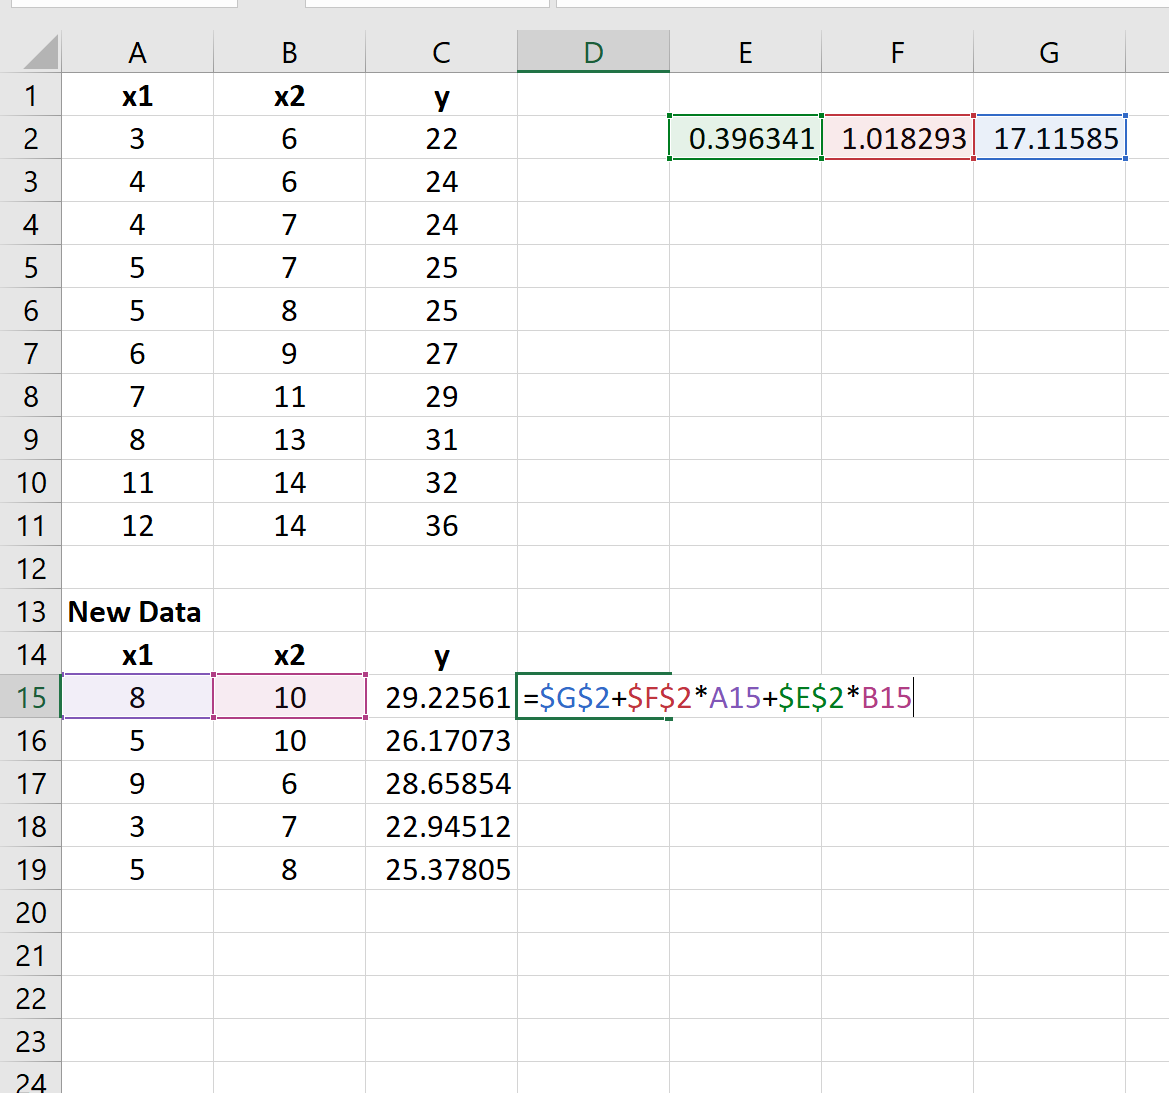
Supposons qu’une grille de saisie opérationnelle mette à disposition de l’utilisateur la cellule I2 pour consigner le niveau de charge cognitive d’un nouveau collaborateur et la cellule J2 pour stipuler son volume d’entraînement prévisionnel. En supposant que les paramètres estimés du modèle soient stockés de façon pérenne dans les cellules K1 pour la constante b0, L1 pour b1 et M1 pour b2, la formule de calcul de la prédiction ponctuelle s’implémente en cellule N2 par l’expression standardisée suivante :
=$K$1 + ($L$1 * I2) + ($M$1 * J2)
L’utilisation scrupuleuse des références absolues (symbolisées par les caractères $) garantit que la formule peut être étirée verticalement le long d’une colonne pour traiter une liste continue de nouveaux cas sans risque de dérive des cellules pointant vers les paramètres du modèle. Par exemple, pour un sujet présentant un profil empirique caractérisé par une charge cognitive évaluée à 8 et un capital de 10 heures d’entraînement pratique, l’exécution numérique de la formule délivre instantanément une valeur de performance ajustée de :
ŷ = 44,82 – (2,74 × 8) + (1,86 × 10) = 44,82 – 21,92 + 18,60 = 41,50 points.
7.2 Méthode matricielle avancée avec SOMMEPROD et PRODUITMAT
Dès lors que le modèle de régression intègre un nombre volumineux de prédicteurs (par exemple dix, quinze ou vingt variables explicatives), l’écriture manuelle de produits scalaires élémentaires devient fastidieuse, inélégante et extraordinairement vulnérable aux fautes d’inattention syntaxiques. L’environnement Excel offre une alternative algorithmique d’une remarquable concision conceptuelle par le biais de la fonction SOMMEPROD.
Dans cette configuration vectorielle, si les coefficients partiels b1, …, bk sont stockés de manière contiguë dans la plage horizontale L1:M1 et que les valeurs d’entrée du profil à prédire occupent la plage I2:J2, le calcul de la prédiction combinée s’exécute par la formule :
=$K$1 + SOMMEPROD($L$1:$M$1; I2:J2)
La fonction SOMMEPROD procède en interne au produit terme à terme des composantes vectorielles correspondantes avant d’en agréger la somme totale, réduisant considérablement la complexité de maintenance du classeur. Pour le traitement simultané d’une cohorte entière de centaines ou de milliers de nouveaux sujets à évaluer en un seul calcul matriciel global, l’analyste peut franchir une étape d’abstraction supplémentaire en recourant à la fonction de multiplication matricielle pure PRODUITMAT, conjointement avec la fonction TRANSPOSE le cas échéant.
En formulant mathématiquement le problème sous la forme vectorielle canonique Ŷ = XnouveauB, où Xnouveau représente la matrice de dimension (N × k) des nouveaux prédicteurs et B le vecteur colonne de dimension (k × 1) des pentes partielles, l’instruction matricielle moderne sous Excel 365 calcule l’ensemble des projections instantanément par déversement vertical. Cette architecture matricielle garantit des gains d’exécution informatique prodigieux et immunise le classeur contre les corruptions de formules individuelles au sein des grandes bases de scoring.
7.3 Utilisation de la fonction PREVISION.LINEAIRE et ses extensions
L’arsenal des fonctions financières et statistiques d’Excel intègre historiquement des outils de projection désignés sous le radical PREVISION, renommé plus récemment PREVISION.LINEAIRE pour se conformer aux nomenclatures internationales de normalisation. Toutefois, une confusion analytique extrêmement répandue persiste quant au champ d’application fonctionnel de cet outil. L’algorithme standard de la fonction PREVISION.LINEAIRE(x; y_connus; x_connus) est nativement restreint à la régression bivariée et ne tolère sous sa forme brute qu’un unique vecteur de covariables indépendantes.
L’introduction d’une matrice bidimensionnelle de variables indépendantes au sein de l’argument x_connus d’une fonction PREVISION.LINEAIRE conventionnelle déclenche immédiatement une erreur d’incompatibilité de dimension du type #VALEUR!. S’il demeure théoriquement envisageable de détourner cette limitation en recomposant des structures matricielles virtuelles imbriquées, cette acrobatie computationnelle s’avère inutilement complexe et obscure au regard de la clarté et de la robustesse natives des combinaisons matricielles offertes par DROITEREG ou PRODUITMAT.
Pour le praticien quantitatif sous Excel, le diagnostic comparatif est sans appel : les fonctions de la famille PREVISION doivent être cantonnées à des extrapolations tendancielles bivariées simples ou à des séries chronologiques unimodales basées sur l’outil PREVISION.ETS. Pour toute démarche de modélisation prédictive explicative multivariée, l’utilisation délibérée des opérateurs matriciels ou la décomposition cellulaire explicite des estimateurs de moindres carrés s’affirme comme la seule méthodologie techniquement rigoureuse et évolutive.
8. Évaluation de la précision du modèle et analyse des résidus
8.1 Calcul des valeurs ajustées et génération de la colonne des résidus
La validation empirique d’une modélisation prédictive requiert une analyse minutieuse des déviations internes constatées sur l’échantillon d’entraînement. La première étape computationnelle consiste à insérer au sein du tableau de données d’apprentissage une nouvelle colonne calculée, dédiée aux valeurs ajustées ou modélisées (ŷi), générées en appliquant rigoureusement l’équation du modèle à chaque ligne d’observation historique.
Immédiatement adjacente à cette série modélisée, une colonne de résidus bruts (ei) doit être impérativement construite. Sur le plan formel, le résidu d’une observation spécifique i se définit comme la divergence algébrique absolue séparant la valeur empirique réellement observée (yi) de la valeur théorique projetée par l’hyperplan de régression (ŷi) :
ei = yi – ŷi
L’intégrité numérique du calcul matriciel sous Excel peut être immédiatement vérifiée par le test d’orthogonalité fondamentale des moindres carrés : la somme arithmétique de l’ensemble des résidus bruts (SOMME(Plage_Residus)) ainsi que leur moyenne arithmétique (MOYENNE(Plage_Residus)) doivent être rigoureusement égales à zéro, aux imprécisions infinitésimales d’arrondi binaire près du processeur (usuellement d’un ordre de grandeur inférieur à 10-12). Une déviation substantielle de cette moyenne par rapport à zéro trahit une erreur critique de positionnement de l’intercepte ou une corruption dans l’assignation des références cellulaires au sein de l’équation prédictive.
8.2 Métriques globales d’ajustement prédictif
L’évaluation des performances globales de l’architecture prédictive ne saurait reposer exclusivement sur le R2, lequel renseigne sur la part de variance expliquée mais omet de quantifier l’amplitude tangible des erreurs de prévision dans les unités du problème opérationnel traité. La panoplie diagnostique sous Excel doit intégrer trois métriques indispensables d’erreur résiduelle, calculables via des formules matricielles natives :
L’Erreur Quadratique Moyenne (EQM ou MSE, pour Mean Squared Error) pénalise lourdement les écarts extrêmes en élevant chaque déviation individuelle au carré avant d’en calculer la moyenne générale. Sa mise en œuvre sous Excel s’effectue via l’une ou l’autre des formulations syntaxiques suivantes :
=SOMME.CARRES(Plage_Residus) / NB(Plage_Residus) ou =MOYENNE(Plage_Residus^2)
La Racine de l’Erreur Quadratique Moyenne (REQM ou RMSE, pour Root Mean Squared Error) s’obtient simplement en extrayant la racine carrée arithmétique du MSE à l’aide de la fonction RACINE. Le RMSE constitue sans doute la métrique prédictive la plus noble et la plus immédiatement communicable aux décideurs, car elle réintègre l’incertitude moyenne d’estimation dans l’unité de mesure exacte de la variable critère d’origine. Enfin, l’Erreur Absolue Moyenne (EAM ou MAE, pour Mean Absolute Error) évalue l’espérance de l’écart arithmétique brut sans surpondérer de façon disproportionnée les erreurs isolées à forte magnitude, offrant une mesure de dispersion hautement robuste face aux valeurs aberrantes sporadiques :
=MOYENNE(ABS(Plage_Residus))
8.3 Exploration graphique des résidus pour validation du modèle
Aucun modèle prédictif ne devrait être déployé en production sur la foi exclusive d’indicateurs d’ajustement numériques globaux. L’exploration graphique approfondie des résidus constitue le filtre diagnostique ultime pour attester de la validité écologique des hypothèses sous-jacentes. L’artefact visuel pivot consiste à élaborer un nuage de points croisant sur l’axe horizontal des abscisses les valeurs prédites modélisées (ŷi) et sur l’axe vertical des ordonnées les résidus correspondants (ei).
L’analyse qualitative de ce tracé sous Excel s’articule autour de trois configurations pathologiques caractéristiques :
- Détection de non-linéarité : L’observation d’un agencement géométrique curvilinéaire, tel qu’une trajectoire parabolique ou en cloche inversée des résidus, indique sans équivoque que le modèle sous-jacent omet un effet non linéaire critique (par exemple un terme d’ordre deux x2 ou une relation logarithmique).
- Détection d’hétéroscédasticité : Un évasement progressif ou une rétraction symétrique de la dispersion des résidus à mesure que l’on progresse de la gauche vers la droite sur l’axe des valeurs prédites (motif dit « en mégaphone ») démontre l’instabilité de la variance résiduelle, invalidant les calculs conventionnels d’intervalles de confiance.
- Identification des résidus aberrants : La mise en place de deux lignes de garde horizontales matérialisant des seuils d’alerte à ± 2 ou ± 3 écarts types permet d’isoler visuellement les observations hautement déviantes qui tirent indûment l’ajustement vers elles.
9. Quantification de l’incertitude : Intervalles de confiance et de prédiction
9.1 Distinction statistique entre espérance conditionnelle et observation individuelle
L’un des contresens conceptuels les plus pernicieux commis par les analystes de données réside dans la confusion entre l’intervalle de confiance de la moyenne conditionnelle et l’intervalle de prédiction d’une observation singulière. Bien que ces deux concepts statistiques mobilisent des formulations analytiques convergentes, ils répondent à des questionnements épistémologiques radicalement divergents et génèrent des enveloppes d’incertitude aux amplitudes considérablement dissemblables.
L’intervalle de confiance vise à quantifier la marge d’erreur inhérente à l’estimation de l’espérance mathématique de la population pour un profil d’entrée donné, c’est-à-dire la valeur moyenne E(y | X = x0) qu’adopterait une infinité de sujets présentant scrupuleusement le même vecteur de caractéristiques prédictives. Son incertitude découle exclusivement de la variabilité d’échantillonnage subie par les estimateurs paramétriques b0, b1, …, bk lors de la phase d’apprentissage initial. Plus la taille n de l’échantillon historique augmente vers l’infini, plus la largeur de cet intervalle converge asymptotiquement vers zéro.
À l’opposé, l’intervalle de prédiction quantifie l’incertitude enveloppant la survenue empirique d’un score singulier y0 chez un nouvel individu spécifique observé ultérieurement. Cette projection doit non seulement absorber l’incertitude relative au positionnement de l’hyperplan moyen (la variance de l’estimation paramétrique), mais elle doit impérativement y additionner la variance stochastique irréductible propre au comportement de cet individu singulier (ε0 ~ N(0, σ2)). Par conséquent, même si la taille de l’échantillon d’apprentissage devenait infinie, l’intervalle de prédiction ne saurait s’effondrer : il conserverait une largeur incompressible égale à deux fois la valeur critique de l’écart-type résiduel σ. L’intervalle de prédiction est donc, par construction théorique, structurellement bien plus vaste que l’intervalle de confiance.
9.2 Formulation mathématique et calcul matriciel sous Excel
L’évaluation quantitative rigoureuse de ces bandes d’incertitude pour un vecteur de nouvelles données d’entrée x0 (structuré sous forme d’un vecteur ligne incluant la valeur 1 pour l’intercepte) exige l’application des équations fondamentales de l’algèbre linéaire statistique. L’erreur standard associée à la prédiction de la moyenne conditionnelle se formalise matriciellement ainsi :
SE(ŷmoyenne) = se × √[ x0 (XTX)-1 x0T ]
Symétriquement, l’erreur standard régissant la projection d’une observation singulière inédite intègre l’unité de variance additionnelle résiduelle, se traduisant par l’expression suivante :
SE(ŷindividuel) = se × √[ 1 + x0 (XTX)-1 x0T ]
Le terme quadratique intermédiaire h00 = x0 (XTX)-1 x0T n’est autre que le coefficient de levier statistique (leverage) associé au nouveau point de requête, lequel reflète directement la distance de Mahalanobis séparant ce profil inédit du centre de gravité multidimensionnel de la cohorte d’apprentissage. L’implémentation de cette séquence matricielle au sein d’Excel s’effectue avec une remarquable pureté grâce à l’orchestration croisée des fonctions INVERSEMAT, PRODUITMAT et TRANSPOSE opérant sur la matrice originale des prédicteurs augmentée de sa colonne d’unités.
Une fois l’erreur type SE obtenue, la dérivation des bornes inférieure et supérieure s’achève en mobilisant le quantile bilatéral de la distribution de Student calculé via la formule LOI.STUDENT.INVERSE.N(1 - α/2; ddl_residus). L’intervalle à 95 % s’obtient alors en retranchant et en ajoutant à la prédiction ponctuelle ŷ0 le produit de cette valeur critique t par l’erreur standard calculée, matérialisant ainsi la rigueur inférentielle au sein du tableur.
9.3 Mise en page graphique de la zone d’incertitude prédictive
L’analyse géométrique des équations d’incertitude révèle une propriété fondamentale : la variance d’estimation s’évase progressivement à mesure que le vecteur de prédiction x0 s’écarte du barycentre des variables explicatives. Pour illustrer graphiquement cet évasement hyperbolique sous Excel, le statisticien peut projeter la courbe de prédiction centrale encadrée par ses deux enveloppes de bornes inférieure et supérieure sur un graphique en nuage de points avec lignes lissées, en faisant varier continûment un prédicteur focal tout en maintenant les autres covariables fixées à leur valeur moyenne empirique.
Cette scénarisation visuelle matérialise instantanément auprès des utilisateurs finaux la dégradation sévère de la fiabilité des estimations lorsque l’on s’aventure aux marges extrêmes de l’échantillon historique. L’adjonction de barres d’erreur dynamiques, configurées pour lire directement les cellules contenant les demi-largeurs calculées de l’intervalle de prédiction, constitue un moyen pédagogique saisissant de rappeler le niveau d’incertitude inhérent à toute décision basée sur des prévisions quantitatives.
Cette modélisation visuelle agit avant tout comme un garde-fou méthodologique capital contre les périls de l’extrapolation abusive. Dans la pratique prédictive, projeter l’équation de régression sur des valeurs de prédicteurs situées bien au-delà de l’enveloppe convexe des données d’apprentissage (out-of-domain prediction) constitue une faute scientifique majeure. Le tableur, par la simple mécanique aveugle de ses formules, générera toujours un résultat numérique déterministe ; cependant, la prise en compte de la divergence exponentielle des intervalles de prédiction met en exergue la caducité opérationnelle de telles projections extérieures.
10. Diagnostics avancés, gestion des pièges méthodologiques et optimisation
10.1 Diagnostic rigoureux de la multicolinéarité par le VIF
Comme énoncé lors de l’examen des postulats statistiques, la multicolinéarité constitue l’un des écueils majeurs susceptibles de paralyser la validité structurelle d’une régression multiple. Pour dépasser le diagnostic superficiel des matrices de corrélation de Pearson bivariées, la métrique analytique reine demeure le Facteur d’Inflation de la Variance (VIF). Le VIF mesure la proportion dans laquelle la variance de l’estimateur d’un coefficient est artificiellement gonflée en raison des interconnexions linéaires existant entre ce prédicteur et l’ensemble de ses pairs.
Le calcul méthodique du VIF sous Excel pour une variable prédictive xj requiert l’exécution d’une régression auxiliaire : la variable xj est temporairement extraite de son statut de prédicteur pour devenir la variable dépendante d’un modèle subsidiaire régressé sur l’intégralité des k-1 autres prédicteurs. Soit R2j le coefficient de détermination issu de cette régression auxiliaire spécifique. Le VIF s’en déduit directement par l’application de la formule fondamentale :
VIFj = 1 / (1 – R2j)
Au sein du classeur, cette étape s’automatise élégamment en combinant INDEX et DROITEREG pour extraire directement le R2 auxiliaire sans générer de rapports superflus. La grille d’interprétation universellement reconnue dans la littérature méthodologique s’articule autour des seuils de décision suivants :
- VIF compris entre 1 et 5 : Niveau de colinéarité faible à modéré, pleinement tolérable dans la majorité des applications empiriques.
- VIF supérieur à 5 : Signal d’alerte sérieux indiquant une instabilité naissante des erreurs types nécessitant une surveillance analytique étroite.
- VIF supérieur à 10 : Multicolinéarité sévère et critique, invalidant l’interprétation individuelle des coefficients partiels et imposant des mesures correctives immédiates.
Face à un VIF critique excédant 10, le praticien dispose de plusieurs voies de remédiation : supprimer la variable redondante la moins théoriquement pertinente, fusionner les prédicteurs fortement colinéaires en un score composite agrégé par analyse en composantes principales, ou recourir à des techniques de régression pénalisée (Ridge ou Lasso).
10.2 Le surapprentissage (overfitting) et la parcimonie
Dans la course à l’optimisation de la performance apparente, l’écueil le plus séduisant mais le plus dévastateur réside dans le surapprentissage (overfitting). Un modèle surajusté est une architecture statistique qui, à force d’intégrer des prédicteurs marginaux ou des termes d’interaction pléthoriques, finit par mémoriser le bruit aléatoire spécifique à l’échantillon d’apprentissage au détriment de la structure sous-jacente du phénomène. Ce piège se manifeste par un R2 d’entraînement spectaculairement élevé, masquant un effondrement dramatique de la précision prédictive dès lors que le modèle est confronté à de nouvelles données opérationnelles.
Pour arbitrer rigoureusement entre la complexité structurelle d’un modèle et sa capacité de généralisation, l’analyste sous Excel peut programmer le calcul d’indices de sélection d’information pénalisée, notamment le Critère d’Information d’Akaike (AIC) et le Critère d’Information Bayésien (BIC). En exploitant la somme des carrés résiduels (SSres) et la taille de l’échantillon (n), une approximation courante de l’AIC s’implémente sous tableur via la formule :
AIC = n × LN(SSres / n) + 2(k + 1)
La règle décisionnelle stipule que face à deux modèles concurrents, celui présentant la valeur d’AIC la plus basse doit être systématiquement préféré, car il offre le meilleur compromis entre parcimonie et ajustement. En pratique sous Excel, l’analyste met fréquemment en œuvre une procédure de sélection descendante manuelle (backward elimination) : partant d’un modèle complet saturé, il élimine pas à pas, une à une, les variables affichant les p-valeurs les plus élevées au-dessus du seuil de 0,05, en vérifiant à chaque itération que le R2 ajusté se maintient ou progresse et que l’AIC décroît, jusqu’à converger vers une structure parcimonieuse et robuste.
10.3 Contrôle de la taille d’échantillon et de la puissance statistique
L’estimation fiable des hyperplans de régression multiple est assujettie à des exigences strictes en termes de volumétrie échantillonnale. L’ajustement d’un modèle comportant trop de prédicteurs sur un échantillon excessivement restreint conduit à un sous-dimensionnement statistique critique, caractérisé par une variance d’échantillonnage démesurée des coefficients et un risque colossal de commettre une erreur de type II (ne pas détecter un effet pourtant bien réel dans la population cible).
Dans la littérature méthodologique de référence, la règle empirique de Green fournit deux bornes canoniques indispensables pour dimensionner convenablement une collecte de données :
- Pour tester la significativité globale du modèle (test F sur le R2), la taille d’échantillon minimale requise s’énonce : N ≥ 50 + 8k (où k représente le nombre de régresseurs).
- Pour tester la significativité individuelle de chaque coefficient de régression partielle (tests t sur les pentes), la recommandation minimale s’élève à : N ≥ 104 + k.
Dans des configurations où l’analyste ambitionne d’isoler simultanément des effets globaux et spécifiques, il convient d’adopter le maximum arithmétique issu de ces deux critères. De surcroît, au-delà du simple effectif global N, le praticien sous Excel doit impérativement auditer la variabilité intrinsèque de ses prédicteurs. Un prédicteur qui ne présente quasiment aucune variance au sein de l’échantillon d’apprentissage n’apportera aucune puissance d’inférence et provoquera des singularités d’inversion matricielle dégradant la fiabilité globale du système prédictif.
11. Automatisation et industrialisation des prédictions dans l’environnement Excel
11.1 Conception d’une calculatrice prédictive ergonomique et interactive
Pour transformer une formulation mathématique complexe en un outil d’aide à la décision immédiatement actionnable par des collaborateurs non statisticiens, la construction d’une interface de calcul prédictif ergonomique, sécurisée et interactive s’avère indispensable. L’architecture de cette calculatrice sous Excel s’articule autour d’une séparation hermétique entre la couche de données brutes, la couche de calcul paramétrique matriciel et la couche de présentation frontale.
L’intégrité de la saisie utilisateur doit être verrouillée en amont via l’outil de Validation des données (onglet Données > Validation des données). Pour chaque paramètre d’entrée, des règles de restriction strictes doivent être instaurées : par exemple, contraindre la saisie de la charge cognitive à un nombre décimal compris entre 1 et 10, et celle de l’entraînement hebdomadaire à une valeur comprise entre 0 et 40 heures. Cette barrière logicielle prévient l’introduction accidentelle d’aberrations numériques susceptibles de corrompre le calcul.
En aval, l’application du Formatage conditionnel offre un levier visuel remarquable pour signaler les risques d’extrapolation statistique. Dès lors que la saisie d’un opérateur dépasse l’intervalle empirique couvert par l’échantillon d’apprentissage historique (± 2 écarts types autour de la moyenne de la covariable), la cellule de saisie peut se teinter dynamiquement d’une couleur d’avertissement ambrée ou rouge. Enfin, l’ensemble des cellules hébergeant les formules d’estimation, les coefficients matriciels et les calculs d’intervalles doivent être rigoureusement verrouillées et masquées via les options de protection de feuille (onglet Révision > Protéger la feuille), ne laissant accessibles à la modification que les seules cellules de saisie réservées aux variables d’entrée.
11.2 Automatisation des flux récurrents par fonctions personnalisées VBA
Lorsque le modèle prédictif doit être disséminé à travers de multiples classeurs opérationnels ou être appelé de manière récurrente au sein de procédures de reporting automatisées complexes, l’écriture d’une Fonction Définie par l’Utilisateur (UDF, pour User Defined Function) en Visual Basic pour Applications (VBA) apporte une compacité fonctionnelle inégalée. Une fonction VBA encapsule l’intégralité de l’équation prédictive au sein d’une routine modulaire facilement invocable directement dans la feuille de calcul au même titre qu’une fonction native d’Excel.
La conception d’une fonction personnalisée dédiée à notre simulation psychométrique s’illustre par la structure de code suivante :
Function PredirePerformance(ChargeCognitive As Double, HeuresEntrainement As Double) As Variant
    Dim b0 As Double, b1 As Double, b2 As Double

    ' Assignation des coefficients issus de la calibration
    b0 = 44.82
    b1 = -2.74
    b2 = 1.86

    ' Contrôle des bornes physiologiques et théoriques
    If ChargeCognitive < 1 Or ChargeCognitive > 10 Or HeuresEntrainement < 0 Then
        PredirePerformance = CVErr(xlErrNum)
        Exit Function
    End If

    ' Calcul déterministe de la prédiction
    PredirePerformance = b0 + (b1 * ChargeCognitive) + (b2 * HeuresEntrainement)
End Function
Cette approche présente l’immense avantage de centraliser la définition mathématique du modèle en un point unique du classeur macro (format .xlsm ou complément .xlam). Toute modification subséquente d’un coefficient ou d’une règle de gestion s’opère directement dans l’éditeur VBA et se répercute instantanément sur l’intégralité des milliers de cellules faisant appel à =PredirePerformance(A2; B2). De surcroît, la routine intègre une gestion explicite des exceptions, interceptant les arguments textuels ou hors limites pour renvoyer des codes d’erreur système standardisés plutôt que de produire des calculs fantaisistes.
11.3 Intégration avec Power Query pour le pipeline de modélisation continue
Dans un contexte d’ingénierie de données industrielle, les matrices de modélisation ne sont pas statiques ; elles sont continuellement enrichies par l’arrivée de nouveaux flux transactionnels ou opérationnels issus de bases de données relationnelles, d’ERP ou de fichiers plats décentralisés. Pour orchestrer ce flux d’actualisation sans manipulation manuelle périlleuse, l’outil ETL (Extract, Transform, Load) intégré d’Excel, Power Query, s’impose comme la fondation technologique indispensable.
Le pipeline commence par l’ingestion automatisée des fichiers sources bruts via Power Query, où s’exécutent les opérations de nettoyage en amont : typage strict des colonnes, suppression systématique des doublons, remplacement ou filtrage des données incomplètes et standardisation des formats textuels. Les données nettoyées sont ensuite déversées sous la forme d’un tableau structuré Excel connecté. Étant donné que les formules matricielles dynamiques telles que DROITEREG et PRODUITMAT pointent directement vers les références structurées de ce tableau, toute actualisation de la requête Power Query (via le bouton Actualiser tout) réinjecte instantanément la nouvelle cohorte dans le moteur d’estimation sans exiger la moindre retouche manuelle des formules.
Ce couplage vertueux entre Power Query et le moteur matriciel permet d’ériger un pipeline de Continuous Training & Scoring (entraînement et notation continus) entièrement hébergé dans un environnement bureautique standard. L’analyste s’assure ainsi d’une cohérence dimensionnelle irréprochable entre le jeu d’apprentissage mis à jour et les matrices de projection opérationnelles, conjuguant la flexibilité d’usage du tableur à la robustesse des flux de données automatisés industriels.
12. Restitution académique, éthique prédictive et recommandations méthodologiques
12.1 Normes de présentation des résultats prédictifs selon les standards scientifiques
La communication scientifique et technique des résultats d’une régression multiple ne saurait tolérer une simple capture d’écran brute de l’interface du tableur. Elle impose une formalisation tabulaire rigoureuse répondant aux canons éditoriaux internationaux, tels que ceux édictés par l’American Psychological Association (normes APA, 7e édition). La restitution formelle doit condenser au sein d’une table épurée l’ensemble des grandeurs paramétriques brutes et standardisées ainsi que leurs métriques d’erreur respectives.
Le tableau de synthèse standardisé doit comporter pour chaque régresseur intégré :
- Le coefficient de régression non standardisé brut (noté B) et son erreur standard associée (notée SE B).
- Le coefficient de régression standardisé (noté β), permettant la hiérarchisation sans équivoque de l’impact relatif des covariables.
- La statistique de test individuelle (t de Student) assortie de son niveau exact de significativité statistique (p-valeur rapportée sans le zéro initial sous la forme p = .003, ou p < .001).
- L’intervalle de confiance à 95 % du coefficient non standardisé présenté sous la forme d’un intervalle délimité [Borne Inférieure, Borne Supérieure].
En pied de tableau, les indicateurs macroscopiques d’ajustement doivent être scrupuleusement documentés : le coefficient de détermination R2, le coefficient de détermination ajusté R2ajusté, la statistique globale F accompagnée de ses deux degrés de liberté formels (degrés de liberté de régression et résiduels, formalisés par F(df1, df2) = valeur), ainsi que l’erreur type globale de l’estimation (se). Enfin, le domaine expérimental de validité doit être rigoureusement stipulé en décrivant les caractéristiques sociodémographiques et les bornes numériques de l’échantillon d’apprentissage, afin de prémunir tout utilisateur tiers contre des généralisations abusives.
12.2 Considérations éthiques et interprétabilité des prédictions
Le déploiement de modèles prédictifs dans les sphères managériales, académiques, financières ou cliniques confère à l’analyste une responsabilité déontologique et éthique majeure. Le danger intellectuel le plus prégnant réside dans la confusion récurrente et pernicieuse entre corrélation prédictive et relation causale structurelle. Constater qu’un coefficient de régression présente une significativité éclatante n’atteste en aucun cas que la manipulation de la variable explicative engendrera mécaniquement la mutation attendue de la variable réponse dans le monde réel. En l’absence d’un protocole expérimental randomisé strict, l’analyste doit formellement prohiber tout lexique causal péremptoire lors de la restitution des conclusions opérationnelles.
Dans ce contexte, la transparence algorithmique intrinsèque de la régression linéaire multiple représente un atout éthique inestimable face à l’avènement des architectures prédictives opaques dites « boîtes noires » (telles que les réseaux de neurones profonds ou les forêts aléatoires de grande envergure). Dans un modèle linéaire, chaque prédiction est mathématiquement auditable, traçable et explicable jusqu’au niveau atomique de chaque prédicteur. L’impact marginal exact de chaque variable sur le score final d’un individu peut être documenté et justifié devant un comité d’audit ou un organe de régulation, répondant ainsi aux exigences de transparence et de justice prévues par les réglementations contemporaines sur la protection des données et l’intelligence artificielle (notamment le RGPD européen et l’AI Act).
Cette exigence d’explicabilité prend une résonance éthique singulière lorsque les prédictions algorithmiques affectent directement des trajectoires humaines, qu’il s’agisse de processus d’admission universitaire, d’évaluation de compétences en recrutement, d’octroi de crédits ou de détection précoce de vulnérabilités cliniques. Le statisticien sous Excel a le devoir impérieux d’auditer continuellement l’équité de ses modèles (fairness metrics) afin de garantir que des biais systémiques d’échantillonnage ne conduisent pas à discriminer indirectement certains sous-groupes de populations par l’entremise de variables de substitution (proxy variables) non identifiées.
12.3 Arbre décisionnel pour le choix des outils : Excel versus progiciels spécialisés
Pour conclure cette fresque méthodologique, il est capital de positionner le tableur Excel avec lucidité au sein de l’écosystème global de la science des données. Si Excel s’affirme comme une plateforme incomparable pour le prototypage rapide, la validation conceptuelle, l’audit visuel des calculs et la diffusion d’interfaces de simulation prédictive au sein d’équipes opérationnelles non techniciennes, il existe des seuils méthodologiques et computationnels infranchissables qui dictent la transition incontournable vers des langages et progiciels spécialisés tels que R, Python (avec ses bibliothèques Statsmodels et Scikit-Learn), ou SPSS Statistics.
L’arbre décisionnel guidant le praticien dans cet arbitrage d’infrastructure repose sur les critères structurels suivants :
- Nature de la variable critère : Si la variable dépendante est strictement continue et distribuée normalement, Excel est parfaitement adapté. En revanche, dès lors que le critère est binaire ou multinomial (régression logistique), de nature ordinale (modèle logit ordonné), ou constitué de données de comptage d’événements discrets (régression de Poisson ou binomiale négative), la complexité d’optimisation numérique par le solveur sous Excel justifie le passage immédiat vers R ou Python.
- Volumétrie et scalabilité : Face à des volumétries massives excédant plusieurs centaines de milliers d’enregistrements ou intégrant plusieurs centaines de dimensions explicatives, le moteur de calcul matriciel d’Excel sature, provoquant des latences rédhibitoires. Les architectures basées sur des structures de données optimisées (telles que NumPy ou DataFrames Polars/Pandas) s’imposent alors de facto.
- Structures de données hiérarchiques ou spatiales : Dès lors que les observations sont emboîtées dans des niveaux d’agrégation naturels (par exemple, des élèves au sein de classes, elles-mêmes intégrées dans des établissements scolaires différents), l’hypothèse d’indépendance est violée. L’implémentation de modèles linéaires mixtes à effets aléatoires (HLM) requiert des algorithmes d’estimation par maximum de vraisemblance restreinte (REML) dont l’encodage manuel sous Excel s’avère hors de portée opérationnelle.
- Reproductibilité industrielle et intégration continue : Si le protocole d’analyse s’inscrit dans un pipeline de recherche reproductible exigeant une traçabilité intégrale de la chaîne de nettoyage, des scripts de tests unitaires et un versionnage collaboratif strict sous Git, les scripts textuels de programmation statistique surpassent intrinsèquement la nature hybride données-code du tableur.
En synthèse, Excel ne doit être ni déprécié par élitisme technologique, ni idéalisé par confort d’usage. Pleinement maîtrisé dans ses capacités matricielles les plus pointues et étayé par une discipline méthodologique inflexible, Microsoft Excel se révèle être un instrument d’analyse prédictive d’une extraordinaire puissance pédagogique et opérationnelle, capable d’amener les analystes à une compréhension viscérale, transparente et mathématiquement irréprochable de la modélisation statistique linéaire multivariée.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
Green, S. B. (1991). How many subjects does it take to do a regression analysis? Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill/Irwin.
Microsoft Corporation. (2023). Documentation de la fonction DROITEREG dans Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/droitereg-fonction-droitereg-8434c1e4-f3c5-4124-b14e-9475fa3ab75b
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.