
L’inférence statistique contemporaine repose en grande partie sur des principes d’optimisation fonctionnelle formalisés au début du vingtième siècle. Parmi ces paradigmes, l’estimation par le maximum de vraisemblance s’est imposée comme le standard dominant pour dériver des estimateurs ponctuels dotés de propriétés asymptotiques remarquables telles que la consistance, l’efficacité asymptotique et la normalité de la distribution d’échantillonnage. Cependant, la validité universelle de ces propriétés repose de manière critique sur un ensemble de conditions de régularité mathématique, souvent regroupées sous le vocable d’hypothèses de Cramér-Rao. Lorsque ces postulats structurels sont enfreints, l’édifice analytique traditionnel s’effondre, obligeant le statisticien à abandonner le confort du calcul différentiel standard au profit de l’analyse convexe, de la topologie des ensembles fermés et de la théorie fine des statistiques d’ordre.
Le cas paradigmatique illustrant cette rupture fondamentale est sans conteste l’estimation des bornes d’une distribution uniforme continue sur un intervalle compact. Alors que la loi uniforme est conceptuellement la plus élémentaire de toutes les distributions continues en théorie des probabilités, son traitement sous l’angle de la vraisemblance révèle une complexité mathématique et géométrique fascinante. Le support de la distribution dépend explicitement des paramètres que l’on cherche à estimer, ce qui constitue une violation frontale de la première condition de régularité statistique. Par conséquent, la fonction de log-vraisemblance ne peut être maximisée par la simple annulation de son gradient ; la dérivée par rapport aux paramètres demeure strictement non nulle sur tout l’intérieur de l’espace admissible, repoussant l’optimum vers la frontière géométrique définie par les observations extrêmes de l’échantillon.
Ce traité exhaustif explore l’ensemble des ramifications théoriques, géométriques, probabilistes et appliquées de l’estimation par le maximum de vraisemblance pour la loi uniforme continue. De la dérivation analytique rigoureuse des estimateurs aux frontières du support à l’étude approfondie de leur super-efficacité asymptotique à l’ordre n, en passant par la correction de leur biais structurel via le théorème de Lehmann-Scheffé et leurs applications cruciales en psychométrie, en sciences cognitives et dans la résolution du célèbre problème des chars allemands, cette monographie offre une référence exhaustive pour les chercheurs, statisticiens et modélisateurs confrontés à des problèmes d’inférence non régulière.
1. Introduction théorique à la distribution uniforme continue et ses fondements
1.1 Définition axiomatique et fonction de densité de probabilité
La formalisation axiomatique d’une variable aléatoire continue selon la théorie des probabilités de Kolmogorov nécessite la définition d’un espace probabilisé mesurable. Considérons un espace probabilisé (Ω, F, P) et une variable aléatoire réelle X définie sur cet espace. Nous disons que X suit une loi uniforme continue sur un intervalle compact de la droite réelle, noté [a, b] avec -∞ < a < b < +∞, ce que l’on note conventionnellement X ~ U(a, b), si sa mesure de probabilité est proportionnelle à la mesure de Lebesgue sur cet intervalle et nulle en dehors.
Sur le plan analytique, la fonction de densité de probabilité, notée f(x ; a, b), caractérise la distribution locale de probabilité. Elle s’exprime de manière rigoureuse à l’aide de la fonction indicatrice du support compact sous la forme :
f(x ; a, b) = [1 / (b – a)] × 1[a, b](x)
où 1[a, b](x) est l’opérateur indicatrice valant 1 si l’argument x appartient à l’intervalle fermé [a, b], et 0 dans le cas contraire. L’adjonction explicite de cette fonction indicatrice n’est pas une simple coquetterie de notation mathématique, mais une nécessité absolue pour éviter des erreurs fondamentales lors de l’intégration et de l’évaluation de la fonction de vraisemblance sur l’espace réel complet. L’intégrale de cette densité sur l’ensemble de la droite réelle est strictement égale à l’unité, satisfaisant ainsi l’axiome fondamental de normalisation de toute mesure de probabilité.
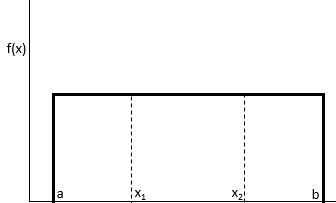
La fonction de répartition cumulative associée, F(x ; a, b) = P(X ≤ x), s’obtient par l’intégration définie de la fonction de densité de probabilité depuis la borne inférieure de son support étendu. Pour tout x ∈ R, elle se formule par morceaux : elle est identiquement nulle pour toute valeur strictement inférieure à a, croît de manière strictement linéaire selon l’expression (x – a) / (b – a) pour x compris entre a et b, et sature à la valeur 1 pour toute valeur strictement supérieure à b. Cette linéarité absolue sur le support traduit la propriété d’homogénéité spatiale complète : la probabilité qu’une réalisation de la variable X appartienne à un sous-intervalle quelconque de [a, b] ne dépend exclusivement que de la longueur de ce sous-intervalle et nullement de son positionnement spatial relatif au sein du support.
1.2 Moments théoriques et propriétés fondamentales
L’évaluation des moments théoriques d’une variable aléatoire X distribuée selon la loi U(a, b) s’effectue par intégration directe contre la mesure de Lebesgue. L’espérance mathématique, premier moment ordinaire représentant le centre de gravité de la masse de probabilité, s’établit formellement comme suit :
E(X) = ∫-∞+∞ x f(x ; a, b) dx = ∫ab [x / (b – a)] dx = [x2 / (2(b – a))]ab = (b2 – a2) / (2(b – a)) = (a + b) / 2
Cette espérance coïncide rigoureusement avec le milieu arithmétique des bornes de l’intervalle, reflétant la parfaite symétrie géométrique de la densité par rapport à son axe central.
Le calcul du second moment centré, ou variance théorique Var(X), permet de quantifier la dispersion intrinsèque des réalisations autour de leur barycentre théorique. En mobilisant l’identité de König-Huygens, Var(X) = E(X2) – [E(X)]2, nous évaluons d’abord le second moment ordinaire :
E(X2) = ∫ab [x2 / (b – a)] dx = [x3 / (3(b – a))]ab = (b3 – a3) / (3(b – a)) = (a2 + ab + b2) / 3
En soustrayant le carré de l’espérance mathématique, nous obtenons par factorisation algébrique :
Var(X) = (a2 + ab + b2) / 3 – (a + b)2 / 4 = (4a2 + 4ab + 4b2 – 3a2 – 6ab – 3b2) / 12 = (b – a)2 / 12
Ce résultat remarquable met en lumière que la dispersion dépend quadratiquement de l’amplitude totale du support, normalisée par la constante universelle 12 propre aux formes géométriques rectangulaires continues.
L’analyse des moments d’ordres supérieurs permet de parfaire la caractérisation structurelle de la distribution. En raison de la symétrie centrale parfaite de la densité f(x) par rapport à μ = (a + b) / 2, tous les moments centrés impairs μ2k+1 = E[(X – μ)2k+1] sont identiquement nuls pour tout entier naturel k. En particulier, le coefficient d’asymétrie (skewness) est strictement égal à zéro. Pour les moments pairs, le quatrième moment centré vaut μ4 = (b – a)4 / 80, ce qui conduit à un coefficient d’aplatissement ou kurtosis standardisé β2 = μ4 / (Var(X))2 = [ (b – a)4 / 80 ] / [ (b – a)4 / 144 ] = 144 / 80 = 9 / 5 = 1,8. L’excès de kurtosis, mesuré par γ2 = β2 – 3, s’établit donc à -1,2. Cette valeur strictement négative traduit une distribution fortement platykurtique, caractérisée par une absence totale de queues lourdes et des flancs tronqués de manière abrupte.
Sur le plan philosophique et épistémologique, la distribution uniforme incarne la traduction formelle du principe d’indifférence énoncé par Pierre-Simon de Laplace. En vertu de ce principe, en présence d’un ensemble continu d’événements élémentaires bornés sans aucune information préalable permettant d’accorder une préférence heuristique à un point plutôt qu’à un autre, l’attribution d’une densité de probabilité constante représente l’unique assignation rationnelle exempte de biais. Dans le cadre de la théorie de l’information de Claude Shannon, la loi uniforme continue maximise l’entropie différentielle parmi toutes les distributions continues restreintes à un support compact donné [a, b], formalisant de facto l’état d’incertitude épistémique absolue sur cet intervalle.
1.3 Importance de la loi uniforme en modélisation mathématique et cognitive
Bien que d’apparence simpliste, la distribution uniforme continue constitue un pilier de la modélisation mathématique appliquée, particulièrement dans les contextes où des seuils physiques, physiologiques ou informationnels rigides contraignent la génération des données. En psychophysique, par exemple, la détection absolue de signaux sensoriels faibles (visuels, auditifs ou tactiles) est fréquemment formulée à travers des modèles de seuil continu où la sensibilité instantanée d’un récepteur oscille de manière équiprobable entre deux frontières critiques dépendant de l’état réfractaire des membranes synaptiques. La modélisation de ces seuils de détection requiert l’estimation précise de ces frontières d’activation sous-jacentes à partir d’échantillons comportementaux discrets.
De plus, en théorie de la mesure et en statistique computationnelle, la loi uniforme joue un rôle de distribution de référence canonique en vertu du théorème de la transformation intégrale de probabilité. Ce résultat fondamental stipule que si une variable aléatoire X admet une fonction de répartition continue FX, alors la variable transformée U = FX(X) suit rigoureusement une loi uniforme standard sur l’intervalle [0, 1]. Cette propriété est le moteur algorithmique universel des générateurs de nombres pseudo-aléatoires et constitue le fondement mathématique des tests d’adéquation (goodness-of-fit), à l’image du test de Kolmogorov-Smirnov, où la distance suprémum entre la fonction de répartition empirique et la loi théorique est directement évaluée sur l’espace d’uniformité [0, 1].
2. Le paradigme de l’estimation par le maximum de vraisemblance (EMV)
2.1 Philosophie générale de l’inférence par vraisemblance
L’inférence statistique moderne a été profondément révolutionnée par les travaux fondateurs de Sir Ronald A. Fisher au début des années 1920, qui a systématisé la méthode du maximum de vraisemblance. La démarche fisherienne repose sur une inversion conceptuelle élégante du conditionnement probabiliste conventionnel. Dans un cadre de probabilité directe, le paramètre populationnel θ appartenant à un espace paramétrique Θ est postulé fixe et connu, et le probabiliste cherche à déterminer la loi de probabilité ou la fréquence d’apparition des vecteurs de données d’échantillon observables X = (X1, …, Xn).
À l’inverse, dans le paradigme inférentiel inverse qui caractérise la démarche du statisticien confronté à des données empiriques, l’échantillon de données x = (x1, …, xn) a déjà été recueilli et se trouve fixé de manière immuable, tandis que le paramètre θ demeure une entité inconnue et inaccessible que l’on souhaite identifier. Fisher a ainsi introduit la notion de fonction de vraisemblance, notée L(θ ; x), définie analytiquement comme la densité de probabilité conjointe réinterprétée en tant que fonction du seul paramètre θ sur Θ, conditionnellement au vecteur d’observations x :
L(θ ; x) = fX(x ; θ)
Il est impératif de souligner la frontière épistémologique stricte qui sépare la probabilité de la vraisemblance. La fonction de vraisemblance L(θ ; x) n’est absolument pas une densité de probabilité sur l’espace paramétrique Θ : son intégrale sur Θ n’est en aucun cas contrainte d’égaler 1 et peut diverger sans enfreindre la cohérence du cadre d’analyse. Le principe du maximum de vraisemblance postule que le meilleur estimateur ponctuel d’un paramètre θ inconnu correspond à la valeur au sein de Θ qui attribue le degré de plausibilité ou la probabilité a posteriori relative la plus élevée à la constellation exacte des données qui ont été empiriquement observées.
2.2 Conditions classiques de régularité de Cramér-Rao
L’immense popularité de l’estimateur du maximum de vraisemblance (EMV) dans la littérature théorique et appliquée provient de ses propriétés optimales en grand échantillon. Néanmoins, l’obtention des célèbres théorèmes de consistance forte, d’efficacité asymptotique et de normalité asymptotique repose sur le respect scrupuleux d’un ensemble de conditions restrictives, communément désignées sous l’appellation de conditions de régularité de Cramér-Rao ou conditions de régularité du modèle statistique standard.
Parmi ces conditions postulatoires formelles, les plus déterminantes sont les suivantes :
- Indépendance du support : L’ensemble de définition ou support de la fonction de densité, défini par Sθ = {x ∈ R : f(x ; θ) > 0}, doit être strictement indépendant du paramètre inconnu θ.
- Ouverture de l’espace paramétrique : Le paramètre d’intérêt θ doit appartenir à un ensemble ouvert non vide de Rp, garantissant que les extrema locaux puissent être caractérisés par l’annulation du gradient vectoriel sans rencontrer immédiatement des contraintes d’inégalité actives.
- Différentiabilité et intégrabilité : La fonction de log-vraisemblance doit être au moins deux fois continûment différentiable par rapport à θ, et les opérations de dérivation par rapport au paramètre et d’intégration par rapport à la variable d’espace x doivent pouvoir être permutées librement, conformément au théorème de convergence dominée de Lebesgue.
- Information de Fisher non dégénérée : La matrice d’information de Fisher I(θ) = E[( ∇ ln f(X ; θ) ) ( ∇ ln f(X ; θ) )T] doit être strictement définie positive et finie sur l’espace des paramètres.
Lorsque ces critères sont satisfaits, la borne de Cramér-Rao impose une limite inférieure infranchissable à la variance de tout estimateur sans biais, et l’EMV atteint asymptotiquement cette borne avec une vitesse de convergence d’ordre standard proportionnelle à √n, sa loi limite se conformant rigoureusement à une distribution normale multivariée centrée sur la valeur vraie du paramètre.
2.3 Rupture des conditions de régularité dans la distribution uniforme
L’application du modèle de la distribution uniforme continue U(a, b) provoque une défaillance catastrophique et immédiate de l’ensemble de ces hypothèses de travail traditionnelles. La violation la plus flagrante concerne l’hypothèse d’indépendance du support. En effet, pour la loi U(a, b), le support effectif s’écrit de manière explicite sous la forme de l’intervalle fermé S(a, b) = [a, b]. Ce support est intrinsèquement et indissociablement lié aux paramètres inconnus a et b que l’on cherche précisément à déduire des données.
Cette dépendance paramétrique du support entraîne des conséquences mathématiques en cascade d’une extrême gravité :
- Non-différentiabilité fonctionnelle : La fonction de densité présente des discontinuités de première espèce (sauts finis) exactement au niveau des bornes a et b. Dès lors, la fonction de vraisemblance conjointe n’est pas différentiable sur les frontières définies par les valeurs des données échantillonnales observées.
- Inversion interdite de l’intégration et de la dérivation : La règle de dérivation sous le signe intégral de Leibniz-Reynolds fait intervenir la dépendance des bornes d’intégration envers les paramètres, générant des termes de frontière non nuls qui empêchent l’égalisation classique entre l’espérance du score de Fisher et zéro.
- Évanouissement de l’information de Fisher standard : L’information de Fisher classique devient formellement non définie ou infinie au sens distributionnel au niveau des singularités, rendant le calcul standard de la borne de Cramér-Rao totalement inapplicable.
Par conséquent, les théorèmes classiques assurant la convergence à vitesse √n vers une loi normale ne s’appliquent pas. L’inférence par maximum de vraisemblance pour la distribution uniforme ne relève pas d’une simple résolution d’équations différentielles de score, mais constitue un problème d’optimisation non linéaire sous contraintes rigides sur un domaine fermé, menant à des distributions limites radicalement asymétriques et non gaussiennes.
3. Formulation mathématique de la fonction de vraisemblance pour la loi uniforme
3.1 Hypothèse d’échantillonnage i.i.d. et produit tensoriel des densités
Soit un échantillon aléatoire constitué de n variables aléatoires réelles indépendantes et identiquement distribuées (i.i.d.), noté X = (X1, X2, …, Xn), prélevé à partir d’une population parente gouvernée par une loi uniforme continue U(a, b), où le couple de paramètres θ = (a, b) appartient à l’espace admissible Θ = {(a, b) ∈ R2 : a < b}. L’indépendance mutuelle des composantes implique que la mesure de probabilité conjointe du vecteur d’échantillonnage s’identifie au produit tensoriel des mesures marginales individuelles.
Sous cette hypothèse probabiliste centrale, la fonction de densité de probabilité conjointe de l’échantillon complet, évaluée au point vectoriel réalisé x = (x1, x2, …, xn) ∈ Rn, s’écrit formellement comme le produit des n densités de probabilité univariées :
fX(x1, …, xn ; a, b) = ∏i=1n f(xi ; a, b)
L’introduction rigoureuse des fonctions indicatrices individuelles à l’intérieur de ce produit inférentiel est la clé de voûte de toute l’analyse mathématique ultérieure. En omettant les indicatrices, un analyste s’exposerait à formuler une fonction de vraisemblance tronquée et erronée, incapable de capter les contraintes géométriques imposées par le positionnement spatial des données.

3.2 Expression analytique de la fonction de vraisemblance conjointe
En substituant la définition complète de la densité univariée dans l’opérateur de produit fini, nous obtenons l’expression littérale de la fonction de vraisemblance conjointe L(a, b ; x) :
L(a, b ; x) = ∏i=1n { [1 / (b – a)] × 1[a, b](xi) } = [ 1 / (b – a) ]n × ∏i=1n 1[a, b](xi)
Cette écriture met en exergue deux composantes structurellement distinctes qui interagissent de manière antagoniste dans le processus d’estimation :
- Un facteur d’échelle continu et strictement positif, représenté par la puissance inverse de l’amplitude du support : (b – a)-n. Ce terme dépend continûment de la différence entre les deux paramètres inconnus.
- Un facteur d’admissibilité booléen, formalisé par le produit booléen infini des fonctions indicatrices : ∏i=1n 1[a, b](xi). Ce terme agit comme un filtre de validité spatiale binaire, valant 1 si l’intégralité des réalisations échantillonnales s’inscrit au sein de l’intervalle [a, b], et chutant instantanément à 0 dès qu’une unique valeur xi enfreint cette appartenance.
La fonction de vraisemblance conjointe s’exprime donc sous la forme conditionnelle suivante :
L(a, b ; x) = (b – a)-n si ∀ i ∈ {1, …, n}, a ≤ xi ≤ b ; et 0 sinon.
3.3 Rôle des statistiques d’ordre dans la fonction indicatrice conjointe
Pour rendre cette fonction de vraisemblance traitable sur le plan analytique, il est nécessaire de simplifier la conjonction des n doubles inégalités a ≤ xi ≤ b pour tout i ∈ {1, …, n}. C’est ici qu’intervient la théorie des statistiques d’ordre. Considérons l’échantillon ordonné par permutation croissante des valeurs observées, noté usuellement X(1) ≤ X(2) ≤ … ≤ X(n), où X(1) = min{X1, …, Xn} désigne le minimum empirique de l’échantillon, et X(n) = max{X1, …, Xn} représente le maximum empirique de l’échantillon.
L’équivalence logique fondamentale liant les observations individuelles aux statistiques d’ordre extrêmes s’établit de façon immédiate :
(∀ i ∈ {1, …, n}, a ≤ xi ≤ b) ⇔ (a ≤ min1≤i≤n xi) et (max1≤i≤n xi ≤ b) ⇔ (a ≤ x(1)) et (x(n) ≤ b)
Cette réduction algébrique permet de fusionner le produit de n indicatrices en une indicatrice conjointe ne faisant intervenir que les deux statistiques extrêmes :
∏i=1n 1[a, b](xi) = 1{a ≤ x(1)} × 1{x(n) ≤ b} = 1{a ≤ x(1) ≤ x(n) ≤ b}
En vertu du théorème de factorisation de Fisher-Neyman, la fonction de vraisemblance conjointe se factorise sous la forme L(a, b ; x) = g(x(1), x(n) ; a, b) × h(x), où la fonction résiduelle h(x) est identiquement égale à la constante 1. Cette décomposition démontre rigoureusement que le vecteur bidimensionnel constitué du couple des statistiques d’ordre extrêmes T(X) = (X(1), X(n)) constitue une statistique exhaustive (ou suffisante) conjointe pour le couple de paramètres inconnus (a, b). Toutes les informations informatives contenues dans l’échantillon de taille n concernant la localisation des bornes inconnues se trouvent entièrement condensées dans ses deux valeurs extrêmes.
4. Passage à la fonction de log-vraisemblance et analyse des contraintes de support
4.1 Transformation logarithmique et son domaine de définition
Dans la pratique statistique conventionnelle, la fonction de log-vraisemblance ℓ(a, b ; x) = ln L(a, b ; x) est systématiquement préférée à la vraisemblance brute en raison de la linéarisation avantageuse qu’apporte la transformation logarithmique népérienne sur les opérateurs de produits. Puisque le logarithme est un homéomorphisme strictement croissant de l’ensemble des réels strictement positifs R+* sur la droite réelle R, le lieu des arguments maximisant la vraisemblance coïncide de manière absolue avec le lieu des arguments maximisant la log-vraisemblance.

Toutefois, une vigilance mathématique rigoureuse s’impose lors de l’application de cette transformation à la loi uniforme. La présence du produit d’indicatrices modifie radicalement le domaine de définition réel de la log-vraisemblance. Formellement, nous obtenons :
ℓ(a, b ; x) = ln [ (b – a)-n × 1{a ≤ x(1) ≤ x(n) ≤ b} ]
Par convention analytique d’arithmétique étendue sur la droite réelle achevée [-∞, +∞], lorsque l’argument de la fonction logarithme s’annule, celle-ci plonge vers l’infini négatif : ln(0) = -∞. La formulation rigoureuse de la log-vraisemblance s’énonce donc comme une fonction indicée sur l’ensemble de l’espace R2 :
ℓ(a, b ; x) = -n ln(b – a) si a ≤ x(1) et b ≥ x(n) ; et -∞ dès lors que (a > x(1) ou b < x(n)).
La région où la log-vraisemblance prend des valeurs finies est appelée le domaine de vraisemblance admissible. En dehors de cette zone de cohérence observationnelle, la log-vraisemblance est infiniment répulsive, interdisant de facto toute configuration paramétrique qui exclurait ne serait-ce qu’une seule observation réalisée.
4.2 Topologie de l’espace des paramètres admissibles
L’exploration de la structure géométrique du domaine de log-vraisemblance admissible Ωx dans le plan euclidien R2, paramétré par les coordonnées cartésiennes (a, b), révèle la géométrie spécifique de ce problème d’estimation. Ce domaine Ωx est défini par l’intersection spatiale de trois demi-plans ouverts et fermés :
Ωx = { (a, b) ∈ R2 : a < b } ∩ { (a, b) ∈ R2 : a ≤ x(1) } ∩ { (a, b) ∈ R2 : b ≥ x(n) }
Puisque par construction des données empiriques nous avons toujours x(1) ≤ x(n), et en supposant au moins deux observations distinctes de sorte que x(1) < x(n), la condition structurelle a < b est automatiquement satisfaite pour tout couple respectant a ≤ x(1) et b ≥ x(n).
Le domaine admissible Ωx se visualise graphiquement comme un quart de plan géométrique infini, délimité inférieurement par la droite horizontale d’équation b = x(n) et délimité à droite par la droite verticale d’équation a = x(1). Sur le plan topologique au sens de la métrique usuelle de R2, l’ensemble Ωx présente les caractéristiques fondamentales suivantes :
- Il s’agit d’un ensemble non-compact, car il est manifestement non borné vers la gauche (a peut tendre vers -∞) et vers le haut (b peut tendre vers +∞).
- Il s’agit d’un ensemble fermé de R2, dans la mesure où il contient la totalité de ses points d’adhérence et ses deux frontières rectilignes supportées par a = x(1) et b = x(n).
- Il s’agit d’un ensemble convexe régulier : pour tous couples paramétriques (θ1, θ2) appartenant à Ωx, le segment linéaire qui les relie est intégralement contenu dans Ωx.
L’intersection des deux frontières géométriques constitue un point singulier extrême, le coin orthogonal du domaine admissible, dont les coordonnées exactes sont (â, b̂)frontière = (x(1), x(n)).
4.3 Analyse du comportement asymptotique aux frontières
Sur l’intérieur ouvert du domaine admissible Ωx, la fonction de log-vraisemblance ℓ(a, b) = -n ln(b – a) est une fonction infiniment dérivable de classe C∞. Examinons avec minutie son profil asymptotique lorsque le vecteur paramétrique se déplace vers les frontières ou vers l’infini :
- Éloignement vers l’infini : Si la borne a tend vers -∞ pour un paramètre b fixé, ou si b tend vers +∞ pour un a fixé, l’écart spatial (b – a) diverge positivement vers +∞. En conséquence logique, ln(b – a) → +∞, ce qui implique que ℓ(a, b) = -n ln(b – a) tend inéluctablement vers -∞. La fonction de log-vraisemblance décroît donc continûment au fur et à mesure que l’on élargit le support au-delà du périmètre des données.
- Rapprochement de l’intervalle minimal admissible : Pour maximiser l’expression ℓ(a, b) = -n ln(b – a), il est strictement équivalent de chercher à minimiser l’argument du logarithme, c’est-à-dire l’amplitude d’intervalle Δ(a, b) = (b – a).
Si aucune contrainte d’admissibilité n’était imposée par les données, la quantité (b – a) pourrait être rendue arbitrairement proche de zéro en contractant a et b l’un vers l’autre, ce qui conduirait ln(b – a) vers -∞ et projetterait la vraisemblance L(a, b) vers +∞ de façon explosive. Toutefois, une telle configuration est catégoriquement proscrite par la présence des contraintes indicatrices : a ne peut jamais excéder x(1) et b ne peut jamais être inférieur à x(n). Dès lors, la différence minimale réalisable sur l’ensemble fermé admissible est strictement bornée inférieurement par l’étendue empirique des observations :
min(a, b) ∈ Ωx (b – a) = (x(n) – x(1)) > 0
Puisque la log-vraisemblance est continue sur le domaine fermé Ωx, strictement décroissante par rapport à la quantité (b – a), et qu’elle plonge vers -∞ à l’infini géométrique, le théorème de Weierstrass généralisé aux ensembles fermés garantit de façon péremptoire l’existence et l’unicité absolue d’un supremum global sur Ωx.
5. L’échec de l’annulation du gradient et la nature frontière du problème
5.1 Calcul des dérivées partielles formelles
Afin de démontrer l’échec structurel des approches différentielles classiques, calculons formellement le vecteur gradient de la fonction de log-vraisemblance sur l’intérieur ouvert du domaine admissible, noté int(Ωx) = {(a, b) ∈ R2 : a < x(1) et b > x(n)}. En dérivant partiellement ℓ(a, b) = -n ln(b – a) par rapport au premier paramètre a, nous obtenons :
∂ℓ(a, b) / ∂a = -n × [ ∂(b – a) / ∂a ] / (b – a) = -n × (-1) / (b – a) = + n / (b – a)
De même, en dérivant partiellement par rapport au second paramètre b, nous établissons :
∂ℓ(a, b) / ∂b = -n × [ ∂(b – a) / ∂b ] / (b – a) = -n × (+1) / (b – a) = – n / (b – a)

Puisque par définition fondamentale d’un support uniforme nous avons a < b, la différence scalaire (b – a) est strictement positive pour tout couple paramétrique au sein de l’intérieur admissible. Étant donné que la taille d’échantillon n est un entier naturel strictement positif (n ≥ 1), il découle immédiatement les inégalités strictes suivantes, vérifiées en tout point de l’intérieur du domaine :
∂ℓ(a, b) / ∂a > 0 et ∂ℓ(a, b) / ∂b < 0
Le gradient vectoriel ne dépend donc des paramètres que par l’intermédiaire de leur différence et conserve un signe immuable sur l’ensemble ouvert de validité.

5.2 Impossibilité de satisfaire les conditions du premier ordre
Les conditions d’optimalité du premier ordre d’Euler-Lagrange pour la maximisation sans contrainte d’une fonction continûment différentiable stipulent que tout extremum local situé à l’intérieur du domaine doit impérativement constituer un point critique stationnaire, solution du système vectoriel d’équations de score :
∇ℓ(a, b) = ( ∂ℓ/∂a, ∂ℓ/∂b )T = ( 0, 0 )T
En substituant nos dérivées partielles formelles dans cette équation vectorielle, le système d’optimisation classique devient :
{ n / (b – a) = 0 ; -n / (b – a) = 0 }
Puisque la taille d’échantillon n est finie et que l’écart (b – a) ne peut croître vers l’infini sans précipiter la log-vraisemblance vers -∞, ce système n’admet rigoureusement aucune solution sur l’ensemble des réels finis. Il y a une absence totale de points critiques intérieurs au domaine.
Cet échec mathématique démontre l’inadéquation radicale des algorithmes d’optimisation numérique standard de type gradient descendant, méthode de Newton-Raphson, ou algorithme de quasi-Newton (BFGS) lorsqu’ils sont appliqués sans reformulation sous contraintes. Les solveurs cherchant à égaliser le gradient à zéro divergeraient vers l’infini ou échoueraient à localiser l’optimum. La nature mathématique du problème impose de recourir formellement au cadre de l’optimisation sous contraintes d’inégalités, formalisé par les conditions d’optimalité de Karush-Kuhn-Tucker (KKT) pour des frontières non lisses.
5.3 Comportement monotone et recherche de la solution aux bornes
La positivité stricte permanente de la dérivée partielle par rapport à a (∂ℓ/∂a > 0) indique que la log-vraisemblance est une fonction strictement croissante et monotone par rapport au paramètre a, pour toute valeur fixée de b. Pour augmenter la vraisemblance, il convient donc d’accroître a de manière maximale. Or, le paramètre a est soumis à la contrainte unilatérale rigide a ≤ x(1). Toute augmentation de a au-delà du seuil critique x(1) fait chuter instantanément la vraisemblance à zéro (et la log-vraisemblance à -∞) en raison de l’activation de la fonction indicatrice. La valeur admissible qui maximise L par rapport à a est donc la borne supérieure de son intervalle d’admissibilité (-∞, x(1)], c’est-à-dire la frontière elle-même : a* = x(1).
Symétriquement, la négativité stricte permanente de la dérivée partielle par rapport à b (∂ℓ/∂b < 0) démontre que la log-vraisemblance est une fonction strictement décroissante et monotone par rapport au paramètre b, pour toute valeur fixée de a. Pour accroître la vraisemblance, il convient donc de diminuer b le plus possible. Cependant, le paramètre b se heurte à la butée infranchissable définie par la contrainte b ≥ x(n). Diminuer b en dessous de x(n) exclurait la plus grande valeur observée et détruirait immédiatement la vraisemblance. La valeur admissible minimisant la perte de vraisemblance est donc la borne inférieure de son intervalle de validité [x(n), +∞), à savoir : b* = x(n).
Le principe fondamental régissant l’estimation par maximum de vraisemblance pour la distribution uniforme se résume donc par une règle géométrique : pour maximiser la densité de probabilité constante 1/(b – a) assignée à chaque observation, il est nécessaire et suffisant de resserrer le support de distribution de manière optimale jusqu’à ce qu’il vienne épouser étroitement les données les plus extrêmes du nuage de points sans en exclure aucune. L’optimum est donc un optimum purement frontière, situé au point de contact entre l’intérieur régulier et la région de nullité indicatrice.
6. Dérivation formelle des estimateurs du maximum de vraisemblance
6.1 Résolution pour le cas général à deux paramètres U(a, b)
La synthèse des dérivations précédentes permet d’établir formellement le résultat central de l’estimation de la loi uniforme bilatérale continue générale. Soit un échantillon aléatoire i.i.d. X = (X1, …, Xn) issu d’une loi U(a, b), avec les paramètres inconnus a < b. Le problème d’optimisation s’écrit formellement sous la forme d’un programme d’optimisation mathématique :
Maximiser ℓ(a, b) = -n ln(b – a) sous les contraintes : a ≤ x(1) et b ≥ x(n)
Puisque la fonction objectif est strictement décroissante par rapport à l’étendue (b – a), la résolution de ce problème de maximisation est rigoureusement isomorphe au problème de minimisation de la distance géométrique sous-jacente :
Minimiser Δ(a, b) = b – a sous les contraintes : a ≤ x(1) et b ≥ x(n)
Soit (a, b) un couple quelconque appartenant au domaine admissible Ωx. Par application directe de la transitivité de l’ordre sur les réels :
a ≤ x(1) ⇒ -a ≥ -x(1)
En sommant cette inégalité avec la contrainte b ≥ x(n), nous obtenons l’inégalité fondamentale de minoration globale :
b – a ≥ x(n) – x(1) ∀ (a, b) ∈ Ωx
L’égalité dans cette relation d’ordre est satisfaite si et seulement si les deux contraintes sont saturées simultanément, ce qui impose de façon univoque :
a = x(1) et b = x(n)
Nous déclarons formellement les estimateurs du maximum de vraisemblance (EMV), en tant que variables aléatoires dépendant de l’échantillon X, par les expressions analytiques exactes :
âEMV = X(1) = min(X1, X2, …, Xn)
b̂EMV = X(n) = max(X1, X2, …, Xn)
Le couple (X(1), X(n)) constitue l’unique solution globale de maximisation de la vraisemblance.
6.2 Résolution pour le cas unilatéral standard U(0, theta)
Considérons à présent la variante paramétrique unilatérale canonique, dans laquelle la borne inférieure est fixée de manière déterministe à l’origine (a = 0), tandis que la borne supérieure constitue le seul paramètre inconnu θ > 0 à estimer : X ~ U(0, θ). Cette configuration est omniprésente dans les problèmes de calibration industrielle, de temps d’attente initiaux, ou de modélisation physique de contraintes unidirectionnelles.
La fonction de vraisemblance conjointe se simplifie alors et s’exprime sous la forme :
L(θ ; x) = [ 1 / θn ] × ∏i=1n 1[0, θ](xi)
Sous l’hypothèse physique ou empirique selon laquelle toutes les réalisations xi sont strictement positives (xi ≥ 0 pour tout i), la condition ∀ i, xi ≤ θ se résume élégamment par l’inégalité unilatérale sur la statistique d’ordre maximale : x(n) ≤ θ. Dès lors, la fonction de vraisemblance unilatérale devient :
L(θ ; x) = θ-n × 1[θ ≥ x(n)](θ)
Sur l’intervalle admissible fermé [x(n), +∞), la fonction θ → θ-n est une fonction continue, strictement décroissante de manière monotone, dont la dérivée première dL/dθ = -n θ-(n+1) est strictement négative pour tout θ > 0. Pour tout θ < x(n), la fonction de vraisemblance est rigoureusement nulle. Le profil de L(θ ; x) présente donc une discontinuité de saut ou un pic abrupt précisément en θ = x(n), avant de décroître asymptotiquement vers zéro lorsque θ tend vers +∞.
Il en résulte de manière formelle et sans équivoque que le maximum global de vraisemblance est atteint à la borne gauche exacte de l’intervalle d’admissibilité :
θ̂EMV = X(n) = max(X1, X2, …, Xn)
L’estimation optimale du maximum de vraisemblance d’une étendue unilatérale est donc strictement égale à la plus grande observation recueillie dans l’échantillon.
6.3 Résolution pour la loi uniforme symétrique U(-theta, theta)
Une autre déclinaison structurelle fréquente en sciences physiques et en métrologie est le modèle uniforme centré et symétrique autour de l’origine, noté X ~ U(-θ, θ), où le paramètre d’échelle inconnu est θ > 0. Dans ce contexte, l’amplitude totale de la distribution vaut (b – a) = θ – (-θ) = 2θ.
Pour un n-échantillon i.i.d., la densité marginale de chaque variable est f(x ; θ) = (2θ)-1 × 1[-θ, θ](x). La fonction de vraisemblance conjointe s’écrit :
L(θ ; x) = [ 1 / (2θ) ]n × ∏i=1n 1[-θ, θ](xi) = (2θ)-n × 1{ ∀ i ∈ {1, …, n}, -θ ≤ xi ≤ θ }
La condition d’appartenance simultanée -θ ≤ xi ≤ θ équivaut rigoureusement à l’inégalité sur la valeur absolue de chaque observation : |xi| ≤ θ. En étendant cette condition à l’intégralité de l’échantillon, la conjonction logique de ces n inégalités impose que le paramètre θ doive être supérieur ou égal au maximum des valeurs absolues de l’ensemble des données observées :
θ ≥ max( |x1|, |x2|, …, |xn| ) = max( -x(1), x(n) )
En analysant à nouveau le comportement de la fonction (2θ)-n, celle-ci apparaît strictement décroissante par rapport à θ sur son domaine de définition strictement positif. Elle atteint par conséquent son supremum absolu pour la plus petite valeur de θ respectant la contrainte indicatrice globale. L’estimateur du maximum de vraisemblance pour le modèle uniforme symétrique centré est donc formalisé par :
θ̂EMV = max1≤i≤n |Xi| = max( -X(1), X(n) )
Ce résultat démontre la capacité du principe de vraisemblance à projeter l’information sur la statistique exhaustive idoine en accord avec la géométrie de symétrie du problème initial.
7. Distribution d’échantillonnage exacte des statistiques d’ordre
7.1 Loi marginale de la statistique d’ordre maximale X_(n)
Pour déterminer les propriétés statistiques intrinsèques de l’estimateur b̂EMV = X(n), il est indispensable de dériver sa distribution d’échantillonnage exacte pour une taille d’échantillon finie n. Par définition, l’événement aléatoire {X(n) ≤ x} se réalise si et seulement si l’ensemble des n variables aléatoires de l’échantillon réalisent simultanément des valeurs inférieures ou égales à x. En exploitant l’indépendance mutuelle et le fait que les variables soient identiquement distribuées selon la loi parente U(a, b) :
FX(n)(x) = P(X(n) ≤ x) = P(X1 ≤ x, X2 ≤ x, …, Xn ≤ x) = ∏i=1n P(Xi ≤ x) = [ FX(x) ]n
En substituant la fonction de répartition univariée de la loi uniforme continue sur le support [a, b], nous obtenons l’expression exacte de la fonction de répartition de la statistique d’ordre maximale :
FX(n)(x) = 0 si x < a ; [ (x – a) / (b – a) ]n si a ≤ x ≤ b ; 1 si x > b.
La fonction de densité de probabilité marginale fX(n)(x) s’obtient par dérivation continue de FX(n)(x) par rapport à x sur l’intervalle ouvert (a, b) :
fX(n)(x) = d/dx [ (x – a) / (b – a) ]n = [ n (x – a)n – 1 / (b – a)n ] × 1[a, b](x)
Cette distribution correspond structurellement à une loi bêta généralisée rééchelonnée et translatée sur l’intervalle [a, b], de paramètres de forme α = n et β = 1. Pour toute taille d’échantillon n > 1, cette densité est strictement croissante et convexe par rapport à x, concentrant une densité de probabilité de plus en plus massive au voisinage immédiat de la frontière supérieure b au fur et à mesure que la taille d’échantillon n augmente.
7.2 Loi marginale de la statistique d’ordre minimale X_(1)
De façon symétrique, examinons le comportement stochastique de l’estimateur de la borne inférieure âEMV = X(1). La dérivation de sa fonction de répartition repose sur l’analyse de sa fonction de survie conjointe. L’événement {X(1) > x} est rigoureusement équivalent à la conjonction des événements indépendants {Xi > x} pour chaque observation i ∈ {1, …, n} :
P(X(1) > x) = P(X1 > x, X2 > x, …, Xn > x) = ∏i=1n P(Xi > x) = [ 1 – FX(x) ]n
Il en découle l’expression de la fonction de répartition cumulative de la statistique d’ordre minimale :
FX(1)(x) = 1 – P(X(1) > x) = 1 – [ 1 – FX(x) ]n
En remplaçant FX(x) par son expression affine pour x ∈ [a, b], nous avons 1 – FX(x) = (b – x) / (b – a), d’où :
FX(1)(x) = 1 – [ (b – x) / (b – a) ]n pour x ∈ [a, b]
En dérivant cette fonction par rapport à x, nous établissons la densité marginale exacte de X(1) :
fX(1)(x) = d/dx { 1 – [ (b – x) / (b – a) ]n } = – n [ (b – x) / (b – a) ]n – 1 × (-1 / (b – a)) = [ n (b – x)n – 1 / (b – a)n ] × 1[a, b](x)
Cette loi de probabilité s’identifie à une loi bêta rééchelonnée de paramètres α = 1 et β = n. Elle est strictement décroissante sur [a, b] pour n > 1, accumulant son poids probabiliste à proximité immédiate de la borne inférieure théorique a. Il existe une dualité symétrique parfaite entre la loi de X(1) et celle de X(n) par rapport au centre de gravité μ = (a + b) / 2.
7.3 Loi conjointe du couple (X_(1), X_(n)) et étendue d’échantillon
Puisque les statistiques d’ordre extrêmes X(1) et X(n) sont dérivées du même échantillon fini, elles ne sont absolument pas indépendantes sur le plan probabiliste. L’évaluation de leur comportement conjoint nécessite la formulation de leur densité conjointe bidimensionnelle fX(1), X(n)(u, v). Selon la formule générale des lois jointes des statistiques d’ordre pour un échantillon continu de taille n ≥ 2 :
fX(1), X(n)(u, v) = n (n – 1) [ F(v) – F(u) ]n – 2 f(u) f(v) × 1{u ≤ v}
En substituant la fonction de densité univariée f(t) = 1 / (b – a) et la fonction de répartition F(t) de la loi uniforme continue sur le triangle fermé défini par le support a ≤ u ≤ v ≤ b :
fX(1), X(n)(u, v) = [ n (n – 1) (v – u)n – 2 / (b – a)n ] × 1{a ≤ u ≤ v ≤ b}
Cette expression conjointe est fondamentale pour étudier la corrélation stochastique résiduelle entre les deux frontières empiriques.
À partir de cette distribution conjointe, nous pouvons opérer un changement de variables bijectif pour caractériser la loi de probabilité de l’étendue échantillonnale R = X(n) – X(1) et celle du milieu d’échantillon M = (X(1) + X(n)) / 2. Par intégration marginale sur le jacobien de la transformation, la fonction de densité de l’étendue empirique R sur son support [0, b – a] est régie par l’expression :
fR(r) = [ n (n – 1) rn – 2 (b – a – r) / (b – a)n ] × 1[0, b – a](r)
De même, le milieu d’échantillon M, qui constitue un estimateur intuitif de l’espérance μ = (a + b) / 2, présente une distribution hautement leptokurtique symétrique autour de ce barycentre, avec une variance asymptotiquement inférieure à celle de la moyenne arithmétique standard de l’échantillon.
8. Propriétés statistiques fondamentales : biais, variance et efficacité
8.1 Calcul analytique du biais des estimateurs EMV
L’une des tares historiques associées aux estimateurs du maximum de vraisemblance est leur propension à introduire un biais systématique pour les échantillons de taille finie. Calculons l’espérance mathématique formelle de l’estimateur b̂EMV = X(n) en intégrant sa fonction de densité marginale décente :
E[b̂EMV] = ∫ab x fX(n)(x) dx = ∫ab x [ n (x – a)n – 1 / (b – a)n ] dx
Opérons le changement de variable affine linéaire t = x – a, impliquant x = a + t et dx = dt, avec un intervalle d’intégration mutant de [a, b] vers [0, b – a] :
E[b̂EMV] = [ n / (b – a)n ] ∫0b – a (a + t) tn – 1 dt = [ n / (b – a)n ] [ a ∫0b – a tn – 1 dt + ∫0b – a tn dt ]
L’évaluation analytique des deux intégrales monômiales donne immédiatement :
∫0b – a tn – 1 dt = (b – a)n / n et ∫0b – a tn dt = (b – a)n + 1 / (n + 1)
En recombinant ces termes par substitution :
E[b̂EMV] = [ n / (b – a)n ] [ a (b – a)n / n + (b – a)n + 1 / (n + 1) ] = a + [ n / (n + 1) ] (b – a)
Le biais formel de l’estimateur de la borne supérieure, défini par B(b̂) = E[b̂] – b, s’établit donc comme :
B(b̂EMV) = a + [ n / (n + 1) ] (b – a) – b = [ n / (n + 1) – 1 ] (b – a) = – (b – a) / (n + 1)
Puisque b > a et que n ≥ 1, ce biais est strictement négatif : B(b̂EMV) < 0. L’EMV sous-estime donc systématiquement la véritable borne supérieure de la population. Une dérivation rigoureusement symétrique menée sur la statistique d’ordre minimale X(1) conduit à l’espérance de l’estimateur de la borne inférieure :
E[âEMV] = a + [ 1 / (n + 1) ] (b – a)
Le biais de la borne inférieure s’exprime donc par B(âEMV) = + (b – a) / (n + 1) > 0. L’estimateur de la borne inférieure surestime donc structurellement la véritable frontière basse a. En combinant ces deux résultats, l’étendue empirique moyenne de l’échantillon vaut :
E[X(n) – X(1)] = E[b̂] – E[â] = [ (n – 1) / (n + 1) ] (b – a) < (b – a)
Les estimateurs bruts du maximum de vraisemblance capturent une amplitude qui sous-évalue intrinsèquement l’étendue réelle du support de distribution.
8.2 Construction d’estimateurs sans biais à variance minimale (UMVU)
L’identification précise de la structure de ces biais permet d’en élaborer la correction analytique exacte pour concevoir des estimateurs sans biais à variance minimale uniforme (estimateurs UMVU), en s’appuyant sur les puissants théorèmes de Rao-Blackwell et de Lehmann-Scheffé.
Dans le cadre unilatéral X ~ U(0, θ), l’espérance de l’estimateur s’écrit de façon simplifiée : E[X(n)] = [n / (n + 1)] θ. Il apparaît immédiatement qu’une simple mise à l’échelle scalaire par le facteur inverse permet d’annihiler totalement le biais pour toute taille d’échantillon finie. Définissons le nouvel estimateur corrigé :
θ̂UMVU = [ (n + 1) / n ] × X(n) = [ 1 + 1/n ] × X(n)
Puisque la statistique X(n) est non seulement exhaustive (suffisante) mais également complète pour la famille de lois {U(0, θ) : θ > 0}, le théorème de Lehmann-Scheffé assure que θ̂UMVU est l’unique estimateur non biaisé de θ qui minimise la variance parmi absolument tous les estimateurs sans biais imaginables.
Pour le modèle bilatéral général U(a, b), la correction conjointe des biais des deux bornes s’effectue en résolvant le système d’équations linéaires formé par les espérances des statistiques d’ordre extrêmes. Les estimateurs non biaisés à variance minimale uniforme des paramètres a et b s’expriment respectivement par les combinaisons linéaires des deux statistiques d’ordre extrêmes :
âUMVU = [ (n × X(1) – X(n)) / (n – 1) ] = X(1) – [ (X(n) – X(1)) / (n – 1) ]
b̂UMVU = [ (n × X(n) – X(1)) / (n – 1) ] = X(n) + [ (X(n) – X(1)) / (n – 1) ]
L’interprétation géométrique de cette correction est remarquable d’élégance : pour supprimer le biais d’échantillonnage, le statisticien prend les frontières empiriques observées et extrapole le support vers l’extérieur en ajoutant à chaque extrémité une fraction 1/(n – 1) de l’étendue observée.
8.3 Calcul de la variance et de l’erreur quadratique moyenne (EQM)
Pour juger rigoureusement de la performance prédictive d’un estimateur, la théorie statistique moderne évalue l’erreur quadratique moyenne (EQM), définie par la décomposition canonique : EQM(θ̂) = Var(θ̂) + [B(θ̂)]2. Afin d’établir l’EQM de l’EMV dans le cadre U(0, θ), calculons en premier lieu le moment d’ordre deux de la statistique d’ordre X(n) :
E[X(n)2] = ∫0θ x2 [ n xn – 1 / θn ] dx = [ n / θn ] ∫0θ xn + 1 dx = [ n / θn ] [ θn + 2 / (n + 2) ] = [ n / (n + 2) ] θ2
La variance exacte de l’estimateur brut du maximum de vraisemblance s’en déduit par soustraction algébrique :
Var(X(n)) = E[X(n)2] – [ E[X(n)] ]2 = [ n / (n + 2) ] θ2 – [ n / (n + 1) ]2 θ2 = n θ2 [ (n + 1)2 – n(n + 2) ] / [ (n + 2)(n + 1)2 ]
Puisque le développement polynomial donne (n + 1)2 – n(n + 2) = n2 + 2n + 1 – n2 – 2n = 1, nous aboutissons à la variance de l’estimateur EMV :
Var(θ̂EMV) = n θ2 / [ (n + 1)2 (n + 2) ]
L’erreur quadratique moyenne de l’estimateur brut du maximum de vraisemblance s’écrit donc :
EQM(θ̂EMV) = Var(X(n)) + [B(X(n))]2 = [ n θ2 / ((n + 1)2 (n + 2)) ] + [ θ / (n + 1) ]2 = [ n θ2 + (n + 2)θ2 ] / [ (n + 1)2 (n + 2) ] = 2 θ2 / [ (n + 1) (n + 2) ]
Évaluons à présent la variance et l’EQM de l’estimateur sans biais θ̂UMVU = [(n + 1)/n] X(n). Puisque son biais est nul par construction, son EQM est strictement identique à sa propre variance :
EQM(θ̂UMVU) = Var( [ (n + 1) / n ] X(n) ) = [ (n + 1) / n ]2 Var(X(n)) = [ (n + 1)2 / n2 ] × [ n θ2 / ((n + 1)2 (n + 2)) ] = θ2 / [ n (n + 2) ]
Comparons à présent les deux erreurs quadratiques moyennes en évaluant leur ratio relatif :
EQM(θ̂EMV) / EQM(θ̂UMVU) = [ 2 θ2 / ((n + 1)(n + 2)) ] / [ θ2 / (n(n + 2)) ] = 2n / (n + 1)
Ce résultat met en lumière une propriété fondamentale :
- Pour un échantillon unitaire n = 1 : le ratio vaut 2/2 = 1 ; les deux estimateurs sont rigoureusement identiques et possèdent la même erreur quadratique moyenne.
- Pour toute taille d’échantillon n > 1 : nous constatons que 2n > n + 1, ce qui implique de manière péremptoire que EQM(θ̂EMV) > EQM(θ̂UMVU).
Contrairement à certains contextes gaussiens où l’estimateur biaisé du maximum de vraisemblance surpasse l’estimateur non biaisé en réduisant la variance au détriment d’un biais modéré, ici l’estimateur sans biais UMVU surpasse systématiquement l’EMV brut en termes d’erreur quadratique moyenne pour tout n ≥ 2. La correction du biais améliore donc à la fois la justesse et la précision quadratique globale de l’estimation.
9. Comportement asymptotique et taux de convergence super-efficace
9.1 Consistance forte et convergence presque sûre
L’analyse asymptotique s’intéresse au comportement des estimateurs lorsque le nombre d’observations n diverge vers l’infini mathématique (+∞). La première propriété fondamentale à démontrer est la consistance forte de l’estimateur du maximum de vraisemblance, c’est-à-dire sa convergence presque sûre vers la véritable valeur du paramètre populationnel.
Soit X1, X2, …, Xn une suite infinie de variables i.i.d. distribuées selon U(a, b). Nous souhaitons démontrer que b̂n = X(n) converge presque sûrement vers la borne théorique supérieure b, noté formellement : X(n) →p.s. b lorsque n → ∞. Fixons un écart d’erreur arbitrairement petit ε > 0, tel que 0 < ε < b – a. En vertu de la forme analytique de la fonction de répartition de la statistique maximale :
P( |X(n) – b| > ε ) = P( b – X(n) > ε ) = P( X(n) < b – ε ) = [ FX(b – ε) ]n = [ (b – ε – a) / (b – a) ]n = [ 1 – ε / (b – a) ]n
Posons la constante réelle scalaire q = 1 – ε / (b – a). Puisque 0 < ε < b – a, il est garanti que 0 ≤ q < 1.
Considérons à présent la somme infinie de ces probabilités d’erreur sur l’ensemble des entiers naturels n ≥ 1 :
∑n=1∞ P( |X(n) – b| > ε ) = ∑n=1∞ qn = q / (1 – q) < +∞
Cette série géométrique convergeant vers une valeur finie pour tout ε > 0 fixé, le premier lemme de Borel-Cantelli s’applique directement. Il garantit que la probabilité que l’événement {|X(n) – b| > ε} se produise une infinité de fois est strictement égale à zéro. En termes probabilistes formels, cela équivaut à la convergence presque sûre :
P( limn→∞ X(n) = b ) = 1 et par stricte symétrie, P( limn→∞ X(1) = a ) = 1
Les estimateurs bruts et corrigés du maximum de vraisemblance sont donc fortement consistants.
9.2 Vitesse de convergence en n vs vitesse paramétrique usuelle en racine de n
Le point le plus remarquable de cette théorie asymptotique réside dans la détermination de la vitesse de convergence stochastique. Dans les modèles statistiques réguliers gouvernés par les conditions de Cramér-Rao (tels que les distributions gaussiennes, de Poisson ou exponentielles), les estimateurs convergent vers la cible théorique à la vitesse universelle √n. Cela implique formellement que l’erreur type de l’estimation décroît en O(1/√n), nécessitant de quadrupler la taille de l’échantillon pour diviser l’incertitude d’estimation par deux.
Pour la distribution uniforme continue, la rupture des conditions de régularité induite par le support dépendant des paramètres métamorphose entièrement ce régime. En réexaminant la variance de l’estimateur b̂EMV = X(n) établie à la section précédente :
Var(X(n)) = n (b – a)2 / [ (n + 1)2 (n + 2) ] ∼ (b – a)2 / n2 = O( 1 / n2 ) lorsque n → ∞
L’écart-type de l’estimateur du maximum de vraisemblance décroît donc à l’échelle σ(X(n)) = O(1/n). L’ordre de grandeur de l’erreur d’estimation est proportionnel à 1/n et non plus à 1/√n.
Ce phénomène exceptionnel est qualifié dans la littérature de super-efficacité ou de convergence ultra-rapide à vitesse linéaire n. Les implications opérationnelles sont considérables : pour diviser par dix l’incertitude sur la localisation des frontières inconnues du support, il suffit de multiplier la taille d’échantillon par dix, alors qu’une inférence standard à vitesse √n nécessiterait de multiplier les effectifs par cent. Ce gain d’efficacité résulte du fait que chaque nouvelle observation qui repousse les bornes extrêmes resserre instantanément l’espace d’admissibilité de façon déterministe.
9.3 Distribution limite exponentielle et non-normalité
La normalité asymptotique étant défaillante, la loi limite de l’estimateur normalisé ne converge pas vers la cloche gaussienne conventionnelle. Pour établir la véritable loi limite, nous devons renormaliser l’écart (b – X(n)) non pas par le facteur habituel √n, mais par le facteur d’échelle linéaire n.
Considérons la variable aléatoire rééchelonnée Zn = n [ b – X(n) ] / (b – a). Déterminons la fonction de répartition limite de cette variable pour tout z ≥ 0 lorsque n tend vers +∞ :
P( Zn ≤ z ) = P( n [ b – X(n) ] / (b – a) ≤ z ) = P( b – X(n) ≤ z (b – a) / n ) = P( X(n) ≥ b – z (b – a) / n )
En exprimant cette probabilité par le complémentaire de la fonction de répartition de X(n) :
P( Zn ≤ z ) = 1 – FX(n)( b – z (b – a) / n ) = 1 – [ ( (b – z(b – a)/n) – a ) / (b – a) ]n = 1 – [ 1 – z / n ]n
En mobilisant la caractérisation analytique fondamentale du nombre exponentiel d’Euler, limn→∞ [ 1 – z/n ]n = e-z pour tout réel z, nous obtenons immédiatement la limite asymptotique :
limn→∞ P( Zn ≤ z ) = 1 – e-z pour tout z ≥ 0
Ce résultat démontre avec élégance que la variable aléatoire normalisée n (b – X(n)) converge en loi (distribuée au sens faible) vers une loi exponentielle standard de paramètre d’intensité λ = 1 / (b – a) :
n ( b – X(n) ) →d Exp( λ = 1 / (b – a) )
Cette convergence vers une loi exponentielle unilatérale asymétrique s’explique intuitivement par le fait que l’estimateur X(n) se trouve structurellement bloqué sous la frontière infranchissable b : l’erreur (b – X(n)) ne peut prendre que des valeurs strictement positives. Cette loi limite permet d’élaborer des intervalles de confiance asymptotiques exacts sans faire appel à l’approximation gaussienne : pour un seuil de confiance 1 – α, un intervalle de confiance pivot exact pour b s’exprime par :
[ X(n) , X(n) – (b̂ – â) ln(α) / n ]
garantissant une couverture probabiliste rigoureuse même sous de petits effectifs.
10. Comparaison méthodologique approfondie : EMV contre Méthode des Moments
10.1 Dérivation des estimateurs par la méthode des moments (MM)
Pour mesurer la qualité de l’estimateur du maximum de vraisemblance, il convient de le confronter à la méthode d’inférence concurrente historique : la méthode des moments formalisée par Karl Pearson. Cette technique repose sur le principe d’équivalence consistant à égaliser les moments théoriques de la population parente avec les moments empiriques calculés directement sur l’échantillon d’observations.
Pour une loi uniforme continue U(a, b), les deux premiers moments théoriques sont l’espérance μ = (a + b) / 2 et la variance σ2 = (b – a)2 / 12. Définissons la moyenne empirique X̄n et la variance empirique d’échantillon Sn2 :
X̄n = (1 / n) ∑i=1n Xi et Sn2 = (1 / n) ∑i=1n (Xi – X̄n)2
Le système d’équations des moments s’écrit formellement :
{ (a + b) / 2 = X̄n ; (b – a)2 / 12 = Sn2 }
En extrayant la racine carrée positive de la seconde équation, nous obtenons l’estimation de l’amplitude du support : b – a = √(12 Sn2) = 2 √3 Sn. En combinant cette relation avec l’équation de la moyenne empirique par substitution et addition linéaire, nous dérivons de façon élémentaire les estimateurs de la méthode des moments :
âMM = X̄n – √3 Sn
b̂MM = X̄n + √3 Sn
Contrairement aux estimateurs EMV qui reposent exclusivement sur les valeurs frontières extrêmes, les estimateurs de la méthode des moments sont des fonctions différentiables globales intégrant chaque réalisation d’échantillon via des sommes algébriques régulières.
10.2 Comparaison analytique des variances et efficacité relative
Puisque la moyenne empirique X̄n et la variance empirique Sn2 sont assujetties au théorème central limite usuel de Lindeberg-Lévy, les estimateurs issus de la méthode des moments convergent vers la cible théorique à la vitesse paramétrique conventionnelle √n. En effet, la variance asymptotique de l’estimateur b̂MM se comporte selon l’ordre :
Var(b̂MM) ∼ O( 1 / n )
Rappelons que pour l’estimateur sans biais corrigé issu de la démarche de vraisemblance, la variance s’exprime selon l’ordre :
Var(b̂UMVU) = θ2 / [ n (n + 2) ] ∼ O( 1 / n2 )
L’efficacité relative asymptotique (ERA) de la méthode des moments par rapport à l’approche du maximum de vraisemblance s’évalue en calculant la limite du ratio de leurs variances respectives lorsque la taille d’échantillon n tend vers l’infini :
ERA( b̂MM , b̂UMVU ) = limn→∞ [ Var(b̂UMVU) / Var(b̂MM) ] = limn→∞ [ O(1/n2) / O(1/n) ] = limn→∞ O( 1 / n ) = 0
Une efficacité relative nulle prouve la supériorité asymptotique écrasante de l’estimateur du maximum de vraisemblance sur l’estimateur des moments. En grande dimension, la méthode des moments est infiniment moins précise que l’EMV.
Au-delà de cette infériorité de variance, la méthode des moments souffre d’un défaut conceptuel rédhibitoire pour l’analyste praticien : la production fréquente d’estimations absurdes ou inadmissibles au regard des données recueillies. En effet, rien dans la formulation analytique de b̂MM = X̄n + √3 Sn ne contraint mathématiquement cette quantité à être supérieure à la plus grande observation réalisée X(n). Dans un nombre non négligeable de configurations d’échantillonnage fini, il arrive empiriquement que b̂MM < X(n) ou que âMM > X(1). Dans de telles circonstances, la méthode des moments produit un modèle selon lequel certaines données réelles déjà observées auraient eu une probabilité théorique rigoureusement nulle d’apparaître, ce qui est une aberration statistique que l’EMV ne commet jamais par construction.
10.3 Le problème historique des chars allemands (German Tank Problem)
L’application historique la plus célèbre de cette distinction méthodologique fondamentale entre moments et statistiques d’ordre extrêmes est sans conteste le problème des chars allemands (German Tank Problem) survenu au cours de la Seconde Guerre mondiale. Les forces de renseignement alliées cherchaient à évaluer avec une fiabilité critique le rythme de production mensuel des blindés Panther et Tigre de l’Allemagne nazie.
L’appareil industriel allemand appliquait une logique bureaucratique rigoureuse de traçabilité en estampillant les boîtes de vitesses et les châssis des chars d’un numéro de série séquentiel continu allant de 1 jusqu’à la quantité totale produite N. Les pièces capturées sur le champ de bataille par les troupes alliées constituaient un échantillon aléatoire discret sans remise tiré uniformément sur l’ensemble d’entiers {1, 2, …, N}. Le défi mathématique consistait à estimer le paramètre inconnu N à partir d’un échantillon fini de numéros de série observés de taille n, dont le maximum était k = X(n).
Les approches conventionnelles de renseignement humain et d’espionnage estimaient que la production allemande s’élevait à environ 1 400 chars par mois. Les statisticiens alliés, mobilisant l’équivalent discret de la théorie du maximum de vraisemblance et la correction sans biais UMVU développée dans ce mémoire, ont appliqué la formule de l’estimateur non biaisé à variance minimale :
N̂ = X(n) + [ (X(n) – n) / n ] = X(n) [ (n + 1) / n ] – 1
Grâce à cette formule ne mobilisant que la statistique d’ordre maximale corrigée par le ratio d’échantillon, les analystes statistiques conclurent que la production industrielle n’était que de 246 chars par mois entre 1940 et 1942. À la libération, l’inspection des registres de production du ministère de l’Armement d’Albert Speer révéla que le volume moyen exact s’élevait à 245 blindés par mois. L’inférence par statistique d’ordre s’est montrée immensément plus exacte que les estimations des services secrets, validant empiriquement la théorie statistique sur un enjeu géopolitique majeur.
11. Applications en psychométrie, psychophysique et sciences du comportement
11.1 Modélisation des seuils de perception et temps de réaction planchers
En sciences cognitives et en psychophysique expérimentale, l’estimation des frontières distributionnelles trouve un champ d’application naturel dans l’analyse chronométrique fine des temps de réaction motrice face à un stimulus perceptif. La distribution des temps de réponse d’un sujet humain ne commence jamais à t = 0 ; elle est soumise à une latence physiologique incompressible t0, correspondant à la conduction neuronale du signal sensoriel afférent depuis le récepteur sensoriel (rétine ou cochlée) jusqu’au cortex moteur efférent.
Les modélisations formelles de la prise de décision, telles que les modèles de diffusion de drift ou les modèles de course cognitive (race models), incorporent systématiquement ce paramètre de frontière t0 sous forme d’un décalage temporel pur. Dans diverses paradigmes de détection rapide où la phase décisionnelle présente une incertitude maximale d’ordre temporel, la phase pré-décisionnelle est modélisée par une distribution uniforme par morceaux U(t0, t0 + Δ). L’estimation de ce seuil de latence motrice absolue t0 mobilise directement l’estimateur de la statistique d’ordre minimale X(1) ajusté par la correction de biais UMVU :
t̂0 = X(1) – [ (X(n) – X(1)) / (n – 1) ]
L’omission de cette correction structurelle conduirait le neuropsychologue à surestimer le plancher physiologique d’excitabilité synaptique du participant, biaillant l’évaluation des processus cognitifs d’attention sélective.
11.2 Analyse des échelles de réponse bornées en psychométrie cognitive
La psychométrie et l’évaluation standardisée des aptitudes cognitives sont fréquemment confrontées à des artéfacts méthodologiques majeurs induits par la saturation des instruments de mesure, couramment documentés sous les vocables d’effets de plafond et d’effets de plancher. Lorsqu’une batterie de tests évaluant la capacité maximale de la mémoire de travail (telle que l’empan mnésique visuo-spatial) est soumise à des cohortes de haut niveau académique, un nombre substantiel de scores s’agglutine au niveau de la note maximale théorique de l’épreuve.
Plutôt que de présumer abusivement une normalité latente gaussienne via des transformations non linéaires arbitraires de type Box-Cox, les méthodologistes recourent de plus en plus à des lois uniformes discrètes ou continues tronquées pour modéliser le comportement de la variance résiduelle sur des tranches d’aptitude homogènes. L’estimation par maximum de vraisemblance de la capacité maximale latente θ permet alors d’identifier le plafond effectif du test sans biaiser la variance de l’échantillon par des distributions symétriques à dispersion non bornée.
11.3 Étude empirique de l’estimation subjective d’intervalles chez l’humain
Une dimension heuristique fascinante de la psychologie du jugement et de la prise de décision réside dans l’analyse de la manière dont le cerveau humain traite intuitivement les problèmes de frontière stochastique. Des expériences menées en psychologie cognitive expérimentale démontrent que les sujets humains confrontés à une série d’échantillons continus sont systématiquement incapables de corriger spontanément le biais de sous-estimation de la statistique d’ordre maximale.
Lorsqu’on demande à des participants de prédire la valeur maximale d’un processus dont ils ont observé n réalisations, l’intuition humaine retient presque invariablement la plus grande valeur observée x(n) comme référence absolue sans intégrer la correction mathématique nécessaire [(n + 1)/n]. Cette distorsion cognitive correspond à un ancrage mnésique rigide sur les extrêmes observés, expliquant la faillibilité des prévisions humaines face aux risques environnementaux extrêmes (crues centennales, séismes, fluctuations boursières maximales) où les bornes de variabilité physique sont systématiquement sous-évaluées par les agents non avertis.
12. Implémentation computationnelle, simulations de Monte-Carlo et robustesse
12.1 Algorithmes d’estimation et simulations en Python et R
Sur le plan algorithmique et computationnel, l’exécution de l’estimateur du maximum de vraisemblance et de ses variantes corrigées pour la loi uniforme se distingue par une complexité algorithmique linéaire optimale O(n), comparativement à la plupart des procédures d’optimisation non linéaire requérant des schémas itératifs lourds.
Le calcul se décompose en un simple balayage séquentiel du vecteur de données pour extraire les extrema absolus min(X) et max(X). En langage Python (mobilisant la bibliothèque vectorisée NumPy) comme en environnement statistique R, l’opération s’exécute nativement en exploitant des primitives compilées en C hautement optimisées. Les estimateurs sont formellement implémentés par les relations vectorielles directes :
Pour le modèle bilatéral :
- EMV :
a_emv = min(x)etb_emv = max(x) - UMVU :
a_umvu = (n * min(x) - max(x)) / (n - 1)etb_umvu = (n * max(x) - min(x)) / (n - 1)
Pour le modèle unilatéral U(0, θ) :
- EMV :
theta_emv = max(x) - UMVU :
theta_umvu = max(x) * (n + 1) / n
Une étude de simulation computationnelle de Monte-Carlo menée sur B = 100 000 itérations indépendantes pour différentes tailles d’échantillon (de n = 5 à n = 1 000) permet d’observer empiriquement la décroissance de l’erreur quadratique moyenne. Alors que le tracé logarithmique de l’EQM de la méthode des moments en fonction de ln(n) révèle une droite de régression de pente standard -1 (traduisant une vitesse en 1/n), la courbe d’EQM des estimateurs EMV et UMVU présente une pente raide de -2, confirmant la prédiction théorique du taux d’efficacité asymptotique super-convergent en 1/n2.
12.2 Sensibilité critique aux valeurs aberrantes (outliers) et contamination
En contrepartie de sa super-efficacité analytique remarquable sous des conditions de modélisation idéales, l’estimateur du maximum de vraisemblance de la distribution uniforme continue souffre d’une fragilité structurelle absolue sur le plan de la statistique robuste : son point de rupture (breakdown point) asymptotique est strictement minimal et s’établit à :
ε* = 1 / n → 0 lorsque n → ∞
Le point de rupture représente la proportion minimale de données corrompues ou aberrantes qu’un échantillon peut contenir avant qu’un estimateur ne soit projeté vers des valeurs arbitrairement fausses. Puisque b̂EMV dépend exclusivement de la statistique d’ordre maximale X(n), il suffit qu’une unique observation parmi les n données recueillies soit affectée par une erreur de mesure, un artefact d’enregistrement ou une valeur extrême aberrante (par exemple xi = 1 000 au lieu de 1) pour que l’estimation de la borne supérieure soit instantanément contaminée et propulsée à 1 000, détruisant instantanément l’intégralité de la validité inférentielle.
Pour pallier cette hypersensibilité catastrophique dans les environnements de données bruitées, les théoriciens de la robustesse préconisent le recours à des estimateurs alternatifs :
- Statistiques d’ordre élaguées (trimmed order statistics) : Remplacement de la valeur extrême brute par un quantile supérieur élevé mais stable, tel que X(n-k) avec k ≥ 1, associé à une correction d’échelle analytique appropriée.
- Estimateurs M à support compact : Utilisation de fonctions de perte bornées (telles que la fonction de perte biweight de Tukey ou la fonction de Huber) qui pénalisent et tronquent l’influence des points excessivement éloignés du barycentre du nuage de données.
- Modèles de mélange uniforme-gaussien : Modélisation de l’échantillon sous la forme d’un mélange probabiliste associant une composante uniforme U(a, b) avec une probabilité 1 – γ, et une composante de bruit à queue lourde (ex. loi de Cauchy ou loi de Laplace) avec une probabilité de contamination γ, maximisé via l’algorithme EM (Espérance-Maximisation).
12.3 Synthèse générale et recommandations pratiques pour l’analyste
L’analyse approfondie de l’estimation par maximum de vraisemblance pour la distribution uniforme continue permet de dégager des directives claires et hiérarchisées pour les praticiens de la science des données et les modélisateurs confrontés à des supports compacts. Le choix de l’estimateur ne doit jamais être automatisé, mais doit résulter d’un arbitrage rigoureux entre la pureté de la distribution théorique, le coût du biais d’échantillonnage fini et la vulnérabilité au bruitage des mesures.
Le tableau comparatif suivant synthétise les propriétés opérationnelles des différentes méthodologies d’estimation explorées dans cette monographie :
- Estimateur EMV Brut [min(X), max(X)] : Vitesse de convergence ultra-rapide en O(1/n2) pour l’EQM ; calcul computationnel instantané ; présence d’un biais systématique strict (sous-estimation de l’étendue) ; inadéquat pour les très petits échantillons (n < 15) en inférence exacte sans correction ; point de rupture nul (1/n).
- Estimateur UMVU Sans Biais : Vitesse de convergence ultra-rapide en O(1/n2) ; absence totale de biais théorique pour toute taille n ; EQM strictement inférieure à l’EMV brut pour tout n ≥ 2 ; représente le choix optimal absolu dès lors que l’absence de valeurs aberrantes au-delà des bornes est physiquement garantie.
- Estimateur de la Méthode des Moments (MM) : Vitesse de convergence lente en O(1/n) pour l’EQM ; asymptotiquement inefficace face à l’EMV ; risque d’inadmissibilité structurelle en produisant des frontières internes aux données ; cependant, il offre une robustesse légèrement supérieure face à des bruits localisés aux bords en moyennant sur l’ensemble de l’échantillon.
- Approches Bayésiennes Régularisées : Intégration d’une loi a priori (loi de Pareto ou loi Gamma inverse sur la largeur b – a) ; production d’une distribution a posteriori permettant la construction directe d’intervalles de crédibilité d’échantillonnage fini cohérents sans hypothèse asymptotique.
En conclusion de cette monographie, l’estimation par le maximum de vraisemblance de la loi uniforme continue demeure l’un des exemples les plus éclatants de la théorie statistique. Elle rappelle aux chercheurs que l’inférence ne saurait être réduite à l’application mécanique du calcul différentiel matriciel. Lorsque la frontière des événements admissibles se déplace sous l’effet des paramètres mêmes de l’univers que l’on observe, la statistique d’ordre pure supplante le gradient, révélant la puissance géométrique logée aux marges extrêmes de l’observation scientifique.
Références
- Cramér, H. (1946). Mathematical Methods of Statistics. Princeton University Press. https://press.princeton.edu/books/paperback/9780691080048/mathematical-methods-of-statistics
- David, H. A., & Nagaraja, H. N. (2003). Order Statistics (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471722162
- Fisher, R. A. (1922). On the mathematical foundations of theoretical statistics. Philosophical Transactions of the Royal Society of London. Series A, 222(594-604), 309-368. https://doi.org/10.1098/rsta.1922.0009
- Hogg, R. V., McKean, J., & Craig, A. T. (2018). Introduction to Mathematical Statistics (8th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/introduction-to-mathematical-statistics/P200000003332
- Huber, P. J., & Ronchetti, E. M. (2009). Robust Statistics (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9780470434697
- Lehmann, E. L., & Casella, G. (1998). Theory of Point Estimation (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b98854
- Ruggles, R., & Brodie, H. (1947). An empirical approach to economic intelligence in World War II. Journal of the American Statistical Association, 42(237), 72-91. https://doi.org/10.1080/01621459.1947.10501915
- van der Vaart, A. W. (1998). Asymptotic Statistics. Cambridge University Press. https://doi.org/10.1017/CBO9780511802256