
L’inférence statistique dans le cadre des devis expérimentaux et quasi expérimentaux repose sur une série de postulats théoriques dont l’exactitude conditionne la validité des conclusions scientifiques. Parmi les procédures d’analyse bivariée les plus couramment mobilisées en psychologie quantitative, en neurosciences cognitives et en sciences du comportement, la comparaison de deux moyennes d’échantillons indépendants occupe une place prépondérante. Formalisée au début du vingtième siècle sous l’impulsion des travaux pionniers de William Sealy Gosset, publiant sous le pseudonyme de Student, cette approche comparative nécessite une attention scrupuleuse accordée aux propriétés distributionnelles des populations sous-jacentes. Trop souvent réduite à un calcul mécanique au sein des logiciels d’analyse de données, l’application du test t pour échantillons indépendants engage en réalité la responsabilité épistémologique du chercheur face à la structure intrinsèque de sa variance.
Le postulat d’homoscédasticité, qui stipule l’égalité stricte des variances au sein des populations dont sont extraits les groupes d’observation, constitue l’une des pierres angulaires du test t classique. Néanmoins, dans la pratique empirique des sciences humaines et médicales, la parfaite homogénéité des dispersions relève plus de l’exception théorique que de la règle observable. Les manipulations expérimentales, l’hétérogénéité étiologique des populations cliniques ou encore la sensibilité différentielle des participants aux protocoles d’intervention induisent fréquemment une variabilité asymétrique entre les conditions. Face à cette réalité empirique, l’évaluation de la variance n’est pas un simple préalable technique accessoire, mais un arbitrage déterminant qui oriente le choix entre le modèle de Student et la correction d’approximation proposée par Bernard Lewis Welch.
Le présent traité méthodologique se propose d’examiner de manière exhaustive les mécanismes statistiques, computationnels et conceptuels permettant de déterminer l’égalité ou l’inégalité des variances dans le cadre des tests t. En explorant la nature mathématique de l’homoscédasticité, les écueils probabilistes soulevés par le dilemme de Behrens-Fisher, l’éventail des tests de diagnostic formels tels que ceux de Levene, Brown-Forsythe et Bartlett, ainsi que les heuristiques empiriques et les représentations visuelles modernes, cet article offre un guide de référence rigoureux. Il aborde également la controverse contemporaine relative aux stratégies de décision en deux étapes et éclaire l’évolution des pratiques vers l’adoption systématique du test de Welch, tout en fournissant des protocoles d’implémentation opérationnels et des directives de rédaction conformes aux standards académiques les plus exigeants de l’American Psychological Association.
1. Fondements conceptuels : la variance et l’homoscédasticité dans les tests t
1.1 Définition théorique de l’homoscédasticité statistique
L’homoscédasticité statistique désigne la propriété selon laquelle deux ou plusieurs distributions conditionnelles présentent une dispersion résiduelle rigoureusement identique autour de leurs paramètres de tendance centrale respectifs. Formellement, si l’on considère deux populations statistiques distinctes modélisées par les variables aléatoires discrètes ou continues X1 et X2, l’homoscédasticité postule l’égalité stricte de leurs paramètres de dispersion du second ordre, soit l’identité mathématique Sigma-carré-1 = Sigma-carré-2 = Sigma-carré. Dans le cadre de l’inférence statistique fréquentiste, cette invariance de la variance résiduelle signifie que l’incertitude aléatoire non expliquée par l’appartenance à un groupe ou à une modalité de traitement opère avec une intensité métrique équivalente au sein de chaque sous-population investiguée.
L’importance fondamentale de cette homogénéité des variances réside dans la préservation des propriétés optimales des estimateurs des moindres carrés ordinaires et du rapport de vraisemblance. Dans le cadre de la théorie de Neyman-Pearson, l’exactitude de la valeur critique tabulée pour une distribution t repose directement sur l’indépendance statistique entre la différence observée des moyennes d’échantillons et l’estimateur de l’erreur-type qui vient en normaliser l’amplitude. Lorsque l’homoscédasticité est satisfaite, la variance totale d’un ensemble de données peut être décomposée de manière parfaitement additive et non biaisée en une variance intra-groupe (exprimant l’erreur aléatoire d’échantillonnage) et une variance inter-groupes (capturant l’effet du facteur expérimental ou de la variable catégorielle indépendante).
Cette distinction mathématique constitue le fondement même du modèle linéaire général, dont le test t d’indépendance n’est qu’une déclinaison univariée élémentaire à deux modalités. En psychométrie et en théorie de la mesure, le modèle linéaire généralisé postule que le score observé d’un sujet individuel est la somme linéaire d’un paramètre fixe de localisation (la moyenne de la condition), d’un effet imputable au statut du groupe et d’un terme résiduel d’erreur individuel epsilon. Pour que l’estimation des erreurs-types soit convergente et efficace au sens du théorème de Gauss-Markov, ce terme d’erreur doit être identiquement distribué pour tous les individus, indépendamment du groupe d’assignation. Dès lors qu’une condition expérimentale module non seulement la position centrale mais également la variabilité intrinsèque des résidus, l’hypothèse de dispersion constante s’effondre, fragilisant les soubassements déductifs de l’analyse standard.
1.2 Différence fondamentale entre test t de Student et test t de Welch
Le test t classique conçu par William Sealy Gosset part du principe que, les variances populationnelles étant inconnues mais postulées rigoureusement identiques, il est méthodologiquement supérieur de combiner les informations de dispersion fournies par les deux échantillons pour forger un estimateur unique plus précis. Cet estimateur mutualisé, désigné sous le terme de variance groupée ou pooled variance (notée Sp-carré), correspond à la moyenne arithmétique des variances d’échantillons pondérée par leurs degrés de liberté respectifs (n1 – 1) et (n2 – 1). L’erreur-type de la différence des moyennes est alors définie par le produit de la racine carrée de cette variance groupée par le facteur d’ajustement de taille racine carrée de ((1/n1) + (1/n2)). La statistique d’épreuve qui en découle suit de manière exacte une loi de Student paramétrée par précisément (n1 + n2 – 2) degrés de liberté sous l’hypothèse nulle.
À l’inverse, l’approche développée par Bernard Lewis Welch et perfectionnée conjointement avec Frank E. Satterthwaite abandonne l’hypothèse d’une variance commune sous-jacente. Le test t de Welch traite les variances d’échantillon s1-carré et s2-carré comme des estimateurs entièrement autonomes des variances populationnelles distinctes Sigma-1-carré et Sigma-2-carré. En conséquence, l’erreur-type n’intègre aucune mutualisation et se calcule simplement comme la racine carrée de la somme des variances d’échantillons divisées par leurs effectifs propres, soit racine carrée de ((s1-carré / n1) + (s2-carré / n2)). La singularité géniale de la solution de Welch-Satterthwaite réside dans le réajustement des degrés de liberté associés à la distribution d’épreuve, lesquels ne sont plus un entier fixé par la combinatoire simple des tailles d’échantillons, mais un scalaire continu, souvent non entier, calculé via une fonction complexe des variances relatives et des tailles d’échantillons.
La comparaison des statistiques d’épreuve et de la précision des erreurs-types révèle des divergences structurelles majeures dès que les conditions empiriques s’écartent du cas idéal homoscédastique. Alors que le test t de Student impose un dénominateur commun qui masque les asymétries de précision entre sous-groupes, le test de Welch adapte la sévérité du seuil critique à la volatilité réelle des données. Les scénarios théoriques favorisant l’une ou l’autre procédure ont longtemps opposé une économie computationnelle en faveur de Student lorsque les effectifs et variances sont égaux à une prudence méthodologique absolue préconisant Welch dès lors qu’un doute raisonnable subsiste sur l’identité des processus générateurs de variance.
1.3 Enjeux méthodologiques de la variance en psychologie expérimentale
En psychologie expérimentale et dans les disciplines cognitives contemporaines, la variance empirique n’est pas un simple paramètre de nuisance mathématique qu’il s’agirait de gommer, mais l’expression directe de la variabilité interindividuelle et intra-individuelle des processus psychiques sous-jacents. Les traits de personnalité, les capacités de mémoire de travail, les latences de décision motrice ou les scores d’autorégulation émotionnelle ne se manifestent jamais de façon rigoureusement homogène au sein de cohortes humaines. Certaines personnes présentent une robustesse cognitive exceptionnelle face aux interférences, tandis que d’autres s’avèrent hautement vulnérables, générant une dispersion naturelle substantielle au sein des mesures psychométriques de référence.
De surcroît, l’introduction d’une manipulation expérimentale active — qu’il s’agisse de l’administration d’un protocole d’entraînement cognitif, de l’induction d’un stress aigu par le paradigme de Trier, ou de la prise d’une molécule psychotrope — a très fréquemment pour conséquence d’altérer la variance en même temps que la moyenne. Par exemple, une intervention pédagogique innovante peut bénéficier massivement à un sous-groupe d’apprenants réceptifs tout en restant sans effet notable sur les participants moins engagés, ce qui a pour conséquence immédiate d’accroître substantiellement la variance du groupe expérimental par rapport à celle du groupe témoin passif. La variance devient alors le témoin empirique d’une réactivité différentielle au traitement.
Les conséquences directes d’une mauvaise spécification de cette dispersion sur la reproductibilité des résultats sont délétères pour l’édifice scientifique. Lorsqu’un chercheur postule à tort l’égalité des variances pour appliquer un test t standard, il s’expose à fausser drastiquement l’estimation de la probabilité critique p. Cette méconnaissance de la structure de variance engendre une cascade de publications contenant des résultats soit indûment positifs (faux positifs), soit faussement négatifs, contribuant de façon directe à la crise de réplication qui secoue la psychologie et les neurosciences comportementales depuis plus d’une décennie.
2. Le problème de Behrens-Fisher et l’impact sur l’erreur statistique
2.1 Origine théorique et mathématique de la question de Behrens-Fisher
Le problème méthodologique connu sous le nom de problème de Behrens-Fisher tire ses origines des travaux de Walter Ulrich Behrens en 1929 et des développements ultérieurs de Ronald Aylmer Fisher. Il touche à l’impossibilité théorique d’élaborer un test d’hypothèse exact, universel et invariant au sens de la théorie classique de l’échantillonnage, visant à comparer les espérances de deux populations normales lorsque le ratio de leurs variances Sigma-1-carré sur Sigma-2-carré est totalement inconnu et potentiellement différent de l’unité. En termes mathématiques stricts, il n’existe aucune statistique pivotale exacte qui dépende uniquement de la différence des moyennes d’échantillons et des paramètres d’intérêt sans faire intervenir de paramètres de nuisance irréductibles.
Cette impasse statistique découle du fait que la distribution de la statistique t classique, sous l’hypothèse nulle d’égalité des moyennes, dépend formellement du ratio inconnu des variances vraies. Par conséquent, aucune valeur tabulée unique ne peut garantir simultanément un seuil de signification de 5 % sous toutes les configurations envisageables de ces paramètres cachés. Pour surmonter cette impossibilité analytique, plusieurs générations de théoriciens ont proposé des approximations probabilistes remarquables, parmi lesquelles les solutions fiduciales de Fisher, les méthodes de région de confiance de Neyman, et surtout les approximations asymptotiques élaborées par Welch et Satterthwaite au moyen du raccordement des moments distributionnels.
La pertinence contemporaine de la question de Behrens-Fisher demeure absolue dans l’analyse de données issues d’échantillons indépendants. Même à l’ère du calcul numérique à haute performance et des méthodes intensives de rééchantillonnage, la structure mathématique de ce problème rappelle constamment aux chercheurs que la comparaison de moyennes isolées n’a pas de sens probabiliste rigoureux sans une modélisation conjointe et adéquate des échelles de dispersion au sein desquelles ces mesures sont ancrées.
2.2 Conséquences de l’hétéroscédasticité sur le taux d’erreur de type I
L’impact premier et le plus pernicieux de l’hétéroscédasticité non prise en compte réside dans la déformation incontrôlée du taux d’erreur de type I, conventionnellement formalisé par le risque nominal alpha, généralement fixé au seuil de 0,05. Lorsque l’hypothèse d’homoscédasticité est violée mais que le chercheur persiste à exploiter le test t de Student en mutualisant les variances d’échantillon, la valeur p calculée perd son étalonnage exact. Selon la configuration conjointe des variances et des effectifs de groupe, le taux effectif de faux positifs peut s’envoler de façon dramatique pour atteindre des valeurs inacceptables de 0,15, 0,20 voire 0,30, transformant une expérience sans le moindre effet réel en une prétendue découverte statistique hautement significative.
Inversement, dans d’autres configurations structurelles de données, l’hétérogénéité des variances provoque un écrasement excessif de la statistique d’épreuve, générant une inflation majeure de l’erreur de type II (bêta). Dans ce contexte, la probabilité d’échouer à rejeter une hypothèse nulle qui est pourtant factuellement fausse augmente considérablement, ce qui entraîne une perte substantielle de puissance statistique. Le chercheur passe alors à côté d’effets réels, réduisant à néant les investissements matériels et humains engagés dans la collecte des données expérimentales.
Cette distorsion systématique fragilise également de manière critique la validité et la précision des intervalles de confiance associés à la taille de l’effet observée, matérialisée par la différence non standardisée des moyennes (Mu-1 – Mu-2) ou par le d de Cohen. L’erreur-type servant à la délimitation des bornes inférieure et supérieure de confiance étant calculée sur une prémisse erronée, l’intervalle obtenu ne garantit plus son taux de couverture nominal de 95 %. Il se révèle soit excessivement étroit, conférant une fausse impression de certitude métrique, soit démesurément large et asymétrique, annihilant toute possibilité de méta-analyse cumulative rigoureuse.
2.3 Effet d’interaction avec le déséquilibre de taille d’échantillon
La vulnérabilité du test t classique aux violations de l’homogénéité des variances est intimement tributaire du ratio des effectifs n1 et n2 au sein des deux groupes comparés. Lorsque les plans expérimentaux sont parfaitement équilibrés, c’est-à-dire lorsque n1 est rigoureusement égal à n2, le test de Student bénéficie d’une propriété remarquable de pseudo-robustesse. Dans cette géométrie symétrique particulière, l’estimateur de la variance groupée coïncide exactement avec la moyenne arithmétique simple des deux variances d’échantillon, ce qui permet à la statistique d’épreuve de préserver un taux d’erreur de type I relativement proche de 0,05, tant que l’hétérogénéité des variances ne devient pas extrême et que la normalité est préservée.
Cependant, dès lors que l’échantillonnage produit des effectifs inégaux — une situation quasi universelle en recherche clinique, épidémiologique ou appliquée —, l’interaction entre hétérogénéité des variances et asymétrie d’effectif produit des distorsions catastrophiques. Deux scénarios opposés doivent impérativement être distingués :
- Le scénario libéral : il survient lorsque le groupe possédant le plus petit effectif (n min) présente la variance empirique la plus élevée (s-carré max). Dans cette configuration, la variance groupée Sp-carré est massivement tirée vers le bas par l’influence pondérale du grand groupe à faible dispersion. L’erreur-type calculée s’avère considérablement sous-estimée, ce qui gonfle artificiellement la statistique d’épreuve t et provoque une explosion incontrôlée du taux d’erreur de type I bien au-delà de 0,05.
- Le scénario conservateur : il se manifeste lorsque le groupe au plus grand effectif (n max) supporte la variance la plus forte (s-carré max). La variance groupée est alors indûment majorée par le poids mathématique du grand échantillon, ce qui produit une erreur-type excessivement large. La statistique t est artificiellement comprimée vers zéro, induisant une dégradation sévère de la puissance statistique et un effondrement de la capacité à détecter des variations de moyennes cliniquement pertinentes.
Les dangers méthodologiques de ces plans non orthogonaux sont omniprésents en psychiatrie et en neuropsychologie clinique, où le recrutement de patients atteints de pathologies rares ou sévères plafonne souvent à des effectifs modestes (par exemple n2 = 18 patients), alors que la cohorte de témoins sains s’avère aisément disponible en plus grand nombre (par exemple n1 = 65 témoins). Les patients affichant fréquemment une désorganisation comportementale qui accroît considérablement leur variabilité individuelle, cette configuration réunit tous les ingrédients du scénario libéral, générant un terreau propice à la prolifération d’inférences trompeuses au sein de la littérature spécialisée.
3. La règle empirique du ratio des variances
3.1 Fondements du seuil empirique (ratio de variance inférieur à 4)
Face à la complexité des calculs exacts et à l’époque où les logiciels d’analyse n’étaient pas omniprésents, les statisticiens appliqués ont forgé diverses heuristiques décisionnelles destinées à encadrer la pratique des chercheurs de terrain. Parmi ces règles pratiques, le principe du rapport entre la plus grande variance échantillonnale observée et la plus petite variance d’échantillon occupe une position historique centrale. Cette heuristique repose sur la quantification de la métrique R-var = (s-carré max / s-carré min), calculée directement à partir des estimations descriptives non biaisées de la dispersion intra-groupe.
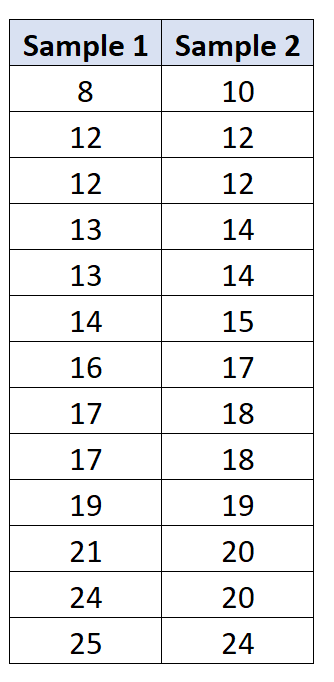
L’origine de ce seuil, largement diffusé et accepté sur le plan pédagogique dans les manuels de référence en biostatistique et en analyse de variance, fixe généralement la limite d’admissibilité de l’homoscédasticité à un ratio maximal ne devant pas excéder la valeur critique de 4, à condition expresse que les tailles d’échantillons demeurent quasi équivalentes. La justification théorique sous-jacente s’appuie sur le comportement numérique de la variance groupée : sous un ratio inférieur à 4 dans un plan équilibré, la déviation du taux d’erreur de type I réel par rapport au niveau nominal de 0,05 demeure contenue dans un intervalle généralement jugé tolérable par les méthodologistes (souvent compris entre 0,04 et 0,07).
Il importe de souligner avec rigueur l’équivalence géométrique de ce critère exprimé en termes d’écarts-types. Puisque l’écart-type n’est rien d’autre que la racine carrée positive de la variance (s = racine carrée de s-carré), un ratio de variances de 4 correspond mathématiquement à un ratio d’écarts-types exactement égal à 2 pour 1 (s max / s min <= 2). Tout rapport de dispersion où l’écart-type de l’un des groupes fait plus que doubler celui de l’autre signale d’emblée une brèche substantielle dans l’hypothèse de stationnarité résiduelle, alertant l’analyste sur la non-fiabilité potentielle d’un modèle de Student standard.
3.2 Démonstration pratique et procédure de calcul pas à pas
Pour illustrer la mise en œuvre de cette heuristique empirique, envisageons une recherche en psychologie cognitive examinant les temps de réponse à une tâche d’attention sélective (paradigme de Stroop) administrée sous deux conditions : une condition contrôle sans bruit distracteur et une condition expérimentale avec induction d’un bruit environnemental imprévisible. Les résultats descriptifs obtenus après traitement primaire des données brutes se structurent de la façon suivante :
Le groupe contrôle (groupe 1), composé de n1 = 30 participants, présente une moyenne de temps de réaction m1 = 450 millisecondes et un écart-type s1 = 45 millisecondes. Sa variance d’échantillon s1-carré s’établit par conséquent à (45 au carré) = 2025 ms au carré. Le groupe soumis au bruit distracteur (groupe 2), réunissant n2 = 28 participants, affiche une moyenne m2 = 495 millisecondes mais présente une dispersion considérablement élargie sous l’effet du stresseur auditif, avec un écart-type s2 = 95 millisecondes, correspondant à une variance d’échantillon s2-carré de (95 au carré) = 9025 ms au carré.
La procédure d’évaluation algorithmique s’exécute selon une séquence d’étapes systématiques :
- Extraction des métriques descriptives : Identifier clairement s1-carré = 2025 et s2-carré = 9025.
- Calcul explicite du ratio : Déterminer quelle variance constitue le numérateur de façon à obtenir un quotient strictement supérieur ou égal à 1 : R-var = s-carré max / s-carré min = s2-carré / s1-carré = 9025 / 2025 = 4,457.
- Application de la règle de décision : Le ratio calculé (4,46) étant strictement supérieur au seuil empirique de 4 (ce qui équivaut à un ratio d’écarts-types de 95 / 45 = 2,11, excédant le seuil de 2), l’hypothèse d’une homoscédasticité approximative doit être formellement rejetée.
Dans ce contexte précis, le maintien du test t de Student classique exposerait les conclusions à une sous-estimation substantielle de la variabilité réelle du traitement distracteur. La décision méthodologique s’impose d’elle-même : le chercheur doit opérer une transition immédiate vers le test t de Welch, ajustant ainsi de manière endogène les degrés de liberté afin de prémunir son inférence contre l’hétérogénéité des variances.
3.3 Avantages opérationnels et limites de cette heuristique
L’attrait opérationnel indéniable de cette règle du ratio réside dans son extrême simplicité et son immédiateté calculatoire. Elle s’affranchit entièrement du recours à des tables statistiques complexes ou à des tests d’hypothèse intermédiaires, permettant une prise de décision rapide lors de l’inspection exploratoire d’un tableau récapitulatif de statistiques descriptives. Elle agit comme une balise de signalisation préliminaire essentielle, prévenant l’analyste contre un aveuglement algorithmique trop fréquent face aux sorties informatisées brutes.
Toutefois, les limites méthodologiques et statistiques de cette approche heuristique sont profondes et interdisent son utilisation exclusive au sein d’une démarche académique de haut niveau. Premièrement, cette méthode est purement descriptive et ne dispose d’aucun mécanisme de contrôle formel du niveau de significativité statistique de la différence observée. Un ratio de variances de 3,8, formellement inférieur au seuil fatidique de 4, peut s’avérer statistiquement hautement significatif si les effectifs d’échantillons sont très importants (par exemple n1 = n2 = 500), révélant une rupture d’homogénéité que l’heuristique choisit arbitrairement d’ignorer.
Deuxièmement, cette règle de décision ne procède à aucun ajustement dynamique en présence d’échantillons très réduits ou, au contraire, substantiellement asymétriques. Lorsque n1 = 12 et n2 = 50, tolérer un ratio de variances de 3,5 peut suffire à dégrader de façon catastrophique le taux d’erreur de type I si la forte dispersion est concentrée au sein du petit groupe. L’heuristique pèche ainsi par son insensibilité à l’incertitude d’échantillonnage qui affecte les estimateurs de variance eux-mêmes lorsque les degrés de liberté sont faibles.
4. Le test d’égalité des variances de Levene
4.1 Mécanique statistique et modèle computationnel sous-jacent
Face à la nécessité de formaliser l’évaluation de l’homoscédasticité au sein d’un cadre inférentiel strict, le statisticien Howard Levene a introduit en 1960 une procédure novatrice destinée à tester la nullité de la différence entre variances sans être excessivement dépendant de l’hypothèse de normalité univariée. Le test de Levene opère une conversion élégante d’un problème d’analyse des dispersions d’ordre deux en un problème classique d’analyse de variance univariée (ANOVA) d’ordre un sur des données transformées.
La mécanique computationnelle sous-jacente commence par la transformation de chaque score brut individuel Y-ij (représentant le score du sujet i dans le groupe j) en un score de déviation absolue calculé par rapport à la tendance centrale de son groupe d’appartenance. Dans la formulation originelle de Levene, la mesure de tendance centrale retenue est la moyenne arithmétique conditionnelle. Le nouveau score transformé Z-ij s’obtient donc selon l’équation Z-ij = |Y-ij – Moyenne-j|. Plus la dispersion des données d’un groupe est vaste, plus l’espérance mathématique de ces distances absolues individuelles sera structurellement élevée.
Une fois l’intégralité des observations convertie en ces scores de déviation absolue, le test de Levene exécute simplement une analyse de variance unilatérale standard à un facteur sur la variable dérivée Z. Les hypothèses probabilistes évaluées se formulent de la façon suivante :
- Hypothèse nulle (H0) : Sigma-1-carré = Sigma-2-carré = … = Sigma-k-carré (les variances des populations d’origine sont strictement identiques, ce qui implique l’égalité des moyennes des déviations absolues).
- Hypothèse alternative (H1) : Il existe au moins une paire de groupes pour laquelle Sigma-j-carré n’est pas égale à Sigma-j’-carré (les variances des populations sont inégales).
La statistique F résultante de cette ANOVA suit, sous l’hypothèse nulle, une loi de Fisher-Snedecor paramétrée par k – 1 degrés de liberté au numérateur et N – k degrés de liberté au dénominateur, où k représente le nombre de groupes (k = 2 dans le cas d’un test t) et N l’effectif total agrégé.
4.2 La variante de Brown-Forsythe : robustesse via la médiane
Bien que le test originel de Levene ait marqué un progrès substantiel par rapport aux méthodes antérieures, des investigations systématiques par simulation de Monte Carlo ont rapidement révélé que le centrage sur la moyenne arithmétique conservait une vulnérabilité résiduelle non négligeable lorsque les distributions parentales présentaient une asymétrie positive ou négative marquée (skewness) ou un étirement prononcé des queues de distribution (leptokurtose). En 1974, Morton B. Brown et Alan B. Forsythe ont proposé une modification de cette procédure qui constitue aujourd’hui la référence méthodologique standard.
La modification de Brown-Forsythe substitue la médiane de chaque groupe (Médiane-j) à la moyenne arithmétique dans le calcul des déviations absolues, définissant ainsi la nouvelle métrique transformée selon Z-ij = |Y-ij – Médiane-j|. Étant donné que la médiane constitue un estimateur non paramétrique de localisation considérablement plus résistant aux valeurs extrêmes et aux asymétries distributionnelles que la moyenne, le calcul des écarts par rapport à ce centre de gravité robuste stabilise l’estimation de la dispersion intrinsèque des groupes.
Dans la quasi-totalité des suites logicielles modernes d’analyse de données, ce que l’on nomme génériquement par tradition le test de Levene correspond en réalité, par défaut ou par option privilégiée, à la variante de Brown-Forsythe centrée sur la médiane. Cette spécification computationnelle offre une robustesse remarquable, préservant de façon adéquate le taux d’erreur de type I du test d’homoscédasticité lui-même face à des distributions modérément log-normales, exponentielles ou polluées par des valeurs aberrantes univariées, fréquentes en chronométrie mentale et en observation comportementale.
4.3 Interprétation rigoureuse de la p-value et prise de décision
L’interprétation de la valeur critique d’un test de Levene ou de Brown-Forsythe requiert une grande lucidité épistémologique quant à la signification mathématique de la valeur p. De manière conventionnelle, un seuil de signification alpha bilatéral de 0,05 est retenu comme critère de démarcation binaire :
- Si la p-value associée à la statistique F est strictement inférieure à 0,05 (p < 0,05), l’hypothèse nulle d’homogénéité des variances est rejetée. L’analyste conclut à la présence d’une hétéroscédasticité statistiquement démontrée et se trouve théoriquement contraint d’abandonner le test t de Student classique au profit du test t de Welch.
- Si la p-value est supérieure ou égale à 0,05 (p >= 0,05), l’hypothèse nulle n’est pas rejetée, ce qui autorise traditionnellement le maintien du modèle homoscédastique de Student avec mutualisation de la variance.
Néanmoins, cette approche mécaniste souffre de biais d’interprétation majeurs dépendants de la puissance statistique du test de Levene. En présence de très grands échantillons (par exemple n1 = n2 = 1500 sujets), le test de Levene acquiert une surpuissance computationnelle extrême. Il détecte alors avec une significativité éclatante (p < 0,001) des écarts de variance infinitésimaux et méthodologiquement triviaux (comme un ratio de variances de 1,06), poussant indûment le chercheur à récuser un modèle de Student qui s’avérerait pourtant parfaitement stable et adéquat dans ce contexte d’effectifs massifs.
À l’inverse, dans le contexte fréquent des études pilotes ou des protocoles cliniques restreints (par exemple n1 = 15 et n2 = 14), le test de Levene souffre d’un manque chronique de puissance statistique. Dans ce cas, une hétérogénéité substantielle des variances réelles (par exemple un ratio de 3,5 ou 4) peut aisément échouer à franchir le seuil de rejet conventionnel (produisant par exemple p = 0,12). Le chercheur novice, concluant à tort que l’absence de preuve équivaut à la preuve de l’absence, applique le test de Student et subit de plein fouet l’altération du taux d’erreur alpha induite par cette hétérogénéité masquée par le manque de puissance de son pré-test.
5. Le test de Bartlett et sa dépendance à la normalité
5.1 Formulation mathématique et distribution du chi-deux
Développé par Maurice Stevenson Bartlett en 1937, le test de Bartlett représente historiquement la procédure paramétrique par excellence d’évaluation de l’égalité de plusieurs variances indépendantes. Ce test procède par une comparaison systématique de l’estimateur de la variance pondérée globale (la variance groupée) avec la moyenne géométrique des variances d’échantillons individuelles, calculée au moyen d’une transformation logarithmique naturelle de ces dernières.
Sur le plan computationnel, la statistique d’épreuve de Bartlett (notée M) agrège la somme des degrés de liberté individuels multipliée par le logarithme de la variance groupée, de laquelle on soustrait la somme des produits des degrés de liberté de chaque groupe par le logarithme de leur variance propre. Pour corriger le biais inhérent à cette statistique dans les petits échantillons, la valeur M est ensuite divisée par un facteur d’échelle multiplicatif C, légèrement supérieur à 1, calculé à partir de la somme des inverses des degrés de liberté individuels et du degré de liberté global. La statistique résultante, B = M / C, suit asymptotiquement une distribution théorique de chi-deux paramétrée par k – 1 degrés de liberté sous l’hypothèse nulle.
D’un point de vue purement mathématique, lorsque l’hypothèse d’une loi normale univariée au sein de chaque population parente est rigoureusement et impeccablement respectée, le test de Bartlett constitue le test le plus puissant au sens de Neyman-Pearson (test du rapport de vraisemblance uniformément le plus puissant pour tester l’homoscédasticité gaussienne). Dans ce cadre idéal, son efficacité à détecter les moindres anomalies de variance surpasse celle des approches basées sur les déviations absolues.
5.2 Vulnérabilité critique face aux déviations de la normalité
En dépit de son élégance mathématique formelle, le test de Bartlett souffre d’une fragilité méthodologique notoire qui en limite l’usage en psychologie, en sociologie et dans les sciences du comportement. Le modèle computationnel de Bartlett confond inextricablement la variabilité du second ordre (la dispersion des scores) et les propriétés du quatrième ordre de la distribution, c’est-à-dire le kurtosis (l’aplatissement ou la lourdeur relative des queues de la loi de probabilité).
Lorsque les données réelles s’écartent ne serait-ce que modérément d’une courbe en cloche parfaite de Gauss — par exemple en présence d’une distribution leptokurtique caractérisée par des valeurs centrales pointues et des queues légèrement épaissies, ce qui constitue la norme descriptive des données comportementales humaines —, la statistique de Bartlett s’effondre. Le test réagit avec une sévérité excessive, rejetant massivement l’hypothèse nulle d’égalité des variances alors même que les variances réelles des deux groupes sont strictement identiques. Le chercheur se retrouve confronté à une fausse détection d’hétérogénéité des variances, induite uniquement par la non-normalité univariée de ses mesures.
Cette sensibilité extrême a fait dire au célèbre statisticien George Box que tester l’égalité des variances à l’aide du test de Bartlett avant d’exécuter une ANOVA ou un test t revenait métaphoriquement à « prendre la mer dans un canot de sauvetage en papier mâché pour vérifier si les conditions météorologiques sont suffisamment calmes pour autoriser la navigation d’un paquebot ». En d’autres termes, l’outil de diagnostic préliminaire se révèle infiniment plus vulnérable et instable face aux imperfections des données que le test principal de comparaison de moyennes qu’il est censé sécuriser.
5.3 Directives d’application comparée entre Bartlett et Levene
Face à ce constat probabiliste, l’état de l’art méthodologique contemporain impose des critères de sélection rigoureux et sans ambiguïté entre l’usage du test de Bartlett et celui de Levene (ou Brown-Forsythe). Le recours au test de Bartlett ne peut être sérieusement envisagé que sous des conditions distributionnelles très strictes, nécessitant une validation préalable de la normalité univariée au moyen de tests d’adéquation exigeants (tels que le test de Shapiro-Wilk) couplés à une inspection méthodique des diagrammes quantile-quantile.
Le tableau analytique suivant synthétise les propriétés comparatives et les conditions d’application requises pour chacun de ces deux tests formels :
- Test de Bartlett : Exige une normalité gaussienne parfaite et certifiée. Statistique d’épreuve : Chi-deux. Sensibilité majeure : hautement vulnérable aux queues lourdes et à l’asymétrie. Recommandation moderne : À proscrire de manière quasi systématique dans les protocoles de psychologie empirique en raison de sa fragilité aux écarts de distribution usuels.
- Test de Levene (centré sur la médiane / Brown-Forsythe) : Ne requiert pas la normalité stricte des populations parentes. Statistique d’épreuve : F de Fisher. Sensibilité : particulièrement robuste aux asymétries modérées et aux contaminations de valeurs résiduelles. Recommandation moderne : Procédure de référence à privilégier universellement si un diagnostic formel de variance par test d’hypothèse intermédiaire doit impérativement être conduit.
Il découle de cette synthèse que pour l’ensemble des études empiriques portant sur des scores d’échelles de Likert agrégées, des chronométries mentales ou des mesures neuropsychologiques, le test de Bartlett doit être écarté au profit exclusif des procédures dérivées de Levene et Brown-Forsythe.
6. Le test F de Fisher-Snedecor pour deux échantillons
6.1 Fondements du rapport F de deux variances indépendantes
Lorsque la comparaison d’homoscédasticité se cantonne strictement au cadre bivarié de deux échantillons indépendants (k = 2), la méthode statistique la plus élémentaire sur le plan calculatoire repose sur le test du rapport des variances de Fisher-Snedecor, communément désigné sous le terme de test F pour deux variances. Cette procédure repose directement sur la propriété probabiliste selon laquelle le quotient de deux variables aléatoires indépendantes suivant chacune une distribution de khi-deux divisée par ses degrés de liberté respectifs suit précisément une loi de Fisher-Snedecor.
La statistique d’épreuve s’obtient par le simple rapport des deux variances d’échantillons non biaisées : F = s1-carré / s2-carré. Les degrés de liberté associés à cette distribution correspondent respectivement à ddl-1 = (n1 – 1) pour le numérateur et ddl-2 = (n2 – 1) pour le dénominateur. Dans la formulation unilatérale exploratoire, le chercheur place traditionnellement la variance empirique la plus forte au numérateur, de sorte que la statistique F calculée soit systématiquement supérieure ou égale à 1.
Néanmoins, dans le cadre rigoureux d’un diagnostic d’homogénéité préalable à un test t, l’évaluation doit impérativement être conduite de manière bilatérale, car une violation de l’homoscédasticité peut survenir avec une dispersion supérieure dans le groupe 1 aussi bien que dans le groupe 2. Pour évaluer correctement la significativité bilatérale au seuil alpha de 0,05, la probabilité critique issue de la distribution F théorique avec les degrés de liberté appropriés doit être systématiquement doublée, sous peine de commettre une erreur d’évaluation fondamentale du risque d’erreur.
6.2 Hypothèses contraignantes du test F classique
À l’instar du test de Bartlett, dont il partage les fondements de vraisemblance paramétrique, le test F classique de comparaison de deux variances repose sur l’hypothèse sine qua non d’une normalité univariée rigoureuse au sein de chacune des deux populations comparées. Cette condition n’est pas une simple clause technique secondaire : l’exactitude de la dérivation analytique de la distribution F dépend de l’indépendance de la moyenne et de la variance de l’échantillon, propriété qui constitue une signature caractéristique et exclusive de la loi normale (selon le théorème de Geary).
La présence de valeurs aberrantes (outliers), même en quantité infime au sein d’un seul groupe expérimental, exerce un impact hautement destructeur sur le comportement du test F. L’estimateur de la variance d’échantillon étant fonction de la somme des carrés des écarts à la moyenne, une unique donnée isolée située à trois ou quatre écarts-types du centre élève drastiquement la valeur de s-carré. Le test F enregistre cette instabilité sous forme d’un pic de variance locale, induisant des rejets intempestifs de l’hypothèse d’homogénéité qui traduisent la présence d’une anomalie ponctuelle de mesure plutôt qu’une différence structurelle de variance entre les deux populations sous-jacentes.
Par conséquent, l’usage du test F classique pour deux échantillons ne saurait être toléré sans une investigation préalable approfondie de la morphologie distributionnelle. Déployer un rapport F direct sur des variables de latence, des seuils perceptifs ou des scores d’anxiété clinique non corrigés constitue une imprudence méthodologique majeure, susceptible de fausser l’ensemble de la chaîne inférentielle ultérieure.
6.3 Comparaison de performance avec les tests de Levene et Brown-Forsythe
Les études de robustesse par simulation statistique (notamment les travaux classiques de Ralph D’Agostino et de James Algina) ont méticuleusement comparé le comportement du test F classique pour deux variances face aux alternatives modernes que constituent le test de Levene originel et la variante de Brown-Forsythe. Les simulations explorent systématiquement le comportement de la statistique sous diverses anomalies de distribution : asymétrie gamma, aplatissement uniforme, queues logistiques lourdes et mélanges de distributions normales à variances hétérogènes.
Les conclusions issues de ces modélisations sont sans équivoque :
- Sous conditions de normalité absolue, le test F de Fisher affiche une puissance statistique marginalement supérieure (un gain souvent inférieur à 2 ou 3 % de puissance détectrice face à Levene).
- Dès que la distribution s’écarte de la symétrie gaussienne, le taux d’erreur de type I du test F de Fisher subit une altération massive, s’élevant souvent à des niveaux réels avoisinant 0,10 ou 0,15 pour un alpha théorique posé à 0,05.
- Le test de Brown-Forsythe (médiane), en contrepartie d’une perte d’efficacité infime en situation gaussienne pure, maintient son erreur de type I à l’intérieur de l’intervalle nominal [0,04 ; 0,06] sous une vaste gamme de perturbations morphologiques.
En pratique empirique contemporaine, la pertinence relative du test F classique de Fisher-Snedecor pour diagnostiquer l’homoscédasticité dans le cadre de tests t est jugée très faible par la communauté des statisticiens. Son emploi direct doit être proscrit de l’arsenal d’assurance qualité des données au profit exclusif de méthodes moins tributaires de la perfection gaussienne théorique.
7. Diagnostics graphiques et visuels de la dispersion des données
7.1 Exploitation méthodique des diagrammes en boîte (boxplots)
Bien que les tests statistiques formels confèrent une apparence de rigueur probabiliste par l’émission d’une p-value tranchée, l’évaluation de la variance ne saurait faire l’économie d’une inspection visuelle méthodique. L’exploration graphique permet au chercheur de contextualiser la distribution des données, de détecter les artéfacts expérimentaux et de comprendre la structure intime des dispersions comparées. Parmi les représentations disponibles, le diagramme en boîte de Tukey, ou boxplot, demeure l’instrument de diagnostic d’homogénéité de premier recours.
L’exploitation méthodique d’un diagramme en boîte dans la perspective de l’évaluation de l’homoscédasticité repose sur l’analyse de plusieurs composantes anatomiques précises :
- La hauteur de la boîte centrale : Délimitée par le premier quartile (Q1, 25e percentile) et le troisième quartile (Q3, 75e percentile), la hauteur de la boîte matérialise l’intervalle interquartile (IQR). L’IQR représente une métrique non paramétrique de dispersion résistant aux extrêmes. Une différence manifeste de hauteur entre les boîtes des deux groupes constitue un indice visuel immédiat d’hétérogénéité structurelle de la variance intra-groupe.
- L’amplitude des moustaches : S’étendant conventionnellement jusqu’aux valeurs extrêmes n’excédant pas 1,5 fois l’IQR à partir des charnières, la portée totale des moustaches illustre l’étendue de dispersion de 95 à 99 % des observations réelles. Un ratio marqué entre l’envergure des moustaches des deux groupes corrobore le soupçon d’inégalité des variances.
- L’emplacement de la barre médiane : La position de la ligne médiane au sein de la boîte informe sur la symétrie de la distribution. Une médiane nettement excentrée signale une asymétrie qui disqualifie les tests de variance paramétriques stricts au profit de Brown-Forsythe.
- Les points individualisés d’outliers : Les cercles ou astérisques isolés au-delà des moustaches permettent d’identifier instantanément si une forte variance mesurée découle d’un étalement global de la distribution ou de la contamination par quelques observations extrêmes isolées.
7.2 Analyse des résidus par groupe expérimental
Une approche graphique complémentaire particulièrement élégante consiste à opérer un basculement du repère des données brutes vers l’espace des résidus du modèle linéaire sous-jacent. Pour chaque participant individuel i assigné au groupe j, le résidu d’échantillonnage e-ij est défini comme la différence arithmétique stricte entre son score observé Y-ij et la moyenne conditionnelle de son groupe, soit e-ij = Y-ij – Moyenne-j. En soustrayant la moyenne de chaque condition, on neutralise l’effet principal de localisation pour ne conserver que la pure composante de dispersion aléatoire résiduelle.
Le tracé de ces résidus sous forme d’un graphique de dispersion bivarié, où l’axe des abscisses indique l’appartenance au groupe et l’axe des ordonnées affiche la valeur du résidu centré sur zéro, offre une lecture immédiate de l’homoscédasticité. Si l’hypothèse de variance constante est respectée, le nuage de points doit présenter une bande de dispersion verticale d’épaisseur approximativement constante d’un groupe à l’autre. Tout étalement asymétrique se traduisant par un élargissement marqué de l’éventail des résidus dans une modalité donnée démasque l’hétérogénéité des variances.
De surcroît, la construction de graphiques quantile-quantile résiduels séparés (Normal Q-Q plots des résidus par groupe) permet de vérifier simultanément le respect de l’hypothèse de normalité au sein de chaque niveau du facteur expérimental. La linéarité des alignements de points le long de la diagonale théorique atteste de la conformité gaussienne, tandis qu’un décrochage systématique en forme de S ou de banane révèle des problèmes d’aplatissement ou d’asymétrie qui interagissent directement avec l’évaluation des variances.
7.3 Graphiques de densité et représentations en violon
Si les diagrammes en boîte constituent un outil d’inspection historique utile, ils souffrent d’une limitation graphique inhérente : leur incapacité à révéler les structures multimodales ou les creux de densité internes au sein des distributions de scores. Pour pallier cette faiblesse, les sciences quantitatives modernes exploitent intensivement les graphiques d’estimation de densité par noyau (Kernel Density Estimation) ainsi que leur déclinaison hybride, les diagrammes en violon (violin plots).
Les courbes de densité superposées ou juxtaposées permettent de comparer directement la forme globale de la distribution de probabilité estimée pour chaque condition expérimentale. L’évaluation de l’homoscédasticité s’y opère en examinant conjointement la largeur de la base de la distribution (l’étendue totale des valeurs plausibles) et la hauteur maximale du pic de densité. Deux groupes véritablement homoscédastiques doivent présenter des courbes de densité possédant une amplitude et une morphologie d’étalement globalement équivalentes, même si leurs sommets sont décalés latéralement sur l’axe des abscisses par l’effet de traitement.
Le diagramme en violon combine les atouts du tracé de densité symétrique et les repères internes quantiles d’un boxplot standard. Il permet à l’expérimentateur d’identifier d’un simple coup d’œil si une variance élargie dans une condition découle d’un phénomène de bimodalité cachée — par exemple, un sous-groupe de patients répondant massivement à une psychothérapie tandis qu’un second sous-groupe y résiste totalement —, fournissant ainsi des hypothèses explicatives substantiellement plus riches qu’une simple p-value d’hétéroscédasticité issue d’un test formel.
8. Interaction entre non-normalité et hétérogénéité de la variance
8.1 Le double défi méthodologique dans les données réelles
Dans l’écosystème des données empiriques recueillies en milieu écologique ou de laboratoire, la nature se plie rarement aux exigences formelles des modèles statistiques idéaux. Loin de se manifester de façon isolée, les violations des postulats fondamentaux surviennent très fréquemment de manière conjointe : la non-normalité distributionnelle et l’hétérogénéité de la variance s’entremêlent pour poser un double défi méthodologique redoutable aux chercheurs.
Cette co-occurrence est particulièrement prononcée dans les phénomènes soumis à des effets de plancher ou de plafond métriques, ou dans les processus dynamiques régis par des lois multiplicatives plutôt qu’additives. Par exemple, dans l’enregistrement de latences de réponse motrice ou de temps de fixation oculaire, les distributions manifestent systématiquement une asymétrie positive prononcée, caractérisée par une longue traîne vers les valeurs élevées. Dans ces contextes morphologiques, il est mathématiquement classique que la condition expérimentale induisant la moyenne la plus élevée supporte également la dispersion la plus considérable, la variance tendant à croître proportionnellement au carré de la moyenne.
Cette distorsion combinée fragilise la précision des estimations des moindres carrés. Les règles de décision séquentielles rigides, qui tentent d’aborder ces problèmes de manière compartimentée en testant d’abord la normalité puis l’homoscédasticité, échouent fréquemment face à ces interactions. La non-normalité vient biaiser l’évaluation formelle de la variance, tandis que l’hétérogénéité résiduelle fausse le diagnostic de la morphologie de distribution globale.
8.2 Comportement comparé des tests paramétriques et non paramétriques
Face à la double violation de la normalité et de l’homoscédasticité, un réflexe méthodologique extrêmement répandu au sein de la communauté des chercheurs consiste à abandonner d’emblée l’arsenal paramétrique pour se réfugier derrière le test non paramétrique de référence : le test U de Mann-Whitney (équivalent au test de la somme des rangs de Wilcoxon). Ce réflexe repose toutefois sur une méconnaissance profonde des fondements de la statistique non paramétrique basée sur les rangs.
Contrairement à une idée reçue tenace, le test de Mann-Whitney n’est nullement immunisé contre l’hétérogénéité des variances. S’il est exact que le test U ne requiert aucune hypothèse de normalité gaussienne pour tester l’égalité des distributions stochastiques sous-jacentes, il n’autorise une inférence valide quant à l’égalité des médianes des deux groupes qu’à la condition expresse que les formes distributionnelles des deux populations soient rigoureusement identiques, ce qui implique obligatoirement une parfaite égalité des dispersions. En d’autres termes, le test U de Mann-Whitney exige lui aussi une forme stricte d’homoscédasticité.
Lorsque deux échantillons présentent des variances drastiquement inégales, la distribution des rangs combinés au sein de l’échantillon agrégé subit un biais structurel majeur. L’échantillon à forte dispersion projette ses scores simultanément vers les rangs les plus bas et les rangs les plus hauts de la série ordonnée. Les simulations statistiques démontrent que sous hétérogénéité des variances couplée à des tailles d’échantillons inégales, le test U de Mann-Whitney souffre d’un gonflement de son erreur de type I tout aussi destructeur, voire supérieur, à celui d’un test t de Student mal calibré. L’abandon de l’approche paramétrique au profit des rangs simples ne constitue donc nullement une panacée méthodologique face à l’hétéroscédasticité.
8.3 Transformations de variables et leurs implications analytiques
Une seconde approche historiquement privilégiée pour résoudre la conjonction de l’asymétrie et de l’hétérogénéité consiste à appliquer une transformation mathématique non linéaire aux données brutes préalablement à l’inférence. L’objectif est de stabiliser la variance tout en restaurant une morphologie symétrique proche de la loi normale. Selon la nature de la dépendance entre la moyenne et la variance, plusieurs fonctions de transformation sont classiquement déployées :
- La transformation logarithmique (log10 ou ln) : Particulièrement efficace lorsque l’écart-type d’échantillon croît linéairement avec la moyenne conditionnelle (ce qui est typique des temps de réaction et des concentrations hormonales).
- La transformation racine carrée : Fréquemment employée pour stabiliser les données de comptage discret issues d’un processus poissonnien où la variance est mathématiquement égale à la moyenne.
- La transformation inverse (1 / Y) : Mobilisée lorsque la variance explose de façon disproportionnée pour les scores d’intensité élevée.
Toutefois, la manipulation non linéaire des échelles de mesure s’accompagne d’effets indésirables majeurs sur l’interprétation théorique des résultats scientifiques. Premièrement, transformer les scores modifie fondamentalement la nature de l’hypothèse testée : un test t conduit sur des données log-transformées ne compare plus les moyennes arithmétiques des populations d’origine, mais leurs moyennes géométriques. En psychométrie, cette distorsion altère la comparabilité des grandeurs d’effet avec la littérature existante et complexifie l’interprétation clinique directe des écarts constatés.
Deuxièmement, les transformations échouent souvent à stabiliser simultanément les variances et à normaliser les queues de distribution pour l’ensemble des sous-groupes d’une expérience, créant parfois des artefacts d’hétéroscédasticité inverse. Dès lors, le consensus méthodologique contemporain tend à déconseiller les transformations systématiques de complaisance, leur préférant l’emploi direct de méthodes inférentielles modernes et intrinsèquement robustes à l’hétérogénéité sur l’échelle métrique naturelle des scores.
9. La controverse du pré-test et l’argument pour le test de Welch par défaut
9.1 Les failles méthodologiques de la stratégie conditionnelle en deux étapes
Pendant plusieurs décennies, les manuels d’introduction à la statistique appliquée ont inculqué aux générations successives de chercheurs une stratégie séquentielle en deux étapes, réputée à tort exemplaire de rigueur scientifique. Cette procédure algorithmique conditionnelle prescrit de procéder comme suit :
- Étape 1 : Réaliser systématiquement un test formel d’homoscédasticité préliminaire (le plus souvent le test de Levene) au seuil alpha de 0,05.
- Étape 2a : Si le test préliminaire est non significatif (p >= 0,05), conclure à l’égalité des variances et exécuter le test t de Student standard avec variance groupée.
- Étape 2b : Si le test préliminaire est statistiquement significatif (p < 0,05), rejeter l’homoscédasticité et opter pour le test t de Welch.
De vastes travaux d’investigation statistique conduits au cours des quinze dernières années ont démontré de manière irréfutable que cette stratégie en deux étapes est méthodologiquement fallacieuse et produit des effets contre-productifs sur la régulation de l’erreur d’inférence. Le problème réside dans le conditionnement d’un second test d’hypothèse par le résultat probabiliste d’un premier test appliqué sur le même jeu de données. Cette dépendance séquentielle viole l’indépendance requise des procédures de décision et conduit à une altération pernicieuse du taux global d’erreur de type I de l’ensemble du protocole.
Comme évoqué précédemment, le manque structurel de puissance statistique du test de Levene dans les échantillons de taille modeste fait en sorte que la stratégie conditionnelle maintient le test t classique de Student précisément dans les scénarios où l’hétérogénéité des variances est substantielle sans franchir le seuil artificiel de p = 0,05. En conséquence, l’erreur de type I effective de la stratégie conditionnelle grimpe bien au-dessus du niveau nominal attendu. La stratégie en deux étapes combine ainsi les défauts du test de Student et les incertitudes d’échantillonnage du test de Levene sans offrir la moindre garantie de protection supplémentaire.
9.2 Performance du test de Welch sous conditions d’homoscédasticité parfaite
L’argument historique qui a longtemps freiné l’abandon du test t classique était la crainte d’une perte de puissance statistique majeure qu’entraînerait l’application du test de Welch en situation d’homoscédasticité avérée. Les chercheurs craignaient que le réajustement systématique des degrés de liberté selon la formule de Welch-Satterthwaite ne réduise excessivement la sensibilité du test en l’absence de violation réelle des postulats.
Les démonstrations analytiques modernes et les simulations massives d’échantillonnage ont définitivement invalidé cette préoccupation théorique. Lorsque les variances populationnelles sont strictement et rigoureusement égales (Sigma-1-carré = Sigma-2-carré), la perte d’efficacité du test de Welch comparativement au test de Student standard est marginale, voire infinitésimale. Dans la quasi-totalité des configurations expérimentales, la différence de puissance statistique entre les deux procédures ne dépasse pas une fraction de point de pourcentage (typiquement de l’ordre de 0,001 à 0,005).
En contrepartie de cette concession théorique microscopique, le test t de Welch offre une garantie méthodologique absolue : il contrôle de manière quasi parfaite le taux nominal d’erreur de type I au seuil alpha de 0,05, quelle que soit la réalité sous-jacente des variances réelles, que les effectifs soient rigoureusement équilibrés ou asymétriques, et que le ratio des variances s’établisse à 1, 2, 5 ou 20. Dès lors, le coût computationnel d’une utilisation indue de Welch sous homoscédasticité parfaite est pour ainsi dire nul, alors que le coût d’une application injustifiée de Student sous hétéroscédasticité s’avère catastrophique pour la robustesse de l’inférence.
9.3 Le consensus méthodologique émergent en psychologie quantitative
À la lumière de ces constats probabilistes accablants pour la tradition, un puissant mouvement de réforme méthodologique s’est structuré au sein de la psychologie quantitative et des sciences statistiques contemporaines. Un article de référence publié en 2017 par Marie Delacre, Daniël Lakens et Christophe Leys sous le titre explicite « Why Psychologists Should by Default Use Welch’s t-test Instead of Student’s t-test » a marqué un tournant décisif dans les recommandations académiques internationales.
Les auteurs démontrent avec clarté pourquoi la pratique séquentielle conditionnelle consistant à pré-tester l’égalité des variances doit être définitivement abandonnée au profit d’une adoption universelle et par défaut du test t de Welch pour toute comparaison de deux moyennes indépendantes. Cette position de principe s’appuie sur la prudence scientifique et le rasoir d’Occam méthodologique : pourquoi s’encombrer d’un test préliminaire faillible et d’un modèle sous-jacent vulnérable alors qu’une procédure robuste généralisée offre des garanties universelles sans pénalité empirique ?
Ce consensus émergent est progressivement intégré au sein des comités éditoriaux des revues scientifiques de premier rang (telles que le Journal of Experimental Psychology, Psychological Science, ou Cortex). Les évaluateurs et méthodologistes considèrent désormais le recours au test de Welch comme le standard de rigueur méthodologique attendu, dispensant le chercheur de la corvée de justification de l’égalité des variances et protégeant directement le corpus scientifique contre les artefacts d’inférence statistique.
10. Implémentation technique dans les logiciels d’analyse statistique
10.1 Exécution et diagnostics avancés dans l’environnement R
L’écosystème open-source R s’est historiquement distingué par son avant-gardisme méthodologique. Dans le package de base stats, les concepteurs du langage ont, dès l’origine, choisi de paramétrer la fonction native t.test() avec l’argument par défaut var.equal = FALSE. Cela signifie que l’exécution de base d’un test t sous R calcule spontanément le test de Welch avec correction continue des degrés de liberté de Satterthwaite, obligeant explicitement l’utilisateur souhaitant exécuter un test t classique de Student à spécifier var.equal = TRUE.
Pour les analystes désireux de conduire des diagnostics formels complets de la variance, la bibliothèque car (Companion to Applied Regression) développée par John Fox fournit la fonction de référence leveneTest(). Cette fonction permet de paramétrer avec souplesse la mesure de tendance centrale de centrage : par défaut, elle implémente la variante ultra-robuste de Brown-Forsythe centrée sur la médiane (center = median), tout en autorisant le retour à la moyenne arithmétique originelle de Levene via l’argument explicite center = mean.
L’automatisation du calcul du ratio empirique des variances s’exécute avec fluidité dans l’environnement R via l’agrégation des données avec le package dplyr ou la syntaxe de base tapply(donnees$score, donnees$groupe, var). L’extraction des variances minimale et maximale permet d’instancier un test conditionnel de contrôle pour la vérification exploratoire des ratios de dispersion :
- Syntaxe pour le diagnostic formel :
car::leveneTest(score ~ groupe, data = mes_donnees, center = median) - Syntaxe pour l’exécution directe de Welch :
stats::t.test(score ~ groupe, data = mes_donnees, var.equal = FALSE) - Calcul du ratio de variance :
vars <- tapply(mes_donnees$score, mes_donnees$groupe, var); max(vars) / min(vars)
10.2 Interprétation des sorties standard sous IBM SPSS Statistics
Le logiciel commercial propriétaire IBM SPSS Statistics adopte une présentation tabulaire particulière qui désarçonne fréquemment les chercheurs débutants et engendre des erreurs d’interprétation récurrentes au sein des laboratoires. Lors de l’appel de la procédure standard « Comparer les moyennes -> Test T pour échantillons indépendants », le logiciel génère un tableau unique scindé horizontalement en deux lignes superposées intitulées respectivement « Hypothèse de variances égales » (Student) et « Hypothèse de variances inégales » (Welch).
La première section latérale de cette table affiche les résultats du « Test de Levene sur l’égalité des variances », caractérisé par sa statistique d’épreuve F et sa signification bilatérale (notée Sig.). La logique procédurale sous SPSS exige d’examiner en premier lieu cette colonne de signification du test de Levene :
- Si la valeur Sig. sous la bannière de Levene est strictement inférieure à 0,05, le chercheur est formellement invité à délaisser la première ligne et à porter son attention exclusivement sur la seconde ligne (Welch), lisant la statistique t, les degrés de liberté fractionnaires et la valeur p ajustée.
- Si la valeur Sig. est supérieure ou égale à 0,05, la tradition SPSS incite à lire les résultats de la première ligne.
L’erreur la plus fréquente commise par les analystes inexpérimentés consiste à confondre la valeur p du test de Levene avec la valeur p de la comparaison des moyennes elle-même. Nombre de manuscrits soumis rapportent à tort une absence d’effet de traitement en citant la significativité du test de variance au lieu de celle de la différence des moyennes. Par ailleurs, SPSS continuant d’implémenter sous le nom de Levene la variante centrée sur la moyenne et non la médiane robuste de Brown-Forsythe, ses alertes d’hétéroscédasticité s’avèrent excessivement sensibles aux déviations de normalité.
10.3 Workflow dans les logiciels ouverts JASP et Jamovi
Les plateformes logicielles open-source modernes orientées vers les standards ouverts de la science reproductible, à l’instar de JASP (développé sous l’égide de l’Université d’Amsterdam) et de Jamovi, ont profondément assaini et fluidifié le flux de travail analytique. Fondées sur des interfaces graphiques élégantes adossées au moteur de calcul de R, ces solutions éliminent les lourdeurs de programmation tout en guidant l’analyste vers les meilleures pratiques méthodologiques contemporaines.
Dans JASP comme dans Jamovi, l’ouverture du menu consacré au test t pour échantillons indépendants présente un volet latéral dédié à la vérification interactive des hypothèses. L’activation d’une unique case à cocher, intitulée « Vérification de l’égalité des variances (test de Levene) », adjoint instantanément au tableau des résultats une table annexe détaillée fournissant la statistique F, les degrés de liberté et la p-value associée calculée selon la robuste variante médiane.
Parallèlement, ces logiciels permettent de cocher simultanément les cases de test pour « Student », « Welch » et « Mann-Whitney ». Les tableaux de sortie dynamiques s’actualisent en temps réel, permettant à l’utilisateur d’observer la quasi-identité des statistiques entre Student et Welch lorsque les variances sont homogènes, et la divergence salutaire des degrés de liberté dès que l’hétérogénéité s’installe. De surcroît, la génération intégrée de diagrammes combinant violon, boîte de dispersion et nuage de points individuels (raincloud plots) offre une synthèse diagnostique visuelle et inférentielle prête pour publication.
10.4 Diagnostic statistique avec l’écosystème Python
Pour les praticiens intégrant l’analyse statistique au sein de pipelines de science des données ou d’apprentissage automatique sous le langage Python, la bibliothèque scientifique SciPy propose un ensemble complet de fonctions spécialisées au sein de son sous-module scipy.stats.
Le diagnostic formel de l’homoscédasticité s’exécute via les fonctions scipy.stats.levene et scipy.stats.bartlett. De façon remarquable, la fonction levene() sous SciPy intègre un argument explicite center qui offre un contrôle total de la métrique centrale :
scipy.stats.levene(groupe_1, groupe_2, center='median'): Calcule la variante recommandée de Brown-Forsythe, idéale pour les données asymétriques ou bruitées.scipy.stats.levene(groupe_1, groupe_2, center='mean'): Calcule la formulation historique de Levene.scipy.stats.levene(groupe_1, groupe_2, center='trimmed'): Implémente une variante de Levene basée sur une moyenne tronquée à 10 %, hautement résistante aux queues de distribution épaissies.
Pour l’exécution du test t proprement dit, la fonction scipy.stats.ttest_ind() intègre un paramètre booléen fondamental : equal_var. Fixé par défaut à True (exécutant le test t de Student historique), il doit impérativement être assigné à equal_var=False pour déployer le test de Welch avec correction de Welch-Satterthwaite sur les degrés de liberté. Pour les visualisations de dispersion diagnostique, le couplage des bibliothèques seaborn (fonctions boxplot(), violinplot(), et stripplot()) et matplotlib assure la production de figures analytiques hautement informatives.
11. Études de cas concrètes appliquées aux recherches en psychologie
11.1 Cas clinique : Comparaison d’un groupe contrôle et d’un groupe pathologique
Afin d’ancrer ces considérations théoriques dans la réalité concrète de la recherche, analysons un cas empirique typique tiré de la neuropsychologie clinique appliquée. Un chercheur souhaite évaluer si des patients atteints d’une lésion focale du cortex préfrontal ventromédian présentent un déficit de prise de décision lors d’une version numérisée de la tâche de jeu de l’Iowa (Iowa Gambling Task). La variable dépendante est un score de latence de décision moyenne exprimé en millisecondes.
En raison des contraintes éthiques et logistiques du milieu hospitalier, le groupe clinique (groupe pathologique) ne compte que N2 = 20 patients, tandis que le groupe témoin (témoins sains appariés sur l’âge et le niveau d’éducation) rassemble N1 = 45 participants. L’analyse descriptive préliminaire livre les résultats statistiques suivants :
- Groupe Témoin : Moyenne = 1250 ms ; Écart-type = 180 ms ; Variance = 32 400 ms au carré.
- Groupe Lésé : Moyenne = 1580 ms ; Écart-type = 420 ms ; Variance = 176 400 ms au carré.
L’évaluation du ratio empirique des variances produit d’emblée un résultat spectaculaire : R-var = 176 400 / 32 400 = 5,44. Le ratio des variances est largement supérieur au seuil de 4, correspondant à un écart-type chez les patients plus de 2,3 fois supérieur à celui des témoins.
Ce cas réunit l’ensemble des caractéristiques du redoutable scénario libéral : le groupe au plus faible effectif (N2 = 20) supporte la dispersion la plus massive. L’exécution d’un test formel de Brown-Forsythe confirme sans équivoque cette rupture d’homoscédasticité : F(1, 63) = 14,82, p < 0,001. Si le chercheur commettait l’erreur d’appliquer un test t de Student standard, la variance groupée s’établirait à 63 943 ms au carré, tirée vers le bas par les 45 témoins, produisant une statistique t = 3,42 avec 63 ddl (p = 0,0011) et un intervalle de confiance artificiellement étroit.
L’arbitrage vers le test t de Welch s’avère ici impératif. L’erreur-type ajustée non mutualisée s’élève à racine carrée de ((32400 / 45) + (176400 / 20)) = 97,67 ms. Les degrés de liberté ajustés par la formule de Welch-Satterthwaite s’effondrent de 63 à seulement 22,86. La statistique t de Welch résultante s’établit à t(22,86) = 3,38, p = 0,0026. Si la significativité statistique est ici préservée du fait de la robustesse de l’écart de moyennes, la correction de Welch a permis de restituer la véritable incertitude expérimentale en élargissant considérablement l’intervalle de confiance à 95 % de la différence, qui passe de [137 ms ; 523 ms] sous Student à [127 ms ; 533 ms] sous Welch, protégeant ainsi le chercheur d’une conclusion exagérément précise sur l’ampleur de l’effet clinique.
11.2 Cas expérimental : Évaluation d’une intervention éducative standardisée
Considérons à présent un second cas pratique issu du champ des sciences de l’éducation et de la psychologie cognitive du développement. Une équipe évalue l’impact d’une nouvelle méthode pédagogique d’apprentissage de la lecture basée sur le décodage grapho-phonémique renforcé par logiciel interactif. Deux classes de cours préparatoire sont réparties par randomisation : un groupe expérimental bénéficiant du protocole interactif (N1 = 50 élèves) et un groupe témoin suivant l’enseignement pédagogique traditionnel standardisé (N2 = 50 élèves).
À l’issue de l’année scolaire, un test standardisé de vitesse et de compréhension en lecture est administré à l’ensemble des 100 participants. Les statistiques descriptives obtenues sont les suivantes :
- Groupe Pédagogie Interactive (N1 = 50) : Moyenne = 78,4 points ; Écart-type = 12,2 points ; Variance = 148,84.
- Groupe Pédagogie Traditionnelle (N2 = 50) : Moyenne = 72,1 points ; Écart-type = 11,1 points ; Variance = 123,21.
L’évaluation exploratoire du ratio empirique livre une valeur modérée : R-var = 148,84 / 123,21 = 1,21. Ce ratio, très proche de la stricte égalité unitaire, s’inscrit largement en deçà du seuil empirique de tolérance de 4 (ratio d’écarts-types de 1,10).
L’exécution conjointe du test de Levene centré sur la médiane confirme la parfaite adéquation de l’hypothèse d’homoscédasticité : F(1, 98) = 0,34, p = 0,56. Le chercheur compare alors les résultats inférentiels délivrés par les deux procédures paramétriques concurrentes :
- Test t de Student classique : t(98) = 2,7018, p = 0,0081, Erreur-Type = 2,3318, ddl = 98.
- Test t de Welch : t(97,18) = 2,7018, p = 0,0081, Erreur-Type = 2,3318, ddl = 97,18.
Cette étude de cas illustre de manière spectaculaire le principe de convergence asymptotique : lorsque les effectifs sont équilibrés et les variances réelles homogènes, le test de Welch reproduit quasi à l’identique la statistique d’épreuve et la valeur p du test de Student, les degrés de liberté ne subissant qu’une correction cosmétique négligeable de moins d’une unité entière. Cette démonstration empirique vient désamorcer la crainte d’un coût inférentiel lié à l’usage systématique de Welch.
11.3 Arbre de décision pratique pour le chercheur
Pour naviguer avec certitude à travers les arbitrages méthodologiques complexes posés par la modélisation de la dispersion, le chercheur ou le psychologue quantitativiste peut structurer son protocole analytique autour d’un algorithme séquentiel rigoureux en trois étapes coordonnées :
- Étape 1 : Évaluation structurelle du plan d’échantillonnage et des effectifs :
Examiner le ratio d’équilibre des effectifs R-n = N-grand / N-petit. Si le plan présente une asymétrie substantielle (par exemple R-n > 1,5), classer d’emblée l’analyse comme étant sous haute vulnérabilité distributionnelle, ce qui prescrit la plus grande méfiance envers le test classique de Student. - Étape 2 : Exploration conjointe descriptive, visuelle et formelle de la dispersion :
Calculer le ratio empirique des variances R-var = s-carré max / s-carré min. Générer un diagramme combiné boxplot et violon pour repérer les asymétries morphologiques et les données extrêmes. Si R-var est supérieur à 4 (ou ratio des écarts-types > 2), l’hétérogénéité des variances est empiriquement avérée. Si le ratio se situe entre 1,5 et 4 dans un cadre à effectifs asymétriques, recourir au test de Levene centré sur la médiane (Brown-Forsythe) comme signal d’alarme complémentaire tout en gardant à l’esprit sa sensibilité dépendante de la taille de l’échantillon. - Étape 3 : Sélection finale de la procédure inférentielle :
Face à toute manifestation caractérisée d’hétéroscédasticité ou d’incertitude liée à un déséquilibre d’effectifs, basculer sans hésitation vers le test t de Welch avec degrés de liberté ajustés. Si la non-normalité univariée est concomitante et sévère (asymétries extrêmes rendant les moyennes non représentatives), envisager les estimateurs de moyennes tronquées robustes (méthode de Yuen) ou le rééchantillonnage par bootstrap plutôt qu’un test de rangs de Mann-Whitney trompeur. Enfin, pour les chercheurs souhaitant sécuriser l’ensemble de leur chaîne de traitement sans risque d’arbitrage subjectif, l’application directe du test t de Welch par défaut constitue l’option recommandée par l’état de l’art.
12. Normes de rapportage académique et transparence méthodologique
12.1 Directives de rédaction selon les normes de l’APA (7e édition)
La restitution académique d’un test t au sein d’un mémoire universitaire, d’une thèse de doctorat ou d’un article soumis à une revue internationale à comité de lecture doit se conformer rigoureusement aux normes de rédaction de l’American Psychological Association (APA, 7e édition). La transparence sur l’évaluation de l’homoscédasticité et la nature exacte du test employé constitue un critère de qualité méthodologique fondamental lors de l’évaluation par les pairs.
Lorsque le test de Welch est mobilisé suite à la constatation d’une hétérogénéité des variances, cette spécification doit être explicitement mentionnée dans la section des résultats. La signature caractéristique du test t de Welch réside dans le rapportage des degrés de liberté, lesquels doivent impérativement être documentés avec leurs décimales calculées (arrondies à une ou deux décimales, par exemple 22,86 ou 22,9) au lieu d’être abusivement tronqués ou arrondis à l’entier le plus proche, ce qui atteste que la formule de Satterthwaite a été formellement activée.
Un paragraphe méthodologique modèle intégrant les standards APA se formule typiquement comme suit dans un manuscrit scientifique rédigé en langue française :
« Une analyse préliminaire a révélé une violation substantielle du postulat d’homogénéité des variances, le ratio des variances s’élevant à 5,44 et le test d’égalité des variances de Levene (version robuste de Brown-Forsythe centrée sur la médiane) s’avérant hautement significatif, F(1, 63) = 14,82, p < ,001. Compte tenu de cette hétéroscédasticité et de l’asymétrie des effectifs d’échantillons (n1 = 45 témoins sains, n2 = 20 patients cérébrolésés), un test t de Welch pour échantillons indépendants a été conduit. Les résultats indiquent que les patients présentent des temps de réaction moyens significativement plus lents (M = 1580 ms, ÉT = 420 ms) que les participants témoins (M = 1250 ms, ÉT = 180 ms), t(22,86) = 3,38, p = ,003, d de Cohen = 0,98, IC à 95 % [127,12 ; 532,88]. »
12.2 Exigences de la science ouverte et reproductibilité computationnelle
Au-delà de la formulation textuelle standardisée, le mouvement international pour la science ouverte (Open Science) et la crise de réplication ont conduit à une refonte des exigences de transparence computationnelle. Il n’est plus suffisant de présenter une conclusion textuelle statique ; les chercheurs sont désormais tenus de documenter l’ensemble de leur flux décisionnel au moyen de données brutes ouvertes et de scripts de programmation reproductibles déposés sur des archives publiques pérennes telles que le Center for Open Science (OSF) ou Zenodo.
Le partage transparent des scripts d’analyse (fichiers de script R, notebooks Python Jupyter ou archives d’analyse Jamovi/JASP) permet aux réviseurs et à la communauté scientifique de vérifier de façon indépendante les hypothèses testées et les choix d’ajustement. Cette transparence permet d’éviter l’écueil du cherry-picking méthodologique ou du « p-hacking » de variance, pratique condamnable qui consiste pour un auteur à tester alternativement le test de Student et le test de Welch, puis à sélectionner opportunément pour publication la seule variante dont la p-value franchit favorablement le seuil magique de significativité de 0,05.
La reproductibilité computationnelle impose ainsi d’expliciter dans le script partagé les arguments logiciels précis retenus, les fonctions de centrage utilisées pour Levene (moyenne ou médiane), ainsi que l’ensemble des diagnostics visuels ayant orienté la sélection du modèle. Cette ouverture intégrale constitue le plus puissant rempart contre les conclusions erronées et participe directement à la restauration de la confiance accordée aux travaux publiés en psychologie expérimentale.
12.3 Synthèse des recommandations pour les futures publications empiriques
Au terme de cette analyse approfondie des enjeux conceptuels et techniques entourant la variance dans les tests t, plusieurs conclusions et directives pratiques majeures peuvent être formulées à l’attention des chercheurs et des méthodologistes désireux de hisser leurs pratiques scientifiques aux plus hauts standards de fiabilité contemporains :
- Primauté de la réalité sur le dogme : La parfaite égalité des variances populationnelles est une commodité mathématique d’école qui ne correspond pratiquement jamais à la réalité complexe des données comportementales et cliniques. Considérer l’hétérogénéité comme l’état par défaut plutôt que comme une anomalie exceptionnelle constitue une posture épistémologique saine et réaliste.
- Abandon des stratégies conditionnelles séquentielles : L’approche en deux étapes subordonnant le test de comparaison de moyennes au résultat binaire préalable d’un test d’homoscédasticité formel doit être bannie de l’enseignement méthodologique et de la pratique de recherche, en raison des distorsions mathématiques incontrôlées qu’elle inflige au taux global d’erreur de type I.
- Adoption résolue du test de Welch par défaut : Conformément aux recommandations méthodologiques de premier plan (Delacre et al., 2017), le test t de Welch doit être systématiquement préféré et déployé comme l’analyse de référence pour la comparaison de deux moyennes indépendantes. Préservant le niveau de fausse détection alpha dans toutes les configurations de variances et de ratios d’effectifs sans consentir de pénalité tangible de puissance sous homoscédasticité, il constitue l’outil de référence le plus prudent, robuste et universel.
- Intégration systématique du diagnostic visuel : Aucune statistique formelle ne saurait remplacer l’examen direct et attentif des morphologies de dispersion à travers l’exploitation de visualisations modernes couplant violons, boîtes et résidus centrés.
En alignant ainsi la pratique quotidienne des laboratoires sur les avancées les plus solides de la méthodologie quantitative, la communauté scientifique se dote des moyens indispensables pour consolider la fiabilité des inférences expérimentales et garantir la pérennité et la reproductibilité des savoirs psychologiques de demain.
Références
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A – Mathematical and Physical Sciences, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Behrens, W. U. (1929). Ein Beitrag zur Fehlerberechnung bei wenigen Beobachtungen. Landwirtschaftliche Jahrbücher, 68, 807–837.
- Box, G. E. P. (1953). Non-normality and tests on variances. Biometrika, 40(3/4), 318–335. https://doi.org/10.2307/2333350
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Fisher, R. A. (1935). The fiducial argument in statistical inference. Annals of Eugenics, 6(4), 391–398. https://doi.org/10.1111/j.1469-1809.1935.tb02120.x
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Student [Gosset, W. S.] (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222