
Dans le vaste champ de la recherche scientifique, de la sociologie empirique aux sciences psychologiques, la constitution d’un échantillon constitue le pivot fondamental sur lequel repose la validité externe de toute investigation. Lorsque les chercheurs tentent de mesurer des attitudes, d’évaluer des fonctions cognitives ou de décrypter les dynamiques sous-jacentes d’un comportement collectif, ils se heurtent immanquablement à une contrainte matérielle incontournable : l’impossibilité pratique, logistique et financière d’examiner l’intégralité d’une population cible. Dès lors, le recours à des protocoles d’échantillonnage rigoureux s’impose pour extraire un sous-ensemble d’individus capable de refléter avec fidélité les caractéristiques structurelles du groupe parent.
Parmi les diverses architectures méthodologiques disponibles, l’échantillonnage par quotas occupe une position singulière et éminemment stratégique. Qualifié d’approche non probabiliste dirigée, ce procédé vise à reproduire en miniature la composition sociodémographique ou psychologique d’une population parente, sans toutefois mobiliser les mécanismes stochastiques propres au tirage au sort aléatoire strict. Cette méthodologie repose sur une prémisse élégante : si un échantillon reflète fidèlement la distribution de caractéristiques observables et mesurables d’une population globale — telles que l’âge, le sexe, la catégorie socio-professionnelle ou le niveau de diplôme —, il présentera également une comparabilité acceptable sur les variables psychologiques ou comportementales non observées directement lors du recrutement.
Toutefois, l’usage de cette technique dans la recherche contemporaine soulève d’importants débats épistémologiques et statistiques. Si les praticiens saluent son efficience remarquable, sa rapidité d’exécution et sa capacité à contourner l’absence récurrente de registres exhaustifs de population, les théoriciens de la statistique rappellent régulièrement les limites inhérentes à l’absence de randomisation formelle. Ce guide exhaustif explore l’échantillonnage par quotas sous toutes ses facettes : ses fondements théoriques, ses déclinaisons typologiques, ses protocoles d’implémentation, son application détaillée à travers une étude de cas en psychologie, ainsi que ses arbitrages éthiques et analytiques.
1. Introduction fondamentale à l’échantillonnage par quotas en recherche psychologique
1.1 Définition conceptuelle et racines méthodologiques
L’échantillonnage par quotas se définit formellement comme une méthode d’échantillonnage non probabiliste par laquelle la population globale est d’abord segmentée en sous-groupes mutuellement exclusifs sur la base de critères prédéfinis, après quoi un nombre déterminé d’unités d’observation (les « quotas ») est assigné à chaque catégorie. Contrairement aux méthodes probabilistes où chaque membre de la population possède une probabilité mathématique connue et non nulle d’être sélectionné, le recrutement au sein des cellules de quotas s’effectue ici par le biais de procédures non aléatoires, guidées par la convenance, le jugement du chercheur ou la disponibilité sélective des participants.
Sur le plan historique, cette méthode trouve son impulsion matricielle dans les travaux pionniers des spécialistes des études de marché et des sondeurs d’opinion publique du début du XXe siècle. Sous l’influence décisive de figures telles que George Gallup, Archibald Crossley et Elmo Roper au cours des années 1930, l’échantillonnage par quotas s’est imposé comme une alternative pragmatique et scientifique aux défaillances criantes de l’échantillonnage de convenance brut, illustrées par le fiasco mémorable du sondage du Literary Digest lors de l’élection présidentielle américaine de 1936. Au fil des décennies, cette méthodologie a franchi les frontières des instituts de sondage pour pénétrer les laboratoires de recherche comportementale, de psychologie différentielle et de sciences sociales appliquées, où la rigueur structurelle doit constamment composer avec les réalités concrètes de terrain.
Le principe sous-jacent fondamental demeure celui de la reproduction structurelle (ou isomorphisme) d’une population cible. L’objectif avoué est de bâtir un échantillon modèle réduit, un « microcosme » artificiel dont les proportions démographiques calquent rigoureusement celles établies par des sources démographiques fiables. Il convient néanmoins d’opérer une distinction préliminaire rigoureuse : un échantillon constitué par quotas n’est pas, au sens statistique strict, un échantillon représentatif au sens probabiliste du terme. Il s’agit plutôt d’un échantillon structurellement équilibré, dont la fidélité représentative est restreinte aux seules variables de contrôle mobilisées pour son édification.
1.2 Pertinence et utilité dans la démarche scientifique moderne
Dans le cadre de la recherche scientifique contemporaine, le recours à l’échantillonnage par quotas ne constitue pas un pis-aller méthodologique ou un compromis au rabais, mais bien souvent un choix stratégique rationnel dicté par les contraintes environnementales. Le motif prépondérant de son adoption réside dans l’absence fréquente d’une base de sondage exhaustive. Dans de nombreux pays et contextes institutionnels, il s’avère juridiquement impossible ou matériellement irréalisable d’accéder à un fichier nominatif centralisé répertoriant l’ensemble des individus composant la population cible (par exemple, la liste exhaustive des patients souffrant de troubles dépressifs légers dans une région administrative donnée). Privé de ce registre énumératif indispensable au tirage aléatoire, le chercheur doit se tourner vers des méthodologies d’approximation structurée.
Parallèlement, l’échantillonnage par quotas optimise considérablement les ressources matérielles, logistiques et temporelles des équipes de recherche académique. Alors qu’un protocole probabiliste implique des processus lourds de suivi, de prises de contact réitérées pour pallier la non-réponse et des coûts de déplacement prohibitifs, les quotas permettent un déploiement rapide et ciblé sur le terrain. Cette agilité opérationnelle s’avère particulièrement précieuse dans le cadre des études exploratoires en psychologie sociale et clinique, où l’urgence de documenter un phénomène émergent — tel que l’impact psychologique immédiat d’une crise sanitaire ou d’un bouleversement sociétal — prime sur la pureté formelle de l’aléatoire.
La méthode réalise ainsi un équilibre subtil et pragmatique entre la rigueur d’une stratification systématique et la flexibilité indispensable face aux aléas de la collecte empirique. Elle offre un cadre de régulation normé qui empêche le recueil de dériver vers une simple sélection opportuniste d’étudiants de premier cycle universitaire, écueil classique documenté sous le terme de « biais WEIRD » (Western, Educated, Industrialized, Rich, and Democratic) qui affecte historiquement une large part de la production en sciences cognitives et comportementales.
1.3 Objectifs fondamentaux et mécanique de représentativité ciblée
L’ambition architecturale de l’échantillonnage par quotas réside dans la sélection guidée des participants en fonction de traits démographiques ou psychologiques délibérément isolés pour leur pertinence théorique par rapport à l’objet de recherche. Cette mécanique d’encadrement vise à conjurer la dérive d’auto-sélection inhérente à la participation volontaire. Dans toute enquête non régulée, certains profils sociologiques présentent une propension naturelle à répondre systématiquement plus élevée que d’autres (les femmes, les individus hautement diplômés ou les personnes disposant de temps libre important). Le système des quotas agit comme un filtre correctif en stoppant les flux de répondants pour les cellules saturées et en contraignant les investigateurs à prospecter activement les segments moins réceptifs.
Un autre objectif fondamental réside dans la garantie mathématique d’inclusion des sous-groupes minoritaires ou des profils cliniques rares au sein du corpus d’étude final. Dans le cadre d’un tirage aléatoire simple sur une population de taille modeste, le risque statistique d’omettre ou de sous-représenter sévèrement un sous-ensemble marginal (par exemple, les individus âgés de plus de 75 ans vivant en milieu rural) est loin d’être négligeable. L’échantillonnage par quotas sanctuarise ces effectifs en imposant des seuils planchers non négociables, offrant ainsi la matière numérique nécessaire aux investigations différentielles.
Enfin, cette démarche méthodologique opère une neutralisation partielle des asymétries de réponse spontanée. Sur le plan de la finalité de l’enquête, elle sert prioritairement une visée descriptive et exploratoire. Bien que les chercheurs l’emploient fréquemment à des fins inférentielles pour comparer des scores moyens à des tests psychométriques ou ajuster des modèles de régression, cette transition d’une logique purement descriptive vers une modélisation inférentielle exige des précautions statistiques substantielles, en raison de la nature non probabiliste de la collecte sous-jacente.
2. Fondements théoriques : Nature non probabiliste de la méthode par quotas
2.1 Distinction formelle entre échantillonnages probabilistes et non probabilistes
Pour appréhender rigoureusement les soubassements de l’échantillonnage par quotas, il est impératif de revenir à la dichotomie fondamentale de la théorie des sondages formalisée notamment par Jerzy Neyman en 1934. Un échantillonnage est qualifié de probabiliste si, et seulement si, chaque unité d’échantillonnage au sein de la population cible possède une probabilité d’inclusion non nulle, calculable a priori par le statisticien avant l’engagement de la collecte. Cette condition sine qua non permet d’ancrer l’analyse dans le cadre rigoureux de la théorie des probabilités et d’invoquer les théorèmes limites fondamentaux, tels que la loi des grands nombres et le théorème central limite.
À l’inverse, l’échantillonnage par quotas relève intrinsèquement du paradigme non probabiliste. En l’absence de tirage au sort mécanique parmi une base de données exhaustive, la probabilité d’inclusion d’un individu donné demeure rigoureusement indéterminée et non quantifiable. Certains sujets de la population peuvent théoriquement afficher une probabilité d’être sélectionnés quasi nulle (par exemple, des personnes ne fréquentant pas les lieux physiques ou numériques où s’effectue le recrutement), tandis que d’autres bénéficient d’une sur-probabilité liée à leur visibilité sociale ou à leur présence active dans les réseaux des enquêteurs.
L’abandon délibéré du tirage aléatoire strict emporte des conséquences théoriques majeures. L’erreur d’échantillonnage purement stochastique devient formellement incalculable, car elle se confond indissolublement avec le biais de sélection de l’opérateur de terrain. Sur le plan épistémologique, la méthode par quotas occupe ainsi une zone frontière au sein du paradigme quantitatif : elle adopte l’apparence, la structure et le formalisme numérique des grands sondages probabilistes, tout en reposant sur des mécanismes d’enrôlement empiriques et déterministes. Cette dualité impose au chercheur une posture de vigilance critique constante quant aux prétentions de généralisation de ses résultats.
2.2 Le postulat d’isomorphisme structurel
L’édifice conceptuel de l’échantillonnage par quotas repose intégralement sur un postulat implicite que la littérature méthodologique qualifie d’isomorphisme structurel ou d’hypothèse de représentativité par projection. Ce postulat avance que si un échantillon d’individus est parfaitement congruent et conforme à la population parente sur une série de caractéristiques manifestes et observables $X_1, X_2, dots, X_k$ (généralement des attributs sociodémographiques stables), il sera par extension congruente et représentatif de cette même population sur les variables cibles non observées $Y$ (telles que des attitudes politiques, des traits de personnalité, des vulnérabilités psychopathologiques ou des performances cognitives).
Or, cette hypothèse séduisante se heurte au risque omniprésent de covariance cachée. L’équivalence structurelle constatée sur les variables $X$ ne garantit nullement l’équivalence sur la variable dépendante $Y$, sauf s’il existe une corrélation déterministe ou quasi-parfaite entre ces deux ensembles de variables, ce qui s’avère exceptionnellement rare en psychologie. Par exemple, deux individus partageant une identité statistique absolue sur les critères de quotas (même tranche d’âge de 35-40 ans, même genre, même statut socio-économique et même zone de résidence) peuvent diverger radicalement sur des variables psychologiques latentes majeures, telles que le niveau d’introversion, l’anxiété de trait ou la réceptivité aux théories du complot.
Ce mimétisme proportionnel pose d’importantes questions touchant à la validité de construit. Les variables démographiques couramment employées comme quotas ne constituent souvent que des proxys imparfaits et distaux des processus psychiques sous-jacents. La sensibilité des variables latentes psychologiques face aux variables démographiques brutes présente une variabilité considérable : si certaines attitudes socioculturelles sont fortement structurées par le niveau d’éducation ou la cohorte générationnelle, de nombreux processus cognitifs fondamentaux (comme la capacité de mémoire de travail ou les mécanismes de perception visuelle) s’avèrent largement orthogonaux aux découpages sociodémographiques conventionnels.
2.3 Implications sur les tests statistiques et l’inférence
L’une des controverses les plus persistantes dans l’usage quantitatif des données issues d’échantillons par quotas concerne la légitimité théorique de l’application des tests d’hypothèse classiques de la statistique inférentielle paramétrique (tests $t$ de Student, analyses de variance $ANOVA$, modèles de régression linéaire ou logistique, modélisation par équations structurelles). D’un point de vue orthodoxe, la dérivation mathématique de la valeur $p$ (p-value), des erreurs-types et des intervalles de confiance à 95% postule de manière axiomatique que les données ont été générées par un mécanisme d’échantillonnage aléatoire simple ou probabiliste complexe.
Lorsque cette condition d’aléation n’est pas satisfaite, le recours aux formules standards de la variance d’échantillonnage devient mathématiquement contestable. Les calculs d’intervalles de confiance tendent à sous-estimer la variabilité réelle en ignorant les biais systématiques d’agrégation introduits par les enquêteurs ou les algorithmes de recrutement en ligne. Cela conduit potentiellement à une inflation artificielle de la précision apparente et à un risque accru d’erreurs de type I (rejeter à tort l’hypothèse nulle d’absence d’effet).
Face à cette aporie statistique, la communauté des chercheurs a développé plusieurs solutions palliatives. D’une part, une focalisation accrue sur l’analyse de la taille d’effet (comme le $d$ de Cohen ou l’$\eta^2$ partiel) plutôt que sur la seule significativité statistique brute, car la taille d’effet offre une mesure plus stable de l’ampleur d’un phénomène indépendamment du mode d’échantillonnage. D’autre part, l’exploitation de techniques non paramétriques intensives en calcul, telles que le rééchantillonnage par bootstrapping (auto-amorçage), permet d’estimer empiriquement les distributions d’échantillonnage sans dépendre des hypothèses distributionnelles paramétriques classiques. Néanmoins, l’inférence tirée d’un échantillon par quotas requiert toujours une formulation prudente, conditionnelle et consciente de ses limitations intrinsèques.
3. Les étapes méthodologiques clés de l’échantillonnage par quotas
3.1 Étape 1 : Segmentation de la population en catégories mutuellement exclusives
L’implémentation opérationnelle d’un protocole par quotas débute impérativement par une phase de décomposition analytique de la population cible. Cette première étape consiste à identifier, sélectionner et opérationnaliser les variables de contrôle qui serviront de fondation à la grille d’échantillonnage. En recherche psychologique et sociale, ces critères s’articulent usuellement autour de dimensions démographiques fondamentales (l’âge, le genre, la catégorie socioprofessionnelle, l’appartenance géographique, le niveau d’instruction), mais peuvent également intégrer des variables comportementales ou cliniques spécifiques (comme le statut tabagique, l’utilisation quotidienne d’un smartphone, ou un antécédent d’épisode dépressif documenté).
Le principe cardinal qui régit cette segmentation est celui du partitionnement strict. Les catégories constituées doivent être à la fois exhaustives et mutuellement exclusives. Cela signifie que chaque individu appartenant à la population cible doit obligatoirement trouver une place au sein du système de classification, tout en ne pouvant appartenir qu’à une seule et unique case à la fois. Par exemple, si l’on retient la variable de la tranche d’âge, les intervalles doivent être formulés sans ambiguïté : 18-29 ans, 30-49 ans, 50-64 ans et 65 ans et plus, excluant toute possibilité de chevauchement ou d’indétermination catégorielle.
Le choix des variables de contrôle ne saurait être arbitraire : il doit être rigoureusement subordonné aux hypothèses directrices de l’investigation psychologique. L’inclusion d’une variable de quota ne se justifie que si la littérature théorique antérieure démontre ou suggère fortement que cette variable est susceptible d’entretenir un lien significatif de corrélation ou de modération avec le phénomène psychologique étudié. Multiplier inutilement des variables non pertinentes complique l’effort logistique sans apporter de gain en matière de contrôle de variance.
3.2 Étape 2 : Détermination mathématique des quotas et proportions
Une fois le schéma de segmentation arrêté, l’étape suivante consiste à quantifier précisément le nombre d’individus devant être interrogés au sein de chaque cellule statistique. Pour ce faire, le chercheur doit s’appuyer sur des sources d’information secondaires institutionnelles d’une fiabilité incontestable, telles que les données de recensement fournies par des organismes nationaux officiels (par exemple, l’INSEE en France ou Statistique Canada), des bases de données épidémiologiques validées ou des registres académiques spécialisés.
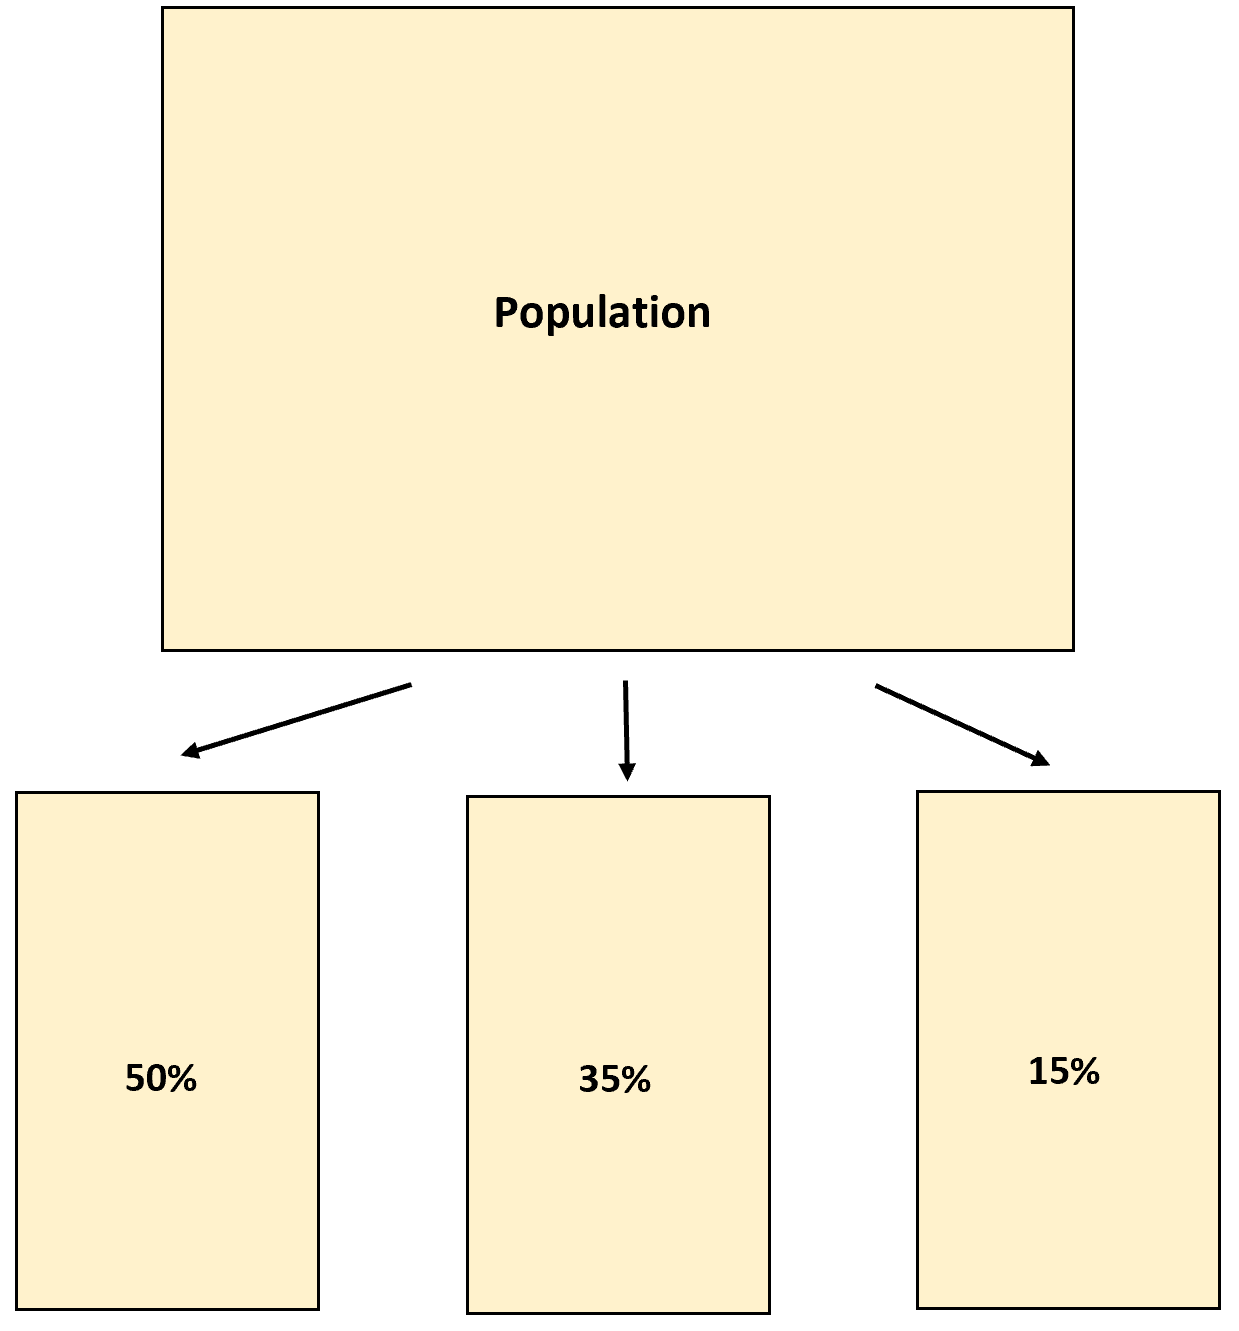
Le calcul mathématique de la taille de chaque sous-groupe repose sur une formule élémentaire mais rigoureuse :
$$n_i = n_{total} \times p_i$$
Dans cette équation, $n_i$ représente l’effectif cible assigné à la cellule spécifique $i$, $n_{total}$ figure la taille globale programmée pour l’échantillon d’étude, et $p_i$ correspond à la proportion relative de cette même cellule observée au sein de la population parente de référence. Ainsi, dans une population où les femmes âgées de 18 à 24 ans représentent 4,5 % du corps social, une étude dimensionnée pour un échantillon global de $n_{total} = 2,000$ individus exigera un quota impératif de :
$$n_i = 2,000 \times 0{,}045 = 90 \text{ participants}$$
La complexité analytique s’accroît lorsque le chercheur décide de croiser plusieurs variables au sein d’une grille multidimensionnelle (par exemple, le genre croisé simultanément avec quatre tranches d’âge et trois niveaux de diplôme, générant une matrice de $2 \times 4 \times 3 = 24$ cellules distinctes). Dans ces configurations, il devient indispensable d’établir des seuils d’effectifs minimaux (souvent fixés à $n ge 30$ par cellule dans les traditions biométriques) pour garantir que chaque sous-groupe dispose d’une masse critique suffisante pour autoriser des analyses de sous-échantillons stables et éviter des calculs de variances dégénérés.
3.3 Étape 3 : Recrutement effectif des participants selon la convenance dirigée
La dernière phase méthodologique correspond à l’entrée sur le terrain et au déploiement actif de la collecte de données. Contrairement à un tirage au sort passif, cette étape mobilise une convenance dirigée. Les enquêteurs, les plateformes de recherche numérique ou les laboratoires déploient des canaux d’acquisition ciblés (affichages ciblés, panels d’accès en ligne rémunérés, sollicitations directes dans des espaces publics prédéfinis, réseaux sociaux spécialisés) afin d’attirer des profils susceptibles de satisfaire les critères de la grille.
Le dispositif opérationnel intègre obligatoirement un module de filtrage initial (questions préliminaires dites de screening). Dès que le sujet entre en contact avec l’enquête, ses caractéristiques sociodémographiques sont immédiatement évaluées et confrontées à l’état de remplissage en temps réel de la matrice des quotas. Si la cellule à laquelle le candidat se rattache n’a pas encore atteint son objectif chiffré, le sujet est formellement admis dans l’étude et son protocole d’évaluation psychologique débute.
Dès l’instant exact où le nombre requis de participants pour une case spécifique est complété (la « saturation de cellule »), tout individu additionnel se présentant avec ce profil identique est immédiatement disqualifié ou réorienté vers d’autres protocoles. Ce mécanisme d’interruption instantanée du recueil requiert une infrastructure de suivi dynamique et une gestion logistique millimétrée, afin d’éviter la collecte superflue de données hors quotas, particulièrement coûteuse en temps d’administration et en incitations financières éventuelles.
4. Typologie approfondie : Quotas proportionnels versus non proportionnels
4.1 L’échantillonnage par quotas proportionnels
L’échantillonnage par quotas proportionnels représente la déclinaison classique et la plus largement diffusée de cette méthode. Son impératif directeur réside dans l’alignement mathématique absolu et rigide des pourcentages d’échantillon sur les proportions démographiques réelles de la population de référence. Si la population cible comporte 52 % d’individus s’identifiant comme femmes et 48 % d’hommes, l’échantillon final devra scrupuleusement refléter cette distribution exacte, à la virgule près ou dans une marge de tolérance infinitésimale (souvent inférieure à 0,5 %).
Cette typologie constitue l’approche préférentielle pour les enquêtes transversales descriptives globales, les études épidémiologiques de prévalence générale et les baromètres d’attitudes à large échelle. Son bénéfice premier est d’offrir une vision macroscopique intuitive et directement interprétable : les statistiques globales obtenues (scores moyens de bien-être subjectif, taux d’approbation d’une politique publique, scores composites d’anxiété générale) reflètent la moyenne pondérée de la société sans qu’il soit nécessaire d’appliquer des redressements mathématiques complexes en phase d’analyse préliminaire.
Cependant, cette modalité proportionnelle présente une vulnérabilité méthodologique majeure lorsqu’elle est confrontée à des groupes statistiques très minoritaires. Considérons une étude sur la santé mentale des personnes transgenres au sein de la population générale, segment estimé à moins de 1 % de la population globale. Dans un échantillon proportionnel standard de $n = 1,000$ répondants, ce groupe ne comptera qu’environ 5 à 10 participants. Cet effectif squelettique s’avère totalement inexploitable sur le plan statistique pour mener des inférences robustes ou des comparaisons intergroupes douées d’une puissance acceptable.
4.2 L’échantillonnage par quotas non proportionnels
Pour surmonter les défaillances de l’approche proportionnelle face aux groupes marginaux, les chercheurs adoptent fréquemment l’échantillonnage par quotas non proportionnels (ou quotas disjonctifs). Dans ce cadre épistémologique, le chercheur s’affranchit délibérément du mimétisme démographique global pour surreprésenter massivement des sous-populations spécifiques d’intérêt théorique ou clinique. Le découpage accorde par exemple un effectif égal à chaque cellule (par exemple, 100 individus pour chaque tranche d’âge ou chaque statut nosologique), indépendamment de leur poids réel dans la démographie parente.
Cette stratégie se révèle indispensable en neuropsychologie différentielle et en psychopathologie comparative, où l’objectif fondamental réside dans la comparaison statistique intergroupes (tests de contrastes d’hypothèses, modélisations par MANOVA) plutôt que dans la description d’une moyenne nationale indifférenciée. En assurant des effectifs équilibrés au sein de chaque strate, le chercheur maximise la puissance statistique (la probabilité de rejeter l’hypothèse nulle lorsqu’elle est fausse, usuellement calibrée à $1 – \beta ge 0{,}80$) et protège les modèles contre l’hétéroscédasticité causée par des variances disproportionnées entre groupes de tailles asymétriques.
Toutefois, cette surreprésentation délibérée interdit toute extrapolation directe de la moyenne brute globale de l’échantillon à la population générale. Pour réagréger les données et produire une estimation populationnelle non biaisée, le statisticien est formellement contraint d’appliquer des coefficients de pondération a posteriori (post-stratification weights). Ces coefficients rééquilibrent le poids mathématique de chaque observation en fonction de son inverse de probabilité de présence dans la matrice démographique réelle, restaurant ainsi l’exactitude des inférences d’ensemble.
4.3 Critères décisionnels pour le choix du protocole de quotas
L’arbitrage entre le déploiement d’un protocole proportionnel ou non proportionnel procède d’une analyse rigoureuse des objectifs scientifiques et des contraintes du projet. La formulation précise de la question de recherche constitue le premier facteur d’arbitrage : dès lors que l’hypothèse centrale postule un effet d’interaction entre sous-groupes (par exemple, tester si l’efficacité d’un protocole de remédiation cognitive varie selon l’âge et le niveau socio-éducatif), la configuration non proportionnelle devient méthodologiquement supérieure, car elle seule peut garantir des cellules remplies de façon optimale pour l’estimation des termes croisés.
Le second critère décisionnel relève de l’accès matériel aux populations ciblées et des contraintes budgétaires associées. Surreprésenter un segment rare dans un quota non proportionnel peut engendrer des coûts de prospection exponentiels sur le terrain, forçant les enquêteurs à passer des dizaines d’heures pour identifier des profils marginaux. Le chercheur doit calibrer le gain attendu en puissance statistique au regard du surcoût d’acquisition unitaire.
Enfin, le modèle d’analyse statistique envisagé doit guider cette décision architecturale. Les modèles d’équations structurelles ($SEM$), les régressions multiniveaux ou les analyses factorielles confirmatoires multigroupes imposent des exigences d’échantillonnage exigeantes au niveau de chaque sous-groupe (exigeant souvent un minimum de 100 à 200 observations par catégorie d’analyse pour une convergence algorithmique stable). Le tableau suivant synthétise les logiques directrices régissant ce choix méthodologique :
| Dimension d’arbitrage | Quotas Proportionnels | Quotas Non Proportionnels |
|---|---|---|
| Objectif prioritaire | Estimation de paramètres descriptifs globaux de la population. | Comparaisons intergroupes et modélisations différentielles. |
| Distribution relative | Miroir exact des pourcentages démographiques connus. | Effectifs fixés a priori selon les besoins de puissance statistique. |
| Exploitation directe des scores | Immédiate, sans pondération corrective obligatoire. | Requiert formellement un redressement par pondération pour les totaux. |
| Traitement des minorités | Effectifs souvent insuffisants pour des analyses fines. | Protection et surreprésentation des segments rares. |
5. Analyse comparative détaillée : Échantillonnage par quotas versus échantillonnage stratifié
5.1 Similitudes conceptuelles et architecturales
Dans les manuels de méthodologie de recherche, l’échantillonnage par quotas et l’échantillonnage probabiliste stratifié sont fréquemment présentés côte à côte, ce qui engendre des confusions terminologiques récurrentes chez les jeunes chercheurs. Cette proximité apparente découle d’une architecture de conception superficiellement identique : les deux méthodologies débutent impérativement par une opération de partitionnement de la population parente en sous-ensembles mutuellement exclusifs et exhaustivement définis, appelés « strates » dans le premier cas et « quotas » dans le second.
Dans l’une comme dans l’autre de ces approches, les investigateurs s’appuient sur des critères de découpage analogues, combinant des descripteurs démographiques, socio-économiques ou comportementaux. L’intention théorique partagée est évidente : conjurer les aléas malheureux d’un tirage simple qui, par le jeu des fluctuations stochastiques d’échantillonnage, pourrait sous-représenter gravement un pan déterminant du corps social étudié. L’une et l’autre des approches postulent que la réduction de la variance intra-groupe et l’accroissement de l’hétérogénéité inter-groupes concourent à optimiser la qualité informationnelle de l’échantillon extrait.
De surcroît, ces deux protocoles requièrent tous deux une connaissance quantitative préalable de la structure populationnelle. Impossible de concevoir un échantillonnage stratifié ou un échantillonnage par quotas sans disposer en amont de données de recensement ou de registres statistiques précis décrivant les proportions respectives de chaque groupe au sein de la population globale. C’est sur la base de ce même tableau de distribution que les tailles cibles des sous-groupes sont calculées dans les deux systèmes.
5.2 Divergence fondamentale : Mécanisme de sélection des sujets
En dépit de leur parenté architecturale évidente, ces deux techniques sont séparées par une frontière épistémologique infranchissable, située au niveau précis du mécanisme de sélection des participants. Dans l’échantillonnage stratifié, qui constitue une méthode rigoureusement probabiliste, le chercheur dispose d’une liste nominative intégrale de chaque strate (la base de sondage). Au sein de chaque strate isolée, les sujets finaux sont extraits par un processus de tirage au sort aléatoire mécanique (tirage systématique, tirage aléatoire simple assisté par ordinateur ou générateur de nombres pseudo-aléatoires).
Dans l’échantillonnage par quotas, ce processus probabiliste mécanique est totalement absent. L’enquêteur n’a accès à aucune liste exhaustive nominative des membres de la strate. Le recrutement concret repose sur un acte de convenance dirigée ou de jugement : le sondeur se rend dans un espace physique déterminé, lance des campagnes d’acquisition sur les réseaux sociaux, ou mobilise les inscrits volontaires d’un panel d’accès en ligne préconstitué. Les individus sont enrôlés selon leur ordre d’arrivée, leur disponibilité active ou leur volonté spontanée de répondre, jusqu’à extinction numérique de la cellule de quota assignée.
Cette divergence dans l’acte de sélection a des répercussions considérables sur le plan statistique. Alors que l’échantillonnage stratifié permet de calculer formellement la variance d’échantillonnage théorique — qui se trouve d’ailleurs être inférieure à celle d’un tirage aléatoire simple grâce au contrôle de la variance inter-strates —, l’échantillonnage par quotas interdit un tel calcul d’erreur formel. Il subsiste au sein de chaque quota un risque indéterminé de biais de sélection qui échappe aux modélisations de la théorie des sondages classiques.
5.3 Tableau comparatif multicritère et arbitrage scientifique
Pour guider les investigateurs dans le choix méthodologique adapté à leurs contraintes institutionnelles et à leurs exigences de publication, il s’avère précieux de synthétiser les axes de différenciation opératoires séparant ces deux paradigmes. Les critères de comparaison portent non seulement sur la théorie de la mesure, mais également sur la logistique d’exécution sur le terrain et la réception par les pairs académiques.
| Critère d’analyse | Échantillonnage Stratifié | Échantillonnage par Quotas |
|---|---|---|
| Nature épistémologique | Probabiliste stricte. | Non probabiliste dirigée. |
| Exigence d’une base de sondage | Indispensable (liste exhaustive préalable obligatoire). | Inutile (aucune liste nominative requise). |
| Mécanisme de sélection interne | Aléatoire formel (tirage au sort mécanique). | Sélection par convenance, jugement ou accessibilité. |
| Coût financier unitaire | Généralement élevé (relances, traçabilité des refus). | Modéré à très bas (optimisation des flux d’enrôlement). |
| Délai opérationnel de recueil | Long (processus d’attente de réponse standardisé). | Extrêmement rapide (remplissage en continu des cases). |
| Calcul de l’erreur d’échantillonnage | Mathématiquement rigoureux et calculable. | Théoriquement impossible ; approximations requises. |
| Attitude des revues de rang A | Excellence académique et conformité consensuelle. | Acceptation sous réserve de justification opérationnelle. |
L’arbitrage entre ces deux approches se résume fréquemment à une équation de faisabilité opérationnelle : dès lors qu’il n’existe aucun registre légal des membres d’une population ou que les délais imposent une restitution d’urgence, l’échantillonnage par quotas s’impose comme le substitut fonctionnel le plus rigoureux, surpassant de très loin les faiblesses méthodologiques de l’échantillon de convenance pure ou de l’échantillonnage opportuniste.
6. Étude de cas et exemple concret d’application pratique
6.1 Contexte de l’enquête : Perception psychologique d’un nouveau produit technologique
Afin d’ancrer ces considérations théoriques dans le réel empirique, considérons une étude concrète menée par une équipe de recherche spécialisée en psychologie ergonomique et interaction homme-machine (Human-Computer Interaction). L’organisation mandatée évalue l’acceptabilité technologique, la charge cognitive perçue (évaluée par l’échelle NASA-TLX) et le niveau de technophobie associé au déploiement d’une nouvelle interface de télémédecine assistée par intelligence artificielle.
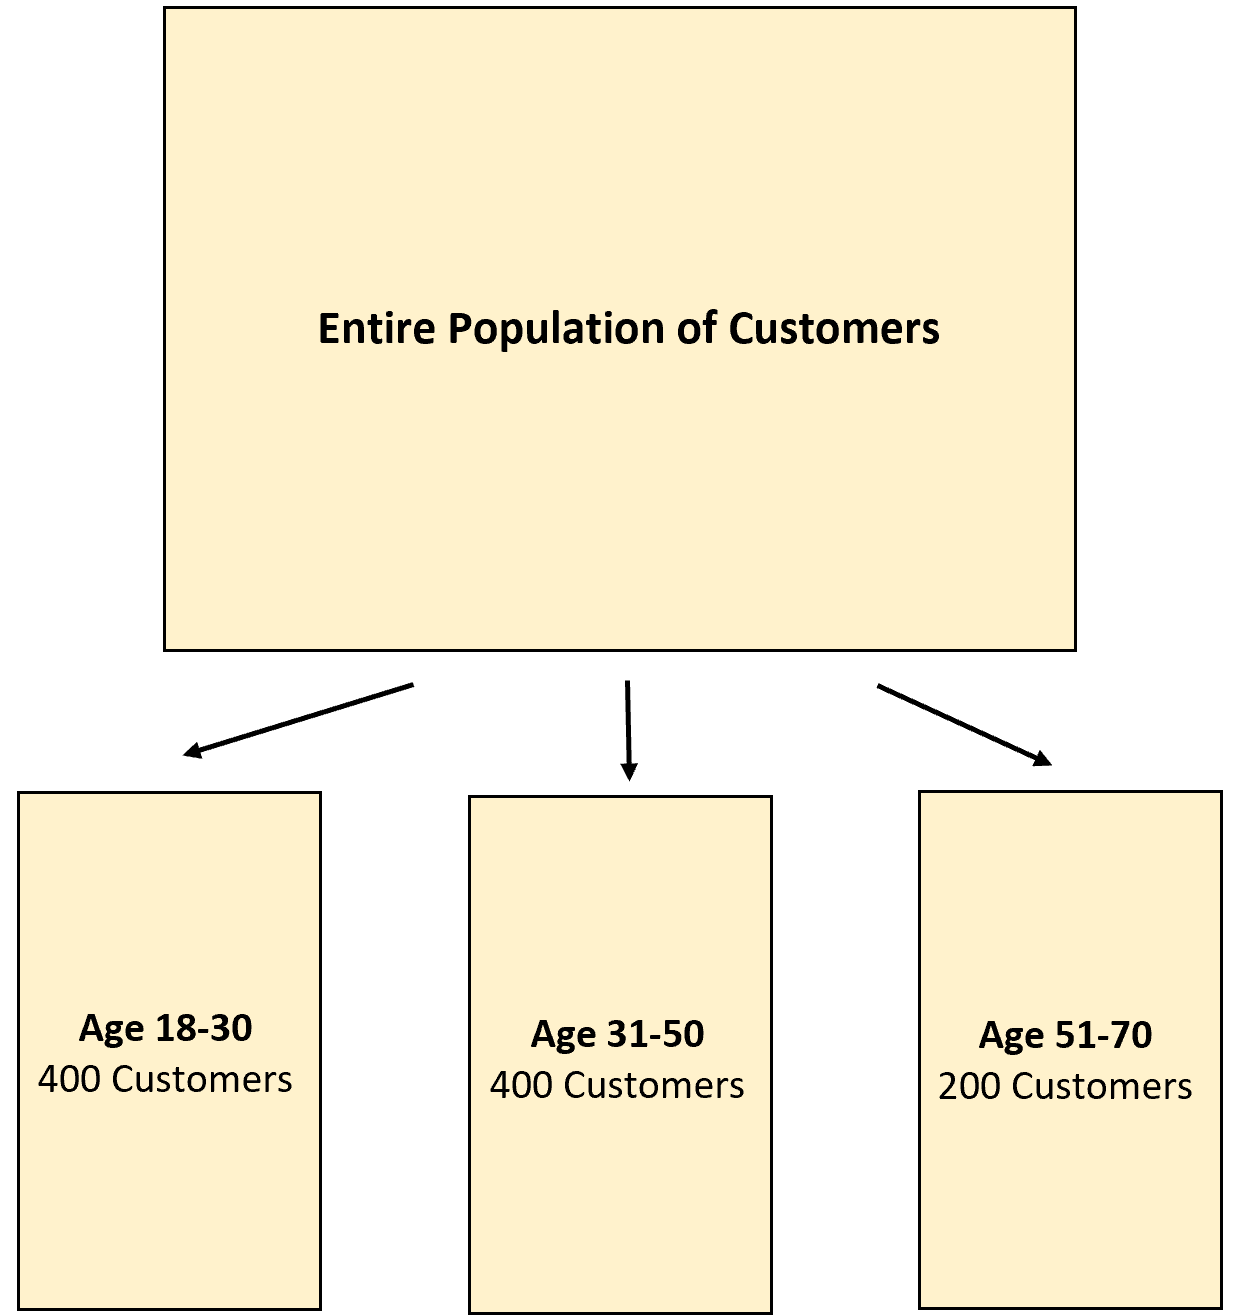
La population parente d’intérêt est définie comme l’ensemble des usagers potentiels d’un système de santé régional, âgés de 18 à 70 ans, résidant au sein d’une zone métropolitaine de 2 millions d’habitants. L’équipe arrête une taille d’échantillon cible globale de $N = 1,000$ participants, seuil jugé optimal pour saturer les modèles d’équations structurelles d’acceptation technologique (modèle TAM).
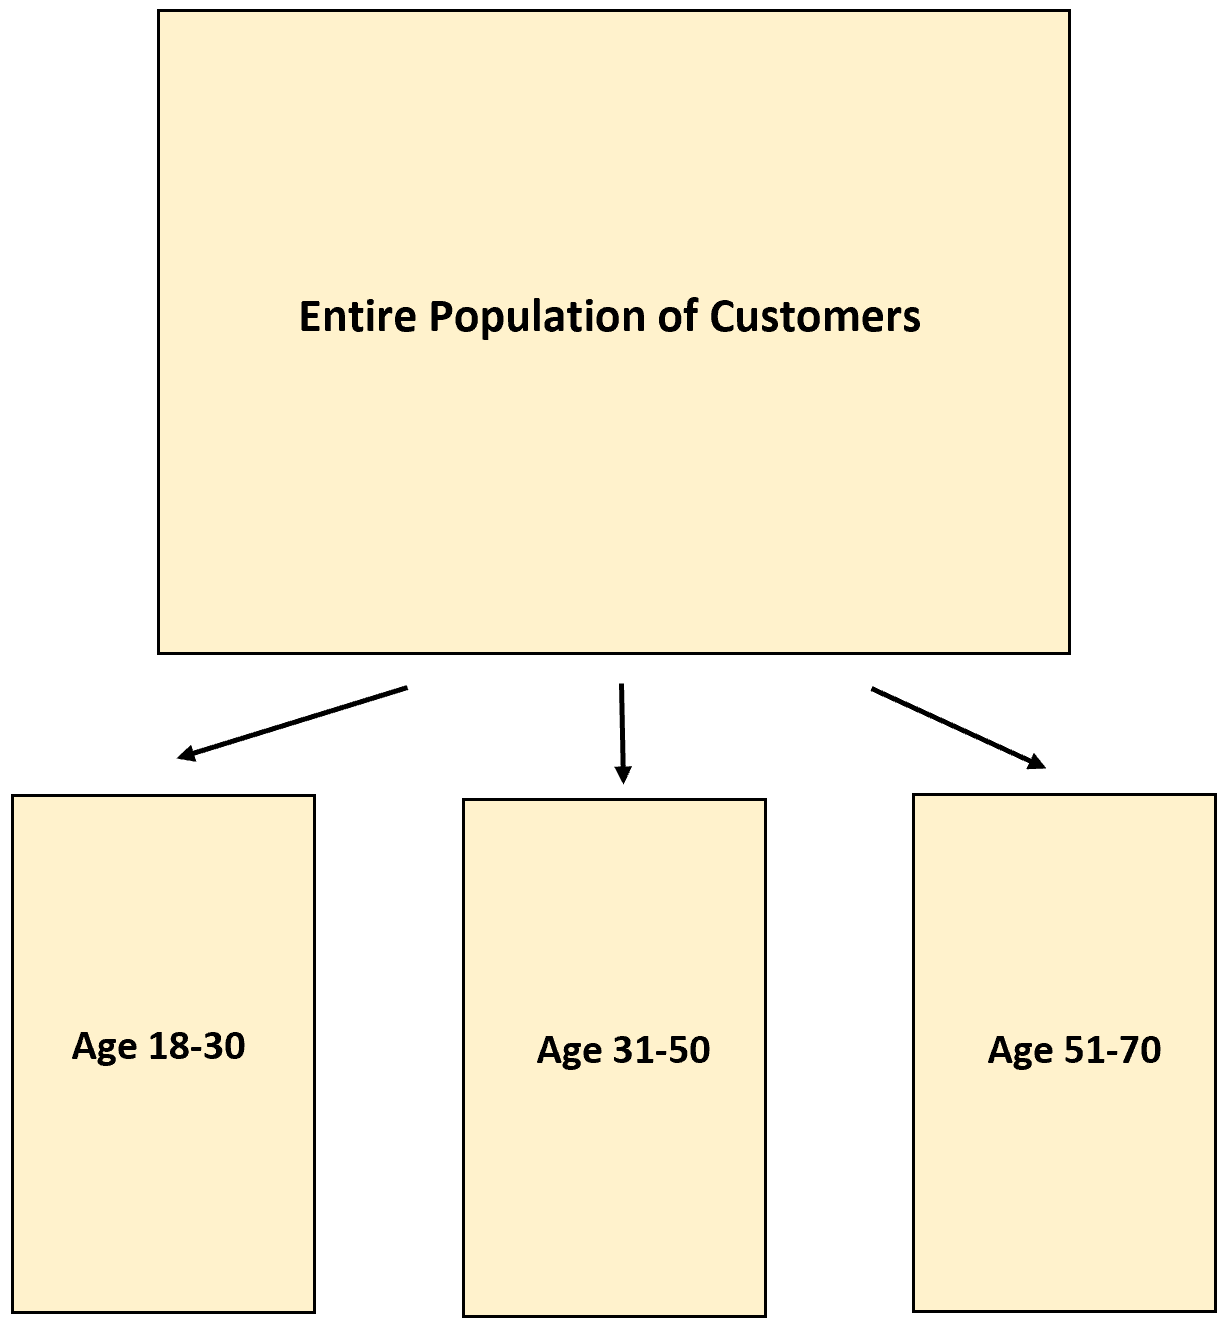
La littérature en psychologie cognitive démontre sans équivoque que la variable chronologique de l’âge exerce un rôle modérateur déterminant sur l’anxiété technologique, les habitudes numériques et l’aisance perceptive face aux interfaces graphiques complexes. Dès lors, l’âge est retenu comme variable de contrôle matricielle fondamentale pour ériger les quotas. L’exploitation des données démographiques les plus récentes du recensement métropolitain permet d’isoler la distribution suivante pour la tranche d’intérêt 18-70 ans :
- Groupe 1 : Jeunes adultes (18 à 30 ans) — représentent 40 % de la population cible.
- Groupe 2 : Adultes d’âge mûr (31 à 50 ans) — représentent 40 % de la population cible.
- Groupe 3 : Seniors autonomes (51 à 70 ans) — représentent 20 % de la population cible.
6.2 Traduction opérationnelle : Calcul des effectifs par cellule
L’application directe de la formule mathématique de détermination des quotas proportionnels permet de traduire immédiatement ces pourcentages macroscopiques en objectifs chiffrés d’individus à tester dans le laboratoire ou via la plateforme expérimentale en ligne :
$$\text{Effectif Groupe 1 (18–30 ans)} = 1,000 \times 0{,}40 = 400 \text{ participants}$$
$$\text{Effectif Groupe 2 (31–50 ans)} = 1,000 \times 0{,}40 = 400 \text{ participants}$$
$$\text{Effectif Groupe 3 (51–70 ans)} = 1,000 \times 0{,}20 = 200 \text{ participants}$$
Pour affiner la représentativité psychométrique de l’échantillon, les chercheurs décident d’intercroiser cette variable d’âge avec la variable du genre biologique (hommes versus femmes, stabilisé à parité exacte 50/50 au sein de cette population régionale pour simplifier l’exemple). La matrice d’échantillonnage opérationnelle qui guide le système de collecte se décompose dès lors en une grille bidimensionnelle à six cellules distinctes, assorties de seuils d’arrêt intangibles :
| Tranche d’âge | Hommes (50 %) | Femmes (50 %) | Total par âge |
|---|---|---|---|
| 18–30 ans (40 %) | $n_1 = 200$ | $n_2 = 200$ | $N_{18-30} = 400$ |
| 31–50 ans (40 %) | $n_3 = 200$ | $n_4 = 200$ | $N_{31-50} = 400$ |
| 51–70 ans (20 %) | $n_5 = 100$ | $n_6 = 100$ | $N_{51-70} = 200$ |
| Total par Genre | 500 | 500 | $N_{Total} = 1,000$ |
6.3 Exécution séquentielle de la collecte sur le terrain
La collecte de données est initiée via une campagne numérique associant diffusion sur réseaux professionnels, partenariats associatifs et bannières programmatiques ciblées. Dès qu’un internaute clique sur le lien de l’étude, il est accueilli par un formulaire de qualification préalable (screener) ne comportant que deux questions fermées : son âge exact en années révolues et son identité de genre.
Le déroulement empirique illustre parfaitement la cinétique typique de l’échantillonnage par quotas :
- Phase d’afflux rapide (Jours 1 à 4) : Les jeunes adultes ultra-connectés s’enregistrent massivement. Au terme du quatrième jour, la cellule « Hommes 18-30 ans » atteint ses 200 répondants, suivie de près par la cellule « Femmes 18-30 ans ». Le système algorithmique applique immédiatement un verrou logique sur ces deux cellules : tout candidat ultérieur âgé de moins de 31 ans reçoit un message courtois l’informant que son profil a atteint la limite d’inscriptions requise, mettant un terme à sa session sans administrer les tests psychologiques d’ergonomie.
- Phase de ralentissement différentiel (Jours 5 à 12) : Les strates intermédiaires (31-50 ans) se comblent à leur tour de manière ordonnée. En revanche, le recrutement des seniors de 51 à 70 ans marque un ralentissement notable, accusant un déficit de répondants masculins (seuls 42 hommes de cette tranche ont complété le protocole au jour 12).
- Phase de ciblage correctif actif (Jours 13 à 18) : L’équipe modifie sa stratégie de déploiement en coupant les canaux généralistes pour concentrer ses investissements publicitaires et ses sollicitations physiques spécifiquement sur des plateformes fréquentées par les seniors (forums d’associations de retraités, affichage dans des clubs d’activités seniors). Cette réorientation ciblée permet de capturer les 58 hommes seniors manquants.
Le recueil est clôturé de manière étanche dès l’enregistrement du 1 000e sujet validé, satisfaisant la distribution exacte de la matrice initiale. Les données psychométriques ainsi isolées peuvent désormais faire l’objet de traitements analytiques épurés de tout biais démographique d’asymétrie générationnelle.
7. Application spécifique de l’échantillonnage par quotas dans les sciences psychologiques
7.1 Standardisation et étalonnage des outils psychométriques
L’un des domaines les plus nobles et les plus exigeants de la psychologie scientifique réside dans la psychométrie, c’est-à-dire la science de l’évaluation quantitative des fonctions cognitives, des aptitudes intellectuelles et des traits de personnalité. Le développement et la publication d’un nouvel instrument d’évaluation (comme l’échelle d’intelligence de Wechsler [WISC / WAIS], le questionnaire de personnalité MMPI ou les inventaires mesurant le modèle des Big Five) nécessitent formellement l’établissement de normes standardisées (étalonnages en percentiles ou en notes standards) permettant de situer le score brut d’un individu par rapport à ses pairs de référence.
Pour construire ces barèmes cliniques normatifs sans engager les budgets astronomiques d’un recensement épidémiologique complet, les éditeurs de tests psychologiques et les laboratoires spécialisés recourent massivement à l’échantillonnage par quotas. La grille de quotas reproduit alors au millimètre près la pyramide des âges, les ratios de sexe, les niveaux de diplôme et les répartitions géographiques du pays de destination de l’outil. Cette rigueur structurelle garantit que la note standard moyenne (par exemple, un QI moyen de 100 avec un écart-type de 15) ne soit pas faussée par une surreprésentation d’étudiants en psychologie de niveau master.
La méthode permet d’éviter l’écueil historique de la standardisation sur des échantillons de complaisance académique. Grâce à des quotas précisément calibrés, les chercheurs psychométriciens s’assurent de déterminer des seuils de significativité clinique et des scores d’alerte pathologique dont la sensibilité et la spécificité sont testées sur un spectre sociodémographique réaliste, condition indispensable à l’utilisation du test en diagnostic clinique et médicolégal.
7.2 Recherche en psychologie sociale et études d’attitudes
En psychologie sociale, l’objet de recherche se concentre sur la manière dont les pensées, les sentiments et les comportements individuels sont influencés par la présence réelle, imaginaire ou implicite d’autrui. Les chercheurs s’intéressent ici aux représentations sociales, aux stéréotypes implicites, aux dynamiques d’exclusion et aux mécanismes d’influence normative. Dans ce paradigme expérimental ou corrélationnel, tester des hypothèses uniquement sur des sujets jeunes et éduqués débouche sur une sévère invalidité écologique, les attitudes sociales étant modelées par la trajectoire de vie et le milieu d’insertion sociologique.
L’échantillonnage par quotas permet aux psychologues sociaux de contrôler activement l’impact de la catégorie socio-professionnelle (CSP) et du capital culturel sur des processus sociocognitifs tels que le biais d’attribution fondamentale, l’autoritarisme de droite ou l’orientation à la dominance sociale. En garantissant l’inclusion proportionnée d’ouvriers, d’employés, de cadres supérieurs et d’inactifs, le chercheur s’assure que les corrélations observées entre des variables psychologiques ne sont pas de simples artefacts générés par l’homogénéité socioéconomique de l’échantillon.
De plus, l’adoption de matrices de quotas multivariées sophistiquées permet d’aborder scientifiquement les questions d’intersectionnalité méthodologique. En croisant simultanément le genre, l’âge, l’origine ethnoculturelle autodéclarée et le niveau de revenu, les psychologues sociaux peuvent modéliser comment l’exposition au stress de minorité ou la vulnérabilité à la menace du stéréotype s’exprime différemment aux confluents de multiples identités sociales.
7.3 Psychopathologie et recherche clinique appliquée
Dans l’investigation des désordres psychopathologiques et de la santé mentale communautaire, l’échantillonnage par quotas remplit un rôle crucial pour la constitution d’échantillons dits « subcliniques » ou pour l’évaluation épidémiologique des facteurs de risque psychologique dans la population générale. Recruter au sein de la communauté des individus présentant des traits de personnalité limite, des symptômes d’anxiété généralisée ou des conduites addictives légères sans qu’ils soient formellement hospitalisés exige une couverture structurée que le système de quotas facilite grandement.
La méthode est particulièrement mobilisée pour bâtir des groupes témoins sains rigoureusement appariés à des cohortes cliniques. Lorsqu’une étude clinique évalue le fonctionnement de la mémoire prospective chez 50 patients atteints d’un premier épisode psychotique, il est scientifiquement impératif de confronter leurs scores à ceux d’un groupe contrôle de 50 sujets exempts de troubles psychiatriques, mais partageant la distribution sociodémographique exacte de la cohorte pathologique. La grille par quotas permet de recruter ce groupe miroir avec une efficacité chirurgicale.
Néanmoins, les cliniciens doivent rester lucides quant aux limites inhérentes de la méthode face aux exigences diagnostiques formelles. Si les quotas permettent d’échantillonner des manifestations symptomatiques auto-rapportées à l’aide d’échelles d’évaluation (comme le BDI-II pour la dépression ou l’audit pour l’alcoolisme), ils ne sauraient se substituer aux protocoles rigides d’entretiens diagnostiques structurés standardisés (comme le SCID-5). L’échantillonnage par quotas identifie des populations à risque avec agilité, mais le diagnostic d’inclusion finale demeure sous la dépendance d’une évaluation clinique approfondie.
8. Avantages méthodologiques, logistiques et économiques du modèle par quotas
8.1 Efficience budgétaire et maîtrise des coûts de recherche
L’argument premier plaidant pour l’intégration de l’échantillonnage par quotas dans les protocoles de recherche contemporains réside dans son efficience économique exceptionnelle. Dans le cadre d’un échantillonnage probabiliste formel, les postes de dépenses s’avèrent considérables : acquisition de bases de sondage exclusives auprès d’organismes de statistiques publiques, déploiement d’enquêteurs sur l’ensemble d’un territoire géographique pour joindre des adresses précises tirées au sort, et surtout gestion chronophage des procédures de relance. Dans un sondage probabiliste par panel ou par téléphone, il n’est pas rare de devoir relancer un individu jusqu’à 8 à 10 fois pour obtenir son consentement, engendrant un coût marginal par questionnaire complété prohibitif pour la plupart des laboratoires de recherche académique.
À l’inverse, l’échantillonnage par quotas neutralise totalement ces dépenses logistiques lourdes. En s’affranchissant du devoir de contacter un individu spécifique tiré au sort, il autorise le remplacement immédiat d’un refusant par un autre sujet répondant aux mêmes critères de quota. Cette substitution d’unités de collecte fluide fait chuter le coût unitaire par participant administré à une fraction de celui d’un protocole probabiliste standard. Cette rationalisation des coûts démocratise l’accès à des échantillons de grande puissance numérique ($N > 1,000$) pour des thèses doctorales ou des programmes de recherche disposant de dotations financières restreintes.
De plus, cette dynamique réduit drastiquement les pertes de temps et les ressources allouées à la traçabilité des non-répondants. L’effort financier est exclusivement concentré sur la complétion active des cellules statistiques ouvertes, éliminant les temps morts et les déperditions budgétaires associées aux adresses erronées ou aux numéros de téléphone désactivés propres aux bases de sondage traditionnelles.
8.2 Rapidité d’exécution et flexibilité logistique
La compression temporelle autorisée par l’échantillonnage par quotas constitue un atout méthodologique déterminant, tout particulièrement lorsque la pertinence de l’investigation psychologique est conditionnée par l’immédiateté d’une situation de crise. Qu’il s’agisse de mesurer la panique collective face à un attentat, le sentiment d’isolement lors d’un confinement sanitaire imprévu ou la réaction émotionnelle immédiate à un scandale institutionnel, la valeur des données psychologiques dépend étroitement de la brièveté du délai séparant l’événement déclencheur du moment de l’administration du test.
Tandis qu’un tirage probabiliste exige des semaines, voire des mois de mise en place administrative et de prospection séquentielle, une enquête par quotas administrée via des panels web pré-qualifiés peut aisément collecter des milliers d’observations complètes en l’espace de 48 à 72 heures. Cette réactivité logistique exceptionnelle confère au chercheur une capacité d’observation quasi-instantanée des phénomènes socio-affectifs mouvants.
Par ailleurs, cette méthodologie offre une adaptabilité en temps réel face aux contingences de terrain. Si les investigateurs constatent en cours de recueil qu’une variable non anticipée introduit une distorsion majeure dans les réponses, la grille d’échantillonnage peut être ajustée dynamiquement en insérant une sous-cellule de contrôle supplémentaire sans devoir annuler l’intégralité du travail déjà accompli. Cette flexibilité itérative est impensable dans le cadre rigide des procédures aléatoires strictes.
8.3 Garantie de non-vacuité des cellules statistiques
L’un des tourments méthodologiques les plus redoutés par les analystes de données réside dans l’apparition inopinée de cellules statistiques vides ou structurellement sous-dotées lors de l’exécution d’un plan d’analyse factoriel. Dans un tirage aléatoire simple de taille modeste, le hasard du tirage peut conduire à ce qu’aucune femme cadre de plus de 60 ans ne soit sélectionnée. Cette absence d’observations rend mathématiquement impossible le calcul de certains termes d’interaction dans les modèles linéaires généraux multivariés (phénomène de rang incomplet de la matrice des variables prédictives).
L’échantillonnage par quotas élimine mécaniquement ce péril grâce à sa logique déterministe d’objectifs quantifiés. Le chercheur s’assure par contrat méthodologique qu’aucune cellule de son plan d’analyse factoriel ne comportera un effectif inférieur au seuil analytique plancher prédéterminé lors de la phase de conception. Cette stabilité structurelle des effectifs intra-groupes facilite grandement la planification des analyses statistiques a priori, notamment en ce qui concerne les calculs de puissance d’adéquation de modèle.
Enfin, cette armature géométrique des effectifs confère une lisibilité immédiate aux rapports de recherche. La clarté structurelle facilitant la communication des résultats descriptifs auprès des décideurs institutionnels, des bailleurs de fonds ou du grand public, sans nécessiter de fastidieuses notes explicatives sur les marges d’erreur asymétriques découlant d’effectifs défaillants dans tel ou tel sous-groupe.
9. Limites statistiques, risques de biais et validité scientifique
9.1 Biais de sélection de l’enquêteur et effet d’accessibilité
En dépit de ses indéniables vertus opérationnelles, l’échantillonnage par quotas héberge des vulnérabilités méthodologiques considérables, au premier rang desquelles figure le biais de sélection de l’enquêteur ou effet d’accessibilité différentielle. Dès lors qu’une marge de liberté humaine intervient dans le choix final de l’individu répondant au quota (que cette liberté soit le fait d’un enquêteur de rue ou du concepteur d’un algorithme de ciblage publicitaire sur le web), des critères subjectifs inconscients ou pragmatiques polluent la neutralité du recueil.
Dans les enquêtes en face-à-face, les enquêteurs manifestent une propension naturelle et documentée à aborder les passants présentant une apparence avenante, bienveillante et perçue comme sécurisante, tout en évitant systématiquement les individus paraissant pressés, hostiles, marginalisés ou en situation de précarité manifeste. Même si les personnes retenues cochent formellement la case du quota (par exemple : « homme de 40 ans »), elles ne représentent en rien l’ensemble de la population de cette cellule, mais uniquement sa fraction la plus accessible et socialement intégrée. Ce biais de convenance intra-groupe altère gravement l’homogénéité interne des sous-groupes constitués.
De façon analogue, dans les enquêtes numériques par quotas, les algorithmes de distribution des plateformes orientent préférentiellement les questionnaires vers les panélistes les plus réactifs et les plus actifs (les « hyper-répondeurs »). Cette sélection automatisée produit une surreprésentation d’individus passant un temps considérable devant leurs écrans d’ordinateur, dotés d’une littératie numérique supérieure à la moyenne et motivés par l’accumulation de micro-rémunérations financières, introduisant des distorsions psychologiques profondes sur les échelles d’estime de soi, de solitude ou de stress perçu.
9.2 Le piège des variables omises et facteurs de confusion masqués
La seconde fragilité théorique majeure découle du principe même de l’isomorphisme structurel : le risque mortel des variables de confusion masquées et des variables omises. Par nécessité logistique, une grille de quotas ne peut réguler simultanément qu’un nombre restreint de critères (rarement plus de trois ou quatre variables croisées simultanément, au risque de voir la matrice s’effondrer sous le poids de centaines de cellules microscopiques impossibles à remplir). Dès lors, tous les déterminants psychologiques et environnementaux non intégrés dans la grille d’échantillonnage échappent à tout contrôle.
Il est scientifiquement erroné de postuler qu’une équivalence démographique superficielle implique une équivalence psychologique sous-jacente. Deux femmes de 28 ans appartenant à la catégorie socioprofessionnelle des employés peuvent partager le même quota d’âge et de statut de travail, tout en présentant des profils radicalement hétérogènes sur des variables latentes déterminantes telles que le soutien social perçu, la névrose, l’exposition à des traumatismes infantiles ou la résilience psychologique. Si ces traits psychologiques latents corrèlent avec la variable d’intérêt mesurée par l’étude, l’échantillon par quotas produira des estimations gravement biaisées sans que le chercheur n’en ait conscience.
Cette omission de facteurs de confusion altère directement la validité interne des conclusions expérimentales. Le chercheur court le risque permanent d’attribuer une différence psychologique observée entre deux groupes d’âge à un effet développemental ou générationnel réel, alors que cette divergence résulte simplement d’un déséquilibre non régulé sur le statut marital, le niveau d’endettement financier ou la stabilité de l’habitat entre les deux segments échantillonnés.
9.3 Impossibilité de calcul de l’erreur d’échantillonnage théorique
Sur le plan de l’orthodoxie statistique mathématique, la lacune la plus rédhibitoire de la méthode par quotas réside dans l’impossibilité absolue de déterminer formellement l’erreur d’échantillonnage et les intervalles de confiance rigoureux. Dans les sondages probabilistes, l’erreur-type est une fonction déterministe de la taille de l’échantillon et de la variance de la population, calculable grâce au théorème central limite qui garantit la convergence de la moyenne d’échantillon vers l’espérance mathématique de la population :
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$
Dans un échantillonnage non probabiliste par quotas, cette formulation théorique s’effondre. Comme les probabilités d’inclusion individuelles demeurent rigoureusement inconnues, la distribution d’échantillonnage de la moyenne ne peut être déduite des axiomes probabilistes standards. L’erreur totale observée agrège de manière indissociable deux composantes distinctes : la variance d’échantillonnage pure et le biais de sélection systématique. Or, le calcul conventionnel d’une marge d’erreur ignore purement et simplement le biais de sélection, ce qui conduit à afficher une illusion mathématique de précision.
Cette carence méthodologique structurelle explique la réticence historique de certains comités de lecture au sein des revues scientifiques internationales de premier rang (comme les revues de l’American Psychological Association ou la revue Psychological Science) face aux protocoles par quotas exclusifs pour valider des modèles théoriques universels. Les réviseurs les plus stricts considèrent que les seuils de significativité conventionnels ($p < 0{,}05$) perdent leur ancrage mathématique standard dès lors que le tirage n'est pas probabiliste, augmentant le spectre des faux positifs dans la littérature scientifique.
10. Stratégies de réduction des biais lors du recrutement par quotas
10.1 Complexification contrôlée des variables de contrôle (quotas croisés)
Afin de juguler l’impact délétère des variables omises et rehausser le niveau de représentativité globale, les méthodologistes préconisent de substituer aux simples quotas marginaux la technique plus avancée des quotas intercroisés (ou quotas imbriqués). Dans un système par quotas marginaux (ou simples), l’enquêteur doit recruter indépendamment 50 % d’hommes et 50 % de femmes, et par ailleurs 30 % de diplômés de l’enseignement supérieur. Ce dispositif autorise une perversion statistique : l’opérateur pourrait théoriquement recruter tous ses diplômés exclusivement parmi les hommes, biaisant dramatiquement l’interaction genre-diplôme.
Le recours à une matrice de quotas croisés neutralise cette dérive en fixant des cibles contraignantes au niveau exact de l’intersection des attributs (par exemple, un quota distinct pour les « femmes sans diplôme », un pour les « femmes diplômées », etc.). Pour aller plus loin encore, l’investigateur en psychologie gagne à introduire dans sa matrice des variables de contrôle comportementales ou d’habitudes de vie directement liées à l’objet d’étude (par exemple, le nombre d’heures de sommeil moyennes, le fait de vivre seul ou en couple, la pratique régulière d’une activité physique).
Cette complexification doit toutefois être rigoureusement régulée pour éviter le piège de l’explosion combinatoire. Si l’on croise 4 tranches d’âge, 2 genres, 4 catégories d’habitat géographique et 3 niveaux de revenus, le chercheur se retrouve confronté à un maillage de :
$$4 \times 2 \times 4 \times 3 = 96 \text{ cellules distinctes}$$
Une telle fragmentation devient un cauchemar logistique où le recrutement des dernières cellules croisées raréfie les profils jusqu’à paralyser la collecte de terrain. L’art de la méthodologie réside dans l’identification du nombre minimal de variables croisées capable de capter la majeure partie de la variance explicative.
10.2 Standardisation rigoureuse des canaux et procédures de recrutement
Pour endiguer les biais d’accessibilité et neutraliser les inclinations préférentielles des enquêteurs de terrain, le protocole d’acquisition doit faire l’objet d’une standardisation opérationnelle draconienne. Si la collecte se déploie dans l’espace public urbain, des consignes aveugles doivent être imposées aux assistants de recherche : obligation d’interpeller systématiquement chaque $k$-ième individu franchissant une ligne imaginaire au sol (par exemple, approcher rigoureusement la 5e personne qui passe, quel que soit son profil apparent), diversifier impérativement les zones de recrutement géographique (alterner quartiers d’affaires, zones commerciales périphériques, campus universitaires et zones résidentielles populaires) et étaler les plages horaires de recueil de 8 heures à 20 heures afin de ne pas filtrer les personnes en horaires de travail classiques.
Dans le cadre des enquêtes numériques et des panels en ligne, les stratégies modernes reposent sur l’intermédiation d’algorithmes de routage automatisé (systèmes dits de river sampling ou routeurs de panels). Les répondants qui se connectent ne choisissent pas leur enquête d’après son intitulé ou son attractivité thématique ; ils sont assignés de manière programmatique et aléatoire par la plateforme vers une étude spécifique dont les quotas d’accueil sont encore ouverts pour leur profil socio-démographique. Cette automatisation algorithmique élimine l’auto-sélection thématique (par exemple, le fait que seuls les individus passionnés par les technologies répondent à une enquête sur l’acceptabilité technologique).
Enfin, la mise en place d’un système d’audit continu de la qualité des données en cours de recueil permet de purger l’échantillon des profils frauduleux. Cela passe par l’implémentation de questions pièges de vérification d’attention (attention checks), l’analyse chronométrique des temps de passation pour exclure les répondants ultra-rapides (speeders) et la détection d’adresses IP dupliquées via des empreintes digitales numériques (digital fingerprinting).
10.3 Méthodes de redressement statistique et pondération post-enquête
Même lorsque la collecte sur le terrain respecte formellement la grille de quotas prescrite, des disparités résiduelles peuvent persister entre la structure de l’échantillon achevé et les paramètres connus de la population globale sur des dimensions secondaires non incluses dans la grille matricielle de départ. Pour juguler ces micro-asymétries, le chercheur dispose d’outils mathématiques éprouvés de redressement statistique a posteriori.
La méthode de référence est le calage sur marges, largement popularisé sous le vocable algorithmique de méthode de Deming-Stephan ou méthode du raking ratio. Cet algorithme itératif ajuste récursivement les poids individuels des répondants de l’échantillon de manière à ce que les distributions marginales recalculées coïncident parfaitement avec les marges de distribution de la population de référence sur toutes les variables sélectionnées pour le calage, tout en minimisant la distance géodésique entre les poids initiaux et finaux :
$$w_j^{(t+1)} = w_j^{(t)} \times \frac{P_k}{p_k^{(t)}}$$
Dans ce modèle d’ajustement récursif, $w_j^{(t)}$ est le coefficient de pondération assigné à l’individu $j$ à l’itération $t$, $P_k$ représente la proportion populationnelle théorique marginale de la catégorie $k$, et $p_k^{(t)}$ est la proportion pondérée estimée de cette même catégorie à l’étape $t$. L’algorithme réitère ses boucles d’ajustement jusqu’à convergence mathématique satisfaisante (stabilisation des vecteurs de pondération au millième près).
Une fois ces poids calculés, les analyses psychométriques et les modélisations d’attitudes sont réexécutées en intégrant cette variable de pondération (weight variable) dans les matrices de covariance des logiciels de traitement statistique (tels que R, SPSS ou Jamovi). L’exigence de transparence méthodologique impose de publier dans le rapport final de recherche la distribution de ces coefficients de pondération (moyenne, écart-type, valeurs extrêmes min et max) afin de certifier qu’aucun répondant singulier n’a vu son poids statistique gonflé de manière disproportionnée au point de dicter artificiellement les conclusions de l’étude.
11. Considérations déontologiques, éthiques et conformité méthodologique
11.1 Respect du consentement libre et élimination de la pression de recrutement
L’obligation méthodologique de compléter une cellule de quota dans des délais restreints peut engendrer, chez les enquêteurs ou les assistants de recherche, une pression psychologique délétère susceptible d’altérer l’intégrité de la relation d’enquête. L’impératif déontologique premier commande de veiller à ce que l’urgence de saturer une case ne se traduise jamais par une forme d’insistance abusive ou de coercition morale auprès de participants hésitants ou vulnérables. Le consentement éclairé doit demeurer rigoureusement libre, éclairé, préalable et révocable à chaque instant de l’interaction, conformément aux directives internationales de la Déclaration d’Helsinki et des codes de déontologie des psychologues.
Les enquêteurs doivent garantir de manière explicite le droit inconditionnel de retrait : tout participant engagé dans l’évaluation psychologique conserve la faculté d’interrompre sa passation à n’importe quel moment, sans avoir à fournir de justification et sans s’exposer à la moindre pénalité ou réprobation, même si cette désertion compromet l’effectif final de la cellule de quota concernée. La rémunération financière d’incitation éventuelle doit alors être versée ou proratisée sans pression punitive.
Un autre écueil éthique réside dans la loyauté de l’information délivrée lors des questions filtres initiales. Le questionnaire de qualification préalable doit demeurer neutre et ne pas dévoiler explicitement les critères d’admissibilité recherchés par l’étude. Si le screener informe d’emblée l’internaute que l’enquête recherche exclusivement des femmes âgées de 45 à 50 ans souffrant d’insomnie chronique, certains répondants désireux de toucher l’incitation financière ou de valoriser une complaisance sociale adapteront stratégiquement leurs réponses sociodémographiques, introduisant une fraude identitaire indétectable qui fausse irrémédiablement la sincérité des données scientifiques collectées.
11.2 Protection des données sensibles liées aux critères de segmentation
L’érection de grilles de quotas requiert la collecte, le traitement et la catégorisation de données personnelles sociodémographiques souvent intimes et hautement sensibles au regard du cadre réglementaire du Règlement Général sur la Protection des Données (RGPD) au sein de l’Union européenne et des réglementations internationales sur la vie privée. Lorsque les critères de quota englobent l’état de santé mentale auto-déclaré, l’orientation sexuelle, l’appartenance ethnique déclarée ou les convictions politiques, ces informations relèvent de régimes juridiques de protection renforcés (données de catégorie particulière de l’article 9 du RGPD).
Une séparation technique et organisationnelle étanche doit être obligatoirement instaurée entre les données signalétiques d’identification (adresses IP, courriels de contact pour incitations) et les matrices de données expérimentales psychologiques. Dès que le statut d’éligibilité et l’assignation au quota sont actés par le système, tout lien direct d’identification doit être neutralisé. Les protocoles de pseudonymisation ou d’anonymisation irréversible doivent opérer avant même que les réponses aux tests cognitifs ou aux échelles de personnalité ne soient enregistrées sur les serveurs de recherche sécurisés.
De surcroît, le stockage de ces jeux de données doit répondre aux normes les plus rigoureuses de cybersécurité (chiffrement AES 256 bits au repos et en transit, protocoles d’accès restreints aux seuls investigateurs principaux accrédités). Les comités d’éthique de la recherche (Institutional Review Boards – IRB) exigent une documentation minutieuse sur la durée de conservation des données de qualification démographique, ces dernières devant être purgées dès la validation définitive de la matrice globale de représentativité de l’échantillon.
11.3 Éthique de transparence dans la publication des données empiriques
La crédibilité de l’entreprise scientifique repose fondamentalement sur la transparence méthodologique absolue lors de la diffusion publique et académique des résultats empiriques. L’époque où les publications pouvaient se contenter d’affirmer évasivement que « l’échantillon était composé de 1 000 participants représentatifs de la population générale » sans autre précision opératoire est révolue. L’éthique de publication impose de divulguer sans fard la nature non probabiliste de l’échantillonnage et le recours délibéré au mécanisme des quotas.
Cette responsabilité de transparence s’incarne dans le respect rigoureux des standards de publication internationaux, tels que les normes du style de l’APA (Publication Manual of the American Psychological Association, 7e édition) ou les directives des grilles d’évaluation observationnelle STROBE (Strengthening the Reporting of Observational Studies in Epidemiology). Les auteurs doivent présenter dans leur section méthodologique un compte-rendu exhaustif intégrant :
- La matrice intégrale des quotas cibles prévus versus les effectifs réels finaux obtenus par cellule.
- La source démographique exacte et l’année de référence des données de recensement utilisées pour dériver les quotas.
- Le nombre total d’individus ayant été exclus ou disqualifiés au stade du filtrage préliminaire (taux de drop-out des screeners).
- Le taux d’abandon en cours de passation (individus ayant commencé l’étude mais n’ayant pas mené le protocole à terme).
- Les algorithmes ou formules de pondération appliqués a posteriori et leur impact concret sur les écarts-types des variables de résultat.
Cette loyauté académique implique également une discussion franche et décomplexée des limitations statistiques induites par le modèle non probabiliste au sein de la section « Discussion » de l’article scientifique, prévenant ainsi toute tentation de survendre la portée universelle des inférences tirées de l’échantillon étudié.
12. Synthèse et critères de décision : Quand privilégier l’échantillonnage par quotas ?
12.1 Arbre décisionnel pour le chercheur et praticien en psychologie
Pour le directeur de laboratoire, l’étudiant chercheur ou le praticien confronté à la conception de son protocole empirique, le choix d’adopter ou de récuser l’échantillonnage par quotas doit s’articuler à travers un arbre décisionnel systématique évaluant la faisabilité, les ressources et l’horizon épistémologique du projet d’investigation :
Niveau 1 : Existe-t-il une base de sondage nominative complète accessible ?
- Oui : L’équipe dispose-t-elle des ressources financières massives et du temps logistique nécessaire pour gérer un tirage au sort probabiliste et les vagues successives de relances de non-répondants ? Si la réponse est affirmative, s’orienter sans hésiter vers l’échantillonnage probabiliste stratifié.
- Non : L’échantillonnage probabiliste strict est matériellement exclu. S’orienter vers le niveau 2.
Niveau 2 : Connaît-on la distribution démographique de la population cible ?
- Oui : Des données de recensement fiables sont documentées sur les variables explicatives clés (âge, sexe, milieu socio-éducatif). L’échantillonnage par quotas s’impose alors comme la solution d’excellence pour modéliser cette population de manière ordonnée.
- Non : La population cible est occulte, clandestine ou totalement indéterminée (par exemple, usagers de drogues dures non répertoriés). S’orienter vers des méthodes de réseau alternatives telles que l’échantillonnage par la méthode boule de neige (snowball sampling) ou le ciblage guidé par les répondants (Respondent-Driven Sampling – RDS).
Niveau 3 : Quelle est la nature de la finalité analytique prépondérante ?
- Si la recherche vise la confirmation absolue d’un paramètre épidémiologique légal à portée réglementaire nationale avec certification d’une marge d’erreur au centième de point, le coût de la stratification pure doit être consenti.
- Si la visée relève de la recherche psychologique fondamentale, de l’exploration de dynamiques attitudinales, du calibrage normatif d’un questionnaire d’évaluation ou d’expérimentations sur l’interaction homme-machine, l’échantillonnage par quotas fournit un rapport rigueur/coût optimal et indiscutable.
12.2 Comparaison synthétique avec d’autres méthodes non probabilistes
Il est épistémologiquement fondamental de ne pas amalgamer l’échantillonnage par quotas avec la nébuleuse des autres méthodologies non probabilistes. Sur l’échelle de la hiérarchie de la preuve et de la rigueur architecturale, le quota se positionne sans conteste au sommet de l’édifice des approches non aléatoires.
Face à l’échantillonnage de convenance pure (ou accidentel) — qui consiste à interroger passivement des volontaires passant à proximité ou des étudiants de première année de son propre département de psychologie —, l’échantillonnage par quotas déploie une armature normative qui empêche le recueil de sombrer dans les biais massifs d’homogénéité démographique. Il impose une contrainte externe de diversité sociétale que la convenance pure ignore par définition.
Comparé à l’échantillonnage au jugé (ou par choix raisonné), où le chercheur sélectionne subjectivement des « cas typiques » ou des « experts » d’après sa propre intuition clinique, le quota repose sur un ancrage mathématique objectif externe (les proportions de recensement officiel), limitant considérablement l’arbitraire interprétatif de l’investigateur. Quant aux méthodes d’échantillonnage en boule de neige, hautement performantes pour les populations stigmatisées ou marginalisées mais fortement vulnérables aux biais d’homophilie sociométrique (les pairs recrutant des profils identiques à eux-mêmes), elles gagnent à être couplées à des logiques de quotas pour interrompre les boucles d’enrôlement consanguines dès qu’un segment spécifique sature ses effectifs.
12.3 Bonnes pratiques pour la valorisation académique et la soumission par les pairs
Pour réussir l’épreuve de la revue par les pairs (peer-review) et valoriser avec succès des données issues d’un échantillonnage par quotas au sein des revues scientifiques les plus exigeantes, les chercheurs doivent adopter une posture méthodologique proactive et rigoureusement documentée :
- Justification théorique en amont : Expliciter clairement dans la sous-section « Participants » les motifs logistiques et scientifiques impérieux ayant dicté le recours aux quotas (absence légale de registre nominatif d’individus, urgence d’une crise environnementale, optimisation de la diversité socio-démographique par rapport à un échantillon d’étudiants).
- Validation empirique des distributions : Inclure un tableau récapitulatif confrontant les effectifs théoriques calculés et les effectifs effectivement capturés, assorti d’un test d’adéquation du Chi-deux ($\chi^2$) attestant de l’absence de discordance significative entre la structure finale de l’échantillon et les marges démographiques de référence.
- Contrôle systématique de sensibilité : Mener des analyses de robustesse croisées en introduisant les variables de quotas comme covariables explicatives dans tous les modèles statistiques (ANCOVA, régressions hiérarchiques), afin de certifier que l’effet psychologique central persiste de manière invariable lorsque l’on contrôle mathématiquement l’influence des strates démographiques.
- Modération des revendications de généralisation : Éviter toute terminologie péremptoire prétendant à une généralisabilité universelle absolue ; privilégier des formulations nuançant la transférabilité des conclusions aux sous-groupes structurellement équivalents à ceux représentés dans la matrice.
À l’ère contemporaine de l’explosion des données numériques massives (Big Data) et de l’intelligence artificielle comportementale, l’échantillonnage par quotas ne constitue nullement une relique du siècle passé. Face aux masses gigantesques mais asymétriques et non représentatives de données issues du web scraping ou des réseaux sociaux, la méthodologie des quotas s’affirme plus que jamais comme un instrument précieux de rééquilibrage critique et de rigueur structurée pour les sciences du comportement humain.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Babbie, E. R. (2020). The Practice of Social Research (15th ed.). Cengage Learning.
- Brick, J. M. (2011). The future of survey sampling. Public Opinion Quarterly, 75(5), 872–888. https://doi.org/10.1093/poq/nfr045
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). John Wiley & Sons.
- DeVille, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Gallup, G. (1944). A Guide to Public Opinion Polls. Princeton University Press.
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Kish, L. (1965). Survey Sampling. John Wiley & Sons.
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- Stephan, F. F. (1945). The relative merits of quota sampling and probability sampling in public opinion public surveys. Public Opinion Quarterly, 9(2), 241–245.
- Vehovar, V., Toepoel, V., & Steinmetz, S. (2016). Non-probability sampling. In C. Wolf, D. Joye, T. W. Smith, & Y.-C. Fu (Eds.), The SAGE Handbook of Survey Methodology (pp. 329–345). SAGE Publications. https://doi.org/10.4135/9781473957892.n22