
La validité des conclusions scientifiques issues des sciences comportementales, de la psychologie empirique et de l’épidémiologie psychiatrique repose fondamentalement sur la qualité de l’inférence statistique. Cette inférence consiste à extrapoler, avec un degré d’incertitude quantifiable et maîtrisé, des observations recueillies auprès d’une fraction restreinte d’individus vers une population parente bien plus vaste. Pourtant, l’histoire de la recherche psychologique est jalonnée de crises de réplicabilité et de biais systématiques qui trouvent souvent leur genèse non pas dans des faiblesses analytiques ou instrumentales, mais dans une négligence fondamentale des protocoles d’échantillonnage. Le choix d’une méthode de sondage détermine irrévocablement la représentativité des données, la structure des erreurs de mesure et la puissance des tests d’hypothèses mis en œuvre.
Au cœur de la théorie classique des sondages probabilistes, deux devis d’échantillonnage complexes dominent la littérature méthodologique : l’échantillonnage stratifié et l’échantillonnage en grappes. Bien qu’ils partagent une architecture commune reposant sur la segmentation initiale de la population cible en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, leurs rationalités statistiques, leurs exigences logistiques et leurs dynamiques de variance obéissent à des logiques diamétralement opposées. Cette divergence conceptuelle fondamentale engendre fréquemment des confusions majeures chez les chercheurs et praticiens, conduisant à des erreurs d’interprétation des erreurs types, à une mauvaise estimation de la taille d’échantillon effective ou à l’application inappropriée de modèles statistiques linéaires classiques ignorant la non-indépendance des observations.
Le présent article propose une dissection exhaustive de ces deux méthodologies d’échantillonnage. En explorant leurs soubassements théoriques, leurs propriétés mathématiques, leurs implications concrètes en recherche clinique ou organisationnelle, ainsi que les risques de biais qui leur sont propres, ce travail fournit aux chercheurs un cadre rigoureux pour concevoir des plans d’échantillonnage robustes et optimiser l’arbitrage universel entre la précision statistique maximale et les contraintes matérielles ou financières du terrain.
1. Introduction aux méthodes probabilistes d’échantillonnage en recherche psychologique
1.1 Importance de la représentativité en psychométrie et sciences comportementales
Dans les disciplines psychologiques et psychométriques, l’objectif fondamental d’une investigation empirique est d’établir des lois de comportement, d’étalonner des outils de mesure ou de quantifier la prévalence d’états psychopathologiques. Pour qu’une telle démarche possède une valeur scientifique robuste, il est impératif que les observations relevées sur un échantillon d’individus puissent être extrapolées fidèlement à l’ensemble de la population cible. La représentativité statistique ne signifie pas que l’échantillon est une reproduction miniature parfaite de la population sous tous ses aspects, mais plutôt qu’il reflète fidèlement la distribution des variables d’intérêt et des facteurs de confusion potentiels sans introduire de distorsions systématiques.
Pendant plusieurs décennies, la recherche comportementale a souffert d’une dépendance excessive envers les échantillons de convenance, souvent constitués d’étudiants de premier cycle universitaire en psychologie, issus de sociétés occidentales, éduquées, industrialisées, riches et démocratiques (dites populations WEIRD). Cette pratique pose des limites critiques en matière de validité externe : les processus cognitifs, émotionnels ou psychopathologiques observés au sein d’un groupe aussi homogène ne peuvent être généralisés à l’ensemble de la population humaine sans encourir des erreurs d’inférence substantielles. Les scores seuils des instruments psychométriques calibrés sur de tels sous-groupes deviennent invalides lorsqu’ils sont appliqués à des populations cliniques réelles ou à des groupes culturellement diversifiés.
Face à ces dérives méthodologiques documentées lors de la crise de réplicabilité, les revues académiques de premier plan et les organismes normatifs, tels que l’American Psychological Association, ont substantiellement rehaussé leurs exigences éditoriales. Il est désormais exigé des auteurs qu’ils justifient formellement la représentativité de leur corpus de données, qu’ils explicitent le plan de sondage et qu’ils calculent a priori la puissance statistique requise pour détecter les effets recherchés. Le plan d’échantillonnage influence directement la variance de l’estimateur : un plan mal articulé peut réduire dramatiquement la puissance effective d’une étude, gonflant le taux de faux négatifs ou créant des artefacts statistiques qui compromettent la réplicabilité des découvertes scientifiques.
1.2 Notions fondamentales : population cible, cadre d’échantillonnage et unité d’analyse
L’élaboration d’un protocole d’échantillonnage rigoureux requiert une distinction conceptuelle claire entre plusieurs entités méthodologiques. La population cible, ou population parente, représente la totalité des entités individuelles ou collectives pour lesquelles le chercheur souhaite formuler des conclusions. Sa définition opérationnelle exige une précision chirurgicale quant aux critères d’inclusion et d’exclusion géographiques, temporels, démographiques ou diagnostiques. Par exemple, définir la population cible comme « les adultes souffrant d’un trouble dépressif majeur » s’avère insuffisant si l’on ne spécifie pas le cadre nosologique de référence (DSM-5 ou CIM-11), la sévérité minimale des symptômes et les éventuelles comorbidités exclues du protocole de recherche.
Le cadre d’échantillonnage constitue la matérialisation empirique de cette population cible. Il s’agit de la liste exhaustive, du répertoire physique ou de la base de données nominative à partir de laquelle les unités d’échantillonnage seront effectivement sélectionnées. Dans la pratique de la recherche psychologique, la constitution d’un cadre parfait est exceptionnellement rare. Des discordances surviennent fréquemment sous la forme d’omissions systématiques (individus appartenant à la population cible mais absents du registre), de duplications ou d’inclusions erronées (entités répertoriées mais n’appartenant pas à la cible). Le traitement méthodologique de ces anomalies requiert des procédures d’audit et de nettoyage préliminaires pour éviter les biais de couverture qui altéreraient la validité de l’enquête.
Enfin, le chercheur doit différencier avec soin l’unité d’échantillonnage primaire de l’unité d’observation finale (ou unité d’analyse). Dans les schémas simples, ces deux entités coïncident : l’individu tiré au sort est la personne soumise à l’évaluation psychométrique. En revanche, dans les devis complexes, l’unité d’échantillonnage primaire peut être un établissement de santé ou une classe scolaire, tandis que l’unité d’analyse ultime est le patient ou l’élève. Lorsque le cadre théorique postule des hypothèses au niveau de l’individu alors que la sélection empirique opère sur des entités agrégées, une discordance structurelle émerge, rendant indispensables des ajustements mathématiques spécifiques pour éviter de confondre les effets de groupe et les propriétés individuelles.
1.3 Taxonomie des méthodes probabilistes versus non probabilistes
La typologie des méthodes d’échantillonnage repose sur une ligne de démarcation fondamentale : le caractère probabiliste ou non probabiliste du mécanisme de sélection des participants. Les méthodes probabilistes reposent sur le principe selon lequel chaque élément de la population possède une probabilité d’inclusion strictement positive, non nulle et calculable a priori. Cette propriété fondamentale garantit l’équiprobabilité ou, à défaut, la quantification exacte des chances de sélection, autorisant l’application de la théorie mathématique de l’échantillonnage et le calcul rigoureux des erreurs types associées aux estimateurs statistiques.
À l’opposé, les méthodes non probabilistes, telles que l’échantillonnage par quotas, l’échantillonnage au jugé ou l’échantillonnage « boule de neige », ne permettent pas de connaître la probabilité qu’un individu donné intègre l’étude. Ces approches sont intrinsèquement vulnérables au biais d’autosélection, où les caractéristiques psychologiques mêmes des volontaires — comme un haut niveau de curiosité intellectuelle, un statut socio-économique élevé ou une symptomatologie moins invalidante — déterminent leur participation. Dès lors, le calcul d’intervalles de confiance conventionnels perd sa légitimité théorique, car l’erreur d’échantillonnage aléatoire ne peut plus être dissociée des biais systématiques induits par le processus de recrutement subjectif.
Au sein de la famille des méthodes probabilistes, l’échantillonnage aléatoire simple sert souvent de référence paradigmatique, mais se révèle fréquemment inapplicable ou sous-optimal dans les recherches psychologiques d’envergure. C’est ici que s’inscrivent l’échantillonnage stratifié et l’échantillonnage en grappes, deux devis probabilistes complexes conçus pour répondre à des impératifs distincts de précision statistique et de faisabilité opérationnelle. Au-delà des considérations quantitatives, ces méthodes répondent également à des exigences éthiques et déontologiques strictes : la sélection probabiliste impartiale garantit que le fardeau de la recherche ainsi que ses bénéfices potentiels sont distribués équitablement au sein de la communauté sociétale visée, sans stigmatisation ni exclusion arbitraire de cohortes particulières.
2. Fondements théoriques et conceptuels de l’échantillonnage stratifié
2.1 Définition formelle et mécanique de la stratification
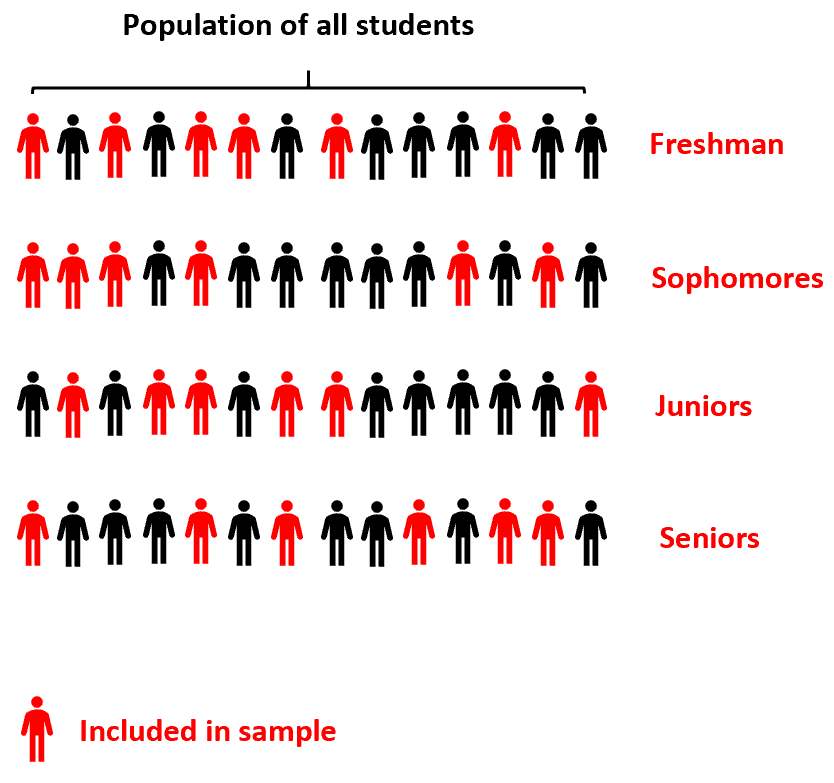
L’échantillonnage stratifié est un protocole de sélection probabiliste qui procède par partitionnement rigoureux d’une population globale hétérogène en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, désignés sous le terme de strates. Mutuellement exclusif implique qu’aucun individu ne peut appartenir à plus d’une strate simultanément ; collectivement exhaustif garantit que chaque membre de la population cible est assigné à l’une des strates sans exception. Une fois la population fragmentée selon ce découpage conceptuel, le chercheur procède à un tirage aléatoire indépendant au sein de chaque strate, extrayant ainsi autant de sous-échantillons qu’il y a de strates répertoriées.
La mécanique fondamentale de cette approche vise à capturer et maîtriser la diversité interne de la population en neutralisant le risque qu’un tirage purement aléatoire simple n’omette, par simple fluctuation d’échantillonnage, des segments cruciaux de la cohorte étudiée. En imposant un quota probabiliste strict à chaque strate, le statisticien s’assure qu’aucune composante essentielle de la population parente ne soit sous-représentée. L’échantillon global agrégé est la somme exacte des sous-échantillons tirés indépendamment les uns des autres dans chaque sous-catégorie identifiée, garantissant une couverture intégrale du spectre démographique ou clinique prédéfini.
Sur le plan mathématique, l’estimateur de la moyenne de la population globale obtenu par un échantillonnage stratifié s’exprime comme une moyenne pondérée des moyennes observées dans chacune des strates. Si une population $N$ est découpée en $H$ strates de tailles respectives $N_h$ (où $\sum N_h = N$), et que l’on extrait de chaque strate un sous-échantillon de taille $n_h$ délivrant une moyenne empirique $\bar{y}_h$, l’espérance mathématique de la moyenne globale stratifiée s’écrit :
$$\bar{y}_{st} = \sum_{h=1}^{H} W_h \bar{y}_h$$
où $W_h = N_h / N$ représente le poids relatif de la strate $h$ au sein de la population. Cet estimateur présente la propriété fondamentale d’être sans biais, ce qui signifie que son espérance statistique équivaut rigoureusement à la véritable moyenne de la population parente, sous réserve que les tirages au sein des strates soient eux-mêmes sans biais.
2.2 Typologies de stratification : proportionnelle versus non proportionnelle
Il existe deux grandes modalités d’allocation des effectifs d’échantillonnage au sein des différentes strates : la stratification proportionnelle et la stratification non proportionnelle. Dans le cadre d’un échantillonnage stratifié proportionnel, la fraction de sondage appliquée est rigoureusement identique dans toutes les strates. Autrement dit, le rapport entre la taille de l’échantillon extrait d’une strate et la taille totale de cette strate dans la population ($f_h = n_h / N_h$) demeure constant à travers l’ensemble des sous-groupes ($f_h = f = n / N$). Cette configuration conserve fidèlement le profil démographique de la population mère ; l’échantillon constitue alors une projection fidèle de la structure démographique initiale, ce qui simplifie grandement l’analyse en rendant l’échantillon auto-pondéré.
À l’inverse, l’échantillonnage stratifié non proportionnel déroge sciemment à cette égalité des fractions de sondage en appliquant des taux de sélection variables d’une strate à l’autre. Cette modalité est particulièrement indispensable en recherche clinique, psychopathologique ou transculturelle, où certaines sous-populations d’intérêt majeur sont extrêmement minoritaires dans la population globale. Si un chercheur étudie une pathologie touchant 1 % de la population générale, un échantillonnage proportionnel sur 1 000 participants ne fournirait qu’environ 10 cas cliniques, un effectif totalement insuffisant pour réaliser des inférences statistiques robustes ou estimer la fiabilité d’un test psychométrique. Le suréchantillonnage de ces cohortes minoritaires s’avère donc impératif pour doter chaque cellule analytique d’une puissance statistique suffisante.
Cependant, l’adoption d’une stratification non proportionnelle impose une contrepartie analytique stricte : l’obligation d’appliquer des facteurs de pondération a posteriori lors de l’estimation de paramètres globaux. Sans cette pondération inverse par les probabilités d’inclusion, les estimateurs seraient gravement biaisés en faveur des strates surreprésentées. L’allocation de l’échantillon peut également suivre le formalisme théorique développé par Jerzy Neyman, connu sous le nom d’allocation optimale de Neyman. Cette méthode mathématique calcule la taille optimale de l’échantillon de chaque strate ($n_h$) non seulement en fonction de sa taille relative ($N_h$), mais aussi de la variance interne de la variable étudiée ($\sigma_h$) et du coût unitaire de collecte ($c_h$) :
$$n_h = n \frac{\frac{N_h \sigma_h}{\sqrt{c_h}}}{\sum_{k=1}^{H} \frac{N_k \sigma_k}{\sqrt{c_k}}}$$
Cette optimisation formelle permet d’atteindre la variance d’estimation globale minimale pour un budget de recherche alloué fixe, ou de minimiser les dépenses globales pour un niveau de précision prédéterminé.
2.3 Choix des variables de stratification en psychologie
L’efficacité statistique d’un plan d’échantillonnage stratifié dépend entièrement du choix pertinent des variables de stratification. En sciences comportementales, les chercheurs s’appuient fréquemment sur des critères sociodémographiques universels : la tranche d’âge, l’identification de genre, le niveau d’instruction formelle et l’appartenance socio-économique. Ces caractéristiques sont privilégiées en raison de leur disponibilité dans les registres d’état civil et de leur association démontrée avec une multitude de fonctions cognitives, d’attitudes psychosociales et de profils de santé mentale. Par exemple, lors de la normalisation d’un test neuropsychologique de mémoire épisodique, l’âge et le niveau d’études constituent des strates obligatoires en raison de leur puissante corrélation avec les scores de performance cognitive.
Dans les contextes cliniques et psychiatriques, les variables de stratification intègrent des dimensions nosologiques ou fonctionnelles spécifiques : la sévérité symptomatique (légère, modérée, sévère), le sous-type diagnostique (trouble bipolaire de type I versus de type II), ou le statut thérapeutique (patients naïfs de traitement, patients sous médication pharmacologique stabilisée, ou patients hospitalisés). La règle méthodologique d’or régissant cette étape stipule que les variables sélectionnées pour définir les strates doivent entretenir une forte corrélation avec la variable dépendante principale mesurée dans l’étude. Plus cette corrélation est élevée, plus la réduction de variance induite par la stratification sera substantielle.
Toutefois, le praticien doit se prémunir contre la tentation d’une stratification excessive. Croiser simultanément quatre tranches d’âge, deux genres, trois niveaux d’éducation et quatre sous-classes diagnostiques génère instantanément une matrice factorielle de 96 strates distinctes ($4 \times 2 \times 3 \times 4$). Cette multiplication exponentielle des cellules impose d’obtenir des effectifs considérables pour éviter la présence de strates vides ou insuffisamment pourvues. De plus, elle complique de façon drastique la gestion logistique du recueil de données et alourdit la charge de calcul computationnel liée aux matrices de pondération statistique.
3. Fondements théoriques et conceptuels de l’échantillonnage en grappes
3.1 Définition formelle et structure des grappes
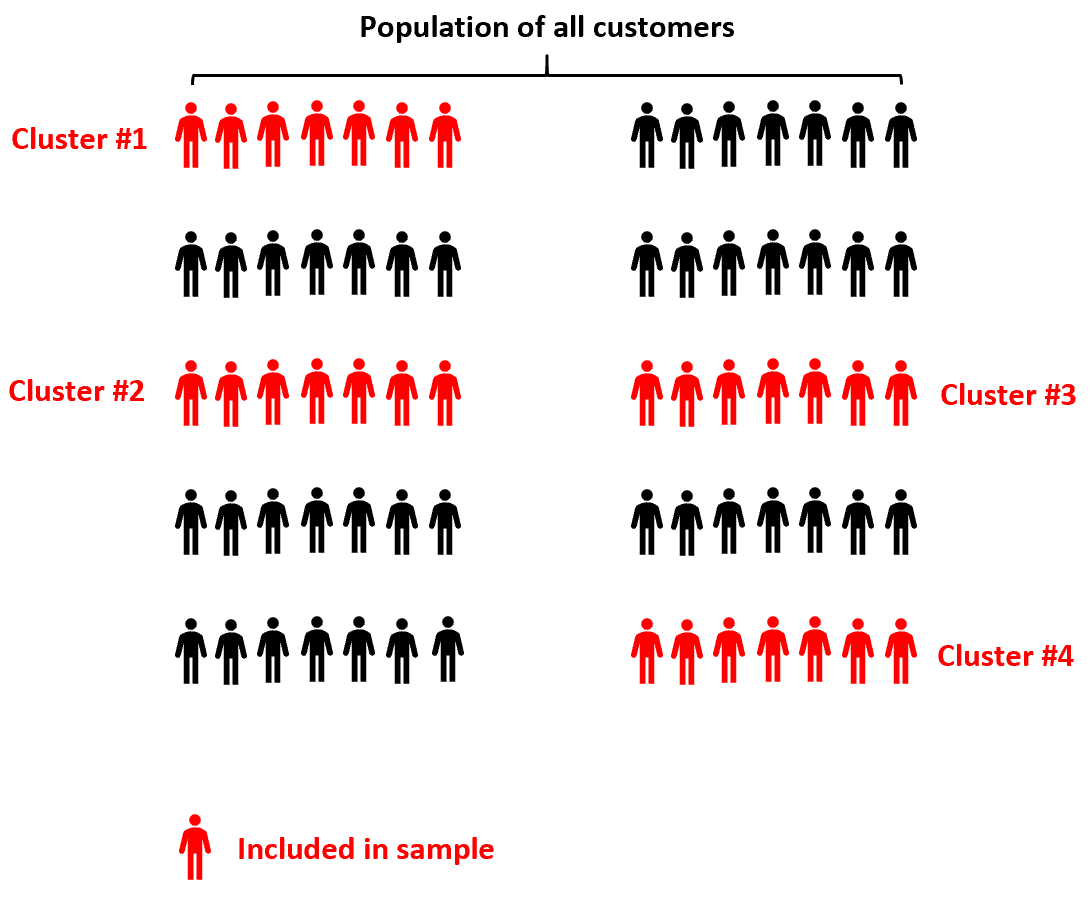
L’échantillonnage en grappes (ou cluster sampling) opère un renversement structurel par rapport aux devis traditionnels d’échantillonnage d’individus isolés. Dans ce schéma probabiliste, la population cible est préalablement partitionnée en sous-ensembles mutuellement exclusifs et collectivement exhaustifs désignés sous le terme de grappes. Contrairement aux strates, qui constituent des catégories analytiques abstraites créées artificiellement par le chercheur sur la base de caractéristiques individuelles, les grappes sont des unités d’agrégation physique, géographique ou institutionnelle naturellement préexistantes dans le monde réel. Les individus y sont déjà regroupés avant même que l’investigation scientifique ne soit conçue.
Le fondement opérationnel de cette méthode réside dans le fait que l’unité d’échantillonnage primaire tirée au sort n’est pas la personne individuelle, mais la grappe toute entière. Lors d’un tirage probabiliste, certaines grappes sont sélectionnées au hasard tandis que d’autres sont purement et simplement écartées du protocole. L’échantillon final est donc composé exclusivement des membres appartenant aux grappes retenues par la roulette statistique. Les individus n’appartenant pas aux grappes sélectionnées n’ont aucune chance d’être évalués, ce qui constitue une différence majeure par rapport à la stratification où chaque strate contribue obligatoirement à l’échantillon final.
Il est crucial de dissiper une confusion théorique récurrente qui assimile la notion de grappe à celle de groupe expérimental. Une grappe est une entité structurelle de sondage qui regroupe des sujets subissant les mêmes conditions écologiques réelles (par exemple, les résidents d’un même quartier ou les salariés d’un même site industriel). Un groupe expérimental, à l’inverse, est une construction manipulée par l’expérimentateur dans le cadre d’un essai contrôlé randomisé, au sein duquel une variable indépendante est administrée de façon standardisée. Dans les essais randomisés en grappes (cluster-randomized trials), les deux concepts se superposent : ce sont des grappes entières qui sont assignées de manière aléatoire au groupe intervention ou au groupe contrôle, introduisant des considérations analytiques très spécifiques.
3.2 Exemples typiques de grappes naturelles en sciences humaines
En sciences sociales et psychologiques, le paysage empirique offre une infinité de regroupements naturels qui servent de grappes opérationnelles. Dans le domaine de la psychologie de l’éducation et du développement de l’enfant, l’école et la classe scolaire constituent les archétypes absolus de la grappe d’échantillonnage. Tenter de constituer un échantillon aléatoire simple d’enfants de huit ans à l’échelle d’un territoire national nécessiterait d’obtenir l’accord individuel de milliers de foyers dispersés, ce qui s’avère matériellement impossible. À la place, les chercheurs tirent au sort une liste d’écoles, puis, au sein de ces écoles, évaluent l’ensemble des élèves scolarisés dans les cours élémentaires correspondants.
En psychopathologie hospitalière et en recherche psychiatrique, les unités de soins fermées, les pavillons hospitaliers, les centres médico-psychologiques (CMP) ou les institutions d’accueil pour personnes âgées dépendantes (EHPAD) fonctionnent comme des grappes institutionnelles. Sélectionner des unités de soins entières permet d’administrer des questionnaires de santé mentale, de climat relationnel soignant-soigné ou de fardeau de l’aidant sans perturber l’organisation globale des départements non retenus. De manière analogue, les cliniques de réhabilitation cardiovasculaire ou de désintoxication constituent des environnements fermés idéaux pour l’application d’un sondage par grappes.
Au sein de la psychologie du travail et des organisations, les entreprises, les filiales régionales, les usines ou les départements fonctionnels (tels que la direction des ressources humaines, le service comptable ou la chaîne logistique) matérialisent des grappes naturelles prégnantes. Enfin, pour les enquêtes épidémiologiques communautaires de grande envergure, les circonscriptions administratives, les districts sanitaires, les îlots urbains ou les secteurs postaux forment le socle géographique classique sur lequel se déploient les enquêteurs de terrain pour recruter des ménages adjacents.
3.3 Échantillonnage en grappes à un degré versus à plusieurs degrés
La typologie interne de l’échantillonnage en grappes se structure principalement autour du nombre d’étapes de sélection probabiliste impliquées dans le protocole. Le schéma le plus élémentaire est l’échantillonnage en grappes à un degré (ou grappe complète). Dans cette architecture, une fois que les grappes primaires ont été tirées au sort, le chercheur procède à l’évaluation exhaustive de la totalité des individus résidant ou travaillant au sein de chacune de ces grappes. Par exemple, si dix écoles secondaires sont tirées au sort parmi un bassin de cent établissements, chaque élève inscrit dans ces dix écoles spécifiques est inclus dans l’étude psychométrique sans exception ni sélection secondaire.
Le protocole d’échantillonnage en grappes à deux degrés (ou sous-échantillonnage) introduit une seconde étape de sélection aléatoire. Dans ce modèle, les grappes constituent les unités primaires d’échantillonnage (UPE). Une fois ces grappes tirées au sort, le chercheur ne recense pas tous leurs composants : il procède à un tirage aléatoire secondaire d’individus (unités secondaires d’échantillonnage) au sein de chaque grappe sélectionnée. Ainsi, dans les dix écoles tirées au sort au premier degré, l’investigateur sélectionnera aléatoirement trente élèves par établissement au second degré. Cette stratégie permet de disperser davantage l’échantillon tout en évitant d’engorger une même structure d’accueil avec une évaluation massive.
Lorsque la recherche s’étend à des échelles géographiques massives, comme dans le cas des grandes enquêtes nationales de santé mentale menées par l’Organisation Mondiale de la Santé, le modèle s’étend naturellement à un échantillonnage polyétapique (ou multi-degrés). On observe alors une cascade de tirages successifs : sélection de régions administratives au premier degré, de municipalités au second degré, de quartiers au troisième degré, de ménages au quatrième degré, et enfin d’un individu unique tiré au sort au sein du foyer selon la grille de Kish. Bien que cette polyétapisation confère une souplesse opérationnelle remarquable face aux contraintes territoriales, elle entraîne une complexification analytique considérable en matière d’estimation des erreurs d’échantillonnage.
4. La règle d’or de l’hétérogénéité et de l’homogénéité : inversion des polarités
4.1 Architecture interne idéale de l’échantillonnage stratifié
Pour appréhender la distinction mathématique fondamentale entre la stratification et la mise en grappes, il est impératif de formuler la règle d’or qui gouverne les dynamiques de variance de ces deux approches. Dans un échantillonnage stratifié, l’objectif méthodologique suprême est de maximiser l’homogénéité intra-strate tout en maximisant simultanément l’hétérogénéité inter-strates. Autrement dit, les individus rassemblés à l’intérieur d’une même strate doivent être aussi semblables que possible en ce qui concerne la variable mesurée, tandis que les moyennes de cette variable doivent diverger de la façon la plus marquée possible d’une strate à une autre.
La logique sous-tendant cette exigence découle directement du théorème de décomposition de la variance (analogue aux principes de l’analyse de variance, ANOVA). La variance totale d’une variable dans une population se divise en deux composantes indépendantes : la variance à l’intérieur des groupes (variance intra-groupe) et la variance entre les groupes (variance inter-groupes). Dans l’échantillonnage stratifié, comme le chercheur échantillonne indépendamment à l’intérieur de chaque strate, la variance entre les strates est totalement neutralisée et éliminée de l’erreur d’échantillonnage globale. L’imprécision statistique de l’estimateur final ne provient que de la variance résiduelle interne aux strates :
$$Var(\bar{y}_{st}) = \sum_{h=1}^{H} W_h^2 \left(1 – f_h\right) \frac{s_h^2}{n_h}$$
Si l’homogénéité intra-strate est parfaite (c’est-à-dire si la variance intra-strate $s_h^2$ tend vers zéro), la variance d’échantillonnage s’annule presque entièrement. Dès lors, plus le chercheur segmente la population à l’aide de variables explicatives fortement corrélées au trait psychologique étudié, plus il compresse la variance intra-strate et plus l’estimation gagne en précision par rapport à un échantillonnage aléatoire simple de taille équivalente. À l’inverse, si une variable de stratification mal choisie n’induit aucune séparation des moyennes (variance inter-strates nulle), le gain d’efficience s’effondre.
4.2 Architecture interne idéale de l’échantillonnage en grappes
L’échantillonnage en grappes obéit à une polarité diamétralement inversée. L’architecture théorique idéale exige ici une hétérogénéité intra-grappe maximale couplée à une homogénéité inter-grappes maximale. Dans ce schéma canonique, chaque grappe individuelle devrait idéalement constituer un microcosme parfait, une réplique miniature complète de la population globale tout entière. Si chaque grappe contient en son sein la même diversité socioculturelle, psychologique et clinique que la population mère, alors deux grappes distinctes seront parfaitement interchangeables sur le plan statistique.
Sous cette condition idéale d’homogénéité entre les grappes, le tirage probabiliste d’une seule grappe permettrait de capturer fidèlement l’ensemble de la variabilité populationnelle sans la moindre distorsion. Malheureusement, cette exigence théorique entre en conflit frontal avec la réalité empirique du terrain. Dans le monde réel des sciences humaines et de la psychologie, les individus appartenant à une même grappe naturelle ont une tendance universelle à se ressembler. Ce phénomène est alimenté par deux mécanismes puissants : l’auto-sélection (les individus de statut socio-économique ou d’intérêts similaires choisissent les mêmes quartiers, les mêmes universités ou les mêmes entreprises) et l’influence environnementale partagée (les élèves d’une même classe partagent le même enseignant, les résidents d’un même quartier subissent les mêmes nuisances ou opportunités locales).
En conséquence, les grappes naturelles violent presque systématiquement la condition d’hétérogénéité interne. Elles présentent une homogénéité intra-grappe notable et une hétérogénéité inter-grappes marquée. Cette violation de l’idéal théorique entraîne une perte sévère d’efficience statistique : mesurer deux personnes appartenant à la même école apporte moins d’informations novatrices que d’évaluer deux individus choisis de façon totalement indépendante dans l’ensemble de la société. Le non-respect de cette polarité idéale transforme l’échantillonnage en grappes en un devis statistiquement moins précis que le sondage aléatoire simple, bien qu’il demeure indispensable pour des raisons économiques.
4.3 Comparaison synoptique directe des dynamiques de variance
L’inversion des exigences relatives aux variances intra et inter-groupes constitue le pivot conceptuel qui distingue les deux méthodes. Ce contraste structurel peut être schématisé à travers l’analyse des propriétés de variabilité attendues et de leurs conséquences statistiques respectives :
- Niveau Intra-Groupe : Dans l’échantillonnage stratifié, l’objectif est une homogénéité maximale (variance faible au sein des strates). Dans l’échantillonnage en grappes, l’idéal théorique est une hétérogénéité maximale (variance élevée au sein des grappes, reflétant la diversité populationnelle).
- Niveau Inter-Groupes : L’échantillonnage stratifié recherche une hétérogénéité maximale (les strates doivent se distinguer nettement les unes des autres). À l’inverse, l’échantillonnage en grappes requiert une homogénéité maximale (les grappes doivent être interchangeables et leurs moyennes aussi proches que possible).
- Unité de tirage probabiliste : L’échantillonnage stratifié sélectionne des individus à l’intérieur de chaque strate. L’échantillonnage en grappes sélectionne des grappes entières lors du premier degré.
- Représentation des groupes : Dans la stratification, 100 % des strates sont représentées dans l’échantillon final. Dans le sondage en grappes, seule une fraction des grappes existantes est retenue dans l’échantillon.
- Conséquence sur la précision statistique : L’échantillonnage stratifié diminue l’erreur type et produit une précision supérieure ou égale à l’échantillonnage aléatoire simple. L’échantillonnage en grappes augmente l’erreur type et induit une perte d’efficience statistique (Design Effect > 1).
Le « paradoxe fréquent du praticien » réside précisément dans cette contradiction : le chercheur recourt souvent à l’échantillonnage en grappes pour des raisons purement pratiques et budgétaires, tout en sachant que les grappes réelles (classes, quartiers, services hospitaliers) violent systématiquement l’hypothèse de représentativité interne, imposant ainsi un surdimensionnement de l’échantillon pour compenser la redondance des informations recueillies.
5. Protocoles de sélection et processus de tirage au sort
5.1 Mécanisme de sélection au sein des strates
L’implémentation opérationnelle d’un échantillonnage stratifié impose une condition méthodologique préalable stricte : le chercheur doit disposer d’un cadre d’échantillonnage exhaustif et nominatif pour chacune des strates individualisées. Cela signifie que l’ensemble des membres de la population cible doit être répertorié dans un fichier centralisé comportant obligatoirement les variables d’intérêt permettant de classifier chaque sujet dans sa strate respective (par exemple, l’âge, le statut d’emploi ou le niveau d’instruction). Si ces attributs individuels sont absents du registre initial, la partition a priori devient impossible.
Une fois le partitionnement réalisé, le mécanisme de sélection consiste à générer des séquences d’échantillonnage pseudo-aléatoires totalement indépendantes pour chaque sous-population. L’investigateur utilise des générateurs de nombres aléatoires certifiés (ou des algorithmes cryptographiques standardisés) pour extraire $n_1$ sujets de la strate 1, $n_2$ de la strate 2, et ainsi de suite jusqu’à la strate $H$. Cette stricte indépendance garantit une absence totale d’interférence statistique entre les opérations de tirage : le fait qu’un sujet soit sélectionné ou refuse de répondre au sein de la strate 1 n’exerce aucune influence sur la composition de l’échantillon de la strate 2.
Ce protocole confère un avantage substantiel lors du monitoring de la collecte et de la gestion des non-réponses. Si un taux d’attrition anormalement élevé est constaté dans une strate spécifique (par exemple, chez les jeunes hommes actifs âgés de 18 à 25 ans), le statisticien peut facilement compenser cette défaillance en tirant des unités de remplacement aléatoires supplémentaires exclusivement au sein de cette sous-population précise. La pureté probabiliste et l’équilibre quantitatif global des autres strates demeurent parfaitement préservés, évitant ainsi la propagation des biais d’attrition à l’ensemble du dispositif de recherche.
5.2 Mécanisme de tirage au sort des grappes
La mécanique de tirage de l’échantillonnage en grappes répond à des contraintes informationnelles beaucoup plus légères au démarrage de l’étude. Pour déployer ce protocole, le chercheur n’a nullement besoin de posséder la liste nominative exhaustive de tous les individus composant la population globale. Il lui suffit d’obtenir ou de constituer le répertoire complet des grappes existantes (par exemple, la liste officielle des collèges d’une académie, la liste des cliniques psychiatriques d’une région ou le cadastre des îlots urbains d’une métropole). Cette caractéristique procure une économie drastique de ressources et de temps lors de la phase initiale de prospection.
Cependant, le tirage au sort des grappes ne doit généralement pas s’opérer par un tirage aléatoire simple équi-probabiliste si celles-ci présentent des tailles très inégales (ce qui est la norme dans le monde réel, où certaines écoles accueillent 200 élèves et d’autres 1 500). Si l’on accordait la même probabilité de sélection à chaque établissement, les individus des petites structures auraient mécaniquement une probabilité d’inclusion finale beaucoup plus élevée que ceux des grandes structures, faussant la représentativité de l’étude. Pour neutraliser ce problème, la théorie des sondages prescrit l’utilisation du tirage avec probabilité proportionnelle à la taille (PPT, ou Probability Proportional to Size – PPS).
Sous la méthode PPT, la probabilité de sélection d’une grappe $i$ lors du premier degré est directement proportionnelle à son effectif $M_i$. Lors du second degré, si l’on extrait un nombre fixe $m$ d’individus dans chaque grappe retenue par tirage aléatoire simple, la probabilité globale d’inclusion d’un individu $j$ au sein de la grappe $i$ devient mathématiquement constante :
$$P(\text{Inclusion}_{ij}) = P(\text{Grappe}_i) \times P(\text{Individu}_j mid \text{Grappe}_i) = \left( k \frac{M_i}{\sum M_i} \right) \times \left( \frac{m}{M_i} \right) = \frac{k \cdot m}{\sum M_i}$$
Cette élégante articulation mathématique permet de restaurer l’auto-pondération de l’échantillon final au niveau individuel, simplifiant grandement le traitement analytique tout en capitalisant sur l’extrême rentabilité logistique du rassemblement spatial des sujets.
5.3 Comparaison algorithmique étape par étape des deux protocoles
Pour assurer une traçabilité rigoureuse lors du déploiement de ces protocoles, il convient de formaliser la chronologie séquentielle propre à chaque architecture d’échantillonnage :
- Algorithme de l’échantillonnage stratifié :
- Délimiter précisément la population cible et acquérir le registre nominatif exhaustif incluant les variables de stratification.
- Segmenter la population globale en $H$ strates mutuellement exclusives selon les variables retenues (âge, genre, sévérité clinique).
- Déterminer l’effectif global $n$ requis et choisir la règle d’allocation (proportionnelle, suréchantillonnage ou Neyman).
- Calculer les effectifs cibles $n_h$ pour chaque strate.
- Générer un tirage aléatoire simple ou systématique indépendant au sein de la liste de chaque strate.
- Contrôler la qualité des données recueillies et vérifier l’absence d’attrition asymétrique entre les strates.
- Algorithme de l’échantillonnage en grappes (deux degrés avec PPT) :
- Identifier la population cible et définir les grappes naturelles d’agrégation (écoles, hôpitaux, entreprises).
- Dresser l’inventaire exhaustif des grappes existantes et documenter la taille relative $M_i$ de chacune.
- Calculer les probabilités d’inclusion de premier degré proportionnelles à la taille pour chaque grappe.
- Tirer au sort les $k$ grappes primaires selon la procédure PPT.
- Se rendre sur le terrain et dresser le registre exhaustif des individus présents exclusivement au sein des $k$ grappes sélectionnées.
- Tirer au sort un nombre fixe $m$ d’individus au sein de chaque grappe retenue (ou recenser l’intégralité des individus si protocole à un degré).
- Appliquer les tests de diagnostic de l’effet de plan lors de l’analyse statistique finale.
Les points d’audit et de contrôle qualité diffèrent profondément : alors que le plan stratifié requiert une vigilance absolue sur la classification sans ambiguïté des sujets au départ, le plan en grappes exige une surveillance accrue sur le respect strict des tirages aléatoires au sein des établissements sans céder à la facilité de recruter les volontaires les plus accessibles.
6. Précision statistique, variance d’échantillonnage et effet de plan
6.1 Coefficient de corrélation intraclasse (ICC) et son interprétation
Dans l’échantillonnage en grappes, l’évaluation de la qualité métrique et de la précision de l’estimateur repose sur une métrique fondamentale de la statistique inférentielle : le coefficient de corrélation intraclasse (noté $rho$ ou ICC). L’ICC quantifie le degré de ressemblance phénotypique, comportementale, affective ou cognitive entre deux individus sélectionnés au hasard au sein d’une même grappe, par rapport à deux individus tirés aléatoirement dans la population générale. Sur le plan de la décomposition de la variance d’un modèle aléatoire, il s’exprime comme le ratio de la variance inter-grappes ($\sigma_b^2$) sur la variance totale, qui est la somme de la variance inter-grappes et de la variance résiduelle intra-grappe ($\sigma_w^2$) :
$$\rho = \frac{\sigma_b^2}{\sigma_b^2 + \sigma_w^2}$$
L’interprétation de l’ICC est intuitive mais lourde de conséquences statistiques. Si $rho = 0$, les individus au sein d’une même grappe ne sont pas plus semblables entre eux qu’avec n’importe quel autre membre de la population : il y a indépendance statistique parfaite des observations. Si $rho = 1$, tous les individus d’une même grappe fournissent exactement la même réponse ; interroger deux cents personnes dans cette grappe équivaut strictement à interroger une seule personne deux cents fois, fournissant une information redondante sans valeur ajoutée statistique.
Dans la recherche comportementale, éducative et psychologique, l’ICC oscille généralement entre 0,02 et 0,20. Dans les études scolaires mesurant les performances académiques ou le bien-être à l’école, des valeurs de $rho$ oscillant entre 0,05 et 0,15 sont très fréquentes. En milieu psychiatrique ou hospitalier, l’ICC peut atteindre des niveaux plus élevés (dépassant 0,25) lorsque les pratiques de prescription médicale, l’orientation diagnostique ou l’ambiance institutionnelle homogénéisent fortement les états psychologiques des patients au sein d’un même service de soins.
6.2 L’effet de plan (Design Effect – DEFF) et taille d’échantillon effective
La conséquence directe de l’existence d’un ICC positif dans un échantillonnage en grappes est l’inflation dramatique de la variance d’échantillonnage de l’estimateur. Pour quantifier cette distorsion par rapport au modèle standard de l’échantillonnage aléatoire simple, Leslie Kish a formalisé le concept d’effet de plan (Design Effect, ou DEFF). Le DEFF représente le ratio entre la variance d’un estimateur calculée sous le plan d’échantillonnage complexe réel et la variance théorique qu’aurait affichée le même estimateur si les sujets avaient été recrutés via un échantillonnage aléatoire simple (EAS) de taille équivalente :
$$\text{DEFF} = \frac{\text{Var}_{\text{complexe}}(\bar{y})}{\text{Var}_{\text{EAS}}(\bar{y})}$$
Pour un échantillonnage en grappes de taille moyenne de grappe égale à $\bar{m}$, le DEFF peut être approché par la célèbre formule linéaire de Kish :
$$\text{DEFF} = 1 + (\bar{m} – 1)\rho$$
Cette équation illustre de façon magistrale la dynamique d’inefficience de l’échantillonnage en grappes. Même avec un coefficient de corrélation intraclasse en apparence modeste ($rho = 0,05$), si l’on évalue des grappes de grande dimension (par exemple des collèges où $\bar{m} = 101$ élèves par établissement), le DEFF atteint :
$$\text{DEFF} = 1 + (101 – 1) \times 0,05 = 1 + 5 = 6$$
Un DEFF de 6 signifie que la variance d’échantillonnage réelle est six fois supérieure à celle d’un tirage aléatoire simple. Par conséquent, la taille d’échantillon effective ($n_{\text{eff}}$), qui mesure le pouvoir inférentiel réel de l’étude, s’effondre :
$$n_{\text{eff}} = \frac{n_{\text{total}}}{\text{DEFF}} = \frac{1,000}{6} \approx 167$$
Bien que le chercheur ait interrogé 1 000 élèves au prix d’efforts substantiels, son jeu de données ne possède que la puissance statistique d’un échantillon indépendant de 167 sujets. À l’inverse absolu, dans un échantillonnage stratifié judicieux, l’effet de plan est systématiquement inférieur à 1 ($\text{DEFF} < 1$). La stratification supprime la variance inter-strates, générant un gain de précision statistique net qui augmente la taille effective de l’échantillon au-delà du nombre réel de personnes interrogées.
6.3 Erreurs types et modélisations inférentielles appropriées
L’ignorance de ces mécanismes théoriques engendre des erreurs analytiques majeures lors de l’exploitation des données. Si un statisticien applique des tests d’hypothèses conventionnels (tests t de Student, régressions des moindres carrés ordinaires, analyses de variance) à des données collectées par grappes sans modéliser l’effet de plan, le logiciel supposera l’indépendance conditionnelle des observations. Les erreurs types estimées seront dramatiquement sous-estimées d’un facteur égal à la racine carrée du DEFF ($\sqrt{\text{DEFF}}$), désigné sous le terme de DEFT (Design Factor) :
$$\text{SE}_{\text{réelle}} = \text{SE}_{\text{naïve}} \times \sqrt{\text{DEFF}}$$
Cette sous-estimation artificielle des erreurs types conduit inéluctablement à un rétrécissement illusoire des intervalles de confiance et à une explosion catastrophique du taux d’erreur de type I (faux positifs). Des corrélations ou des différences intergroupes totalement fallacieuses apparaissent alors comme hautement significatives ($p < 0,001$), simplement parce que l’algorithme sous-estime le bruit d’échantillonnage induit par la ressemblance interne des grappes.
Pour traiter ces données sans compromettre la rigueur scientifique, deux grandes approches méthodologiques sont requises :
- La modélisation linéaire mixte / multiniveau (HLM) : Cette famille d’analyses sépare explicitement la variance résiduelle individuelle (niveau 1) et la variance attribuable à l’appartenance aux grappes (niveau 2), calibrant parfaitement les erreurs types pour les effets fixes et aléatoires.
- Les méthodes d’ajustement de sondage complexe : Disponibles dans les modules avancés des logiciels statistiques (par exemple, le package
surveysous R, ou le moduleComplex Samplessous SPSS), ces procédures s’appuient sur la linéarisation par séries de Taylor ou sur des algorithmes de rééchantillonnage robuste (Jackknife, Bootstrap pondéré) pour corriger les matrices de covariance des estimateurs.
Pour les données issues d’un échantillonnage stratifié, les algorithmes appliquent également ces corrections en pondérant par strate, ce qui aboutit cette fois à des erreurs types plus resserrées que sous l’hypothèse aléatoire simple, valorisant ainsi le gain d’information acquis par le partitionnement méthodique de la population.
7. Équations économiques, logistique de terrain et faisabilité
7.1 Coûts de collecte et contraintes géographiques en recherche empirique
Bien que l’échantillonnage stratifié l’emporte de façon éclatante sur l’échantillonnage en grappes sur le terrain de la rigueur et de la précision de variance, l’équation économique inverse souvent le verdict du chercheur opérationnel. En recherche empirique sur le comportement humain, les budgets alloués aux projets ne sont pas illimités, et le coût global d’une enquête se compose de deux éléments distincts : les coûts fixes d’infrastructure et les coûts marginaux d’administration par participant. L’échantillonnage stratifié disperse quasi inévitablement les participants sélectionnés aux quatre coins du territoire géographique étudié.
Considérons une étude nationale évaluant l’efficacité d’un protocole d’intervention psychothérapeutique administered face-à-face par des psychologues évaluateurs. Si l’on applique un échantillonnage stratifié, l’investigateur devra faire déplacer ses équipes cliniques pour évaluer un sujet dans un village reculé de Bretagne, deux dans une commune d’Alsace, et trois au sein de la banlieue lyonnaise. Les frais de transport, d’hébergement hôtelier, de transport de matériel psychométrique lourd et le temps perdu en transit absorbent une fraction disproportionnée de l’enveloppe budgétaire allouée à la recherche.
À l’opposé, l’échantillonnage en grappes optimise radicalement l’allocation des capitaux en concentrant géographiquement les observations. En tirant au sort cinq centres médico-psychologiques, le chercheur installe une équipe d’évaluateurs sur chaque site pour une durée déterminée, où ils administrent les tests psychométriques en chaîne à des centaines de sujets regroupés en un lieu unique. Le ratio coût-efficacité s’avère infiniment supérieur : même si la taille de l’échantillon nominal doit être doublée pour compenser un DEFF de 2,0, le coût d’acquisition d’un sujet en grappe est souvent cinq à dix fois inférieur au coût d’un sujet isolé géographiquement, validant l’adoption de l’échantillonnage en grappes sur la base d’une stricte fonction de dépense globale.
7.2 Disponibilité et accessibilité des bases de données de population
L’arbitrage entre la stratification et la mise en grappes est également conditionné par l’infrastructure juridique et administrative régissant l’accès aux données personnelles dans le pays d’investigation. L’échantillonnage stratifié exige l’accès préalable à des répertoires exhaustifs nominatifs contenant des variables individuelles sensibles. Or, dans le cadre réglementaire européen contemporain, gouverné par le Règlement Général sur la Protection des Données (RGPD) et les avis de la CNIL, l’accès aux fichiers électoraux ou aux répertoires de sécurité sociale à des fins de prospection scientifique fait l’objet de restrictions draconiennes.
Obtenir l’autorisation de sonder aléatoirement des citoyens stratifiés selon leur âge, leur niveau d’instruction et leur pathologie mentale suppose des démarches juridiques étalées sur plusieurs années, sans garantie de succès. Dans de nombreux contextes, de tels registres n’existent tout simplement pas : il n’existe pas d’annuaire national officiel catégorisant les citoyens en fonction de leur niveau d’anxiété ou de leur orientation cognitive. La stratification à priori sur des traits psychologiques ou psychopathologiques directs s’avère donc virtuellement impossible en population générale.
L’échantillonnage en grappes offre un contournement légal et logistique d’une remarquable élégance face à cette pénurie de données nominatives individuelles. Il est infiniment plus aisé d’obtenir la liste publique des hôpitaux de jour, le répertoire officiel des établissements scolaires géré par le Ministère de l’Éducation Nationale, ou l’annuaire des entreprises cotées. En focalisant la randomisation initiale sur des entités institutionnelles de droit public ou privé, le chercheur s’affranchit de l’obligation de posséder un fichier nominatif individuel global, les consentements et les déclarations de conformité RGPD étant sollicités secondairement au sein des seules entités retenues par le sort.
7.3 Temps de déploiement et charge administrative
L’analyse comparée de la charge administrative et temporelle révèle des asymétries importantes tout au long du cycle de vie du projet de recherche. Si l’échantillonnage en grappes simplifie le démarrage en matière de constitution du fichier de sondage, il concentre des barrières administratives majeures au niveau institutionnel. Pour pénétrer une école, une université ou une entreprise tirée au sort, l’équipe de recherche doit obtenir l’autorisation formelle d’une chaîne de décision hiérarchique complexe : recteurs d’académie, chefs d’établissement, comités d’éthique locaux, délégués du personnel et comités de direction.
Le refus d’un seul directeur d’hôpital ou chef d’entreprise d’ouvrir les portes de son organisation représente la perte sèche d’une grappe entière. Ce phénomène de mortalité institutionnelle requiert des semaines de renégociation ou le tirage de grappes de remplacement, allongeant considérablement le calendrier prévisionnel du recueil de données. En outre, la coordination des visites cliniques sur site impose une logistique rigide dictée par le calendrier opérationnel des institutions d’accueil (vacances scolaires, périodes de clôture comptable, restructurations internes).
L’échantillonnage stratifié en contact individuel direct (par exemple via des plateformes d’évaluation numérique sécurisées ou des enquêtes téléphoniques assistées par ordinateur) présente un schéma temporel beaucoup plus linéaire. Si un individu refuse de participer, ce refus est instantané et géré individuellement sans compromettre l’accès à un groupe de sujets. La charge administrative est répartie uniformément dans le temps, évitant les négociations contractuelles lourdes inhérentes aux partenariats inter-institutionnels. Le taux d’attrition peut être suivi en temps réel à l’aide de tableaux de bord automatisés, permettant des ajustements immédiats de la collecte sans dépendre de tiers institutionnels.
8. Applications pratiques en neuropsychologie et recherche clinique
8.1 Étude de la prévalence des troubles anxio-dépressifs en population générale
L’estimation épidémiologique de la prévalence des troubles anxieux et de la dépression majeure constitue un exemple paradigmatique de l’application de l’échantillonnage stratifié. La distribution de la morbidité psychiatrique n’est pas homogène au sein du corps social : elle varie substantiellement selon l’âge, l’identification de genre et la situation professionnelle. Pour calibrer les besoins en santé mentale d’une nation et allouer adéquatement les ressources hospitalières, les épidémiologistes ne peuvent tolérer l’imprécision statistique ou les biais d’exclusion inhérents aux échantillons de convenance.
Dans ce cadre, la mise en œuvre d’un plan stratifié proportionnel ou à allocation optimale s’impose avec force. Les chercheurs segmentent la population en cellules croisant les tranches d’âge (ex. 18-29 ans, 30-49 ans, 50-64 ans, 65 ans et plus), le genre et le statut d’activité économique (actifs, demandeurs d’emploi, inactifs/retraités). Ce partitionnement garantit la détection des hausses de prévalence spécifiques souvent observées chez les jeunes adultes scolarisés ou les personnes en transition d’emploi. L’absence d’agrégation écologique élimine tout risque de confusion entre la vulnérabilité intrinsèque des sujets et les caractéristiques locales d’un territoire particulier.
Lors de l’administration d’instruments standardisés d’évaluation psychiatrique, tels que le PHQ-9 (Patient Health Questionnaire pour la dépression) ou le GAD-7 (Generalized Anxiety Disorder-7), la moyenne pondérée de la cohorte stratifiée délivre une estimation globale de la sévérité sans biais d’échantillonnage. En cas de non-réponse différentielle (les personnes sévèrement dépressives manifestant parfois une plus forte réticence à répondre aux enquêtes), l’ancrage au sein de strates sociodémographiques bien définies facilite l’application de modèles de post-stratification pour corriger mathématiquement ces décalages d’attrition.
8.2 Évaluation d’interventions cognitives en milieu hospitalier spécialisé
L’investigation expérimentale de protocoles de remédiation cognitive ou d’interventions psychothérapeutiques institutionnelles en milieu psychiatrique illustre l’usage vertueux et quasi obligatoire de l’échantillonnage en grappes. Imaginons un projet visant à mesurer l’efficacité d’un nouvel entraînement cognitif informatisé destiné à restaurer les fonctions exécutives de patients hospitalisés pour un trouble bipolaire ou une schizophrénie stabilisée.
Si les chercheurs devaient appliquer une randomisation individuelle classique au sein d’un même service hospitalier (un lit sur deux recevant l’intervention cognitive et l’autre recevant la prise en charge habituelle), une menace létale à la validité interne apparaîtrait : la contamination expérimentale. Les patients d’une même unité de soins partagent les mêmes espaces communs, échangent quotidiennement lors des repas et bénéficient des soins d’une même équipe soignante. Les soignants formés aux nouvelles stratégies cognitives adapteraient inconsciemment leur attitude auprès des patients du groupe contrôle, tandis que les patients expérimentaux partageraient leurs exercices avec leurs pairs, annihilant le contraste expérimental recherché.
Pour immuniser l’étude contre cette contamination, les chercheurs procèdent à un échantillonnage par grappes randomisé (cluster-randomized trial) : ce sont des services hospitaliers complets, ou des hôpitaux de jour entiers, qui sont tirés au sort puis assignés en bloc soit au protocole innovant, soit au traitement standard. Cependant, cette sécurité expérimentale a un coût méthodologique majeur : l’émergence d’une forte hétérogénéité des pratiques cliniques inter-grappes. L’expérience des soignants, la culture médicale du chef de service ou la vétusté des infrastructures génèrent un ICC clinique élevé, qui impose d’enrôler un nombre d’unités hospitalières bien plus important que ce qu’exigerait un essai individuel classique.
8.3 Échantillonnage de populations cliniques rares ou marginalisées
La recherche psychologique confrontée à des syndromes rares ou hautement stigmatisés — tels que la schizophrénie à début très précoce, le trouble dissociatif de l’identité ou les démences fronto-temporales juvéniles — démontre l’inadéquation totale de l’échantillonnage en grappes non pondéré. Dans une affection dont la prévalence est inférieure à un individu pour 10 000 habitants, tirer au sort des grappes géographiques classiques (comme des municipalités ou des circonscriptions scolaires) relève de la roulette russe : la quasi-totalité des grappes ne présentera strictement aucun cas clinique, tandis qu’une grappe abritant par hasard un centre de soins tertiaires spécialisé en comptera un nombre disproportionné.
Dans ce scénario clinique, l’échantillonnage stratifié ciblé (souvent couplé à des critères de sélection raisonnée) représente l’unique alternative probabiliste rigoureuse. Les chercheurs segmentent le système de soins en strates basées sur le niveau d’expertise médicale des établissements : centres de soins primaires, services psychiatriques généraux de secteur, et centres experts universitaires de référence. Les strates spécialisées de troisième ligne font l’objet d’un suréchantillonnage massif (jusqu’à 100 % d’inclusion) afin de garantir la capture d’un nombre de patients suffisant pour permettre des analyses factorielles confirmatoires ou des modélisations par équations structurelles.
Une vigilance méthodologique extrême s’impose néanmoins lors de la manipulation de ces cohortes hautement sélectionnées. Les patients suivis dans ces strates institutionnelles de pointe présentent régulièrement un biais de sévérité clinique et une comorbidité accrue par rapport aux cas résidant dans la communauté sans suivi spécialisé. L’application rigoureuse de pondérations statistiques complexes reste le seul rempart pour réinsérer ces observations cliniques dans une perspective épidémiologique globale sans biaiser la caractérisation du phénotype psychiatrique étudié.
9. Applications pratiques en psychologie sociale, du travail et de l’éducation
9.1 Mesure du climat organisationnel et du burnout en entreprise
La psychologie organisationnelle et la recherche sur les risques psychosociaux mobilisent fréquemment l’échantillonnage en grappes lors de l’évaluation du burnout, du harcèlement moral ou du climat éthique au travail. L’entreprise industrielle, le site d’ingénierie ou l’agence bancaire forment des grappes écologiques évidentes. Les salariés regroupés au sein d’un même établissement partagent le même management de proximité, la même politique de rémunération, les mêmes charges de travail et subissent les mêmes pressions économiques.
Cette exposition environnementale partagée induit un coefficient de corrélation intraclasse particulièrement substantiel sur les échelles d’épuisement émotionnel (comme le Maslach Burnout Inventory – MBI). Un style de leadership toxique exercé par un directeur d’établissement peut propager une détresse psychologique collective au sein d’une unité entière, alors qu’une unité adjacente dirigée par un manager bienveillant affichera un niveau élevé d’épanouissement professionnel. Si le chercheur ignore cette structure en grappes lors de son analyse, il interprétera des variations de santé mentale causées par le leadership local comme des différences de résilience psychologique individuelle, commettant une faute d’attribution fondamentale.
Pour les grandes entreprises multinationales souhaitant cartographier précisément le bien-être de leurs effectifs sans biais d’agrégation locale, la stratification interne s’avère souvent une approche alternative ou complémentaire très supérieure. En stratifiant l’organisation par échelons hiérarchiques distincts (ouvriers/opérateurs, cadres intermédiaires, directeurs exécutifs) et par familles de métiers, l’équipe de recherche s’assure que la parole de chaque segment socioprofessionnel est captée équitablement, neutralisant le biais classique où seuls les cadres administratifs disponibles trouvent le temps de répondre aux enquêtes de santé au travail.
9.2 Recherches sur le développement socio-émotionnel en milieu scolaire
Le laboratoire naturel par excellence de l’échantillonnage en grappes reste sans conteste le milieu scolaire. L’analyse des phénomènes de victimisation par les pairs, de popularité sociométrique ou d’anxiété de performance chez les adolescents s’articule presque exclusivement autour de la classe scolaire comme unité primaire de groupement social. Tirer des classes entières au sort constitue souvent la seule modalité autorisée par les inspections académiques, qui refusent l’interruption des cours pour un tirage aléatoire individuel d’élèves disséminés.
Cependant, la dynamique sociologique de la classe crée une interdépendance mutuelle intrinsèque des réponses. Le comportement de harcèlement manifesté par un élève leader influence directement le niveau d’insécurité affective ressenti par tous ses camarades de chambrée. De surcroît, les règles de discipline instaurées par l’enseignant principal créent une matrice comportementale commune. Les réponses des élèves appartenant à la même classe ne sont donc en aucune manière des événements indépendants au sens du calcul des probabilités.
Pour optimiser la rigueur scientifique de telles investigations, les spécialistes du développement socio-émotionnel adoptent souvent une stratégie hybride. Ils opèrent une stratification préliminaire des établissements scolaires basée sur leur statut géographique et économique (zones d’éducation prioritaire versus collèges favorisés de centre-ville), puis déploient un échantillonnage en grappes au second degré en tirant au sort deux classes au sein de chaque établissement sélectionné. L’analyse ultérieure fait obligatoirement appel à des modèles de régression multiniveau pour dissocier l’influence du climat de classe de la trajectoire psychologique propre à chaque adolescent.
9.3 Enquêtes d’opinion publique et attitudes psychosociales
Dans l’étude des représentations sociales, de l’adhésion aux croyances complotistes ou des préjugés xénophobes, la conception du plan de sondage probabiliste conditionne l’exactitude des modélisations électorales ou comportementales. L’échantillonnage stratifié est ici l’étalon-or international utilisé par les grands instituts de recherche universitaire (tels que l’European Social Survey ou l’American National Election Studies). Les variables de stratification croisent typiquement les régions administratives, la densité urbaine (zones rurales, petites agglomérations, grandes métropoles) et le capital scolaire des individus.
Recourir à l’échantillonnage en grappes géographiques pour sonder des attitudes sociopolitiques polarisées comporte des risques majeurs d’erreur systématique. En raison des mécanismes de ségrégation spatiale et de gentrification urbaine, les opinions politiques sont extrêmement concentrées dans l’espace territorial : interroger les ménages d’un seul quartier de standing supérieur fournit une vue totalement déformée de l’acceptation des politiques d’aide sociale, générant un ICC territorial massif qui ruine la représentativité de l’enquête.
De plus, les enquêtes sur les attitudes psychosociales se heurtent à des taux de non-réponse différentiels colossaux. Les populations marginalisées, les minorités ethnolinguistiques et les citoyens en situation de précarité extrême sont sous-représentés dans les panels classiques. Seule la stratification assortie de pondérations socio-démographiques itératives rigoureuses (algorithmes de calage sur marges selon la méthode de Deville et Särndal) permet de corriger mathématiquement ces non-réponses sélectives pour restaurer la vérité sociologique du terrain.
10. Risques méthodologiques, biais statistiques et menaces à la validité
10.1 Erreur écologique et biais d’agrégation
L’utilisation de l’échantillonnage en grappes confronte inévitablement le chercheur à une menace épistémologique redoutable : l’erreur écologique (ou biais d’agrégation). Identifiée formellement par le sociologue William S. Robinson en 1950, cette faute analytique consiste à inférer des relations causales ou des corrélations au niveau psychologique individuel à partir de régularités statistiques observées exclusivement au niveau agrégé de la grappe.
Dans son article séminal, Robinson avait démontré que la corrélation statistique entre le taux d’analphabétisme et la proportion d’immigrants aux États-Unis était fortement négative au niveau des États fédéraux (les États comptant le plus d’immigrants affichaient un taux d’analphabétisme globalement plus faible), alors que la corrélation mesurée au niveau strictement individuel était positive. Transposé en psychologie de la santé, le danger est immense : constater qu’une grappe hospitalière ou géographique présentant un taux élevé de chômage affiche simultanément un score moyen de dépression culminant ne prouve en rien que ce sont les individus chômeurs qui sont dépressifs ; il peut s’agir de travailleurs surmenés subissant la dégradation des services publics locaux dans ces zones sinistrées.
Pour immuniser la recherche contre cette erreur, il est rigoureusement prohibé d’agréger les scores individuels pour exécuter des corrélations bivariées standard au niveau de la grappe en prétendant éclairer la psychologie individuelle. Les chercheurs doivent impérativement mobiliser la décomposition des effets intra-niveau et inter-niveaux au sein de modèles hiérarchiques, en centrant les prédicteurs individuels sur la moyenne de la grappe (group-mean centering), seule technique mathématique capable d’isoler la variance comportementale propre à l’individu de l’effet d’environnement macroscopique généré par le collectif.
10.2 Biais de sélection et mortalité expérimentale différentielle
Les deux protocoles d’échantillonnage manifestent des vulnérabilités distinctes mais dévastatrices face aux mécanismes de défection, de refus d’inclusion et de mortalité expérimentale différentielle. Dans le cadre de l’échantillonnage en grappes, le péril suprême réside dans la défaillance de grappes entières. Si un devis s’appuie sur la sélection de vingt services hospitaliers, le refus inopiné de participer émis par la direction de trois services majeurs ampute instantanément 15 % du volume total de l’échantillon, sans aucune garantie que ces structures démissionnaires ne possédaient pas des particularités cliniques uniques (comme un épuisement soignant plus aigu qui justifierait leur refus d’être évaluées).
Dans l’échantillonnage stratifié, la menace s’articule autour de l’attrition asymétrique inter-strates. Dans les essais cliniques longitudinaux évaluant les thérapies des troubles de l’usage de substances psychoactives, les participants appartenant aux strates caractérisées par une précarité sociale sévère ou des comorbidités de la personnalité (trouble borderline ou antisocial) affichent des taux de désengagement et d’abandon d’étude considérablement plus élevés que les sujets insérés dans des strates socio-économiques stables.
Cette déperdition dissymétrique détruit l’équilibre probabiliste initialement conçu. Si aucune intervention statistique n’est appliquée, l’échantillon final résiduel sera artificiellement épuré de ses éléments les plus sévèrement atteints, délivrant une image faussement optimiste de l’efficacité thérapeutique testée. Le chercheur est alors contraint de déployer des procédures mathématiques sophistiquées d’imputation multiple sous l’hypothèse de données manquantes au hasard (MAR), ou de recalculer des scores de propension pour pondérer les individus compléteurs de chaque strate afin de neutraliser cette mortalité expérimentale différentielle.
10.3 Menaces à la validité interne et externe des conclusions scientifiques
Les faiblesses inhérentes à la conception des plans de sondage se répercutent en cascade sur l’ensemble de l’édifice de validation scientifique, menaçant simultanément la validité interne et la validité externe des conclusions publiées :
- Menaces à la validité externe : Si un échantillonnage en grappes ne recrute qu’un nombre restreint de collectifs géographiques (par exemple trois écoles privées de la capitale), la diversité sociétale globale n’est pas représentée. Même si 3 000 élèves sont testés avec un $p < 0,001$, les découvertes sont inexportables vers d’autres contextes culturels ou sociodémographiques. Pour l’échantillonnage stratifié, l’omission d’une variable clé de découpage (comme la maîtrise de la langue maternelle dans les évaluations cognitives) crée des strates invisibles mais hétérogènes, restreignant insidieusement la généralisabilité des seuils cliniques obtenus.
- Menaces à la validité statistique de conclusion : Le calcul naïf des tests paramétriques sur des données en grappes non indépendantes gonfle artificiellement le taux d’erreur de type I ($\alpha$), poussant à proclamer des effets ou des associations psychologiques en réalité factices. Inversement, l’échec de la stratification à réduire la variance (si les strates ont été mal choisies) peut aboutir à une dispersion non maîtrisée des estimateurs, augmentant le risque d’erreur de type II ($\beta$) et conduisant à rejeter prématurément des hypothèses de recherche théoriquement valides.
La pérennité des connaissances scientifiques en psychologie exige donc une transparence absolue sur ces limitations au sein des sections méthodologiques, afin de prévenir la dissémination de dogmes empiriques bâtis sur des artefacts de sondage.
11. L’approche combinée : échantillonnage stratifié polyétapique en grappes
11.1 Architecture théorique des devis mixtes complexes
Face au dilemme classique opposant la précision statistique supérieure de la stratification et l’efficience économique incomparable de la mise en grappes, l’épidémiologie moderne et la psychométrie internationale ont développé une synthèse méthodologique de pointe : l’échantillonnage stratifié polyétapique en grappes (stratified multistage cluster sampling). Cette architecture probabiliste hybride réconcilie le meilleur des deux mondes en superposant hiérarchiquement les deux mécanismes de sélection au sein d’un même devis de recherche.
Le principe théorique repose sur une stratification initiale opérée non pas sur des individus, mais sur les grappes primaires elles-mêmes. Au premier degré de sélection, l’ensemble des grappes du territoire national est fragmenté en macro-strates hautement signifiantes (par exemple, les régions sanitaires croisées avec le degré d’urbanisation). À l’intérieur de chaque macro-strate, le chercheur sélectionne aléatoirement un certain nombre de grappes primaires (écoles, hôpitaux, communes) en appliquant un tirage avec probabilité proportionnelle à leur taille (PPT).
Au second (ou troisième) degré de sélection, une fois les grappes cibles investies sur le terrain, le protocole opère un nouveau sous-échantillonnage aléatoire d’individus, lequel peut être lui-même stratifié selon des attributs individuels (comme le genre ou la tranche d’âge des participants). Cette ingénierie complexe maximise le contrôle de la variance grâce à la stratification macro-territoriale tout en contenant drastiquement les coûts de déplacement grâce à l’ancrage en grappes, fournissant un compromis d’une rentabilité scientifique exceptionnelle pour les programmes d’investigation d’envergure.
11.2 Cas d’usage : grandes cohortes épidémiologiques en santé mentale
L’illustration la plus spectaculaire de cette méthodologie combinée réside dans les grandes enquêtes épidémiologiques conduites sous l’égide de l’Organisation Mondiale de la Santé, comme le consortium international World Mental Health (WMH) Surveys. L’objectif de ce consortium titanesque est d’évaluer la prévalence, la sévérité et les lacunes de prise en charge des troubles mentaux à travers des dizaines de nations sur tous les continents.
Dans un pays donné, il serait totalement impensable de déployer un échantillonnage stratifié simple sur fichier d’état civil en raison des coûts de transport planétaires et des résistances d’accès aux registres. Les équipes du WMH déploient un protocole multi-degrés rigoureux :
- Stratification géographique et socio-économique exhaustive de l’ensemble du territoire national en grandes macro-régions.
- Tirage au sort probabiliste par PPT de secteurs de dénombrement ou de districts sanitaires (Unités Primaires d’Échantillonnage) au sein de chaque strate.
- Recensement physique des îlots d’habitation et tirage aléatoire systématique des ménages au second degré.
- Au sein de chaque ménage visité, sélection aléatoire d’un répondant unique adulte via la méthode objective de Kish, souvent stratifiée par sexe et statut générationnel pour éviter de ne sonder que les personnes les plus disponibles au domicile.
Cette standardisation méthodologique draconienne, accompagnée d’un contrôle d’assurance qualité permanent sur le terrain et d’une formation poussée des enquêteurs laïcs administrant l’interview composite international de diagnostic psychiatrique (CIDI), autorise la comparaison directe de la psychopathologie mondiale avec un degré de fidélité scientifique inégalé.
11.3 Calculs des poids de sondage et redressement statistique
L’exploitation analytique de ces devis complexes ne peut en aucun cas s’effectuer sur les données brutes non traitées. La règle fondamentale de la statistique d’enquête prescrit que chaque observation individuelle doit être assortie d’un poids d’échantillonnage final (design weight), qui représente mathématiquement l’inverse de sa probabilité globale d’inclusion dans l’échantillon. Dans un protocole polyétapique stratifié, cette probabilité est le produit strict des probabilités conditionnelles de sélection calculées à chaque étage du devis :
$$P(\text{Inclusion}_k) = P(\text{Strate}) \times P(\text{Grappe} mid \text{Strate}) \times P(\text{Ménage} mid \text{Grappe}) \times P(\text{Individu} mid \text{Ménage})$$
Le poids de sondage de base ($w_k$) attribué à l’individu $k$ s’écrit alors :
$$w_k = \frac{1}{P(\text{Inclusion}_k)}$$
En pratique, ces poids de base doivent subir des ajustements correctifs supplémentaires. Des facteurs de post-stratification et de calage sur marges sont calculés pour aligner les distributions marginales de l’échantillon sur les recensements nationaux officiels (corrigeant les distorsions d’âge, de sexe et d’éducation induites par les refus de répondre). De plus, pour préserver la robustesse numérique des analyses, les statisticiens appliquent des procédures de troncature des poids extrêmes (weight trimming) évitant qu’un nombre infime d’individus dotés de poids vertigineux n’exerce une influence disproportionnée sur les estimations finales.
L’estimation des variances requiert quant à elle l’exploitation exclusive de progiciels spécialisés capables d’exécuter la linéarisation par séries de Taylor ou le rééchantillonnage par pseudo-réplication équilibrée (Balanced Repeated Replication – BRR), garantissant la publication d’intervalles de confiance rigoureusement étalonnés à l’épreuve de la réplicabilité scientifique.
12. Guide décisionnel méthodologique : critères de choix pour le chercheur
12.1 Matrice de décision multidimensionnelle
Pour accompagner le chercheur, l’étudiant de doctorat ou le praticien hospitalier dans le choix de son architecture d’échantillonnage, il est indispensable de formaliser une matrice d’arbitrage croisant les contraintes de recherche réelles avec les propriétés des deux approches :
- Objectif primaire de l’étude : Si la finalité est l’estimation ultra-précise d’un paramètre psychométrique, d’une moyenne de performance ou d’une prévalence clinique avec l’intervalle de confiance le plus resserré possible, l’échantillonnage stratifié est impératif. Si la finalité est la faisabilité logistique d’une intervention de terrain sous contrainte budgétaire stricte, l’échantillonnage en grappes s’impose.
- État du cadre d’échantillonnage : Disposez-vous d’une liste nominative complète des individus avec leurs caractéristiques sociodémographiques ou cliniques au début de l’étude ? Si oui, privilégiez la stratification. Si vous n’avez accès qu’à une liste d’institutions, de classes scolaires ou de structures territoriales sans données individuelles préalables, optez pour les grappes.
- Présomption sur le coefficient de corrélation intraclasse ($rho$) : Dans le domaine étudié, la littérature documente-t-elle une forte dépendance des individus au sein des groupes (culture d’équipe, pratiques médicales homogènes) ? Si oui, l’échantillonnage en grappes générera un DEFF très élevé, exigeant un surdimensionnement coûteux. Dans ce cas, explorez une méthode stratifiée pour neutraliser cette variabilité.
- Nature de l’intervention testée : L’intervention risque-t-elle de contaminer les sujets du groupe contrôle si elle est déployée au sein d’une même structure ? Si le risque de contamination est réel, le choix des grappes est obligatoire pour préserver la validité interne.
12.2 Check-list opérationnelle avant le lancement du recueil de données
Avant de déployer des moyens humains et matériels sur le terrain, toute équipe de recherche en sciences du comportement doit valider rigoureusement la check-list méthodologique suivante :
- Vérification des partitions : Les strates ou grappes définies sont-elles strictement mutuellement exclusives (aucun individu ou établissement n’apparaît dans deux groupes) et collectivement exhaustives (aucun individu de la cible n’est laissé pour compte) ?
- Dimensionnement ajusté : La taille d’échantillon a-t-elle été calculée a priori en intégrant explicitement la formule de l’effet de plan ? En cas d’échantillonnage en grappes, l’effectif nominal a-t-il été multiplié par le DEFF estimé d’après les revues systématiques du domaine ?
- Conformité éthique et légale : Les formulaires d’information et de consentement éclairé sont-ils adaptés à la structure d’échantillonnage ? Si un devis en grappes est adopté, l’accord formel des autorités institutionnelles (directeurs d’hôpitaux, chefs d’établissement) a-t-il été obtenu en amont de toute prise de contact avec les participants finaux ?
- Validation du pipeline d’analyse : Les scripts d’analyse statistique sont-ils programmés pour traiter la structure non-indépendante des données ? Les logiciels prévus intègrent-ils les packages survey ou les modèles linéaires mixtes appropriés plutôt que des tests paramétriques élémentaires ?
12.3 Synthèse et recommandations pour la publication académique
La crédibilité académique d’un article scientifique repose sur l’exhaustivité et la transparence de sa section « Méthode ». Les standards internationaux de publication (directives STROBE pour les études épidémiologiques observationnelles, CONSORT pour les essais cliniques randomisés en grappes, ou normes de reporting de l’APA) imposent des exigences de déclaration strictes.
Les auteurs doivent consigner explicitement :
- La dénomination exacte du plan d’échantillonnage retenu (stratifié proportionnel, stratifié à allocation optimale de Neyman, grappes à un degré, polyétapique par PPT).
- La description du cadre de sondage et les sources d’information utilisées pour dresser la liste des unités primaires.
- Les variables précises ayant servi à la stratification ou à la définition des grappes, ainsi que la justification empirique de leur sélection.
- Les probabilités d’inclusion de chaque niveau de tirage, les algorithmes de pondération utilisés et les formules de redressement statistique appliquées face aux non-réponses.
- L’estimation explicite du coefficient de corrélation intraclasse (ICC) pour chaque variable dépendante principale et l’effet de plan (DEFF) global constaté sur l’échantillon final.
- La fourniture systématique d’intervalles de confiance calculés à l’aide de méthodes d’estimation de variance robustes (linéarisation de Taylor ou rééchantillonnage) prenant en compte la structure complexe du sondage.
En respectant scrupuleusement ces canons méthodologiques et déontologiques, le chercheur immunise ses travaux contre les critiques de validité, prémunit sa discipline contre les crises de reproductibilité et participe à l’édification d’un corpus scientifique rigoureux, capable d’éclairer véritablement les politiques de santé publique et la compréhension de la psychologie humaine.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
Kessler, R. C., & Üstün, T. B. (Eds.). (2008). The WHO World Mental Health Surveys: Global perspectives on the epidemiology of mental disorders. Cambridge University Press. https://doi.org/10.1017/CBO9780511543814
Kish, L. (1965). Survey sampling. John Wiley & Sons. https://www.wiley.com/en-us/Survey+Sampling-p-9780471109495
Kroenke, K., Spitzer, R. L., & Williams, J. B. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x
Lumley, T. (2010). Complex surveys: A guide to analysis using R. John Wiley & Sons. https://doi.org/10.1002/9780470580066
Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications. https://us.sagepub.com/en-us/nam/hierarchical-linear-models/book9279
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Särndal, C.-E., Swensson, B., & Wretman, J. (1992). Model assisted survey sampling. Springer-Verlag. https://doi.org/10.1007/978-1-4612-0919-5
Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). SAGE Publications. https://us.sagepub.com/en-us/nam/multilevel-analysis/book234978
von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X