
La recherche quantitative contemporaine en sciences humaines, sociales et biomédicales repose sur un postulat méthodologique fondamental : l’impossibilité matérielle d’observer l’intégralité d’une population cible impose le recours à l’inférence statistique fondée sur des protocoles d’échantillonnage rigoureux. Dans les contextes où les individus sont naturellement regroupés au sein d’entités organisationnelles, géographiques ou administratives, telles que les établissements scolaires, les centres hospitaliers, les entreprises ou les municipalités, l’application d’un échantillonnage aléatoire simple se heurte à des obstacles logistiques, financiers et structurels souvent insurmontables. L’absence d’une base de sondage nominative exhaustive à l’échelle nationale ou régionale, couplée à la dispersion spatiale prohibitive des sujets, exige la mise en œuvre de méthodologies d’échantillonnage probabiliste dites complexes.
Parmi ces méthodologies, l’échantillonnage en grappes à deux degrés (ou sondage aréolaire et institutionnel à double étape) s’érige comme l’un des compromis théoriques et opérationnels les plus élégants et efficaces. Conçu pour concilier la robustesse de l’inférence probabiliste avec les impératifs de faisabilité sur le terrain, ce design structure la sélection en deux phases successives : d’abord le tirage aléatoire de collectifs d’individus, appelés unités primaires d’échantillonnage (UPE), puis le sous-échantillonnage probabiliste de sujets ou d’unités secondaires d’échantillonnage (USE) au sein exclusivement des grappes sélectionnées lors de la première étape. Cette architecture séquentielle le distingue nettement tant du sondage en grappes à un seul degré — qui impose l’évaluation exhaustive de tous les membres des grappes tirées — que de l’échantillonnage stratifié, qui opère une sélection au sein de la totalité des strates préétablies.
Le présent article propose une analyse approfondie de l’échantillonnage en grappes à deux degrés. En articulant formalisation mathématique, démonstrations empiriques issues de la psychologie clinique et organisationnelle, et recommandations pratiques pour le traitement des données hiérarchisées, nous examinerons les fondements théoriques, les mécanismes de pondération statistique selon l’approche de Horvitz et Thompson, l’impact de la corrélation intraclasse sur l’erreur-type via l’effet de plan théorisé par Leslie Kish, ainsi que les protocoles d’analyse multiniveaux requis pour éviter les erreurs d’inférence statistique majeures.
1. Introduction et fondements théoriques de l’échantillonnage probabiliste
1.1 Le rôle de l’échantillonnage dans la recherche scientifique et psychologique
L’ambition des sciences du comportement et de la santé mentale consiste à identifier des lois générales régissant le fonctionnement psychique, la cognition et les conduites humaines, tout en mesurant précisément l’impact de variables cliniques, contextuelles ou thérapeutiques. Néanmoins, l’accès direct à l’ensemble des individus constituant une population parente — par exemple l’ensemble des patients souffrant de troubles dépressifs majeurs dans un pays ou l’ensemble des soignants exposés au stress professionnel — est impossible sur les plans économique, temporel et humain. L’inférence statistique constitue la réponse épistémologique à cette aporie : elle autorise l’estimation de paramètres populationnels inconnus (tels que la moyenne μ, la variance σ² ou des coefficients de régression β) à partir de statistiques calculées sur un sous-ensemble fini d’observations.
Sur le plan historique, les bases formelles de l’échantillonnage probabiliste moderne ont été jetées par les travaux séminaux de Jerzy Neyman en 1934, qui a démontré la supériorité méthodologique des tirages probabilistes fondés sur des modèles stochastiques d’assignation par rapport aux approches par quotas ou aux choix raisonnés alors prédominants. Neyman a établi que seule la connaissance préalable et non nulle des probabilités d’inclusion de chaque individu permet de déduire des intervalles de confiance rigoureux et de contrôler l’erreur d’échantillonnage sans faire d’hypothèses invérifiables sur la représentativité intrinsèque des individus sélectionnés. Par la suite, les travaux de Morris Hansen et William Hurwitz dans les années 1940 ont étendu cette architecture aux plans d’échantillonnage complexes à plusieurs degrés, notamment pour les enquêtes gouvernementales et épidémiologiques de grande ampleur, établissant les formulations mathématiques de l’échantillonnage avec probabilité proportionnelle à la taille.
En psychologie comportementale, clinique et organisationnelle, ces exigences probabilistes sont devenues critiques face à la crise de la réplicabilité qui traverse la discipline depuis le début des années 2010. Les études empiriques s’appuyant trop souvent sur des échantillons de convenance (notamment des cohortes d’étudiants de premier cycle universitaire) souffrent d’une validité externe limitée et d’une incapacité à refléter l’hétérogénéité sociodémographique et clinique réelle. L’adoption de protocoles probabilistes rigoureux est donc indispensable pour garantir que les conclusions tirées d’une étude d’évaluation psychométrique, d’une enquête épidémiologique sur la santé mentale ou d’une intervention organisationnelle possèdent une portée généralisable aux populations cibles.
1.2 Taxonomie générale des plans d’échantillonnage probabilistes
Dans la théorie classique du sondage, on catégorise les plans probabilistes selon leur degré de complexité structurelle et la nature des unités sélectionnées à chaque étape. Le modèle de référence fondamental est l’échantillonnage aléatoire simple (EAS), dans lequel chaque élément de la population cible possède une probabilité d’inclusion strictement identique, et où chaque combinaison possible de n individus distincts présente exactement la même probabilité d’être sélectionnée. Bien que théoriquement idéal en raison de l’absence de biais de sélection et de la simplicité des estimateurs statistiques associés, l’échantillonnage aléatoire simple présuppose l’existence d’une base de sondage unique, exhaustive et parfaitement actualisée, listant chaque individu de la population cible sans omission ni duplication.
À l’opposé de cette approche univariée et atomisée se trouvent les plans d’échantillonnage complexes à plusieurs niveaux. La terminologie scientifique distingue rigoureusement l’unité d’observation (l’entité sur laquelle la mesure psychologique ou biomédicale est concrètement effectuée, généralement le sujet individuel), l’unité d’échantillonnage ou de sondage (l’élément soumis au tirage au sort, qui peut être un individu, une famille, un service hospitalier, ou une circonscription géographique), et la population cible (l’ensemble théorique exhaustif auquel les inférences doivent s’appliquer). Dans un plan complexe, ces entités ne coïncident pas nécessairement au point de départ du processus de tirage.
Cette distinction met en évidence la tension méthodologique constante entre l’élégance théorique de la représentativité mathématique pure et les contraintes logistiques inhérentes à la collecte des données empiriques. Échantillonner des individus isolés dispersés sur un territoire national imposerait des coûts de déplacement exorbitants pour les enquêteurs, des taux d’abandon prohibitifs, et une complexité de gestion insurmontable. Les plans complexes, en intégrant des structures de regroupement intermédiaires, cherchent à optimiser l’allocation des ressources scientifiques sans renoncer aux principes cardinaux du calcul des probabilités d’inclusion.
1.3 L’émergence des designs à plusieurs degrés en sciences comportementales
L’intérêt pour les plans d’échantillonnage multi-degrés en sciences comportementales découle directement de la nature écologique et institutionnelle des populations humaines. Dans la réalité empirique, les individus n’évoluent pas sous la forme de particules indépendantes distribuées aléatoirement dans l’espace ; ils sont intrinsèquement imbriqués au sein de structures hiérarchiques emboîtées. Les élèves sont regroupés dans des classes, elles-mêmes intégrées dans des écoles, gérées par des rectorats ; les soignants sont rattachés à des unités de soins, intégrées à des pôles cliniques, logés au sein de centres hospitaliers ; les salariés appartiennent à des équipes de travail au sein de filiales régionales de grandes entreprises.
L’application d’un échantillonnage aléatoire simple à ces populations hiérarchisées engendre des impasses méthodologiques majeures. D’une part, pour prélever aléatoirement 500 infirmiers parmi les 100 000 exerçant dans un pays, il faudrait disposer d’un fichier nominatif centralisé complet — souvent indisponible pour des raisons de secret professionnel, de protection des données personnelles (telles que le RGPD) ou d’absence de centralisation administrative. D’autre part, même si ce fichier existait, le tirage déboucherait sur la sélection d’un ou deux soignants par établissement dans des centaines d’hôpitaux différents. Une telle dispersion rendrait les visites sur site, les observations cliniques directes et la standardisation des protocoles d’administration quasiment impossibles ou financièrement ruineuses.
La transition conceptuelle vers l’échantillonnage en grappes à deux degrés (two-stage cluster sampling) répond précisément à ces limites. En utilisant les collectifs institutionnels ou territoriaux existants comme unités d’accès primaires, les chercheurs peuvent d’abord restreindre le champ de l’investigation à un sous-ensemble probabiliste de grappes, au sein desquelles une base de sondage nominative locale peut être dressée avec précision. Ce protocole concilie l’accès physique standardisé aux participants et le respect rigoureux des conditions de l’inférence probabiliste, sous réserve d’adapter adéquatement les équations d’estimation statistique aux dépendances créées par cette structure en grappes.
2. Définition rigoureuse de l’échantillonnage en grappes à deux degrés
2.1 Concept central et terminologie fondamentale
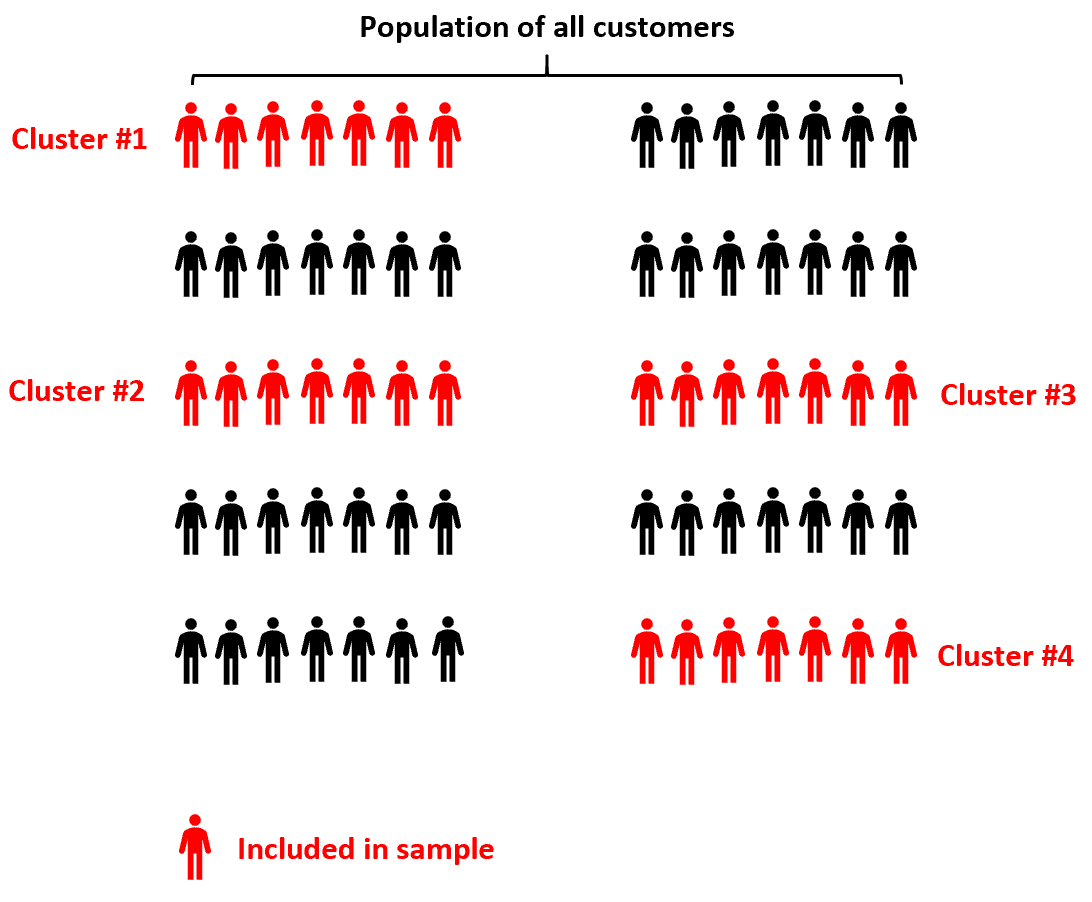
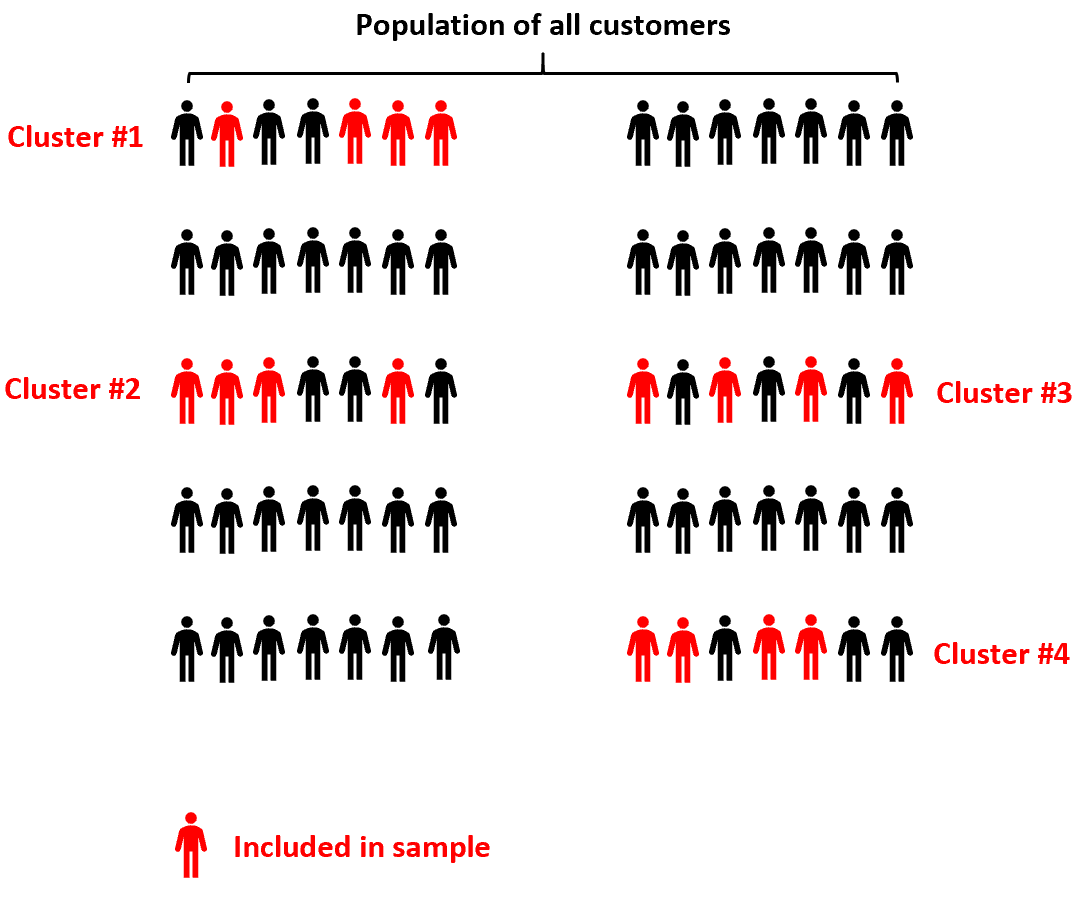
L’échantillonnage en grappes à deux degrés est un protocole de sondage probabiliste dans lequel la population cible globale est partitionnée en un ensemble de sous-groupes mutuellement exclusifs et collectivement exhaustifs, désignés sous le terme d’unités primaires d’échantillonnage (UPE) ou grappes de premier degré. Contrairement aux strates qui doivent être toutes sondées, un sous-échantillon probabiliste de ces UPE est sélectionné au premier degré. Au second degré, au lieu d’observer tous les éléments constitutifs des UPE sélectionnées (ce qui caractériserait un sondage en grappes à un degré), un tirage probabiliste supplémentaire est réalisé pour sélectionner un sous-ensemble d’unités secondaires d’échantillonnage (USE) au sein de chaque UPE retenue.
Sur le plan théorique, la validité et la précision de ce design reposent sur une compréhension précise de la structure de variance interne des grappes. Idéalement, dans une logique d’échantillonnage en grappes, chaque UPE devrait constituer un microcosme fidèle de la population totale. Les propriétés structurelles optimales d’une grappe sont donc l’hétérogénéité intra-grappe maximale (une grande variabilité des profils, scores et caractéristiques des individus au sein d’une même grappe) et une homogénéité inter-grappes maximale (les différentes UPE doivent être aussi similaires que possible entre elles quant à leurs caractéristiques globales et à leurs moyennes). Plus les grappes se ressemblent entre elles, plus l’omission d’une grande partie d’entre elles lors du tirage du premier degré entraîne une faible perte d’information statistique pour l’estimateur de population.
L’articulation séquentielle entre ces deux étapes d’échantillonnage introduit une double source d’incertitude stochastique : la première dérive de la sélection aléatoire des UPE parmi l’ensemble des grappes possibles du système parent, et la seconde découle de la sélection aléatoire des USE parmi l’ensemble des éléments constituant chaque grappe retenue. La théorie mathématique du sondage à deux degrés formalise précisément cette imbrication en décomposant l’espérance mathématique et la variance globale en espérances conditionnelles successives.
2.2 Mécanisme opérationnel en deux étapes successives
Le déroulement opérationnel de l’échantillonnage en grappes à deux degrés s’articule selon un protocole chronologique rigide, illustré par les phases suivantes :
- Étape 1 : Partitionnement et sélection au premier degré. La population totale (N) est partitionnée en un nombre fini (K) d’unités primaires d’échantillonnage, notées (U_1, U_2, dots, U_K), de tailles respectives (M_1, M_2, dots, M_K), telles que la taille globale soit :
[
N = sum_{i=1}^{K} M_i
]
Une procédure probabiliste prédéfinie est appliquée pour extraire un sous-ensemble de (k) unités primaires parmi les (K) disponibles ((k < K)). Chaque UPE (i) dispose ainsi d'une probabilité d'inclusion au premier degré, formellement notée (pi_i). - Étape 2 : Établissement de la base secondaire et tirage intra-grappe. Pour chacune des (k) UPE effectivement sélectionnées à l’étape précédente, le chercheur dresse un inventaire exhaustif des individus ou éléments constitutifs. À partir de cette liste locale de taille (M_i), un tirage probabiliste indépendant est effectué pour sélectionner (m_i) unités secondaires d’échantillonnage ((m_i < M_i)). Chaque individu (j) au sein de l'UPE sélectionnée (i) se voit attribuer une probabilité conditionnelle d'inclusion, notée (pi_{j|i}). L'échantillon final observé comprend ainsi un effectif total de sujets :
[
n = sum_{i=1}^{k} m_i
]
Ce mécanisme se distingue de l’échantillonnage en grappes à un degré, dans lequel (m_i = M_i) pour toute grappe sélectionnée. Dans le modèle à un seul degré, la sélection d’une UPE entraîne l’évaluation exhaustive de la totalité de ses membres. Bien que logistiquement pratique dans de petits collectifs (par exemple tester tous les élèves d’une classe retenue), le modèle à un degré s’avère inefficace sur le plan statistique lorsque la taille des grappes est importante et que les individus d’une même grappe présentent une ressemblance psychologique ou comportementale marquée. Le sous-échantillonnage sélectif au second degré permet de diversifier l’origine des participants en augmentant le nombre de grappes visitées pour un effectif total d’individus constant, réduisant ainsi drastiquement la redondance informationnelle.
2.3 Hypothèses sous-jacentes du modèle à deux degrés
Pour que les estimateurs statistiques dérivés d’un plan à deux degrés demeurent non biaisés et conformes aux théorèmes asymptotiques de l’inférence probabiliste, plusieurs hypothèses méthodologiques doivent être scrupuleusement respectées :
La première hypothèse fondamentale est celle de l’indépendance conditionnelle des sélections au second degré. Cela signifie que le processus de tirage aléatoire des unités secondaires opéré au sein de l’UPE (i) est strictement indépendant du processus de sélection conduit au sein de l’UPE (i’) ((i neq i’)). De surcroît, le tirage au second degré ne doit pas modifier la probabilité qu’un individu quelconque soit sélectionné dans une autre grappe. Toute interférence ou contamination entre les bases de sondage intra-grappes violerait cette indépendance et biaiserait l’estimation des erreurs-types.
La deuxième condition structurelle concerne l’exhaustivité et l’étanchéité absolue des frontières délimitant les grappes. Chaque élément de la population cible doit appartenir à une et une seule unité primaire d’échantillonnage à l’instant du tirage. Si des individus appartiennent simultanément à plusieurs UPE (par exemple un médecin vacataire exerçant dans trois cliniques différentes figurant dans la base de sondage) ou si certains sujets n’appartiennent à aucune UPE répertoriée, le principe d’exhaustivité est violé, introduisant un biais de couverture majeur qui altère le calcul exact des probabilités d’inclusion.
Enfin, la troisième exigence stipule que l’ensemble des probabilités d’inclusion à chaque niveau ((pi_i) pour le premier degré et (pi_{j|i}) pour le second degré) doivent être strictement non nulles et parfaitement calculables a priori pour chaque élément individuel de la population cible. C’est l’essence même de l’échantillonnage probabiliste au sens de Neyman-Hansen-Hurwitz : un tirage où l’on ne peut pas assigner une valeur numérique exacte à la probabilité conjointe (pi_{ij} = pi_i times pi_{j|i}) perd sa nature probabiliste et relève de l’échantillonnage de convenance, privant les inférences de toute validité mathématique rigoureuse.
3. Distinction conceptuelle : grappes à deux degrés, grappes simples et stratification
3.1 Échantillonnage en grappes à un degré versus à deux degrés
La distinction entre l’échantillonnage en grappes à un degré et le modèle à deux degrés réside dans la profondeur de l’extraction probabiliste. Dans le modèle à un degré, le chercheur sélectionne un échantillon probabiliste de grappes et soumet l’intégralité des individus qui les composent aux mesures psychométriques ou expérimentales. Par exemple, si dix écoles secondaires sont tirées au sort dans une académie, tous les élèves scolarisés dans ces dix établissements remplissent le protocole de recherche. Cette approche présente un intérêt lorsque le coût marginal d’administration du test à un élève supplémentaire au sein d’une classe déjà mobilisée est négligeable.
Cependant, sur le plan de l’efficience statistique, l’échantillonnage à un degré souffre d’un coût élevé en termes de précision lorsque les individus au sein d’une même grappe présentent une forte ressemblance comportementale ou attitudinale. Cette similarité — quantifiée par le coefficient de corrélation intraclasse — induit une redondance massive de l’information : les données recueillies auprès du cinquantième élève d’un même établissement n’apportent que très peu de variance résiduelle nouvelle par rapport aux quarante-neuf premiers. L’introduction du second degré vient corriger cette inefficience.
En introduisant un sous-échantillonnage systématique d’un nombre restreint d’individus au sein de chaque grappe sélectionnée (par exemple 20 élèves par école), le design à deux degrés permet, pour une taille globale d’échantillon d’individus équivalente, d’augmenter le nombre d’écoles distinctes incluses dans l’étude. Cette dispersion accrue de l’effort d’échantillonnage à travers un nombre plus vaste d’UPE atténue drastiquement l’effet d’accumulation de la corrélation intra-classe et réduit la variance globale de l’estimateur de population.
3.2 Différenciation critique entre stratification et mise en grappes
L’une des confusions les plus récurrentes dans la littérature empirique réside dans l’assimilation erronée entre l’échantillonnage stratifié et l’échantillonnage en grappes. Bien que ces deux méthodologies impliquent un découpage préalable de la population totale en sous-ensembles identifiés, leurs principes logiques, leurs objectifs statistiques et leurs exigences de variance sont diamétralement opposés.
Dans un échantillonnage stratifié, la population est subdivisée en sous-groupes appelés strates (par exemple selon le genre, la tranche d’âge ou le niveau socio-économique). La règle méthodologique absolue impose qu’un échantillon probabiliste soit prélevé dans chacune des strates sans exception. Pour maximiser la précision des estimations, le chercheur recherche l’homogénéité intra-strate (les individus d’une même strate se ressemblent au maximum sur la variable dépendante) et l’hétérogénéité inter-strates (les moyennes des strates sont très différentes les unes des autres). La stratification vise à éliminer la variance inter-strates de l’erreur d’échantillonnage globale, garantissant ainsi un gain de précision systématique par rapport à l’échantillonnage aléatoire simple.
À l’inverse, dans l’échantillonnage en grappes (qu’il soit à un ou deux degrés), seule une fraction des grappes existantes est sélectionnée au premier degré, les autres étant totalement exclues de l’investigation. En conséquence, les différences existant entre les grappes (la variance inter-grappes) ne sont pas éliminées du calcul d’erreur ; elles s’ajoutent directement à la variance de l’échantillonnage. Pour minimiser cette perte de précision, la condition idéale de constitution des grappes exige donc exactement l’inverse de la stratification : une hétérogénéité intra-grappe maximale et une homogénéité inter-grappes maximale.
| Critère de comparaison | Échantillonnage stratifié | Échantillonnage en grappes (2 degrés) |
|---|---|---|
| Sélection des groupes | Toutes les strates sont obligatoirement sélectionnées | Seul un sous-ensemble aléatoire d’UPE est sélectionné |
| Sélection des individus | Échantillon prélevé dans chaque strate | Échantillon prélevé uniquement dans les UPE sélectionnées |
| Variance intra-groupe | Doit être minimale (forte homogénéité interne) | Doit être maximale (forte diversité interne souhaitée) |
| Variance inter-groupes | Doit être maximale (strates bien distinctes) | Doit être minimale (grappes interchangeables) |
| Objectif prioritaire | Gain de précision statistique pure (réduction de variance) | Réduction des coûts logistiques et gestion de bases incomplètes |
3.3 Combinaisons méthodologiques complexes
Dans la pratique épidémiologique et les grandes enquêtes psychométriques nationales, les chercheurs ne se cantonnent pas à un modèle binaire exclusif. Ils mettent fréquemment en place des plans d’échantillonnage complexes combinant stratification et grappes à plusieurs degrés. Cette architecture hybride exploite simultanément les vertus de réduction de variance propres à la stratification et les gains d’efficience logistique générés par le découpage en grappes.
Le protocole canonique consiste en une stratification préalable des unités primaires d’échantillonnage avant la mise en œuvre du premier degré. Dans une enquête nationale sur la santé psychologique au travail, les hôpitaux (UPE) ne sont pas tirés au sort de manière uniforme dans une liste indifférenciée. Ils sont préalablement stratifiés selon des critères géographiques (régions administratives), statutaires (centres hospitaliers universitaires, hôpitaux généraux, cliniques privées) ou capacitaires (nombre de lits). Au sein de chaque strate institutionnelle ainsi créée, un échantillon probabiliste d’hôpitaux est sélectionné (premier degré). Puis, au sein de chaque établissement tiré, un échantillon probabiliste de professionnels de santé est prélevé (second degré).
Les plans aréolaires complexes s’appuient sur cette même combinatoire pour les populations ne disposant d’aucune infrastructure institutionnelle directe. Le territoire national est divisé en strates territoriales, puis découpé en zones géographiques de petite taille (UPE, telles que des îlots statistiques ou des communes), au sein desquelles un échantillon de ménages (unités secondaires) est sélectionné, avant de désigner aléatoirement l’individu final au sein de chaque ménage (unité tertiaire d’échantillonnage). Le choix du design statistique optimal repose sur l’analyse minutieuse de la structure de décomposition de la variance du phénomène étudié à travers les différents niveaux de la hiérarchie populationnelle.
4. Le premier degré d’échantillonnage : sélection des unités primaires (UPE)
4.1 Identification et délimitation des UPE en psychologie
La première phase opérationnelle consiste à identifier et délimiter avec rigueur les unités primaires d’échantillonnage au sein du champ d’investigation psychologique. En recherche comportementale, les UPE correspondent quasi systématiquement à des institutions naturelles ou à des contextes organisationnels au sein desquels s’articule la vie des sujets : établissements scolaires, campus universitaires, centres médico-psychologiques, services d’urgences psychiatriques, prisons, ou encore départements opérationnels de grandes firmes industrielles.
La principale difficulté méthodologique réside dans la variabilité de la taille populationnelle d’une UPE à l’autre. Dans la quasi-totalité des configurations empiriques réelles, les grappes ne sont pas de taille égale : un grand hôpital psychiatrique régional peut employer 1 200 soignants, tandis qu’une clinique psychiatrique de proximité n’en mobilise que 45. Cette disparité structurelle des effectifs intra-grappe (M_i) influe directement sur les probabilités d’inclusion des individus finaux. Une définition imprécise ou arbitraire des frontières d’une UPE engendre des distorsions majeures : l’agrégation artificielle de services hétérogènes au sein d’une même UPE ou, à l’inverse, le fractionnement injustifié d’une unité cohérente altère la variance inter-grappes et induit des biais d’estimation persistants.
4.2 Méthodes probabilistes applicables au premier degré
Pour extraire les (k) unités primaires de la base comprenant (K) grappes, deux approches probabilistes prévalent : le tirage aléatoire simple d’UPE sans remise et l’échantillonnage avec probabilité proportionnelle à la taille.
Le tirage aléatoire simple sans remise d’UPE attribue à chaque grappe la même probabilité d’être sélectionnée :
[
pi_i = frac{k}{K}
]
Si cette méthode séduit par sa simplicité de calcul, elle présente un inconvénient majeur dès lors que la taille des grappes (M_i) est hétérogène. En effet, un individu appartenant à une petite grappe possédera une probabilité globale d’inclusion mécanique nettement supérieure à celle d’un individu appartenant à une méga-grappe, à moins d’ajuster drastiquement les taux de sondage au second degré. Cet écart engendre une forte variabilité des poids de sondage finaux, ce qui dégrade l’efficacité statistique globale de l’estimateur.
La méthode de référence est l’échantillonnage avec probabilité proportionnelle à la taille (PPT), formalisée à l’origine par Hansen et Hurwitz en 1943. Dans un schéma PPT, la probabilité d’inclusion d’une UPE lors du premier degré est directement indexée sur son effectif individuel répertorié :
[
pi_i = k times frac{M_i}{N}
]
Cette approche accorde aux grandes structures une chance plus élevée d’être sélectionnées au premier degré. L’intérêt méthodologique de cette pondération initiale est remarquable : en combinant ce tirage PPT au premier degré avec l’extraction d’un nombre constant et fixe de sujets (m) au second degré au sein de chaque UPE sélectionnée, on obtient un plan d’échantillonnage global auto-pondéré (self-weighting design). Dans un tel plan, chaque individu de la population parente finale hérite exactement de la même probabilité conjointe globale d’être inclus dans l’échantillon, simplifiant radicalement le calcul des estimateurs statistiques et maximisant la précision de la moyenne d’échantillon.
4.3 Gestion des bases de sondage incomplètes au premier degré
L’un des avantages majeurs de l’échantillonnage en grappes à deux degrés réside dans le fait qu’il n’exige pas l’existence d’une base de sondage individuelle exhaustive au niveau de la population totale. En revanche, il impose de disposer d’une base de sondage rigoureuse des unités primaires d’échantillonnage. Or, sur le terrain de la recherche clinique ou psychosociale, cette base d’UPE s’avère elle-même fréquemment incomplète, obsolète ou mal documentée.
Face à l’absence d’un registre centralisé fiable des structures d’accueil (par exemple, la liste exhaustive des foyers d’hébergement d’urgence pour adolescents en détresse psychologique), le chercheur doit recourir à des procédures de recensement partiel et de validation par recoupement institutionnel. Des techniques de cartographie systématique ou d’échantillonnage aréolaire préparatoire sont mobilisées pour délimiter les zones et en dénombrer les structures d’intérêt. L’existence d’UPE de création récente ou non répertoriées engendre un biais de non-couverture qui ne peut être compensé par la stratification ultérieure.
Un défi encore plus aigu au premier degré concerne l’attrition institutionnelle ou le refus de participation au niveau des grappes. Lorsqu’une clinique ou un établissement scolaire sélectionné aléatoirement refuse d’ouvrir ses portes aux chercheurs, le remplacement sauvage de l’UPE par un autre établissement volontaire ou géographiquement commode détruit irréversiblement la validité probabiliste du design. Le remplacement probabiliste contrôlé via des grappes de réserve issues de la même strate initiale, ou l’ajustement formel des probabilités d’inclusion pour la non-réponse au niveau UPE, constituent les seules réponses mathématiquement acceptables pour préserver l’impartialité des estimations.
5. Le second degré d’échantillonnage : sélection des unités secondaires (USE)
5.1 Constitution de la base de sondage intra-grappe
Une fois les (k) unités primaires d’échantillonnage formellement sélectionnées au premier degré, l’attention méthodologique se focalise sur l’échelle micro-institutionnelle. L’équipe de recherche doit établir la base de sondage des unités secondaires d’échantillonnage (les USE, le plus souvent les sujets individuels) au sein de chaque UPE retenue. Cette opération concrétise l’avantage logistique du modèle à deux degrés : il n’est nécessaire de dresser des listes exhaustives que pour les structures sélectionnées, et non pour la totalité des établissements du territoire national.
Cette étape soulève des exigences déontologiques et réglementaires rigoureuses, particulièrement prégnantes en psychologie clinique et médicale. La constitution des listes nominatives de patients, soignants ou usagers doit impérativement respecter les cadres législatifs de protection des données sensibles et le secret médical. Les registres administratifs internes doivent être anonymisés au moyen d’identifiants de recherche uniques préalablement à la mise en œuvre de la procédure de tirage au sort, empêchant l’accès direct des évaluateurs à des données confidentielles tierces.
De surcroît, le chercheur se heurte à des variations temporelles de présence au sein des grappes : roulement du personnel (turnover), arrêts maladie, congés des salariés ou taux de rotation rapide des patients dans les unités de court séjour. La base intra-grappe doit donc faire l’objet d’un arrêt de liste à une date fixe (cross-sectional snapshot) pour stabiliser formellement l’effectif (M_i) servant de dénominateur probabiliste aux sélections du second degré.
5.2 Procédures de sélection au sein de chaque UPE
Au sein de chaque grappe sélectionnée (i), un tirage probabiliste est exécuté pour choisir les (m_i) unités secondaires à observer. Deux grandes stratégies s’offrent au méthodologue : le tirage aléatoire simple d’individus ou l’échantillonnage systématique.
L’échantillonnage aléatoire simple intra-grappe sans remise est la voie royale : chaque individu présent sur la liste locale se voit attribuer un numéro aléatoire généré par un algorithme stochastique certifié (générateur congruentiel linéaire ou algorithme de Mersenne Twister). La probabilité conditionnelle d’inclusion est alors :
[
pi_{j|i} = frac{m_i}{M_i}
]
L’alternative pratique, souvent plébiscitée sur le terrain organisationnel, est l’échantillonnage systématique intra-grappe, où l’on extrait un individu tous les (I = M_i / m_i) rangs après un point de départ aléatoire tiré entre 1 et (I). Si cette approche simplifie considérablement la sélection sur place, elle requiert une vigilance extrême : si la liste initiale des personnels ou des patients présente une périodicité cyclique implicite (par exemple un ordonnancement par ancienneté, par rotation d’équipe ou par gravité clinique), l’échantillon systématique risque de coïncider avec cette structure cyclique et d’induire un biais d’échantillonnage massif.
Un arbitrage critique à ce stade concerne la détermination du nombre de grappes (k) par rapport à la taille de l’échantillon intra-grappe (m) pour un coût fixe donné. D’un point de vue purement statistique, pour minimiser l’erreur-type globale, il est quasiment toujours préférable d’augmenter le nombre de grappes (k) et de réduire la taille d’échantillonnage intra-grappe (m). Cette règle découle directement de l’effet d’homogénéité intra-grappe : quelques individus par établissement apportent l’essentiel de la variance informative du groupe, tandis que la multiplication des grappes permet d’échantillonner efficacement la variance inter-groupes.
5.3 Attribution des probabilités d’inclusion et poids de sondage
L’impartialité de l’inférence repose sur le calcul rigoureux de la probabilité conjointe d’inclusion finale de chaque sujet participant. En vertu du théorème des probabilités composées, la probabilité d’inclusion globale d’un individu (j) niché au sein de l’UPE (i) correspond au produit de sa probabilité d’inclusion au premier degré par sa probabilité d’inclusion conditionnelle au second degré :
[
pi_{ij} = pi_i times pi_{j|i}
]
Dans un schéma de tirage standard combinant un premier degré probabiliste et un tirage aléatoire simple intra-grappe, cette expression devient :
[
pi_{ij} = pi_i times left( frac{m_i}{M_i} right)
]
Le poids de sondage de base de Horvitz-Thompson, noté (w_{ij}), est défini comme l’inverse strict de la probabilité conjointe d’inclusion :
[
w_{ij} = frac{1}{pi_{ij}}
]
Ce poids statistique représente le nombre d’unités de la population cible que cet individu particulier « représente » dans l’analyse. Dans les contextes où l’échantillonnage à probabilité proportionnelle à la taille (PPT) n’a pas pu être appliqué, ou lorsque des tailles de grappes effectives divergent des prévisions, les poids (w_{ij}) fluctuent considérablement d’un individu à l’autre. Le chercheur doit alors calculer systématiquement ces poids pour pondérer chaque observation lors du calcul des moyennes, des pourcentages et des modèles de régression, sous peine de produire des estimations lourdement biaisées.
Enfin, le protocole méthodologique final implique des étapes de redressement statistique. Les poids bruts de Horvitz-Thompson doivent être ajustés pour corriger l’attrition et la non-réponse individuelle (certains soignants sélectionnés au second degré refusant de répondre au questionnaire), puis soumis à une procédure de post-stratification ou de calage sur marges à l’aide de données auxiliaires fiables (par exemple la distribution officielle par âge et par sexe des soignants à l’échelle régionale) afin de rétablir la représentativité marginale optimale du panel d’étude.
6. Exemple empirique détaillé en psychologie clinique et organisationnelle
6.1 Contexte de l’étude : évaluation de l’épuisement professionnel chez les soignants
Afin d’illustrer la mécanique mathématique et logistique de l’échantillonnage en grappes à deux degrés, développons un cas empirique réaliste en psychologie de la santé au travail. Considérons une équipe de recherche mandatée pour évaluer la prévalence et les déterminants psychologiques du syndrome d’épuisement professionnel (burnout) parmi les personnels infirmiers exerçant au sein des établissements de santé mentale publics d’une vaste région hospitalière.
La variable dépendante principale retenue dans ce protocole est le score de dépersonnalisation (DP) issu du Maslach Burnout Inventory (MBI-HSS), un instrument psychométrique validé internationalement mesurant la dimension interpersonnelle du burnout, caractérisée par des attitudes cyniques, distantes et détachées envers les patients et le travail de soin. L’échelle de dépersonnalisation génère un score continu s’étendant de 0 à 30 points, les scores supérieurs à 10 signalant une manifestation clinique sévère du phénomène.
La population cible est formellement définie comme l’ensemble des infirmiers et infirmières titulaires ou contractuels en poste actif au sein des centres hospitaliers psychiatriques de la région au cours de l’année d’étude. Les données de l’agence régionale de santé dénombrent un total de (N = 10,000) infirmiers psychiatriques répartis dans (K = 50) centres hospitaliers psychiatriques (UPE) distincts. La dispersion géographique de ces 50 établissements sur un rayon de plusieurs centaines de kilomètres, couplée au refus compréhensible des directions de divulguer les identités et adresses personnelles des 10 000 soignants sans accord institutionnel préalable, rend l’échantillonnage aléatoire simple strictement irréalisable. L’échantillonnage en grappes à deux degrés s’impose comme la solution d’investigation de référence.
6.2 Mise en œuvre concrète du premier degré de l’exemple
Le protocole débute par la modélisation de la base de sondage du premier degré. L’équipe dresse le répertoire des (K = 50) hôpitaux de la région, documentant pour chaque établissement (i) son effectif exact d’infirmiers en activité (M_i). Les tailles de ces 50 grappes hospitalières varient fortement, s’échelonnant de (M_i = 60) soignants pour les petites structures médico-psychologiques de secteur, jusqu’à (M_i = 650) soignants pour les grands complexes hospitalo-universitaires départementaux.
L’équipe dispose des ressources budgétaires nécessaires pour déployer des psychologues évaluateurs au sein de (k = 10) centres hospitaliers. Pour éviter les distorsions de variance dues aux fortes variations de taille des hôpitaux, les chercheurs adoptent un tirage avec probabilité proportionnelle à la taille (PPT) systématique. La probabilité d’inclusion de chaque centre hospitalier (i) au premier degré est formellement calculée comme suit :
[
pi_i = k times frac{M_i}{N} = 10 times frac{M_i}{10,000} = frac{M_i}{1,000}
]
Ainsi, un grand établissement hébergeant (M_i = 600) infirmiers possède une probabilité d’inclusion au premier degré de (pi_i = 600 / 1,000 = 0{,}60) (60% de chances d’être sélectionné). À l’inverse, une structure de proximité de (M_i = 100) soignants ne dispose que d’une probabilité d’inclusion de (pi_i = 100 / 1,000 = 0{,}10) (10% de chances de tirage).
La sélection aléatoire des 10 hôpitaux est exécutée via une méthode de sélection systématique cumulative sur une liste ordonnée de manière aléatoire. Dès l’extraction des 10 centres, les directions générales et les comités d’éthique institutionnels des établissements retenus sont sollicités pour autoriser le déploiement du protocole de recherche et garantir le temps de passation aux soignants sélectionnés.
6.3 Mise en œuvre concrète du second degré de l’exemple
Une fois les conventions de recherche validées au sein des 10 centres hospitaliers sélectionnés, la phase de second degré est activée. Au sein de chaque établissement (i) retenu ((i = 1, dots, 10)), la direction des ressources humaines fournit à l’équipe un registre anonymisé exhaustif des infirmiers en poste le mois du déploiement de l’enquête. Ce registre constitue la base de sondage intra-grappe locale, d’effectif certifié (M_i).
Pour assurer le caractère auto-pondéré du dispositif, l’équipe décide d’échantillonner un effectif fixe de (m = 25) soignants par centre sélectionné. Au moyen d’une table de nombres pseudo-aléatoires générée pour chaque site, (m = 25) infirmiers sont tirés au sort selon un protocole d’échantillonnage aléatoire simple sans remise au sein de la liste de taille (M_i). La probabilité conditionnelle d’inclusion d’un soignant (j) rattaché au centre (i) vaut par conséquent :
[
pi_{j|i} = frac{m}{M_i} = frac{25}{M_i}
]
La taille globale finale de l’échantillon d’observation atteint ainsi :
[
n = k times m = 10 times 25 = 250 text{ infirmiers psychiatriques}
]
Examinons à présent la probabilité conjointe finale d’inclusion (pi_{ij}) d’un infirmier quelconque dans cette recherche. En multipliant les deux probabilités conditionnelles :
[
pi_{ij} = pi_i times pi_{j|i} = left( 10 times frac{M_i}{10,000} right) times left( frac{25}{M_i} right) = frac{M_i}{1,000} times frac{25}{M_i} = frac{25}{1,000} = 0{,}025
]
Ce résultat illustre la propriété du plan PPT : le terme (M_i) représentant la taille de la grappe s’annule dans l’équation. Tous les infirmiers psychiatriques de la région, qu’ils travaillent dans une structure de 60 soignants ou un hôpital de 650 agents, disposent rigoureusement de la même probabilité finale d’inclusion de (2{,}5%). Le poids de sondage de base de chaque soignant observé est donc strictement identique :
[
w_{ij} = frac{1}{pi_{ij}} = frac{1}{0{,}025} = 40
]
Chaque participant représente exactement 40 infirmiers de la population parente.
L’administration psychométrique est alors exécutée : les 250 soignants sélectionnés sont convoqués sur leur temps de service dans un bureau dédié pour compléter le protocole standardisé, incluant le module Dépersonnalisation du MBI, garantissant ainsi un taux de complétion élevé (96%, 240 protocoles exploitables).
6.4 Analyse chiffrée comparative des résultats obtenus
Considérons les scores moyens de dépersonnalisation observés dans les 10 grappes hospitalières de l’échantillon, compilés sur les 25 soignants interrogés par établissement. Le tableau suivant consigne les moyennes empiriques intra-grappes ((bar{y}_i)) et les variances associées ((s_i^2)) mesurées sur l’échelle de dépersonnalisation du MBI (score de 0 à 30) :
| Centre hospitalier (UPE (i)) | Taille réelle de l’hôpital ((M_i)) | Échantillon soignants ((m)) | Moyenne dépersonnalisation ((bar{y}_i)) | Variance intra-grappe ((s_i^2)) |
|---|---|---|---|---|
| Hôpital 1 | 180 | 25 | 11{,}2 | 14{,}5 |
| Hôpital 2 | 420 | 25 | 14{,}8 | 16{,}2 |
| Hôpital 3 | 260 | 25 | 9{,}5 | 12{,}8 |
| Hôpital 4 | 550 | 25 | 16{,}1 | 18{,}1 |
| Hôpital 5 | 120 | 25 | 8{,}4 | 11{,}0 |
| Hôpital 6 | 310 | 25 | 12{,}6 | 15{,}4 |
| Hôpital 7 | 600 | 25 | 15{,}3 | 17{,}6 |
| Hôpital 8 | 210 | 25 | 10{,}8 | 13{,}9 |
| Hôpital 9 | 390 | 25 | 13{,}7 | 16{,}0 |
| Hôpital 10 | 150 | 25 | 9{,}1 | 12{,}2 |
Puisque le plan est auto-pondéré ((w_{ij} = 40) pour tous les sujets), l’estimation sans biais de la moyenne populationnelle globale de dépersonnalisation ((hat{bar{Y}})) s’obtient simplement par la moyenne arithmétique des moyennes des grappes sélectionnées :
[
hat{bar{Y}} = frac{1}{k} sum_{i=1}^{k} bar{y}_i = frac{11{,}2 + 14{,}8 + 9{,}5 + 16{,}1 + 8{,}4 + 12{,}6 + 15{,}3 + 10{,}8 + 13{,}7 + 9{,}1}{10} = frac{121{,}5}{10} = 12{,}15
]
La moyenne régionale estimée du score de dépersonnalisation parmi les 10 000 infirmiers s’élève à 12,15 points, ce qui dépasse le seuil critique de 10 points et témoigne d’un niveau d’épuisement professionnel cliniquement préoccupant au sein de la profession.
Cependant, l’analyse chiffrée met en exergue des disparités inter-grappes marquées : la moyenne de dépersonnalisation oscille entre un minimum de 8,4 points dans l’Hôpital 5 (petite structure de 120 agents) et un pic à 16,1 points dans l’Hôpital 4 (grand pôle de 550 soignants). La variance non pondérée entre les moyennes d’hôpitaux s’élève à :
[
s_b^2 = frac{1}{k – 1} sum_{i=1}^{k} (bar{y}_i – hat{bar{Y}})^2 = frac{68{,}125}{9} approx 7{,}57
]
Tandis que la variance intra-grappe moyenne poolée ((s_w^2)) est de 14,77. Cette variabilité substantielle entre les établissements hospitaliers démontre l’existence d’une culture de travail, de climats de service ou de contraintes d’effectifs partagés qui homogénéisent le niveau de stress au sein de chaque hôpital, tout en le différenciant des autres structures. Cette structure de variance illustre empiriquement la nécessité d’incorporer l’effet de grappe dans l’estimation de l’erreur-type.
7. Modélisation mathématique et estimation des paramètres statistiques
7.1 Estimateurs sans biais pour la moyenne et le total de population
La formalisation mathématique de l’échantillonnage en grappes à deux degrés repose sur la classe générale des estimateurs de Horvitz et Thompson (1952). Soit une population partitionnée en (K) unités primaires, chaque grappe (i) contenant (M_i) unités secondaires. Pour toute variable psychologique continue (Y) (telle que le score de dépersonnalisation ou d’anxiété), le total populationnel inconnu est défini par :
[
Y_{total} = sum_{i=1}^{K} sum_{j=1}^{M_i} Y_{ij} = sum_{i=1}^{K} Y_i
]
où (Y_i = sum_{j=1}^{M_i} Y_{ij}) représente le total cumulé de la grappe (i).
L’estimateur sans biais de Horvitz-Thompson pour ce total de population sous un design à deux degrés s’écrit formellement :
[
hat{Y}_{HT} = sum_{i=1}^{k} frac{1}{pi_i} hat{Y}_i = sum_{i=1}^{k} frac{1}{pi_i} left( sum_{j=1}^{m_i} frac{Y_{ij}}{pi_{j|i}} right)
]
où (hat{Y}_i = sum_{j=1}^{m_i} frac{Y_{ij}}{pi_{j|i}}) constitue l’estimateur sans biais du total intra-grappe (Y_i) obtenu à partir des (m_i) unités secondaires observées. Lorsque le plan est auto-pondéré, c’est-à-dire lorsque la probabilité conjointe globale (pi_{ij} = pi_i times pi_{j|i} = pi) est constante pour toute unité (j) de toute grappe (i), l’estimateur se simplifie remarquablement. Le poids s’extrait de la somme :
[
hat{Y} = frac{1}{pi} sum_{i=1}^{k} sum_{j=1}^{m_i} Y_{ij} = w sum_{i=1}^{k} sum_{j=1}^{m_i} Y_{ij}
]
L’estimation sans biais de la moyenne de population (bar{Y} = frac{Y_{total}}{N}) s’obtient en divisant l’estimateur du total par la taille populationnelle (N). Dans les cas où la taille totale (N) est inconnue, on a recours à l’estimateur par quotient de Hájek :
[
hat{bar{Y}}_{Hajek} = frac{sum_{i=1}^{k} frac{1}{pi_i} hat{Y}_i}{sum_{i=1}^{k} frac{1}{pi_i} hat{M}_i} = frac{sum_{i=1}^{k} w_i sum_{j=1}^{m_i} w_{j|i} Y_{ij}}{sum_{i=1}^{k} w_i sum_{j=1}^{m_i} w_{j|i}}
]
Dans un plan auto-pondéré où la taille de chaque sous-échantillon intra-grappe est constante ((m_i = m)), cet estimateur se réduit à la moyenne arithmétique globale de l’échantillon :
[
hat{bar{Y}} = frac{1}{k times m} sum_{i=1}^{k} sum_{j=1}^{m} Y_{ij} = frac{1}{k} sum_{i=1}^{k} bar{y}_i
]
Cet estimateur est rigoureusement non biaisé sous les hypothèses de tirage probabiliste énoncées.
7.2 Décomposition de la variance d’échantillonnage
L’estimation de la variance d’un estimateur sous un plan à deux degrés nécessite la mise en œuvre du théorème de décomposition de la variance conditionnelle (souvent désigné sous le nom de loi de la variance totale) :
[
V(hat{Y}) = V_1 left( E_2(hat{Y} mid mathbf{S}_1) right) + E_1 left( V_2(hat{Y} mid mathbf{S}_1) right)
]
où (E_1) et (V_1) désignent l’espérance et la variance calculées sur l’ensemble de tous les échantillons possibles de grappes au premier degré, tandis que (E_2) et (V_2) représentent l’espérance et la variance conditionnelles relatives au second degré d’échantillonnage, sachant que le sous-ensemble de grappes (mathbf{S}_1) a été sélectionné au premier degré.
Puisque le sous-échantillonnage intra-grappe fournit un estimateur sans biais du total de chaque grappe retenue ((E_2(hat{Y}_i mid i in mathbf{S}_1) = Y_i)), le premier terme (V_1left( E_2(hat{Y} mid mathbf{S}_1) right)) correspond rigoureusement à la variance inter-grappes :
[
V_{inter} = V_1 left( sum_{i in mathbf{S}_1} frac{Y_i}{pi_i} right)
]
Cette composante reflète la variabilité stochastique imputable au fait que nous n’observons qu’un sous-ensemble (k) d’UPE parmi les (K) unités de la population. Si toutes les grappes présentaient des moyennes parfaitement identiques, cette composante s’annulerait totalement.
Le second terme (E_1left( V_2(hat{Y} mid mathbf{S}_1) right)) formalise la variance intra-grappe :
[
V_{intra} = E_1 left( sum_{i in mathbf{S}_1} frac{1}{pi_i^2} V_2(hat{Y}_i) right) = sum_{i=1}^{K} frac{1}{pi_i} V_2(hat{Y}_i)
]
Cette composante quantifie l’incertitude stochastique générée par le fait d’avoir sous-échantillonné (m_i) sujets au lieu de recenser exhaustivement les (M_i) individus composant chaque grappe sélectionnée. La variance totale de l’estimateur à deux degrés s’exprime donc toujours comme la somme arithmétique de ces deux variances disjointes :
[
V(hat{Y}_{HT}) = V_{inter} + V_{intra}
]
7.3 Estimation empirique de l’erreur-type
Pour calculer les intervalles de confiance et mener les tests d’hypothèses sur des données d’échantillonnage à deux degrés, le chercheur doit calculer une estimation sans biais de cette variance totale à partir des seules données observées dans l’échantillon. Dans le cas d’un tirage PPT avec remise au premier degré (ou d’un tirage sans remise où la fraction de sondage du premier degré (k/K) est faible, généralement inférieure à 5%), l’estimateur de la variance de la moyenne d’échantillon (hat{bar{Y}}) se formule de façon élégante selon l’équation de Hansen-Hurwitz :
[
v(hat{bar{Y}}) = frac{s_b^2}{k} = frac{1}{k(k – 1)} sum_{i=1}^{k} (bar{y}_i – hat{bar{Y}})^2
]
où (bar{y}_i) représente la moyenne observée dans l’UPE (i), et (s_b^2) est la variance empirique entre les moyennes des (k) grappes de l’échantillon. Il est remarquable de souligner que cette formule englobe implicitement à la fois l’incertitude du premier degré et celle du second degré ; il n’est pas nécessaire de calculer séparément la variance intra-grappe pour obtenir un estimateur convergent de l’erreur-type sous tirage PPT.
Lorsque les fractions de sondage sont élevées ((k/K > 0{,}10)) ou que les probabilités de tirage sont arbitraires, les expressions analytiques exactes deviennent hautement complexes. Le recours aux méthodes d’estimation robuste et de rééchantillonnage s’impose alors dans les logiciels statistiques contemporains :
- La linéarisation par série de Taylor : cette technique analytique approche l’estimateur non linéaire (comme le ratio de Hájek) par une approximation linéaire de Taylor de premier ordre, permettant de calculer une estimation asymptotique de la variance en grappes.
- Le Bootstrap adapté aux grappes (Cluster Bootstrap) : la procédure consiste à rééchantillonner avec remise des unités primaires d’échantillonnage entières (grappes complètes), et non des individus isolés, afin de préserver intacte la structure de corrélation intra-grappe sous-jacente.
- Le Jackknife par élimination de grappe (Delete-1-cluster Jackknife) : cette méthode recalcule l’estimateur en omettant successivement une UPE complète à chaque réplication, calculant la variance empirique à partir des fluctuations observées entre ces pseudovaleurs.
L’intervalle de confiance à 95% pour la moyenne populationnelle s’exprime enfin classiquement par :
[
IC_{95%}(bar{Y}) = hat{bar{Y}} pm t_{1 – alpha/2, , df} times sqrt{v(hat{bar{Y}})}
]
où les degrés de liberté (df) ne sont pas calculés sur l’effectif individuel total ((n – 1)), mais sont dictés par le nombre de grappes indépendantes : (df = k – 1) (ou (df = k – L) en présence de (L) strates). L’utilisation indue de (n – 1) degrés de liberté constitue l’une des fautes les plus fréquentes dans la littérature psychologique, entraînant une sous-estimation systématique de l’erreur-type et une inflation du taux de faux positifs.
8. L’effet de plan (Design Effect) et le coefficient de corrélation intraclasse (CCI)
8.1 Le coefficient de corrélation intraclasse (rho) en psychologie
L’élément fondamental gouvernant l’ampleur de la variance dans un échantillonnage en grappes est le coefficient de corrélation intraclasse (CCI), universellement noté (rho) (rho). Sur le plan statistique, le CCI quantifie le degré d’homogénéité interne des individus nichés au sein d’une même grappe comparativement à la variabilité totale observée dans la population. Il est défini par le ratio entre la variance inter-grappes ((sigma_b^2)) et la variance totale du phénomène ((sigma_b^2 + sigma_w^2)) :
[
rho = frac{sigma_b^2}{sigma_b^2 + sigma_w^2}
]
où (sigma_w^2) représente la variance intra-grappe.
Sur le plan conceptuel et psychologique, (rho) peut être interprété comme le coefficient de corrélation de Pearson attendu entre les scores de deux individus sélectionnés de manière purement stochastique au sein de la même grappe institutionnelle. Si les grappes sont chimiquement pures et que tous leurs membres partagent des scores strictement identiques, alors (sigma_w^2 = 0) et (rho = 1). À l’inverse, si les individus au sein d’un établissement ne partagent aucune caractéristique commune et sont aussi dissemblables que s’ils avaient été tirés au hasard dans la population mondiale, alors (sigma_b^2 = 0) et (rho = 0).
Dans la recherche empirique en sciences humaines, les valeurs de (rho) sont généralement comprises entre 0,01 et 0,15. Bien que ces chiffres puissent paraître quantitativement modestes à première vue, des valeurs de (rho) de l’ordre de 0,02 à 0,05 dans les écoles, les universités ou les cliniques suffisent à impacter massivement la précision statistique des tests, comme le démontre la formulation de l’effet de plan.
8.2 Formulation et calcul du Design Effect (Deff)
Pour mesurer formellement la perte de précision statistique induite par le regroupement en grappes comparativement à l’idéal théorique de l’échantillonnage aléatoire simple, Leslie Kish a introduit le concept d’effet de plan, internationalement désigné sous l’acronyme Deff (Design Effect). Le Deff est défini comme le ratio mathématique de la variance d’un estimateur sous le plan d’échantillonnage complexe considéré ((V_{complexe})) sur la variance du même estimateur calculée pour un échantillon aléatoire simple hypothétique comprenant rigoureusement le même nombre total de sujets ((V_{EAS})) :
[
text{Deff} = frac{V_{complexe}(hat{bar{Y}})}{V_{EAS}(hat{bar{Y}})}
]
Dans le cas d’un échantillonnage en grappes à deux degrés présentant un nombre moyen de sujets par grappe égal à (bar{m}), la formule fondamentale de Kish établit que :
[
text{Deff} = 1 + (bar{m} – 1)rho
]
Cette équation constitue la pierre angulaire de l’épidémiologie quantitative et de la psychométrie appliquée. Elle démontre avec clarté que l’inflation de la variance d’échantillonnage dépend conjointement de deux facteurs : la force de la ressemblance des sujets au sein de l’unité ((rho)) et la taille de l’échantillon prélevé au sein de chaque grappe ((bar{m})).
Illustrons cette équation à partir de notre cas clinique portant sur l’épuisement professionnel : supposons que le coefficient de corrélation intraclasse du score de dépersonnalisation parmi les infirmiers d’un même hôpital soit de (rho = 0{,}08), et que nous ayons prélevé (m = 25) soignants par établissement. L’effet de plan vaut alors :
[
text{Deff} = 1 + (25 – 1) times 0{,}08 = 1 + 24 times 0{,}08 = 1 + 1{,}92 = 2{,}92
]
Un Deff de 2,92 signifie que la variance réelle de notre moyenne de dépersonnalisation sous ce design à deux degrés est 2,92 fois plus importante que celle que nous aurions obtenue avec 250 soignants recrutés par échantillonnage aléatoire simple à travers toute la région !
Cette inflation de la variance s’interprète symétriquement au travers du concept de taille d’échantillon effective ((n_{eff})). La taille d’échantillon effective représente le nombre d’observations indépendantes équivalentes apportées par l’échantillon en grappes :
[
n_{eff} = frac{n}{text{Deff}} = frac{250}{2{,}92} approx 85{,}6
]
Ainsi, bien que les psychologues aient effectivement administré 250 questionnaires psychométriques complets sur le terrain, l’échantillon n’apporte que l’équivalent de 86 observations indépendantes en termes de puissance statistique d’inférence.
8.3 Implications pour la puissance statistique des tests psychométriques
L’omission de l’effet de plan lors de l’analyse des données constitue l’une des erreurs statistiques les plus destructrices en psychologie quantitative. Lorsque des données recueillies via un échantillonnage en grappes sont traitées à l’aide de tests paramétriques conventionnels (tests t de Student, modèles d’analyse de variance ANOVA, corrélations de Pearson ou régressions linéaires par moindres carrés ordinaires OLS), le logiciel suppose tacitement l’indépendance statistique absolue de toutes les observations ((rho = 0)).
Sous cette fausse prémisse, les erreurs-types des coefficients sont lourdement sous-estimées, car le dénominateur de la variance intègre la taille nominale (n) au lieu de la taille effective (n_{eff}). Les statistiques de test calculées (telles que le score (t) ou le (F)) sont alors artificiellement gonflées, réduisant indûment les p-valeurs. Les conséquences empiriques sont directes :
- Une inflation massive du taux d’erreur de type I (taux de faux positifs) : le chercheur conclut à la significativité statistique d’une différence clinique ou d’un effet thérapeutique alors qu’il ne s’agit que d’un artefact causé par la dépendance intra-grappe non contrôlée. Dans certaines configurations où (m) est élevé, le taux d’erreur de type I effectif peut atteindre 30% à 50% au lieu du seuil nominal de 5% ((alpha = 0{,}05)) !
- Des intervalles de confiance anormalement étroits qui confèrent un sentiment trompeur d’hyper-précision aux estimations psychométriques obtenues.
Pour remédier à cette dérive, l’intégration des méthodologies de modélisation multiniveau (ou modèles linéaires mixtes / HLM pour Hierarchical Linear Modeling) s’avère incontournable. Ces modèles intègrent formellement des résidus stochastiques spécifiques à chaque niveau de la hiérarchie (au niveau 1 pour les USE et au niveau 2 pour les UPE), permettant de dissocier les effets contextuels des effets individuels tout en rétablissant des erreurs-types statistiquement valides.
9. Avantages méthodologiques et logistiques dans les protocoles psychologiques
9.1 Optimisation des coûts financiers et temporels
La rationalité qui motive le choix de l’échantillonnage en grappes à deux degrés dans les programmes de recherche clinique et comportementale relève de l’optimisation sous contrainte budgétaire. Dans une enquête menée à l’échelle d’un territoire étendu ou d’un réseau national, la dispersion spatiale imposée par un tirage aléatoire simple exigerait des déplacements permanents des assistants de recherche pour rencontrer des participants isolés. Les coûts de transport, d’hébergement et les temps de trajet improductifs épuiseraient rapidement les financements alloués.
Le design à deux degrés opère une concentration spatiale et opérationnelle des équipes d’investigation. En restreignant l’intervention des psychologues à un nombre délimité de centres hospitaliers, de cliniques ou d’établissements scolaires (les (k) UPE sélectionnées), l’ensemble du matériel d’évaluation, les salles de passation et les protocoles informatisés peuvent être déployés sur un site unique pour y examiner une cohorte entière de sujets ((m) individus) en quelques journées consécutives. Cette organisation logistique rationalise la passation d’entretiens cliniques semi-structurés longs (comme l’évaluation des troubles de la personnalité ou les batteries neurocognitives), tout en réduisant considérablement le coût unitaire d’observation par sujet inclus.
9.2 Simplification de la base de sondage initiale
L’obstacle méthodologique le plus fréquent dans les protocoles de sondage probabiliste tient à l’inexistence de registres nominatifs exhaustifs à l’échelle d’une population globale. Pour conduire une étude sur la dépression chez les personnes sans domicile fixe, sur les conduites addictives chez les étudiants universitaires ou sur la satisfaction au travail chez les infirmiers d’un pays, il n’existe aucun répertoire centralisé consignant l’identité et les coordonnées de chaque individu cible.
L’échantillonnage en grappes à deux degrés contourne élégamment cette impasse structurelle. Il déplace le besoin d’exhaustivité de l’échelle micro-individuelle vers l’échelle méso-institutionnelle :
- Au stade initial (premier degré), le chercheur n’a besoin que d’un recensement des structures d’accueil ou institutions d’exercice (les UPE : liste des hôpitaux, des universités ou des centres d’hébergement), une information généralement accessible via les bases administratives nationales ou les ministères de tutelle.
- C’est uniquement au stade intermédiaire (second degré), et exclusivement au sein du sous-ensemble restreint des grappes retenues par le tirage, qu’une base de sondage nominative locale doit être dressée.
Cette simplification radicale déverrouille l’accès à des populations vulnérables, marginalisées ou cliniquement confinées, pour lesquelles aucun fichier d’ensemble ne pourrait jamais être compilé sans enfreindre les libertés individuelles ou faire face à des coûts administratifs prohibitifs.
9.3 Acceptabilité institutionnelle et standardisation clinique
Sur le plan de la sociologie des organisations médicales et académiques, la conduite d’un protocole de recherche requiert l’adhésion formelle des instances de gouvernance et d’éthique locale. L’obtention d’autorisations administratives auprès de 300 directions hospitalières distinctes pour inclure un seul soignant par site représente une entreprise titanesque aux retombées incertaines. En revanche, concentrer les démarches de conventionnement sur 10 à 15 établissements sélectionnés aléatoirement rend les démarches partenariales réalistes et gérables.
De plus, cette concentration institutionnelle offre aux psychologues cliniciens l’opportunité de maîtriser et d’harmoniser les conditions physiques et psychologiques de passation des épreuves. Administrer des tests psychométriques dans des salles calmes, standardisées, sous des conditions d’éclairage, de consigne et d’isolement acoustique contrôlées au sein de chaque établissement sélectionné permet de réduire substantiellement les bruits de mesure expérimentaux liés à la variabilité des contextes de passation individuelle.
Enfin, ce format favorise une bien meilleure appropriation de l’étude par les équipes locales. Lorsque la direction et les représentants du personnel d’un établissement constatent qu’une cohorte représentative de leur structure participe à une étude scientifique, ils sont plus enclins à encourager le recrutement, à libérer du temps de travail pour les professionnels évalués, et à faciliter le suivi longitudinal des cohortes cliniques.
10. Limites, biais potentiels et défis d’analyse des données
10.1 Perte de précision par rapport à l’échantillonnage aléatoire simple
La contrepartie inéluctable des vertus logistiques de l’échantillonnage en grappes à deux degrés réside dans sa perte d’efficience statistique théorique face à l’échantillonnage aléatoire simple à effectif équivalent. Cette perte de précision se traduit mathématiquement par une augmentation mécanique des erreurs-types des estimateurs, consécutive à l’effet de plan engendré par le regroupement en grappes.
Pour compenser cette dégradation de la variance et maintenir une puissance statistique équivalente (généralement fixée au seuil conventionnel de (1 – beta = 0{,}80) pour détecter une taille d’effet spécifique), l’investigateur doit obligatoirement gonfler la taille globale de l’échantillon nominal de son étude en la multipliant par le (text{Deff}) attendu :
[
n_{requis_complexe} = n_{EAS} times text{Deff}
]
Si une analyse de puissance classique sous EAS exigeait l’observation de 300 individus, un Deff estimé de 2,0 impose de recruter 600 participants sous le design à deux degrés.
Cette pénalité de variance affecte tout particulièrement les analyses psychométriques multivariées complexes, telles que les analyses factorielles confirmatoires (CFA) et les modèles d’équations structurelles (SEM). L’omission de la structure en grappes dans ces modèles produit des indices d’ajustement globaux faussés (inflation injustifiée du (chi^2), dégradation artificielle du RMSEA ou du CFI) et une instabilité des erreurs-types associées aux saturations factorielles et aux coefficients de régression latents.
10.2 Biais liés à la non-réponse et à l’attrition différentielle
L’échantillonnage en grappes à deux degrés présente une vulnérabilité accrue aux mécanismes d’attrition et de non-réponse, celle-ci pouvant survenir à deux échelons disjoints du protocole :
Au niveau de l’unité primaire (UPE), le désistement ou le refus institutionnel d’un centre hospitalier ou d’une école tirée au sort engendre un impact méthodologique sévère. L’omission d’une grappe entière ampute brutalement l’échantillon d’un bloc homogène d’observations tout en détruisant l’équilibre d’inclusion probabiliste du premier degré. Si les structures qui refusent de participer partagent des traits communs (par exemple des établissements marqués par une surcharge de travail critique ou un climat social détérioré), leur exclusion auto-sélectionne les structures les plus performantes ou les moins dysfonctionnelles, générant un biais de sélection institutionnel qui sous-estime systématiquement la sévérité des psychopathologies organisationnelles étudiées.
Au niveau de l’unité secondaire (USE), les refus individuels au sein des grappes sélectionnées introduisent un biais d’auto-sélection individuelle. Si les soignants souffrant des formes les plus invalidantes d’épuisement professionnel ou de dépression refusent plus fréquemment de compléter les protocoles de recherche par manque d’énergie psychique ou méfiance déontologique, la moyenne empirique observée au sein de la grappe sera biaisée vers le bas. Pour traiter ces distorsions, le chercheur doit déployer des stratégies statistiques avancées d’imputation multiple adaptées aux données hiérarchiques (modèles d’imputation MICE multiniveaux) couplées à des modèles de calage statistique sur marges intégrant des prédicteurs institutionnels et sociodémographiques connus.
10.3 Complexité du traitement statistique des données recueillies
L’exploitation analytique des données générées par un échantillonnage en grappes à deux degrés exige l’abandon pur et simple des outils de la statistique inférentielle classique reposant sur le postulat d’observations indépendantes et identiquement distribuées (i.i.d.). Les régressions linéaires par moindres carrés ordinaires (OLS) et les analyses de variance usuelles doivent être formellement proscrites pour toute inférence globale.
Les biostatisticiens et psychométriciens doivent orienter leurs traitements vers deux grandes approches méthodologiques complémentaires :
- L’approche basée sur le plan de sondage (Design-based approach) : cette méthodologie, implémentée via les modules de sondages complexes des progiciels (tels que le package
surveydans R, le préfixe de commandesvy:dans Stata, ou les procéduresPROC SURVEYREGetSURVEYMEANSdans SAS), préserve le paramétrage standard tout en corrigeant les matrices de variance-covariance des estimateurs à l’aide d’estimateurs robustes de type sandwich d’Huber-White cluster-ajustés, et en incorporant rigoureusement les poids de sondage de Horvitz-Thompson. - L’approche par modélisation multiniveau hiérarchique (Model-based approach) : déployée via des progiciels spécialisés (comme le package
lme4ounlmesous R, ou le logiciel Mplus), cette méthode conceptualise la structure hiérarchique en incorporant explicitement des composantes de variance aléatoire pour chaque niveau d’emboîtement (interception aléatoire et pentes aléatoires). Les équations simultanées formalisent la variation des paramètres individuels de niveau 1 comme des fonctions de caractéristiques institutionnelles de niveau 2.
Le chercheur contemporain se trouve ainsi confronté à une complexité computationnelle substantielle, qui impose une formation spécialisée en statistique mathématique pour articuler de manière congruente l’architecture de tirage du plan d’échantillonnage et les modèles d’analyse multivariée des données psychologiques.
11. Guide pratique de mise en œuvre et considérations éthiques
11.1 Arbre de décision opérationnel pour le chercheur
Face à la préparation d’un protocole quantitatif de grande ampleur, le chercheur doit évaluer la pertinence de recourir à un échantillonnage en grappes à deux degrés à l’aide d’un arbre de décision méthodologique systématique :
La première décision repose sur l’évaluation de l’accessibilité de la base de sondage nominative globale. Si un registre exhaustif et qualifié de tous les individus cibles est disponible et que la dispersion spatiale n’engendre pas de surcoûts majeurs (par exemple dans le cas de protocoles d’évaluation purement numériques auto-administrés en ligne), l’échantillonnage aléatoire simple ou l’échantillonnage stratifié univarié demeure supérieur en précision. Si, en revanche, la base individuelle fait défaut ou si l’administration nécessite une présence sur site des investigateurs, le partitionnement en UPE s’impose.
La deuxième étape consiste en l’estimation préalable du coefficient de corrélation intraclasse ((rho)) à partir de la littérature scientifique existante ou d’une étude pilote. La connaissance de (rho) permet de mobiliser les formules d’optimisation de Cochran pour déterminer simultanément le nombre optimal d’UPE ((k)) et le nombre optimal d’USE par grappe ((m)) sous contrainte budgétaire :
[
m_{opt} = sqrt{frac{C_1}{C_2} times frac{1 – rho}{rho}}
]
où (C_1) représente le coût unitaire fixe d’inclusion et d’ouverture d’une unité primaire (démarches administratives, déplacement sur site de l’équipe, calibration du matériel), et (C_2) symbolise le coût unitaire marginal d’évaluation d’un individu au sein d’une structure déjà mobilisée. Cette formule établit que plus l’homogénéité intra-grappe (rho) est forte, plus la taille optimale intra-grappe (m) doit être réduite pour consacrer le budget à l’inclusion d’un plus grand nombre de grappes distinctes (k).
11.2 Enjeux éthiques spécifiques aux populations cliniques nichées
L’implémentation d’un échantillonnage au sein d’institutions fermées ou hiérarchisées soulève des problématiques éthiques et déontologiques majeures :
Le premier impératif éthique réside dans la séparation du consentement institutionnel et du consentement individuel libre et éclairé. L’autorisation accordée par la direction d’un hôpital, d’une entreprise ou d’un collège à l’équipe de recherche ne saurait en aucun cas valoir consentement automatique pour les personnels, usagers ou élèves placés sous son autorité. Les sujets sélectionnés aléatoirement au second degré doivent conserver la liberté de refuser de participer, de refuser de répondre à certaines épreuves psychométriques ou de se retirer à tout moment, sans que cette décision ne puisse être portée à la connaissance de leur hiérarchie, ni n’entraîne de conséquences négatives sur leur statut professionnel ou leur suivi clinique.
Le deuxième risque éthique majeur concerne la pression de conformité institutionnelle. Dans des structures closes, le fait d’être convoqué pendant ses heures de service pour remplir des questionnaires sur le bien-être au travail peut susciter une anxiété légitime quant au caractère anonyme des résultats. Le protocole doit impérativement garantir un isolement strict lors de la passation et l’absence totale de transmission de données désagrégées à l’encadrement local. Si le nombre de participants au sein d’une grappe est faible (par exemple (m = 5) soignants dans un petit service), le croisement de données sociodémographiques (âge, sexe, grade) permettrait une identification directe des sujets, constituant une violation de l’anonymat. L’équipe d’investigation doit alors proscrire l’accès aux ventilations intra-grappes trop fines et agréger les indicateurs à une échelle macro-institutionnelle.
11.3 Règles de transparence et de reporting (normes APA et STROBE)
Pour assurer la reproductibilité scientifique et la validité des méta-analyses futures, la publication d’une recherche exploitant un échantillonnage en grappes à deux degrés doit scrupuleusement adhérer aux standards éditoriaux internationaux, notamment les directives STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) et les normes méthodologiques de l’American Psychological Association (APA 7th Edition).
La section « Méthode » du manuscrit scientifique doit obligatoirement détailler les composantes suivantes :
- La description explicite de la base de sondage des UPE et des critères de partitionnement utilisés.
- Le mode de tirage stochastique formel au premier degré (aléatoire simple, systématique, ou avec probabilité proportionnelle à la taille PPT).
- La procédure d’inventaire et de sélection probabiliste des individus exécutée au second degré.
- La formule de calcul exacte des probabilités conjointes d’inclusion finales et des poids d’échantillonnage de Horvitz-Thompson.
- La documentation des taux de participation et d’attrition aux deux niveaux (pourcentage d’UPE ayant accepté de participer et pourcentage d’individus répondants au sein de chaque UPE).
- La valeur empirique documentée du coefficient de corrélation intraclasse ((rho)) et de l’effet de plan ((text{Deff})) pour les variables d’intérêt principales.
- L’identification claire des progiciels et des modules de calcul mobilisés pour prendre en compte le plan complexe (nom des packages de modélisation multiniveau ou de sondage, méthodes d’ajustement de la variance).
Le respect méticuleux de ces règles de notification conditionne la crédibilité méthodologique de la recherche et son acceptation au sein des revues scientifiques internationales de premier rang en psychologie et en santé publique.
12. Synthèse critique et perspectives méthodologiques en sciences humaines
12.1 Bilan comparatif des forces et faiblesses du design à deux degrés
L’échantillonnage en grappes à deux degrés s’impose comme une méthodologie d’investigation probabiliste incontournable dans l’arsenal des sciences humaines contemporaines. Son statut privilégié découle de sa capacité à surmonter les deux verrous majeurs des enquêtes empiriques : l’absence de base de sondage individuelle exhaustive et la dispersion prohibitive des coûts de collecte sur des espaces territoriaux étendus.
Néanmoins, la rigueur scientifique exige d’en conserver une vision critique et équilibrée. Le recours à ce design n’est jamais anodin sur le plan de la théorie de la mesure : il échange une rationalisation des coûts logistiques contre une perte mécanique d’efficience statistique pure. Cette pénalité de variance — modélisée par l’effet de plan de Kish — nécessite une surveillance constante, sous peine de biaiser l’estimation des erreurs-types, de générer des taux élevés de faux positifs et d’altérer la validité des déductions psychométriques.
| Forces majeures du design | Limites et contraintes méthodologiques |
|---|---|
| Faisabilité empirique en l’absence de base de sondage nominative nationale préalable. | Perte de précision statistique face à l’échantillonnage aléatoire simple ((text{Deff} > 1)). |
| Concentration des coûts de déplacement et du temps d’administration sur quelques sites ciblés. | Nécessité absolue de recruter une taille d’échantillon nominale plus large pour maintenir la puissance. |
| Standardisation clinique rigoureuse des conditions de passation des tests au sein des institutions. | Vulnérabilité critique en cas de refus ou de défection d’une unité primaire entière (biais d’attrition). |
| Possibilité d’obtenir des plans auto-pondérés élégants via l’échantillonnage PPT au premier degré. | Obligation d’utiliser des modélisations statistiques complexes (modèles multiniveaux, calculs de variance cluster). |
| Adéquation structurelle parfaite avec les populations naturellement emboîtées (santé, école, entreprise). | Complexité du calcul et de la gestion des probabilités conjointes et des poids de sondage de redressement. |
12.2 Innovations méthodologiques et échantillonnage numérique
L’essor des technologies numériques, des sciences des données et des dispositifs de captation mobile redéfinit en profondeur les frontières méthodologiques de l’échantillonnage à plusieurs degrés en sciences comportementales. La transposition conceptuelle de cette architecture s’observe aujourd’hui dans deux domaines émergents de la recherche clinique :
Le premier concerne l’échantillonnage en grappes au sein des communautés en ligne et des réseaux sociaux numériques. Dans l’investigation des psychopathologies associées aux conduites numériques (cyberharcèlement, radicalisation idéologique, cyberaddiction), les unités primaires d’échantillonnage ne sont plus des institutions physiques traditionnelles, mais des entités virtuelles agrégées : serveurs de discussion, canaux thématiques, groupes d’usagers ou forums de soutien psychologique en ligne. Le premier degré probabiliste consiste à sélectionner un échantillon de ces collectifs numériques, au sein desquels un sous-échantillonnage stochastique d’utilisateurs actifs est mené au second degré pour administrer des modules d’évaluation clinique standardisés.
Le second domaine d’innovation conceptuelle réside dans l’évaluation écologique momentanée (Ecological Momentary Assessment ou EMA) et les protocoles de recueil à passages répétés (Experience Sampling Method ou ESM). Dans ces designs biomédicaux et psychologiques modernes utilisant les smartphones des participants, la structure de données est conceptuellement équivalente à un échantillonnage à deux degrés inversé dans le domaine temporel : l’individu humain constitue l’unité primaire d’échantillonnage (UPE), sélectionnée au premier degré au sein de la population cible, tandis que les moments de mesure temporelle (les alertes aléatoires générées 5 à 10 fois par jour par l’application pour capturer l’humeur, le stress ou les conduites addictives) constituent les unités secondaires d’échantillonnage (USE) prélevées au second degré.
L’application rigoureuse des théorèmes de décomposition de variance et des principes d’inférence de l’échantillonnage à deux degrés à ces nouveaux formats numériques démontre la pérennité et la vitalité épistémologique de cette théorie statistique. Qu’il s’agisse de mesurer la santé mentale de soignants au sein de structures hospitalières régionales, d’évaluer la prévalence de troubles dépressifs dans un système scolaire, ou de modéliser les fluctuations émotionnelles instantanées via des protocoles mobiles, l’échantillonnage en grappes à deux degrés demeure l’armature méthodologique garante d’une science quantitative reproductible, éthique et rigoureusement contextualisée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Hansen, M. H., & Hurwitz, W. N. (1943). On the theory of sampling from finite populations. The Annals of Mathematical Statistics, 14(4), 333-362. https://doi.org/10.1214/aoms/1177731356
- Hansen, M. H., Hurwitz, W. N., & Madow, W. G. (1953). Sample survey methods and theory (Vols. 1-2). John Wiley & Sons.
- Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663-685. https://doi.org/10.1080/01621459.1952.10483446
- Kish, L. (1965). Survey sampling. John Wiley & Sons.
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. John Wiley & Sons. https://doi.org/10.1002/9780470580066
- Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory manual (3rd ed.). Consulting Psychologists Press.
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558-625. https://doi.org/10.2307/2342192
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
- Särndal, C.-E., Swensson, B., & Wretman, J. (1992). Model assisted survey sampling. Springer-Verlag. https://doi.org/10.1007/978-1-4612-0919-5
- Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). SAGE Publications.
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453-1457. https://doi.org/10.1016/S0140-6736(07)61602-X