
Dans le domaine des sciences contemporaines, et plus particulièrement au sein des sciences psychologiques, comportementales et sociales, l’ambition ultime de la recherche réside dans l’élucidation des mécanismes fondamentaux qui régissent l’esprit humain et les dynamiques collectives. Cependant, le chercheur se heurte d’emblée à une aporie ontologique et méthodologique incontournable : comment énoncer des vérités générales, voire universelles, à propos d’une population dénombrant des millions, voire des milliards d’individus, alors que l’observation directe ne peut matériellement s’exercer que sur une fraction infime de cette dernière ? C’est précisément à cette intersection fondamentale entre l’empirisme local et l’universalisme théorique que s’impose la notion d’échantillon représentatif.
L’acte d’échantillonner ne se résume pas à une simple modalité technique subordonnée à la collecte de données ; il constitue l’épine dorsale de l’inférence statistique et de l’épistémologie des sciences empiriques. Depuis les travaux pionniers de pionniers tels que Jerzy Neyman sur les intervalles de confiance et le tirage probabiliste jusqu’aux débats contemporains sur la reproductibilité des résultats scientifiques, la validité de toute conclusion dépend intrinsèquement de la nature du lien reliant le microcosme étudié à la totalité observée. Un protocole expérimental d’une rigueur absolue, adossé aux instruments psychométriques les plus perfectionnés, s’avère méthodologiquement stérile si l’échantillon sur lequel reposent ses mesures souffre d’un vice de constitution rédhibitoire.
Cet article propose une exploration exhaustive de la représentativité de l’échantillon en sciences humaines et comportementales. De la distinction épistémologique entre population cible et population accessible jusqu’aux raffinements algorithmiques du calage statistique contemporain, nous disséquerons les principes mathématiques, les compromis méthodologiques, les biais psychométriques insidieux et les impératifs éthiques qui définissent cette discipline. Il s’agira d’examiner en profondeur pourquoi la quête de représentativité est à la fois indispensable, méthodologiquement exigeante et perpétuellement menacée par les illusions de la facilité technique et de l’accumulation brute de données.
1. Fondements conceptuels : De la population cible à l’échantillon d’étude
1.1 Définition opérationnelle de la population parente en sciences du comportement
Dans l’architecture de toute recherche empirique, la première étape méthodologique consiste en la spécification explicite et délimitée de la population parente, couramment désignée sous le terme de population d’intérêt. En sciences du comportement, cette tâche s’avère particulièrement délicate en raison de la nature polymorphe des construits psychologiques. La délimitation d’une population ne saurait se réduire à une intuition géographique ou démographique globale ; elle exige l’établissement rigoureux de critères d’inclusion et d’exclusion théoriques et empiriques. Les critères d’inclusion déterminent avec précision les attributs indispensables (tranche d’âge, niveau d’exposition à une situation, statut diagnostique ou profil professionnel) que chaque unité d’observation doit impérativement posséder pour être admissible à l’investigation, tandis que les critères d’exclusion circonscrivent les conditions de confusion potentielles (comorbidités sévères, barrières linguistiques altérant la compréhension des consignes psychométriques ou interventions pharmacologiques concurrentes) susceptibles de compromettre l’interprétabilité causale des données.
Sur le plan épistémologique, il convient d’opérer une distinction cardinale entre la population cible théorique et la population accessible (ou population d’enquête). La population cible incarne l’ensemble abstrait et exhaustif auquel le chercheur désire généraliser ses déductions, comme la totalité des individus souffrant de trouble d’anxiété généralisée ou l’ensemble des cadres confrontés au stress professionnel dans les économies post-industrielles. En revanche, la population accessible circonscrit la fraction concrète de cette entité théorique qu’il est réalistement possible d’identifier, de contacter et d’enrôler dans un cadre spatiotemporel défini. Le fossé structural qui sépare fréquemment ces deux horizons constitue le premier vecteur de distorsion méthodologique auquel se heurte l’expérimentateur.
Considérons, à titre d’illustration en psychologie du travail, une investigation portant sur l’épuisement professionnel chez les ingénieurs en milieu technologique à haute tension cognitive. Si la population cible englobe théoriquement l’ensemble des professionnels de cette branche, la population accessible se limitera souvent aux salariés de trois parcs technologiques régionaux ayant consenti à ouvrir leurs départements aux investigateurs. De même, en psychopathologie clinique, l’étude d’une pathologie comme le trouble dépressif majeur porte théoriquement sur l’universalité des personnes affectées ; toutefois, la population empiriquement accessible s’avère presque exclusivement composée de patients recrutés en milieu hospitalier universitaire ou au sein de centres médico-psychologiques ambulatoires. Ces individus présentent, de fait, une sévérité symptomatique et un accès aux soins radicalement distincts des personnes non diagnostiquées vivant au sein de la communauté générale.
Cette irréductible divergence découle de l’impossibilité pratique, éthique et financière de procéder à un recensement exhaustif. L’examen minutieux de chaque membre d’une population d’intérêt supposerait des ressources budgétaires astronomiques, un temps de déploiement incompatible avec l’urgence scientifique et une intrusion sociétale inacceptable. Dès lors, le recours à l’échantillonnage ne constitue nullement une concession de convenance ou une résignation intellectuelle, mais s’impose comme une nécessité méthodologique incontournable pour rendre possible l’avancement de la connaissance empirique.
1.2 L’échantillon comme sous-ensemble d’observation empirique
L’échantillon se définit formellement comme un sous-ensemble fini, numériquement délimité, prélevé au sein de la population accessible dans le but délibéré de générer des mesures quantitatives ou qualitatives. Le passage de l’échelle macroscopique de la population à l’échelle microscopique du groupe expérimental constitue un mécanisme fondamental de réduction dimensionnelle. Cette opération permet de concentrer les moyens d’investigation — tels que la passation d’entretiens cliniques approfondis, l’administration de batteries de tests informatisés ou l’enregistrement de biomarqueurs neurophysiologiques — sur un groupe d’individus restreint, tout en prétendant à une portée cognitive qui dépasse infiniment les frontières singulières de ce groupe d’observation.
Ce processus repose intégralement sur les principes de l’inférence inductive, théorisée par des philosophes des sciences tels que David Hume et reformulée statistiquement par Ronald Fisher et ses contemporains. L’inférence inductive consiste à opérer un saut logique rigoureux, autorisant la transposition des lois observées sur des cas particuliers mesurables vers le niveau général et abstrait de la population parente. Dans cette optique, l’échantillon n’est jamais une fin en soi ; sa valeur heuristique ne réside pas dans sa matérialité propre, mais dans sa capacité à faire émerger des propriétés relationnelles et fonctionnelles universellement transposables aux entités non observées qui partagent ses déterminants structuraux.
Ce déploiement empirique incarne en permanence un compromis pragmatique entre des contraintes matérielles sévères et des exigences de puissance métrologique. D’une part, l’accroissement continu de la taille de l’échantillon améliore mécaniquement la précision de l’estimation et atténue l’erreur d’échantillonnage aléatoire ; d’autre part, chaque unité observationnelle supplémentaire induit un coût financier, logistique et temporel substantiel, tout en augmentant potentiellement les risques d’erreurs de mesure non liées à l’échantillonnage (fatigue des expérimentateurs, hétérogénéité des passations, dérive instrumentale). L’art de la recherche quantitative consiste précisément à calibrer cette réduction d’échelle de manière à maximiser le rendement informatif tout en conservant une fidélité absolue aux propriétés latentes de la population génératrice.
1.3 L’isomorphisme structurel entre échantillon et population
Pour qu’une réduction d’échelle prétende valablement à la représentativité, elle doit satisfaire une condition géométrique et statistique essentielle : l’isomorphisme structurel. Ce concept désigne le degré d’adéquation morphologique, distributionnelle et relationnelle existant entre les configurations de l’échantillon et celles de la population de référence. Il ne suffit pas que l’échantillon contienne des éléments appartenant à la population ; il est impératif qu’il reproduise, à une échelle homothétique réduite, les équilibres proportionnels, les dispersions et les dépendances mutuelles des variables qui caractérisent la matrice originelle.
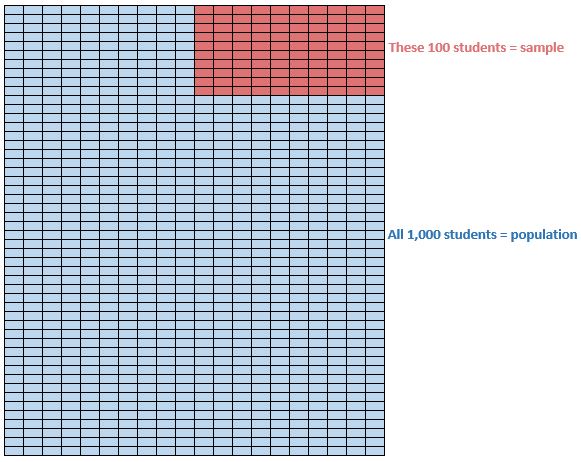
Cette exigence implique, au premier chef, la préservation scrupuleuse des proportions sociodémographiques manifestes telles que l’âge, le sexe biologique, le genre, le niveau d’éducation, la catégorie socio-économique, la répartition géographique et l’appartenance ethnoculturelle. Si une population parente est constituée de 52 % de femmes, de 24 % d’individus âgés de plus de 60 ans et de 35 % d’employés non qualifiés, toute altération substantielle de ces ratios au sein de l’échantillon compromet l’isomorphisme distributionnel. Néanmoins, l’isomorphisme ne saurait se restreindre aux variables manifestes superficielles ; il s’étend de façon impérative aux variables psychologiques sous-jacentes et aux traits latents, tels que la distribution de l’intelligence générale, les profils de personnalité stables ou les niveaux d’exposition au stress chronique.
Au sein des protocoles de psychologie scientifique, l’échantillon idéalement représentatif opère donc comme un véritable microcosme statistique. Tout comme une maquette d’architecture reproduit fidèlement les proportions porteuses, les tensions et les résistances des matériaux de l’édifice final, le microcosme expérimental doit refléter l’intégralité des variances et des covariances de la population parente. Toute rupture d’homothétie — qu’elle découle d’une surreprésentation d’un segment démographique ou de l’omission d’une sous-population marginale — introduit une distorsion géométrique du modèle statistique, altérant irréversiblement la validité des théorisations induites.
2. Définition formelle et critères d’un échantillon représentatif
2.1 Les propriétés statistiques de la représentativité
D’un point de vue formel et probabiliste, la représentativité statistique n’est pas un attribut binaire universel, mais un état d’adéquation mathématique rigoureusement formalisable. Un échantillon est réputé représentatif d’une population d’intérêt au regard d’une variable spécifique ou d’un vecteur de variables lorsque la fonction de distribution empirique de ces variables au sein de l’échantillon converge de manière non biaisée vers la fonction de distribution théorique de la population. Cette exigence impose une distinction fondamentale entre l’erreur systématique (ou biais de mesure) et l’erreur aléatoire (ou fluctuation d’échantillonnage).
L’absence d’erreur systématique implique que l’espérance mathématique de l’estimateur calculé sur l’échantillon ($\hat{\theta}$) soit rigoureusement égale au paramètre véritable ($\theta$) de la population parente, ce qui s’exprime formellement par l’équation de non-biais :
$$\mathbb{E}[\hat{\theta}] = \theta$$
Si un protocole de mesure de l’estime de soi sous-estime systématiquement la variance du score ou en surestime l’espérance en raison d’une méthode de recrutement viciée, l’estimateur est biaisé, indépendamment du nombre de cas analysés. En corollaire, la minimisation de l’erreur aléatoire découle de la loi faible des grands nombres et du théorème central limite : à mesure que le volume d’observation s’accroît, la variance de l’estimateur sans biais décroît de façon asymptotique vers zéro, garantissant une concentration de la mesure autour de la véritable valeur populationnelle.
Le pivot algorithmique garantissant cette absence de biais systématique repose sur le principe de l’équiprobabilité d’inclusion, concept central développé par l’école d’échantillonnage statistique. Dans le schéma probabiliste idéal, chaque unité $i$ appartenant à la population $N$ possède une probabilité d’inclusion strictement positive et calculable :
$$\pi_i > 0$$
Lorsque cette probabilité est rigoureusement identique pour l’ensemble des individus ($\pi_i = n/N$), le design d’échantillonnage est qualifié d’autopondéré (ou épisémal). Ce mécanisme mathématique dissout mécaniquement les risques de surreprésentation sélective, car aucune caractéristique individuelle, manifeste ou latente, ne prédispose un sujet particulier à franchir le filtre d’inclusion au détriment d’un autre.
2.2 Représentativité marginale versus représentativité conjointe
L’une des méprises méthodologiques les plus pernicieuses dans l’évaluation d’un échantillon consiste à confondre la représentativité marginale et la représentativité conjointe. La représentativité marginale correspond à la conformité isolée des distributions univariées : l’échantillon peut reproduire avec une fidélité parfaite le pourcentage d’hommes et de femmes de la population, ainsi que, de façon distincte, les pourcentages des différentes tranches d’âge et catégories socioprofessionnelles. Pourtant, cette adéquation des marges d’un tableau de contingence ne préjuge nullement de la conservation des structures internes de croisement multivarié.
La représentativité conjointe exige que la distribution probabiliste multidimensionnelle des covariables soit rigoureusement préservée dans l’espace factoriel :
$$P(X_1 = x_1, X_2 = x_2, dots, X_p = x_p)$$
Considérons une situation où un échantillon présente 50 % d’individus de sexe féminin et 30 % de personnes âgées de plus de 65 ans, reproduisant à la décimale près les marges du recensement national. Si, par un artéfact de recrutement, l’intégralité des personnes de plus de 65 ans incluses dans l’étude sont exclusivement des hommes, la représentativité marginale sur le sexe et sur l’âge est formellement intacte, mais la représentativité conjointe est anéantie. Le croisement spécifique « femme âgée » est totalement absent du sous-ensemble empirique.
Ce phénomène engendre des distorsions critiques lors de l’estimation de modèles psychologiques complexes fondés sur des termes d’interaction ou de modération. En psychologie cognitive ou clinique, la plupart des hypothèses avancées ne reposent pas sur des effets principaux simples, mais postulent des interactions d’ordre supérieur : l’effet du stress chronique ($X_1$) sur la symptomatologie dépressive ($Y$) est modéré par le statut socio-économique ($X_2$) et médié par les capacités d’inhibition exécutive ($M$). Si la covariance conjointe de ces facteurs est faussée au sein de l’échantillon, les coefficients de régression multivariée et les indices d’ajustement structurel s’avèrent fallacieux, menant les chercheurs à conclure faussement à l’inexistence d’interactions réelles ou, inversement, à la détection d’effets modérateurs purement artéfactuels.
2.3 L’illusion de la taille : Pourquoi un grand échantillon ne suffit pas
L’imaginaire scientifique profane et de nombreuses démarches de recherche contemporaines succombent régulièrement au mythe de la volumétrie brute, postulant que l’accumulation massive d’observations immunise mécaniquement l’analyse contre les biais de sélection. Il s’agit d’une illusion méthodologique majeure. L’adage statistique classique selon lequel un grand échantillon compense l’imprécision des mesures ne s’applique exclusivement qu’à l’erreur d’échantillonnage aléatoire, mais n’exerce absolument aucun pouvoir correcteur sur l’erreur systématique de sélection. Un échantillon colossal constitué selon une méthode biaisée ne fait que quantifier l’erreur de manière plus nette et resserrer fallacieusement les intervalles de confiance autour d’estimations profondément fausses.
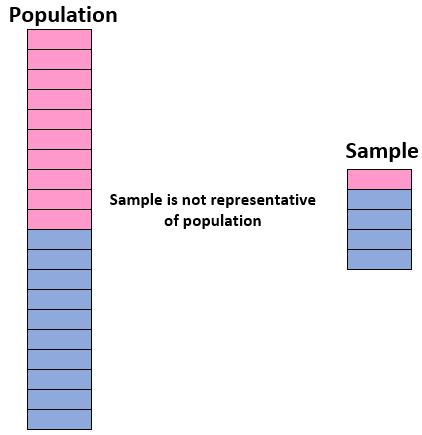
L’histoire de la statistique offre une illustration magistrale de cette aporie avec le désastre prédictif de la revue américaine The Literary Digest lors de l’élection présidentielle de 1936. Le magazine avait colligé les intentions de vote d’un échantillon spectaculaire de plus de deux millions trois cent mille citoyens, prédisant sans ambiguïté la défaite écrasante de Franklin D. Roosevelt face à Alf Landon. Simultanément, un jeune statisticien nommé George Gallup, s’appuyant sur un échantillon probabiliste restreint d’environ cinquante mille individus rigoureusement calibré sur les paramètres sociodémographiques nationaux, prédisait avec exactitude le triomphe historique de Roosevelt. La raison de l’échec monumental du Digest tenait à sa base de sondage : les listes d’abonnés téléphoniques et de propriétaires d’automobiles luxueuses, segments aisés de la population qui se distinguaient radicalement du reste de l’électorat en pleine période de Grande Dépression.
Ce paradigme s’est réactualisé brutalement à l’ère du Big Data. Comme l’a formalisé la statisticienne Xiao-Li Meng de l’Université Harvard dans ses travaux sur le « paradoxe du Big Data », l’augmentation massive de la taille d’un échantillon non représentatif accélère la décroissance de la variance d’échantillonnage beaucoup plus vite qu’elle ne résorbe le biais. En conséquence, l’erreur quadratique moyenne globale est dominée par le carré du biais. L’effectif brut ($N$) n’a aucune vertu rédemptrice face au non-respect des règles du tirage : la manière dont les individus sont sélectionnés supplante toujours le volume brut d’individus interrogés.
3. L’importance fondamentale pour la validité externe et l’inférence
3.1 Garantie de la validité externe et écologique
Dans la taxonomie épistémologique fondamentale formalisée par Donald Campbell et Julian Stanley, la validité scientifique d’une recherche se scinde principalement en validité interne et validité externe. Alors que la validité interne interroge l’exactitude de la relation causale observée au sein du dispositif expérimental (le changement observé sur la variable dépendante est-il indiscutablement imputable à la manipulation de la variable indépendante ?), la validité externe concerne directement le pouvoir de généralisation de ces conclusions à travers d’autres contextes, d’autres moments et, surtout, d’autres populations d’individus.
La représentativité de l’échantillon constitue la clé de voûte indispensable de la validité externe. Elle assure le pont inductif permettant de transposer les observations obtenues dans l’environnement aseptisé et hautement contrôlé du laboratoire vers la complexité foisonnante du monde réel. Cette dimension rejoint étroitement l’exigence de validité écologique formulée par Egon Brunswik : les stimuli, les contextes de tâche et, avant tout, les participants doivent refléter fidèlement les conditions écologiques de vie et les architectures cognitives ordinaires de la population étudiée.
Une distinction opérationnelle stricte doit être maintenue entre ces deux composantes de la validité scientifique. Un protocole randomisé en laboratoire peut afficher une validité interne impeccable — par exemple, en contrôlant minutieusement la luminosité ambiante, les millisecondes d’exposition aux stimuli et la randomisation stricte des conditions expérimentales — tout en affichant une transférabilité nulle si l’échantillon recruté se compose exclusivement d’adultes émergents de 19 ans scolarisés en licence de psychologie. La robustesse des conclusions psychologiques exige d’établir si les mécanismes psychiques découverts constituent des invariants universels ou s’ils sont conditionnés par des modérateurs culturels, sociologiques ou développementaux propres à la cohorte sélectionnée.
3.2 Fondement des tests d’hypothèses et de l’inférence paramétrique
L’ensemble du corpus de la statistique inférentielle classique reposant sur l’approche fréquentiste (tests de Student, analyses de variance de Fisher, régressions linéaires multiples ou modélisations par équations structurelles) est subordonné à des axiomes mathématiques stricts dont la violation vicie la légitimité des conclusions. Au cœur de cette axiomatique figure le postulat que les résidus et les observations individuelles constituent des variables aléatoires indépendantes et identiquement distribuées (i.i.d.), issues directement d’une distribution de probabilité parente bien définie.
Lorsque la représentativité fait défaut, la distribution des données recueillies dévie des postulats sous-jacents aux lois de probabilité usuelles (telles que la loi normale multidimensionnelle). Les conséquences directes sur les outils de décision statistique sont dévastatrices. Les intervalles de confiance calculés à un seuil nominal classique de 95 % ne capturent plus la véritable valeur du paramètre dans 95 % des cas d’échantillonnage répété ; leur couverture effective peut chuter à des niveaux dramatiquement inférieurs, procurant une fausse assurance de précision métrologique.
De surcroît, la signification probabiliste de la valeur $p$ (la probabilité d’observer des données au moins aussi extrêmes que celles mesurées sous l’hypothèse nulle $H_0$) s’en trouve corrompue. Dans un échantillon non représentatif caractérisé par des dépendances résiduelles ou des concentrations distributionnelles atypiques, la distribution de l’estimateur de test sous $H_0$ s’éloigne de sa distribution théorique tabulée (loi de $t$, de $F$ ou du $\chi^2$). Il en résulte une inflation non contrôlée du taux d’erreur de première espèce (le risque d’erreur de type I, $\alpha$), conduisant les chercheurs à rejeter à tort l’hypothèse nulle et à proclamer l’existence d’effets psychologiques statistiquement significatifs qui ne sont, en réalité, que les artefacts de structures distributionnelles viciées dès le stade du recrutement.
3.3 L’étalonnage des instruments psychométriques
L’évaluation psychologique moderne repose fondamentalement sur l’usage d’outils de mesure standardisés (échelles de personnalité, inventaires de psychopathologie, épreuves neuropsychologiques et tests d’efficience cognitive ou de quotient intellectuel). Conformément aux préceptes de la théorie classique des tests et de la théorie de la réponse à l’item (TRI), le score brut obtenu par un sujet à une passation psychométrique n’a aucun sens intrinsèque s’il n’est pas rapporté à un barème normatif, issu de l’étalonnage rigoureux d’un échantillon de référence représentatif.
Le processus d’étalonnage consiste à convertir les scores bruts en notes standardisées (notes $z$, notes T, scores de déviation de QI ou percentiles) reflétant la position exacte de l’individu par rapport à la distribution de sa cohorte de référence. Si l’échantillon normatif mobilisé pour construire ces tables présente un biais de représentativité — par exemple, en sous-représentant drastiquement les milieux socio-économiques défavorisés, les personnes issues de la diversité linguistique ou les individus scolarisés en milieu rural —, le barème est intrinsèquement tronqué. Les percentiles calculés ne reflètent plus la position relative réelle du sujet au sein de la population générale, mais traduisent un positionnement artificiel comparé à un sous-groupe favorisé ou atypique.
Les répercussions cliniques et sociétales de telles distorsions sont majeures. Un biais normatif dans une batterie neuropsychologique d’évaluation de la mémoire de travail ou des fonctions exécutives (telle que les échelles de Wechsler) induit un risque massif d’erreur diagnostique. Des individus issus de strates marginalisées de la société risquent d’être catégorisés à tort comme présentant un déficit intellectuel ou un trouble neurocognitif pathologique (faux positifs), justifiant indûment des orientations éducatives pénalisantes. Inversement, des individus issus de segments hautement privilégiés peuvent voir des dysfonctionnements cognitifs réels masqués en raison d’un étalonnage n’ayant pas suffisamment échantillonné les capacités cognitives moyennes réelles du corps social.
4. Méthodes d’échantillonnage probabiliste : La norme méthodologique
4.1 Échantillonnage aléatoire simple
L’échantillonnage aléatoire simple (EAS) représente l’étalon-or épistémologique et la modalité la plus pure du tirage probabiliste. Au sein d’un EAS, chaque membre d’une population parente de taille $N$ bénéficie d’une chance rigoureusement égale d’être sélectionné, et chaque combinaison possible de $n$ individus distincts possède exactement la même probabilité d’advenue. Ce protocole garantit une indépendance statistique absolue entre les tirages successifs d’unités d’observation, éliminant par essence tout biais d’arbitrage de l’expérimentateur.
Sur le plan pratique, l’EAS requiert impérativement une base de sondage exhaustive, c’est-à-dire un registre univoque recensant l’intégralité des individus composant la population cible, chacun étant indexé par un identifiant exclusif. Le processus de tirage s’effectue traditionnellement par le biais d’algorithmes générateurs de nombres pseudo-aléatoires cryptographiquement sûrs ou au moyen de tables de permutations aléatoires standardisées. La beauté mathématique de l’échantillonnage aléatoire simple réside dans le fait qu’il neutralise de manière égale les variables confondantes connues et inconnues : par le simple jeu du hasard, la distribution de tous les attributs, génétiques, cognitifs, émotionnels ou socio-économiques, tend à s’égaliser entre l’échantillon et la population mère.
Cependant, en dépit de son élégance axiomatique formelle, l’EAS s’avère extrêmement ardu à mettre en œuvre sur le terrain psychologique et social. Dans la grande majorité des recherches, l’accès à une base de sondage nominative exhaustive de la population générale (telle que le registre national de la population ou les fichiers cadastraux unifiés) est juridiquement verrouillé pour des motifs impérieux de confidentialité des données personnelles (exigences du RGPD en Europe). De plus, lorsque la population est géographiquement dispersée, l’EAS génère un échantillon spatialement éclaté, rendant prohibitifs les coûts de déplacement nécessaires pour administrer des protocoles expérimentaux ou des évaluations cliniques en face-à-face.
4.2 Échantillonnage stratifié proportionnel et non proportionnel
Pour dépasser les limites de l’échantillonnage aléatoire simple tout en optimisant la précision métrologique, les méthodologistes recourent couramment à l’échantillonnage stratifié. Cette méthode consiste à subdiviser préalablement la population globale d’intérêt en sous-groupes mutuellement exclusifs et conjointement exhaustifs, appelés strates, en fonction de covariables stratégiques corrélées avec les variables dépendantes d’intérêt (par exemple, le sexe, la tranche d’âge, le niveau d’instruction ou le secteur géographique). Un tirage probabiliste indépendant est ensuite opéré à l’intérieur de chacune des strates ainsi isolées.
Dans le schéma de la stratification proportionnelle, le taux d’échantillonnage est constant à travers l’ensemble des strates ($n_h / N_h = n / N$). La composition de l’échantillon reproduit fidèlement et mécaniquement la configuration de la population de référence. Cette procédure procure un gain d’efficacité statistique significatif par rapport à l’EAS : en éliminant la possibilité que le hasard du tirage ne sélectionne une proportion atypique d’une sous-population particulière, elle réduit drastiquement la variance d’échantillonnage des estimateurs. Plus les strates sont homogènes intérieurement (faible variance intra-strate) et contrastées entre elles (forte variance inter-strates), plus le gain de précision métrologique est élevé.
À l’opposé, la stratification non proportionnelle module délibérément la fraction d’échantillonnage selon les strates. Ce design est tout particulièrement indispensable en recherche psychologique lorsqu’il s’agit d’analyser des sous-groupes minoritaires, cliniquement critiques ou marginalisés (par exemple, les personnes transgenres dans une enquête de santé mentale, ou les patients atteints d’une démence fronto-temporale rare). Dans le cadre d’une allocation strictement proportionnelle, une minorité représentant 1 % de la population générale ne fournirait que 10 participants dans un échantillon global de 1 000 individus, un effectif tragiquement insuffisant pour conduire des régressions ou tester des hypothèses de modération au sein de ce groupe. Le sur-échantillonnage délibéré de ces strates rares restaure la puissance statistique locale requise pour explorer ces sous-systèmes, sous réserve d’appliquer des poids correctifs a posteriori lors des analyses agrégeant l’ensemble de la population.
4.3 Échantillonnage en grappes et échantillonnage à plusieurs degrés
Lorsque la population d’intérêt est spatialement très étendue et que l’établissement d’une base de sondage individuelle exhaustive est matériellement impossible, l’échantillonnage en grappes s’impose comme une alternative logistique incontournable. Contrairement à l’échantillonnage stratifié où l’on extrait des individus au sein de chaque strate, l’échantillonnage en grappes procède par la sélection probabiliste d’unités collectives naturelles, appelées grappes, au sein desquelles les individus sont regroupés. Dans le champ des sciences humaines, ces grappes correspondent typiquement à des établissements scolaires, des cliniques psychiatriques, des tribunaux d’instance ou des entreprises industrielles.
Dans un schéma à plusieurs degrés (ou multistage cluster sampling), la sélection se déploie de manière hiérarchique : au premier degré, on tire au sort un échantillon de districts sanitaires ; au deuxième degré, des centres de consultation au sein des districts retenus ; enfin, au troisième degré, des patients spécifiques au sein des centres sélectionnés. Ce déploiement rationalise de façon remarquable les opérations de collecte en regroupant les enquêteurs sur un nombre circonscrit de sites d’expérimentation, réduisant drastiquement les coûts logistiques et temporels.
Cette rentabilité économique se paie toutefois au prix d’une perte d’efficacité statistique formelle, imputable à l’effet de grappe. En vertu du principe de proximité sociologique et écologique, les individus appartenant à une même grappe (par exemple, des adolescents scolarisés dans le même lycée de quartier prioritaire) se ressemblent davantage entre eux qu’ils ne ressemblent aux membres d’autres grappes. Cette redondance informationnelle est quantifiée par le coefficient de corrélation intraclasse ($rho$ ou ICC). L’existence d’une ICC positive implique que prélever 100 individus dans deux lycées apporte infiniment moins d’informations indépendantes que de prélever 100 individus dispersés aléatoirement dans 100 établissements différents. Pour pallier cette inflation de la variance d’échantillonnage (l’effet de plan ou design effect), le chercheur est contraint d’augmenter substantiellement le nombre total de participants recrutés par rapport aux normes de l’échantillonnage aléatoire simple.
4.4 Échantillonnage systématique avec pas de tirage
L’échantillonnage systématique offre une alternative algorithmique séduisante à la fois par sa commodité d’exécution sur le terrain et par la proximité structurelle qu’il entretient avec l’échantillonnage aléatoire simple. Le protocole implique la disposition ordonnée de la population sous forme de liste ou de flux séquentiel de taille $N$. Après avoir déterminé la taille d’échantillon souhaitée $n$, l’expérimentateur calcule le pas d’échantillonnage $k$, défini par la partie entière du rapport :
$$k = \lfloor N / n \rfloor$$
La première unité est ensuite sélectionnée en tirant aléatoirement un nombre entier $r$ (le point de départ aléatoire) compris strictement entre 1 et $k$. Par la suite, la sélection s’opère de façon déterministe en retenant les individus situés aux rangs $r, r+k, r+2k, dots, r+(n-1)k$.
La validité statistique de l’échantillonnage systématique repose entièrement sur l’hypothèse de l’absence de toute périodicité cachée au sein du registre d’ordonnancement. Si la liste sous-jacente est ordonnée de façon aléatoire par rapport aux traits psychologiques mesurés, l’échantillon produit se comporte asymptotiquement de façon indiscernable d’un échantillon aléatoire simple. Mieux encore, si le registre est classé de façon monotone selon une variable auxiliaire continue corrélée à l’objet de recherche (comme le revenu fiscal médian ou l’ancienneté professionnelle), la méthode reproduit implicitement les vertus de l’échantillonnage stratifié avec allocation proportionnelle.
La vulnérabilité létale de l’échantillonnage systématique réside dans le phénomène de résonance ou de coïncidence de périodicité. Si la variabilité du phénomène mesuré présente une oscillation cyclique dont la longueur d’onde coïncide exactement avec le pas de sondage $k$ (par exemple, si l’on échantillonne un usager des urgences psychiatriques tous les 7 jours, capturant invariablement les admissions du samedi soir), l’échantillon résultant sera irrémédiablement biaisé en sélectionnant en boucle un segment atypique de la dynamique temporelle. Hormis cet écueil, la technique s’avère particulièrement pertinente et robuste dans l’étude des flux continus de patients au sein d’unités hospitalières ou des flux d’usagers de plateformes en ligne.
5. Méthodes d’échantillonnage non probabiliste : Usages et compromis
5.1 Échantillonnage par quotas
L’échantillonnage par quotas constitue indiscutablement la méthode non probabiliste la plus élaborée et la plus largement diffusée, notamment dans les études d’opinion publique, le marketing sociétal et les recherches en psychologie sociale appliquée. Son principe fondateur réside dans la reconstitution artificielle de la structure démographique de la population de référence, sans recourir à un tirage au sort probabiliste formalisé. Le chercheur identifie au préalable un ensemble de variables de contrôle structurelles majeures (typiquement le genre, la tranche d’âge, le niveau de diplôme, la profession et catégorie socioprofessionnelle, la région de résidence) dont la distribution est exhaustivement documentée par les données d’un recensement national officiel.
L’espace des covariables est partitionné en cellules matricielles déterminant le nombre exact d’individus à interroger pour chaque catégorie croisée (les quotas). Les enquêteurs sont ensuite missionnés pour recruter des participants répondant à ces caractéristiques signalétiques précises, avec la consigne de stopper l’inclusion d’une catégorie dès que son quota assigné est comblé. Si la démarche partage une ressemblance formelle avec l’échantillonnage stratifié, elle en diffère fondamentalement sur le plan axiomatique : au sein de chaque strate, le choix ultime de la sélection de l’individu n’est pas le fruit du hasard probabiliste, mais relève du jugement de l’enquêteur ou de l’adhésion spontanée des sujets contactés.
Cette absence d’équiprobabilité laisse la porte grande ouverte aux biais d’auto-sélection dissimulés et aux préférences non conscientes des recruteurs. Même si les distributions marginales de l’échantillon par quotas s’alignent avec une symétrie parfaite sur les proportions du recensement, rien ne garantit que les individus interrogés au sein du quota « ouvrier de 40 à 50 ans » soient psychologiquement et comportementalement représentatifs de l’ensemble des ouvriers de cette tranche d’âge. Les volontaires enrôlés partagent souvent des niveaux de sociabilité, de disponibilité cognitive ou d’intérêt civique radicalement supérieurs à ceux de leurs pairs inaccessibles.
5.2 Échantillons de convenance et opportunistes
L’échantillonnage de convenance, parfois qualifié d’échantillonnage accidentel ou opportuniste, consiste à composer un groupe d’étude exclusivement à partir d’individus facilement accessibles, immédiatement disponibles et prompts à participer à la recherche. Dans le biotope des départements universitaires de psychologie à l’échelle mondiale, cette modalité a historiquement pris la forme de « viviers d’étudiants de licence » (subject pools), contraints ou fortement incités à donner de leur temps en échange de la validation de crédits académiques. Plus récemment, l’avènement des plateformes de micro-travail en ligne (telles qu’Amazon Mechanical Turk ou Prolific) a transposé cette convenance vers des cohortes de télétravailleurs précaires rémunérés à la tâche.
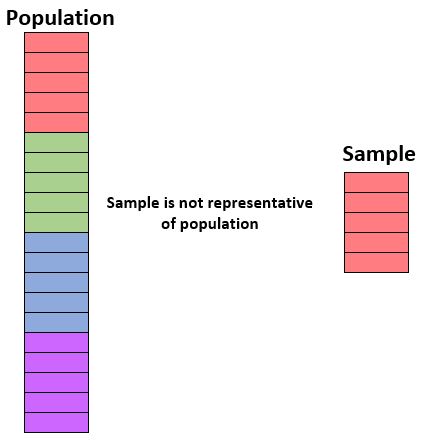
L’utilisation de telles cohortes pose une menace existentielle pour l’inférence des lois universelles de l’architecture cognitive et affective humaine. Les étudiants de premier cycle universitaire se distinguent systématiquement de la population adulte moyenne par des facultés cognitives plus entraînées, une habitude de la réflexivité formelle, un statut socio-économique parental privilégié, mais aussi par une plus grande plasticité de leur système de valeurs et un soi encore en maturation identitaire. Généraliser des mécanismes attentionnels, des prises de décision économiques ou des théories de l’attribution causale à partir de cette population ultra-spécifique relève d’une extrapolation méthodologiquement fragile.
Il existe néanmoins des circonstances épistémologiques précises où le recours à un échantillon de convenance demeure scientifiquement admissible. Lorsque l’objectif premier de la recherche réside dans l’administration de preuves de concept neurobiologiques élémentaires (par exemple, cartographier la rétinopie primaire par IRMf fonctionnelle ou caractériser les potentiels évoqués visuels précoces), il est raisonnable de postuler que l’architecture neuro-anatomique sous-jacente relève d’invariants biologiques de l’espèce Homo sapiens peu sensibles aux variations sociodémographiques. De même, au stade exploratoire de pré-test d’une échelle psychométrique ou d’évaluation de la tolérance d’une manipulation expérimentale inédite, l’échantillon de convenance constitue un compromis pragmatique acceptable pour calibrer le matériel empirique avant le déploiement de protocoles probabilistes rigoureux.
5.3 Échantillonnage par réseau ou boule de neige
L’échantillonnage par réseau, couramment désigné sous le vocable de méthode par boule de neige (snowball sampling), est une technique non probabiliste spécifiquement élaborée pour investiguer les « populations cachées » ou difficiles d’accès (hard-to-reach populations). En recherche psychologique et psychiatrique, ces populations regroupent, entre autres, les utilisateurs de substances illicites en milieu récréatif, les travailleurs du sexe, les migrants en situation administrative irrégulière, ou les individus souffrant de troubles psychopathologiques stigmatisants (par exemple, la paraphilie ou le jeu pathologique compulsif). Pour ces groupes, il n’existe aucune base de sondage officielle, et la stigmatisation sociale interdit le déploiement d’un recrutement ouvert classique.
Le protocole s’amorce par l’identification d’un nombre très restreint de participants initiaux (« les graines » ou seeds), recrutés par le truchement de relais associatifs de confiance ou de travailleurs sociaux. Après avoir complété le protocole d’investigation, ces participants initiaux sont sollicités pour agir comme agents recruteurs auprès de leurs pairs, en distribuant des invitations codées aux membres de leur propre réseau relationnel qui satisfont les critères d’inclusion théoriques. La chaîne de recrutement s’étend ensuite de proche en proche par vagues successives de parrainage mutuel.
La limite méthodologique structurelle de l’échantillonnage en boule de neige réside dans la dépendance extrême des données finales vis-à-vis des caractéristiques idiosyncrasiques des graines originelles et des structures topologiques des réseaux sociaux explorés (phénomène d’homophilie : les individus ont tendance à tisser des liens avec des personnes qui leur ressemblent étroitement). Pour juguler ces distorsions déterministes, Douglas Heckathorn a conceptualisé l’échantillonnage guidé par les répondants (Respondent-Driven Sampling ou RDS). Le RDS intègre un modèle mathématique fondé sur les chaînes de Markov et la théorie des graphes, limitant le nombre de coupons de parrainage par individu et pondérant les scores finaux par l’inverse de la taille du réseau social déclaré de chaque répondant. Cette approche permet de tendre asymptotiquement vers une approximation de représentativité statistique pour des populations qu’il était jusqu’alors impossible de quantifier formellement.
6. Les biais d’échantillonnage et leurs conséquences psychométriques
6.1 Le biais d’auto-sélection et le volontariat
Le biais d’auto-sélection émerge dès lors que la décision d’intégrer le dispositif expérimental relève de la volonté propre du sujet plutôt que d’une assignation aléatoire aveugle. Dans la quasi-totalité des recherches contemporaines en sciences humaines, les exigences éthiques du consentement éclairé rendent la participation strictement libre et révocable. Ce processus introduit inévitablement un filtre de sélection systématique : les individus qui répondent spontanément aux sollicitations d’un appel à volontaires diffèrent sur de multiples dimensions psychologiques de ceux qui choisissent d’ignorer l’invitation.
Les investigations séminales menées par Robert Rosenthal et Ralph Rosnow dès la fin des années 1960 ont permis de brosser le profil psychométrique singulier du « sujet volontaire type ». Comparativement aux non-répondants, les volontaires en recherche psychologique affichent des niveaux significativement plus élevés d’intelligence fluide et de capital culturel, un niveau d’instruction supérieur, un besoin d’approbation sociale exacerbé, une extraversion plus affirmée et un trait d’ouverture à l’expérience sensiblement accru. Ils témoignent également d’un positionnement politique et moral plus libéral et d’un moindre conservatisme socioculturel.
Dans les recherches explorant la psychopathologie ou le bien-être subjectif, le biais d’auto-sélection induit des artefacts distributionnels majeurs. Dans les protocoles ouverts portant sur l’anxiété ou la détresse psychologique, les chercheurs assistent souvent à une distribution bimodale aberrante : d’un côté, une surreprésentation d’individus en quête désespérée d’une écoute clinique ou d’un soulagement thérapeutique (gonflant artificiellement les scores de détresse) ; de l’autre, une surreprésentation d’individus particulièrement résilients et optimistes, motivés par le désir de partager leur équilibre mental. Les cohortes d’individus modérément affectés, mais apathiques, cyniques ou chroniquement débordés par leur quotidien, se trouvent quant à elles presque totalement exclues du paysage observationnel.
6.2 Le biais de non-réponse et l’attrition
Même lorsqu’un plan de tirage probabiliste idéal est déployé à l’origine, sa pureté mathématique est presque systématiquement dégradée sur le terrain par le biais de non-réponse. Ce biais traduit le fait qu’une fraction substantielle des unités tirées au sort refuse formellement de coopérer, s’avère injoignable ou abandonne la passation avant son terme. Le taux de non-réponse ne pose pas seulement un problème de volume brut d’effectif ; il menace directement la représentativité de l’échantillon final dans la mesure où les causes du refus de réponse sont presque systématiquement corrélées aux variables psychologiques sous observation.
Dans les devis de recherche longitudinaux — indispensables pour appréhender les trajectoires développementales ou l’efficacité à long terme des psychothérapies —, ce phénomène prend la forme de l’attrition différentielle (la perte de participants entre les vagues de mesure successives $T_1, T_2, dots, T_k$). Selon la typologie statistique établie par Donald Rubin, la disparition d’unités d’observation peut correspondre à trois mécanismes fondamentaux :
- MCAR (Missing Completely at Random) : L’absence de données est totalement indépendante des variables mesurées et des valeurs manquantes elles-mêmes. L’échantillon résiduel demeure un sous-ensemble parfaitement représentatif, bien qu’amputé de sa puissance statistique.
- MAR (Missing at Random) : La probabilité de défection dépend de variables observées antérieurement (comme l’âge ou le sexe), mais non de la variable d’intérêt elle-même au moment présent. La représentativité peut être restaurée par des ajustements statistiques appropriés.
- MNAR (Missing Not at Random) : La cause de la disparition d’une observation dépend directement de la variable non observée elle-même. Par exemple, des patients dont les symptômes dépressifs s’aggravent massivement cessent de répondre aux questionnaires de suivi précisément en raison de leur prostration psychique et de leur anomie.
Lorsque le mécanisme est non aléatoire (MNAR), la validité de l’échantillon est sévèrement compromise. L’attrition sélective évapore préférentiellement les cas les plus pathologiques, les plus défavorisés ou les moins autonomes, générant une impression fallacieuse de rémission clinique générale ou de stabilité psychologique au sein de la cohorte survivante.
6.3 Le biais de couverture et le biais technologique
Le biais de couverture survient dès lors qu’il existe une discordance structurelle entre la population cible théorique et la base de sondage mobilisée pour l’échantillonnage, conduisant à l’exclusion pure et simple de segments entiers du corps social (sous-couverture) ou, plus rarement, à l’inclusion erronée d’unités surnuméraires n’appartenant pas à la cible (sur-couverture). Historiquement associé à l’omission des personnes sans domicile fixe ou des résidents d’institutions collectives (prisons, maisons de retraite médicalisées) dans les recensements classiques, le biais de couverture s’est profondément métamorphosé avec l’hégémonie des technologies numériques d’acquisition de données.
Le déploiement massif d’enquêtes psychologiques hébergées sur Internet (questionnaires en ligne, passations sur smartphones via des applications dédiées) a engendré un biais technologique profond, intimement indexé sur les disparités de la fracture numérique d’accès et d’usage. Bien que le taux de pénétration des connexions à haut débit et des terminaux mobiles soit très élevé dans les métropoles occidentales, les populations âgées de plus de 75 ans, les personnes vivant sous le seuil de pauvreté monétaire, les résidents de zones géographiques enclavées et les individus affectés par des handicaps cognitifs ou visuels sévères demeurent massivement exclus des protocoles dématérialisés.
Cette exclusion technologique systématique induit des distorsions pernicieuses dès lors que l’objet d’étude concerne l’usage même des technologies, l’isolement relationnel ou l’accès aux soins de santé mentale. Mesurer la prévalence de la dépendance aux écrans ou quantifier le bien-être subjectif via un questionnaire distribué exclusivement sur les réseaux sociaux produit un échantillon structurellement incapable d’appréhender la réalité vécue des catégories les plus vulnérables du corps social, conférant à la recherche une vision aseptisée et déformée des dynamiques sociopsychologiques réelles.
7. La crise de l’échantillonnage WEIRD en psychologie contemporaine
7.1 Déconstruction du paradigme WEIRD
L’une des déconstructions épistémologiques les plus retentissantes de l’histoire moderne des sciences du comportement a été orchestrée en 2010 par les anthropologues et psychologues Joseph Henrich, Steven Heine et Ara Norenzayan dans leur publication fondatrice sur les populations WEIRD (acronyme désignant les sociétés Western, Educated, Industrialized, Rich, Democratic). Leur démonstration a exposé une faille méthodologique systémique : l’édifice tout entier de la psychologie empirique s’est fondé sur l’expérimentation d’une sous-population marginale de l’humanité, tout en prétendant énoncer des lois invariantes sur l’architecture cognitive humaine universelle.
Les métriques colligées par Henrich et ses collègues révèlent l’ampleur de ce biais : environ 96 % des sujets ayant participé aux études publiées dans les revues majeures de l’American Psychological Association (APA) entre 2003 et 2007 provenaient exclusivement de pays industrialisés occidentaux, ces mêmes nations ne représentant pourtant qu’environ 12 % de la population planétaire globale. Mieux encore, près de 70 % des participants de ces études étaient des étudiants de premier cycle en psychologie aux États-Unis. En d’autres termes, un individu sélectionné au hasard dans un amphithéâtre américain avait plus de 4 000 fois plus de chances d’être inclus dans une recherche empirique qu’un citoyen ordinaire de l’Afrique subsaharienne, de l’Inde rurale ou de l’Asie du Sud-Est.
L’erreur épistémologique fondamentale a consisté à ériger ce segment sociologique particulier en étalon normatif de l’espèce humaine tout entière. Les sujets WEIRD ne sont pas simplement des êtres humains évoluant dans des conditions plus confortables ; ils constituent, sur de multiples dimensions cognitives, affectives et décisionnelles, des valeurs extrêmes (outliers) à l’échelle de la variabilité anthropologique planétaire. Présumer sans vérification empirique transculturelle qu’un modèle psychologique découvert chez des étudiants nord-américains capture la nature biologique de l’esprit humain relève d’une pétition de principe invalidée par les faits.
7.2 Impacts documentés sur les processus cognitifs et sociaux
L’impact de ce biais de sélection géopolitique ne se restreint pas à des constructions idéologiques superficielles ; il affecte les processus de perception sensorielle élémentaire les plus enracinés dans la phylogenèse. Le cas de l’illusion de Müller-Lyer en offre un témoignage spectaculaire : cette illusion d’optique célèbre, où deux segments de droite de même longueur semblent inégaux en raison de l’orientation convergente ou divergente de leurs flèches terminales, a longtemps été considérée dans les manuels de neurosciences comme le reflet d’un automatisme perceptif câblé dans le cortex visuel primaire. Or, les investigations comparatives conduites par Segall, Campbell et Herskovits, puis réévaluées par Henrich, ont révélé que les membres de sociétés traditionnelles de chasseurs-cueilleurs (tels que les San du désert du Kalahari) sont pratiquement insensibles à cette illusion. L’effet optique n’est pas un invariant cognitif : il découle de la « carpentered world hypothesis », l’imprégnation précoce de l’œil dans des environnements urbains saturés d’angles droits architecturaux.
Au niveau de la cognition sociale et de la psychologie du soi, les disparités révélées par les travaux d’Hazel Rose Markus et Shinobu Kitayama démontrent une divergence anthropologique fondamentale entre le modèle du soi indépendant (dominant dans les cultures occidentales individualistes) et le modèle du soi interdépendant (prévalant largement en Asie de l’Est, en Afrique et en Amérique latine). Alors que les sujets WEIRD définissent leur identité par des traits internes constants et recherchent l’affirmation de leur autonomie et de leur agentivité exclusive, la majorité des populations de la planète se conceptualisent relationnellement, en fonction des devoirs, des contextes d’appartenance et des équilibres collectifs.
De même, dans les protocoles de micro-économie comportementale évaluant la coopération et la justice distributive (comme le jeu de l’ultimatum ou le jeu du dictateur), les décisions des sujets issus des métropoles occidentales s’écartent massivement de celles des petites sociétés d’agriculteurs ou de pasteurs traditionnels. L’inclination à punir des offres asymétriques à un coût personnel élevé ou la propension à offrir spontanément la moitié d’une manne financière à un inconnu reflètent des institutions morales intériorisées propres aux économies de marché de grande envergure, plutôt qu’une grammaire morale innée propre à notre lignée évolutive.
7.3 Stratégies de diversification et initiatives mondiales
Face à la prise de conscience aiguë de cette crise épistémique, la communauté scientifique a impulsé une refonte radicale de ses modèles de collecte et d’évaluation méthodologique. L’émergence de consortiums de recherche collaborative à très large échelle a ouvert une ère nouvelle pour l’échantillonnage psychologique. L’initiative la plus emblématique est sans conteste le Psychological Science Accelerator (PSA), un réseau décentralisé regroupant des centaines de laboratoires répartis sur plus de 80 pays. Le PSA sélectionne chaque année des projets empiriques majeurs et déploie des protocoles standardisés simultanément sur tous les continents, garantissant l’inclusion d’échantillons diversifiés culturellement, linguistiquement et géographiquement.
Ces déploiements collectifs s’accompagnent d’une sophistication formelle des protocoles de validation transculturelle. Il ne suffit plus de traduire littéralement une échelle psychométrique dans une langue locale ; il est désormais requis d’établir son équivalence de mesure (ou invariance factorielle) à travers des modélisations confirmatoires multigroupes (MGCFA). Ce processus méthodologique permet de valider empiriquement que le construit théorique sous-jacent est compris de façon strictement analogue par les participants, indépendamment de leur idiome ou de leur horizon socioculturel.
Parallèlement, les comités de rédaction des revues de rang mondial ont révisé leurs lignes directrices éditoriales. Les Journal Article Reporting Standards (JARS) promus par l’APA imposent dorénavant aux auteurs d’inclure des sections obligatoires documentant les caractéristiques sociodémographiques complètes de leurs échantillons et d’expliciter sans complaisance les limites de transférabilité géographique et culturelle de leurs conclusions. Les déclarations de généralisation sans nuance empirique ne sont plus admises dans les revues académiques de premier rang.
8. Détermination de la taille de l’échantillon et puissance statistique
8.1 L’analyse de puissance a priori
L’estimation rigoureuse du volume d’observations requis pour une recherche ne saurait relever de l’improvisation empirique ou de l’adoption aveugle d’usages disciplinaires surannés (comme la règle arbitraire des « 30 sujets par groupe »). La démarche scientifique moderne exige la mise en œuvre d’une analyse de puissance a priori, formalisée théoriquement par Jacob Cohen dans ses contributions fondatrices sur l’analyse de puissance statistique pour les sciences du comportement.
Cette approche implique la modélisation mathématique conjointe de quatre paramètres décisionnels intimement interdépendants :
- Le seuil de signification alpha ($\alpha$), fixant le risque toléré de commettre une erreur de type I (le rejet erroné d’une hypothèse nulle vraie), conventionnellement établi à 0,05 ou 0,01.
- La puissance statistique désirée ($1 – \beta$), où $\beta$ représente le risque d’erreur de type II (l’incapacité à détecter un effet qui existe réellement dans la population). Les standards contemporains exigent une puissance minimale de 0,80, et idéalement de 0,90 à 0,95 pour les protocoles critiques.
- La taille d’effet attendue (exprimée au moyen d’indices standardisés tels que le $d$ de Cohen pour les contrastes de moyennes, le $r$ de Pearson pour les associations linéaires, ou l’$\eta^2_p$ pour les analyses de variance). Cette grandeur doit être postulée d’après des méta-analyses antérieures solides ou délimitée en fonction de la taille d’effet minimale présentant un intérêt théorique ou clinique concret (SESOI : Smallest Effect Size of Interest).
- La taille d’échantillon requise ($n$), qui découle algorithmiquement des trois paramètres précédents au moyen de logiciels spécialisés comme G*Power ou de packages dédiés sous environnement R.
Le sous-dimensionnement statistique d’une recherche constitue l’un des moteurs majeurs de la crise contemporaine de la reproductibilité scientifique. Une étude sous-puissante ne souffre pas seulement d’une faible probabilité de découvrir un effet réel ; elle génère également une surévaluation paradoxale de l’amplitude des effets qui franchissent le seuil de significativité statistique. Ce phénomène pernicieux, baptisé « malédiction du vainqueur » (winner’s curse), produit des publications isolées affichant des tailles d’effet spectaculaires mais totalement impossibles à répliquer sur des cohortes calibrées avec rigueur.
8.2 Interaction entre taille d’échantillon et représentativité
Il est fondamental de disséquer conceptuellement les interactions distinctes qu’entretiennent la taille de l’échantillon d’une part, et sa représentativité d’autre part. Ces deux composantes régissent des dimensions orthogonales de la métrologie scientifique : la représentativité gouverne l’exactitude (l’absence de biais systématique de mesure, positionnant l’espérance de l’estimateur au centre de la cible théorique), tandis que la taille d’échantillon régit la précision (la dispersion et la stabilité stochastique des estimations autour de cette espérance).
Un échantillon peut être d’une représentativité exemplaire mais numériquement squelettique : ses paramètres ne seront pas biaisés en espérance, mais leur dispersion aléatoire d’un tirage à l’autre sera si vaste que les intervalles de confiance s’avéreront trop larges pour guider la prise de décision. À l’opposé, un échantillon peut afficher un effectif astronomique mais souffrir d’un biais de sélection structurel : la précision métrologique sera absolue, mais elle cristallisera avec force une mesure systématiquement déviante de la vérité objective.
Cette relation devient particulièrement critique au sein de modélisations multivariées avancées, telles que les modèles d’équations structurelles (SEM) ou les analyses factorielles confirmatoires. L’estimation convergente des matrices de covariance et la stabilité des algorithmes d’optimisation (tels que le maximum de vraisemblance) requièrent des seuils minimaux d’effectifs absolus — souvent fixés entre 200 et 500 cas selon la complexité du réseau de relations latentes et la non-normalité des indicateurs. Au sein de ces architectures mathématiques, la représentativité conjointe des sous-groupes conditionne la robustesse des indices d’ajustement global ($\mathrm{CFI}$, $\mathrm{TLI}$, $\mathrm{RMSEA}$), prévenant l’apparition d’erreurs standard fallacieuses et de solutions factorielles instables dites de Heywood.
8.3 La marge d’erreur et le niveau de confiance
L’estimation ponctuelle d’un paramètre populationnel (une moyenne $\mu$ ou une proportion $P$) au moyen d’un échantillon représentatif s’accompagne obligatoirement de son intervalle de confiance, borné par la marge d’erreur ($E$). Pour l’estimation d’une proportion $p$ au sein d’un échantillon probabiliste de taille $n$, la marge d’erreur au niveau de confiance bilatéral $1 – \alpha$ est régie par la formulation :
$$E = z_{1 – alpha/2} \sqrt{\frac{p(1 – p)}{n}} \sqrt{\frac{N – n}{N – 1}}$$
où $z_{1 – alpha/2}$ correspond au quantile de la distribution normale centrée réduite (valant 1,96 pour un niveau de confiance classique de 95 %), et le dernier terme incarne le facteur de correction pour population finie (négligeable dès lors que la fraction de sondage $n/N$ est inférieure à 5 %).
Cette relation mathématique explicite la loi des rendements décroissants qui pèse sur l’acquisition de données empiriques. En raison de la présence du radical $\sqrt{n}$ au dénominateur, la marge d’erreur diminue selon une fonction inversement proportionnelle à la racine carrée de l’effectif. Pour diviser sa marge d’erreur par deux (passant par exemple de $\pm 4,%$ à $\pm 2,%$), le chercheur n’a pas besoin de doubler son échantillon, mais doit impérativement le quadrupler. Le coût marginal de chaque fraction de pourcentage de certitude statistique additionnelle croît ainsi de façon exponentielle, obligeant les investigateurs à un arbitrage rigoureux entre l’impératif de précision et les contingences budgétaires de terrain.
Sur le versant de l’interprétation clinique, il est impératif de distinguer la signification statistique formelle de la signification clinique pratique. Une marge d’erreur infinitésimale obtenue sur un échantillon gigantesque de 100 000 sujets peut permettre d’établir la significativité statistique d’une variation d’un quart de point sur une échelle d’évaluation de la dépression à 60 items ($p < 0,001$). Pourtant, cette variation, bien qu'estimée avec une certitude mathématique inébranlable, n'exerce absolument aucun impact observable sur la qualité de vie, l'autonomie quotidienne ou le soulagement émotionnel réel du patient sur le terrain de la santé mentale.
9. Techniques de redressement statistique et ajustements a posteriori
9.1 La pondération statistique par calage sur marges
Même lorsqu’un protocole d’échantillonnage a été déployé avec la plus grande rigueur probabiliste, les distorsions inhérentes à la non-réponse de terrain produisent fréquemment des écarts entre la morphologie sociodémographique de l’échantillon final et celle de la population de référence. Afin de restaurer l’isomorphisme structurel sans être contraint d’annihiler l’ensemble des données recueillies, les statisticiens recourent à des méthodes d’ajustement a posteriori, au premier rang desquelles trône la pondération statistique par calage sur marges (technique d’iterative proportional fitting ou algorithme de Deming-Stephan, formalisé en France sous la théorie du calage de Deville et Särndal).
Cette technique mathématique consiste à assigner à chaque unité observationnelle $i$ un coefficient de pondération individuel $w_i$, calculé de façon à ce que, sur un ensemble de variables auxiliaires qualitatives ou quantitatives connues avec exactitude au niveau populationnel (les marges du recensement national), les estimateurs pondérés coïncident scrupuleusement avec les totaux réels de la population. L’algorithme résout un problème d’optimisation sous contraintes, en minimisant une fonction de distance mathématique entre les poids initiaux (uniformes dans le cas d’un tirage simple) et les poids corrigés, tout en satisfaisant les équations d’étalonnage marginales.
Toutefois, le calage sur marges possède des limites mathématiques et empiriques strictes. Si une catégorie sociodémographique spécifique a été massivement boudée lors de la phase de recrutement (par exemple, les jeunes hommes de 18 à 24 ans sans qualification professionnelle), l’algorithme sera contraint de conférer à la poignée d’individus répondants de cette classe des poids statistiques démesurément élevés ($w_i gg 1$). Ce renflement artificiel a pour conséquence d’accroître considérablement la variance des estimateurs finaux et de conférer à quelques sujets idiosyncrasiques une influence décisionnelle démesurée sur les résultats agrégés. Pour pallier cette dérive, les méthodologistes appliquent des procédures d’écrêtement des poids (weight trimming), établissant un compromis assumé entre l’élimination du biais résiduel et la stabilisation de la variance métrologique.
9.2 L’imputation multiple pour les données manquantes
Dans les enquêtes transversales et plus encore au sein des protocoles longitudinaux multi-vagues, la complétude de l’échantillon est inexorablement compromise par la survenue de données manquantes partielles (les répondants omettent volontairement ou involontairement certaines rubriques d’un questionnaire). La pratique historique, encore trop largement répandue par défaut au sein des logiciels statistiques commerciaux, consistait à supprimer purement et simplement toute observation comportant la moindre valeur absente (analyse des cas complets ou listwise deletion). Cette pratique est aujourd’hui universellement reconnue comme désastreuse : elle réduit dramatiquement la puissance statistique et introduit des biais de sélection substantiels dès lors que les données manquantes ne sont pas rigoureusement MCAR.
La norme méthodologique moderne repose sur l’imputation multiple, développée par Donald Rubin et opérationnalisée par des algorithmes tels que le MICE (Multivariate Imputation by Chained Equations). Contrairement à l’imputation par la moyenne — méthode fallacieuse qui comprime artificiellement la variance des indicateurs et surestime la significativité statistique —, l’imputation multiple substitue à chaque cellule vide un vecteur de $m$ valeurs distinctes issues de distributions prédictives conditionnelles estimées à partir de l’intégralité des variables observées du modèle.
Ce processus engendre $m$ bases de données complètes distinctes (généralement entre 20 et 50 selon le volume de non-réponse). Les analyses statistiques d’intérêt (régressions, corrélations, comparaisons de groupes) sont conduites de façon indépendante sur chacun de ces $m$ jeux de données. Enfin, les paramètres estimés et leurs matrices de covariance respectives sont combinés au moyen des règles de combinaison de Rubin (Rubin’s rules). Cette approche permet de préserver fidèlement la représentativité originelle de l’échantillon tout en quantifiant et en intégrant mathématiquement l’incertitude épistémique inhérente à l’absence de données directes.
9.3 Les scores de propension et l’appariement
Dans l’évaluation de l’efficacité de thérapies psychologiques, de programmes psycho-éducatifs ou d’interventions sociologiques en milieu naturel, le recours à une randomisation expérimentale stricte s’avère fréquemment impossible pour des raisons éthiques ou logistiques. Les chercheurs sont alors contraints d’adopter des devis quasi-expérimentaux observationnels, comparant un groupe ayant spontanément bénéficié de l’intervention à un groupe témoin non exposé. Ces deux cohortes présentent invariablement des divergences systématiques préexistantes quant à leurs caractéristiques basales, confondant irrémédiablement l’effet thérapeutique avec des biais d’auto-sélection sous-jacents.
Pour restaurer une comparabilité structurelle équivalente à celle d’une randomisation, Paul Rosenbaum et Donald Rubin ont conceptualisé la méthode des scores de propension (propensity score matching). Le score de propension d’un individu $i$ correspond à sa probabilité conditionnelle d’avoir été affecté au groupe d’intervention, sachant le vecteur complet de ses covariables observables mesurées avant l’exposition :
$$e(X_i) = P(Z_i = 1 mid X_i)$$
Cette probabilité d’assignation scalaire est typiquement estimée par une régression logistique multivariée ou par des algorithmes d’apprentissage automatique supervisé (tels que les forêts aléatoires ou le gradient boosting).
Une fois le score de propension calculé pour chaque unité d’observation, diverses procédures d’ajustement peuvent être déployées : l’appariement au plus proche voisin (nearest-neighbor matching), la stratification sur quantiles de propension, ou la pondération par l’inverse de la probabilité de traitement (IPTW). Ces algorithmes opèrent un rééquilibrage multidimensionnel complet des covariables entre les cohortes traitées et non traitées. Dès lors que l’équilibre structural est atteint, la comparaison des résultats cliniques s’exécute sur des groupes qui ne diffèrent plus sur aucune des variables observées, simulant a posteriori la neutralité d’un tirage représentatif aveugle au sein du groupe témoin.
10. Implications éthiques, épistémologiques et sociétales
10.1 Justice distributive dans la recherche psychologique
La question de la représentativité des échantillons d’étude transcende largement les considérations techniques d’optimisation d’algorithmes statistiques ; elle soulève des enjeux éthiques profonds relevant directement de la théorie de la justice distributive au sein de la cité scientifique. Formalisé dès 1979 par le célèbre Rapport Belmont aux États-Unis, le principe de justice stipule que les charges inhérentes à la participation aux recherches biomédicales et comportementales (temps consacré, inconfort émotionnel, divulgation d’informations privées) et les bénéfices qui en découlent doivent être équitablement répartis à travers l’ensemble des segments composant le corps social.
Pourtant, l’histoire des sciences psychologiques témoigne d’un schéma d’asymétrie structurelle perpétuelle. D’une part, les populations précaires, institutionnalisées ou marginalisées ont parfois été instrumentalisées comme viviers d’expérimentation pratiques sans jamais être destinataires prioritaires des retombées thérapeutiques directes des programmes découverts. D’autre part, la recherche académique classique a systématiquement exclu de ses corpus d’observation les minorités linguistiques, les personnes en situation de handicap, les populations autochtones et les individus défavorisés, sous prétexte d’éliminer la variance de confusion ou de simplifier la logistique de recrutement.
Cette mise à l’écart systématique constitue une injustice épistémique majeure. En privant ces groupes de toute présence au sein des échantillons représentatifs, la science comportementale contribue à les invisibiliser méthodologiquement, produisant des savoirs qui ne reflètent en rien leurs besoins réels et leurs dynamiques psychiques spécifiques. Les directives éthiques internationales contemporaines enjoignent désormais aux chercheurs de planifier proactivement l’inclusion de ces populations vulnérables, non pas par simple conformisme moral, mais pour garantir une démocratisation authentique de la validité de la connaissance scientifique.
10.2 Conséquences cliniques des biais de représentativité
Les carences de représentativité au sein des échantillons cliniques ne demeurent pas confinées aux pages des revues académiques ; elles se traduisent directement en milieu de soin par des échecs d’intervention thérapeutique, des impasses pronostiques et des préjudices réels infligés aux patients. Toute psychothérapie validée empiriquement (Evidence-Based Psychological Intervention) tire sa légitimité de protocoles d’évaluation randomisés et contrôlés. Dès lors que ces cohortes expérimentales ont exclu les patients présentant des comorbidités psychiatriques multiples, des traumatismes complexes ou une précarité sociale aggravée — ce qui représente pourtant l’ordinaire de la pratique en santé mentale —, le praticien hospitalier applique un protocole d’intervention dont l’efficacité réelle sur ce terrain reste totalement indéterminée.
De surcroît, les critères de délimitation diagnostique codifiés au sein de nomenclatures de référence comme le Manuel diagnostique et statistique des troubles mentaux (DSM-5) ou la Classification internationale des maladies (CIM-11) ont historiquement été calibrés sur des échantillons de patients majoritairement blancs, issus de classes moyennes et occidentaux. Il en découle des phénomènes massifs de sous-diagnostic ou de surdiagnostic culturellement conditionnés. Par exemple, l’expression de la souffrance psychique par la somatisation (douleurs physiques diffuses, sensations d’oppression corporelle), particulièrement prévalente au sein de nombreuses cultures asiatiques ou africaines, a longtemps été disqualifiée ou cataloguée à tort comme un trouble de conversion hystérique par des praticiens appliquant des cadres sémiologiques élaborés sur des échantillons uniquement habitués à verbaliser leurs affects sous le prisme de l’introspection cognitive occidentale.
Dans le domaine du développement de l’enfant, l’inapplicabilité de normes cliniques issues d’échantillons non représentatifs se révèle tout aussi dévastatrice. Les échelles de détection des troubles du spectre de l’autisme (TSA) ont initialement été étalonnées sur des cohortes composées de manière quasi exclusive de garçons. Les manifestations phénotypiques du TSA chez les filles — qui déploient fréquemment des stratégies précoces de camouflage social et d’imitation adaptative masquant la sévérité des déficits d’interaction — ont été systématiquement ignorées pendant des décennies, conduisant à des errances diagnostiques tragiques et à une privation prolongée d’accompagnement adapté pour des générations entières de jeunes filles.
10.3 Impact sur les politiques publiques fondées sur des preuves
À l’ère contemporaine des politiques publiques fondées sur la preuve (Evidence-Based Policy), les décideurs gouvernementaux et les organisations internationales mobilisent massivement les données issues de la recherche psychologique et comportementale pour structurer leurs plans d’action sociétaux (campagnes de santé publique, réformes éducatives, programmes de prévention de la radicalisation ou lutte contre les discriminations). Cette interface directe entre science et politique confère à la représentativité de l’échantillon un poids sociétal et économique colossal.
Le transfert inconsidéré de résultats obtenus sur des échantillons hautement sélectifs vers la prise de décision publique constitue une source majeure d’échec politique et de gaspillage de deniers publics. L’engouement suscité par les « architectures de choix » et la théorie du nudge (coup de pouce comportemental) en offre un exemple topique : de nombreuses interventions d’incitation douce démontrées comme hautement efficaces auprès d’échantillons de laboratoire ou de populations aisées et hautement éduquées se sont effondrées lorsqu’elles ont été appliquées à grande échelle au sein de segments de populations confrontés à une rareté financière extrême ou à une anxiété matérielle chronique. L’attention cognitive requise pour traiter ces signaux comportementaux subtils n’est tout simplement pas disponible chez des personnes dont l’espace mental est accaparé par des impératifs élémentaires de survie quotidienne.
Le chercheur en sciences humaines et comportementales se trouve dès lors investi d’une écrasante responsabilité civique et épistémique. Présenter des conclusions empiriques issues d’un échantillon localement biaisé comme des vérités universellement applicables aux politiques d’un pays tout entier relève d’une négligence méthodologique coupable. La diffusion transparente des marges d’erreur, l’explicitation sans fard des populations exclues du périmètre d’observation et la retenue dans l’extrapolation normative constituent des impératifs catégoriques pour préserver le contrat de confiance fondamental reliant la cité à ses scientifiques.
11. Applications pratiques : Études de cas en sciences psychologiques
11.1 Cas n°1 : La mesure de la détresse psychologique au sein d’une entreprise
Pour appréhender concrètement la mise en œuvre pratique d’un plan d’échantillonnage représentatif en milieu écologique complexe, examinons le cas d’une grande entreprise industrielle multi-sites de 15 000 salariés mandatant une équipe de psychologues du travail pour évaluer l’indice de détresse psychologique et la prévalence de l’épuisement professionnel parmi son personnel.
Une approche naïve, fréquemment constatée sur le terrain, consiste à envoyer une invitation numérique à l’ensemble du personnel via la messagerie interne d’entreprise, puis à collecter les réponses sur la base du volontariat spontané. Ce protocole non probabiliste aboutit invariablement à un désastre méthodologique :
- Les salariés occupant des fonctions sédentaires de bureau (cadres, ingénieurs, fonctions support), connectés en continu à leur poste de travail informatique, affichent des taux de réponse massifs de l’ordre de 60 à 70 %.
- À l’inverse, les ouvriers d’usine en chaîne de production postée (3×8) et les techniciens logistiques itinérants, n’ayant pas d’accès direct à un terminal numérique durant leurs heures de service, affichent des taux de participation dérisoires de l’ordre de 5 à 8 %.
- De plus, les salariés en situation de détresse émotionnelle extrême ou nourissant une méfiance aiguë envers la direction managériale boycottent massivement l’enquête par crainte d’une rupture d’anonymat, tandis que les salariés modérément mécontents instrumentalisent le questionnaire comme exutoire revendicatif.
Pour conjurer ces distorsions dévastatrices, l’équipe méthodologique déploie un échantillonnage probabiliste stratifié proportionnel. La matrice des strates combine les filières métiers (production, logistique, R&D, administratif), le statut statutaire (ouvriers, techniciens, cadres) et l’ancienneté dans l’organisation. Un tirage au sort aveugle de 1 200 salariés est réalisé au sein des fichiers informatisés anonymisés de la direction des ressources humaines. Des mesures d’accompagnement logistique strictes sont instaurées : mise à disposition d’isoloirs physiques dédiés équipés de tablettes sur les sites de production, temps de passation de 20 minutes intégralement rémunéré comme temps de travail effectif, et délivrance par un tiers de confiance d’un garant cryptographique d’anonymisation irréversible des réponses.
L’analyse comparative des données brutes issues de l’approche par volontariat et des données redressées issues de l’échantillon stratifié illustre la portée de l’ingénierie méthodologique : l’échantillon de convenance estimait le niveau moyen de détresse psychologique globale à un score alarmiste de 4,2 sur une échelle de 1 à 7, en le localisant de façon erronée au sein des départements de R&D. L’échantillon probabiliste représentatif a rétabli une estimation globale réelle à 2,8 sur 7, tout en révélant que la véritable détresse critique ne se situait pas chez les cadres sur-communicants, mais frappait de façon silencieuse et invisible les équipes logistiques de nuit travaillant en horaires décalés.
11.2 Cas n°2 : Les sondages d’opinion et attitudes sociales
L’arène des sondages d’opinion politique constitue le laboratoire le plus exposé à la sanction empirique immédiate des erreurs d’échantillonnage, la représentativité d’un échantillon y étant périodiquement confrontée à l’arbitrage factuel et indiscutable des résultats électoraux réels.
Lors des grandes consultations démocratiques, les instituts de sondage ne peuvent se contenter d’un échantillonnage probabiliste parfait théorique en raison du délai temporel extrêmement comprimé des cycles d’actualité et de l’effondrement historique des taux de décrochage téléphonique. Ils déploient massivement des échantillons par quotas redressés. Toutefois, un obstacle psychométrique redoutable s’immisce dans l’équation : le biais de désirabilité sociale (ou « effet Bradley »), où les sondés occultent ou travestissent leurs réelles intentions de vote lorsqu’ils soutiennent des candidats ou des thématiques jugés moralement réprouvés par la bienséance médiatique ambiante.
Pour neutraliser ce biais majeur, les méthodologistes mettent en œuvre une stratégie de double calibration combinant un échantillon de quotas serré et une procédure de redressement fondée sur le rappel de vote :
Les sondeurs interrogent systématiquement les participants sur leur vote effectif lors du scrutin présidentiel ou législatif précédent (un événement historique parfaitement documenté à l’échelle de la nation). En confrontant la distribution déclarée du vote passé de l’échantillon aux résultats réels certifiés par le ministère de l’Intérieur, les statisticiens quantifient mathématiquement le biais de sous-déclaration spécifique à chaque famille politique. Un coefficient d’ajustement dynamique est ensuite appliqué aux intentions de vote présentes, augmentant la pondération des courants politiques structurellement sous-déclarés.
Cette méthodologie d’ajustement empirique a permis aux modélisations sociométriques contemporaines d’anticiper avec une exactitude remarquable des basculements électoraux radicaux, là où les collectes brutes sans redressement échouaient de manière répétée à anticiper la montée en puissance de mouvements antisystème.
11.3 Cas n°3 : La standardisation transculturelle d’un inventaire de dépression
Considérons la standardisation et l’adaptation psychométrique d’un instrument de mesure diagnostique international, tel que le Patient Health Questionnaire-9 (PHQ-9) ou le Beck Depression Inventory-II (BDI-II), dans un pays d’Asie du Sud-Est affichant d’importantes disparités entre zones urbaines modernes et communautés rurales traditionnelles.
Le projet méthodologique nécessite le recrutement d’un échantillon représentatif de la population adulte nationale ($N \approx 2,500$) afin d’établir les nouveaux seuils cliniques (cut-off scores) justifiant la prescription d’une prise en charge pharmacologique ou psychothérapeutique. Les investigateurs mettent en place un plan de sondage à plusieurs degrés : stratification préalable par région et par densité démographique (mégapoles, villes moyennes, districts ruraux), suivie d’un tirage en grappes des concessions sanitaires communales.
Avant d’agréger les données pour fixer les barèmes nationaux, une étape statistique incontournable s’impose : l’évaluation de l’invariance de mesure multigroupes (MGCFA). Ce protocole vérifie de façon séquentielle :
- L’invariance de configuration (configurale) : L’organisation générale des items en facteurs latents (par exemple, dimension affective-émotionnelle et dimension somatique-végétative) est-elle structurellement identique chez les citadins cosmopolites et chez les agriculteurs ruraux ?
- L’invariance métrique (faible) : Les saturations factorielles ($\lambda_i$) reliant chaque item au construit latent sous-jacent sont-elles équivalentes entre les deux populations ? Si un item comme « sentiment d’échec existentiel » affiche une saturation deux fois plus faible en milieu rural qu’en milieu urbain, l’unité de mesure psychométrique n’a pas la même métrique à travers les strates.
- L’invariance scalaire (forte) : Les ordonnées à l’origine (intercepts $\tau_i$) des items sont-elles identiques ? Sans cette égalité stricte, un score total identique de 14 sur l’échelle ne correspond absolument pas au même niveau sous-jacent de détresse psychologique entre les deux sous-cultures.
Dans ce cas d’école réel, l’analyse démontre que l’invariance scalaire est invalidée sur plusieurs items somatiques (comme les troubles de l’appétit et les courbatures), ces manifestations traduisant en milieu rural l’épuisement physique du travail agraire saisonnier plutôt qu’une prostration clinique dépressive. La représentativité structurelle de l’échantillon a ainsi empêché une erreur de santé publique monumentale : scinder et calibrer des barèmes normatifs distincts selon le biotope écologique a permis d’éviter la pathologisation erronée de pans entiers de la population paysanne tout en identifiant avec acuité les foyers de détresse psychologique réels.
12. Synthèse méthodologique : Guide pratique pour concevoir un échantillon représentatif
12.1 Arbre décisionnel pour le choix de la méthode d’échantillonnage
Face à la complexité multiforme du terrain empirique, le chercheur ou le praticien en sciences sociales a besoin d’une heuristique rigoureuse pour déterminer la stratégie d’échantillonnage la plus appropriée à son objet de recherche, sans transiger sur la validité scientifique de ses conclusions. Le déploiement méthodologique s’articule autour d’un arbre décisionnel séquentiel fondé sur trois questions nodales :
Étape 1 : Existe-t-il une base de sondage nominative, fiable et accessible recensant l’intégralité de la population d’intérêt ?
- Si OUI : La méthode probabiliste est impérative.
- La population est-elle relativement homogène et géographiquement concentrée ? Optez pour l’échantillonnage aléatoire simple ou l’échantillonnage systématique.
- Existe-t-il des sous-groupes démographiques contrastés ou des minorités critiques qu’il est capital de comparer ? Privilégiez l’échantillonnage stratifié (proportionnel pour maximiser la précision globale ; non proportionnel avec sur-échantillonnage si les groupes minoritaires requièrent une puissance locale dédiée).
- Si NON : Poursuivez vers l’étape 2.
Étape 2 : La population cible est-elle naturellement structurée en grappes institutionnelles ou géographiques facilement identifiables (écoles, hôpitaux, entreprises, districts) ?
- Si OUI : Optez pour un échantillonnage en grappes ou à plusieurs degrés. Prenez soin d’intégrer une estimation a priori du coefficient de corrélation intraclasse (ICC) pour accroître l’effectif brut d’individus et compenser l’effet de plan induit.
- Si NON : Poursuivez vers l’étape 3.
Étape 3 : La population est-elle socialement stigmatisée, clandestine ou dépourvue de toute délimitation officielle (population cachée) ?
- Si OUI : Mettez en œuvre un échantillonnage guidé par les répondants (RDS) ou un échantillonnage par réseau avec traçabilité mathématique des chaînes de recrutement, en évitant le simple parrainage amical informel non redressé.
- Si NON (population générale, mais sans base accessible) : Déployez un échantillonnage non probabiliste par quotas rigoureux, croisant au minimum 3 à 4 covariables démographiques interdépendantes, suivi d’un calage statistique sur marges a posteriori.
12.2 Grille d’évaluation critique de la représentativité pour les chercheurs
Lors de la rédaction ou de l’expertise critique (peer-reviewing) d’une publication scientifique en psychologie ou en sciences comportementales, l’évaluation de la représentativité de l’échantillon ne doit laisser place à aucune ambiguïté complaisante. Une lecture méthodologique exigeante impose le contrôle systématique d’une série de points d’ancrage cruciaux, formalisés notamment au sein des recommandations du JARS-Quant de l’American Psychological Association :
- Délimitation de la cible : Les critères d’inclusion et d’exclusion théoriques et opérationnels sont-ils explicités sans équivoque ? La population accessible est-elle honnêtement confrontée à la population théorique que l’on prétend documenter ?
- Transparence intégrale du recrutement : Les canaux de sollicitation sont-ils décrits exhaustivement (annonces sur les réseaux sociaux, démarchage téléphonique, affichage institutionnel) ? Quel était le montant exact des compensations financières ou des incitations académiques allouées aux volontaires ?
- Traçabilité des non-répondants (Diagramme de flux CONSORT) : L’article rapporte-t-il le nombre précis d’individus contactés, le nombre de refus explicites, le nombre d’abandons en cours de route et le taux d’attrition longitudinal ? Le mécanisme des données manquantes (MCAR, MAR, MNAR) a-t-il été formellement investigué ?
- Évaluation du profil sociodémographique complet : L’article présente-t-il une table synthétique documentant les covariables majeures : sexe biologique, identité de genre, âge, niveau de diplôme, statut d’emploi, origine géographique, appartenance ethnoculturelle et statuts cliniques ? Ces variables sont-elles comparées statistiquement aux indicateurs du recensement de la population cible ?
- Humilité épistémique dans la discussion : Les auteurs s’abstiennent-ils de formuler des extrapolations universelles abusives si leur échantillon est issu d’une cohorte de convenance universitaire ou restreint à un biotope occidental WEIRD ? Les limites structurelles de validité externe sont-elles clairement admises et délimitées ?
12.3 Perspectives d’avenir : Big Data, intelligence artificielle et représentativité
L’irruption contemporaine des données massives (Big Data) issues des traces numériques quotidiennes — historiques de navigation web, géolocalisations smartphones en temps réel, interactions sur les réseaux sociaux, dossiers médicaux dématérialisés — bouleverse les paradigmes traditionnels de la collecte de données. De nombreux commentateurs prédisaient l’obsolescence programmée de la théorie de l’échantillonnage, affirmant péremptoirement que l’analyse exhaustive des traces numériques éliminerait la nécessité même d’échantillonner, l’humanité entière devenant son propre enregistrement empirique ($N = \text{tous}$).
Cette vision techno-positiviste relève d’une illusion méthodologique profonde. Les mégadonnées comportementales ne constituent nullement un recensement universel non biaisé du genre humain ; elles matérialisent un échantillon de convenance géant hautement sélectif et opaque. Comme l’illustrent les travaux pionniers en éthique des algorithmes et en modélisation statistique, les traces numériques souffrent de biais algorithmiques structurels majeurs. Les algorithmes de recommandation des plateformes sélectionnent, modulent et amplifient artificiellement certains comportements en ligne pour maximiser l’engagement attentionnel, créant des chambres d’écho comportementales qui ne reflètent en rien la psychologie ordinaire des populations hors ligne.
Néanmoins, les avancées spectaculaires de l’intelligence artificielle et de l’apprentissage automatique (machine learning) offrent des perspectives méthodologiques inédites pour le perfectionnement de la représentativité. De nouveaux algorithmes de redressement dynamique, adossés à des architectures d’apprentissage profond et de réseaux antagonistes génératifs (GAN), permettent désormais d’opérer des calages multidimensionnels d’une complexité computationnelle inouïe, équilibrant non plus seulement une poignée de covariables sociodémographiques marginales, mais des espaces sémantiques et comportementaux continus à haute dimensionnalité.
Pourtant, en dépit de cette débauche de sophistication algorithmique, une vérité épistémologique fondamentale demeure inaltérable : aucun raffinement computationnel a posteriori, aucun modèle d’intelligence artificielle générative ne pourra jamais compenser intégralement la défaillance originelle d’un protocole de recueil mal conçu. La théorie classique de l’échantillonnage représentatif, loin d’être un vestige du siècle pré-numérique, s’impose plus que jamais comme le rempart méthodologique indispensable préservant l’intégrité de la science empirique face aux dérives de l’illusion quantitative.
Références
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally. https://www.worldcat.org/title/experimental-and-quasi-experimental-designs-for-research/oclc/890457
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Gallup, G. (1938). Public opinion surveys: 1935–1938. Public Opinion Quarterly, 2(3), 373–398. https://doi.org/10.1086/265215
- Heckathorn, D. D. (1997). Respondent-driven sampling: A new approach to the study of hidden populations. Social Problems, 44(2), 174–199. https://doi.org/10.2307/3096941
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Kish, L. (1965). Survey sampling. John Wiley & Sons. https://www.wiley.com/en-us/Survey+Sampling-p-9780471109495
- Markus, H. R., & Kitayama, S. (1991). Culture and the self: Implications for cognition, emotion, and motivation. Psychological Review, 98(2), 224–253. https://doi.org/10.1037/0033-295X.98.2.224
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, insignificance of small uncertainty, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-AOAS1161SF
- Moshontz, H., Campbell, L., Ebersole, C. R., IJzerman, H., Urry, H. L., Forscher, P. S., … & Chartier, C. R. (2018). The Psychological Science Accelerator: Advancing psychology through a distributed collaborative network. Advances in Methods and Practices in Psychological Science, 1(4), 501–515. https://doi.org/10.1177/2515245918797607
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Rosenthal, R., & Rosnow, R. L. (1975). The volunteer subject. John Wiley & Sons. https://psycnet.apa.org/record/1975-22002-000
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. John Wiley & Sons. https://doi.org/10.1002/9780470316696
- VandenBos, G. R. (Ed.). (2015). APA dictionary of psychology (2nd ed.). American Psychological Association. https://www.apa.org/pubs/books/4311021